
Phỏng vấn dự án Agent nên trình bày thế nào? Từ kiến trúc hệ thống, lựa chọn công nghệ đến phân tích Badcase
Phỏng vấn theo hướng ứng dụng Agent/AI hầu như sẽ không dừng ở việc học thuộc khái niệm, mà thường dựa trên dự án của bạn để hỏi sâu: tại sao thiết kế như vậy, trên production từng xảy ra vấn đề gì, đã định vị và sửa lỗi thế nào.
Nếu trước phỏng vấn bạn chỉ học thuộc các khái niệm cốt lõi như ReAct, RAG, Memory, MCP, Function Calling thì thường không thể ứng phó với các câu hỏi đào sâu:
- Thứ bạn làm rốt cuộc có phải Agent không, tại sao không thể giải quyết bằng API thông thường hoặc workflow cố định?
- Sau khi một request đi vào, nó đi qua những component nào, state và data luân chuyển ra sao?
- Phương án quan trọng được chọn dựa trên những constraint nào, cái giá phải trả là gì?
- Dự án từng thất bại ở đâu, bạn đã định vị, sửa và ngăn nó xảy ra lần nữa thế nào?
Để mọi người dễ hiểu hơn, trong bài viết tôi sẽ dùng một Agent xử lý ticket hậu mãi thông minh làm ví dụ để xâu chuỗi các vấn đề này.
Dự án của bạn có tương tự hay không cũng không quan trọng, các phương pháp được chia sẻ trong bài đều có tính tổng quát. Khi chuẩn bị dự án của mình, bạn phải thay bối cảnh nghiệp vụ, trách nhiệm, quy mô dữ liệu và chỉ số bằng nội dung thực tế.
Phỏng vấn dự án Agent thực sự kiểm tra điều gì?
Trước tiên hãy xem tại sao interviewer lại hỏi như vậy. Dự án Agent không có tiêu chuẩn đánh giá hoàn thiện như dự án CRUD, interviewer không thể chỉ dựa vào hai chữ “đã làm” để phán đoán năng lực của bạn, mà chỉ có thể xác minh ba điều bằng cách hỏi sâu:
- Dự án có thật hay không. Người thực sự làm sẽ nói được constraint, data và những vấn đề từng gặp; người học thuộc dự án chỉ có thể nhắc lại sơ đồ kiến trúc. Khi hỏi đến tầng thứ ba, khác biệt giữa hai bên sẽ lập tức lộ rõ.
- Bạn có năng lực ra quyết định kỹ thuật hay không. Lĩnh vực Agent cũng không có silver bullet, cùng một vấn đề có thể được giải quyết bằng Prompt, workflow, RAG, tool calling hoặc Multi-Agent. Interviewer muốn biết: trước constraint cụ thể của bạn, bạn có thể cân nhắc để chọn phương án hợp lý hay chỉ trả lời “tutorial/trên mạng làm như vậy” hoặc phương án do AI đưa ra.
- Bạn nhận thức về system boundary đến đâu. Model output không đáng tin, state có thể không nhất quán, tool có thể thất bại. Người biết các rủi ro này và dùng biện pháp engineering để kiểm soát mới là người có thể đưa hệ thống lên production.
Tương ứng, tại sao những câu trả lời như “hiệu quả dự án rất tốt”, “kiến trúc có thể mở rộng”, “độ chính xác của model cao” lại không đủ? Vì đó là kết luận, không phải lập luận. Thông tin interviewer nhận được bằng không: vừa không phán đoán được thật giả, vừa không biết mức độ tham gia của bạn. Câu trả lời thực sự có tính phân biệt là đặt constraint, lựa chọn, cái giá và bằng chứng cùng nhau:
Dưới constraint nào, tôi đã chọn gì; nó giải quyết vấn đề nào, đồng thời đưa vào cái giá nào; cuối cùng dùng bằng chứng gì để xác nhận lựa chọn đó có hiệu quả.
Thiếu một trong bốn yếu tố này, câu trả lời đều sẽ sụp đổ:
- Thiếu constraint, lựa chọn sẽ biến thành “mọi người đều dùng như vậy”, không thể hiện được năng lực phán đoán;
- Thiếu cái giá, điều đó cho thấy chưa thực sự đưa lên production. Mọi phương án đều có cái giá; sau khi tách Multi-Agent, chi phí debug, truyền context và latency đều tăng;
- Thiếu bằng chứng, hiệu quả chỉ còn là cảm nhận chủ quan. “Tỷ lệ chọn nhầm tool giảm từ 8% xuống 2%, evaluation set có 200 mẫu” mới có thể kiểm chứng;
- Thiếu phương án thay thế, interviewer không thể xác nhận bạn đã thực sự cân nhắc hay chỉ biết một cách làm.
Ví dụ, “chúng tôi dùng Multi-Agent để nâng cao hiệu quả” không nói rõ lý do và cái giá của việc tách ra. Khi trả lời, bạn có thể bổ sung quá trình ra quyết định lần này.
Ban đầu là single Agent. Sau khi số lượng tool tăng, các tool tra cứu chính sách hoàn tiền và ghi ticket dễ bị chọn nhầm. Chúng tôi không tách ngay thành nhiều Agent, mà trước tiên thu gọn bộ tool, viết lại mô tả tool và bổ sung evaluation cho routing, đưa tỷ lệ chọn nhầm từ 8% xuống 3%. Sau đó các domain nghiệp vụ khác nhau cần context độc lập và được các team khác nhau bảo trì, chúng tôi mới tách Agent theo domain nghiệp vụ. Cái giá là task liên domain cần thêm một tầng routing, khiến latency tổng thể tăng vài trăm mili giây, nên chúng tôi triển khai routing thành cơ chế điều phối nhẹ dựa trên phân loại intent thay vì đưa thêm một “Manager Agent”.
So sánh là thấy ngay sự khác biệt: câu trả lời ban đầu chỉ nói “đã dùng gì”, còn câu trả lời mở rộng giải thích hiện tượng (chọn nhầm tool), lựa chọn (quản trị tool trước rồi mới tách), phương án thay thế (không tách vẫn giải quyết được một phần vấn đề), căn cứ phán đoán (data evaluation routing) và cái giá (latency tăng cùng cách xử lý). Từ đoạn này, interviewer có thể đồng thời xác minh tính chân thực của dự án và quá trình ra quyết định của bạn. Mật độ thông tin cao hơn nhiều so với việc đọc ra một chuỗi tên framework.
Ngoài ra, câu trả lời này còn có một tác dụng: chủ động để lại cho interviewer các điểm có thể hỏi sâu như evaluation routing thực hiện thế nào, tại sao không dùng LLM routing cho intent classification, context truyền ra sao. Những điểm này đều nên là lĩnh vực bạn đã chuẩn bị trước, để phần đào sâu diễn ra trên sân nhà thay vì bị động rơi vào vùng kiến thức mù.
Bảng tổng kết dự án nên viết gì?
Trước khi chuẩn bị câu trả lời, nên tổng kết dự án theo bảng dưới đây. Bảng ghi lại các sự thật bạn có thể đưa ra để đối chiếu khi interviewer hỏi tiếp, không có chức năng trình bày trong CV.
| Thành phần dự án | Nội dung cần làm rõ | Lời sáo rỗng thường gặp |
|---|---|---|
| Vấn đề nghiệp vụ | Ai gặp vấn đề gì trong tình huống nào | “Nâng cao trải nghiệm người dùng” |
| Tiêu chuẩn thành công | Kết quả nào mới được tính là task hoàn tất | “Trả lời chính xác hơn” |
| Input và output | Input của user, sản phẩm cuối cùng của hệ thống, có sửa external state hay không | “Hỗ trợ tương tác ngôn ngữ tự nhiên” |
| Phương án cũ | Hạn chế của quy trình thủ công, hệ thống rule hoặc RAG thông thường | “Phương án truyền thống không thông minh” |
| Trách nhiệm cá nhân | Module, quyết định và công việc xử lý sự cố do mình phụ trách | “Tham gia xây dựng tổng thể” |
| Constraint quan trọng | Latency, cost, permission, data, năng lực model và thời gian lên production | “Yêu cầu high availability” |
| Lựa chọn phương án | Các phương án ứng viên, lý do lựa chọn và cái giá đã biết | “Sau khi nghiên cứu đã chọn một framework nào đó” |
| Bằng chứng chất lượng | Dataset, cách định nghĩa chỉ số, baseline, số lượng mẫu và version evaluation | “Độ chính xác tăng 30%” |
| Case thất bại | Input, Trace, root cause, cách sửa và regression case | “Đã giải quyết sau khi tối ưu Prompt” |
| Vị trí bằng chứng | Code, test case, Trace, dataset hoặc commit record | “Có implement trong code” |
Nếu một ô không có tư liệu thực tế, hãy để trống trước. Đặc biệt không được tự tạo các con số như QPS, độ chính xác hay số nhân lực tiết kiệm. Khi interviewer hỏi tiếp về cách thống kê, khoảng thời gian và baseline, data bịa rất dễ bị phát hiện.
Với project cá nhân chưa lên production, bạn vẫn có thể cung cấp bằng chứng đáng tin: test set cố định, Trace có thể tái hiện, phân loại lỗi, kết quả benchmark và các trade-off thiết kế đều được. Điều quan trọng là nói rõ “đây là kết quả thử nghiệm offline”, không đóng gói nó thành data production.
Cũng cần nói rõ dự án đang ở giai đoạn nào: chạy được Demo, hoàn thành evaluation offline, thử nghiệm với traffic nhỏ và production chính thức không phải là một chuyện. Khi chưa có user thực, có thể trình bày test set và fault injection; khi chưa có sự cố production, có thể trình bày rủi ro phát hiện ở giai đoạn review và phương án thiết kế, nhưng không được đổi cách gọi để biến nó thành production Badcase.
Trách nhiệm cá nhân có thể được tách bằng một câu: team cuối cùng hoàn thành những gì, tôi cụ thể phụ trách phần nào, đã tự mình ra những quyết định hoặc xử lý sự cố nào, phần việc nào do đồng nghiệp khác phụ trách. Cách này đáng tin hơn “tôi phụ trách toàn bộ dự án Agent”, đồng thời giúp mọi câu trả lời phía sau giữ được cùng một boundary.
Làm thế nào dùng một case để trình bày rõ dự án Agent?
Giả sử dự án là một Agent xử lý ticket hậu mãi thông minh. User có thể mô tả vấn đề bằng ngôn ngữ tự nhiên, hệ thống sẽ tra cứu order, truy vấn chính sách hậu mãi, xác định còn thiếu thông tin nào và tạo ticket hậu mãi sau khi user xác nhận.
Ở đây cố ý đưa vào ba loại năng lực:
- Truy vấn chính sách hậu mãi thuộc về RAG;
- Tra cứu order và tạo ticket thuộc về tool calling;
- Quyết định tiếp tục tra cứu, hỏi thêm hay kết thúc dựa trên thông tin hiện tại thuộc về Agent decision.
Trong đó, “tạo ticket” sẽ sửa external state, không thể chỉ phụ thuộc vào việc model output một JSON hợp lệ. Permission check, user confirmation, idempotency và kiểm tra kết quả thực thi đều phải do business system phụ trách.
Agent Loop trong dự án có thể dùng cách thực thi như ReAct: model đề xuất action tiếp theo, nhận Observation do environment trả về rồi quyết định tiếp tục gọi tool hay kết thúc.
ReAct nghĩa là action và observation tiến triển xen kẽ, không phải gọi một tool một lần là hoàn tất thiết kế Agent. Production Trace chỉ cần ghi lại action, tool result, state summary và căn cứ có thể kiểm chứng, không cần lưu private chain-of-thought của model.
Nói phiên bản 30 giây thế nào?
Phiên bản 30 giây chỉ trả lời dự án là gì, tại sao cần Agent, bạn phụ trách gì và vấn đề khó nhất là gì.
Vẫn lấy Agent xử lý ticket hậu mãi thông minh làm ví dụ:
Tôi làm một Agent xử lý ticket hậu mãi thông minh. Ngoài hỏi đáp knowledge base, nó còn dựa trên mô tả của user để động tra cứu order, truy vấn chính sách hậu mãi, bổ sung thông tin còn thiếu và tạo ticket sau khi user xác nhận. Tổng thể dùng workflow cố định kết hợp Agent Loop cục bộ: authentication, permission check, confirmation và write là các node có tính xác định; model chỉ phụ trách hiểu intent, bổ sung thông tin và chọn tool tiếp theo.
Tôi chủ yếu phụ trách Agent orchestration, tool governance và evaluation. Hai vấn đề điển hình nhất trong dự án là chọn nhầm tool tương tự và không thể xác định liệu write API đã thực thi sau khi timeout. Chúng tôi lần lượt giải quyết bằng tối ưu tool contract và “idempotency key + state query + reconciliation”.
Đừng trình bày quá chi tiết. Cách làm khôn ngoan hơn là để dành những nội dung có thể bị hỏi sâu mà bạn đã chuẩn bị trước: tại sao dùng hybrid architecture, quản trị tool ra sao, tại sao write operation không thể mù quáng retry, evaluation thực hiện thế nào.
Mở rộng phiên bản 3 phút thế nào?
Phiên bản 3 phút có thể theo thứ tự sau:
- Vấn đề nghiệp vụ và tiêu chuẩn thành công;
- Luồng hoàn chỉnh của một request;
- Hai lựa chọn kỹ thuật quan trọng;
- Một Badcase tiêu biểu nhất;
- Kết quả và boundary trách nhiệm của bản thân.
Đừng lần lượt đọc ra tech stack theo thứ tự “Spring AI, Redis, Milvus, MCP…”. Tech stack nên xuất hiện trong các quyết định cụ thể, không nên chiếm riêng một đoạn.
Làm thế nào trình bày rõ kiến trúc hệ thống từ một request?
“Chúng tôi dùng layered architecture” là quá trừu tượng. Khi phỏng vấn, trước tiên có thể dẫn interviewer đi hết một request, sau đó quay lại giải thích trách nhiệm của từng layer.
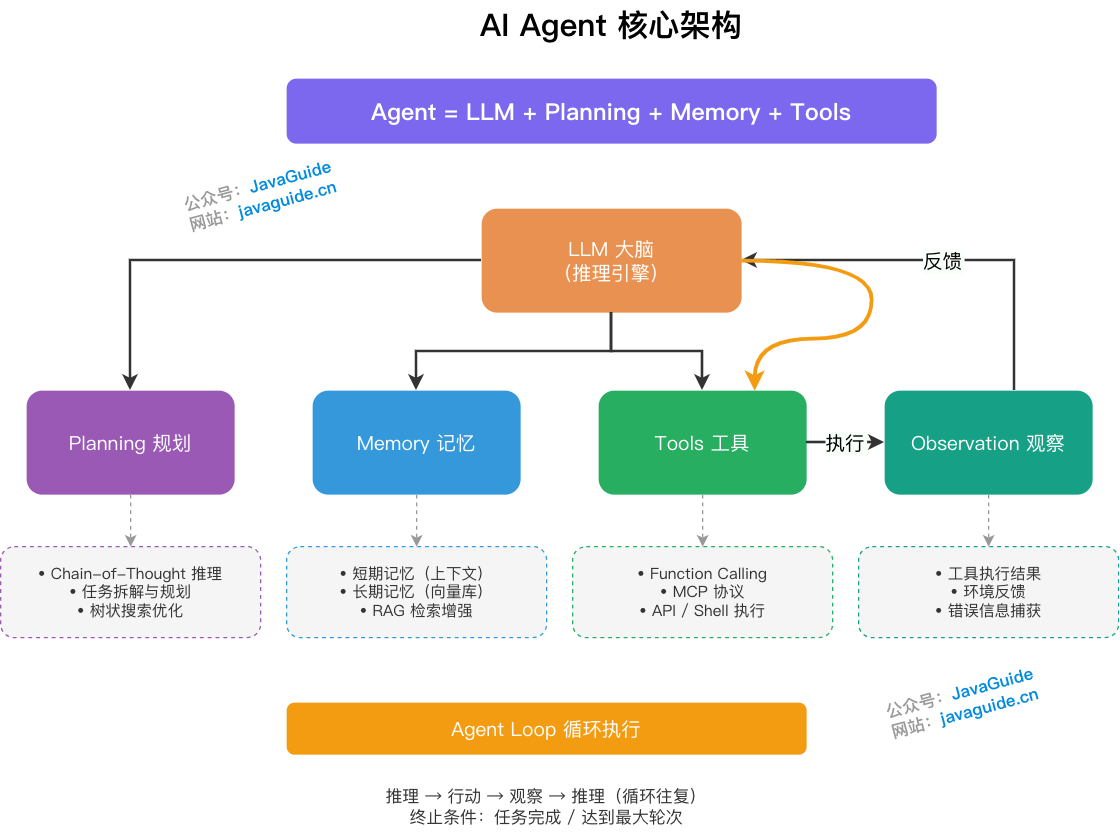
Lấy “tai nghe của order này bị hỏng, hãy giúp tôi đăng ký hậu mãi” làm ví dụ, một request có thể luân chuyển như sau:
- Ingress layer hoàn tất authentication, tenant identification, rate limiting và tạo
requestId,runId. - Orchestration layer đọc task state hiện tại và xác định các thông tin bắt buộc như order number đã đầy đủ hay chưa.
- Agent chọn order query tool dựa trên tool và context khả dụng. Business execution layer kiểm tra lại user có quyền xem order hay không.
- Hệ thống truy vấn chính sách hậu mãi tương ứng dựa trên sản phẩm trong order, thời gian mua và loại vấn đề, rồi đưa evidence vào context của lượt này.
- Nếu thiếu thông tin, Agent hỏi thêm user; nếu đủ điều kiện, tạo structured draft của ticket cần tạo.
- Trước khi thực hiện write operation, hệ thống hiển thị các field quan trọng và chờ user confirmation. Sau khi xác nhận mới kiểm tra lại permission, business rule và idempotency key.
- Sau khi ticket service trả kết quả, hệ thống không thể chỉ tin vào text “call thành công”, mà phải lưu ticket number và final state.
- Ghi lại model call, Prompt, retrieval, tool, approval, latency và result để phục vụ evaluation và Badcase replay.
Quy về các layer hệ thống, có thể rút gọn thành bảy layer sau:
| Layer | Trách nhiệm chính | Công việc không thể giao cho model |
|---|---|---|
| Ingress layer | Authentication, tenant, rate limiting, streaming connection, request identifier | Ranh giới identity và tenant |
| Orchestration layer | Workflow, Graph, Agent Loop, stopping condition | Timeout budget, số bước tối đa, branch bắt buộc |
| Model layer | Model routing, Prompt, structured output | Vendor fallback và cost hard limit |
| Context layer | RAG, conversation history, Memory, context truncation | Data access permission và kiểm tra nguồn fact |
| Tool layer | Tool discovery, parameter validation, execution và trả tool result | Business validation, authorization, transaction và idempotency |
| State layer | Task state, checkpoint, business artifact và memory | Tính nhất quán của authoritative business state |
| Governance layer | Trace, evaluation, audit, alert, canary release và rollback | Release gate và approval cho action rủi ro cao |
Nếu dự án không có nhiều service độc lập như vậy, đừng cố nói thành bảy microservice. Đây là mô tả về logical responsibility, giai đoạn đầu hoàn toàn có thể đặt trong cùng một application. Interviewer quan tâm hơn đến việc boundary có rõ ràng hay không, không phải số lượng service có đủ nhiều hay không.
Lựa chọn công nghệ cho dự án Agent cần trả lời những câu hỏi nào?
Năm câu hỏi đầu dùng để giải thích từng lựa chọn, câu hỏi thứ sáu quyết định phương án có chịu được kiểm chứng hay không:
- Constraint nghiệp vụ lúc đó là gì?
- Đã so sánh những phương án ứng viên nào?
- Tại sao phương án hiện tại phù hợp hơn?
- Nó hy sinh điều gì, và kiểm soát cái giá đó thế nào?
- Dùng evaluation hoặc runtime data nào để xác minh?
- Nếu constraint thay đổi, trong trường hợp nào sẽ đổi phương án?
Tại sao dùng Agent thay vì Workflow thông thường?
Workflow cố định có thể đọc intermediate state, đi theo conditional branch và cũng có thể đặt Agent vào một node. Khi chọn phương án, cần xác nhận bước tiếp theo rốt cuộc do code hoặc graph rule định trước kiểm soát, hay do model chọn action, tool và path trong runtime.
Trong case hậu mãi, authentication, confirmation, ticket write và audit đều có thể xác định trước, nên đặt trong Workflow. User có thể chỉ nói “bị hỏng”, cũng có thể cung cấp order number, ảnh lỗi và cách xử lý đã thử; nếu không thể liệt kê hết candidate path bằng một số rule hữu hạn, đồng thời evaluation chứng minh quyết định của model thực sự tạo ra lợi ích, thì một đoạn nhỏ như tra cứu order, truy vấn policy hay tiếp tục hỏi thêm mới phù hợp giao cho Agent.
Ngược lại, nếu ticket category, required field và processing rule đều hữu hạn và ổn định, “intent classification + form completion + fixed rule” có thể đã đủ. Việc có natural language entry tự nó không chứng minh dự án bắt buộc phải dùng Agent.
Case này phù hợp với hybrid architecture:
Dùng Workflow có tính xác định để cố định security boundary, nhúng Agent Loop cục bộ vào phần có path không xác định.
Về khác biệt giữa Workflow, Graph và Loop, có thể xem thêm Workflow, Graph và Loop trong AI workflow.
Tại sao làm single Agent trước thay vì dùng Multi-Agent ngay?
State, Trace và failure path của single Agent ngắn hơn, thường cũng dễ evaluation hơn. Nhiều tool không đồng nghĩa phải tách thành nhiều Agent, trước tiên có thể thử:
- Load tool động theo scenario;
- Gộp các tool có chức năng trùng lặp;
- Viết lại name, description và parameter Schema;
- Dùng code routing để xử lý các classification có boundary rõ ràng;
- Cô lập sub-context cho task phức tạp.
Chỉ khi task có thể tách độc lập, các role khác nhau lại cần nhiều context chuyên biệt, tool permission khác biệt rõ rệt hoặc trách nhiệm bảo trì độc lập thì lợi ích của Multi-Agent mới có thể bù lại chi phí communication, cost và debug.
Multi-Agent cũng không đồng nghĩa với parallel. Nó có thể thực thi theo thứ tự cố định, chạy parallel các branch không có dependency, được Manager dynamic delegation hoặc Handoff lượt hiện tại cho Specialist.
Khi phỏng vấn cần nói tiếp: topology do code cố định hay model quyết định, context được share hay isolate, các Agent dùng result contract nào, xử lý partial failure và parallel write conflict ra sao, cuối cùng ai chịu trách nhiệm về result.
Phần tổng hợp các vấn đề liên quan đến Multi-Agent có thể tham khảo bài Thiết kế hệ thống cộng tác Multi-Agent.
Phân biệt RAG, Memory, Context và State thế nào?
Bốn khái niệm này thường bị trộn lẫn trong phần giới thiệu dự án.
Dưới đây là cách định nghĩa engineering được dùng trong project hậu mãi của bài viết này, không phải một bộ định nghĩa type mà mọi framework đều thống nhất tuân theo.
| Khái niệm | Nội dung trong case hậu mãi | Câu hỏi chính được trả lời |
|---|---|---|
| RAG | Chính sách hậu mãi, product manual, tài liệu điểm dịch vụ | Trong external knowledge có những evidence liên quan nào? |
| Memory | User preference, thông tin đã xác nhận và được phép lưu lâu dài | Cần ghi nhớ gì giữa các lượt hoặc các session? |
| Context | Instruction, evidence, tool và history thực sự gửi cho model ở lượt này | Lần này model có thể nhìn thấy gì? |
| State | Order hiện tại, field còn thiếu, approval state, action đã thực thi, ticket number | Task đang tiến triển đến bước nào? |
Short-term Memory trong một số framework vốn là một phần của Agent State, Checkpoint cũng có thể lưu State tại một thời điểm. Tên gọi có thể thay đổi, nhưng boundary không thể bị trộn lẫn: Memory, Agent State và workflow Checkpoint đều không thể thay thế authoritative business database. Chỉ lưu “ticket đã được tạo hay chưa” trong conversation history là một thiết kế rất nguy hiểm.
Có thể xem nguyên lý chi tiết lần lượt tại Hướng dẫn thực hành context engineering và Giải thích chi tiết hệ thống memory của AI Agent.
Nếu dự án thực sự dùng long-term Memory, còn phải trả lời được thông tin nào được phép ghi, ai xác nhận nguồn, lưu trong bao lâu, user xem và xóa thế nào, và xử lý ra sao khi nội dung độc hại bị ghi vào. Nếu chỉ lưu vài lượt Chat History thì hãy gọi là conversation history, đừng đóng gói thành hệ thống long-term memory hoàn chỉnh.
RAG cũng không thể dừng ở “đã kết nối vector database”. Ít nhất phải chuẩn bị cách parse và chunk document, cách update index, cách vector và keyword cùng recall, có dùng Reranker hay không, Top-K xác định thế nào, ACL có hiệu lực ở đâu, cũng như cách replay citation và knowledge version. Khi evaluation, hãy tách retrieval hit và final answer để xem riêng, nếu không rất khó xác định vấn đề nằm ở recall hay generation.
Function Calling, MCP và Agent lần lượt phụ trách gì?
Function Calling cho phép model biểu đạt bằng parameter có cấu trúc rằng “muốn gọi function nào”; MCP phụ trách trao đổi context giữa Host, Client và Server, có thể cung cấp các primitive như Resources, Prompts, Tools; Agent phụ trách quyết định bước tiếp theo dựa trên goal và state.
Chúng không ở cùng một layer và cũng không thể thay thế lẫn nhau.
Nếu tool chỉ phục vụ application hiện tại, đăng ký local function trực tiếp thường đơn giản hơn. Nếu cùng một capability cần được nhiều Agent, IDE hoặc model client dùng lại, khi đó mới đánh giá MCP. Sau khi dùng MCP, permission, parameter validation và side-effect governance vẫn phải hoàn thành ở business side.
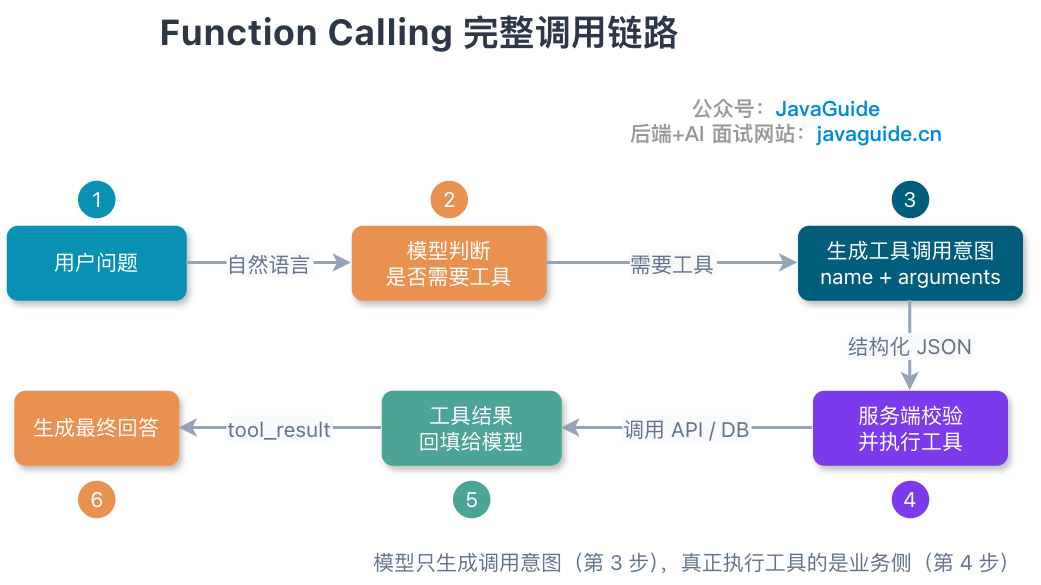
Phần này dễ bị hỏi sâu, nên ôn tập cùng Giải thích chi tiết structured output của LLM và Giải thích chi tiết MCP protocol.
Chọn model thế nào?
Đừng dùng “một model nào đó có hiệu quả tốt nhất” làm lý do duy nhất. Việc chọn model ít nhất phải đồng thời xem xét:
- Success rate trên task mục tiêu;
- Năng lực chọn tool và điền parameter;
- Tính ổn định của long context hoặc multi-turn;
- First Token latency và full response latency;
- Chi phí input, output và cached Token;
- Có hỗ trợ structured output, tool calling và multimodal hay không;
- Data compliance, khu vực và availability của vendor.
Cách tương đối chắc chắn là trước tiên dùng model có năng lực mạnh để thiết lập quality baseline, sau đó lần lượt thử model nhỏ hơn và rẻ hơn ở từng node. Classification, simple extraction và format conversion chưa chắc cần model mạnh nhất; planning, phán đoán phức tạp và tổng hợp cuối cùng có thể cần model mạnh hơn. Mỗi lần thay thế đều chạy cùng một evaluation set để tránh kết luận chỉ dựa vào vài lần hội thoại thủ công.
Tại sao cần đưa vào model gateway?
Khi dự án chỉ kết nối một model và vẫn đang ở giai đoạn validation, có thể gọi API trực tiếp trước. Sau khi số lượng vendor tăng hoặc nhiều nghiệp vụ bắt đầu dùng chung năng lực gọi, hãy dùng model gateway để thống nhất xử lý authentication, model routing, rate limit quota, retry, fallback, cost attribution và audit.
Thiết kế cụ thể có thể xem tại Giải thích chi tiết model gateway.
Đâu là capability của framework, đâu là phần project tự implement?
Khi nhắc đến framework trong phỏng vấn, tốt nhất đồng thời đưa ra version và boundary capability. Framework giúp bạn chạy được Tool Loop không có nghĩa nó đã hoàn thành thay project phần business state, permission, idempotency và audit.
Lấy implementation tại thời điểm đối chiếu của bài viết làm ví dụ: Spring AI 2.0.0 có thể quản lý tool loop thông qua ToolCallingAdvisor và ToolCallingManager, ToolCallbackResolver có thể dynamic resolve tool; user cụ thể có được refund hay không, có cần approval hay không vẫn do business code phán đoán. AgentStateStore của AgentScope Java 2.0.1 có thể lưu Agent session state, nhưng nó không phải order database hay workflow business Checkpoint; streamEvents() cung cấp event stream, cũng không có nghĩa hệ thống đã persist đầy đủ Trace.
Nếu dự án dùng version khác, hãy đối chiếu lại theo API thực tế. Khi trả lời có thể tách thẳng thành hai câu: “framework cung cấp gì” và “tôi bổ sung gì bên ngoài framework”, đừng tính toàn bộ capability của layer wrapper thành thiết kế kiến trúc của mình.
Tại sao tool calling không thể chỉ xem model output?
Model trả về parameter hợp lệ chỉ có thể cho thấy format đã pass, không có nghĩa action đó được phép thực thi.
Một tool calling chain hoàn chỉnh ít nhất phải có các bước kiểm tra sau:
- Schema validation. Kiểm tra type, enum, format và required field có hợp lệ hay không.
- Business validation. Kiểm tra order state, thời hạn hậu mãi và tổ hợp field có thỏa rule hay không.
- Identity và permission. Xác nhận user hiện tại có thể truy cập resource mục tiêu hay không.
- Risk assessment. Xác định riêng execution policy cho read-only, reversible write và irreversible write.
- Human confirmation. Dựa trên risk level để xác định có cần hiển thị parameter cuối cùng và chờ confirmation hay không.
- Idempotency control. Ngăn retry hoặc click lặp tạo ra nhiều side effect.
- Result verification. Kiểm tra final state của external system có đúng như dự kiến hay không.
- Audit record. Ghi lại ai đã thực thi action gì, với parameter nào và vào thời điểm nào.
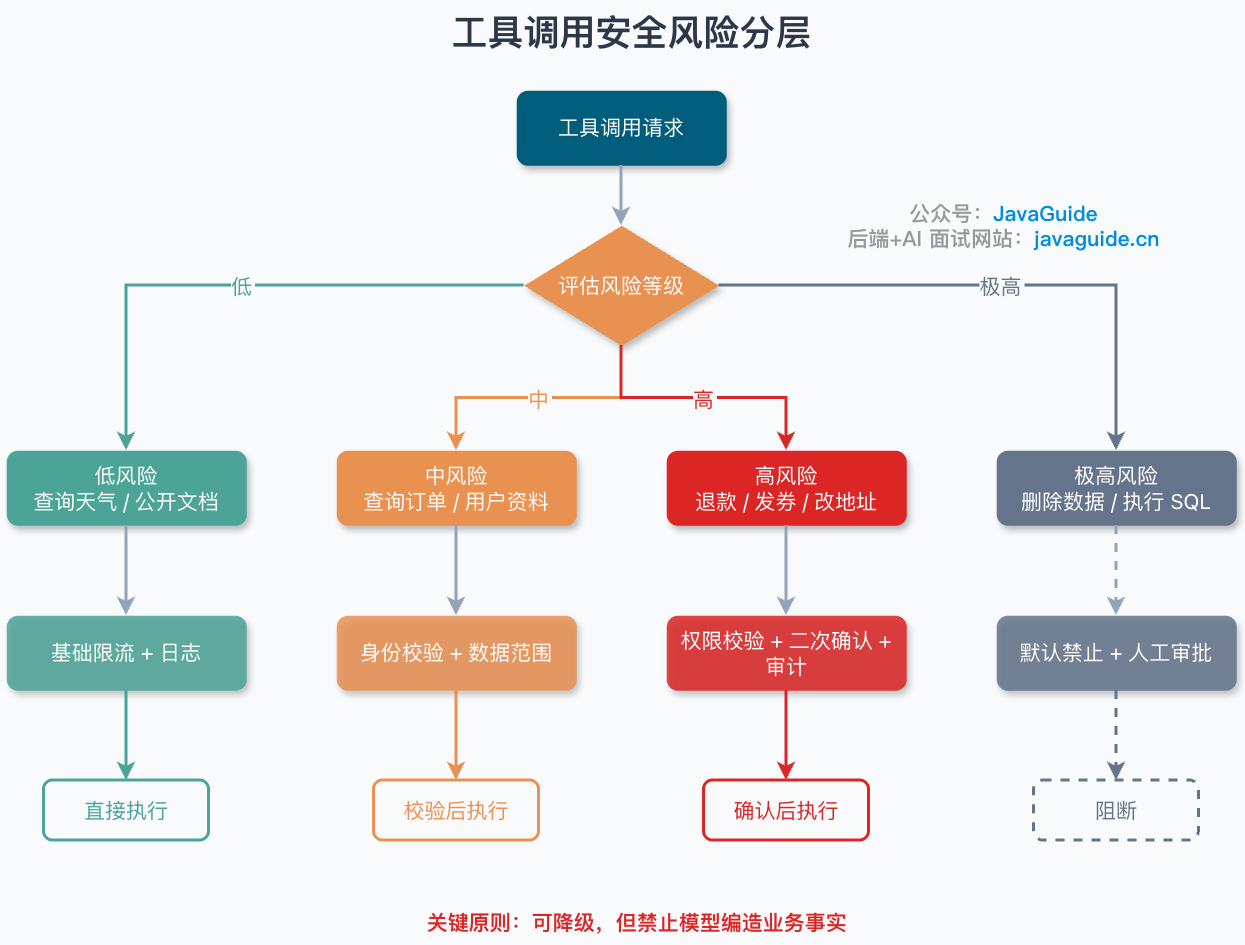
Một cách phân cấp tool risk thực tế như sau:
| Level | Ví dụ | Strategy đề xuất |
|---|---|---|
| Read-only risk thấp | Tra cứu policy công khai, đọc order của chính user | Permission check, parameter limit, timeout và audit |
| Reversible write risk trung bình | Tạo draft, thêm tag | Idempotency, result verification, entry để undo |
| Write risk cao | Refund, hủy order, gửi message | Confirmation rõ ràng, quota limit, approval hoặc human takeover |
| Cấm auto-execution | Action vượt authorization scope hoặc không thể compensate | Từ chối thực thi, chỉ cung cấp giải thích và human entry |
Bản thân tool description cũng phải được đưa vào evaluation. Name mơ hồ, chức năng trùng lặp và result quá dài đều có thể khiến Agent chọn nhầm tool hoặc làm nhiễm context.
Tool result, RAG document, web page và MCP Server description đều có thể chứa indirect Prompt Injection. Khi đi vào context của lượt tiếp theo, chúng vẫn là untrusted data, không thể thay đổi server identity, resource permission và tool risk level. Threat model đầy đủ hơn xem tại Thực hành bảo mật LLM/Agent.
Thiết kế stability cho dự án Agent thế nào?
Tại sao timeout không thể trực tiếp được coi là execution failure?
Khi interviewer hỏi “model hoặc tool timeout thì làm gì”, nhiều người phản ứng đầu tiên là “retry vài lần là được”. Nếu hỏi tiếp “write operation đã thực thi thành công nhưng response bị mất thì sao?”, câu trả lời ban đầu sẽ không đủ.
Lúc này retry nguyên trạng một lần nữa có thể dẫn đến tạo ticket lặp hoặc refund lặp.
Vấn đề nằm ở cách hiểu về timeout. Timeout chỉ cho biết caller không nhận được result trong thời hạn, còn phía server có thể đang ở bất kỳ trạng thái nào trong ba trạng thái: request hoàn toàn chưa đến, đang thực thi, hoặc đã thực thi xong nhưng response bị mất trên network. Caller không thể phân biệt, vì vậy không thể trực tiếp coi timeout là failure.
Với query API thì dễ xử lý, read operation không có side effect nên có thể retry hữu hạn các lỗi tạm thời trong tổng time budget. Write operation thì không được; các request như tạo ticket và refund nếu blind retry có thể tạo side effect lặp.
Phương án chắc chắn hơn là:
- Khi tạo logical action, sinh một
actionIdổn định một lần và dùng nó tham gia idempotency key; cùng một action luôn reuse nó trong SDK retry, message redelivery và manual recovery, chỉ action mới mới sinh ID mới; - Server dùng unique constraint hoặc request record để nhận diện request trùng;
- Khi cùng một idempotency key mang parameter khác nhau, phải từ chối một cách deterministic, không được im lặng trả về result lần đầu;
- Sau timeout, trước tiên query execution state theo idempotency key;
- Khi state vẫn không rõ, chuyển sang reconciliation hoặc xử lý thủ công thay vì retry vô hạn;
- Ghi business object ID cuối cùng trở lại task state và audit log.

Retry còn cần exponential backoff, jitter ngẫu nhiên, số lần tối đa, deadline tổng và retry budget. Model SDK, gateway, HTTP Client, tool adapter và workflow node không thể mỗi bên độc lập retry ba lần, nếu không số lần call sẽ bị khuếch đại theo cấp số nhân. Cách tương đối chắc chắn là dùng chung Deadline tổng và Retry Budget, đồng thời ghi attempt của từng layer trong Trace.
Caller timeout, Future bị cancel hoặc user ngắt SSE cũng không có nghĩa remote write operation đã dừng. Side effect có thể thành công sau đó, nên sau khi cancel vẫn phải giữ idempotency key, state query và reconciliation. Parameter error, permission failure và business rejection là deterministic error, cần fail ngay; chỉ rate limiting và temporary network error mới có thể retry trong budget. Nội dung chi tiết xem Giải thích chi tiết cơ chế timeout và retry và Idempotency của API.
Khi model hoặc tool liên tục unavailable thì fallback thế nào?
Retry chủ yếu xử lý các sự cố tạm thời như rate limiting và temporary network error. Khi model vendor unavailable trong thời gian dài hoặc một tool liên tục báo lỗi, tiếp tục tiêu tốn retry budget chỉ kéo dài response time. Lúc này cần kịp thời circuit break dependency bị lỗi, dừng gửi request mới đến nó và chọn backup model, cache result, trả partial result hoặc chuyển human tùy theo risk của task.
Trước khi chuyển sang backup model, cần dùng cùng một evaluation set để xác nhận nó có thể đảm nhiệm task hiện tại hay không. Text summary risk thấp có thể fallback xuống model yếu hơn; với write operation như refund hoặc gửi message, năng lực model giảm có thể đồng thời ảnh hưởng tool selection và parameter generation. Những task này phù hợp hơn với việc tạm dừng thực thi hoặc chuyển human, không thể âm thầm hạ security requirement chỉ để duy trì availability.
Fallback tool cũng phải xem vai trò của nó trong task. Khi optional tool unavailable, có thể tạm thời xóa khỏi tool set; nếu thiếu nó mà vẫn có thể trả lời, có thể thông báo rõ limitation rồi trả partial result; khi không lấy được data bắt buộc như order, permission hoặc policy evidence, cần dừng sinh kết luận có tính xác định. Hệ thống cũng phải ghi circuit break reason, fallback path và final result vào Trace để phân biệt “hoàn thành bình thường” và “hoàn thành sau fallback”.
Khi traffic tăng, còn phải theo dõi model quota, tool concurrency, thread pool, connection pool và queue length. Rate limiting và backpressure nên đặt gần ingress nhất có thể; slow tool dùng concurrency bulkhead riêng để tránh một third-party API làm kẹt toàn bộ Agent Run. Khi parallel branch cùng ghi shared State, cũng phải định nghĩa trước merge rule và conflict rule.
Đặt exit boundary cho Agent Loop thế nào?
Khi không lấy được thông tin quan trọng, Agent có thể lặp lại việc query cùng một order hoặc liên tục gọi tool với cùng parameter. Model vẫn trả về action tiếp theo nhưng task không hề tiến triển. Nếu executor không chủ động dừng, loop này sẽ tiếp tục tiêu tốn time và Token.
Khi task bắt đầu, executor phải xác định deadline tổng, số lần call tối đa của model và tool, cùng Token và cost budget. Trước mỗi lần chuẩn bị gọi model hoặc tool, phải kiểm tra budget còn lại; từng tool cũng phải có timeout riêng để tránh một slow call chiếm hết deadline của toàn task.
Không vượt quá số lần tối đa vẫn có thể rơi vào infinite loop. Hệ thống có thể so sánh tool name, normalized parameter và State version của các step liên tiếp. Nếu cùng một action lặp lại hoặc state vẫn không thay đổi sau nhiều step, dừng theo lý do “không có tiến triển”. Với action risk cao như refund, tạm dừng task để chờ user confirmation.
Sau khi dừng phải ghi rõ lý do, rồi dựa trên phần đã hoàn tất để quyết định trả về result hiện tại hay chuyển human. Những phán đoán này do execution framework hoặc business code thực thi; câu “gọi tối đa mười lần” trong Prompt chỉ có thể làm behavior hint, không thể thay thế system limit.
Khôi phục long task và human confirmation thế nào?
Lấy refund làm ví dụ, Agent đã thu thập đủ thông tin nhưng trước khi thực thi thật cần chờ user confirmation. User có thể vài giờ sau mới quay lại, hệ thống không thể tiếp tục phụ thuộc vào process và memory state ban đầu. Khi pause phải lưu runId, Checkpoint, tool chờ thực thi, normalized parameter, State hiện tại, actionId, cùng tool Schema và policy version.
Khi user confirmation, hệ thống trước tiên kiểm tra identity và permission của người xác nhận, đồng thời kiểm tra confirmation đã hết hạn hay chưa. Sau khi resume task còn phải đọc lại order state. Nếu trong thời gian chờ refund amount, order state, tool Schema hoặc policy thay đổi, confirmation ban đầu lập tức mất hiệu lực; hệ thống cần hiển thị parameter mới và yêu cầu confirmation lần nữa.
Một số framework khi resume sẽ thực thi lại từ đầu node. Vì vậy write operation node vẫn phải reuse cùng actionId, trước tiên query external state rồi mới quyết định có execute hay không; confirmation event cũng chỉ được consume một lần. Như vậy dù resume action bị trigger lặp, cũng không gây refund lặp hoặc tạo ticket lặp.
Nên trình bày metric của dự án Agent thế nào?
Khi phỏng vấn, trước tiên nói task có hoàn tất hay không, sau đó bổ sung execution process, cost và safety. Một con số “accuracy 85%” tách rời test set và cách thống kê rất khó chứng minh dự án thực sự usable.
| Câu hỏi cần trả lời | Metric có thể dùng |
|---|---|
| Task đã hoàn tất chưa | Task completion rate, final business state correctness rate, evidence-supported fact rate |
| Execution process có đúng không | Tool selection và parameter correctness rate, redundant call rate, số lần unauthorized call |
| Cost có chấp nhận được không | End-to-end P50/P95, số lần model call, Token, cost mỗi task |
| Sau failure có kiểm soát được không | Failure recovery rate, human handoff rate, số side effect lặp, false block rate |
Sau khi nói metric, còn phải giải thích test set đến từ đâu, xác định success thế nào, cùng một task chạy bao nhiêu lần và so sánh với version nào. Với project đã lên production, có thể bổ sung business metric như self-service resolution rate và processing time, đồng thời nói rõ thời gian thống kê và control group. Nếu project chưa lên production, hãy trình bày offline evaluation set và error distribution, đừng đóng gói kết quả thử nghiệm thành data production.
Trong case hậu mãi, ticket có được tạo chính xác hay không thuộc về Outcome; đã gọi những tool nào, parameter có đúng không, có unauthorized call hoặc execution lặp hay không thì phải quay lại Trace để kiểm tra. Open task có thể có nhiều path đúng. Khi evaluation, trước tiên xác minh final business state và security rule bắt buộc, không yêu cầu execution order hoàn toàn giống một Golden Sequence.
Một input cố định và success condition tạo thành một Task, mỗi lần execution là một Trial. Agent output có tính ngẫu nhiên, task quan trọng cần chạy nhiều lần. Grader có thể dùng code rule, LLM-as-Judge hoặc human; Eval Harness phụ trách thực thi các Trial, lưu Trace và tổng hợp result.

Phương pháp đầy đủ có thể xem tại Hệ thống evaluation cho ứng dụng AI.
Phân tích Badcase của dự án Agent thế nào?
Chỉ nói “model trả lời sai, sau đó tối ưu Prompt” không thể cho thấy đã tìm đúng root cause hay chưa. Một Badcase review đạt yêu cầu phải để lại bằng chứng định vị có thể tái hiện.
Có thể trả lời theo bảy bước sau:
- Lưu hiện trường. Giữ lại input, version model và Prompt, context, result retrieval, request và response của tool cùng external state.
- Mô tả hiện tượng. Nói rõ expected result, actual result và phạm vi ảnh hưởng.
- Đặt giả thuyết theo layer. Lần lượt kiểm tra data, retrieval, context, model, tool, orchestration và third-party system.
- Kiểm soát biến số. Mỗi lần chỉ thay một biến, tránh đồng thời sửa model, Prompt và retrieval parameter.
- Xác nhận root cause. Đưa ra bằng chứng có thể tái hiện vấn đề ổn định, không dừng ở correlation.
- Thực hiện fix. Nói rõ fix được đặt ở layer nào và giải thích tại sao không thể chỉ sửa Prompt.
- Thêm regression case. Đưa Case gốc và Case boundary lân cận vào regression set, sau đó tiếp tục quan sát metric production.
Hãy xem hai ví dụ dễ bị hỏi sâu dưới đây. Khi trả lời về project của mình, trước tiên nói rõ bằng chứng thuộc production incident thực tế, offline fault injection hay design proposal. Nếu không có production record, đừng gọi việc mô phỏng tái hiện là production incident.
Tại sao Agent chọn nhầm các tool tương tự?
Hệ thống có hai tool với tên gần giống nhau. query_after_sale_policy tra cứu chính sách hậu mãi chung, không cần order cụ thể; check_after_sale_eligibility nhận order number và xác định order này có đủ điều kiện đăng ký hậu mãi hay không. Khi user đã cung cấp order number, Agent lẽ ra phải gọi tool phía sau nhưng lại chọn tool phía trước. Policy description nó trả về có thể không sai về fact, nhưng không thể trả lời “order của tôi có thể đăng ký hay không”.
Khi điều tra, trước tiên phải xem Trace. Nếu order number không đi vào context của model, điều đó cho thấy state assembly có vấn đề; chỉ khi model đã thấy order number mà vẫn chọn sai mới tiếp tục kiểm tra name, description và parameter của hai tool có dễ gây nhầm lẫn hay không. Sau khi cố định input, mỗi lần chỉ sửa tool description, Prompt hoặc model cũng có thể xác định chính xác thay đổi nào khiến lỗi biến mất.
Khi fix, trước tiên viết rõ responsibility và precondition của hai tool, đồng thời đưa order number vào state summary ngắn gọn. Nếu routing rule có thể do code xác định, chẳng hạn chỉ khi lấy được order number mới có thể kiểm tra order cụ thể, hãy trực tiếp thu hẹp tool set cung cấp cho model ở lượt này. Code sẽ loại trước các tool không thỏa precondition, request không có order number cũng không bị fixed priority trong Prompt dẫn lệch.
Cuối cùng đưa “có order number”, “không có order number”, “order không thuộc user hiện tại” và “order number sai format” vào cùng một nhóm regression test. Khi có nhiều sample hơn, dùng tool confusion matrix để theo dõi hai tool có còn thường xuyên bị chọn nhầm hay không.
Tại sao timeout khi tạo ticket lại tạo ra record trùng?
Request tạo lần đầu đã thực thi thành công trong ticket service, nhưng network timeout khi response trả về. Agent execution layer chỉ thấy timeout nên tạo request mới và gọi API lần nữa. Ticket service không thể nhận diện hai request thuộc cùng một business action, cuối cùng tạo ra hai ticket.
Badcase này xảy ra ở tool execution layer. Caller ghi timeout thành failure, còn API lại thiếu idempotency constraint. Trên thực tế, timeout chỉ đại diện cho việc result tạm thời chưa rõ; request đầu tiên có thể failure, vẫn đang execute hoặc đã success.
Khi bắt đầu action tạo ticket, sinh một actionId ổn định, các SDK retry, message redelivery và manual recovery sau đó đều reuse nó. Ticket service dùng identifier này để tạo idempotency record và unique constraint; khi cùng một actionId mang parameter khác nhau thì từ chối trực tiếp, tránh âm thầm trả về old result không khớp.
Sau khi call timeout, execution layer trước tiên query state của request gốc theo actionId. Nếu thấy success thì ghi lại ticket number; chỉ sau khi xác nhận failure mới được retry theo policy; nếu state vẫn không chắc chắn thì chuyển sang reconciliation hoặc xử lý thủ công. Trace cũng phải phân biệt FAILED, TIMED_OUT_UNKNOWN và SUCCEEDED, không thể ghi cả ba result thành call failure.
Regression test cần cố ý tạo tình huống “server đã write nhưng response bị mất trên đường trả về”, để xác nhận nhiều lần recovery cuối cùng chỉ nhận được một ticket.
Dùng Trace để tái hiện execution process của Agent thế nào?
Khi API thông thường ném exception, status code và exception stack thường có thể chỉ ra vị trí lỗi. Agent dù không ném exception vẫn có thể lấy nhầm document, chọn nhầm tool trong các lượt đầu và cuối cùng tạo ra một câu trả lời sai nhưng trông hợp lý. Trace tái hiện process này theo thời gian, ghi lại input hệ thống thực sự nhìn thấy, output đã tạo ra và action đã thực thi. Nó không lưu private chain-of-thought của model và cũng không thể chứng minh tại sao bên trong model lại đưa ra một phán đoán nào đó.
Lấy một request ticket hậu mãi làm ví dụ, Trace có thể ghi theo thứ tự sau.
- Khi request đi vào hệ thống, tạo
requestIdvàrunId, đồng thời liên kết với user và tenant identifier đã được desensitize, cùng version code, Prompt và tool Schema dùng trong lần chạy này. - Mỗi lần gọi model, lưu input summary đã desensitize và model output, đồng thời ghi Token, latency và stopping reason, tránh chỉ lưu final answer.
- Khi retrieval xảy ra, ghi query content, document ID được hit, score và fragment thực sự inject vào model, đồng thời kèm knowledge base version.
- Khi gọi tool, tạo
toolCallId, ghi parameter summary, permission decision, execution result và error type. Retry còn phải kèmattempt, parent Span và idempotency key summary để có thể thấy cùng một action đã được thực thi bao nhiêu lần. - Khi task kết thúc hoặc pause, ghi state change, Checkpoint, human confirmation, final Outcome, tổng số call, tổng cost và fallback reason.
Khi điều tra, xem ngược từ final result để tìm vị trí đầu tiên lệch khỏi expected. Nếu retrieval lấy nhầm document thì kiểm tra chunking, recall và Reranker; nếu evidence đã đúng nhưng Agent chọn nhầm tool thì kiểm tra context và model; nếu tool trả success nhưng business state không thay đổi thì kiểm tra tool adapter và result verification. Như vậy có thể thu hẹp “trả lời sai” vào một lần retrieval, model call hoặc tool execution cụ thể.
Model input, tool parameter và retrieval fragment có thể chứa personal information hoặc business secret. Production environment thường chỉ lưu desensitized summary, kết hợp sampling, access control và retention period. Field cần cho troubleshooting có thể giữ lại, nhưng không nên mặc định lưu raw content đầy đủ trong thời gian dài.
Replay một request để xem Trace, quan sát latency và error rate trong một khoảng thời gian để xem Metrics, đối chiếu ai đã approve refund hoặc external operation khác để xem Audit, so sánh các version model hoặc Prompt để xem Eval Record. Exception log cụ thể có thể gắn vào Span tương ứng. Các record này liên kết với nhau bằng cùng một runId, không cần nhét vào một table lớn.
Phân chia Session, Run, Trace, Span và Attempt, context propagation của async task, cũng như việc sampling và xử lý sensitive data, xem chi tiết tại AI observability và Trace.
Cần chuẩn bị gì trước phỏng vấn?
Mỗi dự án Agent ít nhất cần chuẩn bị các nội dung sau:
- Một bảng tổng kết dự án;
- Ba phiên bản giới thiệu dài 30 giây, 3 phút và 10 phút;
- Một sơ đồ kiến trúc có thể trình bày từ ingress đến final result;
- Hai lựa chọn công nghệ có phương án thay thế;
- Hai Badcase có root cause khác nhau, tốt nhất một vấn đề về hiệu quả và một vấn đề engineering;
- Một phân loại evaluation set và định nghĩa metric;
- Một Trace có thể giải thích theo từng node;
- Version model, framework, protocol và tool Schema đang sử dụng;
- Các limitation hiện tại của dự án và kế hoạch tiếp theo đã xác định rõ;
- Boundary giữa phần mình phụ trách và không phụ trách.
Cuối cùng có thể dùng nhóm câu hỏi dưới đây để tự kiểm tra:
- Nếu bỏ LLM, flow ban đầu là gì?
- Tại sao là Agent, không phải RAG QA hoặc Workflow?
- Boundary của model, tool, Memory, RAG và State lần lượt là gì?
- Quyết định nào do model đưa ra, quyết định nào bắt buộc do code thực hiện?
- Write operation được authorize, confirm, idempotent và verify thế nào?
- Hạn chế infinite loop, cost và latency tổng thế nào?
- Công thức, sample và baseline của metric là gì?
- Failure nghiêm trọng nhất có thể tái hiện thế nào?
- Sau khi fix, chứng minh không tạo regression mới thế nào?
- Nếu traffic tăng gấp mười, component nào sẽ xuất hiện bottleneck trước tiên?
requestId,runId,sessionId,toolCallIdvàactionIdlần lượt giải quyết vấn đề gì?- Sau khi HITL pause, làm thế nào persist, expire, resume và revalidate business state?
- Trust boundary của RAG, tool result, MCP Server và long-term Memory nằm ở đâu?
- Capability nào do framework cung cấp, permission, state và reliability mechanism nào do project tự implement?
- Kết luận hiện tại nào đến từ production, kết luận nào đến từ offline experiment, kết luận nào chỉ là design proposal?
Nếu có thể trả lời tất cả câu hỏi này dựa trên bằng chứng thực tế, phần giới thiệu dự án về cơ bản sẽ không dừng ở mức “Demo bọc vỏ”.