
Idempotency của API là câu hỏi thường gặp trong phỏng vấn, đồng thời cũng là vấn đề thường phải giải quyết trong quá trình phát triển hằng ngày.
Idempotency là gì?
Idempotency là một khái niệm toán học, thường gặp trong đại số trừu tượng, biểu thị việc một thao tác được thực hiện một lần hay nhiều lần đều cho ra cùng một hiệu quả. Áp dụng vào hàm, có thể hiểu là $f(f(x)) = f(x)$. Ví dụ, $f(x)=|x|$ là idempotent, vì lấy giá trị tuyệt đối của một số một lần hay nhiều lần đều cho cùng kết quả.
Trong ngữ nghĩa của API, idempotency chủ yếu chỉ việc nhiều request giống nhau tạo ra hiệu quả dự kiến trên tài nguyên phía server giống với việc thực hiện một request. Nội dung response có hoàn toàn giống nhau hay không còn tùy vào thiết kế nghiệp vụ; API liên quan đến tiền thường yêu cầu thêm việc trả về kết quả nghiệp vụ ổn định.
Đối với thao tác dữ liệu:
- Thao tác insert cần dựa vào business unique key hoặc idempotency key để tránh tạo dữ liệu trùng lặp.
- Với thao tác update, cần phân biệt update kiểu gán và update kiểu cộng dồn. Kiểu gán như
update set status = 'PAID'dễ đạt idempotency hơn; kiểu cộng dồn nhưupdate set balance = balance - 100phải kiểm soát thêm việc thực thi trùng lặp.
Vấn đề idempotency của API thường được kích hoạt bởi biến động mạng, người dùng thao tác lặp lại, client/gateway retry do timeout, hoặc message bị deliver trùng lặp; response chậm sẽ làm tăng xác suất xuất hiện các request trùng lặp này.
Không bảo đảm idempotency sẽ gây ra hậu quả gì?
Không bảo đảm idempotency có thể dẫn đến các Bug nghiêm trọng trong production, điển hình là những nghiệp vụ liên quan đến tiền. Ví dụ, khi thanh toán mà không bảo đảm idempotency, người dùng có thể đồng thời nhấn nút thanh toán nhiều lần, khiến backend xử lý nhiều request trừ tiền giống nhau và tài khoản bị trừ tiền nhiều lần. Đây là sự cố production rủi ro cao trong nghiệp vụ tài chính.
Vì vậy, các trường hợp như tiền, tồn kho, order và coupon đều cần được xử lý idempotency cẩn thận. Ngoài ra, bảo đảm idempotency không có nghĩa là chỉ cần làm ở frontend; backend cũng phải thực hiện.
Làm thế nào để bảo đảm idempotency cho API?
Frontend có thể làm mờ nút sau khi người dùng submit request hoặc đặt nút ở trạng thái không thể click. Cách này chỉ làm giảm xác suất submit trùng lặp, không thể dùng làm cơ chế bảo đảm idempotency. Người dùng vẫn có thể refresh page, replay request, bypass frontend; gateway retry do timeout hoặc message queue deliver trùng lặp cũng có thể kích hoạt việc gọi trùng lặp. Ranh giới idempotency thực sự phải nằm ở server, đặc biệt với những API làm thay đổi trạng thái nghiệp vụ như tiền, tồn kho và order.
Việc backend bảo đảm idempotency phức tạp hơn một chút, có nhiều phương pháp như pessimistic lock, unique index, deduplication table, optimistic lock, distributed lock và cơ chế Token.
Tư tưởng cốt lõi của pessimistic lock và distributed lock đều là dùng lock để bảo đảm tại cùng một thời điểm chỉ có một request được thực thi. Tuy nhiên, chỉ như vậy là chưa đủ; còn cần kết hợp kiểm tra idempotency theo business logic. Ví dụ, trong trường hợp đăng ký cần kiểm tra số điện thoại/email/username đã được đăng ký hay chưa; trong trường hợp thanh toán order cần kiểm tra trạng thái order.
Trong project thực tế, phương án kết hợp thường gặp hơn: business unique key / idempotency key dùng để nhận diện request trùng lặp, database unique index hoặc deduplication table dùng để làm lớp bảo vệ cuối, state machine ngăn trạng thái quay lui; distributed lock chỉ dùng khi cần tuần tự hóa thao tác trên cùng một business resource.
Có thể hiểu trước các trường hợp thường gặp như sau:
- Submit form trùng lặp: làm mờ nút ở frontend chỉ giảm số lần click trùng lặp; server nên kết hợp thêm Token dùng một lần để bảo đảm cùng một form chỉ submit thành công một lần.
- Tạo order: các business unique key như order number và request number là bắt buộc; database tiếp tục thêm unique index để làm lớp bảo vệ cuối. Khi request trùng lặp đến, không tạo thêm một order mà trả về kết quả của order đã tồn tại.
- Payment callback: third-party transaction number phải nhận diện duy nhất một callback; kết hợp thêm order state machine và deduplication table để tránh ghi nhận cùng một khoản thanh toán nhiều lần.
- Trừ tồn kho: trọng tâm là ngăn trừ lặp và overselling; có thể kết hợp state validation, optimistic lock, Redis Lua hoặc database transaction.
- Consume message: message có thể bị deliver trùng lặp, vì vậy cần dùng message ID hoặc business transaction number để ghi nhận kết quả consume. Message đã được consume thì bỏ qua hoặc trả về thành công ngay.
Khi lựa chọn phương án, có thể tuân theo một số ưu tiên sau:
- Nếu có thể giải quyết bằng business unique key thì ưu tiên business unique key.
- Nếu có thể dùng database unique index để làm lớp bảo vệ cuối thì không nên chỉ dựa vào cache.
- Với các trường hợp có state transition, dùng state machine để ngăn thực thi trùng lặp và trạng thái quay lui.
- Chỉ cân nhắc distributed lock khi cần bảo vệ critical section của cùng một business resource.
- Với nghiệp vụ tài chính rủi ro cao, cần nhiều lớp bảo vệ, không nên đặt cược vào một cơ chế duy nhất.
Pessimistic lock
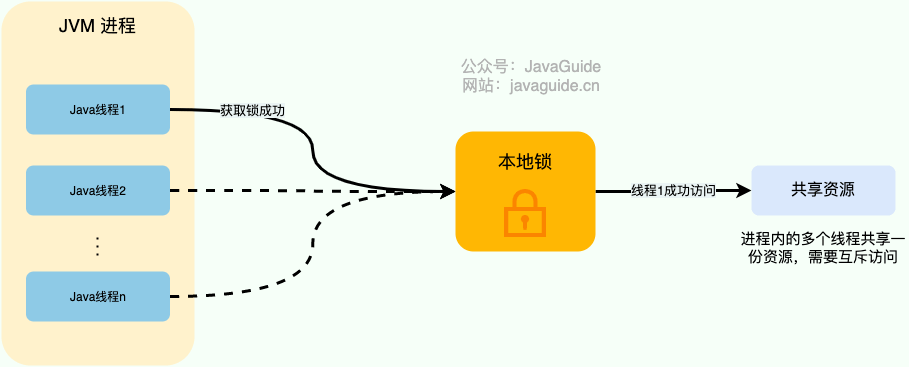
Trong Java, có thể dùng các pessimistic lock có sẵn trong JDK như class ReentrantLock và keyword synchronized để bảo đảm tại cùng một thời điểm chỉ có một thread có thể sửa đổi. Tuy nhiên, lock có sẵn trong JDK là local lock, không thể dùng trong môi trường distributed.
Ngoài pessimistic lock do JDK cung cấp, database cũng có exclusive lock (X lock). Exclusive lock còn được gọi là write lock/exclusive lock; transaction lấy exclusive lock khi sửa record và không cho phép nhiều transaction cùng lấy lock. Nếu một record đã được thêm exclusive lock, các transaction khác không thể thêm lock không tương thích vào record đó.
Sử dụng exclusive lock trong MySQL:
SELECT ... FOR UPDATEExclusive lock chỉ có thể dùng trong storage engine hỗ trợ transaction như InnoDB, đồng thời chỉ có thể dùng trong transaction. SELECT ... FOR UPDATE nên hit đúng index phù hợp; nếu không, InnoDB có thể scan và lock một lượng lớn record, thậm chí tạo hiệu ứng gần như lock toàn bảng, gây ảnh hưởng nghiêm trọng đến concurrency. Ở isolation level RR (REPEATABLE READ) mặc định của MySQL, InnoDB có thể sử dụng Next-Key Lock (record lock + gap lock), vì vậy càng cần dùng EXPLAIN để xác nhận execution plan đã hit index.
Trong trường hợp high concurrency, lock contention gay gắt sẽ khiến thread bị block. Nhiều thread bị block sẽ dẫn đến context switch, làm tăng overhead performance của hệ thống. Ngoài ra, pessimistic lock còn có thể phát sinh deadlock, ảnh hưởng đến việc thực thi bình thường của code. Khi dùng pessimistic lock, cần bảo đảm thứ tự lấy lock nhất quán, transaction ngắn nhất có thể, query hit index, đồng thời kết hợp EXPLAIN và deadlock log để điều tra vấn đề lock wait.
Optimistic lock
Optimistic lock thường được triển khai bằng cơ chế version number hoặc thuật toán CAS.
Với cơ chế version number, thêm một field version number vào table. Mỗi lần update data, kiểm tra version number hiện tại có giống với version number trong database hay không. Nếu giống, update thành công và version number tăng một. Nếu không giống, update thất bại, cho biết data đã bị request khác sửa đổi.
-- Update data, sửa price và tăng version một đơn vị, đồng thời kiểm tra version có phải là 1 hay không (giả sử giá trị ban đầu của version là 1)
update goods set price = price + 100, version = version + 1 where id = 1 and version = 1;
-- Vì version đã trở thành 2 nên SQL bên dưới không có hiệu lực
update goods set price = price + 100, version = version + 1 where id = 1 and version = 1;
Trong trường hợp high concurrency, optimistic lock thường không block chờ trong thời gian dài như pessimistic lock, có thể giảm việc thread bị dồn do lock contention và thường có performance tốt hơn. Tuy nhiên, database update vẫn có thể liên quan đến row lock; trong transaction phức tạp, không thể nói hoàn toàn không có rủi ro deadlock. Nếu conflict xảy ra thường xuyên, tức tỷ lệ write rất cao, việc fail và retry liên tục cũng sẽ ảnh hưởng nghiêm trọng đến performance, khiến CPU tăng vọt. Dù vậy, phương pháp này chủ yếu phù hợp với trường hợp update data.
Sau khi optimistic lock update thất bại, cần thiết kế trước strategy xử lý: có thể trả về thông báo conflict rõ ràng để phía gọi quyết định có retry hay không; cũng có thể retry hữu hạn 2–3 lần ở server; hoặc query trạng thái hiện tại và trả về kết quả đã tồn tại. Với trường hợp tài chính, không nên mù quáng tự động retry; nên ưu tiên trả về conflict hoặc query trạng thái cuối cùng.
Unique index
Thêm unique index vào table để bảo đảm tính duy nhất của data. Nếu insert data trùng lặp, exception sẽ được ném ra và chương trình có thể bắt exception để xử lý. Tuy nhiên, phương pháp này chỉ phù hợp với trường hợp insert data.
create table t_order(
    id int unsigned PRIMARY KEY AUTO_INCREMENT COMMENT "primary key",
    `code` varchar(200) not null COMMENT "transaction number",
    `customer_id`  int unsigned COMMENT "member ID",
    `amount` decimal(10,2) unsigned not null COMMENT "total amount",
    -- Bỏ qua các field khác của order
    -- Bỏ qua các index khác
    -- Order transaction number là duy nhất
    UNIQUE unq_code(`code`)
) COMMENT="order table";
Không nên chỉ dựa vào unique index để hoàn thành toàn bộ logic idempotency, nhưng với các trường hợp insert thì nên dùng unique index làm lớp bảo vệ cuối ở database, tránh phát sinh data trùng lặp khi concurrency.
Deduplication table
Về bản chất, deduplication table cũng là một phương án unique index. Deduplication table là table chuyên dùng để ghi nhận thông tin request, trong đó một field cần được tạo unique index để nhận diện tính duy nhất của request. Khi client gửi request, server sẽ insert một số thông tin của request này như order number và transaction number vào deduplication table. Nếu insert thành công, đây là request đầu tiên và có thể thực thi business logic tiếp theo; nếu insert thất bại, đây là request trùng lặp và có thể trả về hoặc bỏ qua ngay.
CREATE TABLE deduplication_table (
    id int unsigned PRIMARY KEY AUTO_INCREMENT COMMENT "primary key",
    processed_code varchar(200) not null COMMENT "processed order transaction number",
    -- Bỏ qua các field khác
    UNIQUE unq_processed_code(processed_code)
) COMMENT="deduplication table";
Việc insert vào deduplication table và các business operation tiếp theo phải nằm trong cùng một database transaction. Chỉ khi transaction commit thành công mới có thể hiểu rằng “deduplication record tồn tại = business đã được xử lý xong”; nếu business logic thất bại và rollback, deduplication record cũng phải rollback theo để request sau có thể re-enter bình thường. Nếu không, có thể xuất hiện trạng thái không nhất quán “deduplication record đã được ghi nhưng business thực tế chưa hoàn thành”. Khi sharding database khiến deduplication table và business table không nằm trong cùng một physical database, cần cân nhắc thêm giải pháp distributed transaction như TCC/Saga, hoặc chuyển sang thiết kế khác có thể bảo đảm consistency.
Distributed lock
Trong distributed system, các service/client khác nhau thường chạy trên những process JVM độc lập. Nếu cần tuần tự hóa thao tác trên cùng một business resource giữa các JVM, có thể cân nhắc sử dụng distributed lock.
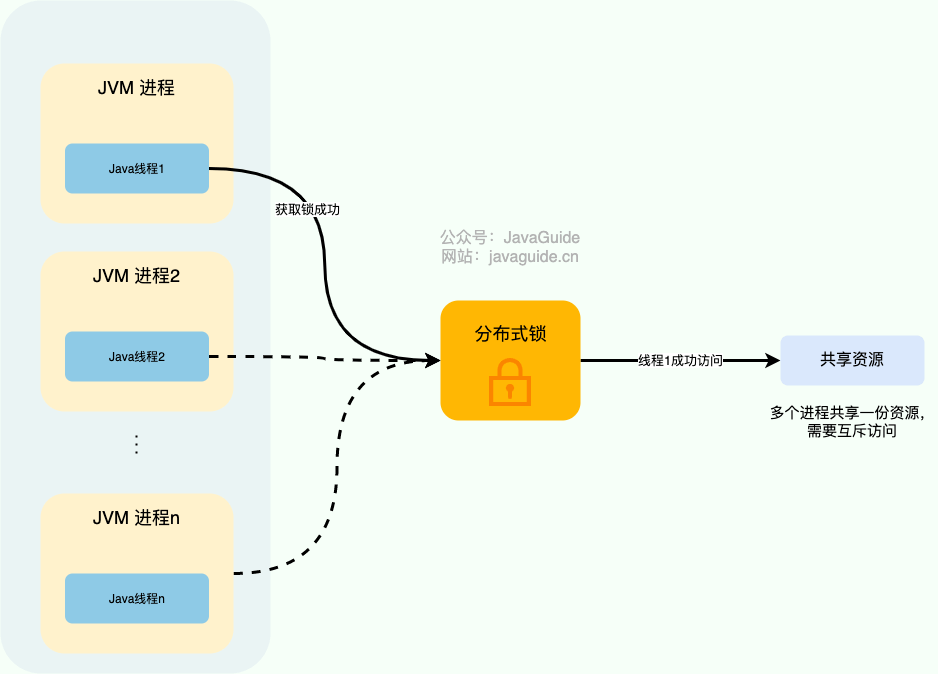
Mặc dù có thể triển khai distributed lock dựa trên MySQL, chẳng hạn dùng SELECT ... FOR UPDATE hoặc unique index, nhưng performance và reliability thường không bằng coordination service chuyên dụng nên production ít dùng cách này.
Thông thường, có thể chọn triển khai distributed lock dựa trên Redis hoặc ZooKeeper; Redis được dùng nhiều hơn.
Relational database cũng có thể tham gia vào việc concurrency control trong distributed scenario, chẳng hạn dùng unique index làm lớp bảo vệ cuối, state machine validation và row lock serialization; tuy nhiên, optimistic lock và unique index thường không được xếp vào distributed lock.
Tôi đã viết các bài riêng giới thiệu chi tiết về distributed lock và cách triển khai distributed lock dựa trên Redis và ZooKeeper, bạn có thể tham khảo:
Cần lưu ý rằng distributed lock ở đây được tạo dựa trên unique identifier như order number. Lấy được lock chỉ có nghĩa là request hiện tại có thể đi vào critical section, không có nghĩa là trong lịch sử chưa từng được xử lý. Sau khi vào critical section, vẫn phải query business state hoặc idempotency record. Ví dụ, API thanh toán phải kiểm tra order đã được thanh toán hay chưa và transaction number đã được xử lý hay chưa, sau đó mới quyết định thực thi business logic hoặc trả về kết quả lịch sử ngay.
Ví dụ dưới đây dựa trên Redisson 3.x, sử dụng RLock để triển khai idempotency bằng pseudo-code:
// Unique identifier
String uniqueId = "order123";

// 1. Tạo distributed lock object dựa trên unique identifier
RLock lock = redisson.getLock("lock:" + uniqueId);
boolean locked = false;

try {
    // 2. Thử lấy lock, chờ tối đa 3 giây; sau khi lấy được lock thì tự động giải phóng sau 30 giây
    locked = lock.tryLock(3, 30, TimeUnit.SECONDS);
    if (!locked) {
        // Lấy lock thất bại: trả về đang xử lý, yêu cầu retry sau hoặc query kết quả xử lý trong lịch sử
        return;
    }

    // 3. Sau khi vào critical section vẫn phải kiểm tra business idempotency
    // Ví dụ: query trạng thái order / kiểm tra idempotency transaction đã tồn tại hay chưa
    // Chỉ thực thi business logic khi chưa xử lý; nếu đã xử lý thì trả về kết quả lịch sử ngay
    ...
} finally {
    // 4. Chỉ thread hiện tại đang giữ lock mới có thể giải phóng lock
    if (locked && lock.isHeldByCurrentThread()) {
        lock.unlock();
    }
}
Nếu không chỉ định rõ leaseTime, Redisson sẽ dùng Watchdog để gia hạn lock đang được giữ; nếu chỉ định leaseTime, lock sẽ tự động được giải phóng sau thời gian thuê. 30 giây ở trên chỉ là giá trị ví dụ; khi sử dụng thực tế, cần chọn theo thời gian thực thi dài nhất của business, thường nên đặt bằng 2–3 lần thời gian ước tính.
Khi sử dụng distributed lock, còn cần chú ý các vấn đề sau:
- Độ lớn của lock: lock theo order number, user ID hoặc resource ID, không dùng global lock.
- Lock timeout: khi thời gian thực thi business vượt quá
leaseTime, lock có thể được giải phóng sớm. - Giải phóng lock: phải kiểm tra thread hiện tại/current owner để tránh giải phóng lock của người khác.
- Lấy lock thất bại: cần quyết định trả về “đang xử lý”, yêu cầu retry sau hay query kết quả xử lý trong lịch sử.
- Business fallback: sau khi vào lock vẫn phải query trạng thái order hoặc idempotency transaction, không thể chỉ dựa vào lock.
Cơ chế Token
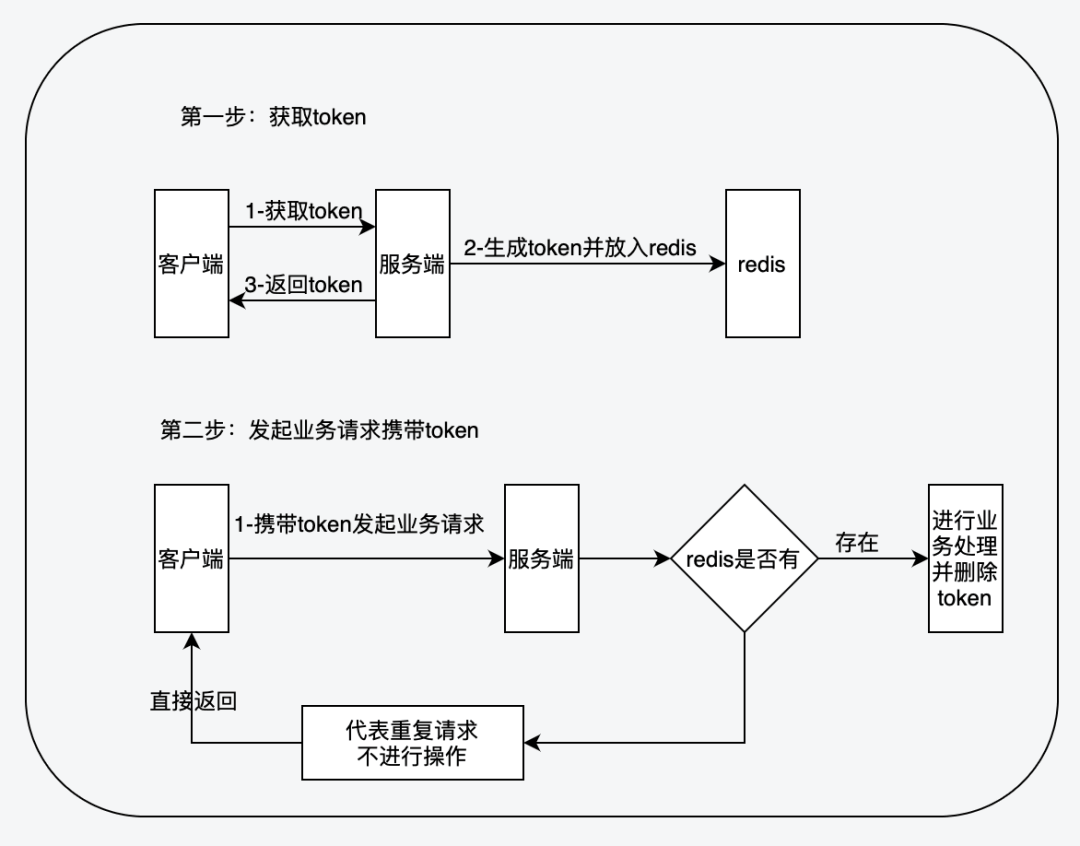
Tư tưởng cốt lõi của cơ chế Token là tạo một credential duy nhất cho mỗi operation. Token nên do server tạo để bảo đảm tính ngẫu nhiên, không thể dự đoán và có thời gian hiệu lực ngắn. Nếu server lưu Token, có thể dùng Redis để ghi nhận và consume một lần; nếu dùng stateless Token thì mới cần cân nhắc signature, chống tamper và thời gian hết hạn.
Như vậy, cần hai request để hoàn tất một business operation:
- Request lấy Token từ server, Token cần được đặt thời gian hiệu lực, có thể đặt ngắn một chút; server lưu Token này, thường là trong cache.
- Thực hiện request thật, đặt Token lấy được ở bước trước vào header hoặc dùng làm request parameter. Server xác minh tính hợp lệ của Token; nếu hợp lệ thì thực thi business logic, nếu không hợp lệ thì từ chối request và trả về thông báo.
Khi server xác minh Token, không được GET trước rồi DEL sau. Redis phiên bản 6.2.0 trở lên có thể dùng GETDEL; phiên bản thấp hơn có thể dùng Lua script để thực hiện thao tác atomic “validate + delete”, bảo đảm cùng một Token chỉ được một request consume.
Bài viết Giải pháp xử lý concurrent access trong thiết kế distributed system của đội ngũ kỹ thuật Dewu mô tả quy trình này khá rõ bằng hình ảnh.
Nên thực thi business logic trước rồi mới xóa Token, hay xóa Token trước rồi mới thực thi business logic? Cả hai cách dường như đều có rủi ro:
- Nếu thực thi business logic trước, client có thể gửi request kèm Token lần nữa trong lúc Token vẫn còn tồn tại; vì Token vẫn còn nên request thứ hai cũng sẽ được xác minh thành công.
- Nếu xóa Token trước, khi business logic timeout hoặc xảy ra biến động mạng, client cần retry request thì Token đã không thể dùng được nữa.
Thông thường nên ưu tiên atomic consume Token trước rồi mới thực thi business logic; đồng thời phải đi kèm thông báo thất bại, lấy Token mới, rollback business transaction và ghi nhận idempotency transaction. Với trường hợp tài chính, không thể chỉ dựa vào Token mà còn phải dùng order state và transaction number để làm lớp bảo vệ cuối.
Cơ chế Token phụ thuộc vào Redis để lưu lifecycle của Token, vì vậy cũng cần thiết kế trước strategy downgrade khi Redis không khả dụng. Với form thông thường, có thể thông báo retry sau; với API tài chính, không nên circuit breaker rồi cho request đi qua, thà trả về thất bại còn hơn để xảy ra trừ tiền hoặc ghi nhận tiền trùng lặp.
Quy trình idempotency của payment callback
Payment callback là một trường hợp rất điển hình trong thiết kế idempotency. Nền tảng thanh toán bên thứ ba có thể callback nhiều lần cho cùng một transaction do timeout mạng, response bị mất hoặc các nguyên nhân khác. Một quy trình an toàn hơn như sau:
- Callback request mang theo third-party transaction number
transaction_id. - Callback record table tạo unique index cho
transaction_id. - Query order state, chỉ cho phép các state transition hợp lệ như
UNPAID -> PAID. - Đặt việc update order state, ghi financial transaction và ghi callback record trong cùng một database transaction.
- Callback trùng lặp trả về thành công ngay để tránh third party tiếp tục retry.
Làm thế nào để verify phương án idempotency?
Không thể chỉ nhìn vào code để đánh giá phương án idempotency; còn phải xác nhận bằng test và data validation rằng phương án thực sự hiệu quả. Đặc biệt với các trường hợp order, payment và inventory, không thể chỉ test “request bình thường thành công một lần” mà còn phải cố ý tạo request trùng lặp, timeout, failure và rollback.
Có một số cách verify thực tế như sau:
- Stress test concurrency: dùng cùng một order number, payment transaction number hoặc idempotency key để đồng thời gửi 50–100 request; cuối cùng chỉ được có một request thực sự thực thi business logic. Các request khác phải trả về cùng kết quả, hoặc trả về “đang xử lý” hay “đã xử lý”; không được tạo nhiều order, nhiều financial transaction hoặc trừ inventory nhiều lần.
- Test retry: mô phỏng client retry do timeout, gateway retry, third-party callback retry và MQ deliver trùng lặp. Trọng tâm là kiểm tra sau khi request trùng lặp đến, nó có hit idempotency record hoặc business state hay không, thay vì thực thi lại business logic.
- Test exception: tạo exception khi business mới thực thi được một nửa, chẳng hạn order state đã update nhưng ghi transaction thất bại, Token đã consume nhưng transaction rollback, hoặc service restart sau khi lấy được distributed lock. Sau khi khôi phục và request lại, data vẫn phải nhất quán, không được xuất hiện trạng thái bẩn “thành công một phần, thất bại một phần”.
- Data validation: sau stress test hoặc exception test, thực hiện kiểm tra chéo order table, transaction table, inventory table và deduplication table. Ví dụ, một payment chỉ được có một transaction thành công; order chỉ được chuyển từ
UNPAIDsangPAIDmột lần; số lượng inventory bị trừ phải bằng số business order thành công. - Log audit: log phải tra được idempotency key, request ID, business order number, processing state và response result. Khi thực sự phát sinh sự cố trên production, có thể dựa vào các field này để xác định request đang được xử lý lần đầu, bị xử lý trùng lặp, đang xử lý hay đã bị logic idempotency chặn lại.
Nói ngắn gọn, verify idempotency không phải là xem “API có trả về thành công hay không”, mà là xem trong các request trùng lặp và exception path, business data có luôn chỉ được xử lý đúng một lần hay không.
Tham khảo
- Làm thế nào để bảo đảm idempotency của API khi high concurrency?: https://mp.weixin.qq.com/s/7P2KbWjjX5YPZCInoox-xQ
- Giải quyết vấn đề idempotency, chỉ cần nhớ câu thần chú này!: https://mp.weixin.qq.com/s/EatpiCzNlTw1viO_flQIpg