
Agent Skills là gì? Khác Prompt và MCP chính xác ở đâu?
Một Code Review có thể phải xem xét architecture, security, performance và quy ước của project. Nếu tạm thời đưa các rule này vào Prompt, sang session khác lại phải dán lại từ đầu.
Các quy ước chung của project có thể đặt trong AGENTS.md; thứ tự kiểm tra, hạng mục kiểm tra và tài liệu tham khảo của Review nên được load cùng task Review. Skill cung cấp một entry point độc lập cho phần nội dung này.
Agent Skills là gì?
Skill là hướng dẫn task mà Agent có thể phát hiện và đọc khi cần. Format response của API, field trong log, hướng điều tra slow SQL và thứ tự cần chú ý khi Review đều có thể viết vào SKILL.md.
Bản thân Skill không cung cấp năng lực dùng tool. Nó giải quyết câu hỏi “loại task này cần được thực hiện theo rule nào”, còn host sẽ đưa hướng dẫn tương ứng cho Agent khi task khớp.
Skill liên hệ thế nào với Prompt, MCP và Function Calling?
Chúng nằm ở các vị trí khác nhau trên cùng một execution path: Prompt mô tả user muốn làm gì, Function Calling khởi phát action, MCP kết nối năng lực bên ngoài, còn Skill quy định process và constraint khi hoàn thành task.
Với request “hãy giúp tôi phân tích báo cáo này”, lời user nói là Prompt. Khi model quyết định gọi read_file và tạo parameter có cấu trúc, năng lực được dùng là Function Calling; nếu read_file do MCP Server cung cấp, MCP chịu trách nhiệm về connection và protocol.
“Trước tiên xác nhận ý nghĩa của các field, sau đó tìm giá trị bất thường, cuối cùng đưa ra kết luận nghiệp vụ, không chỉ chồng chất các chỉ số thống kê” thuộc về Skill. Nó mô tả thứ tự xử lý và constraint, không thay thế request, cách gọi hay connection bên ngoài ở phía trước.
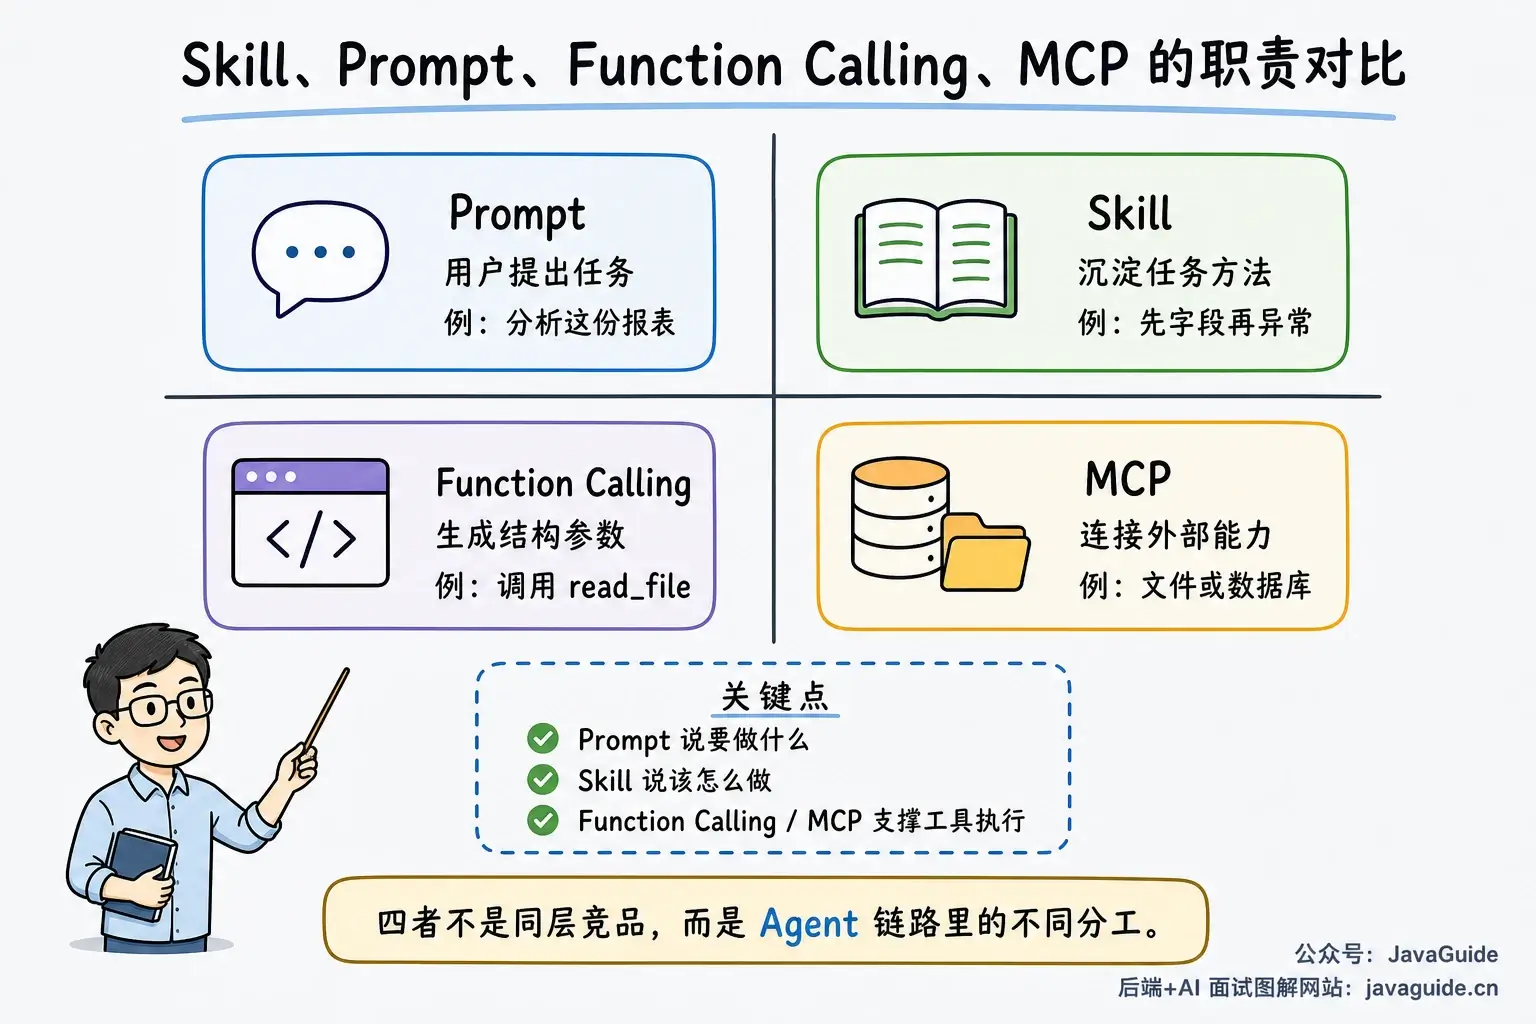
Đặt trong một execution path thực tế, đại khái sẽ như sau:
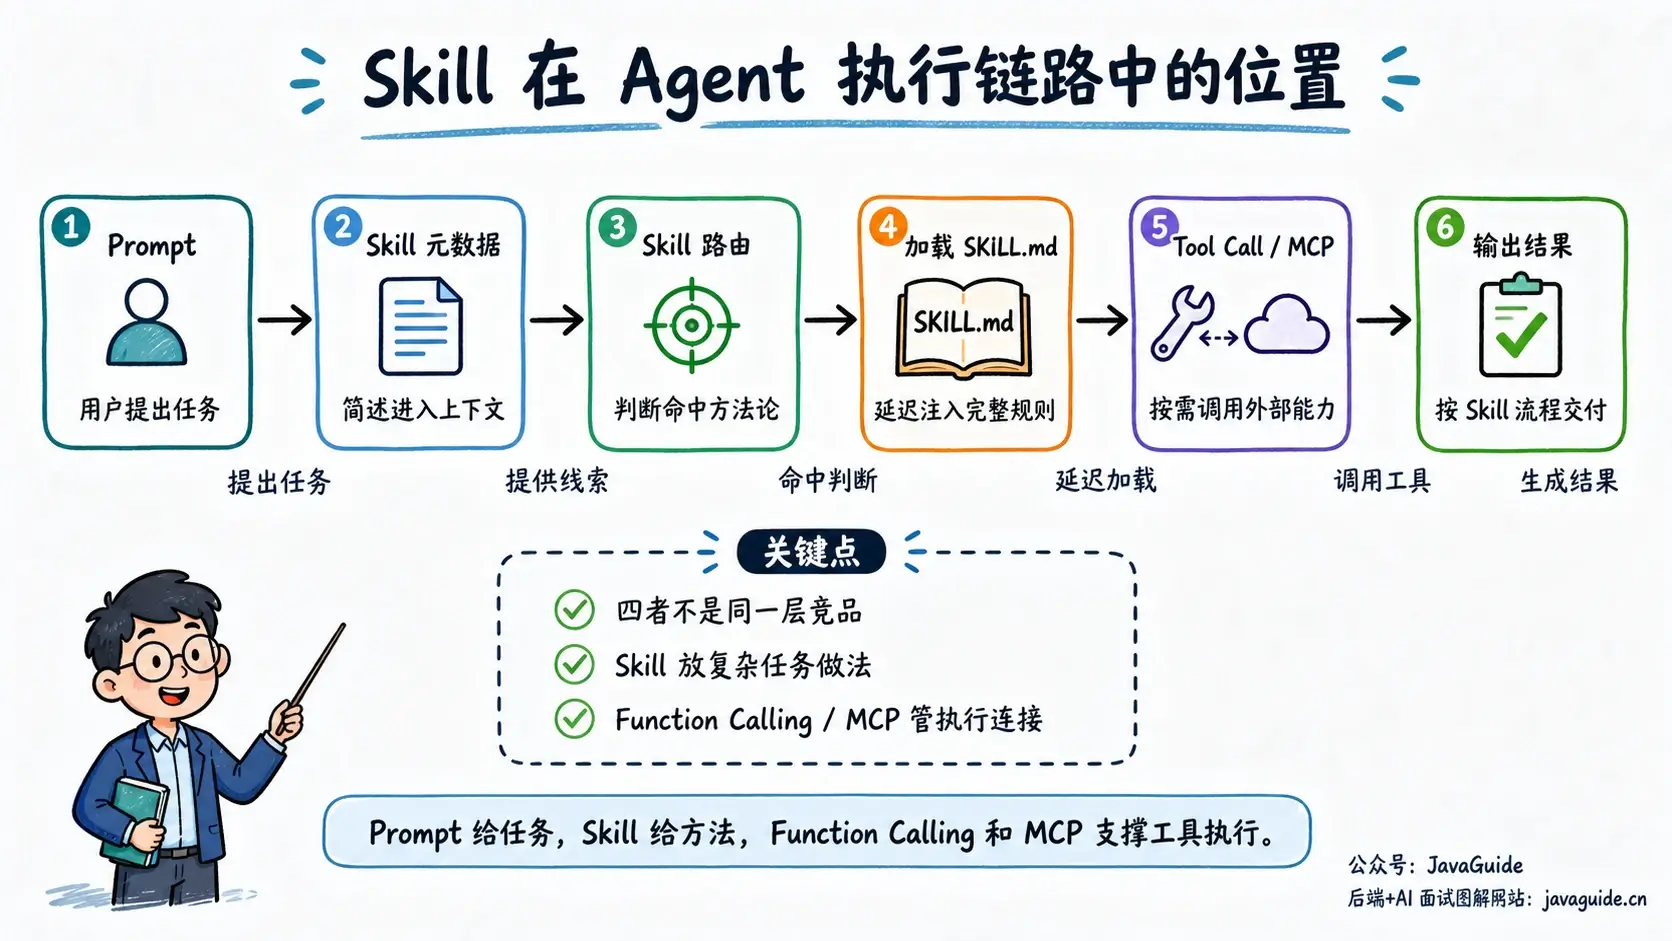
- User đưa ra task (Prompt)
- Host đưa mô tả ngắn của các Skill khả dụng vào context (metadata của Skill)
- Model xác định task hiện tại khớp với một Skill nào đó (routing Skill)
- Host load tiếp
SKILL.mdđầy đủ vào (lazy loading) - Model gọi tool, đọc tài liệu và viết kết quả theo process trong Skill (execution)
Tool không phải phần bắt buộc của Skill. Code Review Expert trong sanyuan-skills chỉ quy định review từ các khía cạnh SOLID, security, performance; TDD Skill của Superpowers thì yêu cầu Agent chạy test, đọc output rồi mới quyết định bước tiếp theo.
Vì vậy, Function Calling là năng lực có thể được dùng khi thực hiện action, còn Skill gần với context injection theo nhu cầu hơn. load_skill() cũng là khái niệm theo nghĩa này, không phải tên API thống nhất trên nhiều platform; cách Claude Code, Cursor, Codex và Copilot phát hiện và load Skill đều khác nhau.
⭐️ Viết SKILL.md chính xác thế nào?
Cấu trúc cơ bản
Một Skill tối thiểu có thể dùng thực ra rất đơn giản: một directory và một file Markdown SKILL.md.
scripts/, references/, assets/ không phải các mục bắt buộc, nhưng Skill phức tạp thường dùng những directory này, chẳng hạn đặt các script mà Skill cần dùng trong scripts/.
skill-name/
├── SKILL.md          # file chính, được load khi trigger
├── scripts/          # script tiện ích (thực thi, không cần load vào context)
├── references/       # tài liệu tham khảo (load khi cần)
└── assets/           # template và file tĩnh (load khi cần)
Một SKILL.md gồm hai phần:
- Phần đầu là YAML frontmatter, cho host biết “tôi là ai, khi nào nên dùng tôi”;
- Phần sau là body, viết process, constraint, ví dụ và xử lý failure cụ thể.
Muốn học cách viết Skill, chỉ cần xem một Skill open source hàng đầu.
Ở đây, ta lấy TDD Skill của Superpowers làm ví dụ.
Metadata của nó chỉ có hai dòng:
---
name: test-driven-development
description: Use when implementing any feature or bugfix, before writing implementation code
---
TDD liên quan đến vòng lặp Red-Green-Refactor, nhưng description của TDD Skill này hoàn toàn không đề cập mà chỉ dùng một câu để nói rõ khi nào nên dùng. Body mới mở rộng cách thực hiện cụ thể, bản rút gọn như sau:
# TDD

## Rule

Write a failing test before production code.

If you did not watch the test fail, the test is not trusted.

## Flow

1. **RED**: Write one small failing test.
2. **VERIFY RED**: Run it. Confirm it fails for the expected reason.
3. **GREEN**: Write the smallest code to pass.
4. **REFACTOR**: Clean up without changing behavior.

## Use For

- Features
- Bug fixes
- Refactoring
- Behavior changes

## Ask Before Skipping

- Throwaway prototypes
- Generated code

## Done Checklist

- [ ] Test written first
- [ ] Failure observed
- [ ] Minimal code added
- [ ] Tests pass
Trước tiên xem skill-creator chính thức
skill-creator là Skill dùng để tạo Skill do repository Skills chính thức của Anthropic cung cấp. Nó trước tiên yêu cầu Agent xác nhận task, điều kiện trigger và boundary, sau đó mới quyết định nội dung nào để trong SKILL.md, nội dung nào tách sang scripts/ hoặc references/.
Nó thể hiện hai trade-off thực tế: description phải giúp host nhận diện task phù hợp; những bước có thể thực thi ổn định bằng script và tài liệu dài chỉ cần ở một số scenario nên được tách khỏi file chính. Tài liệu trợ giúp chính thức của Claude cũng khuyến nghị truy cập các nội dung bổ sung này khi cần.
Metadata (Frontmatter)
Metadata quyết định Skill có được phát hiện và trigger đúng hay không. Nói chung, ít nhất cần viết rõ hai field: name và description.
name là identifier của Skill, chủ yếu dùng để system và con người định vị; description giống một chỉ dẫn routing hơn, cho Agent biết khi nào cần đưa Skill này vào, tức khi nào nên dùng.
Trước hết xem name. Nó có một số yêu cầu bắt buộc:
- Tối đa 64 ký tự
- Chỉ được chứa chữ thường, chữ số và dấu gạch ngang
- Không được chứa XML tag
- Không được chứa reserved word như
anthropic,claude
Khi đặt tên, có thể ưu tiên dạng gerund, tức “verb + -ing”. Như vậy chỉ cần nhìn là biết Skill cung cấp năng lực gì.
| Tên tốt | Tên không tốt |
|---|---|
processing-pdfs | helper, utils, quá mơ hồ |
reviewing-code | documents, quá chung chung |
test-driven-development | tools, không nói lên điều gì |
analyzing-spreadsheets | anthropic-helper, chứa reserved word |
description còn quan trọng hơn. Nếu viết description không tốt, Skill sẽ không được gọi khi cần. Dù sao Agent cũng không đọc trước SKILL.md của mọi Skill, mà xem description trước để xác định có nên load hay không.
Mô tả trong description không nên quá ngắn, cũng không nên quá dài. Một description hữu ích chỉ cần nói rõ hai điều:
- Skill này làm gì
- Cần dùng nó trong scenario nào
TDD Skill của Superpowers được nêu ở trên đáp ứng yêu cầu này.
Tốt nhất nên thêm một số từ mà user có thể nói ra. Chẳng hạn các từ như PDF, form, extraction, commit message, git diff. Như vậy dù matching theo rule hay theo semantics, hệ thống đều dễ bắt được hơn.
# ✓ Tốt: có năng lực, scenario và trigger word
description: Trích xuất text và table từ file PDF, điền form, hợp nhất document. Dùng khi xử lý file PDF hoặc user đề cập đến PDF, form hay document extraction.

# ✗ Tránh: ngôi thứ nhất + điều kiện trigger không rõ
description: Tôi có thể giúp bạn xử lý file PDF

# ✗ Tránh: chỉ viết năng lực, không viết thời điểm sử dụng
description: Xử lý file Excel
Xem một vài ví dụ thực tế:
# TDD của Superpowers
name: test-driven-development
description: Use when implementing any feature or bugfix, before writing implementation code

# Code Review Expert của sanyuan-skills
name: code-review-expert
description: Expert code review of current git changes with a senior engineer lens. Detects SOLID violations, security risks, and proposes actionable improvements.

# Trợ lý Git commit
description: Tạo commit message có tính mô tả bằng cách phân tích git diff. Dùng khi user yêu cầu trợ giúp viết commit message hoặc review staged changes.
Các description chỉ viết khái niệm, có phạm vi quá rộng hoặc thiếu điều kiện trigger như sau:
# Ví dụ ngược của TDD của Superpowers, chỉ viết khái niệm, không viết thời điểm trigger
name: test-driven-development
description: Helps with test-driven development and writing better tests.

# Ví dụ ngược của Code Review Expert, quá chung chung
name: code-review-expert
description: Helps review code and improve quality.

# Ví dụ ngược của Git commit assistant, chỉ viết tên chức năng
description: Tạo commit message.
Body
Body là hướng dẫn thao tác mà Agent chỉ đọc sau khi khớp với Skill. Ở giai đoạn khởi động, thường chỉ name và description tham gia routing; sau khi load, body dùng chung không gian context với system prompt, user request và tài liệu đã có.
Vì vậy, body chỉ giữ lại default solution, convention của project, input/output và xử lý failure cần thiết khi thực thi task. Nếu giấu rule trong một đoạn giải thích dài, Agent sẽ khó tìm thấy hơn khi cần.
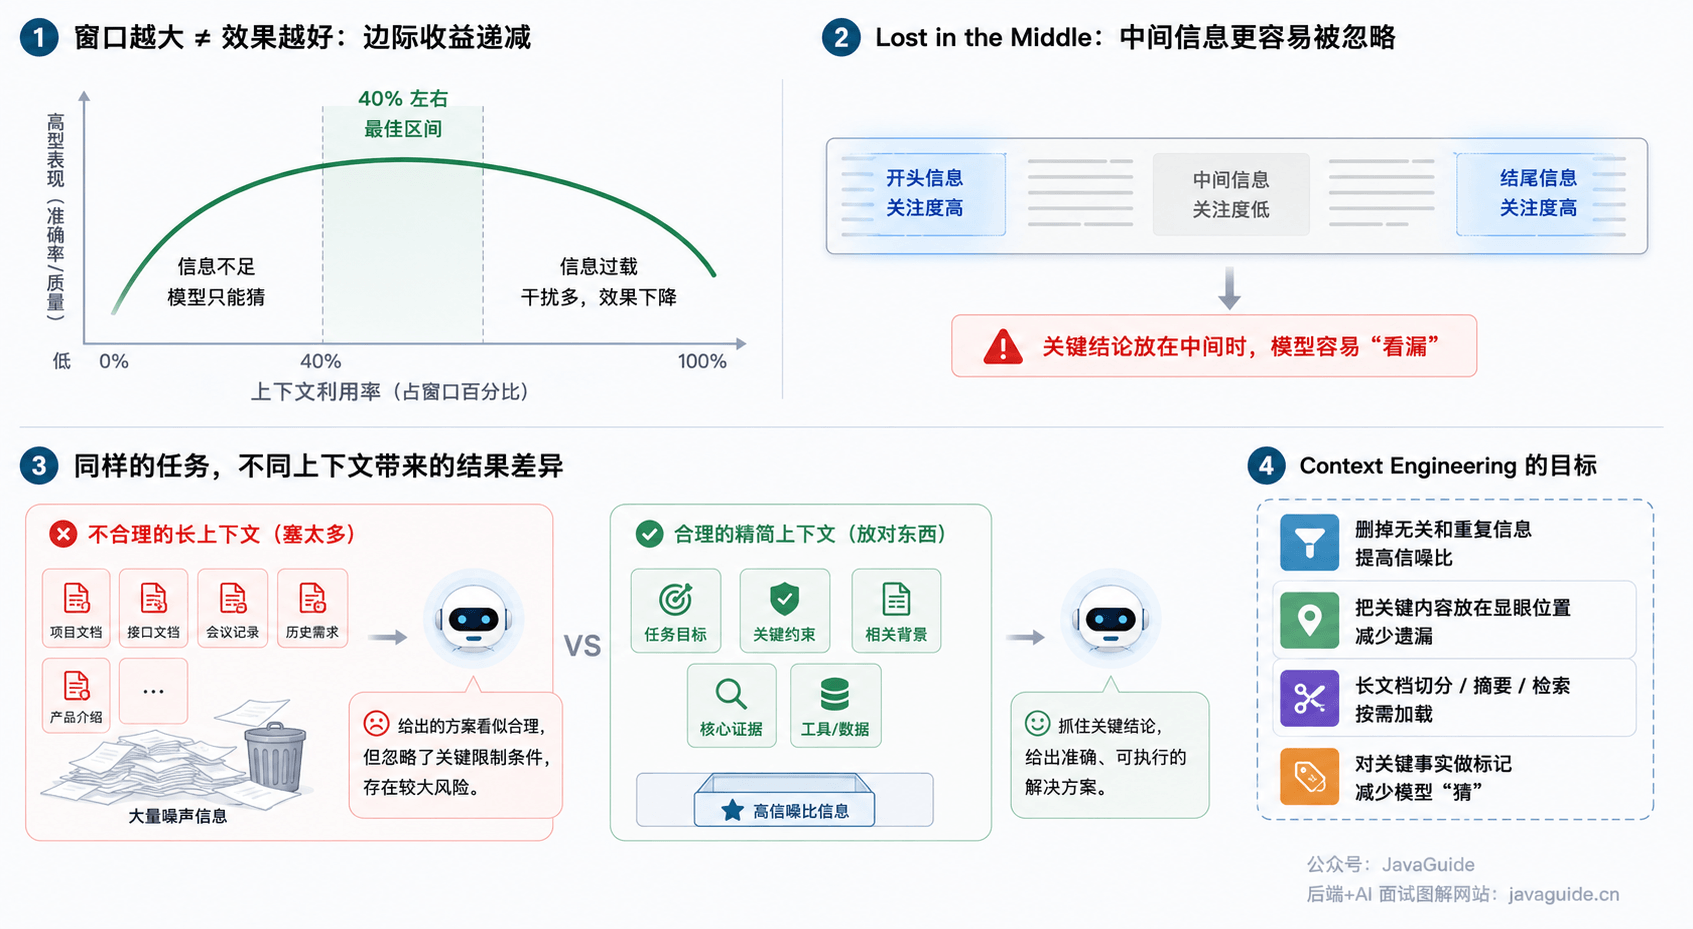
Khi sàng lọc body, có thể lần lượt xác nhận:
- Agent thực sự cần phần giải thích này không?
- Đây là kiến thức riêng của project hay common knowledge?
- Đoạn này có đáng chiếm dụng context không?
Khi xử lý text PDF, body nên trực tiếp đưa ra library mặc định và cách gọi:
## Trích xuất text PDF

Dùng pdfplumber để trích xuất text:

```python
import pdfplumber
with pdfplumber.open("file.pdf") as pdf:
    text = pdf.pages[0].extract_text()
```
Body bắt đầu từ định nghĩa PDF rồi liệt kê tool sẽ không giúp Agent quyết định bước tiếp theo:
## Trích xuất text PDF

PDF (Portable Document Format) là một format file phổ biến, thường chứa text, image và nội dung khác.
Muốn trích xuất text từ PDF, cần dùng library xử lý PDF chuyên dụng.
Hiện có nhiều library có thể hoàn thành việc này, chẳng hạn pypdf, pdfplumber, PyMuPDF.
Ở đây khuyến nghị dùng pdfplumber vì nó dễ bắt đầu và bao phủ được hầu hết scenario trích xuất text PDF thông thường.
Trước hết, bạn cần dùng pip cài đặt nó rồi viết code bên dưới……
Agent cần biết mặc định dùng gì, gọi thế nào, xử lý output ra sao và rẽ nhánh thế nào khi gặp trường hợp đặc biệt. Những constraint trong project không thể suy ra từ common knowledge càng cần được viết rõ, chẳng hạn:
Bảng users dùng soft delete. Mọi query chính thức đều phải thêm `WHERE deleted_at IS NULL`.Constraint này sẽ trực tiếp thay đổi kết quả query; không cần đưa định nghĩa chung về soft delete vào Skill:
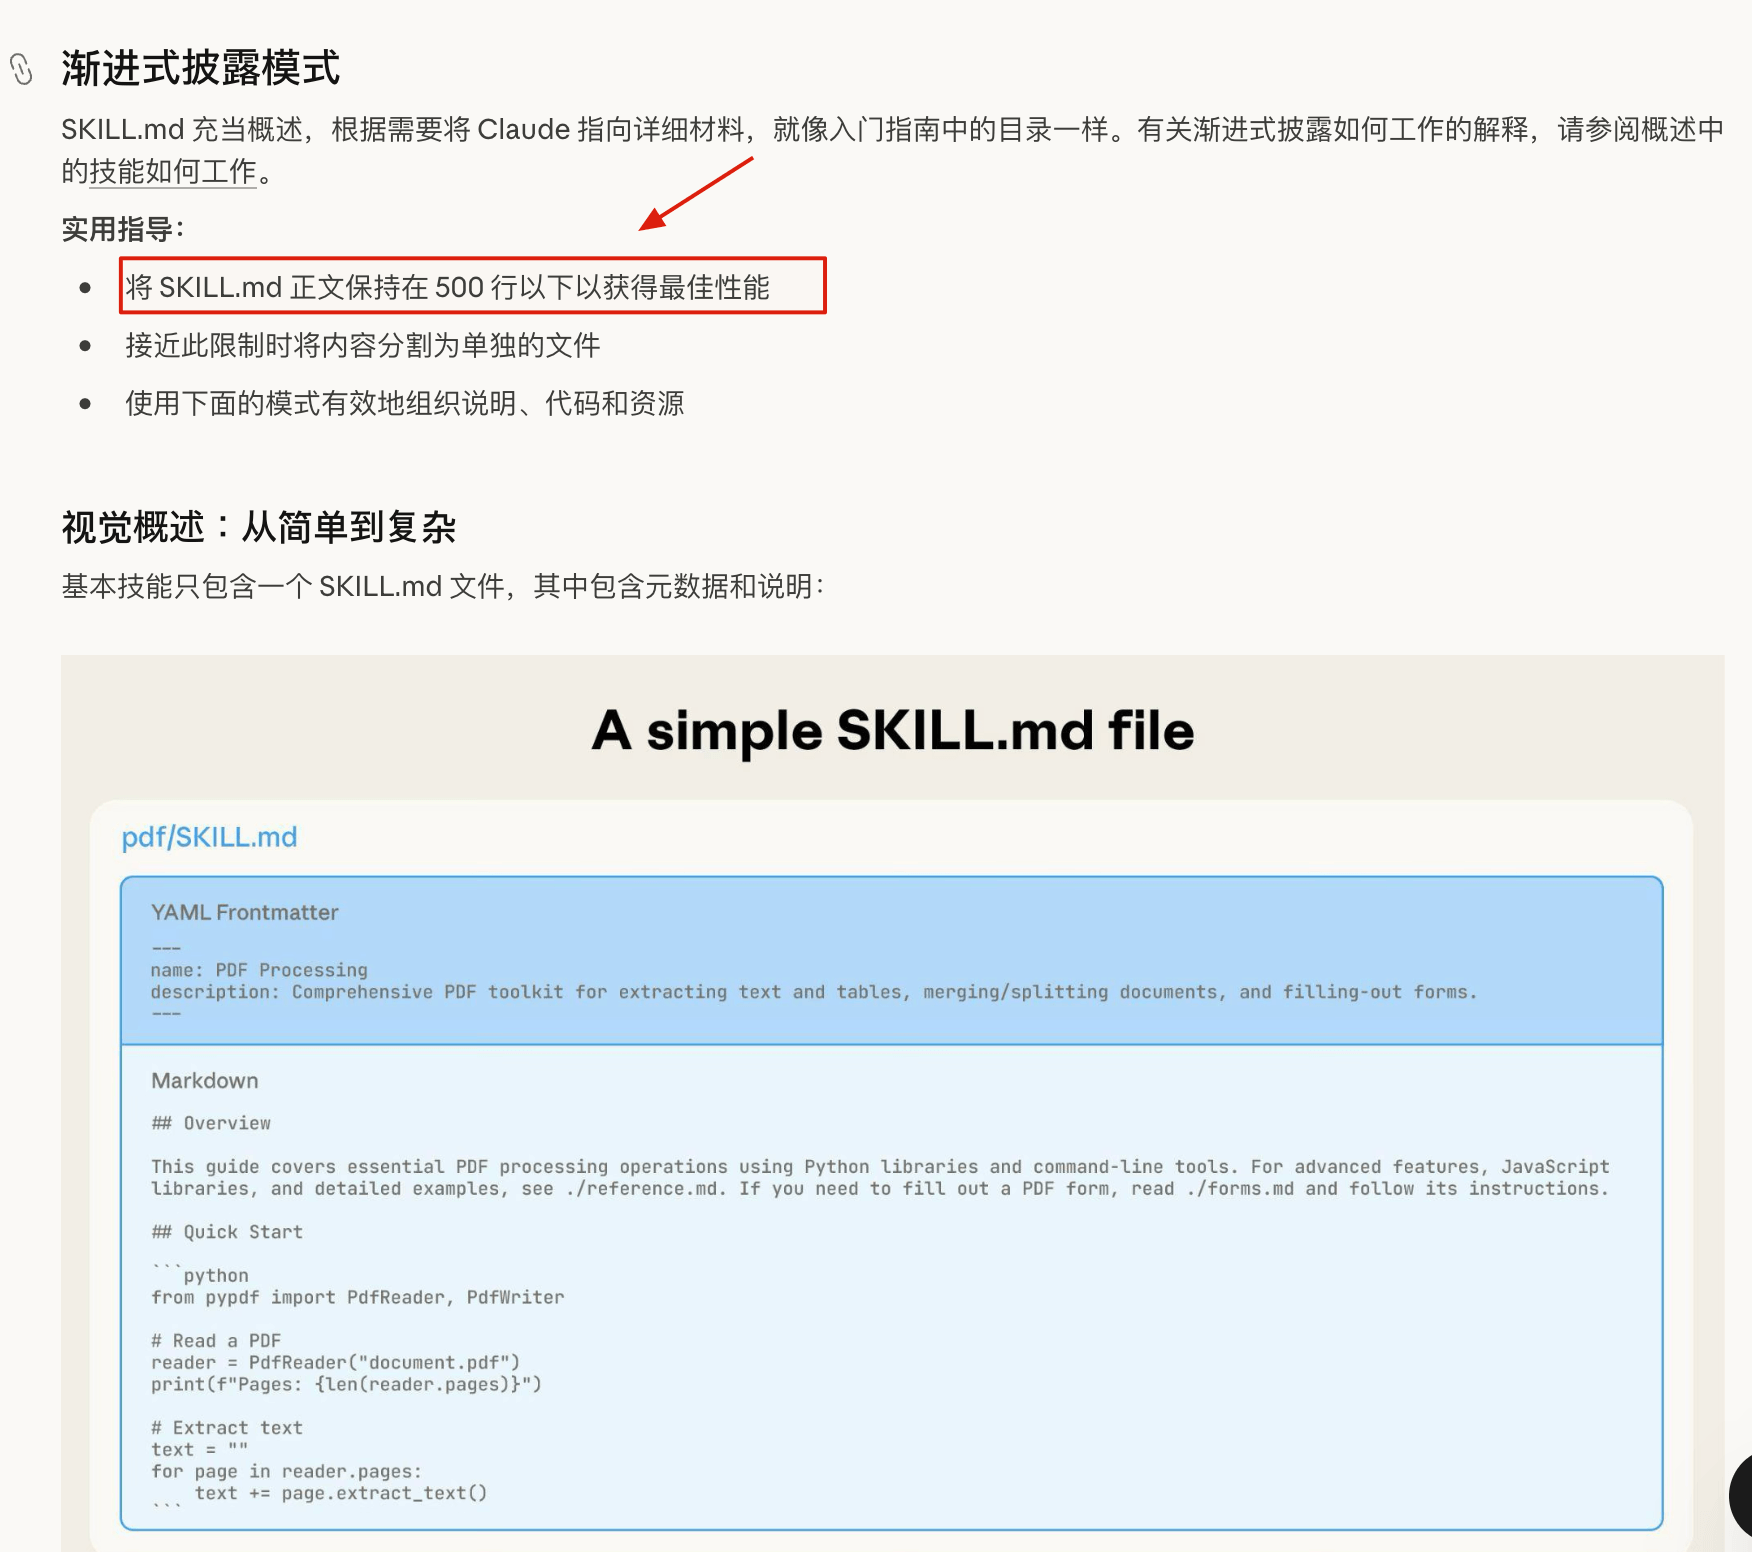
Soft delete là một cách xóa data phổ biến, thường không thực sự xóa record trong database mà đánh dấu trạng thái record bằng một field.Khi file chính quá dài, hãy tách nội dung chỉ dùng ở một bước cụ thể sang file riêng. Anthropic khuyến nghị giới hạn body của SKILL.md trong khoảng 500 dòng, dùng progressive disclosure để đọc chi tiết khi cần.
Chẳng hạn, file chính của Code Review Skill chỉ cần chỉ ra khi nào đọc hạng mục kiểm tra SOLID:
Khi cần kiểm tra thiết kế SOLID, đọc `references/solid-checklist.md`.references/solid-checklist.md lưu checklist cụ thể; nếu task không liên quan đến design review, Agent không cần đọc file này.
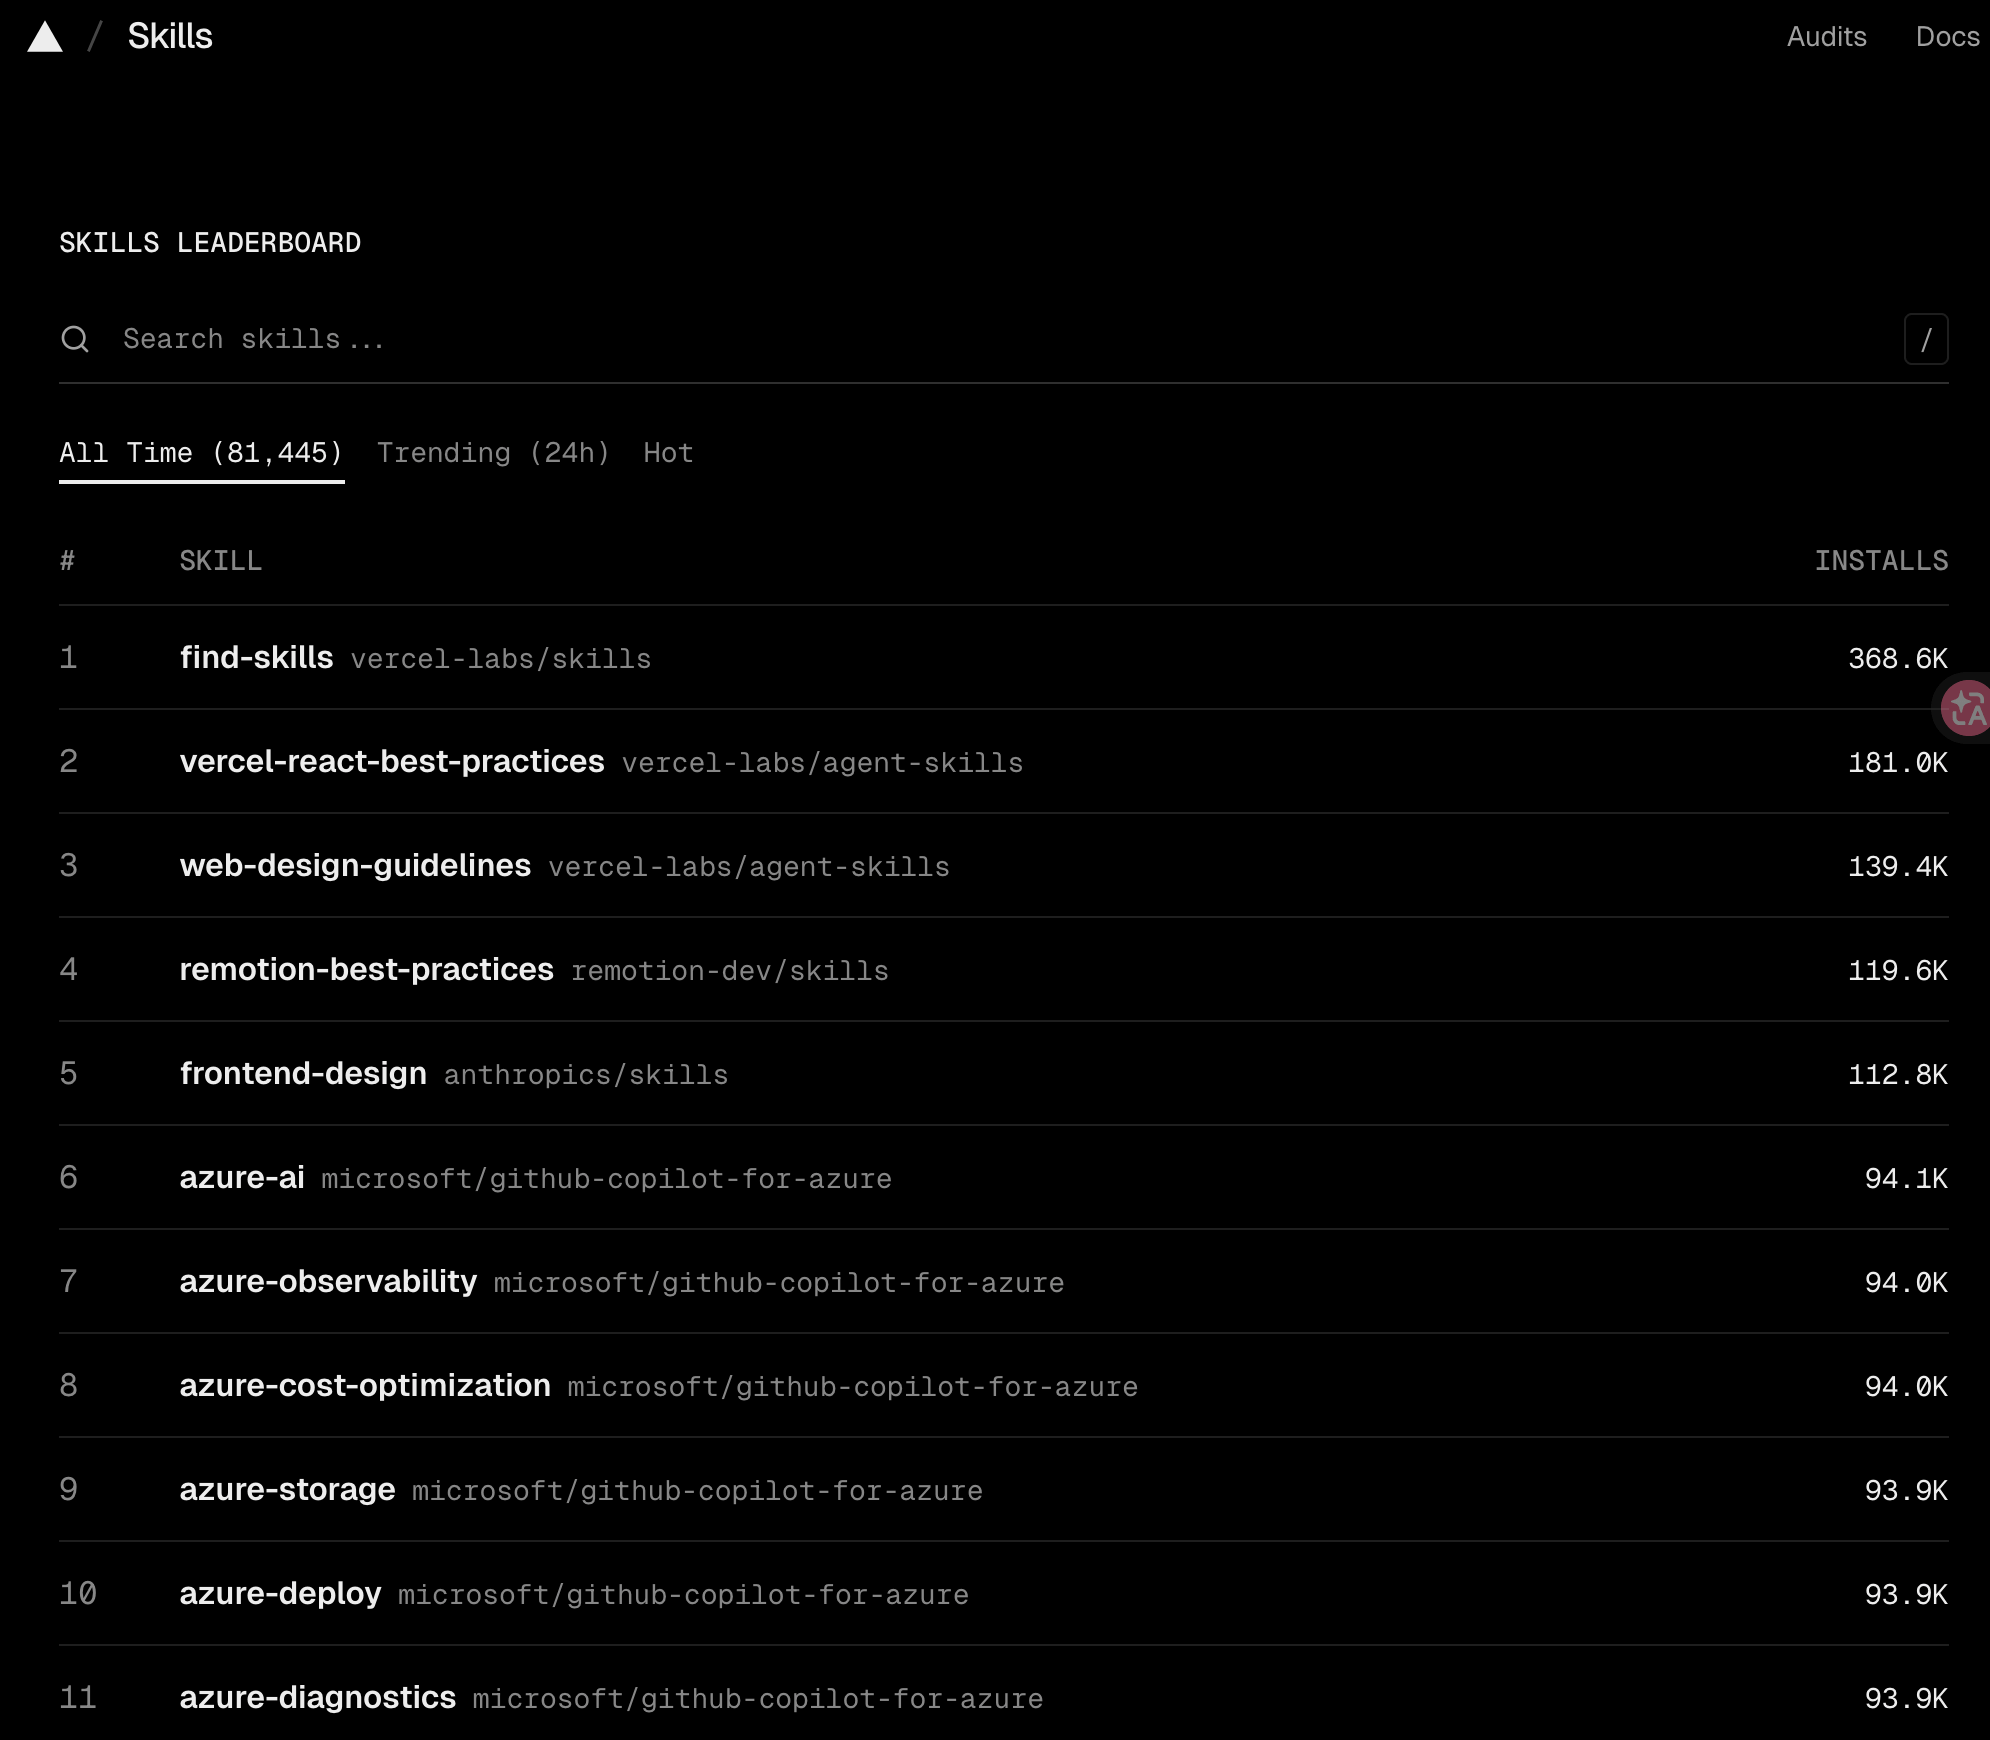
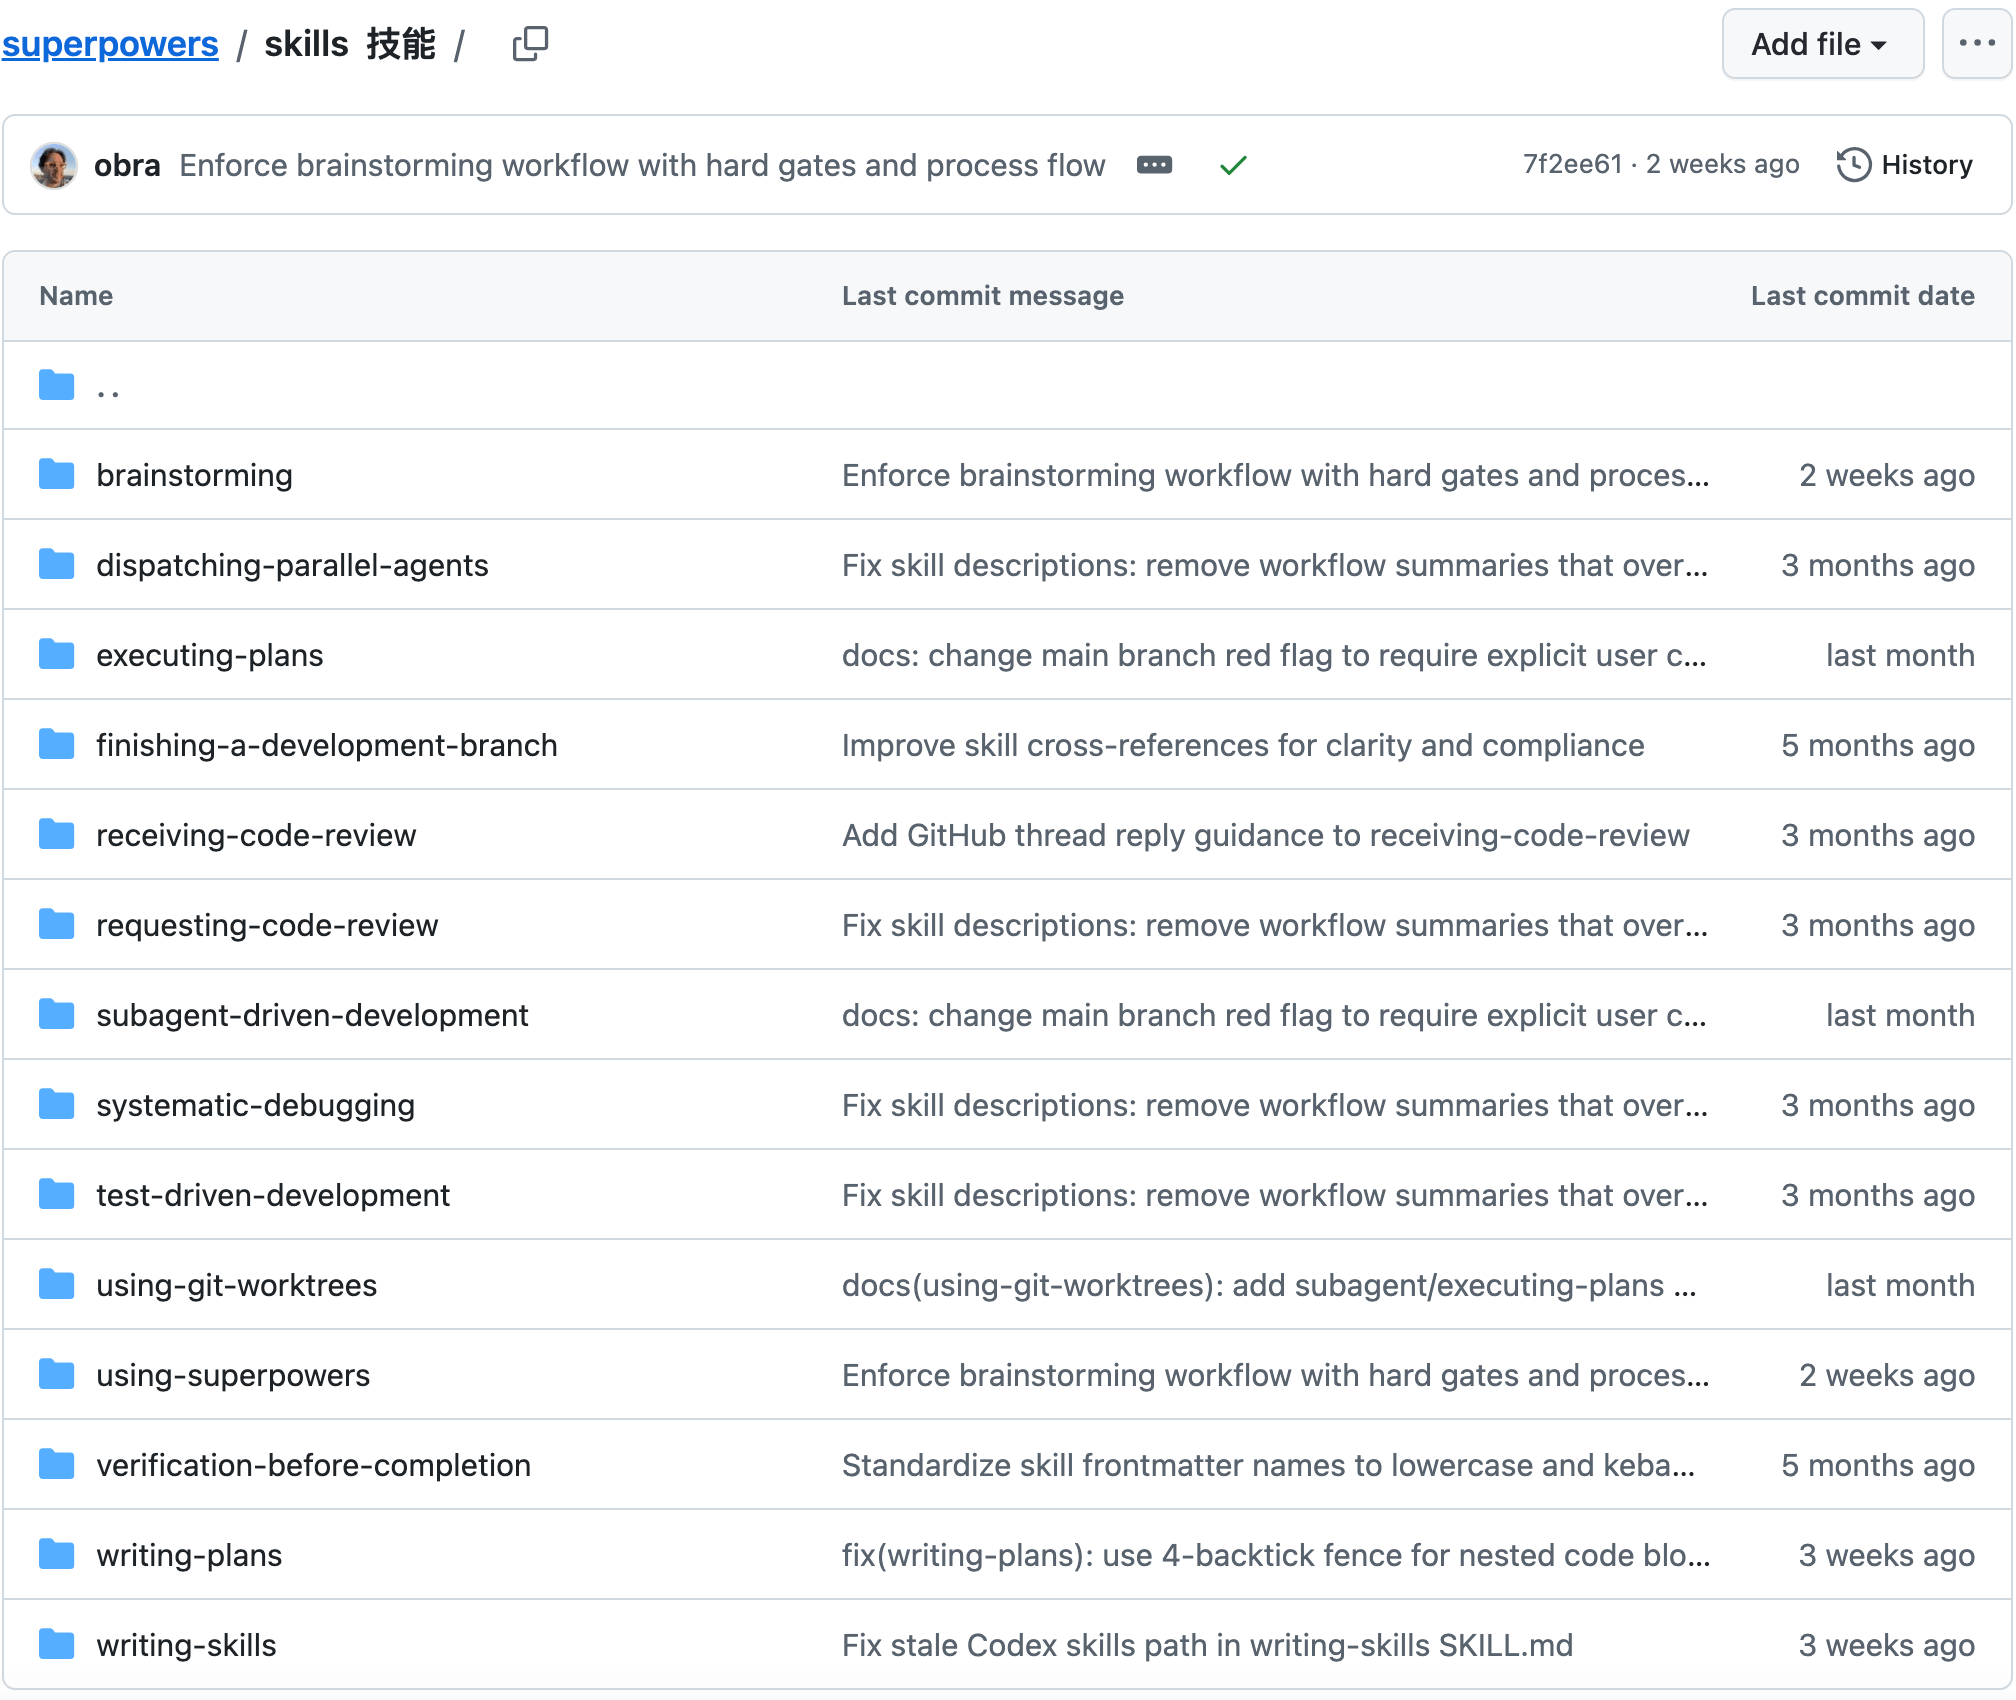
Các collection Skill open source sau thể hiện cách tách file chính và tài liệu tham khảo:
- Superpowers: chứa các Skill như TDD, brainstorming và code review. Cấu trúc của TDD rất rõ ràng, phù hợp để xem cách tổ chức body.
- sanyuan-skills: Code Review Expert tách các hạng mục kiểm tra chi tiết vào
references/, file chính chỉ giữ hướng dẫn trigger và load, phù hợp làm ví dụ về progressive disclosure. - Anthropic official Skills repository: cấu trúc directory và cách viết có thể dùng làm chuẩn tham khảo.
Trong các tool như Claude Code, có thể chủ động gọi bằng /skill-name, hoặc để model chọn theo task; sau khi trigger mới đọc process, constraint, script và file tham khảo.
Kiểm soát mức độ tự do thế nào?
Migration database và production deployment cần cố định command, parameter, validation và điều kiện rollback trong Skill; nếu các thao tác này xảy ra lỗi, thường phải khôi phục data hoặc trạng thái service.
Code review và đánh giá technical solution cần kết hợp với nội dung thay đổi để phán đoán. Skill chỉ cần cố định các dimension kiểm tra như security, performance, maintainability và convention của project, không cần chỉ định thứ tự cho từng file.
Bảng dưới đây phân chia mức độ tự do theo risk của task:
| Mức độ tự do | Scenario phù hợp | Cách viết |
|---|---|---|
| Cao | Cần phán đoán và trade-off, không có đáp án duy nhất | Nêu hướng kiểm tra, không viết cứng các bước |
| Trung bình | Có template cố định nhưng được điều chỉnh theo scenario | Đưa template, parameter và boundary |
| Thấp | Thao tác dễ hỏng, chi phí lỗi cao | Đưa command chính xác, nêu rõ điều không được sửa |
TDD Skill của Superpowers cố định thứ tự process:
NO PRODUCTION CODE WITHOUT A FAILING TEST FIRSTRed, Green và Refactor không thể đổi chỗ; trước khi implement phải nhìn thấy failure đúng như kỳ vọng. Skill đó còn ghi rõ:
Write code before the test? Delete it. Start over.Đối tượng test, tên và assertion do feature hiện tại quyết định. Framework kiểm tra của Code Review cũng có thể cố định ở SOLID, security risk, performance và maintainability; vấn đề cụ thể vẫn do Agent phán đoán theo diff.
Cách viết cho mức độ tự do thấp có thể như sau:
## Database migration

Chạy command sau:

```bash
python scripts/migrate.py --verify --backup
```

Không sửa command và không thêm parameter.

Nếu command failure, dừng thực thi và trả error output cho user.
Với task code review, chỉ cần đưa phạm vi kiểm tra:
## Code review

Tập trung kiểm tra:

1. Có Bug rõ ràng hoặc thiếu trường hợp biên không
2. Có security risk không
3. Có ảnh hưởng đến performance hoặc việc sử dụng resource không
4. Có vi phạm convention sẵn có của project không
5. Có cách implement đơn giản hơn không

Khi output, ưu tiên các vấn đề ảnh hưởng đến correctness và stability trên production, không chỉ đưa ra đề xuất về format.
Process này không chỉ định thứ tự file, nhưng giới hạn phạm vi review và trọng tâm output. Khi sửa data, gửi request, deploy, migration hoặc xóa file thì cần siết chặt mức độ tự do; khi phân tích, review, tổng hợp và tạo draft thì giữ lại khoảng trống phán đoán cần thiết.
⭐️ Lazy loading và progressive disclosure
Vì sao không thể đưa toàn bộ Skill vào cùng một lần?
Context window của Agent có giới hạn, ít nhất hiện tại vẫn vậy.
Hơn nữa, window lớn hơn chỉ có nghĩa là chứa được nhiều nội dung hơn, không có nghĩa là nó tự động chọn được trọng tâm. Chẳng hạn, bạn đưa cho nó một requirements document dài để phân tích; điều kiện giới hạn thực sự quan trọng có thể chỉ có ba câu, nhưng bị kẹp giữa đủ loại background và giải thích, model rất dễ bỏ sót các câu then chốt ở giữa.
Đây chính là hiện tượng thường được gọi là Context Rot, tức context bị mục nát. Context càng dài, thông tin càng lẫn tạp, tính ổn định khi model sử dụng context càng có khả năng suy giảm.
Một hiện tượng kinh điển khác liên quan đến nó là Lost in the Middle: model nhạy hơn với thông tin ở đầu và cuối, còn nội dung nằm giữa dễ bị “bỏ sót” hơn. Vì vậy, đôi khi dù bạn đã đưa tài liệu cho nó, nó vẫn trả lời sai; không nhất thiết là chưa đọc mà có thể nội dung then chốt không đủ nổi bật trong context dài.
Vì thế, Skill không nên được viết thành một database tài liệu.
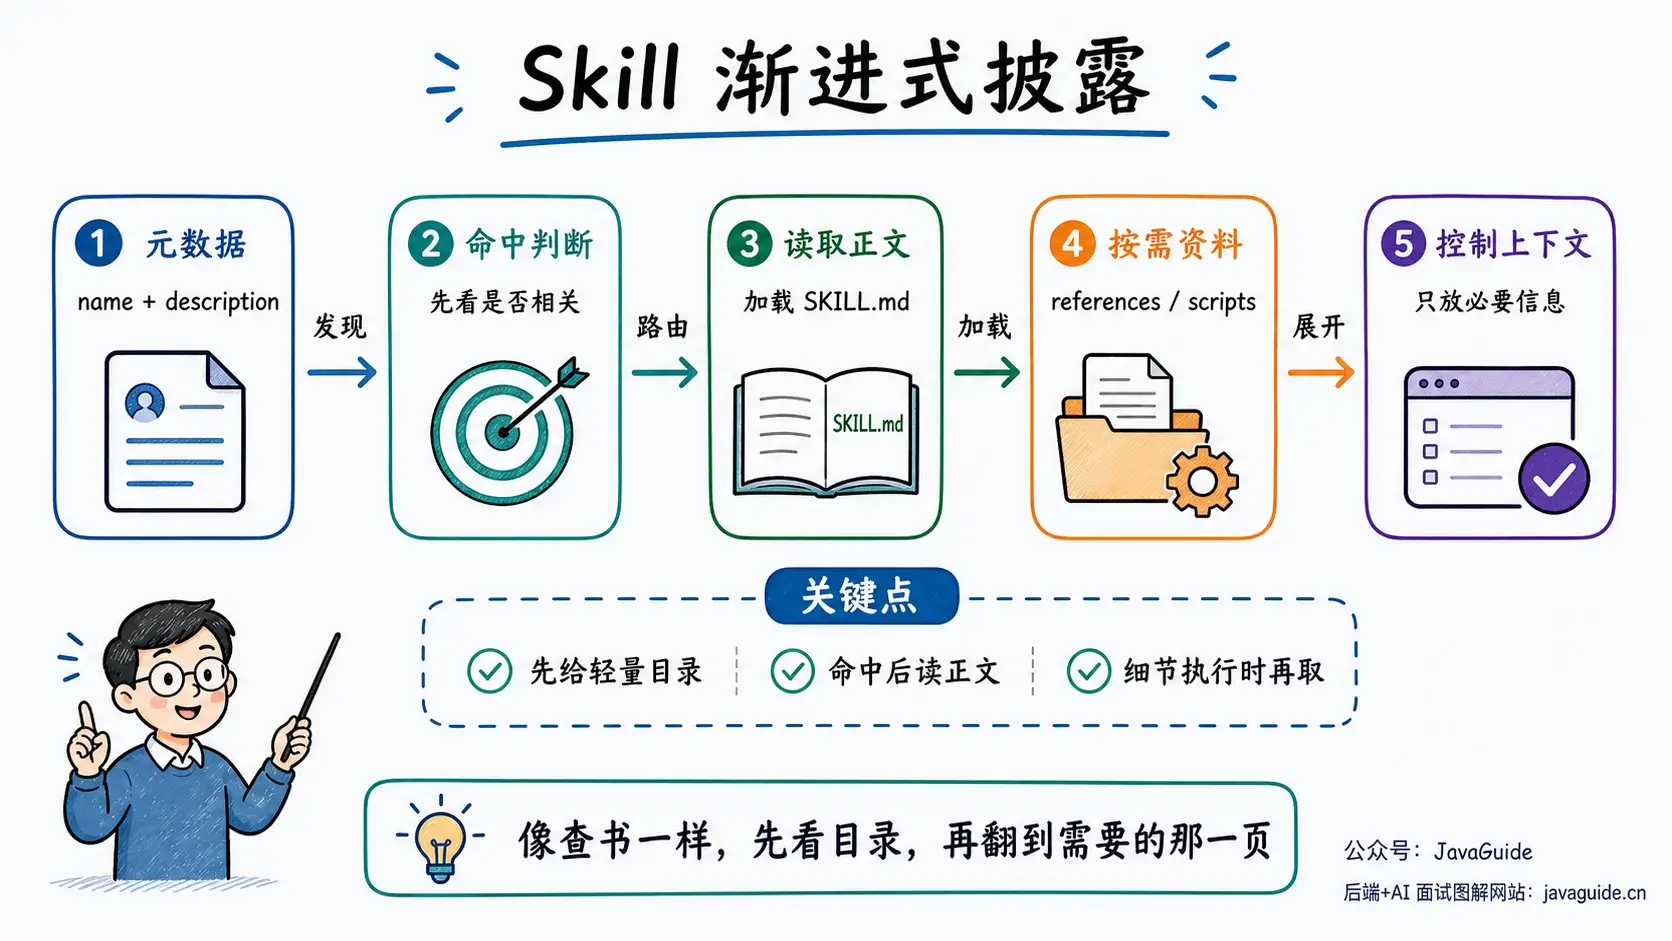
Cách tốt hơn là progressive disclosure: trước tiên đưa cho model một mục lục nhẹ, dùng đến phần nào mới load phần đó.

Giống như tra sách. Bạn sẽ không học thuộc cả quyển sách trước, mà xem mục lục trước, xác định chapter rồi mới lật đến trang cụ thể.
Thông thường có thể chia thành ba layer:
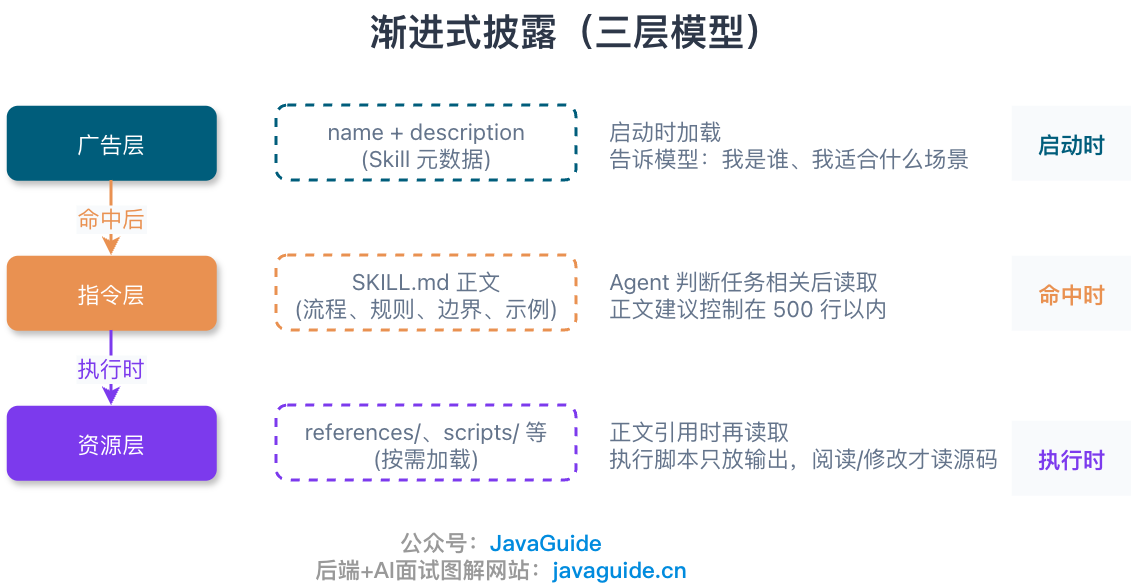
1. Layer quảng cáo: trước tiên cho model biết Skill này tồn tại
Khi khởi động, thường chỉ load metadata của Skill, chẳng hạn name và description. Phần này rất ngắn, dùng để nói cho model biết: tôi là ai, tôi phù hợp với scenario nào.
2. Layer instruction: sau khi khớp mới đọc body
Khi Agent xác định task hiện tại thực sự liên quan, nó mới đọc body SKILL.md tương ứng. Body chứa process, rule, boundary và ví dụ then chốt. Đừng viết quá dài ở đây; Anthropic khuyến nghị body nên được giới hạn trong khoảng 500 dòng.
3. Layer resource: khi thực thi mới đọc chi tiết
Nếu body trỏ đến các file như references/, scripts/, Agent mới đọc hoặc thực thi theo nhu cầu. Chẳng hạn, nếu chỉ thực thi script thì thường chỉ cần đưa output của script vào context; nếu cần đọc hoặc sửa script thì source code mới cần được đưa vào context.
Vì vậy, bạn thường thấy cách viết như sau:
## Tính năng nâng cao

**Điền form**: xem hướng dẫn đầy đủ tại [FORMS.md](FORMS.md)

**API reference**: xem tất cả method tại [REFERENCE.md](REFERENCE.md)
Khi task khớp với việc điền form, Agent mới đọc FORMS.md; việc trích xuất text thông thường không cần load file này.
Tổ chức file trong project thực tế thế nào?
Lấy một Skill phân tích data làm ví dụ, có thể tách như sau:
bigquery-analysis/
├── SKILL.md              # tổng quan và navigation, được load khi khớp
└── reference/
    ├── finance.md        # doanh thu, ARR, chỉ số billing
    ├── sales.md          # opportunity, pipeline, account
    ├── product.md        # API usage, feature adoption
    └── marketing.md      # campaign, attribution, email
File chính chỉ liệt kê dataset khả dụng và tài liệu tương ứng, còn data definition được giữ trong từng file reference:
# Phân tích data BigQuery

## Dataset khả dụng

**Finance**: doanh thu, ARR, billing → xem [reference/finance.md](reference/finance.md)

**Sales**: opportunity, pipeline, account → xem [reference/sales.md](reference/sales.md)

**Product**: API usage, feature adoption → xem [reference/product.md](reference/product.md)

**Marketing**: campaign, attribution, email → xem [reference/marketing.md](reference/marketing.md)
Khi user hỏi “pipeline sales của quý trước thế nào”, Agent chỉ cần mở reference/sales.md; tài liệu về finance, product và marketing không cần load.
Nếu rule bắt buộc bị ẩn sau nhiều tầng reference, Agent sẽ khó định vị trực tiếp:
SKILL.md → advanced.md → details.md → rule quan trọng nhất nằm ở đâyHãy liệt kê cách dùng cơ bản và tài liệu ở layer tiếp theo ngay trong file chính:
SKILL.md
├── chứa trực tiếp cách dùng cơ bản
├── tính năng nâng cao → advanced.md
└── API reference → reference.md
Sau khi đọc file chính, Agent có thể định vị tài liệu. Khi file reference dài, hãy liệt kê mục lục ở đầu file để dễ xác nhận nội dung khả dụng trước.
Thiết kế workflow và feedback loop thế nào?
Với task đơn giản, vài rule là đủ. Nhưng khi scenario phức tạp hơn, như vậy sẽ không đủ.
Agent rất dễ bỏ qua một số bước, chẳng hạn kiểm tra chất lượng output hoặc chạy test code, rồi trực tiếp nói rằng nó đã hoàn thành.
Để tránh vấn đề này, cần viết rõ hai điểm:
- Mỗi bước đi theo thứ tự nào
- Ở đâu bắt buộc phải dừng lại để validation
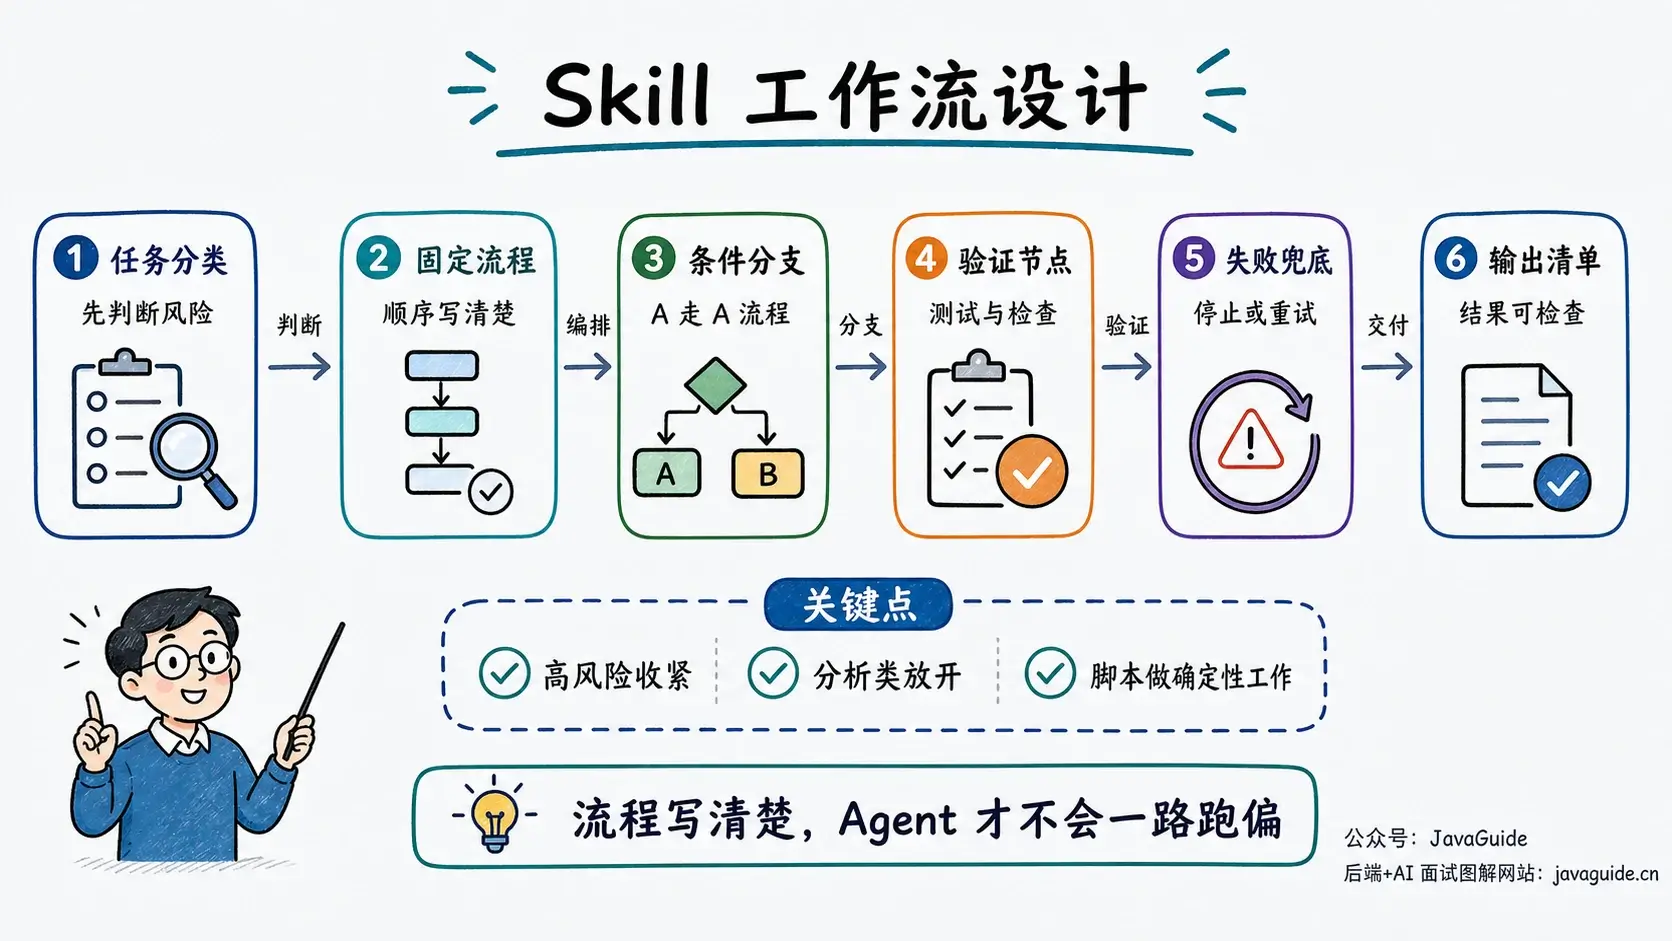
Chú thích hình: Skill phức tạp cần đưa việc phân loại task, branch điều kiện, validation node và fallback khi failure vào process.
Nối các bước bằng checklist
TDD Skill của Superpowers là một ví dụ rất tốt.
Nó không chỉ viết một câu “viết test trước rồi mới viết code”. Câu này quá sơ lược, khi Agent thực thi vẫn dễ làm qua loa.
Nó trực tiếp tách process thành một số phase rõ ràng, bản rút gọn như sau:
### RED - Write Failing Test

Write one minimal test showing what should happen.

### Verify RED - Watch It Fail

**MANDATORY. Never skip.**

Confirm:

- Test fails, not errors
- Failure message is expected
- Fails because feature missing, not typos

### GREEN - Minimal Code

Write simplest code to pass the test.
Don't add features.

### REFACTOR - Clean Up

After green only:

- Remove duplication
- Improve names
- Extract helpers

Keep tests green. Don't add behavior.
Verify RED quy định Agent phải nhìn thấy failure đúng như kỳ vọng trước khi bắt đầu implement.
Failure phải do feature chưa được implement gây ra, không phải do path, syntax hoặc bản thân test bị lỗi.
Nếu không viết rõ bước này, Agent rất dễ implement trước rồi bổ sung một test “trông có vẻ sẽ pass”. Như vậy không còn là TDD.
Điều kiện validation trước khi hoàn thành cũng được viết thành checklist:
## Verification Checklist

Before marking work complete:

- [ ] Every new function/method has a test
- [ ] Watched each test fail before implementing
- [ ] Each test failed for expected reason
- [ ] Wrote minimal code to pass each test
- [ ] All tests pass
- [ ] Output has no errors or warnings
Mỗi item trong checklist đều nên là một action có thể kiểm chứng, chẳng hạn “tất cả test pass” hoặc “mọi method mới đều có test”. Các yêu cầu như “đảm bảo quality”, “tuân thủ test best practice” không có tiêu chí xác định, nên không thể làm validation node.
Feedback loop
Task phức tạp cần đưa validation node ở giữa vào process:
thực thi → validation → sửa lỗi → validation lạiChẳng hạn, nếu code review chỉ yêu cầu “review toàn diện”, Agent dễ xử lý tên, format và comment trước, bỏ sót vấn đề architecture.
Có thể tách code review thành hai vòng:
## Quy trình code review

1. Lấy danh sách file thay đổi và diff

2. Vòng một: review design

   - Kiểm tra cấu trúc tổng thể có hợp lý không
   - Kiểm tra có vi phạm SOLID không
   - Nếu phát hiện vấn đề architecture rõ ràng, báo cáo trước, chưa vội đi vào review chi tiết

3. Vòng hai: review implementation

   - Kiểm tra security risk, chẳng hạn SQL injection, XSS và privilege escalation
   - Kiểm tra performance hotspot, chẳng hạn gọi DB trong loop hoặc thiếu index
   - Kiểm tra error handling và điều kiện biên

4. Output vấn đề
   - Gắn mức độ nghiêm trọng: Critical / Warning / Suggestion
   - Đưa ra đề xuất có thể sửa trực tiếp
Process này kiểm tra design trước, sau đó kiểm tra implementation, cuối cùng output đề xuất sửa đổi.
Branch điều kiện
Khi Skill đồng thời xử lý nhiều loại task, nên liệt kê điều kiện phán đoán và branch. Path xử lý khi tạo document và khi sửa document có sẵn là khác nhau:
## Workflow sửa document

1. Trước tiên xác định loại task

   **Tạo document mới?**

   Đi theo workflow tạo mới.

   **Sửa document hiện có?**

   Đi theo workflow chỉnh sửa.

2. Workflow tạo mới

   - Dùng template tạo document
   - Export sang format mục tiêu
   - Validation file có thể mở bình thường

3. Workflow chỉnh sửa

   - Unpack document hiện có
   - Sửa nội dung được chỉ định
   - Validation sau mỗi lần sửa
   - Đóng gói lại sau khi hoàn tất
Khi branch tăng lên, file chính giữ logic phán đoán, còn process cụ thể tách sang file riêng:
workflows/
├── create-document.md
├── edit-document.md
└── export-document.md
Task khớp branch nào thì Agent đọc file tương ứng. Process quy định thứ tự thực thi, còn feedback node quy định thời điểm kiểm tra; thiếu một trong hai thì dễ bỏ qua bước khi thực thi.
Thực hiện Skill routing thế nào?
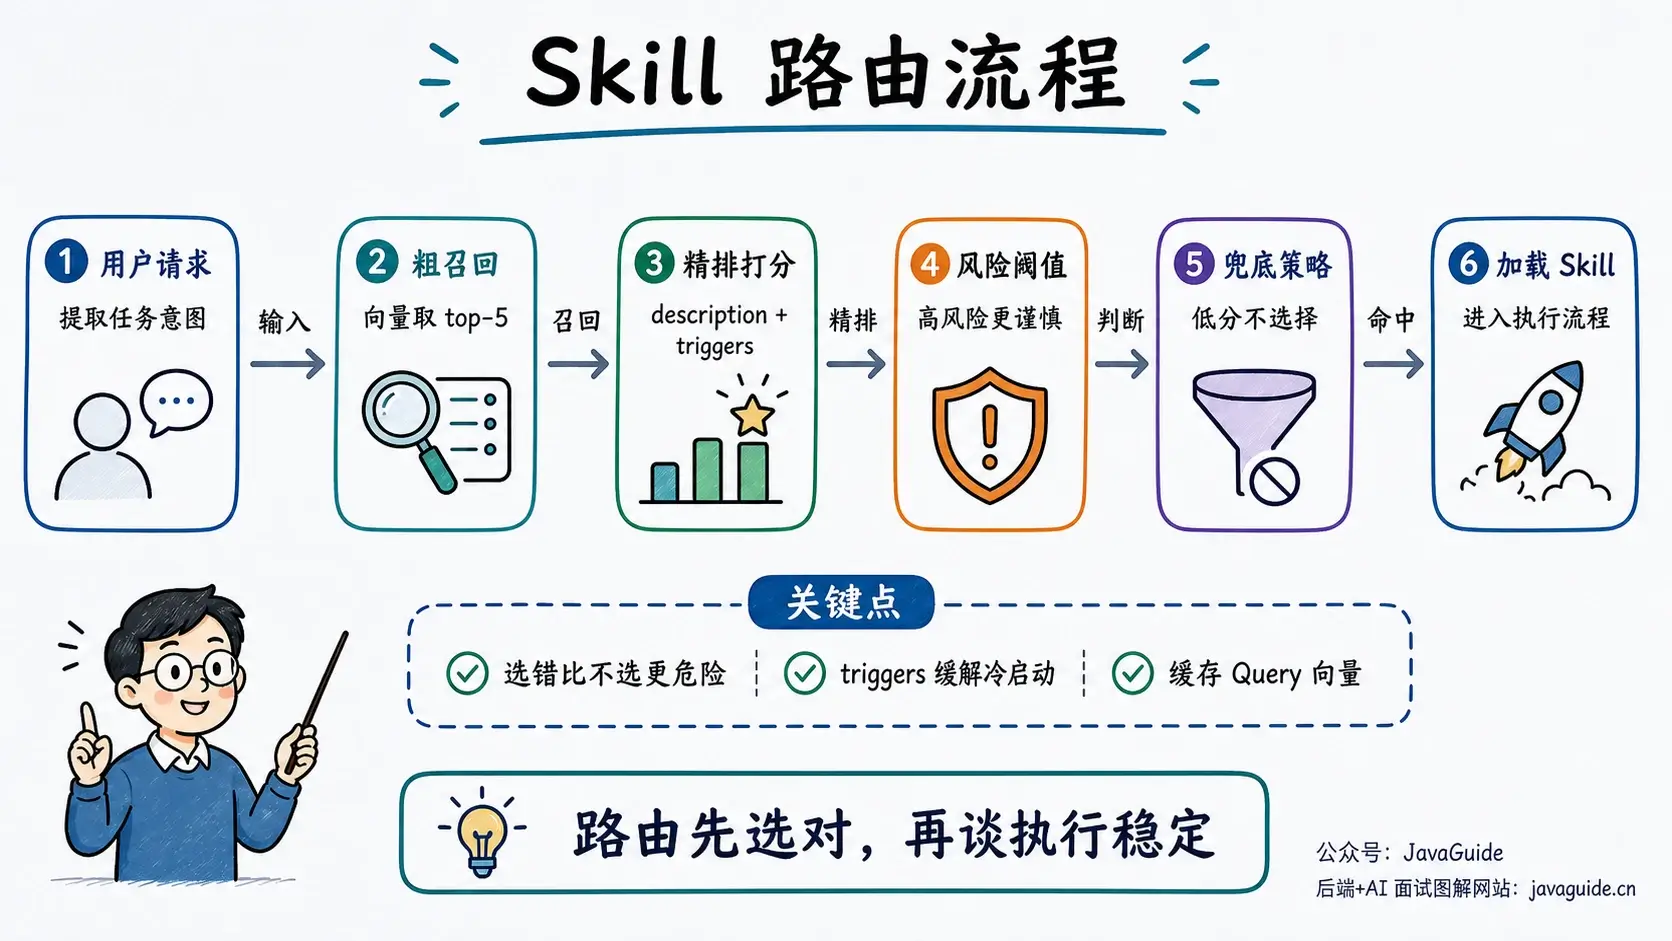
Khi user gửi request “Full GC thường xuyên”, router nên chọn JVM diagnosis Skill và loại database troubleshooting cùng document processing Skill. Sau khi routing xong, cần nhận được một tập Skill có thể load trực tiếp.
Khi chỉ có ba đến năm Skill, model thường đủ khả năng lựa chọn bằng cách đọc description. Khi số lượng tăng lên vài chục, process “recall candidate → rerank → quyết định” sẽ ổn định hơn:
| Giai đoạn | Input và xử lý | Output |
|---|---|---|
| Coarse recall | Vector hóa request cùng name, description và sample Query điển hình của Skill, lấy top-5 theo cosine similarity. | Một số ít candidate Skill |
| Rerank | So sánh mức độ khớp của name, description và example; Skill có risk cao như security, database dùng threshold cao hơn. | Candidate được xếp hạng theo relevance và risk |
| Decision | Nếu điểm cao nhất đạt threshold thì load Skill tương ứng; nếu toàn bộ điểm thấp thì không load Skill nào, đi theo default process. | Một, nhiều hoặc zero Skill được chọn |
Khi một request chứa các task không phụ thuộc nhau, trước tiên tách task rồi mới routing. Chẳng hạn “phân tích GC log và sửa một deployment document” ít nhất liên quan đến JVM diagnosis và document editing, không thể dùng một Skill tổng quát để bao phủ hai process.
Với request “Full GC thường xuyên”, coarse recall có thể thu được ba candidate là jvm-metrics-analyzer, distributed tracing và K8s event viewer; rerank kiểm tra các example “Full GC”, “heap stack” rồi đưa JVM diagnosis Skill lên đầu. Nếu request chỉ viết “giúp tôi xử lý”, không có đủ semantic clue, router nên giữ default process thay vì đoán user muốn database migration hay production operation.

Khi Skill mới chưa có historical Query, description quá trừu tượng sẽ làm giảm chất lượng recall. Agent Skills specification không quy định field triggers dùng chung trong frontmatter, các host cũng không đảm bảo đọc field tùy chỉnh. Khi tự duy trì scheduler, hãy đặt Query điển hình vào một routing index riêng:
skill: jvm-runtime-diagnosis
examples:
  - "API bị treo rồi"
  - "Full GC thường xuyên"
  - "Giúp tôi xem heap stack Java này"
  - "Service bị OOM thì điều tra thế nào"
Router tùy chỉnh vector hóa examples cùng name, description của Skill. Khi dùng host bên thứ ba, chỉ sử dụng các field mà host đó tuyên bố hỗ trợ; không đưa routing index này vào mọi SKILL.md, càng không được giả định host nào cũng đọc nó.
Vài chục Skill có thể dùng NumPy tính similarity trong memory, thời gian thường tốn ở external embedding API. Trước tiên cache vector của Query; khi số lượng tăng lên vài trăm hoặc vài nghìn, hãy đánh giá ANN index hoặc vector database.
Một scheduler dùng chung có thể tách thành bốn phần:
| Phần | Trách nhiệm |
|---|---|
| Registry | Lưu metadata, routing index và vector của Skill. |
| Routing engine | Recall candidate, tính score và áp dụng threshold. |
| Loader | Đọc SKILL.md và tài liệu tham khảo cần thiết theo kết quả routing. |
| Context assembler | Đưa nội dung đã load vào context tương ứng của task. |
Routing engine không chịu trách nhiệm đọc body của Skill, còn loader cũng không tham gia chấm điểm. Như vậy, cập nhật body không thay đổi kết quả recall, thay vector storage cũng không cần sửa logic load.
Những lỗi dễ mắc khi viết Skill
Coi Skill như README của project
README ghi lại background, installation và feature của project, reader có thể tự xác định bước tiếp theo. Khi Agent thực thi task, thứ nó cần là boundary có thể thao tác: khi nào dùng, thực thi theo thứ tự nào, trường hợp nào phải dừng và failure thì xử lý thế nào.
Muốn viết một Skill quá toàn diện
Sau khi đưa JVM, database, K8s, gateway và message queue vào một “system troubleshooting tool”, khi user gửi GC log, Agent vẫn phải lựa chọn giữa resource container, gateway log và rule JVM. Tách theo boundary của vấn đề sẽ giúp input đi thẳng vào tài liệu tương ứng:
jvm-metrics-analyzer: chỉ xem JVM metric, GC và thread stackdistributed-trace-finder: chỉ lần theo latency của chain dựa trên TraceIdk8s-pod-event-viewer: chỉ xem trạng thái Pod, nguyên nhân restart và event record
GC log đi vào JVM metrics Skill, TraceId đi vào distributed tracing Skill, Pod restart đi vào K8s event Skill. Mỗi Skill chỉ duy trì rule và tài liệu cần cho một loại vấn đề.
Đưa cho Agent quá nhiều lựa chọn
Chỉ liệt kê pypdf, pdfplumber, PyMuPDF và pdf2image sẽ khiến Agent không biết PDF thông thường và PDF scan nên đi theo path nào, có thể dùng nhầm OCR trên text PDF:
# ✗ Không khuyến nghị: quá nhiều lựa chọn

Bạn có thể dùng pypdf, pdfplumber, PyMuPDF hoặc pdf2image để xử lý PDF.
Cần viết cả default path và điều kiện ngoại lệ:
# ✓ Khuyến nghị: giải pháp mặc định + fallback

Mặc định dùng pdfplumber để trích xuất text.
Nếu là PDF scan, cần OCR, sau đó chuyển sang pdf2image + pytesseract.
Skill nên đưa ra lựa chọn mặc định trong điều kiện bình thường và nêu rõ điều kiện chuyển đổi.
Đừng thay đổi thuật ngữ qua lại
Cùng một object trong một Skill nên giữ cùng một tên. Chẳng hạn phần trước dùng “API endpoint” thì phần sau không viết lại thành URL, API route hoặc path. Nếu condition dùng thuật ngữ không thống nhất, nó sẽ tạo ra ambiguity.
Đừng để LLM làm công việc deterministic
Hãy giao việc format conversion, tính toán chính xác, xử lý batch file và sửa data cho script:
- LLM phù hợp hơn với việc phán đoán: hiểu task, trích xuất parameter, quyết định bước tiếp theo và giải thích result.
- Script phù hợp hơn với việc thực thi: parse file, convert format, xử lý batch và validate output.
Khi đọc file input bắt buộc, script nên trả về error rõ ràng thay vì tạo file rỗng để che giấu việc thiếu input:
# ✓ Khuyến nghị: viết rõ điều kiện error
def process_file(path):
    try:
        with open(path, encoding="utf-8") as f:
            return f.read()
    except FileNotFoundError as exc:
        raise FileNotFoundError(
            f"File input bắt buộc không tồn tại: {path}. Hãy kiểm tra path hoặc tạo file trước."
        ) from exc
Cách viết sau chỉ giữ lại low-level exception, Agent không thể dựa vào đó để biết nên kiểm tra path hay tạo file còn thiếu:
# ✗ Không khuyến nghị: crash trực tiếp, Agent chỉ có thể đoán nguyên nhân
def process_file(path):
    return open(path).read()
Parameter cấu hình cần nêu constraint về value:
# ✓ Khuyến nghị: có thể thấy vì sao cấu hình như vậy

REQUEST_TIMEOUT = 30 # HTTP request thường nên hoàn thành trong 30 giây
MAX_RETRIES = 3 # Retry ba lần tương đối cân bằng giữa reliability và thời gian xử lý
Tổng kết
Quay lại scenario code review ở đầu bài: Prompt mang request review lần này, Function Calling khởi phát việc gọi tool, MCP kết nối các năng lực bên ngoài như file, database hoặc GitHub, còn Skill lưu process và constraint của review.
description cần đồng thời chỉ ra task và scenario trigger; body đặt convention của project, các bước thực thi, xử lý failure và validation point. File chính giữ process chính, chi tiết tách sang references/, scripts/; các thao tác như migration, deployment và xóa file phải siết chặt step, còn review và đánh giá solution giữ lại khoảng trống phán đoán cần thiết.
Tham khảo
- Repository Skills chính thức của Anthropic: https://github.com/anthropics/skills
- skill-creator chính thức của Anthropic: https://github.com/anthropics/skills/blob/main/skills/skill-creator/SKILL.md
- Superpowers: https://github.com/obra/superpowers
- sanyuan-skills: https://github.com/sanyuan0704/sanyuan-skills
- Everything Claude Code: https://github.com/nicekid1/everything-claude-code
- skills.sh (platform tìm Skill có sẵn): https://skills.sh/
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.