
Giải thích chi tiết LLM Gateway: định tuyến đa mô hình, Fallback, giới hạn lưu lượng và kiểm soát chi phí
Một thời gian trước, có bạn đọc muốn tôi chia sẻ về LLM Gateway: rốt cuộc nó giải quyết vấn đề gì, khi nào đáng triển khai riêng và nên lựa chọn thế nào.
Vì vậy, tôi đã tổng hợp thực tiễn và suy nghĩ khi làm dự án thành bài giới thiệu chi tiết này. Nội dung hơi khô, tính cả phần code rất ít thì có hơn 30.000 chữ.
Nói kết luận trước: với phần lớn dự án monolith hoặc dự án của một team, tự viết một LLM Gateway nhẹ ngay trong application là đủ. Trước hết, tập trung các lời gọi model phân tán trong từng module nghiệp vụ vào một entry point thống nhất, sau đó bổ sung timeout, retry, log và routing đơn giản khi cần. Thông thường không cần đưa thêm các component như LiteLLM, Kong AI Gateway, càng không cần ngay từ đầu dựng một nền tảng gateway độc lập.
Nếu mọi thứ từ phân loại intent, sinh tiêu đề, sửa JSON đến tạo báo cáo phức tạp đều gọi cùng một flagship model, giai đoạn đầu quả thực sẽ nhàn hơn. Khi traffic tăng, chi phí, latency và giới hạn lưu lượng của nhà cung cấp sẽ cùng lộ ra: tác vụ nhẹ chiếm quota của model đắt tiền, tác vụ quan trọng thất bại nhưng không có đường dự phòng, đến cuối tháng lại không thể quy chiếu hóa đơn về tenant và tính năng cụ thể.
Không nên để từng module nghiệp vụ tự giải quyết các vấn đề này, nếu không logic chọn model, retry, giới hạn lưu lượng và ghi nhận lời gọi sẽ nhanh chóng rải rác trong business code. LLM Gateway cung cấp một entry point gọi thống nhất giữa application layer và model provider, tập trung quản lý các logic dùng chung này.
Kiến thức cơ bản về LLM Gateway
LLM Gateway rốt cuộc là gì?
LLM Gateway giống như: năng lực API Gateway + control plane điều khiển lời gọi model.
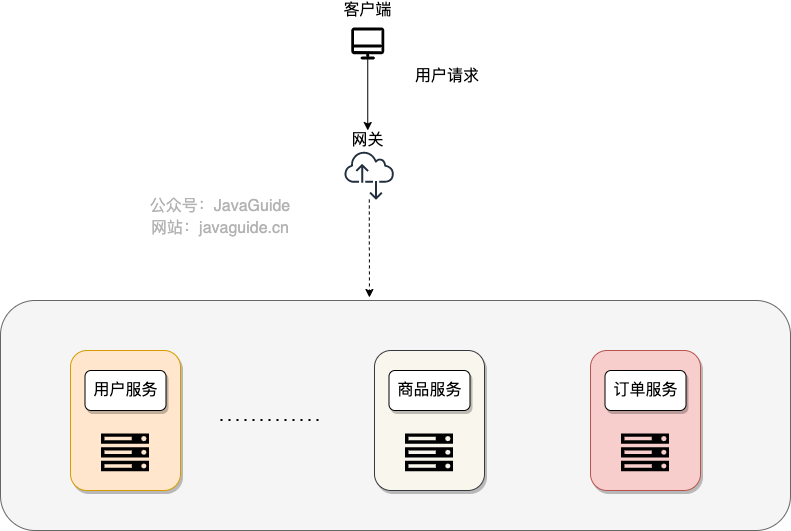
API Gateway truyền thống là entry point thống nhất nằm giữa client và backend service. Mọi request từ client trước tiên đi qua gateway, sau đó gateway route đến service đích cụ thể, chủ yếu quản lý HTTP traffic: xác thực, giới hạn lưu lượng, chuyển tiếp, log và circuit breaker.
LLM Gateway hướng đến lời gọi LLM. Ngoài các vấn đề API thông thường, nó còn phải xử lý các vấn đề riêng của model: chọn model, ngân sách Token, độ dài context, khác biệt giữa các provider, streaming output, tool calling, structured response, thống kê chi phí, phiên bản Prompt và chất lượng output.
Nói chính xác hơn, LLM Gateway là một lớp entry point governance giữa application layer và model provider. Nó không nhất thiết thay thế API Gateway hiện có của doanh nghiệp, nhưng sẽ thu gom logic routing, budget, audit và adaptation liên quan đến lời gọi model.
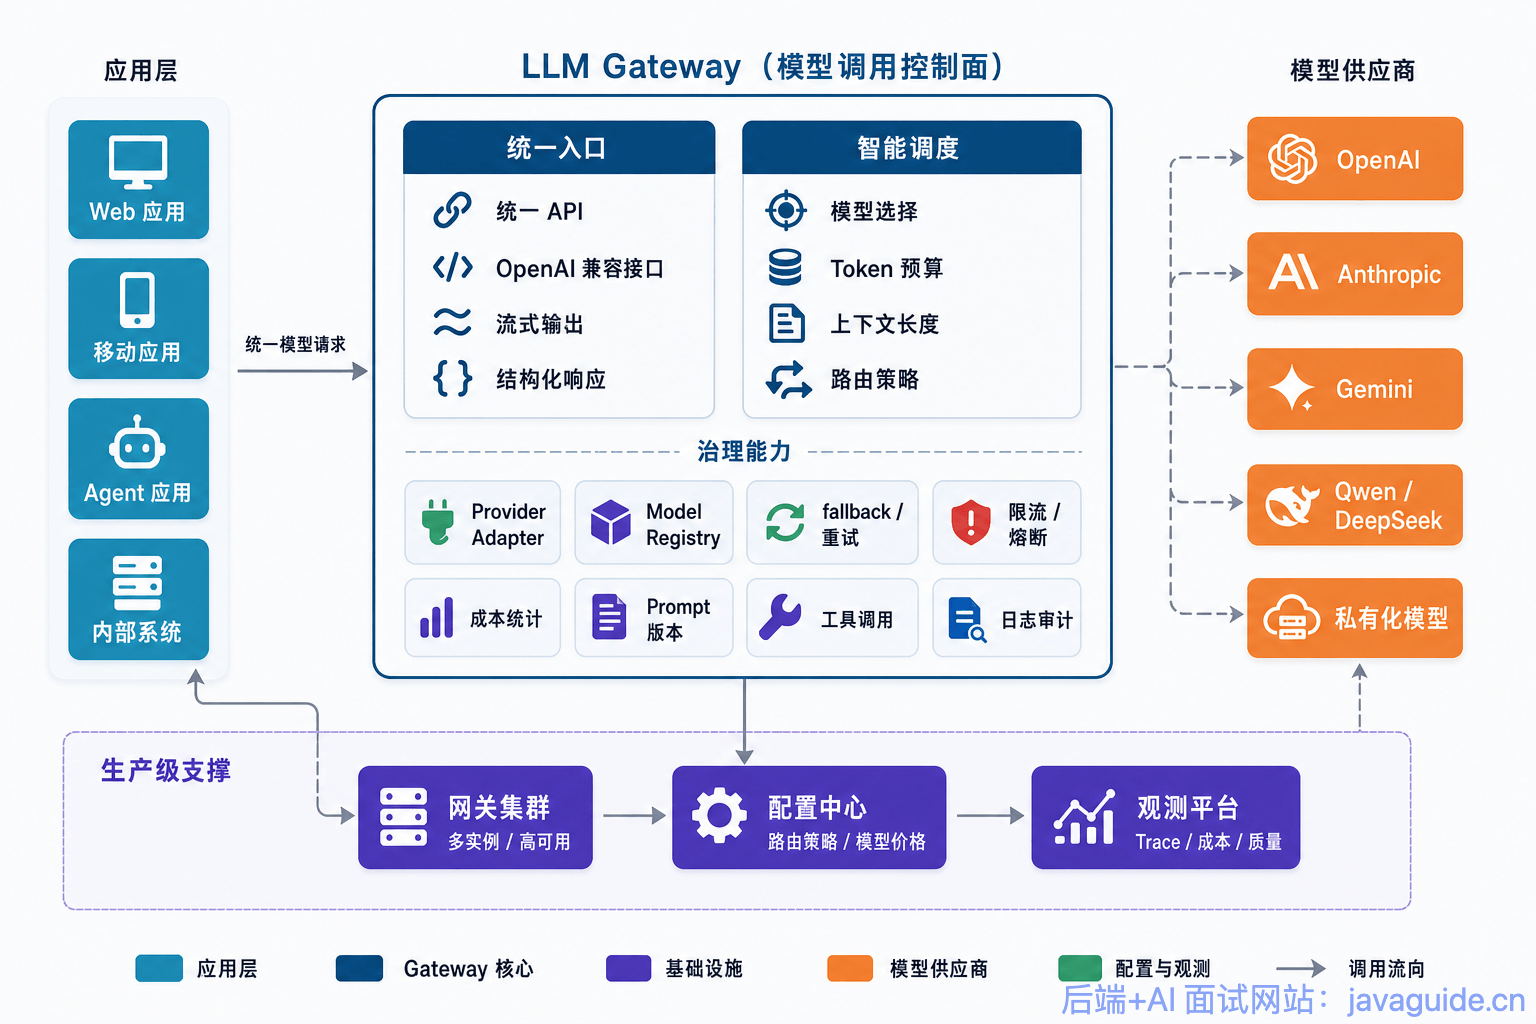
Business code không trực tiếp quan tâm phải gọi OpenAI, Anthropic, Gemini, Qwen, DeepSeek hay private model thế nào, mà gửi một standard request đến Gateway. Gateway dựa trên scenario, budget, latency, model availability và business policy để quyết định gọi model nào, đi qua provider nào, có cần retry hay không, có cần degrade hay không và ghi log thế nào.
Phiên bản Gateway đầu tiên có thể rất nhẹ, chỉ làm unified wrapper, timeout, retry và log. Ở production, nó thường còn quản lý model routing, Token budget, giới hạn lưu lượng, cost attribution, cache, audit và security policy.
Nếu chỉ “chuyển tiếp request”, nó mới là proxy; khi bắt đầu ghi nhận vì sao chọn model này, trừ budget thế nào và sau khi thất bại fallback ra sao, nó mới thuộc phạm vi Gateway.
Vì sao cần LLM Gateway?
Khi lần đầu xây dựng AI application, nhiều team sẽ viết lời gọi model trực tiếp trong business service:
Controller -> Service -> OpenAI SDK -> trả về câu trả lờiChuỗi này ngắn, trải nghiệm phát triển cũng tốt. Nhưng chỉ cần quy mô production tăng lên một chút, các vấn đề sẽ đồng loạt lộ ra.
| Vấn đề điển hình khi gọi trực tiếp model | Biểu hiện trên production | Năng lực tương ứng của Gateway |
|---|---|---|
| Ghi cứng tên model | Phải sửa code khắp nơi khi model nâng cấp, ngừng cung cấp hoặc đổi provider | Model registry + routing cấu hình hóa |
| API Key phân tán | Nhiều service tự lưu secret, khó luân phiên | Quản lý secret thống nhất |
| Provider giới hạn lưu lượng | Service nghiệp vụ retry điên cuồng sau 429, càng retry càng tệ | Giới hạn lưu lượng, xếp hàng, Fallback, circuit breaker |
| Không nhìn thấy chi phí | Cuối tháng chỉ biết tổng hóa đơn, không biết tenant, tính năng hay Prompt nào tiêu tiền | Ghi nhận usage + cost attribution |
| Mọi request đi cùng một model | Tác vụ đơn giản lãng phí tiền, tác vụ phức tạp cho kết quả kém | Routing model theo loại tác vụ |
| Thiếu log | Người dùng phàn nàn “AI vừa nói linh tinh”, lúc điều tra không tìm được input/output của model | Trace, phiên bản Prompt, log lời gọi model |
| SDK của provider phân tán | Mỗi business xử lý streaming, error code, retry và structured parsing | Provider Adapter thống nhất |
Ngoài access control, còn phải thiết kế riêng cost attribution và replay vấn đề.
Giải thích ngắn gọn:
- Cost attribution là xác định “một khoản chi phí model được dùng cho ai, tính năng nào và lời gọi nào”: chẳng hạn phân tách Token và số tiền theo tenant, user, business scenario, phiên bản Prompt, model và provider.
- Replay vấn đề là khi user phản hồi “câu trả lời vừa rồi không đúng”, có thể dùng
request_idđể tìm lại phiên bản Prompt, context truy xuất, kết quả routing, phiên bản model, tool call và thông tin lỗi tại thời điểm đó, từ đó xác định vấn đề nằm ở input, routing, output của model hay parsing phía downstream.
Lời gọi API truyền thống thất bại thường có thể định vị qua status code, request parameter và trạng thái database. Lời gọi LLM thất bại phức tạp hơn nhiều: có thể do phiên bản Prompt thay đổi, model nâng cấp, context truy xuất quá nhiều noise, output bị cắt, hoặc routing chuyển sang model rẻ nhưng không đủ năng lực.
Không có Gateway, tất cả manh mối này đều nằm rải rác trong business system.
Đã phân tán thì rất khó quản lý.
LLM Gateway khác LLM Router thế nào?
Router quản lý phạm vi hẹp hơn: request này nên chọn model nào. Input gồm user question, task type, budget và context length; output là tên một model hoặc một nhóm candidate.
Phạm vi của Gateway rộng hơn nhiều. Từ khi request đi vào đến khi trả về kết quả, authentication, giới hạn lưu lượng, routing, fallback, log và cost record ở giữa đều do nó quản lý. Router chỉ là một công đoạn trong Gateway.
| Khía cạnh | LLM Router | LLM Gateway |
|---|---|---|
| Trách nhiệm chính | Chọn model | Unified access, routing, giới hạn lưu lượng, Fallback, observability, cost governance |
| Phạm vi quyết định | Chọn model cho từng request | Governance toàn bộ vòng đời request |
| Input điển hình | User question, task type, budget, context length | Request, user, tenant, scenario, Prompt, model, provider, policy |
| Output điển hình | Model đích hoặc tập model | Kết quả gọi hoàn chỉnh, usage, log, error, cost, Fallback trace |
| Giai đoạn phù hợp | Khi lời gọi đa model bắt đầu phức tạp | Khi AI application đi vào production |
Có thể hiểu như sau: Router chịu trách nhiệm chọn model, Gateway chịu trách nhiệm quản lý toàn bộ lời gọi model.
Bạn có thể chỉ có Router mà chưa có Gateway để làm chức năng model routing đơn giản. Ví dụ, viết một function trả về model tương ứng theo task type.
Cách này giải quyết được một phần vấn đề chi phí, nhưng không giải quyết được quản lý key, giới hạn lưu lượng, log, audit, xử lý error thống nhất và chuyển đổi provider.
Ngược lại, Gateway giai đoạn đầu cũng có thể chưa cần Router phức tạp. Phiên bản đầu chỉ làm unified access, log và Fallback đã có thể giảm nhiều sự cố production.
Không nên gắn routing policy cứng vào một tên model cụ thể. Nên gắn vào các thuộc tính tương đối ổn định như model tier, khoảng chi phí, năng lực context và risk level. Model sẽ nâng cấp, tên sẽ thay đổi, nhưng các chiều quyết định này không biến mất.
LLM Gateway có quan hệ thế nào với RAG, Agent và MCP?
Bốn khái niệm này thường xuất hiện cùng nhau, nhưng ranh giới khác nhau.
| Khái niệm | Vấn đề chính được giải quyết | Quan hệ với Gateway |
|---|---|---|
| RAG | Truy xuất kiến thức bên ngoài và đưa context liên quan vào request của model | Gateway có thể giới hạn Token, ghi phiên bản Prompt và cache kết quả sau truy xuất, nhưng không chịu trách nhiệm về chất lượng truy xuất |
| Agent | Chia nhỏ task, gọi tool và thực thi nhiều vòng | Gateway có thể quản lý budget, routing và Fallback của từng lời gọi model, nhưng không quyết định logic lập kế hoạch task của Agent |
| MCP | Cho phép model hoặc Agent truy cập tool, resource và context bằng một protocol thống nhất | Gateway có thể audit và governance request của model, phối hợp với log tool call, nhưng không thay thế MCP Server hay tool registry |
Vì vậy, Gateway gần với “governance lời gọi model”; RAG, Agent và MCP gần với “tổ chức năng lực application”.
Một Agent phức tạp có thể gọi Gateway ở nhiều bước, Gateway cũng có thể ghi riêng scene, route_reason, mức sử dụng Token và chi phí cho từng bước.
LLM Gateway có làm tăng latency không?
Có tăng một chút, nhưng phần này thường không phải nguồn chờ đợi chính của user.
Gateway hoàn thành routing, ước tính Token và ghi log trong cùng data center, thời gian tương đối nhỏ; model queue, suy luận với context dài, network liên vùng, output Token, tool call và retry mới dễ kéo dài end-to-end latency.
Gateway cũng có thể can thiệp đúng vào các điểm này. Intent classification đi qua model latency thấp; FAQ lặp lại trả về kết quả cache; context dài được nén trước khi gửi. Voice interaction và online customer service cần đưa TTFT vào health metric của candidate model. Khi provider chập chờn, chuyển candidate hoặc xếp hàng theo policy dễ kiểm soát hơn để business interface chờ đến timeout.
Bản thân routing cũng có cost. Mỗi request đều gọi strong model trước để “phán đoán nên dùng model nào” rất có thể khiến Token và thời gian tiết kiệm được lại bị tiêu hết. Khi chưa có đủ request volume, evaluation set và quality feedback, dùng rule theo scenario hoặc lightweight classifier là đủ.
Bạn có thực sự cần LLM Gateway không?
Trước tiên hãy xem lời gọi model nằm ở vị trí nào trong system. Một internal tool chỉ gọi một model provider, mỗi ngày chỉ có ít request thì thường không cần triển khai riêng Gateway; chỉ cần bọc một LLMClient bên ngoài business service để thống nhất timeout, retry, basic log và error conversion.
Khi lời gọi được nhiều service, team hoặc tenant dùng chung, tình hình sẽ khác. Nếu model config phân tán khắp nơi, đổi provider phải sửa code từng service; khi chi phí của một scenario đột nhiên tăng, hóa đơn lại không thể tách theo tenant, feature và phiên bản Prompt. Chuyển đổi nhiều provider, quota, Fallback, audit và quality replay cũng sẽ lặp lại ở từng call site.
Lúc này chưa chắc cần một platform nặng, nhưng lời gọi model phải có một entry point duy nhất. Có thể để module thống nhất trước tiên quản lý model name, secret, call log và error handling, sau đó từng bước thêm routing, budget và giới hạn lưu lượng; khi nhiều business line dùng chung model, cần tính phí theo tenant hoặc cần quản lý việc lưu Prompt và nội dung nhạy cảm, mới tiến hóa thành LLM Gateway hoàn chỉnh.
Nền tảng phỏng vấn AI của tôi đi theo hướng này. Dự án không triển khai gateway riêng cũng không đưa thêm component LLM Gateway chuyên dụng, mà dùng LlmProviderRegistry trong application để thống nhất quản lý config, model mặc định, API Key, ChatClient và model Embedding của các Provider khác nhau, sau đó dùng StructuredOutputInvoker để tập trung validation, repair, retry và metric của structured output. Hình thái này đã có các yếu tố cốt lõi của một LLM Gateway nhẹ, đủ đáp ứng nhu cầu hiện tại của dự án.
Tuy nhiên, nó vẫn chưa phải production-grade gateway hoàn chỉnh được nói ở phần sau: các năng lực như Fallback tự động giữa Provider, Token budget, cost attribution theo call, giới hạn lưu lượng đa chiều cấp gateway và smart routing vẫn chờ đến khi business thực sự cần mới bổ sung. Ranh giới này cũng cho thấy một điều: LLM Gateway trước hết là một nhóm trách nhiệm cần governance tập trung, không nhất thiết phải tương ứng với một service độc lập hay component bên thứ ba.

Có nên tập trung hay không phụ thuộc vào số service bị ảnh hưởng bởi một lần sửa model policy và số call chain cần điều tra khi xảy ra một sự cố. Khi lời gọi tập trung trong một module, thêm model, đổi provider hay bổ sung audit về sau chỉ cần sửa một chỗ; khi lời gọi đã rải vào các business service, dù traffic không lớn cũng nên xây dựng unified entry point trước.
Vì sao không thể dùng model mạnh nhất cho mọi request?
Model đắt nhất chưa chắc là model phù hợp nhất
Đặt strong model làm giá trị mặc định quả thực giúp giảm một số lựa chọn ban đầu, nhưng không thể thay thế việc phân cấp task. Intent classification, tạo tiêu đề, sửa JSON và summary nhẹ coi trọng response speed, structured output và failure fallback hơn; để chúng chiếm dụng strong model lâu dài chỉ làm phóng đại cost và queue time. Với task phức tạp, model càng đắt cũng không đồng nghĩa kết quả càng tốt; retrieval context, tool return value và output constraint cũng quyết định chất lượng cuối cùng.
Tên như tier-fast, tier-pro chỉ biểu thị capability tier. Việc ánh xạ cụ thể đến provider nào, model version, context window và price nào nên do model registry quản lý. Khi provider thay model hoặc điều chỉnh giá, role rule không cần sửa theo.
Vì vậy, routing record không thể chỉ lưu model name cuối cùng, mà còn phải giữ scenario, model tier, candidate, route reason và usage thực tế. Chỉ như vậy mới có thể xem lại vì sao một call chọn fast model, khi nào đổi sang backup model và quyết định đó ảnh hưởng thế nào đến latency và cost.
Task nào phù hợp với small model? Task nào bắt buộc dùng strong model?
Có thể bắt đầu chọn model từ chính task, thay vì so sánh bảng xếp hạng model trước. Fixed rule, keyword check, permission validation và template filling nên giao cho code; để model phán đoán “input có rỗng không” hoặc “đuôi file có phải PDF không” vừa tăng cost vừa đưa thêm sự không chắc chắn không cần thiết.
Intent classification, tạo tiêu đề, summary nhẹ, rewrite đơn giản và information extraction rủi ro thấp thường phù hợp với model chi phí thấp. Ở đây cần enum constraint, structured output validation và failure path rõ ràng hơn là parameter scale lớn nhất. Khi parsing thất bại hoặc confidence không đủ, mới nâng cấp model theo scenario.
Multi-document summarization, thiết kế architecture cho code, lập kế hoạch Agent phức tạp và fact verification nghiêm ngặt cần reasoning capability hơn; với scenario có chi phí sai lầm cao như tài chính, pháp lý và y tế, còn phải thêm human review hoặc business rule. Strong model nên dành cho các request này, không nên trở thành channel mặc định của mọi request.
Lấy dự án phân tích cổ phiếu multi-agent của tôi làm ví dụ: tổng hợp chỉ báo kỹ thuật và sàng lọc tin tức ban đầu có thể ưu tiên model latency thấp; tổng hợp tài liệu nghiên cứu và hợp nhất kết luận mâu thuẫn giữa nhiều role cần reasoning capability mạnh hơn.
LLM Router chọn model thế nào?
Nhiệm vụ của LLM Router là chọn một model phù hợp cho từng request.
“Phù hợp” không chỉ xét chất lượng câu trả lời, mà còn xét cost, latency, context length, provider availability và risk policy.
Các dự án smart routing như LLMRouter có ý tưởng chọn động model phù hợp hơn cho từng query, từ đó cân bằng chất lượng, cost và latency. Chúng bao phủ các hướng single-turn routing, multi-turn routing, personalized routing và Agentic routing, đồng thời cung cấp các strategy như KNN, SVM, MLP, Matrix Factorization, Elo Rating và Graph-based routing.
Các strategy này phù hợp cho học tập và thử nghiệm, nhưng production cần giải quyết explainability và replay trước. Hướng vững chắc hơn là: bắt đầu model routing bằng rule đơn giản, sau đó dần tiến hóa thành system có thể train, evaluate và iterate dựa trên scenario thực tế.
Các strategy routing thường gặp:
| Strategy routing | Cách làm | Scenario phù hợp | Rủi ro |
|---|---|---|---|
| Fixed-rule routing | Chọn model theo business scenario, interface và tenant package | Gateway phiên bản đầu, đủ dùng cho phần lớn business | Rule do người duy trì, dễ lạc hậu |
| Cost-first / cascade routing | Mặc định dùng model rẻ, thất bại hoặc confidence thấp thì nâng cấp | Classification, summary, customer-service FAQ | Sai lầm của model chi phí thấp có thể lan truyền |
| Semantic / classification routing | Chọn model theo query semantic, độ phức tạp và risk level | Loại vấn đề ổn định, traffic lớn | Threshold và classifier cần tuning liên tục |
| Learning-based routing | Train Router dựa trên quality, cost và latency lịch sử | Nhiều model, nhiều task, traffic lớn | Phụ thuộc evaluation data và feedback loop |
| Personalized routing | Kết hợp user preference và interaction history để chọn model | C-end assistant, education, content platform | Chi phí privacy và consistency cao hơn |
| Agentic routing | Chuyển model và tool động trong task nhiều vòng | Agent phức tạp, task chain dài | Khó debug và kiểm soát cost |
Phiên bản đầu thường bắt đầu từ fixed rule. Translation, code generation và default conversation lần lượt gắn với model tier; package hoặc risk level khác nhau sẽ override default rule. Rule sẽ tăng theo business growth, nhưng có thể cấu hình, audit và rollback bất cứ lúc nào, phù hợp để trước hết tập trung lời gọi model.
Cascade routing đặt model chi phí thấp lên trước, chỉ nâng cấp khi structured output parsing thất bại, confidence không đủ hoặc business validation không đạt. Nó làm tăng một lần inference hoặc evaluation, phù hợp với summary, classification và customer-service FAQ, nơi có thể chấp nhận chờ thêm; real-time voice và online collaborative editing thường không nên đặt nó trên main path.
Semantic/classification routing dùng similarity giữa embedding với task prototype và model profile, hoặc dùng lightweight classifier để gắn độ phức tạp và risk level cho request. Model capability, cách diễn đạt của user và request distribution đều thay đổi, vì vậy cần liên tục kiểm tra threshold, misrouting rate và evaluation sample. Learning-based, personalized và Agentic routing càng phụ thuộc vào các data này: hai loại đầu còn phải xử lý privacy và explainability, loại sau phải xử lý cost ceiling và vấn đề debug của các bước nhiều vòng.
Multi-agent scenario còn thêm một lớp role selection. Có thể trước tiên tra role config, sau đó kế thừa default model của toàn bộ strategy, cuối cùng mới dùng system default; khi technical analysis, sentiment summary và final report do các role khác nhau đảm nhiệm, cách này ổn định hơn routing chỉ theo interface name. Khi Provider trong config healthy thì dùng trực tiếp; chỉ khi chưa register hoặc health check không đạt mới chọn từ candidate khả dụng theo capability, latency, cost và success rate.
Trước khi bắt đầu một Agent call, phải cố định model, Provider, model name đã chọn và việc có xảy ra pre-call fallback hay không thành cùng một routing result. Nếu health state thay đổi trong lúc streaming generation, không được route lại sau khi kết thúc rồi mới ghi usage, nếu không cost thực tế do A tạo ra có thể bị ghi cho B. Pre-call fallback cũng không đồng nghĩa với replay cross-Provider sau failure: trường hợp sau còn phải định nghĩa exception nào có thể replay, có reuse ReAct tool result hay không và xử lý text streaming đã output thế nào.
LLM Gateway cần có những năng lực nào?
Unified access đa model
Thứ ít nên rải rác khắp business code nhất chính là lời gọi Provider SDK.
Hôm nay một service gọi OpenAI, ngày mai service khác gọi DeepSeek, ngày kia một scheduled task lại kết nối Gemini. Ngắn hạn đều chạy được, nhưng lâu dần sẽ thành một đống logic lặp lại: API Key, timeout, retry, parsing streaming, error code, usage, log format và mapping model name, mỗi nơi xử lý một lần.
Cách vững chắc hơn là định nghĩa request và response thống nhất trước.
public record LLMRequest(
        String requestId,
        String idempotencyKey,
        String tenantId,
        String userId,
        String scene,
        List<ChatMessage> messages,
        Map<String, Object> responseSchema,
        LLMOptions options
) {
}

public record LLMResponse(
        String requestId,
        String model,
        String provider,
        String content,
        TokenUsage usage,
        String finishReason,
        boolean fallbackUsed
) {
}

public interface ProviderClient {

    String providerName();

    boolean supports(String model);

    LLMResponse chat(LLMRequest request, RenderedPrompt prompt, ModelRoute route);

    Flux<LLMChunk> streamChat(LLMRequest request, RenderedPrompt prompt, ModelRoute route);
}

public interface LLMGateway {

    LLMResponse chat(LLMRequest request);
}
Các interface này giải quyết một số vấn đề thực tế:
- Phía business chỉ phụ thuộc vào
LLMGateway, không phụ thuộc SDK của một provider cụ thể. - Model name, provider và Fallback policy đều có thể cấu hình.
- Usage, cost, error và latency có thể được ghi nhận thống nhất.
- Khi tích hợp model mới, chỉ cần thêm Provider Adapter.
Hình dạng entry point của request thống nhất thường theo phong cách tương thích với OpenAI Chat Completions. LiteLLM, DeepSeek, Qwen và các giải pháp khác đều cung cấp entry point tương tự; các gateway như Kong AI Gateway cũng dùng OpenAI-compatible format làm một trong những entry point chung của AI plugin.
Lợi ích của việc public OpenAI-compatible interface rất trực tiếp: business thường không cần sửa nhiều SDK, chỉ cần đổi base_url hoặc gateway address là có thể chuyển từ gọi trực tiếp provider sang entry point thống nhất.
Nhưng đây chỉ là thống nhất hình dạng entry point, không có nghĩa exit cũng thống nhất.
Các managed gateway như Cloudflare AI Gateway còn phải tích hợp theo cách Provider Native, REST hoặc Binding mà tài liệu hiện tại của nó hỗ trợ; không được mặc định rằng mọi provider đều có thể được passthrough như cùng một OpenAI protocol. OpenAI protocol cũng không biểu đạt được một số capability riêng của provider, như extended thinking của Anthropic và grounding metadata của Gemini. Các capability này thường được đặt trong extra_body, metadata hoặc internal extension field, rồi Provider Adapter chuyển thành request format riêng của provider đích.
Công việc của Provider Adapter không chỉ là endpoint và auth header; tool call, streaming event, system prompt, structured output, usage và error code cũng phải được chuyển đổi chính xác.
| Khía cạnh | OpenAI Chat Completions | Anthropic Messages API | Gemini generateContent |
|---|---|---|---|
| Field của tool call | tool_calls | tool_use content block | functionCall part |
| Trả tool result | Message role=tool | role=user + tool_result content block | functionResponse part |
| Tool Schema | JSON Schema | Một subset của JSON Schema | Một subset của OpenAPI |
| Vị trí system prompt | system/developer trong messages | Field system ở top level | systemInstruction |
| Multi-tool call | Native support | Native support | Cần validation riêng theo model và SDK behavior |
| Extension cho capability riêng | metadata / extension parameter | thinking, cache_control, v.v. | grounding, cachedContent, v.v. |
OpenAI-compatible interface giải quyết cách business access, không thể xóa bỏ khác biệt protocol giữa các provider. Việc có hỗ trợ Claude, Gemini hay private model chủ yếu phụ thuộc vào Provider Adapter có chuyển đổi chính xác request và event hay không; “hỗ trợ một loại Provider” trong product document cũng không có nghĩa mọi capability riêng đều có thể mapping không mất mát.
Trước hết hãy tập trung lời gọi model, sau đó từng bước bổ sung routing, giới hạn lưu lượng và audit. Cách này thường dễ validation hơn việc ngay từ đầu bao phủ mọi capability riêng.
Model routing
Model routing rất dễ thấy lợi ích, nhất là trong system có phân tầng task rõ ràng.
Phiên bản đầu có thể cấu hình hóa, không cần train model.
routes:
  - scene: intent_classification
    primary: tier-fast
    fallback:
      - tier-nano
      - tier-balanced
    max_output_tokens: 256
    risk_level: low

  - scene: complex_reasoning
    primary: tier-flagship
    fallback:
      - tier-pro
      - tier-balanced
    max_output_tokens: 4096
    risk_level: medium

  - scene: legal_review
    primary: tier-flagship
    fallback:
      - tier-compliance
    require_human_review: true
    risk_level: high

default:
  primary: tier-balanced
  fallback:
    - tier-fast
tier-* ở đây là tên model tier nội bộ của gateway, không phải model ID thật của provider. Trong production, Model Registry thường ánh xạ tier-fast, tier-balanced, tier-flagship tới model cụ thể hiện đang khả dụng, đồng thời ghi cả “model tier” và “model name thực tế” vào log. Khi model nâng cấp, chỉ cần sửa registry và gray-release config, không phải sửa business routing rule.
Khi quyết định routing, Gateway tối thiểu phải xem các yếu tố sau:
| Yếu tố | Tác dụng |
|---|---|
scene | Business scenario, quyết định model mặc định và risk level |
| Input Token | Xác định có vượt context window hoặc budget của model không |
| Output length | Kiểm soát cost và latency |
| User package | Free user và enterprise user có thể dùng model khác nhau |
| Risk level | Task rủi ro cao bắt buộc dùng compliance model hoặc human review |
| Model state hiện tại | Chuyển đi khi provider bất thường, 429 hoặc P95 latency tăng |
| Quality lịch sử | Giảm weight khi model liên tục thất bại ở một loại task |
Một router đơn giản có thể viết như sau:
public class RuleBasedModelRouter {

    private final RouteConfigRepository routeConfigRepository;
    private final ModelHealthService modelHealthService;

    public ModelRoute route(LLMRequest request, TokenBudget budget) {
        RoutePolicy policy = routeConfigRepository.findByScene(request.scene())
                .orElseGet(routeConfigRepository::defaultPolicy);

        for (String model : policy.candidates()) {
            if (!budget.fits(model)) {
                continue;
            }
            if (!modelHealthService.isAvailable(model)) {
                continue;
            }
            return ModelRoute.of(model, policy.providerOf(model), policy);
        }

        throw new NoAvailableModelException(request.scene());
    }
}
Đoạn code này không phức tạp, trọng tâm nằm ở ranh giới trách nhiệm: router chỉ chọn model, không gọi model; health check chỉ cung cấp state, không trộn business logic; budget check được tách riêng để sau này dễ thay cách ước tính.

Graceful degradation
Fallback không đơn giản là thất bại thì đổi model khác rồi thử lại.
Trước hết cần phân biệt loại error.
| Loại error | Có phù hợp Fallback không | Cách xử lý |
|---|---|---|
| Network gián đoạn tức thời | Phù hợp | Retry ngắn rồi chuyển backup model |
| Provider 5xx | Phù hợp | Retry + circuit breaker + chuyển provider |
| Giới hạn lưu lượng 429 | Phù hợp nhưng cần thận trọng | Đọc Retry-After, khi cần thì xếp hàng hoặc đổi model |
| Vượt context | Không phù hợp để retry trực tiếp | Nén context, giảm đoạn truy xuất hoặc đổi model có context dài hơn |
| Parameter error | Không phù hợp | Sửa request, không gửi lại provider |
| Security refusal | Thường không phù hợp | Chuyển vào business refusal hoặc quy trình human |
| Structured parsing thất bại | Có thể repair có giới hạn | Retry trong cùng Schema, sửa format hoặc báo thất bại rõ ràng |
“Chuyển backup model” trong bảng có nghĩa Gateway tạo một call attempt mới, không phải để generic retry callback tùy ý đổi client sau exception. Khi một request đã thực hiện write operation, tool call hoặc trừ phí, trước hết phải xác nhận step đó có thể replay hay không; khi streaming output đã gửi cho user, cũng không thể nối trực tiếp các fragment của hai model thành một kết quả.
Streaming call còn phải xử lý riêng việc user cancel, TTFT timeout, connection disconnect và client reconnect. Gateway cần lưu state, sequence number và termination reason của streaming response, tránh ghi request mất kết nối thành thành công, cũng không trả lặp các fragment đã gửi sau khi reconnect.

Một Fallback chain có thể viết như sau:
Model ưu tiên khả dụng -> gọi bình thường
Model ưu tiên trả 429 -> đọc thông tin giới hạn lưu lượng -> chuyển backup model cùng tier
Backup model cũng không khả dụng -> chuyển model nhẹ và rút ngắn output
Vẫn không khả dụng -> xếp hàng, trả degraded prompt hoặc chuyển human
Các request có side effect như lưu report vào database, thực thi tool và trừ phí phải thiết kế Fallback cùng cơ chế idempotency. Text generation thuần túy tuy không thay đổi business state, nhưng gọi lặp vẫn phát sinh cost và content khác phiên bản; vì vậy mỗi attempt đều nên được ghi nhận và quyết định reuse result theo scenario.
Ngữ nghĩa sau degradation cũng phải nhìn thấy được. Với task rủi ro cao như legal review, nếu từ strong model chuyển sang model chi phí thấp thì phải đánh dấu và đưa vào review; khi không có candidate nào đáp ứng quality constraint, trả “Hệ thống hiện đang bận, vui lòng thử lại sau” phù hợp hơn âm thầm trả về kết luận chất lượng thấp.
Idempotency record không thể chỉ lưu một cờ “đã xử lý”. Với scenario cần reuse result, có thể lưu LLMResponse cuối cùng, nhưng key và value đều phải gắn với request semantic, chẳng hạn tenant_id + scene + idempotency_key + request_fingerprint, đồng thời ghi phiên bản Prompt/routing policy và expiration time. Khi cùng idempotency key nhưng request fingerprint khác nhau, phải từ chối reuse để tránh trả cho user historical result của request khác.
Concurrent request còn cần atomic reservation. Có thể dùng unique constraint của database, conditional update hoặc Redis SET NX để tạo record running; chỉ request claim thành công mới được gọi model, request khác chờ, trả conflict hoặc reuse result completed. Cần định nghĩa rõ failed, running timeout và lease takeover, không thể dùng “check trước, write sau” để thực hiện idempotency. Log và cache cũng phải tuân thủ tenant isolation, sensitive data và retention policy.

Giới hạn lưu lượng và quota
LLM API vẫn có thể giới hạn theo QPS, RPM và số request concurrent, nhưng chỉ nhìn số request là chưa đủ.
Hai request đều là một lần gọi, nhưng cost có thể chênh nhau hàng chục lần:
- Request A: input 500 Token, output 100 Token.
- Request B: input 80K Token, output 8K Token.
Nếu chỉ nhìn số request thì B và A giống nhau. Nhưng với provider quota, bill và latency, chúng hoàn toàn khác cấp độ.
LLM Gateway thường phải giới hạn ở các tầng sau.
| Chiều giới hạn | Đối tượng kiểm soát | Vấn đề giải quyết |
|---|---|---|
| User level | Request của từng user | Chống lạm dụng, chống script spam interface |
| Tenant level | Budget của team | Kiểm soát cost, tách package |
| Model level | Một model | Tránh model hot bị dùng hết capacity |
| Provider level | OpenAI / Anthropic / DeepSeek, v.v. | Tránh external dependency kéo sập system |
| Token level | Input/output Token | Kiểm soát cost thực và áp lực quota |
Cách vững chắc hơn là: trước khi gửi request đến provider, hãy trừ budget trước.
public record TokenBudget(
        int estimatedInputTokens,
        int reservedOutputTokens,
        int totalReservedTokens
) {
}

public interface LLMRateLimiter {

    RateLimitPermit acquire(String tenantId, String userId, String model, TokenBudget budget);

    void reconcile(RateLimitPermit permit, TokenUsage actualUsage);

    void release(RateLimitPermit permit);
}
Sau khi vào Gateway, trước tiên ước tính input_tokens + reserved_output_tokens. Nếu user bucket, tenant bucket, model bucket và provider bucket đều còn đủ thì mới gửi request. Nếu không đủ thì xếp hàng, degradation hoặc từ chối.
Budget phải được reserve và settle theo từng attempt. Khi main model timeout hoặc mất kết nối, có thể đã phát sinh Token, không thể release toàn bộ quota ngay; khi chuyển backup model, còn phải reserve lại theo provider và price tier của backup. Sau khi provider trả usage thì gọi reconcile; nếu tạm thời chưa lấy được usage, ghi nợ theo giá trị bảo thủ rồi sửa qua bill hoặc reconciliation bất đồng bộ.
Token estimation không thể hoàn toàn chính xác, nhưng ước tính sơ bộ vẫn tốt hơn không ước tính. Đặc biệt với RAG, context dài và Agent tool call, không làm budget rất dễ mất kiểm soát.
Ở đây nên đi theo bốn bước: estimate → reserve → actual usage → reconcile. Trước hết chiếm budget bằng giá trị ước tính, sau khi call kết thúc thì đối soát và sửa bằng usage thực tế do provider trả về. Tokenizer và usage field của các provider, model khác nhau không hoàn toàn giống nhau; production thường dùng unified approximation để trừ budget trước, rồi dùng input_tokens, output_tokens thực tế để sửa. Nếu ghi nhận theo giá trị ước tính trực tiếp, cost và quota statistic rất dễ tích lũy sai lệch sau thời gian dài.

Thống kê chi phí
Nhiều team nói muốn “giảm cost LLM”, nhưng ngay cả tiền đã tiêu ở đâu cũng không biết.
Đó không phải optimization, mà là đoán.
LLM Gateway phải ghi các field cost attribution của mỗi call.
| Field | Mô tả |
|---|---|
request_id | ID duy nhất của một business request |
attempt_id | Một lần thử gọi model; Fallback hoặc retry sẽ tạo nhiều attempt |
tenant_id | Tenant hoặc team |
user_id | User |
scene | Business scenario, như customer service, summary, code generation |
prompt_version | Phiên bản Prompt |
provider | Provider |
model_tier | Model tier nội bộ được routing chọn |
model | Model thực tế được gọi |
input_tokens | Input Token |
output_tokens | Output Token |
cached_tokens | Token trúng Prompt cache hoặc cache của provider |
cost | Cost tính theo price snapshot |
price_version | Price version hoặc thời điểm hiệu lực dùng để tính cost |
latency_ms | Tổng latency |
ttft_ms | Latency đến Token đầu tiên |
fallback_used | Có xảy ra Fallback hay không |
error_code | Loại error |
Cost thường được tính theo price snapshot: input_tokens × đơn giá input + output_tokens × đơn giá output, sau đó cộng phí ghi cache, đọc cache hoặc các khoản provider tính thêm. Vì vậy cached_tokens không thể chỉ xem là input Token thông thường; phải giải thích cùng model và price version mới khôi phục được số tiền của một call.
Các field này có thể truy ngược bill về quyết định cụ thể: khi cost của tenant hoặc feature tăng đột biến, trước hết xem Token, Prompt version và model tier; khi một Fallback xảy ra tập trung, xem provider, candidate và error code tại thời điểm đó; sau khi model nâng cấp, so sánh quality, latency và cost của cùng một scenario.
Price table, cache discount và khoản provider tính phí sẽ thay đổi, nên cost record không thể chỉ lưu cost. Chi tiết usage, price version và thời điểm tính phải được lưu cùng mỗi call, khi bill có chênh lệch mới biết dùng rule nào để tính lại. Việc điều chỉnh routing về sau cũng nên dựa trên các call record và failure sample này.
Observability và audit
Khi system truyền thống gặp vấn đề, ta xem log, Trace và metric. AI system cũng vậy, chỉ là cần ghi thêm một số field liên quan đến model.
Các sản phẩm như Cloudflare AI Gateway, LiteLLM và Kong AI Gateway đều đặt log, Token, cost, error, latency, cache và giới hạn lưu lượng ở vị trí nổi bật. Khi AI application gặp vấn đề, nếu chỉ ghi answer cuối cùng thì gần như không thể replay.
Trace của một model call tối thiểu nên như sau:
{
  "request_id": "req_202605210001",
  "attempt_id": "att_01",
  "tenant_id": "team_java",
  "user_id": "u_1024",
  "scene": "knowledge_qa",
  "prompt_version": "rag_qa_v7",
  "provider": "openai",
  "model_tier": "tier-balanced",
  "model": "provider-model-id",
  "route_reason": "scene=knowledge_qa,cost_priority=true",
  "input_tokens": 4210,
  "output_tokens": 612,
  "cost": 0.0059,
  "ttft_ms": 680,
  "latency_ms": 4120,
  "fallback_used": false,
  "finish_reason": "stop"
}request_id, model, route reason và usage đủ để hỗ trợ phần lớn aggregate troubleshooting; Prompt và answer đầy đủ có thể chứa personal information, enterprise document, internal code hoặc contract clause. Không thể mặc định lưu toàn bộ original text dài hạn trong log; data classification, processing purpose, contract, applicable regulation và troubleshooting need phải cùng quyết định. Các sản phẩm như Cloudflare AI Gateway đã biến việc thu thập request/response body thành option cấu hình được; system tự xây cũng nên đưa việc này vào policy thay vì hard-code trong log code.
Metadata cũng phải có thời hạn rõ ràng. usage, model, latency, cost, route_reason và error code cũng có thể liên quan đến user hoặc tenant. Khi cần lưu sample Prompt hoặc response, hãy kiểm soát tỷ lệ và thời lượng theo data level, tenant authorization và thời hạn ngắn nhất cần thiết; phone number, identity card, bank card, email và address phải được mask ở entry point trước khi đi vào log chain. Ngoài retention switch, còn cần access control, encryption, export, deletion và legal hold mechanism, đồng thời ghi lại processing purpose và deletion result của từng loại data.
Cache và semantic cache
Cache chỉ tiết kiệm cost khi answer có thể reuse. Nếu request chứa permission, real-time state, private context hoặc nội dung cần professional judgment, phải bypass cache hoặc dùng key được isolation nghiêm ngặt.
| Loại cache | Cách làm | Scenario phù hợp | Rủi ro |
|---|---|---|---|
| Exact cache | Trả old result khi request hoàn toàn giống nhau | FAQ, fixed explanation, repeated test | Dễ sai trong scenario personalization và permission |
| OpenAI Prompt Caching | Tự động hit cache với stable long prefix | Long system prompt, stable tool Schema | Model hỗ trợ, threshold và discount căn cứ tài liệu chính thức và price table |
| Anthropic Prompt Caching | Đánh dấu block có thể cache bằng cache_control | Long system prompt, large document, multi-turn Agent | Quy tắc tính phí write/read phải đối chiếu price table hiện tại |
| Gemini Context Caching | Reuse context dài qua cơ chế cached content | Long document, video, codebase, multi-turn QA | Phải quản lý cache object, TTL, storage cost và invalidation |
| Semantic cache | Reuse old answer cho câu hỏi semantic tương tự | Customer-service FAQ, product explanation, low-risk QA | Tương tự không đồng nghĩa giống nhau, dễ trả lời lệch |
| Result fragment cache | Cache intermediate summary, retrieval result và tool result | Long-document summary, batch processing | Invalidation và version management phức tạp |
Các câu hỏi như customer-service FAQ rất phù hợp để cache: “Làm thế nào để đổi mật khẩu?”, “Tải hóa đơn ở đâu?” và “Hoàn tiền hội viên thế nào?”. Các answer này ổn định, ít personalization, lợi ích cache rõ ràng.
Các vấn đề có user permission, real-time state, tư vấn tài chính/y tế/pháp lý, private multi-turn conversation và phụ thuộc thời gian hiện tại, order hoặc inventory state không phù hợp để trực tiếp reuse generic answer.
Key của semantic cache tối thiểu phải isolation theo tenant, permission scope, data version, scenario và Prompt version; vector similarity chỉ có thể làm điều kiện candidate hit, không thể thay thế các ranh giới này. “Vì sao order của tôi chưa giao?” và “Order của tôi có thể refund không?” có thể gần nhau trong vector space, nhưng một câu cần giải thích trạng thái logistics, câu kia liên quan after-sales policy; hit nhầm sẽ đưa user vào sai flow. Hit rate nên được xem cùng business validation, complaint rate hoặc human-transfer rate.
Prompt cache cũng không phải bật lên là có lời. Explicit cache thường phải phân biệt write và read; automatic cache cũng chịu ảnh hưởng của model được hỗ trợ, prefix length tối thiểu và thay đổi price table. Nếu system prompt, tool Schema hoặc context mỗi lần đều kèm timestamp, random ID hay temporary user state, prefix luôn thay đổi, cache hit rate không tăng, hiệu quả cost sẽ rất kém. Đặt stable content ở trước và dynamic content ở sau là nguyên tắc cấu trúc Prompt quan trọng nhất khi dùng provider cache.
Nếu được yêu cầu thiết kế LLM Gateway, bạn sẽ làm thế nào?
Production-grade LLM Gateway trông như thế nào?
Khi thiết kế LLM Gateway, có thể trước tiên tách thành các component sau:
| Component | Trách nhiệm |
|---|---|
| API Adapter | Public unified API, tương thích request phong cách OpenAI hoặc internal standard request |
| Auth / Tenant | Authentication, nhận diện tenant, kiểm tra package và permission |
| Prompt Renderer | Render Prompt template, ghi Prompt version |
| Token Budget Estimator | Ước tính input/output Token, xác định có vượt budget không |
| Model Registry | Quản lý capability, price, context, provider và state của model |
| Router | Chọn model theo scenario, budget, latency và risk |
| Provider Adapter | Thích ứng khác biệt protocol của từng bên qua unified ProviderClient, gồm tool call, streaming event, usage và error code |
| Retry / Fallback | Retry, degradation và circuit breaker theo loại error |
| Rate Limiter | Giới hạn đa chiều theo user, tenant, model, provider và Token |
| Cost Tracker | Ghi usage, tính cost và attribution theo tenant, scenario |
| Observability | Xuất metric, log, Trace và alert |
| Audit Log | Audit request quan trọng, hỗ trợ mask, retention và replay |
Phiên bản đầu hãy hoàn thành unified API, Provider Adapter cùng log usage, cost, error và latency trước. Sau khi call record đủ ổn định, mới thêm rule routing, Fallback, Token budget và tenant quota; quality replay, audit và classification routing phải xây dựng trên các data này. Cách này giúp trước tiên xác nhận lời gọi model đã được tập trung đúng, rồi mới đánh giá routing complexity mới có đáng duy trì hay không.
Gateway chạy bên trong thế nào sau khi request đi vào?
Sau khi request vào Gateway, trước tiên hoàn tất authentication và nhận diện tenant để có được feature, package và budget boundary được phép sử dụng; tiếp đó xác định scene từ interface parameter hoặc lightweight classifier, render Prompt version, context và tool Schema tương ứng.
Token estimation và routing diễn ra ngay sau đó. Gateway reserve input và maximum output Token cho candidate model, xin quota theo các chiều user, tenant, model và provider; sau khi routing result được cố định, Provider Adapter thực hiện synchronous hoặc streaming call. Text, structured JSON, tool call, usage và finish reason trong response đều phải gắn với attempt này.
Khi xảy ra network error, 429 hoặc parsing failure, error classification quyết định retry, chuyển candidate, xếp hàng hay thất bại trực tiếp. Mỗi attempt mới đều reserve budget lại; sau khi call kết thúc thì settle theo usage thực tế, ghi model, provider, Prompt version, route reason, latency và error information, cuối cùng mới trả unified result về business service.

Routing policy tiến hóa từ đơn giản đến thông minh thế nào?
Không nên làm routing policy một bước là xong. Fixed rule, cascade routing, semantic/classification routing, learning-based routing, personalized routing và Agentic routing được nhắc ở trên thực ra tương ứng với một lộ trình tiến hóa, không phải checklist “phiên bản đầu phải làm tất cả”.
Nhịp độ vững chắc hơn là: trước hết làm system có thể kiểm soát, sau đó làm system tiết kiệm, cuối cùng mới làm system thông minh.
| Giai đoạn | Strategy tương ứng | Năng lực trọng tâm | Tín hiệu để sang giai đoạn tiếp |
|---|---|---|---|
| Giai đoạn một | Fixed model + manual config | Tập trung lời gọi model, tránh SDK rải rác | Nhiều scenario bắt đầu dùng chung model, chênh lệch cost và latency rõ rệt |
| Giai đoạn hai | Fixed-rule routing | Chọn model theo scenario, tenant và risk level | Rule ngày càng nhiều, bảo trì thủ công bắt đầu khó khăn |
| Giai đoạn ba | Cost-first / cascade routing | Thử small model trước, thất bại hoặc confidence thấp thì nâng cấp | Có quality validation ổn định và extra latency chấp nhận được |
| Giai đoạn bốn | Semantic / classification routing | Routing theo query type, độ phức tạp và risk | Có đủ request sample để đánh giá classifier drift |
| Giai đoạn năm | Quality feedback + cost regression | Replay quality và cost benefit của model bằng trace | Có evaluation set, human sampling hoặc business feedback loop |
| Giai đoạn sáu | Learning-based / personalized / Agentic | Chọn model động, thậm chí đổi model theo từng step | Traffic lớn, nhiều task, nhiều model và có evaluation system liên tục |
Trước khi sang giai đoạn tiếp theo, phải dùng tín hiệu trong bảng để xác nhận complexity tăng thêm thực sự đem lại lợi ích, đồng thời giữ fixed rule làm đường rollback. Classification routing cần monitor misrouting và threshold drift; learning-based hoặc Agentic routing còn cần evaluation set ổn định, online Trace, cost ceiling và privacy control.
Nếu routing sai thì làm gì?
Routing chắc chắn sẽ sai.
Mọi routing policy đều có thể phán đoán nhầm. Production system phải có entry point để phát hiện, fallback và replay các lỗi này.
Các cách fallback thường gặp:
| Vấn đề | Cách fallback |
|---|---|
| Classifier confidence thấp | Dùng default medium-strong model hoặc yêu cầu user làm rõ |
| Output của small model chất lượng thấp | Tự động retry bằng strong model |
| Task rủi ro cao bị route vào low-risk path | Risk rule có priority cao hơn cost rule |
| Chất lượng drift sau khi model mới ra mắt | Gray release, A/B, fixed evaluation set regression |
| User phàn nàn answer sai | Replay Prompt, model, context và route reason bằng request_id |
| P95 latency của một model tăng | Health check giảm weight hoặc tạm circuit break |
“Tự động retry bằng strong model” chỉ phù hợp với request không có side effect và có thể replay. Agent có tool call phải persist tool result của vòng hiện tại trước hoặc xác định bỏ execution này; nếu không, model sau khi nâng cấp có thể gọi tool lặp, khiến state và cost đều không nhất quán.
Ngoài model name, routing log còn phải ghi route_reason, nếu không sẽ không thể khôi phục cơ sở của lựa chọn này.
Ví dụ:
{
  "scene": "intent_classification",
  "selected_model_tier": "tier-fast",
  "selected_model": "provider-model-id",
  "route_reason": "scene_rule:low_risk,cost_priority,estimated_tokens=320",
  "confidence": 0.91,
  "fallback_candidates": ["tier-nano", "tier-balanced"]
}
Không có route_reason, về sau routing system sẽ rất khó tuning.
Chọn giải pháp phổ biến thế nào?
Chọn self-built, LiteLLM, Cloudflare AI Gateway, Kong AI Gateway hay Inworld Router thế nào?
Hiện có rất nhiều giải pháp LLM Gateway / Router, đừng chỉ nhìn “hỗ trợ bao nhiêu model”. Khi lựa chọn, trước hết hãy xem team dùng tech stack nào, yêu cầu compliance mạnh đến đâu, traffic lớn cỡ nào, có cần self-host không, đã có API Gateway chưa và có cần observability chuyên sâu không.
| Giải pháp | Ưu thế chính | Scenario phù hợp | Scenario không phù hợp |
|---|---|---|---|
| Lightweight self-built gateway | Có thể kiểm soát, sát business, kết hợp sâu với permission, billing và audit nội bộ | Có năng lực backend, requirement rõ, muốn tiến hóa dần từ rule routing | Muốn nhanh chóng tích hợp nhiều provider hoặc thiếu năng lực bảo trì gateway |
| LiteLLM | Tích hợp nhiều provider, OpenAI-compatible format, hệ sinh thái Proxy / SDK trưởng thành | Platform team, tích hợp nhanh, thử nghiệm đa model, unified entry point | Scenario compliance nghiêm ngặt hoặc enterprise governance sâu cần cải tạo thêm; production cần chú ý version pinning và supply-chain security |
| Cloudflare AI Gateway | Managed entry point, log analysis, cache, giới hạn lưu lượng, retry, dynamic routing, DLP, BYOK và các năng lực khác | Đã dùng Cloudflare, muốn nhanh chóng có observability, cache và unified entry point | Self-host mạnh, private deployment, enterprise governance phức tạp |
| Kong AI Gateway | Enterprise API governance mạnh, plugin system trưởng thành, kết hợp được authentication, giới hạn lưu lượng, PII masking và cost governance | Đã có Kong infrastructure hoặc cần đưa AI request vào enterprise API Gateway system | Early project của team nhỏ hoặc không muốn đưa vào toàn bộ API Gateway system |
| Inworld Router | Conditional routing, traffic splitting, experiment và sticky user assignment | Real-time voice, conversational AI, AI coding tool, user segmentation và A/B test | Scenario cần open-source audit source, private deployment hoặc enterprise SLA rõ ràng cần xác nhận riêng |
| Research project kiểu LLMRouter / RouteLLM | Routing algorithm phong phú, phù hợp validation complexity routing và cân bằng cost-quality | Research, experiment, offline evaluation, validation routing policy | Dùng trực tiếp làm production Gateway, vì còn phải bổ sung authentication, billing, audit, giới hạn lưu lượng, observability và high availability |
LiteLLM chủ yếu giải quyết vấn đề tích hợp lặp lại SDK của nhiều model. Business dùng thống nhất OpenAI-compatible interface, Proxy phụ trách kết nối các provider khác nhau, đồng thời quản lý tập trung Key, budget, permission, log và routing. Nó phù hợp với team muốn nhanh chóng tích hợp nhiều model provider nhưng không muốn tự phát triển adaptation layer.
Cần chú ý Proxy sẽ lưu provider secret, mọi model request cũng đi qua nó. Production phải pin dependency và image version, thực hiện upgrade test, vulnerability scan và secret rotation, không dùng image latest trong thời gian dài.
Cloudflare AI Gateway phù hợp hơn với team đã dùng Cloudflare. Không cần sửa nhiều request chain, có thể thêm log, cache, giới hạn lưu lượng, retry và Fallback, đồng thời hỗ trợ dynamic routing, BYOK và DLP scan.
Việc chọn model cụ thể vẫn phải do business tự quyết định. Nếu data, network và audit bắt buộc phải hoàn toàn tự kiểm soát, trước khi tích hợp cần xác nhận managed method của Cloudflare có phù hợp hay không.
Kong AI Gateway phù hợp với team đã dùng Kong hoặc chuẩn bị xây dựng API Gateway thống nhất. Có thể reuse trực tiếp năng lực authentication, giới hạn lưu lượng, audit, security và monitoring sẵn có, sau đó dùng AI plugin để thực hiện model transformation, routing và load balancing.
Với team nhỏ, Kong có thể hơi nặng. Một số AI plugin nâng cao còn cần enterprise authorization; khi chọn cần tính cả chi phí authorization, deploy và vận hành.
Inworld Router thiên về routing thời gian thực và A/B experiment. Nó có thể chọn model theo giá, tốc độ, năng lực model hoặc loại user, đồng thời so sánh quality, retention và cost của các model và Prompt khác nhau.
Inworld Router phù hợp với real-time conversation, voice interaction và AI coding tool. Tuy nhiên, đây là managed service; nếu liên quan đến private deployment, giới hạn dữ liệu, SLA hoặc ngân sách mua dịch vụ, cần đối chiếu tài liệu chính thức và điều khoản thương mại mới nhất.
LLMRouter phù hợp hơn với nghiên cứu và đánh giá routing algorithm, hỗ trợ KNN, SVM, MLP, Elo, Graph, personalization, multi-round và Agentic Router.
Không thể dùng trực tiếp LLMRouter làm production Gateway. Cần tự bổ sung permission, quota, billing, audit, rate limiting và vận hành. Nếu không có evaluation set ổn định và trace online, cũng khó chứng minh algorithm phức tạp tốt hơn rule-based routing.
Gợi ý lựa chọn
Nếu business mới bắt đầu, hãy làm lightweight self-built Gateway trước. Đừng ngay lập tức mua platform nặng; trước tiên tập trung lời gọi model, tối thiểu hoàn thành log, usage, Token budget và Fallback.
Nếu cần nhanh chóng tích hợp nhiều model và provider, ưu tiên xem các unified interface trưởng thành như LiteLLM. Nó giúp team nhanh chóng chuyển từ “viết SDK khắp nơi” sang “unified entry point”.
Nếu enterprise đã dùng Kong, có thể cân nhắc Kong AI Gateway. Giá trị của nó nằm ở việc đưa AI traffic vào API governance system hiện có.
Nếu đã sử dụng Cloudflare sâu, có thể dùng Cloudflare AI Gateway để bổ sung observability, cache, giới hạn lưu lượng và unified entry point trước.
Nếu muốn làm smart routing, hãy chuẩn bị evaluation set và online trace trước rồi mới bàn đến learning-based strategy như LLMRouter. Không có data, routing algorithm càng phức tạp càng khó giải thích.
Đừng đảo ngược thứ tự: trước hết giải quyết engineering governance, sau đó mới theo đuổi smart routing.
Đánh giá LLM Gateway hiệu quả đến đâu?
Không thể đánh giá LLM Gateway tốt hay không chỉ bằng “đã tích hợp bao nhiêu model”. Tích hợp nhiều model chỉ cho thấy adaptation layer viết nhiều, không cho thấy production chain ổn định.
Các metric như routing hit rate, quality pass rate, Fallback rate, cost và latency cần được thống kê riêng theo scenario, model tier và provider.
| Metric | Ý nghĩa |
|---|---|
| Routing hit rate | Request có đi vào model hoặc model tier dự kiến không |
| Quality pass rate | Output có vượt evaluation, human sampling hoặc business validation không |
| Fallback rate | Main path có ổn định không, backup path có thường xuyên bị kích hoạt không |
| Average cost | Cost của mỗi request hoặc business scenario |
| P95 latency | User experience, đặc biệt trong online interaction và voice scenario |
| TTFT | Latency đến Token đầu tiên, ảnh hưởng streaming experience |
| 429 rate | Áp lực giới hạn lưu lượng của provider |
| Cache hit rate | Request và Token được cache tiết kiệm |
| Structured parsing failure rate | Schema, Prompt và model adaptation có ổn định không |
| Routing drift | Sau khi model nâng cấp hoặc traffic thay đổi, routing policy cũ có mất hiệu lực không |
Điểm dễ bị bỏ qua nhất ở đây là “routing drift”.
Model capability không tĩnh. Một model rẻ hôm nay không phù hợp với summary phức tạp, nhưng sau khi nâng cấp ba tháng sau có thể đã đủ dùng. Ngược lại, model vốn ổn định cũng có thể kém đi ở một loại formatting task sau khi nâng cấp.
Vì vậy routing rule không thể viết xong rồi bỏ đó. Nó phải có version như Prompt và được regression test như code.
Tổng kết
LLM Gateway giúp business service rút khỏi provider protocol, model routing, giới hạn lưu lượng, cache, Token budget và chi tiết audit, chỉ giữ lại một unified entry point để gọi model.
Nhưng với phần lớn project, entry point này hoàn toàn có thể là một module nhẹ tự viết trong application, không cần đưa thêm component chỉ vì “đã dùng LLM Gateway”. Nền tảng phỏng vấn AI của tôi hiện làm như vậy: trước tiên dùng unified Provider registry và call wrapper để giải quyết vấn đề trước mắt, sau đó dựa trên traffic thực và governance requirement để quyết định có bổ sung routing, budget, Fallback, cost statistics hay tiến hóa thành gateway độc lập hay không.
Phiên bản đầu hãy xác minh ba việc: request có được adaptation đúng không, mỗi call có thể replay theo model thực tế và usage không, sự cố có fallback đúng kỳ vọng không. Quota, cost governance và cache nên do traffic thực thúc đẩy; classification hoặc learning-based routing chỉ nên đưa vào sau khi có evaluation set ổn định, online Trace và cơ chế rollback.
Sau khi model version và price thay đổi, cũng phải đánh giá lại quality, latency và cost của cùng một routing rule.
Tài liệu tham khảo
- LiteLLM Docs
- LiteLLM Security Update: Suspected Supply Chain Incident
- Cloudflare AI Gateway Docs
- Cloudflare AI Gateway Request Handling
- Cloudflare AI Gateway Fallbacks
- Cloudflare AI Gateway DLP
- Cloudflare AI Gateway BYOK
- Kong AI Gateway Docs
- Inworld Router Docs
- LLMRouter GitHub Repository
- OpenAI Prompt Caching
- Anthropic Prompt Caching
- Gemini Context Caching