
Khái niệm cơ bản về RAG: truy xuất, sinh và đánh đổi trong engineering
Khi xây dựng hệ thống hỏi đáp dựa trên knowledge base của doanh nghiệp, phản ứng đầu tiên của nhiều team là: nhét toàn bộ tài liệu cho LLM, để nó tự đọc.
Khi tài liệu còn ít, cách này quả thực có thể chạy. Nhưng khi knowledge base tăng lên đến hàng trăm nghìn chữ, vấn đề nhanh chóng xuất hiện: mỗi request đều có thể chạm giới hạn Token, còn nội dung vừa cập nhật thì model chưa chắc đã biết. Thực tế hơn, tài liệu doanh nghiệp còn phải xét đến quyền hạn, khả năng truy xuất nguồn, chi phí và latency, không thể cứ "nhét tất cả vào" mà xử lý.
RAG sẽ truy xuất nội dung liên quan từ knowledge base trước khi model trả lời, rồi đưa nội dung đó cho model để câu trả lời dựa nhiều nhất có thể trên evidence có thể kiểm tra. Chỉ cần một khâu trong truy xuất, tổ chức context hoặc sinh kết quả gặp lỗi, câu trả lời cuối cùng đều có thể lệch khỏi tài liệu gốc.
RAG là gì?
RAG (Retrieval-Augmented Generation) là cách kết hợp information retrieval với LLM. Hệ thống trước hết truy xuất các đoạn liên quan đến câu hỏi hiện tại từ knowledge base. Knowledge base có thể là database, tập tài liệu hoặc hệ thống nội bộ của doanh nghiệp. Sau đó, hệ thống đưa các đoạn này cùng câu hỏi gốc vào LLM, để model trả lời dựa trên nội dung đã truy xuất thay vì chỉ dựa vào kiến thức ghi nhớ trong quá trình training.

Vì sao cần RAG?
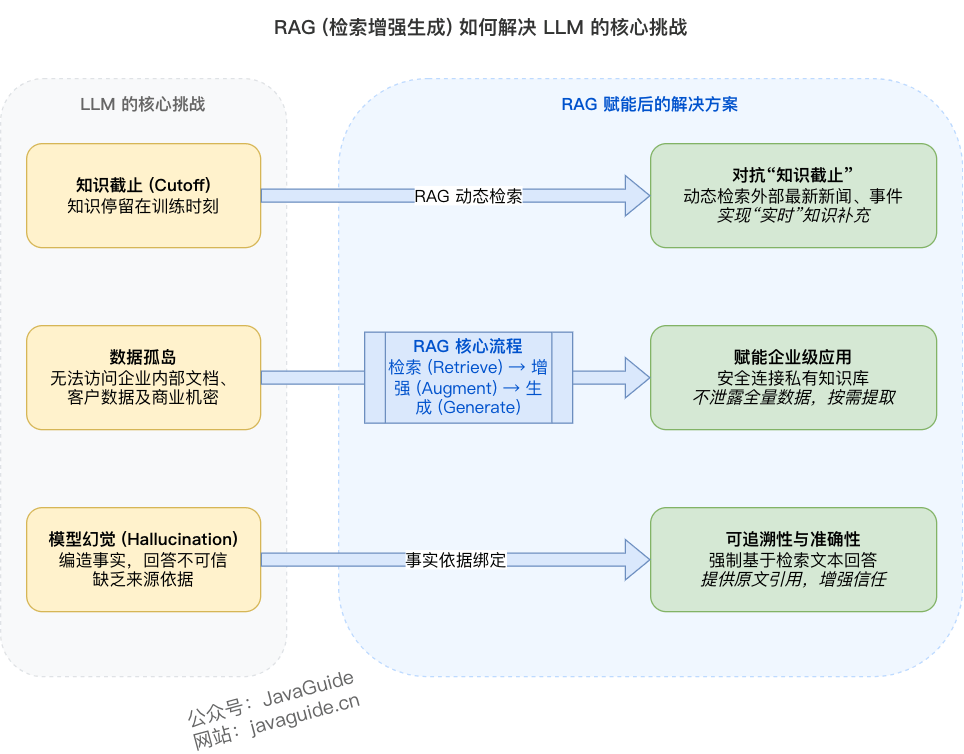
Dù dữ liệu training của LLM lớn đến đâu, vẫn không thể tránh một số vấn đề. RAG có thể bù đắp đúng những điểm này.
Thứ nhất là tính cập nhật của knowledge.
Knowledge của pre-trained model dừng ở thời điểm dữ liệu training kết thúc. Các sự kiện, chính sách mới và tài liệu sản phẩm xuất hiện sau training mặc định đều nằm ngoài knowledge của model, trừ khi model được bổ sung qua kết nối Internet, tool calling hoặc nguồn knowledge bên ngoài. RAG truy xuất động từ external knowledge source, đưa nội dung liên quan mới nhất trực tiếp cho LLM để model không phải chỉ dựa vào knowledge cũ trong parameters.
Thứ hai là quyền truy cập dữ liệu riêng tư.
Tài liệu sản phẩm nội bộ, knowledge base và dữ liệu khách hàng của doanh nghiệp không thể để LLM công khai tùy ý truy cập. Khi người dùng hỏi, RAG chỉ trích xuất các đoạn liên quan đến câu hỏi đưa cho LLM, không cần expose toàn bộ dữ liệu mà model vẫn có thể trả lời dựa trên knowledge của doanh nghiệp.
Thứ ba là vấn đề hallucination.
Việc LLM bịa ra sự thật là vấn đề ai cũng từng gặp. Bằng cách cung cấp văn bản tham chiếu rõ ràng, RAG giúp model cố gắng trả lời dựa trên evidence và thực sự có thể giảm xác suất hallucination. Nhưng đừng kỳ vọng nó loại bỏ hoàn toàn hallucination. Truy xuất sai, nhiễu context, ghép citation sai hoặc model không tuân thủ instruction đều có thể dẫn đến câu trả lời sai. RAG production thường còn cần citation validation, answer evaluation, cơ chế từ chối trả lời và vòng lặp feedback từ con người.
RAG thường được dùng vào việc gì?
RAG phù hợp nhất với những trường hợp "câu trả lời phụ thuộc vào tài liệu bên ngoài, và tài liệu đó có thể thay đổi hoặc rất dài". RAG trước hết truy xuất nội dung liên quan từ knowledge base, sau đó để LLM tạo câu trả lời dựa trên kết quả truy xuất, qua đó giảm việc bịa thông tin và tăng khả năng truy xuất nguồn.
Các trường hợp thường gặp gồm:
- Chatbot chăm sóc khách hàng: hỏi đáp, xử lý sự cố và hướng dẫn quy trình dựa trên knowledge base sản phẩm, chẳng hạn "làm sao đổi trả hàng" hoặc "xử lý mã lỗi của một model thiết bị như thế nào".
- Copilot cho R&D / vận hành: truy xuất codebase, tài liệu API và sổ tay cảnh báo để hỗ trợ định vị vấn đề và tạo đề xuất sửa lỗi.
- Trợ lý y tế: truy xuất guideline, hướng dẫn sử dụng thuốc và quy định nội bộ bệnh viện để tạo đề xuất hỗ trợ, nhưng không đưa ra chẩn đoán cuối cùng, chẳng hạn "thuốc này có chống chỉ định gì" hoặc "giải thích ý nghĩa chỉ số xét nghiệm theo guideline".
- Tư vấn pháp lý: truy xuất dựa trên điều luật, vụ án và template hợp đồng để tạo giải thích điều khoản và cảnh báo rủi ro.
- Hỗ trợ giáo dục: truy xuất kiến thức từ giáo trình, bài giảng và ngân hàng câu hỏi để tạo phần giải thích và các bước giải bài.
- Trợ lý nội bộ doanh nghiệp: kết nối quy định, SOP, biên bản họp và tài liệu kỹ thuật để truy xuất, tổng hợp và so sánh.
- Hỗ trợ nghiên cứu đầu tư, compliance, audit và phương án bán hàng: xử lý báo cáo, thông tin công bố, kiểm soát nội bộ, sổ tay sản phẩm, template hồ sơ thầu và các tài liệu khác.
Vì sao một số doanh nghiệp vẫn thích dùng search truyền thống thay vì RAG?
Không phải vấn đề nào cũng đáng dùng RAG. Nhiều doanh nghiệp vẫn giữ search truyền thống không phải vì họ không biết RAG hữu ích, mà vì nhu cầu của người dùng vốn chưa đến bước "sinh câu trả lời".
Nếu người dùng chỉ muốn tìm bản gốc của một quy định, tài liệu API nào đó hoặc một template hợp đồng, ô search lại trực tiếp hơn. Người dùng nhập keyword, nhận danh sách tài liệu, tự mở ra xác nhận; chain ngắn, chi phí thấp và kết quả cũng dễ kiểm soát hơn. RAG phải truy xuất trước, sau đó tổ chức context rồi giao cho LLM sinh câu trả lời. Chỉ cần đi qua bước sinh là sẽ phát sinh latency, chi phí Token và rủi ro sai lệch khi tổng hợp.
Vì vậy, khi chọn search truyền thống hay RAG, trước hết hãy xem người dùng thực sự muốn gì: "giúp tôi tìm tài liệu" hay "giúp tôi đọc hết tài liệu và đưa ra kết luận".
| Khía cạnh | Search truyền thống (ô search) | RAG (retrieval + generation) |
|---|---|---|
| Mục tiêu người dùng | Tìm tài liệu, trang hoặc file đính kèm | Nhận trực tiếp câu trả lời dễ đọc, bản tổng hợp hoặc kết luận so sánh |
| Latency và chi phí | Thường thấp hơn, dễ mở rộng | Cao hơn, cần retrieval và LLM inference |
| Khả năng kiểm soát / audit | Mạnh, đưa trực tiếp link tài liệu gốc | Yếu hơn, có thể hiểu sai hoặc tổng hợp lệch; cần citation và evaluation |
| Rủi ro | Thấp, chủ yếu là vấn đề recall và ranking | Cao hơn, gồm hallucination, citation sai và rò rỉ vượt quyền |
| Data governance | Tương đối hoàn thiện, ACL và filter field đều dễ thực hiện | Phức tạp hơn, cần retrieval filter, khử dữ liệu nhạy cảm trong context và quản trị log |
| Trường hợp phù hợp | Tìm theo mã số, tiêu đề, keyword; tìm template và bản gốc quy định | Trả lời khách hàng, xử lý sự cố kỹ thuật, giải thích quy định, tổng hợp và so sánh nhiều tài liệu |
| Best practice | ES / BM25 + permission filter | Hybrid retrieval + rerank + citation provenance + permission filter + evaluation loop |
Khi triển khai thực tế, nhiều doanh nghiệp giữ đồng thời hai entry point: tìm đơn giản thì dùng search, hỏi đáp phức tạp thì dùng RAG. Cách kết hợp này thường ổn định và tiết kiệm hơn so với "giao mọi vấn đề cho RAG".
Bạn có biết nguyên lý hoạt động của RAG không?
Engineering pipeline của RAG thường gồm hai giai đoạn: offline indexing và online retrieval generation. Giai đoạn indexing xử lý tài liệu gốc thành data structure có thể truy xuất; giai đoạn online thực hiện query understanding, retrieval recall, xây dựng context và sinh câu trả lời khi người dùng đặt câu hỏi.
Sơ đồ đơn giản hóa của giai đoạn indexing và retrieval:
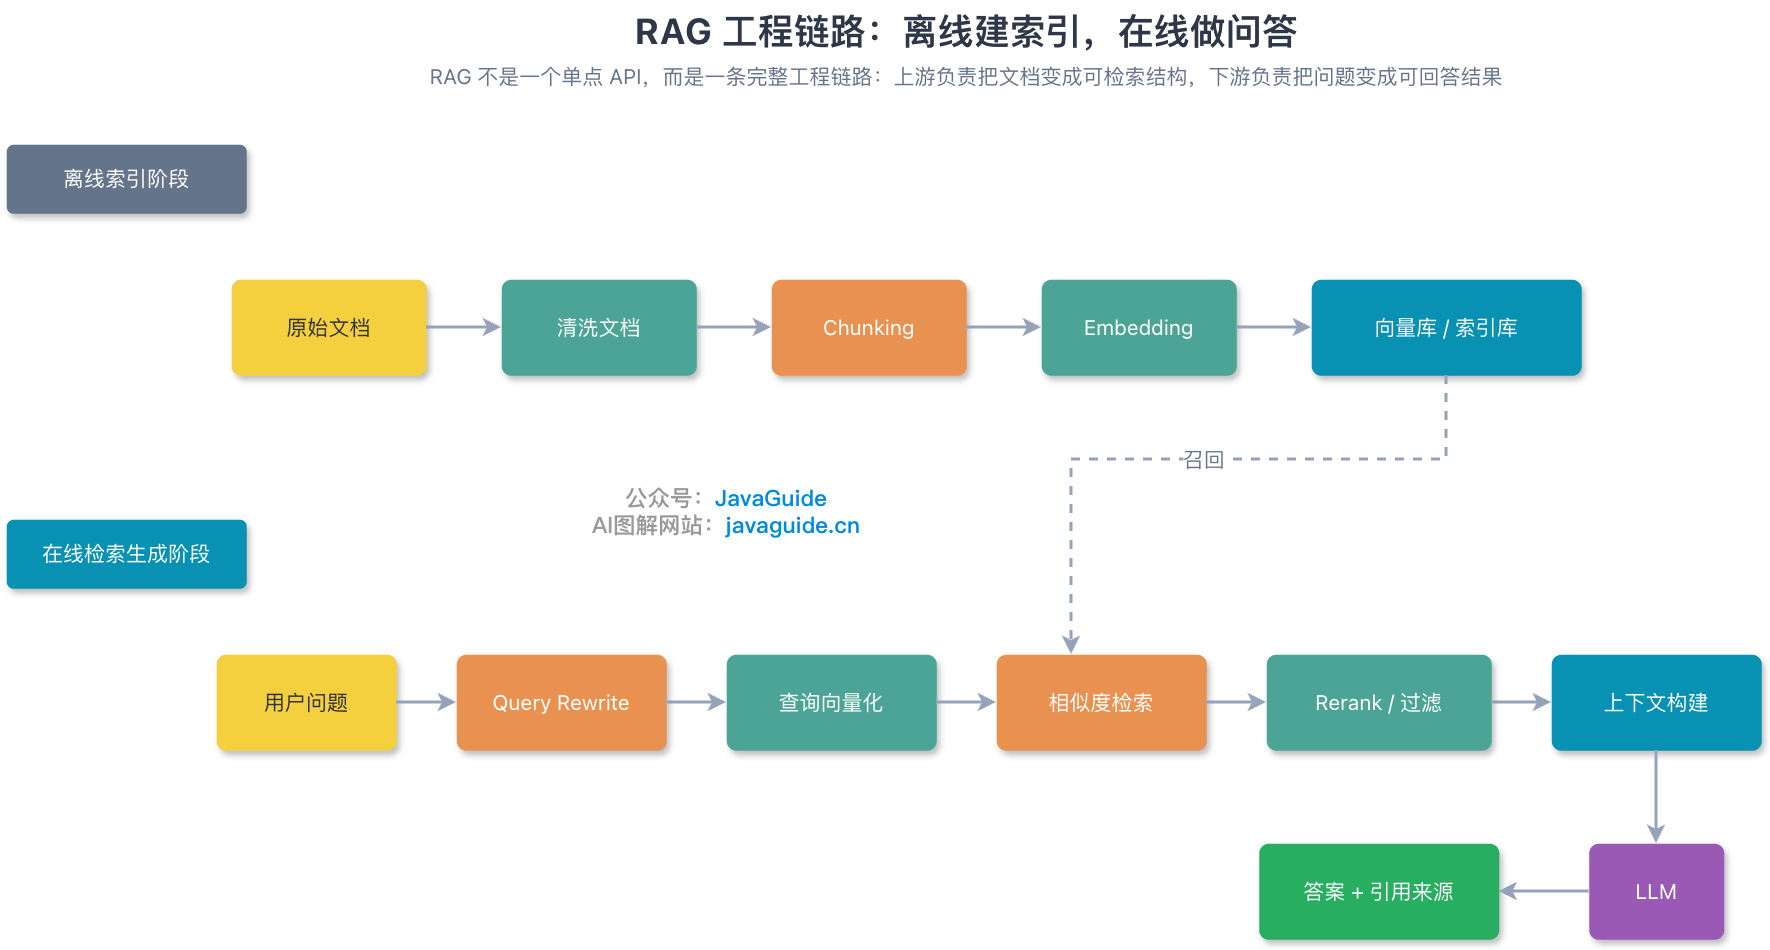
Giai đoạn indexing chủ yếu làm các việc sau:
- Nhập tài liệu: file text, PDF, webpage và record trong database đều được, miễn là có nội dung.
- Làm sạch tài liệu: loại bỏ HTML tag, ký tự đặc biệt và các noise khác.
- Tăng cường tài liệu: bổ sung metadata như timestamp và classification tag để cung cấp chiều filter cho retrieval về sau.
- Chia nhỏ tài liệu (Chunking): dùng text splitter để chia tài liệu thành các đoạn nhỏ hơn. Bước này phải cân bằng semantic completeness, độ dài input của model Embedding, context window của model generation và granularity của recall. Chunk quá lớn dễ đưa vào noise, còn quá nhỏ có thể làm mất context. Chiến lược chia nhỏ ảnh hưởng trực tiếp đến chất lượng recall; xem chi tiết tại RAG: xử lý tài liệu.
- Biểu diễn vector (Embedding Generation): dùng model embedding ánh xạ các đoạn text thành semantic vector, tức dense vector nhiều chiều. Các model embedding phổ biến gồm
text-embedding-3-small/text-embedding-3-largecủa OpenAI và các model open source trên Hugging Face. - Lưu vào vector store hoặc hệ thống index: lưu embedding vector, nội dung gốc và metadata tương ứng vào vector store hoặc vector index system, chẳng hạn Milvus, pgvector, vector search của Elasticsearch / OpenSearch hoặc local vector index xây dựng trên Faiss. Xem lựa chọn vector database, thuật toán index và thực hành pgvector tại RAG: vector database.
Quá trình indexing thường được thực hiện offline. Chẳng hạn, team chạy scheduled job mỗi tuần một lần để index lại các tài liệu mới thêm và đã thay đổi. Với các trường hợp động như người dùng upload tài liệu, indexing cũng có thể thực hiện online và tích hợp trực tiếp vào main application.
Retrieval được thực hiện online. Sau khi người dùng đặt câu hỏi, hệ thống thường đi qua các bước sau:
- Nhận request: lấy natural language query của người dùng. Một số hệ thống sẽ rewrite hoặc expand query trước để retrieval về sau dễ match hơn.
- Vector hóa query: dùng model embedding chuyển query thành vector để có thể so sánh với document vector trong cùng một không gian.
- Information retrieval (R): thực hiện similarity search trong vector database, lấy ra các đoạn tài liệu liên quan nhất với query vector.
- Context augmentation (A): tổ chức các đoạn đã truy xuất, câu hỏi gốc, system instruction và yêu cầu citation thành Prompt rồi giao cho LLM.
- Output generation (G): LLM sinh câu trả lời bằng natural language, đồng thời đính kèm link tài liệu tham khảo.
- Feedback kết quả (tùy chọn): khi người dùng không hài lòng, hệ thống có thể điều chỉnh Prompt hoặc retrieval strategy. Một số implementation cũng hỗ trợ multi-turn conversation để từng bước hoàn thiện câu trả lời.
Khi hiệu quả retrieval không ổn định, vấn đề thường nằm ở query rewrite, recall strategy, ranking hoặc chất lượng context. Xem hướng tối ưu tại RAG: tối ưu.
Embedding là gì?
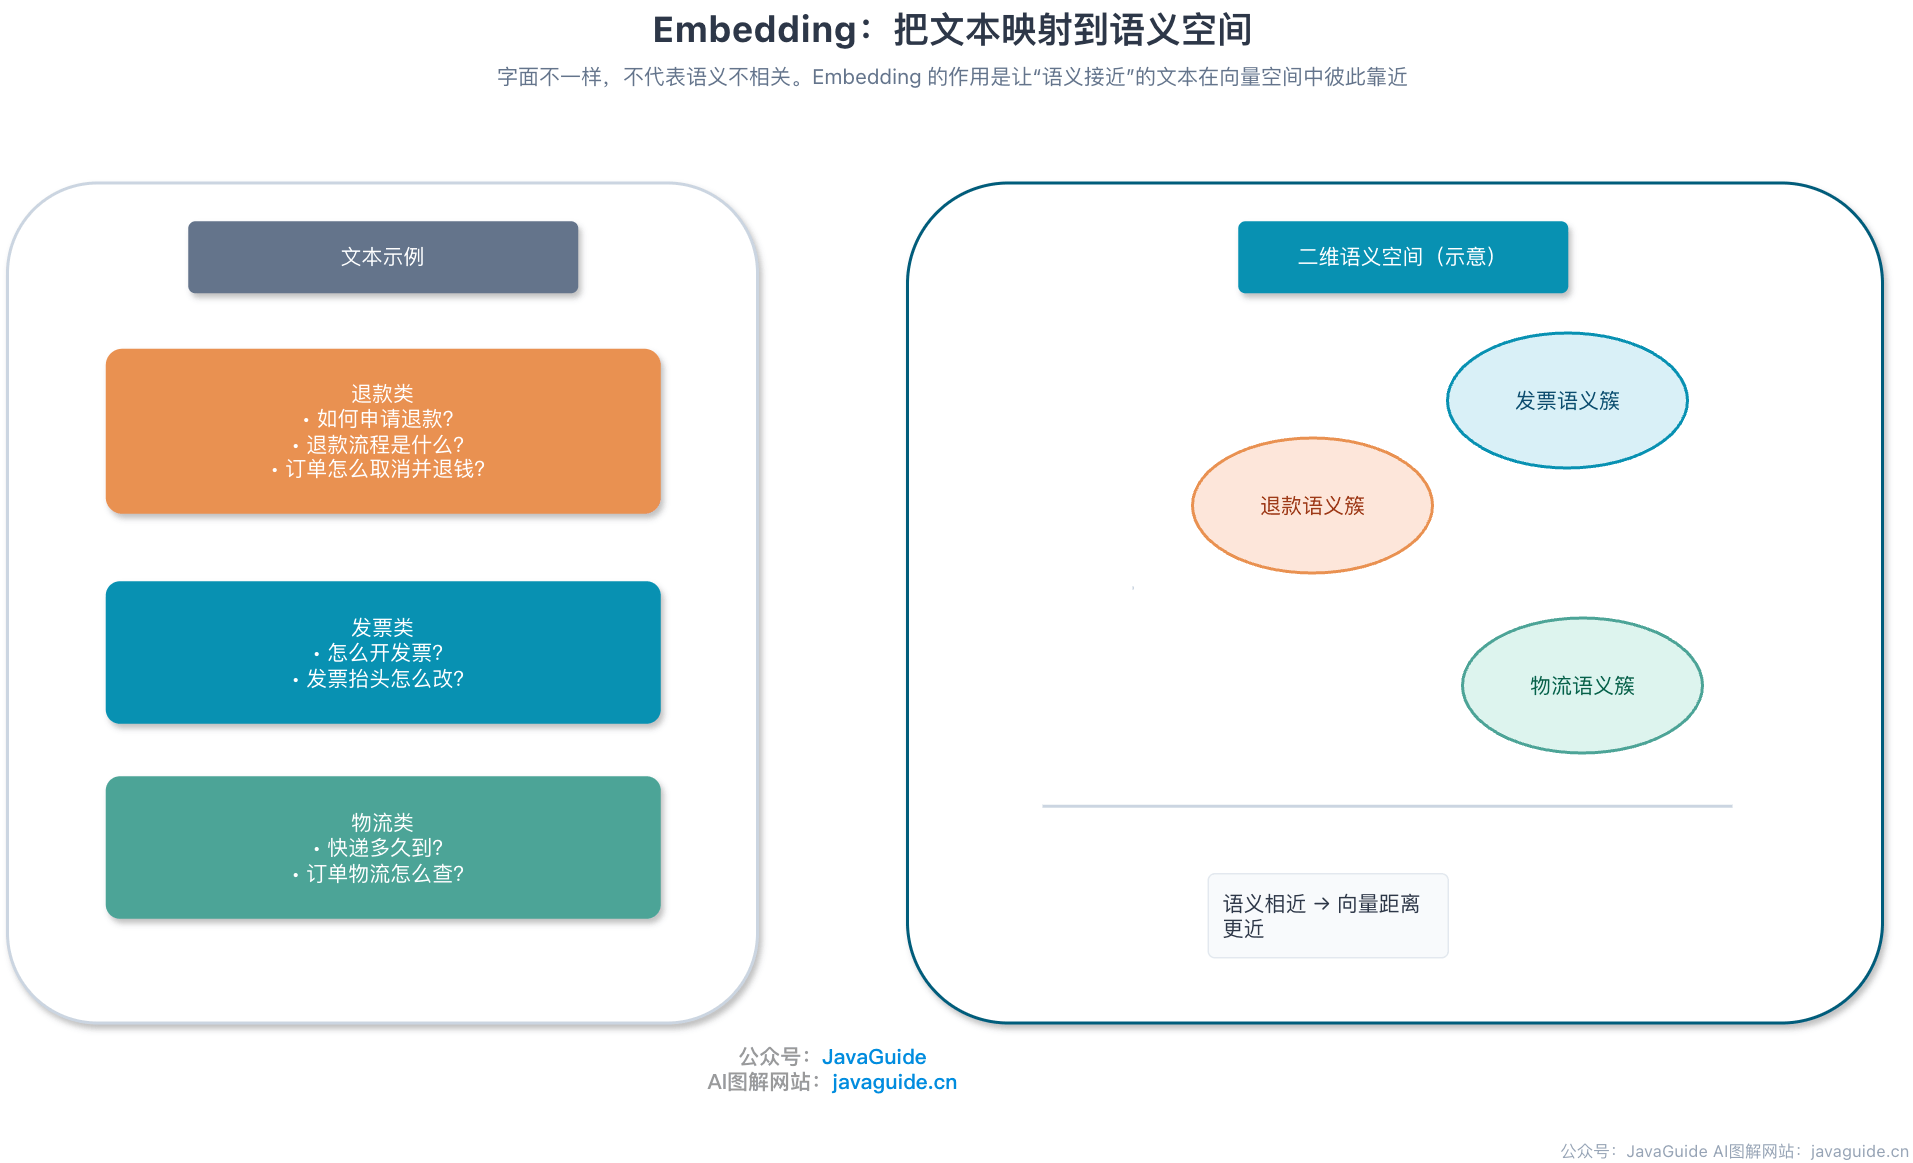
Embedding là biến text thành một dãy số. Nói chính xác hơn, nó ánh xạ text vào một không gian dense vector nhiều chiều, để các text có semantic gần nhau cũng ở gần nhau hơn trong vector space.
Ví dụ ba câu sau:
- "Làm sao yêu cầu hoàn tiền?"
- "Quy trình hoàn tiền là gì?"
- "Hủy đơn hàng và lấy lại tiền như thế nào?"
Về mặt câu chữ, chúng khác nhau nhưng semantic gần nhau. Model Embedding tốt sẽ ánh xạ chúng đến các vị trí gần nhau, nhờ đó vector retrieval mới tìm được Chunk liên quan.
Các chiều Embedding phổ biến gồm 768, 1024, 1536 và 3072. Số chiều là một phần trong thiết kế và cách training model, không thể tách khỏi model để kết luận trực tiếp rằng "dimension càng cao thì hiệu quả semantic càng tốt"; dimension cao hơn thường làm tăng chi phí lưu trữ, indexing và tính similarity. Lấy OpenAI Embedding làm ví dụ, text-embedding-3-small mặc định output 1536 chiều, còn text-embedding-3-large mặc định output 3072 chiều và hỗ trợ giảm số chiều output thông qua parameter dimensions. Khi chọn thực tế, cần so sánh recall quality, latency và storage overhead trên tập evaluation của nghiệp vụ.
Các model Embedding phổ biến có thể chia thành hai loại:
| Loại | Model tiêu biểu | Trường hợp phù hợp |
|---|---|---|
| Closed-source API | OpenAI text-embedding-3-small / text-embedding-3-large, Cohere Embed, Jina Embeddings API | Muốn dùng ngay, hiệu quả đa ngôn ngữ và ít vận hành |
| Open source model | Dòng BGE, GTE, E5, model Jina Embeddings open source | Dữ liệu không được rời intranet, cần triển khai private và muốn kiểm soát chi phí |
Khi chọn model Embedding, đừng chỉ nhìn thứ hạng trên benchmark. MTEB (Massive Text Embedding Benchmark) có thể dùng làm tham khảo, nhưng cuối cùng vẫn phải dùng các câu hỏi nghiệp vụ của mình để evaluation recall, relevance và latency.
Model Embedding cũng không phải thứ "hiểu thế giới theo thời gian thực". Nhiệm vụ chính của nó là ánh xạ text vào vector space, trọng tâm năng lực là semantic matching. Nếu gặp thuật ngữ rất mới, meme, tên sản phẩm hoặc abbreviation của một lĩnh vực, vẫn cần xác nhận hiệu quả recall qua business corpus evaluation.
Tính vector similarity như thế nào?
Sau khi text được chuyển thành vector, retrieval system còn phải xác định vector nào gần query nhất. Có ba loại similarity hoặc distance metric phổ biến.
| Metric | Ý nghĩa | Đặc điểm |
|---|---|---|
| Cosine similarity | Xem hướng của hai vector có nhất quán không | Không nhạy với độ dài vector, được dùng phổ biến nhất trong RAG |
| Inner product / Dot product | Xem tổng tích của các dimension tương ứng của hai vector | Nếu vector đã được L2 normalize, inner product và cosine similarity thường tương đương về kết quả ranking |
| Euclidean distance / L2 distance | Xem khoảng cách tuyệt đối giữa hai điểm trong không gian | Nhạy hơn với độ lớn vector, phù hợp khi model hoặc index được training / tối ưu rõ ràng theo L2 |
Nếu trong phỏng vấn được hỏi "vì sao dùng cosine similarity", có thể trả lời: RAG quan tâm đến việc hướng semantic có gần nhau hay không, chứ không phải bản thân độ dài vector; cosine similarity không nhạy với độ dài nên phù hợp hơn với semantic retrieval của text. Trong dự án thực tế, còn phải thống nhất với distance metric được model Embedding khuyến nghị và loại index của vector database; nếu không, index có thể không match được hoặc recall quality giảm.
RAG khác search engine truyền thống như thế nào?
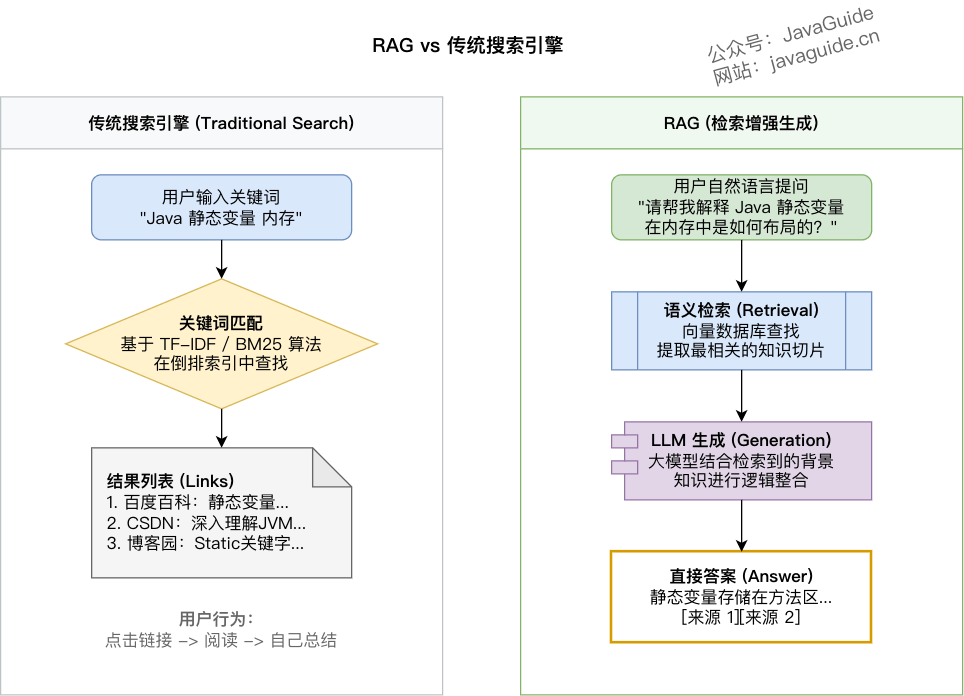
RAG và search truyền thống đều "tìm thông tin", nhưng cách xử lý sau khi nhận được thông tin lại khác nhau.
Sau khi nhận các tài liệu ứng viên, search truyền thống sắp xếp chúng theo relevance rồi đưa danh sách kết quả cho người dùng. Mỗi kết quả độc lập với nhau; người dùng tự mở và tự đánh giá. Nó giống một ranker hơn.
RAG đưa nhiều knowledge fragment đã truy xuất vào context của LLM, để model tổng hợp xuyên tài liệu và hợp nhất thông tin, sau đó sinh ra câu trả lời có thể đọc trực tiếp. Nó giống một information synthesizer hơn.
Một số khác biệt quan trọng:
- Cơ chế retrieval: search truyền thống chủ yếu dựa vào inverted index và keyword matching, BM25 là algorithm kinh điển; search system hiện đại cũng có thể thêm semantic recall và rerank. RAG linh hoạt hơn về retrieval method: có thể dùng vector retrieval, BM25, hybrid retrieval, graph retrieval và database query; điểm then chốt là kết quả retrieval phải đi vào context của LLM để tham gia sinh câu trả lời.
- Dạng kết quả: search đưa danh sách tài liệu, người dùng vẫn phải đọc lần hai; RAG đưa câu trả lời và cố gắng đánh dấu citation source.
- Phạm vi dữ liệu: search truyền thống mạnh ở crawler toàn Internet và large-scale index; RAG thường dùng hơn cho enterprise knowledge base và vertical domain, giúp LLM có thêm domain knowledge với chi phí thấp.
- Chi phí và latency: search phản hồi nhanh, chi phí dễ kiểm soát; RAG có thêm LLM inference nên latency và chi phí đều tăng.
Chọn RAG hay fine-tuning như thế nào?
"Tại sao không fine-tune trực tiếp?" là câu hỏi rất thường gặp trong phỏng vấn RAG.
Có thể phân biệt như sau: RAG giải quyết vấn đề model không biết knowledge mới hoặc knowledge riêng tư; fine-tuning phù hợp hơn với vấn đề model chưa biết nói hoặc làm việc theo cách của bạn.
Hãy hình dung bạn có một employee handbook rất dày và thường xuyên phải tra quy định trong đó. Cách của RAG là tra rồi dùng, để handbook bên ngoài và lật xem trước mỗi lần trả lời. Cách của fine-tuning là học thuộc handbook, để model internalize knowledge đó. Khi handbook thường xuyên được sửa đổi, RAG chỉ cần thay index; còn fine-tuning phải chuẩn bị lại data, training và evaluation, chi phí hoàn toàn khác nhau.
| Khía cạnh | RAG | Fine-tuning |
|---|---|---|
| Cập nhật knowledge | Chỉ cần cập nhật knowledge base hoặc vector index | Thường phải chuẩn bị lại data và training |
| Data security | Knowledge được giữ ở external store, truy xuất khi cần | Pattern và một phần knowledge trong training sample sẽ được cố định vào parameter của fine-tuned model; trước khi đưa dữ liệu nhạy cảm vào training pipeline cần evaluation compliance và data governance bổ sung |
| Kiểm soát hallucination | Có thể citation tài liệu gốc, thuận tiện cho provenance và validation | Model vẫn có thể bịa, hơn nữa citation source không tự nhiên hiện hữu |
| Cấu trúc chi phí | Chi phí retrieval + input Token + vector database | Chi phí gắn nhãn data, training GPU, evaluation và quản lý version |
| Trường hợp phù hợp | Hỏi đáp giàu knowledge, enterprise knowledge base, quy định pháp luật, tài liệu sản phẩm, thông tin real-time | Adapt style, kiểm soát format, căn chỉnh thuật ngữ domain, tối ưu hành vi của task cố định |
| Rủi ro chính | Không retrieval được, recall noise, permission filter phức tạp | Overfitting data, knowledge hết hạn, chi phí training và rollback cao |
Hai cách này cũng có thể kết hợp. Trước hết dùng fine-tuning để model hiểu hơn thuật ngữ domain, output format và ranh giới task, sau đó dùng RAG cung cấp knowledge real-time và evidence có thể truy xuất nguồn. Cách kết hợp này khá phổ biến trong các trường hợp như chăm sóc khách hàng, pháp lý, y tế và nghiên cứu đầu tư tài chính.
Khi kết luận trong phỏng vấn, có thể nói: nếu knowledge thay đổi thường xuyên và cần citation source thì ưu tiên RAG; nếu output style và task behavior không ổn định thì cân nhắc fine-tuning; nếu vừa cần hiểu cách diễn đạt của domain vừa cần tra knowledge real-time thì có thể kết hợp cả hai.
Tuy nhiên, có một giới hạn thực tế: kết hợp cả hai nghĩa là phải vận hành hai hệ thống, chi phí không thấp. Khi nguồn lực team có hạn, ổn định RAG trước rồi mới cân nhắc đưa fine-tuning vào thường thực tế hơn.
Context window dài có thay thế được RAG không?
Không.
Context window dài thực sự khiến nhiều task đơn giản hơn. Chẳng hạn, đưa cả một báo cáo vào để model đọc từ đầu đến cuối rất phù hợp với việc phân tích sâu một tài liệu đơn. Nhưng điều đó không có nghĩa là có thể nhét toàn bộ knowledge base vào model. Context càng dài thì chi phí input Token, first-token latency và noise trong inference càng tăng, hiệu quả chưa chắc tốt hơn.
Các trường hợp phù hợp với long context khá rõ ràng: phân tích sâu một tài liệu dài, hiểu tập trung một code repository hoặc một project directory, tổng hợp lịch sử hội thoại dài, hoặc các task có ít tài liệu nhưng cần đọc đầy đủ trong một lần.
Khi knowledge base lớn, long context sẽ không đủ. Enterprise knowledge base, customer ticket, log và contract database thường có từ hàng triệu đến hàng trăm triệu document fragment, không thể lần nào cũng nhét tất cả vào. Kể cả nhét được, chi phí và latency cũng không chịu nổi. Khó hơn nữa, khi context chứa quá nhiều fragment không liên quan, model lại dễ bị noise làm nhiễu hơn, tạo ra câu trả lời có vẻ đầy đủ nhưng thiếu ổn định về fact. Vấn đề "Lost in the Middle" nói về việc này: khi information quan trọng nằm ở giữa một context dài, model dễ bỏ qua nó hơn.
Enterprise knowledge base còn không thể né permission isolation. Cả long context và RAG đều không tự động hoàn tất authentication; permission check phải do application layer thực hiện. Cách phổ biến là filter theo tenant, role và document ACL trước hoặc trong lúc retrieval, chỉ đưa nội dung người dùng có quyền truy cập vào model context; ngay cả khi dùng long context, cũng có thể authentication trước rồi mới load tài liệu. Ưu thế của RAG là nó vốn có một retrieval entry point, thuận tiện đặt permission filter và recall trên cùng một pipeline.
Còn một điểm thường bị bỏ qua: traceability. RAG có thể trả về citation fragment rõ ràng để truy xuất nguồn khi audit. Long context trộn lượng lớn nội dung rồi giao cho model, khiến người dùng khó xác định câu trả lời thực sự dựa trên đoạn tài liệu nào.
RAG đã tiến hóa qua những giai đoạn nào?
RAG liên tục được cải tiến trong hai năm qua, có thể chia khái quát thành ba giai đoạn.
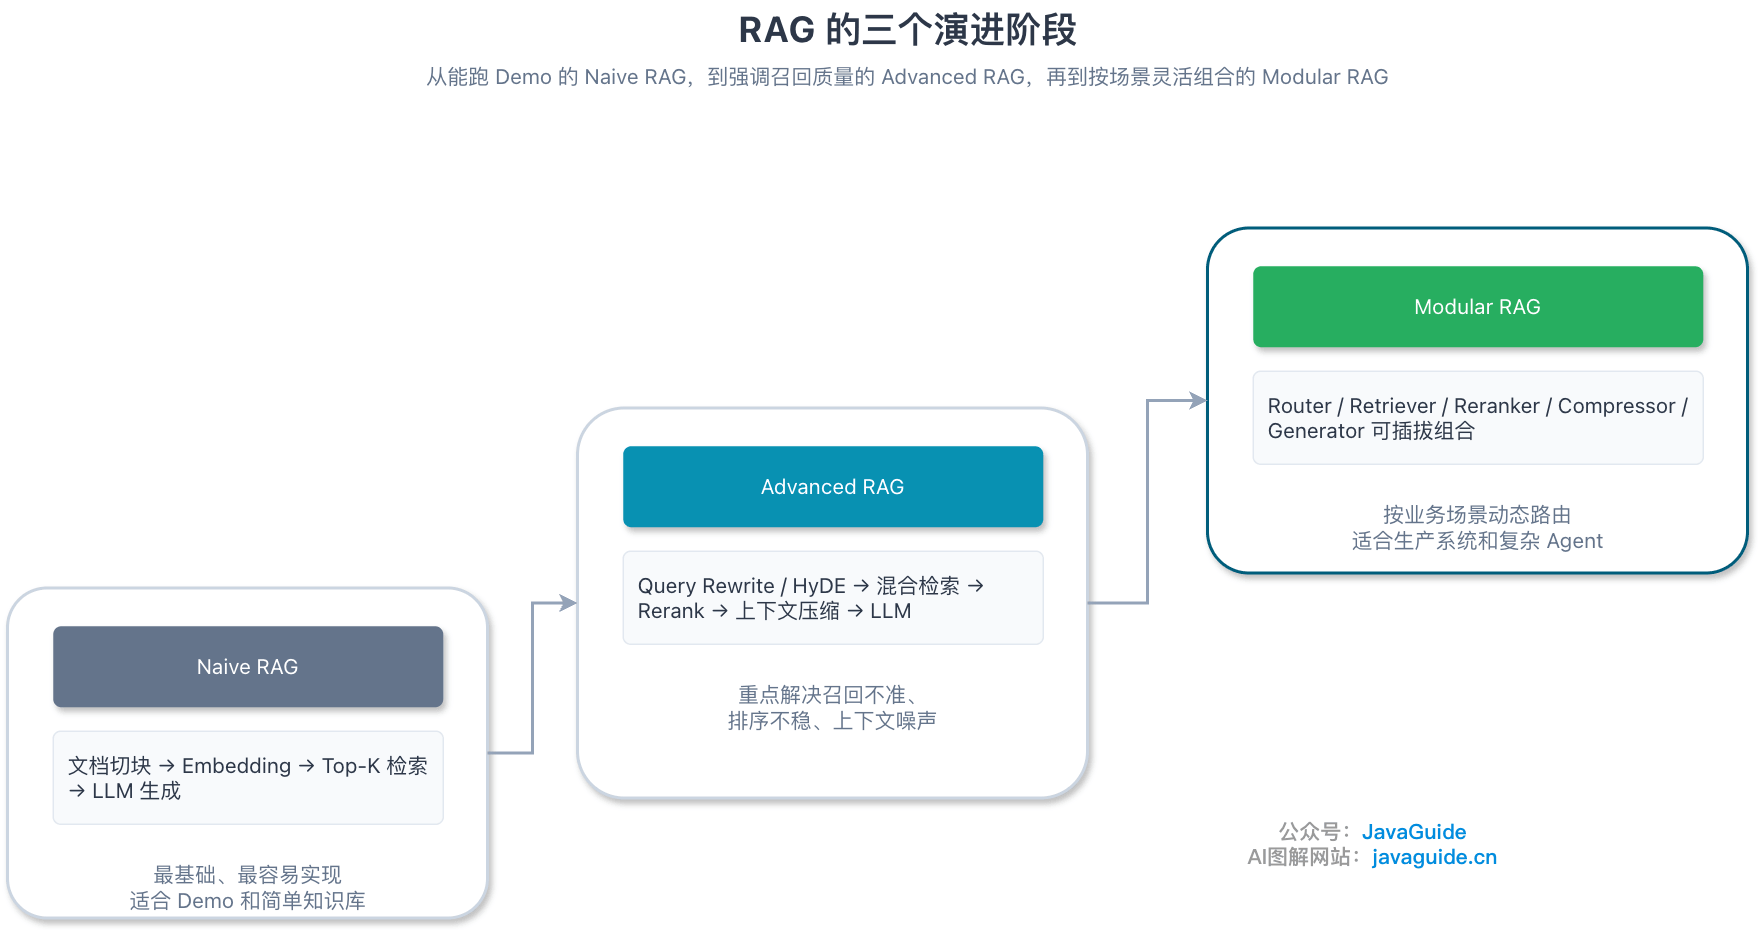
| Giai đoạn | Pipeline tiêu biểu | Đặc điểm |
|---|---|---|
| Naive RAG | Document chunking → Embedding → Top-K retrieval → LLM generation | Cơ bản nhất, dễ triển khai nhất, phù hợp với Demo và knowledge base đơn giản |
| Advanced RAG | Query Rewrite / HyDE → Hybrid retrieval → Rerank → Context compression → LLM generation | Tập trung giải quyết recall không chính xác, context noise và ranking không ổn định |
| Modular RAG | Retriever, reranker, compressor, router, generator và các module khác có thể kết hợp dạng plug-in | Route động theo business scenario, phù hợp với production system và Agent phức tạp |
Naive RAG là điểm bắt đầu, có thể chạy Demo nhưng thường vẫn còn cách production khá xa. Advanced RAG bắt đầu xử lý các vấn đề về recall quality, lọc noise và ranking. Modular RAG tách từng khâu thành module có thể thay thế, phù hợp hơn với scenario phức tạp. Xem tiếp các chiến lược tối ưu cụ thể tại RAG: tối ưu.
Ưu thế và giới hạn cốt lõi của RAG là gì?
Trước hết nói về ưu thế.
Lợi ích lớn nhất của RAG là chi phí cập nhật knowledge thấp. Fine-tuning phải chuẩn bị lại data, training model và evaluation; RAG thường chỉ cần cập nhật knowledge base và index. Với dữ liệu thường xuyên thay đổi như tin tức, quy định pháp luật và tài liệu sản phẩm, RAG nhẹ công bảo trì hơn nhiều.
RAG cũng có thể giảm hallucination và thuận tiện truy xuất nguồn. RAG chuyển model từ "trả lời theo memory" sang "trả lời dựa trên evidence đã truy xuất". Mỗi câu trả lời đều có thể gắn với một document fragment cụ thể, điều này rất quan trọng trong các trường hợp yêu cầu độ chính xác cao như compliance tài chính, hỗ trợ y tế và pháp lý. Tất nhiên, điều đó không có nghĩa RAG sẽ không mắc lỗi: retrieval sai hoặc citation sai thì câu trả lời vẫn thất bại.
Data isolation cũng dễ thực hiện hơn. Có thể triển khai multi-tenant isolation và access control (ACL) ở tầng retrieval, đảm bảo người dùng chỉ nhìn thấy dữ liệu trong phạm vi quyền hạn. So với việc đưa dữ liệu nhạy cảm vào fine-tuning dataset, kiến trúc RAG phù hợp hơn cho permission và compliance governance.
Chi phí chuyển domain cũng thấp. Không cần training lại model cho từng domain; chỉ cần xây knowledge base của domain và chạy xong index là có thể dùng trước.
Tiếp theo là giới hạn. RAG không phải silver bullet, và cũng có không ít vấn đề.
Chất lượng retrieval quyết định giới hạn trên. Nguyên tắc GIGO thể hiện rất rõ ở đây: nếu biểu diễn của Embedding không chính xác hoặc chiến lược chunking làm mất thông tin then chốt, nội dung recall không liên quan đến câu hỏi thì LLM phía sau có mạnh đến đâu cũng không cứu được.
Context cũng không phải càng dài càng tốt. Dù một số model đã mở rộng Context Window lên quy mô hàng triệu token, đưa quá nhiều fragment không liên quan vào sẽ làm attention của model bị loãng, cản trở logical reasoning và kéo chi phí Token tăng theo.
Latency là một vấn đề cứng khác. Full pipeline phải đi qua query rewrite, vectorization, similarity retrieval, reranking, context construction và LLM generation; mỗi bước đều làm tăng thời gian. Với các trường hợp nhạy cảm về response time, không thể chỉ nhìn vào chất lượng câu trả lời mà cũng phải tính nghiêm túc chi phí latency.
Engineering complexity cũng không thấp. Cần vận hành vector database, xử lý incremental index cho tài liệu, liên tục tối ưu retrieval strategy, đồng thời thực hiện permission filter, citation provenance và evaluation loop. So với gọi trực tiếp LLM API, gánh nặng vận hành của RAG rõ ràng lớn hơn.
Chi phí Token cũng phải tính rõ. RAG tiết kiệm chi phí training, nhưng mỗi request đều phải mang theo context, nên input Token thường cao hơn đáng kể so với hội thoại thông thường. Fragment tài liệu đưa vào càng nhiều, hóa đơn và latency đều tăng.
⭐️ Gợi ý project RAG thực chiến
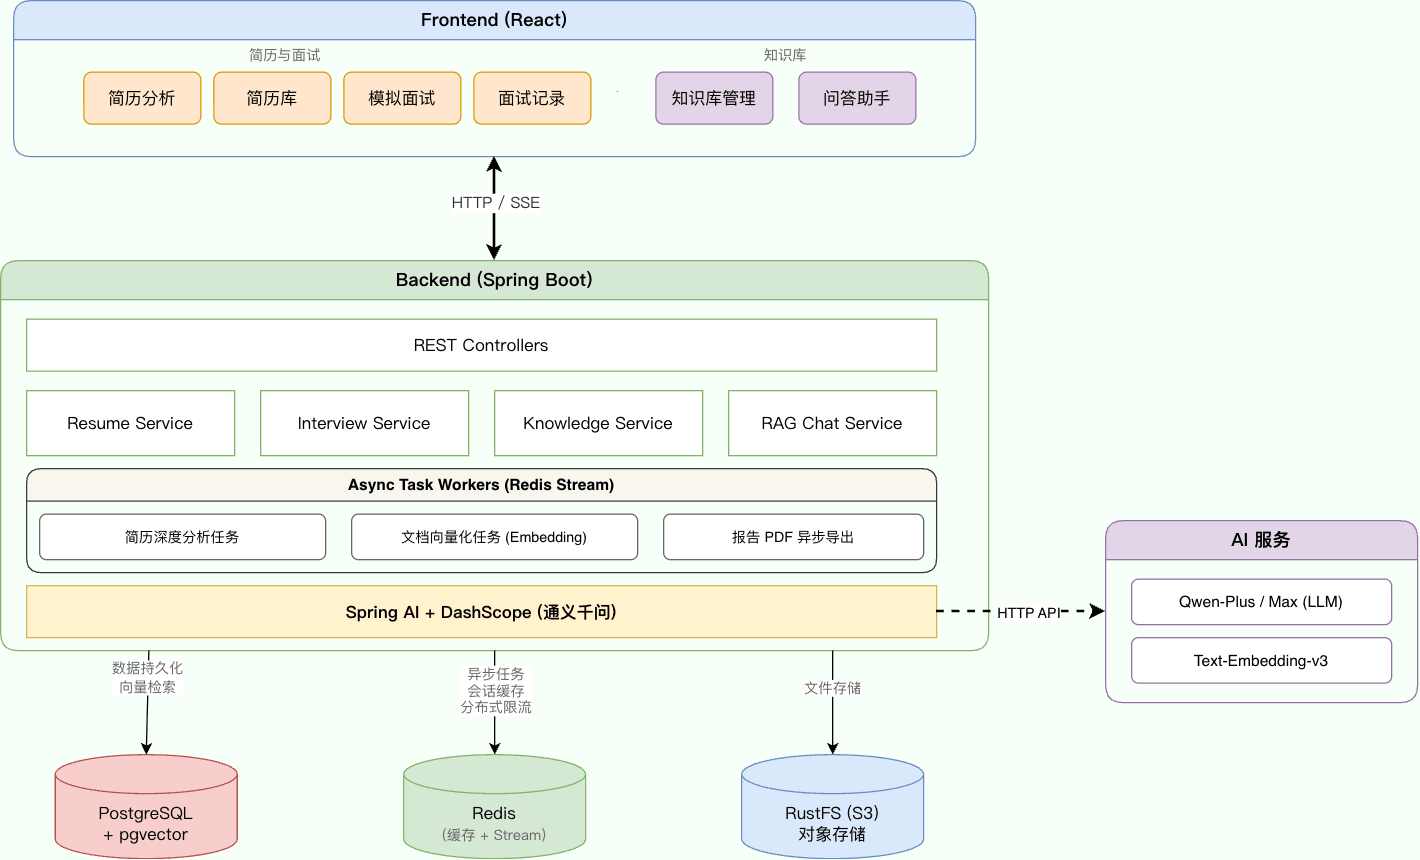
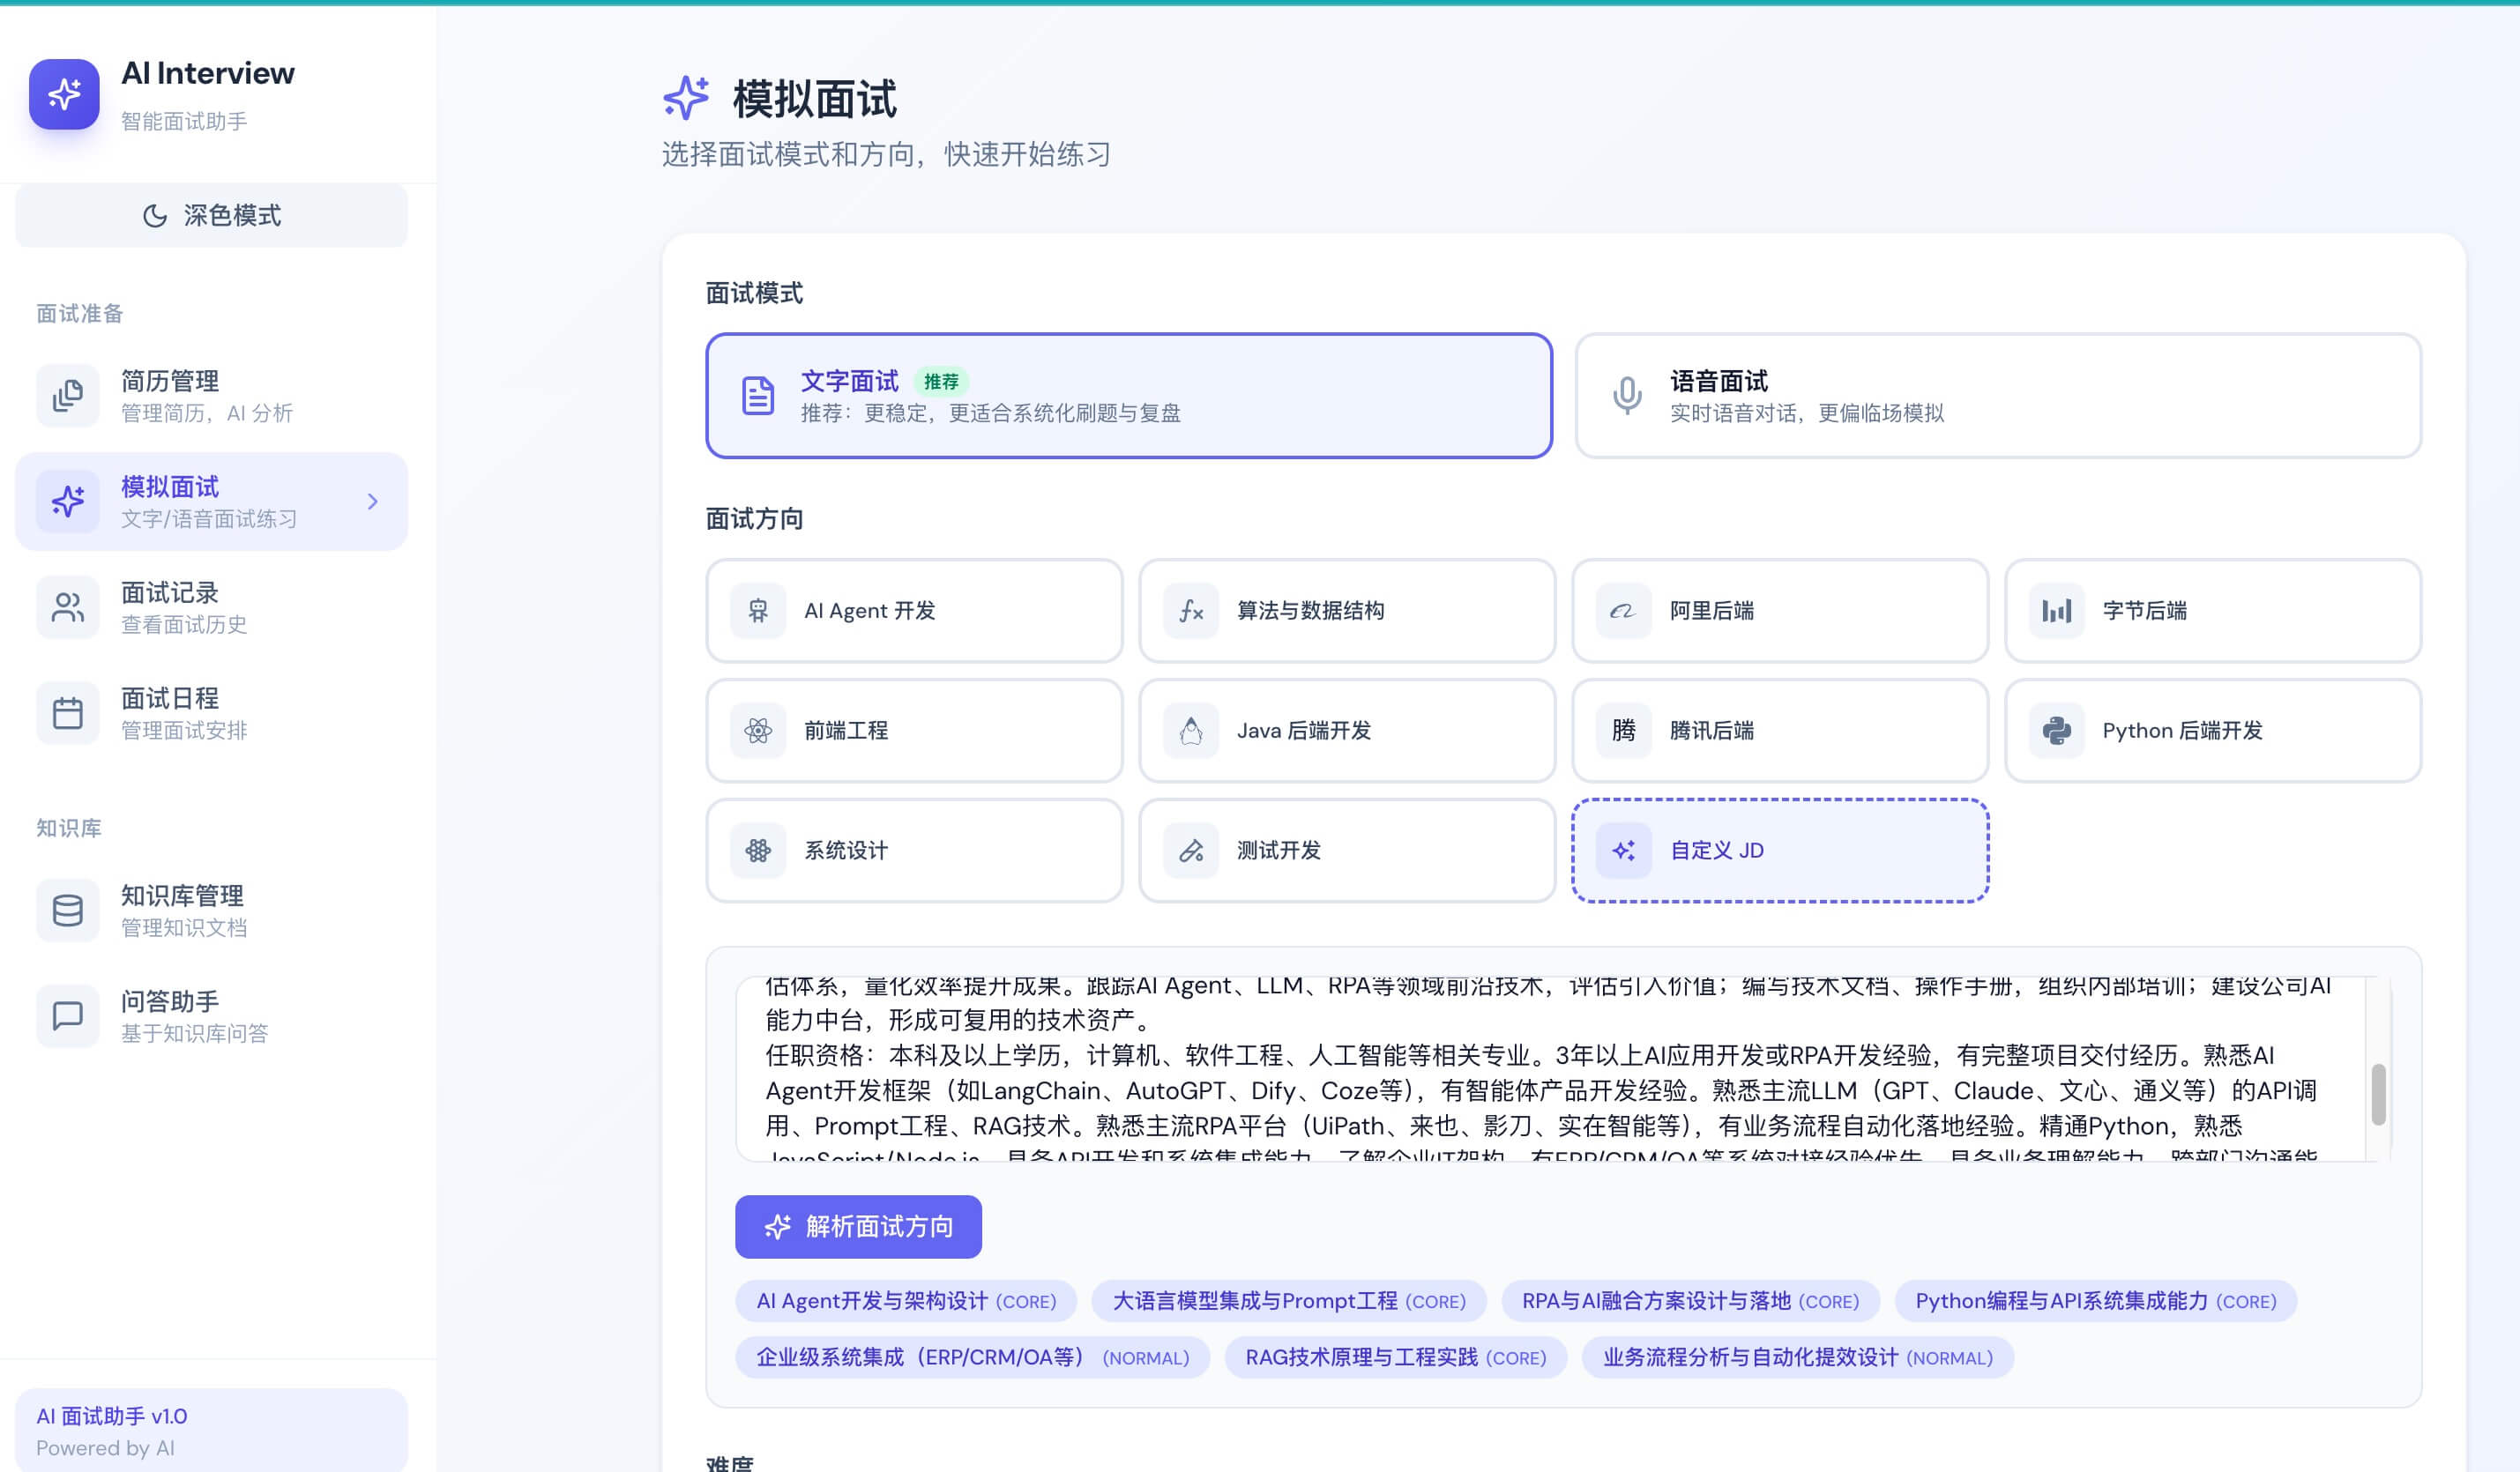
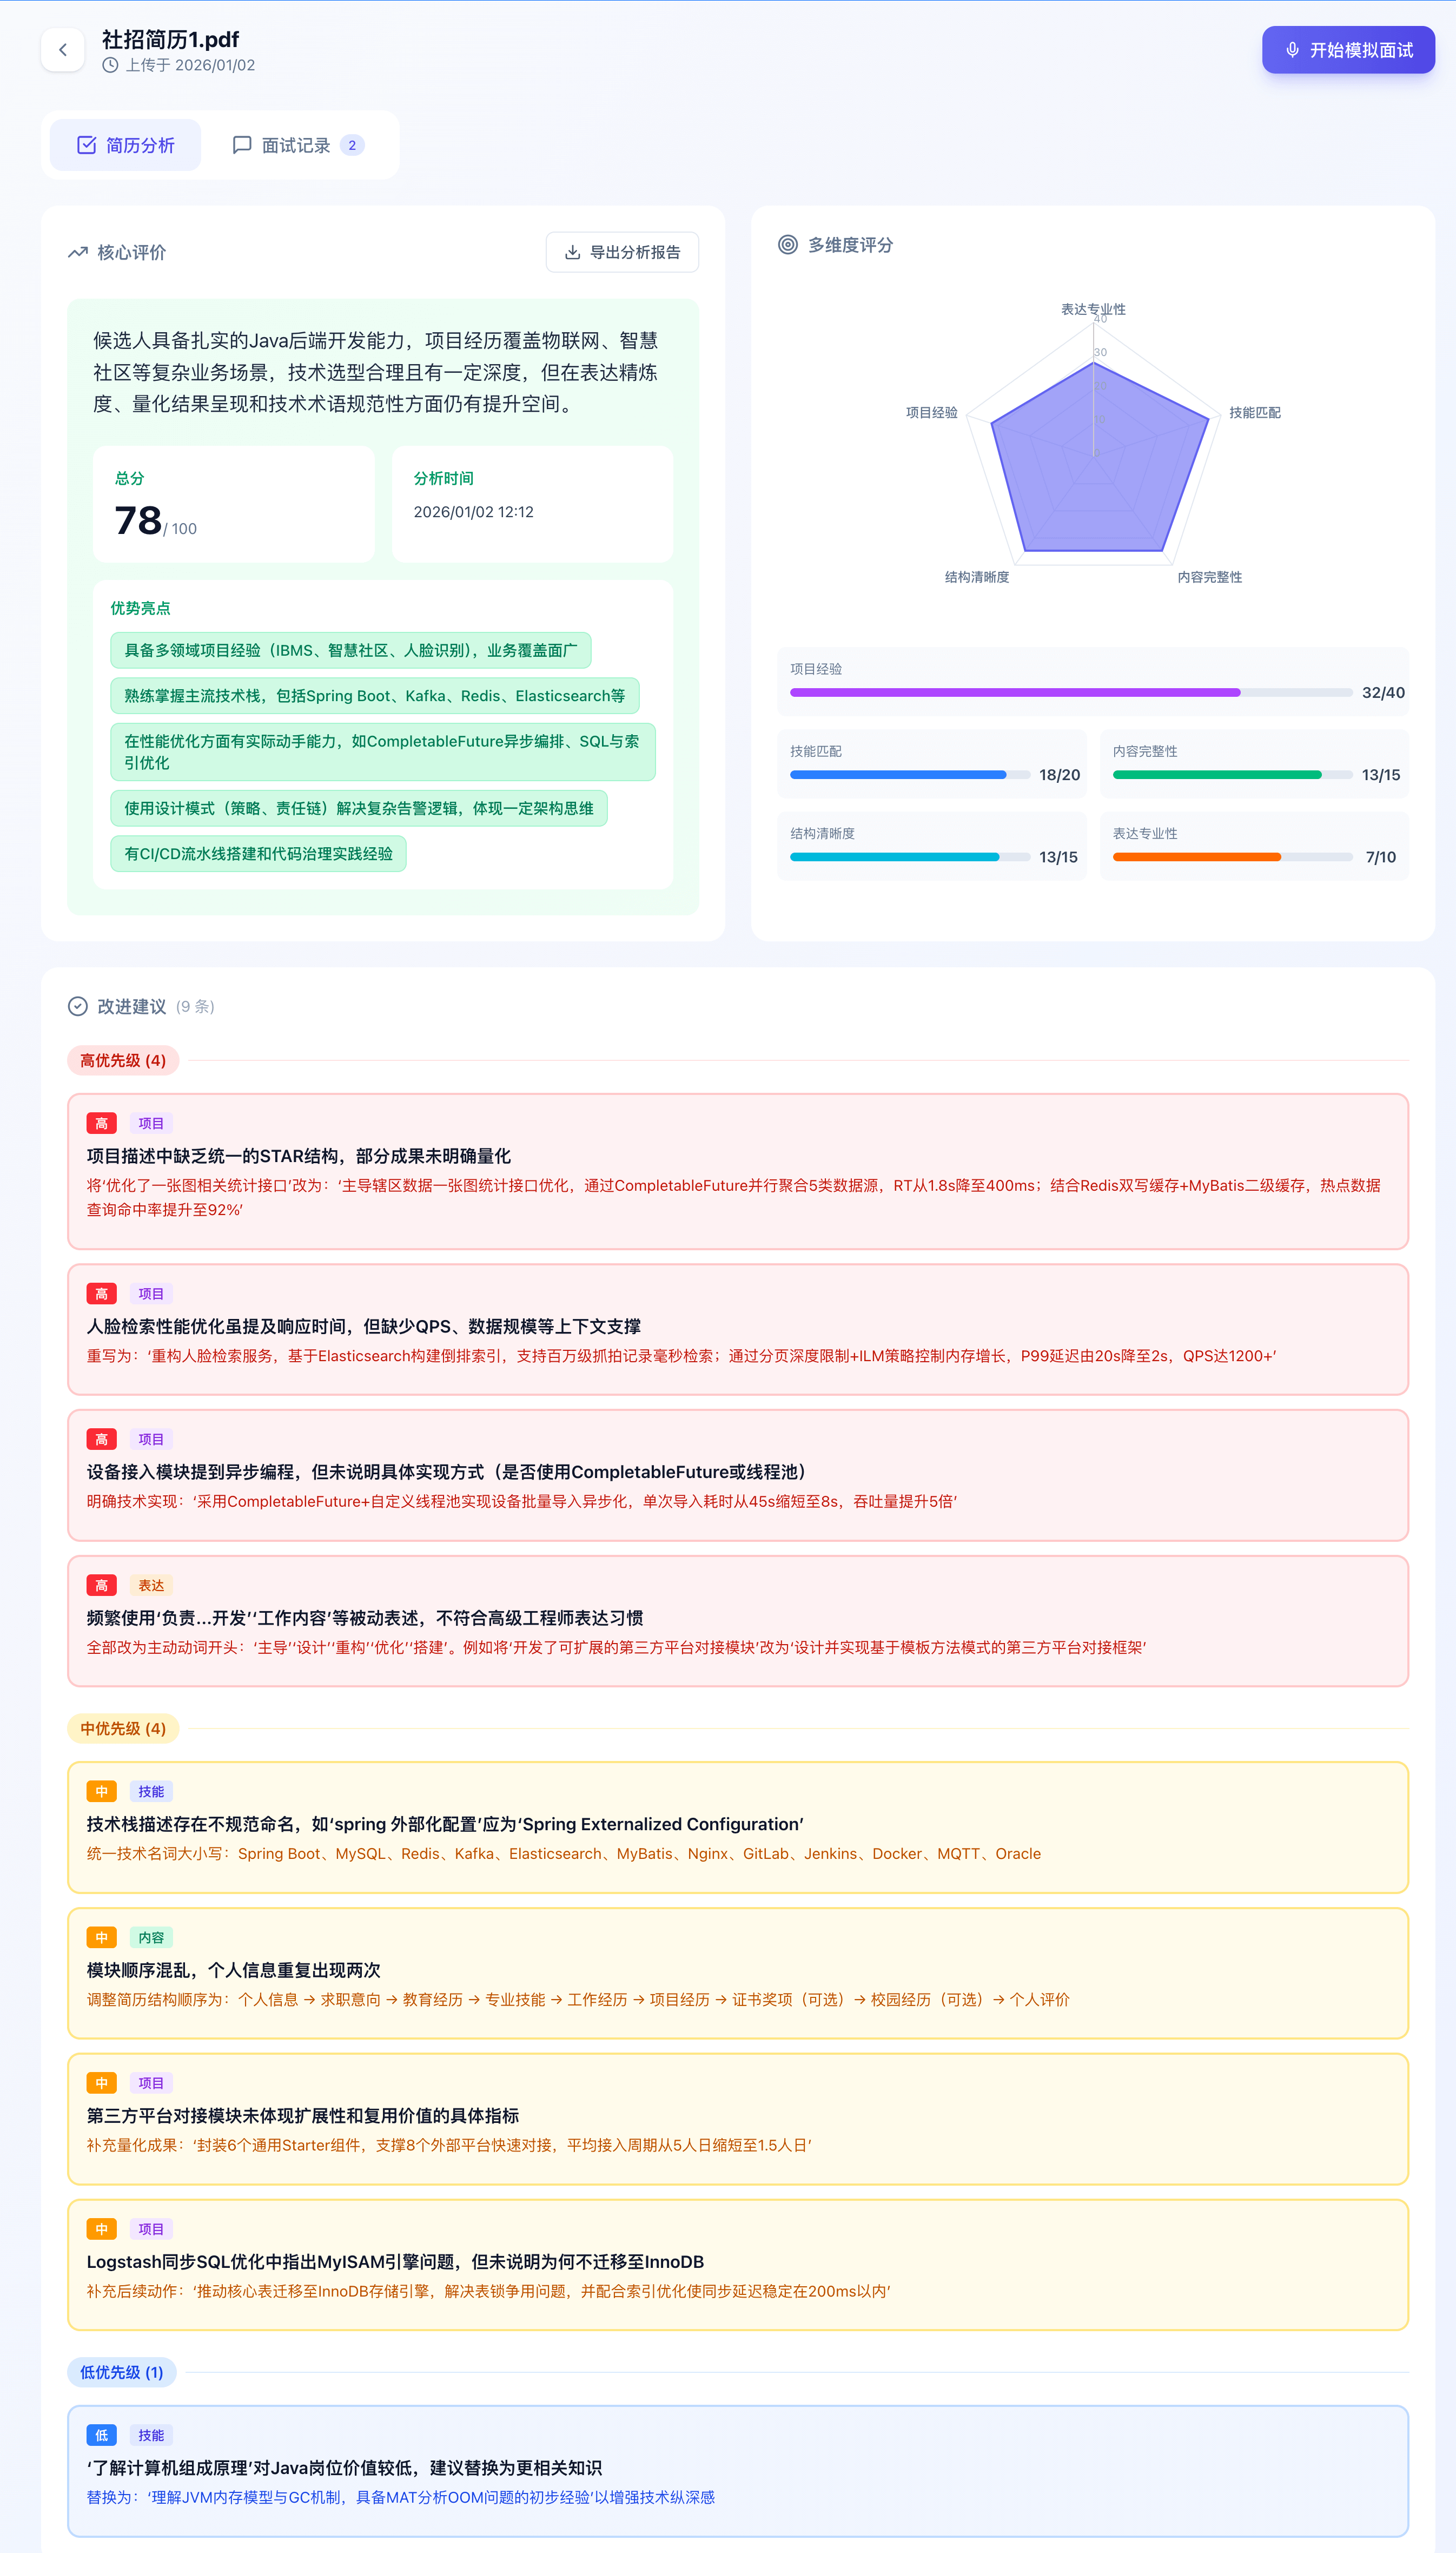
Gợi ý một project thực chiến do tác giả open source, dựa trên Spring Boot 4.0 + Java 21 + Spring AI + PostgreSQL + pgvector + RustFS + Redis, hiện thực các chức năng cốt lõi như phân tích CV thông minh, phỏng vấn mô phỏng bằng AI và truy xuất bằng RAG trong knowledge base. Rất phù hợp làm project học tập và project để đưa vào CV, dễ học.
Kiến trúc hệ thống như sau:
Ảnh minh họa:
Toàn bộ source code đều miễn phí và open source, không có bản Pro hay bản trả phí!
Địa chỉ project (hãy Star để ủng hộ):
- Github: https://github.com/Snailclimb/interview-guide
- Gitee: https://gitee.com/SnailClimb/interview-guide
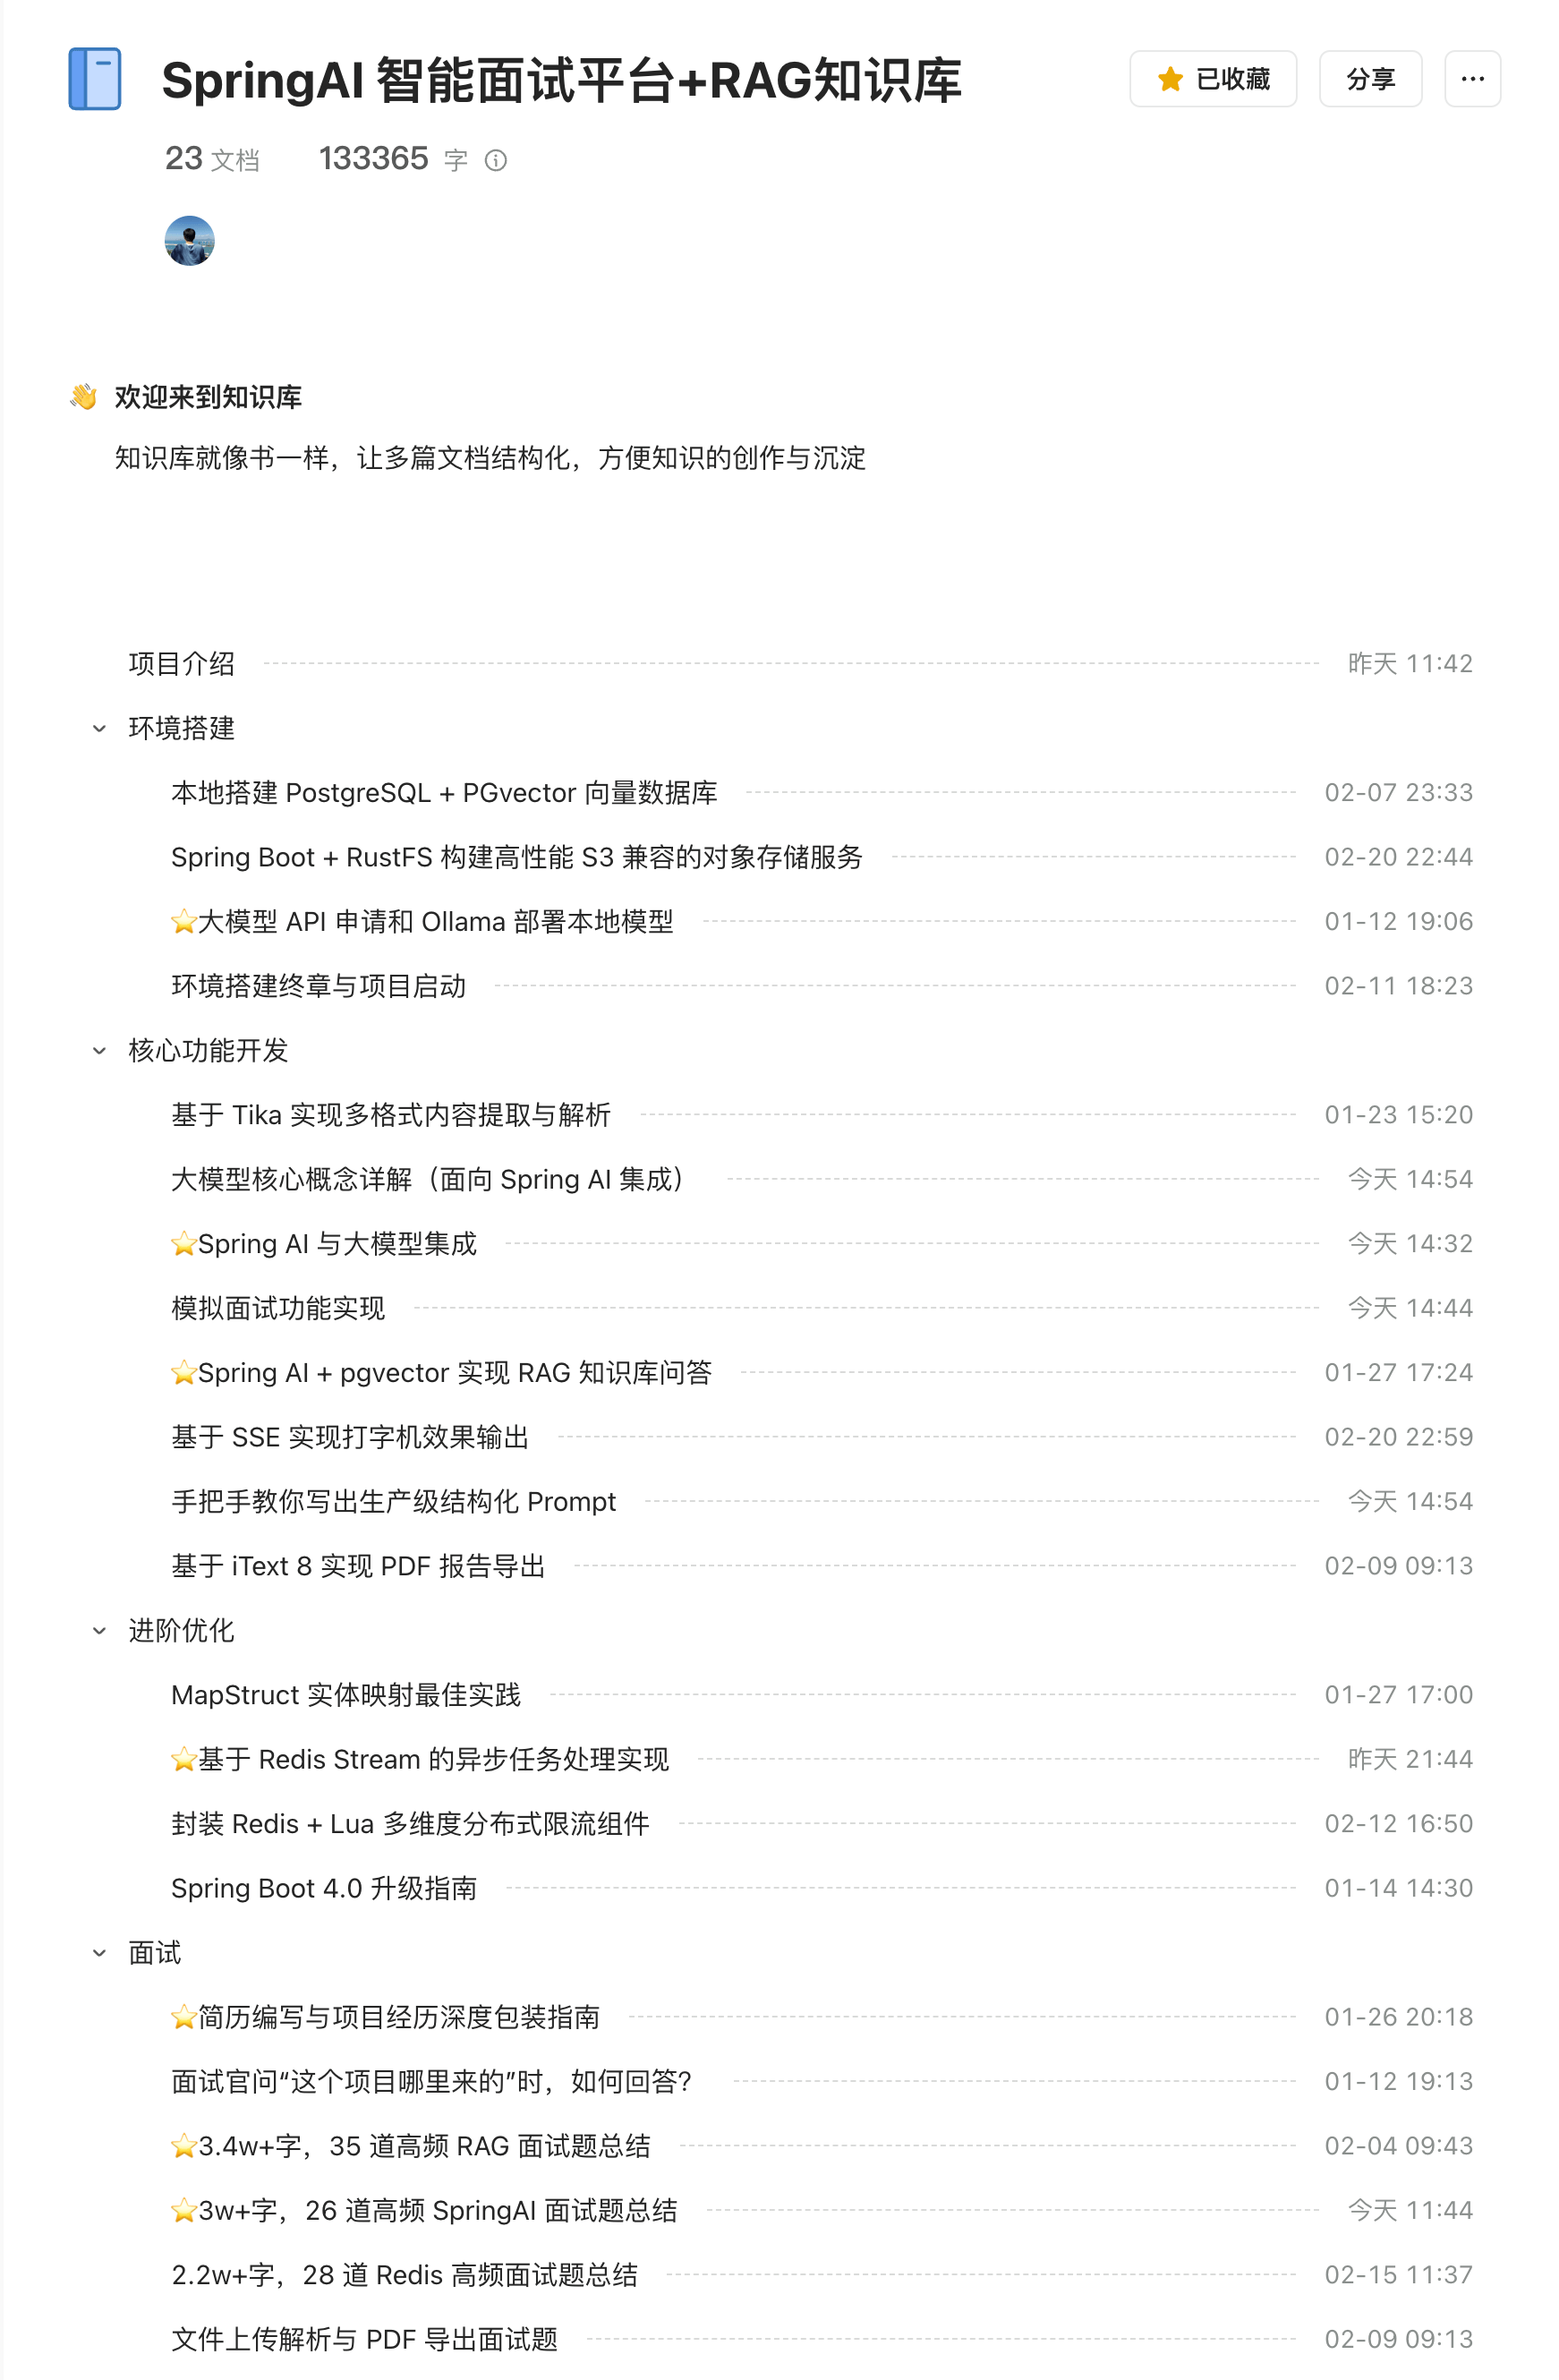
Giới thiệu chi tiết project và giáo trình học hệ thống (dành riêng cho Knowledge Planet, rất đáng tiền): 《Nền tảng phỏng vấn thông minh SpringAI + RAG Knowledge Base》.
Nội dung được sắp xếp như sau (đã hoàn tất, tổng cộng hơn 180.000 chữ)
Tổng kết
Nói ngắn gọn, RAG là trước hết tìm nội dung liên quan từ knowledge base, sau đó để LLM trả lời dựa trên nội dung đã tìm được. Giá trị của nó không phải làm model "thần kỳ hơn", mà là kéo câu trả lời trở lại với evidence có thể truy xuất, citation và audit.
- RAG chủ yếu giải quyết các vấn đề LLM có knowledge lỗi thời, không chạm được dữ liệu riêng tư và dễ hallucination. Search truyền thống đưa danh sách tài liệu, còn RAG đưa câu trả lời có thể đọc trực tiếp; một bên giống ranker hơn, bên kia giống information synthesizer hơn.
- Khi knowledge thay đổi thường xuyên và cần citation source, ưu tiên cân nhắc RAG; nếu muốn model output theo style và format cố định thì cân nhắc fine-tuning.
- Long context phù hợp với việc phân tích sâu lượng tài liệu nhỏ, nhưng enterprise knowledge base quy mô lớn, permission isolation và kiểm soát chi phí vẫn cần pipeline retrieval như RAG để đảm bảo.
Cũng cần nhận thức rõ giới hạn của RAG. Retrieval quality quyết định giới hạn trên, context noise sẽ làm nhiễu generation, còn latency, engineering complexity và chi phí Token đều là những tồn tại thực tế.
Chạy xong Demo không có nghĩa là dùng được trong production. Phần khó nhất của RAG thường không phải "kết nối một vector database", mà là liên tục evaluation và tối ưu recall quality.
Các câu hỏi thường gặp trong phỏng vấn:
- RAG là gì? Vì sao cần RAG?
- RAG khác search engine truyền thống như thế nào?
- Chọn RAG hay fine-tuning ra sao? Khi nào dùng RAG, khi nào fine-tuning, khi nào kết hợp cả hai?
- Chọn model Embedding trong hệ thống RAG như thế nào? Vì sao?
- Cosine similarity, inner product và Euclidean distance khác nhau ra sao?
- Giải quyết hallucination trong hệ thống RAG như thế nào? RAG có chắc chắn không tạo hallucination không?
- Vấn đề Lost in the Middle là gì? Ứng phó ra sao?
- Context window dài có thay thế được RAG không?
- Hệ thống RAG có những metric evaluation nào?
- Ưu thế và giới hạn của RAG là gì?
- Trường hợp nào phù hợp dùng RAG? Trường hợp nào không phù hợp?