
Tổng quan các khái niệm cốt lõi về AI: LLM, Agent, RAG, MCP và system design
Vì sao mỗi lần model trả lời lại không hoàn toàn giống nhau? Vì sao Agent cần loop? RAG đã truy xuất được tài liệu nhưng tại sao vẫn có thể trả lời sai? Những câu hỏi này lần lượt thuộc các chuỗi model generation, task execution, knowledge retrieval và application governance.
Bài viết này tập hợp các khái niệm liên quan trong chuyên đề AI của JavaGuide; phần triển khai cụ thể và case study vẫn được trình bày trong các bài chuyên đề tương ứng.
Nền tảng LLM
Các bài gốc liên quan:
- Cơ chế vận hành LLM: Token, context window và sampling parameter ảnh hưởng đầu ra thế nào
- Thực tiễn engineering khi gọi LLM API: streaming output, retry, rate limiting và structured response
- Prompt Engineering cho LLM là gì? Có những kỹ thuật prompt nào?
- LLM structured output: từ JSON contract đến triển khai Function Calling
- Hệ thống đánh giá ứng dụng AI: từ xây dựng Golden Set đến vòng lặp gray release production
LLM
Khi thấy input method hiển thị “Thời tiết hôm nay thật”, nó có thể đưa “đẹp” vào danh sách từ gợi ý. Quá trình generation của autoregressive LLM cũng tương tự: model dự đoán một Token dựa trên context hiện tại, thêm kết quả vào context rồi dự đoán Token tiếp theo, cho đến khi gặp end marker hoặc đạt giới hạn output. Quá trình này gọi là Autoregressive Generation.
Trong một lần generation, Token là đơn vị văn bản được model xử lý và output từng bước; context window giới hạn tổng số Token mà một lần gọi có thể chứa; các parameter như Temperature và Top-p ảnh hưởng sampling của Token ứng viên; Max Tokens kiểm soát số Token tối đa mà output lần này được phép chiếm dụng.
Token
Trước tiên, model dùng Tokenizer để chia văn bản thành các đoạn có kích thước khác nhau. Không có quy tắc cố định “một chữ một Token” hay “một từ một Token”: từ tiếng Anh có thể bị tách nhỏ, từ tiếng Việt cũng có thể bị tách thành nhiều Token, còn một số chữ hoặc từ có tần suất cao lại có thể được gộp chung.
Chia từng ký tự sẽ làm chuỗi dài hơn, còn chia nguyên từ lại cần vocabulary rất lớn. Các subword tokenization algorithm như BPE và Unigram cân bằng giữa hai cách: cố gắng giữ lại các đoạn có tần suất cao, tiếp tục tách các từ ít gặp. Kết quả chia cụ thể do Tokenizer mà model provider sử dụng quyết định.
Có thể ước tính sơ bộ cho capacity planning theo kinh nghiệm, nhưng billing và monitoring nên đọc usage thực tế do API trả về.
Ví dụ quá trình tokenize:
- Văn bản gốc:
Xin chào, tôi là G nhỏ. - Tách:
[Xin chào][,][tôi là][G nhỏ][.] - Thống kê: 9 ký tự → 5 Token → compression ratio khoảng 1,8 lần
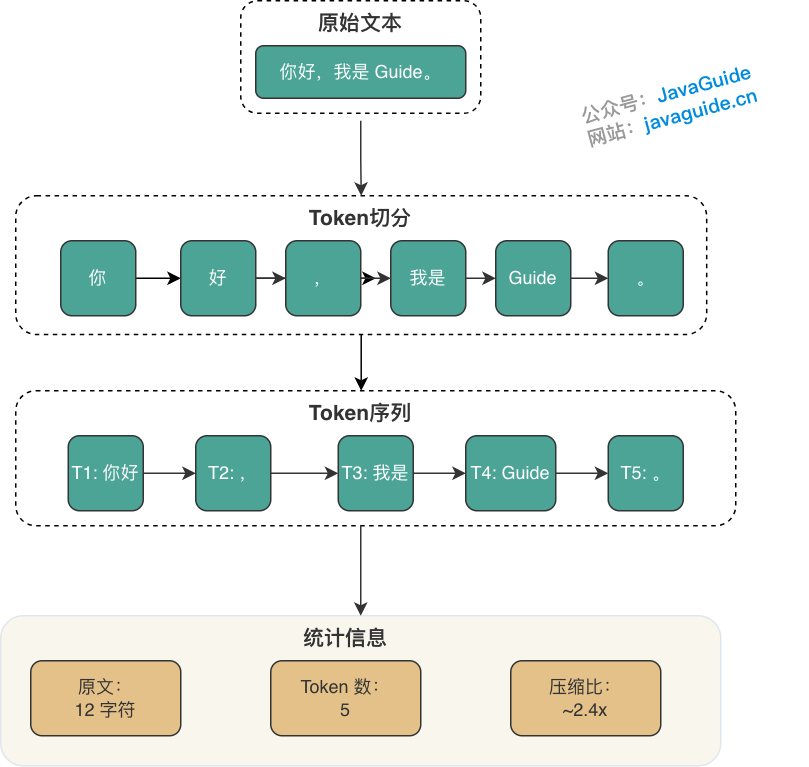
Cách tách ở trên chỉ nhằm minh họa quá trình, không đại diện cho kết quả thật của một model cụ thể. Các provider hoặc model khác nhau sử dụng Tokenizer khác nhau, nên cùng một đoạn văn bản cũng có thể cho ra các chuỗi Token khác nhau.
Context window
Context window là “working memory” của LLM. Nó quyết định lượng văn bản mà model có thể xử lý hoặc “ghi nhớ” tại bất kỳ thời điểm nào, tính theo Token.
- Tính liên tục của hội thoại: quyết định model có thể thực hiện bao nhiêu lượt hội thoại mà không quên các chi tiết ban đầu.
- Khả năng xử lý một lần: quyết định kích thước tối đa của document, codebase hoặc data sample mà model có thể xử lý trong một lần.
“Model hỗ trợ 128K/200K/1M” nghĩa là tổng giới hạn Token có thể đưa vào model trong một lần gọi. Context window của đa số model là tổng input và output, nhưng một số provider như Google Gemini giới hạn riêng input và output; hãy xem API document cụ thể trước khi sử dụng.
Context window thường bị các chi phí ẩn chiếm dụng:
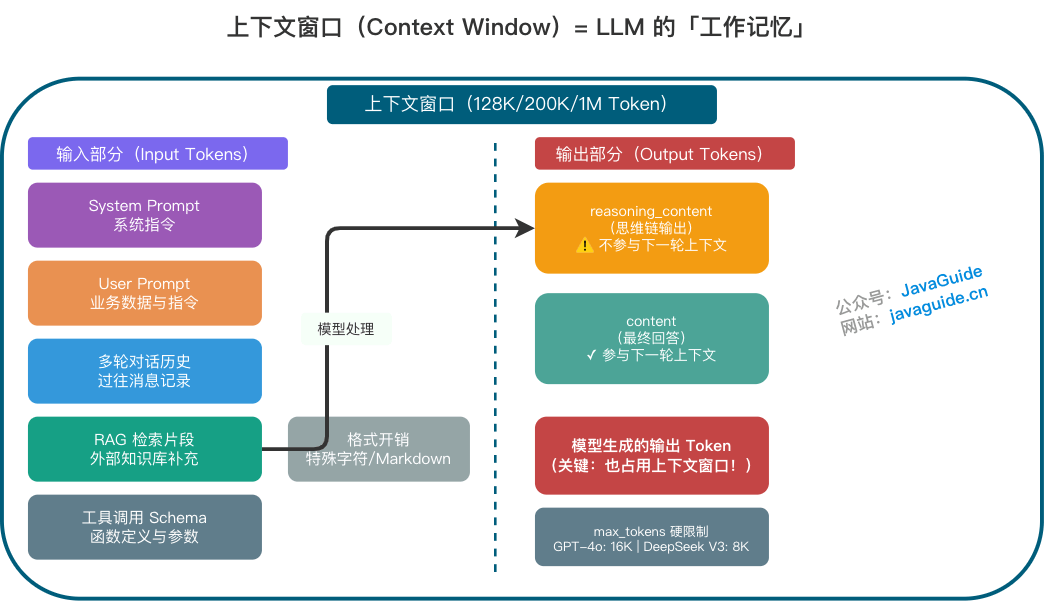
- System Prompt: system instruction điều chỉnh hành vi model (ẩn với người dùng nhưng chiếm window).
- User Prompt: business data và instruction.
- Lịch sử multi-turn conversation: các message trước đó.
- RAG retrieval chunk: thông tin bổ sung truy xuất từ knowledge base bên ngoài.
- Tool calling Schema: function definition và parameter structure.
- Overhead của format: special character, newline, Markdown marker và các thành phần khác.
- Output Token do model generation: output cũng chiếm context window.
Các nội dung này cùng chiếm dụng window, nên không gian thực tế dành cho business content thường nhỏ hơn nhiều so với giới hạn được công bố.
Sampling parameter
Ở mỗi bước, model chấm điểm cho từng Token ứng viên trong vocabulary (gọi nội bộ là logits); điểm càng cao nghĩa là model càng cho rằng Token đó nên xuất hiện ở vị trí này.
Ví dụ, giả sử model đang hoàn thành “Thời tiết hôm nay thật__”, nó có thể cho các điểm như sau:
| Token ứng viên | Điểm thô (logit) |
|---|---|
| đẹp | 5.0 |
| tuyệt | 3.2 |
| tuyệt vời | 2.1 |
| tệ | 0.5 |
| tím | -8.0 |
Điểm thô không phải probability, cần qua softmax mới có distribution xác suất. Giả sử tập ứng viên chỉ gồm năm mục trong bảng, kết quả tính được xấp xỉ:
| Token ứng viên | Xác suất |
|---|---|
| đẹp | 81.21% |
| tuyệt | 13.42% |
| tuyệt vời | 4.47% |
| tệ | 0.90% |
| tím | < 0.001% |
Sau đó model sampling theo distribution xác suất này để quyết định output Token nào.
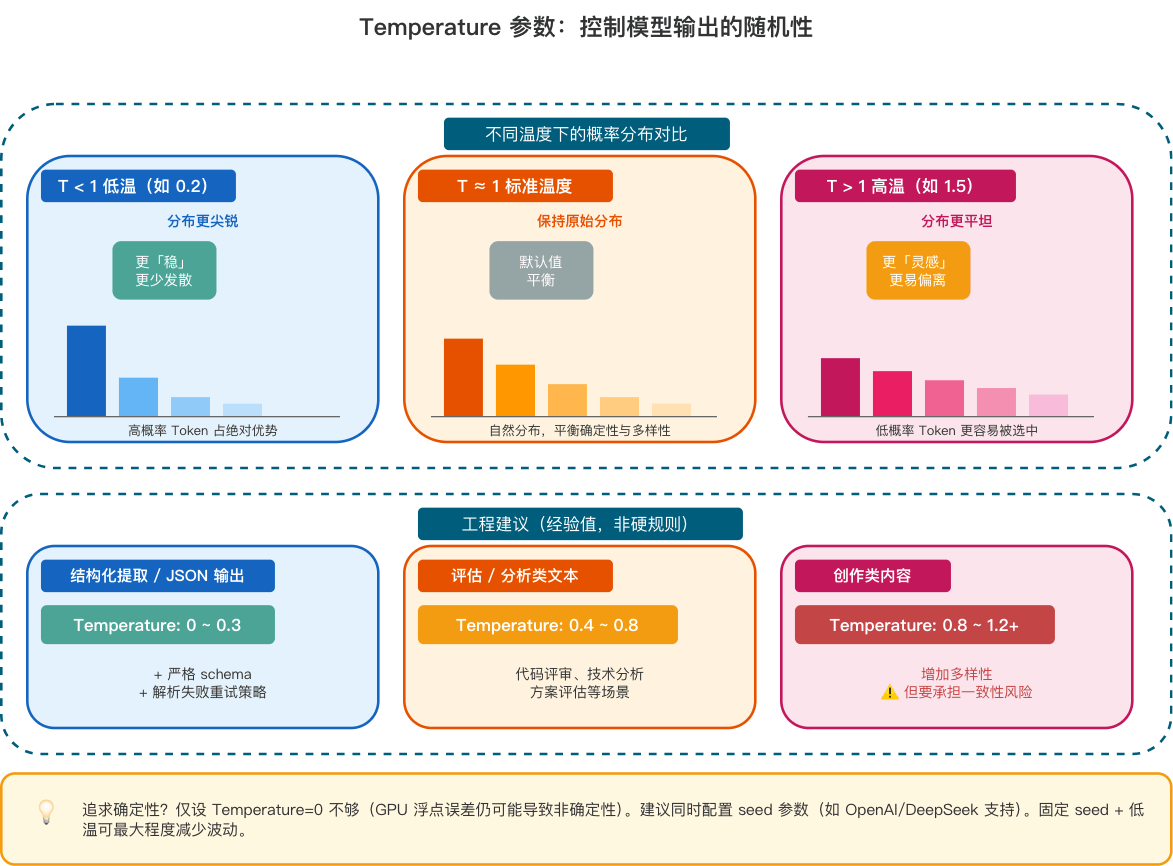
Các decoding parameter (Temperature, Top-p, Top-k...) áp dụng kiểm soát trong quá trình “chấm điểm → xác suất → rút thăm” này:
- Temperature: điều chỉnh “hình dạng” của distribution xác suất, làm các lựa chọn điểm cao nổi bật hơn hoặc làm các lựa chọn đồng đều hơn.
- Top-p / Top-k: trực tiếp loại các ứng viên không đáng tin, thu nhỏ “pool rút thăm”.
- Nhóm Penalty: giảm điểm các từ đã xuất hiện, tránh “lặp như máy ghi âm”.
Prompt
Prompt là task instruction đưa vào large language model (LLM). LLM generation Token tiếp theo dựa trên context hiện tại, đồng thời có thể thể hiện một mức semantic understanding và instruction following nhất định; nhưng khi task boundary không rõ, model vẫn có thể lạc đề hoặc tự bổ sung thông tin không tồn tại.
Vai trò của Prompt là thu hẹp phạm vi generation của model; chất lượng không có quan hệ trực tiếp với độ dài. Thay vì chồng nhiều modifier, điều quan trọng hơn là nói rõ bốn thông tin: Role, Task, Context và Format.

| Yếu tố | Vai trò | Cách diễn đạt thường gặp |
|---|---|---|
| Role (vai trò) | Cho model biết dùng kiến thức và giọng điệu nào | “Bạn là Java architect có 10 năm kinh nghiệm” |
| Task (nhiệm vụ) | Nêu rõ cần hoàn thành action nào | “Hãy review vấn đề performance của code sau” |
| Context (context) | Bổ sung background liên quan đến task | “QPS production hiện tại là 2000, response time trên 500ms” |
| Format (định dạng) | Quy định output có hình dạng gì | “Output JSON, gồm hai field bottleneck và solution” |
Structured output
Trước tiên hãy xem một Prompt rất phổ biến:
Hãy xác định feedback dưới đây của người dùng thuộc loại ticket nào và trả về JSON.

Feedback của người dùng: Tôi đã thanh toán thành công nhưng order luôn hiển thị đang chờ thanh toán.
Model có thể trả về:
{
  "category": "payment",
  "priority": "high",
  "reason": "Người dùng thanh toán thành công nhưng trạng thái order chưa được cập nhật"
}
Kết quả này có thể đọc được, nhưng chưa phải contract mà backend có thể consume ổn định. Phía business còn phải xác định rõ các boundary sau:
categorychỉ được làPAYMENT,LOGISTICS,AFTER_SALE,ACCOUNT.prioritychỉ được làLOW,MEDIUM,HIGH.confidencephải là số thập phân từ0đến1.reasoncó được để trống không? Độ dài tối đa là bao nhiêu?- Nếu input của người dùng thiếu thông tin thì trả về
NEED_MORE_INFO, hay tiếp tục đoán?
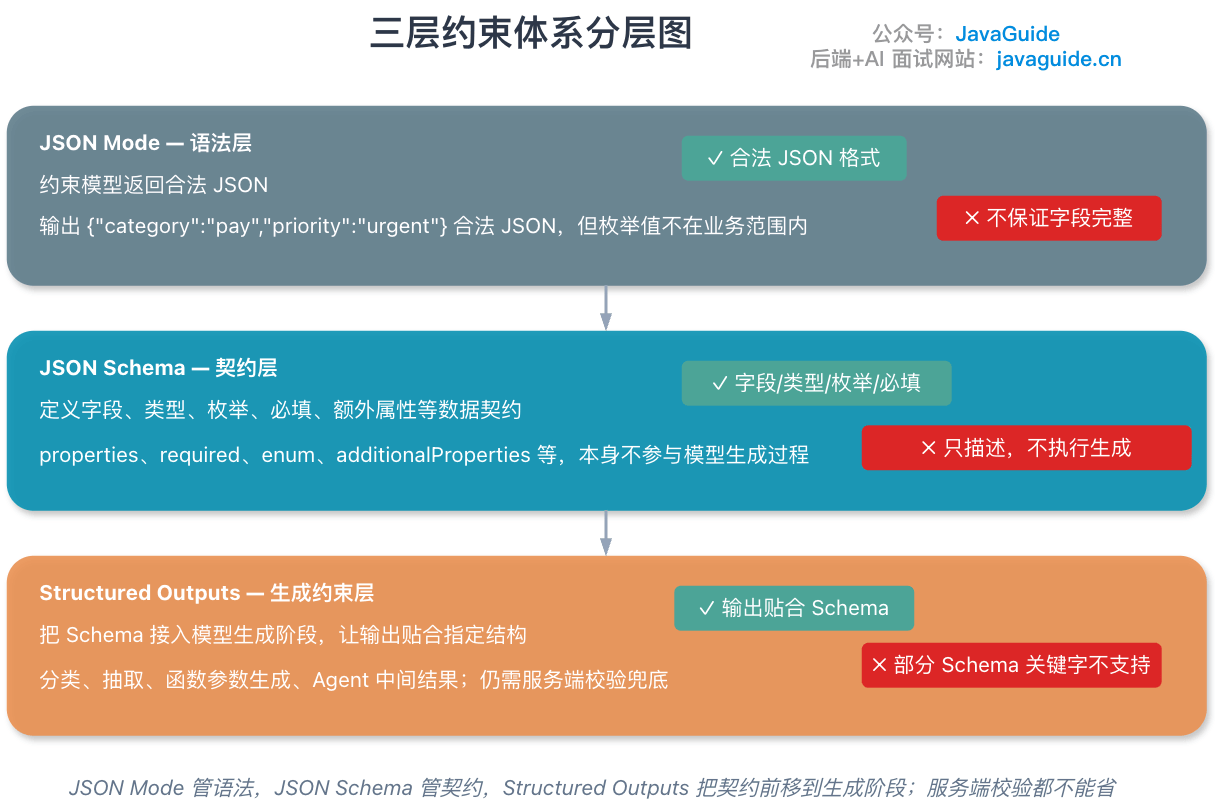
Prompt ngôn ngữ tự nhiên khó duy trì các boundary này trong thời gian dài, vì vậy cần phân biệt JSON Mode, JSON Schema và Structured Outputs lần lượt phụ trách gì:
- JSON Mode là một output mode, ràng buộc model trả về JSON hợp lệ.
- JSON Schema là một specification mô tả structure, dùng để định nghĩa JSON cần có field nào, type của field là gì, field nào bắt buộc, có những giá trị enum nào và có cho phép field thừa hay không.
- Structured Outputs là khả năng structured generation do model provider cung cấp. Nó nhận JSON Schema hoặc Schema tương tự để model bám sát, hoặc bám đúng, structure này trong giai đoạn generation.
JSON Schema phụ trách mô tả contract; các model API capability như Structured Outputs, Function Calling / Tool Calling phụ trách áp dụng contract này trong giai đoạn generation. Chỉ cung cấp Schema text mà không có generation constraint tương ứng thì model vẫn có thể trả về nội dung không đáp ứng yêu cầu về field.
Function Calling / Tool Calling
Khi model trả về query_order và parameter {"orderId": "1029384756"}, Java method vẫn chưa được thực thi. Function Calling / Tool Calling chỉ giúp model generation một calling intent có structure; backend service, Agent Runtime, MCP Host hoặc môi trường do provider quản lý mới chịu trách nhiệm execute tool.
Một lần gọi hoàn chỉnh gồm model generation intent, business validation, tool execution và điền kết quả trở lại:
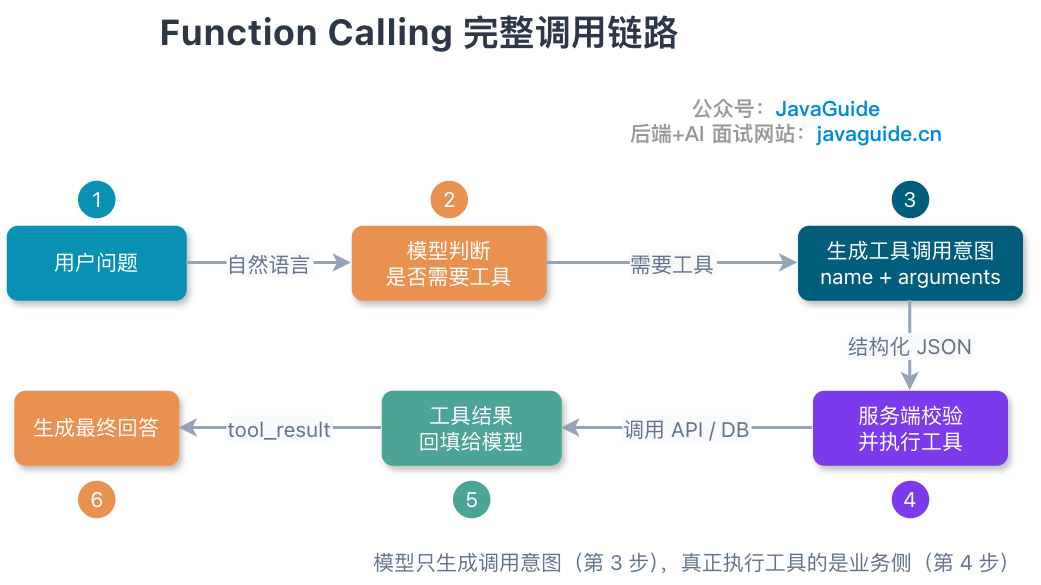
- Server đăng ký tên tool, mục đích và parameter Schema.
- Người dùng yêu cầu “Hãy giúp tôi kiểm tra order 1029384756 đang ở đâu”.
- Model chọn
query_ordervà generation parameter{"orderId": "1029384756"}. - Phía business kiểm tra field type, field bắt buộc, quyền người dùng, order ownership và idempotency key.
- Sau khi validation thành công, phía business mới gọi order system, database hoặc HTTP API.
- Tool result được điền trở lại model cùng
tool_use_id. Anthropic yêu cầutool_use_idkhớp tuyệt đối; Gemini 3 cũng generationidduy nhất cho mỗifunctionCall. Khi gọi song song, nếu thiếu ID tương ứng, result trả về có thể bị ghép nhầm với tool request. - Model tổ chức final response dựa trên tool result.
LLM call production-grade
Một response model mà người dùng nhìn thấy thực chất đi qua business validation, context assembly, model routing, provider call, response parsing và result persistence. Nếu một khâu thiếu status record hoặc error handling, trên giao diện thường chỉ còn một câu chung chung “model call failed”.
Production system ít nhất phải ghi nhận tám giai đoạn:
- Kiểm tra user identity, tenant, plan, feature permission và request size.
- Assemble System Prompt, user input, message history, RAG evidence, tool Schema và output format constraint.
- Ước tính input Token, dành trước output budget; khi cần thì cắt history, nén context hoặc chuyển model.
- Dùng unified client hoặc model gateway để chọn model, provider, timeout, retry và rate limiting policy.
- Gọi provider API, nhận synchronous response hoặc streaming response như SSE, WebSocket.
- Parse incremental text, end reason, tool call, Token usage, refusal và structured result.
- Lưu answer, call attempt, cost, error reason và business status.
- Ghi Trace, TTFT, total latency, retry count, rate limiting ratio và parse failure rate.
Khi retry cũng cần phân biệt error type. Network interruption ngắn, một phần lỗi 5xx của provider và lỗi quá tải có thể retry giới hạn trong tổng deadline; parameter error, authentication error và security refusal thường không có ý nghĩa nếu tiếp tục submit cùng request. Chỉ cần có retry là phải thiết kế idempotency key, đồng thời ghi riêng business message, model call attempt và provider request để tránh trả lời trùng hoặc execute trùng tool có side effect.
AI application evaluation
Public Benchmark có thể dùng để loại các model rõ ràng không phù hợp, nhưng không thể thay thế business validation. Request thực tế có thể chứa typo, abbreviation khẩu ngữ, screenshot, nhiều ngôn ngữ và mâu thuẫn trước sau; một số high-risk path cũng có thể bị điểm trung bình che lấp.
Business evaluation thường bắt đầu từ Golden Set. Mỗi test case phải có input, expected result hoặc success criteria, scenario label và scoring method. RAG cần đánh giá riêng retrieval và generation; ngoài final answer, Agent còn phải được kiểm tra tool selection, parameter, execution trace và state thực tế của external system.
Các scoring method thường dùng có vai trò riêng:
| Method | Nội dung phù hợp để kiểm tra | Hạn chế chính |
|---|---|---|
| Rule evaluation | JSON format, field completeness, enum, numeric boundary, test result | Chỉ bao phủ điều kiện có thể encode rõ |
| LLM-as-Judge | Relevance, faithfulness, completeness, coherence và tone | Có scoring bias theo vị trí, độ dài... |
| Human evaluation | High-risk sample, semantic complexity và kết quả gây tranh cãi | Chậm, tốn kém, khó đảm bảo nhất quán |
Một evaluation workflow có thể duy trì lâu dài sẽ nối offline evaluation, production Trace replay và online gray release thành một chuỗi: giai đoạn development dùng fixed dataset để so sánh version, trước release replay real trace, sau khi release bổ sung sample từ Badcase và user feedback. Prompt, model, retrieval strategy, tool version và evaluation result phải được liên kết; nếu không, khi score thay đổi vẫn không tìm ra nguyên nhân.
Agent
Các bài gốc liên quan:
- Khái niệm cốt lõi của AI Agent: Agent Loop, Plan-and-Execute, A2A, Agentic Workflows, đăng ký Tools
- Workflow, Graph và Loop trong AI workflow: từ khái niệm đến triển khai
- Context Engineering là gì? Khác Prompt Engineering thế nào?
- Memory system của AI Agent: short-term memory, long-term memory và cơ chế memory evolution
- Thiết kế multi-Agent collaboration system: task split, state sharing, conflict handling và failure recovery
- Model Context Protocol (MCP) là gì? Quan hệ với Function Calling và Agent thế nào?
- Agent Skills là gì? Khác Prompt và MCP ở đâu?
- Harness Engineering: framework kiểm tra sáu tầng, context management và engineering practice
- Loop Engineering là gì? Vì sao nói đây là bình mới rượu cũ?
Agent là gì?
Một model call thông thường generation một đoạn text rồi kết thúc. Agent Runtime tiếp tục kiểm tra model có đưa ra tool call hay không, execute tool, ghi result vào context rồi để model quyết định bước tiếp theo. Vì vậy, implementation Agent của các framework như LangChain thường xoay quanh một loop.
Hệ thống này thường được viết là: Agent = LLM + Planning + Memory + Tools. LLM xử lý task understanding và decision; Planning quản lý step và dependency; Memory lưu current state hoặc history; Tools kết nối database, API, file system và code execution environment.
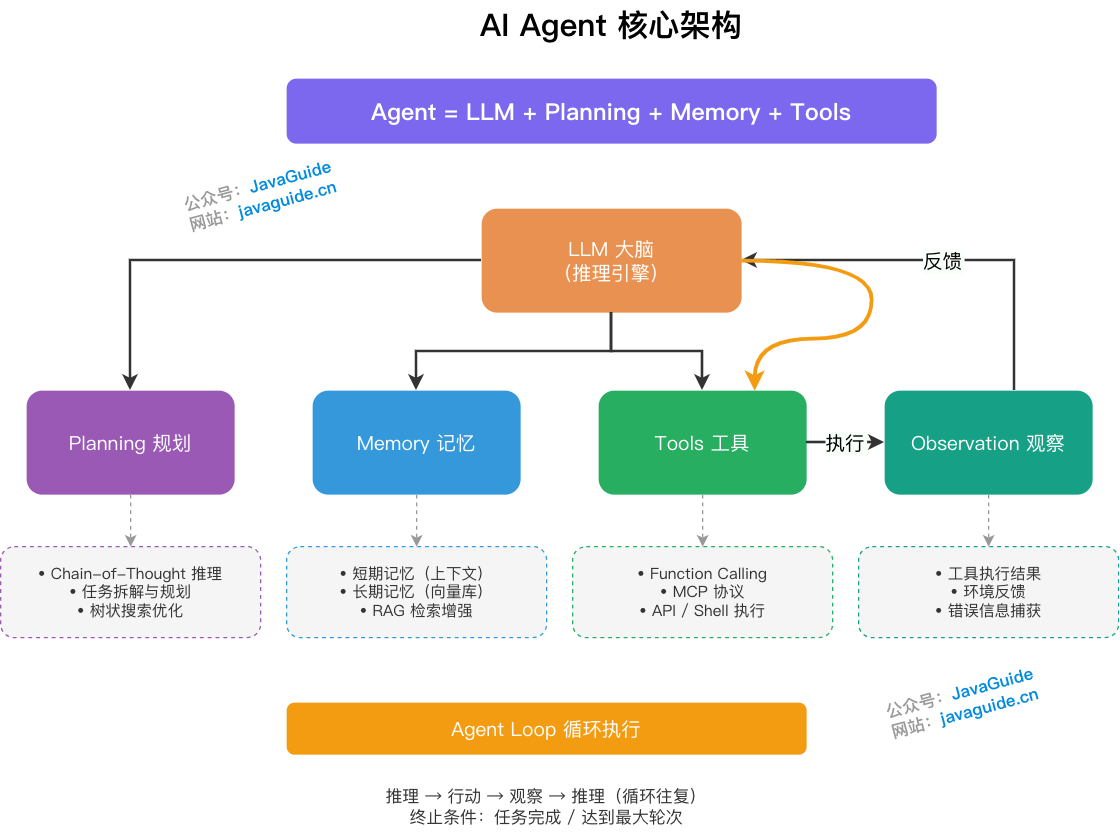
Short-term memory thường giữ session và task state hiện tại; long-term memory phụ trách tái sử dụng user preference, historical decision hoặc task experience giữa các session. Return value do tool execution tạo ra thuộc về Observation; runtime thêm nó vào context để model có thể tiếp tục phán đoán dựa trên result thực tế.
Agent Loop
Agent Loop nối model decision và tool execution thành feedback loop. Mỗi round đọc context hiện tại, model chọn trả lời trực tiếp hoặc gọi tool; runtime execute action và lưu result, sau đó chuyển sang round tiếp theo.
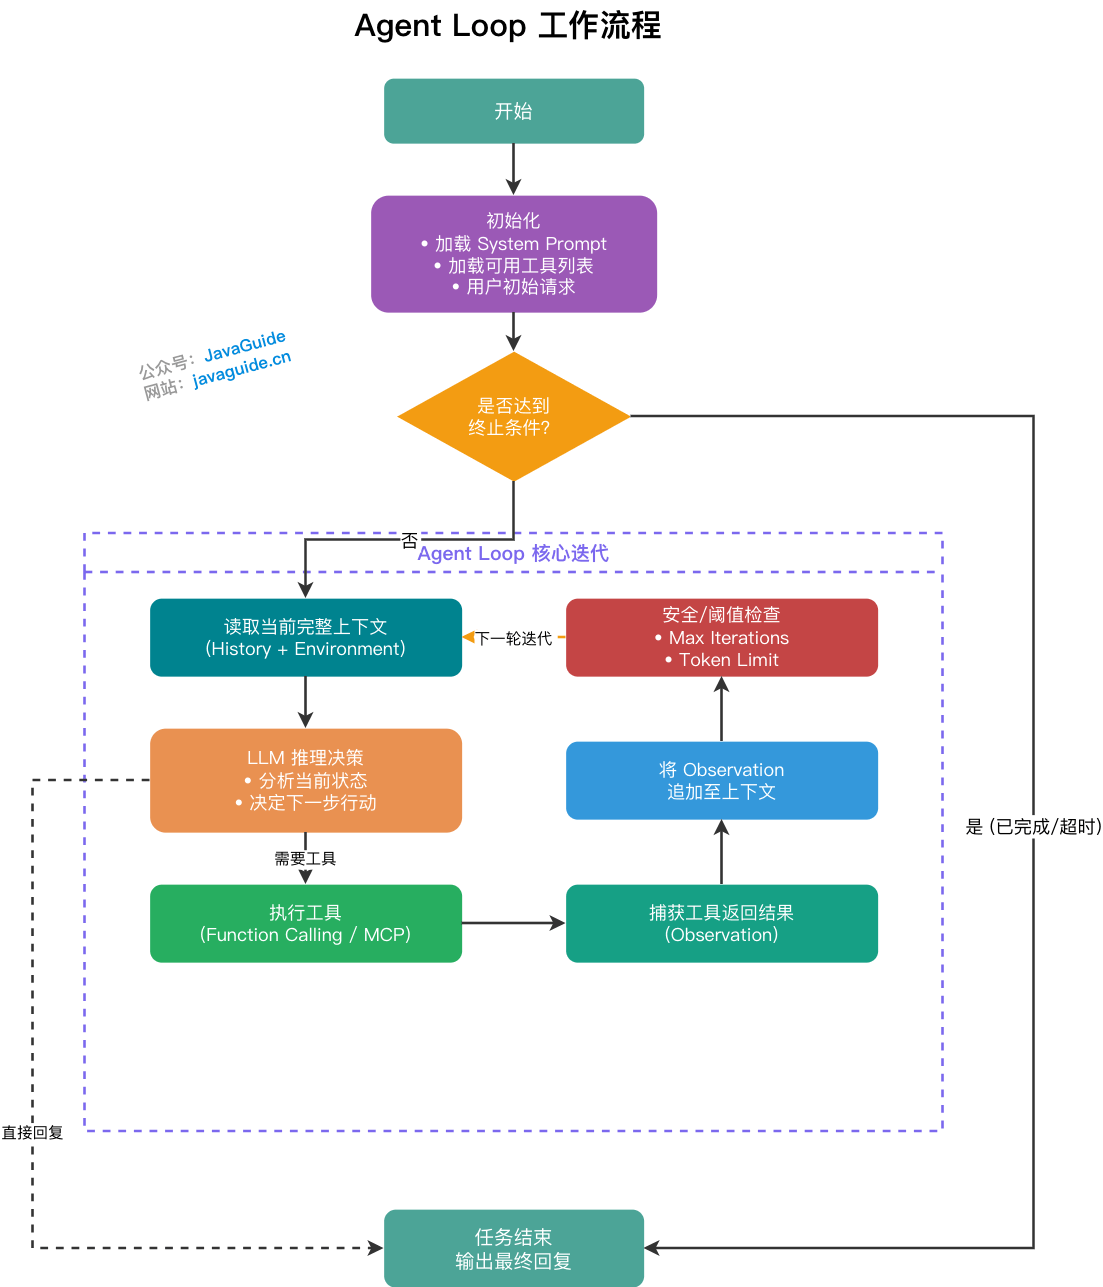
- Khởi tạo System Prompt, tool list và user request.
- Model đọc context, trả về text hoặc tool calling intent.
- Runtime execute tool, ghi result và state trở lại context.
- Khi model không gọi tool nữa thì kết thúc; nếu đạt giới hạn round, Token, thời gian hoặc chi phí, runtime buộc phải dừng.
Bản thân loop không phức tạp. Khi task kéo dài, message history, tool result và intermediate state liên tục chiếm context; constraint ban đầu cũng có thể bị nội dung phía sau làm loãng. Context Engineering quyết định information nào tiếp tục được giữ, khi nào cần compression và round tiếp theo thực sự cần thấy gì.
ReAct
ReAct là Reasoning + Acting, do Shunyu Yao và những người khác đề xuất năm 2022; paper là “ReAct: Synergizing Reasoning and Acting in Language Models”. Nó đặt reasoning, action và observation luân phiên trong cùng một trace: model trước tiên quyết định một action, environment trả về result, round tiếp theo tiếp tục dựa trên result đó.
Ví dụ, khi không biết order hiện đang ở trạng thái nào, model có thể gọi tool query trước. Order system trả về “đã thanh toán, đang chờ giao hàng”, model mới quyết định trả lời trực tiếp hay tiếp tục query logistics. External result cung cấp căn cứ cho phán đoán tiếp theo, nhưng không tự động đảm bảo answer đúng.
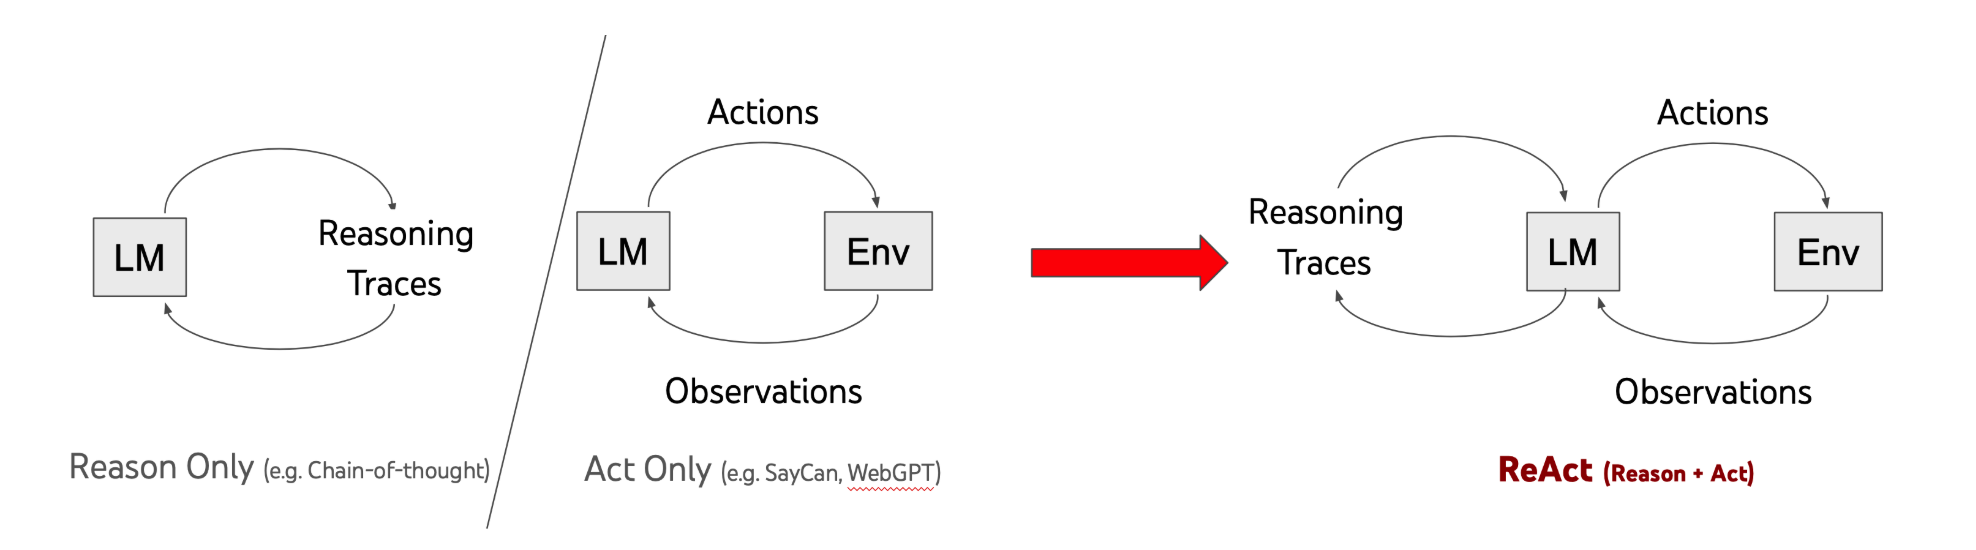
Khi triển khai ReAct, runtime phải lưu execution history và current state, cung cấp available tool hoặc Skills cho model, đồng thời liên kết tool response với call tương ứng dưới dạng Observation. System alert, user bổ sung thông tin và các thay đổi khác của environment cũng phải được cập nhật ở những round sau.
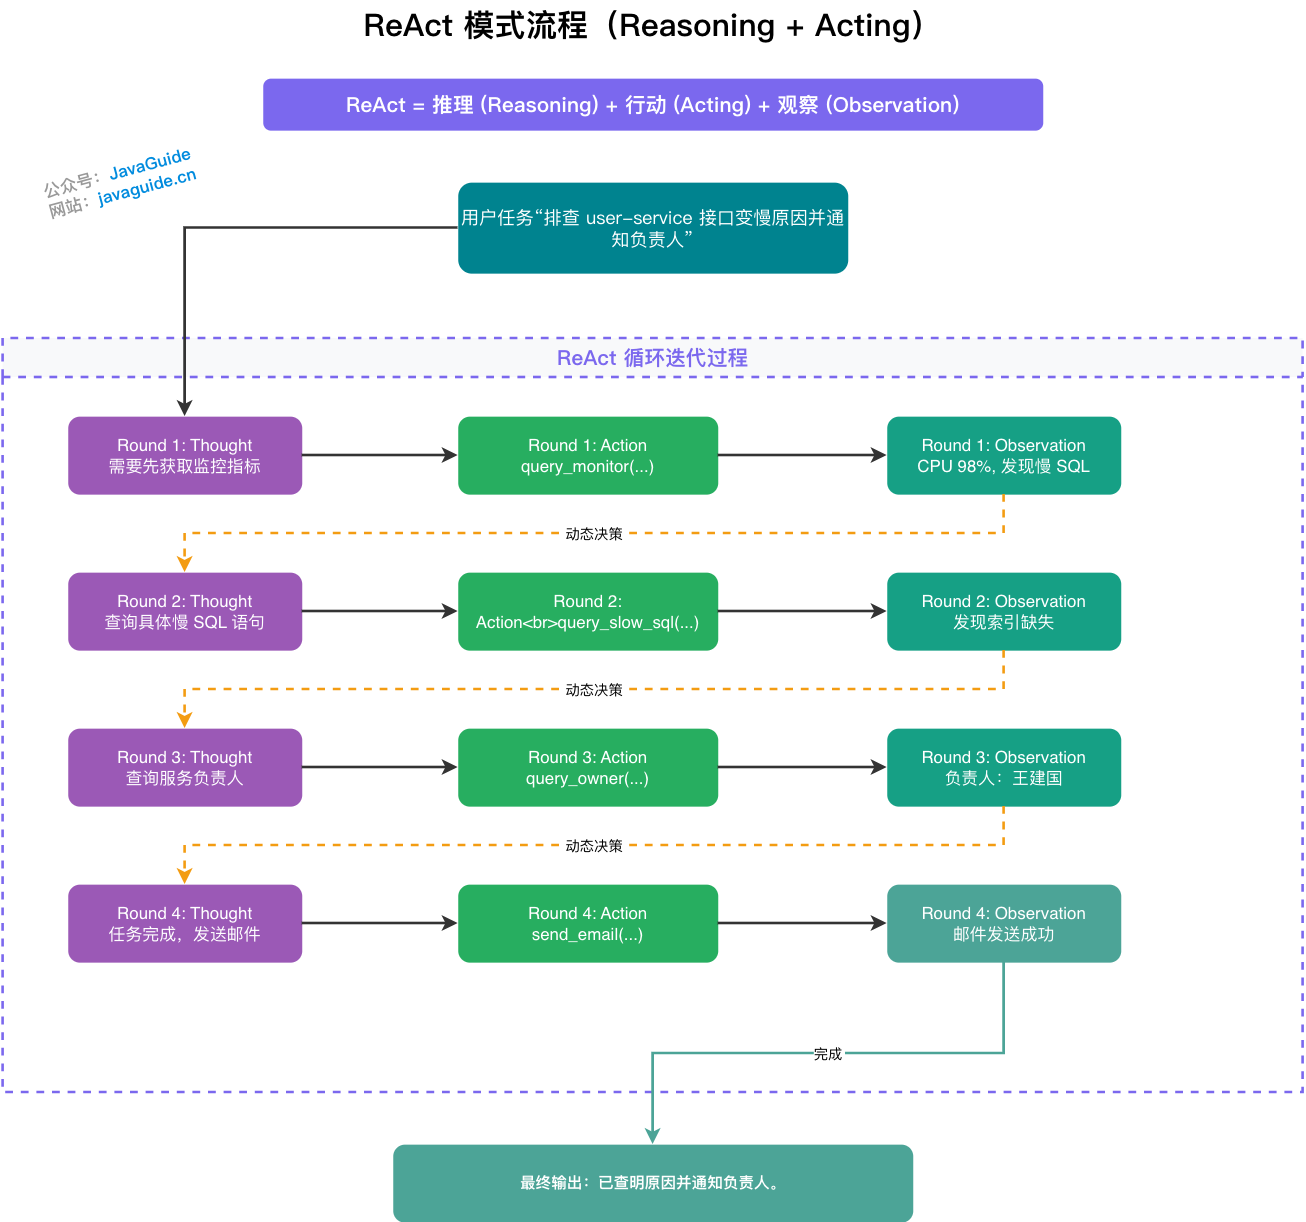
Nhiều lượt tool call làm tăng response latency và Token consumption; chất lượng result cũng chịu ảnh hưởng của tool description, parameter validation, returned data và stopping condition. Trace có thể ghi lại các action đã thực hiện, nhưng không thể đồng nhất trực tiếp reasoning text trong output model với cơ chế decision nội bộ.
Plan-and-Execute
Plan-and-Execute là pattern do team LangChain đề xuất năm 2023. Giai đoạn planning tạo step và dependency trước, sau đó executor xử lý từng mục, nên phù hợp hơn với long task có thể nhận diện các giai đoạn chính từ trước.
Global plan giúp dependency và completion condition lộ ra sớm hơn. Khi environment hoặc task goal thay đổi trong lúc execution, old plan cũng có thể mất hiệu lực; khi đó cần re-plan thay vì tiếp tục chạy theo step cũ.
Trong project có thể dùng plan kiểm soát outer stage, còn bên trong một step chạy ReAct sub-loop. Dependency có tính xác định được plan ràng buộc; khi thiếu local information thì bổ sung bằng tool call.
Workflow, Graph và Loop
Agent giao việc chọn bước tiếp theo cho model, còn Workflow quy định trước node order, conditional jump và failure handling bằng code hoặc graph structure. Cả hai đều có thể gọi model và tool; khác biệt chính là control nằm ở đâu.
Các flow có step ổn định và permission requirement rõ ràng thường nên giao cho Workflow. Khi gặp retrieval, analysis hoặc tool selection không thể liệt kê hết từ trước, có thể nhúng Agent sub-loop vào một node. Agentic Workflow kiểu này dùng outer flow để giới hạn execution scope, rồi giao local decision cho model.
Data structure của AI workflow là directed graph (Graph), gồm ba element: Node thực hiện execution, Edge kiểm soát control flow, State chia sẻ context giữa các node.
Multi-Agent
Multi-Agent quản lý các executor có thể độc lập hoàn thành sub-goal; multi-stage Prompt Chain quản lý các step xử lý trong một Workflow. Điều kiện để tách một role thành Agent độc lập là nó có Prompt, tool, context, permission, runtime state và delivery result riêng.
Chỉ khi các giai đoạn khác nhau rõ rệt về tool, permission và context, hoặc task có thể tách thành một số hướng tương đối độc lập, multi-Agent mới có thể đem lại lợi ích. Nếu các role dùng chung context và tool, chỉ generation các đoạn text tương tự nhau, phần tăng thêm chủ yếu là số lần model call, latency và chi phí merge.
Các cách orchestration thường gặp:
| Mode | Cách kiểm soát | Scenario phù hợp |
|---|---|---|
| Sequential | Code gọi nhiều Agent theo thứ tự cố định | Step xác định, dependency trước sau rõ |
| Parallel | Chạy song song các task độc lập, sau đó merge | Multi-way retrieval, multi-dimensional review, voting |
| Router | Rule hoặc model route request đến một hay nhiều expert | Business domain rõ, classification tương đối ổn định |
| Supervisor/Manager | Agent chính dynamic split task và gọi sub-Agent | Không thể xác định hoàn toàn sub-task từ trước, cần một answer thống nhất |
| Handoff | Agent hiện tại chuyển control và context cần thiết cho role khác | Customer service routing, conversation theo giai đoạn |
Sau khi tách role vẫn phải định nghĩa task contract, gồm sub-goal, success criteria, dependency, tool được phép dùng, output Schema, artifact location, timeout, Token budget và failure strategy. Khi nhiều Agent cùng ghi shared state hoặc gọi tool có side effect, vẫn phải dựa vào idempotency, version control, lock, compensation và checkpoint để đảm bảo consistency; không thể để model tự thương lượng write order.
Context Engineering
Khi context hỗn loạn, dù model đủ năng lực, Agent vẫn có thể bỏ sót constraint, gọi tool lặp lại hoặc lệch khỏi task hiện tại.
Context Engineering phụ trách chọn, tổ chức và cập nhật information mà model cần ở thời điểm hiện tại trong Token window hữu hạn, bao gồm rule, memory, tool description, session state, external observation result và Token budget. Prompt Engineering tập trung hơn vào cách diễn đạt instruction, là một vấn đề cục bộ hơn trong số đó.
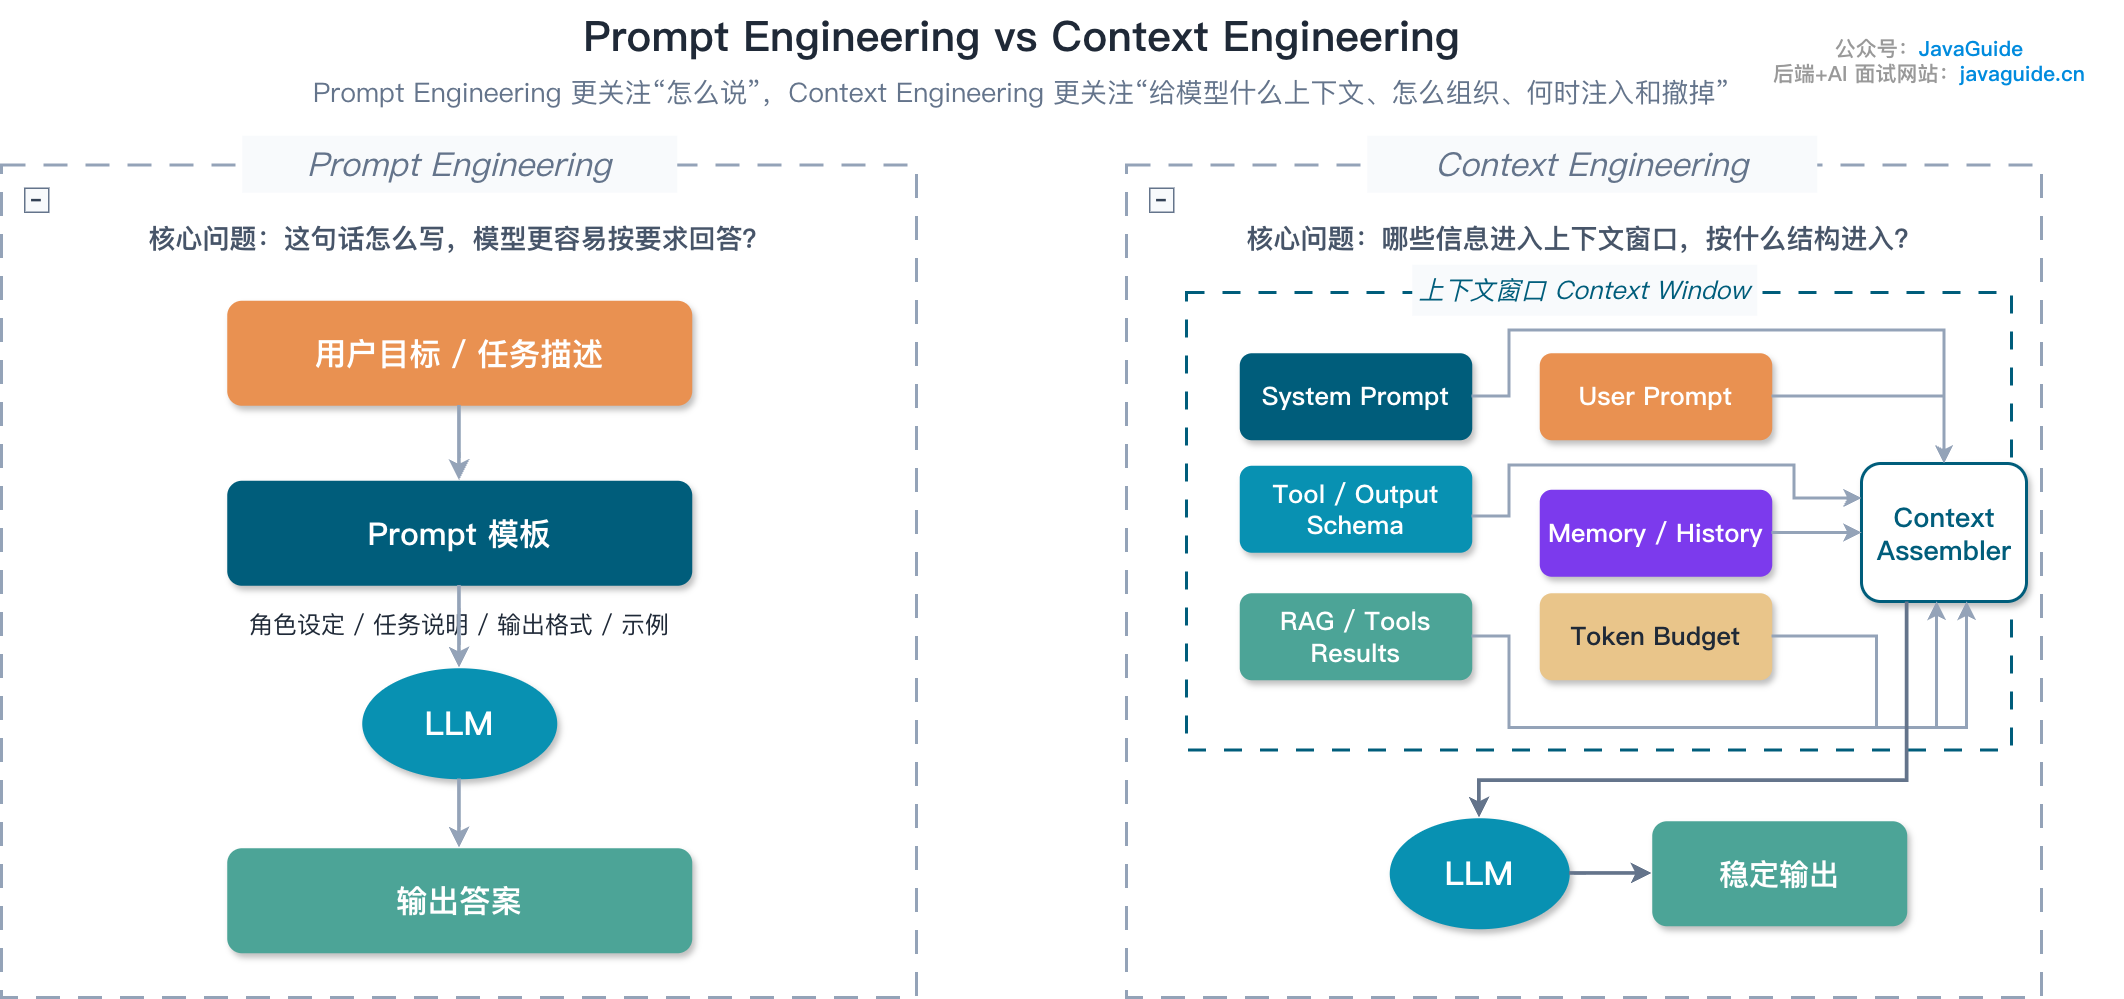
Phương pháp thiết kế chi tiết hơn xem trong “Prompt Engineering” và “Context Engineering”.
Memory

Memory system thường chia thành hai tầng: short-term memory và long-term memory. Short-term memory ở cấp Session, phục vụ task hiện tại; long-term memory trải qua nhiều Session, lưu user preference, historical decision và task experience cần tái sử dụng. Lifecycle, permission và cách update của hai loại data khác nhau, nên khi lưu trữ cần tách riêng ở mức logic.
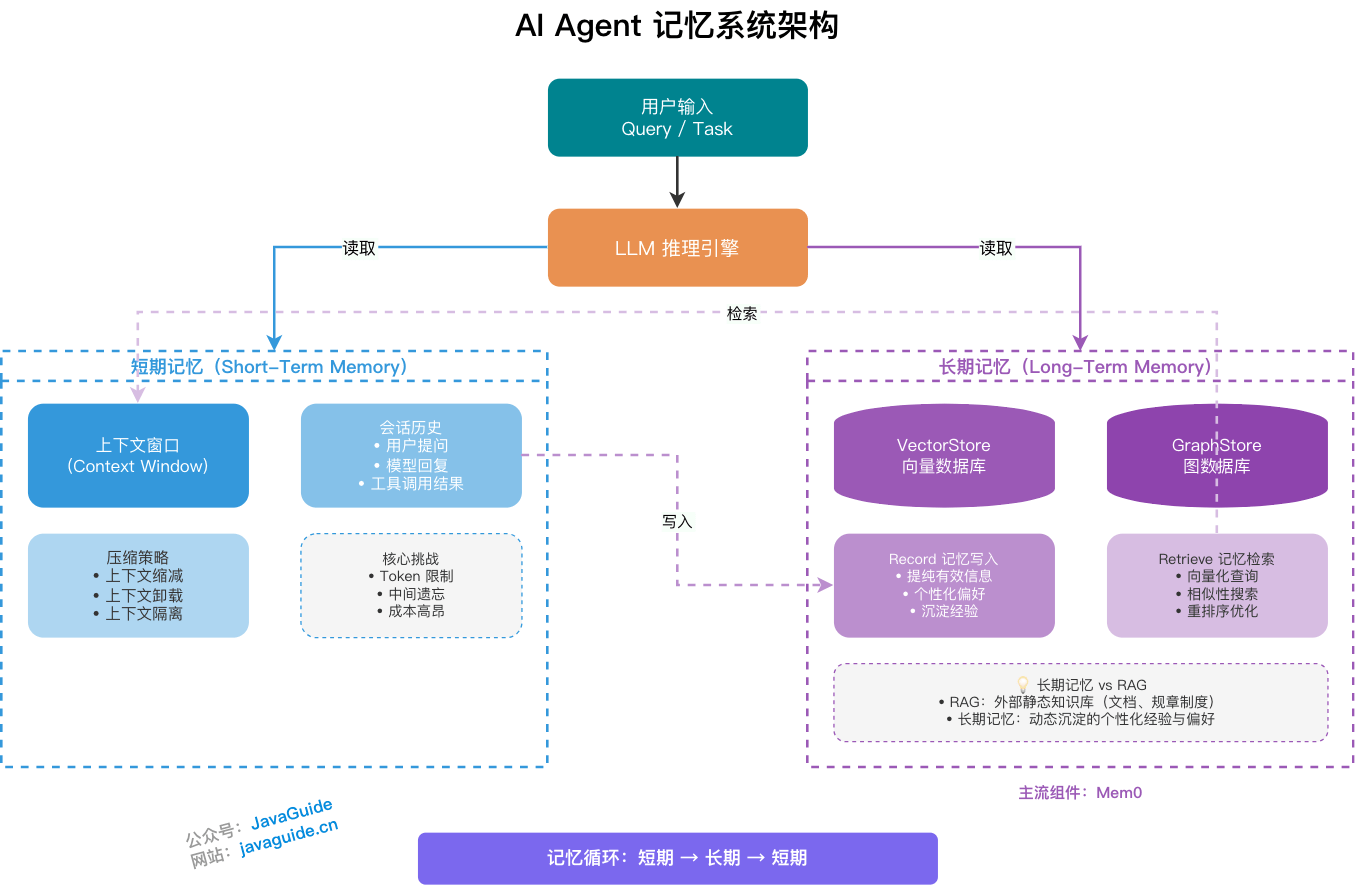
Xét theo mục đích chức năng, Agent memory có thể chia thành ba loại.
| Loại chức năng | Câu hỏi cốt lõi | Nội dung lưu trữ | Scenario điển hình |
|---|---|---|---|
| Fact memory | Agent biết gì | User preference, environment state, explicit fact | Ghi nhớ preference về tech stack của user |
| Experience memory | Agent cải thiện thế nào | Trace trước đây, bài học thành bại, strategy knowledge | Học từ lần code review thất bại |
| Working memory | Agent đang suy nghĩ gì | Current reasoning context, task progress | Intermediate state trong multi-step reasoning |
Long-term memory và RAG khá giống nhau về mặt kỹ thuật, đều dùng vector store và semantic retrieval. Nhưng đối tượng phục vụ của chúng khác nhau.
RAG gắn với knowledge source có thể truy xuất, chẳng hạn company policy, product document và kết quả query từ real-time database. Nó có thể phục vụ shared knowledge base, cũng có thể filter permission hoặc retrieval theo user, tenant, role và session. Khác biệt chính giữa RAG và long-term memory nằm ở data source và lifecycle: RAG truy xuất external knowledge, còn long-term memory lưu information hình thành từ interaction và cần được tái sử dụng giữa các session.
Long-term memory quản lý experience được tích lũy động trong interaction giữa Agent và một user cụ thể, chẳng hạn user preference, habit, historical decision và personal context. Nó có tính cá nhân hóa cao, khác nhau tùy người.

MCP
Tên đầy đủ của MCP là Model Context Protocol, thường gọi là “giao thức ngữ cảnh mô hình”. Ba từ trong tên tương ứng với phạm vi áp dụng của protocol:
- Model: hướng đến ứng dụng LLM;
- Context: đưa external context, tool và data source đến model;
- Protocol: dùng một protocol tiêu chuẩn để quy định cách interaction.
MCP định nghĩa cách giao tiếp giữa MCP Client và MCP Server. Host đảm nhận user interaction và model call, Client giao tiếp với Server, Server cung cấp capability cụ thể ra bên ngoài; bản thân model không có plugin tích hợp chỉ vì kết nối MCP.
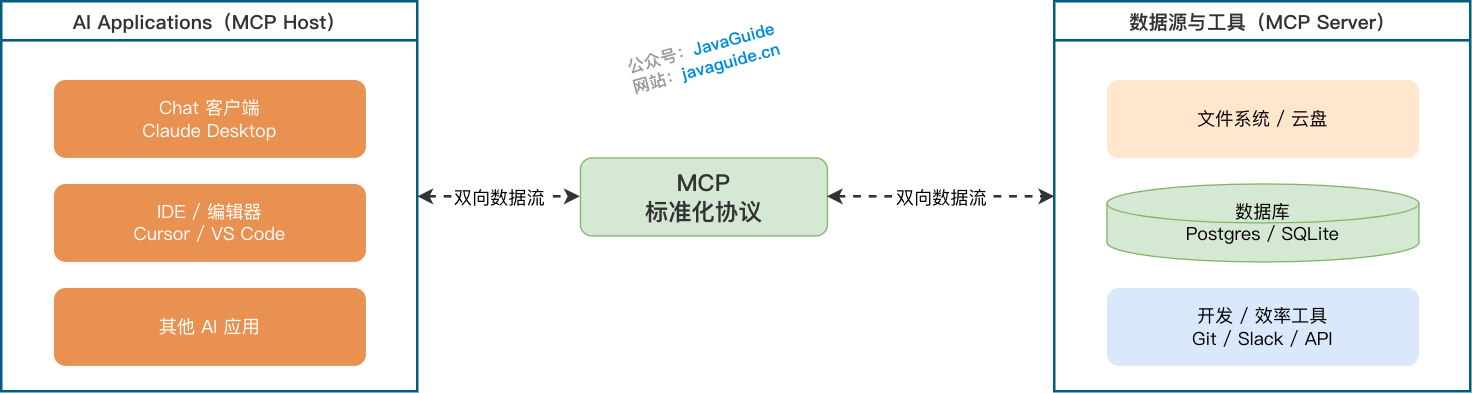
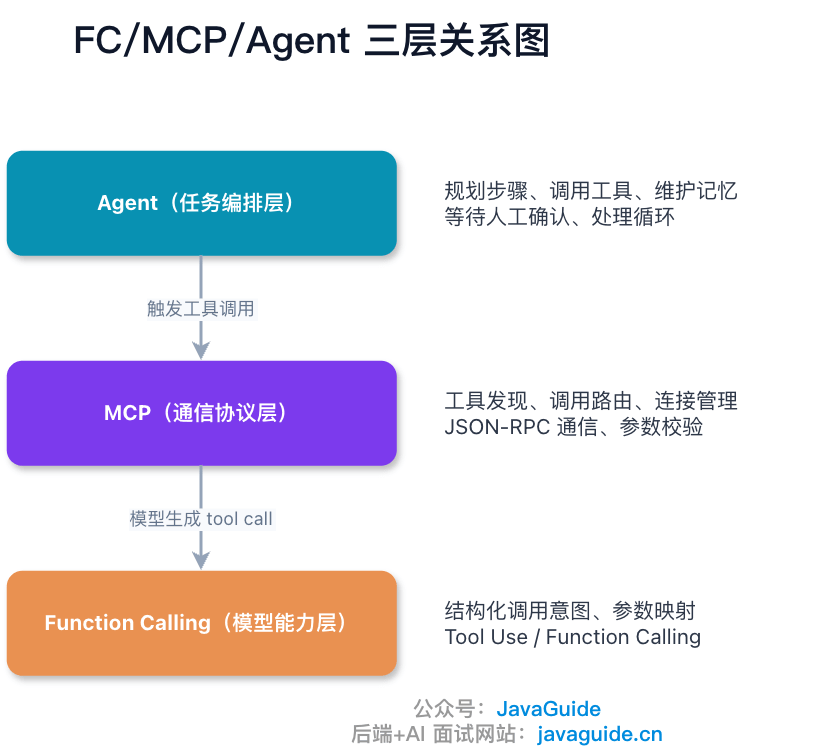
Function Calling, MCP, Agent và Skills thường xuất hiện trong cùng một system, nhưng mỗi thành phần xử lý một vấn đề khác nhau: Function Calling giúp model thể hiện tool calling intent; MCP quy định cách host discover external capability và kết nối backend service; Agent quyết định bước tiếp theo trong multi-round execution; Skills lưu workflow và experience cần cho một loại task.
Skills
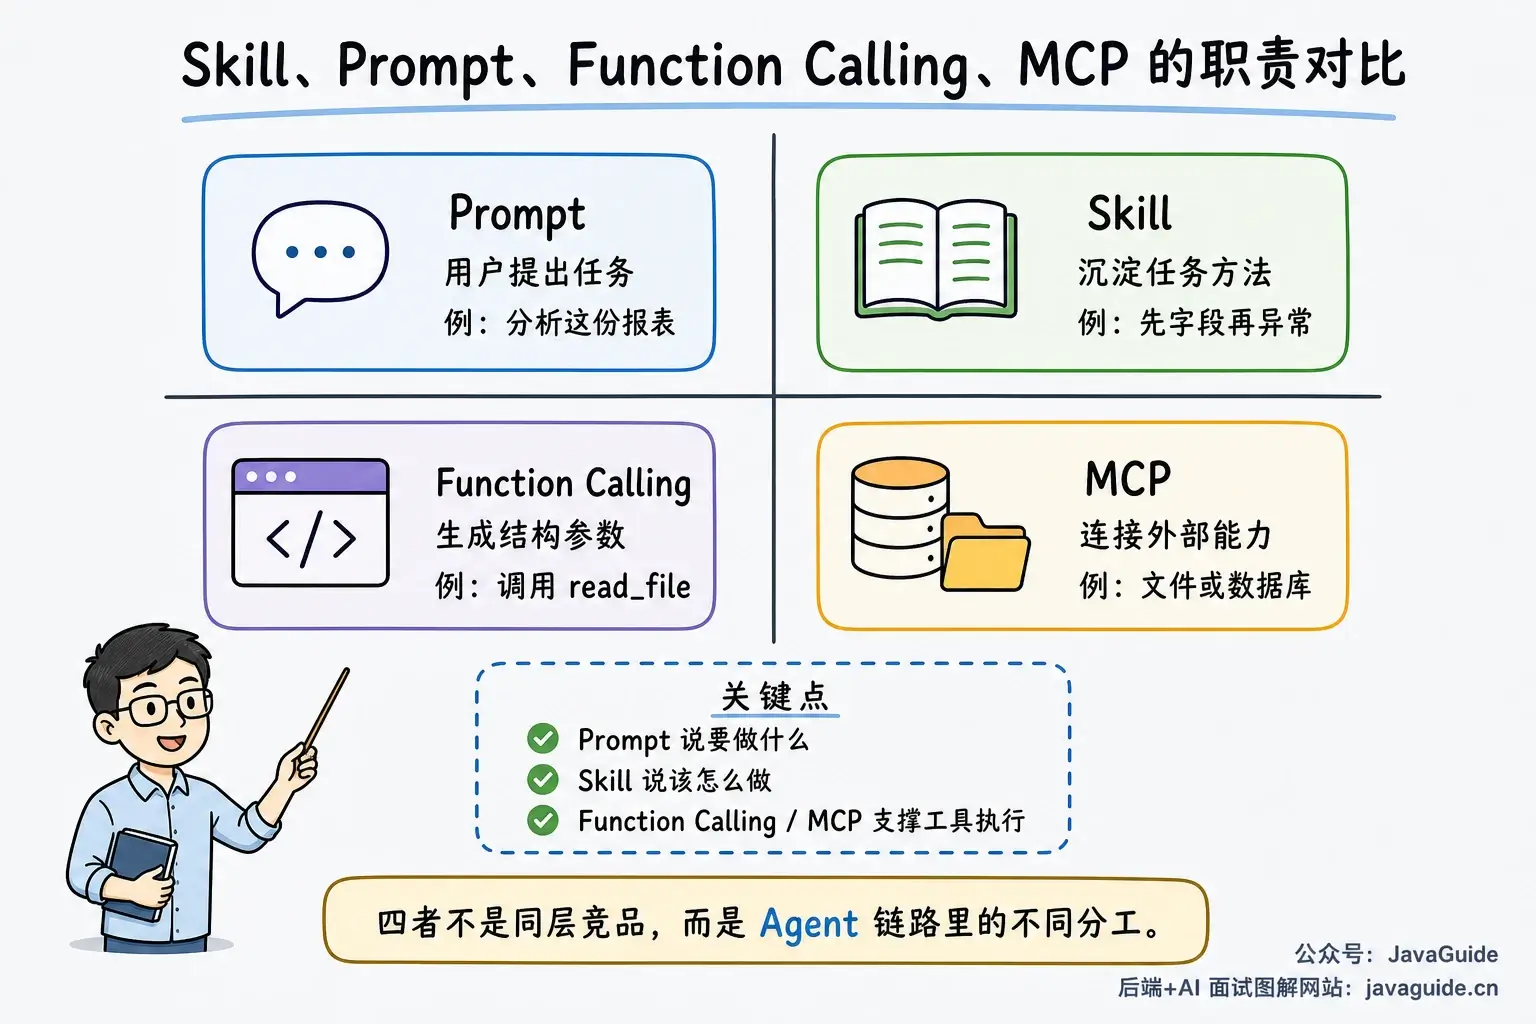
Khi user yêu cầu “Hãy giúp tôi phân tích report này”, Prompt chỉ biểu đạt task hiện tại. Nếu model cần đọc file, nó sẽ dùng Function Calling để generation structured parameter read_file; tool này có thể do MCP Server cung cấp. Còn thứ tự phân tích, chẳng hạn trước tiên kiểm tra ý nghĩa field, sau đó tìm anomaly và cuối cùng giải thích result theo business, phù hợp hơn để viết vào Skill.
Skill là một task instruction mà Agent có thể discover và load on demand. Kinh nghiệm của team về interface format, log field, thứ tự kiểm tra slow SQL và trọng tâm code Review đều có thể đưa vào SKILL.md, tránh phải viết cả bộ rule vào Prompt mỗi lần. Skill, Prompt, Function Calling và MCP lần lượt xử lý task input, calling intent, tool connection và execution method; các responsibility này có thể đồng thời xuất hiện trong một task.
Skill loading và execution gồm năm bước:
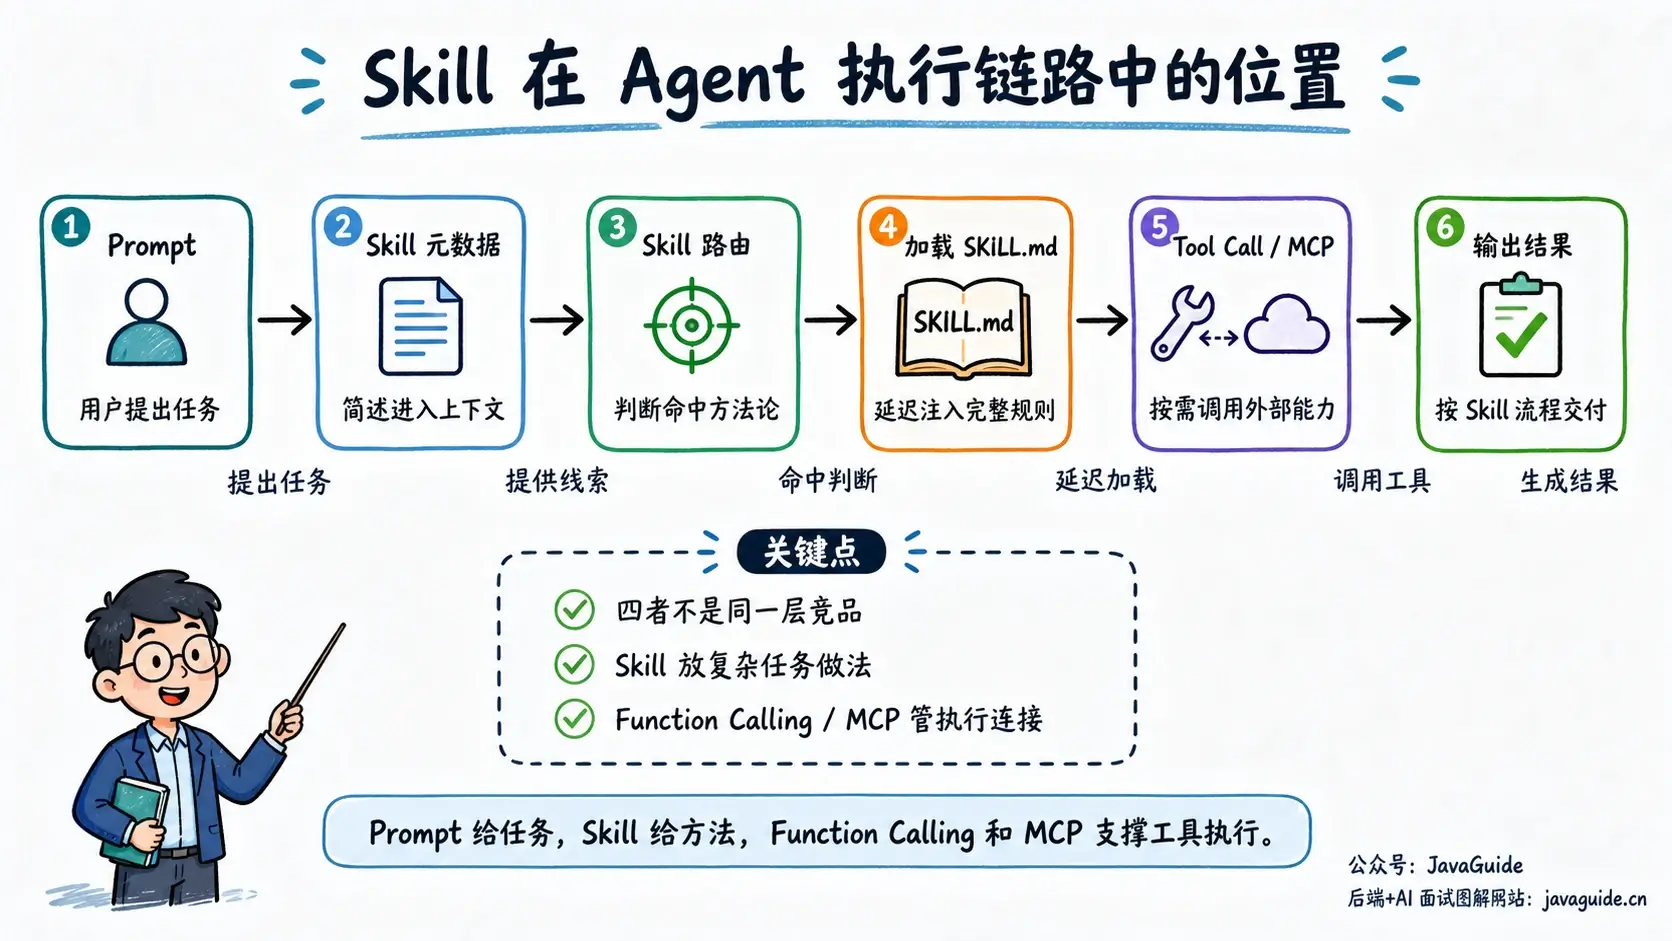
- User đưa ra task (Prompt)
- Host đưa short description của các Skill khả dụng vào context (Skill metadata)
- Model xác định task hiện tại match Skill nào (Skill routing)
- Host load tiếp full
SKILL.mdvào (lazy loading) - Model gọi tool, đọc tài liệu và ghi result theo workflow trong Skill (execution)
Harness Engineering
Model phụ trách reasoning và generation, nhưng không tự lưu task state, giới hạn file permission, execute test hoặc xử lý tool timeout. System prompt, tool call, file system, sandbox, orchestration, Hooks, feedback và constraint mechanism cùng tạo thành Harness. Trong engineering thường dùng công thức Agent = Model + Harness để nhắc rằng ngoài model, execution environment cũng quyết định task có thể tiếp tục chạy hay không.
Vivek Trivedi cũng dùng tư duy phân biệt model responsibility trước rồi kiểm tra surrounding system trong bài [“The Anatomy of an Agent Harness”]. Khi troubleshooting Agent, ngoài model output còn phải xem context có đầy đủ không, tool có khả dụng không, execution environment có được kiểm soát không và sau failure có recovery được không.
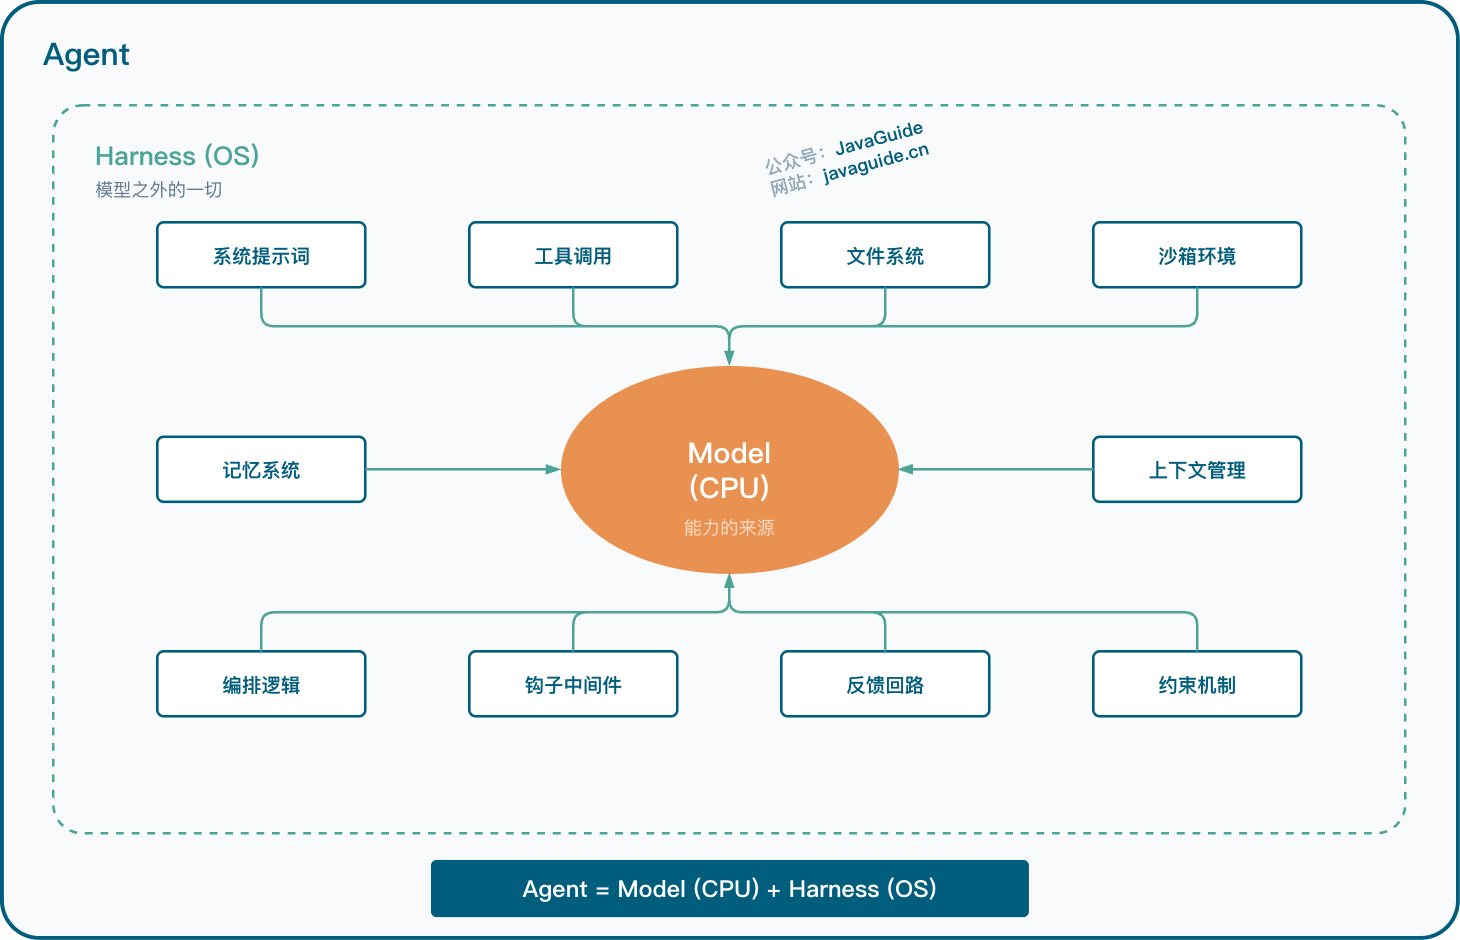
Prompt Engineering, Context Engineering và Harness Engineering có scope khác nhau. Prompt quan tâm cách biểu đạt instruction, Context quyết định information nào cần cung cấp cho call hiện tại, Harness quản lý execution, validation, observability và recovery bên ngoài model.
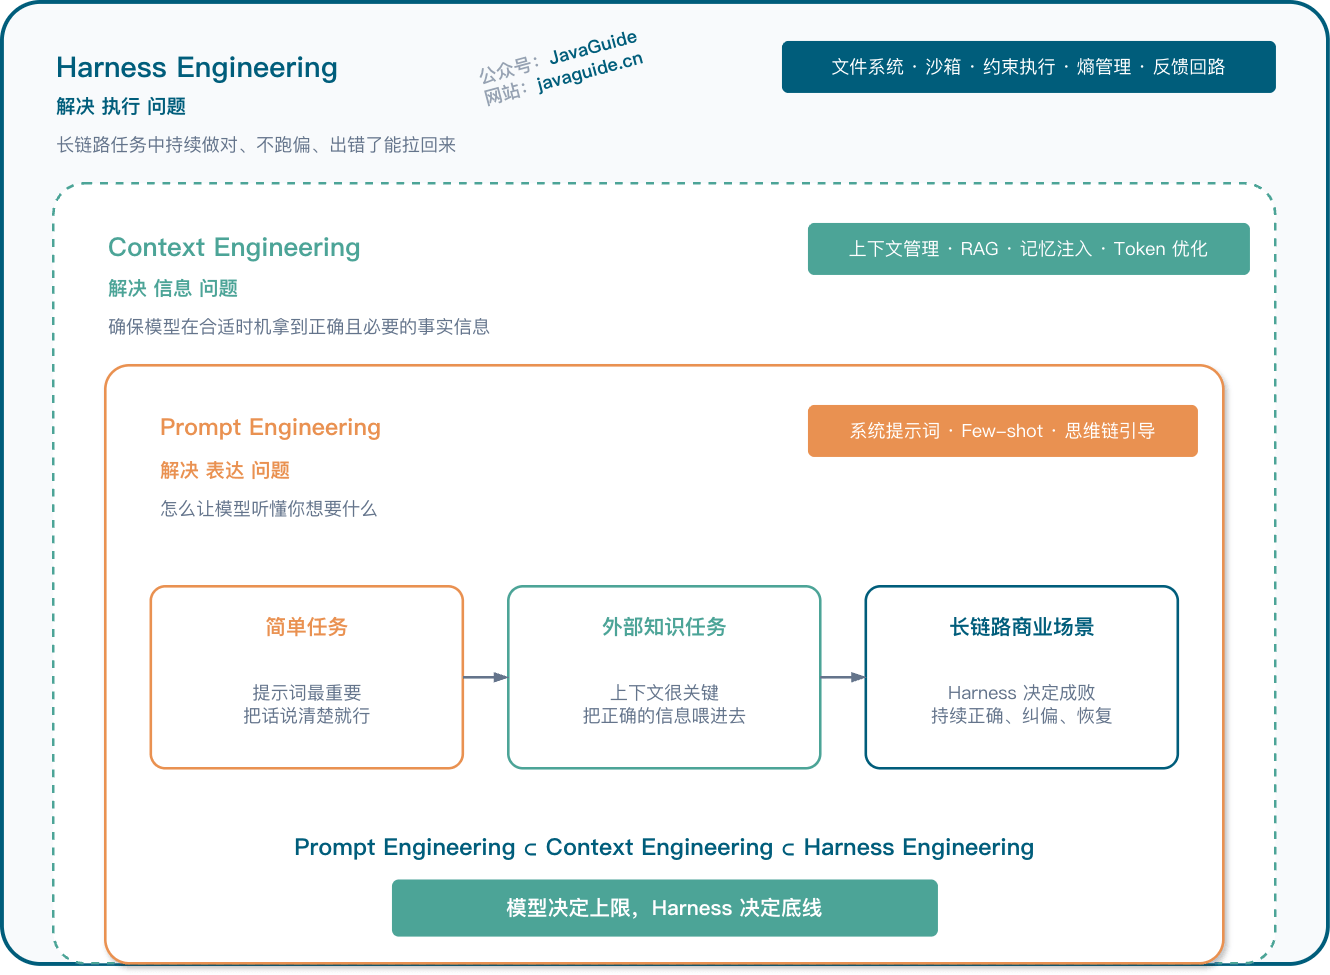
| Tầng | Vấn đề giải quyết | Trọng tâm | Công việc điển hình |
|---|---|---|---|
| Prompt Engineering | Diễn đạt instruction rõ thế nào | Giúp model hiểu intent, giảm ambiguity cục bộ | Thiết kế system prompt, Few-shot example, hướng dẫn chain-of-thought |
| Context Engineering | Cần cho Agent xem gì | Cung cấp đúng và đủ information cho model đúng lúc | Context management, RAG, memory injection, Token optimization |
| Harness Engineering | Hệ thống tiếp tục execution, correction, observability và recovery thế nào | Tính đúng liên tục, correction và fault recovery trong long-chain task | File system, sandbox, constraint execution, feedback loop, observability |
Loop Engineering
Loop Engineering bổ sung trigger, goal, context, validation, state và stopping condition cho việc Agent execute lặp lại. Mỗi round phải để lại result có thể kiểm tra; loop thoát khi task hoàn thành, failure, budget cạn hoặc cần approval.
Trong engineering, chủ yếu cần xem các điểm sau:
- Trigger: ai khởi động round task này? Manual command, scheduled task, CI failure, PR creation, Issue update hay một message event?
- Goal: state nào được xem là hoàn thành? Tất cả test pass, CI green, coverage đạt một giá trị, screenshot page khớp design hay chỉ generation draft chờ người xác nhận?
- Context: mỗi round Agent cần xem file, rule, historical state, tool result và project convention nào?
- Action: Agent có thể sửa code, chạy test, query GitHub, đọc log, tạo PR hay chỉ output suggestion?
- Observation: nó biết action vừa rồi đúng bằng cách nào? Test output, lint, type check, screenshot, review comment và log summary đều có thể là observation result.
- State: round này đã thử gì, failure ở đâu, bước tiếp theo là gì; cần ghi vào external file, Issue, Linear card hoặc database, không thể chỉ dựa vào conversation hiện tại để ghi nhớ.
- Stop: khi nào exit, khi nào chuyển cho người, khi nào dừng ngay vì hết budget hoặc round?
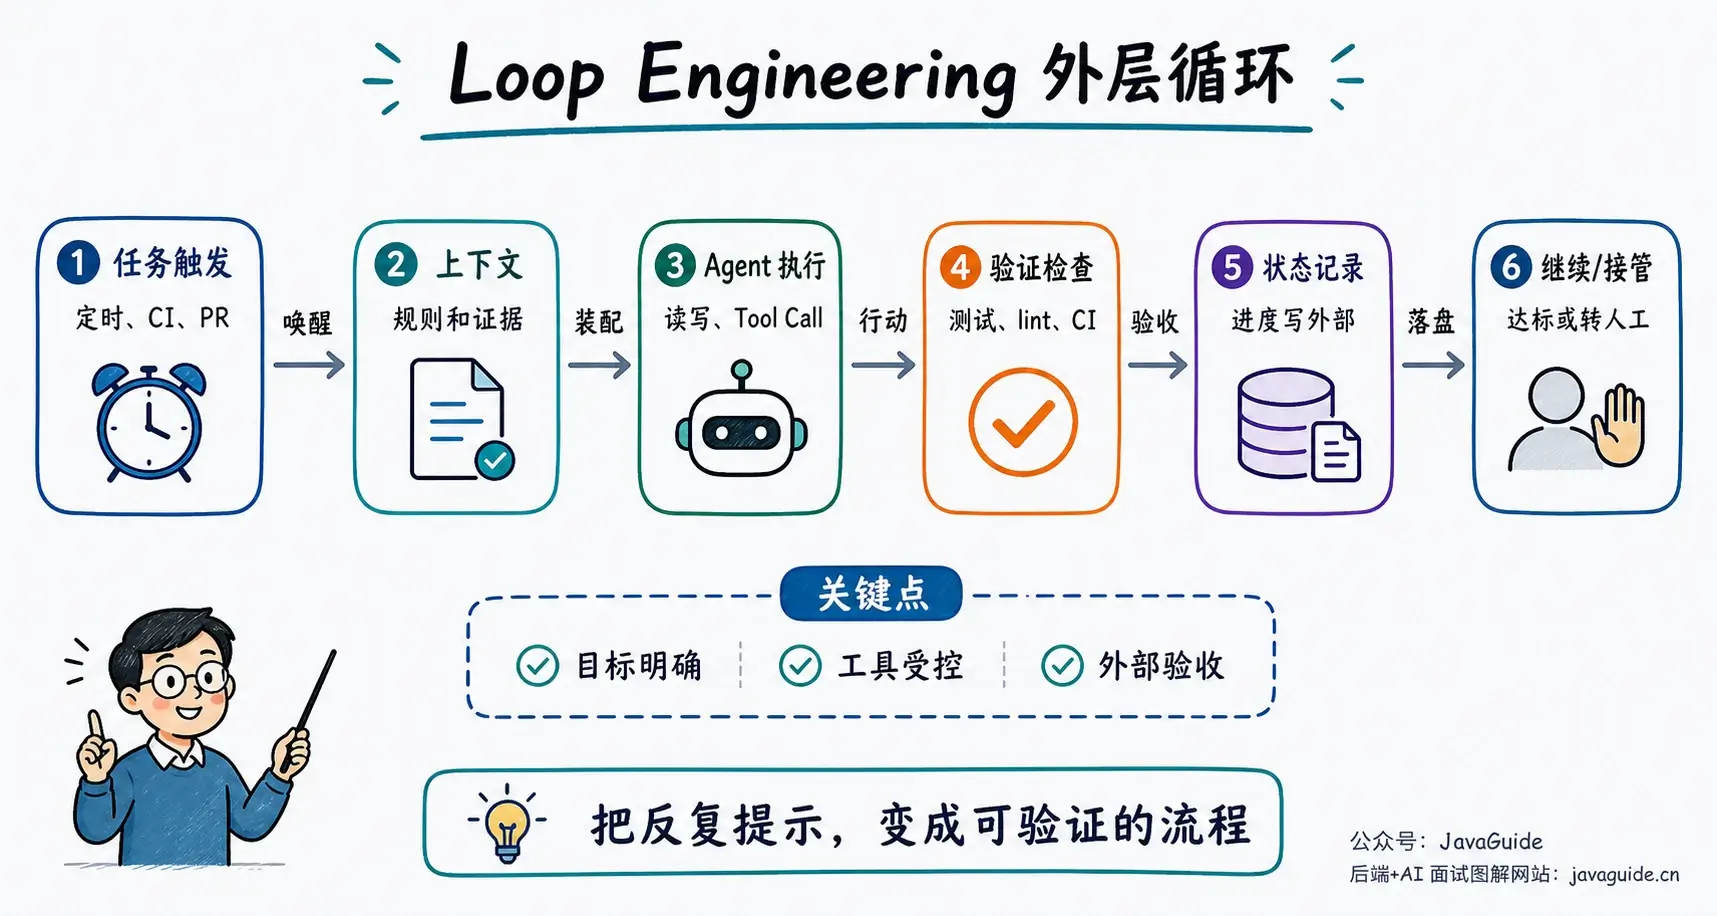
Minimal loop có thể viết thành một execution chain: đọc context → quyết định bước tiếp theo → gọi tool hoặc output answer → ghi result trở lại → kiểm tra stopping condition. ReAct đặt Reasoning và Acting luân phiên trong loop này; Loop Engineering còn phải xử lý trigger, validation, persistence, budget và human takeover bên ngoài loop.
RAG
Các bài gốc liên quan:
- Khái niệm cơ bản về RAG: retrieval, generation và trade-off engineering
- Vector index algorithm và vector database của RAG
- Document processing và chunking strategy của RAG: từ parsing, cleaning, Chunking đến xử lý nội dung multimodal
- RAG optimization: từ recall, rerank đến context engineering
- GraphRAG: bổ sung vector retrieval bằng graph structure
- Cập nhật document trong RAG knowledge base: incremental update, version control, deduplication và full rebuild
RAG là gì?
RAG (Retrieval-Augmented Generation) đưa information retrieval vào quá trình generation của large language model. Trước tiên system tìm nội dung liên quan đến câu hỏi từ database, document collection hoặc enterprise internal system, sau đó đưa retrieval result cùng original question cho LLM. Nhờ vậy model có evidence ngoài parameter knowledge.
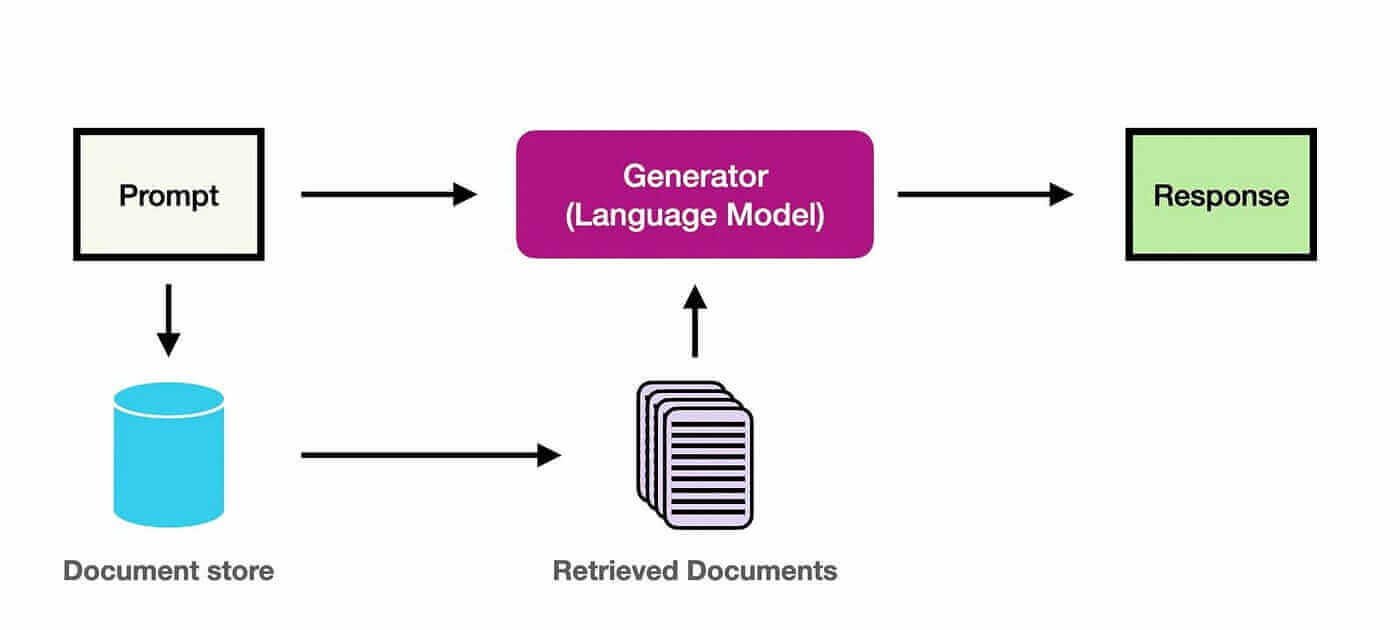
RAG chủ yếu bổ sung ba loại thiếu hụt information:
- Tính cập nhật của knowledge: parameter knowledge của pretrained model dừng ở thời điểm kết thúc training data. RAG có thể retrieval event mới, policy và product document tại thời điểm request.
- Truy cập private data: product document, knowledge base và customer data của doanh nghiệp không nằm trong public training corpus. Application có thể retrieval theo user permission trước, sau đó chỉ cung cấp các chunk cần cho answer.
- Căn cứ của answer: retrieval evidence có thể giới hạn phạm vi answer của model nhưng không thể loại bỏ hoàn toàn hallucination. Retrieval error, context noise, citation mismatch và việc model không tuân thủ instruction vẫn có thể tạo answer sai; production system còn cần citation validation, answer evaluation, refusal và human feedback.
Nguyên lý hoạt động của RAG
Engineering pipeline của RAG thường chia thành hai stage: offline indexing và online retrieval generation. Indexing stage chuyển original document thành data structure có thể retrieval; online stage thực hiện query understanding, retrieval recall, context construction và answer generation khi user đặt câu hỏi.
Sơ đồ đơn giản của indexing và retrieval stage:
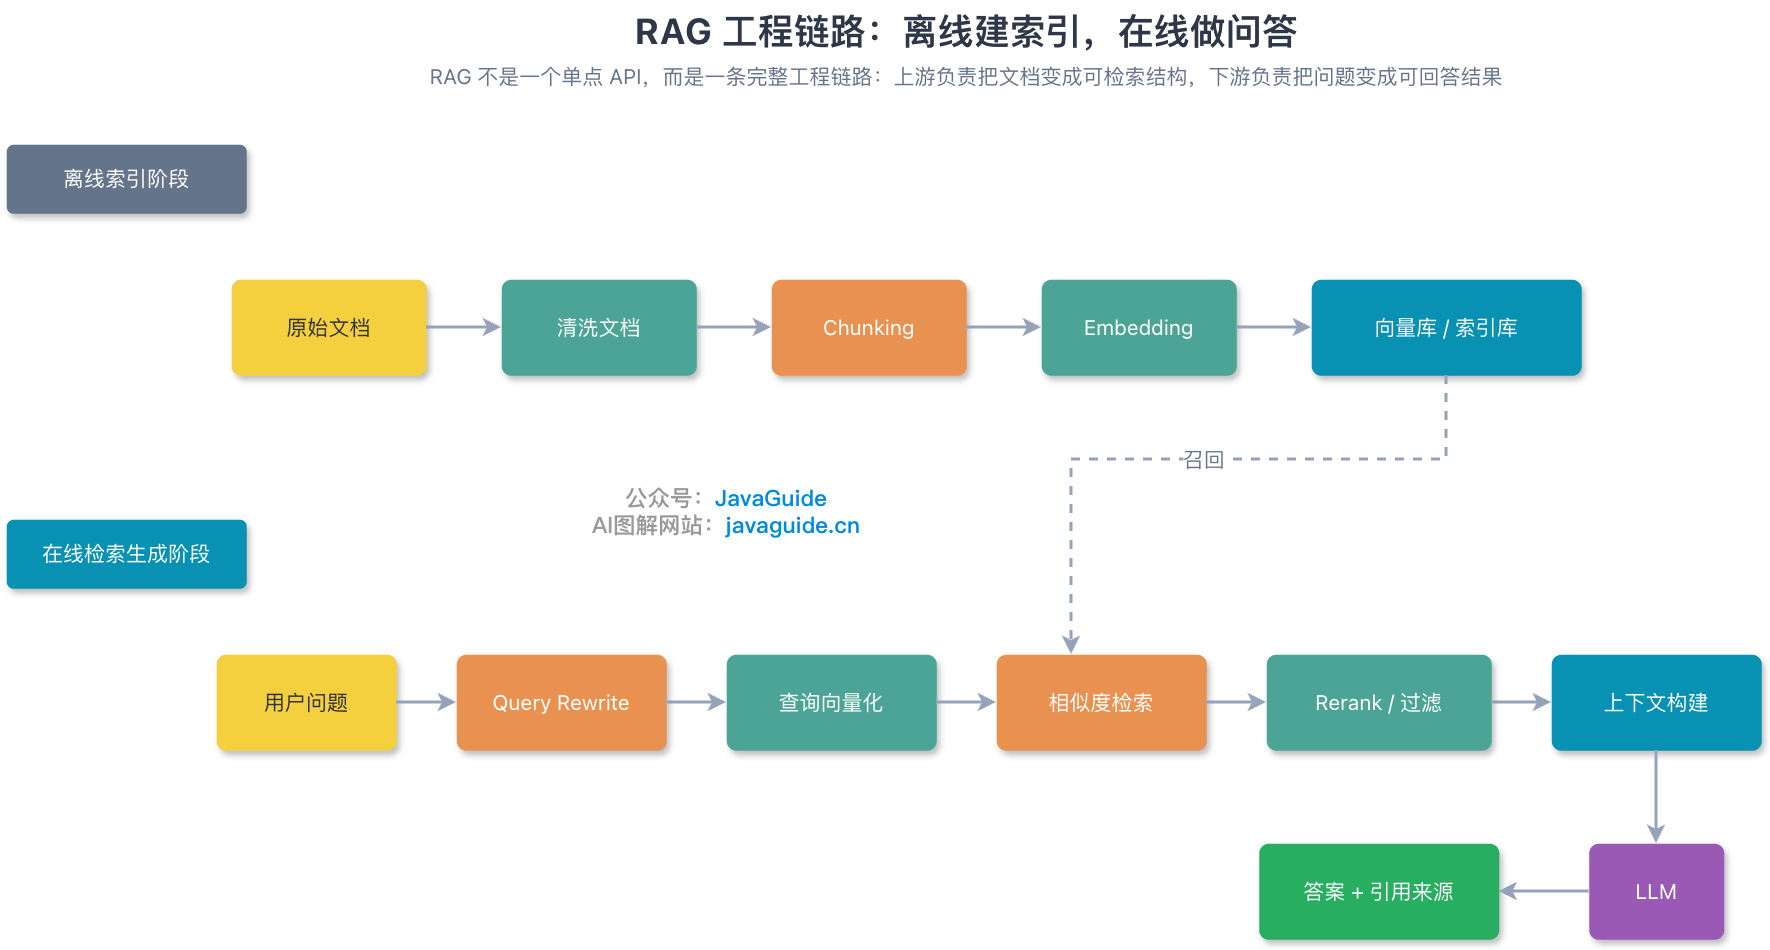
Indexing stage chủ yếu làm các việc sau:
- Input document: text file, PDF, web page và database record đều được, miễn là có content.
- Clean document: loại HTML tag, special character và noise khác.
- Enrich document: bổ sung metadata như timestamp và category label để cung cấp dimension filter cho retrieval sau này.
- Document split (Chunking): dùng text splitter chia document thành các chunk nhỏ hơn. Bước này phải cân bằng semantic completeness, input length của Embedding model, context window của generation model và retrieval granularity. Chunk quá lớn dễ đưa noise vào, quá nhỏ lại có thể mất context. Split strategy ảnh hưởng trực tiếp đến retrieval quality; xem chi tiết trong bài RAG document processing.
- Vector representation (Embedding Generation): dùng embedding model ánh xạ text chunk thành semantic vector, tức high-dimensional dense vector. Các embedding model thường gặp gồm
text-embedding-3-small/text-embedding-3-largecủa OpenAI và open-source model trên Hugging Face. - Lưu vào vector store hoặc index system: lưu embedding vector, original content và metadata tương ứng vào vector store hoặc vector index system, chẳng hạn Milvus, pgvector, vector retrieval của Elasticsearch / OpenSearch, hoặc local vector index xây dựng trên Faiss. Có thể xem việc chọn vector database, index algorithm và thực tiễn pgvector trong bài RAG vector store.
Embedding
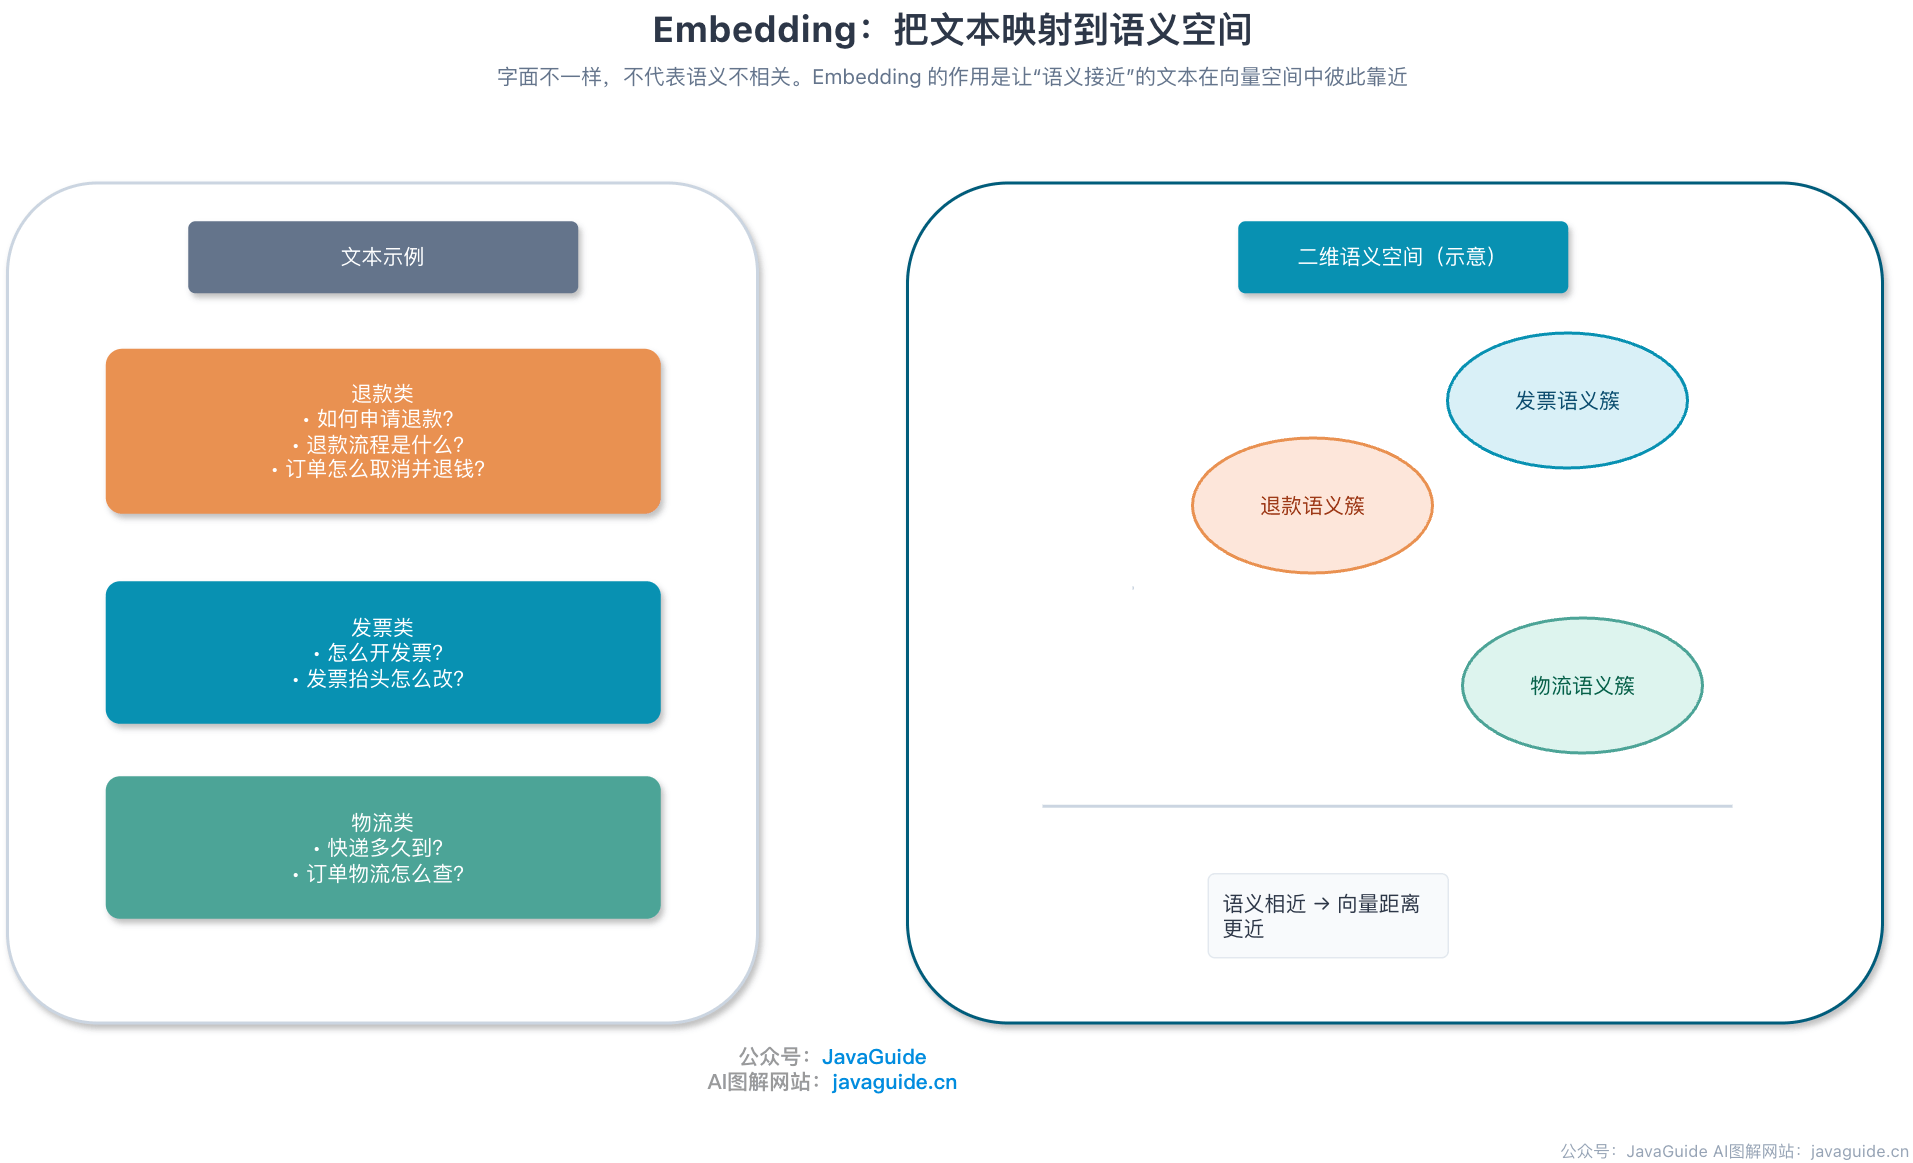
Embedding là biến text thành một chuỗi số. Chính xác hơn, nó ánh xạ text vào một high-dimensional dense vector space, khiến các text có semantic gần nhau nằm gần nhau hơn trong vector space.
Ví dụ ba câu sau:
- “Làm thế nào để yêu cầu hoàn tiền?”
- “Quy trình hoàn tiền là gì?”
- “Hủy order và lấy lại tiền thế nào?”
Về mặt chữ thì khác nhau nhưng semantic gần nhau. Embedding model tốt sẽ ánh xạ chúng vào các vị trí gần nhau, nhờ đó vector retrieval mới tìm được Chunk liên quan.
Embedding dimension thường là 768, 1024, 1536, 3072... Dimension là một phần của model design và training method; không thể tách khỏi model để kết luận “dimension càng cao thì semantic effect càng tốt”. Dimension cao hơn thường làm tăng chi phí storage, index và similarity calculation. Với OpenAI Embedding, text-embedding-3-small mặc định output 1536 dimension, text-embedding-3-large mặc định output 3072 dimension, đồng thời hỗ trợ giảm output dimension bằng parameter dimensions.
Vector retrieval và vector database
Trong retrieval flow của RAG, bước cơ bản nhất là: biến user question và document thành vector, sau đó dùng similarity search để tìm relevant document chunk.
Có thể hiểu như sau:
- Sau khi document vào knowledge base, nó được chia thành Chunk.
- Mỗi Chunk được chuyển thành một vector qua Embedding model.
- Vector được ghi vào vector database cùng original text và metadata.
- Khi user hỏi, question cũng được chuyển thành query vector.
- Vector database retrieval các document vector Top-K giống nhất.
- System đặt các document chunk này vào Prompt rồi giao cho LLM generation answer.
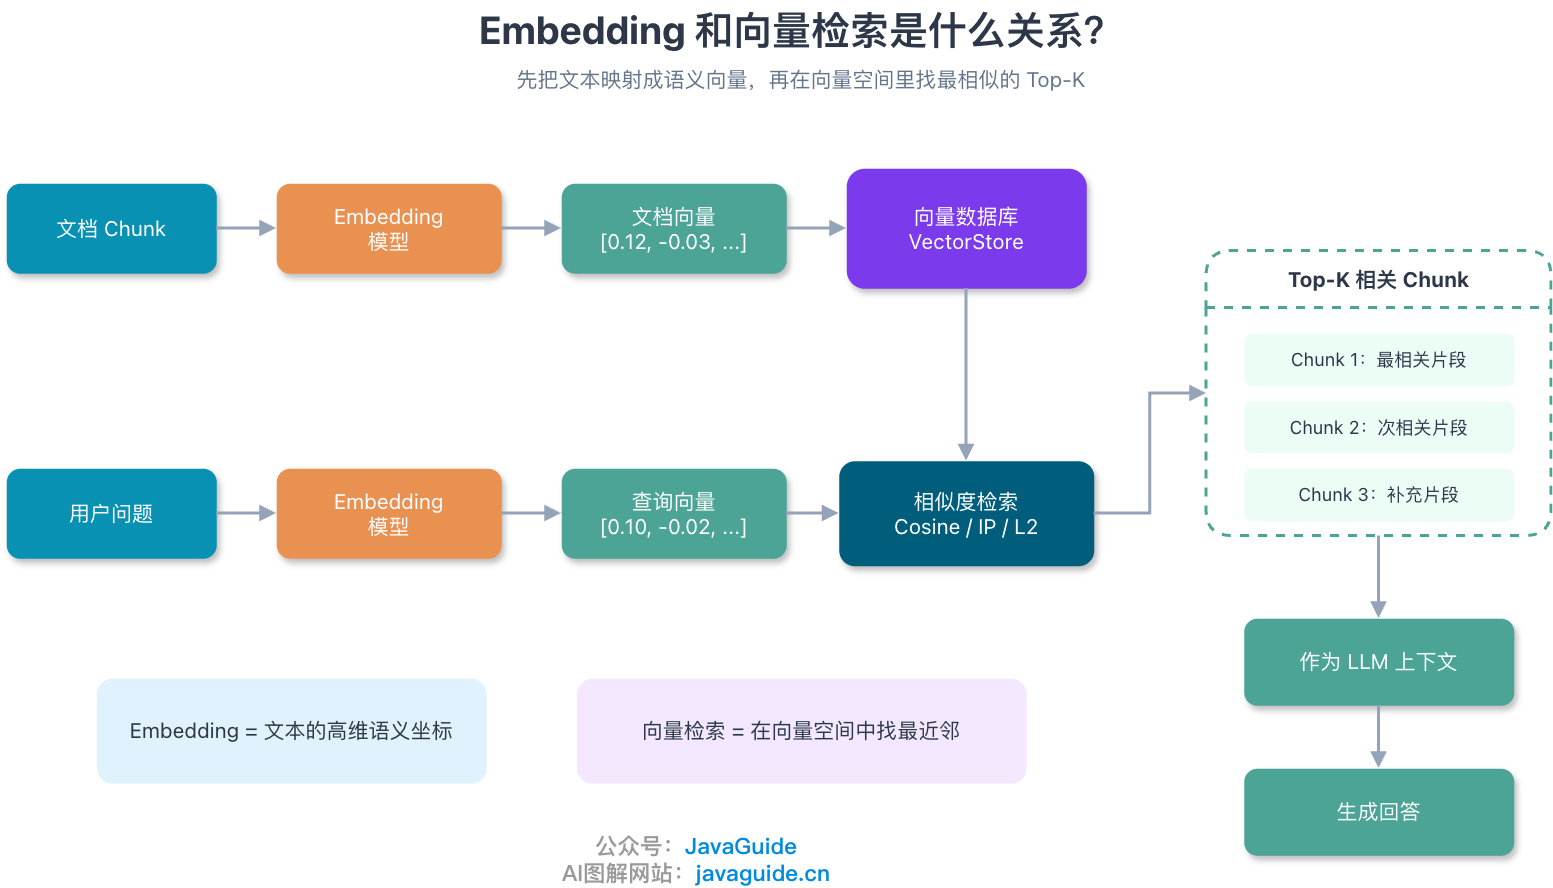
Embedding phụ trách biến text thành vector có thể so sánh; vector retrieval dựa vào đó để tìm content có semantic gần nhau. Vector retrieval chỉ là một implementation của RAG; RAG cũng có thể dùng BM25, SQL, knowledge graph, search API hoặc business query khác để lấy external evidence.
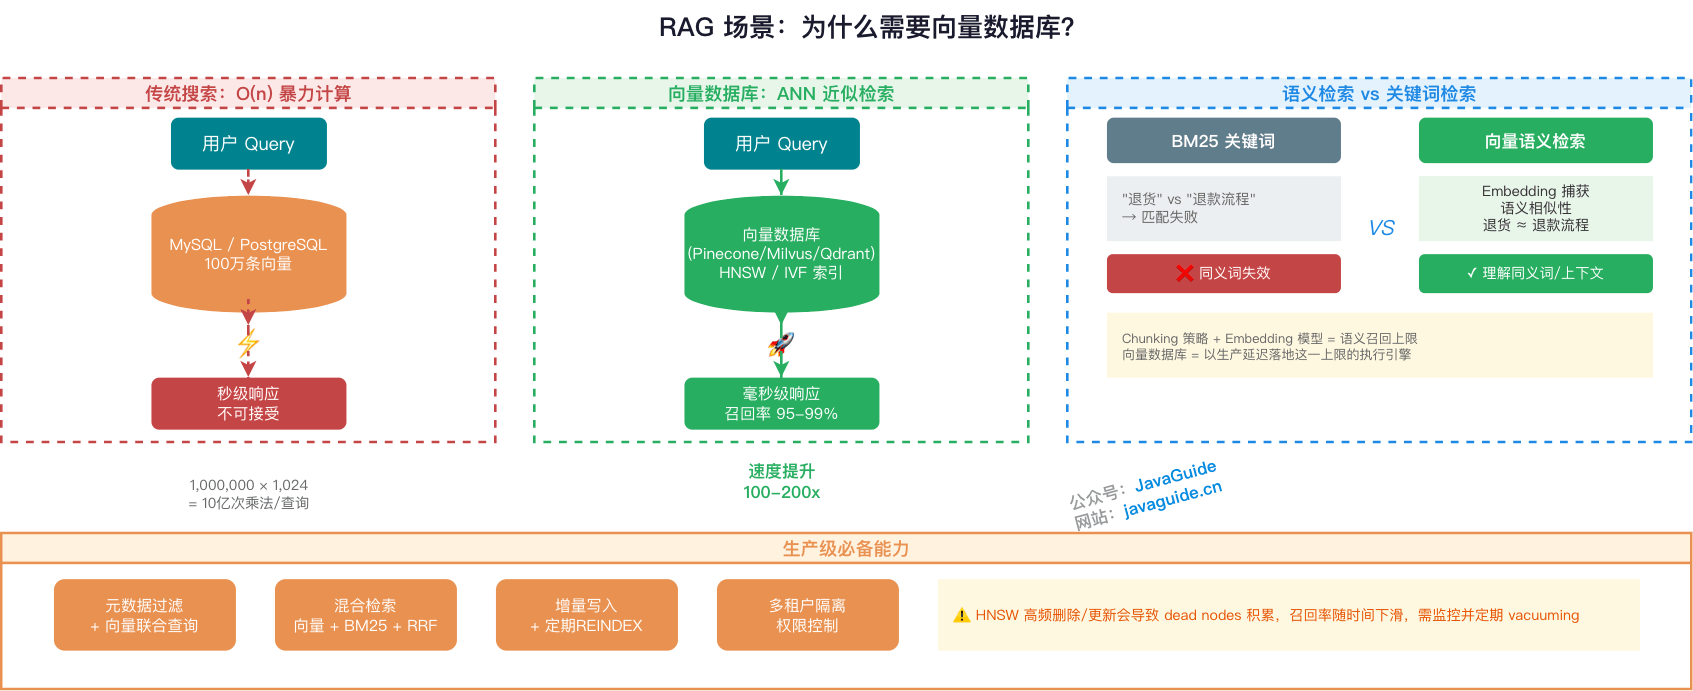
Trong Demo quy mô nhỏ, vài nghìn document vector có thể đặt trực tiếp trong memory để brute-force search. Nhưng trong RAG system thực tế, số document nhanh chóng lên đến hàng triệu, hàng chục triệu hoặc hơn.
Ngoài lưu vector, vector database còn phải xử lý các vấn đề engineering như similarity index, metadata filter, update/delete, concurrent query và persistence:
Document processing
Từ lúc upload đến khi vào vector store, document phải đi qua ít nhất sáu stage:
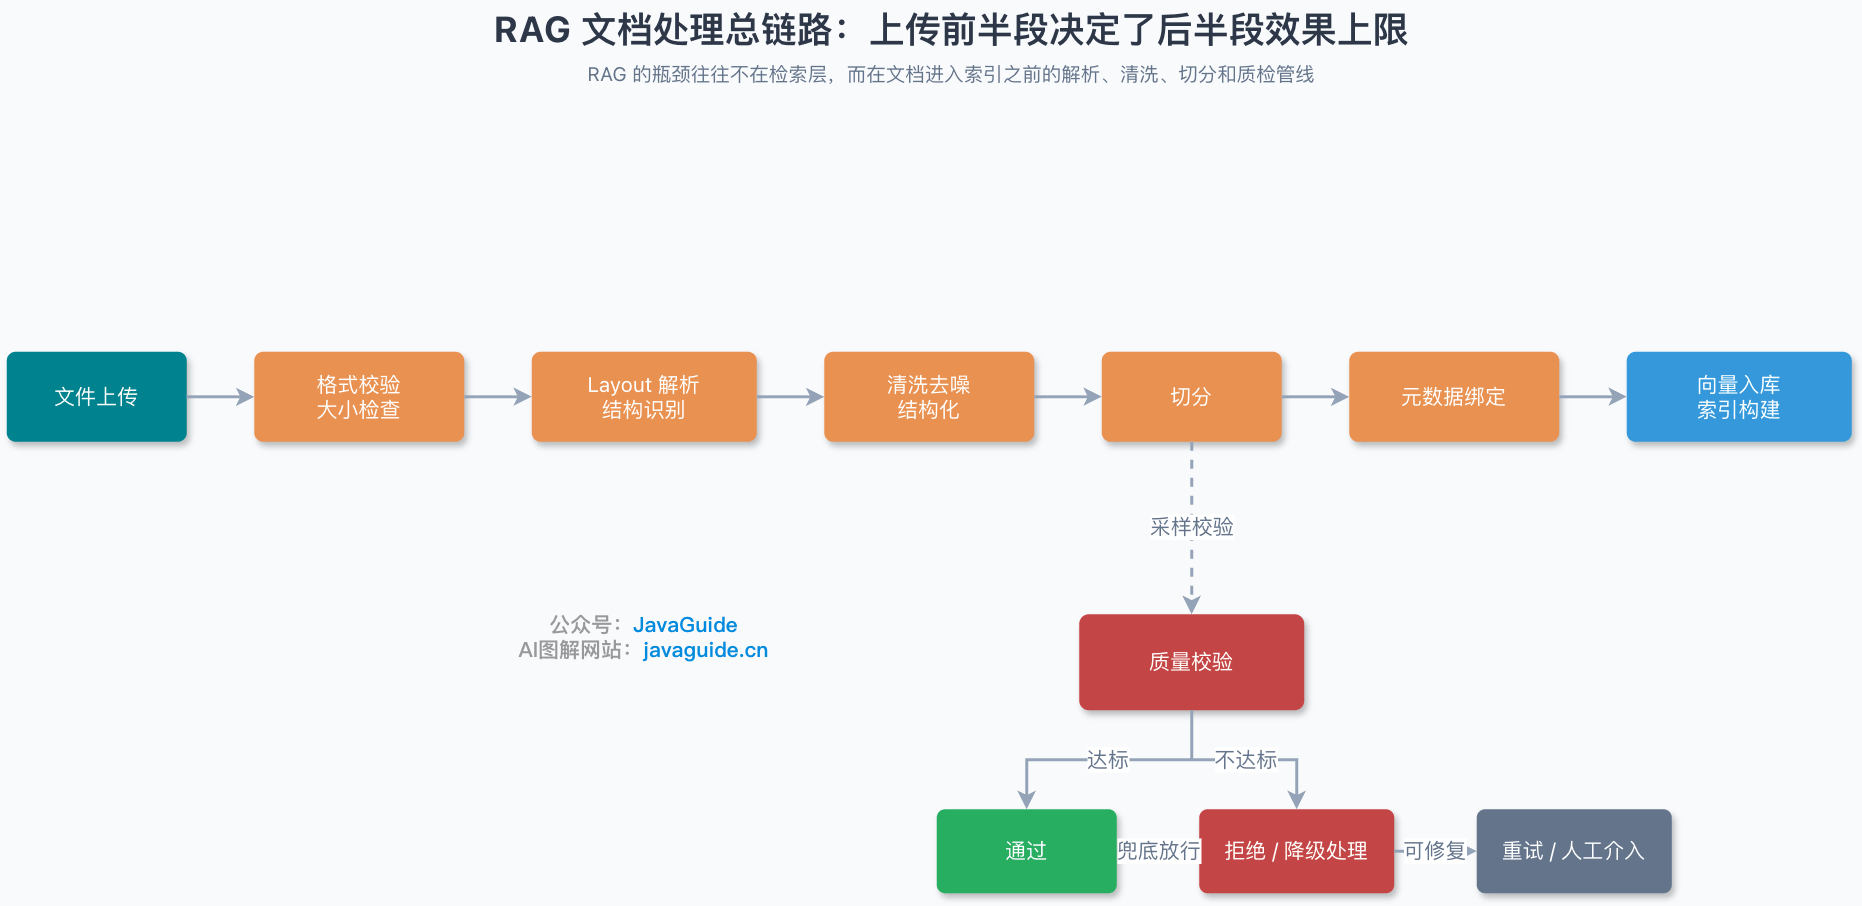
Quality validation không nên chỉ diễn ra sau khi nhập kho. Hoàn tất sample validation ở Chunking stage có thể phát hiện vấn đề sớm, tránh ghi hàng loạt data chất lượng thấp vào vector store.
Rủi ro chính của từng stage:
| Stage | Vấn đề điển hình | Ảnh hưởng cuối cùng |
|---|---|---|
| File upload | Format giả, vượt giới hạn size, encoding lộn xộn | Parser crash hoặc silent failure |
| Format validation | Extension không khớp MIME type thực tế | Chọn nhầm parser |
| Layout parsing | PDF nhiều cột, merge cell trong table, header/footer | Mất structure, lệch context |
| Cleaning và denoise | Garbled text, special character, empty line trùng, mục lục còn sót | Noise vào index, Embedding sai lệch |
| Chunking | Cắt semantic, đứt context, block quá lớn hoặc quá nhỏ | Recall không chính xác, answer thiếu |
| Metadata | Không lưu source, page, version, permission | Không filter được, không citation được |
| Ingestion | Vector dimension không nhất quán, vượt Token limit | Retrieval failure, index hỏng |
Nhiều team tập trung vào việc đổi embedding model nào, nhưng nếu data đã hỏng ở bước này thì đổi model chỉ làm sự hỏng hóc ổn định hơn.
Chunking
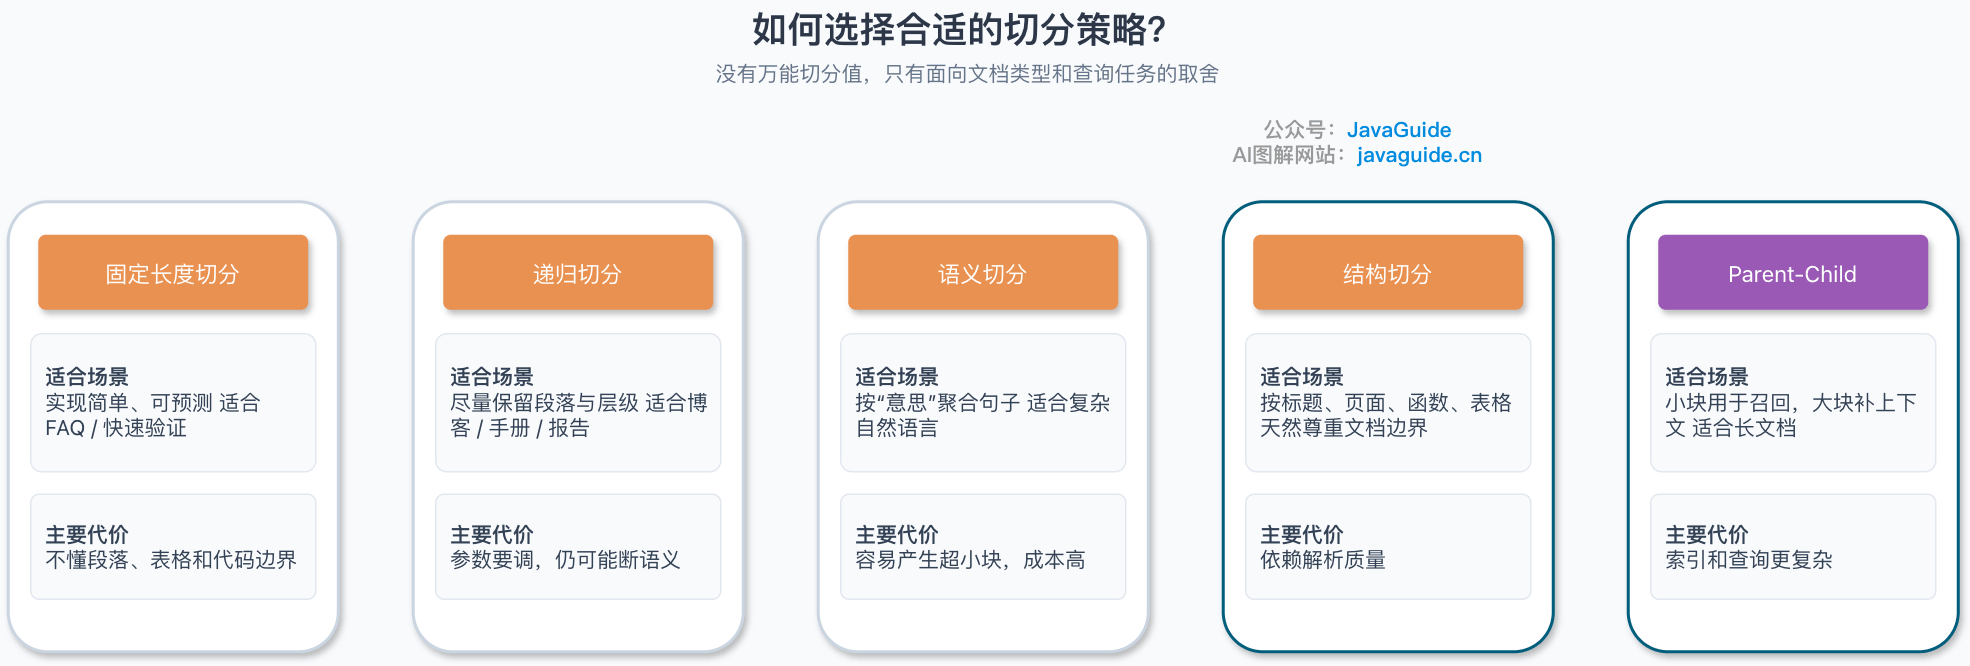
Nếu document vốn có structure rõ ràng, split theo structure thường phù hợp hơn. Trong một nhóm test của NVIDIA, Page-Level Chunking (split theo page) đạt kết quả tốt nhất trên financial report và legal document, accuracy trung bình 0.648 và variance cũng thấp nhất. Ranh giới page thường mang semantic của chapter hoặc layout trong loại tài liệu này, nên khi split cần cố gắng giữ lại.
Tuy nhiên đừng mù quáng tin vào page-level split. Ưu thế này so với Token split thực ra chỉ 0.3-4.5 điểm phần trăm; trên dataset FinanceBench, 1024-token split còn tốt hơn page-level (0.579 so với 0.566). Loại document trong test NVIDIA (financial report, legal document) là scenario mà việc phân trang vốn mang semantic; nếu PDF của bạn chỉ được export tùy tiện từ Word thì page-level split không đem lại lợi ích thêm. Query type cũng ảnh hưởng strategy tối ưu: factual query hợp với chunk nhỏ 256-512 Token, analytical query hợp với 1024+ Token hoặc page-level split.
Với từng loại document, trước tiên có thể chọn một nhóm split method phù hợp với structure, sau đó dùng business query để evaluation:
| Document type | Split method đề xuất | Implementation tool |
|---|---|---|
| Markdown | Split theo heading level (H1/H2/H3) | MarkdownHeaderTextSplitter |
| HTML | Split theo tag level (h1~h6, p, div) | HTMLHeaderTextSplitter |
| Split theo page hoặc chapter | chunk_by_title, chunk_by_page | |
| Code | Split theo function, class, package | PythonCodeTextSplitter |
| Paper | Split theo chapter, paragraph, table | Layout-aware Parser |
Chunk nhỏ giúp vector retrieval dễ hit câu cụ thể hơn, nhưng context model nhận được có thể không đầy đủ; Chunk lớn giữ lại nhiều paragraph information hơn, song content không liên quan cũng cùng đi vào candidate set.
Parent-Child Chunk tách retrieval granularity khỏi generation context. Ví dụ dùng child chunk khoảng 300 Token để lập index trước, mỗi child chunk liên kết với một parent paragraph khoảng 1200 Token. Khi query hit child chunk, system đưa parent paragraph tương ứng cho model. 300/1200 chỉ là parameter khởi đầu, vẫn cần điều chỉnh theo document structure, query type và evaluation result.
Hybrid Search
“Cách hủy subscription” và “tắt auto-renewal” dùng từ khác nhau, vector retrieval dễ tạo semantic association; error code và model như E1027, ABX-4421 lại phù hợp hơn với exact word matching của BM25. Hybrid Search giữ lại cả hai candidate path.
| Query type | Vector retrieval | BM25 | Đề xuất |
|---|---|---|---|
| “Cách hủy subscription” | Match được “tắt auto-renewal” | Có thể không match | Giữ vector recall |
| “Error code E1027” | Có thể recall lỗi chung | Hit chính xác error code | Bắt buộc giữ keyword recall |
| “Parameter model ABX-4421” | Dễ tìm model tương tự | Hit chính xác SKU | Bắt buộc giữ keyword recall |
| “Khác biệt Java thread pool rejection policy” | Semantic understanding tốt | Match được keyword | Hybrid ổn định hơn |
| “Price policy v3.2 mới nhất” | Cần semantic và time condition | Có thể match version | Metadata + Hybrid |
Hai luồng kết quả cần được hợp nhất trước khi rerank:
- Vector retrieval trả về semantic-similar candidate.
- BM25 hoặc sparse vector trả về keyword candidate.
- Dùng RRF hoặc normalized weighted score để merge.
- Deduplicate candidate sau merge rồi mới vào Rerank.
Tài liệu chính thức của Microsoft Azure AI Search, Google Vertex AI Vector Search, Weaviate và các sản phẩm khác đều giới thiệu Hybrid Search và RRF. RRF fusion result theo vị trí ranking của candidate, không cần so sánh trực tiếp BM25 score với vector cosine score.
Việc có nên đưa hybrid retrieval vào hay không phụ thuộc query distribution. Khi có nhiều error code, product model, config item và proper noun, keyword recall thường không thể bỏ; nếu tài liệu có cấu trúc rõ và query hiếm khi chứa exact word, thêm một BM25 path chưa chắc đem lại đủ lợi ích.
Query Rewrite
Query user submit cho retrieval system thường là các câu ngắn như:
- “Lỗi này xử lý sao?”
- “Có hoàn tiền được không?”
- “Vấn đề rate limiting trên production lần trước có phải lại xảy ra không?”
“Cái này”, “tiền”, “vấn đề trên production” phụ thuộc session context, nên khi retrieval trực tiếp sẽ thiếu object và constraint. Query Rewrite bổ sung entity, synonym hoặc filter condition cần thiết để query gần với cách viết trong knowledge base hơn, đồng thời giữ original intent của user.
Các strategy thường gặp:
| Strategy | Scenario phù hợp | Ví dụ |
|---|---|---|
| Normalization rewrite | Khẩu ngữ, abbreviation, thiếu context | “Có hoàn tiền không” đổi thành “refund policy, refund condition, refund flow” |
| Multi-Query | Một expression có thể nói theo nhiều cách | Đồng thời retrieval “cancel subscription”, “disable auto-renewal”, “stop membership plan” |
| Query Decomposition | Question chứa nhiều sub-question | Tách “so sánh phí và xử lý dispute của Stripe và Square” thành 4 sub-question |
| Step-back Query | Question quá chi tiết, thiếu background | Trước tiên retrieval “subscription billing rule”, sau đó trả lời câu hỏi hủy cụ thể |
| HyDE | Query quá ngắn, khác biệt lớn với document form | Generation hypothetical answer trước, sau đó dùng nó để vector retrieval document thật |
| Self-Query | Question chứa filter condition | Trích xuất year và category filter từ “tìm policy liên quan Java năm 2025” |
Các component như MultiQueryRetriever, SelfQueryRetriever của LangChain cung cấp implementation tương ứng. Original query nên được giữ làm một recall input, sau đó fusion result với query đã rewrite; nếu chỉ giữ rewrite result, một khi model hiểu sai intent thì toàn bộ candidate phía sau sẽ lệch.
Rerank
User hỏi: “Vì sao thread pool kích hoạt rejection policy?”
Vector recall có thể tìm ra các chunk sau:
- Mô tả core parameter của thread pool.
- Danh sách enum của rejection policy.
- Điều kiện kích hoạt rejection policy sau khi queue đầy và số thread đạt
maximumPoolSize. - Code example sử dụng thread pool.
Hai mục đầu gần “thread pool” và “rejection policy” về semantic, nhưng mục 3 mới trực tiếp mô tả trigger condition. Bi-encoder retrieval encode query và document riêng rồi recall nhanh theo vector distance; Rerank thường dùng Cross-Encoder hoặc dedicated rerank model, chấm điểm query cùng từng candidate, đưa content có thể trả lời question lên trước. Accuracy chi tiết hơn nhưng computation overhead cũng cao hơn, nên thường chỉ xử lý một lượng nhỏ candidate sau coarse recall.
Một pipeline thường gặp như sau; số candidate cần điều chỉnh theo latency budget và evaluation result:
- Metadata pre-filter.
- Hybrid Search coarse recall 30 đến 100 item.
- Deduplicate và merge chunk liền kề.
- Rerank chọn 5 đến 10 item.
- Context compression rồi đưa vào Prompt.
GraphRAG
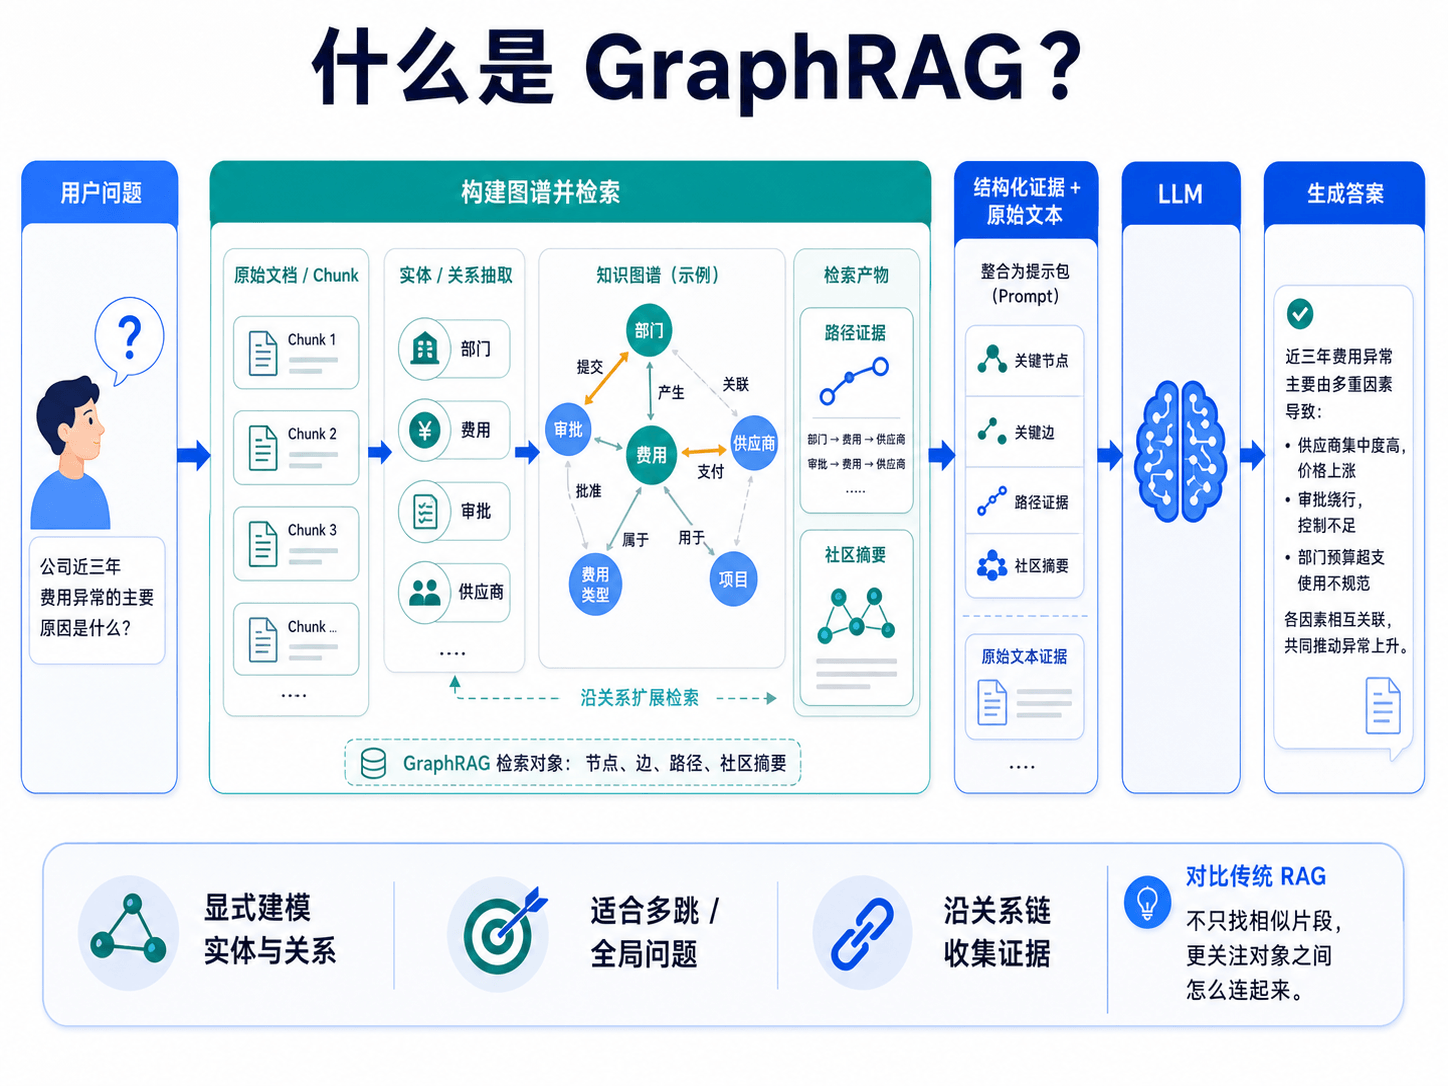
GraphRAG (Graph-based Retrieval-Augmented Generation) là một nhóm solution dùng graph structure cho retrieval augmentation. System có thể model hóa rõ entity, relation và structured context trong document; khi query thì thu thập evidence dọc theo graph relation rồi giao cho LLM generation answer.
GraphRAG thay đổi retrieval object. Graph database có thể chứa data này, nhưng có dùng một graph database product cụ thể hay không không phải điều kiện duy nhất để nhận định đó là GraphRAG.
Traditional vector RAG chủ yếu retrieval text Chunk. GraphRAG có thể retrieval node, edge, graph path và original text evidence; community summary là một dạng index được Microsoft GraphRAG và các implementation khác sử dụng, không phải mọi GraphRAG system đều bắt buộc có.
Có thể hình dung:
- Vector RAG giống như tìm vài trang content tương tự theo semantic trong thư viện.
- GraphRAG giống như trước tiên sắp xếp relationship graph của nhân vật, event timeline và topic directory, sau đó lần theo relationship để tìm evidence.
Vector RAG giỏi phán đoán “đoạn này có giống question của tôi không”, còn GraphRAG giỏi hơn trong việc hiểu “các object này thực sự liên kết với nhau thế nào”.
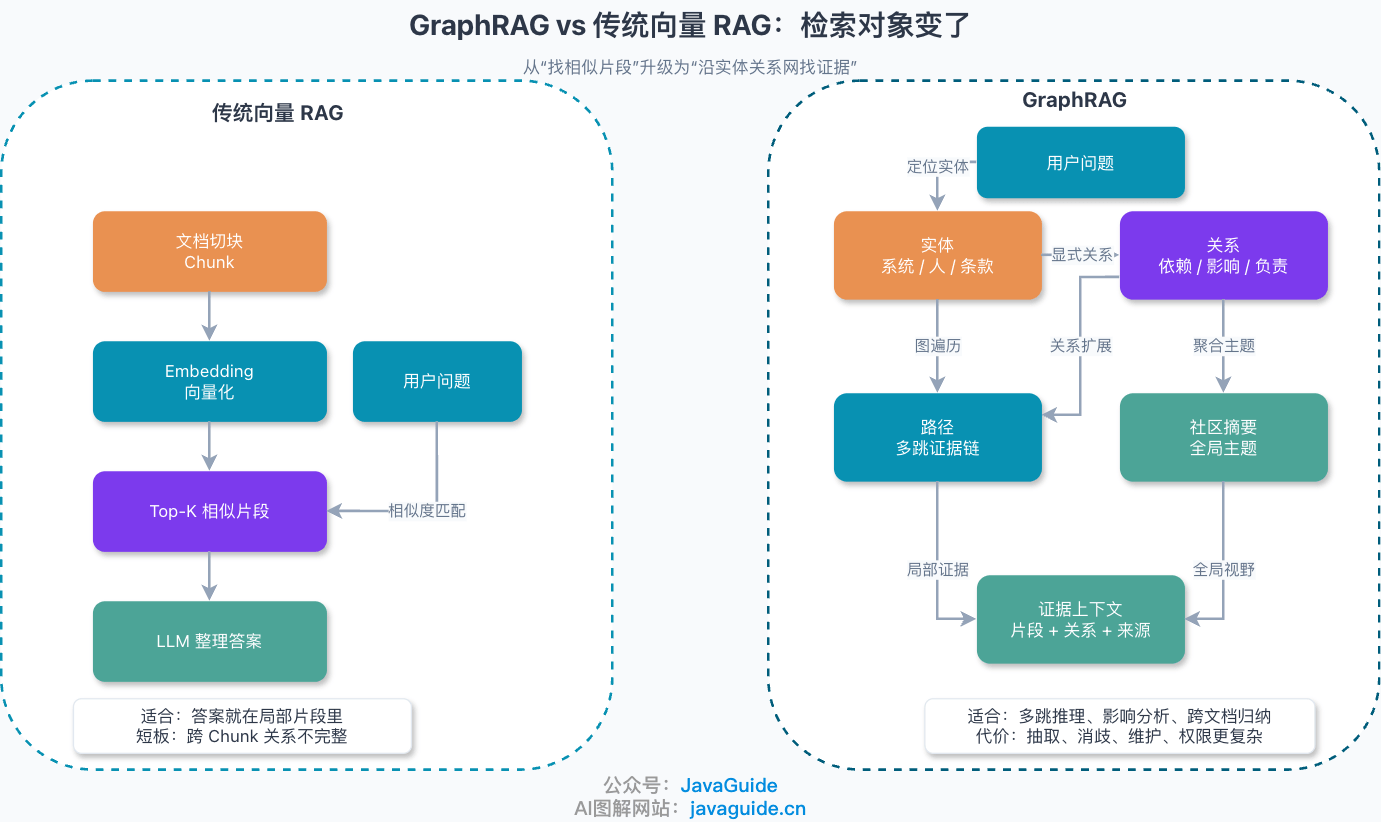
| Dimension | Traditional vector RAG | GraphRAG |
|---|---|---|
| Retrieval object | Text Chunk | Entity, relation, path, community summary, original chunk |
| Core capability | Semantic similarity recall | Relation reasoning, graph traversal, global topic aggregation |
| Data structure | Chủ yếu là vector index | Knowledge graph + vector index + full-text index |
| Question phù hợp | Local factual QA, giải thích document chunk | Multi-hop relation QA, cross-document summarization, complex business analysis |
Knowledge base update
RAG knowledge base cần liên tục xử lý document mới, sửa và xóa. Sau khi update hoàn tất, retrieval result phải nhất quán với document hiện tại, metadata permission cũng phải đồng bộ; khi một write endpoint failure, system còn phải xác định được document cụ thể và khôi phục về bản healthy index trước đó.
Index và query phải sử dụng cùng một Embedding model và version. Vector do model khác tạo ra không dùng chung được trong vector space; dù dimension giống nhau, similarity score cũng không thể so sánh. Khi nâng Embedding model hoặc Chunk strategy, thường cần tạo index mới, dùng cùng evaluation data để so sánh rồi chuyển alias; giữ old index một thời gian để rollback.
Incremental update và structural migration hằng ngày phù hợp với các strategy khác nhau:
| Dimension | Incremental update | Full rebuild |
|---|---|---|
| Scope xử lý | Chỉ xử lý document mới, sửa và xóa | Xử lý lại toàn bộ knowledge base |
| Scenario phù hợp | Thay đổi thường ngày với tần suất cao, đồng bộ theo phút | Upgrade model, điều chỉnh Chunk strategy, recovery sau sự cố nghiêm trọng |
| Dependency chính | Webhook, CDC, polling và message queue | Source system snapshot, chạy song song old/new index và atomic alias switch |
| Risk chính | Bỏ sót event, sai thứ tự, trùng và thành công một phần | Chi phí rebuild cao; thiết kế switch hoặc rollback không đầy đủ ảnh hưởng service |
Production environment thường dùng kết hợp “event-driven + polling fallback + reconciliation repair”. Metadata database ghi document version, content Hash, Embedding version, Chunk version và status của từng index endpoint; khi vector store, full-text index và metadata database thành công một phần, compensation task chạy nền sẽ retry và reconciliation dựa trên status.
AI system design
Các bài gốc liên quan:
- AI application system design: từ Prompt Demo đến production-grade architecture
- Giải thích chi tiết LLM Gateway: multi-model routing, Fallback, rate limiting và cost control
- AI observability và Trace: làm thế nào khôi phục toàn bộ execution process của Agent
- Thực tiễn bảo mật LLM/Agent: từ Prompt Injection, tool privilege escalation đến sandbox isolation
- Giải thích chi tiết AI voice technology: từ ASR, TTS đến engineering cho real-time voice Agent
Production-grade AI application architecture
AI Demo đơn giản nhất chỉ có một pipeline: frontend submit question, backend ghép Prompt, gọi model API rồi trả answer. Nó có thể kiểm chứng product idea, nhưng chưa xử lý stability, permission, cost, observability, evaluation và data governance của production system.
Production-grade AI application thường chia thành nhiều tầng theo responsibility:
| Tầng | Responsibility chính |
|---|---|
| Entry layer | Authentication, authorization, request normalization, rate limiting, idempotency và sensitive content preprocessing |
| Business orchestration layer | Chọn ordinary QA, RAG, Agent hoặc async task; kiểm soát confirmation, retry và degradation |
| Prompt và Context management | Quản lý template version, variable injection, Token budget, gray release và rollback |
| Model gateway | Unified model access, routing, rate limiting, Fallback, cost attribution và call observability |
| Knowledge, memory và tool layer | Quản lý riêng external knowledge, personalized memory và real business operation |
| Evaluation và observability layer | Ghi call chain, version, quality, latency, cost và Badcase; hỗ trợ replay và release gate |
Các module này không nhất thiết phải deploy độc lập. Project giai đoạn đầu có thể phân tách rõ responsibility trong monolith; khi call volume, team size hoặc governance requirement tăng thì mới tách service. Điểm quan trọng là tách model generation khỏi business rule có tính xác định: model phụ trách hiểu intent, generation content và đưa ra tool call; identity, permission, amount, approval và idempotency do code và business system quyết định.
LLM Gateway
LLM Gateway là governance entry point giữa application layer và model provider. Ngoài xử lý các vấn đề API thông thường như authentication, rate limiting và forwarding, nó còn quản lý model selection, Token budget, context length, khác biệt provider, streaming output, tool call, structured response, cost statistics và Prompt version.
LLM Router chỉ phụ trách chọn model cho request hiện tại, là một khâu trong Gateway. Gateway quản lý toàn bộ lifecycle từ request đi vào đến result trả về, gồm unified access, routing, Fallback, error handling, observability, audit và cost attribution.
Với internal tool có call volume rất nhỏ và chỉ dùng một provider, trước tiên có thể dùng shared LLMClient để xử lý thống nhất key, timeout, retry và log. Khi nhiều service, team hoặc tenant bắt đầu dùng chung model capability, mới từng bước bổ sung model registry, quota, routing, cache, cost và audit; LLM Gateway là một nhóm responsibility cần governance tập trung, không nhất thiết ngay ngày đầu đã là một service độc lập.
AI observability và Trace
AI API trả HTTP 200 không có nghĩa answer đúng hoặc task đã hoàn thành. RAG có thể lỗi ở query rewrite, recall, rerank hoặc context truncation; Agent cũng có thể chọn sai tool, execute lặp thao tác có side effect hoặc bỏ sót result khi merge multi-Agent.
Các observability signal thường trả lời những câu hỏi khác nhau:
| Signal | Câu hỏi chính cần trả lời | Nội dung điển hình |
|---|---|---|
| Metrics | Toàn hệ thống có bất thường không | Request volume, error rate, P95 latency, Token usage, tool failure rate |
| Logs | Tại một thời điểm đã xảy ra event gì | Exception stack, state change, retry reason, business alert |
| Trace | Một request đã trải qua các step nào | Model, retrieval, tool, Agent và quan hệ upstream/downstream |
| Evaluation | Output quality và task result có đạt không | Correctness, faithfulness, tool selection, task completion, security |
| Audit | Ai đã thực hiện operation gì với permission nào | User identity, approval record, permission decision, external write operation |
Long task còn phải phân biệt Session, Run, Trace, Span và Attempt. Session nối các lượt conversation, Run biểu thị một task, Trace tương ứng một call chain thực tế, Span biểu thị model, retrieval hoặc tool operation trong đó, Attempt ghi lần thử thứ mấy của cùng một step. Sau human approval hoặc async recovery có thể tạo Trace mới, nhưng phải tiếp tục dùng cùng runId.
Failure Trace đã xác nhận cần được de-identify rồi đưa trở lại Badcase collection. Sau khi sửa Prompt, RAG, tool hoặc orchestration logic, dùng các trace này để offline replay và regression evaluation, sau đó kiểm chứng effect production bằng gray release.
LLM và Agent security
Sau khi Agent kết nối RAG, Memory, tool, MCP, Skills, browser và code execution, external content vừa có thể ảnh hưởng model decision vừa có thể trigger real business operation. User input, web page, email, RAG chunk, Memory, tool result, message từ Agent khác và parameter do model generation đều phải được xử lý như untrusted data.
Prompt Injection mô tả việc attack instruction đi vào application và thay đổi task đã định; indirect injection giấu instruction trong web page, email, document, image, RAG hoặc tool result; Jailbreak chủ yếu tìm cách bypass security policy của chính model. Ba khái niệm có thể chồng lấn; một câu “ignore external instruction” trong System Prompt không thể bao phủ toàn bộ call chain.
Security control phải nằm bên ngoài model:
- Filter permission theo user, tenant và data scope trước retrieval.
- Cắt giảm tool có thể nhìn thấy theo scenario và identity, rồi re-authenticate trước execution.
- Tách generic read/write interface thành các tool có business action rõ ràng và parameter bị giới hạn.
- Gắn high-risk operation với tool, parameter, resource version và validity period cụ thể để approval.
- Mặc định chỉ lưu metadata cần thiết trong Prompt, log và Trace; lưu original text có kiểm soát theo purpose, permission và retention period.
- Đưa code execution và network access vào environment bị giới hạn, đồng thời hạn chế file, process, resource và network egress.
- Đưa model, Prompt, MCP Server, Skill, dataset, container image và evaluator vào supply-chain governance.
Model có thể đưa ra operation suggestion, nhưng permission cuối cùng, business rule, approval và execution result bắt buộc phải do server validation.
Real-time voice Agent
Ngoài Agent pipeline thông thường, voice Agent bổ sung audio capture, preprocessing, VAD, ASR, TTS, streaming playback và interruption handling. Một conversation round lần lượt đi qua các stage:
Audio capture -> noise reduction/echo cancellation -> VAD -> streaming ASR -> context assembly
              -> LLM/tool call -> streaming TTS -> audio playback -> state write-back
Text chat chậm 1 giây thường vẫn chấp nhận được, nhưng voice conversation chậm 1 giây sẽ xuất hiện khoảng ngắt rõ rệt. Khi optimization cần xem end-to-end P95/P99 latency và đưa các stage có thể chạy song song lên trước: dự đoán intent sau khi ASR tạo stable prefix, khởi động TTS ngay khi LLM output câu ngắn đầu tiên, client vừa nhận audio chunk vừa phát.
Interruption cũng không chỉ là pause player. System phải stop TTS hiện tại, clear playback queue, cancel model request còn đang generation và xác định tool đã trigger có thể undo hay không. Khi tool có external side effect, interruption strategy cần được thiết kế cùng idempotency, compensation và task state.
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.