
Hệ thống memory của AI Agent: short-term memory, long-term memory và cơ chế memory evolution

Khi chạy một tác vụ dài, bạn nhanh chóng gặp vài giới hạn cứng: context window có giới hạn, hóa đơn Token tăng liên tục, và nếu không ghi xuống storage sau khi Session kết thúc, trajectory của vòng trước mặc định sẽ biến mất cùng process. Dù model có thể hoàn thành lượt inference hiện tại, nó vẫn thiếu nơi lưu và tái sử dụng history.
Memory layer cần đồng thời giữ lại các fact quan trọng của cuộc hội thoại hiện tại, đồng thời cho Session mới lấy lại user preference, background và historical decision. Bài viết lần lượt thảo luận về dạng biểu diễn và phân loại chức năng của memory, lifecycle đọc ghi, cách triển khai short-term và long-term memory, các product phổ biến và tối ưu retrieval, cùng Markdown memory. Cách cắt sliding window và dỡ overload có phần giao với "Context Engineering là gì? Khác gì với Prompt Engineering?" trên cùng site; bạn có thể đọc đối chiếu hai bài.
Hệ thống memory của Agent được thiết kế như thế nào?

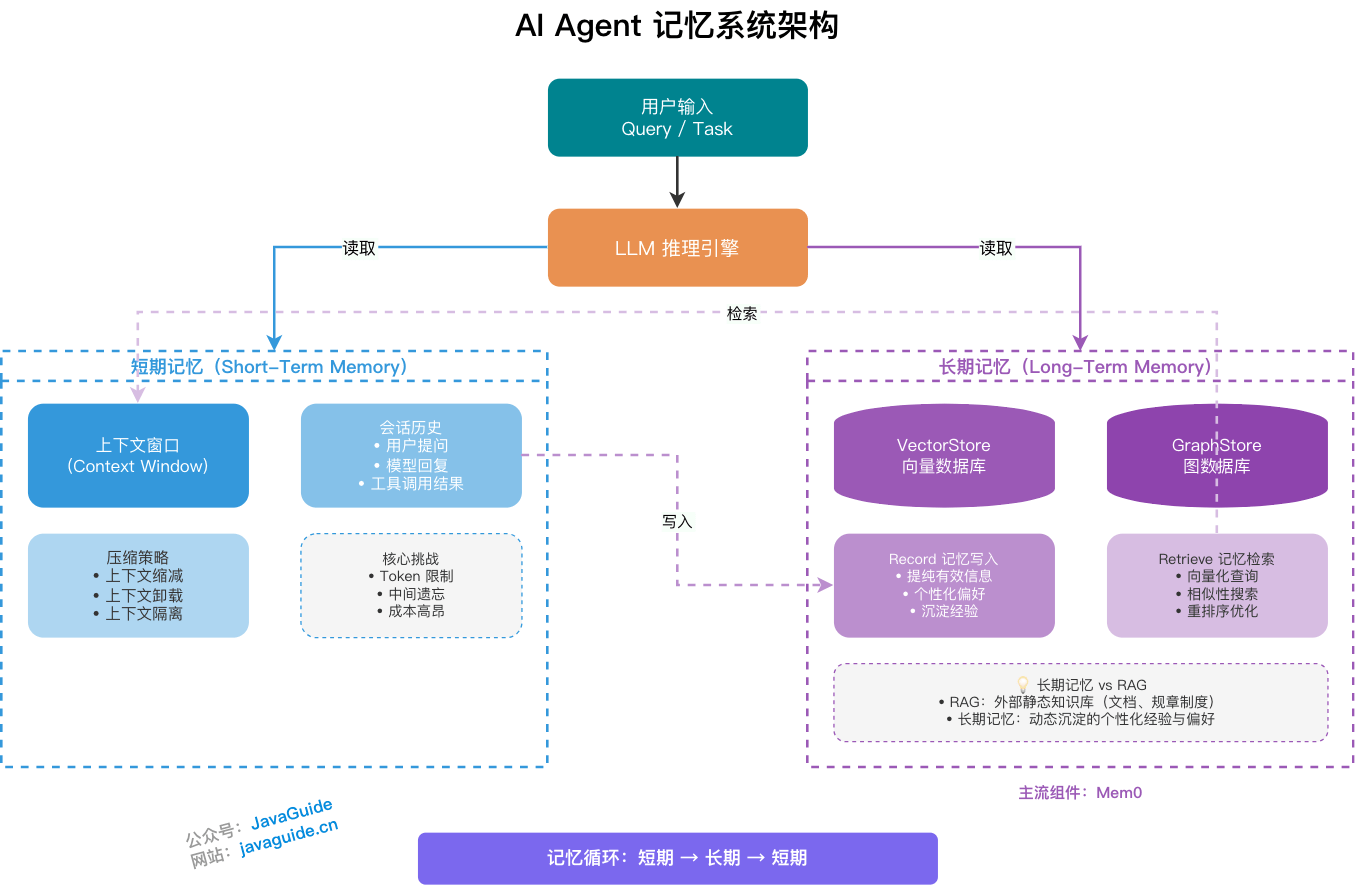
Hệ thống memory thường được chia thành hai layer: short-term memory và long-term memory. Short-term memory ở cấp Session, phục vụ task hiện tại; long-term memory hoạt động xuyên Session, chịu trách nhiệm tích lũy user preference, historical decision và kinh nghiệm trước đây. Hai loại này nên được tách biệt cả về vật lý lẫn logic, không nên trộn lẫn.
Memory có những dạng storage nào?
Ngoài việc chia theo thời gian, memory còn có thể được chia thành ba loại theo vị trí storage và dạng biểu diễn.
| Dạng storage | Mô tả | Triển khai điển hình |
|---|---|---|
| Token-level memory | Lưu dưới dạng natural language hoặc symbol rời rạc trong external database | Text chunk trong vector database, structured JSON |
| Parameterized memory | Encode thông tin vào model parameter | Pre-trained knowledge, LoRA adapter, SFT fine-tuning |
| Latent memory | Mang dưới dạng implicit trong internal representation của model | KV Cache, activation value, Hidden States |
Ba dạng này không hoàn toàn tách rời. Framework “memory cube” do MemOS đề xuất hỗ trợ luân chuyển động từ pure-text memory, qua activation memory (KV Cache), đến parameter memory. Nói đơn giản, memory nóng thường xuyên sử dụng được đặt ở vị trí gần hơn, còn cold memory ổn định, dài hạn được cố định bằng phương thức nặng hơn.
Memory được phân loại theo chức năng như thế nào?
Xét theo mục đích chức năng, Agent memory có thể chia thành ba loại.
| Loại chức năng | Câu hỏi cốt lõi | Nội dung storage | Scenario điển hình |
|---|---|---|---|
| Factual memory | Agent biết gì | User preference, environment state, explicit fact | Ghi nhớ preference về tech stack của user |
| Experiential memory | Agent cải thiện thế nào | Trajectory trước đây, bài học thành bại, strategy knowledge | Học từ một code review thất bại |
| Working memory | Agent đang suy nghĩ gì | Current inference context, task progress | Intermediate state trong multi-step inference |
Theo tính chất nội dung, còn có thể chia nhỏ như sau:
- Episodic Memory: ghi lại event cụ thể trong thời gian và scenario nhất định, trả lời “What happened?”. Ví dụ: “Thứ Tư tuần trước user phản hồi vấn đề order bị timeout”.
- Semantic Memory: tri thức, fact hoặc quy luật phổ quát được rút ra từ nhiều episode, trả lời “What does it mean?”. Ví dụ: “User này nhạy cảm với vấn đề performance hơn là functional requirement”.
- Procedural Memory: lưu skill, rule và hành vi đã học, giúp Agent tự động thực hiện một chuỗi task nào đó thay vì lần nào cũng inference lại. Ví dụ: “Khi code review cho user này, ưu tiên kiểm tra OOM risk”.
Lifecycle của memory operation như thế nào?
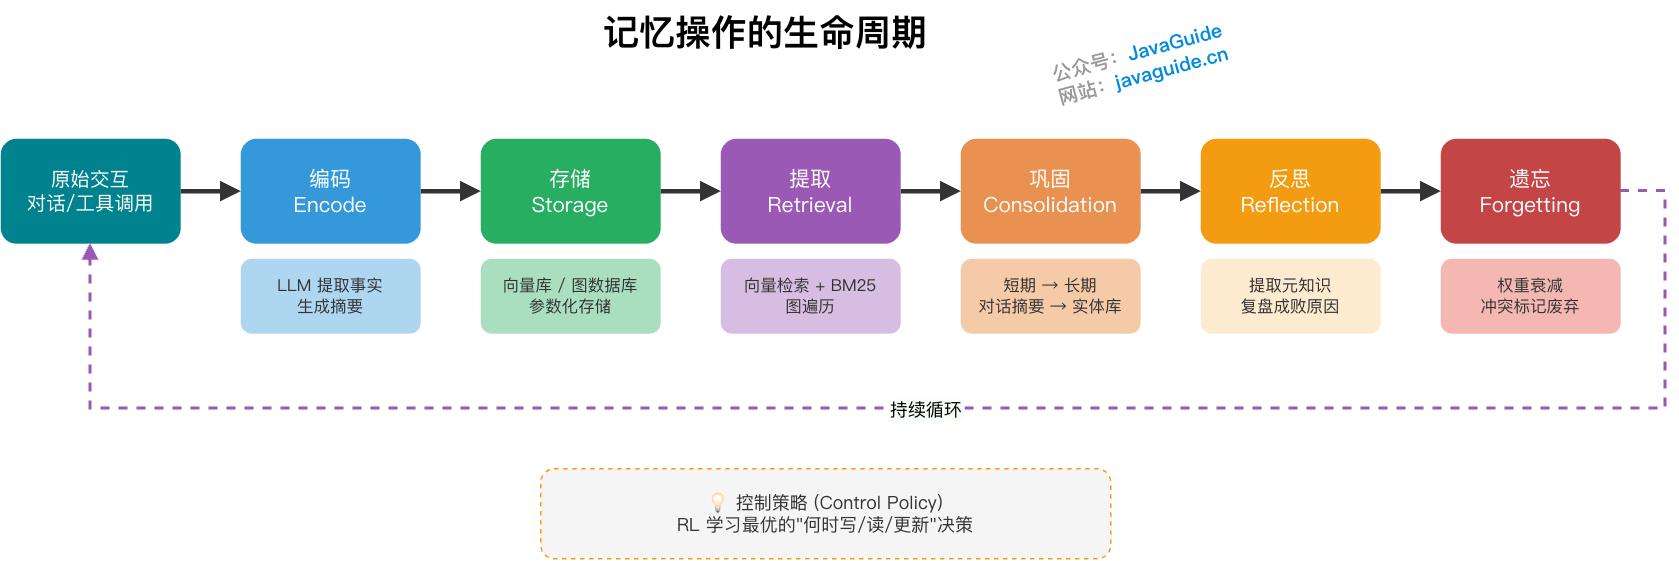
Một memory từ khi vào system đến khi bị loại bỏ cuối cùng thường trải qua các bước sau. Tên gọi trong các paper khác nhau, nhưng về ngữ nghĩa cơ bản tương ứng với nhau.
Encoding (Encode) → Storage (Storage) → Retrieval (Retrieval) → Consolidation (Consolidation) → Reflection (Reflection) → Forgetting (Forgetting)| Operation | Mô tả | Triển khai engineering |
|---|---|---|
| Encoding | Chuyển interaction thô thành thông tin có cấu trúc để storage | LLM trích xuất fact triple, tạo summary |
| Storage | Persistence thông tin đã encode | Ghi vào vector database / graph database / parameter |
| Retrieval | Tìm memory liên quan theo context | Vector retrieval + BM25 + graph traversal |
| Consolidation | Chuyển short-term memory thành long-term memory | Async task: conversation summary → entity store |
| Reflection | Chủ động review, đánh giá nội dung memory và tối ưu decision | Trích xuất Meta-Knowledge sau khi task hoàn thành |
| Forgetting | Loại bỏ memory có value thấp hoặc đã outdated | Weight decay + đánh dấu conflict là deprecated |
Nếu đưa mọi lượt hội thoại đi extract, cả lời chào, phỏng đoán tạm thời và mô tả lặp lại cũng sẽ đi vào database. Dùng reinforcement learning để quyết định thời điểm đọc ghi có thể giảm các lần ghi như vậy, nhưng chi phí training, replay và giải thích lý do lưu giữ cũng không thấp.
Nhiều system trước tiên dùng rule như importance để chặn nội dung vô ích, sau đó dùng offline task xử lý conflict, entry trùng lặp và record hết hạn. Rule cần phù hợp với business, nhưng mỗi lần ghi và dọn dẹp đều có thể để lại kết quả kiểm tra được.
Short-Term Memory / Working Memory là gì?
Short-term memory là thông tin tạm thời Agent nắm giữ trong một session hiện tại, gồm user question, response của model ở mỗi lượt và intermediate result của tool call (Observations). Các nội dung này được đưa trực tiếp vào Prompt của lượt đó, là vật mang chính của task state hiện tại. Hidden state ở phía host machine và state JSON nếu tồn tại cũng nên thống nhất với mạch này.
Short-term memory chủ yếu dựa vào context window của LLM. Giới hạn giữa các model rất khác nhau, ngay trong cùng một product line cũng có thể thay đổi. Ví dụ, context window chính thức của Grok 4 là 256K Token, còn 2M Token tương ứng với Grok 4 Fast; không thể chỉ ghi product family name rồi tái sử dụng parameter. Khi chọn model, nên tra model card chính thức hoặc API document của model ID tương ứng và ghi lại ngày kiểm tra; bài viết này không duy trì một bảng window length dễ lỗi thời.
Window lớn không có nghĩa là có thể nhồi context vô hạn. Inference cost tăng tuyến tính theo số Token. Nghiên cứu 《Lost in the Middle》 cũng cho thấy trong task kiểu multi-document retrieval, model dễ tận dụng thông tin ở đầu và cuối context hơn, còn tỷ lệ tận dụng thông tin ở giữa thấp hơn rõ rệt. Window càng dài, bias theo vị trí này càng rõ, vì vậy trong context engineering cần chủ động kiểm soát phân bố của input information.

Để kiểm soát short-term memory phình to, ở framework layer thường có ba cách, cùng thuộc một nhóm ý tưởng với Token downgrade và JIT offloading trong context engineering.
Cách thứ nhất là Context Reduction. Khi conversation history đạt Token threshold đặt trước, framework tự động loại bỏ N message sớm nhất, tức sliding window; hoặc gọi model nhẹ để nén conversation history thành summary, dùng hao hụt thông tin đổi lấy context space.
Cách thứ hai là Context Offloading. Tool hoặc Skill call có thể trả về lượng data rất lớn, chẳng hạn complete web page HTML hoặc nội dung file CSV. Khi đó có thể đặt heavy result vào external temporary storage, chỉ giữ một short reference trong Prompt, chẳng hạn UUID hoặc file path. Khi cần đào sâu detail, model gọi Function Calling bắt buộc liên kết với internal tool để đọc. Read API cần định nghĩa timeout và size limit; khi vượt giới hạn thì trả về result đã truncate hoặc thông tin downgrade rõ ràng, tránh để một tool call làm sập các bước sau.
Cách thứ ba là Context Isolation. Main Agent chỉ đưa task description và các fragment cần thiết cho sub Agent. Broadcast complete conversation history sẽ lặp lại việc tiêu tốn Token, đồng thời đưa message không liên quan đến subtask vào quá trình judgment.
Long-Term Memory là gì?
Long-term memory nằm bên ngoài Session. Sau khi conversation kết thúc, preference, fact và decision được ghi vào storage; Session mới chỉ lấy lại entry liên quan theo question hiện tại, không chuyển nguyên vẹn toàn bộ chat history sang.
Long-term memory có thể hiểu là hai chain Record và Retrieve.
Memory write (Record) thường xảy ra sau khi conversation kết thúc. Framework trigger background async task, gọi LLM để semantic distillation short-term memory của lượt này: lọc noise dư thừa trong conversation, extract high-value structured fact như “tech stack preference của user là Python + FastAPI” và “đối tượng báo cáo của user là CFO, cần style biểu đạt phi kỹ thuật”, sau đó ghi vào persistent storage.
Chain ghi này nên được thiết kế theo kiểu Best-Effort. LLM extraction có thể bỏ sót fact quan trọng, cũng có thể ghi nhầm một statement giả định thành preference. Bản thân write operation còn cần Idempotent Key để tránh retry tạo memory trùng lặp. Trong scenario LLM extraction, Idempotent Key phù hợp hơn nếu dựa trên source message ID + extraction batch ID thay vì result text của extraction, vì temperature sampling hoặc Prompt tuning có thể khiến ngữ nghĩa giống nhau nhưng câu chữ khác nhau; string hash không đáng tin. Khi conversation đa kênh chạy đồng thời, việc merge và overwrite entity store còn cần optimistic lock hoặc version control (MVCC).
Memory retrieval (Retrieve) thường xảy ra khi Session mới bắt đầu. System vectorize User Query, sau đó thực hiện semantic similarity retrieval với các entry trong long-term memory store, prepend nhóm entry có hit rate cao nhất vào System Prompt hoặc đặt vào parallel slot. Chạy một lần vector retrieval trên first-packet path là rất phổ biến, nhưng P99 của VectorStore sẽ trực tiếp cộng vào TTFT. Cách giảm thường gặp là dùng Redis làm warm-up line, hoặc preload toàn bộ shallow preference và static profile, để deep memory đi qua async rerank, hoặc overlap với generation pipeline nhằm giảm cảm giác phải chờ.
Long-term memory khác RAG như thế nào?

Về kỹ thuật, long-term memory và RAG khá giống nhau, đều dùng vector database và semantic retrieval. Nhưng đối tượng phục vụ của chúng khác nhau.
RAG thường gắn với shared knowledge source như company policy, product document và result query từ real-time database, nhưng bản thân nó không mặc nhiên là “non-personalized”. Retrieval chain có thể filter data theo tenant, user, role hoặc session, cũng có thể dùng user preference để rerank result. So với long-term memory, RAG nhấn mạnh hơn vào việc lấy evidence từ external knowledge source; knowledge source có shared hay personalized hay không phụ thuộc vào index và permission design.
Long-term memory quản lý experience personalized được tích lũy động trong interaction giữa Agent và user cụ thể, chẳng hạn user preference, habit, historical decision và background riêng. Nó có tính cá nhân hóa cao, khác nhau theo từng người.
Khi retrieval, có thể recall riêng external evidence như company policy và product document, cùng personal memory như user preference và historical decision, sau đó sort chung. Entity trong long-term memory còn có thể mở rộng RAG query, user preference cũng có thể tham gia rerank result.
Những memory technology architecture phổ biến là gì?
Vectorized storage, semantic retrieval và memory management thường được tách riêng: Main Agent chịu trách nhiệm scheduling, còn memory component chịu trách nhiệm write, query và maintenance.
Bottom-layer storage architecture thường gồm những layer nào?
Các responsibility thường gặp ở bottom layer có thể chia thành ba layer.
VectorStore chịu trách nhiệm vector storage. Nó chuyển memory text được extract thành Embeddings rồi lưu vào vector database. Lấy single-node Qdrant 1.x, local SSD, HNSW index ef=128, Recall@10 ≥ 0.95 làm baseline, trong scenario concurrency thấp (chẳng hạn QPS nhỏ hơn 50), P99 latency có thể được kiểm soát ở mức vài chục millisecond. Với cùng QPS, P99 giữa các product có thể chênh 5-10 lần, chẳng hạn Pinecone Serverless, Qdrant tự host và Milvus có thể khác biệt rõ rệt. Khi chọn thực tế, nên tham khảo ann-benchmarks.com hoặc benchmark report của từng vendor. Các option phổ biến gồm Pinecone, Weaviate, Chroma, Qdrant.
GraphStore chịu trách nhiệm graph storage. Trong scenario nâng cao, có thể model memory theo dạng “entity-relation” thành knowledge graph, chẳng hạn dùng Neo4j. Nó phù hợp hơn với query phức tạp cần multi-hop inference, ví dụ “đồng nghiệp A được user nhắc đến có liên quan gì với project B”.
Reranker chịu trách nhiệm rerank. Vector retrieval chỉ là recall sơ bộ, semantic relevance không phải lúc nào cũng có thứ tự chính xác. Reranker thường dựa trên cross-encoder (Cross-Encoder) để thực hiện second-stage rerank với candidate result, đưa memory liên quan hơn lên trước và giảm nội dung không liên quan đi vào context.
Khi chọn vector database, cần đồng thời kiểm tra index, filter, isolation, consistency và cost:
| Dimension | Key consideration | Mô tả |
|---|---|---|
| Index type | HNSW / IVF / DiskANN | Ảnh hưởng đến recall rate và latency của tradeoff |
| Metadata filter | pre-filter vs post-filter | Trong scenario filter rate cao, pre-filter dễ phá vỡ connectivity của graph structure |
| Multi-tenant isolation | Namespace / Collection / physical isolation | Ảnh hưởng đến recall rate và data security |
| Persistence consistency | Strong consistency vs eventual consistency | Ảnh hưởng đến write reliability |
| Cost model | Serverless tính phí theo usage vs self-hosted cluster | Ảnh hưởng đến operating cost |
“I may...” do model extract ra không thể trực tiếp được cố định thành stable preference. Trước khi write, có thể dùng JSON Schema để ràng buộc field và review lại entry có confidence thấp; entry có importance cao còn nên giữ source conversation và extraction result để tiện trace source.
So sánh các Memory product phổ biến như thế nào?
Bảng dưới liệt kê trọng tâm của một số project hoặc product công khai. Việc lựa chọn vẫn phải quay về latency, compliance requirement và data shape, không thể chỉ đối chiếu theo tên chức năng.
| Product | Core idea | Technical highlight | Scenario phù hợp |
|---|---|---|---|
| Mem0 | Single ADD-only extraction + multi-signal retrieval | Một LLM call hoàn thành entity extraction và cross-memory linking; semantic + BM25 + Entity Linking chấm điểm song song; bật graph memory (Mem0g) qua GraphStore backend tùy chọn | General conversation memory |
| LETTA (trước đây là MemGPT) | Virtual memory paging của operating system | Main Context ↔ External Context dynamic exchange; recursive summary compression | Context management cho long conversation |
| ZEP | Time-aware knowledge graph | Graphiti engine tự phát triển; ba subgraph episodic/semantic/community; edge expiration mechanism | Enterprise multi-tenant scenario |
| A-MEM | Zettelkasten knowledge management | Card note method; tự động tạo semantic connection giữa các memory | Knowledge-intensive task |
| MemOS | Dynamic conversion của ba memory type | Pure text ↔ activation memory (KV Cache) ↔ parameter memory (LoRA) | Full-stack memory management |
| MIRIX | Phối hợp giữa sáu module | Meta-memory manager routing; các memory component dùng storage structure khác nhau | Complex decision support |
LETTA, ZEP và MemOS khác nhau như thế nào?
LETTA xem context như page trong operating system. Main Context chứa system instruction và workbench hiện tại, FIFO giữ message mới nhất; khi không thể giữ thêm, paragraph cũ được recursive summary rồi chuyển sang External Context. Ý tưởng này khá dễ hiểu, nhưng đây là một lossy path. Sau nhiều vòng recursive summary, các detail như exact key literal, error stack và vài chữ số thập phân rất dễ bị xóa trước. Trông như “mất memory”, nhưng thực ra là side effect do compression.
ZEP thêm ba mức độ granularity trên graph: episodic subgraph giữ chặt payload gốc, semantic subgraph extract entity relation, community subgraph gom các strong connection thành summary lớn. Ý tưởng này có điểm tương đồng với community layer của GraphRAG. Điểm đáng học hơn ở ZEP là edge expiration mechanism: khi fact mới overlap về thời gian với edge cũ, đánh dấu edge cũ là expired và thêm timestamp. Như vậy vừa theo dõi được fact mới, vừa thuận tiện audit judgment cũ.
MemOS thì vẽ gradient “text → KV Cache (activation) → LoRA (parameter)” trong paper và tài liệu giới thiệu. Preload hot entry vào cache có thể giảm cold-start latency; nếu muốn cố định memory thành weight thì phải chạy offline SFT, việc này sẽ trở thành một training cost riêng.
Ở đây có một limitation rất thực tế: sau khi ghi vào LoRA thì khó xóa. Xóa một row trong vector database là đủ, nhưng việc loại bỏ một fact khỏi parameter về bản chất sẽ chạm vào vùng khó của Machine Unlearning, vốn chưa được hoàn thiện. Vì vậy parameter memory chỉ phù hợp với preference thay đổi rất chậm. Trong multi-tenant scenario, còn cần runtime hỗ trợ dynamic mount và unload adapter như vLLM / TGI.
Pure-text memory ──(high-frequency use)──→ Activation memory (KV Cache) ──(long-term solidification)──→ Parameter memory (LoRA)
      ↑                                                                                                  │
      └──────────────(knowledge outdated/offloading)─────────────────────────────────────────────────────┘
Những cơ chế evolution nâng cao của memory là gì?
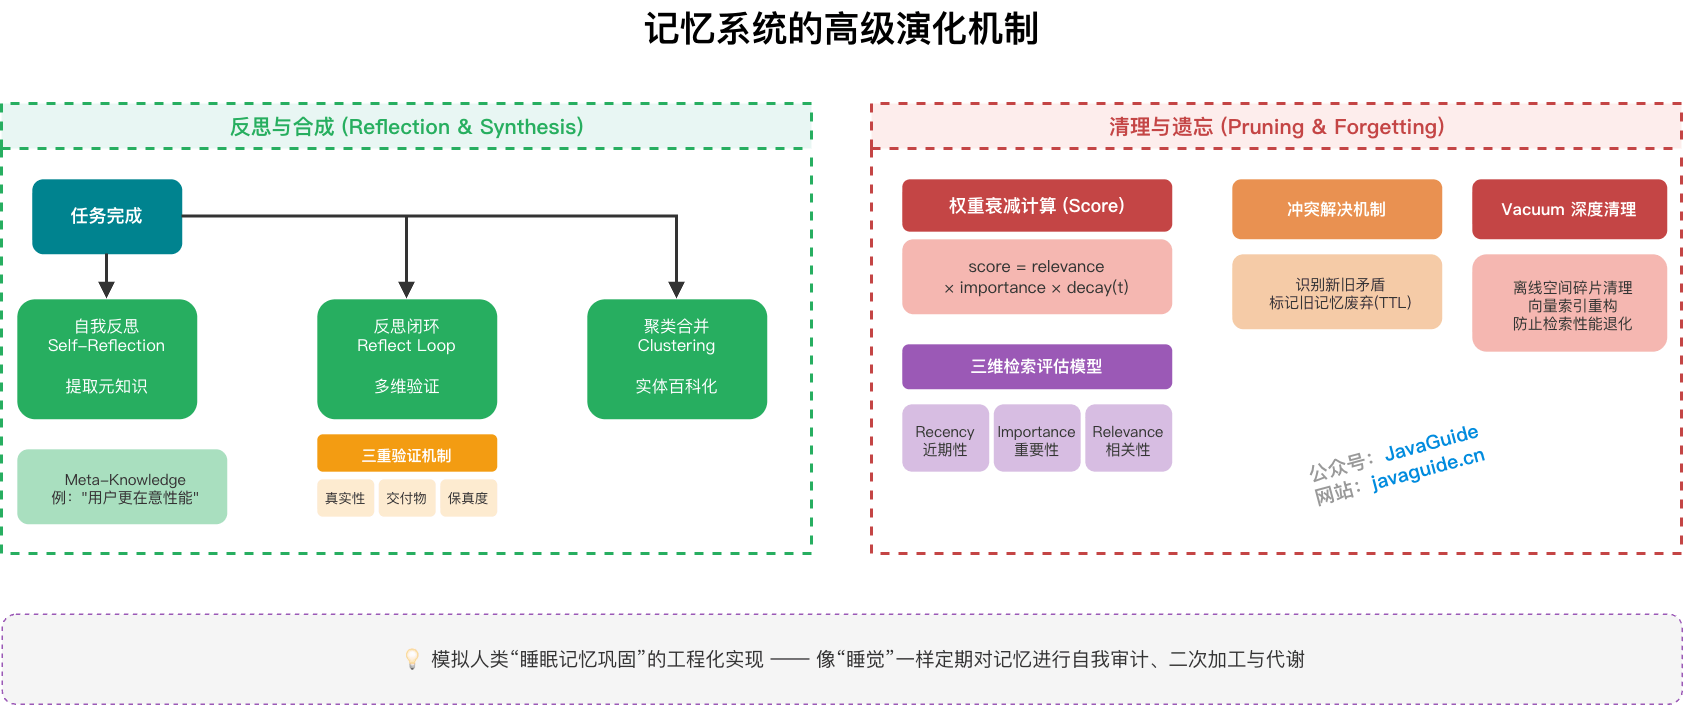
Chỉ write và retrieval là chưa đủ. Agent system cấp production còn cần một cơ chế metabolism để memory có thể reflection, merge, cleanup và forgetting; nếu không, database càng lớn thì noise cũng càng nhiều.
Reflection và synthesis của memory được thực hiện như thế nào?
Nếu system chỉ append, long-term memory sẽ nhanh chóng biến thành một dòng nhật ký. Điều thực sự có value là rút ra rule, preference và lesson có thể tái sử dụng từ dòng nhật ký đó.
Trong production system thường thêm một self-inspection task offline hoặc near-real-time.
Loại thứ nhất là Self-Reflection. Sau khi task hoàn thành, Agent khởi động async task, review nguyên nhân thành bại của task này và extract “lesson” thành một Meta-Knowledge. Cơ chế này được system 《Generative Agents》 của Park et al. (2023) systematize sớm nhất, có thể xem là implementation engineering mô phỏng “memory consolidation khi ngủ” của con người.
Ví dụ, nếu code review record nhiều lần cho thấy user ưu tiên xử lý OOM risk, có thể tích lũy nó thành thứ tự kiểm tra cho review sau, với điều kiện giữ lại source và phạm vi áp dụng. Không thể suy ra stable preference trực tiếp từ một feedback.
Loại thứ hai là fine-grained reflection loop (Reflect Loop). Sau khi high-risk subtask kết thúc, kiểm tra riêng xem evidence của fact, acceptance condition và key data có bị mất giữa các node hay không; nếu thiếu thì trả về execution node để bổ sung, sau khi kiểm tra đạt mới ghi vào long-term memory. Áp dụng layer kiểm tra này cho cả low-risk task sẽ làm tăng latency và cost.
Loại thứ ba là memory clustering và consolidation (Clustering & Consolidation). Khi user nhiều lần đề cập cùng một project background, gộp các fragment record thành entity entry có source, để retrieval result không bị chiếm chỗ bởi các cách diễn đạt khác nhau của cùng một fact.
Cơ chế cleanup và forgetting của memory như thế nào?
Memory không phải càng nhiều càng tốt. Noise vô ích và thông tin outdated sẽ gây nhiễu nghiêm trọng cho judgment của LLM.
Một cách phổ biến là weight decay. System duy trì composite score cho mỗi memory:
score = relevance × importance × decay(t)Trong đó decay(t) thường có dạng exponential, chẳng hạn e^{-λt}. Cơ chế này đến từ mô hình retrieval ba chiều do 《Generative Agents》 đề xuất. Trong engineering thực tế, không nên tính time decay trên toàn bộ memory mỗi lần trong vector database; cách ổn định hơn là để vector database recall semantic tĩnh trước, sau đó áp dụng dynamic adjustment ở giai đoạn Reranker.
Cách khác là conflict resolution. Khi fact mới mâu thuẫn với fact cũ, chẳng hạn năm ngoái user dùng Java 8 nhưng năm nay nâng cấp lên Java 21, memory cũ nên được đánh dấu là deprecated. Lưu ý, soft delete của vector database phổ biến có thể phá connectivity của HNSW graph structure, vì vậy vẫn cần định kỳ chạy Vacuum task để cleanup và rebuild.
Điểm này thường bị nhiều team đánh giá thấp lúc đầu. Mọi người không nỡ “forget”, cho rằng lưu thông tin vẫn tốt hơn làm mất. Kết quả là vector database chất đống hàng trăm nghìn memory, mỗi Top-K đều lẫn một đống outdated noise, còn suggestion Agent đưa ra vẫn dừng ở ba năm trước. Trải nghiệm này rất tệ và khó cứu lại chỉ bằng cách chỉnh Prompt.
Tối ưu hiệu quả retrieval của long-term memory như thế nào?
Ngoài VectorStore và GraphStore, production environment thường cần thêm một layer hybrid retrieval strategy.
Hybrid retrieval và metadata filtering được thực hiện như thế nào?
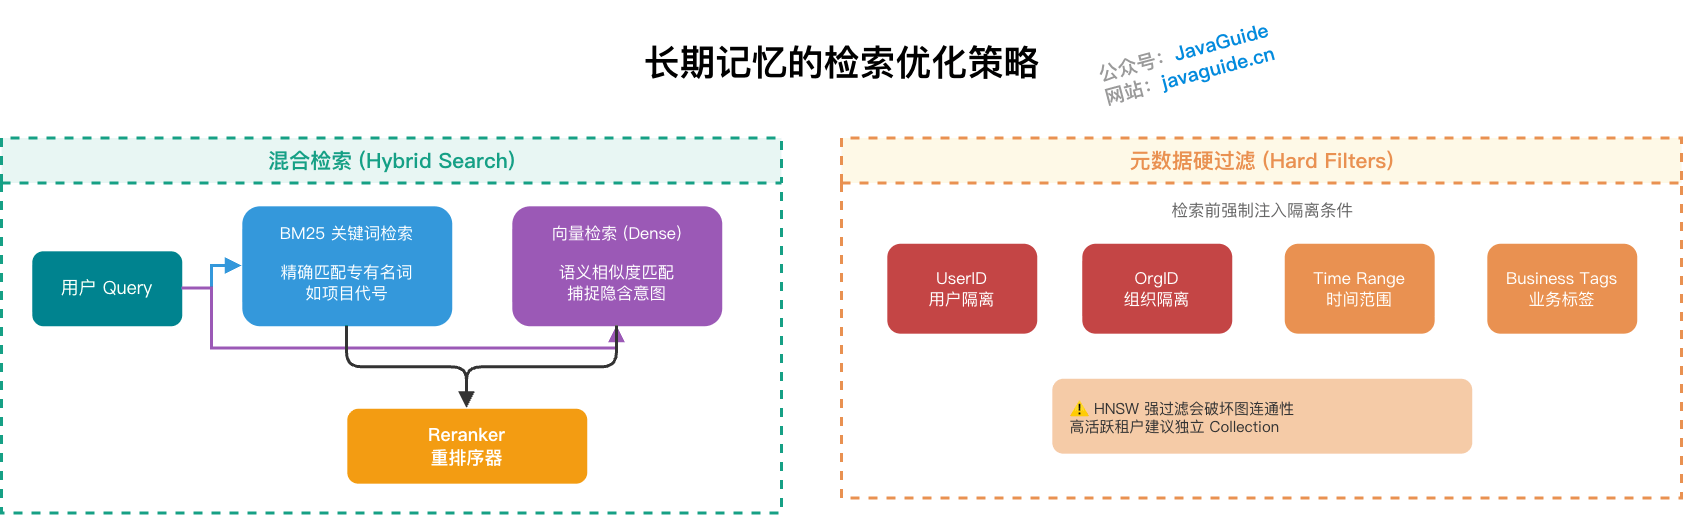
Chỉ dựa vào vector retrieval dễ tạo ra “false association”. Dense Retrieval xét semantic similarity, đôi khi sẽ recall nội dung nghe có vẻ gần nhau nhưng không liên quan về business.
Hybrid Search đưa candidate set của BM25 / Sparse và Dense lại với nhau. Với query chứa proper noun, có thể tăng weight của BM25; khi intent mơ hồ hơn thì phụ thuộc nhiều hơn vào vector recall. Các cách fusion thường gặp như sau:
- RRF (Reciprocal Rank Fusion): gần như không cần tuning parameter, phù hợp cold start, fusion có weight theo reciprocal rank.
- Linear weighted (
α·dense + (1-α)·sparse): có thể điều chỉnh, nhưng cần calibration weight bằng labeled data. - Cross-encoder Reranker: lấy union ở giai đoạn recall, chấm điểm thống nhất ở giai đoạn rerank, hữu ích hơn với long-tail query.
Khi multi-tenant request vào retrieval layer, cần mang theo hard filter condition như UserID, organization ID, time range và business tag. Thiếu giới hạn này, preference của user này có thể xuất hiện trong result của user khác; vì vậy isolation condition nên được data access layer inject thống nhất.
Strong filter trên HNSW cũng có cost: trong graph lớn chỉ giữ lại một số ít tenant tag sẽ làm giảm reachable path của graph, khiến recall rate có thể giảm theo. Core tenant hoạt động cao có thể dùng Collection riêng để physical isolation.
Vì sao tối ưu retrieval chain thường được ưu tiên trước write strategy?
Khi candidate store đã có thông tin cần thiết, sửa retrieval chain trước thường trực tiếp hơn mở rộng write.
Mem0 đạt 91.6 trên LoCoMo, cao hơn algorithm cũ +20 điểm; đạt 93.4 trên LongMemEval, +26 điểm; đạt 64.1 trên BEAM (1M); mỗi retrieval tiêu tốn khoảng 7K Token, tiết kiệm hơn so với full-context solution ở mức 25K+. Xem Mem0 official benchmark để biết chi tiết.
Khi memory không có hiệu lực, trước tiên hãy xem Trace: query được rewrite như thế nào, filter condition có đúng không, entry nào đi vào candidate set, Reranker chấm điểm ra sao. Chỉ khi candidate store thực sự thiếu thông tin cần thiết mới sửa extraction rule hoặc tăng write budget.
Production-grade memory system architecture cần chú ý điểm nào?
Khi thực sự đưa vào production, điều cần theo dõi không chỉ là “có nhớ được không”, mà còn gồm recall precision, compliance, performance và cost.
| Dimension | Core question | Solution |
|---|---|---|
| Multi-dimensional index | Recall precision | Kết hợp ba index: Vector + Graph + Keyword |
| Privacy compliance | Regulation như GDPR | PII de-identification trước khi write |
| Hot-cold separation | Performance và cost | High-frequency preference cache + low-frequency background RAG |
Đằng sau mỗi mục trong bảng đều là cost. Nhiều index đồng nghĩa maintenance burden cao hơn, PII strategy cần legal review, còn ranh giới hot-cold cũng rất dễ bị tranh luận qua lại trong team. Trước khi đạt quy mô multi-tenant, thường hiệu quả hơn nếu dùng một vector chain để làm trơn write idempotence, retrieval trace và rerank.
Dùng Markdown để storage Agent memory như thế nào?
Khi vector chain quá nặng, vẫn có một cách rất đơn giản nhưng hữu dụng: ghi những thứ Agent cần nhớ vào Markdown trong repository. Không có embedding cũng không sao; chỉ cần lượng thông tin có thể kiểm soát và readability quan trọng hơn semantic retrieval thì hướng này có thể hoạt động.
Vì sao Markdown có thể làm Agent memory?
Markdown có thể được xem là long-term memory dạng plain text do người và máy cùng viết. Không bắt buộc dùng vector retrieval, chỉ dựa vào directory organization cùng cơ chế @ / rules trong Claude Code cũng có thể chạy được.
Thứ nó tiết kiệm là visibility và operating cost:
- Transparent và auditable: mở file bất cứ lúc nào cũng thấy Agent đã nhớ gì, ghi gì, không có black box.
- Persistence: file tồn tại trên disk, không phụ thuộc process lifecycle. Sau khi process crash hoặc restart vẫn có thể đọc; khi đổi machine cần dùng Git, sync drive hoặc shared storage để mang file sang.
- Version control: memory có thể commit vào Git, rollback, branch và Code Review đều tự nhiên.
- Zero migration cost: format chuẩn, không vendor lock-in. Khi đổi model hoặc framework, chỉ cần copy file.
- Cost thấp: cost và operating complexity của managed vector database và RAG pipeline hoàn chỉnh đều không thấp, còn local Markdown file gần như không có additional cost.
Manus dùng file system làm external memory có cấu trúc; Claude Code đưa CLAUDE.md và Auto Memory vào product capability. Cơ chế chúng dùng không giống nhau, nhưng đều giữ một phần thông tin có thể review trong file. Với nội dung số lượng hữu hạn như project convention và operation preference, file system kết hợp Markdown đã có thể đáp ứng; khi đối mặt với lượng lớn free text, vẫn cần retrieval layer.
Cơ chế CLAUDE.md của Claude Code như thế nào?
Memory system của Claude Code dùng dual-track: CLAUDE.md do người viết và Auto Memory tự động tích lũy.
Nên và không nên viết gì trong CLAUDE.md?
Khuyến nghị chính thức là giới hạn mỗi CLAUDE.md trong 200 dòng. Vượt quá giới hạn này sẽ làm giảm instruction adherence rate của Claude. Dùng @ để split file có thể cải thiện maintainability, nhưng không giảm context cost, vì file được reference sẽ được load toàn bộ khi startup. Nếu instruction dài, ưu tiên dùng path-scoped rule trong directory .claude/rules/, chỉ load rule tương ứng khi edit path matching.
Vai trò của CLAUDE.md là trình bày những convention trong project không thể suy luận bằng general knowledge. Khi file phình to, rule quan trọng sẽ bị loãng, ngược lại làm giảm tính hữu dụng của instruction.
Tech stack và version cần được ghi rõ; ví dụ nếu không nêu version Spring Boot, Agent có thể áp dụng cách viết phổ biến hơn trong training data. Đặt test, lint và start command vào code block có thể giảm việc command bị sửa khi truyền đạt lại.
Architecture rule cần kèm theo lý do. Chẳng hạn sau “sử dụng QueryWrapper” bổ sung “hệ thống SQL audit phụ thuộc vào việc parse Wrapper để ghi operation log”, khi đó Agent mới có thể phán đoán query tương tự nên tiếp tục dùng cách nào. Project convention như format commit message, branch naming và environment variable dependency cũng nên được ghi lại.
Code style mà formatter có thể bắt buộc thực thi thì không cần lặp lại; default behavior của language hoặc framework cũng không cần chiếm context. Tài liệu tham khảo dài chỉ cần giữ link.
Khi review CLAUDE.md, có thể kiểm tra từng dòng: nếu xóa dòng này, issue gần đây có xuất hiện lại không? Rule không có error tương ứng thường có thể loại bỏ.
Viết thế nào để Claude thực sự tuân thủ?
Rule cần có thể acceptance test. “Chú ý code readability” không thể kiểm tra, còn “tên function bắt đầu bằng verb, mỗi function không quá 40 dòng” thì có thể dùng để phán đoán có phù hợp hay không.
Khi field injection bị disable, rule cũng nên chỉ rõ constructor injection và implementation hiện có có thể tham khảo:
# Dependency injection

- Không sử dụng field injection với @Autowired
- Sử dụng constructor injection, kết hợp với @RequiredArgsConstructor của Lombok
- Ví dụ tham khảo: cách viết trong UserController.java
Có thể dùng marker word, nhưng đừng lạm dụng. Nếu Claude liên tục vi phạm một rule, thêm IMPORTANT: hoặc YOU MUST: có thể tăng nhẹ mức độ chú ý. Nhưng nếu cả file chỗ nào cũng là “important”, cuối cùng sẽ chẳng còn trọng tâm.
Khi cùng một rule liên tục bị bỏ qua, trước tiên hãy kiểm tra xem nó có bị nhiều nội dung không liên quan đẩy xuống sau không, hoặc có conflict với rule khác không. Thêm vài dấu chấm than vào câu không giải quyết được vấn đề loading scope và priority; xóa rule vô hiệu, chuyển convention cục bộ vào file rules tương ứng thường hiệu quả hơn.
Heading có thể dùng các tên phổ biến như Commands, Structure, Conventions và Testing. Chúng thống nhất với structure thường dùng của README, nên purpose của rule cũng dễ được nhận diện hơn.
Cấu trúc hierarchy của các file CLAUDE.md như thế nào?
| Cấp độ | Vị trí | Scope tác dụng | Scenario phù hợp |
|---|---|---|---|
| Organization-level | System directory, như /etc/claude-code/CLAUDE.md | Tất cả user | Coding convention của công ty, security policy, không setting nào có thể loại trừ |
| User-level | ~/.claude/CLAUDE.md | Tất cả project cá nhân | Preference về code style, thói quen dùng tool cá nhân |
| Project-level | ./CLAUDE.md hoặc ./.claude/CLAUDE.md | Team sharing | Project architecture, coding standard, workflow, commit vào Git |
| Local-level | ./CLAUDE.local.md | Project hiện tại của cá nhân | Sandbox URL, preference về test data, cần thêm thủ công vào .gitignore, chạy /init có thể tự động thêm |
File loading tuân theo quy tắc tìm kiếm đi lên theo directory tree: từ current working directory lần lượt đi lên. Trong cùng một directory, CLAUDE.local.md được append sau CLAUDE.md, rule càng gần working directory càng có priority cao.
CLAUDE.md không thích hợp để lưu log dài hoặc complete conversation record, cũng không nên lưu sensitive key, Token hay account information. Runtime data thay đổi thường xuyên và dynamic information có thể query real-time cũng không phù hợp để ghi vào đó.
Khi project lớn lên, cần quản lý theo layer. Với project cá nhân, một CLAUDE.md thường là đủ; với team project thì nên tách ra.
# `CLAUDE.md` (project root)

## Project

Order management service dùng Spring Boot 3.2 + MyBatis-Plus + MySQL 8.0.

## Commands

- Build: `mvn clean package`
- Test: `mvn test`

## Rules

- API convention: @docs/api-conventions.md
- Database convention: @docs/database-rules.md
Có thể dùng @path/to/file để reference external file. Tuy nhiên cần lưu ý, @ reference hỗ trợ tối đa 5 level đệ quy. Lần đầu sử dụng external reference trong project, Claude Code sẽ hiện approval dialog. Nếu từ chối nhầm, reference sẽ bị disable vĩnh viễn và cần reset thủ công. @ reference nhúng toàn bộ nội dung file vào context, file được reference sẽ được load toàn bộ khi startup, nên không làm giảm context cost.
Nếu cần kiểm soát granular hơn, có thể dùng directory .claude/rules/ để tổ chức path-scoped rule. Điểm khác biệt giữa nó và @ reference rất quan trọng: rules chỉ được load khi match path được chỉ định, thuộc kiểu load on demand; @ reference được load toàn bộ khi startup. Khi rule chỉ nhắm đến file hoặc directory cụ thể, chẳng hạn API convention của backend và test configuration, nên ưu tiên dùng rules thay vì tiếp tục chất thêm vào CLAUDE.md.
---
paths:
  - "src/main/java/**/controller/**/*.java"
---
# Controller convention
- Thống nhất dùng Result<T> để wrap return value
- Mọi interface phải thêm Swagger annotation
Như vậy khi edit Controller chỉ load Controller rule, còn khi edit Service chỉ load Service rule.
AGENTS.md và CLAUDE.md có quan hệ gì?
Claude Code tự động đọc CLAUDE.md, không đọc AGENTS.md. Các convention dùng chung cho nhiều coding Agent có thể đặt trong AGENTS.md, sau đó import từ CLAUDE.md; rule riêng của Claude Code tiếp tục đặt trong file sau, còn convention cơ bản cũng chỉ cần maintain một bản.
@AGENTS.md

## Claude Code-specific instruction

- Sử dụng plan mode khi xử lý thay đổi trong `src/billing/`
Auto Memory là gì?
Auto Memory ghi debugging method, coding habit và workflow preference trong conversation thành note. Nó nằm ở ~/.claude/projects/<project>/memory/; MEMORY.md là entry point, detail nằm trong subfile.
MEMORY.md chỉ load 200 dòng đầu hoặc 25KB, phần vượt quá không đi vào context, detail sẽ được tách vào Topic file. Sau 20-30 session, note có thể tích lũy conflict hoặc entry outdated; dream-skill của community thực hiện consolidation theo bốn phase Orient, Gather Signal, Consolidate và Prune, nhưng đây không phải official feature.
Có thể disable Auto Memory bằng /memory, config autoMemoryEnabled, hoặc set environment variable CLAUDE_CODE_DISABLE_AUTO_MEMORY=1. CI/CD thường không cần tích lũy temporary note, có thể tắt trong environment đó.
Auto Memory cần Claude Code v2.1.59+, mặc định được bật.
Thiết kế layer cho Markdown memory như thế nào?
Một Markdown memory system hoàn chỉnh thường được chia thành vài layer:
- User-level memory: lưu personal preference và long-term habit, đặt tại
~/.claude/CLAUDE.md, chẳng hạn indent 2-space, viết test trước rồi mới viết code, không thích dùng emoji. - Project-level memory: lưu project convention, tech stack, directory structure, đặt trong
CLAUDE.mdở repository root, team member chia sẻ qua Git. - Subdirectory-level memory: lưu rule riêng của local module, đặt trong
CLAUDE.mdcủa subdirectory, chẳng hạn API design convention dướibackend/, writing style requirement dướidocs/. - Team shared memory: convention chung cần commit vào repository, thường là
CLAUDE.mdcấp project và versioned rule file trong directory.claude/rules/. - Private memory: workflow cá nhân không nên commit, chẳng hạn
CLAUDE.local.md; sau khi thêm vào.gitignorechỉ giữ lại local.
Ranh giới giữa Markdown memory và long-term memory truyền thống ở đâu?

Markdown và vector database đều có boundary phù hợp riêng, không nên áp dụng một cách máy móc.
| Dimension | Markdown memory | Vector database memory | RAG knowledge base | Database-based framework (Mem0, v.v.) |
|---|---|---|---|---|
| Retrieval precision | Load toàn bộ, không có retrieval mechanism, load tất cả khi startup | Cao, semantic similarity | Cao, semantic retrieval | Cao, hybrid strategy |
| Context cost | Tuyến tính theo file size, file lớn sẽ chiếm chỗ | Retrieval on demand, context efficient | Retrieval on demand, context efficient | Retrieval on demand, context efficient |
| Debugging experience | Rất tốt, đọc ghi file trực tiếp | Trung bình, cần vector query tool | Trung bình, cần retrieval log | Phức tạp, cần hiểu framework logic |
| Deployment cost | Rất thấp, chỉ cần file read/write | Cao, cần maintain vector service | Cao, cần RAG pipeline | Cao, cần framework runtime |
| Version control | Native integration với Git | Cần additional sync mechanism | Cần additional sync mechanism | Cần additional sync mechanism |
| Migration cost | Zero, chỉ cần copy file | Cao, bị khóa vào proprietary format | Cao, bị khóa vào pipeline | Rất cao, bị ràng buộc vào framework |
| Scenario phù hợp | Preference, convention, record về pitfall | Diverse memory retrieval | Shared knowledge query | Complex multi-source memory management |
Khi số lượng file và nội dung tăng lên, directory và việc đặt tên thủ công khó bảo đảm lần nào cũng định vị được fragment liên quan. Nếu cần recall nội dung theo semantic từ lượng lớn record phi cấu trúc, nên giao việc đó cho vector retrieval; tiếp tục chất loại data này vào Markdown chỉ khiến load toàn bộ và maintenance đều chậm hơn.
Ngược lại, nếu memory requirement là “ghi nhớ coding convention của project này” hoặc “ghi nhớ report preference của user”, sự đơn giản và maintainability của Markdown thường phù hợp hơn system phức tạp.
Markdown memory nên được maintain như thế nào?
Lấy CLAUDE.md làm ví dụ, sau khi project phát triển, các rule cũ cũng cần được kiểm tra lại.
Chỉ thêm rule vào file khi đã xuất hiện error cụ thể và rule mới có thể ngăn error cùng loại lặp lại. Trước tiên ghi lại clue của mỗi lần correction, xác nhận là cùng một loại issue rồi mới khái quát thành một rule ngắn gọn; rule mà sau khi xóa behavior vẫn không thay đổi cũng không cần giữ lại chỉ để “đầy đủ”.
Rule đã ghi rõ nhưng Claude vẫn xin lỗi vì vi phạm nó, điều đó cho thấy cần kiểm tra cách diễn đạt, vị trí hoặc loading scope của rule. Một rule liên tục thất bại giữa các Session cũng thường do file quá dài, trọng tâm bị loãng. Khi đó nên rút ngắn file hoặc tách local rule, rồi quan sát behavior có thay đổi không.
Khi maintain có thể dùng conversational review: cứ vài tuần, chọn một vài rule trong CLAUDE.md rồi hỏi Claude, “Nếu tôi xóa rule này, bạn có thay đổi behavior không?”. Nếu nó trả lời không, rule này có thể xóa.
Tuy nhiên, cách này chỉ nên làm heuristic reference, không thể hoàn toàn tin vào self-assessment của Claude. Claude không thể dự đoán chính xác khi thiếu một rule thì behavior của chính nó có thay đổi hay không. Cách đáng tin hơn là backup rule trước, xóa thật, rồi quan sát behavior trong vài task thực tế có thay đổi không.
/init cũng có thể dùng, nhưng đừng dùng trực tiếp. CLAUDE.md được generate tự động là một starting point tốt, nhưng có thể chứa project description không chính xác. Hãy review từng dòng theo nguyên tắc trên, xóa phần dư thừa và bổ sung phần bỏ sót.
Cuối cùng, memory dùng chung của team tốt nhất nên update qua Git. Mỗi lần update memory quan trọng đều commit, khi có issue có thể rollback, Code Review cũng truy nguyên được lý do thay đổi. Với thay đổi trong nội dung dùng chung của team, nên đi qua quy trình PR.
Khi điều tra vấn đề memory, trước tiên hãy xem retrieval Trace
Short-term memory bị giới hạn bởi capacity của window, sliding window, summary compression và offloading heavy result được dùng để kiểm soát nó; long-term memory thì cần xử lý idempotence khi write, conflict, expiration và retrieval ranking.
Một lượng nhỏ thông tin như project convention và coding standard có thể giữ trong Markdown dễ review, dễ version control. Khi cần tìm theo semantic từ lượng lớn record phi cấu trúc, mới tích hợp vector retrieval. Hai cách có thể cùng tồn tại.
Khi Agent không dùng memory đã có, Trace có thể phân biệt vấn đề: bất kỳ bước nào trong query rewrite, filter, candidate set hoặc rerank bị lỗi đều khiến entry đã ghi mất hiệu lực. Sau khi xác nhận candidate store thiếu thông tin, mới điều chỉnh extraction rule hoặc write budget.
Tổng kết
Short-term memory phục vụ task hiện tại, long-term memory lưu thông tin còn value xuyên Session. Loại trước chịu giới hạn của window, loại sau cần xử lý thời điểm write, conflict, expiration và privacy; không thể lưu toàn bộ chat history trong thời gian dài.
Project convention số lượng ít, cần con người maintain phù hợp với Markdown; khi cần semantic retrieval từ lượng lớn record phi cấu trúc, hãy dùng vector retrieval hoặc memory framework chuyên dụng. Bắt đầu troubleshooting từ retrieval Trace mới có thể phân biệt trước là vấn đề recall hay write.