
Các khái niệm cốt lõi về AI Agent: Agent Loop, Plan-and-Execute, A2A, Agentic Workflows, đăng ký Tools
“Giúp tôi kiểm tra nguyên nhân API user-service chậm vào sáng nay và gửi kết quả cho người phụ trách.” Những yêu cầu như vậy không có đáp án cố định: cần xem monitoring, log hay Heap Dump trước, tùy vào bằng chứng thu được ở bước trước. Ngay cả khi đã phát hiện slow SQL, vẫn phải quyết định có cần kiểm tra execution plan hay không, tổ chức kết luận thế nào và có thể gửi thông báo hay chưa.
Chat model có thể đưa ra một checklist kiểm tra, nhưng không tự đi hết quy trình này. Để hoàn thành nhiệm vụ, model cần chọn tool, đọc kết quả tool, rồi dựa vào đó quyết định bước tiếp theo hoặc kết thúc. AI Agent xử lý chính chuỗi quyết định và thực thi liên tục này.
Càng kết nối nhiều tool, càng không thể tùy ý thả lỏng execution path. Những công việc có bước rõ ràng như trừ tồn kho đơn hàng hay quy trình phê duyệt vẫn nên do chương trình truyền thống hoặc Workflow kiểm soát; chỉ khi các bước trung gian phụ thuộc vào bằng chứng thời gian thực và không thể viết cố định từ trước thì mới cần Agent tham gia phán đoán.
Các phần sau sẽ tách riêng chuỗi này theo quá trình tiến hóa, execution loop, kết nối tool và các paradigm thường gặp, đồng thời đưa ra căn cứ chọn Agent, Workflow hay lập trình truyền thống.
Quá trình tiến hóa của AI Agent
Năng lực của Agent không xuất hiện cùng một lúc. Model trước hết có khả năng gọi bên ngoài, sau đó mới phát sinh nhu cầu orchestration, long-running task và online lâu dài.
Năm 2022, khi các sản phẩm như ChatGPT vừa trở nên phổ biến, model chủ yếu trả lời dựa trên kiến thức sẵn có, không thể chủ động gọi tool bên ngoài và cũng không tự hoàn thành thao tác. Prompt Engineering là cách sử dụng quan trọng nhất thời điểm đó: nói rõ constraint và context thì output mới ổn định hơn.
Giữa năm 2023, sau khi Function Calling xuất hiện, mọi thứ bắt đầu thay đổi.
Function Calling cho phép LLM gọi external API; RAG đưa knowledge base bên ngoài vào quá trình trả lời. Những thử nghiệm ban đầu như AutoGPT cũng xuất hiện, nhưng chúng thường gọi lặp lại trong các task nhiều bước, thậm chí rơi vào infinite loop.
Cuối năm 2023, mọi người bắt đầu chú trọng orchestration.
ReAct bắt đầu được áp dụng rộng rãi: model chọn action theo state hiện tại, đọc kết quả tool trả về rồi tiếp tục phán đoán. Việc phân công giữa nhiều Agent cũng được đưa vào thực tiễn trong giai đoạn này, chẳng hạn giao planning, execution và kiểm tra cho các role khác nhau.
Coze, Dify và các platform tương tự dùng DAG (directed acyclic graph) để giới hạn execution path, bổ sung boundary có thể quan sát và kiểm soát cho các giải pháp tự chủ hoàn toàn thời kỳ đầu.
Cuối năm 2024, standardization và multimodal bắt đầu trở nên quan trọng.
MCP protocol bắt đầu xử lý vấn đề phân mảnh khi kết nối tool, còn Computer Use mở rộng phạm vi thực thi đến giao diện đồ họa. Các tool lập trình như Cursor, Claude Code và Codex cũng dần nối việc đọc codebase, sửa đổi, kiểm thử và commit vào cùng một task chain; “Vibe Coding” theo đó được nhiều người thảo luận hơn.
Năm 2025, Agent bắt đầu hướng đến long-running task.
Trong giai đoạn này, Agent bắt đầu đảm nhận task kéo dài ngoài một lần hội thoại: nhận task, chạy flow và lưu lại kết quả. Một Prompt đơn lẻ không thể bao phủ ổn định loại công việc này; flow cố định, context, template, script và rule kiểm tra được đóng gói thành Skill để các task tương tự load khi cần.
Đến năm 2026, Agent bắt đầu gần với một digital work unit online lâu dài hơn.
Các project như OpenClaw đưa Skills và Heartbeat lên vị trí nổi bật hơn.
Skills đóng gói năng lực, Heartbeat đánh thức Agent theo chu kỳ để kiểm tra message, xử lý task hoặc cập nhật state. Đây là đánh thức theo lịch, không phải consciousness liên tục; data sovereignty cục bộ cũng không đồng nghĩa với an toàn tuyệt đối. Agent có thể cài Skill, truy cập file và thực thi script phải đối mặt với rủi ro về permission, sandbox và supply chain.
Điều này cũng thúc đẩy Harness Engineering. Có thể xem nó là Agent = Model + Harness: model phụ trách reasoning và generation, Harness cung cấp runtime environment có thể thực thi, quan sát, khôi phục và kiểm chứng. Vì vậy, mối quan tâm được mở rộng từ model parameter, context length và kỹ thuật viết Prompt sang engineering environment bên ngoài model.
Memory tích hợp sẵn, năng lực prediction và khả năng mở rộng từ digital world sang physical robot vẫn đang được phát triển. Các mốc năm chỉ là lát cắt để dễ hiểu: sản phẩm thực tế thường đồng thời có đặc điểm của nhiều giai đoạn. Ranh giới rõ nhất vẫn là giữa năm 2023, khi model dần có khả năng thực hiện thao tác bên ngoài thay vì chỉ generate text.
Agent, lập trình truyền thống và Workflow khác nhau thế nào?
Chỉ cần xem ai quyết định execution path là có thể phân biệt Agent, automation script và Workflow:
Lập trình truyền thống: Lập trình viên viết code → kết quả thực thi
Workflow: Product vẽ flowchart → kết quả thực thi
Agent: Người dùng nêu intent → AI quyết định → thực thi động
Các logic cố định và có tần suất cao như trừ tồn kho đơn hàng, chuyển trạng thái payment hay consumer của message queue phù hợp với chương trình truyền thống; dùng Agent chỉ làm tăng latency và uncertainty.
Các công việc có path rõ ràng như phê duyệt, publish content hay phân phối lead phù hợp với Workflow. Thứ tự step và branch do graph kiểm soát, vấn đề có thể được truy về node cụ thể để kiểm tra.
“Kiểm tra nguyên nhân service chậm vào sáng nay” lại khác: cần kiểm tra monitoring, log hay Heap Dump phải tùy vào bằng chứng trung gian, khó viết cố định trước mọi branch. Việc hiểu intent bằng natural language và phán đoán động như vậy mới là phạm vi phù hợp của Agent. Khi chỉ có một số ít khâu không chắc chắn trong flow dài, có thể dùng Plan-and-Execute để chừa các subtask động trong một framework cố định.
Agent đối mặt với những thách thức nào?
Nói về Agent không thể chỉ nói về viễn cảnh, cũng cần nhìn vào các vấn đề thực tế.
- Khi long-running task chạy lâu, thông tin lịch sử sẽ bị cắt, model sẽ “mất trí nhớ”. Khó chịu hơn là context dài hơn chưa chắc reasoning tốt hơn; nhiều model không tận dụng hiệu quả thông tin ở vị trí giữa.
- Tool call có thể giảm hallucination nhưng không thể xóa hoàn toàn. LLM vẫn có thể đưa ra phán đoán sai trong các bước reasoning, và kết quả tool trả về cũng chưa chắc kéo nó trở lại đúng hướng.
- Multi-turn iteration, tool call, log trả về và context compression đều tiêu tốn Token. Một task phức tạp chạy một vòng có thể khiến hóa đơn thực sự làm người ta tỉnh ngộ.
- Agent có thể thực thi code, gọi API, đọc ghi file, vì vậy chắc chắn phải đối mặt với rủi ro Prompt Injection và thao tác vượt quyền. Cách thực tế hơn là tối thiểu hóa permission, cô lập sandbox và yêu cầu con người xác nhận thao tác rủi ro cao.
- Trong task reasoning nhiều bước, LLM vẫn dễ rơi vào local optimum, có vẻ luôn tiến lên nhưng thực ra đã lệch khỏi vấn đề.
- Việc kiểm tra tại sao Agent đưa ra một quyết định, tại sao gọi một tool hay bước nào đã làm context lệch hướng thường rất khó.
Các hướng tương đối rõ ở phía trước gồm: context dài hơn, memory phân tầng, thao tác GUI multimodal, hệ thống sandbox và permission, cùng tối ưu hiệu suất reasoning.
AI Agent là gì?
Sau khi nhận yêu cầu “service chậm”, một Agent troubleshooting có thể trước hết đọc monitoring, sau đó xem log theo alert và cuối cùng gửi kết luận cho người phụ trách. Mỗi bước đều phụ thuộc vào bằng chứng thu được ở bước trước. Các framework như LangChain đóng gói quy trình này; bên dưới thường vẫn là một loop liên tục đọc state, chọn action và ghi lại kết quả.
AI Agent là một software system có thể cảm nhận environment, ra quyết định và thực thi action. LLM xử lý intent và decision, tool thực hiện thao tác bên ngoài, còn memory lưu task hiện tại và thông tin lịch sử. So với chatbot chỉ generate reply, nó liên tục quan sát và điều chỉnh trong quá trình thực hiện task cho đến khi thỏa mãn điều kiện kết thúc.
Cách phân tách thường dùng là: Agent = LLM + Planning + Memory + Tools.
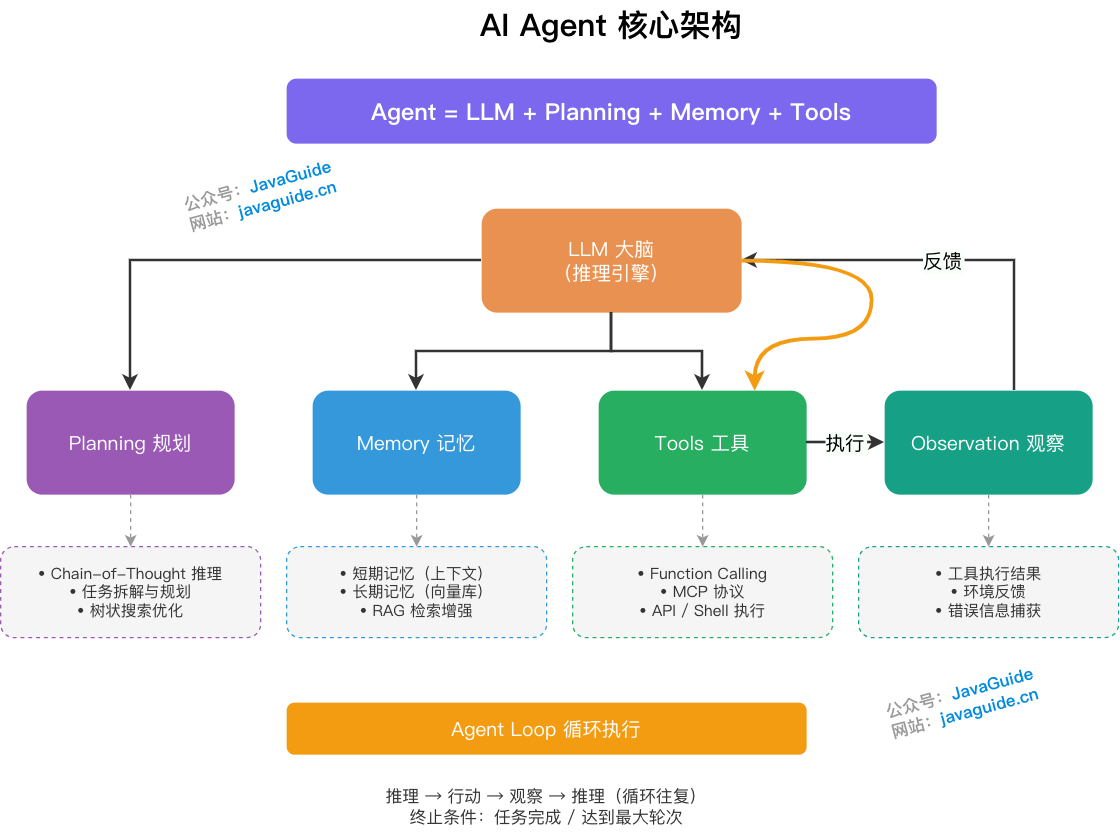
Reasoning và planning (Reasoning / Planning) quyết định goal và action tiếp theo. LLM phân rã goal dựa trên state hiện tại; kỹ thuật prompt Chain-of-Thought (CoT) chia quá trình reasoning thành các step, giảm việc đưa ra ngay kết luận chưa được phân tích đầy đủ.
Short-term memory thường được lưu trong context history để duy trì tính liên tục của hội thoại; long-term memory thường do vector database hoặc knowledge graph và các external knowledge base khác đảm nhiệm để truy xuất thông tin tích lũy trước đó.
Tools phụ trách query data, gọi API, đọc ghi file hoặc thực thi code. Kết quả thực thi phải được append vào context và trở thành Observation (quan sát) của vòng tiếp theo; nếu không, model sẽ không thấy feedback từ thao tác bên ngoài và không thể phán đoán action tiếp theo.
Agent Loop là gì?
Agent Loop chạy liên tục feedback chain này. Mỗi vòng, LLM trước hết chọn action dựa trên context, sau đó thực thi tool và ghi kết quả trở lại; khi task hoàn tất hoặc chạm stop condition thì thoát.
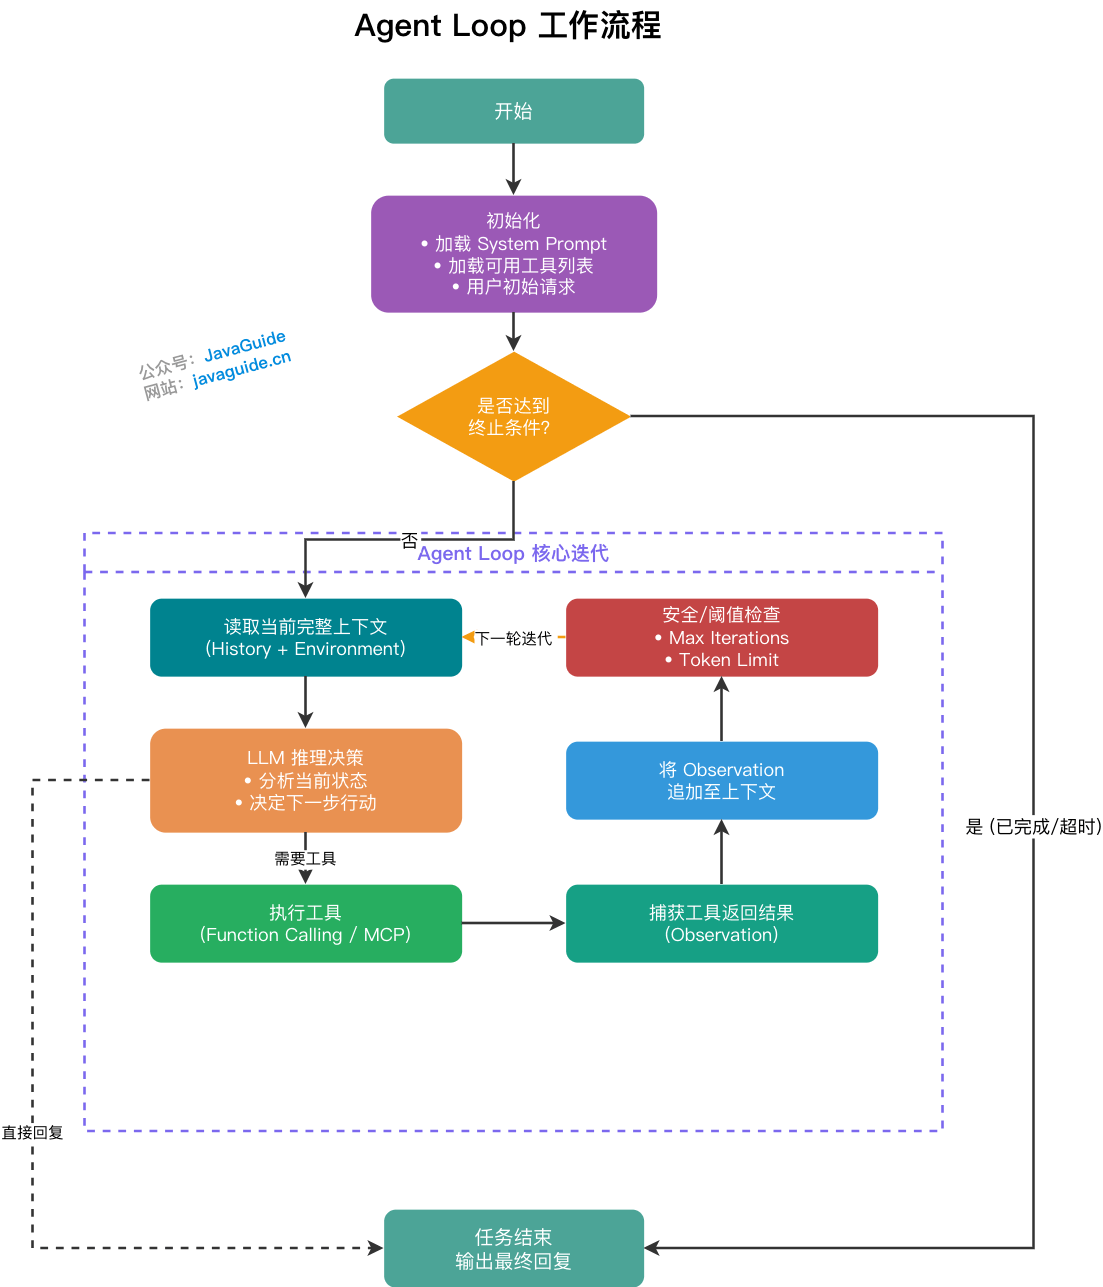
Khi khởi tạo Loop, hệ thống load System Prompt, danh sách tool và request của người dùng. Sau đó model chọn giữa “trả lời trực tiếp” và “gọi tool”; kết quả tool được ghi trở lại context cho đến khi model không còn yêu cầu tool.
Số vòng iteration tối đa thường đặt ở 10 đến 20 vòng, cũng có thể kết thúc theo mức tiêu thụ Token. Boundary này dùng để ngăn phán đoán sai đưa task vào infinite loop.
Context liên tục dài hơn theo kết quả của mỗi vòng; khi thông tin quan trọng bị làm loãng, model dễ lệch hướng hơn. Context Engineering xử lý chính vấn đề lọc và tổ chức các thông tin này. Cách đóng gói của LangChain, LlamaIndex và Spring AI khác nhau, nhưng bên dưới đều không thể bỏ qua Loop này.
Xây dựng một Agent system, tối thiểu cần xử lý ba layer nào?
Code kết nối model thường được xếp vào LLM Call: tại đây xử lý khác biệt giữa API của OpenAI, Anthropic, Hugging Face và các bên khác, cùng streaming output, Token truncation và retry.
Tools Call phụ trách kết nối Function Calling, MCP, Skills, cùng file read/write, web search, code sandbox và third-party API với model. External capability có khả dụng hay không và trả về format gì đều ảnh hưởng đến decision ở vòng tiếp theo.
Prompt, dynamic memory, session state và tool description truyền cho model được tổ chức bởi Context Engineering. Khi context thiếu thông tin cần cho task hoặc trộn quá nhiều nội dung không liên quan, task vẫn có thể không tiến triển dù bản thân model đủ năng lực.
Đăng ký và gọi Tools tuân theo format tiêu chuẩn nào?
Để Agent gọi chính xác external tool, không thể bỏ qua hai thứ: OpenAI Schema và MCP.
OpenAI Schema giải quyết vấn đề data format, MCP giải quyết vấn đề communication integration.
Data format: Function Calling Schema
External tool có thể rất phức tạp, nhưng khi reasoning LLM chỉ nhận diện mô tả có cấu trúc.
Các data format phổ biến hiện nay về cơ bản đều hướng đến OpenAI Function Calling Schema. Các vendor như Anthropic và Google cũng hỗ trợ format tương tự.
Nó dùng JSON Schema để mô tả tên tool, mục đích, kiểu parameter và field bắt buộc. Model dựa trên mô tả này để quyết định có cần gọi tool hay không và điền parameter thế nào.
Ví dụ một tool thường dùng của data engineer: query log slow SQL.
{
  "type": "function",
  "function": {
    "name": "query_slow_sql",
    "description": "Truy vấn log slow SQL của microservice được chỉ định trong khoảng thời gian cụ thể. Dùng khi service phản hồi chậm, database timeout hoặc CPU tăng vọt. Nếu người dùng hỏi về vấn đề network hoặc memory thì không gọi tool này.",
    "parameters": {
      "type": "object",
      "properties": {
        "service_name": {
          "type": "string",
          "description": "Tên service, ví dụ user-service, order-service"
        },
        "time_range": {
          "type": "string",
          "description": "Khoảng thời gian, format HH:MM-HH:MM, ví dụ 09:00-09:30"
        },
        "threshold_ms": {
          "type": "integer",
          "description": "Ngưỡng xác định slow SQL (millisecond), mặc định 1000"
        }
      },
      "required": ["service_name", "time_range"]
    }
  }
}
Viết tool description tốt hay không ảnh hưởng trực tiếp đến phán đoán của Agent.
Model có gọi tool hay không và điền parameter thế nào chủ yếu dựa vào description. Description cần đồng thời nêu điều kiện phù hợp và không phù hợp. Ví dụ, tool query slow SQL loại trừ rõ các vấn đề về network và memory, nên model sẽ không gọi nó khi hướng xử lý không phù hợp.
Đóng gói nâng cao: Skills
Một lần troubleshooting slow query thường cần lần lượt đọc log, chạy script phân tích rồi tổ chức recommendation theo quy chuẩn của team. Nếu lần nào Agent cũng planning tạm thời, step và output khó tái sử dụng ổn định.
Skill lưu thứ tự execution chain, constraint và ghi chú về các lỗi thường gặp trong một instruction file có thể load on-demand. Chỉ sau khi host xác định task phù hợp, nội dung liên quan mới được đưa vào context.
Có hai cách đóng gói phổ biến:
Traditional Toolkits (black box) kết hợp nhiều atomic tool thành high-level tool trong code và chỉ expose JSON Schema ra bên ngoài; LLM không nhìn thấy path bên trong. Cách này phù hợp với logic cố định, cần giảm số bước reasoning và mức tiêu thụ Token.
Agent Skills (white box) cần xem execution path thường dùng SKILL.md làm entry point, diễn đạt task instruction bằng natural language. Một Skill thường là một folder độc lập:
.claude/skills/code-reviewer/
├── SKILL.md          ← YAML front-matter + instruction chi tiết
├── scripts/xxx.py    ← tùy chọn: script đi kèm
└── reference.md      ← tùy chọn: tài liệu tham khảo
Metadata nhẹ ở đầu SKILL.md dùng cho discovery, mô tả mục đích và trigger condition của Skill; phần thân ghi lại flow, constraint và example. Host đọc metadata trước, chỉ sau khi model xác định cần thiết mới load phần thân đầy đủ; lazy loading này là khác biệt then chốt giữa Agent Skills và Traditional Toolkits.
Các tool như Claude Code và Cursor scan thư mục .claude/skills/ trong project, để model quyết định có activate Skill hay không. Khi call path cố định thì dùng Toolkits; khi cần tích lũy kinh nghiệm của team nhưng vẫn giữ độ linh hoạt cho task flow thì Agent Skills phù hợp hơn. Thiết kế routing, cách viết SKILL.md và security audit cho Skill bên thứ ba có thể xem tại: 《Giải thích chi tiết Agent Skills》.
Communication integration: MCP protocol
Function Calling Schema mô tả tên, parameter và mục đích của tool, còn MCP quy định cách tool kết nối với host program; hai bên giải quyết các vấn đề khác nhau.
Anthropic ra mắt MCP vào tháng 11 năm 2024. Pain point mà nó xử lý rất trực tiếp: trước đây developer phải duy trì thủ công một loạt mapping trong code, chẳng hạn:
Tên tool → function thực thi thực tế + mô tả JSON Schema
Mỗi khi kết nối một tool mới lại phải viết một đống glue code. Tool càng nhiều thì càng khó bảo trì.
MCP cung cấp một communication protocol thống nhất dựa trên JSON-RPC 2.0, thường được gọi là “cổng USB-C” trong lĩnh vực AI. External system expose capability thông qua MCP Server; sau khi host program kết nối Server, nó có thể tự động discovery và register tool.
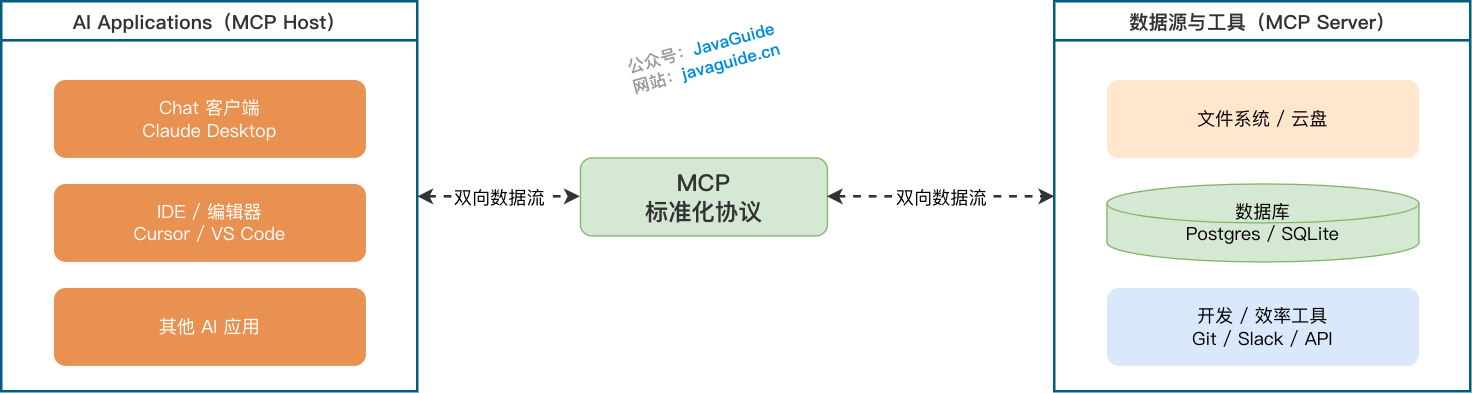
Nhờ vậy, AI application và external code bên dưới được decouple.
MCP định nghĩa ba loại primitive tiêu chuẩn:
| Loại primitive | Tác dụng | Ví dụ |
|---|---|---|
| Tools | Function do LLM chủ động gọi | Query database, gửi email, thực thi code |
| Resources | Read-only data để Agent đọc khi cần | Local file, database record, log stream |
| Prompts | Prompt template có thể tái sử dụng | Template code review, template incident report |
Điểm dễ nhầm là khi MCP Server expose tool ra bên ngoài, bên trong nó vẫn dùng JSON Schema để mô tả quy chuẩn parameter.
JSON Schema là data format, MCP là communication protocol layer.
Prompt Engineering là gì?
Prompt là instruction và context dành cho large language model. Prompt Engineering xử lý task boundary, output format và constraint: khi thiếu các thông tin này, model chỉ có thể tự đoán; khi điều kiện rõ ràng, output mới có cơ sở ổn định. Phương pháp cụ thể xem tại: 《Prompt Engineering》.
Context Engineering là gì?
Khi context trộn quá nhiều thông tin không liên quan, hiệu quả task sẽ giảm dù model có năng lực tương ứng.
Context Engineering làm việc bằng cách đưa thông tin hữu ích nhất cho model trong Token window có giới hạn và chặn noise bên ngoài. Nó rất dễ bị nhầm với Prompt Engineering.
Prompt Engineering thiên về cách viết prompt, còn Context Engineering quản lý phạm vi rộng hơn, bao gồm rule, memory, tool description, session state, external observation result và Token budget.
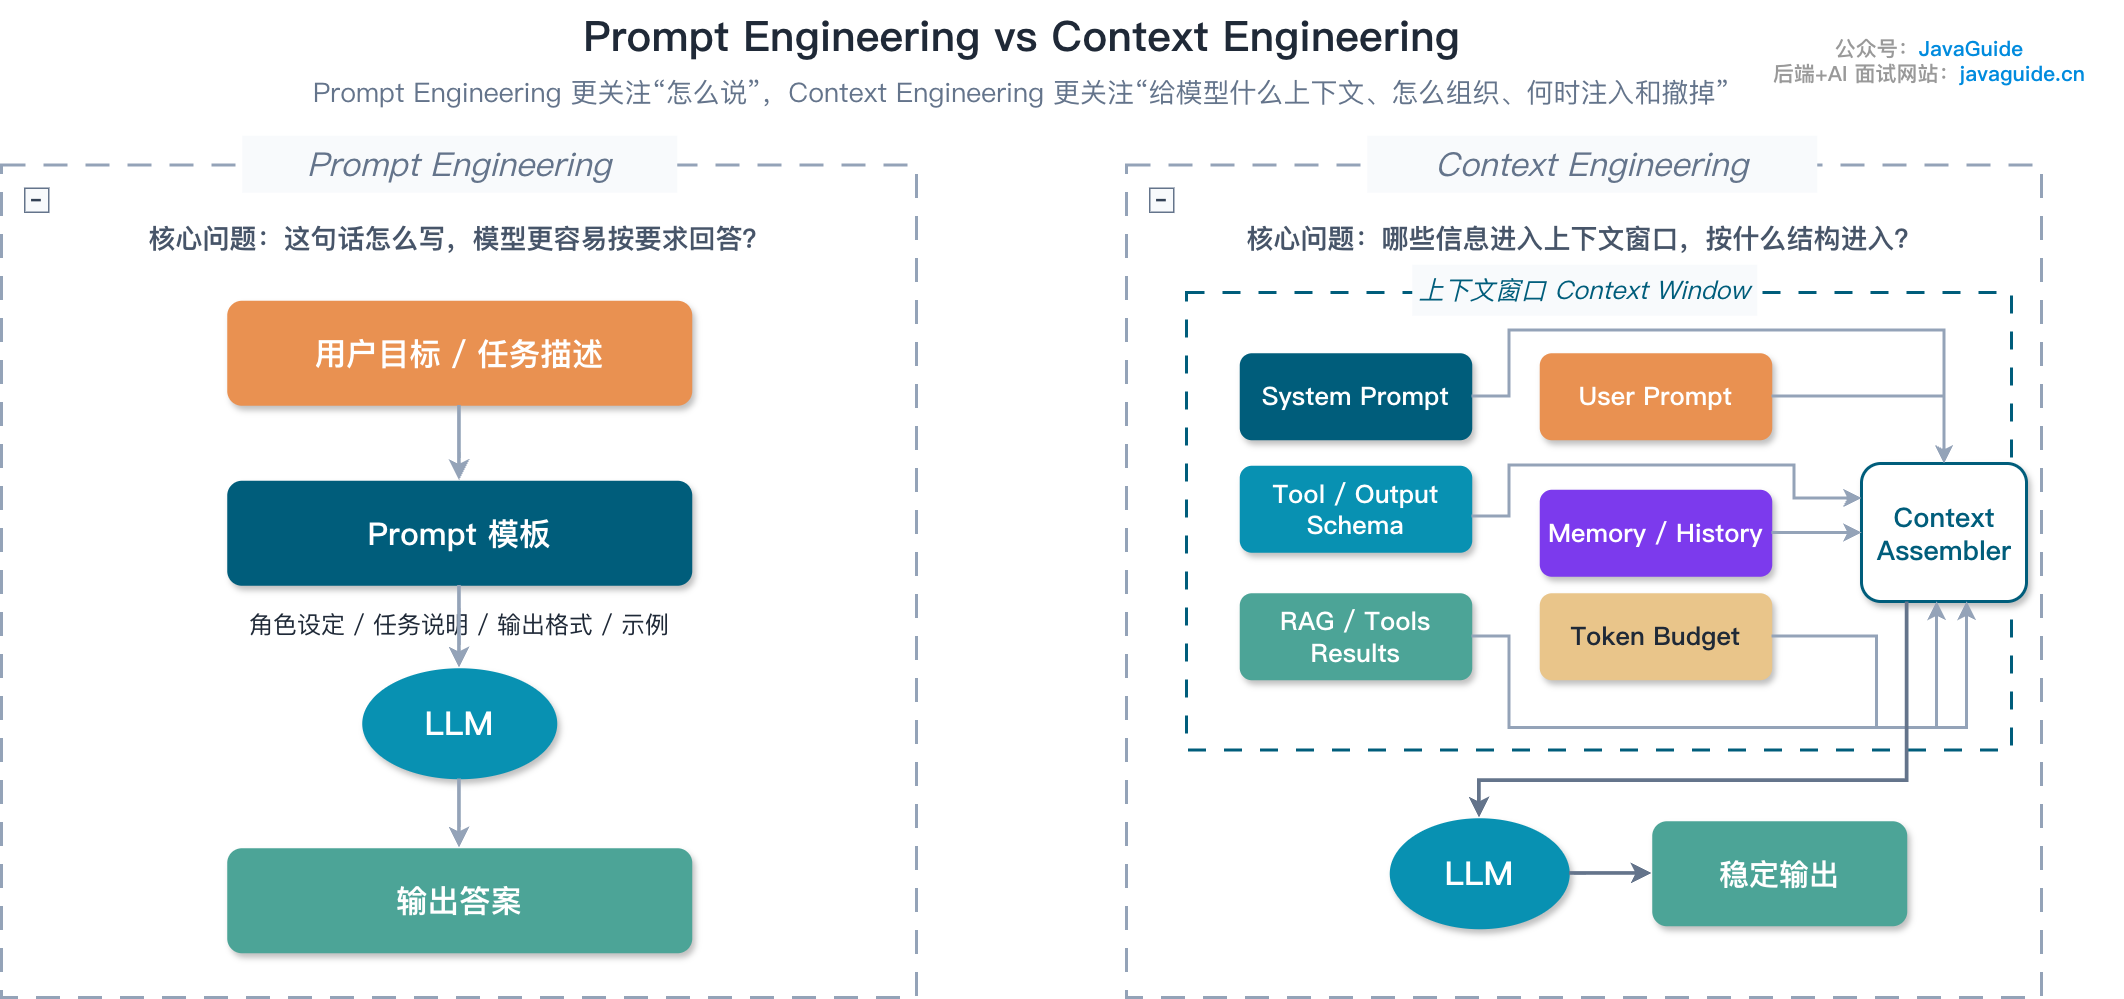
Phần này còn nhiều nội dung có thể triển khai riêng, bạn có thể xem: 《Prompt Engineering》 và 《Context Engineering》.
Các paradigm cốt lõi của Agent là gì?
ReAct
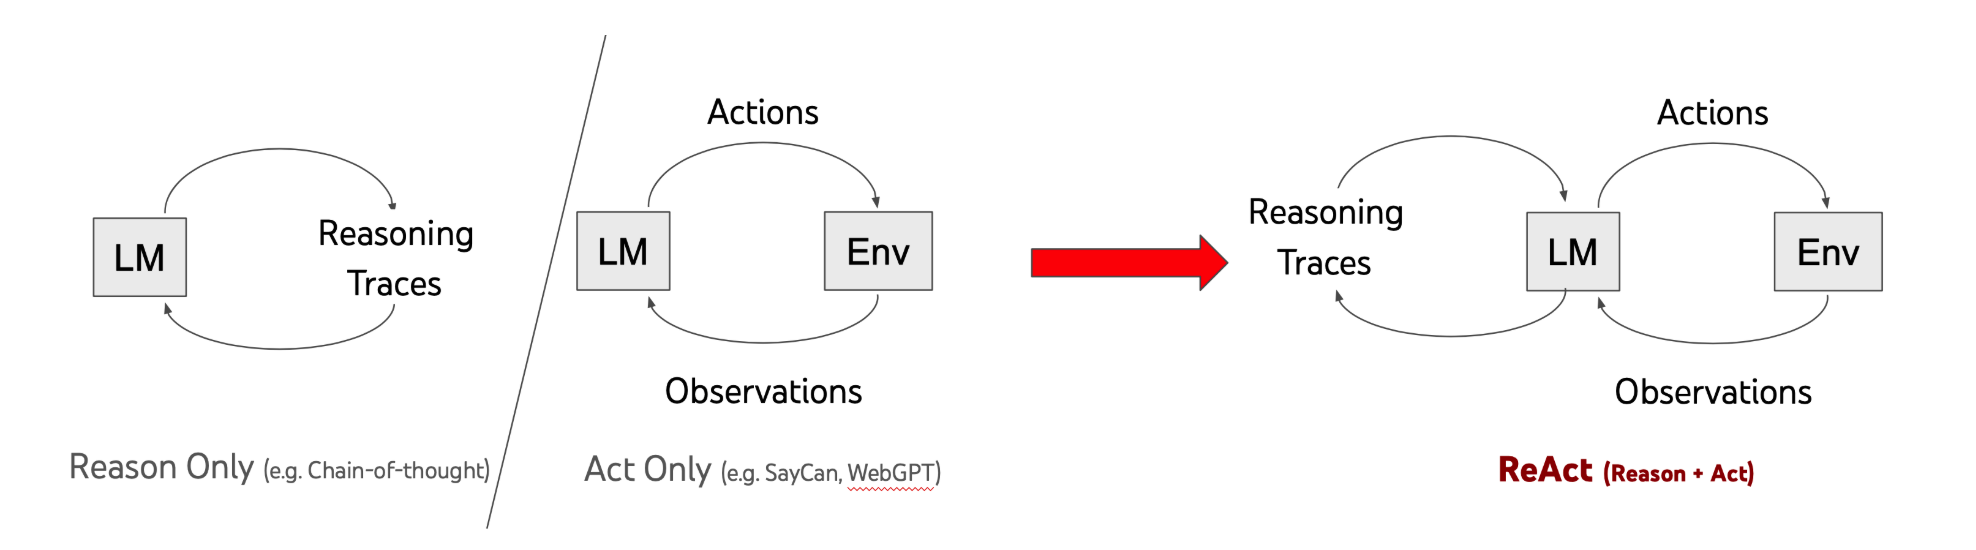
ReAct là Reasoning + Acting, do Shunyu Yao và những người khác đề xuất vào năm 2022, với paper 《ReAct: Synergizing Reasoning and Acting in Language Models》.
Trong module Agent của các framework như LangChain, LlamaIndex và AgentScope, có thể thấy dấu ấn của paradigm này.
Ý tưởng của nó rất trực quan: model reasoning một bước, nhận feedback từ external environment rồi reasoning bước tiếp theo, luân phiên như vậy.
LLM dễ thiếu real-time information và cũng dễ hallucination. ReAct khiến nó “đi một bước, quan sát một bước”, mỗi bước đều tiếp tục phán đoán dựa trên kết quả tool trả về.
Ví dụ task là: giúp tôi kiểm tra nguyên nhân API user-service chậm vào sáng nay và gửi kết quả cho người phụ trách.
ReAct chạy đại khái như sau.
Trước hết, nó kiểm tra monitoring buổi sáng của user-service, phát hiện CPU tăng vọt lên 98% từ 9 giờ đến 9 giờ 30, đồng thời có nhiều cảnh báo slow SQL.
Sau đó, nó lần theo hướng này để xem log, lấy ra slow SQL đó và phát hiện đây là full table scan không dùng index.
Tiếp theo, nó tra cứu người phụ trách service, tìm thấy Wang Jianguo trong address book với email là wangjianguo@company.com.
Cuối cùng, nó tổ chức incident report và gửi email thông báo.
Quy trình này không bị viết cố định ngay từ đầu. Nếu monitoring cho thấy memory OOM, bước thứ hai phải kiểm tra Heap Dump thay vì tiếp tục xem slow SQL.
Giá trị của ReAct nằm ở đây: nó có thể liên tục điều chỉnh hướng dựa trên bằng chứng.
Khi triển khai ReAct thường cần phối hợp các component sau:
- Context history, lưu reasoning step, execution action và feedback observation
- Real-time environment input, chẳng hạn system alert, user feedback và các external variable khác
- LLM reasoning module: phụ trách logic analysis và planning bước tiếp theo
- Tool set và skill library, bao gồm atomic tool và Skills
- Feedback observation mechanism, thu thập tool response rồi append lại vào context
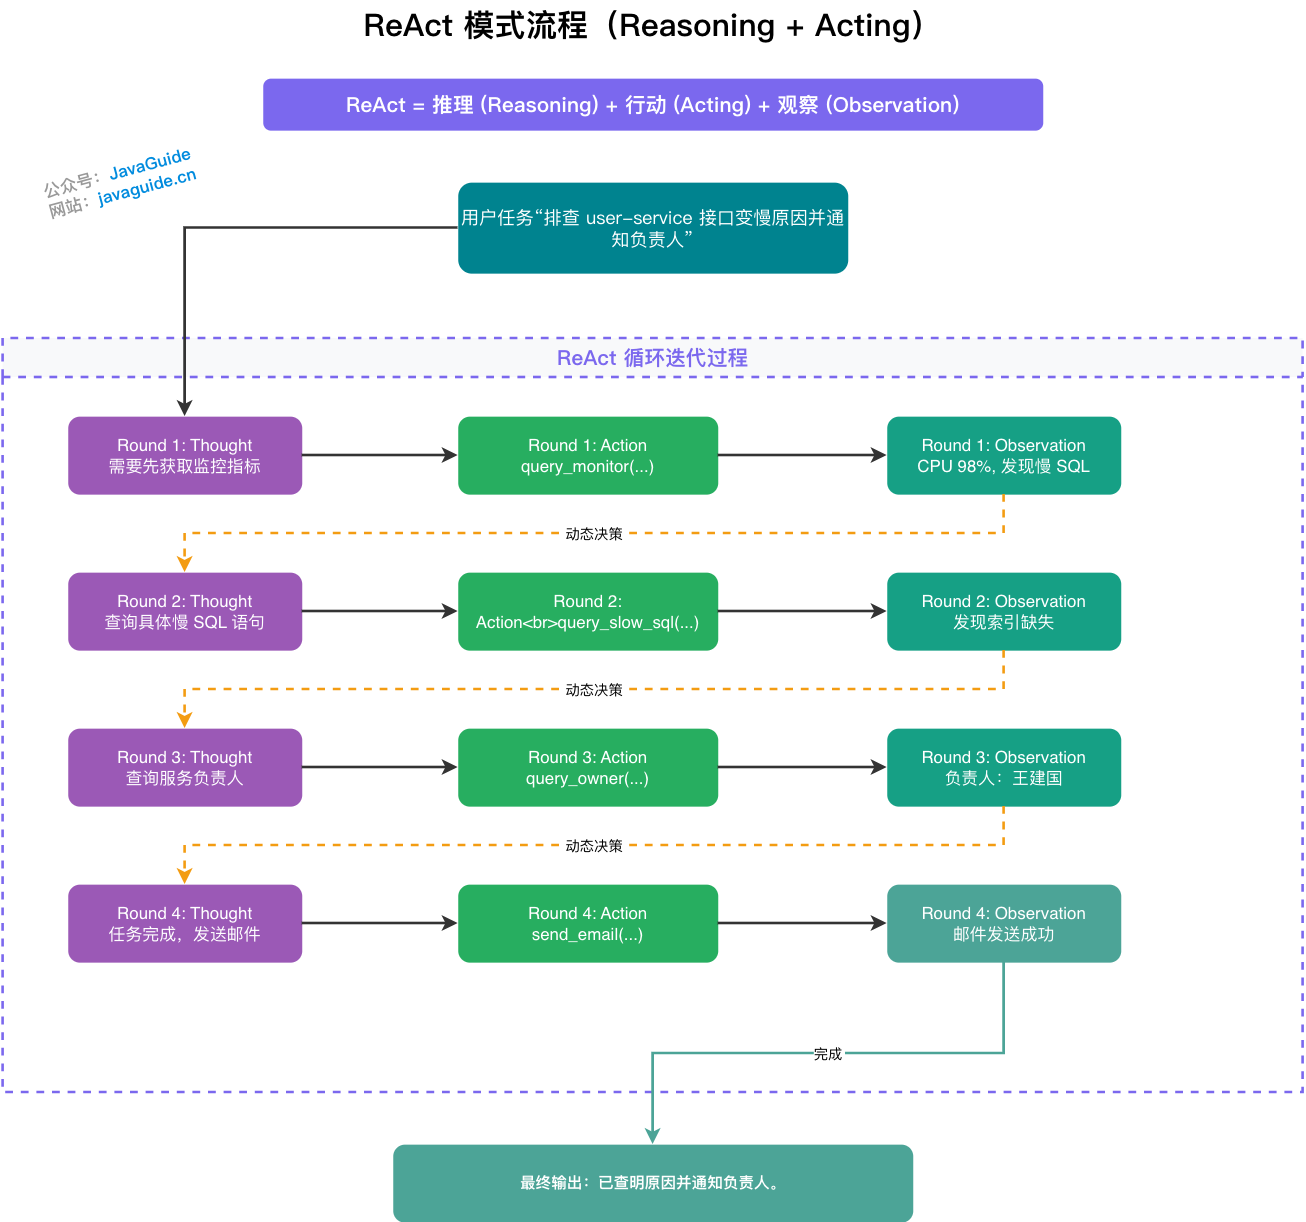
Mỗi bước của ReAct đều được thúc đẩy bởi external observation result, vì vậy dễ truy nguyên căn cứ quyết định hơn và giảm phán đoán tách rời environment so với việc generate một lần. Đổi lại, multi-turn call làm tăng response latency, còn hiệu quả phụ thuộc vào độ tin cậy của tool và Skills.
Ví dụ, có thể đóng gói việc kiểm tra monitoring, kiểm tra log và phân tích bottleneck thành Skill diagnose_service_performance, trả về diagnostic summary có cấu trúc cho LLM. Nhờ vậy không cần kết hợp lại từ atomic step mỗi khi troubleshooting.
Plan-and-Execute
Team LangChain đề xuất Plan-and-Execute vào năm 2023: trước hết LLM generate global step-by-step plan, sau đó giao cho executor hoàn thành từng bước. Cách này phù hợp với long-running task có nhiều step và dependency rõ ràng, giúp giữ global progress dễ hơn.
Plan cũng là boundary của nó. Nếu xuất hiện kết quả không dự đoán được trong quá trình execute, khả năng dynamic adjustment và fault tolerance sẽ yếu hơn ReAct vừa làm vừa phán đoán, hành vi gần với static workflow hơn.
Hai paradigm có thể lồng nhau: dùng CoT để đưa ra global step, rồi chạy ReAct sub-loop bên trong từng step. Plan cung cấp structure, sub-loop xử lý uncertainty cục bộ.
Reflection
Reflection sửa hành vi của Agent bằng natural language feedback mà không cần sửa model weight. Các implementation phổ biến xử lý những phase khác nhau:
- Reflexion ghi kết luận reflection vào memory buffer sau khi task thất bại. Ví dụ khi debug code phát hiện
countchưa được initialize trước khi gọi, vòng tiếp theo có thể tránh lỗi này. - Self-Refine để model review output sau khi hoàn thành answer, code hoặc copywriting rồi thực hiện iteration để sửa.
- CRITIC dùng external tool như search engine và code executor để verify fact, sau đó sửa theo kết quả verification.
Reflection thường được thêm lên ReAct hoặc Plan-and-Execute: thêm verification và adjustment trong quá trình execute, còn task cụ thể vẫn do execution mechanism ban đầu hoàn thành.
Multi-Agent
Khi task có thể tách thành các responsibility tương đối độc lập như planning, execution và acceptance, có thể giao cho nhiều Agent phối hợp. Orchestrator-Subagent pattern để orchestrator Agent lập global plan, phân phối task; sub-Agent execute song song hoặc tuần tự, sau đó orchestration layer tổng hợp kết quả.
Khi cần debate, review hoặc cross-validation, có thể dùng Peer-to-Peer pattern, để các Agent ngang hàng trực tiếp hội thoại và review lẫn nhau.
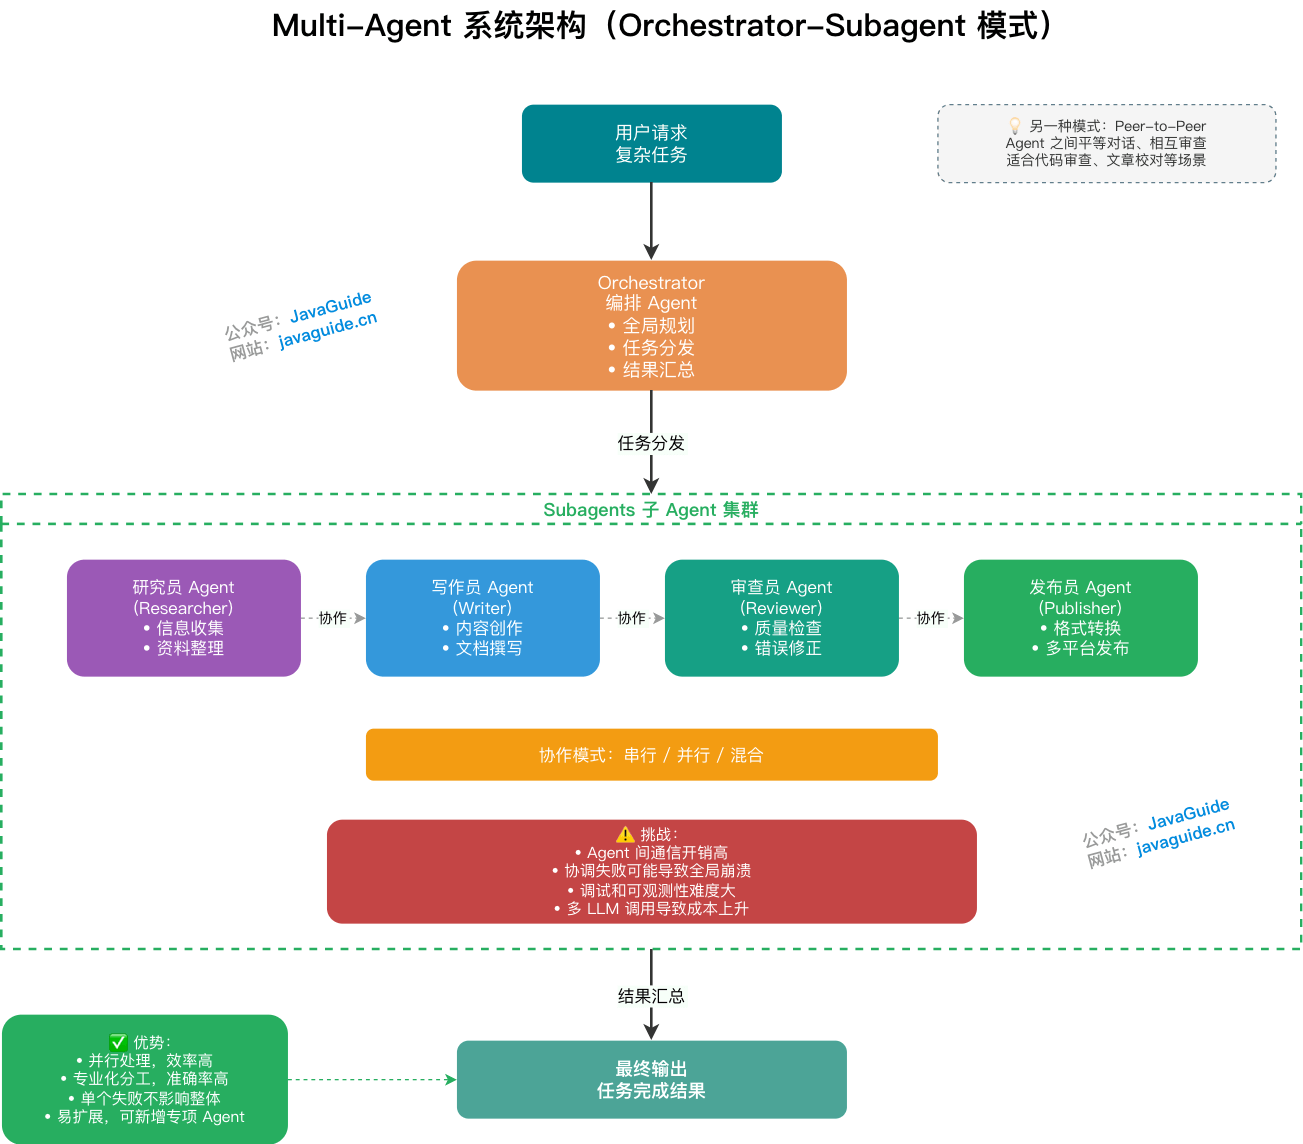
Khi task thực sự có thể tách theo role chuyên môn, Multi-Agent có thể execute song song và việc một subtask thất bại chưa chắc chặn toàn bộ. Cái giá phải trả là communication, coordination và debugging cost giữa các Agent đều tăng, Token consumption cũng tăng theo.
Khi triển khai còn phải xử lý task contract, shared state, conflict khi parallel write, Worker takeover và checkpoint recovery. Thiết kế chi tiết xem tại 《Thiết kế hệ thống phối hợp Multi-Agent: phân tách task, chia sẻ state, xử lý conflict và recovery khi thất bại》.
A2A protocol
Khi một Agent nâng cấp thành Multi-Agent, cách các Agent giao tiếp với nhau sẽ trở thành một vấn đề engineering.
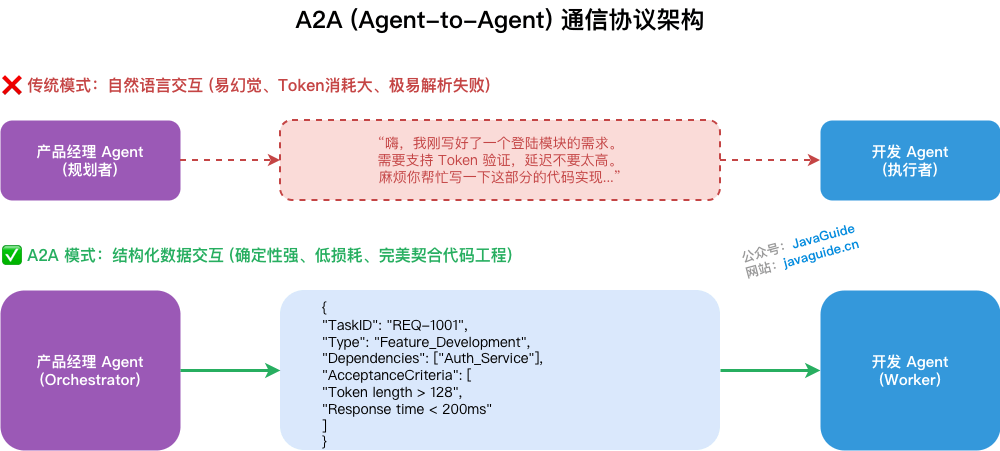
Nếu vẫn dựa vào việc chat bằng natural language, Token consumption sẽ rất cao và cũng dễ xảy ra lỗi parse format.
A2A protocol được tạo ra để giải quyết vấn đề này.
Nó cho phép Agent trao đổi bằng structured data, chẳng hạn JSON có Schema, XML hoặc instruction chuyển state, thay vì một đống natural language dài dòng.
Có thể hình dung rằng các microservice backend không trao đổi data bằng cách parse HTML page, mà dùng RESTful hoặc RPC API để truyền structured object.
A2A protocol định nghĩa interface contract giữa các Agent.
Ví dụ, sau khi “Product Manager Agent” viết xong requirement, nó không output một câu kiểu “Tôi viết xong rồi, bạn phát triển đi”. Nó nên output một JSON Payload chuẩn, chứa TaskID, Dependencies và AcceptanceCriteria. Development Agent nhận được sẽ deserialize trực tiếp và đi vào execution flow.
Agentic Workflows
Agentic Workflows là khái niệm được Andrew Ng đặc biệt ủng hộ, nhấn mạnh việc dùng engineering orchestration để nối reasoning, tool, memory, reflection và collaboration giữa nhiều entity thành execution flow, thay vì chỉ chờ năng lực của model bên dưới thay đổi.
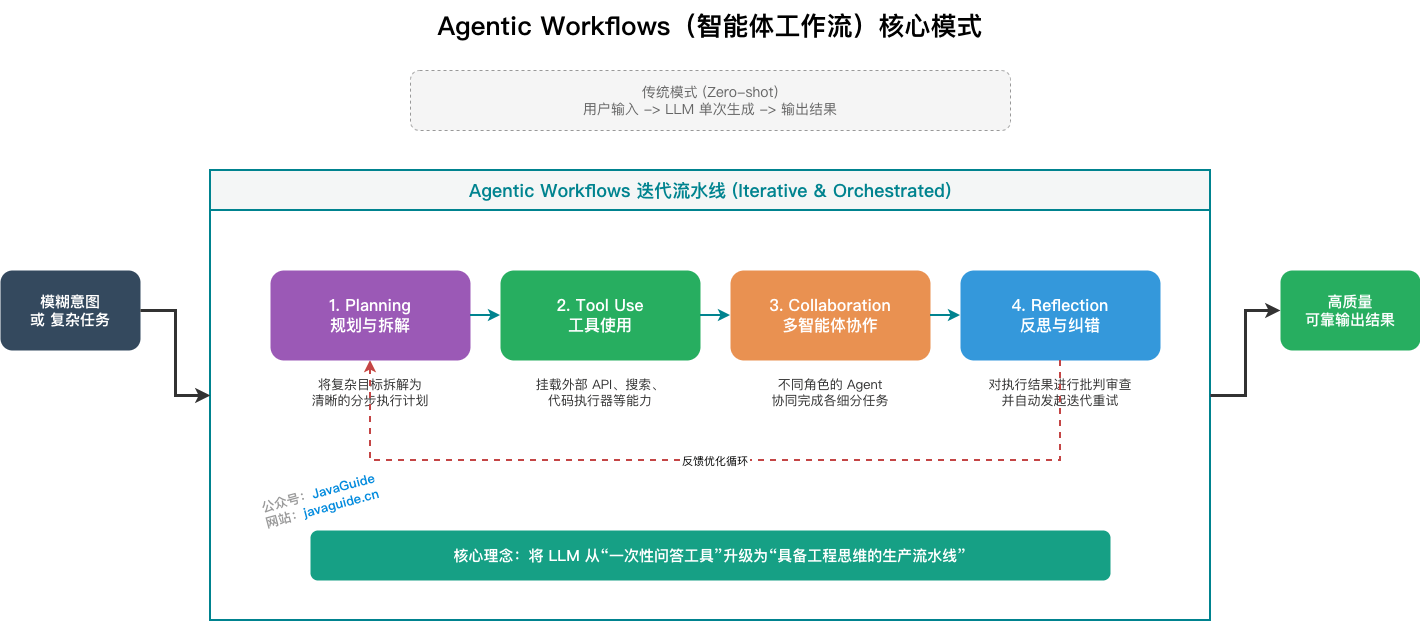
Các design pattern thường gặp gồm:
- Reflection——để model kiểm tra công việc của chính mình
- Tool Use——cung cấp cho LLM các tool như web search và code execution
- Planning——để model đề xuất và thực thi plan nhiều bước
- Multi-agent Collaboration——nhiều Agent phối hợp hoàn thành task
Trong project thực tế, các pattern này thường xuất hiện cùng nhau. Ví dụ trước hết dùng Planning để phân tách task, chạy ReAct và gọi Tools trong subtask, cuối cùng dùng Reflection để kiểm tra kết quả. Agentic Workflows mô tả cách kết hợp này chứ không phải một framework riêng lẻ.
AI Workflow và Agent thực chất có quan hệ thế nào?
Trong flow như “generate draft, quality review, sửa theo feedback”, thứ tự step và điều kiện retry có thể được viết trước vào graph structure; LLM chỉ generate hoặc phán đoán tại một node nào đó. AI workflow như vậy có thể định vị vấn đề đến node và edge cụ thể.
Pure Agent để LLM quyết định trong lúc chạy có gọi tool hay không, gọi tool nào và path tiếp theo. Nó phù hợp với task mà việc cần kiểm tra gì và kiểm tra thế nào phụ thuộc vào evidence trung gian.
Agentic Workflows đặt hai cách này trong cùng một chain: global Workflow cố định main flow, chỉ embed Agent sub-loop tại các local path không chắc chắn.
Node, Edge và State trong Workflow là gì?
Khi Workflow chạy, Node phụ trách execute, Edge quyết định control flow, còn State chia sẻ context giữa các node; ba thành phần tạo thành directed graph (Graph).
Node chỉ làm một việc: đọc state, thực thi logic và ghi kết quả trở lại. Node có thể gọi LLM, gọi tool hoặc chỉ chứa logic code thuần. Trong bài toán viết bài, các node điển hình là “generate draft”, “quality review” và “sửa theo feedback”; responsibility của node càng đơn nhất thì càng dễ kiểm tra. Edge quyết định sau khi execute sẽ chuyển đến đâu: sequential edge đi theo path, conditional edge rẽ nhánh theo runtime state, loop edge đưa flow về node trước để retry. State ghi lại các thông tin như draft hiện tại, score và số lần retry; việc chuyển conditional edge thường dựa vào giá trị trong State.
“Nếu review không đạt thì quay lại sửa, retry tối đa 3 lần” khi chuyển thành graph structure là một conditional edge từ ReviewNode đến ReviseNode, kèm safe boundary chuyển đến ExitNode khi iteration_count >= 3. iteration_count trong State là yếu tố then chốt giúp logic này chạy được.
Graph structure này dễ mở rộng hơn chuỗi if-else viết cố định, khi xảy ra vấn đề cũng dễ xác định node và edge nào. LangGraph (Python) và Spring AI Alibaba Graph (Java) đều được triển khai dựa trên cách này. Thiết kế và code implementation chi tiết xem tại: 《Workflow, Graph và Loop trong AI Workflow》.
Khi nào dùng Agent, khi nào dùng Workflow?
Execution path có thể xác định trước hay không là tiêu chí đơn giản nhất.
Có thể xác định thì dùng Workflow. Không thể xác định thì dùng Agent. Có cả hai thì dùng Agentic Workflows.
Nhưng có một nhận thức sai phổ biến: nhiều người cho rằng task có “path không chắc chắn”, trong khi thực tế là requirement chưa được phân tách rõ. Sau khi tách task cẩn thận, thường sẽ phát hiện phần lớn scenario là “LLM generate hoặc phán đoán trong các node cố định”; dùng Workflow trong trường hợp này ổn định hơn và dễ kiểm tra hơn.
Task thực sự phù hợp với pure Agent là loại task mà bạn không thể viết trước các execution step. Ví dụ “giúp tôi kiểm tra incident production này”, rất khó quy định cố định từ trước cần kiểm tra gì, kiểm tra thế nào và kiểm tra đến mức nào.
Một dimension khác để phán đoán là yêu cầu fault tolerance. Workflow có execution path cố định nên dễ kiểm tra khi xảy ra vấn đề; Agent có execution path động nên độ khó debug cao hơn một order of magnitude. Trong business scenario To B, nên ưu tiên cân nhắc Workflow hoặc Agentic Workflows.
Chọn paradigm thế nào?
Phần trước đã nói về một loạt khái niệm như ReAct, Plan-and-Execute, Reflection, Multi-Agent và AI Workflow; khi làm project, việc chọn giữa chúng dễ khiến người ta đau đầu. Dưới đây là tham khảo đơn giản:
| Đặc điểm scenario | Hướng đề xuất | Cái giá phải trả |
|---|---|---|
| Execution path xác định trước, node cần LLM | AI Workflow (Graph) | Ổn định, dễ quan sát; chi phí thiết kế ban đầu cao |
| Execution path không chắc chắn, cần planning động | ReAct | Linh hoạt, Token consumption cao, khó debug |
| Task rất dài, nhiều step nhưng structure rõ | Plan-and-Execute | Khó lạc hướng, dynamic adjustment yếu |
| Yêu cầu output quality cao, cho phép nhiều iteration | Thêm Reflection | Dùng kết hợp với ReAct/P&E, không dùng riêng |
| Task vốn có thể tách thành nhiều role chuyên môn | Multi-Agent | Chi phí communication và debugging tăng gấp đôi |
| Long-running task + một số subtask không dự đoán được | Agentic Workflows | Global Workflow + local ReAct lồng nhau |
Trước hết hãy chạy thông suốt bằng cách đơn giản nhất, sau đó dựa trên failure mode thực tế để quyết định nâng cấp layer nào.
Ngay từ đầu đã làm Multi-Agent, hoàn toàn dựa vào model dynamic reasoning và không quản lý context, thì khi mắc kẹt sẽ rất khó thoát ra.
Tổng kết
Phần lớn project Agent chạy không ổn định không phải vì model chưa đủ tốt.
Nền tảng chưa được xây đúng. Bốn phần LLM + Planning + Memory + Tools thiếu phần nào cũng tạo ra điểm yếu rõ rệt. Không có Tools, Agent chỉ dừng ở giai đoạn “đưa ra recommendation”; không có Memory, task hơi dài một chút là bắt đầu mất trí nhớ; không quản lý context tốt, model sẽ tùy ý lệch hướng.
Việc chọn paradigm cũng dễ sai. ReAct linh hoạt nhưng khó debug và tốn nhiều Token; Workflow ổn định nhưng yêu cầu phân tách requirement cao, nếu thiết kế ban đầu chưa đủ kỹ thì về sau sửa cũng tốn công; sau khi thêm Multi-Agent, chi phí communication và debugging dễ vượt dự kiến. Ngay từ đầu đã chọn giải pháp phức tạp nhất là cái bẫy thường gặp nhất trong engineering practice.
Còn một phần rất dễ bị bỏ qua: tool description. MCP giải quyết cách kết nối, JSON Schema giải quyết format mô tả, nhưng model có gọi tool này hay không và điền parameter thế nào cuối cùng đều phụ thuộc vào vài câu trong description. Tiết kiệm công sức ở đây thì sau đó sẽ phải trả lại gấp đôi.
Việc chọn Agent hay Workflow thực ra không phức tạp đến vậy: trước hết hãy viết ra execution path của task, viết được thì dùng Workflow, không viết được mới dùng Agent. Làm tốt phán đoán này hữu ích hơn nhiều so với việc chạy theo framework.