
Tổng hợp câu hỏi phỏng vấn về nền tảng LLM
Một lần gọi LLM bắt đầu từ Tokenization, trải qua việc lắp ghép context và sampling để sinh output, sau đó backend xử lý streaming response, rate limiting, retry, structured parsing và log. Các câu hỏi phỏng vấn nền tảng thường lần theo call chain này để hỏi thêm về chi phí, latency, tính ổn định và vấn đề bảo mật.
Các câu hỏi được nhóm theo các chương trong chuyên đề nền tảng LLM của JavaGuide. Nguyên lý chi tiết và ví dụ engineering được đặt trong các bài viết tương ứng. Ở đây chỉ giữ lại các trọng tâm và câu hỏi để tiện ôn tập tập trung.
Cơ chế hoạt động của LLM
Nội dung liên quan: “Cơ chế hoạt động của LLM: Token, context window và sampling ảnh hưởng đến output như thế nào”
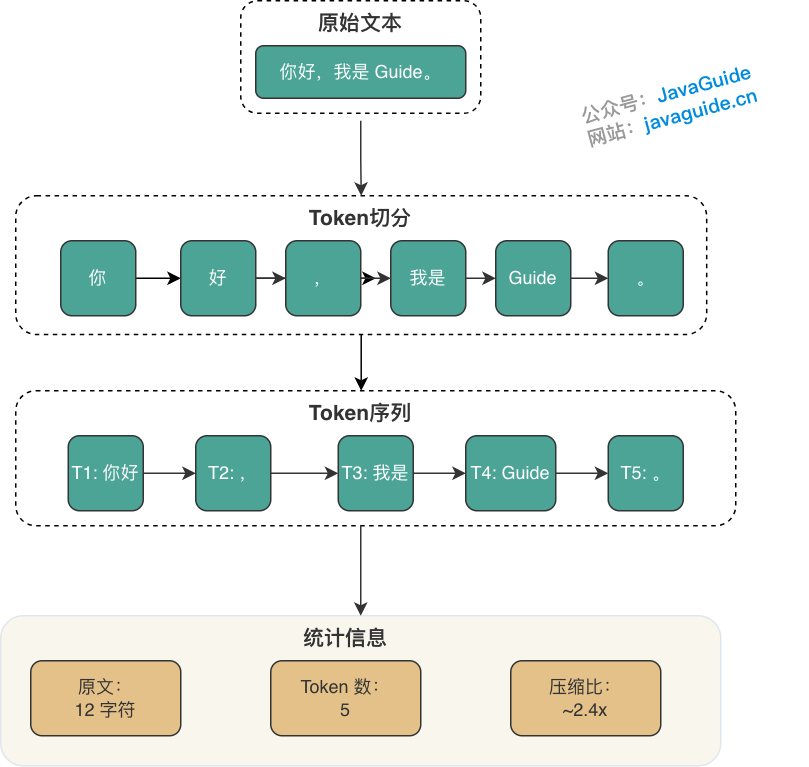
Token, context window và sampling parameter cùng ảnh hưởng đến lượng thông tin có thể đưa vào một lần gọi, lượng tài nguyên tiêu tốn và mức độ biến động của output. Nhóm câu hỏi này thường được hỏi tiếp cùng với hội thoại dài, bằng chứng RAG và structured output.
Câu hỏi phỏng vấn thường gặp:
- Token là gì? Vì sao tiếng Trung, tiếng Anh và code tiêu tốn số Token khác nhau?
- Context window là gì? Context window càng lớn thì hiệu quả có chắc chắn càng tốt không?
- Vấn đề Lost in the Middle là gì? Giảm thiểu vấn đề này trong bối cảnh context dài như thế nào?
- Temperature, Top-P và Top-K lần lượt kiểm soát điều gì? Nên thiết lập ổn định hơn trong môi trường production như thế nào?
- Vì sao dù đặt Temperature bằng 0, output của model vẫn có thể không hoàn toàn nhất quán?
- Vì sao LLM sinh ra hallucination? Có những giải pháp giảm thiểu thường gặp nào?
- Ước tính Token budget như thế nào? Cân đối input, output, historical message và bằng chứng RAG ra sao?
- Context window dài có thay thế được RAG không? Mỗi loại phù hợp với những scenario nào?
Engineering cho API call
Nội dung liên quan: “Thực tiễn engineering cho API call của LLM: streaming output, retry, rate limiting và structured response”
Response time, cách tính phí và loại lỗi của model API đều khác với business API thông thường. Trong phỏng vấn, Streaming, retry, idempotency, rate limiting và model gateway thường được đặt trong cùng một call chain để đánh giá.
Câu hỏi phỏng vấn thường gặp:
- Call chain hoàn chỉnh của API call LLM là gì?
- Vì sao Streaming cải thiện user experience? Nó có giảm tổng thời gian và chi phí Token không?
- Nên chọn SSE, WebSocket hay HTTP Chunked như thế nào trong scenario streaming output?
- Có thể retry những lỗi API LLM nào? Những lỗi nào không thể retry?
- Vì sao API call LLM bắt buộc phải có idempotency?
- Vì sao rate limiting LLM không thể chỉ dựa trên QPS?
- Model gateway thường phải đảm nhiệm những capability nào?
- Log call của ứng dụng AI ít nhất cần ghi lại những field nào?
Structured output và tool call
Nội dung liên quan: “Structured output của LLM: từ JSON contract đến triển khai Function Calling”
Chỉ cần output của model đi vào business system, cần xử lý format validation, field constraint và execution permission. Ở đây dễ nhầm lẫn giữa JSON Mode, Structured Outputs, Function Calling, MCP Tool và HTTP API thông thường.
Câu hỏi phỏng vấn thường gặp:
- Vì sao chỉ viết “hãy trả về JSON” là không đáng tin cậy?
- JSON Mode và Structured Outputs khác nhau như thế nào?
- JSON Schema giải quyết vấn đề gì trong ứng dụng LLM?
- Call chain hoàn chỉnh của Function Calling là gì?
- Function Calling và MCP khác nhau như thế nào?
- MCP Tool có quan hệ gì với HTTP API thông thường?
- Agent Skill và Function Calling có phải là một không?
- Xử lý thế nào khi structured output thất bại?
- Vì sao tool call bắt buộc phải được security governance?
- Trong phỏng vấn, khái quát structured output bằng một câu như thế nào?
Đánh giá ứng dụng AI
Nội dung liên quan: “Hệ thống đánh giá ứng dụng AI: từ xây dựng Golden Set đến closed loop canary release”
Câu hỏi đánh giá tập trung vào cách chứng minh một thay đổi đối với model, Prompt hoặc system thực sự mang lại cải thiện. Golden Set, LLM-as-Judge, Trace replay và canary release lần lượt bao quát các giai đoạn khác nhau; không thể chỉ xem public leaderboard hoặc một vài demo sample.
Câu hỏi phỏng vấn thường gặp:
- Vì sao không thể chỉ dựa vào public benchmark để đánh giá chất lượng ứng dụng AI?
- Nên xây dựng Golden Set như thế nào? Phải làm gì khi giai đoạn cold start chưa có production log?
- LLM-as-Judge có những bias chính nào? Giảm thiểu ra sao?
- Vì sao đánh giá RAG bắt buộc phải tách thành retrieval và generation?
- Vì sao đánh giá Agent phức tạp hơn Q&A và RAG thông thường?
- Offline evaluation, Trace replay và canary release lần lượt giải quyết vấn đề gì?
- Cân bằng tốc độ và độ bao phủ của AI evaluation trong CI như thế nào?
- Nếu kết quả của LLM-as-Judge và đánh giá thủ công không nhất quán, nên xử lý thế nào?
Câu hỏi scenario tổng hợp
- Khi historical session của chatbot chăm sóc khách hàng liên tục tăng, phân bổ Token budget và giữ lại business state quan trọng như thế nào?
- Sau khi streaming response bị ngắt giữa chừng, server xử lý vấn đề retry, resume và double billing như thế nào?
- Khi model upstream chạm giới hạn RPM hoặc TPM, model gateway xếp hàng, downgrade hoặc chuyển model như thế nào?
- Sau khi model sinh parameters cho tool refund, business system còn cần thực hiện những validation nào?
- Sau khi đổi model hoặc sửa Prompt, dùng offline evaluation, Trace replay và canary release để xác minh hiệu quả như thế nào?