
Harness là gì? Kiến trúc sáu lớp của Harness Engineering và thực tiễn kỹ thuật Agent
Agent Harness là một hệ thống thực thi chạy bên ngoài mô hình lớn. Nó chịu trách nhiệm tổ chức context, cung cấp tool và môi trường thực thi, đồng thời đưa kiểm soát quyền hạn, quản lý state, validation kết quả và khôi phục lỗi vào quy trình task. Harness Engineering nghiên cứu cách thiết kế hệ thống này.
Trong một bài đánh giá coding của Can.ac, cùng một model chỉ thay interface chỉnh sửa file mà điểm số đã tăng từ 6.7% lên 68.3%. Tham số model không thay đổi; khác biệt nằm ở việc interface cung cấp thao tác gì, trả kết quả như thế nào và lỗi có thể được bước tiếp theo tận dụng hay không.
Những khác biệt này cũng giải thích các lỗi thường gặp của Agent: lặp lại việc gọi tool, bỏ qua constraint hoặc mất state trong task dài thường không thể chỉ giải quyết bằng cách đổi model hay thêm một câu prompt. Interface tool, môi trường thực thi, feedback và cơ chế khôi phục cũng quyết định task có thể tiếp tục hay không.
Phần sau trước hết xem các component và tầng của Harness, sau đó đối chiếu các trade-off trong triển khai của OpenAI, Anthropic, Stripe và Mitchell Hashimoto.
Harness là gì?
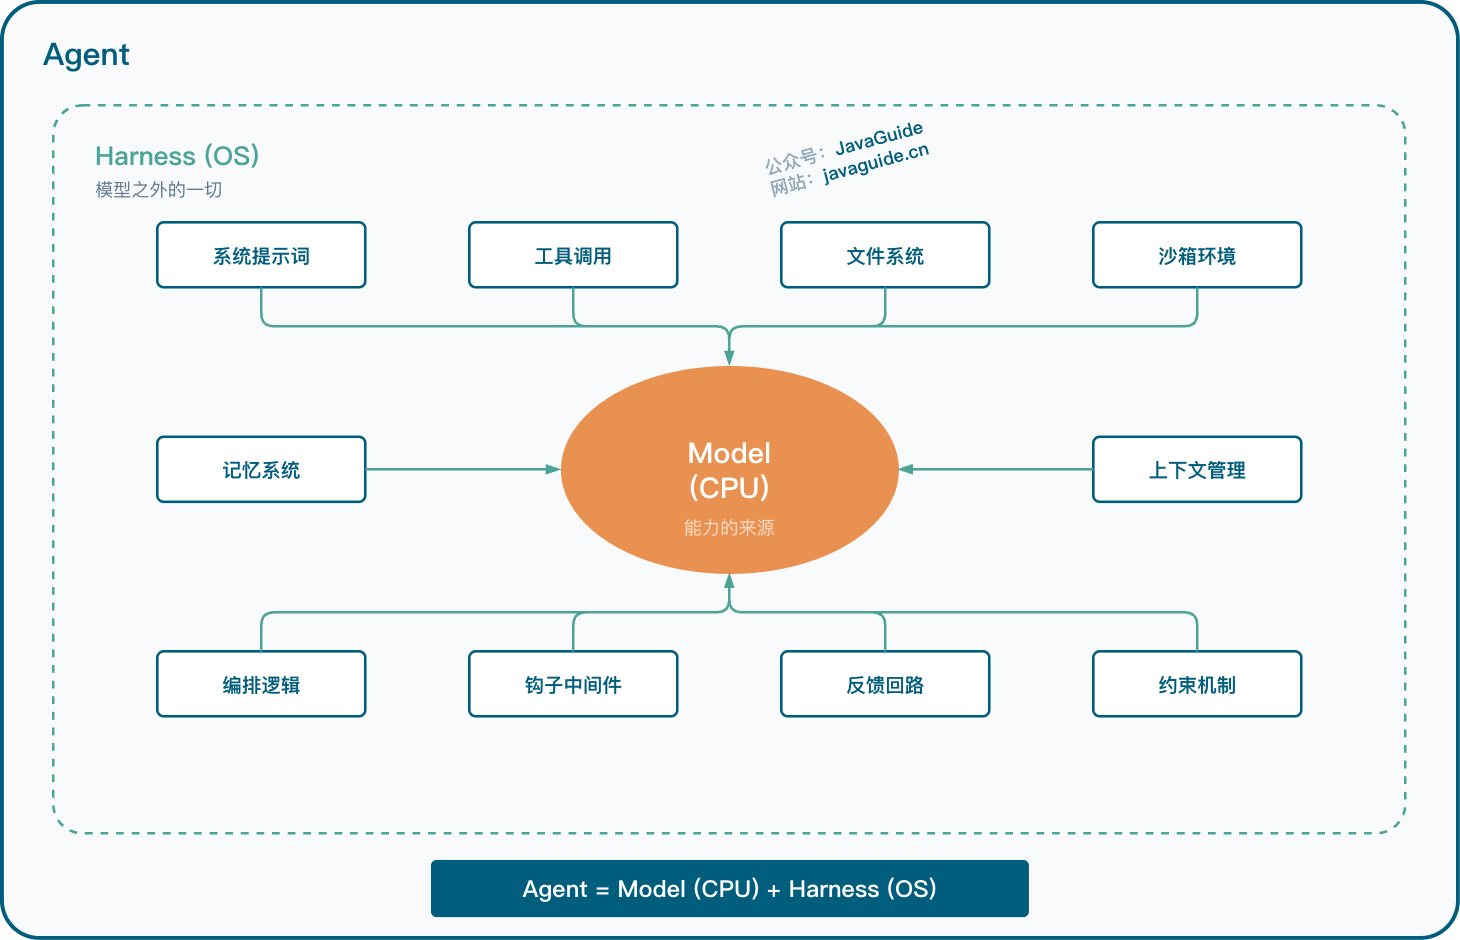
Agent = Model + Harness
Trong kỹ thuật, người ta thường dùng Agent = Model + Harness để phân biệt hai phần. Model chịu trách nhiệm reasoning và generation; Harness quản lý system prompt, gọi tool, file system, sandbox, logic orchestration, middleware hook, feedback loop và constraint.
Bản thân model không lưu state xuyên session, cũng không thể thực thi command hoặc đọc kết quả test. Harness phải kết nối task state, entry point thao tác, môi trường thực thi và ranh giới an toàn, để biến output của model thành action có thể validation.
Vivek Trivedi của LangChain dùng cách phân chia rất thực tế trong《The Anatomy of an Agent Harness》: trước hết liệt kê những việc model có thể làm, sau đó bổ sung từng phần mà nó không thể làm. Kiểm tra theo hướng này sẽ đưa vấn đề về các thiếu sót cụ thể, chẳng hạn kết quả tool có dễ đọc không, task state có được persist không, sau khi thất bại có đưa ra thông tin sửa lỗi có thể thực thi không.
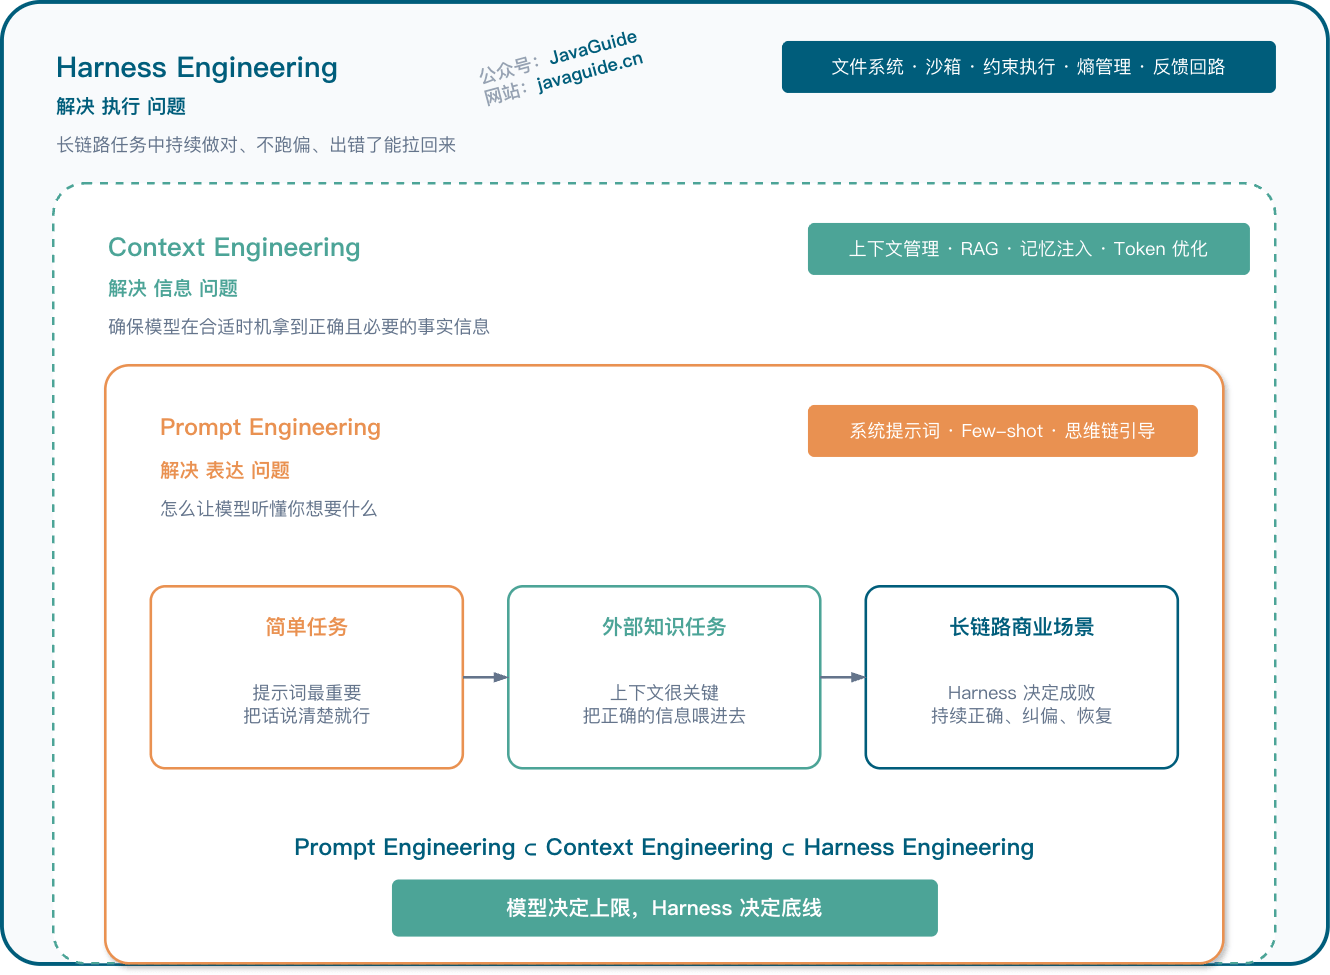
Quan hệ giữa Harness và Prompt / Context Engineering
Prompt Engineering, Context Engineering và Harness Engineering không phù hợp để so sánh trên cùng một tầng. Chúng giống như các lớp lồng vào nhau, với phạm vi vấn đề được xử lý ngày càng rộng.
| Tầng | Vấn đề được giải quyết | Trọng tâm | Công việc điển hình |
|---|---|---|---|
| Prompt Engineering | Nói rõ instruction như thế nào | Giúp model hiểu intent, giảm ambiguity cục bộ | Thiết kế system prompt, ví dụ Few-shot, hướng dẫn chain-of-thought |
| Context Engineering | Nên cho Agent xem gì | Cung cấp thông tin đúng và cần thiết cho model vào thời điểm phù hợp | Quản lý context, RAG, inject memory, tối ưu Token |
| Harness Engineering | Hệ thống thực thi, sửa lệch, quan sát và khôi phục liên tục như thế nào | Tính đúng liên tục, sửa lệch, khôi phục lỗi trong task dài | File system, sandbox, thực thi constraint, feedback loop, observability |
Trong task đơn giản, Prompt có thể là đủ. Chẳng hạn khi yêu cầu model sửa một câu copy, chỉ cần nói rõ prompt thì kết quả thường không tệ. Khi cần kiến thức bên ngoài, Context quan trọng hơn; bạn phải đặt tài liệu, kết quả retrieval và state lịch sử vào đúng vị trí. Khi bước vào các scenario business dài, có thể thực thi và ít dung sai, Harness trở thành vấn đề chính, vì Agent không chỉ cần “biết trả lời” mà còn phải thực thi, validation, rollback và tiếp tục tiến hành.
Prompt có thể làm rõ instruction cục bộ, nhưng không thể cung cấp quyền truy cập file, thực thi test, lưu state hoặc khôi phục lỗi; các vấn đề thực thi này cần Harness đảm nhiệm.
Harness gồm những component nào?
Muốn biết nên đặt gì trong Harness, có thể hỏi ngược lại: model không làm được gì?
Mô hình lớn trông có vẻ rất mạnh, nhưng xét từ góc độ hệ thống, nó vẫn chủ yếu là một hàm input-output. Nhận một đoạn context làm input và trả về một đoạn text hoặc một lời gọi có cấu trúc. Nó không tự nhiên ghi nhớ lịch sử, không tự chạy command, không biết code thực sự đã pass test hay chưa, cũng không tự động phân biệt thông tin nào nên giữ lại và thông tin nào nên loại bỏ.
| Việc model không làm được | Harness bổ sung như thế nào | Component tương ứng |
|---|---|---|
| Ghi nhớ lịch sử hội thoại nhiều lượt | Duy trì lịch sử hội thoại, ghép vào context mỗi lần request | Memory system |
| Thực thi code, chạy command | Cung cấp Bash và môi trường thực thi code | Môi trường thực thi chung |
| Lấy thông tin realtime, như version library mới, thay đổi API | Kết nối Web Search, tool MCP | Lấy kiến thức bên ngoài |
| Thao tác với file và môi trường | Trừu tượng hóa file system, đưa Git version control vào | File system |
| Đánh giá mình đã làm đúng hay chưa | Cung cấp sandbox, tool test, browser automation | Vòng lặp validation |
| Giữ tính mạch lạc trong task dài | Compression context, memory file, theo dõi tiến độ | Quản lý context |
Bổ sung những phần “model không làm được nhưng bạn muốn Agent làm được” này chính là danh sách component của Harness. LangChain cũng tách nó thành vài phần: file system chịu trách nhiệm persistence, thực thi Bash chịu trách nhiệm tool chung, sandbox chịu trách nhiệm cô lập rủi ro, cơ chế memory chịu trách nhiệm tích lũy xuyên session, còn compression context chống lại sự suy giảm chất lượng do context dài gây ra.
Harness nâng cao
Một Harness trưởng thành trông như thế nào?
Phần trước nhìn Harness từ góc độ “model thiếu gì, hệ thống bổ sung gì”. Nếu đổi sang góc độ system design, một Harness trưởng thành thường có các tầng rõ ràng.
Để tiện kiểm tra hệ thống có thiếu phần nào không, bài viết quy các component nói trên thành sáu tầng. Đây là framework phân tích, không phải một protocol hay tiêu chuẩn thống nhất trong ngành:

| Tầng | Tên | Giải quyết vấn đề gì | Thiết kế then chốt |
|---|---|---|---|
| L1 | Tầng ranh giới thông tin | Agent nên biết gì, không nên biết gì | Xác định role và goal, cắt thông tin không liên quan, tổ chức task state có cấu trúc |
| L2 | Tầng hệ thống tool | Agent tương tác với thế giới bên ngoài như thế nào | Chọn tool, kiểm soát thời điểm gọi, chắt lọc và feedback kết quả tool |
| L3 | Tầng orchestration thực thi | Kết nối task nhiều bước như thế nào | Để model tiến hành theo quỹ đạo “hiểu goal, đánh giá thông tin, phân tích, generation, kiểm tra” |
| L4 | Tầng memory và state | Quản lý kết quả trung gian của task dài như thế nào | Quản lý độc lập task state hiện tại, artifact trung gian và memory dài hạn, tránh trộn state |
| L5 | Tầng evaluation và observability | Agent biết mình làm đúng hay chưa như thế nào | Xây dựng cơ chế validation độc lập với quá trình generation |
| L6 | Tầng constraint, validation và recovery | Phải làm gì khi có lỗi | Dùng rule định sẵn để chặn lỗi, cung cấp retry, rollback hoặc degradation khi thất bại |
Có thể hình dung đây là việc dựng môi trường làm việc cho một nhân viên mới. L1 là mô tả vị trí, cho biết họ nên chú ý điều gì; L2 là tool văn phòng; L3 là quy trình thao tác chuẩn; L4 là hệ thống quản lý project và notebook; L5 là quy trình kiểm tra chất lượng; L6 là rule giới hạn và phương án ứng phó khẩn cấp.
Sáu tầng này bao phủ chuỗi từ ranh giới thông tin đến khôi phục lỗi. OpenAI, Anthropic và Stripe được nhắc đến ở phần sau tuy triển khai khác nhau, nhưng thiết kế của họ đều có thể được kiểm tra tại các vị trí này.
Giai đoạn bắt đầu không cần xây dựng đồng thời cả sáu tầng. Có thể bổ sung L1 và L6 trước: tầng đầu làm rõ ranh giới và input của task, tầng sau chặn và khôi phục khi có vượt quyền, thất bại hoặc kết quả không đạt. Khi task chuyển sang thực thi nhiều bước, cần lưu artifact trung gian hoặc validation lặp lại, hãy bổ sung orchestration tool, quản lý state và observability.
Vì sao bottleneck thường không nằm ở model?
Kết quả của Can.ac cho thấy riêng format gọi tool đã có thể thay đổi completion rate của task. Sau khi tối ưu tổ chức tài liệu, vòng lặp validation và hệ thống tracing, LangChain đã tăng từ hạng 30 lên hạng 5 trên Terminal Bench 2.0, điểm số tăng từ 52.8% lên 66.5%; model không đổi.
Vì vậy, khi performance của Agent không ổn định, hãy kiểm tra trước interface tool, error output và validation loop mà nó nhận được. Nếu interface khiến model khó biểu đạt intent thao tác, hoặc sau khi test fail chỉ trả về error mơ hồ, đổi sang model mạnh hơn cũng chỉ khiến nó thử sai lặp lại tại cùng một chỗ.
Cũng cần chú ý đến coupling giữa model và Harness. Các sản phẩm như Claude Code và Codex đồng thời tối ưu model và logic tool; sau khi model quen với một bộ tool, performance khi chuyển sang Harness khác có thể giảm. LangChain quan sát thấy trên bảng xếp hạng Terminal Bench 2.0, điểm của Opus trong Claude Code Harness thấp hơn điểm của nó trong các Harness khác.
the best harness for your task is not necessarily the one a model was post-trained with. Khi chọn, hãy lấy tool, constraint và yêu cầu validation của task làm chuẩn, thay vì mặc định dùng Harness đi kèm model.
Vì sao cho Agent ăn càng nhiều context thì nó lại càng ngốc?
Dex Horthy quan sát trong một buổi demo công khai rằng sau khi sử dụng khoảng 40% context window 168K Token, chất lượng output của Agent bắt đầu giảm. Tỷ lệ này đến từ model và task cụ thể, không thể ngoại suy trực tiếp thành threshold thống nhất cho mọi Agent.

| Khoảng | Tỷ lệ | Biểu hiện |
|---|---|---|
| Smart Zone | 0 - ~40% | Reasoning tập trung, gọi tool chính xác, chất lượng code cao |
| Dumb Zone | Trên ~40% | Hallucination tăng, đi vòng, format lộn xộn, code kém đi |
Anthropic cũng từng gặp vấn đề tương tự và gọi nó là “context anxiety”. Sonnet 4.5 trở nên do dự khi context gần đầy, thậm chí có xu hướng kết thúc sớm dù task chưa hoàn thành. Chỉ compression là chưa đủ; sau đó họ trực tiếp dùng context resets: xóa context window nhưng giữ state quan trọng bằng tài liệu bàn giao có cấu trúc.
Quản lý context cần giữ lại tài liệu cần cho task hiện tại và kịp thời loại bỏ lịch sử đã lỗi thời hoặc không liên quan. Các team tuyến đầu dùng “progressive disclosure” và “phân tầng quản lý” để tránh log tool, quyết định cũ và tài liệu lặp lại chiếm sự chú ý của model.
Trong production, có thể monitor tỷ lệ sử dụng context và dùng evaluation riêng để tìm trigger cho compression, thực thi theo đoạn hoặc bàn giao task. 40% phù hợp làm giá trị quan sát ban đầu cần validation, không nên đặt thẳng làm ngưỡng cảnh báo khi thiếu dữ liệu replay.
Bắt đầu xây Harness từ đâu?
Kết hợp thực tiễn của các team tuyến đầu, có thể tách các action item theo priority. Không cần biến nó thành hệ thống lớn ngay từ đầu; trước hết làm tốt P0 thường đã có thể cải thiện rõ rệt performance của Agent.
P0: Có thể làm ngay
| Action | Vì sao | Thực tiễn tham khảo |
|---|---|---|
Tạo và liên tục duy trì AGENTS.md | Agent tự động load mỗi lần khởi động, cập nhật sau khi mắc lỗi, hình thành feedback loop | Mỗi dòng của Hashimoto tương ứng với một case thất bại trong lịch sử |
| Viết Linter tùy chỉnh + instruction sửa lỗi | Error message nói trực tiếp cho Agent biết cách sửa | Error của Linter của OpenAI có sẵn phương pháp sửa |
| Đưa kiến thức của team vào repository | Kiến thức trong Slack, Wiki, Docs khó hiển thị ổn định cho Agent | OpenAI dùng repository làm source of truth |
Ở đây có một bẫy: đừng viết AGENTS.md thành một System Prompt khổng lồ. Nhiều team ngay từ đầu muốn nhét mọi rule vào đó, khiến context bị quá tải và Agent lại càng dễ đi lệch. Cách làm của OpenAI thận trọng hơn: chỉ dùng AGENTS.md như một directory, khoảng 100 dòng, còn rule chi tiết đặt trong sub-document để load khi cần.
P1: Bổ sung sau khi P0 ổn định
| Action | Vì sao | Thực tiễn tham khảo |
|---|---|---|
| Phân tầng quản lý context | Tránh nhét mọi thông tin vào một file, disclosure theo nhu cầu | OpenAI dùng AGENTS.md như directory, khoảng 100 dòng |
| Xây dựng file tiến độ và danh sách feature | Dùng JSON theo dõi state của feature, Agent ít sửa sai dữ liệu có cấu trúc hơn | Hai giai đoạn: khởi tạo Agent + coding Agent của Anthropic |
| Cung cấp khả năng validation end-to-end cho Agent | Để Agent validation feature như user | Anthropic dùng Playwright / Puppeteer MCP |
| Kiểm soát tỷ lệ sử dụng context | Dùng evaluation riêng xác định threshold compression và bàn giao, tránh lịch sử không liên quan liên tục tích lũy | Quan sát Smart Zone / Dumb Zone của Dex Horthy |
P2: Cân nhắc khi còn năng lực
| Action | Vì sao | Thực tiễn tham khảo |
|---|---|---|
| Chuyên môn hóa Agent | Mỗi Agent mang ít thông tin không liên quan hơn, ở lại Smart Zone | Agent deduplication, optimization và documentation của Carlini |
| Garbage collection định kỳ | Tốc độ dọn dẹp phải theo kịp tốc độ generation | Background cleanup Agent của OpenAI |
| Tích hợp observability | Biến tối ưu performance từ vấn đề cảm tính thành vấn đề đo được | OpenAI tích hợp Chrome DevTools |
Harness của bạn đang ở giai đoạn nào?
Bảng sau dùng để xác định giai đoạn xây dựng Harness hiện tại. Sau khi từ Level 0 lên Level 1, AGENTS.md, Linter cơ bản và test thủ công đã có thể bao phủ một phần lỗi thường gặp; không cần bắt đầu từ Level 4.
| Giai đoạn | Đặc điểm | Vai trò engineer |
|---|---|---|
| Level 0: Không có Harness | Đưa Prompt trực tiếp cho Agent, không có constraint có cấu trúc | Tự viết code, thỉnh thoảng dùng AI |
| Level 1: Constraint cơ bản | AGENTS.md, Linter cơ bản, test thủ công | Chủ yếu viết code, AI hỗ trợ |
| Level 2: Feedback loop | Tích hợp CI/CD, test tự động, theo dõi tiến độ | Chủ yếu planning và review |
| Level 3: Agent chuyên môn hóa | Phân công nhiều Agent, context phân tầng, memory persistence | Thiết kế môi trường và quản lý quy trình thực thi |
| Level 4: Autonomous loop | Parallelization không cần giám sát, tự động cleanup, self-healing | Thiết kế architecture và đảm bảo chất lượng |
Những vấn đề Harness chưa giải quyết
Sau khi nói về các thực tiễn này, cũng cần nêu ra những vấn đề chưa được giải quyết. Hiện có không ít case công khai, nhưng methodology thực sự thuyết phục vẫn chưa nhiều; đặc biệt khi áp dụng vào project hiện có, nhiều vấn đề vẫn còn bỏ ngỏ.
| Vấn đề | Hiện trạng | Ai đang quan tâm |
|---|---|---|
| Cải tạo brownfield project như thế nào | Đã có thực tiễn công khai về codebase hiện có, nhưng phương pháp reuse xuyên team vẫn chưa trưởng thành | Stripe Minions chạy trong codebase hiện có quy mô lớn; Böckeler còn nhắc rằng Ambient Affordances như type system, ranh giới module và abstraction của framework sẽ ảnh hưởng chi phí cải tạo |
| Validation Agent đã làm đúng việc như thế nào | Mọi người giỏi hơn trong việc hạn chế Agent đừng làm sai, nhưng validation tính đúng đắn của feature vẫn còn yếu | Böckeler phê bình: dùng test do AI generation để validation code do AI generation vẫn giống như “dùng cùng một đôi mắt để kiểm tra bài của chính mình” |
| Tính maintainability dài hạn của code do AI generation | Code của LLM thường reimplement feature đã có, hiệu quả dài hạn vẫn khó đánh giá | Greg Brockman từng nêu vấn đề này, nhưng hiện chưa có câu trả lời rõ ràng |
| Harness nên thick hay thin | Manus viết lại năm lần và ngày càng đơn giản, OpenAI làm trong năm tháng và ngày càng phức tạp | Scenario quyết định. Sản phẩm general thường theo đuổi tối giản, sản phẩm đặc thù có thể custom cao. Khi model mạnh hơn, Harness hiện có cũng nên được đơn giản hóa định kỳ; Anthropic đã có validation tương tự |
| Single Agent hay multi-Agent | Hashimoto kiên trì với single Agent, Carlini dùng 16 Agent song song | Quy mô quyết định. Project nhỏ thường chỉ cần single Agent, project lớn dễ đi theo phân công chuyên môn hóa hơn |
Greenfield project và brownfield project là cách gọi kinh điển trong software engineering. Greenfield project chỉ project mới bắt đầu từ số 0, không có gánh nặng lịch sử, giống như xây nhà trên khu đất trống nên tương đối tự do trong thiết kế. Brownfield project chỉ việc cải tạo trên codebase hiện có, bên trong có architecture lịch sử, technical debt và logic legacy, giống như cải tạo khu đô thị cũ nên nhiều đường ống không thể tùy tiện di chuyển.
Stripe Minions chạy trong codebase hiện có quy mô lớn. Với project mười năm tuổi thiếu ranh giới module và có technical debt nặng, trước hết cần khiến quy trình compile và test có thể thực thi lặp lại, sau đó thêm rule cục bộ và structural check cho các directory có tần suất cao, cuối cùng mở rộng phạm vi tự động thực thi.
Case Harness: Các team này thực hiện như thế nào
Các case này đối mặt với task có quy mô khác nhau, nhưng đều phải xử lý context, constraint và validation. Khác biệt nằm ở việc một số team bổ sung cơ chế sau khi lỗi xuất hiện, còn một số team đưa constraint và feedback vào execution path từ trước.
OpenAI: Ba người, năm tháng, một triệu dòng, không có code viết tay
Trước hết xem số liệu:
| Chỉ số | Giá trị |
|---|---|
| Quy mô team | 3 engineer, sau tăng lên 7 người |
| Thời gian | 5 tháng, bắt đầu từ tháng 8 năm 2025 |
| Quy mô code | Khoảng 1 triệu dòng |
| Code viết tay | 0 dòng, thiết kế constraint |
| Số PR merge | Khoảng 1.500 |
| PR/người/ngày | 3.5 |
| Mức tăng hiệu suất | Khoảng 10 lần |
Các con số này phụ thuộc vào đầu tư tương ứng của team, không thể dùng trực tiếp làm kỳ vọng cho team thông thường. Nội dung sau bảng chỉ phân tích các cách làm kỹ thuật trong đó.
Cho Agent một bản đồ, đừng nhét vào đó một cuốn sổ tay nghìn trang
AGENTS.md của OpenAI khoảng 100 dòng, đóng vai trò entry point trỏ đến design document, architecture diagram, execution plan và quality rating trong docs/. Agent trước tiên đọc index cần cho task, sau đó load detail theo path, tránh đưa toàn bộ rule vào mỗi session.
Agent Skills cũng dùng progressive disclosure tương tự: name, description và metadata khác thường trực trong context; sau khi match scenario mới load rule chi tiết và execution flow. Nó đã standardize cách làm dạng directory của AGENTS.md. Có thể đọc thêm bài này: Giải thích chi tiết Agent Skills: Là gì? Dùng thế nào? Khác Prompt và MCP ra sao?.
Constraint architecture phải được thực thi bằng tool
OpenAI định nghĩa phân tầng cố định cho từng domain business:
Types → Config → Repo → Service → Runtime → UIHướng dependency không được đảo ngược. Bảo đảm bằng cách nào? Dùng Linter tùy chỉnh và structural test. Khi vi phạm rule, tool không chỉ báo lỗi mà còn nói cho Agent biết nên sửa thế nào. Trong quá trình sửa lỗi, Agent cũng được train lặp lại để viết theo cách phù hợp hơn với convention của team.
OpenAI có một câu nói rất trực tiếp: If it cannot be enforced mechanically, agents will deviate. Constraint chỉ viết trong document là chưa đủ; nếu không thể thực thi bằng cơ chế máy móc, sớm muộn Agent cũng sẽ lệch.
Cũng phải cho Agent xem observability
Họ tích hợp Chrome DevTools Protocol vào runtime của Agent, để Agent có thể tự lấy DOM snapshot và screenshot. Log, metric và distributed tracing cũng được expose cho Agent thông qua local observability stack.
Nhờ vậy, “giảm startup time xuống dưới 800ms” trở thành một goal mà Agent có thể tự đo lường và tự validation.
Entropy sẽ không tự biến mất
Khi code do AI generation ngày càng nhiều, implementation chất lượng thấp, logic lặp lại và document không nhất quán cũng tăng theo. Ban đầu, team OpenAI dành 20% thời gian mỗi thứ Sáu để cleanup thủ công các artifact này. Sau đó việc này được tự động hóa: background Agent định kỳ scan document không nhất quán, vi phạm architecture và code dư thừa, rồi tự động tạo cleanup PR.
Khi tốc độ generation cao hơn tốc độ cleanup, logic lặp lại và document hết hạn sẽ liên tục đi vào repository, khiến context mà Agent tiếp theo retrieval được cũng kém đi.
Kiến thức trong Slack rất khó được Agent sử dụng ổn định
Kiến thức viết trong thảo luận Slack hoặc Google Docs không ổn định đối với Agent. Cách làm của OpenAI là đưa kiến thức của team vào repository dưới dạng artifact được version control, để repository trở thành source of truth có thể trace và reference.
OpenAI cũng chỉ ra rằng nếu thiếu mức đầu tư tương đương thì không thể trực tiếp giả định sẽ tái hiện được kết quả của họ. Với team thông thường, xây dựng document dạng directory, constraint có thể thực thi bằng cơ chế và cơ chế cleanup trước sẽ khả thi hơn việc sao chép toàn bộ quy trình.
Anthropic: Từ context anxiety đến kiến trúc ba Agent
Anthropic có hai thực tiễn đáng xem xét kỹ trong hướng này. Một là Carlini dùng nhiều Agent để viết compiler C, hai là Anthropic Labs lấy cảm hứng từ GAN để thực hiện collaboration ba Agent.

Dùng 16 Agent để viết compiler C
Nicholas Carlini dùng khoảng hai tuần, chạy 16 instance Claude Opus song song và khoảng 2.000 session Claude Code, tạo ra một compiler C có tỷ lệ pass GCC torture test là 99%.
| Chỉ số | Giá trị |
|---|---|
| Thời gian | Khoảng 2 tuần |
| Số Agent song song | 16 instance Claude Opus |
| Số session | Khoảng 2.000 |
| Output | 100 nghìn dòng code Rust |
| GCC torture test | Tỷ lệ pass 99% |
| Project có thể compile | PostgreSQL, Redis, FFmpeg, CPython, Linux 6.9 Kernel và hơn 150 project khác |
| Chi phí API | Khoảng 20 nghìn USD |
Thiết kế Harness thể hiện trong project này gồm:
- Log được ghi vào file thay vì console và dùng format một dòng thân thiện với grep, chẳng hạn
ERROR: [reason]. Chỉ retrieval file tương ứng khi cần chẩn đoán, tránh log không liên quan liên tục chiếm context. - Mỗi Agent chỉ chạy 1-10% test subset. Subsample của từng Agent là cố định, cùng một lần chạy sẽ cover cùng test; sample giữa các VM khác nhau, kết hợp lại sẽ cover toàn bộ test set. Nhờ vậy test không cần trở thành bước blocking liên tục hàng giờ đối với một Agent.
- Phân công Agent dần chi tiết thành implementation compiler, deduplication, performance, quality code và documentation. Vì LLM dễ reimplement feature đã có, deduplication được tách riêng để xử lý.
Carlini từng nói: “Tôi phải liên tục nhắc mình rằng tôi đang viết test framework cho Claude, không phải cho chính mình.” Điểm cốt lõi ở đây là format log, cách chia test và cách feedback của test framework trước tiên phải giúp Agent consume ổn định, chứ không chỉ theo đuổi việc con người đọc có thoải mái hay không.
Vì sao Anthropic lấy cảm hứng từ GAN?
Team Anthropic Labs công bố một kiến trúc ba Agent lấy cảm hứng từ ý tưởng GAN vào tháng 3 năm 2026. Nguyên văn là Taking inspiration from GANs, nghĩa là mượn ý tưởng chứ không thực sự thực hiện adversarial training.
Planner (planner) → Generator (executor) ⇄ Evaluator (evaluator)Planner nhận mô tả product dài 1-4 câu, mở rộng thành product specification đầy đủ và được yêu cầu “phải mạnh dạn về phạm vi”. Generator thực hiện từng feature một theo Sprint, mỗi Sprint có completion criteria rõ ràng. Evaluator dùng Playwright MCP thực sự click vào application đang chạy, sau đó chấm điểm theo các chiều như độ sâu của product design, tính năng, visual design và quality code.
Kiến trúc này chủ yếu xử lý hai vấn đề:
| Vấn đề | Biểu hiện | Cách giải quyết |
|---|---|---|
| Context anxiety | Sonnet 4.5 kết thúc qua loa khi sắp đạt context limit | context resets + bàn giao có cấu trúc, chỉ compression là chưa đủ |
| Sai lệch trong self-evaluation | Agent tự tin khen mình làm tốt nhưng chất lượng thực tế trung bình | Tách generation và evaluation cho hai Agent độc lập |
Trong task frontend, trọng số của design quality và originality được đặt cao hơn tính năng và quality code, nhằm sửa xu hướng của model tạo output “đủ feature nhưng ngoại hình tầm thường”.
Gặp context anxiety, Anthropic chọn restart
Anthropic phát hiện Sonnet 4.5 trở nên do dự khi context gần đạt limit, thậm chí kết thúc sớm khi task chưa hoàn thành, vì vậy họ dùng context resets.
Trước khi trigger reset, hệ thống trích xuất task state hiện tại, công việc đã hoàn thành và task cần làm thành handoff document có cấu trúc; sau đó khởi động Agent mới, chỉ đưa document này và tài liệu cần để tiếp tục task cho nó. Hội thoại lịch sử không còn chiếm context của session mới.
Cách làm này phụ thuộc vào tính đầy đủ của handoff document: nếu bỏ sót file đã sửa, nguyên nhân thất bại hoặc command validation tiếp theo, Agent mới sẽ tiếp tục từ state sai. Project compiler của Carlini cũng giữ khoảng 2.000 session Claude Code thành các unit tương đối độc lập; Anthropic thì biến restart và state handoff thành một cơ chế rõ ràng.
So sánh chi phí của hai cấu hình như sau:
| Cấu hình | Thời gian | Chi phí | Hiệu quả |
|---|---|---|---|
| Solo Harness, một Agent + ít tool | 20 phút | $9 | Bản nháp không chạy được |
| Full Harness, ba Agent + toolchain đầy đủ | 6 giờ | $200 | Application đầy đủ, dùng được |
Chênh lệch sẽ còn lớn hơn với task phức tạp. Chẳng hạn Full Harness chạy gần 4 giờ và tốn $124.70 để tạo một workstation sản xuất âm nhạc DAW trong browser; kết quả cuối cùng là một chương trình dùng được với arrangement view, mixer và playback control.
Tuy nhiên, họ còn phát hiện quan trọng khác: khi đổi model từ Sonnet 4.5 sang Opus 4.6, có thể loại bỏ hoàn toàn cơ chế Sprint, Evaluator chuyển từ kiểm tra mỗi Sprint sang chỉ kiểm tra một lần ở cuối. Tổng kết của Anthropic rất chính xác: Every component in a harness encodes an assumption about what the model can't do on its own, and those assumptions are worth stress testing.
Sau khi đổi Sonnet 4.5 thành Opus 4.6, có thể loại bỏ Sprint và việc Evaluator kiểm tra từng vòng, cho thấy component Harness phụ thuộc vào các assumption về năng lực model. Sau khi model nâng cấp, cần validation lại các assumption này và xóa những cơ chế bảo vệ đã dư thừa.
Stripe: Chế độ không cần giám sát với hơn 1300 PR mỗi tuần
Hệ thống Minions của Stripe là một cực khác: tự động hóa cao, không cần giám sát. Developer gửi một message trong Slack, Agent hoàn thành toàn bộ từ viết code, chạy CI đến tạo PR, con người chỉ review ở cuối. Mỗi tuần có hơn 1300 PR hoàn toàn do Minions production, không có code con người viết tay, được merge.

Lần đầu nhìn thấy con số này quả thật hơi đáng sợ. Tách ra xem thì nó dựa vào một môi trường kỹ thuật rất trưởng thành, không phải một “Agent siêu mạnh” nào đó.
| Component | Vai trò | Thiết kế then chốt |
|---|---|---|
| Devbox | Môi trường development | AWS EC2 cài sẵn source code và service, cấp phát từ warm pool, khởi động khoảng 10 giây, “cattle not pets” |
| Orchestration state machine | Flow control | Node deterministic hỗn hợp, như lint và push, cùng node Agent, như implement feature và sửa CI; nơi nào cần deterministic thì deterministic, nơi nào cần linh hoạt thì linh hoạt |
| Toolshed MCP | Tool service | MCP service tập trung, gần 500 tool, mỗi Minion nhận subset đã lọc |
| Feedback loop | Đảm bảo quality | Pre-push hook sửa lint trong vài giây; sau push nhiều nhất 2 vòng CI, cover hơn 3 triệu test |
Cách orchestration của Stripe rất giống hybrid pipeline. Các bước như chạy lint và push code đi theo flow deterministic; những phần cần phán đoán như implement feature và sửa lỗi CI giao cho Agent. Nơi nào nên cứng nhắc thì cứng nhắc, nơi nào nên linh hoạt thì linh hoạt.
Họ còn có một quan điểm: What's good for humans is good for agents. Devbox, toolchain và developer experience từng được đầu tư cho engineer con người cũng trực tiếp tạo ra lợi ích trên Agent. Agent không nhất thiết cần một infrastructure hoàn toàn độc lập; đúng hơn, nó nên được xem là first-class citizen trong môi trường development.
Nền tảng bên dưới của Minions là một fork của project mã nguồn mở goose của Block, được Stripe custom cho scenario không cần giám sát.
Mitchell Hashimoto: Kỹ thuật Harness của một người
Mitchell Hashimoto là tác giả của Vagrant, Terraform và terminal emulator Ghostty. Hướng đi của ông rất khác Stripe. Ông kiên trì chỉ chạy một Agent mỗi lần và duy trì sự tham gia sâu. Ông từng nói rõ: “Tôi không định chạy nhiều Agent, và cũng không muốn chạy.”
Thực tiễn của ông có thể chia thành sáu bước:
| Bước | Tên | Cách làm |
|---|---|---|
| 1 | Từ bỏ chế độ chat | Để Agent trực tiếp làm việc trong môi trường có thể đọc file, chạy program và gửi HTTP request |
| 2 | Tái hiện công việc của mình | Làm mỗi việc hai lần, một lần tự làm, một lần để Agent làm; ông mô tả quá trình này là “đau đớn tột cùng” |
| 3 | Khởi động Agent trước khi tan làm | Mỗi ngày trong 30 phút cuối giao task cho Agent, như research sâu, exploration mơ hồ và phân loại Issue |
| 4 | Outsource task deterministic | Chọn các task mà Agent gần như chắc chắn làm tốt để chạy background, khuyên tắt desktop notification để tránh context switch |
| 5 | Kỹ thuật hóa Harness | Mỗi lần Agent mắc lỗi, engineering một giải pháp để cố gắng khiến nó không lặp lại cùng loại lỗi về sau |
| 6 | Luôn có Agent đang chạy | Mục tiêu là Agent background chạy trong 10-20% thời gian làm việc |
AGENTS.md trong project Ghostty rất tiêu biểu. Mỗi dòng tương ứng với một case Agent thất bại trong quá khứ. Nó là một hệ thống phòng lỗi tích lũy liên tục. Khi Agent mắc một loại lỗi mới, thêm một rule; các vấn đề cùng loại về sau sẽ giảm đi.

Tổng hợp của Birgitta Böckeler về Harness
Birgitta Böckeler là Distinguished Engineer của Thoughtworks. Khi phân tích thực tiễn của OpenAI trên website Martin Fowler, thay vì liệt kê component theo feature sản phẩm, bà đặt vấn đề vào ba action kỹ thuật: kiểm soát thông tin Agent tiếp nhận, giao constraint cho tool thực thi và xử lý artifact dư thừa được generation liên tục.
Bà quy component của Harness thành ba loại:
| Phân loại | Trọng tâm | Thực tiễn điển hình |
|---|---|---|
| Context Engineering | Quản lý Agent nhìn thấy gì, khi nào nhìn thấy | Từ AGENTS.md khổng lồ phát triển thành entry file + document phân tầng |
| Architectural Constraints | Bảo đảm Agent không đi lệch | Linter tùy chỉnh, structural test, LLM Agent đóng vai constraint |
| Garbage Collection | Chống lại entropy tích lũy | Định kỳ chạy cleanup Agent, scan sự không nhất quán và vi phạm |
Cách phân loại này giải thích vì sao các case trước đó trông rất khác nhau: thiết kế directory của AGENTS.md thuộc Context Engineering; Linter, structural test và state machine thuộc Architectural Constraints; background cleanup Agent xử lý Garbage Collection. Chúng phục vụ các đối tượng khác nhau, không thể dùng một prompt dài để thay thế tất cả.
Bà còn đề xuất Harness có thể được tích lũy thành template giống service scaffold hiện có. Khi tổ chức chỉ duy trì một số ít tech stack, có thể preset môi trường development, các mục check và tool khả dụng; sau khi tạo service mới thì load rule tương ứng theo directory và task. Template có thể giảm cấu hình lặp lại, nhưng không thể thay thế test, ranh giới module và runtime data của chính project.
Brownfield project là scenario dễ bộc lộ ranh giới này nhất. Sau khi một codebase vận hành nhiều năm, thiếu constraint architecture, được kết nối với Agent, lỗi type, vi phạm dependency và test fail có thể xuất hiện đồng thời; thứ nhận được ban đầu là một danh sách dài các việc cần xử lý. Böckeler dùng Ambient Affordances để mô tả các điều kiện mà bản thân codebase cung cấp: ngôn ngữ strongly typed cung cấp type check, ranh giới module rõ ràng cho phép định nghĩa dependency rule, framework như Spring đóng gói một phần chi tiết implementation. Case của Stripe chứng minh codebase hiện có có thể chạy Agent; các điều kiện này vẫn cần được kiểm tra từng mục trong repository cụ thể.
Validation độc lập về tính đúng đắn của feature vẫn là khoảng trống. Architecture check có thể ngăn dependency direction sai, task cleanup có thể xóa implementation lặp lại, nhưng cả hai không thể chứng minh user flow phù hợp kỳ vọng. Khi test và implementation đều do cùng loại model generation, test pass chỉ cho thấy assumption chung của chúng chưa bị phá vỡ. Böckeler đánh giá: puts a lot of faith into AI-generated tests, that's not good enough yet.
Tổng kết
Để một output của Agent trở thành kết quả kỹ thuật có thể bàn giao, ranh giới thông tin, interface tool, execution state và validation result cần cùng tham gia. Thí nghiệm interface của Can.ac, document dạng directory và constraint cơ học của OpenAI, state handoff của Anthropic, orchestration deterministic của Stripe đều giải quyết các vấn đề thực thi sau khi model generation.
Khi triển khai thực tế, có thể bắt đầu từ loop ngắn nhất: viết rõ entry point và constraint cho task, để Agent compile và chạy test, sau đó feedback nguyên nhân thất bại thành action có thể thực thi ở bước tiếp theo. Khi task dài hơn, bổ sung state file, compression context và validation end-to-end; khi code liên tục được generation, đưa logic lặp lại, document hết hạn và vi phạm architecture vào cleanup định kỳ.
Harness cũng cần được kiểm tra lại theo sự thay đổi năng lực của model. Một Linter, evaluator hoặc bước multi-Agent từng cần thiết không có nghĩa là nó phải được giữ mãi. Giữ lại các cơ chế bắt được lỗi thật, loại bỏ phần chỉ làm tăng chi phí context và orchestration, mới có thể giúp Agent tiến hành ổn định trong project cụ thể.