
Context Engineering là gì? Khác Prompt Engineering ở đâu?
Context window chứa được nhiều tài liệu hơn không có nghĩa Agent sẽ sử dụng chúng ổn định. Khi một lần gọi trộn lẫn state đã lỗi thời, log không liên quan hoặc hàng chục mô tả tool tương tự, model vẫn có thể bỏ sót điều kiện thực sự ảnh hưởng đến quyết định.
Context Engineering xử lý việc lắp ghép thông tin trước khi gọi: quy tắc nào được đưa vào message, evidence nào được truy xuất theo nhu cầu, tool nào hiển thị ở giai đoạn hiện tại, khi nào history được nén và kết quả gốc được giữ reference ra sao. Tác vụ dài còn cần bàn giao state giữa các window, tránh làm mất constraint, version và việc chưa hoàn tất sau khi tóm tắt.
Cùng một Agent, vì sao hiệu quả khác nhau đến vậy?
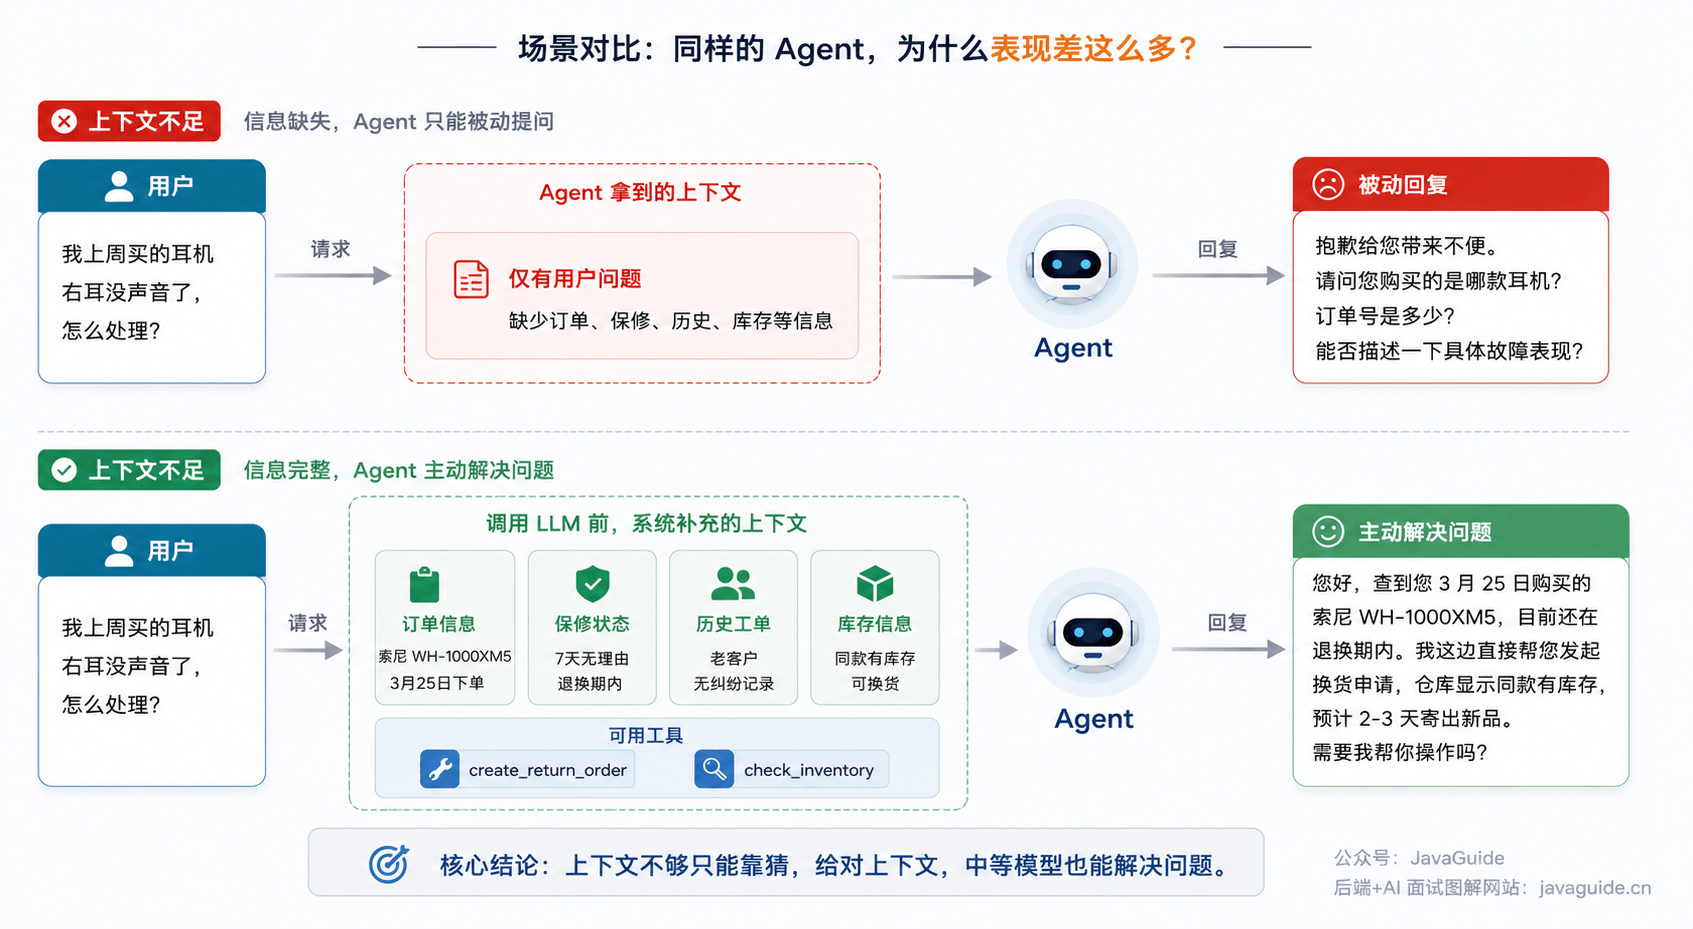
Lấy tình huống chăm sóc sau bán hàng làm ví dụ.
G nói: “MD, tai nghe tôi mua tuần trước bị mất tiếng bên phải, xử lý thế nào?”
Nếu Agent nhận được rất ít context, nhiều khả năng nó sẽ trả lời: “Xin lỗi vì đã gây bất tiện. Bạn mua mẫu tai nghe nào? Mã đơn hàng là gì? Bạn có thể mô tả cụ thể sự cố không?”
Câu trả lời này không hẳn có vấn đề, nhưng trong tình huống chăm sóc sau bán hàng thì khá bực mình. Nó chỉ biết hỏi theo quy trình, không chủ động tổng hợp thông tin.
Hãy thử viết lại với context đầy đủ hơn.
Trước khi gọi LLM, hệ thống tra cứu mọi thông tin có thể lấy được:
- Tra hệ thống đơn hàng, xác định bản ghi mua tuần trước: Sony WH-1000XM5, đặt hàng ngày 25 tháng 3
- Tra trạng thái bảo hành, phát hiện sản phẩm vẫn trong thời hạn đổi trả không cần lý do 7 ngày
- Tra ticket trước đây, phát hiện người dùng là khách hàng cũ và chưa từng có tranh chấp hậu mãi
- Gắn các tool
create_return_ordervàcheck_inventory
Khi đó Agent có thể trả lời: “Xin chào, tôi đã kiểm tra và thấy bạn mua Sony WH-1000XM5 vào ngày 25 tháng 3, hiện vẫn trong thời hạn đổi trả. Tôi có thể trực tiếp tạo yêu cầu đổi hàng cho bạn; kho báo còn sản phẩm cùng mẫu, dự kiến sẽ gửi sản phẩm mới trong 2-3 ngày. Bạn có muốn tôi thực hiện không?”
Khác biệt thể hiện ngay: câu trả lời sau thực sự giải quyết vấn đề, thay vì tiếp tục hỏi ngược người dùng.
Tất nhiên, nhiều thất bại của Agent liên quan đến context, nhưng context không phải nguyên nhân duy nhất. Thiết kế tool, phân rã tác vụ, quản lý state và cơ chế xác minh thường phải được xem xét cùng nhau.
Tuy nhiên có một điểm chắc chắn: khi context không đủ, model dù mạnh đến đâu cũng chỉ có thể đoán; khi context được cung cấp đúng, model mức trung bình cũng có thể hoàn thành tác vụ.
Context Engineering thực sự làm gì?
Khác Prompt Engineering ở đâu?
Tobi Lutke khái quát Context Engineering như sau:
the art of providing all the context for the task to be plausibly solvable by the LLM
Có thể dịch là: bổ sung cho LLM toàn bộ context cần để giải quyết tác vụ, để tác vụ có khả năng giải được trong giới hạn năng lực của model. plausibly ở đây nói đến điều kiện tiên quyết: nếu thiếu trạng thái đơn hàng, ranh giới quyền hạn hoặc constraint của flow cũ, model không có đủ căn cứ để đưa ra phán đoán đáng tin cậy.
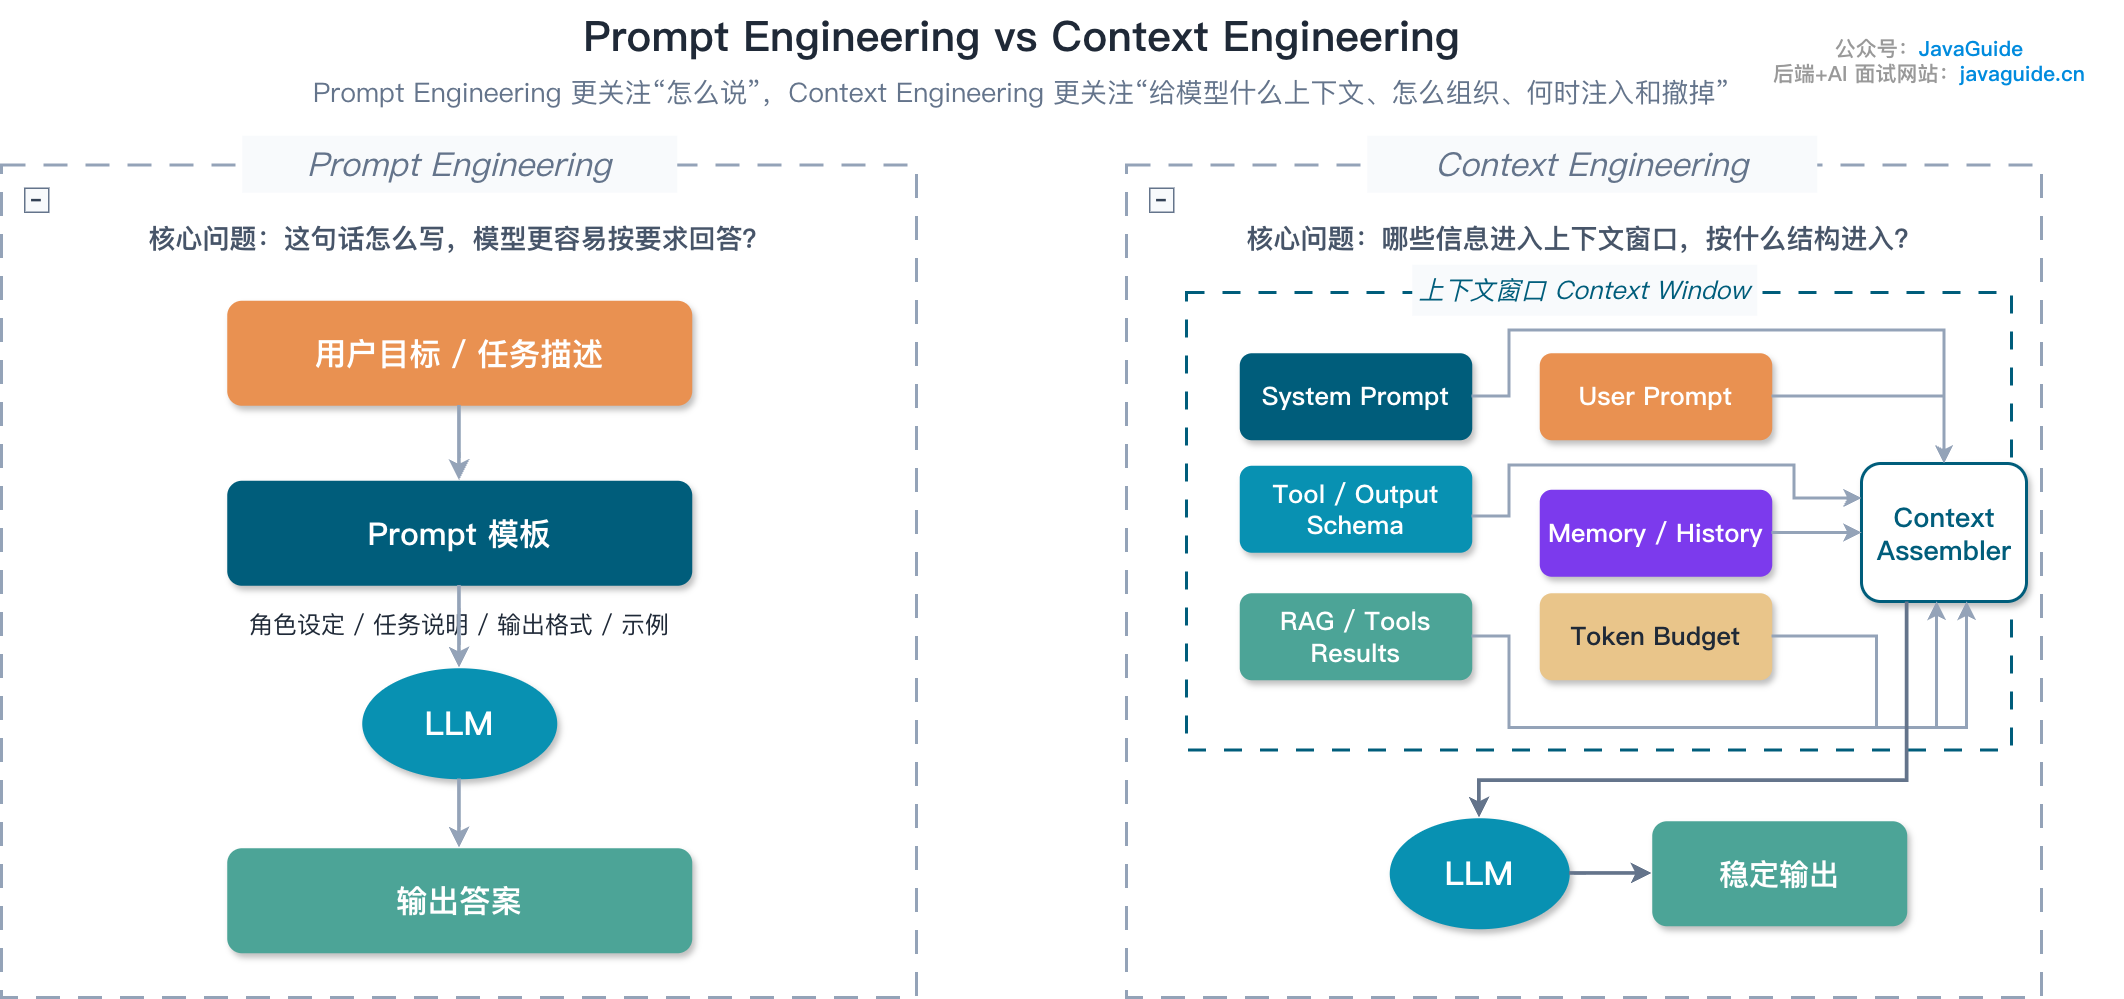
Prompt Engineering xử lý cách viết instruction; Context Engineering quyết định một lần gọi thực tế đưa vào những thông tin nào, và những thông tin đó vào hoặc rời khỏi window khi nào.
- Prompt Engineering quan tâm cách viết instruction: câu chữ, thứ tự, format, giọng điệu đều thuộc phạm vi này.
- Context Engineering quan tâm một việc khác: trước lần gọi này, window của model nên chứa thông tin nào, đặt theo cấu trúc nào, đưa vào lúc nào và khi nào cần loại bỏ.
Blog chính thức của Anthropic dùng hình dưới đây để so sánh hai tầng này:
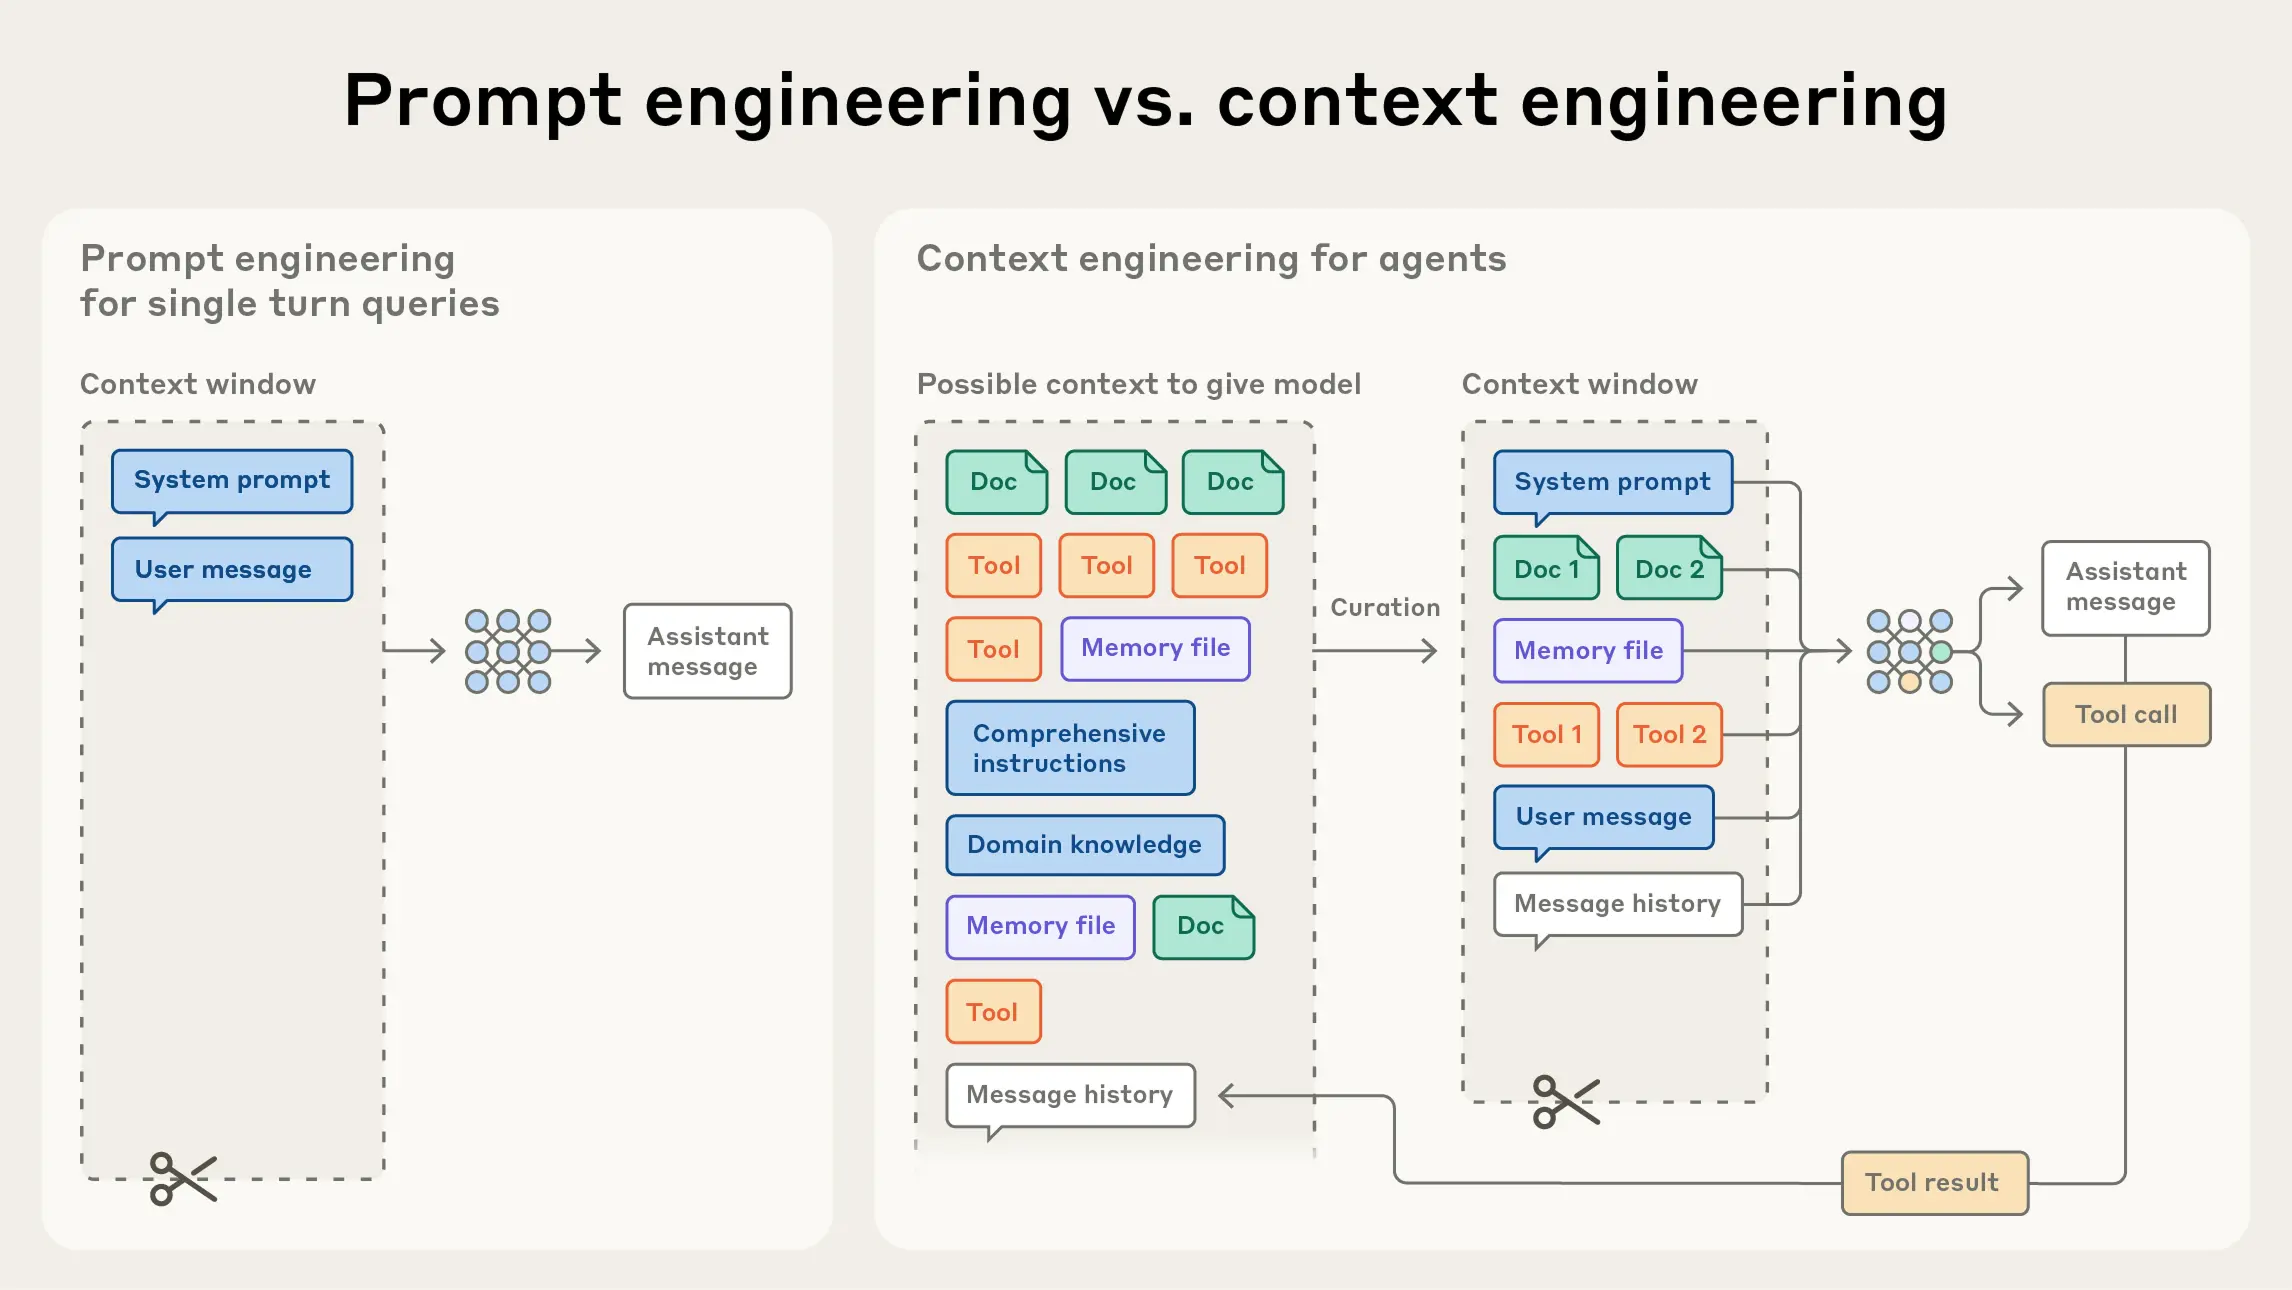
Ví dụ, nếu Prompt Engineering là “nói cho đầu bếp cách nấu món ăn”, thì Context Engineering giống như chuẩn bị căn bếp cho đầu bếp: nguyên liệu đặt ở đâu, dao cụ sắp xếp thế nào, gia vị phân loại ra sao và tài liệu tham khảo về nhiệt độ được dán ở đâu.

Tôi thích một phép so sánh khác hơn: Context Engineering chính là memory management của LLM.
Context window là một vùng memory hữu hạn. Context Engineering quản lý vùng memory này chứa gì, swap out gì, khi nào đọc và khi nào ghi. Khi window đầy, phải loại bỏ nội dung; ý tưởng này giống page replacement trong operating system, chẳng hạn LRU và chiến lược priority. Khi nói đến việc hạ cấp Token ở phần sau, thực ra cũng đang xử lý vấn đề này.
Cụ thể quản lý những gì?
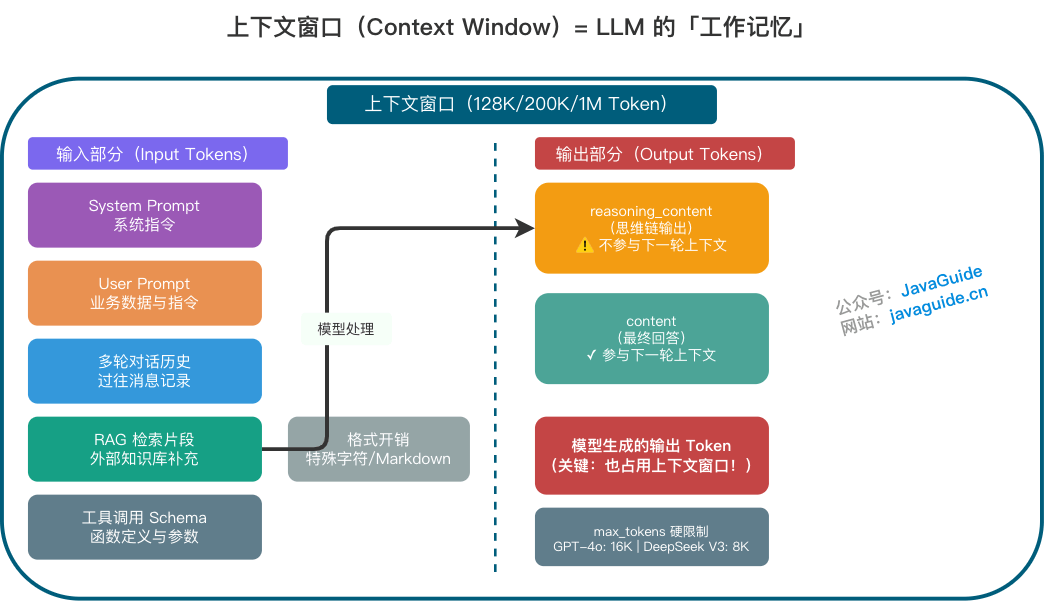
Tách ra thì Context Engineering quản lý ít nhất các phần sau.
System Prompt là instruction có priority cao trong API message. Các file .cursor/rules, .claude/rules, AGENTS.md là nguồn rule do host program đọc; host sẽ dựa trên quy tắc load riêng để chuyển một phần nội dung thành context của model. Chúng không phải cùng một khái niệm với System Prompt xét theo role của API. .cursorrules, từng được Cursor sử dụng ở giai đoạn đầu, đã là dạng cũ; project mới nên dùng .cursor/rules.
User Prompt là business data và instruction do người dùng nhập. Nhìn có vẻ đơn giản, nhưng trong project thực tế nó thường trộn natural language, field nghiệp vụ, state trước đó và nội dung attachment. Xử lý không tốt sẽ làm context bị nhiễu.
Memory gồm short-term và long-term. Short-term memory thường là sliding window trong Session; long-term memory không nhất thiết là vector database, mà có thể là file, KV, relational database, graph database hoặc vector retrieval layer. Vấn đề cốt lõi là: ghi lại gì, khi nào ghi, cập nhật ra sao, quên thế nào và sau khi recall thì đưa vào context hiện tại ra sao.
RAG & Tools cũng thuộc phạm vi này. RAG truy xuất external document để đưa nội dung liên quan vào context; Tools gắn tool description, parameter format và kết quả gọi vào đó. Có thể xem RAG là một implementation cụ thể của Context Engineering: nó trả lời các câu hỏi “retrieval gì, retrieval thế nào và đặt kết quả vào context ra sao”.
JSON Schema, cấu trúc parameter và constraint trả về của Function Calling sẽ giới hạn lần gọi hiện tại, nên cũng là một phần của context. Observation sau khi gọi tool cần được phân biệt: giữ nguyên bản gốc, ghi vào summary hay xóa ở các lượt sau. Nếu không thiết kế trước, giai đoạn parse và replay sẽ để lại rất nhiều kết quả khó xử lý.
Summary compression, loại bỏ history và Context Caching đều là cách quản lý Token. Chúng cần cân bằng giữa lượng thông tin giữ lại và chi phí gọi.
Vì sao context mất hiệu lực?
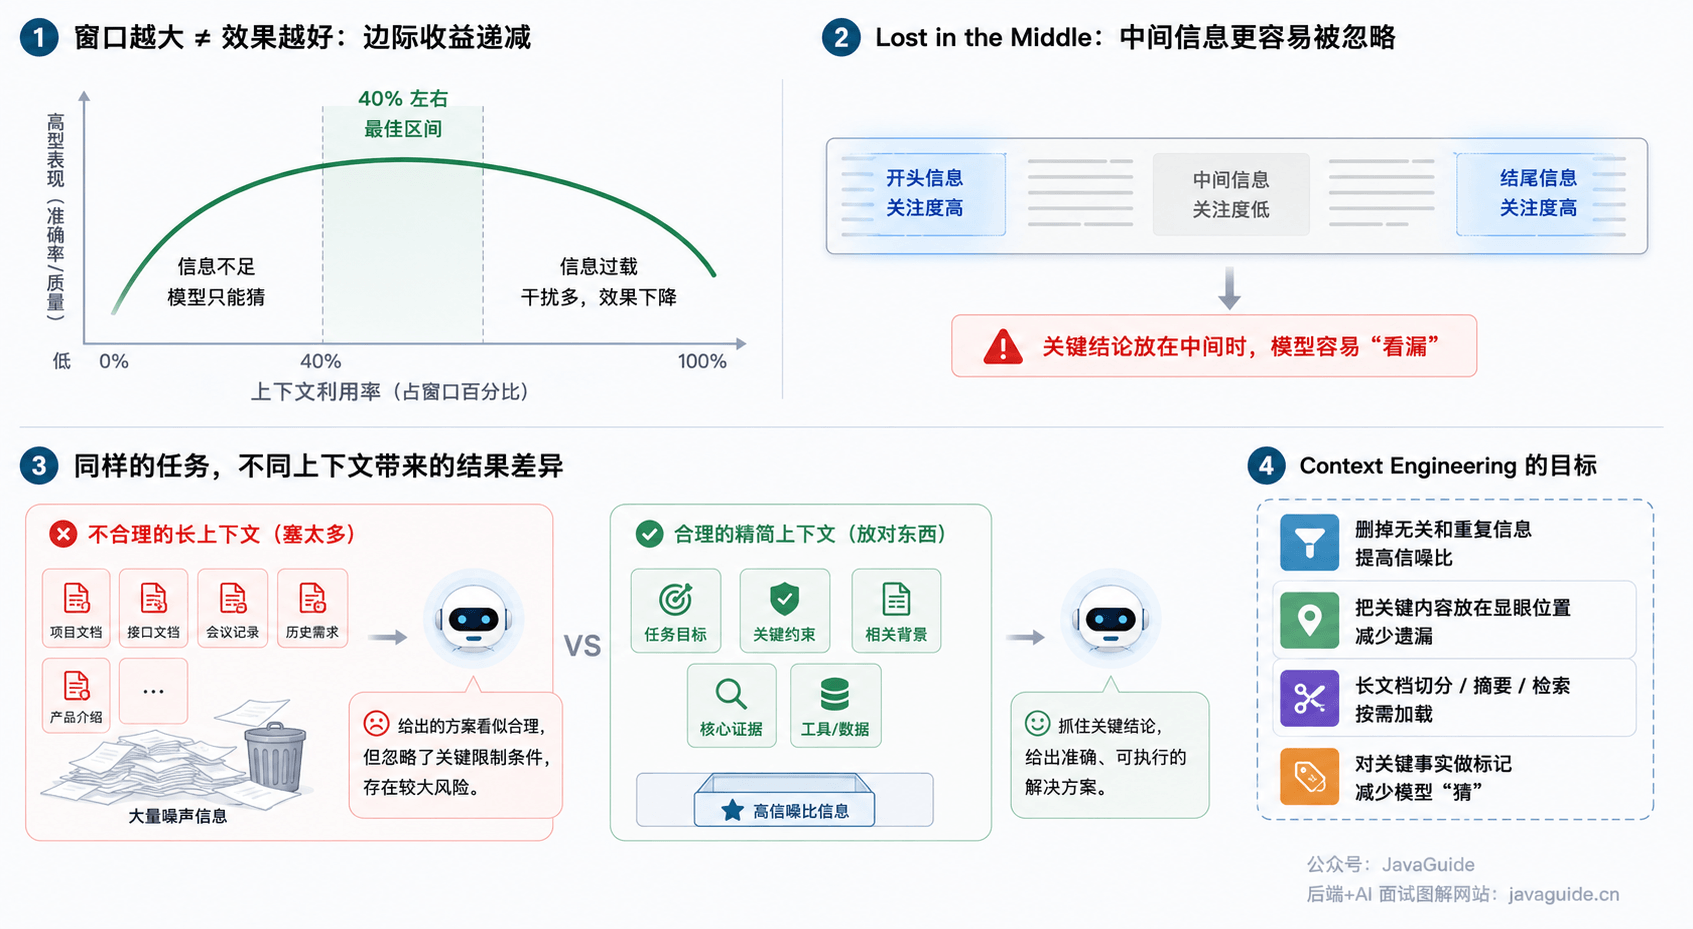
Khi dung lượng window tăng, vấn đề sàng lọc vẫn tồn tại. Khi input vượt quá phạm vi cần cho tác vụ hiện tại, tài liệu bổ sung có thể chỉ làm tăng nhiễu.

Lấy ví dụ cải tạo flow đăng nhập của người dùng cũ: requirement trước đây, tài liệu API và biên bản họp cùng vào window, trong đó câu “vẫn phụ thuộc cơ chế kiểm tra token phiên bản cũ, không thể chuyển thẳng sang module authentication mới” có thể chỉ chiếm một dòng. Dù đọc toàn bộ tài liệu, model vẫn có thể không xem dòng này là tiền đề của phương án.
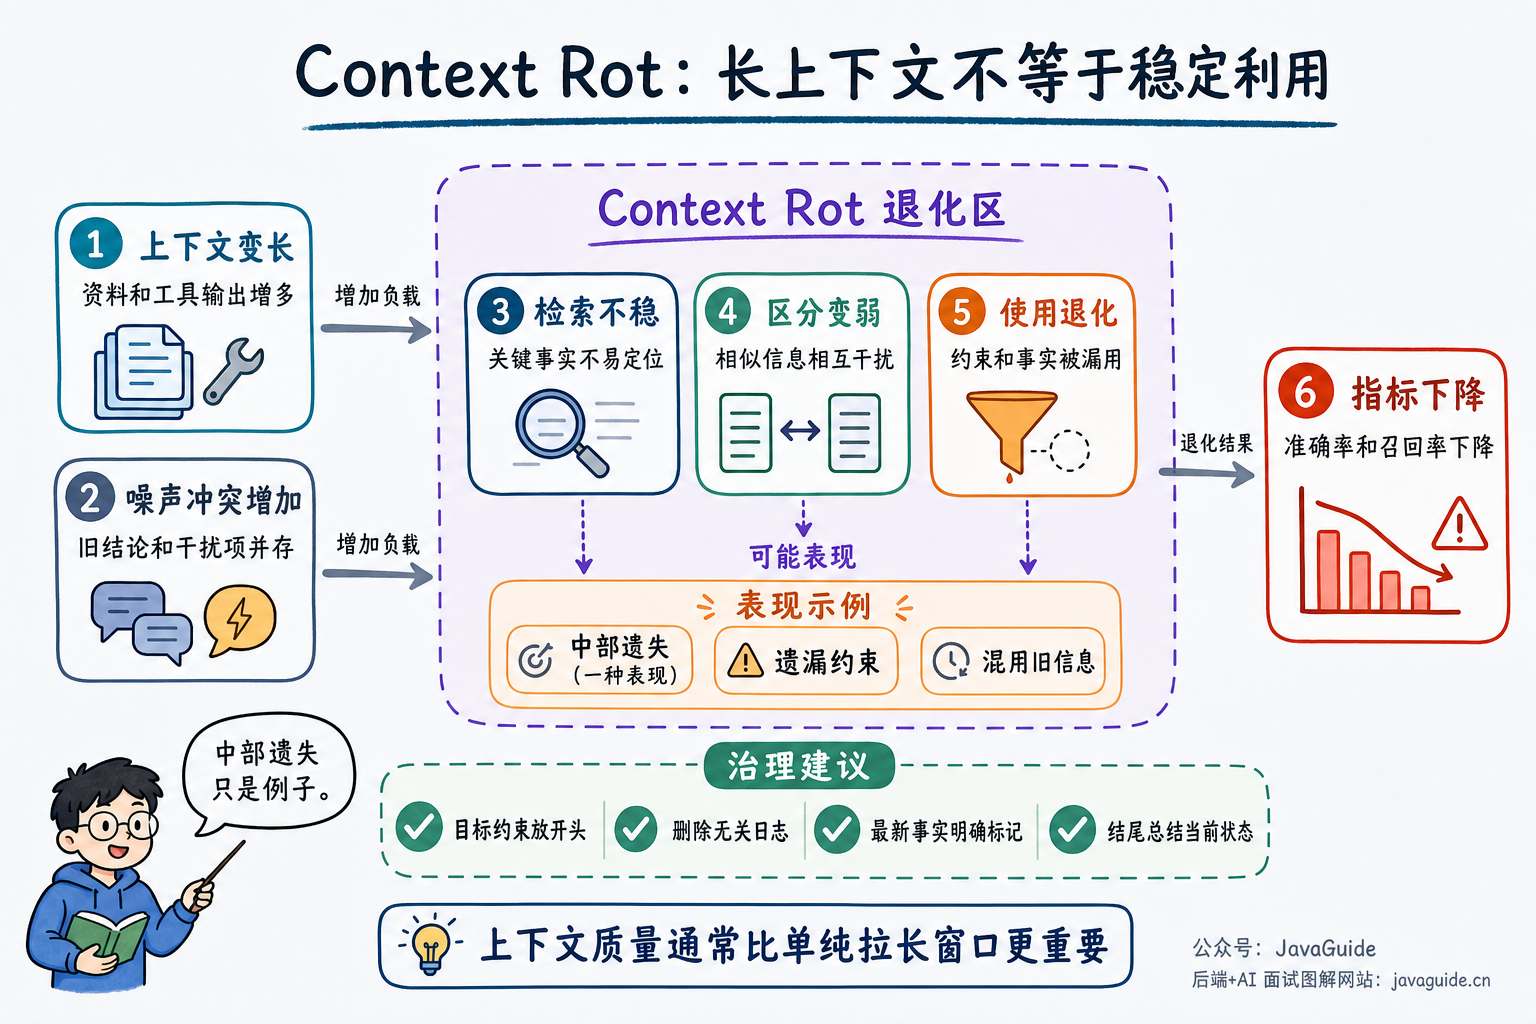
Một hiện tượng kinh điển liên quan là Lost in the Middle: model nhạy hơn với thông tin ở đầu và cuối, còn dễ “bỏ sót” nội dung nằm giữa. Vì vậy đôi khi bạn đã đưa tài liệu cho model nhưng nó vẫn trả lời sai; không nhất thiết là model chưa đọc, mà có thể nội dung quan trọng chưa đủ nổi bật trong context dài.
Trong Transformer, model không đọc văn bản từng dòng như con người. Nó dùng Attention để xác định câu hỏi hiện tại cần tập trung vào nội dung nào trong context. Có thể hiểu Attention là một dạng “chấm điểm mức liên quan”. Ví dụ khi hỏi “Vì sao API này bị timeout?”, model phải tìm trong context thông tin liên quan đến API, timeout, log, SQL, cache và dependency bên ngoài. Khi context ngắn, ít nhiễu hơn nên dễ tìm được trọng tâm.
Nhưng nếu một lần đưa vào hàng chục trang tài liệu, hàng trăm log và hơn mười đoạn mô tả bối cảnh, tình hình sẽ khác. Model không chỉ cần nhìn thấy thông tin là có thể dùng tốt thông tin đó; nó còn phải xác định đâu là phần quan trọng nhất giữa rất nhiều nội dung. Context càng dài, thông tin ứng viên càng nhiều, yếu tố gây nhiễu cũng càng nhiều và attention càng dễ bị phân tán. Nếu hiểu theo full attention tiêu chuẩn, mỗi Token phải tính quan hệ attention với các Token khác; càng nhiều Token thì áp lực tính toán và sàng lọc càng tăng. Tuy nhiên, nhiều model có context dài hiện nay dùng sparse attention, chunking, caching và compression để giảm chi phí, nên không thể đơn giản nói context càng dài thì chắc chắn càng kém.
Cách nói chính xác hơn là: context dài làm tăng độ khó khi model sàng lọc thông tin quan trọng, đồng thời tăng chi phí inference, nhưng mức suy giảm cụ thể còn phụ thuộc vào bản thân model, cấu trúc context và loại tác vụ.
Điều này giải thích vì sao một số model công bố hỗ trợ context 100K hoặc 200K, nhưng khi sử dụng thực tế lại không nhất thiết xử lý ổn định nội dung lấp đầy window.
Đưa vào được và sử dụng tốt là hai chuyện khác nhau.
Trong thực tế, tình huống này rất phổ biến. Bạn đưa toàn bộ tài liệu project, tài liệu API, biên bản họp và requirement cũ cho model, rồi hỏi: “Hãy xem thay đổi này có ảnh hưởng đến flow đăng nhập của người dùng cũ không?”.
Thông tin quan trọng có thể chỉ là một câu: flow đăng nhập của người dùng cũ vẫn phụ thuộc logic kiểm tra token phiên bản cũ, không thể chuyển thẳng sang module authentication mới. Nhưng câu này nằm giữa một đống thông tin bối cảnh, model rất dễ bỏ qua và cuối cùng đưa ra một phương án có vẻ hợp lý nhưng thực tế tiềm ẩn rủi ro.
Điểm khó của context dài là tìm được nội dung quan trọng một cách ổn định. Khi lắp ghép context, nên xóa thông tin trùng lặp và đặt constraint của tác vụ ở vị trí rõ ràng; tài liệu dài nên được chia nhỏ, retrieval hoặc summary, đồng thời giữ reference có thể tra cứu lại cho evidence quan trọng. Cần giữ bao nhiêu nên được đánh giá bằng model mục tiêu và trajectory của tác vụ thực tế.
Đánh giá Context Engineering đã tốt hơn chưa thế nào?
Không thể chỉ dựa vào cảm nhận. Một ảo giác thường gặp là sau khi sửa, Agent trông “ra dáng hơn”, nhưng success rate thực tế không tăng mà chi phí lại tăng.
Ít nhất nên theo dõi năm nhóm metric sau:
| Loại metric | Cần xem gì |
|---|---|
| Success rate của tác vụ | Có hoàn thành mục tiêu không, có cần con người can thiệp không, có tái hiện ổn định flow thành công không |
| Chất lượng tool | Chọn sai tool, bỏ sót tool, sai parameter, gọi lặp, tỷ lệ chặn thao tác nguy hiểm |
| Chi phí context | Input Token, output Token, cache hit rate, tỷ lệ thông tin được giữ sau compression |
| Metric latency | Latency đến Token đầu tiên, thời gian end-to-end, thời gian chờ tool, response time p95 / p99 |
| Chất lượng kết quả | Tỷ lệ hallucination, độ chính xác của evidence reference, tỷ lệ mất thông tin khi summary, tỷ lệ bỏ sót field quan trọng |
Cách nên làm là chọn trước 20 đến 50 trajectory của tác vụ thực tế để tạo evaluation set nhỏ, rồi lần lượt sửa retrieval, compression, tool Schema và Prompt. Mỗi lần chỉ thay đổi một variable, nếu không sẽ rất khó biết hiệu quả đến từ đâu.
Runtime context được load thế nào?
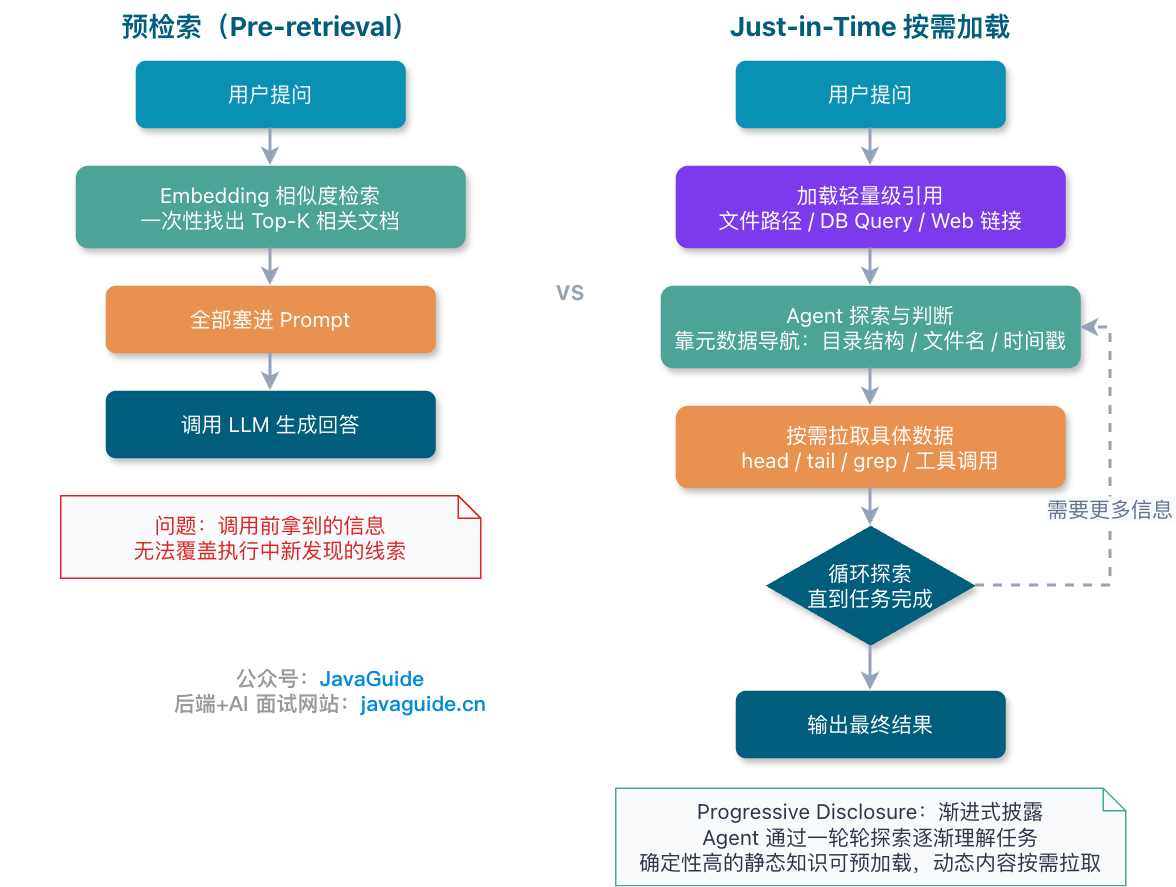
Vì sao pre-retrieval chưa đủ?
Pre-retrieval dựa trên độ tương đồng của Embedding để lấy các đoạn trước khi gọi LLM, rồi đưa toàn bộ vào Prompt một lần. FAQ và các câu hỏi đáp đơn giản có thể dùng flow này; thông tin liên quan trong tác vụ Agent phức tạp lại thay đổi theo quá trình thực thi.
Pre-retrieval chỉ có thể sắp xếp mục tiêu dựa trên những gì đã biết trước khi gọi. Manh mối mới phát hiện sau khi Agent gọi tool sẽ không xuất hiện trong kết quả của lần đó.
Just-in-Time: tải theo nhu cầu
Just-in-Time trước tiên chỉ giữ các reference nhẹ như path file, truy vấn database hoặc Web link; khi tác vụ cần nội dung cụ thể, nó mới đọc qua tool.
Lấy Claude Code phân tích codebase lớn làm ví dụ: trước hết Agent có thể thu hẹp phạm vi dựa trên cấu trúc thư mục, tên file và kết quả search, sau đó dùng head, tail, grep để đọc từng bước. Path, kích thước file và timestamp đều là manh mối định vị; không cần đưa toàn bộ nội dung file vào window ngay từ đầu.
Metadata cũng có thể tham gia phán đoán. Ý nghĩa path của tests/test_utils.py và src/core_logic/test_utils.py khác nhau, đủ để gợi ý rằng chúng phục vụ logic test ở các vị trí khác nhau.
Anthropic gọi cách lấy thông tin theo từng tầng này là Progressive Disclosure, tức disclosure theo từng bước. Agent bổ sung context qua nhiều lượt khám phá: kích thước file gợi ý độ phức tạp, timestamp gợi ý mức liên quan, cấu trúc thư mục cung cấp ngữ nghĩa vị trí. Skills cũng sử dụng ý tưởng này, xem thêm: Agent Skills là gì? Khác Prompt và MCP ở đâu?.
Tải theo nhu cầu làm tăng số lần gọi tool và latency, đồng thời phụ thuộc vào các tool điều hướng như glob, grep, tree. Khi năng lực điều hướng không đủ hoặc heuristic mất hiệu lực, Agent có thể tiếp tục search theo path sai, tiêu tốn thêm context và số lần gọi. Vì vậy vẫn cần thiết kế index, ranh giới tool và chiến lược điều hướng từ trước.
Thực tế hơn là chiến lược hybrid
Trong project thực tế, cách làm phổ biến hơn là hybrid: kiến thức tĩnh có độ chắc chắn cao có thể pre-retrieval, còn thông tin động phát hiện trong lúc chạy thì lấy theo nhu cầu. Claude Code cũng làm như vậy: file CLAUDE.md có thể được preload, còn nội dung file cụ thể do Agent khám phá trong runtime.
Việc chọn lựa giữa các tình huống cũng có quy luật. Các tác vụ có không gian khám phá lớn và nhiều nội dung động như phân tích codebase, information retrieval phù hợp hơn với Just-in-Time. Các tác vụ có context ổn định và ít nội dung động như review văn bản pháp lý, phân tích báo cáo tài chính chỉ cần pre-retrieval kèm một lượng nhỏ bổ sung trong runtime.
| Strategy | Ưu điểm | Chi phí | Tác vụ phù hợp hơn |
|---|---|---|---|
| Pre-retrieval | Nhanh, đơn giản, flow ổn định | Dễ đưa nhiễu vào một lần, kém linh hoạt trong runtime | FAQ, hỏi đáp knowledge base cố định, review tài liệu ổn định |
| Just-in-Time | Context sạch hơn, evidence vào theo nhu cầu | Nhiều tool call hơn, latency cao hơn | Phân tích codebase, troubleshooting, research mở |
| Hybrid | Cân bằng tốc độ khởi động và khả năng khám phá trong runtime | Cần budget manager và năng lực điều hướng tool | Business Agent phức tạp, tác vụ dài, retrieval từ nhiều nguồn |
Khi chọn strategy retrieval, trước hết hãy xem tài liệu của tác vụ có ổn định không, không gian khám phá lớn đến đâu, yêu cầu realtime thế nào và evidence có bắt buộc phải truy xuất được hay không, thay vì so sánh phương án nào “cao cấp hơn”.
Làm sao duy trì context trong tác vụ dài?

Compaction: nén history khi window sắp đầy
Nhiều lượt liên tiếp của một tác vụ sẽ giữ đồng thời phán đoán ban đầu, kết quả tool và mục tiêu hiện tại trong message history. Khi gần giới hạn window, Compaction nén history thành summary, rồi tiếp tục thực thi bằng summary và message mới, qua đó nối context giữa các window.
Anthropic từng giới thiệu một cách triển khai của Claude Code: summary giữ lại quyết định kiến trúc, Bug chưa giải quyết và chi tiết implementation quan trọng, còn kết quả tool dư thừa được loại bỏ; context sau compression kết hợp với các file vừa truy cập để khôi phục state của tác vụ. “5 file” là ví dụ implementation trong bài viết đó; phạm vi giữ lại cụ thể nên do tác vụ và budget của window quyết định.
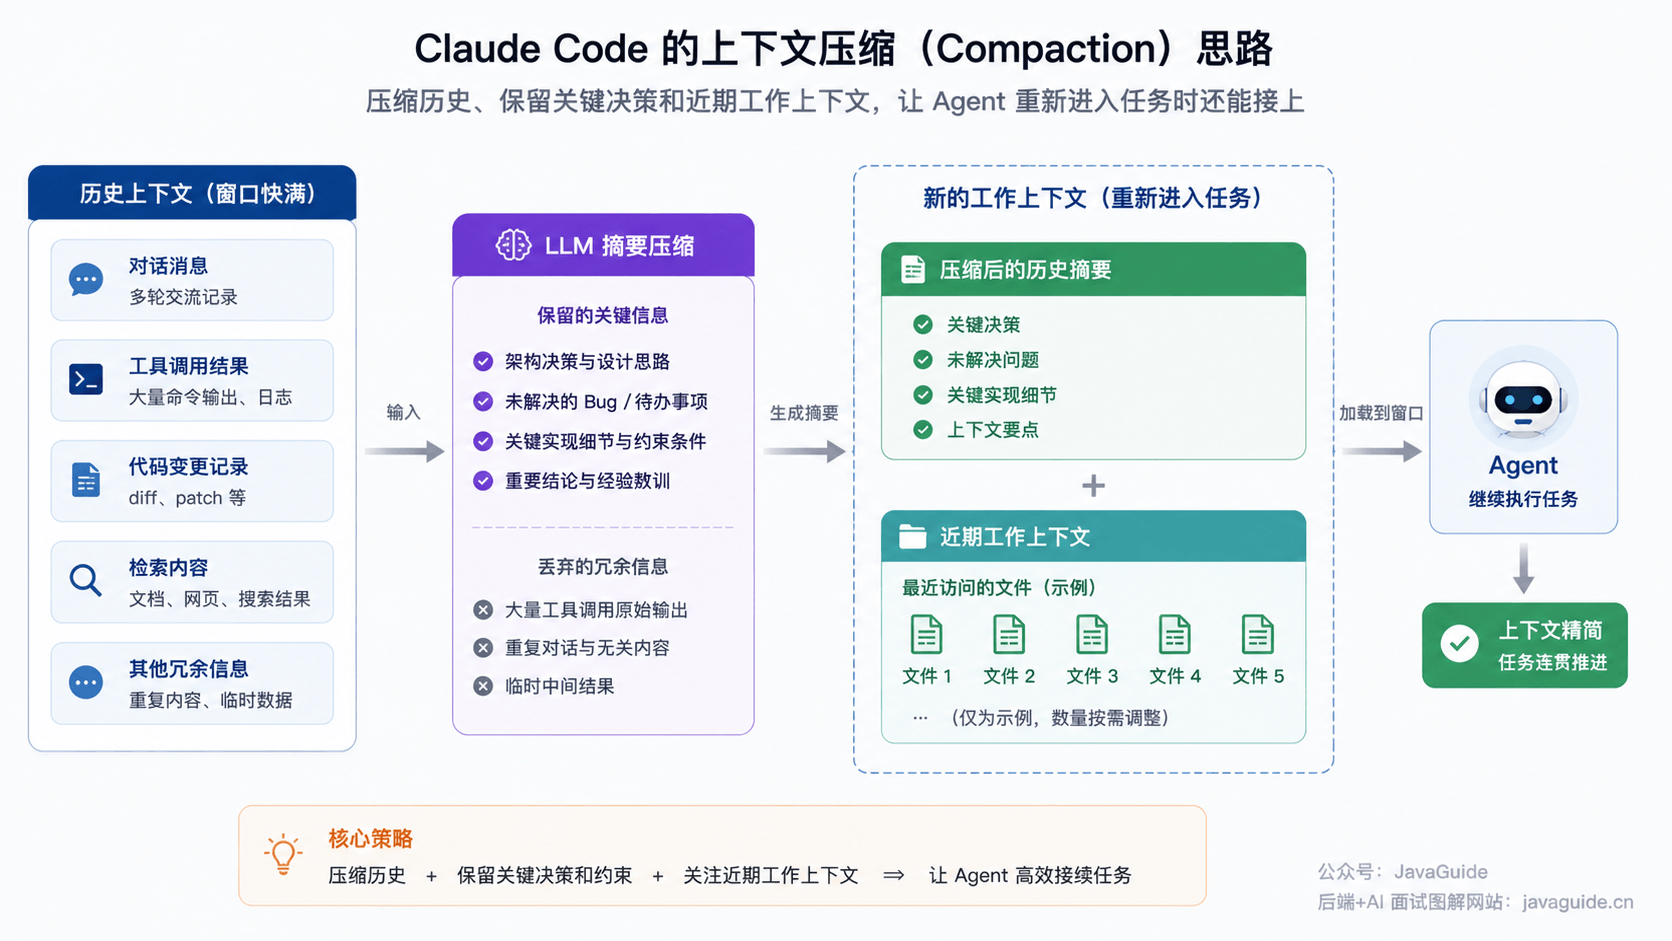
Điểm khó nằm ở việc cân bằng: giữ quá nhiều thì compression mất ý nghĩa, giữ quá ít lại mất context quan trọng. Cách thực tế là dùng trajectory của Agent phức tạp để điều chỉnh Prompt compression nhiều lần, trước hết bảo đảm không bỏ sót thông tin quan trọng rồi từng bước xóa nội dung dư thừa. Không thể viết chính xác ngay trong một lần.
Một cách compression nhẹ hơn là dọn kết quả tool. Sau khi tool đã được gọi và kết quả đã được xử lý, không cần giữ toàn bộ output gốc về sau. Anthropic Developer Platform đã có các khả năng như context editing / tool-result clearing, cho phép dọn tool_result cũ trong khi vẫn giữ record tool_use. Tuy nhiên, các parameter như threshold kích hoạt và số lượng giữ lại vẫn cần được test theo tải nghiệp vụ.
Structured Note-taking: để Agent ghi chú
Structured Note-taking là một cách khác để xử lý tác vụ dài. Cho Agent ghi tiến triển quan trọng vào file bên ngoài, chẳng hạn NOTES.md, rồi đọc lại các note này để tiếp tục sau khi context reset.
Ý tưởng này giống việc kỹ sư viết to-do list và technical memo. Trong tác vụ dài, Claude Code tự duy trì to-do list; Agent tự xây dựng cũng có thể duy trì NOTES.md ở root của project để ghi tiến độ hiện tại, vấn đề đã biết và kế hoạch tiếp theo.
Có một ví dụ khá thú vị: Claude chơi Pokémon. Qua hàng nghìn bước chơi, Agent tự duy trì việc theo dõi số liệu, chẳng hạn “trong 1234 bước vừa qua, tôi đã train Pikachu ở Route 1, đã tăng 8 level và còn thiếu 2 level so với mục tiêu”. Nó còn tự xây dựng note về bản đồ, danh sách achievement và chiến lược chiến đấu. Sau khi context reset, các note này vẫn có thể được đọc lại, nhờ đó nó có thể tiếp tục chơi trong nhiều giờ. Khi phát hành Sonnet 4.5, Anthropic cũng ra mắt bản beta công khai của Memory Tool, dùng file system persistence để Agent xây dựng knowledge base xuyên session.
Sub-agent: đừng để một Agent gánh toàn bộ state
Có thể giao retrieval hoặc đọc code cho Sub-agent trong context độc lập, còn Agent chính chỉ nhận bản tổng hợp evidence. Dù Sub-agent hoàn thành việc khám phá hàng chục nghìn Token, summary trả về Agent chính thường chỉ khoảng 1000 đến 2000 Token; quá trình search chi tiết sẽ không chiếm window chính trong thời gian dài.
Anthropic giới thiệu mô hình cô lập retrieval và nén kết quả trả về trong bài viết 《How we built our multi-agent research system》. Việc có dùng hay không phụ thuộc vào khả năng phân rã tác vụ, quan hệ phụ thuộc giữa các subtask và việc tổng hợp có làm mất evidence quan trọng hay không.
Có thể chọn ba cách như sau:
| Kỹ thuật | Tình huống phù hợp |
|---|---|
| Compaction | Flow dài cần hội thoại liên tục, trọng tâm là giữ context liền mạch |
| Note-taking | Development lặp lại, milestone rõ ràng, tác vụ tiến hành qua nhiều bước |
| Sub-agents | Research phức tạp, cần khám phá song song và cuối cùng phải tổng hợp kết quả |
Triển khai Context Engineering thế nào?
Trong implementation, có thể thiết lập một Context Assembler để thống nhất việc lắp ghép rule, goal, evidence, memory, tool và summary history trước mỗi lần gọi LLM.
Trước một lần gọi LLM, hệ thống thực sự cần lắp ghép gì?
# Input: thông tin tác vụ của người dùng, state của session hiện tại, context nghiệp vụ
input: user_task, session_state, business_context

# 1. Load constraint hệ thống (điều kiện giới hạn, rule policy, quyền hạn...)
constraints = load_system_constraints()

# 2. Dựa trên tác vụ người dùng và state của session, trích xuất goal cụ thể cần đạt hiện tại
goal = extract_current_goal(user_task, session_state)

# 3. Dùng strategy RAG (Retrieval-Augmented Generation) để retrieval evidence hoặc context liên quan
#    - Ví dụ tìm dữ liệu liên quan đến goal từ document, knowledge base và database
#    - Tham khảo tài liệu "Runtime context được load thế nào" để biết strategy retrieval
evidence = retrieve_rag(goal, business_context)

# 4. Recall memory trước đây hoặc thông tin đã có trong session
#    - Gồm preference của người dùng, tương tác trước đó và memory của model
memory = recall_memory(goal, session_state)

# 5. Dựa trên goal, evidence và memory để chọn tool / operation component phù hợp
#    - Có thể là gọi API, thực hiện thao tác trên browser hoặc kích hoạt phép tính...
tools = select_tools(goal, evidence, memory)

# 6. Compress message history của session để quản lý context xuyên window
#    - Tham khảo "Làm sao duy trì context trong tác vụ dài?"
#    - Compress history giúp giảm lượng token tiêu thụ mà vẫn giữ thông tin quan trọng
history = compact_history(session_state.messages)

# 7. Aggregate toàn bộ context và sắp xếp theo importance
#    - Bảo đảm model xử lý nội dung quan trọng nhất trước
context = rank([
  constraints,
  goal,
  evidence,
  memory,
  tools,
  history
])

# 8. Cắt / rút gọn context theo giới hạn token của model
#    - Bảo đảm giữ lại tối đa thông tin quan trọng trong token budget
context = fit_token_budget(context)

# Output: message được tạo, tool schema có thể dùng và metadata bổ sung
output: messages, tool_schema, metadata
Có hai điểm khá quan trọng cần chú ý khi triển khai:
rankquyết định thông tin nào ở trước và thông tin nào ở sau.fit_token_budgetquyết định phần nào giữ nguyên bản gốc, phần nào nén thành summary và phần nào chỉ giữ một reference.
Nếu làm hai bước này không tốt, hiệu quả xử lý của Agent sẽ khá kém. Cần tránh việc retrieval được gì thì đưa hết vào, history chứa được bao nhiêu thì đưa bấy nhiêu, để cuối cùng một nửa window toàn là nhiễu.
Input của Context Assembler có thể được chia theo nguồn thành static rule, tool definition, dynamic evidence, example và Token budget.
Static rule: viết rõ System Prompt trước
Có thể hiểu static rule là “thiết lập xuất xưởng” của Agent, tức những constraint nền tảng không thay đổi theo hội thoại. Cách thường dùng là viết System Prompt bằng Markdown có cấu trúc; đừng trộn tất cả thành một đoạn lớn, mà tách thành role, goal, constraint, execution flow và output format.
Ví dụ một Agent troubleshooting:
## Role

Bạn là chuyên gia troubleshooting backend service, giỏi xác định root cause qua log và dữ liệu monitoring.

## Constraint

- Chỉ gọi tool cần thiết, không gọi lặp tool có cùng logic
- Khi phát hiện thông tin quan trọng, lập tức dừng search và đưa ra kết luận
- Ưu tiên dữ liệu realtime thay vì suy luận từ history

## Execution flow

1. Kiểm tra metric monitoring (CPU/memory/network)
2. Kiểm tra log trong time range tương ứng
3. Nếu phát hiện call chain bất thường, trace dependency upstream và downstream
4. Xuất report có cấu trúc: mô tả vấn đề → root cause → đề xuất cách sửa

## Output format

Dùng JSON, gồm các field: incident_summary, root_cause, evidence, recommendation
Các rule này có thể đặt trong .cursor/rules, .claude/rules hoặc AGENTS.md, sau đó để host tương ứng load theo directory và scope. Rule file thuận tiện cho version control và review trong team, nhưng cuối cùng chúng đi vào loại message nào và được load khi nào còn tùy implementation của host.
Tuy nhiên, khi viết System Prompt cần tránh hai cực đoan phổ biến.
Một là over-design. Một số engineer thích nhồi nhiều logic if-else vào Prompt để cố kiểm soát chính xác từng bước của Agent. Kết quả là Prompt dài và dễ hỏng, chi phí bảo trì cao; khi gặp edge case chưa từng thấy, model vẫn đi lệch.
Hai là over-abstraction. Nếu chỉ viết một câu “bạn phải là một assistant hữu ích”, model không có đủ căn cứ để quyết định, dẫn đến liên tục hỏi người dùng hoặc output lệch xa kỳ vọng nghiệp vụ.
Trạng thái tốt là đủ cụ thể để định hướng behavior, nhưng đủ trừu tượng để bao phủ các thay đổi phổ biến. Blog engineering của Anthropic gọi đây là Goldilocks zone, tức vùng “vừa đủ”.
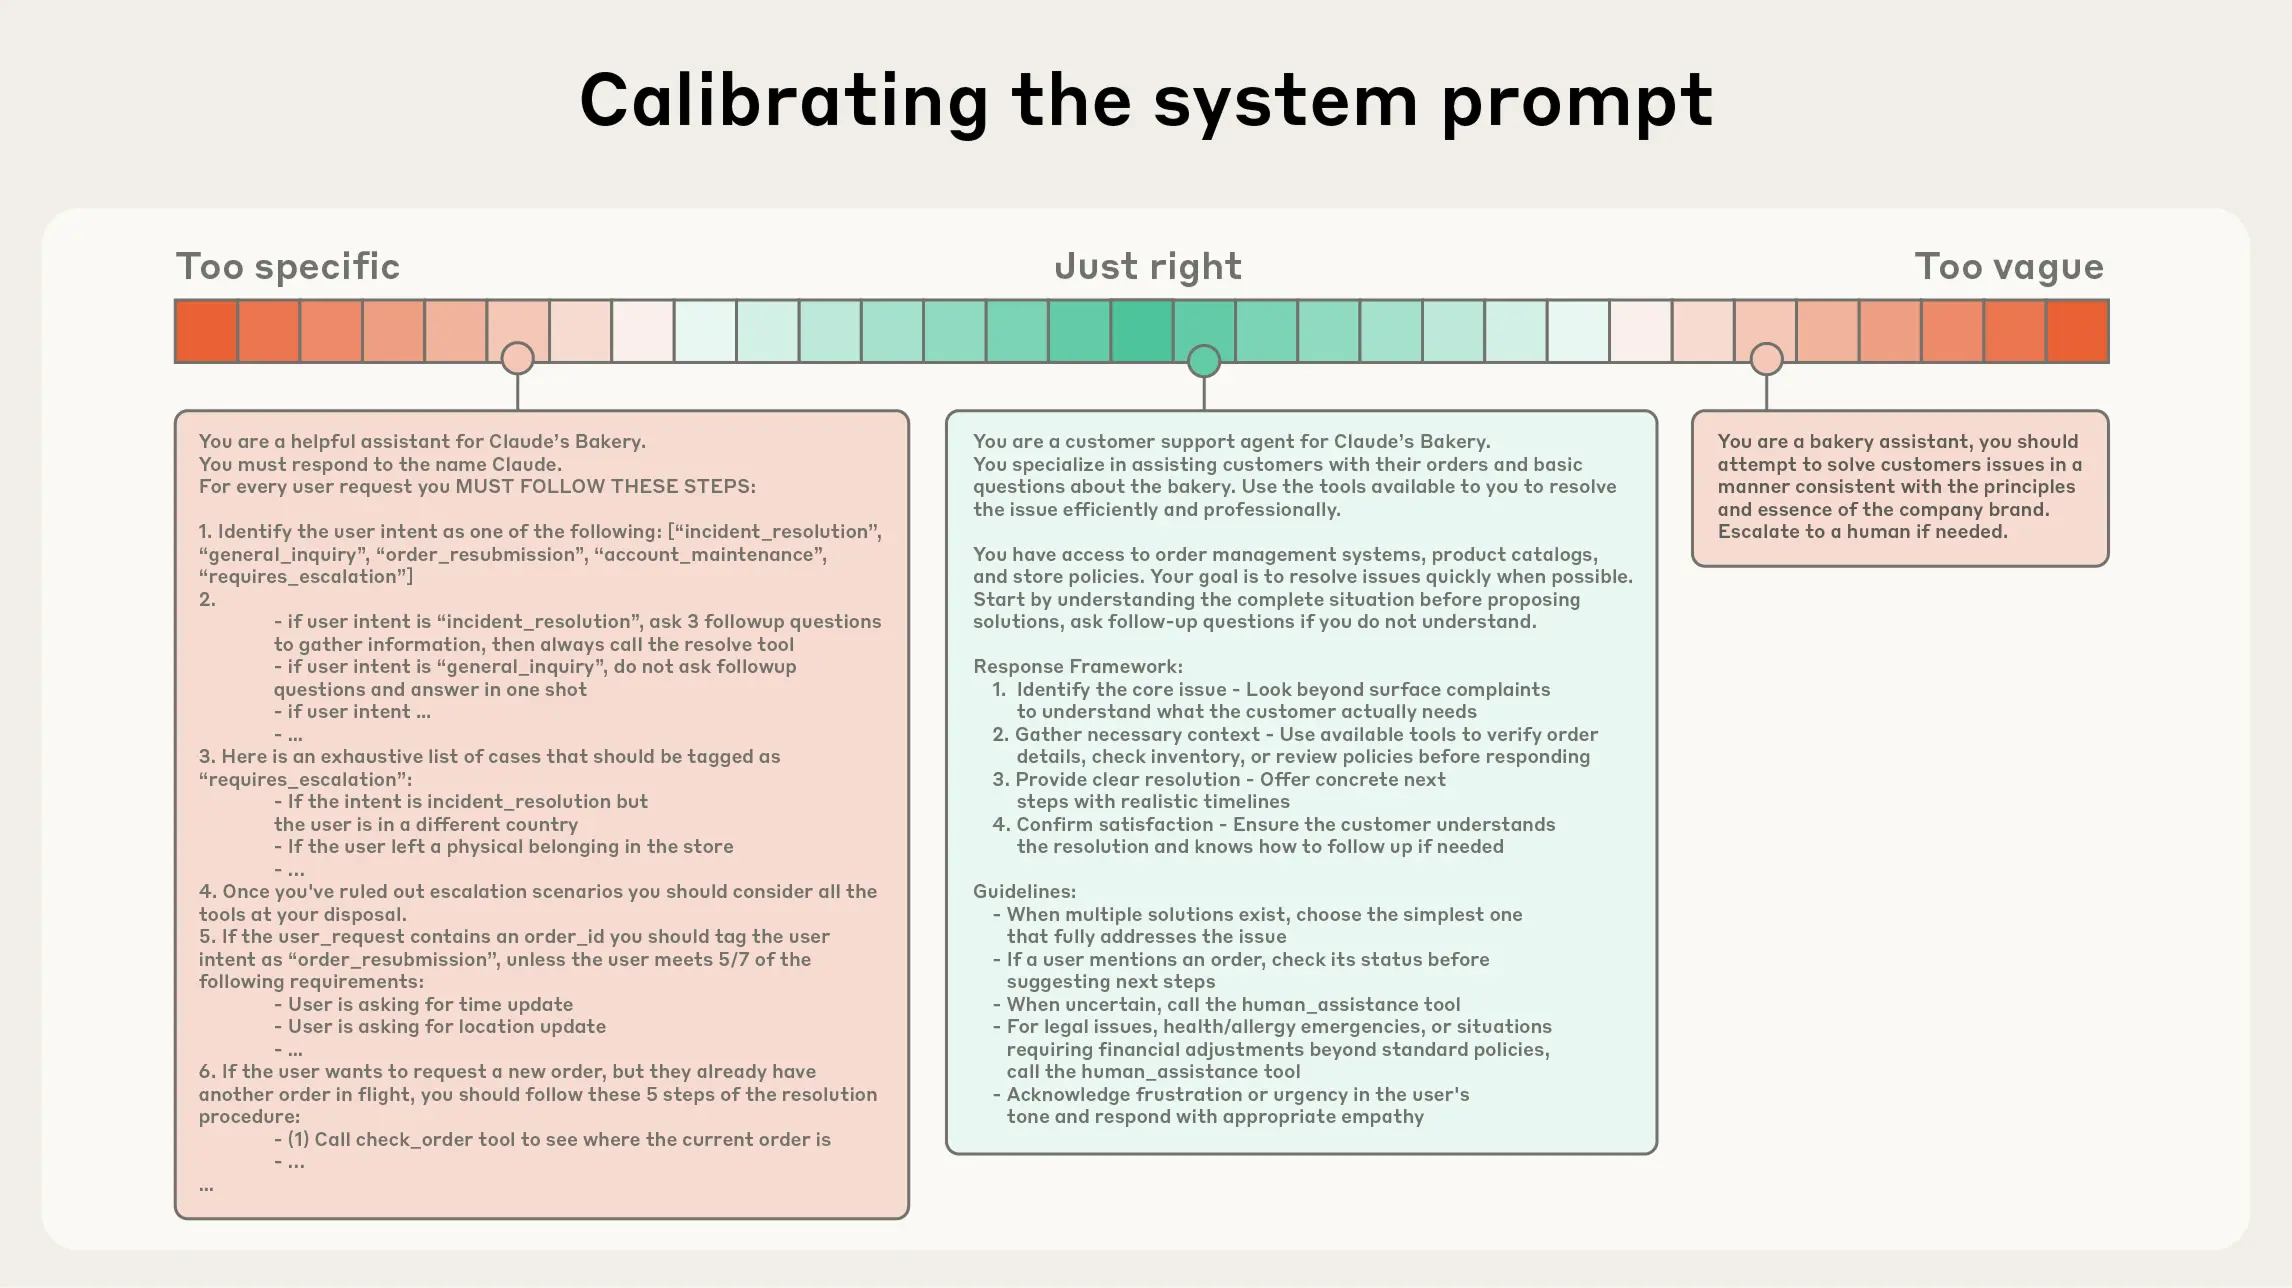
Về thực hành, cách ổn định hơn là dùng Prompt tối thiểu để đo baseline trước, sau đó bổ sung từng rule dựa trên failure case; đừng ngay từ đầu cố liệt kê mọi tình huống. Anthropic gọi đây là Calibrating the system prompt: System Prompt nên là một parameter được điều chỉnh liên tục, không phải configuration document viết xong rồi để đó. Mỗi khi phát hiện một failure case, bổ sung một rule rồi test lại.
Context của tool: nói rõ boundary của tool trước
Viết tool definition tốt hay không quyết định trực tiếp việc Agent có chọn sai tool hay không. Một tool description tốt phải trả lời được hai câu hỏi: khi nào nên gọi và khi nào không nên gọi? Nếu ngay cả engineer cũng không nhìn ra có nên dùng tool này hay không, Agent chắc chắn sẽ mắc lỗi.
Khi một tool đồng thời bao phủ query, modification và approval, Agent phải phân biệt nhiều bộ parameter và side effect trong cùng một Schema, làm tăng xác suất chọn sai path. Tool description cần nêu rõ điều kiện áp dụng và điều kiện cấm; tách operation đơn lẻ và đưa example format vào parameter để boundary gọi có thể được xác định.
Dynamic context: đừng nhồi RAG, memory và tool result vào một lần
Retrieval lúc nào nên thực hiện, pre-retrieval hay tải theo nhu cầu đã được nói ở phần “Runtime context được load thế nào?”. Phần này chỉ nói về cách xử lý sau khi kết quả retrieval đã vào window.
Short-term memory có thể được quản lý bằng sliding window, còn fact dài hạn được retrieval qua external storage. Các Observation như log lỗi API và kết quả trả về từ tool có thể được cắt gọn và summary trước, nhưng thông tin phục vụ troubleshooting nhất định phải giữ reference gốc: traceId, thời gian request, error code, vị trí file log, parameter gọi tool và link đến summary của kết quả gốc đều không được mất. Nếu chỉ giữ câu “API bị lỗi”, việc troubleshooting sau đó sẽ mất mạch; nhưng đưa thẳng dòng log gốc vào cũng dễ làm model bị ngợp.
Sự cố của dynamic context thường xuất hiện do kết quả retrieval sai, memory hết hạn, tool timeout hoặc summary bỏ sót evidence. Bảng sau liệt kê các đường lùi tương ứng:
| Failure path | Biểu hiện điển hình | Fallback |
|---|---|---|
| RAG không có kết quả | Không tìm thấy document liên quan hoặc các đoạn được recall quá rời rạc | Hạ cấp về keyword retrieval; khi cần, để Agent hỏi người dùng để làm rõ phần thiếu |
| Tool timeout | External API bị treo, Agent liên tục chờ | Đặt timeout, giới hạn retry và circuit breaker; dành sẵn human takeover cho flow quan trọng |
| Summary làm mất thông tin | Sau compression thiếu exception stack, version hoặc boundary value | Giữ traceId, vị trí evidence gốc, field quan trọng và link có thể tra cứu lại |
| Memory bị nhiễm | Preference cũ hoặc state cũ bị xem là fact hiện tại | Validate trước khi ghi; đánh dấu source, thời gian và độ tin cậy sau khi đọc |
| Xung đột nhiều tool | Hai tool đều làm được, Agent chọn sai path | Dùng priority, state machine và mức side effect để giới hạn thứ tự gọi |
Context example: đừng xếp quá nhiều Few-shot example
Few-shot example nên bao phủ các scenario tiêu chuẩn khác nhau. Giữ 3 đến 5 canonical example đại diện cho khác biệt về strategy thường hiệu quả hơn việc nhồi hàng chục edge case vào Prompt; example cần cho thấy strategy nên dùng khi gặp một nhóm input, không chỉ trình diễn input và output bề mặt.
Token budget: sắp xếp priority trong một lần gọi
Phần này bàn về priority của nội dung trong một lần gọi; history xuyên window do Compaction xử lý ở phần trước. Khi window gần đầy, hai tầng strategy cần đồng thời có hiệu lực.
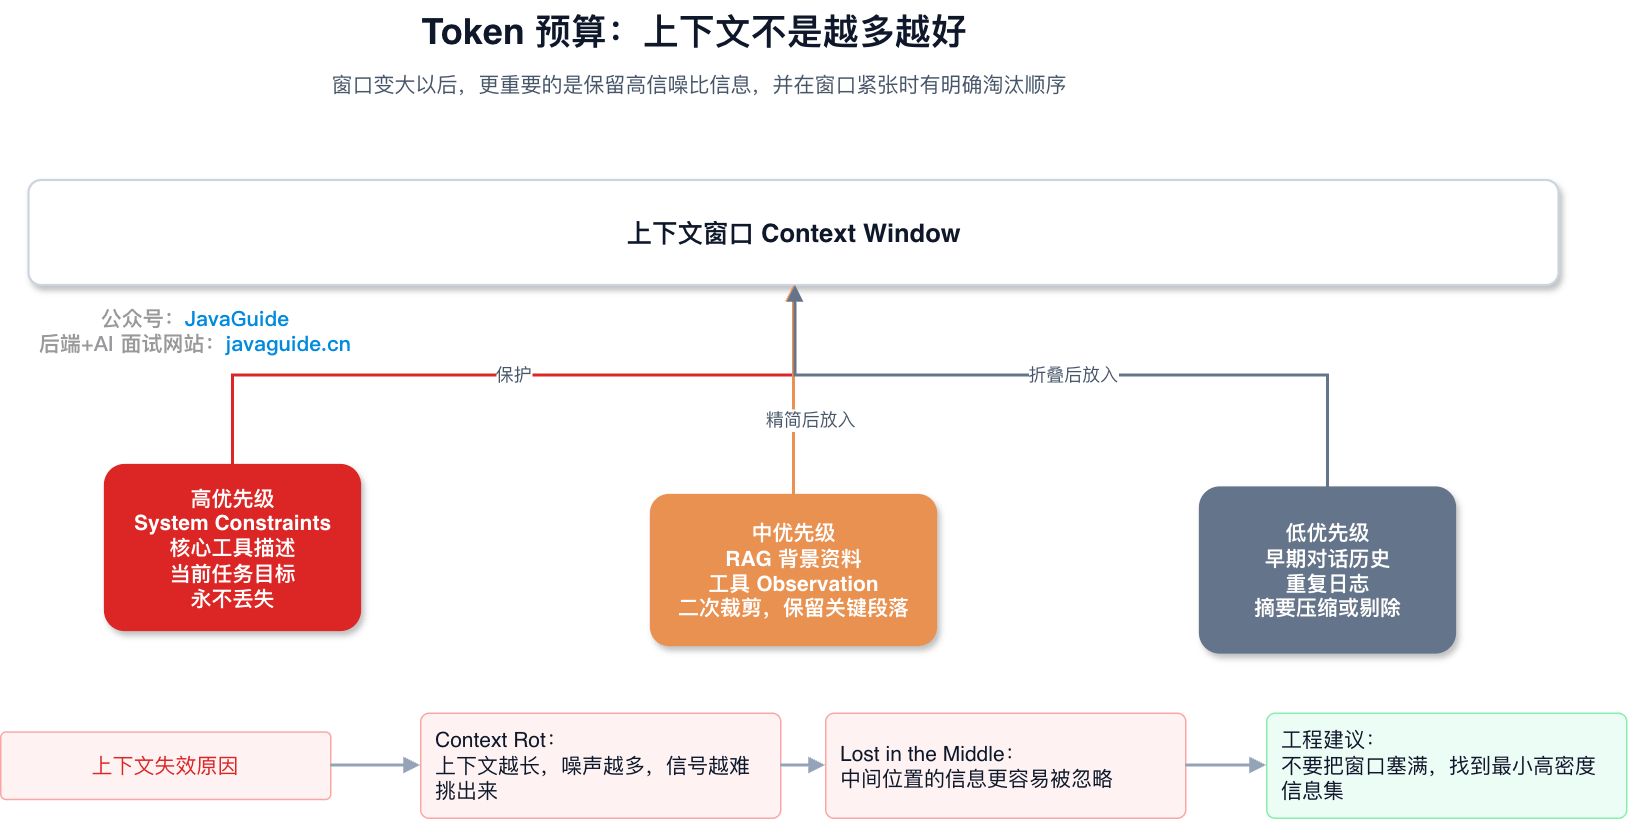
| Priority | Nội dung | Cách xử lý |
|---|---|---|
| Low priority (có thể gấp lại) | History hội thoại cũ | AI summary compression |
| Medium priority (có thể rút gọn) | Tài liệu bối cảnh từ RAG retrieval, tool result cũ | Cắt gọn lần hai, giữ đoạn cốt lõi và reference có thể tra cứu lại |
| High priority (vùng cố định) | System Constraints, goal của tác vụ hiện tại, security boundary | Đặt trong vùng high priority cố định để bảo đảm tính nhất quán logic |
| Priority theo giai đoạn | Tool description, Schema và một lượng nhỏ example quan trọng cần ở giai đoạn hiện tại | Load theo stage của tác vụ; sau khi unload phải bảo đảm có thể discover lại |
Khi concurrency lớn, có thể kết hợp Prompt / Context Caching. Model hỗ trợ cache có thể dùng System Prompt ổn định và tool description làm cache prefix để giảm phí lặp hoặc giảm latency đến Token đầu tiên; hit rate thực tế vẫn phụ thuộc vào implementation của vendor, thay đổi prefix và vòng đời cache, nên cần xác minh theo tải nghiệp vụ.
Những tool nào được dùng trong Context Engineering?
Orchestration, retrieval, vector database, tool integration và memory layer giải quyết các vấn đề khác nhau; chỉ thêm phần cần cho flow hiện tại.
- LangChain và LangGraph phụ trách control flow, state management và loop scheduling; tool call và node fallback thường được tổ chức ở tầng này.
- LlamaIndex thiên về data ingestion, index generation và retrieval optimization của RAG, phù hợp với scenario mà document ingestion và retrieval là flow chính.
- Pinecone, Weaviate, Chroma và Qdrant cung cấp Embedding storage và semantic search. Project nhỏ có thể bắt đầu bằng Chroma local, rồi đánh giá Qdrant, Milvus hoặc Pinecone theo quy mô.
- MCP quy định cách tool được tích hợp chuẩn hóa vào host program. Revision hiện tại
2025-11-25dựa trên JSON-RPC 2.0, phân biệt Host, Client và Server, đồng thời expose các capability như Resources, Prompts và Tools thông qua Server Features. - Mem0, LETTA (trước đây là MemGPT) và ZEP hướng đến memory layer của Agent, thường bọc thêm việc quản lý lifecycle như ghi, retrieval và quên memory trên vector database.
Tool tích hợp qua MCP cũng là entry point của side effect. Cần phân biệt quyền hạn, điều kiện gọi và boundary audit khi đọc file, query database, gửi request hoặc sửa configuration; nếu không sẽ khó định vị và replay sự cố.
Khi triển khai, hãy ghi lại context của từng lượt
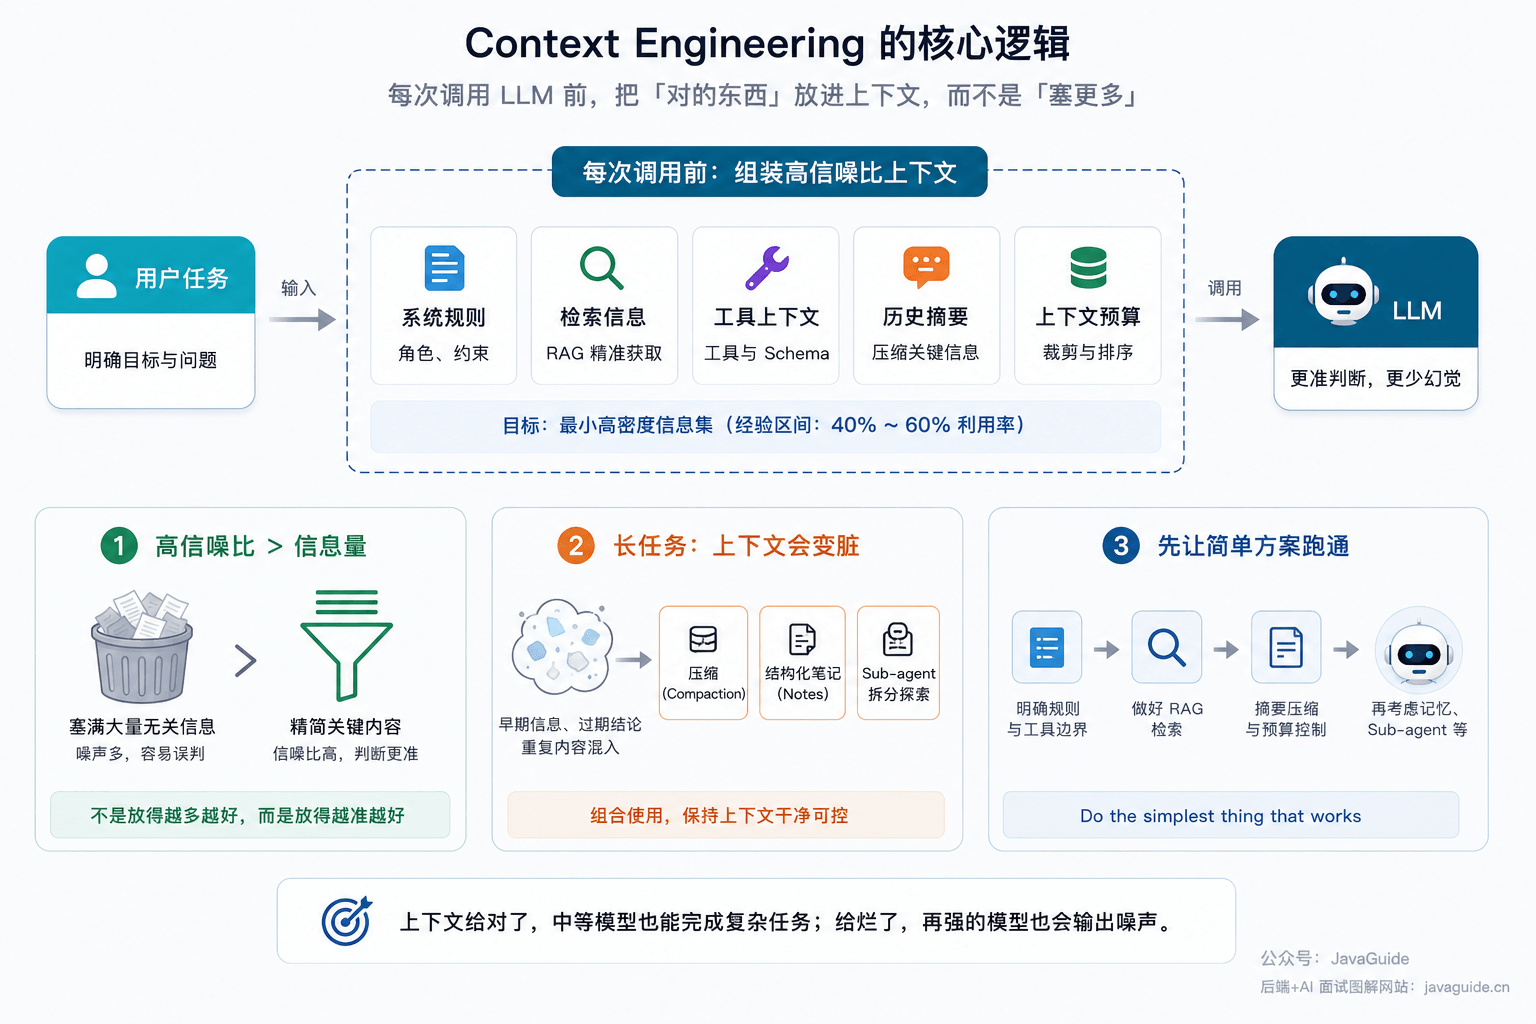
Khi đánh giá Context Engineering, trước hết hãy ghi lại message thực tế đi vào window ở mỗi lượt. Chỉ khi strategy retrieval, cách summary hoặc thứ tự gắn tool Schema thay đổi, bạn mới có thể so sánh success rate, chi phí Token và chất lượng tool call với baseline.
Signal-to-noise ratio cao quan trọng hơn lượng thông tin
Dex Horthy từng đề cập khoảng kinh nghiệm 40% đến 60% về tỷ lệ sử dụng context, nhưng đây không phải threshold chung. Hãy tìm tập thông tin tối thiểu cần cho quyết định từ trajectory thực tế: giữ constraint và evidence, loại bỏ bối cảnh không liên quan.
Tác vụ dài cần chủ động dọn state hết hạn
Khi tác vụ dài liên tục thêm message, phán đoán ban đầu, vấn đề đã giải quyết và tool result trùng lặp đều vẫn nằm trong history. Compaction xử lý compression message, structured note lưu state có thể khôi phục, còn Sub-agent cô lập tác vụ chuyên biệt; có kết hợp chúng hay không phụ thuộc vào độ dài tác vụ và failure mode đã quan sát. Khi tác vụ ngắn chưa xuất hiện context phình to, không cần thêm memory layer phức tạp.
Chạy phương án đơn giản nhất trước
Anthropic nhiều lần nhấn mạnh một câu: do the simplest thing that works.
Nếu baseline chưa chạy ổn mà đã thêm memory phân tầng, retrieval phức tạp và quản lý state dài hạn, khi thất bại sẽ rất khó phân biệt vấn đề đến từ retrieval, summary, tool description hay lựa chọn model; các component cũng kéo dài flow troubleshooting.
Có thể cố định System Prompt và boundary của tool trước, sau đó xác minh RAG retrieval, rồi thêm summary compression và context budget. Khi tác vụ dài xuất hiện bottleneck rõ ràng, mới đánh giá memory layer, Sub-agent hoặc runtime retrieval phức tạp hơn.
Bắt đầu từ baseline có thể replay
Trước hết cố định instruction priority cao và tool definition, lưu message thực tế gửi trong mỗi lần gọi, tool Schema, lượng Token đã dùng và kết quả retrieval, sau đó dùng một nhóm tác vụ thực tế để xây dựng baseline. Về sau mỗi lần chỉ điều chỉnh một variable, chẳng hạn strategy retrieval, cách summary hoặc thứ tự gắn tool.
Long context, Prompt Caching, structured output và MCP sẽ thay đổi theo model, API, SDK và version của client. Tài liệu thiết kế nên ghi model ID, version API và ngày kiểm tra, tránh xem chi tiết implementation của một client là quy luật chung. Chỉ sau khi trajectory baseline cho thấy thông tin hết hạn, budget không đủ hoặc mất state xuyên window, mới thêm RAG, Compaction, cache hoặc persistent memory.
Tổng kết
Các static rule, goal hiện tại, evidence được retrieval, tool có thể dùng, state history và Token budget giao cho model ở mỗi lần gọi đều cần được tổ chức theo priority. Window lớn hơn không tự động cải thiện phán đoán; history không liên quan, tool result trùng lặp và state lỗi thời vẫn gây nhiễu cho quyết định.
Trước hết hãy lưu trajectory gọi thực tế và xây dựng baseline có thể replay, sau đó lần lượt điều chỉnh retrieval, tool description, summary hoặc strategy cắt gọn. Chỉ khi baseline cho thấy vấn đề như tác vụ dài, thông tin hết hạn hoặc window không đủ mới thêm memory phân tầng, Compaction, cache hoặc Sub-agent, để tránh quá nhiều component che lấp nguồn gốc sự cố.
Tài liệu tham khảo
- Effective context engineering for AI agents - Anthropic
- OpenAI API Models Compare
- Claude API Models Overview
- DeepSeek V4 Preview Release
- MCP 2025-11-25 Specification
- Context Rot: How Increasing Input Tokens Impacts LLM Performance
- Lost in the Middle: How Language Models Use Long Contexts
- Context Engineering: The New Frontier of AI Development
- The New Skill in AI is Not Prompting, It Is Context Engineering
- Context Engineering by Simon Willison
- 12 Factor Agents - Own Your Context Window