
Dự án thực chiến LLM + dự án thực chiến Agent: nền tảng phỏng vấn Spring AI và knowledge base RAG
Nhiều backend developer đều gặp cùng một vấn đề khi chuẩn bị project trong CV: project chỉ toàn thêm sửa xoá (CRUD), tech stack trông có vẻ phong phú nhưng interviewer rất khó đào sâu tiếp, đồng thời cũng khó thể hiện hiểu biết của bạn về những hướng mới như phát triển ứng dụng LLM, knowledge base RAG, triển khai Agent.
Bài viết này giới thiệu một dự án thực chiến LLM + dự án thực chiến Agent dành cho Java backend: xây dựng nền tảng hỗ trợ phỏng vấn AI dựa trên Spring Boot 4.0, Java 21, Spring AI 2.0, kết nối các năng lực như phân tích CV, phỏng vấn mô phỏng AI, hỏi đáp knowledge base RAG, phỏng vấn bằng giọng nói, xử lý task bất đồng bộ và rate limiting phân tán thành một project hoàn chỉnh.
Nếu bạn muốn tìm một project có thể ghi vào CV, dùng để trình bày trong phỏng vấn, đồng thời học có hệ thống về thực chiến Spring AI và RAG/Agent, project này phù hợp với bạn hơn một CRUD project chỉ chất đống các bảng nghiệp vụ.
Giới thiệu project
Đây là một nền tảng hỗ trợ phỏng vấn AI dựa trên Spring Boot 4.0 + Java 21 + Spring AI 2.0. Hệ thống cung cấp ba chức năng cốt lõi:
- Phân tích CV thông minh: Sau khi tải CV lên, AI tự động chấm điểm theo nhiều chiều và đưa ra đề xuất cải thiện
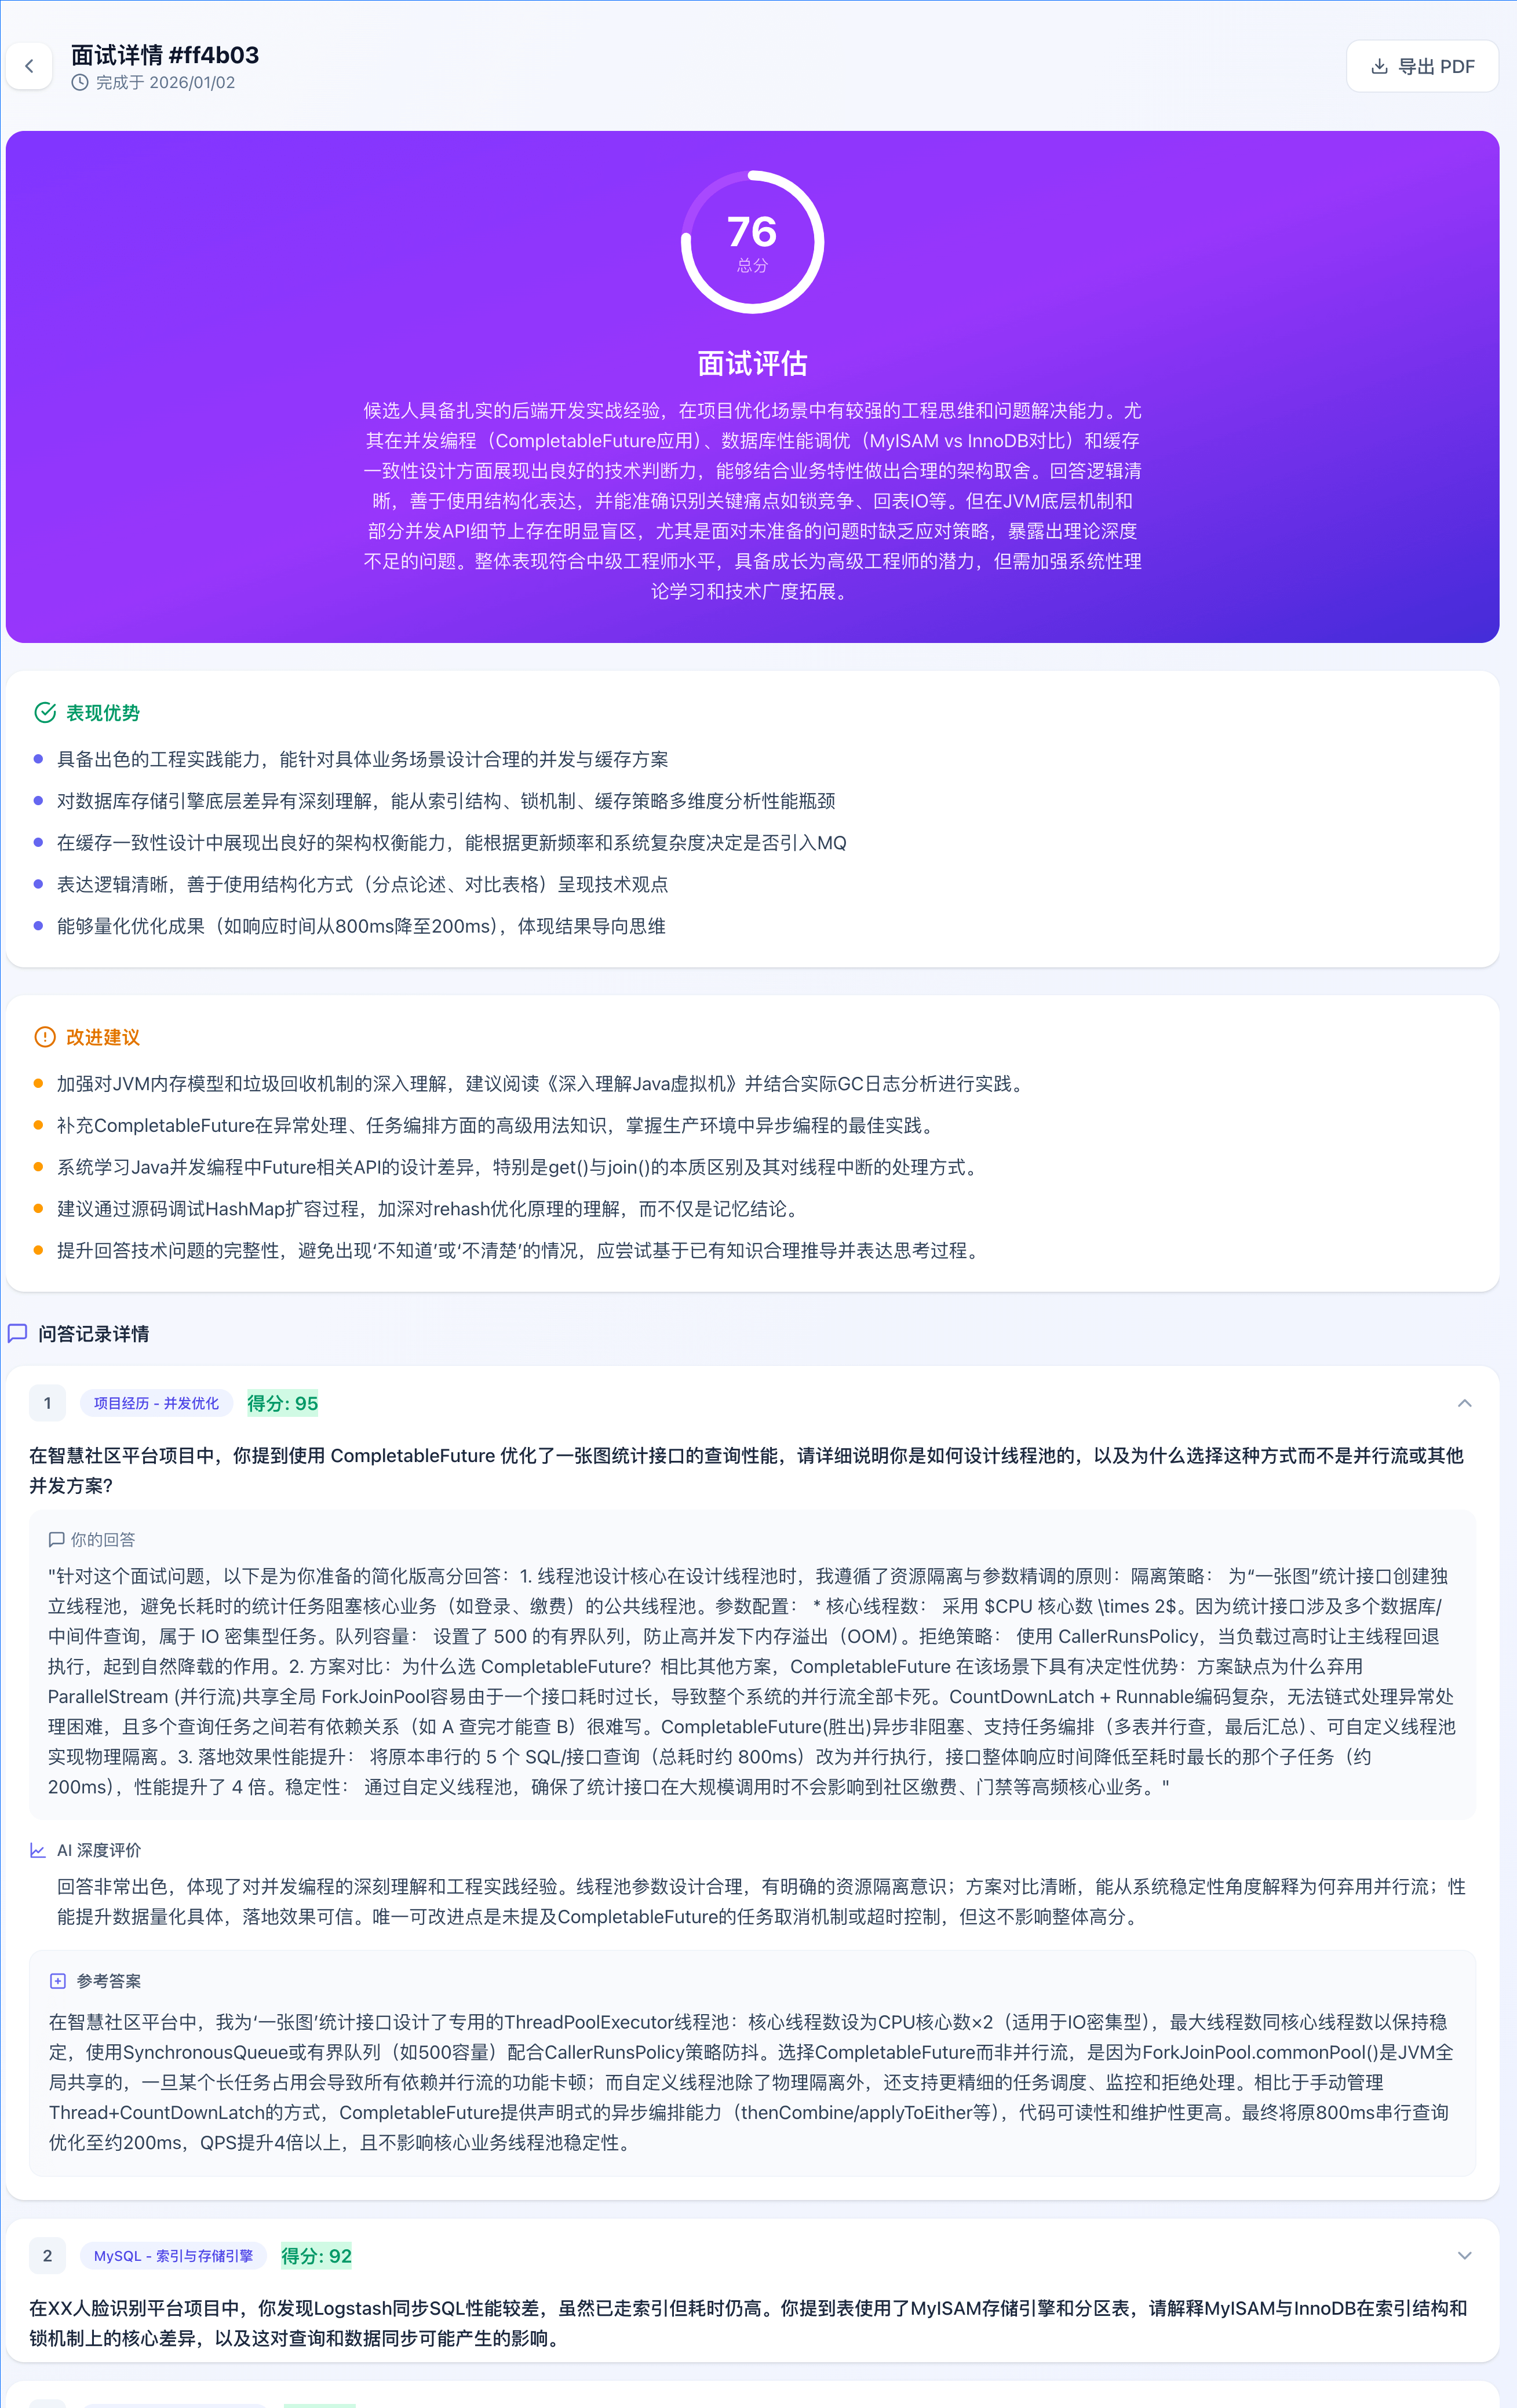
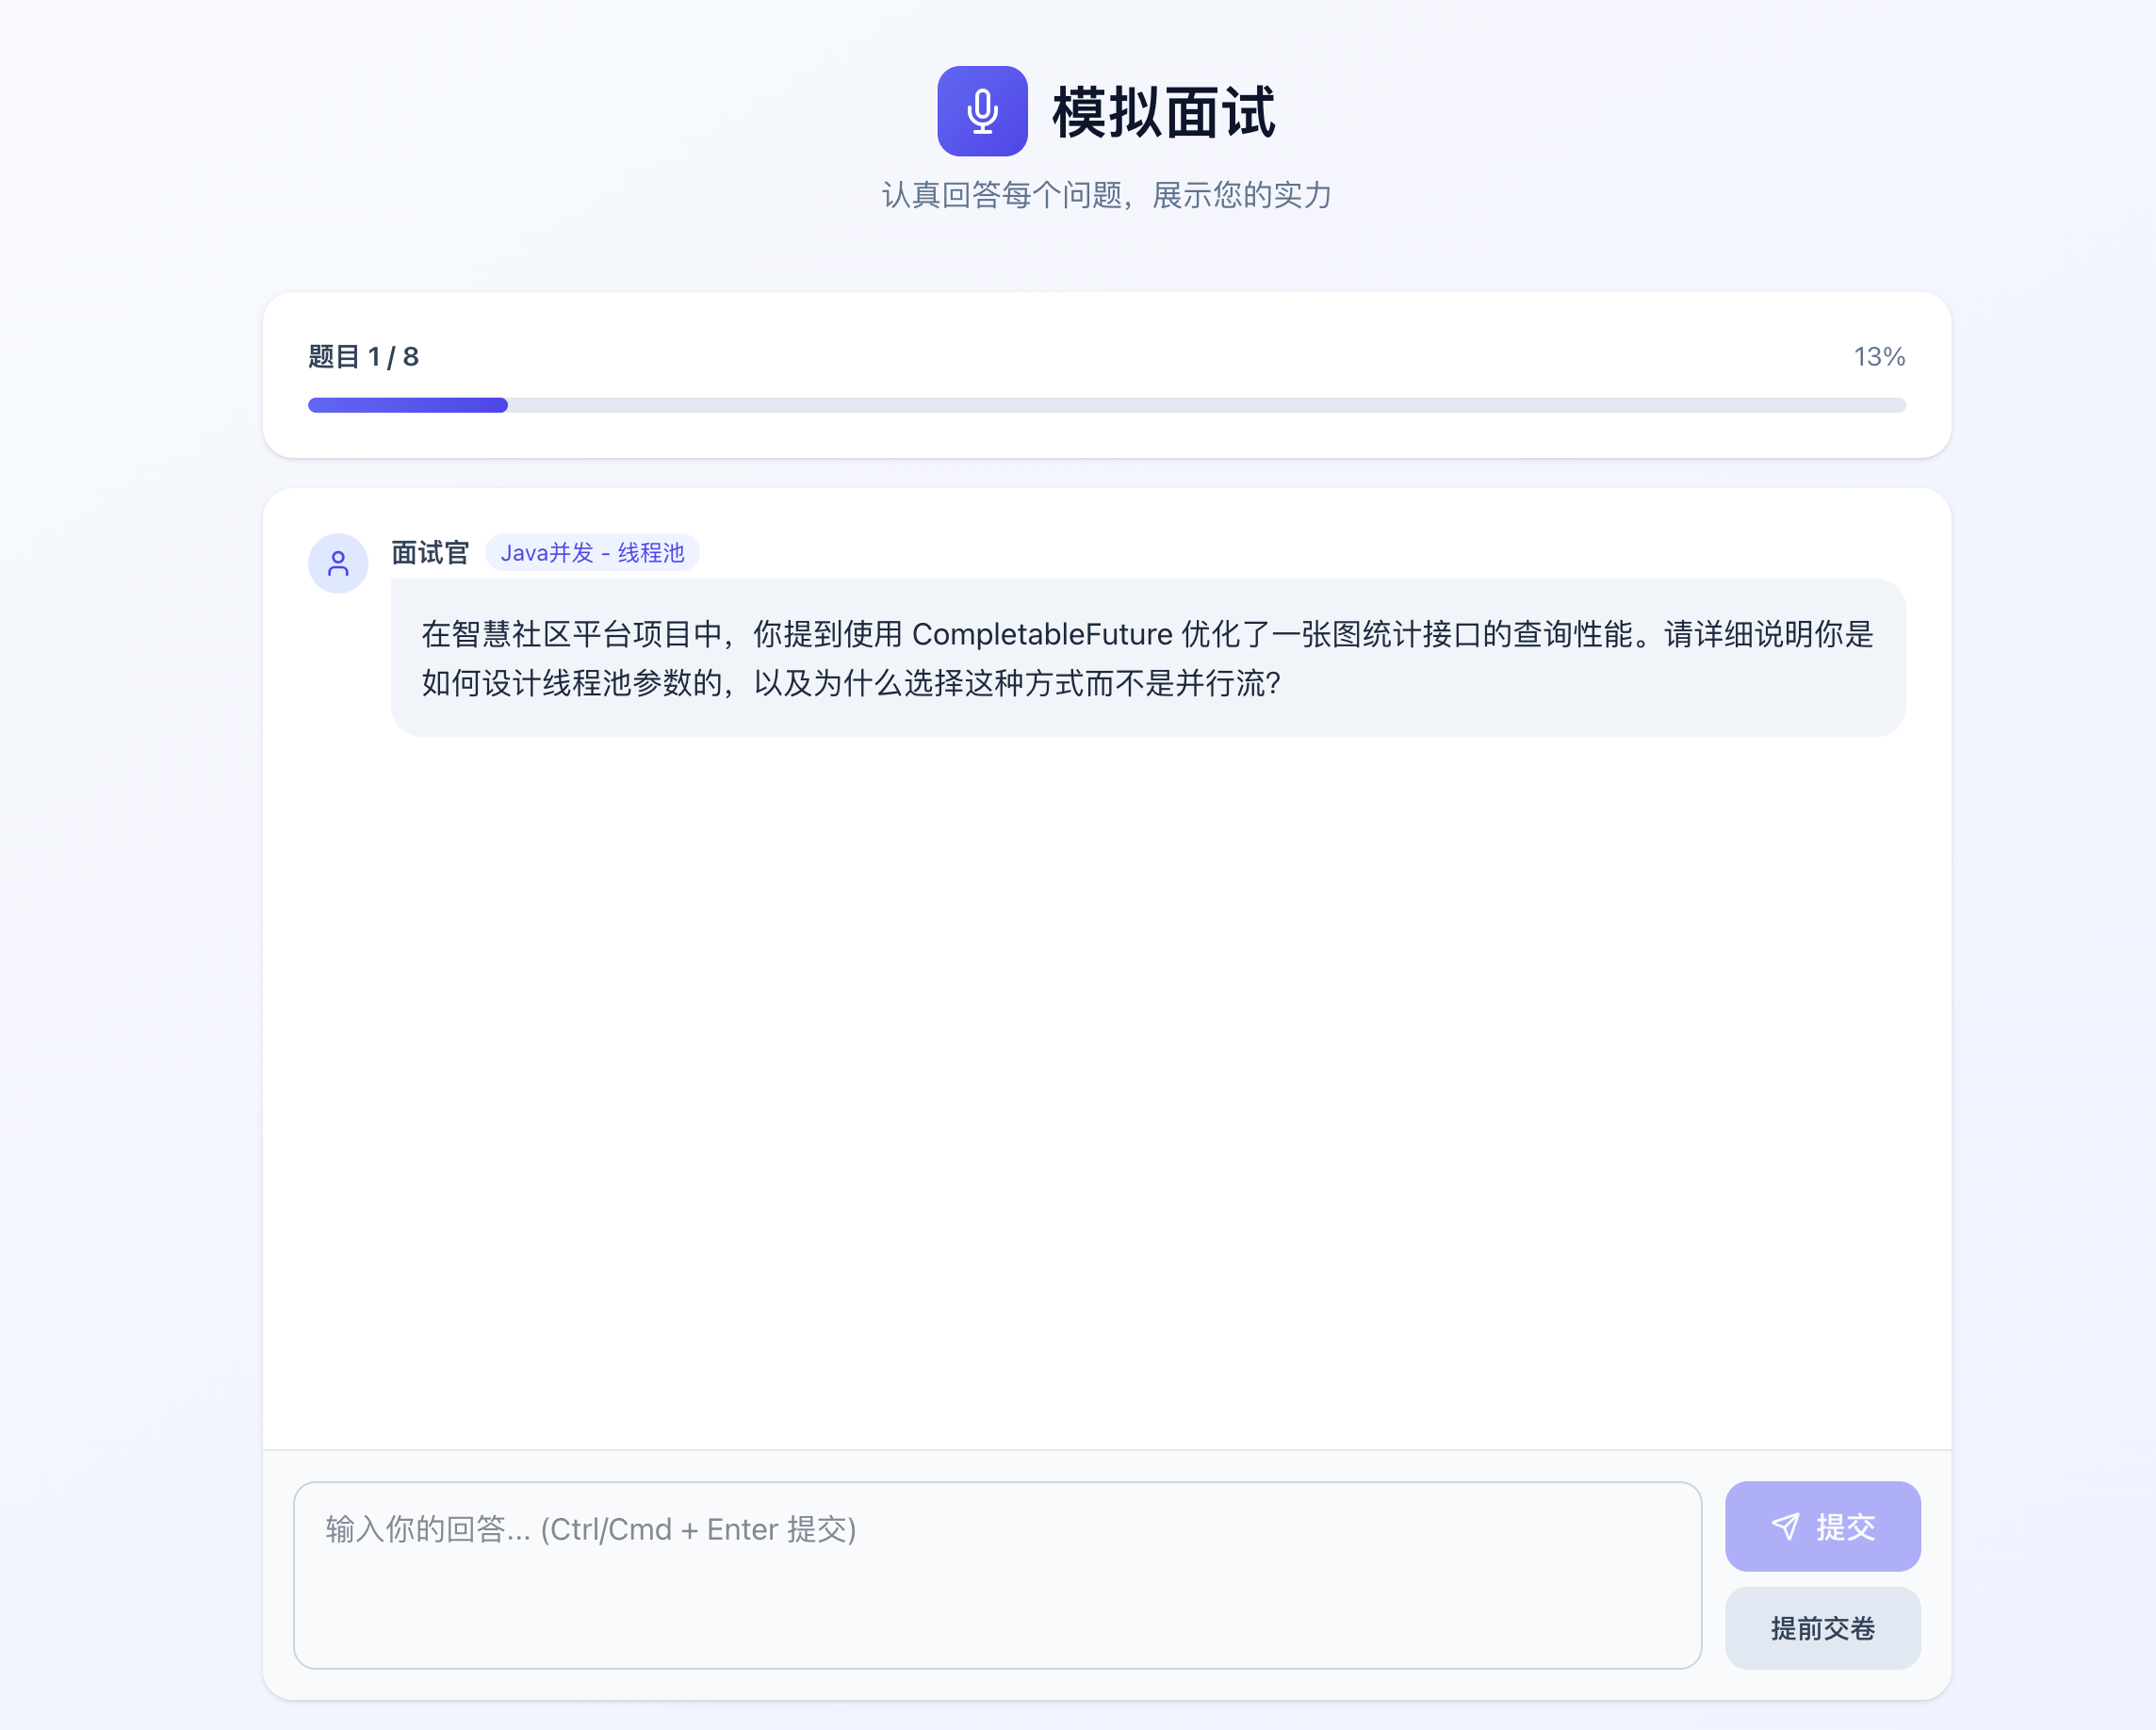
- Hệ thống phỏng vấn mô phỏng: Tạo câu hỏi phỏng vấn được cá nhân hoá dựa trên nội dung CV, hỗ trợ hỏi đáp real-time và đánh giá câu trả lời
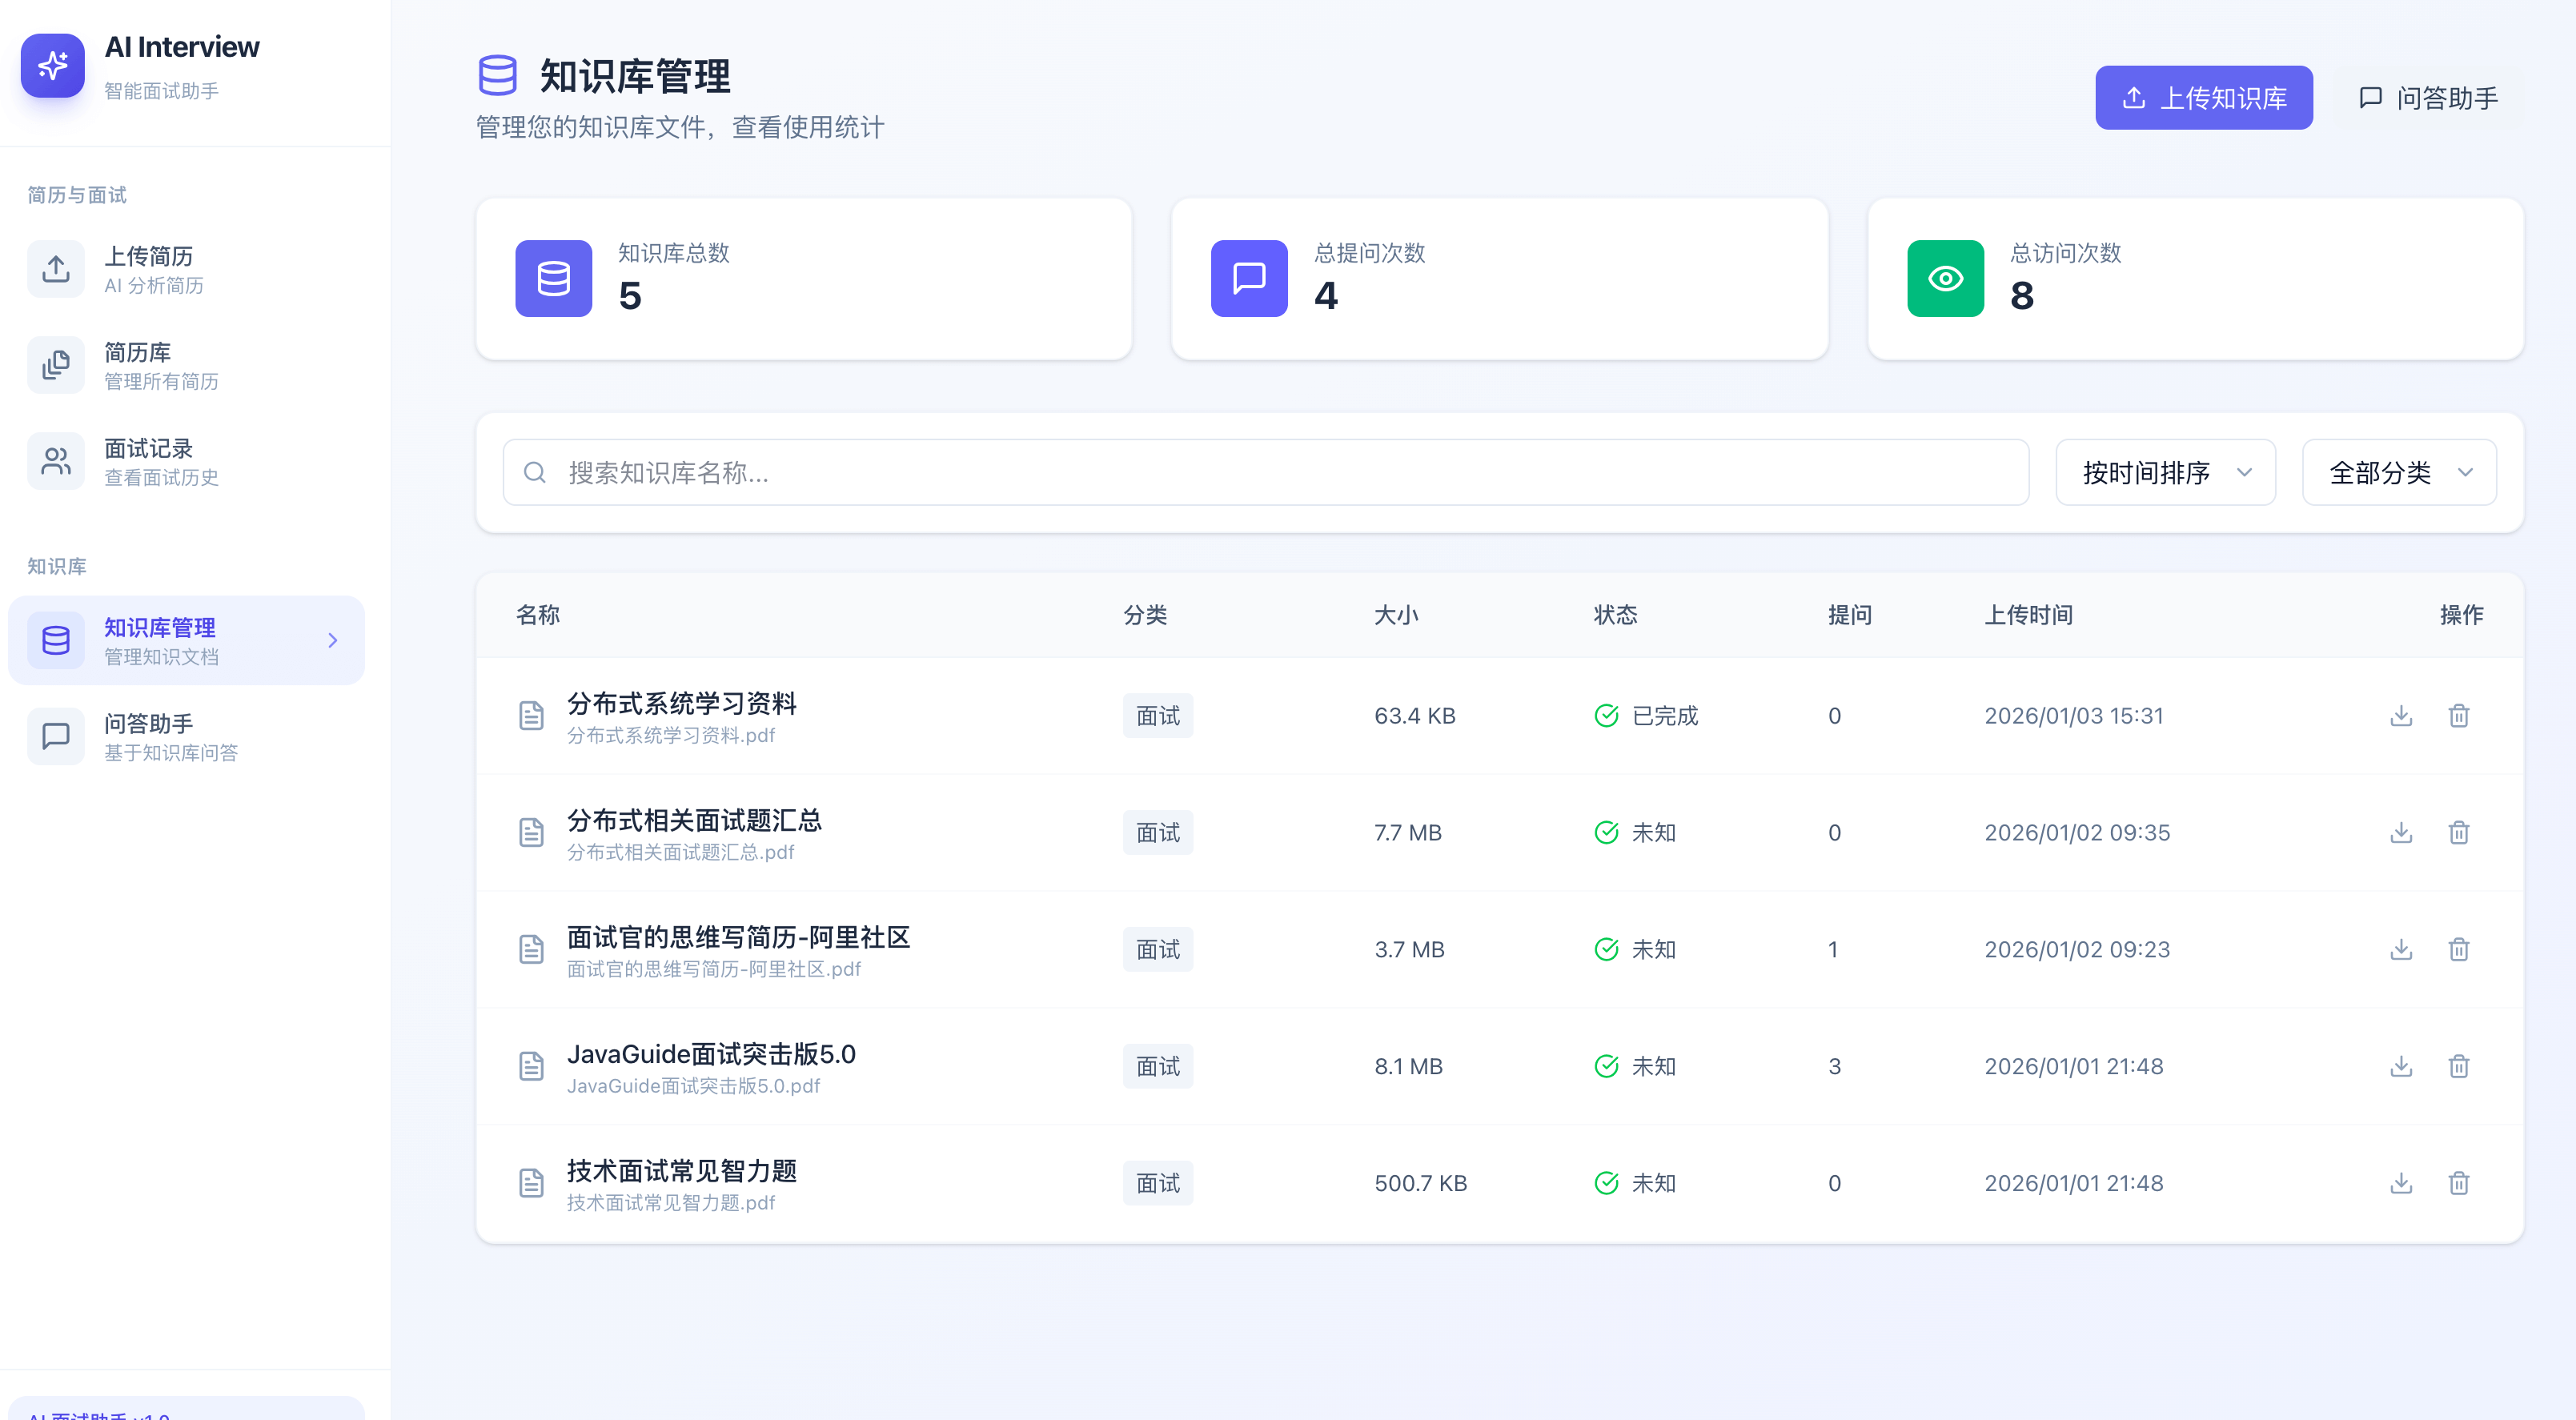
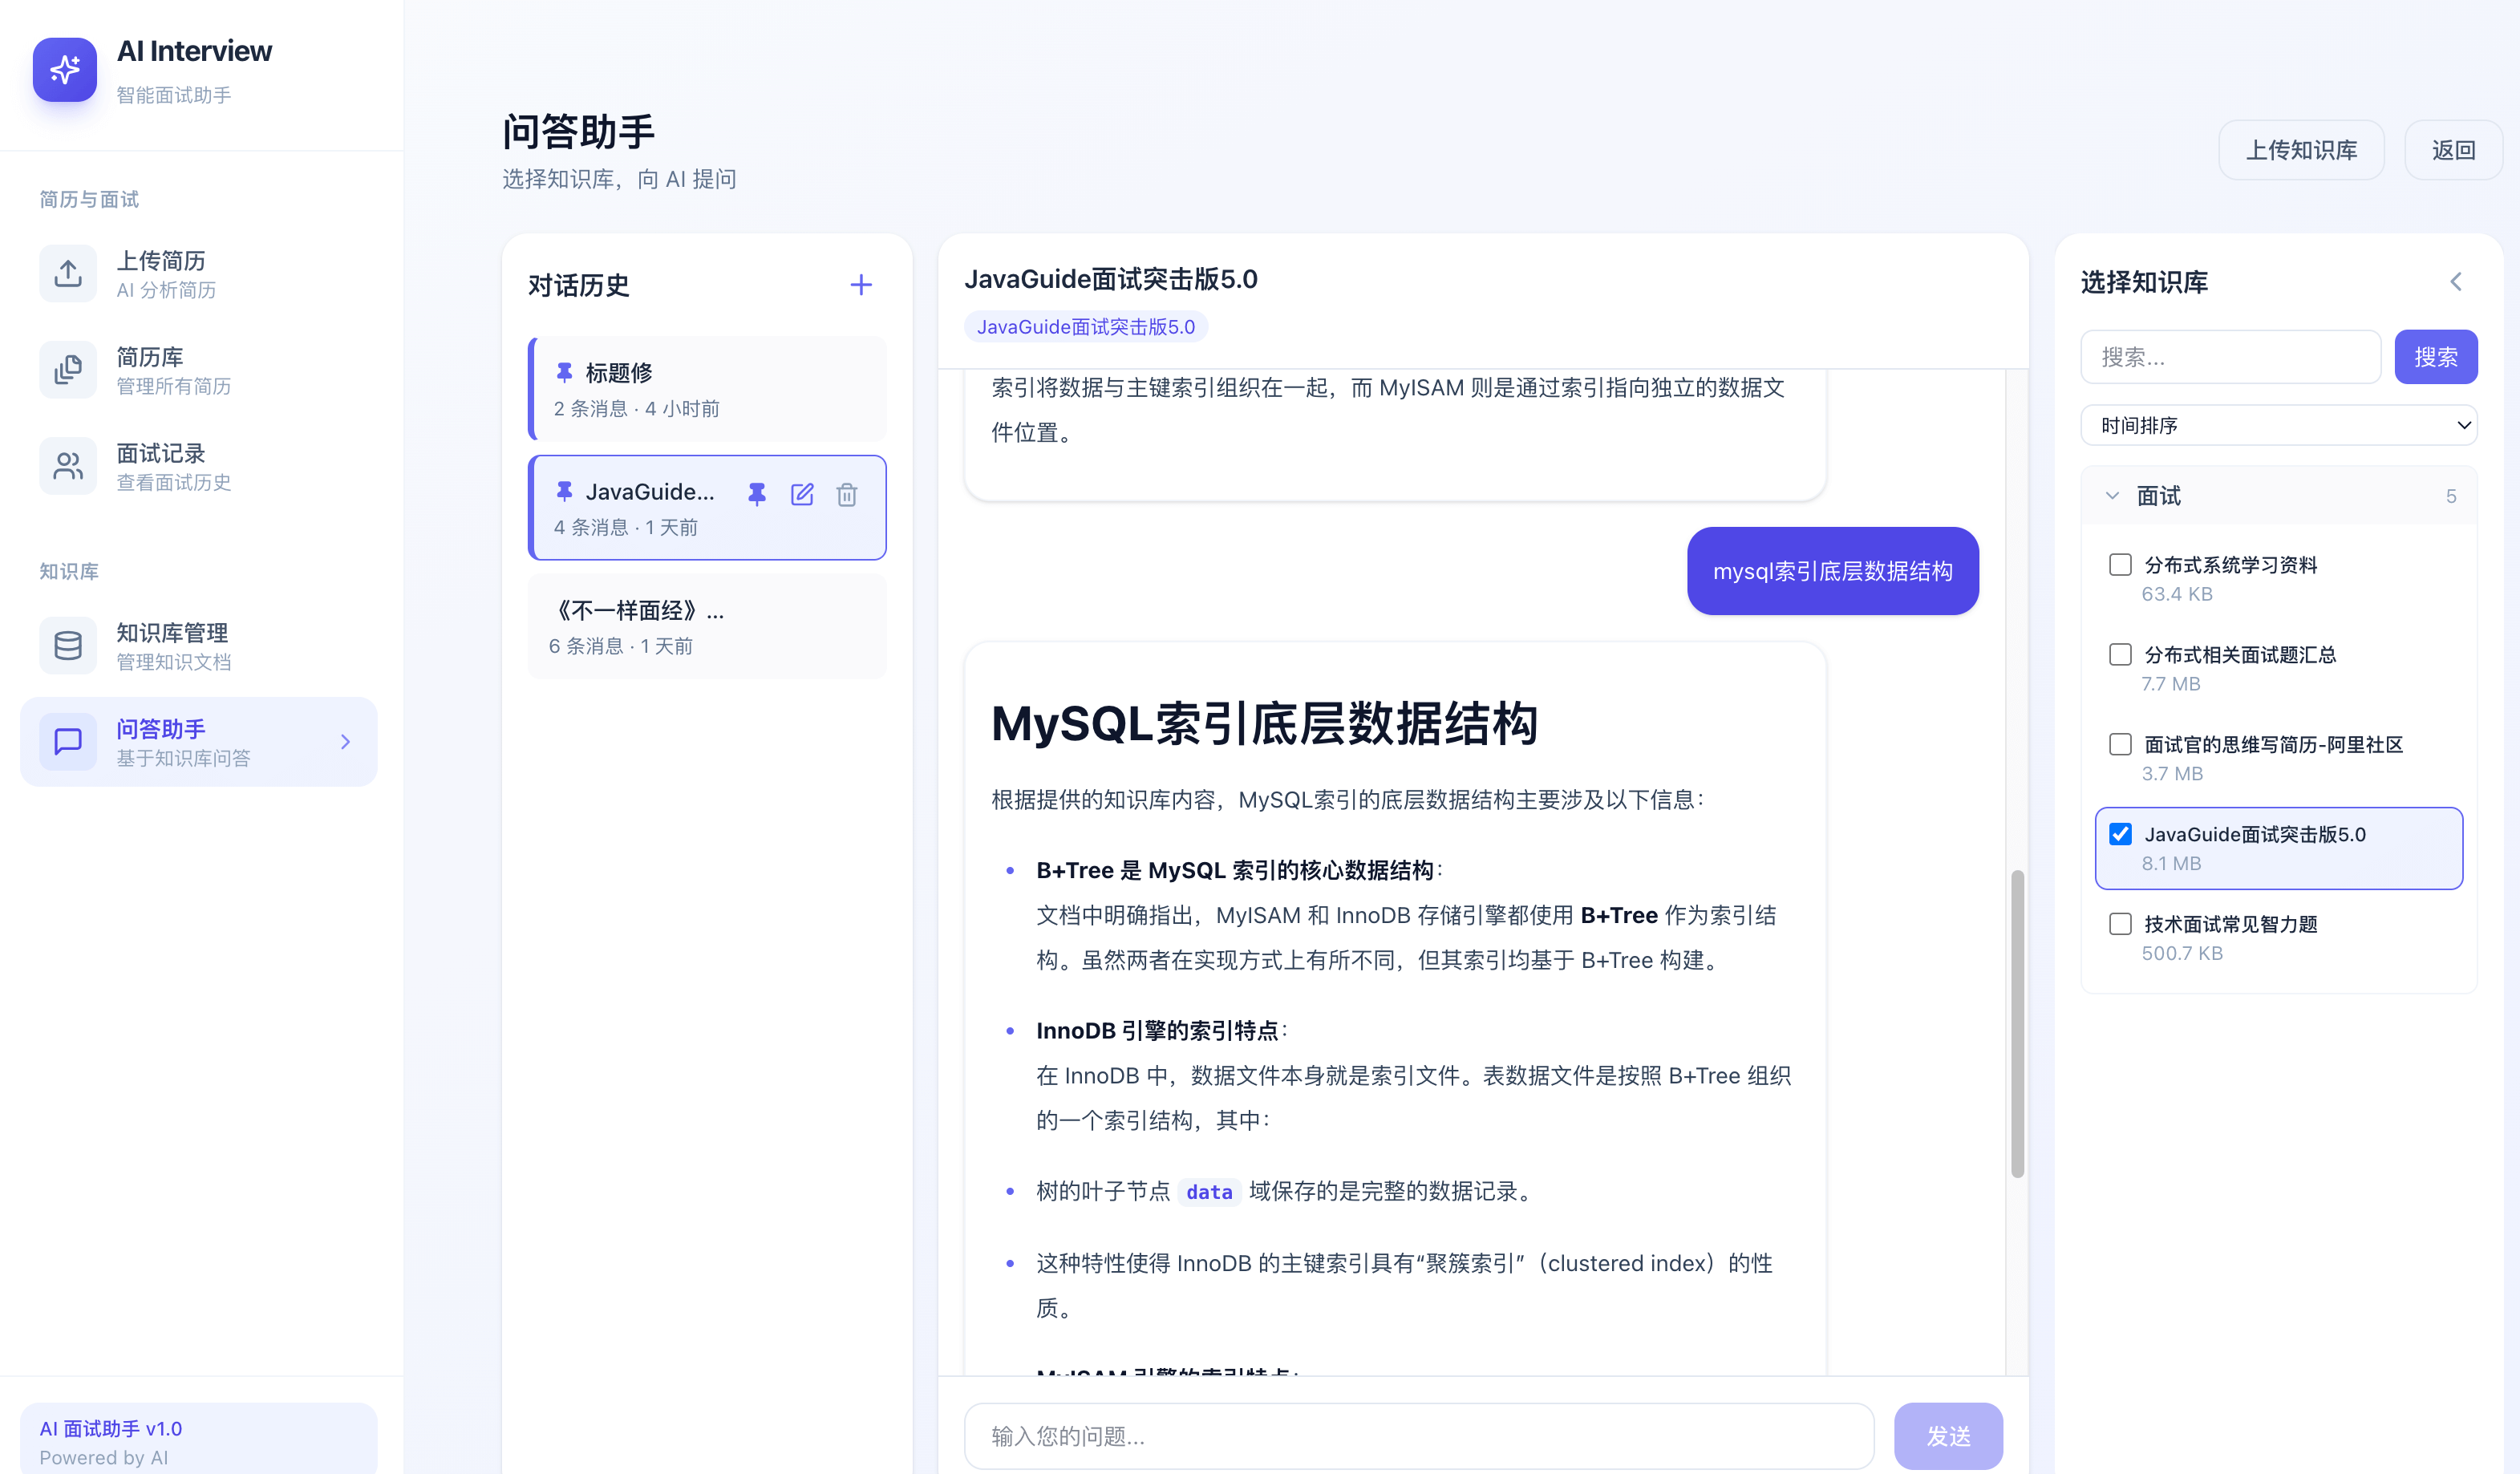
- Hỏi đáp knowledge base RAG: Tải tài liệu kỹ thuật lên để xây dựng knowledge base riêng, hỗ trợ hỏi đáp thông minh có tăng cường bằng vector search
Địa chỉ project (hoan nghênh star để động viên):
- Github: https://github.com/Snailclimb/interview-guide
- Gitee: https://gitee.com/SnailClimb/interview-guide
Toàn bộ source code được open source miễn phí, không có bản Pro hay bản trả phí!
Cách viết CV
Làm thế nào đưa project thực chiến 《nền tảng phỏng vấn AI SpringAI + knowledge base RAG》 vào CV? Tôi cung cấp tổng cộng năm phiên bản theo các hướng để lựa chọn, khớp chính xác với yêu cầu vị trí:
- Hướng backend: Cung cấp ba phiên bản nhấn mạnh “kiến trúc và năng lực phân tán”, “ứng dụng AI và reactive programming”, “engineering và infrastructure”. Dù bạn phỏng vấn vị trí backend, ứng dụng LLM hay kiến trúc, bạn đều có thể tìm được điểm bắt đầu phù hợp nhất.
- Hướng testing/test development: Thiết kế riêng hai phiên bản “unit test và TDD” cùng “bao phủ functional/error scenario”, làm nổi bật năng lực cạnh tranh cốt lõi của test engineer trong việc đảm bảo chất lượng AI.
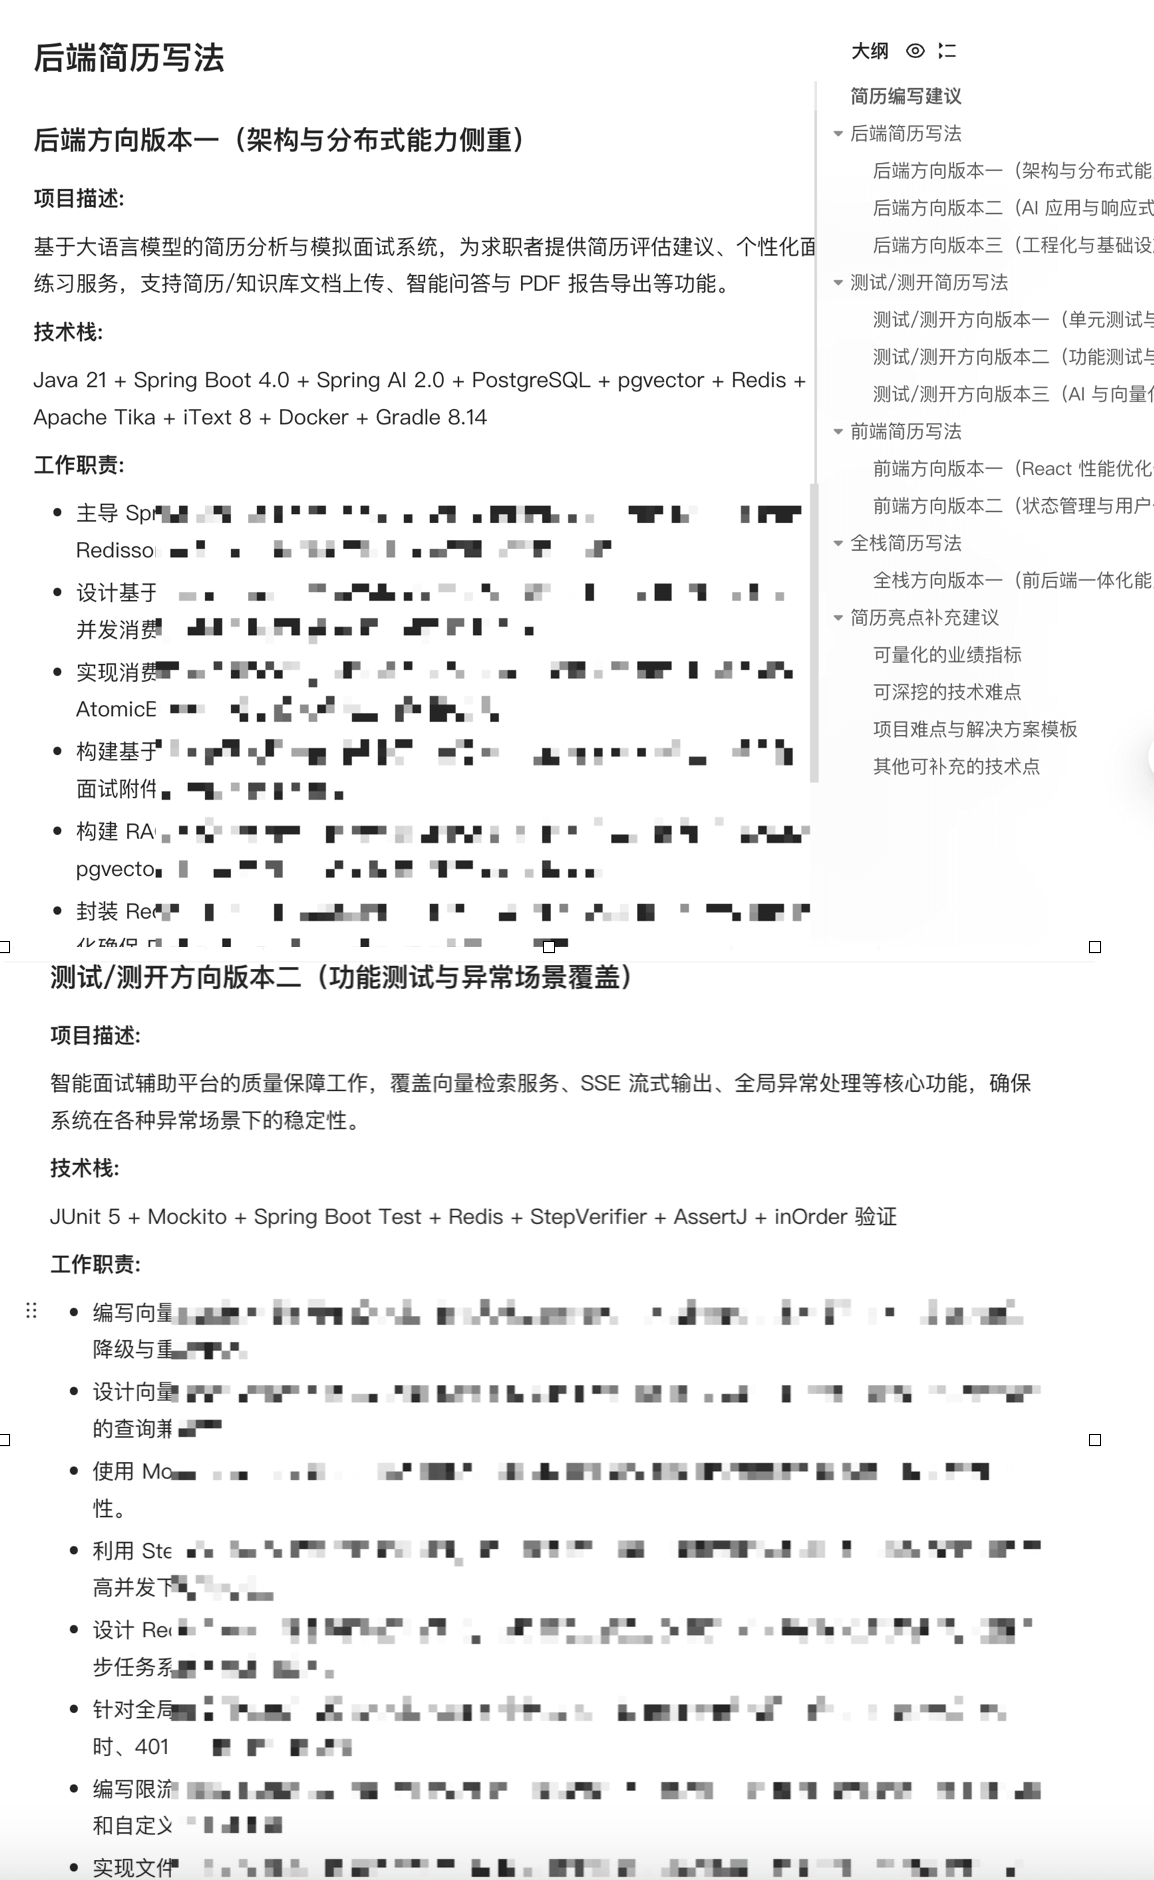
Mỗi mô tả đều bám sát logic thực tế của project và tuân thủ nghiêm ngặt quy chuẩn giới thiệu project. Không chỉ hướng dẫn cách viết, bài viết còn hướng dẫn cách bổ sung, chẳng hạn đưa ra đề xuất cho phần “user authentication và authorization” chưa có trong project này, đồng thời hướng dẫn cách đóng gói các giải pháp authentication và authorization phổ biến dựa trên SpringSecurity/Sa-Token.
Ngoài ra, tôi còn bổ sung các technical challenge mà interviewer có thể đào sâu (như Redis Stream vs message queue truyền thống, chi tiết triển khai rate limiting phân tán), cùng template cho các vấn đề khó và giải pháp của project.
Tổng quan tutorial
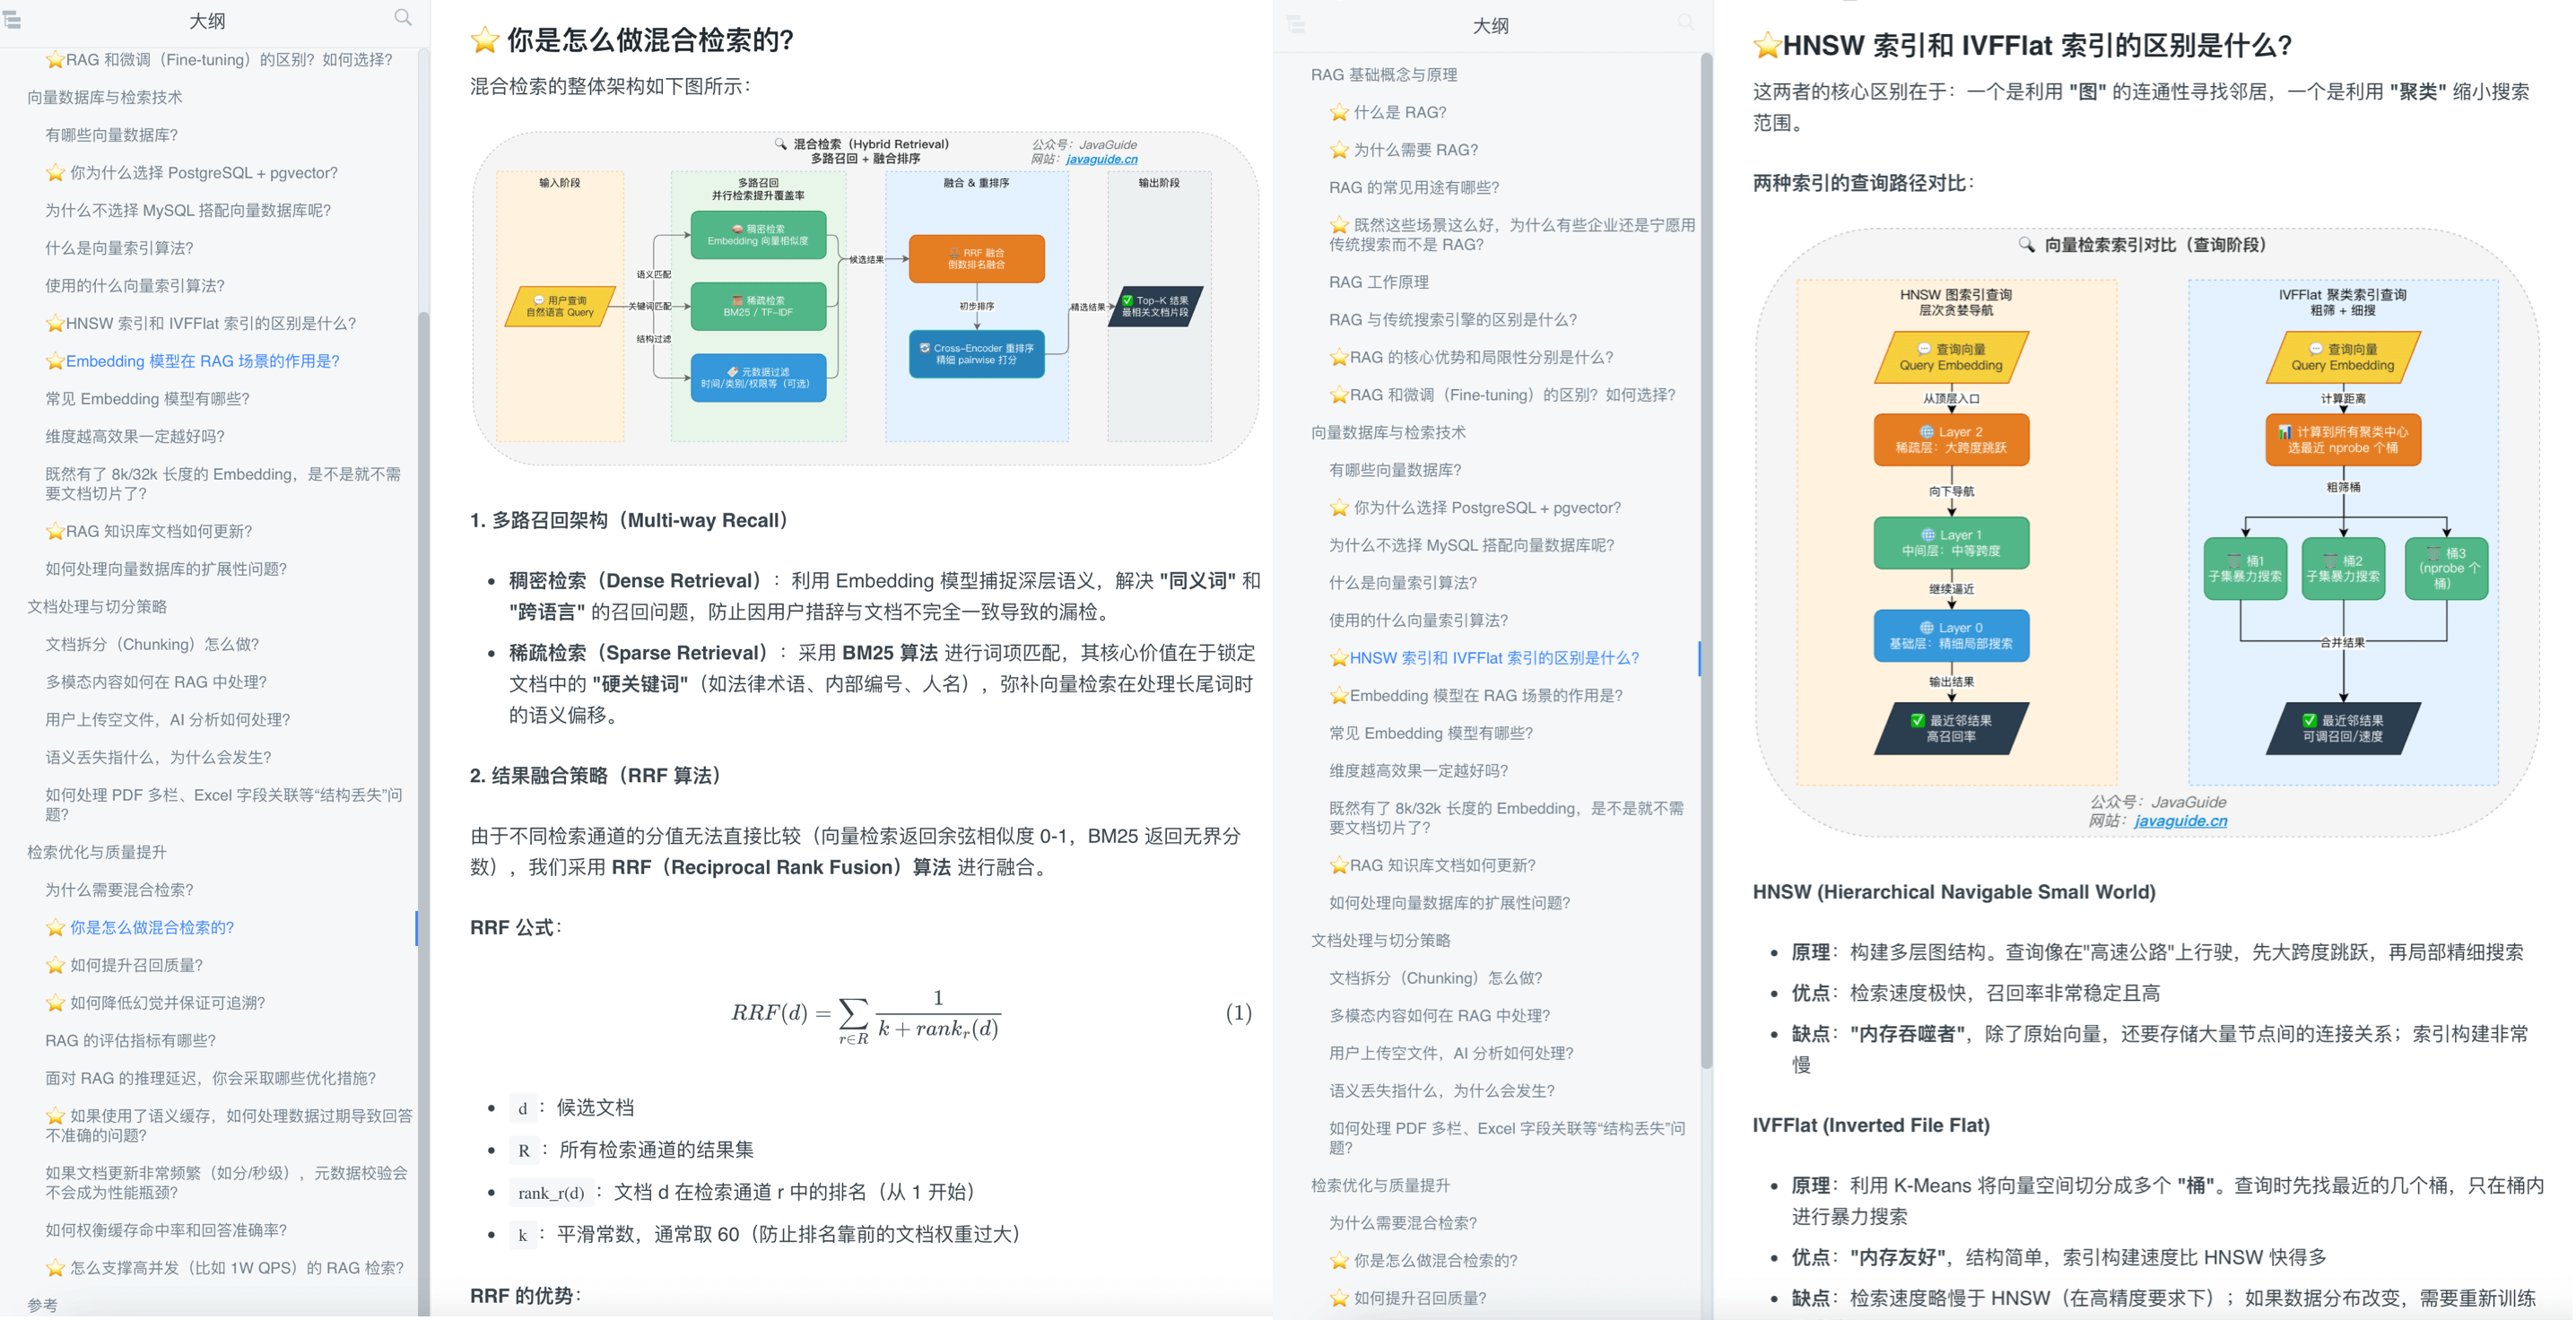
Hãy cùng xem tutorial đi kèm mà tôi đã viết, mức độ tâm huyết đều nằm trong từng câu chữ! Trong toàn bộ tutorial của project, tôi tự vẽ hàng chục sơ đồ kỹ thuật để hỗ trợ việc hiểu bài.
Ví dụ, bài tổng hợp câu hỏi phỏng vấn RAG này mất một tuần mới hoàn thành phiên bản đầu tiên, tổng cộng 34.000 chữ, bao gồm 35 câu hỏi phỏng vấn RAG thường gặp, riêng việc proofreading đã thực hiện ba lần. Hơn nữa, đây mới chỉ là phiên bản đầu tiên, sau này sẽ tiếp tục hoàn thiện và tối ưu!
Bài viết này giới thiệu tư duy phát triển chi tiết knowledge base RAG tương ứng.
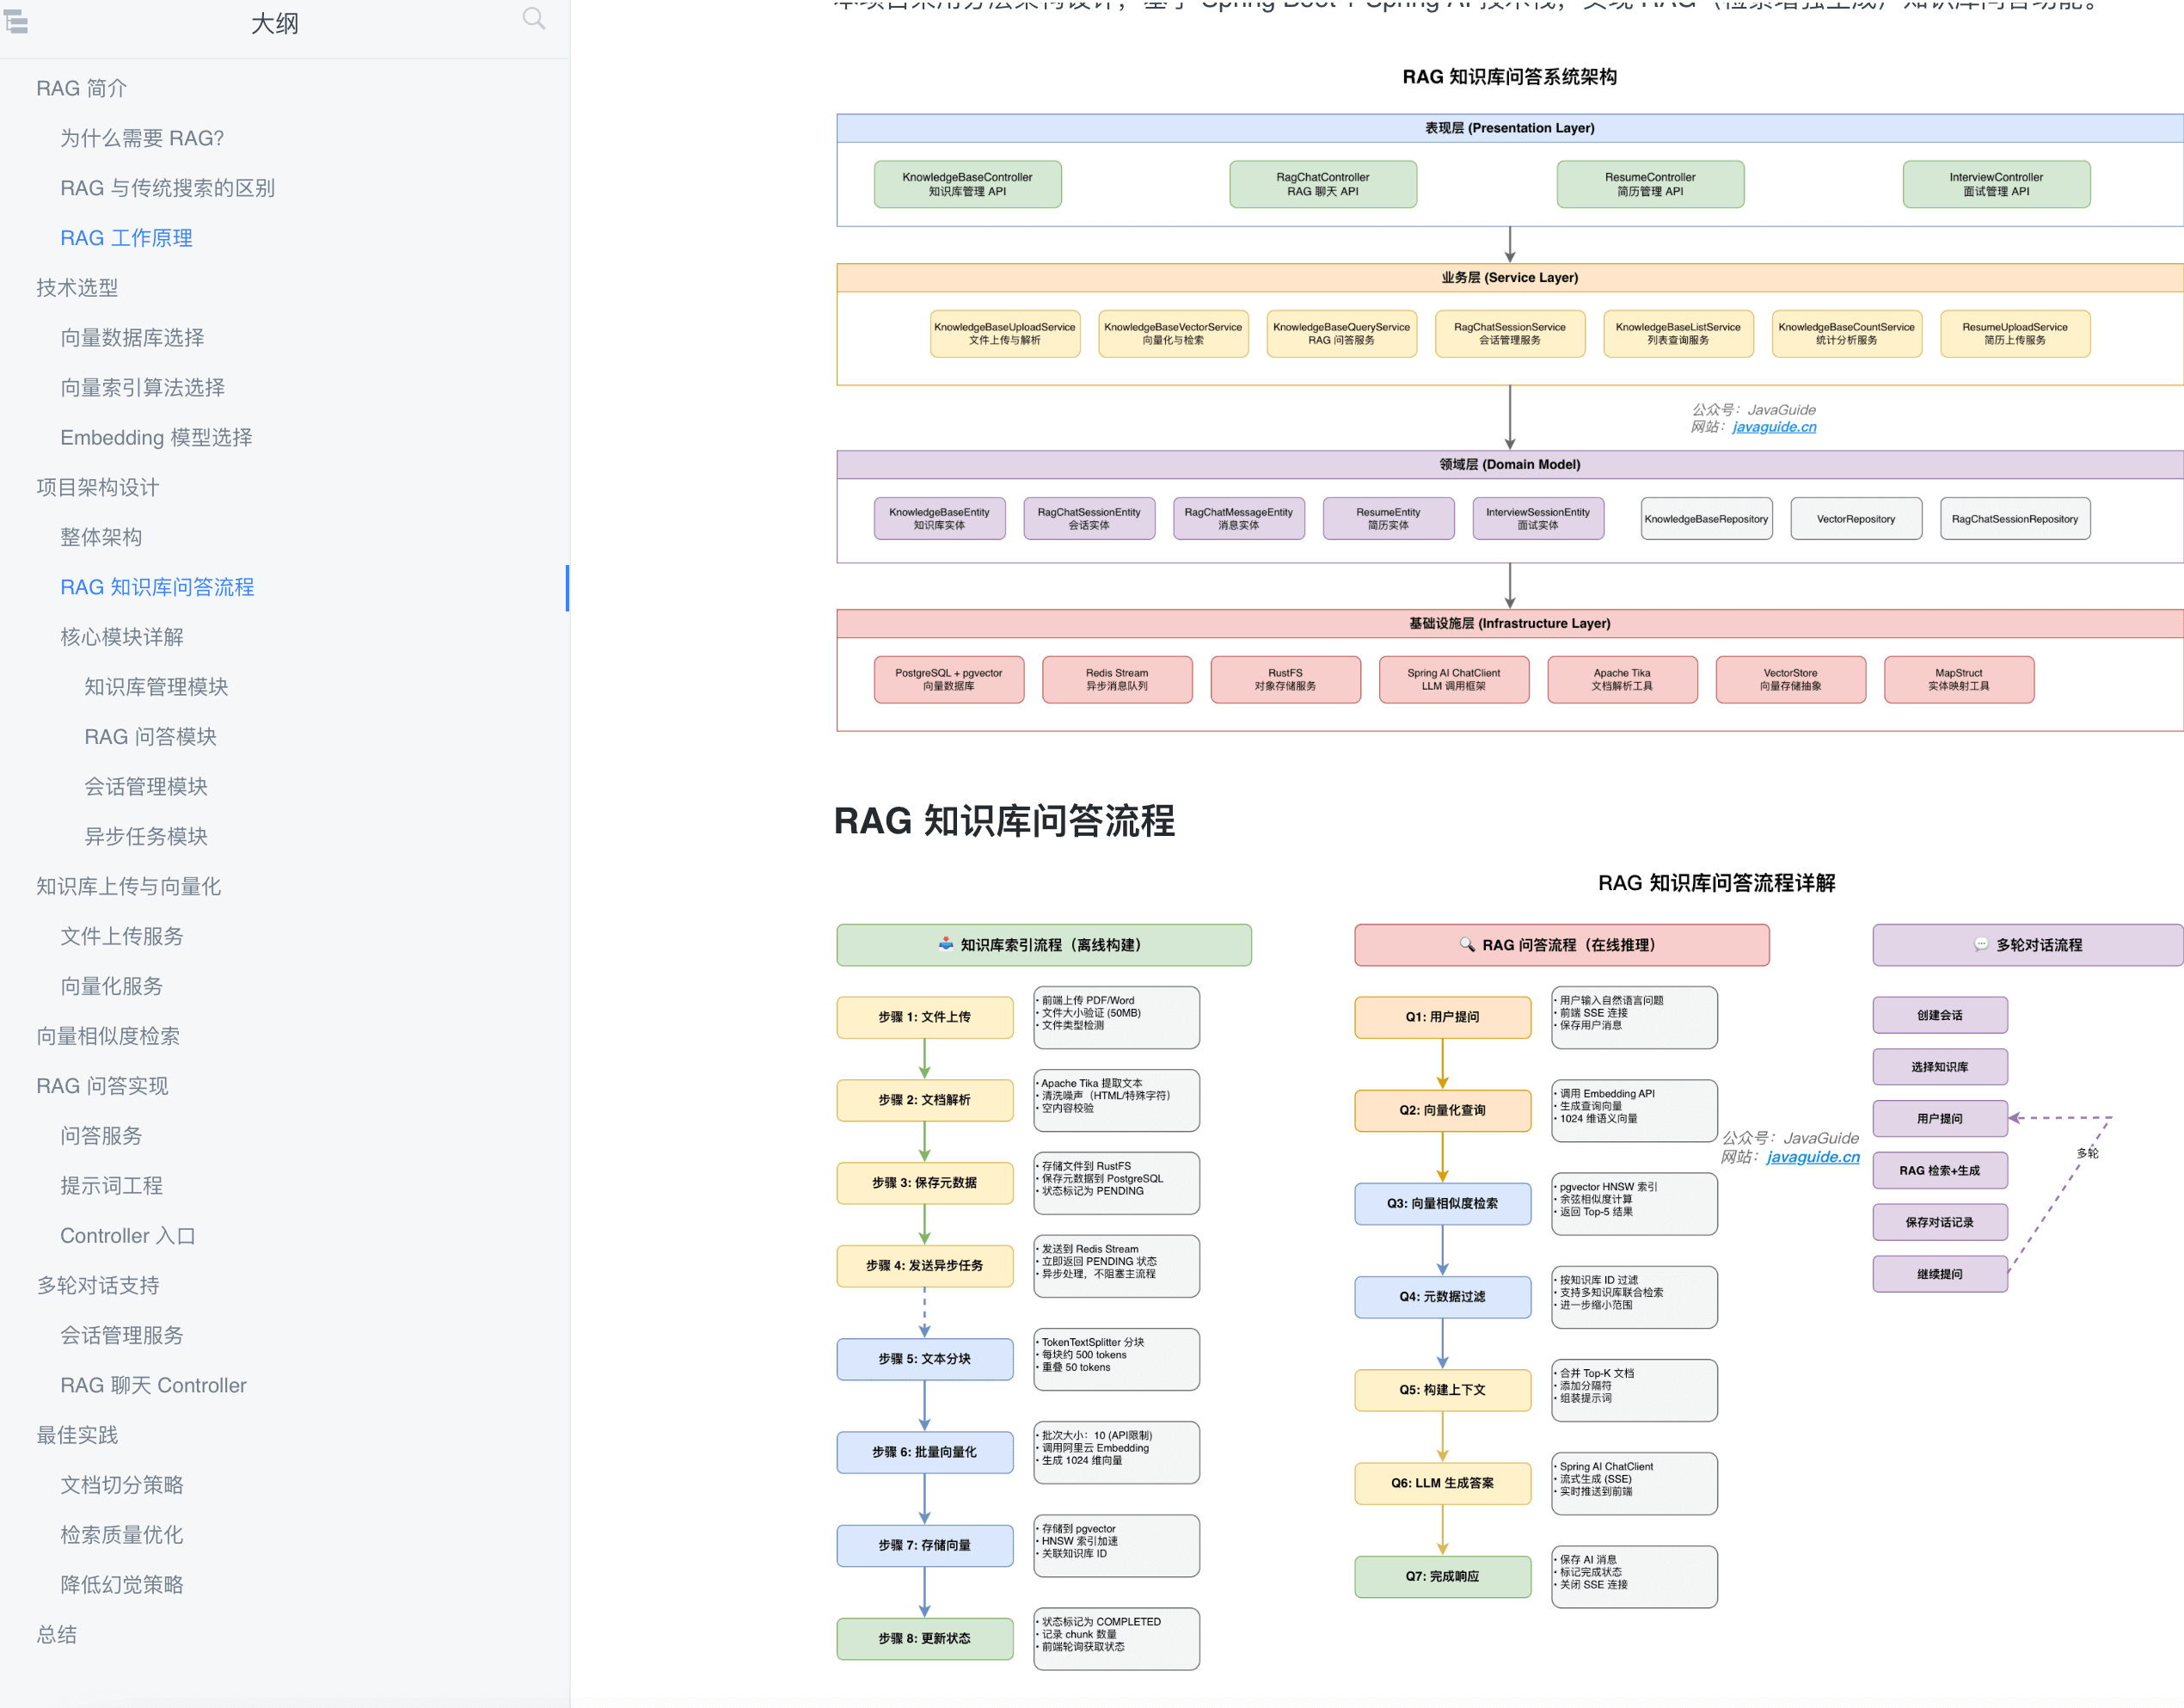
Không chỉ hướng dẫn bạn “viết code như thế nào”, mà còn hướng dẫn “vì sao thiết kế như vậy” và “đối phó với các thách thức phức tạp trong scenario thực tế của doanh nghiệp như thế nào”.
Nội dung tutorial đi kèm
Các chức năng hiện tại của project khá đơn giản, ngưỡng học rất thấp, nhưng các điểm kiến thức liên quan lại khá phong phú. Thông qua tutorial hướng dẫn từng bước, chúng ta sẽ xây dựng từ đầu một backend architecture hoàn chỉnh kết hợp tích hợp LLM, RAG (retrieval-augmented generation), vector database, rate limiting phân tán và xử lý bất đồng bộ.
Dù bạn muốn học các ứng dụng tiên tiến của Spring AI, hay cần một project chất lượng cao cho CV, project này đều cung cấp cho bạn hướng dẫn toàn diện từ dựng infrastructure, xử lý nghiệp vụ khó đến ôn lại cách trình bày khi phỏng vấn.
Tutorial project đi kèm cần trả phí (phần sau/cuối bài có cách tham gia), mong mọi người thông cảm vì chủ yếu cần bù đắp chi phí thời gian. Hơn nữa, so với dịch vụ cung cấp, mức phí thực sự rất hợp lý. Cả đời này không thể làm chuyện trục lợi từ người dùng!
Nội dung được sắp xếp như sau (đã cập nhật xong, tổng cộng hơn 130.000 chữ):
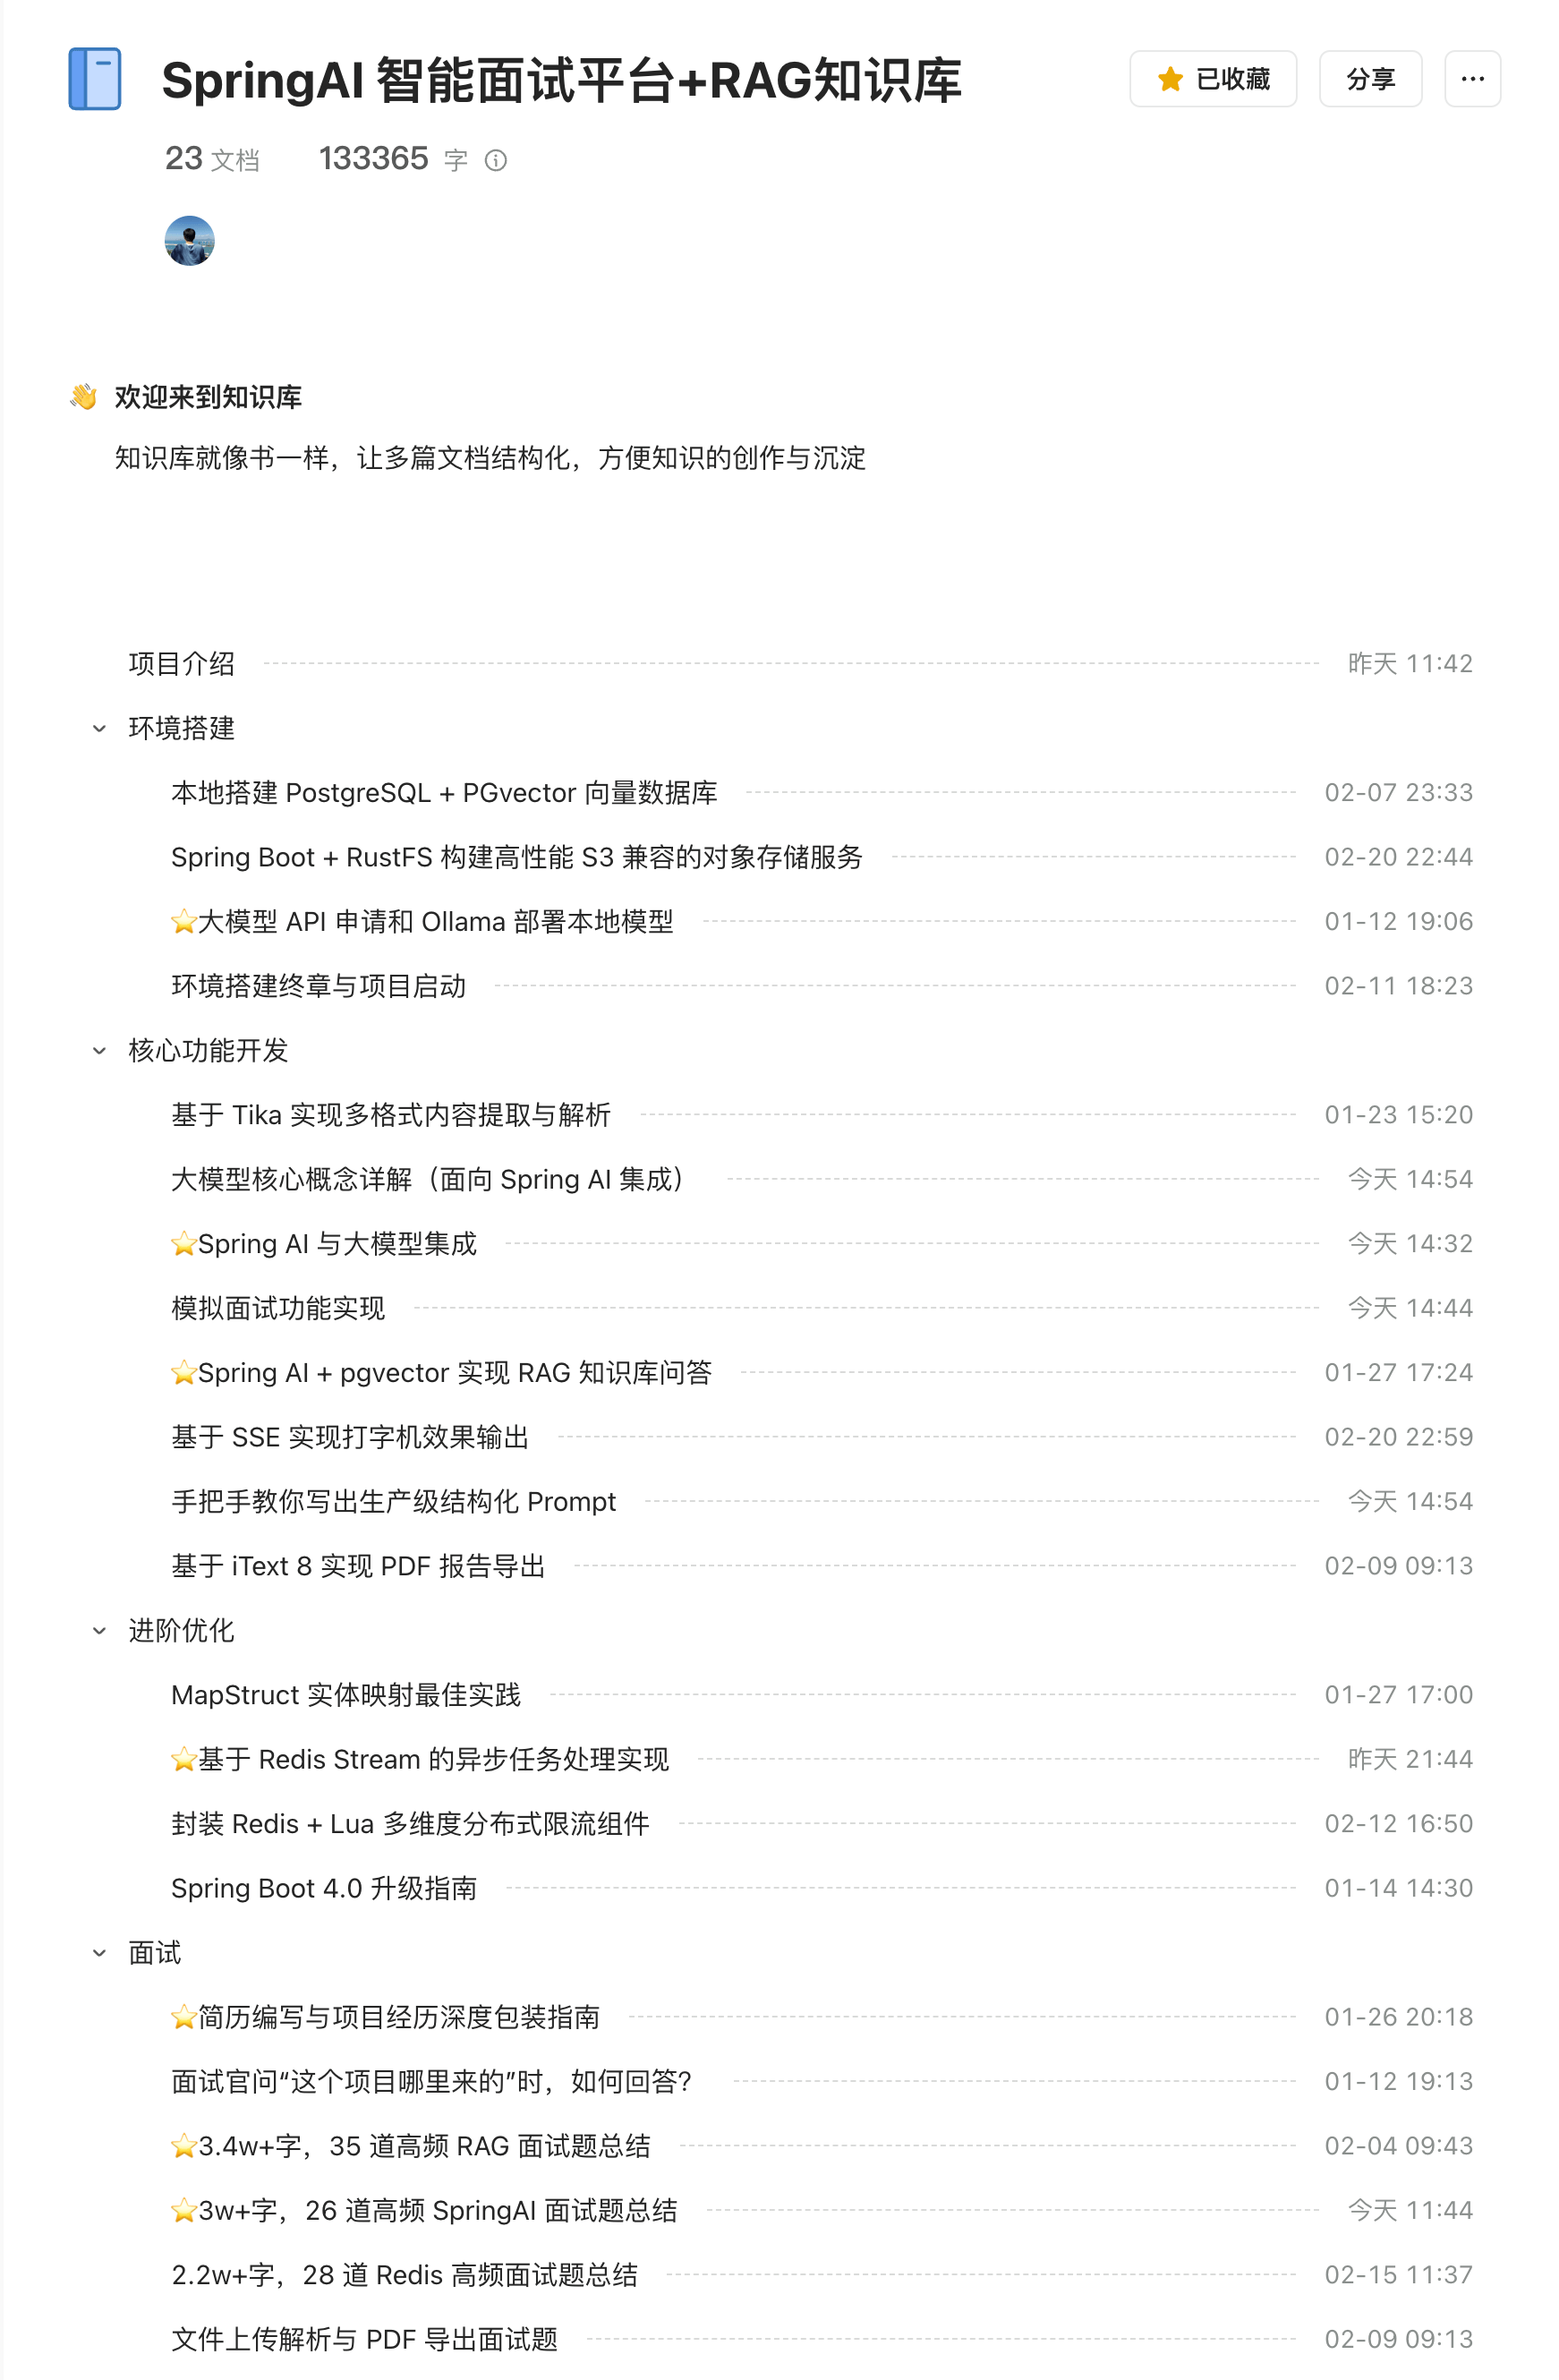
Dựng môi trường
- Dựng PostgreSQL + PGvector vector database cục bộ
- Xây dựng object storage service tương thích S3 hiệu năng cao bằng Spring Boot + RustFS
- ⭐Đăng ký API LLM và deploy model cục bộ bằng Ollama
- Chương cuối của phần dựng môi trường và khởi động project
Phát triển chức năng cốt lõi
- Trích xuất và phân tích nội dung đa định dạng dựa trên Tika
- ⭐Tích hợp Spring AI với LLM
- ⭐Dùng Spring AI + pgvector để triển khai hỏi đáp knowledge base RAG
- Dùng SSE để tạo hiệu ứng output kiểu máy đánh chữ
- Hướng dẫn từng bước viết Prompt có cấu trúc cấp production
- Chức năng phỏng vấn mô phỏng AI
- Dùng iText 8 để export báo cáo PDF
Tối ưu nâng cao
- Best practice mapping entity bằng MapStruct
- ⭐Triển khai xử lý task bất đồng bộ dựa trên Redis Stream
- Đóng gói component rate limiting phân tán đa chiều bằng Redis + Lua
- ⭐Thiết kế architecture Skill
- Hướng dẫn nâng cấp Spring Boot 4.0
- Deploy bằng Docker Compose một lệnh
Phỏng vấn
- ⭐Hướng dẫn viết CV và đóng gói chuyên sâu kinh nghiệm project
- Trả lời thế nào khi interviewer hỏi “project này từ đâu ra”?
- ⭐Khai thác câu hỏi phỏng vấn Spring AI
- ⭐Khai thác câu hỏi phỏng vấn knowledge base RAG
- Khai thác câu hỏi phỏng vấn Redis
- Khai thác câu hỏi phỏng vấn upload file, phân tích và export PDF
Tham gia học
Project này là project thực chiến nội bộ dành riêng cho JavaGuide Knowledge Planet, học và đọc online qua tài liệu Yuque, không mở riêng cho bên ngoài.
Lý do chọn phát hành trong Knowledge Planet là để đảm bảo mỗi người học đều nhận được giải đáp kỹ thuật chuyên sâu và dịch vụ hỗ trợ tìm việc đầy đủ.
Toàn bộ tutorial project dự kiến hoàn thành trong 1-2 tháng. Mỗi bài viết (không cung cấp video vì tốn thời gian và không có lợi cho việc nâng cao năng lực học tập) đều được cân nhắc kỹ nhiều lần, đảm bảo chất lượng cao, không có ngưỡng, ngay cả người có nền tảng yếu cũng có thể chạy project từ đầu đến cuối theo tài liệu.
Đây mới chỉ là khởi đầu. Sau này Knowledge Planet sẽ tiếp tục ra mắt thêm nhiều Java project thực chiến phù hợp với scenario nghiệp vụ thực tế của doanh nghiệp, giúp bạn luôn đứng ở tuyến đầu công nghệ (bật mí một chút, project tiếp theo là hệ thống chăm sóc khách hàng thông minh cấp doanh nghiệp, sẽ cùng mọi người thực hành thêm nhiều năng lực AI).
Ngoài ra, Knowledge Planet của tôi còn có nhiều dịch vụ khác như hỏi đáp một-một, chỉnh sửa CV, tài liệu phỏng vấn hệ thống backend (bao gồm system design và scenario question thường gặp), check-in học tập; giá trị của bất kỳ dịch vụ riêng lẻ nào cũng đã vượt xa phí tham gia Knowledge Planet. Hoan nghênh bạn tìm hiểu chi tiết về Knowledge Planet của tôi!
Đã kiên trì duy trì sáu năm, nội dung liên tục cập nhật, dù giá rất rẻ (0,4 tệ/ngày) nhưng chất lượng cao, chủ yếu là làm nội dung có tâm!
Hiện Knowledge Planet đang có chương trình khuyến mãi, chỉ bằng giá hai cuốn sách là bạn có thể sở hữu dịch vụ của hàng chục nghìn lớp đào tạo! Ở đây còn cung cấp một coupon 30 tệ (giá sắp tăng, người dùng cũ quét mã gia hạn được giảm một nửa):
Tận tâm làm nội dung, kiên trì với nguyên tắc, không trục lợi từ người dùng, những việc khác hãy để thời gian trả lời! Cùng cố gắng!
System architecture
Gợi ý: Sơ đồ architecture được vẽ bằng draw.io và export thành SVG, hiệu quả hiển thị trong Dark mode sẽ có vấn đề.
Hệ thống sử dụng kiến trúc frontend-backend tách biệt, tổng thể chia thành ba layer: presentation layer frontend, service layer backend và data storage layer.
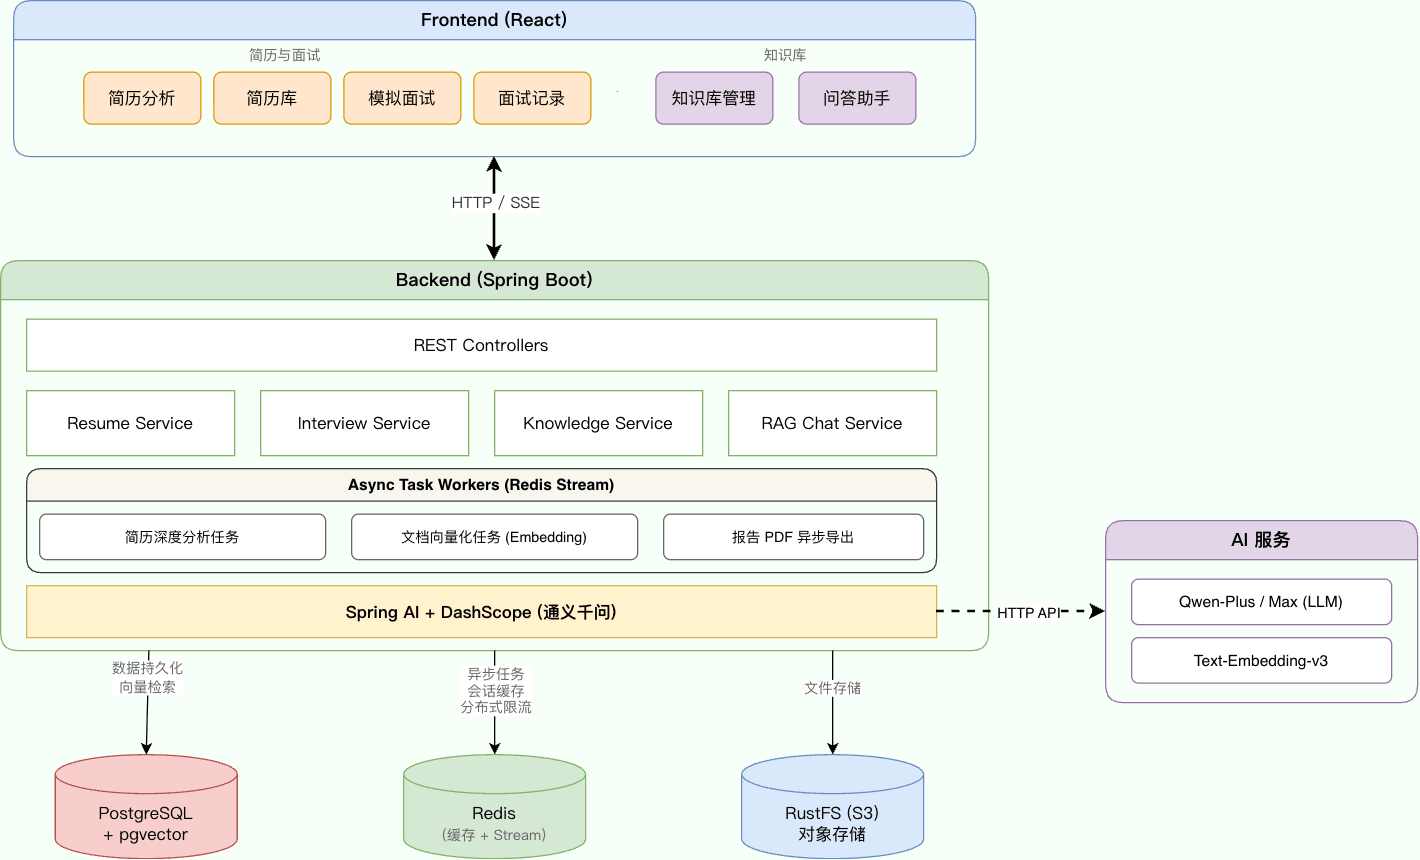
Backend layer:
- REST Controllers: entry point API thống nhất, xử lý HTTP request
- Business service layer:
- Resume Service: upload CV, phân tích, phân tích AI
- Interview Service: quản lý interview session, tạo câu hỏi, đánh giá câu trả lời
- Knowledge Service: upload knowledge base, chia chunk văn bản, vector hóa
- RAG Chat Service: retrieval-augmented generation, hỏi đáp streaming
- Resume Service: upload CV, phân tích, phân tích AI
- Async processing layer: consumer dựa trên Redis Stream, xử lý bất đồng bộ các AI task tốn thời gian (như phân tích CV, vector hóa, đánh giá phỏng vấn)
- AI integration layer: Spring AI + DashScope (Qwen). LLM calling interface thống nhất, hỗ trợ tạo hội thoại và vector hóa văn bản.
Data storage layer:
PostgreSQL + pgvector:
- Dữ liệu quan hệ: CV, interview record, metadata knowledge base
- Vector search: lưu vector tài liệu, hỗ trợ similarity search
Redis:
- Session cache: trạng thái interview session
- Message queue: Redis Stream triển khai async task queue
RustFS/MinIO (S3): file gốc (CV PDF, tài liệu knowledge base)
Quy trình xử lý bất đồng bộ:
Phân tích CV, vector hóa knowledge base và tạo báo cáo phỏng vấn đều được xử lý bất đồng bộ bằng Redis Stream. Dưới đây lấy phân tích CV và vector hóa knowledge base làm ví dụ để giới thiệu quy trình tổng thể:
Upload request → Lưu file → Gửi message vào Stream → Trả về ngay
                                      ↓
                              Consumer consume message
                                      ↓
                           Thực thi task phân tích/vector hóa
                                      ↓
                             Cập nhật trạng thái database
                                      ↓
                       Frontend polling lấy trạng thái mới nhất
Luân chuyển trạng thái: PENDING → PROCESSING → COMPLETED / FAILED
Quy trình xử lý hỏi đáp knowledge base:
Hỏi đáp knowledge base → Vector hóa câu hỏi → pgvector similarity search → Truy vấn tài liệu liên quan
                                                                    ↓
                                      Xây dựng Prompt → LLM tạo câu trả lời → SSE trả về streaming
Tech stack
Công nghệ backend
| Công nghệ | Phiên bản | Mô tả |
|---|---|---|
| Spring Boot | 4.0.1 | Framework ứng dụng |
| Java | 21 | Ngôn ngữ phát triển (virtual thread) |
| Spring AI | 2.0.0-M4 | Framework tích hợp AI |
| PostgreSQL + pgvector | 14+ | Database quan hệ + vector storage |
| Redis + Redisson | 6+ / 4.0.0 | Cache + message queue (Stream) |
| Apache Tika | 2.9.2 | Phân tích tài liệu |
| iText 8 | 8.0.5 | Export PDF |
| MapStruct | 1.6.3 | Mapping object |
| SpringDoc OpenAPI | 3.0.2 | Tài liệu API |
| DashScope SDK | 2.22.7 | Nhận dạng/tổng hợp giọng nói (Qwen3 ASR/TTS) |
| spring-ai-agent-utils | 0.7.0 | Tool library Spring AI Agent Skills |
| WebSocket | - | Giao tiếp hai chiều real-time cho phỏng vấn bằng giọng nói |
| Gradle | 8.14 | Build tool |
Giải đáp các câu hỏi thường gặp về lựa chọn công nghệ:
- Vì sao chọn PostgreSQL + pgvector cho data storage? Khả năng lưu trữ vector của PG đã đủ dùng, giúp tinh gọn architecture và không muốn đưa vào quá nhiều component.
- Vì sao đưa Redis vào?
- Redis thay thế
ConcurrentHashMapđể triển khai cache cho interview session. - Dùng Redis Stream để triển khai xử lý bất đồng bộ cho các scenario như phân tích CV, vector hóa knowledge base (đồng thời tách rời được, phần phân tích và vector hóa có thể dùng ngôn ngữ lập trình khác). Không dùng message queue trưởng thành như Kafka cũng vì không muốn đưa vào quá nhiều component.
- Redis thay thế
- Vì sao chọn Gradle làm build tool? Cá nhân tôi thích dùng Gradle hơn và cũng từng viết bài liên quan: Tổng hợp các khái niệm cốt lõi của Gradle.
Công nghệ frontend
| Công nghệ | Phiên bản | Mô tả |
|---|---|---|
| React | 18.3 | UI framework |
| TypeScript | 5.6 | Ngôn ngữ phát triển |
| Vite | 5.4 | Build tool |
| Tailwind CSS | 4.1 | Style framework |
| React Router | 7.11 | Quản lý route |
| Framer Motion | 12.23 | Thư viện animation |
| Recharts | 3.6 | Thư viện biểu đồ |
| Lucide React | 0.468 | Thư viện icon |
| React Big Calendar | 1.19 | Component lịch phỏng vấn |
| React Markdown | 9.0 | Render Markdown |
| React Virtuoso | 4.18 | Virtual scrolling list |
Giải đáp các câu hỏi thường gặp về lựa chọn công nghệ
Đây chỉ là giới thiệu sơ lược, sau này tôi sẽ chia sẻ bài viết phân tích chi tiết về lựa chọn công nghệ.
Vì sao chọn Spring AI?
Spring AI là framework tích hợp AI do Spring chính thức phát hành, cung cấp abstraction thống nhất cho việc gọi LLM. Các lý do lựa chọn:
- Abstraction thống nhất: một bộ code hỗ trợ nhiều LLM provider (OpenAI, Alibaba Cloud DashScope, Ollama...), chuyển model chỉ cần sửa config
- Tích hợp hệ sinh thái Spring: tích hợp liền mạch với Spring Boot, hỗ trợ auto-configuration, dependency injection và declarative calling
- Hỗ trợ vector storage tích hợp: native support pgvector, Milvus, Pinecone và các vector database khác, đơn giản hóa việc phát triển RAG
- Structured output: thông qua
BeanOutputConverter, map trực tiếp output của LLM thành Java object mà không cần tự parse JSON
// Ví dụ: Spring AI structured output
var converter = new BeanOutputConverter<>(ResumeAnalysisDTO.class);
String result = chatClient.prompt()
    .system(systemPrompt)
    .user(userPrompt + converter.getFormat())
    .call()
    .content();
return converter.convert(result);  // Nhận trực tiếp Java object
Vì sao chọn PostgreSQL + pgvector cho data storage?
Project này cần đồng thời lưu trữ dữ liệu có cấu trúc (CV, interview record) và dữ liệu vector (document Embedding). So sánh các phương án:
| Phương án | Ưu điểm | Nhược điểm |
|---|---|---|
| PostgreSQL + pgvector | Một database giải quyết tất cả, vận hành đơn giản | Hiệu năng vector search không bằng vector database chuyên dụng |
| PostgreSQL + Milvus | Hiệu năng vector search tốt hơn | Thêm một component, độ phức tạp vận hành tăng |
| PostgreSQL + Pinecone | Cloud-hosted, không cần vận hành | Chi phí cao, dữ liệu ở bên thứ ba |
Lý do chọn pgvector:
- Architecture đơn giản: không đưa vào component bổ sung, giảm độ phức tạp deploy và vận hành
- Hiệu năng đủ dùng: HNSW index hỗ trợ search cấp millisecond, hoàn toàn đủ cho scenario hàng chục nghìn tài liệu
- Transaction consistency: dữ liệu vector và dữ liệu nghiệp vụ trong cùng database, native support transaction
- SQL query: có thể kết hợp filter bằng điều kiện WHERE, chẳng hạn “chỉ search trong knowledge base của một category nào đó”
-- Ví dụ pgvector similarity search
SELECT content, 1 - (embedding <=> \$1) as similarity
FROM vector_store
WHERE metadata->>'category' = 'Java'
ORDER BY embedding <=> \$1
LIMIT 5;
Vì sao không chọn MySQL kết hợp với vector database?
Ưu thế lớn nhất của PostgreSQL, cũng là “con át chủ bài” giúp nó vượt qua đối thủ trong thời đại AI, chính là khả năng mở rộng mạnh mẽ. Developer có thể cài đặt nhiều plugin mạnh cho database mà không cần sửa kernel, giống như “plug and play”, biến PostgreSQL thành một “Swiss Army knife về dữ liệu” vạn năng.
- AI vector search? Có extension pgvector được khuyến nghị chính thức, hiệu năng mạnh và hệ sinh thái trưởng thành, đủ sánh với vector database chuyên dụng.
- Full-text search? Hỗ trợ tích hợp (đáp ứng nhu cầu cơ bản), hoặc dùng extension như pg_bm25.
- Time-series data? Có extension TimescaleDB hàng đầu.
- Geographic information? Có extension PostGIS tiêu chuẩn ngành.
Khả năng giải quyết “một cửa” này chính là sức hút của nó. Điều đó có nghĩa là nhiều project không còn cần phụ thuộc vào một lượng lớn middleware bên ngoài như Elasticsearch, Milvus, mà chỉ cần PostgreSQL được tăng cường là có thể đáp ứng đa dạng nhu cầu, từ đó đơn giản hóa đáng kể tech stack và giảm độ phức tạp cũng như chi phí development, vận hành.
Để so sánh chi tiết MySQL và PostgreSQL, có thể tham khảo bài viết tôi đã viết: MySQL vs PostgreSQL, lựa chọn thế nào?.
Vì sao đưa Redis vào?
Project này chủ yếu dùng Redis trong hai scenario:
- Redis thay thế
ConcurrentHashMapđể triển khai cache cho session. - Dùng Redis Stream để triển khai xử lý bất đồng bộ cho các scenario như phân tích CV, vector hóa knowledge base (đồng thời tách rời được, phần phân tích và vector hóa có thể dùng ngôn ngữ lập trình khác).
Vì sao đưa Redis Stream vào? Vì sao không chọn các message queue trưởng thành hơn như Kafka, RabbitMQ?
Các AI task như phân tích CV và vector hóa knowledge base tốn khá nhiều thời gian (10-60 giây), không phù hợp xử lý đồng bộ. Cần message queue để xử lý bất đồng bộ và tách rời.
| Chiều | Redis Stream | RabbitMQ | Kafka | Memory queue |
|---|---|---|---|---|
| Throughput | Cao (QPS hàng trăm nghìn) | Trung bình (QPS hàng chục nghìn) | Cực cao (hàng triệu, scale ngang) | Cực cao (hàng chục triệu/giây, giới hạn bởi CPU/memory) |
| Latency | Cực thấp (cấp dưới millisecond) | Thấp (cấp millisecond) | Trung bình (millisecond đến chục millisecond) | Cực thấp (cấp nanosecond/microsecond) |
| Persistence | Hỗ trợ (RDB/AOF) | Hỗ trợ (Mnesia/disk) | Hỗ trợ mạnh (segmented log native) | Không (process kết thúc là mất) |
| Khả năng tích tụ message | Bình thường (giới hạn bởi memory) | Trung bình (tích tụ trên disk, hiệu năng giảm rõ rệt) | Rất mạnh (lưu trữ disk cấp TB) | Kém (giới hạn bởi heap memory) |
| Consumer mode | Publish-subscribe / consumer group | Flexible routing / nhiều exchange mode | Publish-subscribe / consumer group | Point-to-point / multi-consumer (tùy implementation) |
| Message replay | Hỗ trợ (theo ID / time range) | Không hỗ trợ | Hỗ trợ mạnh (theo Offset / timestamp) | Không hỗ trợ |
| Message ordering | Một Stream có thứ tự | Một queue có thứ tự | Một Partition có thứ tự | Có thứ tự (single queue) |
| Reliability | Trung bình (async replication có thể mất dữ liệu) | Cao (Publisher Confirm / transaction) | Cực cao (multi-replica ISR + acks) | Thấp (không persistence, không confirm) |
| Độ phức tạp vận hành | Thấp | Trung bình | Cao (KRaft mode đã đơn giản hóa) | Cực thấp |
| Scenario phù hợp | Stream processing nhẹ, đã có Redis infrastructure | Routing phức tạp, enterprise integration | Big data stream, event sourcing, log aggregation | Tách rời trong process, scenario cần hiệu năng cực cao |
Lý do chọn Redis Stream:
- Tái sử dụng component hiện có: Redis đã được dùng cho session cache, không cần đưa vào middleware mới.
- Chức năng đáp ứng nhu cầu: hỗ trợ consumer group, message confirmation (ACK), persistence.
- Vận hành đơn giản: với project quy mô vừa và nhỏ, Redis Stream hoàn toàn đủ dùng.
Vì sao chọn Gradle làm build tool?
Spring Boot hiện dùng Gradle chính thức, hơn nữa trong nước hiện nay Maven phổ biến hơn, nên dùng Gradle sẽ mới mẻ hơn.
Cá nhân tôi cũng thích dùng Gradle hơn và từng viết bài liên quan: Tổng hợp các khái niệm cốt lõi của Gradle.
Vì sao sử dụng MapStruct?
Project có nhiều nhu cầu chuyển đổi Entity ↔ DTO, MapStruct là object mapping framework tạo code trong compile time:
| Phương án | Hiệu năng | Type safety | Độ phức tạp sử dụng |
|---|---|---|---|
| MapStruct | Không reflection, nhanh nhất | Compile-time check | Chỉ cần định nghĩa interface |
| BeanUtils | Reflection, chậm | Runtime error | Một dòng code |
| ModelMapper | Reflection, khá chậm | Runtime error | Config phức tạp |
| Tự viết mapping | Nhanh nhất | Compile-time check | Nhiều code lặp |
Vì sao sử dụng Apache Tika?
Hệ thống cần phân tích nhiều định dạng tài liệu (PDF, Word, TXT), Apache Tika là thư viện phân tích tài liệu của Apache Foundation:
- Hỗ trợ đầy đủ định dạng: PDF, DOCX, DOC, TXT, HTML, Markdown và hàng trăm định dạng khác
- Tự động nhận diện: tự động phát hiện định dạng theo nội dung file, không cần phụ thuộc vào phần mở rộng file
- Trích xuất văn bản: API thống nhất để trích xuất plain text, che giấu khác biệt định dạng
// Ví dụ phân tích bằng Tika
Tika tika = new Tika();
String content = tika.parseToString(inputStream);  // Tự động nhận diện định dạng và trích xuất văn bản
Vì sao sử dụng SSE thay vì WebSocket?
Hỏi đáp knowledge base cần output streaming (hiển thị từng chữ như ChatGPT), có hai lựa chọn công nghệ:
| Phương án | Ưu điểm | Nhược điểm |
|---|---|---|
| SSE | Đơn giản, dựa trên HTTP, push một chiều | Chỉ hỗ trợ server → client |
| WebSocket | Giao tiếp hai chiều, chức năng mạnh | Protocol phức tạp, cần duy trì connection state |
Lý do chọn SSE:
- Khớp scenario: output streaming của LLM là một chiều (server → client), không cần giao tiếp hai chiều
- Triển khai đơn giản: dựa trên HTTP, native support reconnect và cross-origin
- Spring hỗ trợ tốt:
Flux<ServerSentEvent<String>>giải quyết chỉ bằng một dòng code
Vì sao frontend chọn React + TypeScript + Tailwind CSS?
| Công nghệ | Lý do lựa chọn |
|---|---|
| React | Hệ sinh thái trưởng thành nhất, phát triển component, tài nguyên cộng đồng phong phú |
| TypeScript | Type safety, IDE gợi ý thông minh, giảm runtime error |
| Vite | Dev server khởi động nhanh (cấp giây), trải nghiệm HMR hot update tốt |
| Tailwind CSS | Atomic CSS, phát triển nhanh, không cần viết CSS file |
Tính năng
Module quản lý CV
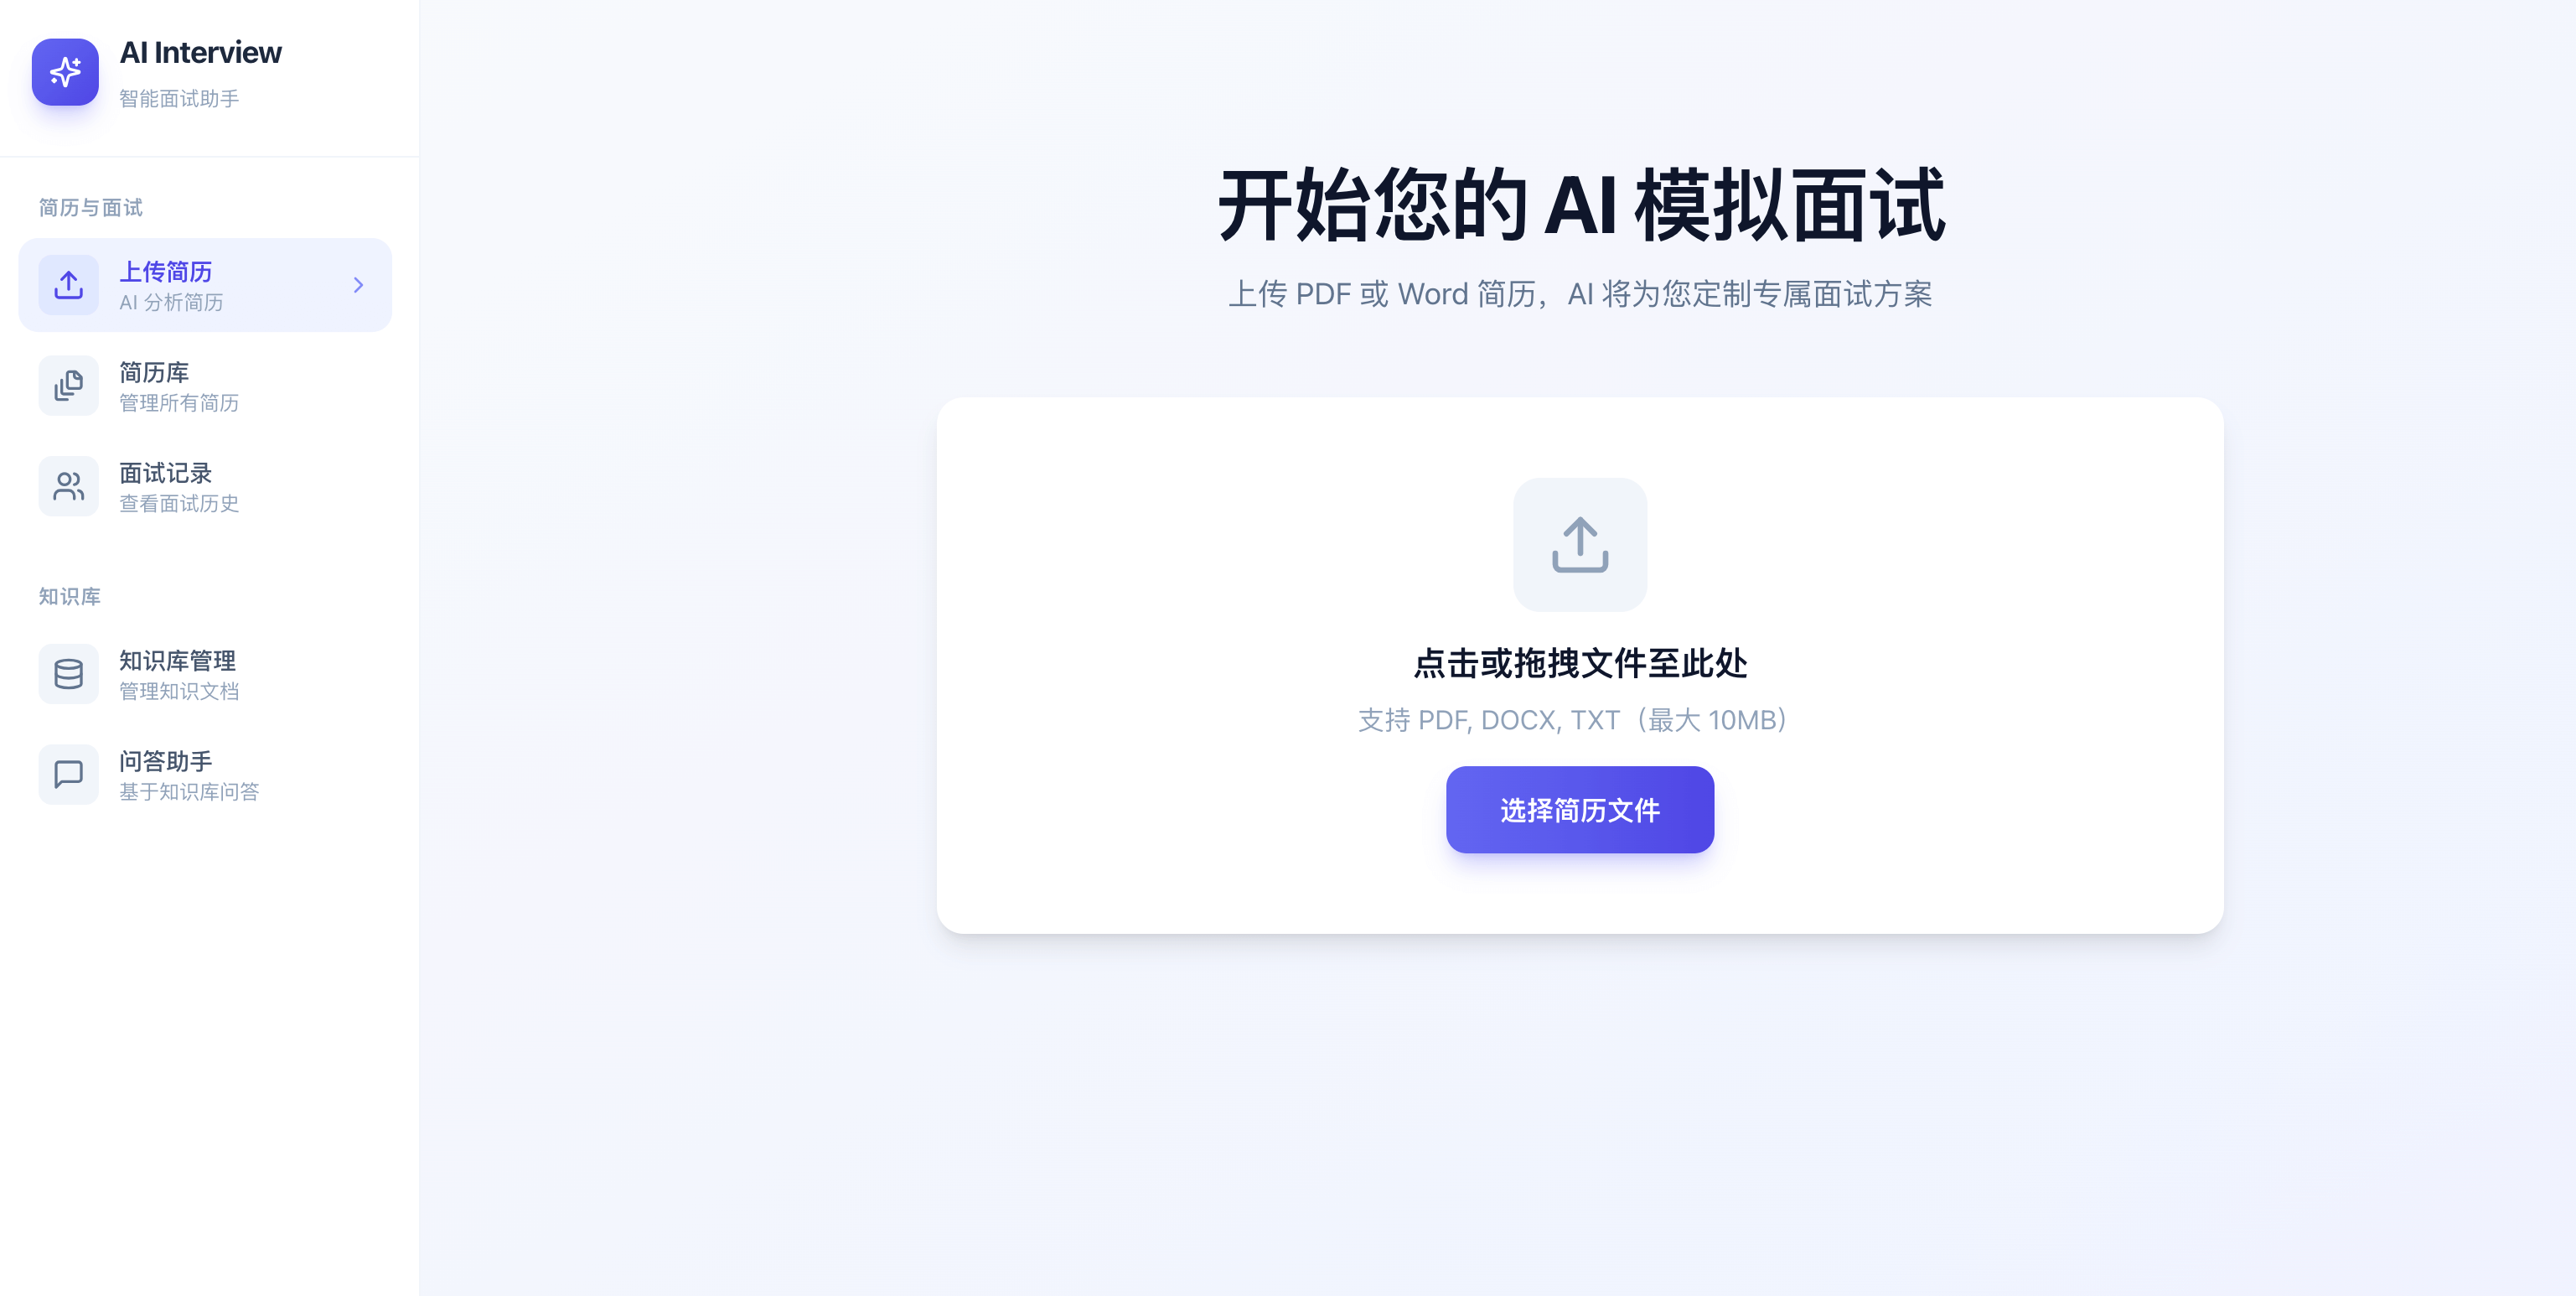
- Phân tích đa định dạng: Hỗ trợ nhiều định dạng CV như PDF, DOCX, DOC, TXT.
- Async processing flow: Dùng Redis Stream để triển khai phân tích CV bất đồng bộ, hỗ trợ xem tiến độ xử lý real-time (chờ phân tích/đang phân tích/đã hoàn thành/thất bại).
- Đảm bảo stability: Tích hợp cơ chế tự động retry khi phân tích thất bại (tối đa 3 lần) và phát hiện trùng lặp dựa trên content hash.
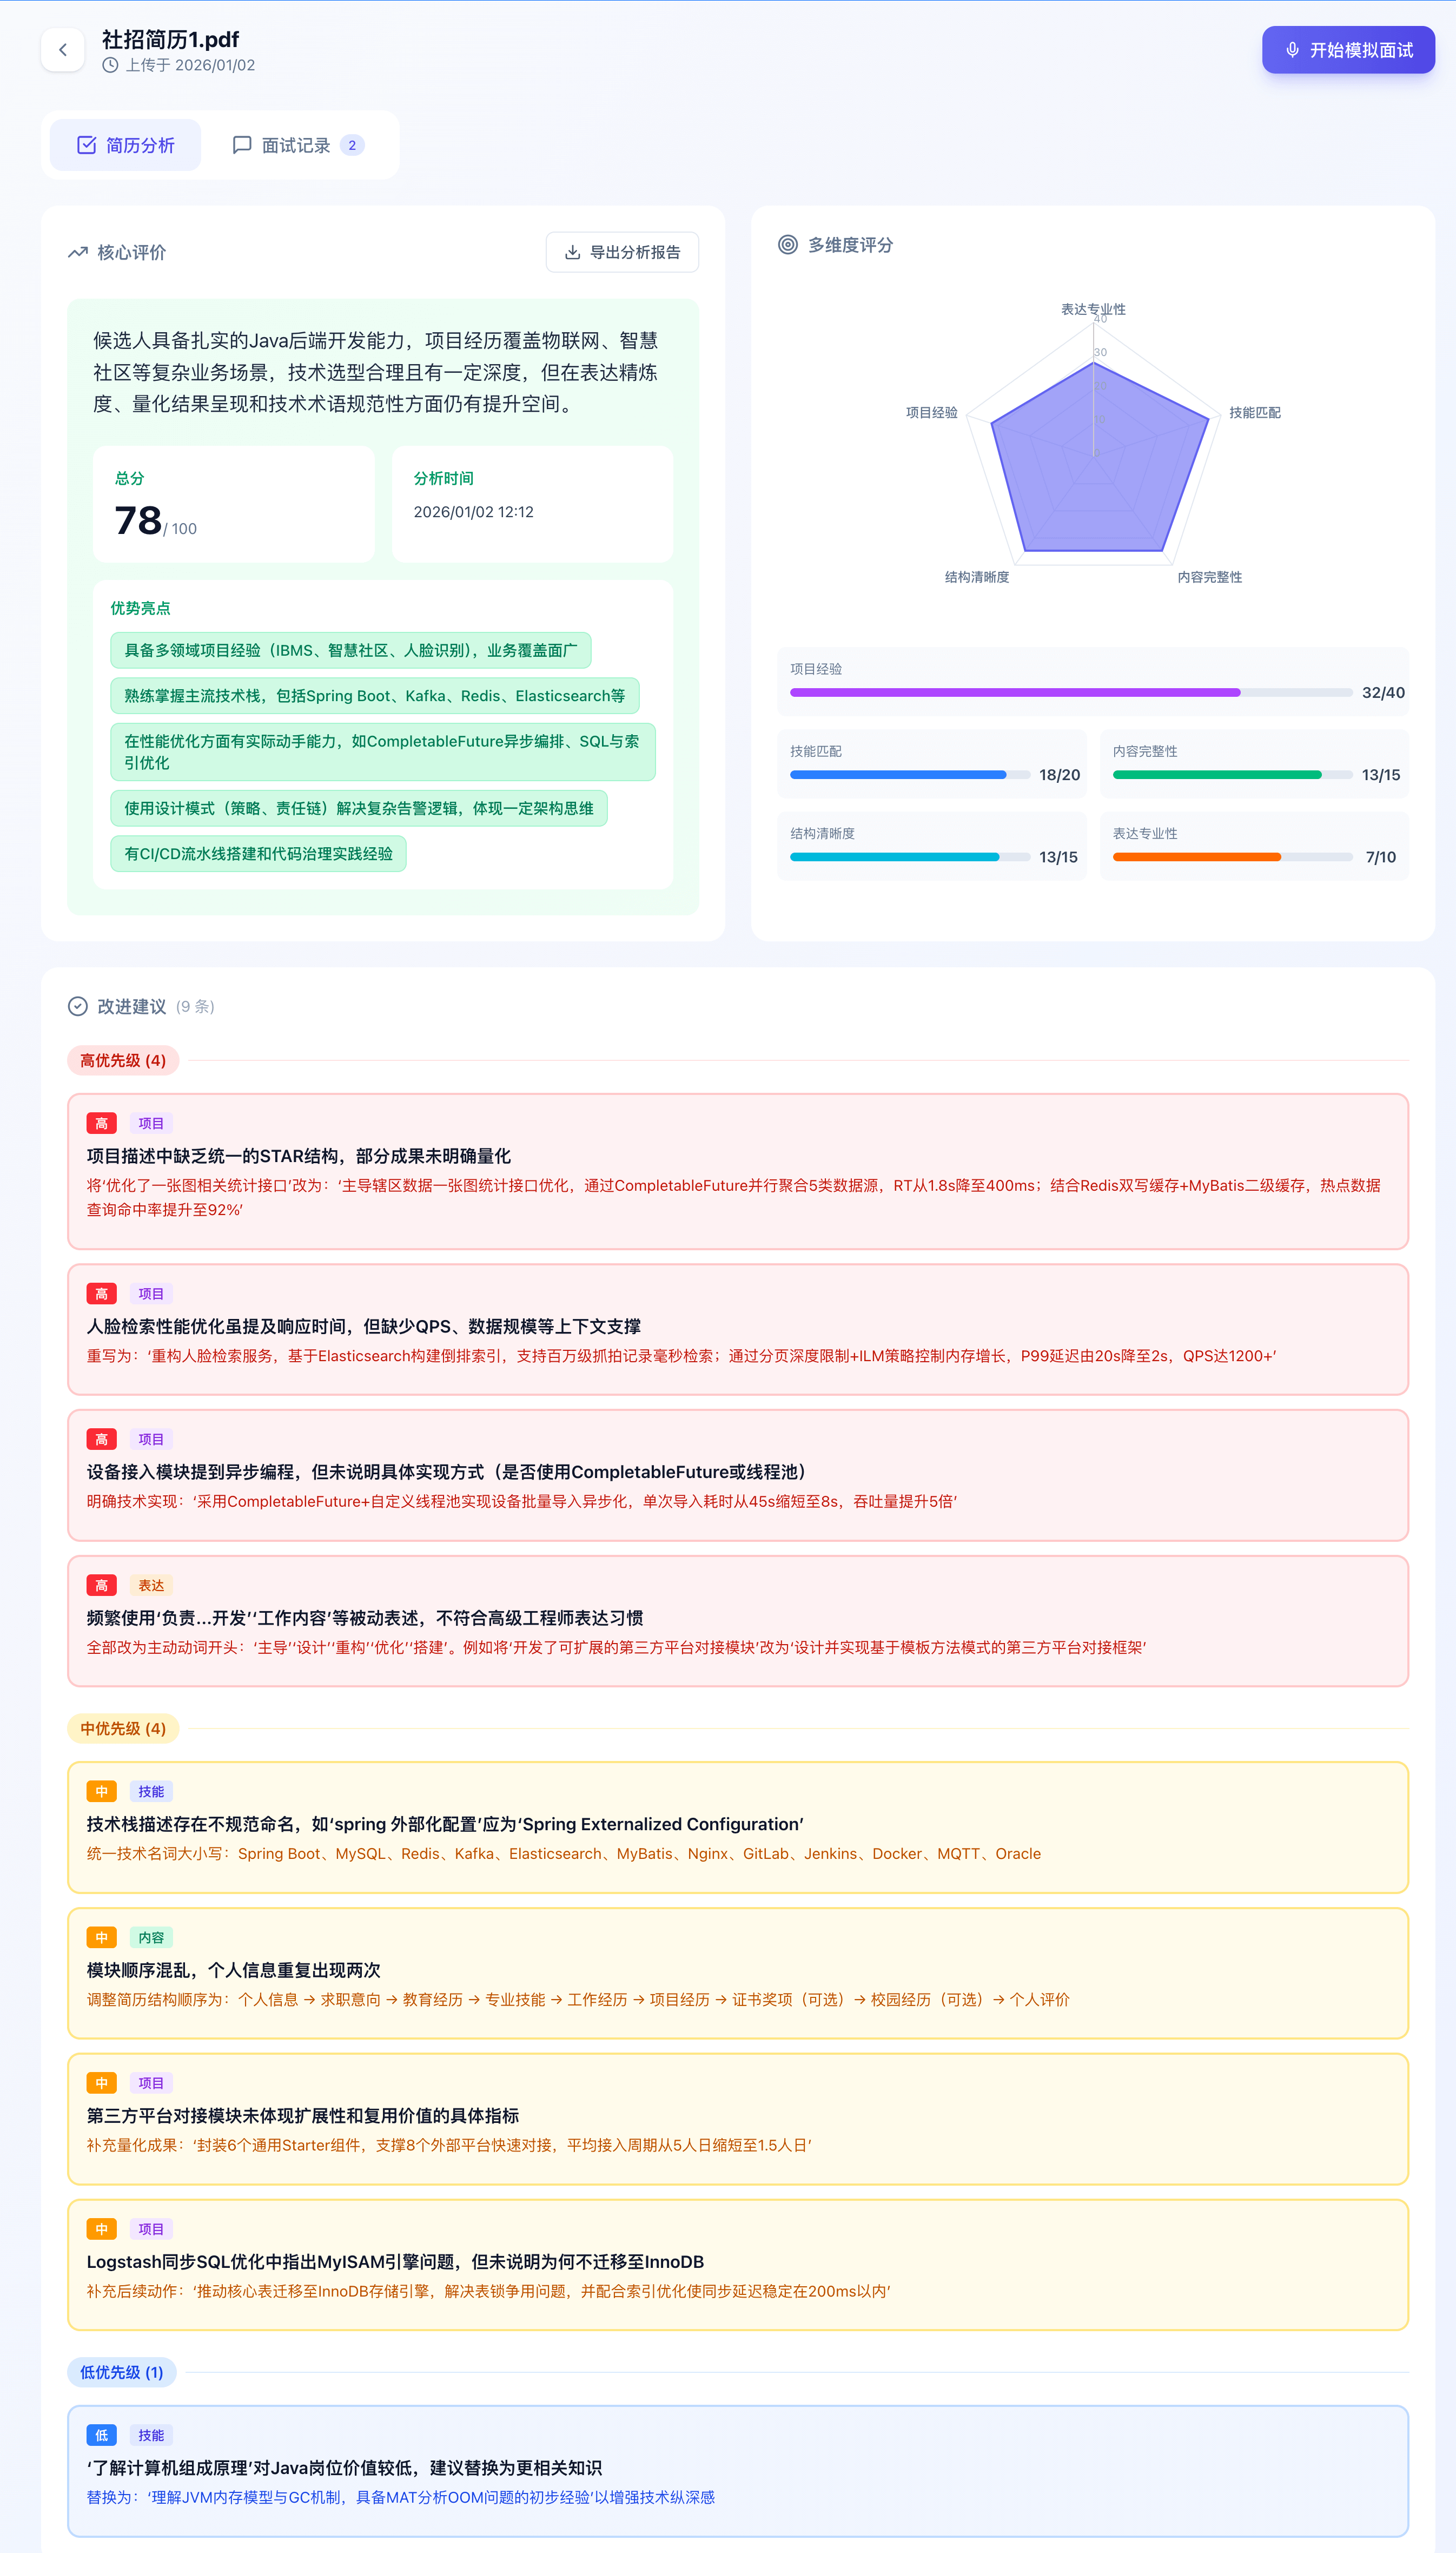
- Export báo cáo phân tích: Hỗ trợ export kết quả phân tích AI thành structured PDF resume analysis report chỉ bằng một nút.
Module phỏng vấn mô phỏng
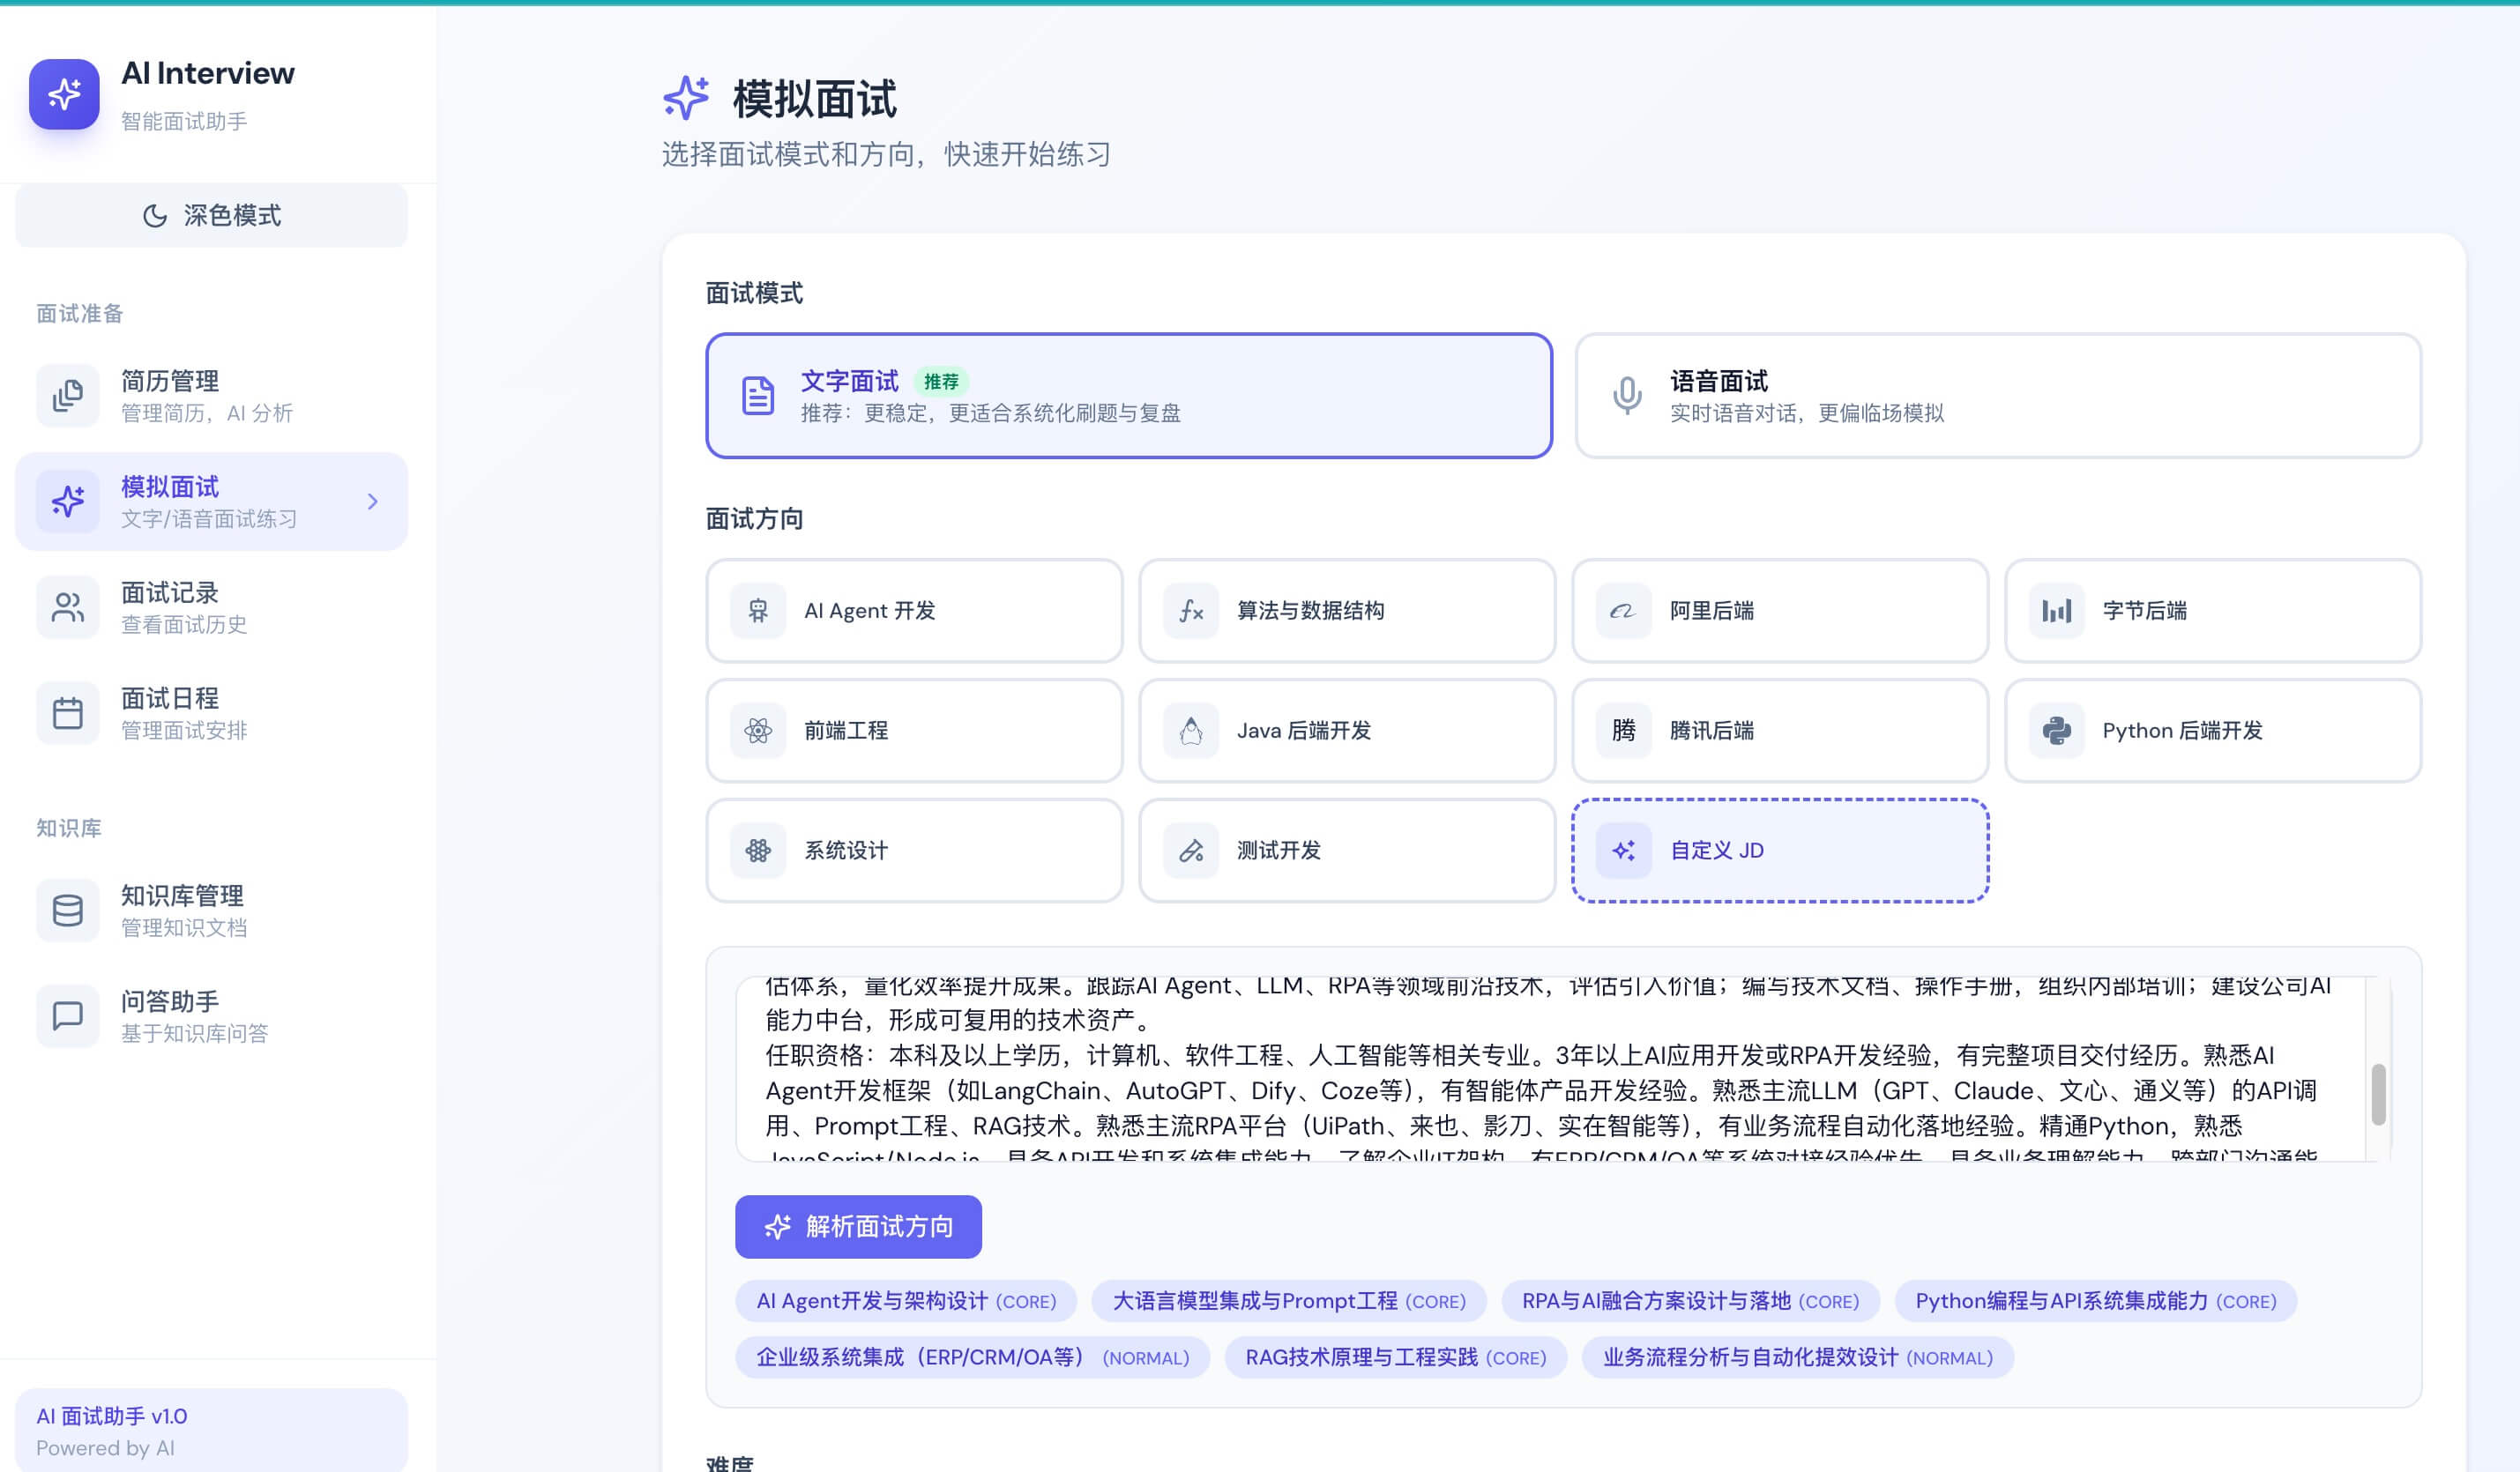
- Skill-driven question generation: Tích hợp sẵn hơn 10 hướng phỏng vấn (Java backend, chuyên đề Alibaba/ByteDance/Tencent, frontend, Python, algorithm, system design, test development, AI Agent...), mỗi hướng do
SKILL.mdđịnh nghĩa phạm vi kiểm tra, phân bố độ khó và knowledge base tham khảo. Triển khai cơ chế Progressive Disclosure load theo nhu cầu dựa trênspring-ai-agent-utils. - Tạo câu hỏi song song hai luồng: Khi có CV, 60% là câu hỏi đào sâu project trong CV (Prompt độc lập) + 40% là câu hỏi cơ bản theo hướng (Skill-driven), dùng virtual thread Java 21 để tạo song song rồi hợp nhất, cách ly vật lý để tránh xung đột Prompt.
- Phân tích JD tùy chỉnh: Dán job description (JD), LLM tự động trích xuất category phỏng vấn và ghép với question bank dùng chung, không cần thiết lập trước hướng phỏng vấn là có thể bắt đầu.
- Đề xuất hướng phỏng vấn từ CV: Sau khi upload CV, LLM dùng Semantic Matching để tự động đề xuất hướng phỏng vấn phù hợp nhất, giảm chi phí lựa chọn của user.
- Loại trùng câu hỏi cũ: Khi tạo câu hỏi, tự động loại các câu đã được hỏi trong session hiện có, tránh kiểm tra trùng lặp.
- Liên kết thời lượng các giai đoạn phỏng vấn: Sau khi kéo slider tổng thời lượng, mỗi giai đoạn (tự giới thiệu, kiểm tra kỹ thuật, đào sâu project, phần đặt câu hỏi ngược) được tự động phân bổ theo tỷ lệ.
- Luồng hỏi sâu thông minh: Hỗ trợ cấu hình nhiều lượt hỏi sâu thông minh (mặc định 1 câu), mô phỏng scenario hỏi đáp nhiều lượt.
- Architecture đánh giá thống nhất: Phỏng vấn bằng text và phỏng vấn bằng giọng nói dùng chung một evaluation engine (đánh giá theo batch + structured output + tổng hợp lần hai + fallback), kết quả đánh giá có thể so sánh.
- Export báo cáo một nút: Hỗ trợ tạo bất đồng bộ và export báo cáo đánh giá phỏng vấn mô phỏng PDF chi tiết.
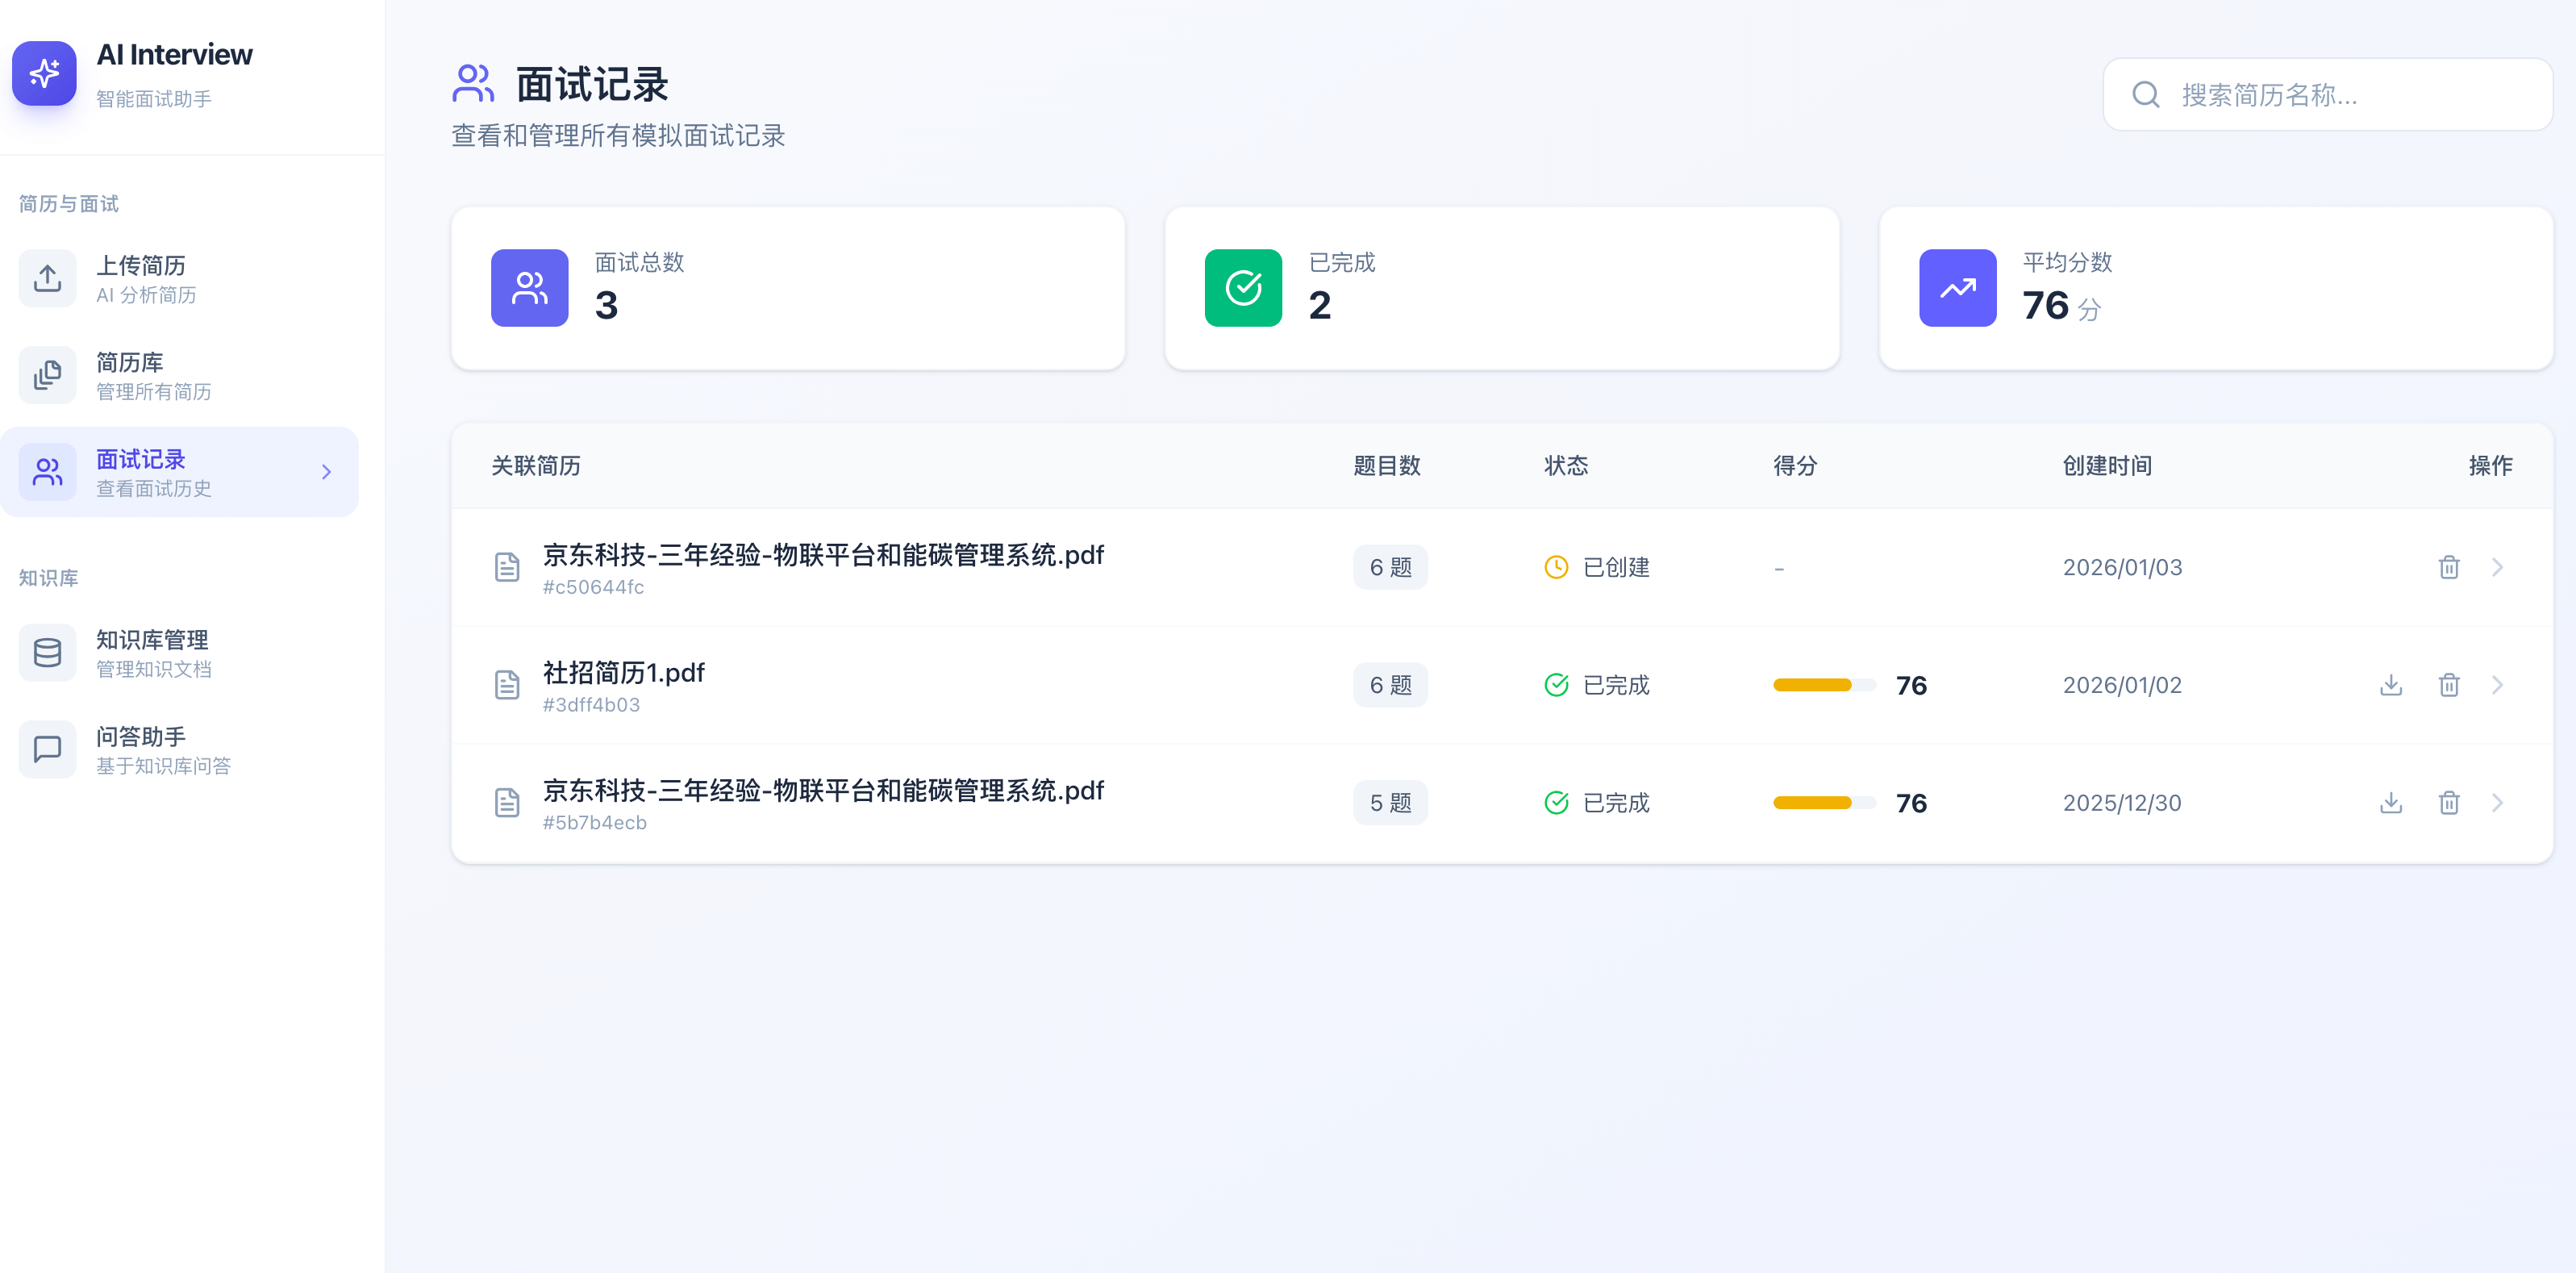
- Entry point interview center: Trang interview center tích hợp entry point của phỏng vấn text và phỏng vấn voice, hỗ trợ tiếp tục phỏng vấn và phỏng vấn lại.
Module sắp xếp phỏng vấn
- Phân tích lời mời: Hai engine rule + AI, hỗ trợ format Feishu/Lark, Tencent Meeting/Zoom, tự động trích xuất company, position, time, meeting link
- Quản lý calendar: View ngày/tuần/tháng + kéo thả điều chỉnh + list view
- Luân chuyển trạng thái: Task định kỳ tự động hết hạn, đánh dấu thủ công chờ phỏng vấn/đã hoàn thành/đã hủy
- Nhắc phỏng vấn: Có thể cấu hình reminder, tránh bỏ lỡ phỏng vấn
Module phỏng vấn bằng giọng nói
Phỏng vấn hội thoại bằng giọng nói real-time, WebSocket + model voice Qwen3 (ASR/TTS/LLM dùng chung API Key):
- Hội thoại streaming real-time: TTS đồng thời cấp sentence, vừa tạo vừa tổng hợp vừa phát, latency packet đầu tiên 200ms
- VAD phía server: Tự động ngắt câu, subtitle real-time (bao gồm intermediate result)
- Bảo vệ echo + submit thủ công: Tránh giọng AI bị thu nhầm vào
- Memory context nhiều lượt + pause/resume: Tự động pause khi timeout
- Micrometer instrumentation: Các metric như latency TTS/ASR, thời lượng session
Vấn đề đã biết: End-to-end latency còn cao (trung chuyển audio phía server), rò echo khi không dùng tai nghe, âm sắc TTS đơn điệu, audio bị giật trong network yếu. Kế hoạch sau này là khám phá WebRTC, giảm noise bằng VAD phía client, end-to-end voice model và các phương án khác.
Module quản lý knowledge base
- Xử lý tài liệu thông minh: Hỗ trợ tự động upload, chia chunk và vector hóa bất đồng bộ tài liệu nhiều định dạng như PDF, DOCX, Markdown.
- RAG retrieval augmentation: Tích hợp vector database, nâng cao độ chính xác và tính chuyên nghiệp của AI Q&A thông qua retrieval-augmented generation (RAG).
- Tương tác response streaming: Dùng công nghệ SSE (Server-Sent Events) để triển khai response streaming kiểu máy đánh chữ.
- Hội thoại hỏi đáp thông minh: Hỗ trợ hỏi đáp thông minh dựa trên nội dung knowledge base và cung cấp thông tin thống kê trực quan về knowledge base.
Demo
CV và phỏng vấn
Interview center:
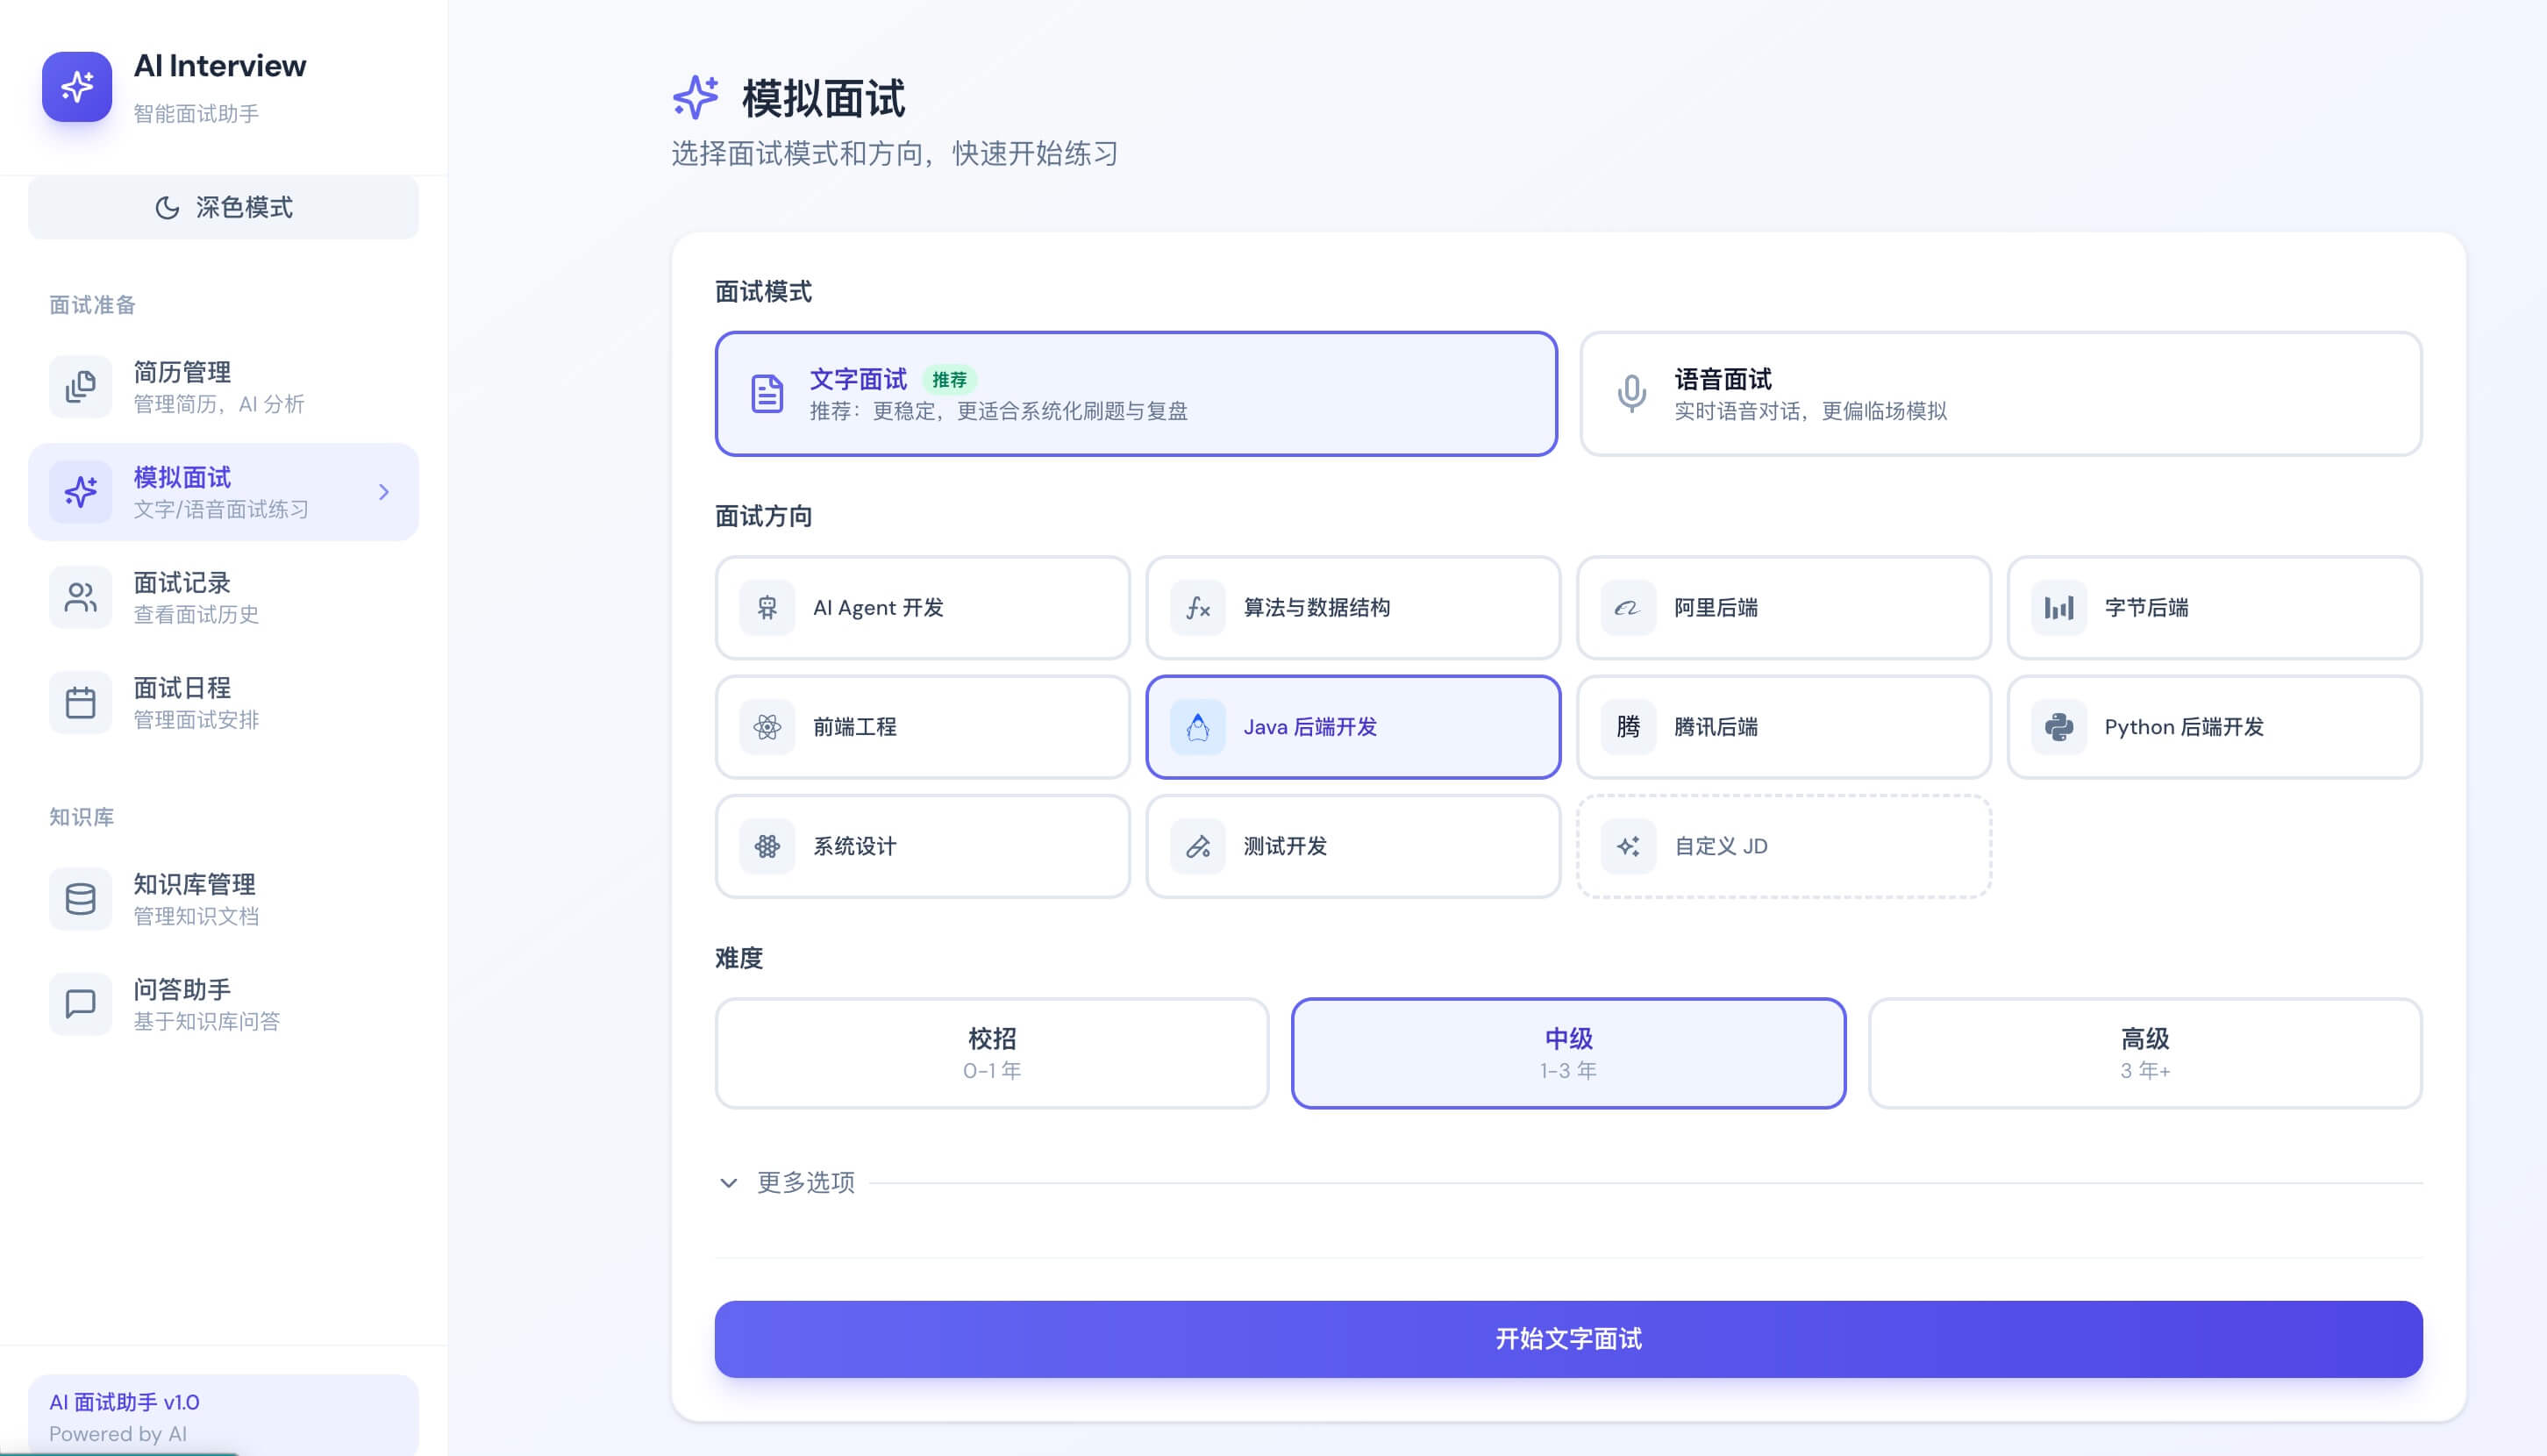
Tạo câu hỏi bằng Skill + phân tích JD:
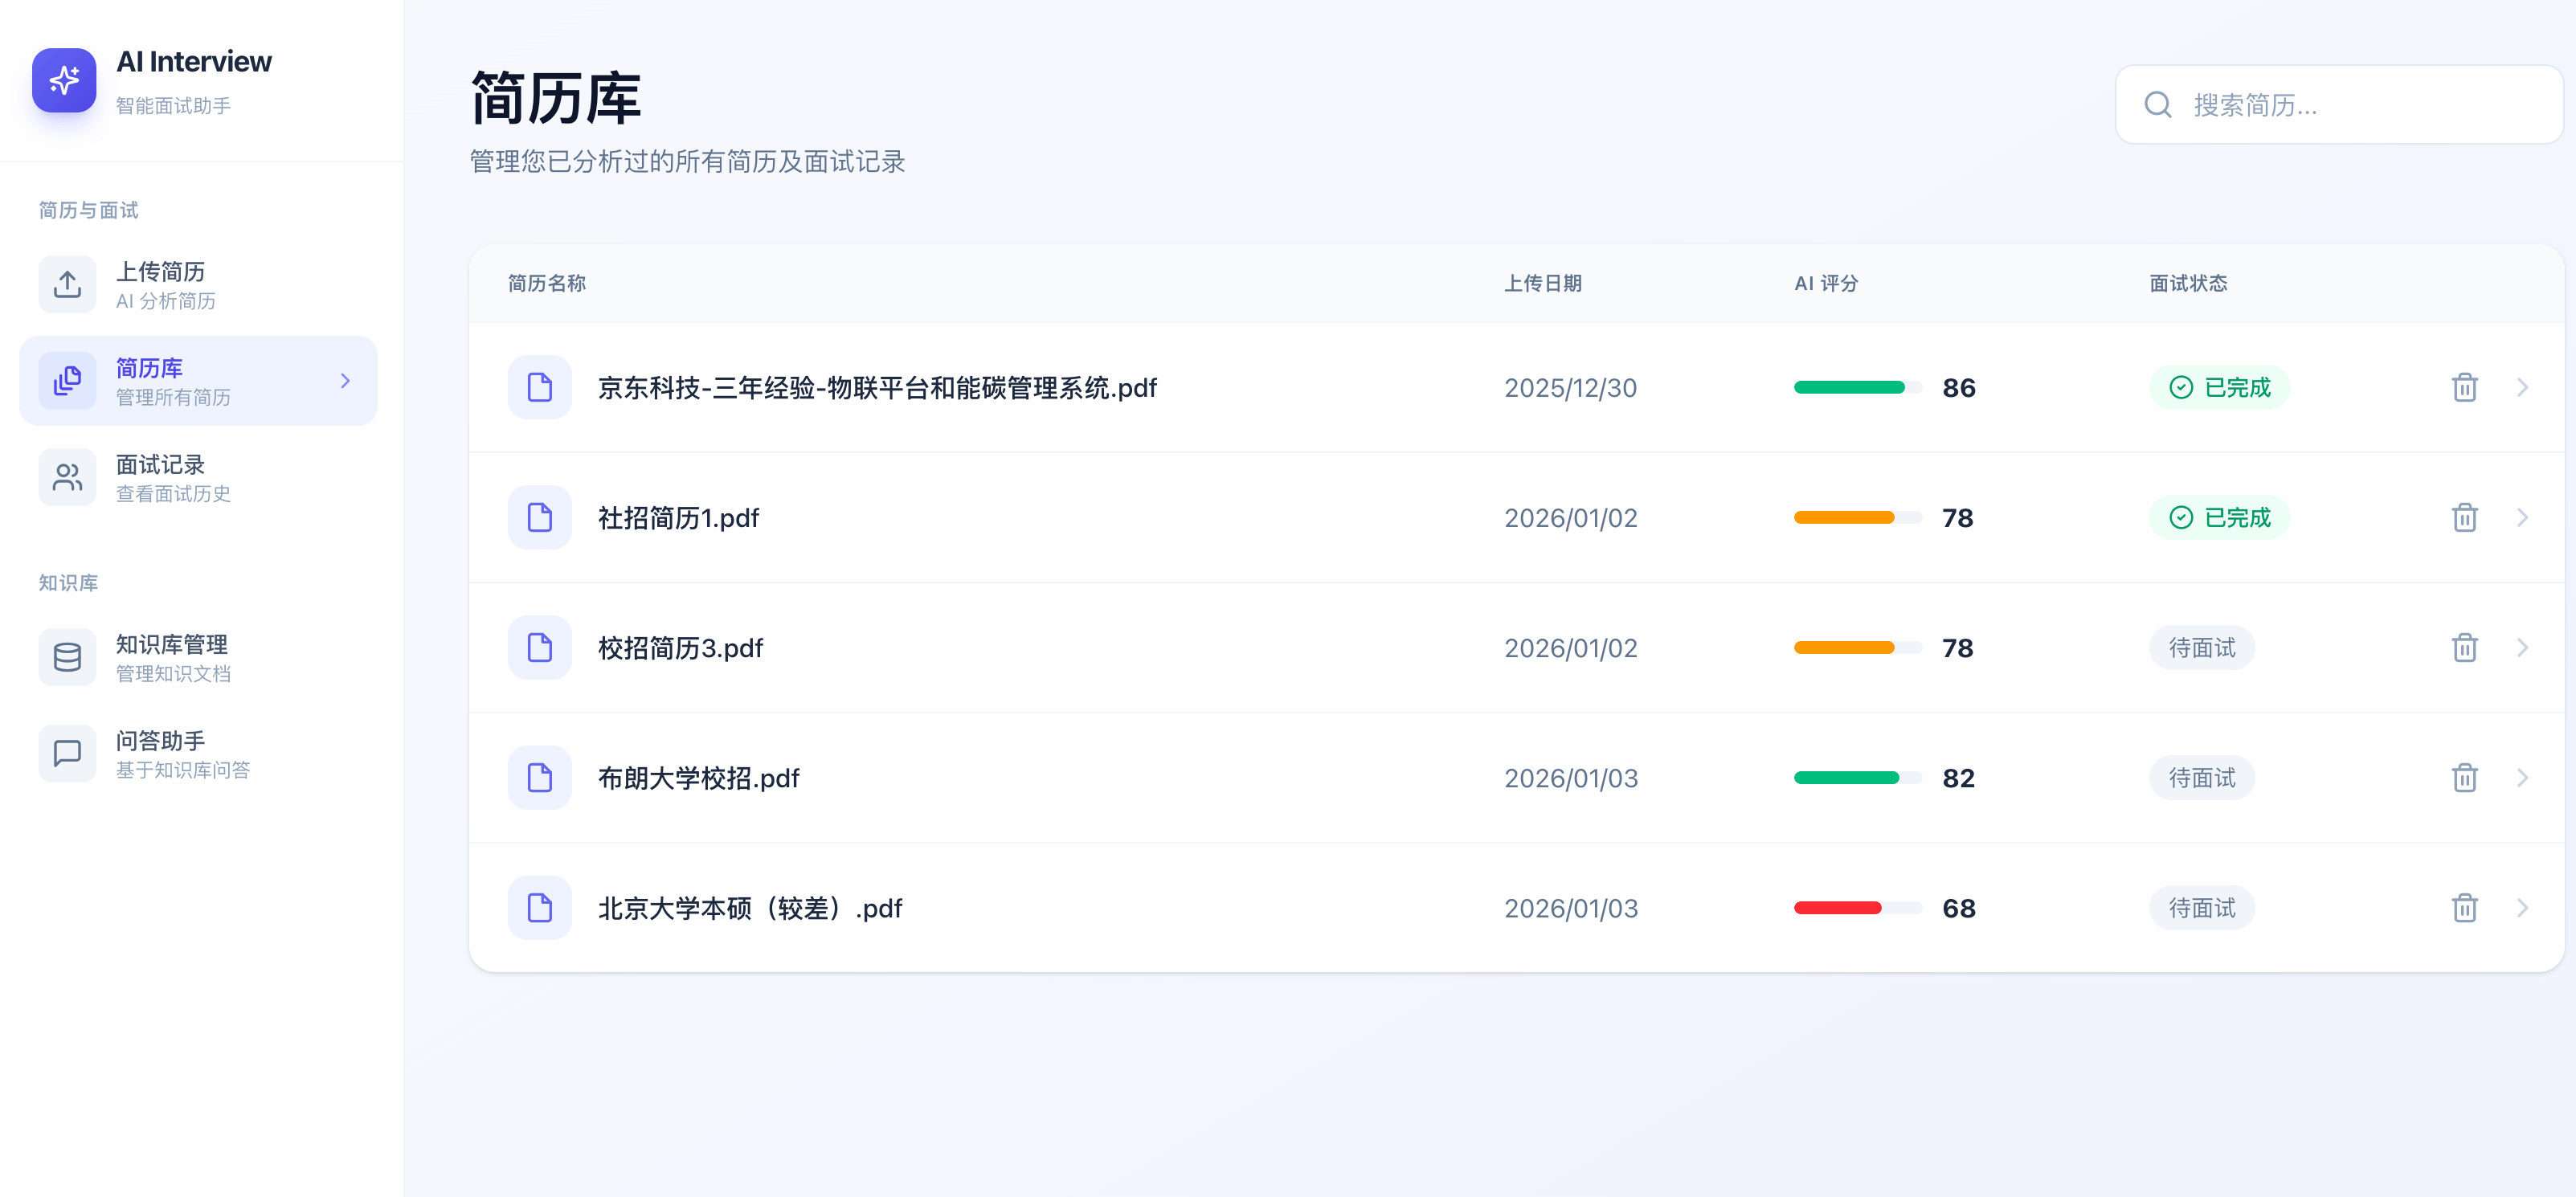
CV library:
Upload và phân tích CV:
Chi tiết phân tích CV:
Interview record:
Chi tiết phỏng vấn:
Phỏng vấn mô phỏng:
Sắp xếp phỏng vấn

Knowledge base
Quản lý knowledge base:
Trợ lý hỏi đáp:
Bạn nhận được gì khi học project này?
Project này sử dụng tech stack Java 21 + Spring Boot 4.0 tiên tiến nhất trong ngành, là full-stack project thực chiến đầu tiên trên thị trường tích hợp sâu Spring AI 2.0. Chúng tôi không chỉ cung cấp code chất lượng cao, mà còn có tutorial phân tích architecture chi tiết đi kèm.
Thiết kế tổng thể của project tuân theo nguyên tắc “từ nông đến sâu”. Ngay cả khi nền tảng lập trình của bạn còn hạn chế, chỉ cần làm theo tutorial hướng dẫn từng bước, bạn vẫn có thể thuận lợi xây dựng từ đầu một AI LLM application cấp production.
Nắm vững các paradigm cốt lõi của phát triển ứng dụng AI
Project này là bước đệm tốt nhất để bạn chuyển từ backend truyền thống sang AI application developer:
Spring AI 2.0 thực chiến cấp công nghiệp: Hiểu sâu AI abstraction layer chính thức của Spring, nắm vững cách kết nối với các model phổ biến như Qwen và OpenAI thông qua declarative interface thống nhất.
Ứng dụng chuyên sâu Prompt Engineering (prompt engineering): Từ bỏ việc nối string đơn giản. Học cách xây dựng System/User Prompt có cấu trúc và dùng BeanOutputConverter để tự động map output LLM thành Java object, chấm dứt hoàn toàn việc parse JSON thủ công phức tạp.
Công nghệ Query Rewrite (query rewriting): Học cách dùng LLM để rewrite thông minh query gốc của user, bổ sung ngữ nghĩa, tối ưu search term, cải thiện đáng kể recall rate của hệ thống RAG. Nắm vững chiến lược cascade retrieval “query gốc → query đã rewrite → fallback về query gốc”.
Tinh chỉnh động tham số retrieval: Hiểu sâu cách tự động điều chỉnh topK và similarity threshold theo các đặc trưng như độ dài query, mật độ ngữ nghĩa, để triển khai chiến lược retrieval khác nhau cho query ngắn, query trung bình/dài và query dài.
RAG (retrieval-augmented generation) khép kín toàn chain: Phân tích sâu chain kỹ thuật hoàn chỉnh “phân tích tài liệu → chia chunk văn bản → vector hóa (Embedding) → lưu vector database → similarity search → context-enhanced generation”. Học cơ chế “xác định hit hiệu quả”, tránh các fragment liên quan yếu kích hoạt câu trả lời dài “không đủ thông tin” của model.
Độ tin cậy của structured output và chiến lược retry: Nắm vững pattern đóng gói thống nhất
StructuredOutputInvoker, học cách nâng cao đáng kể tỷ lệ parse thành công của structured output LLM thông qua auto-retry, error injection và strict JSON instruction.
Tư duy backend architecture Java hiện đại
Bạn có thể học các engineering practice tốt:
Đón nhận Java 21 và Spring Boot 4.0: Đi trước trong việc áp dụng virtual thread (Virtual Threads), Record class và các tính năng hiệu năng cao khác. Thích ứng chuyên sâu với thiết kế module hóa của Spring Boot 4.0, giúp tech stack của bạn dẫn trước thị trường.
Modular monolith architecture: Học cách tổ chức code thông qua các layer rõ ràng (Modules + Infrastructure + Common). Thiết kế này vừa có ưu thế tách rời của microservice, vừa giảm đáng kể gánh nặng tư duy vận hành của monolith application.
Hiệu năng object conversion tối đa: Dùng MapStruct để tạo mapping code trong compile time. Học cách xử lý mapping phức tạp giữa Entity và DTO một cách thanh lịch, an toàn trong scenario theo đuổi tốc độ response tối đa.
Lựa chọn data storage và middleware thực tế
Chúng tôi không mù quáng chất đống middleware, mà hướng dẫn bạn đưa ra lựa chọn “hợp lý nhất” dựa trên scenario nghiệp vụ:
Giải pháp storage “một cửa” PostgreSQL + pgvector: Nắm vững cách xử lý hiệu quả dữ liệu nghiệp vụ quan hệ và dữ liệu vector chiều cao trong cùng một database. Học sâu thực tiễn tối ưu hiệu năng HNSW index trong scenario hàng chục nghìn tài liệu.
Hệ thống rate limiting phân tán Redis + Lua: Thực chiến đóng gói component rate limiting phân tán hiệu năng cao. Dựa trên Lua script để đảm bảo tính atomic của logic rate limiting, hỗ trợ kiểm soát traffic chính xác theo user, IP hoặc global dimension, phòng vệ hiệu quả hành vi spam API và bảo vệ quota của AI API có giá trị cao.
Xử lý task bất đồng bộ bằng Redis Stream: Thảo luận chuyên sâu vì sao chọn Redis Stream nhẹ thay vì Kafka trong các scenario tốn thời gian như phân tích CV (10-60s). Demo thực chiến cách dùng message queue để tách rời hệ thống và san bằng traffic peak.
Tối ưu xử lý và làm sạch file cấp doanh nghiệp: Không chỉ dùng Apache Tika để xây dựng document parsing engine dùng chung, mà còn triển khai TextCleaningService đi kèm. Thông qua regex cleaning, chuẩn hóa dòng trống và khử nhiễu văn bản (như loại bỏ image link, illegal control character), chất lượng recall của RAG được nâng cao đáng kể; đồng thời tích hợp content hash detection để chặn upload trùng lặp từ nguồn, tiết kiệm chi phí storage và Token.
Design pattern cho chức năng AI nâng cao
Architecture Skill và Agent Skills: Học cách tách cấu hình hướng phỏng vấn khỏi code, dựa trên thiết kế config hai tầng
SKILL.md+skill.meta.yml. Nắm vững cơ chế Progressive Disclosure ba tầng Discovery → Semantic Matching → Execution củaspring-ai-agent-utils, cùng chiến lược load resource khác nhau giữa phỏng vấn text (preload bằng một lần gọi) và phỏng vấn voice (load theo nhu cầu bằng ReAct nhiều lượt).Architecture tạo câu hỏi song song hai luồng: Hiểu sâu vấn đề xung đột Prompt khi “một lần gọi không thể đồng thời đảm nhiệm CV và hướng phỏng vấn”, học cách dùng cách ly vật lý (hai bộ Prompt template độc lập + hai luồng AI call song song) để tạo hỗn hợp 60% câu hỏi CV + 40% câu hỏi theo hướng, cùng thiết kế index merge và fallback strategy.
Cơ chế tạo câu hỏi sâu nhiều lượt: Học cách dùng thiết kế Prompt nhiều tầng để tạo cấu trúc dạng cây “câu hỏi chính + câu hỏi sâu” trong scenario tạo câu hỏi phỏng vấn. Nắm vững các kỹ thuật thực chiến như cấu hình số lượng câu hỏi sâu, phân bổ trọng số loại câu hỏi và loại trùng lịch sử.
Xử lý output streaming thông minh: Nắm vững kỹ thuật “detection window” trong scenario SSE streaming, vừa duy trì tốc độ response đầu tiên vừa nhanh chóng nhận diện output “không có thông tin” và thống nhất thành template cố định, tránh để user nhìn thấy đoạn từ chối dài.
Chiến lược no-result thống nhất: Học cách thiết kế trải nghiệm nhất quán khi user không có kết quả trong hệ thống RAG, bao gồm tối ưu toàn chain như xác định hit, chuẩn hóa output và cắt streaming.
Delivery và deploy engineering tiêu chuẩn hóa
Hệ thống build hiện đại Gradle: Thoát khỏi config rườm rà của Maven, nắm vững tính linh hoạt của Gradle 8.14 và version catalog (Version Catalog), học cách quản lý dependency của project lớn một cách thanh lịch.
Containerized deploy cấp production: Dùng Docker Compose để dựng một lệnh toàn bộ runtime environment bao gồm database extension, cache và object storage, hiểu quy chuẩn cấu hình infrastructure trong thời đại cloud native.
Engineering frontend mượt mà và trải nghiệm tương tác
Đối với backend developer, đây còn là cơ hội tuyệt vời để bổ sung “góc nhìn full-stack”:
SSE (Server-Sent Events) streaming render: Nắm vững kỹ thuật bên trong để output câu trả lời từng chữ như ChatGPT, hiểu ưu thế architecture của nó so với WebSocket trong scenario push một chiều.
Thiết kế UI reactive và animation: Dùng Tailwind CSS để xây dựng giao diện đẹp tối giản, kết hợp Framer Motion để tạo animation tương tác nâng cao.
AI data visualization: Dùng Recharts trình bày điểm CV được AI phân tích và so sánh đa chiều dưới dạng radar chart trực quan, giúp dữ liệu “biết nói”.
Làm thế nào tham gia học?
Nhiều AI project chỉ dừng ở việc gọi một API. Còn project này giúp bạn giải quyết vấn đề engineering thực tế:
- Làm thế nào xử lý vấn đề response LLM chậm? (Xử lý bất đồng bộ + Redis Stream)
- Làm thế nào khiến LLM output dữ liệu có format cố định? (Structured Prompt + MapStruct)
- Làm thế nào để LLM trả lời dựa trên tài liệu riêng? (RAG + pgvector)
Project này là project thực chiến nội bộ dành riêng cho JavaGuide Knowledge Planet, học và đọc online qua tài liệu Yuque, không mở riêng cho bên ngoài.
Lý do chọn phát hành trong Knowledge Planet là để đảm bảo mỗi người học đều nhận được giải đáp kỹ thuật chuyên sâu và dịch vụ hỗ trợ tìm việc đầy đủ.
Đây mới chỉ là khởi đầu. Sau này Knowledge Planet sẽ tiếp tục ra mắt thêm nhiều Java project thực chiến phù hợp với scenario nghiệp vụ thực tế của doanh nghiệp, giúp bạn luôn đứng ở tuyến đầu công nghệ (bật mí một chút, project tiếp theo là hệ thống chăm sóc khách hàng thông minh cấp doanh nghiệp, sẽ cùng mọi người thực hành thêm nhiều năng lực AI).
Ngoài ra, Knowledge Planet của tôi còn có nhiều dịch vụ khác như hỏi đáp một-một, chỉnh sửa CV, tài liệu phỏng vấn hệ thống backend (bao gồm system design và scenario question thường gặp), check-in học tập; giá trị của bất kỳ dịch vụ riêng lẻ nào cũng đã vượt xa phí tham gia Knowledge Planet. Hoan nghênh bạn tìm hiểu chi tiết về Knowledge Planet của tôi!
Đã kiên trì duy trì sáu năm, nội dung liên tục cập nhật, dù giá rất rẻ (0,4 tệ/ngày) nhưng chất lượng cao, chủ yếu là làm nội dung có tâm!
Hiện Knowledge Planet đang có chương trình khuyến mãi, chỉ bằng giá hai cuốn sách là bạn có thể sở hữu dịch vụ của hàng chục nghìn lớp đào tạo! Ở đây còn cung cấp một coupon 30 tệ (giá sắp tăng, người dùng cũ quét mã gia hạn được giảm một nửa):
Tận tâm làm nội dung, kiên trì với nguyên tắc, không trục lợi từ người dùng, những việc khác hãy để thời gian trả lời! Cùng cố gắng!