
Thực chiến DeepSeek V4 + Claude Code: Đánh giá chuyên sâu năng lực code

Ngày 24 tháng 4 năm 2026, DeepSeek phát hành và open source V4 Preview. Có rất nhiều báo cáo kỹ thuật và bài kiểm thử cộng đồng, nhưng điều tôi quan tâm hơn là hiệu quả của nó sau khi được đưa vào codebase thực tế.
Các open source model đã khá trưởng thành trong đối thoại và viết lách, các hãng đuổi bắt nhau, tốc độ iteration có thể thấy rõ. Nhưng Agent Coding lại là chuyện khác.
Để model tự phân tích cấu trúc project, hiểu dependency giữa nhiều file và đưa ra giải pháp engineering có thể triển khai, cả năng lực code lẫn độ ổn định khi gọi tool đều phải đạt yêu cầu.
Trước đây, các model khác vẫn luôn tiến bộ ở hướng này, nhưng chỉ cần dùng thực tế là biết: vẫn còn thiếu một chút để có thể “yên tâm giao cho nó tự hoàn thành”.
Vì vậy, ngay khi V4 được phát hành, phản ứng đầu tiên của G là kết nối trực tiếp nó vào Claude Code để bắt tay làm việc.
Bài viết này ghi lại bốn phần:
- Hai cách kết nối Claude Code với DeepSeek V4: dùng file cấu hình + chuyển đổi trực quan bằng CC Switch
- Ghi chép thực chiến về năm task development thực tế: V4-Pro làm việc thực sự ra sao
- Các tham số cốt lõi và pricing của DeepSeek V4-Pro và Flash: có đáng chuyển đổi không
- Đề xuất theo trường hợp sử dụng: khi nào nên dùng, khi nào nên tiếp tục quan sát
Kết nối Claude Code với DeepSeek V4
Toolchain của Claude Code khá trưởng thành, nhưng chi phí API của model chính thức không thấp. DeepSeek V4 cung cấp Anthropic-compatible API, Claude Code có thể kết nối trực tiếp mà không cần service chuyển đổi protocol bổ sung. Tuy nhiên, compatible API không đồng nghĩa với việc tái tạo đầy đủ năng lực của Anthropic model; tool calling, context và các tính năng mới vẫn cần được kiểm chứng theo task thực tế.
Cách một: Dùng file cấu hình (khuyến nghị)
Nếu máy bạn chưa cài Claude Code, trước tiên chạy lệnh dưới đây để cài đặt (Node.js 18+):
npm install -g @anthropic-ai/claude-codeChỉnh sửa hoặc tạo mới file cấu hình Claude Code ~/.claude/settings.json, thêm trường env và điền địa chỉ backend, model cùng API Key:
{
  "env": {
    "ANTHROPIC_AUTH_TOKEN": "your_deepseek_api_key",
    "ANTHROPIC_BASE_URL": "https://api.deepseek.com/anthropic",
    "ANTHROPIC_MODEL": "deepseek-v4-pro[1m]",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "deepseek-v4-pro[1m]",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "deepseek-v4-pro[1m]",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "deepseek-v4-flash",
    "CLAUDE_CODE_SUBAGENT_MODEL": "deepseek-v4-flash",
    "CLAUDE_CODE_EFFORT_LEVEL": "max",
    "API_TIMEOUT_MS": "3000000",
    "CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC": "1"
  }
}
Lưu ý thay your_deepseek_api_key bằng DeepSeek API Key của bạn.
Địa chỉ tạo API Key: https://platform.deepseek.com/.

[1m] ở đây dùng để yêu cầu phiên bản context 1M của V4 Pro. Nếu trong task hằng ngày bạn muốn ưu tiên Flash, có thể đổi ANTHROPIC_MODEL thành deepseek-v4-flash; hãy xem tài liệu kết nối chính thức của DeepSeek để biết model ID và cách mapping.
Sau khi cấu hình xong, khởi động Claude Code:
claudeLần đầu khởi động, bạn cần chọn tin cậy folder hiện tại.
Cách hai: CC Switch (chuyển đổi trực quan)
Nếu bạn muốn chuyển đổi linh hoạt giữa nhiều Provider như DeepSeek, Claude và MiniMax, nên cài CC Switch. Đây là một tool chuyên quản lý việc chuyển đổi model Claude Code, hỗ trợ chuyển đổi chỉ bằng một lần nhấp, đồng thời hỗ trợ quản lý Skills, MCP và prompt.
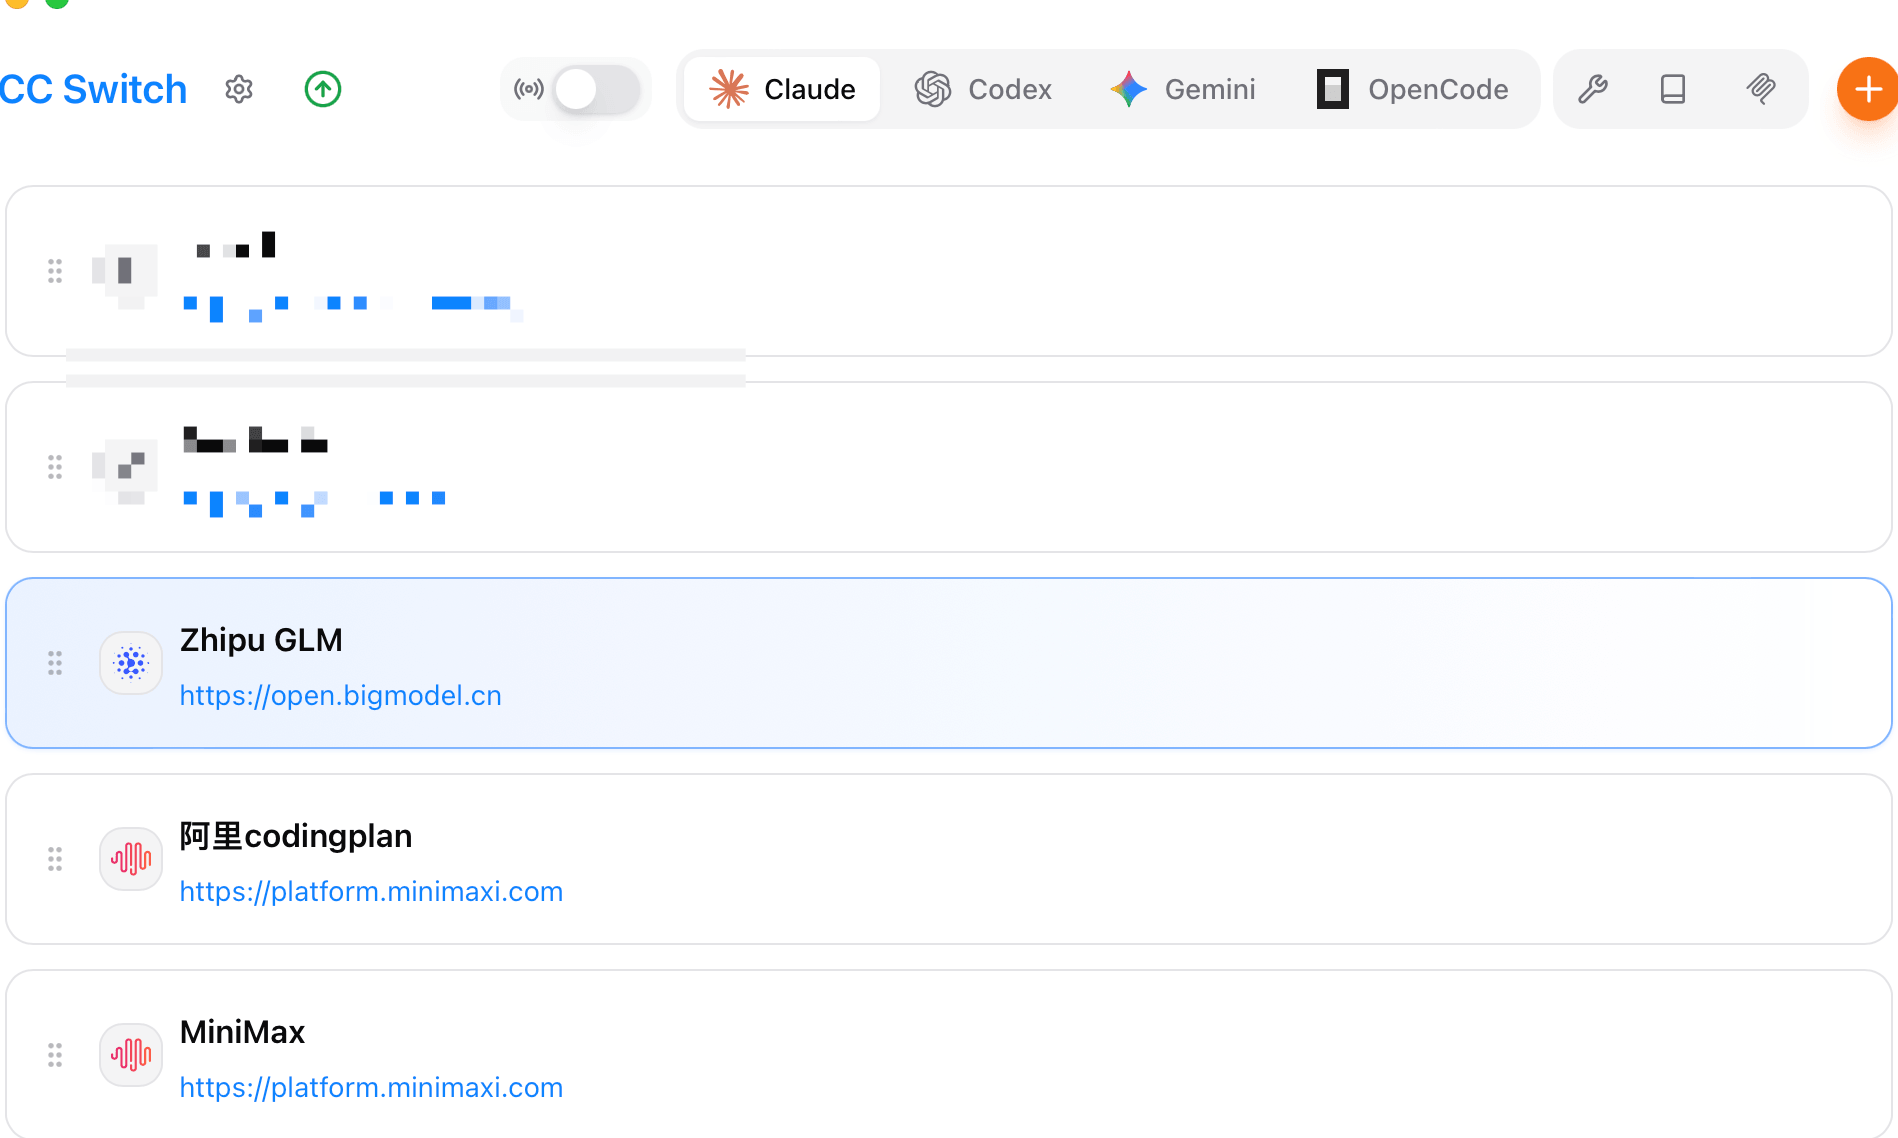
Khởi động CC Switch, nhấp "+" ở góc trên bên phải, chọn nhà cung cấp tùy chỉnh, điền https://api.deepseek.com/anthropic vào Base URL và API Key DeepSeek của bạn vào API Key.
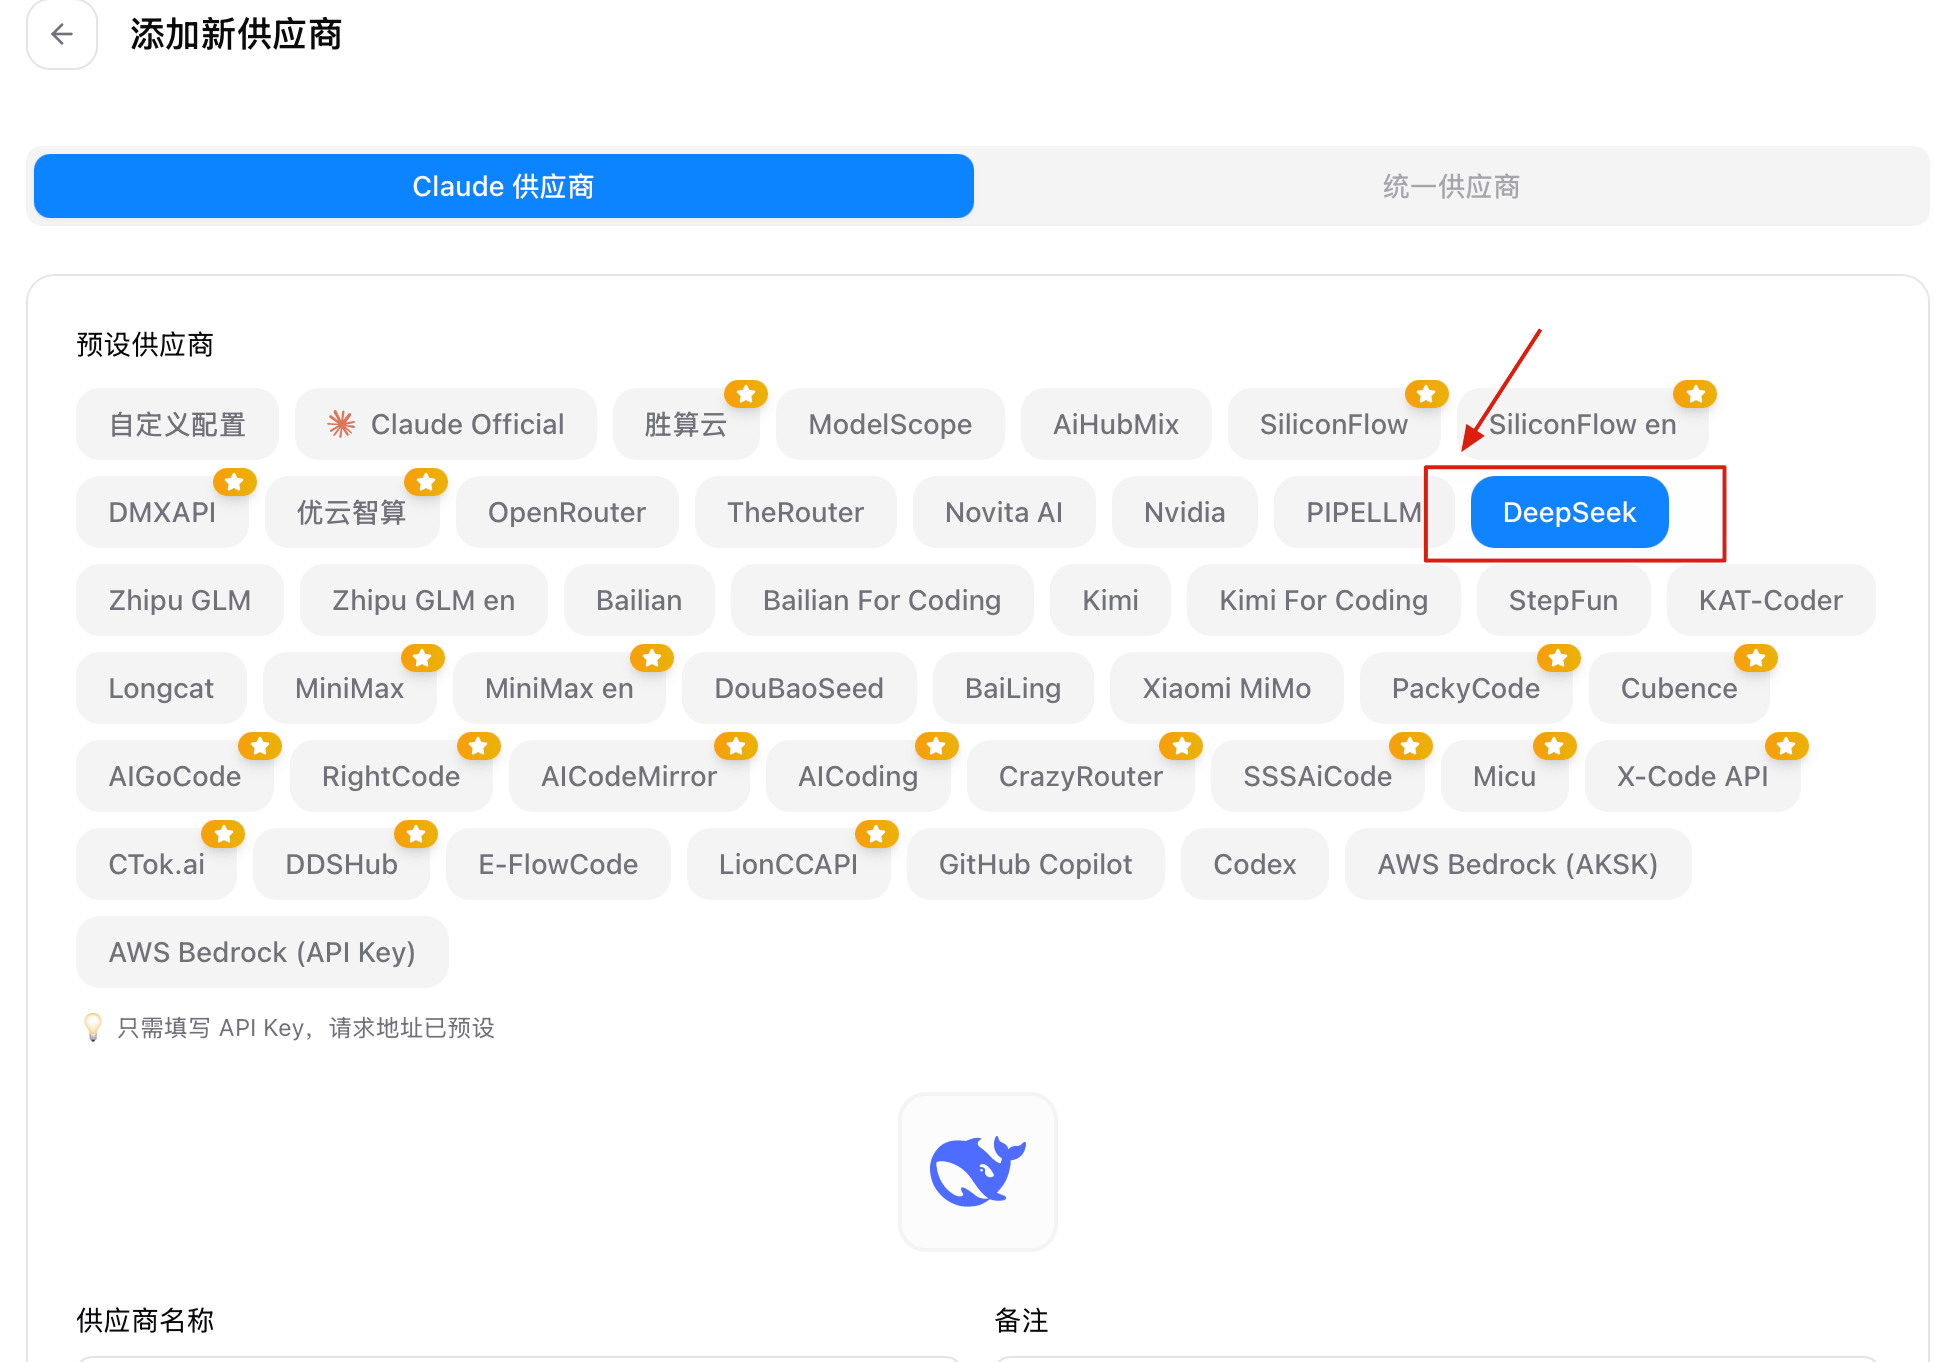
Đổi tên model thành deepseek-v4-pro[1m] (hoặc deepseek-v4-flash), sau đó nhấp “Thêm” ở góc dưới bên phải.
Xác minh đã có hiệu lực
Nhập trực tiếp claude trên command line, sau khi vào Claude Code thì nhập /status để xác nhận. Nếu model hiển thị deepseek-v4-pro[1m] hoặc deepseek-v4-flash, nghĩa là routing đã có hiệu lực.
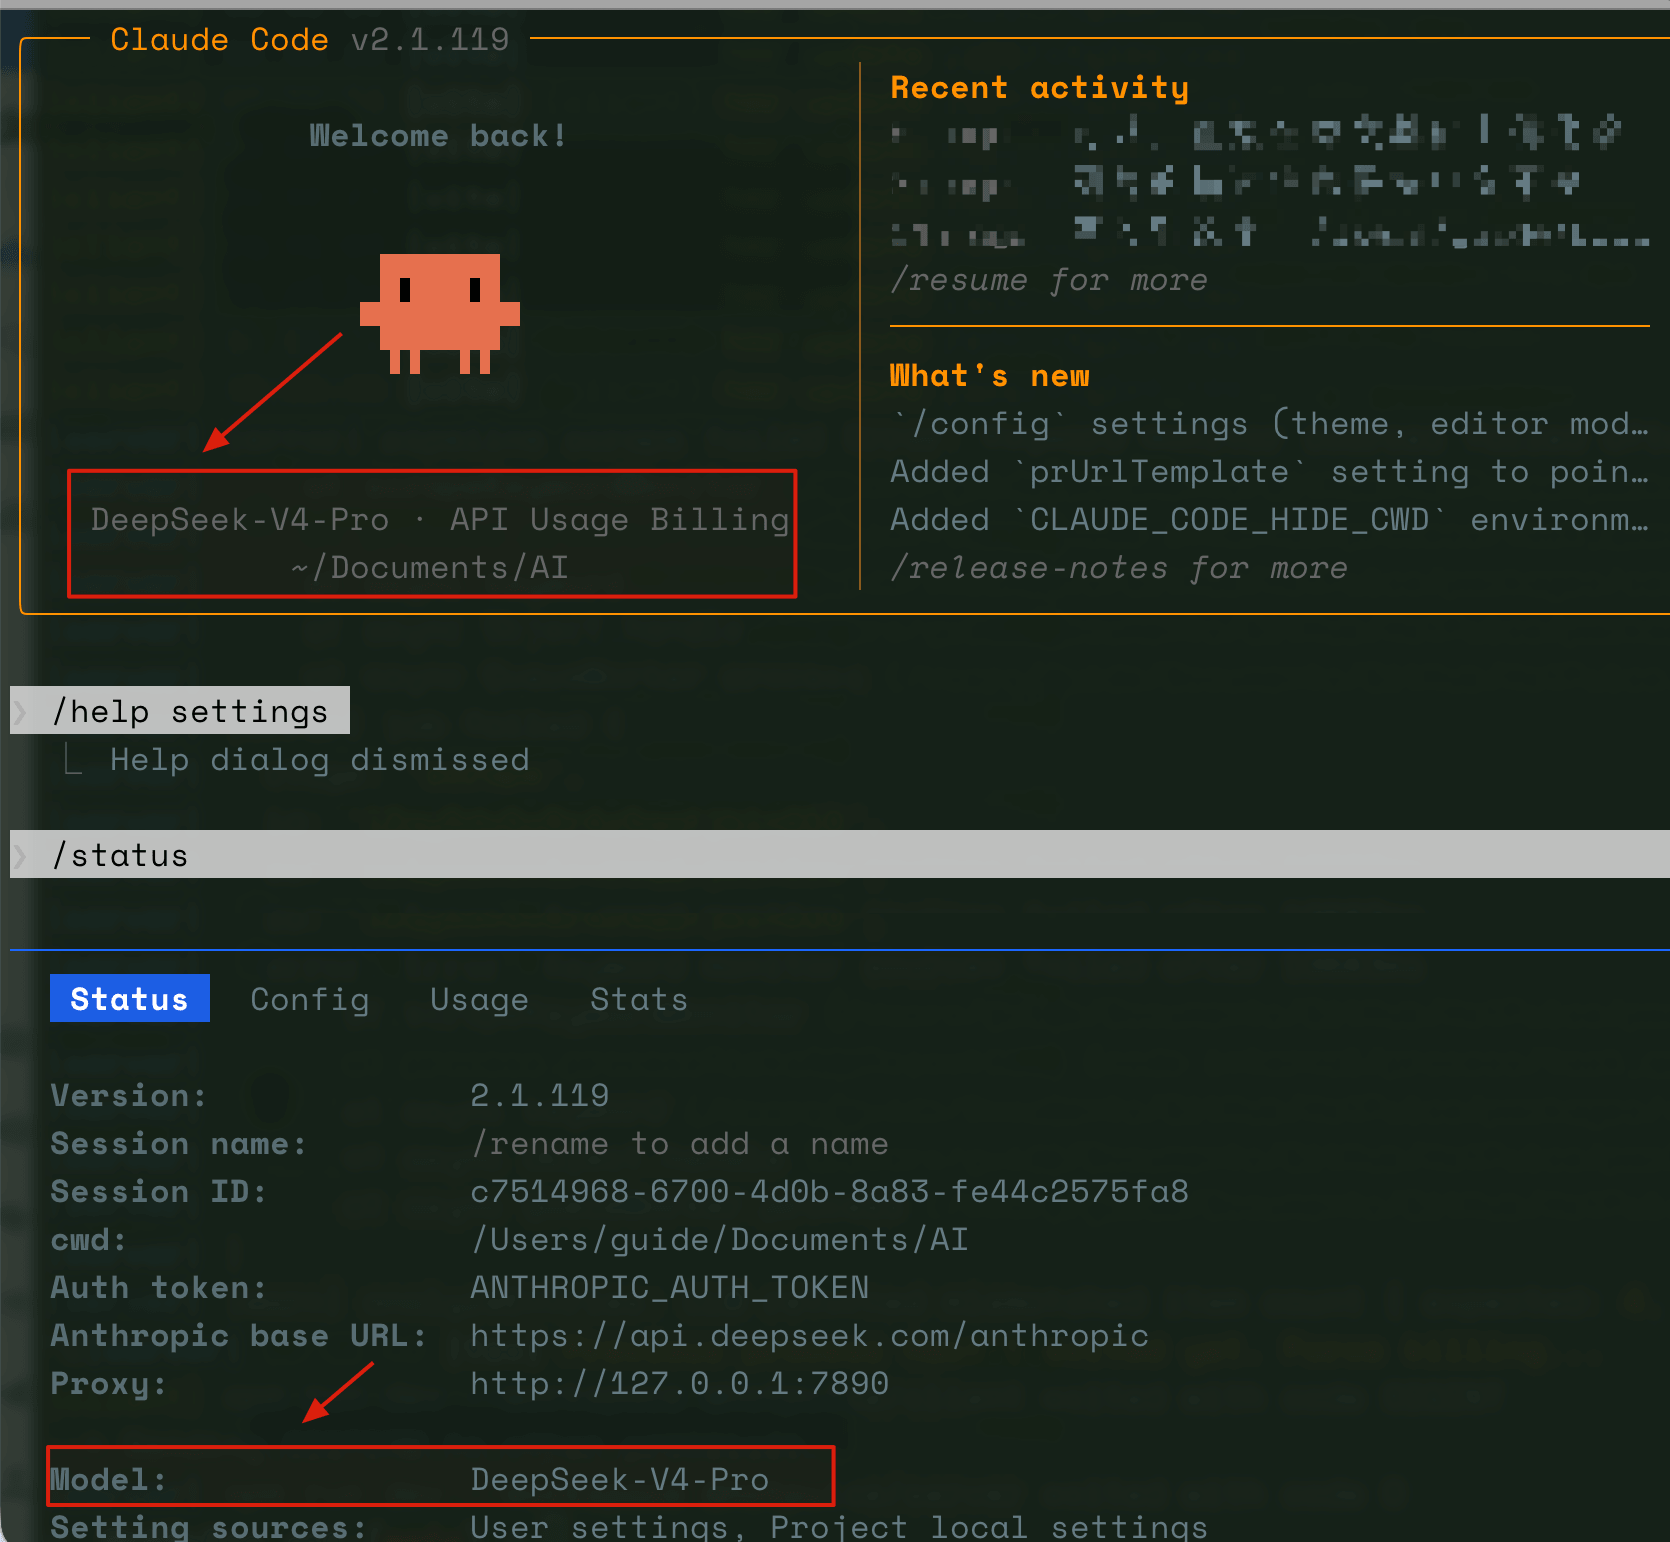
Sau đó bạn có thể gọi DeepSeek V4 thông qua Claude Code. Việc model bên thứ ba có hỗ trợ một năng lực mới nào đó của Claude Code hay không vẫn phải căn cứ vào compatible API và kết quả kiểm thử thực tế.
Thực chiến một: Nâng cấp danh sách model preset đa Provider của LLM
Tôi có một project phân tích cổ phiếu multi-agent đã gần một tháng chưa khởi động. Lần này khởi động lại, việc đầu tiên là cập nhật cấu hình model đã lỗi thời.
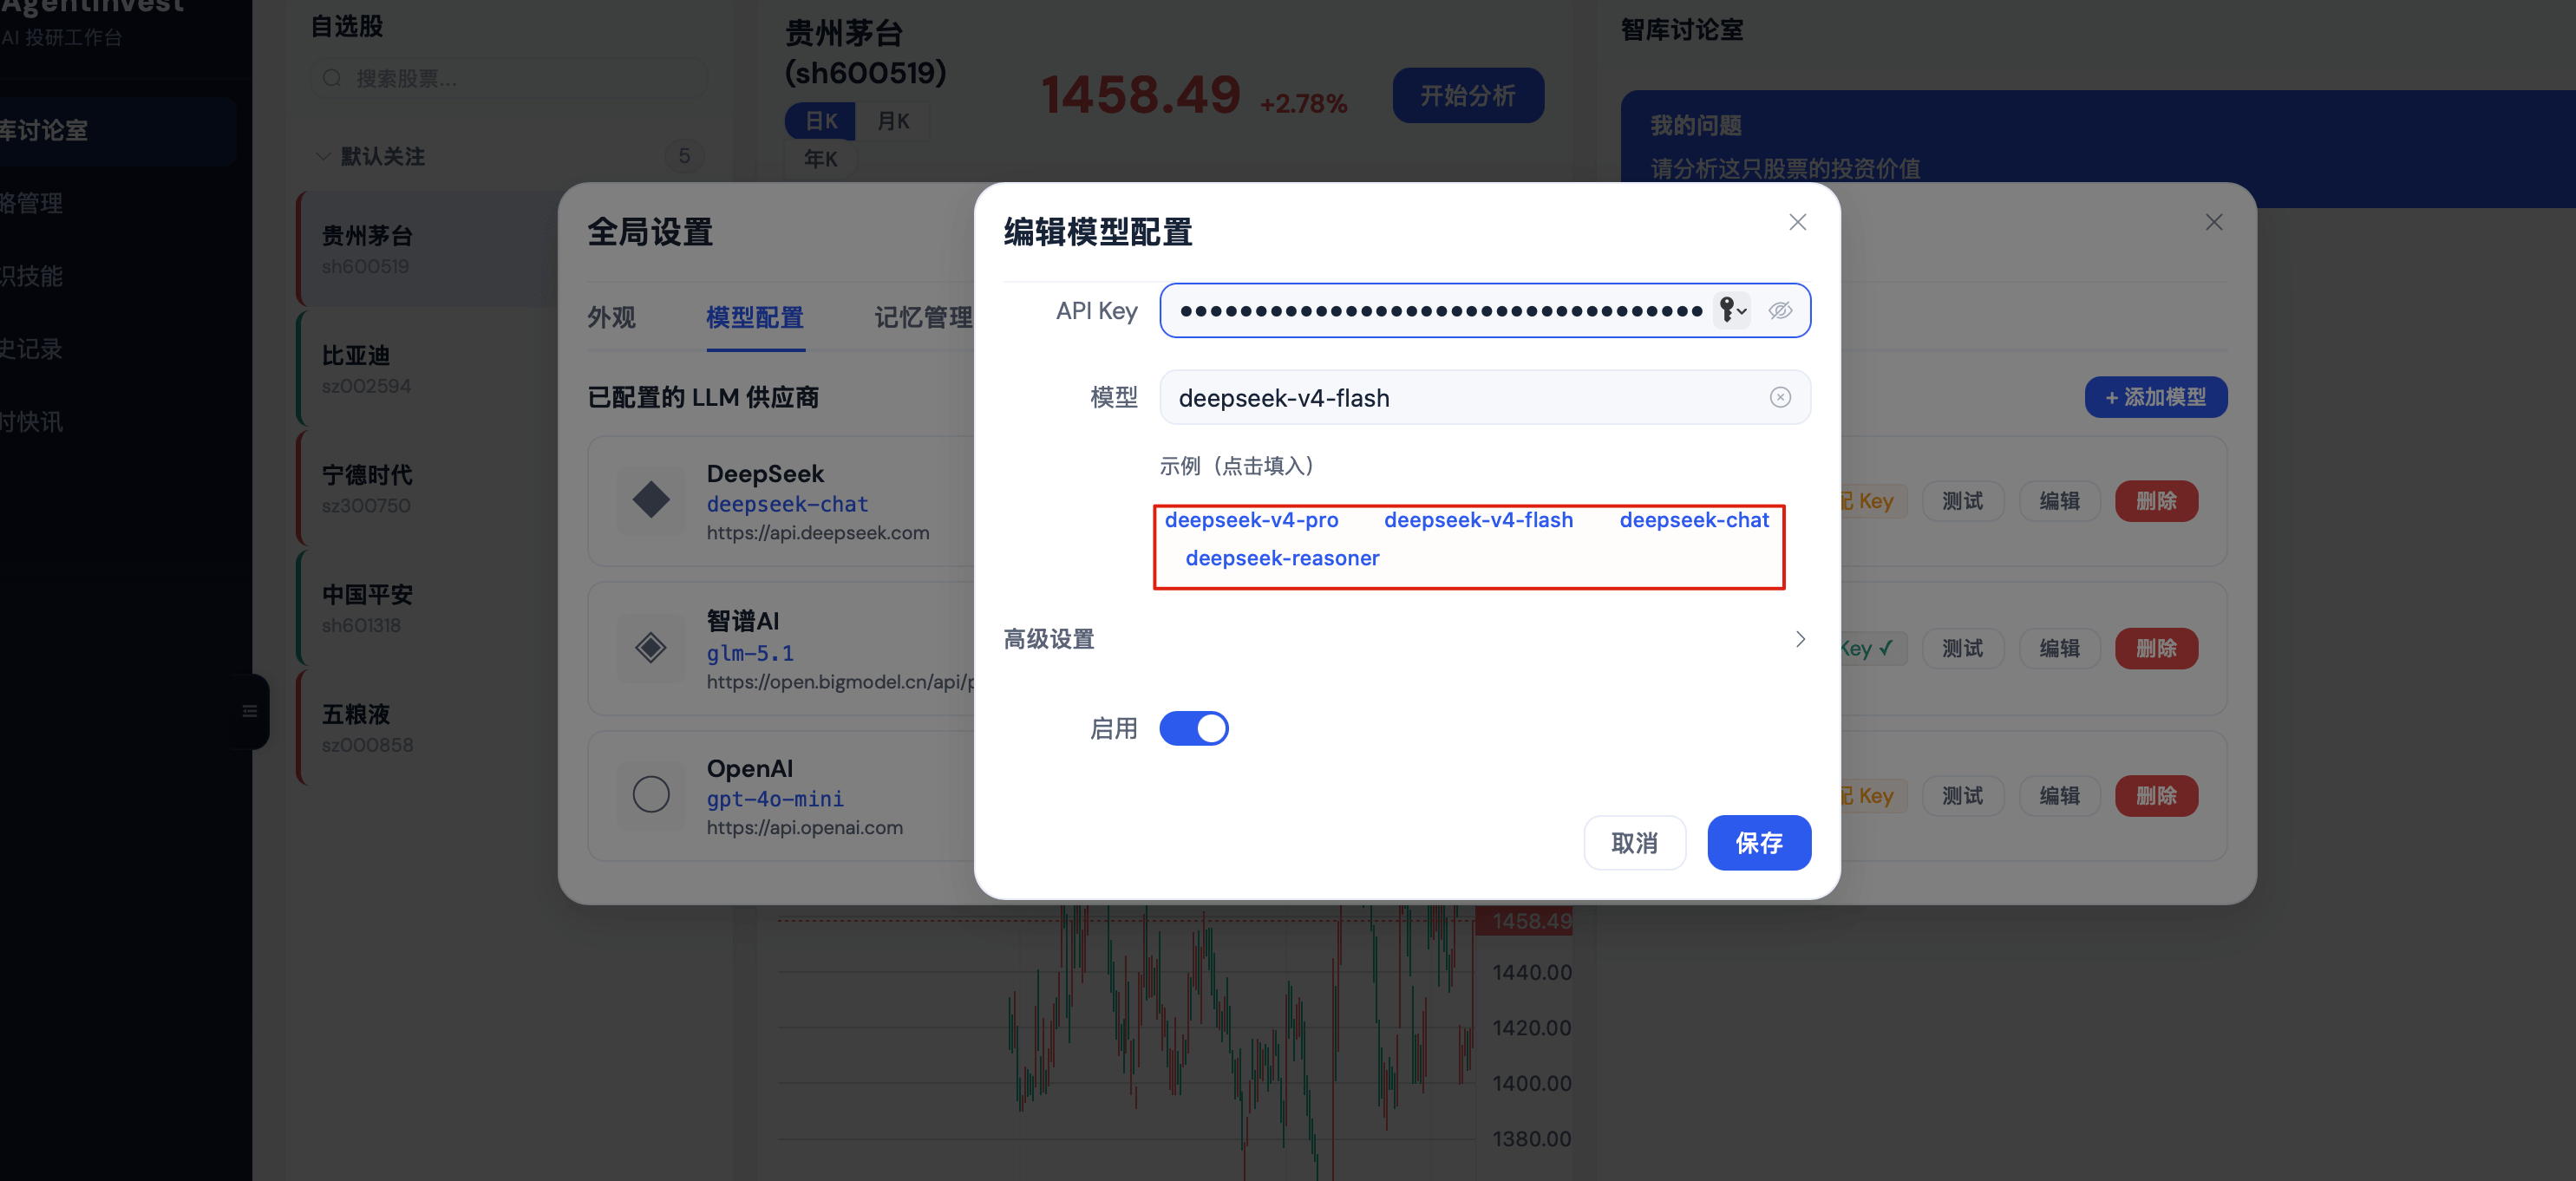
Trước đây, trang Settings của project chỉ có một ô nhập text thuần để người dùng tự điền tên model, chưa đủ thân thiện.
Tôi cần làm hai việc: tìm kiếm phiên bản model mới nhất của các LLM rồi thêm lựa chọn dạng dropdown cho frontend.
Prompt rất đơn giản:
/tavily-search Tìm kiếm model mới nhất hiện tại của deepseek, glm và openai, sau đó điều chỉnh model mặc định được đề xuất và ví dụ trong cấu hình global. Ngoài ra, các icon LLM hiện tại quá đậm chất AI, hãy đổi chúng sang một phong cách cao cấp hơn.
Task không lớn, nhưng có một chi tiết đáng nói: nếu không cấu hình Skill /tavily-search, chỉ dựa vào thời điểm cutoff của dữ liệu training của LLM để đoán phiên bản mới nhất thì phần lớn sẽ sai. Trước đây khi dùng model khác mà chưa cấu hình Tavily, tôi phải nhắc đi nhắc lại nhiều lần thì mới chỉnh đúng phiên bản mới nhất của từng hãng.
Có thể tham khảo cách sử dụng Tavily tại: Kết nối Claude Code với công cụ tìm kiếm AI Agent Tavily để tìm kiếm chất lượng cao.
Lần này V4-Pro hoàn thành việc chỉnh sửa chỉ trong một lượt.
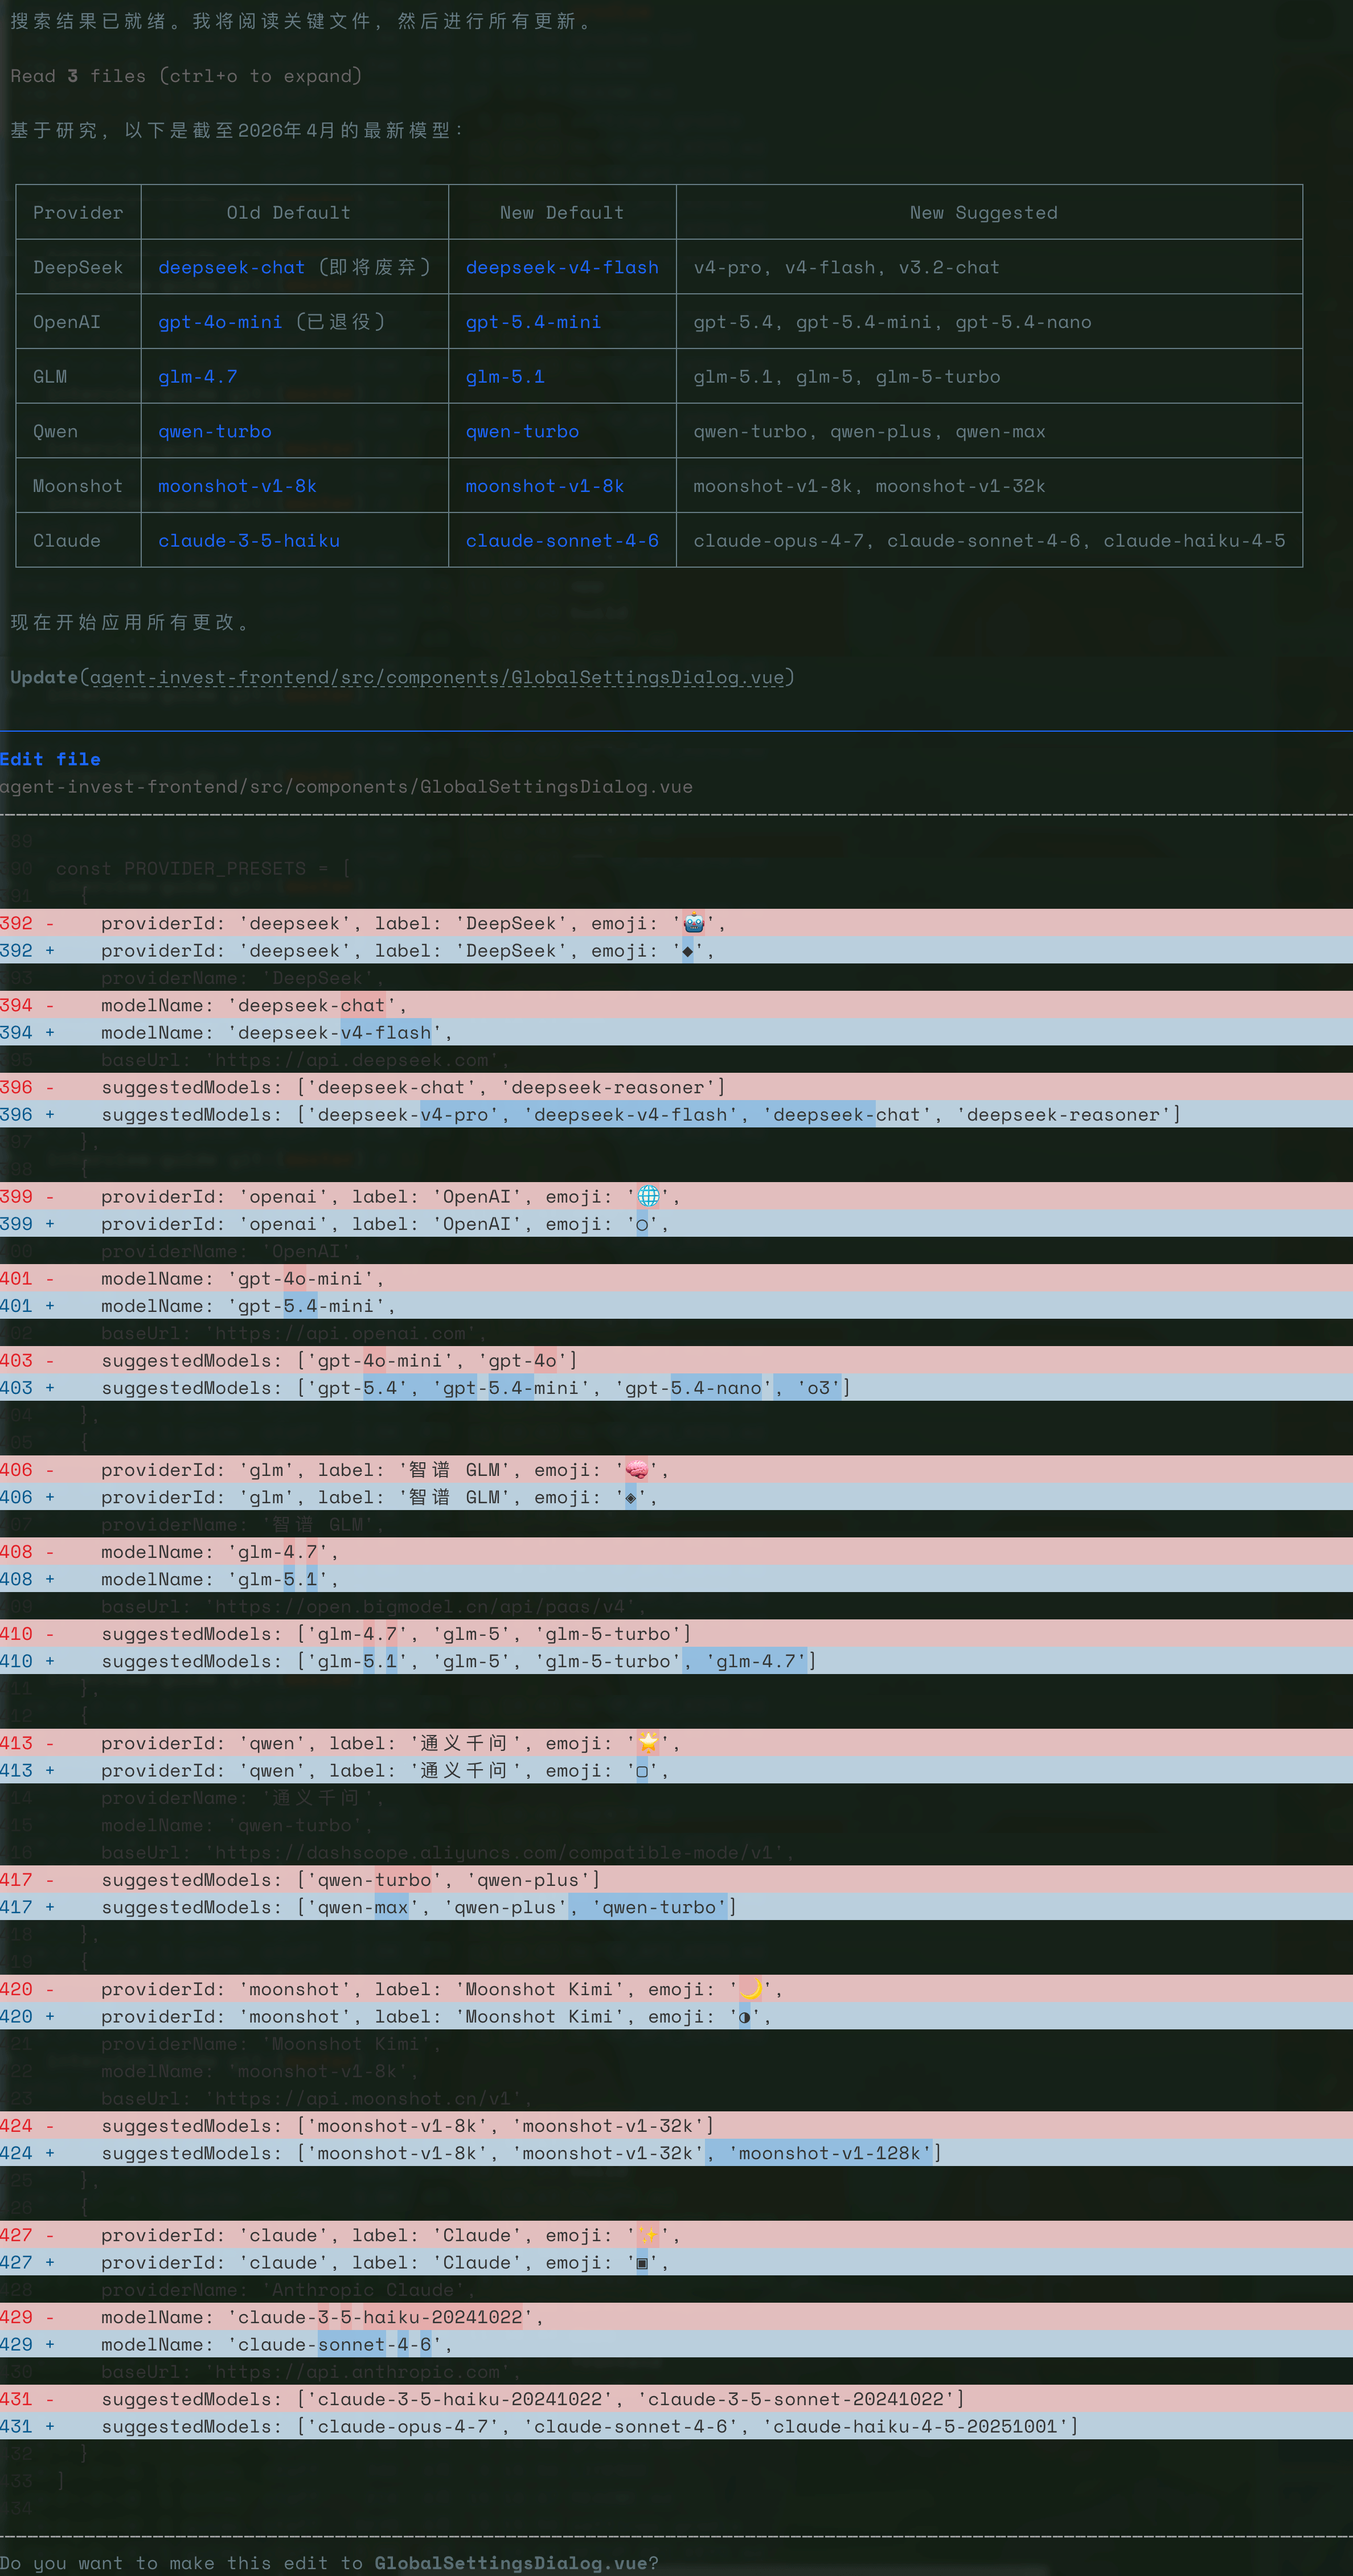
Cấu hình model đã được cập nhật thành công, ví dụ model được đề xuất của từng hãng đều đã chuyển sang phiên bản mới nhất. Đã chỉnh sửa ba file:
application.yml— thêm DeepSeek preset Provider, nâng model mặc định của GLM lênglm-5.env.example— bổ sung biến môi trường DeepSeek, đổi mặc định của Kimi thànhkimi-k2.6SettingsPage.tsx— thêm constantPROVIDER_PRESETS, đổi Model và Embedding Model thành combo box
Dưới đây là danh sách model được đề xuất cuối cùng của bốn Provider (tính đến 2026.04.25):
| Provider | Model được đề xuất |
|---|---|
| DashScope | qwen3.6-flash, qwen3.5-plus, qwen3-max, qwq-32b và 8 model khác |
| DeepSeek | deepseek-v4-flash, deepseek-v4-pro |
| GLM | glm-5.1, glm-5, glm-4.7-flash và 8 model khác |
| Kimi | kimi-k2.6, kimi-k2.5, kimi-k2-thinking và 5 model khác |
Thực chiến hai: Chẩn đoán giải pháp migration database và tích hợp Flyway
Task thứ hai có tính thử thách cao hơn.
Vì đổi máy tính mới nên toàn bộ environment đều được dựng lại. Project có hai file SQL, một file được tự động thực thi khi project khởi động, file còn lại thì không. Tôi cũng đã quên logic này, nên cần model hỗ trợ chẩn đoán.
Prompt:
Project hiện tại có hai file SQL,
sql/init.sqlđược tự động thực thi khi project khởi động, cònsql/V2__knowledge_skill.sqlthì không. Hãy phân tích nguyên nhân, sau đó tối ưu vấn đề hiện có bằng một cách hợp lý.
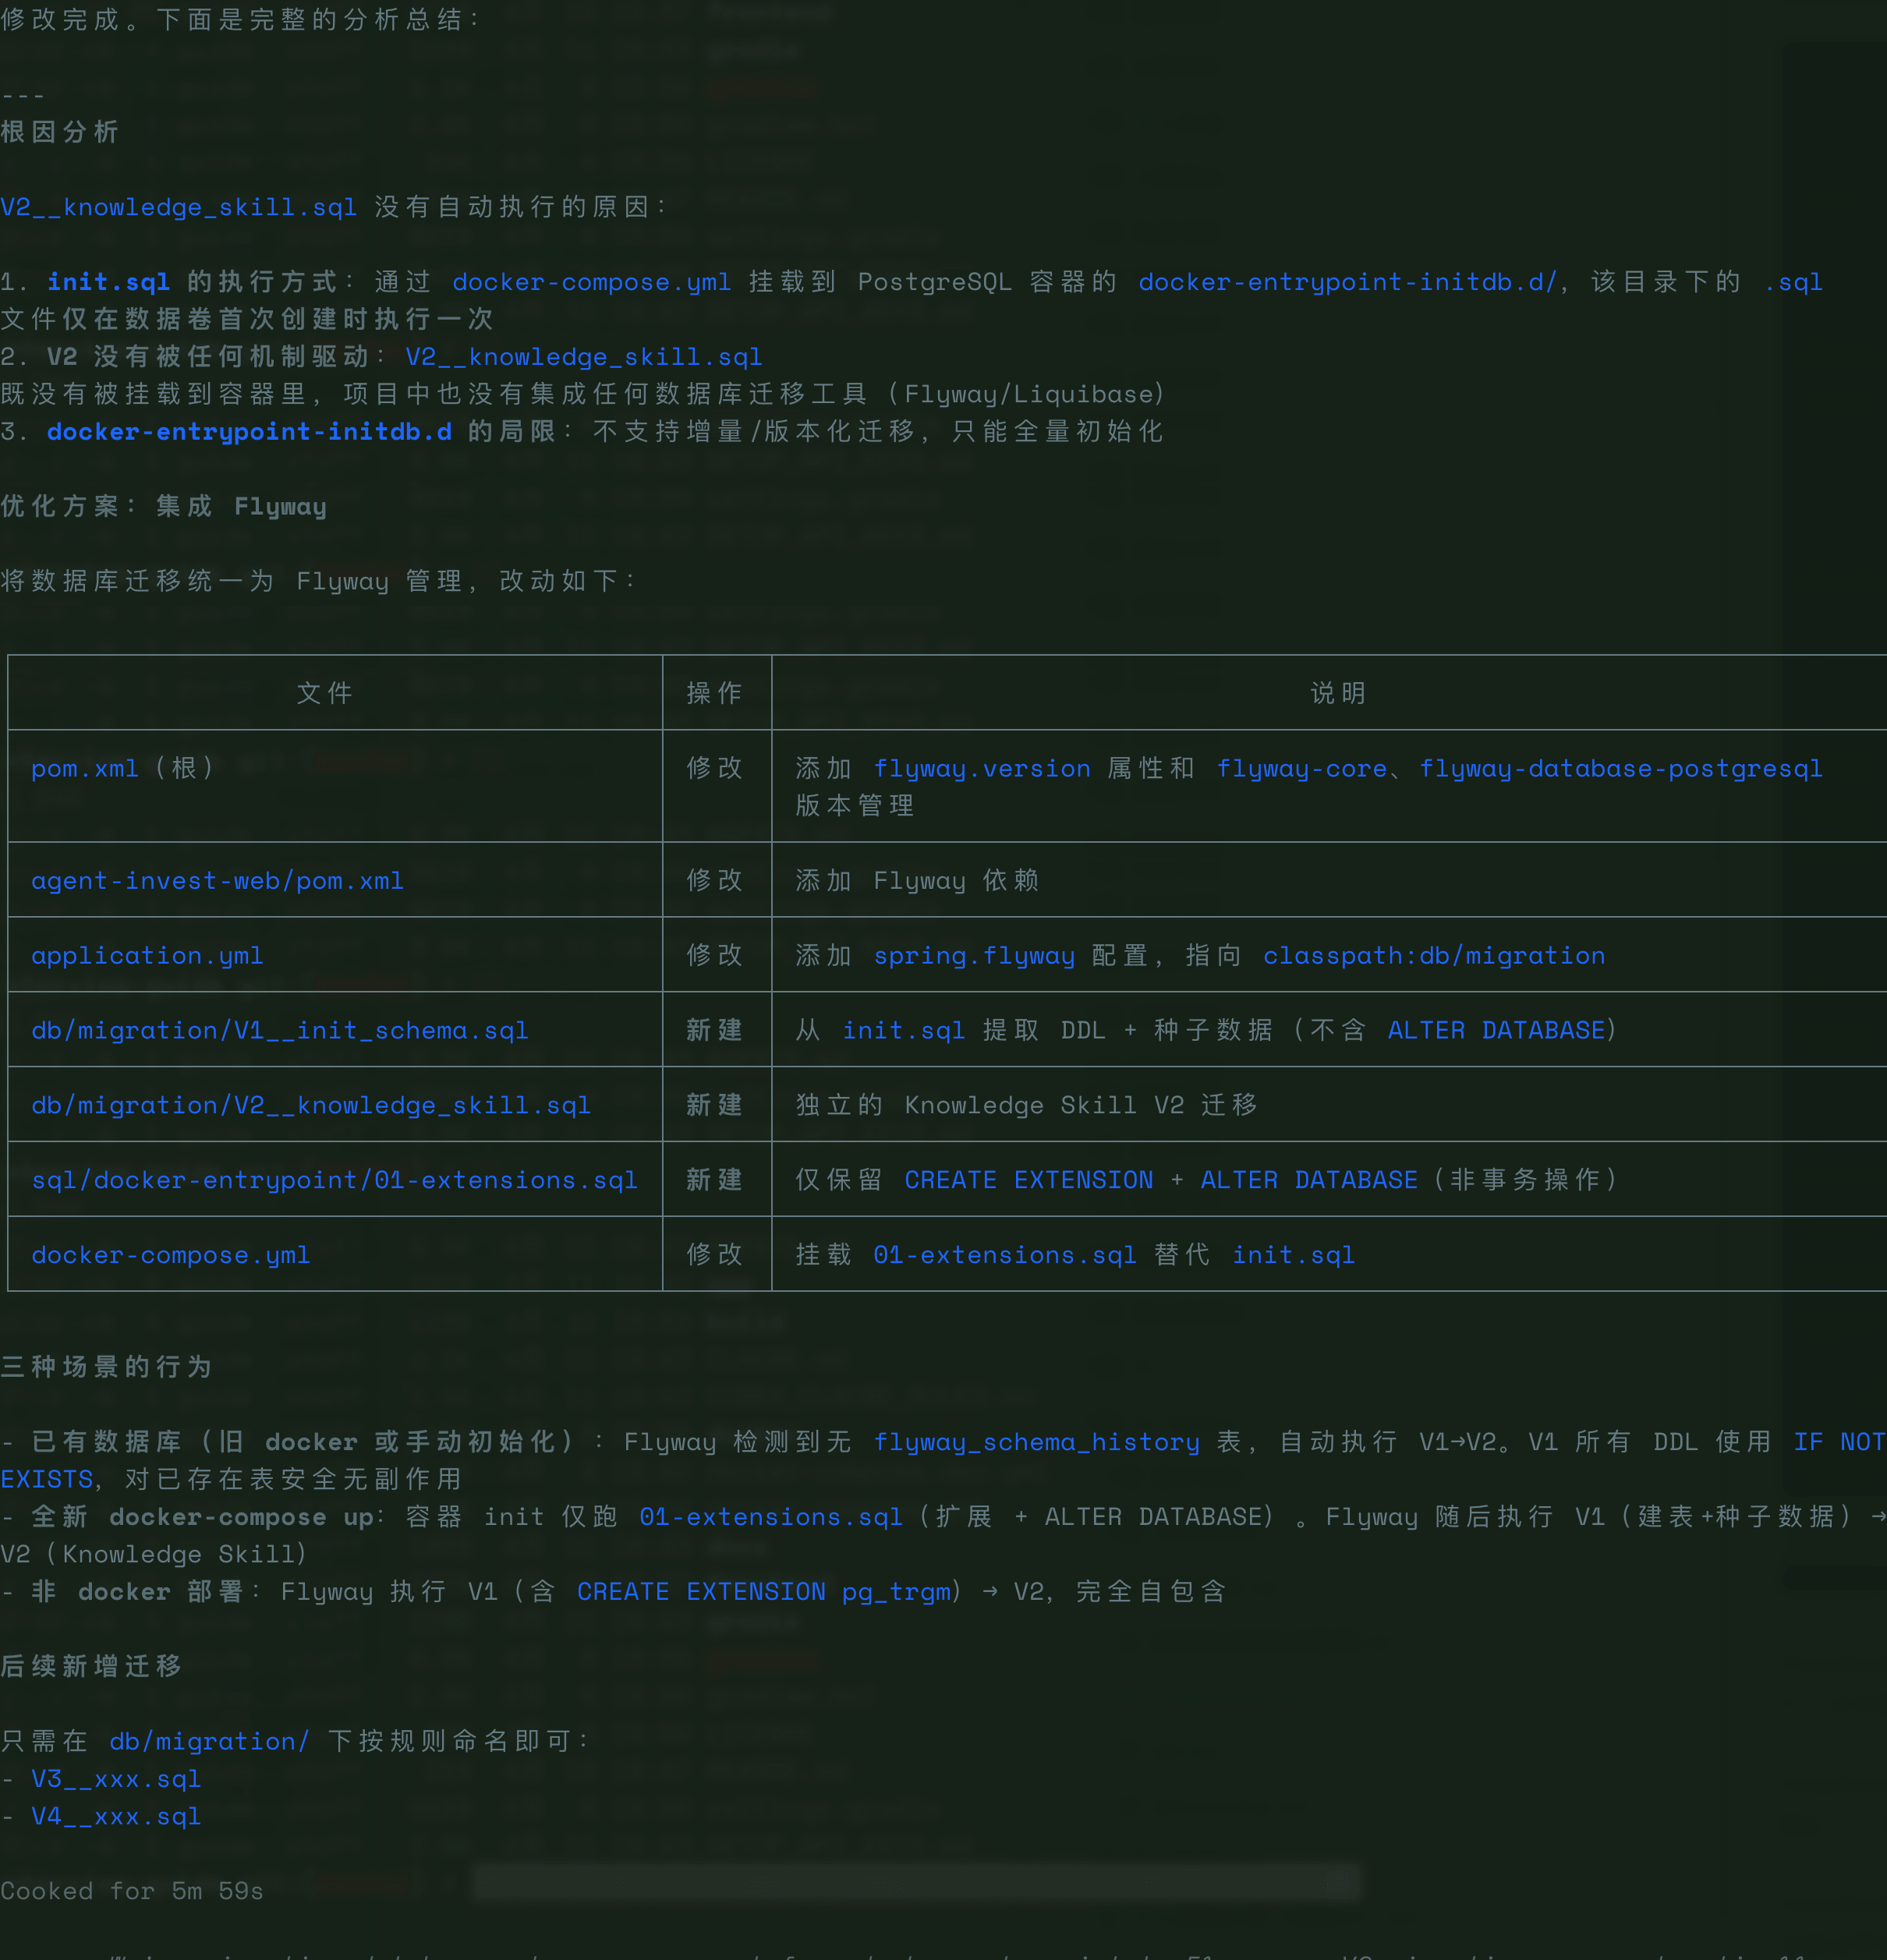
Nguyên nhân trực tiếp mà V4-Pro tìm ra là: V2__knowledge_skill.sql chưa được mount vào Docker container, đồng thời project chưa tích hợp database migration tool, còn việc thực thi init.sql xuất phát từ mount cố định trong Docker Compose.
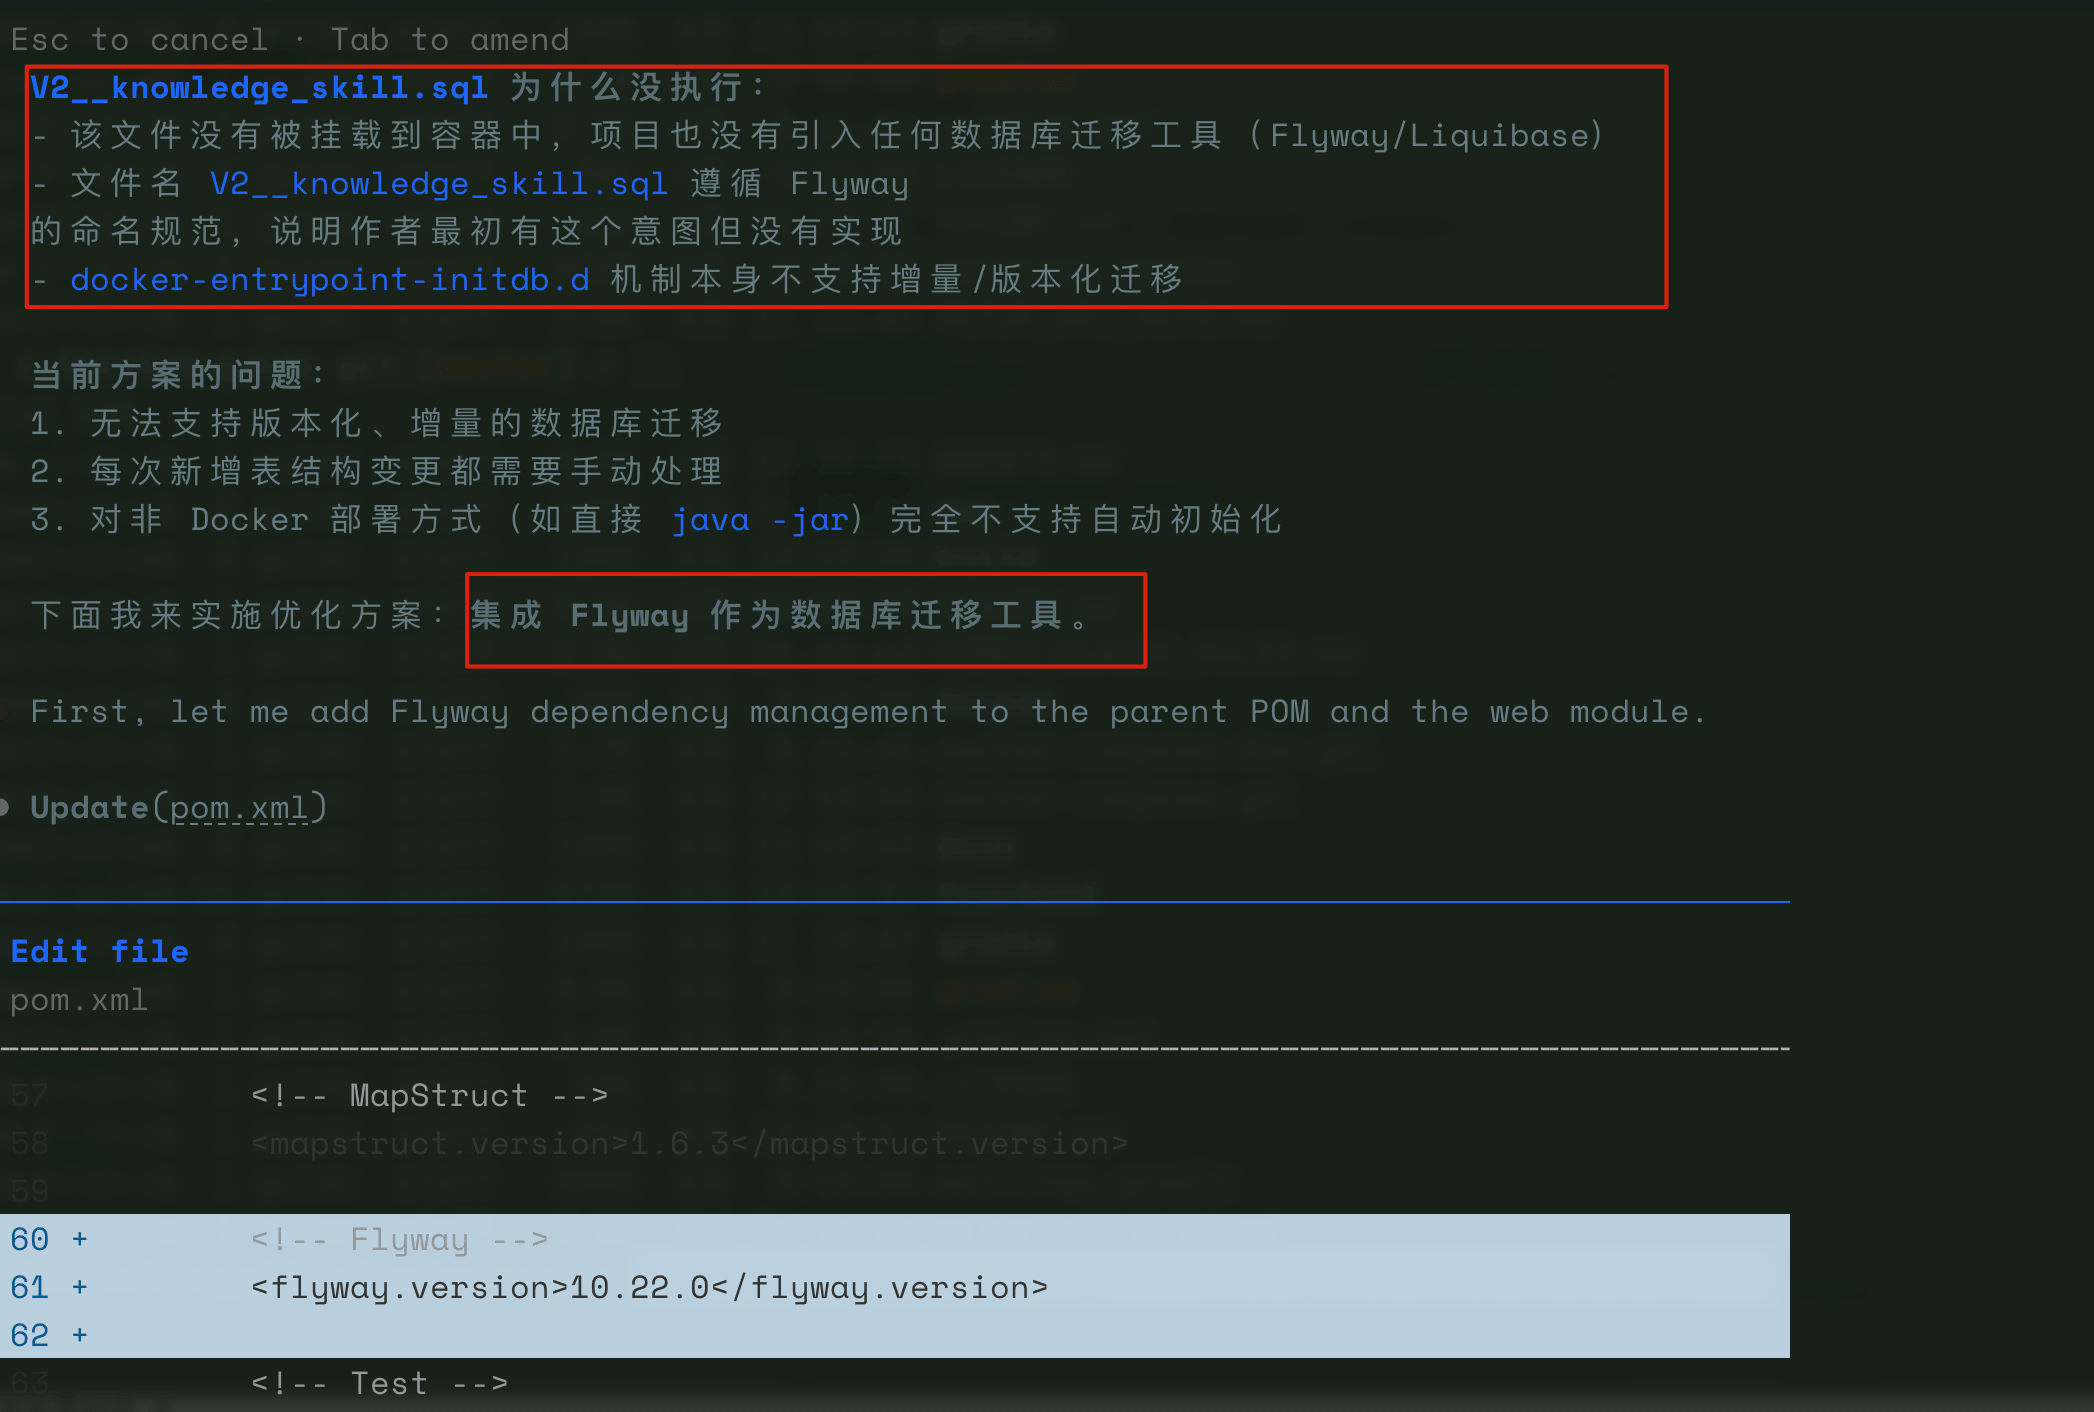
Giải pháp nó đưa ra là tích hợp Flyway làm database migration tool.
Flyway là một trong những giải pháp database migration trưởng thành nhất trong hệ sinh thái Java, tự động quản lý thứ tự migration bằng quy ước đặt tên file (như V1__init.sql, V2__knowledge_skill.sql).
Toàn bộ quá trình DeepSeek V4-Pro đã hoàn thành các công việc sau:
- Phân tích logic mount
init.sqltrong cấu hình Docker Compose - Phát hiện nguyên nhân thiếu
V2__knowledge_skill.sql - Tích hợp dependency Flyway và viết cấu hình migration
- Refactor cách đặt tên file SQL để bảo đảm thứ tự migration chính xác
Có một lỗi phát sinh ở đây: giữa chừng tôi vô tình điều chỉnh kích thước cửa sổ iTerm2, khiến lịch sử hội thoại trong terminal đột nhiên bị xáo trộn.
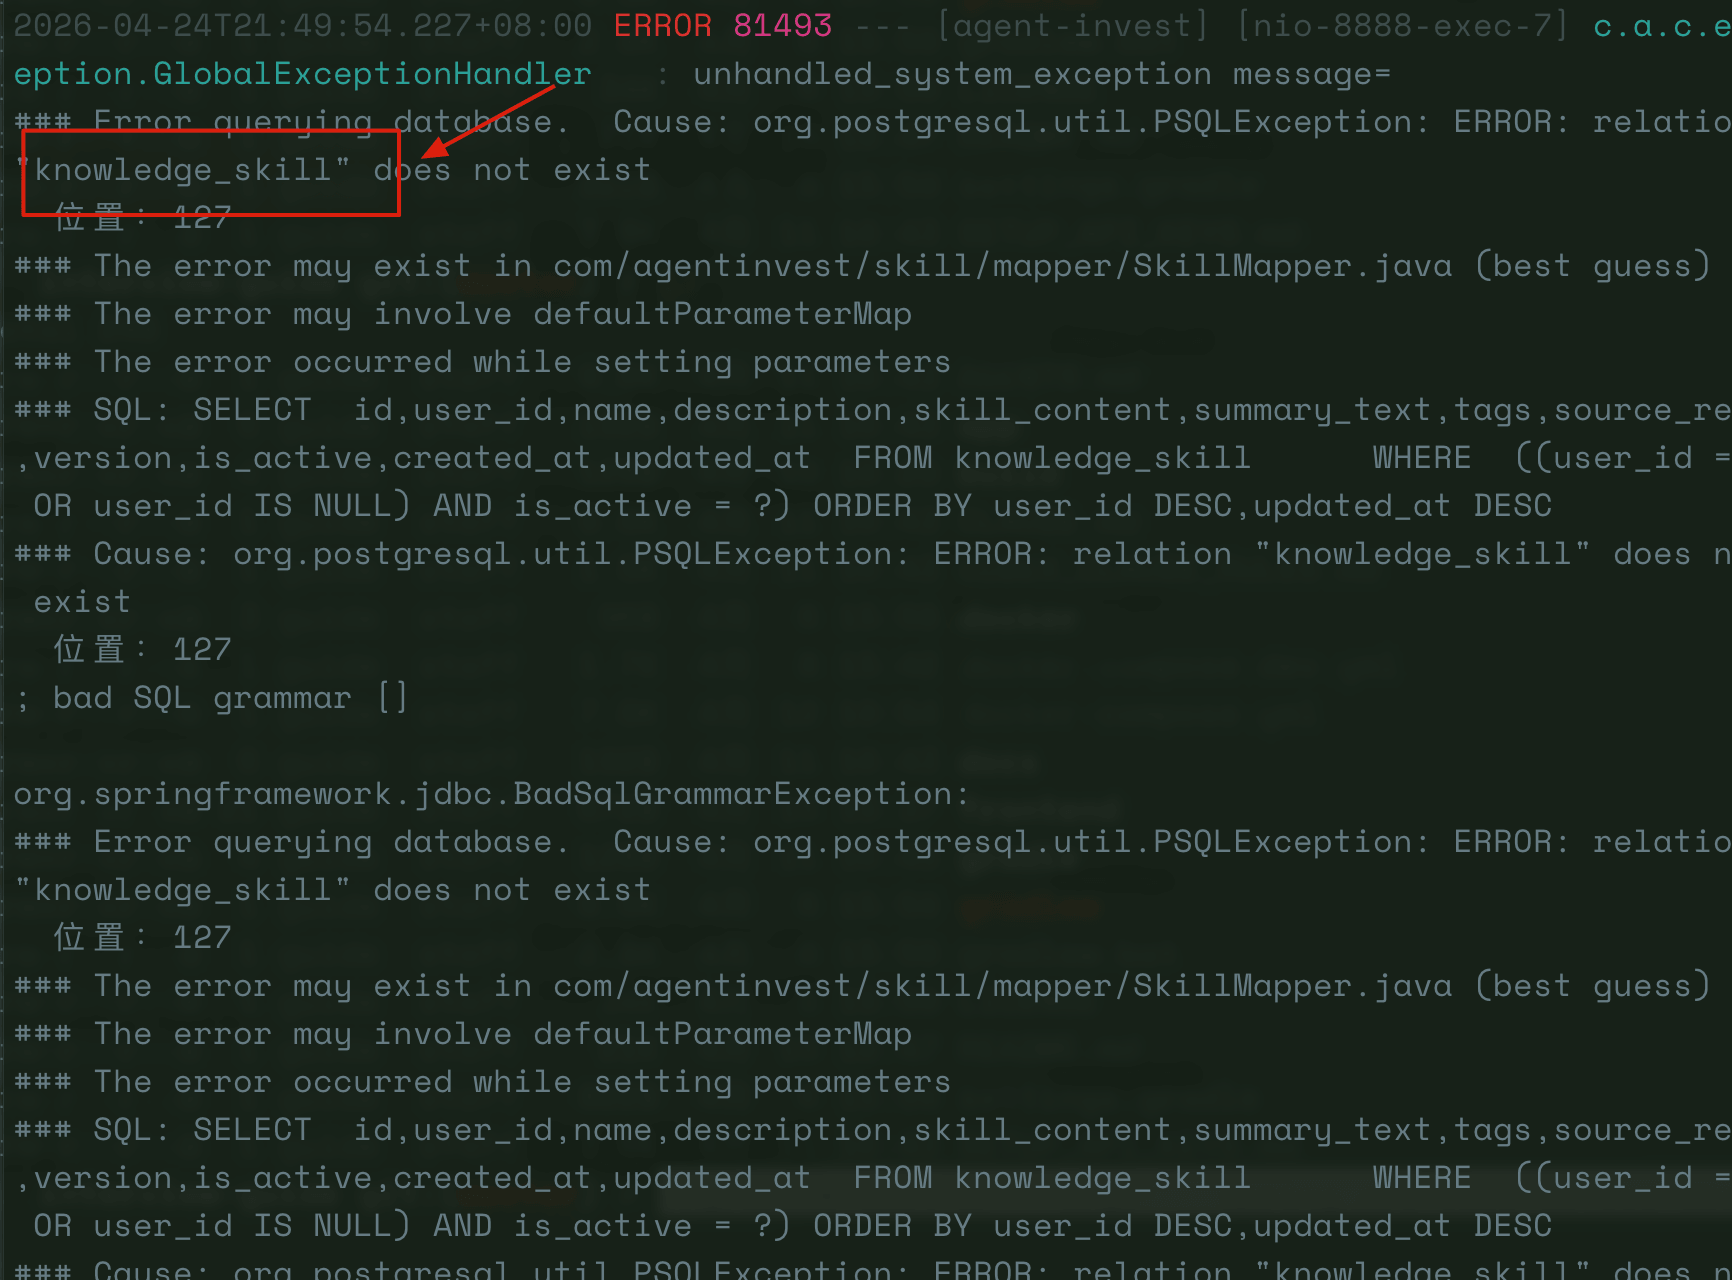
Sau lần chạy đầu tiên, Flyway không thực thi thành công. Tôi gửi error log cho nó, rồi sửa thành công sau hai vòng điều chỉnh.
Vấn đề này đáng được nói riêng: ngay cả DeepSeek V4-Pro cũng gặp lỗi này trong lần tích hợp đầu tiên và phải debug hai vòng mới tìm ra root cause.
Spring Boot 4.x đã tách module auto-configuration trên quy mô lớn, FlywayAutoConfiguration đã được loại khỏi spring-boot-autoconfigure và chuyển sang module độc lập spring-boot-flyway.
Nếu chỉ thêm third-party library flyway-core, Spring Boot sẽ không tự động kích hoạt bất kỳ migration nào. Điều khó chịu nhất là startup log cũng không có bất kỳ output nào liên quan đến Flyway: hoàn toàn không báo lỗi, chỉ âm thầm không làm gì cả. Lỗi này rất dễ khiến bạn bối rối, nghi ngờ cấu hình viết sai rồi liên tục sửa trong file yml.
Hãy sử dụng official Starter, vì nó sẽ đưa cả module auto-configuration vào:
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-flyway</artifactId>
</dependency>
<!-- Vẫn cần thêm riêng hỗ trợ dialect PostgreSQL -->
<dependency>
    <groupId>org.flywaydb</groupId>
    <artifactId>flyway-database-postgresql</artifactId>
</dependency>
Kết luận cụ thể của case này: khi tích hợp Flyway với Spring Boot 4.x, nên sử dụng official Starter tương ứng, không được chỉ thêm flyway-core rồi mặc định cho rằng migration sẽ tự động thực thi. Việc third-party library khác có cần Starter độc lập hay không phải được tra cứu riêng trong tài liệu Spring Boot của version tương ứng, không thể khái quát từ case này.
Thực chiến ba: Kết nối nền tảng phỏng vấn AI với DeepSeek
Nền tảng hỗ trợ phỏng vấn AI hiện đã bổ sung tính năng chuyển đổi và cấu hình multi-model, đồng thời đã hỗ trợ DeepSeek.
Giống như thực chiến một, toàn bộ quá trình kết nối model mới nhất chỉ cần thực hiện một lần là xong, nên không lặp lại nữa. Hãy xem trực tiếp hiệu quả.
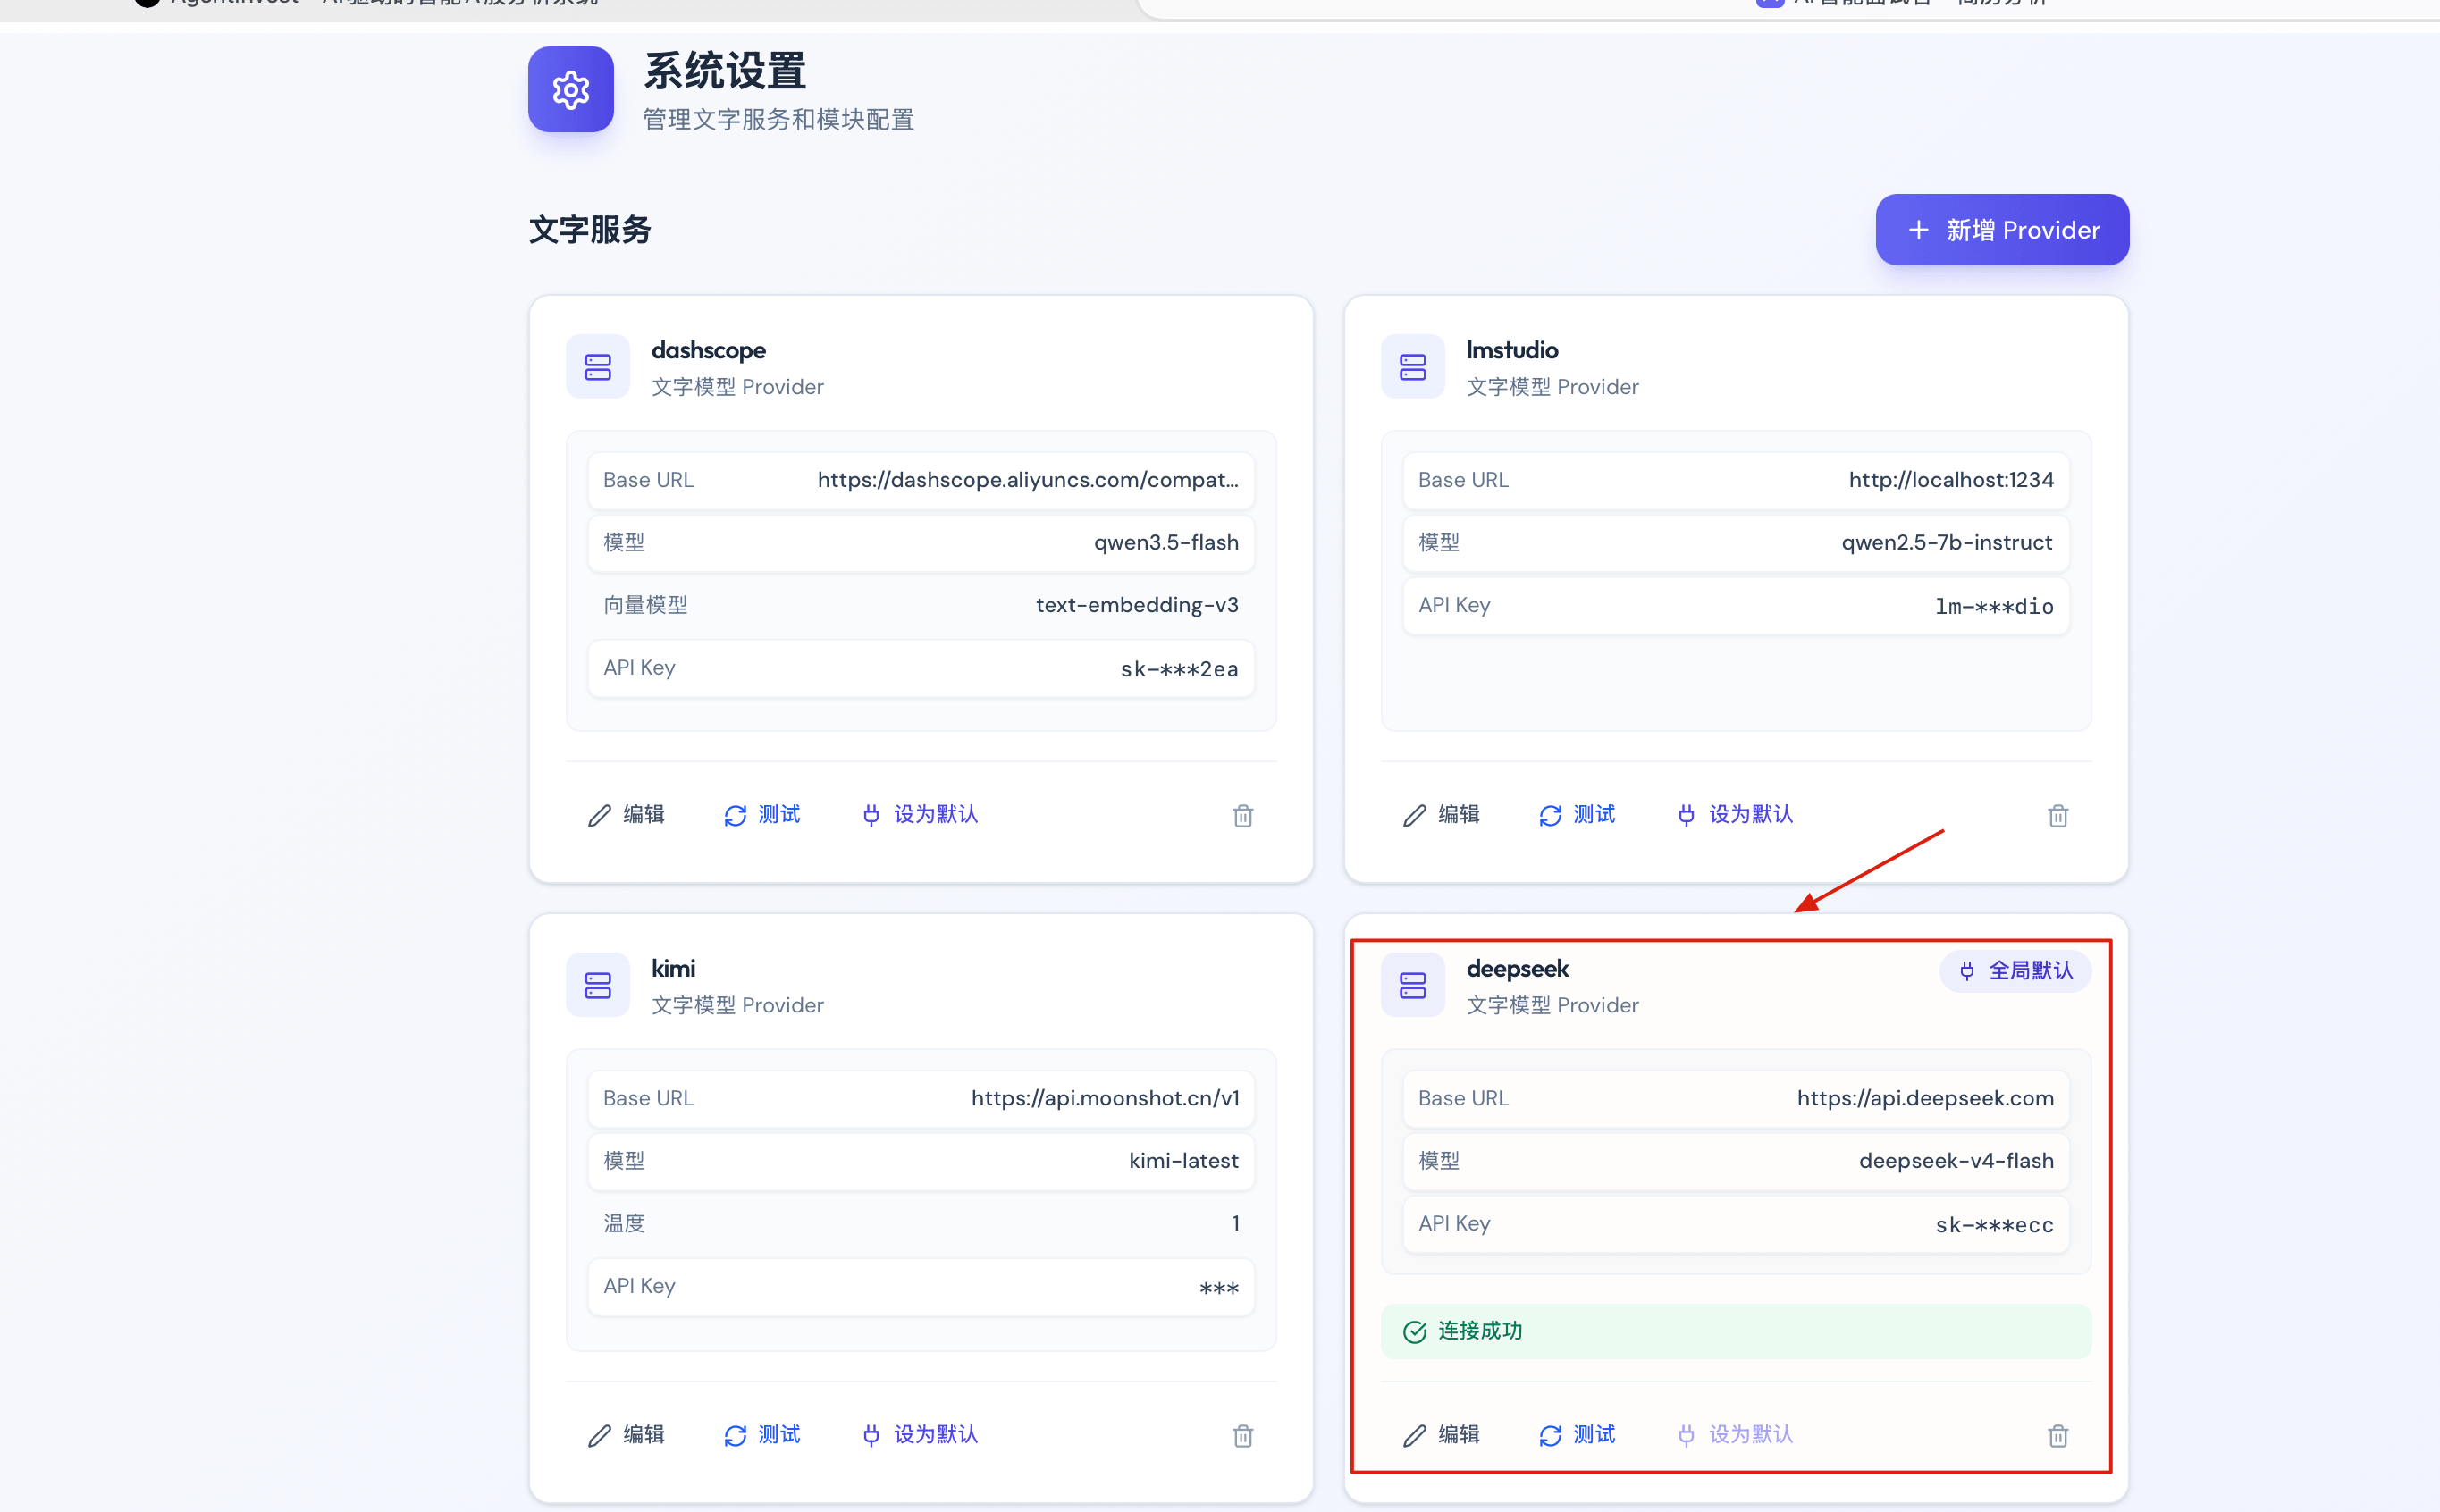
Thông qua giao diện cấu hình, chuyển model mặc định sang DeepSeek và chọn deepseek-v4-flash.
Sau đó upload một resume, tạo một cuộc phỏng vấn mô phỏng dựa trên resume này để xem hiệu quả.
Câu hỏi phỏng vấn được tạo bởi deepseek-v4-flash, câu trả lời cũng do DeepSeek đưa ra ở chế độ nhanh không suy nghĩ (có hai câu hỏi không được trả lời).
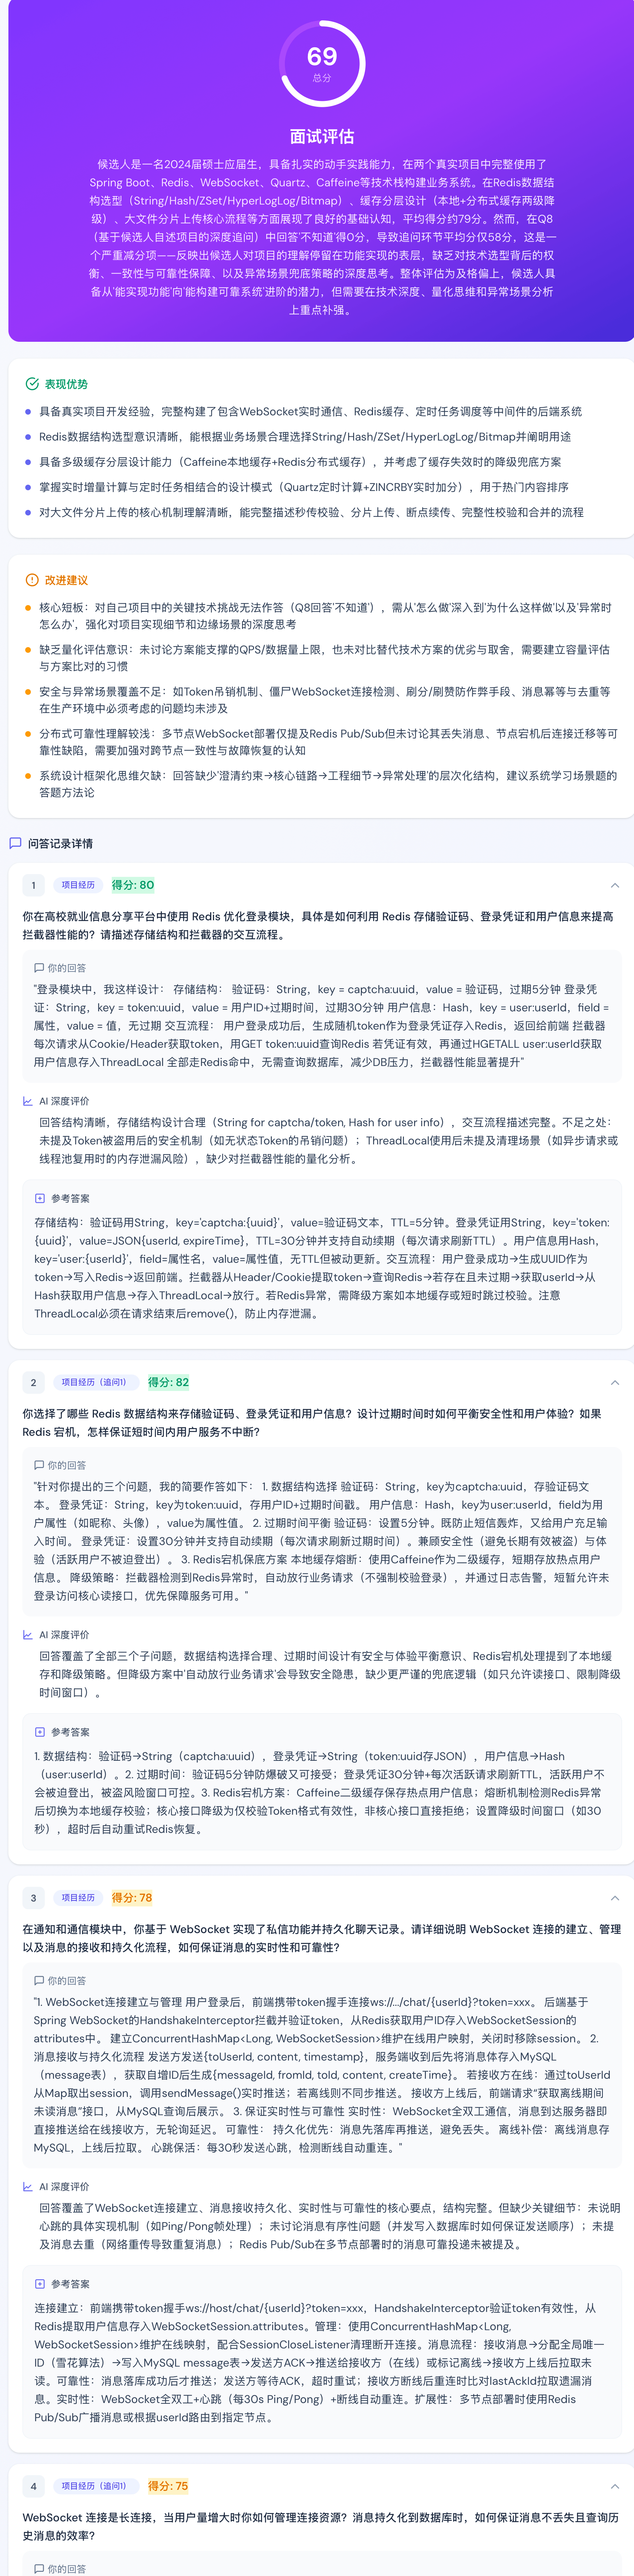
Trong task tạo câu hỏi phỏng vấn từ resume này, chế độ không suy nghĩ của Flash có thể hoàn thành các câu hỏi chính, nhưng vẫn bỏ sót hai câu hỏi. Nó phù hợp với task tạo hàng loạt nhạy cảm về chi phí và cho phép kiểm tra thủ công.
Thực chiến bốn: Kiểm toán code của project và phối hợp multi-model
Project phân tích cổ phiếu multi-agent hiện đã chạy được phiên bản MVP, hỗ trợ phân tích cổ phiếu, nhiều strategy, alert, skill, multi-model, notification và các tính năng khác. Do phải chạy tiến độ trong quá trình phát triển, chất lượng code chưa được kiểm soát kỹ.
Lần này tôi thử một cách tiếp cận: dùng model rẻ để audit, model đắt để ra quyết định và sửa lỗi.
Trong Claude Code, trực tiếp yêu cầu DeepSeek V4-Pro khởi động nhiều Agent, scan toàn bộ project theo các khía cạnh khác nhau như security, tính đúng đắn của chức năng và code quality, rồi tổng hợp các vấn đề phát hiện được vào document.
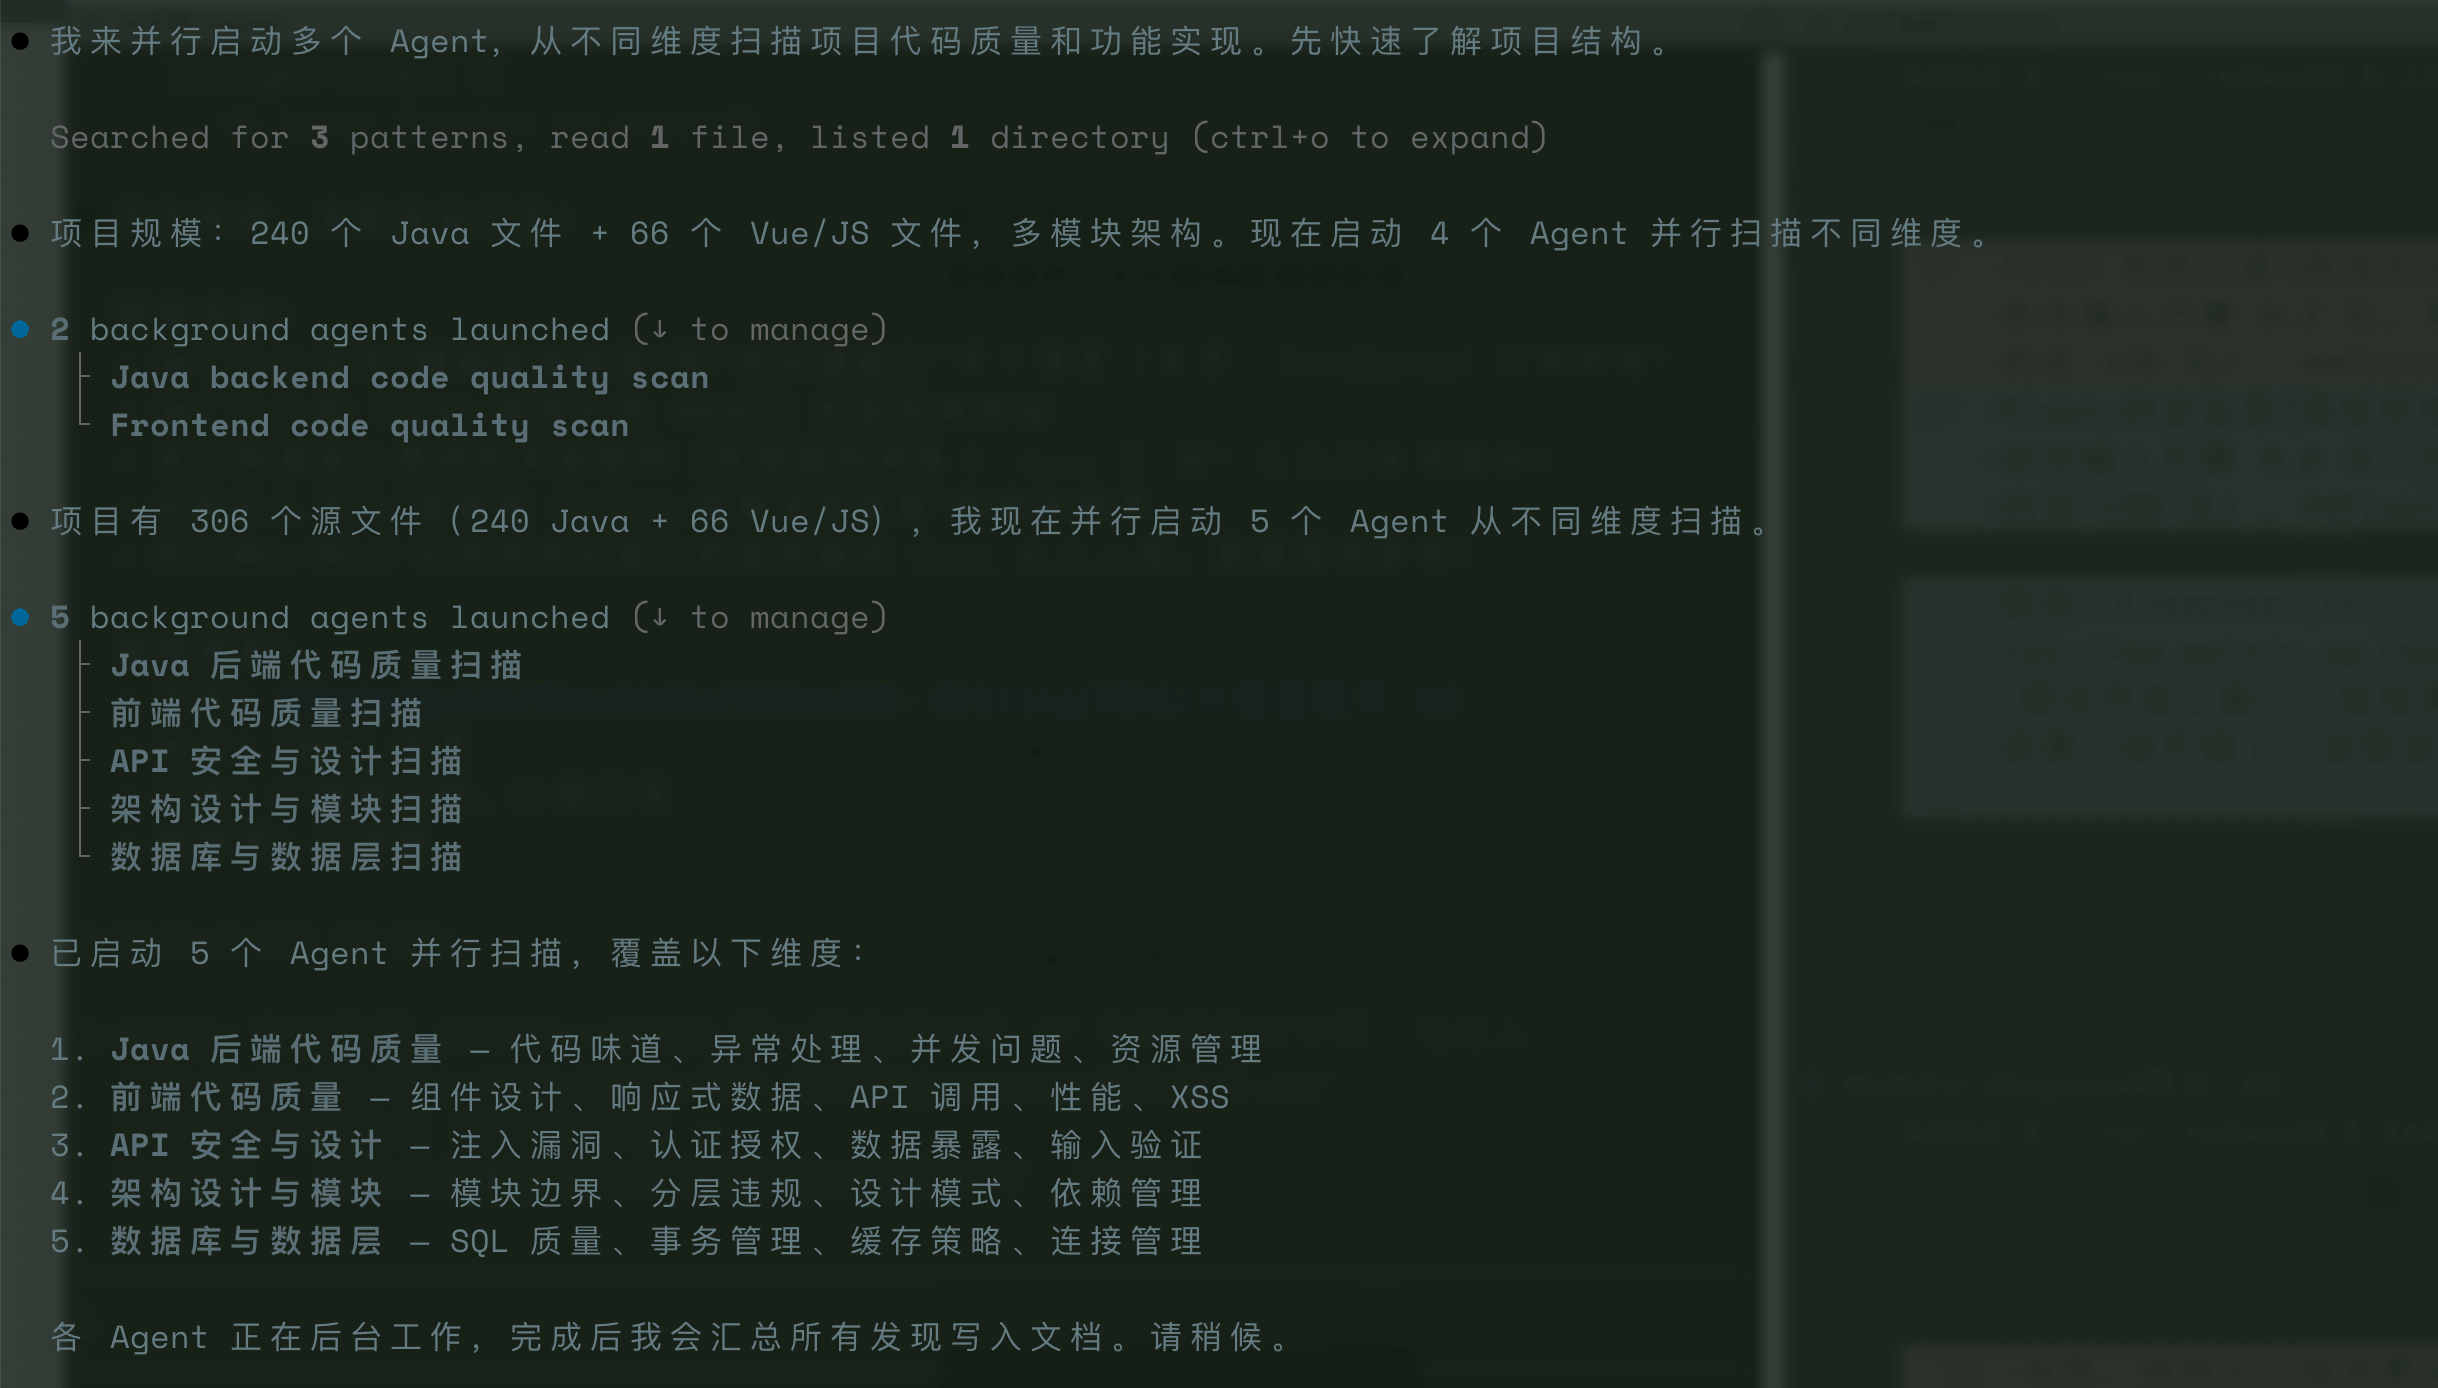
V4-Pro thực sự đã tìm ra khá nhiều vấn đề, 5 vấn đề TOP khẩn cấp nhất:
- API Key lưu trữ dạng plain text — encryption đã được implement nhưng chưa được tích hợp
- API quản trị hệ thống không có authorization control — user thông thường có thể sửa cấu hình LLM
- Lỗ hổng deserialization của Redis —
activateDefaultTypingcho phép instantiate class tùy ý - API Key của third-party bị hard-code — secret thật của Bocha đã được commit vào code
- Functional bug — nút “Phân tích lại” trên trang History không hoạt động vì chưa đọc route parameter
Qua kiểm tra sơ bộ, phần lớn đều hợp lý. Các vấn đề security đặc biệt đáng chú ý; nếu lỗ hổng Redis deserialization ở mục 3 bị khai thác, hậu quả sẽ rất nghiêm trọng.
Sau đó, tôi giao trực tiếp các vấn đề V4-Pro tìm ra cho GPT-5.5, model đang khả dụng trong account lúc đó, để review lại.
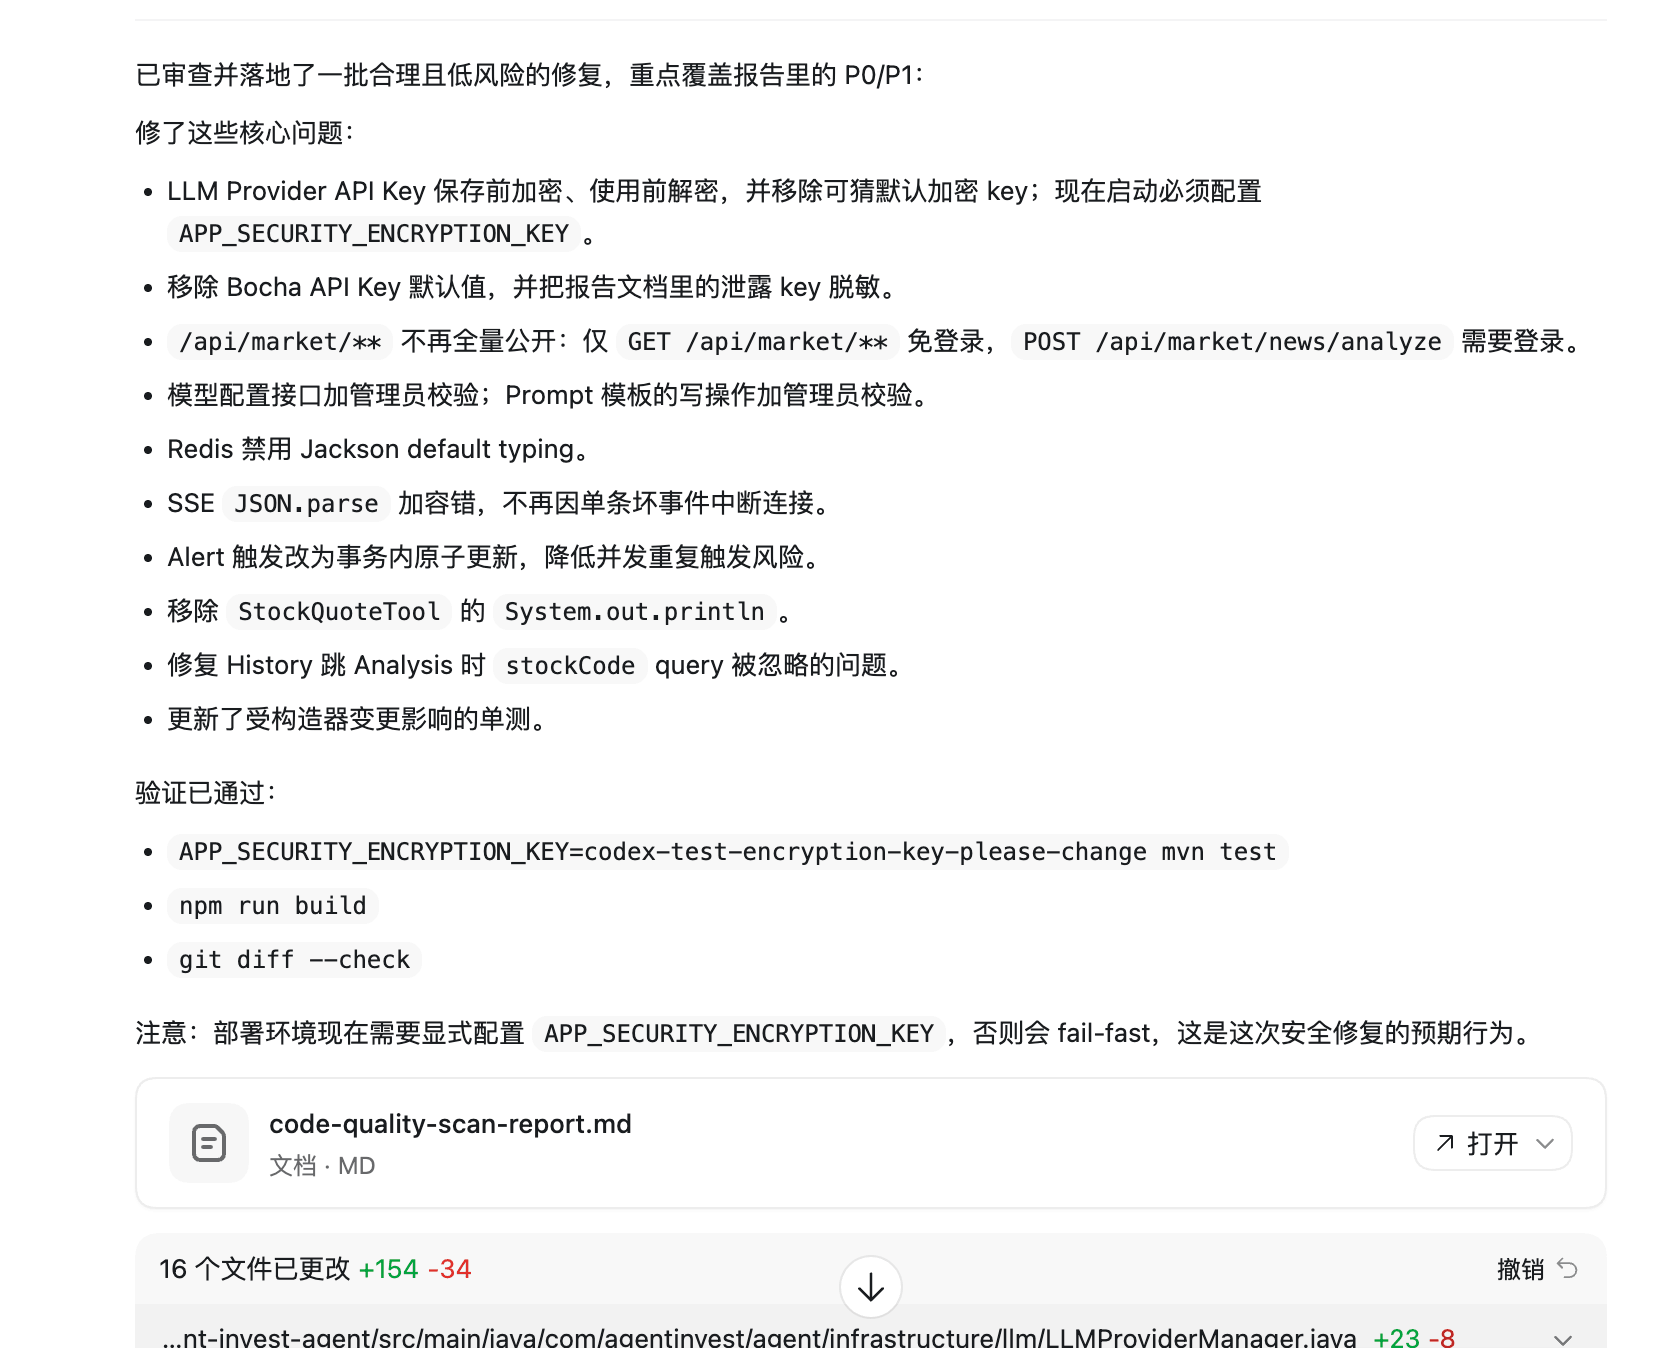
Tại sao không để V4-Pro tự sửa? Vì code audit và code fix là hai năng lực khác nhau; dùng các model khác nhau để cross-validate sẽ đáng tin cậy hơn: một model phụ trách tìm vấn đề, model kia phụ trách xác nhận vấn đề và thực hiện sửa lỗi.
GPT-5.5 đã review lại rồi thực hiện sửa lỗi. Phần này ghi lại lựa chọn model tại thời điểm case xảy ra, không đại diện cho khuyến nghị hiện tại; cuối cùng vẫn phải dựa vào test, code review và kết quả rotate secret, không thể coi sự xác nhận của model thứ hai là một bằng chứng khép kín.
Case này sử dụng cách phân công model chi phí thấp sàng lọc ban đầu, model có năng lực mạnh hơn review lại, cuối cùng do test và nghiệm thu thủ công thực hiện. Tiết kiệm được bao nhiêu phụ thuộc vào độ dài input, cache hit, output và giá model tại thời điểm đó; khi không có đầy đủ call record, không phù hợp để đưa ra kết luận “ít nhất hai bậc độ lớn”.
Thực chiến năm: Scan và phân tích toàn bộ project
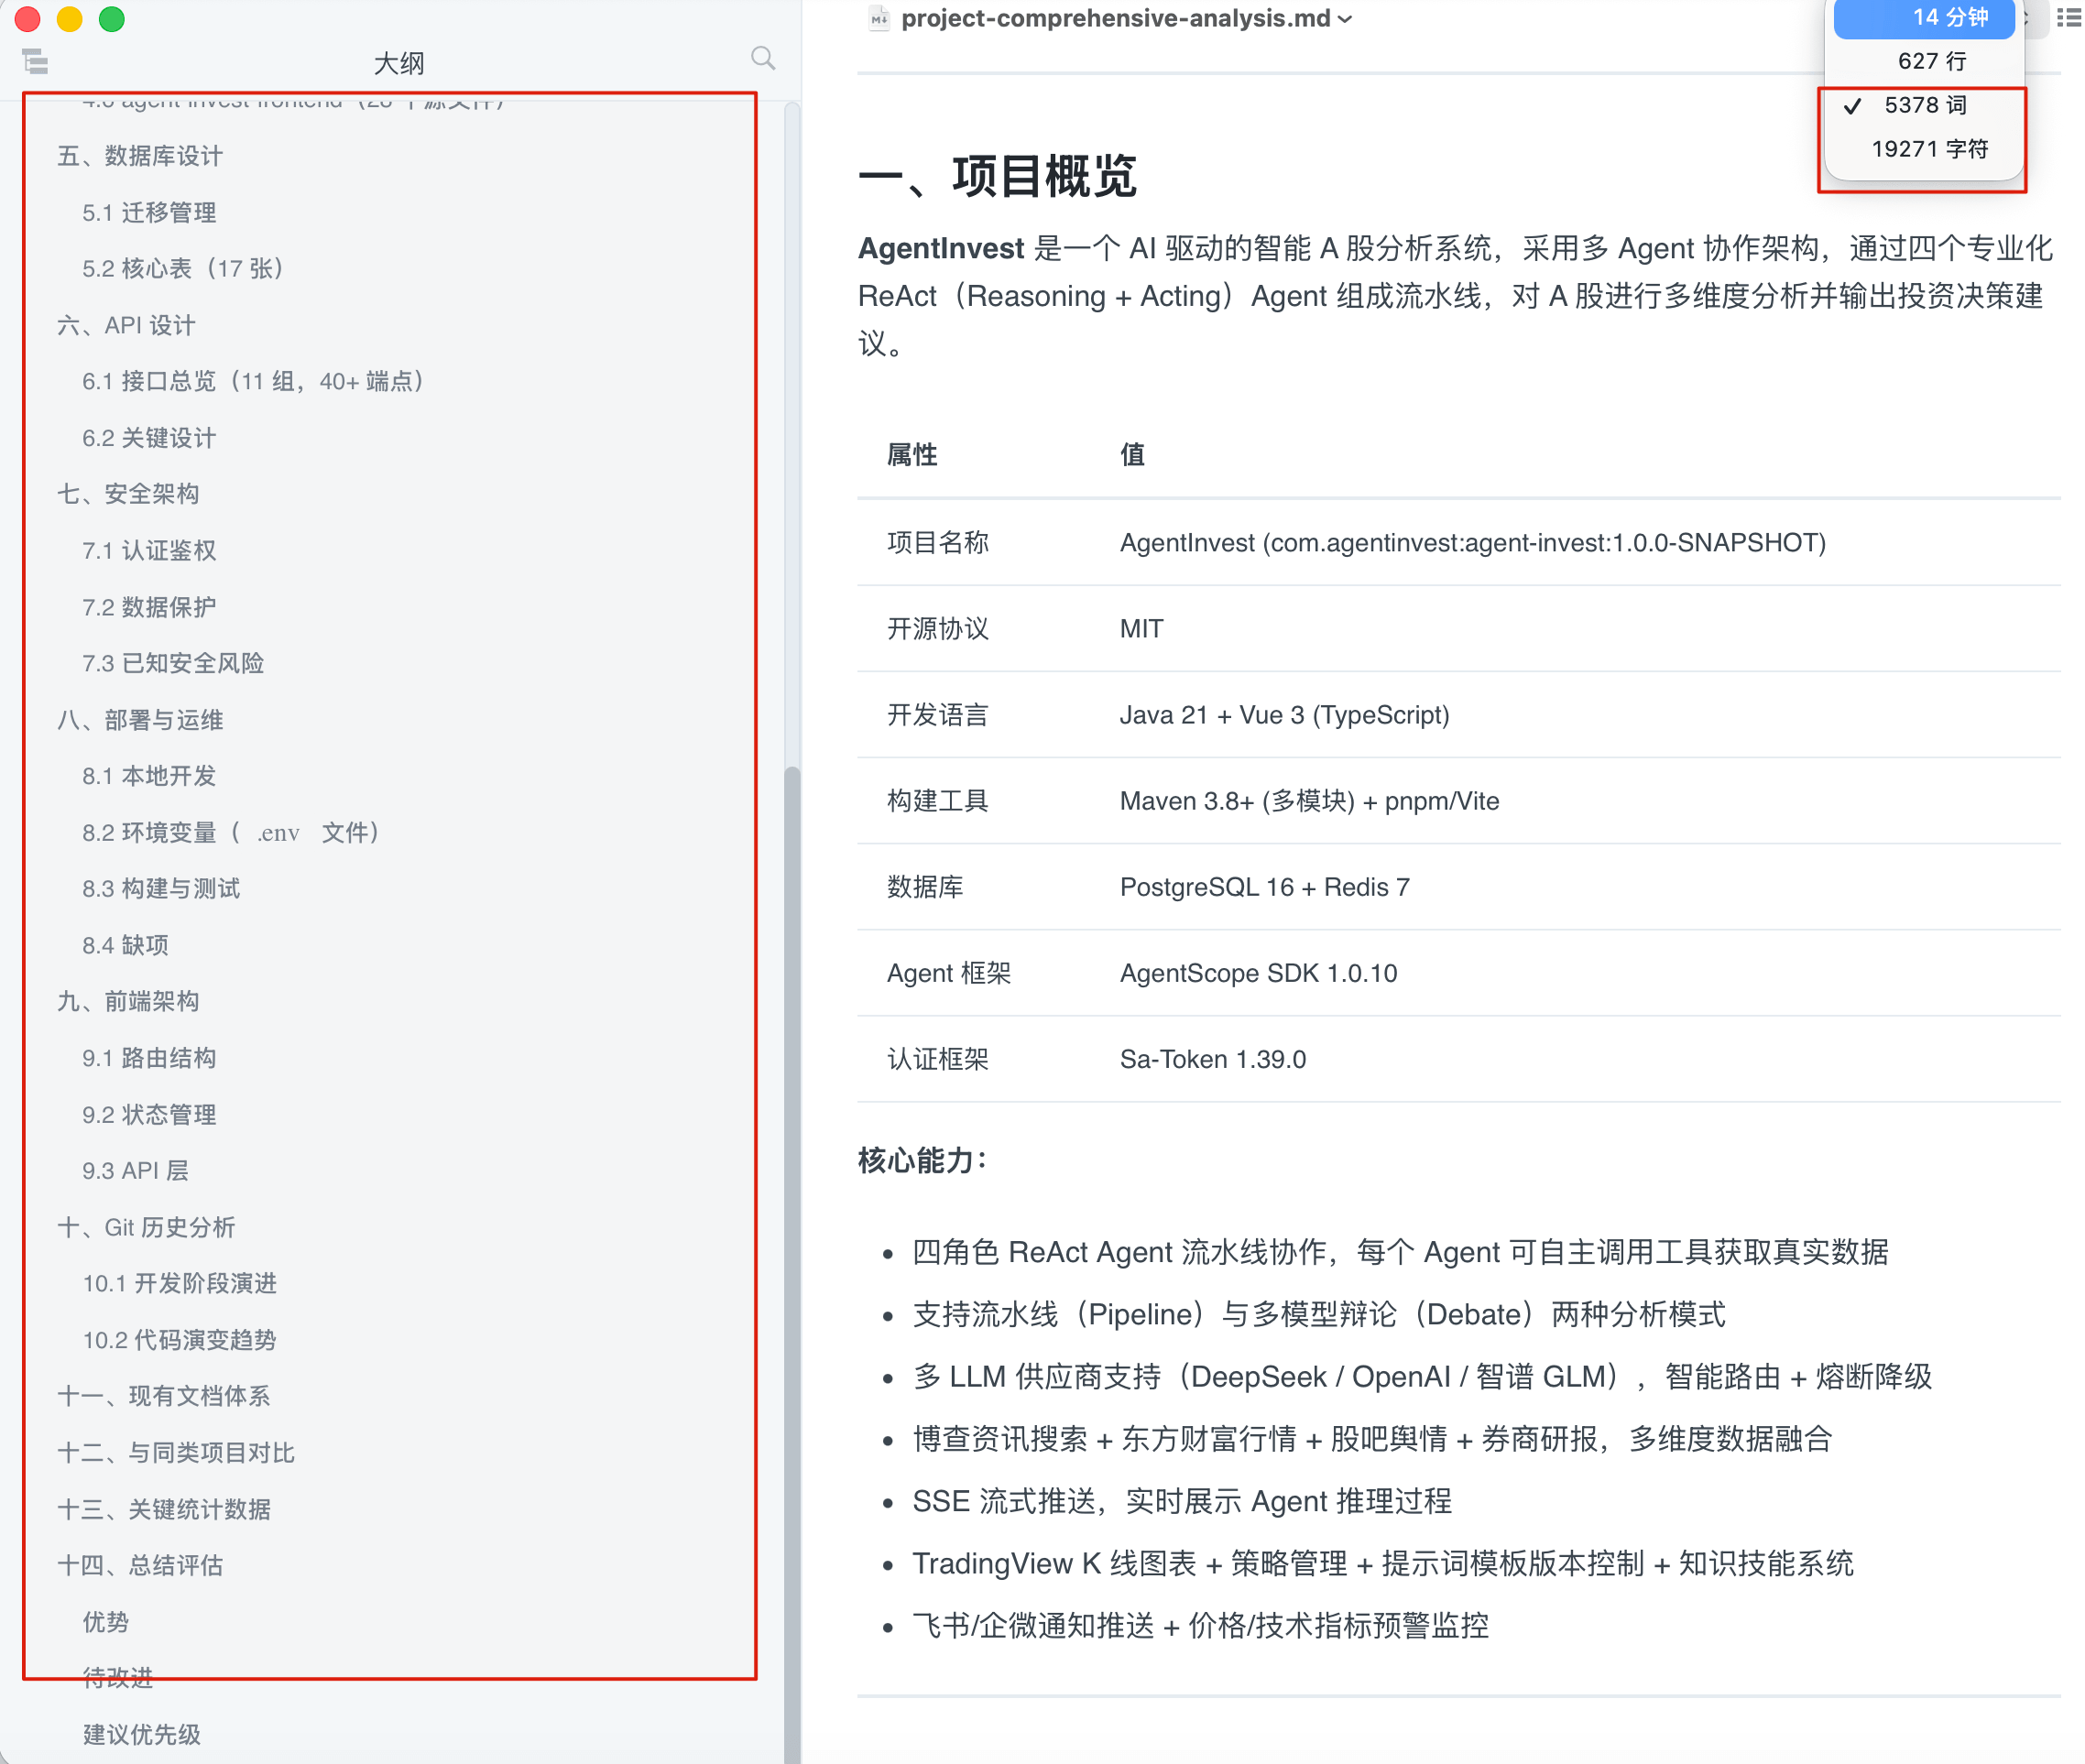
Phần này đơn giản, chủ yếu để xác minh chất lượng phân tích của V4-Pro và tiện thể xem lượng Token tiêu thụ cuối cùng.
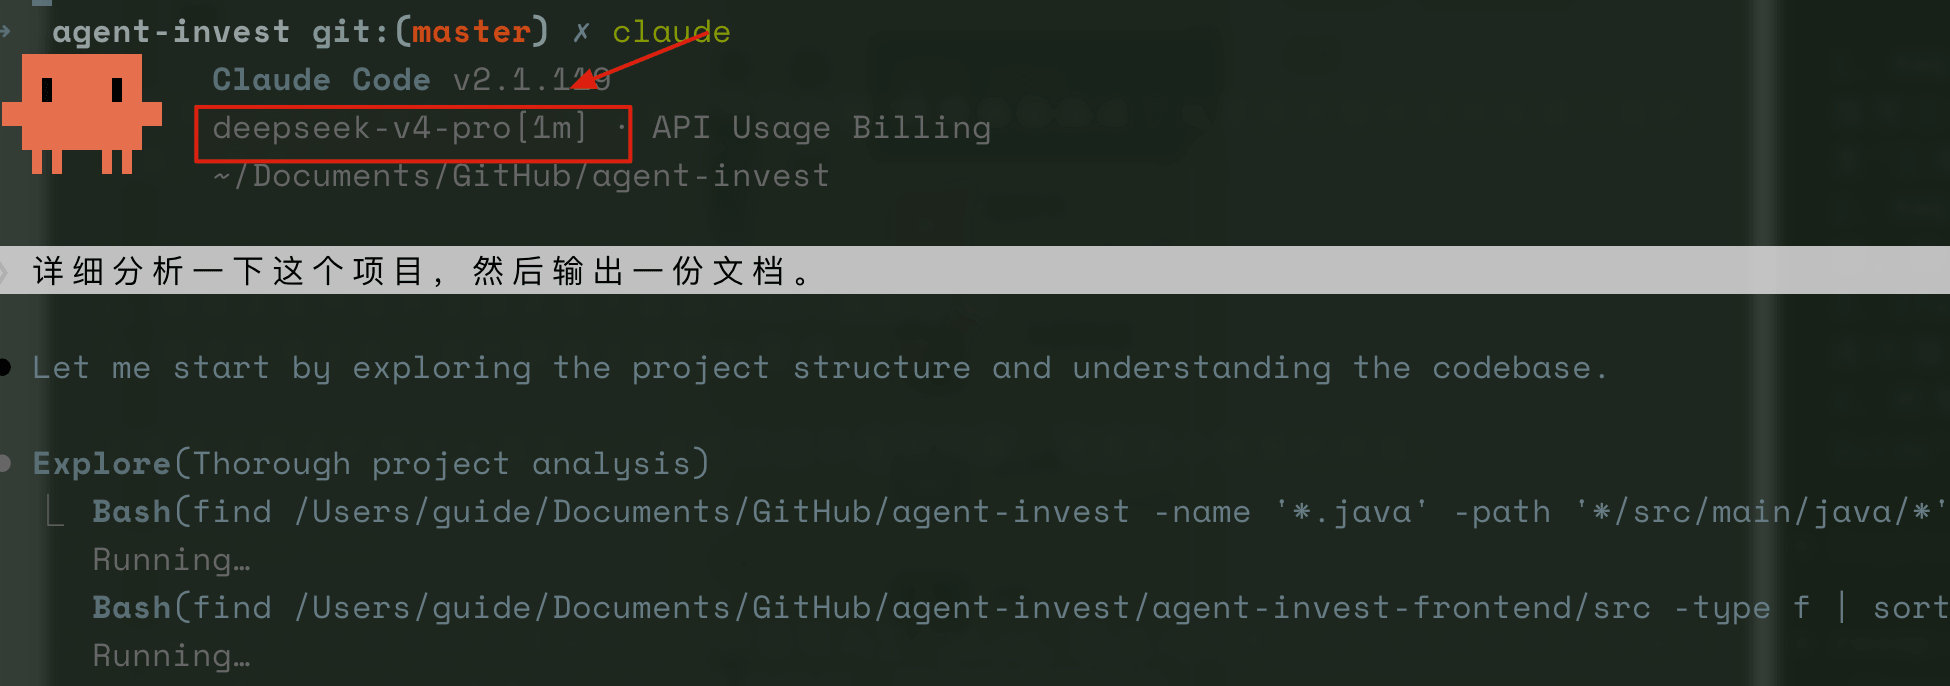
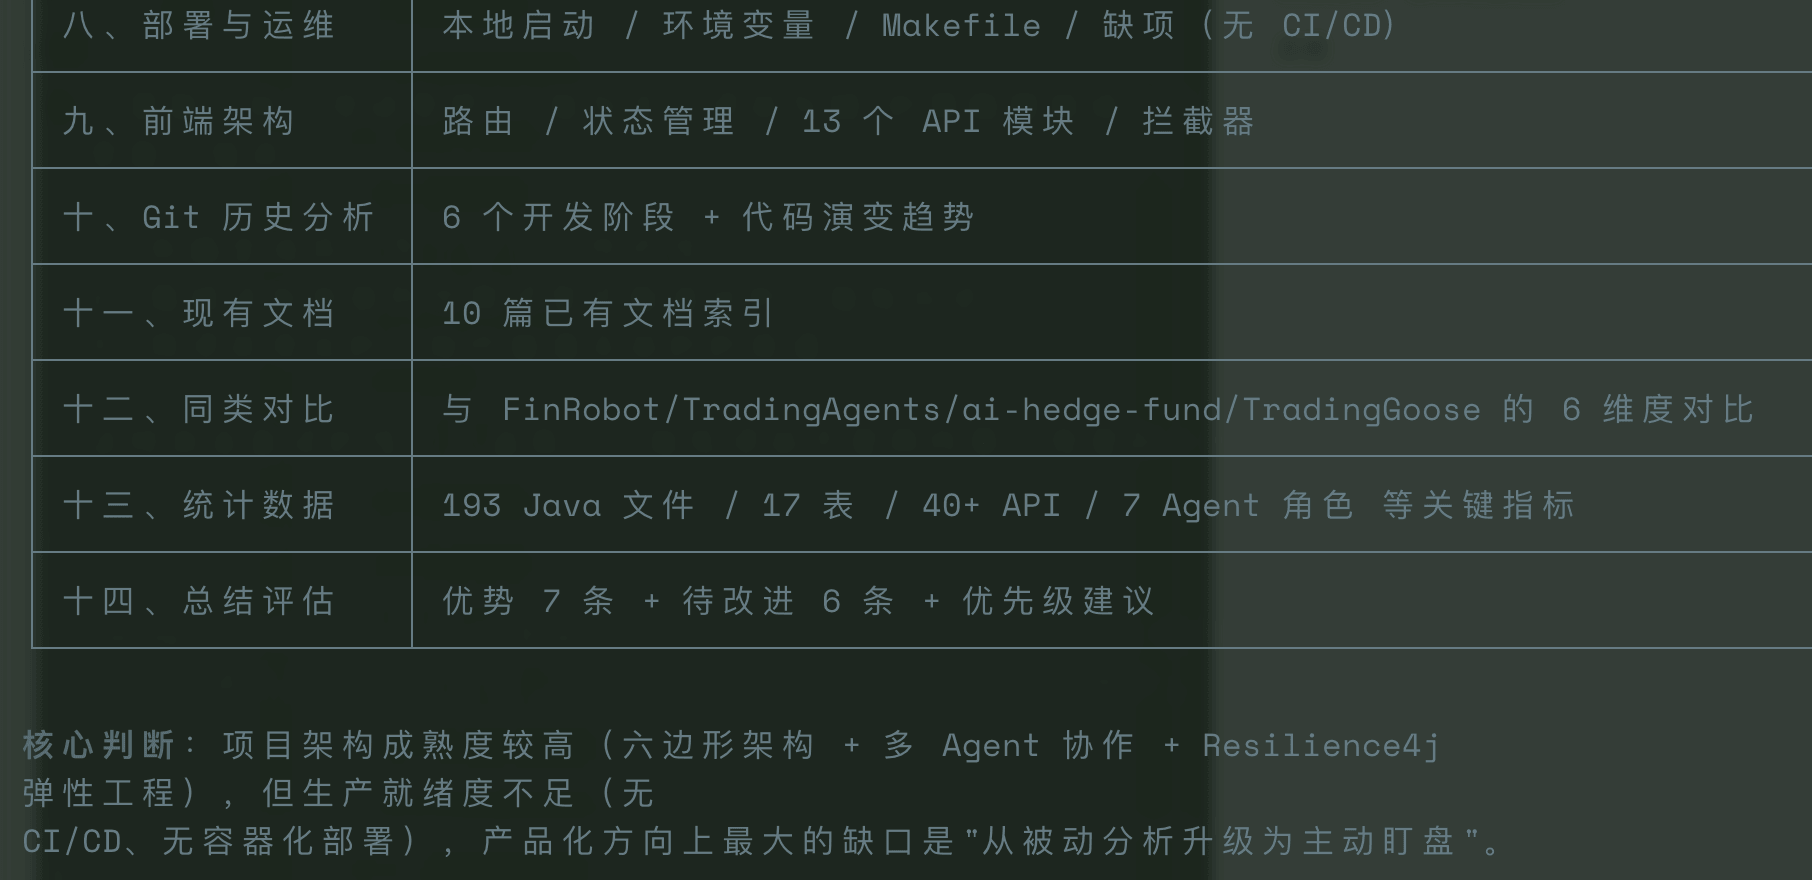
Đây là document cuối cùng V4-Pro output, bao quát cấu trúc project, các module chính và những vấn đề cần xử lý:
Tổng quan DeepSeek V4: Xem con số sau khi xem thực chiến
Sau khi xem một số task thực chiến ở trên, hãy bổ sung các thông số cứng của DeepSeek V4 để có cảm nhận cụ thể hơn.
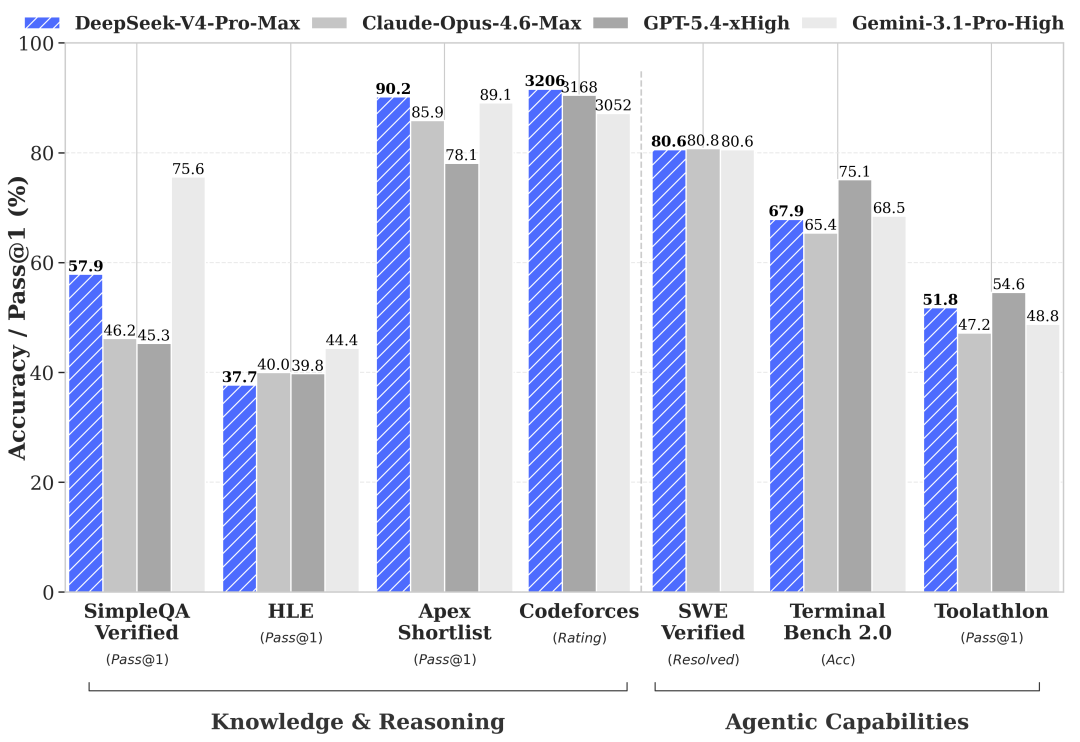
V4 Preview cung cấp đồng thời hai model. Các tham số và Benchmark trong bảng dưới đây đến từ báo cáo chính thức của DeepSeek, là kết quả do nhà cung cấp công bố và không tương đương với đánh giá độc lập của các task trong bài viết này:
| Thông số | deepseek-v4-pro | deepseek-v4-flash |
|---|---|---|
| Tổng số parameter | 1.6T | 284B |
| Parameter được activate mỗi token | 49B | 13B |
| Context window | 1M tokens | 1M tokens |
| Chế độ inference | Không suy nghĩ / Think High / Think Max | Không suy nghĩ / Think High / Think Max |
| License open source | MIT | MIT |
Một số số liệu được liệt kê trong báo cáo chính thức:
- Điểm Codeforces của V4-Pro là 3206, đứng đầu trong các model đối chiếu được chọn trong báo cáo
- SWE-bench Verified 80.6%, kết quả đối chiếu của Claude Opus 4.6 trong báo cáo là 80.8%; không thể trực tiếp suy ra năng lực hoặc tính tương đương về chi phí của hai model trong codebase cụ thể từ nhóm điểm này
- Trong trường hợp context 1M, FLOPs inference trên mỗi token của V4-Pro chỉ bằng 27% V3.2, lượng KV cache chỉ bằng 10%
Tên đối thủ và điểm số ở đây là snapshot lịch sử của báo cáo phát hành V4 Preview, không phải bảng xếp hạng model tại ngày kiểm chứng của bài viết.
Tiếp theo là pricing:
| Pricing API (trên một triệu token, tính đến 2026-08-24) | deepseek-v4-flash | deepseek-v4-pro |
|---|---|---|
| Input (cache miss) thấp điểm / cao điểm | $0.22 / $0.44 | $0.66 / $1.32 |
| Input (cache hit) thấp điểm / cao điểm | $0.007 / $0.014 | $0.022 / $0.044 |
| Output thấp điểm / cao điểm | $0.66 / $1.32 | $1.98 / $3.96 |
Khung giờ cao điểm là 9:00-12:00 và 14:00-18:00 từ thứ Hai đến thứ Sáu theo giờ Bắc Kinh; các khung giờ còn lại (bao gồm cuối tuần) là khung giờ thấp điểm, đơn giá bằng một nửa khung giờ cao điểm.
Hóa đơn thực tế phụ thuộc vào cache hit rate, độ dài context và quy mô output. So sánh chi phí giữa các nhà cung cấp còn phải thống nhất cách tính input, output, cache và retry; bài viết này không có đầy đủ call record nên không đưa ra bội số cố định nữa. Giá sẽ thay đổi, trước khi sử dụng nên xem lại trang pricing chính thức của DeepSeek.
Theo bảng giá này, Flash phù hợp hơn với task nhạy cảm về chi phí và có kết quả dễ kiểm tra; việc có phù hợp với hội thoại hằng ngày, content generation hoặc câu hỏi đáp đơn giản hay không vẫn cần kết hợp với kết quả đo chất lượng và latency thực tế.
Bản thân việc migration model name không thay đổi nhiều, nhưng vẫn phải regression test context window, tool calling và error handling, không thể coi là “zero cost”. Mốc model cũ bị ngừng sử dụng do phía chính thức công bố là 2026-07-24 15:59 UTC (23:59 theo giờ Bắc Kinh); nếu đọc bài viết sau thời điểm này, trước tiên cần xác nhận ID cũ còn khả dụng hay không thông qua model list.
Đề xuất theo trường hợp sử dụng
| Trường hợp sử dụng | Đề xuất | Trọng tâm kiểm chứng |
|---|---|---|
| Hội thoại hằng ngày, content generation, hỏi đáp đơn giản | Thử deepseek-v4-flash trước | Chất lượng, latency và cache hit rate |
| Agent Coding, refactor code, phân tích toàn project | Thử deepseek-v4-pro trước | Tool calling, chỉnh sửa cross-file, tỷ lệ test pass và chi phí thực tế |
| Coding phức tạp rủi ro cao và review độc lập | So sánh với các model hiện tại như Claude Fable 5, GPT-5.6 | Tính khả dụng của account, tỷ lệ task thành công, security boundary và tổng chi phí |
Dòng cuối là snapshot model family tính đến 2026-07-24; model cụ thể và tính khả dụng phải căn cứ vào account và tài liệu chính thức.
Tổng kết
Qua một số task trong bài viết, V4-Pro đã có thể hoàn thành cập nhật cấu hình model, chẩn đoán migration và sàng lọc ban đầu khi code audit. SWE-bench Verified 80.6% và Codeforces 3206 trong báo cáo chính thức có thể dùng làm tham khảo, nhưng không thể thay thế việc đánh giá trên codebase của chính team.
V4-Pro có đáng dùng hay không phụ thuộc vào cache hit rate và độ dài task. V4-Flash rẻ hơn, nhưng trong task phỏng vấn của bài viết vẫn có câu trả lời bị bỏ sót, không phù hợp để làm model chính cho development mà không kiểm tra.
Với coding phức tạp, hỏi đáp phức tạp và suy luận khoa học tiên phong, vẫn cần so sánh các model khác nhau theo từng task. Lựa chọn của tôi sẽ là: thử Flash trước cho task batch rủi ro thấp, giao thay đổi cross-file và các sửa lỗi quan trọng cho model mạnh hơn, đồng thời giữ lại test và nghiệm thu thủ công.