
Tổng hợp mẹo thực tế cho Vibe Coding: Git, Spec, quản lý context và phối hợp nhiều Agent
Xin chào, mình là Tiểu G. Cuối tuần trước, mình đã chia sẻ một số mẹo nhỏ về Vibe Coding qua tin nhắn. Bài viết này bổ sung những nội dung chưa triển khai khi đó, đồng thời tổng hợp các vấn đề mình từng gặp trong vài năm sử dụng AI Coding thực tế.
Trước khi bắt đầu, muốn hỏi mọi người một câu: bạn còn nhớ cảm giác lần đầu Vibe Coding không?
Còn mình thì thực sự rất phấn khích. Năm 2024, lần đầu tiếp xúc với Cursor, mình đã kinh ngạc trước khả năng của nó. Cảm giác đó giống như lần đầu tiếp xúc với game khi còn nhỏ, nhưng còn thú vị hơn game một chút. Mỗi ngày, điều vui nhất là Vibe Coding, nhìn từng dòng code được tự động viết ra. Cảm giác như lượng việc làm được trong một ngày còn nhiều hơn cả một tuần trước đây.
Khoảng thời gian đó mình thật sự chẳng muốn chơi game nữa, chỉ muốn AI giúp mình làm được nhiều việc hơn.
Nhưng sau giai đoạn hứng thú, các sự cố cũng ngày càng nhiều, thường xuyên gặp những vấn đề khó hiểu. Điều này khiến mình nhận ra rằng chỉ Vibe Coding theo cảm tính thì không khả thi lắm.
Dưới đây là một số kinh nghiệm Tiểu G rút ra sau vài năm Coding với AI. Không hào nhoáng, nhưng đều khá hữu ích.
Chuẩn bị Git trước
Nếu chỉ được chọn một mẹo Vibe Coding quan trọng nhất, Tiểu G sẽ chọn Git.
Lý do rất đơn giản: AI viết sai một dòng code không đáng sợ, đáng sợ là nó sửa một lúc 20 file. Đến khi phát hiện hướng đi không đúng, bạn đã không biết phần nào nên giữ, phần nào nên bỏ. Git không phải nghi thức bổ sung sau khi viết code xong, mà nên được chuẩn bị trước khi AI bắt tay vào làm.
Trước khi để Agent sửa code, hãy kiểm tra workspace:
git status --shortNếu thư mục hiện tại đã có thay đổi, trước tiên hãy xác định rõ những thay đổi đó là của ai và có cần giữ lại không. Bước này đặc biệt quan trọng khi nhiều người hoặc nhiều Agent làm việc song song. Đừng để AI rollback những thứ nó không viết, cũng đừng trộn sản phẩm dở dang của người khác vào task của mình.
Sau khi xác nhận workspace sạch, hãy tạo branch riêng cho task hiện tại:
git switch -c feat/order-exportNgay cả task rất nhỏ cũng nên tạo branch. Vibe Coding trực tiếp trên branch chính sẽ khiến áp lực tâm lý ngày càng lớn; sau khi cô lập bằng branch, dù AI viết sai hướng thì đó cũng chỉ là vấn đề của branch hiện tại.
Sau khi AI sửa xong, đừng vội xem phần tổng kết của nó, hãy xem repository tự nói gì trước:
git diff --stat
git diff
git diff --stat cho biết phạm vi ảnh hưởng, git diff cho biết chi tiết. Sau khi xác nhận không có vấn đề, hãy stage và commit theo từng phần:
git add -p
git commit -m "feat: add order export"
Mỗi commit chỉ nên làm một việc. Có thể commit theo từng phần thì hãy commit theo từng phần; về sau việc Review, rollback và định vị vấn đề sẽ nhẹ nhàng hơn nhiều. AI nói “mình chỉ sửa logic export” không đáng tin bằng diff.
Nếu sửa hỏng, cũng nên rollback có kiểm soát:
# Loại bỏ thay đổi của một file chưa commit
git restore path/to/file

# Hủy stage file đã được đưa vào stage
git restore --staged path/to/file

# Đã commit và push, ưu tiên tạo một commit đảo ngược
git revert <commit>
git reset --hard không phải điều cấm kỵ, nhưng đừng tùy tiện giao nó cho Agent. Trừ khi branch hiện tại chỉ là branch thử nghiệm dùng một lần, lệnh này rất dễ xóa luôn các thay đổi chưa được lưu.
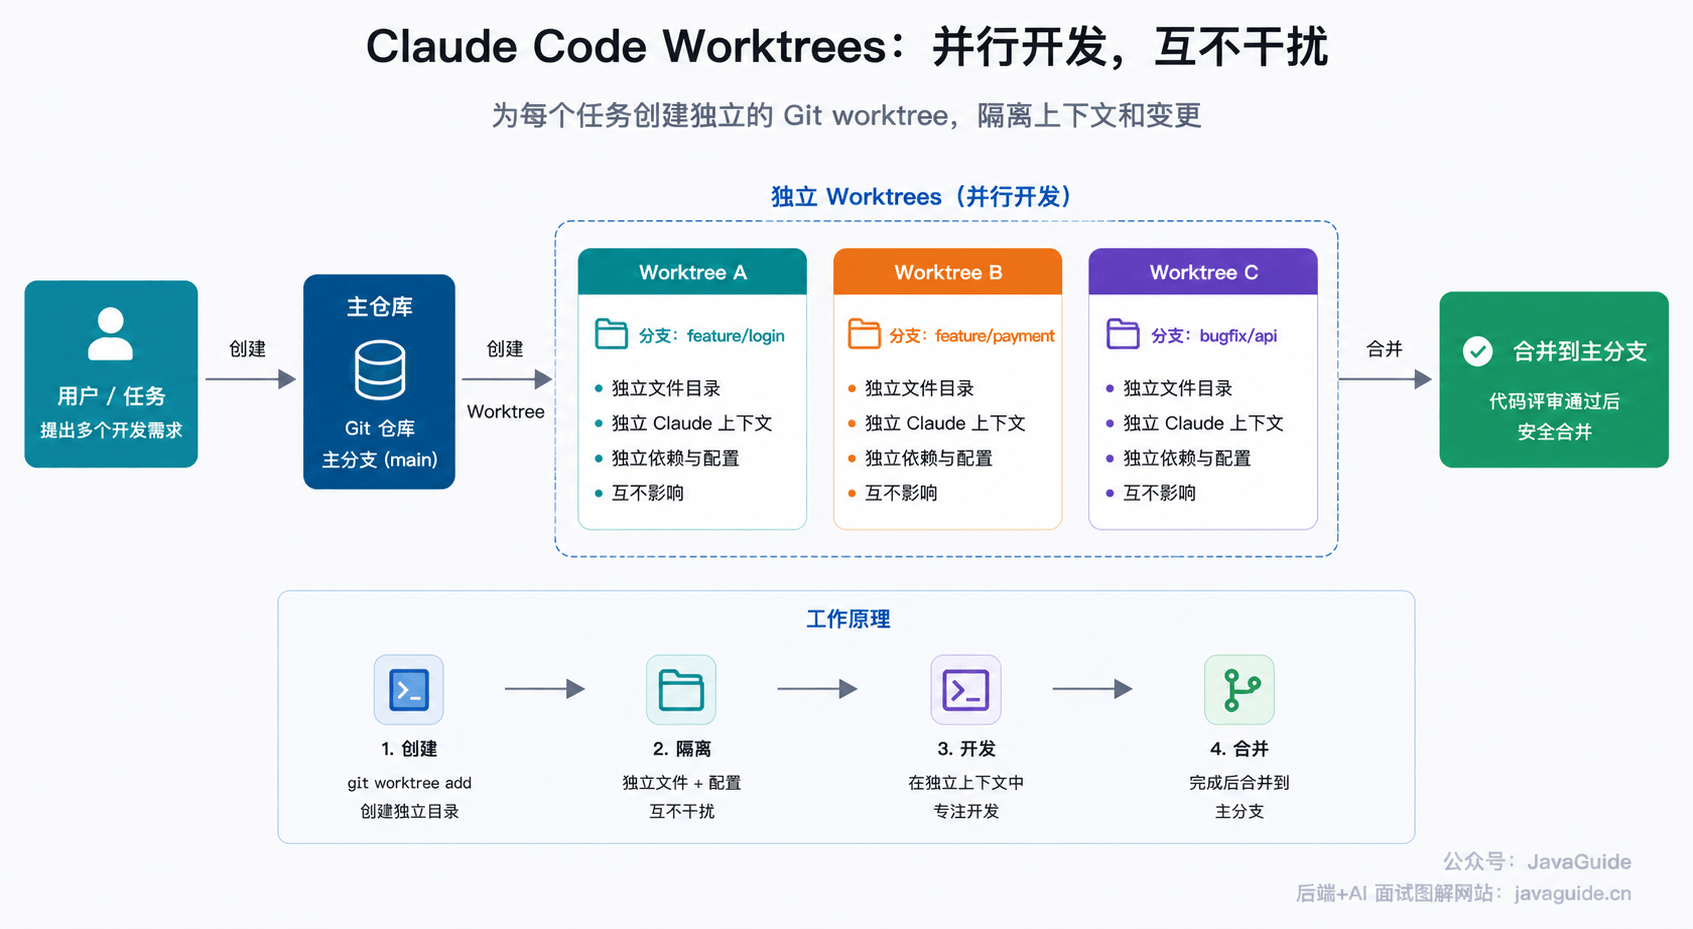
Task song song có thể dùng git worktree để cô lập:
git worktree add ../project-order-export -b feat/order-export
git worktree add ../project-refactor-user -b feat/refactor-user
Mỗi Agent một thư mục, một branch, một task. Như vậy dù chúng có sửa lung tung thì cũng chỉ sửa trong workspace riêng của mình.
Thu hẹp phạm vi trước khi bắt đầu
Khi yêu cầu AI làm gì, hãy cố gắng nói thật cụ thể, đừng để nó tự đoán.
Lấy bối cảnh order làm ví dụ, nếu bạn chỉ nói: hãy giúp tôi triển khai chức năng export order.
Câu này quá rộng, AI không biết mỗi lần export bao nhiêu bản ghi, export định dạng gì, export những field nào và thứ tự field ra sao.
Khi thông tin chưa đủ, nó sẽ tự đoán. Kết quả đoán ra có thể chạy được, nhưng chưa chắc là thứ bạn muốn.
Thay vào đó, hãy dành vài phút viết một Spec nhẹ trước khi bắt đầu. Cách này thường rẻ hơn nhiều so với việc làm lại về sau:
## Mục tiêu

Triển khai API export order, hỗ trợ export CSV theo khoảng thời gian.

## Ràng buộc

- Mỗi lần tối đa export 5000 bản ghi
- Khoảng thời gian không được vượt quá 31 ngày
- Chỉ được export dữ liệu của tenant hiện tại
- Truy vấn bắt buộc sử dụng order_tenant_time_idx
- Khi export thất bại phải ghi lại nguyên nhân, không chỉ trả về unknown error

## Tiêu chí nghiệm thu

- Export CSV bình thường, thứ tự field là order_no, amount, status, created_at
- Vượt quá 5000 bản ghi phải trả về lỗi rõ ràng
- Không được export dữ liệu của tenant vượt quyền
- Unit test bao phủ 4 trường hợp: không có dữ liệu, vượt quyền, vượt số lượng bản ghi và vượt khoảng thời gian
Không cần viết tài liệu này giống như một tài liệu review giải pháp.
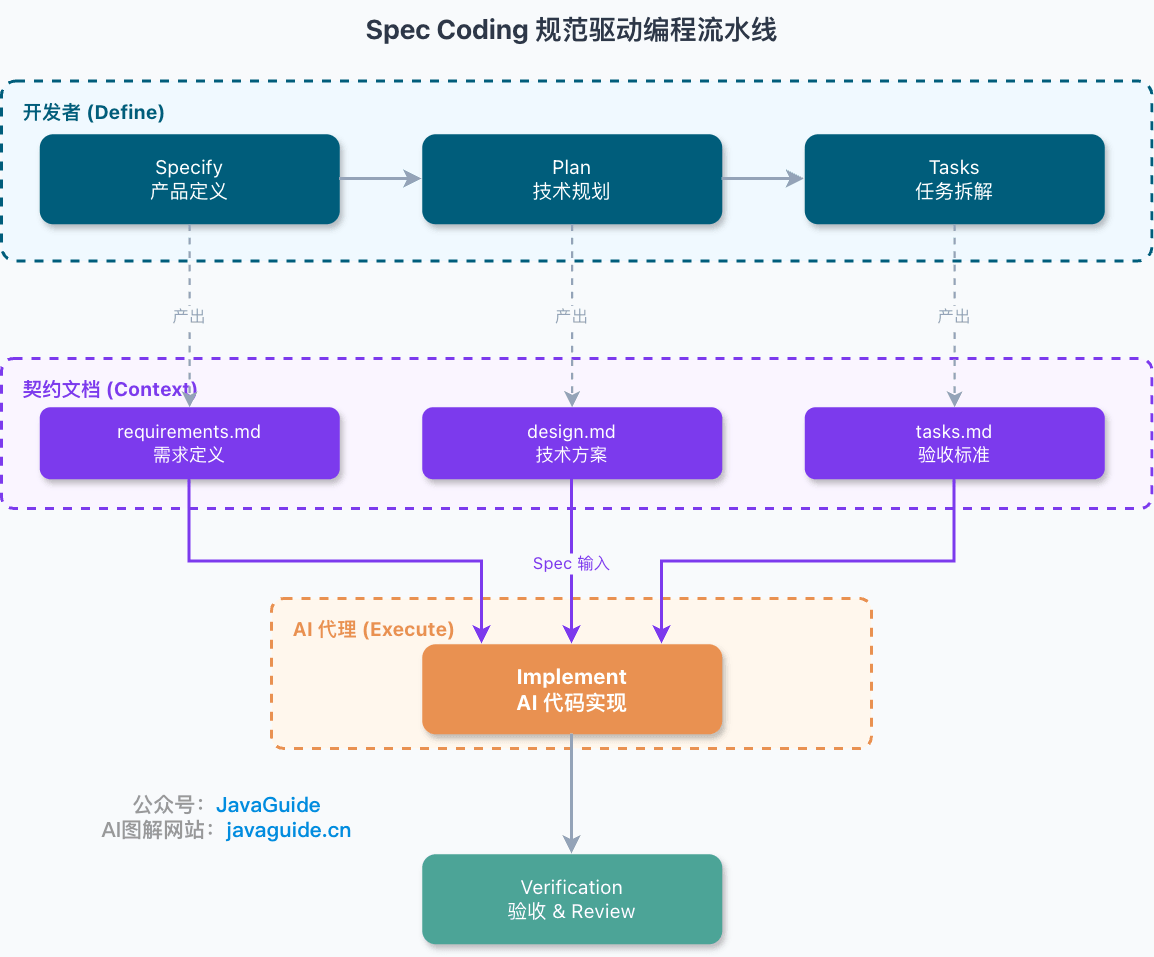
Với task nhỏ, chỉ cần viết rõ mục tiêu, ràng buộc và tiêu chí nghiệm thu; task trung bình thì bổ sung format API, error code và cấu trúc bảng; yêu cầu lớn hơn thì tách thành requirements.md, design.md, tasks.md. Không cần ngay từ đầu làm quy trình quá đầy đủ, nếu không bạn sẽ nản trước tài liệu.
Bạn có thể tham khảo giới thiệu chi tiết về Spec Coding tại: Thực chiến Spec Coding: từ Vibe Coding đến lập trình theo quy chuẩn AI.
Còn một cách hiệu quả hơn cả việc đưa ra quy chuẩn trừu tượng: cho AI xem code được viết tốt trong project.
Trước tiên hãy đọc UserController, UserService, UserRepository và các test tương ứng. Tham khảo cách phân layer, xử lý exception, bọc response, phong cách log và cách viết test của chúng. Sau đó triển khai OrderExportController.

Không được đưa vào format response mới.
Không được thêm global exception handler.
Không được bỏ qua logic kiểm tra quyền hiện có.
Những câu như “code phải thanh lịch, dễ bảo trì và tuân thủ best practice” khi đặt trong Prompt trông rất nghiêm túc, nhưng thực tế có sức ràng buộc khá yếu.
Model giỏi bắt chước các mẫu cụ thể hơn. Khi cho nó xem một đoạn code thực sự đạt yêu cầu trong project, nó lại dễ viết ra code cùng một phong cách hơn.
Ghi lại các điểm dễ mắc lỗi của project trong file rule
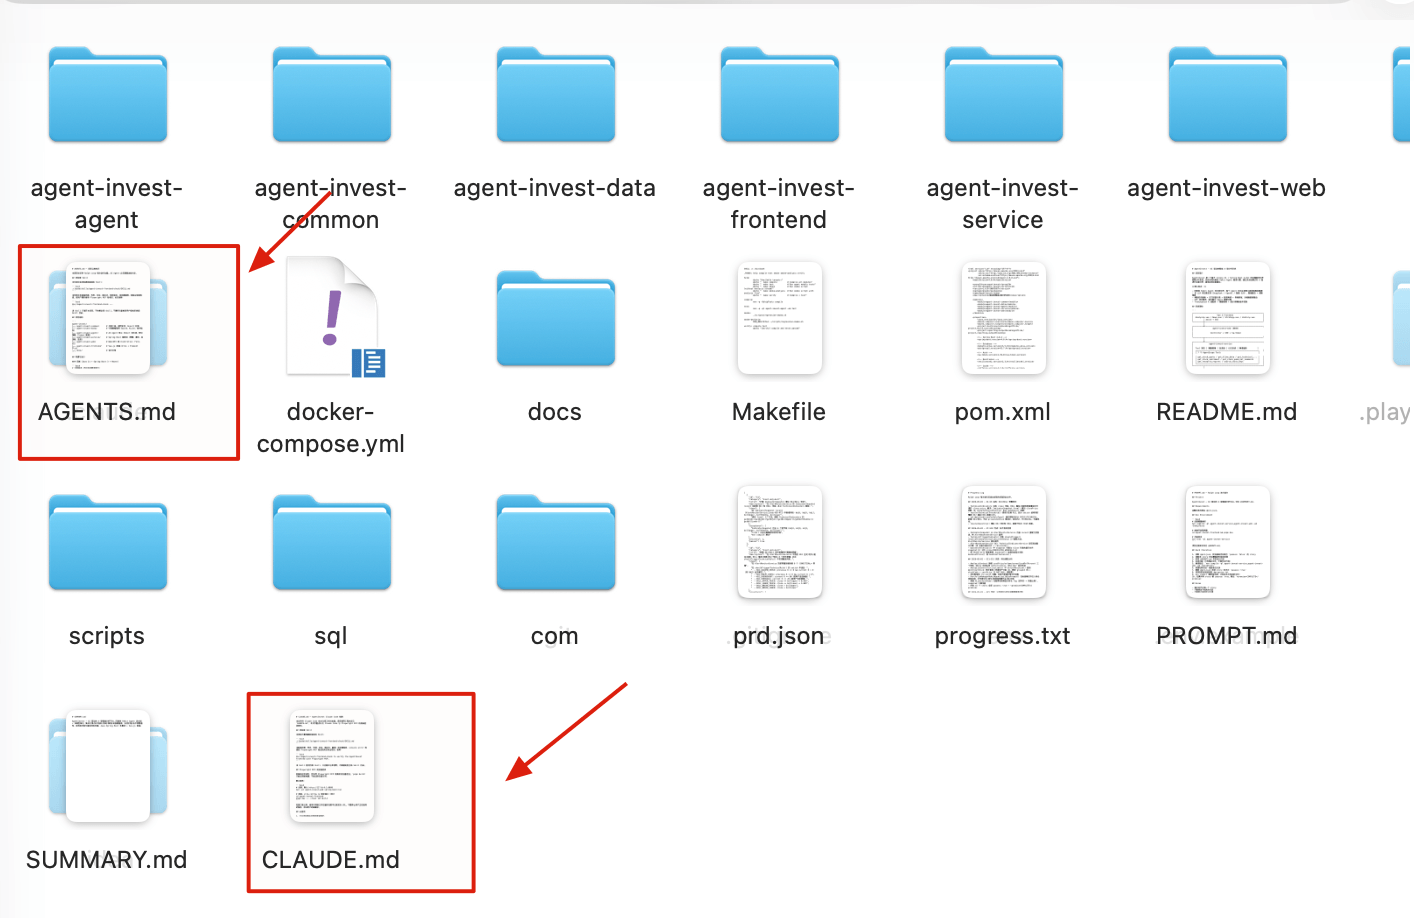
Với project dài hạn, có thể đặt các rule này ở nơi AI tool có thể đọc ổn định. Ví dụ:
- Claude Code:
CLAUDE.md - Codex:
AGENTS.md - Cursor: Project Rules,
.cursor/rules/*.mdc, cũng có thể kết hợp vớiAGENTS.md - GitHub Copilot / VS Code:
.github/copilot-instructions.mdở cấp repository,.github/instructions/*.instructions.mdở cấp path, cũng hỗ trợAGENTS.md
Đừng viết thành tài liệu giới thiệu project! Chỉ nên viết những rule Claude dễ đoán sai, không thể đọc ra từ code và team bắt buộc phải tuân thủ. Trọng tâm là version của tech stack, command thường dùng, lựa chọn kiến trúc, quy ước của team và các điểm dễ mắc lỗi của project; đừng nhét những câu sáo rỗng, hành vi mặc định và các đoạn tài liệu dài vào.
Tiêu chí đánh giá rất đơn giản: nếu xóa dòng này, Claude có dễ mắc lỗi hơn không?
Mỗi khi AI lặp lại một lỗi, cũng đừng chỉ trách nó một câu trong chat.
Lịch sử chat sẽ phân tán, còn file rule sẽ đi cùng repository. Bổ sung điểm dễ mắc lỗi vào rule thì lần sau nó mới có nhiều khả năng tránh được.
Tận dụng Skill để tích lũy quy trình
File rule và Skill giải quyết hai loại vấn đề không hoàn toàn giống nhau.
File rule phù hợp hơn để chứa những điều project này luôn phải tuân thủ, chẳng hạn version của tech stack, command khởi động, cấu trúc thư mục, format error code và những file không được chạm vào.
Skill phù hợp hơn để mô tả cần làm thế nào khi gặp một loại task nào đó. Ví dụ code review, viết test, sửa trang frontend, nghiên cứu web và viết bài kỹ thuật. Những task này lần nào cũng có quy trình gần giống nhau, không cần mỗi lần lại nhắc lại trong chat.
Tiểu G từng viết hai bài liên quan: Agent Skills là gì? Khác Prompt và MCP ở điểm nào? và Danh sách lựa chọn AI Coding Skills.
Nói đơn giản, Skill là một bản hướng dẫn task có thể được Agent load khi cần. Nó không phải plugin, cũng không phải bản thân MCP tool, mà là nơi ghi lại quy trình, ràng buộc, checklist và kinh nghiệm xử lý vấn đề của một loại task trong SKILL.md.
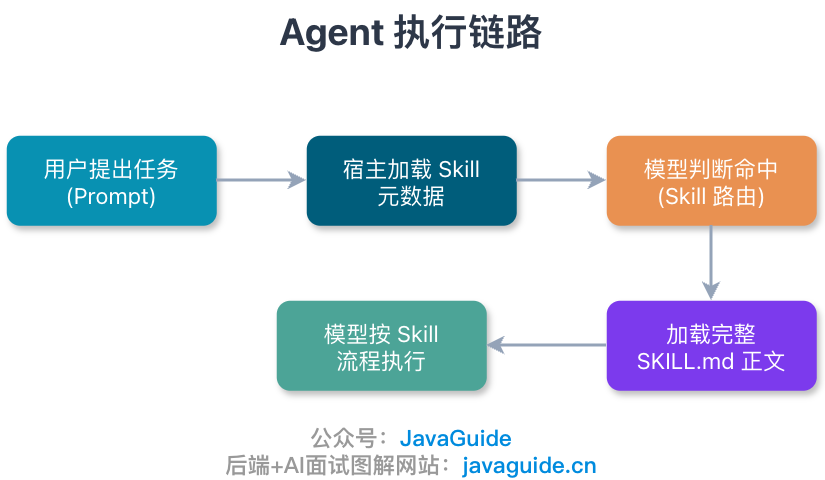
Những việc sau rất phù hợp để tích lũy thành Skill:
- Viết feature theo TDD: trước tiên viết test fail, sau đó viết implementation.
- Khi Code Review, cố định kiểm tra security, transaction, performance, điều kiện biên và quy ước của project.
- Khi viết trang frontend, cố định kiểm tra responsive, trạng thái hover, accessibility và design system.
- Khi nghiên cứu web, cố định thứ tự sử dụng các tool như search, fetch và browser automation.
- Khi viết bài kỹ thuật, cố định kiểm tra nguồn thông tin, trích dẫn, cấp độ heading và dấu vết AI.
Tại sao nên dùng Skill? Vì lần nào cũng nhắc các quy trình này trong chat rất phiền. Hôm nay bạn nhắc nó viết test trước, ngày mai đổi session là nó lại quên; lần này bạn yêu cầu nó Review rủi ro quyền hạn, lần sau nó có thể chỉ xem naming và format. Giá trị của Skill nằm ở đây: biến những lời nhắc lặp lại thành một sổ tay công việc có thể tái sử dụng.
Tuy nhiên, cũng đừng viết Skill thành README.
README dành cho người đọc, có thể trình bày bối cảnh, nguyên lý và hướng dẫn cài đặt; Skill dành cho Agent đọc khi thực hiện task, trọng tâm là: khi nào dùng, thực hiện theo thứ tự nào, trường hợp nào không được làm và xử lý dự phòng thế nào khi thất bại.
Nội dung càng dài thì càng dễ chiếm context. Khi viết Skill, hãy tự hỏi một câu: đoạn này có trực tiếp ảnh hưởng đến bước tiếp theo của Agent không? Nếu không, đừng nhét vào.
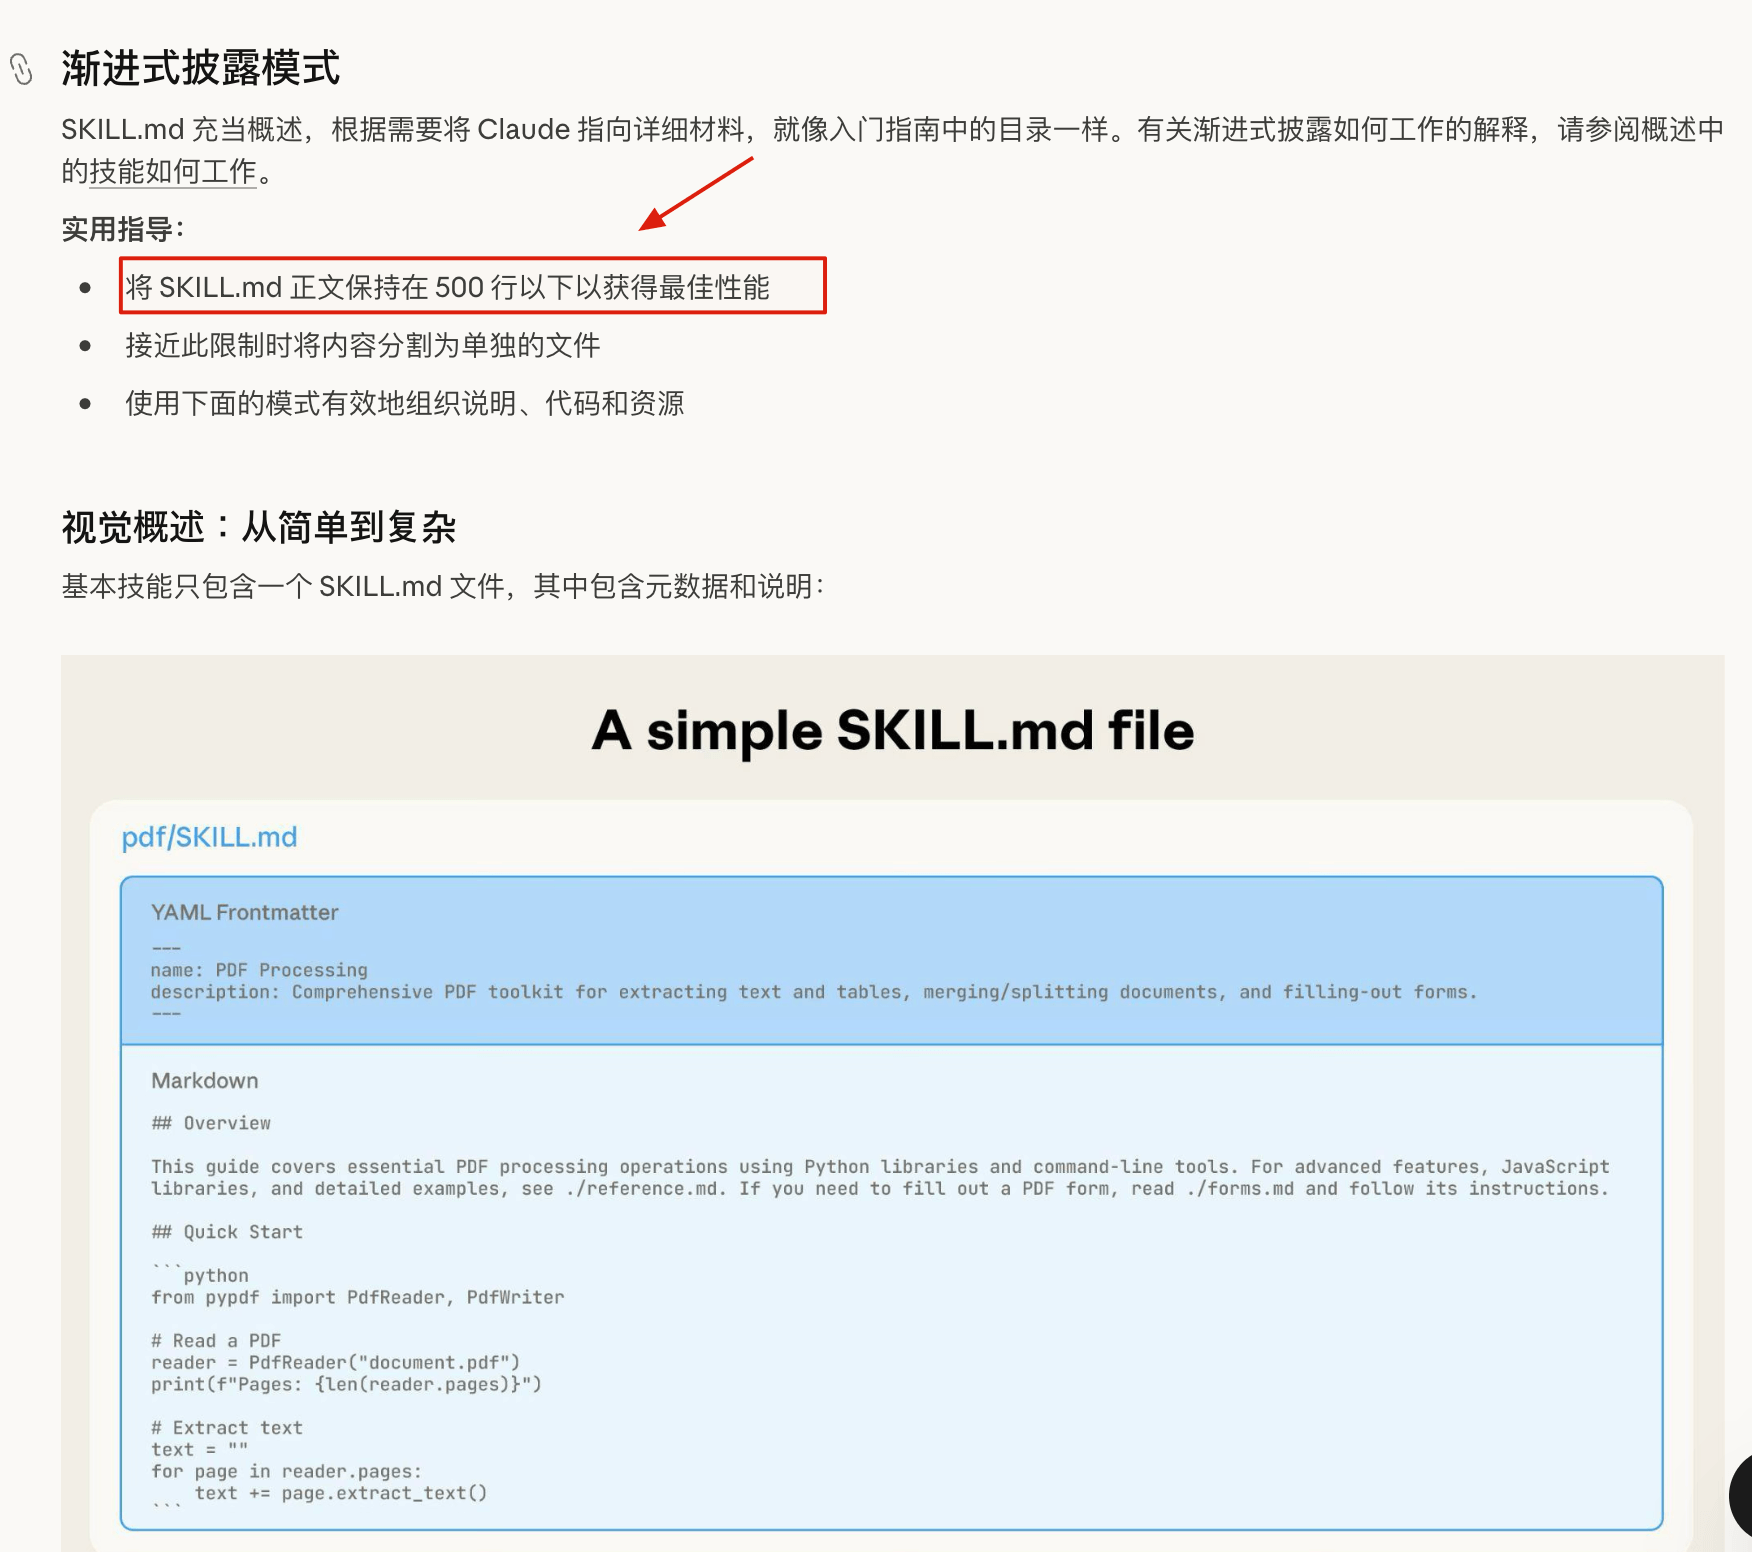
Khuyến nghị của Anthropic là phần nội dung chính của SKILL.md nên được giới hạn trong 500 dòng; nếu vượt quá độ dài này, hãy tách chi tiết sang file riêng và để Agent đọc khi cần theo cách progressive disclosure.
Cũng có thể dùng trực tiếp các Skill có sẵn. Ví dụ Superpowers đã đóng gói các quy trình TDD, Code Review, Spec-Driven, Git Worktree và phối hợp subagent.
Mình đã đề xuất chi tiết trong bài Danh sách lựa chọn AI Coding Skills: làm rõ yêu cầu, TDD, Code Review và UI Design.
Tuy nhiên, đừng lấy Skill bên thứ ba về rồi chạy ngay. SKILL.md cũng là instruction; nếu bên trong có command nguy hiểm, script kỳ lạ hoặc quyền quá rộng, Agent sẽ làm theo. Trước khi cài, ít nhất hãy xem qua nội dung chính, scripts/ và references/, xác nhận nó không thực hiện thao tác vượt quyền.
Đừng dùng model đắt tiền để làm việc vặt
Đừng giao mọi việc cho model đắt nhất.
Điều này giống như mời một kiến trúc sư cấp cao nhưng ngày nào cũng bảo họ sửa tên field, bổ sung getter và chỉnh CSS: tiền đã chi nhưng không tận dụng được giá trị. Ngược lại, vì tiết kiệm mà giao toàn bộ system design, security boundary và refactor phức tạp cho model rẻ hơn, cuối cùng chi phí làm lại có thể còn cao hơn.
Tiểu G thường dùng cách “model reasoning mạnh xác định rõ hướng đi, model chi phí thấp xử lý việc có phạm vi rõ ràng, cuối cùng dùng một model độc lập để xác minh lại”.
Bước một, để model có năng lực reasoning và Code Review tốt đọc yêu cầu và codebase.
Chỉ yêu cầu nó đưa ra giải pháp, liệt kê rủi ro và chia task, không để nó vội viết code.

Bước hai, sau khi xác nhận giải pháp, giao từng Task cho implementation model có chi phí và latency phù hợp hơn.
Để nó code theo task, bổ sung test, chạy command, sau khi hoàn thành thì đưa ra diff summary.

Bước ba, giao git diff cho một review model độc lập.
Lần này chỉ yêu cầu nó Review: Bug, rủi ro vượt quyền, transaction boundary, vấn đề performance và thiếu sót trong test.
Model thay đổi rất nhanh. Tính đến 2026-07-24, các model family có thể lựa chọn gồm Claude Fable 5, GPT-5.6, DeepSeek V4, GLM-5.2, MiniMax M3 và Kimi K3. Đây là snapshot theo thời điểm, không phải một tổ hợp cố định; lựa chọn thực tế còn phụ thuộc vào model có sẵn trong account, kết quả đo trên task, giá, giới hạn context và khả năng tương thích với tool.
Code audit cũng có thể làm như vậy. Trước tiên để model rẻ quét project một lượt và liệt kê các vấn đề nghi ngờ; sau đó để model mạnh review lại xem những vấn đề đó có thực sự tồn tại không. Trực tiếp để model giá cao quét toàn bộ dĩ nhiên cũng được, chỉ là tiền sẽ tiêu nhanh còn lợi ích chưa chắc tương xứng.
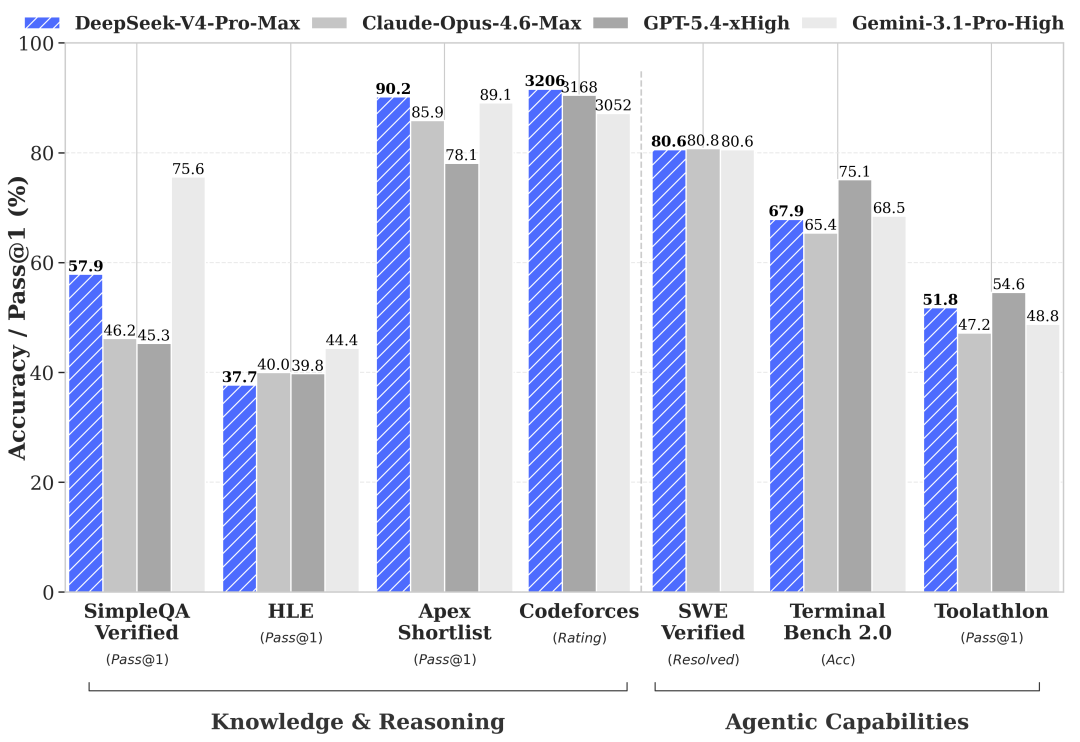
Đừng nghe nó nói đã sửa xong, hãy xem bằng chứng
AI rất thích nói “đã sửa”, “đã tối ưu”, “không có vấn đề”.
Nghe là được, đừng tin ngay.
Tiểu G thích xem ba thứ hơn: test, output của command và diff.
Ví dụ khi yêu cầu nó sửa một Bug trong order export, đừng chỉ hỏi “đã sửa xong chưa?”. Có thể yêu cầu trực tiếp như sau:
Trước tiên đừng sửa implementation.
Trước tiên hãy bổ sung test theo Spec, bao phủ happy path, tham số không hợp lệ, không đủ quyền, không có dữ liệu và request trùng lặp đồng thời.
Test ban đầu phải fail.
Sau khi tôi xác nhận test hợp lý, bạn mới sửa implementation cho đến khi test pass.
Cách làm này hơi giống TDD, nhưng không cần quá giáo điều. Điểm quan trọng là đừng để AI vừa sửa code vừa bổ sung một test sẽ luôn pass. Trước tiên để test fail, sau đó để implementation pass, bạn sẽ yên tâm hơn nhiều.
Nếu không muốn làm TDD đầy đủ, ít nhất cũng phải yêu cầu nó liệt kê rõ các tiêu chí nghiệm thu:
- [ ] API mới có kiểm tra quyền
- [ ] Error response tuân thủ format thống nhất
- [ ] Truy vấn database hit đúng index được chỉ định
- [ ] Giá trị rỗng, vượt giới hạn và request trùng lặp đều có test
- [ ] Log không in token, password, api key
- [ ] Tất cả test đều pass
Cũng phải yêu cầu nó dán command đã chạy và kết quả:
mvn test
npm test
go test ./...
pnpm lint
Nếu chưa chạy thì ghi “chưa chạy” và nêu rõ nguyên nhân. Ví dụ chưa cài dependency, database chưa khởi động hoặc test environment thiếu config đều có thể chấp nhận; đáng sợ nhất là chưa chạy nhưng lại viết một câu “đã xác minh” để cho qua.
Tối ưu performance càng không thể chỉ nghe nó nói. Nếu nó nói “tốc độ tăng rõ rệt”, hãy yêu cầu nó đưa ra bằng chứng: SQL trước và sau tối ưu, EXPLAIN, số lượng test data, P95/P99 hoặc latency của API. Nếu không có kết quả load test thực tế, chỉ được ghi lợi ích dự kiến và các mục cần xác minh, đừng để nó bịa số.
Đừng để context chất đống rồi rối tung
Tiểu G từng viết một bài về Context Engineering, trong đó có một quan điểm cũng rất phù hợp với Vibe Coding: context window lớn không có nghĩa là hiệu quả tốt — window có thể chứa nhiều thứ hơn, nhưng model có tìm được trọng tâm một cách ổn định hay không lại là chuyện khác.
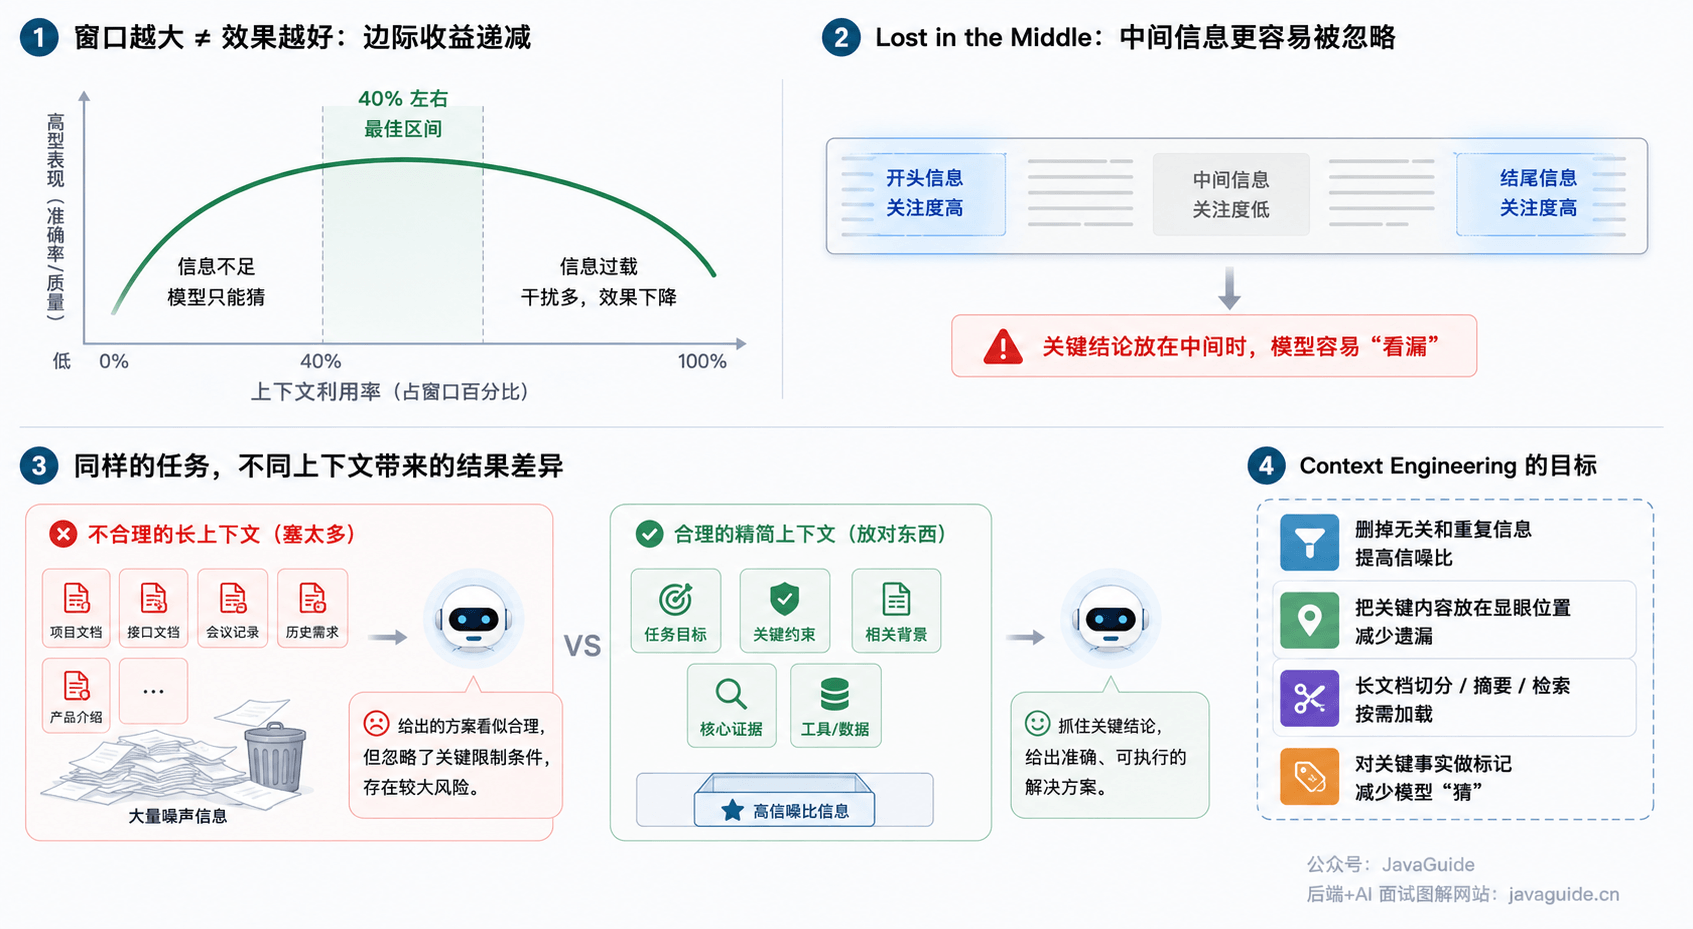
Trong một session, nếu ban đầu viết login, sau đó sửa payment, rồi refactor cache, cuối cùng lại hỏi vì sao test fail, sớm muộn model cũng trộn lẫn constraint cũ, các lần thử thất bại và giải pháp đã bỏ. Bạn tưởng mình đã cung cấp đầy đủ lịch sử, nhưng thứ nó nhận được có thể chỉ là một đống noise.
Trong Vibe Coding, cần quản lý ba việc về context.
Thứ nhất, đừng nhồi cả repository vào một lượt. Task hiện tại chỉ cần Spec, các file liên quan, error log, command nghiệm thu và một ít implementation tham khảo. Những nội dung khác trước tiên chỉ cần giữ bằng path, tên file và cấu trúc thư mục, khi cần mới yêu cầu Agent đọc. Khi phân tích repository lớn, Claude Code cũng dùng cách này: trước tiên định vị bằng search và directory, sau đó đọc dần từng file cụ thể thay vì ngay từ đầu nuốt toàn bộ code.
Thứ hai, hãy kịp thời compact task dài. Claude Code có thể dùng /compact để compact context, dùng /clear để xóa context (cách dùng chi tiết xem Giải thích chi tiết các command cốt lõi của Claude Code); Codex và các Agent khác cũng có cơ chế summary, compact và mở lại tương tự. Compact nhằm giữ lại trọng tâm như quyết định kiến trúc, file đã sửa, vấn đề chưa giải quyết, command thất bại và task tiếp theo, đồng thời bỏ các đoạn chat lặp lại và output tool đã được xử lý.
Thứ ba, hãy ghi tiến triển quan trọng vào file. Ví dụ yêu cầu Agent duy trì một file NOTES.md hoặc handoff của task trong task dài, ghi lại:
## Đã hoàn thành

- Đã sửa những file nào
- Những test nào đã chạy
- Những vấn đề nào đã được xác nhận không phải Bug

## Task còn lại

- Những case fail chưa sửa
- Những trường hợp biên chưa xác nhận
- Agent tiếp theo cần đọc file nào trước
Như vậy dù mở session mới cũng không cần giải thích lại từ đầu. Lịch sử chat sẽ dài hơn, rối hơn và cũ hơn, còn ghi chú có cấu trúc lại ổn định hơn.
Thói quen của Tiểu G là: mỗi session chỉ xử lý một task; nếu sửa hơn hai lần vẫn chưa đúng thì mở session mới; session mới chỉ mang theo Spec hiện tại, file liên quan, log thất bại, command nghiệm thu và handoff của vòng trước. Không có ngưỡng chung cho kích thước context package, nên lấy khả năng model ổn định tìm được constraint, hoàn thành task và vượt qua nghiệm thu làm tiêu chí; có thể bắt đầu bằng lượng tài liệu tối thiểu cần thiết, thiếu thì bổ sung.
Context package có thể viết rất đơn giản:
## Task hiện tại

Triển khai API export order.

## File bắt buộc đọc

- src/main/java/.../UserController.java
- src/main/java/.../OrderRepository.java
- docs/spec/order-export.md

## Không được sửa

- Tên các field đã có trong database
- Format exception toàn cục
- Logic login và authentication

## Command nghiệm thu

- mvn test
- mvn -Dtest=OrderExportServiceTest test
Tài liệu cũng có thể dùng làm context. Sau khi AI sửa nhiều module, hãy yêu cầu nó bổ sung một bản mô tả thay đổi: đã thêm API nào, đã sửa bảng hoặc index nào, rule nghiệp vụ quan trọng là gì, xác minh thế nào và rollback ra sao. Như vậy lần sau tiếp tục phát triển có thể đưa thẳng tài liệu này cho AI.
Trong các project có nhiều gánh nặng lịch sử, những rule được truyền miệng như field nào không được sửa, API nào phải tương thích với client cũ và giá trị enum nào bị hệ thống bên ngoài hard-code đều nên được ghi vào tài liệu.
Nhiều Agent: chạy tuần tự trước, song song sau
Cách nhiều Agent phân công phối hợp quả thực rất hấp dẫn, nhưng thật lòng không khuyến nghị mọi người ngay từ đầu đã thử chạy nhiều Agent song song, chẳng hạn một Agent viết code, một Agent bổ sung test, một Agent làm Review và một Agent viết tài liệu. Cách này rất dễ làm project rối tung.
Ban đầu chỉ cần chạy tuần tự:
- Plan Agent chỉ đọc code, đưa ra giải pháp và chia task;
- Code Agent chỉ phụ trách một Task, không chạm vào task khác;
- Test Agent bổ sung test và chạy xác minh;
- Review Agent chỉ xem diff, tìm vấn đề, không trực tiếp sửa lớn.
Tuyệt đối đừng ngay từ đầu để nhiều Agent đồng thời sửa code. Hãy để chúng lần lượt commit trên cùng một feature branch:
git commit -m "[plan] add order export design"
git commit -m "[code] implement order export api"
git commit -m "[test] add order export tests"
git commit -m "[review] fix tenant permission check"
Sau khi quy trình đã chạy ổn và bạn cũng quen hơn, hãy cân nhắc các cách như worktree chạy song song, Agent View.
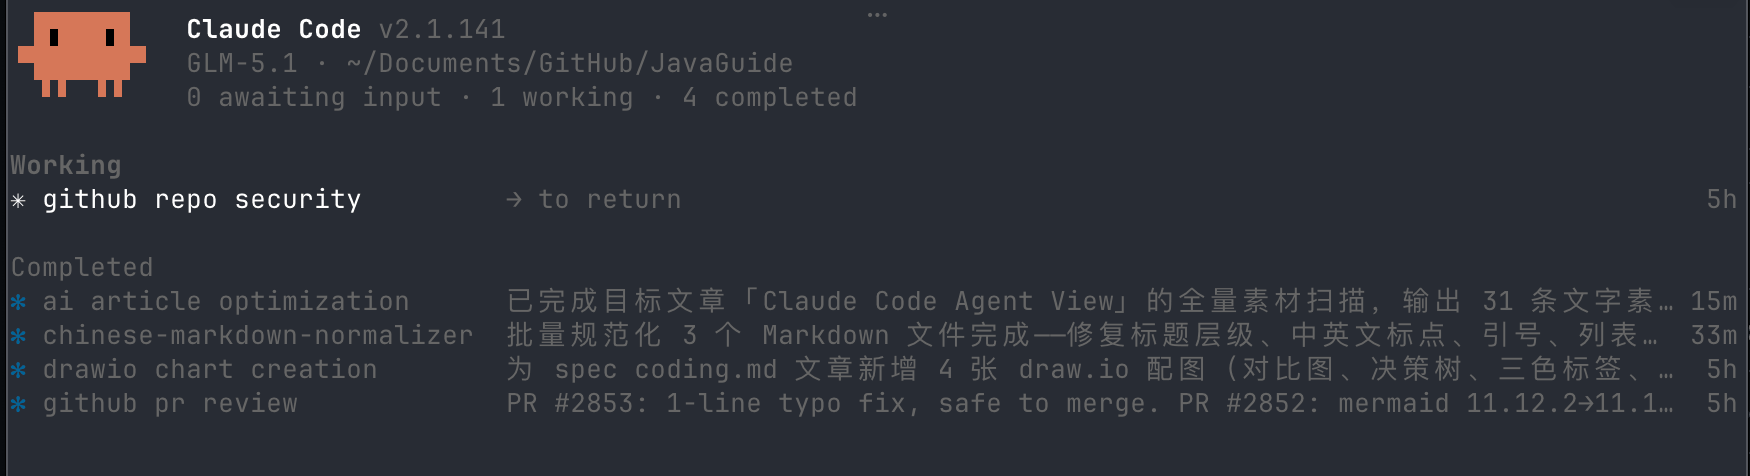
Điều đáng sợ nhất khi chạy song song không phải Git conflict, vì ít nhất conflict còn nhìn thấy được. Vấn đề thực sự phiền phức là không có conflict: hai Agent đồng thời sửa cùng một DTO dùng chung, một Agent thêm field để export, Agent kia xóa field để query. Khi merge trông có vẻ không có vấn đề, nhưng ngữ nghĩa API, kết quả serialization và dependency của frontend có thể đã thay đổi.
Vì vậy, nhiều Agent không thể dựa vào may rủi mà phải được kiểm soát bằng ranh giới task, cô lập branch và tiêu chí nghiệm thu. File nào được sửa, module nào không được chạm vào, sửa xong phải chạy test nào và diff nào bắt buộc phải xem thủ công đều phải được viết rõ từ trước.
subagent phù hợp với task chuyên biệt
Nhân tiện cũng nói về subagent.
Lấy Claude Code làm ví dụ, có thể hiểu subagent là một “trợ lý nhỏ chuyên làm một loại việc”. Nó có context, system prompt và quyền truy cập tool riêng, phù hợp để xử lý các task có ranh giới khá rõ như Code Review, bổ sung test, phân tích log và sắp xếp tài liệu. Tài liệu chính thức cũng đề cập rằng subagent có thể chạy trong context độc lập, giảm áp lực context cho session chính, đồng thời có thể cấu hình quyền truy cập tool khác nhau cho từng task.
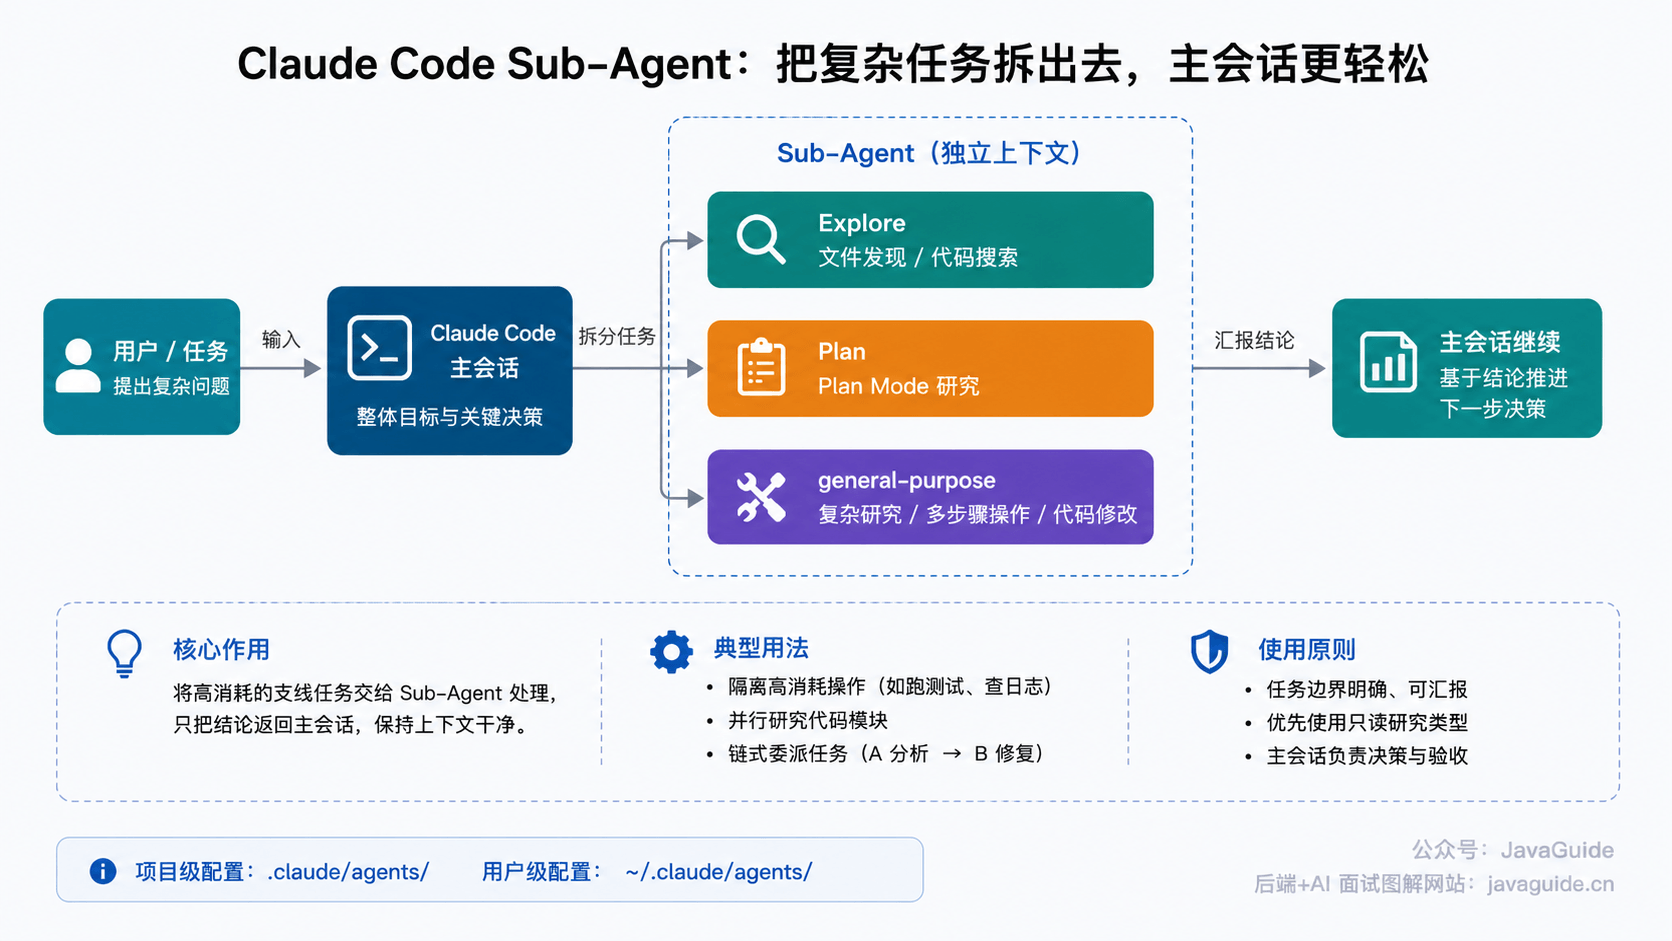
Nó không giống với nhiều Agent chạy song song được nói ở trên. Nhiều Agent thiên về cách phối hợp, còn subagent thiên về ủy thác task. Ví dụ session chính đang triển khai chức năng export order, bạn có thể giao việc “kiểm tra diff lần này có rủi ro bypass quyền hay không” cho Review subagent, giao việc “bổ sung unit test theo code hiện tại” cho Test subagent. Sau khi hoàn thành, chúng sẽ trả kết luận về session chính.
Nhưng cũng đừng lạm dụng subagent. Khi task quá nhỏ, ranh giới không rõ hoặc code vẫn đang thay đổi mạnh, tách task ra ngược lại dễ làm tăng chi phí trao đổi. Cách dùng ổn định hơn là: Agent chính phụ trách context tổng thể và quyết định, subagent phụ trách task cục bộ, rõ ràng và có thể nghiệm thu.
Kiểm soát quyền rất quan trọng
AI Coding không thể chỉ dựa vào một câu trong Prompt: “Hãy cẩn thận, đừng thực hiện thao tác nguy hiểm”.
Các tool như Claude Code không còn chỉ trả lời câu hỏi. Chúng đọc file, sửa code, chạy command và cũng có thể thông qua MCP để gọi tool nội bộ hoặc service bên ngoài. Rủi ro đương nhiên không còn chỉ là code viết sai; vấn đề nghiêm trọng hơn có thể là xóa nhầm file, sửa hỏng config, chạy nhầm migration, push lên remote, thậm chí chạm vào thông tin nhạy cảm như secret, certificate và production config.
Vì vậy cần thu hẹp quyền từ trước.
Các file như .env.production, secret và certificate mặc định không nên cho AI đọc hoặc sửa; các thao tác như xóa file, database migration, push remote và sửa CI config bắt buộc phải có người xác nhận; sau khi sửa các module như login, payment, permission, upload và Webhook, cần thực hiện security Review riêng.
Claude Code chính thức cũng cung cấp cơ chế quyền tương ứng. Ví dụ có thể dùng /permissions để xem và quản lý tool permission; trong rule quyền có thể cấu hình allow, ask, deny, lần lượt biểu thị cho phép thực thi, hỏi trước khi thực thi và từ chối ngay. Những command rủi ro thấp như git diff và chạy unit test có thể nới lỏng hơn; các thao tác như git push, xóa file, đọc .env và truy cập secrets/** nên đặt ở ask hoặc deny.
Nếu chỉ cấu hình rule quyền vẫn chưa yên tâm, có thể bổ sung Hooks và Sandbox. Hooks có thể thực hiện kiểm tra tùy chỉnh trước và sau khi gọi tool, chẳng hạn chặn command nguy hiểm, kiểm tra có sửa path nhạy cảm không, chạy formatter và test trước khi commit; Sandbox thiên về cô lập execution environment, dùng để giới hạn phạm vi file system và network mà Bash command có thể truy cập.
Ví dụ, giả sử Claude Code chuẩn bị thực thi:
rm -rf /tmp/buildPreToolUse Hook sẽ nhận được lần gọi Bash này trước, xác định đó có phải command nguy hiểm hay không; nếu khớp rule, nó trả về deny, Claude Code sẽ hủy lần gọi tool và phản hồi lý do bị từ chối cho Claude.
Hình dưới đây thể hiện toàn bộ quy trình. Nguồn hình là phần giới thiệu về Hooks trong tài liệu chính thức của Claude Code.

Cách ổn định hơn là cố định các rule này trong engineering project:
- Những command nào có thể tự động thực thi;
- Những command nào bắt buộc phải được người xác nhận;
- Những path nào cấm đọc hoặc sửa;
- Những MCP tool nào không được tùy tiện gọi;
- Những CI task nào bắt buộc phải được phê duyệt thủ công;
- Những test nào không pass thì không được merge.
Còn một điểm dễ bỏ qua: rule quyền không phải vạn năng. Ví dụ chỉ chặn rm * không có nghĩa chắc chắn chặn được /bin/rm và các biến thể như find -delete. Vì vậy không thể chỉ dùng một blacklist command để làm lớp dự phòng cho thao tác rủi ro cao; tốt nhất nên kết hợp giới hạn path, Hooks, Sandbox, CI và Review thủ công để cùng kiểm soát.
Sự cẩn trọng trong engineering chắc chắn không thể chỉ viết trong Prompt, mà phải được đặt vào command, script, permission, test, CI và quy trình phê duyệt.
Chia sẻ quy trình mình thường dùng
Khi xử lý yêu cầu hằng ngày, Tiểu G thường làm theo nhịp này:
- Tạo branch mới, trước tiên xác nhận workspace sạch.
- Viết một Spec nhẹ, nói rõ mục tiêu, ràng buộc và tiêu chí nghiệm thu.
- Xem có Skill phù hợp không, chẳng hạn TDD, Code Review, thiết kế frontend và nghiên cứu web.
- Trước tiên để model có năng lực tốt đưa ra giải pháp, chỉ thảo luận giải pháp, không vội viết code.
- Sau khi xác nhận giải pháp, để model giá thấp triển khai từng bước theo Task.
- Hoàn thành mỗi Task thì chạy test, xem diff rồi commit từng bước nhỏ.
- Sau khi diff hiện tại ổn định, để một model độc lập thực hiện Review một lần.
- Sửa các vấn đề hợp lý trong Review rồi chạy test lại.
- Trước khi merge, tự mình xem các diff quan trọng. Với thay đổi liên quan đến dữ liệu, quyền, payment và scheduled task, cần bổ sung tài liệu, phương án rollback hoặc mô tả canary.
Quy trình này chậm hơn một chút so với “dùng một câu để generate code”.
Nhưng khoảng thời gian chậm hơn đó thường sẽ được lấy lại về sau. Ít nhất nó giúp giảm đáng kể việc làm lại, rollback và xử lý sự cố trên production.
Prototype ngắn hạn có thể Vibe mạnh tay, cứ làm cho chạy được trước rồi tính; nhưng chỉ cần code phải được maintain lâu dài thì vẫn phải quay về engineering process. Bản thân GitHub Flow cũng tổ chức phối hợp xoay quanh branch, Pull Request, Review và merge, chứ không phải để mọi người đẩy code trực tiếp vào branch chính. Các tool như Codex cũng hỗ trợ đặt rule cấp project qua AGENTS.md, để AI làm việc theo quy ước trong repository thay vì mỗi lần lại phải nhắc tạm thời trong chat.
Nói thẳng ra, AI viết code càng nhanh thì những thứ cũ như Git, test, Review và Spec càng không thể bỏ.
Trước đây chúng được dùng để ràng buộc con người, giờ cũng phải tiện thể dùng để ràng buộc AI.