
Trae + MiniMax thực chiến đa kịch bản: khắc phục sự cố Redis và refactor đa ngôn ngữ
Xin chào mọi người, tôi là Xiao G. Trước đây tôi từng chia sẻ một bài thực chiến kết hợp IDEA với plugin Qoder, bài đó chủ yếu nói về việc dùng AI hỗ trợ coding trong hệ sinh thái JetBrains. Bài này sẽ đổi góc nhìn, cùng trao đổi về trải nghiệm thực chiến khi kết nối Trae IDE với mô hình lớn.
Trae là AI Coding IDE do ByteDance phát hành, dựa trên hệ sinh thái VS Code và hỗ trợ kết nối với nhiều mô hình lớn. Bài này dùng MiniMax M2.7 làm ví dụ, nhưng cách kết nối của Trae mang tính phổ quát: đổi sang Claude, GPT hoặc mô hình khác thì quy trình về cơ bản vẫn giống nhau.
Tôi dùng MiniMax vì vừa đăng ký MiniMax Code Plan và muốn thực tế kiểm thử một số tính năng, không phải quảng cáo; bạn có thể đổi sang mô hình khác, cách làm vẫn giống nhau.
Tôi chọn hai kịch bản phức tạp tiêu biểu để kiểm chứng thực tế:
- Kịch bản một: API đột nhiên timeout hàng loạt, log chỉ trỏ đến Redis, nhưng dự án sử dụng Redis ở nhiều nơi nên rất khó nhanh chóng xác định root cause.
- Kịch bản hai: phục chế đầy đủ lệnh slow query của Redis từ source code C sang implementation Go, kiểm tra năng lực refactor đa ngôn ngữ và hiểu context.
Bắt đầu nhanh: Trae kết nối với mô hình lớn
Trae hỗ trợ kết nối với nhiều mô hình lớn. Dưới đây dùng việc kết nối custom model làm ví dụ để minh họa quy trình cấu hình phổ quát.
Bước một: truy cập trang web chính thức của Trae để tải xuống và hoàn tất khởi tạo, đồng thời đăng ký trên nền tảng model tương ứng và tạo API Key (ví dụ trong bài dùng nền tảng MiniMax):
https://platform.minimaxi.com/subscribe/token-plan
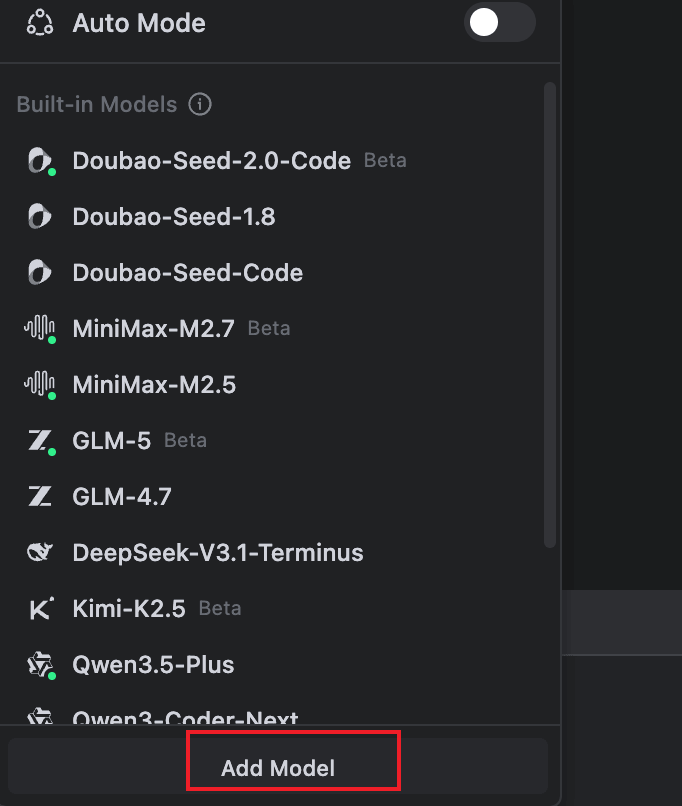
Bước hai: trong Trae, nhấp vào "Add Model" để thêm custom model:
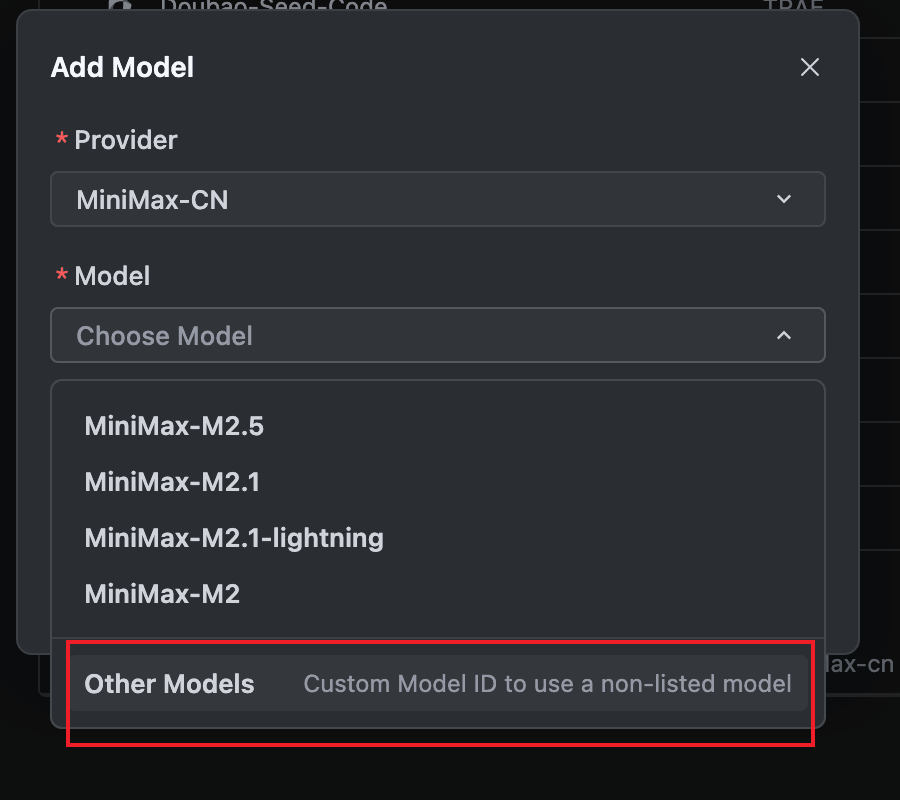
Bước ba: chọn "Other Models" rồi nhập thủ công model ID và API Key:
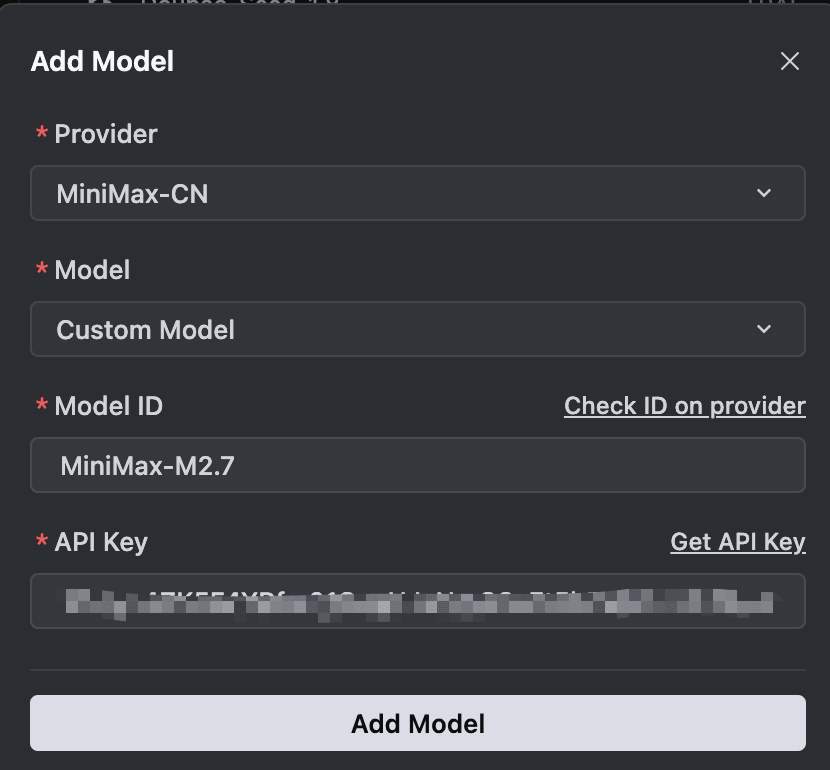
Bước bốn: nhập model ID (chẳng hạn MiniMax-M2.7) và API Key đã đăng ký, nhấp vào "Add Model". Nếu không xuất hiện thông báo lỗi thì kết nối đã thành công:
Sau khi kết nối hoàn tất, bạn có thể dùng model này trong Trae để lập trình có AI hỗ trợ. Tiếp theo, tôi sẽ chia sẻ cách sử dụng và kỹ năng cụ thể qua hai kịch bản thực chiến.
Kịch bản một: xử lý khẩn cấp và xác định root cause của vấn đề API timeout
Xác định vấn đề
Case đầu tiên là việc tái hiện một sự cố production có thật (đã ẩn thông tin nhạy cảm). Khi đó, đồng nghiệp trong bộ phận phản ánh một API truy vấn danh sách bị lỗi, trang không có dữ liệu. Hệ thống monitoring production xác định thông tin API như sau:
API: GET http://localhost:8080/api/rbac/user/list
Kết quả trả về:
{
    "code": 500,
    "message": "Hệ thống bận, vui lòng thử lại sau",
    "data": null,
    "timestamp": "2026-03-19T10:11:02.632242"
}
Kết hợp keyword Read timed out trong exception stack trace và thao tác get(key) ở đoạn code tương ứng, ban đầu có thể cho rằng lỗi này chỉ là biểu hiện chứ không phải root cause.
@Override
public String getConfigValue(String configKey, String environment) {
    String cacheKey = CONFIG_CACHE_PREFIX + configKey + ":" + environment;
    String value = stringRedisTemplate.opsForValue().get(cacheKey);
    if (value != null) {
        return value;
    }
    // Bỏ qua logic phía sau
}
Theo quy trình xử lý thông thường, chúng ta cần nhanh chóng xác định root cause, xử lý khẩn cấp, sau đó liên hệ đội vận hành để điều tra sâu hơn. Tuy nhiên, dự án sử dụng Redis ở nhiều nơi, nếu kiểm tra từng chỗ sẽ mất nhiều thời gian và trong thời gian đó có thể ảnh hưởng đến tính ổn định của business.
Để kiểm chứng hiệu quả thực tế của việc dùng AI hỗ trợ điều tra, tôi đã tái hiện kịch bản sự cố này (đã ẩn thông tin nhạy cảm) và để model tiếp nhận xử lý. Theo quy trình xử lý sự cố production cấp enterprise, trước tiên cần xác định root cause và xử lý khẩn cấp. Vì vậy, tôi gửi cho model chỉ thị đầu tiên:
Khi truy cập API http://localhost:8080/api/rbac/user/list xuất hiện lỗi 500 (thông tin lỗi: "Hệ thống bận, vui lòng thử lại sau"), hãy thực hiện các thao tác sau:
1. Phân tích exception stack trace được cung cấp, xác định chính xác root cause gây ra lỗi nội bộ của server;
2. Cung cấp phương án xử lý khẩn cấp chi tiết cho production, bao gồm nhưng không giới hạn ở: strategy rollback tạm thời, biện pháp giới hạn traffic, phương án service degradation hoặc quy trình restart khẩn cấp;
3. Giải thích nguyên nhân kỹ thuật tạo ra lỗi, chỉ ra module code hoặc vấn đề cấu hình cụ thể;

...... Thông tin quan trọng trong exception stack trace: `java.net.SocketTimeoutException: Read timed out`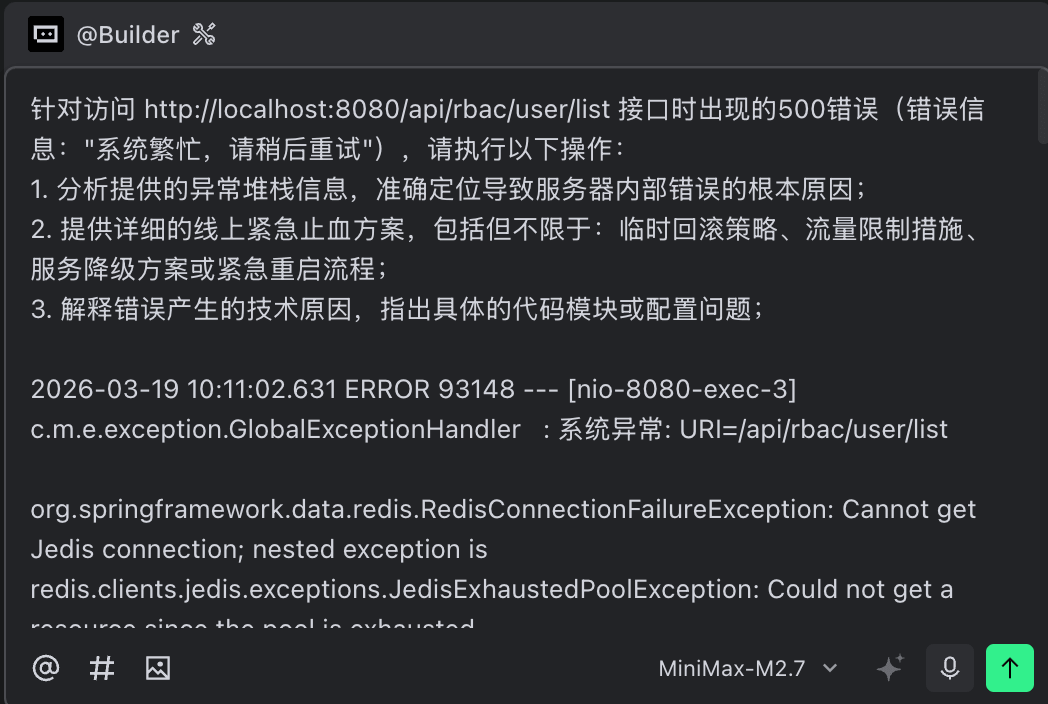
Sau khi nhận request, model nhanh chóng xác định context của đoạn code được chỉ định và suy luận ra 4 root cause có thể xảy ra:
- Redis server bị down hoặc không phản hồi
- Cấu hình connection pool quá nhỏ, bị cạn kiệt khi concurrent cao
- Redis connection leak (connection không được đóng đúng cách)
- Redis server chịu tải quá cao
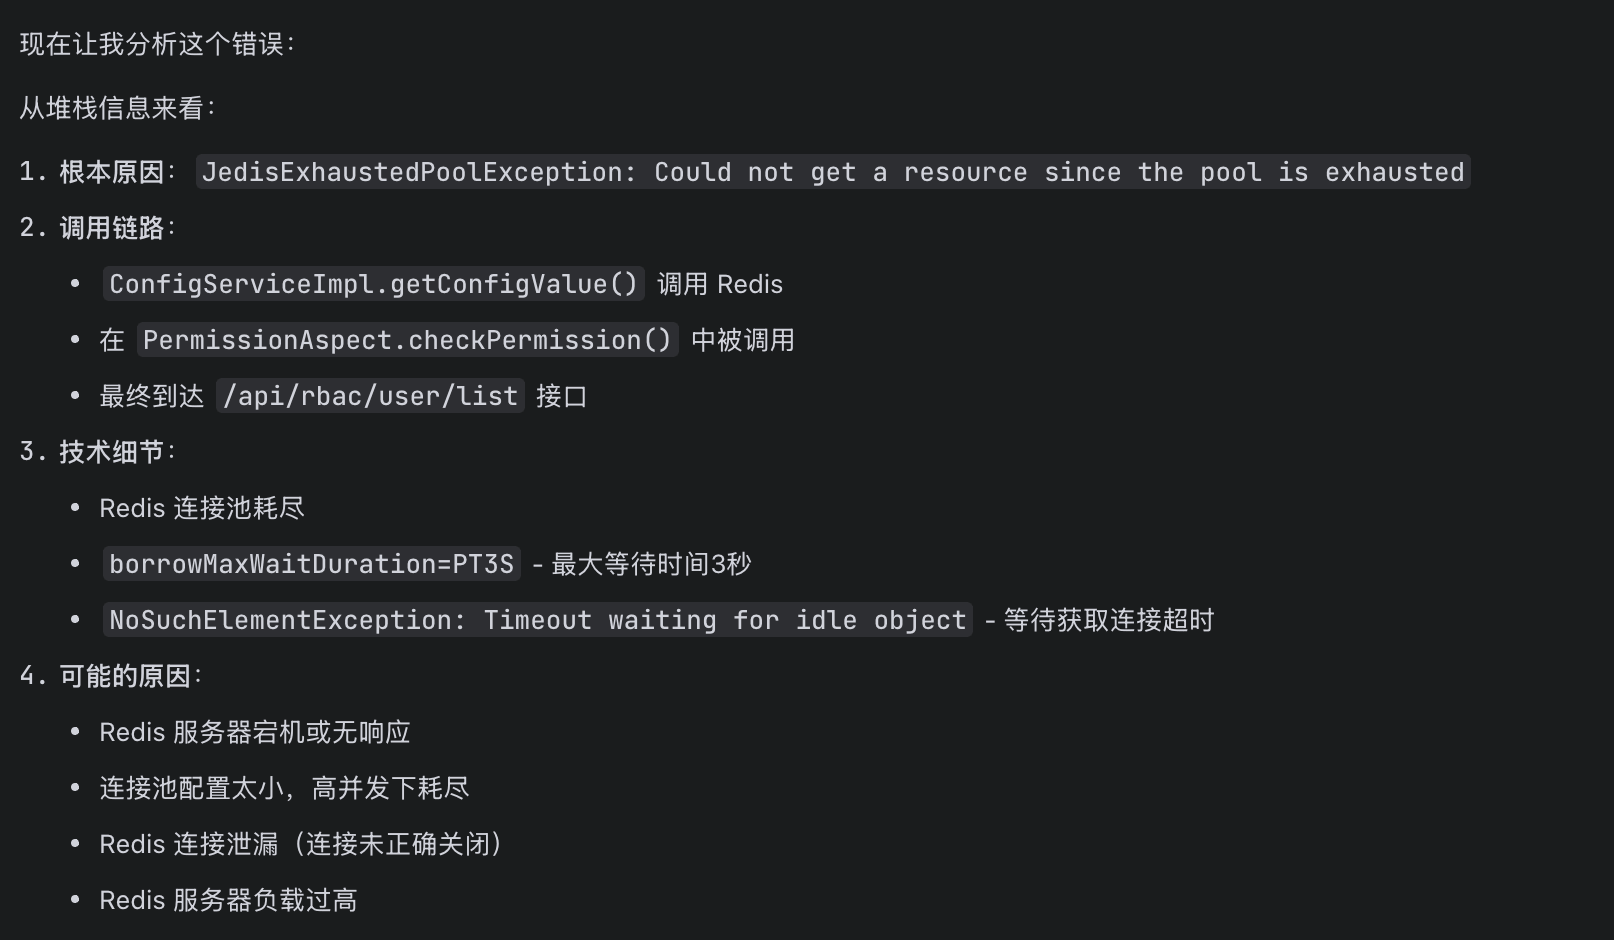
Đến đây, model đã thu hẹp không gian vấn đề từ “N nơi gọi Redis” xuống còn “4 root cause có thể xảy ra”. Năng lực nhanh chóng thu hẹp phạm vi vấn đề này là giá trị cốt lõi của AI hỗ trợ điều tra. Tiếp theo hãy xem cách xử lý khẩn cấp của model.
Xử lý khẩn cấp
Model nhanh chóng hệ thống hóa logic gọi code theo stack frame của exception đã biết và chỉ ra chính xác: API truy vấn danh sách bị aspect intercept, connection pool cạn kiệt là root cause của lỗi 500. Một điểm quan trọng khác là model chỉ ra đoạn code này thiếu strategy degradation; chính tôi chỉ nhận ra điều này trong buổi retrospective.
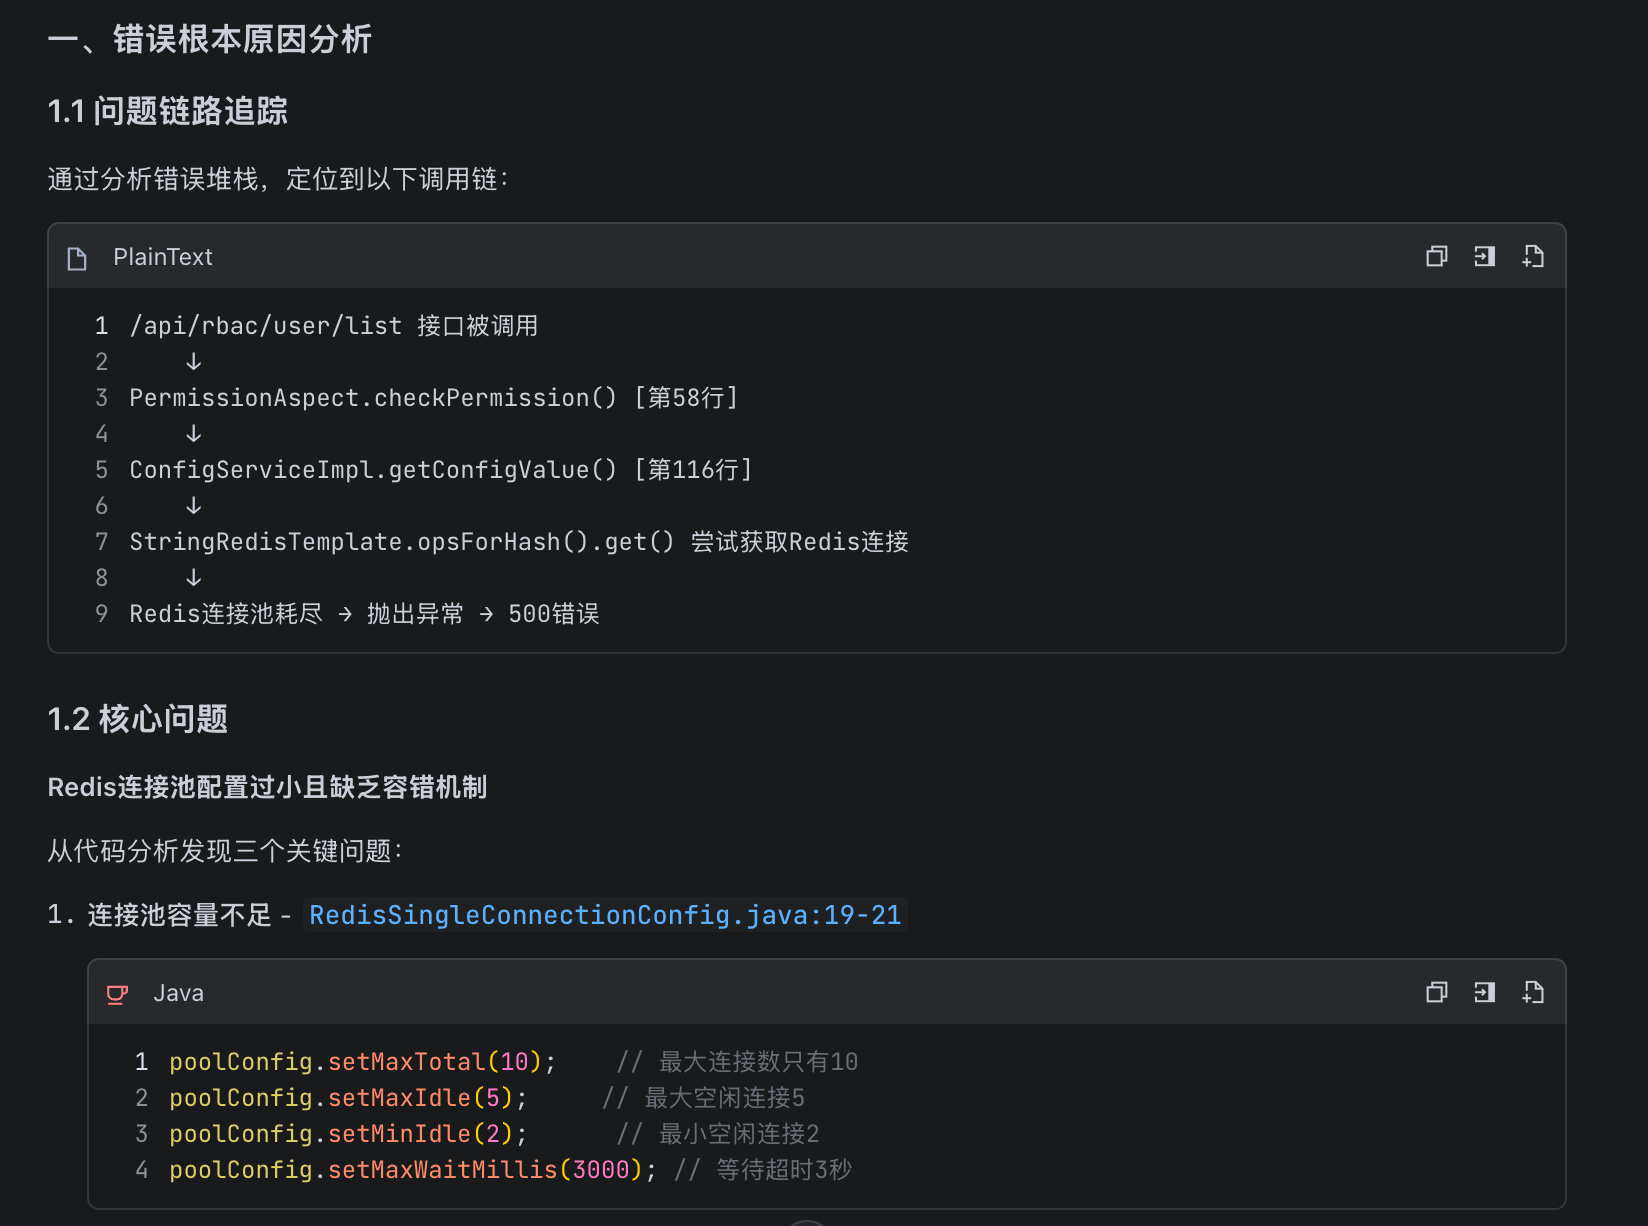
Đối với vấn đề production, strategy xử lý khẩn cấp là khâu quan trọng nhất. Model đưa ra một vài phương án; phương án đầu tiên là tạm thời tắt switch kiểm tra quyền, vì phương án một cần xóa dữ liệu Redis cache. Phương án này hơi quyết liệt, nhưng model đã chỉ rõ call chain và thông tin schema, giúp tôi dựa vào business semantic để phỏng đoán tốt hơn các kịch bản và nguyên nhân có thể xảy ra.
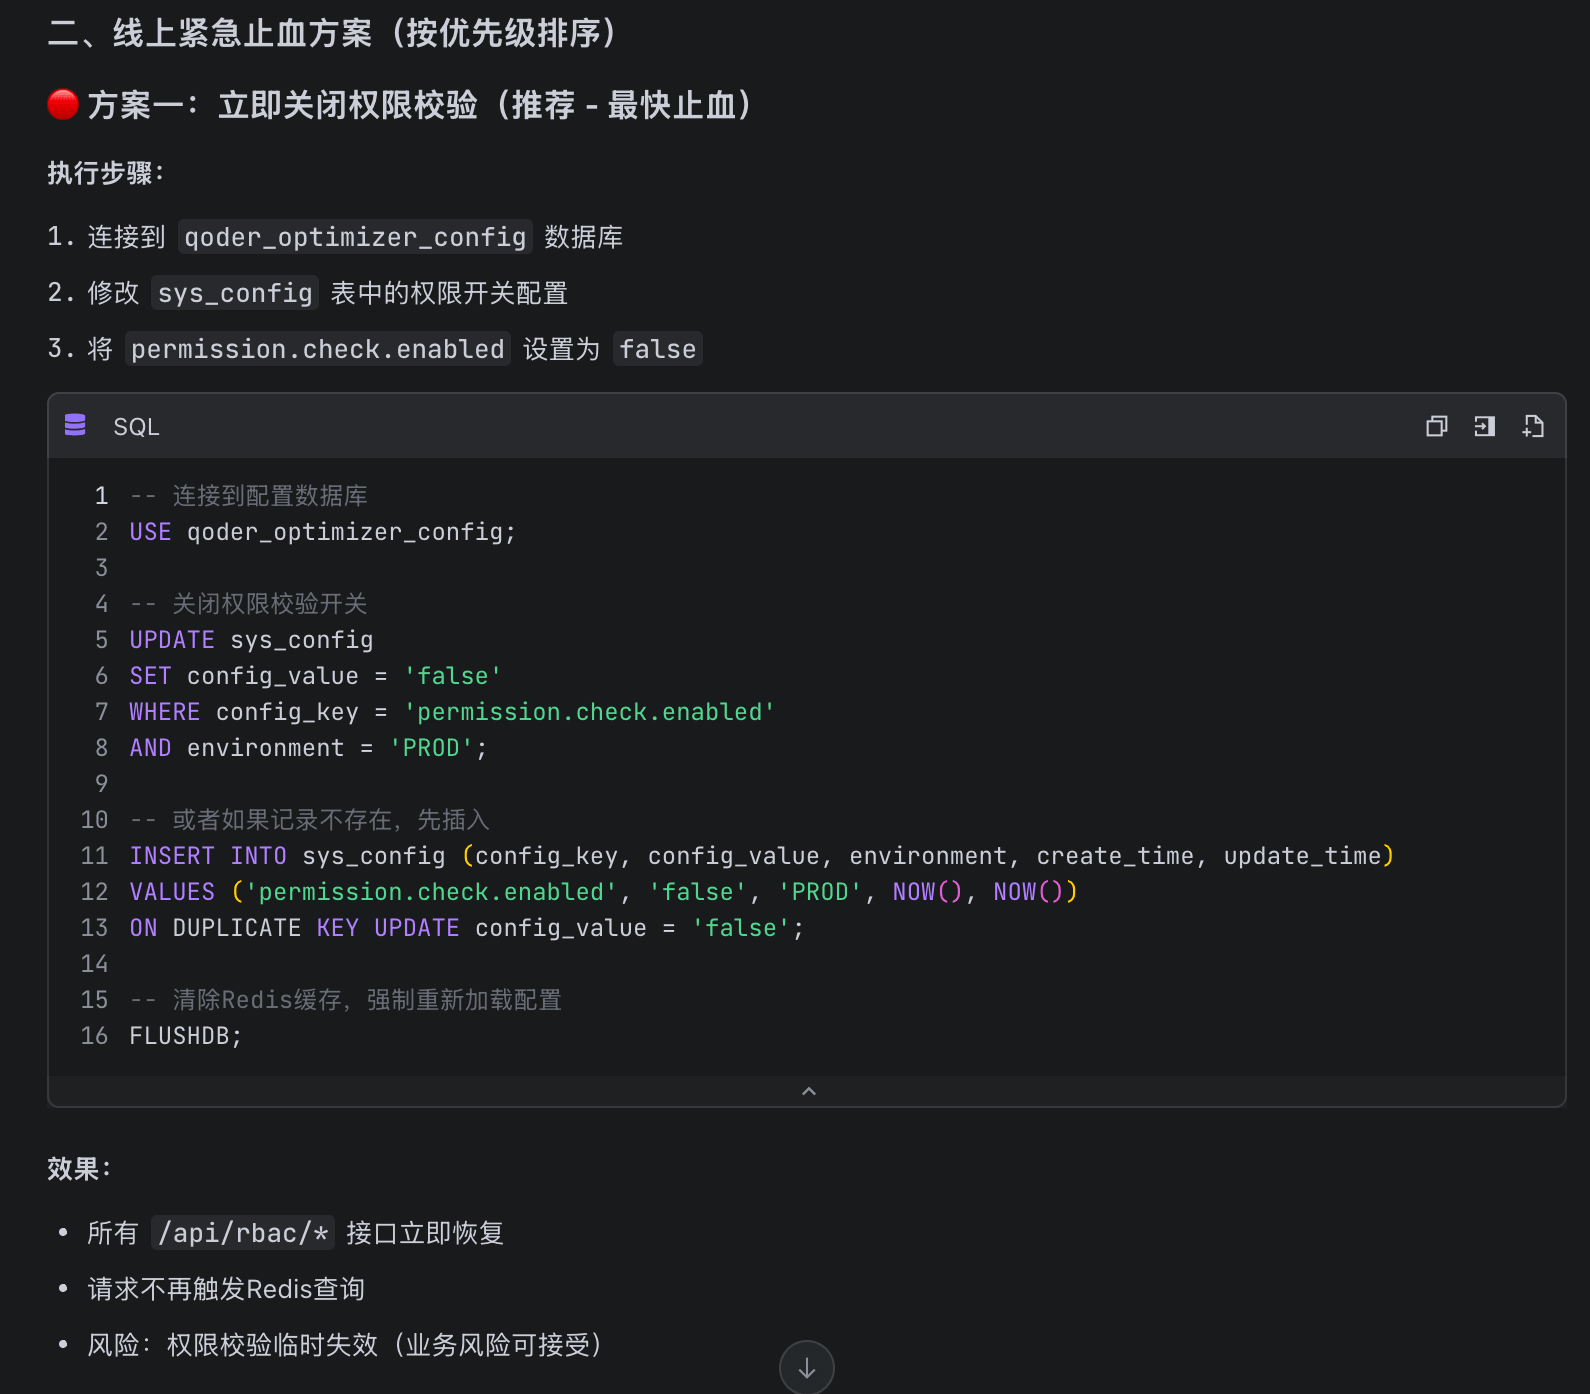
Dựa trên thông tin call chain do model cung cấp, tôi tiếp tục hỏi về căn cứ kỹ thuật của phương án một để nhanh chóng thống nhất cách hiểu về business:
Dựa trên workflow hoàn chỉnh của việc phát triển code, hãy trình bày chi tiết căn cứ kỹ thuật, ý tưởng thiết kế và tính hợp lý khi triển khai phương án một.Đây cũng là điểm khiến tôi khá hài lòng: model đưa ra sơ đồ call chain của code gặp vấn đề, giúp tôi nhanh chóng hiểu đầy đủ các aspect đã đi qua trong quá trình truy vấn danh sách và vị trí cụ thể của sự cố, từ đó hiểu phạm vi ảnh hưởng của vấn đề hiện tại cũng như nguyên nhân trực tiếp của exception lần này.
Sau chưa đến 10 phút tương tác, tôi không chỉ nhanh chóng có được góc nhìn kiến trúc ở mức tổng thể, hiểu sự cố trong kiến trúc phức tạp hiện tại và căn cứ của từng phương án, mà còn hiểu được ví dụ như phương án một: sửa cấu hình database rồi restart để refresh cache, qua đó tránh kiểm tra quyền.
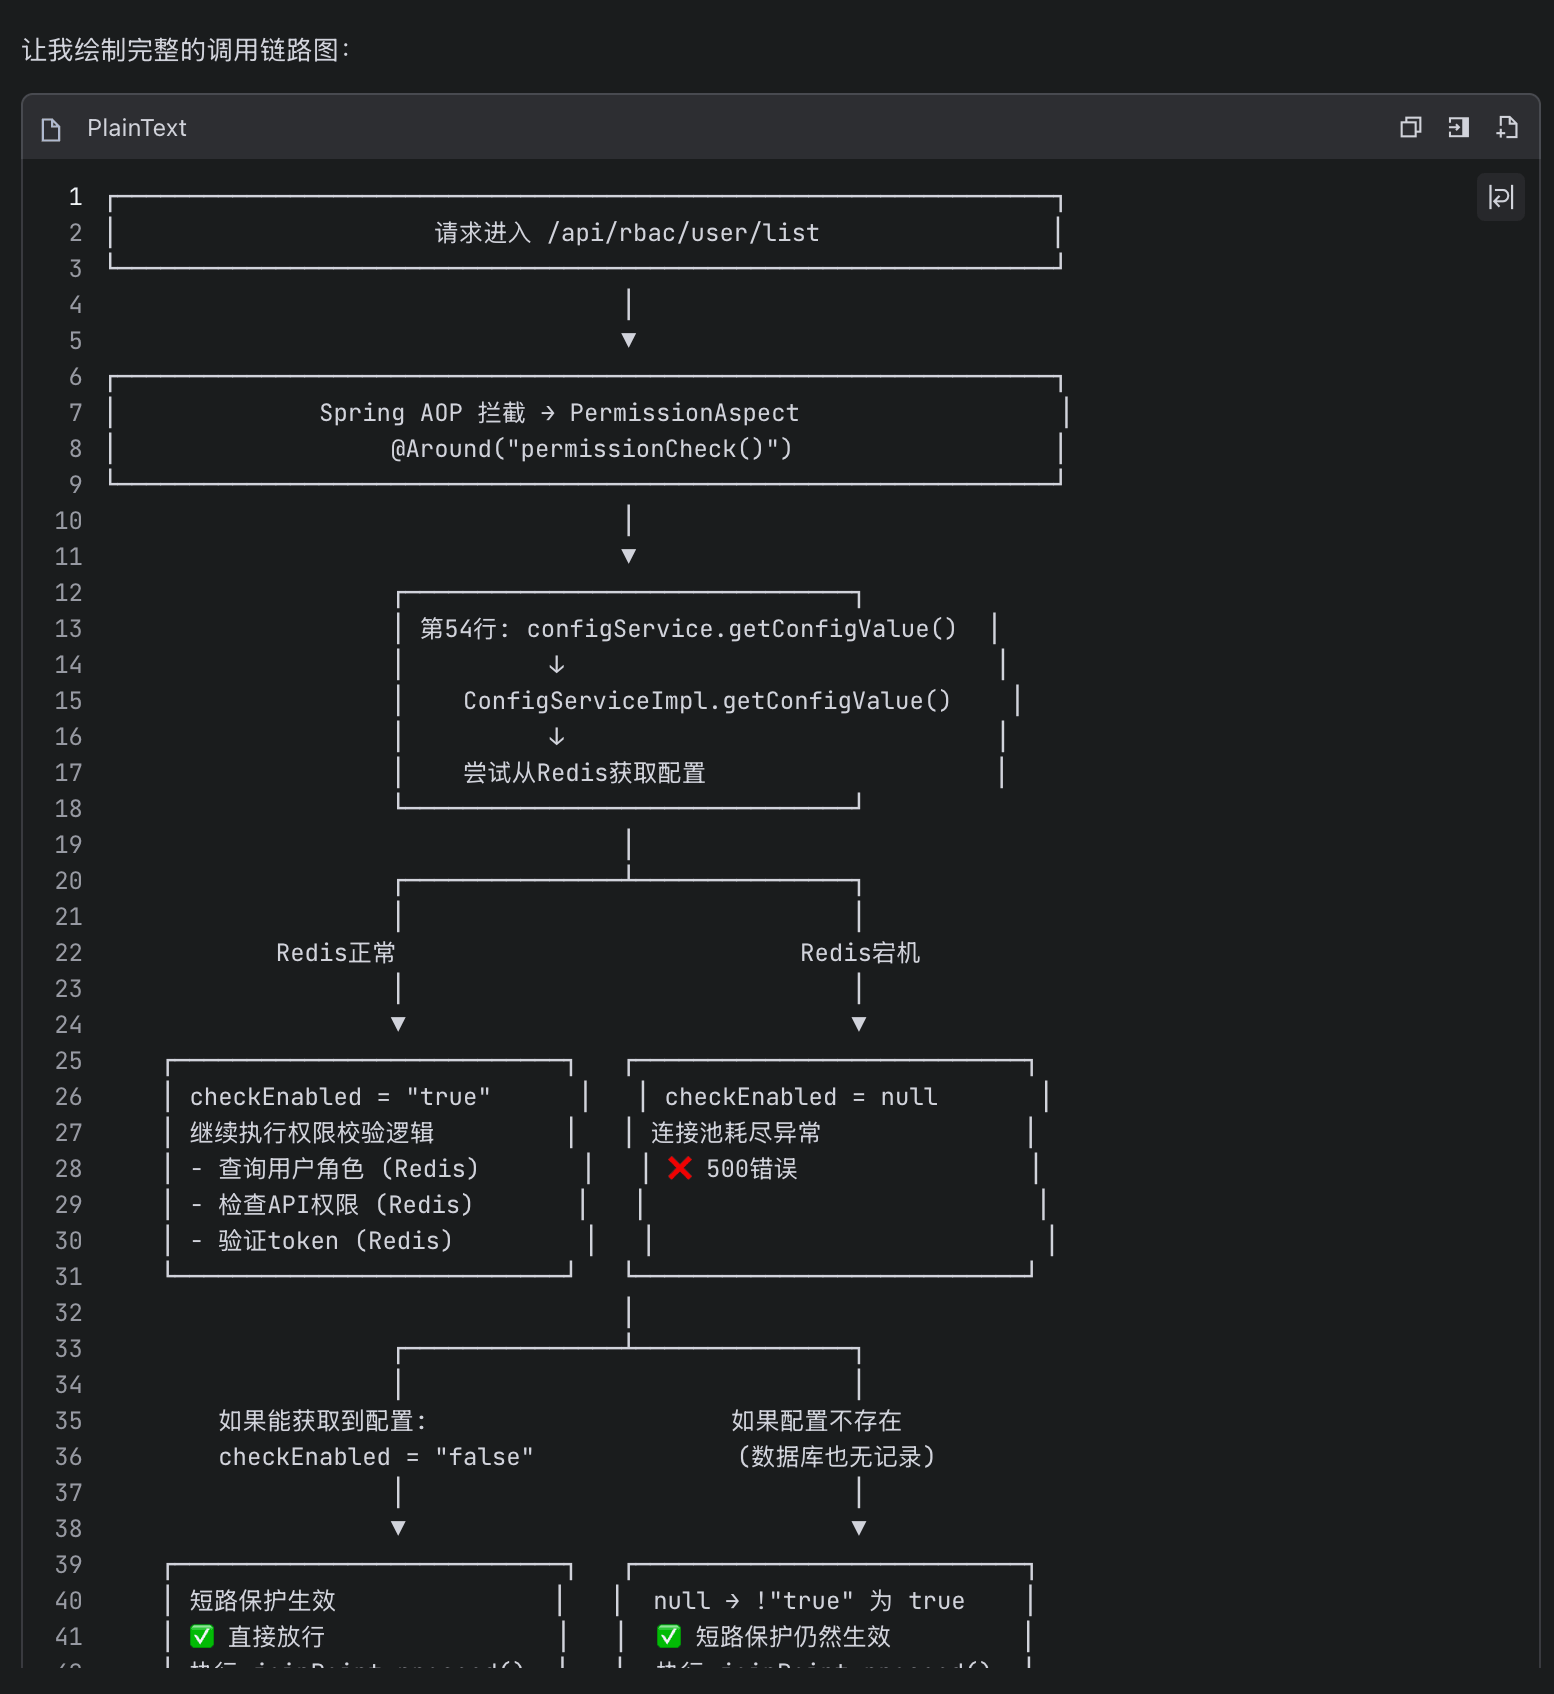
Hãy xem thêm ý tưởng của phương án ba: khi Redis không khả dụng, sử dụng local cache hoặc default value để tránh cascading failure. Model đã kết hợp với đoạn code hiện tại của project và đưa ra đề xuất sửa đổi:
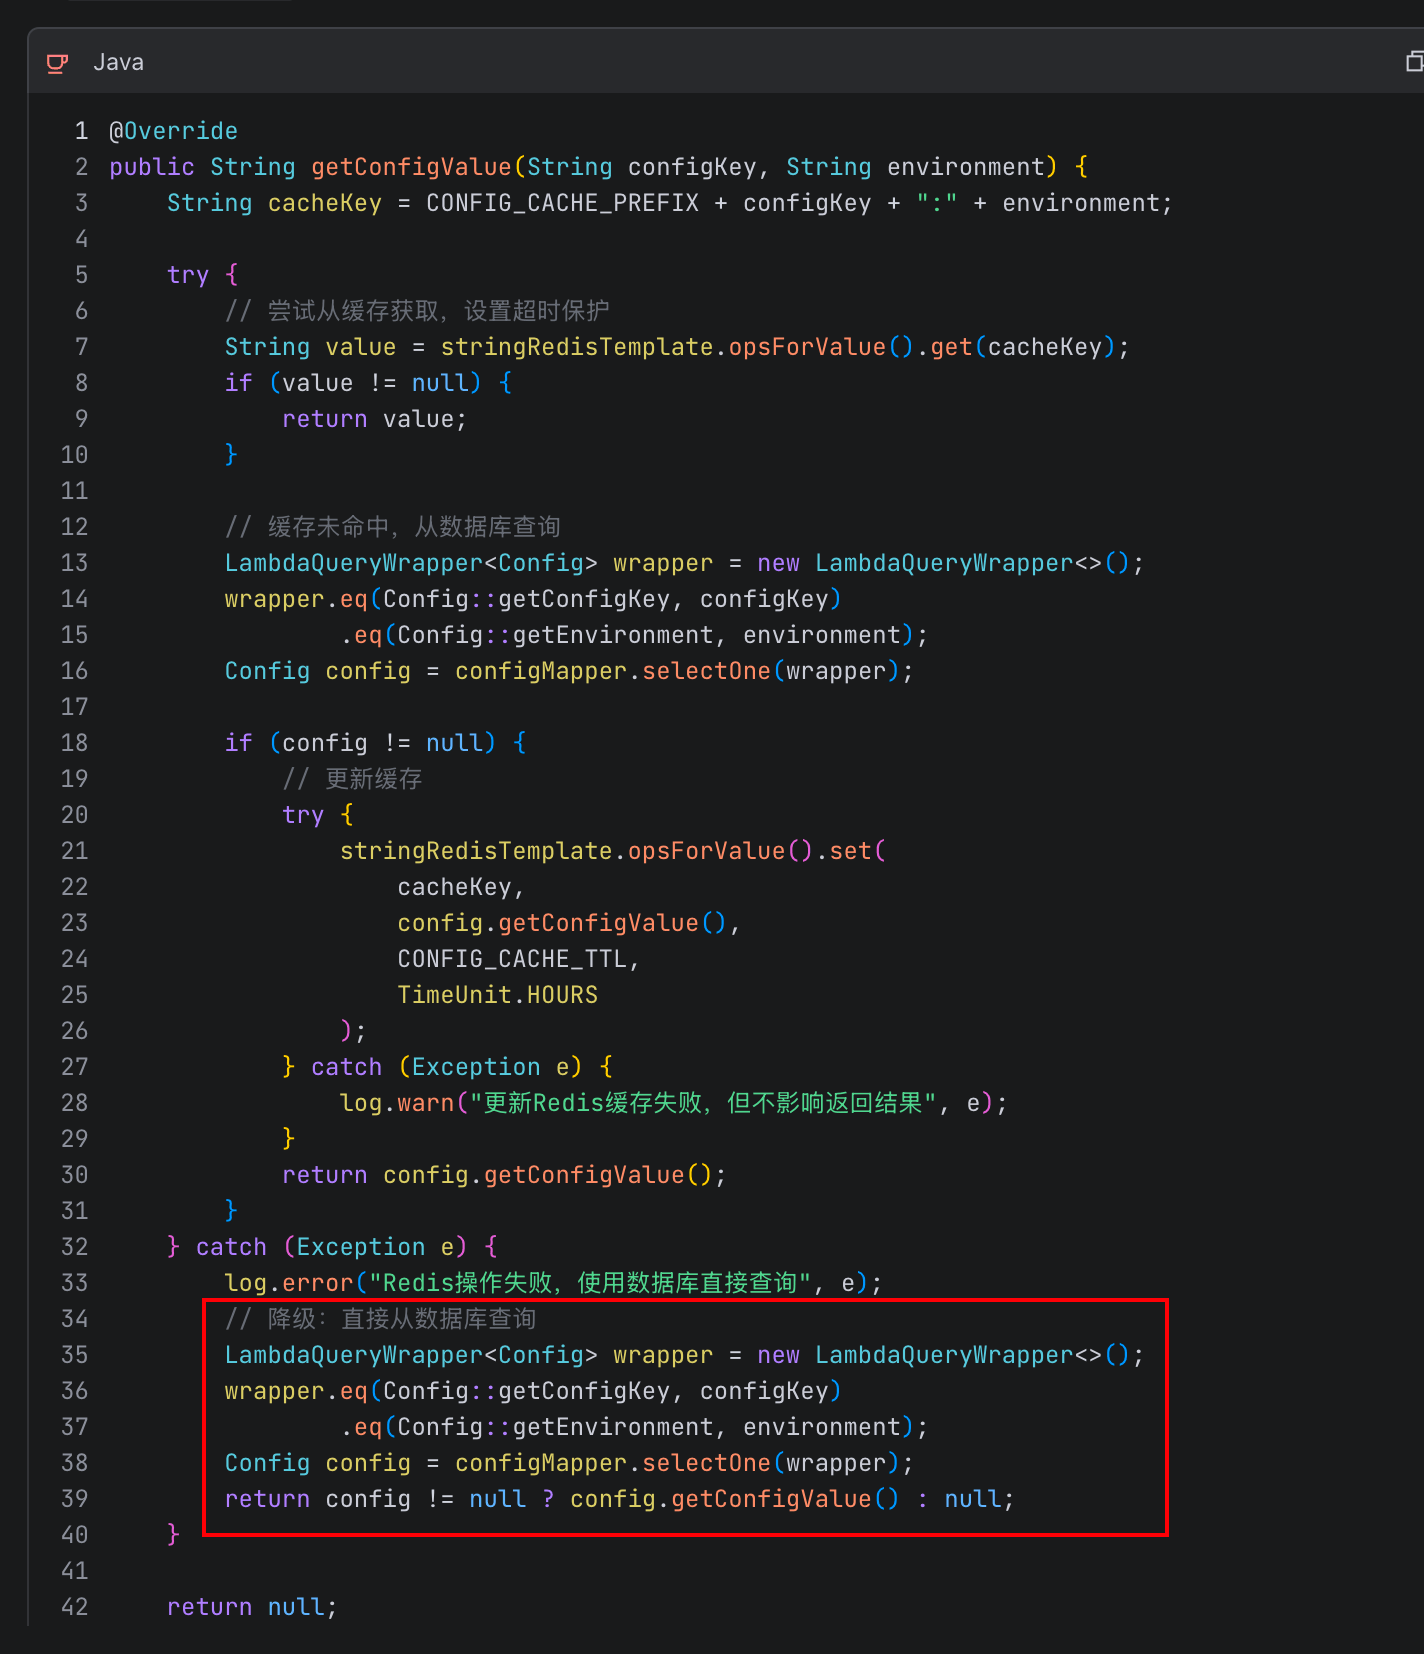
Sau khi model phân tích, chúng tôi có phán đoán ban đầu về vấn đề: Redis client connection pool cạn kiệt, khiến logic truy vấn switch cache của các API business thường ngày bị crash, từ đó gây ra hiệu ứng avalanche. Tổng hợp nhiều đề xuất của model, theo nguyên tắc thận trọng, xử lý khẩn cấp nhanh và không làm database quá tải trong giờ cao điểm business, chúng tôi đưa ra phương án hotfix sau:
Theo phương án được cung cấp, hãy tạo một branch hotfix để xử lý khẩn cấp, dùng cho việc sửa lỗi Redis. Các bước triển khai cụ thể như sau:
1. Tạo branch hotfix dựa trên code của môi trường production hiện tại, quy ước đặt tên là "hotfix/redis-exception-handler"
2. Thực hiện cơ chế bắt exception Redis theo phương án ba, thêm khối try-catch tại mọi thao tác Redis
3. Khi bắt được exception Redis, tự động degradation sang truy vấn trực tiếp database để lấy dữ liệu
4. Implement cơ chế local cache trên JVM, cache kết quả truy vấn vào memory và thiết lập thời gian hết hạn cache hợp lý
5. Hoàn tất unit test và integration test, coverage phải đạt trên 80%
6. Chuẩn bị phương án rollback để đảm bảo có thể nhanh chóng khôi phục về version trước đó trong tình huống khẩn cấp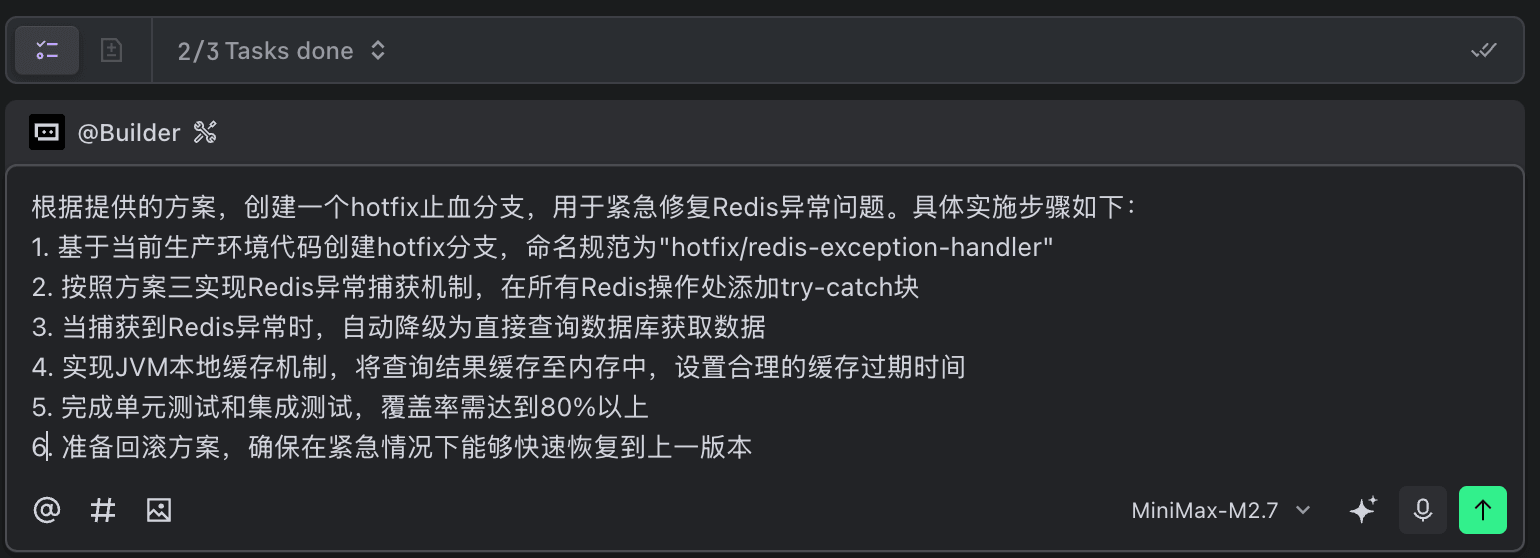
Sau khi nhận chỉ thị, model hiểu chính xác vấn đề, hoàn tất việc chia nhỏ task và thực thi từng bước:
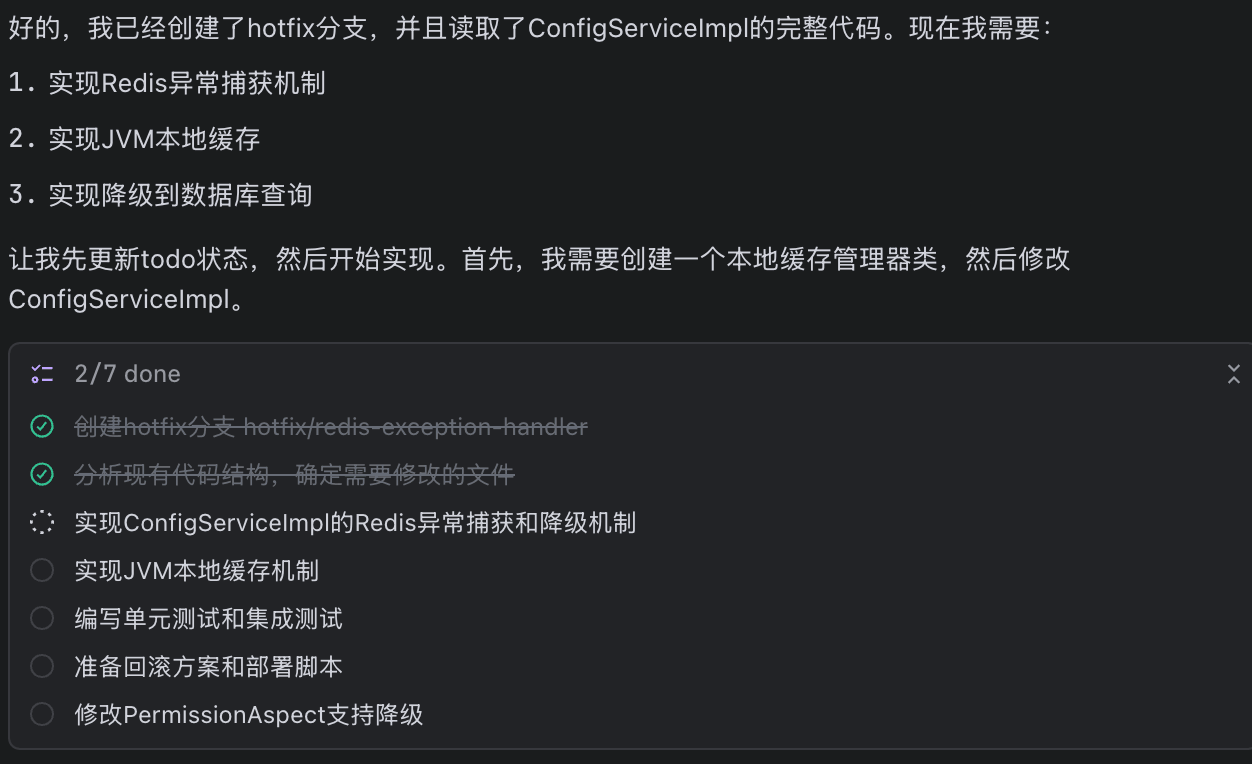
Kết quả code cuối cùng được tạo ra như sau: model đã tích hợp truy vấn degradation đến database vào logic kiểm tra quyền hiện có, việc hiểu logic kiểm tra quyền và tích hợp thiết kế phức tạp được thực hiện khá tốt.
@Around("permissionCheck()")
public Object checkPermission(ProceedingJoinPoint joinPoint) throws Throwable {
    try {
        // Đọc switch kiểm tra quyền từ configuration center
        String checkEnabled = configService.getConfigValue("permission.check.enabled", "PROD");
        if (!"true".equalsIgnoreCase(checkEnabled)) {
            return joinPoint.proceed();
        }

        // ... Logic kiểm tra quyền hiện có ...

        // Thử lấy thông tin quyền từ Redis cache
        Boolean hasPermission = checkPermissionFromCache(redisKey);

        if (hasPermission != null) {
            // ... Xử lý khi cache hit ...
        }

        // Degradation: truy vấn quyền từ database
        boolean hasPermissionFromDB = checkPermissionFromDatabase(userId, apiPath, httpMethod);
        // ... Xử lý logic degradation ...

    } catch (Exception e) {
        if (e instanceof RuntimeException && "Không có quyền truy cập".equals(e.getMessage())) {
            throw e;
        }
        // Khi xảy ra exception, kích hoạt cảnh báo monitoring và cho phép request đi qua theo strategy thận trọng
        AlertManager.notify("PERMISSION_CHECK_ERROR", e.getMessage());
        return joinPoint.proceed();
    }
}
getConfigValue cũng được bổ sung logic local cache, thiết kế multi-level cache được thực hiện khá tốt trong xử lý fault tolerance.
/**
 * Lấy giá trị cấu hình (môi trường được chỉ định)
 */
@Override
public String getConfigValue(String configKey, String environment) {
    String cacheKey = CONFIG_CACHE_PREFIX + configKey + ":" + environment;

    // 【Bước một: thử lấy từ local cache】
    String localValue = localCacheManager.get(cacheKey);
    if (localValue != null) {
        return localValue;
    }

    // 【Bước hai: thử lấy từ Redis】
    try {
        if (isRedisAvailable()) {
            String value = stringRedisTemplate.opsForValue().get(cacheKey);
            if (value != null) {
                localCacheManager.put(cacheKey, value, LOCAL_CACHE_TTL);
                return value;
            }
        }
    } catch (Exception e) {
        // Redis exception, degradation sang database
        handleRedisFailure(e);
    }

    // 【Bước ba: degradation sang database】
    // ... Các logic khác ...
    return getConfigValueFromDatabaseWithFallback(configKey, environment);
}
Một chi tiết đáng chú ý ở đây là thiết kế local cache: model áp dụng open-closed principle, đóng gói local cache utility class dựa trên ConcurrentHashMap, đồng thời tính đến rủi ro heap memory overflow và kết hợp thuật toán LRU để dọn cache:
@Component
public class LocalCacheManager {
    // Storage cốt lõi: ConcurrentHashMap đảm bảo thread safety
    private final Map<String, CacheEntry> cache = new ConcurrentHashMap<>();
    private final ScheduledExecutorService cleanupExecutor;

    // Cấu hình cache
    private static final long DEFAULT_TTL_MILLIS = 300000; // 5 phút
    private static final long MAX_CACHE_SIZE = 10000;

    public LocalCacheManager() {
        // Daemon thread thực hiện dọn dẹp định kỳ
        this.cleanupExecutor = Executors.newSingleThreadScheduledExecutor(r -> {
            Thread t = new Thread(r, "local-cache-cleanup");
            t.setDaemon(true);
            return t;
        });
        this.cleanupExecutor.scheduleAtFixedRate(this::cleanupExpiredEntries, 1, 1, TimeUnit.MINUTES);
    }

    public void put(String key, String value) {
        put(key, value, DEFAULT_TTL_MILLIS);
    }

    public void put(String key, String value, long ttlMillis) {
        // Kích hoạt dọn dẹp LRU khi đầy capacity
        if (cache.size() >= MAX_CACHE_SIZE) {
            cleanupExpiredEntries();
            if (cache.size() >= MAX_CACHE_SIZE) {
                evictOldestHalf();
            }
        }
        cache.put(key, new CacheEntry(value, System.currentTimeMillis() + ttlMillis));
    }

    public String get(String key) {
        CacheEntry entry = cache.get(key);
        if (entry == null || entry.isExpired()) {
            cache.remove(key);
            return null;
        }
        return entry.getValue();
    }

    // ... Bỏ qua các method khác ...

    // Dọn dẹp LRU: xóa 50% dữ liệu cũ nhất
    private void evictOldestHalf() {
        // ...... Bỏ qua logic sắp xếp và dọn dẹp ......
    }

    // Cache entry
    private static class CacheEntry {
        private final String value;
        private final long expirationTime;

        public CacheEntry(String value, long expirationTime) {
            this.value = value;
            this.expirationTime = expirationTime;
        }

        public String getValue() {
            return value;
        }

        public boolean isExpired() {
            return System.currentTimeMillis() > expirationTime;
        }
    }
}
Xác định root cause
Sau khi xử lý khẩn cấp sự cố production bằng branch hotfix, chúng ta tiếp tục điều tra sâu nguyên nhân connection pool Redis cạn kiệt. Theo output và suy luận của model, xét đến performance 100k qps của Redis, một thao tác get thông thường (mỗi thao tác trung bình 1~2ms) với 10 connection trong điều kiện lý tưởng có thể xử lý khoảng 6600 thao tác mỗi giây, thấp hơn rất nhiều so với năng lực xử lý tối đa của Redis. Vì vậy, vấn đề có thể nằm ở tầng code; chúng ta cần tiếp tục suy luận xem trong project có thao tác Redis nào không hợp lý hay không:
Kết hợp hiện tượng và đặc điểm cụ thể của sự cố lần này, hãy thực hiện phân tích toàn cục có hệ thống và toàn diện đối với project. Phạm vi phân tích cần bao phủ nhiều khía cạnh như kiến trúc project, implementation code, dependency management, cấu hình môi trường và tương tác dữ liệu, tập trung nhận diện và xuất ra các nguyên nhân trực tiếp có thể gây ra sự cố production.
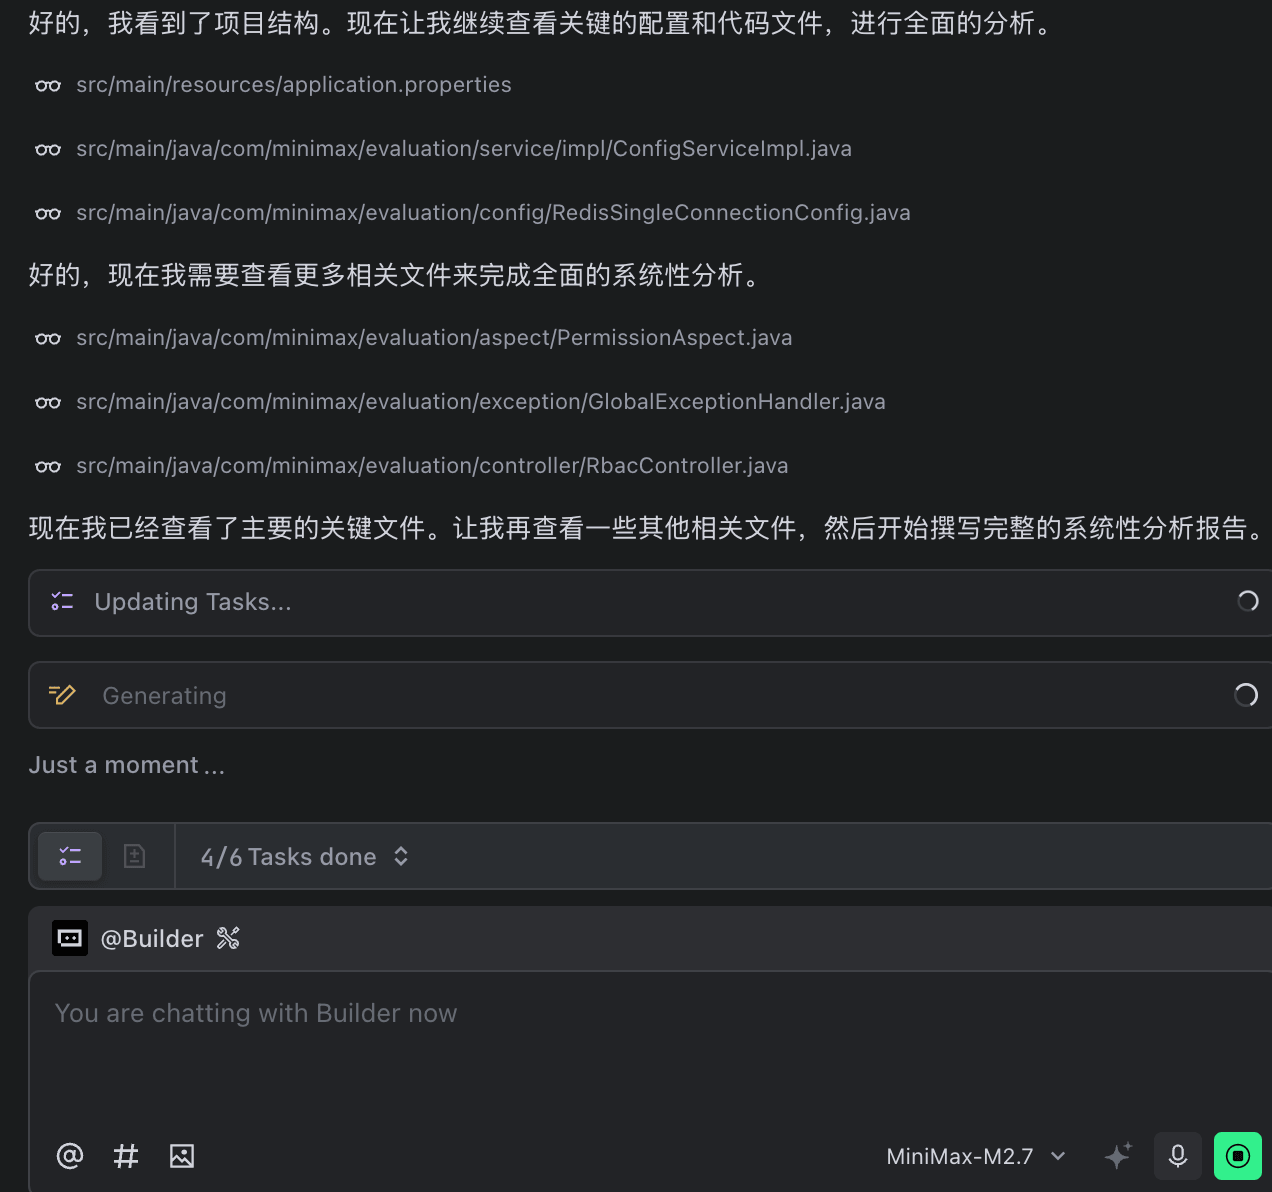
Lúc này model bắt đầu dựa trên cấu trúc project và context toàn cục để đọc và suy luận chi tiết:
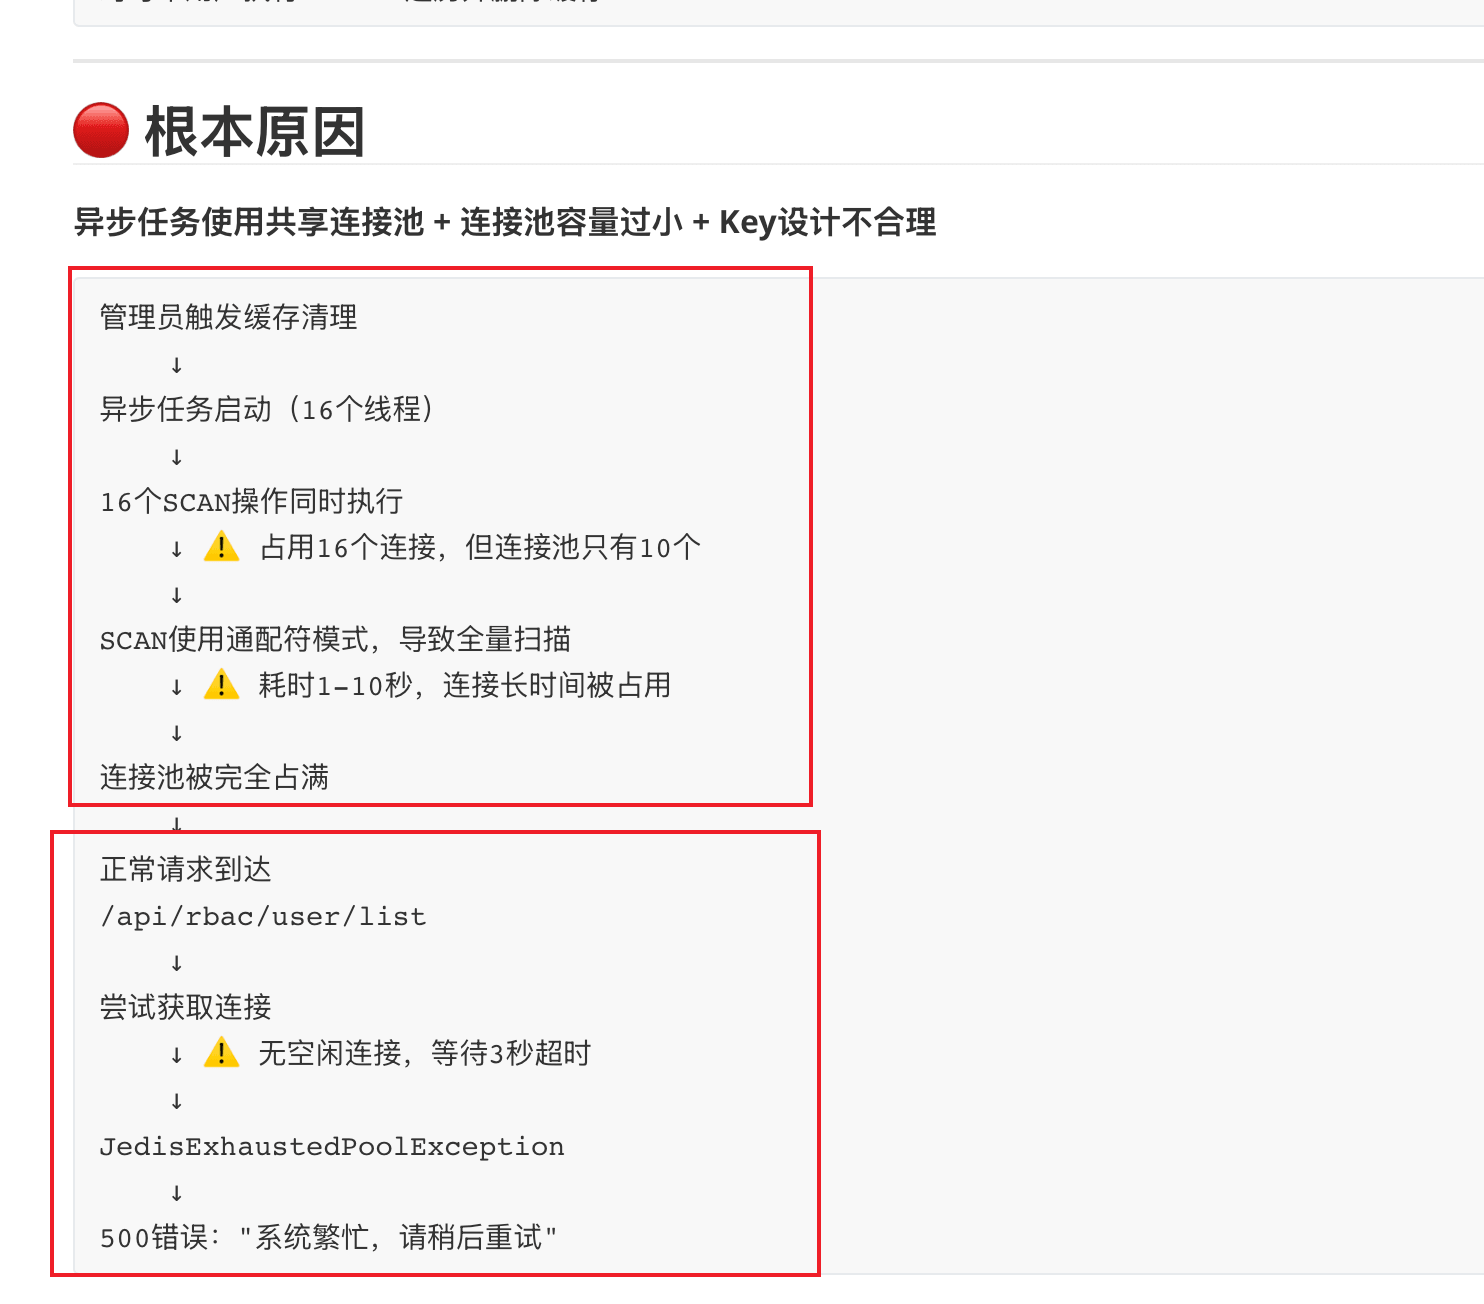
Cuối cùng, model đưa ra báo cáo phân tích sự cố chi tiết và chỉ ra root cause: việc sử dụng không phù hợp data structure Redis với thao tác scan khiến connection pool bị treo. Đồng thời, model còn kết hợp context để đưa ra business flow của thao tác này, giúp chúng ta nhanh chóng hiểu được failure chain:
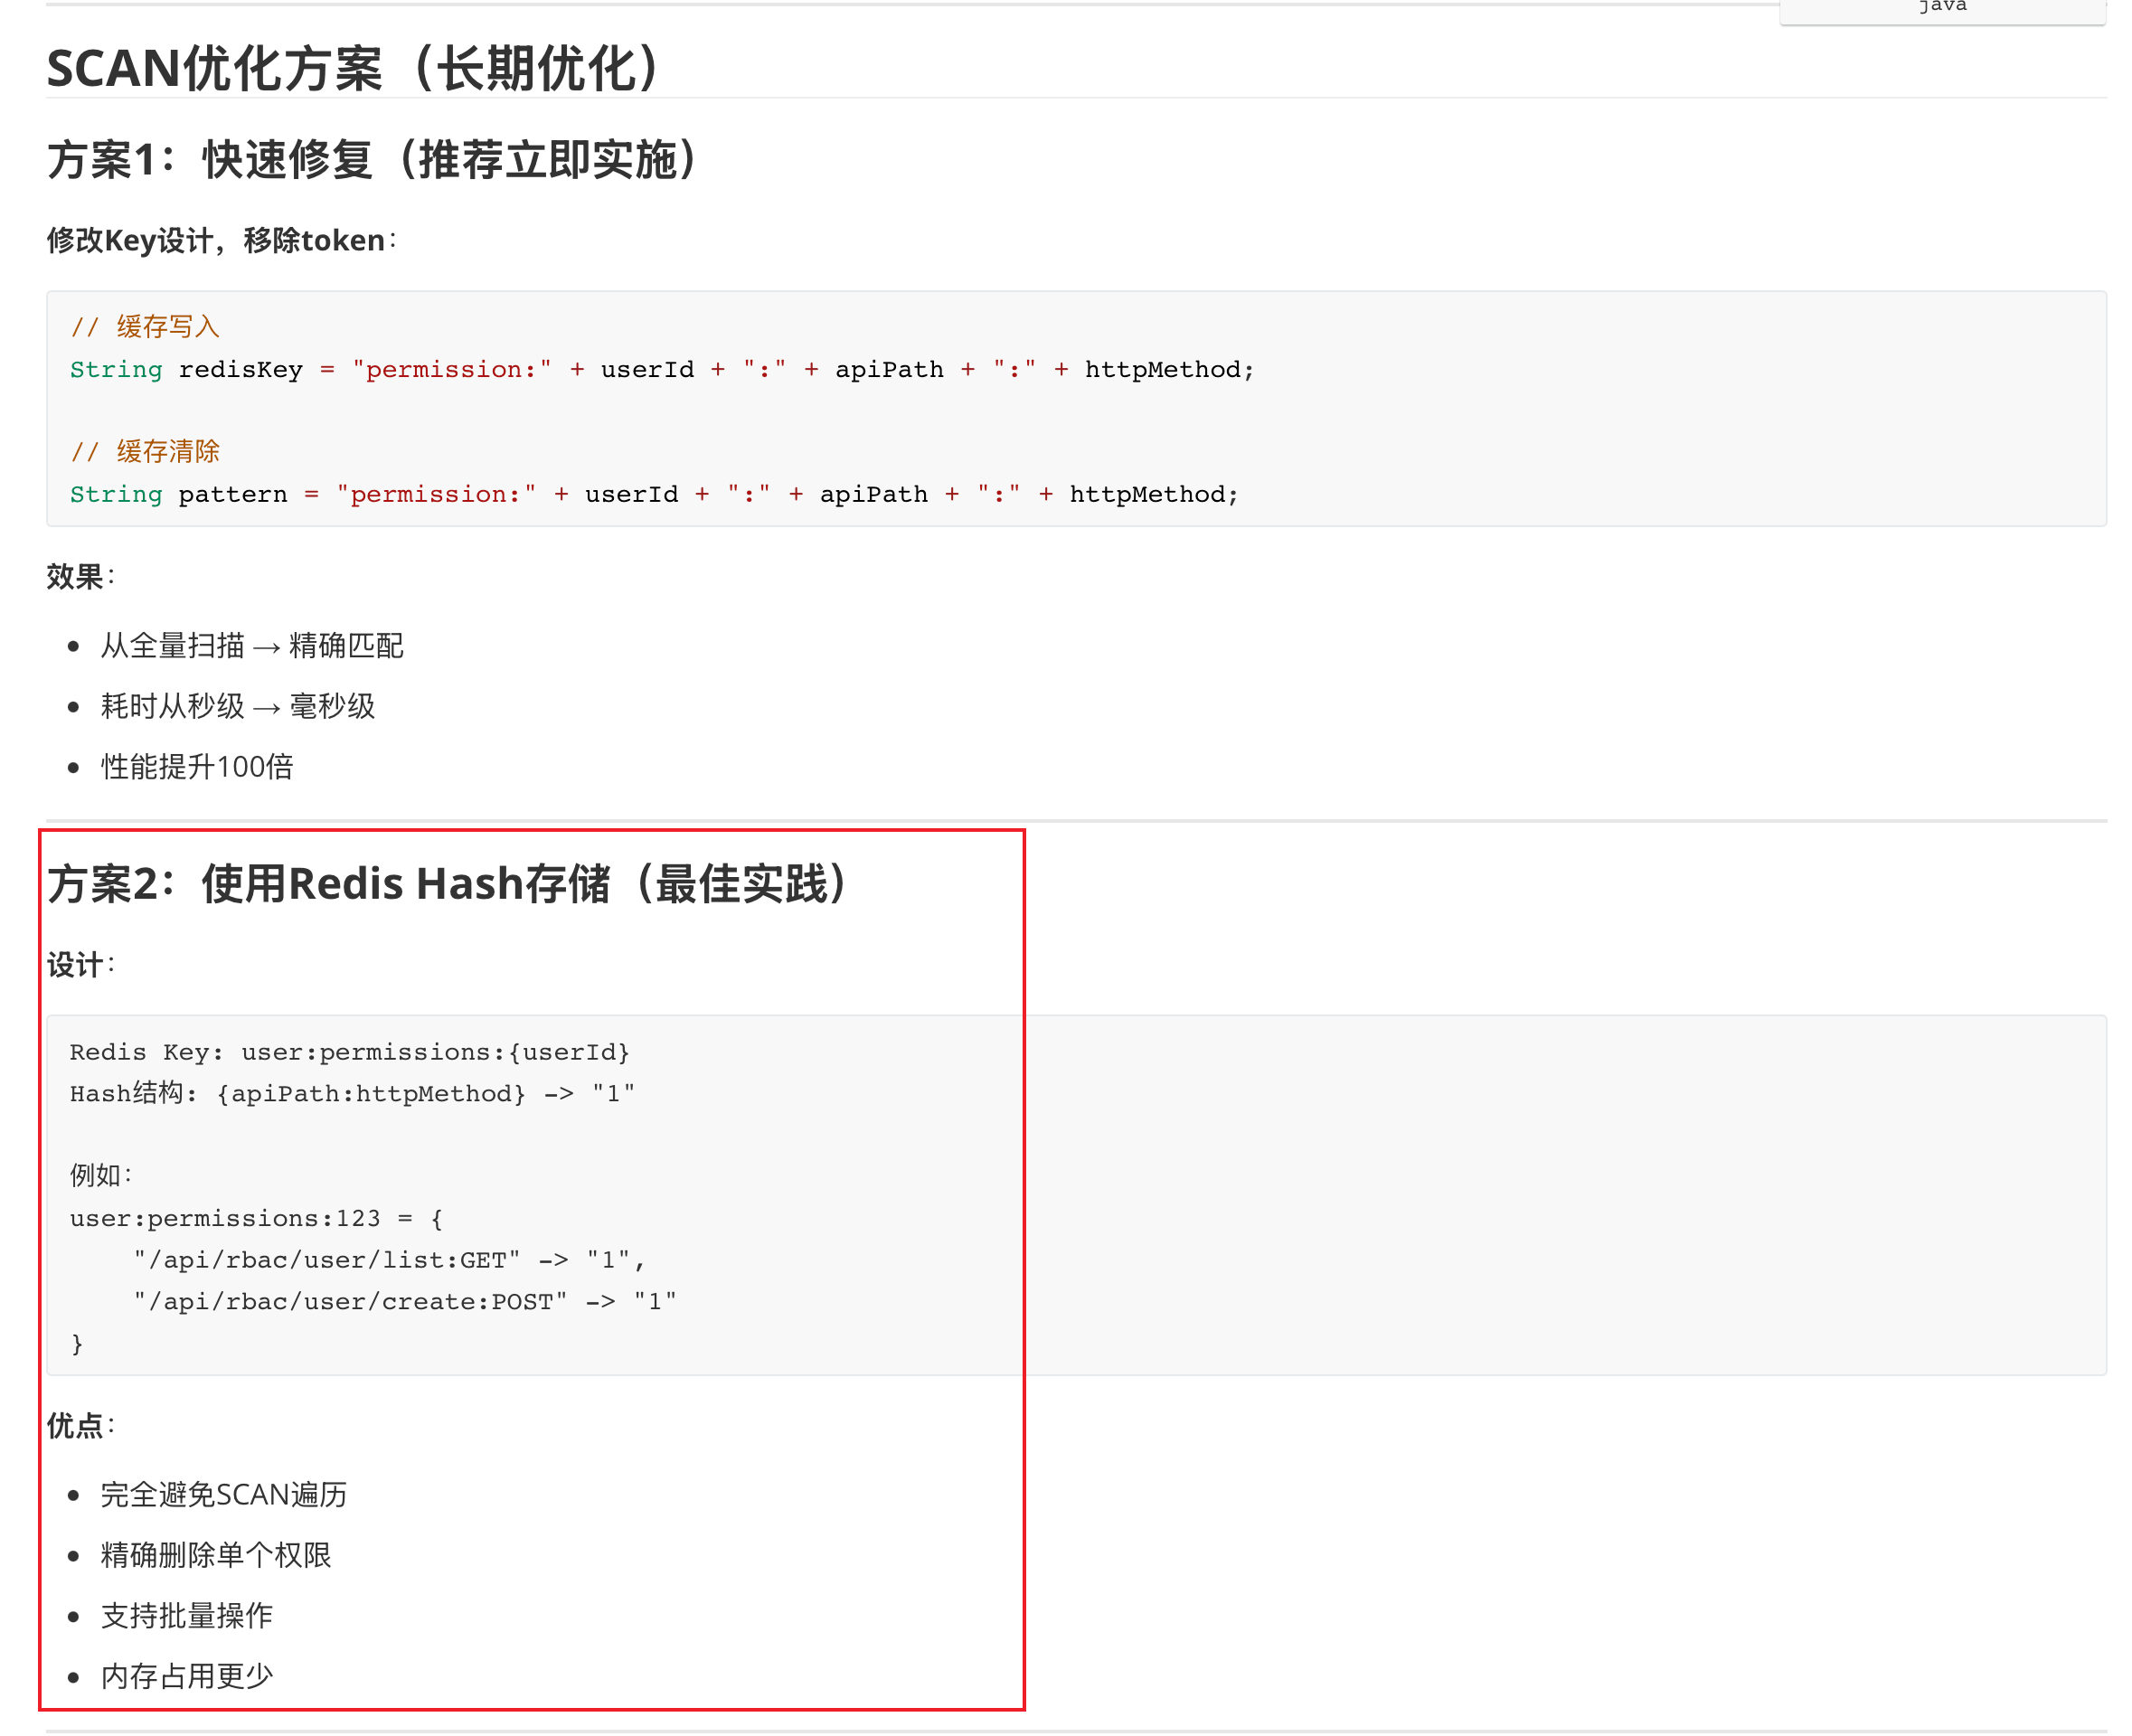
Solution cũng rất gọn và dứt khoát: giảm time complexity của thao tác đọc/ghi Redis bằng cách tối ưu data structure, tránh làm connection pool bị treo:
Trải nghiệm tổng thể của kịch bản một khá tốt. Từ việc xác định chính xác root cause trong N nơi gọi Redis đến việc đưa ra phương án xử lý khẩn cấp hoàn chỉnh, toàn bộ chuỗi suy luận rõ ràng và đầy đủ.
Tuy nhiên, cũng phát hiện một số vấn đề: phương án một (xóa Redis cache) mà model đưa ra hơi quyết liệt, trong production thực tế có thể cần strategy thận trọng hơn. Ngoài ra, phần defensive code cho một số edge case vẫn cần con người bổ sung; AI có thể giúp bạn đi được 90%, 10% còn lại vẫn phải tự mình hoàn thiện.
Kịch bản hai: refactor đa ngôn ngữ từ source code Redis C sang implementation Go
Bối cảnh
Tiếp theo, hãy thử một kịch bản độ khó cao hơn: phục chế lệnh slow query của Redis. mini-redis sử dụng ý tưởng goroutine-per-connection của Go để nâng throughput và dùng phong cách C để implement một middleware cache tuân theo RESP protocol. Do có khác biệt trong ý tưởng thiết kế giữa các ngôn ngữ, công việc liên quan đến việc hệ thống hóa logic phức tạp và triển khai solution dị thể. Đây là bài toán rất phù hợp để kiểm chứng năng lực thiết kế kiến trúc đa ngôn ngữ của mô hình lớn.
Hệ thống hóa yêu cầu và thiết kế solution
Đối với yêu cầu refactor project, theo quy trình phát triển truyền thống, chúng ta cần rất nhiều thời gian đọc source code và hệ thống hóa logic. Do code không có comment vì lý do lịch sử, trong quá trình này còn phải kết hợp context để suy luận và debug. Sau khi hiểu logic cũ, chúng ta còn phải kết hợp với kiến trúc project mới để lập các bước triển khai và thiết kế unit test nhằm đảm bảo logic hiện có chạy ổn định. Toàn bộ quy trình (development, test đến release) ước tính thận trọng cần 3 ngày làm việc. Với tâm lý muốn thử, tôi giao cho AI phụ trách việc đọc source code và hệ thống hóa tài liệu kỹ thuật.
Hiện tại tôi cần dùng Go để phục chế implementation lệnh slow query của Redis. Hãy đọc kỹ source code Redis, hiểu sâu nguyên lý implementation hoàn chỉnh, thiết kế data structure, flow xử lý và các bước then chốt của tính năng slow query. Cụ thể bao gồm nhưng không giới hạn ở: cơ chế lưu trữ slow query log, cấu hình và điều chỉnh slow query threshold, flow thu thập và ghi nhận command slow query, thiết kế và implementation các API liên quan, cũng như cách truy vấn và hiển thị thông tin slow query. Dựa trên những hiểu biết này, hãy hệ thống hóa thành tài liệu kỹ thuật rõ ràng, bao gồm giải thích nguyên lý cốt lõi, phân tích data structure quan trọng, phân rã các bước implementation và các cân nhắc tối ưu performance có thể có.Sau một lúc, model chỉ rõ các yêu cầu kỹ thuật, trình bày từ data structure đến execution chain theo hướng bottom-up, đồng thời phân tích và giới thiệu rất chi tiết:
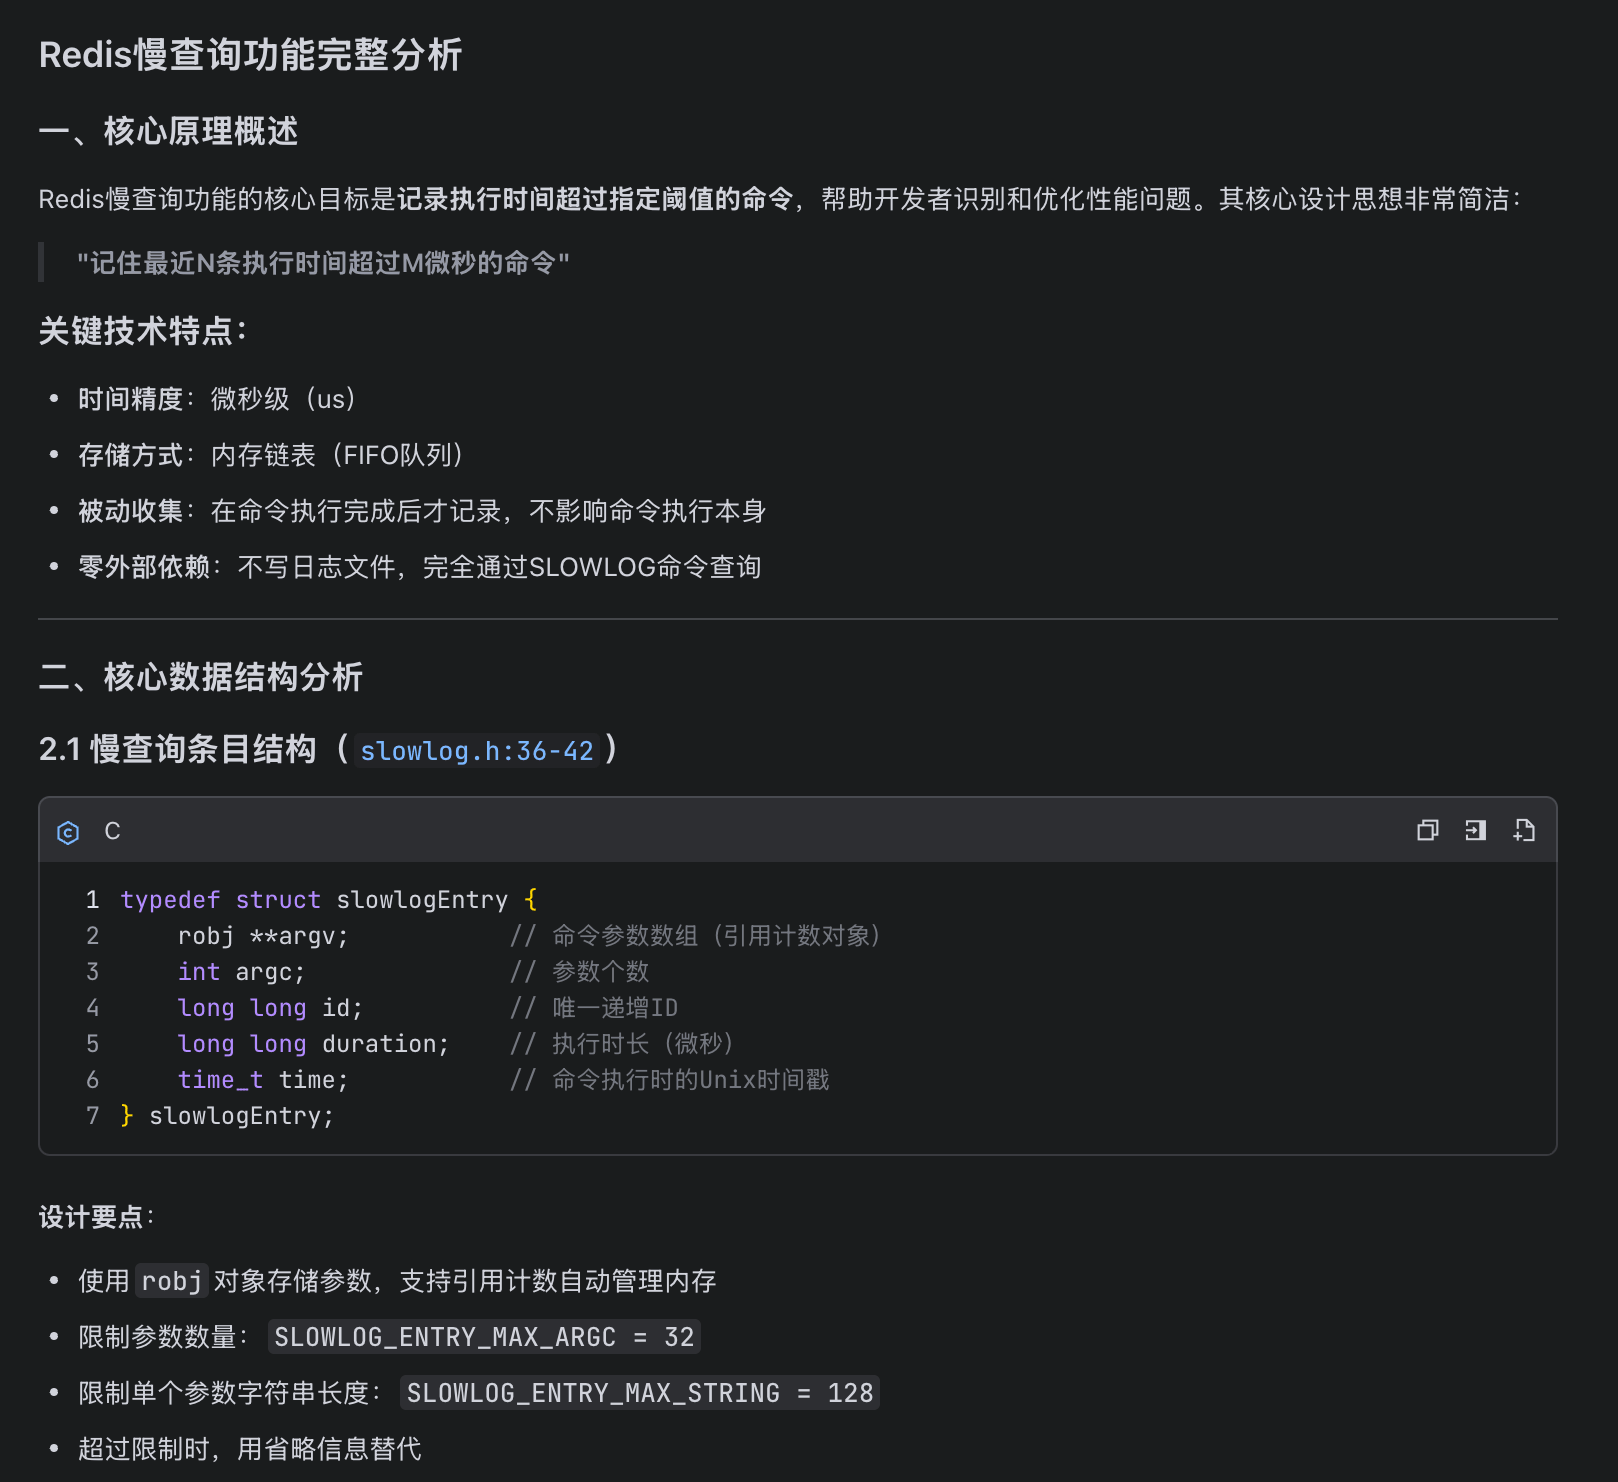
Việc xác định logic aspect của slow query rất chính xác. Trong main flow, model đưa ra các comment cần thiết, giúp tôi nhanh chóng hiểu flow xử lý tổng thể của slow query:
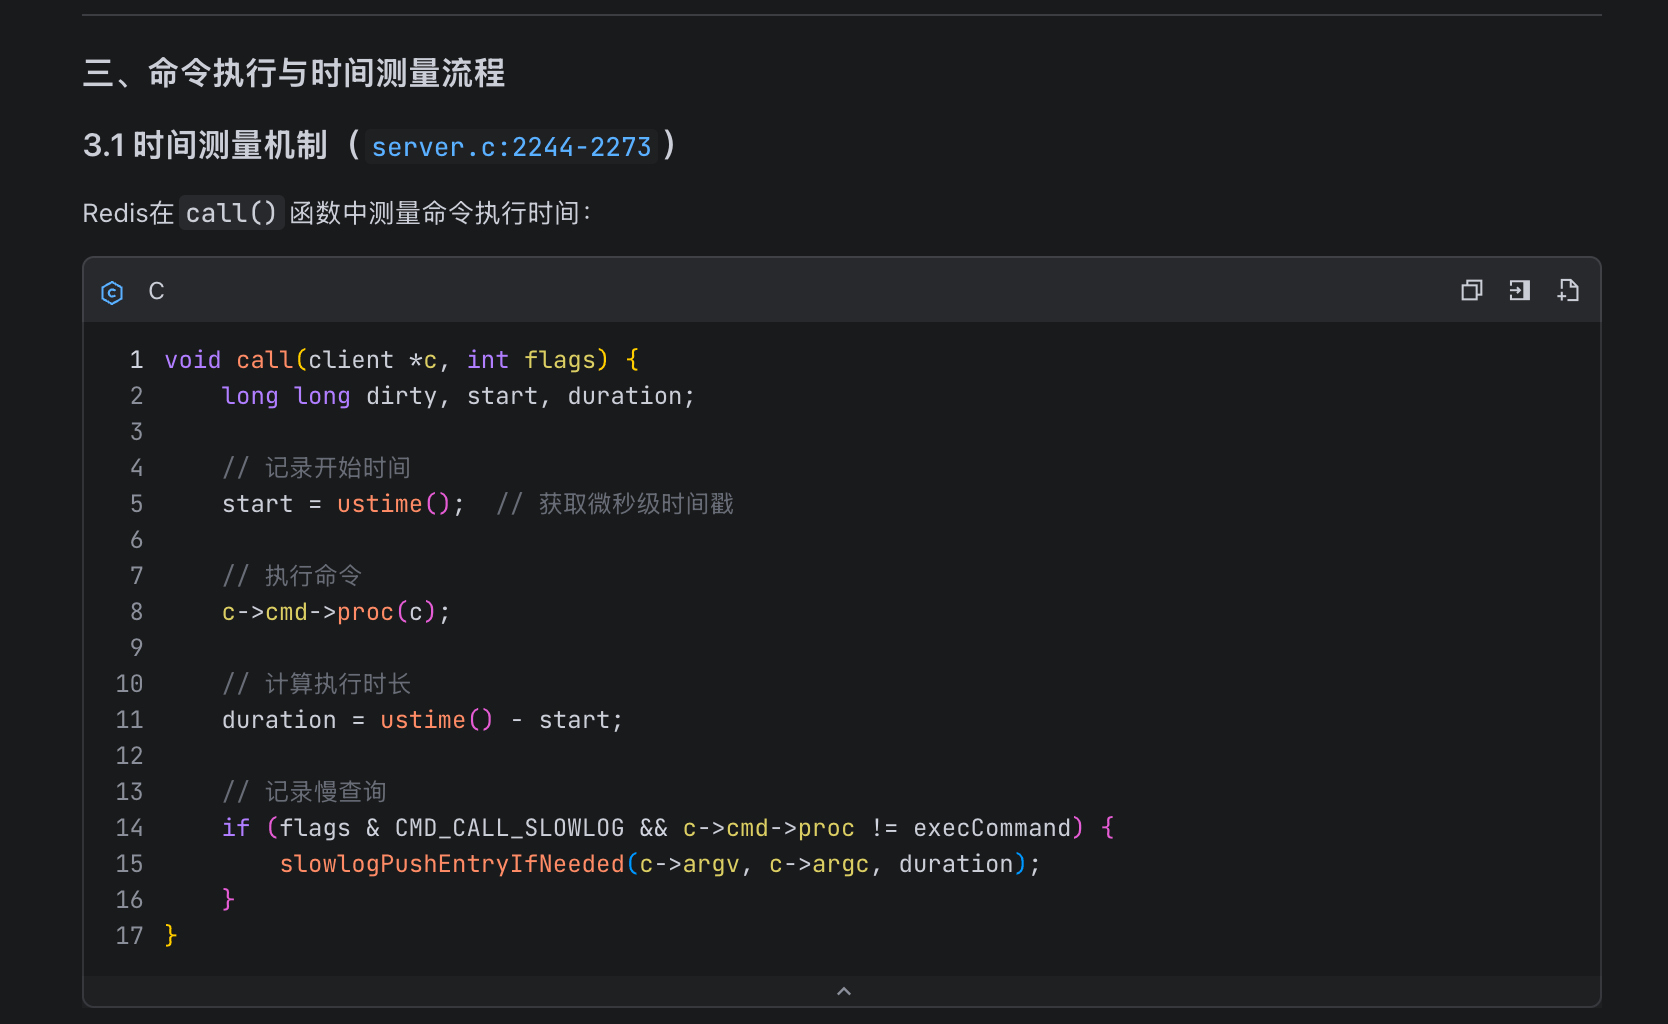
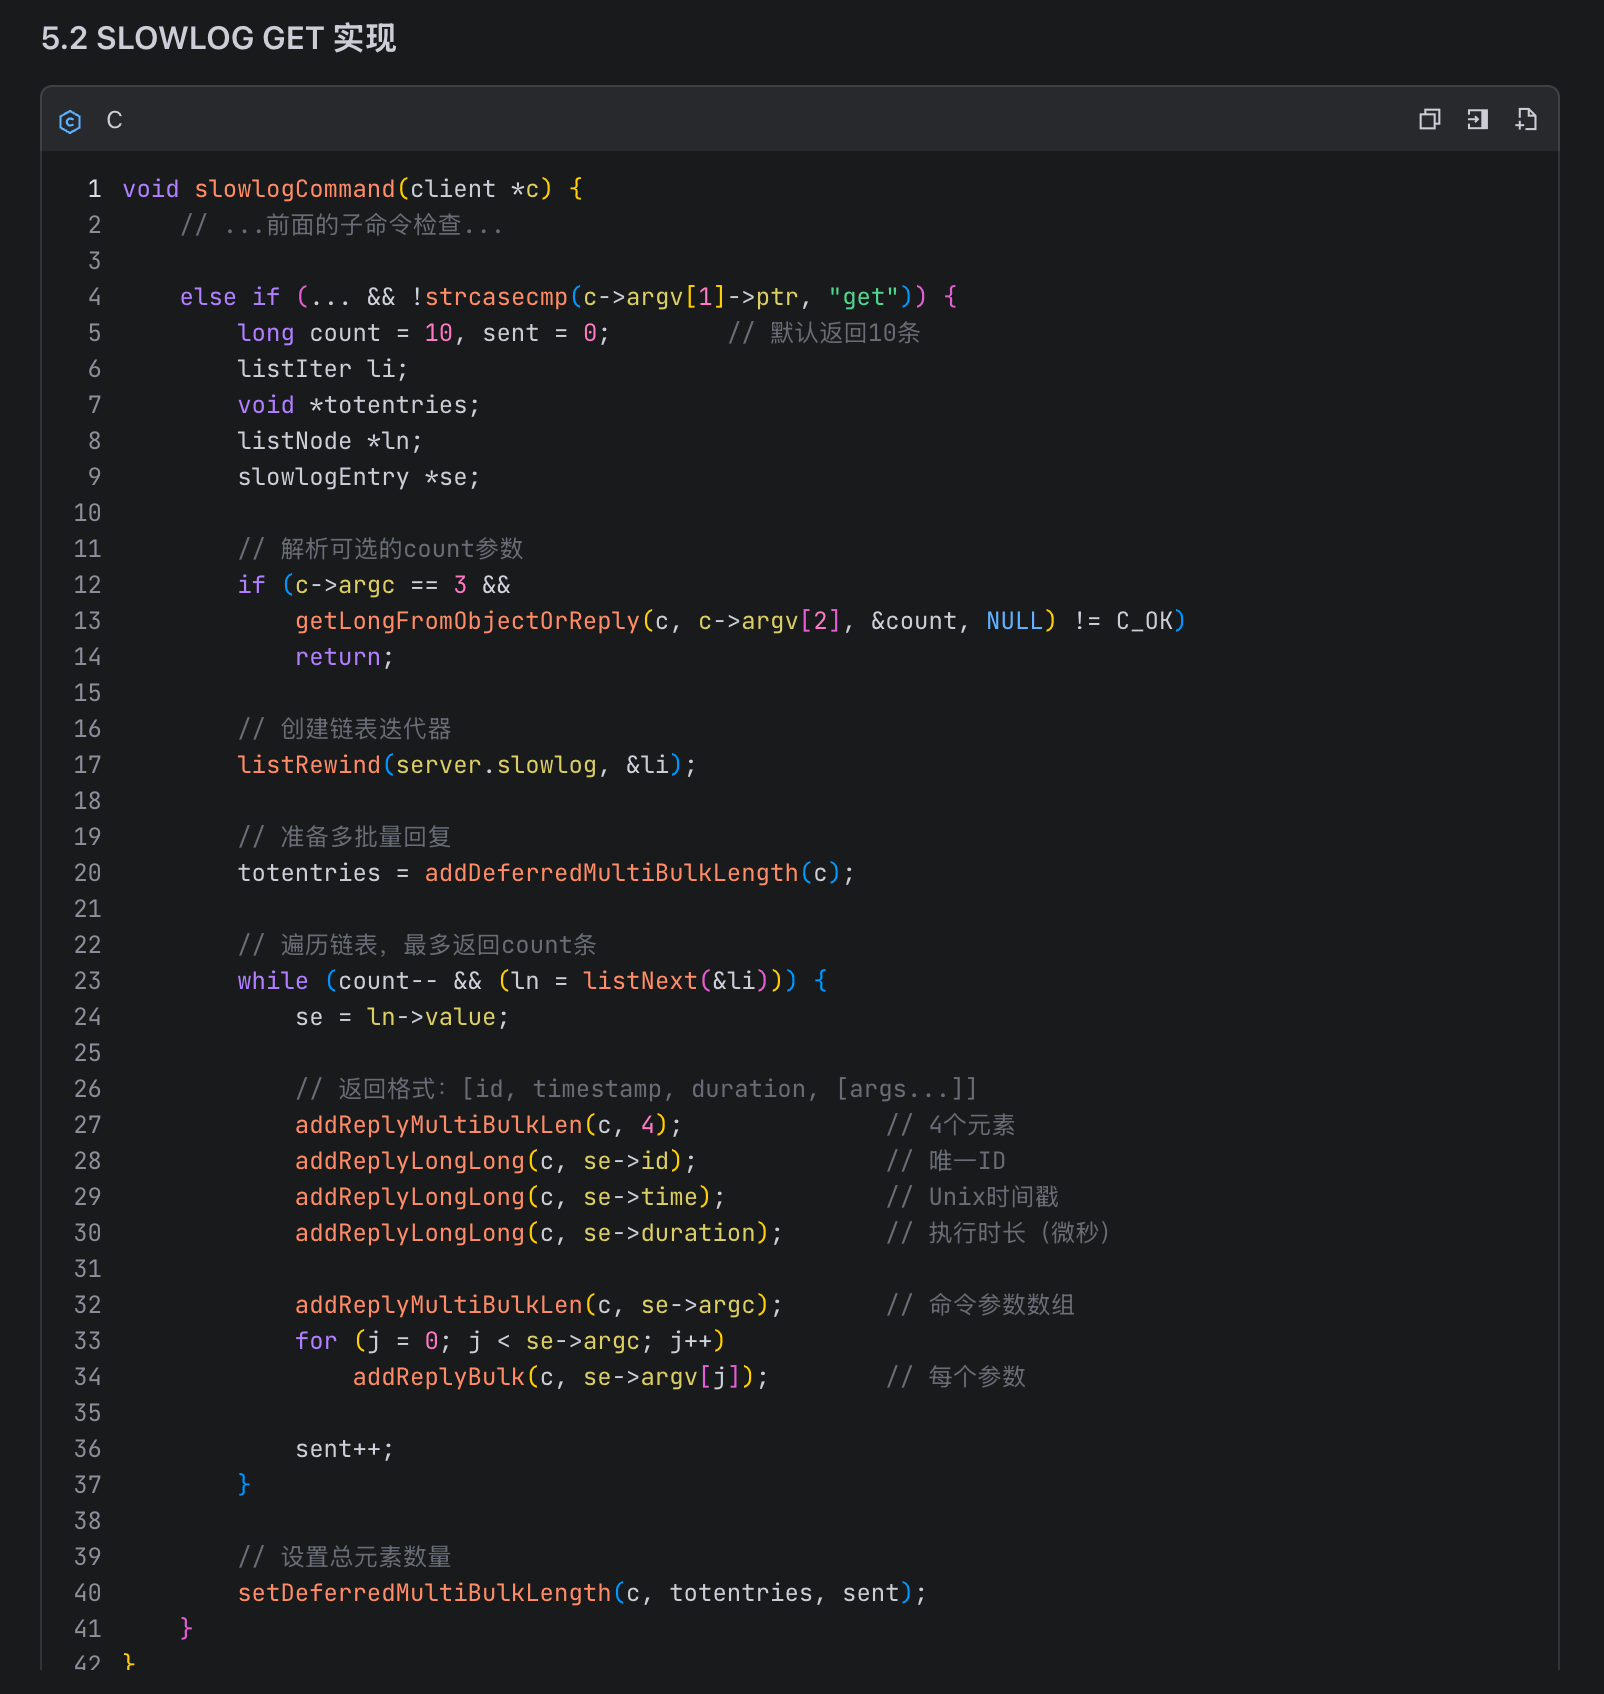
Tiếp theo là cách model hiểu lệnh slot get, cũng rất đúng trọng tâm. Tư duy giống một senior developer: nắm phần lớn, bỏ phần nhỏ, làm rõ logic cốt lõi và đưa ra các comment cần thiết trong main flow:
Sau khi xác nhận model đã hiểu chính xác slow query, tiếp theo tôi yêu cầu model đứng trên góc nhìn của development expert để đưa ra tài liệu thiết kế hoàn chỉnh cho việc phân rã chức năng, triển khai và regression test:
Theo methodology test-driven development (TDD), hãy dùng Go để tạo một tài liệu hướng dẫn development toàn diện và chi tiết, hướng dẫn phục chế implementation của Redis. Tutorial này phải đáp ứng các quy chuẩn sau:

1. Phương pháp development:
   - Nghiêm ngặt thực hiện workflow test-driven development: trước tiên viết test thất bại, sau đó implement code tối giản để test pass, cuối cùng thực hiện refactor
   - Áp dụng phong cách lập trình procedural tương tự implementation Redis bằng C nguyên bản
   - Tận dụng tối đa cú pháp Go thuần và standard library

2. Cấu trúc tutorial:
   - Bắt đầu từ phần thiết lập project và cấu hình môi trường
   - Chia chức năng Redis thành các module logic để phát triển
   - Với mỗi module/tính năng, cung cấp:
     a. Định nghĩa test case rõ ràng, bao gồm input và output dự kiến
     b. Implementation code từng bước, kèm giải thích từng dòng
     c. Command test và flow verification rõ ràng
     d. Kết quả test dự kiến và tiêu chuẩn thành công

3. Yêu cầu kỹ thuật:
   - Bao gồm code snippet hoàn chỉnh của mọi component
   - Chỉ rõ file structure và quy ước đặt tên chính xác
   - Giải thích chi tiết command compile và test
   - Giải thích flow debug các vấn đề thường gặp
   - Khi phù hợp, tham khảo pattern trong source code Redis C tương ứng

4. Chi tiết implementation:
   - Bắt đầu từ data structure cốt lõi (string, list, hash, v.v.)
   - Từng bước tiến tới xử lý command và implementation protocol
   - Bao gồm network layer và giao tiếp client-server
   - Bao quát cơ chế persistence (RDB/AOF)
   - Implement các Redis command cơ bản theo cùng behavior pattern

5. Yêu cầu test:
   - Cung cấp test code hoàn chỉnh cho mỗi component
   - Giải thích assertion và phương pháp verification
   - Bao gồm unit test và integration test
   - Chỉ rõ cách chạy test và đọc kết quả
   - Giải thích chi tiết cách xác minh behavior chính xác theo Redis specification

Tutorial này cần đủ toàn diện để developer có kiến thức Go trung cấp có thể xây dựng thành công một hệ thống Redis có chức năng tương tự theo phương pháp đã chỉ định.
Sau một lúc, chúng tôi nhận được một tài liệu thiết kế. Model kết hợp context source code Redis, hệ thống hóa các mạch cốt lõi và định nghĩa quan trọng của slow query, đồng thời lập kế hoạch các bước development hoàn chỉnh: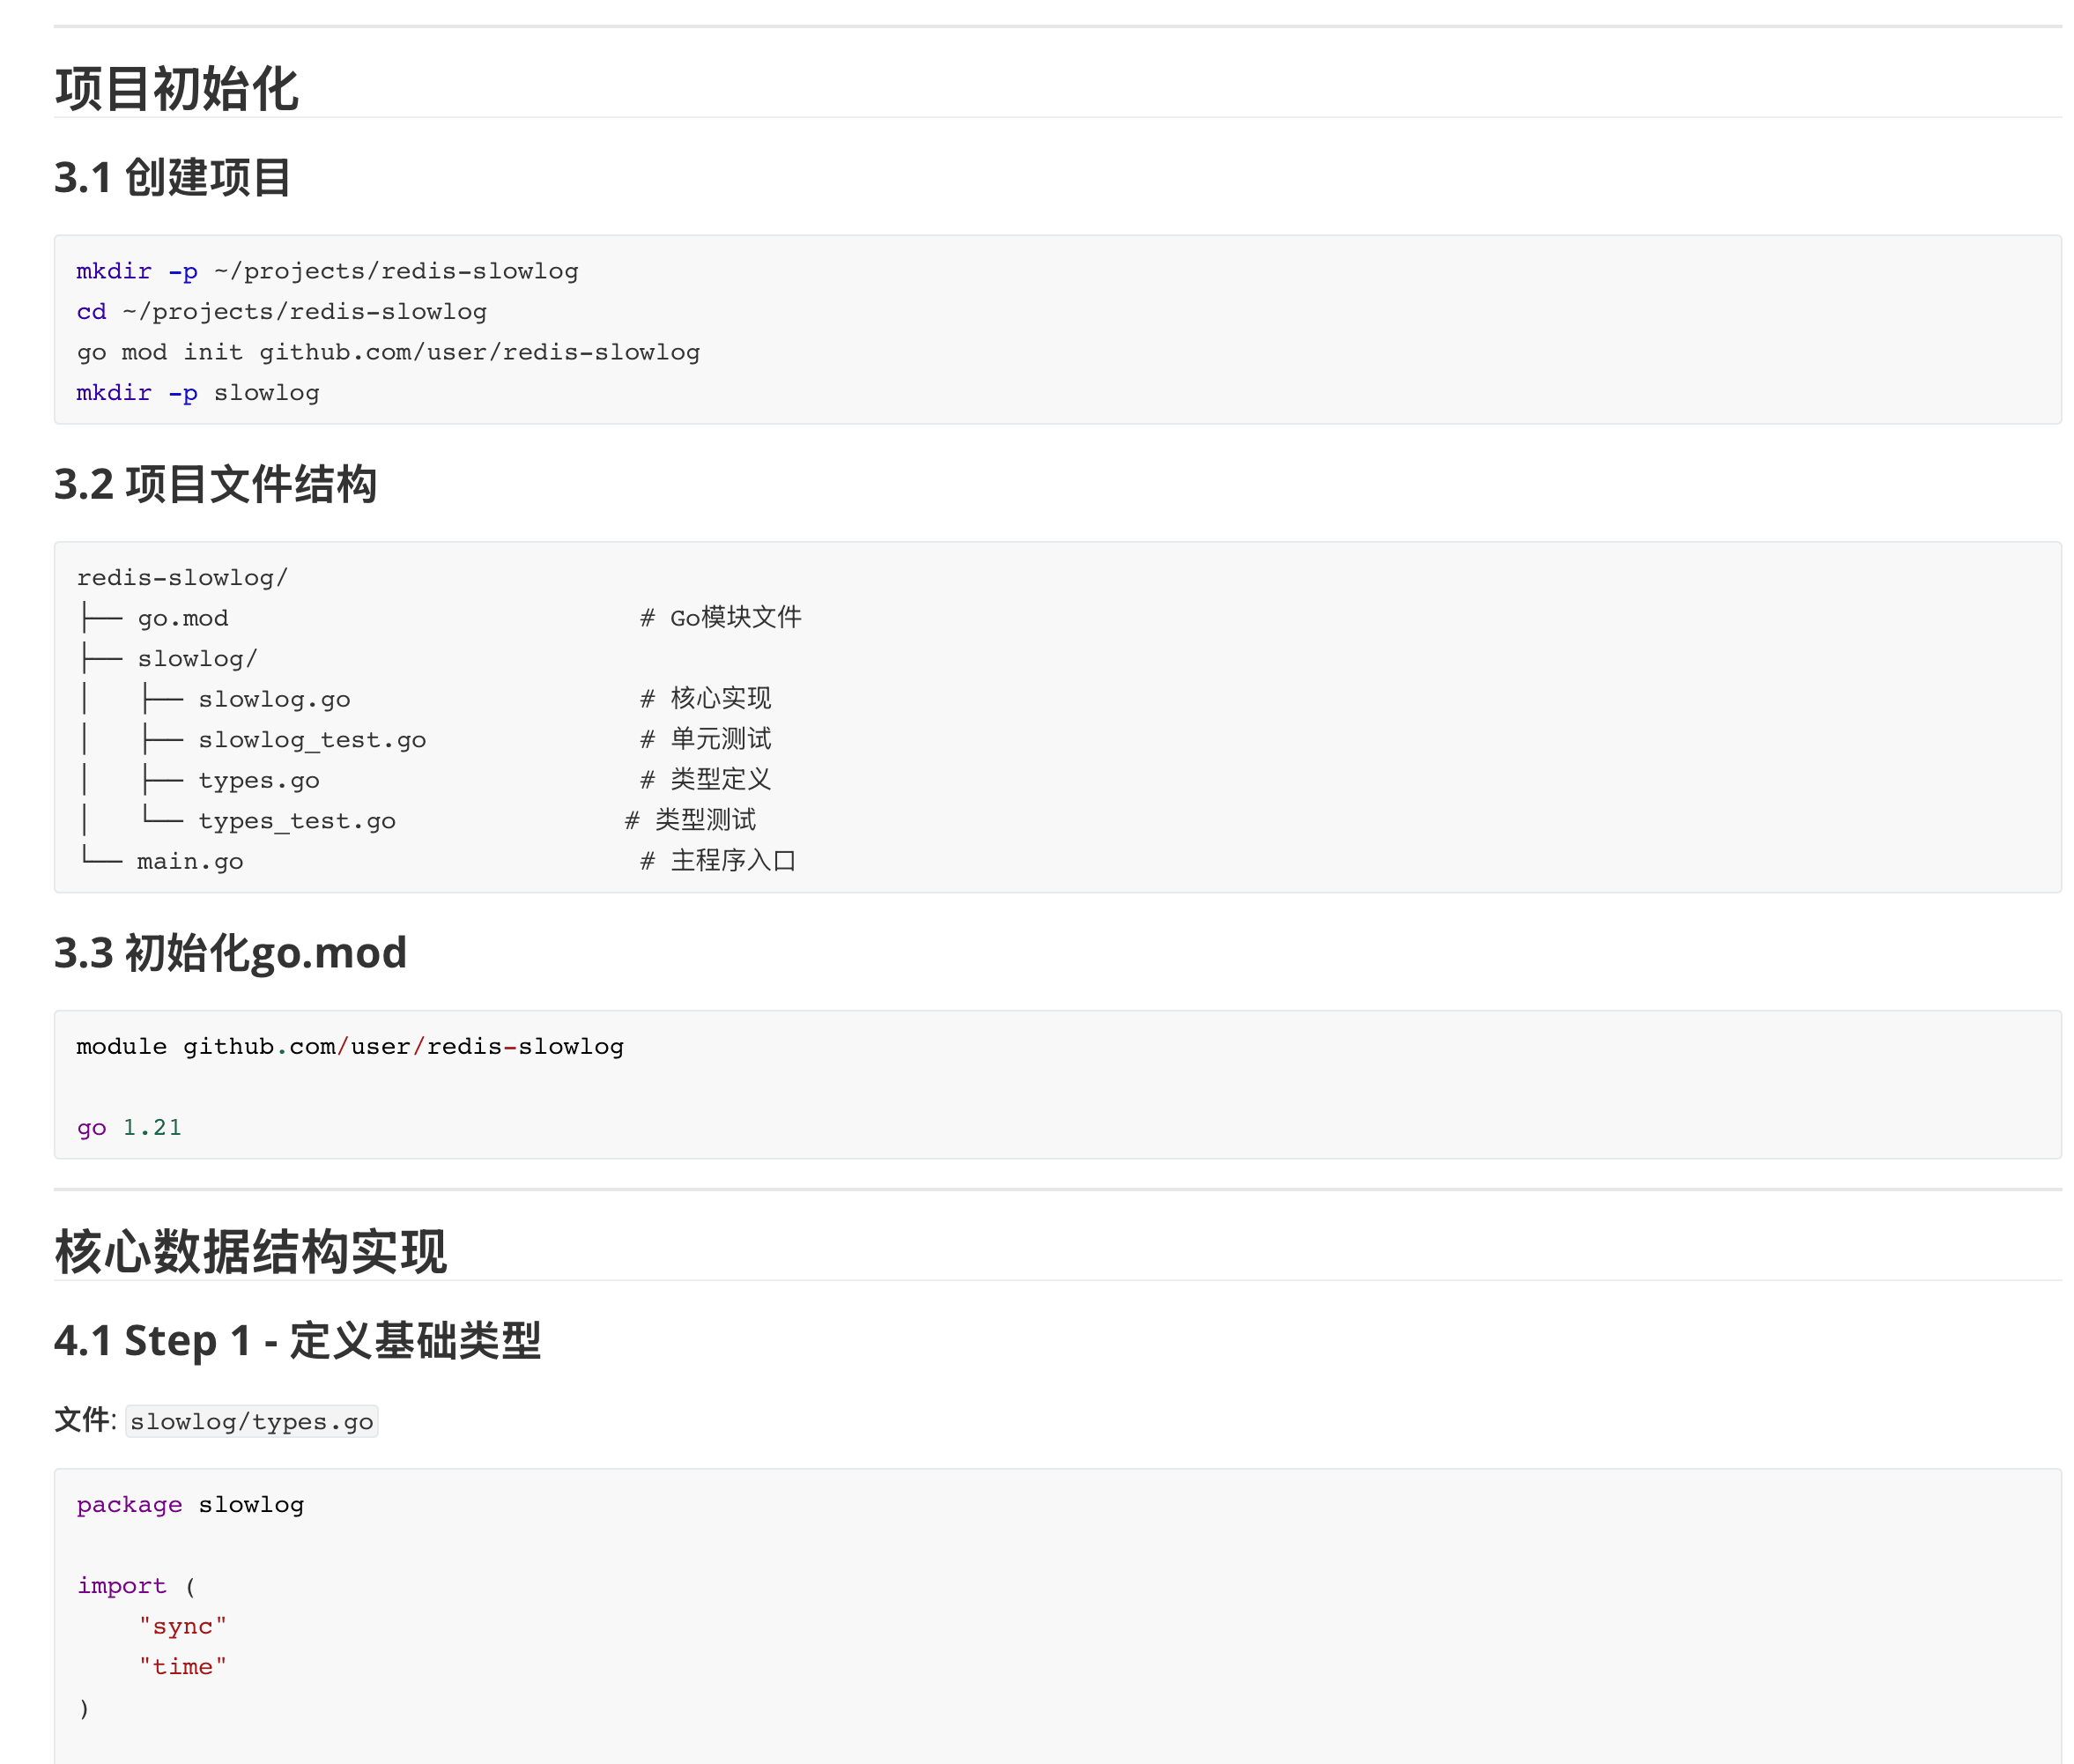
Implementation code
Sau khi trích xuất tài liệu thiết kế từ source code Redis, để đảm bảo ý tưởng thiết kế của project C có thể được triển khai chính xác theo quy chuẩn project Go cá nhân, tôi copy tài liệu đó vào project mini-redis và yêu cầu model phân tích tính khả thi của solution cùng đề xuất sửa đổi:
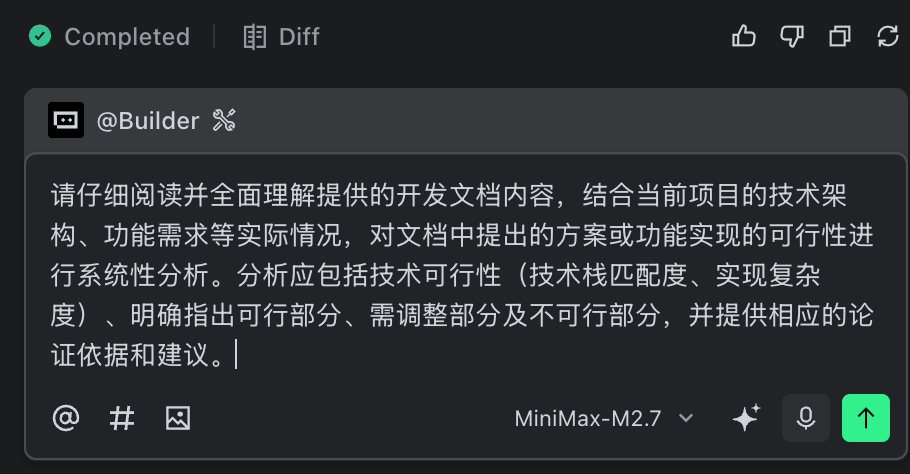
Sau một lúc, model hoàn tất phần phân tích và hệ thống hóa tính khả thi cuối cùng của tài liệu. Chúng tôi bắt đầu review và xác nhận thêm về design solution. Từ phần tổng quan project có thể thấy model đã phân tích structure của project mini-redis, xác định chính xác linked list structure có thể tái sử dụng trực tiếp cho slow query và hoàn tất tinh chỉnh nhỏ cho tài liệu:
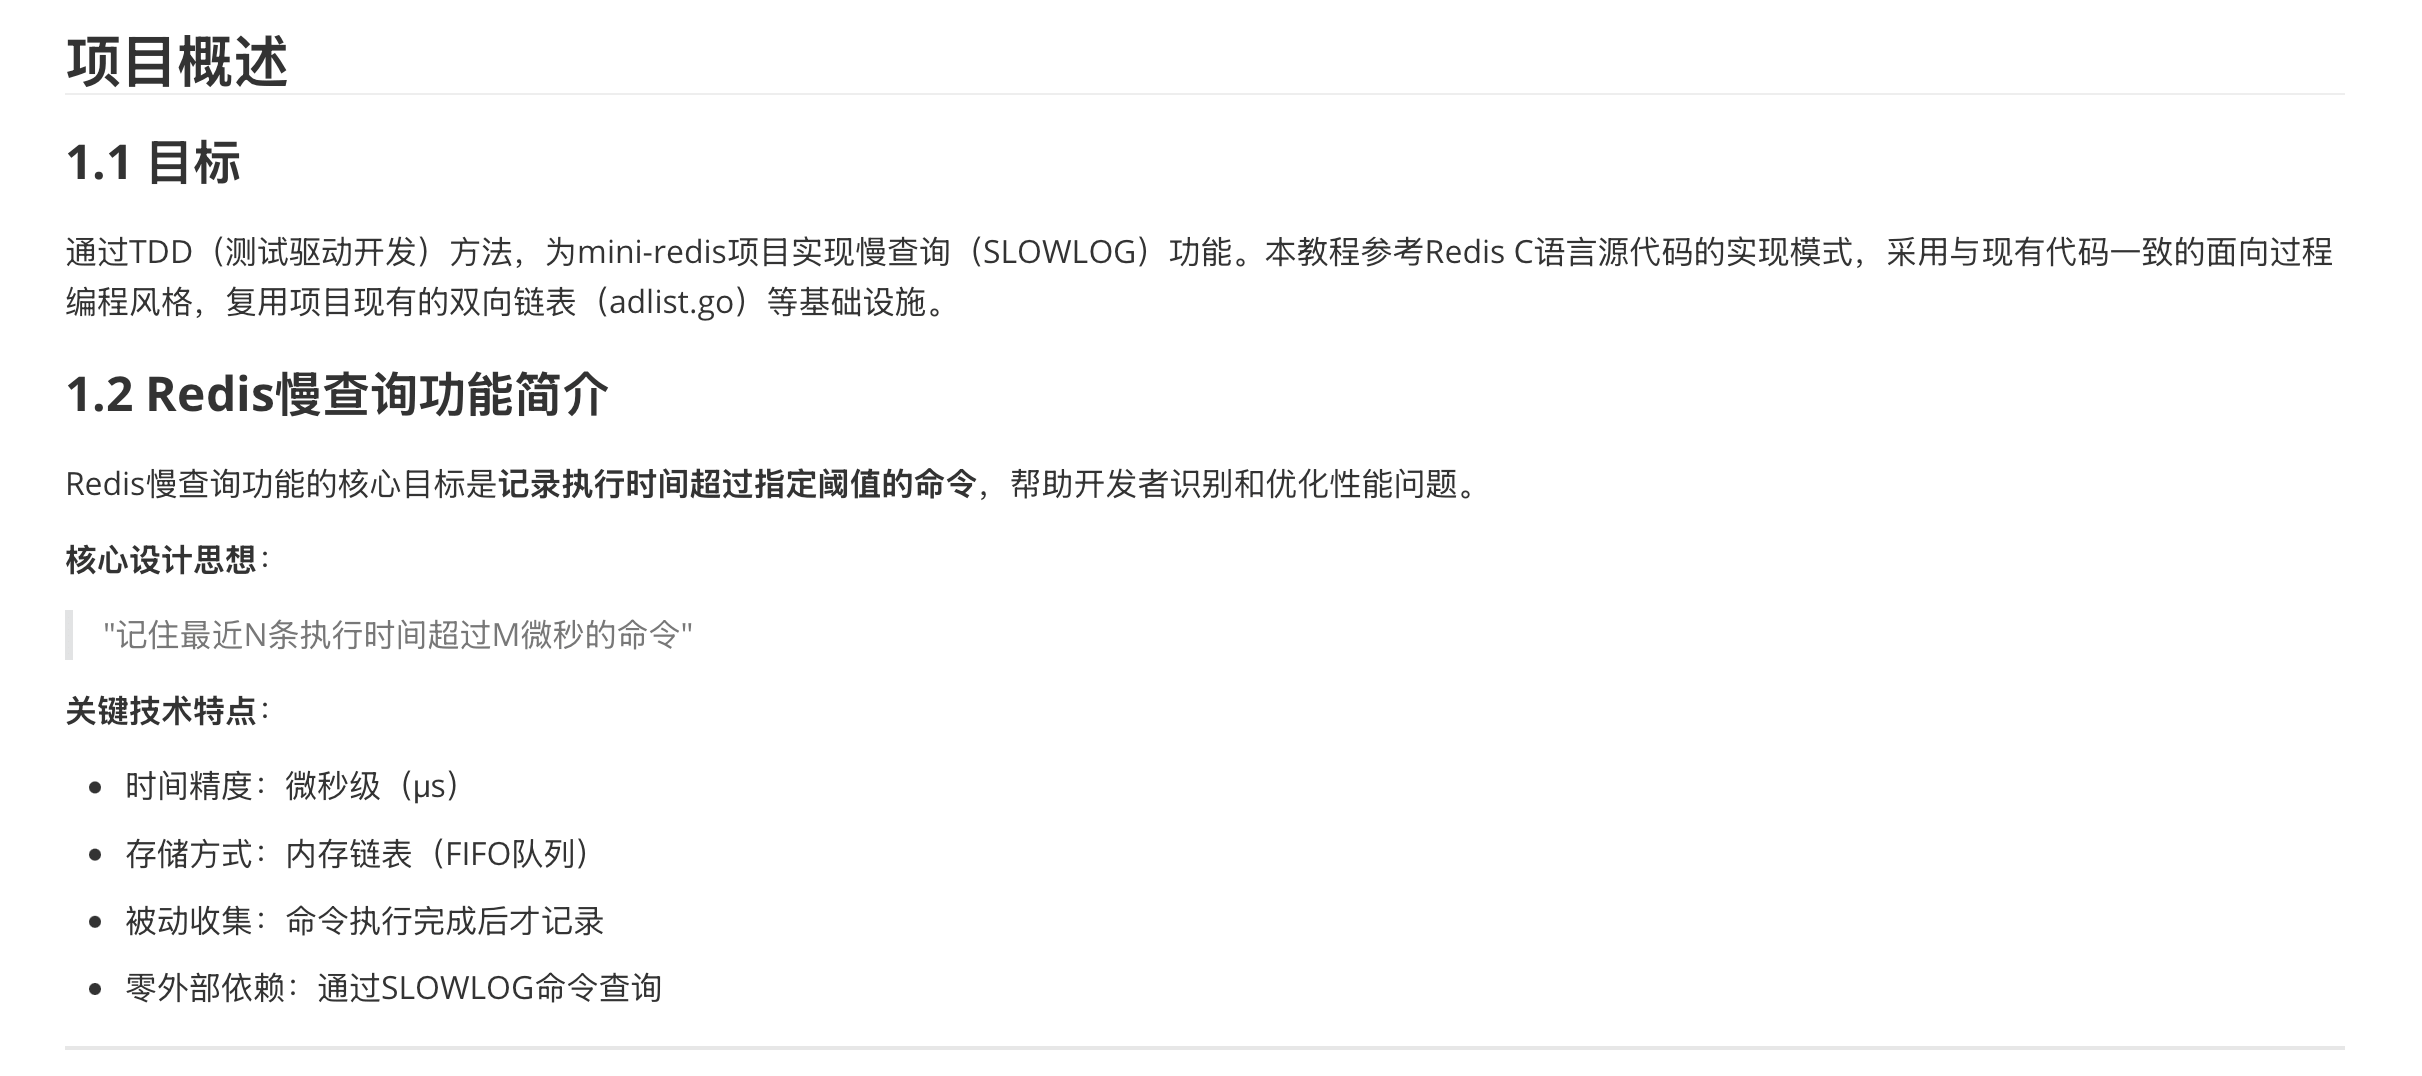
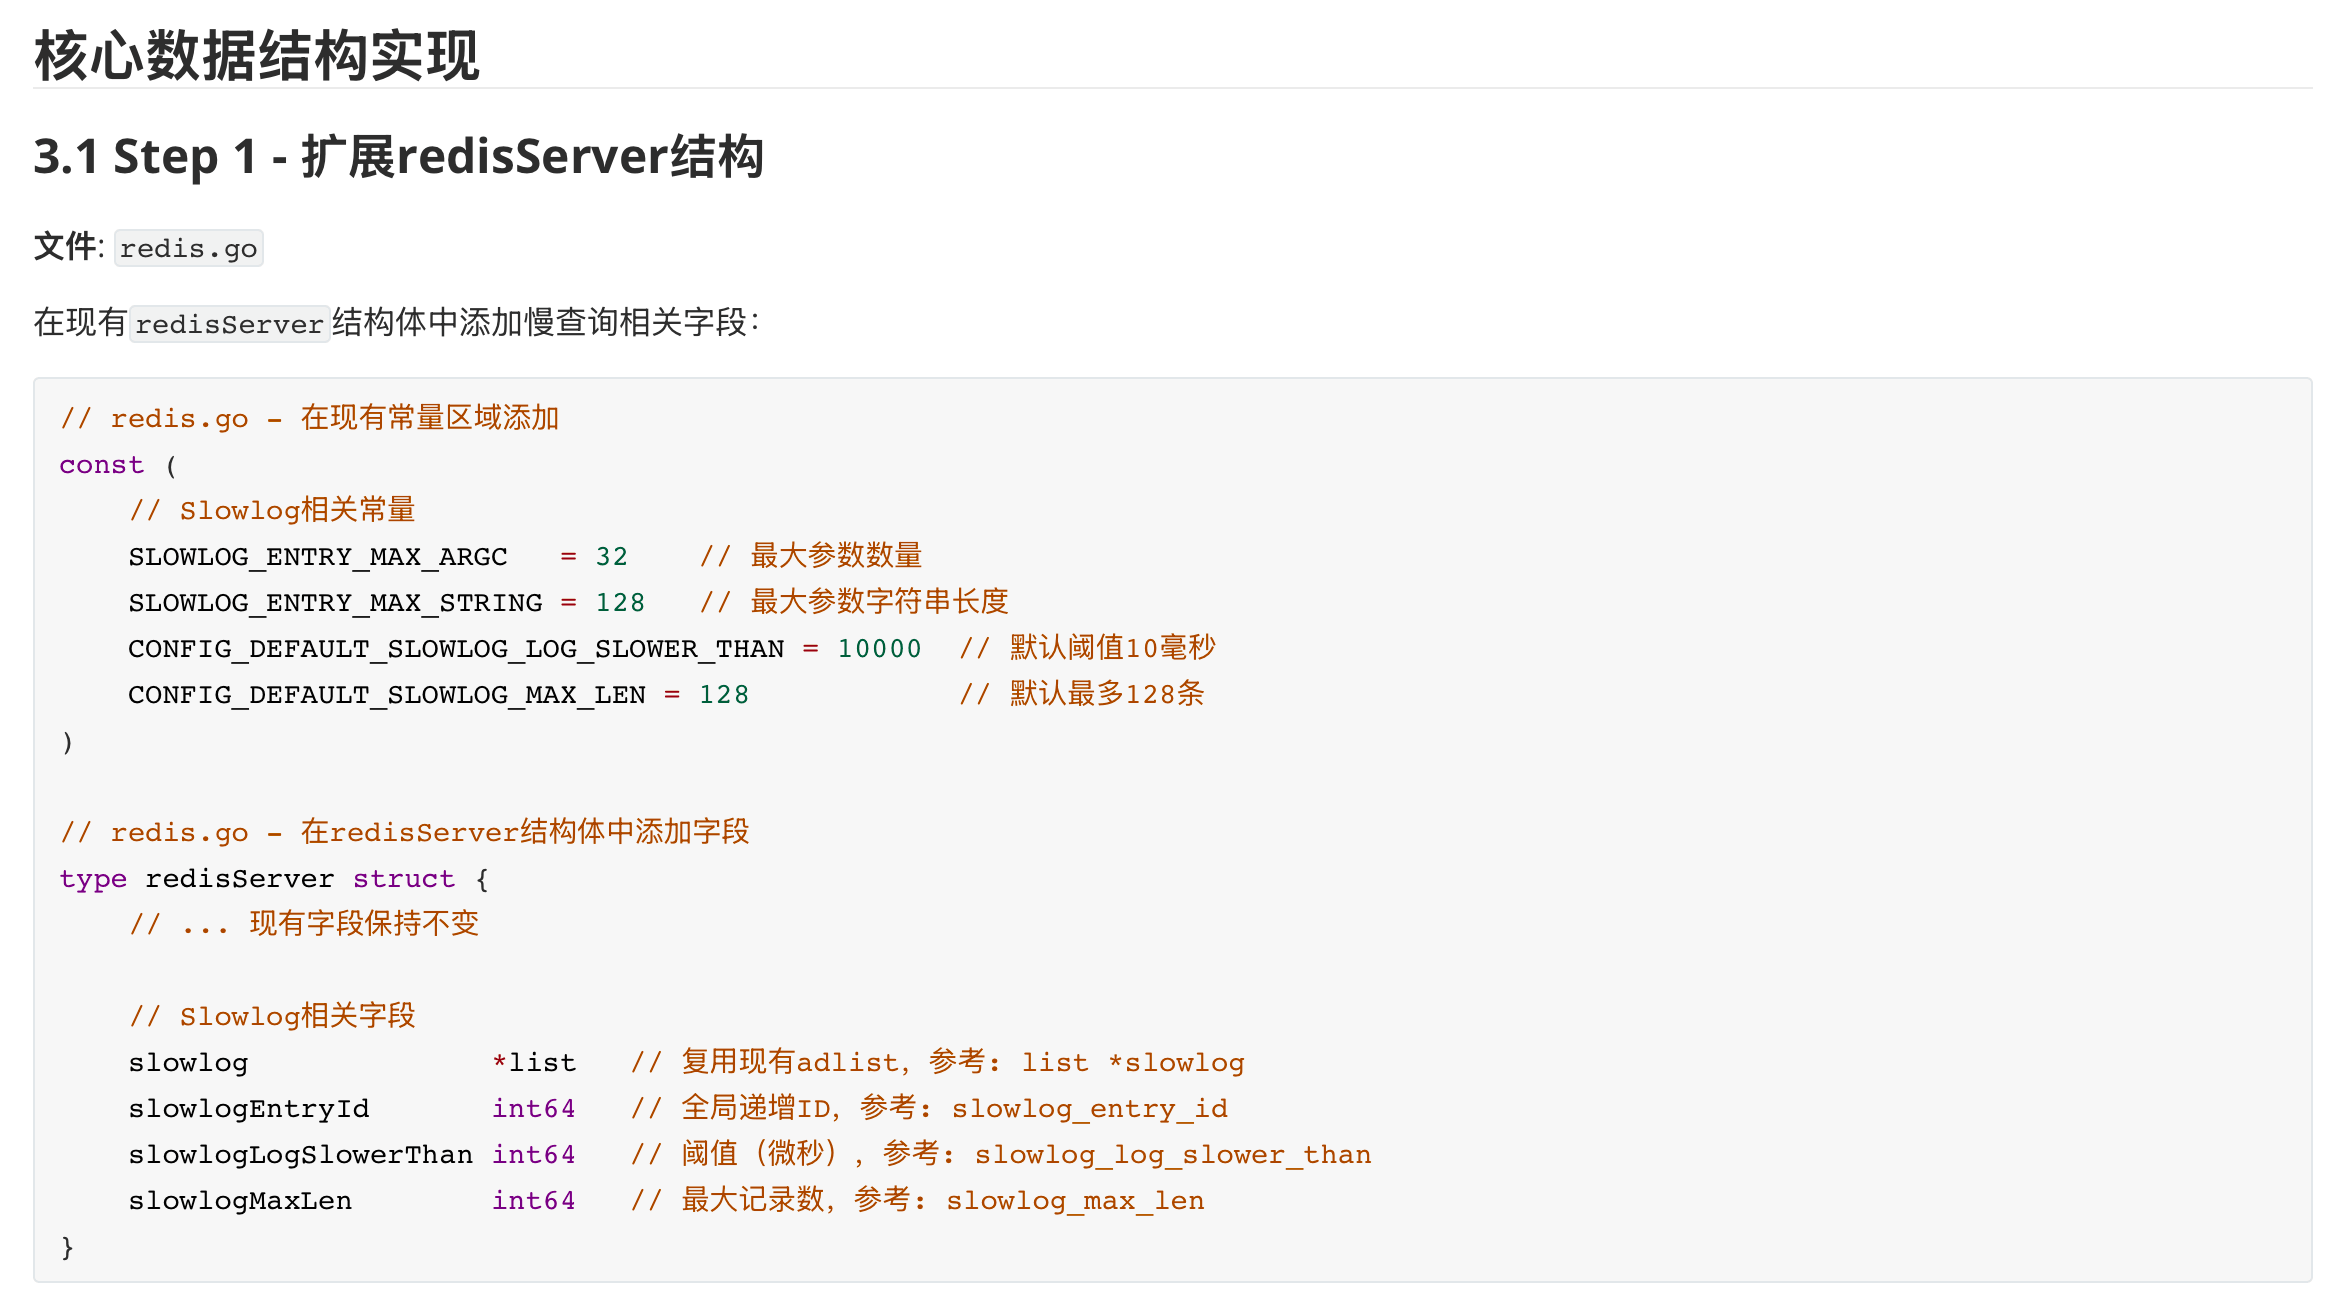
Tiếp theo là ý tưởng implementation của data structure quan trọng nhất. Model cũng kết hợp với coding convention của mini-redis để tạo ra struct theo phong cách Go:
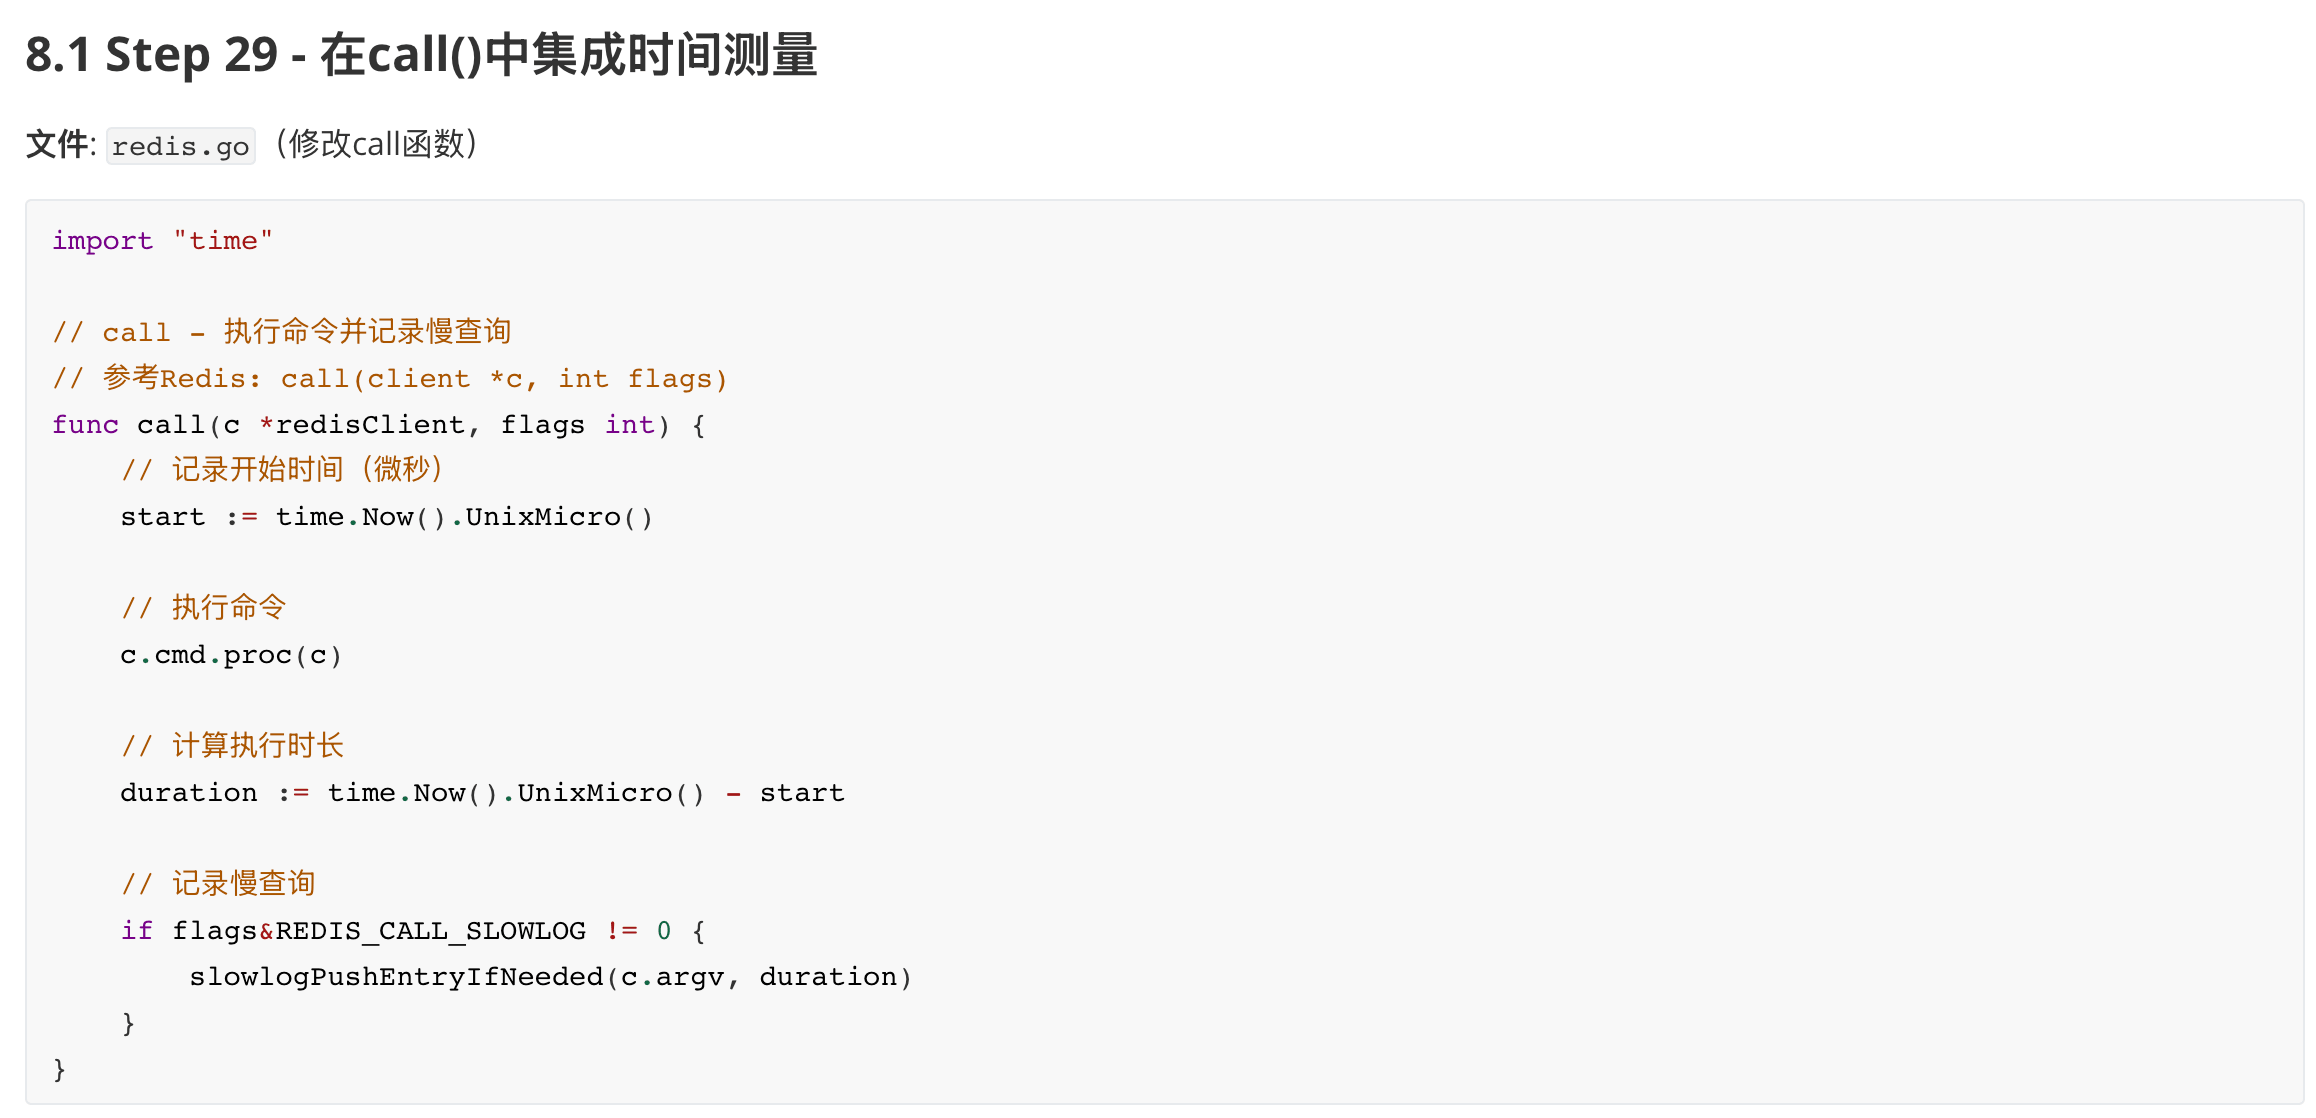
Đối với việc đo thời gian slow query, có một chi tiết đáng nhắc đến. Entry xử lý command trong implementation cá nhân có một số khác biệt về thiết kế so với Redis nguyên bản: do đặc tính syntactic sugar của Go, tôi đã xử lý đặc biệt pointer, pointer function và cách tổ chức file. Model đã xác định chính xác aspect đo thời gian dựa trên coroutine model của tôi, hoàn tất việc đo thời gian trước và thống kê sau, qua đó implement monitoring slow query.
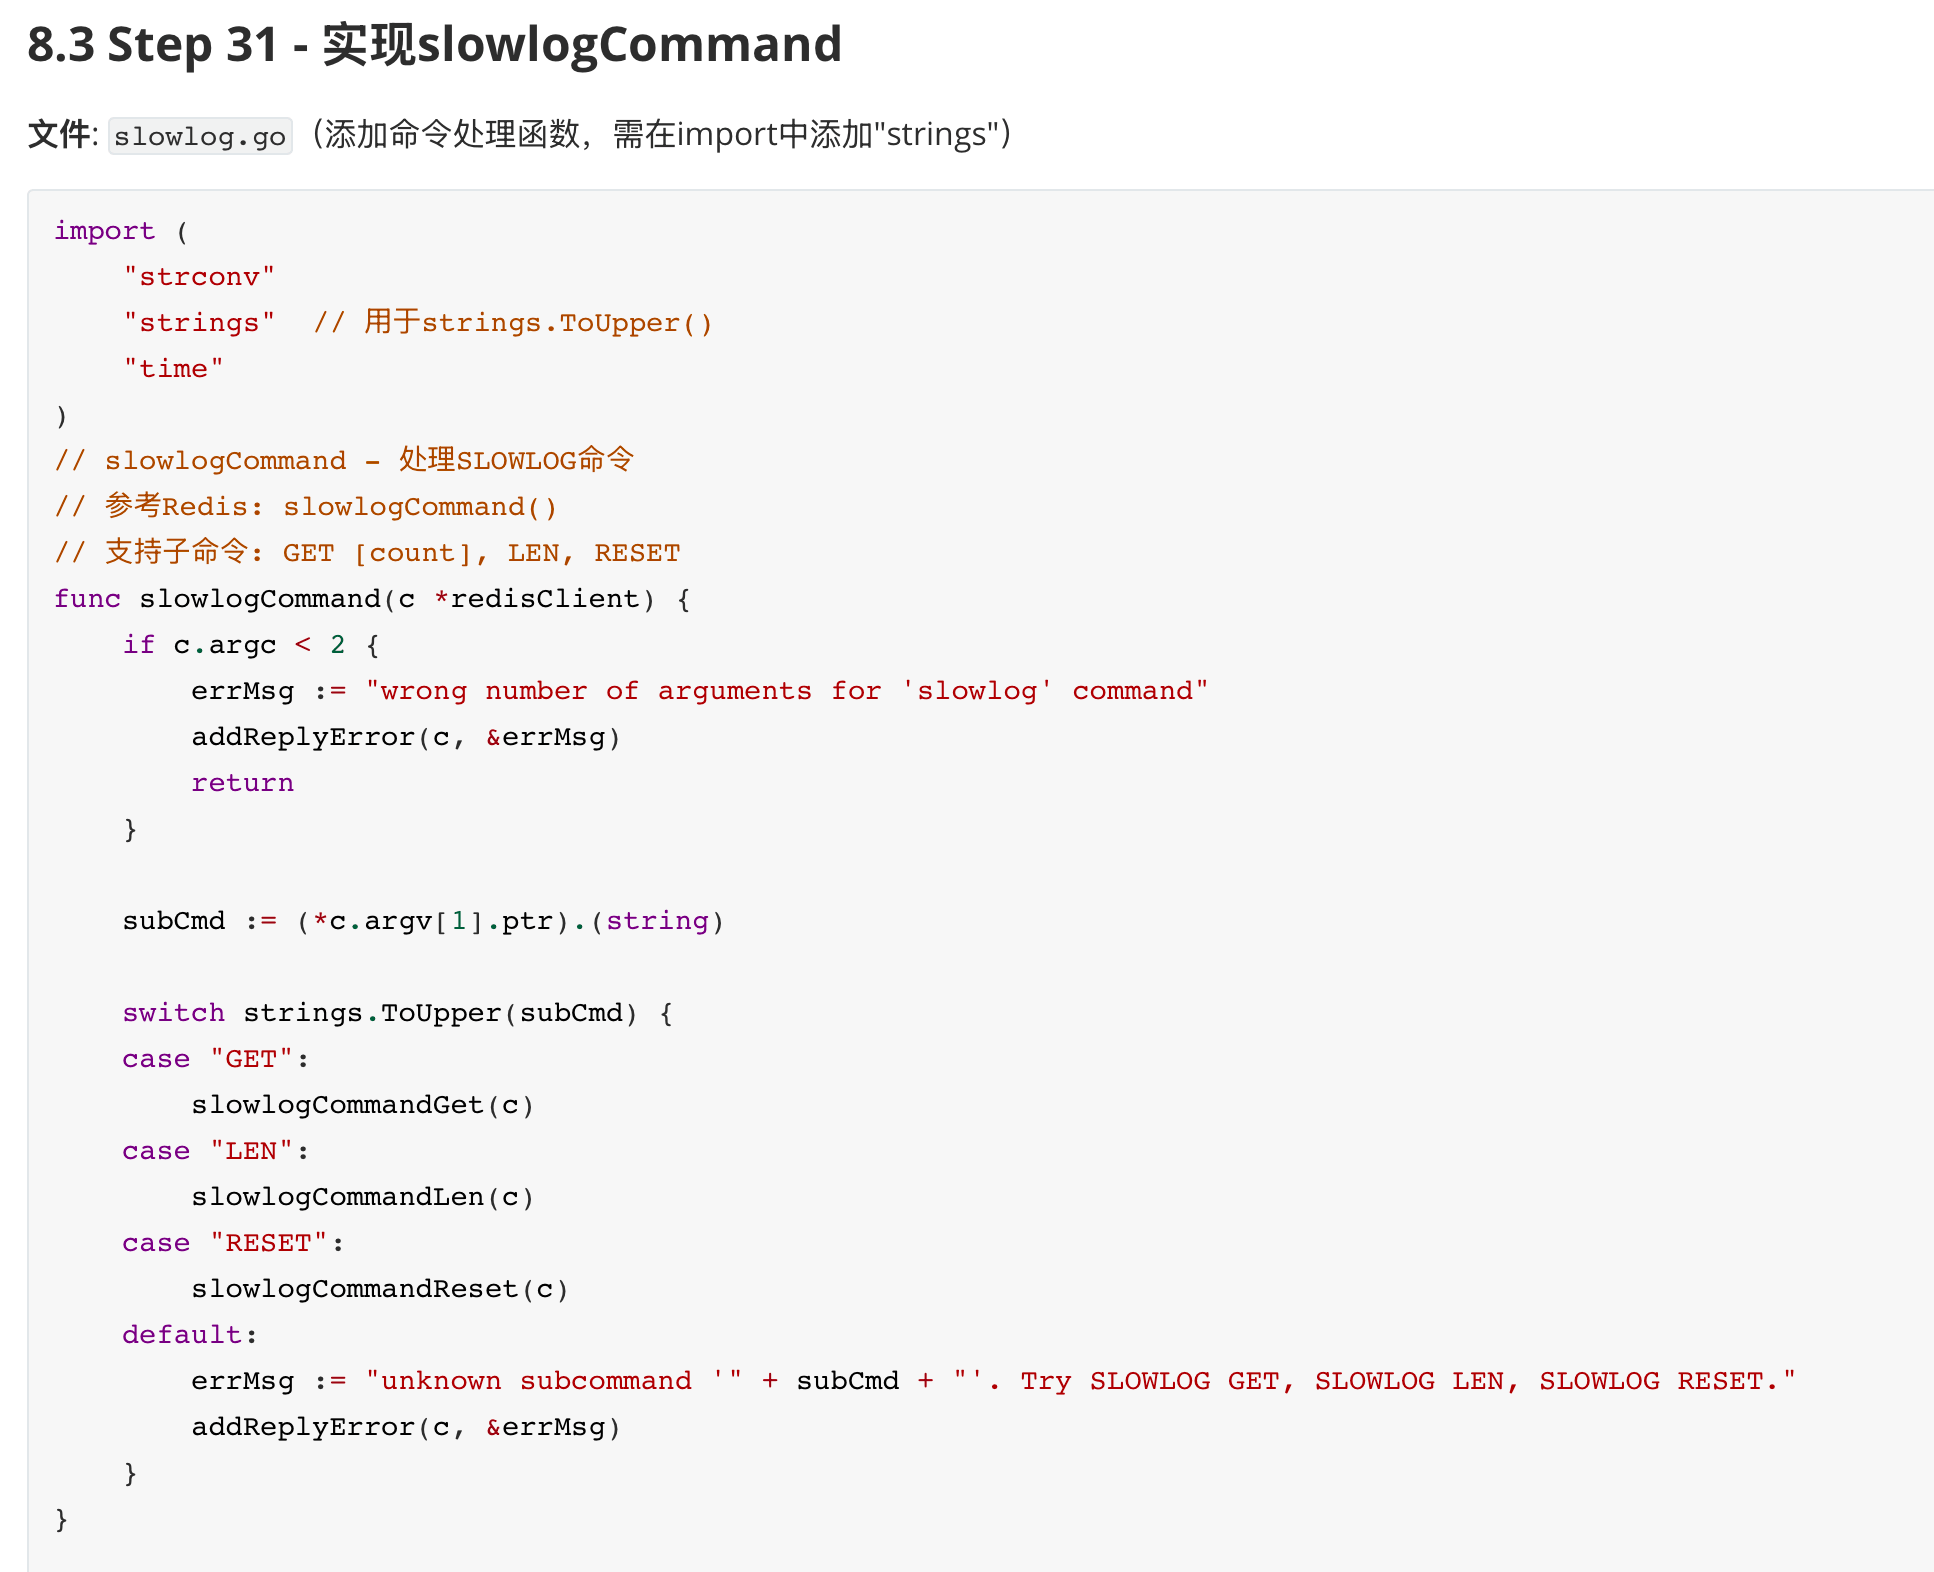
Cuối cùng là implementation cốt lõi của lệnh slow query. Dù là parse parameter hay function truy vấn command và xử lý response, model đều kết hợp logic được đóng gói trong project hiện tại của tôi để đưa ra solution coding rõ ràng:
Sau khi review kỹ tài liệu thiết kế, ý tưởng development tổng thể về cơ bản là nhất quán, nhưng vẫn còn không gian tinh chỉnh ở chi tiết tổ chức code. Chẳng hạn, model tách command slowlog thành một file riêng thay vì tuân theo convention của project và đặt thống nhất vào command.go. Vì tính năng slow query không phải command đọc/ghi memory cốt lõi và logic quản lý log tương đối độc lập, cách xử lý này cũng là một sự cân bằng hợp lý. Sau khi cân nhắc, chúng tôi quyết định giữ implementation của model, đồng thời thủ công điều chỉnh một phần layout file cho phù hợp với convention project hiện có, sau đó tiếp tục phần development còn lại.
Chi tiết này cũng cho thấy: kiến trúc code do AI tạo ra tuy hợp lý, nhưng việc tương thích với convention project hiện có vẫn cần con người kiểm soát.
Ngoài ra, trong toàn bộ quá trình implementation tính năng slow query, model đã hai lần tạo ra code không phù hợp với phong cách project (chẳng hạn cách xử lý error), cần thủ công điều chỉnh. Đây không phải vấn đề lớn, nhưng cho thấy vẫn không thể hoàn toàn phụ thuộc vào code do AI tạo ra.
Nghiệm thu
Vì tôi đã chỉ định rõ model development TDD, trong thời gian này model kết hợp feedback output và giải thích trong tài liệu để hoàn tất việc tự sửa theo vòng lặp, cuối cùng phục chế lệnh slow query theo phong cách project mini-redis.
Nhờ năng lực suy luận và refactor của AI, trong quá trình nghiệm thu chúng tôi có thêm không gian để hình thành ý tưởng. Trước đây, do chi phí hệ thống hóa source code và nghiệm thu kỹ thuật quá lớn, logic load cấu hình redis.conf vẫn luôn chưa được implement.
Vì cần đặt slow query time về 0 để thuận tiện cho công việc nghiệm thu cuối cùng đối với lệnh slow query, tôi nhân tiện tiếp tục yêu cầu model implement việc load cấu hình:
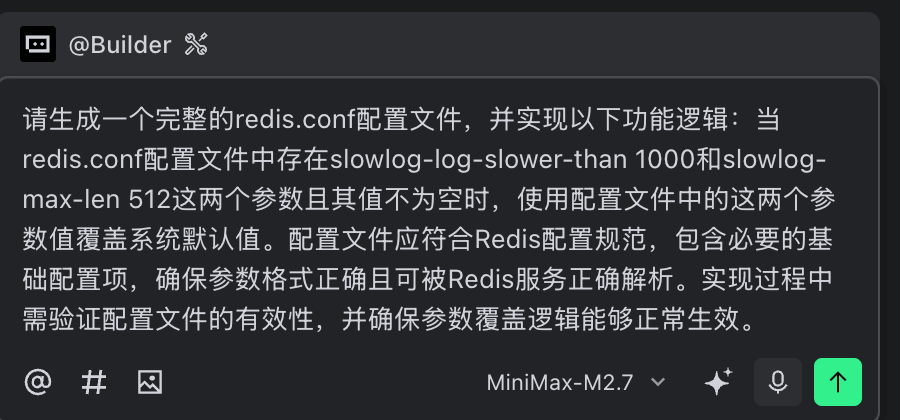
Toàn bộ công việc hệ thống hóa logic và development mất chưa đến 1 giờ. Tôi đã thuận lợi hoàn tất việc phục chế và nghiệm thu lệnh slow query. Để minh họa tính năng slow query, tôi đặt slow query threshold của mini-redis về 0:
# Slow query threshold (microsecond)
# Command có execution time vượt quá giá trị này sẽ được ghi vào slow query log
# Giá trị âm biểu thị vô hiệu hóa slow query log, 0 biểu thị ghi nhận mọi command
# Default value: 10000 (10 millisecond)
slowlog-log-slower-than 0
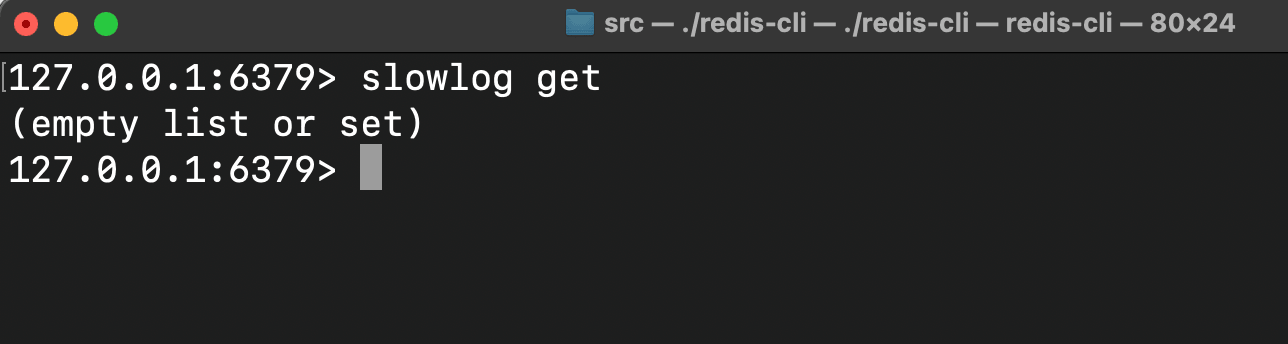
Sau khi khởi động mini-redis server, nhập slowlog get thì mặc định trả về rỗng:
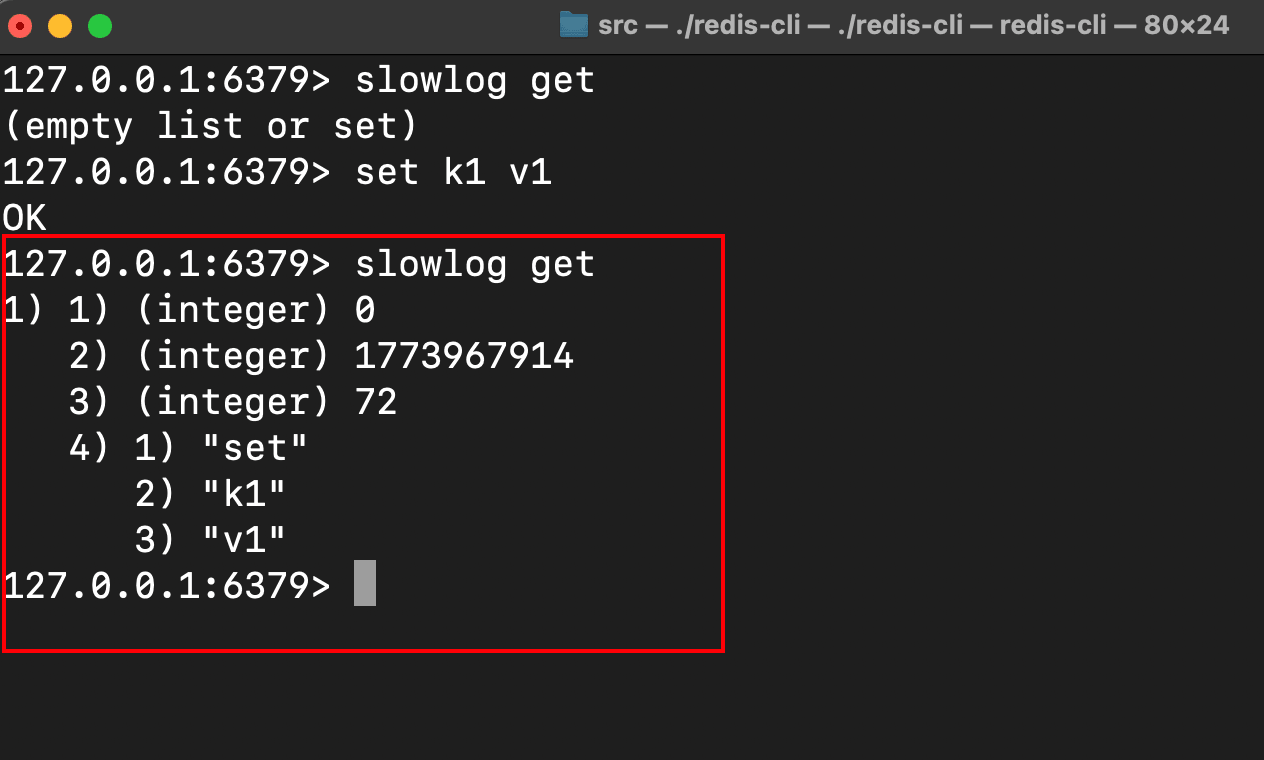
Sau khi thực hiện thao tác set đơn giản rồi nhập slowlog get, command này được xác định là slow query command như dự kiến và được output:
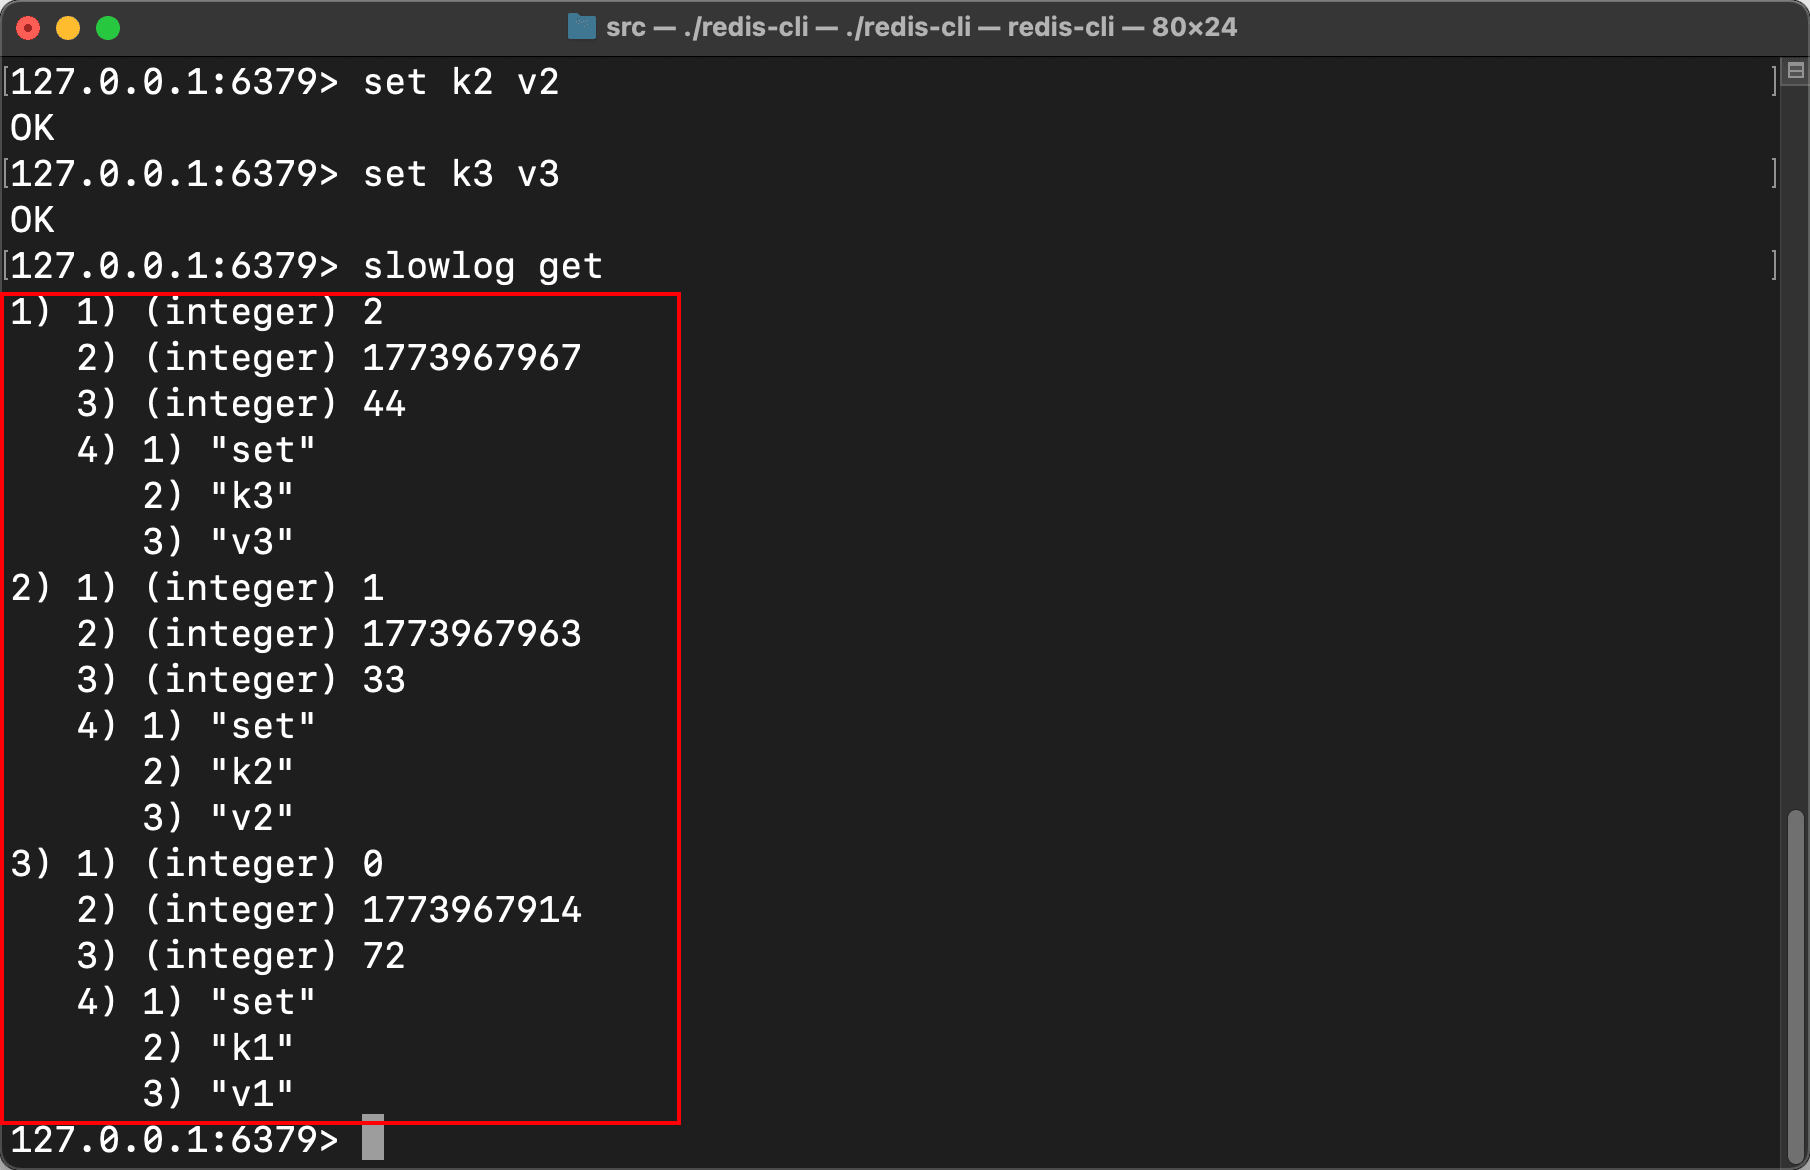
Tương tự, chúng tôi lần lượt nhập thêm vài command tiếp theo, tất cả đều được enqueue chính xác bằng cách chèn vào đầu linked list và output theo thứ tự thời gian giảm dần:
Tổng kết thực chiến: suy nghĩ về workflow lập trình có AI hỗ trợ
Qua thực chiến trong hai kịch bản tiêu biểu, hãy tổng kết một số kinh nghiệm và suy nghĩ khi dùng Trae + mô hình lớn hỗ trợ lập trình.
AI hỗ trợ lập trình có thể làm gì
Trong hai kịch bản trên, AI hỗ trợ lập trình thể hiện một số năng lực cốt lõi:
| Khía cạnh năng lực | Biểu hiện trong kịch bản | Giải thích |
|---|---|---|
| Chẩn đoán sự cố và xử lý khẩn cấp | Kịch bản một: nhanh chóng xác định vấn đề connection pool, cung cấp solution degradation | Chuỗi suy luận hoàn chỉnh, có thể lần theo call chain từ exception stack frame |
| Hiểu context code | Kịch bản một: kết hợp database Schema để phân tích bottleneck truy vấn | Không giới hạn trong một file, có thể liên kết dependency giữa các module |
| Di chuyển code đa ngôn ngữ | Kịch bản hai: phục chế slow query từ C sang Go | Logic cốt lõi chính xác, còn không gian tối ưu trong việc tương thích convention project |
| Hiểu hệ thống phức tạp | Kịch bản hai: phân tích source code Redis | Có thể nắm bắt ý đồ thiết kế và xuất ra tài liệu kỹ thuật có cấu trúc |
Kinh nghiệm và điểm vấp trong thực chiến
Những điểm làm tốt:
- Nhanh chóng thu hẹp phạm vi vấn đề: trong kịch bản một, model nhanh chóng thu hẹp từ N nơi gọi Redis xuống 4 root cause có thể xảy ra, rồi xác nhận cuối cùng rằng thao tác scan khiến connection pool bị treo; toàn bộ chuỗi suy luận rõ ràng
- Output solution nhiều tầng: solution xử lý khẩn cấp, phân tích root cause và đề xuất tối ưu dài hạn được đưa ra theo từng tầng, phù hợp với quy trình xử lý sự cố thực tế
- Tự sửa theo vòng lặp TDD: trong kịch bản hai, sau khi chỉ định mode TDD, model có thể tự sửa theo feedback của test, giảm can thiệp thủ công
Những điểm cần lưu ý:
- Solution quyết liệt: một số solution model đưa ra (chẳng hạn xóa Redis cache) có thể quá quyết liệt; production cần strategy thận trọng hơn và nhất định phải có con người kiểm soát
- Tương thích convention project: structure code được tạo ra tuy hợp lý, nhưng mức độ phù hợp với convention hiện có của cá nhân/team cần được điều chỉnh. Chẳng hạn, tổ chức file của command
slowlogtrong kịch bản hai cần được điều chỉnh thủ công - Xử lý edge case: nên bổ sung thủ công defensive code cho một số kịch bản cực đoan; AI có thể giúp bạn đi được 90%, 10% còn lại vẫn phải tự mình hoàn thiện
- Tính nhất quán trong flow dài: trong quá trình liên tục lặp lại trên project phức tạp, cần chú ý vấn đề suy giảm context memory
Một số đề xuất khi sử dụng Trae + mô hình lớn
- Cung cấp đầy đủ context: nêu rõ điều kiện ràng buộc, coding convention và structure project thì chất lượng output của model sẽ tốt hơn nhiều
- Xác nhận theo từng giai đoạn: với kiến trúc phức tạp, không nên yêu cầu AI tạo quá nhiều code trong một lần; xác nhận và điều chỉnh theo từng giai đoạn sẽ dễ kiểm soát hơn
- Con người kiểm soát quyết định quan trọng: lựa chọn ở tầng kiến trúc (chẳng hạn strategy cache, solution degradation) cần developer phán đoán theo business scenario; AI không thể quyết định thay bạn
- Tận dụng mode TDD: chỉ định workflow test-driven development để model tự sửa theo feedback của test, hiệu quả sẽ cao hơn
Lời kết
Trae là AI Coding IDE có trải nghiệm khá mượt sau khi kết nối với mô hình lớn; context understanding, task breakdown, code generation và test acceptance trong Agent mode tạo thành một workflow hoàn chỉnh.
Nhưng công cụ cuối cùng vẫn chỉ là công cụ. Nhìn lại hai kịch bản trong bài:
- Khắc phục sự cố Redis ở kịch bản một cần hiểu rõ cơ chế Redis connection pool và time complexity của command scan thì mới có thể đánh giá phân tích của model có hợp lý hay không.
- Refactor đa ngôn ngữ ở kịch bản hai cần hiểu sâu ý tưởng thiết kế của source code Redis và coding convention Go thì mới có thể đánh giá chất lượng của refactor solution.
AI Coding tool có thể rút ngắn thời gian “từ ý tưởng đến code”, nhưng việc nắm vững nguyên lý bên trong và năng lực phán đoán kiến trúc hệ thống vẫn cần developer tự tích lũy. Tiền đề để sử dụng AI tốt là phải hiểu mình đang làm gì hơn AI.