
Thực chiến MiniMax M3 + Claude Code: Khắc phục sự cố Redis, tái hiện thuật toán SCAN và xây dựng dashboard giám sát
Xin chào, tôi là G. MiniMax M3 được phát hành vài ngày trước, nhiều người đã dùng ngay và phản hồi khá tốt; cũng có không ít người nhắn tôi thử nghiệm thực tế.
Không phải tôi không muốn thử, mà vài ngày trước quả thật quá bận. Tôi muốn kịp tối ưu JavaGuide trước mùa tuyển dụng mùa thu, đây là việc được thực hiện hằng năm.
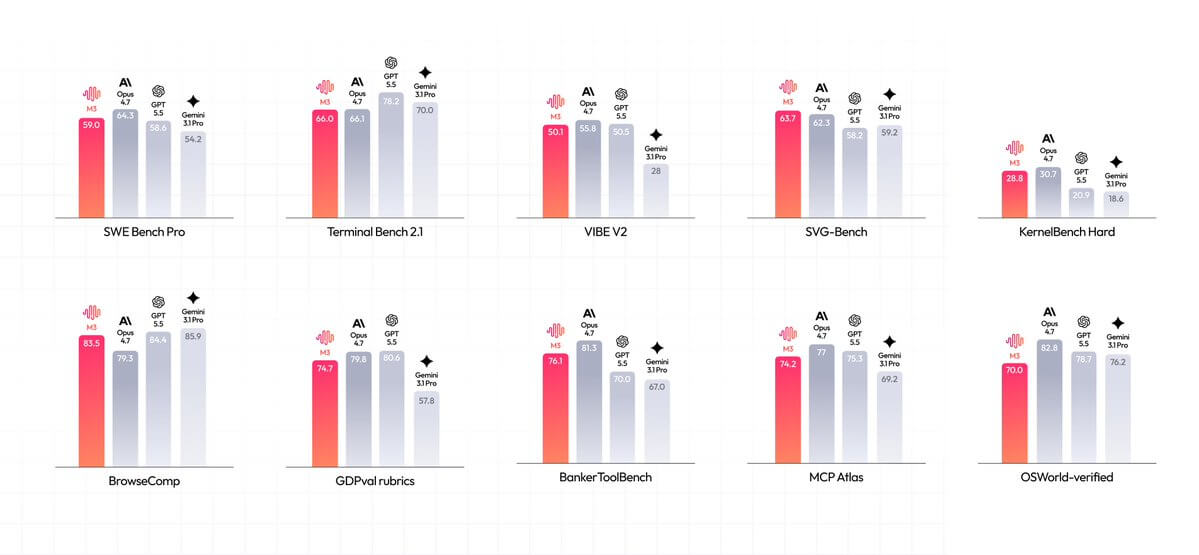
Theo giới thiệu chính thức của MiniMax, M3 là open-weight model đầu tiên của hãng đồng thời cung cấp context 1M, native multimodal và năng lực Coding tiên tiến. Đây là định vị sản phẩm của nhà cung cấp; model có phù hợp với một codebase cụ thể hay không vẫn phải được kiểm chứng bằng task.
Các kết quả benchmark được công bố gồm: SWE-Bench Pro 59.0%, Terminal-Bench 2.1 66.0%, MCP Atlas 74.2%. Các con số này tương ứng với bộ đánh giá và cấu hình đánh giá được chỉ định, không phải kết quả tự benchmark độc lập của bài viết.
Điều tôi quan tâm hơn là hiệu quả của nó sau khi đi vào engineering thực tế.
Vì vậy, tôi dùng một sự cố production từng gặp để kiểm tra. Hiện tượng đã biết là request frontend bị ảnh hưởng trong giờ cao điểm, manh mối điều tra trỏ đến vòng lặp Redis SCAN hoàn chỉnh trong background async task; việc nó có phải nguyên nhân chính do chiếm giữ connection lâu hay không vẫn cần kết hợp monitoring và reproduce để xác minh.
Case này liên quan đến suy luận về business flow phức tạp và chẩn đoán toàn cục. Đồng thời, sau khi xác định sự cố và khống chế ảnh hưởng, tôi tiếp tục dùng M3 để thử tái hiện chức năng từ Redis source code (C) sang Go, cũng như xây dựng dashboard giám sát Redis frontend-backend, tiếp tục quan sát từ hai góc độ refactor khác ngôn ngữ và delivery end-to-end.
Bài viết triển khai theo ba task:
- Khắc phục sự cố
- Tái hiện tầng dưới
- Triển khai giám sát
Chuẩn bị
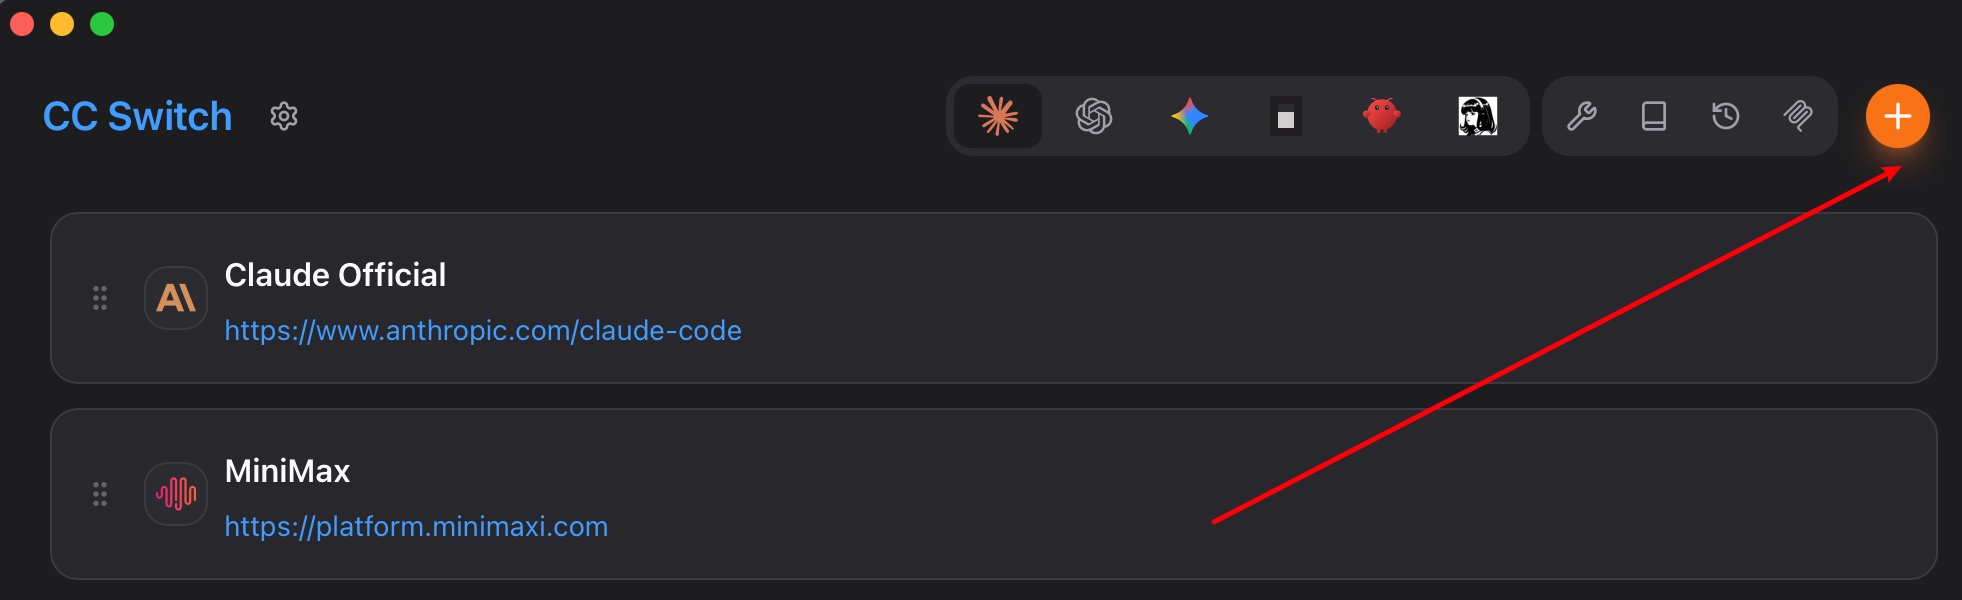
Hằng ngày G dùng Claude Code để phát triển, đồng thời dùng cc-switch để quản lý model tập trung. Dưới đây là các bước cấu hình MiniMax M3. Trước tiên mở cc-switch, nhấp dấu cộng để thêm model config:
Chọn MiniMax M3, điền key của bạn vào tùy chọn api key:
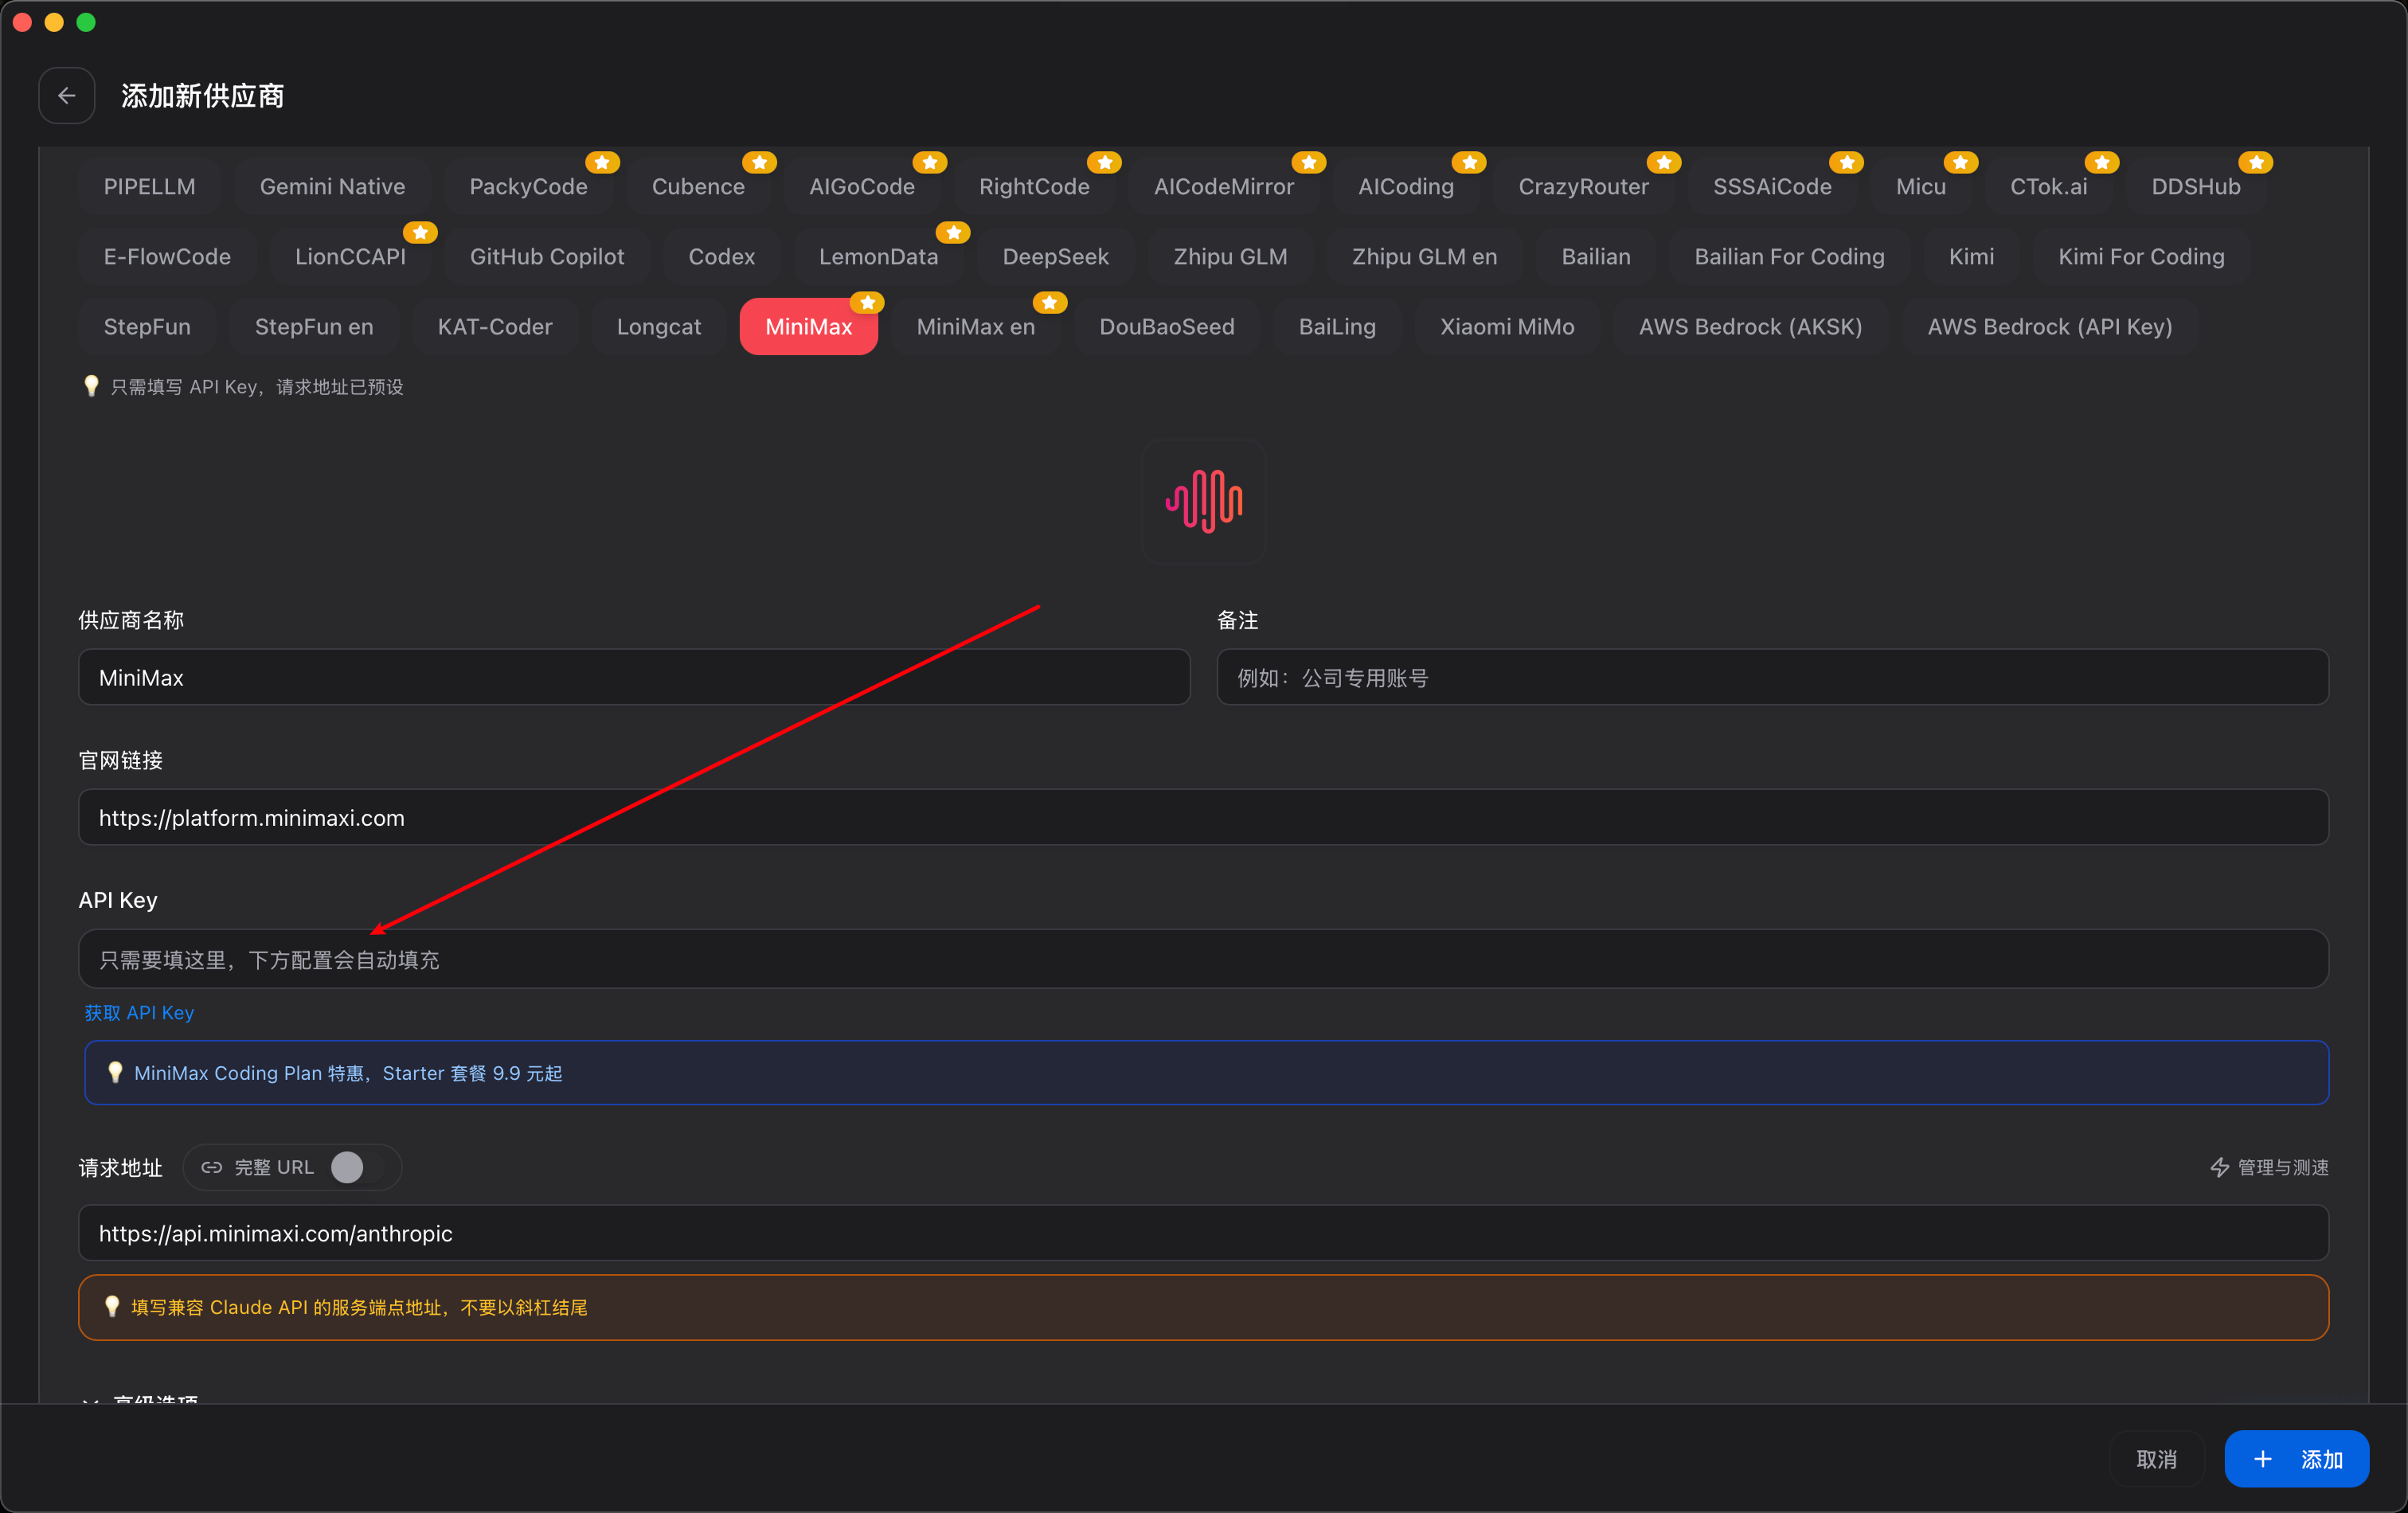
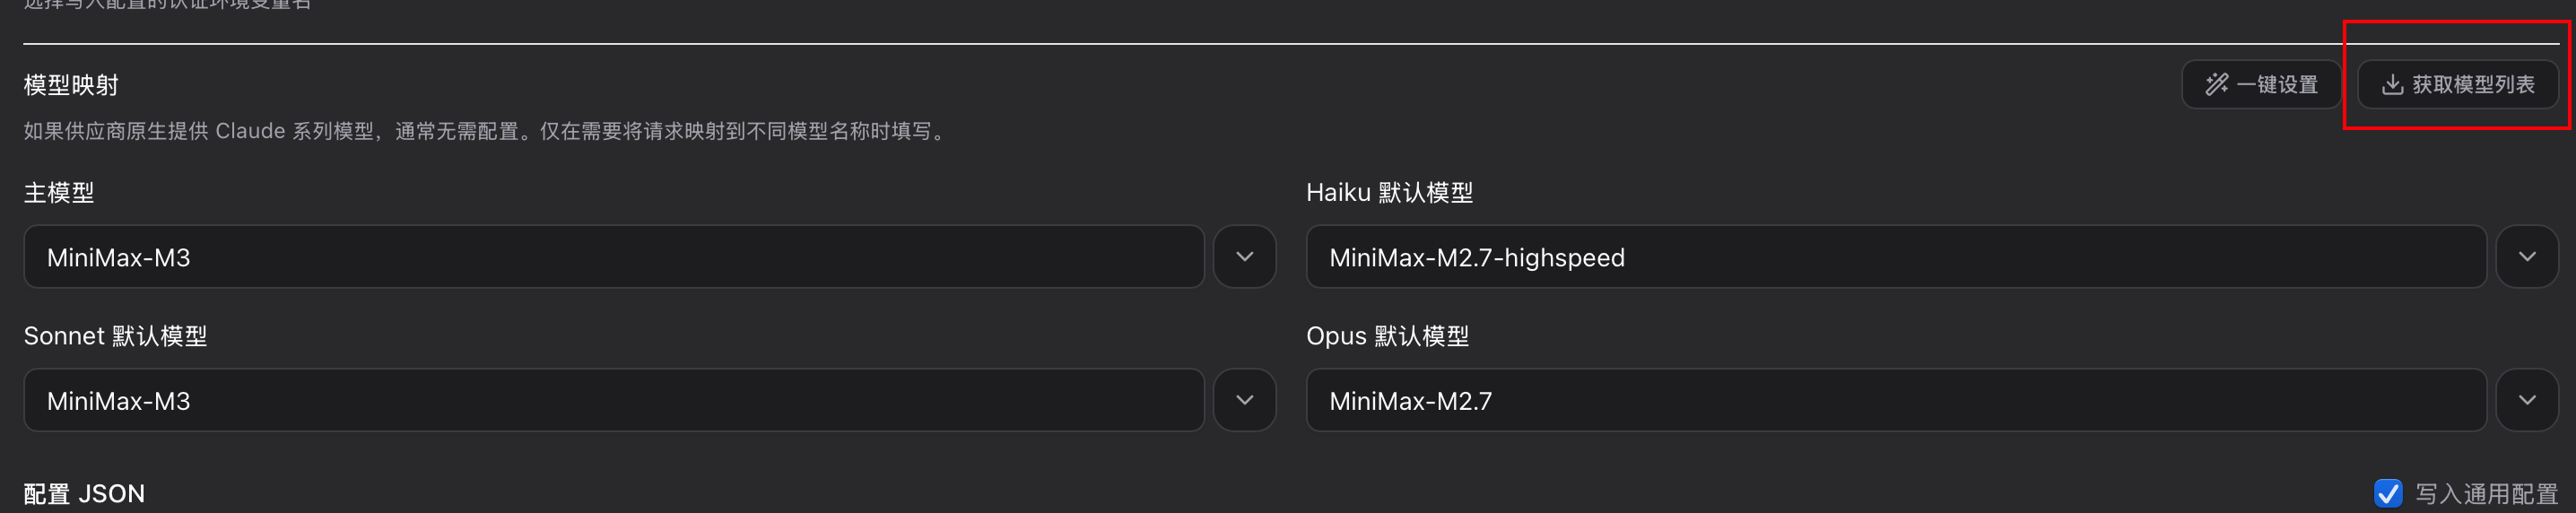
Cuối cùng nhấp lấy danh sách model để hoàn tất cấu hình. Lấy cấu hình của tôi làm ví dụ, tôi đặt main model trực tiếp là MiniMax M3:
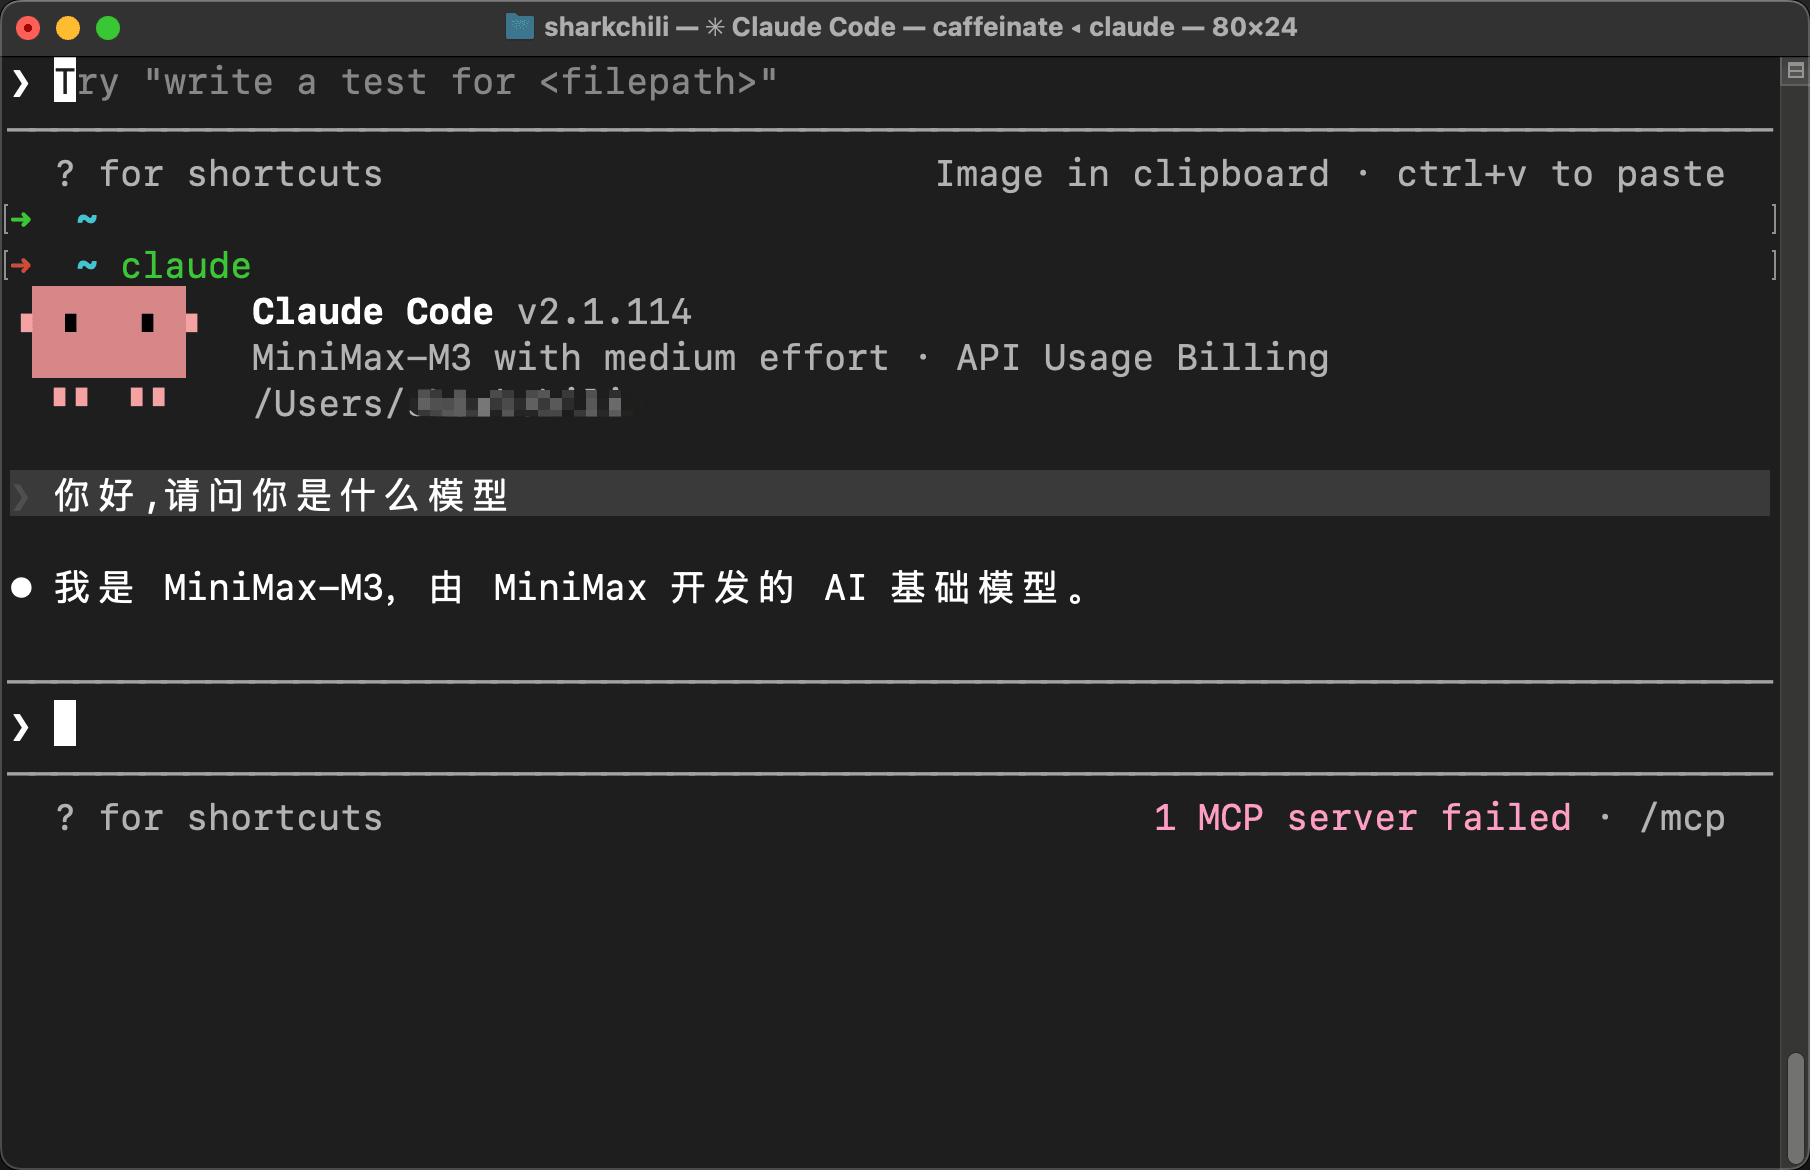
Sau khi cấu hình xong, mở Claude Code và xác minh model hiện tại đã có hiệu lực qua conversation panel:
Khắc phục sự cố: kiểm chứng vấn đề performance xoay quanh vòng lặp SCAN ở application layer
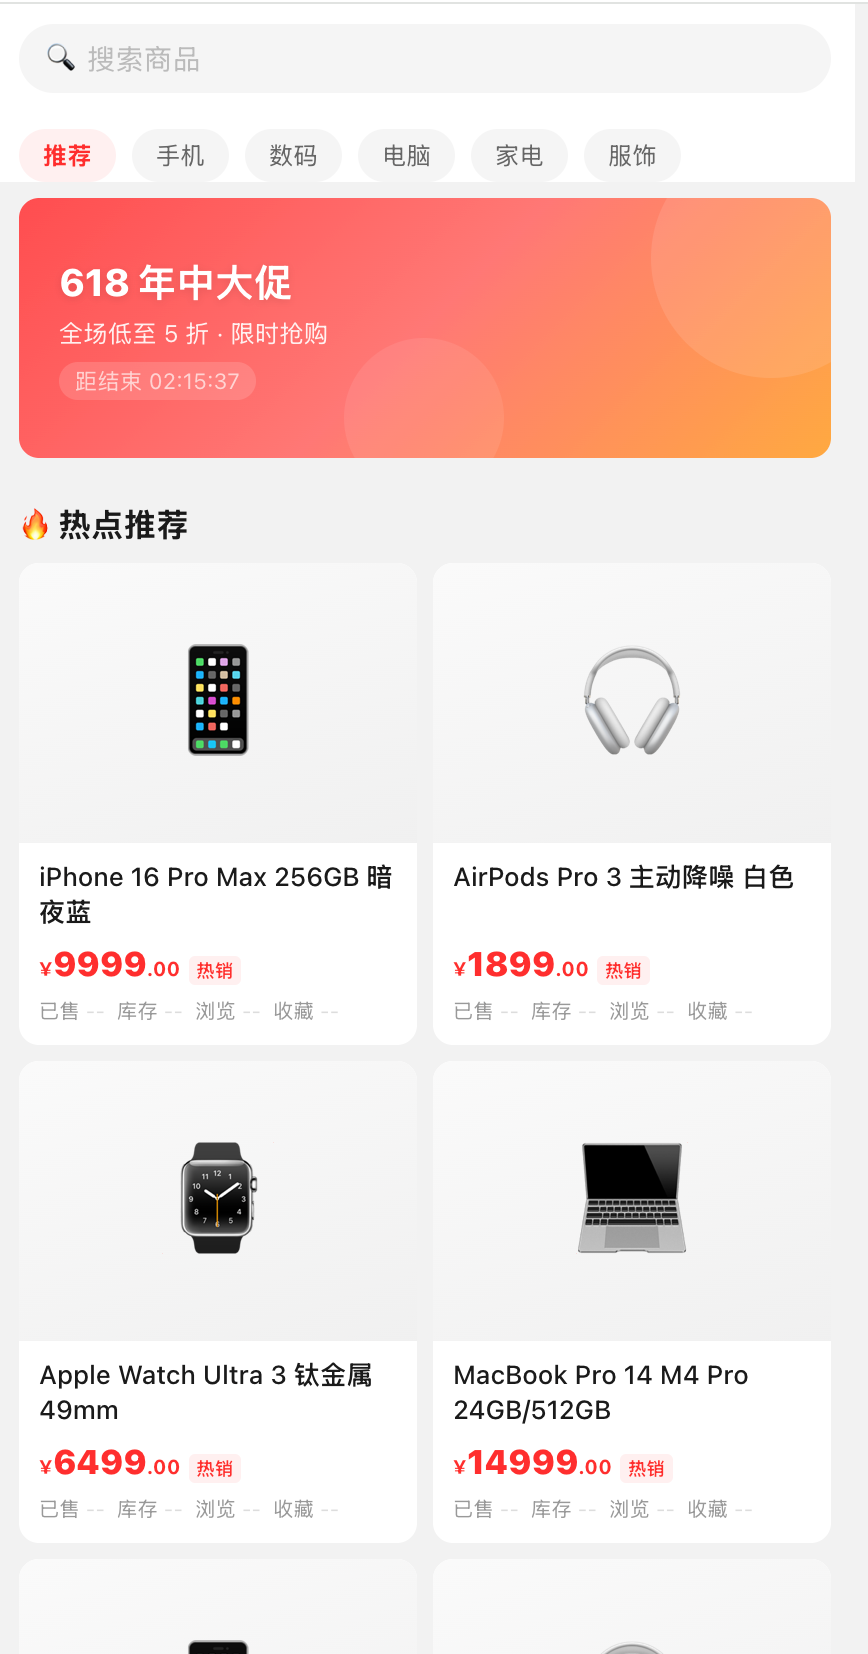
Case đầu tiên được tái hiện từ một sự cố production tôi từng trải qua. Để giảm gánh nặng khi tìm hiểu, ở đây dùng một scenario thương mại điện tử kinh điển để mô phỏng: async task “tự động hủy order hết thời gian” đang chạy trong đợt promotion lớn, đồng thời có lượng lớn user đang xem sản phẩm. Đến một thời điểm, page timeout trên diện rộng — dữ liệu hot về sản phẩm như đã bán, tồn kho, lượt xem và yêu thích đều không thể load:
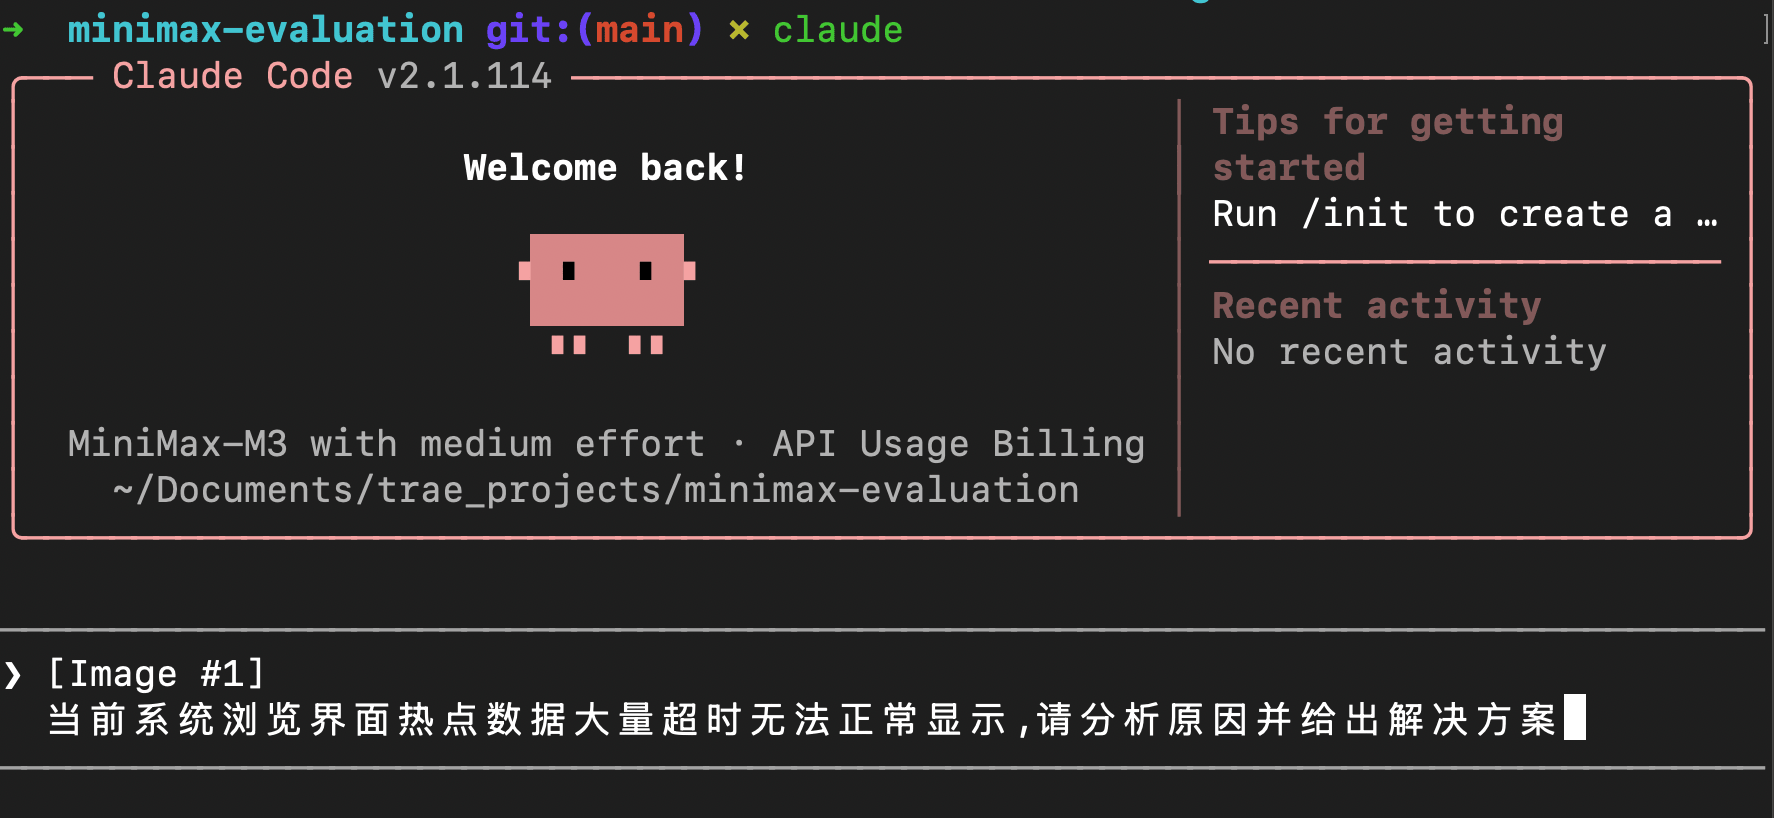
Để đánh giá năng lực điều tra các business flow phức tạp của MiniMax M3, tôi gửi cùng lúc screenshot hiện tượng hệ thống (trong Claude Code có thể dán screenshot bằng Ctrl+V, trên Windows là Alt+V) và mô tả lỗi:
Sau một lúc phân tích, MiniMax M3 xác định vấn đề nằm ở vòng lặp SCAN hoàn chỉnh trong background task. Ban đầu nó tóm tắt nguyên nhân là “SCAN khiến Redis server bị block”, cách nói này chưa chính xác: mỗi lần gọi SCAN là một lần incremental iteration, mục đích thiết kế chính là tránh việc block lâu như KEYS; điều thực sự cần kiểm tra là số vòng lặp, COUNT, kích thước Keyspace, latency mỗi lần gọi và việc application có chiếm connection lâu hay không.
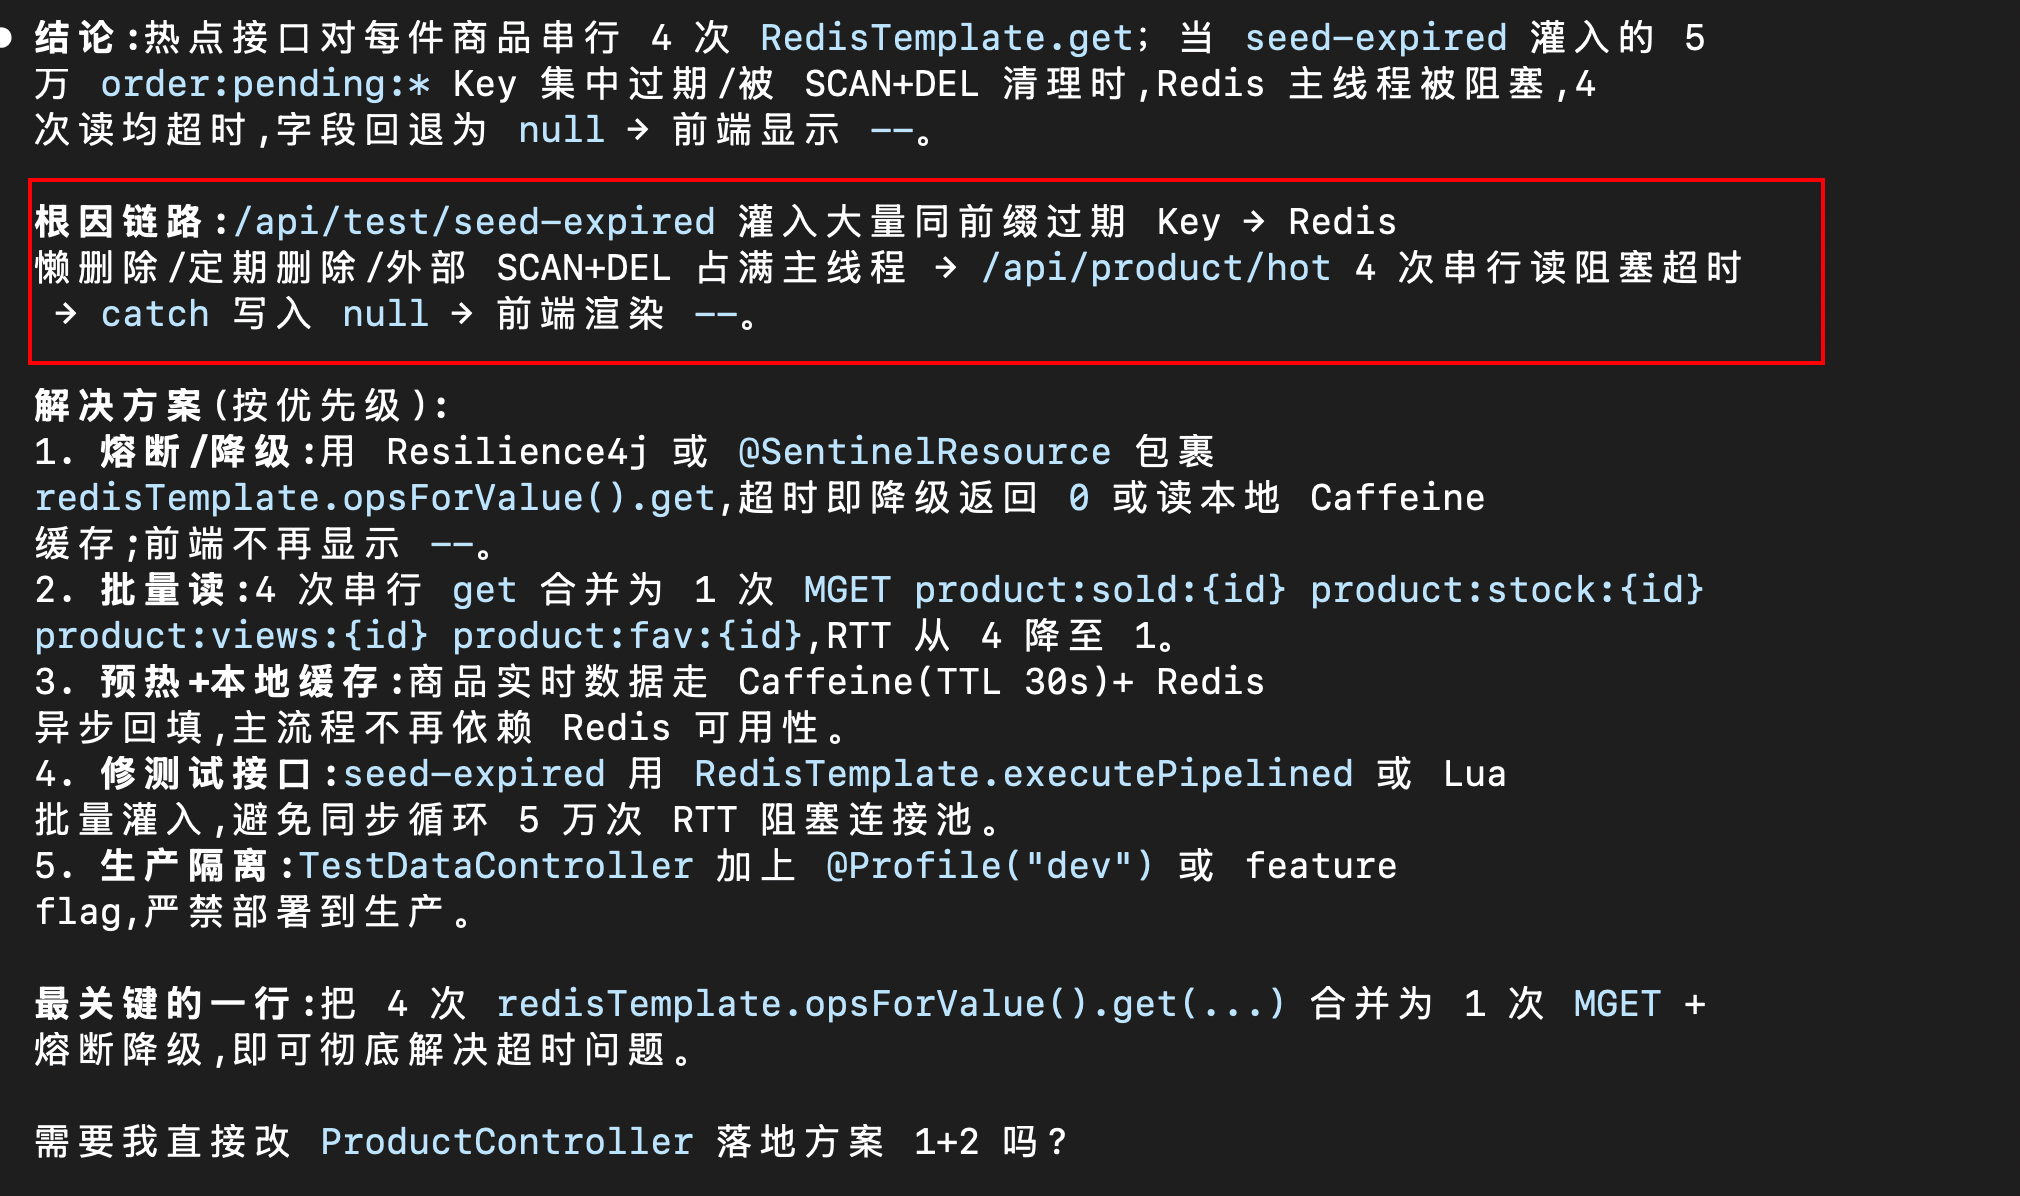
Để đối chiếu thêm business flow, tôi yêu cầu MiniMax M3 vẽ quy trình sự cố bằng sơ đồ ASCII. Sơ đồ đi từ task order timeout vào vòng lặp SCAN, rồi đến số connection khả dụng của connection pool giảm và page request xếp hàng. Ở đây, “Keyspace traversal block main thread” nên được hiểu là một hypothesis cần kiểm chứng, không phải behavior cố định của SCAN:
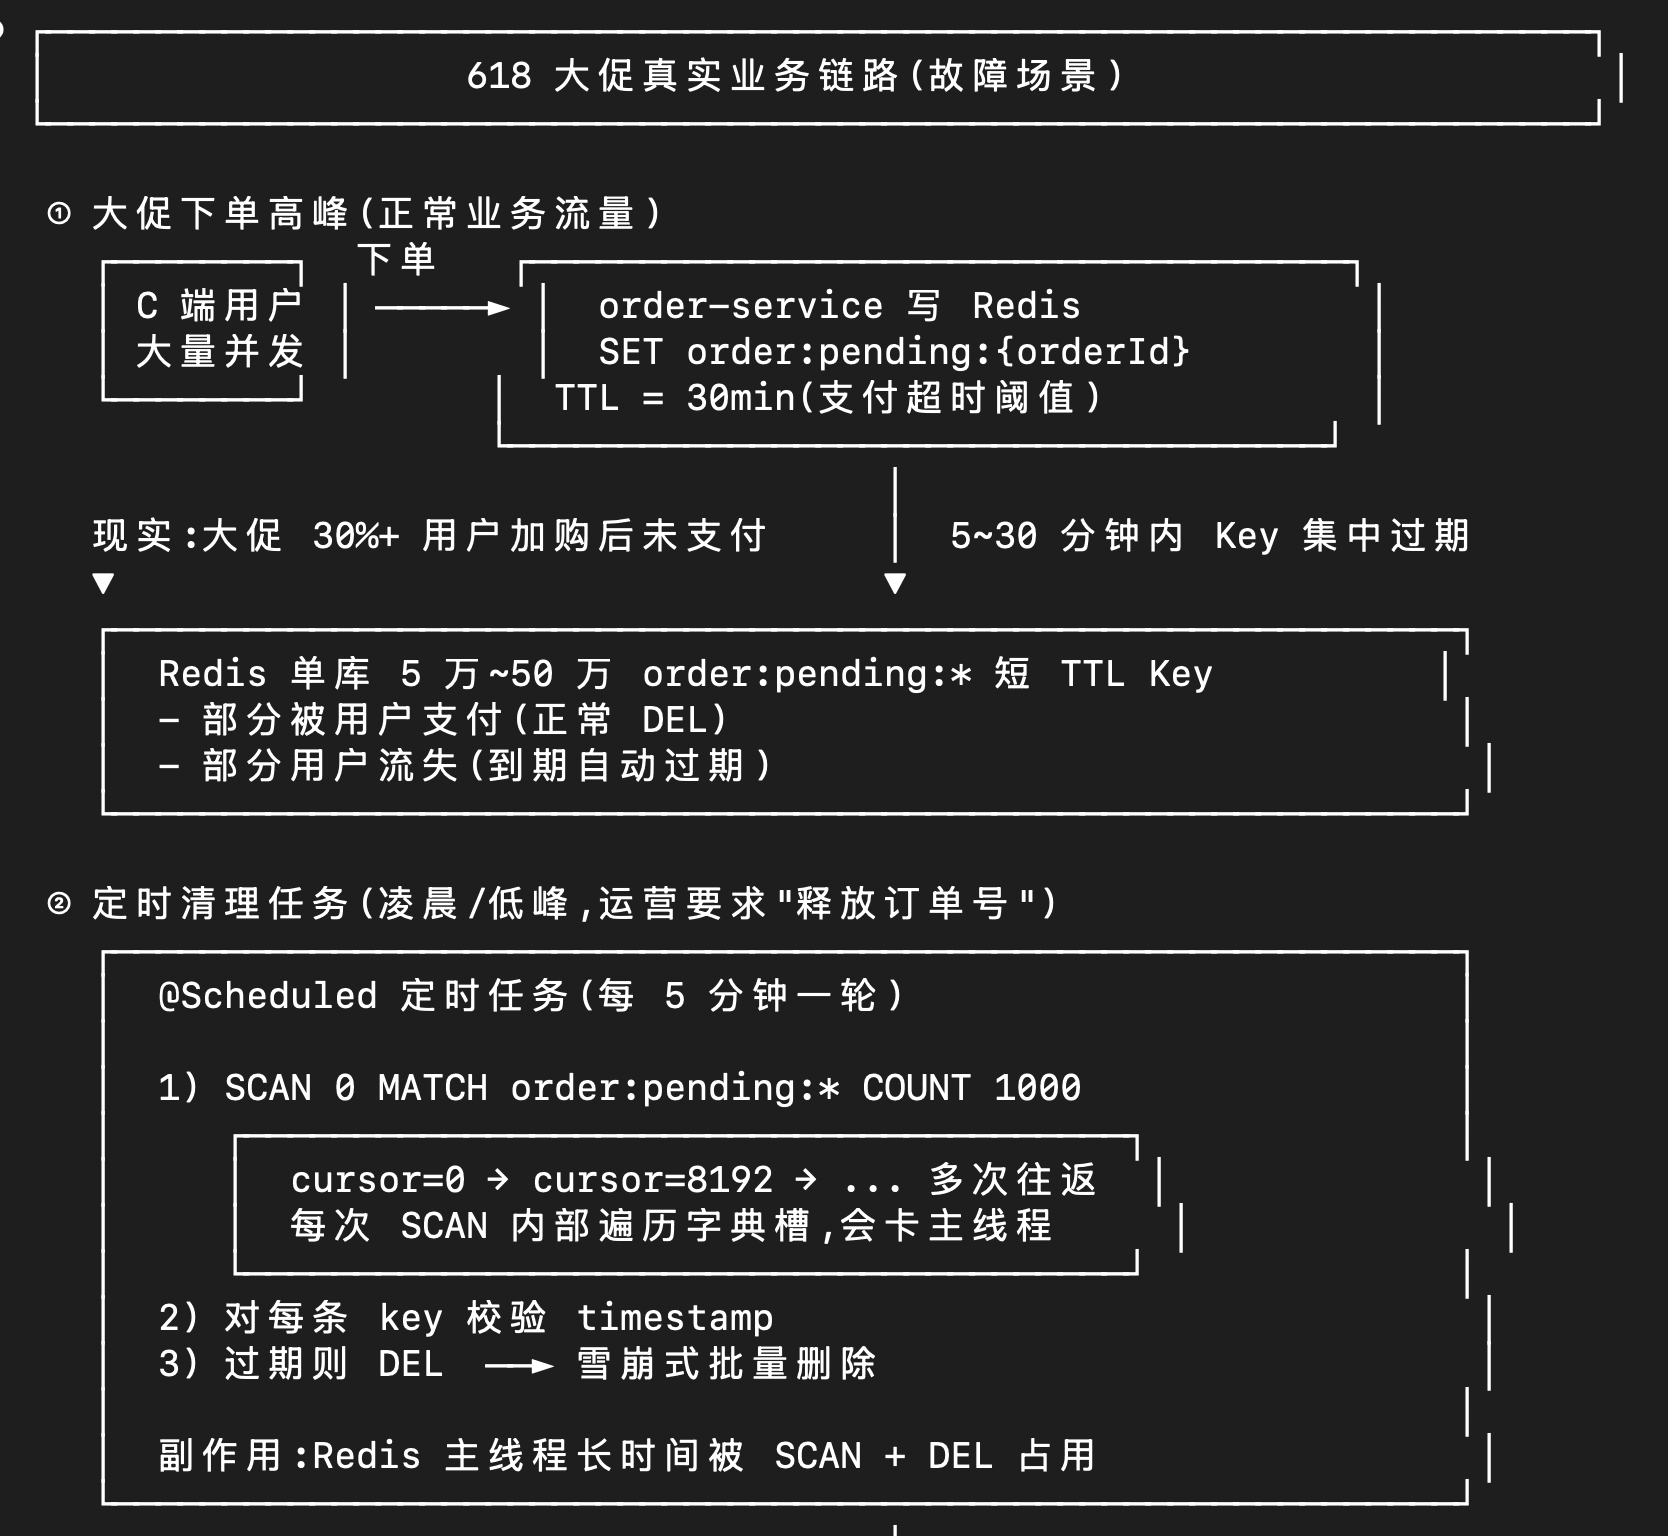
Sau đó M3 đưa ra bốn nhóm đề xuất: điều chỉnh data structure, atomic operation, degradation và monitoring:
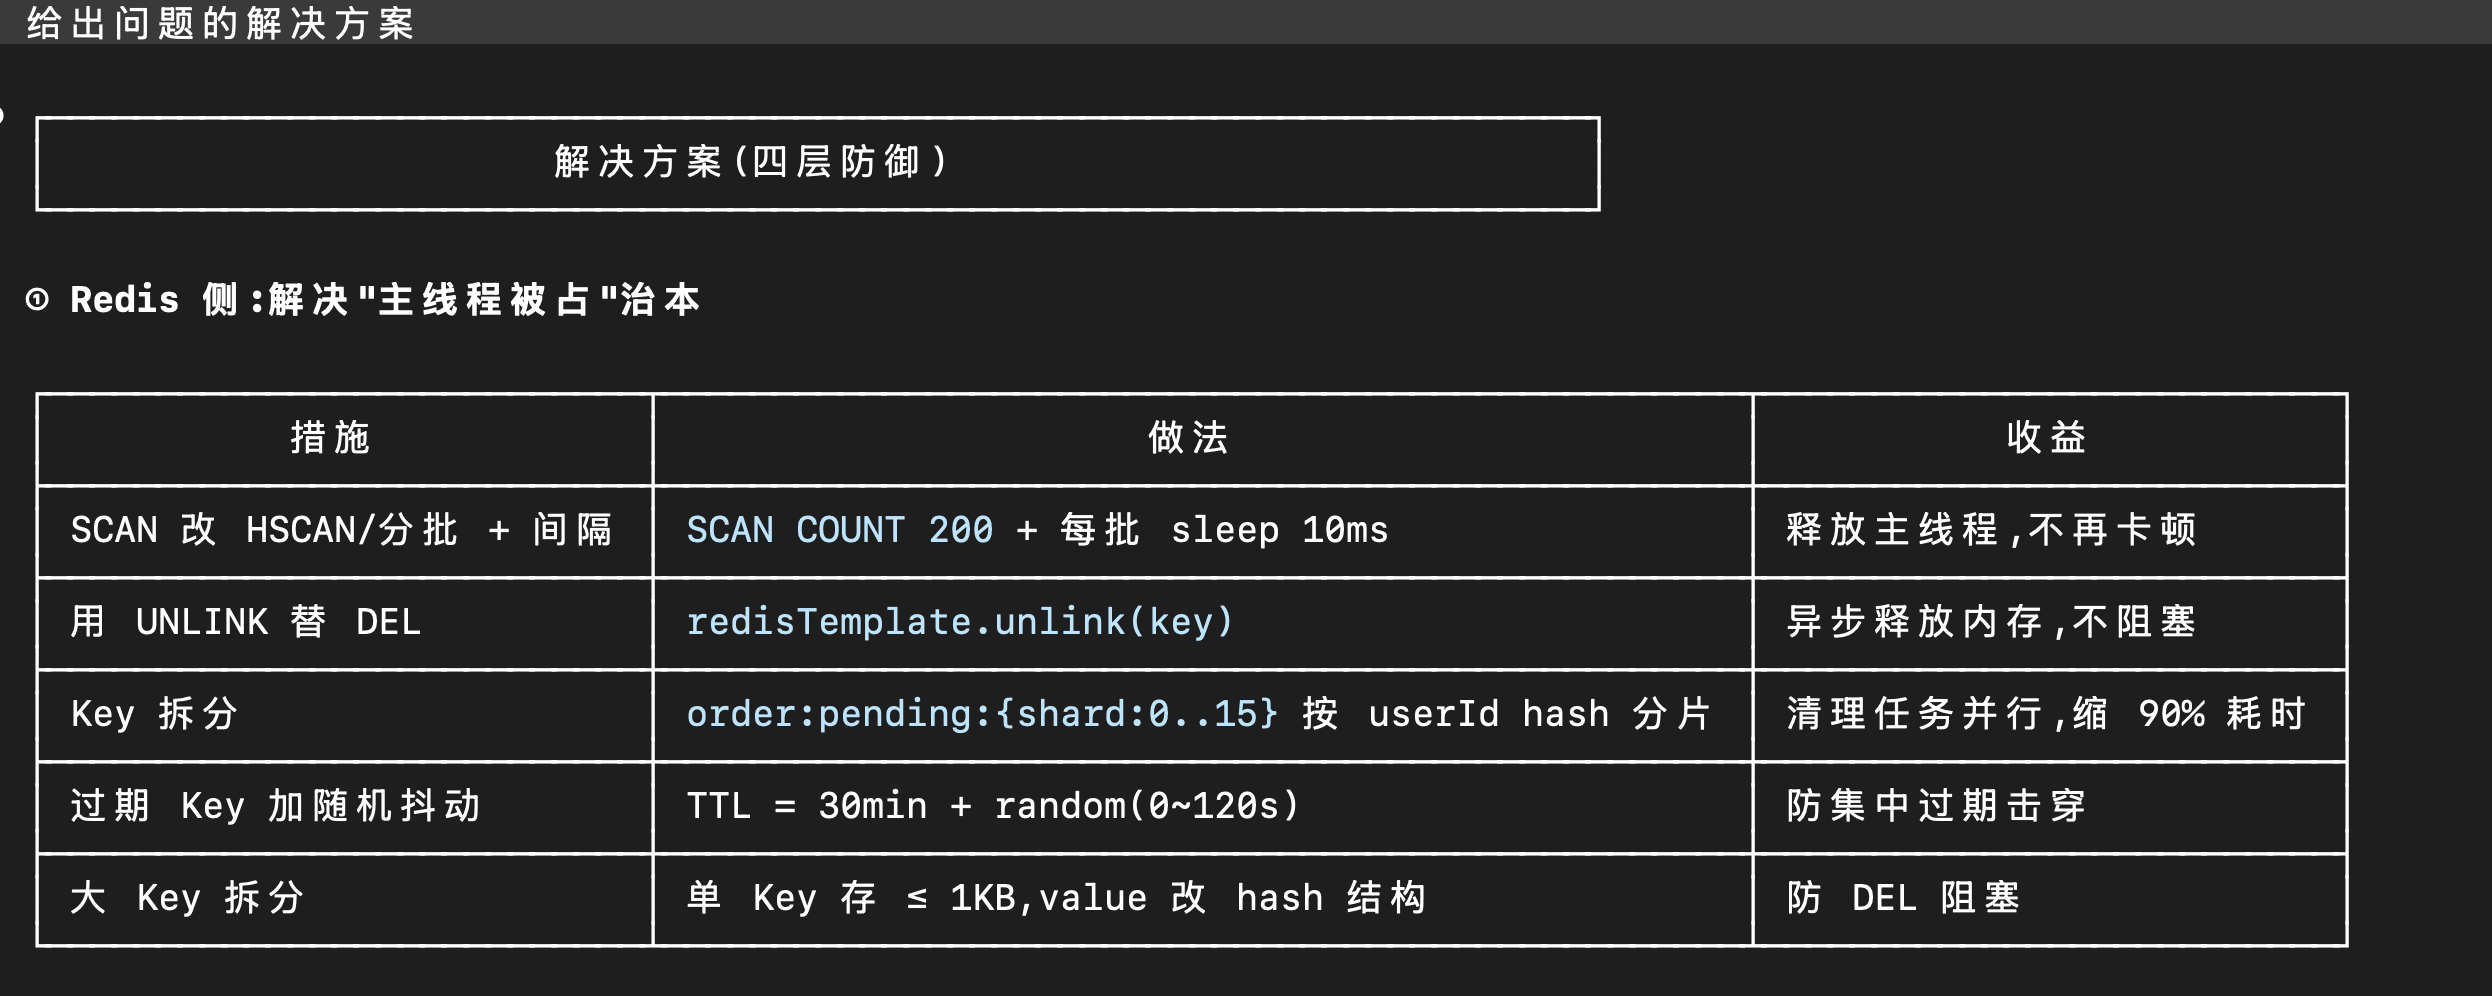
Với business API bị ảnh hưởng, M3 tối ưu các Redis command tuần tự thành một atomic operation và kèm degradation strategy để kiểm soát phạm vi ảnh hưởng trong tình huống cực đoan:
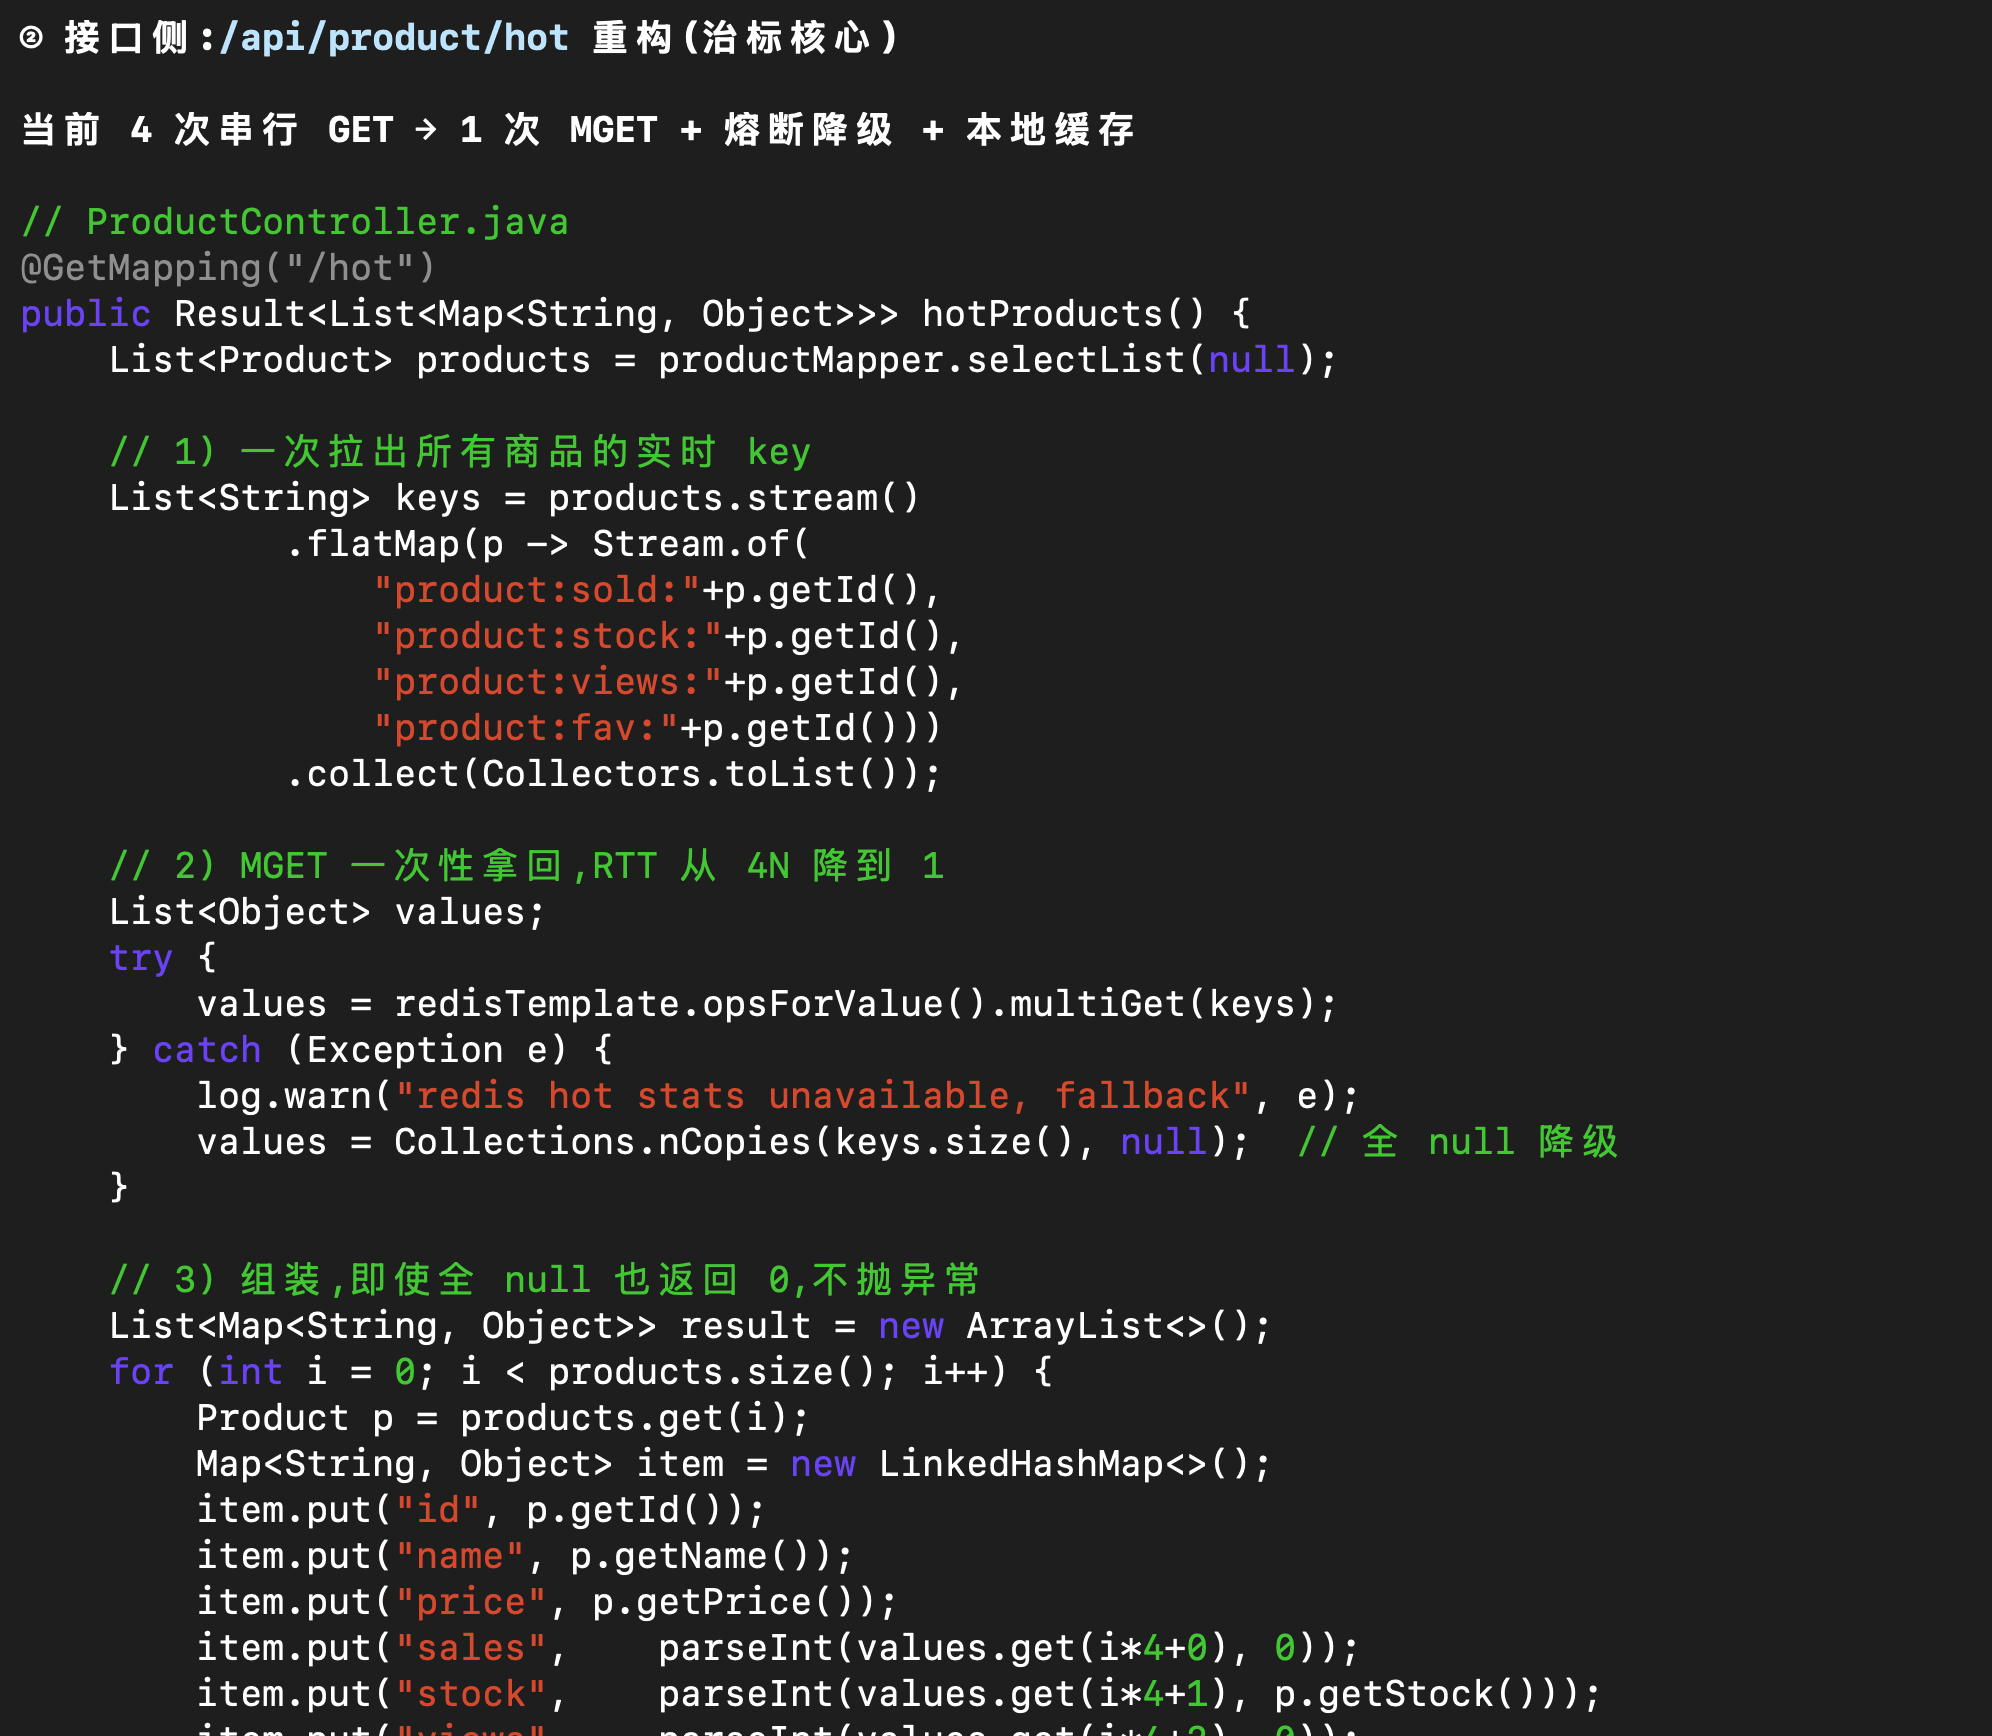
Ở phía engineering, M3 còn đưa ra đề xuất về monitoring instrumentation và lấy 200 ms làm giá trị cảnh báo ví dụ. Không thể dùng “độ dừng mà con người cảm nhận được” để chứng minh con số này; threshold của Redis background task nên được xác định dựa trên SLO của API, capacity của connection pool, tần suất task và latency percentile trong lịch sử:
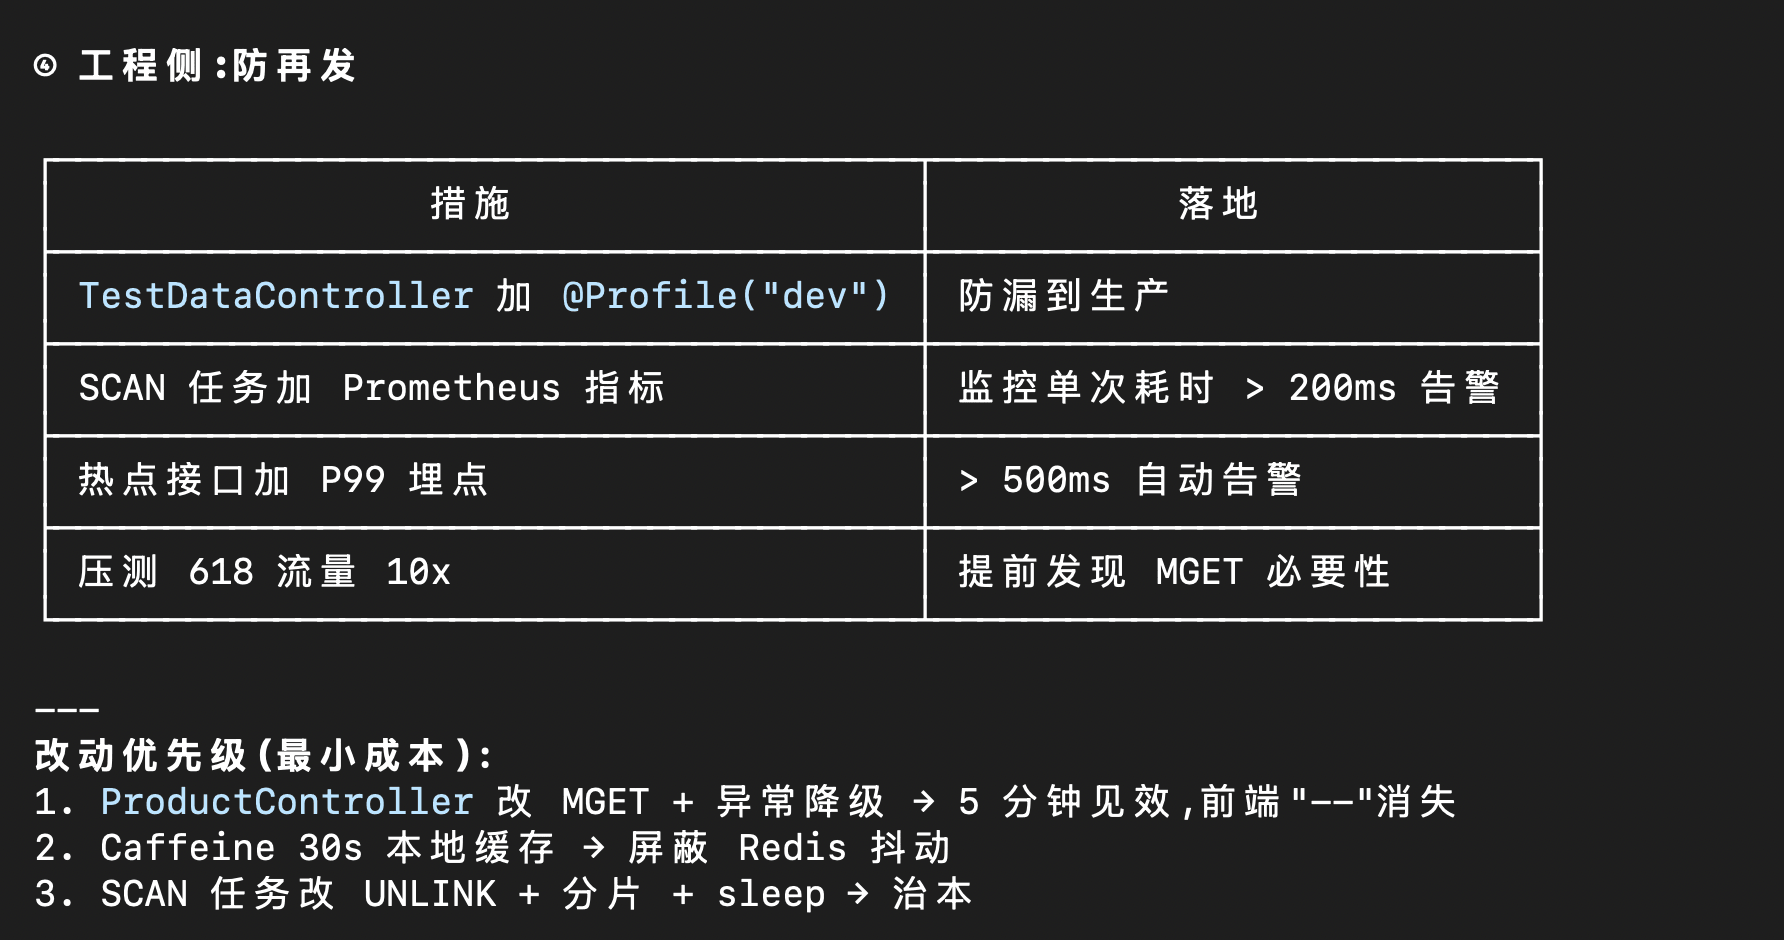
Dưới đây là diff của lần sửa này:
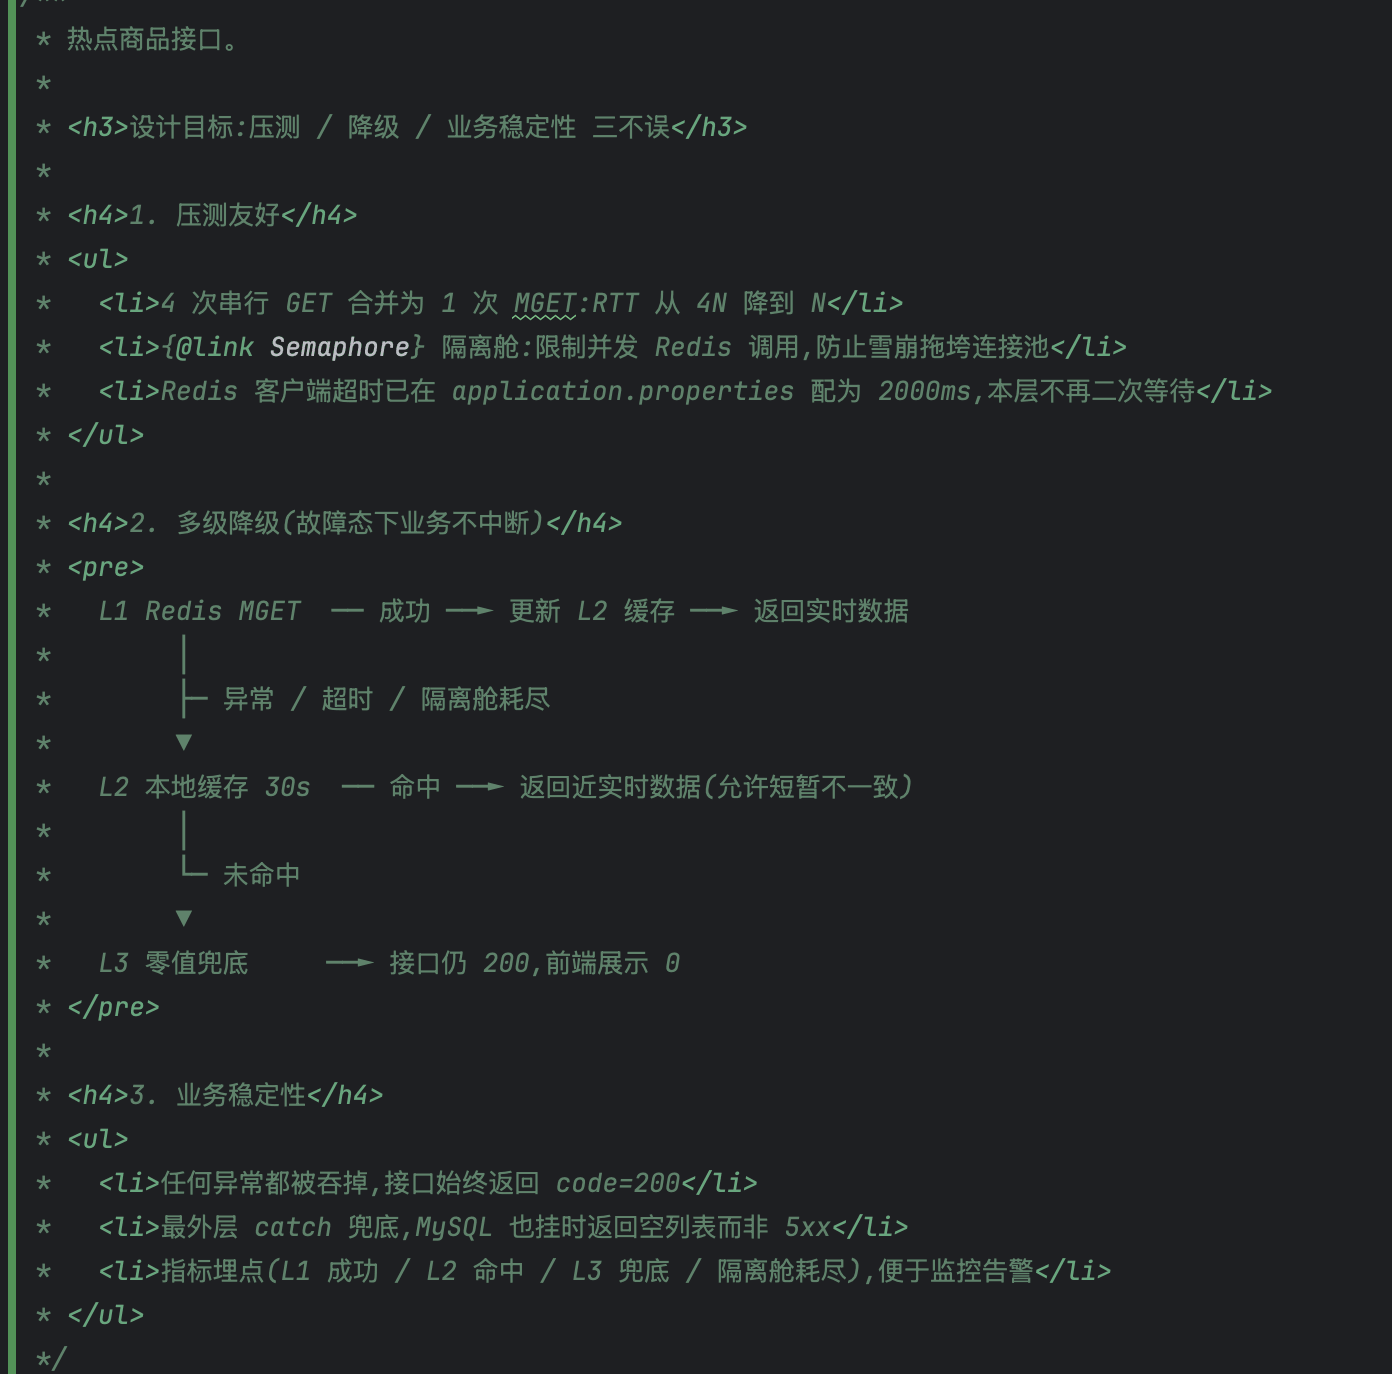
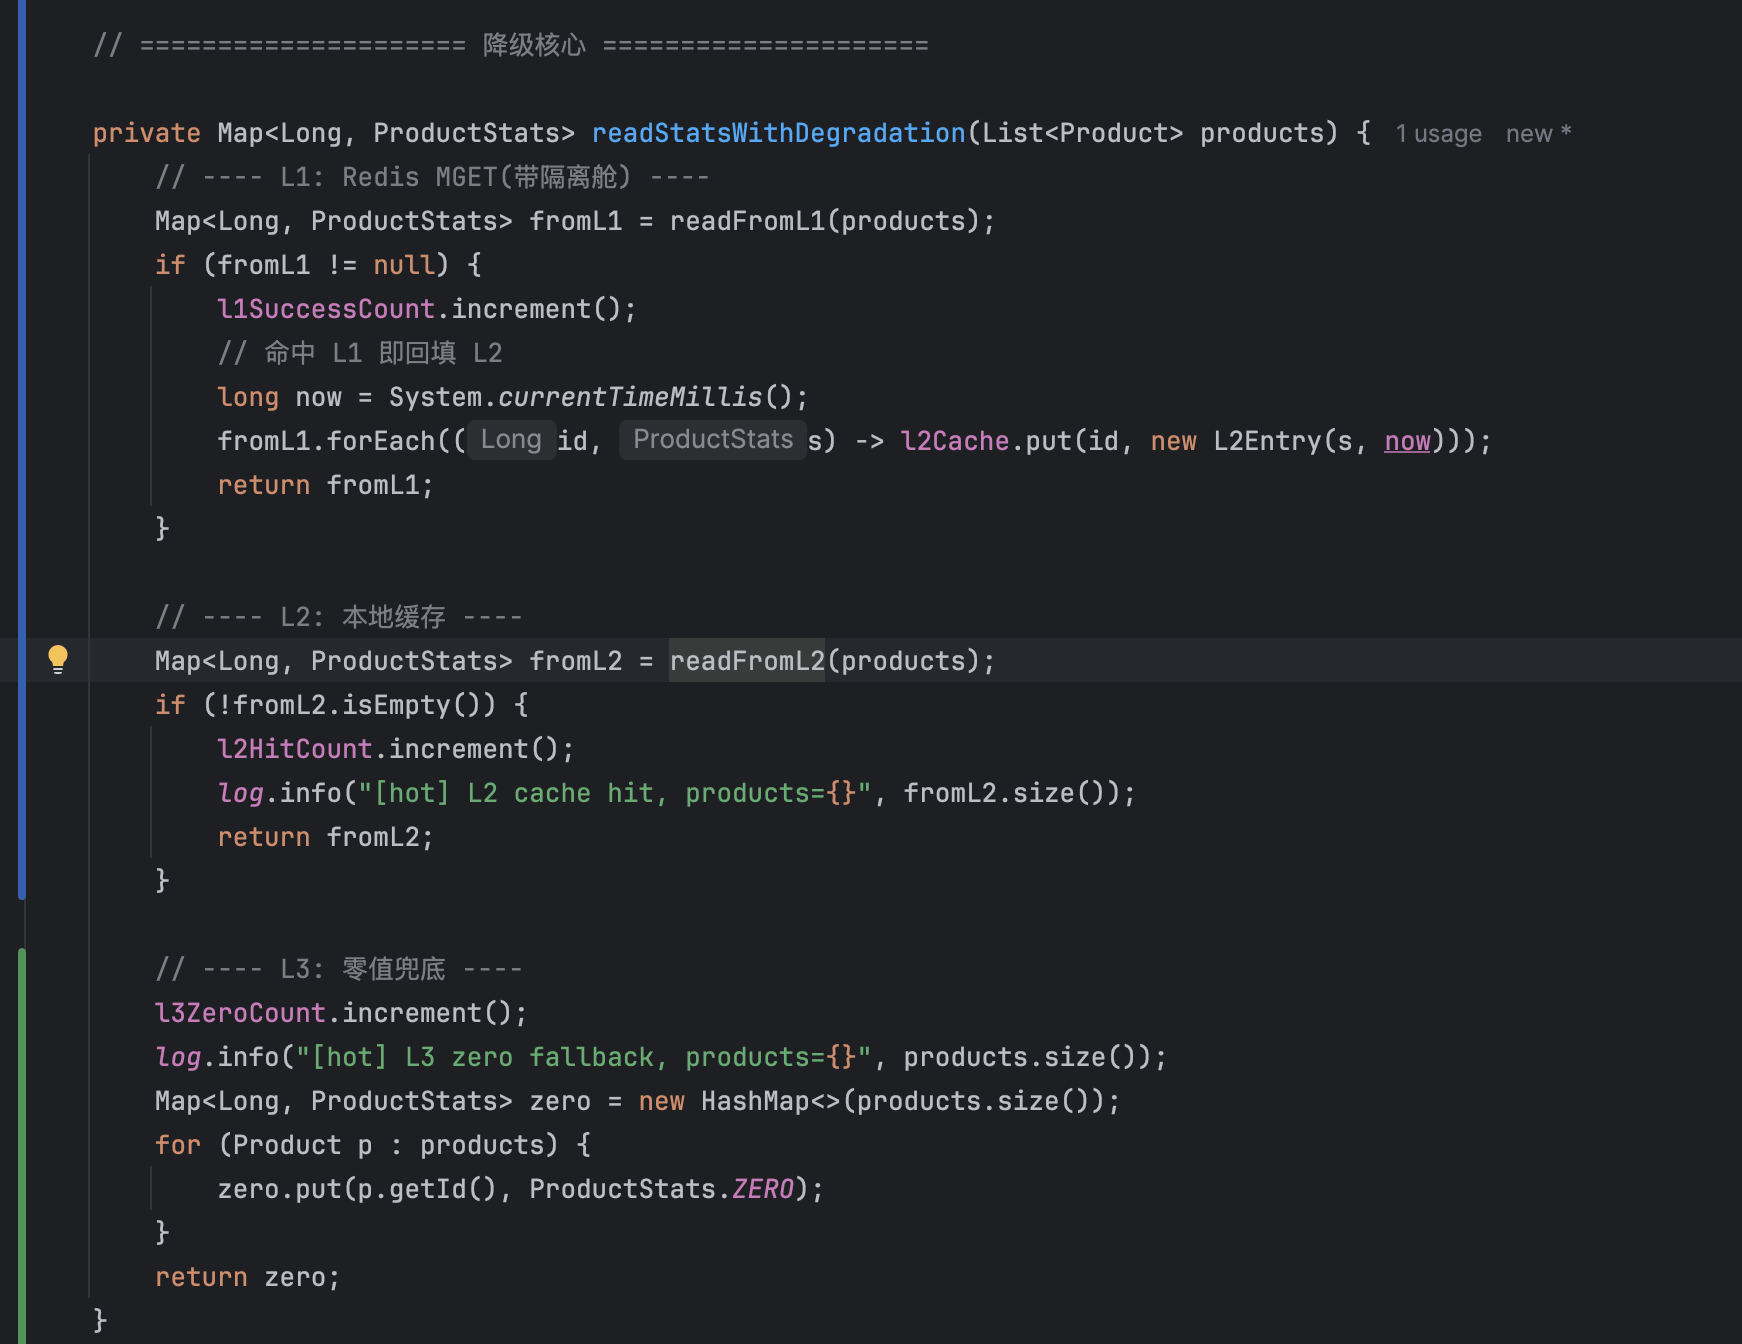
Dưới đây là code degradation cốt lõi. M3 dùng concurrent atomic class để xử lý một phần concurrent state, nhưng điều này chỉ đảm bảo tính atomic của biến tương ứng hoặc một thao tác đơn lẻ, không thể chứng minh toàn bộ chain gồm Redis, local cache và database fallback là thread-safe hoặc nhất quán. Cache breakdown, fallback lặp và ghi đè giá trị cũ vẫn cần được kiểm chứng thông qua synchronization protocol, rate limiting và concurrent test:
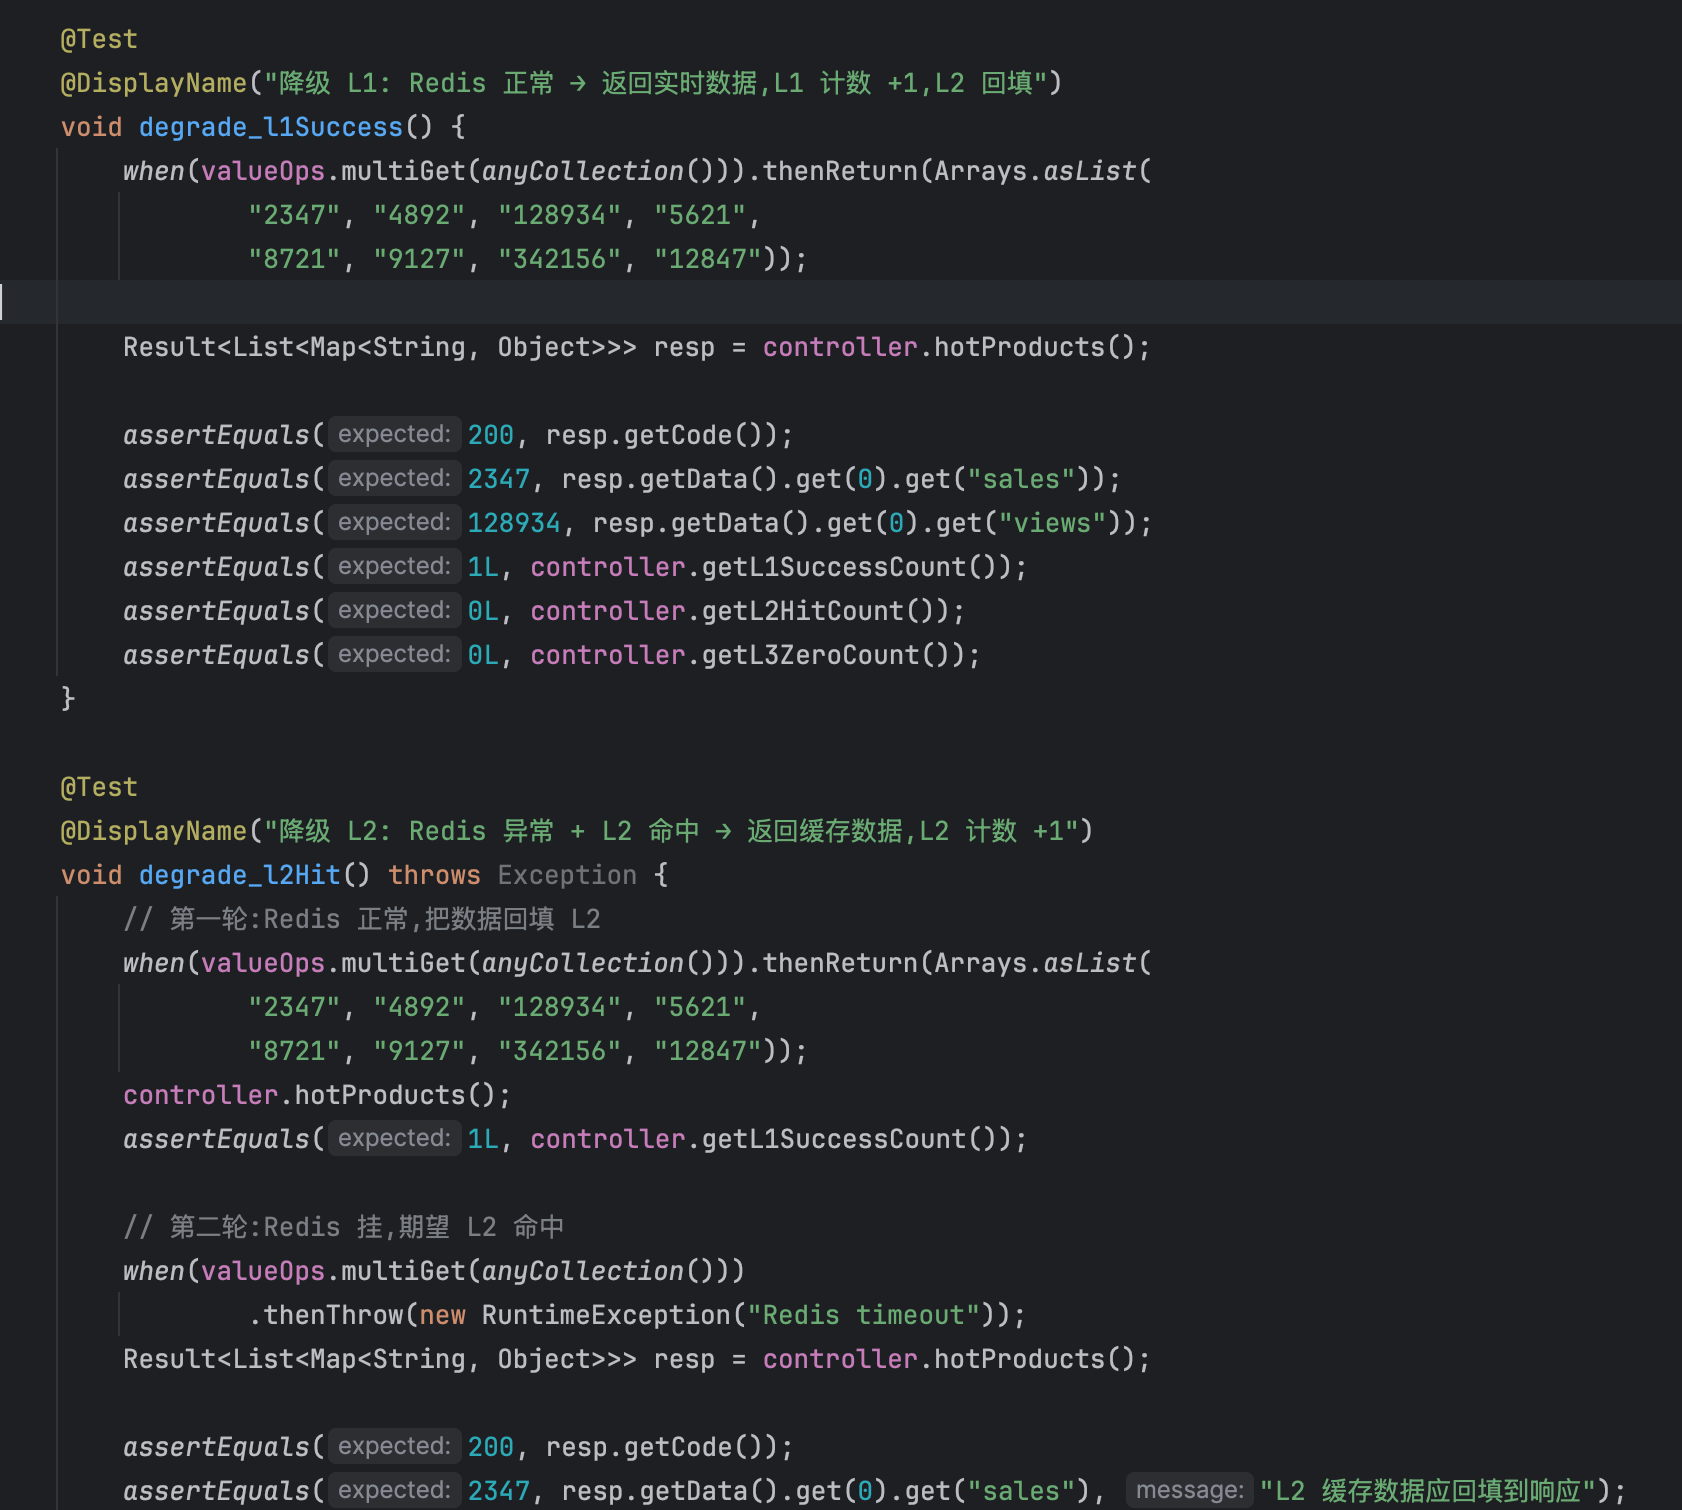
M3 đồng thời tạo các test bao phủ degradation bình thường, fallback khi exception và concurrent race. Screenshot cho thấy các test case liên quan compile thành công, unit test đều pass; “100% logic coverage” chỉ đại diện cho coverage của code được thống kê, không thể chứng minh mọi failure scenario đều đã được kiểm chứng:
Đi sâu vào tầng dưới: tái hiện cursor algorithm của Redis SCAN, tìm hiểu binary flip của rev
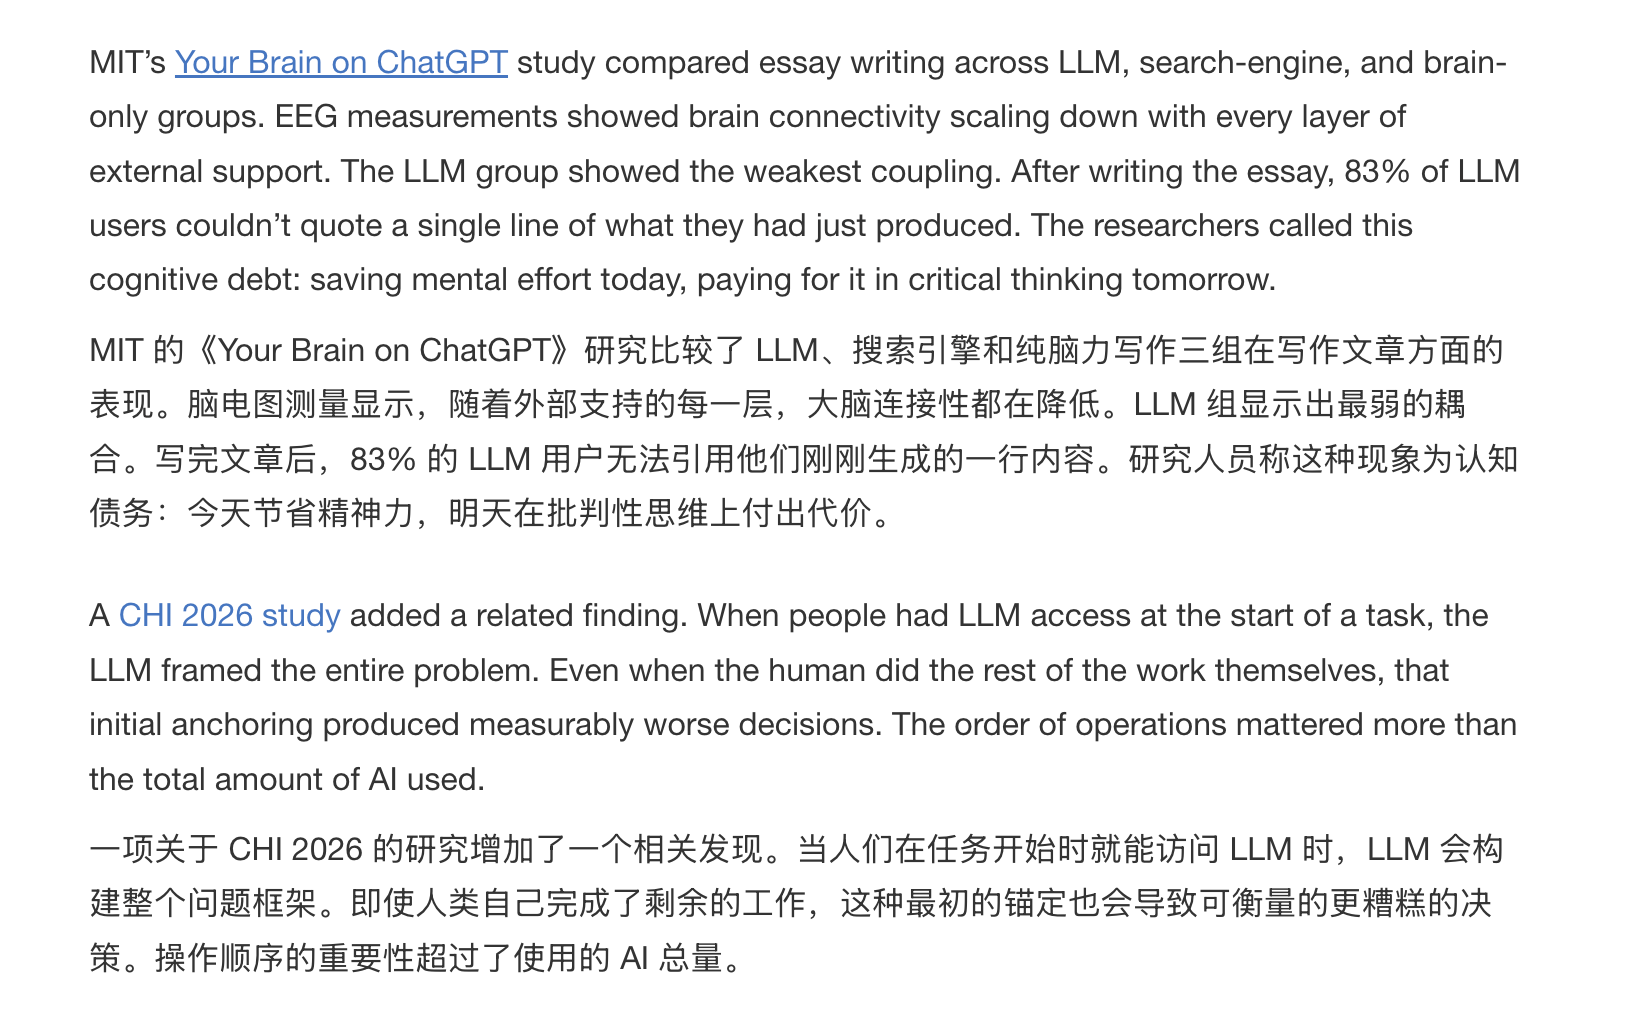
Gần đây, Addy Osmani, Technical Director của Google, nêu một hiện tượng đáng lưu ý trong bài viết “Don't Outsource the Learning”: để AI viết code còn bản thân bỏ qua việc học là điều quá dễ — lỗi được sửa nhưng mental model của bạn không tiến bộ. Ông trích dẫn một random experiment của Anthropic: cùng học một library mới, nhóm có AI hỗ trợ hoàn thành task với tốc độ ngang nhóm làm thủ công, nhưng trong bài test understanding tiếp theo chỉ đạt 50%, thấp hơn nhiều so với 67% của nhóm thủ công. Điều thú vị là trong nội bộ nhóm AI cũng có sự phân hóa — engineer dùng AI để hỏi câu hỏi khái niệm đạt trên 65%, còn người trực tiếp copy paste code thì dưới 40%. Kết luận của Osmani là: tool không học thay bạn, điểm khác biệt nằm ở cách bạn sử dụng:
Quay lại sự cố lần này. Khắc phục sự cố và hạ cấp để khống chế ảnh hưởng là bước đầu tiên, nhưng để hiểu SCAN duyệt dict như thế nào, ý nghĩa thực tế của COUNT và binary flip của rev tiến cursor ra sao, vẫn phải tiếp tục đọc document và source code. Official document đã chỉ ra COUNT chỉ là gợi ý về workload, còn source code có thể giải thích version cụ thể được implement như thế nào. Tôi nhờ MiniMax M3 tái hiện core algorithm của SCAN, sau đó đưa kết quả vào learning project mini-redis do người bạn sharkchili duy trì để kiểm chứng.
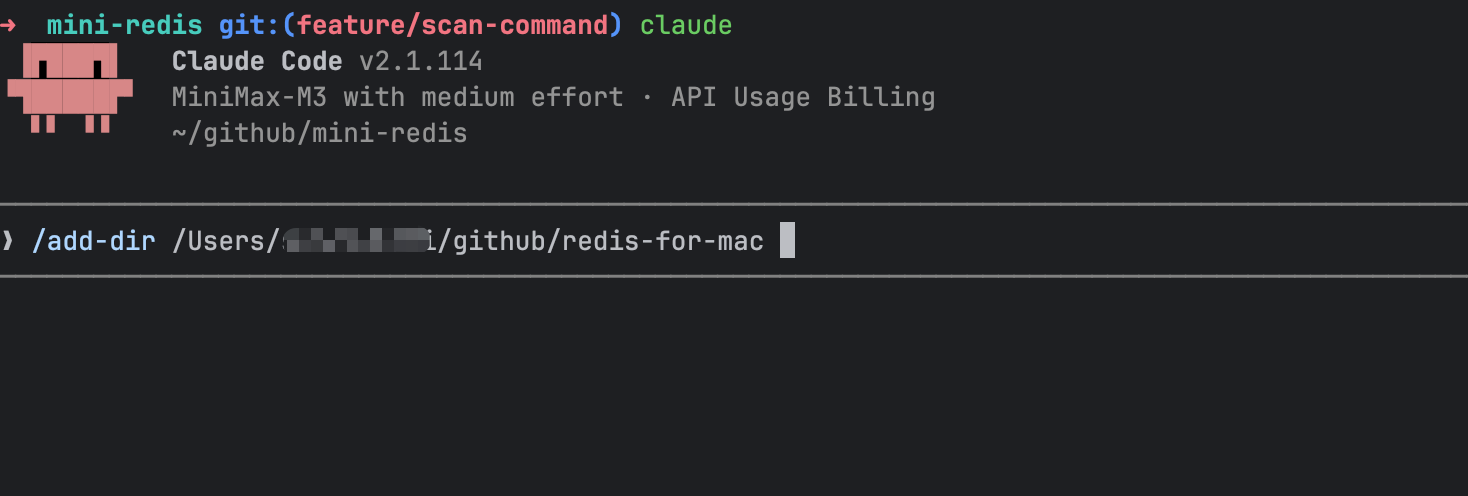
Để cung cấp đủ context, tôi truyền trực tiếp các source file liên quan đến Redis SCAN vào project mini-redis thông qua add-dir:
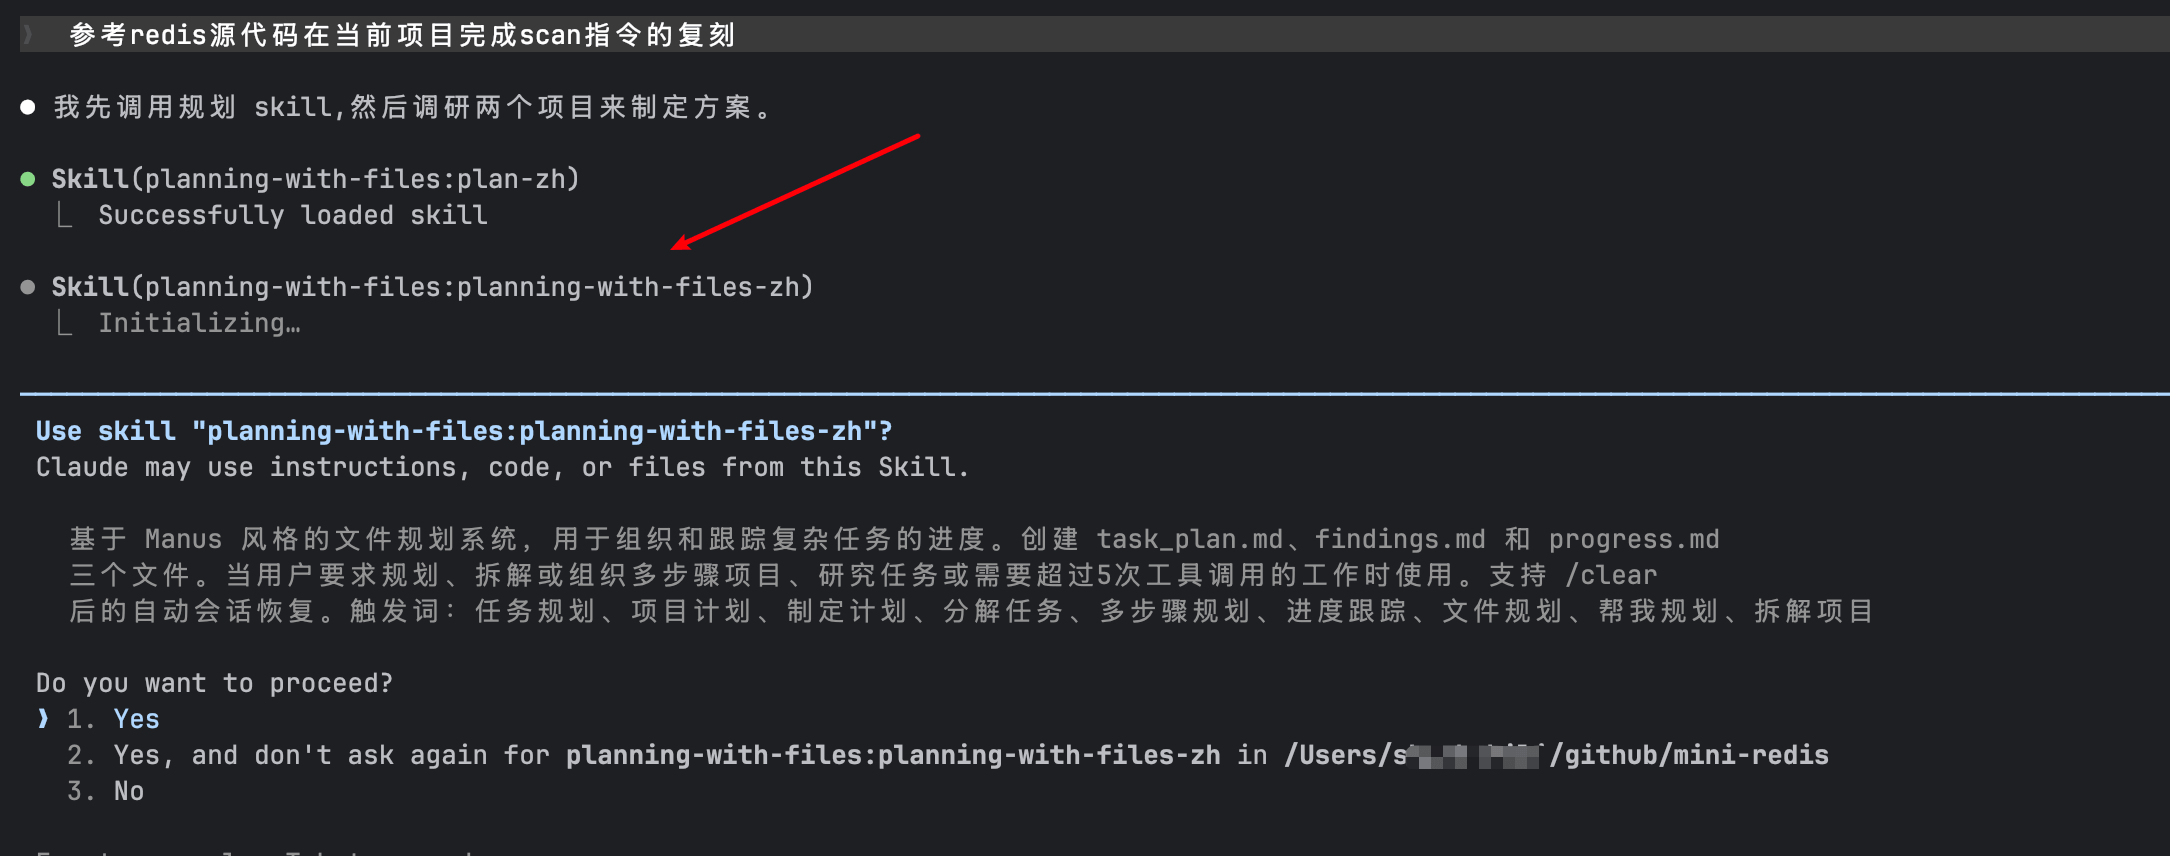
Sau đó nhập thẳng requirement. Sau khi scan Redis source được truyền vào, M3 nhận định đây là một long task và gọi skill plan-with-files để phân rã, lập kế hoạch task:
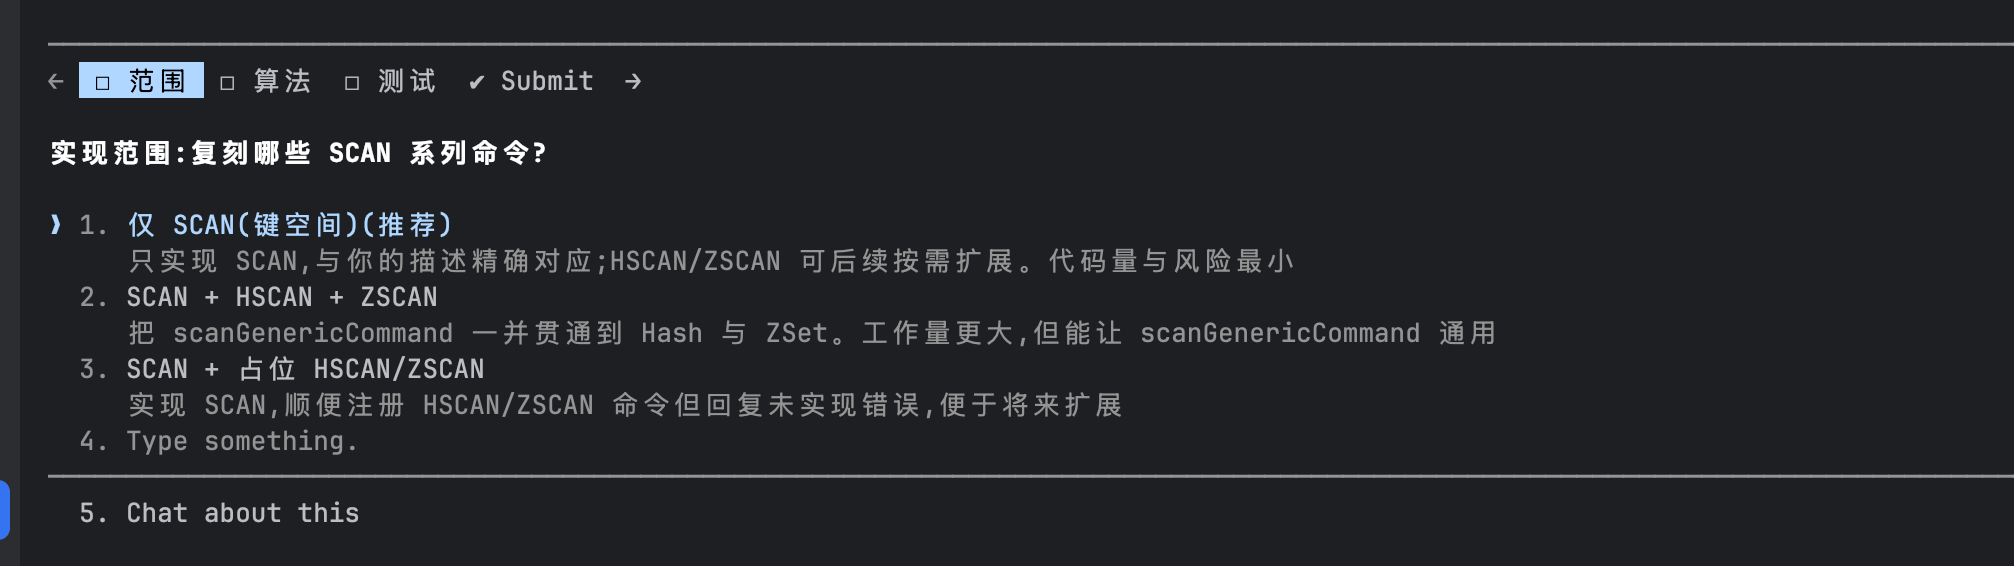
Sau khi lập kế hoạch xong, M3 chủ động yêu cầu clarification. Điểm đầu tiên là xác nhận phạm vi requirement, tôi chọn tái hiện command SCAN:
Điểm thứ hai là chọn algorithm. M3 phát hiện mini-redis đã tái hiện data structure dict của Redis thay vì dùng Go native map, nên đề xuất tái hiện việc tiến cursor trên dict hiện có. Cách này giữ lại behavior chính và giá trị học tập của algorithm Redis. Còn thứ tự hash bucket, memory locality và performance có nhất quán hay không vẫn phụ thuộc vào data layout và runtime của implementation Go, không thể suy ra trực tiếp chỉ từ tên data structure:
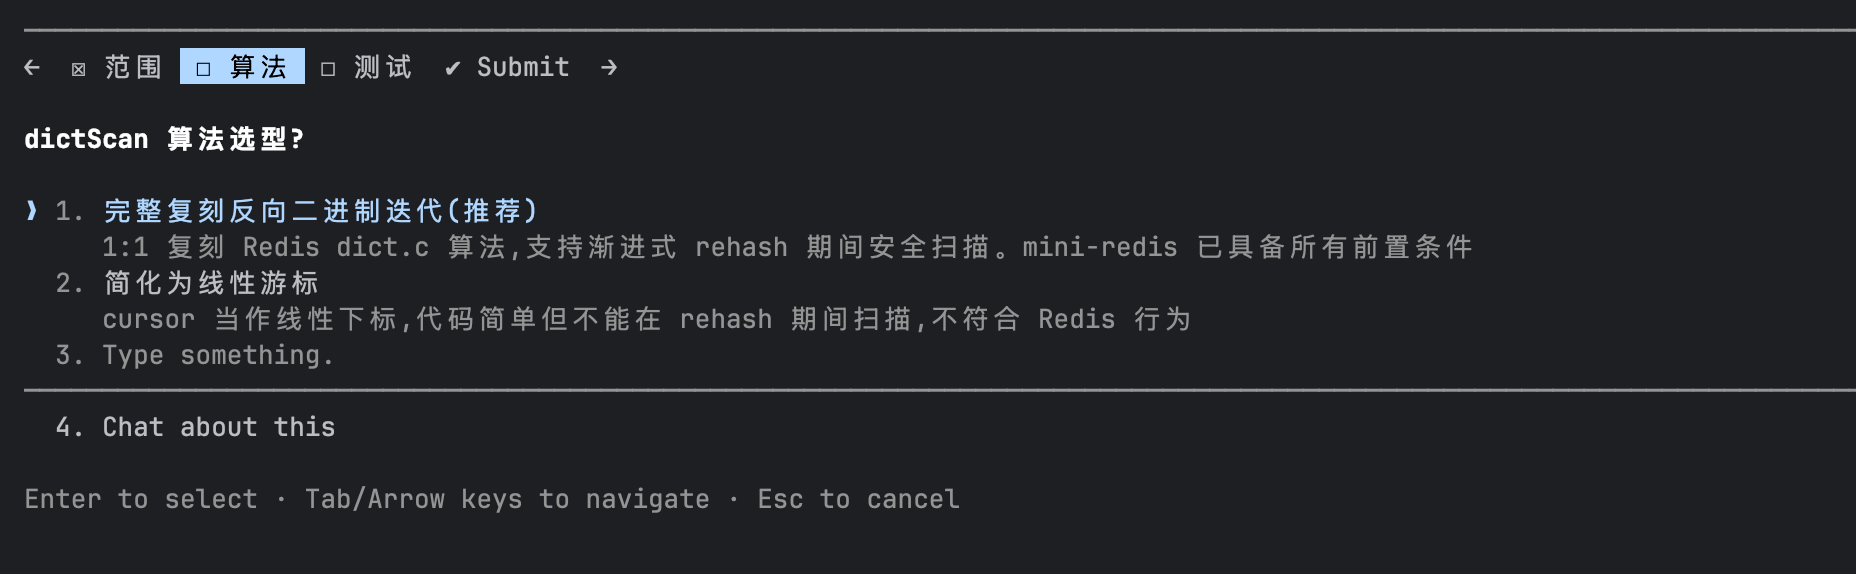
Sau nhiều vòng tương tác và clarification, chúng tôi đưa ra kế hoạch như sau:
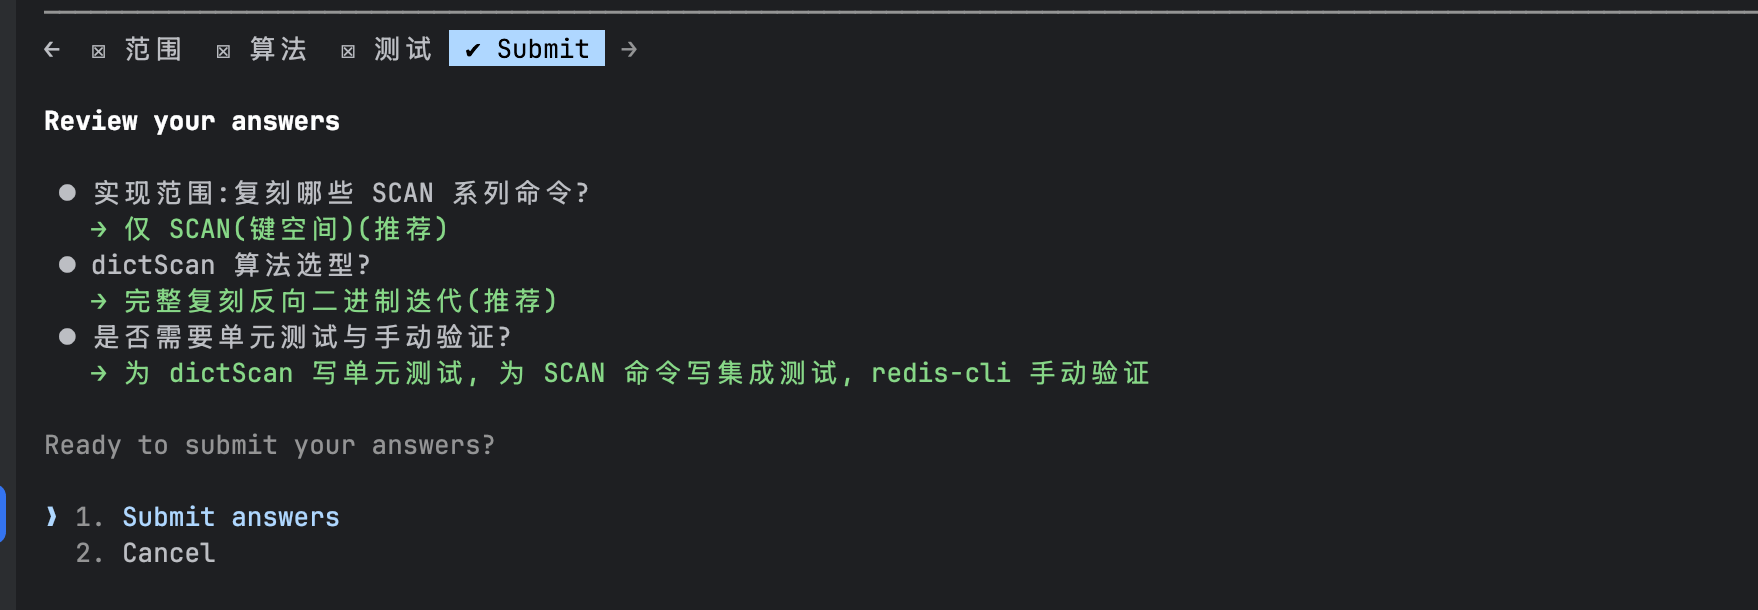
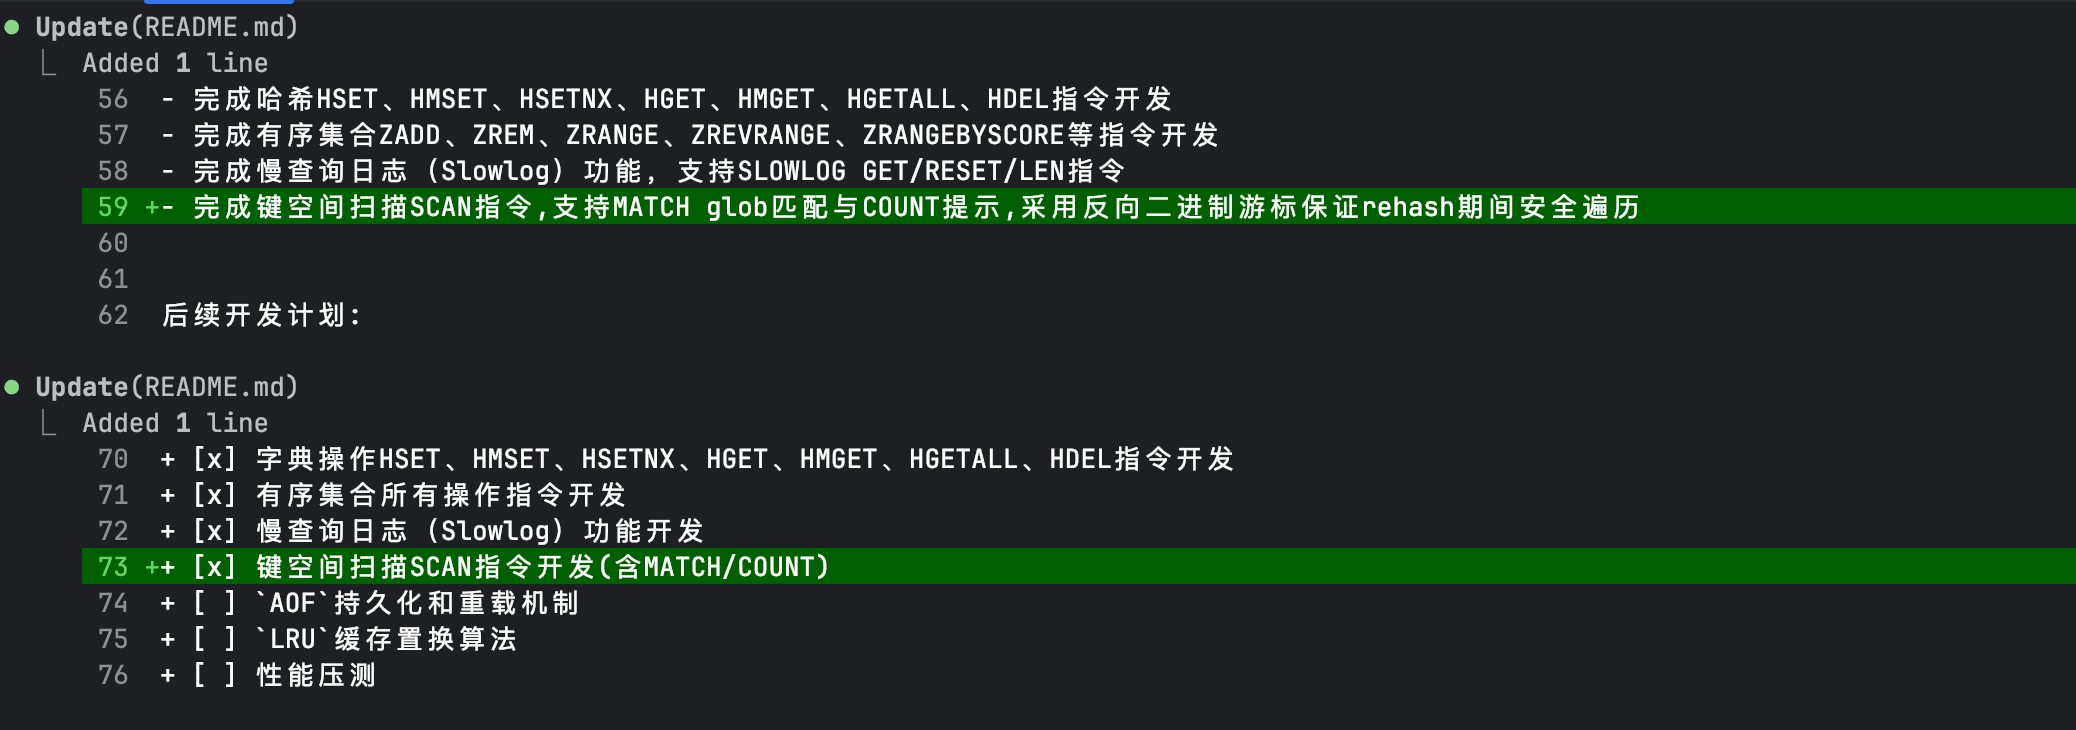
Sau khi thống nhất phương án, M3 hoàn thành implementation function theo từng layer từ bottom lên top, trước tiên dựng framework nền tảng cho dict traversal, sau đó nối cursor advancement và parameter parsing, cuối cùng cập nhật project README plan:
Cấu trúc code được delivery cuối cùng như sau. Implementation SCAN bao phủ việc parse parameter match, count và logic cursor loop:
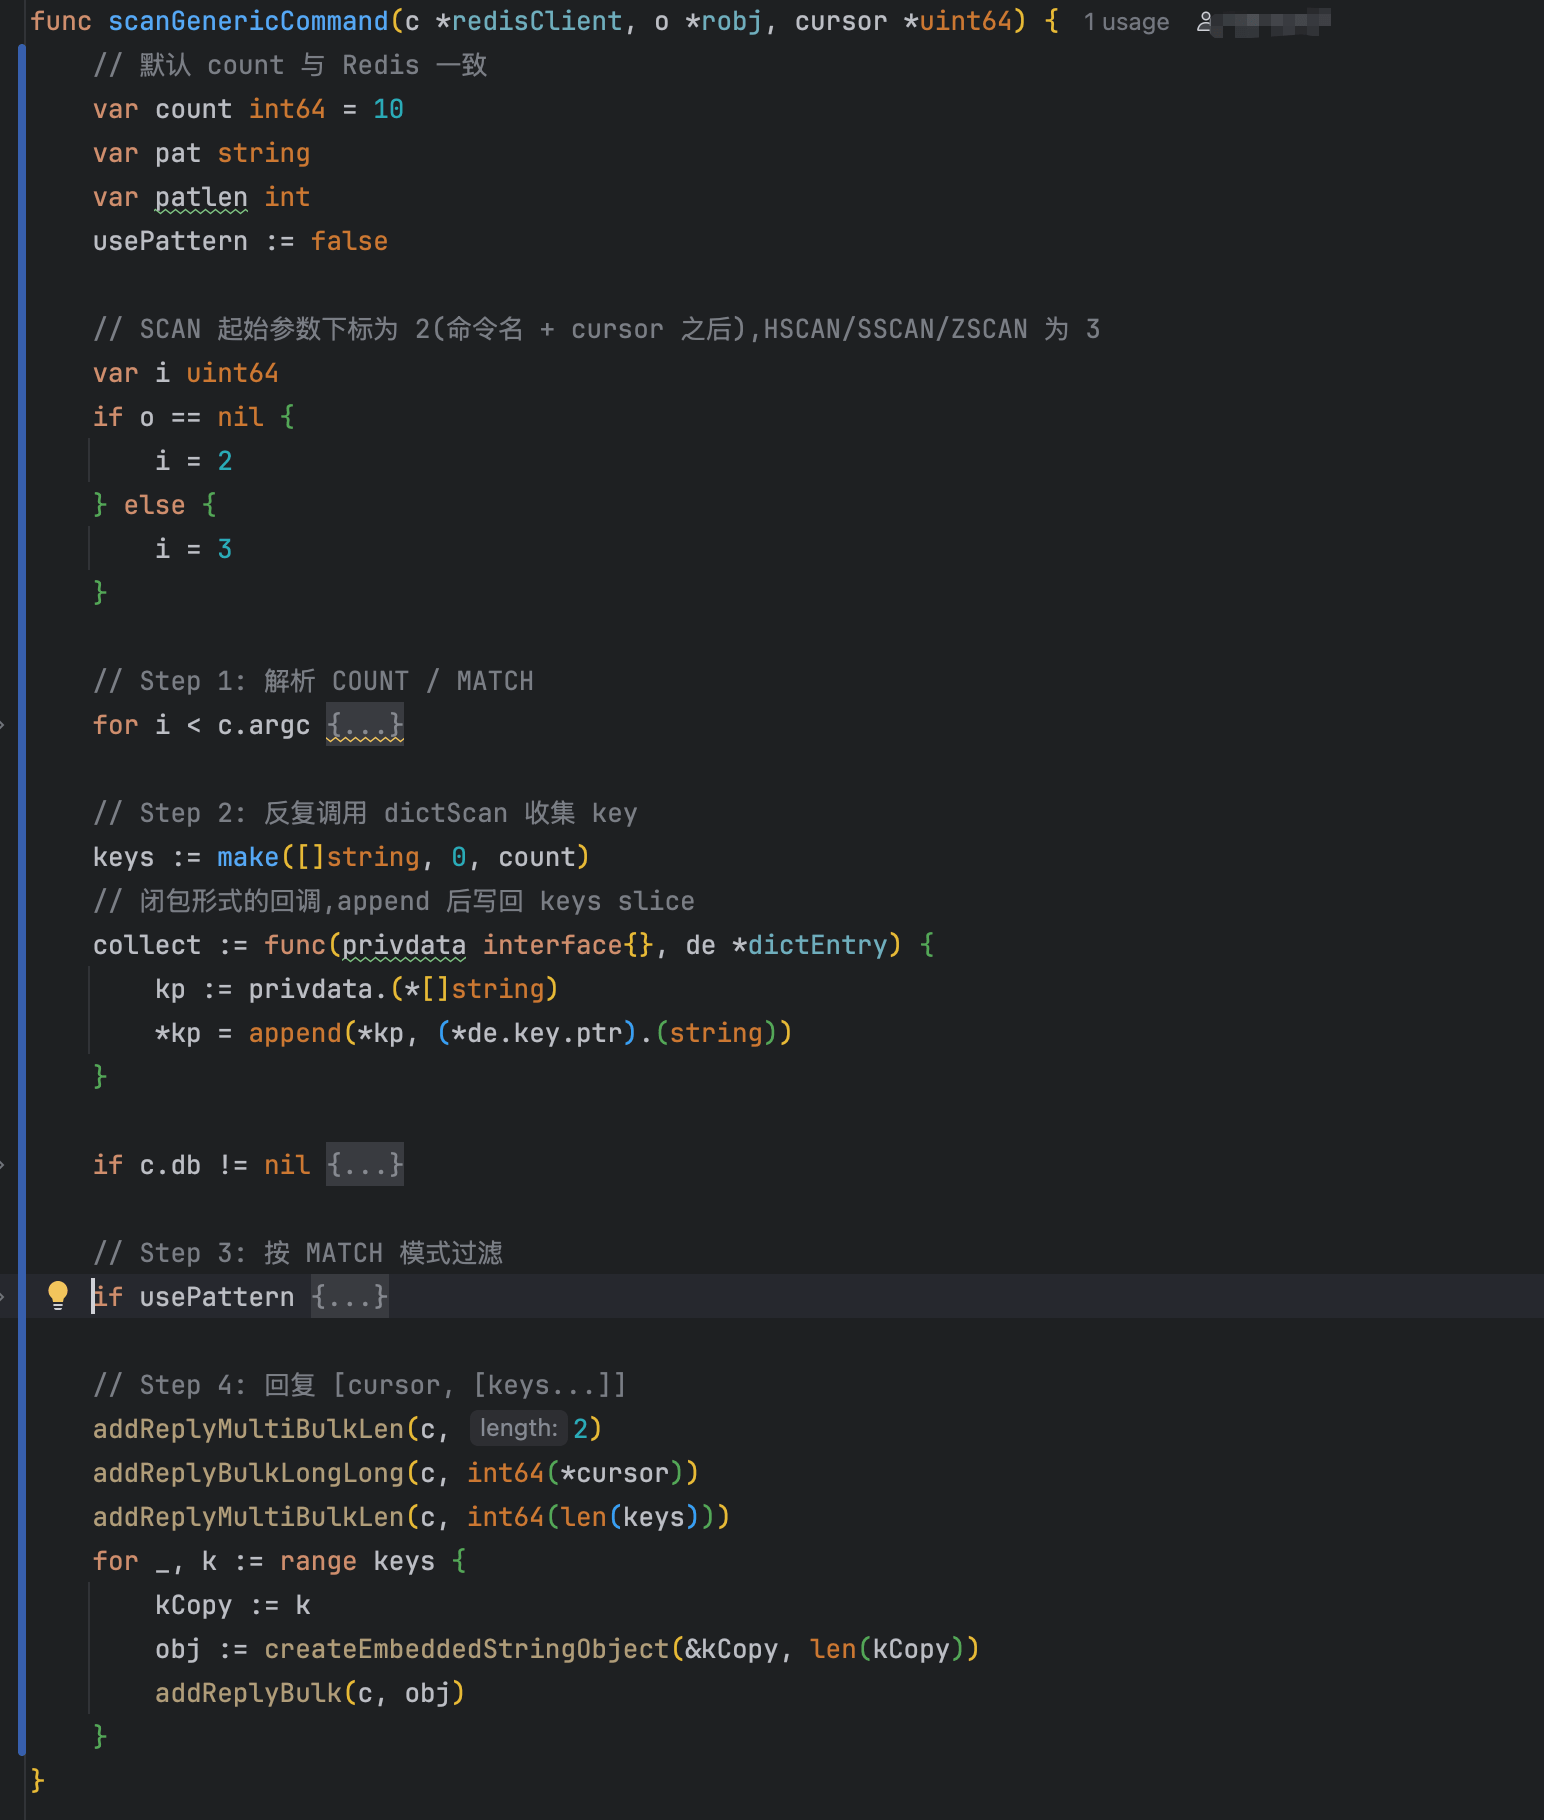
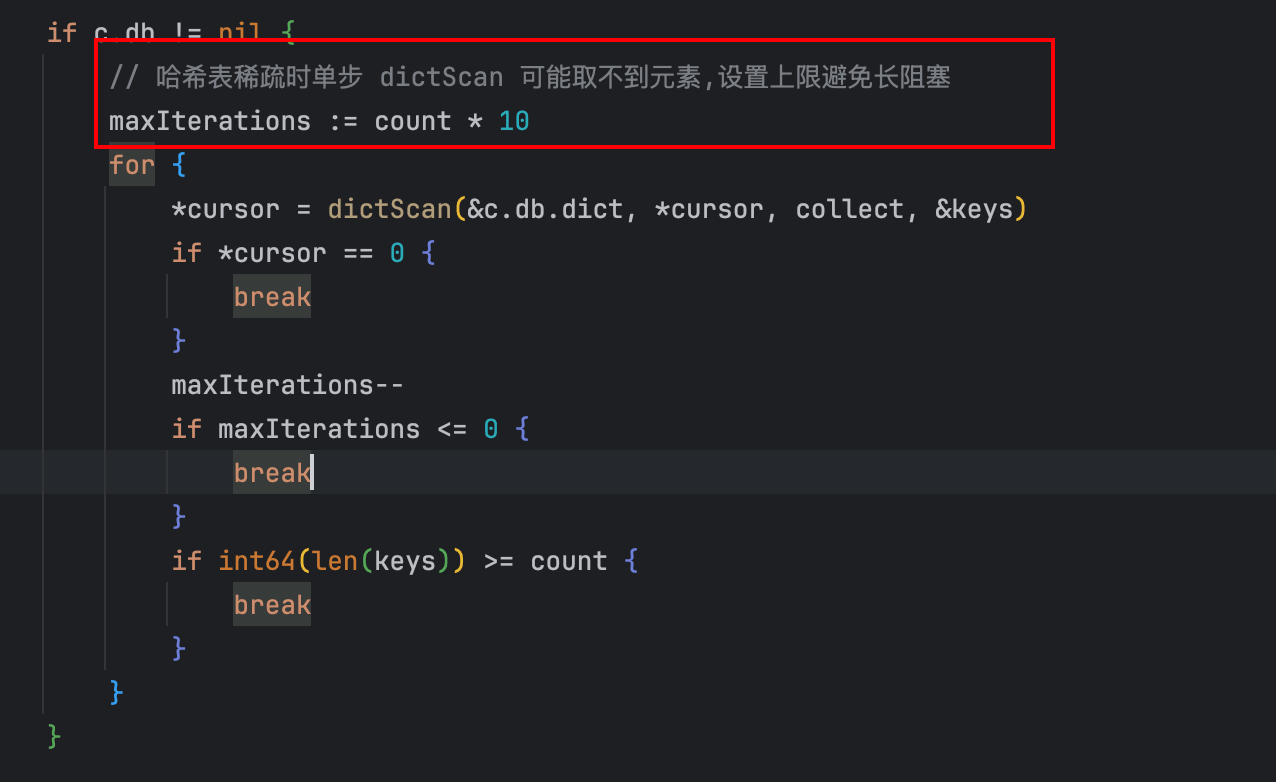
Thông qua lần tái hiện này và code comment, tôi thấy một chi tiết implementation của SCAN: Redis source hiện tại đặt count × 10 làm số lần iteration tối đa trong scanGenericCommand, dùng để giới hạn workload mỗi lần trên sparse hash table. Nó không phải là “số bucket thực tế được duyệt luôn tăng gấp mười”, cũng không đảm bảo gom đủ COUNT return value:
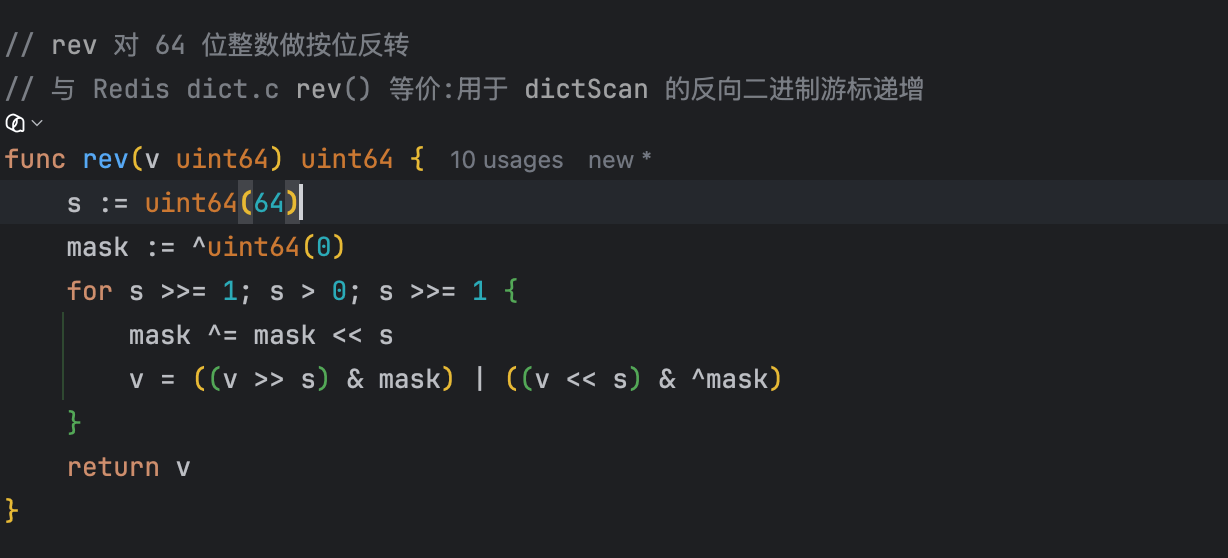
Một chi tiết đáng chú ý: trong Go, ^ đồng thời mang hai ngữ nghĩa là XOR và NOT theo bit, còn trong C hai ngữ nghĩa này lần lượt là ^ và ~. Algorithm rev liên quan đến nhiều thao tác binary flip; ở mỗi bước phải phân biệt chính xác “flip một bit” và “flip toàn bộ binary number” — chỉ cần nhầm lẫn một bước, cursor advancement sẽ sai hoàn toàn. Phần này cần được Review kỹ để xác nhận M3 có máy móc thay ~ bằng ^ hay không:
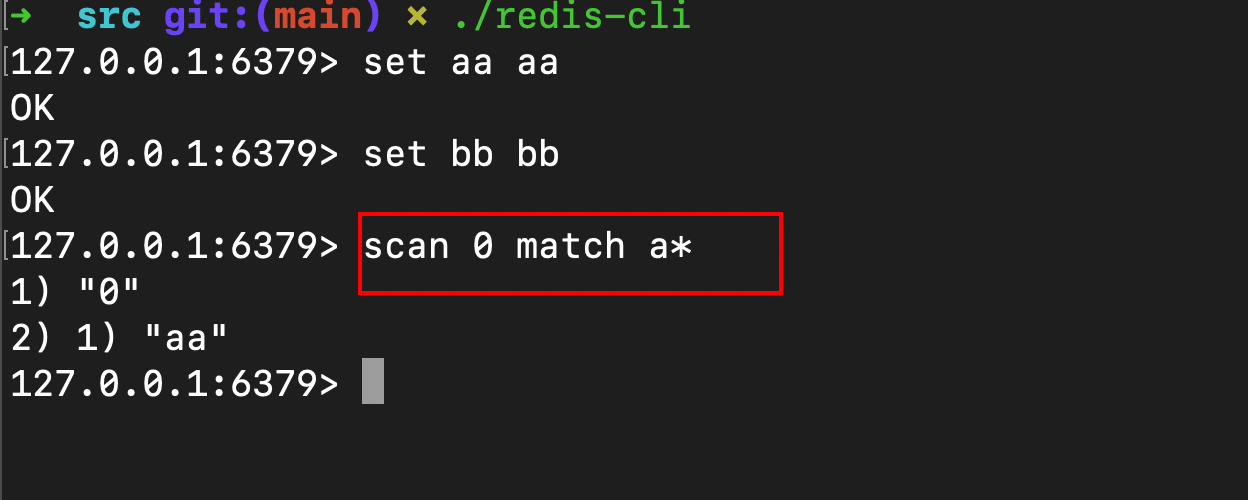
Dựa trên chất lượng implementation nói trên, compile và unit test đều pass ngay lần đầu:
Học đi đôi với hành: xây dựng dashboard giám sát Redis nhẹ
Sau khi khống chế ảnh hưởng và review, vẫn cần bổ sung năng lực monitoring cho architecture hiện có, bảo đảm có thể quan sát trạng thái vận hành của Redis theo thời gian thực và nhanh chóng xác định, khống chế ảnh hưởng khi vấn đề tái diễn.
Ở bước này, tôi truyền engineering hiện có làm context vào một project mới, để M3 thiết kế và implement từ đầu một dashboard giám sát Redis trực quan, qua đó xem xét hiệu quả delivery end-to-end frontend-backend của nó.
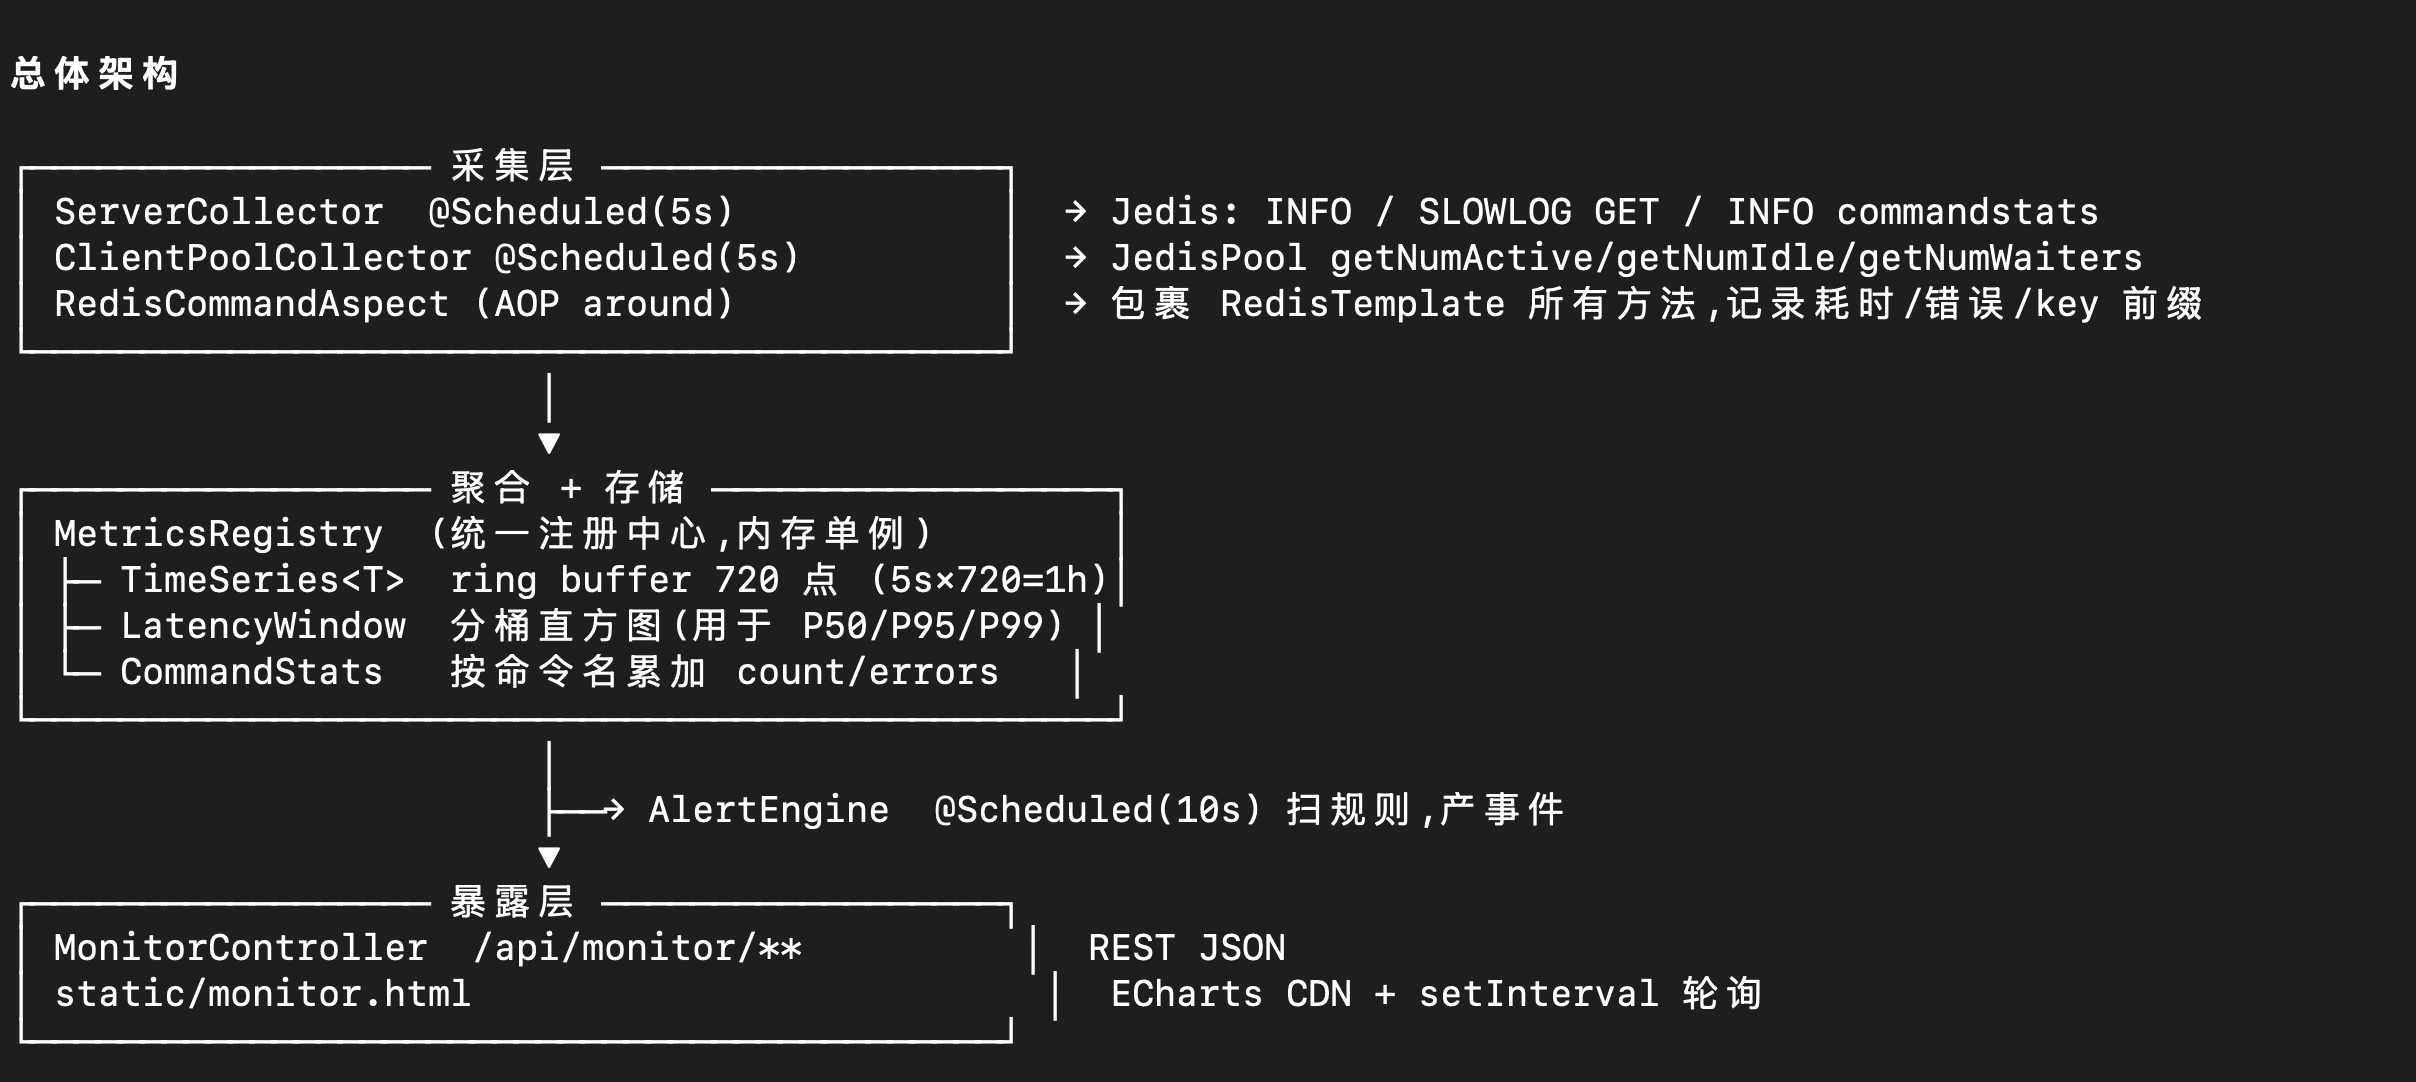
Sau một lần clarification vấn đề đơn giản, M3 đưa ra sơ đồ ASCII architecture của monitoring system, làm rõ data flow:
- Collection layer (instrumentation reporting)
- Buffer layer (ring buffer giảm đỉnh)
- Presentation layer (HTTP API + frontend dashboard)
Trách nhiệm giữa ba layer rõ ràng, coupling thấp:
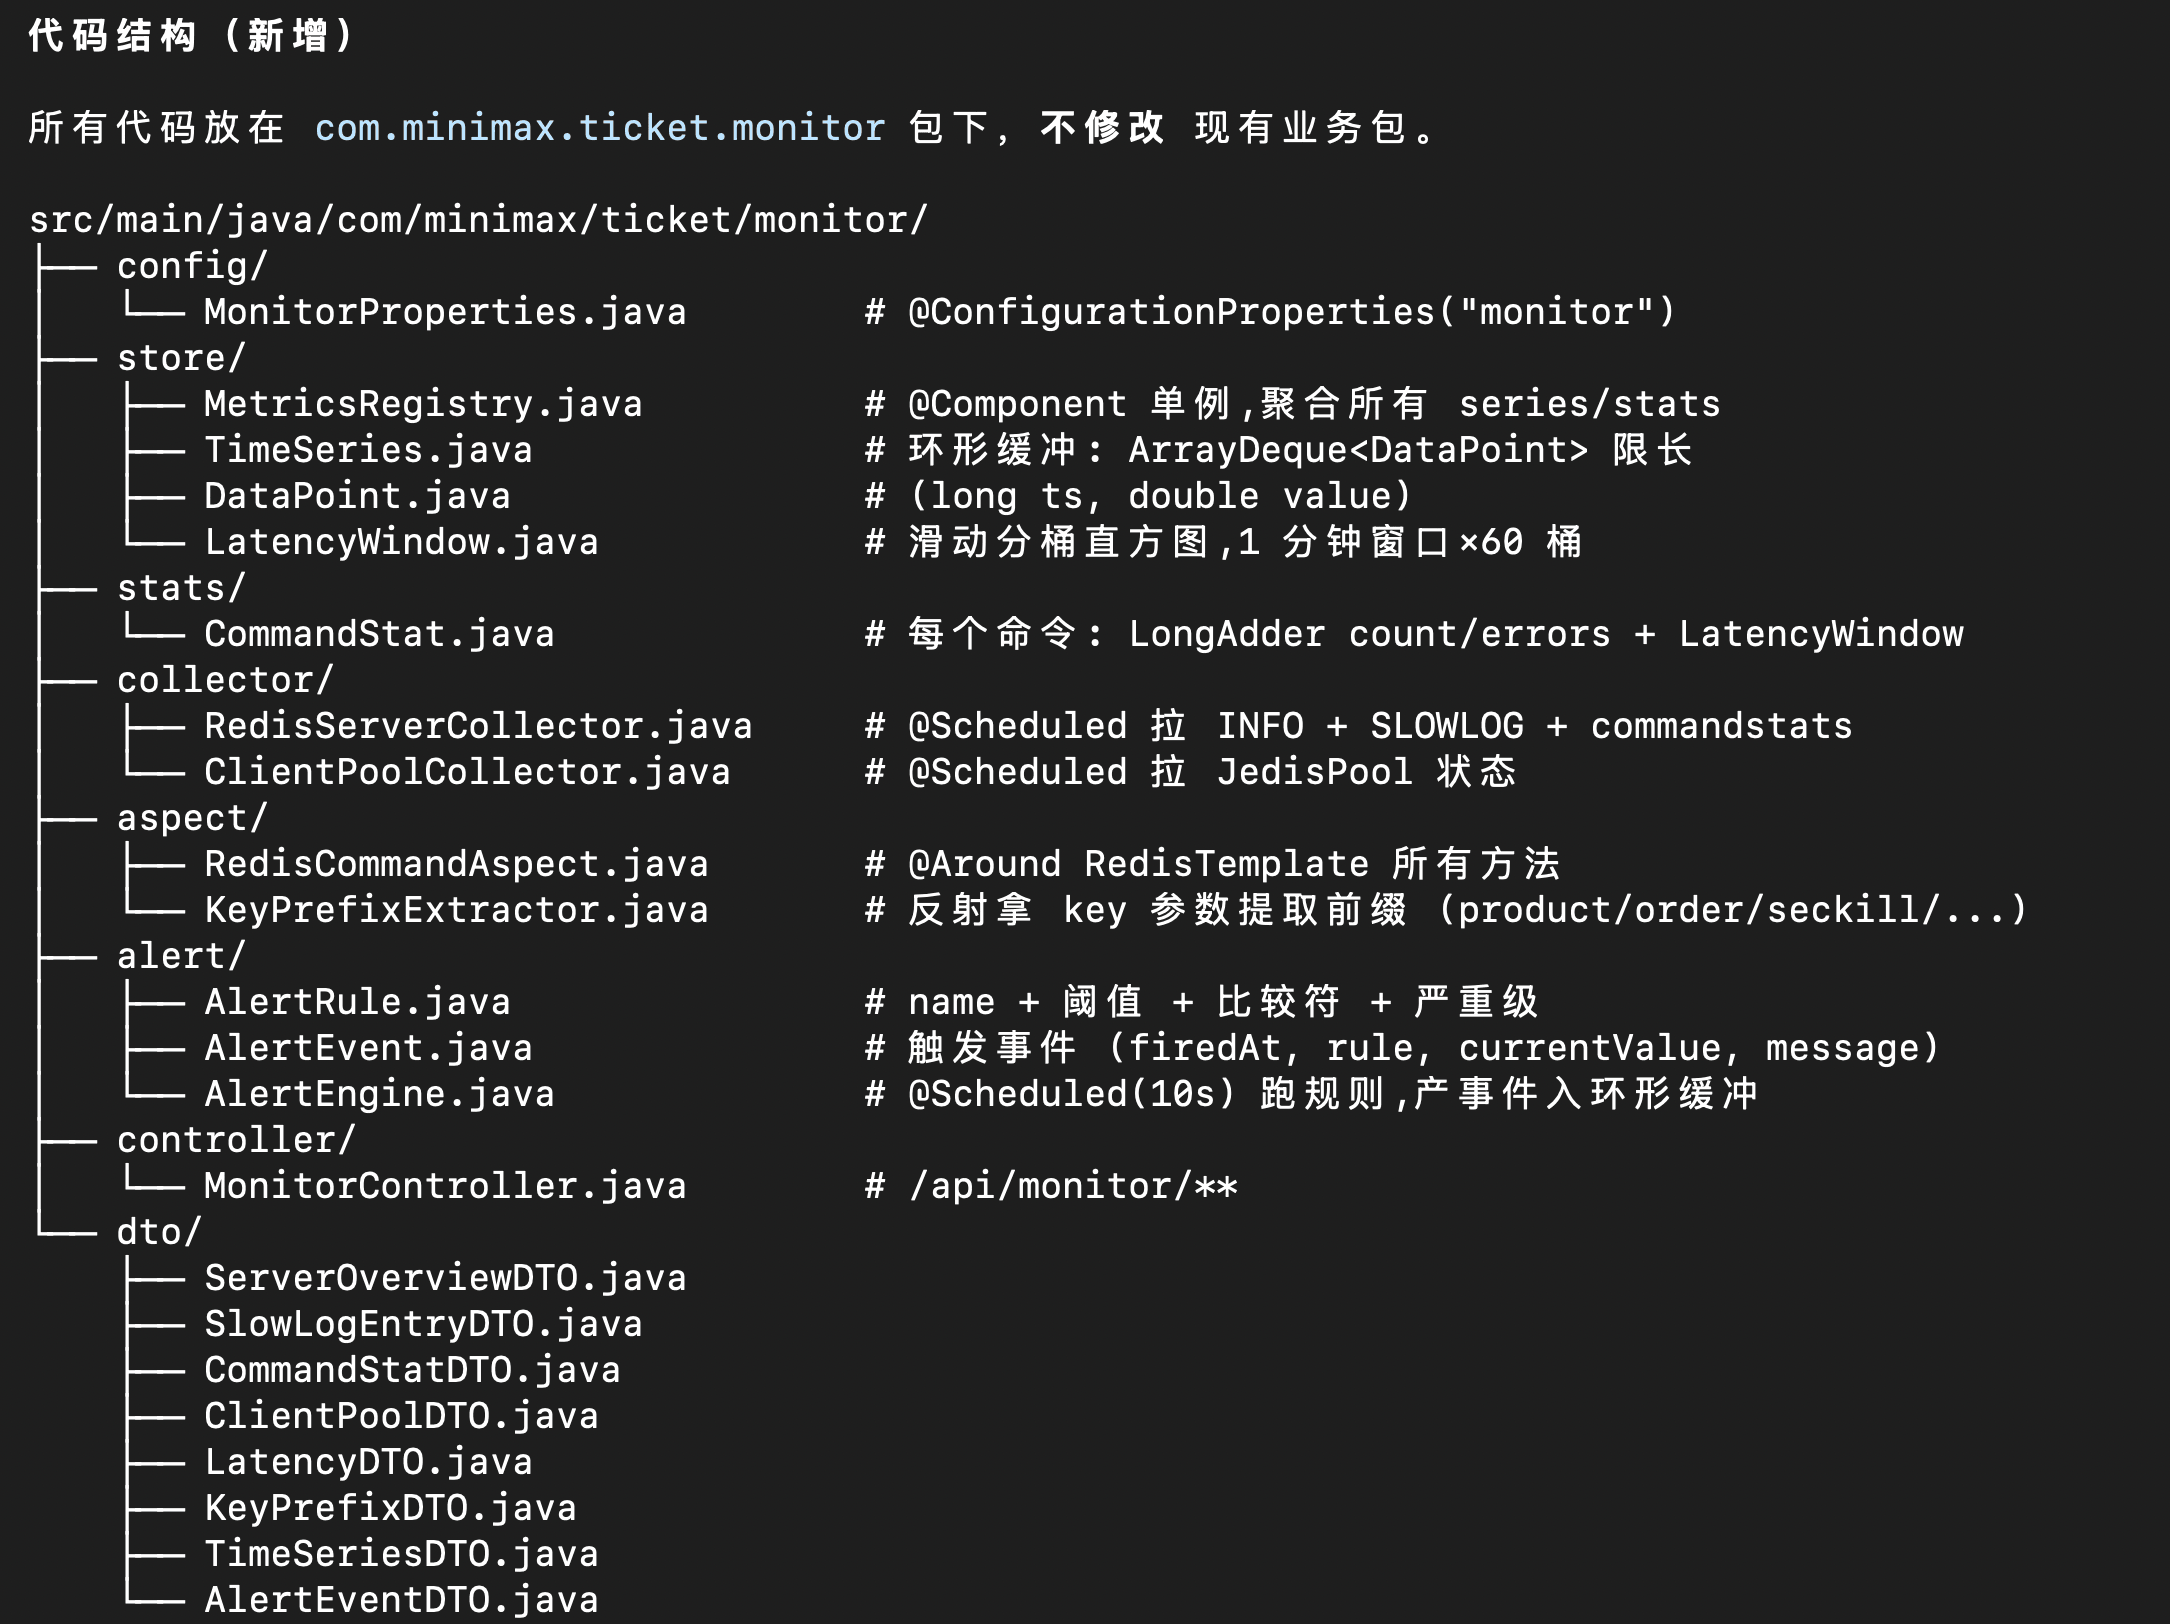
Cấu trúc code:
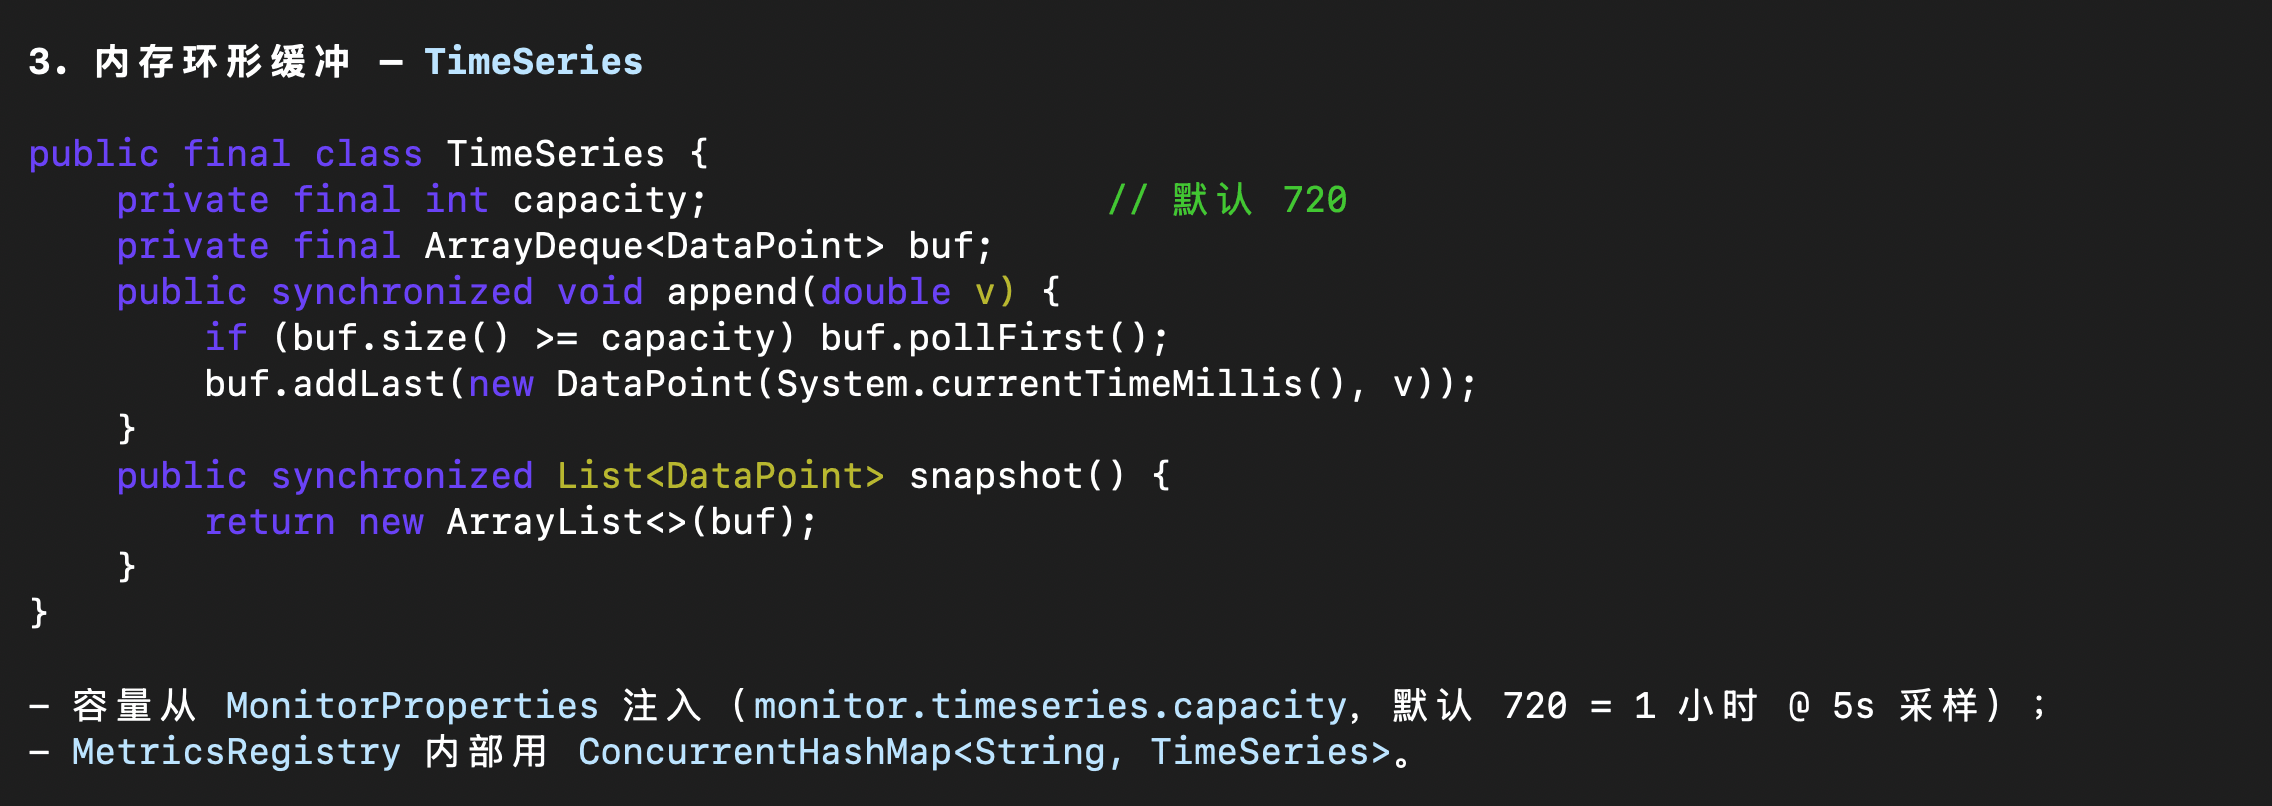
Dù chỉ là MVP rapid prototype, data structure ring buffer của monitoring instrumentation tầng dưới vẫn đáng xem — gồm fixed-size array được pre-allocate, concurrent read/write được bảo vệ bằng mutex và tự động ghi đè dữ liệu cũ nhất khi buffer đầy:
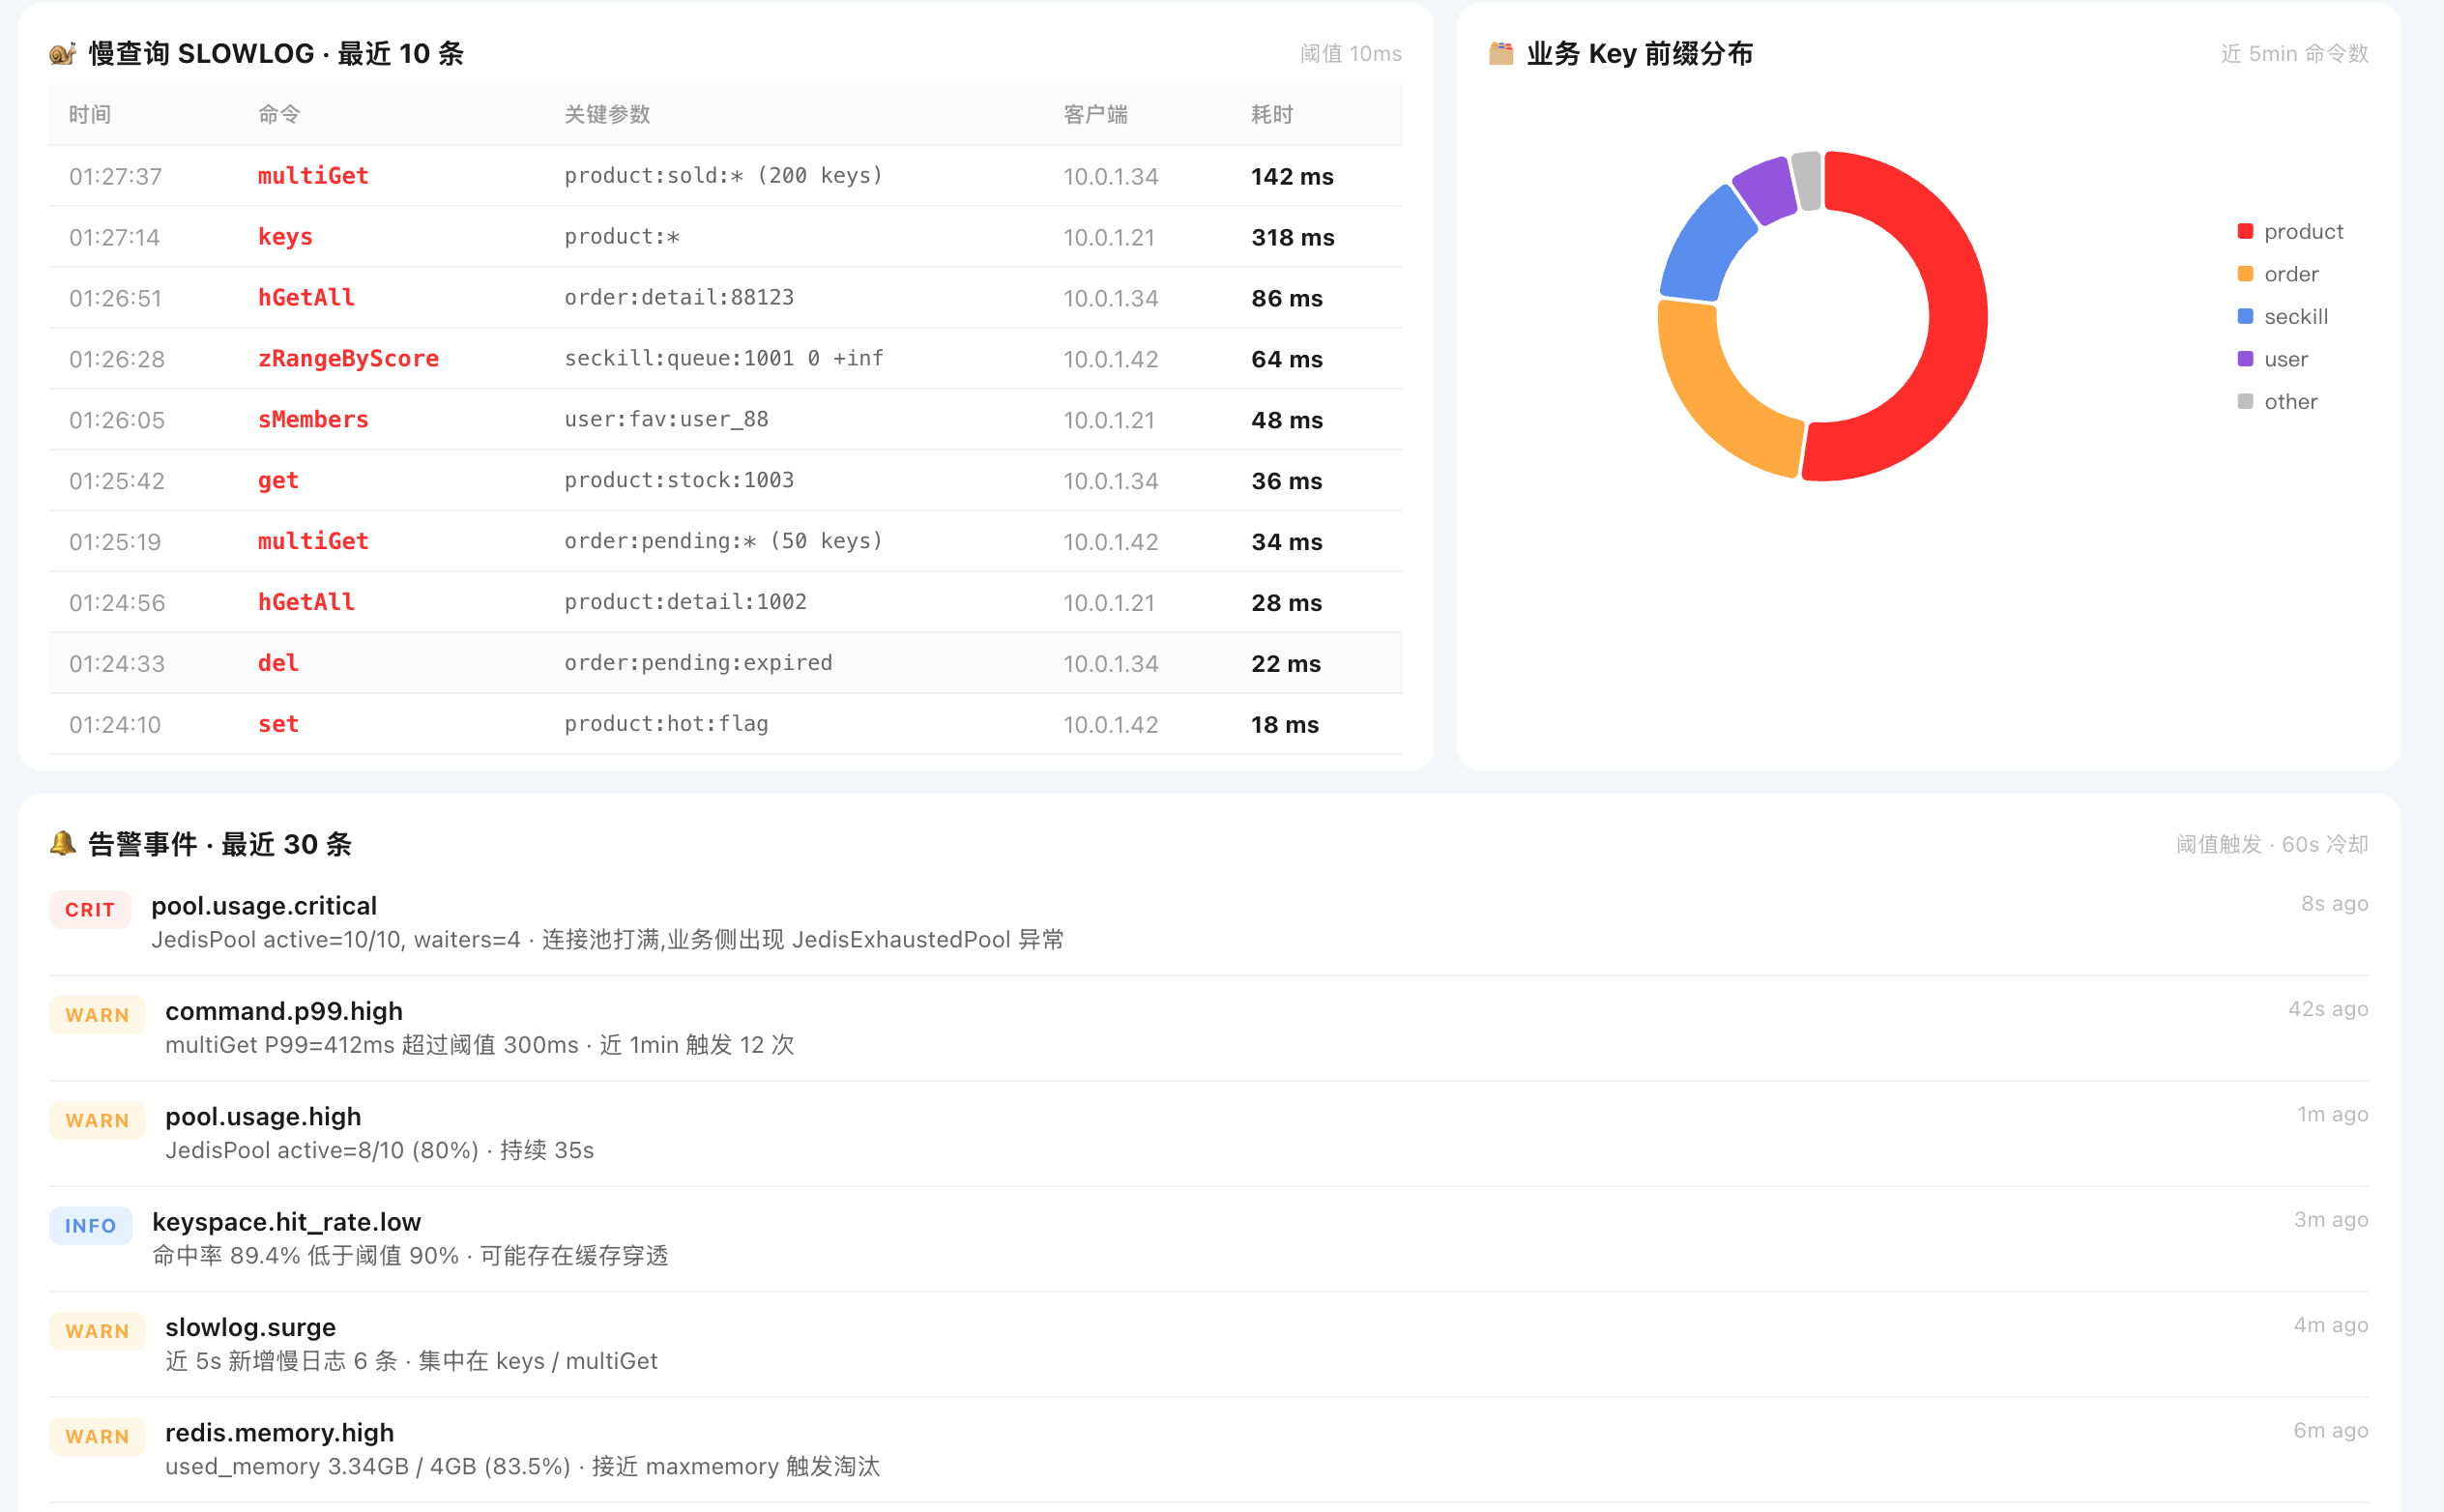
Dashboard monitoring được tạo cuối cùng như sau. Tổng thể dùng dark theme, layout chia thành nhiều panel: trạng thái realtime của Redis instance (memory usage, số connection, QPS), biểu đồ thống kê phân bố theo command type và timeline của slow query:
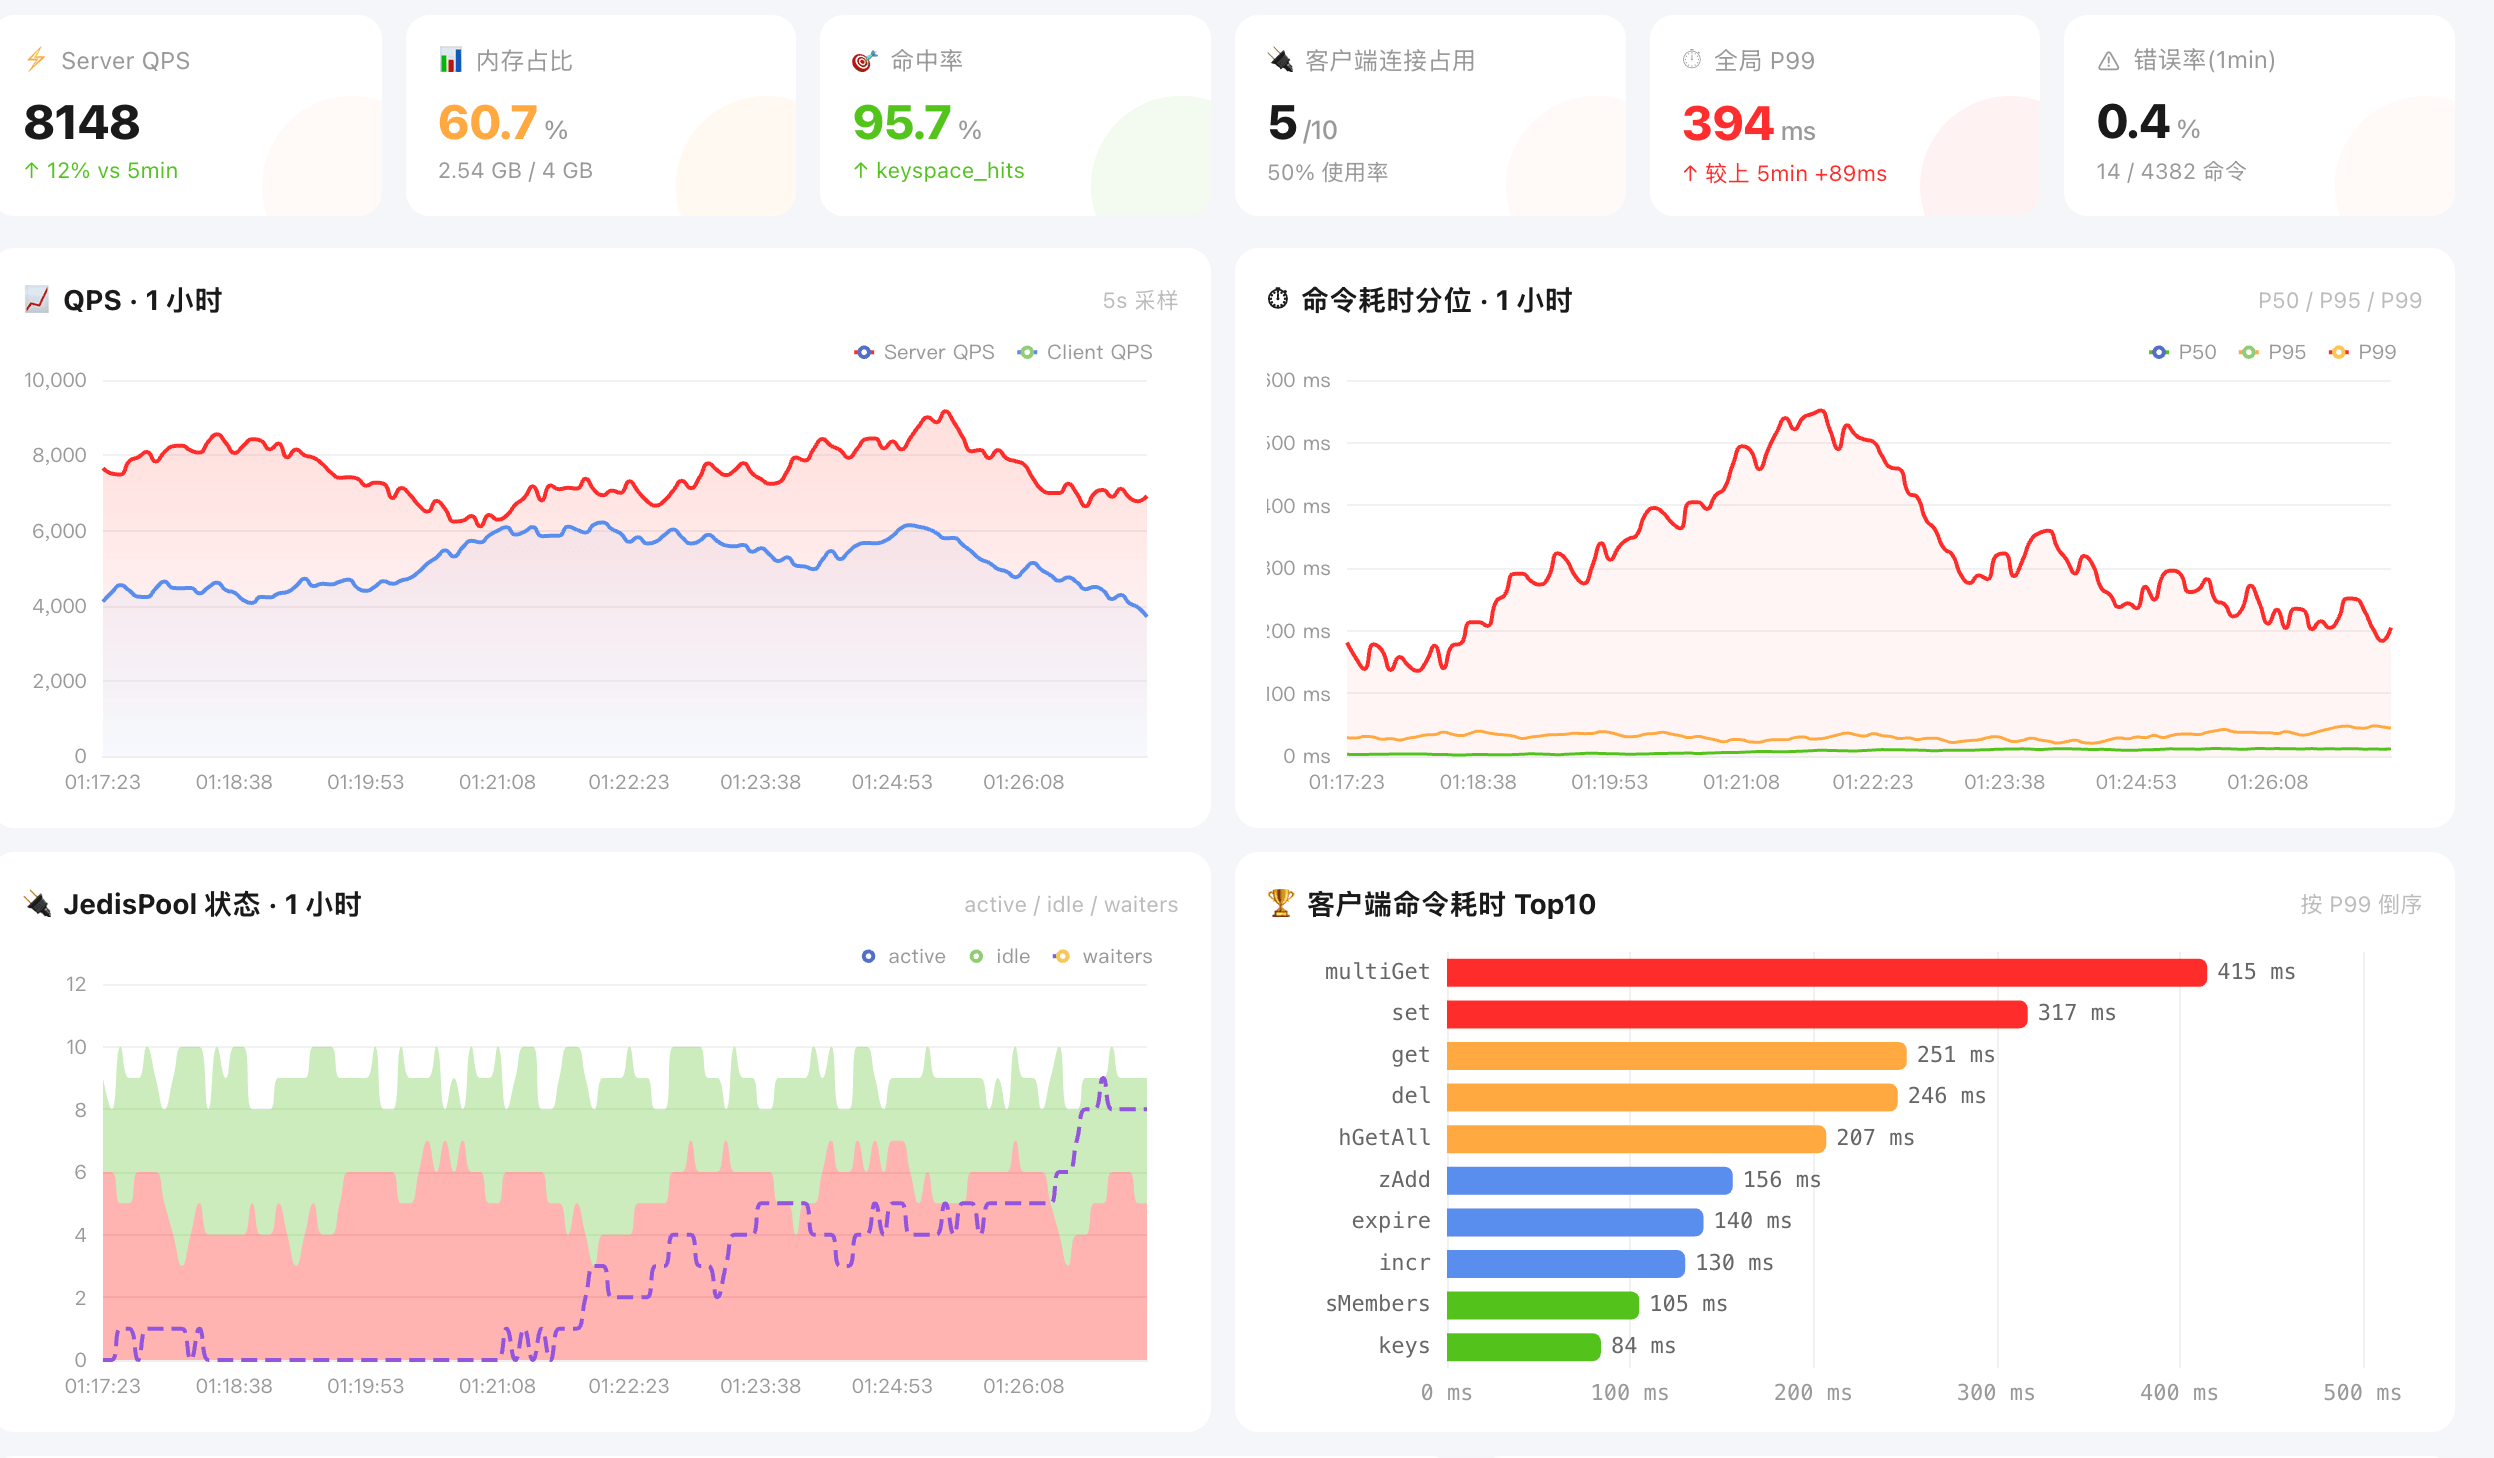
Với Redis server, dashboard cũng output và hiển thị chi tiết slow query cùng phân bố key, có thể dùng trực tiếp cho việc quan sát hằng ngày:
Tóm tắt
Lần này tôi dùng M3 để thực hiện ba task: phân tích sự cố connection pool Redis, tái hiện cursor algorithm SCAN từ C sang Go và xây dựng dashboard monitoring Redis. Điều thực sự đáng giữ lại là bằng chứng của task và các giới hạn đã bộc lộ:
- Khi khắc phục sự cố, nó đưa ra các hướng tiềm năng như data structure, atomicity, degradation và monitoring, nhưng giải thích ban đầu về cơ chế block của
SCANchưa chính xác. - Khi tái hiện tầng dưới, nó nhận diện project dùng dict tự xây dựng và phân biệt ngữ nghĩa XOR với NOT của
^trong Go; implementation vẫn phải được kiểm chứng bằng source code và test. - Dashboard monitoring bao phủ collection, buffer và presentation layer, nhưng các trade-off trong thiết kế như ring buffer chưa được lập luận đầy đủ.
Trong quá trình tái hiện Redis SCAN từ C sang Go, M3 nhận diện project đã tái hiện dict thay vì dùng Go map, trên cơ sở đó đề xuất tái hiện đầy đủ cursor của SCAN; operator ^ trong Go đồng thời có hai ngữ nghĩa XOR và NOT, phần này cũng đã được phân biệt từng dòng.
Còn trong scenario dashboard monitoring, M3 bộc lộ một giới hạn đáng chú ý: ở giai đoạn from-0-to-1, lựa chọn architecture nó đưa ra là “giải pháp thận trọng có thể chạy” chứ không phải “giải pháp tối ưu đã được cân nhắc”. Lấy ring buffer làm ví dụ, tại sao là ring buffer thay vì lock-free queue? Khi buffer đầy và ghi đè dữ liệu cũ nhất, ở QPS cao có làm mất metric quan trọng không? M3 mặc định một đáp án tiêu chuẩn cho các điểm quyết định này mà không chủ động nêu trade-off. Nếu developer không có kiến thức chuyên môn liên quan, họ không thể quyết định phương án tối ưu trong giai đoạn brainstorming — thứ cuối cùng nhận được chỉ là một prototype “có thể chạy”, không phải prototype “có thiết kế hợp lý”.
Điều này cũng quay lại quan điểm của Addy Osmani: tool không học thay bạn. M3 tạo code degradation và algorithm rev, nhưng cách model giải thích về block của SCAN và count × 10 vẫn cần document, source code và load test để hiệu chỉnh. Với tôi, giá trị của lần thử nghiệm thực tế này nằm ở đây — nó có thể tăng tốc việc đọc và implementation, nhưng kết luận engineering vẫn phải tự mình kiểm chứng.