
Thực chiến Spec Coding: Lập trình theo đặc tả từ Vibe Coding đến quy chuẩn code cho AI
Xin chào, tôi là G. Trì hoãn khá lâu rồi, giờ bù bài đây.
Spec Coding đã được các thành viên trong nhóm đề cập từ khá sớm và đề nghị viết một bài. Quả thật nó khá quan trọng: có thể dùng trong công việc, và phỏng vấn cũng bắt đầu hỏi về nó.
Tuần trước, tôi nói chuyện với đồng nghiệp về Spec Coding. Anh ấy hỏi: “Claude Code đã có thể tự viết code, tại sao còn phải dành thời gian viết quy chuẩn?”
Câu hỏi này rất thực tế. AI viết code quả thật nhanh. Với Demo, script và page dùng một lần, có thể dùng ràng buộc nhẹ hơn để kiểm chứng nhanh.
Nhưng khi áp dụng cách đó vào project phối hợp nhiều người và cần bảo trì lâu dài, thông tin thiếu sẽ biến thành rủi ro: những phần yêu cầu chưa rõ sẽ được model tự bổ sung, điều kiện biên được suy luận theo pattern thường gặp, còn error code và quy ước quyền riêng của team có thể chưa được đưa vào context. Output được tạo dựa trên pattern model đã học và context hiện tại, không phải do tự động phát hiện các ràng buộc thực tế của project.
Bài viết này chủ yếu giải thích ba vấn đề:
- Khác biệt thực tế giữa Vibe Coding và Spec Coding, cũng như khi nào nên dùng cách nào
- Quy trình triển khai Spec Coding hoàn chỉnh, từ viết yêu cầu đến để AI thực thi đúng quy tắc
- Cấu hình và quản lý Spec trong các AI IDE phổ biến (Cursor, Claude Code, Copilot...), cũng như cách ngăn AI vượt quyền
Vibe Coding không phải là không dùng được
Vibe Coding (lập trình theo cảm tính), làm theo cảm giác. Chỉ cần đưa cho AI một ý định mơ hồ, nó sẽ bắt đầu xuất code ngay.
Khi Karpathy đề cập thuật ngữ này lần đầu, ông cũng nói về cách làm kiểu ném yêu cầu cho AI, liên tục điều chỉnh theo cảm giác, thậm chí tạm thời không quá quan tâm đến chi tiết code.
Vibe Coding không phải là tội lỗi. Với các tình huống dưới đây, dùng nó còn rất phù hợp:
- Kiểm chứng một ý tưởng, trước tiên viết một Demo để xem hiệu quả
- Viết một script dùng một lần, chạy xong là bỏ
- Làm tool nhỏ nội bộ, phạm vi ảnh hưởng rất nhỏ
- Sau khi AI viết xong có test đầy đủ làm lớp bảo vệ, đồng thời không trực tiếp expose cho user bên ngoài
Trong các tình huống này, cố viết một đống Spec lại là lãng phí thời gian.
Vấn đề thật sự là: sau khi kiểm chứng ý tưởng, nhiều người tiện tay đưa code do Vibe tạo ra lên production.
Đó là chuyện khác.
Ở giai đoạn Demo, bạn có thể làm theo cảm giác vì sai thì sửa, hỏng thì xóa. Production code thì không được: sau này nó sẽ kết nối database, payment, user data và chi phí bảo trì của người khác. Nửa giờ bạn tiết kiệm hôm nay có thể biến thành vài ngày điều tra và xử lý sau này.
Tiêu chuẩn phán đoán của tôi chỉ có một: đoạn code này sẽ tồn tại bao lâu?
- Script bỏ sau hai ngày thì Vibe là đủ. Viết Spec còn làm giảm hiệu suất.
- 3-5 ngày là vùng trung gian, có thể viết Spec nhẹ. Không cần triển khai thiết kế hoàn chỉnh, chỉ viết các ràng buộc chính và tiêu chuẩn nghiệm thu, khoảng nửa giờ là đủ.
- Với code hơn một tuần, nếu cần người khác bảo trì, liên quan đến persistence dữ liệu hoặc kết nối external API thì đừng Vibe trần. Ít nhất phải viết rõ ràng ràng buộc, boundary và tiêu chuẩn nghiệm thu.
Hơn nữa, kết hợp với Spec nhẹ trong nhiều trường hợp cũng không sao, không cần quá cứng nhắc.
Spec nhẹ có thể đơn giản như sau:
## Mục tiêu task

Triển khai API export order, hỗ trợ export CSV theo khoảng thời gian.

## Ràng buộc chính

- Mỗi lần export tối đa 5000 bản ghi
- Khoảng thời gian không được vượt quá 31 ngày
- Bắt buộc kiểm tra quyền user, chỉ được export data của tenant hiện tại
- Query bắt buộc hit composite index order_tenant_time_idx
- Khi export thất bại phải ghi lại nguyên nhân thất bại, không chỉ trả về unknown error

## Tiêu chuẩn nghiệm thu

- Export CSV bình thường, thứ tự field phù hợp với quy ước của product
- Khi vượt quá 5000 bản ghi phải trả về error rõ ràng
- Không được export data của tenant vượt quyền
- Unit test bao phủ bốn scenario: thời gian trống, thời gian vượt giới hạn, không có quyền, không có data
Spec Coding thực chất là gì
Spec Coding, dịch trực tiếp là lập trình theo đặc tả. Nói đơn giản: viết rõ quy chuẩn trước, sau đó để AI làm việc.
Khi thường nhờ AI viết code, nhiều người sẽ trực tiếp ném vào một câu:
Hãy làm một user system.
AI dĩ nhiên có thể viết, nhìn qua còn khá ra dáng. Nhưng vấn đề cũng nằm ở đây: bạn không nói user system cụ thể phải như thế nào, nên nó chỉ có thể tự đoán.
User đăng ký thế nào? Email có được trùng không? Password lưu thế nào? Khi API thất bại trả về format gì? Những chức năng nào không làm trong phase này? Admin có khả năng disable user không? Nếu ngay từ đầu không viết rõ các việc này, AI sẽ không dừng lại hỏi bạn mà phần lớn sẽ bổ sung trước một bộ giải pháp mà nó cho là hợp lý.
Spec Coding làm chính là viết sẵn các quy tắc này.
Spec ở đây không phải tùy tiện viết vài câu yêu cầu, mà là một technical agreement để AI có thể làm theo. API, data structure, error code, boundary condition, yêu cầu security, giới hạn tech stack, thậm chí những thao tác không được phép chạm vào, đều phải viết trong đó.
Đó cũng là khác biệt giữa nó và Vibe Coding.
Vibe Coding giống như bạn đưa cho AI một hướng lớn rồi để nó tự do phát huy. Sau khi code được tạo ra, bạn mới nghiệm thu, sửa bug và bổ sung chi tiết. Làm vậy với script nhỏ, nhanh thì không có vấn đề gì, thậm chí còn rất sướng.
Nhưng project hơi phức tạp một chút là dễ xảy ra chuyện. Khi phát hiện AI hiểu sai, code đã được viết cả đống. Bạn quay lại kiểm tra cũng khó nói rõ rốt cuộc do yêu cầu chưa nói rõ hay AI tự phát huy lung tung.
Tóm tắt đơn giản khác biệt giữa Spec Coding và Vibe Coding: hành vi của AI do bạn định nghĩa hay do nó tự đoán?
Một cách triển khai bốn bước
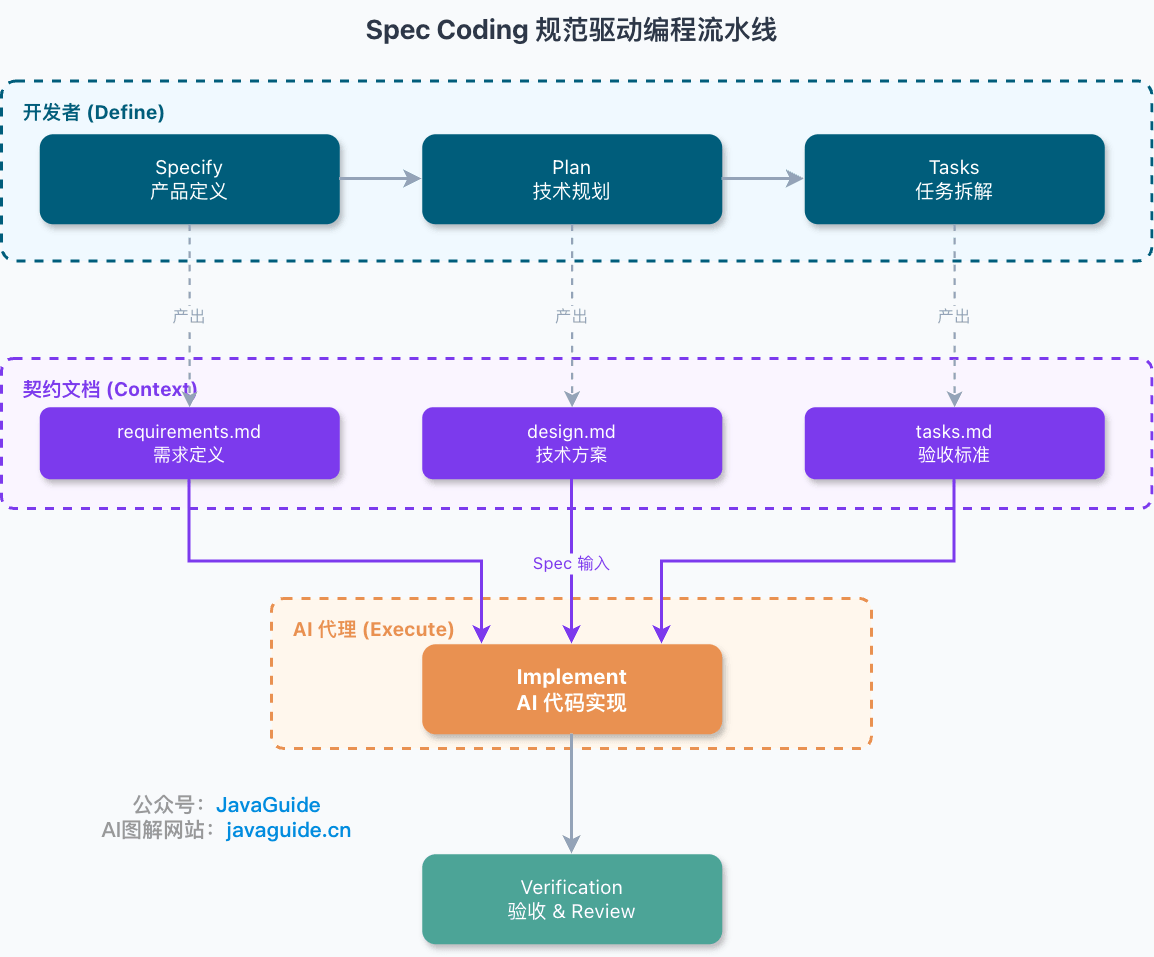
Bài viết này dùng bốn bước Specify, Plan, Tasks, Implement trong ví dụ Spec Kit của GitHub để giải thích. Đây là một workflow có thể thực hiện, không phải standard mà mọi tool Spec Coding đều tuân theo; một số team sẽ gộp phase design và task, một số tool còn bổ sung phase clarification, validation hoặc change management.
| Phase | Làm gì | Output | Action chính |
|---|---|---|---|
| Specify | Định nghĩa product | requirements.md | Làm rõ chức năng, user, pain point, định “làm gì” |
| Plan | Lập kế hoạch kỹ thuật | design.md | Chốt tech stack, architecture, contract, định “làm thế nào” |
| Tasks | Phân rã task | tasks.md | Tách thành task nguyên tử, viết tiêu chuẩn nghiệm thu |
| Implement | AI thực thi | - | AI làm theo Spec, người nghiệm thu |
Thực ra hiểu rất đơn giản, cốt lõi là viết rõ trước cần làm gì, sau đó viết rõ làm thế nào, rồi tách task và cuối cùng giao cho AI thực thi.
Specify: Trước tiên làm rõ cần làm gì
Bước đầu tiên là Specify, output thường là requirements.md, hoặc có thể gọi là spec.md.
Bước này hơi giống viết PRD, nhưng người sử dụng là AI.
Vì vậy, không thể chỉ viết hướng đi, mà phải viết cả boundary.
Ví dụ bạn viết một câu:
Làm một user system.
Con người đọc không thấy vấn đề, còn AI đọc xong sẽ bắt đầu đoán: user đăng ký thế nào? Email có được trùng không? Password có yêu cầu gì? Có làm third-party login không? Admin có thể ban user không? Sau khi bị ban thì data xử lý thế nào?
Bạn không viết thì nó tự quyết.
Cách viết ổn định hơn là:
Hỗ trợ đăng ký và đăng nhập bằng email; email phải unique; password single-factor tối thiểu 15 ký tự; tạm thời không hỗ trợ third-party login; admin có thể disable user; sau khi user bị disable thì không thể đăng nhập nhưng vẫn giữ lại data lịch sử.
Câu này giúp AI biết việc nào được làm, việc nào không được làm và boundary nào không được chạm vào.
Plan: Chốt technical solution
Bước thứ hai là Plan, thường được ghi trong design.md hoặc plan.md.
Nhiều người bỏ qua bước này vì nghĩ AI biết viết code, cứ để nó tự phát huy là được.
Sau đó vấn đề xuất hiện.
Bạn không nói dùng version Java nào, nó có thể viết code Java 8; bạn không nói version Spring Boot, nó có thể dùng cách viết cũ; bạn không nói format error code, mỗi API có thể trả về một kiểu; bạn không nói cách phân layer, nó có thể viết business logic trực tiếp trong Controller; bạn không nói cách đặt tên field, nó cũng sẽ dùng thói quen của riêng mình.
Vì vậy design.md không cần viết quá nặng, nhưng phải chốt trước một số ràng buộc chính.
Ví dụ viết như sau là đủ dùng:
## Tech stack

- Ngôn ngữ: Java 21 (LTS)
- Framework: Spring Boot 3.2.x (snapshot của project cũ hiện có; project mới chọn version theo support matrix tại thời điểm đó)
- Database: PostgreSQL 16
- Cache: Redis 7.x

## Thiết kế architecture

- Phân layer: Controller → Service → Repository
- Communication: REST API + gRPC (internal service)
- Deploy: Docker + Kubernetes

## Quy ước API

- Quy chuẩn API: OpenAPI 3.0
- Error code: format thống nhất {"code": "USER_NOT_FOUND", "message": "..."}
- Format log: JSON, bắt buộc chứa trace_id
Bạn có thể nghĩ: đây chẳng phải design document sao?
Đúng là hơi giống.
Nhưng điểm khác là design document truyền thống chủ yếu dành cho con người đọc. Đọc xong, con người biết hướng lớn, còn nhiều chi tiết có thể dựa vào thói quen của team để bổ sung. Ví dụ password không được lưu plaintext, error code phải thống nhất, log phải chứa trace_id, trong team trưởng thành thường không cần nhấn mạnh đi nhấn mạnh lại.
AI thì khác.
Bạn không viết thì nó đoán. Đoán đúng thì tốt, đoán sai thì bạn phải quay lại làm lại.
Lấy việc lưu password làm ví dụ. Nếu chỉ viết một câu “đăng nhập phải an toàn”, phạm vi quá rộng, model có thể chọn giải pháp đã lỗi thời hoặc không phù hợp với system hiện tại.
System mới có thể viết rule như dưới đây, sau đó xác định parameter bằng benchmark trên server mục tiêu:
Password được lưu dưới dạng hash Argon2id, parameter được xác định bằng benchmark trên server mục tiêu và ghi lại version của algorithm để phục vụ migration sau này.
Nếu system hiện tại bắt buộc phải tương thích với bcrypt, giữ lại việc verify hash cũ và từng bước migrate sang Argon2id sau khi user đăng nhập thành công.
Database chỉ lưu salted hash, không lưu plaintext password; sử dụng password library được maintain để tạo salt ngẫu nhiên.
Password single-factor có tối thiểu 15 ký tự, độ dài tối đa phải hỗ trợ ít nhất 64 ký tự, không bắt buộc kết hợp chữ hoa, số hoặc ký tự đặc biệt.
Khi đăng ký và đổi password, kiểm tra password bị lộ trong Blocklist, API login thiết lập rate limiting.
Các yêu cầu này đến từ OWASP Password Storage Cheat Sheet và NIST SP 800-63B-4. Security parameter vẫn phải qua architecture review và đo thực tế, không thể chỉ copy các con số ví dụ vào Spec.
Xử lý error cũng vậy. Đừng viết “khi API thất bại thì trả về thông báo thân thiện”, câu này gần như không có ràng buộc. AI có thể để API này trả về error, API kia trả về message, còn chỗ khác thì trực tiếp throw exception.
Hãy viết rõ:
{
  "code": "USER_NOT_FOUND",
  "message": "User không tồn tại",
  "trace_id": "xxx"
}
Sau đó bổ sung một đoạn quy ước status code:
Lỗi parameter trả về 400.
Chưa login trả về 401.
Không có quyền trả về 403.
Resource không tồn tại trả về 404.
Các conflict như email trùng hoặc username trùng trả về 409.
Như vậy ít nhất AI biết nên viết theo hướng nào.
Nói cho cùng, design.md chủ yếu nhằm giảm việc AI tự bổ sung thiết lập. Khi bạn viết sẵn tech stack, format API, error code, log, concurrency và security, lúc để AI viết code sau đó nó sẽ ít đi sai hướng hơn.
Tasks: Task phải nhỏ đến mức có thể nghiệm thu
Bước thứ ba là Tasks, thường được viết trong tasks.md.
Đừng ngay từ đầu bảo AI “hoàn thành user module”. Phạm vi này quá lớn. API đăng ký, đăng nhập, query, disable, permission, parameter validation, exception handling và unit test đều nhét vào một task, AI rất dễ viết rồi bỏ sót. Cuối cùng khi xem code, bạn vẫn phải bổ sung từng mục một.
Nhưng cũng đừng tách quá vụn. Tạo UserDTO, thêm field email, viết một method Service trống, những task như vậy nhìn có vẻ chi tiết nhưng thực tế sẽ làm con người kiệt sức. Thời gian bạn maintain task list có thể còn lâu hơn thời gian để AI viết code.
Độ hạt tôi thích là: một Task tương ứng với một API, một thao tác cốt lõi của một table, hoặc một chức năng nhỏ có thể nghiệm thu độc lập.
Ví dụ API đăng ký user có thể viết như sau:
### Task-001: API đăng ký user

Mô tả: Triển khai đăng ký user, bao gồm parameter validation, password hash và lưu user vào database.

Tiêu chuẩn nghiệm thu:

- [ ] Khi thành công POST /api/v1/users trả về 201
- [ ] Password mới được hash và lưu bằng parameter Argon2id đã qua benchmark
- [ ] Password single-factor tối thiểu 15 ký tự, độ dài tối đa hỗ trợ ít nhất 64 ký tự và kiểm tra password bị lộ trong Blocklist
- [ ] Các API liên quan đến login và đăng ký có rate limiting
- [ ] Email unique, đăng ký trùng trả về 409
- [ ] Response body bắt buộc chứa user_id, email, created_at
- [ ] Branch coverage đạt baseline theo quy ước của project (ví dụ này là 80%), đồng thời mọi security branch quan trọng đều có assertion

Thời gian ước tính: 2h
Điều thực sự có giá trị ở đây là tiêu chuẩn nghiệm thu. “Đảm bảo security”, “code elegant”, “performance tốt” - viết cũng gần như không viết, AI không biết security trong suy nghĩ của bạn cụ thể là gì, elegant đến mức nào.
Nhưng parameter Argon2id đã qua benchmark, email trùng trả về 409, response body chứa user_id, email, created_at, cùng việc test các branch quan trọng - những thứ này đều có thể kiểm chứng, không cần dựa vào cảm giác.
Đừng máy móc áp dụng ngưỡng coverage. Team nên xác định baseline dựa trên risk của module, defect lịch sử và loại test; quan trọng hơn một phần trăm đơn lẻ là các branch quan trọng như permission, số tiền, state migration, retry và exception compensation có assertion hiệu lực hay không.
Implement: Để AI làm việc
Prompt không cần làm quá huyền bí, chỉ cần đưa Spec liên quan vào:
Hãy triển khai Task-001 theo Spec dưới đây.

Mô tả yêu cầu:
[Dán các đoạn liên quan trong requirements.md]

Ràng buộc kỹ thuật:
[Dán các đoạn liên quan trong design.md]

Tiêu chuẩn nghiệm thu của task:
[Dán Task-001 trong tasks.md]
Có một điểm cần tránh: đừng nhồi toàn bộ Spec vào context cùng một lúc.
Trong một session, tôi sẽ ưu tiên đưa vào ba loại nội dung:
- Ràng buộc global, như code style, format error code và quy chuẩn log;
- Mô tả yêu cầu của task hiện tại;
- Tiêu chuẩn nghiệm thu của task hiện tại.
Các nội dung khác bổ sung khi cần, đừng vì “đầy đủ” mà dán toàn bộ document vào.
Không có ngưỡng 3000–8000 Token dùng chung cho mọi model và task về lượng Token nên đưa vào một lần. Cách thực tế hơn là trước tiên đưa vào hard constraint global, task hiện tại và tiêu chuẩn nghiệm thu, sau đó đọc evidence khi cần thông qua index hoặc file path; khi tài liệu không liên quan bắt đầu gây nhiễu phán đoán, hoặc task có thể tách độc lập, hãy tách session.
Đừng mong model có thể quan tâm hết mọi thứ trong context đặc biệt dài. Context càng dài, thông tin quan trọng càng có khả năng bị chôn ở giữa, cuối cùng lại bỏ sót constraint quan trọng nhất.
Tôi sẽ tuân thủ ba nguyên tắc:
Thứ nhất, ghi quy ước vào document, đừng chỉ ghi trong chat. Lần sau chat history rất có thể không nối tiếp được, còn document là context có thể tái sử dụng.
Thứ hai, tiêu chuẩn nghiệm thu có thể định lượng thì hãy định lượng. “Performance cao” không thể nghiệm thu, còn QPS > 1000, P95 < 200 ms, branch coverage >= 80% thì có thể nghiệm thu.
Thứ ba, Spec phải vào Git và đi cùng code. Code thay đổi thì Spec cũng phải sửa. Nếu không, lần sau tiếp tục để AI phát triển, thứ nó nhận được sẽ là một bản mô tả đã lỗi thời.
Sau khi thông suốt bước này, AI sẽ không đột nhiên thông minh hơn, nhưng không gian tự đoán sẽ nhỏ đi nhiều.
Tiếp theo còn một vấn đề rất thực tế: rốt cuộc đặt các Spec này ở đâu, làm thế nào để tool lần nào cũng đọc được?
Triển khai Spec trong AI IDE
Sau khi viết xong Spec, có một vấn đề thường bị bỏ qua: những file này rốt cuộc đặt ở đâu? Làm thế nào để AI tự động đọc?
Các tool phổ biến đều có cơ chế file quy chuẩn riêng:
| Tool | Vị trí file quy chuẩn | Phạm vi | Cách load |
|---|---|---|---|
| Cursor | .cursor/rules/*.mdc (hiện tại) hoặc .cursorrules (Legacy) | Cấp project / global | Rules có thể đặt Always apply hoặc bổ sung theo glob |
| Claude Code | CLAUDE.md, .claude/rules/*.md | Cấp project / directory | Rule root thường trực, rule trong subdirectory hoặc có paths được load theo file được truy cập |
| GitHub Copilot | .github/copilot-instructions.md, .github/instructions/*.instructions.md, AGENTS.md | Cấp repository / path | Repository instruction, path-level Instructions và Agent instruction được load theo capability của client hiện tại |
| Windsurf | .windsurf/rules/*.md, AGENTS.md (project cũ có thể vẫn có .windsurfrules) | Cấp project / directory | Workspace Rules và AGENTS.md cấp directory được load theo scope |
| Aider | CONVENTIONS.md (root repository) | Cấp project | Thông qua --read CONVENTIONS.md, hoặc tự động load read: trong .aider.conf.yml |
Đến đây, một vấn đề khác cũng nảy sinh: Cursor, Claude Code, Copilot là các entry point để viết code hằng ngày, vậy những tool chuyên xoay quanh Spec Coding như Superpowers, Spec-Kit, Open Spec, Kiro, BMAD-METHOD rốt cuộc nên chọn thế nào?
Triển khai vấn đề này sẽ khá dài, tôi định để riêng trong bài tiếp theo. Ở đây trước tiên làm rõ cách viết Spec, cách đặt Spec và cách quản lý AI.
Biết đặt ở đâu xong, vẫn còn một vấn đề: Spec nào được inject mỗi lần, Spec nào chỉ đưa vào khi cần?
Trong thực tế, tôi thường chia thành hai layer.
Gần như session nào cũng phải đưa vào (bắt buộc inject):
- Tech stack: ghi rõ version và library chính, ví dụ Go 1.21 + Gin + GORM + PostgreSQL 14. Đừng để AI tự đoán version.
- Code style: đưa ra path của một số file “golden standard” hoặc đoạn code ngắn, thể hiện naming, exception handling và format return. Đừng cố định nhồi 150–200 dòng code vào context every-session.
- Boundary condition: dùng nhãn ba màu (sẽ nói sau) để phân định rõ việc nào được làm, việc nào phải hỏi và việc nào tuyệt đối không được chạm vào.
Đặt các nội dung này trong file rule always-on của tool để tự động inject ở mỗi session.
Chỉ đưa vào khi liên quan đến task hiện tại (inject theo nhu cầu):
- Tầm nhìn project: dùng một hai câu nói rõ tại sao làm project này, ví dụ “tách user service khỏi monolith và viết lại bằng Go, giữ tương thích API”. Chỉ cần đưa một lần khi bắt đầu task mới.
- Danh sách command: liệt kê command build, test, run, ví dụ
make build,go test ./.... Đưa vào khi thực hiện task. - Cấu trúc directory: dùng tree để nói rõ code, test và document lần lượt đặt ở đâu. Chỉ cần khi có file mới.
- Quy chuẩn Git: branch name, commit message và yêu cầu PR. Đưa vào khi thao tác Git.
Cách chia này dựa trên tần suất sử dụng: ràng buộc global gần như session nào cũng phải tuân thủ nên đáng để thường trực. Các nội dung khác thêm theo task để tránh nhồi quá nhiều nội dung không liên quan vào context. Spec đưa càng nhiều, AI càng dễ bỏ sót một vài điều thực sự quan trọng.
Nhãn ba màu: AI được làm gì và không được làm gì
Khi gặp thao tác không chắc chắn, AI nên tự quyết định hay dừng lại hỏi bạn?
Ba màu, ba loại quyền.
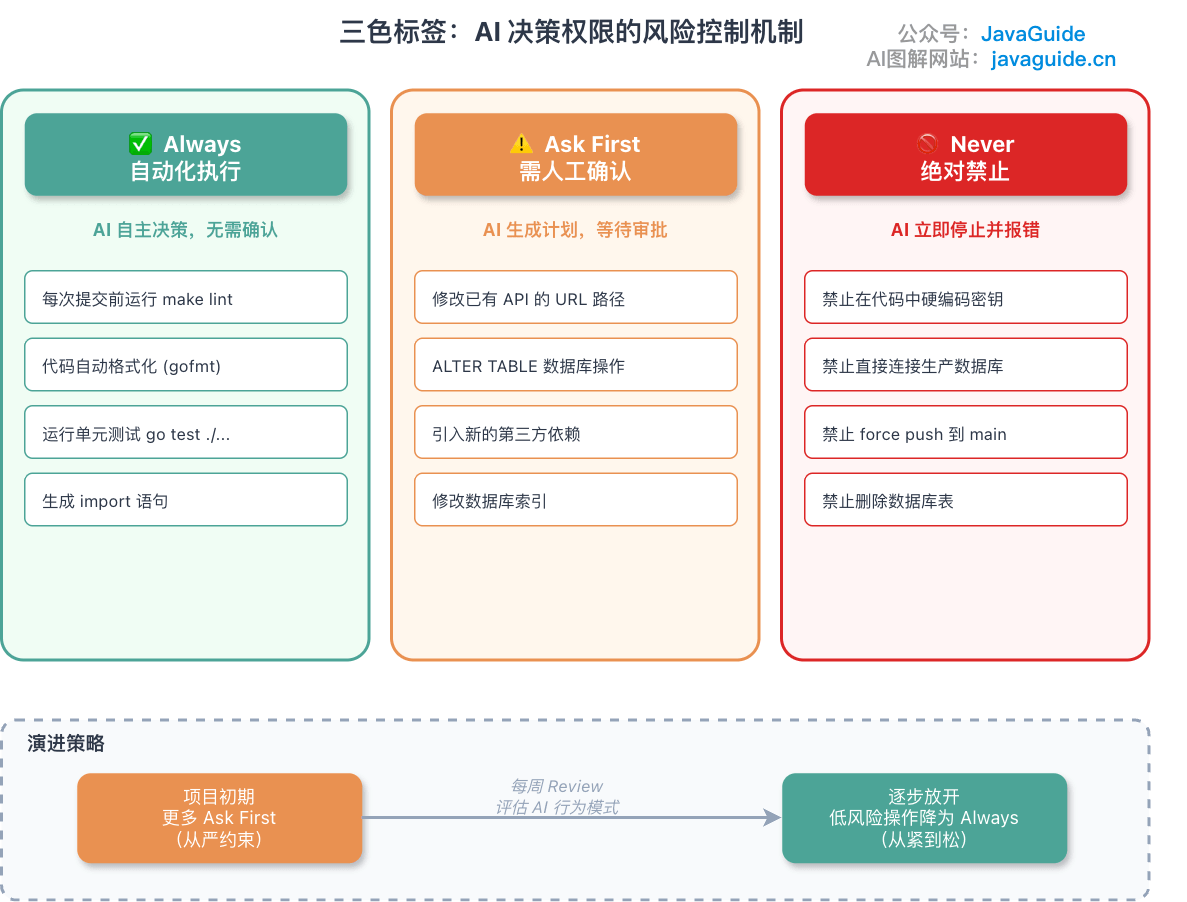
- ✅ Always (tự động thực thi): các việc như kiểm tra code, test và format có thể để AI tự quyết. Ví dụ tự động chạy
make linttrước khi commit. - ⚠️ Ask first (cần xác nhận): thay đổi có thể ảnh hưởng đến module khác thì AI đưa ra phương án để bạn review. Thay đổi database index hoặc API route thuộc nhóm này.
- 🚫 Never (tuyệt đối cấm): kết nối trực tiếp production database, commit secret, xóa data trên production. Khi gặp việc này AI phải dừng và báo lỗi.
Khi triển khai, có vài việc dễ bị bỏ qua.
Ban đầu nên nghiêm ngặt hơn là nới lỏng. Đặt nhiều việc vào Ask First, sau một tuần xem những thao tác nào AI lần nào cũng làm đúng rồi mới chuyển sang Always.
Rule phải viết cụ thể. “Thay đổi quan trọng cần xác nhận” là câu AI không thể thực thi, vì nó không biết thế nào là “quan trọng”. Phải viết thành “thay đổi URL path của API hiện có cần xác nhận”. “Cẩn thận khi thao tác database” cũng không được, phải viết “thao tác ALTER TABLE cần xác nhận”.
Rule Never không thể chỉ dựa vào ý thức của AI. Chỉ viết “cấm kết nối trực tiếp production database” trong document thì không thể thực sự ngăn nó. AI sẽ không chủ động kiểm tra output của mình có vi phạm hay không. Rule Never cần nhiều lớp bảo vệ:
- Spec declaration: ảnh hưởng đến xu hướng generate của AI nhưng không ngăn được
- Config template: không đặt secret thật trong
.env.example, AI sẽ không có gì để copy - Pre-commit hook: dùng regex quét hard-coded secret và production connection string, tự động chặn khi commit
- AI IDE config: dùng permission rule và sandbox để giới hạn phạm vi đọc;
.cursorignorecó thể giảm index và context access nhưng không phải security boundary hoàn chỉnh - Cô lập secret: credential production không được đặt trong workspace mà Agent có thể truy cập, sử dụng credential ngắn hạn với quyền tối thiểu
Rule Never càng quan trọng thì càng phải đẩy việc kiểm tra cứng xuống layer CI. Dừng ở bước “đã viết trong document” thì sớm muộn cũng xảy ra sự cố.
Mỗi tuần xem lại một lần. AI có thường xuyên dừng lại hỏi không? Nếu có, một số thao tác trong Ask First có thể được cho phép. AI có lén làm việc không nên làm không? Nếu có thì bổ sung Never. Project có xuất hiện thao tác nhạy cảm mới không? Hãy thêm vào.
Project lớn rồi thì quản lý Spec thế nào
Project nhỏ có ít Spec, chỉ cần thủ công đưa vào context là được. Khi có nhiều module mà nhồi hết vào context thì sẽ hỏng, AI nhìn thấy một đống constraint không liên quan đến task hiện tại và càng dễ đi sai hướng.
Hãy chọn strategy theo quy mô.
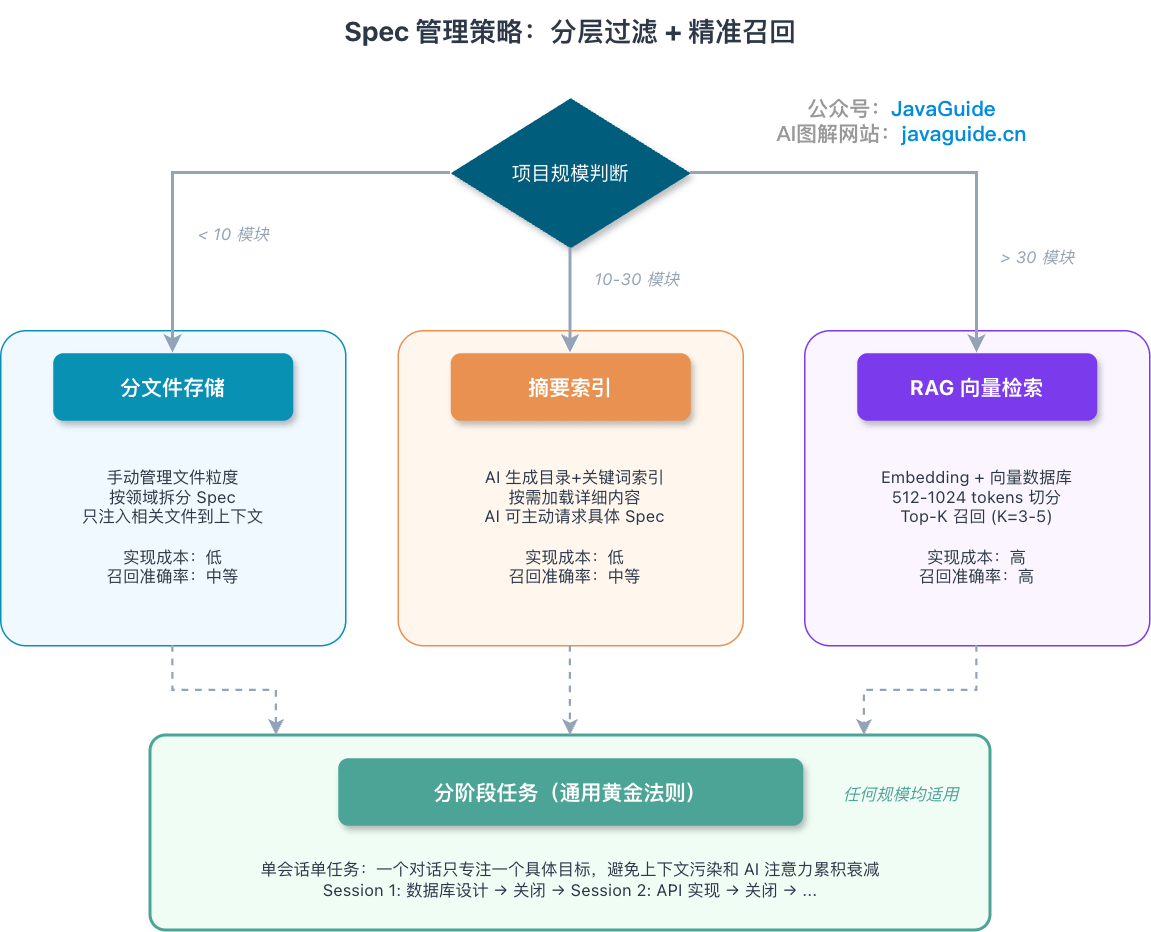
Khi rule chưa nhiều: lưu theo từng file
Chỉ cần tách theo domain:
specs/
├── global/              # Ràng buộc global
│   ├── conventions.md   # Quy chuẩn code
│   └── architecture.md  # Tổng quan architecture
├── backend/             # Đặc tả backend
│   ├── api/
│   ├── service/
│   └── persistence/
├── frontend/            # Đặc tả frontend
└── shared/              # Contract dùng chung
    └── dto.md
Mỗi lần chỉ đưa hai ba file liên quan đến task hiện tại vào, đừng tham nhiều.
Khi chọn thủ công bắt đầu vất vả: index tóm tắt
Chọn file thủ công bắt đầu mệt thì hãy để AI tạo trước một index gồm directory và keyword:
## Index Spec

- [Thiết kế database](specs/db/schema.md) - Keyword: PostgreSQL, tối ưu index
- [User API](specs/backend/api/user.md) - Keyword: REST, JWT, authentication
- [Order service](specs/backend/service/order.md) - Keyword: transaction, idempotent
Khi cần chi tiết thì để AI chủ động yêu cầu, không cần bơm toàn bộ vào.
Khi index keyword thường xuyên bỏ sót việc truy hồi: đánh giá RAG
Không thể chỉ dựa vào số lượng module để quyết định có cần dùng RAG hay không. Trước tiên quan sát một vài tín hiệu: cùng một concept bị phân tán trong nhiều document, tìm kiếm bằng keyword thường xuyên bỏ sót cách diễn đạt đồng nghĩa, việc con người chọn context đã ảnh hưởng đến delivery, đồng thời team có thể maintain permission, index update và evaluation set. Sau khi đáp ứng các điều kiện này mới đánh giá full-text search, vector search hoặc hybrid search.
Chunk size, Top-K và similarity threshold đều phải được tuning theo Embedding model, cấu trúc document và task evaluation. Phân bố similarity của các model khác nhau, không thể trực tiếp dùng lại Top-K 3–5, > 0.7 giữa các model. Trước khi đưa lên production, ít nhất phải chuẩn bị một nhóm câu hỏi thực tế để đánh giá recall, false recall, latency và cost, đồng thời bảo đảm permission filter xảy ra trước khi kết quả đi vào model.
Một điều hiệu quả với mọi quy mô: một session một task
Session 1: Thiết kế database
├── Input: global/conventions.md + backend/db/
├── Output: hoàn thành thiết kế entity
└── Đóng session

Session 2: Implement API
├── Input: Output của Session 1 + backend/api/
├── Output: hoàn thành Controller
└── Đóng session
Context sạch sẽ giúp AI không bị các phần thừa của task trước kéo đi. Điều này hữu ích hơn mọi strategy retrieval cầu kỳ.
Tại sao domain knowledge quan trọng đến vậy
Dù training data của AI nhiều đến đâu, nó cũng không biết các rule đặc thù trong project của bạn, bạn phải chủ động nói cho nó.
Ví dụ bạn làm một project mall, trong đó có rule coupon và flash sale không được cộng dồn. Nếu không ghi rule này vào Spec, AI rất có thể sẽ tính cả hai discount. Code chạy được, test cũng có thể pass, nhưng business sai hoàn toàn.
Những knowledge kiểu này thường có thể chia thành vài loại:
- Business rule: coupon và flash sale không được cộng dồn, một user mỗi ngày chỉ được nhận reward một lần
- Ràng buộc kỹ thuật: pagination của order phải dùng composite index được chỉ định; deep pagination (> 100 page) chuyển sang cursor, cấm full-table scan
- Technical debt lịch sử: external upload API chỉ hỗ trợ 5 MB, vượt quá sẽ báo lỗi nên phải validation trước trong code
- Baseline performance: query trên một table phải kiểm soát trong 50 ms; API quan trọng vượt quá 200 ms thì phải cân nhắc degrade hoặc fallback
Những thứ này là boundary của AI khi viết code.
Hiện nay nhiều tư duy Spec-Driven Development chính là biến Spec từ “document viết cho người đọc” thành “rule ràng buộc AI generate code”.
Đừng nghĩ Spec chỉ dùng ở giai đoạn đầu, khi implement, validation và maintenance sau đó cũng cần dùng.
Tuy nhiên, chỉ ghi rule vào vẫn chưa đủ, tốt nhất bổ sung thêm một self-checklist. Vì AI rất dễ viết xong chức năng là kết thúc, không chủ động quay lại xác nhận các constraint ẩn này.
Checklist tự kiểm tra sau khi hoàn thành
Sau khi viết xong task, đừng để AI chỉ nói một câu “đã hoàn thành”.
Ít nhất hãy để nó tự rà soát một lượt theo checklist. Ví dụ sau khi hoàn thành Task-001, bắt buộc xác nhận từng mục:
Nếu có mục nào không thể xác nhận thì không được làm qua loa, phải viết rõ nguyên nhân.
AI rất dễ coi việc viết xong code là hoàn thành task. Nhưng trong project thực tế, chức năng chạy được mới chỉ là bước đầu; format error, index hit, boundary test và kiểm soát complexity mới là những thứ giúp bạn ít phải chịu trách nhiệm hơn về sau.
Cạm bẫy khi phối hợp multi-agent
Có người sẽ hỏi: một AI không đủ dùng, vậy dùng thêm vài AI có được không?
Được, nhưng cạm bẫy nhiều hơn bạn nghĩ.
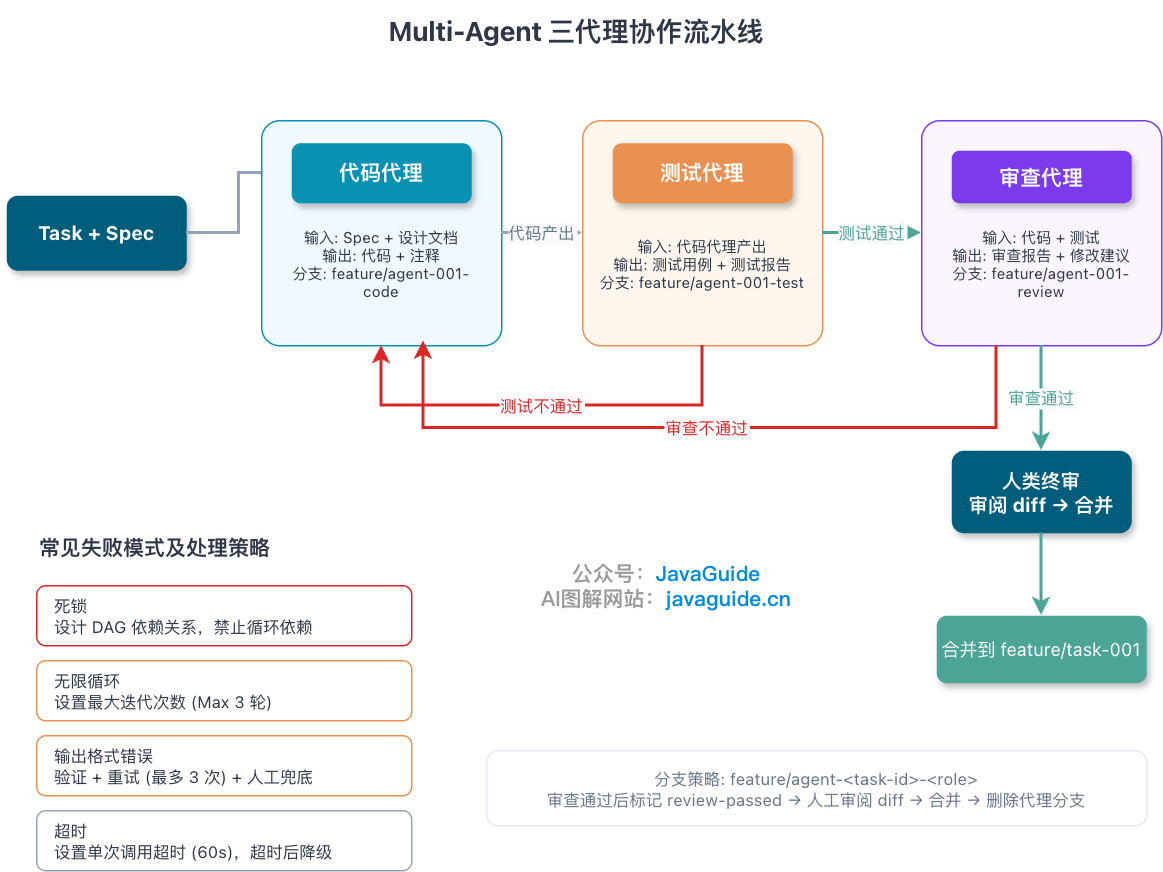
Ý tưởng phối hợp ba agent là code, test và review mỗi bên phụ trách một đoạn, tiến hành theo pipeline. Code agent nhận Task và viết chức năng, viết xong giao cho test agent viết case và chạy test, pass rồi giao cho review agent kiểm tra chất lượng code, cuối cùng con người review lần cuối và merge.
Có một cạm bẫy phải nói rõ trước: test agent viết test trên branch riêng, nhưng code được test nằm trên branch của code agent. Hai branch này song song, test agent phải merge code branch trước hoặc hoàn toàn không thể chạy.
Hai mode có thể chạy thông suốt:
Cùng một branch tuần tự (khuyến nghị khi bắt đầu). Ba agent dùng chung một feature branch và lần lượt commit, phân biệt role bằng prefix trong commit message. Đơn giản, không có merge conflict, phù hợp với phần lớn project.
git commit -m "[code] implement user registration API"
git commit -m "[test] add unit tests for user registration"
git commit -m "[review] fix null check in email validation"
Kế thừa theo chain (sau khi capability của agent đã được kiểm chứng). Test agent checkout từ code branch, review agent checkout từ test branch, cuối cùng merge review branch về mainline. Các branch có quan hệ kế thừa thay vì song song, mỗi agent đều nhìn thấy output của agent trước đó.
Các scenario multi-agent bị fail có khá nhiều: deadlock (A đợi B, B đợi A, khi design phải bảo đảm dependency là DAG), infinite loop (agent tự iterate không dừng, đặt số vòng tối đa Max 3), sai format output (JSON parse thất bại, thêm validation và retry, tối đa 3 lần). Đặt sẵn các fallback này giúp tránh phần lớn vấn đề.
Nói thật, phần multi-agent này tôi cũng vẫn đang tìm hiểu. Kinh nghiệm hiện tại là mode cùng một branch tuần tự có thể bao phủ 80% scenario, còn orchestration phức tạp thì nếu team không có người chuyên maintain, xác suất fail không thấp.
Spec không phải viết xong là bỏ
Sau khi chạy vài project, tôi cố định một số thói quen.
Tinh chỉnh dần. Đừng nghĩ phải viết một Spec hoàn hảo trong một lần. Trước tiên viết outline cấp cao, để AI chạy được skeleton, sau đó bổ sung chi tiết từng module.
Tổ chức theo module. API, database, style convention, error code và permission rule mỗi loại một file. Mỗi lần chỉ đưa context cần cho task hiện tại vào AI.
Iterate liên tục. Mỗi lần Code Review phát hiện vấn đề, hoặc AI lại mắc cùng một lỗi, quay lại sửa Spec. Chỉ sửa code mà không sửa quy chuẩn thì lần sau vẫn mắc lỗi như cũ.
Có một scenario thường xuyên fail đáng để nói riêng: khi Task-001 hoàn thành, Spec quy định error format là {"code": "USER_NOT_FOUND", "message": "..."}, hai tuần sau Spec update thêm field trace_id nhưng code của Task-001 đã không còn ai quản lý. Quy chuẩn và implementation cứ thế âm thầm lệch nhau.
Cách xử lý: khi Spec thay đổi, đánh giá phạm vi ảnh hưởng. Có thể duy trì trong mỗi file Spec một danh sách “module phụ thuộc file này”; khi Spec update thì chủ động trigger regression test của module bị ảnh hưởng. Thêm một điều kiện trong CI pipeline: khi file Spec thay đổi, tự động chạy test của module liên quan.
Chia sẻ một số template Spec
Tôi thường dùng ba loại này, chọn một theo scenario là được.
Template một: kiểu OpenAPI, phù hợp phát triển API
## API: POST /api/v1/users

### Thông tin cơ bản

- **Endpoint**: `/api/v1/users`
- **Method**: POST

### Request parameter

| Field    | Type   | Bắt buộc | Ràng buộc                                                                                               | Ví dụ            |
| -------- | ------ | -------- | ------------------------------------------------------------------------------------------------------- | ---------------- |
| email    | string | Có       | Format email                                                                                            | user@example.com |
| password | string | Có       | Password single-factor tối thiểu 15 ký tự, tối đa hỗ trợ ít nhất 64 ký tự; không bắt buộc kết hợp ký tự | -                |

### Response format

- **201 Created**: Tạo user thành công

  ```json
  { "id": "uuid", "email": "user@example.com", "created_at": "..." }
  ```

- **409 Conflict**: Email đã tồn tại
  ```json
  { "code": "EMAIL_ALREADY_EXISTS", "message": "Email already exists" }
  ```

### Tiêu chuẩn nghiệm thu

- [ ] Password mới sử dụng parameter Argon2id đã benchmark trên server mục tiêu
- [ ] Password được kiểm tra trong Blocklist password bị lộ, API đăng ký và login có rate limiting
- [ ] Tính unique của email được bảo đảm bằng database unique index
- [ ] Branch coverage đạt baseline theo quy ước của project (ví dụ: 80%), mọi security branch quan trọng đều có assertion
Template hai: kiểu Gherkin, phù hợp BDD
Feature: User login

  Scenario: Login bằng credential hợp lệ
    Given User đã đăng ký email "test@example.com" và password "CorrectHorse123!"
    When User gửi login request
    Then Trả về status code 200 và JWT token
    And Token có thời hạn 24 giờ

  Scenario: Login bằng password không hợp lệ
    Given User đã đăng ký email "test@example.com"
    When User gửi login request bằng password sai
    Then Trả về 401
    And Thông báo lỗi là "Invalid credentials"
    And Không tiết lộ email hay password sai cụ thể
Template ba: kiểu Checklist, phù hợp code review
## Code Review Checklist

### Tính năng

- [ ] Implementation phù hợp với mô tả trong Spec
- [ ] Đã xử lý boundary condition: giá trị trống, vượt giới hạn, concurrency
- [ ] Exception handling đầy đủ

### Chất lượng

- [ ] Độ dài function <= 50 dòng
- [ ] Cyclomatic complexity phù hợp với ngưỡng static check của project, exception có record review
- [ ] Không có code trùng lặp (DRY)

### Security

- [ ] Không hard-code thông tin nhạy cảm
- [ ] Input đã được validation/escape
- [ ] Đã thêm permission check
Những cạm bẫy từng gặp
Nói về vài lỗi tôi từng gặp.
Viết constraint quá cứng khiến AI không còn sự linh hoạt bình thường. Ví dụ bạn quy định sẵn signature của mọi method trong Service layer, AI đến cả tên parameter cũng không dám đổi. Spec quy định boundary, không phải pseudo-code từng dòng.
Ngược lại, viết quá ít constraint còn thường gặp hơn. Boundary quan trọng không được định nghĩa thì AI tự đoán. Đoán đúng là may mắn, đoán sai là chuyện thường ngày. Có một project, AI dùng MD5 để lưu password chỉ vì Spec không viết dùng algorithm mã hóa nào.
Spec thay đổi nhưng không đồng bộ là việc kín đáo nhất. Code và document dần đi lệch, lần sau AI nhận được vẫn là quy chuẩn cũ, code viết ra đương nhiên cũng không khớp.
Thêm một lỗi nữa: chỉ viết mà không kiểm tra. Spec viết cả đống nhưng không nối vào CI, cuối cùng biến thành hình thức. Viết xong không ai kiểm tra thì gần như không viết.
Nút merge đó, bạn luôn phải tự mình nắm giữ.