
Giải thích chi tiết hệ thống memory của Claude Code: chọn Markdown, Auto Memory hay vector retrieval?
Mở một session Claude Code mới, vậy mà nó biết dự án này chạy test thế nào, coding style ra sao, thư mục nào không được tùy tiện sửa, thậm chí còn nhớ bạn từng sửa một câu: “Integration test đừng dùng H2, phải kết nối MySQL thật”.
Chẳng lẽ model đã nhớ toàn bộ cuộc trò chuyện lần trước?
Khả năng cao là không. Mỗi lần inference, LLM vẫn chỉ nhìn thấy input của lượt hiện tại. Claude Code có thể tiếp nối giữa các session là nhờ hệ thống file và logic loading bên ngoài model: quy tắc nào luôn được nạp, kinh nghiệm nào trước tiên được đưa vào index, nội dung nào chỉ được đọc khi liên quan đến task.
Bài viết này bổ sung cho 《Hệ thống memory của AI Agent》. Bài đó trình bày memory của Agent nói chung: short-term memory, long-term memory và cơ chế memory evolution. Đặt vào Claude Code, câu hỏi trở nên cụ thể hơn: CLAUDE.md rốt cuộc nên chứa gì? Auto Memory ghi lại những gì? .claude/rules/ và claude-mem, memsearch của bên thứ ba nên phân công thế nào?
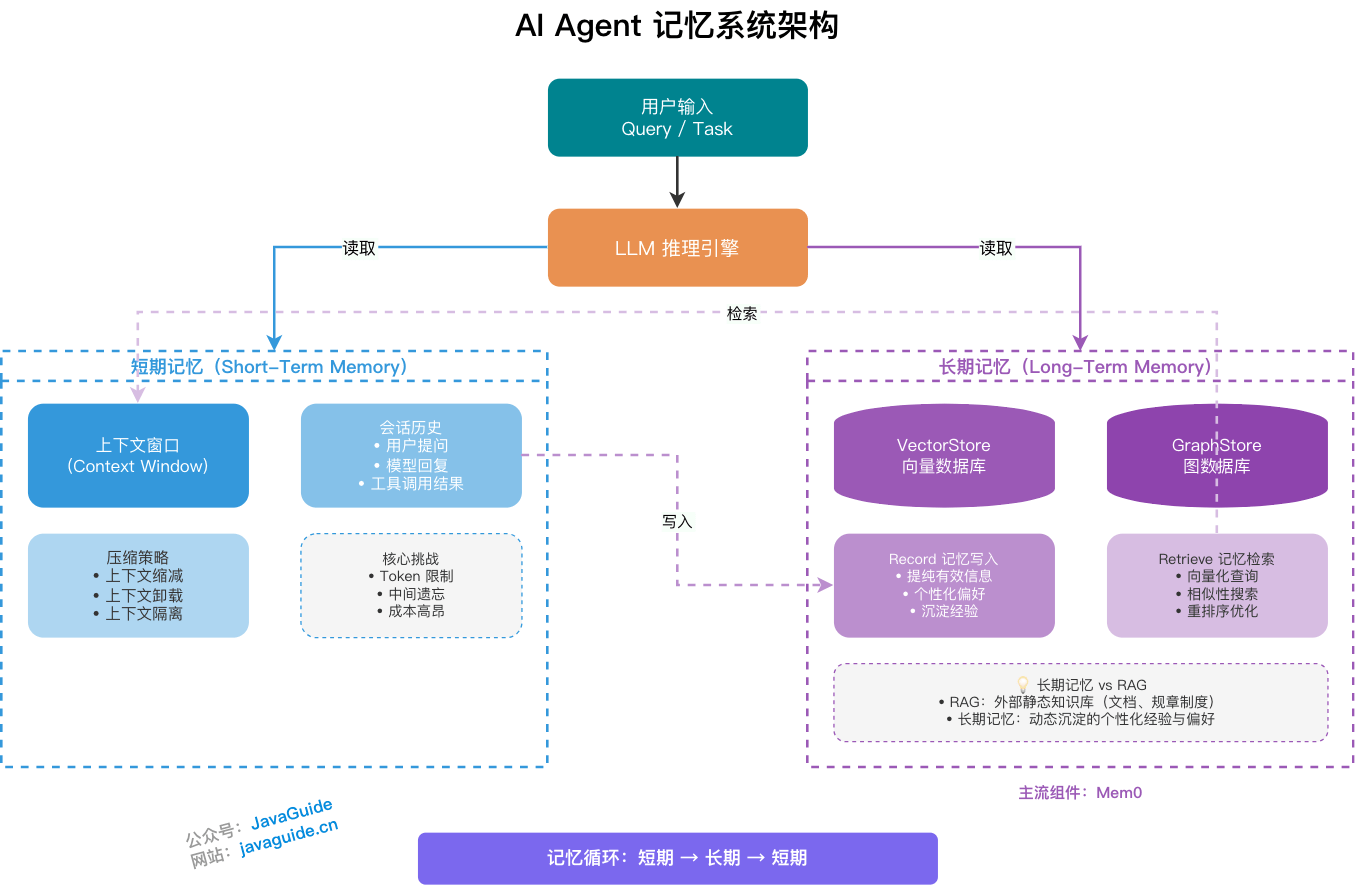
LLM không tự lưu state giữa các session
Trước hết cần làm rõ điểm này: bản thân model không âm thầm lưu state giữa hai request.
Trong một lần gọi, client ghép system prompt, lịch sử hội thoại, kết quả trả về của tool và câu hỏi mới của user lại với nhau, rồi model tạo output tiếp theo dựa trên những nội dung đó. Sang lượt sau model có thể “nhớ” được chỉ vì application layer lại đưa nội dung liên quan trở lại.
Chat thông thường không dễ bộc lộ vấn đề này. Bạn trò chuyện liên tục hàng chục lượt, client đưa phần trước vào, model tự nhiên có thể tiếp lời. Nhưng bối cảnh Agent phức tạp hơn nhiều: nó đọc file, chạy command, gọi tool, lấy log, mỗi kết quả trả về đều ngốn context. Sau vài lượt, cửa sổ context bị nhồi đầy tài liệu tạm thời, còn các quy tắc dài hạn lại bị trộn lẫn vào đó.

Nếu ví von theo hướng engineering, Context Engineering hơi giống làm “memory management” cho LLM: context window có dung lượng hữu hạn, điều thực sự cần quản lý là thông tin nào thường trú, thông tin nào đọc on-demand, thông tin nào hết hạn thì loại bỏ. Khi token khan hiếm, summarization, compression, retrieval và lựa chọn ưu tiên về bản chất đều đang xử lý cùng một vấn đề: đừng để nội dung giá trị thấp lấn át context thực sự cần cho task hiện tại.
Tôi đã trình bày riêng việc tổ chức context, khi nào loading on-demand và khi nào compression trong 《Context Engineering là gì? Khác gì với Prompt Engineering?》, nên ở đây không giới thiệu lại để tránh dài.
Quay lại Claude Code, long-term memory trước tiên cần trả lời các câu hỏi sau:
- Thông tin nào đáng lưu dài hạn?
- Lưu ở đâu, ai có thể nhìn thấy?
- Khi khởi động nên load bao nhiêu, trong task bổ sung thế nào?
- Khi memory hết hạn, xung đột hoặc bị codebase bác bỏ, làm sao phát hiện và dọn dẹp?
Nhiều vấn đề mắc ngay ở mục đầu tiên: rốt cuộc điều gì đáng ghi vào.

Đừng nhầm lẫn rule với kinh nghiệm
Long-term context của Claude Code trước hết có thể chia thành hai loại: rule do con người viết cho Claude và kinh nghiệm Claude tự tích lũy khi làm việc.
CLAUDE.md thuộc loại thứ nhất. Nó giống một tài liệu hướng dẫn công việc trước khi session bắt đầu: coding convention, command thường dùng, ràng buộc thư mục, quy trình của team, khu vực không được chạm vào đều nên viết ở đây. Tài liệu chính thức xếp nó vào instructions and rules.
Auto Memory thuộc loại thứ hai. Nó ghi lại các pattern Claude gặp trong project, chẳng hạn build command, kinh nghiệm debug, user preference và một số vấn đề lặp đi lặp lại. Tài liệu chính thức xếp nó vào learnings and patterns.
Cả hai đều đi vào session, nhưng trách nhiệm khác nhau:
| Cơ chế | Ai viết | Phù hợp để lưu gì | Cách load mặc định |
|---|---|---|---|
CLAUDE.md | Người | Rule ổn định, convention của project, quy trình cộng tác | Load ở mỗi session |
| Auto Memory | Claude | Kinh nghiệm, preference, pattern phát hiện trong lúc làm việc | Load 200 dòng đầu hoặc 25KB của MEMORY.md ở mỗi session |
Hai loại này tốt nhất nên được tách bạch. Rule nên do con người duy trì vì gần với quy ước của team hơn; còn kinh nghiệm có thể để Claude ghi nhớ, nhưng trước khi sử dụng vẫn nên quay lại code hiện tại để kiểm tra.
CLAUDE.md: đặt các rule phải xem mỗi lần
Cách viết cụ thể cho CLAUDE.md tôi đã trình bày riêng trong 《Best practice cho CLAUDE.md: nên viết gì, không nên viết gì, tách thế nào khi project lớn lên》. Bài này không lặp lại template và example, chỉ xem vị trí của nó trong hệ thống memory.
Trong tài liệu chính thức, các vị trí này nằm rải rác ở nhiều đoạn khác nhau; tôi khuyên nên ghi nhớ trực tiếp theo năm tầng:
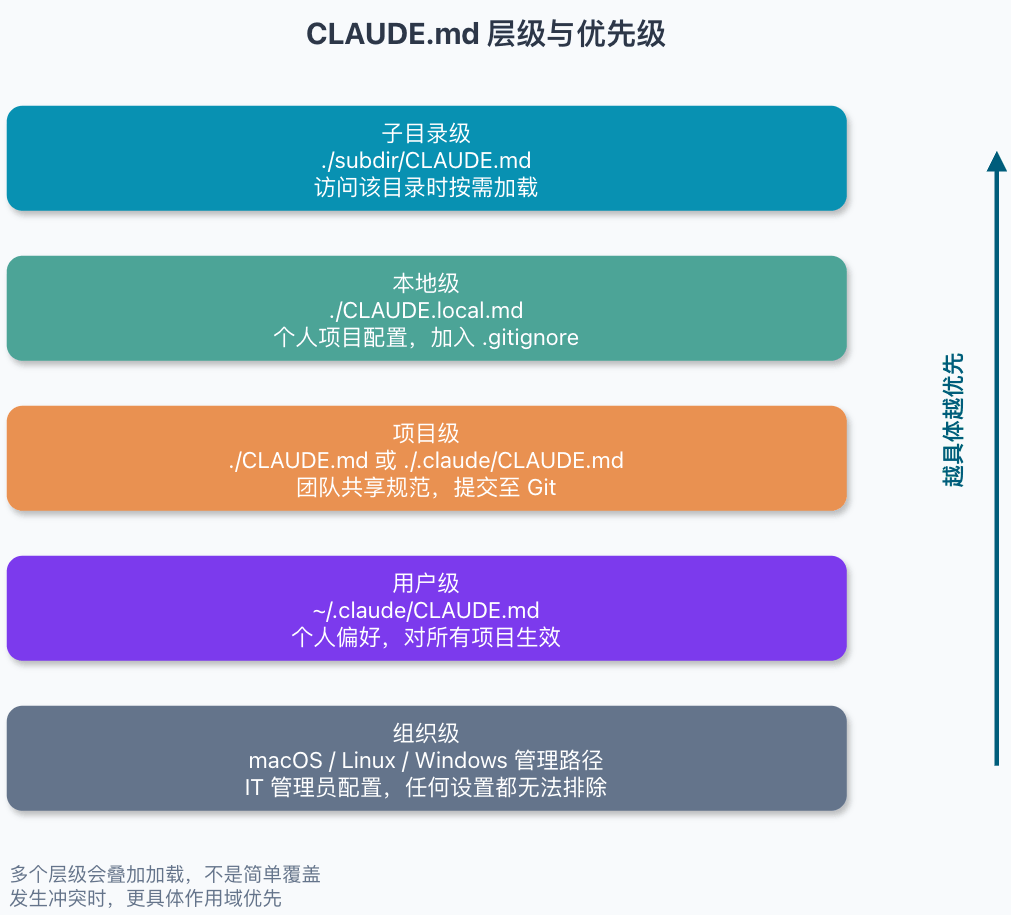
| Vị trí | Path | Nội dung phù hợp |
|---|---|---|
| Cấp tổ chức | macOS: /Library/Application Support/ClaudeCode/CLAUDE.md; Linux/WSL: /etc/claude-code/CLAUDE.md; Windows: C:\Program Files\ClaudeCode\CLAUDE.md | Coding convention, security policy và yêu cầu compliance do IT/DevOps phân phối thống nhất |
| Cấp user | ~/.claude/CLAUDE.md | Preference và thói quen dùng tool dùng chung cho mọi project |
| Cấp project | ./CLAUDE.md hoặc ./.claude/CLAUDE.md | Kiến trúc project, command và code standard dùng chung trong team |
| Cấp local | ./CLAUDE.local.md | Cấu hình cá nhân trong project hiện tại, chẳng hạn sandbox URL và preference về test data |
| Cấp subdir | ./subdir/CLAUDE.md và CLAUDE.local.md trong cùng thư mục | Rule của một module hoặc subdir; Claude chỉ loading on-demand khi đọc file trong thư mục đó |
Các file này không phải là quan hệ file này override file kia. Claude ghép CLAUDE.md và CLAUDE.local.md nhìn thấy trên path khởi động vào context; phạm vi càng rộng thì được load càng sớm, càng gần directory hiện tại thì càng được load về sau. File trong subdir không được load lúc khởi động, mà chỉ được bổ sung khi Claude đọc file trong directory đó. Managed policy cấp tổ chức không thể bị cấu hình cá nhân loại trừ.
Mỗi CLAUDE.md tốt nhất nên được giới hạn trong 200 dòng. File càng dài, model càng dễ chỉ ghi nhớ một phần.
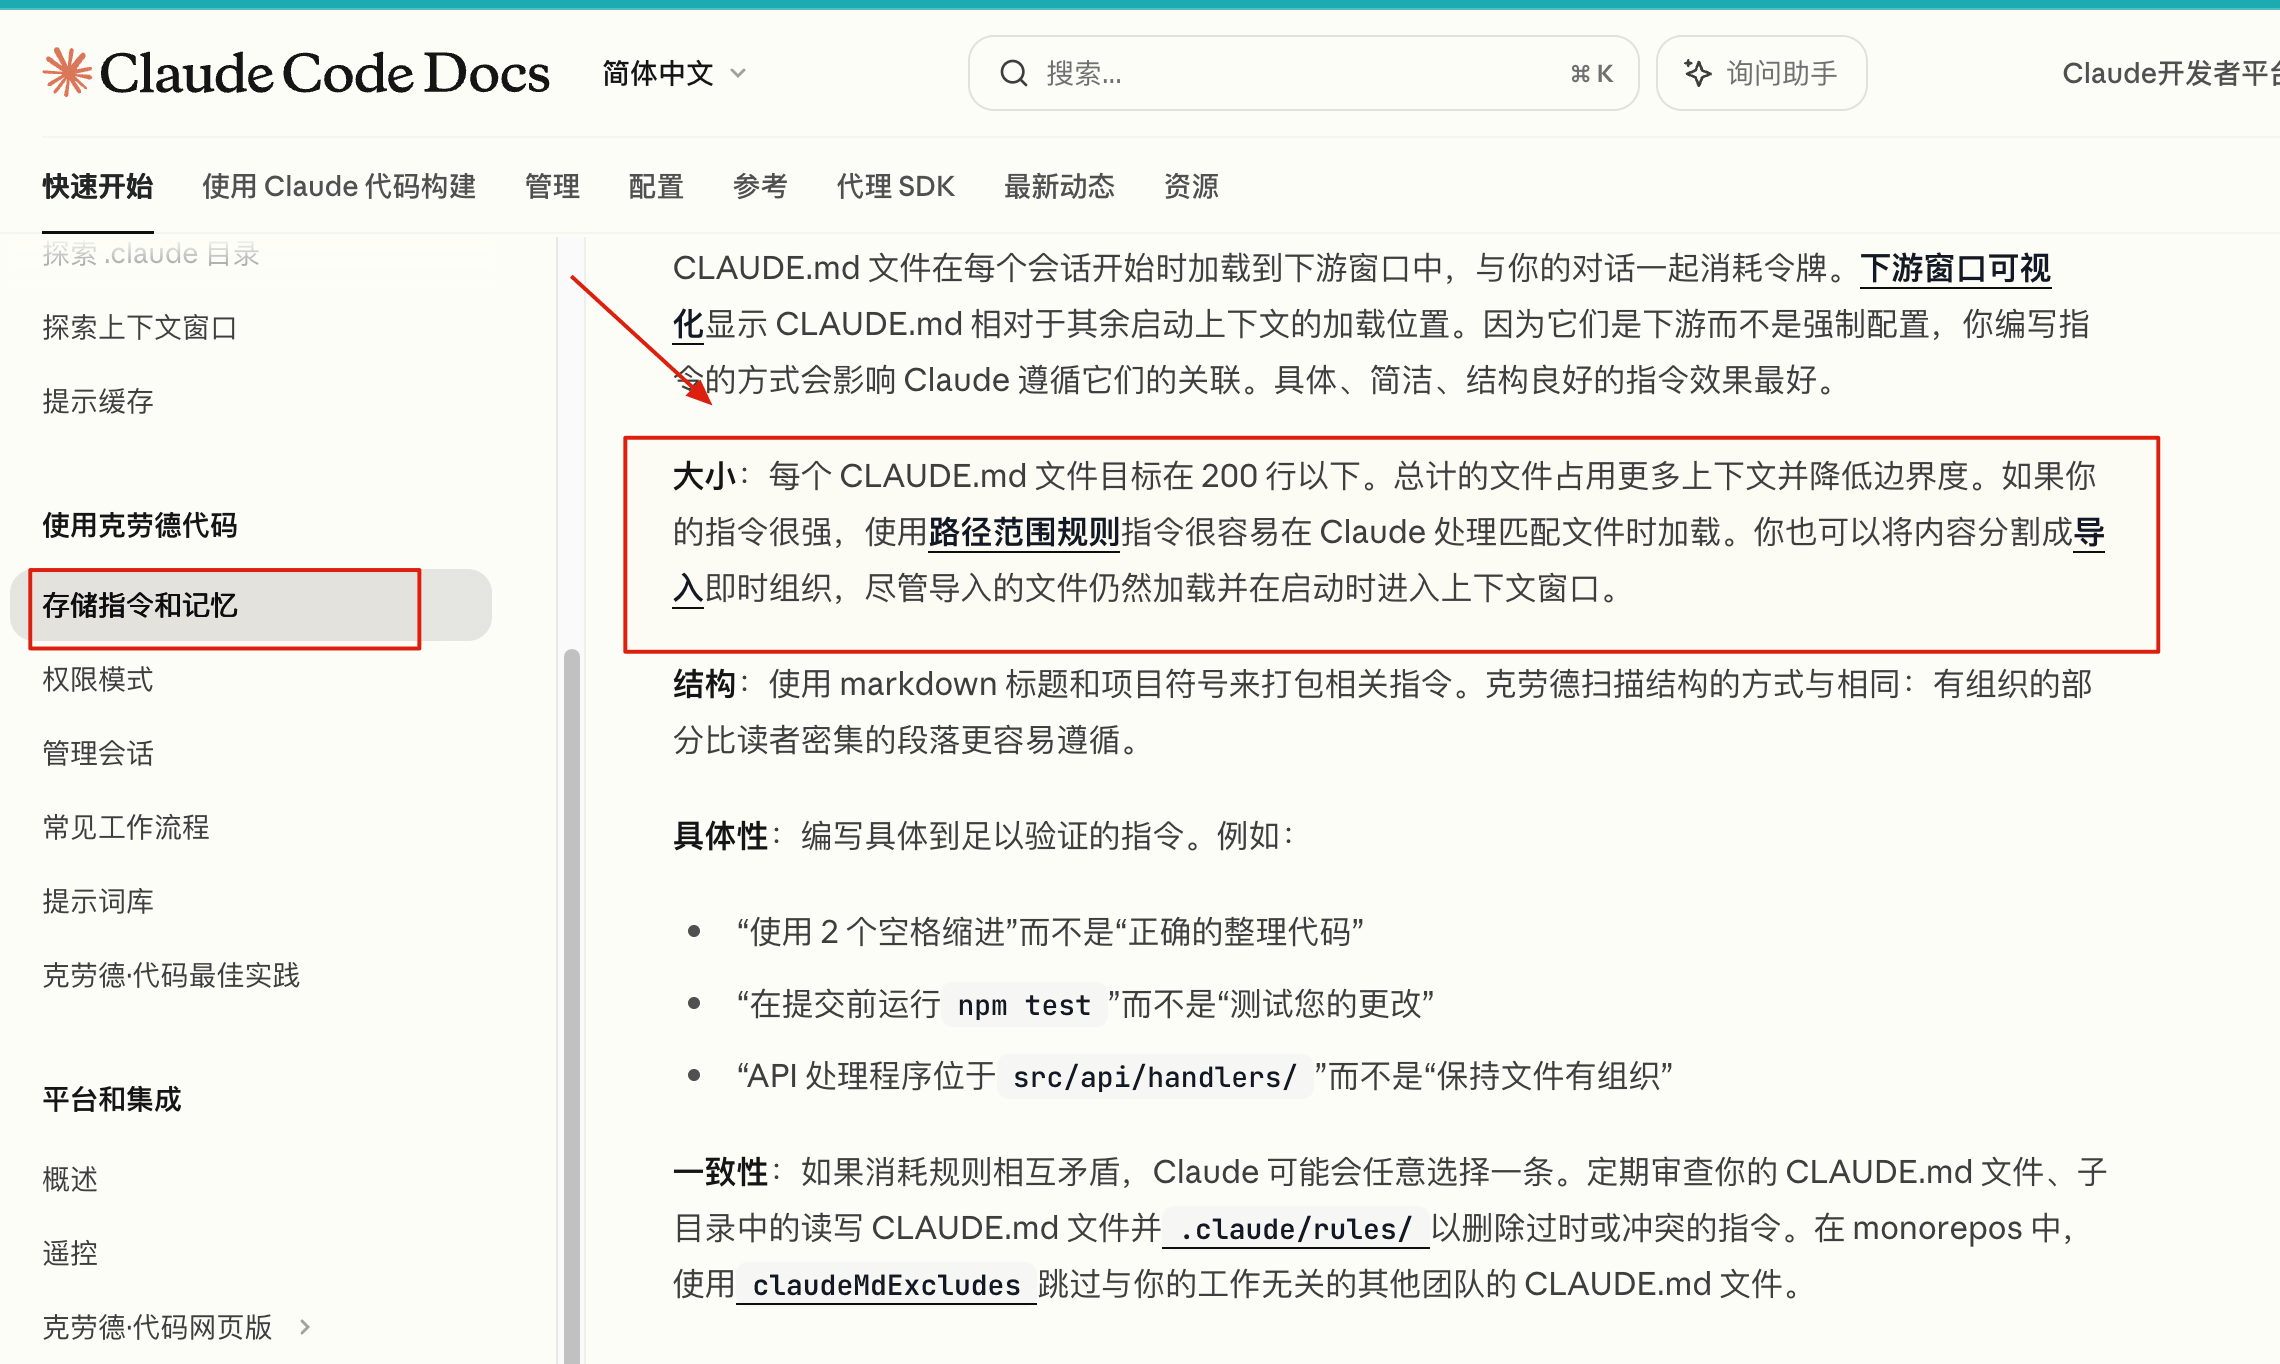
Đây chính là vấn đề thường gọi là Context Rot. Context càng dài, thông tin càng tạp, độ ổn định khi model tận dụng context càng có khả năng giảm.
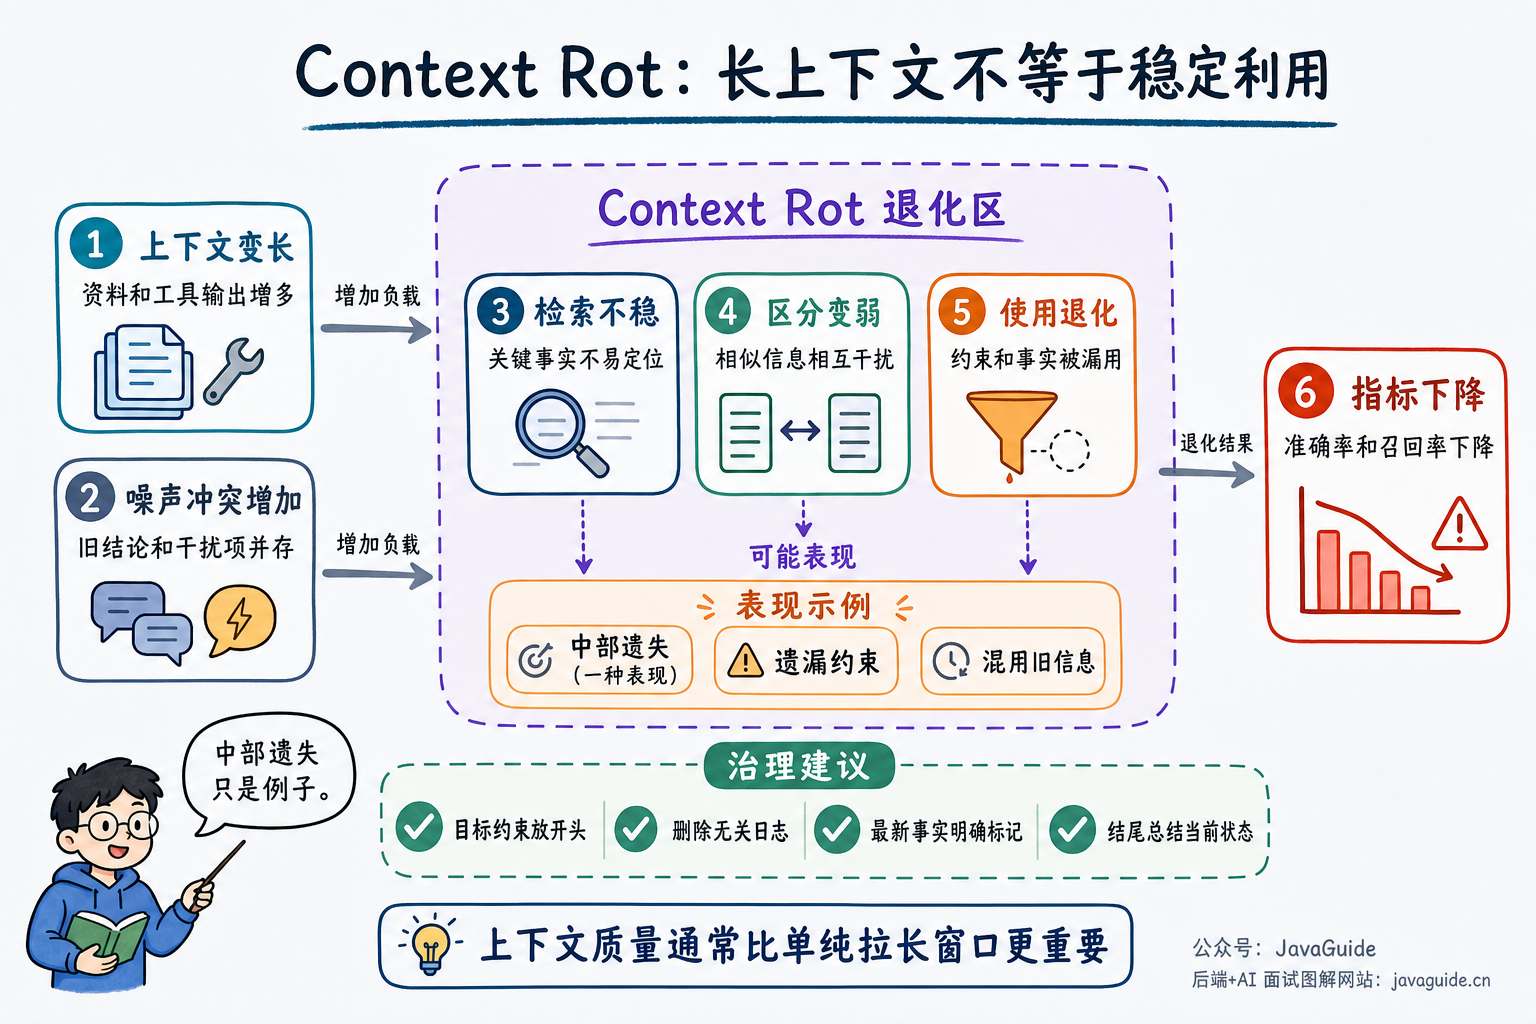
CLAUDE.md rất dễ bị dùng sai, đặc biệt trong các trường hợp sau.
CLAUDE.mdkhông phải cấu hình bắt buộc.
CLAUDE.md được inject dưới dạng user message sau system prompt. Nó rất hữu ích, nhưng nếu rule viết mơ hồ, đã lỗi thời hoặc các file xung đột với nhau, model vẫn có thể chọn sai.
- Block HTML comment chỉ bị loại bỏ trước khi inject context.
Bạn có thể viết hướng dẫn bảo trì trong CLAUDE.md:
<!-- Đoạn này dành cho maintainer, sẽ bị loại bỏ khi inject context -->Nhưng nếu Claude mở trực tiếp file bằng file reading tool, comment vẫn có thể nhìn thấy.
@path/to/filecó thể import file bên ngoài, nhưng không tiết kiệm token.
File được reference sẽ được expand vào context lúc khởi động, tối đa đệ quy bốn lần; lần đầu reference file bên ngoài còn có thể cần approval. Đừng kỳ vọng tách các rule lớn bằng @ sẽ “tiết kiệm context window”.
Rule thực sự phù hợp để loading on-demand là .claude/rules/.
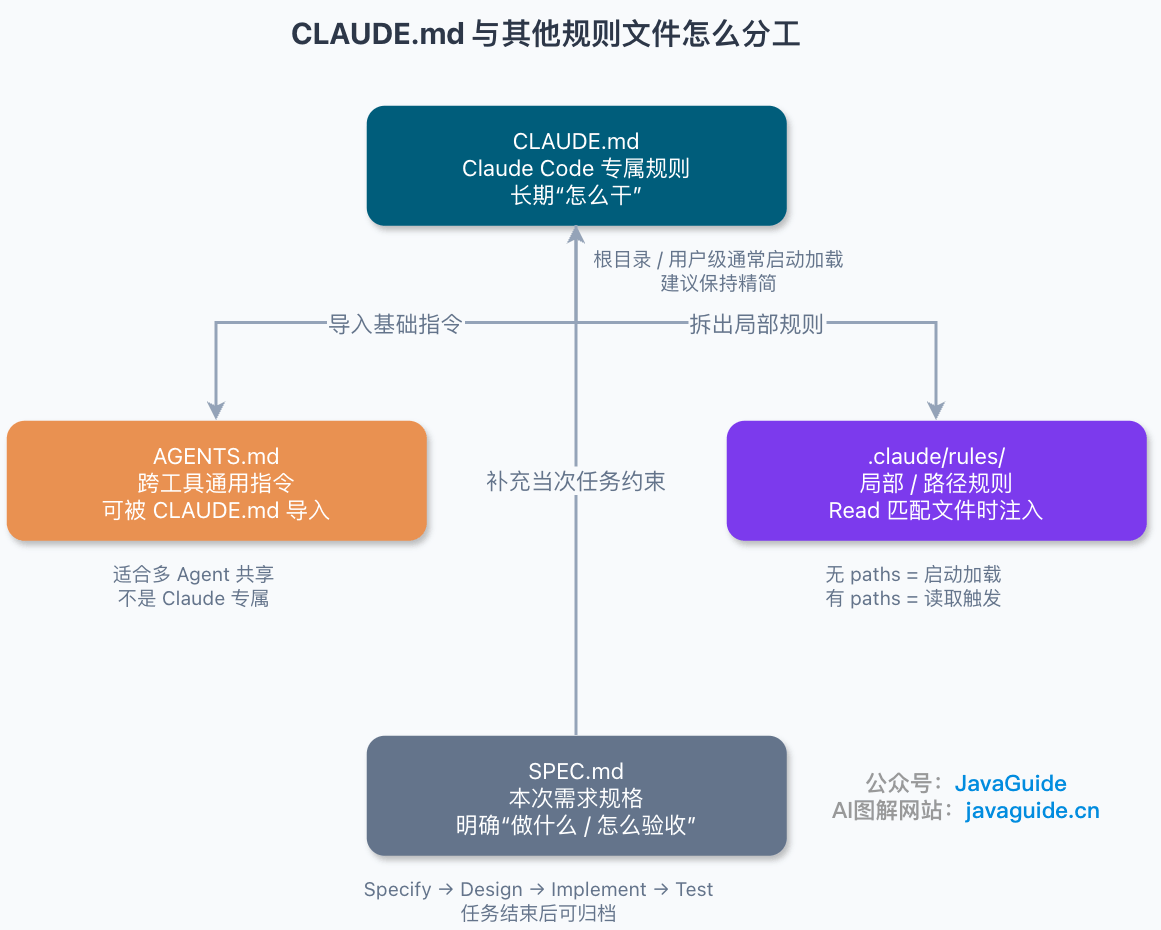
.claude/rules/: đặt các rule trigger theo file
Giả sử bạn có một bộ rule frontend, chỉ cần khi xử lý src/**/*.tsx. Nếu task backend lần nào cũng load chúng vào thì đang lãng phí context.
.claude/rules/ phù hợp để đặt các rule có điều kiện như vậy. Mỗi rule là một file Markdown, có thể ghi paths trong frontmatter:
---
paths:
  - "src/**/*.{ts,tsx}"
  - "tests/**/*.test.ts"
---

# TypeScript Rules

- Phải validate input của API.
- Ưu tiên reuse fixture đã có trong test file.
Rule có paths sẽ không được nhồi toàn bộ vào lúc khởi động. Chỉ khi Claude đọc file khớp với glob thì rule tương ứng mới được trigger. Nhờ vậy, nội dung có hiệu lực lâu dài nhưng chỉ hữu ích cho một loại task nào đó không cần nhồi hết vào CLAUDE.md.
Khi đưa vào project, tôi thường tách theo mục đích:
- Rule cần nhìn thấy ở mỗi session, đặt trong
CLAUDE.md; - Rule chỉ hữu ích với một loại file hoặc directory, đặt trong
.claude/rules/; - Quy trình thao tác nhiều bước, có thể reuse, làm thành skill và trigger on-demand;
- Hành vi bắt buộc phải chặn, dùng hook hoặc permission configuration, đừng chỉ viết trong Markdown.
Các yêu cầu như “cấm chạy rm -rf” hay “trước khi commit bắt buộc chạy một script nào đó”, nếu viết trong CLAUDE.md thì chỉ được xem như lời nhắc. Muốn thực sự chặn tool call vẫn phải dựa vào hook, permissions hoặc outer CI.
Auto Memory: đặt kinh nghiệm Claude ghi lại trong lúc làm việc
Auto Memory là cơ chế memory tự động do Claude Code cung cấp. Tính “tự động” chủ yếu thể hiện ở việc Claude tự viết notes trong lúc làm việc, chẳng hạn build command, kinh nghiệm debug, thông tin kiến trúc, preference về code style và thói quen làm việc.
Tuy nhiên, nó không ghi ở mỗi lượt session mà do Claude tự phán đoán nội dung nào sau này còn dùng đến. Bạn có thể dùng /memory để mở trực tiếp directory tương ứng.

Theo tài liệu chính thức, Auto Memory có từ Claude Code v2.1.59 và được bật mặc định. Nó đặt project memory vào ~/.claude/projects/<project>/memory/, lúc khởi động trước tiên đọc 200 dòng đầu hoặc 25KB của MEMORY.md. Nội dung chi tiết hơn không được nhồi toàn bộ cùng lúc mà đặt trong topic files để mở khi cần; /memory có thể dùng để xem và chỉnh sửa.

Cũng có thể tắt trực tiếp:
{
  "autoMemoryEnabled": false
}
Hoặc dùng environment variable:
CLAUDE_CODE_DISABLE_AUTO_MEMORY=1Directory lưu mặc định là:
~/.claude/projects/<project>/memory/Cấu trúc điển hình do tài liệu chính thức đưa ra là:
~/.claude/projects/<project>/memory/
├── MEMORY.md
├── debugging.md
├── api-conventions.md
└── ...
MEMORY.md chỉ làm index entry point; lúc khởi động tự động load 200 dòng đầu hoặc 25KB, chạm ngưỡng nào trước thì dừng. Phần giải thích chi tiết hơn đặt trong topic files, Claude sẽ đọc khi cần.
Thiết kế này rất giống Skill progressive disclosure mà tôi đã viết ở phần trước: trước tiên để model biết “có những gì”, đừng ngay lập tức nhồi “toàn bộ nội dung” đầy context.
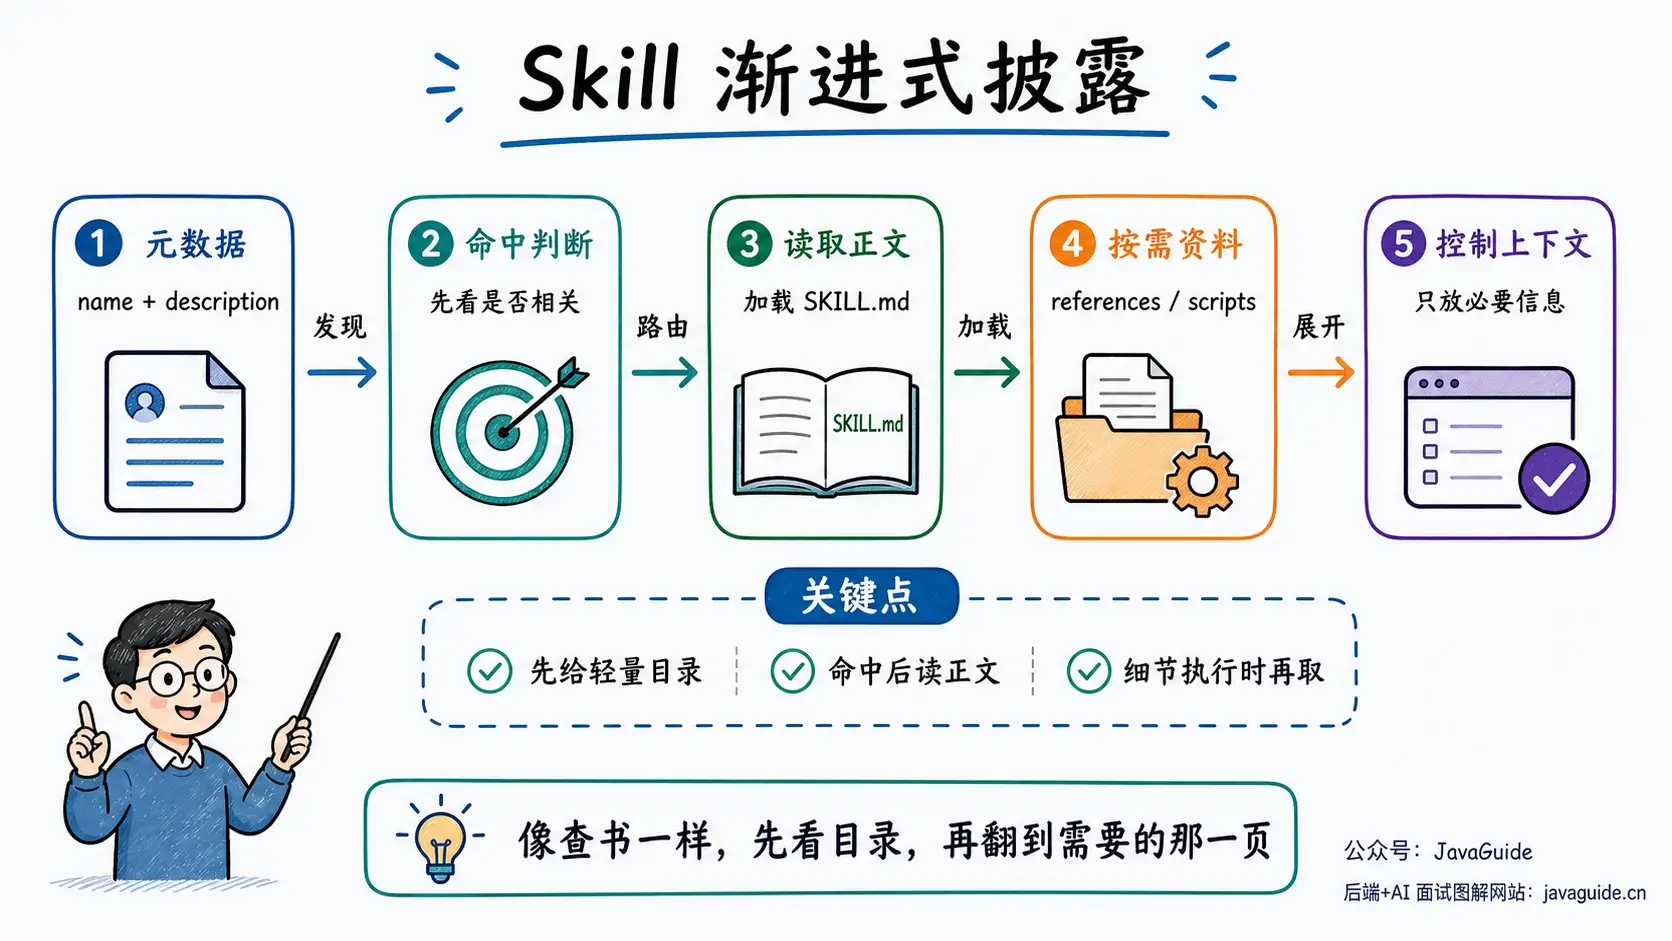
Tài liệu chính thức không yêu cầu topic file phải dùng một schema cụ thể nào, cũng không công khai cam kết “loại memory bắt buộc phải là user / feedback / project / reference”.
Bốn loại dưới đây được suy ra từ phân tích source code bị lộ trước đây:
| Loại | Phù hợp để lưu | Không phù hợp để lưu |
|---|---|---|
user | Preference dài hạn, nền tảng kỹ thuật, thói quen giao tiếp của user | Ý nghĩ tạm thời chỉ user vừa nói |
feedback | Cách làm được user trực tiếp sửa lại | Preference do Agent tự đoán |
project | Giai đoạn project, lý do quyết định, rule tạm thời đóng băng | Structure hiện tại của code, line number của file và các sự thật có thể thay đổi |
reference | Tra thông tin ở đâu, tài liệu nào là nguồn chính thức | Nội dung tài liệu copy nguyên đoạn |
Auto Memory sẽ tự động viết notes, nhưng không có nghĩa là có thể hoàn toàn bỏ mặc. Khi bạn yêu cầu Claude “nhớ một việc”, sau đó dùng /memory để review nội dung tự động ghi vào, hoặc tự xây hệ thống tương tự, đều cần một bộ tiêu chuẩn sàng lọc. Nguyên tắc của tôi là thà ghi nhớ ít hơn vài mục còn hơn chất đống nội dung vô ích.
Hãy tập trung vào ba điểm:
- Lần sau khi ra quyết định có dùng đến không?
- User đã xác nhận rõ ràng chưa?
- Khi hết hạn có ai phát hiện được không?
Nếu không trả lời được thì cứ để nó trong session hiện tại, không cần ghi vào long-term memory.
Nếu thực sự muốn lưu lại, cũng đừng chỉ nhét một câu kết luận vào topic file. Ít nhất hãy ghi cả fact, lý do quyết định như vậy lúc đó, thời gian ghi/thời gian hết hiệu lực và có cần kiểm tra trước khi dùng hay không. Lần sau Agent đọc lại memory này, thứ nó thấy không phải một dead rule mà là một record có boundary.

Ví dụ:
---
type: feedback
created_at: 2026-06-17
updated_at: 2026-06-17
---

# Integration test kết nối MySQL thật

Nếu integration test chỉ cần verify behavior của database thì hãy kết nối MySQL thật, không dùng H2 in-memory database để thay thế.

Lý do: trước đây có test pass trên H2 nhưng sau khi deploy lại phát sinh vấn đề vì khác biệt về transaction và SQL dialect của MySQL.

Phạm vi áp dụng: test validation parameter và logic branch thuần túy vẫn có thể tiếp tục dùng giải pháp thay thế nhẹ hơn; khi liên quan đến transaction, index, SQL dialect và behavior concurrent thì bắt buộc quay lại MySQL.
Chỉ viết “integration test không dùng H2” đương nhiên vẫn có tác dụng, nhưng Agent rất dễ thực thi máy móc. Bổ sung lý do và phạm vi áp dụng giúp nó có cơ hội đưa ra lựa chọn đúng khi gặp các trường hợp như validation parameter hoặc logic branch thuần túy.
Những thứ không nên đặt trong long-term memory
Phần trước nói về những thứ đáng ghi nhớ. Ngược lại, có một số nội dung tốt nhất chỉ nên giữ trong session hiện tại.
Thông thường tôi sẽ không khuyên đưa những thứ sau vào Auto Memory:
- Số dòng hiện tại của một file, vị trí hiện tại của một function;
- Command output, log tạm thời, error dùng một lần và state trung gian khi điều tra trong session này;
- Lịch sử thay đổi có thể tra trong Git, nội dung ổn định đã có trong README hoặc API documentation;
- Preference hoặc phán đoán do Agent tự suy ra nhưng chưa được user xác nhận.
Đặt chúng trong context hiện tại thì rất hữu ích, nhưng đưa vào memory lại chẳng có ý nghĩa gì, thậm chí còn ảnh hưởng đến phán đoán của Agent.
Thời gian cũng nên ghi thành ngày cụ thể. Nếu user nói “đừng đụng module order trước cuối tháng”, muốn đưa câu này vào memory thì hãy ghi thành “không sửa module order trước 2026-06-30”. Các cách nói như “cuối tháng”, “tuần sau”, “hôm qua” chỉ có ý nghĩa tại thời điểm nói; đọc lại sau vài ngày, Claude khó biết chúng chỉ ngày nào.
Sau khi một memory được ghi vào, chi phí không chỉ là vài chục token. Nó còn cần được review, chỉnh sửa hoặc xóa; khi không ai quản lý, Agent có thể tiếp tục ra quyết định dựa trên tiền đề cũ này.
Đừng hardcode cách Auto Memory được đọc lại
Trong tài liệu chính thức chỉ đề cập một tầng gồm MEMORY.md và topic files: lúc khởi động load index trước, nội dung chi tiết hơn được đọc on-demand.
Ở tầng sâu hơn, Auto Memory rốt cuộc dùng grep, LLM picker, vector retrieval hay chiến lược nào khác thì tài liệu chính thức không nói rõ.

Dựa trên các đoạn source code bị lộ trên Internet và phân tích decompile, có vẻ Claude có thể đọc MEMORY.md và summary của từng file trước, sau đó chọn file liên quan theo task hiện tại; cũng có người cho rằng nó thiên về keyword matching hơn.
Khi triển khai thực tế, chỉ cần nắm vài điểm là đủ: index ngắn, tách phần nội dung chính ra ngoài, không nhồi lặp lại memory đã inject trong cùng một lượt. Đọc lại cũng không phải càng nhiều càng tốt; nhồi nhầm một memory đã hết hạn còn dễ làm Agent đi lệch hướng hơn bỏ sót một memory.
Đọc memory xong, trước tiên hãy xác định nó thuộc loại thông tin nào
Sau khi Auto Memory được đọc lại vào context, trước tiên hãy xử lý nó như một manh mối có timestamp: nó có thể cho biết trước đây vì sao đã làm như vậy, có thể chỉ cho bạn bắt đầu tra từ đâu, nhưng không thể chứng minh hiện tại vẫn còn như thế.
Ví dụ, memory ghi “job xử lý timeout của order nằm trong module order-job”. Record này có thể đúng vào ngày được ghi; về sau code tách module, job có thể đã được chuyển đi hoặc đổi tên. Nếu Agent trực tiếp sửa file theo memory cũ thì rất dễ đi sai hướng. Trình tự chắc chắn hơn là: dùng memory để định hướng trước, sau đó quay lại repository hiện tại, document hiện tại hoặc command output để xác nhận.
Cách tin cậy cũng khác nhau tùy loại memory.
Preference dài hạn của user có thể được ưu tiên áp dụng, nhưng instruction rõ ràng trong session hiện tại luôn gần hơn. Lý do của quyết định lịch sử có thể dùng để tham khảo, nhưng nó chỉ giải thích vì sao lúc đó đã chọn như vậy, không có nghĩa hiện tại vẫn bắt buộc phải làm như thế. Nội dung như file path, vị trí module và command parameter chỉ có thể xem là manh mối, trước khi dùng nhất định phải quay lại repository hiện tại để đối chiếu. Project freeze, release window và schedule phải xem ngày tuyệt đối; hết hạn thì update hoặc delete. Kết luận từ tài liệu bên thứ ba cũng vậy, cuối cùng vẫn phải quay lại tài liệu chính thức hiện tại hoặc version thực tế để xác nhận.
Giá trị của Auto Memory là giảm việc giải thích lặp lại, giúp Agent bớt phải tự tìm hiểu từ đầu. Nhưng trước khi thực sự bắt tay làm, code hiện tại, document hiện tại và command output hiện tại vẫn có độ ưu tiên cao nhất.
Subagent Memory và Agent Teams lần lượt giải quyết vấn đề gì
Trong các tài liệu liên quan đến multi-Agent, Subagent Memory và Agent Teams rất dễ bị xem chung. Cái trước quản lý long-term experience của một subagent, cái sau quản lý cách nhiều Claude Code session phối hợp trong một task.
Subagent Memory vẫn là file-based long-term memory, chỉ khác là chủ thể của memory chuyển từ session chính sang một subagent nào đó. Trong tài liệu chính thức về subagent, field memory hỗ trợ ba scope là user, project và local.
Tùy scope, Claude Code sẽ sử dụng các directory sau:
~/.claude/agent-memory/<agent-name>/
.claude/agent-memory/<agent-name>/
.claude/agent-memory-local/<agent-name>/
Các directory này sẽ được tạo hoặc sử dụng on-demand. Khi chưa cấu hình memory cho subagent, không thấy agent-memory/ trong ~/.claude/ là hoàn toàn bình thường.
Sau khi bật, lúc khởi động subagent sẽ đọc 200 dòng đầu hoặc 25KB của MEMORY.md trong directory tương ứng, chạm ngưỡng nào trước thì dừng. Nó cũng nhận được các file tool cần thiết để đọc và ghi directory memory, dùng để duy trì kinh nghiệm của riêng mình.
Loại memory này phù hợp để lưu kinh nghiệm của worker chuyên dụng. Ví dụ, một subagent chỉ phụ trách database migration có thể tích lũy quy chuẩn của migration script, nguyên nhân thất bại thường gặp và các lựa chọn lịch sử trong project. Lần sau xử lý task tương tự, ít nhất nó biết nên kiểm tra ở đâu trước và những vấn đề nào không được lặp lại.
Agent Teams đi theo hướng điều phối cộng tác. Tài liệu chính thức đề cập team lead, teammates, shared task list và mailbox; chúng giải quyết việc nhiều Claude Code session độc lập phân công, giao tiếp và đồng bộ task state như thế nào, không phải một loại shared long-term memory.
Agent Teams có thể reference một subagent definition để tạo teammate, nhưng điều này chỉ cho thấy teammate sẽ reuse một phần configuration trong definition. Tài liệu chính thức nói rõ tools, model sẽ được sử dụng, còn phần nội dung sẽ được thêm vào system prompt của teammate; skills, mcpServers không có hiệu lực theo đường này. Cách xử lý memory trong bối cảnh teammate tốt nhất nên được verify riêng theo version hiện tại, đừng tiện tay suy rộng thành shared long-term memory cho team.
Vì vậy tôi sẽ tách riêng cách dùng hai thứ: Subagent Memory dùng để tích lũy long-term experience của worker chuyên dụng; Agent Teams dùng để cộng tác song song trong một task. Nếu thực sự muốn role trong team mang theo long-term experience, trước tiên hãy xác minh lúc khởi động nó load gì, ghi vào đâu, có thể giữ lại qua session hay không, rồi mới đưa vào quy trình chính thức.
Memory plugin bên thứ ba giải quyết vấn đề gì
Auto Memory tích hợp sẵn giúp Claude Code ghi nhớ trong local file các preference, command và kinh nghiệm project có thể còn dùng về sau. Nó tiện, nhưng không nhằm lưu đầy đủ quá trình của mỗi session, cũng không gom lịch sử của nhiều machine, nhiều developer và nhiều Agent vào một search entry point duy nhất.
Plugin bên thứ ba chủ yếu giải quyết hai vấn đề này.
claude-mem tập trung vào quá trình session. Nó dùng Lifecycle Hooks để ghi lại session và các quan sát từ tool, sau đó giao cho local Worker xử lý.
Nó có một số component chính: Worker Service mặc định ở port 37777, sessions / observations / summaries trong SQLite, Chroma vector database, mem-search skill và MCP Tools.
Giải pháp này phù hợp để xem lại quá trình lịch sử, chẳng hạn: tại sao lần trước tạm dừng merge module payment? Trước đây command nào đã được dùng để kiểm tra slow query?
Chi phí cũng tăng theo: worker, database, index và permission đều cần được bảo trì.
memsearch giống một Memory Store bên ngoài hơn. Nó dùng Markdown theo ngày để lưu nội dung gốc, Milvus làm cache của vector index, khi retrieval kết hợp semantic vector, BM25 và RRF.
Nó phù hợp với project có nhiều tool, nhiều member và vòng đời dài, chẳng hạn Claude Code, OpenClaw, OpenCode và Codex CLI dùng chung một bộ memory.
Các giải pháp kiểu này nặng hơn local Markdown rất nhiều. Index, embedding model, Milvus Lite hoặc Zilliz cloud, strategy đồng bộ và quyền dữ liệu đều cần người phụ trách. Khi memory chỉ có vài chục mục thì thường chưa cần nâng lên tầng này.
Chọn thế nào?
Với project cá nhân muốn Claude nhớ test command, thói quen commit và preference của project, trước tiên hãy dùng CLAUDE.md cùng Auto Memory. Rule ổn định dùng chung trong team thì đặt trong CLAUDE.md, .claude/rules/ hoặc tài liệu chính thức trong repository để thay đổi đi qua review.
Nếu cần tự động lưu quá trình session, hãy xem các giải pháp như claude-mem kết hợp Hooks và local database.
Chỉ khi nhiều Agent, nhiều machine và nhiều developer cần dùng chung long-term memory mới nên cân nhắc memsearch, Mem0 hoặc tự xây database.
Còn BM25, vector retrieval và reranker phù hợp hơn với các scenario cần tìm kiếm lẫn trong hàng chục nghìn document, ticket và Wiki.
Cách xây một hệ thống memory nhẹ
Nếu muốn xây một hệ thống memory nhẹ cho team, bạn có thể bắt đầu bằng việc xác định cấu trúc file và quy tắc ghi.
CLAUDE.md chỉ nên đặt nội dung mà mỗi session đều bắt buộc phải biết, chẳng hạn test command, quy ước commit và directory cấm sửa. Rule liên quan đến directory hoặc loại file đừng tiếp tục nhồi vào file này, hãy đặt trong .claude/rules/ rồi dùng paths để kiểm soát phạm vi loading.
Đặt long-term memory riêng trong directory memory/. Lúc đầu đừng chia quá nhỏ, bốn loại là đủ: user lưu preference dài hạn của user, feedback lưu cách làm được user trực tiếp sửa, project lưu quyết định theo giai đoạn và rule tạm thời đóng băng, reference lưu entry point của tài liệu. Trong mỗi topic file, ghi created_at, updated_at, lý do ghi và phạm vi áp dụng; nội dung phụ thuộc vào state hiện tại của code thì sau khi mở phải kiểm tra trước khi dùng.

Phiên bản này trước tiên có thể được duy trì thủ công. Nó không hào nhoáng, nhưng ít dirty data, team có thể review, xóa nhầm cũng có thể tìm lại từ Git. Đợi đến khi index thủ công thực sự bắt đầu làm chậm việc sử dụng rồi thêm auto summary, full-text retrieval hoặc vector retrieval cũng chưa muộn.
Directory không cần được thiết kế phức tạp ngay từ đầu. Trước tiên chỉ cần để index, user preference, feedback rõ ràng, quyết định của project và entry point tài liệu có vị trí riêng:
memory/
├── MEMORY.md
├── feedback/
│   └── integration-test-real-mysql.md
├── project/
│   └── payment-freeze-before-2026-06-30.md
├── reference/
│   └── slow-query-wiki.md
└── user/
    └── backend-preferences.md
MEMORY.md không chịu trách nhiệm giải thích đầu đuôi, chỉ làm entry point. Nó cho Claude biết hiện có những memory nào và khi cần xem kỹ thì nên mở file nào:
# Memory Index

- [Integration tests use real MySQL](feedback/integration-test-real-mysql.md): Integration test liên quan đến behavior của database phải kết nối MySQL thật.
- [Payment freeze before 2026-06-30](project/payment-freeze-before-2026-06-30.md): Tạm dừng merge requirement mới vào module payment trước 2026-06-30.
- [Slow query wiki](reference/slow-query-wiki.md): Entry point để điều tra slow query trên production nằm ở trang db-slow-log trong internal Wiki.
Đưa phần giải thích, background và phạm vi áp dụng vào topic file. Như vậy MEMORY.md có thể luôn ngắn, phù hợp để thường trú; về sau khi cần sửa, xóa hoặc review cũng có thể xem trực tiếp diff của file tương ứng.
Tổng kết
Memory của Claude Code phát huy tác dụng nhờ file bên ngoài, index và rule loading, không phải vì model tự lưu lịch sử trong đầu.
CLAUDE.md phù hợp để viết rule ổn định, .claude/rules/ phù hợp để viết rule trigger theo path, Auto Memory phù hợp để lưu preference và kinh nghiệm Claude phát hiện trong quá trình làm việc. Đừng biến MEMORY.md thành một bài văn dài, chỉ cần làm index; các chi tiết như lý do, phạm vi áp dụng và thời gian hết hạn hãy đặt trong topic file.
So với việc tìm kiếm chính xác hơn, tôi quan tâm hơn đến việc không nên ghi thứ gì vào. Log tạm thời, số dòng hiện tại của file, error dùng một lần và preference do Agent tự đoán cứ giữ trong context của session này là được. Một khi long-term memory đã được ghi vào thì về sau phải có người đối chiếu, cập nhật và xóa.
Thêm tool bên thứ ba theo nhu cầu, tuyệt đối đừng dùng chỉ vì muốn dùng; giữ được sự đơn giản là tốt nhất. Muốn lưu quá trình session thì claude-mem phù hợp hơn; muốn nhiều tool và member dùng chung một bộ memory thì xem memsearch, Mem0 hoặc tự xây database. Khi memory chỉ có vài chục mục, đừng vội dùng vector database, file index thường đã đủ.
Đề xuất của tôi rất đơn giản: trước tiên viết rõ CLAUDE.md và .claude/rules/, sau đó để Auto Memory hoặc memory/ thủ công chỉ lưu lại một lượng nhỏ kinh nghiệm có giá trị cao. Chỉ khi memory thực sự nhiều đến mức index thủ công không theo kịp, role cộng tác cũng trở nên phức tạp, hãy cân nhắc database, BM25, vector retrieval và reranker.
Để Agent nhớ mọi thứ không có nhiều ý nghĩa. Cách đáng tin cậy hơn là để nó biết bước tiếp theo cần kiểm tra ở đâu.
Tài liệu tham khảo
- Tài liệu chính thức Claude Code: How Claude remembers your project
- Tài liệu chính thức Claude Code: Subagents
- Tài liệu chính thức Claude Code: Agent Teams
- Tài liệu chính thức Claude Code: Hooks guide
- GitHub: thedotmack/claude-mem
- MindStudio: Claude Code Memory Systems Explained
- Milvus: Claude Code Memory System Explained: 4 Layers, 5 Limits, and a Fix