
Thực chiến tích hợp Claude Code với model bên thứ ba: chẩn đoán JVM thông minh và xử lý slow query
Xin chào, mình là G. Trước đây mình đã chia sẻ thực chiến kết hợp IDEA với plugin Qoder và thực chiến kết nối Trae với LLM, lần lượt bao quát việc lập trình có AI hỗ trợ trong hệ sinh thái JetBrains và VS Code. Bài này sẽ đổi góc nhìn để trao đổi về trải nghiệm thực chiến khi Claude Code kết nối với model bên thứ ba.
Claude Code là CLI coding tool chính thức của Anthropic. Một số nhà cung cấp dịch vụ cung cấp khả năng kết nối model bên thứ ba thông qua interface tương thích Anthropic và environment variable, nhưng mức độ tương thích, tính năng khả dụng và cách xử lý dữ liệu do nhà cung cấp quyết định, không thể mặc định giống hoàn toàn model Claude. Bài viết này ghi lại quá trình sử dụng GLM-5.1 tại thời điểm đó.
Hiện tại, GLM-5.2 cũng đã được phát hành và sau này sẽ còn có các model mới hơn. Tuy nhiên, cách kết nối và thực chiến coding đều giống nhau, không phụ thuộc model.
Mình chọn hai scenario phức tạp có tính đại diện để kiểm chứng:
- Scenario một: xây dựng từ đầu một JVM diagnosis Agent dựa trên Arthas, bao quát toàn bộ quy trình từ chọn công nghệ, thiết kế architecture đến triển khai coding
- Scenario hai: xác định và xử lý slow query trong hệ thống order hiện có với dữ liệu hàng triệu bản ghi, kiểm tra khả năng AI hiểu codebase hiện tại và thực hiện incremental optimization
Một scenario là bàn giao engineering từ con số không, scenario còn lại là performance governance trên hệ thống hiện có, vừa đủ bao quát hai mode làm việc điển hình của lập trình có AI hỗ trợ.
Chuẩn bị môi trường: Claude Code kết nối với model bên thứ ba
Trước khi bắt đầu, cần hoàn tất việc kết nối Claude Code với model bên thứ ba. Toàn bộ quá trình cấu hình gồm ba bước:
Bước một: cài đặt Claude Code
npm i -g @anthropic-ai/claude-code@latestBước hai: cài đặt cc-switch để chuyển model (người dùng macOS có thể cài qua homebrew, xem chi tiết trong tài liệu chính thức của cc-switch: https://github.com/farion1231/cc-switch/blob/main/README_ZH.md)
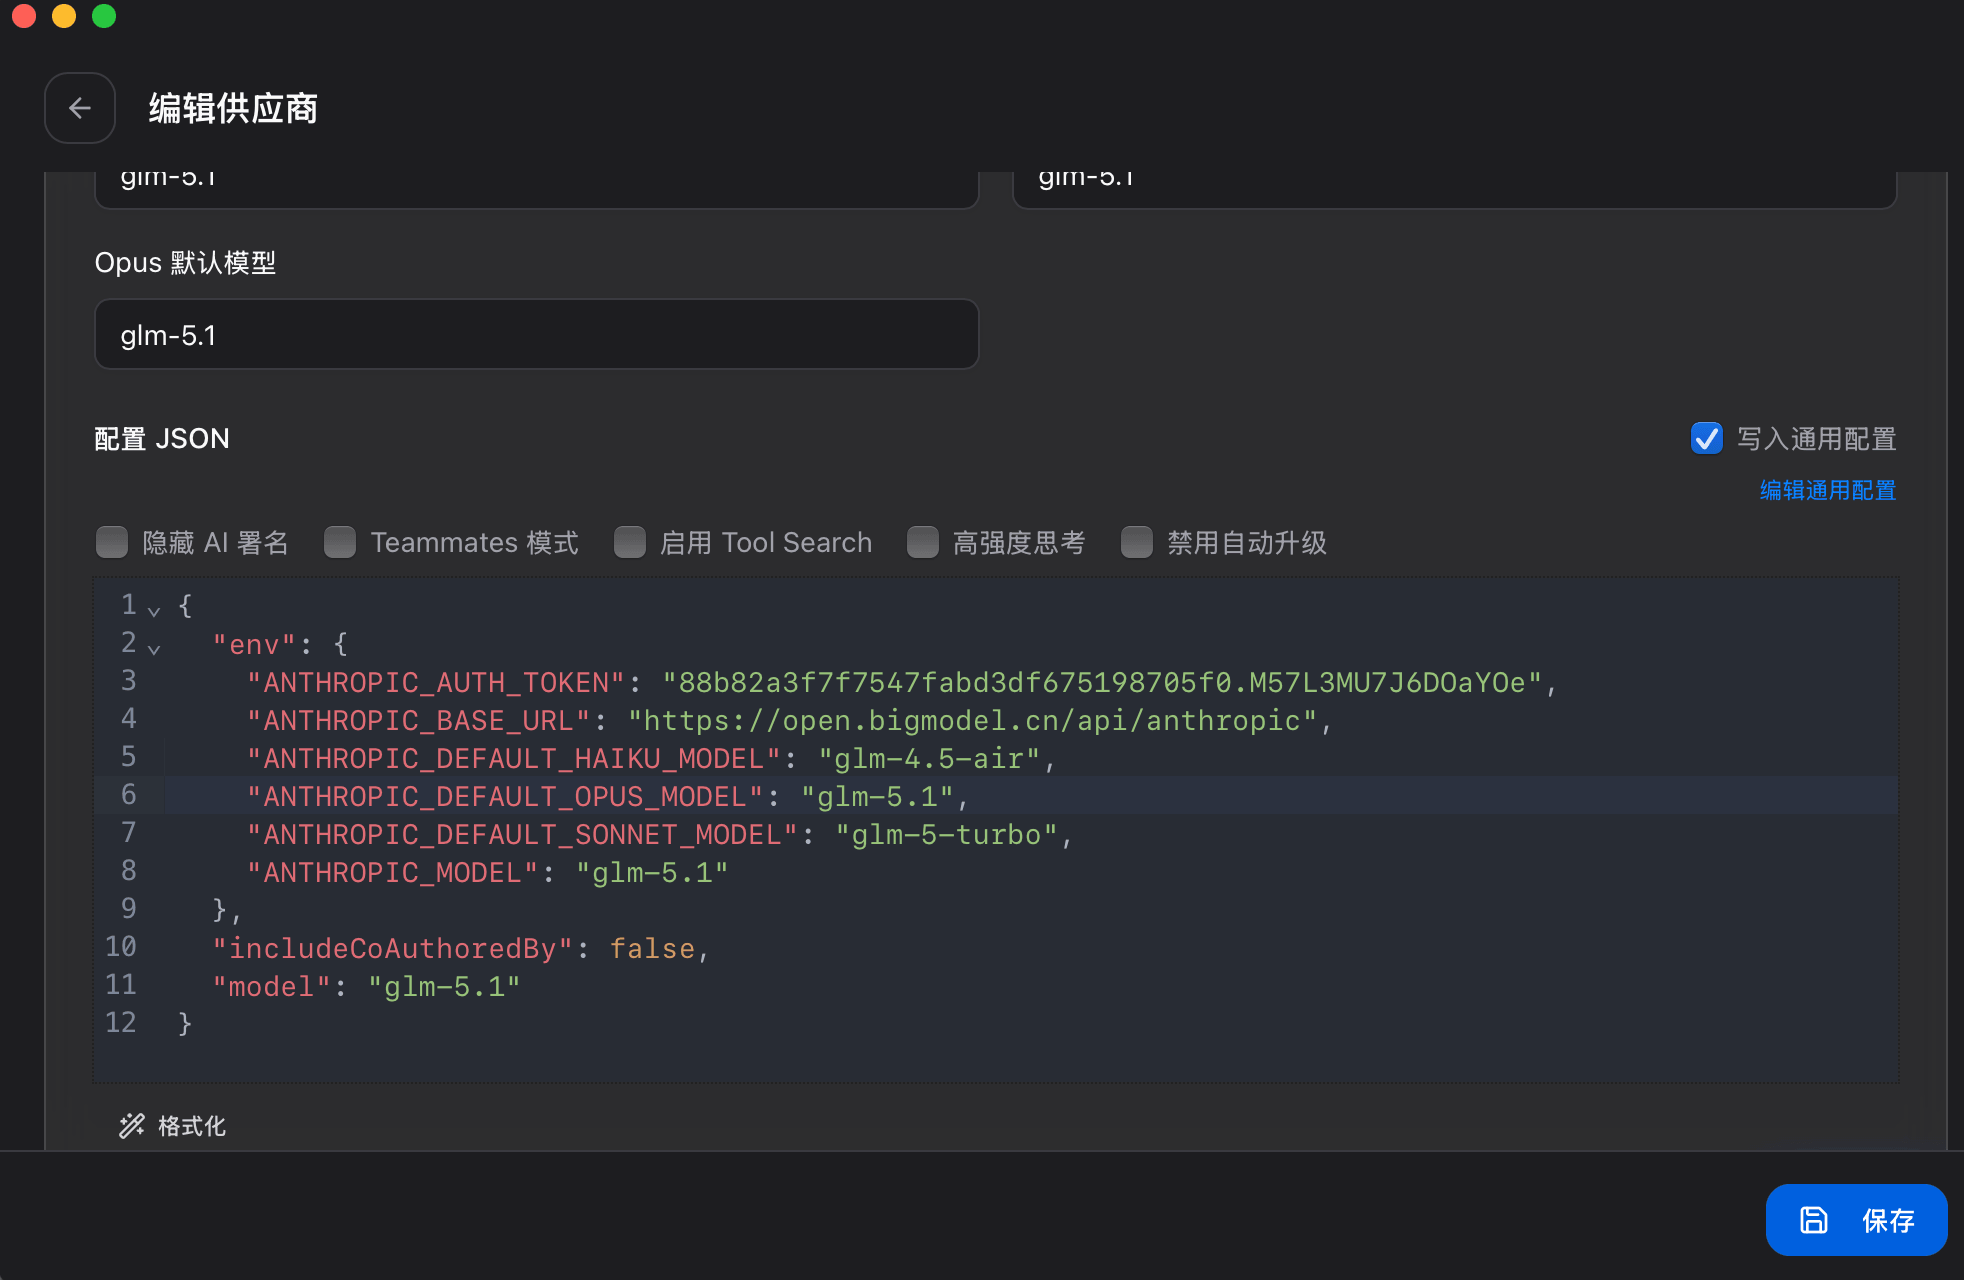
Bước ba: theo hướng dẫn của nhà cung cấp model, hoàn tất việc cấu hình quan hệ tương ứng giữa environment variable của model bên trong Claude Code và model đích. Với GLM-5.1, tham khảo: https://docs.bigmodel.cn/cn/coding-plan/tool/claude
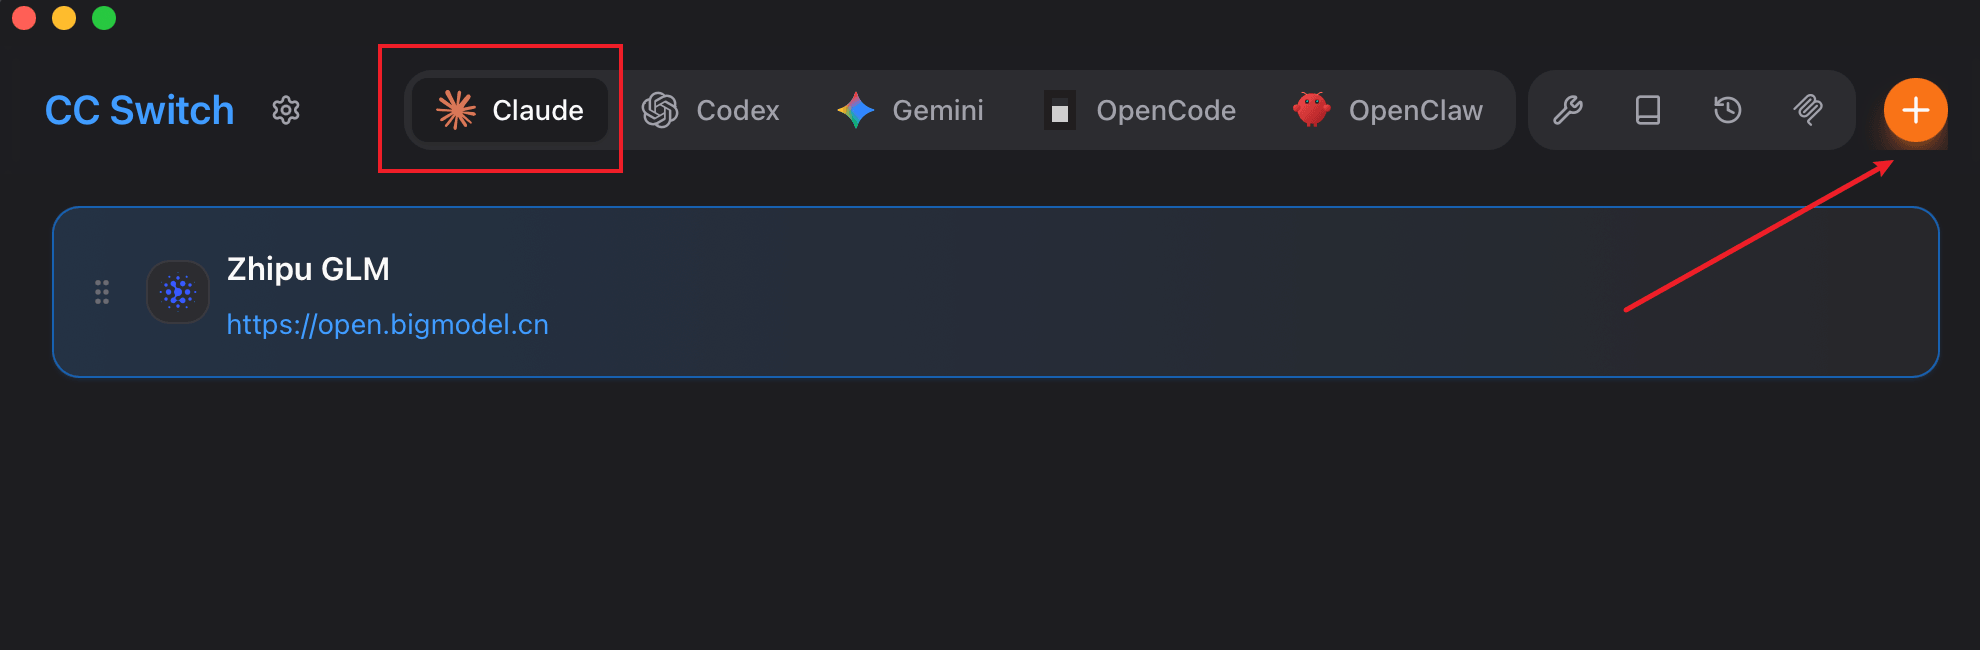
Ảnh chụp quá trình cấu hình như sau:
Nhấn dấu cộng để thêm model:
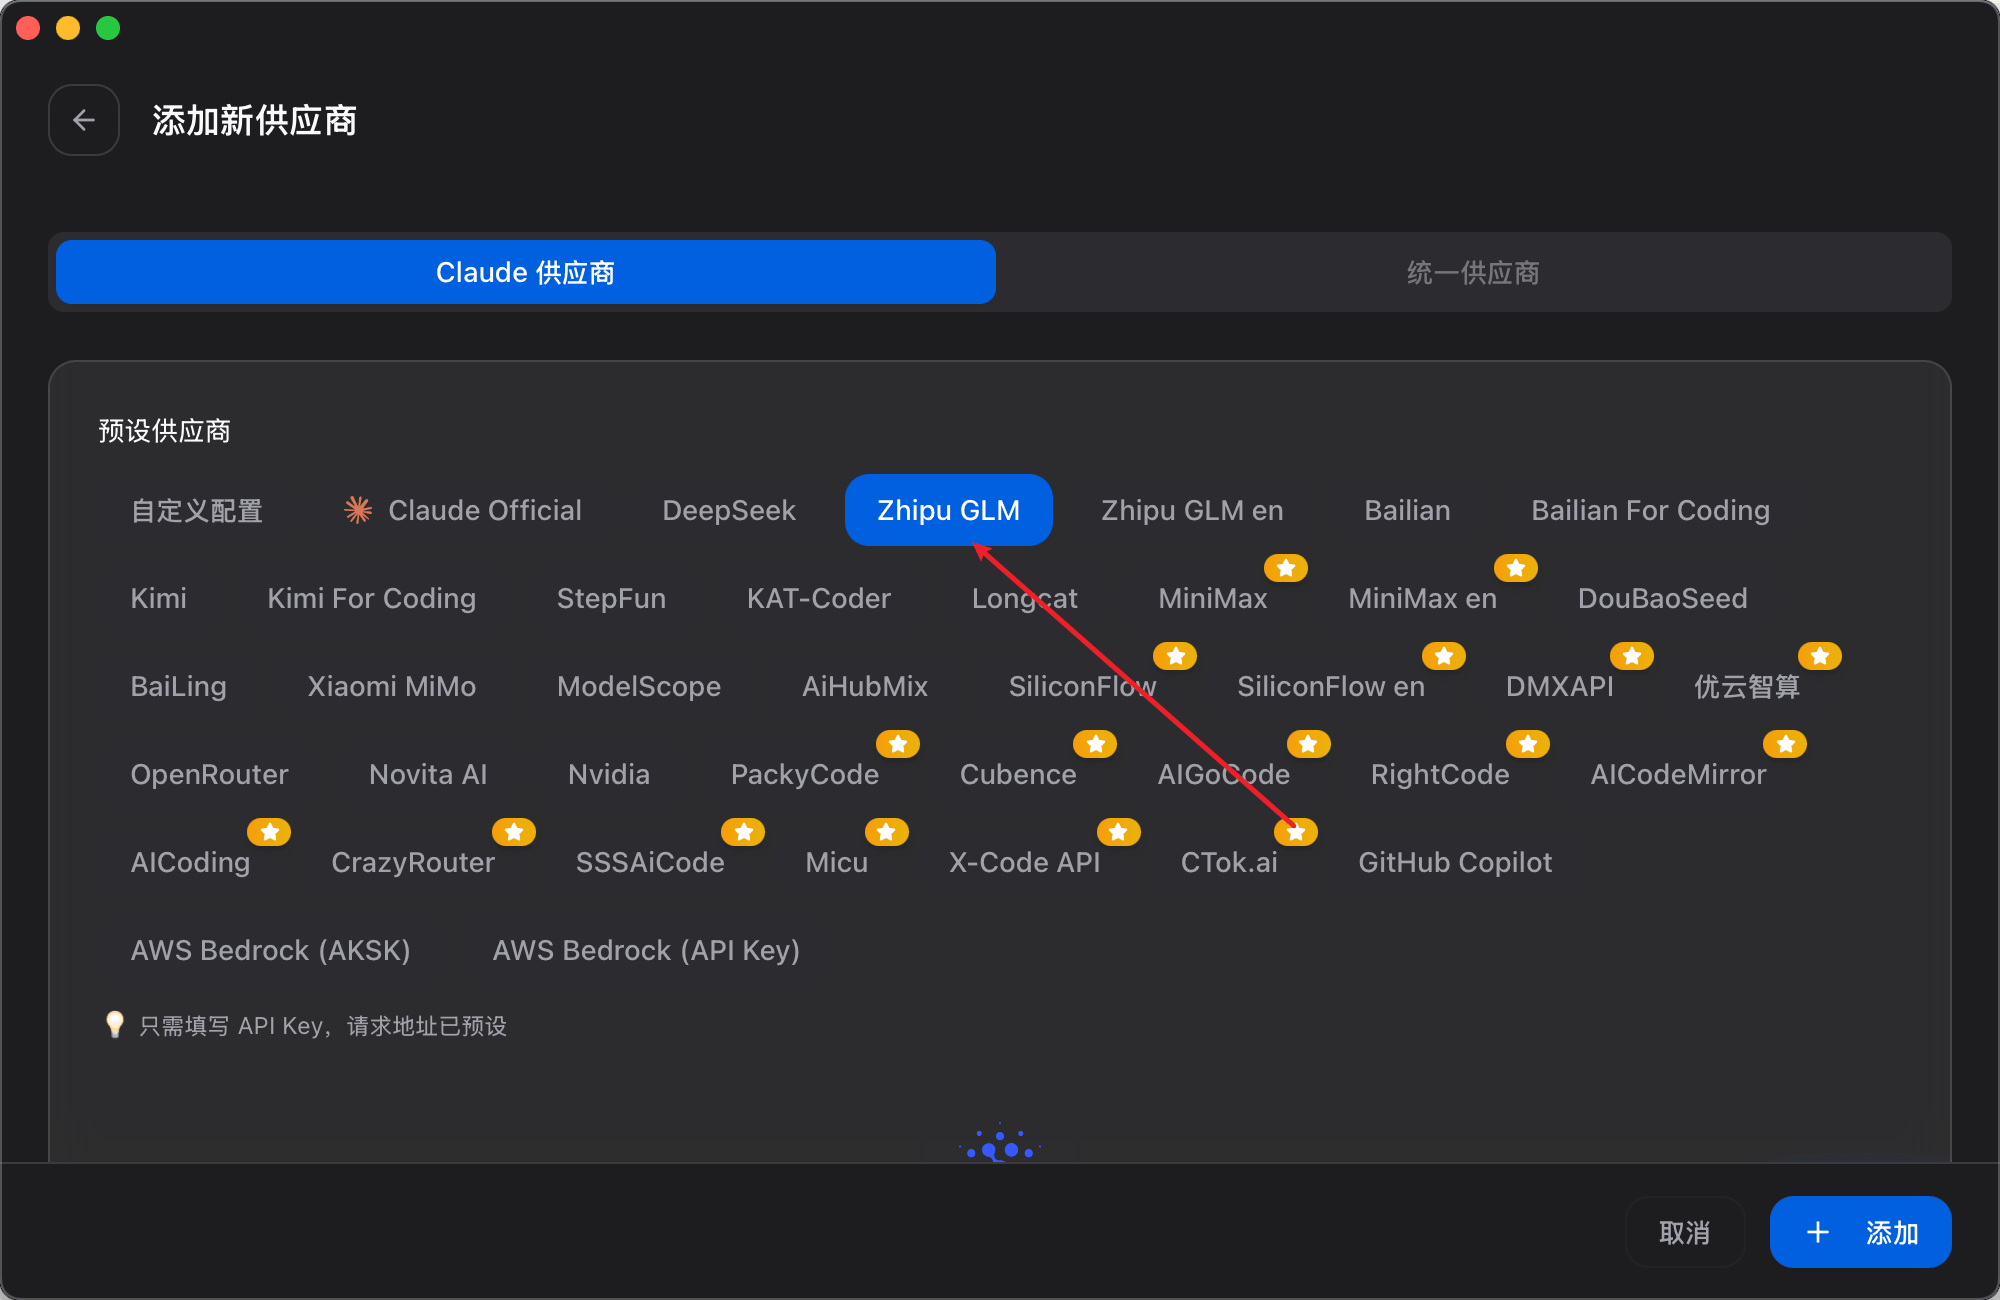
Chọn model tương ứng:
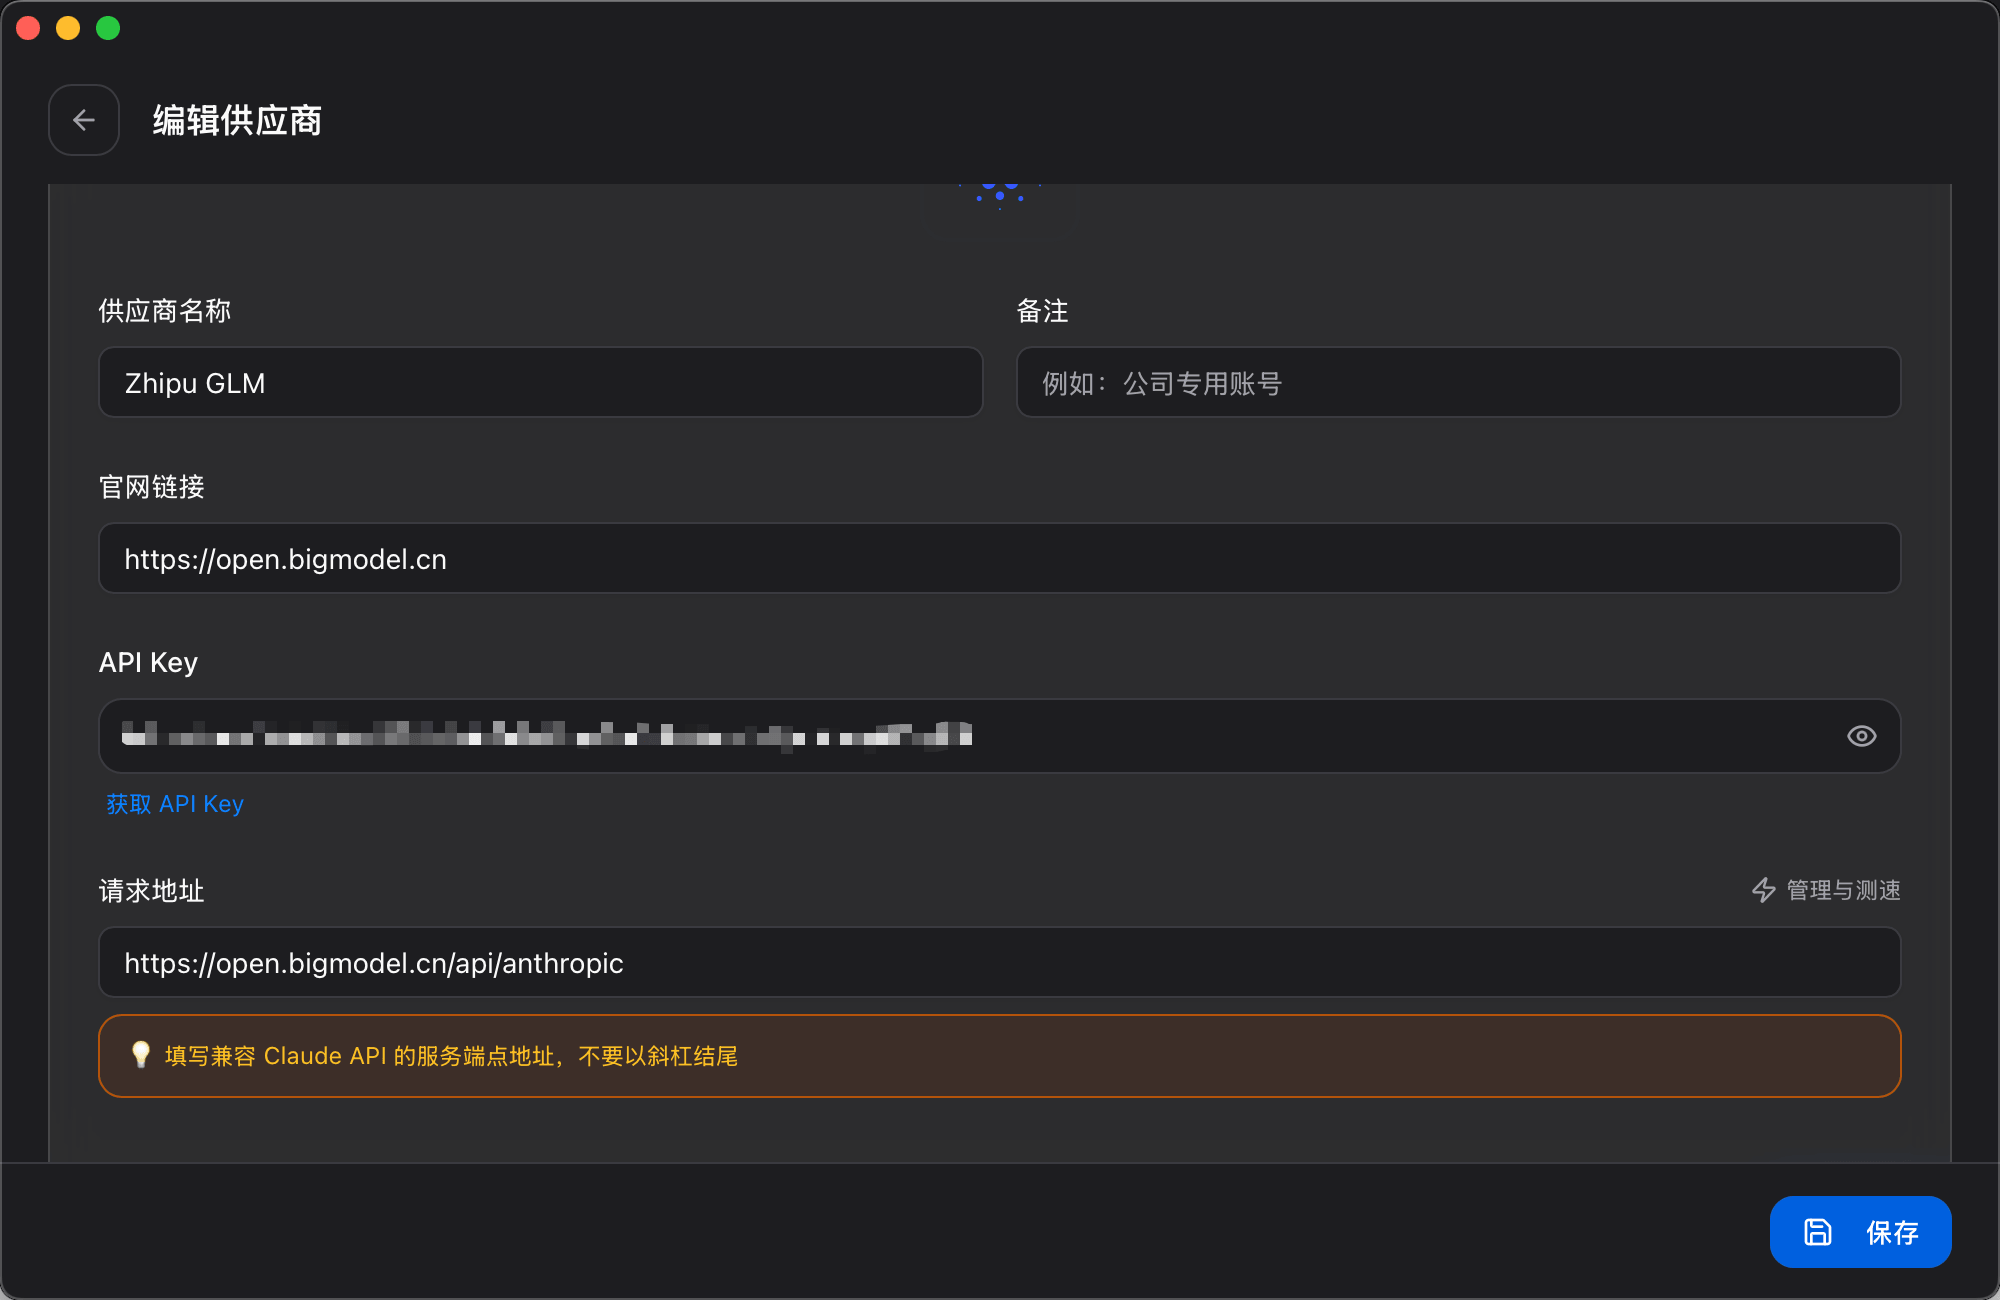
Cấu hình parameter:
Cấu hình JSON cho quan hệ giữa environment variable của model bên trong Claude Code và model:
Nếu bạn thiên về phát triển UI, khuyến nghị tương tác và nghiệm thu coding qua VSCode + Claude Code for VS Code. Sau khi cài plugin, bạn có thể trực tiếp trao đổi với model và review code trong IDE, trực quan hơn CLI interface:
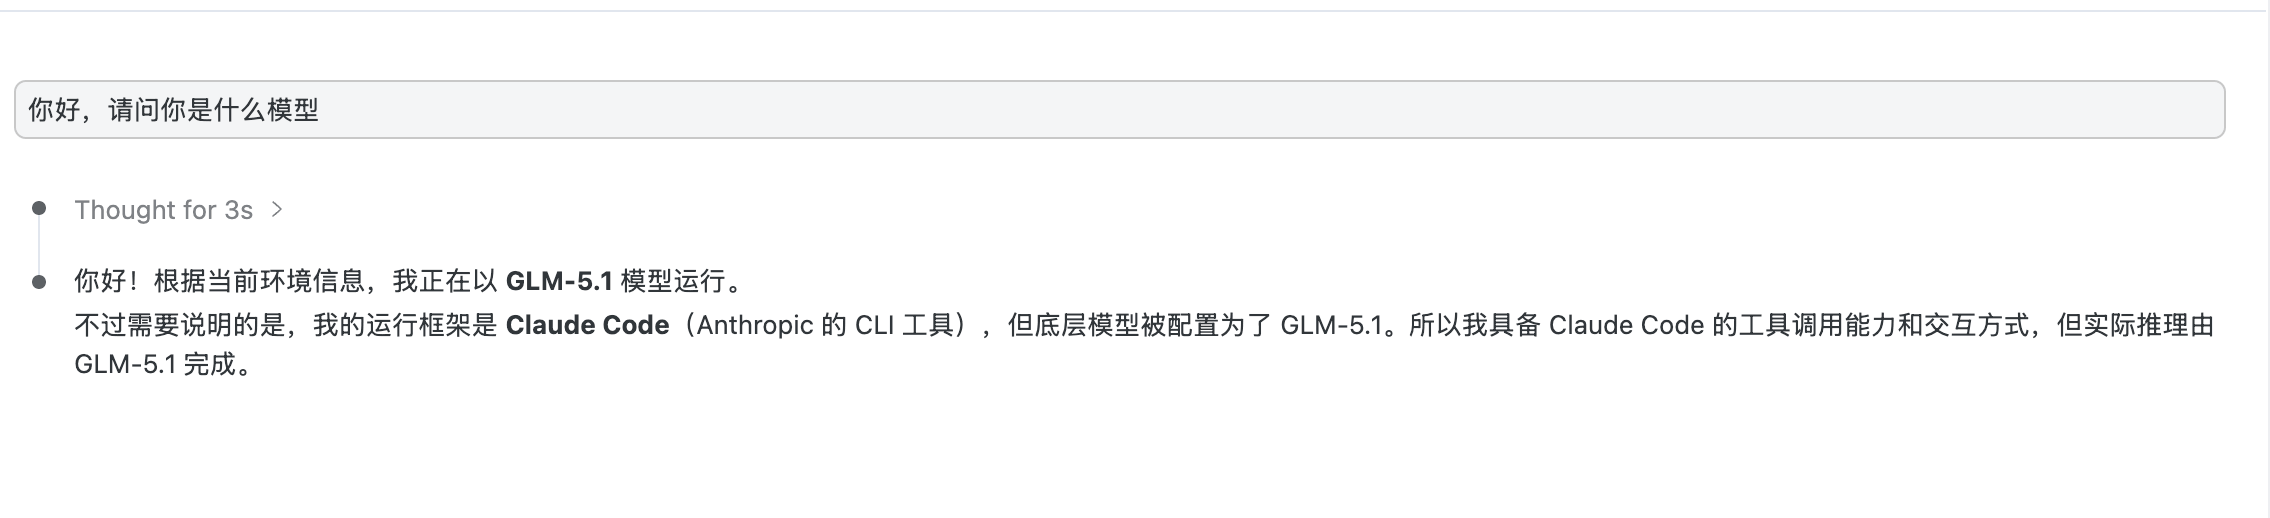
Scenario một: xây dựng JVM diagnosis Agent từ đầu
Vì sao cần trợ lý JVM diagnosis thông minh?
Chẩn đoán JVM trên production từ lâu vẫn là một trong những vấn đề khó nhất khi phát triển Java. Trong mode phát triển truyền thống, khi đối mặt với performance bottleneck hoặc sự cố production, quy trình kiểm tra của đội ngũ R&D cơ bản cố định:
- Xem dashboard giám sát Grafana để bước đầu xác định hướng bất thường
- Đăng nhập server production, kiểm tra các chỉ số như CPU, memory và GC
- Sau khi xác định vấn đề ở tầng Java application, khởi động Arthas và thực thi một loạt lệnh diagnosis để từng bước thu hẹp phạm vi vấn đề
- Xác định đoạn code cụ thể, phân tích root cause và xây dựng phương án sửa chữa
Trước khi AI xuất hiện, quy trình này tuy rườm rà nhưng quả thực là phương thức trực tiếp và hiệu quả nhất. Tuy nhiên, khi nghiệp vụ ngày càng phức tạp và yêu cầu về thời gian phản hồi sự cố ngày càng cao, nhược điểm của mode truyền thống càng rõ rệt:
- Chỉ số giám sát quá chủ quan: trước những vấn đề đa dạng như CPU tăng vọt, memory leak và OOM, dashboard có rất nhiều chỉ số, đội ngũ R&D thường dựa vào kinh nghiệm để suy đoán chủ quan, thiếu methodology diagnosis có hệ thống
- Chuỗi diagnosis quá dài: từ dashboard Grafana đến server production rồi đến diagnosis bằng Arthas, toàn bộ chuỗi kiểm tra liên quan đến việc chuyển đổi và kết nối nhiều tool, không chỉ tốn thời gian mà còn rất kém hiệu quả khi cần khẩn cấp xử lý sự cố production
- Phụ thuộc nhiều vào kinh nghiệm engineer: Arthas quả thực là một công cụ JVM diagnosis mạnh, tích hợp nhiều lệnh nâng cao để đi sâu vào bytecode và xem chi tiết runtime. Nhưng đổi lại, developer phải quen với nhiều parameter của lệnh và đường suy luận thì mới có thể xác định vấn đề chính xác
Khi các khả năng như Agent và Skill dần hoàn thiện, mình hình thành một ý tưởng engineering: hệ thống hóa kinh nghiệm diagnosis thành các bước có thể audit, để AI chọn quy trình diagnosis chỉ đọc dựa trên hiện tượng sự cố, thu thập bằng chứng và tạo các nguyên nhân khả dĩ. Việc kết nối instance production, thực thi command và xác nhận root cause vẫn cần quyền hạn rõ ràng cùng sự kiểm soát của con người, không thể chỉ bị chi phối bởi “tên service + biểu hiện sự cố”.
Bàn giao requirement và thiết kế architecture
Sau khi có ý tưởng, bước tiếp theo là chọn công nghệ và triển khai solution. Mình giao toàn bộ mô tả requirement cho AI:
Phát triển một tool diagnosis Agent dựa trên Arthas, tool này cần triển khai các chức năng cốt lõi sau:
1. Khi user nhập tên service gặp sự cố production và hiện tượng sự cố cụ thể, hệ thống có thể tự động định vị server gặp sự cố mục tiêu, chủ động giám sát realtime và phân tích chuyên sâu service mục tiêu.
2. Thông qua việc tích hợp chức năng decompile của Arthas, xác định chính xác đoạn code cụ thể gây ra sự cố
3. Dựa trên kết quả phân tích, tạo một solution hoàn chỉnh bao gồm root cause, đề xuất sửa code và các bước triển khai.

Hãy cung cấp solution chọn công nghệ cho tool này, bao gồm nhưng không giới hạn ở language phát triển (ưu tiên Java stack), core framework, thiết kế database table, deployment architecture, v.v.; đồng thời thiết kế solution triển khai system chi tiết, bao quát phân chia module chức năng, thiết kế data flow, các điểm khó về kỹ thuật và solution tương ứng.
Sau khi nhận requirement, AI không lập tức bắt đầu viết code mà trước tiên sắp xếp một technical plan theo từng giai đoạn dựa trên project trống. Plan này phù hợp để tạo một hướng đi chờ review, nhưng developer và đội ngũ vận hành vẫn phải xác nhận plan có an toàn và phù hợp với hệ thống vận hành hiện tại hay không.
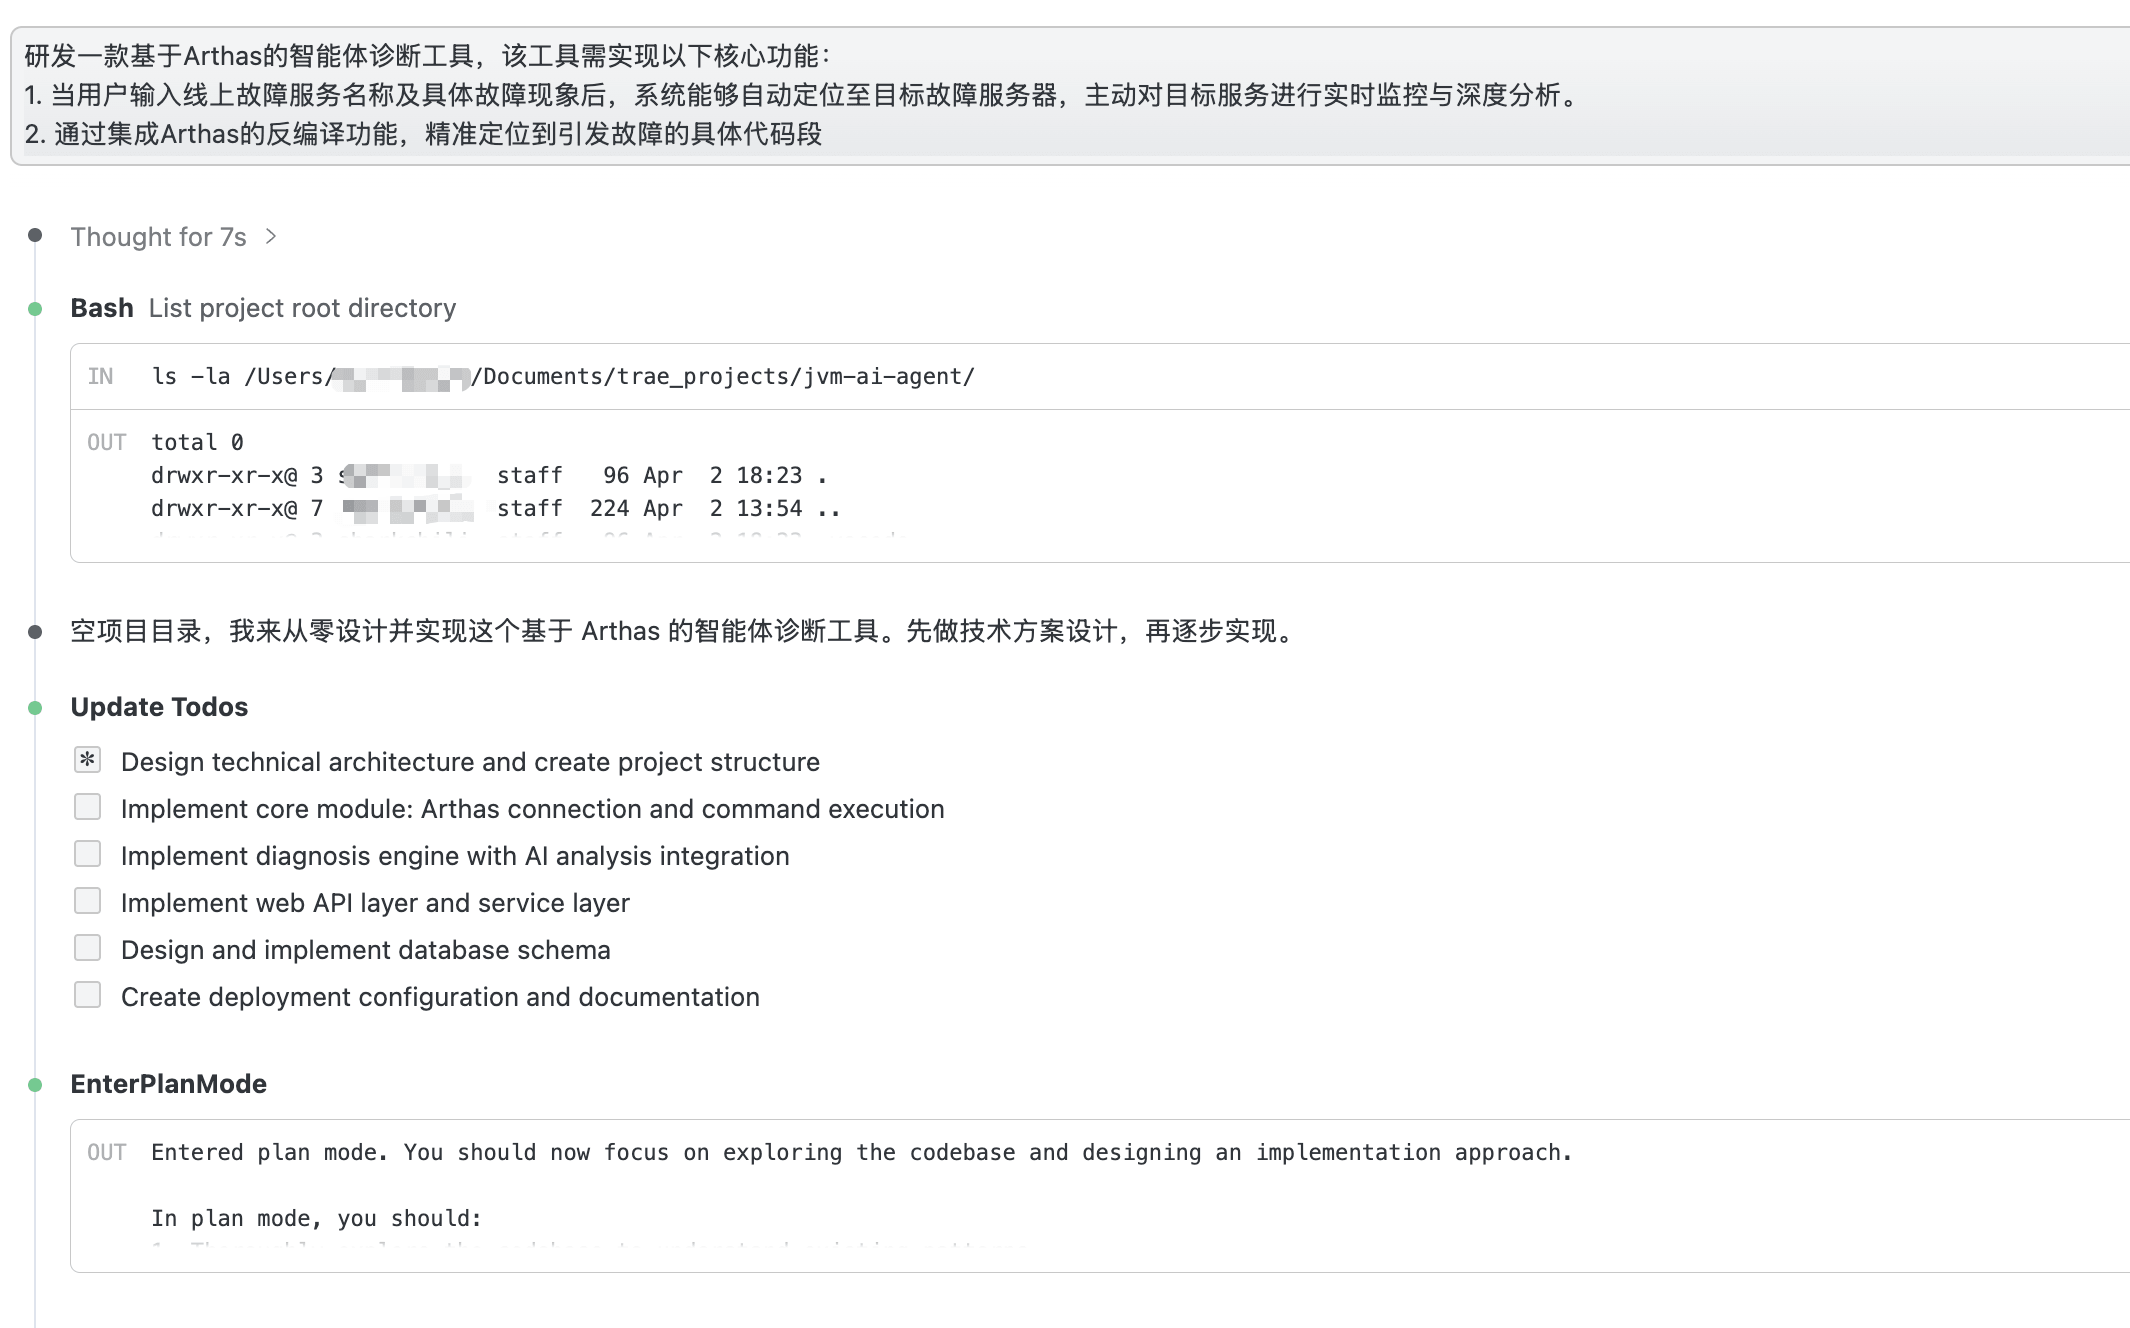
AI kết hợp requirement và phân rã phần tìm kiếm technology selection cùng Arthas integration cho Agent. Từ keyword tìm kiếm có thể thấy, khi chọn solution, AI ưu tiên solution trưởng thành và ổn định:
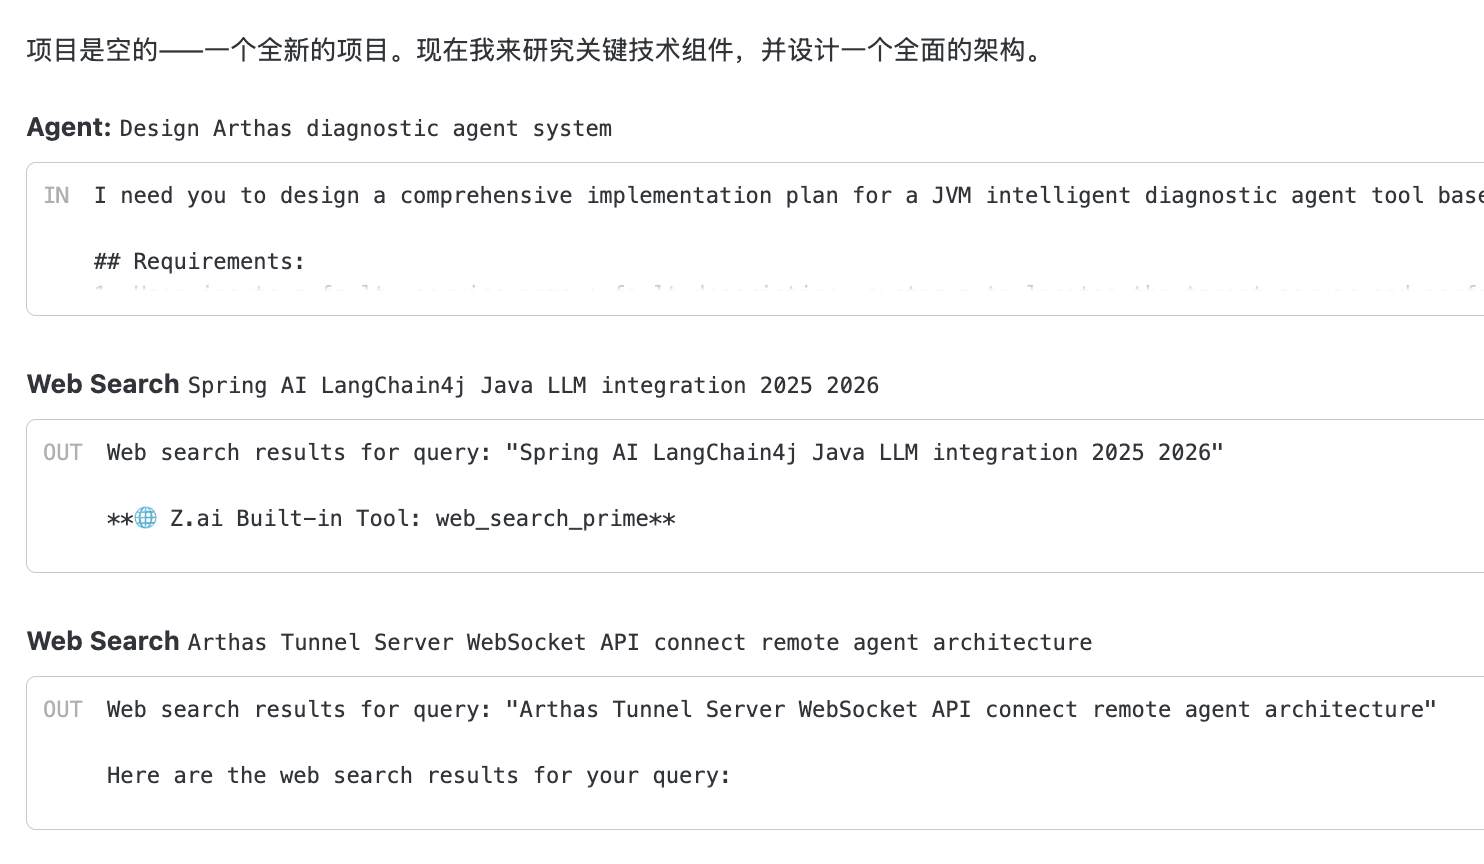
Sau khi tìm kiếm tài liệu chính thức của Arthas, AI xuất ra sơ đồ thiết kế system architecture dưới đây. Từ trên xuống dưới gồm ba tầng: tầng user nhập tên service và hiện tượng sự cố; tầng Agent do Skill engine, Arthas HTTP Client và AI analysis engine phối hợp hoạt động; tầng thấp nhất kết nối với service instance mục tiêu thông qua Arthas HTTP API. Sơ đồ này bao quát các business module chính nhưng chưa thể hiện các production control plane như authentication, approval, command policy và audit; phần sau sẽ bổ sung riêng:
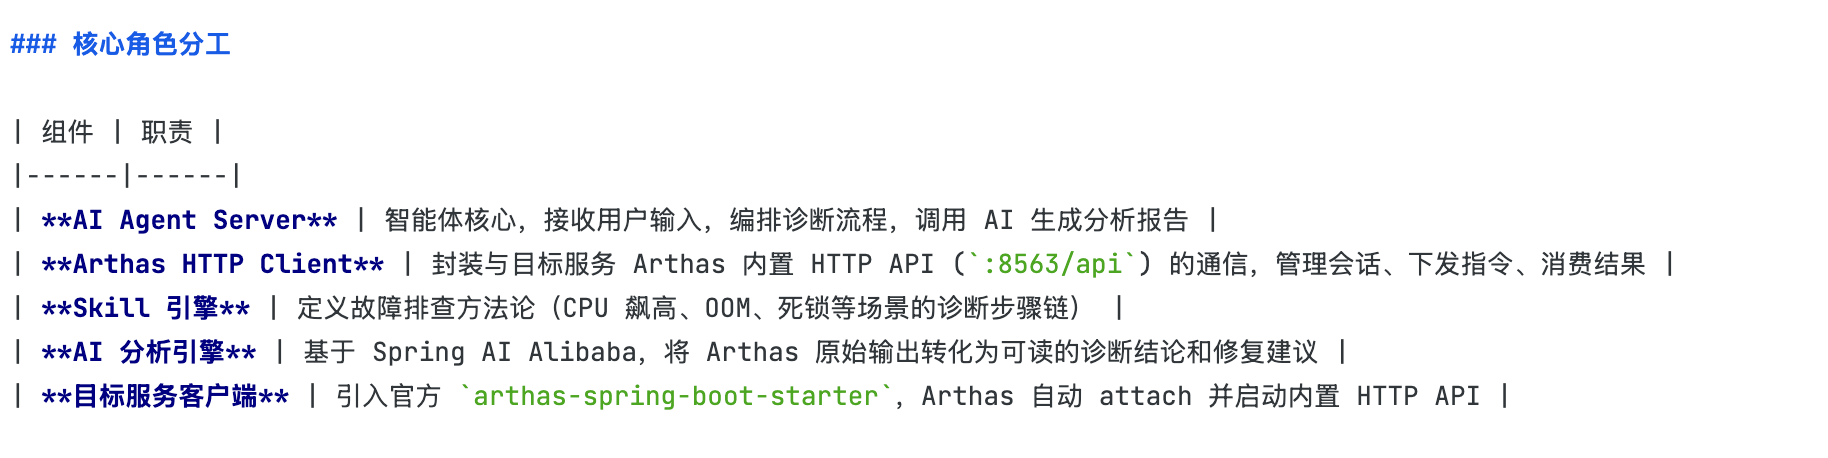
Sau khi đưa ra architecture diagram, AI tiếp tục phân tách trách nhiệm của 6 core component — từ flow orchestration của AI Agent Server, session management của Arthas HTTP Client, định nghĩa chuỗi bước diagnosis của Skill engine cho đến report generation của AI analysis engine; boundary và quan hệ phối hợp của từng component đều được trình bày khá rõ:
Cuối cùng là thiết kế data flow. AI kết hợp một scenario RT timeout phổ biến để đưa ra flow từ Skill matching, thực thi các bước diagnosis đến output report. Flow session init_session → async_exec → pull_results → interrupt_job → close_session được sử dụng ở đây phù hợp với async job model của Arthas HTTP API, có thể quản lý command async liên tục output. Các command như watch, trace sẽ enhance target class, không thể coi là truy vấn chỉ đọc thông thường chỉ vì “không sửa business data”. Trọng tâm review không nên dừng ở việc “API này có phải AI bịa ra hay không”, mà cần tiếp tục kiểm tra command tiering, session cleanup, timeout và security control:
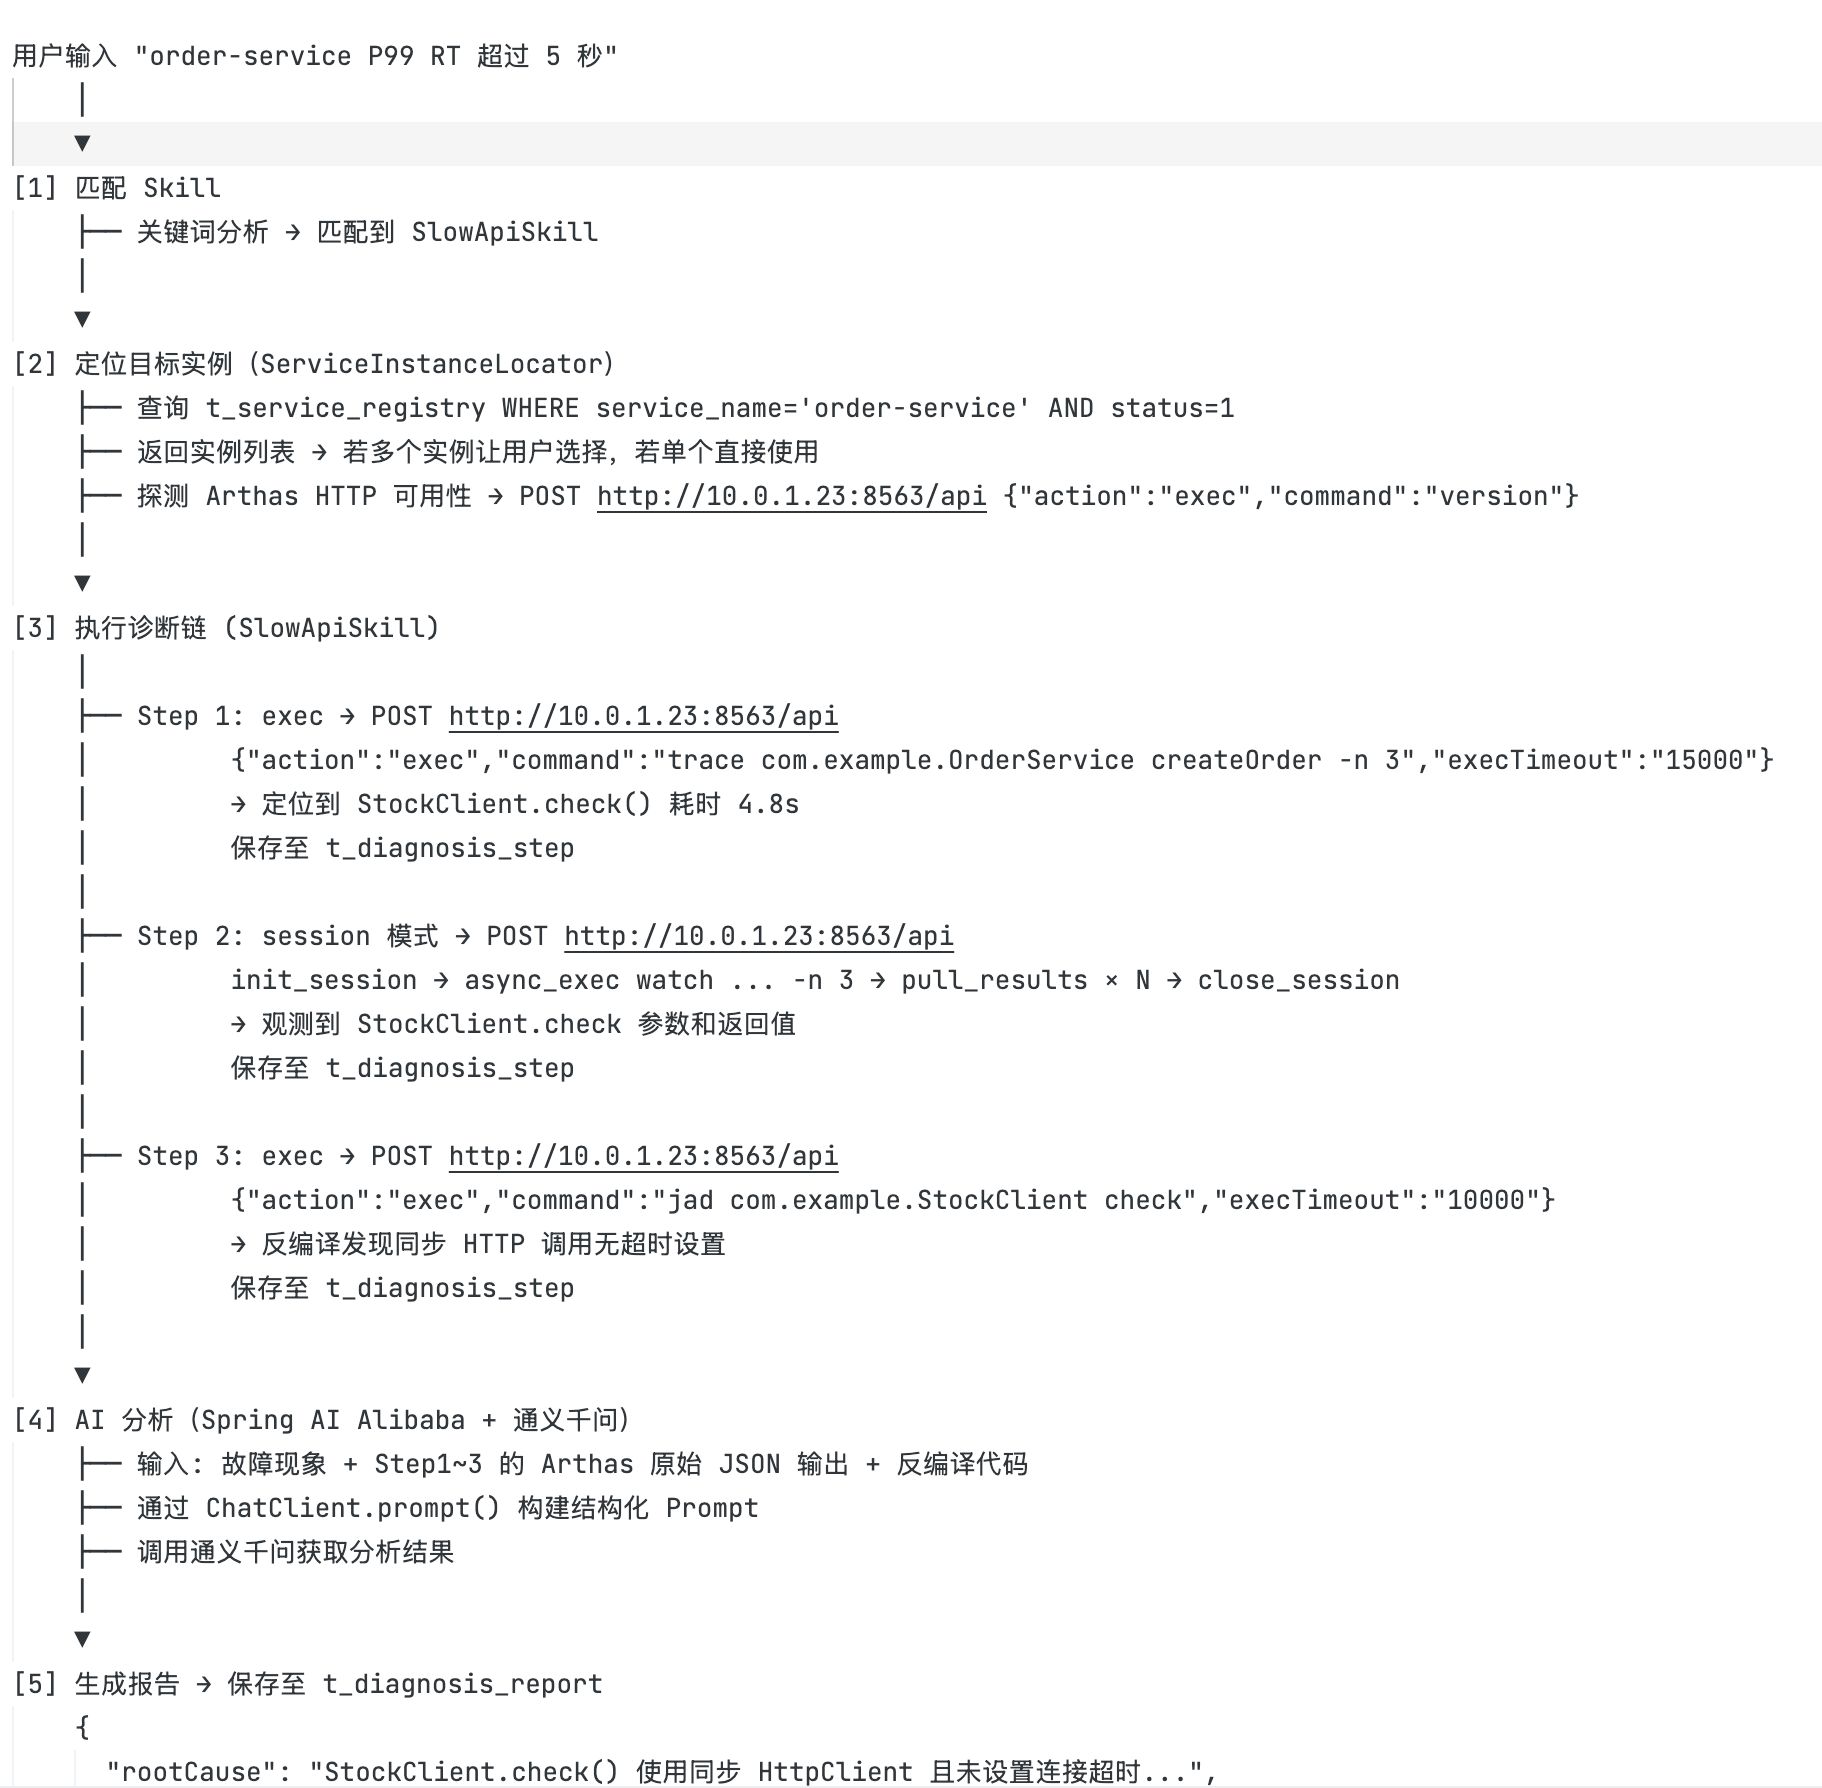
Arthas HTTP API có thể trực tiếp nhận diagnostic command, tài liệu chính thức cũng cung cấp cấu hình authentication. Vì vậy, trước khi Agent này đi vào production, ít nhất cần bổ sung các control sau:
- Identity và network boundary: bật Arthas authentication, đặt diagnosis entry trong isolated network; Agent sử dụng service identity riêng và credential với quyền tối thiểu, không được giao account hoặc password cho model.
- Whitelist target instance: tên service chỉ được resolve đến instance đã đăng ký, cấm user hoặc model truyền vào IP, port và URL tùy ý; production và test environment sử dụng credential và policy khác nhau.
- Command whitelist: mặc định chỉ mở các read-only diagnosis template đã review, không thực hiện bytecode enhancement. Các dynamic parameter như class name và method name phải được validate theo type và length, cấm trực tiếp dùng string do model tạo làm Arthas command.
- Approval cho operation rủi ro cao: mặc định tắt các dynamic enhancement command như
watch,trace,tt. Khi thực sự cần thực thi, sử dụng template đã được review và qua human approval, giới hạn số lần thực thi, thời gian chạy tối đa, phạm vi sampling và output; OGNL expression chỉ được tạo từ template trong whitelist, sau khi task kết thúc phải xác nhận enhancement đã được thu hồi. Các operation khác có thể thay đổi runtime state, tạo high load hoặc làm lộ sensitive data cũng cần short-lived authorization và double review. - Resource protection: đặt timeout, concurrency limit, rate limiting và circuit breaker cho từng instance; command dạng liên tục phải đặt thời gian chạy tối đa và bảo đảm
interrupt_jobcùngclose_sessioncũng được thực thi trên exception path. - Audit và desensitization: ghi lại người khởi tạo, target instance, template, parameter thực tế, thời gian bắt đầu/kết thúc và result summary; trước khi log, decompiled code và report được đưa vào model, cần desensitize secret, thông tin cá nhân và business data.
Các hướng mở rộng cũng phải chịu cùng boundary. Ví dụ, “alert linkage” có thể tự động tạo diagnosis task nhưng không được bypass approval để tự động thực thi command tùy ý; “auto-fix patch” chỉ được tạo Diff ứng viên, không được trực tiếp sửa production instance.
Bàn giao coding và engineering structure
Sau khi xác nhận solution không có vấn đề, mình trực tiếp ra lệnh phát triển:
Solution tổng thể không có vấn đề, hãy hoàn thành công việc phát triển.Sau khi nhận lệnh, AI bắt đầu tự động coding. Theo architecture design trước đó, AI tiến hành theo từng module — từ dựng parent POM và Maven multi-module skeleton, đến common utility class, data model, data access layer, Arthas client wrapper, Skill engine, AI analysis engine, business logic layer, Web controller, cho đến startup module và deployment config; hoàn tất toàn bộ 11 sub-step:
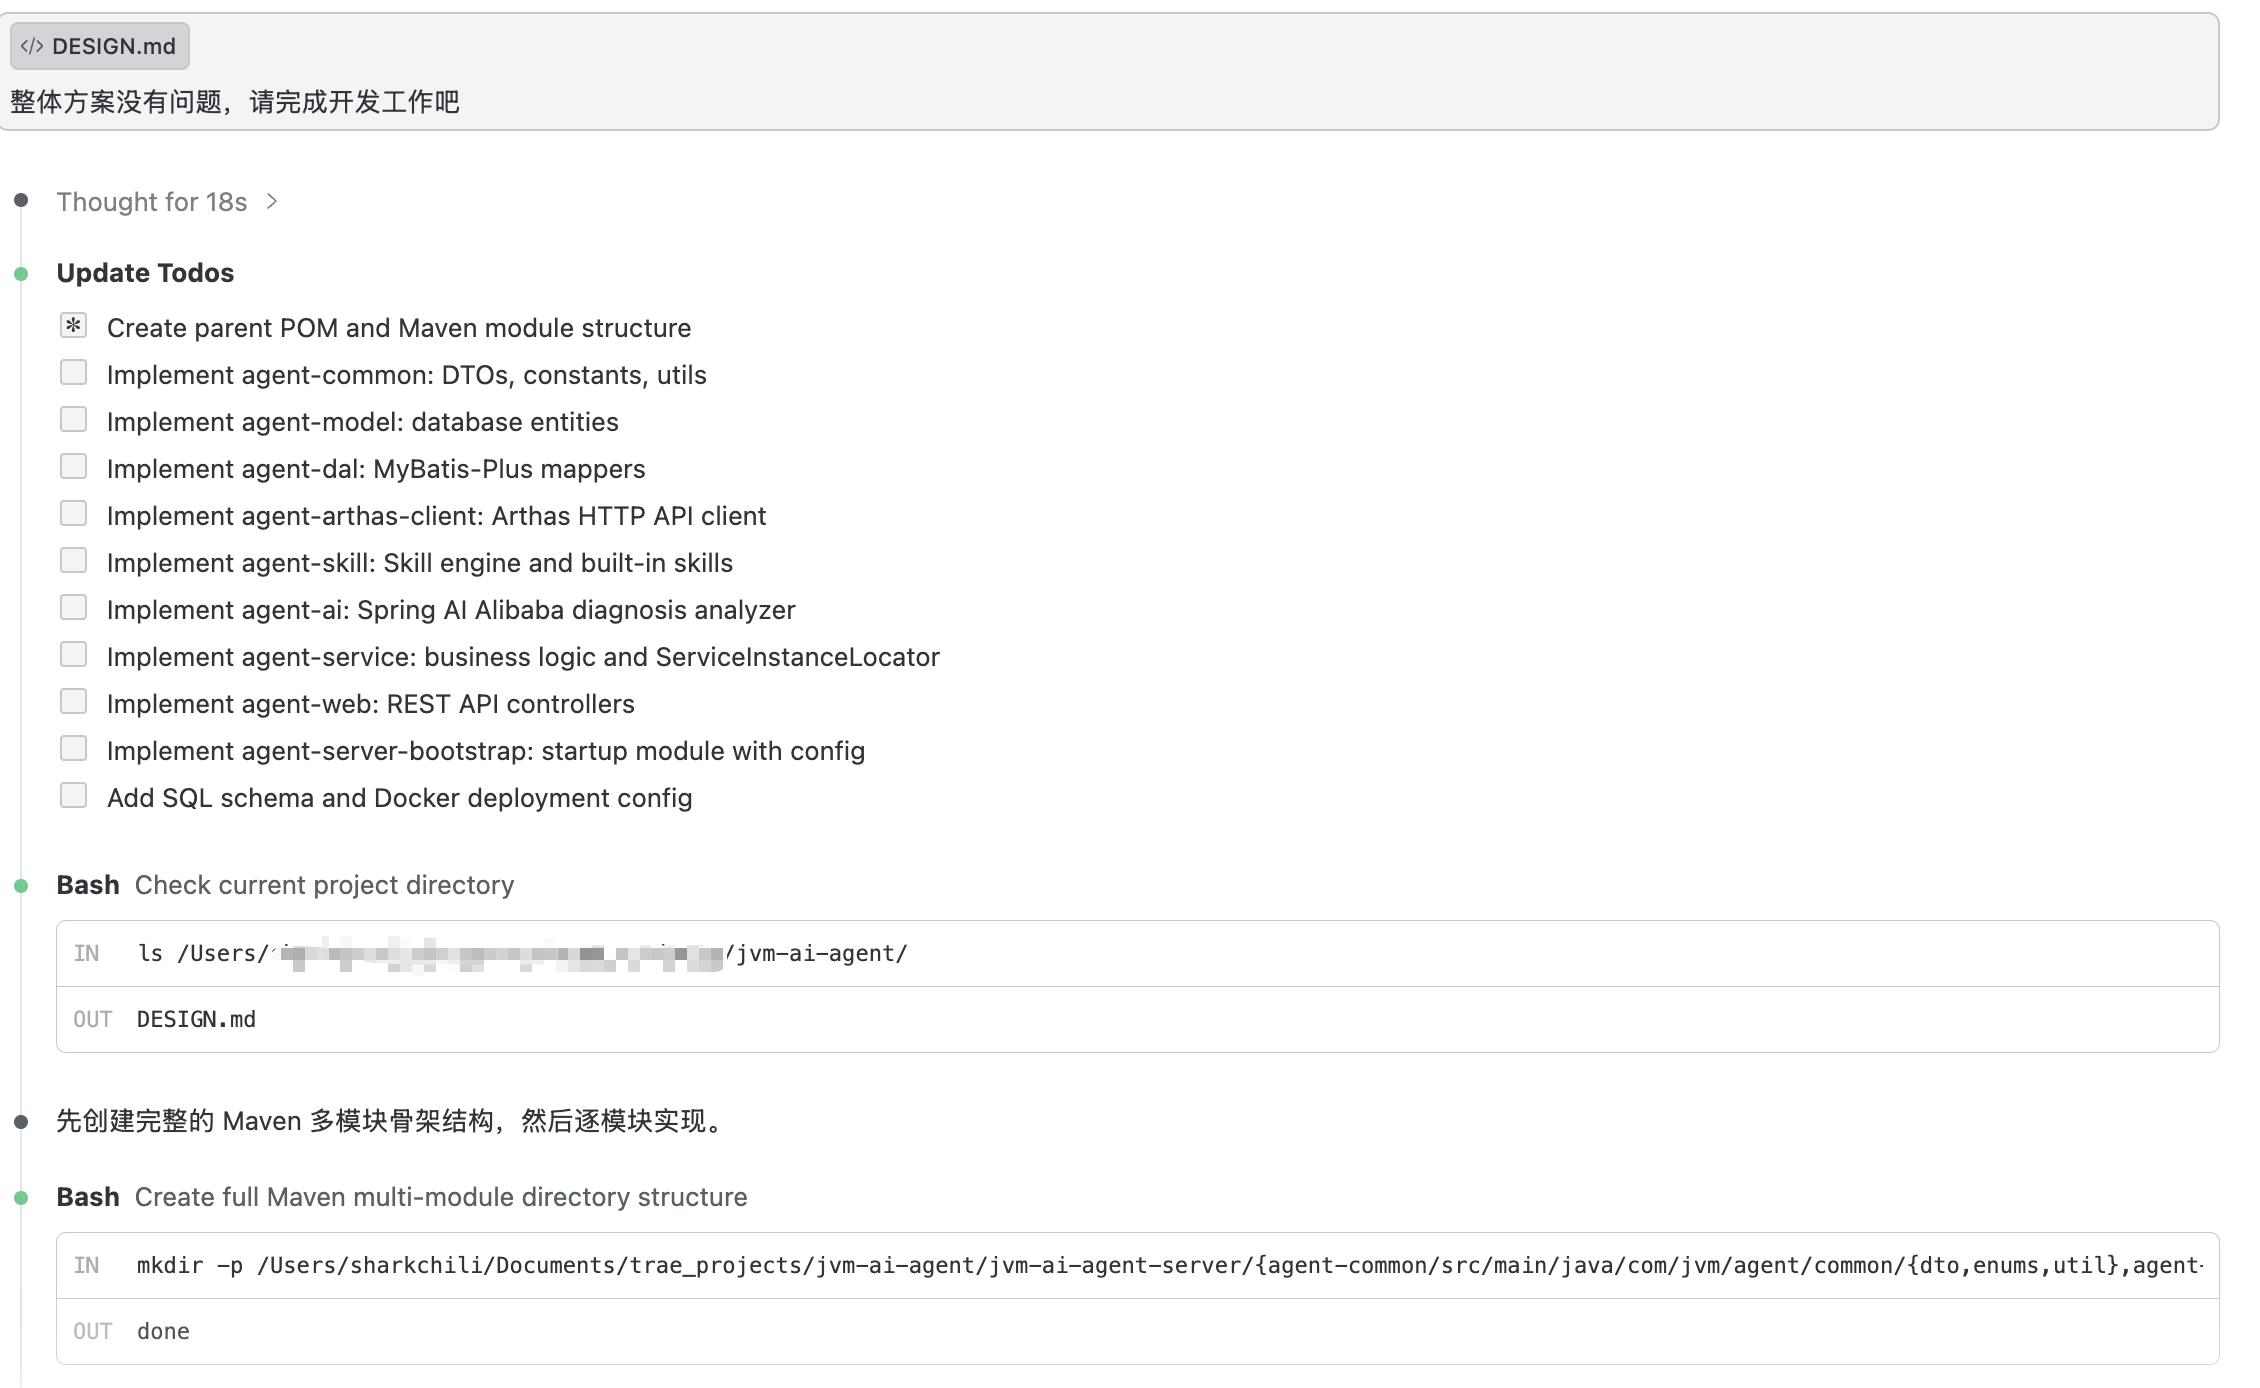
Một lát sau, AI tạo ra candidate implementation gồm 9 module và 46 file, bao quát common utility class, 7 diagnosis Skill, Arthas HTTP API client và Spring AI Alibaba analyzer. Số lượng file chỉ cho biết phạm vi bàn giao, không thể chứng minh tính an toàn và correctness:
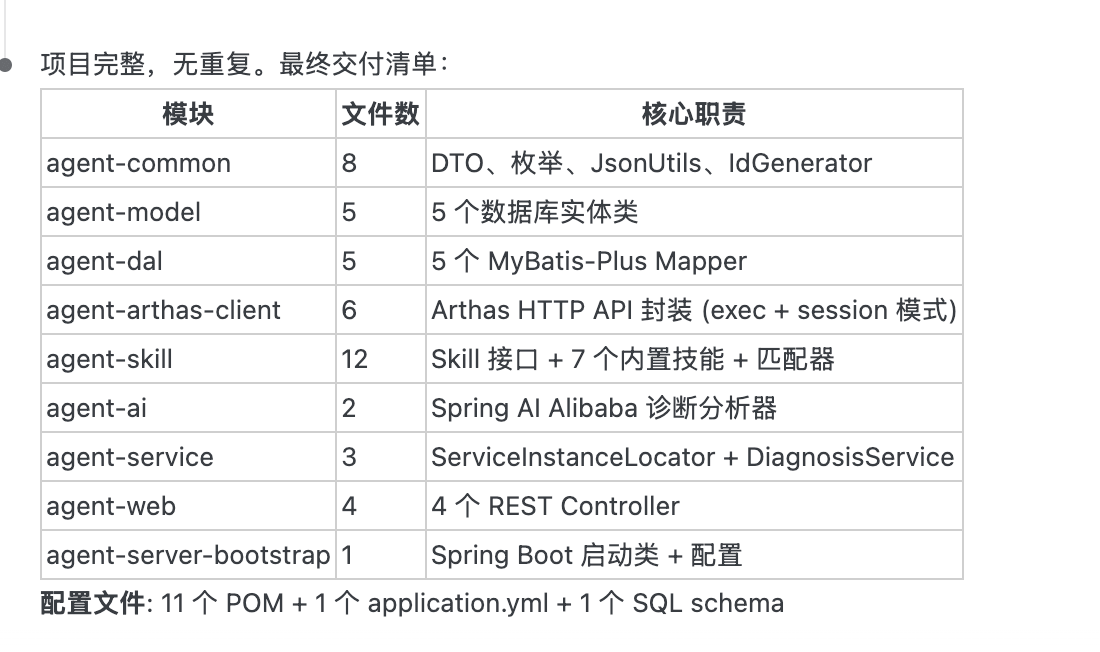
Trước tiên xem module structure tổng thể. AI hoàn thành việc phân chia project theo standard của Java multi-module, từ trên xuống dưới tuân thủ nghiêm dependency hierarchy common→model→dal→client→skill→ai→service→web→bootstrap, naming convention thống nhất.
Module agent-skill đáng chú ý. AI thiết kế abstract interface cho Skill engine và tích hợp sẵn 7 diagnosis skill bao quát các JVM failure scenario phổ biến (CPU tăng cao, OOM, deadlock, slow API, GC bất thường, thread leak, không tìm thấy class); mỗi Skill đều định nghĩa đầy đủ diagnosis step chain. Cách thiết kế “framework + built-in implementation” này có khả năng mở rộng khá tốt:
jvm-ai-agent/
├── jvm-ai-agent-server/                 # Agent server (core)
│   ├── agent-common/                    # Common module: utility class, constant, DTO
│   ├── agent-model/                     # Data model: entity, database mapping
│   ├── agent-dal/                       # Data access layer: Mapper, Repository
│   ├── agent-arthas-client/             # Arthas HTTP API client wrapper
│   ├── agent-skill/                     # Skill engine (diagnosis methodology)
│   ├── agent-ai/                        # AI analysis engine
│   ├── agent-service/                   # Business logic layer (bao gồm service instance query)
│   ├── agent-web/                       # Web layer: REST API, WebSocket
│   └── agent-server-bootstrap/          # Startup module
│
└── pom.xml                              # Parent POM
Tiếp theo là core logic của diagnosis. executeDiagnosis tiến hành theo Skill matching, instance location, diagnosis chain execution, result analysis và report generation. Bản implementation ban đầu còn cho phép trích xuất variable từ Arthas output rồi nối thành command tiếp theo; implementation production phải cố định command trong template đã review, chỉ cho phép thay thế variable đã được validate. Việc “tiếp tục sau khi một bước không quan trọng thất bại” cũng phải được định nghĩa theo từng bước; authentication failure, target không nằm trong whitelist, timeout và audit failure đều không được âm thầm bỏ qua:
- Skill matching: thông qua
DefaultSkillMatcher, match diagnosis skill phù hợp nhất dựa trên keyword của hiện tượng sự cố - Instance location: thông qua
ServiceInstanceLocator, resolve target instance IP và Arthas port dựa trên service name - Diagnosis chain execution: duyệt các read-only diagnosis template đã qua approval, lần lượt thực thi Arthas command và thu thập result
- Parameter replacement có giới hạn: trích xuất variable như class name và method name từ result; chỉ sau khi validate format, length và allowed range mới được inject vào template tiếp theo
- AI analysis report: giao toàn bộ diagnosis data cho AI analysis engine để tạo structured report bao gồm root cause, đề xuất sửa chữa và severity
private void executeDiagnosis(DiagnosisRecord record, DiagnosisRequest request) {
    try {
        // 1. Match Skill
        Optional<SkillDefinition> skillOpt = skillMatcher.findBestMatch(request.getSymptom());
        if (skillOpt.isEmpty()) {
            failDiagnosis(record, "Không thể match diagnosis skill phù hợp");
            return;
        }
        SkillDefinition skill = skillOpt.get();
        // ......

        // 2. Định vị target instance
        ServiceRegistry instance = instanceLocator.resolveInstance(
                request.getServiceName(), request.getInstanceIp());
        // ......

        // 3. Thực thi diagnosis step chain
        List<DiagnosticStep> chain = skill.getDiagnosticChain();
        StringBuilder allDiagnosticData = new StringBuilder();
        String decompiledCode = "";
        Map<String, String> contextVars = new HashMap<>();

        for (int i = 0; i < chain.size(); i++) {
            DiagnosticStep step = chain.get(i);
            // ...... Khởi tạo step entity

            try {
                // Chỉ resolve command template đã được review trước; variable phải qua type và whitelist validation
                String command = resolveCommand(step, contextVars);
                // ......

                // Thực thi Arthas command và ghi lại thời gian
                String result = executeStep(host, port, step, command);

                // Nếu là jad result, ghi lại dưới dạng decompiled code
                if ("jad".equals(step.getResultType())) {
                    decompiledCode = result;
                }

                // Trích xuất context variable từ result để các step sau sử dụng
                extractContextVars(result, contextVars);
            } catch (Exception e) {
                // Chỉ tiếp tục sau khi read-only step được đánh dấu rõ ràng là non-critical thất bại
                // ......
            }
        }

        // 4. AI analysis
        String report = diagnosisAnalyzer.analyze(
                request.getSymptom(), allDiagnosticData.toString(), decompiledCode, skill);

        // 5. Lưu report (trích xuất các field có cấu trúc như root cause, severity từ Markdown report)
        // ......

        // 6. Cập nhật diagnosis record status
        record.setStatus(DiagnosisStatus.COMPLETED.getCode());
        // ......
    } catch (Exception e) {
        failDiagnosis(record, e.getMessage());
    }
}
Tích hợp Agent interaction page
Trong quá trình AI coding, mình đã tham khảo tài liệu chính thức của Spring AI Alibaba và phát hiện framework này cung cấp sẵn Agent Chat UI. Thay vì để AI tự tạo frontend page từ đầu, tốt hơn là tích hợp trực tiếp interaction component này để triển khai trải nghiệm diagnosis với SSE streaming output. Vì vậy mình đưa ra một lệnh ngắn:
Dựa trên tài liệu chính thức của Spring AI Alibaba (link tham khảo https://java2ai.com/docs/frameworks/studio/quick-start/), hãy triển khai Agent interaction page.Chỉ với một link tài liệu và một câu, AI đã tự đọc tài liệu chính thức, hiểu các bước integration và hoàn tất phát triển page. Đây cũng là một mẹo thực tế khi sử dụng AI hỗ trợ coding: khi chỉ cần tích hợp một component có sẵn, đưa trực tiếp link tài liệu thường hiệu quả hơn mô tả requirement chi tiết.
Đến đây, flow chính cần cho local demo đã được tạo. Đây vẫn chưa phải diagnosis platform có thể trực tiếp deploy lên production; ngoài functional test, còn phải bổ sung các security control, fault injection và load protection đã nêu. Để verify flow cơ bản, mình khởi chạy một test API gây CPU tăng cao ở local:
@Slf4j
@RestController
public class TestController {
    @RequestMapping("cpu-100")
    public  void cpu() {
        while (true){
        }
    }
}
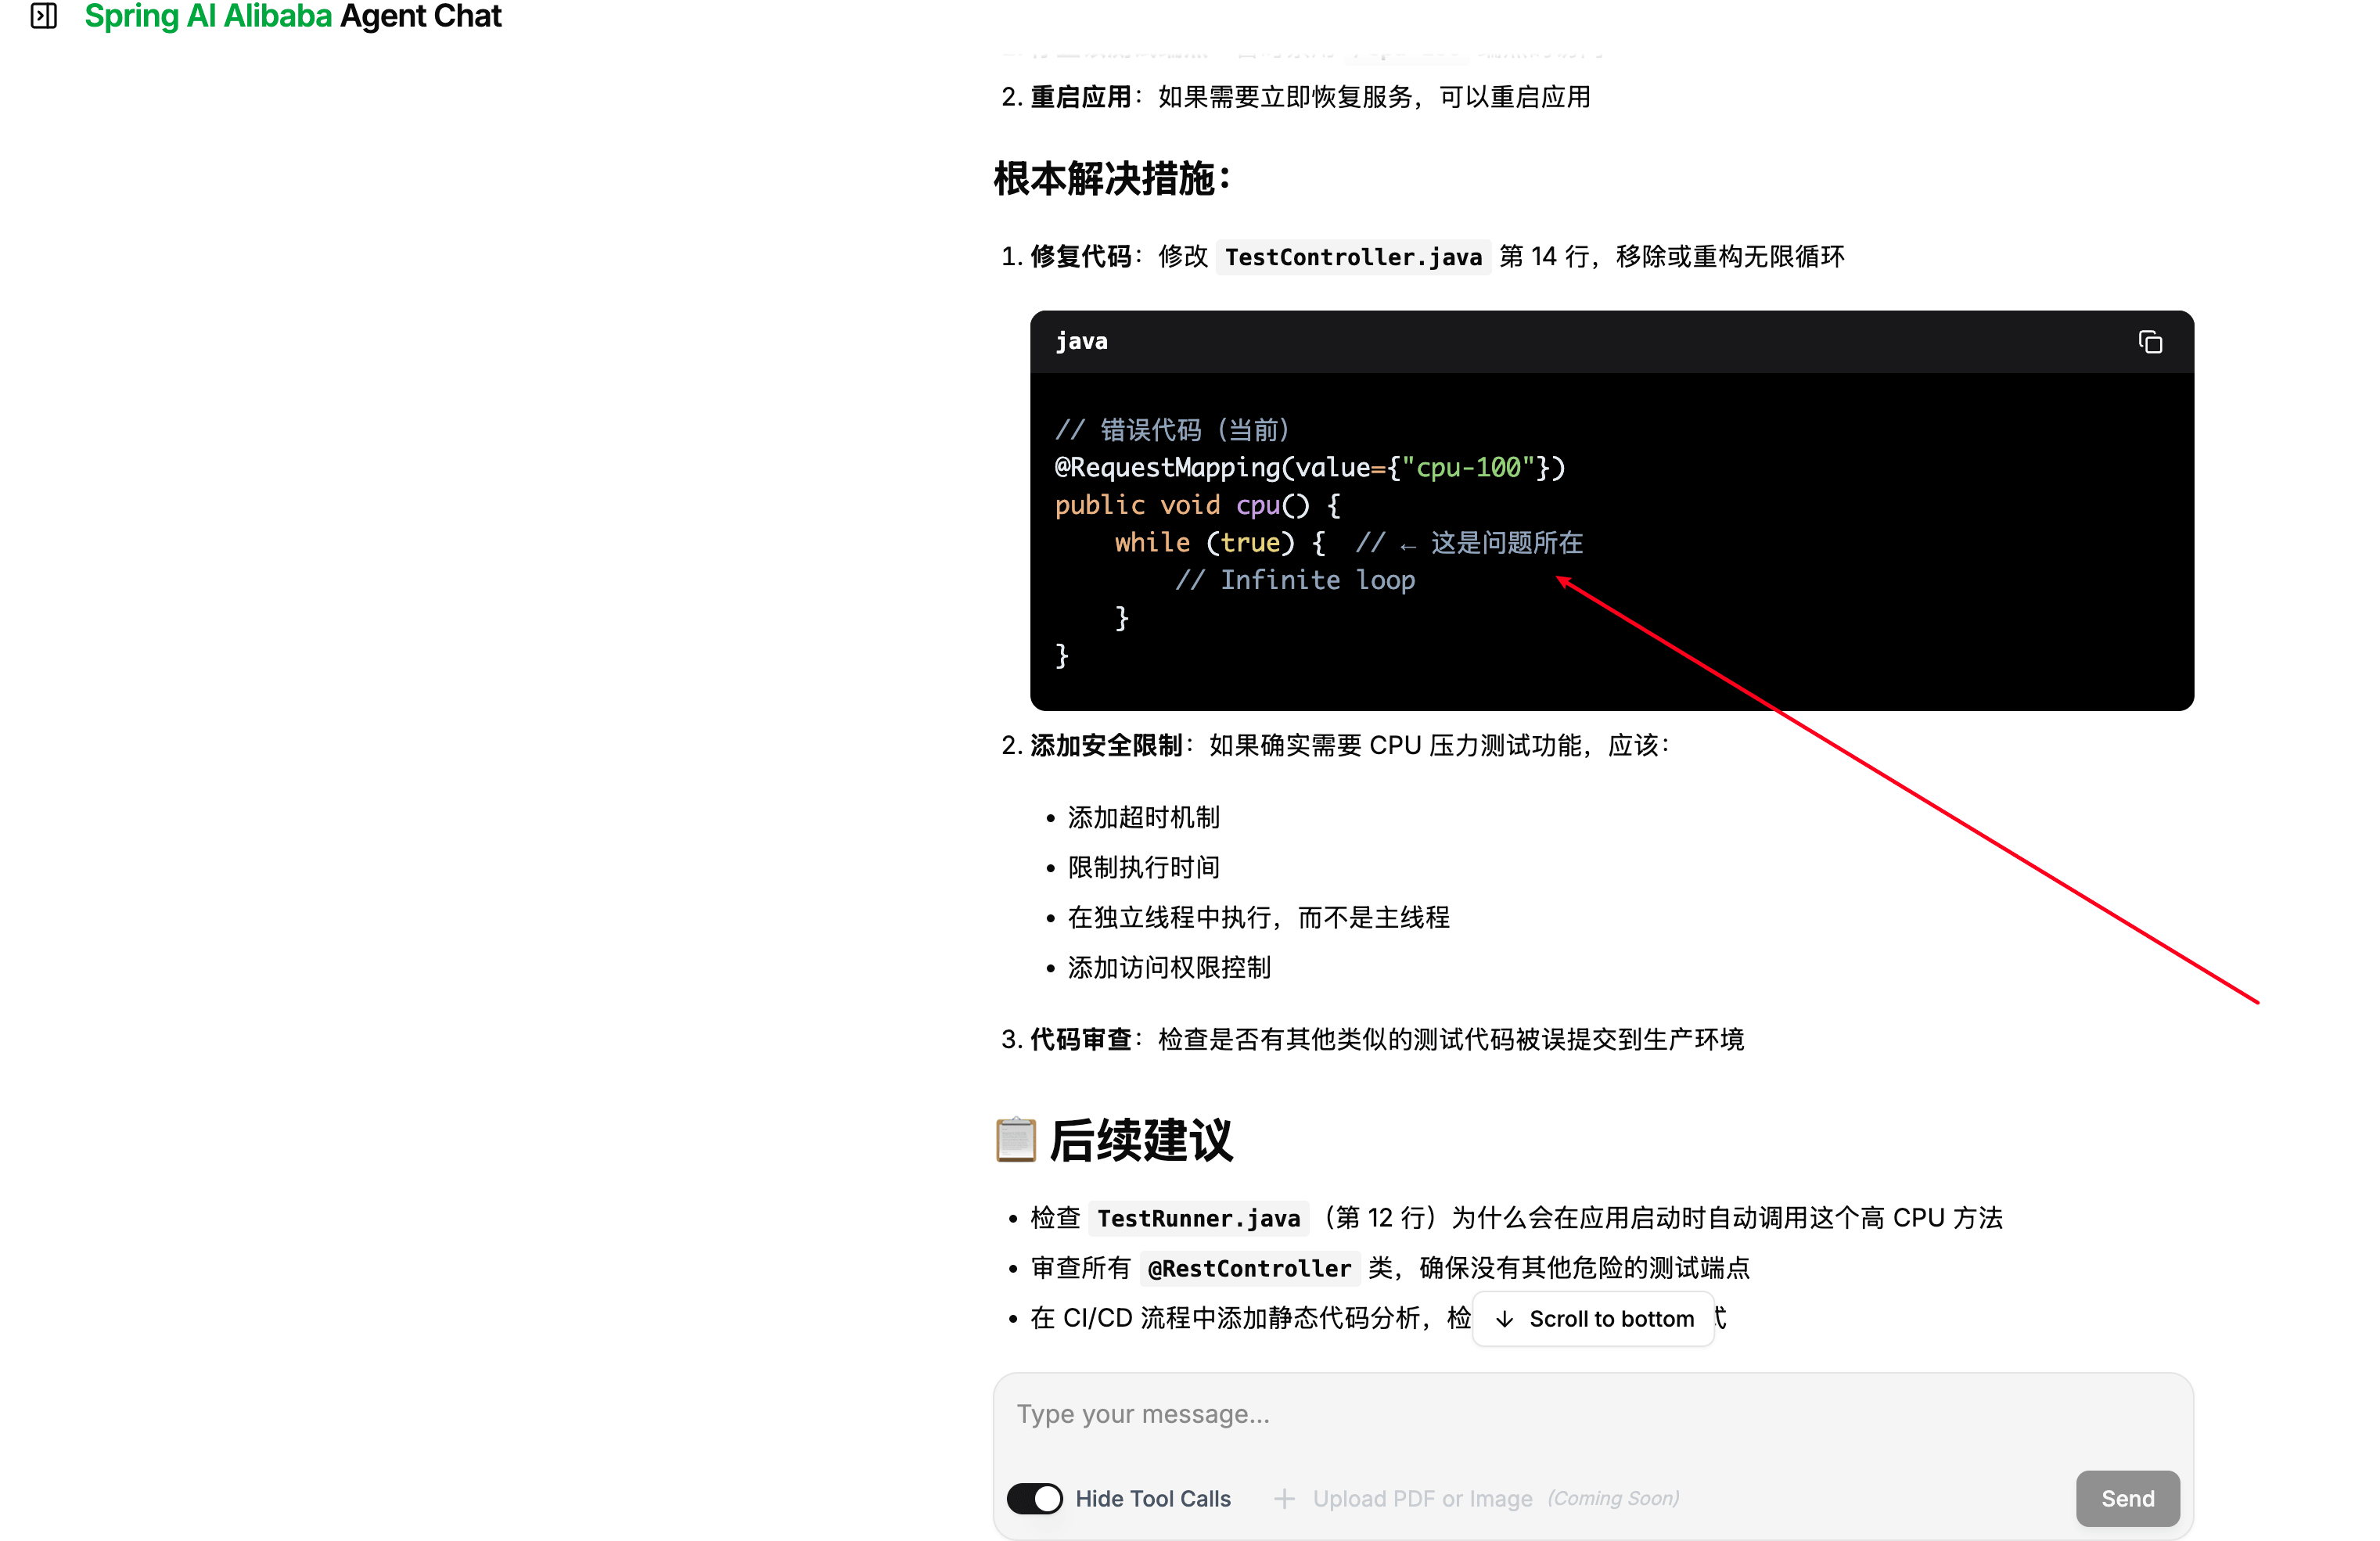
Khởi động Agent service, truy cập http://localhost:{application-port}/chatui/index.html, rồi nhập vào chat box: order-service CPU của chương trình tăng cao, hãy hỗ trợ kiểm tra. Trong local sample được kiểm soát này, Agent trước tiên lấy overview thông qua Dashboard, sau đó định vị code dựa trên thread stack, dùng jad xuất decompiled result và cuối cùng tạo diagnosis report. Report là kết luận cần review lại, không thể chỉ dựa trên output của model để trực tiếp xử lý sự cố production:
Scenario hai: xử lý slow query trên dữ liệu hàng triệu bản ghi
Scenario một kiểm chứng “khả năng planning và delivery từ 0 đến 1” của AI, còn scenario hai kiểm chứng một chiều khác: trong một codebase đã có độ phức tạp nhất định, AI có thể hiểu chính xác architecture hiện tại, định vị vấn đề và hoàn tất incremental optimization hay không.
Định vị vấn đề: search API mất 18 giây
Đây là một order query service dựa trên Spring Boot + MyBatis (glm-testing-service), business chính xoay quanh query và analysis của order, gồm bốn API:
| API | Path | Mô tả |
|---|---|---|
| User order query | POST /api/orders/user | Query order list theo user ID, hỗ trợ lọc status |
| Order search | POST /api/orders/search | Search order theo time range + amount + product keyword |
| Category sales statistics | GET /api/orders/category-stats | Thống kê tổng hợp doanh số từng category theo order status |
| Combined condition filter | POST /api/orders/filter | Filter kết hợp theo user + nhiều status + nhiều category |
Database được nạp dữ liệu test ở quy mô hàng triệu bản ghi, table structure tương ứng như sau:
CREATE TABLE `orders` (
    `id`           BIGINT PRIMARY KEY AUTO_INCREMENT,
    `order_no`     VARCHAR(64)  NOT NULL,
    `user_id`      BIGINT       NOT NULL,
    `status`       TINYINT      NOT NULL DEFAULT 0,
    `total_amount` DECIMAL(10,2) NOT NULL,
    `product_name` VARCHAR(256) NOT NULL,
    `category`     VARCHAR(64)  NOT NULL,
    `create_time`  DATETIME     NOT NULL DEFAULT CURRENT_TIMESTAMP,
    `update_time`  DATETIME     NOT NULL DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP,
    UNIQUE KEY `uk_order_no` (`order_no`),
    KEY `idx_user_id` (`user_id`),
    KEY `idx_status` (`status`),
    KEY `idx_category` (`category`),
    KEY `idx_create_time` (`create_time`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci;
Project tự động ghi lại execution time của từng API thông qua AOP aspect để nhanh chóng định vị performance bottleneck:
@Around("controllerPointcut()")
public Object printExecutionTime(ProceedingJoinPoint joinPoint) throws Throwable {
    long startTime = System.currentTimeMillis();
    Object result = joinPoint.proceed();
    long costTime = System.currentTimeMillis() - startTime;
    log.info("[{}] {}.{} duration: {}ms", Thread.currentThread().getName(), className, methodName, costTime);
    return result;
}
Sau khi nạp dữ liệu test quy mô hàng triệu bản ghi vào database, tiến hành load test order search API. API này liên quan đến combined query gồm fuzzy keyword match + time range + amount filter, ví dụ search request dưới đây:
curl -X POST http://localhost:8080/api/orders/search \
  -H "Content-Type: application/json" \
  -d '{"startTime": "2025-01-01", "endTime": "2026-12-31", "minAmount": 500, "productName": "Bluetooth", "pageNum": 1, "pageSize": 10}'
System log trực tiếp xuất slow query alert gây chú ý:
[http-nio-8080-exec-1] OrderController.searchOrders duration: 18375msFull table scan do LIKE '%Bluetooth%' khiến API mất gần 18 giây, performance của business API hiện tại hoàn toàn không đáp ứng yêu cầu production:

Thiết kế solution phân tích và optimization
Mình trực tiếp đưa slow query alert trong system log cho AI, yêu cầu AI kết hợp code hiện có của project để suy luận, phân tích và thiết kế optimization solution:
Hãy phân tích toàn diện order business và đưa ra đề xuất optimization cho vấn đề slow query API được ghi trong system log: "[http-nio-8080-exec-1] OrderController.searchOrders duration: 18375ms".AI định vị business code mục tiêu, kết hợp SQL và table structure, đưa ra một solution có hệ thống từ góc độ index design:
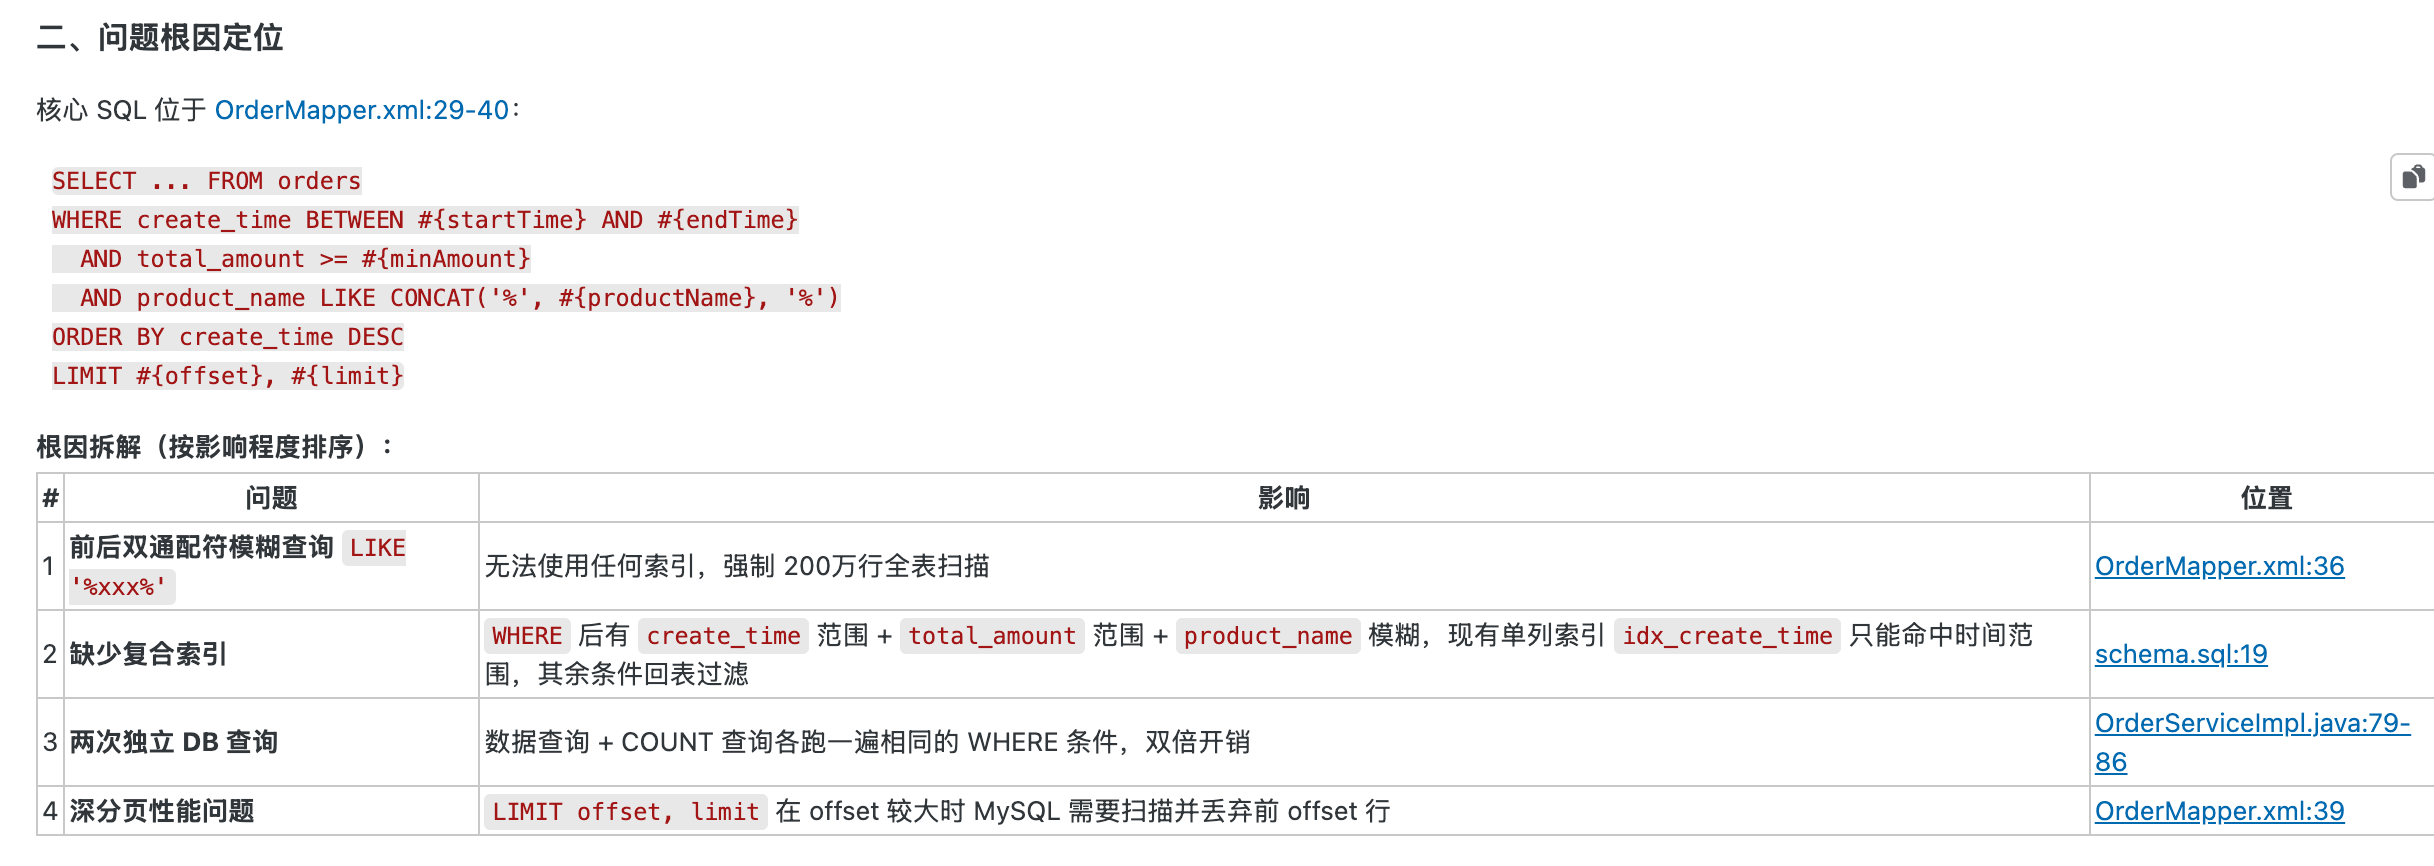
Đồng thời đưa ra đề xuất optimization theo từng giai đoạn và hiệu quả kỳ vọng:
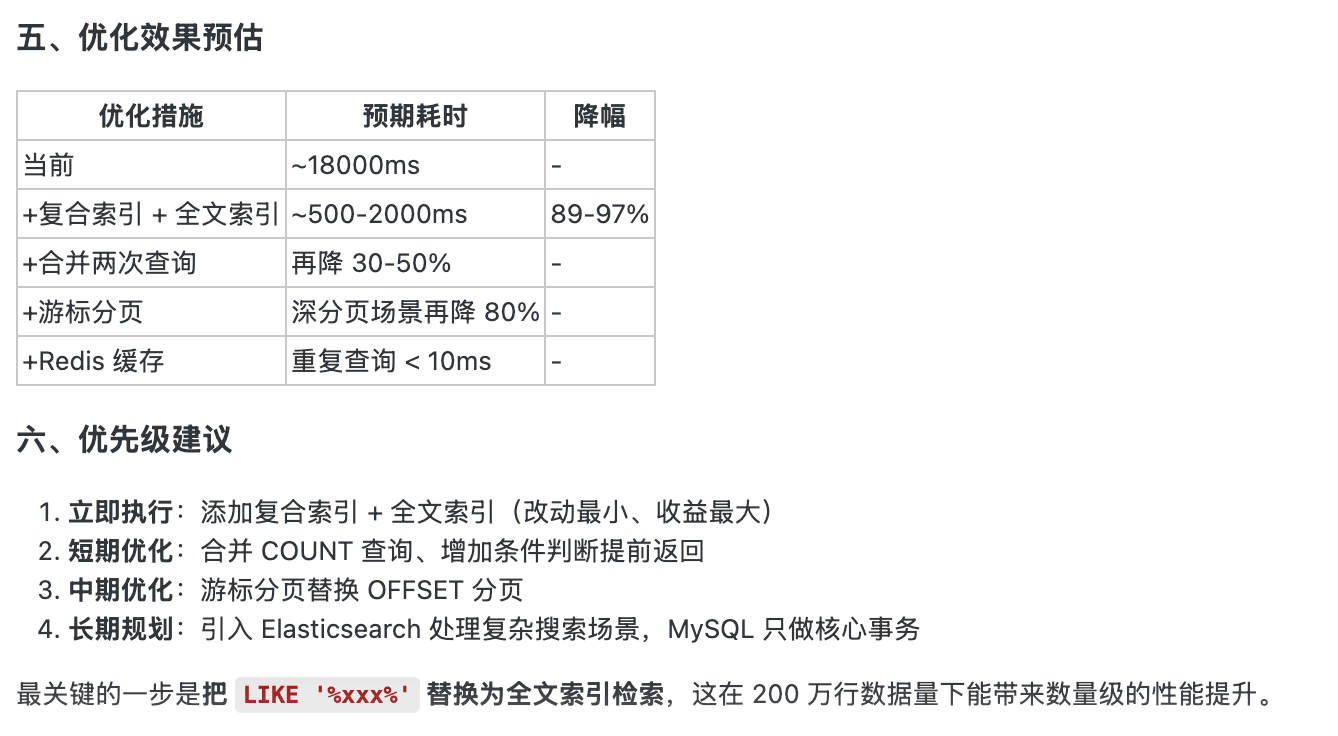
Sau khi xác nhận hướng đi không có vấn đề, mình đưa ra optimization command cuối cùng:
Hãy kết hợp technology stack hiện có của project để thực hiện system optimization cho slow query module.AI lần lượt hệ thống hóa business logic và query detail của từng API. Các bước optimization tiến hành từ dưới lên, từ database layer đến application layer, solution bao gồm các điểm chính sau:
Database layer — 5 candidate index do AI đưa ra:
- Full-text index
ft_product_name(ngram parser, hỗ trợ Chinese word segmentation) thay cho full table scanLIKE '%xxx%' - Composite index
idx_create_time_amountthử hỗ trợ time filter, amount filter và sorting - Candidate covering index
idx_search_coveringthử giảm việc quay lại table trong COUNT query - Composite index
idx_user_status_categorytối ưu multi-condition filter - Covering index
idx_status_category_amounttối ưu category aggregation statistics
ALTER TABLE `orders` ADD FULLTEXT INDEX `ft_product_name` (`product_name`) WITH PARSER ngram;
ALTER TABLE `orders` ADD INDEX `idx_create_time_amount` (`create_time` DESC, `total_amount`);
ALTER TABLE `orders` ADD INDEX `idx_search_covering` (`create_time`, `total_amount`, `product_name`);
ALTER TABLE `orders` ADD INDEX `idx_user_status_category` (`user_id`, `status`, `category`);
ALTER TABLE `orders` ADD INDEX `idx_status_category_amount` (`status`, `category`, `total_amount`);
Application layer — SQL và Service layer được optimization đồng thời:
- Chuyển search semantic
LIKE '%xxx%'sang full-text searchMATCH ... AGAINST - Trong deep pagination scenario, tự động chuyển sang Deferred Join, trước tiên dùng covering index subquery để định vị primary key rồi quay lại table
- COUNT on demand: mặc định không query tổng số, chỉ thực thi khi frontend truyền rõ
needTotal=true
Dưới đây là index optimization solution do AI xuất ra. Hiệu quả của composite index phụ thuộc vào leftmost prefix, filter selectivity, sorting method và optimizer selection; full-text index cũng làm tăng write cost và storage cost. Trước khi thực thi DDL, nên chạy EXPLAIN ANALYZE với SQL thực tế và data distribution, đồng thời xóa các index bị trùng chức năng hoặc có benefit không đủ. Có thể tham khảo tài liệu MySQL multi-column index và ngram full-text index:
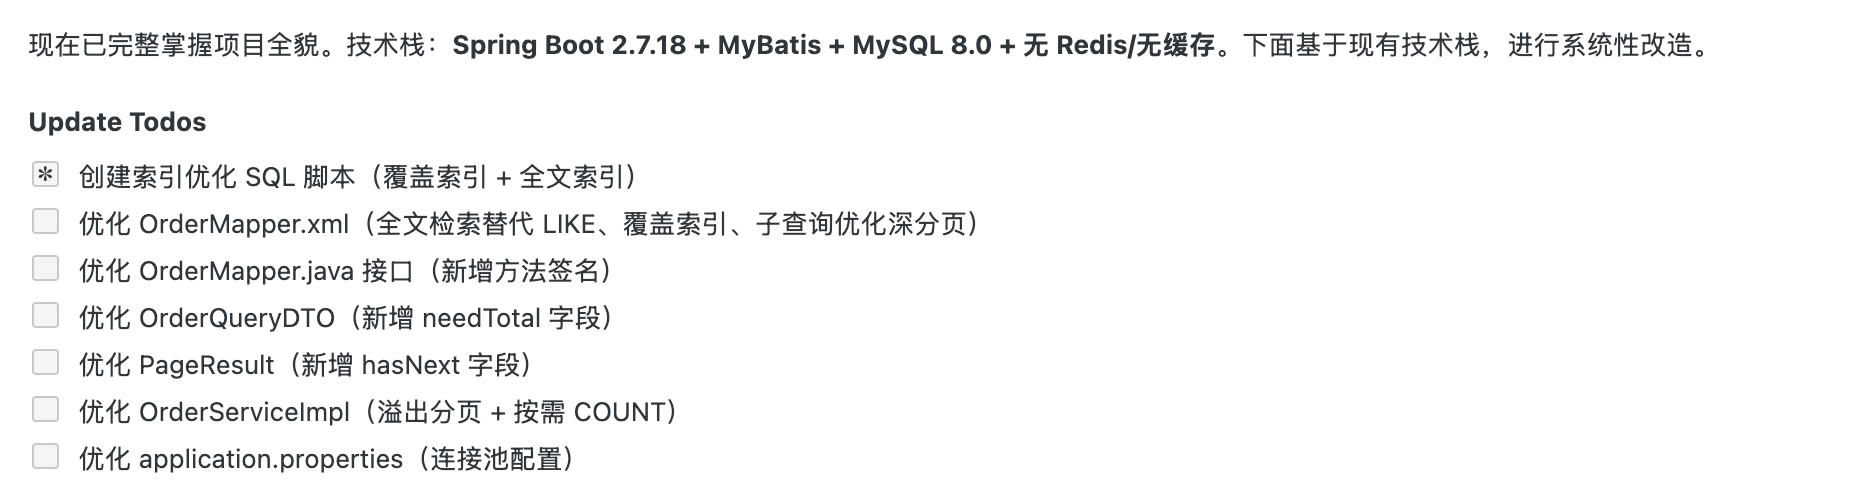
Từ code diff có thể thấy AI đã thay fuzzy query LIKE trong code hiện có bằng full-text search. Đây không phải là một performance replacement transparent: word segmentation, stop word, short word, substring matching và default sorting đều có thể thay đổi. Trước khi đưa lên production, cần nghiệm thu bằng search sample thực tế về Chinese word segmentation, short word, special character và sorting result, đồng thời thiết kế compatibility path cho semantic cũ cần được giữ lại:
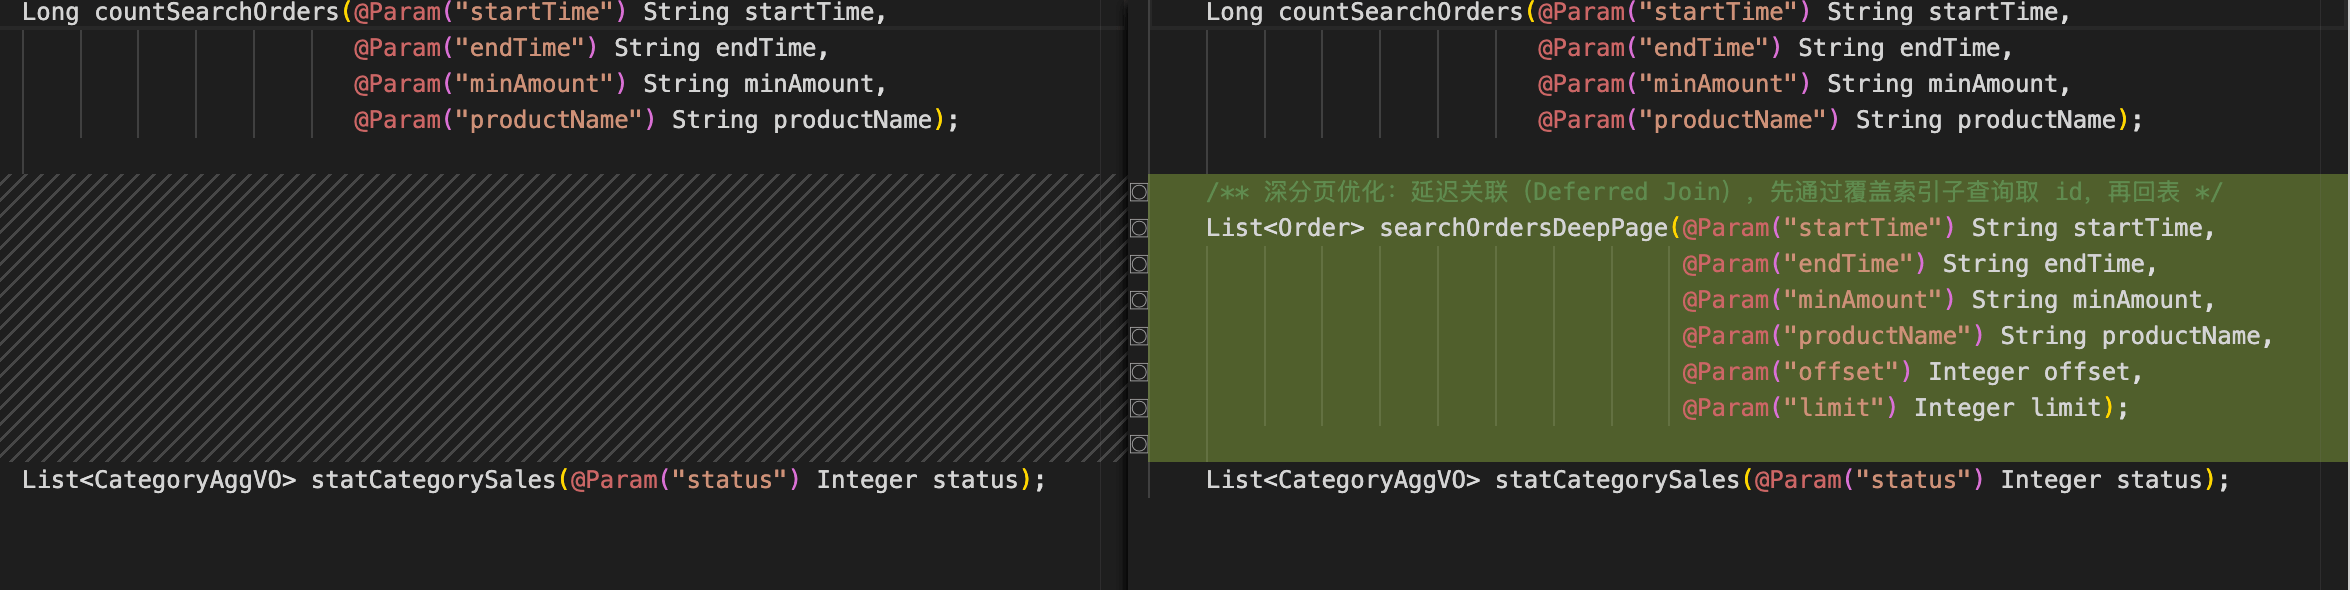
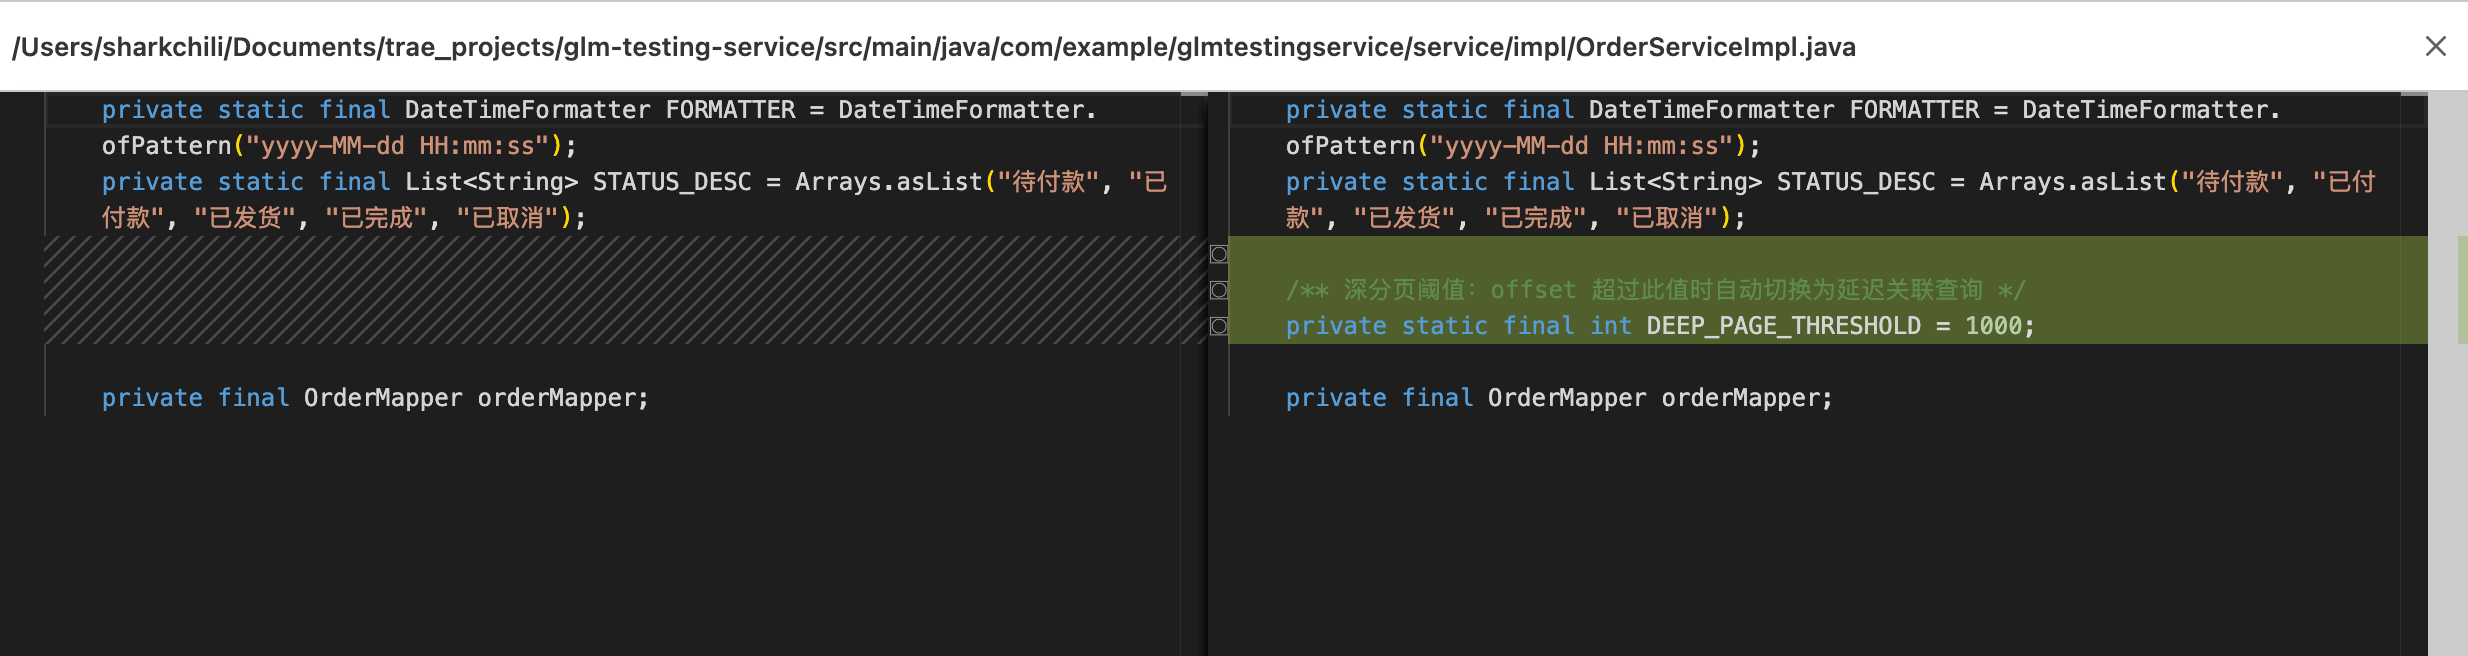
Đối với vấn đề deep pagination, AI đưa ra pagination threshold cụ thể dựa trên dữ liệu hàng triệu bản ghi hiện tại — khi offset vượt quá 1000, tự động chuyển sang Deferred Join; shallow pagination dùng query thông thường, deep pagination dùng covering index subquery để định vị primary key trước rồi quay lại table:
/** Deep pagination threshold: tự động chuyển sang Deferred Join khi offset vượt quá giá trị này */
private static final int DEEP_PAGE_THRESHOLD = 1000;

// Deep pagination (offset > 1000) dùng Deferred Join, shallow pagination dùng query thông thường
boolean isDeepPage = offset > DEEP_PAGE_THRESHOLD;
List<Order> orders;
if (isDeepPage) {
    orders = orderMapper.searchOrdersDeepPage(...);
} else {
    orders = orderMapper.searchOrders(...);
}
1000 chỉ là threshold ban đầu được tạo lần này, không thể cho rằng nó hợp lý chỉ vì dữ liệu ở quy mô hàng triệu bản ghi. Row width, filter selectivity, index coverage, sorting method và API SLO đều ảnh hưởng đến điểm chuyển đổi; nên load test riêng các offset khác nhau, quan sát số row được scan và p95/p99 rồi mới xác định có chuyển sang Deferred Join hay không. Nếu product cho phép, cursor pagination dựa trên stable sorting key thường đáng được ưu tiên đánh giá hơn.
Sau khi hoàn tất toàn bộ optimization, AI xuất ra summary về hiệu quả optimization cuối cùng, bao gồm so sánh trước và sau optimization của từng API:
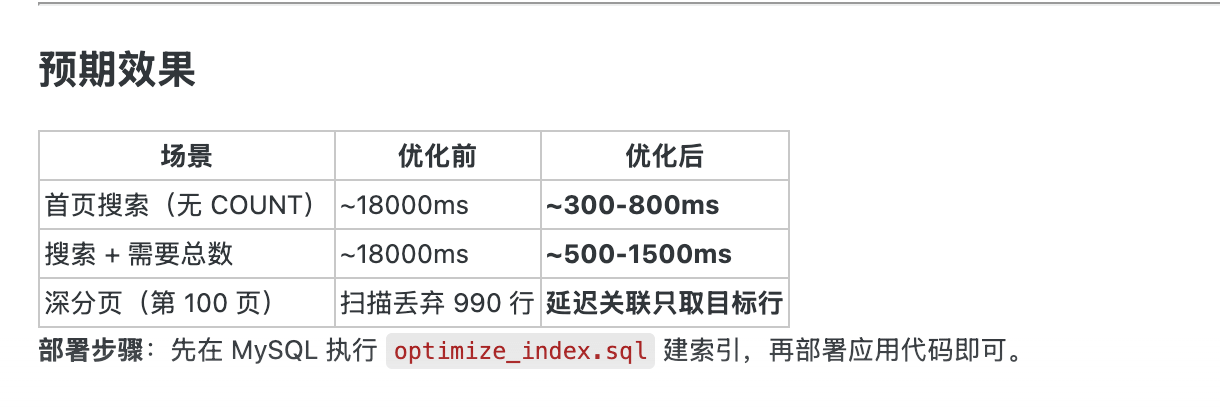
Verify hiệu quả optimization
Sau khi hoàn tất migration, gọi API lần nữa. Ảnh chụp này ghi nhận một request sau warm-up có duration dưới 300ms; so với 18375ms ban đầu, request này nhanh hơn khoảng 60 lần. Một cặp ảnh chụp trước và sau không thể chứng minh “ổn định dưới 300ms”: để có kết luận reproducible, còn cần nêu hardware, phiên bản và config MySQL, data distribution, cache warm/cold, concurrency và sample count, đồng thời báo cáo p50/p95/p99 cùng error rate.

Tổng kết thực chiến
Thông qua thực chiến hai scenario, hãy tổng kết kinh nghiệm và suy nghĩ về lập trình có Claude Code + model bên thứ ba hỗ trợ.
AI hỗ trợ coding có thể làm gì
| Khía cạnh năng lực | Biểu hiện trong scenario | Mô tả |
|---|---|---|
| Planning từ requirement đến architecture | Scenario một: đưa ra requirement, AI tự hoàn tất technology selection và architecture design | Phù hợp để nhanh chóng verify ý tưởng, nhưng solution vẫn cần human review |
| End-to-end coding delivery | Scenario một: tự bàn giao 9 module và 46 file | Từ dựng skeleton đến business logic, giảm khối lượng coding lặp lại |
| Incremental optimization code hiện có | Scenario hai: định vị và tối ưu slow query trong project có dữ liệu hàng triệu bản ghi | Có thể kết hợp table structure và SQL để đưa ra phased optimization solution |
| Tạo candidate parameter | Scenario hai: đưa ra pagination threshold ban đầu dựa trên data volume | Threshold vẫn cần benchmark và execution plan verification |
Những điểm cần lưu ý trong thực chiến
Điểm làm tốt:
- Nhanh chóng tạo review material: trong scenario một, model nhanh chóng tạo technical plan và architecture sketch, phù hợp làm điểm bắt đầu cho review
- Output solution nhiều tầng: trong slow query scenario, index optimization ở database layer và SQL refactor ở application layer được tiến hành đồng thời, phạm vi khá đầy đủ
- Đưa ra parameter có thể test: scenario hai đưa ra pagination threshold ban đầu, có thể dùng làm cơ sở để thiết kế benchmark test
Điểm cần lưu ý:
- Production security cần được thiết kế riêng: flow session của Arthas có cơ sở chính thức, điều thực sự không được bỏ sót là authentication, instance và command whitelist, approval, rate limiting và audit
- Đôi khi đứt flow trong quá trình thực thi flow dài: trong task coding liên tục phức tạp, AI đôi khi quên constraint design ở nửa sau. Khuyến nghị chia task phức tạp thành các phase rõ ràng và xác nhận riêng từng phase
- Code style và engineering convention: code được tạo có structure hợp lý, nhưng cần điều chỉnh để phù hợp convention hiện có của cá nhân/team. Trong scenario một, một phần naming và file organization cần được chỉnh thủ công
- Trade-off khi chọn solution: AI đưa ra nhiều solution nhưng không thể thay bạn cân nhắc. Ví dụ trong scenario hai, lựa chọn full-text index vs ES và trade-off Deferred Join vs cursor pagination cần được phán đoán theo business scenario
Một số đề xuất khi sử dụng Claude Code + model bên thứ ba
- Mô tả requirement phải cụ thể: trong scenario một, quality của architecture solution được quyết định trực tiếp bởi requirement prompt đầy đủ; requirement mơ hồ chỉ cho ra solution mơ hồ
- Xác nhận theo giai đoạn: đừng để AI tạo một project phức tạp từ đầu đến cuối trong một lần; technology selection → architecture design → coding implementation, mỗi phase cần được review riêng
- Con người kiểm soát quyết định quan trọng: các lựa chọn ở architecture layer (như cache strategy và pagination solution) cần được phán đoán theo business scenario, AI không thể thay bạn quyết định
- Tận dụng document link: khi cần tích hợp một component có sẵn (như Spring AI Alibaba trong scenario một), đưa trực tiếp document link hiệu quả hơn mô tả requirement chi tiết
Lời kết
Sau khi Claude Code kết nối với model bên thứ ba, việc hiểu context, phân rã task và tạo code trong Agent mode hình thành một workflow khá hoàn chỉnh. Sau khi chạy qua hai scenario, AI hỗ trợ coding quả thực có thể rút ngắn thời gian “từ ý tưởng đến code”.
Nhưng công cụ cuối cùng vẫn chỉ là công cụ. Nhìn lại hai scenario trong bài:
JVM diagnosis Agent trong scenario một cần hiểu lifecycle của Arthas session và methodology JVM diagnosis, càng cần thiết kế rõ production permission boundary. Model chỉ có thể tạo candidate step, không thể được cấp quyền thực thi target tùy ý và command tùy ý.
Slow query governance trong scenario hai cần hiểu sâu nguyên lý MySQL index, cơ chế full-text search và strategy optimization cho deep pagination thì mới có thể phán đoán solution optimization do AI đưa ra có phù hợp với business scenario của bạn hay không — ví dụ full-text index có thể gây performance cost trong scenario write thường xuyên, threshold của Deferred Join cần được điều chỉnh theo data volume thực tế.
Tool AI coding đang thay đổi cách developer làm việc — từ “người viết code” thành “người review code”. Điều kiện để sử dụng AI tốt là hiểu việc mình đang làm sâu hơn AI.
Tham khảo
- Hướng dẫn chuyển model GLM Coding Plan: https://docs.bigmodel.cn/cn/coding-plan/using5-1
- Hướng dẫn cài đặt Claude Code: https://docs.anthropic.com/en/docs/claude-code
- Tool chuyển model cc-switch: https://github.com/farion1231/cc-switch
- Tài liệu Spring AI Alibaba Agent Chat UI: https://java2ai.com/docs/frameworks/studio/quick-start/
- Tài liệu chính thức Arthas: https://arthas.aliyun.com/doc/
- Arthas HTTP API: https://arthas.aliyun.com/doc/http-api.html
- Cấu hình Arthas authentication: https://arthas.aliyun.com/doc/auth.html