
Giải thích chi tiết về quản lý context của Claude Code: ngân sách window, compaction và quản trị task dài
Xin chào, tôi là G. Gần đây, nhiều G friend trong cộng đồng chia sẻ kinh nghiệm phỏng vấn vị trí Agent. Tôi xem qua và nhận thấy câu hỏi về quản lý context xuất hiện khá nhiều.

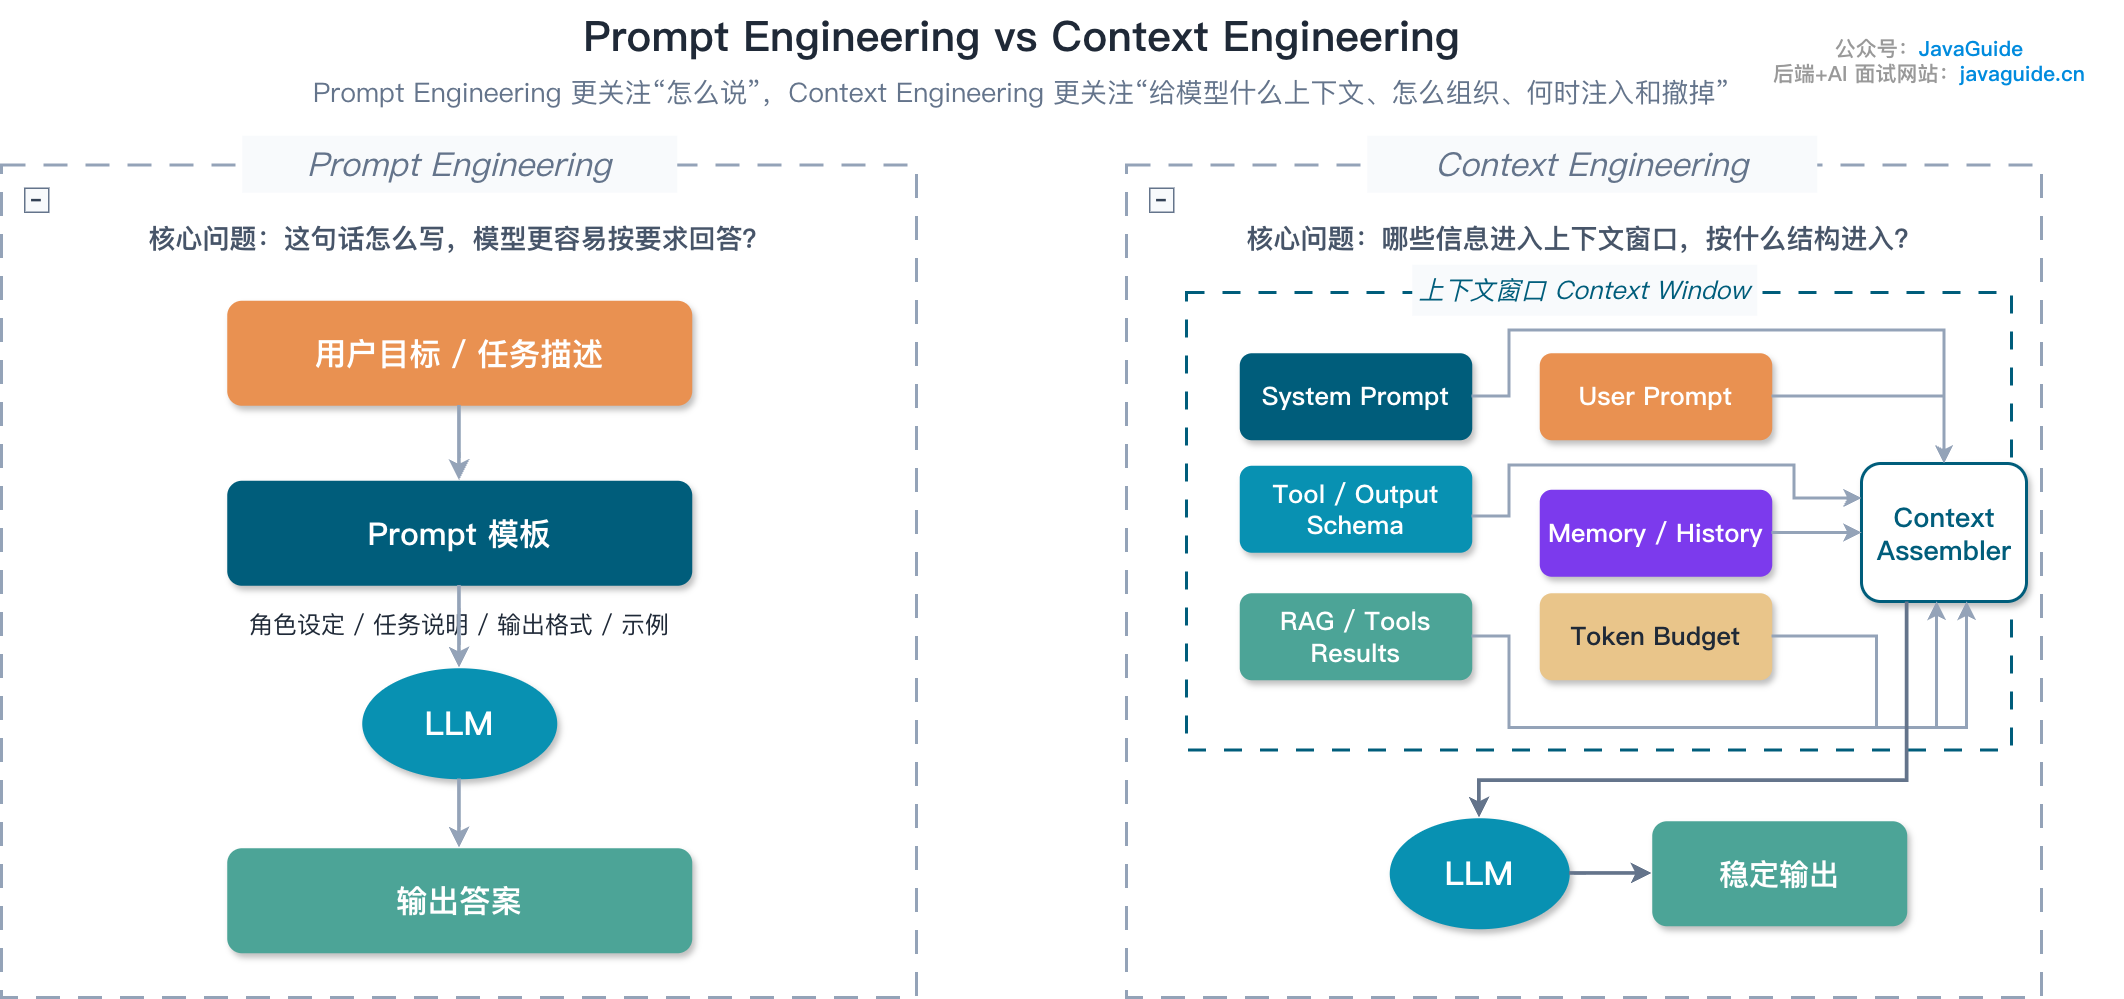
Trong bài viết trước, tôi đã chia sẻ một bài: Context Engineering là gì? Khác gì với Prompt Engineering?, giới thiệu nội dung cốt lõi của quản lý context.
Vì vậy, bài viết này muốn kết hợp với Coding Agent hàng đầu là Claude Code để tiếp tục tìm hiểu tư tưởng bên trong.
Nó không chỉ liên quan đến việc nén lịch sử chat, mà còn liên quan đến việc nên lưu mục tiêu task, output của tool, bản ghi file và thông tin bàn giao ở đâu.
Sau khi Claude Code thực thi /compact, nó sẽ dùng summary có cấu trúc để thay thế lịch sử hội thoại trước đó và load lại một phần instruction được persist.
Summary thường giữ lại mục tiêu task, constraint quan trọng, quyết định then chốt, tiến độ hiện tại và manh mối code liên quan, nhưng không đảm bảo giữ nguyên nội dung file, kết quả truy vấn và output test. Nếu sau đó cần nội dung chính xác của các tài liệu này, cần đọc lại hoặc thực thi lại.
Điều thực sự cần giải quyết trong task dài là đặt thông tin vào đúng vị trí: window chỉ giữ tài liệu cần dùng ngay; nội dung có thể kiểm tra lại và tái sử dụng được ghi vào file; khi chuyển session, chỉ bàn giao kết luận và manh mối cần cho bước tiếp theo. Dọn dẹp output tool, nén history, persist file, dùng sub-agent và bàn giao session đều phục vụ mục tiêu này.
Bài viết này đề cập đến hai loại tài liệu. Hành vi có thể được tài liệu chính thức xác nhận sẽ được mô tả theo tài liệu; phần “quan sát reverse engineering” và “có thể thấy trong source code” chủ yếu đến từ tài liệu source code không công khai gần Claude Code 2.1.x và tổng hợp của cộng đồng, không thuộc stable API chính thức.
Toàn cảnh kiến trúc Claude Code

Khi window chịu áp lực, có thể trực tiếp dọn dẹp kết quả tool, nén history, reset context hoặc cô lập nhánh phụ vào sub-agent. Việc load Skills theo nhu cầu, ghi trạng thái task vào filesystem và thực thi task ở background cũng làm thay đổi ngân sách khả dụng.
Claude Code đang chạy cần truy cập trực tiếp System Prompt, định nghĩa tool, quy tắc project, lịch sử hội thoại, kết quả tool và các file vừa đọc. Context window là working memory chứa các tài liệu này.
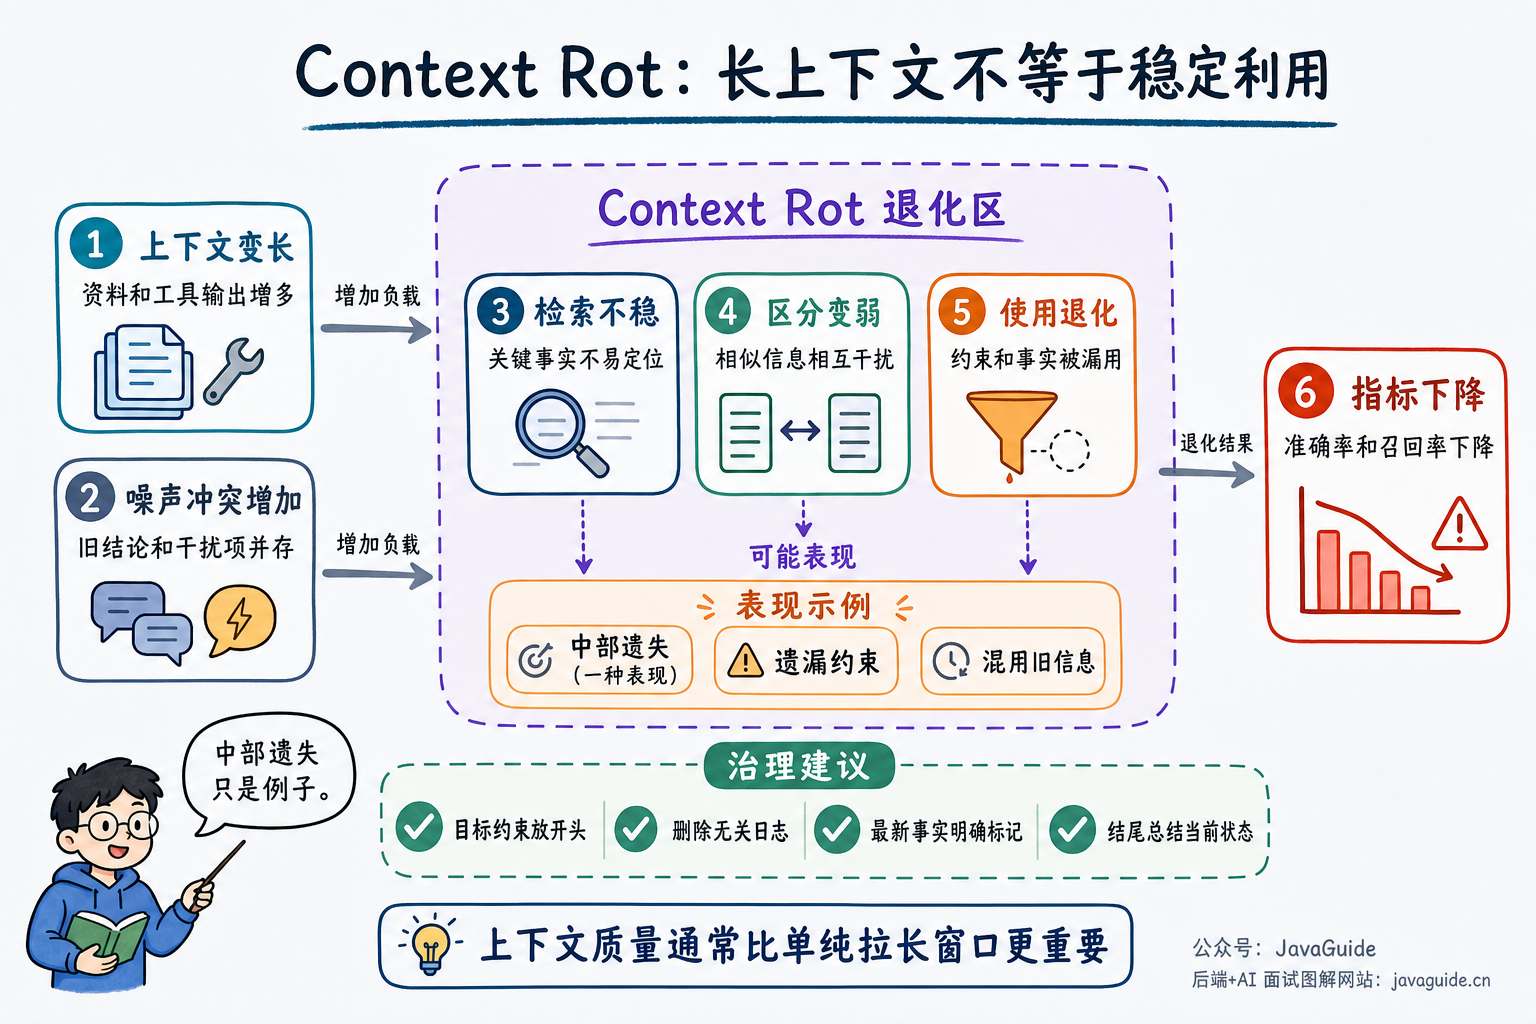
Khi log hết hạn, kết quả tìm kiếm trùng lặp hoặc các phán đoán cũ mâu thuẫn cùng xuất hiện, Agent dễ bỏ sót constraint, khám phá lại hoặc kết thúc quá sớm.
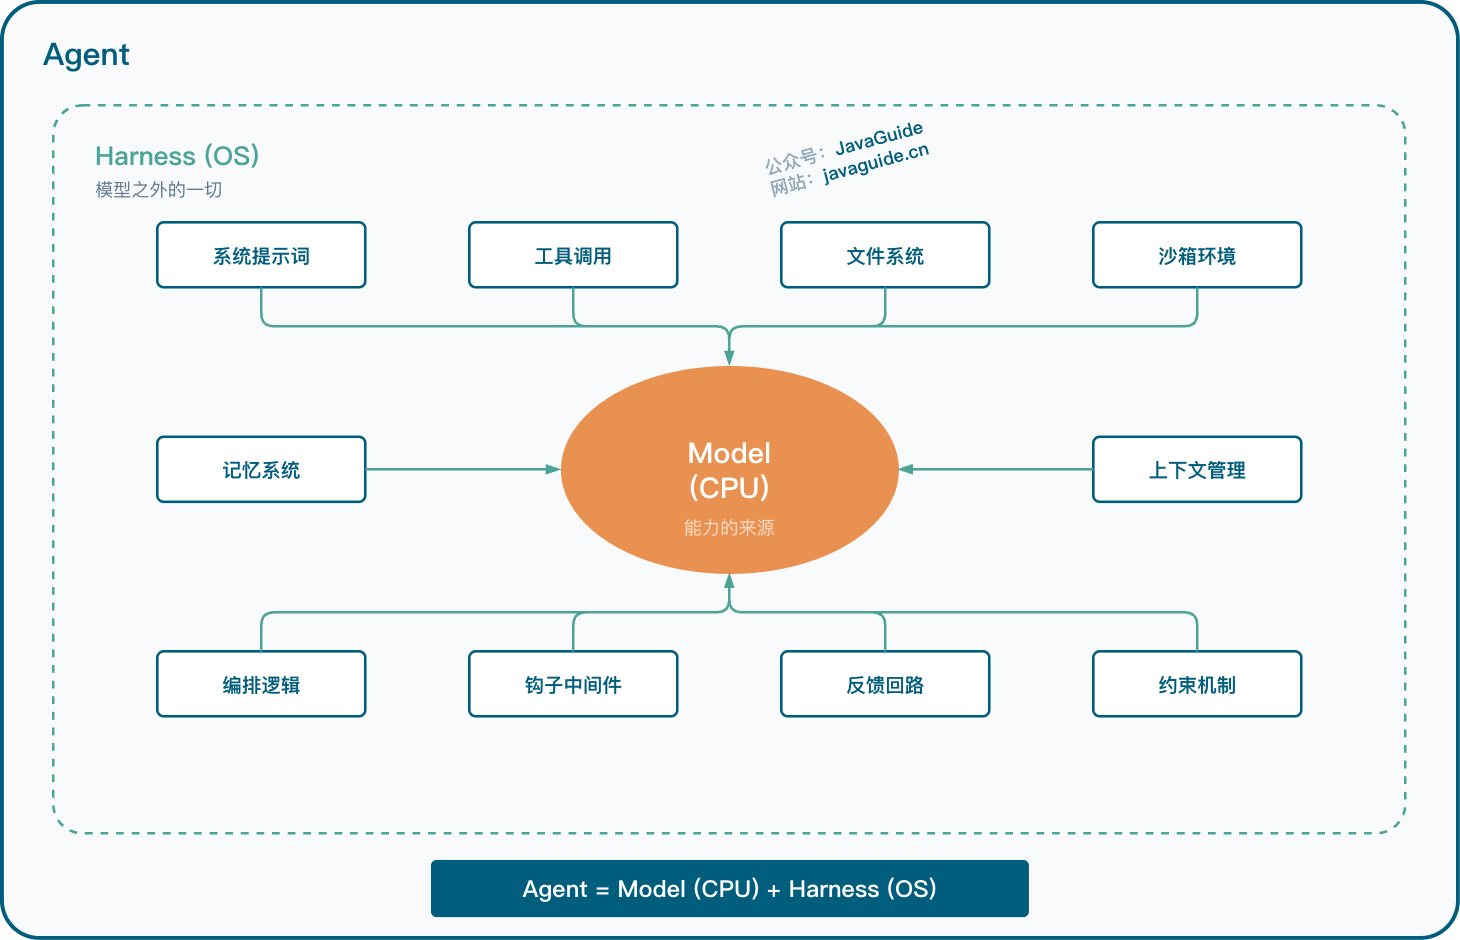
Trong công thức Agent = Model + Harness, model cung cấp năng lực suy luận, còn Harness chịu trách nhiệm lấy thông tin, gọi tool và thúc đẩy task. Quản lý context thuộc về Harness: nó quyết định state nào được giữ trong window hiện tại, kết quả tạm thời nào cần dọn và nội dung nào nên ghi ra ngoài window.
Khi phỏng vấn hỏi loại vấn đề này, điều thường được đánh giá là khả năng xem Agent như một hệ thống có state. Nó có một số điểm tương đồng với hệ thống backend truyền thống (các phép so sánh dưới đây nhằm hỗ trợ hiểu, không tương đương về cơ chế):
| Khái niệm Agent | So sánh backend | Điểm chung |
|---|---|---|
| Context window | JVM heap memory | Dung lượng hữu hạn, đầy thì chất lượng giảm |
| Compaction | GC | Thu hồi nội dung cũ, giữ lại state còn sống |
| Context Reset | Restart process + khôi phục checkpoint | Bỏ history bẩn, tiếp tục từ state bàn giao |
| Cô lập Sub-agent | Tách microservice | Dùng context độc lập xử lý task cục bộ |
| Context Rot | Cache pollution / memory leak | Thông tin cũ tích tụ, làm chậm phán đoán |
| Dọn dẹp kết quả tool | Loại bỏ LRU cache | Giữ nội dung gần đây, xóa nội dung hết hạn |
Sự khác nhau giữa Prompt Engineering và Context Engineering cũng nằm ở đây. Cái trước quan tâm cách viết input cho một lần, cái sau quan tâm cách thông tin lưu chuyển trong toàn bộ session.
Dù viết System Prompt chi tiết đến đâu, bạn cũng không thể giải quyết vấn đề quản lý context. Điều này còn có tác dụng ngược, làm tăng chi phí cố định và khiến window sớm bước vào vùng áp lực cao / vùng nguy hiểm.
Ngân sách window và load thông tin
Window có những chi phí nào
Trong chat thông thường, user thường gửi một đoạn văn mỗi lượt, thỉnh thoảng dán một đoạn code. Claude Code thì khác. Khi khởi động, nó đã có tool và rule; khi thực thi task, nó còn tự đọc file, chạy test, xem Git history và gọi MCP.
Nội dung file, output command và history hội thoại liên tục đi vào window. Chỉ thảo luận một vấn đề trong một lần và đọc hàng chục file rồi chạy full test tạo ra mức tăng context hoàn toàn khác nhau; trường hợp sau dễ khiến Claude bỏ sót constraint ban đầu, tìm kiếm lặp lại hoặc tiếp tục xoay quanh hướng đã bị loại bỏ.
Model mạnh hơn chỉ có thể trì hoãn sự suy giảm này, không thay đổi sự thật rằng input liên tục tăng.
Mức sử dụng window có thể chia thành hai phần: System Prompt, rule và tool registration đã tồn tại từ lúc khởi động; cùng tool result và history hội thoại liên tục được thêm trong task. Phần trước quyết định dung lượng còn lại khi session bắt đầu; đọc file, chạy command và thu thập log liên tục đẩy phần sau lên.
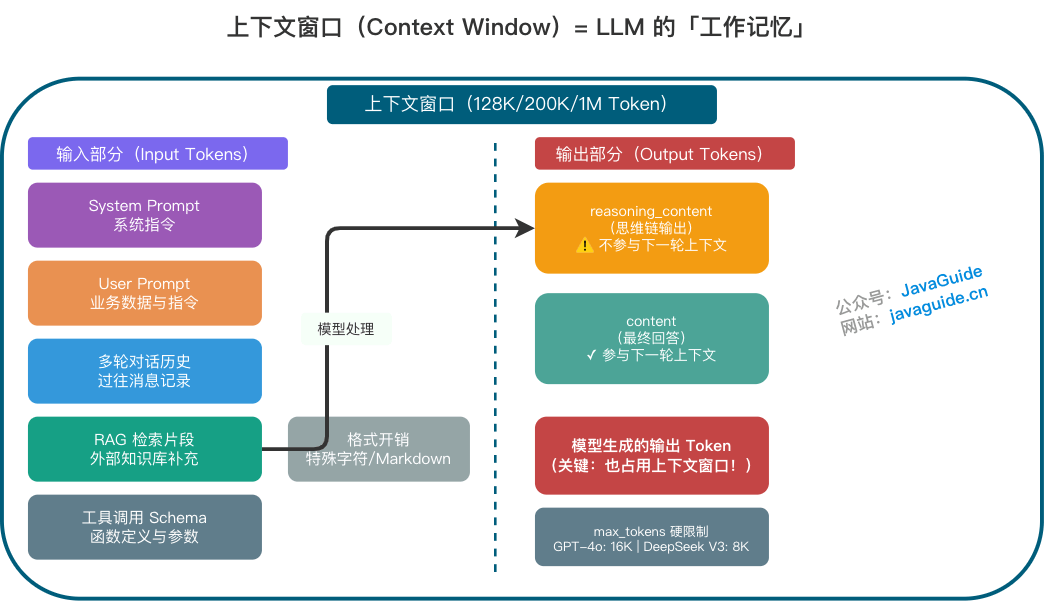
Chi phí khởi động chủ yếu đến từ System Prompt, CLAUDE.md, mô tả Skills và một phần thông tin tool. Implementation được quan sát cố gắng trì hoãn việc load một phần định nghĩa MCP tool:
- Khi ToolSearch được bật và tool chưa được cấu hình “bắt buộc load lúc khởi động”, một phần MCP tool trước tiên chỉ expose tên;
- Chỉ khi model thực sự chọn tool đó, full JSON Schema mới được load vào;
- Một số tool khác sẽ load full description ngay lúc khởi động.
Rule file càng dài, Skills và MCP Server càng nhiều thì không gian còn lại lúc bắt đầu càng ít.
Muốn xem mức sử dụng thực tế của session hiện tại, có thể dùng command /context. Nó liệt kê model window hiện tại, Token đã dùng, không gian còn lại, cũng như mức sử dụng được phân loại theo System Prompt, tool, Skills, message và các thành phần khác.

Trong nội dung động, tool call thường chiếm phần lớn. Một source file vài trăm dòng có thể tương đương vài nghìn Token; kết quả tìm kiếm và test log có thể còn dài hơn. Tham số và kết quả tool call đi vào session hiện tại; nội dung file, output command và kết quả tìm kiếm liên tục tích lũy theo tiến độ task. Khi gần giới hạn window, Claude Code trước tiên sẽ dọn các tool result cũ hơn; nếu vẫn không đủ, nó mới nén session.
Context dài hơn cũng ảnh hưởng đến hiệu quả sử dụng thông tin. Input càng nhiều thì latency và cost thường càng tăng. Model cũng không nhất thiết tận dụng đồng đều từng phần nội dung trong window; khi thông tin liên quan nằm giữa một context dài, hiệu quả truy vấn và trả lời của model có thể giảm. Hiện tượng nhạy cảm với vị trí này thường được gọi là Lost in the Middle. Window lớn hơn có thể chứa nhiều thông tin hơn, nhưng không đảm bảo mọi thông tin đều được sử dụng ổn định.
Đây là vấn đề context corruption (Context Rot) mà chúng ta thường nói đến. Context càng dài, thông tin càng tạp, tính ổn định khi model tận dụng context càng dễ giảm.
Mỗi lần Claude Code gọi LLM, window thường có các nội dung sau:
| Thành phần | Nội dung | Tính chất |
|---|---|---|
| Context khởi tạo session | System Prompt, CLAUDE.md, .claude/rules/ không điều kiện, Auto Memory | Chi phí cố định |
| Rule theo path | .claude/rules/ có paths | Load khi đọc file khớp |
| Mô tả MCP và tool | Định nghĩa tool built-in, tên MCP tool và Schema đã load | Cố định hoặc theo nhu cầu |
| Nội dung inject từ Hook | additionalContext, prompt hoặc tool feedback được Hook trả về rõ ràng | Inject động |
| Skills | Mặc định load description ngắn; nội dung đi vào context sau khi gọi | Load theo nhu cầu |
| History hội thoại | Message của user, reply của Claude | Tăng liên tục |
| Tool call và kết quả | Tham số gọi, giá trị trả về, log, nội dung file | Tăng liên tục |
| State môi trường và IDE | Workspace, code được chọn và thông tin do client hoặc integration cung cấp | Inject theo cấu hình |
| Báo cáo của sub-agent | Summary và một lượng nhỏ metadata do Sub-agent trả về | Theo nhu cầu |
Chi phí cố định thường không tăng theo số lượt hội thoại, nhưng quyết định dung lượng còn lại khi task bắt đầu. Nội dung động mới là phần tăng chính trong task dài. Cùng là 20 lượt hội thoại, chỉ chat và mỗi lượt đều đọc file, chạy test có thể tạo ra mức sử dụng cuối cùng chênh lệch rất lớn; vì vậy không thể chỉ dùng số lượt để phán đoán áp lực context.
Prompt Caching có thể tiết kiệm cost và latency, nhưng không giải phóng không gian context. Dù System Prompt, định nghĩa tool và CLAUDE.md hit cache, chúng vẫn là input của request hiện tại.
Extended Thinking cũng phải tính vào khoản này. Thinking budget của lượt hiện tại là một phần của max_tokens, được tính phí theo output Token và cũng được tính vào rate limit.
Một điểm dễ bị bỏ qua hơn là Thinking Blocks trong history. Theo API documentation hiện tại, Opus từ 4.5 trở đi, Sonnet từ 4.6 trở đi, Fable 5, Mythos 5 và Mythos Preview mặc định giữ lại Thinking Blocks trong history.
Các model Opus / Sonnet cũ hơn và model Haiku sẽ tự động tách các block history này khỏi context. Vì vậy, Thinking trong session dài có tiếp tục chiếm window hay không phụ thuộc vào model và cấu hình cụ thể.
Nếu đồng thời dùng tool, quy tắc nghiêm ngặt hơn: khi trả về tool_result, phải mang nguyên vẹn Thinking Block tương ứng với tool call của lượt này, bao gồm cả signature. Sau khi tool loop kết thúc, việc có tiếp tục giữ lại hay không sẽ được xử lý theo hành vi mặc định của model hoặc cấu hình context editing.
Window hiệu dụng và ngưỡng kích hoạt
Về mặt khái niệm, có thể ước tính window hiệu dụng như sau:
Context hiệu dụng ≈ tổng dung lượng window - chi phí cố định - chi phí historyLogic trong source code đại khái như sau:
function getEffectiveContextWindowSize(
  modelWindowSize: number,
  maxOutputTokens: number,
): number {
  const reservedForSummary = Math.min(maxOutputTokens, 20000);
  return modelWindowSize - reservedForSummary;
}
Giá trị trả về ở đây được dùng cho các phán đoán tiếp theo như cảnh báo, auto compaction và block. getEffectiveContextWindowSize() chỉ chịu trách nhiệm trừ phần output summary được reserve khỏi model window. System Prompt, rule, message history và tool result đã nằm trong mức sử dụng Token thực tế, không bị trừ từng phần trong function này.
Các threshold này cũng đến từ những tài liệu nêu trên, không thuộc stable interface công khai và có thể được điều chỉnh ở version sau.
Một số giá trị constant:
| Constant | Giá trị | Mục đích |
|---|---|---|
AUTOCOMPACT_BUFFER_TOKENS | 13,000 | Vùng đệm để kích hoạt AutoCompact sớm hơn window hiệu dụng, giúp compaction bắt đầu khi vẫn còn dư lượng |
WARNING_THRESHOLD_BUFFER_TOKENS | 20,000 | Cảnh báo trước request, nhắc có thể /compact thủ công |
ERROR_THRESHOLD_BUFFER_TOKENS | 20,000 | Đánh dấu context bước vào vùng nguy hiểm |
MANUAL_COMPACT_BUFFER_TOKENS | 3,000 | Dung lượng an toàn tối thiểu khi compact thủ công |
Có hai con số dễ bị nhầm ở đây.
reservedForSummary = min(maxOutputTokens, 20000) chịu trách nhiệm reserve không gian output summary. Comment trong source code đề cập p99.99 của summary khoảng 17.3K, vì vậy giới hạn 20K có thể bao phủ output cực đoan kiểu này.
AUTOCOMPACT_BUFFER_TOKENS (13K) dành ra vùng đệm trước giới hạn trên của window hiệu dụng và khởi động AutoCompact khi vẫn còn dung lượng. Không gian output summary do mức reserve 20K đảm nhiệm.
13K chỉ là buffer của AutoCompact; comment về p99.99 của summary tương ứng với 20K không gian output summary được reserve. Ưu điểm của thiết kế này là có thể dự đoán: khi model window tăng từ 200K lên 500K, ngân sách output phía summary không tăng theo tỷ lệ tương ứng.
Các giai đoạn thực sự độc lập chủ yếu là ngưỡng cảnh báo, AutoCompact và giới hạn block. isAboveAutoCompactThreshold kích hoạt AutoCompact; isAtBlockingLimit chặn request mới, buộc compact hoặc reset.
Implementation tham khảo vẫn giữ hai state field là isAboveWarningThreshold và isAboveErrorThreshold. Trong version được quan sát, cả hai dùng cùng threshold 20K nên điểm kích hoạt Token giống nhau. Chúng có thể đảm nhận mục đích khác nhau trong UI hoặc call path khác nhau, nhưng không có nghĩa là hai vùng sử dụng độc lập.
Chuỗi phán đoán trước khi gửi request đại khái như sau (đây là implementation được trích từ source mirror do cộng đồng cung cấp, không phải API ổn định được Anthropic cam kết). Chuỗi này mặc định được hiểu là AutoCompact đang bật; nếu AutoCompact tắt, warning / error sẽ quay về lấy window hiệu dụng làm cơ sở:
reservedForSummary = min(maxOutputTokens, 20_000)
effectiveWindow = modelWindow - reservedForSummary

autoCompactThreshold = effectiveWindow - 13_000
warningThreshold = autoCompactThreshold - 20_000
errorThreshold = autoCompactThreshold - 20_000
blockingLimit = effectiveWindow - 3_000

if currentUsageEstimate >= warningThreshold:
  đưa ra cảnh báo context

if currentUsageEstimate >= autoCompactThreshold:
  kích hoạt AutoCompact

if currentUsageEstimate >= blockingLimit:
  chặn request mới, yêu cầu compact thủ công hoặc reset
Lấy window 200K và reserve summary 20K làm ví dụ, window hiệu dụng là 180K. AutoCompact kích hoạt ở 167K, đường cảnh báo / lỗi là 147K, đường block là 177K; cả đường cảnh báo và lỗi đều được tính bằng cách lấy đường AutoCompact trừ tiếp 20K.
Thông tin đi vào context như thế nào
Khi định vị caller của TokenRefreshService, trước tiên dùng Grep tìm symbol, sau đó dựa vào các path như tests/test_utils.py và src/core_logic/test_utils.py để phán đoán vai trò file. Chỉ sau khi xác nhận liên quan mới dùng Read mở đoạn cần thiết; ls, find, git log và command test được thực thi khi cần bổ sung bằng chứng.
Read, Glob, Grep, Bash và sub-agent lấy tài liệu từng bước theo task; lúc bắt đầu không cần xây dựng vector index cho toàn bộ repository. Path, symbol, quan hệ import và trạng thái file mới nhất được dùng để thu hẹp phạm vi; quan hệ gọi vẫn phải căn cứ vào source code và kết quả verification.
Natural-language Q&A hoặc truy vấn khái niệm có thể tích hợp RAG (Retrieval-Augmented Generation) thông qua MCP, plugin hoặc custom Skill. Khi khám phá code, các fragment do RAG trả về vẫn cần được kiểm tra cùng keyword search, phân tích symbol và đọc trực tiếp.
Kiểu định vị này trước tiên xem directory và filename, sau đó đi đến dòng quan trọng; chỉ mở rộng full content khi cần xác nhận:
| Quyết định thiết kế | Cách thực hiện | Lợi ích |
|---|---|---|
| Metadata chính là thông tin | Path file, cấu trúc directory, timestamp và kích thước file vốn đã là tín hiệu có giá trị | Có thể phán đoán sơ bộ mà không đọc content |
| Load theo nhu cầu | Chỉ đọc file cụ thể khi cần, không preload toàn bộ content | Context luôn chỉ chứa thông tin cần thiết |
| Đào sâu lặp lại | Từ thô đến chi tiết: directory → filename → dòng quan trọng → full content | Giảm mức tiêu hao context do khám phá vô ích |
| Khám phá trực tiếp workspace | Dùng Glob, Grep, Read, Git và tool test để định vị từng bước | Không cần duy trì index độc lập trước, kết quả đọc thường khớp workspace hiện tại |
Các Skill mà trước đây chúng ta đã trao đổi nhiều cũng theo thứ tự tương tự: lúc khởi động chỉ load metadata, sau khi model quyết định gọi mới lấy document cụ thể. Cơ chế chi tiết có thể xem trong bài tôi viết: Agent Skills là gì? Khác Prompt và MCP ở đâu?.
Document, knowledge base và history phù hợp với việc trước tiên gọi RAG. Còn repository code có path, config, dependency và test result liên tục thay đổi thì cần vừa search, vừa đọc, vừa verify; khi chọn sai search term sẽ phải đi thêm vài vòng, còn cross-repository search, semantic search hoặc monolith lớn đôi khi phù hợp hơn với semantic index.
| Tình huống | Cách phù hợp hơn |
|---|---|
| Tra cứu knowledge base, document, history | RAG |
| Khám phá repository code, config, cấu trúc directory | Progressive Disclosure |
| Project lớn có cả document và code | Kết hợp cả hai |
Các AI IDE như Cursor thực hiện Codebase Indexing, dùng index để hỗ trợ completion có latency thấp và Q&A nhanh. Task của Claude Code còn phải trải qua việc đọc, phán đoán và verification, nên khám phá nhiều vòng do tool điều khiển chiếm tỷ trọng cao hơn.
Vì sao context suy giảm
Trong task dài, khi window mở rộng, nó đồng thời chứa thêm nhiều constraint, log và phán đoán cũ, khiến tài liệu cần cho quyết định hiện tại khó được sử dụng ổn định hơn. Một số thực tiễn cộng đồng lấy khoảng 40% làm đường nhắc nhở để dọn dẹp hoặc nén; model, loại task và cấu trúc context khác nhau sẽ khiến vị trí xuất hiện dao động.

Ở lượt 3 ghi “không được thay đổi database schema”, đến lượt 30 constraint này có thể bị kẹp giữa kết quả tìm kiếm và test log. Hiện tượng phần đầu và cuối dễ được chú ý hơn, còn nội dung ở giữa dễ bị bỏ sót thường được gọi là Lost in the Middle.
CLAUDE.md ở root và rule không giới hạn path sẽ được inject lại sau khi compact; input hiện tại của user và tool result gần đây nằm ở cuối message; giá trị trả về của tool cũ và hội thoại hết hạn sẽ được ưu tiên dọn. Ba yếu tố này cùng giảm khả năng constraint quan trọng bị nội dung cũ nhấn chìm. Rule vẫn là instruction của model; giới hạn an toàn nên giao cho permission rule, Sandbox hoặc PreToolUse Hook.
Khi window gần đạt giới hạn, không gian còn lại còn phải dành cho output và error recovery. History tiếp tục tăng có thể khiến model kết thúc sớm trước khi task hoàn tất; Anthropic gọi hiện tượng này là Context Anxiety.
Bài viết Harness design for long-running application development mô tả đầy đủ như sau:

Phán đoán cũ, kết quả tìm kiếm trùng lặp, vấn đề đã giải quyết và log vô ích cũng tiêu tốn sự chú ý, ngay cả khi window chưa tới ngưỡng. Chúng lặp lại trong mỗi request, còn quyết định mới có thể chỉ có một câu; trạng thái tỷ lệ signal-to-noise giảm này được gọi là Context Rot. Window lớn hơn chỉ trì hoãn áp lực; quá nhiều thông tin vẫn khiến constraint ở vị trí giữa bị bỏ sót, cuối cùng còn có thể bước vào Context Anxiety.
Claude Code quản trị context như thế nào
Tool result có thể lấy lại thì không cần chiếm window mãi. Claude Code trước tiên xử lý tầng này, sau đó mới nén history; nếu vẫn không thể tiếp tục task, nó mới reset context hoặc giao nhánh phụ cho sub-agent.
Dọn tool result trước
Một lần Read có thể trả về 500 dòng, một lần test cũng có thể in ra hàng nghìn dòng log. Chúng chiếm nhiều không gian, nhưng content gốc có thể đọc lại, nên xử lý phần này trước có mức mất thông tin tương đối thấp và không cần gọi model thêm.
Trong implementation gần 2.1.x được tham khảo trong bài viết này, tool result lớn được ghi vào tool-results trong session storage, thường nằm dưới dữ liệu session tương ứng trong ~/.claude/projects/...; window chỉ giữ preview và file reference.
Threshold mặc định khoảng 50,000 ký tự, không phải 50KB. Các tool khác còn có thể có threshold thấp hơn, chẳng hạn Bash / PowerShell khoảng 30,000 ký tự, Grep khoảng 20,000 ký tự. Khi tổng tool result trong cùng một message vượt khoảng 200,000 ký tự, kết quả lớn nhất cũng sẽ được ưu tiên ghi ra disk.
Ở đây có một ngoại lệ: tool Read được miễn maxResultSizeChars = Infinity. Tool không có threshold hữu hạn như vậy thường không bị Tool Result Budget xem là large result. Nếu không, sẽ xuất hiện vòng lặp “đọc file -> quá lớn nên ghi ra disk -> summary chỉ thấy path -> lại đọc lại”.
Tool result cũng có thể được Tool Result Budget xử lý. Path này chịu ảnh hưởng của version và experimental flag, không phải mọi environment đều bật. State của nó có thể chia thành mustReapply, frozen và fresh.
mustReapply nghĩa là tool result trước đó đã được persist hoặc thay thế, cần apply lại nội dung thay thế; frozen là result đã được thấy và tạm thời không xử lý lại; fresh là tool result mới tạo, có thể được chọn để ghi ra disk thay thế khi vượt quá budget của một message.
Implementation tham khảo còn có Snip và MicroCompact. Sau khi Snip xóa một đoạn history range, nó sẽ nối lại message chain và giao số Token được giải phóng cho phán đoán AutoCompact tiếp theo, tránh việc vừa giải phóng không gian đã nén quá mức lần nữa.
MicroCompact sẽ thay tool result cũ bằng [Old tool result content cleared]. Quan hệ call và reference vẫn nằm trong message chain, còn phần content trả về lớn sẽ bị xóa.
Tại sao không xóa thẳng cả message?
Message phía sau có thể vẫn reference tool_use ID phía trước. Nếu xóa trực tiếp record call, message chain sẽ bị đứt và model cũng không thể phán đoán thao tác nào đã hoàn tất. Cái giá phải trả là mất content cụ thể; khi sau đó cần line number chính xác, vẫn phải đọc lại file.
Trước khi gửi request hoặc khi xuất hiện cảnh báo áp lực context, MicroCompact giữ lại một số tool result gần đây và thay thế result cũ hơn. Nếu environment, model hoặc path Sub-agent hiện tại không hỗ trợ nó, flow sẽ bỏ qua bước này, sau đó AutoCompact tiếp tục xử lý.
Một entry point khác liên quan đến việc Prompt Cache hết hạn. Khi hai API call cách nhau khá lâu và cache phía server có thể hết hạn, xóa tool result cũ trước khi gửi giúp tránh việc full retransmission tiếp tục phình to. Path này mặc định tắt và do GrowthBook gate kiểm soát.
Implementation tham khảo còn xuất hiện path cache prefix / cache sharing: khi compact sẽ cố gắng tái sử dụng cache prefix, nếu thất bại thì fallback về compaction thông thường. Đây là cache optimization phụ thuộc version, không nên xem là capability ổn định.
Ranh giới của tầng dọn dẹp này phụ thuộc vào việc thông tin có thể lấy lại hay không. Output của Read, Grep, Glob và truy vấn log phần lớn có thể chạy lại khi cần; các tool có side effect như Edit, Write không nên dựa vào việc replay output để khôi phục state, mà phải quay lại đối chiếu filesystem. Kết quả phân tích của sub-agent và snapshot trạng thái task là các sản phẩm dùng một lần, cũng không thể tùy tiện xóa; mất là mất thật, chỉ có thể giữ bằng summary hoặc attachment.
Sau đó nén history
Sau khi dọn tool result mà vẫn chưa đủ, mới đến lượt nén history. AutoCompact không phải phương thức nén duy nhất. Trước khi gần đạt giới hạn window, Claude Code trước tiên sẽ thử dọn output tool cũ hơn; nếu giải phóng không đủ không gian, mới cần nén session thành summary.
Sau khi xóa tool result, history hội thoại vẫn tiếp tục tăng. Đến một mức nhất định, cần viết lại history cũ thành summary state. Trong implementation được quan sát ở bài viết này, việc này đi qua một pipeline nhiều tầng. Tài liệu chính thức có thể xác nhận rằng: khi gần đạt giới hạn, trước tiên tool result cũ sẽ được dọn, nếu chưa đủ thì session mới được summary.

| Cấp | Tên | Thao tác | Mất thông tin | Chi phí API |
|---|---|---|---|---|
| 0 | Ghi large result ra disk | Ghi tool output vượt threshold vào session storage | Rất thấp | Không |
| 1 | Snip | Xóa một đoạn history range và nối lại message chain | Rất thấp | Không |
| 2 | MicroCompact | Xóa content của tool result cũ hoặc đi qua API-level cache edit | Thấp đến vừa | Không |
| 3 | Collapse | Gộp các message group đã hoàn thành thành state snapshot | Vừa | Thấp |
| 4 | AutoCompact | Điều phối Session Memory hoặc full summary bằng LLM | Tùy path | Cao |
Ghi large result ra disk, Snip và MicroCompact có thể xử lý một phần session. Khi mức sử dụng window tiếp tục tăng, flow mới đi vào Collapse hoặc AutoCompact.
Collapse cũng thuộc implementation này và nhẹ hơn AutoCompact. Khi gọi API, nó tạo dynamic compaction view: full history vẫn ở local, còn model nhận version đã collapse.
Có thể hiểu tư tưởng này là tách view và storage. Theo threshold được quan sát trong implementation đó, ở mức sử dụng khoảng 90%, Collapse bắt đầu xử lý các message group đã hoàn thành; ở khoảng 95%, nó sẽ chặn Sub-agent spawn mới để tránh tiếp tục gây áp lực lên context.
Vì Collapse làm mất ít thông tin hơn, nó thường được kích hoạt trước AutoCompact. Nếu sau khi collapse vẫn không đủ, mới đi vào full summary nặng hơn. Không nên xem các chi tiết phân tầng kiểu Collapse là stable interface công khai.
AutoCompact dùng một state summary mới để thay thế chat history cũ. Mục tiêu, tiến độ, quyết định và task chưa hoàn thành sẽ được giữ lại; các file đã đọc, keyword đã tìm và toàn bộ test output thường không được giữ; khi cần các chi tiết này, Agent phải đọc lại từ filesystem.

Manual /compact và auto compaction dùng cùng loại capability, nhưng input parameter khác nhau. Khi gọi thủ công, có thể chỉ rõ nội dung summary bắt buộc phải giữ; khi gọi tự động, nó bật suppressFollowUpQuestions để tránh summarizer hỏi lại giữa chừng.
Khi một phase kết thúc, /context cho thấy mức sử dụng tăng rõ rệt hoặc tool call bắt đầu lặp lại, có thể chủ động thực thi /compact và chỉ rõ trọng tâm cần giữ:
/compact giữ database schema, payment state machine và test case hiện đang thất bạiKhôi phục sau compaction và fallback
Tầng xử lý thứ ba là khôi phục sau compaction và fallback khi thất bại.
Session Memory là một fast path trước Full Compact. Session Memory ở đây là session helper state dùng cho compaction trong internal implementation, không phải Auto Memory trong tài liệu chính thức của Claude Code. Nó refresh session note có cấu trúc theo mức tăng Token và nhịp tool call; khi AutoCompact được kích hoạt, nếu note này cộng với message gần đây, attachment và Hook result đã có thể nén xuống dưới threshold thì có thể bỏ qua Full Compact.
Hai tên này dễ bị nhầm, có thể tách ra xem như sau:
| So sánh | Session Memory | Auto Memory |
|---|---|---|
| Định vị | Note hỗ trợ compaction trong session hiện tại | Memory về kinh nghiệm của project xuyên session |
| Nguồn | Internal flow refresh theo mức tăng Token và nhịp tool call | Claude ghi lại dựa trên correction, preference và kinh nghiệm project |
| Tác dụng | Được AutoCompact tái sử dụng, giảm khả năng Full Compact | Load khi session khởi động, cung cấp preference và kinh nghiệm dài hạn cho Agent |
| Storage | Chi tiết internal implementation, phụ thuộc version | ~/.claude/projects/<project>/memory/, MEMORY.md là index |
Nó cũng có cost: bản thân việc update Session Memory cần background model call. Nó giảm khả năng phải thực hiện một lần summary quy mô lớn khi gần chạm giới hạn window, đồng thời phân bổ công việc compaction trong quá trình thực thi session.
Trong implementation được quan sát ở bài viết này, Session Memory không khởi động ngay từ đầu session. Nó chỉ initialize sau khi lần đầu đạt khoảng 10,000 Token.
Các lần update sau đó cũng có nhịp: thường phải tăng thêm khoảng 5,000 Token và tích lũy một số lượng tool call nhất định, hoặc đúng lúc ở một điểm dừng tự nhiên không có tool call, note mới được refresh.
Template note được tổ chức theo các section cố định, chẳng hạn Current State, Task specification, Files and Functions, Errors & Corrections. Soft limit của mỗi section khoảng 2,000 Token, hard limit của toàn bộ là 12,000 Token; khi vượt hard limit, model sẽ nhận nhắc nhở MUST condense.
Khi Session Memory compact được bật và đã có Session Memory hợp lệ, AutoCompact sẽ ưu tiên thử tái sử dụng nó: dùng note, message gần đây, attachment và Hook result để lắp message chain mới, rồi ước tính Token có thấp hơn threshold hay không. Nếu giảm xuống dưới threshold thì bỏ qua Full Compact; nếu note rỗng, không tìm thấy message boundary hoặc sau khi lắp vẫn quá lớn thì fallback về full summary.
Full Compact cũng có thể báo prompt_too_long do input quá dài. Khi Full Compact được kích hoạt bởi manual /compact hoặc AutoCompact, nếu chính summary request báo prompt_too_long, hệ thống sẽ đi vào path fallback PTL (Prompt Too Long).
Mục đích của việc group theo API round là bảo đảm tool_use và tool_result không bị tách rời. Nếu error có tokenGap, hệ thống có thể loại bỏ chính xác hơn theo số Token vượt quá; nếu không có tokenGap, nó sẽ xử lý theo tỷ lệ thô hơn, chẳng hạn trước tiên bỏ khoảng 20% message group cũ. Reactive Compact là một path khác để recovery từ lỗi prompt_too_long của API; nó cũng truncate message rồi retry. Hướng và chiến lược truncate cụ thể phụ thuộc version, không nên hard-code thống nhất.
Partial Compact trong implementation này đồng thời giải quyết hai vấn đề: chỉ compact một đoạn history để giảm mất state, và cố gắng giữ cache prefix ở một số hướng. Full Compact thường rebuild message chain chính, khiến cache prefix gốc gần như mất hiệu lực; Partial Compact chỉ compact một đoạn history, cố gắng giữ một phía message để tái sử dụng cache. Compaction không chỉ xem tỷ lệ nén, mà còn phải cân bằng cache, khả năng tiếp tục và mất thông tin sau khi compact.
Partial Compact có hai hướng:
from: compact các message sau pivot, giữ lại phần sớm hơn. Phù hợp với session dài đã có một đoạn summary ban đầu, đồng thời có lợi hơn cho việc tái sử dụng cache prefix;up_to: compact các message trước pivot, giữ lại phần gần đây hơn. Phù hợp khi Agent đang xử lý một file hoặc Bug, không nên để state ở giữa bị summary ngắt quãng. Tuy nhiên vì summary được chèn trước message được giữ, cache prefix gốc thường sẽ mất hiệu lực.
Full Compact dùng một summary Prompt có cấu trúc, không chỉ đơn giản yêu cầu model “tóm tắt”.
Summary Prompt của Full Compact giới hạn tool call ở đầu và cuối: bước này chỉ nên tạo text, không nên thực thi Read, Write hoặc Bash, nếu không sẽ tạo thêm tool result. Trước tiên model sắp xếp thông tin trong <analysis>, sau đó ghi nội dung cần cho session tiếp theo vào <summary>; chỉ phần sau mới trở thành tài liệu tiếp nối.
<summary> được tổ chức theo các section cố định, gồm Primary Request and Intent, Key Technical Concepts, Files and Code Sections, Errors and fixes, Problem Solving, All user messages, Pending Tasks, Current Work và Optional Next Step.
All user messages không chỉ ghi history: yêu cầu, hướng đi và constraint user bổ sung sẽ thay đổi phán đoán sau đó; nếu bỏ sót, Agent có thể tiếp nhận sai task. Current Work cũng nên ghi rõ filename, function name, test case thất bại và command tiếp theo; “đang kiểm tra vấn đề module” không đủ để Agent sau compaction tiếp tục trực tiếp.
Implementation tham khảo còn cho thấy mức độ tuân thủ Compact Prompt có thể khác nhau giữa các version model. Chẳng hạn trong một cấu hình cụ thể, tỷ lệ model version mới thử gọi tool rõ ràng cao hơn version cũ. Nói cách khác, quy tắc compaction phải được verify lại theo model version, không thể giả định câu “không gọi tool” có hiệu lực giống nhau trên mọi model.
Sau khi compaction hoàn tất, Claude Code ghi system record có subtype: "compact_boundary" vào local session event / JSONL. compactMetadata trong sample chủ yếu ghi trigger, preTokens và một số path còn có preservedSegment. Token sau compaction có thể xuất hiện trong compact result hoặc telemetry, không phù hợp để xem là field ổn định của boundary metadata. Boundary marker cho loader phía sau biết history đã được thay bằng summary ở đây, không được tiếp tục nối nó như hội thoại thông thường.
Local record có thể thấy cấu trúc tương tự dưới đây, field sẽ thay đổi theo version:
{
  "type": "system",
  "subtype": "compact_boundary",
  "content": "Conversation compacted",
  "compactMetadata": {
    "trigger": "manual",
    "preTokens": 160442,
    "preservedSegment": {
      "headUuid": "...",
      "anchorUuid": "...",
      "tailUuid": "..."
    }
  }
}
Sau khi Full / Partial Compact kết thúc, message chain mới thường gồm boundary marker, summary message, attachment và Hook result. Phạm vi khôi phục của Session Memory compact hẹp hơn, chủ yếu xoay quanh summary, message được giữ, plan và hook. File được truy cập gần đây, plan đang active, Skill hiện tại và state của background task chịu giới hạn về số lượng và Token budget; System Prompt không tham gia summary, sau compaction sẽ được lắp lại cùng danh sách tool, permission setting và MCP Server mới nhất.
Sau compaction không nên load lại toàn bộ các file đã đọc trước đó, nếu không rất dễ quay lại vòng lặp “compact -> phình to -> compact tiếp”. Chỉ cần khôi phục các file thiết yếu để tiếp tục task hiện tại.
Hệ thống sẽ ước tính lại message payload thực tế tạo bởi boundary marker, summary, attachment khôi phục và Hook result; nếu vẫn gần threshold, lượt tiếp theo có thể lập tức compact lần nữa. Một phần state tạm thời và cache cũng được reset theo path implementation, các mục cụ thể được dọn sẽ thay đổi theo version.
Việc khôi phục attachment cần cân nhắc theo mức liên quan. File được truy cập gần đây, Plan đang active, Skill đang dùng và state background task đều có thể giúp Agent tiếp tục task, nhưng cũng chiếm window. Source path thường được chọn theo lần truy cập gần đây, số file / Token budget, rule loại trừ và ràng buộc deduplicate của preserved tail; chẳng hạn khi xử lý payment state machine, nên khôi phục file state machine, test thất bại và plan liên quan, thay vì log hoặc module không liên quan đã tiện tay đọc trước đó.
CLAUDE.md ở root của project và rule không giới hạn path sẽ được inject lại từ disk sau compaction, không cần ghi lại vào summary. CLAUDE.md trong subdirectory và rule có paths chỉ được load lại khi đọc file khớp lần nữa.
Khi chọn model rẻ hơn cho compaction, cần đồng thời đánh giá độ trung thực của summary, chi phí khám phá bổ sung và tình trạng cache hit. Giá model chỉ là một biến số; tiêu chí phán đoán vẫn là sau compaction có thể tiếp tục task chính xác hay không.
Reset, cô lập và circuit breaker
Tầng thứ tư không còn cố chấp “cứu window cũ” nữa. Compaction là việc vá trên context cũ; vá nhiều lần sẽ làm mất chi tiết tích lũy. Đến một điểm, tiếp tục compact không bằng mở lại trực tiếp. Cách làm của Context Reset là xóa window, ghi state hiện tại thành handoff document, rồi Agent mới khôi phục từ handoff document.

Anthropic quan sát thấy trong một Harness task dài cụ thể dựa trên Sonnet 4.5, khi model gần đạt giới hạn context, nó sẽ kết thúc qua loa, tức Context Anxiety. Trong tình huống này, chỉ Compaction là chưa đủ.
Reset kết hợp với handoff có cấu trúc giúp bỏ context cũ, chỉ giữ thông tin then chốt bằng handoff để Agent mới tiếp tục làm việc.
Nhưng đây không phải bước bắt buộc cố định của task dài. Sau đó, khi chuyển sang Opus 4.5, cùng Harness đã có thể bỏ Reset và chỉ dựa vào auto compaction. Vì vậy, Reset giống một phương án kỹ thuật phụ thuộc model và task hơn, không phải flow chung.
Rủi ro của Reset cũng rõ ràng: tài liệu bàn giao là cầu nối chính. Nó không nhất thiết chỉ là một Markdown file, mà còn có thể gồm progress file, record test thất bại, Git diff, task list và log quan trọng. Nếu bỏ sót boundary condition, quyết định tạm thời hoặc nguyên nhân thất bại, Agent mới sẽ tiếp tục trong trạng thái thiếu thông tin.
Session mới cần tiếp tục từ điểm thực thi trước đó; handoff tối thiểu phải lưu mục tiêu và tiêu chuẩn hoàn thành, công việc đã hoàn thành, file và function hiện tại, phương án đã loại trừ, test case thất bại hoặc error log, cùng bước đầu tiên sau khi tiếp nhận:
1. Mục tiêu task hiện tại: mô tả trong một câu sản phẩm cuối cùng cần bàn giao
2. Công việc đã hoàn thành: liệt kê phần đã sửa xong và verify
3. Điểm dừng hiện tại: ghi đến file, function, test case hoặc command
4. Constraint quan trọng: không được thay đổi gì, phải tương thích gì, user đã đặc biệt nhấn mạnh điều gì
5. Record loại trừ: đã thử phương án nào, tại sao từ bỏ
6. Sự cố hiện tại: failure log, error stack, bước reproduce
7. Hành động khởi động: sau khi session mới tiếp nhận, trước tiên xem file nào hoặc chạy command nào
Nếu chỉ có câu “tiếp tục hoàn thành task còn lại”, các file đã sửa, test thất bại và phương án đã loại trừ sẽ không xuất hiện trong session mới.
Khi phân tích hàng nghìn dòng log, định vị xuyên file hoặc review độc lập, session chính thường không cần thấy toàn bộ quá trình. Sub-agent hoàn thành nhánh phụ trong window độc lập, sau đó chỉ trả về summary và bằng chứng cần thiết; full log và quá trình thử sai ở giữa vẫn nằm trong history của sub-agent.
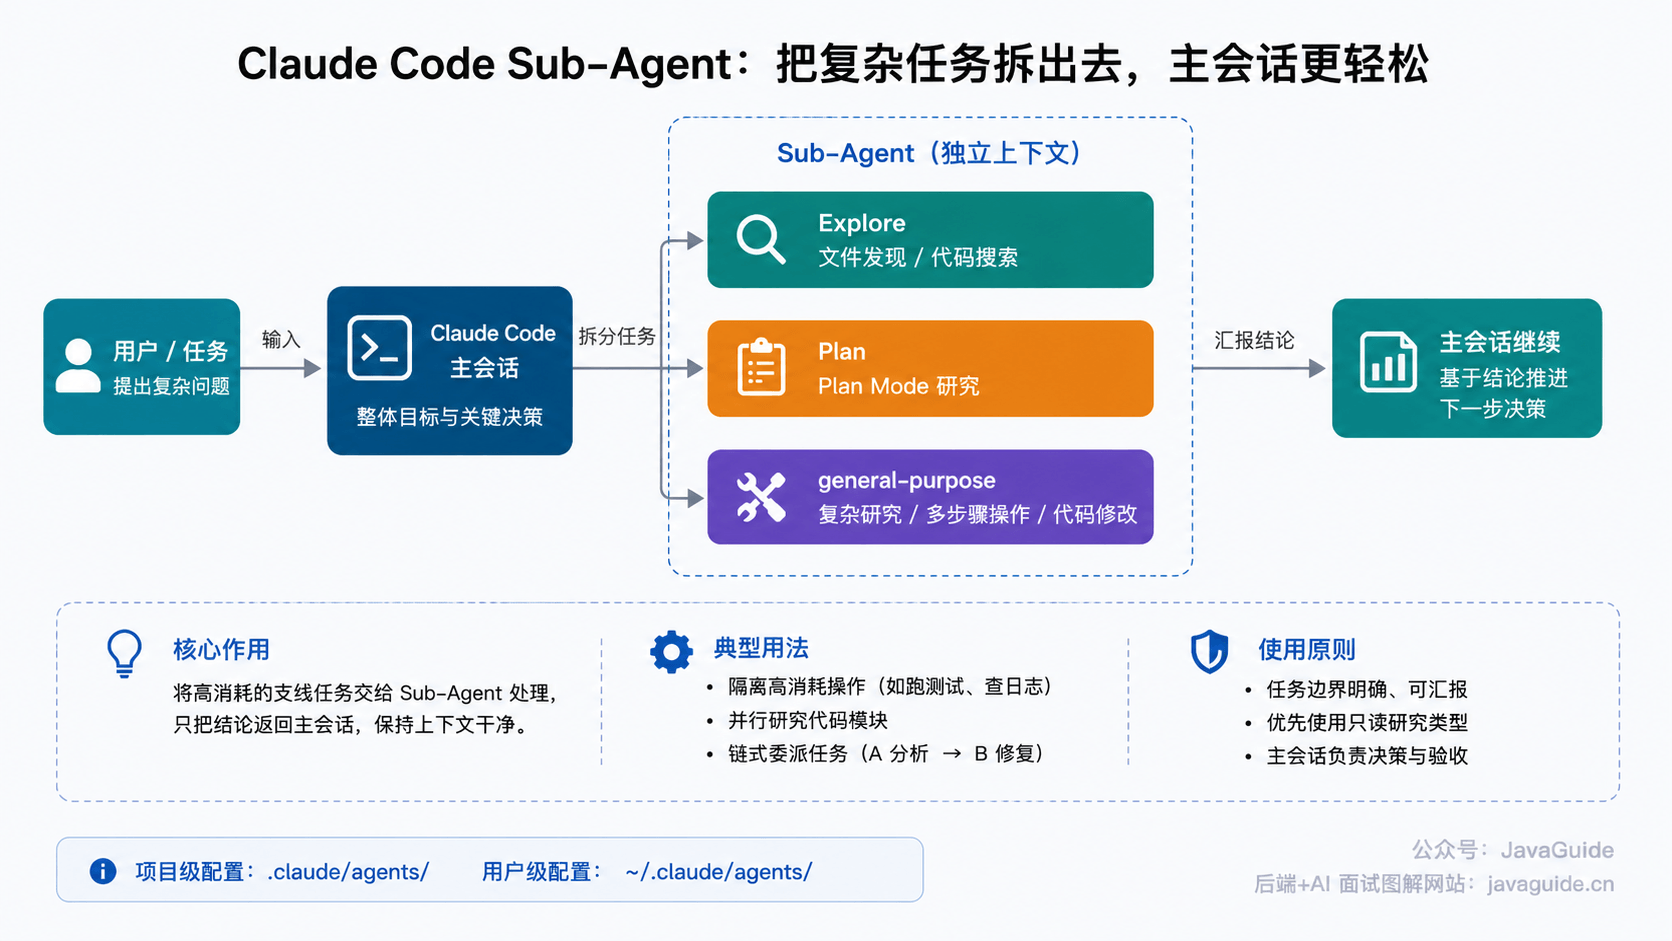
Các task log mà session chính chỉ cần root cause và bằng chứng phù hợp để tách ra. Khi task nhỏ đến mức chỉ cần vài bước là hoàn thành, subtask thường xuyên phải chờ nhau hoặc boundary bản thân chưa rõ, việc điều phối và summary ngược lại sẽ tạo thêm cost.
Context sub-agent nhận được khi khởi động cũng khác nhau:
| Mode | Hành vi context | Tình huống phù hợp |
|---|---|---|
| Named / non-fork Subagent | Không kế thừa message history của parent session; nhưng vẫn load tool / permission, CLAUDE.md / memory, Git state và runtime context khác | Cô lập search noise, phân tích log, review độc lập |
| Fork | Kế thừa context của parent session thay vì khởi động từ window rỗng | Nhánh phụ phụ thuộc nhiều vào background và cần dùng state của parent session |
Cả hai mode chỉ trả result về session chính. Sub-agent có Agent tool có thể tiếp tục tạo sub-agent, độ sâu đến 5 tầng thì không còn cung cấp tool này; Fork không thể tiếp tục tạo Fork.
Sau khi session chính compact, nó không load lại full transcript của sub-agent mà chỉ khôi phục summary và một lượng nhỏ metadata.
Circuit Breaker
Circuit Breaker là cơ chế bảo vệ cứng của auto compaction. Tài liệu chính thức cho biết: khi một file lớn hoặc tool output khiến window nhanh chóng đầy lại sau mỗi lần summary, Claude Code sẽ dừng auto compaction sau nhiều lần thử để tránh lặp lại việc tiêu tốn API call.
Implementation tham khảo dùng bộ đếm lỗi liên tiếp: sau khi AutoCompact thành công thì reset về 0; khi lỗi liên tiếp đạt MAX_CONSECUTIVE_AUTOCOMPACT_FAILURES (3), các request sau sẽ bỏ qua AutoCompact.
Auto compaction
  -> window nhanh chóng đầy lại sau summary hoặc compaction thất bại
Bộ đếm lỗi liên tiếp tăng
  -> sau khi đạt 3 lần thì bỏ qua AutoCompact
Nếu không có tầng bảo vệ này, session sẽ rơi vào vòng lặp “compact -> lập tức phình to -> compact tiếp”. Nếu AutoCompact chưa kịp thực thi và API đã trả về prompt_too_long, Reactive Compact sẽ recovery từ error, truncate message rồi retry.
Tổng kết
Có thể sắp xếp thứ tự xử lý dựa trên việc thông tin có thể lấy lại hay không:
| Nguồn gây áp lực context | Cách ưu tiên xử lý | Chi phí |
|---|---|---|
| Tool output quá dài | Ghi ra disk, MicroCompact, khi cần thì Snip history fragment | Mất thông tin thấp, thường không cần gọi model thêm |
| History hội thoại quá dài | Collapse, AutoCompact, Full Compact | Mất một phần chi tiết quá trình, cần chất lượng summary làm fallback |
| Session chính bị search và log làm bẩn | Cô lập nhánh phụ bằng Sub-agent | Thêm một lần điều phối, session chính chỉ nhận summary |
| Sau compaction vẫn không thể tiếp tục task | handoff + Context Reset | Nếu handoff document ghi thiếu thì session mới thiếu thông tin |
Trong sử dụng hằng ngày, trước tiên dọn tool result có thể lấy lại; history quá dài thì compact; search, review và phân tích log giao cho Sub-agent; sau compaction vẫn không thể tiếp tục ổn định thì viết handoff và mở session mới. Càng xử lý về sau thì mất thông tin và chi phí điều phối càng cao, vì vậy không nên Reset ngay từ đầu.
Triển khai task dài
Hai case cực đoan
Năm 2026, team Anthropic Labs công bố một kiến trúc ba agent lấy cảm hứng từ tư tưởng GAN (Generative Adversarial Network):

Planner mở rộng mô tả sản phẩm 1-4 câu thành specification hoàn chỉnh, Generator triển khai feature theo Sprint, còn Evaluator dùng Playwright MCP để trực tiếp thao tác ứng dụng đang chạy, rồi chấm điểm theo độ sâu thiết kế sản phẩm, tính năng, thiết kế trực quan và chất lượng code. Phân chia role giúp planning, implementation và evaluation mỗi phần có context độc lập.
Long-running Harness ban đầu dựa trên Sonnet 4.5 dùng Context Reset để giảm Context Anxiety. Đến Harness ba agent dựa trên Opus 4.5, Anthropic chuyển sang session liên tục, dùng auto compaction của Claude Agent SDK để kiểm soát mức tăng context.
- Planner chỉ lập kế hoạch, không phải mang theo chi tiết implementation;
- Generator dùng auto compaction kiểm soát độ dài history sau mỗi Sprint, tránh history cản trở implementation tiếp theo;
- Evaluator đánh giá độc lập, không bị context của Generator làm nhiễu.
Chi phí và kết quả của hai cấu hình như sau:
| Cấu hình | Thời gian | Chi phí | Hiệu quả |
|---|---|---|---|
| Solo Harness, một Agent + tối thiểu tool | 20 phút | $9 | Bản bán thành phẩm không chạy được |
| Full Harness, ba Agent + full tool chain | 6 giờ | $200 | Ứng dụng hoàn chỉnh, dùng được |
Case của Carlini còn cực đoan hơn: 16 instance Claude Opus chạy song song, khoảng 2,000 session độc lập, kéo dài khoảng 2 tuần.
Kết quả cuối cùng là 100 nghìn dòng code Rust, tỷ lệ pass GCC torture test 99%, chi phí API khoảng 20 nghìn USD.
Điểm then chốt ở đây là chia công việc cho số lượng lớn session độc lập để tiến hành song song. Log được ghi vào file thay vì in lên console, test cũng lấy sub-sample: mỗi Agent chỉ chạy 1%-10% test case để tránh test output chiếm đầy window.
Sau đó Carlini từng nói trong Building a C compiler with a team of parallel Claudes:
“I had to constantly remind myself that I was writing this test harness for Claude and not for myself.”
Trong cách phân công của Carlini, compiler cốt lõi, deduplication, tối ưu performance, chất lượng code và document dần do các role khác nhau phụ trách. LLM dễ lặp lại việc triển khai feature đã tồn tại; bố trí riêng một role deduplication có thể giảm gánh nặng cho Agent chính khi vừa code, vừa kiểm tra trùng lặp và duy trì history.
Việc nâng cấp model cũng thay đổi trade-off của Harness. Sau khi Anthropic nâng từ Opus 4.5 lên Opus 4.6, họ loại bỏ cơ chế Sprint cũ và thu gọn việc evaluation bị ràng buộc chặt theo từng Sprint thành QA tập trung cuối cùng / một số vòng evaluation. Tách, kiểm tra và reset đều phụ thuộc vào giả định về năng lực model; sau khi version thay đổi cần verify lại.
Project hằng ngày dĩ nhiên không cần ba agent, cũng không cần 2,000 session độc lập. Trước tiên hãy phán đoán task sẽ tiêu tốn bao nhiêu code context.
Chọn thế nào cho project hằng ngày
Tôi từng gặp một vấn đề trong project nền tảng phỏng vấn. Một task đi qua vài module, lúc đó tôi nghĩ một Agent có thể gánh được. Kết quả Claude Code tự dừng giữa chừng vì context bị đầy. Sau đó tôi chuyển sang Sub-agent chạy song song: mỗi subtask chỉ xem module mình phụ trách, cuối cùng trả summary về Agent chính, nhờ vậy mới hoàn thành ngay một lần.
| Quy mô task | Strategy đề xuất | Cách quản lý context |
|---|---|---|
| Nhỏ: sửa một file, bổ sung một function | Một Agent | Tự động dọn tool result là đủ |
| Vừa: một module hoặc một feature | Một Agent + Compaction chủ động | /compact khi phase kết thúc hoặc /context cho thấy mức sử dụng tăng |
| Lớn: refactor xuyên module, subsystem mới | Agent chính + Sub-agent | Giao search, review và phân tích log cho sub-agent |
| Rất lớn: iteration dài hạn hoặc system độc lập | Nhiều Agent + handoff / Reset, hoặc session liên tục + AutoCompact | Viết handoff khi chuyển phase; có Reset hay không phụ thuộc model và task |
Chi tiết command /compact, Sub-agent và /context có thể xem trong Hướng dẫn sử dụng Claude Code và Giải thích chi tiết command cốt lõi của Claude Code.
Tôi thường không đợi AutoCompact chạm sát ngưỡng mới hành động. Khi /context ở khoảng 70%, hoặc đã xuất hiện dấu hiệu search lặp lại và quên constraint, tôi sẽ manual /compact và nói rõ cần giữ gì; khi đó summarizer có trọng tâm rõ ràng hơn. Nếu chờ hệ thống bị động kích hoạt, window thường đã lẫn log cũ, phán đoán cũ và một đống kết quả khám phá tạm thời.
Khi kết thúc phase khám phá, có thể ghi boundary module, file quan trọng, phương án loại trừ và test thất bại vào compact instruction:
/compact giữ boundary module, file quan trọng, phương án đã loại trừ, test hiện đang thất bạiVới vấn đề database, nên ghi rõ Schema, migration và SQL thất bại cần tiếp tục:
/compact giữ toàn bộ database schema, migration script, entity relation và SQL hiện đang thất bạiVới task xuyên module, sau khi đọc xong file và xác nhận boundary module, có thể compact một lần; sau khi xác định solution, constraint và risk thì compact lần nữa; sau khi sửa code và hoàn thành verification thì cập nhật state. PLAN.md hoặc design.md lưu state quan trọng; summary truyền mục tiêu, trade-off và bước tiếp theo; line number, SQL thất bại và chi tiết interface vẫn ở trong file.
Project nhiều file có thể chọn strategy theo tình huống:
| Tình huống | Cách làm đề xuất |
|---|---|
| Đọc lượng lớn file trong một lần | Dùng MicroCompact / Snip / compaction để xóa content cũ của phần phân tích đã hoàn thành |
| Tiếp tục sau thời gian gián đoạn dài | Để hệ thống dọn tool result hết hạn, khi cần đọc lại file quan trọng |
| Liên tục triển khai nhiều feature độc lập | Compact một lần sau mỗi feature hoàn thành |
| Thay đổi lớn xuyên nhiều module | Chia theo phase, compact và update note ở cuối phase |
| Nhiều log hoặc test output | Chỉ giữ failure summary, command reproduce và stack quan trọng, không giữ full output |
| Cần search hoặc review song song | Giao cho Sub-agent, Agent chính chỉ nhận summary |
Các file đã đọc nhiều trong phase khám phá thường chỉ cần giữ kết luận về sau; constraint và trade-off của phase thiết kế cần được lưu lại; failure log có thể reproduce không cần giữ full text lâu dài. Khi thông tin ổn định đến mức này, thực hiện compaction sẽ phù hợp hơn.
Externalize state, memory và Hooks
Task API như TaskCreate, TaskUpdate chia mục tiêu lớn thành các task node, ghi state và quan hệ dependency như pending, in_progress, completed, đồng thời persist thành task list có cấu trúc (internal storage format không thuộc stable interface). Agent đọc tiến độ hiện tại qua Task Tools, không cần dựa vào history hội thoại để nhớ “đã làm đến đâu”.
Khi nhiều Agent cùng ghi vào một repository, worktree isolation giúp git status của mỗi bên chỉ hiển thị thay đổi của chính mình. Full test, cross-file search và phân tích module lớn có thể chạy ở background, hoàn tất rồi chỉ trả summary; khi compact, state của task vẫn đang chạy sẽ được inject lại vào context mới dưới dạng attachment.
Nguyên tắc tương tự cũng áp dụng cho memory: chỉ ghi nội dung không thể suy ra từ source code.
| Nên ghi | Không nên ghi |
|---|---|
| Preference của user, chẳng hạn coding style và thói quen ngôn ngữ | Cấu trúc directory của project, có thể tra bằng glob |
| Convention riêng của project, chẳng hạn API prefix | Function signature của interface, đã có trong source code |
| Nguyên nhân của một quyết định kỹ thuật | Dependency version, đã có trong package.json / pom.xml |
| Pitfall từng gặp và cách fix | Git commit history, có thể xem bằng git log |
Session history chỉ phục vụ session hiện tại và sau đó có thể bị compact. Persistent instruction do user hoặc project ghi vào đặt trong CLAUDE.md / Rules; Auto Memory lưu note kinh nghiệm theo Git repository, path mặc định là ~/.claude/projects/<project>/memory/, có thể override bằng CLAUDE_COWORK_MEMORY_PATH_OVERRIDE hoặc autoMemoryDirectory trong trusted settings. Khi session khởi động, chỉ load 200 dòng đầu hoặc 25KB đầu của MEMORY.md.

Sau khi memory file tăng lên, lúc khởi động chỉ load index; khi cần chi tiết cụ thể mới mở file tương ứng.
Một số project Agent cũng dùng AGENTS.md làm index.
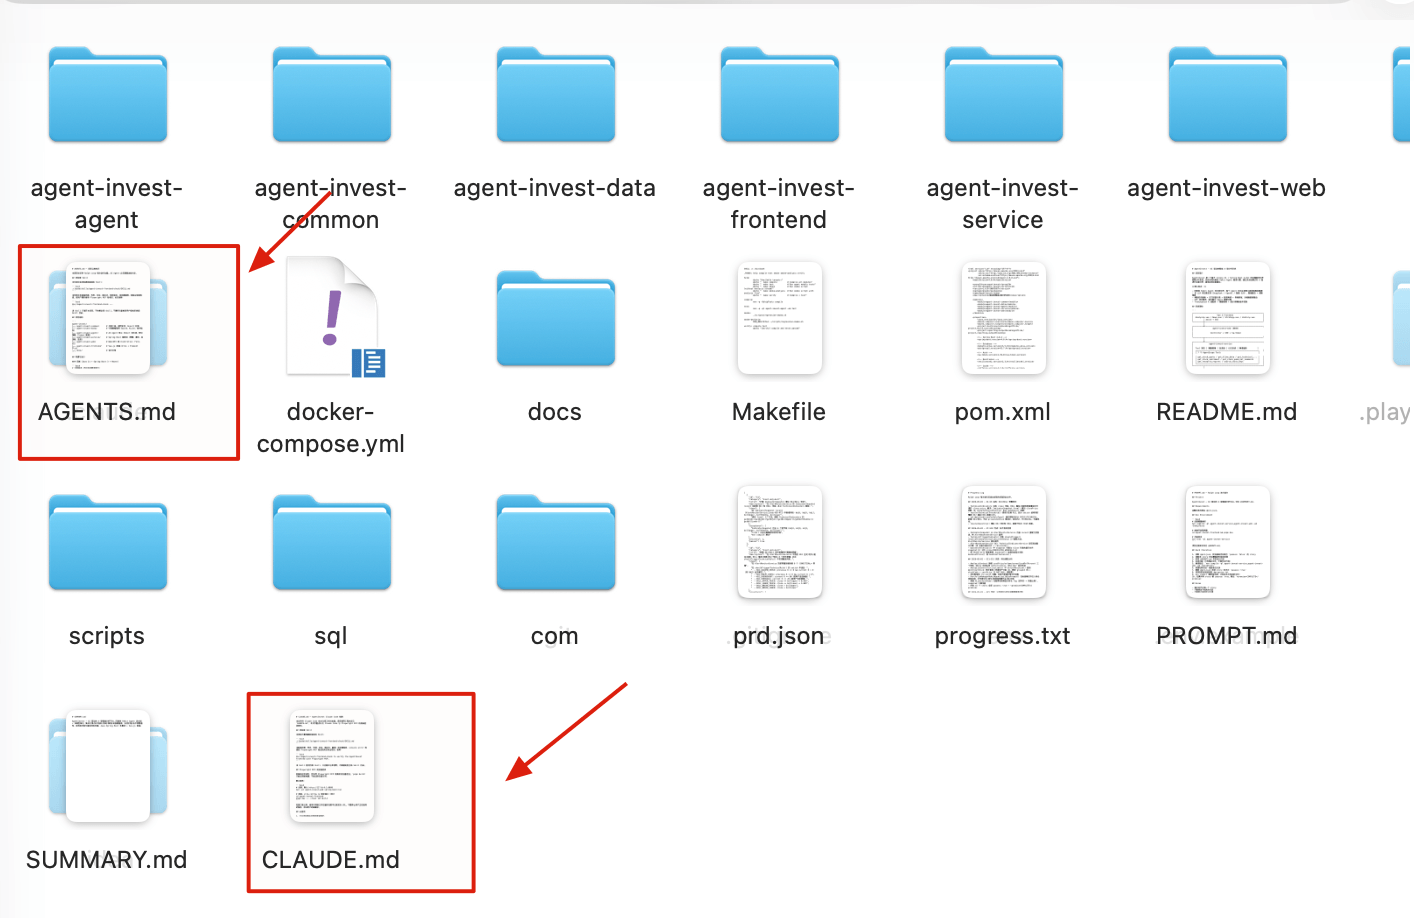
Có thể tham khảo Harness Engineering: Why Coding Agents Need Infrastructure. Các file kiểu này chịu trách nhiệm cho Agent biết “tài liệu ở đâu, lúc nào cần đọc”, chứ không nhồi toàn bộ tài liệu vào context từ trước.
Auto Memory chính thức được lưu theo Git repository; các worktree khác nhau của cùng repository dùng chung một memory.
Rule cá nhân, rule project và rule tổ chức sẽ được cộng dồn vào window, không nên kỳ vọng rule load sau tự động ghi đè preference phía trước. Nếu project nhất thiết phải override thói quen cá nhân, hãy ghi rõ priority trong project rule.
Khi phỏng vấn hỏi “Agent triển khai memory xuyên session như thế nào”, trả lời “lưu vào file” là quá sơ sài. Cách trả lời đầy đủ hơn là: chỉ lưu thông tin không thể tra trong source code, phân tầng theo phạm vi tác dụng, lúc khởi động trước tiên load index nhẹ, khi cần mới đọc chi tiết, không nhồi toàn bộ memory vào window.
Theo tài liệu chính thức, có thể đặt ba loại thông tin persist như sau:
| Loại | Tác dụng | Storage |
|---|---|---|
| Session history | State tạm thời của task hiện tại, có thể bị compact | messages[] trong memory |
| CLAUDE.md / Rules | Persistent instruction do user, project và tổ chức ghi | Project .claude/ hoặc ~/.claude/ |
| Auto Memory | Note kinh nghiệm do Claude duy trì theo Git repository | Mặc định ở ~/.claude/projects/<project>/memory/, có thể bị override bởi CLAUDE_COWORK_MEMORY_PATH_OVERRIDE hoặc trusted settings; MEMORY.md là entry point của index, dùng chung giữa các worktree |

Một solution tạm thời để bypass Bug nếu được ghi vào project memory, session sau có thể tiếp tục dùng tiền đề sai. File path, dependency version và function signature có thể tra trực tiếp từ source code, không cần ghi lại; số lượng entry tăng sẽ đẩy chi phí cố định lên, entry sai còn liên tục ảnh hưởng đến phán đoán.
Một phần chi phí cố định khác đến từ config. Config key thông thường của Claude Code tuân theo priority này:
Managed (tổ chức quản lý) > CLI argument > local project > shared project > user configConfig dạng array như permission và Sandbox path là ngoại lệ, có thể dùng quy tắc merge và deduplicate thay vì override đơn giản.
Các rule mới trong project config thêm 5, user config thêm 3 và MCP thêm 2 service có thể khiến rule, permission và tool definition cộng lại chiếm vài nghìn Token. Đặt rule chung ở global, rule riêng của project ở cấp project có thể giảm việc inject lặp lại.
Hook dùng để can thiệp context tại node được chỉ định: SessionStart inject memory, PreCompact thêm compact instruction, PostCompact chịu trách nhiệm notification hoặc display; PostToolUse điều chỉnh MCP tool output, PreToolUse phán đoán tool có được phép thực thi hay không.
Hook output sẽ đi vào context nên không phải không có cost. Khi external web page, script output hoặc file tạm chứa instruction bẩn trộn vào, chúng cũng có thể mang đến prompt injection. Project coding thông thường chỉ cần cơ chế dọn dẹp, compaction và circuit breaker built-in.
Bảng dưới liệt kê thời điểm các Hook này can thiệp vào context:
| Event | Thời điểm kích hoạt | Tác dụng trong quản lý context |
|---|---|---|
SessionStart | Session bắt đầu | Inject memory, thông tin environment |
InstructionsLoaded | Sau khi load rule | Notification, audit observation |
PreToolUse | Trước tool call | Phán đoán tool có được phép thực thi |
PostToolUse | Sau khi MCP tool trả về | Điều chỉnh MCP tool output |
PreCompact / PostCompact | Trước và sau compaction | Thêm instruction trước compaction, notification hoặc display sau summary |
Mỗi Hook thêm vào là thêm một phần output có khả năng đi vào context. Chỉ cấu hình Hook khi project team có constraint domain nghiêm ngặt, cần compliance audit hoặc cần làm sạch tool output.
Phiên bản trả lời phỏng vấn
Có thể xem quản lý context là việc quản trị working memory hữu hạn. Khi Agent thực hiện task dài, nó phải tiếp tục suy luận đồng thời với mục tiêu task, rule project, code đã đọc, tool output, plan và kết luận trung gian. Window liên tục tích lũy, log cũ, kết quả tìm kiếm trùng lặp và vấn đề đã giải quyết sẽ chiếm sự chú ý; khi gần đạt giới hạn, model còn có thể kết thúc task sớm do không đủ output space khả dụng.
Tôi sẽ trước tiên phân biệt hai loại thông tin. Hàng chục kết quả từ một lần search, full test log và nguyên văn file dài đã xác nhận trước đó đều có thể lấy lại sau này, không đáng chiếm window mãi. Mục tiêu task, business constraint, quyết định then chốt, test thất bại, file đã sửa và bước tiếp theo thì bắt buộc phải giữ; các thông tin này sẽ được nén thành summary có thể tiếp tục thực thi, rồi ghi vào PLAN.md, design document hoặc task file để tránh chỉ tồn tại trong một lượt hội thoại.
Đặt vào Claude Code, tôi sẽ để nó trước tiên xử lý tool result có thể lấy lại; khi history quá dài thì thực thi /compact, giữ mục tiêu, constraint, quyết định và task chưa hoàn thành. Nếu sau compaction vẫn cần đổi session, handoff tối thiểu phải ghi rõ thay đổi hiện tại, test thất bại, phương án đã loại trừ và cách verification tiếp theo. Với các nhánh như phân tích log, search xuyên file và review độc lập, tôi sẽ giao cho Sub-agent; session chính chỉ nhận kết luận và bằng chứng cần thiết, không nhồi lại toàn bộ quá trình.
Vì vậy, tiêu chí đánh giá quản lý context có tốt hay không không phải là window lưu bao nhiêu thông tin, mà là sau khi compact, đổi session hoặc tách task thì task có thể tiếp tục hay không: window phục vụ suy luận hiện tại, filesystem lưu state task có thể tái sử dụng và truy nguyên.
Tổng kết
Khi window đầy, trước tiên xử lý tài liệu tạm thời có thể lấy lại như tool result, test log và search output; sau khi phase kết thúc mới compact history hội thoại quá dài. Các nhánh search, review và phân tích log đưa vào Sub-agent, session chính chỉ giữ kết luận.
Nếu session sau compaction vẫn không thể tiếp tục, handoff phải nêu test case thất bại, constraint tạm thời, file đang sửa và phương án đã loại trừ, sau đó session mới xử lý. Các thông tin sẽ tiếp tục được dùng như Plan, Spec, SQL thất bại và trade-off thiết kế nên được ghi vào PLAN.md, design.md, NOTES.json hoặc task file riêng của project. Như vậy, window chỉ giữ tài liệu tạm thời, còn filesystem chịu trách nhiệm lưu task state.