
Tổng hợp câu hỏi phỏng vấn MySQL thường gặp
MySQL Basics
Relational database là gì?
Đúng như tên gọi, relational database (RDB, Relational Database) là database được xây dựng trên relational model. Relational model thể hiện mối liên hệ giữa dữ liệu được lưu trong database (one-to-one, one-to-many, many-to-many).
Trong relational database, dữ liệu được lưu trong nhiều table khác nhau (ví dụ user table), mỗi row trong table lưu một bản ghi (ví dụ thông tin của một user).
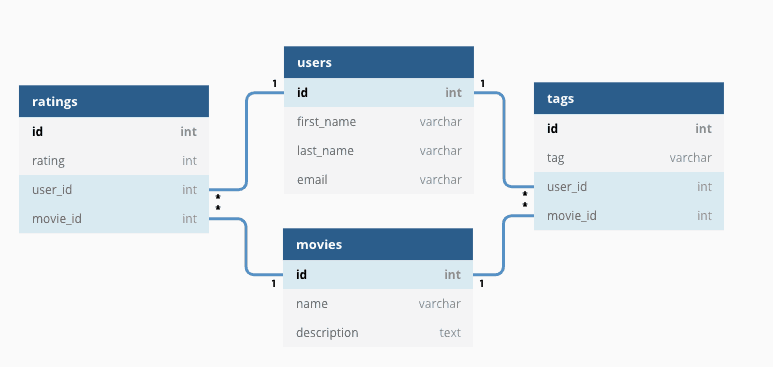
Phần lớn relational database dùng SQL để thao tác với dữ liệu trong database. Đồng thời, phần lớn relational database đều hỗ trợ bốn đặc tính (ACID) của transaction.
Có những relational database phổ biến nào?
MySQL, PostgreSQL, Oracle, SQL Server, SQLite (SQLite được dùng để lưu trữ chat local của WeChat) …….
SQL là gì?
SQL là ngôn ngữ truy vấn có cấu trúc (Structured Query Language), chuyên dùng để làm việc với database, nhằm cung cấp một cách đơn giản và hiệu quả để đọc, ghi dữ liệu từ database.
Gần như mọi relational database phổ biến đều hỗ trợ SQL, nên tính ứng dụng rất cao. Ngoài ra, một số non-relational database cũng tương thích với SQL hoặc dùng ngôn ngữ truy vấn tương tự SQL.
SQL có thể giúp bạn:
- Tạo database, table và field;
- Thêm, xóa, sửa, truy vấn dữ liệu trong database;
- Tạo view, function và stored procedure;
- Phân tích dữ liệu đơn giản trong database;
- Kết hợp với Hive, Spark SQL để xử lý big data;
- Kết hợp với SQLFlow để machine learning;
- …
MySQL là gì?

MySQL là một relational database, chủ yếu dùng để lưu trữ bền vững một số dữ liệu trong hệ thống, chẳng hạn thông tin user.
Vì MySQL là database open source, miễn phí và khá trưởng thành, nên được sử dụng rộng rãi trong nhiều hệ thống. Bất kỳ ai cũng có thể tải xuống và sửa đổi MySQL theo nhu cầu cá nhân dưới giấy phép GPL (General Public License). Port mặc định của MySQL là 3306.
⭐️MySQL có ưu điểm gì?
Bản chất câu hỏi này là hỏi nguyên nhân MySQL phổ biến đến vậy.
Thành công của MySQL đến từ lợi thế tổng hợp ở ba phương diện: hệ sinh thái, tính năng và vận hành.
Thứ nhất, xét từ góc độ hệ sinh thái và chi phí, lợi thế của nó rất vững chắc.
- Open source và miễn phí: Đây là nền tảng giúp MySQL phổ biến rộng rãi. Mọi công ty và cá nhân đều có thể dùng miễn phí, giảm đáng kể ngưỡng kỹ thuật và chi phí ban đầu.
- Cộng đồng lớn, hệ sinh thái hoàn chỉnh: Sau vài chục năm phát triển, MySQL có cộng đồng rất năng động và hệ sinh thái phong phú. Điều này có nghĩa là gần như mọi vấn đề bạn gặp đều có thể tìm được lời giải trên Internet; đồng thời, mọi programming language, framework, ORM tool và hệ thống monitoring phổ biến trên thị trường đều hỗ trợ MySQL tốt. Tài liệu của MySQL cũng rất phong phú, dễ tìm tài nguyên học tập.
Thứ hai, xét từ các tính năng kỹ thuật cốt lõi, MySQL mạnh và cân bằng.
- Hỗ trợ transaction mạnh: Đây là nền tảng để MySQL tồn tại với tư cách relational database. Đáng chú ý là isolation level REPEATABLE-READ mặc định của InnoDB, thông qua MVCC và Next-Key Lock, phần lớn đã tránh được phantom read. Nhiều database khác phải dùng isolation level cao hơn mới làm được điều này, còn MySQL cân bằng được performance và consistency. Có thể đọc bài viết chi tiết: Giải thích chi tiết isolation level của MySQL transaction.
- Performance và khả năng mở rộng tốt: MySQL đã trải qua thử thách khắc nghiệt của lượng lớn nghiệp vụ Internet, performance trên một máy rất tốt. Quan trọng hơn, MySQL đã hình thành một bộ kiến trúc horizontal scaling trưởng thành, như master-slave replication, read/write splitting và sharding thông qua middleware. Nhờ đó, MySQL có thể phục vụ nhiều quy mô nghiệp vụ khác nhau, từ startup đến nền tảng Internet lớn.
Thứ ba, xét từ góc độ vận hành và sử dụng, MySQL rất “thân thiện”.
- Dùng được ngay, dễ bắt đầu: So với các commercial database lớn như Oracle, MySQL cài đặt, cấu hình và sử dụng hằng ngày đơn giản, trực quan hơn; đường cong học tập phẳng, thân thiện với developer và DBA mới.
- Chi phí bảo trì thấp: Nhờ tính đơn giản và cộng đồng lớn, việc tìm nhân sự vận hành cùng giải pháp tương ứng tương đối dễ, nên chi phí bảo trì tổng thể cũng thấp hơn.
Đáng chú ý là vài năm gần đây, PostgreSQL phát triển rất mạnh, thậm chí vượt qua MySQL. Trên Internet xuất hiện nhiều bài viết công kích, bôi xấu MySQL. Theo tác giả, việc mù quáng công kích một bên hoặc tâng bốc bên còn lại đều không phù hợp.
Tác giả cũng từng viết một bài chia sẻ quan điểm về hai representative relational database này, nếu quan tâm bạn có thể xem: MySQL bị hạ xuống hạng hai rồi?.
MySQL field type
MySQL field type có thể chia đơn giản thành ba nhóm:
- Numeric type: integer type (TINYINT, SMALLINT, MEDIUMINT, INT và BIGINT), floating-point type (FLOAT và DOUBLE), fixed-point type (DECIMAL), bit field data type (BIT)
- String type: CHAR, VARCHAR, TINYTEXT, TEXT, MEDIUMTEXT, LONGTEXT, BINARY, TINYBLOB, BLOB, MEDIUMBLOB và LONGBLOB..., thường dùng nhất là CHAR và VARCHAR.
- Datetime type: YEAR, TIME, DATE, DATETIME và TIMESTAMP...
Hình dưới đây không phải do tôi vẽ, tôi quên đã lưu từ đâu. Nội dung tổng hợp khá tốt.
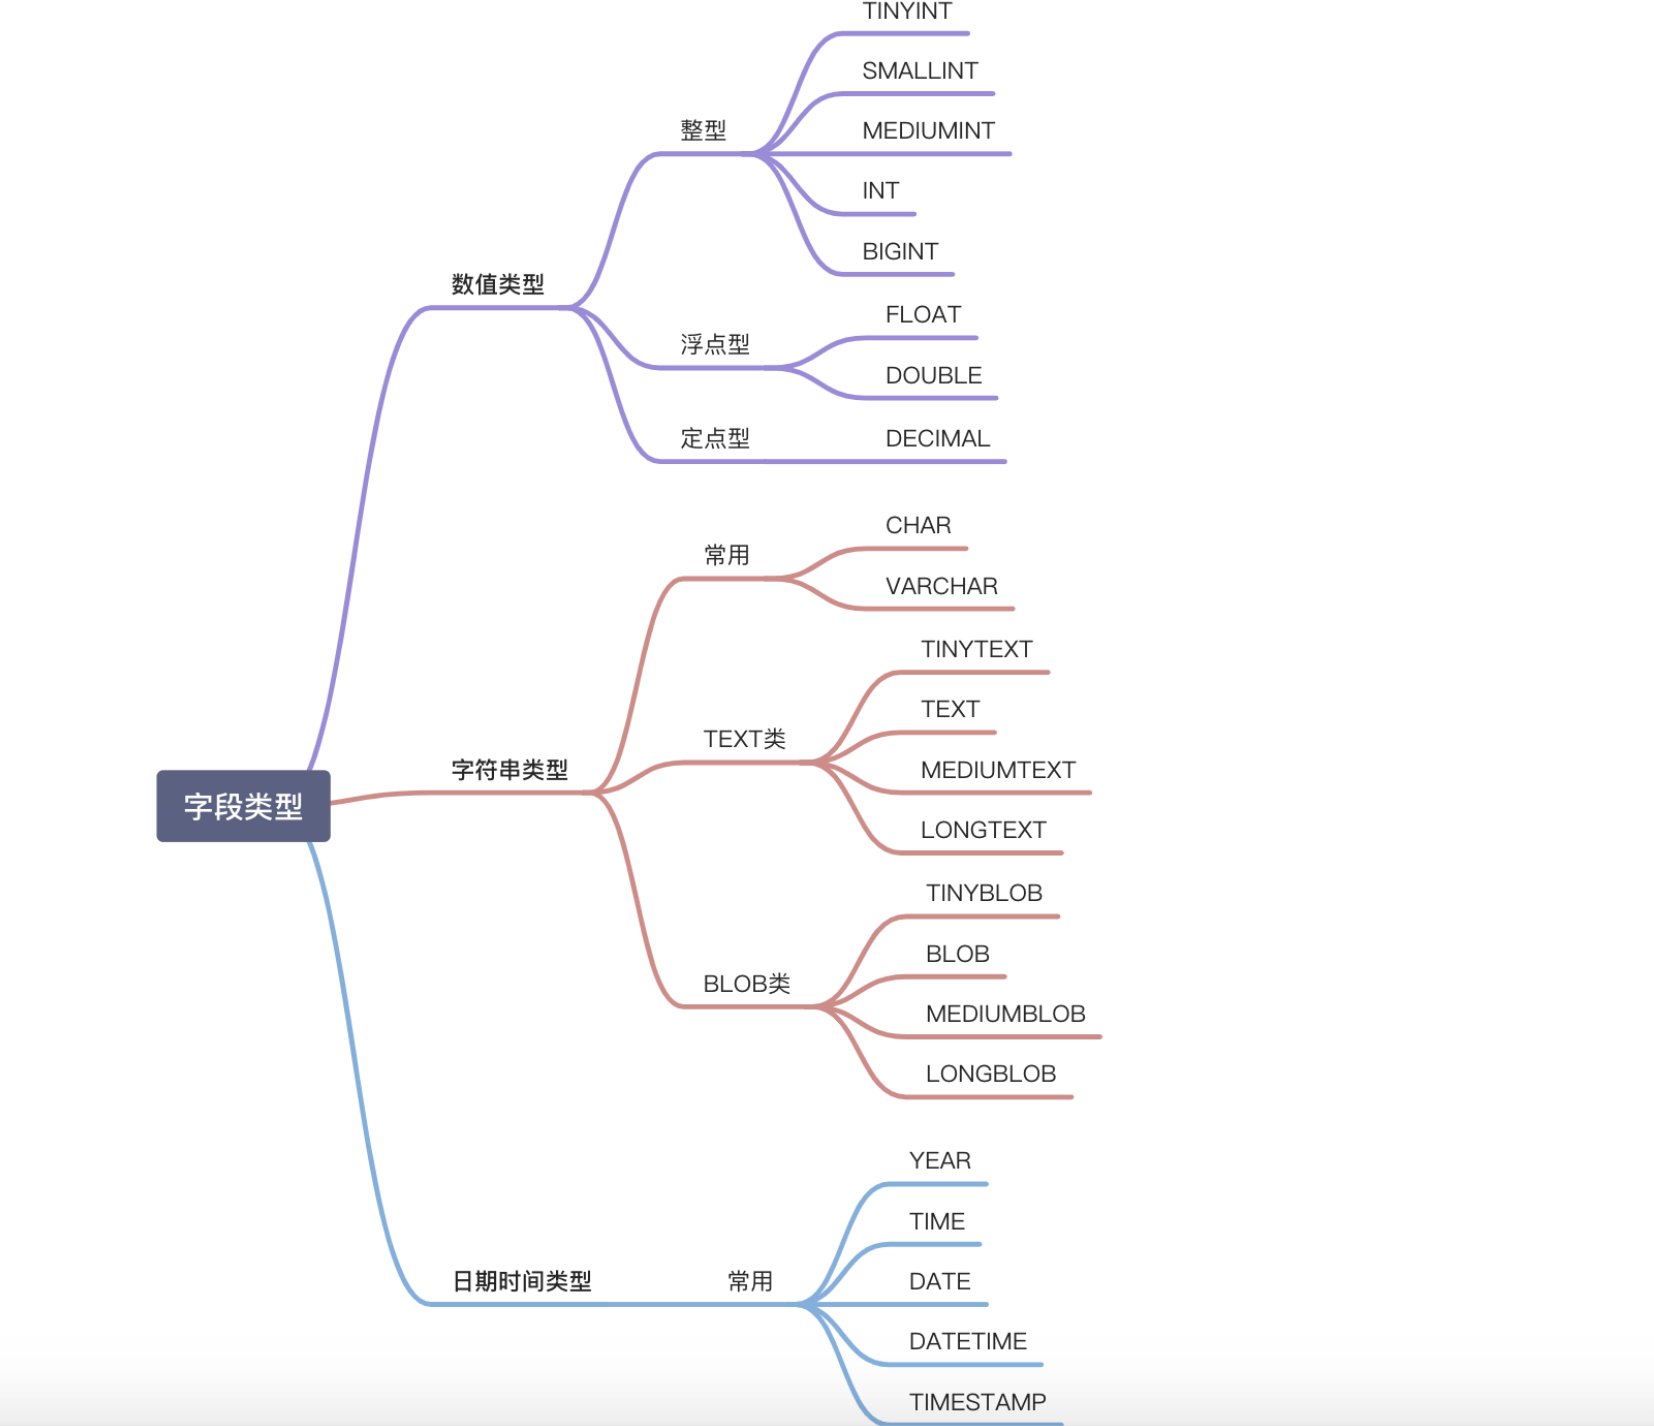
MySQL có khá nhiều field type. Ở đây tôi chọn một số field type được dùng thường xuyên trong phát triển hằng ngày và thường được hỏi khi phỏng vấn, rồi giải thích chi tiết dưới dạng câu hỏi phỏng vấn. Nếu không có ghi chú đặc biệt, nội dung đều áp dụng cho InnoDB storage engine.
Ngoài ra, bạn nên đọc chương 4 của 《High Performance MySQL (Third Edition)》, trong đó có giải thích chi tiết về tối ưu MySQL field type.
⭐️UNSIGNED attribute của integer type có tác dụng gì?
Integer type trong MySQL có thể dùng attribute UNSIGNED tùy chọn để biểu thị unsigned integer không cho phép giá trị âm. Dùng attribute UNSIGNED có thể tăng gấp đôi giới hạn trên của positive integer vì không cần lưu giá trị âm.
Ví dụ, range giá trị của TINYINT UNSIGNED là 0 ~ 255, còn TINYINT thông thường là -128 ~ 127. Range giá trị của INT UNSIGNED là 0 ~ 4,294,967,295, còn INT thông thường là -2,147,483,648 ~ 2,147,483,647.
Với cột ID tăng dần từ 0, attribute UNSIGNED rất phù hợp vì không cho phép giá trị âm, có giới hạn trên lớn hơn và cung cấp nhiều ID khả dụng hơn.
CHAR và VARCHAR khác nhau thế nào?
CHAR và VARCHAR là hai string type được dùng phổ biến nhất. Khác biệt chính là: CHAR là fixed-length string, VARCHAR là variable-length string.
Khi lưu, CHAR thêm space ở bên phải để đạt độ dài chỉ định; khi truy xuất, space được loại bỏ. Khi lưu, VARCHAR cần thêm 1 hoặc 2 byte để ghi lại độ dài string; khi truy xuất không cần xử lý bước này.
CHAR phù hợp hơn để lưu string có độ dài ngắn hoặc gần bằng nhau, chẳng hạn password sau khi mã hóa bằng Bcrypt, password sau khi mã hóa bằng MD5 và số định danh. VARCHAR phù hợp để lưu string có độ dài không cố định hoặc chênh lệch lớn, chẳng hạn nickname của user và tiêu đề bài viết.
M trong CHAR(M) và VARCHAR(M) đều là số character tối đa có thể lưu. Dù là chữ cái, chữ số hay tiếng Trung, mỗi ký tự đều chỉ chiếm một character.
VARCHAR(100) và VARCHAR(10) khác nhau thế nào?
VARCHAR(100) và VARCHAR(10) đều là variable-length type, lần lượt biểu thị khả năng lưu tối đa 100 và 10 character. Vì vậy, VARCHAR(100) đáp ứng nhu cầu lưu character trong phạm vi lớn hơn và có khả năng mở rộng nghiệp vụ tốt hơn. Khi VARCHAR(10) lưu quá 10 character, cần sửa table structure.
Mặc dù phạm vi character mà VARCHAR(100) và VARCHAR(10) có thể lưu khác nhau, nhưng khi lưu cùng một string, dung lượng disk thực tế chiếm dụng là như nhau. Đây là điểm nhiều người dễ hiểu lầm.
Tuy nhiên, VARCHAR(100) tiêu tốn nhiều memory hơn. Nguyên nhân là khi thao tác với VARCHAR trong memory, thường sẽ cấp phát memory block cố định để lưu value, tức dùng độ dài được định nghĩa trong character type. Ví dụ khi sorting, VARCHAR(100) được xử lý theo độ dài 100, nên sẽ tiêu tốn nhiều memory hơn.
DECIMAL và FLOAT/DOUBLE khác nhau thế nào?
Khác biệt giữa DECIMAL và FLOAT là: DECIMAL là fixed-point number, FLOAT/DOUBLE là floating-point number. DECIMAL có thể lưu decimal value chính xác, còn FLOAT/DOUBLE chỉ lưu được decimal value gần đúng.
DECIMAL dùng để lưu decimal có yêu cầu về precision, chẳng hạn dữ liệu liên quan đến currency, giúp tránh precision loss do floating-point number.
Trong Java, MySQL DECIMAL tương ứng với Java class java.math.BigDecimal.
Vì sao không khuyến nghị dùng TEXT và BLOB?
TEXT tương tự CHAR (0-255 byte) và VARCHAR (0-65,535 byte), nhưng có thể lưu string dài hơn, tức long text data, chẳng hạn nội dung blog.
| Type | Dung lượng có thể lưu | Mục đích |
|---|---|---|
| TINYTEXT | 0-255 byte | Text string thông thường |
| TEXT | 0-65,535 byte | Long text string |
| MEDIUMTEXT | 0-16,772,150 byte | Text data lớn |
| LONGTEXT | 0-4,294,967,295 byte | Text data cực lớn |
BLOB chủ yếu dùng để lưu binary large object, chẳng hạn file hình ảnh, audio và video.
| Type | Dung lượng có thể lưu | Mục đích |
|---|---|---|
| TINYBLOB | 0-255 byte | Binary string text ngắn |
| BLOB | 0-65KB | Binary string |
| MEDIUMBLOB | 0-16MB | Long text data dạng binary |
| LONGBLOB | 0-4GB | Text data cực lớn dạng binary |
Trong phát triển hằng ngày, TEXT ít được dùng, đôi khi mới cần đến; BLOB gần như không dùng. Nếu độ dài dự kiến có thể đáp ứng bằng VARCHAR, khuyến nghị tránh dùng TEXT.
Quy chuẩn database thường không khuyến nghị dùng BLOB và TEXT vì hai type này có một số nhược điểm và giới hạn, chẳng hạn:
- Không thể có default value.
- Khi dùng temporary table, không thể dùng memory temporary table mà chỉ có thể tạo temporary table trên disk (sách 《High Performance MySQL》 có đề cập).
- Hiệu suất truy xuất thấp hơn.
- Không thể tạo index trực tiếp, cần chỉ định prefix length.
- Có thể tiêu tốn nhiều network và I/O bandwidth.
- Có thể khiến DML operation trên table chậm hơn.
- …
⭐️DATETIME và TIMESTAMP khác nhau thế nào? Chọn ra sao?
DATETIME không có timezone information, còn TIMESTAMP liên quan đến timezone.
TIMESTAMP chỉ cần 4 byte storage space, còn DATETIME cần 8 byte. Tuy nhiên, điều này cũng tạo ra một vấn đề: range thời gian mà TIMESTAMP biểu thị nhỏ hơn.
- DATETIME: '1000-01-01 00:00:00.000000' đến '9999-12-31 23:59:59.999999'
- Timestamp: '1970-01-01 00:00:01.000000' UTC đến '2038-01-19 03:14:07.999999' UTC
Ưu điểm cốt lõi của TIMESTAMP là khả năng xử lý timezone được tích hợp sẵn. Database phụ trách lưu trữ theo UTC và tự động chuyển đổi theo session timezone, giúp đơn giản hóa việc phát triển application cần xử lý nhiều timezone. Nếu application cần xử lý nhiều timezone hoặc muốn database tự quản lý việc chuyển đổi timezone, TIMESTAMP là lựa chọn tự nhiên (lưu ý giới hạn range thời gian, tức vấn đề năm 2038).
Nếu use case không liên quan đến chuyển đổi timezone, hoặc muốn application hoàn toàn kiểm soát logic timezone và cần biểu thị thời gian sau năm 2038, DATETIME là lựa chọn an toàn hơn.
Để xem so sánh chi tiết và đề xuất chọn datetime storage type, hãy tham khảo bài viết: Đề xuất lưu trữ dữ liệu datetime trong MySQL.
NULL và '' khác nhau thế nào?
NULL và '' (empty string) là hai value hoàn toàn khác nhau, biểu thị ý nghĩa khác nhau và có behavior khác nhau trong database. NULL biểu thị data bị thiếu hoặc chưa biết, còn '' biểu thị một empty string đã biết là tồn tại. Khác biệt chính như sau:
- Ý nghĩa:
NULLbiểu thị một value không xác định, không bằng bất kỳ value nào, kể cả chính nó. Vì vậy, kết quả củaSELECT NULL = NULLlàNULL, không phảitruehayfalse.NULLcó nghĩa là thông tin bị thiếu hoặc chưa biết. DùNULLkhông bằng value nào, trong một số operation database system sẽ xử lý các valueNULLnhư cùng một nhóm, chẳng hạnDISTINCT,GROUP BY,ORDER BY. Cần lưu ý rằng việc xử lý các valueNULLnhư cùng một nhóm không có nghĩa các valueNULLbằng nhau. Chúng chỉ được xử lý đặc biệt trong operation cụ thể để bảo đảm tính đúng đắn và nhất quán của kết quả. Cách xử lý này nhằm thuận tiện cho thao tác dữ liệu, không thay đổi ngữ nghĩa củaNULL.''biểu thị một empty string, là một value đã biết.
- Storage space:
- Storage space của
NULLphụ thuộc vào implementation của database, thường cần một phần space để đánh dấu value này là null. - Storage space của
''thường nhỏ vì chỉ lưu dấu hiệu của empty string, không cần lưu character thực tế.
- Storage space của
- Comparison operation:
- Kết quả so sánh bất kỳ value nào với
NULL(chẳng hạn=,!=,>,<) đều làNULL, biểu thị kết quả không xác định. Muốn kiểm tra một value có phảiNULLhay không, phải dùngIS NULLhoặcIS NOT NULL. ''có thể tham gia comparison operation như các string khác. Ví dụ kết quả của'' = ''làtrue.
- Kết quả so sánh bất kỳ value nào với
- Aggregate function:
- Phần lớn aggregate function (chẳng hạn
SUM,AVG,MIN,MAX) bỏ qua valueNULL. COUNT(*)đếm tất cả row, bao gồm row chứa valueNULL.COUNT(tên_cột)đếm số row có value khácNULLtrong cột được chỉ định.- Empty string
''được aggregate function tính đến. Ví dụ,SUMxem nó là 0, cònMINvàMAXxem nó là empty string.
- Phần lớn aggregate function (chẳng hạn
Sau phần giới thiệu trên, có lẽ bạn đã có câu trả lời cho một câu hỏi phỏng vấn thường gặp khác: “Vì sao MySQL không khuyến nghị dùng NULL làm default value của column?”.
⭐️Boolean type được biểu thị thế nào?
MySQL không có boolean type riêng. BOOL và BOOLEAN là synonym của TINYINT(1), thường dùng 0 biểu thị false, khác 0 biểu thị true. BIT(1) là bit field type, cũng có thể lưu 0 hoặc 1, nhưng không phải mapping thực tế của BOOL/BOOLEAN.
⭐️Nên lưu số điện thoại bằng INT hay VARCHAR?
Khi lưu số điện thoại, đặc biệt khuyến nghị dùng VARCHAR, thay vì INT hoặc BIGINT. Các nguyên nhân chính:
- Tương thích và đầy đủ format:
- Số điện thoại có thể chứa leading zero (chẳng hạn mã vùng điện thoại cố định ở một số khu vực), prefix country code ('+'), thậm chí separator ('-' hoặc space). Numeric type như INT hoặc BIGINT sẽ tự động làm mất các format information quan trọng này (leading zero bị loại bỏ, '+' và '-' không thể lưu).
- VARCHAR có thể lưu nguyên dạng nhiều format number, dù là số điện thoại 11 chữ số trong nước hay international number có country code.
- Không mang tính arithmetic: Dù trông giống number, số điện thoại không được dùng cho mathematical operation (chẳng hạn sum, average). Bản chất nó là một identifier, giống string hơn. Dùng VARCHAR phù hợp với data nature hơn.
- Query linh hoạt:
- Nghiệp vụ thường cần query theo number segment (prefix), chẳng hạn tìm tất cả user bắt đầu bằng
"138". Dùng VARCHAR kết hợp SQL query nhưLIKE '138%'vừa trực quan vừa hiệu quả. - Nếu dùng numeric type, prefix matching tương tự thường cần function conversion phức tạp (như CAST hoặc SUBSTRING), hoặc range query (như
WHERE phone >= 13800000000 AND phone < 13900000000), không chỉ viết dài mà còn có thể không tận dụng index hiệu quả, dẫn đến performance giảm.
- Nghiệp vụ thường cần query theo number segment (prefix), chẳng hạn tìm tất cả user bắt đầu bằng
- Yêu cầu lưu trữ được mã hóa (rất quan trọng):
- Vì yêu cầu data security và privacy compliance, thông tin cá nhân nhạy cảm như số điện thoại thường phải được mã hóa khi lưu trong database.
- Dữ liệu sau mã hóa (ciphertext) là một string dài (thường gồm chữ cái, chữ số, symbol hoặc được encode bằng Base64/Hex), INT hoặc BIGINT hoàn toàn không thể lưu. Chỉ VARCHAR, TEXT hoặc BLOB mới có thể lưu.
Chọn độ dài VARCHAR:
- Nếu không mã hóa (đặc biệt không khuyến nghị!): Xét international number và format symbol có thể có, VARCHAR(20) đến VARCHAR(32) thường là range tương đối an toàn, đủ cho phần lớn format số điện thoại trên toàn cầu. VARCHAR(15) có thể không đủ với một số number có country code và format symbol.
- Nếu lưu trữ được mã hóa (cách làm chuẩn được khuyến nghị): Độ dài phải được tính và thiết lập chính xác theo max length của ciphertext do encryption algorithm đã chọn tạo ra, cùng encoding method có thể dùng (chẳng hạn Base64 làm length tăng khoảng 1/3). Thông thường cần VARCHAR dài hơn, ví dụ VARCHAR(128), VARCHAR(256) hoặc dài hơn.
Cuối cùng, bảng dưới đây tổng hợp các điểm chính:
| Tiêu chí so sánh | VARCHAR type (khuyến nghị) | INT/BIGINT type (không khuyến nghị) | Giải thích/Ghi chú |
|---|---|---|---|
| Tương thích format | ✔ Lưu được leading zero, "+", "-", space | ✘ Tự mất leading zero, không lưu được symbol | VARCHAR lưu nguyên nhiều format số điện thoại, INT/BIGINT chỉ hỗ trợ number thuần và leading zero sẽ mất |
| Tính đầy đủ | ✔ Không mất format information | ✘ Mất format information | Ví dụ "013800012345" lưu vào INT sẽ thành 13800012345, '+' cũng không thể lưu |
| Không mang tính arithmetic | ✔ Phù hợp để lưu “identifier” | ✘ Chỉ phù hợp cho numeric operation | Bản chất số điện thoại là string identifier, không làm mathematical operation, VARCHAR phù hợp hơn |
| Query linh hoạt | ✔ Hỗ trợ LIKE '138%'... | ✘ Prefix query bất tiện hoặc performance kém | VARCHAR có thể query theo number segment/prefix hiệu quả, numeric type cần chuyển thành string hoặc xử lý phức tạp khác |
| Hỗ trợ encrypted storage | ✔ Lưu được encrypted ciphertext (chữ cái, symbol...) | ✘ Không lưu được ciphertext | Ciphertext sau khi mã hóa số điện thoại là string/binary, chỉ VARCHAR, TEXT, BLOB... mới tương thích |
| Đề xuất độ dài | 15~20 (chưa mã hóa), mã hóa tùy trường hợp | Không có ý nghĩa | Khi chưa mã hóa, VARCHAR(15~20) dùng chung; khi mã hóa, length phụ thuộc algorithm và encoding method |
MySQL basic architecture
Nên đọc cùng bài Quy trình thực thi SQL statement trong MySQL để hiểu MySQL basic architecture. Ngoài ra, “flow thực thi một SQL statement trong MySQL” cũng là câu hỏi khá thường gặp khi phỏng vấn.
Hình dưới đây là architecture diagram đơn giản của MySQL, giúp bạn thấy rõ một SQL statement từ client được thực thi bên trong MySQL như thế nào.

Từ hình trên có thể thấy MySQL chủ yếu gồm các phần sau:
- Connector: authentication và permission (khi login MySQL).
- Query cache: khi thực thi query statement, trước tiên sẽ query cache (đã bị loại bỏ từ MySQL 8.0 vì tính năng này không thực sự hữu ích).
- Analyzer: nếu không hit cache, SQL statement đi qua analyzer. Nói đơn giản, analyzer trước hết xem SQL statement muốn làm gì, sau đó kiểm tra syntax của SQL statement có đúng hay không.
- Optimizer: thực thi theo solution mà MySQL cho là tối ưu nhất.
- Executor: thực thi statement rồi trả data từ storage engine. Trước khi thực thi statement, executor kiểm tra permission; nếu không có permission sẽ báo lỗi.
- Pluggable storage engine: chủ yếu phụ trách lưu trữ và đọc data, dùng pluggable architecture, hỗ trợ nhiều storage engine như InnoDB, MyISAM và Memory. InnoDB là default storage engine của MySQL; trong phần lớn use case, InnoDB là lựa chọn tốt nhất.
MySQL storage engine
Cốt lõi của MySQL nằm ở storage engine. Muốn học sâu MySQL, nhất định phải nghiên cứu sâu storage engine của MySQL.
MySQL hỗ trợ những storage engine nào? Mặc định dùng engine nào?
MySQL hỗ trợ nhiều storage engine. Bạn có thể dùng command SHOW ENGINES để xem tất cả storage engine mà MySQL hỗ trợ.
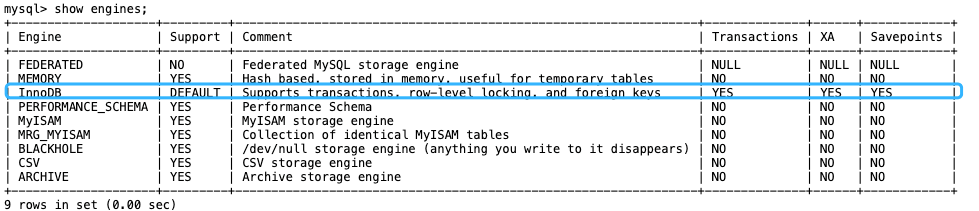
Từ hình trên có thể thấy storage engine mặc định hiện tại của MySQL là InnoDB. Trong tất cả storage engine, chỉ InnoDB là transactional storage engine, nghĩa là chỉ InnoDB hỗ trợ transaction.
MySQL được dùng trong bài viết này là version 8.x. Các MySQL version khác nhau có thể có khác biệt.
Trước MySQL 5.5.5, MyISAM là default storage engine của MySQL. Từ version 5.5.5 trở đi, InnoDB là default storage engine của MySQL.
Bạn có thể dùng command SELECT VERSION() để xem MySQL version.
mysql> SELECT VERSION();
+-----------+
| VERSION() |
+-----------+
| 8.0.27    |
+-----------+
1 row in set (0.00 sec)
Bạn cũng có thể dùng command SHOW VARIABLES LIKE '%storage_engine%' để xem trực tiếp default storage engine hiện tại của MySQL.
mysql> SHOW VARIABLES  LIKE '%storage_engine%';
+---------------------------------+-----------+
| Variable_name                   | Value     |
+---------------------------------+-----------+
| default_storage_engine          | InnoDB    |
| default_tmp_storage_engine      | InnoDB    |
| disabled_storage_engines        |           |
| internal_tmp_mem_storage_engine | TempTable |
+---------------------------------+-----------+
4 rows in set (0.00 sec)
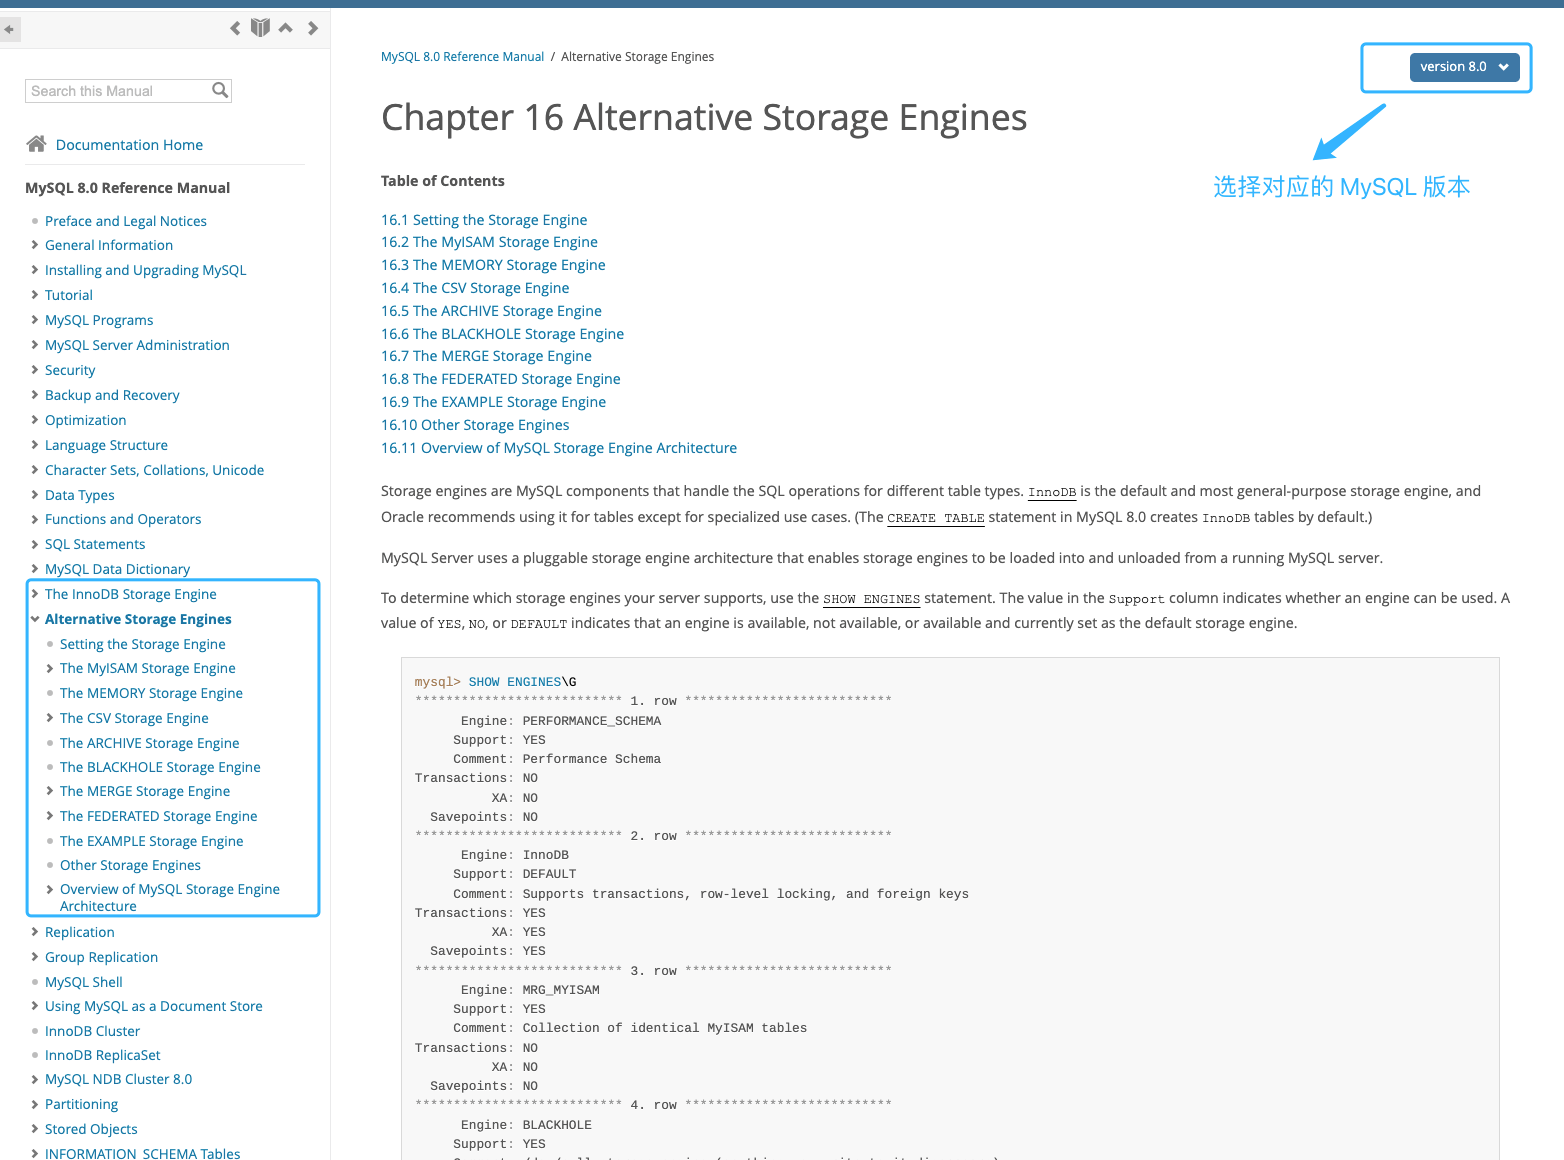
Nếu muốn hiểu sâu từng storage engine và khác biệt giữa chúng, bạn có thể đọc phần giới thiệu tương ứng trong tài liệu chính thức của MySQL (phỏng vấn không hỏi chi tiết đến vậy, chỉ cần biết):
- Giới thiệu chi tiết về InnoDB storage engine: https://dev.mysql.com/doc/refman/8.0/en/innodb-storage-engine.html .
- Giới thiệu chi tiết về các storage engine khác: https://dev.mysql.com/doc/refman/8.0/en/storage-engines.html .
Bạn biết gì về storage engine architecture của MySQL?
MySQL dùng pluggable architecture cho storage engine, hỗ trợ nhiều storage engine. Thậm chí có thể thiết lập storage engine khác nhau cho các database table khác nhau để đáp ứng use case khác nhau. Storage engine dựa trên table, không phải database.
Hình dưới đây thể hiện MySQL architecture có pluggable storage engine:
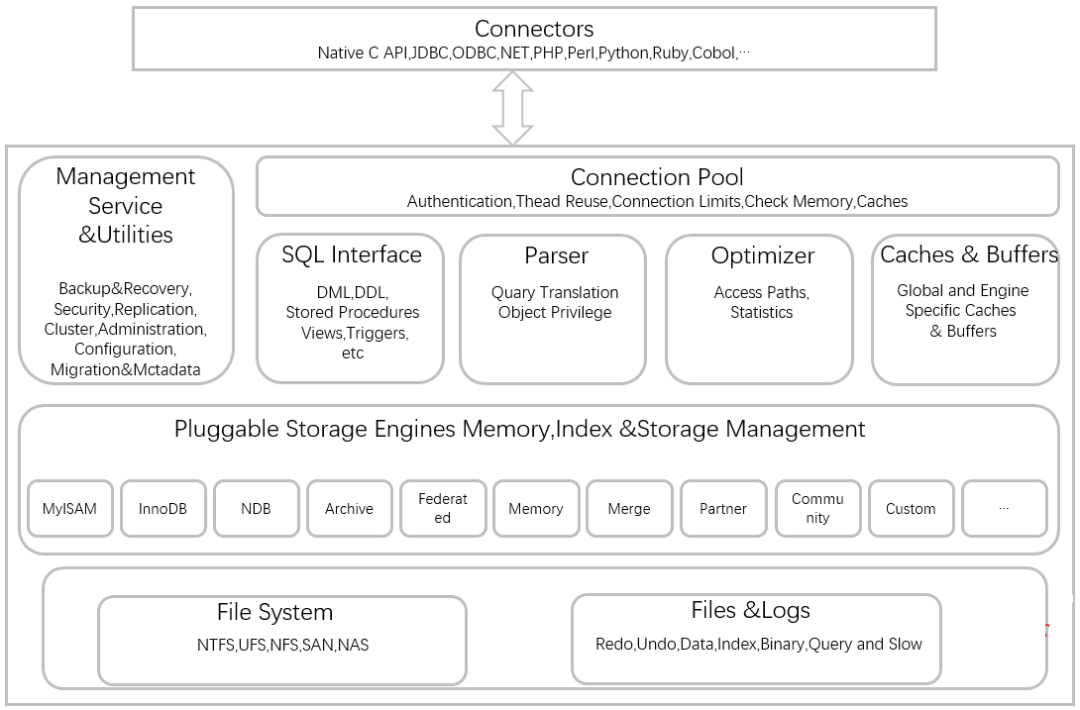
Bạn cũng có thể dựa trên standard interface do MySQL định nghĩa để implement storage engine của riêng mình. Các storage engine không do official cung cấp có thể gọi là third-party storage engine, khác với official storage engine. InnoDB được dùng phổ biến hiện nay thực ra ban đầu cũng là third-party storage engine; sau đó nhờ quá tốt nên được Oracle mua lại trực tiếp.
Tài liệu chính thức của MySQL cũng giới thiệu cách viết custom storage engine, tại: https://dev.mysql.com/doc/internals/en/custom-engine.html .
⭐️MyISAM và InnoDB khác nhau thế nào?
Trước MySQL 5.5, MyISAM engine là default storage engine của MySQL và từng có thời kỳ rất nổi bật.
Mặc dù performance của MyISAM khá ổn và có nhiều feature tốt (chẳng hạn full-text index, compression, spatial function), MyISAM không hỗ trợ transaction và row-level lock; khuyết điểm lớn nhất là sau crash không thể recovery an toàn.
Sau MySQL 5.5, InnoDB là default storage engine của MySQL.
Quay lại vấn đề chính, hãy cùng so sánh đơn giản hai engine:
1. Có hỗ trợ row-level lock không
MyISAM chỉ có table-level lock (table-level locking), còn InnoDB hỗ trợ row-level lock (row-level locking) và table-level lock, mặc định là row-level lock.
Nói cách khác, MyISAM lock một lần là lock cả table, điều này rất tệ khi concurrent write! Đây cũng là lý do performance của InnoDB tốt hơn khi concurrent write.
2. Có hỗ trợ transaction không
MyISAM không hỗ trợ transaction.
InnoDB hỗ trợ transaction, implement bốn isolation level được SQL standard định nghĩa, có khả năng commit (commit) và rollback (rollback) transaction. Ngoài ra, isolation level REPEATABLE-READ (repeatable read) mặc định của InnoDB có thể giải quyết phantom read (dựa trên MVCC và Next-Key Lock).
Để xem giới thiệu chi tiết về MySQL transaction, có thể đọc bài viết: Giải thích chi tiết isolation level của MySQL transaction.
3. Có hỗ trợ foreign key không
MyISAM không hỗ trợ, còn InnoDB hỗ trợ.
Foreign key hữu ích cho việc duy trì data consistency, nhưng gây tổn hao nhất định cho performance. Vì vậy, trong trường hợp thông thường, không khuyến nghị dùng foreign key trong production project; có thể constraint trong business code!
《Java Development Manual》 của Alibaba cũng quy định rõ là cấm dùng foreign key.
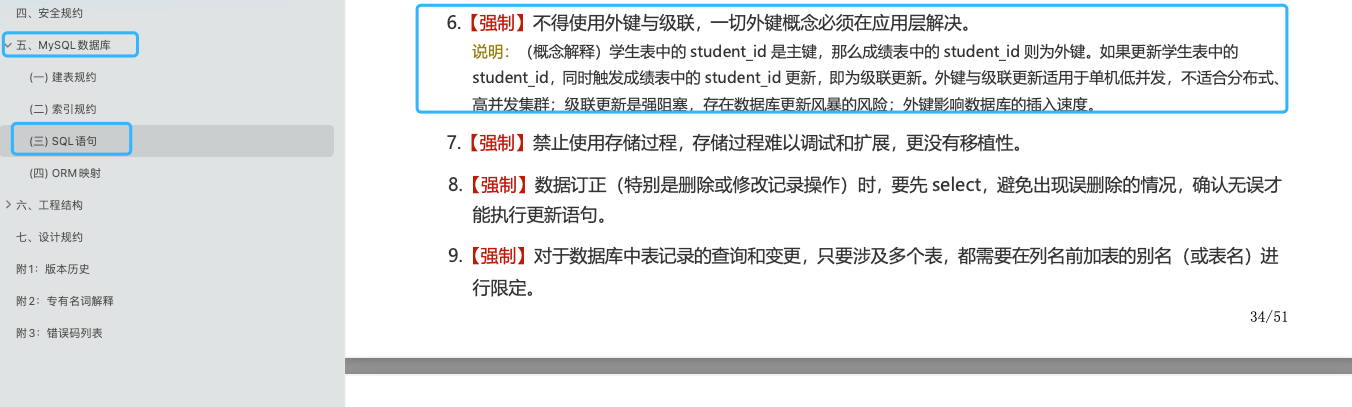
Tuy nhiên, nếu constraint trong code, yêu cầu đối với năng lực của developer sẽ cao hơn. Việc có dùng foreign key hay không cần dựa trên tình hình thực tế của project.
Tóm lại: nhìn chung không khuyến nghị dùng foreign key ở database layer; application layer có thể giải quyết. Tuy nhiên, cách này sẽ đe dọa data consistency. Có nên dùng foreign key hay không vẫn cần quyết định theo project cụ thể.
4. Có hỗ trợ safe recovery sau database crash bất thường không
MyISAM không hỗ trợ, còn InnoDB hỗ trợ.
Sau khi database dùng InnoDB crash bất thường rồi khởi động lại, database sẽ bảo đảm khôi phục về trạng thái trước crash. Quá trình recovery này phụ thuộc vào redo log.
5. Có hỗ trợ MVCC không
MyISAM không hỗ trợ, còn InnoDB hỗ trợ.
Nói thật, so sánh này hơi thừa vì MyISAM còn không hỗ trợ row-level lock. Có thể xem MVCC là một nâng cấp của row-level lock, giúp giảm lock operation và cải thiện performance.
6. Cách implement index khác nhau.
MyISAM engine và InnoDB engine đều dùng B+Tree làm index structure, nhưng cách implement không giống nhau.
Trong InnoDB engine, data file bản thân là index file. Khác với MyISAM, index file và data file tách rời; table data file của InnoDB bản thân là một index structure được tổ chức theo B+Tree, data field của leaf node lưu full data record.
Để xem khác biệt chi tiết, có thể đọc bài viết: Giải thích chi tiết MySQL index.
7. Performance khác nhau.
Performance của InnoDB mạnh hơn MyISAM. Dù ở read/write mixed mode hay read-only mode, khi số CPU core tăng, read/write capability của InnoDB tăng tuyến tính. Vì read và write của MyISAM không thể concurrent, processing capability không liên quan đến số core.
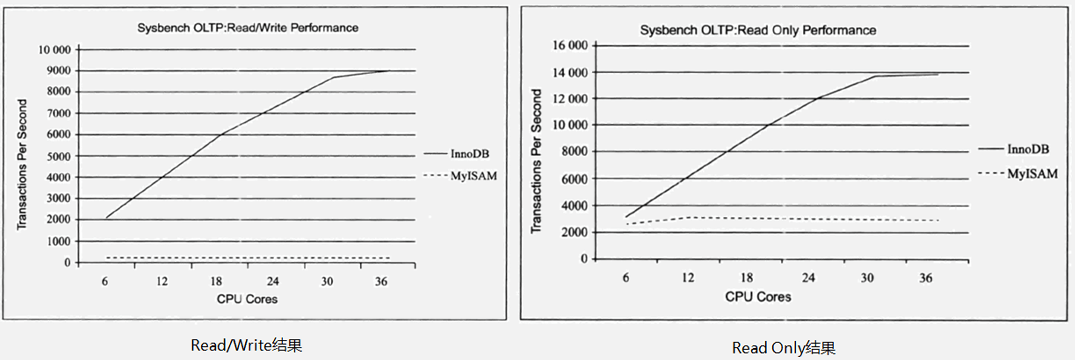
8. Caching strategy và mechanism của data khác nhau.
InnoDB dùng buffer pool (Buffer Pool) để cache data page và index page; MyISAM dùng key cache (Key Cache), chỉ cache index page chứ không cache data page.
Tóm tắt:
- InnoDB hỗ trợ lock granularity ở row level, MyISAM không hỗ trợ mà chỉ hỗ trợ lock granularity ở table level.
- MyISAM không hỗ trợ transaction. InnoDB hỗ trợ transaction và implement bốn isolation level được SQL standard định nghĩa.
- MyISAM không hỗ trợ foreign key, còn InnoDB hỗ trợ.
- MyISAM không hỗ trợ MVCC, còn InnoDB hỗ trợ.
- MyISAM và InnoDB đều dùng B+Tree làm index structure, nhưng cách implement không giống nhau.
- MyISAM không hỗ trợ safe recovery sau database crash bất thường, còn InnoDB hỗ trợ.
- Performance của InnoDB mạnh hơn MyISAM.
Cuối cùng, đây là một hình ảnh so sánh chi tiết một số MySQL storage engine phổ biến:
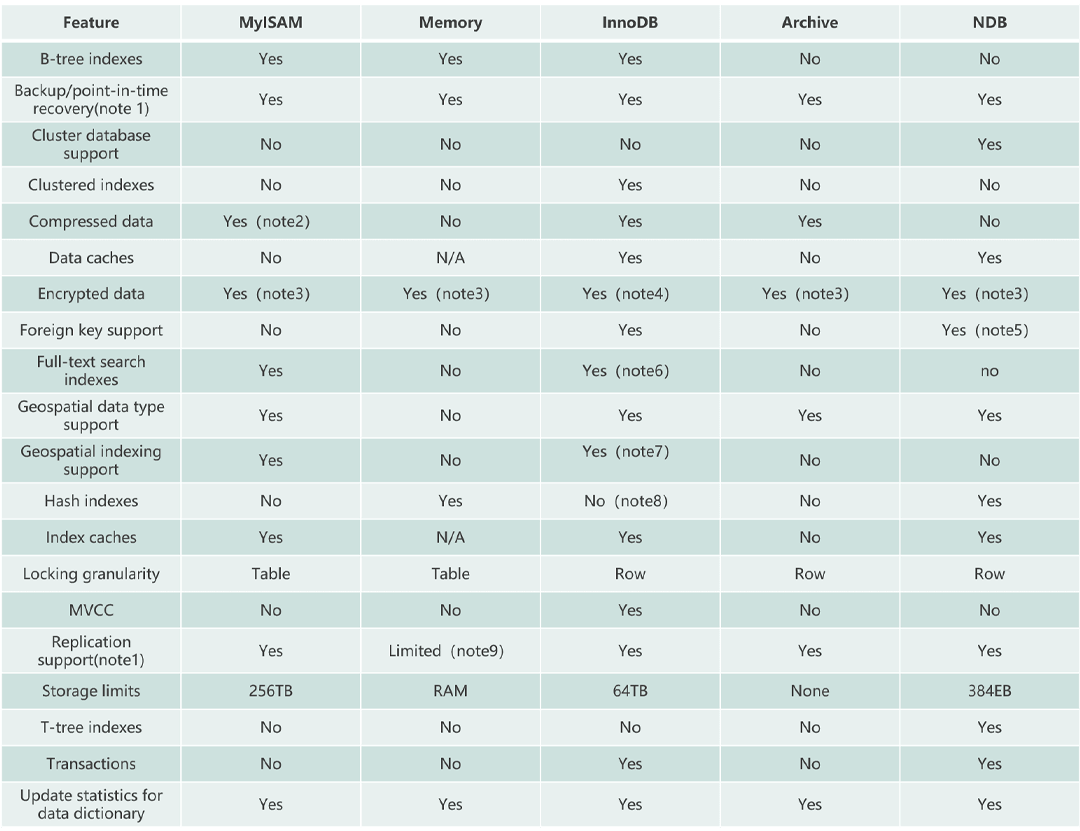
Nên chọn MyISAM hay InnoDB?
Phần lớn thời gian chúng ta dùng InnoDB storage engine. Trong một số trường hợp read-intensive, dùng MyISAM cũng phù hợp. Tuy nhiên, điều kiện là project không ngại các khuyết điểm như MyISAM không hỗ trợ transaction và crash recovery (nhưng thông thường chúng ta đều ngại).
《High Performance MySQL》 có một câu như sau:
Đừng dễ dàng tin vào kinh nghiệm như “MyISAM nhanh hơn InnoDB”. Kết luận này thường không tuyệt đối. Trong nhiều use case đã biết, tốc độ của InnoDB có thể bỏ xa MyISAM, đặc biệt khi dùng clustered index hoặc khi data cần truy cập đều có thể đặt trong memory.
Vì vậy, với business system trong phát triển hằng ngày, gần như không có lý do để dùng MyISAM. Cứ dùng InnoDB mặc định là được!
⭐️MySQL index
Các câu hỏi liên quan đến MySQL index khá nhiều và cũng rất quan trọng. Để xem giới thiệu chi tiết hơn, có thể đọc bài viết: Giải thích chi tiết MySQL index .
Index là gì?
Index là một data structure dùng để query và retrieve data nhanh, bản chất có thể xem là một data structure đã được sort.
Tác dụng của index tương đương mục lục của sách. Ví dụ khi tra từ điển, nếu không có mục lục, ta chỉ có thể tìm từ cần tra từng trang một, tốc độ rất chậm; nếu có mục lục, ta chỉ cần tìm vị trí của từ trong mục lục rồi lật trực tiếp đến trang đó.
Có nhiều loại index data structure ở tầng dưới. Các index structure thường gặp gồm B tree, B+ tree, Hash và red-black tree. Trong MySQL, dù là InnoDB hay MyISAM, đều dùng B+ tree làm index structure.
Ưu điểm của index:
- Tốc độ query tăng mạnh (mục đích chính): Nhờ index, database có thể giảm đáng kể lượng data cần scan, trực tiếp định vị record phù hợp điều kiện, từ đó tăng rõ rệt tốc độ data retrieval và giảm số lần disk I/O.
- Bảo đảm data uniqueness: Bằng cách tạo unique index, có thể bảo đảm value của một column (hoặc tổ hợp nhiều column) trong table là duy nhất, chẳng hạn user ID và email. Primary key bản thân là một unique index.
- Tăng tốc sorting và grouping: Nếu column trong mệnh đề ORDER BY hoặc GROUP BY của query có index, database thường có thể tận dụng đặc tính đã được sort của index để tránh sorting bổ sung, từ đó cải thiện performance.
Nhược điểm của index:
- Tạo và maintain tốn thời gian: Bản thân việc tạo index cần thời gian, đặc biệt khi thao tác trên large table. Quan trọng hơn, khi insert, delete, update (DML operation) data trong table, không chỉ data cần được thao tác mà index liên quan cũng phải được update và maintain động, làm giảm execution efficiency của các DML operation này.
- Chiếm storage space: Bản chất index cũng là một data structure, cần lưu dưới dạng physical file (hoặc memory structure), nên chiếm thêm một phần disk space. Càng nhiều và càng lớn index, space chiếm dụng càng lớn.
- Có thể bị dùng sai hoặc mất hiệu lực: Nếu index design không phù hợp hoặc query statement viết không tốt, database optimizer có thể không chọn dùng index (hoặc chọn sai index), ngược lại làm performance giảm.
Vậy dùng index có chắc chắn cải thiện query performance không?
Không chắc. Trong phần lớn trường hợp, dùng index hợp lý nhanh hơn nhiều so với full table scan. Nhưng cũng có ngoại lệ:
- Data quá ít: Nếu data trong table rất ít (chẳng hạn chỉ vài trăm row), full table scan có thể nhanh hơn việc tìm qua index vì bản thân việc đi qua index cũng có overhead.
- Tỷ lệ query result set quá lớn: Nếu data cần query chiếm phần lớn table (chẳng hạn hơn 20%-30%), optimizer có thể cho rằng full table scan có lợi hơn vì chi phí nhiều lần quay lại table qua index (random I/O) có thể cao hơn một lần full table scan tuần tự.
- Index maintain không đúng hoặc statistics cũ: Khiến optimizer đưa ra phán đoán sai.
Vì sao index nhanh?
Lý do cốt lõi khiến index nhanh là nó giảm đáng kể số lần disk I/O.
Bản chất của nó là một data structure đã được sort, giống mục lục sách, giúp ta không phải lật từng trang một (full table scan).
Trong MySQL, data structure này là B+ tree. B+ tree được tối ưu chủ yếu ở hai phương diện:
- Đặc điểm của B+ tree là “thấp và rộng”. Với table có mười triệu data, height của index tree có thể chỉ 3-4 tầng. Điều này có nghĩa là chỉ cần tối đa 3-4 lần disk I/O để định vị chính xác data cần tìm, trong khi full table scan có thể cần hàng nghìn, hàng vạn lần, nên tốc độ rất nhanh.
- Leaf node của B+ tree được liên kết bằng linked list. Sau khi tìm được điểm bắt đầu, có thể đọc tuần tự theo linked list. Điều này rất thân thiện với disk và còn có thể trigger prefetch.
Data structure ở tầng dưới của MySQL index là gì?
Trong MySQL, MyISAM engine và InnoDB engine đều dùng B+Tree làm index structure. Có thể tham khảo bài viết: Giải thích chi tiết MySQL index.
Vì sao InnoDB không dùng hash làm index data structure?
Tôi phát hiện nhiều ứng viên, thậm chí interviewer, đều hiểu sai câu hỏi này. Họ mặc định cho rằng tầng dưới của MySQL không dùng hash hoặc B tree làm index data structure.
Thực tế, khi hỏi hoặc trả lời câu hỏi này phải phân biệt rõ storage engine. Chẳng hạn MEMORY engine đồng thời hỗ trợ hash và B tree.
Tầng dưới của hash index là hash table. Ưu điểm của nó là khi exact equality query, time complexity về lý thuyết là O(1), tốc độ cực nhanh. Ví dụ WHERE id = 123.
Tuy nhiên, nó có một số khuyết điểm nghiêm trọng đối với database dùng chung:
- Không hỗ trợ range query: Đây là nguyên nhân chính. Đặc điểm của hash function là ánh xạ các input value gần nhau (chẳng hạn
id=100vàid=101) vào các vị trí hoàn toàn không gần nhau trong hash table. Việc phá vỡ thứ tự này khiến ta không thể xử lý range query nhưWHERE age > 30hoặcBETWEEN 100 AND 200. Muốn hoàn thành query này, hash index chỉ có thể suy biến thành full table scan. - Không hỗ trợ sorting: Tương tự, vì hash value không có thứ tự nên không thể dùng hash index để tối ưu mệnh đề
ORDER BY. - Không hỗ trợ query một phần index key: Với composite index như
(col1, col2), hash index phải dùng tất cả index column để query, không thể dùng riêngcol1để tăng tốc query. - Hash collision: Khi các key khác nhau tạo ra cùng hash value, cần dùng linked list hoặc open addressing bổ sung để xử lý, làm performance giảm.
Vì range query và sorting cực kỳ phổ biến trong database query, một index structure không hỗ trợ các feature này rõ ràng không thể làm index type mặc định, dùng chung.
Vì sao InnoDB không dùng B tree làm index data structure?
B tree và B+ tree đều là multiway balanced search tree tốt, rất phù hợp với disk storage vì đều “thấp và rộng”, có thể tận dụng tối đa mỗi lần disk I/O.
Nhưng B+ tree là phiên bản cải tiến của B tree, được tối ưu một số điểm quan trọng cho database scenario:
- I/O efficiency cao hơn: Trong B+ tree, chỉ leaf node lưu data (hoặc data pointer), non-leaf node chỉ lưu index key. Vì non-leaf node không lưu data nên có thể chứa nhiều index key hơn. Điều này khiến “fan-out” của B+ tree lớn hơn. Với cùng lượng data, B+ tree thường thấp hơn B tree, nghĩa là số lần disk I/O cần để tìm data ít hơn.
- Query performance ổn định hơn: Trong B+ tree, mọi query đều phải đi từ root node đến leaf node mới tìm được data, nên độ dài query path cố định. Trong B tree, nếu may mắn có thể tìm thấy data ở non-leaf node, nếu không vẫn phải đi đến leaf, khiến query performance không ổn định.
- Cực kỳ phù hợp với range query: Đây là ưu điểm cốt lõi của B+ tree. Tất cả leaf node được nối với nhau bằng doubly linked list. Khi thực hiện range query (chẳng hạn
WHERE id > 100), chỉ cần dùng tree structure tìm leaf node củaid=100, sau đó scan tuần tự về sau theo linked list mà không cần quay lại upper node. Nhờ vậy, efficiency của range query tăng đáng kể.
Covering index là gì?
Nếu một index chứa (hay nói cách khác là cover) value của tất cả field cần query, ta gọi đó là covering index.
Trong InnoDB storage engine, leaf node của non-primary-key index chứa value của primary key. Điều này có nghĩa khi query bằng non-primary-key index, database trước tiên tìm primary key tương ứng, sau đó dùng primary key index để định vị và retrieve full row data. Quá trình này gọi là “quay lại table”.
Nếu field cần query vừa đúng là field của index thì covering index có thể trực tiếp lấy data theo index đó mà không cần quay lại table.
Hãy giải thích composite index của MySQL và leftmost-prefix principle
Dùng nhiều field trong table để tạo index gọi là composite index, còn gọi là combined index hoặc compound index.
Tạo composite index bằng hai field score và name:
ALTER TABLE `cus_order` ADD INDEX id_score_name(score, name);Leftmost-prefix matching principle nghĩa là khi dùng composite index, MySQL sẽ dựa theo thứ tự field trong index, lần lượt match từ trái sang phải với field trong query condition. Nếu query condition match field ngoài cùng bên trái của index, MySQL sẽ dùng index để filter data, từ đó cải thiện query efficiency.
Leftmost matching principle sẽ tiếp tục match sang phải cho đến khi gặp range query (như >, <). Với range query dùng >=, <=, BETWEEN và prefix matching LIKE, việc match không dừng lại (bài đọc thêm: Một kết luận sai về leftmost matching principle của composite index đang được nói khắp nơi).
Giả sử có composite index (column1, column2, column3), tất cả prefix từ trái sang phải của nó là (column1), (column1, column2), (column1, column2, column3) (tạo 1 composite index tương đương tạo 3 index). Mọi query chứa các column này đều dùng index thay vì full table scan.
Khi dùng composite index, có thể đặt field có độ phân biệt cao ở ngoài cùng bên trái để filter nhiều data hơn.
Sau đây là demo đơn giản về hiệu quả của leftmost-prefix matching.
- Tạo table tên
student, table này chỉ có 3 fieldid,name,class.
CREATE TABLE `student` (
  `id` int NOT NULL,
  `name` varchar(100) DEFAULT NULL,
  `class` varchar(100) DEFAULT NULL,
  PRIMARY KEY (`id`),
  KEY `name_class_idx` (`name`,`class`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;- Lần lượt test ba SQL statement khác nhau.
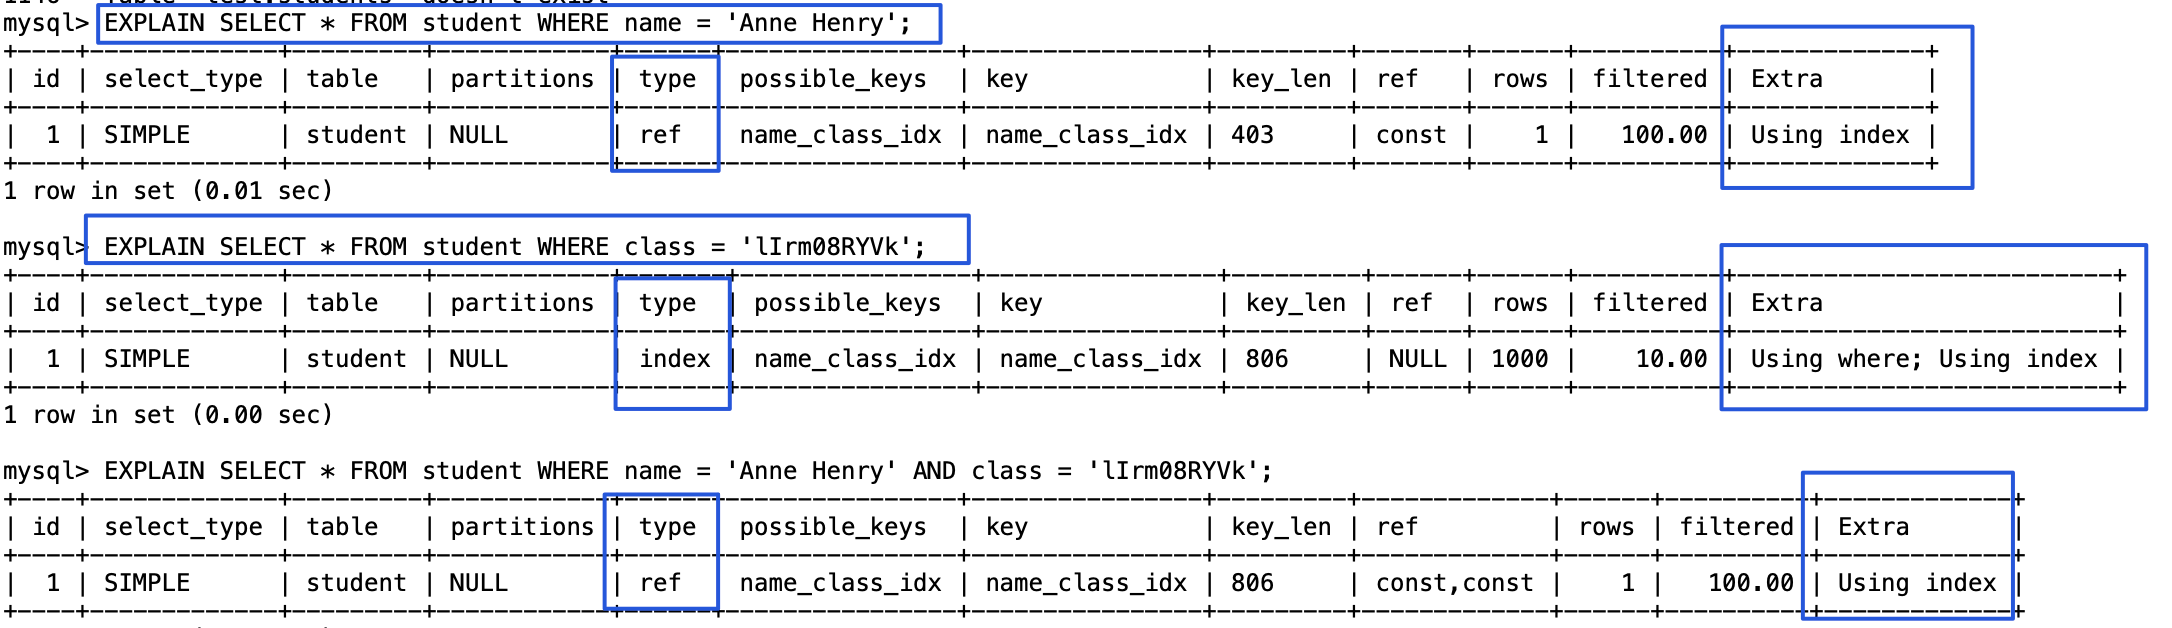
# Có thể hit index
SELECT * FROM student WHERE name = 'Anne Henry';
EXPLAIN SELECT * FROM student WHERE name = 'Anne Henry' AND class = 'lIrm08RYVk';
# Không thể hit index
SELECT * FROM student WHERE class = 'lIrm08RYVk';
Xét thêm một câu hỏi phỏng vấn thường gặp: nếu có composite index (a, b, c), query a=1 AND c=1 có dùng index không? Còn c=1? b=1 AND c=1? b = 1 AND a = 1 AND c = 1?
Đừng xem đáp án ngay, hãy tự suy nghĩ 3 phút.
- Query
a=1 AND c=1: Theo leftmost-prefix matching principle, query có thể dùng phần prefix của index. Vì vậy query này chỉ dùng index trêna=1, sau đó filter kết quả theoc=1. - Query
c=1: Vì query không chứa leftmost columna, theo leftmost-prefix matching principle, toàn bộ index không thể được dùng. - Query
b=1 AND c=1: Tương tự trường hợp thứ hai, toàn bộ index không được dùng. - Query
b=1 AND a=1 AND c=1: Query này có thể dùng index. Khi phân tích SQL statement, query optimizer sẽ reorder query condition của composite index để dùng được index. Điều kiệnb=1vàa=1sẽ được reorder thànha=1 AND b=1 AND c=1.
MySQL 8.0.13 giới thiệu index skip scan (Index Skip Scan, viết tắt ISS), có thể cải thiện query efficiency trong một số index query scenario. Trước ISS, composite-index query không thỏa leftmost-prefix matching principle sẽ full table scan. ISS cho phép MySQL tránh full table scan trong một số trường hợp, ngay cả khi query condition không thỏa leftmost-prefix. Tuy nhiên, feature này khá ít tác dụng, không thể so với Oracle; MySQL 8.0.31 còn báo một bug: Bug #109145 Using index for skip scan cause incorrect result (đã được sửa ở version sau). Theo tôi, chỉ cần biết có feature này là được, không cần đào sâu; project thực tế chưa chắc dùng đến.
SELECT * có làm index mất hiệu lực không?
SELECT * không trực tiếp làm index mất hiệu lực (nếu không dùng index thì phần lớn nguyên nhân là where query range quá lớn), nhưng có thể gây một số vấn đề performance khác, chẳng hạn lãng phí network transmission và data processing, không thể dùng covering index.
Field nào phù hợp để tạo index?
- Field không NULL: Data của index field nên cố gắng không là NULL vì database khó tối ưu field có data là NULL. Nếu field thường xuyên được query nhưng không thể tránh NULL, khuyến nghị dùng short value hoặc short character có ngữ nghĩa rõ như 0, 1, true, false để thay thế.
- Field được query thường xuyên: Field tạo index nên là field được query rất thường xuyên.
- Field được dùng làm query condition: Field được dùng làm WHERE condition nên được cân nhắc tạo index.
- Field thường xuyên cần sorting: Index đã được sort, query có thể tận dụng thứ tự của index để tăng tốc sorting query.
- Field thường xuyên dùng cho join: Field thường dùng để join có thể là foreign key column. Với foreign key column không nhất thiết phải tạo foreign key; ở đây chỉ nói column đó liên quan đến quan hệ giữa các table. Với field thường xuyên được join query, có thể cân nhắc tạo index để cải thiện efficiency của multi-table join query.
Những nguyên nhân nào khiến index mất hiệu lực?
- Tạo composite index nhưng query condition không tuân thủ leftmost matching principle;
- Thực hiện calculation, function, type conversion... trên index column;
- LIKE query bắt đầu bằng %, chẳng hạn
LIKE '%abc';; - Dùng OR trong query condition, trong đó một column ở trước hoặc sau OR không có index, khiến các index liên quan đều không được dùng;
- Khi range value của IN quá lớn, index có thể mất hiệu lực và thực hiện full table scan (NOT IN và IN có scenario mất hiệu lực giống nhau);
- Xảy ra implicit conversion.
MySQL query cache
MySQL query cache là cache của query result. Khi thực thi query statement, trước tiên sẽ query cache; nếu cache có query result tương ứng thì trả về trực tiếp.
Thêm cấu hình sau vào my.cnf, rồi restart MySQL để bật query cache:
query_cache_type=1
query_cache_size=600000
MySQL cũng có thể bật query cache bằng các command sau:
set global  query_cache_type=1;
set global  query_cache_size=600000;
Khi query condition và data giống nhau, query cache trả trực tiếp result từ cache. Tuy nhiên cần chú ý rằng điều kiện match của query cache rất chặt; mọi khác biệt nhỏ đều khiến cache miss. Query condition ở đây bao gồm query statement, database đang sử dụng và các yếu tố khác có thể ảnh hưởng result, như protocol version của client.
Các trường hợp query cache miss:
- Hai query khác nhau ở bất kỳ character nào cũng khiến cache miss.
- Nếu query chứa bất kỳ user-defined function, stored function, user variable, temporary table hoặc system table trong MySQL, query result cũng không được cache.
- Sau khi cache được tạo, query cache system của MySQL theo dõi từng table liên quan trong query. Nếu data hoặc structure của các table này thay đổi, toàn bộ cache data liên quan đến table sẽ mất hiệu lực.
Cache có thể cải thiện query performance của database, nhưng đồng thời tạo thêm overhead: sau mỗi query phải thực hiện một lần cache operation, sau khi mất hiệu lực còn phải destroy. Vì vậy cần thận trọng khi bật query cache, đặc biệt với write-intensive application. Nếu bật, cần kiểm soát hợp lý cache space; nhìn chung vài chục MB là phù hợp. Ngoài ra, có thể dùng sql_cache và sql_no_cache để kiểm soát một query statement có cần cache hay không:
SELECT sql_no_cache COUNT(*) FROM usr;Từ MySQL 5.6, query cache mặc định bị disable. Từ MySQL 8.0, query cache không còn được support (có thể tham khảo bài viết: MySQL 8.0: Retiring Support for the Query Cache).
⭐️MySQL log
Câu trả lời cho các vấn đề trên có thể tìm thấy trong phần “Câu hỏi phỏng vấn kỹ thuật” của 《Java Interview Guide》 (trả phí, click link để nhận ưu đãi).
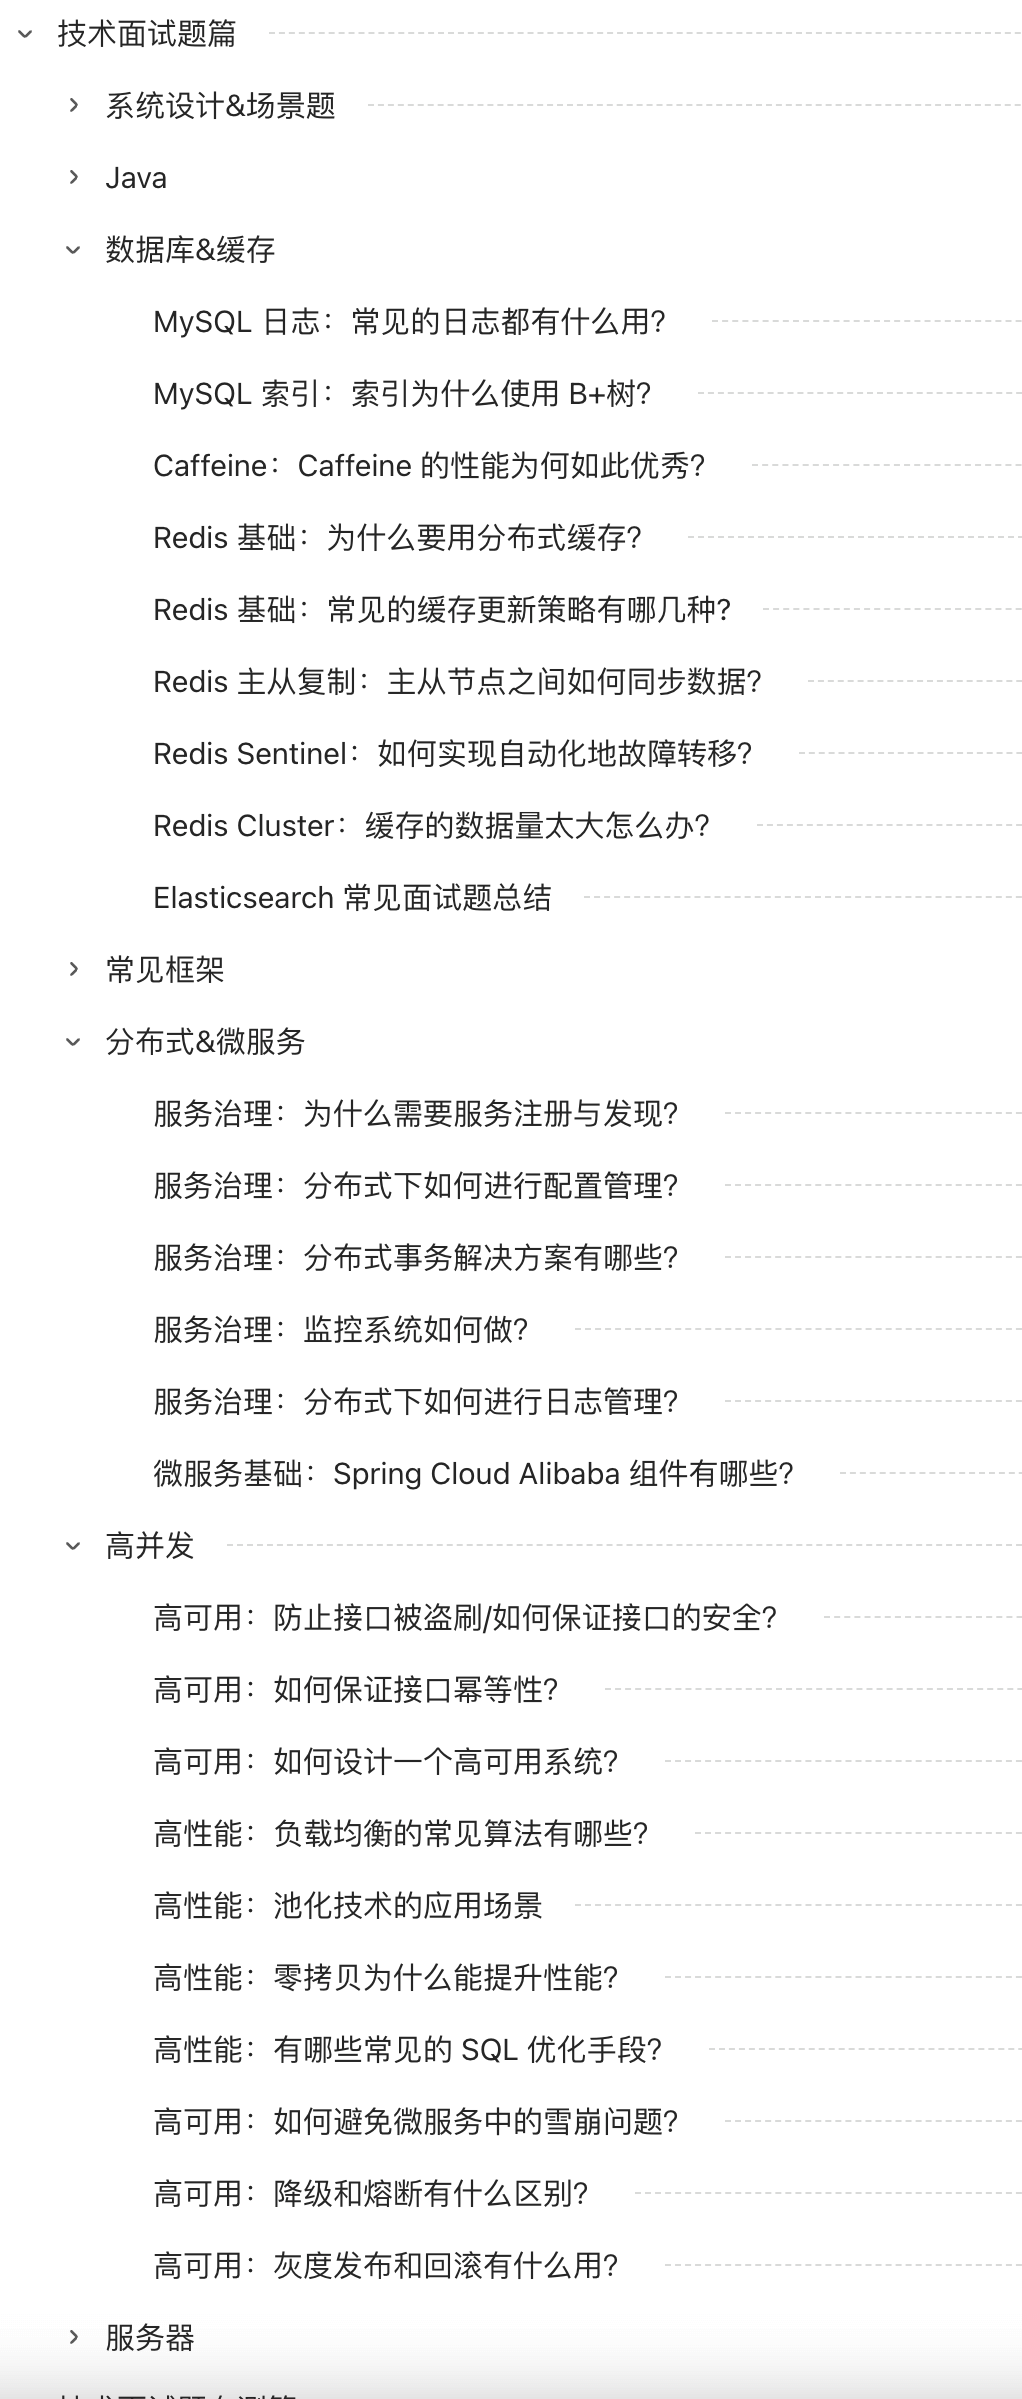
Địa chỉ bài viết: https://www.yuque.com/snailclimb/mf2z3k/zr4kfk (cách lấy password: https://t.zsxq.com/avfM0).
⭐️MySQL transaction
Transaction là gì?
Hãy hình dung một scenario: cần insert nhiều data liên quan vào database, nhưng không may quá trình này có thể gặp các vấn đề sau:
- Database đột nhiên down giữa chừng vì một nguyên nhân nào đó.
- Client đột nhiên không thể connect database do vấn đề network.
- Khi concurrent access database, nhiều thread đồng thời write database và overwrite thay đổi của nhau.
- …
Bất kỳ vấn đề nào ở trên cũng có thể khiến data không consistency. Để bảo đảm data consistency, system phải có khả năng xử lý các vấn đề này. Transaction là cơ chế được abstraction để đơn giản hóa các vấn đề trên. Khái niệm transaction bắt nguồn từ database, hiện đã trở thành một khái niệm được dùng rộng rãi.
Transaction là gì? Nói ngắn gọn, transaction là một nhóm operation về mặt logic, hoặc tất cả cùng thực thi, hoặc không operation nào thực thi.
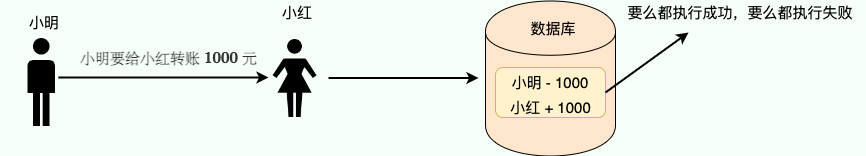
Ví dụ kinh điển và thường được nhắc đến nhất của transaction là chuyển tiền. Giả sử Tiểu Minh chuyển 1000 đồng cho Tiểu Hồng, việc chuyển tiền liên quan đến hai operation quan trọng và hai operation này phải cùng thành công hoặc cùng thất bại.
- Giảm số dư của Tiểu Minh 1000 đồng
- Tăng số dư của Tiểu Hồng 1000 đồng.
Transaction xem hai operation này như một chỉnh thể về mặt logic. Các operation trong chỉnh thể này hoặc cùng thành công, hoặc cùng thất bại. Như vậy sẽ không xảy ra tình trạng số dư của Tiểu Minh giảm nhưng số dư của Tiểu Hồng không tăng.
Database transaction là gì?
Trong phần lớn trường hợp, khi nói về transaction mà không chỉ rõ distributed transaction, ta thường nói đến database transaction.
Database transaction là loại transaction chúng ta tiếp xúc nhiều nhất trong phát triển hằng ngày. Nếu project của bạn dùng monolithic architecture, transaction bạn thường tiếp xúc chính là database transaction.
Database transaction có tác dụng gì?
Nói đơn giản, database transaction bảo đảm nhiều operation trên database (tức SQL statement) tạo thành một chỉnh thể về mặt logic. Các database operation tạo thành chỉnh thể logic này tuân theo quy tắc: hoặc tất cả thực thi thành công, hoặc không operation nào thực thi.
# Bắt đầu một transaction
START TRANSACTION;
# Nhiều SQL statement
SQL1,SQL2...
## Commit transaction
COMMIT;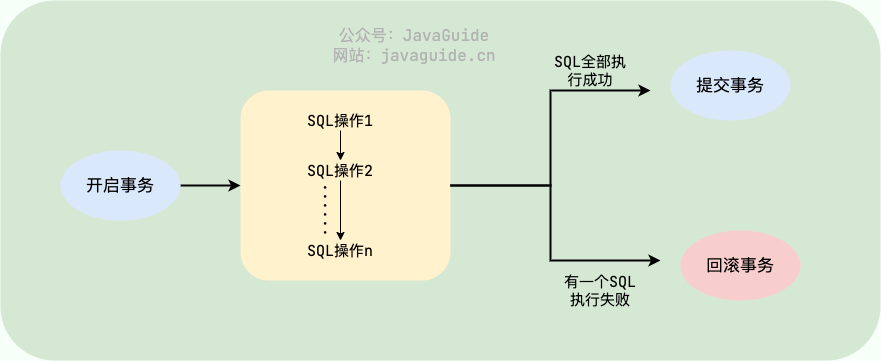
Ngoài ra, transaction của relational database (chẳng hạn MySQL, SQL Server, Oracle) đều có đặc tính ACID:
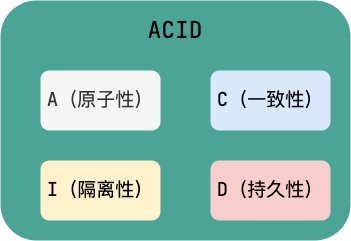
- Atomicity: Transaction là execution unit nhỏ nhất, không được phép tách. Atomicity của transaction bảo đảm operation hoặc hoàn thành toàn bộ, hoặc hoàn toàn không có tác dụng;
- Consistency: Trước và sau khi thực thi transaction, data giữ consistency. Ví dụ trong nghiệp vụ chuyển tiền, dù transaction thành công hay thất bại, tổng tiền của người chuyển và người nhận phải không đổi;
- Isolation: Khi concurrent access database, transaction của một user không bị transaction khác can thiệp; database giữa các concurrent transaction là độc lập;
- Durability: Sau khi transaction commit, thay đổi của nó đối với data trong database là bền vững; ngay cả khi database gặp sự cố cũng không được ảnh hưởng.
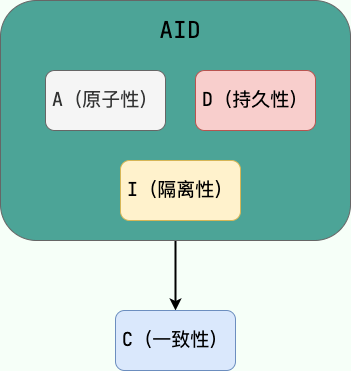
🌈 Bổ sung một điểm: chỉ khi bảo đảm durability, atomicity và isolation của transaction thì consistency mới được bảo đảm. Nói cách khác, A, I, D là phương tiện, C là mục tiêu! Có lẽ nhiều người cũng như tôi đã bị khái niệm ACID dẫn dắt sai trong thời gian dài! Tôi chỉ hiểu rõ điều này sau khi xem public course Software Architecture Course của Zhou Zhiming (hãy đọc thêm sách hay!!!).
Ngoài ra, tác giả của DDIA, tức 《Designing Data-Intensive Application (Thiết kế hệ thống ứng dụng chuyên sâu dữ liệu)》, cũng viết như sau trong sách:
Atomicity, isolation, and durability are properties of the database, whereas consis‐
tency (in the ACID sense) is a property of the application. The application may rely
on the database’s atomicity and isolation properties in order to achieve consistency,
but it’s not up to the database alone.Dịch nghĩa: atomicity, isolation và durability là thuộc tính của database, còn consistency (theo nghĩa ACID) là thuộc tính của application. Application có thể dựa vào atomicity và isolation của database để đạt consistency, nhưng điều này không chỉ phụ thuộc vào database. Vì vậy, chữ C không thuộc ACID.
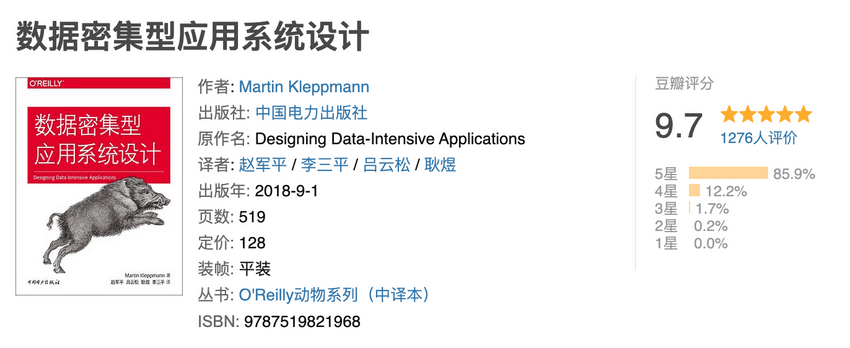
Rất khuyến nghị đọc cuốn 《Designing Data-Intensive Application (Thiết kế hệ thống ứng dụng chuyên sâu dữ liệu)》, cuốn sách đáng đọc nhiều lần! Trên Douban, gần 90% người đọc đã đánh giá năm sao sau khi đọc. Bản dịch tiếng Trung cũng đã open source trên GitHub, địa chỉ: https://github.com/Vonng/ddia.
Concurrent transaction gây ra những vấn đề gì?
Trong application điển hình, nhiều transaction chạy concurrent, thường thao tác trên cùng data để hoàn thành nhiệm vụ riêng (nhiều user thao tác cùng một data). Concurrency là cần thiết, nhưng có thể gây ra các vấn đề sau.
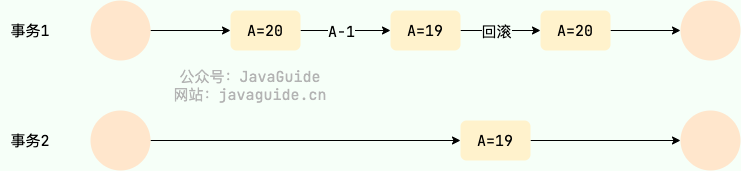
Dirty read
Một transaction read data và sửa data. Thay đổi này visible với transaction khác dù transaction hiện tại chưa commit. Khi đó transaction khác read data chưa commit này, nhưng transaction đầu tiên đột nhiên rollback, khiến data không được commit vào database. Data mà transaction thứ hai read được là dirty data, từ đó có tên dirty read.
Ví dụ: transaction 1 read data trong một table, A=20; transaction 1 sửa A=A-1; transaction 2 read A=19; transaction 1 rollback nên thay đổi A chưa commit vào database, value của A vẫn là 20.
Lost modify
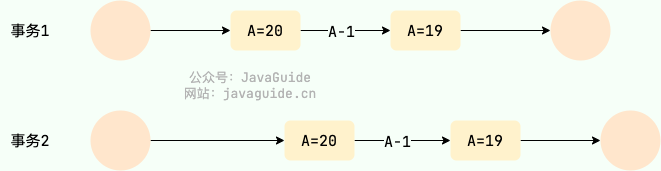
Khi một transaction read data, transaction khác cũng access data đó. Sau khi transaction đầu tiên sửa data, transaction thứ hai cũng sửa data. Kết quả sửa trong transaction đầu tiên bị mất, nên gọi là lost modify.
Ví dụ: transaction 1 read data A=20 trong một table, transaction 2 cũng read A=20; transaction 1 sửa A=A-1 trước, transaction 2 sau đó cũng sửa A=A-1; kết quả cuối cùng A=19, thay đổi của transaction 1 bị mất.
Unrepeatable read
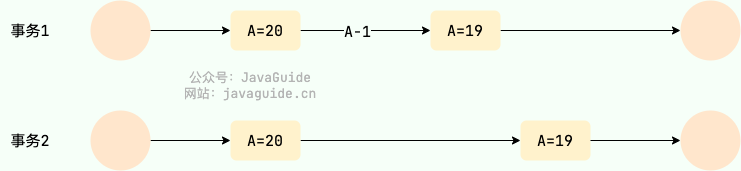
Là việc read cùng một data nhiều lần trong một transaction. Khi transaction này chưa kết thúc, transaction khác cũng access data đó. Vì transaction thứ hai sửa data giữa hai lần read của transaction thứ nhất, kết quả hai lần read data của transaction thứ nhất có thể khác nhau. Tình trạng đọc được data khác nhau trong cùng một transaction được gọi là unrepeatable read.
Ví dụ: transaction 1 read data A=20 trong một table, transaction 2 cũng read A=20; transaction 1 sửa A=A-1; transaction 2 read A=19 lần nữa, kết quả khác lần read đầu tiên.
Phantom read
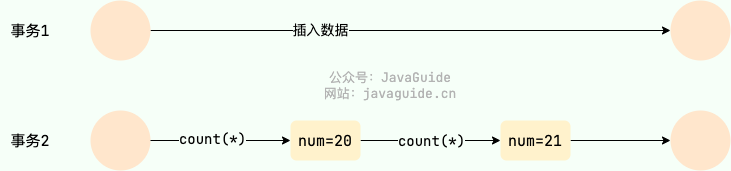
Phantom read tương tự unrepeatable read. Nó xảy ra khi một transaction read vài row data, sau đó concurrent transaction khác insert thêm data. Trong query tiếp theo, transaction đầu tiên phát hiện thêm các record vốn không tồn tại, giống như xảy ra ảo giác, nên gọi là phantom read.
Ví dụ: transaction 2 read data trong một range, transaction 1 insert data mới vào range này; transaction 2 read range đó lần nữa và phát hiện result có thêm data mới so với lần đầu.
Unrepeatable read và phantom read khác nhau thế nào?
- Unrepeatable read: trong cùng một transaction, cùng một record bị transaction khác sửa hoặc xóa, khiến content hoặc existence của record thay đổi khi read lại.
- Phantom read: trong cùng một transaction, khi cùng một range condition query được thực thi nhiều lần, tập record thỏa condition thay đổi, xuất hiện record mới hoặc record biến mất.
Phantom read thực ra có thể xem là một trường hợp đặc biệt của unrepeatable read. Lý do tách riêng phantom read chủ yếu là solution để xử lý phantom read và unrepeatable read khác nhau.
Ví dụ, khi thực thi delete và update, có thể trực tiếp lock record để bảo đảm transaction an toàn. Khi thực thi insert, vì Record Lock chỉ lock được record đã tồn tại, muốn tránh insert record mới cần dựa vào Gap Lock. Nói cách khác, khi thực thi insert, cần dùng Next-Key Lock (Record Lock+Gap Lock) để lock nhằm bảo đảm không xảy ra phantom read.
Có những cách nào để control concurrent transaction?
Trong MySQL, control concurrent transaction chỉ có hai cách: lock và MVCC. Lock có thể xem là pessimistic control, còn multi-version concurrency control (MVCC, Multiversion concurrency control) có thể xem là optimistic control.
Với lock, shared resource được control rõ ràng bằng lock thay vì scheduling. MySQL chủ yếu dùng read/write lock để thực hiện concurrency control.
- Shared lock (S lock): còn gọi là read lock. Transaction lấy shared lock khi read record, nhiều transaction có thể cùng lấy (lock compatible).
- Exclusive lock (X lock): còn gọi là write lock/exclusive lock. Transaction lấy exclusive lock khi sửa record, không cho phép nhiều transaction cùng lấy. Nếu một record đã có exclusive lock, transaction khác không thể thêm bất kỳ loại lock nào vào record đó (lock incompatible).
Read/write lock có thể cho phép read-read parallel, nhưng không cho phép write-read và write-write parallel. Ngoài ra, tùy lock granularity, lock được chia thành table-level lock (table-level locking) và row-level lock (row-level locking). InnoDB không chỉ hỗ trợ table-level lock mà còn hỗ trợ row-level lock, mặc định là row-level lock. Row-level lock có granularity nhỏ hơn, chỉ cần lock record liên quan (lock một hoặc nhiều row), nên performance của InnoDB cao hơn với concurrent write. Dù là table-level lock hay row-level lock, đều có shared lock (Share Lock, S lock) và exclusive lock (Exclusive Lock, X lock).
MVCC là multi-version concurrency control, tức lưu nhiều version của một data và bảo đảm transaction nhìn thấy version cần thấy dựa trên visibility của transaction. Thông thường sẽ có một global version allocator để đặt version number cho mỗi row data, version number là duy nhất.
MVCC trong MySQL chủ yếu dựa trên các cơ chế: hidden field, read view, undo log.
- undo log: undo log dùng để ghi nhiều version data của một row.
- read view và hidden field: dùng để xác định visibility của current version data.
Để xem implementation cụ thể của MVCC trong InnoDB, có thể đọc bài viết: Implementation của MVCC trong InnoDB storage engine .
SQL standard định nghĩa những isolation level nào?
SQL standard định nghĩa bốn isolation level để cân bằng isolation của transaction và concurrent performance. Level càng cao, data consistency càng tốt nhưng concurrent performance có thể càng thấp. Bốn level là:
- READ-UNCOMMITTED: isolation level thấp nhất, cho phép read data change chưa commit, có thể gây dirty read, phantom read hoặc unrepeatable read. Level này ít dùng trong application thực tế vì bảo đảm data consistency quá yếu.
- READ-COMMITTED: cho phép read data của concurrent transaction đã commit, có thể ngăn dirty read, nhưng phantom read hoặc unrepeatable read vẫn có thể xảy ra. Đây là default isolation level của phần lớn database (như Oracle, SQL Server).
- REPEATABLE-READ: nhiều lần read cùng một field đều có kết quả nhất quán, trừ khi data bị chính transaction sửa. Có thể ngăn dirty read và unrepeatable read, nhưng phantom read vẫn có thể xảy ra. InnoDB storage engine của MySQL mặc định dùng REPEATABLE READ. Ngoài ra, ở level này InnoDB dùng MVCC (multi-version concurrency control) và Next-Key Locks (Gap Lock+row lock) để phần lớn giải quyết phantom read.
- SERIALIZABLE: isolation level cao nhất, hoàn toàn tuân thủ isolation của ACID. Tất cả transaction thực thi lần lượt, nên hoàn toàn không thể can thiệp lẫn nhau; level này có thể ngăn dirty read, unrepeatable read và phantom read.
| Isolation level | Dirty read | Unrepeatable read | Phantom read |
|---|---|---|---|
| READ UNCOMMITTED | √ | √ | √ |
| READ COMMITTED | × | √ | √ |
| REPEATABLE READ | × | × | √ (standard) / ≈× (InnoDB) |
| SERIALIZABLE | × | × | × |
Default isolation level của MySQL là gì?
Default isolation level của MySQL InnoDB storage engine là REPEATABLE READ. Có thể xem bằng command sau:
- Trước MySQL 8.0:
SELECT @@tx_isolation; - Từ MySQL 8.0 trở đi:
SELECT @@transaction_isolation;
mysql> SELECT @@tx_isolation;
+-----------------+
| @@tx_isolation  |
+-----------------+
| REPEATABLE-READ |
+-----------------+
Để xem giới thiệu chi tiết về MySQL transaction isolation level, có thể đọc bài viết: Giải thích chi tiết isolation level của MySQL transaction.
Isolation level của MySQL có được implement dựa trên lock không?
Isolation level của MySQL được implement đồng thời dựa trên lock và MVCC.
SERIALIZABLE isolation level được implement bằng lock; READ-COMMITTED và REPEATABLE-READ isolation level dựa trên MVCC. Tuy nhiên, các isolation level khác ngoài SERIALIZABLE cũng có thể cần lock, chẳng hạn REPEATABLE-READ trong current read cần dùng locking read để bảo đảm không xảy ra phantom read.
MySQL lock
Lock là một cách phổ biến để control concurrent transaction.
Bạn biết gì về table-level lock và row-level lock? Khác nhau thế nào?
MyISAM chỉ hỗ trợ table-level lock (table-level locking), lock một lần là lock cả table, nên performance rất kém khi concurrent write. InnoDB không chỉ hỗ trợ table-level lock (table-level locking), mà còn hỗ trợ row-level lock (row-level locking), mặc định là row-level lock.
Row-level lock có granularity nhỏ hơn, chỉ lock record liên quan (lock một hoặc nhiều row), nên performance của InnoDB cao hơn với concurrent write.
So sánh table-level lock và row-level lock:
- Table-level lock: Loại lock có granularity lớn nhất trong MySQL (ngoại trừ global lock), là lock trên non-index field, lock toàn bộ table của operation hiện tại. Nó dễ implement, ít tốn resource, lock nhanh và không xảy ra deadlock. Tuy nhiên, xác suất lock conflict cao nhất, efficiency cực thấp khi high concurrency. Table-level lock không liên quan storage engine; cả MyISAM và InnoDB đều hỗ trợ.
- Row-level lock: Loại lock có granularity nhỏ nhất trong MySQL, là lock trên index field, chỉ lock row record của operation hiện tại. Row-level lock giảm đáng kể conflict giữa các database operation. Granularity nhỏ, concurrency cao, nhưng overhead lock cũng lớn nhất, lock chậm và có thể xảy ra deadlock. Row-level lock liên quan storage engine và được implement ở storage engine layer.
Cần lưu ý gì khi dùng row-level lock?
Row lock của InnoDB là lock trên index field, table-level lock là lock trên non-index field. Khi thực thi UPDATE, DELETE, nếu field trong WHERE không hit unique index hoặc index mất hiệu lực, sẽ scan toàn table và lock tất cả row record trong table. Đây là tình huống thường gặp trong phát triển hằng ngày, nhất định phải chú ý!
Tuy nhiên, nhiều khi dù dùng index vẫn có thể full table scan, nguyên nhân là query optimizer của MySQL.
InnoDB có những loại row lock nào?
InnoDB row lock được implement bằng cách lock record trên index data page. MySQL InnoDB hỗ trợ ba cách row locking:
- Record Lock: lock trên một row record riêng lẻ.
- Gap Lock: lock một range, không bao gồm chính record.
- Next-Key Lock: Record Lock+Gap Lock, lock một range có bao gồm chính record, chủ yếu để giải quyết phantom read (đã đề cập ở phần MySQL transaction). Record Lock chỉ lock được record đã tồn tại; muốn tránh insert record mới cần dựa vào Gap Lock.
Trong isolation level mặc định REPEATABLE-READ của InnoDB, row lock mặc định dùng Next-Key Lock. Tuy nhiên, nếu index được thao tác là unique index hoặc primary key, InnoDB sẽ tối ưu Next-Key Lock và hạ xuống Record Lock, tức chỉ lock index chứ không lock range.
Còn shared lock và exclusive lock?
Dù là table-level lock hay row-level lock đều có hai loại: shared lock (Share Lock, S lock) và exclusive lock (Exclusive Lock, X lock):
- Shared lock (S lock): còn gọi là read lock. Transaction lấy shared lock khi read record, nhiều transaction có thể cùng lấy (lock compatible).
- Exclusive lock (X lock): còn gọi là write lock/exclusive lock. Transaction lấy exclusive lock khi sửa record, không cho phép nhiều transaction cùng lấy. Nếu một record đã có exclusive lock, transaction khác không thể thêm bất kỳ loại lock nào vào record đó (lock incompatible).
Exclusive lock không compatible với bất kỳ lock nào, shared lock chỉ compatible với shared lock.
| S lock | X lock | |
|---|---|---|
| S lock | Không conflict | Conflict |
| X lock | Conflict | Conflict |
Do có MVCC, với SELECT statement thông thường, InnoDB không thêm lock. Tuy nhiên, có thể dùng các statement sau để thêm shared lock hoặc exclusive lock rõ ràng.
# Shared lock, dùng được trong MySQL 5.7 và MySQL 8.0
SELECT ... LOCK IN SHARE MODE;
# Shared lock, dùng được trong MySQL 8.0
SELECT ... FOR SHARE;
# Exclusive lock
SELECT ... FOR UPDATE;
Intention lock có tác dụng gì?
Nếu cần dùng table lock, làm sao xác định các record trong table chưa có row lock? Duyệt từng row chắc chắn không được vì performance quá kém. Cần dùng intention lock để nhanh chóng xác định có thể dùng table lock trên table nào đó hay không.
Intention lock là table-level lock, có hai loại:
- Intention shared lock (Intention Shared Lock, IS lock): transaction có ý định thêm shared lock (S lock) vào một số record trong table; trước khi thêm shared lock phải lấy IS lock của table đó.
- Intention exclusive lock (Intention Exclusive Lock, IX lock): transaction có ý định thêm exclusive lock (X lock) vào một số record trong table; trước khi thêm exclusive lock phải lấy IX lock của table đó.
Intention lock do data engine tự maintain, user không thể thao tác intention lock thủ công. Trước khi thêm shared/exclusive lock cho data row, InnoDB trước hết lấy intention lock tương ứng của table chứa data row.
Các intention lock tương thích lẫn nhau.
| IS lock | IX lock | |
|---|---|---|
| IS lock | Compatible | Compatible |
| IX lock | Compatible | Compatible |
Intention lock và shared lock/exclusive lock loại trừ nhau (ở đây là table-level shared lock và exclusive lock; intention lock không loại trừ row-level shared lock và exclusive lock).
| IS lock | IX lock | |
|---|---|---|
| S lock | Compatible | Incompatible |
| X lock | Incompatible | Incompatible |
Mô tả tương ứng trong sách 《MySQL Technical Inner Secrets: InnoDB Storage Engine》 có lẽ là lỗi đánh máy.

Current read và snapshot read khác nhau thế nào?
Snapshot read (consistent non-locking read) là SELECT statement đơn thuần, nhưng không bao gồm hai loại SELECT statement sau:
SELECT ... FOR UPDATE
# Shared lock, dùng được trong MySQL 5.7 và MySQL 8.0
SELECT ... LOCK IN SHARE MODE;
# Shared lock, dùng được trong MySQL 8.0
SELECT ... FOR SHARE;
Snapshot là historical version của record; mỗi row record có thể có nhiều historical version (multi-version technology).
Trong snapshot read, nếu record đang thực hiện UPDATE/DELETE, read operation không chờ X lock trên record được release mà đọc một snapshot của row.
Chỉ trong transaction isolation level RC (READ COMMITTED) và RR (REPEATABLE READ), InnoDB mới dùng consistent non-locking read:
- Ở RC level, với snapshot data, consistent non-locking read luôn đọc snapshot mới nhất của locked row.
- Ở RR level, với snapshot data, consistent non-locking read luôn đọc data version của row tại thời điểm transaction này bắt đầu.
Snapshot read phù hợp hơn với business scenario không yêu cầu data consistency quá cao nhưng theo đuổi performance tối đa.
Current read (consistent locking read) là thêm X lock hoặc S lock cho row record.
Một số loại SQL statement phổ biến của current read:
# Thêm X lock cho record được read
SELECT...FOR UPDATE
# Thêm S lock cho record được read
SELECT...LOCK IN SHARE MODE
# Thêm S lock cho record được read
SELECT...FOR SHARE
# Thêm X lock cho record được sửa
INSERT...
UPDATE...
DELETE...
Bạn biết gì về auto-increment lock?
Đây không phải knowledge point quan trọng, chỉ cần hiểu đơn giản.
Khi design table cho relational database, thường có một column làm auto-increment primary key. Trong InnoDB, auto-increment primary key liên quan đến một table-level lock khá đặc biệt: auto-increment lock (AUTO-INC Locks).
CREATE TABLE `sequence_id` (
  `id` BIGINT(20) UNSIGNED NOT NULL AUTO_INCREMENT,
  `stub` CHAR(10) NOT NULL DEFAULT '',
  PRIMARY KEY (`id`),
  UNIQUE KEY `stub` (`stub`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
Nói chính xác hơn, không chỉ auto-increment primary key mà mọi column có AUTO_INCREMENT đều liên quan đến auto-increment lock, vì non-primary key cũng có thể đặt auto-increment.
Nếu một transaction đang insert data vào table có auto-increment column, trước tiên nó sẽ lấy auto-increment lock; nếu không lấy được có thể bị block. Đây chỉ là một trong các behavior của auto-increment lock. Có thể hiểu auto-increment lock là một interface, có nhiều implementation cụ thể. Config tương ứng là innodb_autoinc_lock_mode (được giới thiệu từ MySQL 5.1.22), các value có thể chọn:
| innodb_autoinc_lock_mode | Giới thiệu |
|---|---|
| 0 | Traditional mode |
| 1 | Consecutive mode (default trước MySQL 8.0) |
| 2 | Interleaved mode (default từ MySQL 8.0) |
Ở interleaved mode, mọi statement “INSERT-LIKE” (tất cả insert statement, gồm INSERT, REPLACE, INSERT…SELECT, REPLACE…SELECT, LOAD DATA...) đều không dùng table-level lock mà dùng lightweight mutex lock. Nhiều insert statement có thể chạy concurrent, tốc độ nhanh hơn và khả năng mở rộng tốt hơn.
Tuy nhiên, nếu MySQL database có nhu cầu master-slave synchronization và Binlog dùng Statement format, không nên đặt InnoDB auto-increment lock mode thành interleaved mode, nếu không sẽ có vấn đề data inconsistency. Nguyên nhân là trong concurrency, thứ tự thực thi insert statement không được bảo đảm.
Nếu MySQL dùng Statement format, master-slave synchronization của MySQL thực tế đồng bộ từng SQL statement.
Cuối cùng, đề xuất thêm bài viết: Vì sao auto-increment primary key của MySQL không monotonic và không continuous .
⭐️MySQL performance optimization
Để xem tổng hợp đề xuất về MySQL performance optimization, hãy đọc bài viết: Tổng hợp đề xuất quy chuẩn tối ưu MySQL performance .
Có thể lưu file (chẳng hạn hình ảnh) trực tiếp bằng MySQL không?
Có thể, chỉ cần lưu trực tiếp binary data tương ứng với file. Tuy nhiên, vẫn khuyến nghị không lưu file trong database vì sẽ ảnh hưởng nghiêm trọng đến database performance và tiêu tốn quá nhiều storage space.
Có thể chọn file storage service dùng ngay do cloud service provider cung cấp. Các service này trưởng thành, ổn định và giá tương đối thấp.

Cũng có thể tự xây dựng file storage service. Việc implement không khó, có thể dựa trên open source project như FastDFS, MinIO (khuyến nghị) để implement distributed file service.
Database chỉ lưu địa chỉ file; file do file storage service phụ trách lưu trữ.
MySQL lưu IP address thế nào?
Có thể convert IP address thành integer data để lưu, performance tốt hơn và chiếm ít space hơn.
MySQL cung cấp hai method để xử lý IP address:
INET_ATON(): chuyển IP thành unsigned integer (4-8 bit)INET_NTOA(): chuyển integer IP thành address
Trước khi insert data, dùng INET_ATON() chuyển IP thành integer; khi hiển thị data, dùng INET_NTOA() chuyển integer IP thành address để hiển thị.
Có những cách SQL optimization phổ biến nào?
《Java Interview Guide》 (trả phí) có một bài viết trong phần “Câu hỏi phỏng vấn kỹ thuật” giới thiệu chi tiết các cách SQL optimization phổ biến, rất đầy đủ và dễ hiểu!

Địa chỉ bài viết: https://www.yuque.com/snailclimb/mf2z3k/abc2sv (cách lấy password: https://t.zsxq.com/avfM0).
Phân tích SQL performance thế nào?
Có thể dùng command EXPLAIN để phân tích execution plan của SQL. Execution plan là cách thực thi cụ thể của một SQL statement sau khi được MySQL query optimizer tối ưu.
EXPLAIN không thực sự thực thi statement tương ứng mà phân tích statement thông qua query optimizer, tìm query solution tối ưu và hiển thị information tương ứng.
EXPLAIN áp dụng cho statement SELECT, DELETE, INSERT, REPLACE và UPDATE; thông thường chúng ta phân tích SELECT query nhiều hơn.
Sau đây là demo đơn giản về cách dùng EXPLAIN.
Output format của EXPLAIN:
mysql> EXPLAIN SELECT `score`,`name` FROM `cus_order` ORDER BY `score` DESC;
+----+-------------+-----------+------------+------+---------------+------+---------+------+--------+----------+----------------+
| id | select_type | table     | partitions | type | possible_keys | key  | key_len | ref  | rows   | filtered | Extra          |
+----+-------------+-----------+------------+------+---------------+------+---------+------+--------+----------+----------------+
|  1 | SIMPLE      | cus_order | NULL       | ALL  | NULL          | NULL | NULL    | NULL | 997572 |   100.00 | Using filesort |
+----+-------------+-----------+------------+------+---------------+------+---------+------+--------+----------+----------------+
1 row in set, 1 warning (0.00 sec)
Ý nghĩa các field:
| Column name | Ý nghĩa |
|---|---|
| id | Sequence identifier của SELECT query |
| select_type | Query type tương ứng với SELECT keyword |
| table | Table name được dùng |
| partitions | Partition được match; với table không partition, value là NULL |
| type | Access method của table |
| possible_keys | Index có thể được dùng |
| key | Index thực tế được dùng |
| key_len | Length của index được chọn |
| ref | Khi dùng index equality query, column hoặc constant được so sánh với index |
| rows | Số row dự kiến sẽ read |
| filtered | Tỷ lệ phần trăm record còn lại sau khi filter theo table condition |
| Extra | Information bổ sung |
Vì giới hạn độ dài bài viết, ở đây chỉ giới thiệu đơn giản về MySQL execution plan. Để xem chi tiết, hãy đọc bài SQL execution plan.
Bạn biết gì về read/write splitting và sharding?
Các câu hỏi liên quan đến read/write splitting và sharding khá nhiều, nên tôi viết riêng một bài: Giải thích chi tiết read/write splitting và sharding.
Tối ưu deep pagination thế nào?
Giới thiệu và đề xuất tối ưu deep pagination
Thực hiện data cold/hot separation thế nào?
Giải thích chi tiết data cold/hot separation
Tối ưu MySQL performance thế nào?
MySQL performance optimization là một systematic engineering, liên quan đến nhiều phương diện. Trong phỏng vấn không thể đề cập hết mọi mặt. Vì vậy, nên triển khai theo tư duy “điểm - tuyến - mặt”: bắt đầu từ vấn đề cốt lõi rồi mở rộng dần, thể hiện chiều sâu suy nghĩ và khả năng giải quyết vấn đề.
1. Nắm trọng tâm: định vị và phân tích slow SQL
Bước đầu tiên của performance optimization luôn là tìm bottleneck. Khi phỏng vấn, nên bắt đầu bằng định vị và phân tích slow SQL. Điều này không chỉ thể hiện cách giải quyết vấn đề mà còn cho thấy bạn thành thạo database performance monitoring:
- Monitoring tool: Giới thiệu các slow SQL monitoring tool thường dùng như MySQL slow query log, Performance Schema, thể hiện mức độ quen thuộc với các tool này và cách dùng chúng để định vị vấn đề.
- EXPLAIN command: Giải thích chi tiết cách dùng
EXPLAIN, phân tích query plan và index usage; có thể kết hợp case thực tế để minh họa cách đọc kết quả, chẳng hạn execution order, index usage và full table scan.
2. Từ điểm mở rộng ra mặt: index, table structure và SQL optimization
Sau khi định vị slow SQL, tiếp theo cần tối ưu theo vấn đề cụ thể. Có thể tập trung giới thiệu kỹ thuật tối ưu index, table structure và SQL coding convention:
- Index optimization: Đây là trọng tâm của MySQL performance optimization. Có thể giới thiệu nguyên tắc tạo index, covering index và leftmost-prefix matching principle. Nếu kết hợp được application thực tế của project để giải thích cách chọn index phù hợp thì càng tốt.
- Table structure optimization: Tối ưu table structure design, gồm chọn field type phù hợp, tránh redundant field, sử dụng hợp lý normalized và denormalized design.
- SQL optimization: Tránh dùng
SELECT *, cố gắng dùng field cụ thể, dùng join query thay subquery, dùng pagination query hợp lý, batch operation... đều là các chi tiết cần chú ý khi viết SQL.
3. Solution nâng cao: architecture optimization
Khi interviewer đã hài lòng với kiến thức optimization cơ bản, họ có thể đi sâu vào architecture-level optimization. Một số architecture optimization strategy thường gặp:
- Read/write splitting: Tách read operation và write operation vào các database instance khác nhau, tăng concurrent processing capability của database.
- Sharding: Phân tán data vào nhiều database instance hoặc data table, giảm lượng data trong một table và cải thiện query efficiency. Tuy nhiên cần cân nhắc complexity và maintenance cost, sử dụng thận trọng.
- Data cold/hot separation: Dựa trên access frequency và business importance của data để chia data thành cold data và hot data. Cold data thường lưu trên medium có cost thấp, performance thấp; hot data lưu trên high-performance storage medium.
- Cache mechanism: Dùng cache middleware như Redis để cache hot data vào memory, giảm áp lực cho database. Cách này rất phổ biến, hiệu quả cải thiện rõ rệt và cost-performance ratio rất cao!
4. Các cách optimization khác
Ngoài slow SQL positioning, index optimization và architecture optimization, cũng có thể nhắc đến một số cách optimization khác để thể hiện hiểu biết toàn diện về MySQL performance tuning:
- Connection pool configuration: Cấu hình database connection pool hợp lý (như connection pool size, timeout...), giúp nâng cao hiệu quả database connection và tránh connection overhead thường xuyên.
- Hardware configuration: Nâng cao hardware performance cũng là một cách optimization quan trọng. Dùng high-performance server, tăng memory, dùng hardware upgrade như SSD đều có thể cải thiện performance tổng thể của database.
5. Tóm tắt
Trong phỏng vấn, nên lần lượt giới thiệu slow SQL positioning, index optimization, table structure design và SQL optimization theo thứ tự ưu tiên. Architecture optimization như read/write splitting và sharding, data cold/hot separation nên là phương án cuối cùng. Trừ khi có bottleneck performance rõ ràng trong scenario cụ thể, không nên tùy tiện dùng vì complexity do chúng đưa vào sẽ tạo thêm maintenance cost.
Đề xuất tài liệu học MySQL
Đề xuất bài viết:
- Tutorial series MySQL của Yishu Yixi
- Tutorial series MySQL của Yes
- Viết xong bài này, khả năng SQL optimization của tôi trực tiếp lên level mới - Biến thành Patrick Star - 2022
- Giải thích chi tiết hai vạn chữ! Chuyên đề InnoDB lock! - Cậu bé nhặt ốc - 2022
- Auto-increment primary key của MySQL chắc chắn continuous sao? - Thịt bò nhỏ bay trên trời - 2022
- Hiểu sâu nguyên lý tầng dưới của MySQL index - Tencent Technical Engineering - 2020
Tham khảo
- 《High Performance MySQL》 chương 7, MySQL advanced feature
- 《MySQL Technical Inner Secrets: InnoDB Storage Engine》 chương 6, lock
- Relational Database: https://www.omnisci.com/technical-glossary/relational-database
- Một bài viết giúp hiểu VARCHAR trong MySQL lưu được bao nhiêu chữ Hán, chữ số và khác biệt giữa varchar(100) với varchar(10): https://www.cnblogs.com/zhuyeshen/p/11642211.html
- Technical sharing | Isolation level: Hiểu đúng phantom read: https://opensource.actionsky.com/20210818-mysql/
- MySQL Server Logs - MySQL 5.7 Reference Manual: https://dev.mysql.com/doc/refman/5.7/en/server-logs.html
- Redo Log - MySQL 5.7 Reference Manual: https://dev.mysql.com/doc/refman/5.7/en/innodb-redo-log.html
- Locking Reads - MySQL 5.7 Reference Manual: https://dev.mysql.com/doc/refman/5.7/en/innodb-locking-reads.html
- Hiểu sâu database row lock và table lock https://zhuanlan.zhihu.com/p/52678870
- Giải thích chi tiết tác dụng của intention lock trong MySQL InnoDB: https://juejin.cn/post/6844903666332368909
- Phân tích sâu MySQL auto-increment lock: https://juejin.cn/post/6968420054287253540
- Phân biệt unrepeatable read và phantom read trong database thế nào?: https://www.zhihu.com/question/392569386
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.