
Giải thích chi tiết về tách dữ liệu nóng và lạnh
Tách dữ liệu nóng và lạnh là gì?
Tách dữ liệu nóng và lạnh là chiến lược kiến trúc phân loại dữ liệu thành dữ liệu lạnh và dữ liệu nóng dựa trên tần suất truy cập và mức độ quan trọng với nghiệp vụ, sau đó lưu trữ chúng trên các storage medium có performance và chi phí khác nhau.
Mục tiêu cốt lõi của kiến trúc này gồm ba điểm:
- Nâng cao performance truy vấn: Lưu trữ dữ liệu nóng trên medium có performance cao (như SSD, memory) để bảo đảm tốc độ phản hồi của nghiệp vụ cốt lõi.
- Giảm chi phí storage: Di chuyển dữ liệu lạnh sang medium có chi phí thấp (như HDD, object storage), cắt giảm đáng kể chi phí storage.
- Đáp ứng yêu cầu compliance: Một số ngành (như tài chính, y tế) yêu cầu archive dữ liệu dài hạn; tách nóng và lạnh có thể cân bằng compliance với chi phí.
Dữ liệu lạnh và dữ liệu nóng
Dữ liệu nóng là dữ liệu được truy cập và sửa đổi thường xuyên, đồng thời cần phản hồi nhanh; dữ liệu lạnh là dữ liệu có tần suất truy cập cực thấp, giá trị với nghiệp vụ hiện tại không cao nhưng cần được lưu giữ dài hạn.
Có hai phương pháp chính để phân biệt dữ liệu nóng và lạnh:
- Phân biệt theo thời gian: Phân loại theo thời điểm tạo, cập nhật hoặc hết hạn của dữ liệu. Ví dụ, hệ thống đơn hàng đánh dấu dữ liệu đơn hàng từ một khoảng thời gian trước (như 90 ngày hoặc 1 năm) là dữ liệu lạnh. Phương pháp này phù hợp với các trường hợp tần suất truy cập dữ liệu liên quan chặt với thời gian, dễ triển khai và có chi phí thấp.
- Phân biệt theo tần suất truy cập: Xem dữ liệu được truy cập thường xuyên là dữ liệu nóng, dữ liệu ít được truy cập là dữ liệu lạnh. Ví dụ, hệ thống nội dung đánh dấu bài viết có lượt xem thấp hơn ngưỡng là dữ liệu lạnh. Phương pháp này cần ghi nhận thêm tần suất truy cập, phù hợp với các trường hợp tần suất truy cập liên quan chặt với đặc tính của dữ liệu.
Chọn chiến lược phân biệt thế nào?
- Nếu dữ liệu nghiệp vụ vốn có tính thời hạn (như đơn hàng, log, hóa đơn), ưu tiên chọn thời gian, vì chi phí triển khai thấp nhất.
- Nếu giá trị dữ liệu không liên quan đến thời gian (như bài viết, sản phẩm, chân dung người dùng), cần kết hợp tần suất truy cập để xác định.
- Trong dự án thực tế, có thể kết hợp cả hai: lấy thời gian làm chính, tần suất truy cập làm phụ để bao phủ nhiều trường hợp nghiệp vụ hơn.
Quy tắc xác định nóng/lạnh không nên chỉ do đội kỹ thuật tự quyết. Truy vấn đơn hàng, hóa đơn, audit, chăm sóc khách hàng và vận hành đều ảnh hưởng đến việc “dữ liệu lạnh còn được truy vấn hay không, cần trả kết quả trong bao lâu, có bắt buộc truy vấn toàn bộ hay không”. Trước khi triển khai, nên liệt kê các query path cốt lõi rồi mới quyết định thời điểm di chuyển dữ liệu lạnh.
Chiến lược phân tầng nhiều cấp cho tách nóng và lạnh
Trong thực tế, “lạnh” và “nóng” thường không phải phép chia nhị phân hoặc cái này hoặc cái kia, mà là phân tầng nhiều cấp theo từng bước:
| Cấp | Đặc tính dữ liệu | Ví dụ quy tắc xác định | Chiến lược storage |
|---|---|---|---|
| Dữ liệu nóng | Truy cập thường xuyên, phản hồi real-time | 30 ngày gần nhất + mọi đơn hàng chưa hoàn tất | MySQL hot database (SSD) |
| Dữ liệu ấm | Truy cập trung bình, có thể được truy vấn | Đơn hàng từ 30~90 ngày trước | MySQL warm database (HDD) |
| Dữ liệu lạnh | Truy cập thấp, truy vấn không thường xuyên | Đơn hàng lịch sử từ 90 ngày~3 năm | Cold database độc lập hoặc object storage |
| Dữ liệu archive | Cực ít truy cập, chỉ lưu giữ để compliance | Đơn hàng trên 3 năm | Object storage (chỉ giữ dữ liệu tổng hợp) |
Khuyến nghị thực tiễn: Nên quản lý động các quy tắc xác định thông qua configuration center, tránh phải thường xuyên sửa code do nghiệp vụ thay đổi.
Xử lý thế nào khi dữ liệu lạnh được truy cập?
Nếu dữ liệu lạnh đột nhiên được truy cập (chẳng hạn người dùng truy vấn đơn hàng từ 3 năm trước), có cần “nâng cấp nóng” không?
| Strategy | Trường hợp sử dụng | Ưu điểm | Nhược điểm |
|---|---|---|---|
| Không di chuyển ngược | Truy vấn không thường xuyên, tần suất truy vấn cực thấp | Dễ triển khai | Tốc độ truy vấn chậm |
| Cache layer | Truy vấn với tần suất trung bình | Tăng tốc truy vấn, không thay đổi storage | Cần thêm cache component |
| Di chuyển ngược bất đồng bộ | Truy vấn với tần suất cao, cần truy cập liên tục | Giải quyết triệt để vấn đề performance | Triển khai phức tạp, có thể phát sinh vấn đề nhất quán |
Cách làm khuyến nghị: Phần lớn trường hợp dùng phương án kết hợp “không di chuyển ngược + cache layer”. Khi truy vấn dữ liệu lạnh, trước tiên truy vấn cache; nếu cache hit thì trả về ngay, nếu cache miss thì truy vấn cold database rồi ghi kết quả vào cache (với truy vấn không thường xuyên, chỉ cần đặt TTL ngắn 5~15 phút).
⚠️Lưu ý: Để ngăn kẻ tấn công lợi dụng tham số ngẫu nhiên truy vấn thường xuyên dữ liệu không tồn tại khiến cold database bị đánh sập, có thể đặt Bloom Filter trước cache layer hoặc thiết lập placeholder giá trị rỗng trong cache, tránh để request độc hại xuyên tới cold database. Xem chi tiết tại Tổng hợp câu hỏi phỏng vấn Redis thường gặp (phần dưới) (Redis transaction, tối ưu performance, vấn đề production, cluster, quy tắc sử dụng, v.v.).
Tư tưởng tách nóng và lạnh
Tư tưởng cốt lõi của tách nóng và lạnh là lưu trữ phân tầng (Tiered Storage), phân bổ dữ liệu vào các medium storage thuộc những tầng khác nhau dựa trên đặc tính truy cập. Trong kiến trúc storage cấp doanh nghiệp, thường chia thành các tầng sau:
| Tầng | Đặc tính dữ liệu | Medium storage điển hình | Độ trễ truy cập |
|---|---|---|---|
| Hot (tầng nóng) | Truy cập thường xuyên, phản hồi real-time | NVMe SSD, memory | Mức millisecond |
| Warm (tầng ấm) | Truy cập trung bình, dữ liệu gần đây | SATA SSD, HDD tốc độ cao | Mức hàng trăm millisecond |
| Cold (tầng lạnh) | Truy cập thấp, dữ liệu lịch sử | HDD dung lượng lớn, object storage | Mức giây |
| Archive (tầng archive) | Cực ít truy cập, lưu giữ để compliance | Tape library, glacier storage | Mức phút đến giờ |
Tư tưởng phân tầng này được ứng dụng rộng rãi trong hạ tầng IT, không chỉ giới hạn ở database mà còn gồm file system, object storage, CDN cache và các trường hợp khác.
Ưu và nhược điểm của tách dữ liệu nóng và lạnh
Ưu điểm:
- Tối ưu performance truy vấn dữ liệu nóng: Tập trung dữ liệu nóng trên storage có performance cao, giảm đáng kể dung lượng dữ liệu trong table, nâng cao rõ rệt hiệu quả index, giúp trải nghiệm của phần lớn thao tác người dùng tốt hơn.
- Giảm mạnh chi phí storage: Có thể di chuyển dữ liệu lạnh sang HDD hoặc object storage. Chênh lệch chi phí đơn vị giữa SSD và HDD có thể đạt 5~10 lần, hiệu quả tiết kiệm rõ rệt với trường hợp dữ liệu lớn.
- Tăng khả năng maintain system: Có thể kiểm soát dung lượng dữ liệu trong hot database, backup và recovery nhanh hơn, thao tác DDL (như thêm index) tốn ít thời gian hơn.
Nhược điểm:
- Tăng độ phức tạp của system: Cần thêm component di chuyển, logic routing và hệ thống monitoring, làm tăng rủi ro nhất quán dữ liệu.
- Hiệu quả query cross-database thấp: Nếu nghiệp vụ cần đồng thời truy vấn dữ liệu nóng và lạnh (như report thống kê theo năm), cần join cross-database hoặc aggregate dữ liệu, khiến performance truy vấn và chi phí phát triển đều tăng.
- Chi phí maintain strategy di chuyển: Quy tắc xác định dữ liệu nóng và lạnh cần được tối ưu liên tục, tránh chuyển nhầm dữ liệu nóng thành dữ liệu lạnh.
Di chuyển dữ liệu lạnh
Di chuyển dữ liệu lạnh thế nào?
Di chuyển dữ liệu lạnh là khâu cốt lõi của tách nóng và lạnh. Có ba phương án phổ biến:
| Phương án | Nguyên lý triển khai | Ưu điểm | Nhược điểm | Trường hợp sử dụng |
|---|---|---|---|---|
| Triển khai bằng code tầng nghiệp vụ | Xác định nóng/lạnh khi write và route trực tiếp đến database tương ứng | Tính real-time cao | Xâm lấn code nghiệp vụ, logic xác định phức tạp | Hầu như không dùng |
| Di chuyển bằng scheduler | Scheduler định kỳ scan hot database, di chuyển theo batch dữ liệu thỏa điều kiện | Dễ triển khai | Có độ trễ di chuyển, scan table có thể làm bẩn Buffer Pool | Trường hợp phân biệt theo thời gian |
| Di chuyển bằng lắng nghe Binlog | Lắng nghe database change log, di chuyển real-time hoặc gần real-time | Tính real-time tốt, không xâm lấn nghiệp vụ | Cần thêm component (như Canal), không phù hợp với xác định theo thời gian | Trường hợp phân biệt theo tần suất truy cập (khuyến nghị) |
Di chuyển bằng scheduler là phương án được dùng phổ biến nhất, có thể triển khai nhờ các nền tảng distributed scheduler như XXL-Job, Elastic-Job. Về phương án scheduler, tôi cũng đã viết bài giới thiệu chi tiết, bạn có thể xem bài này: Giải thích chi tiết về Java scheduler.
⚠️ Cảnh báo rủi ro: Di chuyển bằng scheduler tiềm ẩn rủi ro performance khi dữ liệu lớn. Thao tác scan table trên phạm vi rộng (như
SELECT * FROM orders WHERE create_time < 'xxx' LIMIT 10000) sẽ làm bẩn nghiêm trọng InnoDB Buffer Pool, đẩy dữ liệu nóng thực sự của nghiệp vụ ra khỏi memory. Khuyến nghị trong production:
- Dùng range query dựa trên primary key, tránh full table scan;
- Kiểm soát kích thước batch của mỗi lần di chuyển, thực hiện theo từng batch;
- Thực hiện job di chuyển vào thời gian thấp điểm của nghiệp vụ;
- Với dữ liệu cực lớn, ưu tiên phương án lắng nghe Binlog để giảm tác động lên hot database.
Quy trình điển hình như sau:
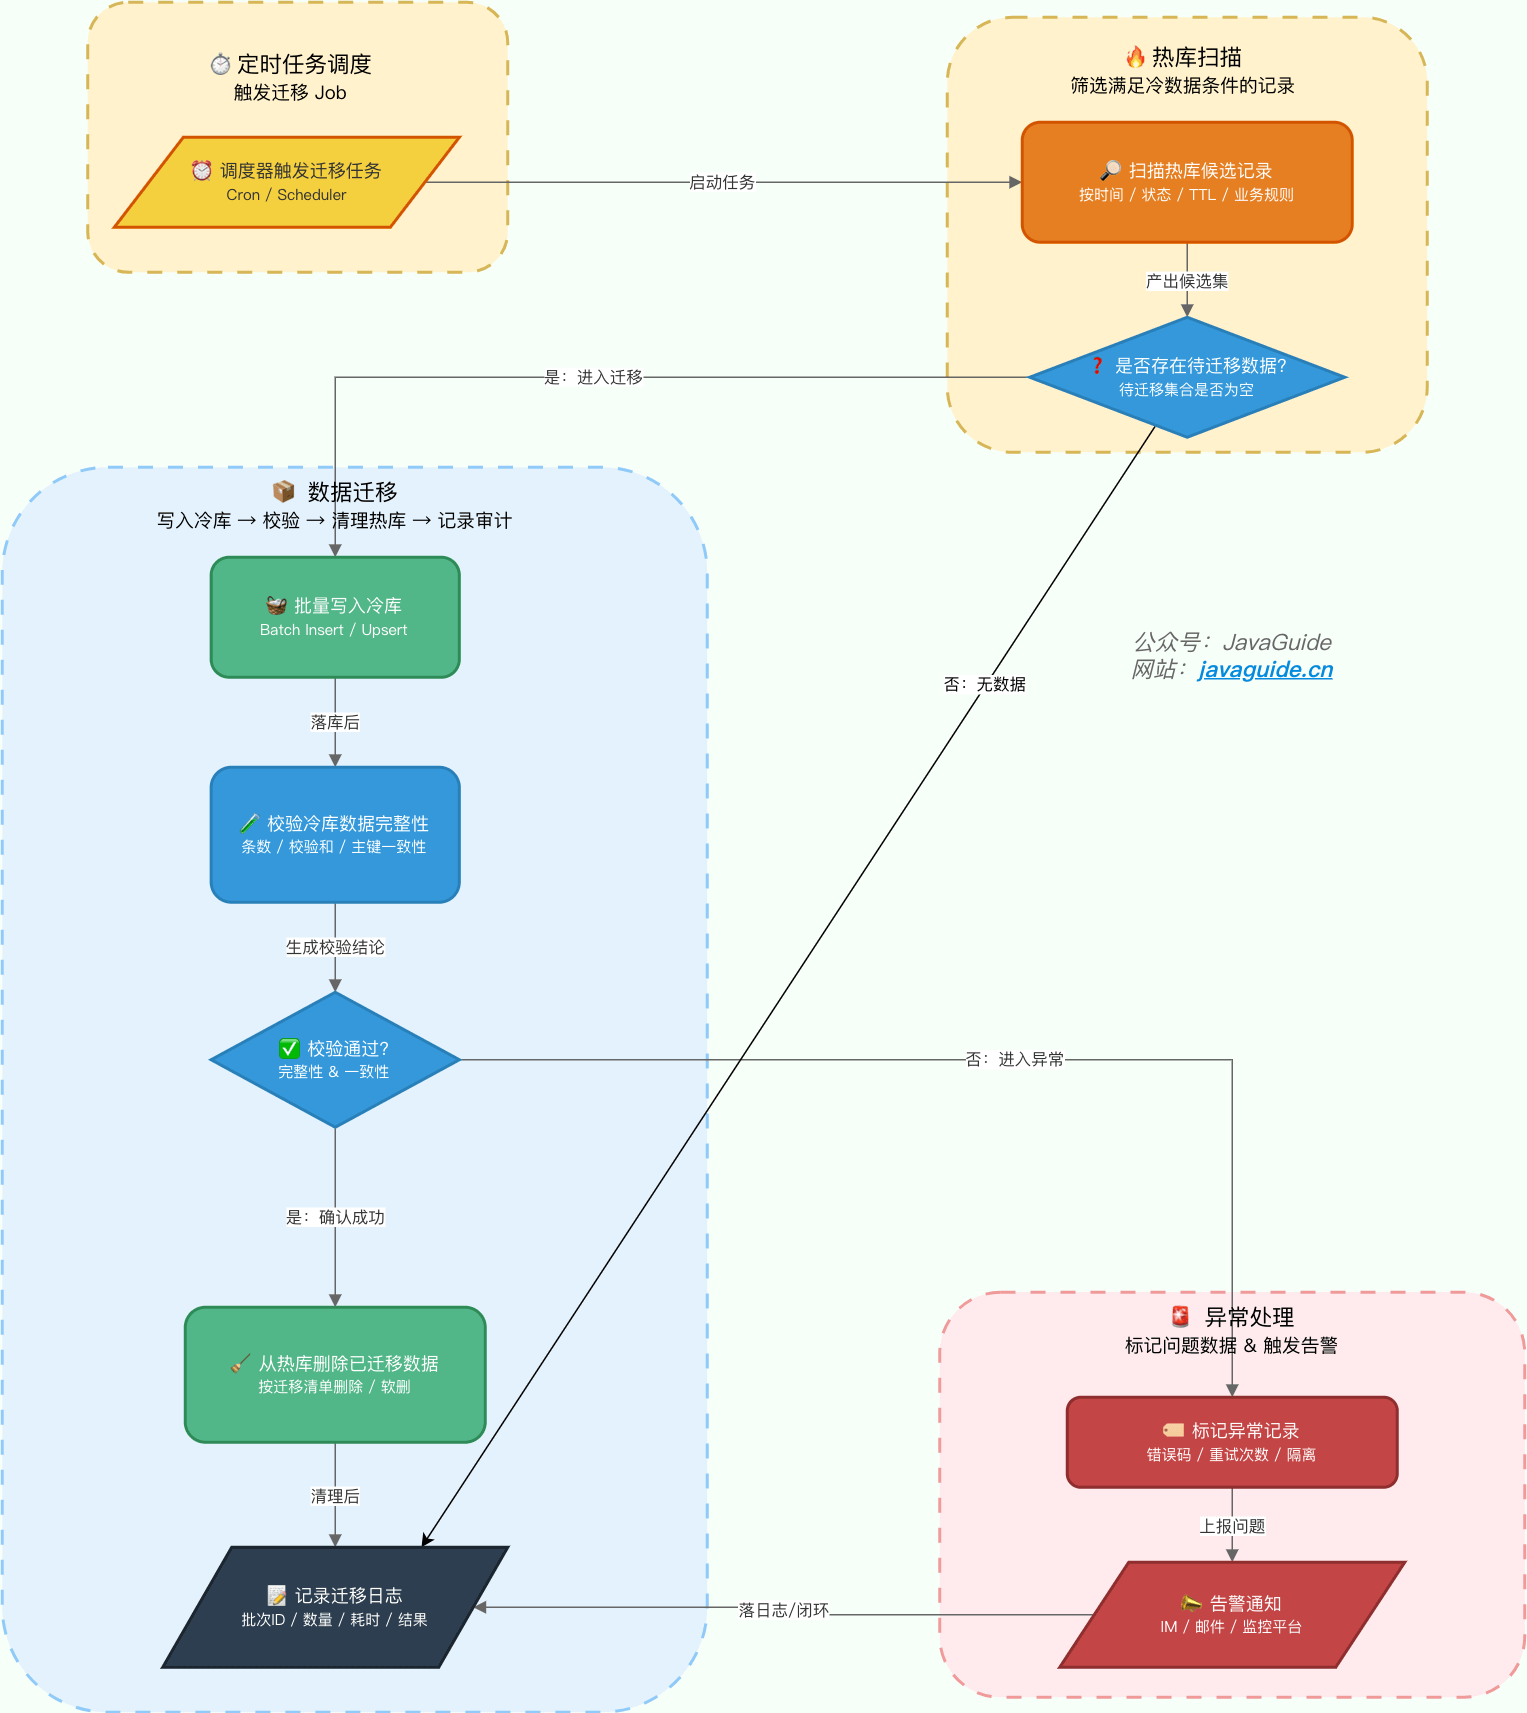
Khuyến nghị thực tiễn: Nếu công ty có DBA hỗ trợ, có thể di chuyển thủ công một lần dữ liệu lạnh hiện có, import dữ liệu lịch sử theo batch vào cold database; sau đó tự động hóa di chuyển incremental bằng scheduler.
Bảo đảm tính nhất quán dữ liệu trong quá trình di chuyển thế nào?
Vấn đề khó xử lý nhất trong quá trình di chuyển dữ liệu là: nếu dữ liệu được cập nhật trong lúc di chuyển thì xử lý thế nào?
Các phương án thường gặp
| Phương án | Cách triển khai | Ưu điểm | Nhược điểm |
|---|---|---|---|
| Lock trước khi di chuyển | Thêm write lock cho record trước khi di chuyển, giải phóng sau khi hoàn tất | Tính nhất quán mạnh | Ảnh hưởng ghi nghiệp vụ, throughput giảm |
| Optimistic lock bằng version | Ghi nhận version khi di chuyển, kiểm tra version có thay đổi trước khi xóa | Không lock, performance tốt | Cần thêm field version vào business table, phải retry khi conflict |
| Đánh dấu trạng thái + idempotent | Thêm field trạng thái di chuyển vào hot database, đánh dấu trước rồi di chuyển | Có thể trace, hỗ trợ rollback | Cần cải tạo business table |
Lưu ý: Hot database và cold database thường là các database instance khác nhau.
INSERT(cold database) vàDELETE(hot database) không thể đặt trong cùng một local transaction, cần xử lý đặc biệt vấn đề atomicity cross-database.
Phương án khuyến nghị: Đánh dấu trạng thái + di chuyển idempotent
Thêm field migrate_status vào table của hot database, dùng state machine để bảo đảm tính atomic và khả năng trace:
-- 1. Thêm field trạng thái di chuyển vào table hot database
ALTER TABLE orders ADD COLUMN migrate_status TINYINT DEFAULT 0
    COMMENT '0-chưa di chuyển 1-đang di chuyển 2-đã di chuyển';
// 2. Quy trình di chuyển (pseudo-code, trường hợp cold database độc lập cần thực hiện từng bước ở application layer)
// Step 1: Đánh dấu đang di chuyển (hot database transaction)
hotDb.execute("UPDATE orders SET migrate_status = 1 WHERE id = ? AND migrate_status = 0", id);
// Step 2: Đọc dữ liệu hot database và ghi vào cold database (cần đổi database connection)
Order order = hotDb.query("SELECT * FROM orders WHERE id = ?", id);
coldDb.execute("INSERT IGNORE INTO orders_cold VALUES (?, ?, ...)", order.id, order.data...);
// Step 3: Đánh dấu đã di chuyển (hot database transaction)
hotDb.execute("UPDATE orders SET migrate_status = 2 WHERE id = ? AND migrate_status = 1", id);
// Step 4: Xóa dữ liệu hot database sau một khoảng trễ (tùy chọn, thực hiện sau khi xác nhận dữ liệu cold database chính xác)
hotDb.execute("DELETE FROM orders WHERE id = ? AND migrate_status = 2", id);Lưu ý: Trong trường hợp cold database độc lập, MySQL tiêu chuẩn không thể thực thi trực tiếp
INSERT ... SELECTcross-database; bắt buộc phải tách thành hai bước ở application layer: “đọc hot database → ghi cold database”.
Ưu điểm của phương án:
- Idempotent:
INSERT IGNOREbảo đảm thao tác ghi vào cold database idempotent, việc chuyển trạng tháimigrate_statusbảo đảm cập nhật hot database idempotent. - Có thể trace: Có thể truy vấn tiến độ di chuyển thông qua field trạng thái, can thiệp thủ công khi có exception.
- Có thể rollback: Khi di chuyển thất bại, có thể reset trạng thái về 0 để di chuyển lại.
- Xóa theo từng bước: Không xóa ngay dữ liệu hot database; chỉ cleanup sau khi xác nhận cold database không có vấn đề, giúp giảm rủi ro.
Thu hồi dung lượng: Sau khi InnoDB thực thi
DELETE, data page chỉ được đánh dấu là đã xóa, physical space chưa được giải phóng ngay cho operating system. Cần thực thiOPTIMIZE TABLEhoặcALTER TABLE ENGINE=InnoDBđể rebuild table vào thời gian thấp điểm của nghiệp vụ, khi đó mới thực sự thu hồi được disk space.
Cơ chế dự phòng:
- Đối soát định kỳ: Định kỳ scan các record có
migrate_status = 1vượt quá ngưỡng, tự động reset hoặc cảnh báo. Lưu ý: Fieldmigrate_statuscó độ phân biệt cực thấp, bắt buộc kết hợp composite index (nhưidx_create_time_migrate_status) để giới hạn khoảng scan, tránh full table scan. - Dự phòng cho cập nhật thường xuyên: Với record bị bỏ qua nhiều lần do cập nhật thường xuyên, đặt số lần retry tối đa; khi vượt quá thì bắt buộc di chuyển hoặc can thiệp thủ công.
Lưu trữ dữ liệu lạnh thế nào?
Nguyên tắc lựa chọn phương án lưu trữ dữ liệu lạnh là: dung lượng lớn, chi phí thấp, độ tin cậy cao; có thể hy sinh một phần tốc độ truy cập.
Phương án cho công ty vừa và nhỏ
Chỉ cần dùng MySQL/PostgreSQL, giữ cùng loại database với hot database để giảm độ phức tạp vận hành. Cách triển khai cụ thể:
- Tách table trong cùng database: Thêm table dữ liệu lạnh (như
order_history) trong cùng database, phân biệt dữ liệu nóng và lạnh qua tên table. - Cold database độc lập: Triển khai một database instance riêng làm cold database, hot database và cold database truy cập thông qua routing ở application layer.
⚠️Lưu ý: Phương án cold database độc lập liên quan đến query cross-database. Nếu nghiệp vụ có nhu cầu query kết hợp dữ liệu nóng và lạnh, cần đánh giá có nên đưa vào data synchronization hoặc aggregation layer hay không.
Phương án cho công ty lớn
Các công ty lớn thường dùng storage engine chuyên dụng được tối ưu cho dữ liệu lớn:
| Phương án storage | Đặc điểm | Trường hợp sử dụng |
|---|---|---|
| HBase | Column family storage, throughput cao, hỗ trợ dữ liệu cấp PB | Archive log, hành vi người dùng, dữ liệu IoT |
| RocksDB | KV storage performance cao, cấu trúc LSM-Tree | Trường hợp embedded, làm storage layer bên dưới của system khác |
| Doris/ClickHouse | OLAP engine, hỗ trợ phân tích real-time | Trường hợp dữ liệu lạnh cần aggregate analysis |
| Cassandra | Distributed, high availability, không có single point of failure | Trường hợp archive triển khai cross-region, yêu cầu high availability |
| Object storage (OSS/S3) | Chi phí cực thấp, mở rộng không giới hạn | Dữ liệu lạnh quy mô cực lớn, archive compliance |
Phương án TiDB (khuyến nghị)
Nếu technology stack của công ty cho phép, có thể dùng trực tiếp distributed relational database như TiDB, vốn hỗ trợ tách nóng và lạnh, triển khai một lần là xong.
TiDB 6.0 giới thiệu tính năng Placement Rules in SQL, tức placement framework dựa trên SQL interface, dùng để cấu hình vị trí đặt dữ liệu trong TiKV cluster thông qua SQL interface.
- Dữ liệu nóng: Dùng Placement Rules chỉ định lưu trên SSD node để bảo đảm performance truy vấn.
- Dữ liệu lạnh: Chỉ định lưu trên HDD node để giảm chi phí storage.
-- Tạo placement policy: dữ liệu nóng lưu trên SSD node
CREATE PLACEMENT POLICY hot_data
  CONSTRAINTS="[+disk=ssd]";

-- Tạo placement policy: dữ liệu lạnh lưu trên HDD node
CREATE PLACEMENT POLICY cold_data
  CONSTRAINTS="[+disk=hdd]";

-- Áp dụng placement policy cho table hoặc partition
ALTER TABLE orders PLACEMENT POLICY = hot_data;
ALTER TABLE orders PARTITION p2022 PLACEMENT POLICY = cold_data;
Ưu điểm của phương án này là: nghiệp vụ không cần biết logic tách nóng và lạnh, TiDB tự động route dữ liệu, giảm mạnh độ phức tạp ở application layer.
Thực tiễn đầy đủ:
Placement Ruleschỉ định loại medium nơi dữ liệu được lưu trữ, nhưng việc dữ liệu chuyển từ “hot partition” sang “cold partition” vẫn cần kết hợp với partition table (Range Partitioning). Tạo partition theo khoảng thời gian, gắn placement policy HDD cho partition lịch sử và placement policy SSD cho partition đang hoạt động. Theo thời gian, chỉ cần maintain việc tạo và hủy partition, dữ liệu tầng dưới sẽ tự nhiên chuyển đổi giữa các medium khác nhau.
Truy vấn dữ liệu lạnh thế nào?
Tuy dữ liệu lạnh có tần suất truy cập thấp, nhưng một khi cần query (như audit, đối soát, report theo năm), làm thế nào để bảo đảm hiệu quả query?
Phân tích nhu cầu query dữ liệu lạnh
Trước tiên cần xác định rõ: nghiệp vụ có thực sự cần query dữ liệu lạnh không?
- Không cần: Có thể hoàn toàn đưa dữ liệu lạnh ra khỏi business database, chỉ giữ archive (như object storage), khi cần thì trích xuất thủ công.
- Cần: Cần thiết kế phương án query hợp lý, cân bằng performance với chi phí.
Phương án tối ưu query dữ liệu lạnh
| Biện pháp tối ưu | Cách triển khai | Trường hợp sử dụng |
|---|---|---|
| Cold database read-only instance | Triển khai read-only replica cho cold database, tránh query lạnh ảnh hưởng hot database | Trường hợp query lạnh với tần suất cao |
| Query routing | Application layer tự động route đến hot database hoặc cold database dựa trên khoảng thời gian | Trường hợp query cross hot/cold |
| Pre-aggregation | Định kỳ tạo report theo tháng/quý từ dữ liệu lạnh, khi query thì đọc trực tiếp kết quả aggregate | Trường hợp statistical analysis |
| Columnar storage | Cold database dùng OLAP engine như ClickHouse, Doris | Query phân tích quy mô lớn |
Xử lý query cross hot/cold:
Nếu phạm vi query đồng thời liên quan đến dữ liệu nóng và lạnh (như “query đơn hàng trong 2 năm gần đây”), có hai cách xử lý:
- Tách query: Query riêng hot database và cold database, application layer merge kết quả.
- Giới hạn phạm vi: Nhắc người dùng thu hẹp phạm vi query, tránh query cross-database.
Cảnh báo avalanche: Nếu nghiệp vụ có pagination và sorting toàn cục (như
ORDER BY create_time LIMIT 10000, 20), application layer bắt buộc lấy từ mỗi hot database và cold database10000 + 20record để merge trong memory. Khi offset lớn, rất dễ gây OOM. Bắt buộc:
- Giới hạn phạm vi thời gian query, tránh query cross-database trên khoảng thời gian quá rộng;
- Hoặc route đến wide table được đồng bộ ở tầng dưới (như ClickHouse) để tính toán;
- Nghiêm cấm thực hiện merge pagination với depth lớn ở application layer.
Application layer route dữ liệu nóng và lạnh thế nào?
| Phương án | Cách triển khai | Ưu điểm | Nhược điểm |
|---|---|---|---|
| Hard-code | Trực tiếp xác định routing trong code | Dễ triển khai | Chi phí maintain cao, phải sửa code khi rule thay đổi |
| Configuration center | Lưu routing rule vào configuration center (như Nacos, Apollo) | Điều chỉnh động, không cần restart | Cần component bổ sung |
| Proxy layer | Đưa vào middleware như ShardingSphere, ProxySQL | Nghiệp vụ không cần biết | Độ phức tạp kiến trúc cao |
Cách làm khuyến nghị: Quy mô vừa và nhỏ dùng phương án configuration center, quy mô lớn dùng phương án Proxy layer.
⚠️ Cảnh báo rủi ro: Sau khi đưa vào Proxy layer, mọi phép aggregate cross hot/cold database (như global sorting,
GROUP BYmerge pagination) đều dồn lên memory và CPU của Proxy node. Cần nghiêm ngặt giới hạn số row trả về tối đa của các thao tác này, nếu không rất dễ khiến Proxy node OOM (out of memory).
Monitoring và rollback
Sau khi tách nóng và lạnh được đưa lên production, ít nhất cần theo dõi các metric sau:
- Tiến độ di chuyển: Số lượng chờ di chuyển, số di chuyển thành công, số di chuyển thất bại, số lần retry.
- Độ trễ di chuyển: Thời gian từ khi dữ liệu trong hot database đáp ứng điều kiện trở thành dữ liệu lạnh đến khi di chuyển hoàn tất thực sự.
- Kiểm tra tính nhất quán: Số record trong hot database và cold database, digest của các field quan trọng, tổng các field dạng tiền tệ.
- Phân bố query hit: Tỷ lệ query hot database, query cold database và query cross hot/cold.
- Áp lực cold database: QPS, RT, slow query, số connection và tốc độ tăng storage của cold database.
- Dòng dữ liệu bất thường quay lại: Khi dữ liệu lạnh đột nhiên được truy cập thường xuyên, cache hit rate và áp lực cold database có bất thường hay không.
Chiến lược rollback cũng cần được thiết kế trước. Cách tương đối an toàn là giai đoạn đầu chỉ copy, không xóa; sau khi query routing và kiểm tra tính nhất quán ổn định mới cleanup hot database sau một khoảng trễ. Nhờ vậy, ngay cả khi query path của cold database gặp vấn đề, vẫn có thể tạm thời chuyển lại sang hot database.
Tách nóng và lạnh vs archive dữ liệu vs partition table
Ba khái niệm này dễ bị nhầm lẫn, cần phân biệt rõ:
| Khía cạnh so sánh | Tách nóng và lạnh | Archive dữ liệu | Partition table |
|---|---|---|---|
| Dữ liệu có thể truy cập không | Dữ liệu lạnh vẫn nằm trên query path của nghiệp vụ | Dữ liệu archive thường được đưa ra khỏi business database | Có thể truy cập mọi partition |
| Medium storage | Dữ liệu nóng/lạnh có thể nằm trên các instance hoặc storage khác nhau | Thường di chuyển sang storage chi phí thấp | Trong cùng một instance |
| Độ phức tạp triển khai | Trung bình | Thấp | Thấp |
| Trường hợp điển hình | Dữ liệu có tính thời hạn như đơn hàng, log | Lưu giữ để compliance, backup dữ liệu | Dung lượng một table lớn nhưng không cần tách storage |
Hạn chế của partition table: Partition table của MySQL có thể partition theo thời gian, nhưng mọi partition vẫn nằm trong cùng một instance, không thể tách medium storage. Nếu mục tiêu là giảm chi phí storage, partition table không thể thay thế tách nóng và lạnh.
Trường hợp nghiệp vụ điển hình
Giải thích: Các chiến lược storage dưới đây chỉ mang tính tham khảo. Khi lựa chọn thực tế, cần cân nhắc tổng hợp dung lượng dữ liệu, nhu cầu query, technology stack của đội ngũ và ngân sách chi phí.
Hệ thống đơn hàng
| Giai đoạn | Phạm vi dữ liệu | Chiến lược storage | Giải thích |
|---|---|---|---|
| Dữ liệu nóng | 90 ngày gần nhất + đơn hàng chưa hoàn tất | MySQL hot database (SSD) | Truy cập thường xuyên, bảo đảm performance query |
| Dữ liệu lạnh | 90 ngày~3 năm | MySQL cold database (HDD) hoặc TiDB | Có thể cần query, giữ relational storage |
| Dữ liệu archive | Trên 3 năm | Object storage / HBase / chỉ giữ aggregate table | Cực ít query, ưu tiên cân nhắc chi phí |
Hệ thống log
| Giai đoạn | Phạm vi dữ liệu | Chiến lược storage | Giải thích |
|---|---|---|---|
| Dữ liệu nóng | 7 ngày gần nhất | Elasticsearch hot node | Search real-time, query thường xuyên |
| Dữ liệu ấm | 7~30 ngày | Elasticsearch warm node | Query không thường xuyên, giảm chi phí storage |
| Dữ liệu lạnh | Trên 30 ngày | Elasticsearch cold node / archive nén sang object storage / ClickHouse | Chọn theo nhu cầu query, ClickHouse phù hợp với trường hợp analysis |
Hệ thống nội dung
| Giai đoạn | Phạm vi dữ liệu | Chiến lược storage | Giải thích |
|---|---|---|---|
| Dữ liệu nóng | Trong 3 tháng sau khi phát hành + lượt đọc cao | MySQL hot database | Được truy cập thường xuyên |
| Dữ liệu lạnh | Sau 3 tháng + lượt đọc thấp | MySQL cold database / HBase / object storage | Tần suất truy cập thấp, có thể di chuyển sang storage chi phí thấp |
Khuyến nghị lựa chọn:
- Cần hỗ trợ transaction hoặc query phức tạp: Ưu tiên MySQL cold database hoặc TiDB
- Cần aggregate analysis quy mô lớn: Ưu tiên ClickHouse hoặc Doris
- Chỉ thỉnh thoảng cần query detail: Có thể chọn object storage (như OSS/S3), khi query thì load tạm thời
- Dung lượng dữ liệu cực lớn và tần suất truy cập cực thấp: HBase hoặc object storage có cost performance cao nhất
Chia sẻ case study
- Cách tối ưu nhanh table đơn hàng có hàng chục triệu dữ liệu - Lập trình viên Tế Điên - 2023
- Phương án và thực tiễn tách nóng/lạnh cho dữ liệu lớn - Đội kỹ thuật ByteDance - 2022
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.