
Giải thích chi tiết về MySQL index
Cảm ơn WT-AHA đã hoàn thiện bài viết này, PR liên quan: https://github.com/Snailclimb/JavaGuide/pull/1648.
Chỉ cần đã trải qua vài cuộc phỏng vấn, bạn hẳn biết kiến thức về database index xuất hiện với tần suất cao đến mức khó tin.
Ngoài việc rất quan trọng khi chuẩn bị phỏng vấn, sử dụng index đúng cách còn cải thiện rõ rệt performance của SQL, là một biện pháp SQL optimization có hiệu quả cao so với chi phí.
Giới thiệu về index
Index là một data structure dùng để query và tìm kiếm data nhanh; về bản chất, có thể xem đây là một data structure đã được sắp xếp.
Vai trò của index tương đương với mục lục của một cuốn sách. Ví dụ, khi tra từ điển, nếu không có mục lục thì bạn chỉ có thể tìm từ cần tra từng trang một, tốc độ rất chậm; nếu có mục lục, bạn chỉ cần tra vị trí của từ trong mục lục rồi lật thẳng đến trang đó.
Có nhiều loại data structure ở tầng dưới của index. Các index structure thường gặp gồm B tree, B+ tree, Hash và red-black tree. Trong MySQL, cả InnoDB và MyISAM đều sử dụng B+ tree làm index structure.
Ưu và nhược điểm của index
Ưu điểm của index:
- Tốc độ query tăng vọt (mục đích chính): Thông qua index, database có thể giảm đáng kể lượng data cần scan, định vị trực tiếp các record phù hợp điều kiện, từ đó tăng rõ rệt tốc độ truy xuất data và giảm số lần disk I/O.
- Đảm bảo tính duy nhất của data: Thông qua việc tạo unique index, có thể đảm bảo giá trị của một column (hoặc tổ hợp vài column) trong table là duy nhất, chẳng hạn user ID, email. Bản thân primary key cũng là một dạng unique index.
- Tăng tốc sort và group: Nếu column được dùng trong mệnh đề ORDER BY hoặc GROUP BY của query có index, database thường có thể tận dụng đặc tính đã được sort của index, tránh thao tác sort bổ sung và cải thiện performance.
Nhược điểm của index:
- Tốn thời gian tạo và maintain: Bản thân việc tạo index cần thời gian, đặc biệt khi thao tác trên table lớn. Quan trọng hơn, khi insert, delete, update (DML operation) data trong table, ngoài việc thao tác với data, các index liên quan cũng phải được update và maintain, điều này sẽ làm giảm hiệu suất thực thi của các DML operation này.
- Chiếm storage space: Bản chất index cũng là một data structure, cần được lưu dưới dạng physical file (hoặc memory structure), vì vậy sẽ chiếm thêm một phần disk space. Càng nhiều index, index càng lớn thì càng chiếm nhiều space.
- Có thể bị dùng sai hoặc mất hiệu lực: Nếu thiết kế index không phù hợp hoặc câu query viết không tốt, query optimizer có thể không chọn sử dụng index (hoặc chọn nhầm index), thậm chí khiến performance giảm.
Vậy dùng index có nhất định cải thiện query performance không?
Không nhất định. Trong phần lớn trường hợp, sử dụng index hợp lý quả thực nhanh hơn full table scan rất nhiều. Nhưng cũng có ngoại lệ:
- Lượng data quá nhỏ: Nếu data trong table rất ít (chẳng hạn chỉ vài trăm record), full table scan có thể nhanh hơn tìm kiếm thông qua index, vì bản thân việc đi qua index cũng có overhead.
- Tỷ lệ result set quá lớn: Nếu data cần query chiếm phần lớn cả table (chẳng hạn vượt quá 20%-30%), optimizer có thể cho rằng full table scan có lợi hơn, vì chi phí nhiều lần table lookup qua index (random I/O) có thể cao hơn một lần full table scan tuần tự.
- Index được maintain không đúng cách hoặc statistics đã cũ: Khiến optimizer đưa ra phán đoán sai.
Lựa chọn data structure ở tầng dưới của index
Hash table
Hash table là tập hợp các cặp key-value. Thông qua key, có thể nhanh chóng lấy value tương ứng, vì vậy hash table có thể truy xuất data nhanh (gần O(1)).
Vì sao có thể nhanh chóng lấy value thông qua key? Nguyên nhân nằm ở hash algorithm (còn gọi là hashing algorithm). Thông qua hash algorithm, ta có thể nhanh chóng tìm index tương ứng với key; tìm được index là tìm được value tương ứng.
hash = hashfunc(key)
index = hash % array_size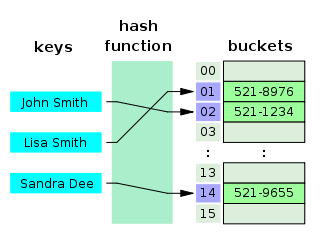
Tuy nhiên! Hash algorithm có vấn đề hash collision, tức là nhiều key khác nhau cuối cùng cho ra cùng một index. Cách giải quyết thường dùng là chaining, tức lưu data bị hash collision trong linked list. Chẳng hạn, trước JDK 1.8, HashMap giải quyết hash collision bằng chaining. Tuy nhiên, từ JDK 1.8 trở đi, để tăng search performance khi linked list quá dài, HashMap đã đưa vào red-black tree.
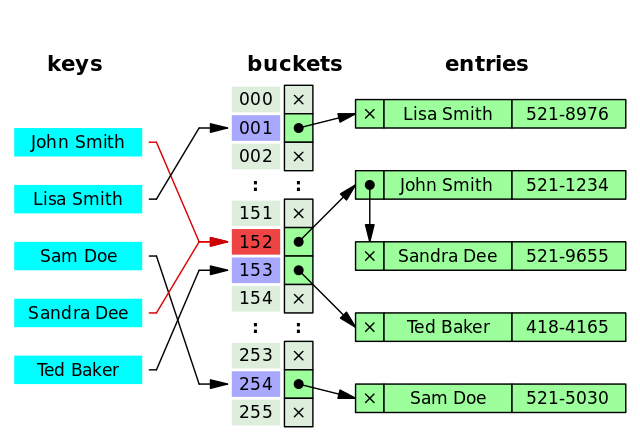
Để giảm khả năng xảy ra hash collision, một hash function tốt nên phân phối data một cách “đồng đều” trong toàn bộ tập hợp hash value có thể có.
Storage engine InnoDB của MySQL không trực tiếp hỗ trợ hash index thông thường, nhưng trong InnoDB tồn tại một loại “adaptive hash index” đặc biệt. Adaptive hash index không phải hash index thuần túy theo nghĩa truyền thống, mà kết hợp đặc điểm của B+Tree và hash index để thích ứng tốt hơn với data access pattern và performance requirement trong ứng dụng thực tế. Mỗi hash bucket của adaptive hash index thực tế là một cấu trúc B+Tree nhỏ. Cấu trúc B+Tree này có thể lưu nhiều cặp key-value thay vì chỉ một key. Điều này giúp rút ngắn hash collision chain và nâng cao hiệu quả của index. Để xem giới thiệu chi tiết về Adaptive Hash Index, có thể tham khảo bài viết Các “Buffer” khác nhau của MySQL: Adaptive Hash Index.
Hash table nhanh như vậy, vì sao MySQL không dùng nó làm index structure? Chủ yếu vì Hash index không hỗ trợ query theo thứ tự và range query. Nếu cần sort data trong table hoặc thực hiện range query thì Hash index không đáp ứng được. Ngoài ra, mỗi lần I/O chỉ có thể lấy một record.
Hãy thử hình dung tình huống sau:
SELECT * FROM tb1 WHERE id < 500;Trong range query này, ưu thế rất rõ: chỉ cần duyệt trực tiếp các leaf node nhỏ hơn 500 là đủ. Còn Hash index định vị theo hash algorithm; chẳng lẽ phải tính hash một lần cho từng data từ 1 đến 499 để định vị hay sao? Đây chính là nhược điểm lớn nhất của Hash.
Binary Search Tree (BST)
Binary Search Tree (BST) là một data structure dựa trên binary tree, có các đặc điểm sau:
- Giá trị của mọi node trong left subtree đều nhỏ hơn giá trị của root node.
- Giá trị của mọi node trong right subtree đều lớn hơn giá trị của root node.
- Left subtree và right subtree cũng lần lượt là binary search tree.
Khi binary search tree balanced, tức là độ sâu left subtree và right subtree của mỗi node chênh lệch không quá 1, time complexity của query là O(log2(N)), có hiệu suất khá cao. Tuy nhiên, khi binary search tree không balanced, chẳng hạn trong trường hợp xấu nhất (insert node theo thứ tự), tree sẽ suy biến thành linked list tuyến tính (còn gọi là oblique tree), khiến query performance giảm mạnh và time complexity suy biến thành O(N).
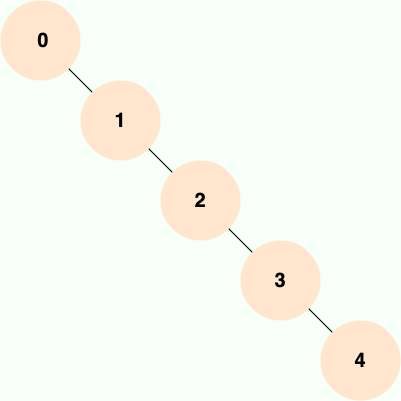
Nói cách khác, performance của binary search tree phụ thuộc rất nhiều vào mức độ balance của nó, khiến nó không phù hợp làm data structure của MySQL index ở tầng dưới.
Để giải quyết vấn đề này và nâng cao query performance, người ta đã phát minh nhiều data structure cải tiến dựa trên binary search tree, chẳng hạn balanced binary tree, B-Tree, B+Tree.
AVL tree
AVL tree là binary search tree tự balance được phát minh sớm nhất trong computer science. Tên gọi này là viết tắt từ tên của các nhà phát minh G.M. Adelson-Velsky và E.M. Landis. AVL tree đảm bảo chênh lệch height giữa left subtree và right subtree của mọi node không vượt quá 1, vì vậy còn được gọi là height-balanced binary tree. Time complexity của search, insert và delete trong cả trường hợp trung bình lẫn xấu nhất đều là O(logn).
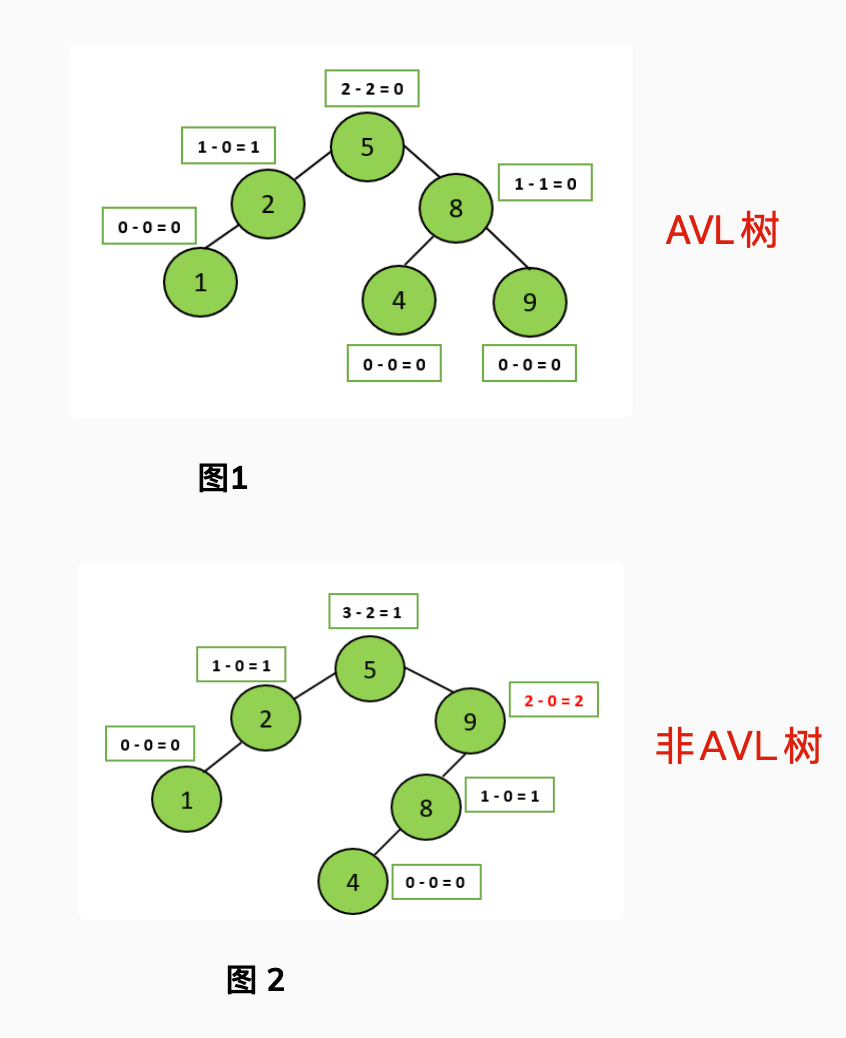
AVL tree sử dụng rotation để duy trì balance. Có bốn rotation chính: LL rotation, RR rotation, LR rotation và RL rotation. LL rotation và RR rotation lần lượt xử lý mất balance kiểu left-left và right-right, còn LR rotation và RL rotation xử lý mất balance kiểu left-right và right-left.
Vì AVL tree cần thực hiện rotation thường xuyên để duy trì balance nên có overhead tính toán lớn, từ đó làm giảm performance của thao tác write trong database. Ngoài ra, khi sử dụng AVL tree, mỗi tree node chỉ lưu một data, mỗi lần disk I/O chỉ đọc được data của một node. Nếu data cần query phân bố trên nhiều node thì phải thực hiện nhiều disk I/O. Disk I/O là thao tác tốn thời gian; khi thiết kế database index, cần ưu tiên cân nhắc cách giảm tối đa số lần disk I/O.
Trong ứng dụng thực tế, AVL tree không được dùng nhiều.
Red-black tree
Red-black tree là một binary search tree tự balance. Thông qua color change và rotation khi insert, delete node, tree luôn được duy trì ở trạng thái balanced. Nó có các đặc điểm sau:
- Mỗi node hoặc đỏ hoặc đen;
- Root node luôn có màu đen;
- Mỗi leaf node là một node rỗng màu đen (NIL node);
- Nếu node có màu đỏ thì child node của nó phải có màu đen (chiều ngược lại không nhất thiết đúng);
- Mỗi path từ một node bất kỳ đến leaf node hoặc empty node của nó phải chứa cùng số lượng black node (tức cùng black height).
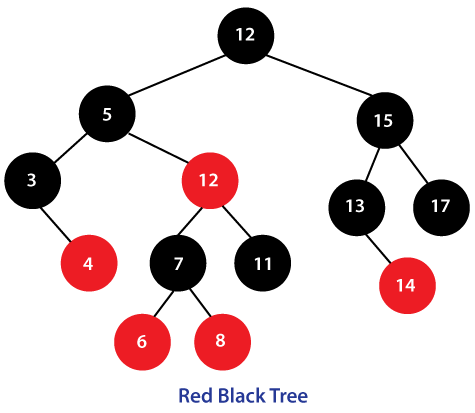
Khác với AVL tree, red-black tree không theo đuổi balance nghiêm ngặt mà chỉ balance tương đối. Vì vậy, query performance của red-black tree giảm đôi chút: do tính balance tương đối yếu, height của tree có thể lớn hơn, khiến một số data cần trải qua nhiều disk I/O mới query được. Đây cũng là nguyên nhân chính MySQL không chọn red-black tree. Cũng vì vậy, hiệu suất insert và delete của red-black tree được nâng cao đáng kể: khi insert và delete node, red-black tree chỉ cần thực hiện số lần rotation và color change là O(1) để duy trì trạng thái cơ bản balanced, thay vì phải thực hiện O(logn) rotation như AVL tree.
Red-black tree được ứng dụng khá rộng rãi. Tầng dưới của TreeMap, TreeSet và HashMap từ JDK1.8 đều sử dụng red-black tree. Với trường hợp data nằm trong memory, performance của red-black tree rất tốt.
Để so sánh cơ bản giữa binary search tree, AVL tree, red-black tree, B tree và B+ tree, bạn có thể xem trước Giải thích chi tiết về tree structure và Giải thích chi tiết về red-black tree.
B tree & B+ tree
B tree còn gọi là B-Tree, tên đầy đủ là multi-way balanced search tree; B+ tree là một biến thể của B tree. Chữ B trong B tree và B+ tree mang nghĩa Balanced.
Hiện nay phần lớn database system và file system đều sử dụng B-Tree hoặc biến thể B+Tree của nó làm index structure.
B tree và B+ tree giống và khác nhau thế nào?
- Mọi node của B tree đều lưu cả key và data, trong khi chỉ leaf node của B+ tree lưu key và data, các internal node khác chỉ lưu key.
- Leaf node của B tree độc lập với nhau; leaf node của B+ tree có một reference chain trỏ đến các leaf node liền kề.
- Quá trình search của B tree tương đương binary search key của từng node trong range, có thể kết thúc trước khi đến leaf node. Query performance của B+ tree ổn định hơn: mọi lần search đều đi từ root node đến leaf node, và thứ tự search của leaf node rất rõ ràng.
- Khi range query trong B tree, trước tiên tìm lower bound, sau đó inorder traversal B tree cho đến khi tìm được upper bound; còn range query của B+ tree chỉ cần duyệt linked list.
Tóm lại, so với B tree, B+ tree có các ưu điểm: ít lần I/O hơn, query performance ổn định hơn và phù hợp hơn với range query.
Nếu chỉ muốn ôn nhanh B tree và B+ tree từ góc độ data structure, có thể xem lại phần ôn tập phỏng vấn trong Giải thích chi tiết về tree structure.
Trong MySQL, MyISAM engine và InnoDB engine đều sử dụng B+Tree làm index structure, nhưng cách implement của hai engine không hoàn toàn giống nhau (nội dung dưới đây được tổng hợp từ Con đường tu dưỡng của Java engineer).
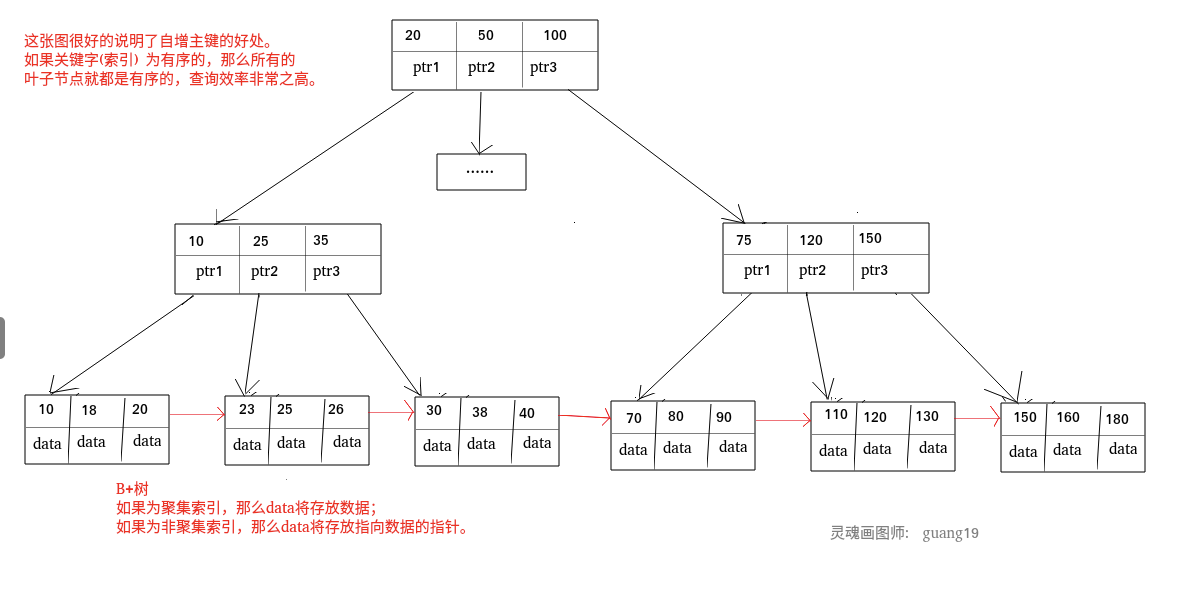
Trong MyISAM engine, data field của leaf node B+Tree lưu địa chỉ của data record. Khi search index, trước tiên thực hiện search index theo B+Tree search algorithm; nếu key được chỉ định tồn tại thì lấy giá trị data field, sau đó dùng giá trị của data field làm địa chỉ để đọc data record tương ứng. Đây được gọi là non-clustered index.
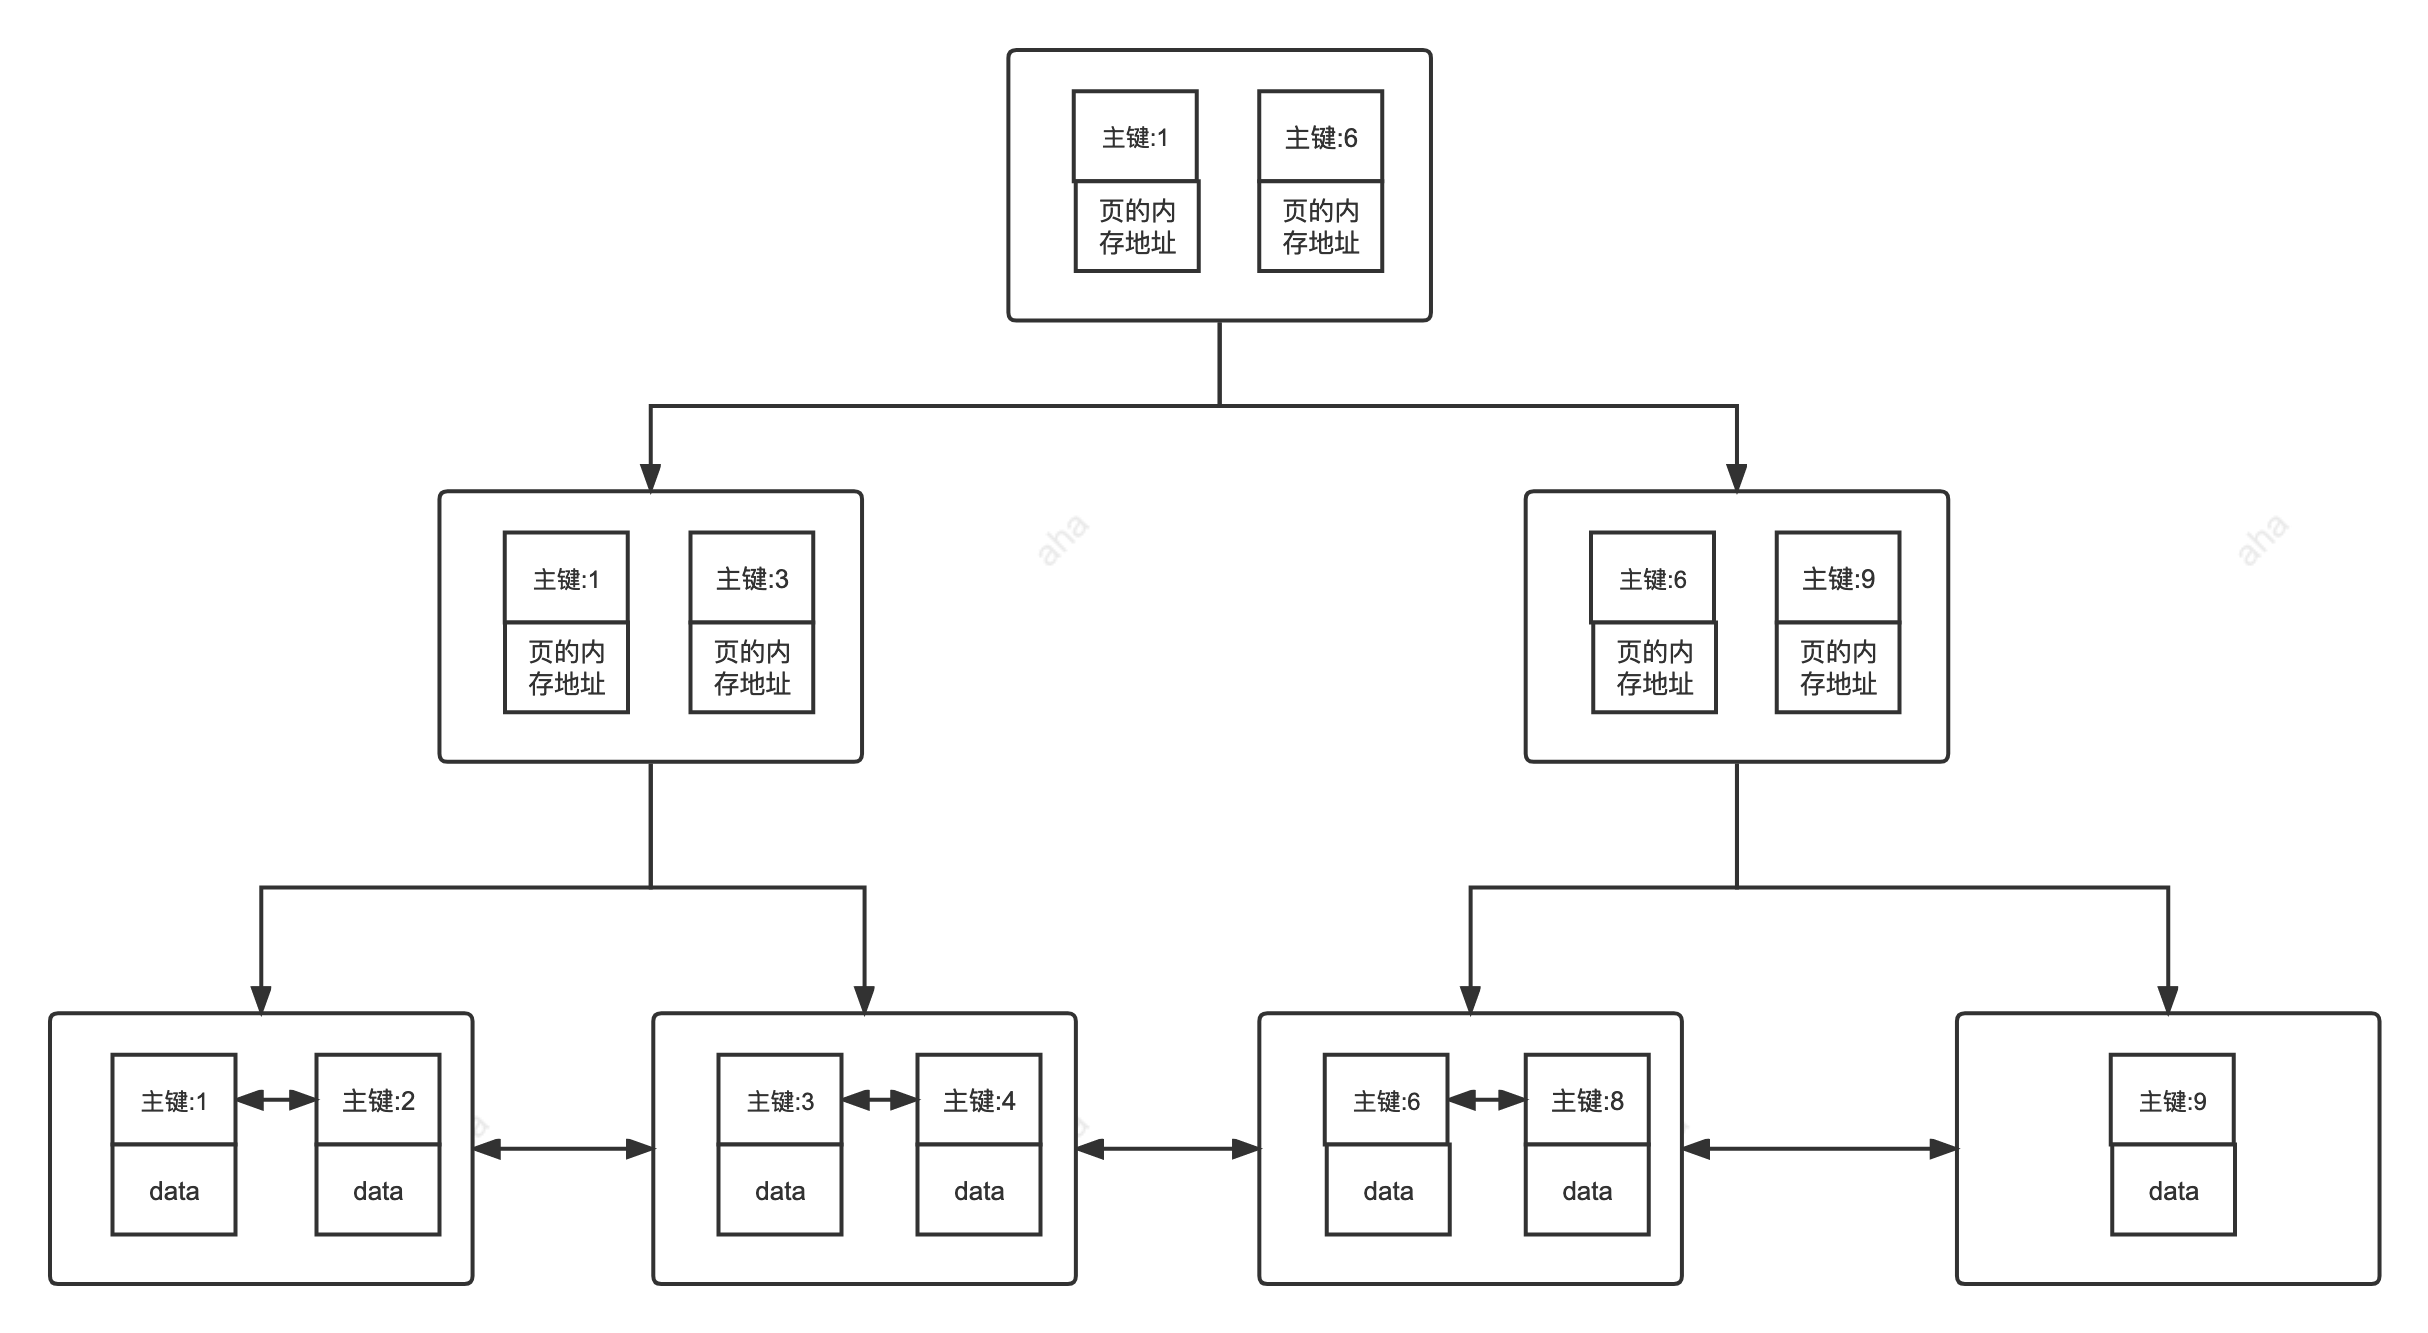
Trong InnoDB engine, bản thân data file chính là index file. Khác với MyISAM, index file và data file tách rời; bản thân data file của table là một index structure được tổ chức theo B+Tree, data field của leaf node lưu full data record. Key của index này là primary key của data table, vì vậy bản thân data file của InnoDB table chính là primary index. Đây được gọi là clustered index; các index còn lại đều là secondary index, data field của secondary index lưu giá trị primary key của record tương ứng thay vì địa chỉ, đây cũng là điểm khác MyISAM. Khi search theo primary index, chỉ cần tìm node chứa key là có thể lấy data; khi search theo secondary index, trước tiên phải lấy giá trị primary key rồi đi qua primary index một lần nữa. Vì vậy, khi thiết kế table, không nên dùng field quá dài làm primary key, cũng không nên dùng field không monotonic làm primary key, vì điều đó khiến primary index thường xuyên bị split.
Tổng hợp các loại index
Phân loại theo data structure:
- BTree index: Loại index mặc định và phổ biến nhất trong MySQL. Chỉ leaf node lưu value, non-leaf node chỉ có pointer và key. MyISAM và InnoDB đều implement BTree index bằng B+Tree, nhưng cách implement khác nhau (đã giới thiệu ở trên).
- Hash index: Có dạng tương tự key-value, có thể định vị chỉ bằng một lần.
- RTree index: Thường không dùng, chỉ hỗ trợ data type geometry, ưu điểm là range search nhưng hiệu suất thấp; thường dùng search engine như ElasticSearch thay thế.
- Full-text index: Phân tách nội dung text thành các term để search. Hiện chỉ có thể tạo full-text index trên column
CHAR,VARCHAR,TEXT. Thường không dùng vì hiệu suất thấp, thường dùng search engine như ElasticSearch thay thế.
Phân loại theo storage method ở tầng dưới:
- Clustered index: Index mà index structure và data được lưu cùng nhau; primary key index trong InnoDB thuộc clustered index.
- Non-clustered index: Index mà index structure và data được lưu tách rời; secondary index (auxiliary index) thuộc non-clustered index. MyISAM engine của MySQL, bất kể primary key hay non-primary key, đều sử dụng non-clustered index.
Phân loại theo application:
- Primary key index: Tăng tốc query + giá trị column duy nhất (không được có NULL) + mỗi table chỉ có một index.
- Normal index: Chỉ tăng tốc query.
- Unique index: Tăng tốc query + giá trị column duy nhất (có thể có NULL).
- Covering index: Một index chứa (hay nói cách khác là cover) value của mọi field cần query.
- Composite index: Nhiều column value tạo thành một index, chuyên dùng cho combination search, hiệu suất cao hơn index merge.
- Full-text index: Phân tách nội dung text thành các term để search. Hiện chỉ có thể tạo full-text index trên column
CHAR,VARCHAR,TEXT. Thường không dùng vì hiệu suất thấp, thường dùng search engine như ElasticSearch thay thế. - Prefix index: Tạo index trên một số character đầu tiên của text. So với normal index, data được tạo nhỏ hơn vì chỉ lấy một số character đầu tiên.
Các index feature mới được implement trong MySQL 8.x:
- Invisible index: Còn gọi là hidden index, không được optimizer sử dụng nhưng vẫn cần maintain, thường dùng trong các scenario soft delete và gray release. Primary key không thể đặt thành hidden (dù đặt explicit hay implicit).
- Descending index: Các version trước đã hỗ trợ chỉ định index giảm dần bằng desc, nhưng thực tế index tạo ra vẫn là ascending index thông thường. Chỉ từ MySQL 8.x mới thực sự hỗ trợ descending index. Ngoài ra, trong MySQL 8.x, câu lệnh GROUP BY không còn được implicit sort.
- Functional index: Từ MySQL 8.0.13 bắt đầu hỗ trợ dùng function hoặc expression value trong index, tức là index có thể chứa function hoặc expression.
Primary key index (Primary Key)
Column primary key của data table sử dụng primary key index.
Một data table chỉ có thể có một primary key, primary key không được là null và không được trùng lặp.
Trong table InnoDB của MySQL, khi không explicit chỉ định primary key cho table, trước tiên InnoDB sẽ tự động kiểm tra xem table có field nào có unique index và không cho phép giá trị null hay không. Nếu có, field đó sẽ được chọn làm primary key mặc định; nếu không, InnoDB sẽ tự động tạo một primary key tự tăng 6 byte.
Secondary index
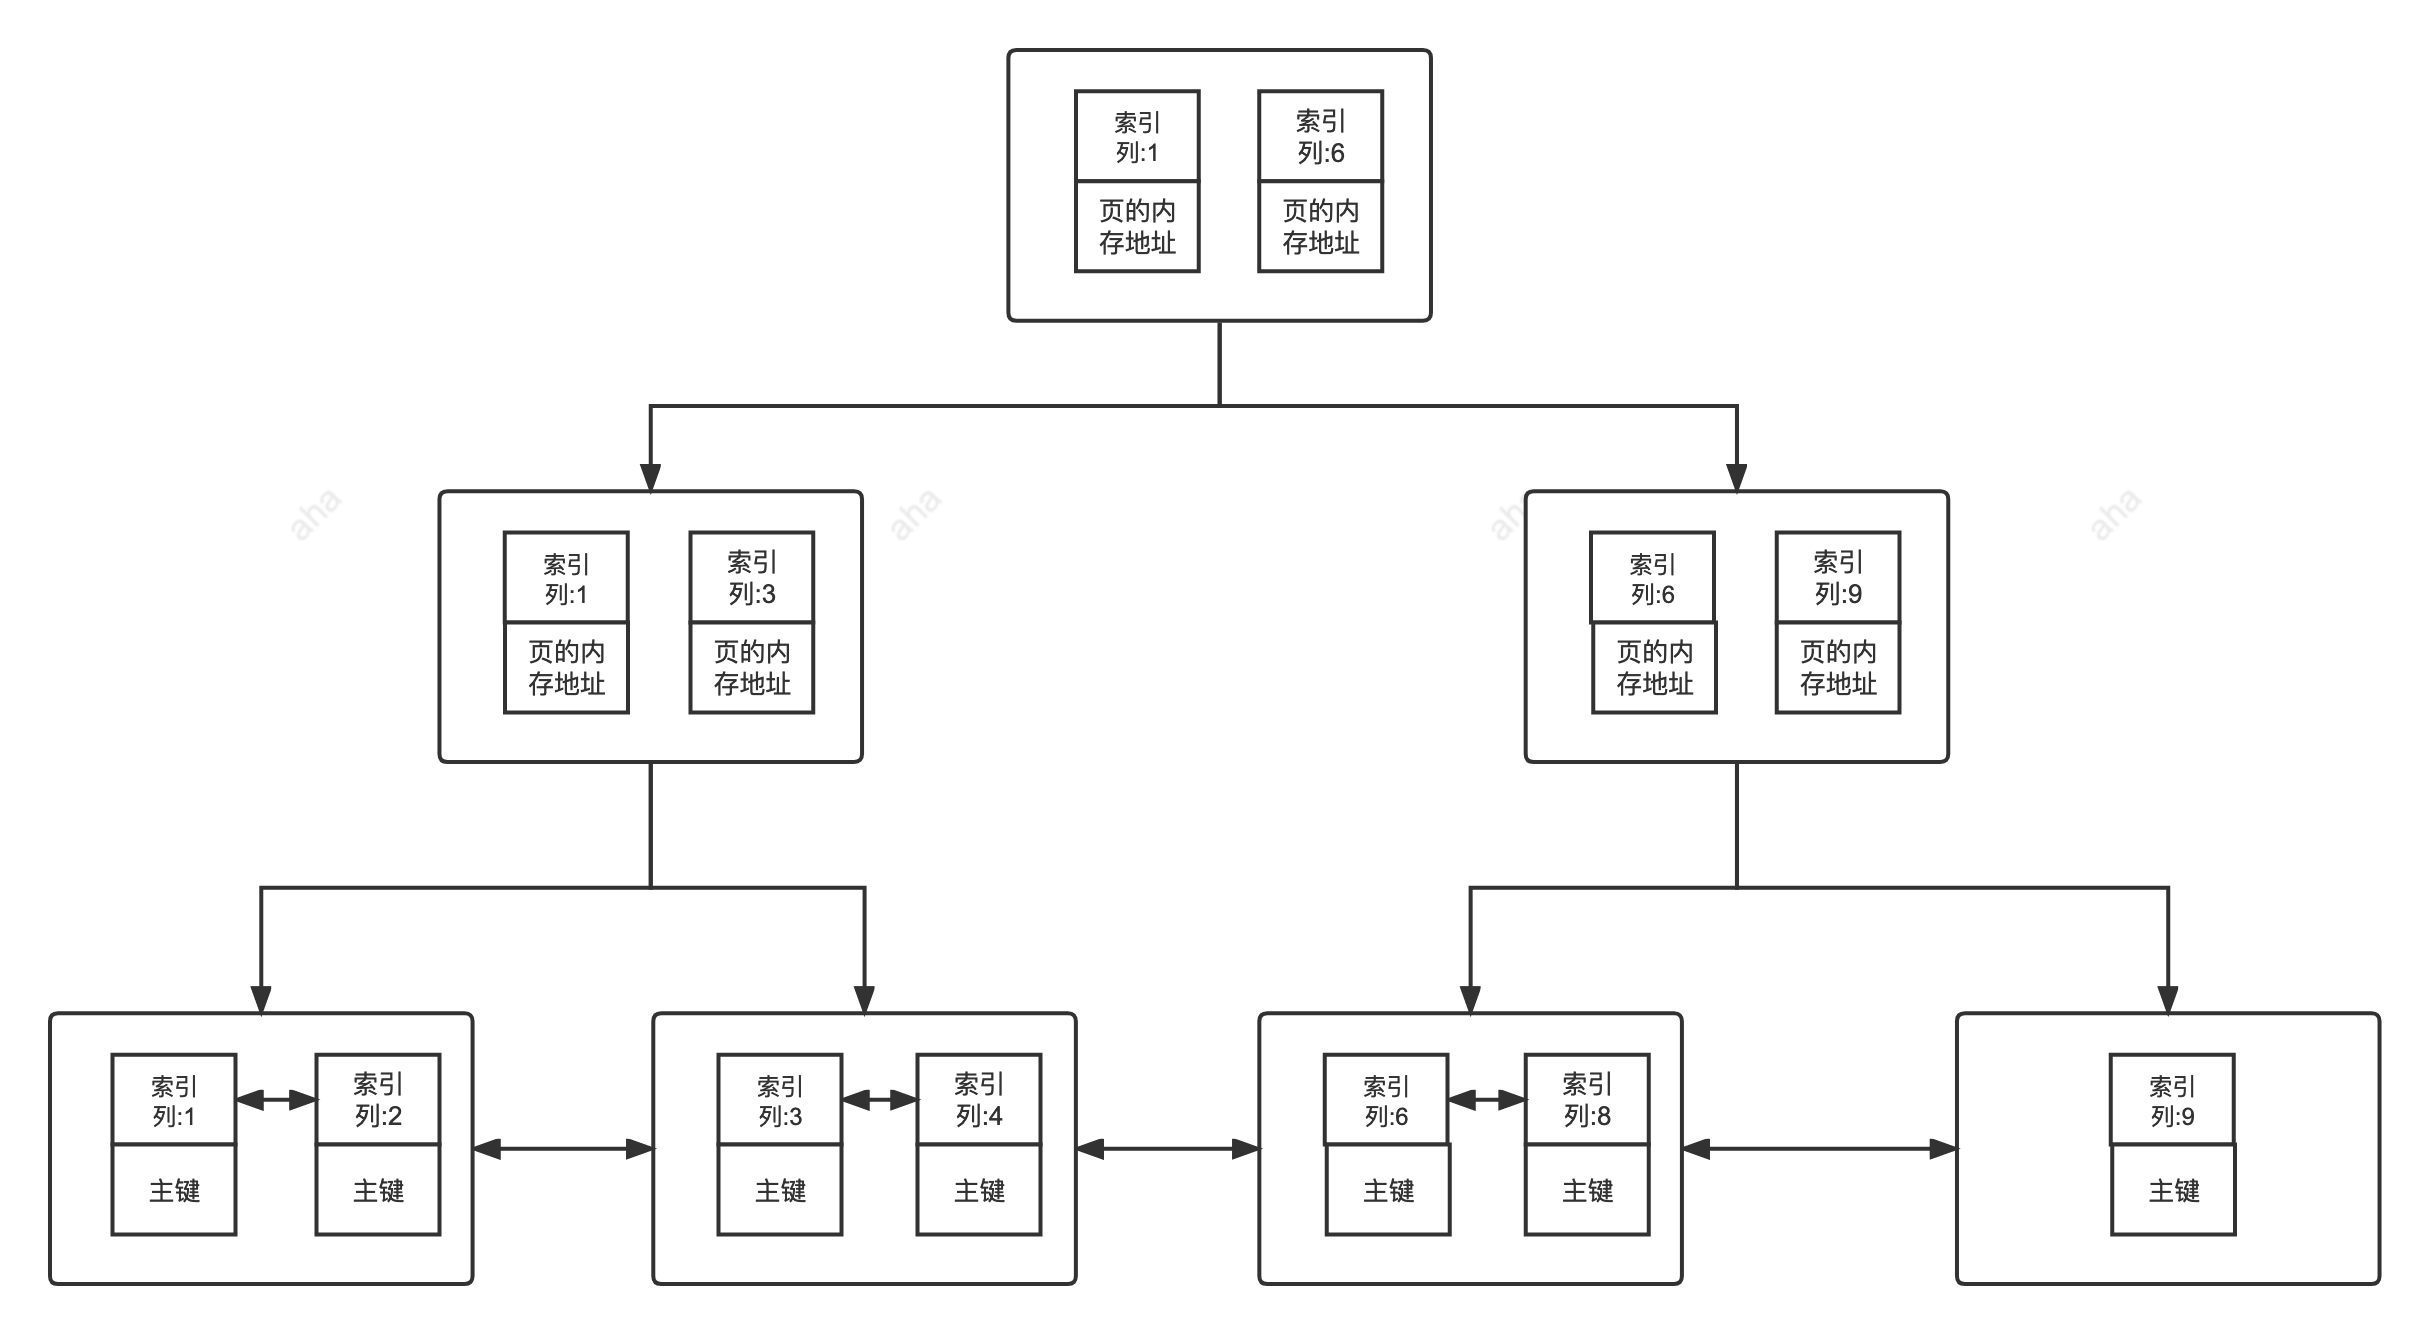
Leaf node của secondary index lưu primary key value. Nói cách khác, thông qua secondary index có thể tìm được primary key; secondary index còn được gọi là auxiliary index/non-primary key index.
Unique index, normal index, prefix index và các index khác đều thuộc secondary index.
PS: Nếu chưa hiểu, bạn có thể tạm bỏ qua, xem tiếp từ từ; phần sau sẽ có câu trả lời, hoặc bạn cũng có thể tự search.
- Unique index (Unique Key): Unique index cũng là một constraint. Column của unique index không được chứa data trùng lặp, nhưng cho phép data là NULL; một table cho phép tạo nhiều unique index. Phần lớn mục đích tạo unique index là đảm bảo tính duy nhất của data trong column chứ không phải query efficiency.
- Normal index (Index): Tác dụng duy nhất của normal index là query data nhanh. Một table cho phép tạo nhiều normal index và cho phép data trùng lặp, có NULL.
- Prefix index (Prefix): Prefix index chỉ áp dụng cho data dạng string. Prefix index tạo index trên một số character đầu tiên của text; so với normal index, data được tạo nhỏ hơn vì chỉ lấy một số character đầu tiên.
- Full-text index (Full Text): Full-text index chủ yếu dùng để tìm thông tin keyword trong lượng lớn text data, là một kỹ thuật được database của search engine sử dụng. Trước Mysql5.6 chỉ MyISAM engine hỗ trợ full-text index; từ 5.6 trở đi InnoDB cũng hỗ trợ full-text index.
Secondary index:
Clustered index và non-clustered index
Clustered index (clustered index)
Giới thiệu clustered index
Clustered index (Clustered Index) là index mà index structure và data được lưu cùng nhau, không phải một loại index độc lập. Primary key index trong InnoDB thuộc clustered index.
Trong MySQL, file .ibd của table thuộc InnoDB engine chứa index và data của table đó. Với table thuộc InnoDB engine, mỗi non-leaf node của index (B+ tree) lưu các key của index, còn leaf node lưu key và data tương ứng.
Ưu và nhược điểm của clustered index
Ưu điểm:
- Query performance rất nhanh: Query performance của clustered index rất nhanh vì toàn bộ B+ tree bản thân nó là một multi-way balanced tree, các leaf node cũng có thứ tự. Định vị được index node tương đương với định vị được data. So với non-clustered index, clustered index giảm được một lần đọc data bằng I/O.
- Tối ưu cho sort search và range search: Clustered index có tốc độ rất nhanh khi sort search và range search theo primary key.
Nhược điểm:
- Phụ thuộc vào data có thứ tự: Vì B+ tree là multi-way balanced tree, nếu index data không có thứ tự thì cần sort khi insert. Với data dạng integer thì không sao, nhưng với data dài và khó so sánh như string hoặc UUID, tốc độ insert hoặc search chắc chắn khá chậm.
- Chi phí update lớn: Nếu data của index column bị sửa thì index tương ứng cũng phải sửa; hơn nữa leaf node của clustered index còn lưu data, nên chi phí sửa chắc chắn lớn. Vì vậy, với primary key index, primary key thường không được sửa.
Non-clustered index (non-clustered index)
Giới thiệu non-clustered index
Non-clustered index (Non-Clustered Index) là index mà index structure và data được lưu tách rời, không phải một loại index độc lập. Secondary index (auxiliary index) thuộc non-clustered index. MySQL MyISAM engine, bất kể primary key hay non-primary key, đều sử dụng non-clustered index.
Leaf node của non-clustered index không nhất thiết lưu pointer của data, vì leaf node của secondary index lưu primary key; sau đó dựa vào primary key để table lookup lấy data.
Ưu và nhược điểm của non-clustered index
Ưu điểm:
Chi phí update nhỏ hơn clustered index. Chi phí update của non-clustered index không lớn như clustered index vì leaf node của non-clustered index không lưu data.
Nhược điểm:
- Phụ thuộc vào data có thứ tự: Giống clustered index, non-clustered index cũng phụ thuộc vào data có thứ tự.
- Có thể phải query lần hai (table lookup): Đây có lẽ là nhược điểm lớn nhất của non-clustered index. Sau khi tìm được pointer hoặc primary key tương ứng với index, có thể vẫn cần dựa vào pointer hoặc primary key để query tiếp trong data file hoặc table.
Đây là ảnh chụp file của MySQL table:
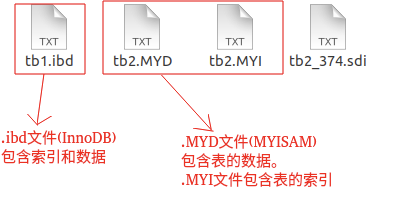
Clustered index và non-clustered index:
Non-clustered index có nhất định phải table lookup không (covering index)?
Non-clustered index không nhất định phải table lookup.
Hãy hình dung một tình huống: user muốn dùng SQL query username, và column username vừa hay đã được tạo index.
SELECT name FROM table WHERE name='guang19';Khi đó key của index này chính là name, sau khi tìm được name tương ứng thì trả về trực tiếp là được, không cần table lookup.
Ngay cả MyISAM cũng như vậy. Mặc dù primary key index của MyISAM quả thực cần table lookup vì leaf node của primary key index lưu pointer. Nhưng! Nếu SQL query chính là primary key thì sao?
SELECT id FROM table WHERE id=1;Key của primary key index bản thân là primary key, tìm được thì trả về là xong. Trường hợp này được gọi là covering index.
Covering index và composite index
Covering index
Nếu một index chứa (hay nói cách khác là cover) value của mọi field cần query, chúng ta gọi đó là covering index.
Trong InnoDB engine, leaf node của non-primary key index chứa primary key value. Điều này có nghĩa là khi query bằng non-primary key index, database trước tiên tìm primary key value tương ứng, sau đó thông qua primary key index để định vị và lấy full row data. Quá trình này được gọi là “table lookup”.
Covering index nghĩa là field cần query vừa đúng là field của index; khi đó chỉ cần dựa vào index này là có thể lấy data mà không cần table lookup.
Ví dụ với primary key index, nếu một SQL cần query primary key thì có thể query được primary key trực tiếp dựa vào primary key index. Tương tự, với normal index, nếu một SQL cần query name và column name vừa hay có index,
thì có thể lấy data trực tiếp dựa vào index này, không cần table lookup.
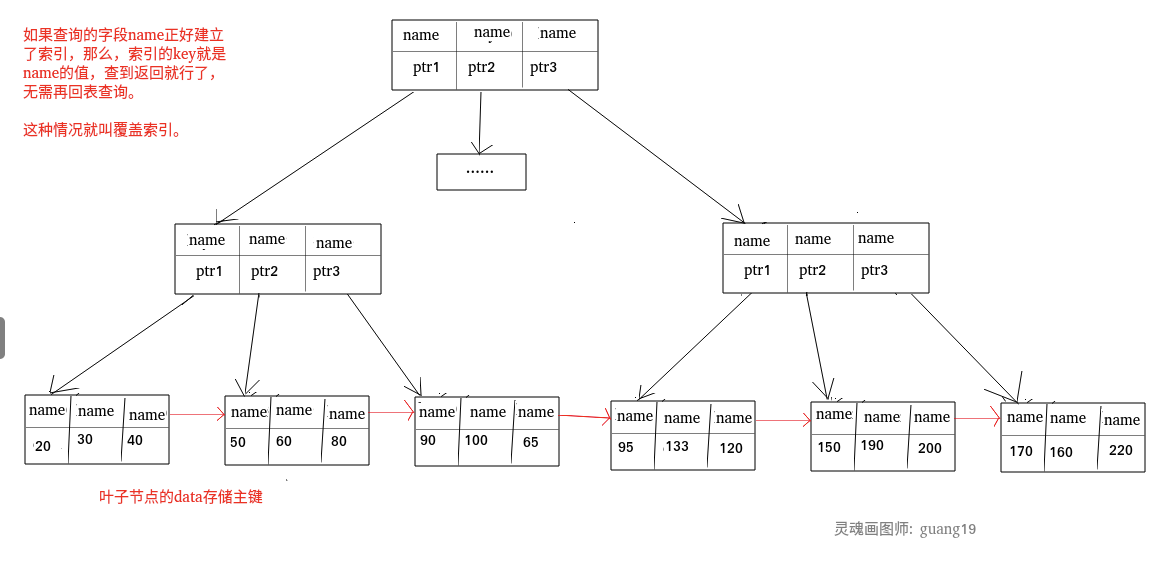
Ở đây chúng ta minh họa đơn giản hiệu quả của covering index.
- Tạo table tên
cus_orderđể kiểm thử thực tế cách sort này. Để thuận tiện kiểm thử, tablecus_orderchỉ có 3 fieldid,score,name.
CREATE TABLE `cus_order` (
  `id` int(11) unsigned NOT NULL AUTO_INCREMENT,
  `score` int(11) NOT NULL,
  `name` varchar(11) NOT NULL DEFAULT '',
  PRIMARY KEY (`id`)
) ENGINE=InnoDB AUTO_INCREMENT=100000 DEFAULT CHARSET=utf8mb4;- Định nghĩa một stored procedure đơn giản (PROCEDURE) để insert 1 triệu test data.
DELIMITER ;;
CREATE DEFINER=`root`@`%` PROCEDURE `BatchinsertDataToCusOder`(IN start_num INT,IN max_num INT)
BEGIN
      DECLARE i INT default start_num;
      WHILE i < max_num DO
          insert into `cus_order`(`id`, `score`, `name`)
          values (i,RAND() * 1000000,CONCAT('user', i));
          SET i = i + 1;
      END WHILE;
  END;;
DELIMITER ;
Sau khi định nghĩa stored procedure xong, chỉ cần thực thi stored procedure!
CALL BatchinsertDataToCusOder(1, 1000000); # Insert hơn 1 triệu random dataChờ một lúc, 1 triệu test data sẽ được insert xong!
- Tạo covering index và dùng lệnh
EXPLAINđể phân tích.
Để sort 1 triệu data theo score, cần thực thi SQL dưới đây.
#Sort giảm dần
SELECT `score`,`name` FROM `cus_order` ORDER BY `score` DESC;
Dùng lệnh EXPLAIN phân tích SQL này. Qua column Using filesort trong Extra, chúng ta phát hiện covering index chưa được dùng.

Điều này cũng hoàn toàn hợp lý, vì hiện tại chúng ta chưa tạo index!
Ở đây tạo composite index trên hai field score và name:
ALTER TABLE `cus_order` ADD INDEX id_score_name(score, name);Sau khi tạo xong, dùng lệnh EXPLAIN để phân tích lại SQL này.

Qua Using index trong column Extra, có thể thấy SQL này đã sử dụng covering index thành công.
Xem giới thiệu chi tiết về lệnh EXPLAIN tại bài Phân tích execution plan của MySQL.
Composite index
Tạo index bằng nhiều field trong table được gọi là composite index, còn gọi là combined index hoặc compound index.
Tạo composite index trên hai field score và name:
ALTER TABLE `cus_order` ADD INDEX id_score_name(score, name);Leftmost-prefix matching principle
Leftmost-prefix matching principle nghĩa là khi sử dụng composite index, MySQL sẽ dựa theo thứ tự field trong index và lần lượt match các field trong query condition từ trái sang phải. Nếu query condition match field ngoài cùng bên trái của index, MySQL sẽ dùng index để filter data, từ đó nâng cao query efficiency.
Leftmost matching principle sẽ tiếp tục match sang phải cho đến khi gặp range query (chẳng hạn >, <). Với range query >=, <=, BETWEEN và prefix matching LIKE thì việc match không dừng lại.
Giả sử có composite index (column1, column2, column3), toàn bộ prefix từ trái sang phải của nó là (column1), (column1, column2), (column1, column2, column3) (tạo một composite index tương đương tạo 3 index), mọi query chứa các column này đều dùng index thay vì full table scan.
Khi sử dụng composite index, có thể đặt field có độ phân biệt cao ở ngoài cùng bên trái để filter nhiều data hơn.
Ở đây chúng ta minh họa đơn giản hiệu quả của leftmost-prefix matching.
- Tạo table tên
student, table này chỉ có 3 fieldid,name,class.
CREATE TABLE `student` (
  `id` int NOT NULL,
  `name` varchar(100) DEFAULT NULL,
  `class` varchar(100) DEFAULT NULL,
  PRIMARY KEY (`id`),
  KEY `name_class_idx` (`name`,`class`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;- Lần lượt kiểm thử ba SQL khác nhau dưới đây.
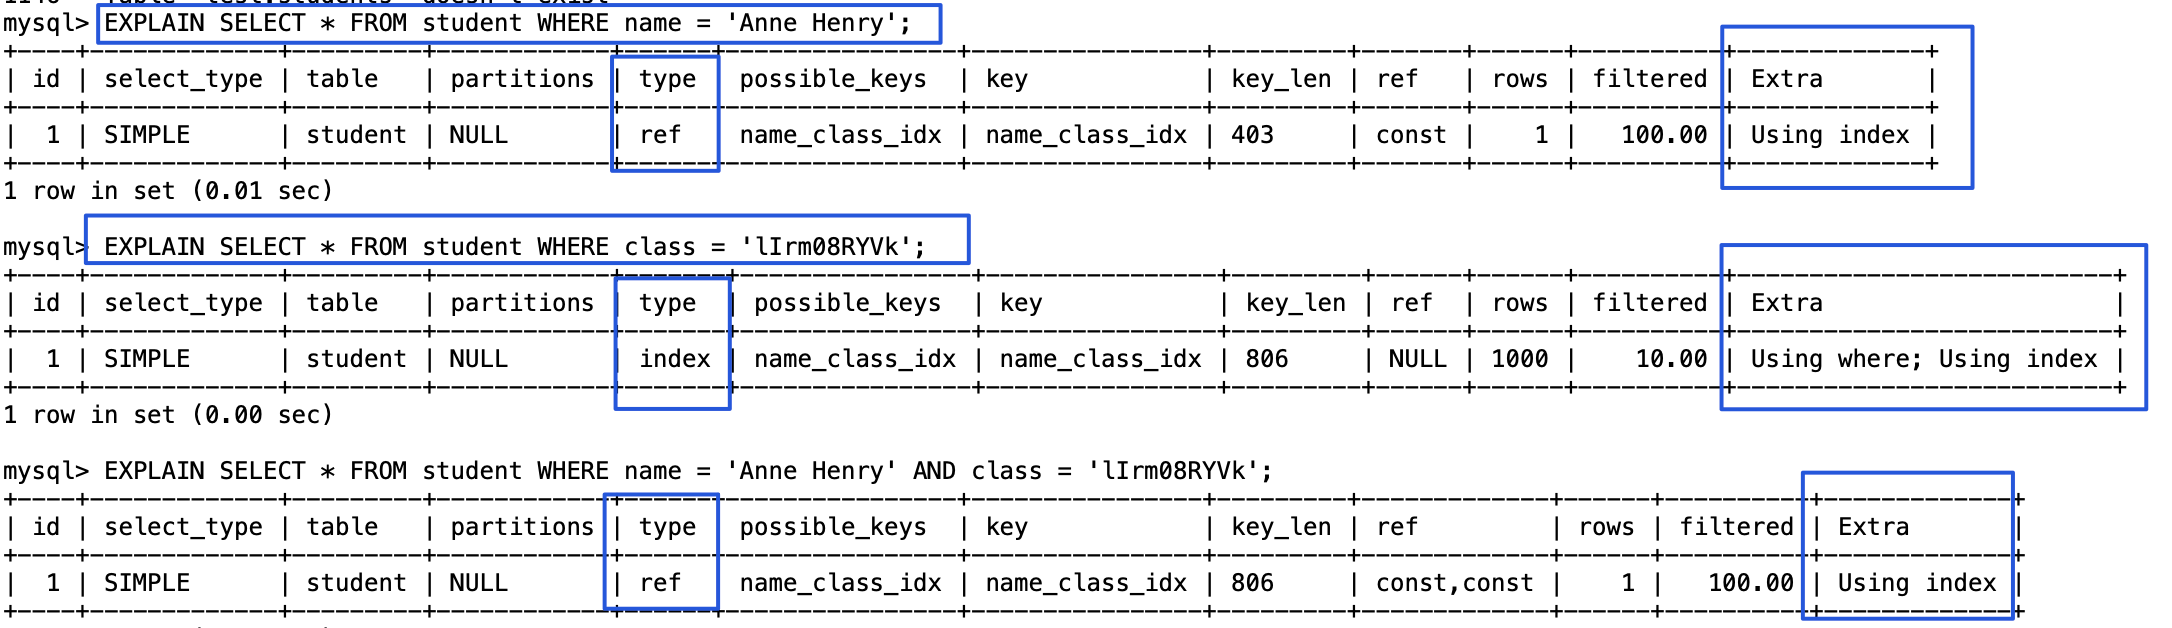
# Có thể hit index
SELECT * FROM student WHERE name = 'Anne Henry';
EXPLAIN SELECT * FROM student WHERE name = 'Anne Henry' AND class = 'lIrm08RYVk';
# Không thể hit index
SELECT * FROM student WHERE class = 'lIrm08RYVk';
Tiếp theo là một câu hỏi phỏng vấn thường gặp: nếu có index composite index (a, b, c), query a=1 AND c=1 có dùng index không? Còn c=1 thì sao? b=1 AND c=1 thì sao? b = 1 AND a = 1 AND c = 1 thì sao?
Đừng xem đáp án ngay, hãy dành 3 phút tự suy nghĩ.
- Query
a=1 AND c=1: Theo leftmost-prefix matching principle, query có thể dùng phần prefix của index. Vì vậy, query này chỉ dùng index choa=1, sau đó filter kết quả bằngc=1. - Query
c=1: Vì query không chứa leftmost columna, theo leftmost-prefix matching principle, toàn bộ index không thể được sử dụng. - Query
b=1 AND c=1: Giống trường hợp thứ hai, toàn bộ index cũng không được sử dụng. - Query
b=1 AND a=1 AND c=1: Query này có thể dùng index. Khi query optimizer phân tích SQL, với composite index, nó sẽ reorder query condition để sử dụng index. Nó sẽ reorder điều kiệnb=1vàa=1thànha=1 AND b=1 AND c=1.
MySQL 8.0.13 giới thiệu index skip scan (Index Skip Scan, viết tắt là ISS), có thể nâng cao query efficiency trong một số scenario index query. Trước khi có ISS, composite index query không thỏa leftmost-prefix matching principle sẽ thực hiện full table scan. ISS cho phép MySQL tránh full table scan trong một số trường hợp, ngay cả khi query condition không phù hợp leftmost prefix. Tuy nhiên, feature này khá ít tác dụng, không thể so với Oracle; MySQL 8.0.31 còn báo cáo một bug: Bug #109145 Using index for skip scan cause incorrect result (đã được sửa ở version sau). Theo đề xuất cá nhân, chỉ cần biết có feature này là được, không cần đào sâu; project thực tế cũng chưa chắc dùng được.
Index condition pushdown
Index condition pushdown (Index Condition Pushdown, viết tắt là ICP) là một index optimization feature được cung cấp từ MySQL 5.6. Nó cho phép storage engine đánh giá một phần điều kiện trong mệnh đề WHERE khi traversal index, trực tiếp filter các record không thỏa điều kiện, từ đó giảm số lần table lookup và nâng cao query efficiency.
Giả sử có table tên user, gồm 4 field id, username, zipcode và birthdate, đồng thời đã tạo composite index (zipcode, birthdate).
CREATE TABLE `user` (
  `id` int NOT NULL AUTO_INCREMENT,
  `username` varchar(20) CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci NOT NULL,
  `zipcode` varchar(20) CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci NOT NULL,
  `birthdate` date NOT NULL,
  PRIMARY KEY (`id`),
  KEY `idx_zipcode_birthdate` (`zipcode`,`birthdate`) ) ENGINE=InnoDB AUTO_INCREMENT=1001 DEFAULT CHARSET=utf8mb4;

# Query user có zipcode là 431200 và sinh nhật trong tháng 3
SELECT * FROM user WHERE zipcode = '431200' AND MONTH(birthdate) = 3;- Trước khi có index condition pushdown, dù index của column
zipcodecó thể giúp nhanh chóng định vị user cózipcode = '431200', chúng ta vẫn cần table lookup từng user tìm được để lấy full user data, sau đó mới phán đoánMONTH(birthdate) = 3. - Sau khi có index condition pushdown, khi dùng index của column
zipcodeđể tìm user cózipcode = '431200', storage engine đồng thời phán đoánMONTH(birthdate) = 3. Như vậy chỉ record đồng thời thỏa điều kiện mới được trả về, giảm số lần table lookup.


Tiếp theo hãy nói về nguyên lý cụ thể của index condition pushdown, trước tiên xem sơ đồ kiến trúc MySQL đơn giản dưới đây.

MySQL có thể được chia đơn giản thành hai layer: Server layer và storage engine layer. Server layer xử lý query parsing, analysis, optimization, cache và interaction với client; storage engine layer chịu trách nhiệm lưu trữ và đọc data. MySQL hỗ trợ nhiều storage engine như InnoDB, MyISAM, Memory.
Pushdown trong index condition pushdown thực chất nghĩa là giao một phần công việc vốn do upper layer (Server layer) phụ trách cho lower layer (storage engine layer) xử lý.
Ở đây kết hợp nguyên lý index condition pushdown để giải thích ví dụ đã nêu ở trên.
Trước khi có index condition pushdown:
- Storage engine layer trước tiên dựa vào
zipcodeindex column để tìm primary key ID của mọi user cózipcode = '431200', sau đó thực hiện table lookup lần hai để lấy full user data; - Storage engine layer giao toàn bộ user data có
zipcode = '431200'cho Server layer; Server layer tiếp tục filter theo điều kiệnMONTH(birthdate) = 3.
Sau khi có index condition pushdown:
- Storage engine layer trước tiên dựa vào
zipcodeindex column để tìm mọi user cózipcode = '431200', sau đó trực tiếp phán đoánMONTH(birthdate) = 3và filter ra primary key ID phù hợp; - Thực hiện table lookup lần hai, lấy full user data theo primary key ID phù hợp;
- Storage engine layer giao toàn bộ user data phù hợp cho Server layer.
Có thể thấy, ngoài giảm số lần table lookup, index condition pushdown còn giảm lượng data truyền giữa storage engine layer và Server layer.
Cuối cùng, hãy tổng hợp phạm vi áp dụng của index condition pushdown:
- Áp dụng cho query của InnoDB engine và MyISAM engine.
- Áp dụng cho query có execution plan thuộc range, ref, eq_ref hoặc ref_or_null.
- Với InnoDB table, chỉ dùng cho non-clustered index. Mục tiêu của index condition pushdown là giảm số lần đọc full row, từ đó giảm I/O operation. Với clustered index của InnoDB, full record đã được đọc vào InnoDB buffer. Trong trường hợp này, dùng index condition pushdown không giảm được I/O.
- Subquery không thể dùng index condition pushdown, vì subquery thường tạo temporary table để xử lý result, mà các temporary table này không có index.
- Stored procedure không thể dùng index condition pushdown, vì storage engine không thể gọi stored function.
Một số đề xuất sử dụng index đúng cách
Chọn field phù hợp để tạo index
- Field không NULL: Data của index field nên cố gắng không là NULL, vì database khó tối ưu hơn với field có data là NULL. Nếu field thường xuyên được query nhưng không thể tránh NULL, nên dùng short value hoặc short character có semantic rõ ràng như 0, 1, true, false để thay thế.
- Field được query thường xuyên: Field dùng để tạo index nên là field được query rất thường xuyên.
- Field được dùng làm query condition: Field được dùng làm WHERE condition nên được cân nhắc tạo index.
- Field thường xuyên cần sort: Index đã được sort, query có thể tận dụng thứ tự của index để tăng tốc sort query.
- Field thường xuyên dùng để join: Field thường dùng để join có thể là foreign key column. Với foreign key column không nhất thiết phải tạo foreign key, chỉ có nghĩa column đó liên quan đến quan hệ giữa các table. Với field thường xuyên được join query, có thể cân nhắc tạo index để nâng cao hiệu suất multi-table join query.
Tránh index mất hiệu lực
Index mất hiệu lực cũng là một trong những nguyên nhân chính của slow query. Các tình huống thường gặp khiến index mất hiệu lực gồm hai loại sau:
1. Cách viết SQL xung đột với logic tầng dưới (phá vỡ tính có thứ tự của B+Tree)
Loại vấn đề này thường gặp nhất. Bản chất là query condition khiến B+Tree ở tầng dưới mất khả năng định vị nhanh bằng “binary search”.
- Vi phạm leftmost-prefix principle: Bỏ qua leading column của composite index, hoặc gặp range query (chẳng hạn
>,<,BETWEEN,LIKE "abc%") khiến việc định vị chính xác ở các column phía sau bị ngắt, chuyển thành range scan kèm filter. - Xử lý index column: Thực hiện phép tính hoặc áp dụng function lên index column ở bên trái
WHERE, khiến data gốc thay đổi về logic và thể hiện trạng thái không có thứ tự trong index tree. - Implicit type conversion (kín đáo nhưng nguy hiểm): Khi “column dạng string” so sánh với “value dạng number”, MySQL mặc định áp dụng conversion function lên column, trực tiếp phá vỡ tính có thứ tự của tree.
- Wildcard ở đầu trong LIKE fuzzy query: Chẳng hạn
LIKE "%abc", tính không xác định của prefix character khiến optimizer không thể khóa điểm bắt đầu của scan range. - ORDER BY sorting trap: Sort column không hit index, hướng sort không nhất quán với index structure, v.v. khiến phát sinh memory sort hoặc disk sort bổ sung (
Using filesort).
2. Quyết định về cost của optimizer (thỏa hiệp dựa trên I/O cost)
Loại vấn đề này không phải do bản thân index không dùng được, mà là sau khi tính toán, MySQL optimizer cho rằng tổng chi phí khi không dùng normal index lại nhỏ hơn.
SELECT \*không suy nghĩ khiến table lookup quá tải: Khi query nhiều column không được covering index và lượng data hit khá lớn (thường trên 20%~30%), optimizer sẽ nhận định sequential I/O của full table scan tốt hơn random I/O do table lookup thường xuyên, từ đó chủ động bỏ index.- Điều kiện
ORdẫn đến full table scan: Chỉ cần một phía của điều kiện nối bằngORkhông có index tương ứng thì sẽ trigger full table scan. Ngay cả khi hai phía đều có index, nếu cost dự kiến của Index Merge quá cao thì vẫn bị bỏ qua. - IN list quá dài gây sai lệch estimation: Khi độ dài IN list vượt threshold của system (mặc định 200), optimizer chuyển từ deep probe chính xác (Index Dive) sang statistical estimation thô, rất dễ phán đoán sai execution cost vì statistics đã cũ.
Giới thiệu chi tiết: Tổng hợp các tình huống MySQL index mất hiệu lực.
Cân nhắc kỹ khi tạo index cho field được update thường xuyên
Index có thể cải thiện query efficiency, nhưng chi phí maintain index cũng không nhỏ. Nếu một field không thường xuyên được query mà ngược lại thường xuyên bị sửa, càng không nên tạo index trên field đó.
Giới hạn số lượng index trên mỗi table
Index không phải càng nhiều càng tốt, nên giới hạn index của một table không quá 5! Index có thể nâng cao efficiency, nhưng cũng có thể làm giảm performance.
Index có thể tăng query efficiency, nhưng đồng thời cũng làm giảm insert và update efficiency, thậm chí trong một số trường hợp còn làm giảm performance của query.
Vì khi MySQL optimizer chọn cách optimization query, nó sẽ dựa trên statistics để đánh giá từng index có thể dùng nhằm tạo execution plan tốt nhất. Nếu đồng thời có quá nhiều index có thể dùng cho query, thời gian MySQL optimizer tạo execution plan sẽ tăng và query performance cũng giảm.
Cố gắng cân nhắc composite index thay vì single-column index
Vì index cần chiếm disk space, có thể hiểu đơn giản mỗi index tương ứng với một B+ tree. Nếu field của một table quá nhiều và index quá nhiều, khi data của table đạt đến một quy mô nhất định, space mà index chiếm cũng rất lớn, đồng thời việc sửa index cũng tốn nhiều thời gian. Nếu là composite index, nhiều field nằm trên một index thì sẽ tiết kiệm được nhiều disk space và hiệu suất thao tác sửa data cũng tăng.
Lưu ý tránh redundant index
Redundant index là index có chức năng giống nhau. Nếu có thể hit index (a, b) thì chắc chắn có thể hit index (a), vậy index (a) là redundant index. Chẳng hạn hai index (name,city) và (name) là redundant index; query có thể hit index thứ nhất chắc chắn cũng hit được index thứ hai. Trong phần lớn trường hợp, nên mở rộng index hiện có thay vì tạo index mới.
Dùng prefix index thay cho normal index với field dạng string
Prefix index chỉ áp dụng cho field dạng string và chiếm ít space hơn normal index, vì vậy có thể cân nhắc dùng prefix index thay cho normal index.
Xóa index không được sử dụng trong thời gian dài
Xóa index không được sử dụng trong thời gian dài, vì sự tồn tại của index không dùng sẽ gây suy giảm performance không cần thiết.
MySQL 5.7 có thể query view schema_unused_indexes của database sys để xem những index nào chưa từng được sử dụng.
Biết cách phân tích SQL có dùng index để query hay không
Có thể dùng lệnh EXPLAIN để phân tích execution plan của SQL, từ đó biết câu lệnh có hit index hay không. Execution plan là cách thực thi cụ thể của một SQL statement sau khi được MySQL query optimizer tối ưu.
EXPLAIN không thực sự execute statement liên quan mà chỉ thông qua query optimizer để phân tích statement, tìm query plan tối ưu và hiển thị information tương ứng.
Output format của EXPLAIN như sau:
mysql> EXPLAIN SELECT `score`,`name` FROM `cus_order` ORDER BY `score` DESC;
+----+-------------+-----------+------------+------+---------------+------+---------+------+--------+----------+----------------+
| id | select_type | table     | partitions | type | possible_keys | key  | key_len | ref  | rows   | filtered | Extra          |
+----+-------------+-----------+------------+------+---------------+------+---------+------+--------+----------+----------------+
|  1 | SIMPLE      | cus_order | NULL       | ALL  | NULL          | NULL | NULL    | NULL | 997572 |   100.00 | Using filesort |
+----+-------------+-----------+------------+------+---------------+------+---------+------+--------+----------+----------------+
1 row in set, 1 warning (0.00 sec)
Ý nghĩa của từng field như sau:
| Tên column | Ý nghĩa |
|---|---|
| id | Sequence identifier của SELECT query |
| select_type | Query type tương ứng với SELECT keyword |
| table | Tên table được dùng |
| partitions | Partition được match; với table chưa partition, value là NULL |
| type | Access method của table |
| possible_keys | Index có thể được dùng |
| key | Index thực tế được dùng |
| key_len | Length của index được chọn |
| ref | Khi dùng equality query với index, column hoặc constant được so sánh với index |
| rows | Số row dự kiến cần đọc |
| filtered | Tỷ lệ phần trăm record còn lại sau khi filter theo condition của table |
| Extra | Information bổ sung |
Do giới hạn độ dài, ở đây chỉ giới thiệu đơn giản về MySQL execution plan. Xem giới thiệu chi tiết tại bài Phân tích execution plan của MySQL.
Đọc thêm về data structure
Khi tìm hiểu MySQL index, nên quay lại xem bản thân tree structure:
- Giải thích chi tiết về tree structure: So sánh binary search tree, AVL, red-black tree, B tree và B+ tree.
- Giải thích chi tiết về red-black tree: Tìm hiểu trade-off của self-balancing search tree trong memory, sau đó so sánh vì sao B+ tree phù hợp hơn với disk index.
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.