
Giải thích chi tiết về character set: Character set là gì? Dùng như thế nào?
Trong MySQL có hai cách triển khai UTF-8: utf8 và utf8mb4.
Nếu dùng utf8, việc lưu ký hiệu emoji, một số chữ phức tạp và chữ phồn thể sẽ xảy ra lỗi.
Tại sao lại như vậy? Bài viết này sẽ giải thích vấn đề từ gốc rễ.
Character set là gì?
Character là tên gọi chung cho chữ và ký hiệu, bao gồm chữ viết của các quốc gia, dấu câu, biểu tượng cảm xúc, chữ số, v.v. Character set là một tập hợp các character. Có khá nhiều loại character set; phạm vi character mà mỗi character set biểu diễn được cũng khác nhau. Chẳng hạn, một số character set không thể biểu diễn chữ Hán.
Máy tính chỉ có thể lưu trữ dữ liệu nhị phân. Vậy các character như chữ tiếng Anh, chữ Hán, biểu tượng cảm xúc được lưu trữ như thế nào?
Ta cần ánh xạ từng character với dữ liệu nhị phân tương ứng. Ví dụ, character “a” tương ứng với “01100001”, và ngược lại, “01100001” tương ứng với “a”. Quá trình ánh xạ character với dữ liệu nhị phân được gọi là character encoding, còn quá trình giải mã dữ liệu nhị phân thành character được gọi là character decoding.
Character encoding là gì?
Character encoding là phương pháp chuyển đổi qua lại giữa các character trong character set và dữ liệu nhị phân trong máy tính, có thể xem như một quy tắc ánh xạ. Nói cách khác, mục đích của character encoding là giúp máy tính có thể lưu trữ và truyền tải nhiều loại thông tin văn bản.
Mỗi character set có quy tắc character encoding riêng. Các quy tắc encoding thường gặp gồm ASCII encoding, GB2312 encoding, GBK encoding, GB18030 encoding, Big5 encoding, UTF-8 encoding, UTF-16 encoding, v.v.
Có những character set thường gặp nào?
Các character set thường gặp gồm: ASCII, GB2312, GB18030, GBK, Unicode……
Điểm khác biệt chính giữa các character set là:
- Phạm vi character có thể biểu diễn
- Cách encoding
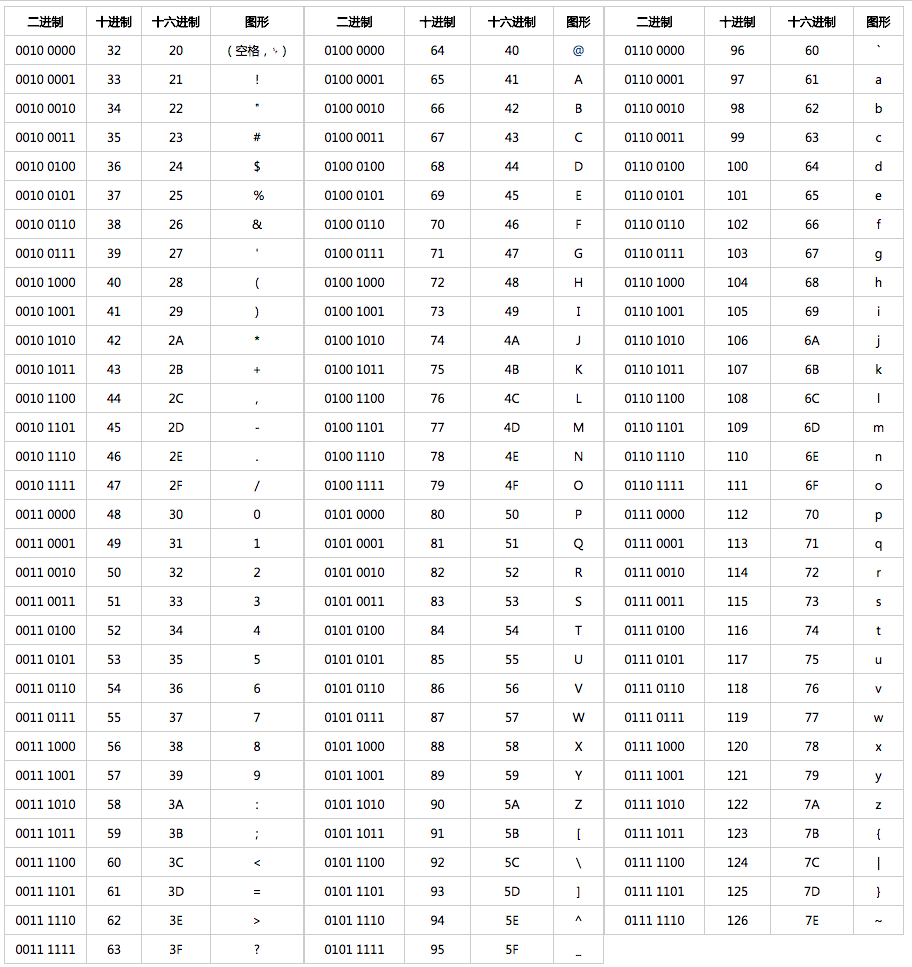
ASCII
ASCII (American Standard Code for Information Interchange, mã tiêu chuẩn Hoa Kỳ về trao đổi thông tin) là một character set chủ yếu dùng cho tiếng Anh hiện đại của Hoa Kỳ (đây cũng là điểm hạn chế của ASCII character set).
Tại sao ASCII character set không tính đến tiếng Trung và các character khác? Vì máy tính do người Mỹ phát minh. Khi đó, máy tính vẫn đang ở giai đoạn phát triển sơ khai và chưa được sử dụng rộng rãi ở các quốc gia khác. Vì vậy, khi Hoa Kỳ công bố ASCII character set, họ không tính đến khả năng tương thích với ngôn ngữ của các quốc gia khác.
ASCII character set đã định nghĩa tổng cộng 128 character, trong đó có 33 control character (chẳng hạn carriage return, ký tự xóa) không thể hiển thị.
Độ dài một mã ASCII là một byte, tức 8 bit. Ví dụ, mã ASCII tương ứng với “a” là “01100001”. Tuy nhiên, bit cao nhất bằng 0 chỉ được dùng làm parity bit, 7 bit còn lại được tổ hợp từ 0 và 1. Vì vậy, ASCII character set có thể định nghĩa 128 (2^7) character.
Do số character mà ASCII có thể biểu diễn quá ít, về sau người ta đã mở rộng nó để tạo ra ASCII extended character set. ASCII extended character set dùng 8 bit (bits) để biểu diễn một character, nên có thể định nghĩa 256 (2^8) character.
GB2312
Như đã nói ở trên, ASCII character set là character set phù hợp với tiếng Anh hiện đại của Hoa Kỳ. Vì vậy, nhiều quốc gia đã tự xây dựng một character set phù hợp với ngôn ngữ của mình.
GB2312 character set là một character set khá phù hợp với chữ Hán, bao gồm hơn 6.700 chữ Hán, về cơ bản bao quát phần lớn chữ Hán thường dùng. Tuy nhiên, GB2312 character set không hỗ trợ phần lớn chữ hiếm gặp và chữ phồn thể.
Với character tiếng Anh, GB2312 encoding giống ASCII code và chỉ cần 1 byte để encode. Với character không phải tiếng Anh, cần 2 byte để encode.
GBK
GBK character set có thể xem là phần mở rộng của GB2312 character set và tương thích với GB2312 character set, bao gồm hơn 20.000 chữ Hán.
Chữ K trong GBK là chữ cái đầu của “Kuo” trong Hanyu Pinyin Kuo Zhan (mở rộng).
GB18030
GB18030 hoàn toàn tương thích với GB2312 và GBK character set, bổ sung chữ viết của một số dân tộc thiểu số ở Trung Quốc và chữ Hán của Nhật Bản, Hàn Quốc. Đây là character set hỗ trợ chữ Hán toàn diện nhất hiện nay, bao gồm hơn 70.000 chữ Hán.
BIG5
BIG5 chủ yếu dành cho tiếng Trung phồn thể, bao gồm hơn 13.000 chữ Hán.
Unicode & UTF-8
Để phù hợp hơn với ngôn ngữ của mỗi quốc gia, nhiều loại character set đã ra đời.
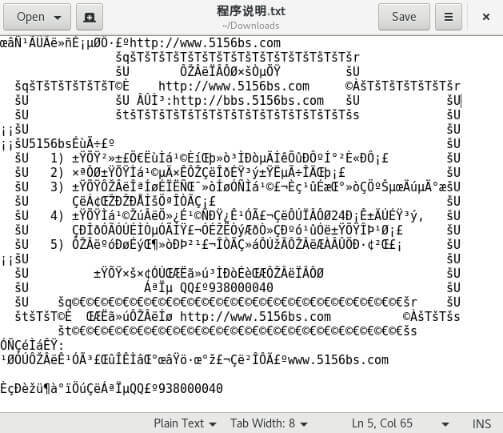
Như đã nói ở trên, các character set khác nhau có phạm vi character biểu diễn và quy tắc encoding khác nhau. Điều này dẫn đến một vấn đề rất nghiêm trọng: mở một file chứa character bằng encoding không phù hợp sẽ tạo ra hiện tượng mojibake.
Ví dụ, nếu mở file có encoding GB2312 bằng UTF-8 encoding, file sẽ xuất hiện mojibake. Cụ thể, character mang nghĩa “bò” có giá trị hệ thập lục phân sau khi được encode bằng GB2312 là “C5A3”, nhưng khi “C5A3” được decode bằng UTF-8, kết quả lại là “ţ”.
Bạn có thể thực hiện encoding và decoding trực tuyến tại website này: https://www.haomeili.net/HanZi/ZiFuBianMaZhuanHuan
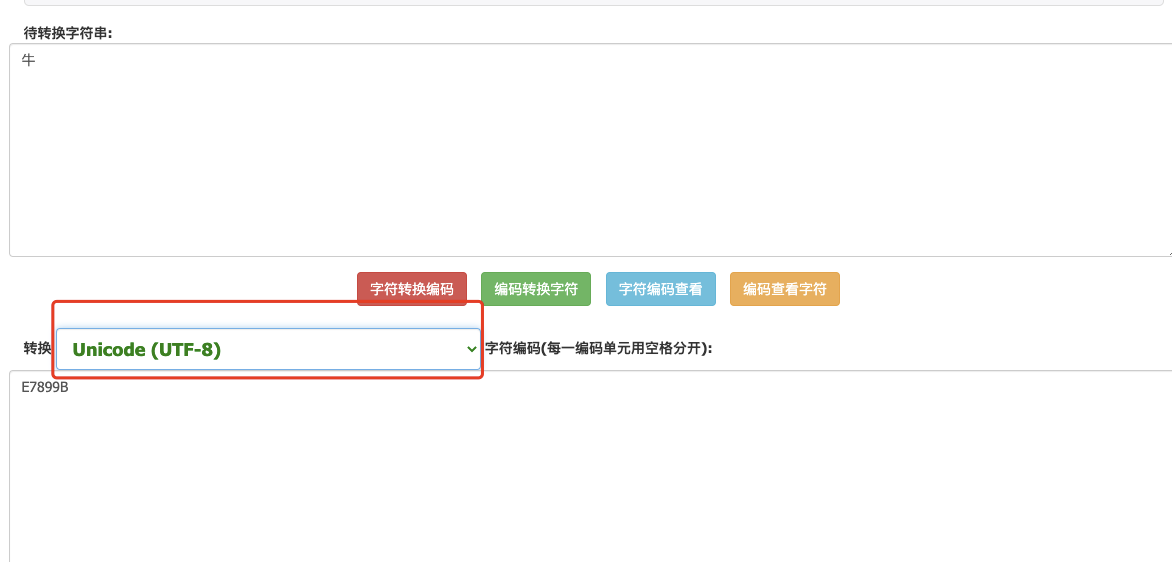
Như vậy, ta đã hiểu bản chất của mojibake: encoding và decoding sử dụng character set khác nhau hoặc không tương thích.
Để giải quyết vấn đề này, người ta nghĩ: “Nếu có một character set có thể bao quát tất cả character trên thế giới thì tốt biết mấy!”.
Sau đó, Unicode ra đời với sứ mệnh này.
Unicode character set chứa gần như tất cả character đã biết trên thế giới. Tuy nhiên, Unicode character set không quy định cách lưu trữ các character này (tức cách dùng dữ liệu nhị phân để biểu diễn chúng).
Sau đó, UTF-8 (8-bit Unicode Transformation Format) ra đời. Tương tự còn có UTF-16 và UTF-32.
UTF-8 dùng từ 1 đến 4 byte để encode mỗi character, UTF-16 dùng 2 hoặc 4 byte để encode mỗi character, còn UTF-32 luôn dùng 4 byte để encode mỗi character.
UTF-8 có thể tự động chọn độ dài encoding tùy theo ký hiệu. Character tiếng Anh chỉ cần 1 byte, giống như ASCII character set. Vì vậy, với character tiếng Anh, UTF-8 encoding và ASCII code giống nhau.
Quy tắc của UTF-32 đơn giản nhất, nhưng nhược điểm cũng khá rõ ràng: các character như chữ cái tiếng Anh tiêu tốn không gian gấp 4 lần UTF-8.
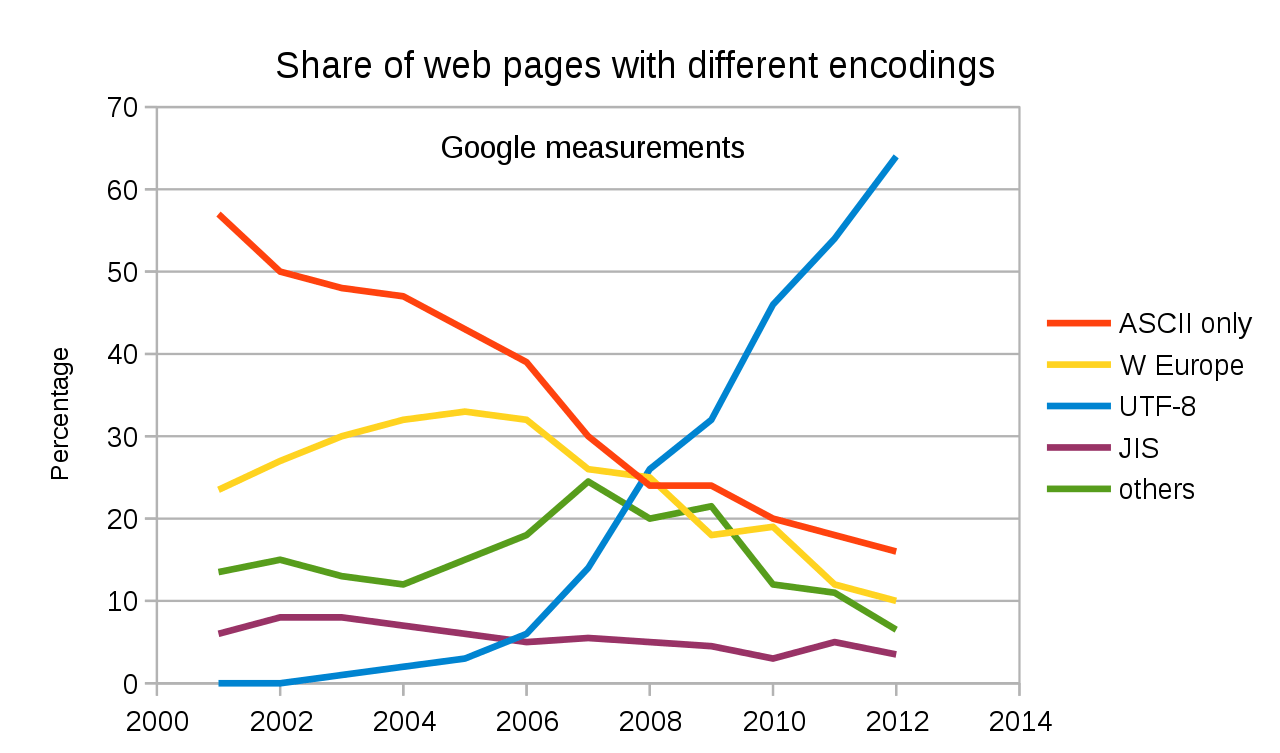
UTF-8 hiện là character encoding được sử dụng rộng rãi nhất.
Character set trong MySQL
MySQL hỗ trợ nhiều loại character set, chẳng hạn GB2312, GBK, BIG5 và nhiều Unicode character set (UTF-8 encoding, UTF-16 encoding, UCS-2 encoding, UTF-32 encoding, v.v.).
Xem character set được hỗ trợ
Bạn có thể dùng lệnh SHOW CHARSET để xem, lệnh này hỗ trợ mệnh đề like và where.
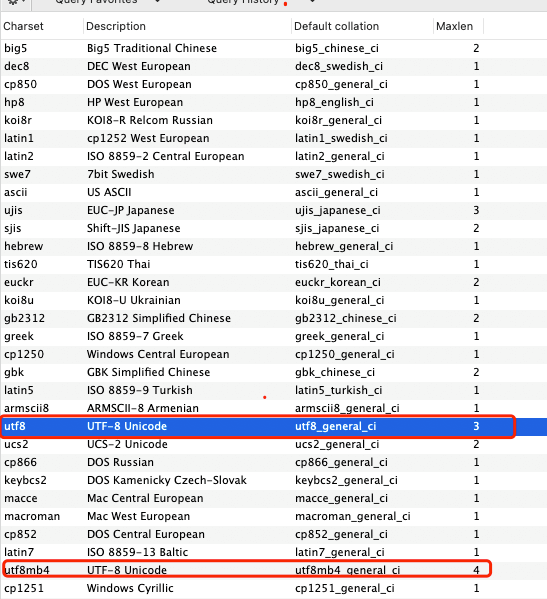
Character set mặc định
Trong MySQL5.7, character set mặc định là latin1; trong MySQL8.0, character set mặc định là utf8mb4.
Các cấp độ của character set
Character set trong MySQL có các cấp độ sau:
server(cấp độ MySQL instance)database(cấp độ database)table(cấp độ table)column(cấp độ column)
Có thể hiểu đơn giản rằng độ ưu tiên của chúng tăng dần từ trên xuống dưới, tức độ ưu tiên của column cao hơn các cấp độ còn lại như table. Nếu character set ở cấp độ MySQL instance được chỉ định là utf8mb4, còn character set của một table được chỉ định là latin1, thì encoding của mọi field trong table đó sẽ là latin1 nếu không được chỉ định riêng.
server
Giá trị mặc định của character set ở cấp độ server khác nhau tùy phiên bản MySQL. Trong MySQL5.7, giá trị mặc định là latin1; trong MySQL8.0, giá trị mặc định là utf8mb4.
Bạn cũng có thể chỉ định --character-set-server khi khởi động mysqld để thiết lập character set ở cấp độ server.
mysqld
mysqld --character-set-server=utf8mb4
mysqld --character-set-server=utf8mb4 \
  --collation-server=utf8mb4_0900_ai_ci
Hoặc nếu khởi động MySQL bằng cách build từ source code, bạn có thể chỉ định option trong lệnh cmake:
cmake . -DDEFAULT_CHARSET=latin1
or
cmake . -DDEFAULT_CHARSET=latin1 \
  -DDEFAULT_COLLATION=latin1_german1_ci
Ngoài ra, bạn cũng có thể thay đổi giá trị character_set_server lúc runtime để thay đổi character set ở cấp độ server.
Character set ở cấp độ server là thiết lập global của MySQL server. Nó không chỉ được dùng làm character set mặc định khi tạo hoặc sửa database (nếu không chỉ định character set khác), mà còn ảnh hưởng đến connection character set giữa client và server. Bạn có thể xem chi tiết tại MySQL Connector/J 8.0 - 6.7 Using Character Sets and Unicode.
database
Character set ở cấp độ database được chỉ định khi tạo và sửa database:
CREATE DATABASE db_name
    [[DEFAULT] CHARACTER SET charset_name]
    [[DEFAULT] COLLATE collation_name]

ALTER DATABASE db_name
    [[DEFAULT] CHARACTER SET charset_name]
    [[DEFAULT] COLLATE collation_name]
Như đã nói ở trên, nếu không chỉ định character set khi thực thi các câu lệnh trên, MySQL sẽ dùng character set ở cấp độ server.
Bạn có thể dùng cách dưới đây để xem character set của một database:
USE db_name;
SELECT @@character_set_database, @@collation_database;
SELECT DEFAULT_CHARACTER_SET_NAME, DEFAULT_COLLATION_NAME
FROM INFORMATION_SCHEMA.SCHEMATA WHERE SCHEMA_NAME = 'db_name';table
Character set ở cấp độ table được chỉ định khi tạo và sửa table:
CREATE TABLE tbl_name (column_list)
    [[DEFAULT] CHARACTER SET charset_name]
    [COLLATE collation_name]]

ALTER TABLE tbl_name
    [[DEFAULT] CHARACTER SET charset_name]
    [COLLATE collation_name]
Nếu không chỉ định character set khi tạo hoặc sửa table, character set ở cấp độ database sẽ được sử dụng.
column
Character set ở cấp độ column cũng được chỉ định khi tạo và sửa table, chỉ khác là nó được định nghĩa trong column. Ví dụ:
CREATE TABLE t1
(
    col1 VARCHAR(5)
      CHARACTER SET latin1
      COLLATE latin1_german1_ci
);
Nếu không chỉ định character set ở cấp độ column, character set ở cấp độ table sẽ được sử dụng.
Connection character set
Ở trên đã đề cập các cấp độ của character set, vốn liên quan đến việc lưu trữ. Connection character set lại liên quan đến việc giao tiếp với MySQL server.
Connection character set liên quan mật thiết đến các biến sau:
character_set_client: mô tả character set được sử dụng trong câu lệnh SQL mà client gửi đến server.character_set_connection: mô tả character set được server dùng để chuyển đổi câu lệnh SQL sau khi nhận được.character_set_results: mô tả character set của kết quả mà server trả về client.
Có thể dùng câu lệnh SQL dưới đây để truy vấn giá trị của chúng:
SELECT * FROM performance_schema.session_variables
WHERE VARIABLE_NAME IN (
'character_set_client', 'character_set_connection',
'character_set_results', 'collation_connection'
) ORDER BY VARIABLE_NAME;
SHOW SESSION VARIABLES LIKE 'character\_set\_%';Nếu muốn sửa giá trị của các biến nêu trên, có các cách sau:
- Sửa file cấu hình
[mysql]
# Chỉ áp dụng cho chương trình client MySQL
default-character-set=utf8mb4- Dùng câu lệnh SQL
set names utf8mb4
# Hoặc sửa từng biến
# SET character_set_client = utf8mb4;
# SET character_set_results = utf8mb4;
# SET collation_connection = utf8mb4;
Ảnh hưởng của JDBC đến connection character set
Bạn đã từng gặp trường hợp lưu emoji bình thường nhưng khi dùng phần mềm như Navicat để truy vấn lại thấy emoji biến thành dấu hỏi chưa? Vấn đề này rất có thể do JDBC driver gây ra.
Từ nội dung trên, ta biết connection character set cũng ảnh hưởng đến dữ liệu được lưu trữ, còn JDBC driver lại ảnh hưởng đến connection character set.
mysql-connector-java (JDBC driver) chủ yếu ảnh hưởng đến connection character set thông qua các property sau:
characterEncodingcharacterSetResults
Ví dụ với DataGrip 2023.1.2, trong hộp thoại nâng cao khi cấu hình data source, có thể thấy giá trị mặc định của characterSetResults là utf8. Khi dùng mysql-connector-java 8.0.25, connection character set cuối cùng sẽ được đặt thành utf8mb3. Trong trường hợp đó, emoji sẽ hiển thị thành dấu hỏi. Hơn nữa, driver của phiên bản hiện tại chưa hỗ trợ đặt characterSetResults thành utf8mb4, nhưng mysql-connector-java driver 8.0.29 lại cho phép làm vậy.
Bạn có thể xem cụ thể câu trả lời trên StackOverflow: DataGrip MySQL stores emojis correctly but displays them as?.
Sử dụng UTF-8
Thông thường, nên dùng UTF-8 làm character encoding mặc định.
Tuy nhiên, có một điểm dễ nhầm ở đây.
Trong MySQL có hai cách triển khai UTF-8:
utf8:utf8chỉ hỗ trợ1-3byte cho mỗi character. Trongutf8encoding, chữ Hán chiếm 3 byte, còn chữ số, chữ tiếng Anh và ký hiệu chiếm 1 byte. Tuy nhiên, ký hiệu emoji chiếm 4 byte, một số chữ phức tạp và chữ phồn thể cũng chiếm 4 byte.utf8mb4: triển khai đầy đủ UTF-8, phiên bản hoàn chỉnh! Hỗ trợ tối đa 4 byte để biểu diễn một character, nên có thể dùng để lưu ký hiệu emoji.
Tại sao lại có hai cách triển khai UTF-8? Nguyên nhân như sau:
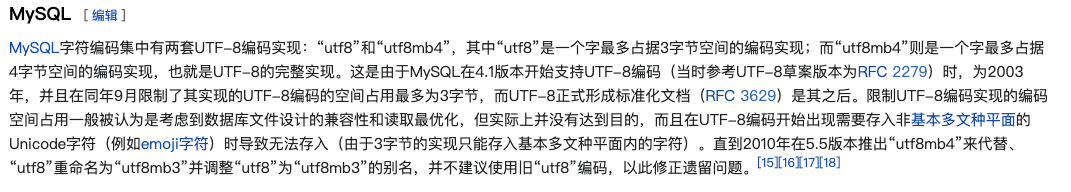
Vì vậy, nếu cần lưu dữ liệu kiểu emoji hoặc một số chữ phức tạp, chữ phồn thể vào MySQL database, bạn nhất định phải chỉ định encoding của database là utf8mb4 thay vì utf8; nếu không, việc lưu trữ sẽ báo lỗi.
Cùng xem ví dụ (môi trường: MySQL 5.7+).
Câu lệnh tạo table như sau, trong đó CHARSET của database được chỉ định là utf8.
CREATE TABLE `user` (
  `id` varchar(66) CHARACTER SET utf8mb3 NOT NULL,
  `name` varchar(33) CHARACTER SET utf8mb3 NOT NULL,
  `phone` varchar(33) CHARACTER SET utf8mb3 DEFAULT NULL,
  `password` varchar(100) CHARACTER SET utf8mb3 DEFAULT NULL
) ENGINE=InnoDB DEFAULT CHARSET=utf8;
Khi thực thi câu lệnh insert dưới đây để chèn dữ liệu vào database, quả nhiên đã xảy ra lỗi!
INSERT INTO `user` (`id`, `name`, `phone`, `password`)
VALUES
 ('A00003', 'guide bro😘😘😘', '181631312312', '123456');
Thông tin lỗi như sau:
Incorrect string value: '\xF0\x9F\x98\x98\xF0\x9F...' for column 'name' at row 1Tham khảo
- Character set và character encoding (Charset & Encoding): https://www.cnblogs.com/skynet/archive/2011/05/03/2035105.html
- Làm rõ character set và character encoding trong mười phút: http://cenalulu.github.io/linux/character-encoding/
- Unicode - Wikipedia: https://zh.wikipedia.org/wiki/Unicode
- GB2312 - Wikipedia: https://zh.wikipedia.org/wiki/GB_2312
- UTF-8 - Wikipedia: https://zh.wikipedia.org/wiki/UTF-8
- GB18030 - Wikipedia: https://zh.wikipedia.org/wiki/GB_18030
- Tài liệu MySQL8: https://dev.mysql.com/doc/refman/8.0/en/charset.html
- Tài liệu MySQL5.7: https://dev.mysql.com/doc/refman/5.7/en/charset.html
- Tài liệu MySQL Connector/J: https://dev.mysql.com/doc/connector-j/8.0/en/connector-j-reference-charsets.html
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.