
Tổng hợp các cách tối ưu SQL thường gặp
SQL chậm thì đừng vội áp dụng các quy tắc như “thêm index”, “không dùng SELECT *”. Trước hết hãy tìm slow SQL, xem nó chậm do số dòng scan, sorting, đọc lại bảng, lock wait hay tần suất gọi quá cao. Sau khi đối chiếu execution plan với cách truy cập của nghiệp vụ, mới quyết định sửa index, SQL, cấu trúc bảng hay chuyển query sang cache, search engine hoặc báo cáo offline.
Khi kiểm tra, có thể làm theo thứ tự này:
- Xác nhận vấn đề là average latency, P99 hay timeout ngẫu nhiên; là một SQL cụ thể chậm hay toàn database chịu tải cao.
- Dùng slow query log, APM và công cụ monitor database để định vị slow SQL có tần suất cao.
- Xem
type,key,rows,filtered,Extratrong execution plan để xác nhận có full table scan, quá nhiều lần đọc lại bảng, temporary table hay filesort không. - Kết hợp với cách truy cập của nghiệp vụ để xử lý: chỉ query các field cần thiết, bổ sung index, sửa SQL, tách transaction lớn, giới hạn độ sâu phân trang.
- Cuối cùng kiểm tra lại với cùng lượng dữ liệu và cùng điều kiện, không chỉ xác minh trên data set nhỏ.
Tránh sử dụng SELECT *
SELECT *có thể làm tăng chi phí I/O, truyền dữ liệu qua network, deserialization và memory của application, đặc biệt với các field lớn (như varchar, blob, text).SELECT *làm giảm cơ hội sử dụng covering index.SELECT <danh sách field>có thể giảm ảnh hưởng do thay đổi cấu trúc bảng.
Thận trọng khi dùng Join, không cấm Join một cách máy móc
Trong “Sổ tay phát triển Java” của Alibaba có đoạn mô tả như sau:
【Bắt buộc】Cấm join quá ba bảng. Các field cần join phải có data type hoàn toàn nhất quán; khi query liên kết nhiều bảng, phải đảm bảo các field được liên kết có index.
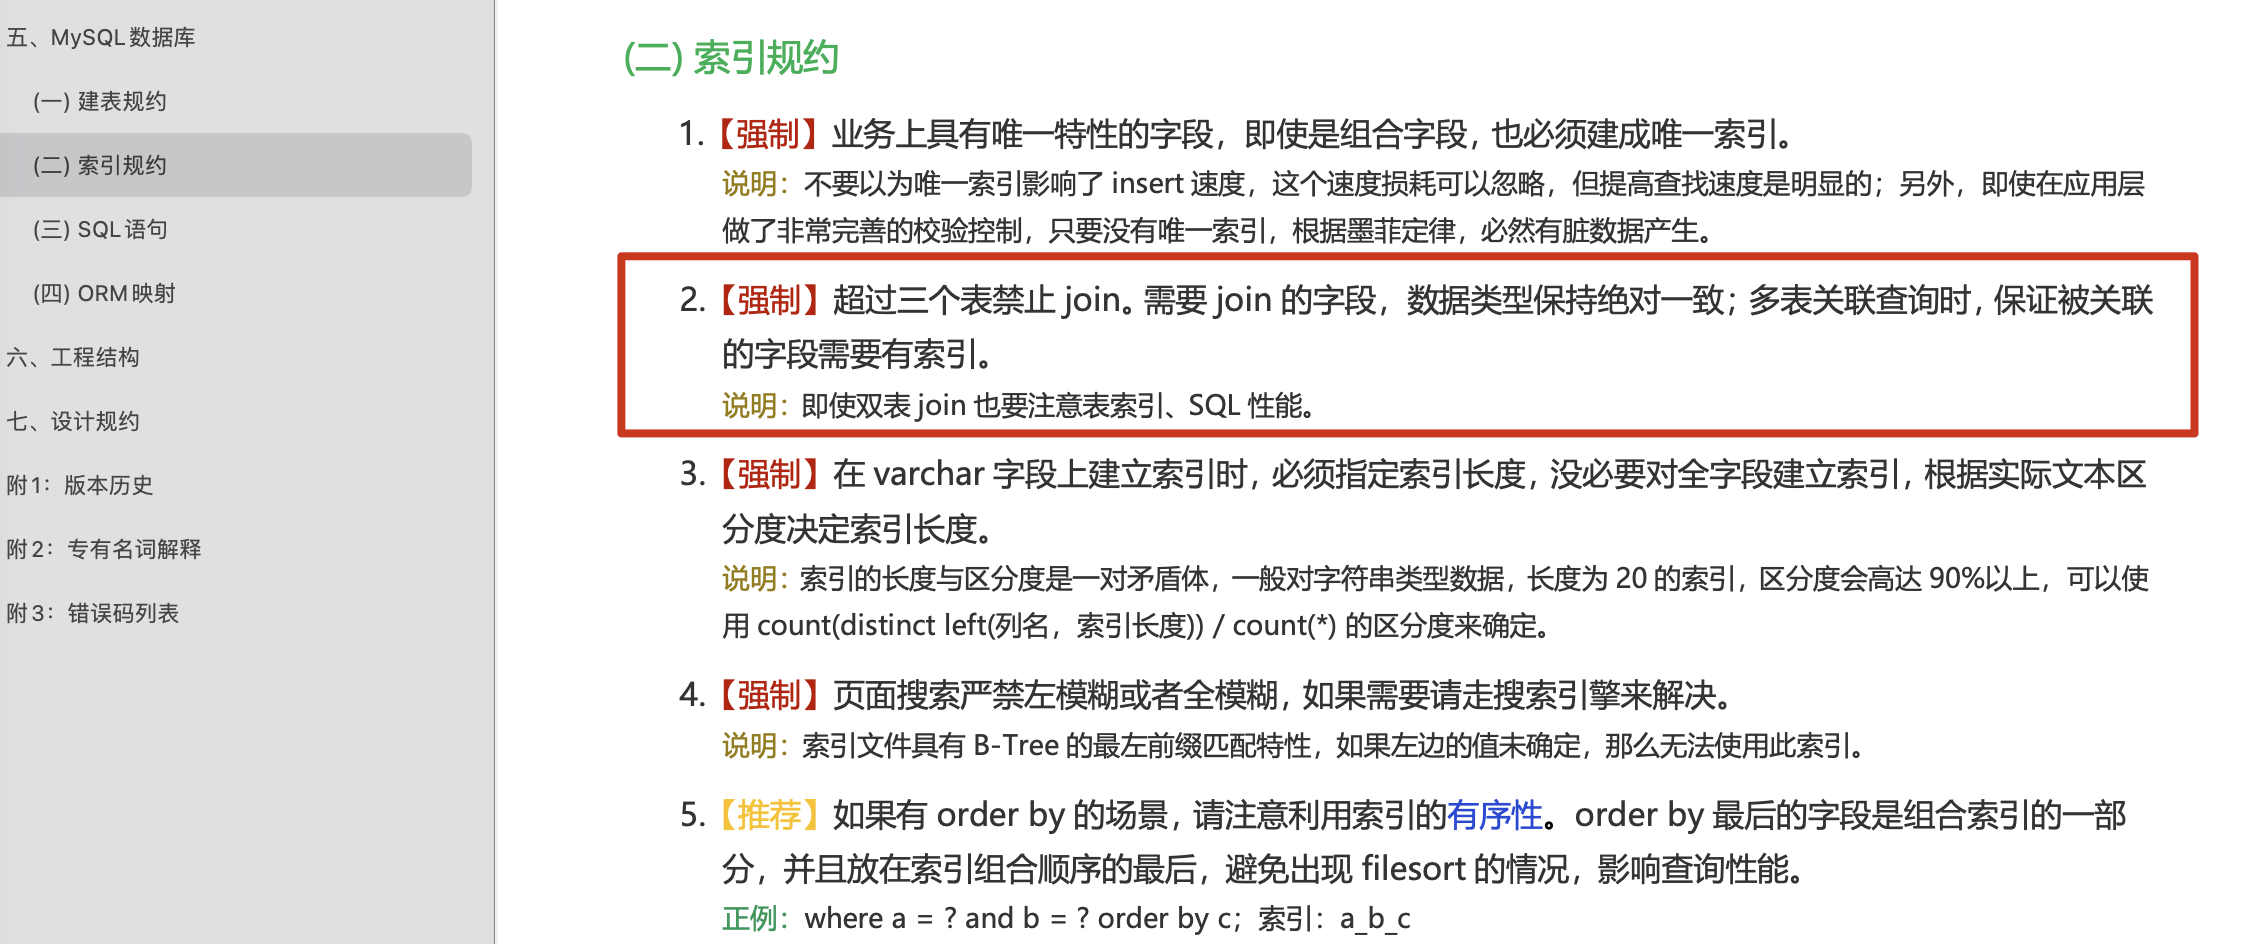
Join là năng lực cơ bản của relational database, không nên đơn giản xem nó là kém hiệu quả. Trong cùng một database, nếu data type của các field liên kết nhất quán, index phù hợp và lượng dữ liệu trả về có thể kiểm soát, Join thường rõ ràng hơn việc query nhiều lần ở application rồi lắp ghép, đồng thời dễ đảm bảo tính nhất quán của kết quả hơn.
Điều thực sự cần thận trọng là Join phức tạp:
- Field liên kết không có index hoặc data type không nhất quán;
- Có quá nhiều bảng Join, khiến execution plan phức tạp;
- Lượng dữ liệu trả về quá lớn, chi phí đọc lại bảng, temporary table hoặc filesort cao;
- Join xuyên database hoặc xuyên shard, cần query, merge và sort giữa các node;
- Đã xác định rõ trong tương lai sẽ shard database hoặc tách bảng theo query path này.
Từ MySQL 8.0.20, Block Nested-Loop Join đã được thay thế bởi Hash Join. Khi phân tích performance của Join, đừng chỉ học thuộc các thuật toán Join của phiên bản cũ; nên xem execution plan thực tế của EXPLAIN / EXPLAIN ANALYZE, tập trung vào type, key, rows, filtered, Extra, cũng như việc có xuất hiện temporary table, filesort hay nhiều lần đọc lại bảng không.
Trong nghiệp vụ thực tế, nếu query xuyên service, xuyên database hoặc tương lai sẽ shard database và tách bảng, có thể cân nhắc tách Join thành nhiều query trên một bảng rồi lắp ghép ở business layer. Nhưng cách này không phải lúc nào cũng nhanh hơn: nó làm tăng network round trip, query N+1, memory của application và vấn đề consistency. Cần đánh giá theo tần suất query, lượng dữ liệu, chi phí network và yêu cầu consistency.
Một cách thường gặp khác là data redundancy: sao chép một số field ổn định cần cho query có tần suất cao vào bảng chính hoặc bảng rộng, giảm việc liên kết trong runtime. Redundancy làm tăng chi phí đảm bảo consistency và maintenance, phù hợp với các trường hợp cấu trúc bảng tương đối ổn định, read nhiều write ít và query path rất rõ ràng.
Tối ưu phân trang sâu
Nguyên nhân cốt lõi của vấn đề phân trang sâu là: khi offset của LIMIT quá lớn, MySQL phải scan và bỏ qua rất nhiều record mới lấy được dữ liệu mục tiêu; query optimizer có thể bỏ index và chọn full table scan. Khi đó, ngay cả khi có index, vẫn không thể tránh nhiều lần đọc lại bảng, khiến performance của query giảm mạnh.
Bài viết này giới thiệu bốn phương án tối ưu phân trang sâu thường gặp. Đặc điểm và trường hợp sử dụng của từng phương án như sau:
| Phương án tối ưu | Ý tưởng chính | Trường hợp sử dụng | Hạn chế |
|---|---|---|---|
| Range query | Ghi lại ID cuối cùng của trang trước, dùng WHERE id > last_id LIMIT n để lấy trang tiếp theo | Sort theo ID, chấp nhận cursor pagination | Không hỗ trợ nhảy trang; nếu không sort theo ID thì cần dùng composite cursor |
| Subquery | Trước hết dùng subquery lấy primary key bắt đầu, sau đó filter theo primary key | Cần hỗ trợ phân trang bằng OFFSET truyền thống | Subquery có thể tạo temporary table, phụ thuộc vào index của field sort |
| Delayed join | Dùng INNER JOIN chuyển phần phân trang sang primary key index, giảm số lần đọc lại bảng | Phân trang với lượng dữ liệu lớn, cần logic phân trang truyền thống | SQL tương đối phức tạp |
| Covering index | Tạo composite index chứa các field cần query, tránh đọc lại bảng | Các field query cố định, có thể tạo index phù hợp | Khi có nhiều field, chi phí maintenance index cao; result set lớn có thể dùng full table scan |
Khi chọn phương án, trước hết xem interaction của sản phẩm có thể thay đổi không. Nếu chấp nhận kiểu duyệt “trang tiếp theo”, range query, tức cursor pagination, thường ổn định nhất. Các trường hợp như feed của mạng xã hội và infinite scroll đều phù hợp với cách này.
Nếu bắt buộc giữ LIMIT offset, size và hỗ trợ nhảy trang, hãy cân nhắc delayed join, covering index hoặc search engine. Khi field query cố định và không nhiều, covering index có thể dùng bổ sung; khi offset đã đến mức hàng triệu, nên hỏi trước nghiệp vụ có thực sự cần hỗ trợ phân trang sâu như vậy không, thay vì chỉ cố xử lý bằng SQL.
Dùng phương án nào cũng phải xem execution plan thực tế. Nếu EXPLAIN không sử dụng index như dự kiến thì phương án có viết đẹp đến đâu cũng không có tác dụng.
Xem giới thiệu chi tiết tại bài viết: Giới thiệu và đề xuất tối ưu phân trang sâu.
Nên hạn chế sử dụng foreign key và cascade
Trong “Sổ tay phát triển Java” của Alibaba có đoạn mô tả như sau:
Không được sử dụng foreign key và cascade; mọi khái niệm về foreign key phải được xử lý ở application layer.
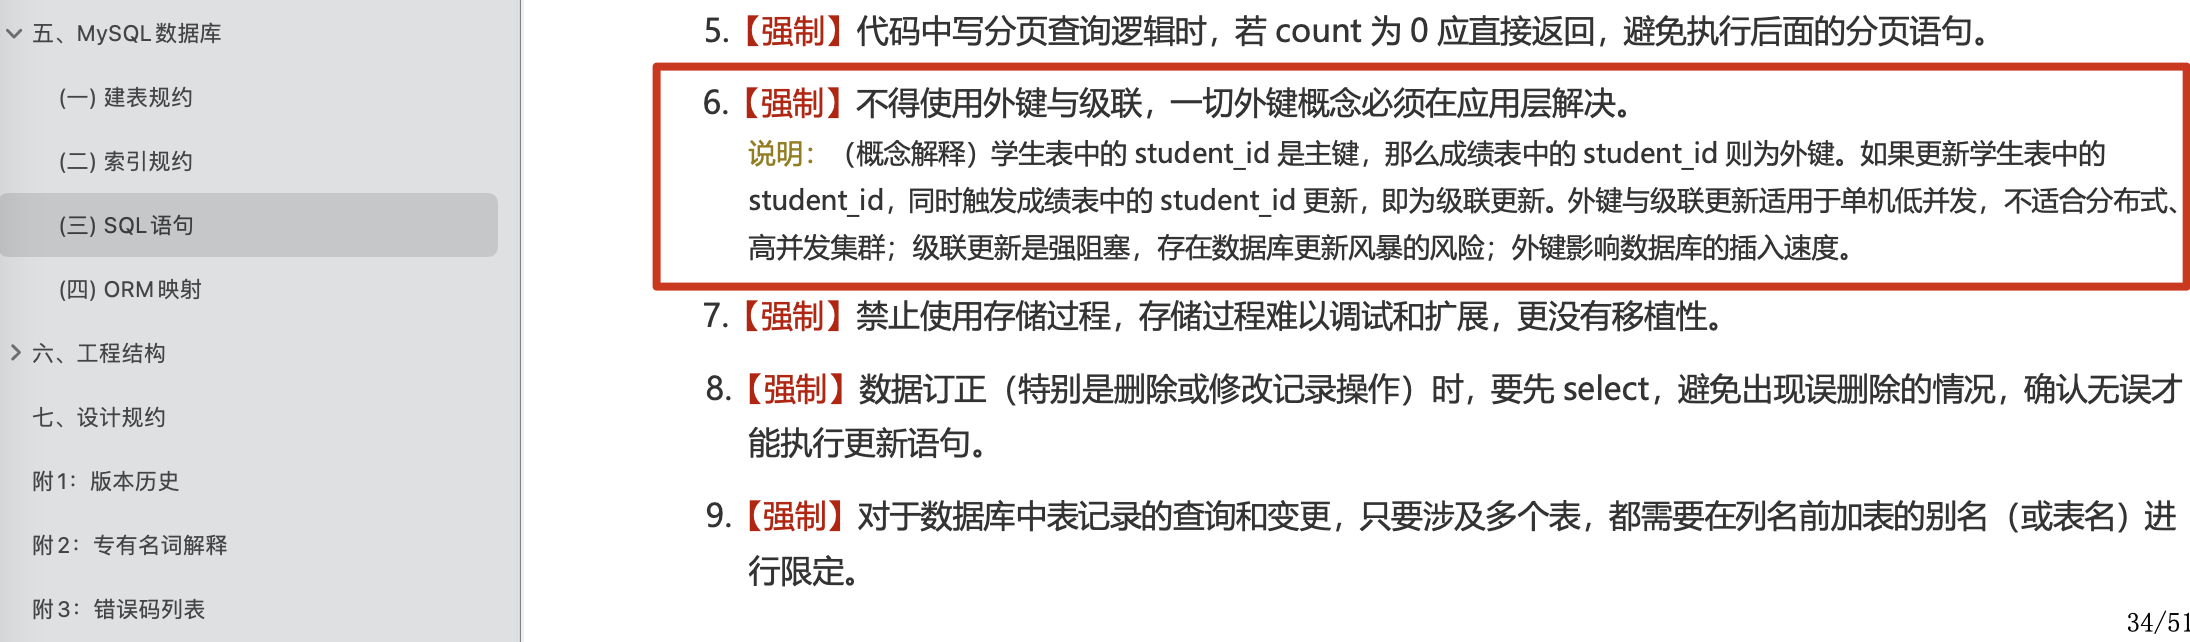
Quy tắc này chủ yếu hướng tới các trường hợp business Internet có concurrency cao, tách microservice, shard database và tách bảng. Trong các trường hợp đó, việc phụ thuộc vào foreign key và cascade sẽ làm tăng coupling giữa các bảng, chi phí migration và độ phức tạp của thay đổi trên production.
Tuy nhiên, foreign key không phải là “vô dụng”. Trong monolithic application, hệ thống backend và các bảng dữ liệu chính quan trọng có quy mô kiểm soát được và yêu cầu consistency mạnh rõ ràng, foreign key có thể giúp database bảo vệ tính toàn vẹn tham chiếu. Kết luận chính xác hơn là: có dùng foreign key hay không cần được quyết định dựa trên dạng kiến trúc, quy mô dữ liệu và chi phí vận hành, không nên đơn giản nói rằng “foreign key có performance kém”.
Chọn data type phù hợp
Số byte cần lưu trữ càng nhỏ thì không gian chiếm dụng càng ít và performance càng tốt.
a. Một số string có thể chuyển thành data type số để lưu trữ, chẳng hạn chuyển địa chỉ IP thành dữ liệu số.
Số có tính liên tục, performance tốt hơn và chiếm ít không gian hơn.
MySQL cung cấp một số method để xử lý địa chỉ IP:
INET_ATON(): chuyển IPv4 thành unsigned integer; nên dùngINT UNSIGNEDđể lưu trữ, sau đó dùngINET_NTOA()chuyển lại thành string.INET6_ATON(): chuyển IPv6 thành binary string, đồng thời có thể xử lý IPv4; nếu system cần hỗ trợ IPv6, nên thống nhất dùngVARBINARY(16)hoặcBINARY(16)để lưu trữ, sau đó dùngINET6_NTOA()chuyển lại thành string.
Nếu chỉ lưu IPv4, INET_ATON() + INT UNSIGNED là đủ; nếu tương lai có thể hỗ trợ IPv6, thiết kế trước theo binary 16 byte sẽ ổn định hơn.
b. Với dữ liệu không âm (như ID tự tăng, IP dạng integer, tuổi), nên ưu tiên dùng unsigned integer để lưu trữ.
Unsigned không thay đổi số byte lưu trữ của integer; nó chỉ chuyển range có thể biểu diễn từ bao gồm số âm thành range không âm bắt đầu từ 0. Ví dụ, INT dù là signed hay unsigned đều chiếm 4 byte, range tương ứng như sau:
SIGNED INT -2147483648~2147483647
UNSIGNED INT 0~4294967295
Số byte lưu trữ và range cụ thể có thể tham khảo tài liệu chính thức của MySQL: Integer Types và Data Type Storage Requirements.
c. Với giá trị nhỏ (như tuổi, trạng thái biểu diễn bằng 0/1), ưu tiên dùng data type TINYINT.
d. Với data type ngày tháng, tuyệt đối không dùng string để lưu ngày tháng. Có thể cân nhắc DATETIME, TIMESTAMP và timestamp dạng số.
Ba cách này đều có ưu điểm riêng; chọn cách phù hợp nhất theo trường hợp thực tế mới là quan trọng. Dưới đây là so sánh đơn giản để bạn chọn đúng data type lưu thời gian trong quá trình phát triển:
Lưu ý: Không gian lưu trữ dưới đây dựa trên MySQL 5.6.4+ (hỗ trợ độ chính xác microsecond). Trước 5.6.4, DATETIME cố định 8 byte, TIMESTAMP cố định 4 byte. Khi độ chính xác phần giây là 1~2, 3~4 hoặc 5~6 chữ số, lần lượt chiếm thêm 1, 2 hoặc 3 byte.
| Type | Không gian lưu trữ | Date format | Date range | Xử lý time zone |
|---|---|---|---|---|
| DATETIME | 5~8 byte | YYYY-MM-DD hh:mm:ss[.fraction] | 1000-01-01 00:00:00[.000000] ~ 9999-12-31 23:59:59[.999999] | Không chuyển đổi time zone |
| TIMESTAMP | 4~7 byte | YYYY-MM-DD hh:mm:ss[.fraction] | 1970-01-01 00:00:01[.000000] ~ 2038-01-19 03:14:07[.999999] | Chuyển đổi khi lưu và đọc theo session time_zone |
| Numeric timestamp | 4 hoặc 8 byte | Toàn số, như 1578707612 | Phụ thuộc vào integer type và precision | Không chuyển đổi time zone |
TIMESTAMP không lưu tên time zone, mà chuyển đổi khi lưu và đọc theo time_zone của session hiện tại; DATETIME biểu diễn date time theo nghĩa đen và không chuyển đổi time zone. Unix timestamp cấp giây có thể dùng INT UNSIGNED, nhưng sẽ bị giới hạn bởi range có thể biểu diễn; timestamp cấp millisecond thường cần BIGINT.
Xem giới thiệu chi tiết về việc chọn time type của MySQL tại bài viết: Đề xuất lưu trữ data type thời gian của MySQL.
e. Dùng decimal cho field tiền, tránh mất precision.
decimal dùng để lưu số thập phân yêu cầu precision, chẳng hạn dữ liệu liên quan đến tiền, giúp tránh mất precision do số floating-point.
Trong Java, data type decimal của MySQL tương ứng với class Java java.math.BigDecimal.
Xem giới thiệu chi tiết về BigDecimal tại bài viết: Giải thích chi tiết BigDecimal.
f. Cố gắng dùng id tự tăng làm primary key.
Nếu primary key là id tự tăng, dữ liệu mới sẽ được thêm vào cuối B+ tree, tránh page split ở vị trí giữa nên performance tương đối tối ưu. Khi một data page được ghi đầy, chỉ cần xin thêm một data page mới để tiếp tục ghi.
Nếu primary key không phải id tự tăng, để các leaf node của B+ tree vẫn có thứ tự sau khi thêm dữ liệu mới, hệ thống phải tìm vị trí ở giữa leaf node để chèn. Nếu page mục tiêu đã đầy thì cần thực hiện page split: chia page thành hai và chuyển một nửa dữ liệu sang page mới. Thao tác page split cần thêm pessimistic lock, liên quan đến việc di chuyển nhiều dữ liệu nên performance kém hơn.
Tuy nhiên, trong trường hợp shard database và tách bảng, không nên phụ thuộc vào auto-increment ID của một database để làm primary key toàn cục. Các cách phổ biến hơn là dùng Snowflake, mô hình phân đoạn ID, ID tăng dần theo xu hướng, UUIDv7/ULID và các distributed ID khác. Nếu dùng UUID, không nên trực tiếp dùng random UUID string làm primary key của InnoDB; có thể cân nhắc lưu bằng BINARY(16), dùng UUID có thứ tự theo thời gian hoặc dùng UUID_TO_BIN() của MySQL để lưu dưới dạng binary gọn hơn.
Đọc thêm: Primary key của database có nhất thiết phải tự tăng không? Trường hợp nào không nên tự tăng?.
g. Dùng NULL theo đúng ngữ nghĩa, không cấm một cách máy móc.
NULL hoàn toàn khác với '' (empty string) và số 0, biểu thị giá trị chưa biết hoặc không tồn tại. Khi kiểm tra NULL, phải dùng IS NULL hoặc IS NOT NULL, không thể dùng các toán tử so sánh như =, !=, <, >.
Không nên thiết kế tất cả column đều có thể là NULL một cách máy móc, vì điều đó làm tăng độ phức tạp về ngữ nghĩa và xử lý query; nhưng cũng không thể nói NULL chắc chắn làm index mất hiệu lực. MySQL có thể dùng index để tối ưu IS NULL. Điều nên ưu tiên xem xét thực sự là ngữ nghĩa nghiệp vụ: nếu field thực sự có thể chưa biết, như paid_at, deleted_at, last_login_at, dùng NULL thường rõ ràng hơn việc nhét một magic default value.
Ngoài ra, NULL ảnh hưởng đến kết quả của aggregate function. Các aggregate function như SUM, AVG, MIN, MAX sẽ bỏ qua giá trị NULL. COUNT(*) thống kê mọi record, còn COUNT(tên column) chỉ thống kê các giá trị không phải NULL.
Ưu tiên dùng UNION ALL thay cho UNION
UNION đưa toàn bộ dữ liệu của hai result set vào temporary table rồi mới deduplicate, tốn thời gian và CPU hơn.
UNION ALL không deduplicate result set, nên dữ liệu nhận được có thể chứa các phần tử trùng lặp.
Nếu nghiệp vụ xác định được hai result set không trùng lặp hoặc cho phép trùng lặp, hãy ưu tiên dùng UNION ALL. Nếu bắt buộc deduplicate, vẫn nên dùng UNION hoặc deduplicate tường minh.
Ưu tiên thao tác batch
Khi update dữ liệu trong database, nếu có thể dùng batch operation thì nên ưu tiên dùng để giảm số lần request đến database và cải thiện performance.
# Ví dụ ngược
INSERT INTO `cus_order` (`id`, `score`, `name`) VALUES (1, 426547, 'user1');
INSERT INTO `cus_order` (`id`, `score`, `name`) VALUES (1, 33, 'user2');
INSERT INTO `cus_order` (`id`, `score`, `name`) VALUES (1, 293854, 'user3');

# Ví dụ đúng
INSERT into `cus_order` (`id`, `score`, `name`) values(1, 426547, 'user1'),(1, 33, 'user2'),(1, 293854, 'user3');
SHOW PROFILE đã deprecated, không phụ thuộc vào nó trong phiên bản mới
SHOW PROFILE và SHOW PROFILES đã được MySQL đánh dấu là deprecated, có thể bị xóa trong các phiên bản tương lai. Hiện nay khi kiểm tra performance của SQL, thường trước hết dùng slow query log để tìm SQL có vấn đề, sau đó dùng EXPLAIN xem optimizer thực thi như thế nào; từ MySQL 8.0.18+ có thể dùng EXPLAIN ANALYZE để xem thời gian và số dòng thực tế, còn mức tiêu thụ resource thì dùng Performance Schema.
Ví dụ, nếu muốn xem thời gian của các SQL vừa được thực thi gần đây, có thể query events_statements_history_long:
SELECT
    EVENT_ID,
    SQL_TEXT,
    TIMER_WAIT / 1000000000 AS duration_ms,
    LOCK_TIME / 1000000000 AS lock_ms,
    ROWS_EXAMINED,
    ROWS_SENT,
    CPU_TIME / 1000000000 AS cpu_ms
FROM performance_schema.events_statements_history_long
WHERE SQL_TEXT IS NOT NULL
ORDER BY TIMER_WAIT DESC
LIMIT 10;
CPU_TIME cần MySQL 8.0.28+; nếu version thấp hơn, trước hết có thể xem các field như TIMER_WAIT, LOCK_TIME, ROWS_EXAMINED, ROWS_SENT. events_statements_history_long chỉ lưu một phần event statement vừa kết thúc gần đây trên toàn cục; khi bảng đầy, record cũ sẽ bị loại bỏ. Nếu các consumer và instrument liên quan chưa được bật, cũng có thể không thu thập đủ thông tin.
Tối ưu slow SQL
Để tối ưu slow SQL, trước hết cần tìm ra những SQL statement nào thực thi chậm.
Slow query log của MySQL dùng để ghi lại các SQL statement có response time vượt quá threshold đã thiết lập khi MySQL thực thi command. Do đó, phân tích slow query log giúp tìm ra các SQL statement thực thi chậm.
Vì lý do performance, tính năng slow query log mặc định bị tắt. Có thể bật bằng các command sau:
# Bật tính năng slow query log
SET GLOBAL slow_query_log = 'ON';
# Vị trí lưu slow query log
SET GLOBAL slow_query_log_file = '/var/lib/mysql/ranking-list-slow.log';
# Ghi lại cả query chưa dùng index dù có timeout hay không; thận trọng khi bật trong thời gian ngắn trên production.
SET GLOBAL log_queries_not_using_indexes = 'ON';
# Slow query threshold (giây), SQL thực thi vượt threshold này sẽ được ghi vào log.
SET GLOBAL long_query_time = 1;
# Slow query chỉ ghi lại SQL có số dòng scan lớn hơn parameter này
SET GLOBAL min_examined_row_limit = 100;
SET GLOBAL chỉ ảnh hưởng đến connection mới; connection hiện tại có thể vẫn giữ giá trị session cũ. Trên production, nên ghi vào file config và phát hành thông qua quy trình thay đổi.
Sau khi thiết lập thành công, dùng command show variables like 'slow%'; để kiểm tra.
| Variable_name       | Value                                |
+---------------------+--------------------------------------+
| slow_launch_time    | 2                                    |
| slow_query_log      | ON                                   |
| slow_query_log_file | /var/lib/mysql/ranking-list-slow.log |
+---------------------+--------------------------------------+
3 rows in set (0.01 sec)
Cố ý thực thi một câu lệnh sort trên bảng có hàng triệu record (chưa dùng index):
SELECT `score`,`name` FROM `cus_order` ORDER BY `score` DESC;Đừng trực tiếp thay đổi quyền của MySQL data directory chỉ để xem slow log. Cách ổn định hơn là dùng account có quyền để xem, xuất slow log vào directory chuyên dụng hoặc thu thập qua hệ thống log collection.
Xem slow query log tương ứng:
cat /var/lib/mysql/ranking-list-slow.logSQL vừa cố ý thực thi đã được slow query log ghi lại:
# Time: 2022-10-09T08:55:37.486797Z
# User@Host: root[root] @  [172.17.0.1]  Id:    14
# Query_time: 0.978054  Lock_time: 0.000164 Rows_sent: 999999  Rows_examined: 1999998
SET timestamp=1665305736;
SELECT `score`,`name` FROM `cus_order` ORDER BY `score` DESC;
Giải thích một số thông tin trong log:
Time: thời gian đoạn code được ghi log chạy trên server.User@Host: ai đã thực thi đoạn code này.Query_time: thời gian đoạn code chạy.Lock_time: thời gian bị lock khi thực thi đoạn code.Rows_sent: số record slow query trả về.Rows_examined: số dòng slow query đã scan.
Trong project thực tế, slow query log thường khá phức tạp. Cần dùng một số tool để phân tích. Tool mysqldumpslow tích hợp sẵn trong MySQL có thể gom các SQL giống nhau thành một nhóm, đồng thời thống kê số lần thực thi, thời gian mỗi lần thực thi và các thông tin tương ứng khác.
Khi xử lý slow SQL, nên đồng thời chú ý các metric sau:
| Metric | Mô tả | Vấn đề thường gặp |
|---|---|---|
Query_time | Tổng thời gian SQL | Thực thi chậm, lock wait, I/O chậm |
Lock_time | Thời gian chờ lock | Xung đột row lock, table lock, ảnh hưởng của DDL |
Rows_examined | Số dòng scan | Thiếu index, selectivity của index kém |
Rows_sent | Số dòng trả về | Phạm vi query quá lớn, phân trang quá sâu |
| Tần suất thực thi | Số lần thực thi trong một đơn vị thời gian | Mỗi lần không chậm nhưng tổng lượng làm database quá tải |
Đừng chỉ tập trung vào SQL có thời gian dài nhất. Trên production, nguy hiểm nhất thường là SQL “mỗi lần 50 ms nhưng được thực thi vài nghìn lần mỗi giây”.
Sau khi tìm được slow SQL, có thể dùng command EXPLAIN để phân tích câu lệnh SELECT tương ứng. Trước và sau khi tối ưu trên production, tốt nhất nên lưu EXPLAIN FORMAT=TREE, EXPLAIN ANALYZE, metric của slow log và QPS nghiệp vụ quan trọng của cùng một SQL, tránh tình trạng “đã sửa index nhưng execution plan không thay đổi”.
mysql> EXPLAIN SELECT `score`,`name` FROM `cus_order` ORDER BY `score` DESC;
+----+-------------+-----------+------------+------+---------------+------+---------+------+--------+----------+----------------+
| id | select_type | table     | partitions | type | possible_keys | key  | key_len | ref  | rows   | filtered | Extra          |
+----+-------------+-----------+------------+------+---------------+------+---------+------+--------+----------+----------------+
|  1 | SIMPLE      | cus_order | NULL       | ALL  | NULL          | NULL | NULL    | NULL | 997572 |   100.00 | Using filesort |
+----+-------------+-----------+------------+------+---------------+------+---------+------+--------+----------+----------------+
1 row in set, 1 warning (0.00 sec)
Giải thích các field quan trọng:
select_type: type của query. Các giá trị thường dùng gồm SIMPLE (query thông thường, không có union query hoặc subquery), PRIMARY (primary query), UNION (query phía sau trong UNION), SUBQUERY (subquery) và các giá trị khác.table: bảng hoặc derived table liên quan đến query.type: phương thức thực thi, là metric tham khảo quan trọng để đánh giá query có hiệu quả hay không. Giá trị từ kém đến tốt lần lượt là: ALL (full table scan) < index (full index scan) < range (index range scan) < index_merge (index merge) < ref (lookup trên non-unique index) < eq_ref (lookup trên unique index) < const (constant một dòng) < system (system table). Performance thực tế vẫn cần được đánh giá kết hợp với các field như rows và Extra.rows: số dòng dữ liệu cần scan và đọc để SQL tìm được result set; về nguyên tắc rows càng ít càng tốt.- ……
Đề xuất đọc: Phân tích execution plan của MySQL giới thiệu chi tiết ý nghĩa các column của EXPLAIN (id, select_type, type, key, rows, Extra...), bao gồm tính năng phân tích thực thi thực tế
EXPLAIN ANALYZEđược thêm từ MySQL 8.0.18+. Bài Tổng hợp kinh nghiệm xử lý slow SQL của Alibaba cũng khá hữu ích.
Sử dụng index đúng cách
Sử dụng index đúng cách có thể tăng mạnh tốc độ truy xuất dữ liệu (giảm đáng kể lượng dữ liệu cần truy xuất).
Chọn field phù hợp để tạo index
- Ưu tiên field có ngữ nghĩa rõ ràng và ít
NULL: field của index nên có ngữ nghĩa nghiệp vụ rõ ràng và hạn chế độ phức tạp khi phán đoán doNULL. Nếu field thực sự có thể chưa biết, hãy giữNULL, đừng nhét một magic value không rõ nghĩa vì “performance”. - Field được query thường xuyên: field dùng để tạo index nên là field được query rất thường xuyên.
- Field được dùng làm điều kiện query: các field được query làm điều kiện WHERE nên được cân nhắc tạo index.
- Field thường xuyên cần sort: index đã được sort, vì vậy query có thể tận dụng thứ tự của index để tăng tốc độ sort.
- Field thường xuyên được dùng để liên kết: các field thường dùng để liên kết có thể là foreign key column. Với foreign key column không nhất thiết phải tạo foreign key, ở đây chỉ nói rằng column đó liên quan đến mối quan hệ giữa các bảng. Với field thường xuyên được dùng trong query liên kết, có thể cân nhắc tạo index để cải thiện hiệu quả query liên kết nhiều bảng.
Tránh làm index mất hiệu lực
Index mất hiệu lực cũng là một trong các nguyên nhân chính gây slow query. Hai trường hợp thường gặp khiến index mất hiệu lực như sau:
1. Cách viết SQL làm index khó được sử dụng
Vấn đề này thường nằm ở cách viết: vốn có thể tìm kiếm có thứ tự theo B+Tree, nhưng sau khi viết SQL lại biến thành scan rồi filter.
- Vi phạm nguyên tắc leftmost prefix: bỏ qua leading column của composite index hoặc gặp range query (như
>,<,BETWEEN,LIKE "abc%") thì các column phía sau thường không thể tiếp tục dùng để thu hẹp chính xác vùng scan index, nhưng vẫn có thể được dùng cho ICP filter, covering index hoặc tối ưu sort. Cuối cùng cần xemkey_len,rows,ExtracủaEXPLAINvàEXPLAIN ANALYZE. - Xử lý index column: khi index thông thường được tạo trên column gốc, thực hiện phép tính hoặc áp dụng function lên index column ở bên trái
WHEREthường khiến optimizer khó dùng index đó. Cách viết tốt hơn là chuyển function sang phía constant hoặc đổi thành range condition; nếu thường xuyên query theo expression, có thể cân nhắc generated column index hoặc function index. - Implicit type conversion (kín đáo nhưng nghiêm trọng): khi “column dạng string” so sánh với “giá trị dạng số”, MySQL mặc định áp dụng function conversion lên column, trực tiếp phá vỡ tính có thứ tự của tree.
- Wildcard ở đầu LIKE fuzzy query: như
LIKE "%abc", sự không xác định của các ký tự prefix khiến optimizer không thể xác định điểm bắt đầu của vùng scan. - Sort bổ sung của ORDER BY: khi column sort không dùng được index hoặc hướng sort không nhất quán với cấu trúc index, MySQL có thể cần sort bổ sung trong memory hoặc trên disk. Execution plan thường hiển thị
Using filesort.
2. Optimizer tính toán cost xong rồi bỏ index
Trong một số trường hợp, không phải index không dùng được, mà optimizer tính cost rồi cho rằng full table scan rẻ hơn.
- Quá nhiều lần đọc lại bảng do
SELECT *: khi query nhiều column không được index cover, nếu lượng dữ liệu khớp lớn (thường trên 20%~30%), optimizer có thể cho rằng sequential I/O của full table scan có lợi hơn random I/O do đọc lại bảng thường xuyên, nên chủ động bỏ index. - Điều kiện
ORdẫn đến full table scan: chỉ cần một phía của điều kiện nối bằngORkhông có index tương ứng là có thể dẫn đến full table scan. Ngay cả khi cả hai phía đều có index, nếu cost dự kiến của Index Merge quá cao thì vẫn sẽ bị bỏ qua. - Danh sách
INquá dài làm sai lệch ước tính: khi danh sáchINquá dài, cost do optimizer ước tính có thể không chính xác. MySQL dùngeq_range_index_dive_limitđể kiểm soát việc khi số lượng equality range đạt một threshold thì có chuyển từ index dive sang statistical estimation hay không. Điều này có thể khác nhau theo version và config; không nên chỉ học thuộc con số “200”, mà nên đánh giá kết hợp vớiEXPLAIN, statistic vàANALYZE TABLE.
Giới thiệu chi tiết: Tổng hợp các trường hợp MySQL index mất hiệu lực.
Cân nhắc khi tạo index trên field được update thường xuyên
Index giúp query hiệu quả hơn, nhưng chi phí maintenance index cũng không nhỏ. Nếu một field không được query thường xuyên mà lại thường xuyên bị sửa đổi, càng không nên tạo index trên field đó.
Ưu tiên cân nhắc composite index thay vì single-column index
Index chiếm không gian trên disk; có thể hiểu đơn giản rằng mỗi index tương ứng với một B+ tree. Nếu một bảng có quá nhiều field và quá nhiều index, khi dữ liệu đạt đến quy mô nhất định, không gian index chiếm dụng cũng rất lớn, đồng thời thời gian sửa index cũng tăng. Với composite index, nhiều field nằm trong cùng một index, giúp tiết kiệm đáng kể không gian disk và cải thiện hiệu quả thao tác sửa dữ liệu.
Chú ý tránh redundant index
Redundant index là các index có chức năng giống nhau. Nếu query có thể dùng index (a, b) thì chắc chắn cũng có thể dùng index (a), vì vậy index (a) là redundant index. Ví dụ, (name,city) và (name) là hai redundant index; query có thể dùng index trước thì trong phần lớn trường hợp cũng có thể dùng index sau. Nên ưu tiên mở rộng index hiện có thay vì tạo index mới.
Cân nhắc dùng prefix index thay cho index thông thường trên field dạng string
Prefix index chỉ áp dụng cho field dạng string và chiếm ít không gian hơn index thông thường, vì vậy có thể cân nhắc dùng prefix index thay cho index thông thường.
Xóa index không được sử dụng trong thời gian dài
Xóa index không được sử dụng trong thời gian dài; index không cần thiết sẽ gây tổn hao performance không đáng có. MySQL 5.7 có thể query view schema_unused_indexes trong sys database để xem các index chưa từng được sử dụng.
Tuy nhiên, view này chỉ có ý nghĩa khi service đã chạy đủ lâu và workload có tính đại diện. Với MySQL 8.0+, trước khi xóa index có thể đặt index thành invisible, theo dõi execution plan và metric nghiệp vụ, rồi mới quyết định có xóa thật hay không:
ALTER TABLE t ALTER INDEX idx_name INVISIBLE;Lưu ý khi tối ưu trên production
- Không trực tiếp thêm index vào giờ cao điểm: thêm index cho bảng lớn có thể chiếm resource trong thời gian dài. Trên production cần đánh giá online DDL, metadata lock, không gian disk, backup, rollback, time window thấp điểm của nghiệp vụ và replication lag của replica.
- Không hy sinh performance ghi chỉ vì một query có tần suất thấp: càng nhiều index thì chi phí maintenance khi insert, update và delete càng cao.
- Không bỏ qua data distribution: cùng một SQL có thể chạy rất nhanh trên database test nhưng dùng execution plan hoàn toàn khác trên production do data skew hoặc statistic cũ.
- Không chỉ tối ưu SQL text: một số vấn đề cần sản phẩm giới hạn phạm vi query, một số cần cache, một số cần báo cáo async hoặc data warehouse xử lý.
- Tiếp tục theo dõi sau khi tối ưu: sau khi release, tiếp tục theo dõi số lượng slow query, CPU, I/O, tỷ lệ hit của Buffer Pool, số connection và lock wait.
Tham khảo
- MySQL 8.2 Optimizing SQL Statements:https://dev.mysql.com/doc/refman/8.0/en/statement-optimization.html
- Vì sao Alibaba cấm join nhiều bảng trong database - Hollis:https://mp.weixin.qq.com/s/GSGVFkDLz1hZ1OjGndUjZg
- Câu lệnh COUNT của MySQL cũng có thể khiến interviewer “hành” đến vậy - Hollis:https://mp.weixin.qq.com/s/IOHvtel2KLNi-Ol4UBivbQ
- Phân tích cách sử dụng Explain, công cụ tối ưu performance của MySQL:https://segmentfault.com/a/1190000008131735
- Cách sử dụng slow query log của MySQL để tối ưu performance:https://kalacloud.com/blog/how-to-use-mysql-slow-query-log-profiling-mysqldumpslow/