
Tổng hợp câu hỏi phỏng vấn Redis thường gặp (phần 2)

Redis transaction
Redis transaction là gì?
Bạn có thể hiểu transaction trong Redis như sau: Redis transaction cung cấp chức năng đóng gói nhiều command request. Sau đó, tất cả command đã đóng gói sẽ được thực thi theo thứ tự và không bị ngắt giữa chừng.
Redis transaction được sử dụng rất ít trong phát triển thực tế, chức năng khá hạn chế; không nên nhầm lẫn nó với transaction của relational database mà chúng ta thường hiểu.
Ngoài việc không đáp ứng atomicity và durability, mỗi command trong transaction đều phải trao đổi qua network với Redis server, đây là hành vi khá lãng phí tài nguyên. Rõ ràng có thể thực thi nhiều command một lần, nên cách làm này thực sự khó hiểu.
Vì vậy, không khuyến nghị sử dụng Redis transaction trong phát triển hằng ngày.
Sử dụng Redis transaction như thế nào?
Redis có thể sử dụng các command như MULTI, EXEC, DISCARD và WATCH để triển khai chức năng transaction.
> MULTI
OK
> SET PROJECT "JavaGuide"
QUEUED
> GET PROJECT
QUEUED
> EXEC
1) OK
2) "JavaGuide"
Sau command MULTI, bạn có thể nhập nhiều command. Redis không thực thi ngay các command này mà đưa chúng vào queue. Khi gọi command EXEC, tất cả command mới được thực thi.
Quy trình như sau:
- Bắt đầu transaction (
MULTI); - Đưa command vào queue (các command của Redis được thực thi theo thứ tự first in, first out (FIFO));
- Thực thi transaction (
EXEC).
Bạn cũng có thể dùng command DISCARD để hủy một transaction; command này sẽ xóa toàn bộ command được lưu trong transaction queue.
> MULTI
OK
> SET PROJECT "JavaGuide"
QUEUED
> GET PROJECT
QUEUED
> DISCARD
OK
Bạn có thể dùng command WATCH để theo dõi các key được chỉ định. Khi gọi command EXEC để thực thi transaction, nếu một key đang được command WATCH giám sát bị client/session khác sửa đổi thì toàn bộ transaction sẽ không được thực thi.
# Client 1
> SET PROJECT "RustGuide"
OK
> WATCH PROJECT
OK
> MULTI
OK
> SET PROJECT "JavaGuide"
QUEUED

# Client 2
# Sửa giá trị PROJECT trước khi client 1 thực thi command EXEC để commit transaction
> SET PROJECT "GoGuide"

# Client 1
# Sửa đổi thất bại vì giá trị PROJECT đã bị client 2 sửa
> EXEC
(nil)
> GET PROJECT
"GoGuide"
Tuy nhiên, nếu WATCH và transaction nằm trong cùng một session, đồng thời thao tác sửa key được WATCH giám sát xảy ra bên trong transaction, transaction này vẫn có thể thực thi thành công (issue liên quan: Hiệu ứng khác nhau khi command WATCH gặp command MULTI).
Sửa key được WATCH giám sát bên trong transaction:
> SET PROJECT "JavaGuide"
OK
> WATCH PROJECT
OK
> MULTI
OK
> SET PROJECT "JavaGuide1"
QUEUED
> SET PROJECT "JavaGuide2"
QUEUED
> SET PROJECT "JavaGuide3"
QUEUED
> EXEC
1) OK
2) OK
3) OK
127.0.0.1:6379> GET PROJECT
"JavaGuide3"
Sửa key được WATCH giám sát bên ngoài transaction:
> SET PROJECT "JavaGuide"
OK
> WATCH PROJECT
OK
> SET PROJECT "JavaGuide2"
OK
> MULTI
OK
> GET USER
QUEUED
> EXEC
(nil)
Phần giới thiệu liên quan trên website Redis: https://redis.io/topics/transactions

Redis transaction có hỗ trợ atomicity không?
Redis transaction khác với transaction của relational database mà chúng ta thường hiểu. Chúng ta biết transaction có bốn đặc tính: 1. Atomicity, 2. Isolation, 3. Durability, 4. Consistency.
- Atomicity: transaction là đơn vị thực thi nhỏ nhất và không được phép chia tách. Atomicity của transaction bảo đảm một action hoặc hoàn tất toàn bộ, hoặc hoàn toàn không có tác dụng;
- Isolation: khi truy cập database đồng thời, transaction của một user không bị transaction khác can thiệp; database giữa các transaction đồng thời là độc lập;
- Durability: sau khi transaction được commit, thay đổi của nó đối với dữ liệu trong database là bền vững; ngay cả khi database gặp sự cố, thay đổi đó cũng không bị ảnh hưởng;
- Consistency: dữ liệu nhất quán trước và sau khi thực thi transaction; kết quả đọc cùng một dữ liệu của nhiều transaction là giống nhau.
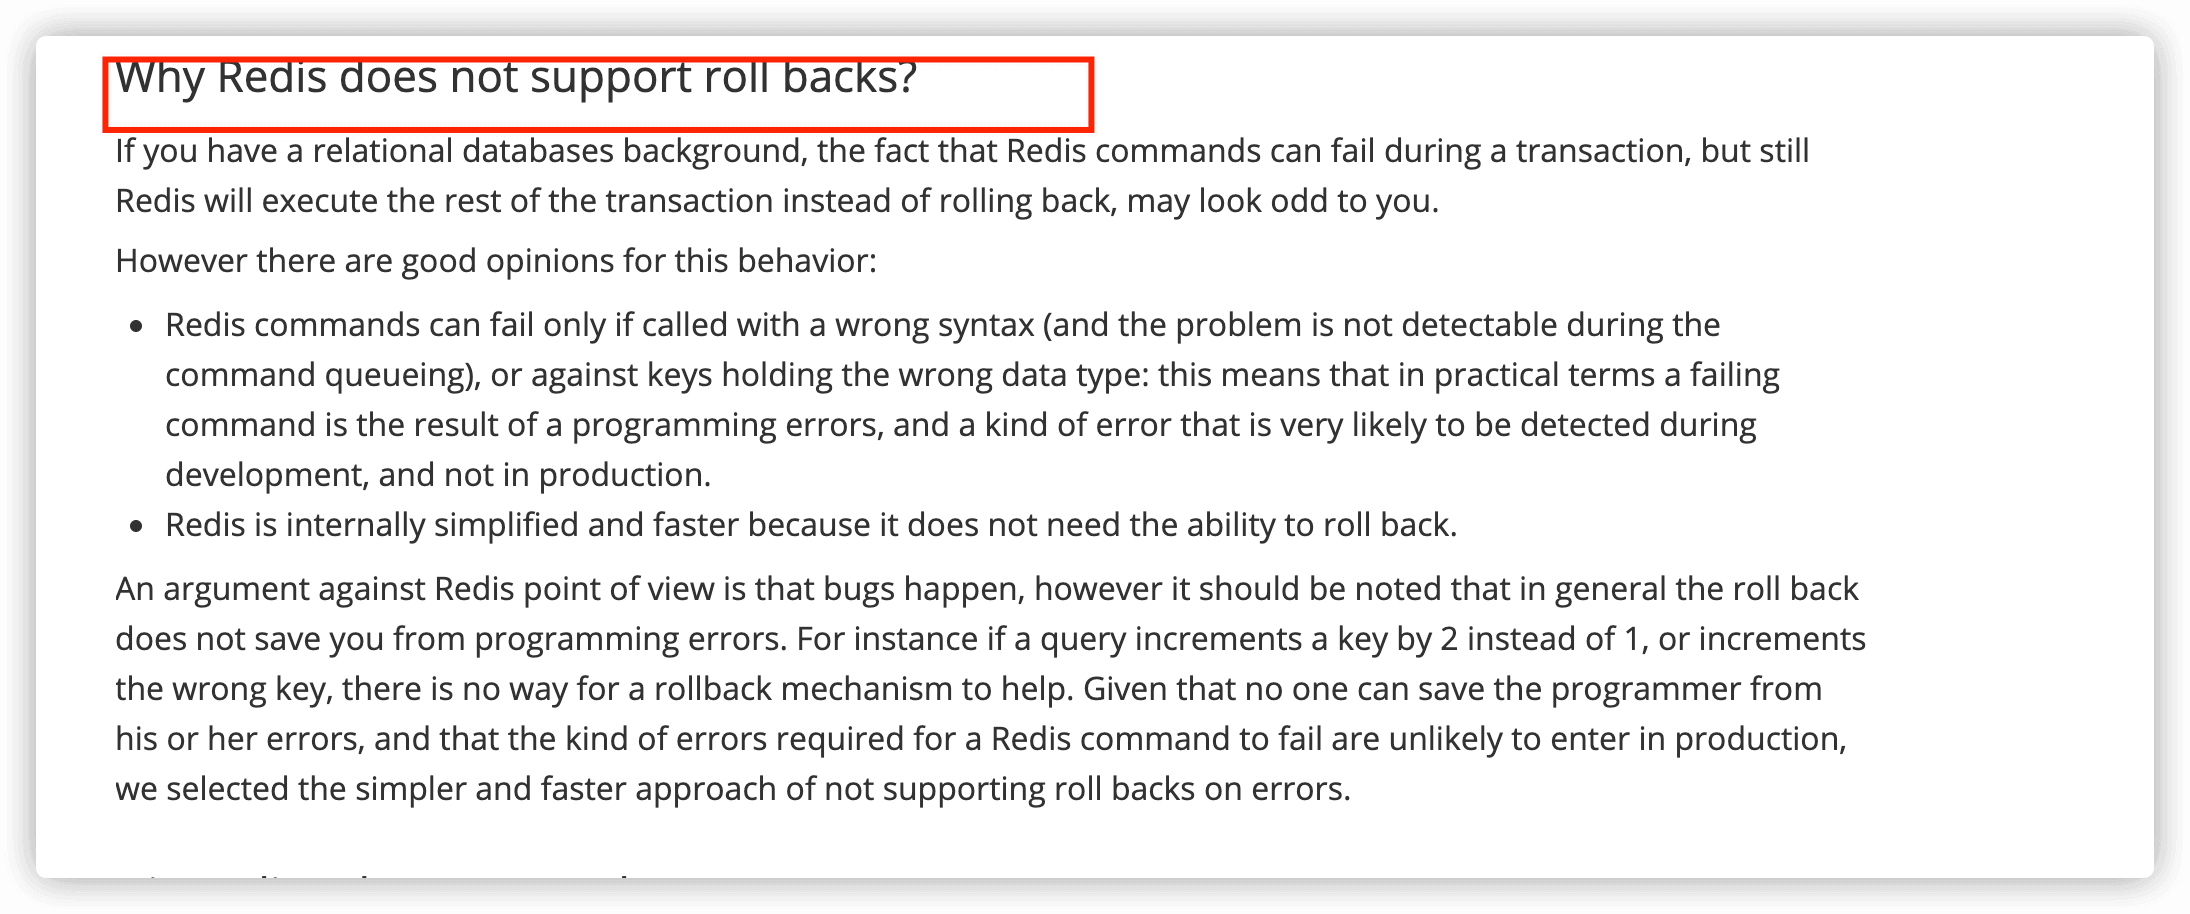
Khi xảy ra lỗi lúc chạy, ngoài command bị lỗi trong quá trình thực thi, các command khác trong Redis transaction vẫn có thể thực thi bình thường. Ngoài ra, Redis transaction không hỗ trợ thao tác rollback. Vì vậy, Redis transaction thực tế không đáp ứng atomicity.
Website Redis cũng giải thích lý do không hỗ trợ rollback. Nói ngắn gọn, các developer của Redis cho rằng không cần hỗ trợ rollback; cách này đơn giản, thuận tiện hơn và performance tốt hơn. Họ cho rằng ngay cả khi command thực thi lỗi, lỗi đó cũng nên được phát hiện trong quá trình phát triển chứ không phải ở production.
Issue liên quan:
- issue#452: Vấn đề Redis transaction không đáp ứng atomicity.
- Issue#491: Vì sao Redis không có transaction rollback?.
Redis transaction có hỗ trợ durability không?
Một điểm rất quan trọng khiến Redis khác Memcached là Redis hỗ trợ persistence, đồng thời hỗ trợ 3 phương thức persistence:
- Snapshot (snapshotting, RDB);
- Append-only file (AOF);
- Persistence kết hợp giữa RDB và AOF (được bổ sung từ Redis 4.0).
So với RDB persistence, AOF persistence có tính realtime tốt hơn. Trong file cấu hình Redis có ba phương thức AOF persistence khác nhau (strategy fsync), gồm:
appendfsync always    # Khi xảy ra mỗi lần sửa dữ liệu, main thread trực tiếp gọi fsync để đồng bộ file AOF (flush xuống disk); trả về sau khi fsync hoàn tất. always do main thread thực thi thay vì background thread, làm giảm nghiêm trọng performance Redis
appendfsync everysec  # Gọi function fsync mỗi giây một lần để đồng bộ file AOF
appendfsync no        # Để operating system quyết định thời điểm đồng bộ, thường là 30 giây một lần
Khi strategy fsync của AOF persistence là no hoặc everysec, dữ liệu đều có thể bị mất. always về cơ bản có thể đáp ứng yêu cầu durability, nhưng performance quá kém nên không được sử dụng trong phát triển thực tế.
Vì vậy, durability của Redis transaction cũng không thể được bảo đảm.
Giải quyết hạn chế của Redis transaction như thế nào?
Từ phiên bản 2.6, Redis hỗ trợ thực thi Lua script, có chức năng rất giống transaction. Chúng ta có thể dùng Lua script để thực thi batch nhiều Redis command; các Redis command này được gửi đến Redis server và thực thi trong một lần, giúp giảm đáng kể network overhead.
Một Lua script có thể được xem như một command để thực thi. Trong quá trình thực thi Lua script sẽ không có script hoặc Redis command khác được thực thi đồng thời, bảo đảm thao tác không bị instruction khác chèn vào hoặc can thiệp.
Tuy nhiên, nếu Lua script bị lỗi và kết thúc giữa chừng, các command sau thời điểm lỗi sẽ không được thực thi. Đồng thời, command đã thực thi trước khi lỗi không thể bị hoàn tác, nên không thể đạt được atomicity tương tự việc relational database rollback khi thực thi thất bại. Vì vậy, nói chính xác thì việc dùng Lua script để thực thi batch Redis command cũng không hoàn toàn đáp ứng atomicity.
Nếu muốn tất cả command trong Lua script được thực thi, phải bảo đảm cú pháp statement và command đều đúng.
Ngoài ra, Redis 7.0 bổ sung tính năng Redis functions; bạn có thể xem Redis functions là một script mạnh hơn Lua.
⭐️ Tối ưu performance Redis (quan trọng)
Ngoài nội dung bên dưới, đề xuất thêm hai bài viết hữu ích:
- Redis của bạn thực sự chậm đi sao? Làm thế nào để tối ưu performance - Alibaba Cloud Developer.
- Tổng hợp nguyên nhân Redis bị blocking thường gặp - JavaGuide.
Dùng batch operation để giảm network transmission
Việc thực thi một Redis command có thể được đơn giản hóa thành 4 bước:
- Gửi command;
- Đưa command vào queue;
- Thực thi command;
- Trả về kết quả.
Tổng thời gian của bước 1 và bước 4 được gọi là Round Trip Time (RTT, thời gian khứ hồi), tức thời gian dữ liệu truyền trên network.
Dùng batch operation có thể giảm số lần network transmission, từ đó giảm network overhead một cách hiệu quả và giảm mạnh RTT.
Ngoài việc giảm RTT, chi phí socket I/O khi gửi một command cũng khá cao (liên quan đến context switch và các system call read() và write()). Batch operation còn có thể giảm chi phí socket I/O. Nội dung này được đề cập trong phần giới thiệu pipeline chính thức: https://redis.io/docs/manual/pipelining/.
Native batch operation command
Redis có một số command native hỗ trợ batch operation, ví dụ:
MGET(lấy giá trị của một hoặc nhiều key được chỉ định),MSET(đặt giá trị cho một hoặc nhiều key được chỉ định),HMGET(lấy giá trị của một hoặc nhiều field được chỉ định trong hash table),HMSET(đồng thời đặt một hoặc nhiều cặp field-value vào hash table được chỉ định),SADD(thêm một hoặc nhiều element vào set được chỉ định)- ……
Tuy nhiên, trong Redis Cluster, giải pháp cluster sharding chính thức của Redis, việc dùng các native batch operation command này có thể có một số vấn đề cần xử lý. Ví dụ, MGET không bảo đảm mọi key đều nằm trên cùng một hash slot; MGET có thể vẫn cần nhiều lần network transmission và cũng không bảo đảm atomic operation. Tuy vậy, so với non-batch operation, cách này vẫn tiết kiệm được không ít lần network transmission.
Phiên bản đơn giản của toàn bộ quy trình như sau (thường do Redis client triển khai, chúng ta không cần tự triển khai thủ công):
- Tìm tất cả hash slot tương ứng với key;
- Gửi request
MGETđến các Redis node tương ứng để lấy dữ liệu; - Chờ tất cả request thực thi xong, lắp ghép lại dữ liệu kết quả, giữ thứ tự giống các key trong input rồi trả về kết quả.
Nếu muốn giải quyết vấn đề nhiều lần network transmission này, cách thường dùng là tự duy trì quan hệ giữa key và slot. Tuy nhiên, cách này kém linh hoạt; dù cải thiện performance nhưng cũng làm tăng độ phức tạp của hệ thống.
Redis Cluster không sử dụng consistent hashing mà dùng phân vùng hash slot; mỗi key-value pair thuộc về một hash slot. Khi client gửi command request, trước tiên cần tìm hash slot tương ứng theo key bằng công thức tính ở trên, sau đó tra cứu quan hệ mapping giữa hash slot và node để tìm Redis node đích.
Tôi đã giới thiệu chi tiết phần Redis Cluster trong bài Giải thích chi tiết Redis Cluster (trả phí), nếu quan tâm bạn có thể xem.
pipeline
Đối với command không hỗ trợ batch operation, chúng ta có thể dùng pipeline để đóng gói một loạt Redis command thành một nhóm. Các Redis command này được gửi đến Redis server trong một lần, chỉ cần một lần network transmission. Tuy nhiên, cần chú ý kiểm soát số lượng element trong một batch operation (chẳng hạn không quá 500; thực tế còn liên quan đến số byte của element), tránh khiến lượng dữ liệu truyền qua network quá lớn.
Tương tự các native batch operation command như MGET và MSET, pipeline cũng có một số vấn đề khi dùng trên Redis Cluster. Nguyên nhân tương tự: không thể bảo đảm mọi key đều nằm trên cùng một hash slot. Nếu muốn sử dụng, client cần tự duy trì quan hệ giữa key và slot.
Native batch operation command và pipeline có những điểm khác nhau sau, cần chú ý khi sử dụng:
- Native batch operation command là atomic operation, còn pipeline là non-atomic operation.
- Pipeline có thể đóng gói các command khác nhau, còn native batch operation command thì không.
- Native batch operation command được Redis server hỗ trợ triển khai, còn pipeline cần server và client cùng triển khai.
Bổ sung so sánh giữa pipeline và Redis transaction:
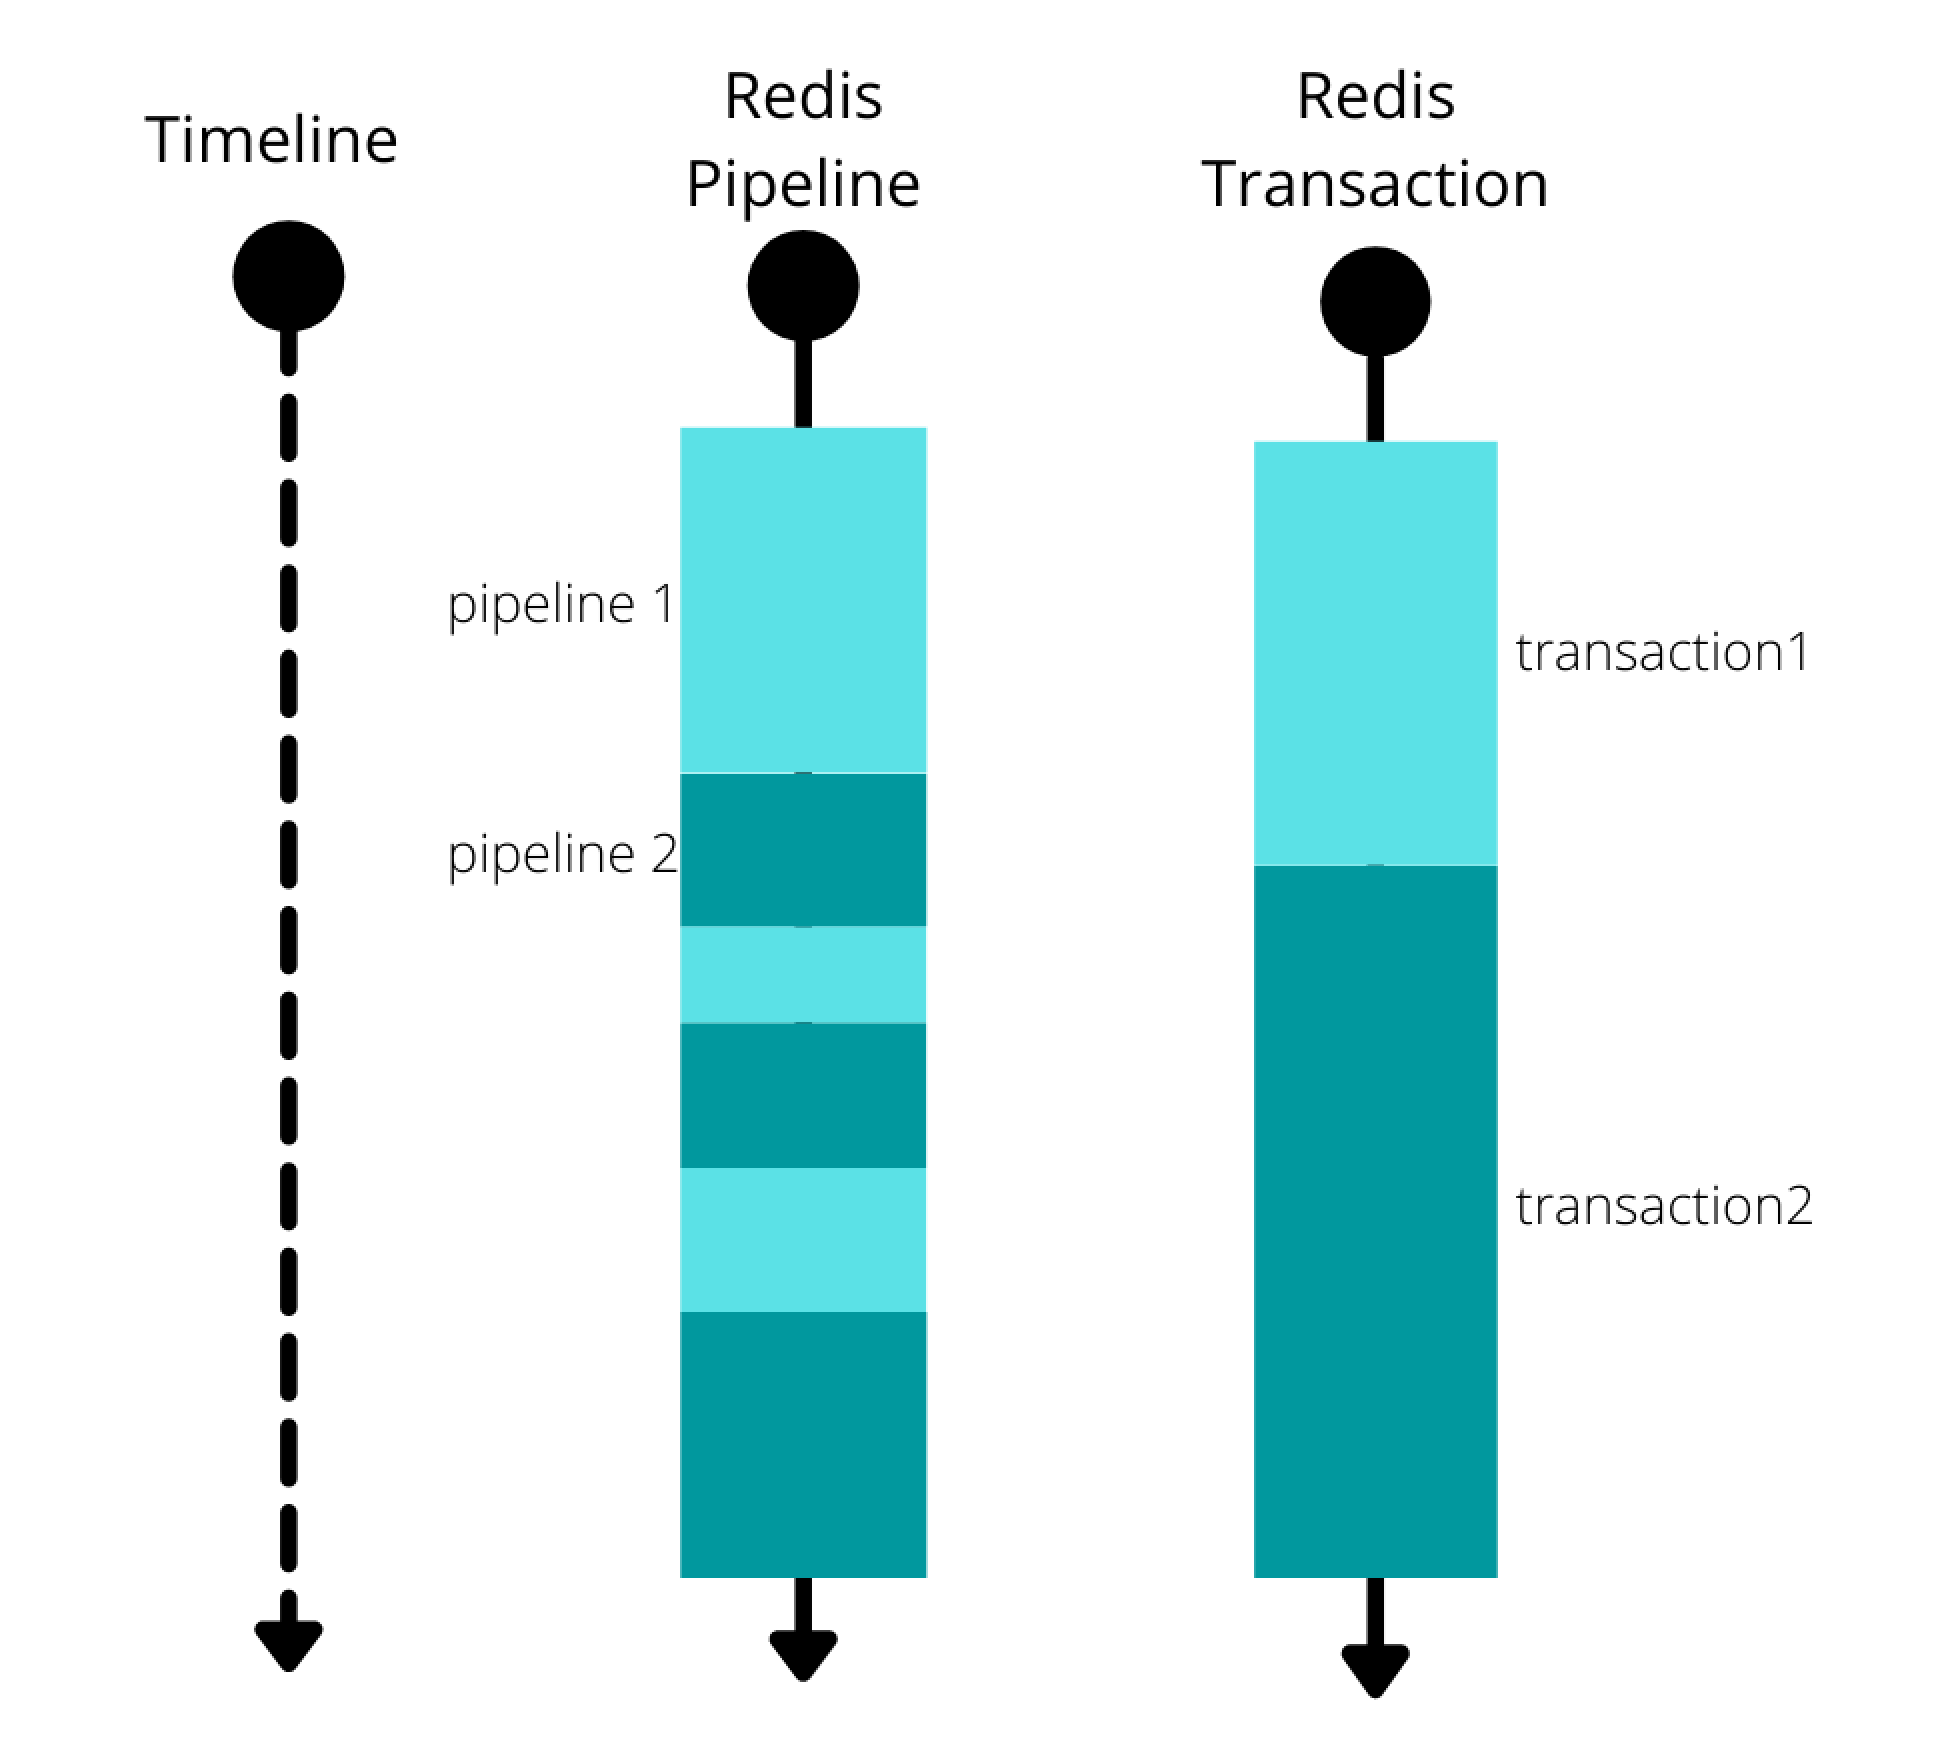
- Transaction là atomic operation, pipeline là non-atomic operation. Hai transaction khác nhau không chạy đồng thời, còn pipeline có thể được thực thi đồng thời theo cách xen kẽ.
- Trong Redis transaction, mỗi command đều cần được gửi đến server; Pipeline chỉ cần gửi một lần nên số request ít hơn.
Có thể xem transaction là một atomic operation, nhưng thực tế nó không đáp ứng atomicity. Khi đề cập đến atomic operation trong Redis, chủ yếu có nghĩa operation đó (chẳng hạn transaction hoặc Lua script) không bị operation khác (chẳng hạn transaction hoặc Lua script khác) can thiệp; không thể bảo đảm hoàn toàn rằng mọi write command trong operation đó hoặc đều thực thi, hoặc đều không thực thi. Nguyên nhân chính cũng là Redis không hỗ trợ rollback.
Ngoài ra, pipeline không phù hợp để thực thi một nhóm command có quan hệ phụ thuộc về thứ tự. Ví dụ, nếu cần dùng kết quả của command trước cho command sau, pipeline không thể đáp ứng nhu cầu này. Với nhu cầu đó, chúng ta có thể dùng Lua script.
Lua script
Lua script cũng hỗ trợ batch operation nhiều command. Một Lua script có thể được xem như một command để thực thi, có thể xem là atomic operation. Nghĩa là trong quá trình thực thi Lua script, không có script hoặc Redis command khác được thực thi đồng thời, bảo đảm operation không bị command khác chèn vào hoặc can thiệp; đây là điều pipeline không thể bảo đảm.
Ngoài ra, Lua script hỗ trợ một số xử lý logic đơn giản, chẳng hạn dùng command để đọc value rồi xử lý trong Lua script; pipeline không có khả năng này.
Tuy nhiên, Lua script vẫn có các hạn chế sau:
- Nếu Lua script gặp lỗi và kết thúc giữa chừng, các operation sau đó sẽ không được thực hiện, nhưng write operation đã xảy ra trước đó sẽ không bị hoàn tác. Vì vậy, ngay cả khi dùng Lua script cũng không thể đạt được atomicity giống rollback của database.
- Trong Redis Cluster, atomic operation của Lua script cũng không thể được bảo đảm, nguyên nhân tương tự là không thể bảo đảm mọi key đều nằm trên cùng một hash slot.
Vấn đề nhiều key hết hạn tập trung
Trước đây tôi đã đề cập: với expired key, Redis dùng strategy periodic deletion + lazy deletion.
Trong lúc thực hiện periodic deletion, nếu đột nhiên gặp nhiều expired key, client request phải chờ thread dọn expired key định kỳ hoàn tất, vì thread này chạy trong Redis main thread. Điều đó khiến client request không được xử lý kịp thời và tốc độ response chậm hơn.
Giải quyết như thế nào? Dưới đây là hai cách thường dùng:
- Đặt thời gian hết hạn ngẫu nhiên cho key.
- Bật lazy-free. Tính năng lazy-free được giới thiệu từ Redis 4.0, cho phép Redis giải phóng bất đồng bộ phần memory mà key sử dụng; operation này được giao cho một child thread riêng xử lý để tránh blocking main thread.
Theo tôi, bất kể có bật lazy-free hay không, chúng ta vẫn nên cố gắng đặt thời gian hết hạn ngẫu nhiên cho key.
Redis bigkey (big key)
bigkey là gì?
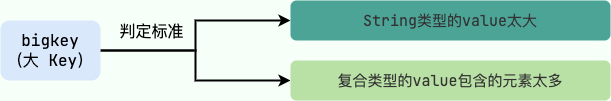
Nói đơn giản, nếu value tương ứng với một key chiếm lượng memory khá lớn thì key đó có thể được xem là bigkey. Lớn đến mức nào mới được xem là lớn? Có một tiêu chuẩn tham khảo chưa thật sự chính xác:
- Value kiểu String vượt quá 1MB;
- Value kiểu composite (List, Hash, Set, Sorted Set, v.v.) chứa hơn 5000 element (tuy nhiên với value kiểu composite, không phải cứ nhiều element hơn thì luôn chiếm nhiều memory hơn).
bigkey được tạo ra như thế nào? Có tác hại gì?
bigkey thường được tạo ra bởi các nguyên nhân sau:
- Thiết kế chương trình không phù hợp, chẳng hạn trực tiếp dùng kiểu String để lưu binary data của file lớn.
- Không cân nhắc đầy đủ quy mô dữ liệu nghiệp vụ, chẳng hạn khi dùng kiểu collection không tính đến tốc độ tăng nhanh của dữ liệu.
- Không kịp thời dọn garbage data, chẳng hạn hash chứa quá nhiều key-value pair vô dụng.
Ngoài việc tiêu tốn nhiều memory và bandwidth hơn, bigkey còn ảnh hưởng khá lớn đến performance.
Trong bài Tổng hợp nguyên nhân Redis bị blocking thường gặp, chúng ta đã đề cập big key còn gây ra vấn đề blocking. Cụ thể, chủ yếu thể hiện ở ba khía cạnh sau:
- Client timeout blocking: Redis xử lý command bằng single thread nên thao tác trên big key khá tốn thời gian, từ đó Redis bị blocking. Nhìn từ phía client, điều này biểu hiện là rất lâu không có response.
- Network blocking: mỗi lần lấy big key tạo ra lượng network traffic lớn. Nếu một key có kích thước 1 MB và lượng truy cập mỗi giây là 1000, mỗi giây sẽ tạo ra 1000MB traffic; với server dùng network card gigabit thông thường thì đây là thảm họa.
- Worker thread blocking: nếu dùng
delđể xóa big key, worker thread sẽ bị blocking và không thể xử lý command tiếp theo.
Vấn đề blocking do big key gây ra còn tiếp tục ảnh hưởng đến master-slave synchronization và cluster expansion.
Tóm lại, big key tiềm ẩn rất nhiều vấn đề, chúng ta nên cố gắng tránh để bigkey tồn tại trong Redis.
Phát hiện bigkey như thế nào?
1. Dùng parameter --bigkeys tích hợp sẵn trong Redis để tìm.
# redis-cli -p 6379 --bigkeys

# Scanning the entire keyspace to find biggest keys as well as
# average sizes per key type.  You can use -i 0.1 to sleep 0.1 sec
# per 100 SCAN commands (not usually needed).

[00.00%] Biggest string found so far '"ballcat:oauth:refresh_auth:f6cdb384-9a9d-4f2f-af01-dc3f28057c20"' with 4437 bytes
[00.00%] Biggest list   found so far '"my-list"' with 17 items

-------- summary -------

Sampled 5 keys in the keyspace!
Total key length in bytes is 264 (avg len 52.80)

Biggest   list found '"my-list"' has 17 items
Biggest string found '"ballcat:oauth:refresh_auth:f6cdb384-9a9d-4f2f-af01-dc3f28057c20"' has 4437 bytes

1 lists with 17 items (20.00% of keys, avg size 17.00)
0 hashs with 0 fields (00.00% of keys, avg size 0.00)
4 strings with 4831 bytes (80.00% of keys, avg size 1207.75)
0 streams with 0 entries (00.00% of keys, avg size 0.00)
0 sets with 0 members (00.00% of keys, avg size 0.00)
0 zsets with 0 members (00.00% of keys, avg size 0.00
Từ kết quả chạy command này, có thể thấy command sẽ scan toàn bộ key trong Redis, gây ảnh hưởng nhất định đến performance Redis. Ngoài ra, cách này chỉ tìm được top 1 bigkey của mỗi data structure (String type chiếm nhiều memory nhất, composite data type có nhiều element nhất). Tuy nhiên, nhiều element trong một key không có nghĩa key đó cũng chiếm nhiều memory; cần phán đoán thêm dựa trên tình hình nghiệp vụ cụ thể.
Khi thực thi command này trên production, cần chỉ định parameter -i để kiểm soát tần suất scan và giảm ảnh hưởng đến Redis. redis-cli -p 6379 --bigkeys -i 3 nghĩa là sau mỗi lần scan sẽ nghỉ 3 giây.
2. Dùng command SCAN tích hợp sẵn trong Redis
Command SCAN có thể trả về các key khớp theo pattern và số lượng nhất định. Sau khi lấy được key, có thể dùng các command như STRLEN, HLEN, LLEN để trả về độ dài hoặc số lượng member của key.
| Data structure | Command | Complexity | Kết quả (tương ứng với key) |
|---|---|---|---|
| String | STRLEN | O(1) | Độ dài String value |
| Hash | HLEN | O(1) | Số lượng field trong hash table |
| List | LLEN | O(1) | Số lượng element trong List |
| Set | SCARD | O(1) | Số lượng element trong Set |
| Sorted Set | ZCARD | O(1) | Số lượng element trong Sorted Set |
Với data type dạng collection, còn có thể dùng command MEMORY USAGE (Redis 4.0+); command này trả về memory space mà key-value pair chiếm dụng.
3. Phân tích RDB file bằng open-source tool.
Tìm big key bằng cách phân tích RDB file. Điều kiện tiên quyết của giải pháp này là Redis sử dụng RDB persistence.
Trên Internet có sẵn code/tool có thể dùng trực tiếp:
- redis-rdb-tools: tool viết bằng Python để phân tích Redis RDB snapshot file.
- rdb_bigkeys: tool viết bằng Go để phân tích Redis RDB snapshot file, performance tốt hơn.
4. Dùng Redis analysis service của public cloud.
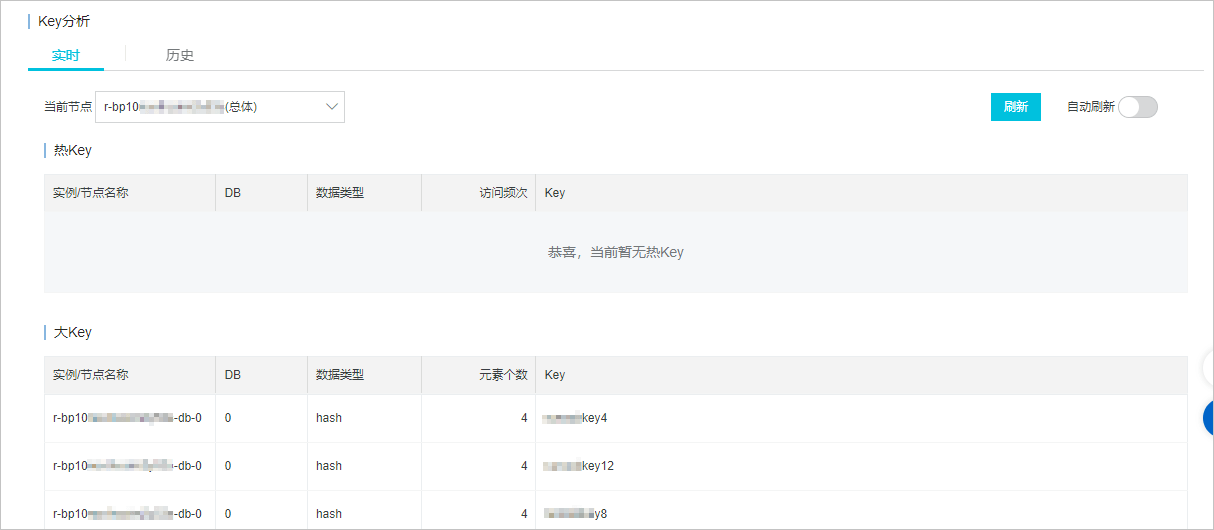
Nếu bạn dùng Redis service của public cloud, có thể kiểm tra xem service đó có cung cấp chức năng phân tích key hay không (thường là có).
Ở đây lấy Alibaba Cloud Redis làm ví dụ: service này hỗ trợ phân tích và phát hiện bigkey realtime, tài liệu tại: https://www.alibabacloud.com/help/zh/apsaradb-for-redis/latest/use-the-real-time-key-statistics-feature.
Xử lý bigkey như thế nào?
Các cách xử lý và tối ưu bigkey thường dùng như sau (có thể kết hợp các cách này):
- Chia nhỏ bigkey: chia một bigkey thành nhiều key nhỏ. Ví dụ, chia một Hash có hàng vạn field thành nhiều Hash theo strategy nhất định (chẳng hạn rehash lần hai).
- Dọn thủ công: Redis 4.0+ có thể dùng command
UNLINKđể bất đồng bộ xóa một hoặc nhiều key được chỉ định. Với Redis dưới 4.0, có thể cân nhắc dùng commandSCANkết hợpDELđể xóa theo batch. - Dùng data structure phù hợp: chẳng hạn không dùng String để lưu binary data của file, dùng HyperLogLog để thống kê page UV, dùng Bitmap để lưu thông tin trạng thái (0/1).
- Bật lazy-free: tính năng lazy-free được giới thiệu từ Redis 4.0, cho phép Redis bất đồng bộ giải phóng memory mà key sử dụng; operation này được giao cho một child thread riêng xử lý để tránh blocking main thread.
Redis hotkey (hot key)
hotkey là gì?
Nếu số lần truy cập một key khá nhiều và rõ ràng nhiều hơn các key khác, key đó có thể được xem là hotkey. Ví dụ, một Redis instance xử lý 5000 request mỗi giây, trong đó lượng truy cập một key nào đó lên tới 2000 request mỗi giây, key đó có thể được xem là hotkey.
Nguyên nhân chính khiến hotkey xuất hiện là lượng truy cập vào một hot data tăng đột biến, chẳng hạn sự kiện hot search nổi bật hoặc sản phẩm tham gia flash sale.
hotkey có tác hại gì?
Xử lý hotkey sẽ chiếm dụng nhiều CPU và bandwidth, có thể ảnh hưởng đến việc Redis instance xử lý bình thường các request khác. Ngoài ra, nếu request truy cập hotkey đột nhiên vượt quá capacity xử lý của Redis, Redis có thể trực tiếp bị down. Khi đó, lượng lớn request sẽ dồn xuống database phía sau và có thể khiến database crash.
Vì vậy, hotkey rất có thể trở thành performance bottleneck của hệ thống, cần được tối ưu riêng để bảo đảm high availability và stability của hệ thống.
Phát hiện hotkey như thế nào?
1. Dùng parameter --hotkeys tích hợp sẵn trong Redis để tìm.
Redis 4.0.3 bổ sung parameter hotkeys; parameter này có thể trả về số lần được truy cập của mọi key.
Điều kiện tiên quyết để dùng giải pháp này là parameter maxmemory-policy của Redis Server phải được đặt thành thuật toán LFU, nếu không sẽ xuất hiện lỗi như bên dưới.
# redis-cli -p 6379 --hotkeys

# Scanning the entire keyspace to find hot keys as well as
# average sizes per key type.  You can use -i 0.1 to sleep 0.1 sec
# per 100 SCAN commands (not usually needed).

Error: ERR An LFU maxmemory policy is not selected, access frequency not tracked. Please note that when switching between policies at runtime LRU and LFU data will take some time to adjust.
Redis có hai thuật toán LFU:
- volatile-lfu (least frequently used): chọn và loại bỏ data ít được sử dụng nhất từ data set đã đặt thời gian hết hạn (
server.db[i].expires). - allkeys-lfu (least frequently used): khi memory không đủ chứa data mới ghi, loại bỏ key ít được sử dụng nhất trong keyspace.
Dưới đây là ví dụ trong file cấu hình redis.conf:
# Dùng strategy volatile-lfu
maxmemory-policy volatile-lfu

# Hoặc dùng strategy allkeys-lfu
maxmemory-policy allkeys-lfu
Cần lưu ý command --hotkeys cũng làm tăng CPU và memory consumption của Redis instance (global scan), vì vậy cần thận trọng khi sử dụng.
2. Dùng command MONITOR.
Command MONITOR là một cách Redis cung cấp để xem realtime mọi operation của Redis. Có thể dùng nó để tạm thời monitor operation của Redis instance, bao gồm read, write, delete, v.v.
Vì command này ảnh hưởng khá lớn đến performance Redis, nghiêm cấm bật MONITOR trong thời gian dài (trong production nên thận trọng khi sử dụng command này).
# redis-cli
127.0.0.1:6379> MONITOR
OK
1683638260.637378 [0 172.17.0.1:61516] "ping"
1683638267.144236 [0 172.17.0.1:61518] "smembers" "mySet"
1683638268.941863 [0 172.17.0.1:61518] "smembers" "mySet"
1683638269.551671 [0 172.17.0.1:61518] "smembers" "mySet"
1683638270.646256 [0 172.17.0.1:61516] "ping"
1683638270.849551 [0 172.17.0.1:61518] "smembers" "mySet"
1683638271.926945 [0 172.17.0.1:61518] "smembers" "mySet"
1683638274.276599 [0 172.17.0.1:61518] "smembers" "mySet2"
1683638276.327234 [0 172.17.0.1:61518] "smembers" "mySet"
Khi xảy ra tình huống khẩn cấp, có thể chọn thời điểm phù hợp để chạy MONITOR trong thời gian ngắn và redirect output vào file. Sau khi tắt command MONITOR, phân loại và phân tích các request trong file để tìm hotkey trong khoảng thời gian đó.
3. Dùng open-source project.
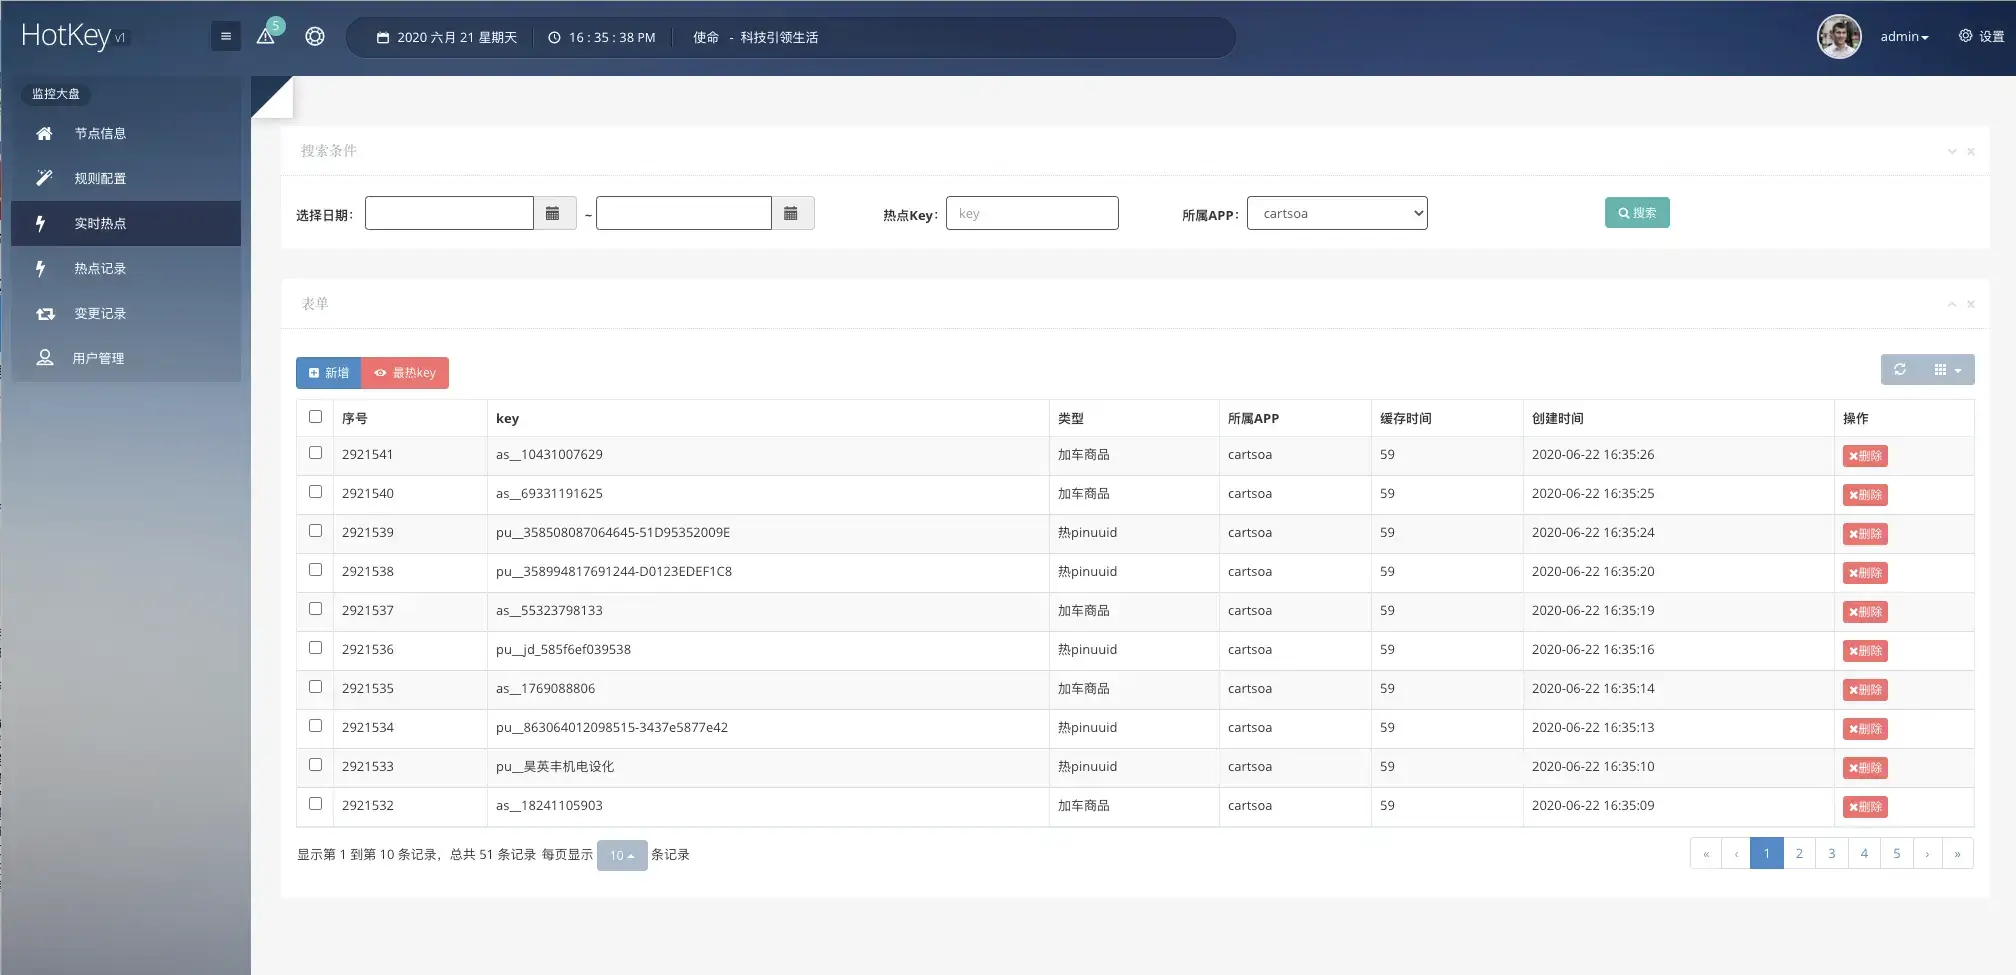
Project hotkey của JD Retail không chỉ hỗ trợ phát hiện hotkey mà còn hỗ trợ xử lý hotkey.
4. Ước tính trước dựa trên tình hình nghiệp vụ.
Có thể dự đoán một số hotkey dựa trên tình hình nghiệp vụ, chẳng hạn data sản phẩm tham gia flash sale. Tuy nhiên, không thể dự đoán mọi hotkey, ví dụ các sự kiện tin tức nóng phát sinh đột ngột.
5. Ghi lại và phân tích trong business code.
Thêm logic tương ứng trong code nghiệp vụ để ghi lại và phân tích tình hình truy cập key. Tuy nhiên, cách này làm tăng độ phức tạp của code nghiệp vụ nên thường cũng không được dùng.
6. Dùng Redis analysis service của public cloud.
Nếu bạn dùng Redis service của public cloud, có thể kiểm tra xem service đó có cung cấp chức năng phân tích key hay không (thường là có).
Ở đây lấy Alibaba Cloud Redis làm ví dụ: service này hỗ trợ phân tích và phát hiện hotkey realtime, tài liệu tại: https://www.alibabacloud.com/help/zh/apsaradb-for-redis/latest/use-the-real-time-key-statistics-feature.
Giải quyết hotkey như thế nào?
Các cách xử lý và tối ưu hotkey thường dùng như sau (có thể kết hợp các cách này):
- Tách read/write: master node xử lý write request, replica node xử lý read request.
- Dùng Redis Cluster: phân tán lưu trữ hot data trên nhiều Redis node.
- Secondary cache: xử lý hotkey bằng secondary cache, lưu một bản hotkey vào local memory của JVM (có thể dùng Caffeine).
Ngoài các cách trên, nếu sử dụng Redis service của public cloud, bạn cũng có thể chú ý đến các giải pháp có sẵn mà service cung cấp.
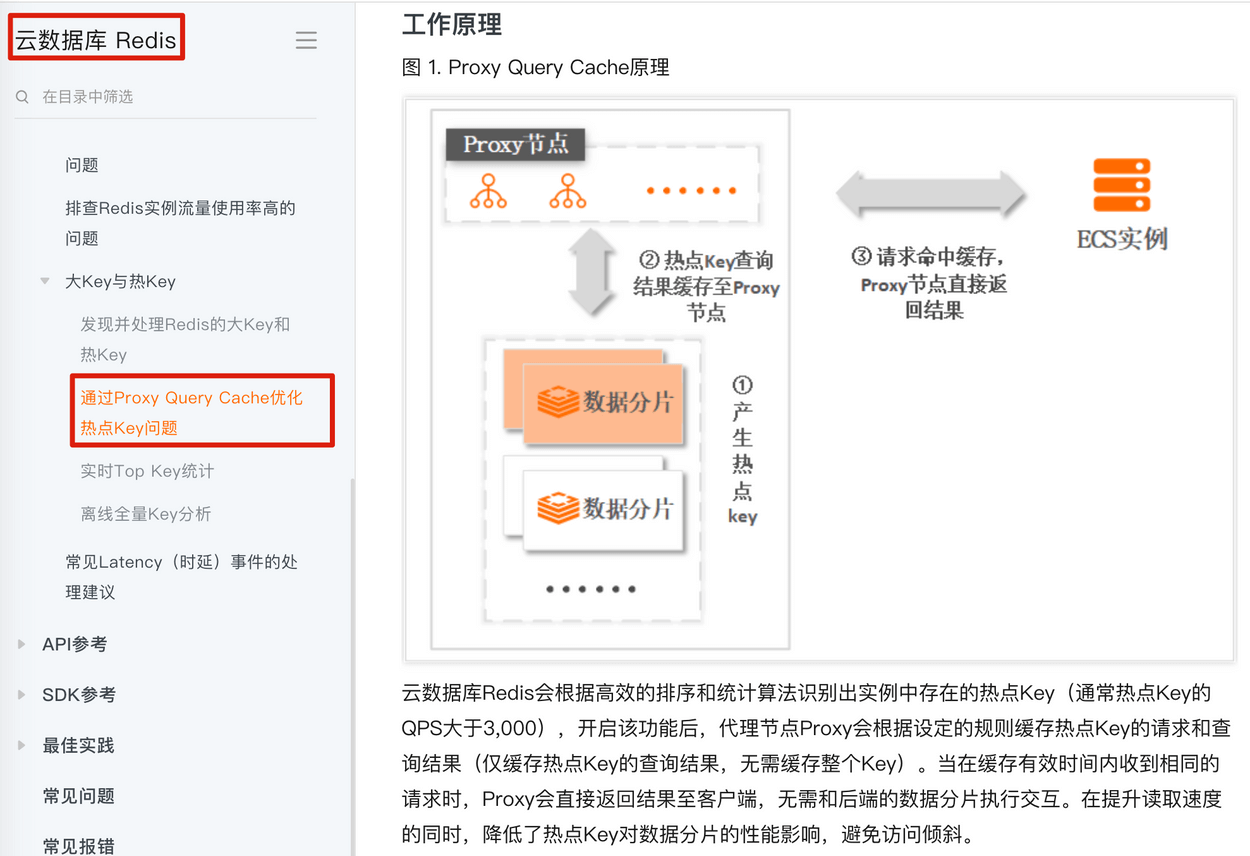
Ở đây lấy Alibaba Cloud Redis làm ví dụ: service hỗ trợ tối ưu vấn đề hot key thông qua chức năng Proxy Query Cache.
Slow query command
Vì sao có slow query command?
Chúng ta biết việc thực thi một Redis command có thể được đơn giản hóa thành 4 bước:
- Gửi command;
- Đưa command vào queue;
- Thực thi command;
- Trả về kết quả.
Redis thống kê thời gian thực thi command; slow query command chính là các command có thời gian thực thi dài.
Vì sao Redis có slow query command?
Phần lớn command trong Redis có time complexity O(1), nhưng cũng có một số ít command có time complexity O(n), ví dụ:
KEYS *: trả về mọi key phù hợp với rule.HGETALL: trả về toàn bộ key-value pair trong một Hash.LRANGE: trả về element trong range được chỉ định của List.SMEMBERS: trả về toàn bộ element trong Set.SINTER/SUNION/SDIFF: tính intersection/union/difference của nhiều Set.- ……
Vì time complexity của các command này là O(n), đôi khi chúng cũng quét toàn bộ table; n càng tăng thì thời gian thực thi càng dài. Tuy nhiên, không phải tuyệt đối không được dùng các command này mà cần xác định rõ giá trị N. Khi có nhu cầu traversal, có thể dùng HSCAN, SSCAN, ZSCAN thay thế.
Ngoài các command có time complexity O(n) có thể gây slow query, còn có một số command có time complexity có thể lớn hơn O(N), chẳng hạn:
ZRANGE/ZREVRANGE: trả về toàn bộ element trong range rank được chỉ định của Sorted Set. Time complexity là O(log(n)+m), n là tổng số element, m là số element trả về; khi m và n tương đối lớn, time complexity O(n) sẽ nhỏ hơn.ZREMRANGEBYRANK/ZREMRANGEBYSCORE: xóa toàn bộ element trong range rank/range score được chỉ định của Sorted Set. Time complexity là O(log(n)+m), n là tổng số element, m là số element bị xóa; khi m và n tương đối lớn, time complexity O(n) sẽ nhỏ hơn.- ……
Tìm slow query command như thế nào?
Redis cung cấp chức năng Slow Log tích hợp sẵn, chuyên dùng để ghi lại các command có thời gian thực thi vượt quá threshold được chỉ định. Chức năng này rất hữu ích khi điều tra performance bottleneck và tìm operation "chậm" gây blocking Redis; nguyên lý tương tự slow query log của MySQL.
Trong file redis.conf, có thể dùng parameter slowlog-log-slower-than để đặt threshold cho command tốn thời gian và dùng parameter slowlog-max-len để đặt số lượng record tối đa của command tốn thời gian.
Khi Redis server phát hiện command có thời gian thực thi vượt threshold slowlog-log-slower-than, nó sẽ ghi command đó vào slow query log (slow log), tương tự việc MySQL ghi slow query statement. Khi slow query log vượt số lượng record tối đa đã đặt, Redis sẽ lần lượt loại bỏ các command được thực thi sớm nhất.
⚠️ Lưu ý: slow query log chiếm một lượng memory nhất định. Nếu đặt số lượng record tối đa quá lớn, có thể dẫn đến memory consumption quá cao.
Cấu hình mặc định của slowlog-log-slower-than và slowlog-max-len như sau (có thể tự sửa):
# The following time is expressed in microseconds, so 1000000 is equivalent
# to one second. Note that a negative number disables the slow log, while
# a value of zero forces the logging of every command.
slowlog-log-slower-than 10000

# There is no limit to this length. Just be aware that it will consume memory.
# You can reclaim memory used by the slow log with SLOWLOG RESET.
slowlog-max-len 128
Ngoài việc sửa file cấu hình, bạn cũng có thể trực tiếp dùng command CONFIG để đặt:
# Command có thời gian thực thi vượt quá 10000 microsecond (tức 10 millisecond) sẽ được ghi lại
CONFIG SET slowlog-log-slower-than 10000
# Chỉ giữ lại 128 command tốn thời gian gần nhất
CONFIG SET slowlog-max-len 128
Lấy nội dung slow query log rất đơn giản, chỉ cần dùng command SLOWLOG GET.
127.0.0.1:6379> SLOWLOG GET # truy vấn slow log
 1) 1) (integer) 5
   2) (integer) 1684326682
   3) (integer) 12000
   4) 1) "KEYS"
      2) "*"
   5) "172.17.0.1:61152"
   6) ""
  // ...
Mỗi entry trong slow query log gồm sáu giá trị sau:
- Unique ID: identifier duy nhất của log entry.
- Timestamp: Unix timestamp khi command thực thi xong.
- Duration: thời gian command thực thi, đơn vị là microsecond.
- Command và parameter: command cụ thể được thực thi và mảng parameter của nó.
- Client information (Client IP:Port): địa chỉ và port của client thực thi command.
- Client name: nếu client đã đặt tên (
CLIENT SETNAME).
Theo mặc định, command SLOWLOG GET trả về 10 slow query command gần nhất; bạn cũng có thể chỉ định số lượng slow query command cần trả về bằng SLOWLOG GET N.
Dưới đây là các command liên quan đến slow query thường dùng khác:
# Trả về số lượng slow query command
127.0.0.1:6379> SLOWLOG LEN
(integer) 128
# Xóa slow query command
127.0.0.1:6379> SLOWLOG RESET
OK
Redis memory fragmentation
Câu hỏi liên quan:
- Memory fragmentation là gì? Vì sao Redis có memory fragmentation?
- Dọn Redis memory fragmentation như thế nào?
Câu trả lời tham khảo: Giải thích chi tiết Redis memory fragmentation.
⭐️ Vấn đề Redis production (quan trọng)
Cache penetration
Cache penetration là gì?
Nói đơn giản, cache penetration là khi key trong nhiều request không hợp lệ, hoàn toàn không tồn tại trong cache cũng không tồn tại trong database. Điều này khiến các request đi thẳng đến database mà không qua cache, gây áp lực rất lớn cho database và có thể khiến database trực tiếp bị down vì quá nhiều request.
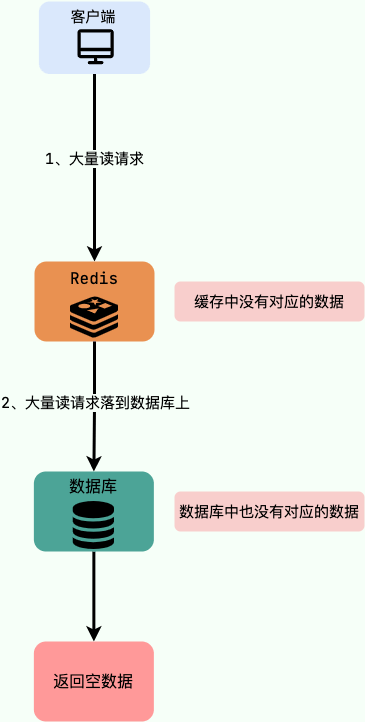
Ví dụ: một hacker cố ý tạo các key không hợp lệ để gửi lượng lớn request, khiến nhiều request dồn xuống database nhưng database cũng không tìm thấy data tương ứng. Nói cách khác, cuối cùng các request này đều dồn xuống database và gây áp lực rất lớn cho database.
Có những cách giải quyết nào?
Cách cơ bản nhất là thực hiện tốt việc validate parameter trước tiên; request có parameter không hợp lệ thì trực tiếp throw exception và trả thông tin lỗi cho client. Ví dụ, database id dùng để query không được nhỏ hơn 0; khi format email truyền vào không đúng thì trực tiếp trả error message cho client, v.v.
1. Cache invalid key
Nếu cả cache và database đều không tìm thấy data của một key, ghi key đó vào Redis và đặt thời gian hết hạn, command cụ thể là: SET key value EX 10086. Cách này có thể giải quyết trường hợp key request thay đổi không thường xuyên. Nếu hacker tấn công ác ý và tạo một request key khác nhau mỗi lần, Redis sẽ cache một lượng lớn invalid key. Rõ ràng, giải pháp này không thể giải quyết vấn đề từ gốc. Nếu nhất định phải dùng cách này để giải quyết cache penetration, nên đặt thời gian hết hạn của invalid key ngắn hơn, chẳng hạn 1 phút.
Ngoài ra, thông thường chúng ta thiết kế key như sau: table name:column name:primary key name:primary key value.
Nếu minh họa bằng Java code thì gần giống như sau:
public Object getObjectInclNullById(Integer id) {
    // Lấy data từ cache
    Object cacheValue = cache.get(id);
    // Cache rỗng
    if (cacheValue == null) {
        // Lấy data từ database
        Object storageValue = storage.get(key);
        // Cache object rỗng
        cache.set(key, storageValue);
        // Nếu storage data rỗng, cần đặt thời gian hết hạn (300 giây)
        if (storageValue == null) {
            // Phải đặt thời gian hết hạn, nếu không có nguy cơ bị tấn công
            cache.expire(key, 60 * 5);
        }
        return storageValue;
    }
    return cacheValue;
}
2. Bloom filter
Bloom filter là một data structure rất đặc biệt; thông qua nó, chúng ta có thể thuận tiện phán đoán một data đã cho có tồn tại trong một tập data khổng lồ hay không. Có thể xem nó là data structure gồm hai phần: binary vector (hay bit array) và một loạt random mapping function (hash function). So với các data structure thường dùng như List, Map, Set, nó chiếm ít space hơn và hiệu quả hơn, nhưng nhược điểm là kết quả trả về mang tính xác suất chứ không hoàn toàn chính xác. Về lý thuyết, càng nhiều element được thêm vào collection thì khả năng false positive càng lớn. Ngoài ra, data được lưu trong Bloom filter không dễ xóa.
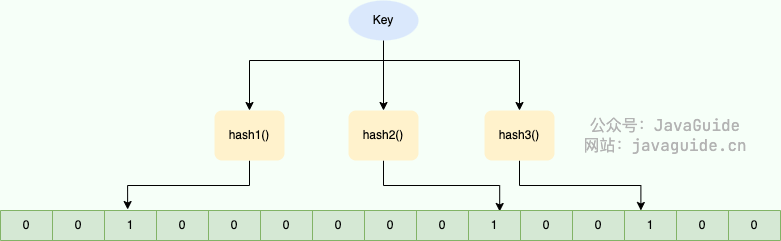
Bloom Filter dùng một bit array lớn để lưu toàn bộ data; mỗi element trong array chỉ chiếm 1 bit và mỗi element chỉ có thể là 0 hoặc 1 (đại diện cho false hoặc true). Đây cũng là cốt lõi giúp Bloom Filter tiết kiệm memory. Tính như vậy, bit array chứa 1 triệu element chỉ chiếm 1000000Bit / 8 = 125000 Byte = 125000/1024 KB ≈ 122KB.
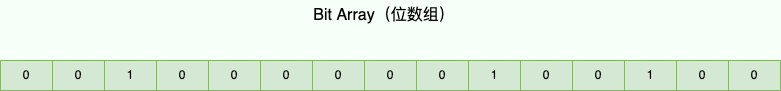
Cụ thể, thực hiện như sau: lưu mọi request value có khả năng tồn tại vào Bloom filter. Khi user request đến, trước tiên kiểm tra request value do user gửi có tồn tại trong Bloom filter hay không. Nếu không tồn tại, trực tiếp trả thông tin request parameter error cho client; nếu tồn tại mới tiếp tục quy trình bên dưới.
Sơ đồ xử lý cache sau khi thêm Bloom filter như sau:
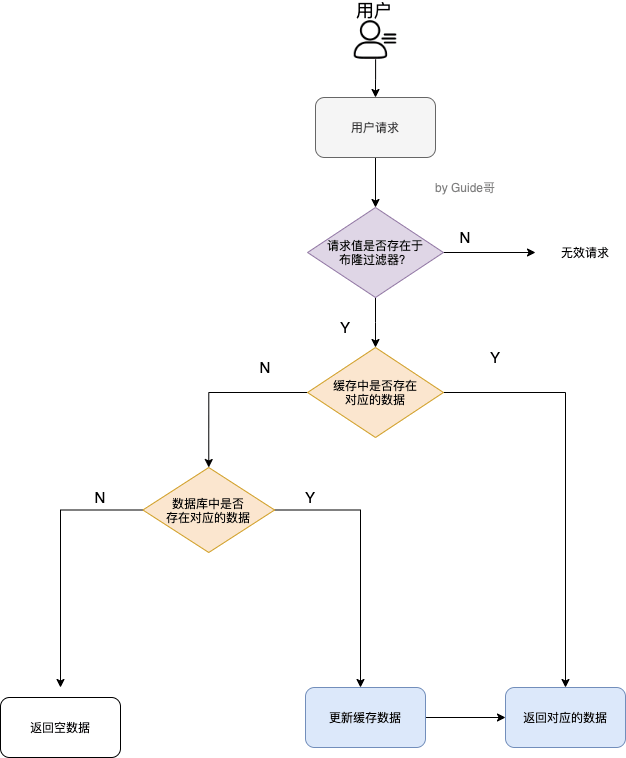
Muốn biết thêm chi tiết về Bloom filter, có thể xem bài viết gốc của tôi: Chưa hiểu Bloom filter? Bài viết này giải thích rõ ràng cho bạn!, rất đáng đọc.
3. Rate limiting interface
Thực hiện rate limiting cho interface theo user hoặc IP. Với hành vi truy cập bất thường, quá thường xuyên, còn có thể dùng cơ chế blacklist, chẳng hạn đưa IP bất thường vào blacklist.
Cache breakdown và cache avalanche được đề cập sau cũng có thể kết hợp với rate limiting interface để giải quyết; suy cho cùng, điểm mấu chốt của các vấn đề này đều là quá nhiều request dồn xuống database khiến database chịu áp lực quá lớn.
Giải pháp rate limiting cụ thể có thể tham khảo bài viết: Giải thích chi tiết service rate limiting.
Cache breakdown
Cache breakdown là gì?
Trong cache breakdown, key của request tương ứng với hot data; data đó tồn tại trong database nhưng không tồn tại trong cache (thường vì bản data trong cache đã hết hạn). Điều này có thể khiến một lượng lớn request trong thời gian ngắn đổ thẳng vào database, gây áp lực rất lớn cho database và có thể khiến database bị down.
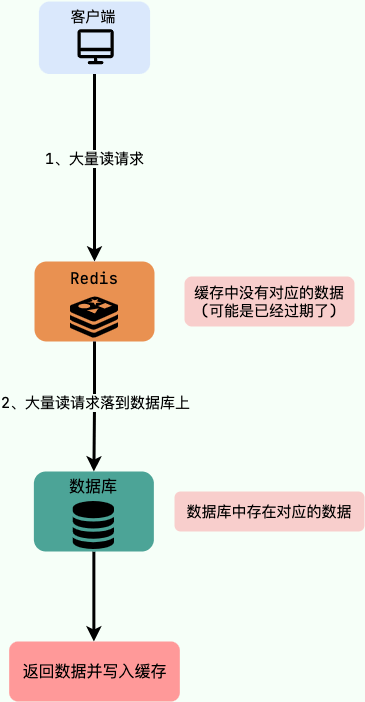
Ví dụ: trong quá trình flash sale, data của một sản phẩm flash sale trong cache đột nhiên hết hạn, khiến lượng lớn request đến sản phẩm đó trong thời gian ngắn trực tiếp dồn xuống database và gây áp lực rất lớn cho database.
Có những cách giải quyết nào?
- Không bao giờ hết hạn (không khuyến nghị): đặt hot data không hết hạn hoặc đặt thời gian hết hạn rất dài.
- Preheat (khuyến nghị): đưa hot data vào cache trước và đặt thời gian hết hạn hợp lý; ví dụ data trong flash sale không hết hạn trước khi flash sale kết thúc.
- Dùng lock (tùy tình huống): sau khi cache hết hạn, dùng mutex lock để bảo đảm chỉ một request query database và update cache.
Cache penetration và cache breakdown khác nhau như thế nào?
Trong cache penetration, key của request không tồn tại trong cache cũng không tồn tại trong database.
Trong cache breakdown, key của request tương ứng với hot data; data đó tồn tại trong database nhưng không tồn tại trong cache (thường vì bản data trong cache đã hết hạn).
Cache avalanche
Cache avalanche là gì?
Tôi thấy cái tên cache avalanche khá thú vị, haha.
Thực tế, cache avalanche mô tả một tình huống đơn giản: cache mất hiệu lực trên diện rộng cùng một thời điểm, khiến lượng lớn request trực tiếp dồn xuống database và gây áp lực rất lớn cho database. Điều này giống như avalanche, database có thể trực tiếp bị down vì áp lực quá lớn từ các request.
Ngoài ra, cache service down cũng gây ra hiện tượng cache avalanche, khiến mọi request dồn xuống database.
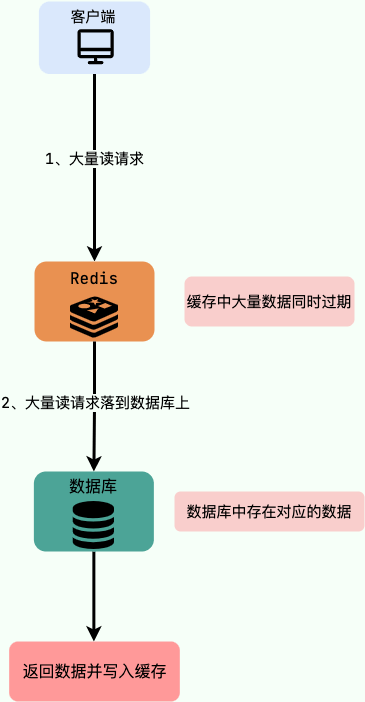
Ví dụ: lượng lớn data trong cache hết hạn cùng một thời điểm, lúc này đột nhiên có rất nhiều request cần truy cập data đã hết hạn đó. Điều này khiến lượng lớn request trực tiếp dồn xuống database và gây áp lực rất lớn cho database.
Có những cách giải quyết nào?
Với trường hợp Redis service không khả dụng:
- Redis Cluster: dùng Redis Cluster để tránh việc toàn bộ cache service không thể sử dụng khi một node đơn gặp sự cố. Redis Cluster và Redis Sentinel là hai giải pháp triển khai Redis cluster phổ biến nhất; có thể tham khảo bài Giải thích chi tiết Redis Cluster (trả phí).
- Multi-level cache: thiết lập multi-level cache, chẳng hạn kết hợp local cache và Redis cache thành secondary cache; khi Redis cache gặp vấn đề vẫn có thể lấy một phần data từ local cache.
Với trường hợp lượng lớn cache đồng thời mất hiệu lực:
- Đặt thời gian mất hiệu lực ngẫu nhiên (tùy chọn): đặt thời gian mất hiệu lực ngẫu nhiên cho cache, chẳng hạn cộng thêm một giá trị ngẫu nhiên trên thời gian hết hạn cố định. Cách này tránh nhiều cache đồng thời hết hạn và giảm rủi ro cache avalanche.
- Preheat (khuyến nghị): đưa hot data vào cache trước và đặt thời gian hết hạn hợp lý, chẳng hạn data trong flash sale không hết hạn trước khi flash sale kết thúc.
- Persistent cache strategy (tùy tình huống): dù thường không khuyến nghị đặt cache không bao giờ hết hạn, với một số data quan trọng và ít thay đổi có thể cân nhắc strategy này.
Triển khai cache preheating như thế nào?
Có hai cách cache preheating thường dùng:
- Dùng scheduled task, chẳng hạn xxl-job, để định kỳ trigger logic cache preheating, query hot data trong database rồi lưu vào cache.
- Dùng message queue, chẳng hạn Kafka, để thực hiện cache preheating bất đồng bộ: gửi primary key hoặc ID của hot data trong database vào message queue, sau đó cache service consume data trong message queue, query database theo primary key hoặc ID rồi update cache.
Cache avalanche và cache breakdown khác nhau như thế nào?
Cache avalanche và cache breakdown khá giống nhau, nhưng nguyên nhân cache avalanche là lượng lớn hoặc toàn bộ data trong cache mất hiệu lực; nguyên nhân chính của cache breakdown là một hot data nào đó không tồn tại trong cache (thường vì bản data trong cache đã hết hạn).
Bảo đảm consistency giữa cache và database như thế nào?
Consistency giữa cache và database là một technical challenge khá phổ biến. Đưa cache vào chủ yếu để cải thiện performance và giảm áp lực database, nhưng đúng là nó cũng mang đến rủi ro data không nhất quán. Consistency tuyệt đối thường đồng nghĩa với complexity và performance overhead cao hơn, vì vậy trong thực tế chúng ta thường chọn strategy phù hợp theo business scenario để tìm điểm cân bằng giữa performance và consistency.
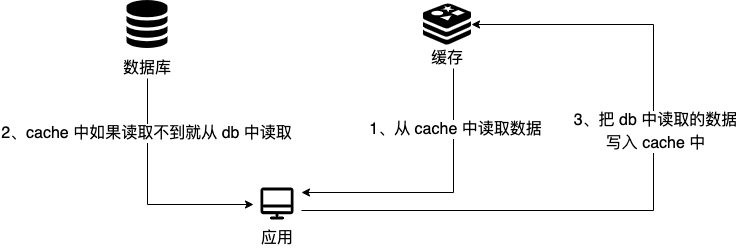
Dưới đây là phần riêng về Cache Aside Pattern. Đây là một cache read/write strategy rất phổ biến, logic read/write như sau:
- Read operation:
- Trước tiên thử đọc data từ cache.
- Nếu cache hit, trực tiếp trả về data.
- Nếu cache miss, query data từ database, đưa data lấy được vào cache rồi trả về data.
- Write operation:
- Trước tiên update database.
- Sau đó trực tiếp xóa data tương ứng trong cache.
Sơ đồ như sau:

Nếu update database thành công nhưng bước xóa cache thất bại, có hai giải pháp đơn giản:
- Rút ngắn cache expiration time (TTL - Time To Live) (không khuyến nghị, chỉ xử lý phần ngọn): làm thời gian hết hạn của cache data ngắn hơn để cache load data từ database. Giải pháp này không phù hợp với scenario thao tác cache trước rồi mới thao tác database.
- Thêm cơ chế retry cache update (thường dùng): nếu cache service hiện không khả dụng khiến xóa cache thất bại, đợi một khoảng thời gian rồi retry; số lần retry có thể tự đặt. Tuy nhiên, phù hợp hơn là dùng message queue để triển khai asynchronous retry: gửi message retry xóa cache vào message queue, sau đó consumer chuyên dụng retry cho đến khi thành công. Dù thêm một message queue, lợi ích tổng thể vẫn lớn hơn.
Bài viết liên quan: Vấn đề consistency giữa cache và database, đọc bài này là đủ - Waterdrop and Silver Bullet.
Những trường hợp nào có thể khiến Redis bị blocking?
Các nguyên nhân thường gặp khiến Redis bị blocking:
- Thực thi command có complexity
O(n)(nhưKEYS *,HGETALL,LRANGE,SMEMBERS, v.v.); data volume tăng khiến thời gian thực thi quá dài. - Khi thực thi command
SAVEđể tạo RDB snapshot, main thread bị synchronous blocking; cònBGSAVEtránh blocking bằng child processfork. - AOF ghi log trong main thread, có thể chặn các command tiếp theo do ghi log sau khi command thực thi.
- Khi AOF flush xuống disk (
fsync), background thread đồng bộ với disk; disk pressure lớn khiếnfsyncblocking, từ đó blocking thao tácwritecủa main thread, đặc biệt rõ ràng với cấu hìnhappendfsync alwayshoặceverysec. - Trong quá trình AOF rewrite, khi append nội dung rewrite buffer vào AOF file mới sẽ phát sinh blocking.
- Thao tác trên big key (string > 1MB hoặc composite type có > 5000 element) gây client timeout, network blocking và worker thread blocking.
- Khi dùng
flushdbhoặcflushallđể xóa database, việc xóa nhiều key-value pair và giải phóng memory gây main thread blocking. - Khi cluster expansion hoặc shrink, data migration là synchronous operation; big key migration khiến node ở cả hai đầu bị blocking trong thời gian dài và có thể trigger failover.
- Memory không đủ trigger Swap, operating system swap memory của Redis ra hard disk, khiến performance read/write giảm mạnh.
- Process khác chiếm CPU quá mức khiến Redis throughput giảm.
- Các vấn đề network như connection refusal, latency cao, network card soft interrupt, v.v. khiến Redis bị blocking.
Có thể đọc bài viết này để biết chi tiết: Tổng hợp nguyên nhân Redis bị blocking thường gặp.
Redis Cluster
Redis Sentinel:
- Sentinel là gì? Có tác dụng gì?
- Sentinel phát hiện node offline như thế nào? Khác nhau giữa subjective down và objective down?
- Sentinel triển khai failover như thế nào?
- Vì sao khuyến nghị deploy nhiều sentinel node (sentinel cluster)?
- Sentinel chọn master mới như thế nào (election mechanism)?
- Chọn Leader từ Sentinel cluster như thế nào?
- Sentinel có thể ngăn split-brain không?
Redis Cluster:
- Vì sao cần Redis Cluster? Đã giải quyết vấn đề gì? Có ưu điểm gì?
- Redis Cluster thực hiện sharding như thế nào?
- Vì sao Redis Cluster có 16384 hash slot?
- Làm thế nào xác định key đã cho được phân bố vào hash slot nào?
- Redis Cluster có hỗ trợ reassign hash slot không?
- Redis Cluster có thể cung cấp service trong thời gian expansion/shrink không?
- Các node trong Redis Cluster giao tiếp với nhau như thế nào?
Câu trả lời tham khảo: Giải thích chi tiết Redis Cluster (trả phí).
Quy ước sử dụng Redis
Trong quá trình sử dụng Redis thực tế, chúng ta nên cố gắng tuân thủ một số quy ước thường gặp:
- Dùng connection pool: tránh thường xuyên tạo và đóng client connection.
- Cố gắng không dùng command có độ phức tạp O(n), khi dùng command O(n) cần chú ý số lượng n: các command O(n) như
KEYS *,HGETALL,LRANGE,SMEMBERS,SINTER/SUNION/SDIFFkhông phải tuyệt đối không được dùng, nhưng cần xác định rõ giá trị n. Khi có nhu cầu traversal, có thể dùngHSCAN,SSCAN,ZSCANthay thế. - Dùng batch operation để giảm network transmission: native batch operation command (như
MGET,MSET, v.v.), pipeline và Lua script. - Cố gắng không dùng Redis transaction: chức năng Redis transaction khá hạn chế, có thể dùng Lua script thay thế.
- Nghiêm cấm bật
MONITORtrong thời gian dài: ảnh hưởng khá lớn đến performance. - Kiểm soát lifecycle của key: tránh lưu quá nhiều data ít được truy cập trong Redis.
- ……
Tài liệu tham khảo
- 《Redis Development and Operations》
- 《Redis Design and Implementation》
- Redis Transactions: https://redis.io/docs/manual/transactions/
- What is Redis Pipeline: https://buildatscale.tech/what-is-redis-pipeline/
- Giải thích chi tiết việc phát hiện và xử lý BigKey, HotKey trong Redis: https://mp.weixin.qq.com/s/FPYE1B839_8Yk1-YSiW-1Q
- Khám phá ý tưởng và phương thức giải quyết vấn đề Bigkey: https://mp.weixin.qq.com/s/Sej7D9TpdAobcCmdYdMIyA
- Hướng dẫn toàn diện điều tra và xử lý vấn đề latency Redis: https://mp.weixin.qq.com/s/mIc6a9mfEGdaNDD3MmfFsg
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.