
Giới thiệu và đề xuất tối ưu deep pagination
Deep pagination là gì? Vì sao xảy ra?
Tình huống offset truy vấn quá lớn được gọi là deep pagination. Điều này khiến hiệu năng truy vấn thấp, ví dụ:
# MySQL bỏ qua 1000000 bản ghi rồi lấy 10 bản ghi tiếp theo khi không thể sử dụng index
SELECT * FROM t_order ORDER BY id LIMIT 1000000, 10
Khi offset truy vấn quá lớn, query optimizer của MySQL có thể chọn full table scan thay vì sử dụng index để tối ưu truy vấn.
Nguyên nhân cốt lõi khiến deep pagination chậm nằm ở cơ chế thực thi của MySQL: với LIMIT offset, N, MySQL không thể nhảy thẳng đến vị trí offset, mà phải scan từ đầu offset + N bản ghi. Nếu truy vấn phụ thuộc vào secondary index nhưng không phải covering index, MySQL phải thực hiện table lookup (tạo ra lượng lớn random I/O) với offset bản ghi đầu tiên dù không mang lại giá trị, rồi loại bỏ toàn bộ dữ liệu đã vất vả lấy được. Kể cả khi optimizer chuyển sang full table scan vì chi phí quá cao, việc scan tuần tự hàng triệu dòng vẫn rất tốn kém.
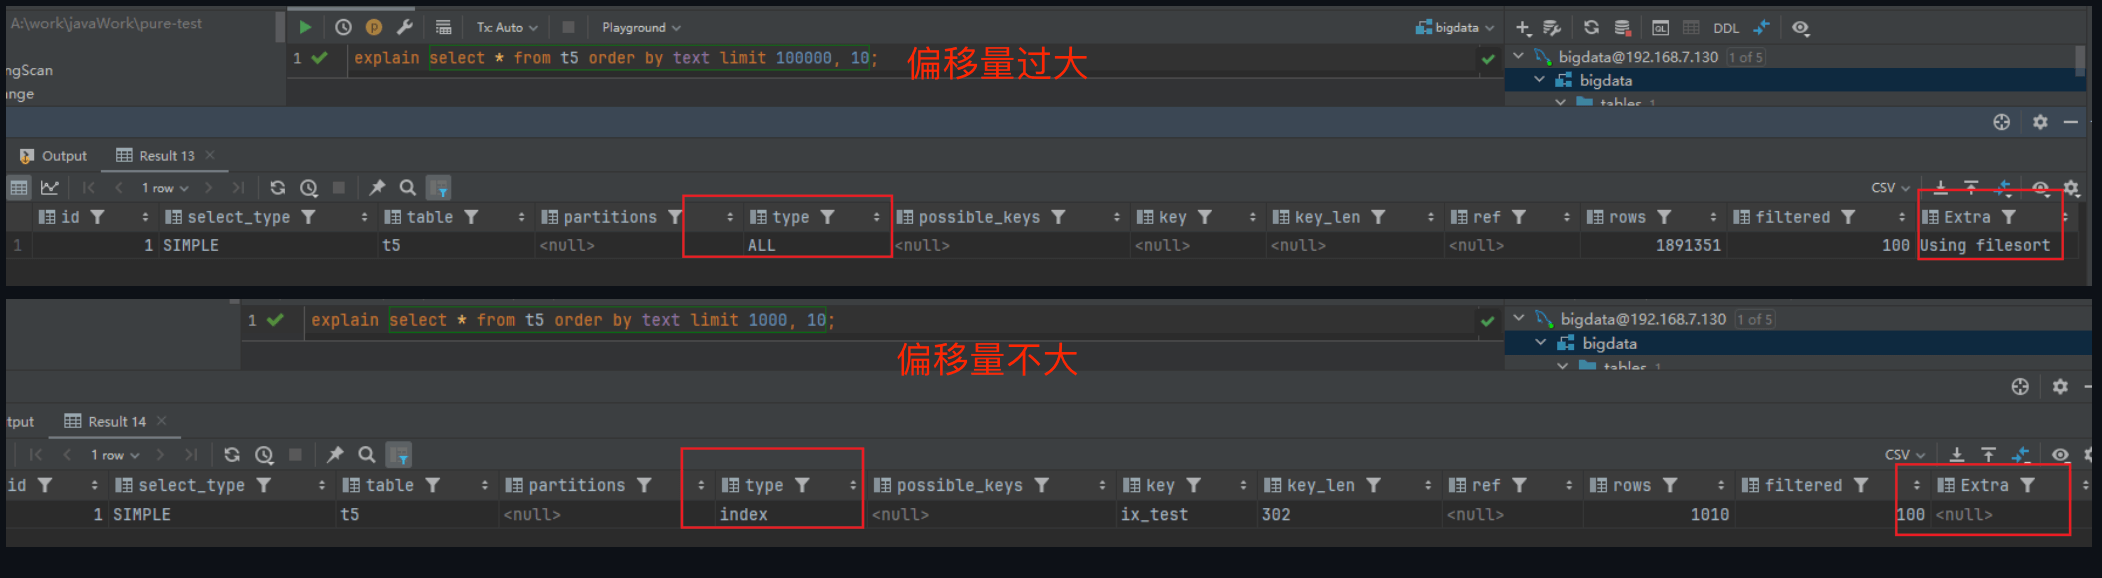
Ngưỡng offset truy vấn quá lớn có thể khác nhau trên từng máy, tùy thuộc vào nhiều yếu tố như cấu hình phần cứng (ví dụ hiệu năng CPU, tốc độ ổ đĩa), kích thước bảng, loại index và thông tin thống kê.
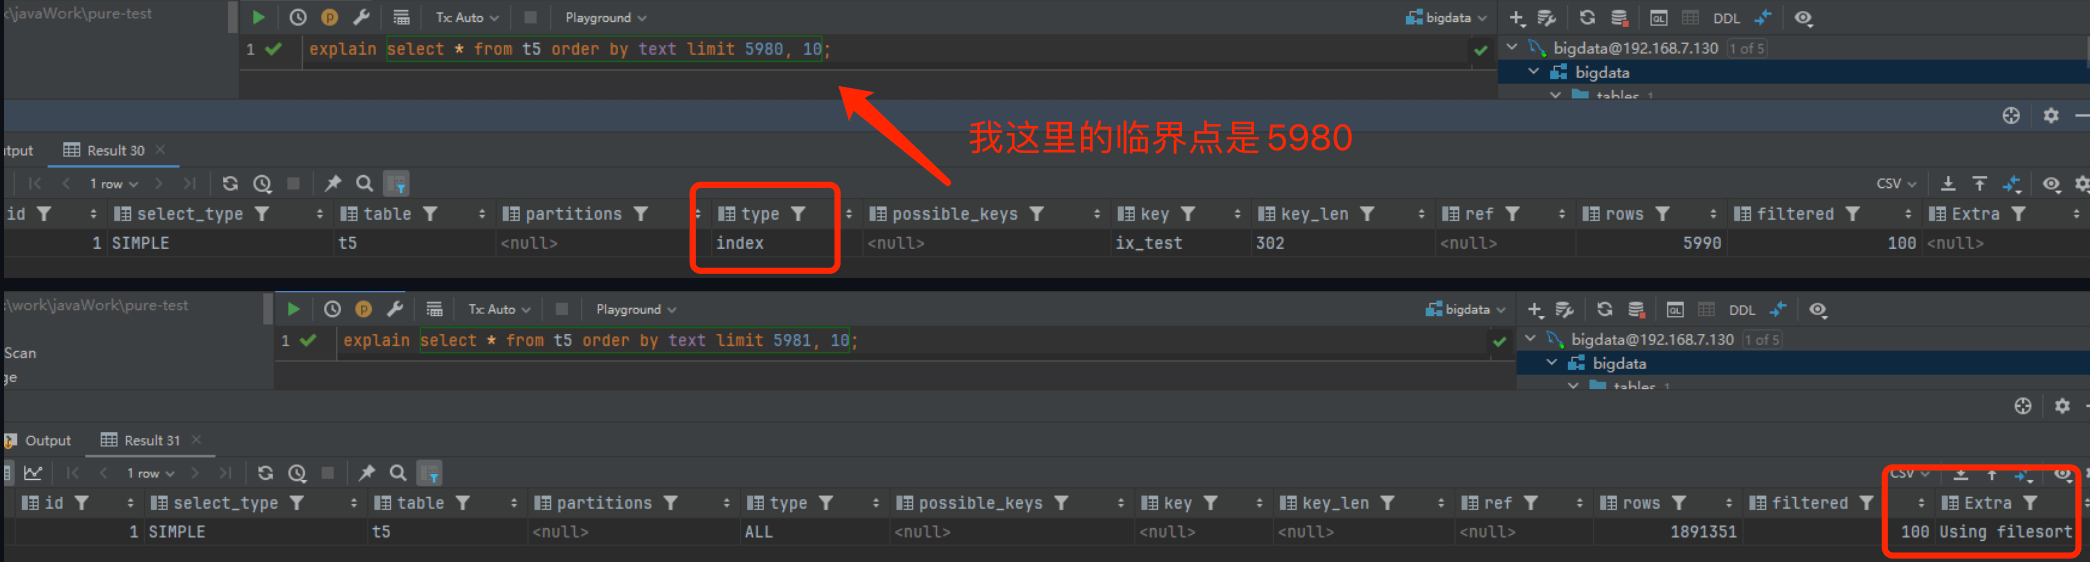
Query optimizer của MySQL sử dụng chiến lược dựa trên cost để chọn execution plan tối ưu. Nó quyết định sử dụng index scan hay full table scan dựa trên cost của CPU và I/O. Nếu optimizer cho rằng full table scan có cost thấp hơn, nó sẽ bỏ qua index. Tuy nhiên, ngay cả khi offset lớn, nếu truy vấn sử dụng covering index, MySQL vẫn có thể dùng index để tránh table lookup.
Đề xuất tối ưu deep pagination
Bài viết dựa trên MySQL 8.0 + InnoDB storage engine. Hành vi của optimizer có thể khác nhau giữa các phiên bản.
Range query (cursor pagination)
Ghi lại ID của bản ghi cuối cùng ở trang trước, rồi dùng WHERE id > last_id LIMIT n để lấy dữ liệu trang tiếp theo:
# Dùng ID của bản ghi cuối cùng trong kết quả truy vấn trước để truy vấn trang tiếp theo
SELECT * FROM t_order WHERE id > 100000 ORDER BY id LIMIT 10
Ưu điểm cốt lõi của cursor pagination: không phụ thuộc vào tính liên tục của ID. MySQL chỉ cần định vị vị trí của last_id trên B+ tree rồi đọc tuần tự n bản ghi tiếp theo. Việc ở giữa có khoảng trống (ví dụ ID đã bị xóa) hoàn toàn không ảnh hưởng đến tính chính xác và hiệu năng của kết quả.
Hạn chế của cách này:
- Không hỗ trợ chuyển trang trực tiếp: không thể nhảy thẳng đến trang N, chỉ có thể chuyển từng trang về phía sau (hoặc phía trước).
- Hạn chế về trường sắp xếp: nếu truy vấn cần sắp xếp theo trường khác (ví dụ thời gian tạo) thay vì theo ID, cần dùng cursor kết hợp
(sort_field, id)để bảo đảm tính duy nhất và thứ tự. - Trường hợp concurrent: khi có dữ liệu mới được thêm hoặc xóa trong lúc truy vấn phân trang, có thể xảy ra:
- Bỏ sót dữ liệu: khi truy vấn trang thứ hai, dữ liệu mới được thêm vào phạm vi trang thứ nhất, khiến dữ liệu đó bị “đẩy” sang trang thứ hai, nhưng truy vấn trang thứ hai đã bỏ qua nó dựa trên ID cuối cũ.
- Dữ liệu trùng lặp: khi truy vấn trang thứ hai, dữ liệu ở cuối trang thứ nhất bị xóa, bản ghi đầu tiên của trang thứ hai cũ “tăng lên” cuối trang thứ nhất, khiến truy vấn trang thứ hai trả về nó lần nữa.
Subquery
Trước tiên, ta truy vấn giá trị primary key tương ứng với tham số đầu tiên của LIMIT, sau đó dùng primary key này để lọc rồi LIMIT, nhờ đó hiệu năng sẽ tốt hơn.
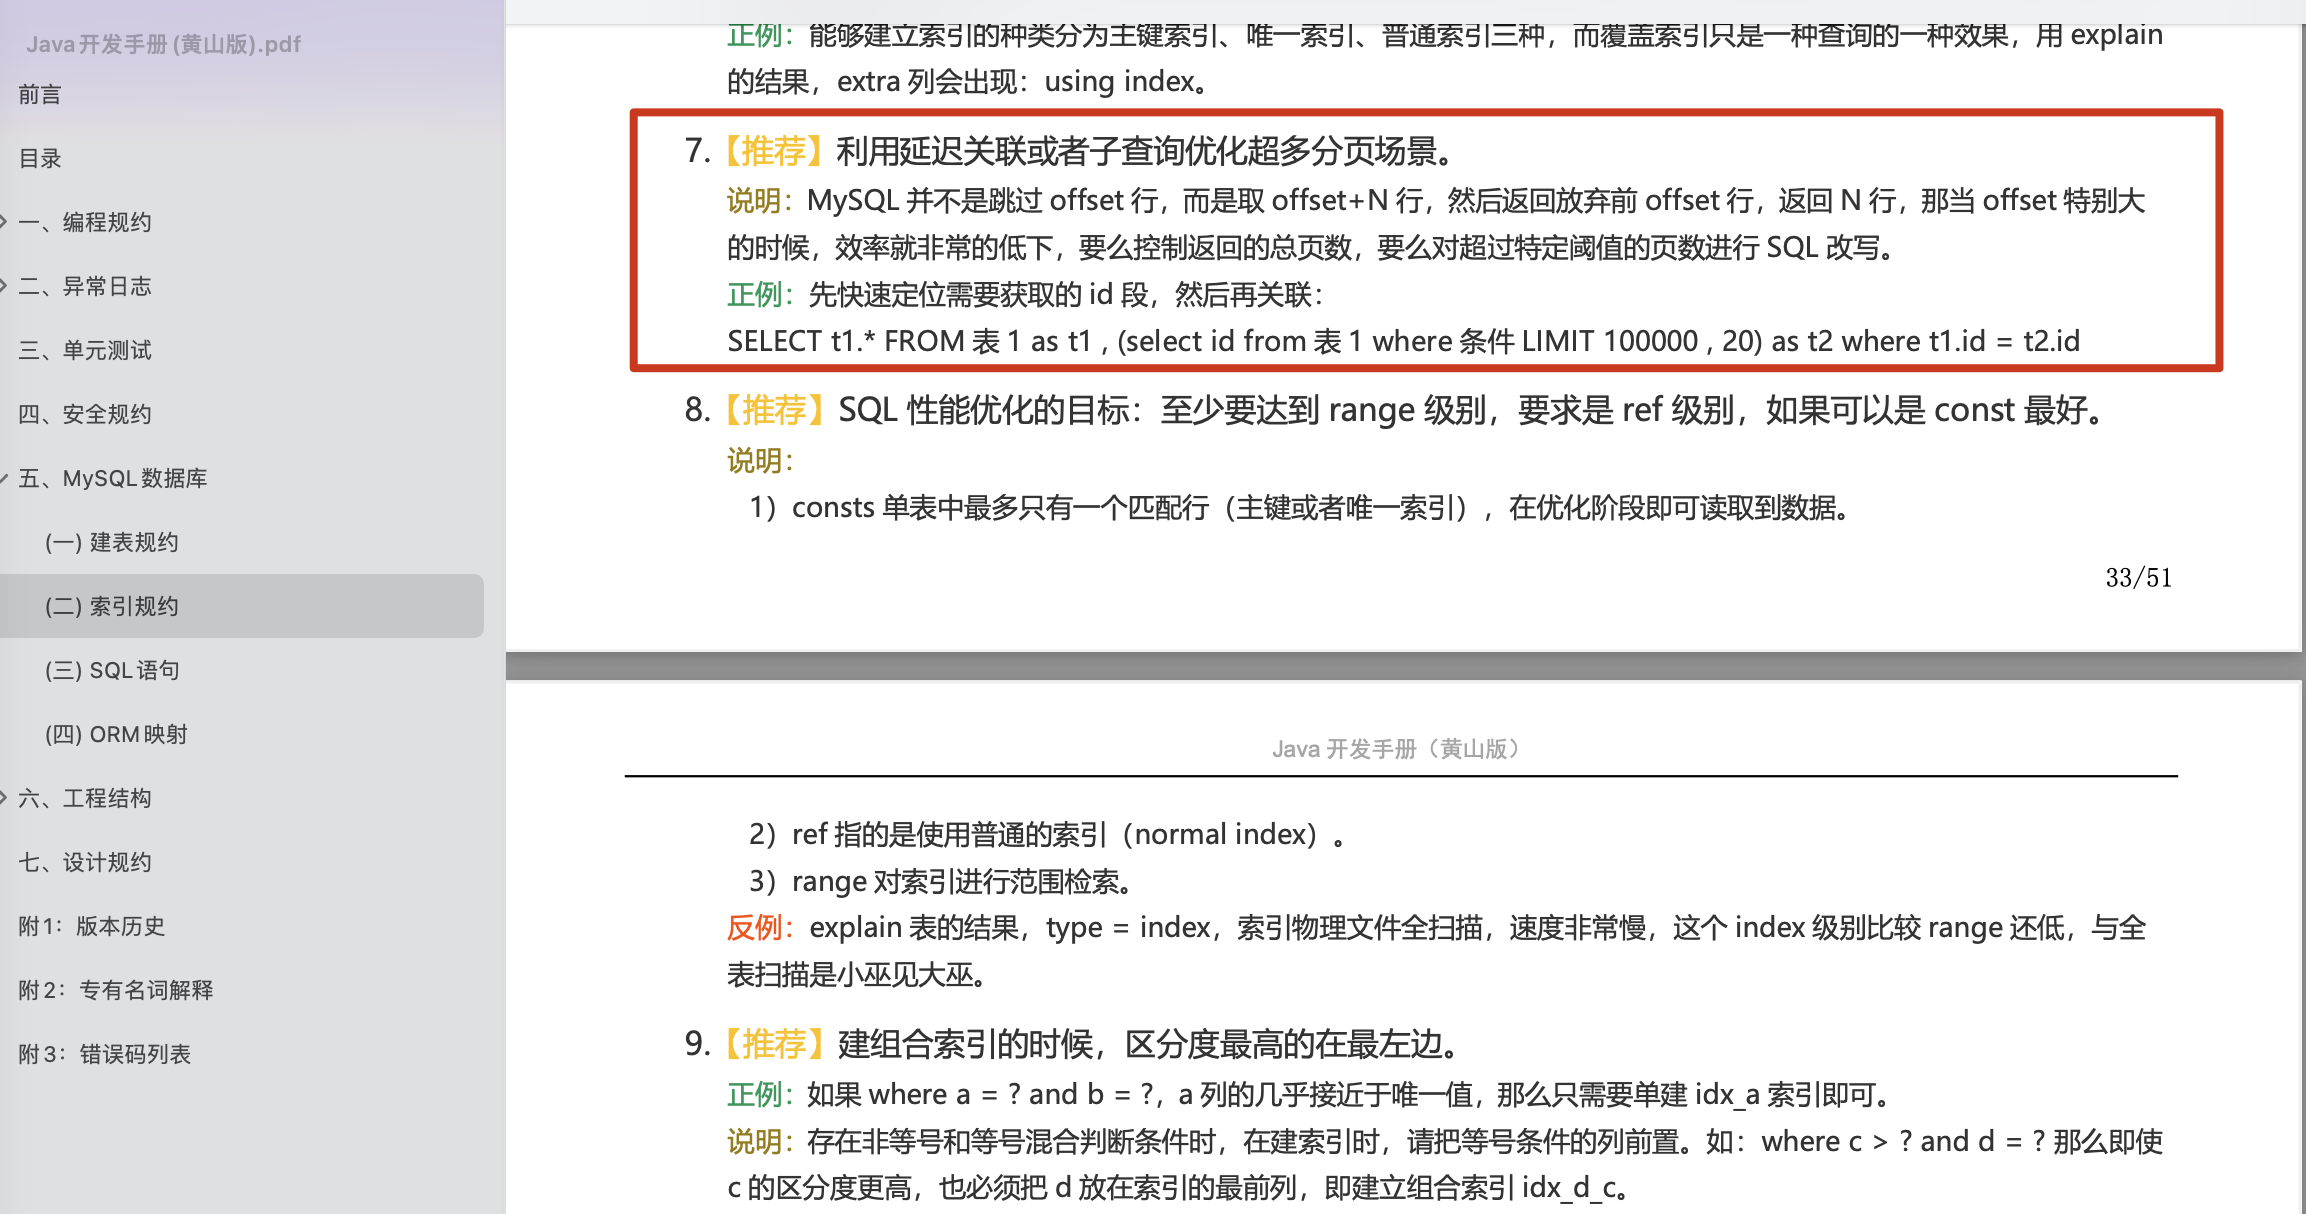
Alibaba cũng mô tả nội dung tương ứng trong 《Java Development Manual》:
Tối ưu các tình huống phân trang với số lượng rất lớn bằng delayed association hoặc subquery.
-- Dùng subquery trên primary key index để offset và nhanh chóng tìm ID bắt đầu
SELECT * FROM t_order
WHERE id >= (
    SELECT id FROM t_order ORDER BY id LIMIT 1000000, 1
) ORDER BY id LIMIT 10;
Nguyên lý hoạt động:
- Subquery
(SELECT id FROM t_order ORDER BY id LIMIT 1000000, 1)dùng primary key index để scan và bỏ qua 1000000 bản ghi đầu tiên, rồi trả về giá trị primary key của bản ghi thứ 1000001. - Main query
SELECT * FROM t_order WHERE id >= ... ORDER BY id LIMIT 10lấy primary key đó làm điểm bắt đầu để lấy 10 bản ghi đầy đủ tiếp theo.
Tuy nhiên, trong một số trường hợp, subquery có thể tạo temporary table và ảnh hưởng đến hiệu năng. Vì vậy, trong các truy vấn phức tạp, nên ưu tiên delayed association.
Tình huống lọc phức tạp: trong tình huống phân trang có điều kiện lọc phức tạp (ví dụ
WHERE status = 1 ORDER BY id LIMIT 1000000, 10), các ID phù hợp thường rời rạc. Khi đó, ưu điểm của subquery càng rõ: dùng composite index (ví dụ(status, id)) trong subquery để thực hiện covering index scan, nhanh chóng bỏ qua 1 triệu bản ghi phù hợp đầu tiên và định vị ID mục tiêu; main query chỉ cần table lookup 10 lần.
Tất nhiên, ta cũng có thể dùng subquery để lấy trước tập ID của trang mục tiêu, rồi lấy nội dung dựa trên tập ID đó. Tuy nhiên, cách viết này rất rườm rà, không bằng delayed association với INNER JOIN.
Delayed association
Delayed association có ý tưởng tối ưu tương tự subquery: chuyển thao tác LIMIT sang primary key index tree để giảm số lần table lookup. So với việc dùng subquery trực tiếp, delayed association dùng INNER JOIN để tích hợp kết quả subquery vào main query, tránh temporary table mà subquery có thể tạo ra. Khi thực thi INNER JOIN, MySQL optimizer có thể sử dụng index để thực hiện join hiệu quả (ví dụ index scan hoặc các chiến lược tối ưu khác). Vì vậy, trong tình huống deep pagination, hiệu năng thường tốt hơn dùng subquery trực tiếp.
-- Dùng INNER JOIN để thực hiện delayed association
SELECT t1.*
FROM t_order t1
INNER JOIN (
    -- Subquery ở đây có thể dùng covering index, hiệu năng rất cao
    SELECT id FROM t_order ORDER BY id LIMIT 1000000, 10
) t2 ON t1.id = t2.id;
Nguyên lý hoạt động:
- Subquery
(SELECT id FROM t_order ORDER BY id LIMIT 1000000, 10)dùng primary key index để scan và bỏ qua 1000000 bản ghi đầu tiên, rồi trả về ID của 10 bản ghi thuộc trang mục tiêu. - Dùng
INNER JOINđể liên kết kết quả subquery với bảng chínht_order, lấy dữ liệu đầy đủ của các bản ghi.
Ngoài INNER JOIN, cũng có thể dùng cú pháp dấu phẩy để liên kết subquery.
-- Dùng dấu phẩy để thực hiện delayed association
SELECT t1.* FROM t_order t1,
(SELECT id FROM t_order ORDER BY id LIMIT 1000000, 10) t2
WHERE t1.id = t2.id;
Lưu ý: dù cách liên kết subquery bằng dấu phẩy cũng cho hiệu quả tương tự, để code dễ đọc và dễ bảo trì hơn, nên dùng cú pháp INNER JOIN chuẩn hơn.
Covering index
Cách truy vấn mà index đã chứa toàn bộ trường cần lấy được gọi là covering index.
Lợi ích của covering index:
- Tránh truy vấn lần hai trên table của InnoDB, tức table lookup: InnoDB lưu trữ dữ liệu theo thứ tự của clustered index. Với InnoDB, secondary index lưu thông tin primary key của dòng trong leaf node. Khi dùng secondary index để truy vấn dữ liệu, sau khi tìm được key tương ứng, vẫn phải truy vấn lần hai thông qua primary key mới lấy được dữ liệu thực sự cần. Với covering index, có thể lấy toàn bộ dữ liệu từ key của secondary index, tránh truy vấn lần hai bằng primary key (table lookup), giảm thao tác I/O và tăng hiệu năng truy vấn.
- Giảm random I/O do table lookup: trả về dữ liệu trực tiếp qua covering index, tránh random I/O khi quay lại clustered index để truy vấn theo primary key của secondary index. Mỗi lần table lookup tìm clustered index theo primary key về bản chất là random I/O.
Giả sử đã tạo composite index (code, type), truy vấn dưới đây có thể dùng covering index:
# Trong InnoDB, secondary index mặc nhiên chứa primary key id
# Nếu chỉ cần truy vấn ba cột id, code, type, chỉ cần tạo composite index (code, type) là có covering index
SELECT id, code, type FROM t_order
ORDER BY code
LIMIT 1000000, 10;
⚠️Lưu ý:
- Khi tập kết quả truy vấn chiếm phần lớn tổng số dòng của bảng, MySQL query optimizer có thể bỏ qua index và tự động chuyển sang full table scan.
- Dù có thể dùng
FORCE INDEXđể buộc query optimizer sử dụng index, cách này có thể khiến query optimizer không chọn được execution plan tốt hơn, nên hiệu quả không phải lúc nào cũng lý tưởng.
Đề xuất triển khai production
Trước hết, tối ưu phân trang phải phù hợp với hình thức sản phẩm. Hệ thống quản trị thường cần chuyển trang và tổng số chính xác; information feed, danh sách bình luận và danh sách đơn hàng thường chỉ cần “trang trước/trang sau” hoặc “tải thêm”. Nếu nghiệp vụ không cần nhảy đến trang 10000, không nên hy sinh hiệu năng truy vấn để tương thích với kiểu phân trang truyền thống.
Các lựa chọn thường gặp:
| Hình thức nghiệp vụ | Phương án đề xuất | Lý do |
|---|---|---|
| Information feed, bình luận, danh sách tin nhắn | Cursor pagination | Chỉ cần chuyển trang trước/sau, hiệu năng ổn định |
| Danh sách quản trị, truy vấn vận hành | Delayed association hoặc subquery | Tương thích page number truyền thống, nhưng phải giới hạn số trang tối đa |
| Bảng xếp hạng có trường cố định | Covering index | Ít trường truy vấn, có thể giảm table lookup |
| Tìm kiếm phức tạp, sắp xếp nhiều điều kiện | Search engine hoặc OLAP | MySQL không phù hợp để xử lý tìm kiếm và sắp xếp trên phạm vi lớn |
Monitoring và alert
- Monitoring slow query: theo dõi SQL có offset
LIMITquá lớn trong slow query log để kịp thời phát hiện vấn đề. - Cảnh báo theo ngưỡng: đặt ngưỡng
long_query_timeđể bắt các truy vấn deep pagination. - Kiểm tra execution plan: định kỳ dùng
EXPLAINkiểm tra execution plan của các SQL phân trang quan trọng, bảo đảm optimizer sử dụng index đúng dự kiến. - Rate limiting API: giới hạn riêng các request đến page number quá sâu để tránh crawler hoặc request bất thường làm quá tải database.
- Giới hạn số trang tối đa: ví dụ chỉ cho phép truy vấn 100 trang đầu; với dữ liệu sâu hơn, hướng người dùng thu hẹp điều kiện tìm kiếm.
Các hiểu lầm thường gặp
| Hiểu lầm | Thực tế |
|---|---|
Cho rằng FORCE INDEX giải quyết được mọi vấn đề | Ép dùng index có thể ngăn optimizer chọn execution plan tốt hơn, nên cần thận trọng |
| Cho rằng covering index phù hợp với mọi tình huống | Khi có quá nhiều trường, chi phí bảo trì index cao; tập kết quả lớn vẫn có thể dùng full table scan |
| Cho rằng cursor pagination giải quyết được mọi vấn đề | Cursor pagination không hỗ trợ chuyển trang trực tiếp và chỉ có thể chuyển trang theo thứ tự của các trường nhất định |
Tổng kết
Nguyên nhân cốt lõi của vấn đề deep pagination là: khi offset của LIMIT quá lớn, MySQL phải scan và bỏ qua lượng lớn bản ghi mới lấy được dữ liệu mục tiêu. Query optimizer có thể bỏ index và chọn full table scan. Khi đó, ngay cả khi có index, vẫn không thể tránh lượng lớn table lookup, khiến hiệu năng truy vấn giảm mạnh.
Bài viết đã giới thiệu bốn phương án tối ưu deep pagination thường gặp. Đặc điểm và trường hợp sử dụng của từng phương án như sau:
| Phương án tối ưu | Ý tưởng cốt lõi | Trường hợp sử dụng | Hạn chế |
|---|---|---|---|
| Range query | Ghi lại ID của bản ghi cuối trang trước, dùng WHERE id > last_id LIMIT n để lấy trang tiếp theo | Sắp xếp theo ID, cho phép cursor pagination | Không hỗ trợ chuyển trang trực tiếp; nếu không sắp xếp theo ID thì phải dùng cursor kết hợp |
| Subquery | Trước hết dùng subquery lấy primary key bắt đầu, rồi lọc theo primary key | Cần hỗ trợ phân trang OFFSET truyền thống | Subquery có thể tạo temporary table, phụ thuộc vào index của trường sắp xếp |
| Delayed association | Dùng INNER JOIN chuyển thao tác phân trang sang primary key index, giảm table lookup | Phân trang lượng dữ liệu lớn, cần logic phân trang truyền thống | SQL tương đối phức tạp |
| Covering index | Tạo composite index chứa các trường truy vấn để tránh table lookup | Trường truy vấn cố định, có thể tạo index phù hợp | Khi có nhiều trường, chi phí bảo trì index cao; tập kết quả lớn có thể dùng full table scan |
Đề xuất chọn phương án:
- Ưu tiên delayed association: với đa số tình huống cần hỗ trợ logic phân trang truyền thống
LIMIT offset, size, delayed association là lựa chọn tốt về hiệu năng và khả năng bảo trì. - Cân nhắc range query (cursor pagination): nếu nghiệp vụ cho phép phân trang dạng cursor “trang tiếp theo” (ví dụ feed mạng xã hội, infinite scroll), range query có hiệu năng tốt nhất và ổn định.
- Bổ sung bằng covering index: khi các trường truy vấn cố định và không nhiều, có thể kết hợp các phương án khác để tạo covering index và tối ưu thêm.
Lưu ý:
- Dù dùng phương án nào, cũng cần theo dõi execution plan thực tế (
EXPLAIN) để bảo đảm optimizer sử dụng index đúng dự kiến. - Với deep pagination cực lớn (ví dụ offset ở mức hàng triệu), nên đánh giá ở tầng nghiệp vụ xem có thực sự cần hỗ trợ hay không; cân nhắc giới hạn số lần chuyển trang tối đa hoặc dùng cách truy vấn khác (ví dụ search engine).
Tài liệu tham khảo
- Trao đổi về cách giải quyết vấn đề deep pagination của MySQL - Cậu bé nhặt ốc: https://juejin.cn/post/7012016858379321358
- Giới thiệu deep pagination và phương án tối ưu database - Kỹ thuật bán lẻ JD: https://mp.weixin.qq.com/s/ZEwGKvRCyvAgGlmeseAS7g
- Tối ưu deep pagination của MySQL - Kỹ thuật Dewu: https://juejin.cn/post/6985478936683610149