
Tổng hợp câu hỏi phỏng vấn Redis thường gặp (Phần 1)
Redis cơ bản
Redis là gì?
Redis (REmote DIctionary Server) là một database NoSQL mã nguồn mở (giấy phép BSD) được phát triển bằng ngôn ngữ C. Khác với database truyền thống, dữ liệu của Redis được lưu trong memory (in-memory database, hỗ trợ persistence), vì vậy tốc độ đọc ghi rất nhanh và được sử dụng rộng rãi cho distributed cache. Ngoài ra, Redis lưu trữ dữ liệu dạng cặp key-value (KV).
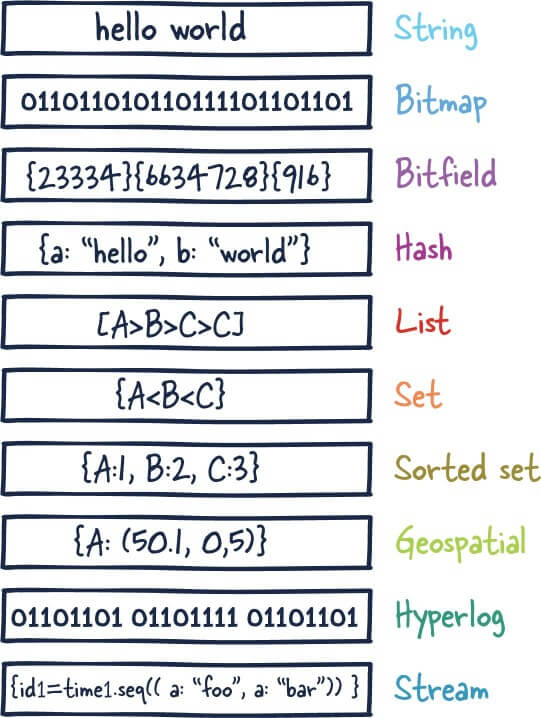
Để đáp ứng các business scenario khác nhau, Redis tích hợp nhiều data type (ví dụ String, Hash, Sorted Set, Bitmap, HyperLogLog, GEO). Redis cũng hỗ trợ transaction, persistence, Lua script, publish-subscribe model và nhiều cluster solution có thể dùng ngay (Redis Sentinel, Redis Cluster).
Redis không có external dependency. Linux và OS X là hai operating system được dùng nhiều nhất để phát triển và test Redis; Redis official khuyến nghị deploy Redis trên Linux trong production.
Nếu tự học, bạn có thể tự cài Redis trên máy hoặc trải nghiệm thực tế thông qua môi trường Redis online do website chính thức của Redis cung cấp (một số ít command không thể sử dụng).
Trên thế giới có rất nhiều website sử dụng Redis. techstacks.io chuyên duy trì danh sách các website phổ biến sử dụng Redis, nếu quan tâm bạn có thể xem thử.
⭐️Vì sao Redis lại nhanh như vậy?
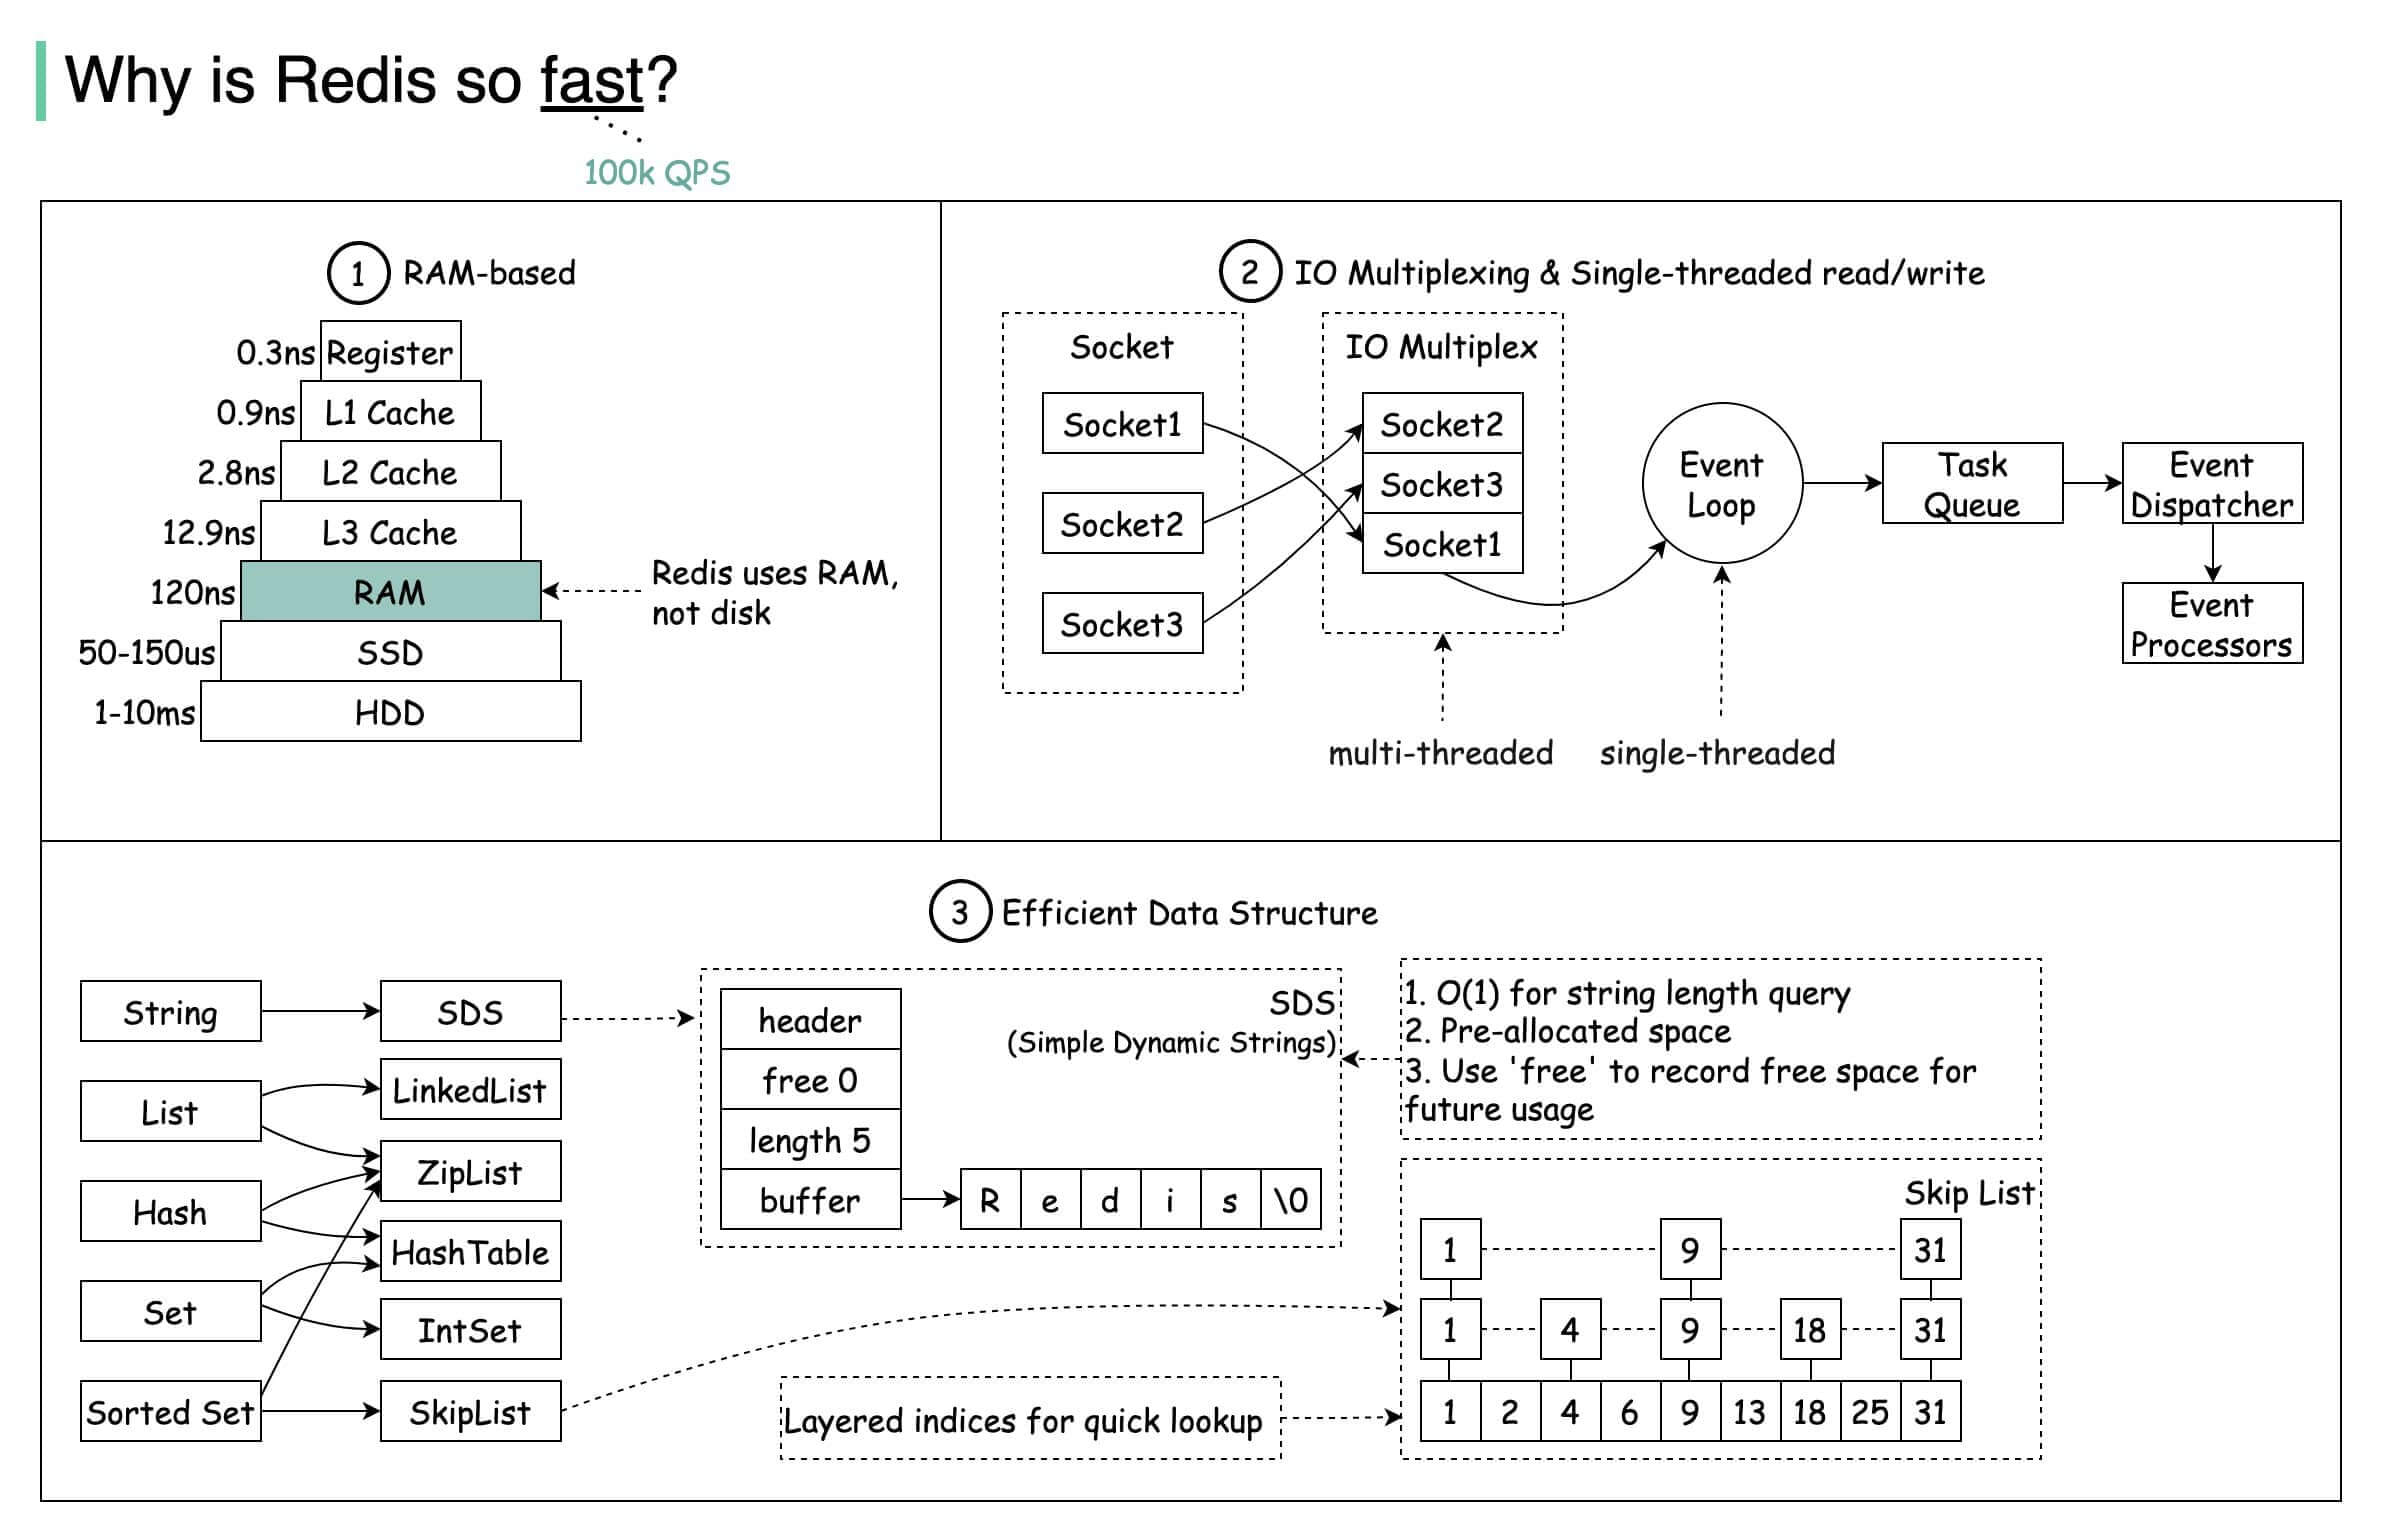
Redis đã thực hiện rất nhiều tối ưu performance nội bộ, trong đó 4 điểm quan trọng là:
- Pure memory operation (Memory-Based Storage): Đây là nguyên nhân chính. Mọi thao tác đọc ghi dữ liệu Redis đều diễn ra trong memory, tốc độ truy cập ở cấp nanosecond, trong khi database truyền thống thường xuyên đọc ghi trên disk ở cấp millisecond; hai bên chênh nhau vài bậc độ lớn.
- I/O model hiệu quả (I/O Multiplexing & Single-Threaded Event Loop): Redis sử dụng single-thread event loop kết hợp kỹ thuật I/O multiplexing, cho phép một thread đồng thời xử lý nhiều I/O event trên nhiều network connection (như đọc ghi), tránh context switch và lock contention trong multi-thread model. Dù là single-thread, nhờ hiệu quả của memory operation và I/O multiplexing, Redis vẫn dễ dàng xử lý lượng lớn concurrent request (Redis thread model sẽ được giới thiệu chi tiết ở phần sau).
- Data structure nội bộ được tối ưu (Optimized Data Structures): Redis cung cấp nhiều data type (như String, List, Hash, Set, Sorted Set, v.v.), phần triển khai bên trong sử dụng các encoding được tối ưu cao (như ziplist, quicklist, skiplist, hashtable, v.v.). Redis sẽ tự động chọn encoding nội bộ phù hợp nhất theo kích thước và type của data, đạt cân bằng tốt nhất giữa performance và space efficiency.
- Communication protocol đơn giản, hiệu quả (Simple Protocol - RESP): Redis sử dụng protocol RESP (REdis Serialization Protocol) do chính mình thiết kế. Protocol này có cách triển khai đơn giản, performance parse tốt và binary-safe. Chi phí serialization/deserialization khi client và server giao tiếp rất nhỏ, giúp cải thiện tốc độ tương tác tổng thể.
Hình dưới đây tổng hợp khá hay, chia sẻ ở đây, từ Why is Redis so fast?.
Vậy nếu đã nhanh như thế, tại sao không dùng Redis trực tiếp làm primary database? Chủ yếu vì chi phí memory quá cao, đồng thời persistence mà Redis cung cấp vẫn có rủi ro mất dữ liệu.
Ngoài Redis, bạn còn biết giải pháp distributed cache nào khác không?
Nếu được hỏi câu này trong phỏng vấn, interviewer chủ yếu muốn xem:
- Khi chọn Redis làm distributed cache solution, bạn đã nghiên cứu và suy nghĩ nghiêm túc hay chỉ vì Redis là technology đang “hot”.
- Độ rộng kỹ thuật của bạn trong lĩnh vực distributed cache.
Nếu bạn biết các solution khác và có thể giải thích vì sao cuối cùng chọn Redis (thậm chí tiến thêm một bước nữa!), điều này sẽ giúp phần thể hiện trong phỏng vấn được cộng điểm đáng kể!
Dưới đây là trao đổi ngắn về việc chọn distributed cache technology phổ biến.
Trong distributed cache, các technology có thâm niên và được sử dụng nhiều vẫn là Memcached và Redis. Tuy nhiên hiện nay hầu như không còn thấy project nào dùng Memcached làm cache, mà đều dùng trực tiếp Redis.
Memcached khá phổ biến khi distributed cache mới bắt đầu phát triển. Sau đó, cùng với sự phát triển của Redis, mọi người dần chuyển sang Redis mạnh hơn.
Một số công ty lớn cũng open source distributed high-performance KV storage database tương tự Redis, ví dụ Tendis do Tencent open source. Tendis sử dụng project mã nguồn mở nổi tiếng RocksDB làm storage engine, tương thích 100% với Redis protocol và mọi data model của Redis 4.0. Về so sánh Redis và Tendis, Tencent từng đăng một bài viết: Redis vs Tendis: Giải mã kiến trúc cold-hot mixed storage, có thể tham khảo sơ lược.
Tuy nhiên, từ lịch sử commit trên Github của project Tendis có thể thấy bản open source của Tendis hầu như đã không còn được maintain và update. Thêm vào đó, mức độ quan tâm không cao, số công ty sử dụng cũng ít. Vì vậy, không khuyến nghị dùng Tendis để triển khai distributed cache.
Hiện tại, hai distributed cache open source được giới chuyên môn công nhận hơn để thay thế Redis là:
- Dragonfly: một in-memory database được xây dựng cho nhu cầu tải của application hiện đại, tương thích hoàn toàn với API của Redis và Memcached, không cần sửa code khi migration, được tuyên bố là in-memory database nhanh nhất thế giới.
- KeyDB: một high-performance fork của Redis, tập trung vào multi-thread, memory efficiency và high throughput.
Tuy nhiên, vẫn nên ưu tiên Redis cho distributed cache. Dù sao Redis đã được kiểm chứng qua nhiều năm, ecosystem rất tốt và tài liệu cũng đầy đủ!
PS: Do giới hạn độ dài bài viết, tôi không giới thiệu và so sánh chi tiết các lựa chọn distributed cache nêu trên. Nếu quan tâm, bạn có thể tự nghiên cứu thêm.
Hãy nói về điểm khác biệt và điểm chung giữa Redis và Memcached
Hiện nay các công ty thường dùng Redis để triển khai cache, bản thân Redis cũng ngày càng mạnh hơn! Tuy nhiên, hiểu điểm khác biệt và điểm chung giữa Redis và Memcached giúp chúng ta có cơ sở rõ ràng khi lựa chọn technology phù hợp!
Điểm chung:
- Đều là in-memory database, thường được dùng làm cache.
- Đều có expiration policy.
- Performance của cả hai đều rất cao.
Điểm khác biệt:
- Data type: Redis hỗ trợ data type phong phú hơn (đáp ứng application scenario phức tạp hơn). Redis không chỉ hỗ trợ data type k/v đơn giản mà còn cung cấp storage cho các data structure như list, set, zset, hash; còn Memcached chỉ hỗ trợ data type k/v đơn giản nhất.
- Data persistence: Redis hỗ trợ persistence, có thể lưu data trong memory xuống disk và load lại để sử dụng khi restart; còn Memcached lưu toàn bộ data trong memory. Nói cách khác, Redis có disaster recovery mechanism, còn Memcached thì không.
- Cluster mode support: Memcached không có cluster mode native, cần dựa vào client để shard và write data vào cluster; từ Redis 3.0, Redis đã native support cluster mode.
- Thread model: Memcached sử dụng network model multi-thread, non-blocking và I/O multiplexing; Redis sử dụng model I/O multiplexing single-thread (Redis 6.0 đã thêm multi-thread cho đọc ghi network data).
- Feature support: Redis hỗ trợ publish-subscribe model, Lua script, transaction và các feature khác, còn Memcached không hỗ trợ. Ngoài ra Redis hỗ trợ nhiều programming language hơn.
- Xóa data hết hạn: Policy xóa expired data của Memcached chỉ dùng lazy deletion, còn Redis đồng thời dùng lazy deletion và periodic deletion.
Sau khi xem phần so sánh trên, tin rằng chúng ta không còn nhiều lý do để chọn Memcached làm distributed cache cho project của mình.
⭐️Tại sao nên dùng Redis?
1. Truy cập nhanh hơn
Dữ liệu của database truyền thống được lưu trên disk, còn Redis dựa trên memory; tốc độ truy cập memory nhanh hơn disk rất nhiều. Sau khi đưa Redis vào, chúng ta có thể đặt một số data được truy cập thường xuyên vào Redis, lần sau đọc trực tiếp từ memory, tốc độ có thể tăng vài chục, thậm chí hơn một trăm lần.
2. High concurrency
Thông thường database như MySQL có QPS khoảng 4k (4 core 8g), nhưng sau khi dùng Redis cache rất dễ đạt 5w+, thậm chí 10w+ (trong trường hợp Redis chạy trên một máy; Redis cluster còn cao hơn).
QPS (Query Per Second): số query server có thể thực hiện mỗi giây;
Có thể thấy số lượng database request mà thao tác trực tiếp trên cache chịu được lớn hơn rất nhiều so với truy cập trực tiếp database. Vì vậy, chúng ta có thể cân nhắc chuyển một phần data trong database vào cache, để một phần request của user đi thẳng đến cache mà không cần qua database. Nhờ đó, concurrency tổng thể của system cũng được nâng cao.
3. Feature đầy đủ
Ngoài làm cache, Redis còn có thể dùng cho distributed lock, rate limiting, message queue, delayed queue và các scenario khác; tính năng rất mạnh!
⭐️Tại sao dùng Redis thay vì local cache?
| Đặc tính | Local cache | Redis |
|---|---|---|
| Data consistency | Khi deploy nhiều server có thể không nhất quán | Data nhất quán |
| Memory limit | Bị giới hạn bởi memory của một server | Deploy độc lập, memory space lớn hơn |
| Rủi ro mất data | Server down làm mất data | Có persistence, data khó mất hơn |
| Quản lý bảo trì | Phân tán, khó quản lý | Quản lý tập trung, cung cấp nhiều management tool |
| Độ phong phú feature | Feature hạn chế, thường chỉ cung cấp storage key-value đơn giản | Feature phong phú, hỗ trợ nhiều data structure và feature |
Về giới thiệu chi tiết local cache, distributed cache và multi-level cache, có thể xem bài viết tôi viết: Tổng hợp câu hỏi phỏng vấn cache cơ bản.
Có những cache read/write strategy phổ biến nào?
Về giới thiệu chi tiết các cache read/write strategy phổ biến, có thể xem bài viết: Giải thích chi tiết 3 cache read/write strategy thường dùng.
Redis Module là gì? Dùng để làm gì?
Từ Redis 4.0, Redis hỗ trợ mở rộng feature thông qua Module để đáp ứng nhu cầu đặc biệt. Các Module này được load vào Redis dưới dạng dynamic-link library (file so), đây là cách triển khai dynamic extension rất linh hoạt và đáng để tham khảo học tập!
Mỗi người đều có thể dựa trên Redis để tự phát triển Module của riêng mình, ví dụ triển khai search engine, custom distributed lock và distributed rate limiting.
Các Module hiện được Redis official khuyến nghị gồm:
- RediSearch: module dùng để triển khai search engine.
- RedisJSON: module dùng để xử lý JSON data.
- RedisGraph: module dùng để triển khai graph database.
- RedisTimeSeries: module dùng để xử lý time series data.
- RedisBloom: module dùng để triển khai Bloom filter.
- RedisAI: module dùng để thực thi deep learning/machine learning model và quản lý data của chúng.
- RedisCell: module dùng để triển khai distributed rate limiting.
- ……
Về giới thiệu chi tiết Redis module, có thể xem tài liệu chính thức: https://redis.io/modules.
⭐️Ứng dụng Redis
Ngoài làm cache, Redis còn làm được gì?
- Distributed lock: Dùng Redis làm distributed lock là một cách khá phổ biến. Thông thường chúng ta triển khai distributed lock dựa trên Redisson. Về giới thiệu chi tiết distributed lock triển khai bằng Redis, có thể xem bài viết: Giải thích chi tiết distributed lock.
- Rate limiting: Thông thường triển khai rate limiting bằng Redis + Lua script. Nếu không muốn tự viết Lua script, cũng có thể dùng
RRateLimitertrong Redisson để triển khai distributed rate limiting; implementation bên dưới dựa trên Lua code + token bucket algorithm. - Message queue: Data structure List tích hợp sẵn của Redis có thể dùng làm queue đơn giản. Data structure type Stream được thêm vào Redis 5.0 phù hợp hơn để làm message queue. Nó khá giống Kafka, có khái niệm topic và consumer group, hỗ trợ message persistence và cơ chế ACK.
- Delayed queue: Redisson tích hợp sẵn delayed queue (triển khai dựa trên Sorted Set).
- Distributed Session: Dùng data type String hoặc Hash để lưu Session data, mọi server đều có thể truy cập.
- Complex business scenario: Thông qua data structure do Redis và Redis extension (như Redisson) cung cấp, chúng ta có thể dễ dàng hoàn thành nhiều business scenario phức tạp, ví dụ dùng Bitmap thống kê active user, dùng Sorted Set duy trì ranking, dùng HyperLogLog thống kê UV và PV của website.
- ……
Làm thế nào để triển khai distributed lock dựa trên Redis?
Về giới thiệu chi tiết distributed lock triển khai bằng Redis, có thể xem bài viết: Giải thích chi tiết distributed lock.
Redis có thể làm message queue không? Triển khai thế nào?
Trước hết là kết luận:
- Nếu business đơn giản, volume nhỏ, theo đuổi performance tối đa và có thể chấp nhận xác suất rất nhỏ mất data, dùng Redis Stream là lựa chọn tối ưu, vì bỏ qua chi phí deploy và maintain MQ, đồng thời tái sử dụng Redis component hiện có (phần lớn project cần MQ thường cũng cần Redis).
- Nếu là business cấp tài chính, data volume khổng lồ, cần đảm bảo nghiêm ngặt không mất message, bắt buộc chọn MQ trưởng thành hơn như Kafka, RabbitMQ.
Đây là một câu hỏi khá quan trọng, cũng có thể áp dụng khi lựa chọn technology. Tôi đã viết riêng một bài giới thiệu và phân tích chi tiết, khuyến nghị bạn có thời gian thì đọc kỹ vài lần và bookmark: Redis có thể làm message queue không? Triển khai thế nào?.
Làm thế nào để triển khai delayed task dựa trên Redis?
Câu hỏi tương tự:
- Order chưa thanh toán sau 10 phút thì hết hạn, triển khai bằng Redis thế nào?
- Red envelope chưa được nhận sau 24 giờ thì tự động hoàn lại, triển khai bằng Redis thế nào?
Chức năng delayed task dựa trên Redis về cơ bản chỉ có hai cách sau:
- Redis expiration event listener.
- Delayed queue tích hợp trong Redisson.
Redis expiration event listener có các vấn đề như tính kịp thời kém, mất message, message bị consume lặp trong trường hợp có nhiều service instance, nên không được khuyến nghị.
Delayed queue tích hợp trong Redisson có các ưu điểm sau:
- Giảm khả năng mất message: Message trong DelayedQueue sẽ được persist. Ngay cả khi Redis down, theo cơ chế persistence cũng chỉ có thể mất một ít message, ảnh hưởng không lớn. Dĩ nhiên, bạn cũng có thể dùng cách scan database làm cơ chế bù.
- Không có vấn đề duplicate message consumption: Mỗi client đều lấy task từ cùng một target queue, không xảy ra duplicate consumption.
Về giới thiệu chi tiết delayed task triển khai bằng Redis, có thể xem bài viết: Làm thế nào để triển khai delayed task dựa trên Redis?.
⭐️Các data type của Redis
Về giới thiệu chi tiết 5 basic data type và 3 special data type của Redis, hãy xem hai bài viết dưới đây và tài liệu chính thức của Redis:
Redis có những data type thường dùng nào?
Các data type tương đối phổ biến trong Redis gồm:
- 5 basic data type: String (chuỗi), List (danh sách), Set (tập hợp), Hash (bảng băm), Zset (tập hợp có thứ tự).
- 3 special data type: HyperLogLog (đếm cardinality), Bitmap (bitmap), Geospatial (dữ liệu địa lý).
Ngoài các type nêu trên, còn có một số type khác như Bloom filter, Bitfield (trường bit).
String có những application scenario nào?
String là data type đơn giản nhất và cũng thường dùng nhất trong Redis. Đây là binary-safe data type, có thể dùng để lưu mọi loại data như string, integer, floating-point number, image (base64 encoding hoặc decoding của image hay path của image), object sau serialization.
Các application scenario phổ biến của String:
- Cache data thông thường (như Session, Token, object sau serialization, path của image);
- Counter, ví dụ số request của user trong một đơn vị thời gian (có thể dùng cho rate limiting đơn giản), số lượt truy cập page trong một đơn vị thời gian;
- Distributed lock (dùng command
SETNX key valuecó thể triển khai distributed lock đơn giản nhất); - ……
Về giới thiệu chi tiết String, hãy xem bài viết: Giải thích chi tiết 5 basic data type của Redis.
Lưu object data bằng String hay Hash thì tốt hơn?
So sánh đơn giản hai loại:
- Cách lưu object: String lưu object data sau serialization, lưu toàn bộ object, thao tác đơn giản và trực tiếp. Hash lưu riêng từng field của object, có thể lấy thông tin một phần field, cũng có thể sửa hoặc thêm một phần field, tiết kiệm network traffic. Nếu một số field của object thường xuyên thay đổi hoặc thường xuyên cần query riêng từng field, Hash rất phù hợp.
- Memory consumption: Hash thường tiết kiệm memory hơn String, đặc biệt khi có nhiều field và độ dài field ngắn. Redis tối ưu Hash nhỏ (ví dụ dùng ziplist để lưu trữ), tiếp tục giảm memory usage.
- Lưu complex object: String thuận tiện hơn khi xử lý object có nested level hoặc structure phức tạp, vì không cần xử lý việc lưu và thao tác độc lập trên từng field.
- Performance: Thao tác String thường có time complexity O(1), vì lưu toàn bộ object nên thao tác đơn giản, trực tiếp và performance đọc ghi tổng thể tốt hơn. Hash cần xử lý thêm, sửa, xóa, query nhiều field; khi có nhiều field và thường xuyên thay đổi có thể phát sinh performance overhead.
Tóm lại:
- Trong phần lớn trường hợp, String phù hợp hơn để lưu object data, đặc biệt khi object structure đơn giản và thao tác đọc ghi toàn bộ là chính.
- Nếu cần thao tác thường xuyên trên một phần field của object hoặc tiết kiệm memory, Hash có thể là lựa chọn tốt hơn.
Cách triển khai bên trong của String là gì?
Redis được viết bằng ngôn ngữ C, nhưng cách triển khai bên trong của String type trong Redis không phải là string trong C (tức character array kết thúc bằng null character \0), mà là SDS (Simple Dynamic String) do Redis tự viết.
SDS ban đầu là C string do tác giả Redis thiết kế cho việc phát triển C hằng ngày, sau đó được áp dụng vào Redis và trải qua nhiều chỉnh sửa, hoàn thiện để phù hợp với high-performance operation.
Một phần source code SDS của Redis 7.0 như sau (https://github.com/redis/redis/blob/7.0/src/sds.h):
/* Note: sdshdr5 is never used, we just access the flags byte directly.
 * However is here to document the layout of type 5 SDS strings. */
struct __attribute__ ((__packed__)) sdshdr5 {
    unsigned char flags; /* 3 lsb of type, and 5 msb of string length */
    char buf[];
};
struct __attribute__ ((__packed__)) sdshdr8 {
    uint8_t len; /* used */
    uint8_t alloc; /* excluding the header and null terminator */
    unsigned char flags; /* 3 lsb of type, 5 unused bits */
    char buf[];
};
struct __attribute__ ((__packed__)) sdshdr16 {
    uint16_t len; /* used */
    uint16_t alloc; /* excluding the header and null terminator */
    unsigned char flags; /* 3 lsb of type, 5 unused bits */
    char buf[];
};
struct __attribute__ ((__packed__)) sdshdr32 {
    uint32_t len; /* used */
    uint32_t alloc; /* excluding the header and null terminator */
    unsigned char flags; /* 3 lsb of type, 5 unused bits */
    char buf[];
};
struct __attribute__ ((__packed__)) sdshdr64 {
    uint64_t len; /* used */
    uint64_t alloc; /* excluding the header and null terminator */
    unsigned char flags; /* 3 lsb of type, 5 unused bits */
    char buf[];
};
Từ source code có thể thấy SDS có năm implementation: SDS_TYPE_5 (không được sử dụng), SDS_TYPE_8, SDS_TYPE_16, SDS_TYPE_32, SDS_TYPE_64; chỉ bốn loại sau được sử dụng thực tế. Redis quyết định sử dụng type nào dựa trên độ dài ban đầu, từ đó giảm memory usage.
| Type | Byte | Bit |
|---|---|---|
| sdshdr5 | < 1 | <8 |
| sdshdr8 | 1 | 8 |
| sdshdr16 | 2 | 16 |
| sdshdr32 | 4 | 32 |
| sdshdr64 | 8 | 64 |
Bốn implementation sau đều chứa 4 thuộc tính:
len: độ dài của string, tức số byte đã sử dụng.alloc: tổng character space có thể sử dụng; alloc-len là space còn lại của SDS.buf[]: array thực tế lưu string.flags: ba bit thấp lưu type flag.
SDS có các cải tiến sau so với string trong C:
- Tránh buffer overflow: Khi string trong C bị sửa (ví dụ nối string), nếu không allocate đủ memory space thì sẽ gây buffer overflow. Khi SDS bị sửa, nó kiểm tra space có đáp ứng yêu cầu theo property len trước; nếu không đủ thì mở rộng đến size cần thiết rồi mới sửa.
- Độ phức tạp khi lấy string length thấp hơn: Length của string trong C thường được tính bằng cách duyệt, time complexity là O(n). SDS chỉ cần đọc trực tiếp property len để lấy length, time complexity là O(1).
- Giảm số lần memory allocation: Để tránh mỗi lần đều phải reallocate memory khi sửa (tăng/giảm) string (string trong C làm như vậy), SDS triển khai hai optimization strategy là pre-allocation space và lazy space release. Khi SDS cần tăng string, Redis allocate memory cho SDS và theo algorithm cụ thể allocate thêm memory dư, nhờ đó giảm số lần memory reallocation cần cho các thao tác tăng string liên tiếp. Khi SDS cần giảm string, phần memory này chưa được thu hồi ngay mà được ghi lại để chờ dùng sau (hỗ trợ release thủ công, có API tương ứng).
- Binary-safe: String trong C dùng null character
\0làm dấu hiệu kết thúc string, điều này gây ra một số vấn đề vì binary file (ví dụ image, video, audio) có thể chứa null character, khiến C string không thể lưu chính xác. SDS dùng property len để xác định string kết thúc nên không gặp vấn đề này.
🤐 Nói thêm một chút, trong nhiều bài viết định nghĩa SDS như sau:
struct sdshdr {
    unsigned int len;
    unsigned int free;
    char buf[];
};
Điều này cũng không sai; trước Redis 3.2 đã định nghĩa như vậy. Sau đó, vì cách định nghĩa này có vấn đề, định nghĩa len và free dùng 4 byte, gây lãng phí. Sau Redis 3.2, Redis cải tiến định nghĩa SDS và chia thành 5 type như hiện nay.
Lưu thông tin giỏ hàng bằng String hay Hash thì tốt hơn?
Vì sản phẩm trong giỏ hàng thường xuyên được sửa đổi và thay đổi, thông tin giỏ hàng được khuyến nghị lưu bằng Hash:
- user id là key
- product id là field, số lượng sản phẩm là value
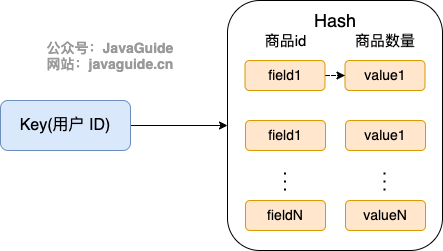
Vậy cụ thể phải duy trì thông tin giỏ hàng của user như thế nào?
- User thêm sản phẩm tức là thêm field và value mới vào Hash;
- Query thông tin giỏ hàng tức là duyệt Hash tương ứng;
- Thay đổi số lượng sản phẩm tức là sửa value tương ứng (có thể set trực tiếp hoặc thực hiện phép tính);
- Xóa sản phẩm tức là xóa field tương ứng trong Hash;
- Xóa toàn bộ giỏ hàng tức là xóa key tương ứng.
Đây chỉ là ví dụ trong scenario giỏ hàng tương đối đơn giản; trong e-commerce scenario thực tế, chỉ lưu product id vào field là không đủ đáp ứng yêu cầu.
Triển khai bảng xếp hạng bằng Redis như thế nào?
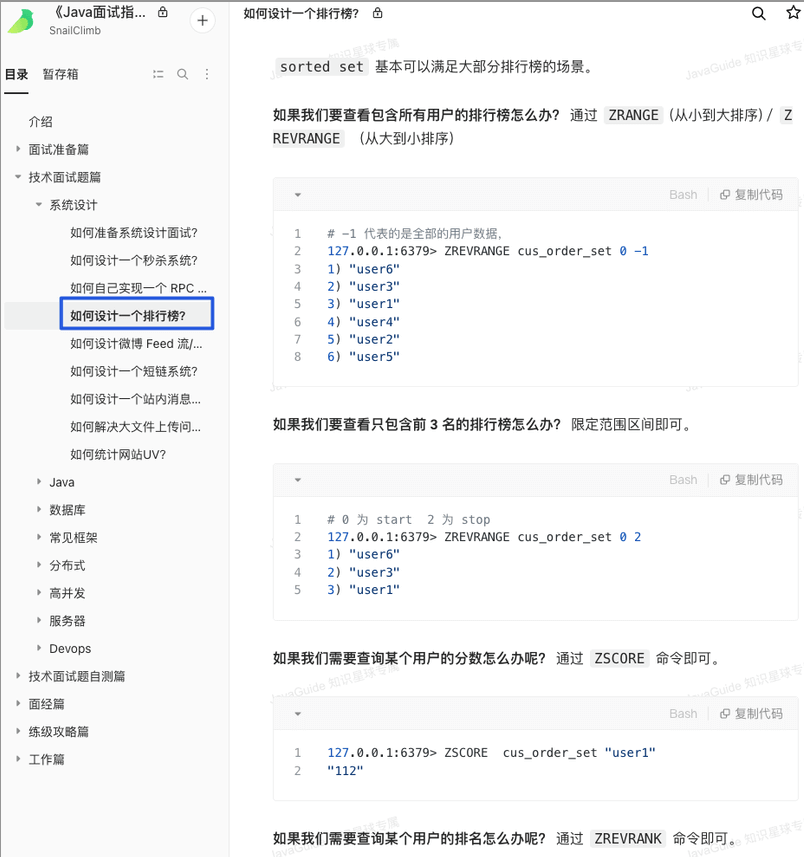
Redis có một data type tên là Sorted Set thường được dùng trong nhiều scenario bảng xếp hạng, ví dụ bảng xếp hạng tặng quà trong livestream, bảng xếp hạng số bước chân WeChat trong vòng bạn bè, bảng xếp hạng tier trong Honor of Kings, bảng xếp hạng độ hot của topic, v.v.
Một số Redis command liên quan: ZRANGE (sort từ nhỏ đến lớn), ZREVRANGE (sort từ lớn đến nhỏ), ZREVRANK (thứ hạng của element được chỉ định).

Trong 《Java Interview Guide》, phần “Technical Interview Questions” có một bài viết giới thiệu chi tiết cách dùng Sorted Set để thiết kế và tạo bảng xếp hạng; nếu quan tâm bạn có thể xem.
Vì sao cách triển khai bên trong của Redis Sorted Set dùng skiplist thay vì balanced tree, red-black tree hoặc B+ tree?
Câu hỏi phỏng vấn này được nhiều công ty lớn yêu thích, độ khó cũng khá cao.
- Balanced tree vs skiplist: Time complexity của insert, delete và query ở balanced tree và skiplist đều là O(log n). Với range query, balanced tree cũng có thể đạt hiệu quả như skiplist thông qua in-order traversal. Tuy nhiên mỗi thao tác insert hoặc delete của nó đều cần đảm bảo toàn bộ tree cân bằng tuyệt đối ở node trái và phải; chỉ cần mất cân bằng thì phải dùng rotation để duy trì balance, quá trình này khá tốn thời gian. Skiplist ra đời nhằm khắc phục một số nhược điểm của balanced tree. Skiplist sử dụng probabilistic balance thay vì balance cứng nhắc, vì vậy algorithm insert và delete trong skiplist đơn giản hơn nhiều và cũng nhanh hơn nhiều so với algorithm tương đương của balanced tree.
- Red-black tree vs skiplist: So với red-black tree, implementation của skiplist cũng đơn giản hơn, không cần rotation và coloring (red-black transformation) để đảm bảo black balance. Ngoài ra, với thao tác tìm data theo range, hiệu quả của red-black tree không cao bằng skiplist.
- B+ tree vs skiplist: B+ tree phù hợp hơn để làm một trong các index structure thường dùng trong database và file system. Core idea của nó là dùng số lượng I/O ít nhất để định vị nhiều index nhất có thể nhằm lấy query data. Với in-memory database như Redis, cách này không thực sự phù hợp, vì Redis không thể lưu lượng data lớn; index không cần được maintain theo cách của B+ tree, chỉ cần random maintain theo probability là đủ, giúp tiết kiệm memory. Hơn nữa, khi dùng skiplist triển khai zset, cách này đơn giản hơn B+ tree: khi insert chỉ cần dùng index để insert data vào vị trí phù hợp trong linked list rồi random maintain index ở một độ cao nhất định, không cần như B+ tree phải split và merge node khi phát hiện mất balance trong lúc insert.
Ngoài ra, tôi đã viết riêng một bài từ cách sử dụng cơ bản của sorted set đến phân tích source code và implementation của skiplist, giúp bạn hiểu sâu hơn về skiplist trong cách triển khai bên trong của Redis Sorted Set: Vì sao Redis dùng skiplist để triển khai sorted set. Nếu chỉ muốn xem nhanh structure cơ bản, complexity và range query của skiplist, có thể xem Tổng hợp câu hỏi phỏng vấn skiplist.
Trường hợp sử dụng của Set là gì?
Set trong Redis là một unordered set, các element trong set không có thứ tự trước sau nhưng đều unique, hơi giống HashSet trong Java.
Các application scenario phổ biến của Set:
- Scenario cần data lưu trữ không được trùng: thống kê UV website (với scenario có data volume khổng lồ,
HyperLogLogphù hợp hơn), like article, like post, v.v. - Scenario cần lấy intersection, union và difference của nhiều data source: mutual friend (intersection), mutual follower (intersection), mutual following (intersection), friend recommendation (difference), music recommendation (difference), subscription account recommendation (difference + intersection), v.v.
- Scenario cần lấy ngẫu nhiên element trong data source: lottery system, random name selection, v.v.
Triển khai lottery system bằng Set như thế nào?
Nếu muốn dùng Set để triển khai một lottery system đơn giản, chỉ cần dùng các command sau:
SADD key member1 member2 ...: thêm một hoặc nhiều element vào set được chỉ định.SPOP key count: random remove và lấy một hoặc nhiều element trong set được chỉ định, phù hợp với scenario không cho phép trúng thưởng trùng.SRANDMEMBER key count: random lấy số lượng element được chỉ định trong set được chỉ định, phù hợp với scenario cho phép trúng thưởng trùng.
Thống kê active user bằng Bitmap như thế nào?
Bitmap lưu các số nhị phân liên tiếp (0 và 1). Thông qua Bitmap, chỉ cần một bit để biểu thị value hoặc state tương ứng của một element, key chính là element tương ứng. Ta biết 8 bit tạo thành một byte, vì vậy bản thân Bitmap tiết kiệm storage space rất lớn.
Bạn có thể xem Bitmap như một array lưu các số nhị phân (0 và 1), index của mỗi element trong array gọi là offset.
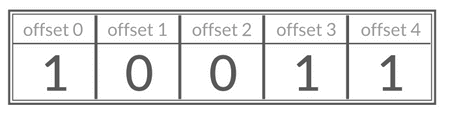
Nếu muốn dùng Bitmap để thống kê active user, có thể dùng date (chính xác đến ngày) làm key, user ID làm offset; nếu đã active trong ngày thì set thành 1.
Khởi tạo data:
> SETBIT 20210308 1 1
(integer) 0
> SETBIT 20210308 2 1
(integer) 0
> SETBIT 20210309 1 1
(integer) 0
Thống kê tổng số active user từ 20210308~20210309:
> BITOP and desk1 20210308 20210309
(integer) 1
> BITCOUNT desk1
(integer) 1
Thống kê số active user online từ 20210308~20210309:
> BITOP or desk2 20210308 20210309
(integer) 1
> BITCOUNT desk2
(integer) 2
HyperLogLog phù hợp với scenario nào?
HyperLogLog (HLL) là một probabilistic data structure rất tinh tế, chuyên giải quyết một loại big data problem khó: dùng memory cực nhỏ để ước tính số element không trùng trong một set giữa lượng data khổng lồ, tức cardinality (số lượng phần tử khác nhau).
Trade-off cốt lõi nhất của HLL là dùng một chút mất mát về độ chính xác để đổi lấy việc tiết kiệm memory space rất lớn. Kết quả nó đưa ra không phải con số chính xác 100%, mà là giá trị xấp xỉ có standard error rất nhỏ (mặc định trong Redis là 0.81%).
Dựa trên trade-off cốt lõi này, HyperLogLog phù hợp nhất với các scenario có đặc điểm sau:
- Data volume khổng lồ, nhạy cảm với memory: Đây là sân chơi chính của HLL. Ví dụ cần thống kê số unique visitor hằng ngày của một app có daily active user hàng trăm triệu. Nếu dùng Set truyền thống để lưu user ID, một ID chiếm vài chục byte, hàng trăm triệu ID có thể cần vài GB thậm chí hàng chục GB memory, điều này không thể chấp nhận trong nhiều scenario. Còn HLL trong Redis chỉ cần memory cố định 12KB nhưng có thể xử lý cardinality ở quy mô thiên văn, đây là ưu thế mang tính đột phá.
- Không yêu cầu độ chính xác của kết quả là 100%: Đây là tiền đề để dùng HLL. Ví dụ product manager muốn biết UV của một bài post hot khoảng 10 triệu hay 10,1 triệu, khác biệt nhỏ này thường không ảnh hưởng đến business decision. Nhưng nếu scenario là thống kê chính xác số giao dịch của transaction system, HLL hoàn toàn không phù hợp vì financial scenario yêu cầu độ chính xác 100%.
Vì vậy, application scenario cụ thể của HyperLogLog rất rõ ràng:
- Thống kê UV (Unique Visitor) của website/app: Ví dụ thống kê mỗi ngày có bao nhiêu IP hoặc user ID khác nhau đã truy cập trang chủ.
- Thống kê keyword của search engine: Thống kê mỗi ngày có bao nhiêu user khác nhau đã search một keyword.
- Thống kê interaction trên social network: Ví dụ thống kê một Weibo post được bao nhiêu user khác nhau repost.
Trong các scenario này, điều chúng ta quan tâm là quy mô và xu hướng chứ không phải chênh lệch ở chữ số đơn vị.
Cuối cùng, implementation của Redis cũng rất thông minh: bên trong sẽ tự động chuyển đổi giữa sparse matrix (chiếm ít space hơn) và dense matrix (cố định 12KB) theo cardinality, tiếp tục tối ưu memory usage. Tóm lại, khi cần deduplicate count trên lượng data khổng lồ và có thể chấp nhận sai số nhỏ, HyperLogLog là lựa chọn rất phù hợp.
Thống kê UV của page bằng HyperLogLog như thế nào?
Để thống kê UV của page bằng HyperLogLog, chủ yếu cần hai command sau:
PFADD key element1 element2 ...: thêm một hoặc nhiều element vào HyperLogLog.PFCOUNT key1 key2: lấy unique count của một hoặc nhiều HyperLogLog.
- Thêm từng user ID truy cập page được chỉ định vào
HyperLogLog.
PFADD PAGE_1:UV USER1 USER2 ...... USERn- Thống kê UV của page được chỉ định.
PFCOUNT PAGE_1:UVNếu muốn xác định một element không nằm trong tập hợp khổng lồ các element thì dùng data type nào?
Đây là application scenario kinh điển của Bloom filter. Bloom filter có thể cho biết một element chắc chắn không tồn tại hoặc có khả năng tồn tại. Nó có space efficiency cực cao và một false positive rate nhất định, nhưng tuyệt đối không false negative. Nói cách khác, khi Bloom filter nói một element tồn tại thì có xác suất nhỏ bị nhận định sai; khi Bloom filter nói một element không tồn tại thì element đó chắc chắn không tồn tại.
Sơ đồ nguyên lý đơn giản của Bloom Filter như sau:
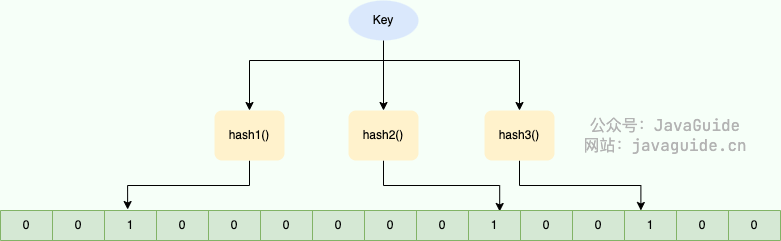
Khi string cần lưu được thêm vào Bloom filter, string trước hết được băm bởi nhiều hash function để tạo ra các hash value khác nhau, sau đó index tương ứng trong bit array được set thành 1 (khi bit array khởi tạo, mọi vị trí đều là 0). Khi lưu cùng string lần thứ hai, vì vị trí tương ứng trước đó đã được set thành 1 nên dễ dàng biết value này đã tồn tại (rất thuận tiện cho deduplication).
Nếu cần xác định một string có nằm trong Bloom filter hay không, chỉ cần thực hiện lại cùng phép hash trên string đã cho, sau khi có value thì kiểm tra xem mọi element trong bit array có đều là 1 không. Nếu đều là 1 thì value này nằm trong Bloom filter; nếu có một value khác 1 thì element đó không nằm trong Bloom filter.
Về false positive, khó khăn khi delete, cách dùng Guava và RedisBloom của Bloom filter, có thể xem tiếp Giải thích chi tiết Bloom filter.
⭐️Cơ chế persistence của Redis (quan trọng)
Có khá nhiều câu hỏi liên quan đến persistence mechanism của Redis (RDB persistence, AOF persistence, hybrid persistence giữa RDB và AOF), đồng thời đây cũng là chủ đề quan trọng. Vì vậy tôi đã tách riêng một bài để tổng hợp kiến thức và câu hỏi về persistence mechanism của Redis: Giải thích chi tiết persistence mechanism của Redis.
⭐️Redis thread model (quan trọng)
Đối với read/write command, Redis luôn sử dụng single-thread model. Tuy nhiên từ Redis 4.0 đã thêm multi-thread để thực hiện một số thao tác async delete trên large key-value pair; từ Redis 6.0 đã thêm multi-thread để xử lý network request (tăng network I/O read/write performance).
Bạn có hiểu Redis single-thread model không?
Redis dựa trên Reactor pattern để thiết kế và phát triển một event processing model hiệu quả (thread model của Netty cũng dựa trên Reactor pattern; Reactor pattern đúng là nền tảng của high-performance I/O). Event processing model này tương ứng với file event handler trong Redis. Vì file event handler chạy theo cách single-thread nên chúng ta thường nói Redis là single-thread model.
《Redis Design and Implementation》có một đoạn giới thiệu file event handler như sau, tôi thấy viết khá hay.
Redis phát triển network event handler của riêng mình dựa trên Reactor pattern: handler này được gọi là file event handler.
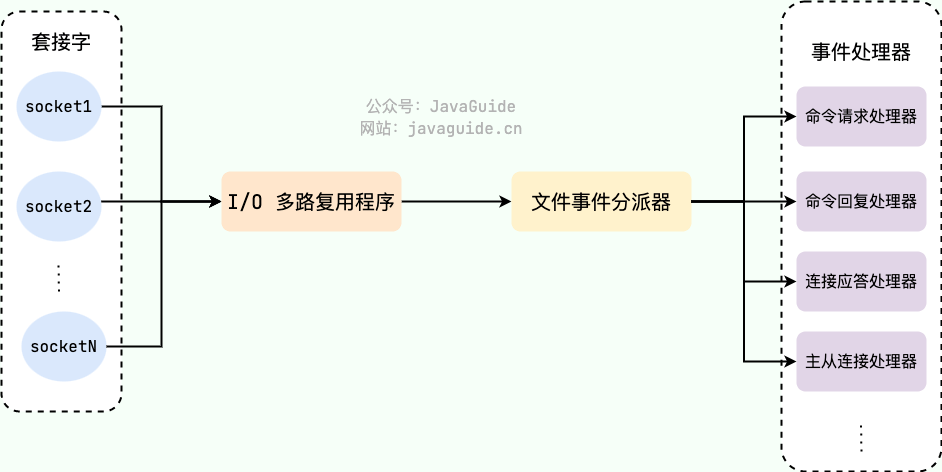
- File event handler dùng chương trình I/O multiplexing để đồng thời lắng nghe nhiều socket và liên kết các event handler khác nhau với socket theo task mà socket hiện đang thực hiện.
- Khi socket đang được lắng nghe sẵn sàng thực hiện các thao tác như connection response (accept), read, write, close, file event tương ứng sẽ được tạo ra. Khi đó file event handler sẽ gọi event handler đã liên kết trước đó với socket để xử lý các event này.
Dù file event handler chạy theo cách single-thread, nhưng thông qua việc dùng chương trình I/O multiplexing để lắng nghe nhiều socket, file event handler vừa triển khai high-performance network communication model, vừa có thể kết nối tốt với các module khác trong Redis server cũng chạy theo cách single-thread; điều này giữ được sự đơn giản của thiết kế single-thread bên trong Redis.
Đã là single-thread thì lắng nghe lượng lớn client connection như thế nào?
Redis dùng I/O multiplexing program để lắng nghe lượng lớn connection từ client (hay nói cách khác là lắng nghe nhiều socket), đăng ký các event và type được quan tâm (read, write) vào kernel rồi theo dõi xem từng event có xảy ra hay không.
Lợi ích rất rõ ràng: việc sử dụng I/O multiplexing giúp Redis không cần tạo thêm thread để lắng nghe lượng lớn connection của client, giảm mức tiêu thụ resource (khá giống component Selector trong NIO).
File event handler chủ yếu gồm 4 phần:
- Nhiều socket (client connection)
- I/O multiplexing program (chìa khóa hỗ trợ nhiều client connection)
- File event dispatcher (liên kết socket với event handler tương ứng)
- Event handler (connection response handler, command request handler, command reply handler)
Tại sao trước Redis 6.0 không dùng multi-thread?
Dù nói Redis là single-thread model, nhưng trên thực tế từ Redis 4.0 trở đi, Redis đã thêm support cho multi-thread.
Tuy nhiên multi-thread được thêm trong Redis 4.0 chủ yếu nhằm xử lý command xóa một số large key-value pair; các command này sử dụng thread khác ngoài main thread để “xử lý async”, từ đó giảm ảnh hưởng lên main thread.
Vì vậy, sau Redis 4.0 có thêm một số async command:
UNLINK: có thể xem là async version của commandDEL.FLUSHALL ASYNC: dùng để xóa toàn bộ key của mọi database, không giới hạn ở database đang đượcSELECT.FLUSHDB ASYNC: dùng để xóa toàn bộ key của databaseSELECThiện tại.
Nhìn chung, cho đến trước Redis 6.0, các operation chính của Redis vẫn được xử lý bằng single-thread.
Tại sao trước Redis 6.0 không dùng multi-thread? Tôi cho rằng chủ yếu có 3 nguyên nhân:
- Lập trình single-thread dễ hơn và dễ maintain hơn;
- Performance bottleneck của Redis không nằm ở CPU mà chủ yếu ở memory và network;
- Multi-thread sẽ tồn tại các vấn đề như deadlock, thread context switch, thậm chí ảnh hưởng performance.
Đọc thêm: Tại sao Redis chọn single-thread model?.
Vì sao sau Redis 6.0 lại thêm multi-thread?
Redis 6.0 thêm multi-thread chủ yếu để cải thiện network I/O read/write performance, vì đây được xem là một performance bottleneck trong Redis (bottleneck của Redis chủ yếu bị giới hạn bởi memory và network).
Dù Redis 6.0 thêm multi-thread, multi-thread của Redis chỉ được dùng cho các operation tốn thời gian như network data read/write; việc thực thi command vẫn tuần tự bằng single-thread. Vì vậy bạn không cần lo về thread safety.
Multi-thread của Redis 6.0 mặc định bị disable, chỉ dùng main thread. Nếu cần enable, phải đặt số lượng I/O thread > 1 và sửa Redis config file redis.conf:
io-threads 4 #Setting 1 only enables the main thread; the official recommendation is 2 or 3 threads for a 4-core machine and 6 threads for an 8-core machineNgoài ra:
- Sau khi số lượng io-threads được set thì không thể dynamic set thông qua config.
- Khi bật ssl, io-threads sẽ không hoạt động.
Sau khi enable multi-thread, mặc định chỉ dùng multi-thread cho I/O write, tức gửi data đến client. Nếu cần enable multi-thread I/O read, cũng cần sửa Redis config file redis.conf:
io-threads-do-reads yesTuy nhiên official document mô tả rằng bật multi-thread read không mang lại cải thiện lớn, nên thông thường không khuyến nghị bật.
Đọc thêm:
- Redis 6.0 feature mới - 13 câu hỏi liên hoàn về multi-thread!
- Giải mã toàn diện Redis multi-thread network model (khuyến nghị)
Bạn có hiểu Redis background thread không?
Mặc dù chúng ta thường nói Redis là single-thread model (logic chính được hoàn thành bằng single-thread), thực tế Redis còn có một số background thread dùng để thực hiện các operation tương đối tốn thời gian:
- Dùng background thread
bio_close_fileđể release temporary file resource sinh ra trong quá trình AOF / RDB, v.v. - Dùng background thread
bio_aof_fsyncgọi functionfsyncđể flush cưỡng chế data trong system kernel buffer chưa đồng bộ xuống disk (AOF file). - Dùng background thread
bio_lazy_freeđể release memory space mà large object (đã xóa) chiếm dụng.
Được định nghĩa trong file bio.h (Redis version 6.0, source address: https://github.com/redis/redis/blob/6.0/src/bio.h):
#ifndef __BIO_H
#define __BIO_H

/* Exported API */
void bioInit(void);
void bioCreateBackgroundJob(int type, void *arg1, void *arg2, void *arg3);
unsigned long long bioPendingJobsOfType(int type);
unsigned long long bioWaitStepOfType(int type);
time_t bioOlderJobOfType(int type);
void bioKillThreads(void);

/* Background job opcodes */
#define BIO_CLOSE_FILE    0 /* Deferred close(2) syscall. */
#define BIO_AOF_FSYNC     1 /* Deferred AOF fsync. */
#define BIO_LAZY_FREE     2 /* Deferred objects freeing. */
#define BIO_NUM_OPS       3

#endif
Về giới thiệu chi tiết các background thread của Redis, có thể xem bài Redis 6.0 có những background thread nào?.
⭐️Redis memory management
Đặt expiration time cho cache data trong Redis có tác dụng gì?
Thông thường khi lưu cache data, chúng ta đều đặt expiration time. Tại sao?
Memory có giới hạn và quý giá. Nếu không đặt expiration time cho cache data, memory usage sẽ tiếp tục tăng, cuối cùng có thể gây ra OOM. Bằng cách đặt expiration time hợp lý, Redis sẽ tự động xóa data tạm thời không cần dùng để giải phóng space cho cache data mới.
Redis có sẵn feature đặt expiration time cho cache data, ví dụ:
127.0.0.1:6379> expire key 60 # Data expires after 60s
(integer) 1
127.0.0.1:6379> setex key 60 value # Data expires after 60s (setex:[set] + [ex]pire)
OK
127.0.0.1:6379> ttl key # Check how long until the data expires
(integer) 56
Lưu ý ⚠️: Ngoài String type có command riêng setex để set expiration time, các method khác trong Redis đều cần dựa vào command expire để set expiration time. Ngoài ra command persist có thể xóa expiration time của một key.
Ngoài giúp giảm memory consumption, expiration time còn tác dụng nào khác không?
Nhiều khi business scenario của chúng ta yêu cầu một data chỉ tồn tại trong một khoảng thời gian, ví dụ SMS verification code chỉ có hiệu lực trong 1 phút, user login Token chỉ có hiệu lực trong 1 ngày.
Nếu dùng database truyền thống để xử lý, thông thường phải tự kiểm tra expiration, vừa phức tạp hơn vừa có performance kém hơn nhiều.
Redis xác định data đã hết hạn như thế nào?
Redis lưu expiration time của data thông qua một expiration dictionary (có thể xem như hash table). Key của expiration dictionary trỏ đến một key trong Redis database, value là một số nguyên kiểu long long lưu expiration time của database key mà key đó trỏ tới (UNIX timestamp với độ chính xác millisecond).
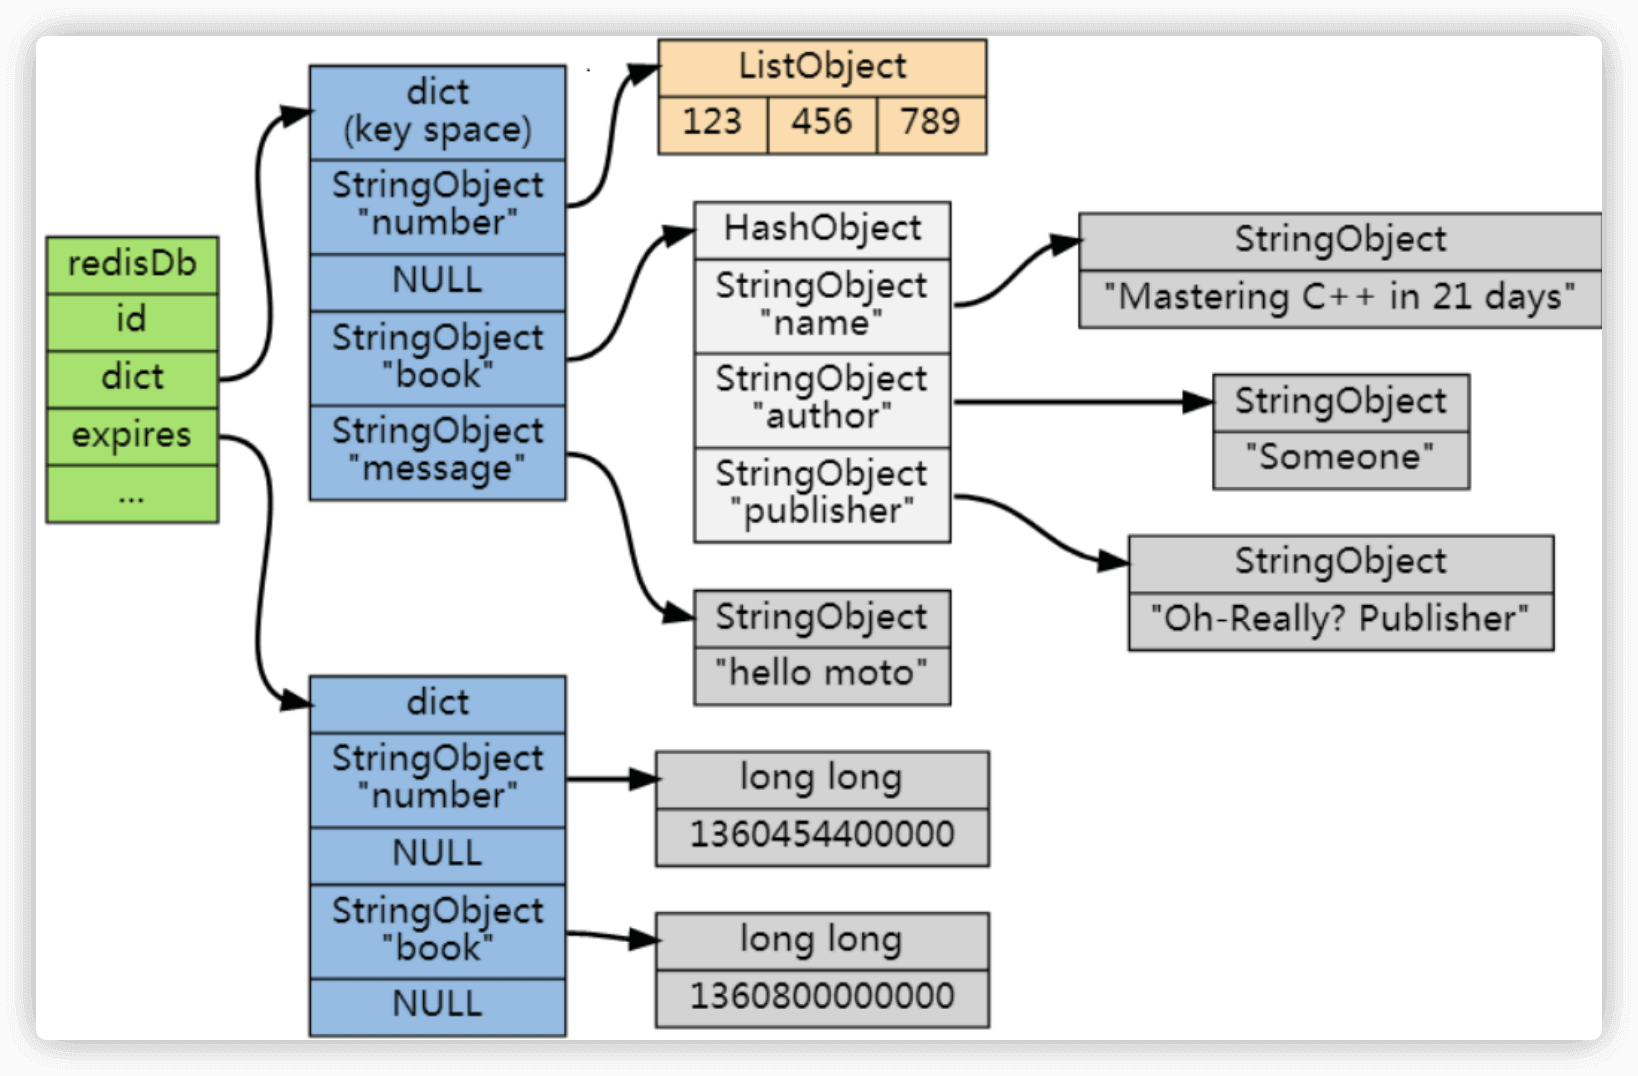
Expiration dictionary được lưu trong structure redisDb:
typedef struct redisDb {
    ...

    dict *dict;     //Database key space, storing all key-value pairs in the database
    dict *expires   //Expired dictionary, storing the expiration time of keys
    ...
} redisDb;
Khi query một key, trước hết Redis kiểm tra key đó có tồn tại trong expiration dictionary không (time complexity O(1)). Nếu không có thì return trực tiếp; nếu có thì cần kiểm tra key đã expired chưa, nếu expired thì xóa key rồi return null.
Bạn có biết policy xóa expired key của Redis không?
Giả sử bạn đặt một nhóm key chỉ sống 1 phút, vậy sau 1 phút Redis xóa nhóm key này như thế nào?
Các policy xóa expired data thường dùng gồm:
- Lazy deletion: Chỉ kiểm tra expiration khi lấy/query key. Cách này thân thiện nhất với CPU, nhưng có thể khiến quá nhiều expired key chưa được xóa.
- Periodic deletion: Định kỳ random kiểm tra một batch key đã đặt expiration time, lần lượt kiểm tra các key này có expired không và xóa key expired. So với lazy deletion, periodic deletion thân thiện hơn với memory nhưng kém thân thiện với CPU.
- Delayed queue: Đặt key đã có expiration time vào delayed queue, đến hạn thì xóa key. Cách này đảm bảo mỗi expired key đều được xóa, nhưng maintain delayed queue quá phức tạp và bản thân queue cũng chiếm resource.
- Timed deletion: Mỗi key có expiration time sẽ bị xóa ngay khi đến thời điểm đã đặt. Cách này đảm bảo memory không có key expired, nhưng tạo áp lực lớn nhất lên CPU vì phải đặt một timer cho từng key.
Redis dùng deletion policy nào?
Redis dùng strategy kết hợp periodic deletion + lazy/lazy-style deletion, đây cũng là lựa chọn của phần lớn cache framework. Periodic deletion thân thiện hơn với memory, lazy deletion thân thiện hơn với CPU. Mỗi cách đều có ưu điểm; kết hợp giúp vừa thân thiện với CPU vừa thân thiện với memory.
Dưới đây là giới thiệu chi tiết cách periodic deletion trong Redis hoạt động.
Quá trình periodic deletion của Redis là random (định kỳ random kiểm tra một batch key đã đặt expiration time), nên không đảm bảo mọi expired key đều bị xóa ngay. Điều này giải thích tại sao có key đã expired nhưng chưa bị xóa. Ngoài ra, Redis giới hạn duration và frequency thực thi deletion operation để giảm ảnh hưởng của thao tác xóa lên CPU time.
Ngoài ra, periodic deletion còn bị ảnh hưởng bởi execution time và tỷ lệ expired key:
- Nếu execution time đã vượt threshold thì interrupt periodic deletion loop lần này để tránh dùng quá nhiều CPU time.
- Nếu tỷ lệ expired key trong batch này vượt một tỷ lệ nhất định thì lặp lại deletion flow này để dọn expired key tích cực hơn. Ngược lại, nếu tỷ lệ expired key thấp hơn tỷ lệ này thì interrupt periodic deletion loop lần này để tránh làm quá nhiều việc nhưng thu hồi được quá ít memory.
Trong Redis 7.2, execution time threshold là 25ms, giá trị tỷ lệ expired key là 10%.
#define ACTIVE_EXPIRE_CYCLE_FAST_DURATION 1000 /* Microseconds. */
#define ACTIVE_EXPIRE_CYCLE_SLOW_TIME_PERC 25 /* Max % of CPU to use. */
#define ACTIVE_EXPIRE_CYCLE_ACCEPTABLE_STALE 10 /* % of stale keys after which
                                                   we do extra efforts. */
Mỗi lần random kiểm tra bao nhiêu key?
Số lượng random check mỗi lần được định nghĩa trong expire.c; ở Redis 7.2 là 20, tức mỗi lần random chọn 20 key đã đặt expiration time để kiểm tra đã expired chưa.
#define ACTIVE_EXPIRE_CYCLE_KEYS_PER_LOOP 20 /* Keys for each DB loop. */Kiểm soát frequency thực thi periodic deletion như thế nào?
Trong Redis, frequency của periodic deletion được điều khiển bởi parameter hz. hz mặc định là 10, nghĩa là thực thi 10 lần mỗi giây, tức mỗi giây thử 10 lần để tìm và xóa expired key.
Giá trị hz nằm trong khoảng 1~500. Tăng hz sẽ nâng frequency periodic deletion. Nếu muốn thực hiện periodic deletion task thường xuyên hơn, có thể tăng hz phù hợp, nhưng điều này sẽ tăng CPU usage. Theo khuyến nghị chính thức của Redis, không nên đặt hz quá 100; với phần lớn user, mặc định 10 là đủ.
Dưới đây là comment chính thức của parameter hz, tôi đã dịch các thông tin quan trọng (Redis version 7.2).
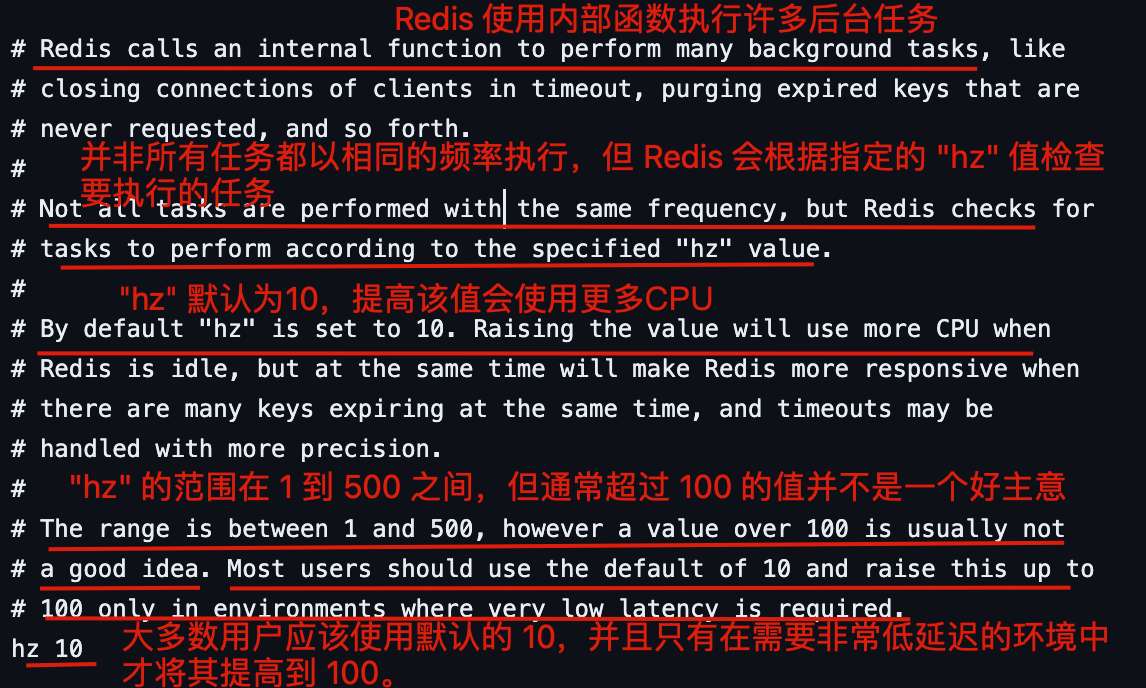
Một parameter tương tự là dynamic-hz. Sau khi bật parameter này, Redis sẽ tính động một value dựa trên hz. Redis cung cấp và mặc định enable khả năng dùng adaptive hz value,
Hai parameter này đều nằm trong Redis config file redis.conf:
# Mặc định là 10
hz 10
# Mặc định bật
dynamic-hz yes
Nói thêm một chút, ngoài periodic task xóa expired key, còn có một số periodic task khác như đóng client connection timeout, update statistic; frequency thực thi các periodic task này cũng do parameter hz quyết định.
Tại sao periodic deletion không xóa toàn bộ expired key?
Vì điều đó ảnh hưởng quá lớn đến performance. Nếu số lượng key rất lớn, duyệt và kiểm tra từng key sẽ rất tốn thời gian, ảnh hưởng nghiêm trọng đến performance. Redis thiết kế strategy này nhằm cân bằng memory và performance.
Tại sao không xóa key ngay khi expired? Như vậy chẳng phải sẽ lãng phí nhiều memory space sao?
Vì khó thực hiện, hay nói cách khác chi phí của cách xóa này quá cao. Giả sử dùng delayed queue làm deletion policy thì sẽ có các vấn đề sau:
- Overhead của bản thân queue có thể rất lớn: Khi có nhiều key, một delayed queue có thể không chứa hết.
- Maintain delayed queue quá phức tạp: Khi sửa expiration time của key, cần điều chỉnh vị trí của nó trong delayed queue, đồng thời còn phải thêm concurrency control.
Xử lý thế nào khi nhiều key hết hạn cùng lúc?
Khi Redis có lượng lớn key cùng expired tại một thời điểm, có thể xảy ra các vấn đề sau:
- Request latency tăng: Redis cần tiêu tốn CPU resource khi xử lý expired key. Nếu số lượng expired key lớn, CPU usage của Redis instance tăng, ảnh hưởng tốc độ xử lý request khác và khiến latency tăng.
- Memory usage quá cao: Dù expired key đã mất hiệu lực, trước khi Redis thực sự xóa chúng, chúng vẫn chiếm memory space. Nếu expired key không được dọn kịp thời, memory usage có thể quá cao, thậm chí gây memory overflow.
Để tránh các vấn đề này, có thể dùng các giải pháp sau:
- Cố gắng tránh key hết hạn cùng lúc: Khi set expiration time cho key, cố gắng random hơn một chút.
- Enable lazy free mechanism: Sửa Redis config file
redis.conf, set parameterlazyfree-lazy-expirethànhyesđể enable lazy free mechanism. Sau khi enable, Redis sẽ async delete expired key ở background, không block main thread, từ đó giảm ảnh hưởng đến performance của Redis.
Bạn có biết Redis memory eviction policy không?
Câu hỏi liên quan: MySQL có 20 triệu bản ghi, Redis chỉ lưu 200 nghìn bản ghi, làm thế nào đảm bảo data trong Redis đều là hot data?
Redis memory eviction policy chỉ được trigger khi runtime memory đạt maximum memory threshold đã cấu hình. Threshold này được định nghĩa bởi parameter maxmemory trong redis.conf. Trên 64-bit operating system, maxmemory mặc định là 0, nghĩa là không giới hạn memory size. Trên 32-bit operating system, maximum memory mặc định là 3GB.
Bạn có thể dùng command config get maxmemory để xem value của maxmemory.
> config get maxmemory
maxmemory
0
Redis cung cấp 6 memory eviction policy:
- volatile-lru (least recently used): Chọn và loại bỏ data ít được sử dụng gần đây nhất từ data set đã set expiration time (
server.db[i].expires). - volatile-ttl: Chọn và loại bỏ data sắp expired từ data set đã set expiration time (
server.db[i].expires). - volatile-random: Random chọn và loại bỏ data từ data set đã set expiration time (
server.db[i].expires). - allkeys-lru (least recently used): Loại bỏ data ít được sử dụng gần đây nhất từ data set (
server.db[i].dict). - allkeys-random: Random chọn và loại bỏ data từ data set (
server.db[i].dict). - no-eviction (memory eviction policy mặc định): Không loại bỏ data; khi memory không đủ chứa data write mới, write operation mới sẽ báo lỗi.
Sau version 4.0 thêm hai loại sau:
- volatile-lfu (least frequently used): Chọn và loại bỏ data ít được sử dụng thường xuyên nhất từ data set đã set expiration time (
server.db[i].expires). - allkeys-lfu (least frequently used): Loại bỏ data ít được sử dụng thường xuyên nhất từ data set (
server.db[i].dict).
allkeys-xxx nghĩa là loại bỏ data từ tất cả key-value, còn volatile-xxx nghĩa là loại bỏ data từ key-value đã set expiration time.
Enumeration array của memory eviction policy được định nghĩa trong config.c:
configEnum maxmemory_policy_enum[] = {
    {"volatile-lru", MAXMEMORY_VOLATILE_LRU},
    {"volatile-lfu", MAXMEMORY_VOLATILE_LFU},
    {"volatile-random",MAXMEMORY_VOLATILE_RANDOM},
    {"volatile-ttl",MAXMEMORY_VOLATILE_TTL},
    {"allkeys-lru",MAXMEMORY_ALLKEYS_LRU},
    {"allkeys-lfu",MAXMEMORY_ALLKEYS_LFU},
    {"allkeys-random",MAXMEMORY_ALLKEYS_RANDOM},
    {"noeviction",MAXMEMORY_NO_EVICTION},
    {NULL, 0}
};
Bạn có thể dùng command config get maxmemory-policy để xem memory eviction policy hiện tại của Redis.
> config get maxmemory-policy
maxmemory-policy
noeviction
Có thể dùng command config set maxmemory-policy memory eviction policy để sửa memory eviction policy, có hiệu lực ngay nhưng sẽ mất hiệu lực sau khi Redis restart. Sửa parameter maxmemory-policy trong redis.conf thì không mất hiệu lực khi restart, nhưng phải restart thì thay đổi mới có hiệu lực.
maxmemory-policy noevictionVề giải thích chi tiết eviction policy, có thể tham khảo tài liệu chính thức của Redis: https://redis.io/docs/reference/eviction/.
Tham khảo
- 《Redis Development and Operations》
- 《Redis Design and Implementation》
- 《Redis Core Principles and Practice》
- Redis command manual: https://www.redis.com.cn/commands.html
- RedisSearch Ultimate Usage Guide, bạn xứng đáng có nó!: https://mp.weixin.qq.com/s/FA4XVAXJksTOHUXMsayy2g
- WHY Redis choose single thread (vs multi threads): https://medium.com/@jychen7/sharing-redis-single-thread-vs-multi-threads-5870bd44d153
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.