
Giải thích chi tiết về lock và cơ chế synchronization trong Operating System: mutex, semaphore, condition variable, spinlock và futex
Hai thread đồng thời cộng 1 vào cùng một counter, nhìn thì chỉ là một việc rất nhỏ nhưng kết quả cuối cùng lại có thể bị thiếu một lần tăng.
Nguyên nhân thực ra khá đơn giản. Trong source code, count++ chỉ là một dòng, nhưng khi máy thực thi thường phải trải qua các bước đọc, tính toán và ghi trở lại. Thread A vừa đọc được giá trị cũ nhưng chưa ghi trở lại; thread B cũng đọc được đúng giá trị cũ đó. Mỗi bên tự tính ra giá trị mới, nhưng cuối cùng lại ghi cùng một kết quả.
Để tránh các vấn đề concurrency như vậy, Operating System cung cấp lock và một loạt cơ chế synchronization. Những vấn đề chúng giải quyết không chỉ là một đoạn code có thể được thực thi đồng thời hay không, mà còn gồm thread có nên block hay không, số lượng resource được kiểm soát ra sao và phải chờ thế nào khi điều kiện chưa thỏa mãn. Trong kernel còn phải tiếp tục cân nhắc interrupt, preemption, nhiều CPU, tính realtime và scheduling latency.
Bài viết này chỉ nói về cơ chế synchronization dưới góc nhìn Operating System. synchronized, ReentrantLock, AQS, CAS và lock optimization trong Java đã được trình bày trong Giải thích chi tiết về Java lock, nên ở đây sẽ không lặp lại nội dung đó. Trọng tâm của bài là xem mutex, semaphore, condition variable, spinlock và futex, mỗi khái niệm giải quyết vấn đề gì. Sau khi hiểu các synchronization primitive này, đọc tiếp Giải thích chi tiết về deadlock sẽ dễ hiểu hơn vì sao “quan hệ chờ lại tạo thành vòng”.
Trước tiên, hãy xem sơ bộ các cơ chế synchronization này lần lượt giải quyết vấn đề gì:
| Cơ chế | Giải quyết chủ yếu | Cách chờ | Tình huống thường gặp |
|---|---|---|---|
| mutex | Mutual exclusion trong critical section | Về mặt ngữ nghĩa là chờ lock khả dụng, có thể spin/block | Bảo vệ shared structure |
| spinlock | Mutual exclusion cho critical section rất ngắn | Busy-wait | Path trong kernel không thể sleep |
| semaphore | Đếm resource, kiểm soát concurrency | Chờ khi counter bằng 0 | Slot của buffer, số connection, số task concurrent |
| condition variable | Chờ shared state chuyển thành true | Atomic release mutex rồi chờ | Queue không rỗng, task hoàn tất, buffer không đầy |
| futex | Nền tảng block/wakeup cho user-space lock | Fast path ở user space, slow path ở kernel | pthread mutex, runtime synchronizer |
| memory barrier | Ràng buộc thứ tự và visibility của memory access | Thông thường không phụ trách block | Lock-free structure, kernel synchronization, truy cập device register |
Critical section thực sự bảo vệ điều gì?
Critical section là đoạn code truy cập shared mutable state và không thể để nhiều execution flow tùy ý đan xen. Nó có thể là một đoạn cập nhật counter trong user program, cũng có thể là code sửa scheduling queue, file descriptor table, page table hoặc device state trong kernel.
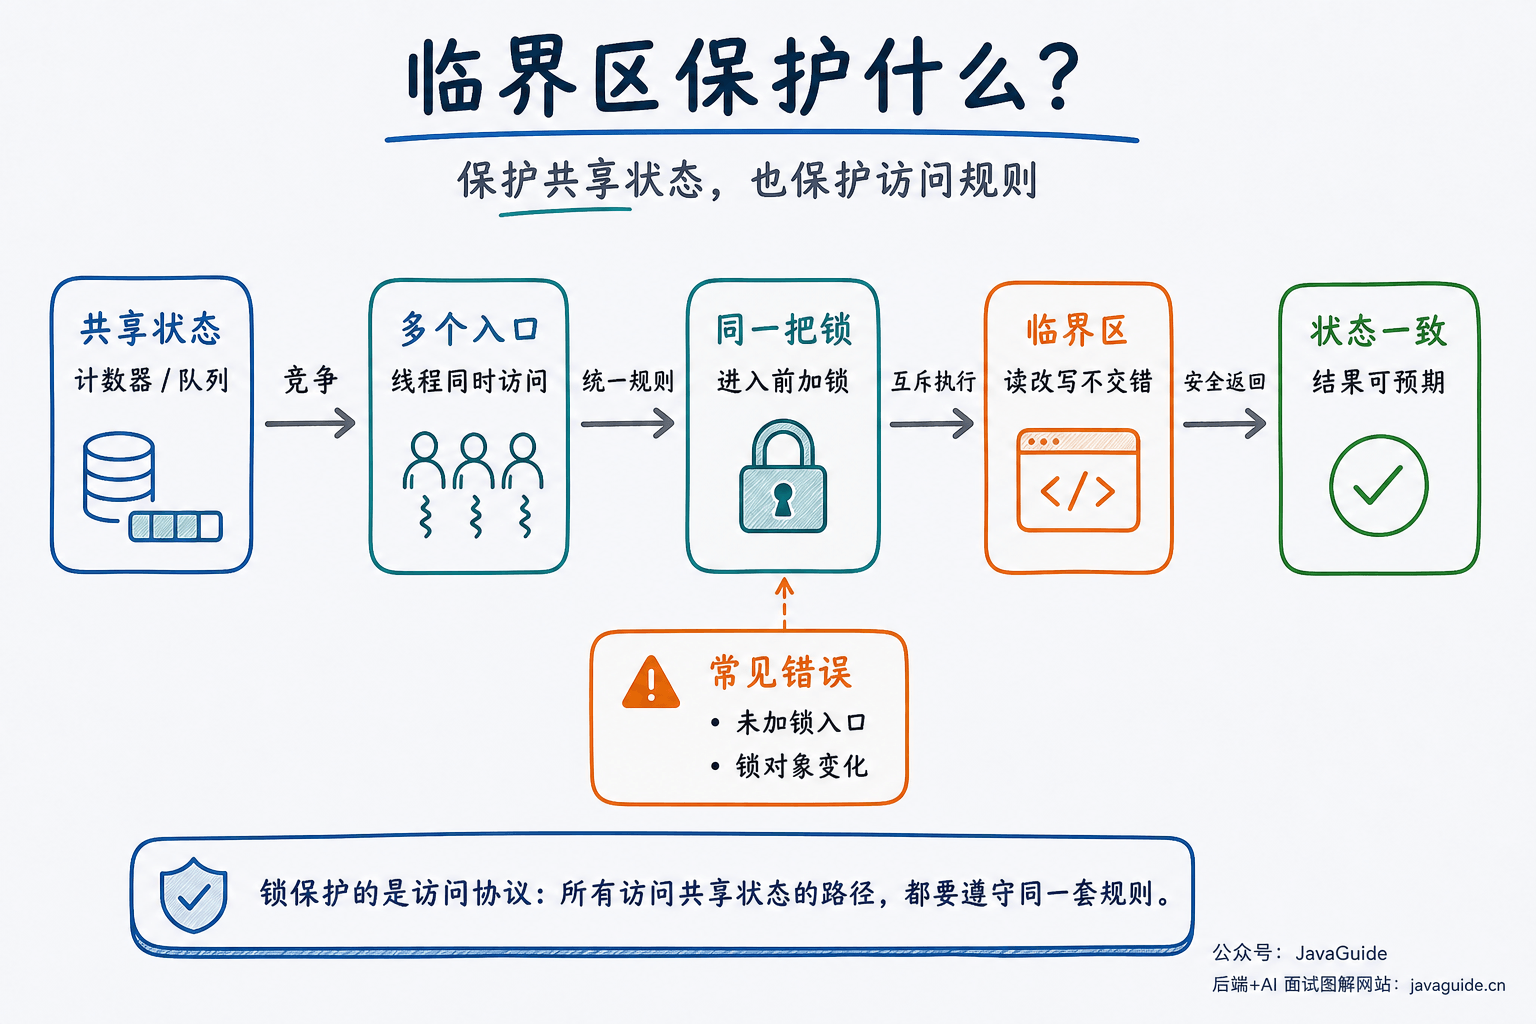
Khi đánh giá một lock hoặc synchronization mechanism, có thể xem xét từ 4 góc độ: correctness, progress, fairness và performance.
Thứ nhất là correctness. Không được để nhiều execution flow tùy ý đan xen sửa shared state tại cùng một thời điểm; trong môi trường nhiều CPU, còn cần synchronization semantic phù hợp để thread tiếp theo acquire lock đó có thể nhìn thấy state mà thread trước đã ghi trước khi release lock.
Thứ hai là progress. Bản thân synchronization mechanism không được khiến tất cả waiter bị kẹt, làm hệ thống không còn thread nào có thể tiếp tục.
Thứ ba là fairness. Khi nhiều thread cùng chờ một lock, cần cố gắng tránh để một thread không lấy được lock trong thời gian dài. Hệ thống thực tế không nhất thiết phải FIFO nghiêm ngặt, nhưng phải nghiêm túc xử lý vấn đề starvation.
Thứ tư là performance. Khi không có contention, path lock và unlock phải đủ nhẹ; khi contention rất lớn, các thread đang chờ không được lãng phí quá nhiều CPU vào những vòng lặp vô ích.
OSTEP cũng quan tâm các vấn đề này khi nói về lock: có thật sự đạt được mutual exclusion hay không, thread đang chờ có bị starvation không, khi không có contention phải trả bao nhiêu cost, và hiệu năng trên single CPU và multi-CPU khác nhau thế nào. Chỉ hỏi “lock nào nhanh nhất” không có nhiều ý nghĩa; cùng một lock nhưng trên machine khác nhau, với critical section dài ngắn khác nhau và mức contention khác nhau thì câu trả lời thường thay đổi.
Mutex: đóng cửa trước, rồi sửa shared state
Quay lại count++ ở trên. Nếu phép increment này bắt buộc phải chính xác, cách trực tiếp nhất là đặt một mutex (mutual exclusion lock) bên ngoài các thao tác đọc, cộng và ghi. Ai lấy được lock trước thì sửa trước; thread chưa lấy được lock sẽ chờ bên ngoài.
Dùng POSIX threads viết ra đại khái như sau:
pthread_mutex_t mutex = PTHREAD_MUTEX_INITIALIZER;
int count = 0;

void increase(void) {
    pthread_mutex_lock(&mutex);
    count++;
    pthread_mutex_unlock(&mutex);
}
Trong đoạn code này, pthread_mutex_lock() không chỉ thực hiện một lần đánh dấu. Theo POSIX semantics, nếu lock đang được thread khác giữ, thread gọi sẽ chờ lock khả dụng; chỉ sau khi return thành công, thread đó mới sở hữu lock này.
Cách implement cụ thể có thể linh hoạt hơn. Nhiều pthread mutex hoặc lock trong language runtime có thể spin ngắn ở user space trước; nếu contention chưa được giải quyết thì mới đi vào blocking path như futex. Với người sử dụng, trọng tâm là semantic: trước khi lấy lock thì không được vào critical section, sau khi lấy lock mới có quyền truy cập state được bảo vệ.
Mutex phù hợp để bảo vệ việc sửa shared state có boundary rõ ràng. Cập nhật reference count, sửa linked-list pointer, duy trì process table, cập nhật một đoạn nhỏ trong memory cache đều là các ví dụ điển hình. Khi viết loại code này, điều cần xác nhận đầu tiên là lock này bảo vệ phần state nào và mọi entry point truy cập phần state đó có tuân theo cùng một bộ quy tắc hay không.
Một lỗi rất thường gặp là: một shared object có 5 access path, 4 path đều lấy cùng một lock, còn 1 path vì “tiện” nên sửa field trực tiếp. Khi đó, dù 4 path trước có viết cẩn thận đến đâu, quan hệ mutual exclusion vẫn bị bypass. Lock bảo vệ access protocol; chỉ đặt variable cạnh lock thì không có tác dụng.
Còn một chi tiết: mutex thường có owner semantics. Nói đơn giản, ai lấy lock thì người đó phải release. Tài liệu Linux kernel khi giới thiệu lock types đã nhấn mạnh owner semantics; phần lớn lock yêu cầu context lấy lock phải chịu trách nhiệm release. Semaphore hơi khác: nó giống một counter hơn, và sự khác biệt này sẽ thấy rõ ở phần sau.
Spinlock: đừng sleep, chờ tại chỗ một lát
Khi không lấy được mutex, thread có thể sleep và chờ kernel wakeup sau. Spinlock thì ngược lại: trước tiên đừng sleep, hãy tiếp tục lặp trên CPU để kiểm tra lock đã được release hay chưa.
Nghe có vẻ hơi ngớ ngẩn, nhưng thực tế còn tùy vào thời gian chờ.
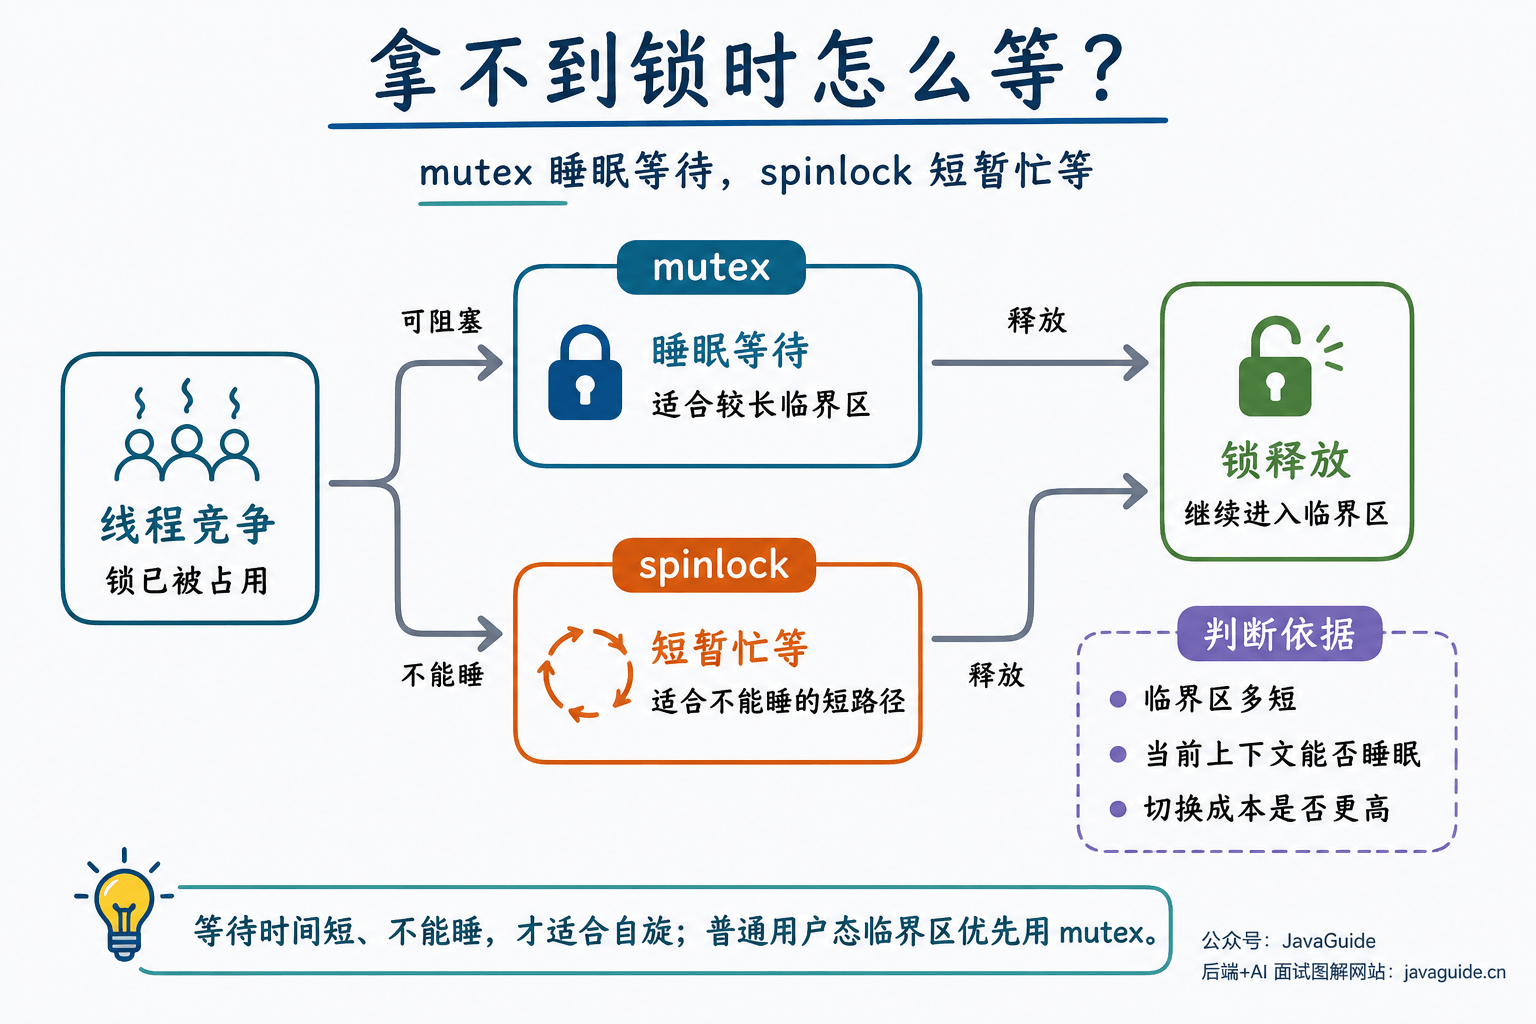
Nếu một lock chỉ bảo vệ vài dòng code và thread giữ lock sẽ rời critical section ngay, cho thread đang chờ sleep đôi khi còn không đáng. Sleep và wakeup đều phải đi qua scheduler, trong thời gian đó còn có thể xảy ra context switch; trên machine nhiều CPU, thread giữ lock có thể đang chạy trên CPU khác và sẽ release lock sau vài instruction. Lúc này, thread đang chờ quay vài vòng tại chỗ có thể ít cost hơn.
Nhưng spin có hai giới hạn cứng.
Thứ nhất, critical section phải ngắn. Nếu thread giữ lock phải truy cập disk, chờ network hoặc allocate memory có thể sleep, thread chờ sẽ đốt CPU time vào việc quay vòng.
Thứ hai, phải cẩn thận trong single CPU hoặc context có thể bị preempt. Nếu thread giữ lock bị preempt trong khi thread đang chờ spin trên cùng CPU, dù thread đang chờ có quay chăm chỉ đến đâu cũng không chờ được hành động release.
Trong Linux kernel không phải PREEMPT_RT, sau khi lấy spinlock_t, preemption sẽ bị disable ngầm; nếu còn phải ngăn interrupt handler ngắt critical section hiện tại trên CPU này thì mới dùng các API có hậu tố như spin_lock_irq() và spin_lock_irqsave(). Nói cách khác, plain spin_lock() không đồng nghĩa với việc luôn disable hard interrupt.
Tài liệu Linux kernel phân loại lock khá rộng thành sleeping locks, CPU local locks và spinning locks. mutex, semaphore, rw_semaphore thuộc nhóm lock có thể sleep; raw_spinlock_t là strict spinlock trong kernel thường và PREEMPT_RT kernel. Semantic của spinlock_t thay đổi theo PREEMPT_RT: dưới kernel không phải PREEMPT_RT, nó map tới raw_spinlock_t; dưới PREEMPT_RT, nó được implement dựa trên rt_mutex, không còn disable preemption ngầm, và hậu tố _irq / _irqsave cũng không còn trực tiếp thay đổi trạng thái disable hard interrupt.
Business code ở user space thường không nên tự viết spinlock. Library và runtime có thể thực hiện adaptive spin trên path rất ngắn, nhưng trong application code, tự viết vòng while để chờ lock phần lớn chỉ khiến CPU nóng lên.
Semaphore: không chỉ là lock với giá trị 0 hoặc 1
Semaphore có thể được xem như một counter không giảm xuống số âm. sem_wait() thử giảm counter đi 1; nếu giá trị hiện tại lớn hơn 0 thì giảm xong sẽ tiếp tục; nếu giá trị hiện tại bằng 0 thì thread gọi sẽ block. sem_post() tăng counter lên 1 và có thể wakeup waiter.
Khi đặt giá trị khởi tạo bằng 1, semaphore có thể được dùng như mutex:
sem_t sem;

sem_init(&sem, 0, 1);

sem_wait(&sem);
// critical section
sem_post(&sem);
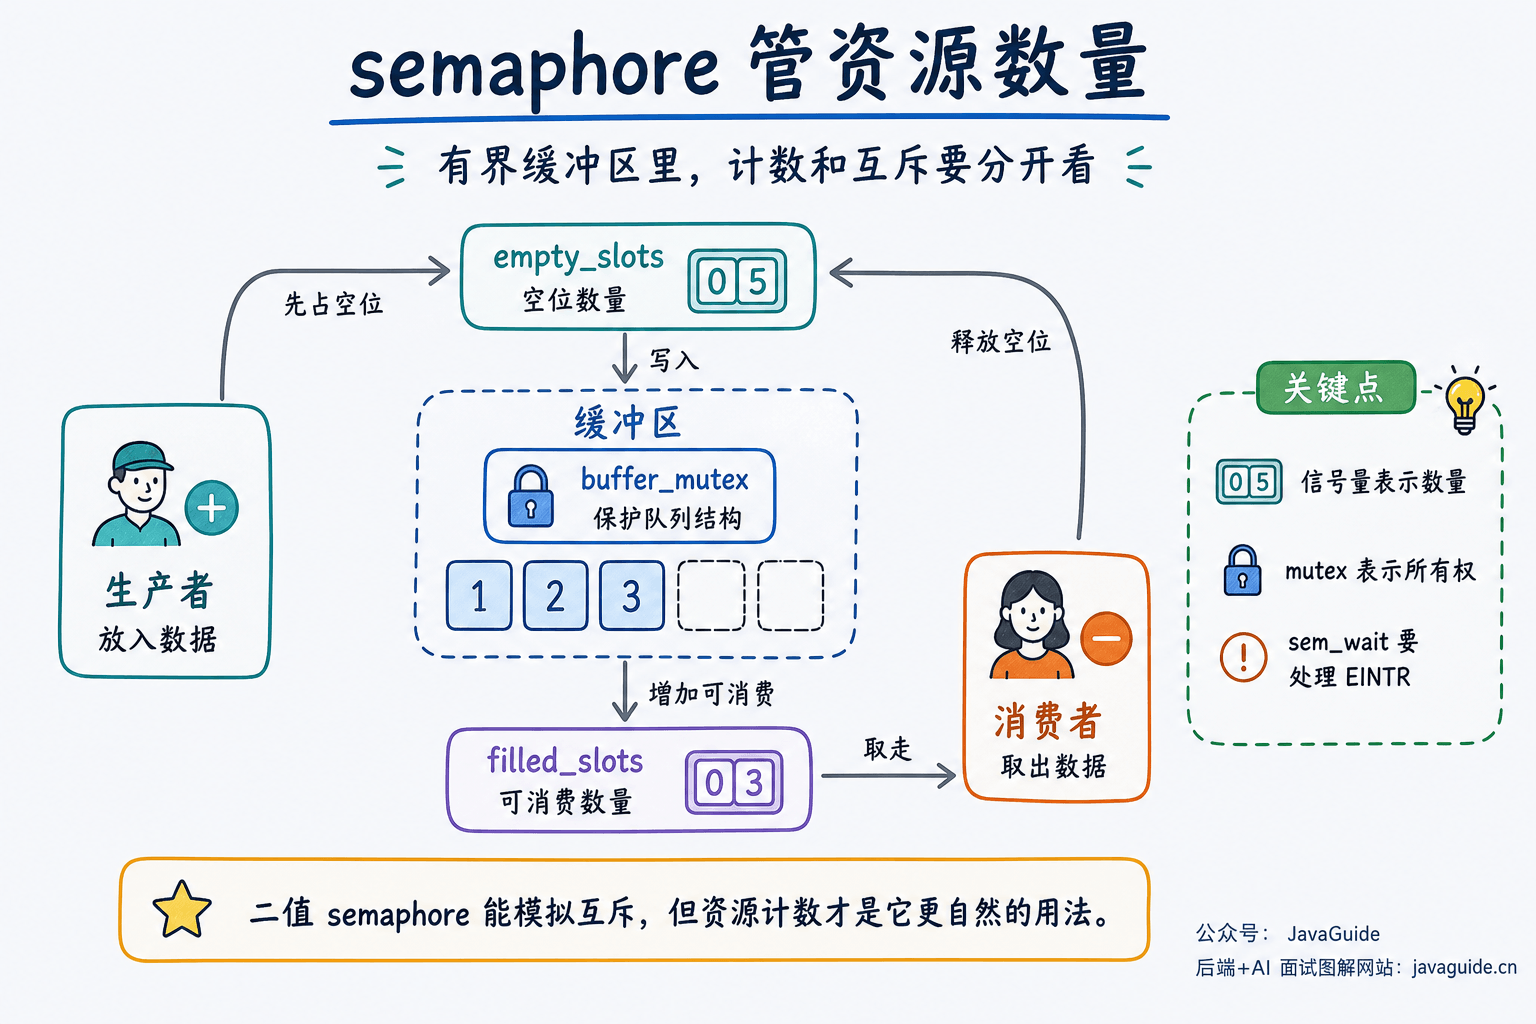
Tuy nhiên, cách dùng phổ biến thực sự của semaphore là “đếm resource”. Ví dụ buffer có N empty slot, connection pool cho phép tối đa N connection, hoặc tối đa N task cùng loại được chạy đồng thời. Lúc này, giá trị khởi tạo của semaphore chính là số lượng resource.
Binary semaphore có thể mô phỏng mutual exclusion, nhưng không đồng nghĩa với mutex. Mutex nhấn mạnh owner và ownership của critical section, còn semaphore nhấn mạnh counter và số lượng permit. Một bounded buffer thường tách hai loại vấn đề này: semaphore quản lý số lượng slot, mutex quản lý cấu trúc bên trong của buffer.
Đoạn code dưới đây lược bỏ implementation cụ thể của item_t và buffer, chỉ giữ lại khung synchronization:
#include <errno.h>
#include <pthread.h>
#include <semaphore.h>
#include <stdlib.h>

#define BUFFER_SIZE 1024

sem_t empty_slots;
sem_t filled_slots;
pthread_mutex_t buffer_mutex = PTHREAD_MUTEX_INITIALIZER;

void init_buffer(void) {
    if (sem_init(&empty_slots, 0, BUFFER_SIZE) == -1) {
        abort();
    }
    if (sem_init(&filled_slots, 0, 0) == -1) {
        abort();
    }
}

static void wait_sem(sem_t *sem) {
    while (sem_wait(sem) == -1) {
        if (errno == EINTR) {
            continue;
        }
        abort();
    }
}

void producer(void) {
    item_t item = produce_item();

    wait_sem(&empty_slots);
    pthread_mutex_lock(&buffer_mutex);
    put_item(item);
    pthread_mutex_unlock(&buffer_mutex);
    sem_post(&filled_slots);
}

void consumer(void) {
    wait_sem(&filled_slots);
    pthread_mutex_lock(&buffer_mutex);
    item_t item = take_item();
    pthread_mutex_unlock(&buffer_mutex);
    sem_post(&empty_slots);

    consume(item);
}
empty_slots ghi lại còn bao nhiêu slot trống, filled_slots ghi lại đã có bao nhiêu phần tử có thể tiêu thụ. Producer trước tiên sử dụng một slot trống, sau khi đặt dữ liệu vào thì tăng số phần tử có thể tiêu thụ lên 1; consumer làm ngược lại. buffer_mutex chỉ phụ trách bảo vệ việc put_item() và take_item() sửa cấu trúc của buffer.
Việc retry EINTR trong wait_sem() cũng không phải để trang trí. Linux man-pages nêu rõ sem_wait() có thể bị signal handler làm gián đoạn và trả về -1, đồng thời đặt errno thành EINTR. Nếu example code hoàn toàn không xử lý nhánh này, người đọc copy lại rất dễ để sót một bug thỉnh thoảng xảy ra.
Tài liệu Linux Kernel locking nêu rõ semaphore có thể dùng để tuần tự hóa và chờ; khi viết code mới, nên tách các semantics như mutual exclusion và event completion vào những mechanism như mutex và completion. Một trong các nguyên nhân là semaphore không có owner rõ ràng, PREEMPT_RT không thể cung cấp priority inheritance cho nó, và việc block trên semaphore có thể dẫn đến priority inversion.
Condition variable: chờ không phải để lấy lock, mà để một condition được thỏa mãn
Mutex giải quyết vấn đề “ai có thể vào critical section tại cùng một thời điểm”. Nhưng nhiều khi thread vào critical section rồi mới phát hiện condition vẫn chưa được thỏa mãn.
Ví dụ, consumer lấy được lock rồi phát hiện queue đang rỗng. Nó không thể tiếp tục lấy data, cũng không thể giữ lock mãi rồi sleep. Nếu không, producer không lấy được lock để đưa data vào queue, và hệ thống sẽ bị treo.
Condition variable giải quyết chính vấn đề chờ condition này. Nó thường được dùng cùng mutex:
pthread_mutex_t mutex = PTHREAD_MUTEX_INITIALIZER;
pthread_cond_t not_empty = PTHREAD_COND_INITIALIZER;
queue_t queue;
void consumer(void) {
pthread_mutex_lock(&mutex);
while (queue_empty(&queue)) {
pthread_cond_wait(¬_empty, &mutex);
}
item_t item = queue_pop(&queue);
pthread_mutex_unlock(&mutex);
consume(item);
}
void producer(item_t item) {
pthread_mutex_lock(&mutex);
queue_push(&queue, item);
pthread_cond_signal(¬_empty);
pthread_mutex_unlock(&mutex);
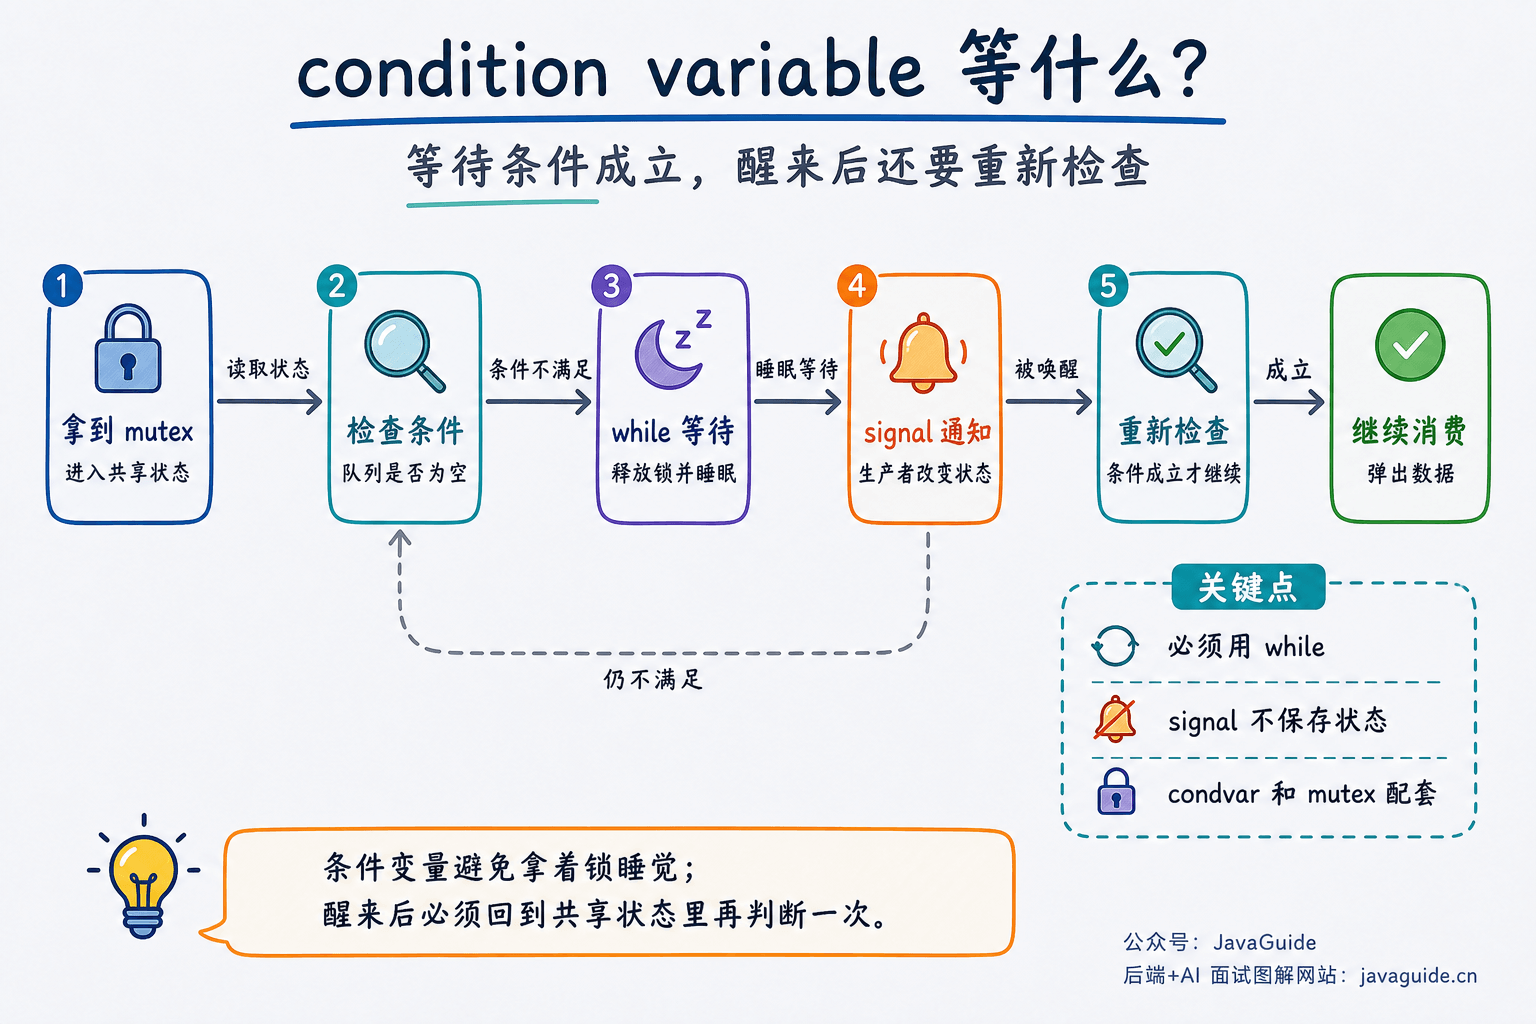
}pthread_cond_wait() thực hiện một việc rất quan trọng: nó release mutex một cách atomic và cho thread hiện tại chờ condition variable; trước khi thức dậy và return, nó lại acquire mutex. Hành động “release lock rồi sleep” này phải được nối liền, nếu không có thể xảy ra lost signal: thread vừa chuẩn bị sleep thì producer đã gửi notification, sau đó consumer mới sleep và không còn ai đánh thức nó.
Có ba quy tắc quan trọng khi dùng condition variable.
Thứ nhất, điều kiện chờ phải được kiểm tra trong while, không viết thành if. POSIX cho phép condition wait xuất hiện spurious wakeup, nghĩa là condition chưa chắc đã được thỏa mãn khi thread thức dậy. Ngay cả khi không có kiểu wakeup này, sau khi nhiều consumer đồng thời được đánh thức, cũng có thể chỉ một thread lấy được data, còn các thread khác lại phát hiện queue rỗng.
Thứ hai, bản thân condition variable không lưu state; state thực sự phải nằm trong shared variable được mutex bảo vệ. pthread_cond_signal() không phải là đặt một vé có hiệu lực vĩnh viễn vào queue. Nếu signal xảy ra khi không có ai waiting, notification lần đó có thể trôi qua. Thứ thực sự quyết định consumer có thể tiếp tục thực thi hay không là độ dài queue mà queue_empty() kiểm tra.
Thứ ba, trong thời gian vẫn còn waiter, một condition variable phải được dùng cùng một mutex. POSIX gọi đây là dynamic binding: chỉ cần vẫn còn thread block trên một condition variable nào đó, nếu thread khác dùng mutex khác để wait trên cùng condition variable thì hành vi sẽ là undefined. Quy tắc này không thường được nhắc đến, nhưng nó giải thích vì sao code condition variable thường quản lý “state variable, mutex, condvar” trong cùng một data structure.
Nhiều bug của condition variable đều xuất phát từ đây: coi signal là state, hoặc không kiểm tra lại condition sau khi thức dậy.
Futex: thử trước ở user space, thất bại mới vào kernel
Trong Linux, thường sẽ nghe đến futex (fast userspace mutex). Tên có mutex, nhưng futex giống nền móng để xây lock hơn.
Ý tưởng thiết kế của futex là: khi không có contention, hoàn toàn dùng atomic instruction ở user space để sửa một integer 32-bit; chỉ khi cần sleep hoặc wakeup waiter mới gọi vào kernel bằng futex(). Nhờ vậy có thể tránh cost system call ở mỗi lần lock.
Một flow đơn giản hóa là:
- Thread trước tiên dùng atomic operation ở user space để thử đổi lock word từ 0 thành 1.
- Nếu thành công, nghĩa là không có contention, thread vào thẳng critical section.
- Nếu thất bại, nghĩa là lock đang bị chiếm, thread gọi
FUTEX_WAITđể kernel suspend nó. - Sau khi thread giữ lock release lock, nếu phát hiện có waiter thì gọi
FUTEX_WAKEđể wakeup một hoặc nhiều waiter.
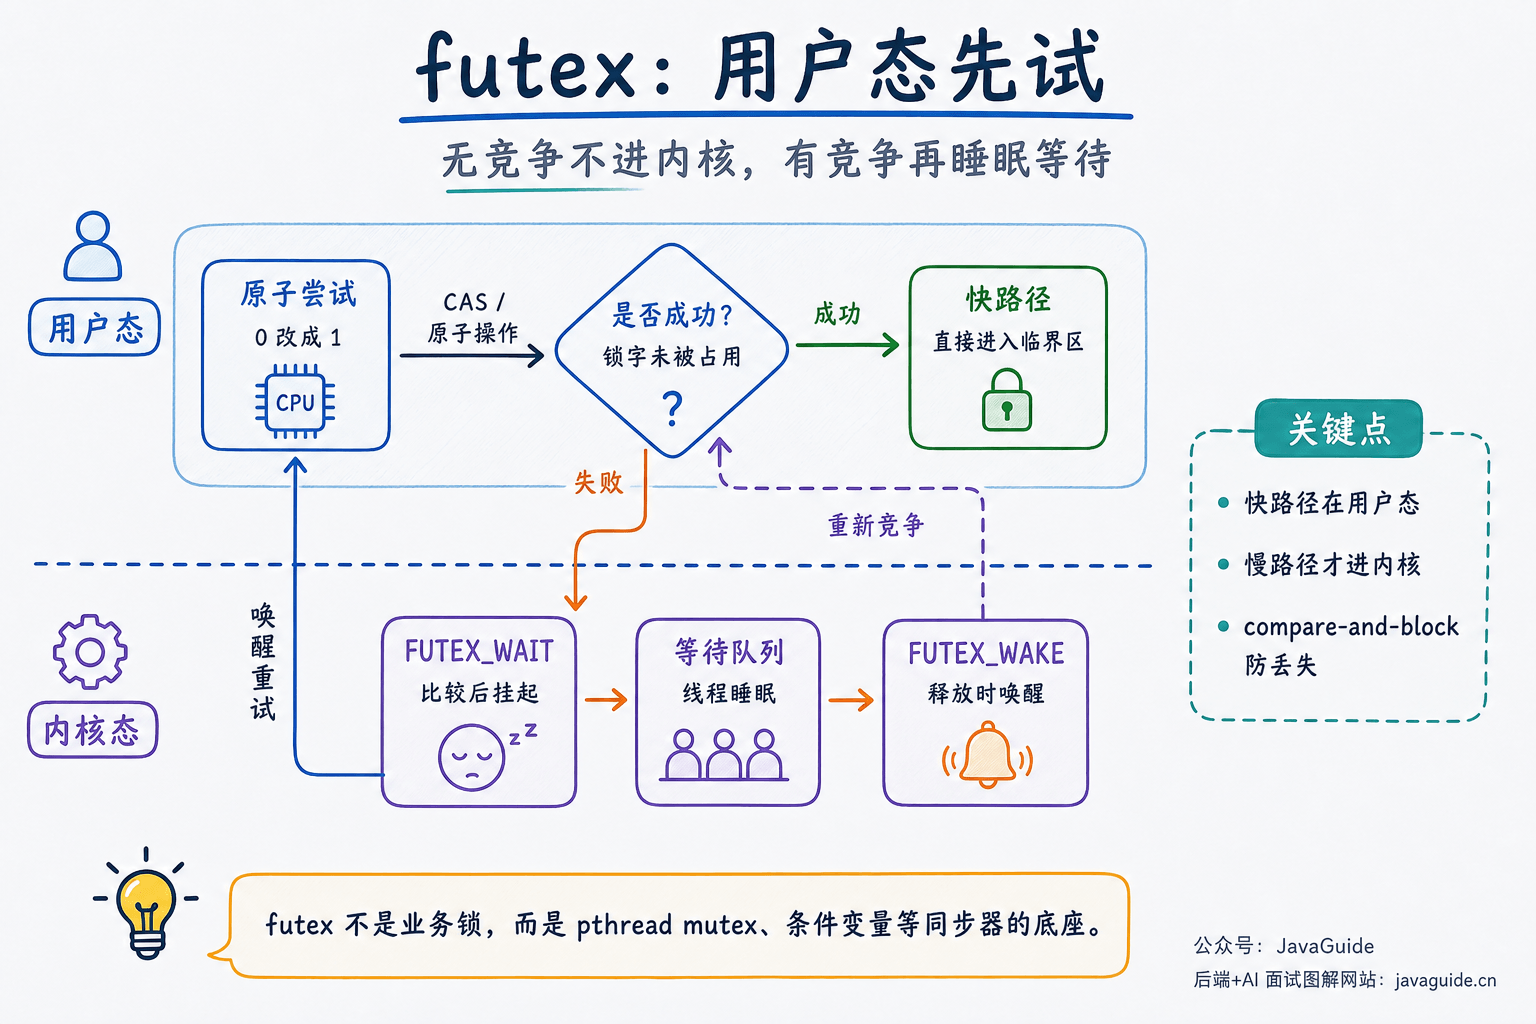
FUTEX_WAIT sử dụng compare-and-block: kernel trước tiên xác nhận futex word vẫn bằng giá trị kỳ vọng do caller truyền vào, chỉ khi khớp mới suspend thread. Phép so sánh và việc block là atomic, nên nó có thể nối user-space atomic operation với kernel sleep queue.
Mô tả về futex trong man-pages cũng nhấn mạnh điểm này: futex operation xoay quanh một giá trị 32-bit tại một user-space address, các operation thường gặp gồm wait và wakeup. Application thường không trực tiếp dùng futex làm business lock; những library như pthread mutex, condition variable và runtime synchronizer sẽ sử dụng nó trong synchronization primitive ở tầng cao hơn.
Vì vậy, khi xem user-space lock trong Linux, có thể nhớ câu này: fast path cố gắng ở lại user space, chỉ slow path mới vào kernel để xếp hàng và sleep.
Atomic instruction: lock luôn cần một điểm bắt đầu không thể tách rời
Bất kể là mutex, spinlock hay futex, cuối cùng đều phải dựa trên một loại atomic operation được hardware hỗ trợ. Nếu không, giữa “kiểm tra lock có rảnh hay không” và “đánh dấu lock đã bị chiếm” vẫn có thể bị thread khác chen vào.
Các atomic instruction thường gặp gồm test-and-set, compare-and-swap, fetch-and-add, v.v. Chúng bảo đảm việc read-modify-write tại một memory location không bị CPU khác quan sát thành trạng thái dang dở.
Giáo trình cũ còn nói về “implement lock bằng cách disable interrupt”. Trong kernel single CPU, disable interrupt có thể ngăn execution flow hiện tại bị interrupt handler làm gián đoạn, từ đó bảo vệ một số kernel critical section. Nhưng cách này có giới hạn rất rõ: nó chỉ ảnh hưởng CPU hiện tại, không thể ngăn CPU khác đồng thời truy cập cùng một vùng memory. Trong multiprocessor system, mutual exclusion giữa các CPU vẫn phải dựa vào atomic instruction, cache coherence protocol và quy tắc kernel lock.
Đó cũng là lý do môn Operating System thường dạy atomic instruction trước rồi mới dạy lock implementation. Với programmer, lock expose API lock() / unlock(); bên dưới là các update không thể tách rời được CPU và kernel cùng duy trì.
Lock cũng phụ trách memory order
Lock không chỉ xếp hàng ở cửa critical section. Trong hệ thống nhiều CPU, CPU và compiler đều có thể reorder memory access; nếu synchronization semantic không đủ, state được một CPU ghi có thể không được CPU khác nhìn thấy theo thứ tự trong source code.
Vì vậy, lock acquire và lock release thường cũng mang ý nghĩa về memory order. Có thể hiểu trước qua hai từ này:
- acquire: memory access sau khi lấy lock không được reorder lên trước thao tác lấy lock.
- release: memory access trước khi release lock không được reorder ra sau thao tác release lock.
Tài liệu memory barrier của Linux kernel cũng xếp operation LOCK vào acquire và operation UNLOCK vào release. Khi dùng đúng synchronization primitive như mutex và spinlock, developer thường không cần tự viết memory barrier; chỉ khi viết lock-free structure, driver, kernel-level synchronization hoặc tương tác với device mới cần trực tiếp xử lý memory barrier.
Ở đây còn một giới hạn: acquire và release là bảo đảm tối thiểu, kết hợp cả hai không đồng nghĩa với full memory barrier trong mọi scenario. Business code thông thường không cần học thuộc các chi tiết này, nhưng nếu đã viết lock-free queue, RCU, driver hoặc MMIO access thì không thể bỏ qua sự khác biệt đó.
Priority inversion: lock cũng ảnh hưởng scheduling
Lock còn đưa vấn đề scheduling vào trong hệ thống.
Vấn đề kinh điển là priority inversion. Thread có priority thấp L đang giữ một lock, thread có priority cao H chờ lock đó; lúc này thread có priority trung bình M liên tục chạy và preempt L. Kết quả là H rõ ràng có priority cao nhất nhưng vẫn không chờ được L release lock.
Một hướng giải quyết là priority inheritance. Thread có priority thấp đang giữ lock tạm thời nhận priority cao nhất trong các waiter, nhanh chóng chạy xong critical section rồi release lock.
Protocol của POSIX mutex có các thuộc tính PTHREAD_PRIO_INHERIT và PTHREAD_PRIO_PROTECT. rt_mutex của Linux cũng được thiết kế xoay quanh priority inheritance, dùng để hỗ trợ PI-futex và pthread mutex có priority inheritance attribute.
Đây cũng là lý do semaphore không có owner gây ra giới hạn như đã nói ở trên. Khi không có owner rõ ràng, hệ thống không biết nên nâng priority cho ai; tài liệu Linux Kernel locking cũng chỉ ra rằng semaphore không thể cung cấp priority inheritance dưới PREEMPT_RT, và việc block trên semaphore có thể gây priority inversion.
User-space lock và kernel lock khác nhau thế nào?
User-space program quan tâm đến cách các thread phối hợp với nhau. Pthreads cung cấp mutex, condition variable và semaphore; C++, Java, Go, Rust lại đóng gói các synchronization tool gần với ngôn ngữ hơn trong runtime và standard library tương ứng.
Lock trong kernel có thêm một tầng ràng buộc về context. Kernel code có thể chạy trong process context thông thường, cũng có thể chạy trong interrupt, soft interrupt hoặc vùng không thể preempt; có path có thể sleep, có path tuyệt đối không thể sleep; khi được giữ, một số lock sẽ disable preemption hoặc interrupt; realtime kernel còn phải xử lý priority inversion và scheduling latency.
Vì vậy, khi xem kernel lock, cần hỏi thêm:
- Context hiện tại có thể sleep không?
- Trong thời gian giữ lock có thể bị preempt không?
- Có khả năng bị interrupt handler re-enter không?
- Lock bảo vệ per-CPU data hay data shared giữa các CPU?
- Kernel hiện tại là ordinary kernel hay PREEMPT_RT kernel?
- Có cần priority inheritance để kiểm soát realtime latency không?
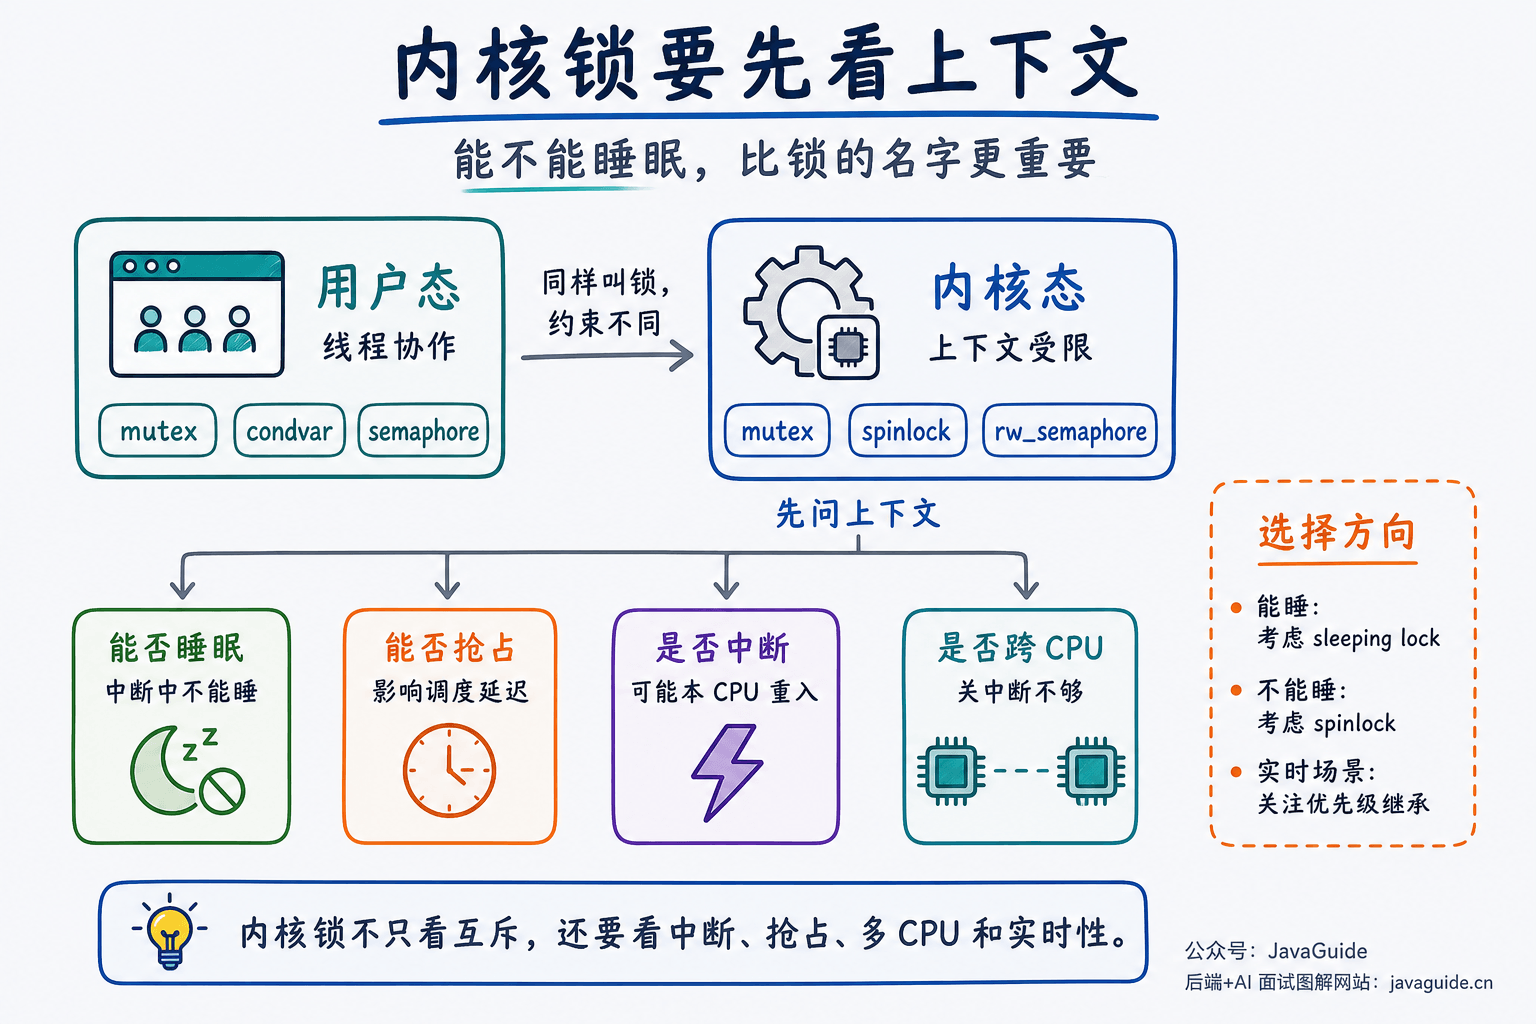
Có thể nắm trước một số khác biệt thường gặp:
- Sleeping lock như mutex có thể cho task sleep, phù hợp với critical section tương đối dài, nhưng không thể tùy tiện dùng trong interrupt context.
- Spinlock phù hợp với kernel path rất ngắn và không thể sleep; trong thời gian giữ lock phải tránh gọi function có thể block.
rw_semaphore,rwlockhướng tới nhiều reader, một writer, nhưng fairness và realtime semantic sẽ thay đổi theo kernel configuration.- local lock, disable preemption và disable interrupt thiên về bảo vệ data trên CPU hiện tại, không thể tự nhiên thay thế cross-CPU lock.
Tài liệu Linux Kernel locking viết rất chi tiết các quy tắc này, đặc biệt là sự thay đổi trong lock semantic dưới PREEMPT_RT. Application developer thường không cần học thuộc toàn bộ chi tiết, nhưng cần biết một điều: không thể hiểu kernel lock chỉ qua vài cái tên như “mutual exclusion/read-write/spin”; nó còn gắn chặt với việc context hiện tại có thể sleep, có thể preempt và có thể xử lý interrupt hay không.
Chọn synchronization primitive thế nào?
Nếu chỉ bảo vệ việc sửa một đoạn shared state, trước tiên hãy cân nhắc mutex. Nó biểu đạt rõ ràng, có thể sleep khi chờ, phù hợp với phần lớn user-space critical section.
Nếu cần giới hạn số thread đồng thời sử dụng một loại resource, semaphore tự nhiên hơn. Ví dụ tối đa 10 task download chạy đồng thời hoặc connection pool tối đa 50 connection. Điểm mấu chốt của scenario này là “số lượng”, không phải ai vào critical section.
Nếu thread phải chờ một state thay đổi, hãy dùng condition variable. Queue chuyển từ rỗng sang không rỗng, task chuyển từ chưa hoàn thành sang hoàn thành, buffer chuyển từ đầy sang chưa đầy đều là kiểu chờ condition này. Hãy nhớ đặt state trong shared variable, dùng mutex bảo vệ và chờ trong while.
Nếu trong kernel cần bảo vệ một path rất ngắn và context hiện tại không thể sleep, mới cân nhắc spinlock. Trong business code ở user space, spin lâu thường là một bad smell.
Nếu đang implement language runtime, thread library hoặc high-performance synchronizer, những cơ chế như futex mới nằm trong phạm vi cần quan tâm. Business code thông thường nên dùng standard library hoặc thư viện concurrency đã được kiểm chứng, thay vì trực tiếp lập trình với futex system call.
Các phán đoán này cũng giải thích vì sao bài viết Java thường đặt synchronized, ReentrantLock, AQS và CAS cạnh nhau. Java developer làm việc với abstraction ở cấp ngôn ngữ; ở cấp Operating System, trọng tâm là thread scheduling, block/wakeup, CPU atomic instruction và kernel context.
Lỗi thường gặp
Coi lock như một performance switch.
Lock trước hết bảo đảm correctness, sau đó mới nói đến performance. Nếu shared state bị ghi hỏng, bỏ bớt một lock chỉ khiến bug phụ thuộc vào scheduling timing.
Dùng if để chờ condition variable.
Thread thức dậy từ condition variable không có nghĩa condition đã được thỏa mãn. Sau khi thức dậy bắt buộc phải kiểm tra lại condition. Ở đây dùng while mới phù hợp với semantic sử dụng condition variable.
Coi semaphore là universal lock.
Semaphore làm được nhiều việc, cũng chính vì vậy code dễ trở nên khó hiểu về semantic. Chỉ cần mutual exclusion thì dùng mutex; chỉ cần chờ một one-shot event thì trong kernel các tool trực tiếp hơn như completion thường phù hợp hơn; chỉ dùng semaphore khi cần đếm resource.
Thực hiện slow operation trong thời gian giữ lock.
Truy cập disk, gửi network request hoặc chờ external system khi đang giữ lock đều kéo dài critical section. Thread càng nhiều, lock contention càng dễ khuếch đại thành giảm throughput, queue backlog, thậm chí deadlock.
Bỏ qua lock order.
Hai thread lần lượt lấy lock theo A -> B và B -> A rất dễ tạo thành wait cycle. Operating System, database và các thread Java đều gặp cùng một vấn đề. Có thể xem phần giới thiệu đầy đủ về deadlock trong Giải thích chi tiết về deadlock.
Tổng kết
Không thể hiểu lock trong Operating System chỉ qua một API riêng lẻ. Đây là một nhóm synchronization mechanisms được thiết kế xoay quanh shared state, wait condition, số lượng resource và scheduling context.
Mutex phụ trách mutual exclusion, spinlock dùng busy-wait để đổi lấy việc không sleep và context switch, semaphore phụ trách counting và rate limiting, condition variable cho thread sleep khi condition chưa thỏa mãn, còn futex nối user-space atomic operation với kernel block/wakeup. Chúng có vẻ đều liên quan đến việc “chờ”, nhưng đối tượng chờ thực tế không giống nhau: có cái chờ được vào critical section, có cái chờ số lượng resource, có cái chờ state thay đổi, có cái chờ kernel đưa mình trở lại runnable queue.
Khi học Java lock, nhiều chi tiết được JVM và class library đóng gói; quay về tầng Operating System, trọng tâm trở thành: khi nào thread nên sleep, khi nào có thể spin, ai chịu trách nhiệm wakeup, đoạn code nào không thể bị preempt và context nào không thể block.
Tài liệu tham khảo
- OSTEP: Locks
- OSTEP: Condition Variables
- OSTEP: Semaphores
- POSIX Programmer's Manual: pthread_mutex_lock
- POSIX Programmer's Manual: pthread_cond_wait
- POSIX Programmer's Manual: pthread_mutexattr_getprotocol
- Linux man-pages: sem_wait
- Linux man-pages: futex
- Linux Kernel Documentation: Lock types and their rules
- Linux Kernel Documentation: Memory Barriers
- Linux Kernel Documentation: RT-mutex subsystem with PI support