
Tổng hợp câu hỏi phỏng vấn Operating System thường gặp (phần trên)
Nhiều độc giả phàn nàn rằng kiến thức về hệ điều hành khá phức tạp, họ không có nhiều kiên nhẫn để đọc, nhưng khi phỏng vấn lại thường xuyên gặp phải. Vì vậy, tôi mang đến các câu hỏi thường gặp về hệ điều hành đã được tôi tổng hợp!
Bài viết 《Tổng hợp câu hỏi phỏng vấn hệ điều hành thường gặp (phần trên)》 sẽ bắt đầu từ kiến thức cơ bản về hệ điều hành, sau đó tập trung hệ thống hóa các trọng tâm thường gặp như user mode/kernel mode, system call, process và thread, IPC, process scheduling, deadlock. Bài viết phù hợp để nhanh chóng xây dựng danh sách câu hỏi phỏng vấn, đồng thời cũng thích hợp làm điểm bắt đầu để bổ sung kiến thức còn thiếu khi ôn tập.
Học hệ điều hành không chỉ để học thuộc các câu trả lời phỏng vấn. Những ý tưởng như cache, scheduling, synchronization, memory mapping, zero-copy và I/O multiplexing đều có thể thấy trong Redis, Kafka, Nginx, Netty, JVM và database. Khi hiểu rõ cơ chế bên trong, việc hiểu framework ở tầng trên và các vấn đề performance trên production sẽ dễ dàng hơn nhiều.
Bài viết thiên về “tra cứu nhanh khi phỏng vấn + liên kết các khái niệm cốt lõi”; nếu muốn học sâu, bạn vẫn nên đọc cùng giáo trình và các bài viết chuyên đề. Một phần nội dung trong bài được tham khảo từ 《Hệ điều hành hiện đại》 phiên bản thứ ba, xin cảm ơn tác giả.
Kiến thức cơ bản về hệ điều hành
Hệ điều hành là gì?
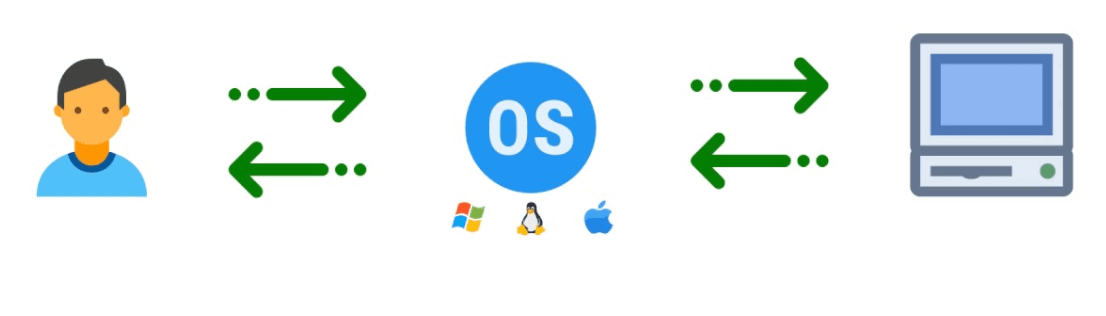
Có thể khái quát hệ điều hành qua bốn điểm sau:
- Hệ điều hành (Operating System, viết tắt là OS) là chương trình quản lý tài nguyên phần cứng và phần mềm của máy tính, là nền tảng của máy tính.
- Về bản chất, hệ điều hành là một chương trình phần mềm chạy trên máy tính, chủ yếu dùng để quản lý tài nguyên phần cứng và phần mềm. Ví dụ: mọi application trên máy tính của bạn đều thông qua hệ điều hành để sử dụng memory hệ thống, disk và các phần cứng khác.
- Hệ điều hành che giấu sự phức tạp của tầng phần cứng. Hệ điều hành giống như người phụ trách việc sử dụng phần cứng, điều phối tất cả công việc liên quan.
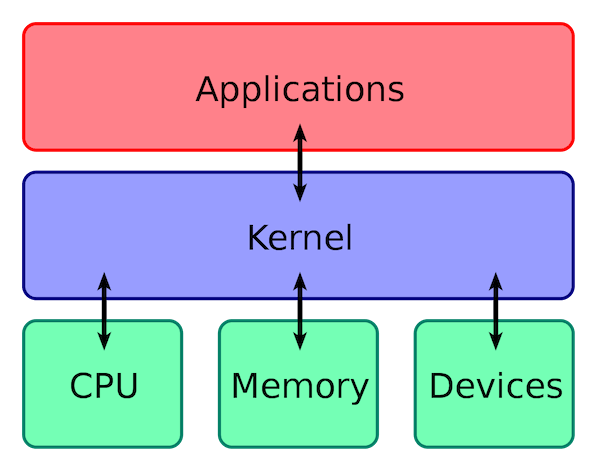
- Kernel của hệ điều hành là phần cốt lõi, chịu trách nhiệm quản lý memory hệ thống, thiết bị phần cứng, file system và application. Kernel là cầu nối giữa application và phần cứng, quyết định performance và stability của hệ thống.
Nhiều người dễ nhầm Kernel của hệ điều hành với CPU (Central Processing Unit). Bạn có thể phân biệt đơn giản qua hai điểm sau:
- Kernel của hệ điều hành thuộc tầng hệ điều hành, còn CPU thuộc phần cứng.
- CPU chủ yếu cung cấp khả năng tính toán và xử lý instruction. Kernel chủ yếu chịu trách nhiệm quản lý hệ thống, chẳng hạn như memory management; nó che giấu thao tác trực tiếp với phần cứng.
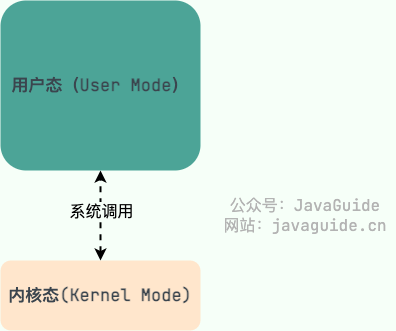
Hình dưới đây mô tả rõ mối quan hệ giữa application, kernel và CPU.
Hệ điều hành có những chức năng chính nào?
Xét từ góc độ resource management, hệ điều hành có 6 chức năng lớn:
- Quản lý process và thread: tạo, hủy, block, wake up process, IPC, v.v.
- Quản lý storage: cấp phát và thu hồi memory, address translation, process isolation, thu hồi page và quản lý không gian external storage, v.v.
- Quản lý file: tổ chức các storage block tầng dưới thành file và directory, chịu trách nhiệm đọc, ghi, tạo, xóa file, kiểm soát permission và khôi phục sau crash, v.v.
- Quản lý device: thực hiện yêu cầu hoặc giải phóng device (chẳng hạn như I/O device và external storage device), cũng như khởi động device, v.v.
- Quản lý network: hệ điều hành chịu trách nhiệm quản lý việc sử dụng computer network. Network là phương thức kết nối các máy tính khác nhau trong computer system; hệ điều hành cần quản lý configuration, connection, communication và security của computer network để cung cấp network service hiệu quả và đáng tin cậy.
- Quản lý security: authentication người dùng, access control, mã hóa file, v.v. nhằm ngăn người dùng trái phép truy cập và thao tác trên system resource.
Memory management và file system là hai phần dễ bị hỏi sâu nhất trong phỏng vấn hệ điều hành, sẽ được trình bày riêng trong bài này: Tổng hợp câu hỏi phỏng vấn hệ điều hành thường gặp (phần dưới).
Những hệ điều hành thường gặp là gì?
Windows
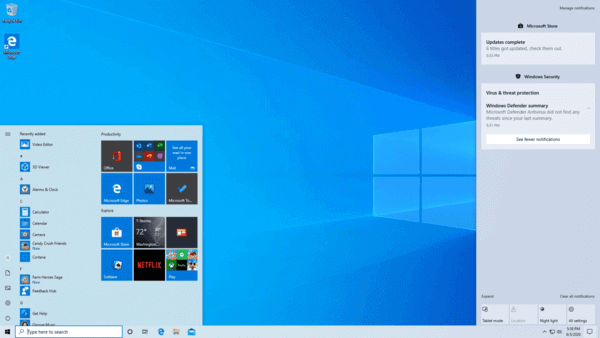
Đây là hệ điều hành desktop cá nhân phổ biến nhất hiện nay, không cần giới thiệu nhiều vì mọi người đều biết. Giao diện đơn giản, dễ sử dụng, hệ sinh thái software rất tốt.
Chơi game trên máy tính thì vẫn nhất thiết phải có Windows, vì vậy hiện tại tôi dùng một máy Windows để chơi game và một máy Mac để phát triển cũng như học tập hằng ngày.
Unix
Unix là một trong những hệ điều hành multi-user, multi-task có ảnh hưởng nhất thời kỳ đầu. Các system dạng Unix như Linux và BSD sau này đều chịu ảnh hưởng từ Unix. Thị phần của Unix thương mại truyền thống đã giảm rõ rệt, nhưng Unix standard, system certification và các tư tưởng thiết kế của nó vẫn đang được sử dụng.
Linux
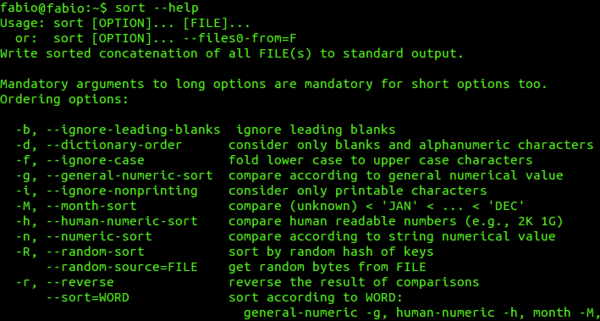
Linux là một hệ điều hành dạng Unix miễn phí và open source. Linux có nhiều distribution khác nhau, nhưng tất cả đều sử dụng Linux kernel.
Nói chính xác, bản thân từ Linux chỉ biểu thị Linux kernel. Trong system GNU/Linux, Linux thực tế chính là Linux kernel, còn các phần còn lại của system chủ yếu là các program do GNU project viết và cung cấp. Riêng Linux kernel không thể trở thành một hệ điều hành có thể hoạt động bình thường.
Nhiều người có xu hướng dùng từ "GNU/Linux" để biểu đạt "Linux" mà mọi người thường nói đến.
Mac OS
Đây là hệ điều hành do Apple phát triển, trải nghiệm lập trình tương đương Linux, nhưng giao diện, hệ sinh thái software và user experience đều tốt hơn hệ điều hành Linux.
User mode và kernel mode
User mode và kernel mode là gì?
User mode và kernel mode mô tả mức đặc quyền khi CPU thực thi code. Application code thường chạy ở user mode; khi cần truy cập resource được bảo vệ, CPU sẽ đi vào kernel mode qua entry point được quy định để kernel đại diện cho thread hiện tại hoàn tất thao tác.
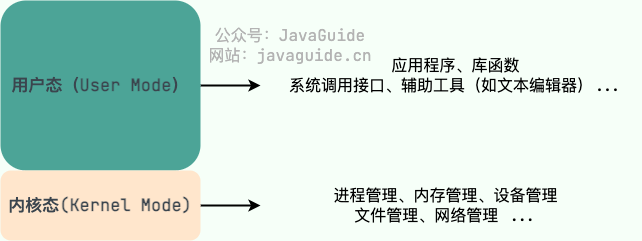
- User mode (User Mode): permission thấp, không thể trực tiếp thực thi privileged instruction, cũng không thể tùy ý truy cập kernel address space hoặc thao tác phần cứng. Khi application đọc file, gửi và nhận network data, cần yêu cầu kernel service thông qua system call.
- Kernel mode (Kernel Mode): permission cao, có thể thực hiện các privileged operation như quản lý page table, interrupt và device. Sau khi system call, interrupt hoặc synchronous exception đi vào kernel, code đang chạy là kernel code, không phải toàn bộ user process biến thành “kernel process”.
Việc chuyển đổi user mode/kernel mode cần đi qua entry point do architecture quy định, lưu state cần thiết và kiểm tra permission cũng như parameter, vì vậy tốn kém hơn function call thông thường. Tuy nhiên, điều đó không đồng nghĩa với thread context switch: chỉ khi scheduler chuyển sang execution entity khác mới xảy ra thread switch.
Tại sao cần user mode và kernel mode? Chỉ có một kernel mode không được sao?
Thiết kế này chủ yếu nhằm bảo đảm security và stability.
- Hạn chế privileged operation: các thao tác sửa page table, điều khiển interrupt, truy cập register của device cụ thể có thể ảnh hưởng đến toàn bộ system, nên chỉ kernel được thực hiện.
- Cô lập lỗi và permission: nếu application đều có thể chạy với kernel permission, một lần ghi vượt biên hoặc một malicious program có thể phá hỏng dữ liệu của process khác và kernel, khi đó process isolation cũng mất nền tảng.
Cơ chế privilege level này giới hạn application thông thường trong môi trường được kiểm soát, còn phần cứng và system resource được giao cho kernel quản lý thống nhất.
User mode và kernel mode chuyển đổi như thế nào?
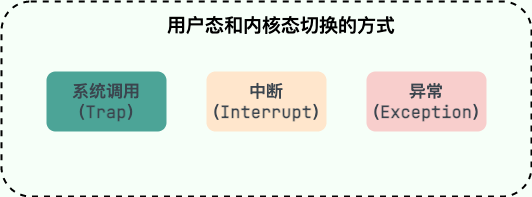
Các event chính khiến CPU đi từ user mode vào kernel mode gồm ba loại:
- System call (Trap): application chủ động thực thi instruction như
syscall,ecall, yêu cầu kernel hoàn thành thao tác nhưread(),send(). Nó do instruction hiện tại kích hoạt, thuộc synchronous event. - Hardware interrupt (Interrupt): do hardware bên ngoài như timer, network card, disk kích hoạt, không liên quan trực tiếp đến instruction đang thực thi, nên thuộc asynchronous event.
- Synchronous exception (Exception): do instruction hiện tại kích hoạt, chẳng hạn chia cho zero, illegal instruction hoặc Page Fault. Exception không nhất thiết biểu thị program bị lỗi; lazy allocation, COW và paging từ file cũng có thể kích hoạt Page Fault có thể được xử lý và khôi phục.
Interrupt, exception và system call mô tả lý do CPU đi vào kernel; signal là một software mechanism để kernel thông báo cho process hoặc thread. Truy cập memory bất hợp pháp có thể trước tiên kích hoạt Page Fault; sau khi kernel xác định không thể xử lý, nó mới gửi SIGSEGV đến thread hiện tại.
Chi tiết entry point của các architecture khác nhau không hoàn toàn giống nhau, nhưng đều chuyển đến kernel handler tương ứng dựa trên event type. Có thể xem phần so sánh khái niệm và đường đi xử lý đầy đủ tại: Giải thích chi tiết interrupt, exception và system call: từ kernel entry đến page fault.
System call
System call là gì?
System call là interface cung cấp service có kiểm soát cho user program. Application không thể trực tiếp thao tác disk, page table, network card và các resource được bảo vệ khác, mà cần thông qua system call để kernel thực hiện thay.
Các system call này có thể được chia đại khái thành các nhóm sau theo chức năng:
- Device management: thực hiện yêu cầu hoặc giải phóng device (chẳng hạn như I/O device và external storage device), cũng như khởi động device, v.v.
- File management: thực hiện đọc, ghi, tạo và xóa file, v.v.
- Process management: tạo, hủy, block, wake up process và IPC, v.v.
- Memory management: thực hiện cấp phát, thu hồi memory, lấy kích thước và địa chỉ của vùng memory mà job chiếm dụng, v.v.
- Network communication: tạo Socket, thiết lập connection, gửi và nhận data, v.v.
System call và library function không phải là hai khái niệm cùng một tầng. Function call thông thường luôn thực thi ở user mode; wrapper function read() do runtime library như glibc cung cấp sẽ chuẩn bị system call number và parameter theo ABI, sau đó thực thi special instruction để đi vào kernel. Ngoài ra, nhiều library function hoàn toàn không cần system call.
Bạn có hiểu quy trình của system call không?
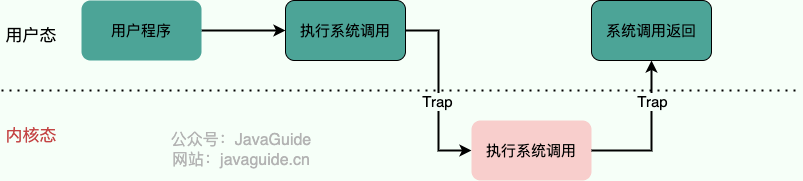
Lấy read(fd, buf, count) trên Linux x86-64 làm ví dụ, quy trình của system call có thể khái quát như sau:
- Wrapper function của glibc đặt system call number và parameter vào các register được chỉ định theo calling convention, rồi thực thi
syscall. - CPU chuyển sang kernel privilege level và entry point tương ứng. Kernel entry code lưu state của các register cần dùng về sau, sau đó phân phối đến logic xử lý tương ứng với
readtheo system call number. - Kernel kiểm tra file descriptor, user buffer, access permission và file state, sau đó đi vào các path như VFS, file system, network protocol stack hoặc device driver.
- Khi data đã sẵn sàng, kernel hoàn thành việc đọc và trả về result; khi data chưa sẵn sàng, thread hiện tại có thể chuyển sang waiting state, scheduler chuyển sang chạy task khác có thể chạy.
- Khi call hoàn tất, return value được truyền cho user mode thông qua register. Khi xảy ra lỗi, glibc thường chuyển error code của kernel thành
-1vàerrno.
System call có nhất thiết xảy ra context switch không?
System call sẽ khiến CPU đi vào kernel mode. Nếu kernel xử lý xong nhanh và trả về thread ban đầu, toàn bộ quá trình chỉ có chuyển đổi user mode/kernel mode, không có thread switch.
Khi system call cần chờ I/O, lock hoặc resource khác, thread hiện tại có thể bị block, lúc đó scheduler mới chọn task có thể chạy khác, và thread context switch sẽ xảy ra. Ngược lại, sau khi timer interrupt đi vào kernel, nếu scheduler vẫn để thread ban đầu tiếp tục chạy thì cũng không xảy ra thread switch.
Có thể xem call chain đầy đủ hơn của read(), signal interrupt và system call restart tại: Giải thích chi tiết interrupt, exception và system call: từ kernel entry đến page fault.
Process và thread
Process và thread là một nhóm khái niệm không thể bỏ qua khi phỏng vấn hệ điều hành. Trước tiên, dưới đây là câu trả lời ngắn gọn cho các cách hỏi thường gặp; nếu muốn học có hệ thống, bạn có thể tiếp tục đọc các bài viết chi tiết sau:
- Giải thích chi tiết process và thread: khác biệt, state, communication, context switch và virtual thread, đường dẫn:
./process-and-thread.md - Giải thích chi tiết IPC: pipe, message queue, shared memory, Socket và Binder, đường dẫn:
./ipc.md - Giải thích chi tiết CPU scheduling và system load, đường dẫn:
./cpu-scheduling-and-load.md
Process và thread khác nhau như thế nào?
Process và thread là hai khái niệm cốt lõi về concurrent execution trong hệ điều hành, có thể hiểu mối quan hệ giữa chúng như mối quan hệ giữa nhà máy và công nhân.
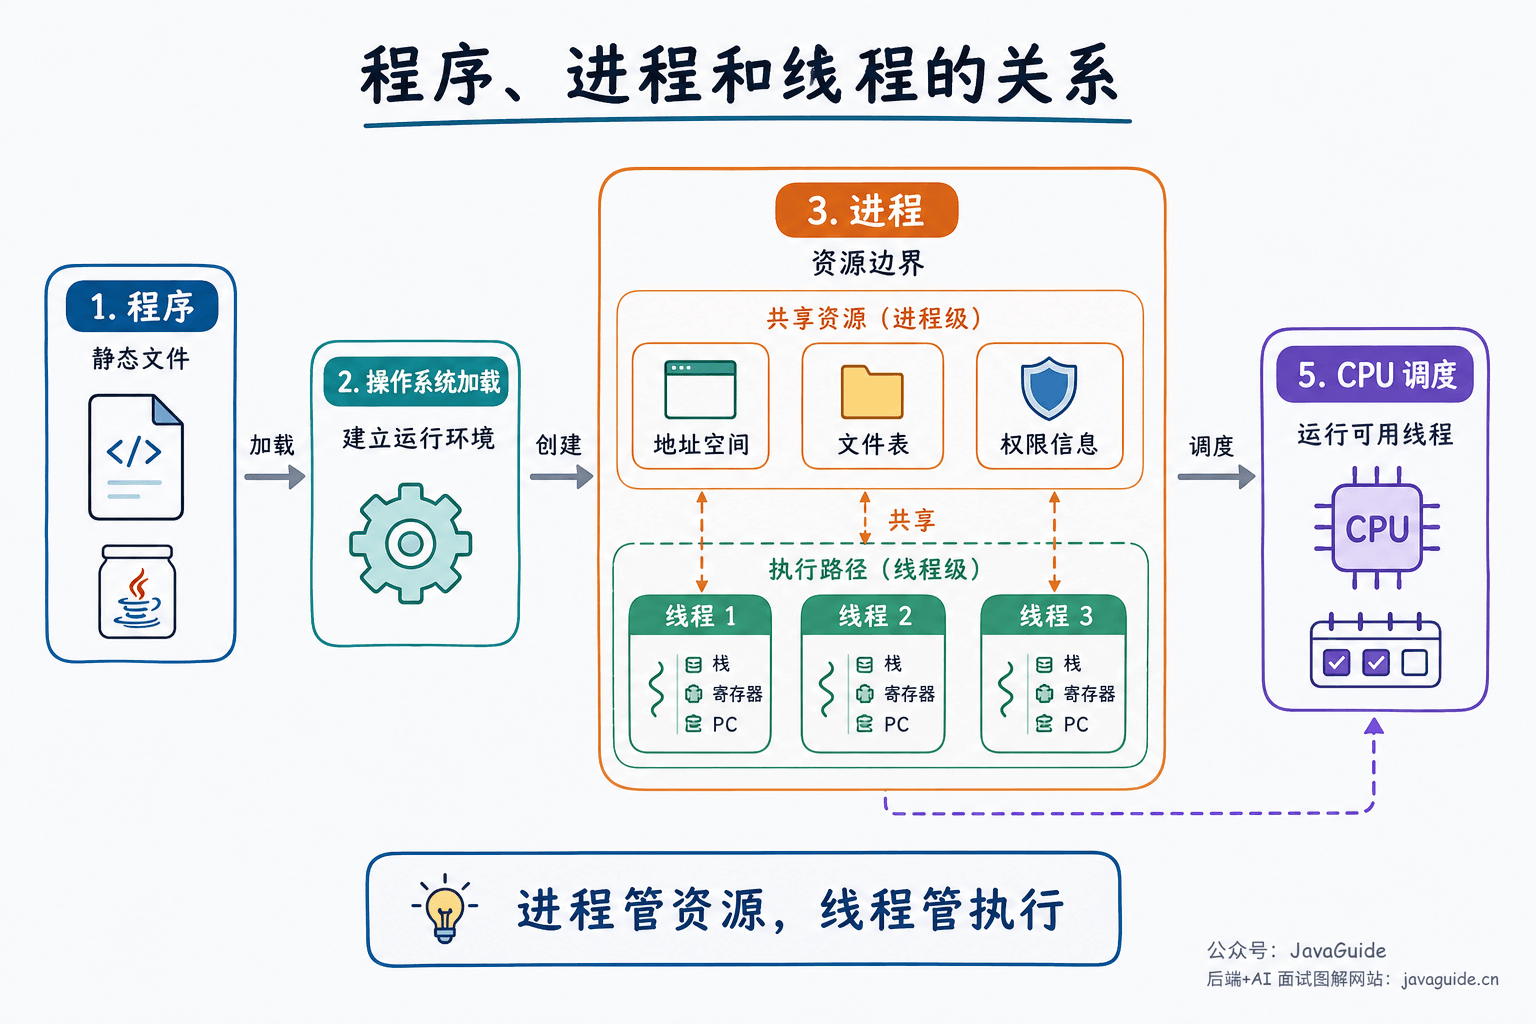
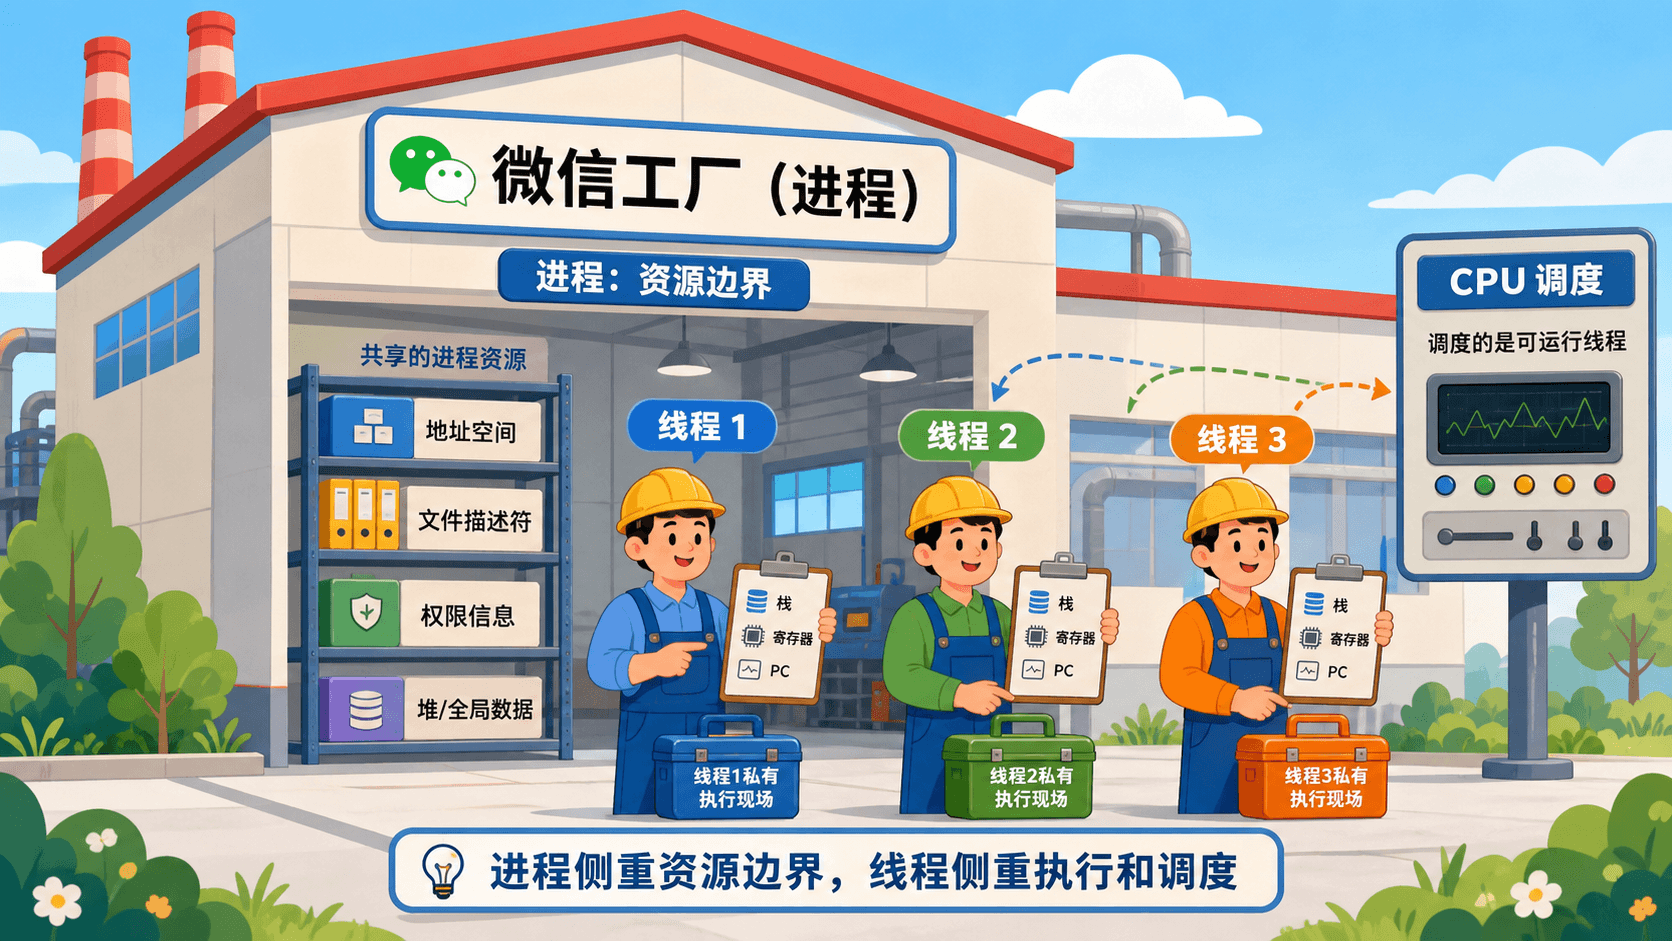
Process giống như một nhà máy. Khi phân bổ resource, hệ điều hành lấy process làm đơn vị cơ bản. Ví dụ, khi tôi khởi động một WeChat, hệ điều hành sẽ tạo cho nó một nhà máy độc lập, phân bổ memory space, file handle và các resource khác dành riêng cho nó. Nhà máy này được cô lập nghiêm ngặt với các nhà máy khác (chẳng hạn browser process tôi mở).
Thread giống như công nhân trong nhà máy. Một nhà máy có thể có nhiều công nhân, họ dùng chung resource của nhà máy, nhưng mỗi công nhân có bộ công cụ và task list riêng, giúp họ độc lập thực thi các task khác nhau. Ví dụ, trong nhà máy WeChat có thể có một công nhân (thread) chịu trách nhiệm nhận message và một công nhân chịu trách nhiệm render giao diện.
Đây là hình ảnh tôi dùng AI để vẽ, có thể nói là rất trực quan:
Dưới đây là các memory area của Java; hãy cùng nói về mối quan hệ giữa thread và process từ góc độ JVM!
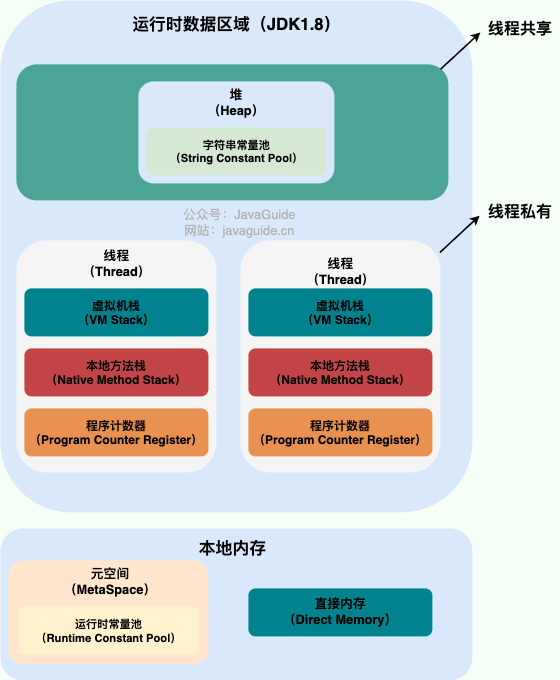
Từ hình trên có thể thấy: một process có thể có nhiều thread; nhiều thread dùng chung resource heap và method area (metaspace sau JDK1.8) của process, nhưng mỗi thread có program counter, virtual machine stack và native method stack riêng.
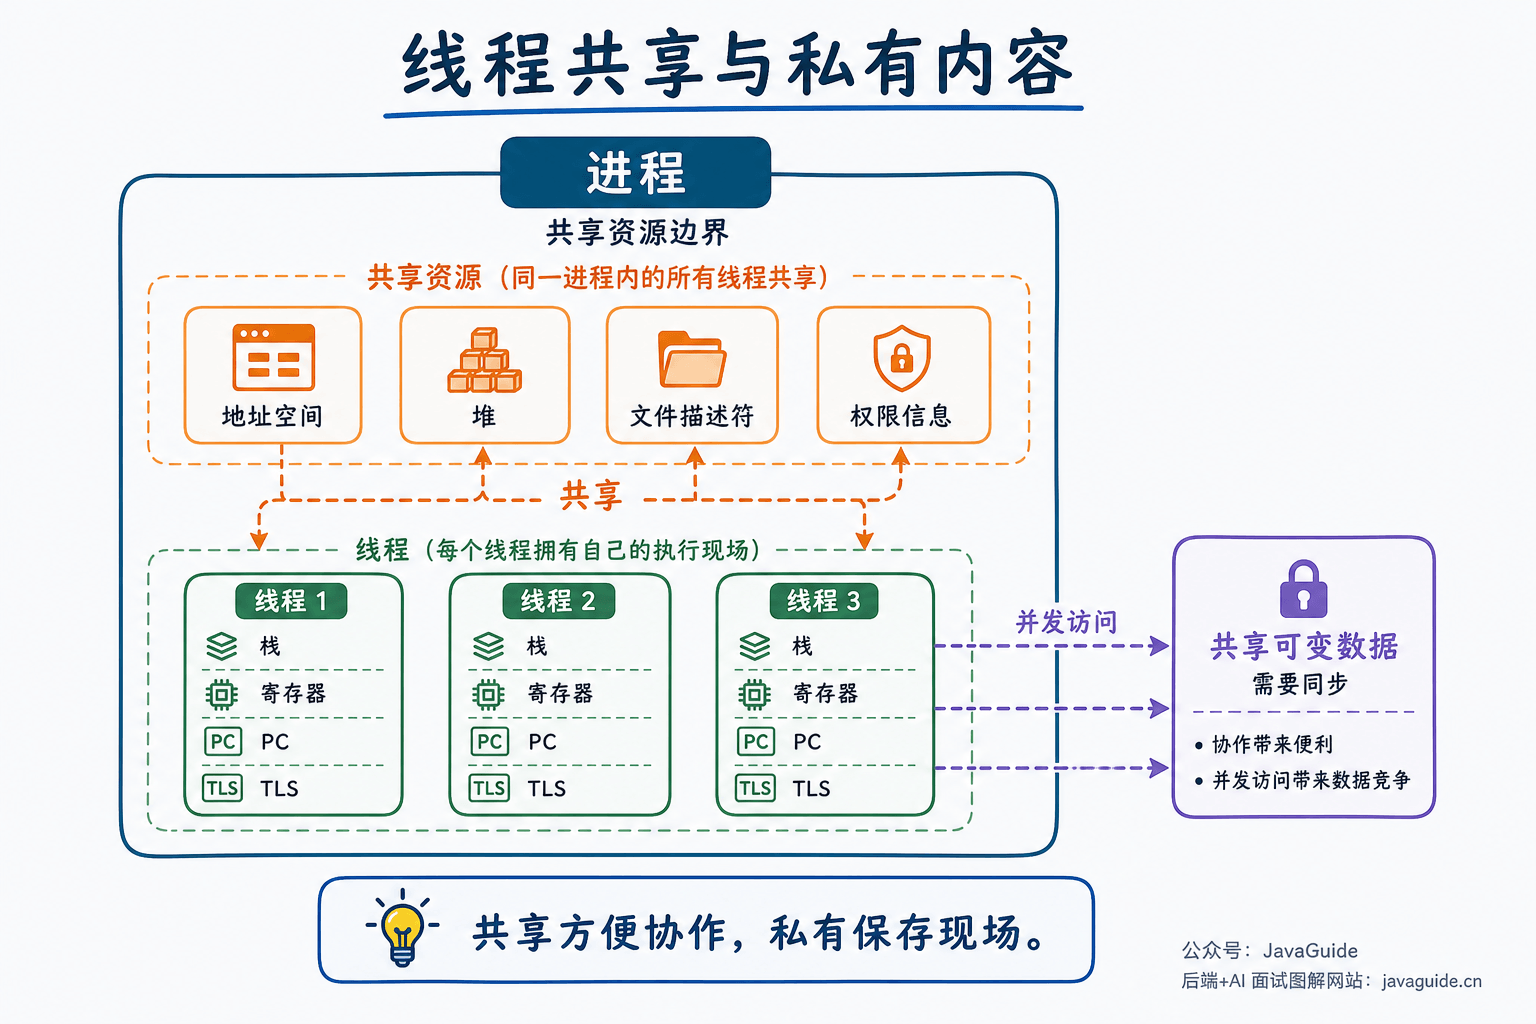
Có thể tổng kết từ 5 góc độ: resource, scheduling, communication, overhead và reliability:
| Khía cạnh | Process | Thread |
|---|---|---|
| Vai trò cơ bản | Đơn vị cơ bản để phân bổ và cô lập resource | Đơn vị cơ bản để CPU scheduling và execution |
| Address space | Mặc định có virtual address space độc lập | Các thread trong cùng process dùng chung process address space |
| Nội dung riêng | PID, address space, open file table, permission và các process-level resource khác | Thread ID, stack, register, program counter, thread-local storage và execution context khác |
| Cách communication | Cần IPC, chẳng hạn pipe, message queue, shared memory, Socket | Có thể trực tiếp đọc ghi shared memory, nhưng phải xử lý synchronization và thread safety |
| Chi phí tạo/chuyển đổi | Thường cao hơn; process switch có thể liên quan đến address space switch, TLB invalidation, v.v. | Thường thấp hơn; thread switch trong cùng process thường không cần chuyển toàn bộ address space |
| Ảnh hưởng khi lỗi | Tính cô lập tốt hơn; một process crash thường không ảnh hưởng process khác | Một thread lỗi có thể khiến toàn bộ process thoát |
Có thể tổ chức câu trả lời phỏng vấn tương đối đầy đủ như sau:
Process là nơi chứa các resource khi program chạy, có virtual address space độc lập cùng các resource như file và permission; thread là execution flow bên trong process, nhiều thread dùng chung process resource nhưng mỗi thread tự lưu execution context như stack, register và program counter. Process có isolation mạnh hơn, chi phí communication và switch cao hơn; thread phối hợp thuận tiện hơn, việc tạo và switch thường nhẹ hơn, nhưng shared memory mang đến vấn đề thread safety.
Đã có process rồi, tại sao vẫn cần thread?
Lý do cốt lõi là để thực hiện concurrency với overhead thấp và hiệu quả cao trong một application.
Nếu một server cần đồng thời xử lý network read/write, tính toán nghiệp vụ và ghi log xuống disk, dùng nhiều process cũng có thể làm được, nhưng việc chia sẻ state giữa các process phức tạp, communication phải đi qua IPC, mức tiêu thụ resource cũng cao hơn. Chuyển sang nhiều thread, chúng có thể trực tiếp dùng chung heap memory và connection đã mở; chỉ cần viết synchronization đúng thì chi phí phối hợp sẽ thấp hơn nhiều.
Thread cũng có thể nâng cao resource utilization. Trên single-core CPU, khi một thread bị block tại disk hoặc network I/O, các thread khác có thể tiếp tục chạy; trên multi-core CPU, nhiều thread có cơ hội thực thi song song trên các core khác nhau. Tuy nhiên, thread không phải càng nhiều càng tốt. Quá nhiều thread sẽ dẫn đến stack memory consumption, scheduling overhead, lock contention và suy giảm cache locality; cách cấu hình số thread cho CPU-bound task và I/O-bound task cũng khác nhau.
Multithreading có nhất thiết nâng cao performance không?
Việc multi-thread có tăng tốc được hay không phụ thuộc vào loại task, số CPU core và contention trên shared resource:
- I/O-bound task: khi một thread chờ disk, network hoặc lock, các thread có thể chạy khác vẫn tiếp tục sử dụng CPU; multi-thread có thể che giấu một phần waiting time.
- CPU-bound task: các phép tính có thể tách rời và độc lập có thể được phân bổ cho nhiều CPU core để thực thi song song, nhưng hiệu quả tăng tốc còn chịu ảnh hưởng của phần tuần tự, data dependency, cache và scheduling overhead.
- Quá nhiều thread: khi số thread có thể chạy lớn hơn nhiều so với số CPU core, run queue sẽ dài hơn, context switch, cache invalidation và lock contention cũng tăng theo, khiến throughput và latency đều có thể xấu đi.
Số lượng thread cần được thiết lập dựa trên đặc trưng task, CPU quota, tỷ lệ block và kết quả load test; không thể chỉ suy ra trực tiếp theo số physical core của host hoặc số concurrent request.
Có những cách synchronization nào giữa các thread?
Thread synchronization là việc phối hợp thực thi concurrent của hai hoặc nhiều thread cùng truy cập resource quan trọng. Cần synchronization giữa các thread để tránh conflict khi sử dụng resource đó.
Dưới đây là một số cách thread synchronization thường gặp:
- Mutex (Mutex): sử dụng cơ chế mutex object; chỉ thread sở hữu mutex object mới có quyền truy cập resource dùng chung. Vì chỉ có một mutex object nên có thể bảo đảm nhiều thread không đồng thời truy cập resource dùng chung. Ví dụ, keyword
synchronizedvà cácLockkhác nhau trong Java đều là cơ chế này. - Read-Write Lock (Read-Write Lock): cho phép nhiều thread đồng thời đọc shared resource, nhưng chỉ một thread được ghi vào shared resource.
- Semaphore (Semaphore): cho phép nhiều thread truy cập cùng một resource tại một thời điểm, nhưng cần giới hạn số thread tối đa truy cập resource đó cùng lúc.
- Barrier (Barrier): Barrier là một synchronization primitive dùng để chờ nhiều thread đến một điểm rồi cùng tiếp tục thực thi. Khi một thread đến barrier, nó sẽ dừng thực thi và chờ các thread khác đến barrier; chỉ sau khi tất cả thread đến thì chúng mới cùng tiếp tục thực thi. Ví dụ,
CyclicBarriertrong Java là cơ chế này. - Condition Variable (Condition Variable)/event notification: thread chờ khi condition chưa thỏa mãn; thread khác thông báo để thread đang chờ tiếp tục thực thi sau khi condition thay đổi. Nó thường cần phối hợp với mutex để tránh vấn đề mất notification do “notification xảy ra trước, waiting xảy ra sau”.
Object.wait()/notify()vàCondition.await()/signal()trong Java đều thuộc tư tưởng này; Event object trong Windows cũng có thể xem là một implementation của synchronization primitive dạng event notification.
PCB là gì? Bao gồm những thông tin nào?
PCB (Process Control Block), tức process control block, là data structure được hệ điều hành dùng để quản lý và theo dõi process; mỗi process tương ứng với một PCB độc lập. Bạn có thể xem PCB là bộ não của process.
Khi hệ điều hành tạo process mới, nó phân bổ một process ID duy nhất cho process đó, đồng thời tạo process control block tương ứng. Khi process thực thi, thông tin trong PCB liên tục thay đổi; hệ điều hành dựa vào những thông tin này để quản lý và scheduling process.
- Identity information: PID, parent process ID, user ID, v.v.
- Process state và scheduling information: ready, running, block, priority, time slice, CPU time statistic, v.v.
- CPU context: program counter, stack pointer, general-purpose register, program status word PSW, v.v.; dùng để khôi phục execution sau context switch.
- Memory management information: virtual address space, page table, memory mapping, v.v.
- Resource information: open file, file descriptor, I/O state, working directory, signal handling information, v.v.
- …
Khi xảy ra context switch, hệ điều hành lưu register và execution context khác của process hiện tại vào PCB, sau đó khôi phục execution context từ PCB của process tiếp theo để process đó tiếp tục thực thi từ vị trí tạm dừng lần trước.
TCB là gì? Có quan hệ thế nào với PCB?
TCB (Thread Control Block), tức thread control block, dùng để lưu control information ở cấp thread, chẳng hạn thread ID, thread state, register context, stack information, scheduling priority, thread-local storage, v.v.
Trong một số giáo trình hoặc implementation của system, PCB và TCB tách biệt: PCB thiên về process-level resource, TCB thiên về thread-level execution context. Implementation của Linux khá đặc biệt: nó xem cả process và thread đều là task, dùng task_struct để mô tả scheduling entity, sau đó phân biệt process và thread thông qua việc các resource structure có được dùng chung hay không. Khi hiểu không cần quá bận tâm đến tên gọi; điều quan trọng là phân biệt: address space, file table và các thành phần khác thuộc resource boundary; stack, register, program counter và các thành phần khác thuộc execution context.
Process có những trạng thái nào?
Thông thường chúng ta chia process thành 5 trạng thái chính, khá giống thread:
- Creation state (new): process đang được tạo, chưa chuyển sang ready state.
- Ready state (ready): process đã ở trạng thái sẵn sàng chạy, tức đã có tất cả resource cần thiết ngoại trừ processor; ngay khi nhận được processor resource (time slice do processor phân bổ) thì có thể chạy.
- Running state (running): process đang chạy trên processor (trên single-core CPU, tại mỗi thời điểm chỉ có một process ở running state).
- Blocked state (waiting): còn gọi là waiting state; process đang chờ một event nên tạm dừng chạy, chẳng hạn chờ resource khả dụng hoặc chờ I/O hoàn tất. Ngay cả khi processor idle, process này cũng không thể chạy.
- Terminated state (terminated): process đang được loại khỏi system. Có thể process kết thúc bình thường hoặc bị gián đoạn và thoát do nguyên nhân khác.
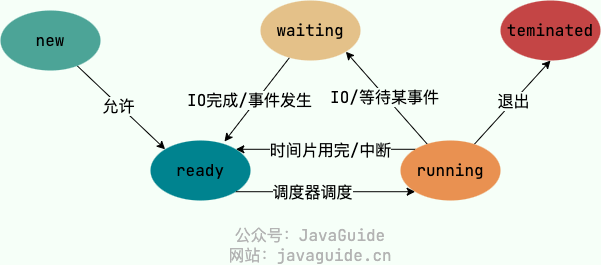
Khi xem state transition, cần chú ý nguyên nhân trigger: ready state nhận CPU rồi đi vào running state; running state hết time slice có thể quay lại ready state; khi đang chạy mà thực hiện blocking I/O, chờ lock hoặc chờ event thì sẽ đi vào blocked state; sau khi event mà blocked state chờ hoàn tất, process thường trước tiên quay lại ready state và chờ được scheduling lần tiếp theo.
Một số giáo trình còn thêm suspended state. Suspended state nhấn mạnh process tạm thời không ở trong memory hoặc bị user/system tạm dừng; block nhấn mạnh process đang chờ một event. Hai khái niệm này không giống nhau: process có thể bị block nhưng vẫn ở trong memory, cũng có thể bị swap ra external storage rồi ở trạng thái blocked và suspended.
Có những cách nào để IPC?
Process mặc định có virtual address space độc lập, không thể trực tiếp truy cập user-mode memory của nhau, vì vậy cần IPC (Inter-Process Communication, communication giữa các process).
Trong phỏng vấn, trước tiên chỉ cần trả lời theo use case:
- Process cha-con truyền ít byte stream: anonymous pipe.
- Process không có quan hệ họ hàng giao tiếp trên cùng máy: named pipe, Unix Domain Socket.
- Structured message quy mô nhỏ: message queue.
- Trao đổi lượng lớn data trên cùng máy: shared memory, nhưng cần phối hợp với semaphore, mutex,
futex,eventfdvà các synchronization mechanism khác. - Asynchronous event notification: signal.
- Giao tiếp giữa các máy: TCP/UDP Socket hoặc RPC framework tầng trên.
Có thể xem cách phân loại, boundary và lựa chọn chi tiết hơn tại: Giải thích chi tiết IPC: pipe, message queue, shared memory, Socket và Binder, đường dẫn: ./ipc.md.
fork, exec, wait lần lượt làm gì?
Trong lập trình Unix/Linux, khi tạo process và thay thế program thường không thể bỏ qua ba thao tác fork(), exec(), wait(). Trước tiên hãy ghi nhớ câu trả lời ngắn khi phỏng vấn; các chi tiết khác về file descriptor inheritance, copy-on-write và fork trong multi-thread có thể xem tại: Giải thích chi tiết process và thread, đường dẫn: ./process-and-thread.md.
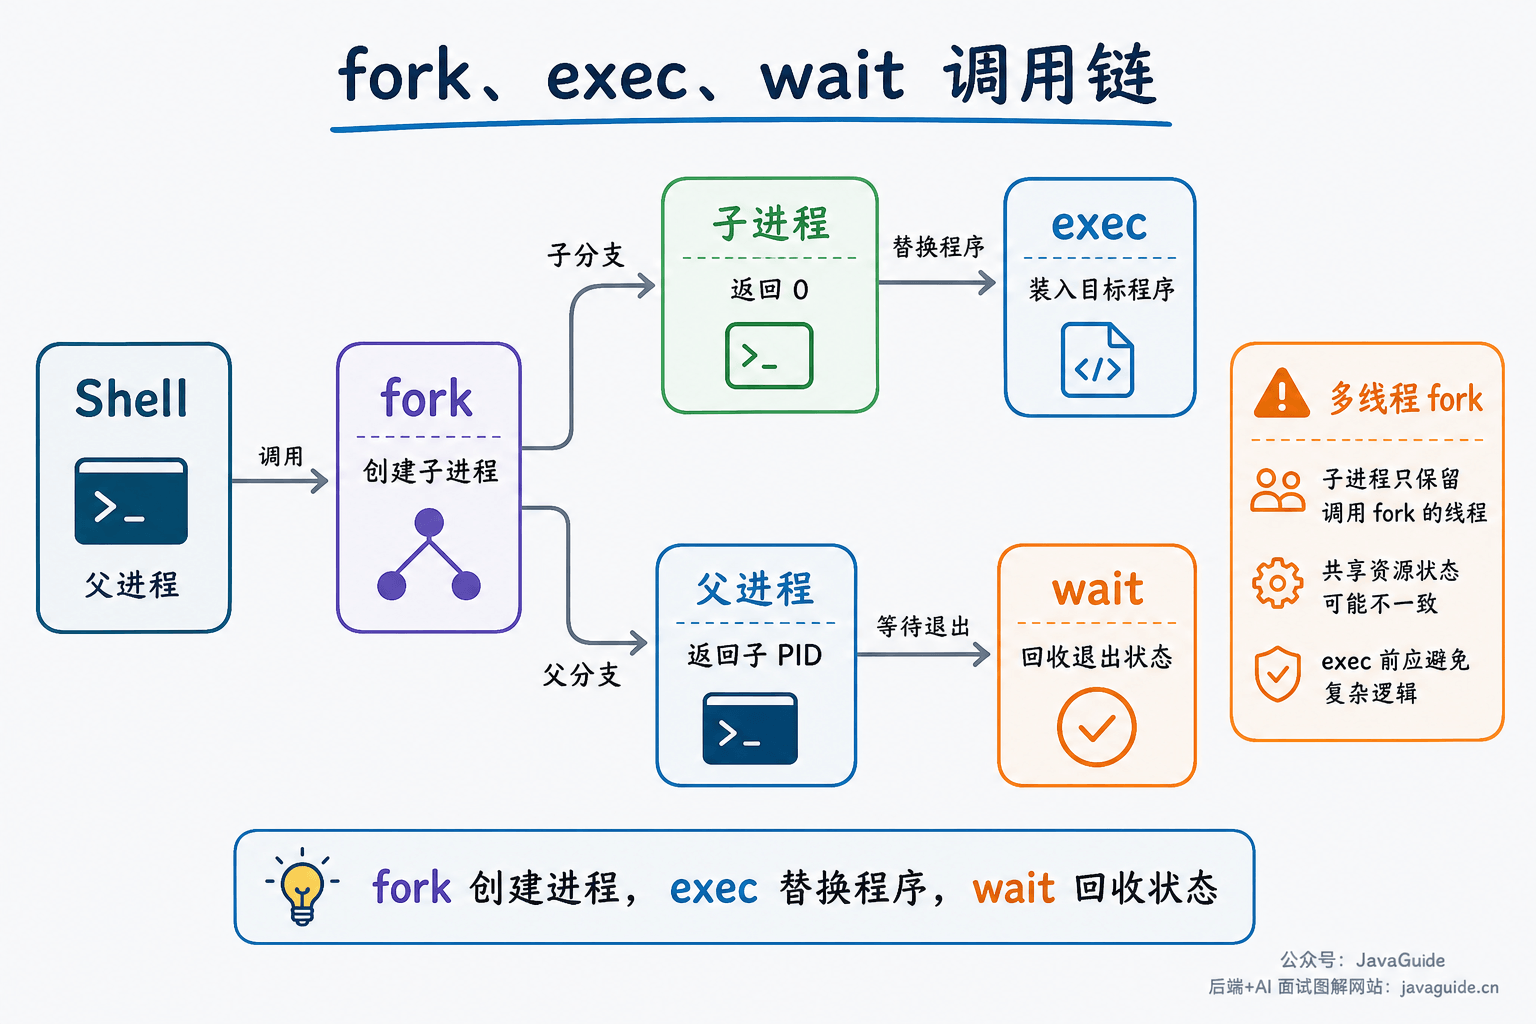
fork(): tạo child process. Parent process và child process tiếp tục thực thi từ cùng một vị trí, nhưng return value khác nhau.exec(): nạp một program khác vào process hiện tại. Nó không tạo process mới mà thay thế user-mode code và data của process hiện tại.wait()/waitpid(): chờ state của child process thay đổi, đồng thời thu hồi state information mà child process để lại trong kernel sau khi thoát.
Khi Shell khởi động external command, call chain thường là: Shell trước tiên fork() ra child process, child process sau đó exec() thành target program, parent process dùng wait() hoặc waitpid() để chờ và thu hồi exit state. Nếu parent process không thu hồi child process đã thoát, có thể để lại zombie process.
Context switch là gì?
Context switch là việc CPU chuyển từ execution entity này sang execution entity khác. Hệ điều hành cần lưu execution context như register, program counter và stack pointer của execution entity hiện tại, sau đó khôi phục execution context của execution entity tiếp theo.
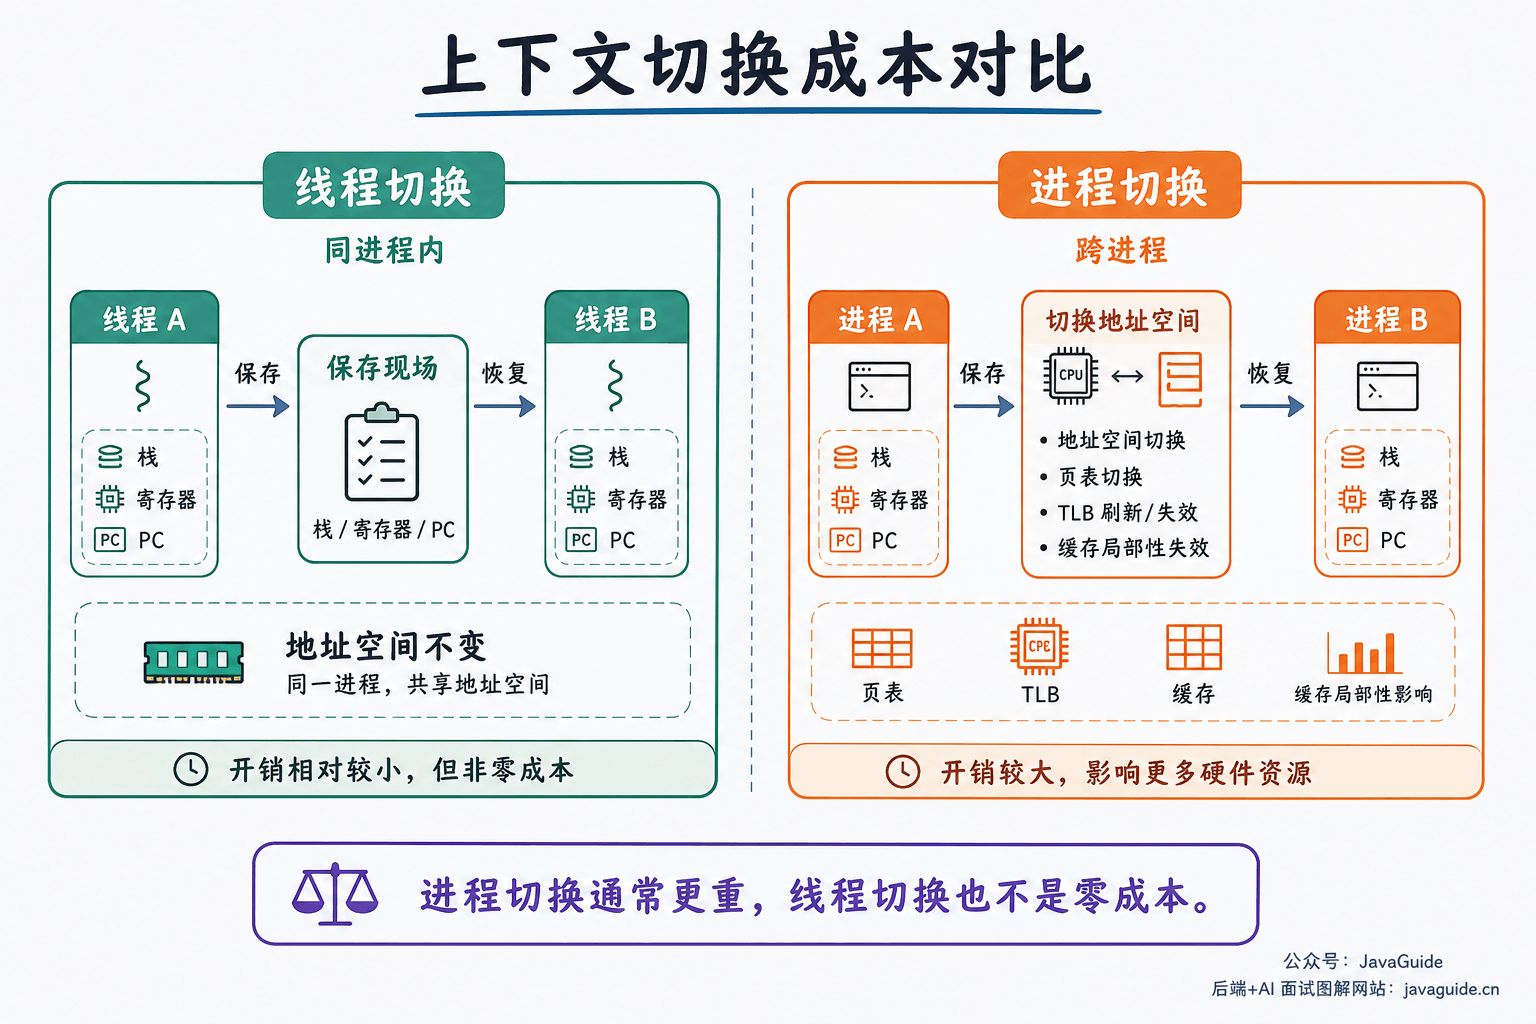
Thread switch và process switch đều có overhead, nhưng process switch thường nặng hơn. Nguyên nhân là process có address space độc lập; khi switch có thể phát sinh chi phí như page table switch, TLB invalidation và suy giảm cache locality. Thread trong cùng process dùng chung address space, nên khi switch thường không cần thay đổi toàn bộ memory mapping.
Có thể hiểu đơn giản như sau: thread switch trong cùng process chủ yếu thay execution context như stack, register và program counter của thread; process switch ngoài việc thay execution context còn có thể chuyển address space, đồng thời ảnh hưởng đến TLB và cache locality. Khi phân tích performance trên production, nếu phát hiện phần lớn thời gian tiêu tốn ở scheduling, lock waiting, system call và context switch, tiếp tục tăng thread một cách mù quáng thường chỉ khiến tình hình tệ hơn.
Cũng cần phân biệt context switch với user mode/kernel mode switch. System call, Page Fault và hardware interrupt đều đi vào kernel, nhưng chỉ cần sau khi kernel xử lý vẫn quay về thread ban đầu thì không xảy ra thread context switch.
Process có những thuật toán scheduling nào?
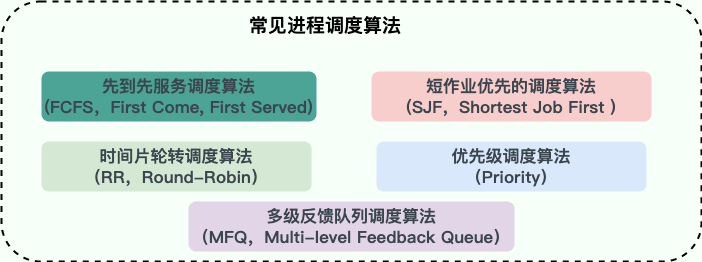
Các thuật toán process scheduling trong giáo trình dùng để giải thích: khi số task có thể chạy nhiều hơn số CPU core, nên cho task nào chạy trước. Scheduler thường cần cân bằng giữa throughput, turnaround time, response time, fairness và switch overhead.
Các thuật toán này có thể chia thành hai loại: non-preemptive và preemptive.
Loại thứ nhất: non-preemptive scheduling (Non-Preemptive)
Với cách này, một khi CPU được phân bổ cho process, process sẽ tiếp tục chạy cho đến khi task hoàn tất hoặc chủ động nhường CPU (chẳng hạn khi chờ I/O).
- First Come, First Served (FCFS): chạy theo thứ tự đến, implementation đơn giản; khi task dài xếp trước, task ngắn phía sau cũng phải chờ, dẫn đến convoy effect.
- Shortest Job First (SJF): ưu tiên chạy task có execution time dự kiến ngắn, có thể giảm average waiting time; trong thực tế khó dự đoán chính xác độ dài task, đồng thời task dài có thể không được chạy trong thời gian dài.
Loại thứ hai: preemptive scheduling (Preemptive)
Hệ điều hành có thể tạm dừng task hiện tại và giao CPU cho task có thể chạy khác phù hợp hơn. Hệ điều hành đa dụng hiện đại thường hỗ trợ preemption.
- Round-Robin (RR): mỗi task lần lượt chạy một time slice. Time slice quá ngắn sẽ khuếch đại context switch overhead, quá dài thì dần gần với FCFS.
- Priority scheduling: ưu tiên chạy task có priority cao, có thể thể hiện mức độ khẩn cấp của task, nhưng cần xử lý vấn đề starvation của task có priority thấp.
Multi-Level Feedback Queue (MLFQ) thiết lập nhiều queue theo priority và điều chỉnh vị trí dựa trên behavior khi chạy của task. Task mới thường trước tiên đi vào queue priority cao; CPU-bound task thường dùng hết time slice sẽ dần bị hạ priority, còn interactive task thường chủ động chờ I/O có thể giữ priority cao hơn. Quy tắc nâng/hạ priority cụ thể và chống starvation phụ thuộc vào implementation.
FCFS, SJF, RR, priority và MLFQ chủ yếu là model đơn giản hóa trong giáo trình. Linux thực tế scheduling task hoặc scheduling entity; task thông thường trong thời gian dài được CFS phân bổ CPU theo weight và vruntime; từ Linux 6.6, fair scheduling class bắt đầu đưa EEVDF vào, dùng lag và virtual deadline để cải thiện việc lựa chọn task. Implementation cụ thể trên máy production còn phụ thuộc kernel version và patch của distribution.
Giới thiệu chi tiết: Giải thích chi tiết CPU scheduling và system load.
Vậy rốt cuộc ai thực hiện scheduling process này?
Đảm nhiệm scheduling là scheduler (Scheduler) trong kernel của hệ điều hành. Khi task hiện tại bị block, chủ động nhường CPU, time slice hoặc execution quota dùng hết, priority thay đổi, hoặc task phù hợp hơn được wake up, kernel đều có thể trigger scheduling.
Giáo trình còn dùng dispatcher để mô tả quá trình đưa quyết định scheduling lên CPU:
- Scheduler chọn task tiếp theo từ run queue.
- Quá trình dispatch hoàn thành context switch cụ thể:
- Lưu context của process hiện tại (CPU register state, program counter, v.v.) vào process control block (PCB) của nó.
- Load context của process được chọn tiếp theo, đọc state từ PCB của nó và khôi phục vào CPU register.
- Chính thức chuyển quyền điều khiển CPU cho process mới để process bắt đầu chạy.
Implementation trong Linux kernel hiện đại không tách nghiêm ngặt thành hai component độc lập; khi phỏng vấn chỉ cần hiểu hai trách nhiệm “chọn task tiếp theo” và “hoàn thành context switch”.
load average khác CPU utilization như thế nào?
load average phản ánh số lượng task có thể chạy và task ở uninterruptible sleep trong system trong một khoảng thời gian; trên Linux chủ yếu tương ứng với R state và D state. CPU utilization mô tả CPU time cụ thể được dùng ở user mode, kernel mode, I/O wait, interrupt, idle hoặc virtualization steal, v.v.
load cao có thể do task có thể chạy đang tranh chấp CPU, cũng có thể do nhiều task đang chờ block device, network storage, file system hoặc Swap; trong trường hợp sau, CPU vẫn có thể idle. Khi đánh giá load, còn phải kết hợp với số logical CPU: cùng là load 8 nhưng áp lực trên 1 logical CPU và 64 logical CPU hoàn toàn khác nhau.
Khi troubleshooting, trước tiên có thể dùng uptime để xem xu hướng load trong 1, 5 và 15 phút, sau đó kết hợp top, vmstat 1, pidstat và mpstat để xác định task đang tranh chấp CPU, chờ I/O hay thường xuyên xảy ra context switch. Có thể xem giải thích metric và troubleshooting path đầy đủ hơn tại: Giải thích chi tiết CPU scheduling và system load.
Deadlock
Deadlock là gì?
Deadlock mô tả tình huống như sau: một nhóm process/thread chờ nhau giải phóng resource hoặc hoàn thành action, quan hệ waiting tạo thành vòng khép kín, khiến tất cả thành phần tham gia đều không thể tự tiếp tục thực thi.
Cụ thể hơn, deadlock không đơn giản chỉ là “chờ lâu”. Block thông thường có thể tiếp tục thực thi sau khi lock được giải phóng, I/O trả về hoặc transaction commit; trong deadlock, waiting chain tạo thành cycle, nếu không có tác động bên ngoài thì cycle này không tự được tháo gỡ.
Về quá trình hình thành deadlock, troubleshooting Java thread deadlock và xử lý database deadlock, có thể xem chuyên đề đầy đủ hơn này: Giải thích chi tiết deadlock: bốn điều kiện cần, troubleshooting Java deadlock và xử lý database deadlock.
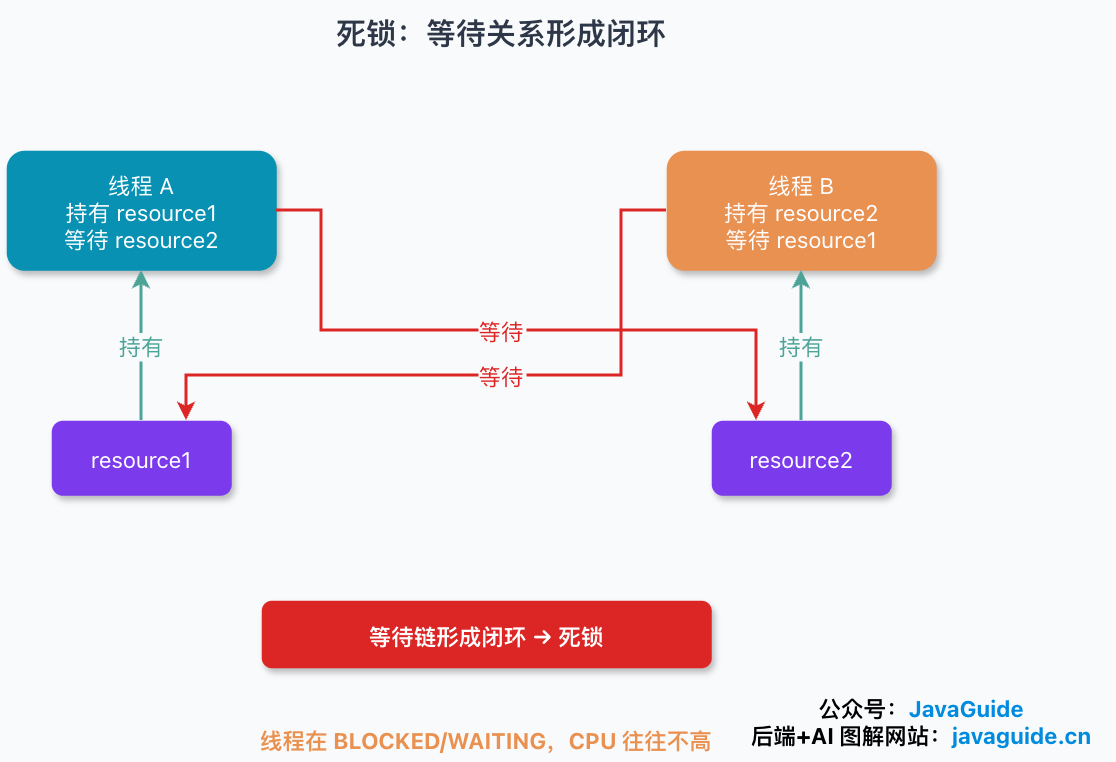
Một ví dụ kinh điển nhất là “giữ lock chéo”. Hãy tưởng tượng có hai thread và hai lock:
- Thread 1 lấy được lock A trước, sau đó thử lấy lock B.
- Gần như đồng thời, thread 2 lấy được lock B, sau đó thử lấy lock A.
Khi đó, thread 1 chờ thread 2 giải phóng lock B, thread 2 chờ thread 1 giải phóng lock A; hai bên đều giữ resource mà bên kia cần và chờ bên kia giải phóng, từ đó hình thành waiting cycle.
Bốn điều kiện cần để deadlock xảy ra là gì?
Deadlock xảy ra không phải ngẫu nhiên; nó cần đồng thời thỏa mãn bốn điều kiện cần:
- Mutual exclusion: resource phải ở chế độ non-shared, tức mỗi lần chỉ một process có thể sử dụng. Nếu process khác yêu cầu resource đó, process phải chờ đến khi resource được giải phóng.
- Hold and wait: một process ít nhất đang giữ một resource và chờ resource khác, trong khi resource đó đang do process khác chiếm giữ.
- No preemption: resource không thể bị preempt. Chỉ sau khi process đang giữ resource hoàn thành task thì resource mới được giải phóng.
- Circular wait: có một nhóm waiting process
{P0, P1, ..., Pn}, resource màP0chờ đang doP1giữ, resource màP1chờ đang doP2giữ, ... resource màPn-1chờ đang doPngiữ, resource màPnchờ lại doP0giữ.
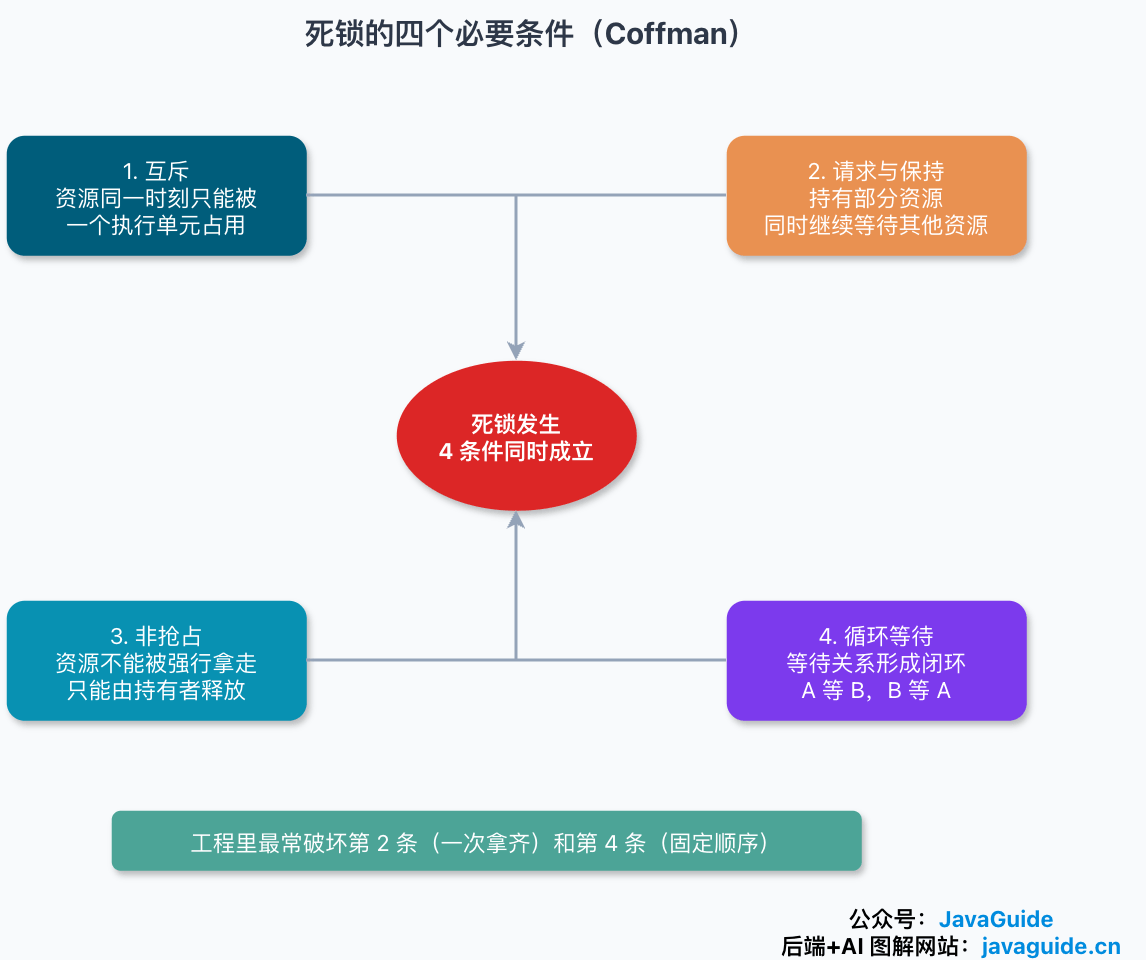
Lưu ý: bốn điều kiện này là điều kiện cần để deadlock xảy ra và phải đồng thời tồn tại. Chỉ thỏa mãn một hoặc hai điều kiện chưa chắc xảy ra deadlock; ngược lại, chỉ cần ổn định phá vỡ bất kỳ một điều kiện nào thì có thể ngăn deadlock ngay từ cấu trúc.
Có thể viết code mô phỏng deadlock không?
Dưới đây là một ví dụ thực tế để tái hiện tình huống giữ lock chéo ở trên:
public class DeadLockDemo {
    private static final Object resource1 = new Object(); // Resource 1
    private static final Object resource2 = new Object(); // Resource 2

    public static void main(String[] args) {
        new Thread(() -> {
            synchronized (resource1) {
                System.out.println(Thread.currentThread() + "get resource1");
                try {
                    Thread.sleep(1000);
                } catch (InterruptedException e) {
                    Thread.currentThread().interrupt();
                }
                System.out.println(Thread.currentThread() + "waiting get resource2");
                synchronized (resource2) {
                    System.out.println(Thread.currentThread() + "get resource2");
                }
            }
        }, "Thread 1").start();

        new Thread(() -> {
            synchronized (resource2) {
                System.out.println(Thread.currentThread() + "get resource2");
                try {
                    Thread.sleep(1000);
                } catch (InterruptedException e) {
                    Thread.currentThread().interrupt();
                }
                System.out.println(Thread.currentThread() + "waiting get resource1");
                synchronized (resource1) {
                    System.out.println(Thread.currentThread() + "get resource1");
                }
            }
        }, "Thread 2").start();
    }
}
Output
Thread[Thread 1,5,main]get resource1
Thread[Thread 2,5,main]get resource2
Thread[Thread 1,5,main]waiting get resource2
Thread[Thread 2,5,main]waiting get resource1
Thread 1 lấy monitor lock của resource1 thông qua synchronized (resource1), thread 2 lấy monitor lock của resource2 thông qua synchronized (resource2). Thread.sleep(1000) không phải nguyên nhân của deadlock; nó chỉ kéo dài khoảng thời gian hai thread thực thi đan xen, giúp deadlock dễ tái hiện hơn. Sau khi sleep kết thúc, cả hai thread đều bắt đầu yêu cầu resource mà thread kia đang giữ, từ đó rơi vào trạng thái chờ lẫn nhau.
Cách giải quyết deadlock
Khi phỏng vấn, trả lời đến mức này là đủ: giải quyết deadlock thường có bốn hướng là prevention, avoidance, detection và resolution/recovery.
- Prevention: chủ động phá vỡ một trong bốn điều kiện cần của deadlock. Trong engineering, cách thường gặp nhất là cố định thứ tự lock, thu hẹp phạm vi lock và tránh thực hiện thao tác chậm khi đang giữ lock.
- Avoidance: trước khi phân bổ resource, kiểm tra xem system còn ở safe state hay không; đại diện điển hình là Banker’s algorithm. Cách này thiên về hiểu theo giáo trình, các business system thông thường rất ít khi implementation trực tiếp.
- Detection: cho phép waiting xảy ra, sau đó kiểm tra xem cycle có xuất hiện trong wait-for graph hoặc resource allocation graph hay không. Trong Java có thể dùng
jcmd <pid> Thread.print -l,jstack -l <pid>hoặcThreadMXBean.findDeadlockedThreads()để hỗ trợ troubleshooting; database cũng sẽ phát hiện transaction waiting cycle. - Resolution/Recovery: sau khi phát hiện deadlock, phá vỡ waiting cycle, chẳng hạn terminate process, rollback transaction, preempt resource hoặc để application retry. Database transaction vốn hỗ trợ rollback nên phù hợp hơn với detection và recovery.
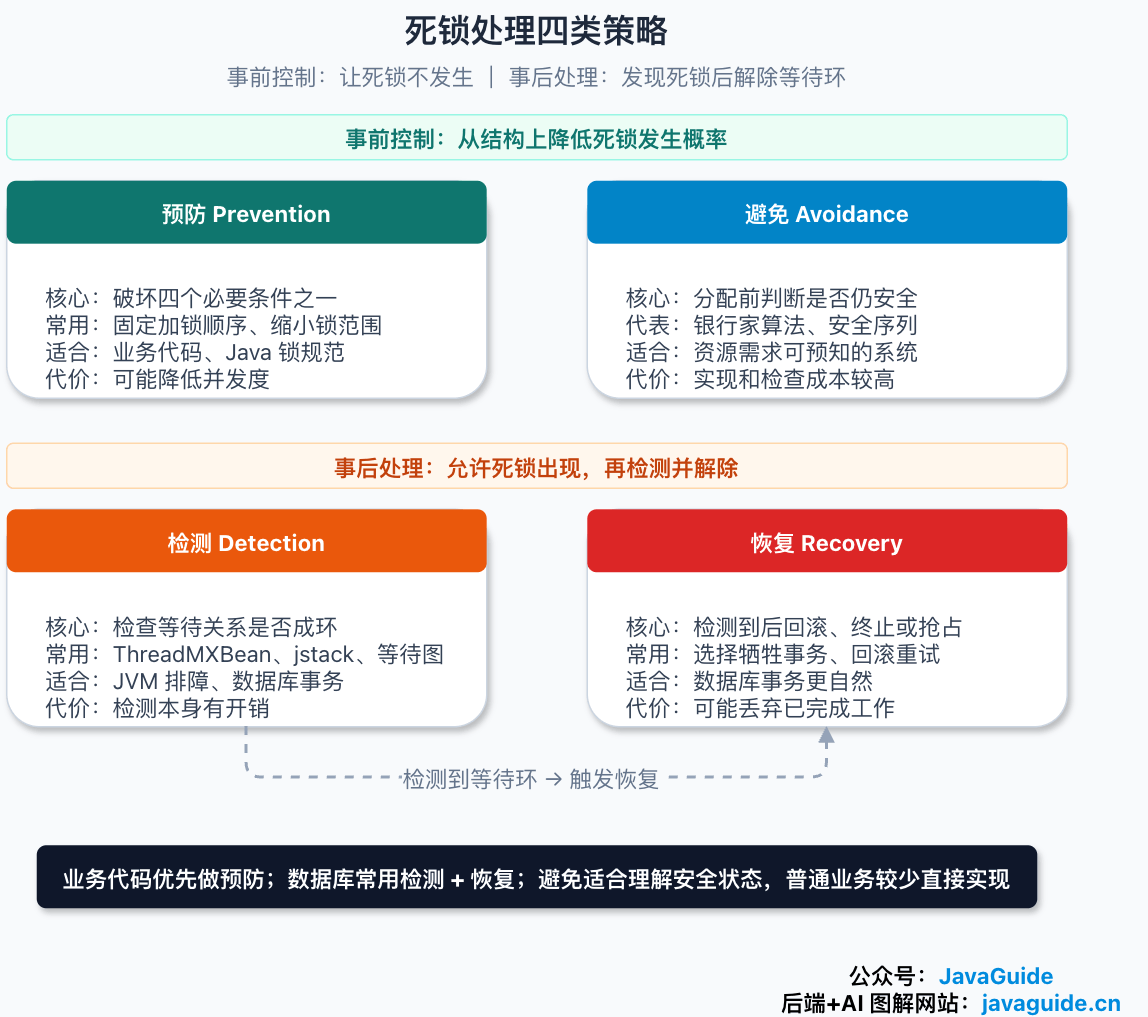
Phần này khi phỏng vấn không cần trình bày quá chi tiết, chỉ cần nắm được các tầng là đủ. Nếu muốn tiếp tục xem resource allocation graph, wait-for graph, troubleshooting Java thread stack và database deadlock retry, có thể đọc: Giải thích chi tiết deadlock: bốn điều kiện cần, troubleshooting Java deadlock và xử lý database deadlock.
Tài liệu tham khảo
- 《Hệ điều hành máy tính》 của Tưởng Tiểu Đan, phiên bản thứ tư
- 《Hiểu sâu về hệ thống máy tính》
- 《Học lại hệ điều hành》
- Tại sao hệ điều hành cần phân biệt user mode và kernel mode: https://blog.csdn.net/chen134225/article/details/81783980
- Hiểu user mode và kernel mode từ gốc: https://juejin.cn/post/6923863670132850701
- Zombie process và orphan process là gì: https://blog.csdn.net/a745233700/article/details/120715371
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.