
Giải thích chi tiết về zero-copy: mmap, sendfile và splice
Trong phỏng vấn thường có một kiểu hỏi quen thuộc: trước tiên hỏi bạn “Vì sao Kafka nhanh?”, “Vì sao RocketMQ chịu được lượng tồn đọng lớn?”. Sau khi bạn trả lời được về sequential write, Page Cache và zero-copy, người phỏng vấn sẽ đào sâu: “Cụ thể zero-copy đã loại bỏ những lần copy nào?”, “mmap và sendfile khác nhau thế nào?”, “splice dùng để làm gì?”.
Đến bước này, nhiều người bắt đầu trả lời vòng vo. Không ít người có thể học thuộc câu “zero-copy là không đi qua user space”, nhưng không nhiều người có thể tính rõ 4 lần copy, 2 lần DMA và số lần chuyển đổi context.
Bài viết này bắt đầu từ việc gửi một file: I/O truyền thống thực hiện bao nhiêu lần copy, “zero” trong zero-copy thực sự tiết kiệm ở đâu, ba hướng mmap, sendfile, splice lần lượt tiết kiệm những gì và mỗi hướng phải đánh đổi điều gì.
Trước khi bắt đầu bài viết, chúng ta cần thống nhất cách tính.
Khi đề cập đến “mấy lần copy, mấy lần chuyển đổi” ở phần sau, mặc định sẽ tính theo mô hình đơn giản hóa dưới đây. Nếu đổi bối cảnh, các con số cũng sẽ thay đổi:
- Bối cảnh là gửi một file thông thường qua TCP socket, dữ liệu ban đầu không nằm trong Page Cache (cần thực sự đọc đĩa).
- Không xét các xử lý như mã hóa TLS, nén, chuyển đổi format, vốn cần chạm vào dữ liệu trong user space.
- Thiết bị hỗ trợ DMA và scatter-gather thông dụng.
- “Số lần copy” chỉ tính payload, không tính descriptor và metadata.
- “Context switch” được nói đến bên dưới, chính xác là chuyển đổi mode giữa user space và kernel space (mỗi lần vào/ra system call được tính một lần), không phải “thread context switch” khi thread được scheduler đưa vào chạy hoặc lấy ra; chỉ khi system call thực sự bị block và thread bị đổi ra thì mới phát sinh thêm thread context switch.
Khi Page Cache hit, đi qua TLS hoặc phần cứng không hỗ trợ SG-DMA, các con số này đều sẽ thay đổi. Các giả định trên chỉ nhằm làm rõ cơ chế, đừng xem các con số là đáp án cố định trong mọi môi trường.
read/write truyền thống thực hiện bao nhiêu lần copy
Hãy xem một bối cảnh phổ biến nhất: một API tải file, server cần gửi file trên đĩa qua socket đã kết nối đến client. Cách viết trực tiếp nhất là một read cộng một write:
while ((n = read(file_fd, buf, BUF_SIZE)) > 0)
    write(socket_fd, buf, n);
Nhìn thì chỉ có hai dòng, nhưng bên dưới lại phải xử lý khá nhiều. Một lần “đọc đĩa + gửi network” hoàn chỉnh cần CPU và DMA di chuyển dữ liệu 4 lượt, đồng thời còn phải qua lại giữa user space và kernel space 4 lần.
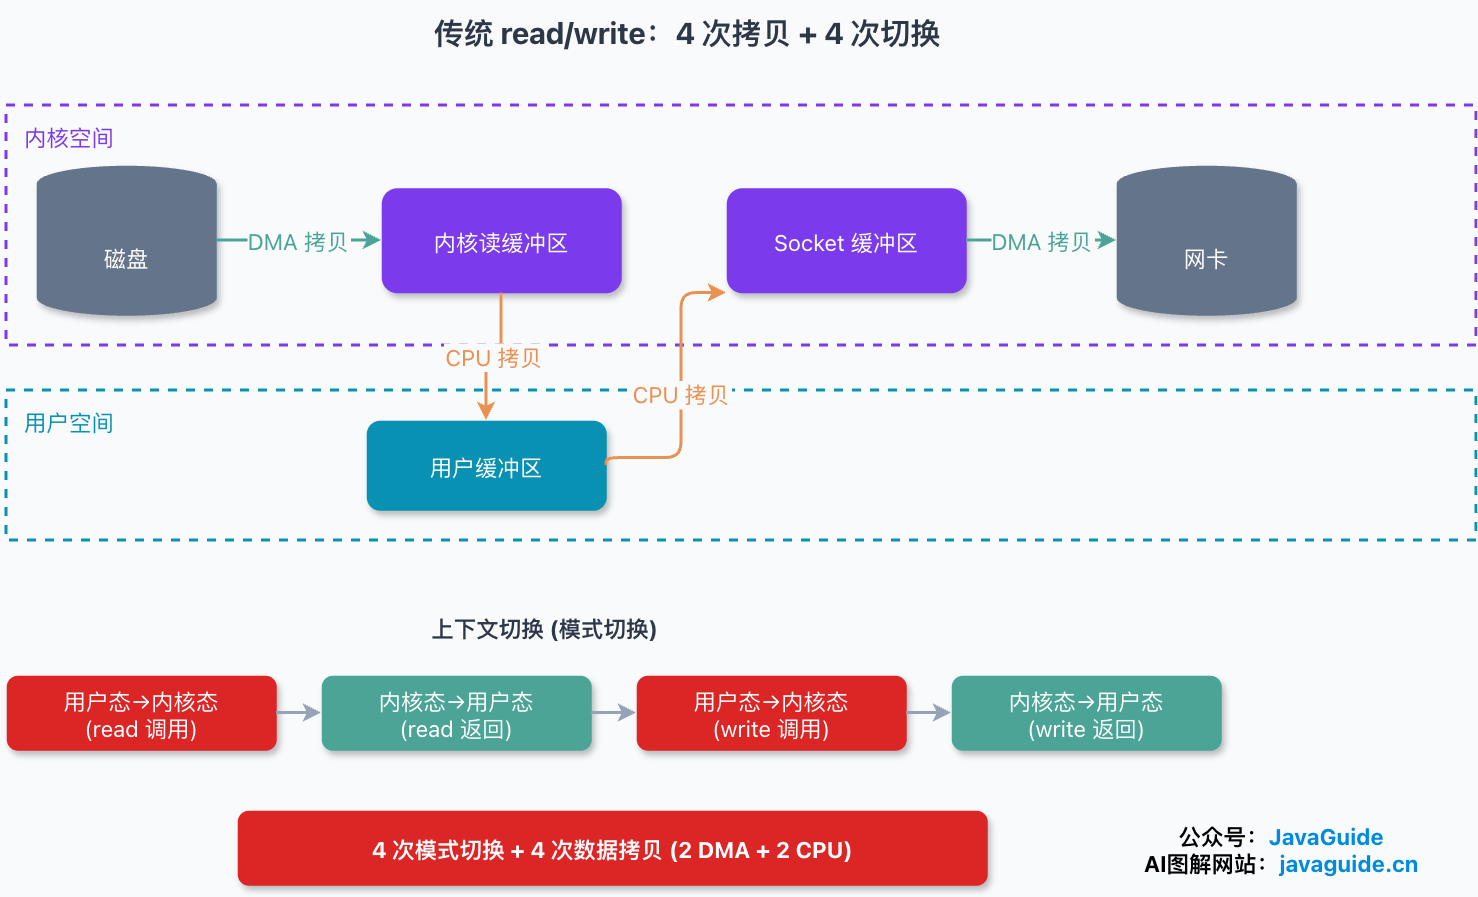
Tách hai dòng này ra, phần read diễn ra như sau:
- Process ứng dụng gọi
read, thực hiện system call, context chuyển từ user space sang kernel space (lần chuyển đổi thứ 1). - Bộ điều khiển DMA đọc dữ liệu từ đĩa vào read buffer của kernel (lần copy thứ 1, DMA copy).
- CPU copy dữ liệu từ buffer đọc của kernel vào buffer của user (lần copy thứ 2, CPU copy), context chuyển ngược về user space (lần chuyển đổi thứ 2),
readtrả về.
Nửa write có tính đối xứng:
- Process ứng dụng gọi
write, thực hiện system call, context chuyển sang kernel space (lần chuyển đổi thứ 3). - CPU copy dữ liệu từ buffer của user vào buffer của socket (lần copy thứ 3, CPU copy).
- DMA copy dữ liệu từ buffer của socket vào card mạng (lần copy thứ 4, DMA copy), context chuyển ngược về user space (lần chuyển đổi thứ 4),
writetrả về.
Đếm lại: 4 lần mode switch, 4 lần copy dữ liệu, trong đó 2 lần là DMA copy và 2 lần là CPU copy. (Nói chính xác, sau khi write copy dữ liệu vào send buffer của socket thì thường đã trả về; việc card mạng xếp hàng, phân đoạn và gửi bằng DMA được protocol stack hoàn thành bất đồng bộ, không cần chờ DMA gửi xong mới chuyển về user space. Ở đây gộp chúng vào cùng một lần gọi chỉ để tính đủ các khoản.)
Nói thêm về DMA (Direct Memory Access, truy cập bộ nhớ trực tiếp). Đây là khả năng do device controller hoặc DMA engine trong hệ thống cung cấp, có thể trực tiếp di chuyển dữ liệu giữa peripheral và memory, gần như không cần CPU theo dõi trong suốt quá trình (trong phần cứng hiện đại, nó thường được tích hợp trong device controller, SoC hoặc chipset, không nhất thiết là một chip độc lập). Những việc vận chuyển thuần túy như từ đĩa đến buffer của kernel, từ buffer của socket đến card mạng được giao cho nó, CPU có thể rảnh tay xử lý việc khác, vì vậy DMA copy hầu như không tốn CPU.
Điều thực sự gây lãng phí là hai lần CPU copy đó. Dữ liệu được copy từ buffer đọc của kernel vào buffer của user, sau đó lại copy nguyên vẹn từ buffer của user trở về buffer của socket, trong khi API download của chúng ta hoàn toàn không chạm vào nội dung này, dữ liệu chỉ đi qua user space một vòng. CPU liên tục thực hiện việc di chuyển vô nghĩa, cộng thêm overhead lưu và khôi phục register qua 4 lần chuyển đổi. Trong bối cảnh concurrency cao và file lớn, phần lãng phí này sẽ bị khuếch đại rõ rệt.
Zero-copy nhằm tiết kiệm phần này.
“Zero” trong zero-copy là lần copy nào
Trước hết cần sửa một hiểu lầm phổ biến: zero-copy không có nghĩa là thực sự không có lần copy nào.
Trong mô hình “file không hit Page Cache, sau đó được gửi qua TCP” được đặt ra trong bài viết này, dữ liệu vẫn phải trải qua hai lượt DMA: từ đĩa đến memory và từ memory đến card mạng. Zero-copy loại bỏ công việc CPU copy payload giữa các vùng memory, đồng thời có thể giảm số lần chuyển đổi mode giữa user space và kernel space. Nếu đổi sang bối cảnh Page Cache đã hit hoặc thiết bị truy cập trực tiếp vào persistent memory, số lần di chuyển cũng sẽ thay đổi.
Vì vậy, định nghĩa chính xác hơn của zero-copy là: trong thao tác I/O, không để CPU tham gia copy dữ liệu giữa các vùng memory, từ đó giảm số lần CPU copy và chuyển đổi giữa user space/kernel space. Đây là tên gọi chung của một nhóm kỹ thuật; ba hướng bên dưới đều tập trung vào câu hỏi “làm thế nào loại bỏ CPU copy”.
Hướng một: mmap + write
Ý tưởng đầu tiên đến từ virtual memory. Các Operating System hiện đại dùng virtual address thay cho physical address, trong đó có một đặc điểm quan trọng: nhiều virtual address có thể trỏ đến cùng một vùng physical memory.
mmap tận dụng chính điểm này. Function signature của nó như sau:
void *mmap(void *addr, size_t length, int prot, int flags, int fd, off_t offset);Trong đó fd là file descriptor của file cần map, length là độ dài mapping, offset là offset của file. Sau khi gọi, read buffer của kernel và một vùng virtual address trong user space được map đến cùng một vùng physical memory. Nói cách khác, buffer của kernel và buffer của user “chia sẻ” cùng một bản dữ liệu, không còn lưu thành hai bản riêng.
Vì vậy, read + write ban đầu trở thành mmap + write. Trước tiên cần phá bỏ một hiểu lầm phổ biến: bản thân lời gọi mmap chỉ thiết lập mapping từ file đến một vùng virtual address, không lập tức đọc file vào memory. Việc đọc đĩa thực sự xảy ra sau đó, khi truy cập vào page của mapping chưa resident và gây ra page fault; kernel sẽ load theo page từ Page Cache (nếu không có thì từ đĩa). Quy trình đại khái như sau:
- Process ứng dụng gọi
mmap, kernel thiết lập mapping từ file đến vùng virtual address, mỗi lần vào và ra kernel space đều tính một lần chuyển đổi, rồi trả về. Lúc này chưa có dữ liệu file nào được nạp vào. - Sau đó truy cập vùng mapping này (điển hình là dùng nó làm data source cho
write), lần đầu chạm vào page chưa resident sẽ gây ra page fault; nếu Page Cache không có page đó, DMA đọc dữ liệu từ đĩa vào Page Cache (DMA copy). - Sau khi page table thiết lập mapping, page trong Page Cache của kernel được map đồng thời vào user address space; hai bên chia sẻ cùng một vùng physical memory.
- Ứng dụng gọi
write, CPU copy dữ liệu này từ Page Cache của kernel vào buffer của socket (CPU copy). Vì chia sẻ physical memory, cách này loại bỏ CPU copy dư thừa “kernel đến user rồi quay lại kernel” của phương thức truyền thống. - DMA gửi dữ liệu trong buffer của socket đến card mạng (DMA copy),
writetrả về.
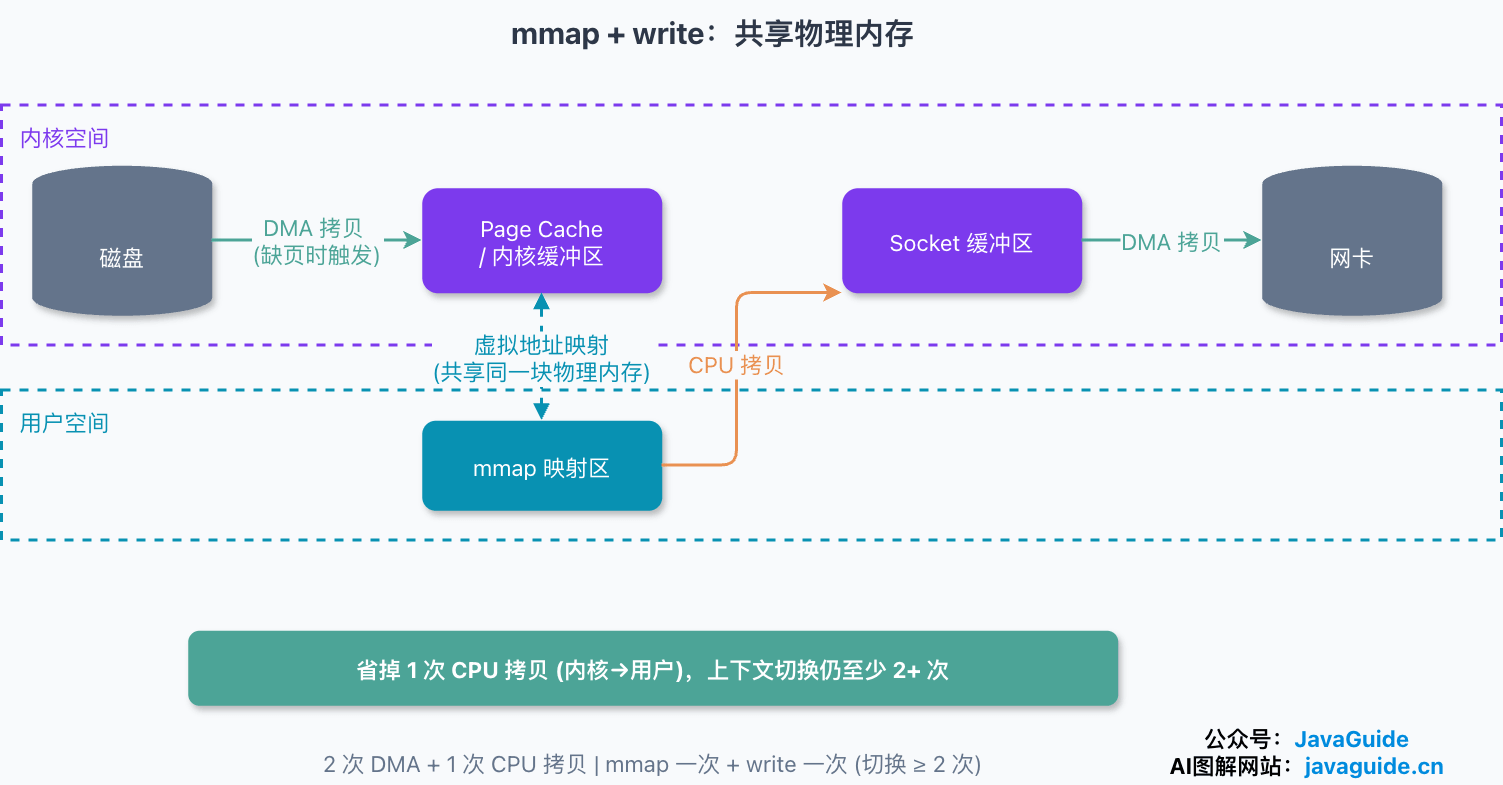
Tính toán (khi cache miss và đi hết path): khoảng 2 lần DMA + 1 lần CPU copy; về chuyển đổi, mmap một lần, write một lần, cộng thêm xử lý page fault khi truy cập lần đầu. So với phương thức truyền thống, mmap loại bỏ CPU copy “kernel đến user”.
Vì vậy, câu “mmap + write cố định là 4 lần chuyển đổi, 3 lần copy” chỉ có thể xem là mô hình đơn giản hóa để giảng dạy; việc Page Cache hit hay không, page fault xảy ra lúc nào đều khiến con số thực tế dao động.
mmap còn có một lợi ích đi kèm: process của user không cần duy trì thêm một buffer đọc trong user space trùng nội dung với Page Cache, tiết kiệm phần buffer và copy thêm này. Còn thực sự tiết kiệm bao nhiêu physical memory thì phụ thuộc vào processing window, kích thước buffer và access pattern, không thể nói chung chung là “tiết kiệm một nửa”.
Tuy nhiên mmap không phải không có vấn đề. Bản thân mapping có overhead, việc thiết lập và hủy page table, xử lý page fault đều tốn thời gian; với file rất nhỏ, overhead này có thể còn khiến mmap chậm hơn read/write thông thường, vì vậy mmap phù hợp hơn với file lớn và đọc/ghi lặp lại. Một vấn đề khó nhận thấy hơn: nếu file bạn map bị process khác truncate, sau đó bạn truy cập vùng mapping đã bị cắt, chương trình sẽ trực tiếp nhận signal SIGBUS và crash tại chỗ. Loại vấn đề này rất khó điều tra trong production, nên khi dùng mmap cần nắm rõ.
Hướng hai: sendfile
mmap đã loại bỏ một CPU copy, nhưng vẫn không tránh được hai loại system call là mmap và write; nếu chỉ gửi nguyên vẹn file, có thể dùng một system call để hoàn tất việc truyền dữ liệu hoàn toàn trong kernel không?
Linux kernel 2.1 giới thiệu sendfile để làm việc này:
ssize_t sendfile(int out_fd, int in_fd, off_t *offset, size_t count);in_fd: nguồn dữ liệu, phải là object hỗ trợ đọc theo kiểu mmap (thường là file thông thường), không thể là socket.out_fd: đích dữ liệu, trước Linux 2.6.33 chỉ có thể là socket, sau đó có thể là file bất kỳ. Cần xem giới hạn cụ thể theo kernel version.offset: bắt đầu đọc từ vị trí nào trong file; truyềnNULLnghĩa là dùng offset hiện tại của file.count: truyền bao nhiêu byte.
Ý nghĩa của nó là: trực tiếp truyền dữ liệu giữa hai file descriptor, toàn bộ quá trình hoàn thành trong kernel, dữ liệu hoàn toàn không đi qua user space. Quy trình rút ngắn thành:
- Process ứng dụng gọi sendfile, chuyển sang kernel space (lần mode switch thứ 1).
- DMA copy dữ liệu từ đĩa vào buffer đọc của kernel (DMA copy).
- CPU copy dữ liệu từ buffer đọc của kernel vào buffer của socket (CPU copy).
- DMA copy dữ liệu từ buffer của socket vào card mạng (DMA copy), chuyển về user space (lần mode switch thứ 2), sendfile trả về.
Tính toán: 2 lần mode switch, 3 lần copy dữ liệu (2 lần DMA + 1 lần CPU).
So với mmap, ưu thế cốt lõi của sendfile là gom việc chuyển tiếp từ file đến socket vào một system call, thường ít hơn một lượt qua lại giữa user space/kernel space; cái giá phải trả là dữ liệu đi hoàn toàn trong kernel, user space không thể trực tiếp xử lý dữ liệu này. Nếu cần sửa nội dung trước khi truyền, sendfile không phù hợp; nên chuyển sang mmap, read/write thông thường hoặc cách xử lý khác khiến dữ liệu đi vào user space.
Đến đây vẫn còn một CPU copy (từ buffer đọc của kernel đến buffer của socket). Có thể loại bỏ cả lần này không?
Hướng ba: sendfile + SG-DMA (zero-copy thực sự)
Linux 2.4 nâng cấp sendfile; điểm mấu chốt là đưa vào SG-DMA (scatter/gather DMA, DMA phân tán/tập hợp). Khả năng phần cứng này cho phép DMA trực tiếp di chuyển dữ liệu từ buffer đọc của kernel đến card mạng, không cần đi qua buffer của socket.
Quy trình sau nâng cấp:
- Process ứng dụng gọi sendfile, chuyển sang kernel space (lần mode switch thứ 1).
- DMA copy dữ liệu từ đĩa vào buffer đọc của kernel (DMA copy).
- CPU không còn copy bản thân dữ liệu, chỉ ghi thông tin mô tả của dữ liệu trong buffer của kernel (địa chỉ memory, offset và length) vào buffer của socket.
- SG-DMA dựa trên các thông tin mô tả này, trực tiếp di chuyển dữ liệu từ buffer đọc của kernel đến card mạng (DMA copy), chuyển về user space (lần mode switch thứ 2), sendfile trả về.
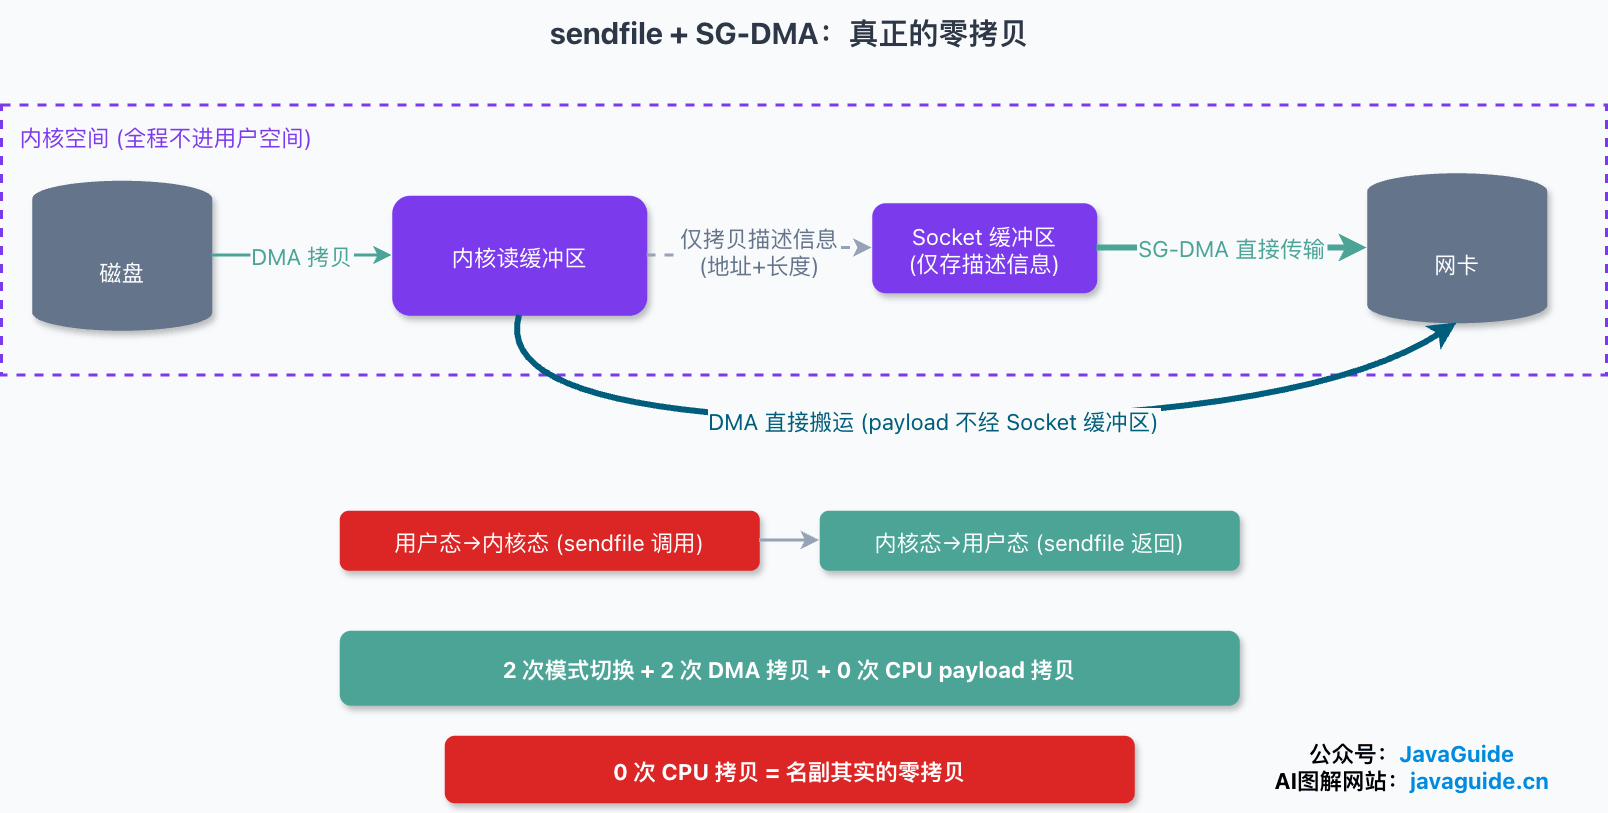
Tính toán: 2 lần mode switch, 2 lần copy dữ liệu, trong đó cả hai đều là DMA copy; CPU copy payload bằng 0.
Đây mới đúng nghĩa là zero-copy: trong toàn bộ quá trình không có lần nào CPU di chuyển payload, việc từ đĩa đến card mạng hoàn toàn do DMA thực hiện. Một ít thông tin mô tả mà CPU ghi ở bước 3 chỉ là vài byte metadata, không tính là data copy. Tuy nhiên, để thực sự đi theo path này cần có điều kiện: card mạng phải hỗ trợ scatter-gather, kernel version phải đủ mới, protocol stack không được cần chạm vào dữ liệu giữa chừng. Khi bật mã hóa TLS trong user space hoặc cần chuyển đổi format, kernel buộc phải thực sự đọc payload, con đường 0 CPU copy này sẽ không thể hoạt động.
Hướng bốn: splice
sendfile đã rất tốt, nhưng nó có một giới hạn cứng: in_fd phải là object hỗ trợ đọc kiểu mmap (thường là file thông thường), không thể là socket; trong giai đoạn đầu, out_fd cũng chỉ có thể là socket. Nếu muốn chuyển tiếp zero-copy giữa hai socket, hoặc giữa hai descriptor nói chung, sendfile không đủ dùng.
Linux kernel 2.6.17 giới thiệu splice (do Jens Axboe đưa vào, cần glibc 2.5 hỗ trợ) để bổ sung phần này. Ý tưởng của nó là mượn pipe:
ssize_t splice(int fd_in, loff_t *off_in, int fd_out, loff_t *off_out,
               size_t len, unsigned int flags);
splice yêu cầu ít nhất một trong fd_in và fd_out là pipe. Vì sao nó phải gắn với pipe? Vì bên dưới pipe của Linux là một nhóm page pointer có reference count: thứ được lưu trong buffer của pipe không phải bản thân dữ liệu, mà là pointer trỏ đến memory page trong kernel, cộng thêm reference count của từng page. Cái gọi là “di chuyển dữ liệu từ pipe sang đầu kia” trong phần lớn trường hợp chỉ là copy pointer và tăng reference count của page tương ứng thêm một, không thực sự di chuyển payload. Cần lưu ý rằng SPLICE_F_MOVE chỉ là một gợi ý cho kernel, không phải bảo đảm cứng; khi gặp một số filesystem, device hoặc dạng buffer không thể trực tiếp di chuyển page, kernel vẫn có thể fallback thành copy thực sự.
Dùng splice để truyền từ file đến socket cần thực hiện hai bước bằng hai system call:
splice(file_fd, NULL, pipe_w, NULL, len, SPLICE_F_MOVE);   // File -> đầu ghi của pipe
splice(pipe_r, NULL, socket_fd, NULL, len, SPLICE_F_MOVE); // Đầu đọc của pipe -> socket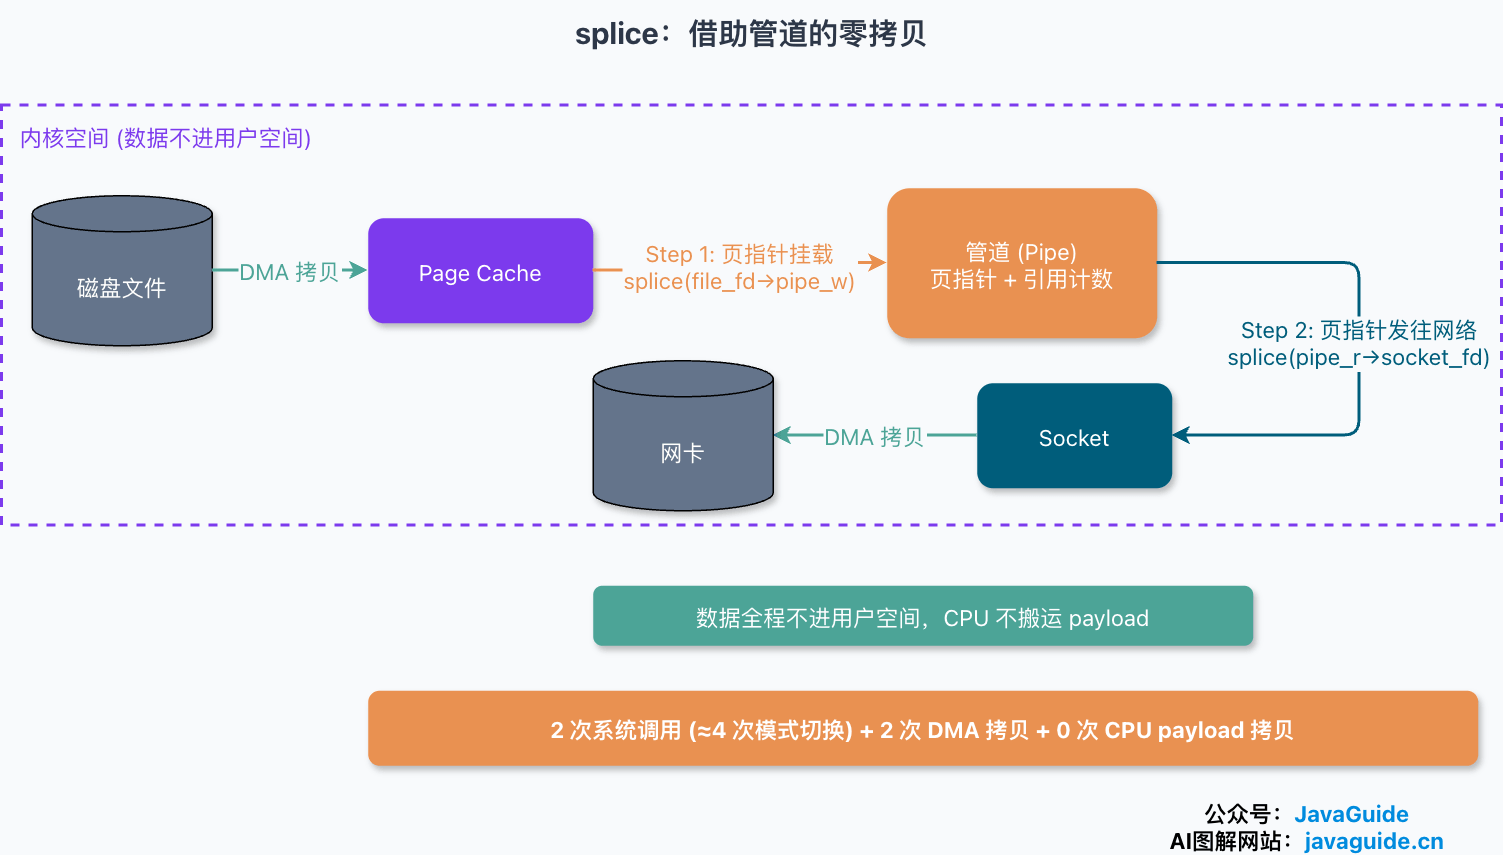
Lần đầu gắn page trong Page Cache vào buffer của pipe, lần thứ hai dùng các page pointer này làm fragment của network packet để gửi đến socket. Dữ liệu không đi vào user space trong toàn bộ quá trình, CPU không di chuyển payload. Nhưng cần nhìn rõ: đây là hai lần gọi splice, mỗi lần vào/ra kernel space tính một lần, tổng cộng khoảng 4 lần mode switch, không phải “giống sendfile, chỉ có một system call và hai lần chuyển đổi” như một số bài viết nói. Trong dự án thực tế, hai fd còn phải được thiết lập non-blocking, phối hợp với epoll, đồng thời xử lý short transfer và EAGAIN.
Có thể hiểu sự khác biệt giữa splice và các cách trước như sau:
- Tổng quát hơn sendfile: sendfile tập trung hơn vào truyền giữa các fd trong kernel (điển hình là file đến socket); splice nhờ pipe nên có thể chuyển tiếp dữ liệu giữa nhiều loại descriptor hơn, bao gồm socket đến socket. Một số kernel version có thể reuse implementation liên quan ở bên trong, nhưng đây là hai system call độc lập, giới hạn tham số và quá trình phát triển khác nhau, đừng đơn giản hiểu chúng là quan hệ kế thừa cha con nghiêm ngặt.
- Đối lập về cách tiếp cận với mmap: mmap map dữ liệu vào user space để bạn có thể sửa; toàn bộ ý nghĩa của splice nằm ở việc dữ liệu hoàn toàn không chạm vào user space, bạn không nhìn thấy cũng không sửa được.
Bổ sung một chi tiết về version: trong Linux 2.6.30 trở về trước, fd_in và fd_out phải có chính xác một bên là pipe; từ 2.6.31, hai đầu có thể đều là pipe.
So sánh bốn cách
Đặt bốn hướng trên cạnh nhau, sự khác biệt sẽ rất rõ ràng:
| Cách thức | CPU payload copy | DMA copy | Mode switch | System call điển hình |
|---|---|---|---|---|
| read + write truyền thống | 2 | 2 | 4 | read + write |
| mmap + write | 1 | 2 | Sau khi mapping thường ít nhất 2, lần truy cập đầu có page fault riêng | mmap một lần + write nhiều lần |
| sendfile | 0 hoặc 1 (tùy path gửi) | Thường 2 | 2 | sendfile |
| splice (file→pipe→socket) | Thường có thể tránh | Thường 2 | 4 | splice hai lần |
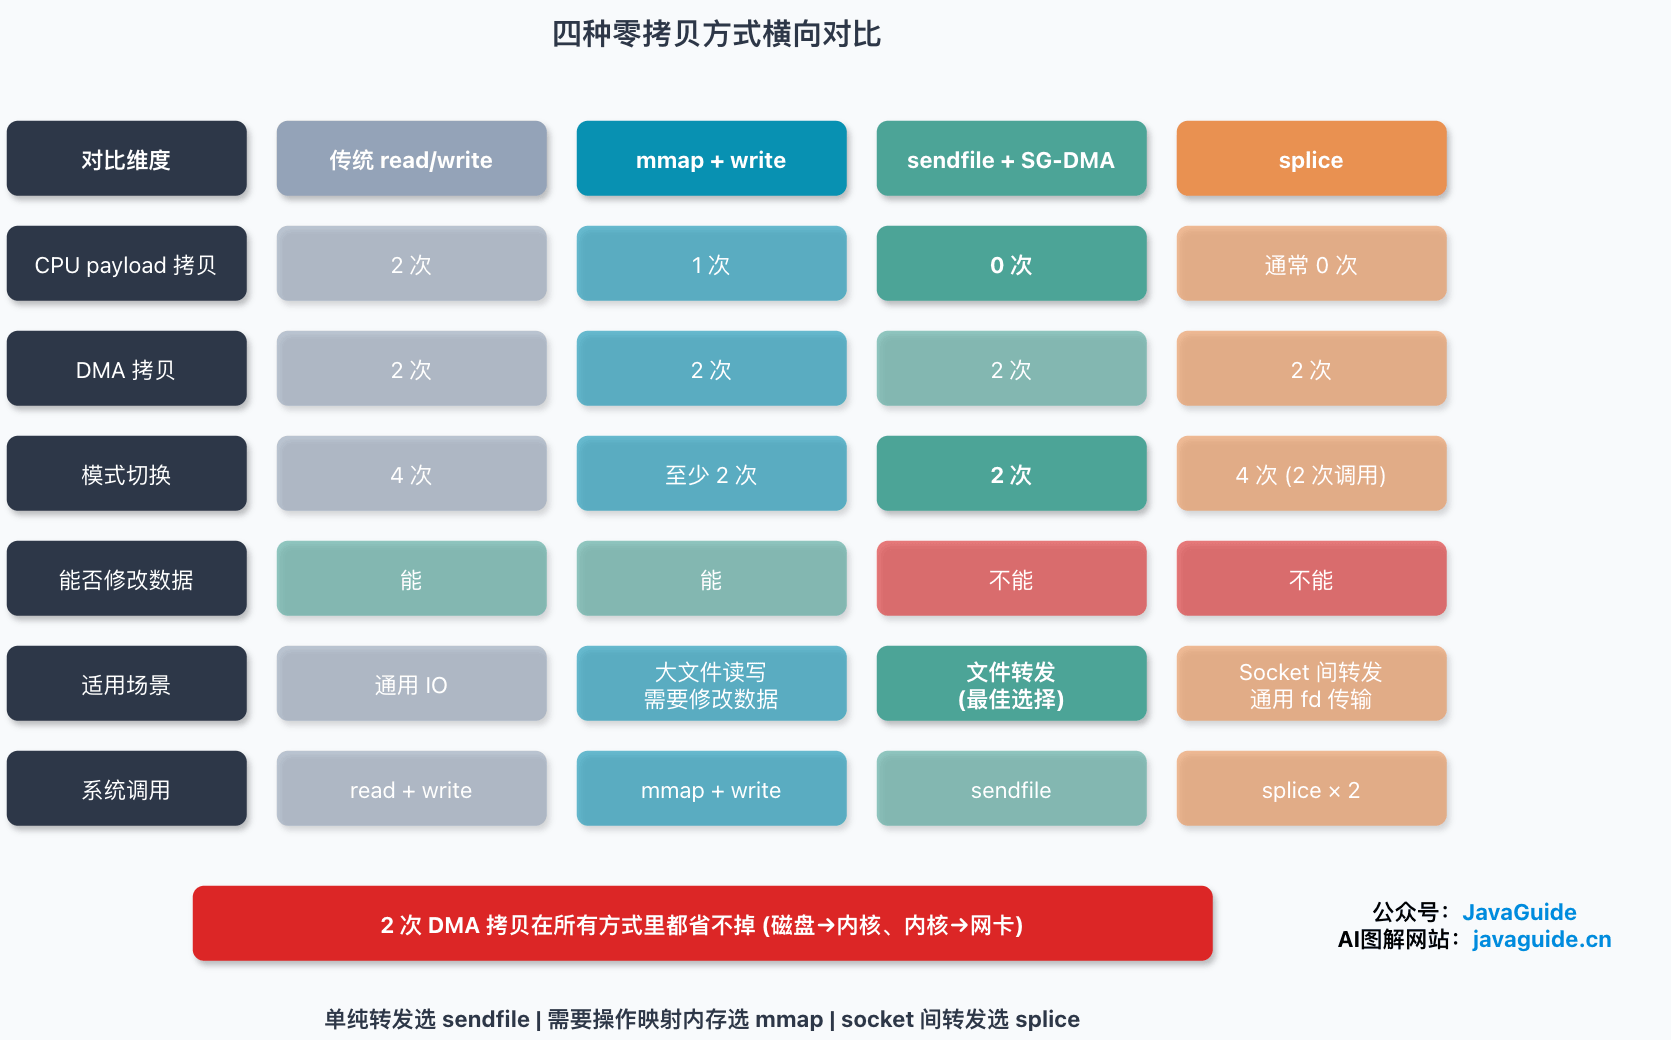
(Số lần copy/mode switch ở dòng mmap dao động theo việc Page Cache hit và thời điểm xảy ra page fault, không nên cố định thành một giá trị; khi card mạng hỗ trợ SG-DMA, CPU payload copy của sendfile giảm xuống 0.)
Hai kết luận:
Thứ nhất, trong mô hình file đến TCP khi cache miss của bài viết này, 2 lượt DMA vẫn tồn tại. Chúng lần lượt tương ứng với “đĩa đến memory” và “memory đến card mạng”. Zero-copy chủ yếu giảm CPU payload copy và mode switch; khi đổi sang một bối cảnh I/O khác, không thể tiếp tục áp dụng máy móc con số cố định này.
Thứ hai, chọn hướng nào thì trước tiên phải xem ứng dụng có cần chạm vào dữ liệu hay không. Nếu cần sửa nội dung trước khi truyền, mmap thuận tiện hơn; nếu chỉ gửi nguyên vẹn file, sendfile phù hợp hơn, khi card mạng hỗ trợ SG-DMA còn có thể đưa CPU payload copy về 0. splice chỉ đáng dùng khi cần chuyển tiếp giữa các fd khác ngoài cặp file đến socket, chẳng hạn socket đến socket; khi đó cần đưa thêm lớp pipe vào và chấp nhận cost của hai system call.
Zero-copy cũng không phải bật lên là luôn có lợi. Khi bật TLS, cần nén hoặc chuyển đổi format, sớm muộn payload cũng phải đi vào user space để xử lý; lọc nội dung, thêm watermark và rate limiting cũng là các vấn đề cùng loại. Khi file rất nhỏ hoặc truy cập rất ngẫu nhiên, các fixed cost như mapping, page fault và pipe ngược lại có thể nổi bật hơn.
mmap cũng cần cẩn thận với việc file bị truncate rồi truy cập mapping cũ gây ra SIGBUS; khi lưu lượng zero-copy rất lớn, Page Cache bị chiếm chỗ và việc thu hồi memory trở nên nặng hơn cũng sẽ làm mất một phần lợi ích.
Dùng zero-copy trong Java như thế nào
Trong Java NIO, hai hướng chính có thể dùng trực tiếp là mmap và sendfile.
MappedByteBuffer tương ứng với mmap. Sau khi dùng FileChannel.map để lấy MappedByteBuffer, file (hoặc một phần file) sẽ được map vào memory. Khi đọc ghi buffer này, thao tác sẽ diễn ra trên vùng mapping, không còn giống read/write thông thường là trước tiên copy dữ liệu vào buffer do JVM tự quản lý:
FileChannel channel = FileChannel.open(
        Paths.get("./data.bin"),
        StandardOpenOption.READ, StandardOpenOption.WRITE);
// Map file vào memory, bên dưới là mmap
MappedByteBuffer buffer = channel.map(
        FileChannel.MapMode.READ_WRITE, 0, channel.size());
FileChannel.transferTo / transferFrom gần với hướng sendfile hơn. Nhưng ở đây đừng đánh đồng Java API với sendfile: transferTo chỉ cam kết ghi các byte vào Channel đích; cách truyền bên dưới thế nào còn phụ thuộc vào JDK, Operating System và loại Channel đích. Khi đích là SocketChannel đã kết nối và platform hỗ trợ, JDK mới có thể đi theo zero-copy transmission trong kernel; nếu đổi sang file thông thường hoặc Channel khác, nó có thể dùng implementation khác, thậm chí fallback sang việc copy trong user space. Vì vậy ví dụ dưới đây đặt đích là SocketChannel:
FileChannel source = FileChannel.open(
        Paths.get("./in.dat"), StandardOpenOption.READ);
// socketChannel là một SocketChannel đã kết nối
// File -> socket, JDK có thể dùng zero-copy optimization trên platform hỗ trợ (như sendfile)
source.transferTo(0, source.size(), socketChannel);
Có một bẫy dễ gặp ở đây: transferTo không bảo đảm truyền xong trong một lần, phía gọi phải xử lý phần dữ liệu còn lại dựa trên giá trị trả về. Nếu bên dưới đi qua Linux sendfile, giới hạn mỗi lần là 0x7ffff000 (khoảng 2 GB) byte; nhưng giới hạn cụ thể ở Java layer và việc có thực sự đi qua zero-copy path hay không vẫn phải xác minh theo JDK version và target platform, chẳng hạn behavior trên Windows không hoàn toàn giống Linux.
Kafka và RocketMQ lần lượt dùng cách nào
Zero-copy thường được dùng nhất để giải thích vì sao Kafka và RocketMQ nhanh, nhưng hai hệ thống thực ra chọn hai hướng khác nhau, do khác biệt trong read/write pattern của mỗi bên.
Consumer của Kafka dùng zero-copy sending. Khi consumer pull message, Kafka cần gửi log segment file từ disk đến network. Đây là kiểu “chỉ chuyển tiếp, không sửa nội dung”, vì vậy Kafka dùng FileChannel.transferTo để đưa log trực tiếp từ Page Cache vào socket, dữ liệu không đi vào JVM heap. Kết hợp với sequential write và Page Cache ở phía producer, đó là cách Kafka đạt throughput cao. (Nói thêm, Kafka dùng mmap cho index file.) Nhưng zero-copy không phải lúc nào cũng có hiệu lực: khi cần chuyển đổi message format, giải nén rồi nén lại, hoặc bật TLS để mã hóa trong user space, payload phải được đọc ra xử lý, path này sẽ fallback; có dùng được zero-copy hay không cần đánh giá dựa trên version của Kafka, JDK và Operating System.
RocketMQ chủ yếu dùng mmap. CommitLog của RocketMQ dùng MappedByteBuffer để map memory khi đọc ghi file, đây cũng là một trong những lý do nó thiết kế CommitLog thành các file có kích thước cố định; kích thước cố định giúp quản lý mapping dễ hơn. Nó chọn mmap thay vì sendfile vì read/write pattern cần thao tác linh hoạt hơn trên vùng memory đã map, chứ không chỉ chuyển tiếp nguyên vẹn file.
Phân biệt trong một câu: chỉ chuyển tiếp thì chọn sendfile, cần thao tác trên memory đã map thì chọn mmap, điều này khớp với tiêu chí “có cần sửa dữ liệu hay không” ở trên.
Mở rộng: Rust zerocopy crate là chuyện khác
Tìm kiếm “zerocopy” rất dễ thấy một thư viện Rust google/zerocopy do Google duy trì và được các kỹ sư của Google cập nhật liên tục, có lượng download lớn và hoạt động tích cực. Phiên bản của nó cập nhật khá nhanh (tại thời điểm viết bài đã thuộc dòng 0.8.x), ở đây không cố định một con số cụ thể, hãy lấy crates.io và GitHub Release làm chuẩn.
Nhưng cần lưu ý: crate này không phải cùng một khái niệm với zero-copy của Operating System được nói trong bài, đừng nhầm lẫn. Zero-copy ở tầng OS nói về việc giảm CPU di chuyển dữ liệu giữa buffer của kernel và user trong quá trình I/O; còn Rust zerocopy crate giải quyết việc chuyển đổi memory type-safe, thực hiện chuyển đổi an toàn (safe transmutation) giữa byte sequence và struct, không cần copy và không phải viết unsafe. Cả hai đều gọi là “zero copy”, một bên nói về system call và DMA, một bên nói về memory layout và type safety ở tầng ngôn ngữ, đừng gộp chúng thành một trong phỏng vấn.
Trả lời thế nào trong phỏng vấn?
Khi được hỏi “zero-copy là gì”, trước tiên phải nói rõ “zero”: nó không có nghĩa là không có bất kỳ copy nào; hai lượt DMA từ đĩa đến memory và từ memory đến card mạng thường vẫn tồn tại. Zero-copy chủ yếu tiết kiệm các lần CPU di chuyển payload giữa buffer của kernel và buffer của user, và nhờ đó giảm số mode switch.
Có thể giải thích read + write truyền thống là 4 lần copy: từ đĩa đến buffer của kernel là DMA, từ kernel đến buffer của user là CPU, từ buffer của user đến buffer của Socket vẫn là CPU, từ buffer của Socket đến card mạng là DMA. Lãng phí nhất ở đây là hai lần CPU copy, vì ứng dụng không sửa dữ liệu mà chỉ cho dữ liệu đi một vòng qua user space.
Thứ tự trả lời về các phương án có thể sắp xếp như sau: mmap + write map user space và Page Cache vào cùng một tập physical page, loại bỏ CPU copy “kernel đến user”, nhưng vẫn phải write vào buffer của Socket; sendfile đưa việc chuyển tiếp file đến socket vào một system call, dữ liệu không đi vào user space; khi kết hợp với SG-DMA, buffer của Socket chỉ chứa thông tin mô tả, payload có thể được DMA trực tiếp từ buffer của kernel đến card mạng; còn splice truyền page reference nhờ pipe, phù hợp hơn với việc chuyển tiếp giữa các fd nói chung, nhưng thường cần hai system call.
Nếu người phỏng vấn chuyển chủ đề sang Kafka và RocketMQ, câu trả lời cũng không được nhầm. Consumer của Kafka gửi nguyên vẹn log segment file đến consumer, phù hợp với path sendfile như FileChannel.transferTo; CommitLog của RocketMQ cần đọc/ghi memory đã map linh hoạt hơn, nên thường gắn với mmap. Cần nêu thêm giới hạn: các bối cảnh TLS, nén, chuyển đổi format và lọc nội dung cần ứng dụng thực sự xử lý payload, nên zero-copy path sẽ fallback.