
Tổng hợp câu hỏi phỏng vấn Operating System thường gặp (Phần 2)

Bài viết 《Tổng hợp câu hỏi phỏng vấn Operating System thường gặp (Phần 2)》 tiếp nối phần trước, tập trung vào memory management, virtual memory, paging và segmentation, TLB, page fault, page replacement, I/O multiplexing, zero-copy, file system và disk scheduling.
Nếu phần trước thiên về “process, thread và concurrency control”, bài này thiên về “chương trình sử dụng memory như thế nào khi chạy, thực hiện I/O ra sao và tương tác với file system thế nào”. Những nội dung này có vẻ khá xa business code, nhưng nhiều vấn đề backend cuối cùng đều quy về đây: Vì sao mmap có thể giảm một lần copy? Vì sao epoll có thể xử lý nhiều connection? Vì sao cùng một virtual address lại không ảnh hưởng lẫn nhau trong các process khác nhau? Vì sao page fault thường xuyên khiến system chậm đi?
Khi đọc, bạn nên nắm một trục chính: Operating System dùng virtual memory để quản lý address space và isolation, dùng cơ chế I/O để quản lý luồng dữ liệu, dùng file system để quản lý dữ liệu persistent. Kết nối được trục này, nhiều khái niệm rời rạc sẽ không còn chỉ là những tên gọi.
Memory Management
Memory management chủ yếu làm gì?
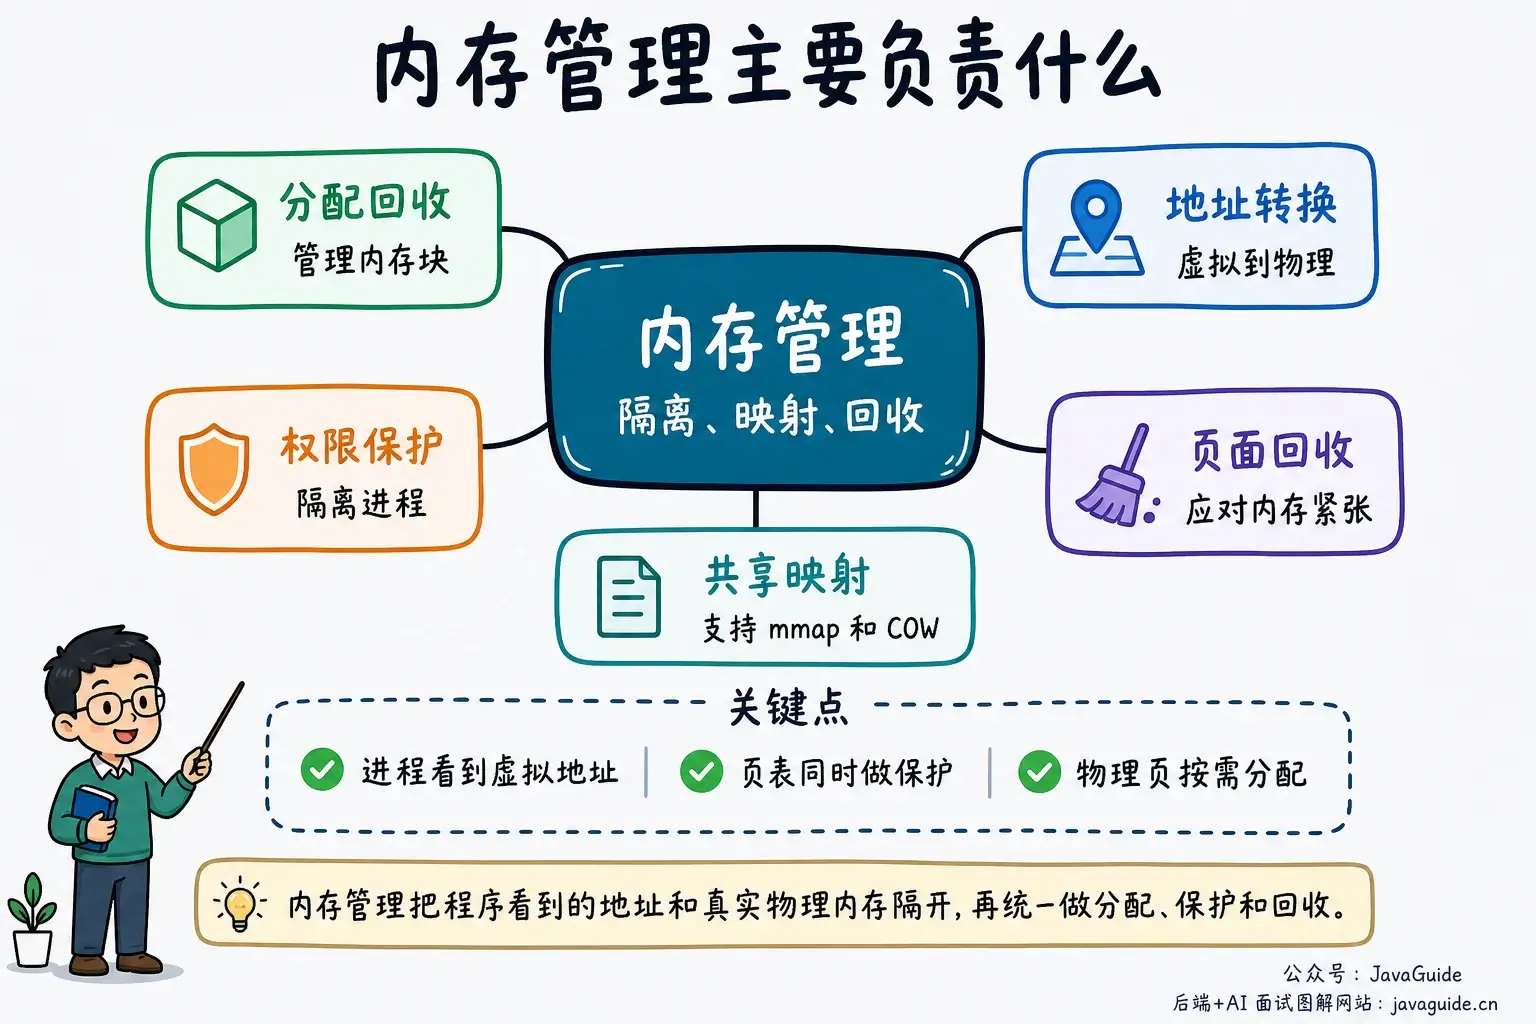
Trong phỏng vấn, khi trả lời “memory management làm gì”, có thể bắt đầu từ 5 việc:
- Phân bổ và thu hồi memory: allocator ở user space thông qua các interface như
brk(),mmap()để yêu cầu hoặc giải phóng virtual address region từ kernel; sau đó kernel quản lý physical page và kernel object. - Address translation: chương trình truy cập virtual address, MMU trong CPU phối hợp với page table và TLB để dịch virtual address thành physical address.
- Process isolation và permission protection: mỗi process có address space riêng, page table entry còn có thể ghi lại các permission như read, write, execute, user mode/kernel mode.
- Thu hồi page và paging: khi physical memory thiếu, kernel sẽ thu hồi file page hoặc anonymous page, khi cần sẽ ghi anonymous page vào Swap.
- Sharing và mapping: dynamic library sharing, shared memory IPC, file mapping bằng
mmap(), copy-on-write (COW) đều phụ thuộc vào khả năng mapping từ virtual address đến physical page.
Trong phỏng vấn, có thể nắm một trục chính: memory management tách address mà chương trình nhìn thấy khỏi physical memory thực tế, sau đó quản lý memory bằng allocation, mapping, protection và reclaim.
VSZ, RSS và PSS khác nhau thế nào?
Khi xem memory của process trong Linux, VSZ, RSS và PSS là ba khái niệm rất dễ nhầm.
- VSZ: kích thước virtual address space mà process đã mapping. Nó bao gồm anonymous mapping chưa thực sự resident, file mapping, shared library và address đã reserve, không thể trực tiếp xem là physical memory đang dùng.
- RSS: tổng số page hiện đã resident trong RAM và được mapping cho process đó. Shared library, shared memory và shared page trong Page Cache cũng được tính vào RSS của các process liên quan.
- PSS: memory usage sau khi phân bổ theo tỷ lệ các shared page. Nếu một physical page được 4 process cùng share, PSS của mỗi process chỉ tính một phần tư.
Vì vậy, khi xem resident memory của một process có thể tham khảo RSS; để ước tính tổng memory mà nhiều process chiếm dụng, PSS phù hợp hơn. Cộng trực tiếp RSS của nhiều process thường sẽ tính lặp shared page.
Các command thường dùng:
grep -E 'VmSize|VmRSS|RssAnon|RssFile|RssShmem|VmSwap' /proc/<pid>/status
cat /proc/<pid>/smaps_rollup
Memory fragmentation là gì?
Memory fragmentation phát sinh do việc request và release memory, thường được chia thành hai loại sau:
- Internal Memory Fragmentation (gọi tắt là internal fragmentation): phần memory đã được cấp cho process sử dụng nhưng chưa được dùng. Nguyên nhân chính gây ra internal fragmentation là khi cấp phát memory theo các mức cố định, chẳng hạn lũy thừa của 2, memory mà process được cấp có thể lớn hơn nhu cầu thực tế. Ví dụ, một process chỉ cần 65 byte memory nhưng được cấp block memory kích thước 128 (2^7), thì 63 byte memory sẽ trở thành internal fragmentation.
- External Memory Fragmentation (gọi tắt là external fragmentation): do các vùng memory liên tiếp chưa được cấp phát quá nhỏ, không thể đáp ứng request cấp phát memory của bất kỳ process nào, những vùng memory nhỏ và không liên tiếp này được gọi là external fragmentation. Nói cách khác, external fragmentation là phần memory chưa được cấp cho process nhưng cũng không thể sử dụng. Cơ chế segmentation được giới thiệu sau đây sẽ gây ra external fragmentation.
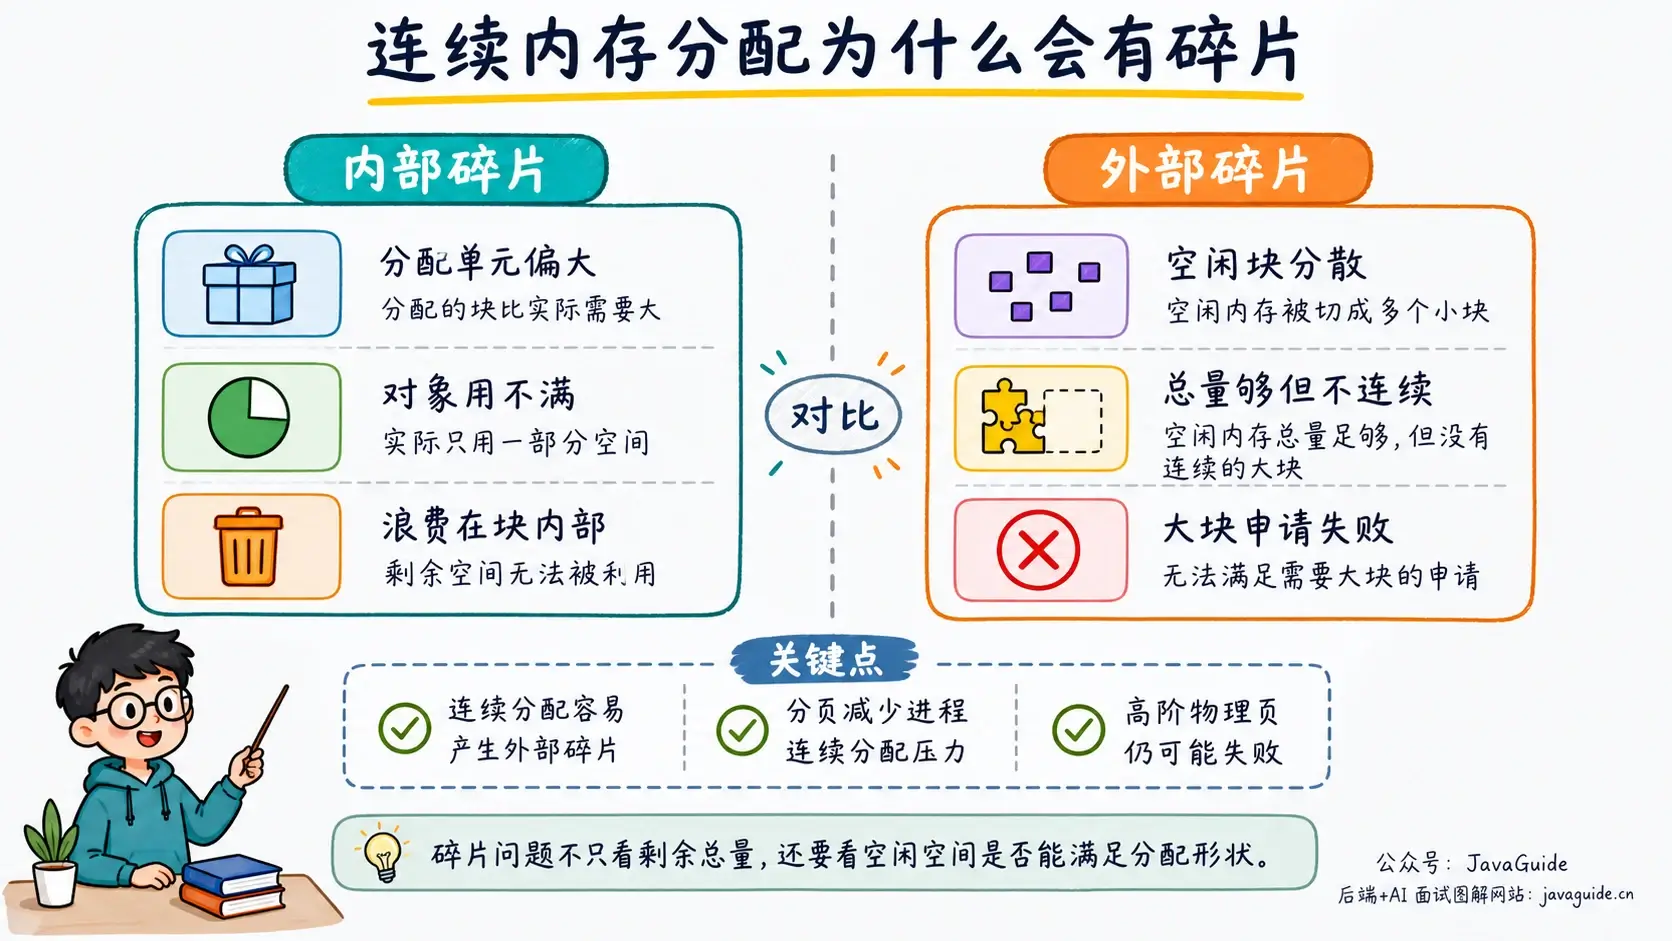
Memory fragmentation khiến memory utilization giảm, vì vậy giảm memory fragmentation là một việc rất cần được memory management chú trọng.
Có những cách memory management phổ biến nào?
Có thể đơn giản chia cách memory management thành hai loại sau:
- Contiguous memory management: cấp cho một user program một vùng memory liên tiếp, memory utilization thường không cao.
- Non-contiguous memory management: cho phép memory mà một chương trình sử dụng nằm ở các vùng memory rời rạc, hay nói cách khác là không liền kề, linh hoạt hơn tương đối.
Contiguous memory management
Block-based management là một cách contiguous memory management của các Operating System thời kỳ đầu, tồn tại vấn đề memory fragmentation nghiêm trọng. Block-based management chia memory thành một số block có kích thước cố định, mỗi block chỉ chứa một process. Nếu chương trình cần memory để chạy, Operating System sẽ cấp cho nó một block; nếu chương trình chỉ cần một vùng nhỏ, phần lớn block memory được cấp gần như bị lãng phí. Những vùng chưa được sử dụng trong mỗi block này được gọi là internal fragmentation. Ngoài internal fragmentation, giữa hai memory block cũng có thể có external fragmentation; những khoảng trống external fragmentation không liên tiếp này quá nhỏ nên không thể tiếp tục được cấp phát.
Trong Linux, contiguous memory management được thực hiện bằng Buddy System, một algorithm cấp phát contiguous memory kinh điển, có thể giải quyết hiệu quả external fragmentation. Ý tưởng chính của Buddy System là chia memory theo lũy thừa của 2 (mỗi block memory đều có kích thước là lũy thừa của 2, chẳng hạn 2^6=64 KB), sau đó ghép các memory block liền kề thành một cặp buddy (lưu ý: chỉ các block liền kề mới là buddy).
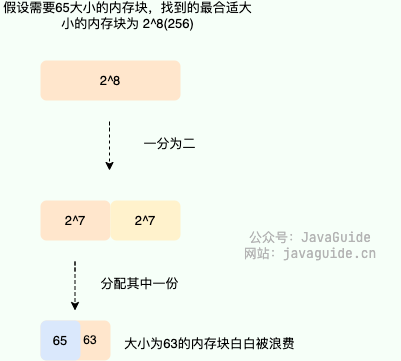
Khi cấp phát memory, Buddy System cố gắng tìm memory block có kích thước phù hợp nhất. Nếu memory block tìm được quá lớn, nó sẽ chia block thành hai buddy block có kích thước bằng nhau. Nếu vẫn còn lớn, nó tiếp tục chia cho đến khi đạt kích thước phù hợp.
Giả sử hai memory block liền kề đều được release, system sẽ merge hai memory block này để tạo thành một memory block lớn hơn, phục vụ các lần cấp phát memory tiếp theo. Nhờ vậy có thể giảm memory fragmentation và nâng cao memory utilization.
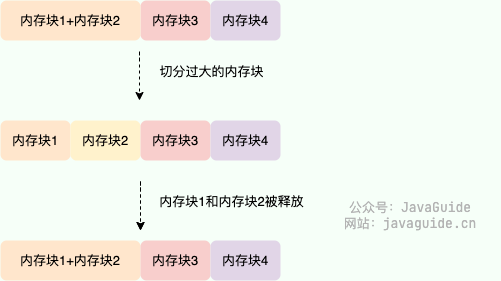
Mặc dù đã giải quyết external fragmentation, Buddy System vẫn có vấn đề memory utilization không cao (internal fragmentation). Nguyên nhân chính là Buddy System chỉ có thể cấp phát memory block có kích thước 2^n, nên khi kích thước memory cần cấp phát không phải bội số nguyên của 2^n, một phần memory space sẽ bị lãng phí. Ví dụ: nếu cần cấp phát memory block kích thước 65, vẫn phải cấp memory block kích thước 2^7=128.
Để tối ưu internal fragmentation và vấn đề performance do cấp phát object nhỏ thường xuyên, Linux còn sử dụng các allocator như SLAB/SLUB. Chúng cache các kernel object thường dùng, tái sử dụng các memory block đã được initialize theo loại object, giảm cost của việc cấp phát, initialize và release lặp lại. Vì nội dung này không phải trọng tâm của bài viết, ở đây chỉ giới thiệu sơ lược.
Non-contiguous memory management
Non-contiguous memory management có 3 cách sau:
- Segmentation: quản lý/cấp phát physical memory dưới dạng segment (một đoạn physical memory liên tiếp). Virtual address space của application được chia thành các segment có kích thước khác nhau, mỗi segment mang ý nghĩa logic và định nghĩa một nhóm thông tin, chẳng hạn có code segment MAIN, subroutine segment X, data segment D và stack segment S.
- Paging: chia physical memory thành các physical page liên tiếp có cùng độ dài, virtual address space của application cũng được chia thành các virtual page liên tiếp có cùng độ dài, đây là một cách memory management được các Operating System hiện đại sử dụng rộng rãi.
- Segmentation-paging: kết hợp segmentation và paging. Address space của chương trình trước hết được chia theo logic thành các segment, mỗi segment tiếp tục được chia thành các page có kích thước cố định, physical memory vẫn được cấp phát theo page frame.
Virtual memory
Virtual memory là gì? Có tác dụng gì?
Virtual Memory là một lớp abstraction về memory do Operating System cung cấp. Chương trình nhìn thấy một virtual address space liên tiếp và riêng biệt; dữ liệu thực sự nằm ở vị trí nào trong physical memory thì do Operating System và hardware cùng quyết định.
Nói đơn giản, virtual memory tách “address mà chương trình sử dụng” khỏi “address thực tế trong physical memory”. Khi process truy cập virtual address, MMU trong CPU dựa trên mapping như page table để chuyển virtual address thành physical address, sau đó truy cập memory thực tế.
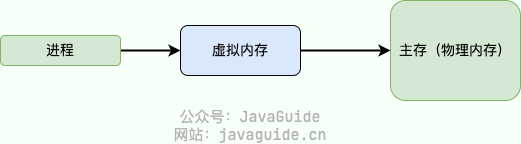
Tóm lại, virtual memory chủ yếu cung cấp các khả năng sau:
- Process isolation: mỗi process có virtual address space và page table riêng. Ngay cả khi các process khác nhau sử dụng cùng virtual address, chúng vẫn có thể mapping đến các physical page khác nhau, không trực tiếp ghi đè memory của nhau.
- Nâng cao physical memory utilization: Operating System không cần nạp toàn bộ code và data của process vào physical memory một lần, chỉ load các page thực sự cần dùng.
- Đơn giản hóa memory management: process nhìn thấy một virtual address space liên tiếp, physical memory có thể là các page frame rời rạc; công việc ghép nối phức tạp được giao cho page table và MMU.
- Nhiều process share physical memory: process sẽ load nhiều dynamic library của Operating System trong quá trình chạy; các library này có thể dùng chung một physical page cho nhiều process. Nhiều process cũng có thể chủ động mapping cùng một physical memory thông qua shared memory IPC để trao đổi data hiệu quả.
- Nâng cao memory safety: kiểm soát process truy cập physical memory, cô lập permission truy cập giữa các process, nâng cao security của system.
- Cung cấp memory space có thể sử dụng lớn hơn: khi physical memory không đủ, có thể swap các page tạm thời chưa dùng ra disk và swap trở lại khi cần. Nhờ vậy, memory space mà chương trình cảm nhận có thể vượt quá physical memory thực tế, nhưng swap thường xuyên sẽ khiến system chậm đi rõ rệt.
Không có virtual memory thì có vấn đề gì?
Nếu không có virtual memory, chương trình sẽ trực tiếp truy cập và thao tác trên physical memory. Có vẻ như đã bớt một lớp trung gian, nhưng lại phát sinh nhiều vấn đề.
Cụ thể là những vấn đề gì? Dưới đây là một vài ví dụ (tham khảo các khả năng mà virtual memory cung cấp để trả lời câu hỏi này):
- User program có thể truy cập bất kỳ physical memory nào, có thể vô tình thao tác vào vùng memory cần thiết cho hoạt động của system, từ đó khiến Operating System crash và ảnh hưởng nghiêm trọng đến security của system.
- Dễ crash khi chạy đồng thời nhiều chương trình. Ví dụ bạn muốn đồng thời chạy WeChat và QQ Music, khi WeChat đang chạy và gán giá trị cho memory address 1xxx, QQ Music cũng gán giá trị cho memory address 1xxx, khi đó QQ Music sẽ ghi đè giá trị mà WeChat đã gán trước đó, có thể khiến chương trình WeChat crash.
- Tất cả data hoặc instruction được sử dụng trong quá trình chạy chương trình đều phải load vào physical memory. Theo nguyên lý locality, phần lớn trong số đó có thể không được sử dụng, chiếm vô ích tài nguyên physical memory quý giá.
- …
Virtual address và physical address là gì?
Physical Address là address trong physical memory thực tế, cụ thể hơn là address trong memory address register. Address mà chương trình truy cập không phải physical address mà là Virtual Address.
Nói cách khác, khi lập trình và phát triển, thực tế chúng ta đang làm việc với virtual address. Ví dụ trong C, giá trị được lưu trong pointer có thể được hiểu là một address trong memory, và address này chính là virtual address.
Operating System thường sử dụng một component quan trọng trong chip CPU là MMU (Memory Management Unit) để chuyển virtual address thành physical address; quá trình này được gọi là Address Translation. Trong các system hiện đại, quá trình chuyển đổi này thường dựa vào page table, TLB sẽ cache kết quả address translation được dùng gần đây để giảm chi phí tra page table.
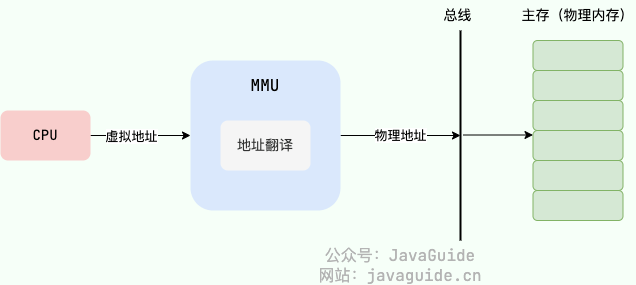
Sau khi MMU chuyển virtual address thành physical address, CPU truy cập vị trí tương ứng trong physical memory để hoàn thành request read/write. Cũng chính nhờ lớp translation này, cùng một virtual address về mặt giá trị trong các process khác nhau cuối cùng có thể trỏ đến các physical page hoàn toàn khác nhau.
Đây cũng là nền tảng của process isolation và inter-process communication: theo mặc định, một process không thể trực tiếp read/write address space ở user space của process khác; nếu hai process thực sự cần trao đổi data, chúng phải dựa vào các IPC mechanism như pipe, message queue, shared memory, Socket. Có thể xem bản tổng hợp IPC tại: Giải thích chi tiết inter-process communication (IPC): pipe, message queue, shared memory, Socket và Binder.
MMU có hai cơ chế chính để chuyển virtual address thành physical address: segmentation và paging.
Virtual address space và physical address space là gì?
- Virtual address space là tập hợp các virtual address, là phạm vi của virtual memory. Mỗi process có một virtual address space nhất quán và private.
- Physical address space là tập hợp các physical address, là phạm vi của physical memory.
Virtual address được mapping với physical memory address như thế nào?
MMU có 3 cơ chế chính để chuyển virtual address thành physical address:
- Segmentation
- Paging
- Segmentation-paging
Trong đó, các Operating System hiện đại sử dụng paging rộng rãi, cần đặc biệt chú ý!
Segmentation
Segmentation chia address space theo cấu trúc logic của chương trình, chẳng hạn code segment, data segment, heap, stack. Độ dài mỗi segment có thể khác nhau, segment có ý nghĩa rõ ràng và có thể kết hợp với permission control.
Segment table có tác dụng gì? Quá trình address translation diễn ra thế nào?
Segmentation ánh xạ virtual address và physical address thông qua Segment Table. Segment table entry thường ghi lại segment base address, segment limit (độ dài segment), access permission và các thông tin khác.
Virtual address trong segmentation gồm hai phần:
- Segment number: xác định virtual address này thuộc segment nào trong toàn bộ virtual address space.
- Offset trong segment: offset tính từ address bắt đầu của segment.
Quá trình address translation cụ thể như sau:
- MMU trước hết parse và lấy segment number trong virtual address;
- Dùng segment number để lấy thông tin segment tương ứng từ segment table của application (tìm segment table entry tương ứng);
- Kiểm tra offset trong segment có vượt segment limit hay không, kiểm tra access permission có hợp lệ hay không;
- Nếu hợp lệ, cộng segment base address với offset trong segment để có physical address cuối cùng.
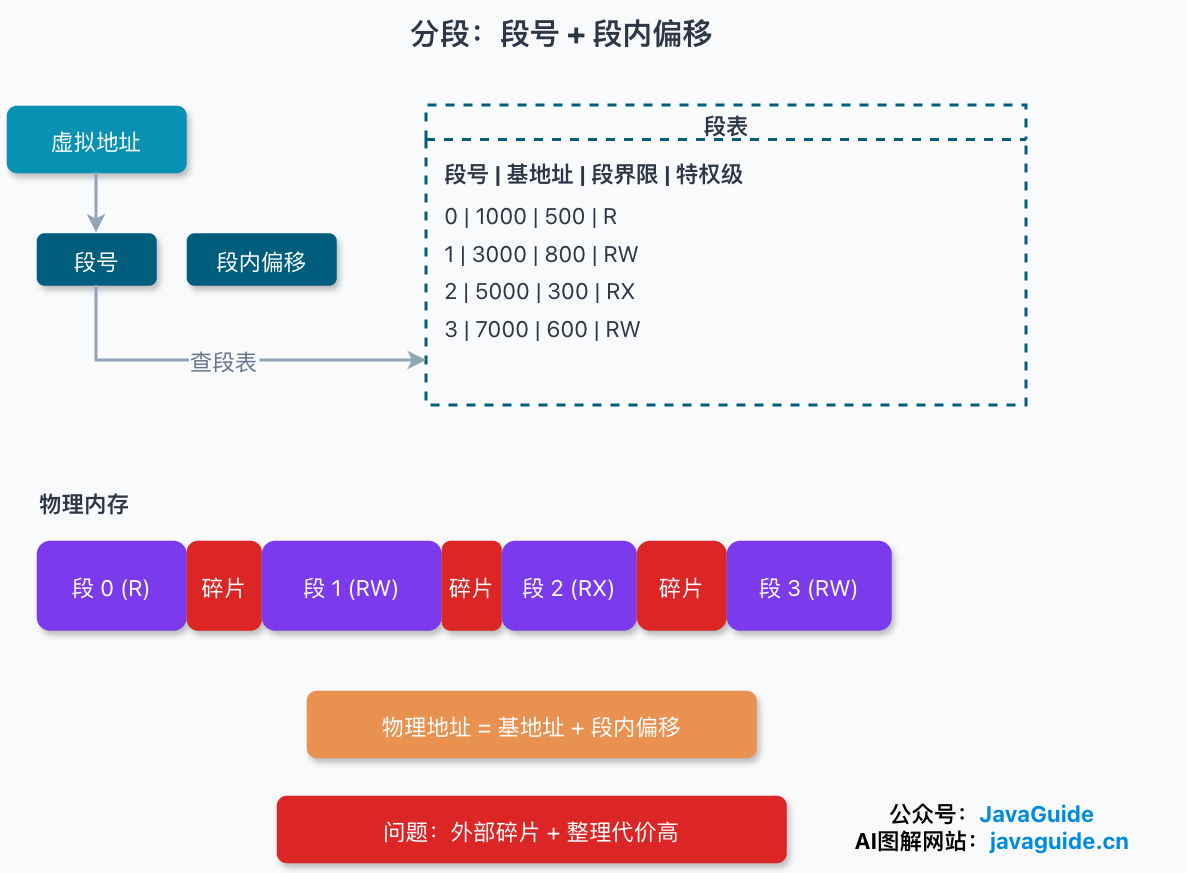
Ví dụ, để truy cập address thuộc segment 3 với offset 500, nếu base address của segment 3 là 7000 và offset không vượt giới hạn, physical address cuối cùng là 7000 + 500 = 7500.
Nếu segment selector không hợp lệ, offset trong segment vượt giới hạn hoặc access permission không phù hợp, CPU sẽ trigger exception theo quy định của architecture. Việc page đã resident trong physical memory hay chưa thuộc vấn đề của paging và Page Fault handling, không nên trộn lẫn với mô hình segmentation thuần túy.
Vì sao segmentation gây ra external memory fragmentation?
Segmentation dễ xuất hiện external memory fragmentation, nguyên nhân cốt lõi là độ dài segment không cố định và mỗi segment thường cần một vùng physical memory liên tiếp. Sau khi process liên tục tạo và release segment, physical memory sẽ để lại nhiều khoảng trống rời rạc; tổng các khoảng trống có thể đủ dùng, nhưng một khoảng trống riêng lẻ lại không đủ lớn, vẫn không thể cấp cho segment lớn mới.
Ví dụ: giả sử một system có physical memory khả dụng 5G sử dụng segmentation để cấp phát memory. Hiện có 4 process, phân bố memory của mỗi process như sau:
- Process 1: 0~1G (segment 1)
- Process 2: 1~3G (segment 2)
- Process 3: 3~4.5G (segment 3)
- Process 4: 4.5~5G (segment 4)
Lúc này, nếu đóng process 1 và process 4, memory của segment 1 và segment 4 được release, physical memory còn trống 1.5 GB. Vì 1.5 GB physical memory này không liên tiếp, không thể cấp vùng physical memory liên tiếp 1.5 GB cho một process cần nó.
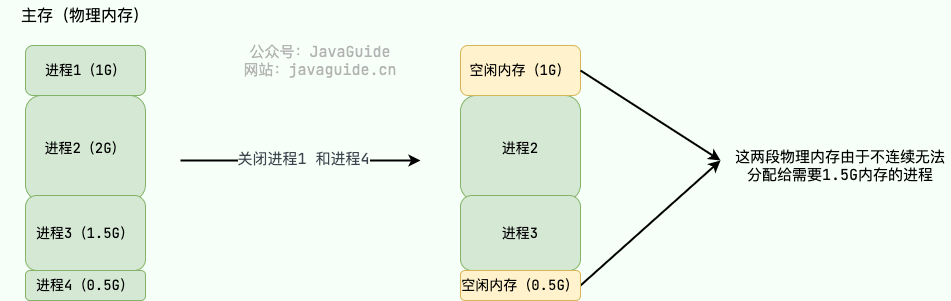
Có thể giảm external fragmentation bằng memory compaction, tức là gom các segment còn đang được sử dụng lại gần nhau để giải phóng vùng liên tiếp. Nhưng việc di chuyển segment lớn tốn nhiều thời gian; nếu đồng thời còn swap ra/vào disk, system sẽ chậm đi rõ rệt.
Paging
Paging chia virtual address space và physical memory thành các block có kích thước cố định. Block trong virtual address space gọi là virtual page, block trong physical memory gọi là physical page hoặc page frame. Trên Linux, một page thường có kích thước 4 KB.
Lưu ý: page ở đây liên tiếp và có cùng độ dài, khác với các segment có độ dài khác nhau trong segmentation.
Trong paging, bất kỳ virtual page nào trong virtual address space của application cũng có thể mapping đến bất kỳ physical page frame nào trong physical memory, vì vậy physical memory có thể được cấp phát rời rạc. Paging quản lý memory theo page size cố định, về cơ bản loại bỏ external memory fragmentation dễ phát sinh trong segmentation; tuy nhiên page cuối cùng có thể không được lấp đầy, tạo ra một lượng nhỏ internal fragmentation.
Paging còn có một khả năng rất quan trọng: demand paging. Chương trình không cần load tất cả page vào physical memory ngay khi khởi động; chỉ khi thực sự truy cập một virtual page nào đó, Operating System mới load data tương ứng vào.
Page table có tác dụng gì? Quá trình address translation diễn ra thế nào?
Paging ánh xạ virtual address và physical address thông qua Page Table. Page table entry ghi lại quan hệ giữa virtual page number và physical page frame number, đồng thời ghi các state information như access bit, dirty bit, permission bit, present bit. Ở đây có một sơ đồ address translation dựa trên single-level page table.
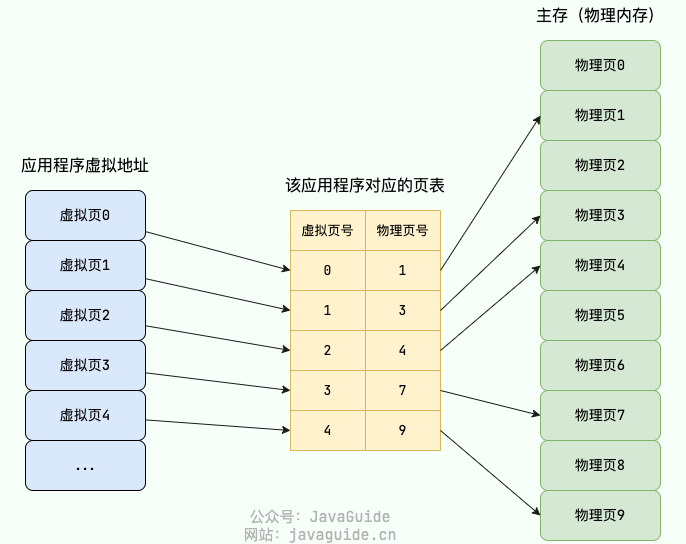
Trong paging, mỗi process đều có page table riêng. Vì page table là private cho process, cùng một virtual page number trong các process khác nhau có thể mapping đến các physical page frame khác nhau, nhờ đó cô lập address space.
Virtual address trong paging gồm hai phần:
- Page number: dùng virtual page number để lấy physical page frame number tương ứng từ page table;
- Offset trong page: physical page frame start address + offset trong page = physical memory address.
Quá trình address translation cụ thể như sau:
- MMU trước hết parse và lấy virtual page number trong virtual address;
- Dùng virtual page number để lấy physical page frame number tương ứng từ page table của process (tìm page table entry tương ứng);
- Cộng start address tương ứng với physical page frame number với offset trong page của virtual address để có physical address cuối cùng.
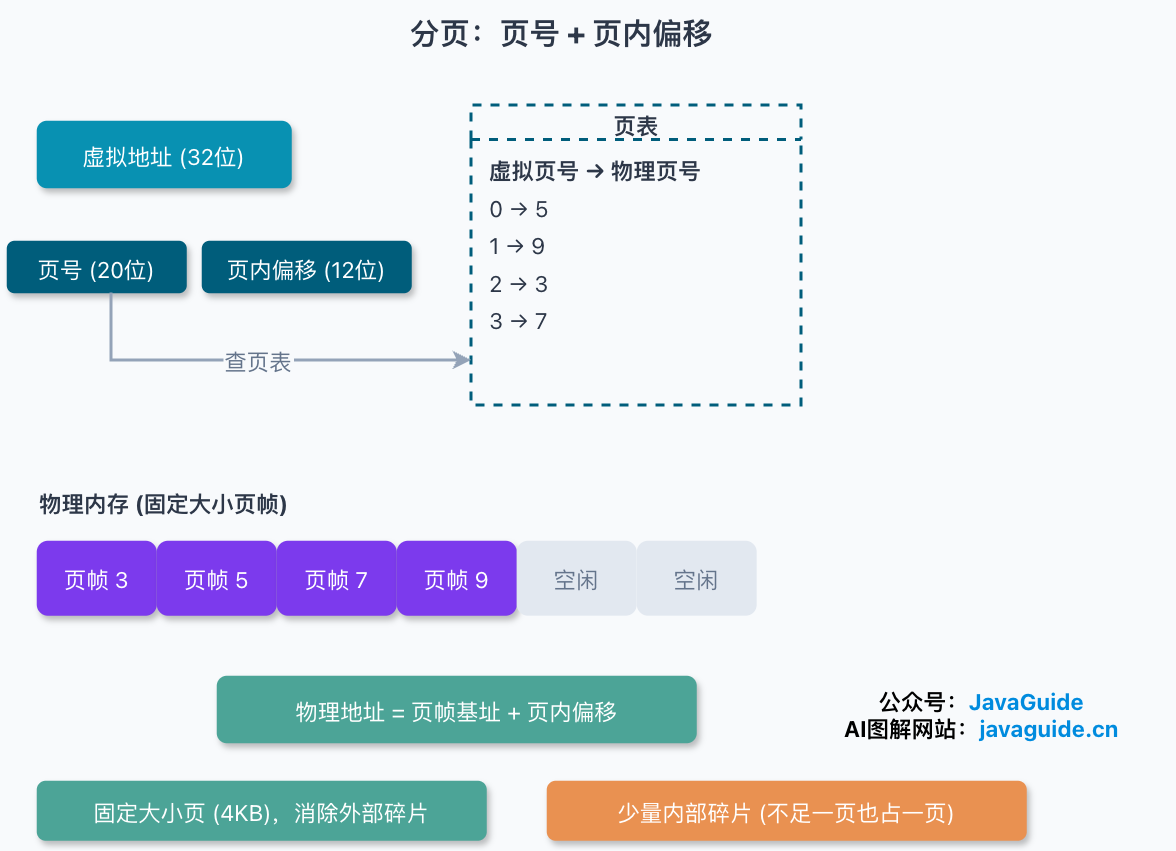
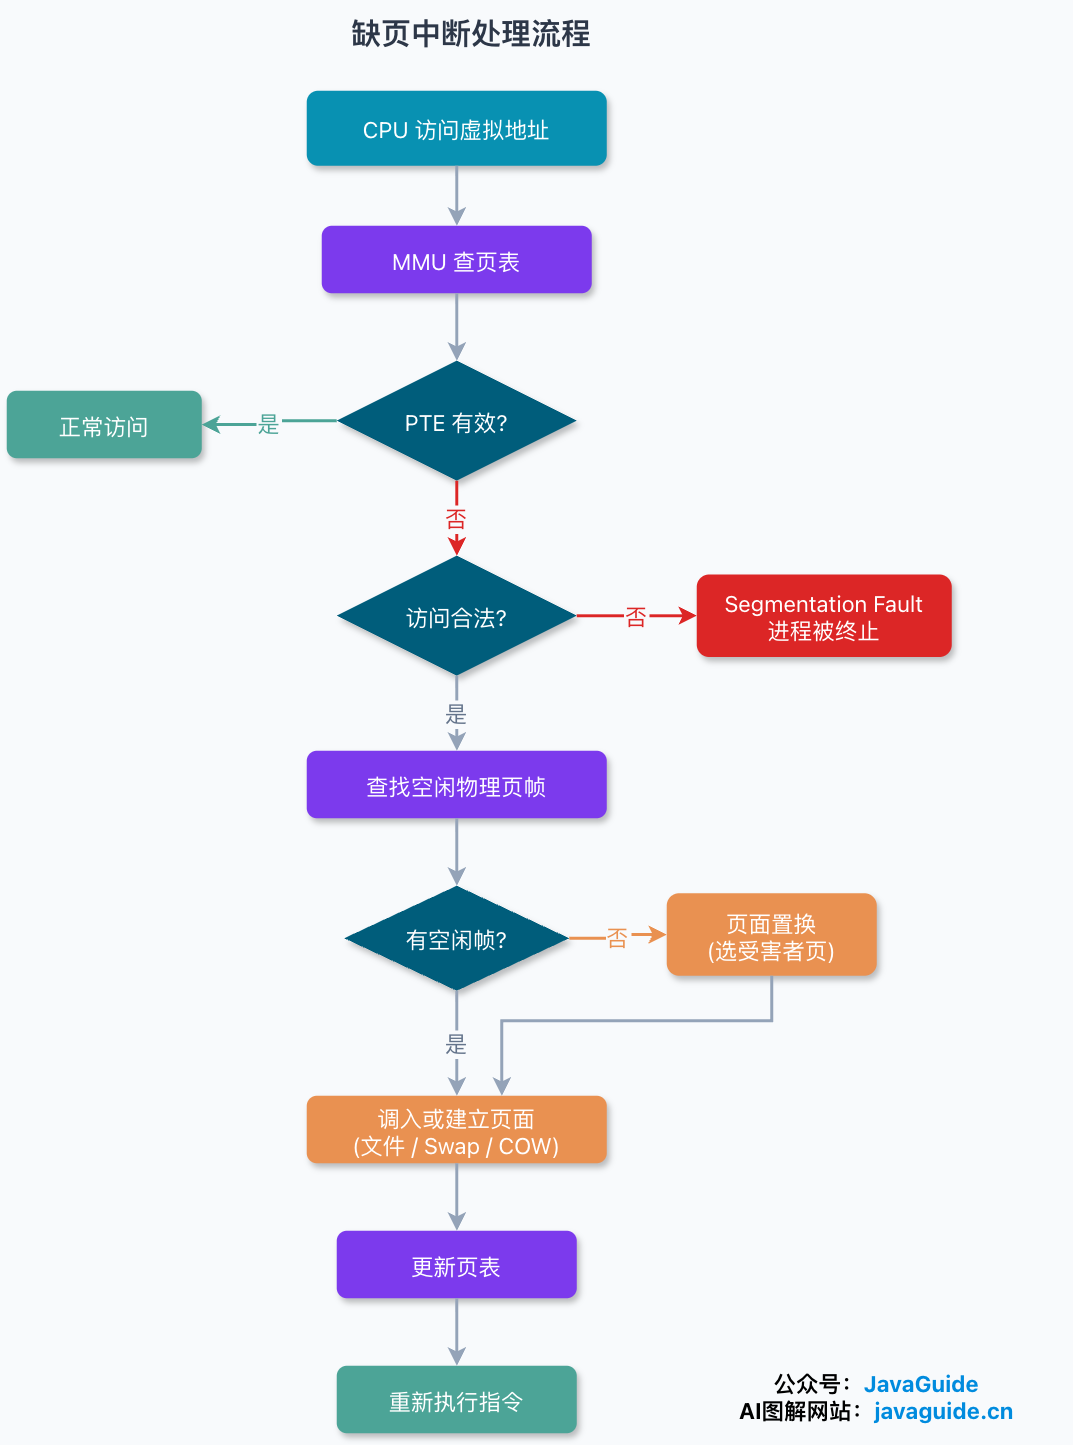
Nếu page table entry không tồn tại, page hiện không nằm trong physical memory hoặc access permission không phù hợp, CPU sẽ trigger Page Fault. Sau đó kernel phán đoán access này có thể được khắc phục hay không: nếu có thể thì thiết lập mapping hoặc page-in, nếu không thể thì thường gửi SIGSEGV đến thread hiện tại.
Có chắc chắn tìm được physical page frame number tương ứng thông qua virtual page number không? Sau khi tìm được physical page frame number và có physical address cuối cùng, physical page tương ứng có chắc chắn tồn tại không?
Không chắc chắn. Page table entry có thể không tồn tại, page có thể chưa resident trong physical memory, access mode cũng có thể không phù hợp với permission được ghi trong page table entry. Những tình huống này đều trigger Page Fault; quá trình xử lý cụ thể sẽ được giới thiệu ở phần sau.
Single-level page table có vấn đề gì? Vì sao cần multi-level page table?
Lấy môi trường 32-bit làm ví dụ, virtual address space có phạm vi tổng cộng 2^32 (4 GB). Giả sử page size là 2^12 (4 KB), khi đó cần 4 GB / 4 KB = 2^20 page table entry. Mỗi page table entry chiếm 4 byte, toàn bộ single-level page table có kích thước khoảng 4 MB. Nói cách khác, ngay cả khi process chỉ dùng một đoạn nhỏ virtual address space, single-level page table vẫn phải reserve page table entry cho toàn bộ 4 GB address space.
Khi số lượng process đang chạy tăng lên, phần overhead này rất rõ ràng. Nghiêm trọng hơn, phần lớn process chỉ sử dụng một phần nhỏ virtual address space, rất nhiều page table entry trong single-level page table thực ra đều trống.
Để giải quyết vấn đề này, Operating System đưa vào multi-level page table. Ý tưởng cốt lõi của multi-level page table là: top-level page table bao phủ toàn bộ virtual address space, các lower-level page table được tạo on demand; nếu một vùng virtual address hoàn toàn chưa được dùng thì không cần tạo lower-level page table cho nó.
Ở đây lấy two-level page table làm ví dụ: first-level page table có 1024 page table entry, mỗi first-level page table entry có thể trỏ đến một second-level page table; mỗi second-level page table cũng có 1024 page table entry. Chỉ khi address range mà một first-level page table entry bao phủ thực sự được sử dụng thì mới cần tạo second-level page table tương ứng.
Giả sử chỉ cần 2 second-level page table, memory usage của two-level page table là: 4 KB (memory của first-level page table) + 4 KB * 2 (memory của second-level page table) = 12 KB.
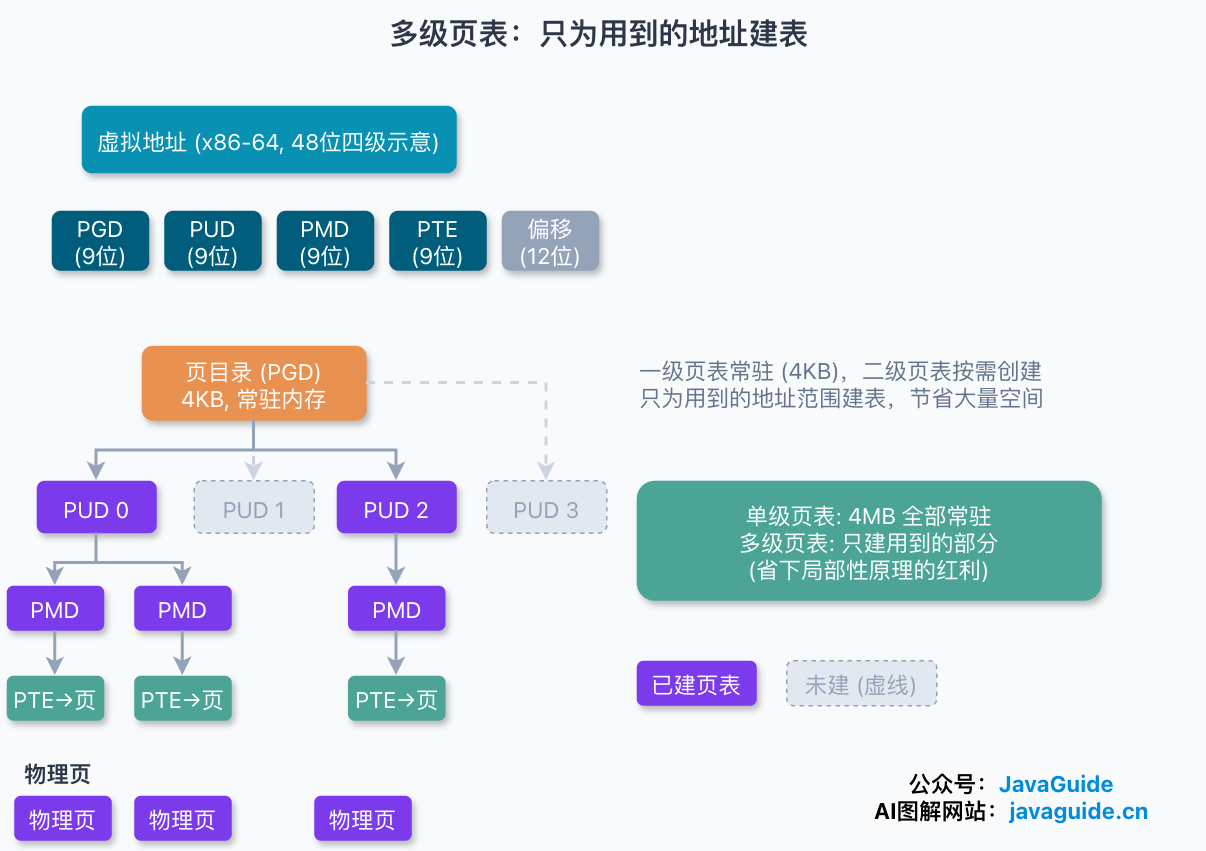
Multi-level page table tiết kiệm page table space: tra cứu qua nhiều tầng index hơn để đổi lấy page table memory usage nhỏ hơn. System thực tế sẽ phối hợp TLB để cache page table entry thường dùng, nên overhead tra table thêm do multi-level page table không phải lần nào cũng xảy ra đầy đủ.
TLB có tác dụng gì? Quá trình address translation sau khi dùng TLB diễn ra thế nào?
Để tăng tốc độ chuyển virtual address thành physical address, CPU/MMU sử dụng Translation Lookaside Buffer (TLB, còn gọi là bảng nhanh) để cache kết quả address translation gần đây.

Trong các architecture AArch64 và x86-64 phổ biến, TLB là hardware cache do MMU sử dụng. Có thể hiểu nó là high-speed cache mapping theo virtual page đến physical page frame, nhưng không thể đồng nhất cấu trúc hardware cụ thể với software hash table. Operating System chịu trách nhiệm duy trì page table; sau khi page table mapping thay đổi, còn phải invalidate TLB entry liên quan theo yêu cầu của architecture để tránh CPU tiếp tục sử dụng mapping cũ.
Quá trình address translation sau khi dùng TLB như sau:
- CPU dùng virtual page number, address space identifier và các thông tin khác để match TLB entry;
- Nếu tra được physical page tương ứng thì không cần tra page table nữa, tình huống này gọi là TLB hit.
- Nếu không tra được physical page tương ứng thì vẫn cần tra page table trong main memory, đồng thời thêm mapping entry này vào TLB, tình huống này gọi là TLB miss.
- Khi TLB đầy và cần nạp page mới, sẽ dùng eviction policy nhất định để loại bỏ một entry trong TLB.
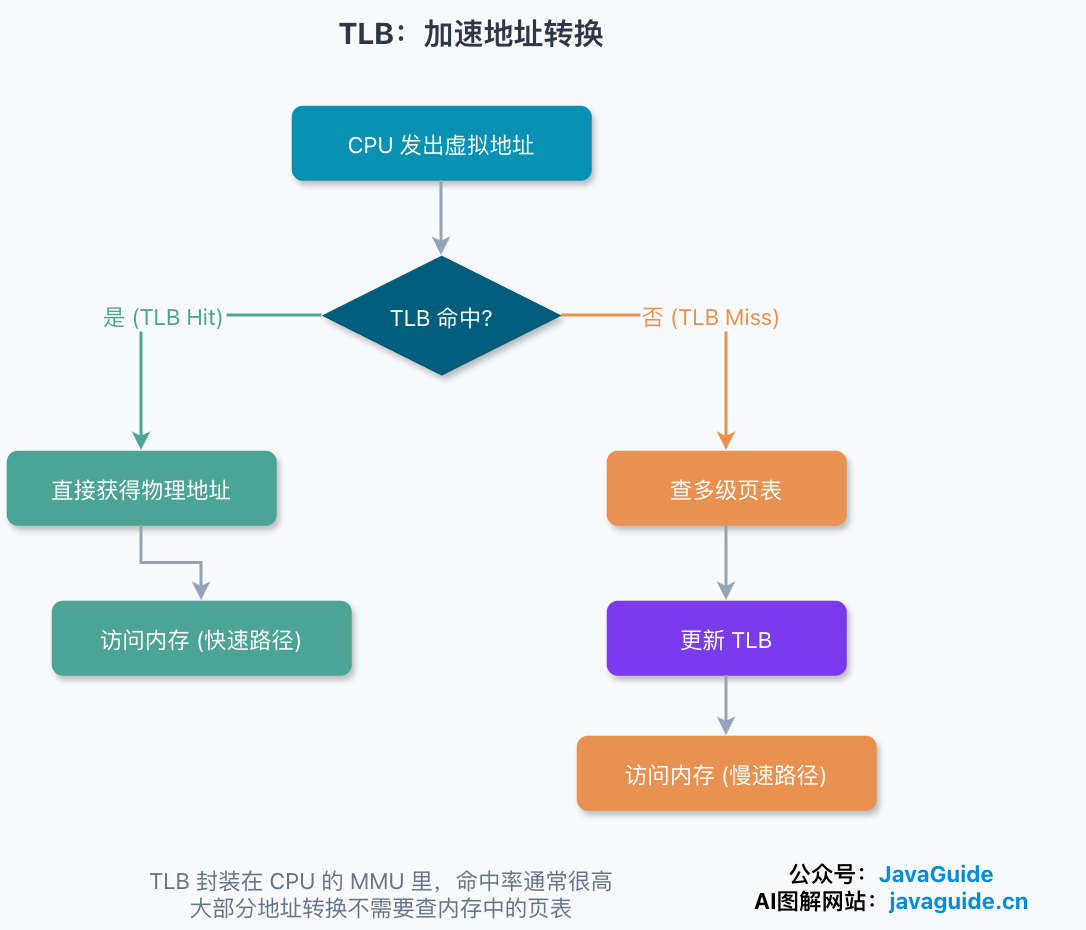
Vì page table cũng nằm trong main memory, trước khi có TLB, CPU khi truy cập một virtual address thường phải truy cập memory để tra page table trước, sau đó mới truy cập data thực tế; với multi-level page table, số lần tra table còn nhiều hơn. Sau khi có TLB, khi hit có thể bỏ qua việc tra page table và lấy trực tiếp physical page frame number, nhờ đó address translation nhanh hơn nhiều.
Ý tưởng thiết kế của TLB rất đơn giản, nhưng hit rate thường rất cao và hiệu quả tốt. Điều này vẫn dựa trên locality: trong một khoảng thời gian, các page mà chương trình thường xuyên truy cập thường chỉ là một vài page.
Sau khi đọc xong, bạn sẽ thấy bảng nhanh khá giống cache mà chúng ta thường sử dụng khi phát triển system (chẳng hạn Redis), thực tế đúng là như vậy. Nhiều ý tưởng và algorithm kinh điển trong Operating System đều có thể tìm thấy dấu vết của chúng trong các tool hoặc framework dùng trong phát triển hằng ngày.
Paging có tác dụng gì?
Ý tưởng của paging là: khi physical memory không đủ, Operating System chọn một số physical page tạm thời ít dùng và swap chúng ra disk; khi process truy cập các page này lần nữa, chúng được swap trở lại physical memory. Nói cách khác, paging tận dụng disk, một storage device có cost thấp hơn, để mở rộng available memory về mặt logic.
Điều này cũng giải thích một vấn đề thường gặp khi sử dụng computer hằng ngày: vì sao dù physical memory cần để tất cả process trong Operating System chạy lớn hơn physical memory thực tế một chút, các process này vẫn có thể chạy bình thường, chỉ là tốc độ chạy sẽ chậm đi.
Đây cũng là một strategy dùng time đổi lấy space, dùng thời gian page-in/page-out để đổi lấy available memory space lớn hơn. Vấn đề cũng rất trực tiếp: một khi major page fault và disk paging xảy ra thường xuyên, system sẽ chậm đi rõ rệt; nghiêm trọng có thể xuất hiện Thrashing, CPU dành phần lớn thời gian cho việc paging.
Page Fault là gì?
Page Fault là synchronous exception được CPU trigger khi address translation hoặc page-level permission check không thể hoàn thành trực tiếp. Nó do memory access instruction hiện tại gây ra, không phải hardware interrupt do peripheral trigger, cũng không có nghĩa chương trình chắc chắn bị lỗi.
Sau khi kernel tiếp quản, nó kiểm tra address có nằm trong virtual memory area (VMA) hợp lệ của process hay không, đồng thời access type có phù hợp với permission hay không:
- Recoverable Page Fault: ví dụ anonymous page chỉ được cấp physical page khi được access lần đầu, file page hoặc Swap page chưa resident trong memory, ghi vào COW page cần copy trước. Kernel hoàn thành allocation, page-in hoặc COW, update page table, sau đó CPU thực thi lại instruction đã trigger exception.
- Unrecoverable Page Fault: ví dụ address không thuộc VMA hợp lệ nào, write vào read-only mapping, execute page không executable. Linux thường gửi
SIGSEGVđến thread hiện tại, process terminate theo default action.
Từ góc độ performance statistics, recoverable Page Fault thường được chia thành:
- Major Page Fault: quá trình xử lý cần read page từ file hoặc Swap, có I/O thực tế và cost lớn.
- Minor Page Fault: không cần read page từ storage device, chẳng hạn thiết lập mapping cho physical page đã có, cấp zero page hoặc xử lý một số COW scenario, cost thường nhỏ hơn.
Out-of-bounds access trong C/C++ cũng không đảm bảo lập tức trigger SIGSEGV. Nếu out-of-bounds address vẫn nằm trong page đã mapping và permission cho phép, CPU không thể chỉ dựa vào array boundary ở language level để nhận ra lỗi, chương trình có thể chỉ phá hỏng data liền kề.
Có thể xem mối quan hệ giữa Page Fault với system call và signal tại: Giải thích chi tiết interrupt, exception và system call: từ kernel entry đến Page Fault.
Có những page replacement algorithm phổ biến nào?
Khi xảy ra major page fault, nếu physical memory không còn physical page free để sử dụng, Operating System buộc phải evict một physical page trong physical memory để giải phóng space để load page mới.
Rule dùng để chọn physical page nào cần evict gọi là page replacement algorithm, có thể xem page replacement algorithm là rule để evict physical page.
Page fault xảy ra quá thường xuyên sẽ ảnh hưởng rất lớn đến performance; một page replacement algorithm tốt phải có khả năng giảm số lần page fault xuất hiện.
Có 5 page replacement algorithm phổ biến sau (ngoài ra còn nhiều page replacement algorithm khác được cải tiến dựa trên các algorithm này):
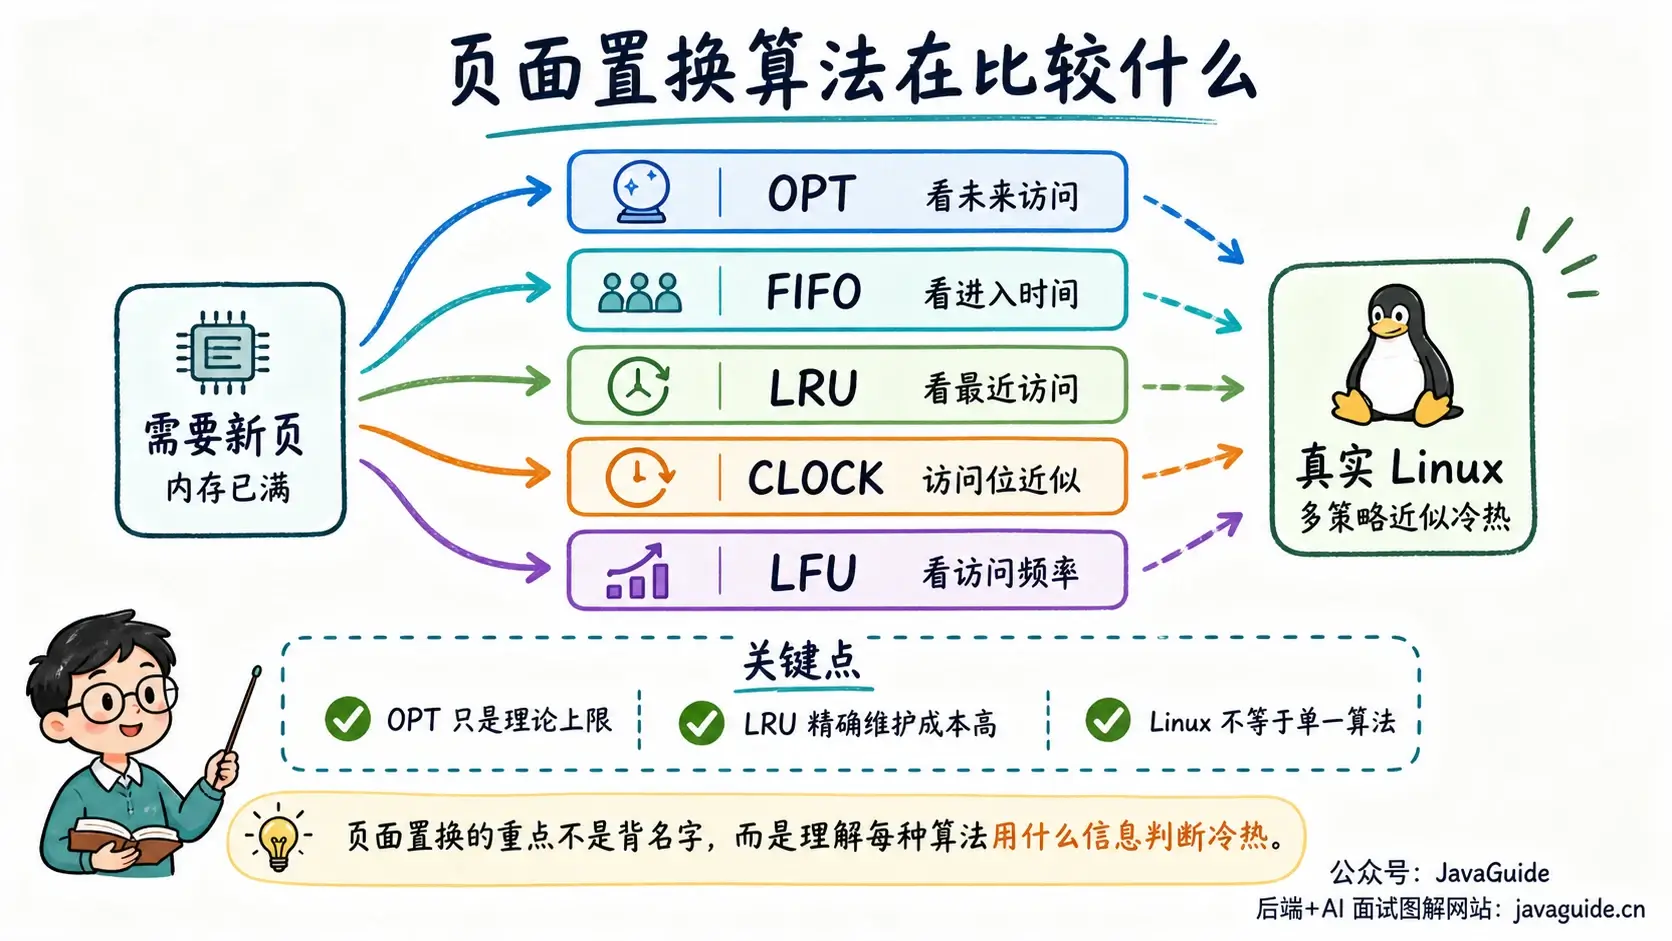
- Optimal Page Replacement Algorithm (OPT, Optimal): ưu tiên evict page trong tương lai lâu nhất không được access lại. Về lý thuyết có page fault rate thấp nhất. Nhưng nó cần biết trước tương lai nên không thể thực hiện trong thực tế, thường được dùng làm baseline để đánh giá algorithm khác.
- First-In First-Out Page Replacement Algorithm (FIFO, First In First Out): luôn evict page vào memory sớm nhất, dễ implement nhưng dễ evict nhầm hot page và có thể xuất hiện Belady anomaly.
- Least Recently Used Page Replacement Algorithm (LRU, Least Recently Used): evict page lâu nhất chưa được access. Nó tận dụng temporal locality, hiệu quả gần OPT, nhưng implementation chính xác cần maintain timestamp hoặc linked list, cost khá cao.
- Least Frequently Used Page Replacement Algorithm (LFU, Least Frequently Used): evict page có số lần access ít nhất trong một khoảng thời gian. Nó quan tâm access frequency, nhưng dễ khiến page từng được access thường xuyên ở giai đoạn đầu rồi không dùng nữa vẫn lưu lại lâu trong memory, vì vậy khi sử dụng thực tế thường kết hợp decay counter.
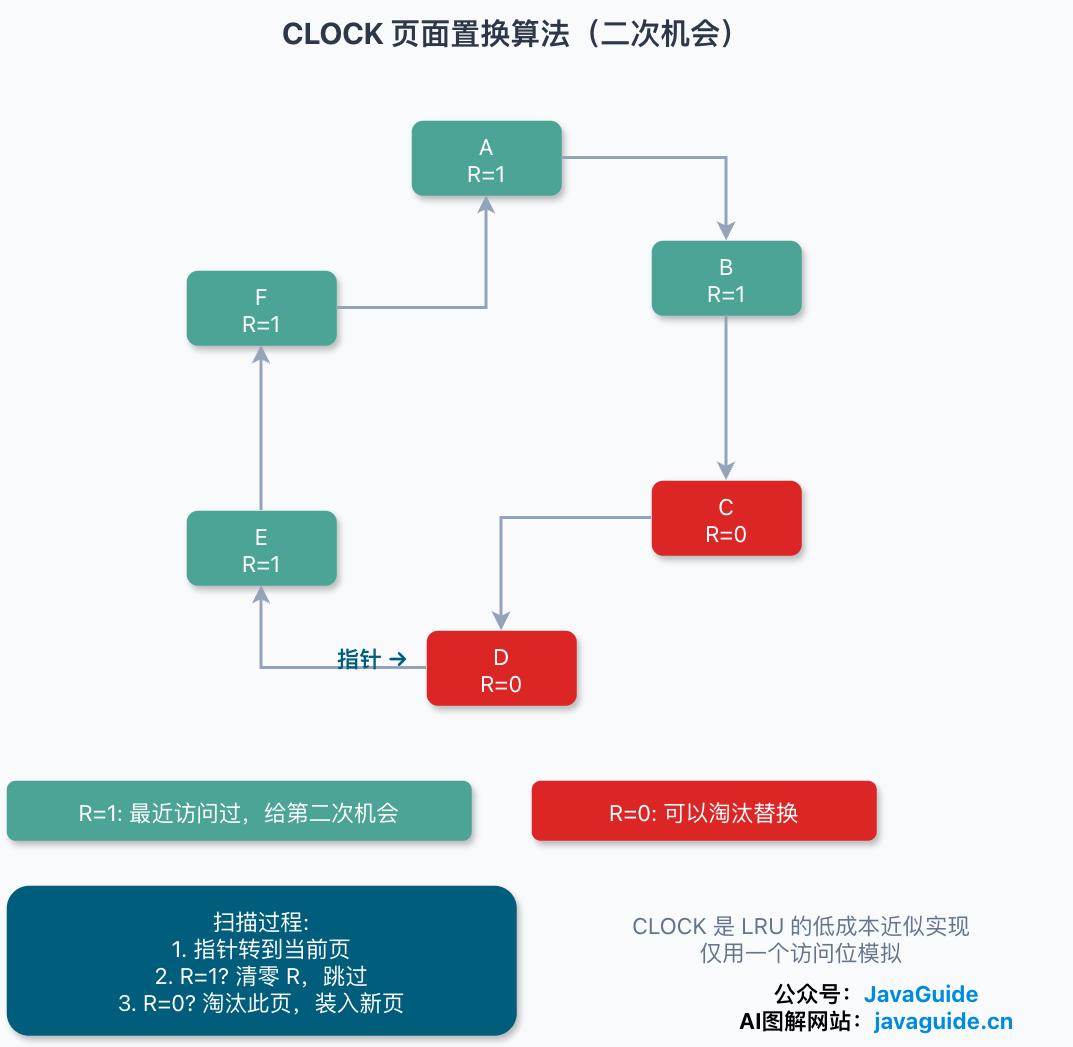
- Clock Page Replacement Algorithm (Clock): còn gọi là second-chance algorithm, là một implementation approximation có cost thấp của LRU. Nó maintain một access bit cho mỗi page, các page xếp thành circular queue; khi access bit là 1 thì trước tiên clear bit rồi skip, khi access bit là 0 mới evict.
Vì sao performance của FIFO page replacement algorithm không tốt?
Chủ yếu có hai nguyên nhân:
- Page thường xuyên được access hoặc cần tồn tại lâu bị paging vào/ra thường xuyên: page được paging vào sớm thường là page thường xuyên được access hoặc cần tồn tại lâu, các page này sẽ bị paging vào và ra lặp đi lặp lại.
- Tồn tại Belady phenomenon: page bị replacement không phải là page process sẽ không access, đôi khi xuất hiện hiện tượng bất thường là số page được cấp tăng nhưng page fault rate lại tăng theo. Nguyên nhân của anomaly này là FIFO chỉ xét thứ tự page vào memory mà không xét access frequency và mức độ cấp thiết của page.
Page replacement algorithm nào được dùng nhiều hơn trong thực tế?
LRU và các algorithm approximation của nó được dùng khá nhiều trong system thực tế vì tương đối phù hợp với locality của chương trình. Tuy nhiên, system thực tế thường không bê nguyên algorithm trong textbook vào sử dụng mà thực hiện nhiều cải tiến engineering. Ví dụ, Linux kernel không đơn giản chọn một algorithm trong OPT/FIFO/LRU/CLOCK mà sử dụng các mechanism như active/inactive LRU, workingset, refault detection để xấp xỉ reclaim; InnoDB Buffer Pool cũng cải tiến LRU truyền thống để tránh prefetch và full table scan đẩy hot page ra ngoài.
Swap, workingset và Thrashing lần lượt là gì?
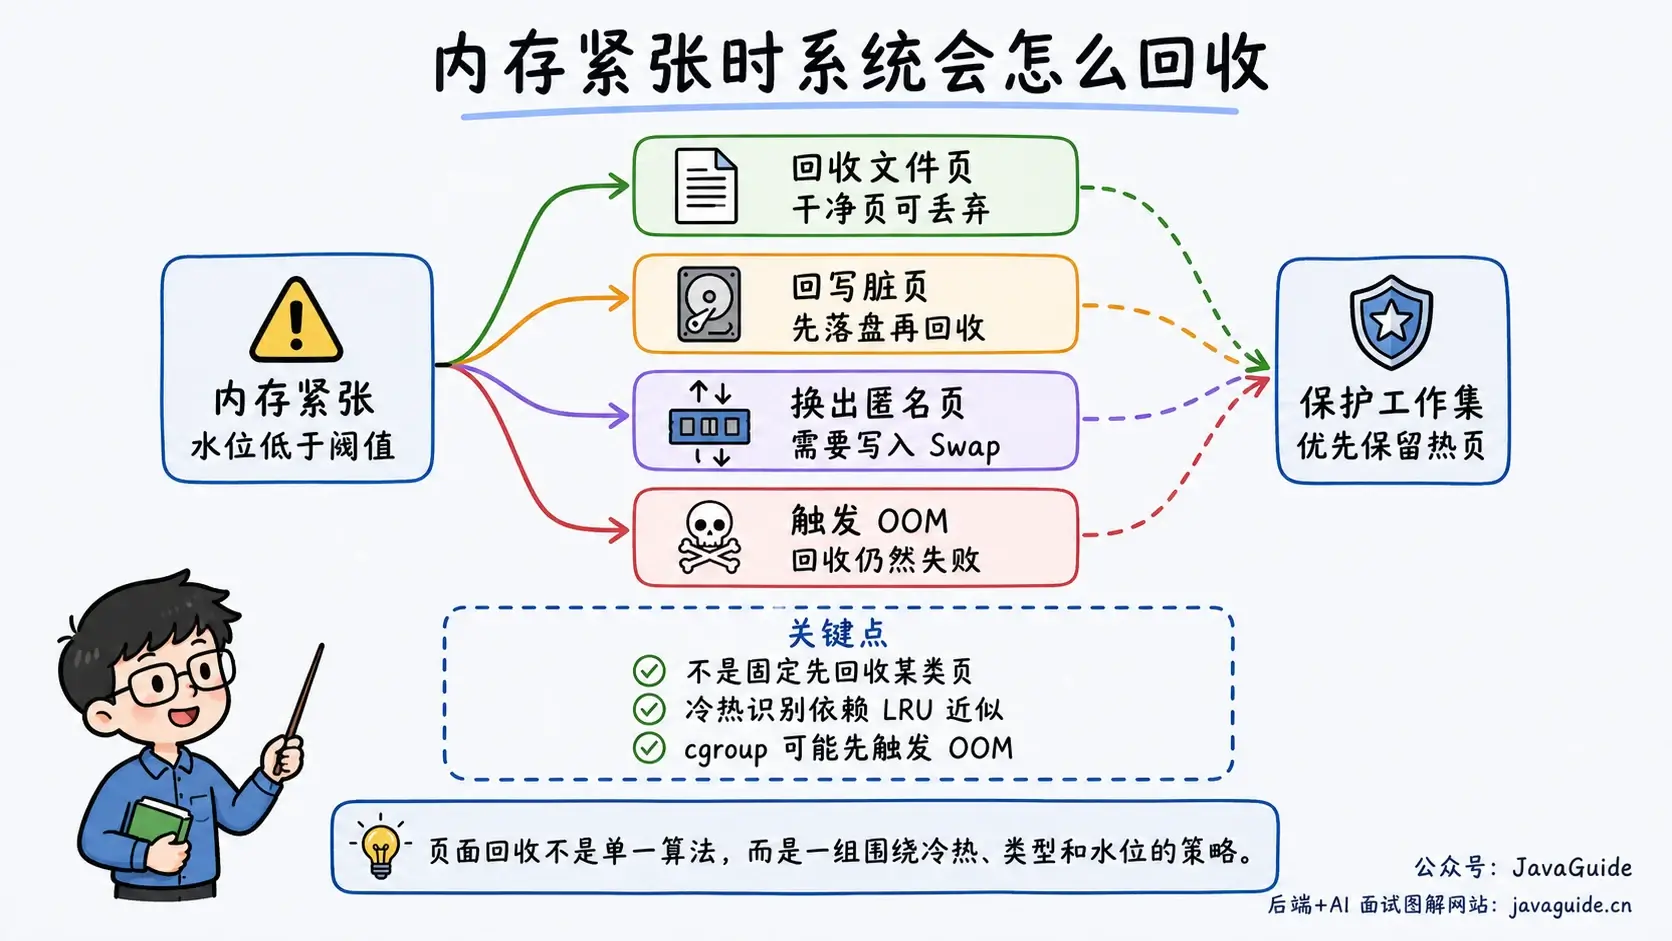
Swap là backing space trên disk. Anonymous page không có file source tương ứng; khi physical memory thiếu, nếu kernel cần reclaim loại page này, nó có thể ghi page vào Swap; sau đó khi process access lại, read page từ Swap trở lại memory.
Swap không phải memory expansion miễn phí. Disk chậm hơn memory rất nhiều, khi Swap active, latency của business thường xấu đi.
Workingset là tập hợp các page mà process thực sự access thường xuyên trong một khoảng thời gian. Chỉ cần physical memory chứa được workingset chính của process, page fault còn kiểm soát được; nếu không chứa được, page sẽ liên tục bị swap out rồi swap in.
Trạng thái này gọi là Thrashing. Khi Thrashing, CPU không nhất thiết bận với business computation mà có thể dành rất nhiều thời gian cho page fault handling, page reclaim và disk I/O.
Khi troubleshooting có thể xem các metric sau:
free -h
vmstat 1
grep -E 'pgfault|pgmajfault|pswpin|pswpout|pgscan|pgsteal' /proc/vmstat
cat /proc/pressure/memory
Mối quan hệ giữa Overcommit và OOM là gì?
Linux cho phép process request virtual memory lớn hơn RAM và Swap hiện tại, đây gọi là Overcommit. Nó phù hợp với các chương trình reserve address space rất lớn nhưng không nhất thiết thực sự sử dụng hết.
Vì vậy, malloc() hoặc mmap() thành công thường chỉ có nghĩa là request virtual address space thành công, không có nghĩa tất cả physical page đã được chuẩn bị. Nhiều physical page phải chờ đến lần access đầu tiên mới thực sự được cấp phát.
Khi process thực sự access page, nếu kernel không thể thu được đủ memory bằng reclaim, writeback hoặc Swap, nó có thể trigger OOM Killer, chọn kill một hoặc nhiều process để release memory.
Trong container environment, còn phải xem giới hạn cgroup. Host vẫn còn free memory không có nghĩa container còn có thể tiếp tục sử dụng; sau khi container đạt memory.max, cgroup-level OOM cũng có thể được trigger trước.
Quan hệ giữa mmap, COW và shared memory là gì?
mmap() tạo một mapping trong virtual address space của process. Nó có thể mapping file hoặc tạo anonymous mapping. Khi tạo mapping, data không nhất thiết được read ngay; chỉ khi thực sự access một page, mới có thể trigger page fault.
Khi nhiều process mapping cùng một file, kernel có thể cho chúng share physical page trong Page Cache. Shared memory IPC cũng theo ý tưởng tương tự: virtual address của các process khác nhau mapping đến cùng một nhóm physical page, process có thể read/write data trao đổi mà không cần mỗi lần đều đi qua kernel để copy.
COW (Copy-On-Write) thường xuất hiện trong fork(). Khi process cha và con vừa được tạo, chúng có thể share cùng một nhóm physical page, page table trước hết được đánh dấu read-only; bên nào write trước thì trigger page fault, kernel sau đó copy một page cho bên thực hiện write.
Giới thiệu chi tiết: Giải thích chi tiết memory management của Operating System: paging, segmentation, page replacement, Swap và OOM
Paging và segmentation có những điểm chung và khác biệt nào?
Điểm chung:
- Đều là cách non-contiguous memory management.
- Đều sử dụng address mapping, mapping virtual address đến physical address để quản lý và bảo vệ memory.
Khác biệt:
- Cơ sở phân chia khác nhau: paging chia address space và physical memory theo kích thước cố định, page là physical granularity của memory management; segmentation chia theo cấu trúc logic của chương trình, chẳng hạn code segment, data segment, heap, stack, segment là logical unit gần với ý nghĩa của chương trình hơn.
- Kích thước có cố định hay không khác nhau: page size cố định, thường là 4 KB; segment size không cố định, phụ thuộc vào kích thước logical region tương ứng trong chương trình.
- Vấn đề fragmentation khác nhau: segmentation dễ tạo external fragmentation vì mỗi segment cần space liên tiếp; paging về cơ bản loại bỏ external fragmentation, nhưng page cuối cùng có thể không được lấp đầy và tạo một lượng nhỏ internal fragmentation.
- Cấu trúc address khác nhau: paging address thường gồm page number và offset trong page, mapping qua page table; segmentation address gồm segment number và offset trong segment, mapping qua segment table.
- Cách sử dụng trong engineering khác nhau: Operating System đa dụng hiện đại chủ yếu dựa vào paging để quản lý memory. Lấy x86 làm ví dụ, hardware trước đây hỗ trợ segmentation và paging, nhưng Linux về cơ bản đặt segment base address là 0, khiến segmentation chủ yếu còn là permission và compatibility mechanism, còn memory management thực tế chủ yếu dựa vào paging.
Segmentation-paging
Đây là một memory management mechanism kết hợp segmentation và paging. Từ góc nhìn của chương trình, memory được chia thành nhiều logical segment, mỗi logical segment tiếp tục được chia thành các page có kích thước cố định.
Trong segmentation-paging, quá trình address translation gồm hai bước:
- Segment address mapping (virtual address -> linear address):
- Virtual address = segment selector (segment number) + offset trong segment.
- Tra segment table theo segment number, tìm segment base address, cộng offset trong segment để có linear address.
- Page address mapping (linear address -> physical address):
- Linear address = page number + offset trong page.
- Tra page table theo page number, tìm physical page frame number, cộng offset trong page để có physical address.
Locality
Để hiểu tốt hơn kỹ thuật virtual memory, cần biết Locality Principle, một nguyên lý nổi tiếng trong computer architecture. Ngoài ra, locality áp dụng cho cả program structure và data structure, là một khái niệm rất quan trọng.
Locality là đặc điểm cho thấy data và instruction được access theo tính locality về không gian và thời gian trong quá trình chương trình thực thi. Temporal locality là đặc điểm một data item hoặc instruction được sử dụng lặp lại trong một khoảng thời gian; spatial locality là đặc điểm một data item hoặc instruction được sử dụng lặp lại cùng với các data item hoặc instruction liền kề trong một khoảng thời gian.
Trong paging, page table dùng để chuyển virtual address thành physical address, qua đó hoàn thành memory access. Trong quá trình này, locality thể hiện ở hai khía cạnh:
- Temporal locality: vì chương trình có một số loop hoặc operation lặp lại, nên sẽ lặp lại việc access cùng một page hoặc một số page cụ thể, thể hiện đặc điểm temporal locality. Để tận dụng temporal locality, paging thường dùng cơ chế cache để nâng cao page hit rate, tức là đưa một số page được access gần đây vào cache; nếu page của lần access tiếp theo đã ở trong cache thì không cần access memory lần nữa mà đọc trực tiếp từ cache.
- Spatial locality: vì access data và instruction của chương trình thường có tính liên tục nhất định về space, khi access một page thường sẽ đồng thời access một số page liền kề. Để tận dụng spatial locality, paging thường dùng prefetching để đọc trước một số page liền kề vào memory cache, từ đó có thể sử dụng trực tiếp khi access trong tương lai và nâng cao access speed.
Tóm lại, locality là một trong những nguyên tắc quan trọng của computer architecture design, đồng thời là nền tảng của nhiều optimization algorithm. Trong paging, tận dụng temporal locality và spatial locality, sử dụng cache và prefetching có thể nâng cao page hit rate, từ đó nâng cao memory access efficiency.
Virtual memory thực hiện address translation và process isolation như thế nào?
Khi được hỏi về virtual memory trong phỏng vấn, đừng chỉ học thuộc “isolate process”. Có thể trả lời theo trục sau: virtual memory tách address mà process nhìn thấy khỏi physical address thực tế, sau đó MMU, page table và TLB thực hiện address translation.
Process access virtual address (VA), còn address thực sự được ánh xạ vào physical memory là physical address (PA). Mỗi process có virtual address space và page table riêng, vì vậy ngay cả khi các process khác nhau sử dụng cùng virtual address, chúng vẫn có thể mapping đến các physical page khác nhau, từ đó thực hiện process isolation.
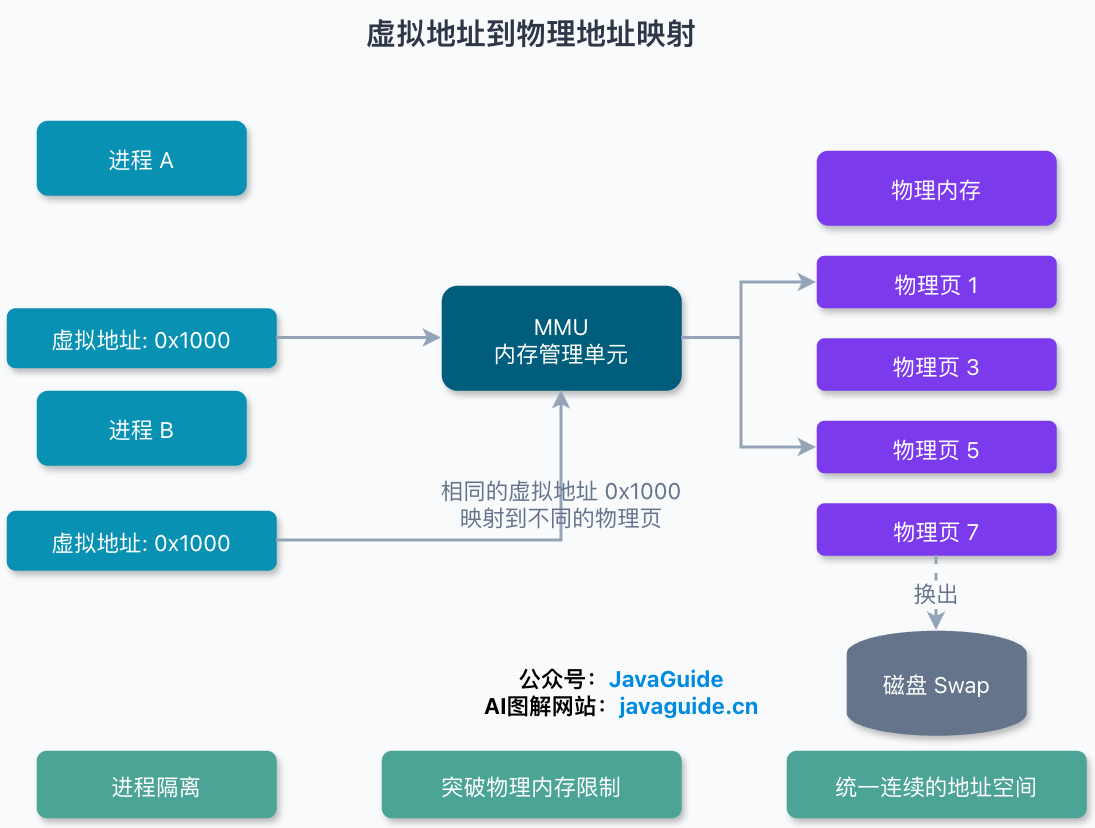
Tuy nhiên, isolation không có nghĩa các process hoàn toàn không thể share data. Operating System có thể kiểm soát để nhiều process mapping cùng một nhóm physical page, chẳng hạn shared dynamic library, file mapping bằng mmap, shared memory IPC. Điểm khác biệt là: page table permission bảo đảm default isolation; còn shared thì kernel phải thiết lập mapping một cách tường minh và phối hợp permission control. Nếu là shared memory IPC thì còn cần xử lý synchronization.
Paging chia virtual address space và physical memory thành các page có kích thước cố định, dùng page table ghi lại mapping “virtual page number -> physical page frame”. Nhờ vậy về cơ bản loại bỏ external fragmentation dễ phát sinh trong segmentation, đồng thời cho phép physical memory được cấp phát rời rạc; bản thân page table chiếm space nên các system hiện đại dùng multi-level page table để tạo lower-level page table on demand.
Có thể hiểu TLB là cache của page table entry. CPU tra TLB trước, hit thì lấy trực tiếp physical page frame number; miss mới tra multi-level page table và điền kết quả trở lại TLB. Nếu page table entry cho thấy page không ở trong memory, sẽ trigger page fault; kernel phán đoán access có hợp lệ hay không, nếu hợp lệ thì cấp page frame, khi cần evict page cũ, page-in từ file hoặc Swap, cuối cùng update page table và thực thi lại instruction đó.
Về page replacement algorithm, có thể nắm một câu: page bị evict tốt nhất là page sẽ được dùng lại muộn nhất trong tương lai. OPT tối ưu về lý thuyết nhưng không thể implement, LRU gần OPT nhưng cost implementation cao, CLOCK dùng access bit để approximation LRU, FIFO đơn giản nhưng có thể xuất hiện Belady anomaly.
Giới thiệu chi tiết: Giải thích chi tiết virtual memory: address translation, TLB, Page Fault và page replacement
I/O
Một lần blocking read() trải qua những gì?
Lấy read(fd, buf, count) làm ví dụ, user program thường gọi glibc wrapper function trước. Wrapper function chuẩn bị system call number và parameter theo ABI, thực thi instruction như syscall để vào kernel. Kernel kiểm tra file descriptor, user buffer và access permission, sau đó đi vào read path tương ứng của VFS, file system, Socket hoặc device driver.
Nếu data đã sẵn sàng, kernel copy data vào user buffer và return số byte đã read; nếu data chưa sẵn sàng, blocking fd khiến thread hiện tại đi vào waiting state, scheduler có thể chạy task khác đang runnable. Sau khi disk I/O hoàn thành hoặc network card nhận được data, device thông báo kernel qua hardware interrupt, kernel wake thread trong waiting queue. Thread đó phải giành lại CPU sau đó mới tiếp tục hoàn thành read() và return về user space.
Path này có thể đồng thời xuất hiện system call, hardware interrupt và thread context switch, cũng có thể chỉ trải qua một phần trong số đó. Khi Page Cache đã có data, read() có thể return trực tiếp, không cần chờ device interrupt, cũng không cần switch sang thread khác.
Giới thiệu chi tiết: Giải thích chi tiết interrupt, exception và system call: từ kernel entry đến Page Fault.
I/O multiplexing là gì?
I/O multiplexing không giải quyết vấn đề “một lần read/write nhanh hơn”, mà là một thread làm thế nào để đồng thời chờ ready event của nhiều file descriptor (fd).
Một network read thường chia thành hai giai đoạn: trước hết chờ data từ network card đến và đi vào kernel buffer, sau đó copy data từ kernel buffer vào user buffer. Vấn đề của blocking I/O nằm ở giai đoạn đầu: sau khi một thread gọi recv, nếu connection đó chưa có data thì thread chỉ có thể bị block ở đó để chờ.
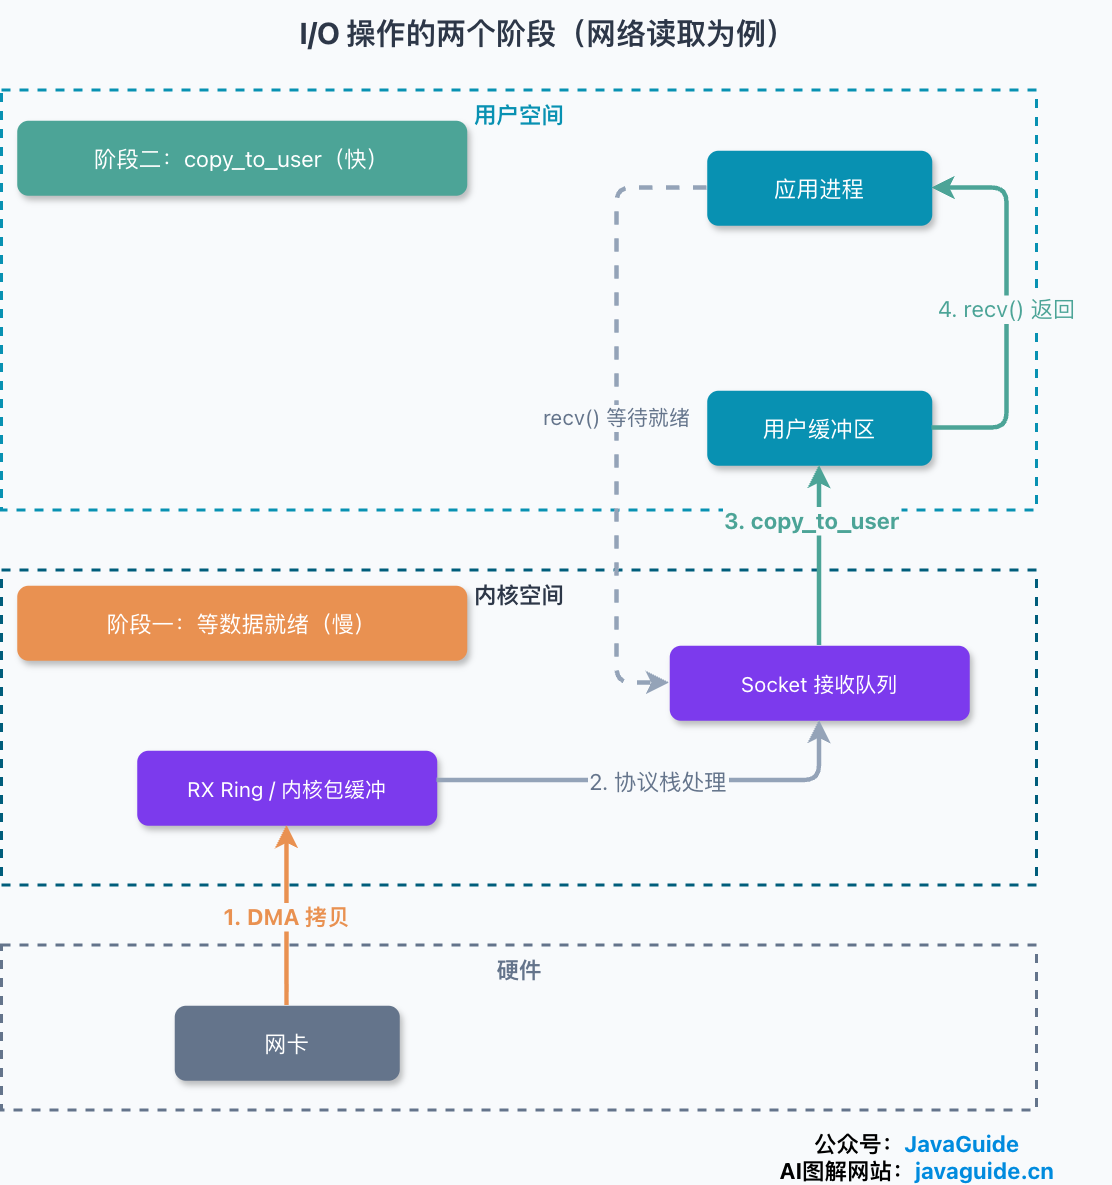
I/O multiplexing giao một nhóm fd cho kernel, để thread block trong các system call như select, poll hoặc epoll. Chỉ cần bất kỳ fd nào trong đó ready, system call sẽ return và application xử lý connection tương ứng. Nhờ vậy một thread có thể quản lý hàng nghìn connection, đặc biệt phù hợp với scenario nhiều connection idle và ít connection active, chẳng hạn các high-performance network program như Redis, Nginx, Netty.
Cần lưu ý: I/O multiplexing vẫn thuộc synchronous I/O. Kernel chỉ thông báo “có thể read/có thể write”, còn read/recv thực tế vẫn do application gọi; bước copy data từ kernel buffer sang user buffer không được loại bỏ.
Giới thiệu chi tiết: Giải thích chi tiết I/O multiplexing: nguyên lý và khác biệt của select, poll, epoll
select, poll và epoll khác nhau thế nào?
Kết luận: mỗi lần wait, select và poll đều phải giao toàn bộ listen set cho kernel, sau khi return phải scan tuyến tính; epoll duy trì listen set lâu dài trong kernel, epoll_wait chủ yếu return event đã ready, phù hợp hơn với scenario “nhiều connection nhưng ít active connection”.
select dùng bitmap fd_set có kích thước cố định, trên Linux glibc thường bị giới hạn bởi FD_SETSIZE, chỉ có thể xử lý an toàn fd có số hiệu từ 0~1023. Trước mỗi call phải setup lại listen set, sau khi return còn phải duyệt bitmap để tìm fd nào ready.
poll thay bitmap bằng array pollfd, loại bỏ giới hạn FD_SETSIZE, nhưng về bản chất vẫn truyền toàn bộ array vào kernel mỗi lần, sau khi return duyệt toàn bộ array để kiểm tra revents. Vì vậy khi số connection rất lớn và tỷ lệ active rất thấp, cost scan vẫn đáng kể.
epoll dùng epoll_ctl để maintain listen set và dùng epoll_wait để lấy ready event. Kernel maintain interest list và ready list; sau khi fd ready, fd đi vào ready list, application chỉ lấy nhóm ready event này khi wait. Nó còn hỗ trợ LT (level-triggered) và ET (edge-triggered): LT liên tục notify khi buffer còn data; ET chỉ notify một lần khi state thay đổi, phải phối hợp với non-blocking fd và loop read đến EAGAIN.
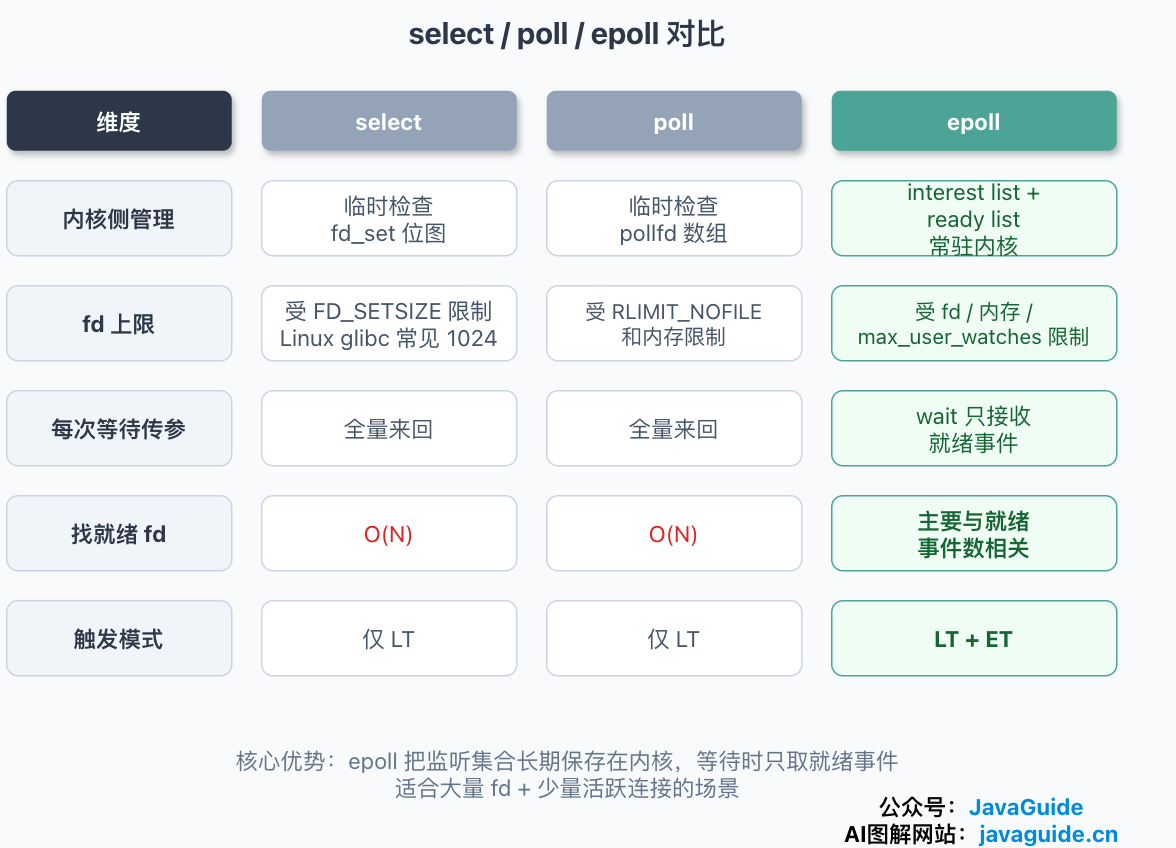
Tuy nhiên, epoll không nhanh hơn trong mọi scenario. Khi số connection ít hoặc tất cả connection đều active, cost duy trì như epoll_ctl, callback, ready linked list cũng phải được tính đến. Nó phù hợp nhất với server program có lượng lớn long connection, phần lớn thời gian ở trạng thái idle.
Giới thiệu chi tiết: Giải thích chi tiết I/O multiplexing: nguyên lý và khác biệt của select, poll, epoll
Zero-copy là gì?
Zero-copy không có nghĩa hoàn toàn không copy, mà là cố gắng tránh CPU vận chuyển data giữa kernel buffer và user buffer, từ đó giảm CPU copy và context switch giữa user mode/kernel mode.
Lấy việc gửi file bằng read + write truyền thống làm ví dụ, data thường trải qua 4 lần copy: từ disk đến kernel buffer là DMA copy, từ kernel buffer đến user buffer là CPU copy, từ user buffer đến Socket buffer vẫn là CPU copy, từ Socket buffer đến network card là DMA copy. Lãng phí nhất ở đây là hai lần CPU copy ở giữa, vì application không sửa data mà chỉ làm data đi một vòng qua user space.
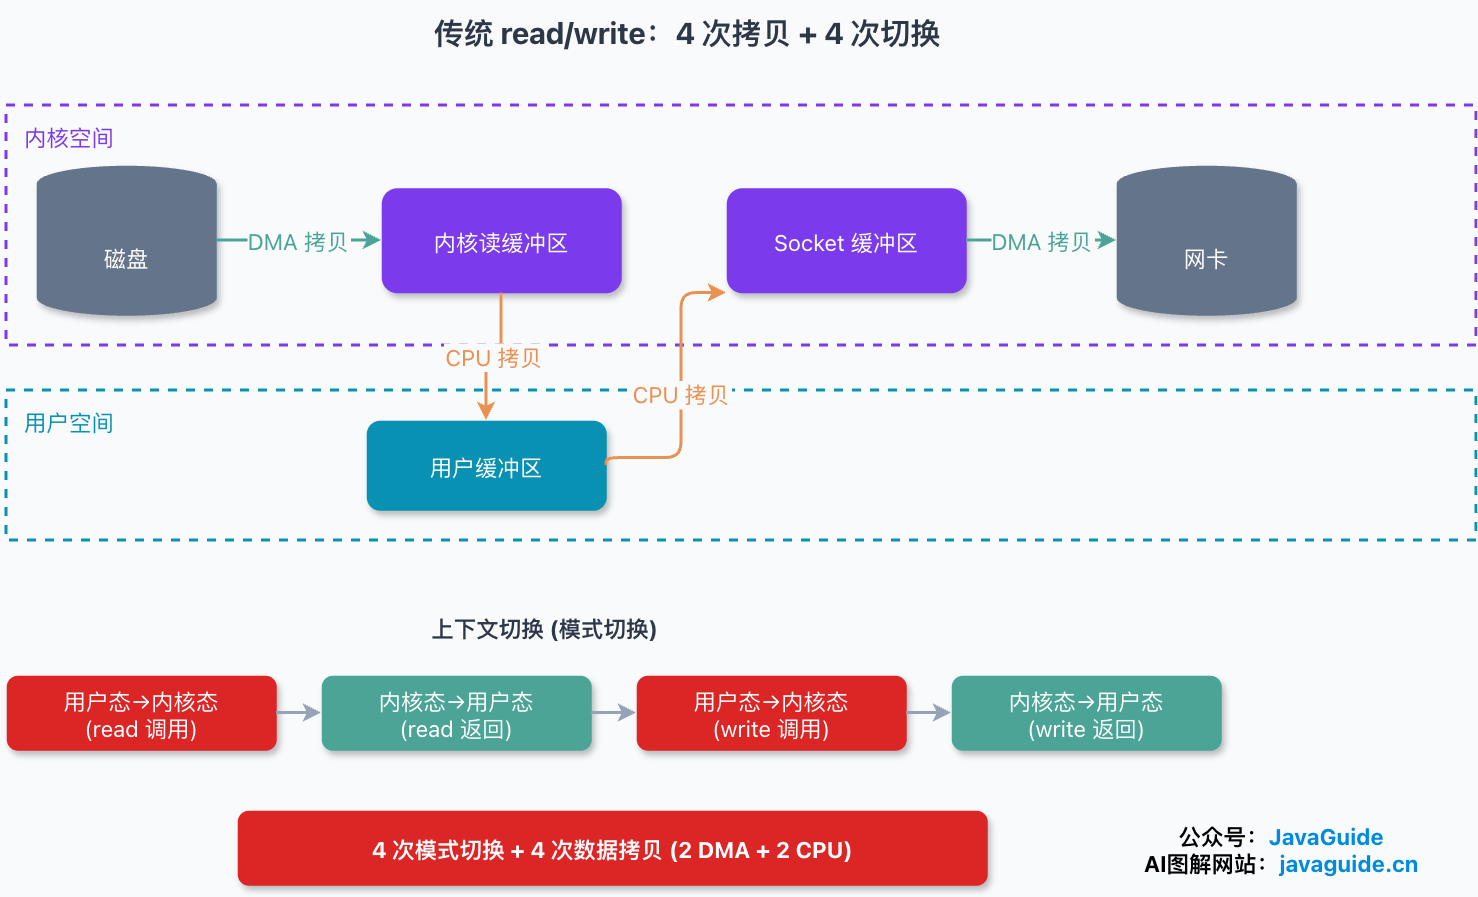
Ý tưởng của zero-copy là giữ data trong kernel path để forward nhiều nhất có thể. Chẳng hạn sendfile có thể chuyển file data trực tiếp từ Page Cache đến Socket; nếu network card hỗ trợ SG-DMA, trong Socket buffer thậm chí chỉ cần đặt thông tin mô tả, payload được DMA trực tiếp từ kernel buffer đến network card.
Zero-copy rất phù hợp với các scenario forward file nguyên trạng, truyền file lớn, gửi log của message queue. Khi Kafka consumer gửi log segment file cho consumer, rất phù hợp đi theo sendfile path như FileChannel.transferTo.
Giới thiệu chi tiết: Giải thích chi tiết zero-copy: mmap, sendfile và splice
mmap, sendfile và splice khác nhau thế nào?
Kết luận: cần sửa data thì dùng mmap; chỉ forward nguyên trạng từ file đến Socket thì dùng sendfile; forward giữa các fd tổng quát hơn thì cân nhắc splice.
mmap + write tận dụng virtual memory mapping để mapping file vào address space của process. Khi application access vùng memory này, thực tế nó access physical page tương ứng với Page Cache, bỏ qua CPU copy “kernel buffer -> user buffer” trong read truyền thống. Tuy nhiên, write tiếp theo đến Socket buffer thường vẫn có một lần CPU copy. Nó phù hợp với scenario cần read, modify hoặc parse data trước khi send.
sendfile phù hợp hơn với việc send nguyên trạng “file -> Socket”. Data không đi vào user space, số lần system call cũng ít hơn; trên network card hỗ trợ SG-DMA, còn có thể giảm CPU payload copy xuống 0. Static file server và việc gửi Kafka log segment là các scenario điển hình.
splice nhờ pipe để di chuyển page reference trong kernel, phù hợp với forward giữa các descriptor tổng quát hơn, chẳng hạn socket đến socket, file đến pipe rồi đến socket. Hạn chế của nó là path thường phải có pipe, hơn nữa file đến socket thường cần hai lần gọi splice, vì vậy cần cân nhắc cả code complexity và số lần system call.
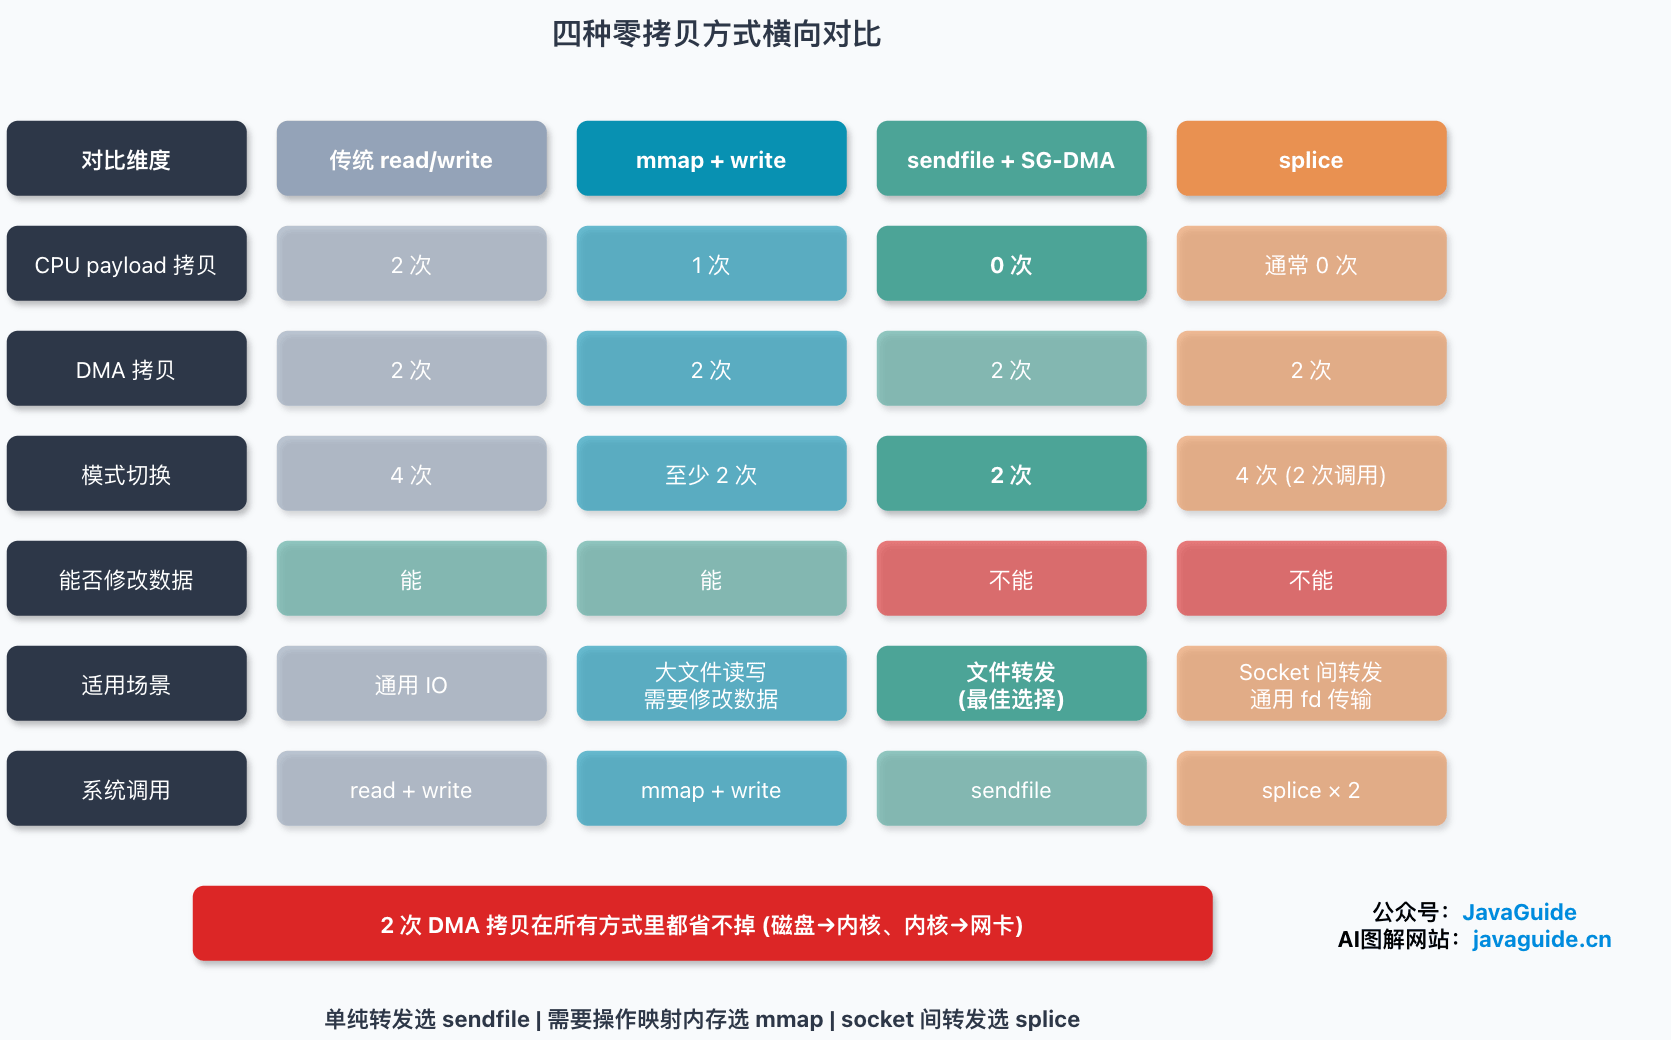
Zero-copy cũng có các scenario mất tác dụng: TLS encryption, compression, format conversion, content filtering, watermark processing đều cần application thực sự xử lý payload, khiến data khó tiếp tục nằm trong kernel path. Với file nhỏ hoặc random access, fixed cost của mapping, page fault và pipe cũng có thể lớn hơn benefit.
Giới thiệu chi tiết: Giải thích chi tiết zero-copy: mmap, sendfile và splice
File System
File system chủ yếu làm gì?
File system chịu trách nhiệm tổ chức block trên storage device thành file và directory mà application có thể hiểu. Trong phỏng vấn có thể trả lời từ 6 việc sau:
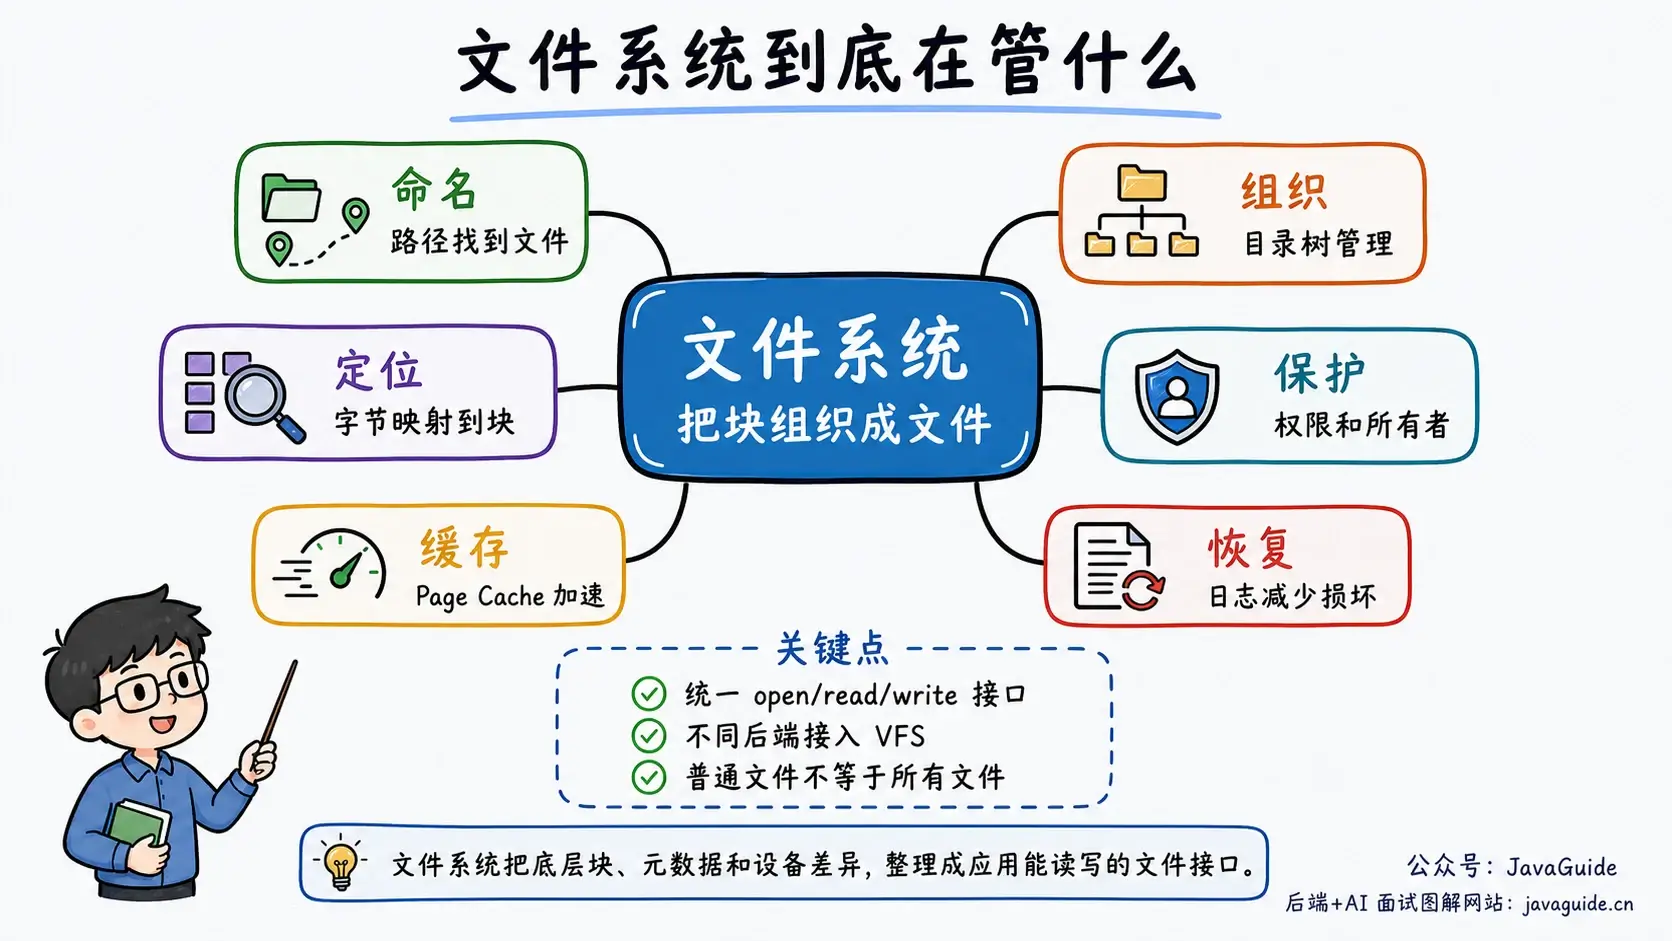
- Naming: dùng path và file name để tìm file đích, chẳng hạn
/var/log/app.log. - Organization: dùng directory tree để quản lý file và directory, giúp các file có cấu trúc phân cấp rõ ràng.
- Location: mapping byte thứ N của file đến data block bên dưới.
- Space management: allocate, release và reuse disk block, ghi lại block nào free và block nào đã dùng.
- Permission protection: ghi lại metadata như owner, permission, timestamp và thực hiện check khi access.
- Cache và recovery: dùng Page Cache để nâng cao read/write performance, dùng logging mechanism để giảm hư hỏng file system structure sau crash.
Không phải file system nào cũng tương ứng với local disk. tmpfs chủ yếu dùng memory làm backend, procfs cung cấp kernel runtime state, còn NFS kết nối remote file system vào local directory tree. Linux cung cấp interface thống nhất cho các file system này thông qua VFS.
Quan hệ giữa file, directory, inode và dentry là gì?
Trong Linux/Unix file system, file name thường không được lưu trong inode.
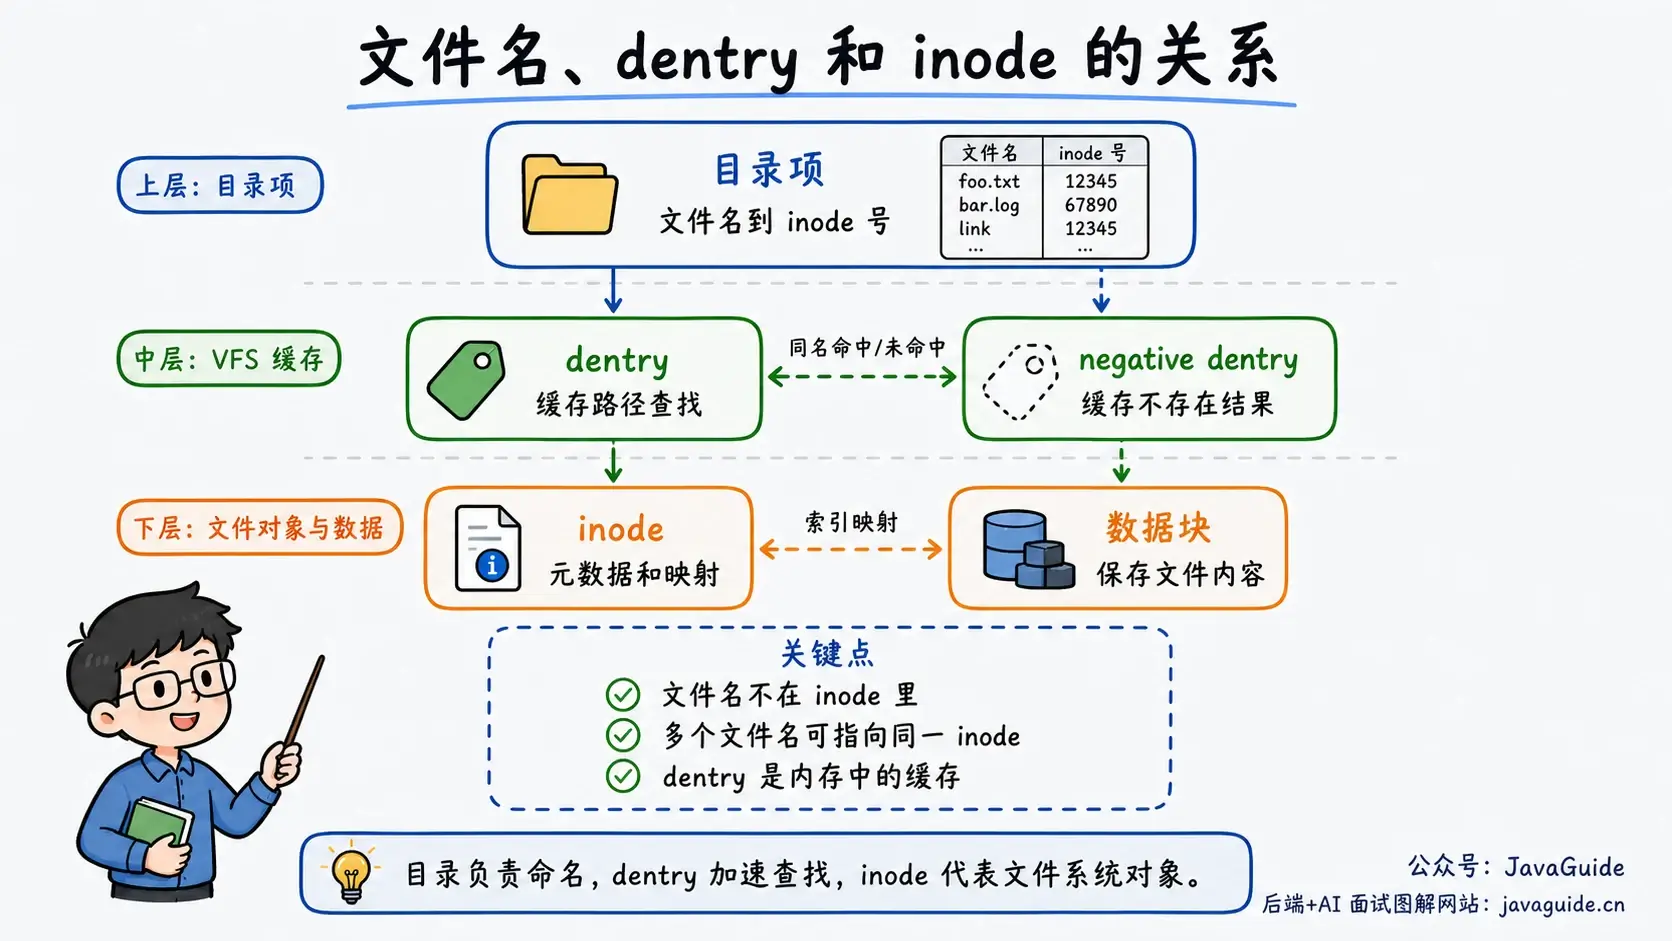
- Directory entry: lưu mapping từ file name đến inode number.
- inode: ghi lại file type, permission, owner, size, timestamp, link count và mapping information của data block hoặc extent.
- dentry: directory entry cache được VFS maintain trong memory, dùng để tăng tốc path lookup. Nó thường trỏ đến inode, cũng có thể cache kết quả lookup “không tồn tại”, tức negative dentry.
- Data block hoặc extent: lưu actual content của regular file.
Điều này cũng giải thích vì sao cùng một file có thể có nhiều tên: nhiều directory entry có thể trỏ đến cùng một inode. Nếu mv a.txt b.txt xảy ra trong cùng một file system, nhiều khi chỉ cần sửa directory entry, bản thân file content không cần di chuyển.
Có thể dùng các command sau để quan sát inode và metadata:
ls -li app.log
stat app.log
df -i
Điều gì xảy ra khi open một file?
open() không read toàn bộ file vào memory, nó chủ yếu thực hiện path resolution và tạo open object.
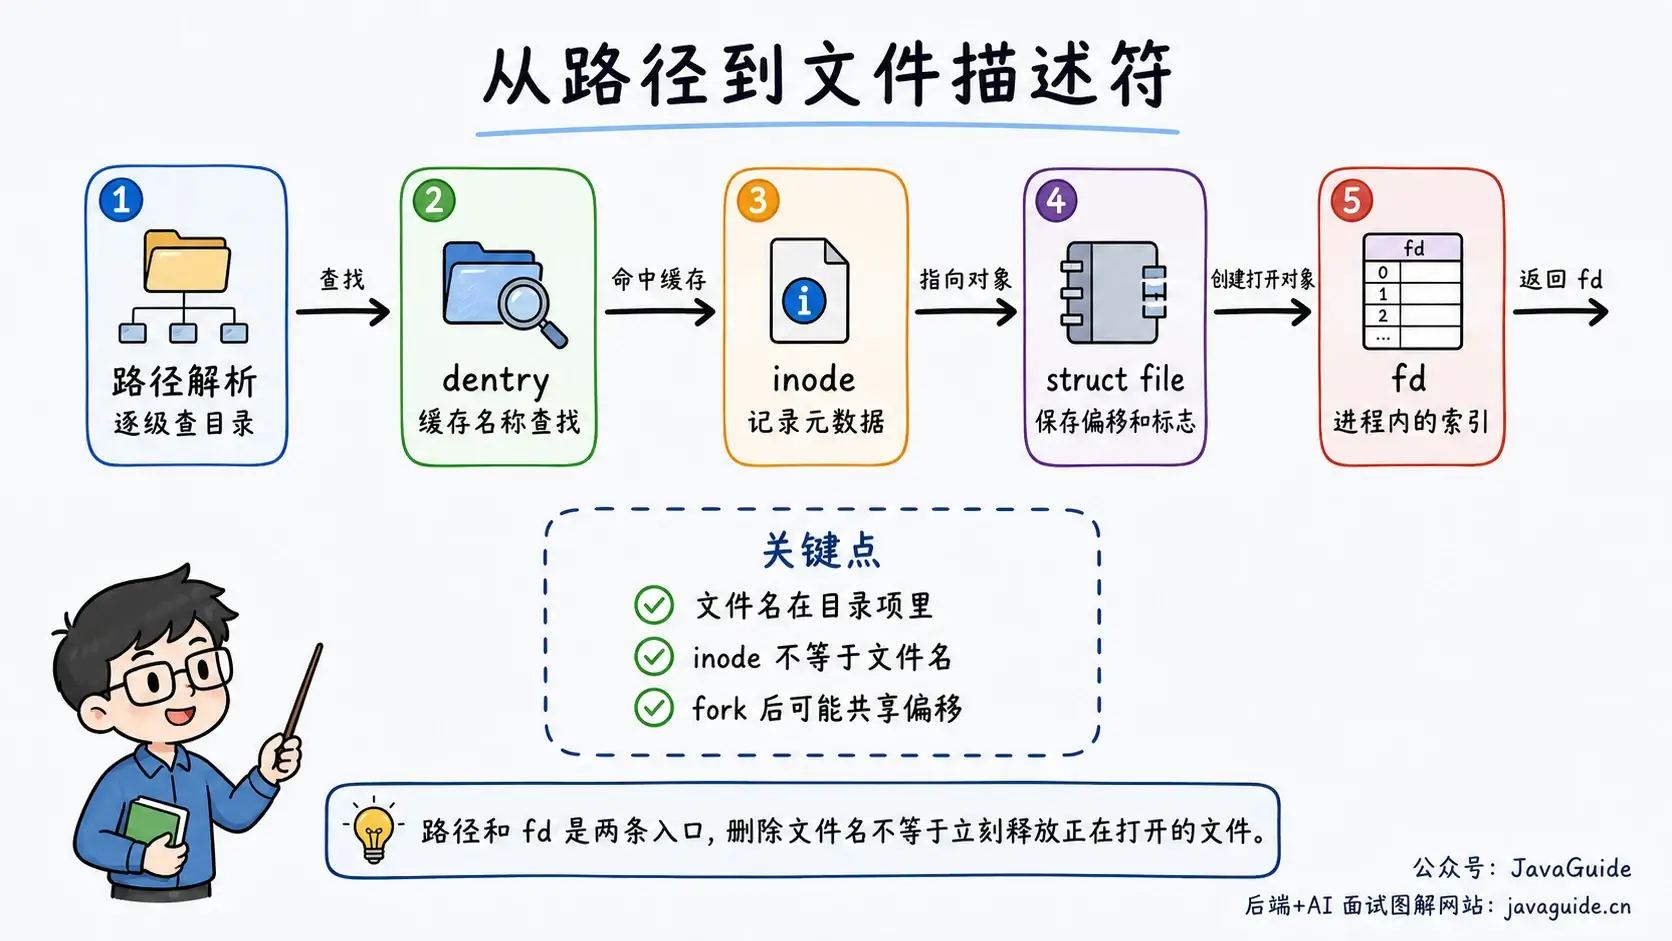
Quy trình đại khái là:
- Bắt đầu từ root directory hoặc current directory để resolve path, lần lượt tra directory entry và dentry cache.
- Sau khi tìm được inode đích, kiểm tra permission, open flag và file type.
- Tạo open file object trong kernel, ghi lại current file offset, open state, read/write flag và các thông tin khác.
- Allocate một số nguyên không âm nhỏ nhất khả dụng trong file descriptor table của process hiện tại, tức fd.
fd là index trong file descriptor table của process, không phải inode. Sau dup() hoặc fork(), nhiều fd có thể tham chiếu cùng một open file object, vì vậy chúng share file offset; hai process lần lượt open() cùng một file thường nhận các open file object khác nhau và tự duy trì offset riêng.
File được lưu trên disk như thế nào?
File system chia partition hoặc volume thành nhiều block, sau đó dùng metadata ghi lại quan hệ giữa file content và block. Ba cách allocation thường gặp trong textbook là:
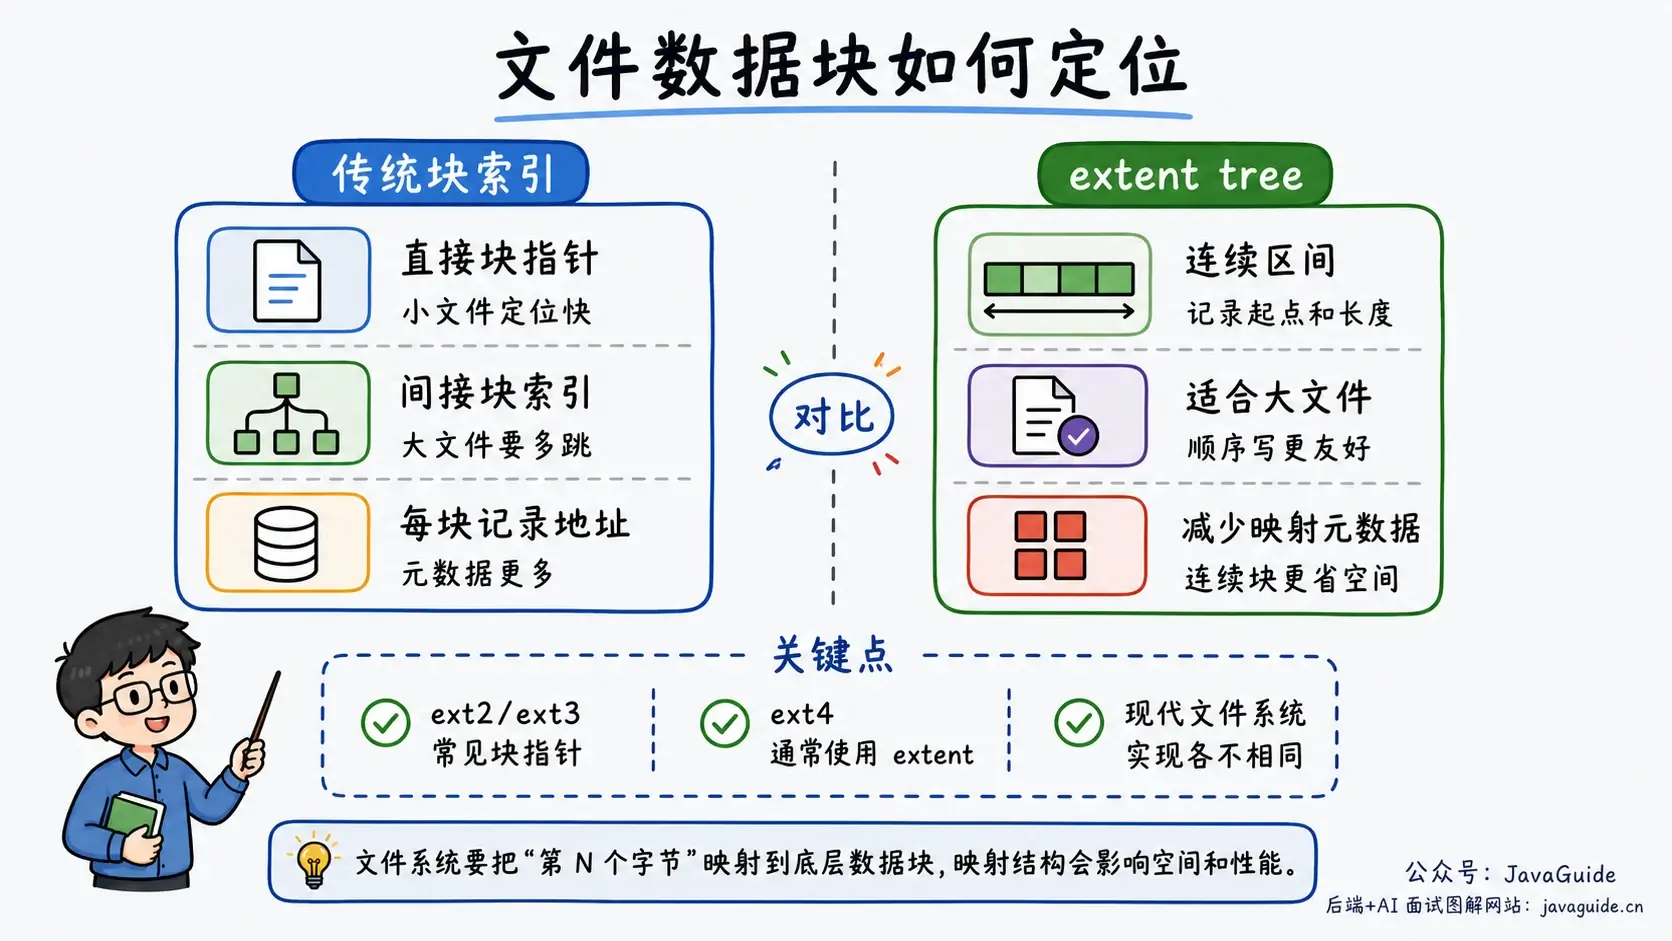
- Contiguous allocation: file chiếm một đoạn block liên tiếp, sequential read/write và random access đều nhanh; nhược điểm là khó mở rộng file và dễ tạo external fragmentation.
- Linked allocation: mỗi block trỏ đến block tiếp theo, không yêu cầu space liên tiếp; nhược điểm là random access kém.
- Indexed allocation: tập trung address của data block trong index block, random access thuận tiện hơn; nhược điểm là cần thêm index space.
ext2/ext3 kinh điển dùng direct block pointer, single indirect, double indirect và triple indirect block để định vị file data. ext4 thường dùng extent tree, mỗi extent ghi logical start, physical start và length của một đoạn physical block liên tiếp; với large file liên tiếp, cách này tiết kiệm metadata hơn “mỗi block ghi một address”.
Hard link và soft link khác nhau thế nào?
Hard link và soft link đều có thể khiến một path liên kết đến file khác, nhưng object mà chúng trỏ đến khác nhau.
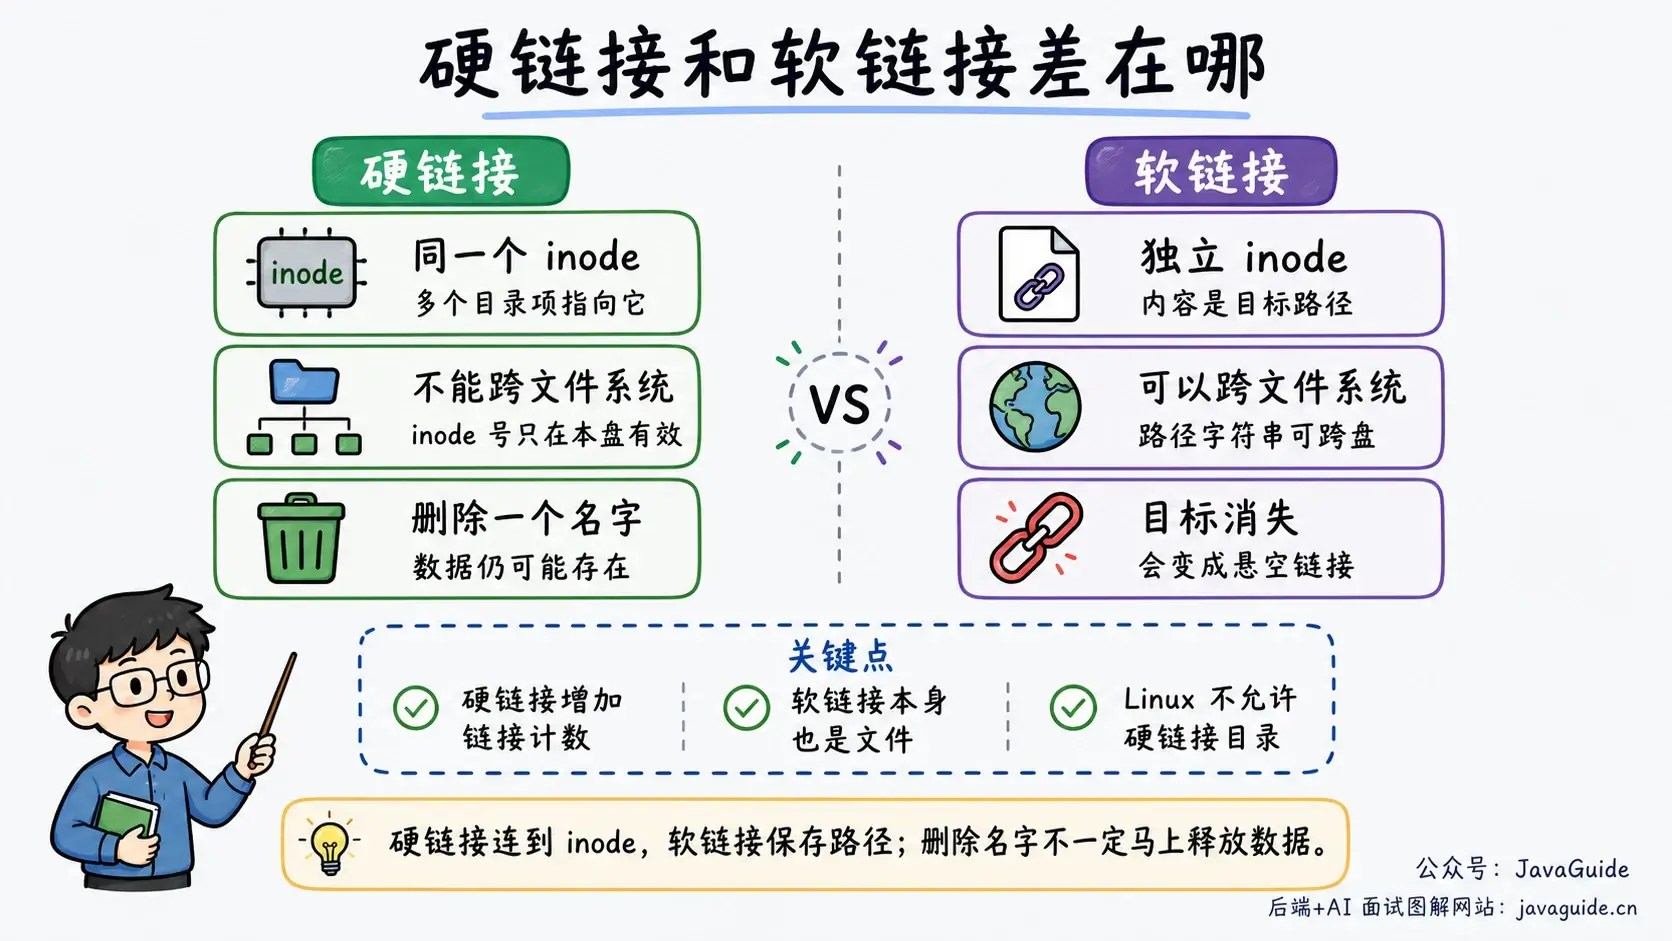
| Hạng mục so sánh | Hard link | Soft link |
|---|---|---|
| Object được trỏ đến | Cùng một inode | Một path khác |
| Có tạo inode mới không | Không tạo inode cho target file mới, chỉ thêm directory entry và tăng link count | Bản thân soft link là file độc lập, có inode riêng |
| Sau khi source file bị xóa | Chỉ cần còn hard link thì data vẫn còn | Soft link có thể trở thành dangling link |
| Có thể đi qua file system không | Không | Có |
| Có thể link directory không | Linux không cho ordinary user tạo hard link đến directory | Có |
Có thể dùng các command sau để thực hiện một thí nghiệm nhỏ:
echo hello > a.txt
ln a.txt hard.txt
ln -s a.txt soft.txt

ls -li a.txt hard.txt soft.txt
a.txt và hard.txt có cùng inode number, inode number của soft.txt khác. Sau khi xóa a.txt, hard.txt vẫn đọc được nội dung, còn soft.txt sẽ trỏ đến một path không tồn tại.
Vì sao hard link không thể liên kết xuyên file system?
Hard link trỏ đến inode, còn inode number chỉ có ý nghĩa trong file system hiện tại. Mỗi file system có inode table riêng, cùng một inode number trong một file system khác không đại diện cho cùng một file.
Soft link lưu path string, khi resolve sẽ tìm lại target file theo path, vì vậy có thể liên kết xuyên file system.
Sau khi write thành công, data chắc chắn đã được persist xuống disk chưa?
Chưa chắc. Với buffered I/O thông thường, write() thành công thường chỉ có nghĩa data đã được kernel nhận, thường đi vào Page Cache và được đánh dấu là dirty page, không có nghĩa data đã persistent xuống underlying device.
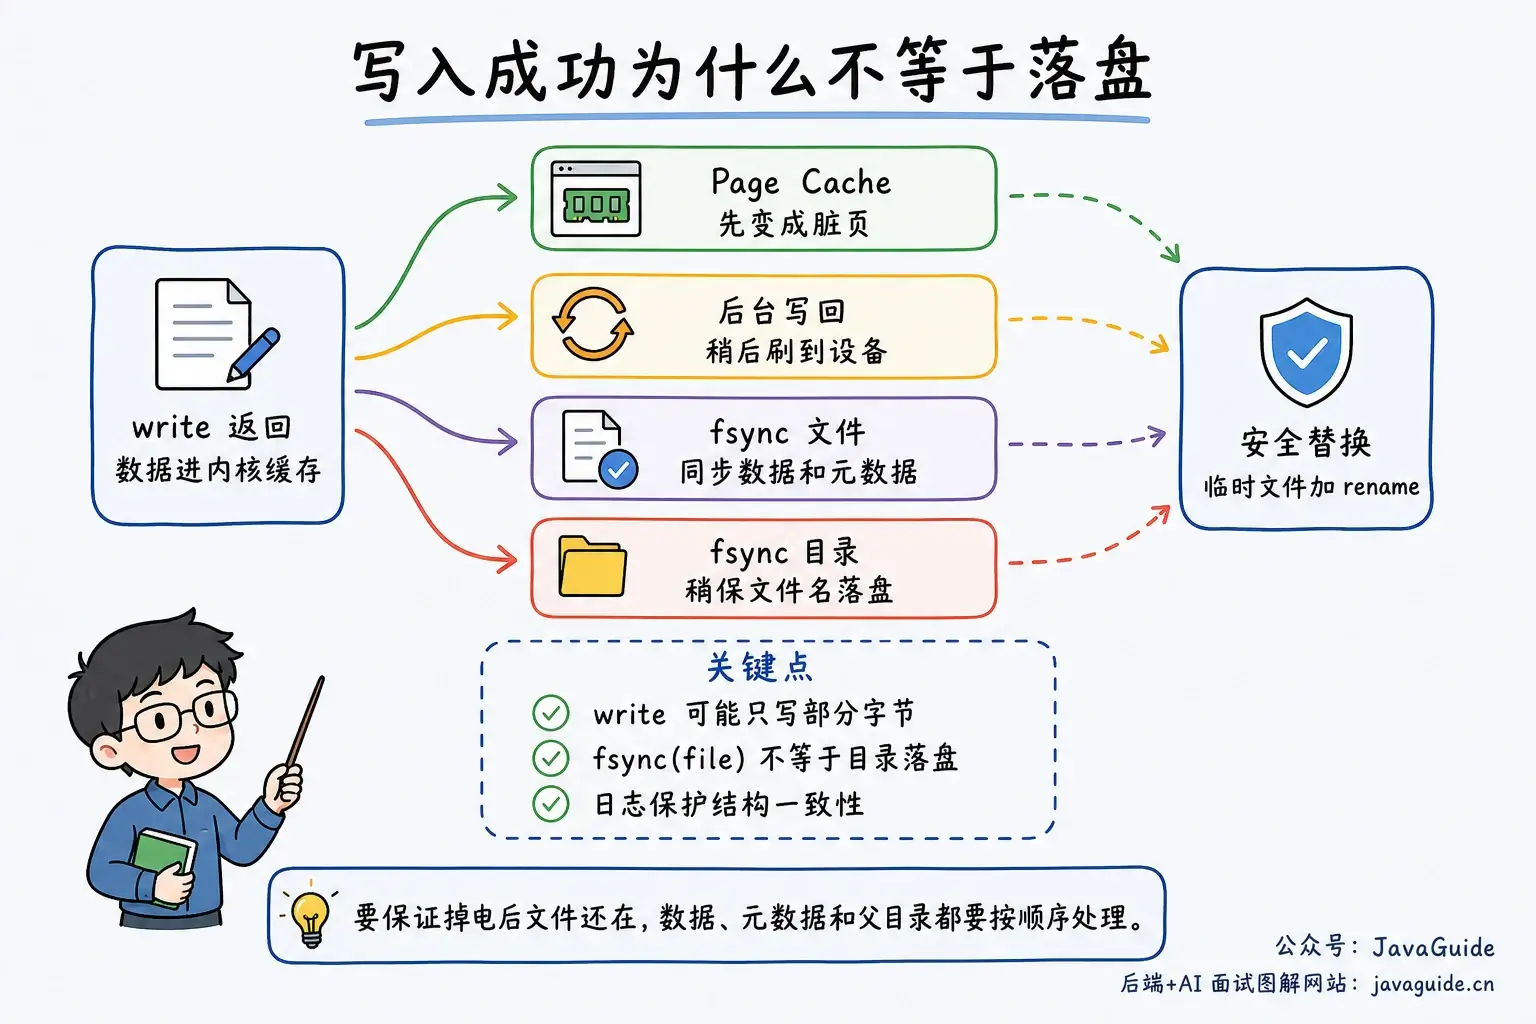
Nếu application cần persistence chắc chắn hơn, cần gọi:
fsync(): sync file data và metadata liên quan.fdatasync(): sync file data cùng metadata cần thiết cho các lần read data sau, chẳng hạn file size.- Open flag có synchronous semantic, chẳng hạn
O_SYNC,O_DSYNC.
Cũng cần chú ý hai chi tiết:
write()có thể chỉ write được một phần số byte, caller phải xử lý partial write.- Sau khi create file mới,
rename()hoặcunlink(), nếu yêu cầu directory entry cũng được persist đáng tin cậy sau mất điện, thường còn cần gọifsync()trên parent directory fd.
Journaling file system giải quyết vấn đề gì?
Một operation của file system thường phải sửa nhiều metadata. Ví dụ khi tạo file, cần allocate inode, allocate data block, update directory entry và update bitmap. Nếu máy mất điện giữa chừng, file system có thể dừng ở trạng thái inconsistent.
Journaling file system trước hết ghi các metadata change sắp thực hiện vào log area, sau đó mới update vị trí đích. Khi system recovery, transaction đã commit đầy đủ nhưng chưa write back vào vị trí đích có thể được replay; transaction chưa commit đầy đủ sẽ bị discard.
Lấy ext4 làm ví dụ, có ba data mode phổ biến:
| Mode | Mô tả |
|---|---|
data=writeback | Chỉ bảo đảm metadata được journal, không bảo đảm related data block được write trước metadata |
data=ordered | Mode mặc định, trước khi metadata vào log, related data block sẽ được write vào main file system |
data=journal | Data và metadata đều được write vào log trước, sau đó write đến vị trí cuối cùng, write amplification rõ hơn |
Journaling file system chủ yếu bảo đảm consistency của file system structure, không có nghĩa nó giúp application bảo đảm toàn bộ business data không bị mất. Transaction-level persistence vẫn cần application sử dụng đúng fsync(), write order và recovery logic.
Có những cách nào để nâng cao file system performance?
Có thể trả lời từ các khía cạnh access pattern, cache, metadata và hardware:
- Ưu tiên sequential read/write: sequential I/O dễ tận dụng prefetch, write merge và contiguous space mapping như extent hơn.
- Tận dụng Page Cache: regular file read/write đi qua Page Cache, khi hit có thể giảm số lần access disk; nhưng cache không phải càng lớn càng tốt, còn phải xem memory pressure và writeback pressure.
- Giảm file nhỏ và metadata operation: quá nhiều file nhỏ sẽ khuếch đại cost của inode, directory entry, permission check, create/delete và các metadata operation khác.
- Kiểm soát tần suất flush xuống disk:
fsync()thường xuyên làm throughput giảm, nhưng hoàn toàn không flush sẽ mở rộng khoảng thời gian có nguy cơ mất data khi mất điện; cần cân bằng theo yêu cầu persistence của business. - Chọn file system và mount parameter phù hợp: ext4, XFS, Btrfs có implementation khác nhau; journaling mode, atime, barrier và các parameter khác cũng ảnh hưởng performance và reliability.
- Sử dụng hardware phù hợp hơn: SSD, NVMe, RAID và disk cache policy đều ảnh hưởng read/write latency và throughput.
Khi troubleshooting thường xem các command sau:
df -h
df -i
lsof +L1
iostat -x 1
Khi df gần đầy nhưng du không tìm thấy file lớn, trước tiên kiểm tra file đã bị delete nhưng vẫn được process open; khi có quá nhiều small file, df -i có thể bộc lộ vấn đề sớm hơn df -h.
Giới thiệu chi tiết: Giải thích chi tiết file system của Operating System: inode, VFS, Page Cache và journaling mechanism
Có những disk scheduling algorithm phổ biến nào?
Các algorithm SCAN, SSTF, LOOK được giới thiệu dưới đây chủ yếu hướng đến mechanical hard disk. Một lần read/write của mechanical hard disk gồm seek time, rotational latency và transfer time; scheduler có thể điều chỉnh request order để giảm head movement và waiting time.
Có 6 disk scheduling algorithm phổ biến sau (ngoài ra còn nhiều disk scheduling algorithm khác được cải tiến dựa trên các algorithm này):
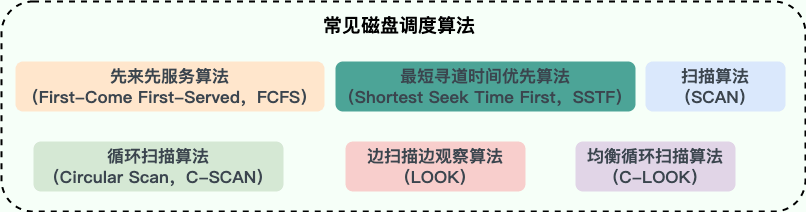
- First-Come First-Served Algorithm (FCFS): xử lý theo thứ tự request đến disk scheduler, implementation đơn giản nhưng không xét path và direction của head movement, average seek time có thể khá dài. Nó không bỏ qua một request vô thời hạn nên thường không có starvation theo nghĩa của algorithm, nhưng request xếp sau một request dài có thể phải chờ khá lâu.
- Shortest Seek Time First Algorithm (SSTF): còn gọi là Shortest Service Time First (SSTF), ưu tiên request gần vị trí head hiện tại nhất. SSTF có thể minimize seek time của head, nhưng dễ xuất hiện starvation, tức các request gần head liên tục được service còn request xa head chờ lâu không được response. Trong application thực tế, cần optimize implementation của algorithm để tránh starvation.
- SCAN Algorithm: còn gọi là Elevator Algorithm, ý tưởng cơ bản rất giống elevator. Head scan disk theo một direction; nếu track đi qua có request thì xử lý, đến boundary của disk thì đổi direction và lặp lại. SCAN bảo đảm tất cả request được service, giải quyết starvation. Tuy nhiên, nếu request xuất hiện ngay sau khi head vừa scan xong một direction, request đó phải chờ đến khi head đi từ direction ngược lại mới được xử lý.
- Circular Scan Algorithm (C-SCAN): variant của SCAN, chỉ scan một phía của disk và chỉ scan theo một direction; đến boundary của disk thì quay về start của disk và bắt đầu vòng mới.
- LOOK Algorithm: trong SCAN, head chỉ đổi direction khi đến boundary của disk, điều này có thể tạo nhiều movement vô ích vì trên direction mà head di chuyển có thể không còn request cần xử lý. LOOK cải tiến SCAN: nếu direction của head không còn request khác thì lập tức đổi direction. Tức là vừa scan vừa look xem direction đã chỉ định còn request hay không, vì vậy gọi là LOOK.
- C-LOOK Algorithm: C-SCAN chỉ đổi direction khi đến boundary của disk, khi head quay về cũng phải quay đến start của disk, điều này có thể tạo nhiều movement vô ích. C-LOOK cải tiến C-SCAN: nếu direction head di chuyển không còn track access request thì lập tức cho head quay về, và head chỉ cần quay đến vị trí có track access request.
Ví dụ đơn giản: giả sử head hiện tại ở track số 50, request sequence là 82, 170, 43, 140, 24. FCFS xử lý theo thứ tự request đến, path head di chuyển có thể rất dài; SSTF trước tiên tìm 43 gần 50 nhất rồi lần lượt chọn request gần nhất, average seek distance thường ngắn hơn nhưng request ở xa có thể liên tục bị trì hoãn; SCAN/LOOK cố định một direction scan và xử lý request trên đường đi, giống elevator di chuyển lên xuống hơn, fairness tốt hơn.
SSD và NVMe device không có mechanical seek, không thể trực tiếp áp dụng head scheduling model ở trên. Tuy nhiên, modern Linux block layer vẫn có thể merge, sort request và xử lý throughput, fairness, latency target thông qua blk-mq và I/O scheduler; strategy cụ thể phụ thuộc device, kernel version và scheduler được chọn.
References
- 《Operating System》 — Tang Xiaodan, edition 4
- 《Hiểu sâu về hệ thống máy tính》
- 《Relearning Operating System》
- 《Principles and Implementation of Modern Operating Systems》
- Tổng hợp kiến thức Operating System cho kỳ thi nghiên cứu sinh Wangdao: https://wizardforcel.gitbooks.io/wangdaokaoyan-os/content/13.html
- Buddy System và SLAB trong memory management: https://blog.csdn.net/qq_44272681/article/details/124199068
- Vì sao Linux cần virtual memory: https://draveness.me/whys-the-design-os-virtual-memory/
- Self-cultivation of Programmers (7): memory page fault: https://liam.page/2017/09/01/page-fault/
- Những điều về virtual memory: https://juejin.cn/post/6844903507594575886
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.