
Giải thích chi tiết virtual memory: chuyển đổi địa chỉ, TLB, page fault và page replacement
Khi mở task manager, bạn có thể thấy một hiện tượng khá trái với trực giác: mỗi process như đang có một vùng “memory riêng”, một số địa chỉ trong các process còn trông gần giống nhau, nhưng chúng không ảnh hưởng lẫn nhau. Browser, IDE và database chạy đồng thời, ai cũng tưởng mình có một vùng không gian liên tục, gọn gàng và độc lập.
Điều này không phải vì các chương trình tin tưởng lẫn nhau, mà vì operating system đã thêm một lớp translation ở giữa.
Chương trình nhìn thấy virtual address, còn vị trí thực sự nằm trên memory module do kernel và hardware cùng quyết định. Virtual memory giải thích cách thực hiện lớp translation này, vì sao các process có thể isolation, và khi memory không đủ thì làm thế nào để tạm chuyển một phần data lên disk.
Nếu không có virtual memory thì sao?
Hãy xem một phản ví dụ.
Nhiều người từng học và chơi với single-chip microcomputer ở đại học. Trên single-chip microcomputer không có operating system phức tạp, CPU thao tác trực tiếp với physical address. Trong môi trường này, nếu muốn chạy đồng thời hai chương trình, rắc rối sẽ xuất hiện ngay: chương trình thứ nhất ghi một value vào address 2000, chương trình thứ hai cũng vừa hay đặt data ở 2000, lần ghi đó sẽ overwrite data của chương trình kia, khiến cả hai chương trình cùng gặp vấn đề.
Nguyên nhân cũng rất đơn giản: hai chương trình đều tham chiếu trực tiếp cùng một hệ physical address, không chương trình nào tránh được chương trình còn lại.
Cách operating system làm là thêm một lớp isolation: cấp cho mỗi process một không gian “virtual address” độc lập. Process chỉ làm việc với virtual address của mình, còn địa chỉ đó cuối cùng nằm trên vùng physical memory nào thì process không cần biết, operating system sẽ thống nhất sắp xếp.
Vì vậy có hai khái niệm:
- Địa chỉ được dùng trong chương trình gọi là virtual address (Virtual Address).
- Địa chỉ thực sự tồn tại trên memory module gọi là physical address (Physical Address).
Khi process truy cập virtual address, memory management unit (MMU) trong CPU sẽ dựa vào mapping để dịch nó thành physical address, rồi truy cập memory. Dù các process khác nhau ghi vào virtual address có cùng giá trị, physical address được mapping tới vẫn có thể hoàn toàn khác nhau, nên đương nhiên không xảy ra xung đột.
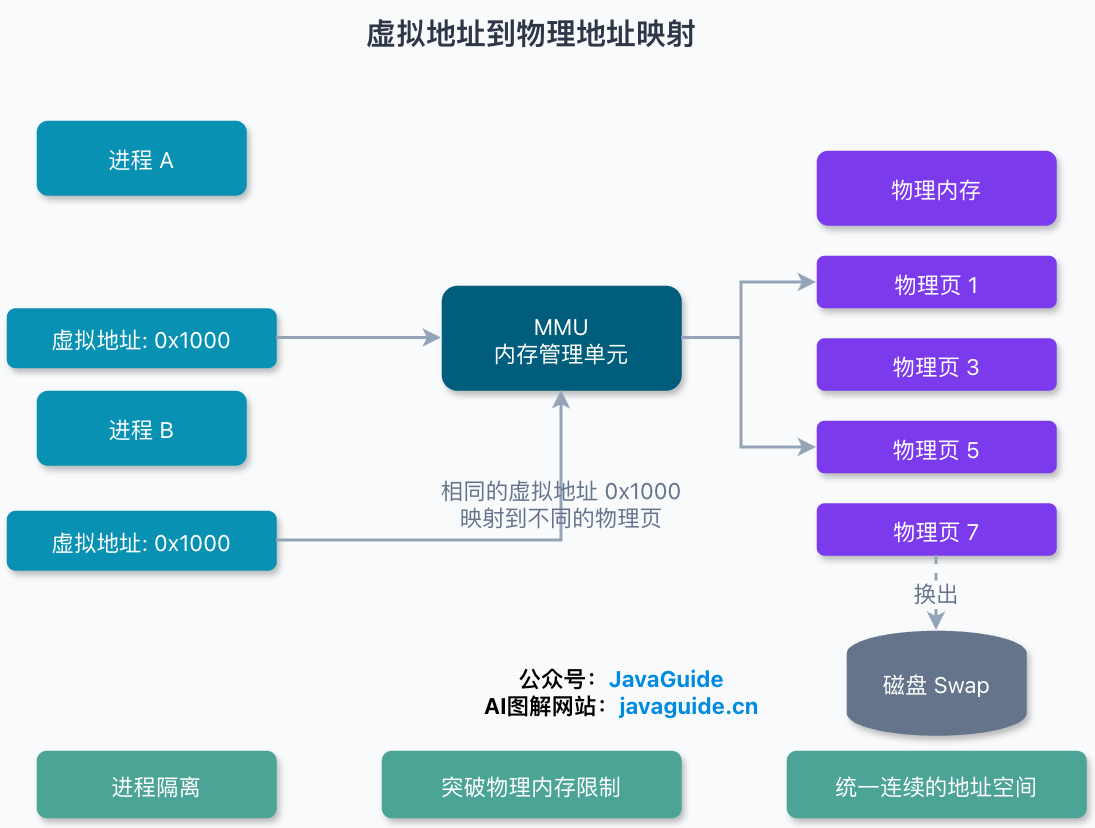
Có thể tóm tắt lợi ích của virtual memory thành ba điểm; thực ra toàn bộ bài viết phía sau đều xoay quanh chúng:
- Process isolation: mỗi process có một page table, không nhìn thấy physical memory của nhau; process A không thể dựa vào một địa chỉ để trực tiếp chạm tới data của process B.
- Vượt giới hạn kích thước physical memory: chương trình có tính locality, các page tạm thời chưa cần dùng có thể được đặt trên disk trước, khi cần thì đưa trở lại, nên memory mà process “cảm nhận” có thể lớn hơn physical memory.
- Không gian địa chỉ thống nhất và liên tục: process nhìn thấy một vùng virtual address liên tục, nhưng về mặt vật lý các page có thể nằm rải rác. Việc ghép chúng lại giao cho mapping table.
Câu hỏi quan trọng nhất tiếp theo chỉ có một: virtual address được mapping tới physical address như thế nào?
Có hai cách chính: segmentation và paging.
Segmentation được mapping như thế nào?
Segmentation xuất hiện khá sớm, cách tư duy cũng phù hợp với trực giác của programmer. Một chương trình vốn gồm code, data, stack và heap; quyền truy cập và lifecycle của chúng khác nhau, vậy nên có thể chia thành các segment theo logic.
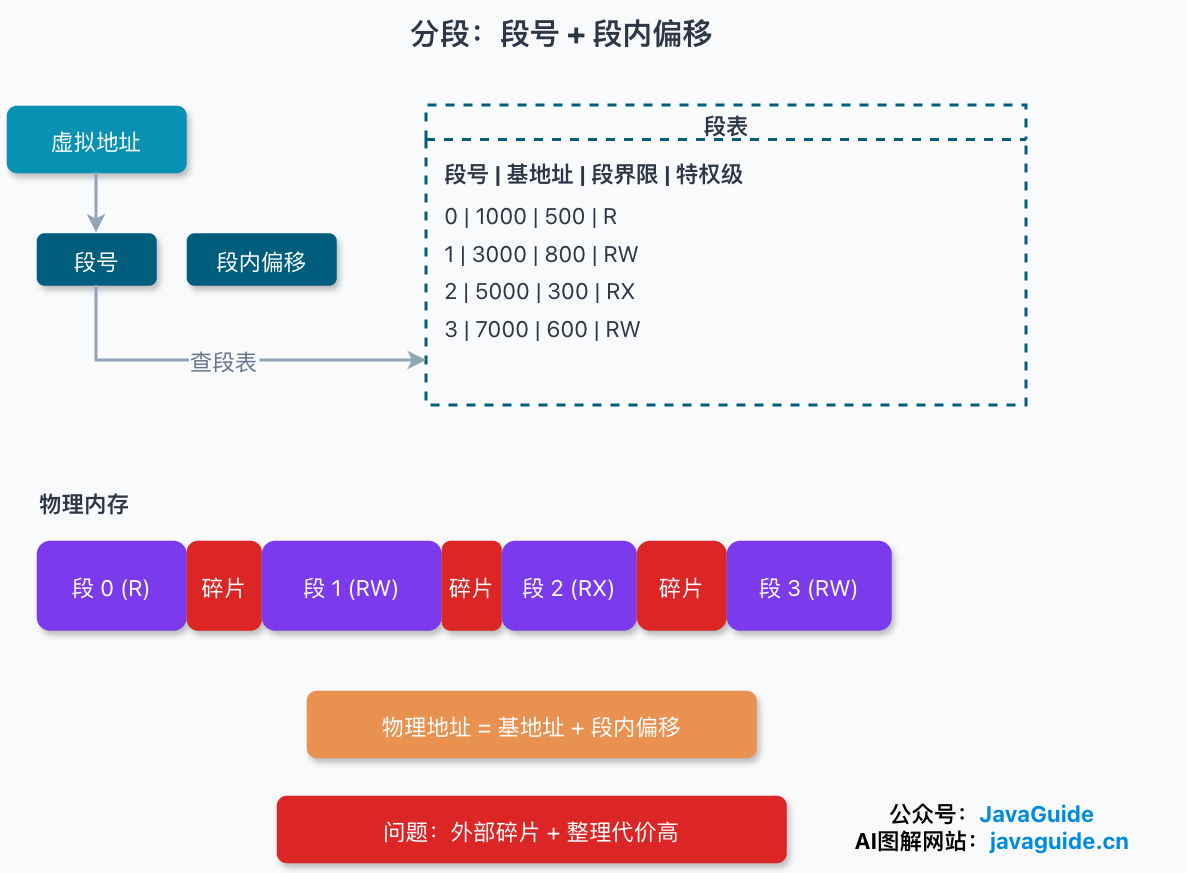
Trong segmentation, virtual address gồm hai phần: segment selector và offset trong segment.
Segment selector được đặt trong segment register, trong đó quan trọng nhất là segment number, dùng làm index của segment table. Segment table ghi base address, segment limit (độ dài của segment) và privilege level của segment.
Quá trình translation cũng không phức tạp: dùng segment number tra segment table để lấy segment base address, sau đó kiểm tra offset trong segment có vượt quá segment limit hay không. Trong model chỉ dùng segmentation, không bật paging, base address cộng với offset chính là physical address. Ví dụ, cần truy cập segment 3 với offset 500, base address của segment 3 là 7000, vậy physical address là 7000 + 500 = 7500; nếu system còn bật paging thì kết quả của bước này là linear address, sau đó phải tiếp tục đi qua page table.
Segmentation giải quyết vấn đề “chương trình không cần quan tâm tới physical address”, nhưng cũng để lại hai vấn đề.
Vấn đề thứ nhất là external memory fragmentation. Độ dài của mỗi segment không cố định, giữa các segment rất dễ còn lại những khoảng trống vụn. Ví dụ, physical memory lần lượt chứa bốn segment: A chiếm 256 MB, B chiếm 128 MB, C chiếm 256 MB, D chiếm 128 MB. Bây giờ giải phóng B và D, tổng dung lượng trống là 256 MB, nhưng C chia nó thành hai vùng 128 MB. Lúc này muốn đặt thêm một segment liên tục 200 MB thì không thể. Tổng dung lượng đủ, nhưng không đủ vùng liên tục.
Vấn đề thứ hai là chi phí compact cao. Muốn ghép các vùng trống rải rác này thành một vùng hoàn chỉnh thì phải thực hiện memory compaction: di chuyển các segment vẫn đang được sử dụng, sắp xếp lại thành vùng liên tục. Nếu quá trình di chuyển còn đi kèm việc swap segment ra disk rồi swap trở lại, sẽ phát sinh thêm một lượng lớn disk I/O. Dù thực hiện thế nào, việc di chuyển với granularity lớn của các segment có độ dài thay đổi đều rất nặng; khi gặp segment lớn, system rất dễ bị treo.
Vấn đề của segment nằm ở đây: granularity lớn, độ dài không cố định, nên fragmentation và chi phí compact đều khó kiểm soát.
Paging được mapping như thế nào?
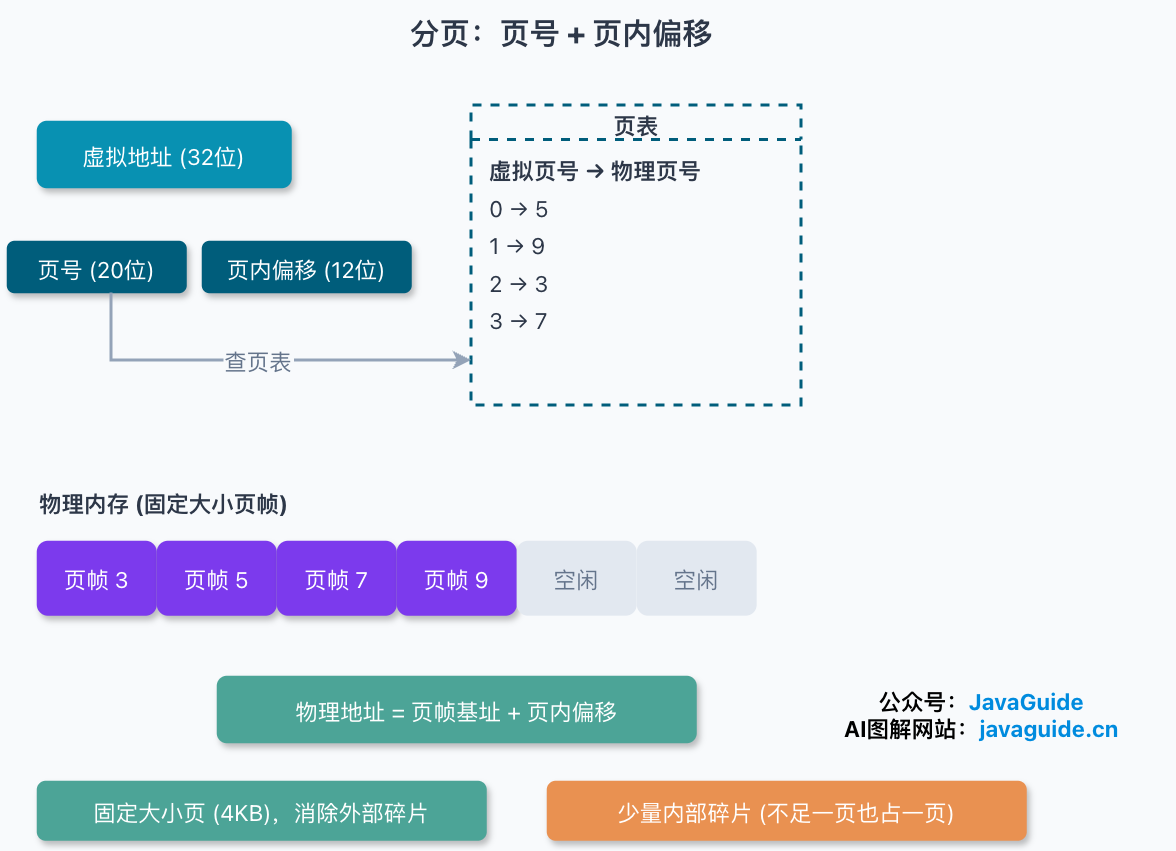
Paging dùng một cách khác: không chia theo các logic như code, data và stack, mà chia cả virtual address space lẫn physical address space thành các block có kích thước cố định; mỗi block gọi là một page (Page). Trên Linux, một page mặc định là 4 KB.
Virtual address được mapping tới physical address thông qua page table (Page Table). Page table nằm trong memory, MMU chịu trách nhiệm tra table và translation. Address translation thường gồm ba bước:
- Tách virtual address thành page number và offset trong page;
- Dùng page number tra page table để tìm physical page number tương ứng;
- Ghép physical page number với offset trong page để có physical address cuối cùng.
Paging giải quyết vấn đề của segmentation như thế nào?
Kích thước page cố định, physical page cũng được quản lý theo granularity cố định, nên không để lại những khoảng trống nhỏ bất thường giữa các block như segment có độ dài thay đổi; vì vậy về cơ bản loại bỏ external fragmentation. Cái giá phải trả là có thể lãng phí trong page: dù chương trình chỉ dùng vài byte cũng phải chiếm trọn một page, phần này gọi là internal fragmentation. Tuy nhiên mức lãng phí thường có thể kiểm soát, dễ xử lý hơn external fragmentation.
Granularity quản lý cũng nhỏ hơn. Khi physical memory không đủ, operating system có thể chọn một số page “gần đây không được sử dụng nhiều” để swap out ra disk (Swap Out), khi cần thì swap in trở lại (Swap In). Đơn vị swap out và swap in giảm từ một segment có độ dài thay đổi xuống một page có kích thước cố định.
Đừng hiểu nhầm, paging không có nghĩa là áp lực lên disk chắc chắn thấp. Nếu thực sự xảy ra nhiều major page fault hoặc thrashing, page-level I/O thường xuyên cũng có thể kéo sập system.
Paging còn có một điểm rất hữu ích: chương trình không cần load toàn bộ vào memory ngay từ đầu. Trước tiên chuẩn bị mapping giữa virtual page và physical page, nhưng chưa cần chuyển page thực sự vào physical memory. Khi chương trình truy cập tới một virtual page, mới load nó vào. Đây là nền tảng của demand paging.
Segmentation-paging: hai cách có thể kết hợp
Segmentation và paging không nhất thiết chỉ chọn một, mà có thể kết hợp với nhau, đây là segmentation-paging memory management.
Cách làm là segmentation trước rồi paging: trước tiên chia chương trình thành các segment có ý nghĩa logic, sau đó chia mỗi segment thành các page có kích thước cố định. Địa chỉ cũng trở thành ba phần: segment number, page number trong segment và offset trong page. Mỗi chương trình có một segment table, mỗi segment lại gắn với một page table; segment table entry lưu địa chỉ bắt đầu của page table tương ứng với segment đó.
Nhược điểm cũng dễ hiểu: số lần truy cập memory tăng lên. Một lần address translation theo segmentation-paging phải đi qua memory ba lần:
- Lần thứ nhất tra segment table để lấy địa chỉ bắt đầu của page table;
- Lần thứ hai tra page table để lấy physical page number;
- Lần thứ ba mới dùng physical page number cộng với offset trong page để truy cập data thực sự.
Lịch sử ở đây có thể giải thích vì sao Linux trông như vừa segmentation vừa paging. Intel bắt đầu dùng quản lý bằng segmentation từ 80286, đến 80386 bổ sung paging, nhưng paging được xây dựng trên segmentation: logical address trước tiên qua segmentation để trở thành linear address, cũng chính là virtual address thường được nhắc tới; linear address sau đó qua paging để trở thành physical address. Hardware của CPU được thiết kế như vậy, Linux chỉ có thể phối hợp.
Linux x86 32-bit thường dùng flat memory model, đặt base address của code segment và data segment chính bằng 0, khiến logical address và linear address bằng nhau về mặt giá trị; memory management chủ yếu giao cho paging. Khi chuyển sang long mode trên x86-64, vai trò segmentation của CS, SS, DS và ES về cơ bản bị suy yếu, nhưng FS và GS vẫn có thể dùng base address khác 0, thường được dùng cho thread-local storage và data per-CPU của kernel.
Vì sao single-level page table không đủ?
Khi paging đi vào system thực tế, vấn đề đầu tiên gặp phải không phải là cách làm, mà là không gian.
Hãy tính thử. Trong môi trường 32-bit, virtual address space là 4 GB, kích thước page là 4 KB (2^12), vậy một process có khoảng 1 triệu (2^20) page. Mỗi page table entry chiếm 4 byte, toàn bộ page table là 4 × 2^20 = 4 MB.
4 MB trông vẫn ổn, nhưng đừng quên, mỗi process có page table riêng. 100 process sẽ dùng 400 MB memory chỉ để lưu page table. Đến môi trường 64-bit, con số còn lớn hơn nhiều.
Khó chịu hơn là single-level page table phải trải đầy toàn bộ virtual address space ngay từ đầu. Công việc của page table là address translation; nếu một virtual address không có vị trí để tra trong page table thì translation bị gián đoạn. Vì vậy dù process thực tế chỉ dùng một vùng địa chỉ nhỏ, 1 triệu page table entry đó vẫn phải được tạo trước, phần lớn còn là entry trống.
Điều này quá lãng phí.
Multi-level page table tiết kiệm không gian như thế nào?
Multi-level page table (Multi-Level Page Table) dùng một cách rất trực tiếp: chỉ tạo page table cấp dưới cho những vùng địa chỉ thực sự được dùng, vùng chưa dùng thì không tạo.
Vẫn là bối cảnh 32-bit, page 4 KB. Chia hơn 1 triệu page table entry thành một cấp nữa: page table cấp một (page directory) có 1024 entry, mỗi entry trỏ tới một page table cấp hai, mỗi page table cấp hai cũng có 1024 entry. 1024 × 1024 vừa đủ bao phủ hơn 1 triệu page table entry đó.
Có thể bạn sẽ lập tức hỏi ngược: chẳng phải đã thêm một cấp sao? Một page table cấp một chiếm 4 KB, cộng thêm page table cấp hai 4 MB, chẳng phải còn tốn hơn?
Nếu thực sự mapping đầy đủ virtual address 4 GB thì đúng là tốn hơn. Nhưng trong thực tế, một process thường không dùng hết 4 GB. Điểm then chốt nằm ở đây: page table cấp một phải luôn resident, bao phủ toàn bộ address space nhưng chỉ chiếm 4 KB; page table cấp hai được tạo on demand, nếu một entry của table cấp một chưa được dùng thì page table cấp hai tương ứng sẽ không được tạo.
Hãy tính thử. Giả sử chỉ có 20% entry của table cấp một được sử dụng, tổng overhead của page table là 4 KB (cấp một) + 20% × 4 MB (cấp hai) ≈ 0.804 MB. So với 4 MB của single-level page table, mức tiết kiệm rất rõ ràng. Memory tiết kiệm được ở đây dựa vào nguyên lý locality: trong một khoảng thời gian, chương trình thường chỉ truy cập một vùng nhỏ trong address space.
Đến 64-bit thì hai cấp không đủ nữa. Cấu trúc page table phổ biến hiện nay của Linux là năm cấp, từ trên xuống dưới là:
- Global page directory PGD (Page Global Directory)
- Directory cấp bốn P4D (Page 4th Directory)
- Upper page directory PUD (Page Upper Directory)
- Middle page directory PMD (Page Middle Directory)
- Page table entry PTE (Page Table Entry)
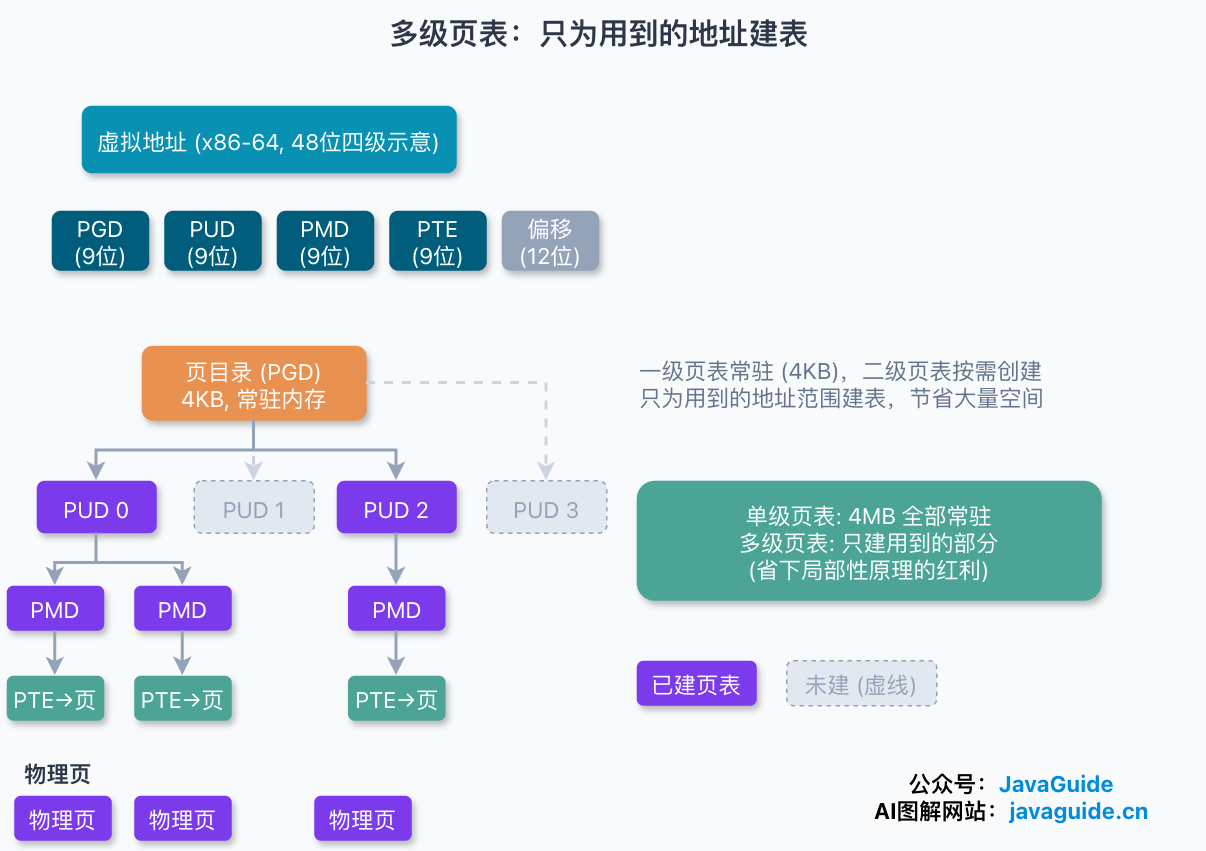
Trên x86-64 chỉ dùng hardware paging bốn cấp, cấp P4D sẽ bị “fold” và không thực sự tham gia address translation. Vì vậy bạn thường nghe nói “page table bốn cấp”; đó là hình thái sau khi fold, không phải Linux chỉ định nghĩa bốn cấp.
Cụ thể trên x86-64, hiện nay paging bốn cấp là phổ biến, dùng virtual address 48-bit (address space 256 TB). Một virtual address 64-bit thường được tách như sau: 16 bit cao là sign-extension bit, tiếp đó PGD, PUD, PMD và PTE mỗi cấp chiếm 9 bit (mỗi cấp 512 entry, 2^9), 12 bit thấp nhất là offset trong page (tương ứng page 4 KB). Mỗi page table entry có 8 byte, 512 entry × 8 byte = 4 KB, mỗi cấp page table vừa khít một page.
Khi cần address space lớn hơn, x86-64 cung cấp five-level paging (LA57), mở rộng canonical linear address từ 48 bit lên 57 bit, physical address tối đa 52 bit. Đừng nhớ nhầm timeline ở đây: Linux hỗ trợ five-level paging từ 4.14 (năm 2017), việc bật hay không phụ thuộc vào CPU và kernel configuration; phía Intel, CPU hỗ trợ rõ ràng virtual address 57 bit và physical address 52 bit là Xeon Scalable thế hệ thứ ba (nền tảng Ice Lake server, phát hành năm 2021). Tài liệu Linux cũng đề cập five-level paging có thể cung cấp tối đa virtual address 56 bit cho user space; để tương thích với các chương trình dùng bit cao của pointer cho tagging, kernel mặc định không chủ động cấp địa chỉ trên bit 47, trừ khi application yêu cầu rõ ràng. Trên máy thông thường, four-level vẫn phổ biến hơn.
TLB (Translation Lookaside Buffer) giải quyết vấn đề gì?
Multi-level page table tiết kiệm không gian nhưng tốn thêm thời gian: trước đây chỉ cần tra một table, còn trên 64-bit có thể phải tra bốn cấp. Nếu mỗi memory access còn kéo theo bốn hoặc năm lần tra table trong memory, chi phí sẽ quá cao.
Một lần nữa, nguyên lý locality giúp giải quyết vấn đề. Các page mà chương trình lặp đi lặp lại truy cập trong một khoảng thời gian thường chỉ là vài nhóm. Vậy hãy cache những page table entry thường dùng nhất vào hardware nhanh hơn memory rất nhiều. Cache này là TLB (Translation Lookaside Buffer), trong tiếng Trung thường gọi là “bảng nhanh” hoặc “bộ đệm chuyển đổi địa chỉ”, được đóng gói trong MMU của CPU.
Có TLB, khi CPU tìm địa chỉ, trước tiên nó sẽ tra TLB:
- Hit (TLB Hit), trực tiếp lấy physical page number, bỏ qua việc tra multi-level page table.
- Miss (TLB Miss), tiếp tục tra multi-level page table trong memory, sau khi tra được thì đưa entry này vào TLB để tiện cho lần truy cập sau.
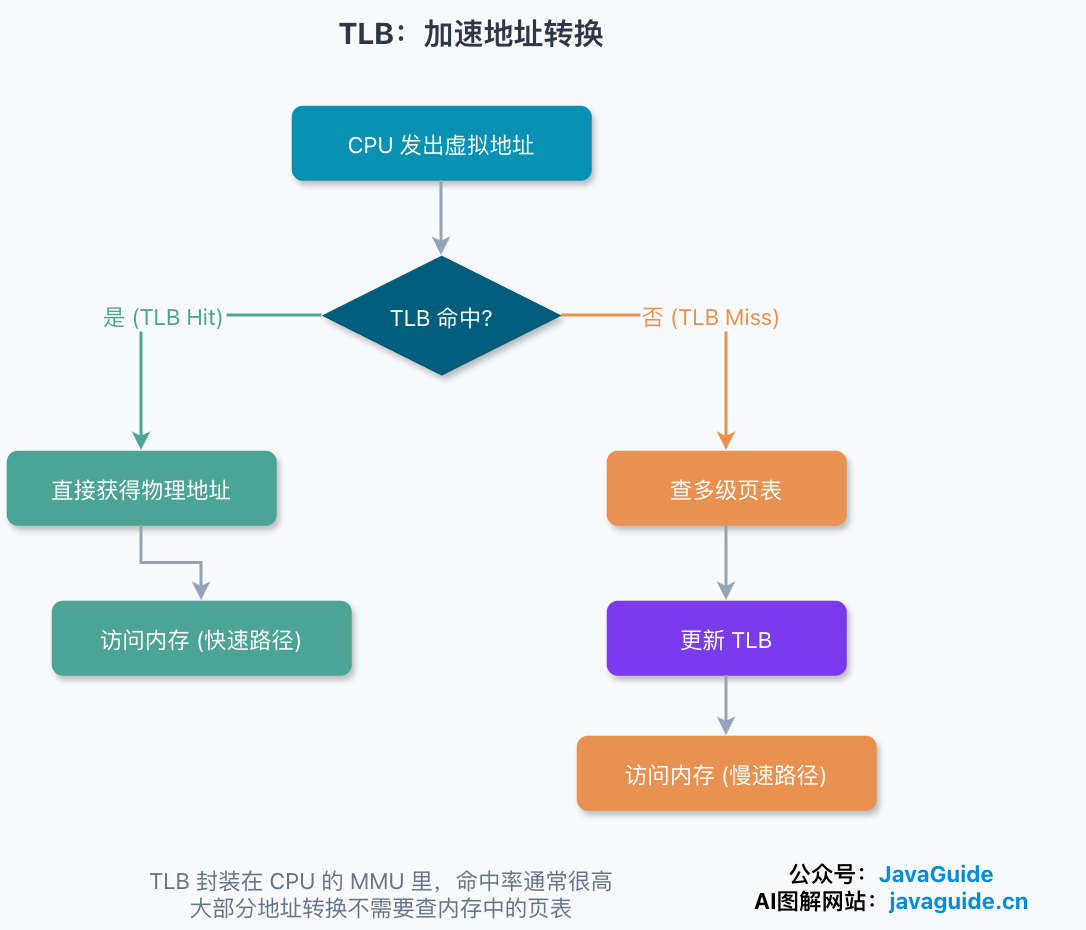
Vì số lượng hot page không nhiều, TLB hit rate thường không thấp. Phần lớn thời gian, chi phí tra table do multi-level page table mang lại đã được TLB gánh thay.
Page fault (Page Fault) diễn ra thế nào?
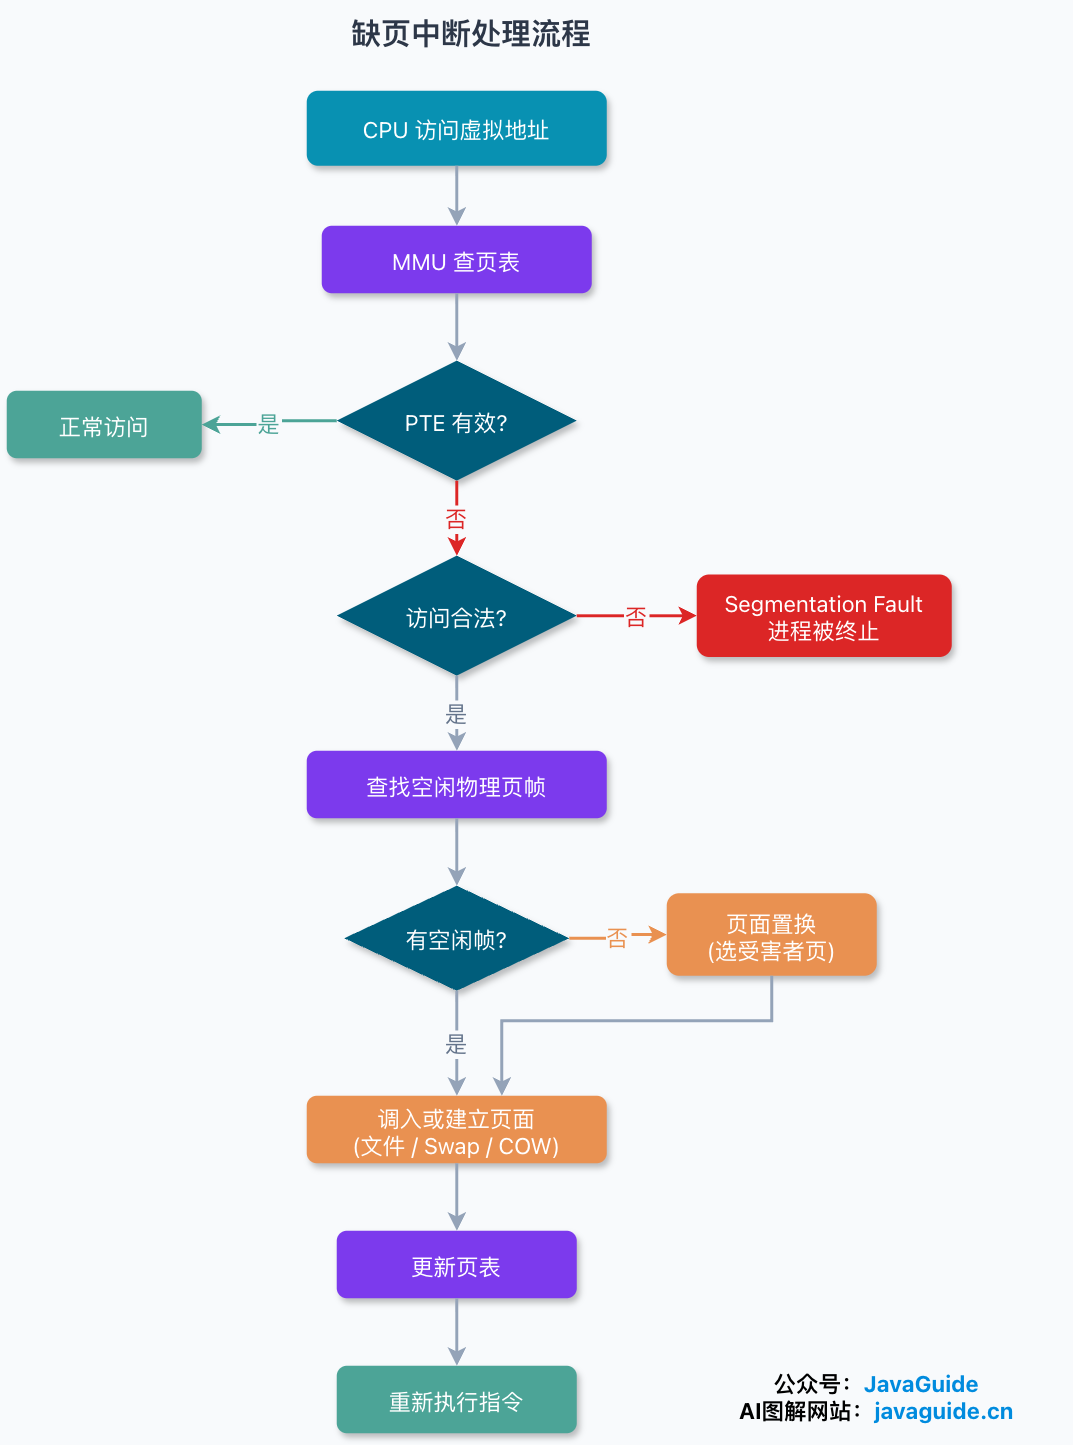
Demand paging có một tiền đề: khi process truy cập một virtual page, page đó chưa chắc đã nằm trong physical memory. Khi MMU tra page table, nếu phát hiện address translation hoặc kiểm tra quyền theo page không thể hoàn tất, CPU sẽ trigger page fault exception và bàn giao quyền điều khiển cho page fault handler của kernel. Tài liệu tiếng Trung cũng thường gọi nó là “page fault interrupt”, nhưng xét theo phân loại architecture, đây là exception được trigger đồng bộ bởi instruction memory access hiện tại, không phải hardware interrupt do thiết bị ngoại vi phát ra.
Có thể ghi nhớ quy trình qua các bước sau:
- CPU dùng virtual address để tra page table, phát hiện address translation hoặc kiểm tra quyền không thể hoàn tất, trigger page fault exception.
- Vào kernel mode, page fault handler trước tiên xác định access lần này có hợp lệ hay không. Nếu truy cập một địa chỉ bất hợp lệ, chẳng hạn wild pointer, thì báo segmentation fault (Segmentation Fault), process thường sẽ bị kill.
- Nếu hợp lệ, tìm một physical page frame còn trống. Nếu không có frame trống, reclaim hoặc replace một page “victim”: file page sạch có thể bị discard trực tiếp, khi cần sẽ đọc lại từ file gốc; file page dirty phải được write back vào file gốc trước; anonymous page thì khi bật Swap sẽ được ghi vào swap space. Có phát sinh disk write hay không phụ thuộc vào loại page và page có dirty hay không.
- Đọc page cần thiết từ disk (Swap area hoặc file) vào physical memory, update page table entry để nó trỏ tới physical page frame mới.
- Trở về user mode, thực thi lại instruction vừa trigger page fault; lần này có thể access bình thường.
Xét từ góc độ performance statistics của Linux, page fault chủ yếu được chia thành hai loại; trong getrusage cũng chỉ có ru_minflt và ru_majflt:
- Minor page fault (Minor Page Fault): page thực ra đã nằm trong physical memory, chỉ là page table của process hiện tại chưa tạo mapping, chẳng hạn library được nhiều process share; việc copy page do copy-on-write (COW) trigger cũng thường được tính là minor page fault vì cần tạo hoặc copy page mới nhưng không cần đọc disk. Chi phí thấp.
- Major page fault (Major Page Fault): page thực sự không ở trong memory, bắt buộc phải đọc từ disk (file hoặc Swap) vào, chi phí cao.
Truy cập địa chỉ bất hợp lệ, chẳng hạn wild pointer, cũng khiến hardware trigger page-fault exception và vào kernel. Nhưng sau khi kernel xác định là bất hợp lệ, thông thường nó sẽ gửi SIGSEGV cho process. Đây là error handling, thường không được xếp ngang hàng với minor/major như một loại performance statistics thứ ba.
Nếu physical memory quá căng, system dành phần lớn thời gian để swap page in và out, CPU gần như không làm việc hữu ích mà chỉ chuyển data; trạng thái này gọi là thrashing (Thrashing).
Page replacement algorithm: thay page nào ra ngoài?
Physical memory đã đầy nhưng cần load page mới, vì vậy phải chọn một page để swap out. Chọn tốt thì sau đó ít page fault; chọn kém thì page vừa swap out đã phải dùng lại, mọi công sức đều vô ích.
Có một số algorithm thường gặp.
OPT (optimal replacement): swap out page “sẽ không được access trong khoảng thời gian dài nhất trong tương lai”. Số page fault của nó về lý thuyết là ít nhất, nhưng cần biết trước tương lai, không thể implement trong thực tế, chủ yếu dùng làm baseline để đánh giá các algorithm khác.
FIFO (first in, first out): duy trì một queue, page nào vào trước thì swap out trước. Implement đơn giản, nhưng rất dễ loại nhầm hot page, vì một page tồn tại lâu không có nghĩa là sau này không dùng nữa.
LRU (least recently used): swap out page “lâu nhất chưa được access”. Nó đánh cược vào locality: page vừa được dùng gần đây có xác suất cao sẽ tiếp tục được dùng. Hiệu quả của LRU gần OPT, nhưng chi phí cao; hoặc phải duy trì timestamp cho từng page, hoặc dùng linked list và move page lên đầu list sau mỗi lần access. Implement thuần software rất khó chịu được access frequency cao.
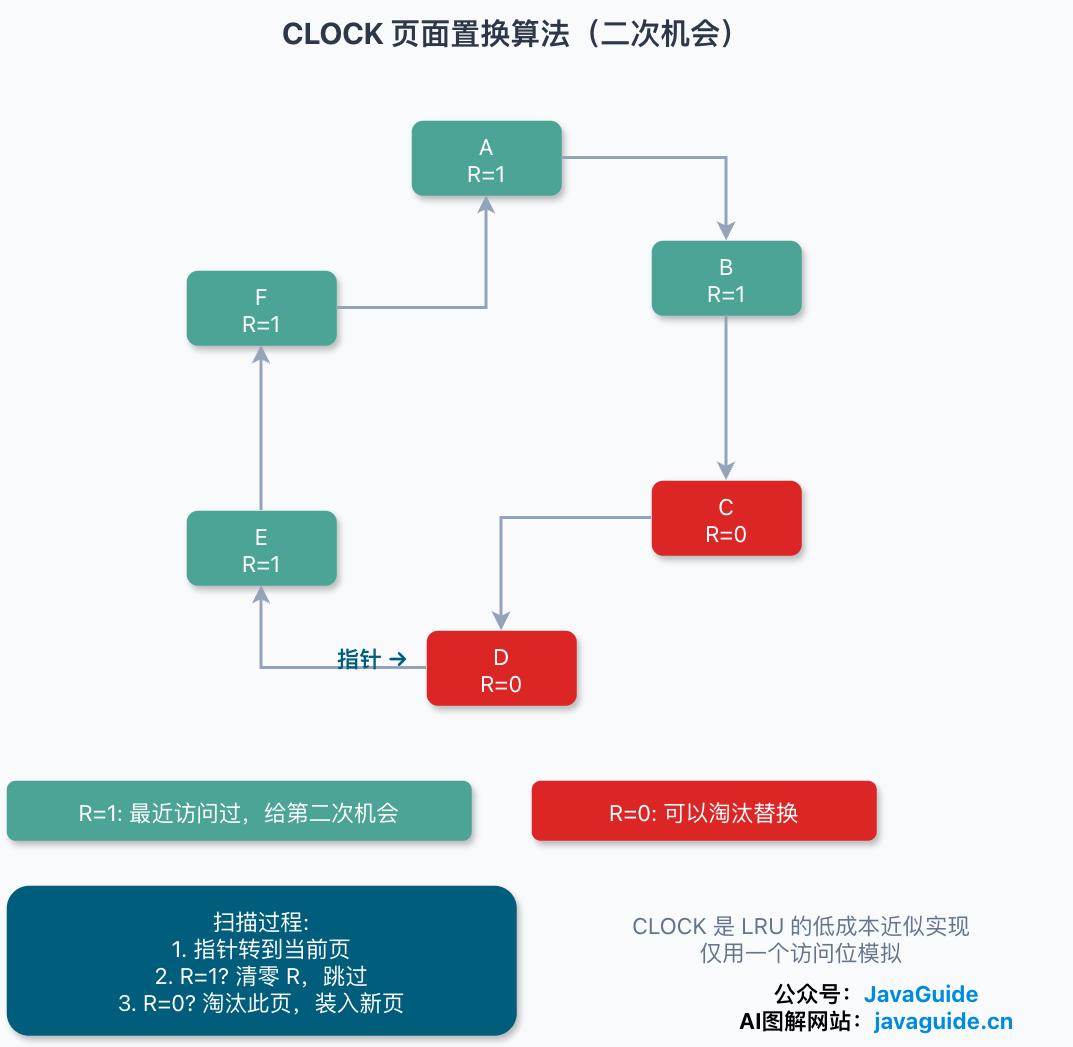
CLOCK (clock / second chance): implementation gần đúng của LRU, dùng để tránh chi phí cao của LRU. Thêm access bit (reference bit) cho mỗi page, xếp tất cả page thành một vòng, một pointer quay như clock. Khi cần replace page, pointer trỏ tới page nào thì kiểm tra access bit của page đó: nếu là 1, nghĩa là page vừa được dùng gần đây, cho nó “cơ hội thứ hai”, clear access bit về 0 rồi pointer đi tiếp; nếu là 0 thì swap page này ra. Chỉ với một access bit và một vòng scan, có thể mô phỏng rẻ việc “gần đây có được sử dụng hay không”.
LFU (least frequently used): ghi lại số lần access của mỗi page, swap out page có số lần access ít nhất. Nó xét tần suất access chứ không xét thời điểm access. Vấn đề là page từng được access thường xuyên trong giai đoạn đầu nhưng về sau không dùng nữa vẫn có counter cao và không chịu rời đi, nên thực tế thường kết hợp cơ chế decay counter.
So sánh theo chiều ngang:
| Algorithm | Căn cứ swap out | Chi phí implement | Hiệu quả | Có thể áp dụng không |
|---|---|---|---|---|
| OPT | Không được dùng lâu nhất trong tương lai | Không thể implement | Tối ưu về lý thuyết | Chỉ làm baseline |
| FIFO | Thời điểm vào sớm nhất | Rất thấp | Bình thường, có thể loại nhầm hot page | Có |
| LRU | Lâu nhất chưa access | Cao (timestamp/linked list) | Gần OPT | Thuần software khá nặng |
| CLOCK | Access bit + vòng scan | Thấp | Gần LRU | Có, giải pháp gần đúng phổ biến |
| LFU | Ít access nhất | Trung bình (cần counter) | Tùy trường hợp | Có, thường kết hợp decay |
Đừng hiểu nhầm: các algorithm trên là algorithm trong textbook, dùng để hiểu strategy replacement. Linux kernel thực tế không trực tiếp chọn một algorithm trong OPT/FIFO/LRU/CLOCK, mà dùng cơ chế gần đúng gồm active/inactive LRU list kép, workingset và refault detection; cơ chế reclaim của file page và anonymous page cũng khác nhau, đồng thời còn chịu ảnh hưởng của NUMA, cgroup và memory watermark. Vì vậy nói “Linux dùng CLOCK” là không chặt chẽ.
Belady anomaly: thêm memory lại chậm hơn?
Theo trực giác, càng nhiều page frame trong physical memory thì page fault phải càng ít. Nhưng FIFO lại phản bác điều đó: đôi khi tăng số page frame khiến số page fault lại tăng. Đây là Belady anomaly (Belady's Anomaly), được László Bélády phát hiện vào thập niên 1960.
Có thể tái hiện bằng access sequence kinh điển. Với sequence 1, 2, 3, 4, 1, 2, 5, 1, 2, 3, 4, 5, chạy FIFO:
- Với 3 page frame, có 9 page fault.
- Với 4 page frame, có 10 page fault.
Thêm một page frame nhưng page fault lại tăng một lần.
Nguyên nhân là FIFO không thỏa stack property: tập page resident khi có n page frame không nhất thiết là subset của tập page resident khi có n+1 page frame. Khi quan hệ bao hàm này bị phá vỡ, thêm page frame có thể khiến chọn nhầm page.
Algorithm thỏa stack property được gọi là stack algorithm. Thứ tự ưu tiên replacement của chúng đối với từng page không phụ thuộc vào số page frame, nên về mặt toán học có thể tránh Belady anomaly. OPT và LRU đều là stack algorithm; có thể chứng minh khi số page frame tăng, page fault chỉ giảm hoặc không đổi, không tăng ngược lại. FIFO không có property này nên sẽ gặp vấn đề. Còn LFU có xuất hiện Belady anomaly hay không phụ thuộc vào cách thống kê frequency và cách break tie khi frequency bằng nhau, không thể trực tiếp nói nó chắc chắn miễn nhiễm.
Đừng mặc định CLOCK cũng như vậy. Classic second chance/CLOCK là approximation của LRU nhưng không có stack property chặt chẽ như LRU; trong trường hợp cực đoan, khi tất cả access bit đều là 1, nó sẽ degrade thành FIFO. Vì vậy không thể vì nó “gần đúng LRU” mà suy ra nó chắc chắn miễn nhiễm Belady anomaly. Kết luận an toàn là: FIFO có access sequence có thể trigger Belady anomaly, OPT và LRU chắc chắn không gặp, còn CLOCK và LFU thì phụ thuộc vào definition cụ thể.
Chỉ cần nhớ một kết luận: Belady anomaly là vấn đề của nhóm non-stack algorithm như FIFO. Khi gặp hiện tượng lạ “tăng memory nhưng performance giảm”, trước tiên hãy nghi ngờ replacement strategy, không phải memory module bị hỏng.
Các khái niệm này được dùng trong engineering như thế nào?
Virtual memory không chỉ tồn tại trong textbook của operating system; ở các tầng application phía trên cũng thường gặp nó.
mmap và zero-copy: mmap() mapping file trực tiếp vào virtual address space của process, biến việc đọc file thành access memory. Khi mapping được tạo, file chưa được đọc vào ngay; chỉ khi access tới một page thì mới trigger page fault và load theo page, đây chính là demand paging. Nó loại bỏ một lần copy từ kernel buffer sang user buffer, nên thường xuất hiện trong zero-copy solution.
Memory và fragmentation trong Redis: Redis là in-memory database, nhưng memory mà nó request cuối cùng cũng phải nằm trên physical page. Memory allocator (mặc định là jemalloc) cấp phát theo các size class cố định, nên có thể lãng phí không gian. Điều này tương tự với việc “chưa đủ một page vẫn phải chiếm một page” trong paging ở điểm “allocation granularity lớn hơn lượng sử dụng thực tế”, nhưng một trường hợp xảy ra ở user-space allocator, trường hợp kia xảy ra ở operating system paging layer; vị trí và cách quản lý khác nhau, không thể coi trực tiếp là cùng một loại fragmentation. Khi Redis thực hiện persistence, nó fork process con để tạo snapshot, cũng dựa vào copy-on-write (Copy-On-Write): process cha và con trước tiên share cùng một nhóm physical page, ai write thì người đó mới trigger copy page, phía sau vẫn là cơ chế page table.
Heap của JVM: heap mà JVM request từ operating system cũng là một vùng virtual address space. Heap lớn khiến phạm vi page table phải bao phủ lớn hơn; dùng huge page (HugePage / page 2 MB) có thể giảm số page table entry, giảm áp lực lên TLB và giúp giảm chi phí memory access trong lúc GC. Khi GC scan object, việc nhảy qua lại liên tục khiến locality kém; chi phí trực tiếp hơn là tăng cache miss và TLB miss. Chỉ khi page liên quan chưa resident, đã bị reclaim, hoặc bản thân system đang thiếu memory thì mới tiếp tục biểu hiện thành page fault. Đây cũng là lý do khi tuning heap lớn cần theo dõi TLB.
Bên dưới là page table và TLB của hardware, bên trên là database, JVM và zero-copy. Virtual memory trông có vẻ khá low-level, nhưng thực tế thường xuất hiện từ nhiều vấn đề performance khác nhau.
Trả lời trong phỏng vấn như thế nào?
Nếu interviewer hỏi “vì sao cần virtual memory”, đừng chỉ trả lời ngay “để isolation”. Có thể trả lời như sau: chương trình dùng virtual address chứ không phải địa chỉ thực trên memory module. Khi CPU access memory, MMU dựa vào page table để translate virtual address thành physical address. Nhờ vậy mỗi process giống như đang dùng một vùng memory độc lập, liên tục; cho dù giá trị địa chỉ trong hai process giống nhau, cuối cùng chúng vẫn có thể rơi vào các vùng physical memory khác nhau.
Sau đó bổ sung lợi ích: các process không thể sửa data của nhau, chương trình không cần quan tâm physical memory cụ thể nằm ở đâu, operating system còn có thể cấp phát memory on demand, swap page và dùng cơ chế như COW để giảm copy.
Nếu interviewer hỏi tiếp “paging giải quyết vấn đề gì”, hãy so sánh nó với segmentation. Segmentation chia theo các module logic như code segment, data segment và stack, độ dài không cố định nên dễ tạo external fragmentation, sau đó cũng khó compact. Paging đơn giản hơn nhiều: virtual address space và physical memory đều được chia thành page có kích thước cố định, page table chỉ chịu trách nhiệm ghi lại quan hệ “virtual page number → physical page frame”. Nhờ vậy về cơ bản loại bỏ external fragmentation, nhưng trong page có thể lãng phí một chút không gian, tức internal fragmentation.
Cũng có thể nói thêm về multi-level page table: nó không nhằm làm việc tra table nhanh hơn, mà nhằm tiết kiệm memory. Với phần address space chưa được sử dụng, không cần thực sự tạo page table cấp dưới.
Khi được hỏi về TLB và page fault exception, có thể trình bày theo hướng “đi fast path trước, rồi xử lý exception”. CPU trước tiên tra TLB, hit thì trực tiếp lấy physical page number; miss mới tra multi-level page table. Nếu page table entry cho biết page đó chưa ở trong memory thì trigger page fault exception. Kernel trước tiên xác định access này có hợp lệ không; nếu hợp lệ mới cấp phát page frame, khi cần thì reclaim page cũ, sau đó load page từ file hoặc Swap vào, cuối cùng update page table và thực thi lại instruction vừa rồi.
Minor fault thường không cần đọc disk, major fault cần đọc disk; nếu truy cập địa chỉ bất hợp lệ thì cuối cùng thường đi tới SIGSEGV.
Với page replacement algorithm, không cần học thuộc từng cái tên, chỉ cần nắm một câu: page bị swap out tốt nhất là page sau đó sẽ rất lâu không được dùng. OPT tối ưu nhưng không thể thực hiện trong thực tế; LRU có hiệu quả gần OPT nhưng chi phí implement cao; CLOCK dùng access bit để approximation LRU; FIFO đơn giản nhất nhưng có thể xuất hiện Belady anomaly. Linux thực tế cũng không sao chép nguyên xi một algorithm trong textbook, mà dùng active/inactive LRU, workingset, refault và các cơ chế khác để reclaim gần đúng.