
Giải thích chi tiết về deadlock: bốn điều kiện cần, xử lý deadlock trong Java và database
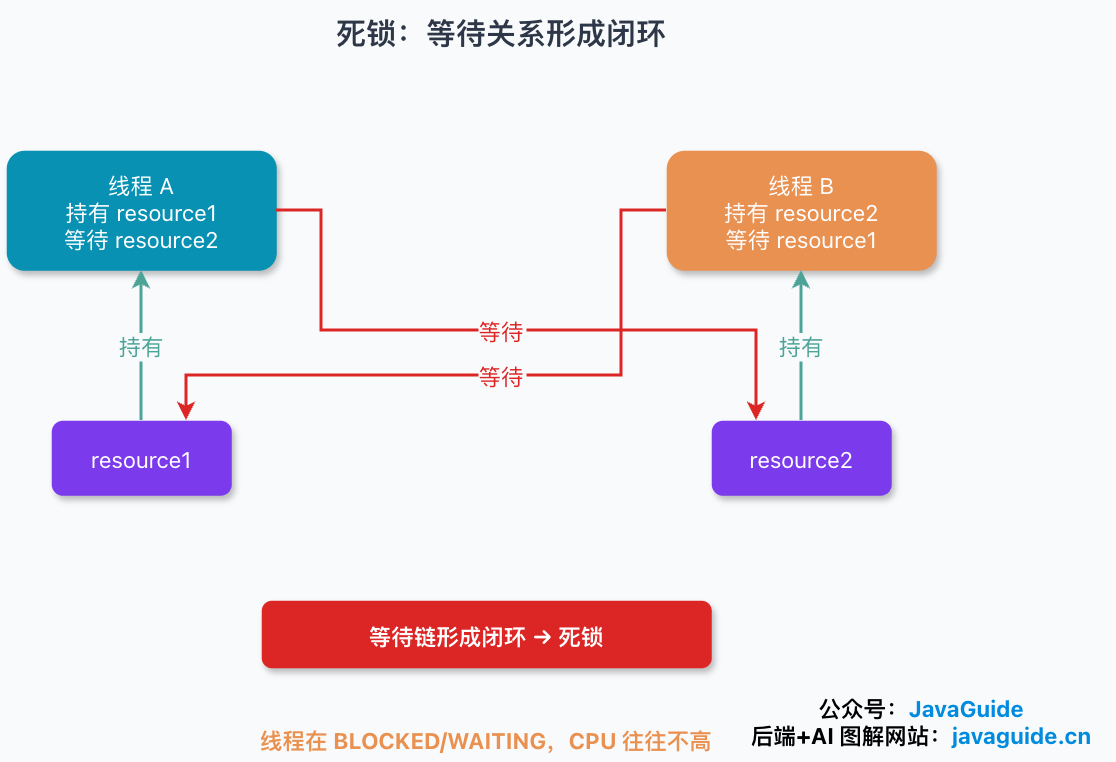
Thread A đã lấy được resource 1, thread B cũng đã lấy được resource 2. Tiếp theo, thread A muốn tiếp tục chạy thì cần resource 2; thread B muốn tiếp tục chạy thì lại cần resource 1.
Hai thread đều không ném exception, cũng không phải CPU bị chạy hết công suất. Hiện tượng nhìn thấy trên production có thể chỉ là vài request không trả về trong thời gian dài, còn worker thread trong thread pool dần bị chiếm hết.
Điểm phiền phức của loại vấn đề này nằm ở đây: chương trình không “tính sai”, mà bị kẹt trên một chuỗi chờ không thể tự tháo gỡ.
Thread deadlock chính là tình huống này: một nhóm thread chờ nhau giải phóng resource, quan hệ chờ tạo thành vòng kín, các thread tham gia đều không thể tự tiếp tục thực thi.
Nếu các thread này vừa hay đang xử lý những luồng quan trọng như order, payment, inventory, thứ bên ngoài nhìn thấy không chỉ là một thread BLOCKED, mà còn có thể là API timeout, queue dồn ứ, thậm chí process mãi không thể shutdown sạch.
Mở rộng phạm vi một chút, deadlock không chỉ thuộc về thread Java. Process, database transaction, distributed task, chỉ cần cùng giữ resource rồi tiếp tục chờ nhau đều có thể mắc kẹt theo cùng một dạng. Resource ở đây cũng không nhất thiết là printer hay tape drive trong giáo trình Operating System; nó có thể là Java object monitor, ReentrantLock, database row lock, distributed lock, connection trong connection pool, worker thread trong thread pool, thậm chí là pipe buffer.
Phần sau sẽ dùng code Java để minh họa vì loại ví dụ này dễ tái hiện nhất. Nhưng hãy nhớ, deadlock không phải vấn đề riêng của Java. Chỉ cần trong system đồng thời xuất hiện resource độc quyền, giữ resource rồi tiếp tục chờ, resource không thể bị cưỡng chế thu hồi, và quan hệ chờ tạo thành vòng, thread, process và transaction đều có thể mắc vào.
Nếu bạn muốn trước hết làm rõ ranh giới trách nhiệm của các synchronization primitive như mutex, semaphore, condition variable, futex, có thể đọc trước bài Giải thích chi tiết về lock và cơ chế đồng bộ của Operating System: mutex, semaphore, condition variable, spinlock và futex. Chuyên đề deadlock này sẽ tập trung vào cách quan hệ chờ tạo thành vòng và cách xử lý sự cố, khôi phục trên production.
Bài viết này trình bày theo thứ tự thường dùng hơn khi xử lý sự cố: trước tiên xem vòng chờ hình thành thế nào, sau đó xem bốn điều kiện cần, code tái hiện trong Java, resource allocation graph, chiến lược xử lý, cuối cùng đi vào cách dump thread stack và xem database lock trên production.
Deadlock hình thành như thế nào?
Trước tiên hãy xem tình huống thường gặp nhất trong concurrent programming. Hệ thống có hai thread và hai resource:
- Thread A lấy resource 1 trước, sau đó request resource 2.
- Thread B lấy resource 2 trước, sau đó request resource 1.
Nếu hai thread vừa hay thực thi xen kẽ, trạng thái sau sẽ xuất hiện:
- Thread A giữ resource 1, chờ resource 2.
- Thread B giữ resource 2, chờ resource 1.
Để tiếp tục chạy, thread A phải chờ thread B giải phóng resource 2; để tiếp tục chạy, thread B lại phải chờ thread A giải phóng resource 1. Hai bên đều chờ đối phương đi trước, nhưng không bên nào có cơ hội tiếp tục thực thi đến bước giải phóng resource.
Vì vậy, deadlock không giống với “chờ lâu”. Blocking thông thường vẫn có cơ hội tự khôi phục: thread khác release lock, transaction commit, network I/O trả về, rồi thread phía sau có thể tiếp tục chạy. Trong deadlock có thêm một vòng; mọi participant trên vòng đều chờ người khác release resource trước.
Còn một điểm rất dễ phán đoán sai khi xử lý sự cố: deadlock không nhất thiết đi kèm CPU cao. Nhiều khi thread chỉ yên lặng dừng ở BLOCKED hoặc WAITING, CPU ngược lại còn rất thấp. Khi API timeout, thread pool đầy, database connection cạn, CPU chỉ có thể là một manh mối, không thể dùng làm căn cứ duy nhất.
Bốn điều kiện cần của deadlock
Giáo trình Operating System thường trình bày các điều kiện Coffman. Để deadlock xảy ra, 4 điều kiện sau phải đồng thời đúng:
| Điều kiện | Ý nghĩa | Tương ứng với Java hoặc database |
|---|---|---|
| Mutual exclusion | Một resource tại cùng một thời điểm chỉ có thể được một execution unit chiếm dụng | synchronized lock object, exclusive row lock, exclusive file lock |
| Request and hold (hold and wait) | Đã giữ một phần resource, đồng thời tiếp tục chờ resource khác | Thread giữ resource1 rồi tiếp tục request resource2 |
| No preemption | Resource không thể bị bên ngoài cưỡng chế lấy đi, chỉ holder mới có thể release | Java built-in lock không thể bị thread khác trực tiếp thu hồi |
| Circular wait | Quan hệ chờ tạo thành vòng kín | Thread 1 chờ thread 2, thread 2 lại chờ thread 1 |
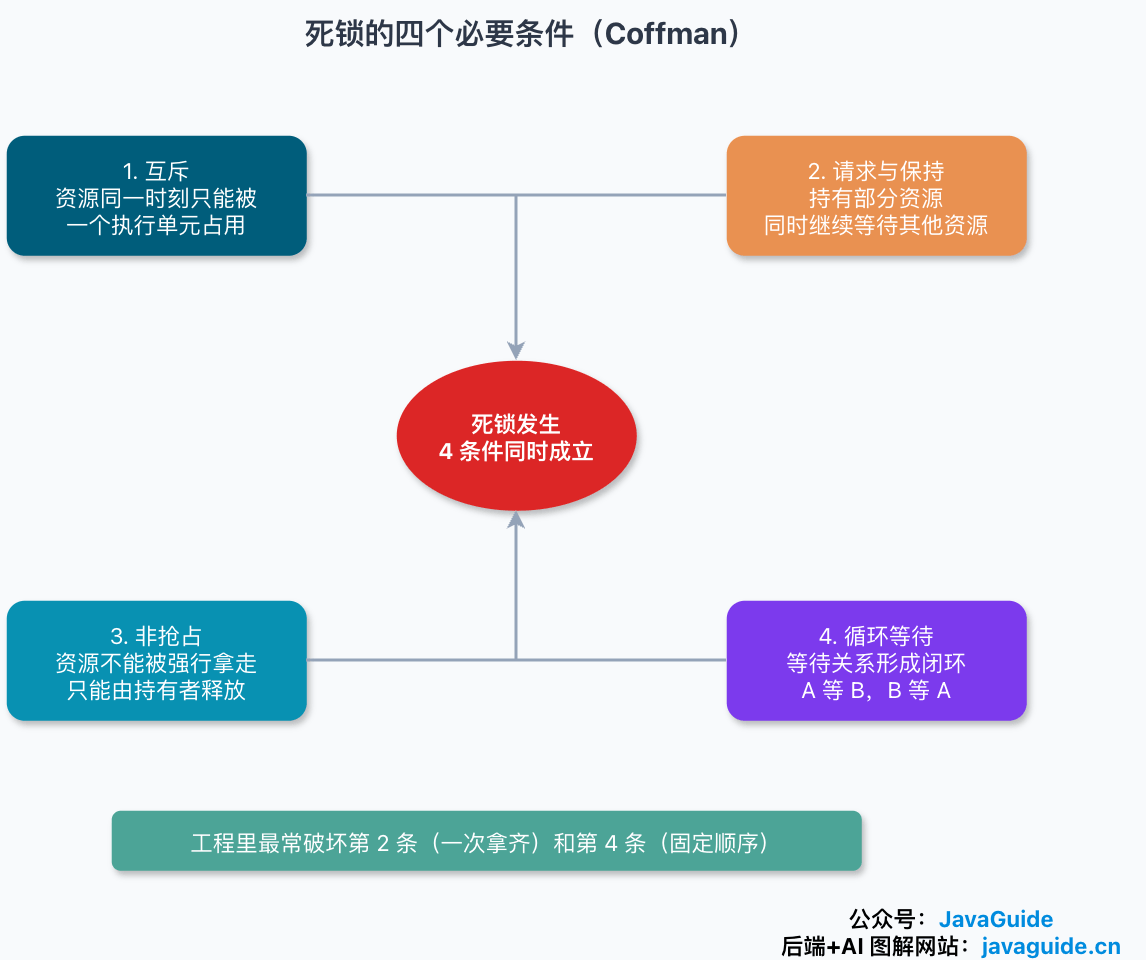
Đừng xem bảng này như checklist “chỉ cần thỏa một điều kiện là deadlock”. Ý nghĩa thực sự là: cả bốn điều kiện cùng xuất hiện thì deadlock mới có thể xảy ra; thiếu bất kỳ điều kiện nào, vòng chờ sẽ rất khó khép kín.
Khi viết business code, điều dễ can thiệp nhất thường là điều kiện thứ 2 và thứ 4.
Mutual exclusion thường khó tránh. Inventory của cùng một row, balance của cùng một account, cùng một vùng shared memory vốn không thể để nhiều thread cùng ghi tùy ý. No preemption cũng khó sửa cứng, vì lock thường bảo vệ một state chưa hoàn tất; cưỡng chế lấy đi có thể để lại state dang dở. So với chúng, việc để thread lấy đủ resource một lần, hoặc quy định mọi entry point đều lấy lock theo cùng một thứ tự, dễ trở thành coding convention mà team có thể thực thi hơn.
Tái hiện một deadlock bằng Java
Đoạn code dưới đây chuyển sơ đồ 1 thành Java. Hai Object lần lượt đóng vai trò resource 1 và resource 2, hai thread vào synchronized theo thứ tự ngược nhau.
Thread.sleep(1000) không phải nguyên nhân của deadlock; nó chỉ mở rộng khoảng thời gian để hai thread thực thi xen kẽ, giúp vấn đề dễ tái hiện hơn.
public class DeadLockDemo {
    private static final Object resource1 = new Object();
    private static final Object resource2 = new Object();

    public static void main(String[] args) {
        new Thread(() -> {
            synchronized (resource1) {
                System.out.println(Thread.currentThread() + "get resource1");
                try {
                    Thread.sleep(1000);
                } catch (InterruptedException e) {
                    Thread.currentThread().interrupt();
                }
                System.out.println(Thread.currentThread() + "waiting get resource2");
                synchronized (resource2) {
                    System.out.println(Thread.currentThread() + "get resource2");
                }
            }
        }, "Thread 1").start();

        new Thread(() -> {
            synchronized (resource2) {
                System.out.println(Thread.currentThread() + "get resource2");
                try {
                    Thread.sleep(1000);
                } catch (InterruptedException e) {
                    Thread.currentThread().interrupt();
                }
                System.out.println(Thread.currentThread() + "waiting get resource1");
                synchronized (resource1) {
                    System.out.println(Thread.currentThread() + "get resource1");
                }
            }
        }, "Thread 2").start();
    }
}
Một output khá điển hình là:
Thread[Thread 1,5,main]get resource1
Thread[Thread 2,5,main]get resource2
Thread[Thread 1,5,main]waiting get resource2
Thread[Thread 2,5,main]waiting get resource1
Chương trình dừng ở đây. sleep() sớm muộn cũng kết thúc; thứ thực sự bị kẹt là synchronized bên trong: thread 1 không vào được resource2, thread 2 không vào được resource1.
Đối chiếu trạng thái thực tế với bốn điều kiện ở trên:
- Mutual exclusion:
resource1vàresource2tại cùng một thời điểm chỉ có thể được một thread giữ. - Request and hold: thread 1 giữ
resource1và chờresource2, thread 2 giữresource2và chờresource1. - No preemption: Java sẽ không cưỡng chế lấy
resource1khỏi thread 1. - Circular wait: thread 1 chờ thread 2, thread 2 lại chờ thread 1.
Cả bốn điều kiện đều khớp, phần còn lại chỉ là timing của scheduler. Cũng vì việc trigger phụ thuộc timing, một số deadlock trên production không phải lần nào cũng tái hiện được; chạy load test mười lần có thể chỉ kẹt một hoặc hai lần.
Sửa đoạn code này thế nào để không còn vấn đề deadlock?
Cách sửa trực tiếp nhất là cố định thứ tự lock. Mọi thread đều lấy resource1 trước, sau đó lấy resource2; khi đó vòng chờ không có cơ hội quay về điểm bắt đầu.
public class OrderedLockDemo {
    private static final Object resource1 = new Object();
    private static final Object resource2 = new Object();

    public static void main(String[] args) {
        Runnable task = () -> {
            synchronized (resource1) {
                System.out.println(Thread.currentThread() + "get resource1");

                synchronized (resource2) {
                    System.out.println(Thread.currentThread() + "get resource2");
                }
            }
        };

        new Thread(task, "Thread 1").start();
        new Thread(task, "Thread 2").start();
    }
}
Cách sửa này phá vỡ “circular wait”. Chỉ cần mọi code path tuân thủ cùng một thứ tự, vòng kín A chờ B, B lại chờ A sẽ không xuất hiện.
Điểm khó nằm ở “mọi code path”. Trong ví dụ nhỏ chỉ có hai lock, nhìn một lần là hết; trong business system, lock có thể nằm rải rác ở các module order, inventory, payment. Luồng A lấy order lock trước rồi lấy inventory lock, luồng B lấy inventory lock trước rồi lấy order lock; nhìn riêng từng method đều có vẻ hợp lý, nhưng kết hợp lại mới phát sinh vấn đề.
Trong project thực tế, tôi khuyến nghị đưa các mục dưới đây vào checklist kiểm tra concurrent code:
- Resource phải có thứ tự ổn định. Có thể sắp xếp theo business ID, database primary key, account number, những giá trị không thay đổi; đừng phụ thuộc vào object hash vốn không phù hợp để biểu đạt thứ tự business.
- Chỉ thực hiện state modification cần thiết bên trong lock. Các thao tác như RPC, slow SQL, file I/O nên đặt bên ngoài lock nếu có thể, nếu không một slow call sẽ kéo dài vòng chờ.
- Không lấy đủ resource thì thoát ra. Khi đã lấy A nhưng không lấy được B, release A rồi retry sẽ an toàn hơn giữ A và chờ B mãi.
- Khi business cho phép thất bại, dùng
tryLock(timeout, unit)để đặt giới hạn cho thời gian chờ, đừng để thread bị treo vô hạn. - Nếu hai lock luôn xuất hiện cùng nhau, cân nhắc gộp thành một lock thô hơn. Concurrency sẽ giảm, nhưng đổi lại là correctness dễ chứng minh hơn.
Mục cuối trông có vẻ hơi “thụt lùi”, nhưng thường hữu ích trong engineering. Lock quá nhỏ không nhất thiết cao cấp hơn; nếu vài state vốn liên quan chặt chẽ, tách chúng ra ngược lại còn tạo khoảng trống cho deadlock.
Resource allocation graph và wait-for graph
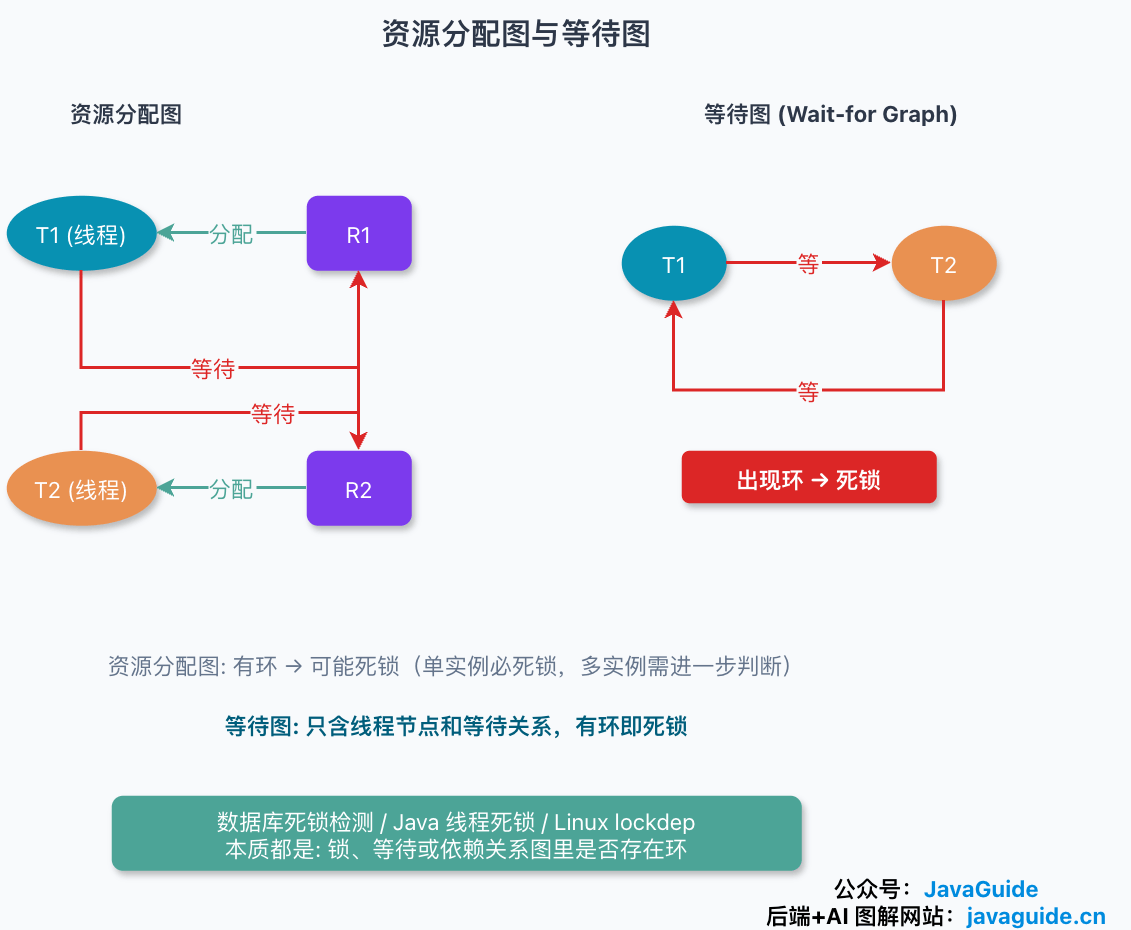
Trong giáo trình Operating System, resource allocation graph thường được dùng để vẽ deadlock. Trong graph thực ra chỉ có hai loại node:
- Process hoặc thread node.
- Resource node.
Arrow cũng có hai loại:
- Từ thread trỏ đến resource, biểu thị thread đang chờ resource này.
- Từ resource trỏ đến thread, biểu thị resource đã được phân bổ cho thread này.
Hãy xem kết luận hữu ích nhất trước: graph không có vòng thì không có deadlock.
Khi graph có vòng, không thể lập tức kết luận dứt khoát, còn phải xem số instance của resource:
- Khi mỗi loại resource chỉ có 1 instance, có vòng nghĩa là deadlock.
- Khi mỗi loại resource có nhiều instance, có vòng chỉ cho thấy khả năng deadlock; còn phải tiếp tục xác định có thread nào có thể hoàn tất trước rồi release resource hay không.
Lấy database row lock làm ví dụ. Transaction T1 đã lock order id=1, tiếp theo muốn update id=2; transaction T2 lock id=2 trước, rồi quay lại update id=1. Khi đó có thể bỏ resource node, chỉ xem quan hệ chờ giữa các transaction:
T1 -> T2
T2 -> T1
Graph chỉ giữ lại “ai chờ ai” này gọi là wait-for graph, có thể xem là phiên bản rút gọn của resource allocation graph. Java thread deadlock, database deadlock detection và Linux lockdep đều dùng cách tư duy graph tương tự, chỉ khác thời điểm sử dụng: database thường đợi transaction thực sự bị blocking rồi mới kiểm tra vòng chờ; lockdep giống như ghi nhận thứ tự lấy lock để phát hiện trước một số tổ hợp thứ tự có thể tạo thành vòng.
Prevention, avoidance, detection, recovery
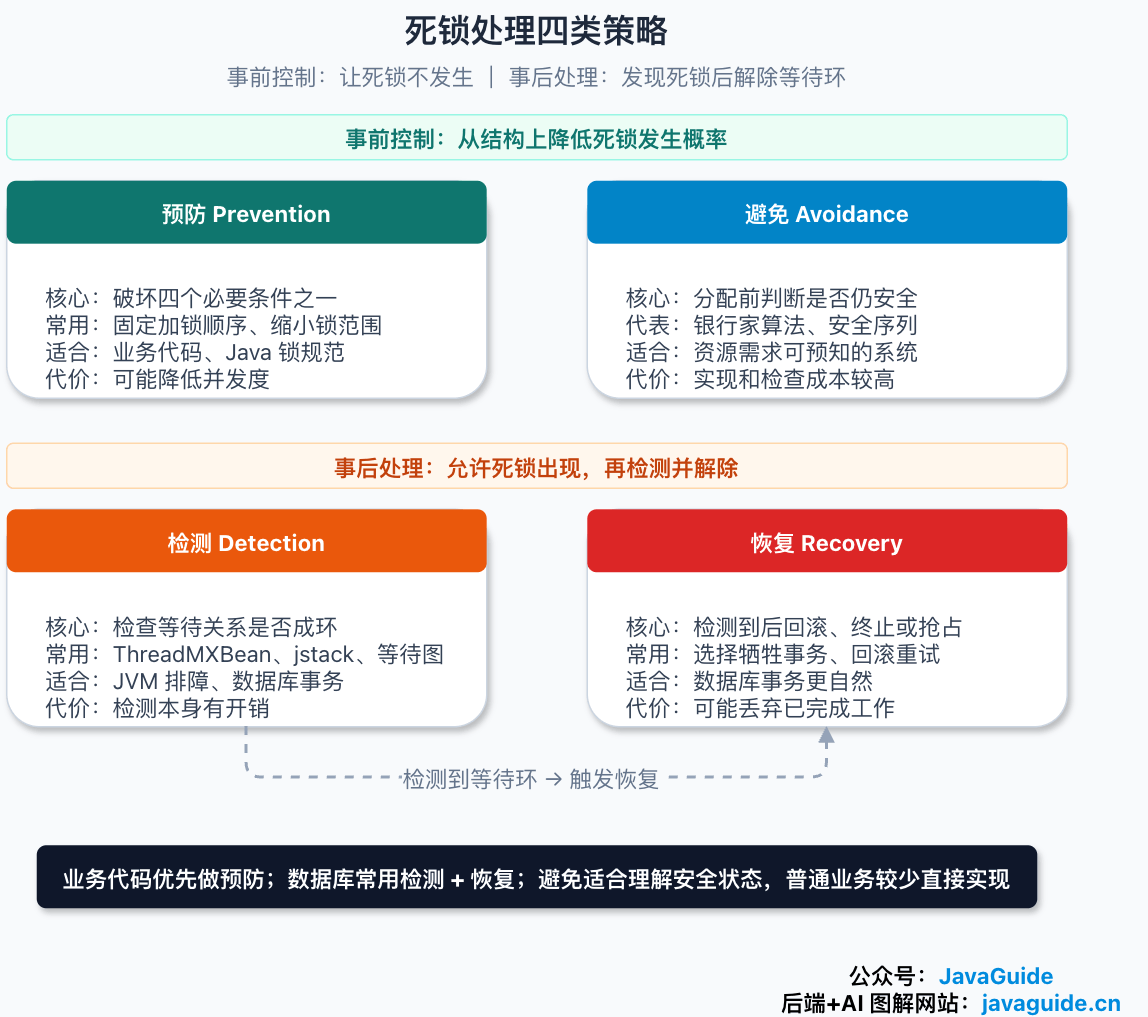
Khi nói về xử lý deadlock, thường thấy 4 từ: prevention, avoidance, detection, recovery. Tên gọi khá giống nhau, nhưng thời điểm can thiệp khác nhau.
Trong business code, phổ biến nhất là prevention, chẳng hạn thống nhất thứ tự lấy lock và rút ngắn thời gian giữ lock; database thường dùng detection và recovery vì transaction có thể rollback; Banker’s algorithm thuộc avoidance, rất phù hợp để hiểu safe state, nhưng backend service thông thường hiếm khi thực sự triển khai một bộ hoàn chỉnh theo cách này.
| Phương pháp | Cách làm | Chi phí | Mức độ phổ biến trong thực tế |
|---|---|---|---|
| Prevention | Phá vỡ một trong bốn điều kiện deadlock để cấu trúc deadlock không hình thành | Có thể giảm concurrency hoặc tăng constraint trong code | Rất phổ biến |
| Avoidance | Trước khi phân bổ resource, phán đoán việc phân bổ này có đẩy system vào dangerous state không | Cần biết trước resource demand, chi phí kiểm tra cao | Thường được dạy trong giáo trình, ít gặp ở system thông thường |
| Detection | Cho phép deadlock xảy ra, định kỳ hoặc theo nhu cầu kiểm tra vòng chờ | Bản thân việc detection có chi phí | Thường gặp ở database, tool JVM, kernel debugging |
| Recovery | Sau khi phát hiện deadlock, terminate, rollback hoặc preempt resource | Có thể làm mất phần việc đã hoàn tất | Khá tự nhiên trong database transaction |
Deadlock prevention
Prevention làm một việc rất trực tiếp: không để cả bốn điều kiện cần đồng thời được thỏa mãn.
Phá vỡ mutual exclusion: biến resource thành dạng có thể dùng chung. Read-only data, immutable object, lock-free data structure, append-only log đều có thể giảm nhu cầu mutual exclusion. Nhưng con đường này thường không đi được, chẳng hạn việc giảm inventory trên cùng một row, ghi vào cùng một vị trí trong file, hay cập nhật balance của cùng một user vốn không thể để nhiều execution unit tùy ý sửa đồng thời.
Phá vỡ hold and wait: hoặc lấy đủ resource một lần, hoặc không lấy resource nào. Như vậy sẽ không xuất hiện trạng thái “đang nắm A nhưng cứ chờ B”. Cái giá cũng rõ ràng: resource utilization có thể giảm, caller còn phải biết trước chính xác mình cần những resource nào.
Phá vỡ no preemption: khi không lấy được resource mới, chủ động release resource đã lấy, sau đó thử lại. Java built-in lock không hỗ trợ lấy lock có timeout, cũng không cho thread khác cưỡng chế thu hồi; Lock interface cung cấp tryLock(), có thể viết hành vi “không chờ được thì thoát” vào code.
boolean gotA = false;
boolean gotB = false;

try {
    gotA = lockA.tryLock(100, TimeUnit.MILLISECONDS);
    if (!gotA) {
        return;
    }

    gotB = lockB.tryLock(100, TimeUnit.MILLISECONDS);
    if (!gotB) {
        return;
    }

    // Chỉ xử lý shared state sau khi đã lấy được cả hai lock
    updateSharedState();
} catch (InterruptedException e) {
    Thread.currentThread().interrupt();
    // Không nuốt interrupt signal; return hay throw exception do business quyết định.
} finally {
    if (gotB) {
        lockB.unlock();
    }
    if (gotA) {
        lockA.unlock();
    }
}
Ưu điểm của đoạn code này là không chờ vô hạn. Nhược điểm cũng cần nhìn rõ: nó chỉ biến việc chờ thành kết quả thất bại; retry thế nào, có cho phép retry hay không, có idempotency key hay không đều phải do business tự xử lý. Nếu không, deadlock biến mất nhưng failure thường xuyên hoặc livelock lại xuất hiện.
Phá vỡ circular wait: sắp xếp resource theo một thứ tự ổn định, mọi thread chỉ được request theo thứ tự này. Ví dụ phổ biến nhất trong backend business là khi batch update database row, sort theo primary key trước rồi update từng row.
Deadlock avoidance
Deadlock avoidance không trực tiếp phá bốn điều kiện, mà trước khi phân bổ resource sẽ hỏi một câu: sau khi phân bổ lần này, system còn tìm được thứ tự “mọi người lần lượt hoàn tất” hay không?
Ví dụ điển hình nhất trong giáo trình là Banker’s algorithm. Nó yêu cầu mỗi process khai báo trước maximum resource demand; mỗi lần chuẩn bị phân bổ resource, system phải thực hiện một lần safety check:
- Nếu sau khi phân bổ vẫn tồn tại safe sequence thì cho phép phân bổ.
- Nếu sau khi phân bổ không tìm thấy safe sequence thì để requester chờ trước.
Safe state sẽ không đi đến deadlock; unsafe state cũng chưa phải đã deadlock, chỉ là về sau có thể đi vào deadlock.
Banker’s algorithm phù hợp để hiểu “safe state”, nhưng business service thông thường hiếm khi dùng trực tiếp. Lý do không phức tạp: phần lớn chương trình khó nói rõ maximum resource demand từ trước, thứ tự request cũng thay đổi theo business branch; thực hiện global check trước mỗi lần phân bổ còn tốn chi phí.
Deadlock detection
Detection đổi hướng tiếp cận: system chạy bình thường trước, đợi thread hoặc transaction thực sự chờ nhau, rồi mới tìm vòng chờ.
Database rất phù hợp với cách này. Transaction vốn có rollback boundary; sau khi phát hiện deadlock, rollback một transaction thì transaction còn lại có thể tiếp tục. Việc phía application cần làm là nhận diện loại lỗi này và quyết định có retry toàn bộ transaction hay không.
Trong Java process cũng có thể chẩn đoán. JDK cung cấp ThreadMXBean:
import java.lang.management.ManagementFactory;
import java.lang.management.ThreadInfo;
import java.lang.management.ThreadMXBean;

public class DeadlockDetector {
    public static void printDeadlocks() {
        ThreadMXBean bean = ManagementFactory.getThreadMXBean();
        long[] threadIds = bean.findDeadlockedThreads();

        if (threadIds == null || threadIds.length == 0) {
            System.out.println("No deadlock found");
            return;
        }

        ThreadInfo[] threadInfos = bean.getThreadInfo(threadIds, true, true);
        for (ThreadInfo threadInfo : threadInfos) {
            System.out.println(threadInfo);
        }
    }
}
findDeadlockedThreads() có thể kiểm tra object monitor, đồng thời bao phủ ownable synchronizer trong java.util.concurrent. Nó phù hợp hơn khi đặt trong diagnostic tool hoặc script xử lý sự cố tạm thời, không phù hợp để nhét thường xuyên vào business main flow; bản thân việc kiểm tra cũng có overhead.
Giới hạn của nó cũng cần nói rõ: nó chỉ nhìn thấy monitor và ownable synchronizer có thể quan sát bên trong JVM. Thread A giữ Java lock rồi chờ database row lock, thread B giữ database row lock rồi lại bị kẹt ở một application action khác; loại cross-system wait chain này không thể xem đầy đủ chỉ bằng ThreadMXBean, mà còn phải đối chiếu thread stack, database lock view và business log.
Trên production, cách thường gặp hơn là dump trực tiếp thread stack:
jcmd <pid> Thread.print -l
jstack -l <pid>
Nếu output xuất hiện Found one Java-level deadlock, waiting to lock, which is held by, thông thường có thể lần theo wait chain để truy ngược về business code. Ở đây nên kèm -l, vì nhiều project dùng các JUC lock như ReentrantLock, ReentrantReadWriteLock; thiếu -l, thông tin về ownable synchronizer có thể không đầy đủ.
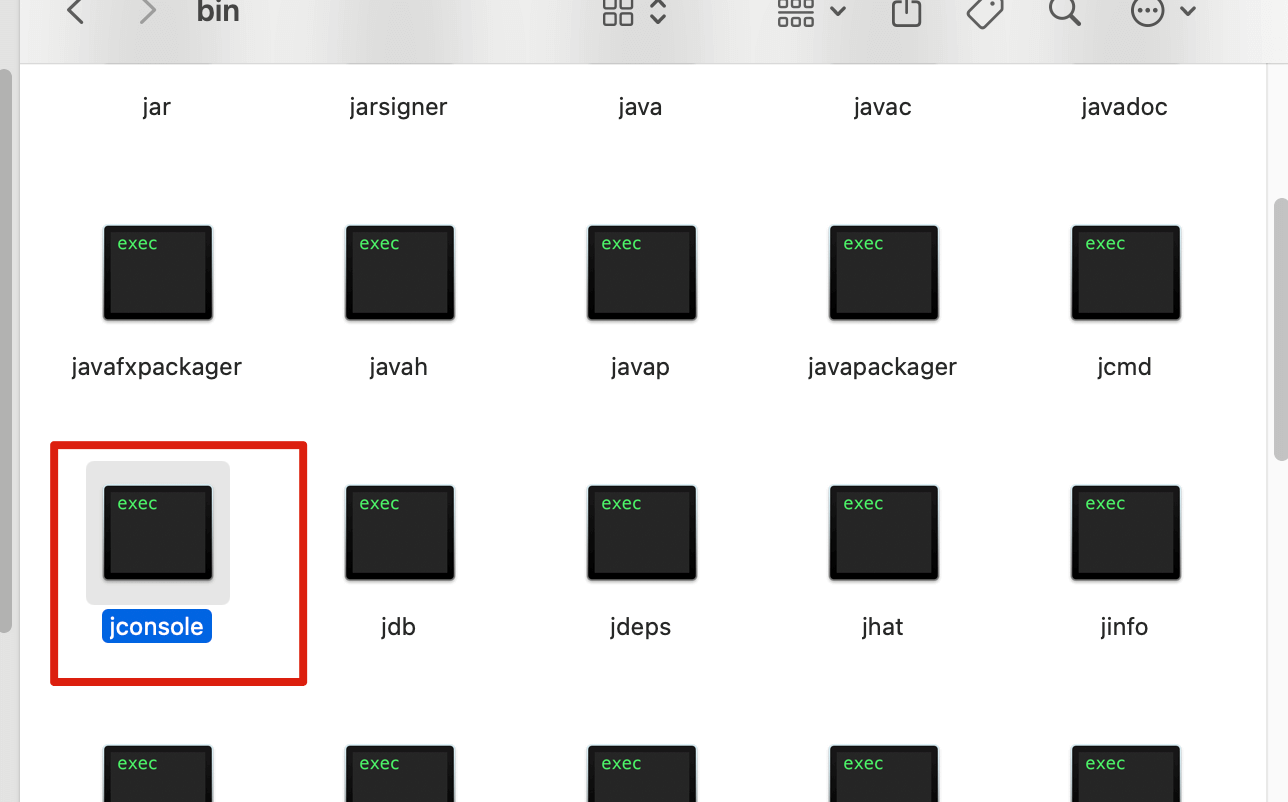
Khi tái hiện local, các tool đồ họa như JConsole, VisualVM cũng rất hữu ích. Với JConsole, trước tiên tìm thư mục bin của JDK rồi mở jconsole.
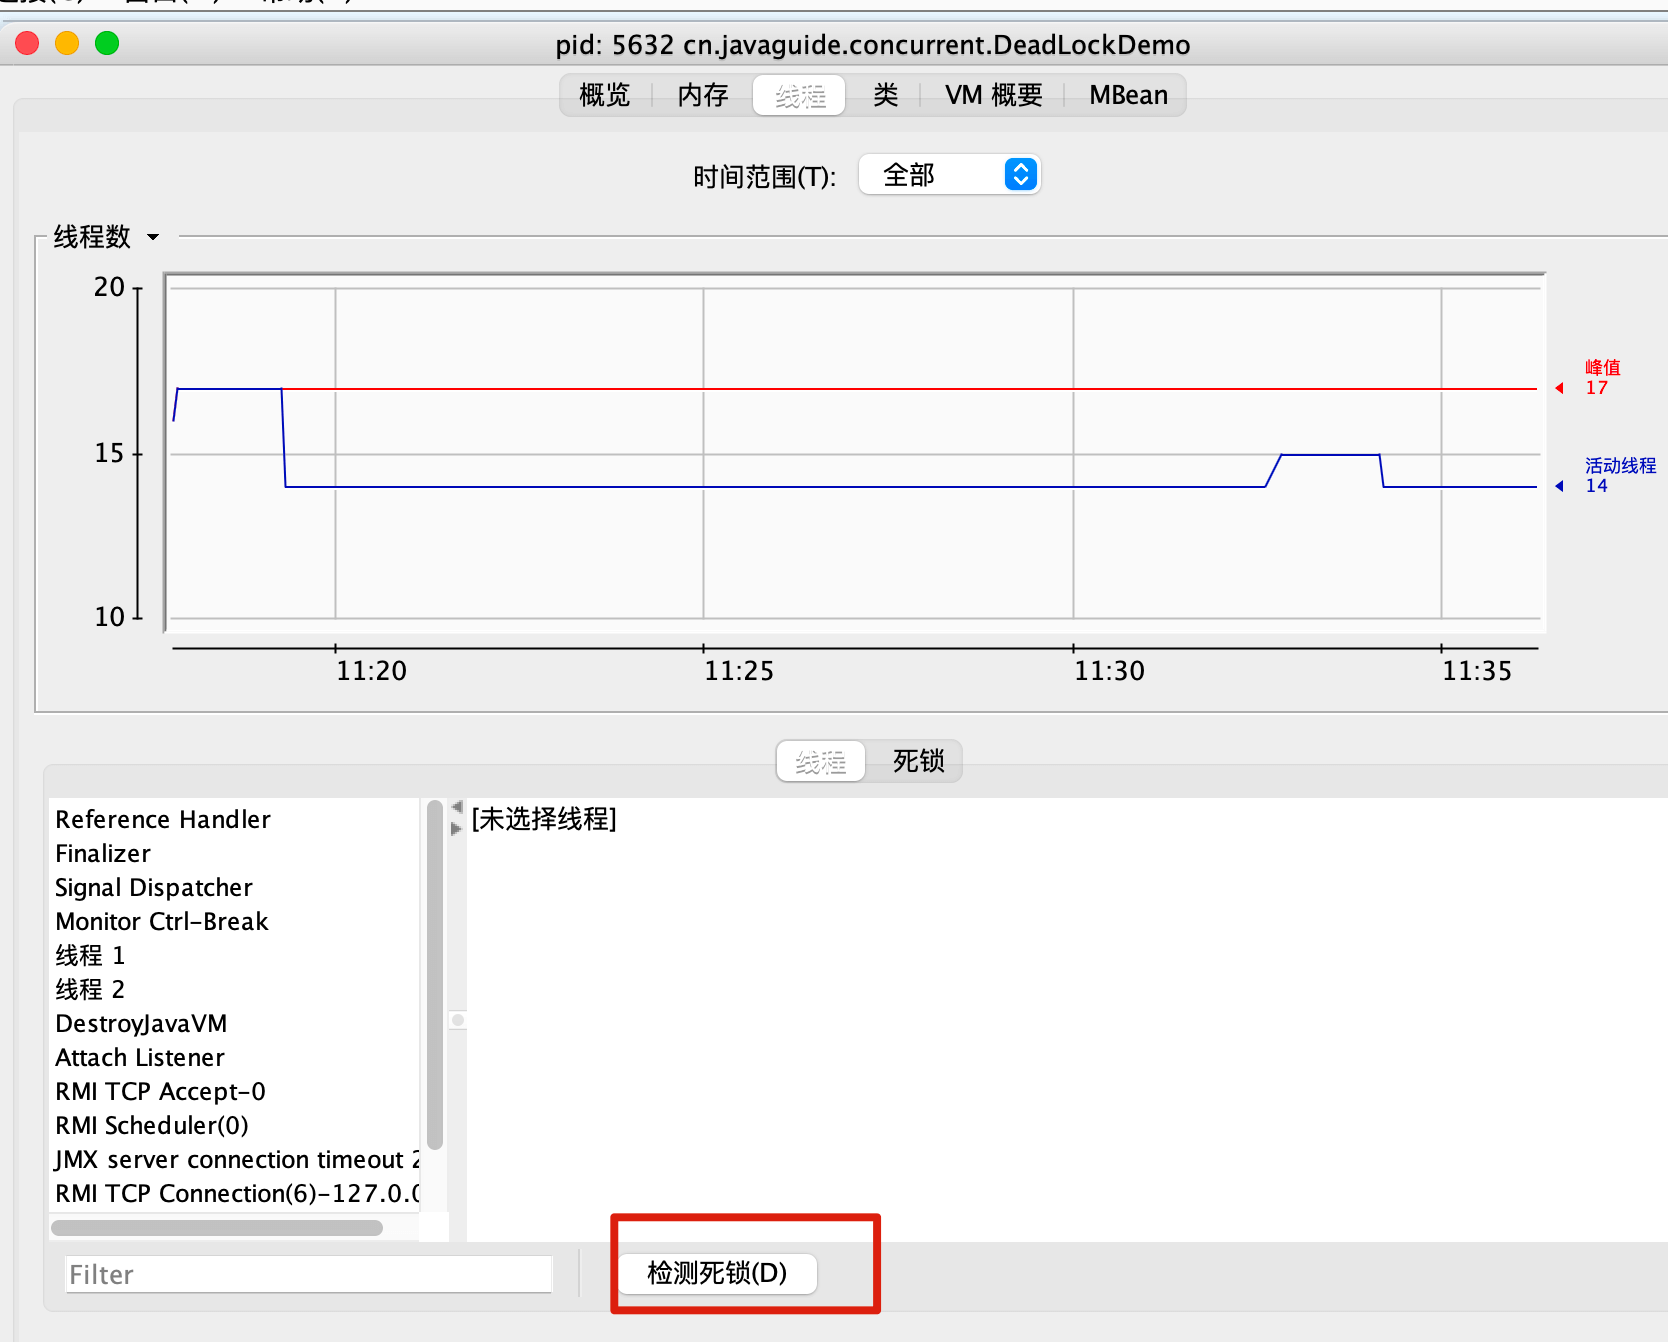
Sau khi connect đến Java process mục tiêu, vào trang “Threads”, click “Detect Deadlock”.
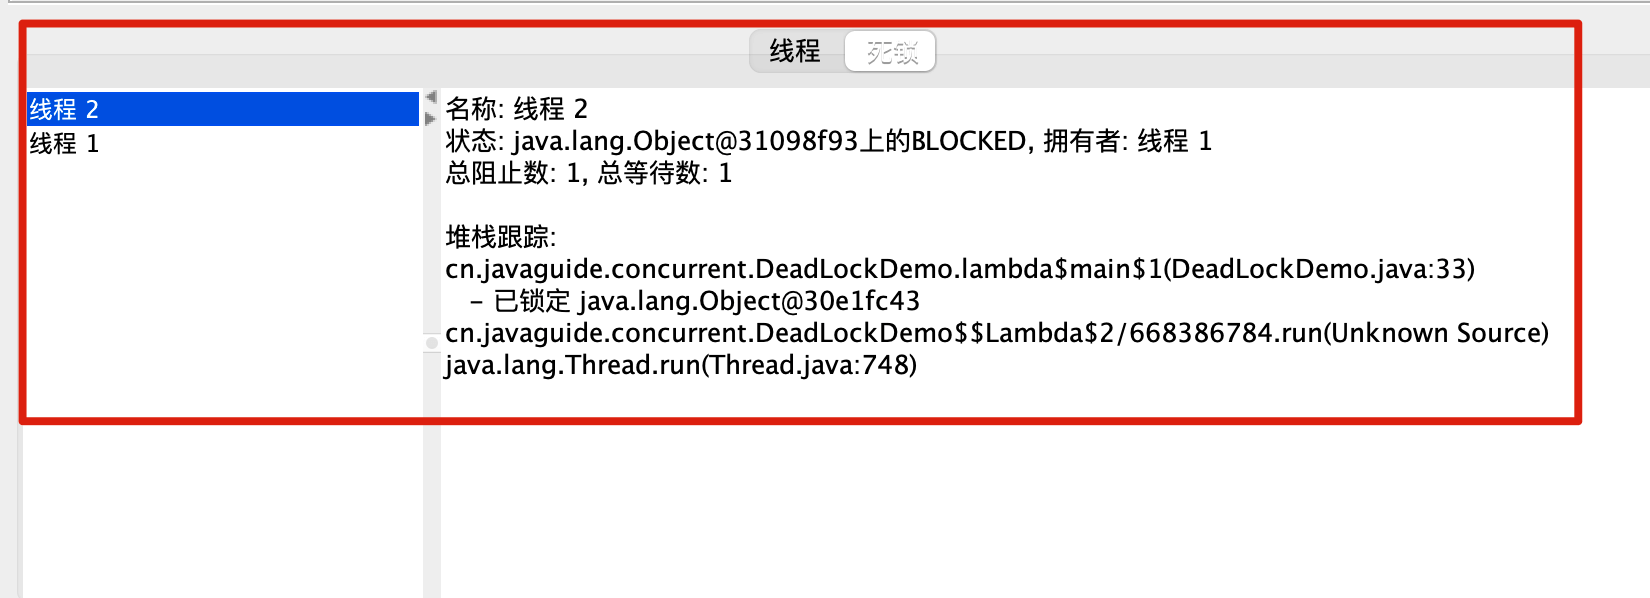
Nếu process mục tiêu có Java thread deadlock, JConsole sẽ liệt kê riêng các thread liên quan.
Trong production, nhìn chung vẫn ưu tiên jcmd, jstack. Chúng có thể thực thi qua SSH, output cũng dễ lưu lại. JConsole phù hợp hơn với việc tái hiện local, demo giảng dạy hoặc xem nhanh thread state trong test environment. Khi remote connect JConsole đến production, cần cân nhắc thêm permission, network exposure và runtime overhead; nhiều team sẽ chọn export thread stack trước rồi phân tích offline.
Nếu application dùng nhiều virtual thread của Java 21+, cần chú ý thêm. Virtual thread không bind lâu dài vào một OS thread, thông tin nhìn thấy bằng jstack hoặc Thread.print truyền thống có thể không trực quan bằng platform thread. Có thể dùng command dưới đây để export virtual thread dump:
jcmd <pid> Thread.dump_to_file -format=text thread-dump.txt
jcmd <pid> Thread.dump_to_file -format=json thread-dump.json
Các field trong virtual thread dump và traditional thread dump không hoàn toàn giống nhau; object address, lock, JNI statistic, heap statistic và những thông tin thường có trong traditional thread dump có thể không xuất hiện. Khi xử lý sự cố đừng chỉ xem một dump, cần xem cùng business log, JFR, database và state của external dependency.
Deadlock recovery
Recovery khó hơn detection, vì system phải quyết định “hy sinh ai”.
Các cách thường gặp có 3 loại:
- Terminate toàn bộ execution unit tham gia deadlock.
- Mỗi lần terminate một execution unit, kiểm tra xem deadlock đã được giải quyết chưa.
- Preempt một số resource, rollback về state có thể tiếp tục thực thi.
Database transaction phù hợp với recovery vì transaction boundary rõ ràng, sau khi rollback có thể thực thi lại. Java thread thông thường phức tạp hơn nhiều: khi một thread giữ lock, nó có thể đã sửa một nửa state trong memory, ghi một nửa file, gửi một nửa remote request; kill trực tiếp thường không phải lựa chọn tốt. Java từ lâu đã không khuyến nghị dùng Thread.stop(), cũng vì lý do này.
Application code càng nên tránh tự đẩy mình vào đường cụt: một khi bị kẹt thì chỉ có thể kill process để recovery.
Deadlock trong database
Deadlock rất phổ biến trong database, đặc biệt khi nhiều transaction update nhiều row.
Giả sử có một order table:
CREATE TABLE orders (
  id BIGINT PRIMARY KEY,
  status VARCHAR(32) NOT NULL
);
Hai transaction thực thi như sau:
-- Transaction T1
BEGIN;
UPDATE orders SET status = 'PAID' WHERE id = 1;
UPDATE orders SET status = 'PAID' WHERE id = 2;
COMMIT;
-- Transaction T2
BEGIN;
UPDATE orders SET status = 'CANCELLED' WHERE id = 2;
UPDATE orders SET status = 'CANCELLED' WHERE id = 1;
COMMIT;Nếu T1 lock id=1 trước, T2 lock id=2 trước, sau đó chúng sẽ chờ lẫn nhau.
Database thường không để hai transaction này treo mãi. PostgreSQL có parameter deadlock_timeout, mặc định là 1s; sau khi transaction chờ lock quá thời gian này, database mới bắt đầu kiểm tra deadlock vì việc dựng và scan wait-for graph cũng tốn chi phí. MySQL InnoDB mặc định bật deadlock detection; sau khi phát hiện vòng chờ, nó sẽ rollback một transaction để giải quyết tình trạng này, thường có xu hướng chọn transaction sửa ít row hơn.
Application layer cần phối hợp hai việc.
Thứ nhất, sau khi transaction thất bại phải có thể chạy lại. Deadlock error code của PostgreSQL là SQLSTATE 40P01; khi MySQL InnoDB gặp deadlock, nó sẽ rollback toàn bộ transaction. Sau khi nhận loại lỗi này, application nên thực thi lại toàn bộ transaction, thay vì chỉ thực thi lại câu SQL cuối cùng.
Thứ hai, thứ tự lock phải ổn định. Khi batch update nhiều row, sort theo primary key hoặc unique business key trước, mọi entry point đều update theo cùng một thứ tự. Thói quen này rất đơn giản nhưng có thể giảm đáng kể các quan hệ chờ chéo.
Trước khi retry cũng phải xác nhận business có idempotency hay không. Cách thường gặp là dùng unique request number, business serial number hoặc state machine check. Nếu không, database đã xử lý deadlock xong nhưng application layer lại có thể tạo duplicate charge, duplicate shipment do retry.
Để giảm và xử lý sự cố database deadlock, trước tiên có thể xem các thông tin sau:
- Transaction nên ngắn, đừng chờ user input, gọi API chậm hoặc xử lý file lớn bên trong transaction.
- Index phải đúng; nếu không, update một row có thể scan và lock nhiều record hơn.
- Hạn chế dùng
SELECT ... FOR UPDATEkhông cần thiết. - MySQL có thể dùng
SHOW ENGINE INNODB STATUSđể xem thông tin InnoDB deadlock gần nhất; nếu deadlock xảy ra thường xuyên, có thể cân nhắc bậtinnodb_print_all_deadlocksđể ghi toàn bộ thông tin deadlock vào error log. - PostgreSQL có thể kết hợp error log,
pg_locks,pg_stat_activityđể kiểm tra quan hệ blocking.
Trong PostgreSQL, trước tiên có thể dùng query dưới đây để xem session nào hiện đang chờ lock và bị pid nào chặn:
SELECT
    a.pid,
    a.usename,
    a.state,
    a.wait_event_type,
    a.wait_event,
    pg_blocking_pids(a.pid) AS blocking_pids,
    a.query
FROM pg_stat_activity a
WHERE a.wait_event_type = 'Lock';
SQL này chỉ xem được quan hệ chờ hiện tại. Để phân tích một deadlock đã xảy ra, còn phải quay lại chi tiết deadlock trong database error log, tìm traceId/requestId trong application log, rồi dựng lại thứ tự SQL mà hai transaction lần lượt thực thi.
Database deadlock không có nghĩa là “database bị hỏng”. Thông thường, nó đang nhắc bạn rằng thứ tự application layer truy cập cùng một nhóm resource chưa đủ ổn định.
Deadlock, starvation và livelock khác nhau thế nào?
Các khái niệm này đều biểu hiện thành “chương trình không tiến triển như dự kiến”, nhưng hiện trường rất khác nhau.
| Vấn đề | Biểu hiện | Nguyên nhân điển hình |
|---|---|---|
| Deadlock | Nhiều execution unit chờ lẫn nhau, tạo thành vòng kín | Lấy lock ngược thứ tự, transaction update chéo |
| Starvation | Một execution unit không lấy được resource trong thời gian dài, nhưng toàn system vẫn tiến triển | Priority quá thấp, cạnh tranh trên unfair lock |
| Livelock | Execution unit liên tục hoạt động nhưng luôn nhường nhau, không ai hoàn tất | Cùng retry sau failure, strategy backoff quá đồng bộ |
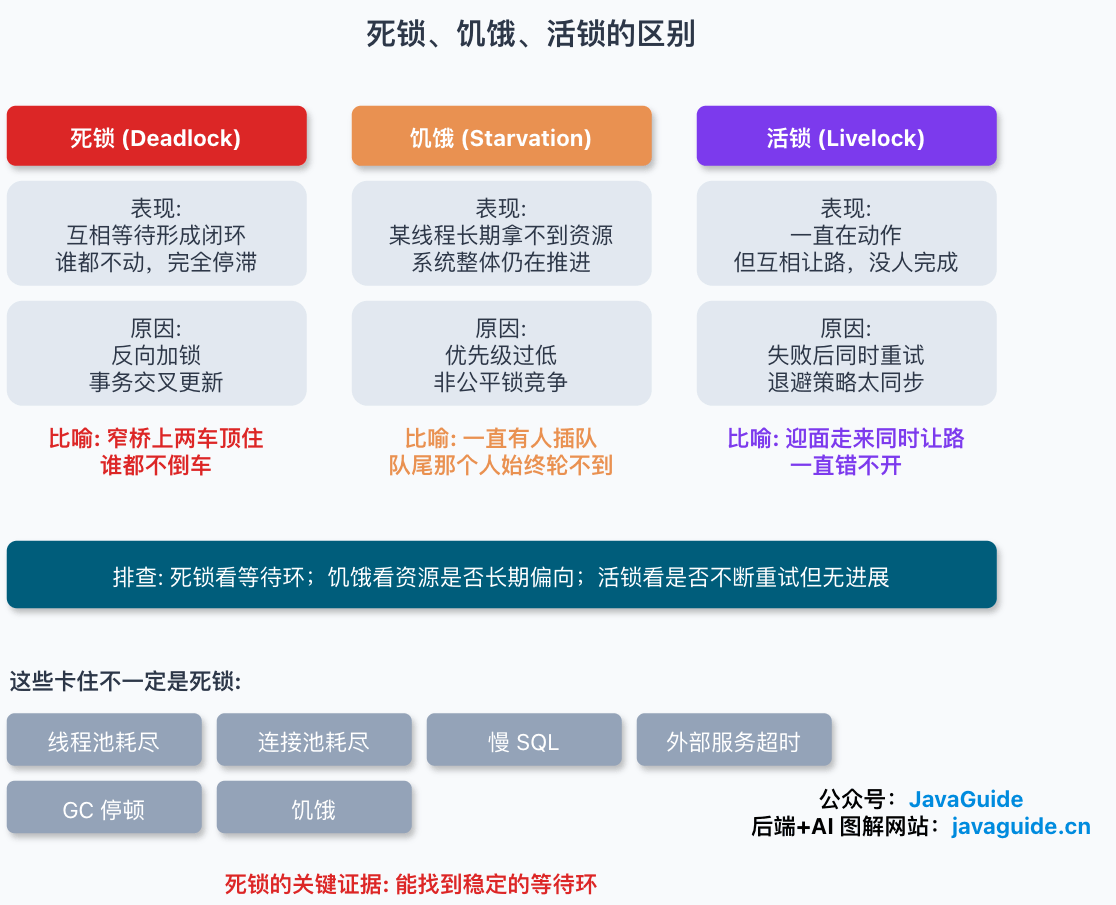
Có thể ghi nhớ bằng ba hình ảnh: deadlock giống hai chiếc xe chắn nhau giữa cầu hẹp, không ai chịu lùi; starvation giống việc luôn có người chen hàng, người ở cuối hàng mãi không đến lượt; livelock giống hai người đi ngược chiều, lần nào cũng đồng thời tránh về cùng một phía nên mãi không đi qua được.
Khi xử lý sự cố đừng chỉ nhìn hiện tượng “bị kẹt”. Deadlock cần tìm vòng chờ, starvation cần xem scheduling hoặc lock contention có thiên lệch trong thời gian dài hay không, livelock cần xem retry logic có khiến mọi participant cùng nhịp hay không.
Những gì bị kẹt nhưng chưa chắc là deadlock?
Trên production có nhiều tình huống “bị kẹt” trông giống deadlock, nhưng cuối cùng kiểm tra không có vòng chờ. Những tình huống thường gặp gồm:
- Thread pool cạn: mọi worker thread đều đang chạy slow task, request mới chỉ có thể xếp hàng.
- Connection pool cạn: mọi thread đều chờ database connection, nhưng không hình thành vòng chờ lẫn nhau.
- Slow SQL: thread dừng trong JDBC call, database vẫn đang thực thi.
- External service timeout: thread kẹt ở HTTP/RPC call, chờ response từ phía đối phương.
- GC hoặc safepoint pause: mọi Java thread tạm dừng trong thời gian ngắn.
- Starvation: một số thread không tranh được resource trong thời gian dài, nhưng toàn system vẫn tiến triển.
Bằng chứng mấu chốt để nhận định deadlock không phải “chậm” hay “kẹt”, mà là có tìm được vòng chờ ổn định hay không.
Xử lý sự cố Java deadlock trên production thế nào?
Nếu API trên production bị kẹt, trước hết đừng vội restart. Chỉ cần process còn sống, hãy cố gắng lưu lại thread stack và các metric tại thời điểm đó trước.
1. Trước tiên xác nhận có phải “treo toàn bộ” không
Trước tiên xem hiện tượng có tập trung vào việc “thread không release resource” hay không:
- Một số API liên tục timeout nhưng process vẫn còn sống.
- CPU không cao, số thread, số connection và request queue liên tục dồn lại.
- Số active thread trong thread pool luôn đầy trong thời gian dài, queue không giảm.
- Connection trong database connection pool bị chiếm mà không được release.
Những hiện tượng này chỉ cho thấy service đang chờ, chưa đủ chứng minh là deadlock. Slow SQL, external dependency bị kẹt, hay thread pool config không hợp lý cũng tạo ra hiện trường tương tự.
2. Liên tục dump thread stack từ 2 đến 3 lần
Nên dump thread stack liên tục vài lần, cách nhau 10 đến 30 giây. Chỉ dump một lần rất dễ phán đoán nhầm transient blocking thành deadlock:
jcmd <pid> Thread.print -l > thread-1.log
sleep 10
jcmd <pid> Thread.print -l > thread-2.log
sleep 10
jcmd <pid> Thread.print -l > thread-3.log
Giá trị của nhiều stack nằm ở việc so sánh. Nếu cả ba lần đều dừng ở cùng một lock, cùng một connection pool, cùng một đoạn business code, phán đoán sẽ đáng tin hơn nhiều so với chỉ một stack.
Thread deadlock mà Java có thể nhận diện thường sẽ in trực tiếp thông tin deadlock trong thread stack. Nếu không có output trực tiếp, cũng có thể quan sát xem nhiều thread có dừng lâu ở cùng một nhóm lock, cùng logic lấy connection từ connection pool hoặc cùng một business method hay không.
3. Lần theo waiting to lock để tìm holder
Khi đọc thread stack, trước tiên thu thập các loại thông tin sau:
- Tên thread và thread state, chẳng hạn
BLOCKED,WAITING. - Lock object đang chờ.
- Lock hiện đang giữ.
- Business method ở đầu stack.
Lockhoặc condition queue tương ứng vớiparking to wait for.
Nếu thấy A chờ lock do B giữ, còn B lại chờ lock do A giữ, vòng chờ cơ bản đã hiện ra.
Deadlock liên quan đến synchronized thường sẽ thấy waiting to lock <...> và locked <...>; JUC lock như ReentrantLock thường sẽ thấy parking to wait for <...>, đồng thời cần chú ý Locked ownable synchronizers. Vì vậy khi dump stack nên kèm -l.
4. Quay lại code để xem thứ tự lock
Sau khi định vị business method trong stack, quay lại code để kiểm tra các điểm sau:
- Có nhiều entry point lấy ngược cùng một nhóm lock hay không.
- Có gọi external service hoặc database trong thời gian giữ lock hay không.
- Có lock object có phạm vi quá rộng hay không, chẳng hạn global
Map, singleton object,Classobject. - Có trộn Java lock với database transaction lock khiến chain dài hơn hay không.
- Có dùng unfair lock, chờ vô hạn hoặc lấy lock không timeout hay không.
Nhiều deadlock không do riêng một dòng code gây ra, mà chỉ xuất hiện sau khi hai call chain kết hợp. Nhìn riêng call chain A và B đều hợp lý, đặt cạnh nhau mới tạo thành vòng.
Viết code thế nào để giảm deadlock?
Các mục dưới đây giống checklist hơn khi code review, đặc biệt phù hợp với tình huống nhiều lock, nhiều transaction, nhiều resource update.
Cố định thứ tự lấy lock
Khi đồng thời thao tác trên nhiều user, order hoặc account, hãy sort trước rồi lấy lock. Ví dụ transfer dưới đây giả sử Account ID là duy nhất trên toàn hệ thống và không thay đổi sau khi tạo.
public void transfer(Account from, Account to, long amount) {
    if (from == to) {
        return;
    }

    Account first;
    Account second;
    int compare = Long.compare(from.id(), to.id());
    if (compare < 0) {
        first = from;
        second = to;
    } else if (compare > 0) {
        first = to;
        second = from;
    } else {
        throw new IllegalStateException("Account id must be unique");
    }

    synchronized (first) {
        synchronized (second) {
            from.withdraw(amount);
            to.deposit(amount);
        }
    }
}
Trong ví dụ này, dù A chuyển tiền cho B hay B chuyển tiền cho A, đều lock account có ID nhỏ trước, sau đó lock account có ID lớn. Sau khi cố định thứ tự, một cạnh trong circular wait không còn xuất hiện.
Tránh thực hiện slow operation khi đang giữ lock
Trong thời gian giữ lock, cố gắng đừng làm những việc sau:
- RPC hoặc HTTP request.
- Slow SQL hoặc transaction lớn.
- Upload/download file.
- Chờ message queue trả về.
- Gọi third-party code mà không rõ bên trong có lấy lock hay không.
Lock nên bảo vệ shared state, không nên bao trùm toàn bộ business flow. Data có thể tính trước thì tính bên ngoài lock, bên trong lock chỉ giữ state transition ngắn nhất.
Dùng timeout và failure strategy
Built-in lock synchronized không có khả năng lấy lock với timeout. Khi business cho phép failure hoặc retry, có thể cân nhắc ReentrantLock.tryLock():
try {
    if (!lock.tryLock(200, TimeUnit.MILLISECONDS)) {
        throw new IllegalStateException("System busy, please retry later");
    }

    try {
        updateSharedState();
    } finally {
        lock.unlock();
    }
} catch (InterruptedException e) {
    Thread.currentThread().interrupt();
    throw new IllegalStateException("Interrupted while acquiring lock", e);
}
Timeout chỉ giới hạn thời gian chờ, không tự động bảo đảm business correctness. Sau khi không lấy được lock, có retry hay không, retry tối đa mấy lần, có duplicate submit hay không, có cần idempotency key hay không, tất cả đều phải được thiết kế trước. Nếu không, timeout chỉ khiến lỗi lộ ra nhanh hơn.
Hạn chế trộn nhiều lock system
Khó xử lý sự cố nhất là cross-layer deadlock, chẳng hạn:
- Java thread giữ JVM lock, đồng thời chờ database row lock.
- Request khác giữ database row lock, callback vào application logic rồi chờ JVM lock.
Wait chain này đồng thời xuất hiện trong JVM thread stack và database log, chỉ xem một phía sẽ không đầy đủ. Nếu có thể kiểm soát lock trong cùng một layer thì đừng để quan hệ chờ xuyên qua quá nhiều component; khi bắt buộc cross-layer, ít nhất phải có timeout, log và thứ tự thống nhất.
Đặt tên cho lock, đặt tên cho thread
Khi xử lý sự cố trên production, điều đáng sợ nhất là thấy thông tin kiểu “Thread-17 chờ Object@4afcd809”. Hãy đặt custom thread name cho thread pool, gắn lock object với business ID và log thứ tự resource quan trọng; bình thường viết thêm vài dòng có thể tiết kiệm rất nhiều thời gian khi có sự cố.
Ví dụ thêm tên business pool vào thread name:
private static final AtomicInteger THREAD_INDEX = new AtomicInteger();

ThreadFactory factory = runnable -> {
    Thread thread = new Thread(runnable);
    thread.setName("order-worker-" + THREAD_INDEX.incrementAndGet());
    return thread;
};
AtomicInteger đến từ java.util.concurrent.atomic. Tự đánh số ổn định hơn việc phụ thuộc trực tiếp vào thread ID, đồng thời tương thích với các runtime phổ biến như Java 8/11.
Bản thân việc đặt tên không thể ngăn deadlock, nhưng giúp bạn nhanh chóng biết loại business thread nào đang bị kẹt.
Trả lời câu hỏi phỏng vấn về deadlock thế nào?
Khi phỏng vấn về deadlock, không cần vừa bắt đầu đã đọc thuộc một định nghĩa dài. Có thể dùng ví dụ hai lock chờ lẫn nhau để giải thích rõ tình huống trước:
Deadlock là trạng thái nhiều thread hoặc process chờ nhau release resource, khiến mọi participant không thể tiếp tục thực thi. Ví dụ điển hình là thread A giữ lock 1 và chờ lock 2, thread B giữ lock 2 và chờ lock 1.
Sau đó bổ sung bốn điều kiện cần:
Deadlock phải đồng thời thỏa 4 điều kiện: mutual exclusion, hold and wait, no preemption, circular wait. Chỉ cần phá vỡ một điều kiện là có thể tránh deadlock từ cấp độ cấu trúc.
Tiếp theo nói về cách xử lý:
Trong thực tế, cách dùng phổ biến nhất là prevention, chẳng hạn thống nhất thứ tự lấy lock, thu nhỏ phạm vi lock, request toàn bộ resource một lần, sử dụng timed lock. Giáo trình Operating System còn trình bày Banker’s algorithm, thuộc deadlock avoidance và cần biết trước maximum resource demand. Database thường dùng detection và recovery: sau khi phát hiện vòng chờ thì rollback một transaction, sau đó application layer retry.
Nếu được hỏi tiếp về cách xử lý sự cố trong Java:
Java có thể dùng
jcmd <pid> Thread.print -lhoặcjstack -l <pid>để dump thread stack, cũng có thể dùngThreadMXBean.findDeadlockedThreads()để chẩn đoán trong chương trình. Khi xử lý sự cố, hãy xem thread state, lock đang chờ, lock đã giữ, rồi quay lại code để xác nhận có lấy lock ngược thứ tự hoặc thực hiện slow operation trong thời gian giữ lock hay không.
Cách trả lời này bao quát khái niệm, điều kiện, phương án và cách xử lý sự cố, đầy đủ hơn so với chỉ học thuộc bốn điều kiện.
Tổng kết
Điều đáng nhớ nhất về deadlock không phải thuật ngữ, mà là quan hệ chờ.
Chỉ cần trong code tồn tại path “đã giữ một phần resource nhưng tiếp tục chờ phần khác”, hãy hỏi thêm: các quan hệ chờ này có khả năng tạo thành vòng hay không? Nếu có, hãy cố định thứ tự, rút ngắn thời gian giữ, cho phép timeout để rút lui, hoặc giao việc xử lý cho hệ thống như database, vốn có thể detection và rollback transaction.
Một số nơi không thể bảo đảm vĩnh viễn không có deadlock, chẳng hạn database transaction phức tạp, batch update có concurrency cao, resource orchestration xuyên service. Mục tiêu thực tế hơn là giảm xác suất, giữ lại hiện trường, biến failure thành thứ có thể retry an toàn, thay vì kéo dài đến mức chỉ còn cách restart process.
Tài liệu tham khảo
- JavaGuide: Tổng hợp câu hỏi phỏng vấn Operating System thường gặp (phần 1)
- Giải thích deadlock bằng một ví dụ dễ hiểu - chuyên mục Zhihu
- Yale CS: Deadlock
- University of Wisconsin CS 537 Notes: Deadlock
- Oracle Java Tutorials: Deadlock
- Oracle JDK API: ReentrantLock
- Oracle JDK API: ThreadMXBean
- Oracle Troubleshooting Guide: The jstack Utility
- Oracle Java Documentation: Virtual Threads
- Linux Kernel Documentation: Runtime locking correctness validator
- PostgreSQL Documentation: Lock Management
- PostgreSQL Documentation: Error Codes
- PostgreSQL Documentation: pg_locks
- MySQL 8.4 Reference Manual: Deadlock Detection
- MySQL 8.4 Reference Manual: InnoDB Error Handling