
Giải thích chi tiết về CPU scheduling và system load
CPU scheduling không chỉ là tên các algorithm như FCFS, RR, CFS. Khi kiểm tra sự cố trong production, còn phải hiểu vì sao thread bị đưa khỏi CPU, chi phí của context switch nằm ở đâu, cũng như load average cao nhưng CPU usage thấp có ý nghĩa gì.
Đằng sau các vấn đề này là cùng một nhóm ràng buộc: số core CPU có hạn, task cần xếp hàng, scheduler chịu trách nhiệm quyết định task nào chạy trước; các metric hệ thống giúp xác định task đang tranh chấp CPU, chờ I/O, hay bị kẹt ở kernel, interrupt hoặc lớp virtualization.
Ví dụ, một máy có 8 logical CPU có load average đã lên 40 nhưng CPU vẫn còn idle, wa trong %Cpu(s) duy trì ở mức cao. Lúc này, đi tìm ngay các CPU hotspot function có thể không đem lại kết quả; nhiều khả năng máy đang có một loạt task chờ I/O. CPU usage và load average cần được đánh giá riêng.
Vì sao cần CPU scheduling
Số core CPU có hạn, nhưng số task có thể chạy có thể rất nhiều.
Trong một Java service, business thread, GC thread, JIT thread và Netty event loop thread đều có thể cần chạy; trên cùng máy còn có log collector, monitoring Agent, scheduled task và database client. Nếu hệ thống có 8 logical CPU, cùng một thời điểm nhiều nhất chỉ khoảng 8 task có thể chiếm CPU và chạy; các task còn lại chỉ có thể xếp hàng, sleep hoặc chờ I/O. Trong môi trường container còn phải xem CPU quota, không thể chỉ nhìn số physical core của host.
Tên gọi của đối tượng scheduling không hoàn toàn giống nhau giữa các hệ thống. Khi kiểm tra vấn đề backend, có thể tạm hiểu scheduling entity của Linux là execution unit có thể được kernel sắp xếp chạy độc lập trên CPU.
Một process có thể chứa nhiều thread. Chúng chia sẻ process address space và file descriptor, nhưng mỗi thread có stack, register, program counter và execution context riêng.
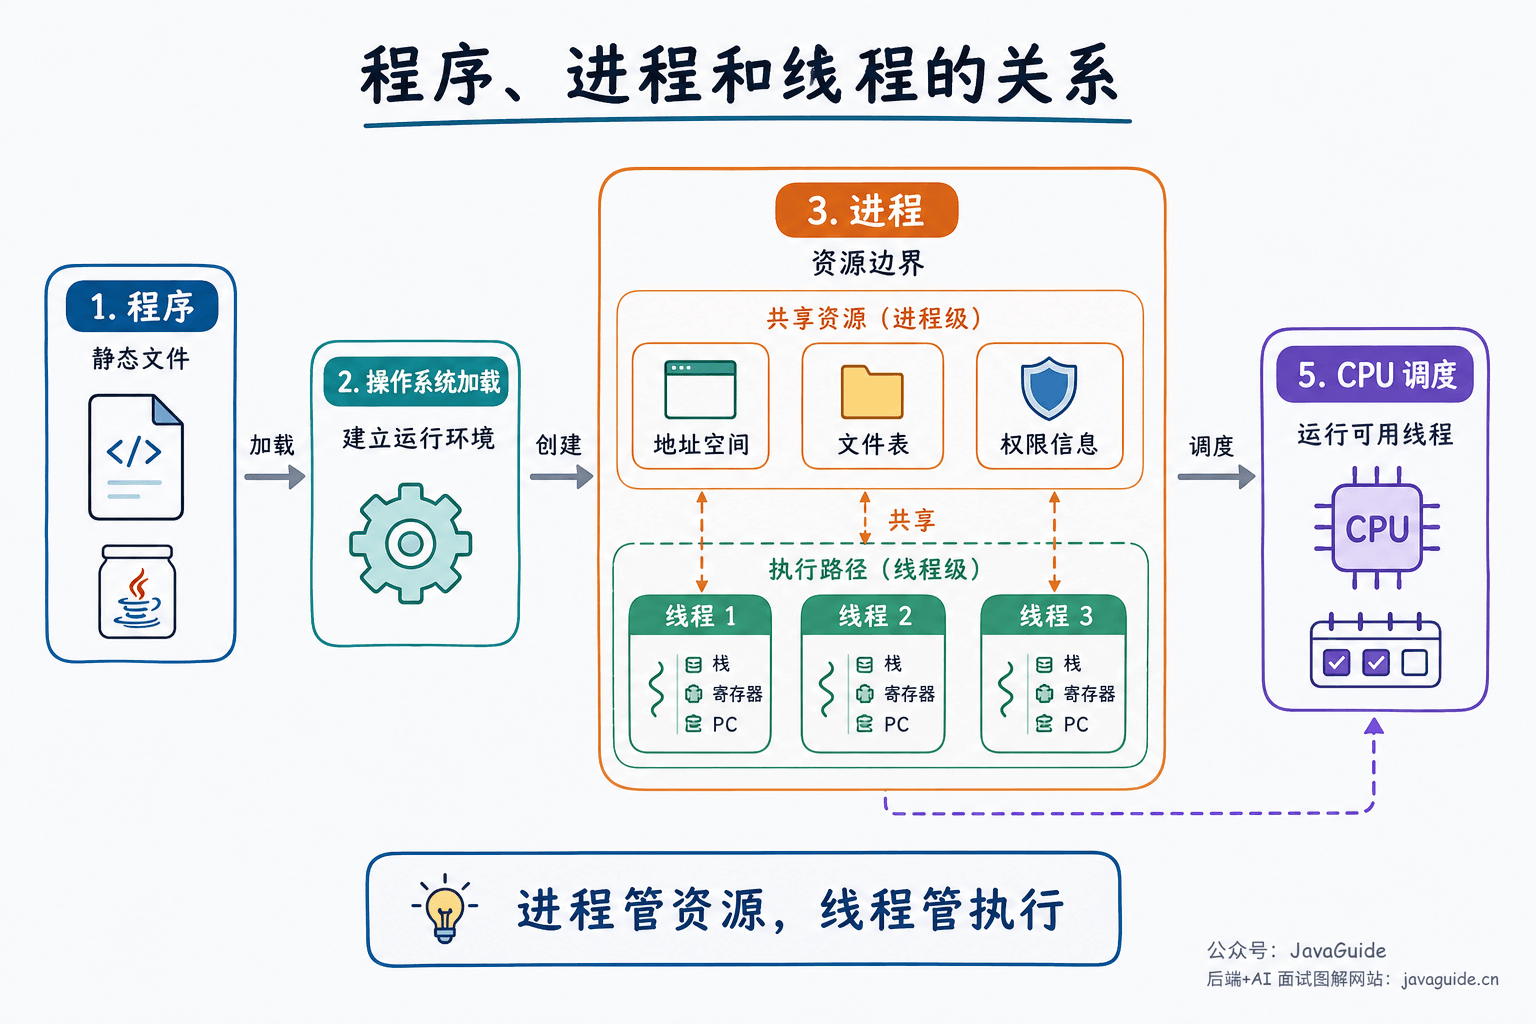
Trong Linux kernel, process và thread đều được biểu diễn bằng task, scheduler thực tế scheduling task hoặc scheduling entity; một thread được nhìn thấy ở user space phần lớn tương ứng với một kernel schedulable task.
Nếu không có scheduling, một infinite loop trên máy single-core có thể chiếm CPU mãi, khiến các program khác không có cơ hội phản hồi. Máy multi-core chỉ biến số task có thể chạy cùng lúc từ 1 thành N; khi số task vượt số core, chúng vẫn phải xếp hàng và chuyển đổi.
Scheduler phải cân bằng khả năng phản hồi trong tương tác, fairness, throughput, priority, real-time task, power consumption và cache locality. Các mục tiêu này thường xung đột: time slice dài hơn giúp giảm số lần chuyển đổi, nhưng interactive task có thể phải chờ lâu hơn; time slice ngắn hơn cải thiện response nhưng lại làm tăng switching overhead.

Một số trường hợp task rời CPU
Một task rời CPU thường vì một trong vài nguyên nhân. Hết time slice chỉ là một trong số đó.
Phổ biến nhất là task chủ động nhường CPU. Ví dụ, thread gọi read() để đọc disk nhưng dữ liệu chưa sẵn sàng, nó sẽ chuyển sang trạng thái waiting; khi thread chờ lock, condition variable hoặc timer, nó cũng rời running state. CPU không nên chờ nó một cách lãng phí, nên scheduler sẽ chọn task khác có thể chạy.
Một trường hợp khác là bị preempt. Hệ điều hành general-purpose thường sử dụng preemptive scheduling. Sau khi task chạy một khoảng thời gian, clock interrupt sẽ cho kernel một cơ hội kiểm tra; nếu task hiện tại đã chạy đủ lâu hoặc có task phù hợp hơn trở nên runnable, kernel có thể đưa task hiện tại ra khỏi CPU.
Để giải thích rõ preemption, nhiều giáo trình thường đơn giản hóa quá trình này thành: timer định kỳ phát sinh clock interrupt.
Mô hình này có thể minh họa quy trình tổng quát của preemption. Tuy nhiên, Linux hiện đại hỗ trợ NO_HZ / tickless, có thể giảm scheduling clock tick khi CPU idle hoặc với một số cấu hình. Timer và scheduling tick là các cơ chế quan trọng để kernel có cơ hội kiểm tra preemption, nhưng máy production không nhất thiết luôn phát sinh tick theo tần số cố định.
Priority cũng ảnh hưởng đến scheduling. Task có priority cao được xếp trước, task có priority thấp sẽ dễ phải chờ hơn. Nếu hệ thống hoàn toàn ưu tiên task có priority cao, task có priority thấp có thể không lấy được CPU trong thời gian dài, đó là starvation. Các algorithm trong giáo trình thường dùng dynamic priority, aging hoặc queue promotion để giảm starvation; cách xử lý trong hệ thống thực tế phụ thuộc vào scheduling class và implementation cụ thể.
Context switch xảy ra tại thời điểm chuyển task. Kernel phải lưu register, program counter, stack pointer và các execution context khác của task hiện tại, sau đó khôi phục task tiếp theo. Chuyển giữa các process còn có thể phát sinh chi phí thêm cho page table, TLB và cache locality. Khi có quá nhiều thread, lock contention nghiêm trọng, task thường xuyên sleep và wakeup, business code chưa chạy được bao nhiêu nhưng CPU time có thể đã bị tiêu tốn cho scheduling và synchronization.
Số lượng thread cần được thiết lập dựa trên loại task và số core CPU. Thread có thể che giấu thời gian chờ I/O và tận dụng multi-core; nhưng khi số thread lớn hơn nhiều lần số core CPU, run queue, context switch, cache miss và lock contention đều tăng theo.
Các scheduling algorithm kinh điển
Trong phỏng vấn thường hỏi về FCFS, SJF, RR, priority và multilevel feedback queue.
Đặt các algorithm này vào bối cảnh xếp hàng của short task, long task và interactive task sẽ dễ thấy khác biệt hơn. Chúng chủ yếu là model rút gọn trong giáo trình; scheduling task thông thường của Linux thực tế không sao chép nguyên xi một algorithm nào, mà còn liên quan đến CFS/EEVDF, real-time scheduling class, cgroup, CPU affinity, NUMA và các cơ chế khác.
| Algorithm | Cách lựa chọn | Vấn đề dễ bị hỏi thêm |
|---|---|---|
| FCFS | Đến trước phục vụ trước | Long task đứng đầu khiến short task cũng phải chờ |
| SJF | Task có thời gian chạy dự kiến ngắn chạy trước | Khó biết trước task còn chạy bao lâu, long task có thể bị starvation |
| RR | Mỗi task lần lượt chạy một time slice | Time slice quá ngắn làm tăng chi phí context switch, quá dài lại gần với FCFS |
| Priority scheduling | Task có priority cao chạy trước | Task priority thấp có thể phải chờ rất lâu |
| Multilevel feedback queue | Nhiều priority queue, điều chỉnh vị trí theo hành vi chạy | Nhiều rule và parameter, implementation phức tạp hơn |
Ví dụ, trong thread pool có vài task nén file lớn xếp ở phía trước, nhiều request phía sau chỉ cần đọc cache cũng phải chờ theo, khiến average response time bị long task kéo dài. SJF có thể cải thiện tình huống này, nhưng điều kiện tiên quyết rất khó: hệ thống phải biết mỗi task còn cần chạy bao lâu. Hệ thống thực tế không có góc nhìn toàn tri như vậy, chỉ có thể ước đoán dựa trên hành vi trước đó, thời gian chờ I/O và đặc điểm interactive.
RR gần với một model nhập môn của time-sharing system hơn. Mỗi task chạy một time slice, chạy xong thì được đưa lại vào queue. Khi user gõ command, di chuyển mouse hoặc gửi request, hệ thống không cần đợi long task kết thúc hoàn toàn mới phản hồi. Context switch có chi phí cố định, vì vậy time slice càng ngắn thì tỷ lệ switching overhead càng cao; khi kéo dài time slice, chi phí chuyển đổi được phân bổ trên thời gian chạy dài hơn nhưng interactive latency có thể tăng.
Multilevel feedback queue đồng thời cân nhắc response time của short task và tiến độ của long task. Task mới thường được đưa vào queue có priority cao trước; nếu luôn sử dụng hết time slice, task gần với long task thiên về CPU và có thể dần bị hạ priority; nếu thường xuyên chủ động chờ I/O, task gần với interactive task hoặc I/O-bound task và có thể giữ priority cao hơn. Số lượng queue, time slice và quy tắc tăng, giảm priority đều ảnh hưởng đến hiệu quả scheduling; hệ thống thực tế còn chồng thêm nhiều cơ chế khác.
Từ CFS đến EEVDF
Linux từ lâu sử dụng CFS để scheduling task thông thường, tức Completely Fair Scheduler.
Để hiểu CFS, trước tiên hãy xem vruntime.
vruntime ghi lại task đã chạy bao lâu trên trục thời gian công bằng. Sau khi task chạy một khoảng thời gian thực, kernel quy đổi khoảng thời gian đó vào virtual runtime của nó; nice value khác nhau có weight khác nhau nên tốc độ quy đổi cũng khác nhau. Scheduler có xu hướng chọn task có vruntime nhỏ hơn, để các task được phân phối CPU lâu dài theo weight.
CFS không có khái niệm timeslice cố định như scheduler cũ, mà gần với việc phân phối CPU share theo weight trong một khoảng thời gian. Khi có ít runnable task, mỗi task có thể chạy lâu hơn một chút; khi có nhiều runnable task, phần thời gian của mỗi task sẽ ngắn hơn. CFS dùng red-black tree để duy trì các runnable task theo thứ tự virtual runtime, thường chọn task ngoài cùng bên trái, tức task tương đối nhận được ít CPU hơn trên trục thời gian công bằng.
Từ Linux 6.6, EEVDF được đưa vào scheduling task thông thường, tức Earliest Eligible Virtual Deadline First.
EEVDF vẫn xoay quanh việc phân phối CPU một cách fair, đồng thời đưa lag và virtual deadline vào quá trình chọn task. lag dương nghĩa là task còn thiếu CPU time; trong số các task đủ điều kiện, task có virtual deadline sớm hơn được ưu tiên chạy. Task nhạy với latency và yêu cầu time slice ngắn sẽ sớm có cơ hội được scheduling.
Trong code và tool output của Linux, task thông thường vẫn thuộc fair scheduling class. EEVDF thay đổi logic lựa chọn task trong fair class, không có nghĩa mọi khái niệm scheduling đều đổi sang một bộ tên khác.
Máy production đã sử dụng EEVDF hay chưa còn phải xem kernel version thực tế, cũng như distribution có backport hoặc điều chỉnh patch liên quan hay không. Khi kiểm tra production, không nên mặc định mọi máy đều dùng cùng một implementation.
Trong phỏng vấn backend thường cần trình bày vruntime, weight và fair share của CFS, cùng lag, virtual deadline và latency-sensitive task của EEVDF. Nội dung chi tiết hơn sẽ liên quan đến implementation trong kernel.

Load average và CPU usage không phải cùng một khái niệm
Ba con số load average nhìn thấy trong uptime tương ứng với average load ở các time scale 1, 5 và 15 phút. Đây là exponential decay average, không phải arithmetic average đơn giản của các sample trong N phút gần nhất.
Load average thống kê runnable task ở trạng thái R và uninterruptible sleep task ở trạng thái D. Trạng thái D thường liên quan đến I/O, nhưng khi kiểm tra không thể chỉ nhìn local disk; cũng cần xem xét block device, network storage, file system, Swap và các đường chờ uninterruptible khác.
Vì vậy, load cao không đồng nghĩa CPU bị bão hòa. Nguyên nhân có thể là runnable task tranh chấp CPU, cũng có thể là nhiều task bị kẹt trong uninterruptible wait.
Đánh giá load phải kết hợp với số logical CPU. Trên máy có 8 logical CPU, load khoảng 8 có thể chỉ là CPU đã đầy; load 40 thường cho thấy nhiều task đang xếp hàng hoặc ở uninterruptible sleep. Trên máy có 1 logical CPU, load 8 đã rất cao; trên máy có 64 logical CPU, load 8 có thể vẫn khá nhẹ.
Trường thứ tư của /proc/loadavg có dạng 3/1024. Phần trước dấu slash là số kernel scheduling entity hiện runnable, phần sau là tổng số scheduling entity hiện tồn tại trong hệ thống. Trường này bổ sung số lượng task tại thời điểm lấy mẫu, có thể kết hợp với ba giá trị average load phía trước để đánh giá.
CPU usage cho biết CPU time đã được dùng vào đâu. Các field phổ biến trong %Cpu(s) của top có thể đọc như sau:
us: user-space time với nice value chưa được điều chỉnh. Tính toán nghiệp vụ, JSON serialization, regex, compression, encryption/decryption thường nằm ở đây.ni: user-space time đã điều chỉnh nice value. Thường gặp ở user process bị giảm priority.sy: kernel-space time. System call, network protocol stack, file system và kernel lock contention sẽ làm giá trị này tăng.wa: I/O wait. Cho biết thời gian CPU idle trong khi hệ thống còn I/O request chưa hoàn tất, có thể dùng làm manh mối khi kiểm tra nhưng không thể dùng riêng để quy kết chính xác.id: idle time. CPU không có việc để làm hoặc task đang bị chặn bởi resource khác.hi/si: hard interrupt / soft interrupt time. Cần chú ý khi lượng network packet lớn, interrupt của network card tập trung hoặc áp lực xử lý protocol stack cao.st: CPU time bị host lấy đi trong môi trường virtualization. Khi giá trị này cao trên cloud host, đừng vội sửa business code.

wa đặc biệt dễ bị hiểu sai. I/O wait không phải căn cứ quy kết đáng tin cậy: CPU thực tế không chờ I/O hoàn tất; trong hệ thống multi-core, task chờ I/O cũng không chạy trên một CPU cụ thể. Vì vậy, wa cao chỉ cho thấy hệ thống có manh mối về I/O wait, không thể trực tiếp kết luận CPU đang bận xử lý I/O.
Bước tiếp theo nên xem b, bi/bo, si/so của vmstat, sau đó dùng pidstat -d và iostat -x để tìm process và block device cụ thể.
Bắt đầu kiểm tra từ cảnh báo CPU
Khi kiểm tra, đừng ngay lập tức đi sâu vào Java stack. Trước hết hãy phân loại dạng pressure, sau đó mới đi sâu xuống process, thread, CPU core và hotspot function.

Trước tiên dùng uptime để xem xu hướng load. Nếu 1-minute load cao nhưng 5-minute và 15-minute load không cao, có thể là spike ngắn; nếu cả ba giá trị đều cao, pressure đã kéo dài một thời gian. Sau đó mở top, xem trong %Cpu(s) field nào đang tăng, us, ni, sy, wa, si hay st, đồng thời xem thứ tự process và task state.
Nếu us rất cao, trước hết tìm business hotspot. Với Java process, có thể nhấn H trong top để chuyển sang thread view, tìm thread có CPU cao, chuyển thread ID sang hexadecimal, rồi tìm stack tương ứng trong jstack hoặc jcmd Thread.print. Một lần jstack chỉ phản ánh một thời điểm, tốt nhất nên lấy liên tiếp 2-3 lần; nếu cùng một thread nhiều lần dừng ở cùng đoạn business stack thì độ tin cậy sẽ cao hơn. Cũng có thể dùng:
pidstat -u -t -p <pid> 1Lệnh này cho biết CPU usage theo từng thread. Sau khi định vị thread, tiếp tục xem nó đang ở business loop, serialization, regex, encryption/decryption hay GC/JIT. jstack phù hợp để xem stack frame hiện tại của thread; muốn tìm CPU hotspot thì các sampling tool như perf top và async-profiler đáng tin cậy hơn.
Nếu sy hoặc si rất cao, đừng chỉ nhìn Java stack. Nhiều short connection, việc nhận network packet, file I/O, system call và soft interrupt đều có thể đẩy CPU time lên kernel-space. Có thể dùng:
mpstat -P ALL 1
sudo perf top
mpstat cho biết liệu một vài CPU core có đặc biệt bận hay không, perf top cho biết hotspot symbol nằm ở user-space function, kernel network stack, soft interrupt hay lock-related path. Khi một core ở mức 100% còn các core khác rất rảnh, cần chú ý đến single-thread bottleneck, soft interrupt tập trung trên một core, CPU affinity configuration hoặc queue imbalance.
Nếu load cao và wa cũng cao, trước hết chạy:
vmstat 1Tập trung xem r, b, wa, bi, bo, si, so. r là số runnable task, b không phải số lượng tất cả sleeping thread mà là số task đang block chờ I/O; bi/bo là block device read/write throughput, đơn vị thường là KiB/s chứ không phải số I/O request; si/so là Swap in/out. Nếu wa cao đồng thời b, bi/bo cao, tiếp tục kiểm tra disk; nếu wa cao đồng thời si/so cao, memory pressure và Swap có thể đã làm service chậm đi.
Tiếp theo dùng:
pidstat -d -p ALL 1
iostat -x 1
Xem process nào đang read/write và block device nào có latency cao. Với iostat -x, tập trung xem await, aqu-sz, throughput read/write và số request; %util có giá trị tham khảo với mechanical disk; RAID, SSD và NVMe có thể xử lý request song song, không thể chỉ dựa vào nó để kết luận thiết bị đã bão hòa. Dòng đầu tiên của iostat thường là average từ khi hệ thống khởi động, khi kiểm tra vấn đề hiện tại nên xem các sample tiếp theo; khi cần có thể dùng iostat -x -y 1 để bỏ qua dòng đầu.
Nếu I/O của business process không cao nhưng wa của system cao, cũng cần xem log compression, backup, database, image pull và các container khác trên cùng node.
Nếu hệ thống hỗ trợ PSI, cũng có thể xem:
cat /proc/pressure/cpu
cat /proc/pressure/io
cat /proc/pressure/memory
PSI cho biết task đã bị dừng bao lâu vì CPU, memory hoặc I/O pressure. some nghĩa là có ít nhất một task bị dừng do resource tương ứng không đủ; với memory và I/O, full nghĩa là tất cả non-idle task cùng bị dừng. full của /proc/pressure/cpu ở cấp system không có ý nghĩa chẩn đoán; khi kiểm tra CPU pressure chủ yếu xem some. PSI phản ánh trực tiếp business có bị dừng vì resource pressure hay không, điều mà chỉ nhìn CPU usage không thể cho biết.
Trong môi trường container còn phải xem giới hạn cgroup. Một container chỉ được cấp quota 2 core, dù host có 64 core, task bên trong container cũng có thể đã phải xếp hàng. Khi kiểm tra cần kết hợp các metric cgroup như cpu.max, cpu.stat, cpu.pressure, memory.current, memory.events, memory.pressure, io.stat, io.pressure, thay vì chỉ nhìn CPU tổng thể của host. Đây là các tên file thường gặp của cgroup v2; nếu hệ thống vẫn dùng cgroup v1, path và tên file sẽ nằm rải rác trong các controller directory khác nhau.
Nếu load cao nhưng wa không cao, còn r trong vmstat 1 luôn lớn hơn đáng kể so với số CPU core, điều đó cho thấy runnable task đang xếp hàng. Tiếp theo xem số thread, thread pool, lock contention và context switch:
vmstat 1
pidstat -w -p ALL 1
ps -eo pid,ppid,stat,ni,pri,psr,pcpu,comm --sort=-pcpu | head
cs của vmstat cho biết tần suất system context switch, còn pidstat -w cần tập trung vào cswch/s và nvcswch/s. cswch/s là voluntary context switch, thường gặp khi chờ I/O, lock hoặc condition variable; nvcswch/s là involuntary context switch, thường gặp khi task bị preempt sau khi hết time slice. Khi thread pool quá lớn, r, cs và CPU usage cùng tăng nhưng request latency lại tăng; tiếp tục tăng thread chỉ khiến tình trạng tắc nghẽn nặng hơn.
Lệnh time phù hợp để xem một command đơn lẻ tiêu tốn thời gian vào đâu:
/usr/bin/time -p <command>real là wall-clock time, user là user-space CPU time, sys là kernel-space CPU time. real cao nhưng user + sys không cao thường là đang chờ I/O, network hoặc lock; user rất cao cho thấy bản thân computation tiêu tốn CPU; sys cao thì cần xem system call và kernel path.
Các lệnh kiểm tra thường dùng
Các command dưới đây có thể giúp phân loại hướng xử lý cho phần lớn vấn đề CPU/load:
| Command | Cách dùng thường gặp | Chủ yếu xem gì |
|---|---|---|
uptime | uptime | Load average trong 1, 5, 15 phút |
top | top, sau đó nhấn H | Tổng CPU, CPU của process/thread, task state, load |
vmstat | vmstat 1 | r, b, us/sy/wa/id/st, cs, bi/bo, si/so |
pidstat | pidstat -u -d -w -t -p <pid> 1 | CPU, I/O, context switch của process/thread |
iostat | iostat -x 1 | Block device throughput, queue length, average wait time, device utilization |
mpstat | mpstat -P ALL 1 | Usage, iowait, softirq và steal của từng CPU core |
ps | ps -eo pid,stat,ni,pri,psr,pcpu,comm --sort=-pcpu | Process state, priority, CPU core, CPU usage |
perf top | sudo perf top | CPU hotspot function theo thời gian thực, phân biệt user-space và kernel-space hotspot |
PSI | cat /proc/pressure/{cpu,io,memory} | Tỷ lệ task bị dừng do CPU, I/O và memory pressure |
Kết quả của perf top phụ thuộc vào quyền perf và khả năng resolve kernel symbol, user-space symbol và JIT symbol; trong Java khi cần còn phải kết hợp async-profiler.
Điểm cần nêu khi trả lời phỏng vấn
Khi trả lời về CPU scheduling, cần nói rõ vì sao task phải xếp hàng, kernel chuyển task lúc nào và việc chuyển đổi phát sinh những chi phí nào. Cách này đầy đủ hơn chỉ học thuộc tên algorithm.
CPU scheduling
Số core CPU có hạn, trong khi số process và thread runnable có thể rất nhiều. Scheduler chọn task từ runnable queue để đưa lên CPU; khi task block, hết time slice, priority thay đổi hoặc xuất hiện task phù hợp hơn, kernel sẽ thực hiện scheduling và context switch. Scheduling phải cân bằng giữa response time, throughput, fairness và switching overhead; mở quá nhiều thread ngược lại có thể khiến thời gian bị tiêu tốn vào xếp hàng và chuyển đổi.
Trả lời thế nào về scheduling algorithm kinh điển
FCFS đơn giản nhưng long task sẽ chặn short task; SJF có average turnaround time tốt nhưng khó biết độ dài task và cũng có thể khiến long task bị starvation; RR cải thiện response time nhờ time slice, nhưng time slice quá ngắn sẽ làm switching overhead tăng mạnh; priority scheduling thể hiện mức độ khẩn cấp của task nhưng phải xử lý starvation của task priority thấp; multilevel feedback queue điều chỉnh vị trí queue theo hành vi chạy của task, cố gắng ưu tiên interactive task đồng thời giúp long task tiếp tục tiến triển.
Linux scheduling
Scheduling task thông thường của Linux không thể áp dụng trực tiếp một algorithm trong giáo trình. CFS dùng virtual runtime và weight để phân phối CPU, có xu hướng chọn task đã nhận được ít CPU hơn; EEVDF tiếp tục lựa chọn dựa trên fair share, dùng
lagđể xác định task còn thiếu CPU, sau đó chọn task theo virtual deadline. Với vị trí backend thông thường, trình bày đến mức này là đủ.
Load average và CPU usage
Load average thống kê runnable task ở trạng thái R và uninterruptible sleep task ở trạng thái D, cần xem cùng số CPU core. CPU usage mô tả CPU time được dùng vào đâu,
us/ni/sy/wa/id/hi/si/stlần lượt tương ứng với user-space thông thường, user-space có nice, kernel-space, I/O wait, idle, interrupt, soft interrupt và virtualization steal. Load cao nhưng CPU không cao thường do nhiều task đang uninterruptible sleep; CPU cao nhưng load không quá lớn có thể do một vài thread đã chiếm hết CPU.
Nếu được hỏi thêm về cách kiểm tra, có thể trả lời: dùng uptime và top để định vị hiện tượng, dùng vmstat để xác định vấn đề nằm ở run queue, I/O hay context switch, sau đó dùng pidstat, mpstat để định vị process và CPU core; khi cần thì dùng perf top để tìm hotspot function.