
Giải thích chi tiết I/O multiplexing: nguyên lý và khác biệt giữa select, poll, epoll
Viết một TCP server, cách trực quan nhất là thread chính accept một connection, rồi giao cho một thread mới read, xử lý và write. Khi số connection ít, cách này hoạt động rất tốt.
Nhưng một khi số connection tăng lên hàng chục nghìn, vấn đề sẽ xuất hiện. Trong không ít bản phân phối Linux, mỗi thread mới mặc định sẽ dự trù vài MB stack, cấu hình thường gặp là 8 MB (giá trị thực tế phụ thuộc vào ulimit -s, runtime library và thuộc tính thread). Dù stack page của mười nghìn connection được cấp phát theo nhu cầu, address space đã dự trù, stack page thực sự được dùng và metadata của thread cộng lại vẫn rất lớn; nghiêm trọng hơn là hàng nghìn, hàng chục nghìn thread cùng tranh nhau vài CPU core, chỉ riêng context switch giữa các thread đã ngốn hơn nửa CPU, thời gian thực sự làm việc còn lại chẳng bao nhiêu. Chưa kể phần lớn connection thực ra đang idle — mỗi connection chiếm một thread nhưng chỉ ngồi chờ dữ liệu.
Đây chính là vấn đề C10K kinh điển: làm thế nào để một thread (hoặc một vài thread) đồng thời theo dõi hàng nghìn, hàng chục nghìn connection và xử lý connection nào có dữ liệu.
Câu trả lời là I/O multiplexing.
Dưới đây, bài viết sẽ lần lượt tìm hiểu select, poll, epoll. Chúng giải quyết cùng một vấn đề, nhưng cái sau thông minh hơn cái trước.
I/O multiplexing là gì?
Muốn giải thích rõ, trước hết cần biết một thao tác đọc mạng thực ra được chia thành hai giai đoạn trong kernel:
- Chờ dữ liệu sẵn sàng: dữ liệu vẫn còn ở network card, vẫn đang trên đường truyền; kernel phải chờ dữ liệu đến rồi copy vào kernel buffer. Bước này thường rất chậm.
- Copy dữ liệu: dữ liệu đã đến kernel buffer, sau đó được copy từ kernel space sang application buffer trong user space. Bước này rất nhanh.
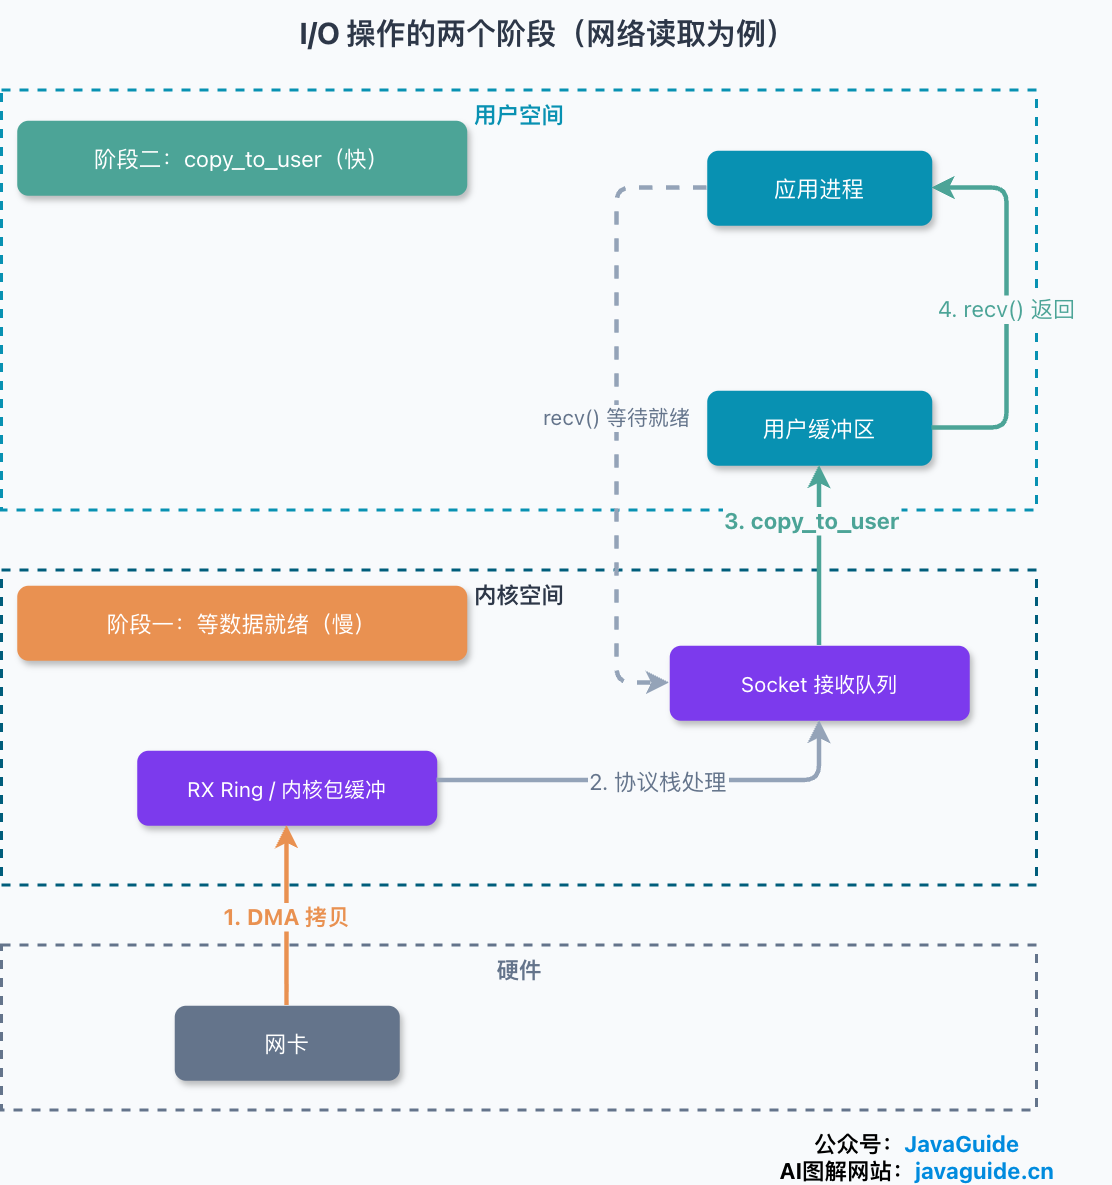
Vấn đề của blocking model một connection một thread nằm ở giai đoạn đầu: sau khi thread gọi recv, nó bị block ở đó để chờ dữ liệu cho connection này và không thể làm gì khác trong lúc chờ.
I/O multiplexing đổi cách tiếp cận: giao tất cả file descriptor (fd) cần theo dõi cho kernel, để thread block trên một system call chuyên dụng. Chỉ cần bất kỳ fd nào trong nhóm này sẵn sàng, system call sẽ trả về và cho biết fd nào có thể đọc, fd nào có thể ghi, sau đó bạn xử lý các fd sẵn sàng đó.
Hãy hình dung: một nhân viên phục vụ đồng thời quản lý mười bàn, thay vì đứng chờ ở bàn đầu tiên để khách chọn món, họ đi qua lại quan sát, bàn nào giơ tay thì đến bàn đó.
Tên gọi này nhấn mạnh hai ý: xử lý nhiều connection và dùng chung một thread để xử lý chúng.
Lưu ý một điểm dễ nhầm: bản thân multiplexing vẫn là synchronous I/O. Các lời gọi như select chỉ báo fd đã sẵn sàng, ứng dụng vẫn phải chủ động gọi recv để hoàn tất việc đọc. Synchronous không đồng nghĩa với blocking: lần recv này có phải chờ hay không còn phụ thuộc vào việc fd có được đặt ở chế độ non-blocking hay không, trạng thái sẵn sàng có thay đổi trước khi đọc hay không và các yếu tố khác. Event loop thường kết hợp với non-blocking fd.
Vị trí của multiplexing trong năm I/O model
UNP phân loại I/O trên Unix thành năm model. Hiểu multiplexing đứng ở vị trí nào sẽ rõ hơn so với chỉ xem riêng nó:
- Blocking I/O: sau khi gọi
recv, thread ngủ liên tục; cả hai giai đoạn chờ dữ liệu sẵn sàng và copy đều bị kẹt. Đơn giản nhất nhưng lãng phí thread nhất. - Non-blocking I/O:
recvlập tức trả vềEWOULDBLOCKnếu không có dữ liệu, thread không ngủ, nhưng phải liên tục polling để hỏi “đã xong chưa”, khiến CPU bận vô ích. - I/O multiplexing: block trên
select/poll/epoll, một thread đồng thời chờ nhiều fd, fd nào sẵn sàng thì xử lý fd đó. Đây là nội dung chính của bài viết. - Signal-driven I/O: đăng ký
SIGIO; khi dữ liệu sẵn sàng, kernel gửi signal thông báo, còn bình thường thread làm việc khác. Ít được dùng. - Asynchronous I/O: sau khi submit request thì lập tức trả về, khi I/O hoàn tất mới thông báo cho ứng dụng. Đây là mô hình ngữ nghĩa; triển khai cụ thể phụ thuộc vào platform và API. Ví dụ,
aio_readPOSIX của Linux glibc chủ yếu được triển khai bằng worker thread trong user space, không thể đồng nhất trực tiếp với asynchronous I/O nguyên bản của kernel.
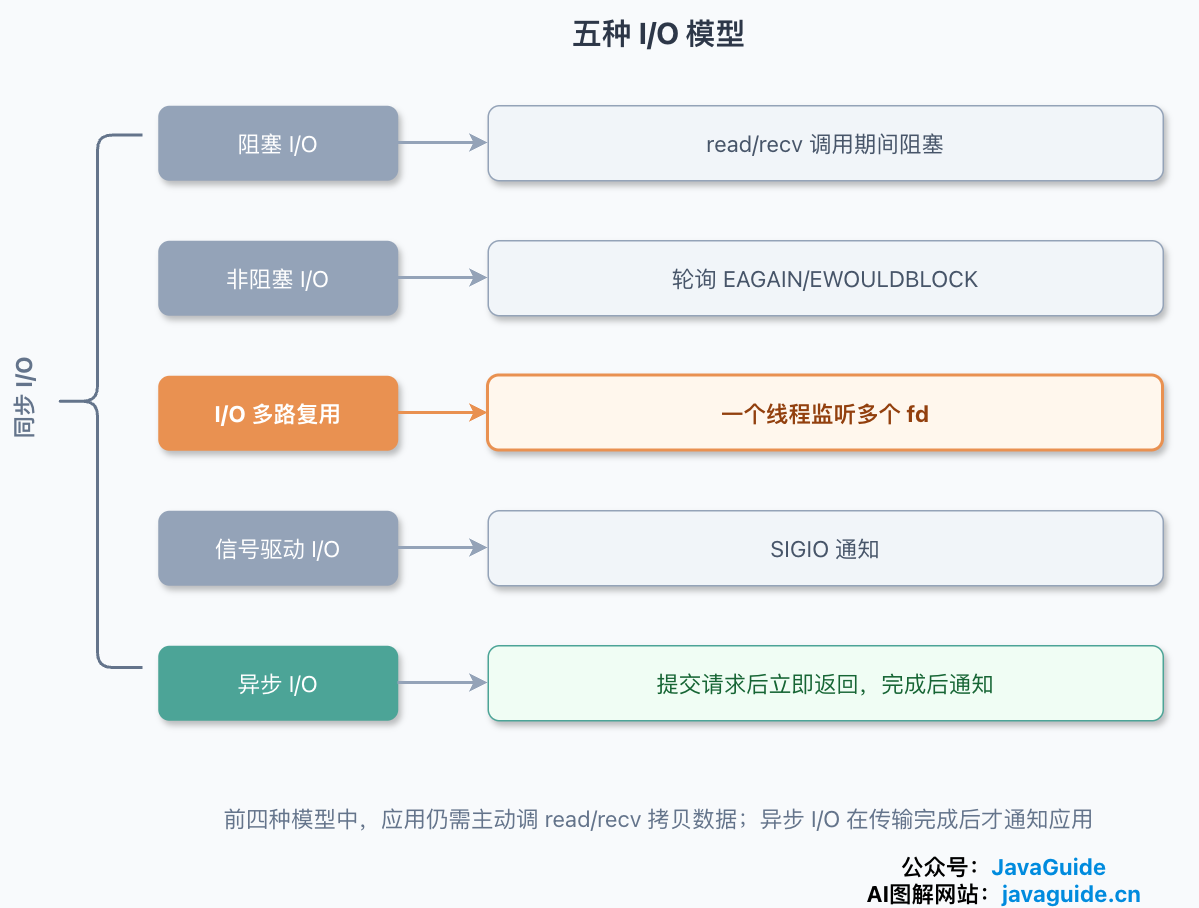
Khác biệt then chốt nằm ở việc ai hoàn thành thao tác “chuyển dữ liệu từ kernel buffer sang user buffer”: trong bốn model đầu, cuối cùng ứng dụng đều phải tự gọi read/recv để hoàn thành lần copy này, chỉ sau khi lời gọi trả về mới có thể dùng dữ liệu, vì vậy chúng đều được xem là synchronous (còn lời gọi này có thực sự ngủ hay không phụ thuộc vào việc fd có non-blocking hay không và lúc đó dữ liệu có tồn tại hay không); chỉ asynchronous I/O giao cả việc chờ và copy cho kernel, rồi thông báo sau khi hoàn tất. Giá trị của multiplexing không nằm ở việc làm một lần đọc đơn lẻ nhanh hơn, mà ở việc để một thread đồng thời đảm nhiệm việc “chờ” cho nhiều connection.
select hoạt động như thế nào?
select là triển khai sớm nhất và gần như được mọi platform hỗ trợ. Hàm có signature như sau:
#include <sys/select.h>

int select(int nfds, fd_set *readfds, fd_set *writefds,
           fd_set *exceptfds, struct timeval *timeout);
Cốt lõi là cấu trúc dữ liệu fd_set, về bản chất là một bitmap: mỗi bit tương ứng với một fd, đặt thành 1 nghĩa là quan tâm đến fd đó. Có bốn macro đi kèm để thao tác:
void FD_ZERO(fd_set *set);          // Xóa tất cả bit
void FD_SET(int fd, fd_set *set);   // Đặt bit tương ứng với fd thành 1
void FD_CLR(int fd, fd_set *set);   // Xóa bit tương ứng với fd về 0
int  FD_ISSET(int fd, fd_set *set); // Kiểm tra bit tương ứng với fd có là 1 không
Vòng lặp chính của một echo server viết bằng select đại khái như sau:
fd_set rset;
int maxfd = listenfd;

while (1) {
    FD_ZERO(&rset);                       // Mỗi vòng đều phải xóa lại
    FD_SET(listenfd, &rset);              // Sau đó thêm từng fd cần quan tâm vào
    for (int i = 0; i < n; i++)
        if (conns[i] >= 0) FD_SET(conns[i], &rset);

    // Không quan tâm write set và exception set nên truyền NULL; NULL cuối cùng nghĩa là block mãi
    int ready = select(maxfd + 1, &rset, NULL, NULL, NULL);

    if (FD_ISSET(listenfd, &rset)) {      // Listening fd sẵn sàng, có connection mới
        int connfd = accept(listenfd, NULL, NULL);
        // Lưu vào conns[], cập nhật maxfd
    }
    for (int i = 0; i < n; i++)           // Hỏi từng cái O(N): bạn đã sẵn sàng chưa?
        if (conns[i] >= 0 && FD_ISSET(conns[i], &rset)) {
            // Xử lý read event trên connection này
        }
}
Đoạn code này ẩn chứa một số nhược điểm nghiêm trọng của select. Hiểu rõ chúng mới thấy poll và epoll về sau đã thay đổi điều gì.
Thứ nhất, số lượng fd có giới hạn. Trong môi trường Linux/glibc, kích thước bitmap fd_set do hằng số glibc FD_SETSIZE quyết định, mặc định là 1024, chỉ có thể biểu diễn an toàn fd từ 0 đến 1023 — giới hạn này đến từ cấu trúc dữ liệu kích thước cố định và macro FD_* ở user space của glibc, không phải từ bản thân Linux kernel. Sử dụng các macro này với fd vượt quá phạm vi là undefined behavior; cũng đừng kỳ vọng có thể vượt qua bằng cách định nghĩa lại FD_SETSIZE hoặc biên dịch lại kernel. Nếu thực sự cần theo dõi nhiều connection hơn, cách đúng là chuyển sang poll hoặc epoll.
Thứ hai, mỗi lần gọi đều phải copy bitmap qua lại giữa user space và kernel space. Trước khi gọi, bạn điền bitmap ở user space, select copy nó vào kernel; khi trả về, kernel ghi lại bitmap (xóa các bit chưa sẵn sàng), rồi copy ngược về user space. Phạm vi kernel thực sự kiểm tra và ghi lại do nfds quyết định, vì vậy fd number càng lớn, số fd theo dõi càng nhiều thì lượt đi lượt về này càng tốn kém.
Thứ ba, bitmap là tham số “vào rồi ra” (value-result). Khi trả về, kernel xóa các bit chưa sẵn sàng, vì vậy vòng tiếp theo bắt buộc phải FD_ZERO + FD_SET lại một lần, không thể dùng lại danh sách cần quan tâm cũ. Câu “mỗi vòng đều phải xóa lại” trong code xuất phát từ điều này.
Thứ tư, sau khi trả về vẫn phải tự duyệt O(N). Giá trị trả về của select chỉ cho biết số fd sẵn sàng; fd cụ thể nào sẵn sàng được thể hiện trong fd_set đã bị ghi đè tại chỗ. Ứng dụng vẫn phải duyệt phạm vi ứng viên và gọi FD_ISSET; dù chỉ một trong mười nghìn connection có dữ liệu, vẫn có thể phải kiểm tra mười nghìn lần.
Tham số timeout khá hữu ích: truyền NULL để block liên tục, truyền một timeval có giá trị 0 để lập tức trả về mà không chờ (polling), truyền giá trị cụ thể để chỉ rõ chờ tối đa bao lâu.
poll đã cải tiến điều gì?
poll và select là sản phẩm cùng thời, có cách tiếp cận giống nhau nhưng thay đổi cấu trúc dữ liệu. Nó không dùng bitmap mà dùng một mảng struct pollfd:
#include <poll.h>

struct pollfd {
    int   fd;       // File descriptor cần theo dõi
    short events;   // Event bạn quan tâm, điền trước khi gọi, ví dụ POLLIN (có thể đọc)
    short revents;  // Event thực sự xảy ra, do kernel điền lại
};

int poll(struct pollfd *fds, nfds_t nfds, int timeout);
Vòng lặp chính như sau:
struct pollfd fds[MAX];
fds[0].fd = listenfd;
fds[0].events = POLLIN;
// Các fds[i].fd còn lại = connfd; fds[i].events = POLLIN;

while (1) {
    int ready = poll(fds, nfds, -1);      // timeout bằng -1 nghĩa là block mãi
    for (int i = 0; i < nfds; i++) {
        if (fds[i].revents & POLLIN) {    // Kernel ghi kết quả vào revents
            // Xử lý read event
        }
    }
}
So với select, poll đã khắc phục hai điểm:
Không có giới hạn cứng 1024. Số fd theo dõi phụ thuộc vào kích thước mảng bạn truyền vào, không còn bị FD_SETSIZE chặn cứng; giới hạn chủ yếu phụ thuộc vào số fd mà process có thể mở.
Event cần quan tâm và event đã xảy ra được tách riêng. events do bạn điền (input), revents do kernel điền lại (output), mỗi field đảm nhiệm một việc. Vì vậy vòng tiếp theo không cần reset toàn bộ danh sách cần quan tâm như select, chỉ cần giữ nguyên events.
Nhưng poll chưa giải quyết hai vấn đề hiệu năng nghiêm trọng nhất của select: mỗi lần gọi vẫn phải copy toàn bộ mảng từ user space vào kernel space, sau khi trả về vẫn phải duyệt O(N) toàn bộ mảng để tìm fd nào sẵn sàng. Khi quy mô connection tăng, chi phí vẫn tăng tuyến tính.
Nói thẳng ra, poll chỉ làm gọn interface của select, còn performance model không thay đổi. Bước nhảy thực sự nằm ở epoll.
Vì sao epoll tạo ra thay đổi mang tính bước ngoặt?
epoll là cơ chế dành riêng cho Linux, do Davide Libenzi triển khai, được đưa vào kernel từ phiên bản 2.5.44, glibc bắt đầu cung cấp wrapper từ phiên bản 2.3.2. Nó tách cách “một system call giải quyết tất cả” thành ba system call, mỗi cái đảm nhiệm một việc:
#include <sys/epoll.h>

int epoll_create1(int flags);  // Tạo epoll instance, trả về một fd (interface cũ là epoll_create(int size))
int epoll_ctl(int epfd, int op, int fd, struct epoll_event *event);  // Thêm, xóa, sửa fd cần theo dõi
int epoll_wait(int epfd, struct epoll_event *events, int maxevents, int timeout);  // Chờ event sẵn sàng
op của epoll_ctl có ba loại: EPOLL_CTL_ADD (đăng ký), EPOLL_CTL_MOD (sửa), EPOLL_CTL_DEL (xóa). Event được mô tả bằng epoll_event:
typedef union epoll_data {
    void     *ptr;
    int       fd;
    uint32_t  u32;
    uint64_t  u64;
} epoll_data_t;

struct epoll_event {
    uint32_t     events;   // Loại event, ví dụ EPOLLIN, EPOLLOUT, EPOLLET
    epoll_data_t data;     // User data, được trả nguyên dạng khi epoll_wait trả về, thường lưu fd
};
Cách sử dụng đầy đủ như sau:
int epfd = epoll_create1(0);              // Bước 1: tạo instance

struct epoll_event ev;
ev.events = EPOLLIN;                       // Quan tâm khả năng đọc, mặc định là level-triggered
ev.data.fd = listenfd;
epoll_ctl(epfd, EPOLL_CTL_ADD, listenfd, &ev);  // Bước 2: chỉ cần đăng ký một lần

struct epoll_event events[MAX_EVENTS];
while (1) {
    // Bước 3: chỉ trả về fd thực sự sẵn sàng, n là số lượng fd sẵn sàng
    int n = epoll_wait(epfd, events, MAX_EVENTS, -1);
    for (int i = 0; i < n; i++) {          // Chỉ duyệt fd sẵn sàng, không quét toàn bộ
        int fd = events[i].data.fd;
        if (fd == listenfd) {
            int connfd = accept(listenfd, NULL, NULL);
            ev.events = EPOLLIN;
            ev.data.fd = connfd;
            epoll_ctl(epfd, EPOLL_CTL_ADD, connfd, &ev);  // Đăng ký connection mới
        } else {
            // Xử lý read event trên fd
        }
    }
}
So với đoạn code select, khác biệt có thể thấy ngay: việc đăng ký fd và chờ event được tách riêng, mảng events do epoll_wait trả về chỉ chứa event của các fd sẵn sàng, chỉ cần duyệt nó, không cần hỏi từng fd trong toàn bộ danh sách.
Khác biệt này không chỉ là mẹo nhỏ trong thiết kế interface, mà đến từ việc thay đổi cấu trúc dữ liệu bên dưới. Một epoll instance tương ứng với một cấu trúc eventpoll trong kernel, bên trong có hai thành phần then chốt:
- Một red-black tree (rbr): lưu tất cả fd đã đăng ký qua
epoll_ctl(mỗi fd tương ứng với một nodeepitem). Thêm, xóa, sửa là thao tác trên tree có độ phức tạp O(log N). fd chỉ được đăng ký ở đây một lần rồi tồn tại liên tục, không giống select/poll phải chuyển toàn bộ danh sách vào kernel ở mỗi lần gọi. - Một ready list (rdllist): một doubly linked list chuyên lưu fd “đã sẵn sàng”.
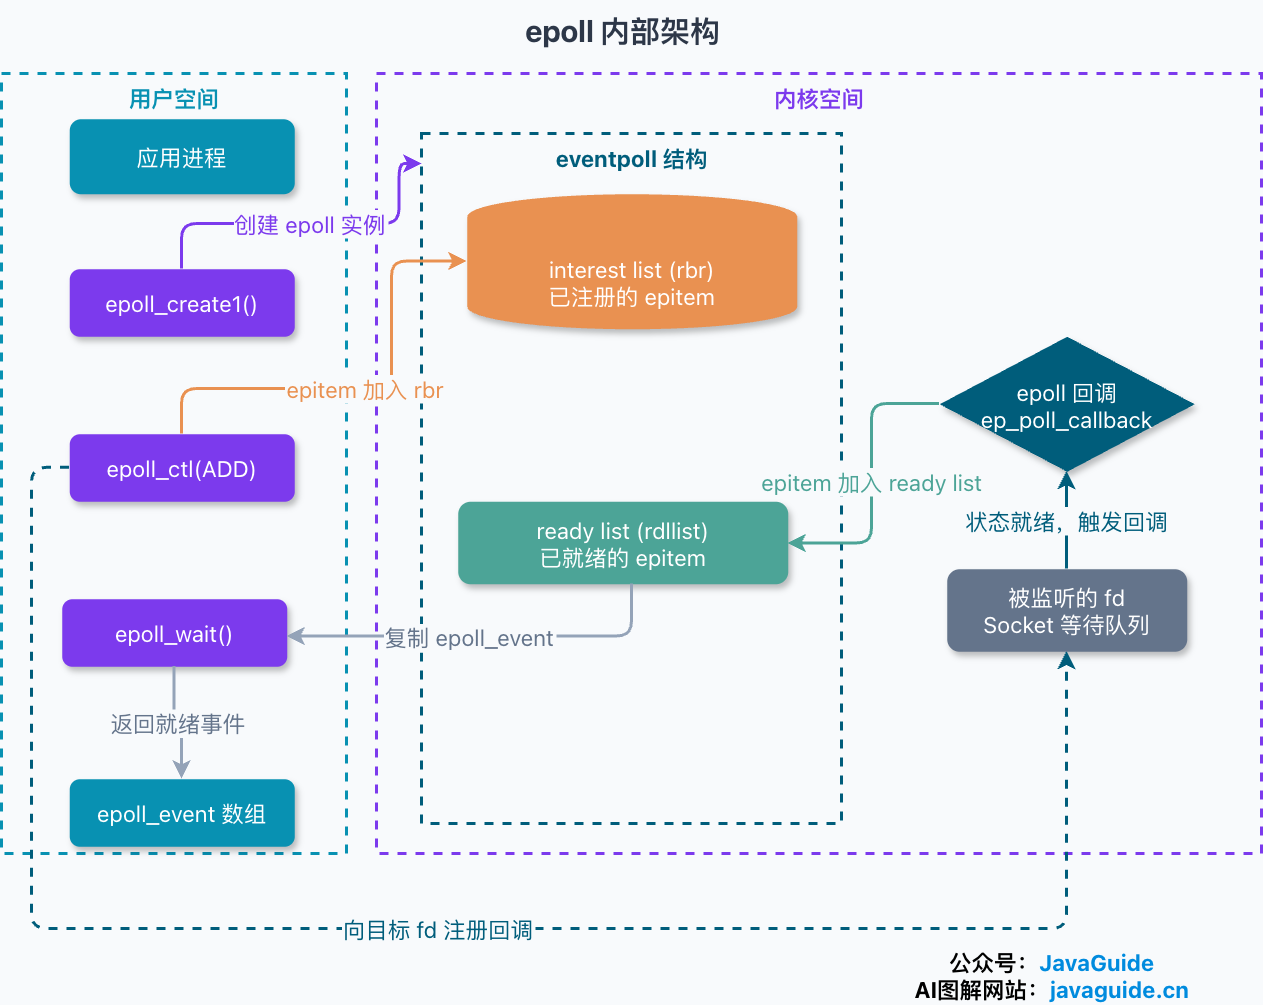
Điểm then chốt nằm ở cơ chế callback. Khi epoll_ctl đăng ký fd, kernel gắn một callback vào fd này. Khi network card nhận dữ liệu, một fd trở nên có thể đọc, callback này được trigger, đưa object sẵn sàng tương ứng vào ready list và đánh thức thread đang block trên epoll_wait. Vì vậy việc epoll_wait cần làm chỉ là kiểm tra ready list có rỗng hay không — nếu có thì copy event bên trong sang user space, nếu không thì ngủ và chờ callback đánh thức. (Bổ sung: red-black tree và ready list là cách triển khai của kernel hiện tại; điều mà epoll cam kết với user space chỉ là semantic abstraction ở tầng “tập đăng ký + danh sách sẵn sàng”, không nên xem cấu trúc tree là ABI ổn định.)
Đây là gốc rễ hiệu quả của epoll: trong trường hợp có nhiều connection nhưng ít connection active, sau khi epoll_wait trả về, chỉ cần duyệt các event sẵn sàng trong batch này, không phụ thuộc vào tổng số fd đã đăng ký. Đăng ký một trăm nghìn fd nhưng chỉ có ba fd nhận dữ liệu, epoll_wait chỉ xử lý ba fd đó, không cần quét toàn bộ như select/poll. Tuy nhiên cần nhấn mạnh: tổng chi phí của epoll không chỉ là khoảnh khắc epoll_wait trả về — thay đổi đăng ký (epoll_ctl), callback event, lock contention khi concurrent và việc copy event sẵn sàng về user space đều có chi phí; khi tỷ lệ connection active gần 100%, ưu thế của nó so với select/poll cũng thu hẹp. Tóm lại trong một câu: select và poll phải giao toàn bộ tập fd cần theo dõi cho kernel và quét tuyến tính ở mỗi lần chờ; epoll lưu lâu dài tập fd cần theo dõi trong kernel, khi chờ chỉ lấy event đã sẵn sàng, nên phù hợp hơn với trường hợp nhiều fd, ít connection active.
Việc copy dữ liệu cũng được giảm. fd được đăng ký một lần trên red-black tree thông qua epoll_ctl, sau đó các lần gọi epoll_wait tiếp theo không cần truyền lại toàn bộ danh sách fd.
Ở đây cần đính chính một quan niệm rất phổ biến: “epoll nhanh là vì dùng mmap để chia sẻ memory giữa kernel và user space, nhờ đó loại bỏ copy.” Cách nói này sai. Xem implementation epoll của kernel sẽ thấy khi epoll_wait trả về, kernel thực sự dùng __put_user để copy event sẵn sàng vào mảng events ở user space, không hề có vùng shared memory nào dùng mmap. Phần copy mà epoll loại bỏ là việc khác: loại bỏ việc “mỗi lần gọi đều chuyển toàn bộ danh sách fd vào kernel” như select/poll, chứ không loại bỏ lần copy event sẵn sàng khi trả về. Không được nhầm lẫn hai việc này.
Level-triggered và edge-triggered khác nhau thế nào?
epoll hỗ trợ hai trigger mode. Đây là một khả năng có thêm so với select/poll, đồng thời cũng là nơi dễ gặp lỗi nhất trong phỏng vấn và thực tế.
Level-triggered (LT, Level Triggered) là mode mặc định. Chỉ cần fd vẫn còn dữ liệu chưa đọc hết (hoặc vẫn còn chỗ để ghi), mỗi lần epoll_wait đều tiếp tục thông báo cho bạn. select và poll chỉ có mode này.
Edge-triggered (ET, Edge Triggered) phải được bật rõ ràng bằng flag EPOLLET. Nó chỉ thông báo một lần tại thời điểm trạng thái thay đổi.
Hãy dùng một trường hợp cụ thể để làm rõ khác biệt (đây cũng là ví dụ kinh điển trong Linux man page): giả sử peer ghi 2 KB dữ liệu vào một socket.
- Mode LT:
epoll_waitthông báo có thể đọc. Bạn chỉ đọc 1 KB, trong buffer còn 1 KB. Lầnepoll_waittiếp theo vẫn sẽ tiếp tục thông báo “ở đây còn dữ liệu chưa đọc hết”, cho đến khi bạn đọc hết 2 KB. - Mode ET:
epoll_waitthông báo một lần. Bạn chỉ đọc 1 KB rồi rời đi, 1 KB còn lại — trừ khi peer lại ghi dữ liệu mới khiến trạng thái thay đổi lần nữa,epoll_waitsẽ không chủ động thông báo lại cho bạn. 1 KB này có thể nằm lâu trong buffer, khiến connection bị trì hoãn xử lý.
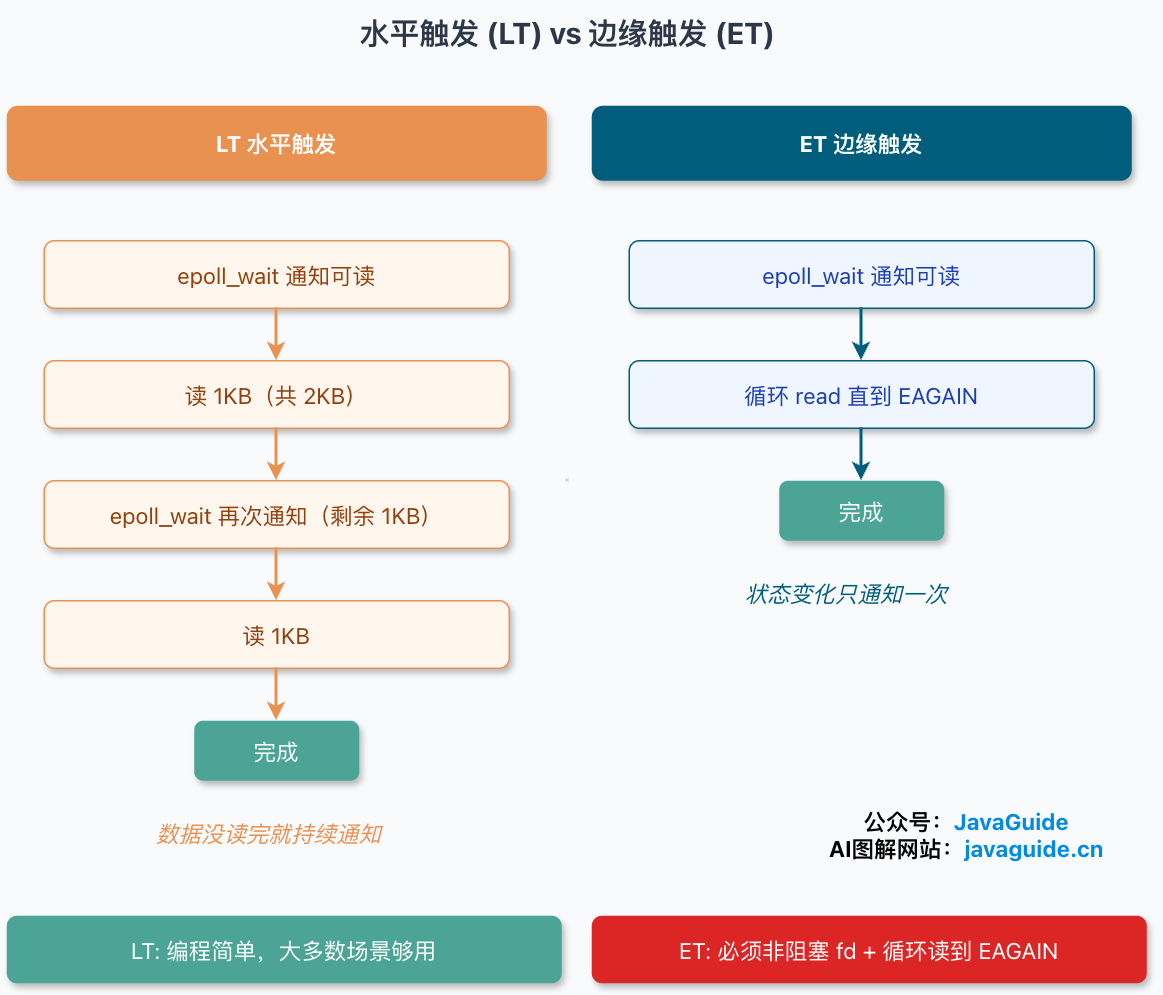
Vì vậy khi dùng ET phải tuân thủ hai nguyên tắc thép: đặt fd ở chế độ non-blocking, đồng thời lặp read cho đến khi trả về EAGAIN (hoặc EWOULDBLOCK), bảo đảm đọc hết dữ liệu trong một lần. Cách đọc ET điển hình như sau:
// Tiền đề: connfd đã được đặt ở chế độ non-blocking và khi đăng ký có kèm EPOLLET
while (1) {
    ssize_t n = read(connfd, buf, sizeof(buf));
    if (n > 0) {
        // Xử lý batch dữ liệu này, sau đó tiếp tục lặp để rút cạn buffer
    } else if (n == 0) {
        close(connfd);                 // Peer đóng connection
        break;
    } else {  // n < 0
        if (errno == EAGAIN || errno == EWOULDBLOCK)
            break;                      // Đã đọc hết dữ liệu, đây mới là điểm thoát bình thường
        if (errno == EINTR)
            continue;                   // Bị signal ngắt, thử lại
        close(connfd);                  // Thực sự xảy ra lỗi
        break;
    }
}
Nếu fd là blocking, lần read cuối cùng khi không còn dữ liệu sẽ khiến toàn bộ thread bị kẹt ở đây — đây cũng là lý do ET và non-blocking fd phải đi cùng nhau.
Ưu điểm của ET là giảm số lần đánh thức epoll_wait, phù hợp với trường hợp theo đuổi throughput tối đa và có thể viết logic đọc ghi chặt chẽ; cái giá phải trả là ngưỡng lập trình cao hơn rõ rệt. Bỏ sót việc đọc đến EAGAIN khiến connection đình trệ lâu dài là bug thường gặp nhất của loại code này. Ngược lại, nếu cứ đọc mãi trên một active fd để “đọc cho sạch”, các connection khác có thể bị bỏ đói, vì vậy trong thực tế thường đặt budget xử lý mỗi vòng cho từng fd và kết hợp với việc luân phiên application-level ready queue. LT dễ lập trình, ít lỗi, phần lớn business chỉ cần LT là đủ. Chỉ các service nhạy cảm với performance như Nginx mới dùng ET.
Khi viết event loop production-grade, chỉ biết đọc là chưa đủ, còn phải xử lý một loạt trường hợp biên: epoll_wait bị signal ngắt và trả về EINTR thì phải thử lại; trong ET, accept cũng phải lặp đến EAGAIN; phải kiểm tra EPOLLERR/EPOLLHUP/EPOLLRDHUP cùng với read/write event; read trả về 0 nghĩa là peer đã đóng hướng ghi; write có thể ghi thiếu, phải tự buffer dữ liệu chưa gửi hết và đăng ký EPOLLOUT khi cần; khi nhiều thread xử lý cùng một fd, cân nhắc dùng EPOLLONESHOT kết hợp với việc rearm.
So sánh ba cơ chế
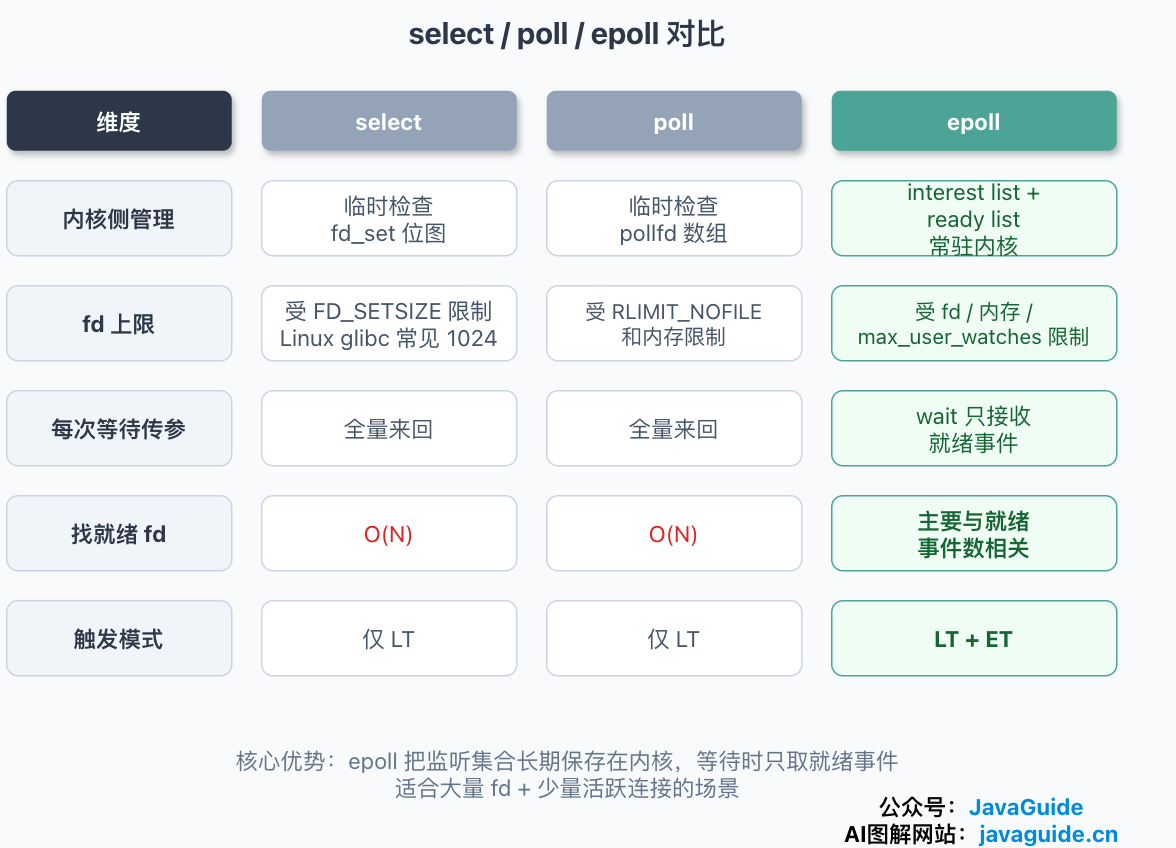
Tổng hợp các nội dung đã phân tích ở trên vào một bảng để tiện so sánh:
| Khía cạnh | select | poll | epoll |
|---|---|---|---|
| Platform | Khả năng cross-platform tốt; có trên Unix và Windows (Windows chủ yếu dùng cho socket) | Chủ yếu dùng trên hệ thống Unix-like | Dành riêng cho Linux (Linux 2.6+) |
| Quản lý phía kernel | Tạm thời kiểm tra tập fd ở mỗi lần gọi | Tạm thời kiểm tra mảng fd ở mỗi lần gọi | Duy trì lâu dài interest list và ready list; implementation hiện tại của Linux thường dùng red-black tree và ready list |
| Giới hạn số fd | Bị giới hạn bởi FD_SETSIZE; Linux glibc thường là 1024, chỉ có thể xử lý an toàn fd mang số từ 0 đến 1023 | Không bị giới hạn bởi FD_SETSIZE, nhưng vẫn bị giới hạn bởi RLIMIT_NOFILE và memory | Không bị giới hạn bởi FD_SETSIZE, nhưng bị giới hạn bởi file descriptor, memory và các giới hạn như max_user_watches |
| Tham số mỗi lần chờ | Truyền bitmap đầy đủ mỗi vòng, sau khi trả về tập fd bị sửa, vòng sau phải xây dựng lại | Truyền đầy đủ mảng pollfd mỗi vòng, kernel điền revents (events không cần xây dựng lại) | Tập fd theo dõi được duy trì qua epoll_ctl, epoll_wait chỉ nhận event sẵn sàng |
| Chi phí tìm fd sẵn sàng | Quét đến nfds - 1, thường ký hiệu là O(N) | Duyệt toàn bộ mảng, O(N) | Giai đoạn chờ không quét toàn bộ tập fd theo dõi, chi phí trả về chủ yếu liên quan đến số event sẵn sàng |
| Trigger mode | Chỉ LT | Chỉ LT | Mặc định LT, cũng hỗ trợ ET (EPOLLET) |
epoll không phải viên đạn bạc
Nói đến đây rất dễ kết luận “epoll áp đảo toàn diện”, nhưng trong thực tế không tuyệt đối như vậy; có một số ranh giới đáng ghi nhớ.
Khi số connection ít và đều active, epoll chưa chắc nhanh hơn. Việc epoll duy trì red-black tree, gắn callback và đi qua ready list vốn đã có chi phí cố định. Nếu chỉ theo dõi vài chục fd và chúng gần như lần nào cũng có dữ liệu, cách “quét một lượt” của select/poll lại trực tiếp và tiết kiệm hơn. epoll phát huy tác dụng nhất trong trường hợp nhiều connection + phần lớn idle: duy trì hàng chục nghìn long-lived connection nhưng cùng một thời điểm chỉ có một số ít active, lúc này chỉ xử lý những fd sẵn sàng mới thực sự đáng giá.
Nó là cơ chế dành riêng cho Linux. Trên macOS và BSD, cơ chế tương ứng là kqueue, trên Windows là IOCP. Khi viết network program cross-platform, thông thường không gọi epoll trực tiếp mà dùng các library wrapper như libevent, libuv để chúng dùng epoll trên Linux và implementation tương ứng trên hệ thống khác.
Vấn đề thundering herd. Nhiều process/thread cùng chờ event trên một listen fd; khi có connection đến, có thể tất cả đều bị đánh thức nhưng chỉ một process/thread accept thành công, số còn lại làm việc vô ích. Từ Linux 4.5 có thể dùng flag EPOLLEXCLUSIVE để giảm nhẹ vấn đề, giúp kernel chỉ đánh thức một hoặc ít exclusive waiter hơn trong số các waiter; nó không bảo đảm “nghiêm ngặt chỉ đánh thức một” trong mọi cách triển khai (chẳng hạn nhiều epoll instance hoặc đăng ký kết hợp non-exclusive).
Cạm bẫy của mode ET đã nói ở trên: một khi bỏ sót việc đọc đến EAGAIN, dữ liệu còn lại có thể không còn trigger notification trong thời gian dài, khiến connection bị trì hoãn xử lý. Đây không phải vấn đề performance mà là vấn đề correctness, lại rất khó debug. Nếu không chắc chắn, hãy dùng LT.
Chúng được dùng ở đâu?
Cơ chế này không chỉ là khái niệm trong giáo trình; nhiều high-performance component phổ biến đều dựa vào nó ở tầng dưới.
Redis là ví dụ điển hình của single-thread event loop + I/O multiplexing. Nó không tạo thread cho từng client mà dùng một thread kết hợp với multiplexing để đồng thời theo dõi nhiều socket; socket nào sẵn sàng thì gọi event handler tương ứng. Redis tự đóng gói một lớp (ae.c), chọn epoll, kqueue hoặc select tùy platform. Đây là một trong những yếu tố then chốt giúp nó vẫn chịu được high concurrency khi chỉ có một thread, loại bỏ context switch và lock contention của multi-thread.
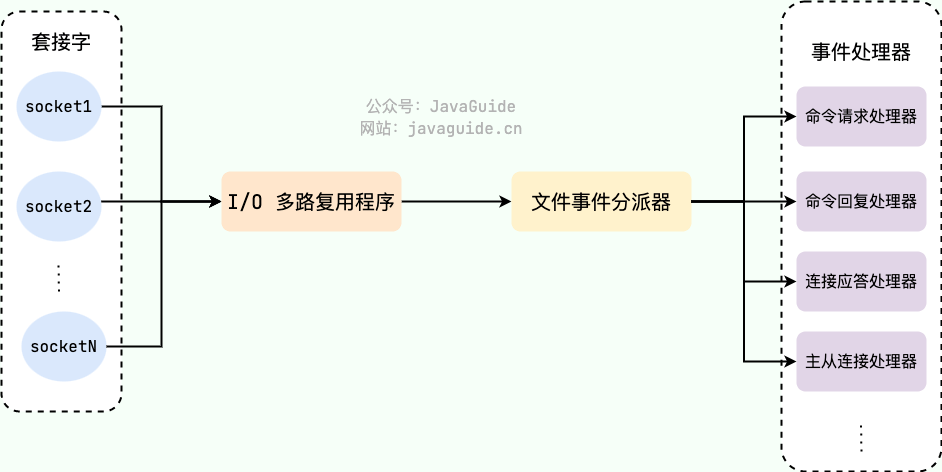
Bổ sung một điểm thường bị hiểu nhầm: Redis 6.0 bổ sung multi-thread, nhưng chỉ thêm phần network I/O read/write và protocol parsing; việc thực thi command thực tế vẫn là single-thread. Cốt lõi của event loop multiplexing này không thay đổi, multi-thread chỉ phân chia công việc tốn thời gian như “đọc socket, parse request” cho một vài thread, tránh để nó trở thành bottleneck của single-thread.
Để tìm hiểu chi tiết, bạn có thể đọc bài viết này: Tổng hợp câu hỏi phỏng vấn Redis thường gặp (Phần 1).
Nginx là multi-process + epoll và dùng mode ET, kết hợp với non-blocking socket để giảm số lượng xử lý trong mỗi lần đánh thức xuống mức tối thiểu. Đây là nền tảng giúp nó dùng rất ít process nhưng vẫn xử lý được lượng connection khổng lồ.
Selector trong Java NIO là wrapper Java của multiplexing. Trên Linux, Selector thực chất sử dụng epoll ở tầng dưới (tương ứng với EPollSelectorImpl); khi chuyển sang hệ thống khác, nó chuyển sang implementation tương ứng, việc chuyển đổi này không ảnh hưởng đến code tầng trên.
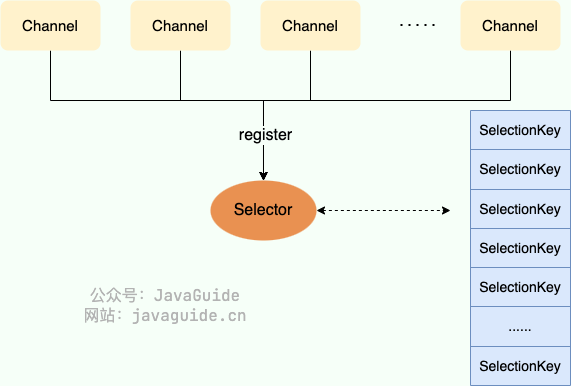
Ngoài NIO tiêu chuẩn, Netty còn cung cấp thêm một native epoll transport (EpollEventLoop), kết nối trực tiếp với epoll và bỏ qua lớp wrapper của JDK, nhờ đó có thể khai thác performance cao hơn trên Linux. Cần lưu ý khác biệt version: native epoll transport của Netty 4.0 từng chủ yếu dùng edge-triggered; đến Netty 4.2, EpollMode đã được đánh dấu deprecated và ghi rõ transport luôn sử dụng level-triggered. Hành vi ở các minor version 4.1 cần căn cứ vào source code và API của version đang dùng.
Ngoài ra, nếu muốn đọc phần giải thích chi tiết riêng về Java I/O model, bạn có thể xem bài viết này: Giải thích chi tiết Java I/O model.
Trả lời trong phỏng vấn như thế nào?
Khi được hỏi “I/O multiplexing giải quyết vấn đề gì”, đừng trả lời rằng “làm một lần read nhanh hơn”. Nó giải quyết vấn đề “chờ”: một thread không cần block trên một connection đơn lẻ mà giao một nhóm fd cho select, poll hoặc epoll, fd nào sẵn sàng thì xử lý fd đó. Việc thực sự copy dữ liệu từ kernel buffer sang user buffer vẫn do ứng dụng tự gọi read/recv, vì vậy nó thuộc synchronous I/O model.
Có thể trình bày sự khác biệt giữa select, poll, epoll từ ba điểm. Thứ nhất, cấu trúc dữ liệu khác nhau: select dùng bitmap fd_set có kích thước cố định, trong Linux glibc thường bị giới hạn ở 1024; poll đổi sang mảng pollfd, tránh được FD_SETSIZE nhưng mỗi lần vẫn phải truyền mảng vào kernel; epoll lưu lâu dài tập fd theo dõi trong kernel, thêm, xóa, sửa thông qua epoll_ctl, còn epoll_wait chỉ lấy event sẵn sàng.
Thứ hai, performance model khác nhau. select và poll phải truyền toàn bộ tập fd ở mỗi lần chờ, sau khi trả về còn phải quét tuyến tính; khi có nhiều connection nhưng ít connection active thì rất lãng phí. epoll phù hợp với nhiều fd, ít connection active vì giai đoạn chờ không cần quét toàn bộ tập fd theo dõi, chi phí trả về chủ yếu liên quan đến số event sẵn sàng trong vòng đó. Tuy nhiên nó không nhanh hơn trong mọi trường hợp; khi số connection ít nhưng đều active, chi phí cố định để duy trì callback, red-black tree và ready list cũng phải được tính đến.
Thứ ba, LT/ET của epoll thường được hỏi thêm. LT là mode mặc định, chỉ cần buffer còn dữ liệu chưa đọc hết thì lần sau vẫn thông báo; ET chỉ thông báo một lần khi trạng thái thay đổi, vì vậy phải kết hợp với non-blocking fd và đọc lặp đến EAGAIN. Trong phỏng vấn, nếu nói rõ được câu này rồi bổ sung các trường hợp biên mà production code phải xử lý như EINTR, short write, EPOLLHUP/EPOLLERR, thì về cơ bản bạn không chỉ học thuộc khái niệm.