
Giải thích chi tiết file system của Operating System: inode, VFS, Page Cache và cơ chế journaling
Cách trực quan nhất để viết một interface lưu file là: nhận path, open một file, write dữ liệu vào đó, cuối cùng close. Khi số lượng file ít, concurrency thấp và máy không gặp sự cố, quy trình này có vẻ không khó.
Nhưng khi phỏng vấn hỏi sâu hơn, vấn đề sẽ xuất hiện. fd mà open() trả về thực sự trỏ tới đâu? Tên file có nằm trong inode không? Vì sao hai hard link có thể nhìn thấy cùng một nội dung? write() trả về thành công có nghĩa là dữ liệu đã được ghi xuống disk chưa? File log đã bị xóa, vì sao df -h vẫn hiển thị disk đầy?
Những câu hỏi này đều không thể tách khỏi file system. Nó phải phân giải path thành file object, định vị byte thứ N của file trong data block bên dưới, đồng thời xử lý permission, cache, xóa, rename và khôi phục sau crash.
Câu trả lời nằm trong inode, dentry, VFS, Page Cache và cơ chế journaling.
Trước hết, hãy bắt đầu từ câu hỏi cơ bản nhất: file system thực sự quản lý những gì?
File system thực sự quản lý những gì?
Khi viết code hằng ngày, thứ bạn thấy là path, file name, directory, read, write. Với file system được xây dựng trên local block device, tầng bên dưới thường là logical block, sector và device I/O; file system tổ chức các tài nguyên tầng thấp này thành file, directory và metadata.
Tuy nhiên, không phải file system nào cũng tương ứng với disk trên máy cục bộ. tmpfs chủ yếu dùng memory làm backend, procfs cung cấp trạng thái đang chạy của kernel, còn NFS kết nối file system ở remote vào directory tree cục bộ. VFS cung cấp file interface thống nhất trên các implementation này.
Bạn nên nhìn file system như sau: nó không chỉ chịu trách nhiệm “lưu nội dung file”, mà còn phải đồng thời giải quyết 4 việc.
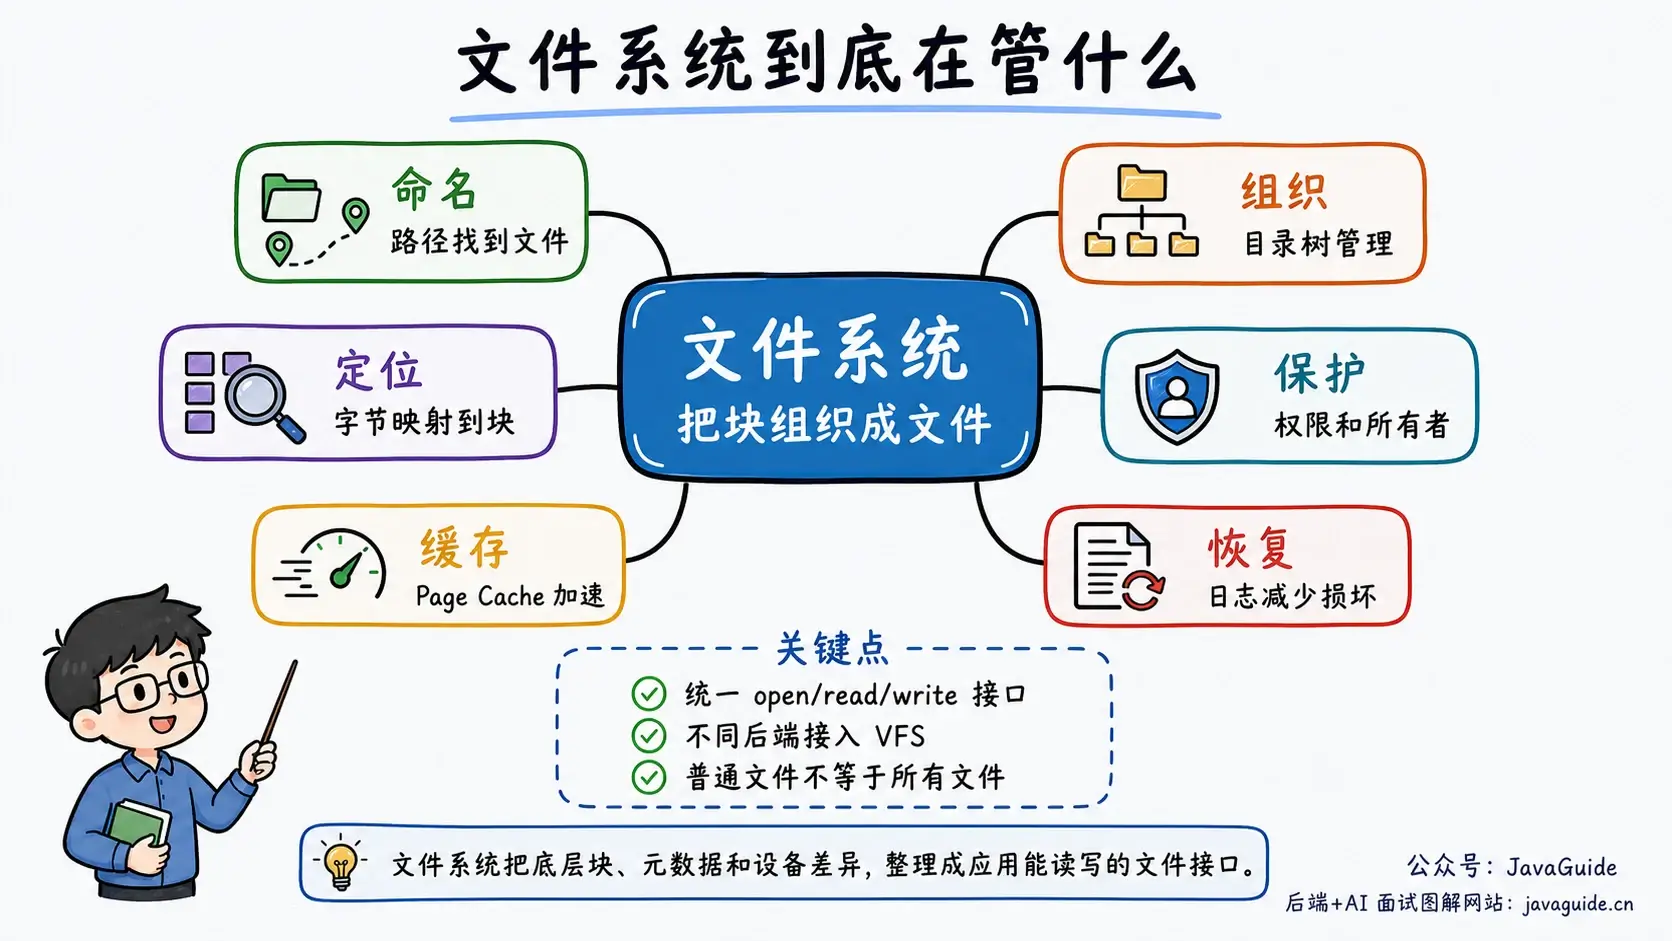
- Đặt tên: dùng path và file name để tìm file đích, chẳng hạn
/var/log/app.log. - Tổ chức: dùng directory tree để quản lý file, giúp các file khác nhau thuộc về các directory khác nhau.
- Định vị: ánh xạ byte thứ N của file tới một data block nào đó trên disk hoặc SSD.
- Bảo vệ: ghi lại permission, owner, timestamp và kiểm tra chúng khi truy cập.
Không có file system, ứng dụng phải tự ghi nhớ “dải block nào thuộc về file nào”, đồng thời tự xử lý việc xóa, mở rộng, permission và khôi phục sau crash. File system đưa các việc này vào một interface thống nhất, ứng dụng chỉ cần dùng file descriptor để read/write.
Bài viết này chủ yếu trình bày theo phong cách Linux/Unix. Implementation của NTFS, APFS, Btrfs, XFS và ext4 có khác nhau, nhưng các vấn đề về file, directory, metadata, cache, allocation và recovery đều không thể tránh khỏi.
File và directory là gì?
Trong ngữ cảnh Unix/Linux, có thể hiểu regular file là một chuỗi byte có tên và metadata, thường được lưu trên persistent storage. VFS cũng dùng các file interface tương tự để cung cấp directory, device, FIFO, Socket và các object của pseudo file system.
Vì vậy, cách hiểu chính xác hơn về “mọi thứ đều là file” là: Linux cố gắng cho phép các resource khác nhau được truy cập thông qua file descriptor và I/O interface thống nhất, chứ không phải mọi object đều thực sự được ghi lên disk. Dữ liệu của pipe nằm trong buffer của kernel, còn nhiều nội dung dưới /proc là pseudo file được kernel tạo ra theo thời gian thực.
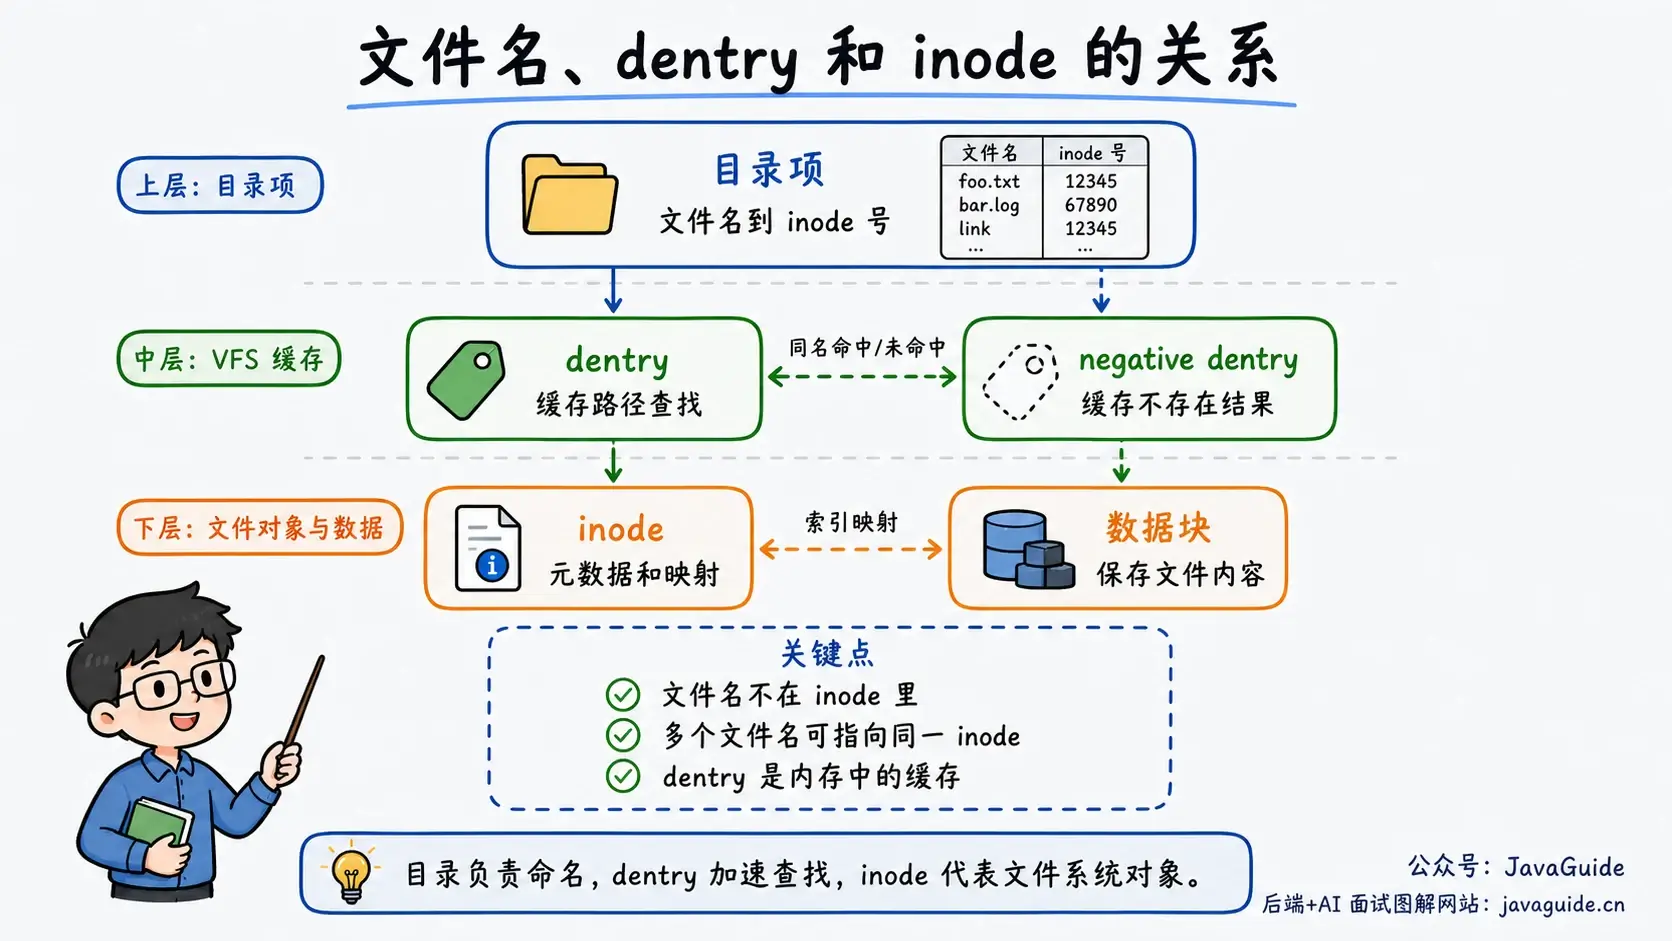
Directory cũng là một loại file, chỉ là nội dung data của nó khá đặc biệt. Trong các file system theo phong cách Unix như ext4, data của directory chủ yếu lưu mapping từ “file name đến inode number”. Khi user tìm file thông qua path, file system sẽ lần lượt tra cứu các directory:
/home/guide/a.txt
  -> Tra cứu root directory /
  -> Tìm thấy home
  -> Vào home rồi tìm thấy guide
  -> Vào guide rồi tìm thấy a.txt
Directory tree tạo ra hierarchy cho file. Cơ chế mount lại kết nối nhiều file system vào cùng một directory tree, chẳng hạn sau khi mount /dev/sda2 vào /data, lúc truy cập /data/app.log, thực tế bạn đang truy cập file system trong một partition khác.
Mặc dù directory cũng có data block và inode bên trong file system, user space thường không thể read() nó trực tiếp như regular file, mà phải đọc directory entry thông qua các interface duyệt directory như readdir() và getdents().
Mối quan hệ giữa inode, dentry và file name là gì?
Trong file system Linux/Unix, việc hiểu inode rất quan trọng.
inode (index node) ghi lại metadata của file, thường bao gồm file type, permission, owner, size, timestamp, link count và vị trí các data block.
Thông thường inode không lưu file name. File name thuộc về directory entry, một inode có thể có nhiều file name. Data của regular file thường được lưu trong các data block hoặc extent độc lập, inode chỉ lưu thông tin mapping data. Tuy nhiên, một số file system có inline optimization, chẳng hạn ext4 có thể đưa nội dung của file rất nhỏ hoặc target của short symbolic link trực tiếp vào inode.
Linux VFS còn duy trì dentry trong memory. dentry biểu diễn một directory entry trong path, dùng để cache kết quả name lookup; nó thường trỏ tới inode, nhưng cũng có thể là negative dentry biểu thị “target không tồn tại”. Có thể hiểu khái quát như sau:
- File name: được lưu trong directory entry trên disk.
- dentry: component của path và lookup cache được VFS duy trì trong memory.
- inode: đại diện cho file system object, lưu hoặc liên kết tới metadata và data mapping của object đó.
- Data block hoặc extent: lưu nội dung data của regular file.
Điều này cũng giải thích vì sao rename file thường rất nhanh. Nếu mv a.txt b.txt xảy ra trong cùng một file system, nhiều khi chỉ cần sửa name mapping trong directory entry, bản thân nội dung file không cần di chuyển.
Có thể dùng các lệnh sau để quan sát các thông tin này:
# Xem inode number
ls -li app.log

# Xem metadata của file
stat app.log

# Xem tình trạng sử dụng inode của file system
df -i
Với các file system có inode table được tạo sẵn như ext4, số lượng inode cũng có thể cạn kiệt trước data block. Disk của server nhìn qua vẫn còn space, nhưng sau khi nhiều file nhỏ chiếm hết inode, việc tạo file vẫn có thể báo No space left on device. Cách cấp phát inode của các file system khác nhau không hoàn toàn giống nhau, vì vậy cần dựa vào file system cụ thể khi diễn giải df -i.
Điều gì xảy ra khi open một file?
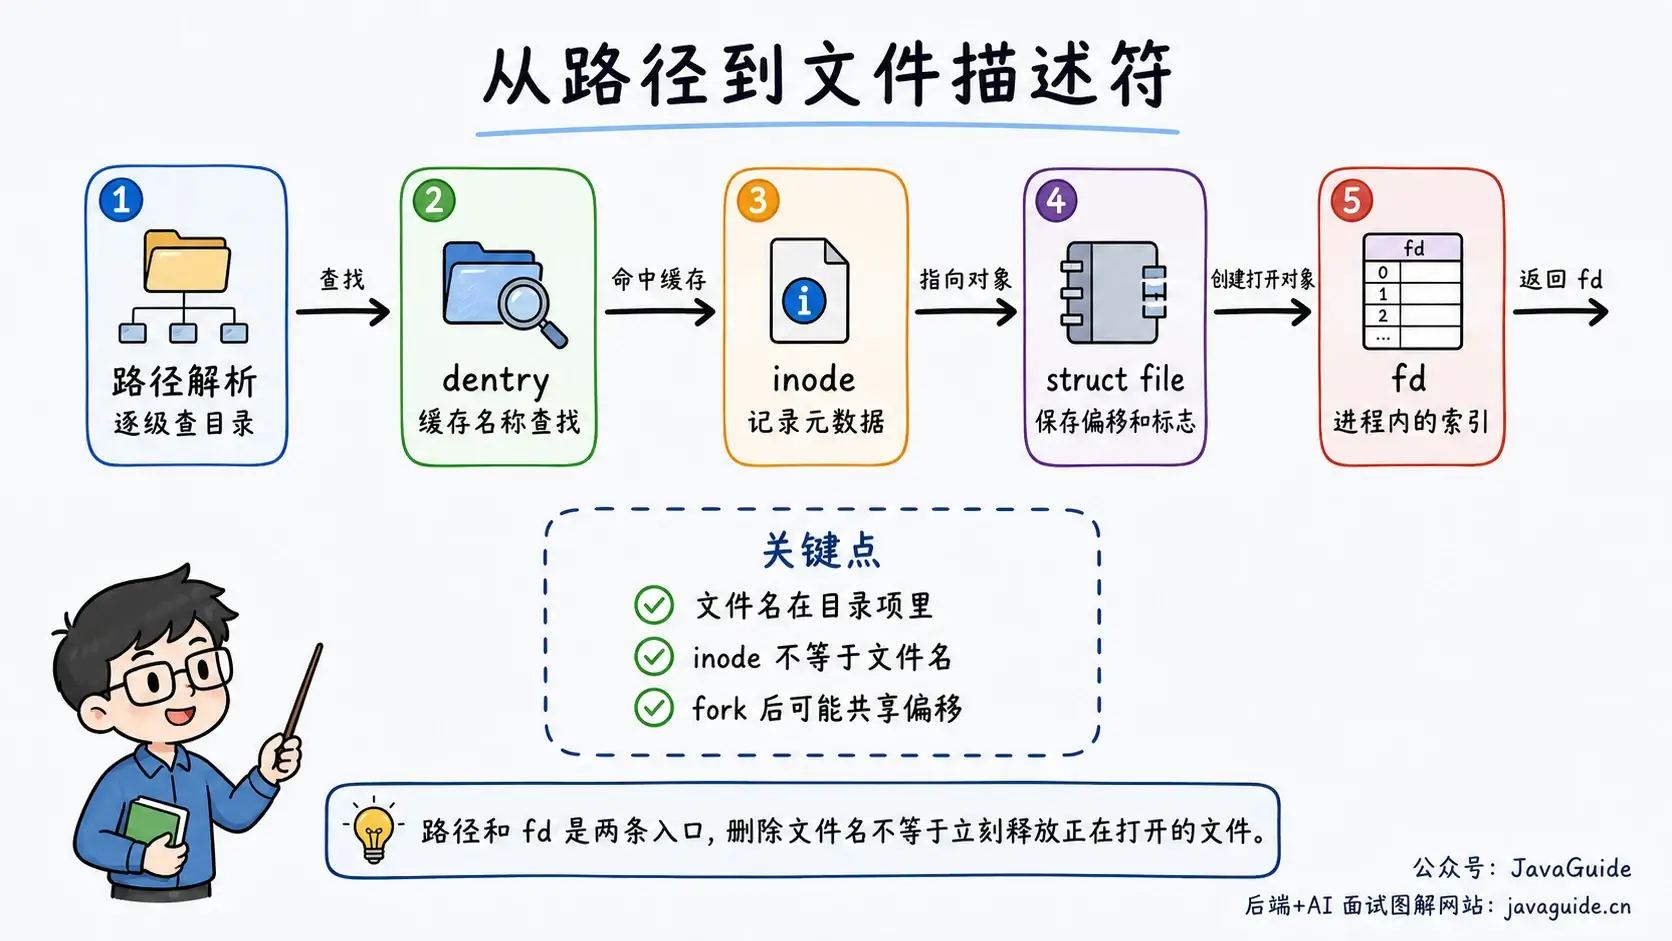
Sau khi ứng dụng gọi open(), kernel không đọc toàn bộ file vào memory. Kernel chủ yếu thực hiện các việc sau:
- Phân giải path, tìm directory entry và inode tương ứng.
- Kiểm tra permission, open flag và file type có hợp lệ hay không.
- Tạo một open file object trong kernel, ghi lại file offset, state flag và các thông tin khác.
- Cấp phát một số nguyên không âm nhỏ nhất còn dùng được trong file descriptor table của process hiện tại, đó chính là fd.
Linux man-pages giải thích phần này rất rõ: open() trả về index trong file descriptor table của process; mỗi lần open() cũng tạo một open file description ở phạm vi toàn hệ thống, dùng để ghi lại file offset và state flag.
Ba cấu trúc này rất dễ bị nhầm lẫn:
| Cấu trúc | Phạm vi sở hữu | Chủ yếu ghi lại gì |
|---|---|---|
| File descriptor table | Mỗi process một bảng | Reference từ fd tới open file object |
| Open file object | Phạm vi toàn hệ thống | Offset hiện tại, open state, read/write flag |
| Inode table/cache | File system và kernel | Metadata của file, vị trí data block |
Sau dup() và fork(), nhiều fd có thể reference cùng một open file object, vì vậy chúng share file offset. Nếu hai process lần lượt open() cùng một file, thông thường chúng sẽ nhận được hai open file object khác nhau và tự duy trì offset riêng.
Đây là nguyên nhân của hiện tượng sau: sau khi một file bị xóa, process đang ghi file đó có thể vẫn tiếp tục ghi. unlink() xóa name trong directory và giảm link count của inode. Chỉ khi hard link cuối cùng đã bị xóa, đồng thời mọi open reference và memory mapping cũng được giải phóng, space mà file chiếm mới thực sự được thu hồi.
File được lưu trên disk như thế nào?
Disk và SSD thường đọc/ghi theo đơn vị block. File system chia một partition hoặc volume thành nhiều block, sau đó dùng các cấu trúc metadata để quản lý chúng. Lấy file system họ ext làm ví dụ, disk layout thường bao gồm các khu vực sau:
- Superblock: ghi lại thông tin tổng thể của file system, chẳng hạn block size, số lượng inode, số lượng free block và mount state.
- Khu vực inode: lưu inode.
- Khu vực data block: lưu nội dung của regular file và directory.
- Bitmap hoặc free space structure khác: ghi lại inode nào và data block nào chưa được sử dụng.
Các phương thức file allocation thường gặp trong giáo trình gồm contiguous allocation, linked allocation và indexed allocation. Chúng phù hợp để hiểu các trade-off trong thiết kế.
Contiguous allocation đặt một file vào một đoạn block liên tiếp. Ưu điểm là sequential read/write và random access đều rất trực tiếp, chỉ cần biết start block và length là có thể định vị. Nhược điểm cũng rõ ràng: file khó mở rộng, sau nhiều lần tạo và xóa dễ để lại external fragmentation.
Linked allocation phân tán các block của file ở nhiều vị trí trên disk, mỗi block trỏ tới block tiếp theo. Cách này không yêu cầu space liên tiếp, việc mở rộng file thuận tiện, nhưng random access kém. Để đọc block thứ 1000, có thể phải đi theo pointer từ block thứ 1 đến tận đó. File system FAT tập trung các pointer này vào file allocation table, cải thiện một phần vấn đề tìm kiếm, nhưng bản thân table lại trở thành metadata cần được bảo trì.
Indexed allocation tập trung địa chỉ của các data block của file vào index block. Để đọc block thứ i, trước tiên tra mục thứ i trong index block, rồi đọc data block tương ứng. Cách này hỗ trợ random access và không có external fragmentation như contiguous allocation, nhưng phải trả giá bằng việc lưu thêm một index block.
ext2/ext3 kinh điển dùng direct block pointer, single indirect, double indirect và triple indirect block để định vị data của file. ext4 thường chuyển sang dùng extent tree: một extent ghi lại logical start, physical start và length của một đoạn physical block liên tiếp; với file lớn có các block liên tiếp, cách này tiết kiệm nhiều mapping metadata hơn so với “mỗi block lưu một address”.
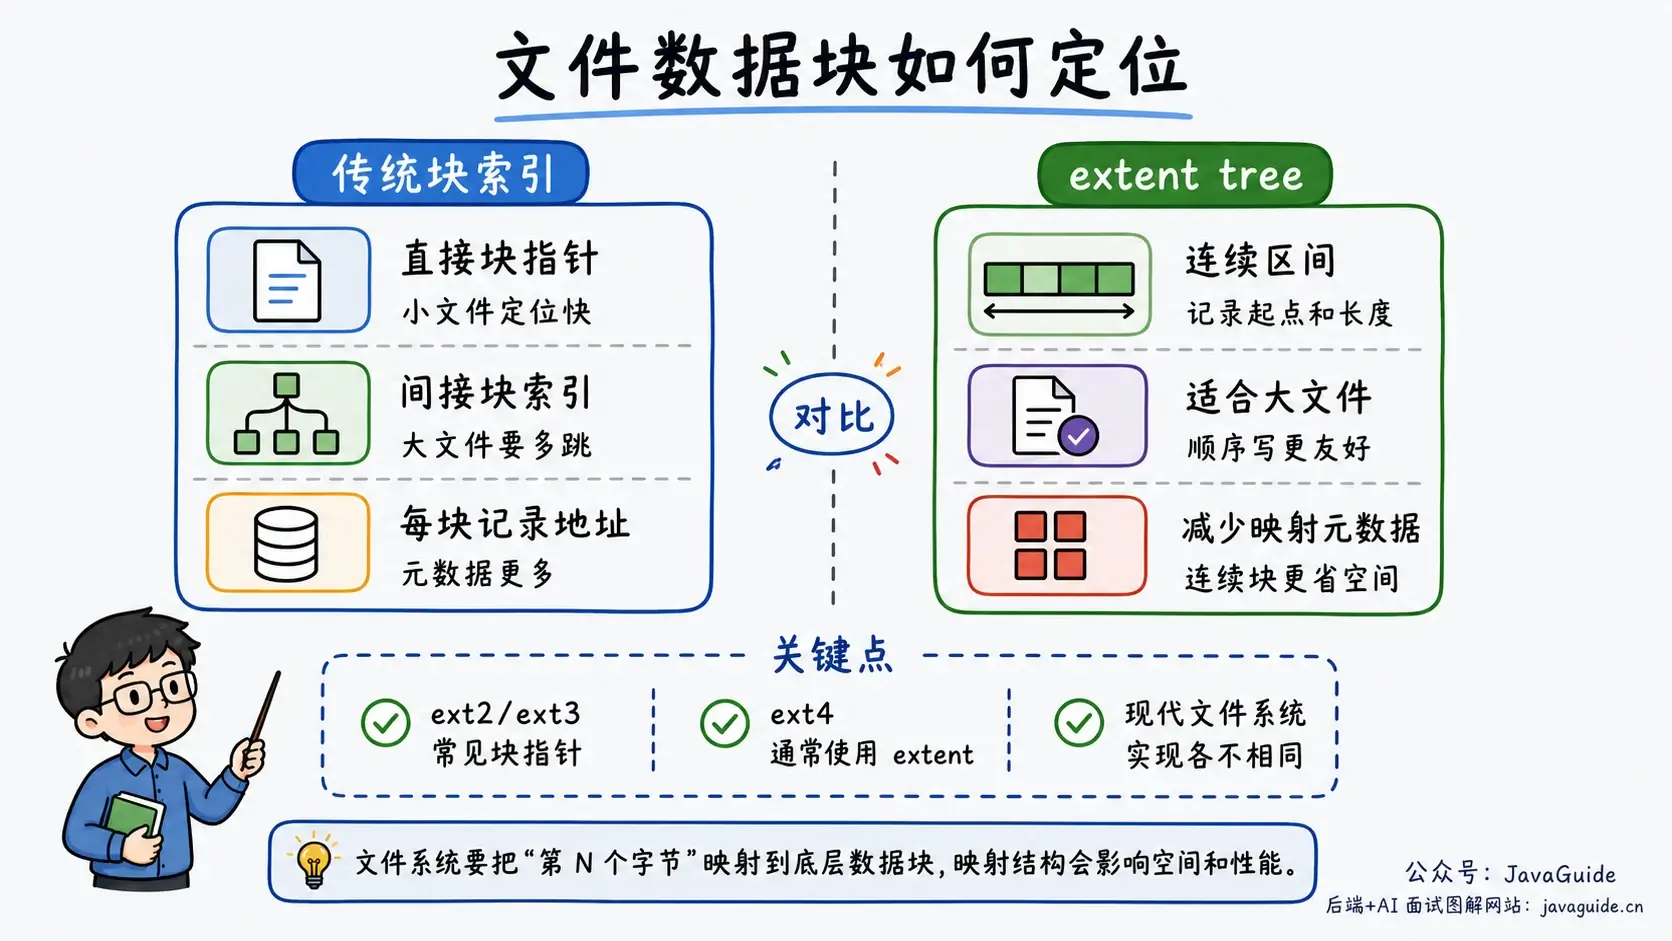
Các file system hiện đại khác cũng có thể dùng những kết hợp khác nhau của B-tree, extent, delayed allocation và copy-on-write; không thể xem cấu trúc direct/indirect block là implementation thống nhất của mọi file system hiện đại.
Quản lý free space như thế nào?
Sau khi file bị xóa, data block đã chiếm trước đó phải được trả lại cho file system; khi ghi file mới, cũng phải nhanh chóng tìm được block có thể sử dụng. Đây chính là free space management.
Có một số phương pháp thường gặp:
- Free table: ghi lại start block và length của mỗi vùng free liên tiếp. Phù hợp với contiguous allocation, nhưng table sẽ phức tạp hơn khi fragmentation tăng lên.
- Free linked list: nối các free block thành linked list, việc allocation và thu hồi từng block khá trực tiếp, nhưng không thuận tiện khi tìm space liên tiếp.
- Bitmap: mỗi block tương ứng với 1 bit,
0biểu thị free,1biểu thị đã dùng. Có thể scan bitmap để tìm free block liên tiếp, overhead về space cũng kiểm soát được. - Grouped linking: đặt địa chỉ của một nhóm free block vào một block, sau đó link tới nhóm tiếp theo, thường gặp trong các Unix system đời đầu.
Bitmap rất phổ biến. Giả sử file system có size 1 TiB, block size là 4 KiB, khi đó có tổng cộng 2^28 block. Mỗi block dùng 1 bit để đánh dấu, bitmap có size khoảng 32 MiB. Overhead này có thể chấp nhận được để đổi lấy việc quản lý trạng thái block rõ ràng.
File system thực tế còn kết hợp allocation policy để giảm fragmentation. Chẳng hạn ưu tiên đặt các file trong cùng một directory và các extent liên tiếp của cùng một file lớn ở gần nhau hơn, giúp sequential read hiệu quả hơn. SSD không có vấn đề seek như mechanical disk, nhưng các yếu tố như sequential write, write amplification, erase block và TRIM vẫn ảnh hưởng tới performance và lifespan.
VFS giải quyết vấn đề gì?
Linux hỗ trợ nhiều file system như ext4, XFS, Btrfs, tmpfs, procfs và NFS. User program không thể viết một bộ open_ext4() và open_xfs() cho từng file system.
VFS (Virtual File System, virtual file system) chính là abstraction layer trung gian. Application vẫn gọi thống nhất open, read, write, close; VFS dựa vào file system chứa file đích để chuyển tiếp operation tới implementation cụ thể.
Tài liệu VFS chính thức của Linux giải thích trực tiếp một số object:
- superblock: đại diện cho một file system đã được mount.
- inode: đại diện cho một object trong file system, chẳng hạn regular file, directory hoặc FIFO.
- dentry: đại diện cho một directory entry trong path, thường trỏ tới inode.
- file: đại diện cho một file object sau một lần open, cũng là kernel structure phía sau fd.
Nhờ VFS, cat /proc/cpuinfo, cat /var/log/app.log và đọc file trên NFS đều có thể dùng cùng user space interface. Khác biệt được đẩy xuống implementation của file system cụ thể bên dưới VFS.
Hard link và soft link khác nhau như thế nào?
Hard link và soft link đều có thể liên kết một path với một file khác, nhưng object mà chúng trỏ tới khác nhau.
| Hạng mục so sánh | Hard link | Soft link |
|---|---|---|
| Object được trỏ tới | Cùng một inode | Một path khác |
| Có tạo inode mới không | Không tạo inode mới cho target file, chỉ thêm directory entry và tăng link count | Bản thân soft link là một file độc lập, có inode riêng |
| Sau khi xóa source file | Chỉ cần còn hard link thì data vẫn còn | Soft link có thể trở thành dangling link |
| Có thể cross file system không | Không | Có |
| Có thể link directory không | Linux không cho phép link directory qua hard link interface thông thường | Có |
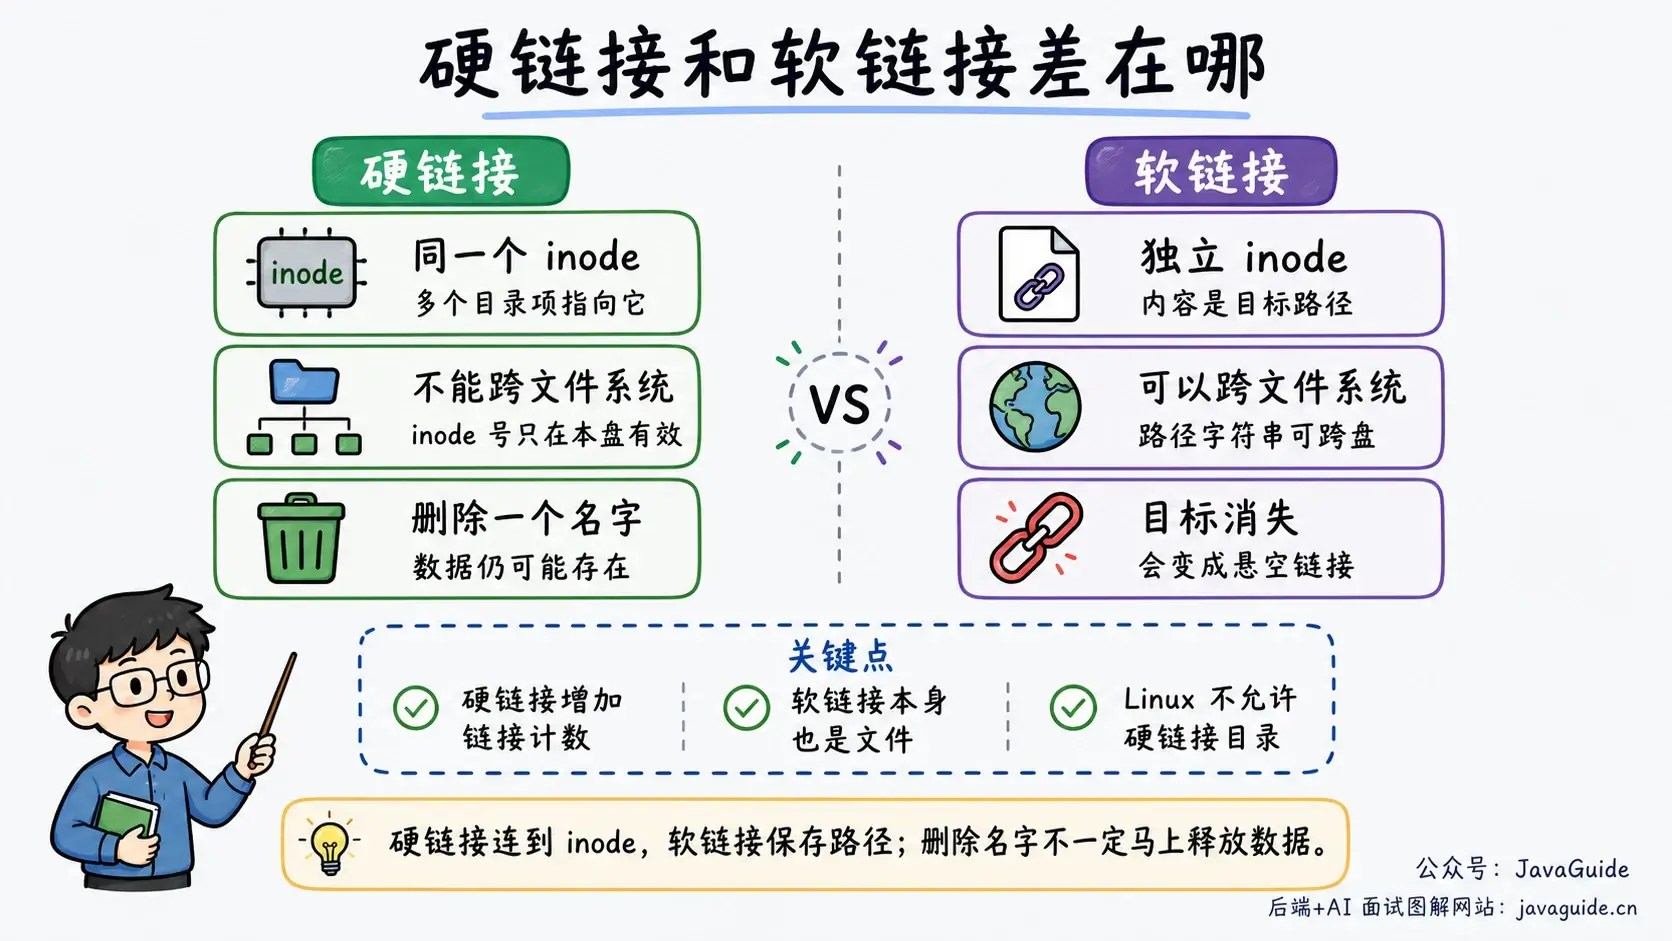
Hard link không thể cross file system vì inode number chỉ có ý nghĩa trong file system hiện tại. File system khác có inode table riêng, cùng một số không đại diện cho cùng một file.
Có thể dùng các lệnh sau để làm một thí nghiệm nhỏ:
echo hello > a.txt
ln a.txt hard.txt
ln -s a.txt soft.txt

ls -li a.txt hard.txt soft.txt
Bạn sẽ thấy số inode của a.txt và hard.txt giống nhau, còn số inode của soft.txt khác. Sau khi xóa a.txt, hard.txt vẫn đọc được nội dung, còn soft.txt sẽ trỏ tới một path không tồn tại.
Vì sao Page Cache ảnh hưởng tới performance khi read/write file?
Read/write trực tiếp trên disk quá chậm. Linux dùng Page Cache để cache data của file, lưu một phần các page của file trên disk vào memory.
Khi read file, nếu target page đã nằm trong Page Cache, kernel có thể copy trực tiếp từ memory sang user space mà không cần thực sự đọc disk. Nếu cache miss, kernel mới đọc page từ disk vào Page Cache rồi trả về cho application.
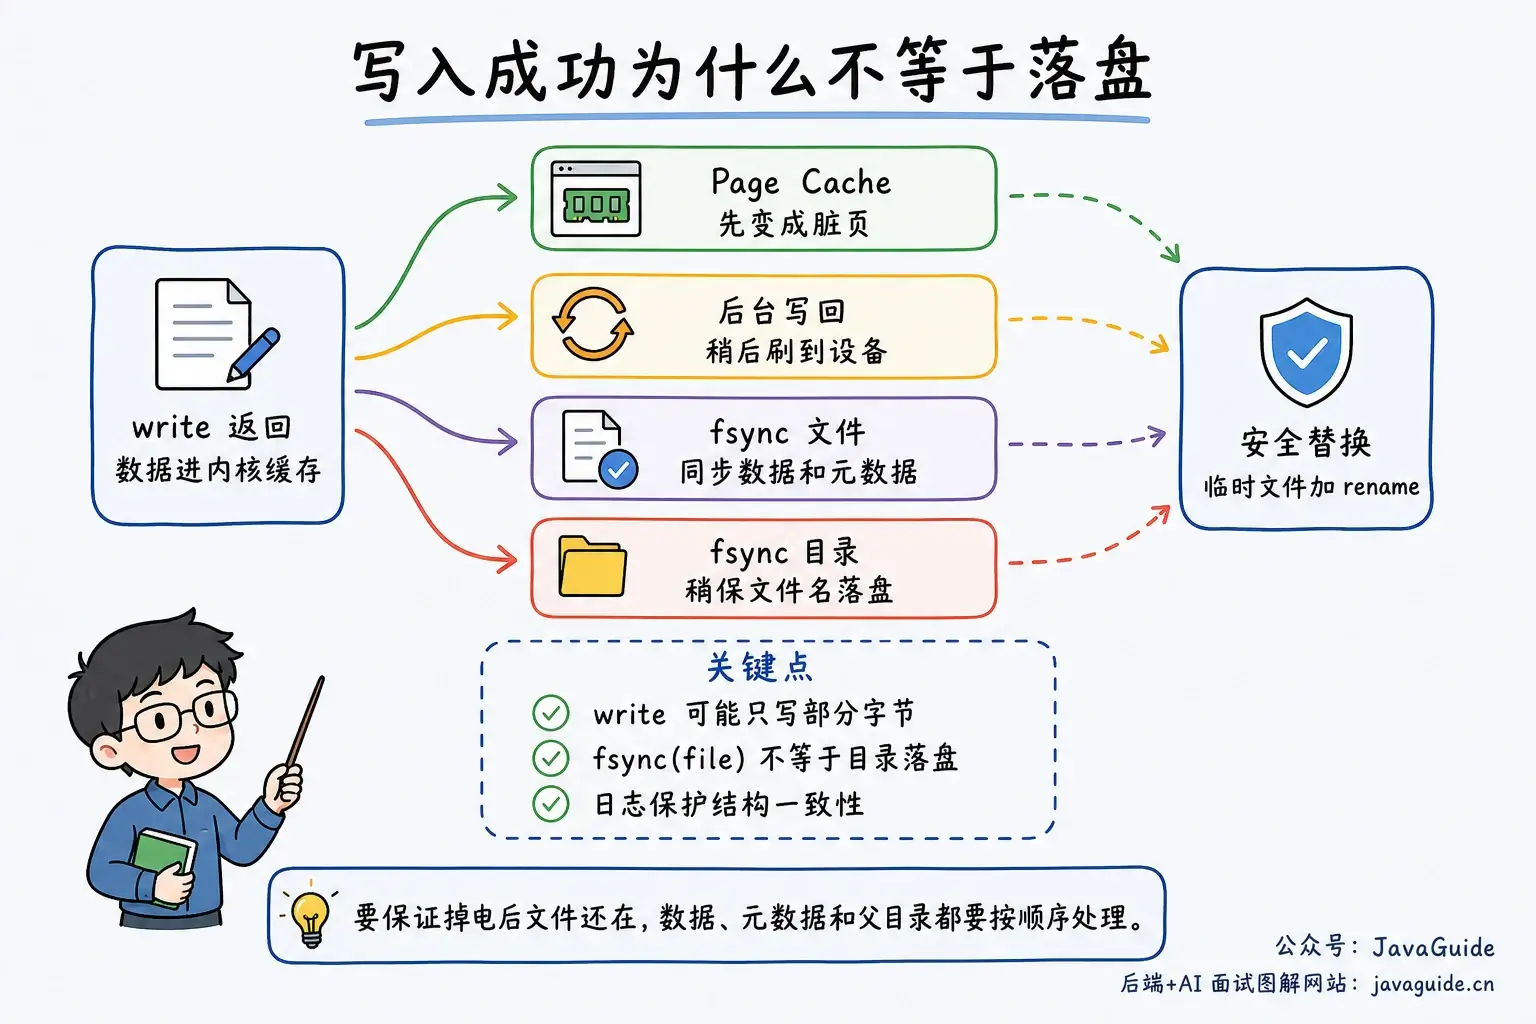
Với buffered I/O của regular file, write() thành công thường chỉ có nghĩa là data đã được kernel nhận, trong trường hợp thường gặp là đã vào Page Cache và được đánh dấu là dirty page. Điều đó không đảm bảo toàn bộ byte của write request đã được ghi, cũng không đảm bảo data đã persistent xuống device bên dưới. Caller phải xử lý partial write; nếu cần persistence, còn phải kiểm tra error của fsync(), fdatasync() và close().
fdatasync() cũng sync data của file, nhưng chỉ sync metadata cần thiết cho các lần read sau đó, chẳng hạn file size; còn fsync() sync data của file và metadata liên quan đầy đủ hơn. Phần này nói về buffered I/O thông thường; các path như O_DIRECT, O_SYNC và DAX sẽ làm thay đổi behavior cụ thể.
Cái giá phải trả là crash risk. Sau khi process ghi xong file, nếu máy đột ngột mất điện, các write đã trả về thành công chưa chắc đều được ghi xuống disk. Khi cần persistence mạnh hơn, phải dùng fsync(), fdatasync() hoặc open flag có synchronous semantic, nhưng các operation này khiến application phải chờ flush xuống disk, làm throughput giảm.
Một điểm rất dễ bỏ sót: fsync(fileFd) chỉ sync bản thân file, không nhất thiết sync thay đổi file name trong parent directory. Sau khi tạo file mới, thực hiện rename() hoặc unlink(), nếu yêu cầu directory entry cũng được persist đáng tin cậy sau khi mất điện, còn cần open parent directory và gọi fsync() trên directory fd.
Một quy trình thay thế an toàn điển hình là: tạo temporary file trong cùng directory, ghi đầy đủ nội dung, gọi fsync() trên temporary file, sau đó dùng rename() để atomic replace target file, cuối cùng gọi fsync() trên parent directory. rename() trong cùng file system có thể atomic replace target name, nhưng “operation trên namespace là atomic” không đồng nghĩa với “chắc chắn persistent sau khi mất điện”.
Database, message queue và logging system đều không thể bỏ qua điểm này. Chúng thường tự quản lý flushing policy: có hệ thống cố gắng flush xuống disk sau mỗi transaction commit, có hệ thống chấp nhận mất data trong một khoảng thời gian ngắn để đổi lấy throughput. Không có một đáp án tối ưu chung, chỉ có recovery point objective mà business có thể chấp nhận.
Journaling filesystem giảm hư hỏng sau crash như thế nào?
File system sợ nhất là crash giữa chừng khi đang write. Chẳng hạn khi tạo file, vừa phải cấp phát inode, vừa phải cấp phát data block, vừa phải update directory entry và bitmap. Nếu mới write xong một phần mà mất điện, file system có thể rơi vào trạng thái inconsistent.
Journaling filesystem trước hết ghi các thay đổi metadata sắp thực hiện vào khu vực log, sau đó mới update vị trí chính thức. Khi system recovery, nó scan log: transaction đã commit đầy đủ nhưng chưa được write hết về vị trí chính thức có thể được replay; transaction không có commit record hoặc checksum không hợp lệ sẽ bị loại bỏ. Mục tiêu của log là tránh để cấu trúc file system dừng ở trạng thái “chỉ update một nửa”.
Lấy ext4 làm ví dụ, tài liệu chính thức liệt kê 3 data mode:
data=writeback: chỉ đảm bảo metadata được log, không đảm bảo data block liên quan được write trước metadata. Performance thường tốt hơn, nhưng sau crash, file mới được write có thể xuất hiện data cũ.data=ordered: mode mặc định. Trước khi metadata vào log, data block liên quan sẽ được write vào main file system trước. Nó không ghi bản thân file data vào log, nhưng giảm risk metadata trỏ tới data chưa được write.data=journal: cả data và metadata trước tiên được write vào log, sau đó mới write tới vị trí cuối. Cung cấp crash consistency guarantee mạnh hơn cho data đi qua log, nhưng write amplification và chi phí performance cũng cao hơn.
Journaling filesystem giải quyết “tính nhất quán của cấu trúc file system”, chứ không thay application đảm bảo mọi business data đều không mất. Nếu application muốn đảm bảo persistence ở transaction level, vẫn phải dùng fsync() đúng cách, đồng thời xử lý các chi tiết như rename, temporary file và flush directory.
Vấn đề performance của file system thường cần xem ở đâu?
Khi troubleshoot vấn đề file system, đừng chỉ nhìn vào disk capacity. Các chỉ số sau phổ biến hơn.
Inode đã dùng hết chưa:
df -iKhi có quá nhiều file nhỏ, inode có thể cạn kiệt trước khi dung lượng disk cạn.
File descriptor có bị leak không:
ulimit -n
cat /proc/<pid>/limits
lsof -p <pid>
ls /proc/<pid>/fd | wc -l
Khi service báo Too many open files, trước tiên hãy xem fd limit của process và số fd hiện tại, sau đó kiểm tra xem có connection, log file hoặc temporary file nào chưa được close hay không. Cũng cần phân biệt hai loại error: EMFILE biểu thị file descriptor của process hiện tại đã đạt limit, ENFILE biểu thị số lượng open file trên toàn system đã đạt limit.
Trong program đa thread khi tạo fd, nên ưu tiên các option close-on-exec atomic như O_CLOEXEC, tránh fd vô tình bị leak sang program mới sau exec().
Page Cache size và memory pressure:
free -h
vmstat 1
free -h và vmstat 1 có thể hỗ trợ đánh giá cache size, memory pressure, paging và I/O activity, nhưng không thể trực tiếp suy ra Page Cache hit rate. Linux cố gắng dùng free memory làm cache, vì vậy buff/cache trong free lớn không nhất thiết là điều xấu. Điều thực sự cần xem là application có thường xuyên phải chờ I/O không, có nhiều writeback không, và cache có bị thu hồi liên tục vì memory pressure không.
Khi cần quan sát các page được cache của một file cụ thể, Linux phiên bản mới cung cấp cachestat(); cũng có thể dùng các tool dựa trên eBPF như cachestat, nhưng trước khi dùng trong production cần đánh giá overhead của việc thu thập.
Disk có bận không:
iostat -x 1Với serial device truyền thống, %util liên tục gần 100% có thể có nghĩa là device bận. Nhưng với NVMe SSD, RAID và các device có khả năng xử lý song song nhiều request khác, %util không thể trực tiếp đồng nghĩa với saturation. Cần kết hợp thêm await, r_await, w_await, aqu-sz, throughput, IOPS và latency ở phía application để đánh giá.
df gần đầy nhưng du lại không tìm thấy file lớn:
lsof +L1
ls -l /proc/<pid>/fd
du thống kê các file vẫn còn tên trong directory tree; df thống kê các block đã được file system cấp phát. Nếu một log lớn đã bị unlink(), nhưng process vẫn giữ fd mở, nó sẽ không còn xuất hiện trong kết quả duyệt directory, du không nhìn thấy nó; tuy nhiên dung lượng bên dưới vẫn chưa được giải phóng, nên df vẫn cao. Khi xử lý, thông thường nên để process mở lại log file hoặc restart service một cách bình thường, không trực tiếp thực hiện operation mang tính phá hủy chưa được kiểm chứng trên /proc/<pid>/fd/*.
Ở đây cũng cần lưu ý một giới hạn: các file system khác nhau, kernel version, mount parameter và hardware cache policy đều có thể làm behavior thay đổi. Chẳng hạn O_DIRECT trên Linux còn có alignment restriction, hơn nữa restriction sẽ thay đổi theo file system và kernel version. Khi đánh giá performance, tốt nhất nên kết hợp thông tin từ mount, uname -a, kết quả fio của system hiện tại hoặc benchmark của business thực tế, không chỉ phán đoán theo kết luận trong giáo trình.
Trả lời câu hỏi về file system trong phỏng vấn như thế nào?
Nếu được hỏi “file system là gì”, có thể trả lời theo hướng sau:
File system chịu trách nhiệm tổ chức các block trên storage device thành file và directory mà user có thể hiểu. Nó phải quản lý naming, directory, metadata, data block allocation, free space, permission, cache và crash recovery.
Khi nói về Linux, có thể bổ sung inode, dentry, file và superblock. File name được lưu trong directory entry, inode lưu metadata của file và vị trí data block; open() phân giải path, kiểm tra permission rồi trả về fd, fd trỏ tới open file object, khi read/write lại thông qua VFS để gọi tới file system cụ thể.
Nếu được hỏi tiếp “hard link và soft link”, chỉ cần nhớ: hard link là nhiều directory entry cùng trỏ tới một inode, soft link là một file độc lập có nội dung là target path.
Nếu được hỏi tiếp “vì sao write file xong vẫn có thể mất data”, hãy trả lời về Page Cache và writeback policy: write() thành công thường chỉ có nghĩa là data đã vào cache của kernel, không có nghĩa là đã persistent; khi cần guarantee mạnh hơn, phải kết hợp fsync(), cơ chế journaling và thứ tự write chính xác.