
Giải thích chi tiết memory management trong Operating System: paging, segmentation, page replacement, Swap và OOM
Khi xem thông tin memory của một process thông thường, bạn sẽ thấy nhiều con số trông khá trái với trực giác: process có virtual address space riêng, phạm vi địa chỉ có thể rất lớn; physical memory thực sự chiếm dụng lại là một chuyện khác; cùng một shared library còn có thể được nhiều process dùng chung.
Khi viết code, chương trình chỉ đang truy cập các địa chỉ, nhưng Operating System lại phải xử lý những vấn đề cụ thể hơn: vùng memory này được cấp cho ai? Process khác có được truy cập không? Khi physical memory không đủ, đẩy page nào ra? Sau khi giải phóng, các khoảng trống còn lại có thể tiếp tục sử dụng không?
Đó là những việc memory management phải xử lý. Tiểu G khuyên bạn đừng vội học thuộc các thuật ngữ như paging, segmentation, TLB, mà trước hết hãy nắm vững một ý chính: Operating System tách địa chỉ mà chương trình nhìn thấy khỏi physical memory thực tế, sau đó quản lý memory bằng allocation, mapping, protection và reclamation.
VSZ, RSS và PSS lần lượt có ý nghĩa gì?
Trong Linux, các số liệu memory của process là những thứ dễ bị hiểu sai nhất. VSZ trong ps và VmSize trong /proc/<pid>/status biểu thị kích thước virtual address space mà process đã mapping. Nó có thể bao gồm anonymous mapping, file mapping, shared library và vùng địa chỉ đã được reserve nhưng chưa thực sự resident, nên không thể trực tiếp coi là mức physical memory sử dụng.
RSS biểu thị các page hiện đang resident trong RAM và được mapping vào process đó. Shared library, shared memory và shared page trong Page Cache cũng được tính vào RSS của từng process liên quan, nên cộng trực tiếp RSS của nhiều process dễ dẫn đến tính trùng.
PSS phù hợp hơn để ước tính phần memory thực tế được process sử dụng. Nếu một physical page được 4 process dùng chung, PSS của mỗi process chỉ tính một phần tư. Khi cần xem số liệu tổng hợp, có thể dùng:
grep -E 'VmSize|VmRSS|RssAnon|RssFile|RssShmem|VmSwap' /proc/<pid>/status
cat /proc/<pid>/smaps_rollup
smaps_rollup cung cấp số liệu tổng hợp cấp process; nếu muốn phân tích từng mapping, hãy xem thêm /proc/<pid>/smaps. Tuy nhiên, smaps đầy đủ sẽ duyệt VMA và page table của process, vì vậy cần thận trọng khi thu thập với tần suất cao trong production.
Memory management chủ yếu làm những gì?
Nhìn từ góc độ Operating System, memory management ít nhất phải thực hiện 5 việc.
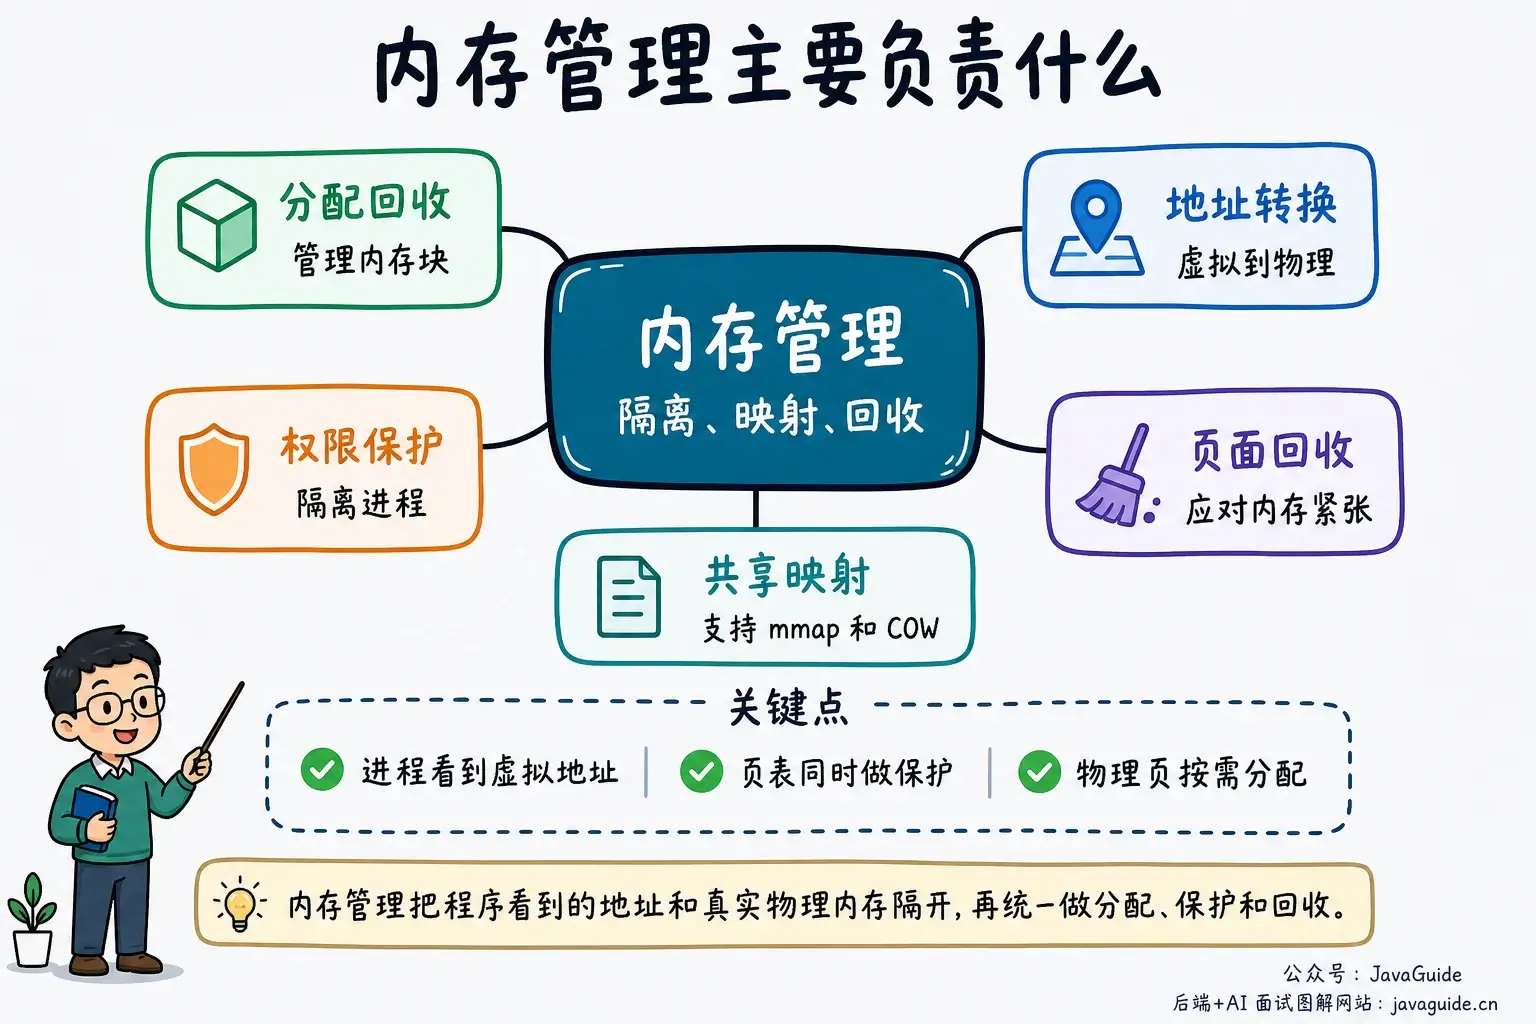
Thứ nhất, allocation và reclamation của memory. malloc()/free() ở user space phụ trách quản lý các memory block trong heap của process. Ví dụ với glibc, khi cần, allocator sẽ thông qua các API như brk(), mmap() để mở rộng vùng virtual address khả dụng; sau khi virtual region được tạo, physical page thường vẫn phải chờ đến lần truy cập đầu tiên, thông qua page fault path, mới được thiết lập. Bên trong kernel, page allocator và các object allocator như SLAB/SLUB quản lý các physical page và kernel object.
Thứ hai, hoàn tất address translation. Chương trình truy cập virtual address, còn địa chỉ thực sự trỏ tới physical memory là physical address. MMU trong CPU phối hợp với page table và TLB để dịch virtual address thành physical address.
Thứ ba, process isolation và permission control. Mỗi process có address space riêng. 0x1000 trong process A và 0x1000 trong process B có thể được mapping đến các physical page hoàn toàn khác nhau; page table entry còn có thể đánh dấu quyền read, write, execute, và việc truy cập trái quyền sẽ gây ra exception.
Thứ tư, reclaim page khi physical memory thiếu hụt. Clean file page có thể bị loại bỏ trực tiếp, khi cần thì đọc lại từ file; dirty file page thường phải write back trước; nếu muốn reclaim anonymous page, thường phải ghi vào Swap. Linux sẽ dựa trên nhiều yếu tố như độ nóng/lạnh của page, refault, memory watermark, cgroup và swappiness để chọn đối tượng reclaim, chứ không cố định rằng loại page nào luôn được reclaim trước.
Thứ năm, hỗ trợ sharing và mapping. Shared dynamic library, shared memory IPC, file mapping bằng mmap(), copy-on-write (COW) đều phụ thuộc vào khả năng “nhiều virtual address được mapping tới cùng một nhóm physical page”.
Điều gì xảy ra nếu không có memory abstraction?
Trong các system đời đầu hoặc rất nhỏ, chương trình có thể truy cập trực tiếp physical address. Khi chỉ chạy một chương trình, cách này còn tạm chấp nhận được; nhưng ngay khi nhiều chương trình chạy đồng thời, vấn đề lập tức xuất hiện.
Giả sử chương trình A ghi dữ liệu vào physical address 1000, chương trình B cũng đặt biến của mình tại physical address 1000. Hai chương trình không biết sự tồn tại của nhau, cuối cùng chương trình nào ghi sau sẽ ghi đè dữ liệu của chương trình trước. Tệ hơn, user program thông thường cũng có thể ghi vào memory của Operating System, khiến không thể bảo đảm tính ổn định của system.
Giải pháp là đưa vào address space. Mỗi process nhìn thấy một không gian địa chỉ riêng, thường gồm code segment, data segment, heap, stack, memory-mapped region và các vùng khác. Process chỉ làm việc với virtual address, còn physical page thực tế do Operating System và hardware cùng quyết định.
Nhờ vậy, process isolation, demand loading, shared memory và COW mới có nền tảng để hoạt động.
Contiguous memory allocation và vấn đề fragmentation
Cách memory allocation dễ hiểu nhất là contiguous allocation: process cần bao nhiêu memory thì Operating System tìm một vùng physical memory liên tục có kích thước tương ứng cho nó. Các system đời đầu thường dùng fixed partition hoặc dynamic partition để quản lý.
Vấn đề của contiguous allocation là fragmentation.
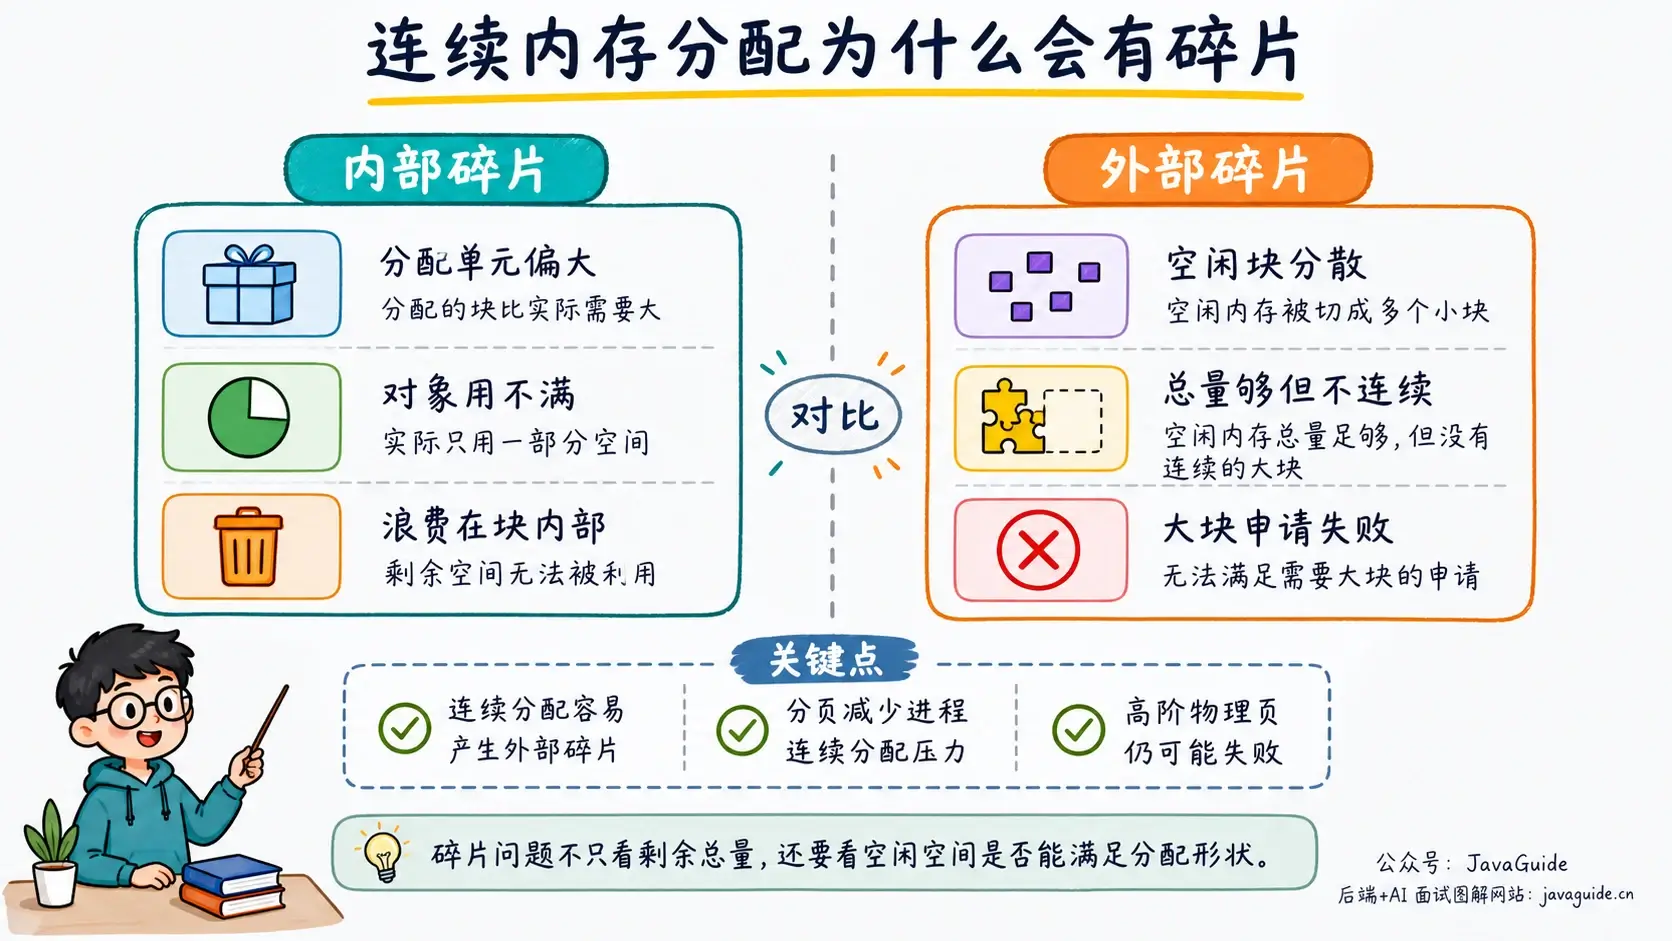
Internal fragmentation là vùng đã được allocation nhưng thực tế chưa dùng đến. Ví dụ, system cấp phát theo đơn vị 128 byte, một object chỉ cần 65 byte, 63 byte còn lại sẽ bị lãng phí bên trong allocation unit đó.
External fragmentation là tổng free space đủ nhưng không liên tục, không thể đáp ứng một allocation block liên tục có kích thước lớn. Ví dụ memory có hai free area, mỗi area 128 MB, tổng cộng 256 MB; hiện tại cần một vùng liên tục 200 MB thì vẫn thất bại.
Các allocation strategy phổ biến của dynamic partition gồm first fit, best fit và worst fit. Chúng có thể thay đổi vị trí và tốc độ xuất hiện fragmentation, nhưng không thể loại bỏ external fragmentation tận gốc. Memory compaction sẽ di chuyển các movable page, gom các free page phân tán thành vùng physical liên tục lớn hơn. Nó không đồng nghĩa với Swap I/O, nhưng compaction đồng bộ có thể chiếm CPU, di chuyển nhiều page và gây latency spike.
Buddy system của Linux giải quyết vấn đề gì?
Khi quản lý physical page, Linux sử dụng buddy system. Nó tổ chức free memory theo lũy thừa của 2, chẳng hạn 4 KB, 8 KB, 16 KB, 32 KB… Khi request memory, trước hết tìm block nhỏ nhất có thể đáp ứng request; nếu block tìm được quá lớn, liên tục chia đôi; khi giải phóng, nếu buddy block liền kề cũng free thì merge thành block lớn hơn.
Ưu điểm của thiết kế này là quy tắc split và merge rất đơn giản, có thể nhanh chóng tìm được các physical page liên tục, đồng thời giảm external fragmentation.
Tuy nhiên, nó cũng gây lãng phí một phần space: đơn vị allocation của buddy system là 2^order physical page liên tục. Với base page 4 KB, nếu kernel caller cần ít nhất 65 KB physical memory liên tục, nó có thể xin 32 page, tức block order-5 có kích thước 128 KB, từ đó tạo ra internal waste. Ví dụ này mô tả việc xin physical page liên tục trong kernel, không có nghĩa là user gọi malloc(65KB) thì chắc chắn sẽ trực tiếp chiếm một buddy block 128 KB.
Ngoài ra, buddy system chủ yếu quản lý physical memory theo từng page. Trong kernel còn có nhiều object nhỏ hơn page, chẳng hạn file object, inode và network buffer structure. Nếu lần nào cũng xin theo page thì sẽ lãng phí quá nhiều. Linux sử dụng các allocator như SLAB/SLUB bên trên buddy system để cache và reuse memory block theo kích thước object, qua đó giảm chi phí allocation, initialization và release lặp đi lặp lại.
Segmentation, paging và segmented paging khác nhau thế nào?
Address space không nhất thiết chỉ được chia theo một cách. Trong giáo trình Operating System thường gặp ba cách: segmentation, paging và segmented paging.
| Cách thức | Tiêu chí phân chia | Cấu trúc địa chỉ | Ưu điểm | Vấn đề chính |
|---|---|---|---|---|
| Segmentation | Theo logic của chương trình, như code segment, data segment, stack segment | Segment number + offset trong segment | Gần với cấu trúc chương trình, thuận tiện cho sharing và protection | Segment có độ dài không cố định, dễ tạo external fragmentation |
| Paging | Chia virtual address và physical memory thành các phần có kích thước cố định | Page number + offset trong page | Physical memory có thể allocation phân tán, giảm external fragmentation do contiguous allocation của process | Page table chiếm space, page cuối cùng có thể có internal fragmentation |
| Segmented paging | Trước hết chia theo logic thành segment, sau đó chia segment thành page | Segment number + page number trong segment + offset trong page | Kết hợp logical protection và allocation phân tán | Address translation phức tạp hơn |
Các Operating System hiện đại chủ yếu dựa vào paging để quản lý memory. Ví dụ với x86, hardware từng hỗ trợ segmentation và paging; trong long mode của x86-64, user address space thông thường của Linux chủ yếu dựa vào paging, còn code segment và data segment truyền thống về cơ bản dùng flat model. Tuy vậy, FS/GS vẫn có công dụng thực tế, chẳng hạn FS thường được dùng cho thread-local storage (TLS) ở user space.
Cũng cần bổ sung một điểm thường bị giáo trình đơn giản hóa: paging làm giảm external fragmentation do contiguous allocation của process address space, chứ không khiến vấn đề fragmentation của bản thân physical memory biến mất. DMA, huge page và một số request trong kernel vẫn có thể cần physical page liên tục; vì vậy dù tổng free memory đủ, request physical page liên tục ở order cao vẫn có thể thất bại, và kernel vẫn cần buddy merge và memory compaction.
Paging thực hiện address translation như thế nào?
Paging chia virtual address space thành các virtual page có kích thước cố định, đồng thời chia physical memory thành các page frame có cùng kích thước. Trong hệ thống Linux x86-64 phổ biến, một page thường có kích thước 4 KB, nhưng kích thước page cụ thể còn phụ thuộc vào architecture.
Một virtual address có thể được tách thành hai phần:
- Virtual page number: dùng để tra page table, tìm page frame tương ứng.
- Offset trong page: vị trí cụ thể bên trong page.
Address translation đại khái diễn ra như sau: CPU phát ra virtual address, MMU lấy virtual page number để tra page table, nhận được physical page frame number, sau đó ghép với offset trong page để tạo thành physical address.
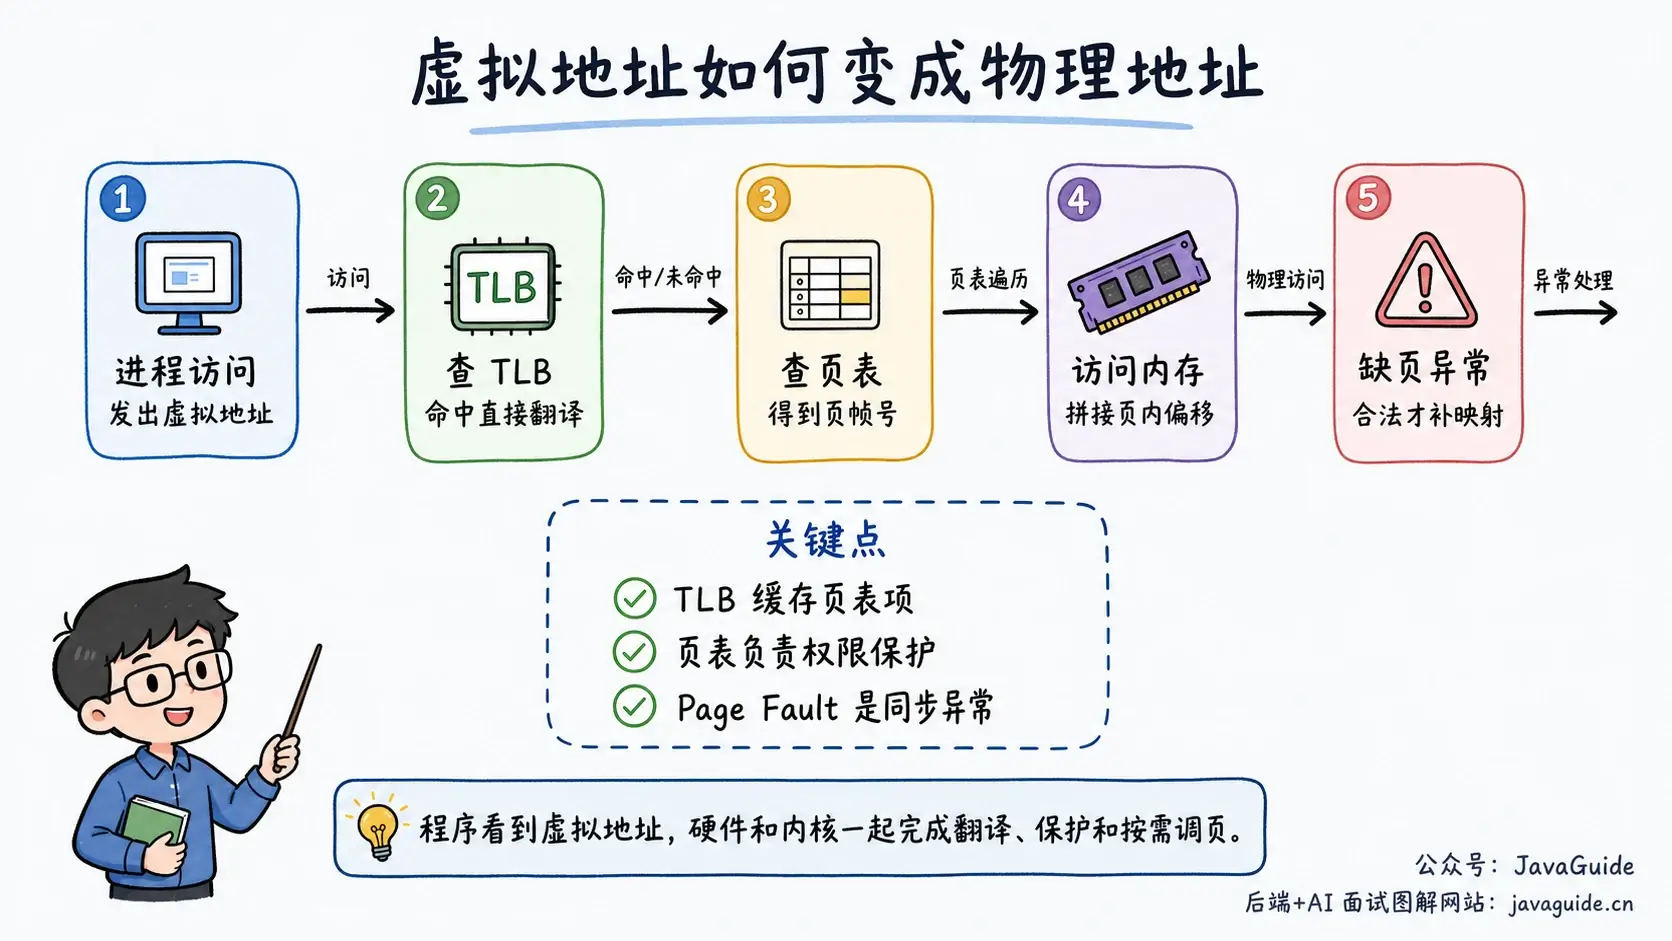
Page table entry không chỉ lưu physical page frame number mà còn lưu nhiều status bit, chẳng hạn present bit, read/write permission, user/kernel permission, dirty bit và accessed bit. Present bit biểu thị page đã ở trong physical memory hay chưa; permission bit dùng để protection; accessed bit và dirty bit sẽ tham gia vào việc quyết định page reclaim.
Vì sao cần multi-level page table?
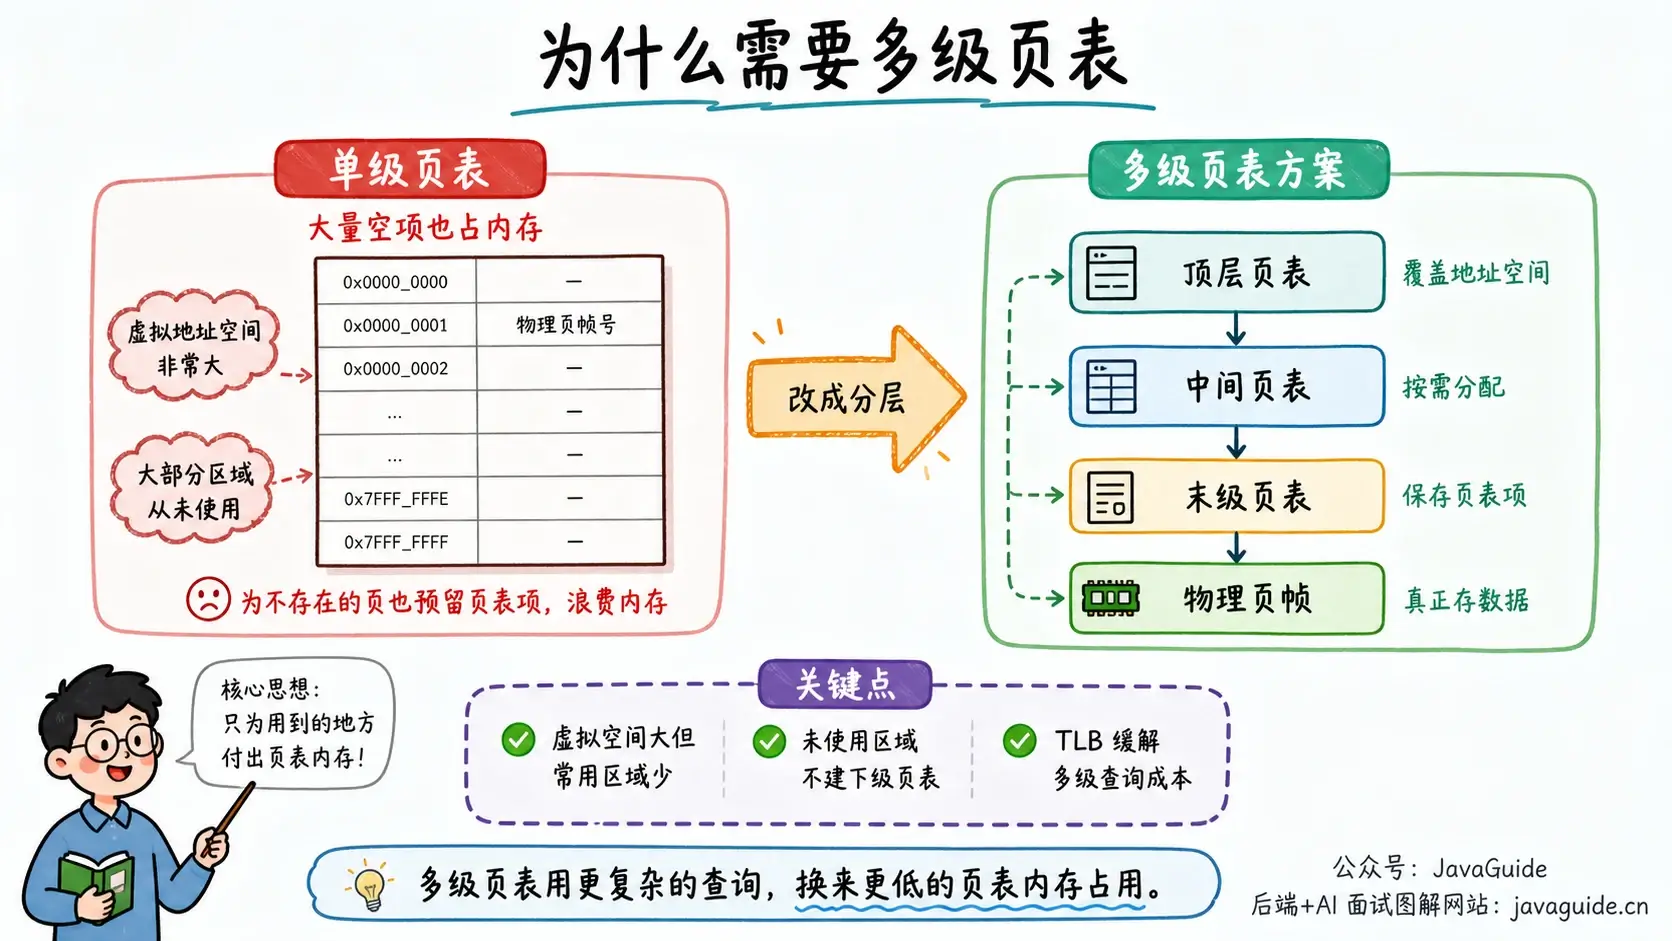
Single-level page table rất dễ hiểu, nhưng space overhead quá lớn.
Với address space 32 bit và page size 4 KB, một process có virtual address space 4 GB, cần 4 GB / 4 KB = 2^20 page table entry. Nếu mỗi page table entry có 4 byte, page table của một process sẽ cần khoảng 4 MB. Khi số process tăng lên, phần memory này không thể xem nhẹ.
Vấn đề hơn nữa là phần lớn process không dùng hết virtual address space. Tuy vậy, single-level page table vẫn phải chuẩn bị page table entry cho toàn bộ space, khiến một lượng lớn entry bị bỏ trống.
Multi-level page table phân tầng: page table tầng cao nhất bao phủ toàn bộ virtual address space, còn page table tầng dưới được tạo on demand. Nếu một vùng virtual address hoàn toàn chưa được sử dụng thì page table tầng dưới tương ứng cũng không được tạo. Phần code page table độc lập với architecture của Linux được viết theo cấu trúc 5 tầng; nếu architecture hoặc machine cụ thể không sử dụng đủ các tầng, những tầng thừa sẽ được fold lại.
Trên x86-64, cấu hình truyền thống thường dùng paging 4 tầng; chỉ khi CPU, kernel và configuration hỗ trợ LA57 thì mới dùng paging 5 tầng. Tài liệu Linux cho biết paging 5 tầng có thể cho phép user space sử dụng virtual address space 56 bit, nhưng để tương thích với một số chương trình sử dụng các bit cao của pointer, kernel mặc định sẽ không chủ động cấp phát virtual address cao hơn bit 47, trừ khi application chỉ định rõ thông qua địa chỉ hint ở vùng cao.
Vì sao TLB quan trọng?
Multi-level page table tiết kiệm space nhưng khiến address translation phải thực hiện thêm vài lần truy cập memory. Nếu trước mỗi lần truy cập data đều tra đầy đủ multi-level page table thì chi phí sẽ quá cao.
TLB (Translation Lookaside Buffer, fast table) là cache của page table entry, thường nằm trong MMU. Khi CPU truy cập memory, trước tiên nó tra TLB:
- Hit: nhận trực tiếp physical page frame number.
- Miss: tiếp tục đi qua multi-level page table, sau khi tra được thì đưa kết quả trở lại TLB.
Memory access của chương trình có locality: page vừa được truy cập thì khả năng cao sẽ tiếp tục được truy cập; khi truy cập một địa chỉ, các địa chỉ lân cận cũng có thể nhanh chóng được truy cập. TLB chính là nơi tận dụng lợi ích từ locality này.
Đây cũng là một trong những lý do huge page có giá trị. Với page 4 KB thông thường, một TLB entry chỉ bao phủ 4 KB; nếu dùng huge page 2 MB, một TLB entry có thể bao phủ phạm vi địa chỉ lớn hơn, từ đó giảm khả năng xảy ra TLB miss. Tuy nhiên, huge page cũng mang đến chi phí allocation và reclamation lớn hơn. Việc có bật THP hoặc HugeTLB cho các chương trình như database và JVM hay không cần được kiểm chứng theo mục tiêu latency và throughput.
Page fault là gì?
Virtual memory không nạp tất cả page vào physical memory ngay khi process khởi động. Nhiều page chỉ thực sự được load khi được truy cập lần đầu, cách này gọi là demand paging.
Page Fault là processor exception được instruction hiện tại kích hoạt một cách đồng bộ, không phải hardware interrupt phát sinh bất đồng bộ từ external device.
Khi process truy cập một virtual page, nếu MMU không tìm thấy translation hợp lệ thì sẽ trigger page fault và đi vào kernel để xử lý. Kernel trước hết xác định truy cập có nằm trong VMA hợp lệ hay không, đồng thời permission có cho phép hay không. Địa chỉ không hợp lệ hoặc vi phạm permission thường được chuyển thành SIGSEGV; page fault hợp lệ sẽ được xử lý tùy theo loại mapping: có thể mapping page đã có trong Page Cache, thiết lập anonymous zero page, thực hiện COW, allocation một page mới, hoặc đọc data từ file và Swap. Sau khi xử lý xong, page table được cập nhật rồi instruction gây ra lỗi sẽ được thực thi lại.
getrusage(2) của Linux chia thống kê page fault thành hai loại:
- Minor fault: quá trình xử lý không cần I/O thực tế. Ví dụ page đã ở trong memory nhưng process hiện tại chưa thiết lập mapping; việc COW trigger copy cũng thường nằm trong path này.
- Major fault: quá trình xử lý cần I/O, ví dụ phải đọc page từ disk file hoặc Swap.
Major fault chậm hơn minor fault rất nhiều. Khi điều tra vấn đề memory trong production, tốc độ tăng nhanh của majflt thường đáng lo hơn minflt.
Page replacement: khi memory không đủ thì đẩy page nào ra?
Physical memory đã đầy nhưng vẫn cần load page mới, vì vậy trước hết phải reclaim một số page. Page replacement phải giải quyết một vấn đề rất trực tiếp: khi memory không đủ, đẩy page nào ra trước để giảm ảnh hưởng nhiều nhất đến các lần truy cập sau?
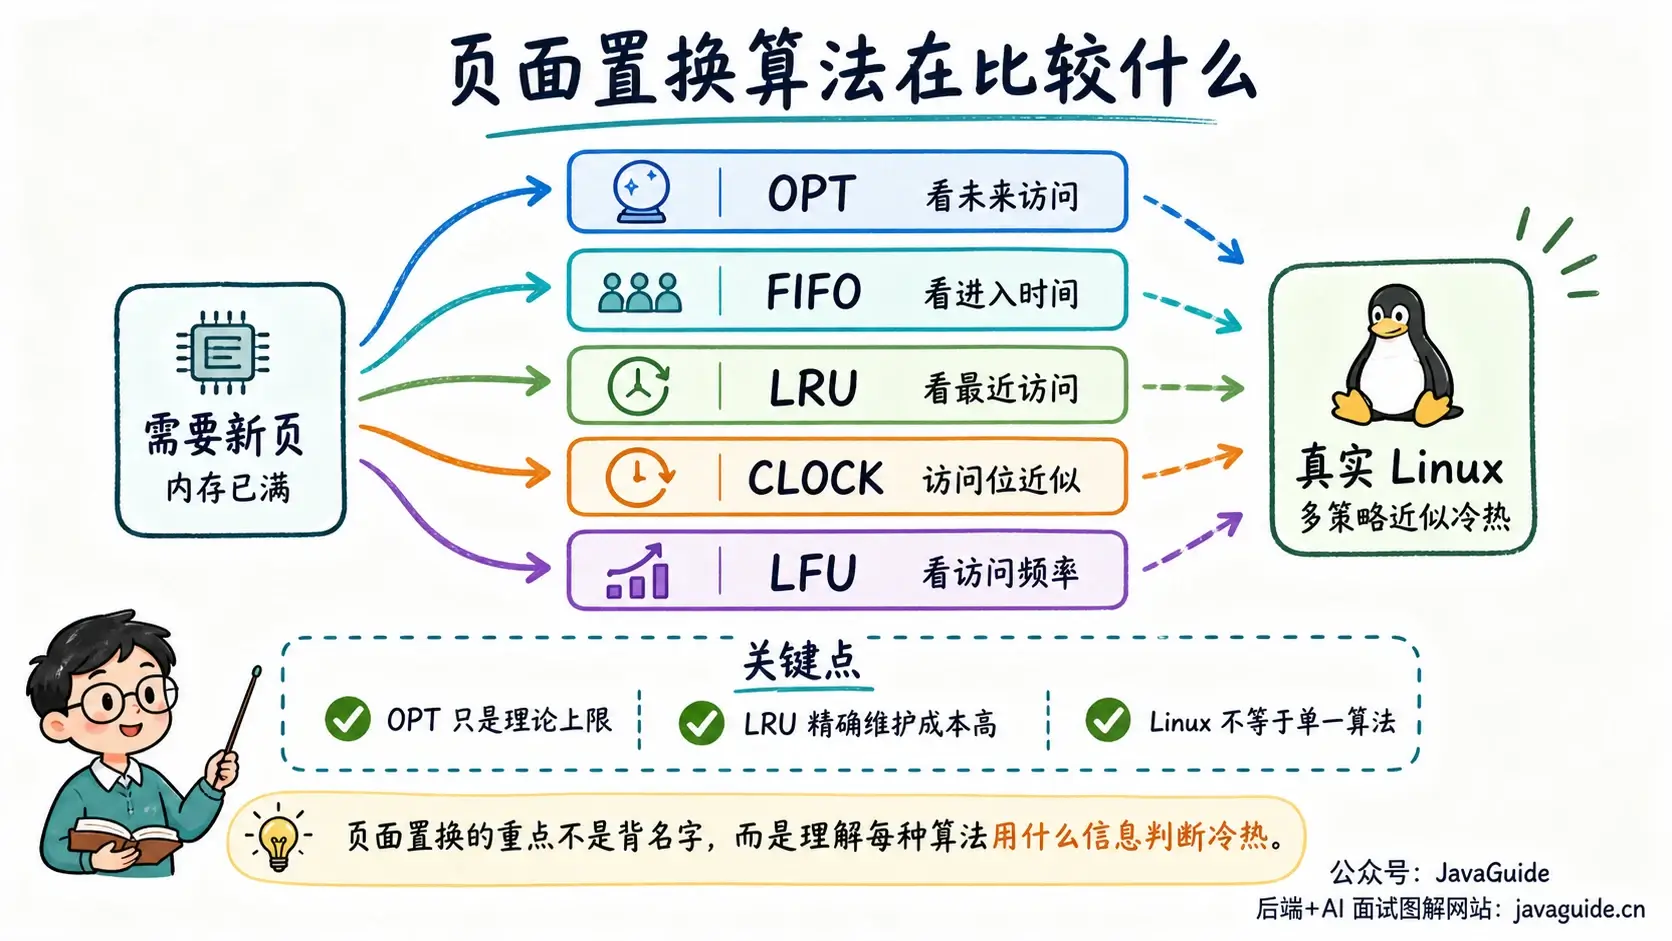
Lý tưởng nhất là OPT: đẩy ra page có thời điểm được truy cập lại xa nhất trong tương lai. Nó chỉ có thể dùng làm theoretical upper bound, vì Operating System không thể biết trước tương lai. FIFO dễ implement hơn, page nào vào memory trước thì ra trước, nhưng không quan tâm page đó còn hot hay không, thậm chí có thể xuất hiện Belady anomaly: allocation nhiều page frame hơn nhưng số page fault lại có thể tăng.
Trực giác của LRU gần với chương trình thực tế hơn: page đã lâu không được truy cập thì về sau nhiều khả năng cũng chưa được dùng lại ngay. Vấn đề nằm ở chi phí implement, vì duy trì chính xác thứ tự truy cập của từng page quá đắt. CLOCK xuất hiện như một giải pháp trung gian trong bối cảnh đó, dùng accessed bit và circular queue để cho page một “second chance”, mô phỏng LRU với chi phí thấp hơn. LFU đi theo hướng khác, eviction theo access frequency; nhưng nếu không có cơ chế decay, hot page từ giai đoạn đầu có thể chiếm chỗ rất lâu, dù về sau không còn dùng cũng khó bị đẩy ra.
Linux thực tế không áp dụng nguyên xi một algorithm trong giáo trình. Reclaim path kinh điển sử dụng file page/anonymous page, active/inactive LRU, workingset và refault cùng các cơ chế khác để gần đúng việc nhận diện page nóng/lạnh; kernel mới hơn còn có thể bật Multi-Gen LRU, dùng nhiều generation truy cập để biểu thị mức độ mới/cũ của page. File page, anonymous page, cgroup, NUMA và memory watermark đều ảnh hưởng đến reclaim path; algorithm cụ thể còn phụ thuộc vào kernel version và configuration.
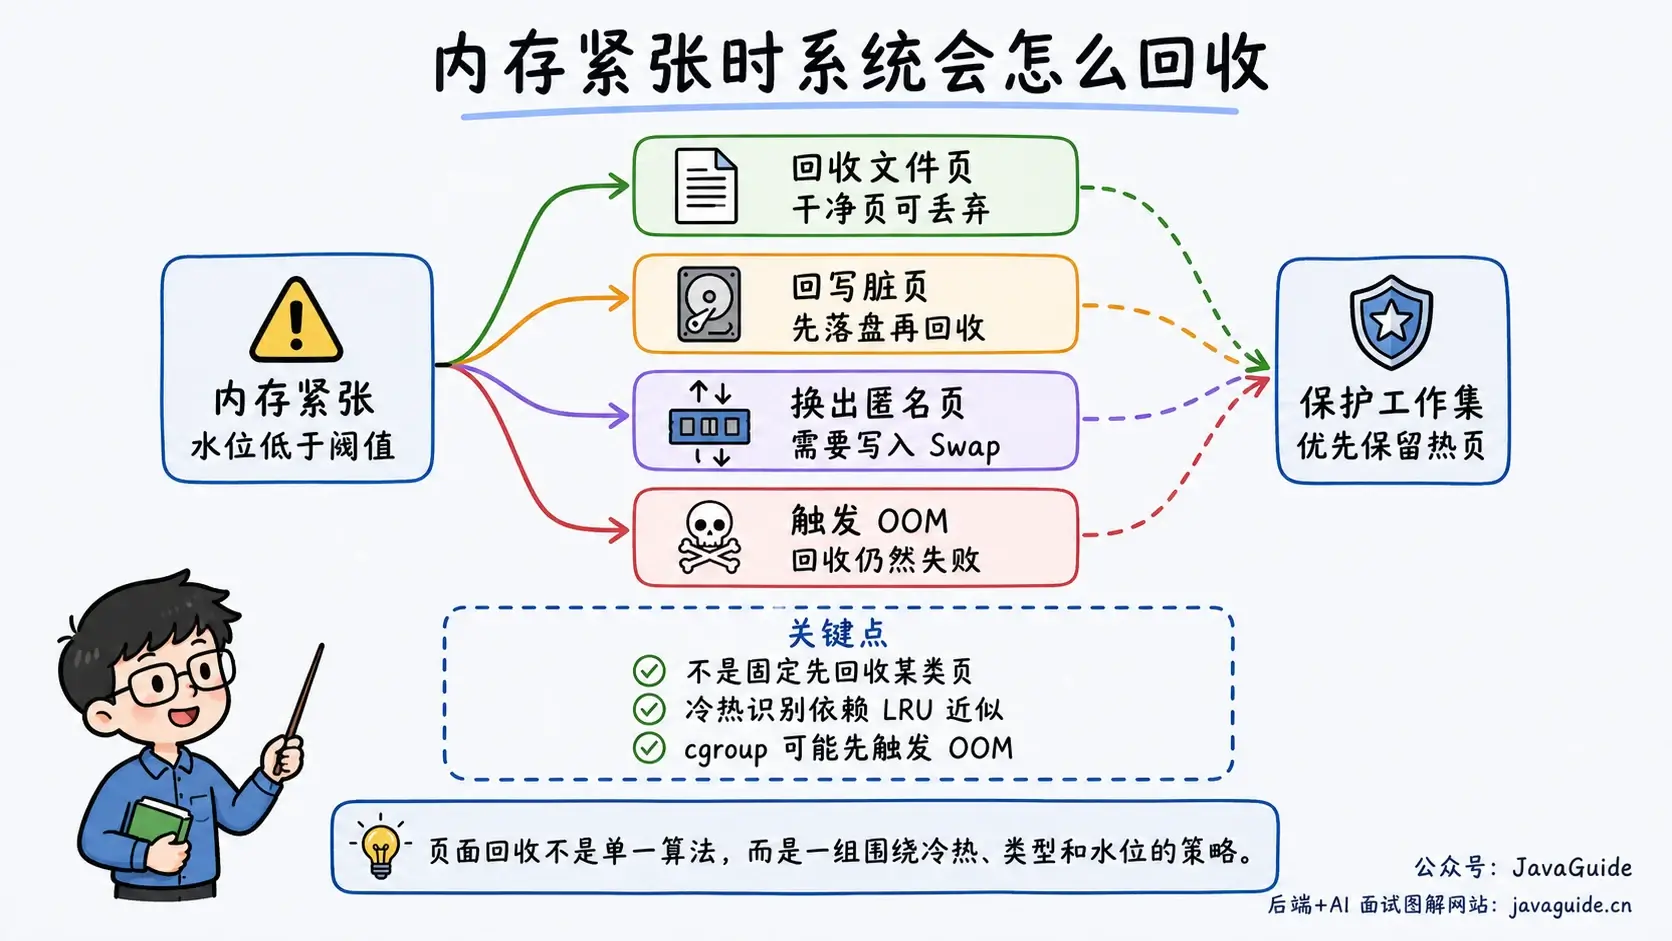
Vì vậy, nói đơn giản rằng Linux page reclaim chỉ dùng một algorithm nào đó là không chính xác. Nó giống một nhóm strategy được kết hợp xoay quanh việc bảo vệ working set, nhận diện page nóng/lạnh và kiểm soát memory watermark.
Swap, working set và thrashing
Swap không phải là “memory dư ra”, mà giống một vùng backup có tốc độ thấp hơn. Anonymous page không có nguồn file; khi memory căng thẳng, nếu cần reclaim nó thì có thể ghi vào Swap, sau này khi được truy cập lại thì đọc lại từ Swap.
Tập hợp các page mà một process thực sự đang sử dụng tích cực được gọi là working set. Chỉ cần physical memory có thể chứa working set của các process chính trong system thì page fault còn tương đối kiểm soát được; nếu không chứa đủ, page sẽ liên tục bị swap out rồi swap in, khiến system rơi vào trạng thái thrashing.
Khi thrashing, CPU nhìn bề ngoài chưa chắc đang bận với business computation, nhưng disk I/O, major fault và memory reclaim sẽ trở nên rất rõ rệt. Khi điều tra, có thể xem các metric sau:
# Toàn bộ system
free -h
vmstat 1
cat /proc/meminfo
cat /proc/pressure/memory
grep -E 'pgfault|pgmajfault|pswpin|pswpout|pgscan|pgsteal' /proc/vmstat

# Một process
grep -E 'VmSize|VmRSS|RssAnon|RssFile|RssShmem|VmSwap' /proc/<pid>/status
cat /proc/<pid>/smaps_rollup
pmap -x <pid>
perf stat -e page-faults,major-faults <command>

# Container / cgroup v2
cat /sys/fs/cgroup/memory.current
cat /sys/fs/cgroup/memory.max
cat /sys/fs/cgroup/memory.events
cat /sys/fs/cgroup/memory.pressure
Khi đọc các metric này, có thể tách theo nguồn: phía process xem RSS/PSS và smaps_rollup để xác nhận phần resident memory nằm ở anonymous page, file page hay shared memory; phía page fault xem pgmajfault và major-faults để xác định chậm do I/O hay chỉ do đang tạo mapping; phía system xem Swap, reclaim scan và PSI để xác nhận memory pressure có truyền đến business latency hay không.
Khi điều tra, đừng chỉ xem free. Linux sẽ cố gắng dùng free memory cho Page Cache, vì vậy MemFree thấp không nhất thiết biểu thị pressure rất lớn; nên kết hợp MemAvailable, mức hoạt động của Swap, major fault, reclaim scan và PSI để phán đoán. some trong PSI biểu thị có ít nhất một task bị dừng do memory pressure, còn full biểu thị tất cả task không idle đều đồng thời bị dừng vì resource tương ứng, thường phản ánh rõ hơn ảnh hưởng của memory pressure đến business latency.
Overcommit và OOM: allocation thành công không có nghĩa physical memory đã sẵn sàng
Linux có thể cho phép process commit lượng virtual memory vượt quá RAM và Swap hiện tại, cách này gọi là memory overcommit. Nó phù hợp với các chương trình request một virtual address space rất lớn nhưng chỉ thực sự sử dụng một phần trong đó.
vm.overcommit_memory thường có 3 mode:
0: đánh giá theo heuristic, từ chối request rõ ràng không hợp lý.1: cố gắng cho phép request cho đến khi resource thực sự cạn kiệt.2: sử dụng commit limit nghiêm ngặt hơn.
Vì vậy, malloc() hoặc mmap() thành công thường chỉ có nghĩa là address space và commit check đã thông qua, không có nghĩa toàn bộ physical page tương ứng đã resident. Khi page thực sự được truy cập mà kernel không thể lấy đủ memory thông qua reclaim, writeback hoặc Swap, OOM Killer có thể được kích hoạt và chọn process để terminate nhằm giải phóng resource.
Trong container, OOM trong phạm vi cgroup cũng có thể xảy ra trước. Toàn bộ host vẫn có free memory, nhưng một container vẫn có thể bị giới hạn khi đạt memory.max; memory.events của cgroup v2 sẽ ghi lại các event như high, max, oom, oom_kill.
mmap, COW và shared memory
mmap() tạo một mapping trong virtual address space của process. Nó có thể mapping file hoặc tạo anonymous mapping. Khi mapping được tạo, data không nhất thiết được đọc vào ngay; chỉ khi thực sự truy cập một page chưa resident mới có thể trigger page fault.
File mapping phù hợp với các trường hợp random access, dùng chung file page và muốn truy cập nội dung file trực tiếp qua memory address. Nó có thể giảm việc copy tường minh qua user-space buffer và số lần system call, nhưng không bảo đảm luôn nhanh hơn read()/write(); hiệu quả thực tế còn phụ thuộc vào access pattern, page fault cost, prefetch, writeback, exception handling và file size.
Khi nhiều process mapping cùng một file, kernel có thể cho phép chúng dùng chung physical page trong Page Cache. Thay đổi của MAP_SHARED có thể được các mapping khác nhìn thấy và được write back xuống file nền; MAP_PRIVATE tạo private COW mapping, việc ghi sẽ không truyền sang process khác và cũng không write back vào file gốc. Shared memory IPC cũng dựa trên ý tưởng tương tự: virtual address của các process khác nhau mapping đến cùng một nhóm physical page, việc đọc/ghi data không cần lần nào cũng đi qua copy trong kernel.
COW (Copy-On-Write) cũng rất phổ biến. Sau fork(), parent process và child process ban đầu có thể dùng chung cùng một nhóm physical page, page table đánh dấu chúng là read-only; process nào ghi trước sẽ trigger page fault, sau đó kernel copy một bản page cho bên ghi. Nhờ vậy, không cần lập tức copy toàn bộ address space khi fork().
Tuy nhiên, COW không miễn phí. Khi Redis tạo RDB snapshot, nó sẽ fork() child process, còn parent process tiếp tục xử lý write request; càng nhiều write request thì càng nhiều page bị copy và memory pressure càng lớn. Nắm được điểm này sẽ giúp hiểu nhiều vấn đề về fork, mmap, Page Cache và memory peak trong database và cache system.
Memory management liên quan gì đến Java backend?
Memory management của Operating System không chỉ nằm trong giáo trình. Java backend thường gặp nhiều hiện tượng liên quan.
JVM heap là một phần của virtual address space. -Xmx giới hạn kích thước tối đa của Java heap, nhưng RSS của process còn bao gồm metaspace, thread stack, JIT code cache, DirectBuffer, native library, file mapping bằng mmap và các phần khác. Thấy RSS lớn hơn -Xmx chưa thể trực tiếp kết luận là heap leak.
Thread stack cũng chiếm address space và physical page. Khi có nhiều platform thread, thread stack, scheduling overhead, TLB và cache invalidation đều tăng. Virtual thread có thể giảm sự phụ thuộc của nhiều blocking task vào platform thread, nhưng CPU-intensive task vẫn bị giới hạn bởi số core.
DirectBuffer và mmap không nằm trong Java heap. Chúng do JVM hoặc native code quản lý, cuối cùng vẫn nằm trong process address space và physical page. Khi điều tra, không thể chỉ xem GC log mà còn phải kết hợp NMT, pmap, smaps_rollup và các metric của cgroup.
HotSpot NMT mặc định bị tắt, cần thêm parameter khi khởi động JVM:
-XX:NativeMemoryTracking=summary
# Hoặc
-XX:NativeMemoryTracking=detail

jcmd <pid> VM.native_memory summary
NMT có thể thống kê native memory theo từng JVM subsystem, chẳng hạn Java Heap, Class, Code và Thread; nhưng nó không phải bản thống kê đầy đủ về memory của process ở cấp Operating System, cũng không bao quát allocation của mọi third-party native library. RSS/PSS, smaps_rollup và memory limit của container vẫn cần được xem cùng nhau.
Huge page không phải lúc nào cũng mang lại lợi ích. Huge page có thể giảm áp lực lên TLB, nhưng direct reclaim của THP, memory compaction, việc zeroing huge page và COW đều có thể gây biến động latency. Tài liệu chính thức của Redis đã nhắc rõ: background task của RDB/AOF phụ thuộc vào fork() và COW, khi write-intensive thì lượng memory bổ sung có thể gần bằng lượng memory sử dụng thường ngày; THP còn có thể khuếch đại chi phí COW sau fork(). JVM, database và cache system không thể dùng chung một kết luận cố định, mà cần kiểm thử theo tài liệu sản phẩm và tải thực tế.
Trả lời thế nào trong phỏng vấn?
Nếu được hỏi “Operating System memory management làm gì”, đừng bắt đầu bằng việc học thuộc các thuật ngữ như paging hay segmentation. Hãy nói mạch chính trước:
Operating System trước hết cấp cho mỗi process một virtual address space độc lập, sau đó dùng page table, TLB và MMU để dịch virtual address thành physical address. Page table không chỉ làm address translation mà còn ghi lại permission, page có đang ở trong memory hay không, có bị sửa hay không và đã được truy cập hay chưa. Khi physical memory căng thẳng, kernel sẽ dựa trên độ nóng/lạnh của page, loại page và memory watermark của system để reclaim file page hoặc anonymous page; chỉ khi cần mới sử dụng Swap.
Khi được hỏi sâu hơn về paging và segmentation, hãy đặt khác biệt vào cách “chia address space”. Paging chia theo kích thước cố định, physical memory có thể được allocation phân tán và về cơ bản loại bỏ external fragmentation phát sinh từ contiguous allocation của process; segmentation chia theo các vùng logic như code, data và stack, thể hiện cấu trúc chương trình trực quan hơn nhưng segment có độ dài không cố định, dễ để lại external fragmentation. Các system hiện đại phổ biến chủ yếu dựa vào paging, còn segmentation chủ yếu giúp hiểu thiết kế lịch sử và logical protection.
Có thể trình bày page fault theo quá trình xử lý: CPU truy cập một virtual address, nếu page table entry không tồn tại, page không ở trong memory hoặc permission không khớp thì sẽ trigger page fault. Kernel trước hết xác định lần truy cập này có hợp lệ không; truy cập không hợp lệ thường trở thành SIGSEGV, còn truy cập hợp lệ mới được thiết lập page theo loại mapping, chẳng hạn mapping page đã có trong Page Cache, allocation một anonymous page, xử lý COW hoặc đọc page từ file và Swap. minor fault thường không cần I/O, còn major fault cần I/O.
Nếu thực sự trao đổi về việc điều tra vấn đề trong production, hãy bổ sung giới hạn này: algorithm trong giáo trình phù hợp để hiểu ý tưởng, nhưng Linux memory reclaim, THP, NUMA, memory limit của cgroup, memory compression và cơ chế cache riêng của database sẽ chồng lên nhau. Khi định vị vấn đề, dùng một “LRU” để giải thích mọi hiện tượng thường là chưa đủ.