
Giải thích chi tiết giao thức ZAB: ZooKeeper Atomic Broadcast, message broadcast, crash recovery và Leader election
Là một distributed coordination framework cực kỳ ưu tú, ZooKeeper được giới chuyên môn đánh giá cao về high availability và data consistency. Nhiều người lầm tưởng ZooKeeper sử dụng thuật toán Paxos nổi tiếng, nhưng trên thực tế, “linh hồn” của nó là một consensus protocol được thiết kế riêng — ZAB (ZooKeeper Atomic Broadcast, atomic broadcast protocol).
ZAB không phải là distributed consistency algorithm dùng chung như Paxos, mà là một atomic message broadcast algorithm được thiết kế đặc biệt cho ZooKeeper và hỗ trợ crash recovery. Dựa trên ZAB protocol, ZooKeeper triển khai kiến trúc primary-backup để duy trì data consistency giữa các replica trong cluster.
Bài viết này chỉ trình bày quy trình của ZAB protocol. Nếu bạn chưa quen với ZNode, Watcher, Session và các trường hợp sử dụng của ZooKeeper, nên đọc trước Hướng dẫn nhập môn ZooKeeper. Nếu muốn hiểu trước các vấn đề dùng chung như Leader, Quorum và network partition, bạn có thể đọc Giải thích chi tiết về distributed coordination.
Vai trò và trạng thái cốt lõi của ZAB cluster
Trước khi đi sâu vào cách protocol vận hành, cần hiểu ba vai trò chính trong ZooKeeper cluster:
- Leader: nút duy nhất xử lý write request trong cluster. Leader chịu trách nhiệm khởi tạo vote và điều phối transaction; mọi write operation đều phải đi qua Leader.
- Follower: Có thể trực tiếp xử lý read request của client. Khi nhận write request, Follower chuyển tiếp request đó đến Leader. Trong quá trình Leader election, Follower có quyền bầu cử và được bầu.
- Observer: Có chức năng tương tự Follower nhưng không có quyền bầu cử và được bầu. Observer tồn tại để scale ngang read performance của cluster mà không ảnh hưởng đến consensus performance (tức không làm tăng số vote cần chờ).
Tương ứng, node trong cluster thường ở một trong bốn trạng thái sau:
LOOKING: Trạng thái tìm Leader (đang tiến hành election).LEADING: Node hiện tại là Leader và đang dẫn dắt cluster.FOLLOWING: Node hiện tại là Follower và tuân theo sự dẫn dắt của Leader.OBSERVING: Node hiện tại là Observer.
Định danh cốt lõi: ZXID và Epoch
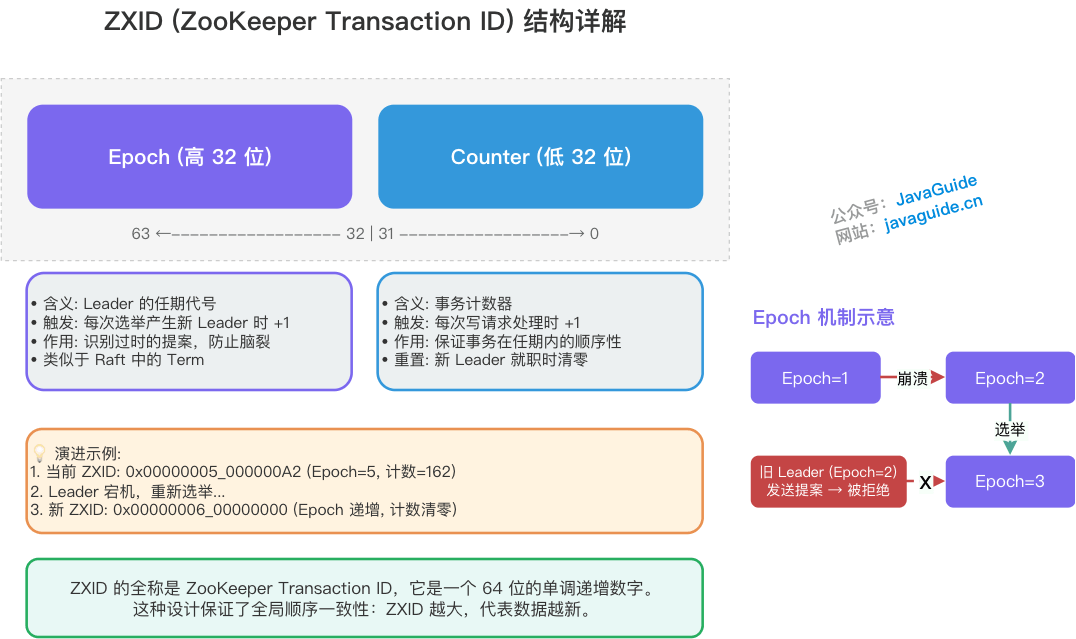
Để bảo đảm thứ tự tuyệt đối của message trong distributed environment, ZAB protocol đưa vào một transaction ID tăng đơn điệu trên toàn cục — ZXID.
ZXID là một số nguyên dài 64-bit (long):
- 32 bit cao (Epoch): Đại diện cho nhiệm kỳ của Leader hiện tại. Khi một Leader mới được bầu, Epoch tăng 1 trên cơ sở Epoch trước đó. Điều này tương tự việc thay đổi triều đại.
- 32 bit thấp (transaction ID): Một counter tăng đơn giản. Với mỗi write request của client, counter tăng 1. Khi Leader mới lên nắm quyền, 32 bit thấp được reset về 0.
Hai mode cơ bản của ZAB
ZAB protocol có thể được rút gọn thành sự luân phiên của hai mode cơ bản: message broadcast (trạng thái hoạt động bình thường) và crash recovery (trạng thái bất thường hoặc khởi động).
1. Message broadcast mode (xử lý write request bình thường)
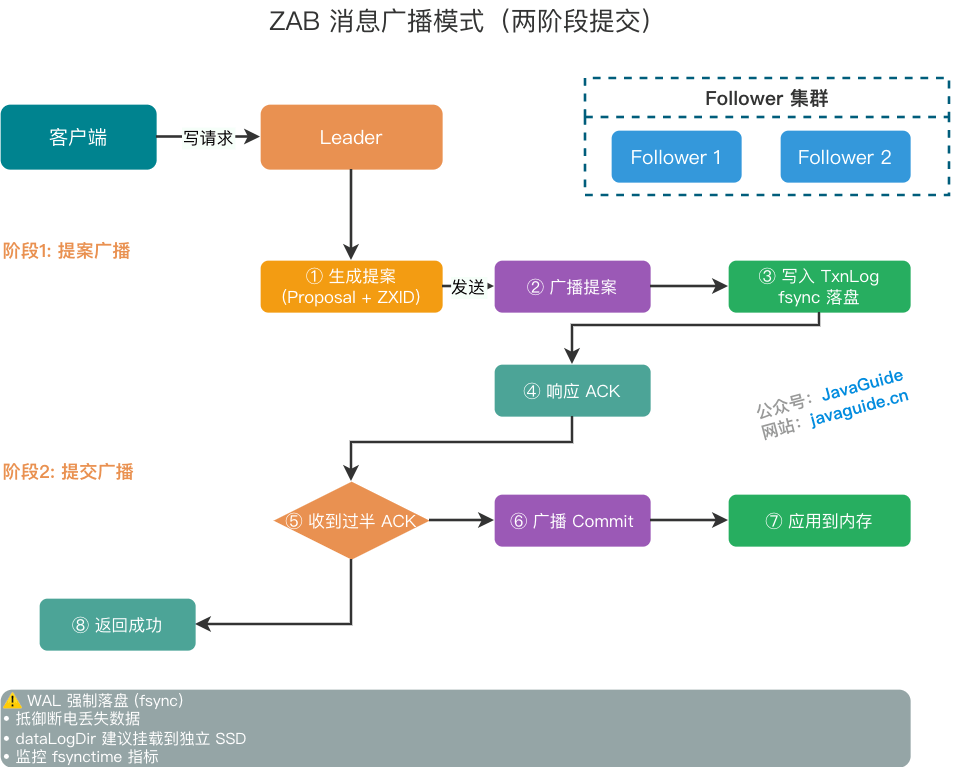
Khi cluster có Leader hoạt động bình thường và hơn một nửa node đã hoàn tất state synchronization, cluster sẽ chuyển sang message broadcast mode. Quy trình này tương tự một two-phase commit (2PC) được đơn giản hóa:
- Tạo proposal: Sau khi nhận write request, Leader chuyển request đó thành một Proposal có chứa ZXID.
- Gửi theo thứ tự: Leader duy trì một network queue first-in-first-out (FIFO) cho mỗi Follower (dựa trên TCP protocol), bảo đảm Proposal được gửi đến Follower theo thứ tự tạo ra.
- Ghi và phản hồi (WAL force flush): Sau khi nhận Proposal, Follower phải append Proposal vào transaction log cục bộ (TxnLog) và bắt buộc thực thi system call
fsyncđể flush vật lý dữ liệu trong kernel buffer xuống disk. Chỉ sau khi xác nhận dữ liệu đã thực sự được ghi xuống disk, Follower mới phản hồiACKcho Leader. Đây là tuyến phòng thủ cốt lõi của ZAB trước việc mất dữ liệu do mất điện. Vì vậy, khi triển khai vật lý, nên mount thư mục transaction log của ZooKeeper (dataLogDir) vào một SSD độc lập và không bị lock, tránh tranh chấp disk với các process có I/O cao khác, từ đó tránh việc response time P99 xấu đi dofsyncbị block. Trong production environment, phải đặc biệt monitor metricfsynctime; nếu thời gian flush trung bình thường xuyên vượt quá 100ms, cluster có thể crash bất cứ lúc nào. - Broadcast commit: Khi nhận được phản hồi
ACKtừ hơn một nửa node, Leader sẽ xem write operation đó là thành công. Khi ghi log cục bộ, Leader cập nhật quorum counter bên trong (thay vì gửiACKmột cách tường minh cho chính mình), sau khi xác nhận đạt quá bán thì trả response thành công cho client và broadcast messageCommitđến mọi node. Sau khi nhậnCommit, Follower chính thức apply data vào memory.
2. Crash recovery mode (Leader down hoặc network exception)
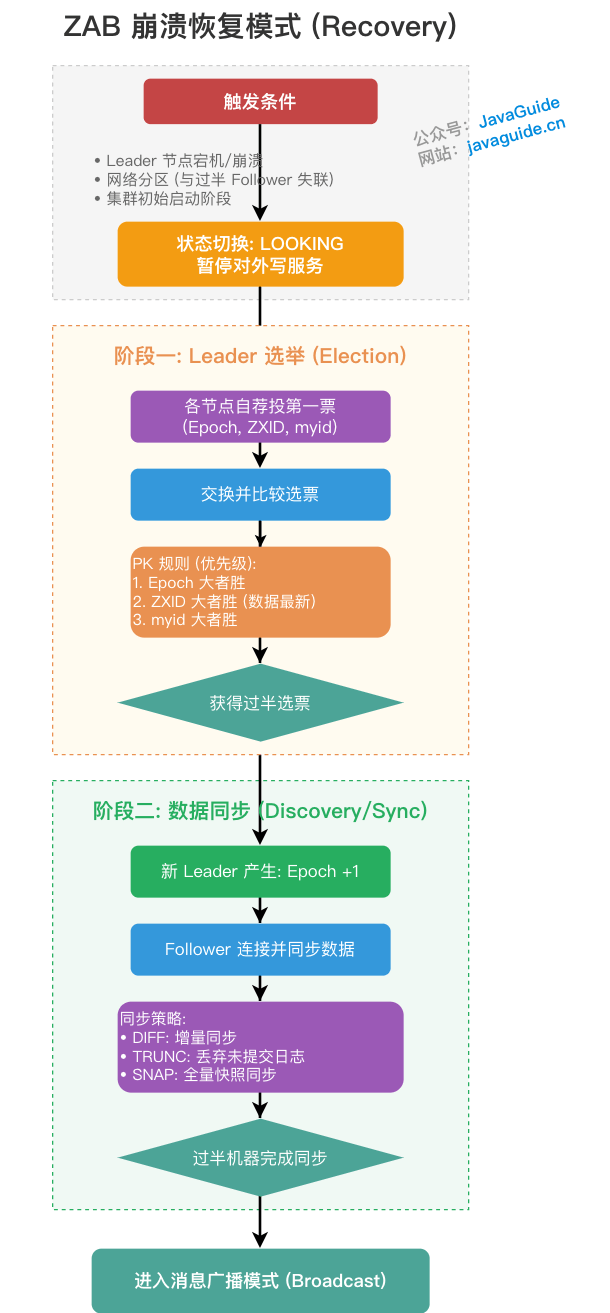
Khi system vừa khởi động, hoặc server Leader crash hay mất liên lạc với hơn một nửa Follower, toàn bộ cluster sẽ tạm dừng cung cấp service ra bên ngoài, chuyển sang trạng thái LOOKING và trigger crash recovery mode. Crash recovery chủ yếu gồm hai phase: Leader election và data recovery.
Phase một: Leader election
Nguyên tắc cốt lõi của election là: node có data mới nhất được ưu tiên bầu làm Leader. Mỗi node trước tiên tự bỏ một vote cho mình; thông tin vote chứa (Epoch, ZXID, myid). Sau đó, các node trao đổi vote và thực hiện PK theo thứ tự sau:
- So sánh Epoch: Epoch lớn hơn được ưu tiên.
- So sánh ZXID: Nếu Epoch giống nhau, ZXID lớn hơn được ưu tiên (đại diện cho data mới hơn).
- So sánh myid: Nếu hai giá trị trước giống nhau, server có định danh duy nhất
myidlớn hơn được ưu tiên.
Ngay khi một node nhận được hơn một nửa vote, node đó sẽ trở thành Leader mới. (Đây cũng là lý do ZooKeeper khuyến nghị deploy số server lẻ: có thể đạt fault tolerance quá bán với chi phí thấp nhất.)
Phase hai: data recovery
Bầu được Leader mới chỉ là bước đầu. Để bảo đảm data consistency, ZAB phải đạt được hai bảo đảm cực kỳ quan trọng trong phase data synchronization:
- Bảo đảm transaction đã commit trên Leader cũ cuối cùng được commit trên mọi node. (Ngăn mất data.)
- Loại bỏ những transaction mới chỉ được đề xuất trên Leader cũ nhưng chưa kịp commit. (Ngăn dirty data gây nhiễu.)
Leader mới tìm Epoch lớn nhất hiện tại và tăng 1 để làm Epoch mới, sau đó đối chiếu với tất cả Follower. Follower gửi record mới nhất trong transaction log của mình là lastZxid (bao gồm Proposal đã được đề xuất nhưng chưa commit). Dựa trên giá trị này, Leader áp dụng strategy đồng bộ tùy trường hợp: differential incremental synchronization (DIFF), bắt buộc loại bỏ uncommitted log (TRUNC) hoặc truyền snapshot toàn bộ (SNAP).
Thiết kế này cực kỳ quan trọng: Leader cần xác định chính xác liệu trong log của Follower còn sót lại “phantom Proposal” mà Leader cũ chưa hoàn tất commit hay không, từ đó mới có thể gửi đúng lệnh TRUNC để truncate và rollback. Nếu chỉ báo cáo ZXID đã commit, dirty data chưa commit này sẽ không thể được phát hiện và nhánh TRUNC sẽ không bao giờ được trigger.
Quan trọng hơn, Epoch mới đã có hiệu lực tại thời điểm này. Nếu Leader cũ bị “giả chết” do JVM trigger Full GC kéo dài hàng chục giây, khi tỉnh lại và cố broadcast Proposal sử dụng Epoch cũ đến cluster, các node sẽ thẳng thừng từ chối và loại bỏ những phantom Proposal đó, vì hơn một nửa node đã ghi nhận Epoch mới cao hơn và đã commit quorum với Leader mới. ZAB miễn nhiễm với network partition trong network environment về bản chất nhờ sự kết hợp của Epoch mechanism + majority quorum — chỉ dùng Epoch để từ chối là chưa đủ; phải có hơn một nửa node đã kết nối với Leader mới thì Leader cũ mới thực sự mất write capability.
Khi hơn một nửa machine hoàn tất state synchronization và data synchronization với Leader mới, ZAB protocol sẽ thoát êm khỏi crash recovery mode và trở lại message broadcast mode.
So sánh với Raft
Điểm tương đồng cao giữa ZAB và Raft: Nếu đã tìm hiểu thuật toán Raft, bạn sẽ thấy chúng rất giống nhau. Cả hai đều có một primary node duy nhất, đều dùng Epoch/Term để định danh nhiệm kỳ và đều áp dụng strategy chỉ cần hơn một nửa node xác nhận là có thể commit. Điều này cho thấy trong lĩnh vực distributed consensus hiện đại, kiến trúc dựa trên primary-backup và majority election đã trở thành tiêu chuẩn trên thực tế.
Trong thực tiễn distributed system hiện nay, Raft thường được xem là lựa chọn thực dụng và phổ biến hơn ZAB. Lý do là ngay từ khi thiết kế, Raft đã nhấn mạnh tính dễ hiểu và khả năng triển khai; Raft tách riêng Leader election, log replication và safety một cách rõ ràng, giúp developer dễ triển khai và debug chính xác hơn. Trong khi đó, ZAB là protocol độc quyền của ZooKeeper, tập trung hơn vào các yêu cầu đặc thù của atomic broadcast nên tính dùng chung kém hơn.
Raft đã được ứng dụng rộng rãi trong các system hiện đại như etcd của Kubernetes, Hashicorp Consul, Apache Kafka (trong phiên bản KIP-500 đã loại bỏ dependency vào ZooKeeper và chuyển sang KRaft dựa trên Raft), TiKV. Điều này đã “dân chủ hóa” mạnh mẽ việc phát triển distributed consensus.
Ngược lại, ZAB chủ yếu gắn với ZooKeeper. Dù ZooKeeper vẫn là một coordination service kinh điển, nhiều project mới có xu hướng chọn Raft để tránh complexity bổ sung và bottleneck tiềm ẩn của ZooKeeper (chẳng hạn consensus overhead ở quy mô lớn).
Ngoài ra, Raft có community support tích cực hơn và phát triển nhiều biến thể tối ưu (chẳng hạn các phiên bản cải tiến dùng cho blockchain), khiến Raft có ưu thế hơn về efficiency và trường hợp sử dụng. Tuy nhiên, nếu system của bạn đã tích hợp sâu với ZooKeeper, ZAB vẫn là lựa chọn được tối ưu nhất; ngược lại, với thiết kế mới hoặc nhu cầu consensus dùng chung, Raft là tiêu chuẩn thực dụng hơn hiện nay.
Tổng kết
Thông qua Leader election và majority confirmation mechanism được thiết kế cẩn thận, ZAB protocol lựa chọn giữa partition tolerance (P) và consistency (C) trong distributed system (đáp ứng thuộc tính CP). Khi xảy ra network partition, ZAB chấp nhận hy sinh availability (A) trong thời gian ngắn để election, đồng thời bảo đảm data consistency.
Cần đặc biệt nhấn mạnh rằng ZAB protocol mặc định không bảo đảm strong consistency nghiêm ngặt (linearizability), mà cung cấp sequential consistency.
Vì Follower có thể trực tiếp xử lý read request của client và không bắt buộc data phải đồng bộ tuyệt đối, client hoàn toàn có thể đọc stale data (Stale Read) chậm hơn Leader. Trong production environment, nếu nghiệp vụ liên quan đến các trường hợp yêu cầu data freshness cực cao như distributed lock, phải gọi tường minh primitive sync() trước khi thực hiện operation read(), buộc Follower mà connection đang kết nối đến phải catch up transaction state machine của Leader.
Khi xảy ra network partition, nếu client kết nối đến Follower thuộc minority bị cô lập, dù write operation sẽ thất bại, client vẫn có thể đọc data đã hết hạn. Đây là boundary case cần cân nhắc khi sử dụng ZAB protocol.