
Giải thích chi tiết thuật toán Raft: bầu chọn Leader, sao chép log, tính an toàn và thay đổi thành viên
Bài viết do SnailClimb và Xieqijun cùng thực hiện.
1 Bối cảnh
Trong kiến trúc Internet ngày nay, để chịu được lưu lượng khổng lồ, hệ thống thường cần mở rộng bằng cách bổ sung máy theo chiều ngang. Khi số lượng máy tăng lên, các sự cố như máy sập, mất mạng trở thành chuyện thường ngày. Làm thế nào để nhóm server có thể mất kết nối bất cứ lúc nào này giữ được nhịp hoạt động nhất quán và không cung cấp dữ liệu sai lệch ra bên ngoài? Đây là lúc distributed consensus algorithm phát huy tác dụng.
Năm 2014, Diego Ongaro và những người khác công bố thuật toán Raft. Nó ra đời với một sứ mệnh rất rõ ràng: giải cứu các lập trình viên bị thuật toán Paxos hành hạ. Raft tập trung vào việc “dễ hiểu”, tách bài toán consensus phức tạp thành một số module độc lập:
- Leader election: sử dụng election timeout ngẫu nhiên (trong thực tế thường là 150–300ms hoặc một phạm vi lớn hơn, tùy thuộc vào network và failure model).
- Log replication: Leader broadcast log thông qua AppendEntries RPC.
- Tính an toàn: bao gồm giới hạn bầu chọn và log matching.
Raft được ứng dụng rộng rãi trong production. Các implementation dựa trên Raft như etcd, Consul đã trở thành thành phần quan trọng của distributed system. Sau đó, giới học thuật và ngành công nghiệp cũng mở rộng và tối ưu Raft theo nhiều hướng, bao gồm:
- Pre-Vote (2014): ngăn node trong network partition can thiệp vào việc bầu chọn của cluster ổn định
- Read Index (2014): tối ưu read performance bằng linearizable read trong nhiệm kỳ của Leader
- Lease Read: giải pháp linearizable read dựa trên lease
- Joint Consensus: cơ chế consensus kết hợp dùng cho việc thay đổi thành viên cluster (bằng cách đưa vào một configuration chuyển tiếp, quy trình điển hình là configuration cũ → configuration kết hợp → configuration mới)
Vì vậy, hệ thống phải xử lý việc server online và offline trong quá trình hoạt động bình thường. Chúng phải phản ứng với sự cố và tự động thích nghi trong vài giây; đối với khách hàng, một sự gián đoạn rõ rệt thường là không thể chấp nhận.
May mắn là distributed consensus có thể giúp ứng phó với những thách thức này.
1.1 So sánh với việc “chọn Leader” trong điều kiện không Byzantine
Raft có một giả định tiền đề: Crash Fault Tolerance không Byzantine (CFT). Nói đơn giản, các node có thể sập hoặc mất mạng, nhưng tuyệt đối không có node nội gián truyền tin giả.
Ta có thể dùng hình ảnh “các vị tướng chọn thống soái” để hiểu sơ bộ quy trình này: giả sử có ba vị tướng A, B, C và hiện tại không có người đứng đầu. Mỗi người có một bộ đếm ngược ngẫu nhiên trong đầu (election timeout). Ai kết thúc đếm ngược trước sẽ đứng ra hô lớn: “Tôi muốn làm thống soái, hãy bỏ phiếu cho tôi!”. Nếu các vị tướng khác chưa bắt đầu tranh cử và cũng chưa bỏ phiếu cho người khác, họ sẽ thuận theo và đồng ý. Khi vị tướng này nhận được hơn một nửa số phiếu tán thành, ông ta trở thành người đứng đầu (Leader). Từ đó mọi quyết định đều theo ông ta. Nếu sứ giả chết giữa đường và mọi người không nhận được phản hồi, họ sẽ reset bộ đếm ngược và bắt đầu lại một vòng.
1.2 Consensus algorithm là gì?
Mục tiêu cốt lõi của consensus algorithm là khiến một nhóm máy trông giống như một máy duy nhất. Chỉ cần hơn một nửa số máy trong cluster còn hoạt động, toàn bộ hệ thống vẫn có thể phục vụ bình thường.
Điều này thường được thực hiện thông qua replicated state machine: gửi cho mỗi node một cuốn sổ cái (log) giống hệt nhau. Chỉ cần mọi node thực thi các command trong sổ theo cùng một thứ tự, kết quả cuối cùng đương nhiên sẽ hoàn toàn giống nhau. Vì vậy, về bản chất consensus algorithm chỉ làm một việc: đảm bảo sổ cái của mọi node hoàn toàn nhất quán. Consensus là một bài toán nền tảng trong hệ thống fault-tolerant: ngay cả khi có sự cố, server vẫn có thể đạt được sự đồng thuận về shared state.
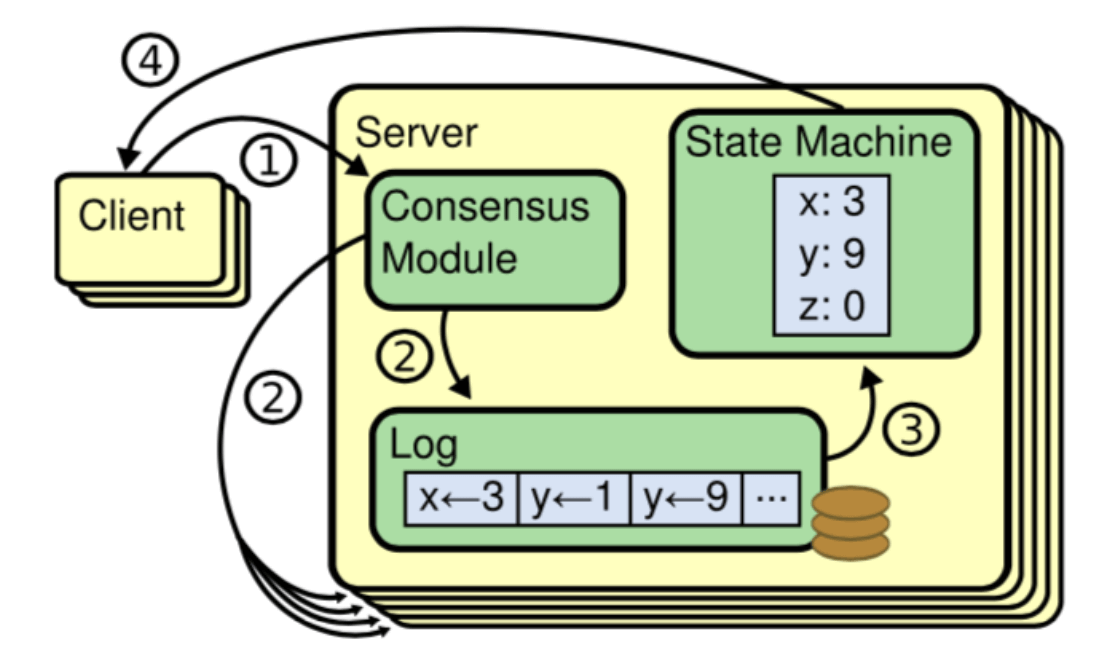
2 Khái niệm cơ bản
Trước khi đi sâu vào Raft, trước hết cần làm quen với ba role cốt lõi, cơ chế term và cấu trúc log.
2.1 Loại node
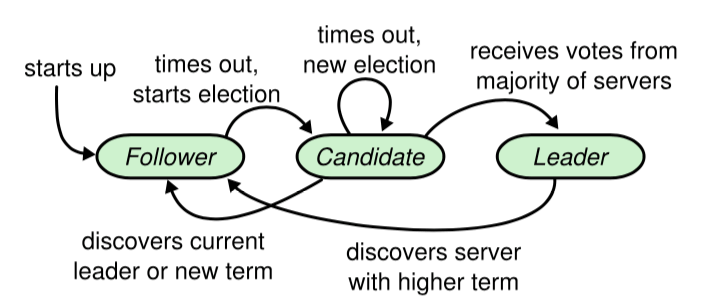
Một Raft cluster gồm một số server, lấy cluster 5 server điển hình làm ví dụ. Tại mọi thời điểm, mỗi server chắc chắn ở một trong ba state sau:
- Leader: người đứng đầu. Chịu trách nhiệm toàn bộ việc tiếp nhận client, ghi sổ và đồng bộ sổ cho các node khác. Để ngăn người khác chiếm quyền, Leader phải liên tục gửi heartbeat cho toàn bộ node, thông báo “tôi vẫn còn sống”.
- Follower: node tuân thủ. Bình thường tuyệt đối không chủ động gửi request, chỉ bị động nhận heartbeat và đồng bộ log từ Leader.
- Candidate: state tạm thời. Nếu node này mãi không nhận được heartbeat từ Leader, nó sẽ cho rằng mình có thể đảm nhận vai trò đó, chuyển thành Candidate và bắt đầu vận động bỏ phiếu.
Trong điều kiện bình thường, chỉ có một server là Leader, các server còn lại là Follower. Follower ở trạng thái bị động; chúng không gửi request mà chỉ phản hồi request từ Leader và Candidate.
2.2 Term
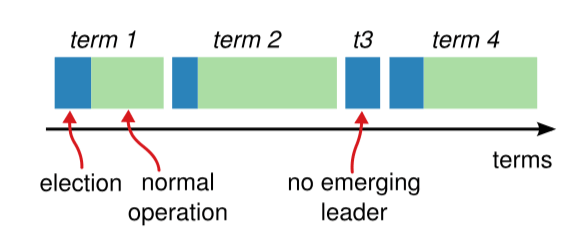
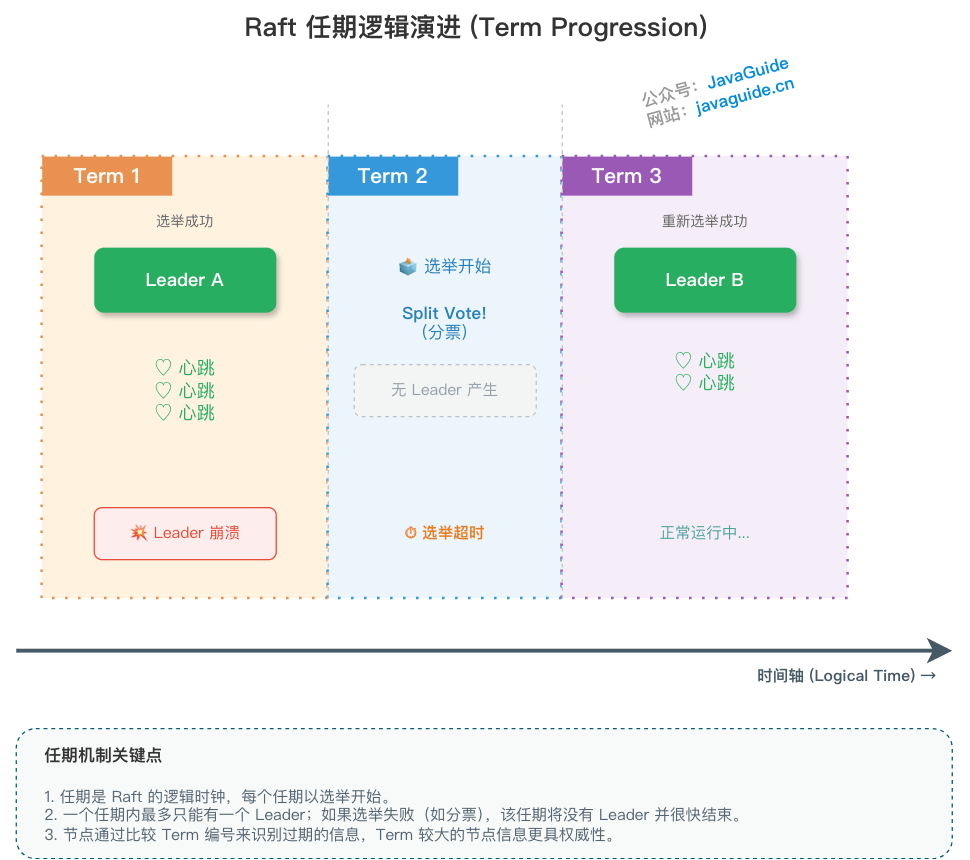
Thuật toán Raft chia thời gian thành các term có độ dài tùy ý, được biểu diễn bằng các số liên tiếp và xem như số term hiện tại. Mỗi term bắt đầu bằng một cuộc bầu chọn. Khi cuộc bầu chọn bắt đầu, một hoặc nhiều Candidate sẽ cố gắng trở thành Leader. Nếu một Candidate thắng bầu chọn, nó sẽ giữ vai trò Leader trong term đó. Nếu không bầu được Leader (ví dụ xảy ra split vote), term đó có thể không có Leader; sau election timeout mới, hệ thống sẽ chuyển sang term tiếp theo và khởi động lại cuộc bầu chọn. Chỉ cần phần lớn node khả dụng và network cuối cùng có thể kết nối, hệ thống thường sẽ bầu được Leader sau một vài vòng bầu chọn.
Mỗi node lưu số term hiện tại. Khi các server giao tiếp, chúng trao đổi số term hiện tại; nếu một server phát hiện số term của mình nhỏ hơn node khác, nó sẽ cập nhật lên term lớn hơn. Nếu Candidate hoặc Leader phát hiện term của mình đã cũ, nó lập tức quay về Follower. Nếu server nhận được request có số term đã cũ, nó sẽ từ chối request đó.
Sơ đồ dưới đây do tôi tự vẽ, dễ hiểu hơn một chút:
2.3 Log
Chỉ Leader có quyền append record (Entry) vào sổ cái. Một log có ba thành phần cốt lõi: <term hiện tại, index, command cụ thể>.
Có hai progress pointer rất quan trọng:
- commitIndex: progress của log mà mọi node đều công nhận đã được ghi an toàn (đã được replicate tới hơn một nửa số node).
- lastApplied: progress của log đã thực sự được máy này execute xong ở local.
3 Bầu chọn Leader
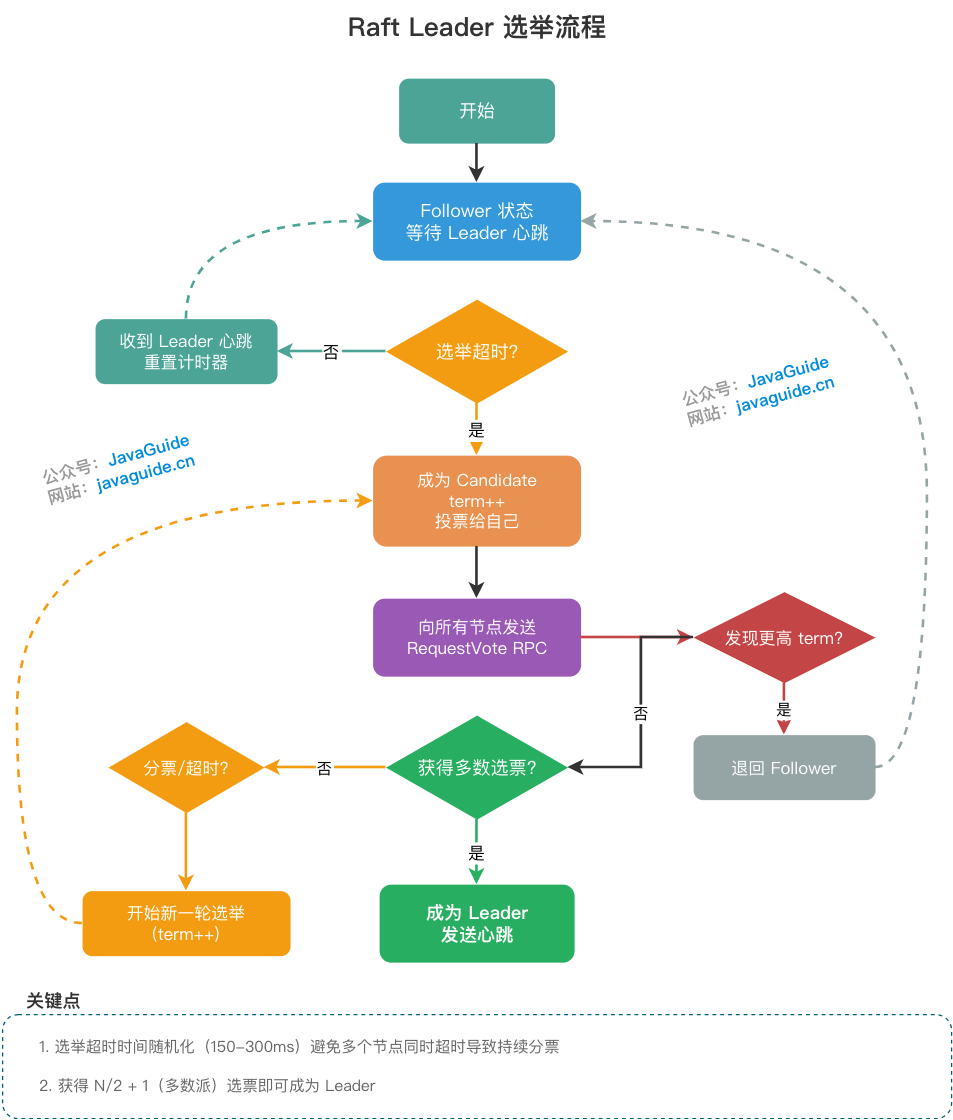
Raft sử dụng cơ chế heartbeat để trigger việc bầu chọn Leader.
Nếu một server liên tục nhận được AppendEntries (heartbeat hoặc log replication) và các RPC hợp lệ khác từ Leader, nó sẽ giữ state Follower và refresh election timer.
Leader định kỳ gửi heartbeat tới mọi Follower để duy trì vai trò Leader của mình. Nếu một Follower không nhận được heartbeat trong một khoảng thời gian, điều đó được gọi là election timeout. Khi đó, nó cho rằng hiện không có Leader khả dụng và bắt đầu một cuộc bầu chọn để chọn Leader mới.
Để bắt đầu cuộc bầu chọn mới, Follower tăng số term của mình và chuyển state thành Candidate. Sau đó, nó gửi request RequestVote RPC tới mọi node. Candidate sẽ duy trì state này cho đến khi một trong các tình huống sau xảy ra:
- Thắng bầu chọn
- Node khác thắng bầu chọn
- Một vòng bầu chọn kết thúc nhưng không ai thắng
Điều kiện để thắng bầu chọn là: Candidate nhận được đa số phiếu trong cluster trong một term ((N/2+1)) thì có thể trở thành Leader.
Trong khi Candidate chờ phiếu, nó có thể nhận được heartbeat từ node khác tuyên bố mình là Leader. Khi đó có hai trường hợp:
- Nếu số term của Leader đó lớn hơn hoặc bằng số term của mình, nghĩa là đối phương đã trở thành Leader, node này sẽ quay về Follower.
- Nếu số term của Leader đó nhỏ hơn số term của mình, node này sẽ từ chối request và yêu cầu node kia cập nhật term.
Do có thể xuất hiện nhiều Candidate cùng lúc, không Candidate nào nhận được đa số phiếu. Nếu không có cách nào khác để phân phối lại phiếu, tình trạng này có thể lặp vô hạn.
Raft sử dụng election timeout ngẫu nhiên để tránh tình huống trên. Mỗi Candidate sau khi bắt đầu bầu chọn sẽ random một election timeout mới. Cơ chế này giúp các server phân tán thời điểm timeout; trong phần lớn trường hợp, chỉ một server timeout trước. Nó sẽ thắng bầu chọn trước khi các server khác timeout.
4 Log replication
Ngay khi Leader được bầu, nó bắt đầu tiếp nhận request từ client. Mỗi request của client chứa một command cần được replicated state machine (Replicated State Machine) execute.
Sau khi nhận request từ client, Leader tạo một entry chứa <index,term,cmd>, thêm entry này vào cuối log của mình, rồi broadcast entry tới mọi node và yêu cầu các server khác replicate entry đó.
Nếu Follower chấp nhận entry, nó sẽ thêm entry vào cuối log của mình và trả về xác nhận đồng ý cho Leader.
Nếu Leader nhận được response cho biết phần lớn Follower đã replicate log thành công, Leader sẽ tiến commitIndex của mình. Sau đó, nó lần lượt apply các log đã commit vào state machine rồi trả kết quả cho client.
Cần lưu ý một giới hạn quan trọng: Leader chỉ có thể tiến commitIndex dựa trên việc “log được tạo trong term hiện tại (current term) đã replicate thành công trên majority”. Đối với log còn lại từ các term trước, ngay cả khi chúng đã được replicate tới phần lớn node, Leader cũng không nên chỉ dựa vào majority để commit trực tiếp. Thông thường, Leader sẽ commit một log mới của term hiện tại (cách phổ biến là append và commit một log no-op sau khi được bầu), từ đó gián tiếp thúc đẩy các log lịch sử được commit cùng.
Follower không tự quyết định commit point. Chúng biết index lớn nhất hiện có thể commit từ leaderCommit đi kèm trong AppendEntries RPC của Leader, cập nhật commitIndex local thành min(leaderCommit, lastLogIndex), rồi lần lượt apply vào state machine.
4.1 Log Matching Property
Raft đảm bảo log tuyệt đối không bị phân nhánh thông qua Log Matching Property. Đây là một trong những nền tảng của tính an toàn trong Raft. Property này gồm hai đảm bảo cốt lõi:
- Đảm bảo một: nếu entry ở cùng vị trí index trong hai log có cùng term, cmd mà chúng lưu trữ chắc chắn giống nhau
- Đảm bảo hai: nếu entry ở cùng vị trí index trong hai log có cùng term, mọi entry trước vị trí đó cũng hoàn toàn giống nhau
Chứng minh bằng quy nạp
Log Matching Property được đảm bảo bằng quy nạp:
- Trường hợp cơ sở: khi log rỗng, property đương nhiên đúng
- Bước quy nạp: giả sử log hoàn toàn giống nhau trước index N. Khi Leader cố gắng append entry N+1, consistency check của AppendEntries RPC đảm bảo:
Tham số AppendEntries RPC:
- prevLogIndex: index của log trước đó (vị trí mà Leader cho rằng đã khớp với Follower)
- prevLogTerm: term của log trước đó
- entries[]: các log entry mới đang chờ append
Logic consistency check:
- Sau khi nhận request AppendEntries, Follower kiểm tra vị trí index = prevLogIndex trong log local
- Nếu entry.term ở vị trí đó == prevLogTerm, điều đó cho biết log của Leader và Follower hoàn toàn giống nhau trước prevLogIndex, nên vượt qua kiểm tra
- Nếu vị trí không tồn tại hoặc term không khớp, Follower từ chối append và trả về thất bại
Điểm then chốt: bằng cách kiểm tra cặp prevLogIndex và prevLogTerm, Leader và Follower có thể đảm bảo về mặt toán học rằng lịch sử log của chúng nhất quán. Chỉ khi “điểm nhất quán cuối cùng đã biết” thực sự khớp thì log mới được append. Điều này tạo thành chuỗi truyền dẫn của phép chứng minh quy nạp:
entry[0] nhất quán → entry[1] nhất quán → entry[2] nhất quán → ... → entry[N] nhất quán
       ↑_____________xác minh đệ quy qua prevLogIndex/prevLogTerm_____________↑
Vì vậy, sẽ không bao giờ có tình huống hai giá trị khác nhau tại cùng một vị trí index cùng được “commit” — nói cách khác, log không bị phân nhánh.
Tối ưu trong implementation
Trong implementation production thực tế (như etcd 3.5.x), ngoài consistency check cơ bản ở trên, còn có một số tối ưu:
Fast Backup: khi consistency check của AppendEntries thất bại, Follower trả về term tương ứng với log xung đột và các index biên của term đó (entry đầu tiên và cuối cùng của term). Leader dựa vào đó để bỏ qua cả đoạn xung đột trong một lần, thay vì giảm nextIndex từng bước và retry.
Bảo vệ khỏi retry storm: dưới tải cao, có thể xuất hiện rất nhiều lần retry do AppendEntries thất bại. Implementation thường bổ sung:
- Jitter backoff: thêm dao động ngẫu nhiên vào khoảng retry để tránh nhiều Follower retry cùng lúc
- Backpressure: giới hạn tốc độ retry của từng Follower, ngăn việc chiếm dụng quá nhiều network bandwidth
Những tối ưu này không ảnh hưởng đến tính đúng đắn về lý thuyết của Log Matching Property, mà chỉ nâng cao hiệu quả phục hồi của hệ thống trong các tình huống bất thường.
4.2 Phục hồi khi log không nhất quán
Trong điều kiện hoạt động bình thường, sổ cái của Leader và Follower được đồng bộ hoàn toàn. Tuy nhiên, khi Leader cũ đột ngột sập, trong quá trình chuyển giao giữa Leader cũ và mới, cluster thường còn lại nhiều dữ liệu chưa khớp.
Khi đó, request đồng bộ AppendEntries do Leader mới khởi tạo sẽ trigger lỗi consistency check. Raft xử lý xung đột dữ liệu theo một nguyên tắc rất dứt khoát: sổ cái của Leader hiện tại là chuẩn cao nhất, mọi record không nhất quán ở local của Follower đều phải bị xóa và ghi đè.
Cụ thể, Leader sẽ lần ngược như kéo khóa kéo để tìm node lịch sử cuối cùng mà hai bên hoàn toàn khớp. Sau khi tìm được “điểm phân nhánh”, Follower sẽ xóa toàn bộ phần dữ liệu lộn xộn sau điểm đó và nghiêm túc copy log mới nhất do Leader cung cấp.
Ở cấp độ code, Leader lưu riêng một sổ theo dõi cho từng Follower trong memory. Pointer cốt lõi có tên nextIndex (vị trí log tiếp theo dự kiến gửi cho Follower đó). Khi vừa đảm nhận vai trò, Leader tự tin đặt nextIndex của mọi Follower thành index của log mới nhất của mình cộng một. Nếu dữ liệu của Follower thực sự bị tụt lại hoặc có xung đột, lần AppendEntries đầu tiên chắc chắn bị từ chối. Sau đó có hai cách tìm điểm phân nhánh:
- Cách đơn giản truyền thống (thử từng entry): khi gặp trở ngại thì lùi lại một bước. Leader giảm
nextIndexđi một rồi gửi RPC để thử lại. Nếu vẫn không được, nó tiếp tục giảm một, lùi từng entry như rùa bò, cho đến khi hai bên hoàn toàn khớp. - Tối ưu tăng tốc cấp production (Fast Backup): trong môi trường production thực tế, việc lùi từng entry là thảm họa performance. Vì vậy, ngành công nghiệp đưa vào cơ chế Fast Backup. Khi từ chối đồng bộ, Follower không chỉ đơn giản lắc đầu mà còn đưa ra thông tin: “đống log lộn xộn này thuộc term lịch sử nào và biên đầu cuối của term đó ở đâu”. Leader nhận được thông tin này sẽ lập tức vượt qua toàn bộ term lỗi trong một lần, giảm đáng kể số lần retry network dư thừa.
Sau quá trình giằng co này, nextIndex cuối cùng sẽ neo chính xác vào điểm bắt đầu consensus của hai bên. Lúc này, AppendEntries nhận được response thành công, dữ liệu xung đột trên Follower bị xóa hoàn toàn và log chính thống còn thiếu được bổ sung khớp từng phần. Sau khi vượt qua trở ngại này, sổ cái của hai bên có thể duy trì sự nhất quán cao trong toàn bộ term.
5 Tính an toàn
5.1 Giới hạn bầu chọn
Leader cần đảm bảo mình lưu trữ toàn bộ log entry đã commit. Nhờ vậy, log entry chỉ chảy theo một hướng: từ Leader tới Follower; Leader sẽ không bao giờ ghi đè log entry đã tồn tại.
Mỗi khi gửi RequestVote RPC, Candidate đều kèm thông tin của entry cuối cùng. Khi nhận thông tin bỏ phiếu, mọi node sẽ so sánh entry đó. Nếu phát hiện log của mình mới hơn, node sẽ từ chối bỏ phiếu cho Candidate đó.
Cách xác định log nào mới hơn: nếu term của hai log khác nhau, term lớn hơn là mới hơn; nếu term giống nhau, index dài hơn là mới hơn.
5.2 Quy tắc commit (chỉ commit log của term hiện tại)
Khi Leader tiến commitIndex, điều kiện cần thỏa mãn là “một log được tạo trong term hiện tại đã được replicate tới majority”. Đối với log còn lại từ term cũ, ngay cả khi chúng đã được replicate tới majority, Leader cũng không nên chỉ dựa vào đó để commit trực tiếp; thông thường sẽ commit một log mới của term hiện tại (thường là no-op) để gián tiếp commit các log lịch sử. Giới hạn này nhằm tránh vấn đề an toàn trong đó log đã commit bị ghi đè khi Leader liên tục chuyển đổi.
5.3 Node sập và network partition
Nếu Follower hoặc Candidate sập, cách xử lý đơn giản hơn nhiều. Các RequestVote RPC và AppendEntries RPC gửi tới chúng sau đó sẽ thất bại. Vì mọi request của Raft đều idempotent, hệ thống có thể retry vô hạn khi thất bại. Sau khi node khôi phục, nó có thể nhận request mới rồi chọn append hoặc từ chối entry.
Nếu Leader sập, node không nhận được heartbeat trong electionTimeout sẽ trigger một vòng bầu Leader mới. Trước khi hoàn tất bầu chọn, hệ thống thường không thể cung cấp linearizable write ra bên ngoài (cũng như linearizable read), tạo thành một availability window.
Phân tích định lượng: trong cluster 5 node, availability window sau khi Leader sập thường nhỏ hơn 1 giây (P99 < 500ms election timeout + thời gian của một vòng bầu chọn). Đây là biểu hiện của PACELC theorem: khi xảy ra partition (P), hệ thống chọn hy sinh availability (A) để đảm bảo consistency (C). Cơ chế retry idempotent đảm bảo node có thể an toàn bắt kịp data state sau khi khôi phục.
Cô lập một node và vấn đề Term Inflation
Trong thuật toán Raft tiêu chuẩn, network isolation của một node có thể gây ra vấn đề Term Inflation, dẫn đến tình trạng “tiền xấu đuổi tiền tốt”: một node thiểu số bị cô lập phá vỡ sự ổn định của cluster khỏe mạnh sau khi khôi phục.
Mô phỏng tình huống:
Giả sử cluster 5 node, Leader là node A, Follower là B, C, D, E. Lúc này node E gặp network partition và bị cô lập hoàn toàn:
Vùng bình thường: {A, B, C, D}    (Leader A + majority, có thể phục vụ bình thường)
Vùng bị cô lập: {E} (cô lập một node, không thể nhận heartbeat)| Timeline | Vùng bình thường {A, B, C, D} | Vùng bị cô lập {E} |
|---|---|---|
| T0 | Leader A phục vụ bình thường, Term = 5 | E không nhận heartbeat, election timeout |
| T1 | Cluster tiếp tục hoạt động bình thường | E tự tăng Term và bắt đầu bầu chọn (Term 6), nhưng không có response |
| T2 | ... | E tiếp tục tự tăng (Term 7, 8, ...), giả sử tăng đến Term 99 |
| T3 | Network khôi phục, E tham gia cluster với Term 99 | E broadcast RequestVote (Term 99) tới {A, B, C, D} |
| T4 | Node A nhận Term 99 > Term 5 của mình, buộc phải thoái vị | “Term cao” của E phá vỡ cluster khỏe mạnh |
Phân tích vấn đề:
- {A, B, C, D} là majority hợp lệ (4/5), hệ thống đáng lẽ phải tiếp tục hoạt động bình thường
- Node E là minority (1/5), việc nó bị cô lập không nên ảnh hưởng đến toàn bộ cluster
- Vấn đề then chốt: Term Inflation của E khiến Leader A khỏe mạnh buộc phải ngừng hoạt động
- Hậu quả: toàn bộ cluster phải bầu chọn lại, gây gián đoạn write không cần thiết
Đây là một giới hạn đã biết của Raft tiêu chuẩn: “cuộc bầu chọn điên cuồng” của node minority có thể can thiệp vào hoạt động bình thường của majority.
Cơ chế Pre-Vote
Để giải quyết vấn đề trên, extension Pre-Vote của Raft được đề xuất. Pre-Vote yêu cầu node thực hiện một vòng “pre-vote” trước khi thực sự bắt đầu bầu chọn:
- Giai đoạn pre-vote: Candidate gửi PreVoteRequest tới các node khác, kèm thông tin log của mình
- Điều kiện pre-vote:
- Log của Candidate ít nhất phải mới bằng log của receiver (giới hạn bầu chọn)
- Receiver xác nhận kết nối giữa mình và Leader đã bị ngắt (không nhận heartbeat trong thời gian dài hơn
electionTimeout)
- Bầu chọn chính thức: chỉ sau khi nhận được response PreVote từ majority node, Candidate mới thực sự tăng term và gửi RequestVote
Pre-Vote ngăn Term Inflation như thế nào:
- Trong tình huống cô lập một node ở trên, khi E khởi tạo Pre-Vote trong thời gian bị cô lập, các node khác vẫn nhận được heartbeat từ Leader A
- Vì vậy, các node khác sẽ từ chối request PreVote của E (vì kết nối với Leader vẫn bình thường)
- E không thể nhận được majority response PreVote nên không thực sự tăng Term
- Sau khi network khôi phục, Term của E vẫn thấp và không can thiệp vào Leader A khỏe mạnh
Tư tưởng cốt lõi: chỉ sau khi xác nhận mất kết nối với Leader, node mới bắt đầu thực sự tăng Term. Điều này ngăn hiệu quả việc Term Inflation của node minority can thiệp vào majority.
Cơ chế Pre-Vote đã được ứng dụng rộng rãi trong các Raft implementation production như etcd, TiKV và Consul.
5.4 Thời gian và availability
Một trong các yêu cầu của Raft là tính an toàn không phụ thuộc vào thời gian: hệ thống không được tạo ra lỗi chỉ vì một số event xảy ra nhanh hoặc chậm hơn dự kiến. Để đảm bảo yêu cầu trên, tốt nhất nên thỏa mãn điều kiện thời gian sau:
broadcastTime << electionTimeout << MTBF
broadcastTime: thời gian response trung bình khi gửi message đồng thời tới các node khác;electionTimeout: thời gian election timeout;MTBF(mean time between failures): thời gian hoạt động trung bình của một máy trước khi xảy ra failure;
broadcastTime nên nhỏ hơn electionTimeout một bậc độ lớn, để Leader có thể liên tục gửi heartbeat nhằm ngăn Follower bắt đầu bầu chọn;
electionTimeout cũng nên nhỏ hơn MTBF vài bậc độ lớn, để hệ thống hoạt động ổn định. Khi Leader sập, hệ thống sẽ không khả dụng trong khoảng thời gian xấp xỉ toàn bộ electionTimeout; ta mong tình huống này chỉ chiếm một phần rất nhỏ trong tổng thời gian.
Vì broadcastTime và MTBF là các thuộc tính do hệ thống quyết định, cần quyết định giá trị của electionTimeout.
Nói chung, broadcastTime thường là 0.5~20ms, electionTimeout có thể đặt là 10~500ms (trong thực tế thường là 150–300ms), còn MTBF thường là một hoặc hai tháng.
6 Tham khảo
- https://tanxinyu.work/raft/
- https://github.com/OneSizeFitsQuorum/raft-thesis-zh_cn/blob/master/raft-thesis-zh_cn.md
- https://github.com/ongardie/dissertation/blob/master/stanford.pdf
- https://knowledge-sharing.gitbooks.io/raft/content/chapter5.html
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.