
Giải thích chi tiết các phương án triển khai distributed lock: Redis, Redlock, ZooKeeper và Watch Dog của Redisson
Thông thường, chúng ta sẽ chọn Redis hoặc ZooKeeper để triển khai distributed lock. Redis được dùng nhiều hơn, nên trước hết tôi sẽ lấy Redis làm ví dụ để giới thiệu cách triển khai distributed lock.
Bài viết này mặc định bạn đã biết vì sao cần distributed lock. Nếu chưa nắm rõ lock granularity, owner token, lock timeout và business critical section, bạn nên đọc trước Nhập môn distributed lock. Nếu muốn hiểu lock expiration, việc client cũ khôi phục và Fencing Token trong một mô hình coordination lớn hơn, bạn có thể đọc thêm Giải thích chi tiết về distributed coordination.
Triển khai distributed lock dựa trên Redis
Làm thế nào triển khai một distributed lock đơn giản nhất dựa trên Redis?
Dù là local lock hay distributed lock, cốt lõi đều là “mutual exclusion”.
Trong Redis, lệnh SETNX có thể giúp triển khai mutual exclusion. SETNX là SET if Not eXists (tương ứng với method setIfAbsent trong Java). Lệnh này chỉ set value cho key khi key chưa tồn tại. Nếu key đã tồn tại, SETNX không làm gì cả.
> SETNX lockKey uniqueValue
(integer) 1
> SETNX lockKey uniqueValue
(integer) 0
Để release lock, chỉ cần dùng lệnh DEL xóa key tương ứng.
> DEL lockKey
(integer) 1
Để tránh xóa nhầm lock của client khác, nên dùng Lua script để kiểm tra value tương ứng với key có phải unique value đã ghi khi lock hay không, rồi mới xóa nếu kiểm tra hợp lệ.
Chọn Lua script nhằm bảo đảm tính atomic của thao tác unlock. Khi Redis thực thi Lua script, script được chạy theo cách atomic, nhờ đó thao tác release lock cũng được bảo đảm atomic.
-- Khi release lock, trước hết kiểm tra value của key có phải unique value đã ghi khi lock hay không, rồi mới xóa để tránh xóa nhầm lock do client khác nắm giữ
if redis.call("get", KEYS[1]) == ARGV[1] then
    return redis.call("del", KEYS[1])
else
    return 0
end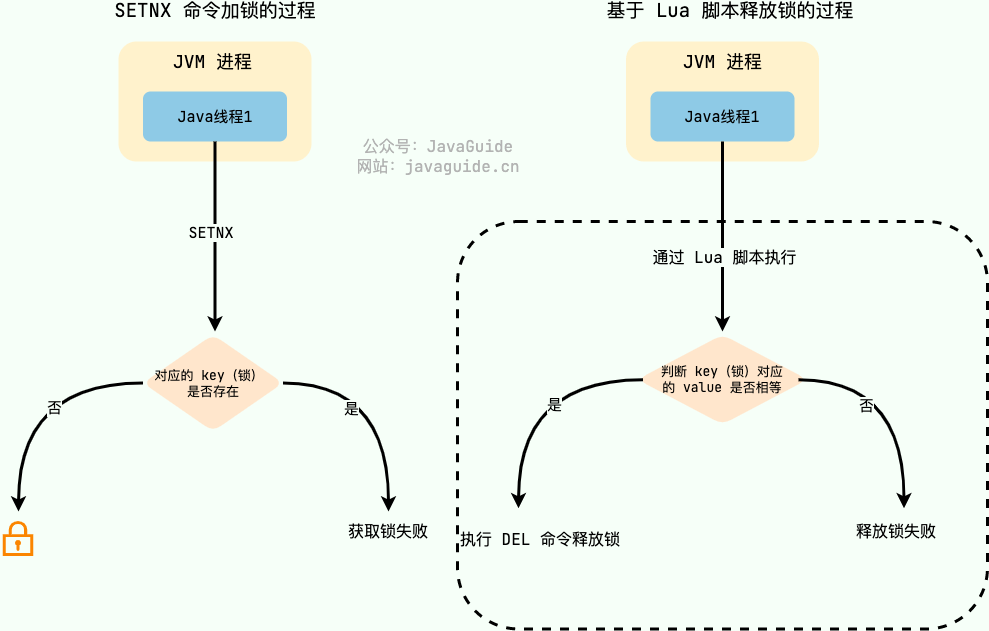
Đây là cách triển khai distributed lock bằng Redis đơn giản nhất, cách làm đơn giản và performance cũng rất tốt. Tuy nhiên, cách này vẫn có vấn đề. Chẳng hạn, nếu ứng dụng gặp sự cố khiến logic release lock đột ngột dừng lại, lock có thể không được release, khiến thread/process khác không thể truy cập shared resource.
Vì sao cần đặt thời gian expiration cho lock?
Để tránh lock không được release, một giải pháp dễ nghĩ đến là: đặt thời gian expiration cho key này, tức lock.
127.0.0.1:6379> SET lockKey uniqueValue EX 3 NX
OK- lockKey: tên lock được dùng để lock;
- uniqueValue: chuỗi ngẫu nhiên có thể định danh duy nhất lock;
- NX: chỉ khi value của key tương ứng với lockKey không tồn tại thì SET mới thành công;
- EX: thiết lập thời gian expiration, tính bằng giây.
EX 3nghĩa là lock tự động hết hạn sau 3 giây. Tương ứng vớiEXlàPX, tính bằng millisecond; cả hai đều dùng để thiết lập thời gian expiration.
Phải bảo đảm việc set value cho key và việc set thời gian expiration là một thao tác atomic!!! Nếu không, lock vẫn có thể không được release.
Vì sao dùng SET NX EX thay vì SETNX rồi EXPIRE? Cách thường gặp trước đây là hai thao tác SETNX rồi EXPIRE. Nếu client crash sau khi SETNX thành công nhưng trước khi chạy EXPIRE, một lock vĩnh viễn sẽ bị để lại. Từ Redis 2.6.12, Redis hỗ trợ cách ghi atomic SET key value NX EX seconds, nên ưu tiên dùng cách này để tránh nguy cơ deadlock.
Cách này đúng là giải quyết được vấn đề, nhưng cũng có lỗ hổng: nếu thời gian thao tác trên shared resource dài hơn thời gian expiration, lock sẽ hết hạn sớm, khiến distributed lock mất hiệu lực. Nếu đặt timeout của lock quá dài, performance lại bị ảnh hưởng.
Đây cũng là nguyên nhân cần Fencing Token ở phần sau: chỉ kéo dài TTL không thể loại bỏ khoảng thời gian “client A vẫn nghĩ mình đang giữ lock, nhưng lock thực tế đã hết hạn và được client B lấy”.
Có thể bạn đang nghĩ: nếu thao tác trên shared resource chưa hoàn tất thì lock có thể tự gia hạn sẽ tốt biết bao!
Làm thế nào gia hạn lock một cách hiệu quả?
Với developer Java, đã có sẵn giải pháp: Redisson. Giải pháp cho các ngôn ngữ khác có thể tìm trong tài liệu chính thức của Redis tại: https://redis.io/docs/latest/develop/clients/patterns/distributed-locks/.
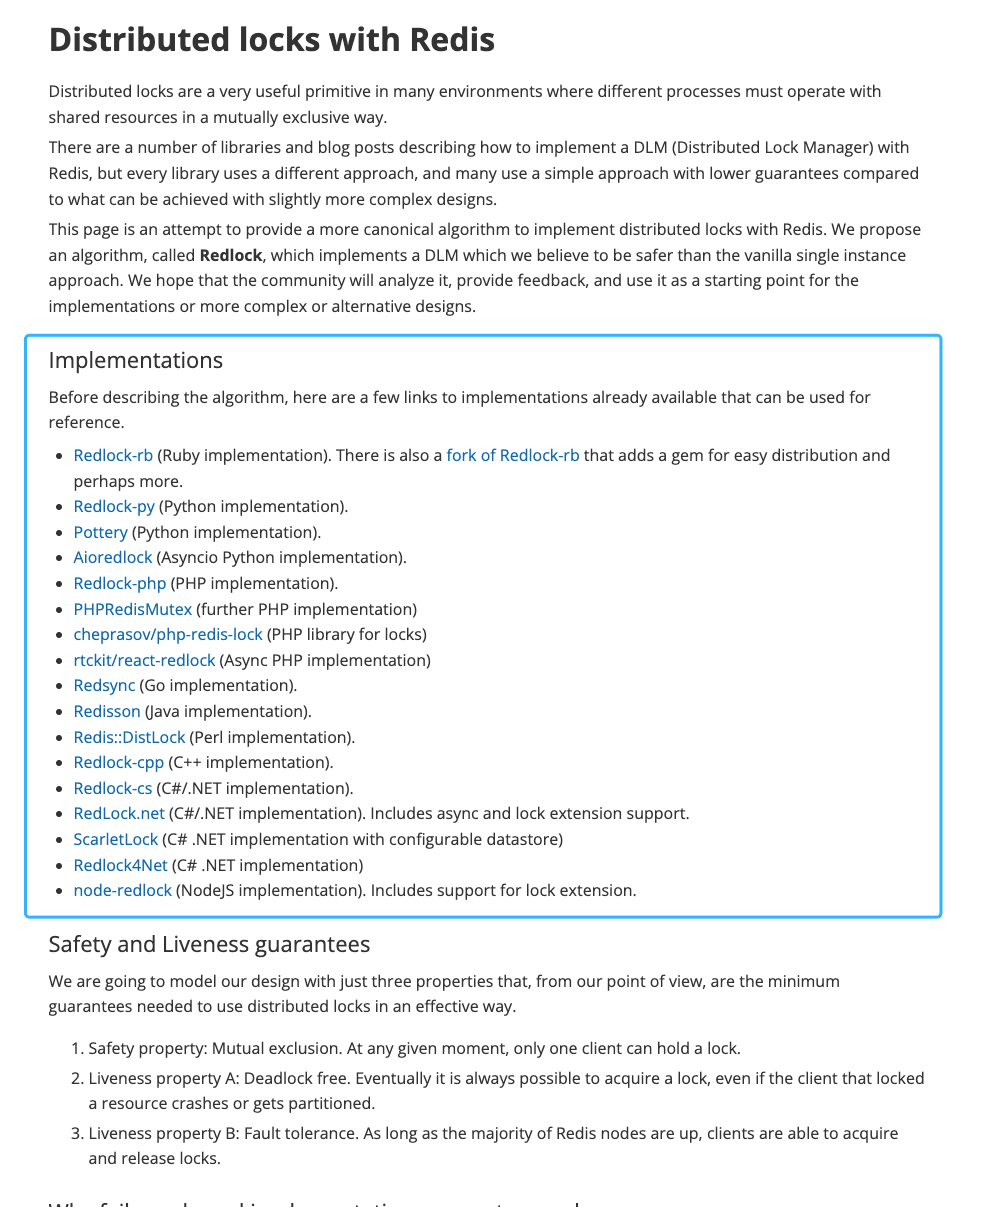
Redisson là Redis client mã nguồn mở cho Java, cung cấp nhiều tính năng dùng được ngay, không chỉ nhiều cách triển khai distributed lock. Redisson còn hỗ trợ nhiều deployment architecture như Redis standalone, Redis Sentinel và Redis Cluster.
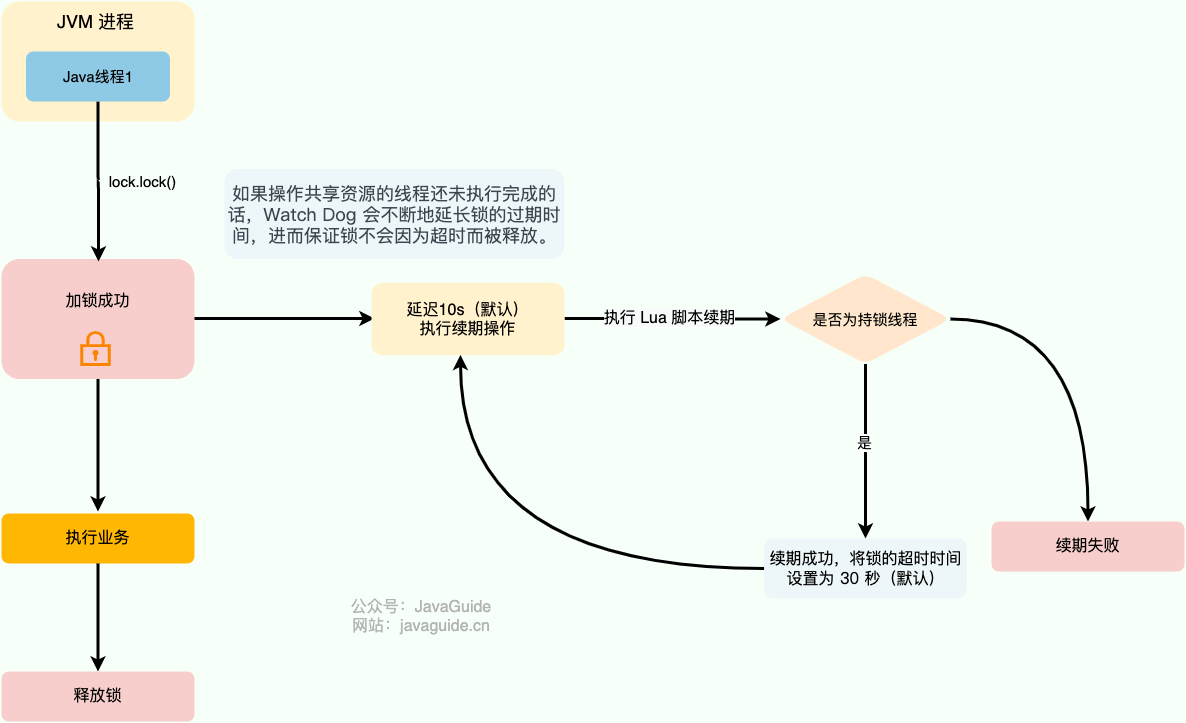
Distributed lock trong Redisson có cơ chế tự động gia hạn, cách dùng và nguyên lý đều khá đơn giản. Redisson cung cấp một Watch Dog (watchdog) chuyên theo dõi và gia hạn lock. Nếu thread thao tác trên shared resource chưa thực thi xong, Watch Dog sẽ liên tục kéo dài thời gian expiration của lock, nhờ đó lock không bị release do timeout.
Tên Watch Dog bắt nguồn từ method getLockWatchdogTimeout(). Method này trả về thời gian expiration dùng để Watch Dog gia hạn lock, mặc định là 30 giây (dựa trên redisson-3.17.6). Redisson hiện đã ở phiên bản 4.x; ý nghĩa cấu hình cụ thể nên căn cứ vào source code Config#getLockWatchdogTimeout và RedissonBaseLock#renewExpiration của phiên bản thực tế trong project.
// Mặc định 30 giây, có thể thay đổi
private long lockWatchdogTimeout = 30 * 1000;

public Config setLockWatchdogTimeout(long lockWatchdogTimeout) {
    this.lockWatchdogTimeout = lockWatchdogTimeout;
    return this;
}
public long getLockWatchdogTimeout() {
   return lockWatchdogTimeout;
}
Method renewExpiration() chứa logic chính của Watch Dog:
private void renewExpiration() {
         //......
        Timeout task = commandExecutor.getConnectionManager().newTimeout(new TimerTask() {
            @Override
            public void run(Timeout timeout) throws Exception {
                //......
                // Gia hạn bất đồng bộ, dựa trên Lua script
                CompletionStage<Boolean> future = renewExpirationAsync(threadId);
                future.whenComplete((res, e) -> {
                    if (e != null) {
                        // Không thể gia hạn
                        log.error("Can't update lock " + getRawName() + " expiration", e);
                        EXPIRATION_RENEWAL_MAP.remove(getEntryName());
                        return;
                    }

                    if (res) {
                        // Kích hoạt lần gia hạn tiếp theo qua chuỗi callback của timer, không phải đệ quy trên stack nên không làm call stack tăng vô hạn
                        renewExpiration();
                    } else {
                        // Hủy gia hạn
                        cancelExpirationRenewal(null);
                    }
                });
            }
         // Gọi lại sau internalLockLeaseTime/3 (mặc định 10s, tức 30/3)
        }, internalLockLeaseTime / 3, TimeUnit.MILLISECONDS);

        ee.setTimeout(task);
    }
Theo mặc định, cứ mỗi 10 giây Watch Dog thực hiện gia hạn, đặt timeout của lock thành 30 giây. Trước khi gia hạn, Watch Dog cũng kiểm tra xem có cần gia hạn hay không; nếu không cần thì hủy thao tác gia hạn.
Watch Dog thực hiện gia hạn bất đồng bộ cho lock bằng method renewExpirationAsync():
protected CompletionStage<Boolean> renewExpirationAsync(long threadId) {
    return evalWriteAsync(getRawName(), LongCodec.INSTANCE, RedisCommands.EVAL_BOOLEAN,
            // Kiểm tra có phải thread đang giữ lock hay không; nếu đúng thì gia hạn, đặt thời gian expiration của lock thành 30s (mặc định)
            "if (redis.call('hexists', KEYS[1], ARGV[2]) == 1) then " +
                    "redis.call('pexpire', KEYS[1], ARGV[1]); " +
                    "return 1; " +
                    "end; " +
                    "return 0;",
            Collections.singletonList(getRawName()),
            internalLockLeaseTime, getLockName(threadId));
}
Có thể thấy method renewExpirationAsync thực chất gọi Lua script để gia hạn. Mục đích chính là bảo đảm tính atomic của thao tác gia hạn.
Ở đây dùng implementation reentrant lock RLock của Redisson để minh họa cách dùng Redisson triển khai distributed lock:
// 1. Lấy object distributed lock được chỉ định
RLock lock = redisson.getLock("lock");
// 2. Lấy lock mà không đặt timeout, có cơ chế Watch Dog tự động gia hạn
lock.lock();
// 3. Thực hiện nghiệp vụ
...
// 4. Release lock
lock.unlock();
Chỉ khi không chỉ định timeout cho lock thì cơ chế Watch Dog tự động gia hạn mới được sử dụng.
// Đặt thời gian expiration cho lock thủ công, không có cơ chế Watch Dog tự động gia hạn
lock.lock(10, TimeUnit.SECONDS);
Nếu dùng Redis để triển khai distributed lock, thường nên dùng trực tiếp Redisson.
Làm thế nào triển khai reentrant lock?
Reentrant lock là lock mà một thread có thể lấy cùng một lock nhiều lần. Ví dụ, khi một thread đang thực thi method có lock và method đó lại gọi một method khác cần cùng lock, thread đó có thể trực tiếp thực thi method được gọi mà không cần lấy lock lại. synchronized và ReentrantLock trong Java đều là reentrant lock.
Distributed lock không reentrant về cơ bản đã đáp ứng được phần lớn business scenario; một số scenario đặc biệt mới có thể cần distributed lock reentrant.
Ý tưởng cốt lõi của distributed reentrant lock là khi thread lấy lock, hãy kiểm tra lock có phải của chính nó hay không. Nếu đúng thì không cần lấy lại. Vì vậy, có thể gắn với mỗi lock một reentrant counter và một thread đang chiếm lock. Khi reentrant counter lớn hơn 0, lock đang bị chiếm; cần kiểm tra thread đang chiếm lock có phải thread đang request lấy lock hay không.
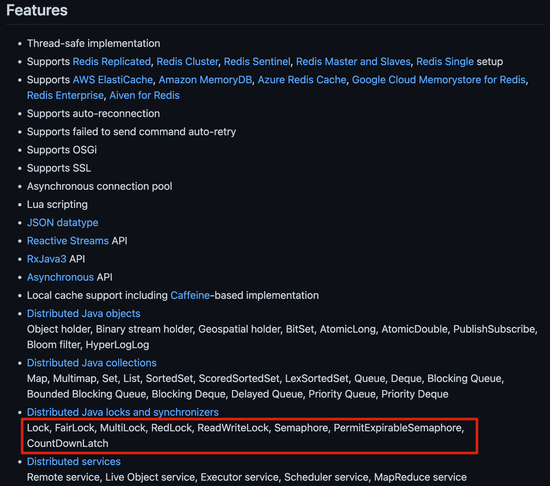
Trong project thực tế, không cần tự triển khai. Nên dùng Redisson đã đề cập ở trên. Redisson tích hợp nhiều loại lock như reentrant lock (Reentrant Lock), spin lock (Spin Lock), fair lock (Fair Lock), multi-lock (MultiLock), RedLock và read-write lock (ReadWriteLock).
Redis giải quyết reliability của distributed lock trong môi trường cluster như thế nào?
Để tránh single point of failure, Redis trong production thường được deploy theo cluster.
Trong Redis cluster, implementation distributed lock đã giới thiệu ở trên có một số vấn đề. Replication master-slave của Redis mặc định là asynchronous: sau khi master ghi lock thành công, nó lập tức trả về client rồi mới đồng bộ bất đồng bộ sang replica. Nếu master crash trước khi đồng bộ, cơ chế failover của Sentinel hoặc Redis Cluster có thể nâng replica chưa nhận dữ liệu lock lên làm master mới. Khi đó lock cũ bị mất, client khác có thể lock lại, phá vỡ mutual exclusion.
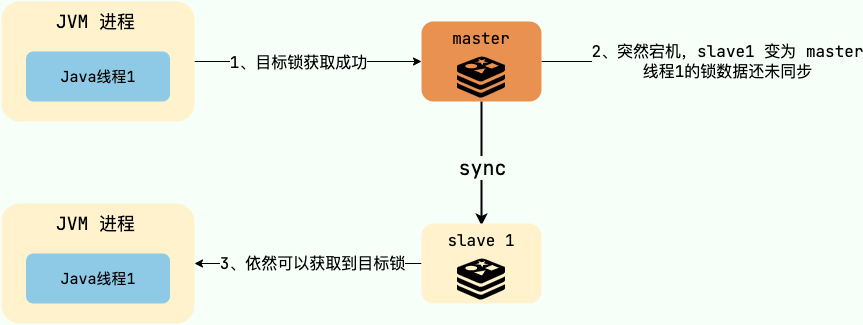
Để giải quyết vấn đề này, antirez, cha đẻ của Redis, đã thiết kế thuật toán Redlock.

Ý tưởng của thuật toán Redlock là client lần lượt request lock tới nhiều Redis master độc lập với nhau. Nếu client có thể lock thành công trên strict majority instance, có thể xem là client đã lấy được distributed lock; nếu không thì lock thất bại.
Điều kiện phán đoán đầy đủ của Redlock:
- Dùng N Redis master độc lập với nhau, không phải Redis Cluster sharding.
- Client ghi nhận thời điểm bắt đầu.
- Lần lượt lock trên từng node bằng cùng key, value và TTL; mỗi request đặt timeout ngắn để tránh một node làm chậm toàn bộ quá trình lock.
- Chỉ khi lock thành công trên ít nhất
N/2 + 1node và tổng thời gian nhỏ hơn TTL thì mới xem là lock thành công. - Thời gian hiệu lực thực tế của lock xấp xỉ
TTL - thời gian lock - phần bù clock drift. - Khi thất bại, phải release trên tất cả node, bao gồm cả node lock thất bại hoặc request timeout.
Redlock thao tác trực tiếp trên các Redis node độc lập, không thông qua Redis Cluster. Nhờ đó có thể tránh mất lock do failover của một shard master-slave.
Redlock có implementation khá phức tạp, performance kém và còn có rủi ro về safety khi xảy ra clock drift. Martin Kleppmann, tác giả sách Designing Data-Intensive Applications, từng viết riêng bài (How to do distributed locking - Martin Kleppmann - 2016) để phê bình Redlock và cho rằng đây là một implementation distributed lock rất tệ. Nếu quan tâm, bạn có thể đọc bài Từ câu hỏi liên hoàn phỏng vấn về Redis lock đến cuộc tranh luận giữa các chuyên gia, trong đó giới thiệu chi tiết tranh luận về Redlock giữa antirez và Martin Kleppmann.
Làm thế nào quyết định có nên dùng Redlock hay không? Cốt lõi là phân biệt scenario sử dụng lock:
- Nếu là lock vì hiệu suất, tức lock mất hiệu lực chỉ gây tính toán lặp hoặc thực thi task lặp, là các hậu quả có thể chấp nhận, có thể dùng Redis standalone, Sentinel hoặc Cluster và chấp nhận rõ rủi ro đôi khi thực thi đồng thời trong trường hợp cực đoan.
- Nếu là lock vì tính đúng đắn, tức lock mất hiệu lực sẽ gây sai inventory, sai số tiền hoặc hỏng dữ liệu, là các hậu quả không thể chấp nhận, nên ưu tiên ZooKeeper/etcd kết hợp Fencing Token thay vì dựa vào failover master-slave của Redis để bảo đảm mutual exclusion chặt chẽ.
- Redlock phụ thuộc vào network latency có giới hạn, process pause có giới hạn và clock drift có giới hạn. GC pause dài, clock jump và packet đến trễ đều làm suy yếu tính đúng đắn.
- Quan điểm cốt lõi của Martin Kleppmann là: lock vì tính đúng đắn phải kết hợp Fencing Token; phản biện của antirez tập trung vào việc clock drift trong production có ảnh hưởng giới hạn và random value có thể tránh xóa nhầm. Người đọc nên phân biệt scenario trước rồi mới chọn giải pháp.
Triển khai distributed lock dựa trên ZooKeeper
So với Redis, ZooKeeper có độ tin cậy tương đối cao hơn khi triển khai distributed lock, đồng thời còn có một feature rất hữu ích ở cấp độ chức năng: cơ chế Watch. Cơ chế này có thể dùng để triển khai distributed lock công bằng. Tuy nhiên, distributed lock triển khai bằng ZooKeeper có performance tương đối kém, nên nếu yêu cầu performance cao thì ZooKeeper có thể không phù hợp.
Làm thế nào triển khai distributed lock dựa trên ZooKeeper?
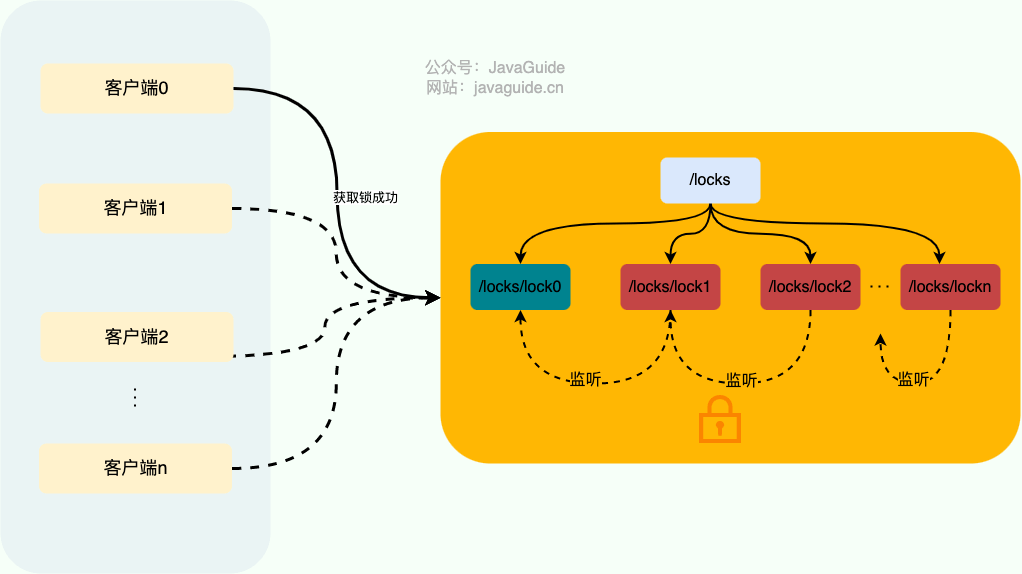
ZooKeeper distributed lock được triển khai dựa trên temporary sequential node và Watcher (event listener).
Lấy lock:
- Trước hết cần một persistent node
/locks; client lấy lock bằng cách tạo temporary sequential node dưới/locks. - Giả sử client 1 tạo node
/locks/lock1. Sau khi tạo thành công, client kiểm tralock1có phải child node nhỏ nhất dưới/lockshay không. - Nếu
lock1là child node nhỏ nhất thì lấy lock thành công. Nếu không thì lấy lock thất bại. - Nếu lấy lock thất bại, nghĩa là client khác đã lấy lock thành công. Client 1 không liên tục lặp để thử lock mà đăng ký event listener trên node trước đó, chẳng hạn
/locks/lock0. Listener này sẽ thông báo cho client 1 sau khi node trước đó release lock (tránh spin không hiệu quả), khi đó client 1 lấy lock thành công.
Release lock:
- Client lấy lock thành công sẽ xóa child node tương ứng sau khi hoàn tất business flow.
- Nếu client lấy lock thành công gặp sự cố, child node tương ứng là temporary sequential node nên sẽ tự động bị xóa, tránh lock không được release.
- Event listener nói ở trên thực chất theo dõi event xóa child node; child node bị xóa nghĩa là lock đã được release.
Trong project thực tế, nên dùng Curator để triển khai ZooKeeper distributed lock. Curator là ZooKeeper Java client framework do Netflix open source. So với client zookeeper đi kèm ZooKeeper, Curator có abstraction hoàn thiện hơn và các API dễ sử dụng hơn.
Curator chủ yếu triển khai bốn loại lock sau:
InterProcessMutex: distributed reentrant exclusive lockInterProcessSemaphoreMutex: distributed non-reentrant exclusive lockInterProcessReadWriteLock: distributed read-write lockInterProcessMultiLock: container quản lý nhiều lock như một entity; khi lấy lock thì lấy tất cả lock, khi release cũng release toàn bộ lock resource (bỏ qua các lock release thất bại).
CuratorFramework client = ZKUtils.getClient();
client.start();
// Distributed reentrant exclusive lock
InterProcessLock lock1 = new InterProcessMutex(client, lockPath1);
// Distributed non-reentrant exclusive lock
InterProcessLock lock2 = new InterProcessSemaphoreMutex(client, lockPath2);
// Gộp nhiều lock thành một thể thống nhất
InterProcessMultiLock lock = new InterProcessMultiLock(Arrays.asList(lock1, lock2));

if (!lock.acquire(10, TimeUnit.SECONDS)) {
   throw new IllegalStateException("Không thể lấy multi-lock");
}
System.out.println("Đã lấy multi-lock");
System.out.println("Có lock thứ nhất: " + lock1.isAcquiredInThisProcess());
System.out.println("Có lock thứ hai: " + lock2.isAcquiredInThisProcess());
try {
    // Thao tác trên resource
    resource.use();
} finally {
    System.out.println("Release nhiều lock");
    lock.release();
}
System.out.println("Có lock thứ nhất: " + lock1.isAcquiredInThisProcess());
System.out.println("Có lock thứ hai: " + lock2.isAcquiredInThisProcess());
client.close();
Vì sao dùng temporary sequential node?
Mỗi data node trong ZooKeeper được gọi là znode, là đơn vị dữ liệu nhỏ nhất trong ZooKeeper.
Thông thường, znode được chia thành 4 loại:
- Persistent node (PERSISTENT): sau khi tạo sẽ luôn tồn tại, kể cả khi ZooKeeper cluster crash, cho đến khi bị xóa.
- Ephemeral node (EPHEMERAL): vòng đời của temporary node gắn với client session; session biến mất thì node biến mất. Ngoài ra, temporary node chỉ có thể là leaf node, không thể tạo child node.
- Persistent sequential node (PERSISTENT_SEQUENTIAL): ngoài các đặc điểm của persistent node (PERSISTENT), tên child node còn có tính tuần tự. Ví dụ
/node1/app0000000001,/node1/app0000000002. - Ephemeral sequential node (EPHEMERAL_SEQUENTIAL): ngoài các đặc điểm của ephemeral node (EPHEMERAL), tên child node còn có tính tuần tự.
Có thể thấy, điểm khác biệt chính giữa ephemeral node và persistent node nằm ở cách xử lý khi session mất hiệu lực: session của ephemeral node biến mất thì node tương ứng cũng biến mất. Vì vậy, nếu client gặp exception và chưa kịp release lock thì cũng không sao; node sẽ tự động bị xóa khi session mất hiệu lực, tránh process của client crash rồi giữ lock vĩnh viễn.
Tuy nhiên, ZooKeeper cũng cần xét đến GC pause, network partition và session timeout. Khi client GC lâu hoặc network partition làm session hết hạn, ZooKeeper sẽ xóa ephemeral node và cho client mới lấy lock, trong khi client cũ có thể chưa nhận biết session mất hiệu lực và vẫn nghĩ mình đang giữ lock. Với scenario yêu cầu tính đúng đắn cao, vẫn nên kết hợp Fencing Token để ngăn client cũ ghi dữ liệu lỗi thời sau khi khôi phục.
Khi dùng Redis triển khai distributed lock, ta dựa vào expiration để tránh deadlock do lock không được release. ZooKeeper có thể tận dụng đặc điểm của ephemeral node để xử lý việc release lock sau khi client crash.
Nếu không dùng sequential node, tất cả client đang thử lấy lock sẽ theo dõi lock trên child node đang được giữ. Khi lock được release, tất cả client đang thử lấy lock chắc chắn sẽ tranh nhau lấy lock, không tốt cho performance. Sau khi dùng sequential node, chỉ cần theo dõi node trước đó, nên thân thiện hơn với performance.
Vì sao cần theo dõi node trước đó?
Watcher (event listener) là một feature rất quan trọng trong ZooKeeper. ZooKeeper cho phép user đăng ký một số Watcher trên node được chỉ định. Khi một event cụ thể được trigger, ZooKeeper server sẽ thông báo event cho các client quan tâm. Cơ chế này là feature quan trọng để ZooKeeper triển khai dịch vụ distributed coordination.
Trong cùng một khoảng thời gian, nhiều client có thể đồng thời lấy lock nhưng chỉ một client lấy thành công. Nếu lấy lock thất bại, nghĩa là client khác đã lấy lock thành công. Client thất bại không liên tục lặp để thử lấy lock mà đăng ký event listener trên node trước đó.
Listener này có tác dụng: sau khi client tương ứng với node trước đó release lock (tức node trước đó bị xóa; listener theo dõi event xóa), nó sẽ thông báo cho client lấy lock thất bại (đánh thức thread đang chờ, tương tự wait/notifyAll trong Java), để client thử lấy lock và lấy thành công.
Làm thế nào triển khai reentrant lock?
Ở đây dùng implementation reentrant lock của Curator là InterProcessMutex để giới thiệu (source code: InterProcessMutex.java).
Khi gọi method InterProcessMutex#acquire để lấy lock, method này sẽ gọi method InterProcessMutex#internalLock.
// Lấy reentrant mutex lock cho đến khi thành công
@Override
public void acquire() throws Exception {
  if (!internalLock(-1, null)) {
    throw new IOException("Lost connection while trying to acquire lock: " + basePath);
  }
}
Method internalLock trước hết lấy thread đang request lock, sau đó lấy lockData tương ứng với thread hiện tại từ threadData (kiểu ConcurrentMap<Thread, LockData>). lockData chứa thông tin lock và số lần lock, là yếu tố then chốt để triển khai reentrant lock.
Ở lần lấy lock đầu tiên, lockData là null. Sau khi lấy lock thành công, thread hiện tại và lockData tương ứng sẽ được đưa vào threadData.
private boolean internalLock(long time, TimeUnit unit) throws Exception {
  // Lấy thread đang request lock
  Thread currentThread = Thread.currentThread();
  // Lấy lockData tương ứng
  LockData lockData = threadData.get(currentThread);
  // Ở lần lấy lock đầu tiên, lockData là null
  if (lockData != null) {
    // Thread hiện tại đã từng lấy lock
    // Vì lock của thread hiện tại đang tồn tại, tăng lockCount rồi return để thực hiện reentrant lock
    lockData.lockCount.incrementAndGet();
    return true;
  }
  // Thử lấy lock
  String lockPath = internals.attemptLock(time, unit, getLockNodeBytes());
  if (lockPath != null) {
    LockData newLockData = new LockData(currentThread, lockPath);
    // Sau khi lấy lock thành công, đưa thread hiện tại và lockData tương ứng vào threadData
    threadData.put(currentThread, newLockData);
    return true;
  }

  return false;
}
LockData là một static inner class trong InterProcessMutex.
private final ConcurrentMap<Thread, LockData> threadData = Maps.newConcurrentMap();

private static class LockData
{
    // Thread hiện đang giữ lock
    final Thread owningThread;
    // Child node tương ứng với lock
    final String lockPath;
    // Số lần lock
    final AtomicInteger lockCount = new AtomicInteger(1);

    private LockData(Thread owningThread, String lockPath)
    {
      this.owningThread = owningThread;
      this.lockPath = lockPath;
    }
}
Nếu đã lấy lock một lần rồi tiếp tục lấy lại, code sẽ bị chặn ngay tại if (lockData != null), sau đó thực thi lockData.lockCount.incrementAndGet(); để tăng số lần lock lên 1.
Logic triển khai toàn bộ reentrant lock rất đơn giản: chỉ cần kiểm tra ở client xem thread hiện tại đã lấy lock chưa; nếu đã lấy thì tăng số lần lock lên 1.
Cần chú ý giới hạn của reentrant: Curator InterProcessMutex chỉ reentrant trong cùng một JVM và cùng một thread. RLock của Redisson cũng dùng UUID:threadId để ghi nhận thread giữ lock và số lần reentrant, không có nghĩa là cùng một business user giữa các JVM hoặc thread tự nhiên có thể reentrant. Nếu cần reentrant ở cấp business giữa process hoặc JVM, cần thiết kế business identity, idempotency và deduplication ở application layer.
Triển khai Fencing Token trong production
Bản thân Fencing Token (fencing token) chỉ là một version number tăng đơn điệu; chỉ khi resource side phối hợp kiểm tra thì nó mới phát huy tác dụng. Khi client truy cập database, object storage hoặc external resource, client phải mang theo token; resource side cần lưu token lớn nhất từng thấy và từ chối mọi write có token nhỏ hơn. Nếu không, chỉ tạo token riêng lẻ là vô nghĩa.
Các cách triển khai phổ biến như sau:
| Storage/system | Nguồn token | Cách kiểm tra |
|---|---|---|
| MySQL | Thêm field fencing_token vào business table | UPDATE ... SET fencing_token = ? WHERE id = ? AND ? > fencing_token, bảo đảm token mới lớn hơn token đã lưu |
| Object storage | Mang token hoặc version condition khi write | Dùng conditional write (Conditional Write) hoặc ràng buộc version của object |
| ZooKeeper | Có thể dùng zxid hoặc znode stat version | Resource side từ chối write của version cũ |
| etcd | revision / mod_revision | Kiểm tra version qua conditional transaction (Txn) |
Lưu ý: nếu external resource không hỗ trợ conditional write hoặc version check thì không phù hợp để đảm nhận scenario distributed lock yêu cầu tính đúng đắn. Khi đó nên cân nhắc đổi sang coordination service có consistency mạnh hơn, hoặc thay đổi write path của resource để hỗ trợ kiểm tra token.
Đây chính là nguyên nhân của vấn đề “lock hết hạn sớm” đã nói ở trên: chỉ kéo dài TTL không thể loại bỏ khoảng thời gian “client A vẫn nghĩ mình đang giữ lock, nhưng lock thực tế đã hết hạn và được client B lấy”. Fencing Token dùng version check ở resource side để làm lớp bảo vệ cuối.
Đối chiếu ngắn gọn etcd / Consul
- etcd: dựa trên Raft, cung cấp Lease, Txn, revision và các khả năng khác, phù hợp tự nhiên hơn cho coordination có fencing. Trong hệ sinh thái cloud-native/Kubernetes, etcd phổ biến hơn.
- Consul: cung cấp Session + Lock, nhưng vẫn phải xét đến việc session TTL bị nhận định sai và fencing.
Trong hệ sinh thái Java, ZooKeeper + Curator trưởng thành hơn; trong hệ sinh thái cloud-native/Kubernetes, etcd phổ biến hơn.
Khi chọn giải pháp thực tế, cần kết hợp infrastructure hiện có của team, client ecosystem, yêu cầu performance và năng lực xử lý sự cố.
Tổng kết
Trong bài viết này, tôi chủ yếu giới thiệu hai cách phổ biến để triển khai distributed lock: Redis và ZooKeeper, đồng thời đối chiếu ngắn gọn etcd / Consul. Việc chọn giải pháp nào vẫn phải căn cứ vào nhu cầu cụ thể của business.
- Nếu yêu cầu performance cao và có thể chấp nhận rủi ro đôi khi thực thi đồng thời trong trường hợp cực đoan, có thể dùng Redis để triển khai distributed lock. Nên ưu tiên distributed lock có sẵn do Redisson cung cấp thay vì tự triển khai.
- Nếu yêu cầu reliability và tính đúng đắn cao, nên dùng ZooKeeper hoặc etcd để triển khai distributed lock, kết hợp Fencing Token. Nên dựa trên framework Curator để triển khai ZooKeeper distributed lock. Tuy nhiên, hiện nay nhiều project không dùng ZooKeeper. Nếu chỉ vì distributed lock mà đưa ZooKeeper vào thì không phù hợp; không nên tăng system complexity chỉ vì một feature nhỏ.
Cần lưu ý rằng dù chọn cách nào để triển khai distributed lock, bao gồm Redis, ZooKeeper hay etcd, khi xảy ra GC pause trong process, network latency, network partition, clock drift và các exception khác, mọi distributed lock dựa trên lease đều có khoảng thời gian client lầm tưởng mình vẫn đang giữ lock. Để tăng thêm reliability cho system, nên đưa vào cơ chế bảo vệ ở resource side như Fencing Token, nhằm ngăn client cũ ghi dữ liệu lỗi thời.
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.