
Hướng dẫn nhập môn ZooKeeper: khái niệm cốt lõi, ZNode, Watcher, ACL và các trường hợp sử dụng điển hình
Có lẽ bạn không còn xa lạ với ZooKeeper. Nhưng bạn có thật sự hiểu ZooKeeper dùng để làm gì không? Nếu người khác hoặc interviewer yêu cầu bạn trình bày hiểu biết về ZooKeeper, bạn có thể trả lời đến đâu?
Lấy bản thân tôi làm ví dụ. Khi còn học đại học và dùng Dubbo để làm một dự án phân tán, tôi đã dùng ZooKeeper làm registry. Để bảo đảm các hệ thống phân tán có thể truy cập đồng bộ vào một tài nguyên, tôi cũng từng dùng ZooKeeper để triển khai distributed lock. Khi học Kafka, tôi biết nhiều chức năng của Kafka phụ thuộc vào ZooKeeper.
Vài ngày trước, khi tổng hợp kinh nghiệm dự án, tôi chợt tự hỏi ZooKeeper rốt cuộc là gì. Suy nghĩ hồi lâu, trong đầu tôi chỉ hiện ra vài câu đơn giản:
- ZooKeeper có thể dùng làm registry và distributed lock;
- ZooKeeper là một thành viên của hệ sinh thái Hadoop;
- Khi xây dựng cluster ZooKeeper, tốt nhất nên dùng số server lẻ.
Có thể thấy hiểu biết của tôi về ZooKeeper khi đó chỉ dừng ở bề mặt.
Vì vậy, qua bài viết này, tôi hy vọng có thể giúp bạn tìm hiểu ZooKeeper chi tiết hơn một chút. Nếu chưa học ZooKeeper, bài viết này sẽ là bước đệm để bạn bước vào thế giới ZooKeeper. Nếu đã tiếp xúc với ZooKeeper, bài viết này sẽ giúp bạn ôn lại một số khái niệm cơ bản.
Ngoài các khái niệm về ZooKeeper, những bài viết sau sẽ giới thiệu cách dùng các lệnh thường gặp của ZooKeeper và cách sử dụng Apache Curator làm client của ZooKeeper.
Nếu bài viết còn điểm nào cần cải thiện, hãy góp ý ở phần bình luận để cùng tiến bộ!
Giới thiệu ZooKeeper
Nguồn gốc ZooKeeper
Trước khi chính thức giới thiệu ZooKeeper, hãy cùng xem nguồn gốc của ZooKeeper. Câu chuyện khá thú vị.
Nội dung dưới đây được trích từ mục đầu tiên của chương 4 trong cuốn Từ Paxos đến ZooKeeper, rất đáng đọc:
ZooKeeper bắt nguồn từ một nhóm nghiên cứu tại Yahoo Research. Khi đó, các nhà nghiên cứu nhận thấy nhiều hệ thống lớn bên trong Yahoo về cơ bản đều cần một hệ thống tương tự để thực hiện distributed coordination, nhưng các hệ thống này thường tồn tại vấn đề single point trong hệ thống phân tán. Vì vậy, các developer của Yahoo đã cố gắng phát triển một framework distributed coordination tổng quát, không có single point, để developer có thể tập trung xử lý logic nghiệp vụ.
Tên của dự án “ZooKeeper” cũng có một câu chuyện thú vị. Ở giai đoạn đầu của dự án, vì nhiều dự án nội bộ trước đó đều được đặt tên theo động vật (chẳng hạn dự án Pig nổi tiếng), các kỹ sư Yahoo muốn đặt cho dự án này một cái tên động vật. RaghuRamakrishnan, chief scientist của viện nghiên cứu lúc bấy giờ, đùa rằng: “Cứ tiếp tục thế này thì chỗ chúng ta sẽ biến thành sở thú mất!” Mọi người nghe vậy liền đồng ý gọi dự án là người quản lý sở thú — vì khi các component phân tán mang tên động vật được đặt cạnh nhau, toàn bộ hệ thống phân tán của Yahoo trông như một sở thú lớn, còn ZooKeeper lại được dùng để điều phối môi trường phân tán. Từ đó, cái tên ZooKeeper ra đời.
Tổng quan ZooKeeper
ZooKeeper là một dịch vụ distributed coordination mã nguồn mở. Mục tiêu thiết kế của nó là đóng gói các dịch vụ consistency phân tán phức tạp và dễ xảy ra lỗi thành một tập primitive hiệu quả, đáng tin cậy, rồi cung cấp cho người dùng qua một loạt interface đơn giản, dễ dùng.
Primitive: thuật ngữ trong hệ điều hành hoặc network. Là một quy trình gồm nhiều instruction, dùng để hoàn thành một chức năng nhất định. Primitive có tính không thể phân chia, tức việc thực thi phải diễn ra liên tục và không được ngắt giữa chừng.
ZooKeeper cung cấp cho chúng ta một giải pháp consistency dữ liệu phân tán có availability cao, performance cao và ổn định. Nó thường được dùng để triển khai các chức năng như publish/subscribe dữ liệu, load balancing, naming service, distributed coordination/notification, quản lý cluster, bầu chọn Master, distributed lock và distributed queue. Những chức năng này chủ yếu dựa vào lưu trữ dữ liệu + theo dõi sự kiện do ZooKeeper cung cấp, sẽ được giới thiệu chi tiết ở phần sau.
ZooKeeper lưu dữ liệu trong memory nên có performance tốt. Nó đặc biệt hiệu quả trong các ứng dụng có số lần “read” nhiều hơn “write”, vì “write” khiến tất cả server phải đồng bộ state. “Read” nhiều hơn “write” là trường hợp điển hình của coordination service.
Ngoài ra, nhiều dự án open source hàng đầu cũng sử dụng ZooKeeper, chẳng hạn:
- Kafka: ZooKeeper chủ yếu cung cấp cho Kafka chức năng đăng ký Broker và Topic, load balancing giữa nhiều Partition, v.v. Tuy nhiên, từ Kafka 2.8 trở đi, Kafka giới thiệu mode KRaft dựa trên protocol Raft và không còn phụ thuộc vào ZooKeeper, giúp đơn giản hóa đáng kể kiến trúc Kafka.
- Hbase: ZooKeeper cung cấp cho Hbase các chức năng như bảo đảm toàn cluster chỉ có một Master, lưu và cung cấp thông tin state của regionserver (có online hay không).
- Hadoop: ZooKeeper cung cấp hỗ trợ availability cao cho Namenode.
Đặc điểm của ZooKeeper
- Consistency theo thứ tự: các request transaction do cùng một client gửi đi cuối cùng sẽ được apply vào ZooKeeper đúng theo thứ tự.
- Tính atomic: kết quả xử lý mọi request transaction được apply trên tất cả machine trong toàn cluster là nhất quán. Nghĩa là toàn bộ machine trong cluster hoặc cùng apply thành công một transaction, hoặc không machine nào apply transaction đó.
- Single system image: bất kể client kết nối đến server ZooKeeper nào, data model mà client nhìn thấy ở server đều nhất quán.
- Độ tin cậy: một khi request thay đổi được apply, kết quả thay đổi sẽ được persist cho đến khi bị một thay đổi tiếp theo ghi đè.
- Consistency theo thứ tự: thứ tự thay đổi dữ liệu mà mọi client nhìn thấy là nhất quán, được cập nhật theo thứ tự FIFO toàn cục mà operation được commit. Tuy nhiên, điều này không bảo đảm thay đổi được truyền ngay đến mọi node.
- Triển khai cluster: 3–5 machine (tốt nhất là số lẻ) có thể tạo thành một cluster. Mỗi machine lưu toàn bộ dữ liệu ZooKeeper trong memory, các machine giao tiếp và đồng bộ dữ liệu với nhau, client có thể kết nối đến bất kỳ machine nào.
- Availability cao: nếu một machine down, dữ liệu vẫn không bị mất. Khi số machine down trong cluster không vượt quá một nửa, cluster vẫn được bảo đảm availability. Ví dụ, cluster 3 machine có thể down 1 machine, cluster 5 machine có thể down 2 machine.
Các trường hợp sử dụng ZooKeeper
Trong phần tổng quan ZooKeeper, chúng ta đã biết ZooKeeper thường được dùng để triển khai các chức năng như publish/subscribe dữ liệu, load balancing, naming service, distributed coordination/notification, quản lý cluster, bầu chọn Master, distributed lock và distributed queue.
Dưới đây là 3 trường hợp sử dụng điển hình:
- Naming service: có thể dùng sequential node của ZooKeeper để tạo ID duy nhất trên toàn hệ thống.
- Publish/subscribe dữ liệu: có thể dễ dàng triển khai publish/subscribe dữ liệu thông qua cơ chế Watcher. Khi publish dữ liệu lên node được theo dõi trong ZooKeeper, các machine khác có thể theo dõi thay đổi của node trên ZooKeeper để cập nhật config động.
- Distributed lock: tạo node duy nhất để nhận distributed lock. Sau khi bên giữ lock thực thi xong code liên quan hoặc bị down, lock sẽ được giải phóng. Việc triển khai distributed lock cũng cần cơ chế Watcher. Trong bài viết Giải thích chi tiết về distributed lock, tôi đã giới thiệu chi tiết cách triển khai distributed lock dựa trên ZooKeeper.
Thực tế, việc triển khai các chức năng này chủ yếu nhờ khả năng lưu dữ liệu của ZooKeeper. Tuy nhiên, ZooKeeper không phù hợp để lưu lượng dữ liệu lớn, cần lưu ý điểm này.
Các khái niệm quan trọng của ZooKeeper
Nói nhỏ: hãy lấy sổ ra ghi chép, nội dung dưới đây rất quan trọng!
Data model (mô hình dữ liệu)
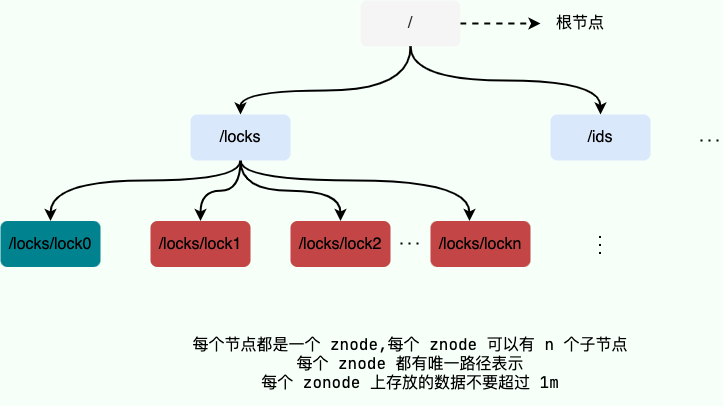
Data model của ZooKeeper sử dụng cấu trúc cây nhiều nhánh phân cấp. Mỗi node có thể lưu dữ liệu, có thể là số, string hoặc chuỗi binary. Mỗi node còn có thể có N child node, tầng trên cùng là root node được biểu diễn bằng “/”. Mỗi data node trong ZooKeeper được gọi là znode, là đơn vị dữ liệu nhỏ nhất trong ZooKeeper. Mỗi znode có một path duy nhất.
Nhấn mạnh một lần: ZooKeeper chủ yếu dùng để điều phối service, không phải để lưu business data. Vì vậy, không nên đặt dữ liệu lớn vào znode. Giới hạn kích thước dữ liệu của mỗi node do ZooKeeper quy định là 1M.
Hình dưới đây cho thấy trực quan hơn cách biểu diễn path của node ZooKeeper. Cách này rất giống path trong file system Unix: đều là chuỗi path được phân tách bằng dấu slash “/”. Developer có thể ghi dữ liệu vào node này và tạo child node bên dưới node. Các operation này sẽ được giới thiệu ở phần sau.
znode (data node)
Sau khi tìm hiểu data model dạng cây của ZooKeeper, chúng ta biết mỗi data node trong ZooKeeper được gọi là znode, là đơn vị dữ liệu nhỏ nhất trong ZooKeeper. Dữ liệu bạn muốn lưu sẽ được đặt tại đây. Đây là một khái niệm thường xuyên cần tiếp xúc khi sử dụng ZooKeeper.
Thông thường, znode được chia thành 4 loại:
- Persistent node: sau khi được tạo sẽ luôn tồn tại, kể cả khi ZooKeeper cluster down, cho đến khi bị xóa.
- Ephemeral node: vòng đời của ephemeral node gắn với client session. Session biến mất thì node cũng biến mất. Ngoài ra, ephemeral node chỉ có thể là leaf node, không thể tạo child node.
- Persistent sequential node: ngoài các đặc điểm của persistent node, tên child node còn có tính tuần tự. Ví dụ
/node1/app0000000001,/node1/app0000000002. - Ephemeral sequential node: ngoài các đặc điểm của ephemeral node, tên child node còn có tính tuần tự.
Mỗi znode gồm 2 phần:
- stat: thông tin state
- data: nội dung dữ liệu cụ thể được lưu trong node
Ví dụ dưới đây dùng command get để lấy nội dung của node dubbo dưới root directory. Command get sẽ được giới thiệu ở phần sau.
[zk: 127.0.0.1:2181(CONNECTED) 6] get /dubbo
# Nội dung dữ liệu liên kết với data node này là rỗng
null
# Dưới đây là một số thông tin state của data node, thực chất là output đã format của đối tượng Stat
cZxid = 0x2
ctime = Tue Nov 27 11:05:34 CST 2018
mZxid = 0x2
mtime = Tue Nov 27 11:05:34 CST 2018
pZxid = 0x3
cversion = 1
dataVersion = 0
aclVersion = 0
ephemeralOwner = 0x0
dataLength = 0
numChildren = 1
Class Stat chứa các field thông tin state của một data node, bao gồm transaction ID (cZxid), thời điểm tạo node (ctime), số child node (numChildren), v.v.
Hãy cùng xem từng thông tin state của znode có ý nghĩa gì. Nội dung dưới đây lấy từ cuốn Từ Paxos đến ZooKeeper: nguyên lý và thực tiễn của consistency phân tán; Guide không phải lúc nào cũng giải thích thật rõ, nên cần biết tham khảo tài liệu:
| Thông tin state của znode | Giải thích |
|---|---|
| cZxid | create ZXID, tức transaction ID tại thời điểm data node được tạo |
| ctime | create time, tức thời điểm node được tạo |
| mZxid | modified ZXID, tức transaction ID tại lần cuối node được cập nhật |
| mtime | modified time, tức thời điểm node được cập nhật lần cuối |
| pZxid | transaction ID tại lần cuối danh sách child node của node được thay đổi. pZxid chỉ cập nhật khi danh sách child node thay đổi, nội dung child node thay đổi thì không cập nhật |
| cversion | version của child node. Giá trị tăng 1 mỗi khi child node của node hiện tại thay đổi |
| dataVersion | version nội dung của data node. Khi node được tạo, giá trị là 0; mỗi lần nội dung node được cập nhật (bất kể nội dung có thay đổi hay không), giá trị tăng 1 |
| aclVersion | version ACL của node, biểu thị số lần thông tin ACL của node thay đổi |
| ephemeralOwner | sessionId của session tạo ephemeral node; nếu node hiện tại là persistent node thì ephemeralOwner=0 |
| dataLength | độ dài nội dung data node |
| numChildren | số child node của node hiện tại |
Version
Ở phần trên, chúng ta đã đề cập rằng ZooKeeper duy trì một data structure có tên Stat cho mỗi znode. Stat ghi lại 3 version liên quan đến znode này:
- dataVersion: version của znode hiện tại
- cversion: version child node của znode hiện tại
- aclVersion: version ACL của znode hiện tại
ACL (kiểm soát quyền)
ZooKeeper sử dụng policy ACL (AccessControlLists) để kiểm soát quyền, tương tự cơ chế kiểm soát quyền của file system UNIX.
Đối với quyền operation trên znode, ZooKeeper cung cấp 5 loại sau:
- CREATE: có thể tạo child node
- READ: có thể lấy dữ liệu node và liệt kê child node của node
- WRITE: có thể set/update dữ liệu node
- DELETE: có thể xóa child node
- ADMIN: có thể set quyền ACL của node
Đặc biệt cần chú ý, quyền CREATE và DELETE đều là quyền kiểm soát đối với child node.
Về authentication, ZooKeeper cung cấp các cách sau:
- world: cách mặc định, mọi user đều có thể truy cập không điều kiện.
- auth: không sử dụng id nào, đại diện cho mọi user đã được authenticate.
- digest: authentication theo username và password: username:password.
- ip: giới hạn theo IP được chỉ định.
Watcher (event listener)
Watcher (event listener) là một feature rất quan trọng trong ZooKeeper. ZooKeeper cho phép user đăng ký một số Watcher trên node được chỉ định. Khi một event cụ thể được trigger, ZooKeeper server sẽ notify client quan tâm đến event đó. Cơ chế này là một feature quan trọng để ZooKeeper triển khai dịch vụ distributed coordination.
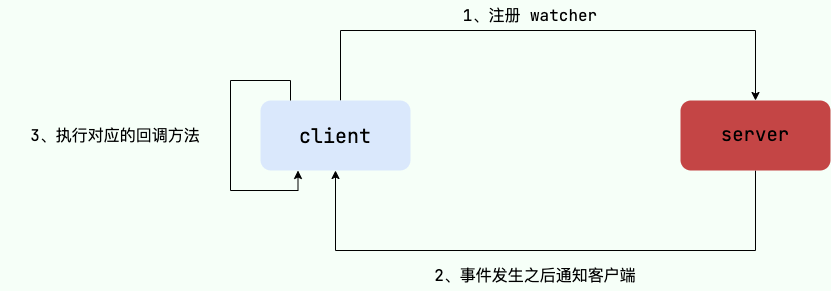
Nói nhỏ: đây là một feature rất hữu ích, hãy ghi nhớ. Về sau, khi sử dụng ZooKeeper, gần như không thể thiếu cơ chế Watcher (event listener).
Session
Session có thể được xem là một TCP long connection giữa ZooKeeper server và client. Thông qua connection này, client có thể duy trì session hợp lệ với server bằng heartbeat, gửi request đến ZooKeeper server và nhận response, đồng thời nhận thông báo event Watcher từ server qua connection này.
Session có một thuộc tính tên là sessionTimeout. sessionTimeout là thời gian timeout của session. Khi connection của client bị ngắt vì server chịu áp lực quá lớn, network failure, client chủ động ngắt connection hoặc các nguyên nhân khác, chỉ cần client reconnect thành công đến bất kỳ server nào trong cluster trong thời gian do sessionTimeout quy định thì session đã tạo trước đó vẫn còn hiệu lực.
Ngoài ra, trước khi tạo session cho client, server sẽ cấp một sessionID cho mỗi client. Vì sessionID là một định danh quan trọng của ZooKeeper session và nhiều cơ chế liên quan đến session đều dựa trên sessionID, nên dù server nào cấp sessionID cho client cũng phải bảo đảm ID này duy nhất trên toàn hệ thống.
ZooKeeper cluster
Để bảo đảm availability cao, tốt nhất nên triển khai ZooKeeper dưới dạng cluster. Chỉ cần phần lớn machine trong cluster còn hoạt động (có thể chịu được một số machine failure), bản thân ZooKeeper vẫn còn khả dụng. Thông thường, 3 server đã có thể tạo thành một ZooKeeper cluster. Sơ đồ kiến trúc chính thức của ZooKeeper cũng mô tả một ZooKeeper cluster cung cấp service ra bên ngoài.
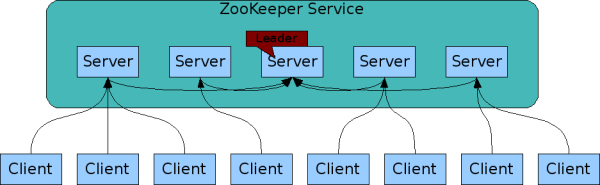
Mỗi Server trong hình trên đại diện cho một server đã cài ZooKeeper service. Các server tạo thành ZooKeeper service đều duy trì state hiện tại của server trong memory và luôn giữ liên lạc với nhau. Các node trong cluster dùng protocol ZAB (ZooKeeper Atomic Broadcast) để duy trì consistency dữ liệu.
Mode cluster điển hình nhất: mode Master/Slave (mode primary/standby). Trong mode này, Master server thường đóng vai trò primary server và cung cấp write service. Các Slave server đóng vai trò standby server, lấy dữ liệu mới nhất từ Master server bằng asynchronous replication để cung cấp read service.
Role trong ZooKeeper cluster
Tuy nhiên, ZooKeeper không sử dụng khái niệm Master/Slave truyền thống mà đưa vào 3 role là Leader, Follower và Observer, như hình dưới đây.
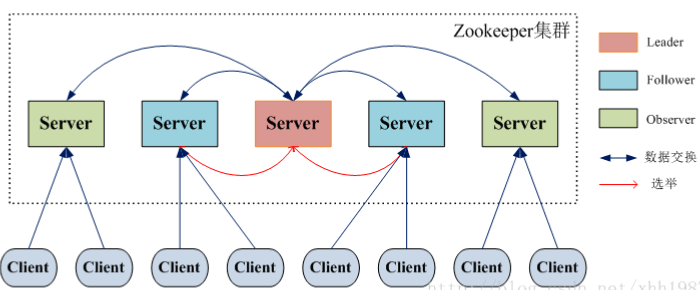
Tất cả machine trong ZooKeeper cluster chọn một machine có tên Leader thông qua quá trình Leader election. Leader có thể cung cấp cả write service và read service cho client. Ngoài Leader, Follower và Observer chỉ có thể cung cấp read service. Điểm khác biệt duy nhất giữa Follower và Observer là machine Observer không tham gia quá trình Leader election và không tham gia policy “write thành công khi quá nửa”. Vì vậy, machine Observer có thể tăng read performance của cluster mà không ảnh hưởng đến write performance.
| Role | Mô tả |
|---|---|
| Leader | Cung cấp read và write service cho client, chịu trách nhiệm khởi tạo và quyết định việc voting, cập nhật state hệ thống. |
| Follower | Cung cấp read service cho client; nếu là write service thì forward đến Leader. Tham gia voting trong quá trình election. |
| Observer | Cung cấp read service cho client; nếu là write service thì forward đến Leader. Không tham gia voting trong quá trình election và không tham gia policy “write thành công khi quá nửa”. Tăng read performance của cluster mà không ảnh hưởng đến write performance. Role này được bổ sung trong dòng ZooKeeper 3.3. |
Quá trình Leader election của ZooKeeper cluster
Khi Leader server gặp các tình huống bất thường như network interruption, crash hoặc restart, cluster sẽ đi vào quá trình Leader election để bầu ra Leader server mới.
Quá trình này đại khái diễn ra như sau:
- Leader election (giai đoạn election): lúc đầu các node đều ở giai đoạn election. Chỉ cần một node nhận được phiếu của hơn một nửa số node, node đó có thể trở thành candidate leader.
- Discovery (giai đoạn discovery): trong giai đoạn này, follower giao tiếp với candidate leader để đồng bộ các transaction proposal gần nhất mà follower nhận được.
- Synchronization (giai đoạn synchronization): giai đoạn synchronization chủ yếu dùng proposal history mới nhất mà leader thu được ở giai đoạn trước để đồng bộ tất cả replica trong cluster. Sau khi synchronization hoàn tất, candidate leader mới trở thành leader thật sự.
- Broadcast (giai đoạn broadcast): đến giai đoạn này, ZooKeeper cluster mới có thể chính thức cung cấp transaction service ra bên ngoài và leader có thể broadcast message. Nếu có node mới tham gia, node mới cũng cần được đồng bộ.
Các state của server trong ZooKeeper cluster gồm:
- LOOKING: đang tìm Leader.
- LEADING: state Leader, node tương ứng là Leader.
- FOLLOWING: state Follower, node tương ứng là Follower.
- OBSERVING: state Observer, node tương ứng là Observer; node này không tham gia Leader election.
Vì sao ZooKeeper cluster tốt nhất nên có số node lẻ?
Sau khi một số ZooKeeper server trong ZooKeeper cluster down, toàn bộ ZooKeeper chỉ còn khả dụng nếu số ZooKeeper server còn lại lớn hơn số server đã down. Giả sử cluster có n ZooKeeper server, số server còn lại phải lớn hơn n/2. Kết luận trước: khả năng chịu lỗi của 2n và 2n-1 là như nhau, đều là n-1. Bạn có thể tự suy nghĩ kỹ, đây là một bài toán khá đơn giản.
Ví dụ, với 3 machine, tối đa có thể down 1 ZooKeeper server; với 4 machine cũng chỉ có thể down tối đa 1 machine.
Với 5 machine, tối đa có thể down 2 ZooKeeper server; với 6 machine cũng chỉ có thể down tối đa 2 machine.
Vậy thì cần gì phải thêm một ZooKeeper không cần thiết?
Cơ chế quá nửa trong election của ZooKeeper ngăn split-brain
Split-brain trong cluster là gì?
Trong một cluster, nhiều machine thường được triển khai ở các data center khác nhau để tăng availability. Tuy nhiên, cùng với việc bảo đảm availability, có thể xảy ra network failure giữa các data center khiến network giữa chúng bị ngắt và cluster bị tách thành vài cluster nhỏ. Khi đó, các cluster con tự bầu leader, dẫn đến tình trạng “split-brain”.
Ví dụ, một cluster gồm 6 server được triển khai ở 2 data center, mỗi nơi 3 server. Bình thường chỉ có 1 leader. Nhưng khi network giữa 2 data center bị ngắt, 3 server ở mỗi data center sẽ cho rằng 3 server ở data center còn lại đã offline, rồi tự bầu leader và cung cấp service ra bên ngoài. Nếu không có cơ chế quá nửa, khi network khôi phục sẽ xuất hiện 2 leader. Giống như một bộ não (leader) lớn bị tách thành 2 bộ não, đây chính là hiện tượng split-brain. Trong thời gian split-brain, cả 2 bộ não đều có thể cung cấp service ra bên ngoài, gây ra các vấn đề như consistency dữ liệu.
Cơ chế quá nửa ngăn hiện tượng split-brain như thế nào?
Cơ chế quá nửa của ZooKeeper khiến không thể xuất hiện 2 leader, vì số node nhỏ hơn hoặc bằng một nửa không thể bầu ra leader. Nhờ đó, bất kể machine được phân bổ giữa các data center như thế nào, split-brain cũng không thể xảy ra.
Protocol ZAB và thuật toán Paxos
Có thể nói thuật toán Paxos là linh hồn của ZooKeeper. Tuy nhiên, ZooKeeper không sử dụng hoàn toàn thuật toán Paxos mà dùng protocol ZAB làm thuật toán cốt lõi bảo đảm consistency dữ liệu. Ngoài ra, tài liệu chính thức của ZooKeeper cũng chỉ ra rằng protocol ZAB không phải là một thuật toán consistency phân tán tổng quát như Paxos, mà là một thuật toán atomic message broadcast có khả năng khôi phục sau crash, được thiết kế riêng cho ZooKeeper.
Giới thiệu protocol ZAB
ZAB (ZooKeeper Atomic Broadcast, atomic broadcast) là protocol atomic broadcast hỗ trợ khôi phục sau crash, được thiết kế riêng cho dịch vụ distributed coordination ZooKeeper. ZooKeeper chủ yếu dựa vào protocol ZAB để triển khai consistency dữ liệu phân tán. Dựa trên protocol này, ZooKeeper triển khai kiến trúc hệ thống theo mode primary/standby để duy trì consistency dữ liệu giữa các replica trong cluster.
Hai mode cơ bản của protocol ZAB: crash recovery và message broadcast
Protocol ZAB gồm 2 mode cơ bản:
- Crash recovery: khi toàn bộ service framework đang khởi động, hoặc khi Leader server gặp các tình huống bất thường như network interruption, crash hoặc restart, protocol ZAB sẽ chuyển sang recovery mode và bầu ra Leader server mới. Sau khi Leader server mới được bầu và hơn một nửa machine trong cluster đã hoàn tất state synchronization với Leader server, protocol ZAB sẽ thoát recovery mode. State synchronization ở đây nghĩa là đồng bộ dữ liệu, nhằm bảo đảm hơn một nửa machine trong cluster có state dữ liệu nhất quán với Leader server.
- Message broadcast: khi hơn một nửa Follower server trong cluster đã hoàn tất state synchronization với Leader server, toàn bộ service framework có thể chuyển sang message broadcast mode. Khi một server cũng tuân thủ protocol ZAB khởi động và tham gia cluster, nếu cluster đã có Leader server đang phụ trách broadcast message, server mới sẽ tự chuyển sang data recovery mode: tìm server đang giữ Leader, đồng bộ dữ liệu với server đó, rồi cùng tham gia quy trình message broadcast.
Bài viết đề xuất về protocol ZAB và thuật toán Paxos
Có quá nhiều nội dung cần trình bày và hiểu về protocol ZAB và thuật toán Paxos. Bạn có thể xem các bài viết sau:
- Giải thích chi tiết thuật toán Paxos
- Giải thích chi tiết protocol Zab
- Giải thích chi tiết thuật toán Raft
ZooKeeper VS ETCD
ETCD là một distributed key-value store có consistency mạnh. Nó cung cấp một phương thức đáng tin cậy để lưu dữ liệu cần được distributed system hoặc machine cluster truy cập. Bên trong ETCD sử dụng thuật toán Raft làm thuật toán consistency và được triển khai bằng ngôn ngữ Go.
Tương tự ZooKeeper, ETCD cũng có thể được dùng trong các trường hợp như publish/subscribe dữ liệu, load balancing, naming service, distributed coordination/notification và distributed lock. Vậy nên chọn hai hệ thống này thế nào?
Bài viết Phân tích cách triển khai kiến trúc availability cao dựa trên ZooKeeper của Dewu Technology đưa ra bảng so sánh dưới đây (tôi đã tối ưu thêm), có thể dùng để tham khảo:
| ZooKeeper | ETCD | |
|---|---|---|
| Ngôn ngữ | Java | Go |
| Protocol | TCP | Grpc |
| Gọi interface | Bắt buộc dùng client riêng để gọi | Có thể truyền qua HTTP, tức có thể dùng các command như CURL để gọi |
| Thuật toán consistency | Protocol Zab | Thuật toán Raft |
| Cơ chế Watcher | Khá hạn chế, trigger một lần | Một Watch có thể theo dõi mọi event |
| Data model | Mode phân cấp dựa trên directory | Tham khảo data model của zk, là một model kv phẳng |
| Lưu trữ | Lưu trữ kv bằng ConcurrentHashMap trong memory, thường không khuyến nghị lưu quá nhiều dữ liệu | Lưu trữ kv bằng storage engine bbolt, có thể xử lý dữ liệu vài GB |
| MVCC | Không hỗ trợ | Hỗ trợ, quản lý version bằng 2 B+ Tree |
| Global Session | Có khuyết điểm | Linh hoạt hơn, tránh vấn đề security |
| Kiểm tra quyền | ACL | RBAC |
| Khả năng transaction | Cung cấp khả năng transaction đơn giản | Chỉ cung cấp khả năng kiểm tra version |
| Triển khai và bảo trì | Phức tạp | Đơn giản |
ZooKeeper có một số hạn chế về storage performance, global Session và cơ chế Watcher. Ngày càng nhiều dự án open source thay thế ZooKeeper bằng implementation dựa trên Raft hoặc các dịch vụ distributed coordination khác, chẳng hạn: Kafka Needs No Keeper - Removing ZooKeeper Dependency (confluent.io), Moving Toward a ZooKeeper-Less Apache Pulsar (streamnative.io).
ETCD nhìn chung tốt hơn, cung cấp khả năng read/write dưới tải cao ổn định hơn, đồng thời cải thiện và tối ưu nhiều vấn đề mà ZooKeeper bộc lộ. Ngoài ra, ETCD về cơ bản có thể bao phủ mọi trường hợp sử dụng của ZooKeeper và thay thế ZooKeeper.
Tổng kết
- Bản thân ZooKeeper là một distributed program (chỉ cần hơn một nửa node còn sống, ZooKeeper có thể cung cấp service bình thường).
- Để bảo đảm availability cao, tốt nhất nên triển khai ZooKeeper dưới dạng cluster. Chỉ cần phần lớn machine trong cluster còn hoạt động (có thể chịu được một số machine failure), bản thân ZooKeeper vẫn còn khả dụng.
- ZooKeeper lưu dữ liệu trong memory, nhờ đó bảo đảm throughput cao và latency thấp. Tuy nhiên, memory giới hạn capacity có thể lưu không lớn; đây cũng là lý do khiến lượng dữ liệu lưu trong znode cần được giữ ở mức nhỏ.
- ZooKeeper có performance cao, đặc biệt rõ rệt trong các ứng dụng có số lần “read” nhiều hơn “write”, vì “write” khiến tất cả server phải đồng bộ state. “Read” nhiều hơn “write” là trường hợp điển hình của coordination service.
- ZooKeeper có khái niệm ephemeral node. Khi client session tạo ephemeral node còn active, ephemeral node vẫn tồn tại. Khi session kết thúc, ephemeral node bị xóa. Persistent node là znode sau khi được tạo sẽ luôn được lưu trên ZooKeeper, trừ khi chủ động xóa znode.
- Về bản chất, ZooKeeper chỉ cung cấp 2 chức năng: ① quản lý (lưu trữ, đọc) dữ liệu do user program submit; ② cung cấp dịch vụ theo dõi data node cho user program.
Tài liệu tham khảo
- Từ Paxos đến ZooKeeper: nguyên lý và thực tiễn của consistency phân tán
- Những hạn chế của ZooKeeper: https://wingsxdu.com/posts/database/zookeeper-limitations/
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.