
Giải thích chi tiết các giải pháp tạo distributed ID: UUID, Snowflake, segment mode, Leaf và Tinyid
Giới thiệu về distributed ID
Bài viết này chủ yếu nói về “chọn giải pháp tạo ID thế nào”, chẳng hạn UUID, database segment, Redis, Snowflake, Leaf, Tinyid. Sau khi xem so sánh các giải pháp, nếu muốn tìm hiểu thêm cách thiết kế các business ID như mã đơn hàng, mã coupon, TraceId, URL ngắn, bạn có thể đọc Thực chiến thiết kế distributed ID.
ID là gì?
Trong phát triển hằng ngày, chúng ta cần dùng ID để nhận diện duy nhất nhiều loại dữ liệu trong hệ thống. Ví dụ, user ID nhận diện duy nhất một người dùng, product ID nhận diện duy nhất một sản phẩm, order ID nhận diện duy nhất một đơn hàng.
Trong đời sống cũng có nhiều ID khác nhau, chẳng hạn ID căn cước nhận diện duy nhất một người, ID địa chỉ nhận diện duy nhất một địa chỉ.
Nói đơn giản, ID là định danh duy nhất của dữ liệu.
Distributed ID là gì?
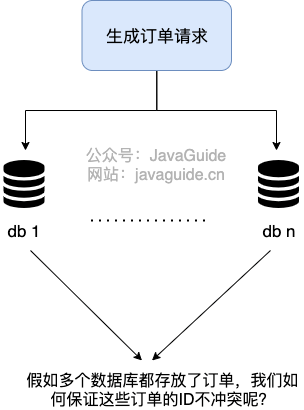
Distributed ID ở đây chủ yếu là ID dùng trong distributed system để nhận diện duy nhất dữ liệu giữa các node, database và service. Nó giải quyết vấn đề xung đột khi nhiều node đồng thời tạo ID.
Hãy xem một ví dụ đơn giản về sharding.
Một dự án của công ty tôi dùng MySQL đơn lẻ. Nhưng sau khi chạy một tháng, số người dùng tăng dần khiến lượng dữ liệu của toàn hệ thống ngày càng lớn. MySQL đơn lẻ không còn đáp ứng được, cần thực hiện sharding, có thể cân nhắc các giải pháp như Apache ShardingSphere-JDBC. Tuy nhiên, lựa chọn cụ thể còn phụ thuộc vào độ phức tạp của SQL, yêu cầu transaction, năng lực vận hành và kinh nghiệm của team.
Sau khi sharding, dữ liệu được phân tán trên các database node khác nhau, nên database auto-increment primary key không còn đảm bảo primary key được tạo ra là duy nhất. Làm thế nào để tạo global unique primary key cho các data node khác nhau?
Lúc này cần tạo distributed ID.
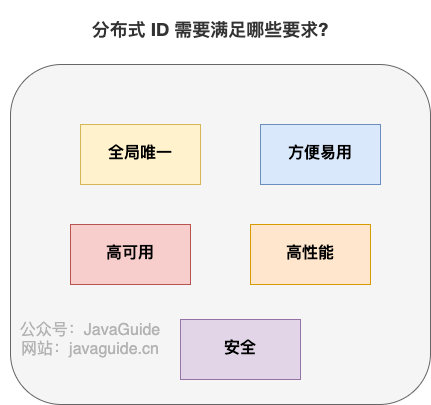
Distributed ID cần đáp ứng những yêu cầu nào?
Distributed ID là một phần không thể thiếu trong distributed system và được dùng ở nhiều nơi.
Một distributed ID cơ bản cần đáp ứng các yêu cầu sau:
- Global unique: tính duy nhất trên toàn cục là yêu cầu đầu tiên phải đáp ứng.
- Performance cao: tốc độ tạo distributed ID phải nhanh, tiêu tốn ít tài nguyên local.
- High availability: ID generator service phải có availability cao, tránh trở thành single point trong business flow.
- Dễ dùng: có thể dùng ngay, dễ tích hợp và kết nối nhanh.
Ngoài các yêu cầu trên, một distributed ID tốt còn nên đảm bảo:
- An toàn: ID không chứa thông tin nhạy cảm.
- Tăng dần theo xu hướng: nếu lưu ID trong database, ID tăng dần theo xu hướng thường có lợi hơn cho việc ghi vào B+ tree index. Nhiều trường hợp dùng primary key trong database cần tăng dần theo xu hướng thay vì tăng dần nghiêm ngặt trên toàn cục. Tăng dần nghiêm ngặt tuy thuận tiện cho việc sắp xếp nhưng thường cần ID generator tập trung hoặc coordination chặt, chi phí cao hơn.
- Kiểm soát được business meaning: cần thận trọng khi nhúng business meaning. Business meaning giúp điều tra vấn đề, nhưng cũng có thể làm lộ quy mô business, khu vực, thời gian, kênh và khiến quy tắc ID gắn chặt với business. Nhiều hệ thống có xu hướng giữ ID không mang ngữ nghĩa, đưa thông tin business vào field riêng.
- Triển khai độc lập: distributed system có một ID generator service riêng, chuyên tạo distributed ID. Nhờ vậy service tạo ID có thể tách khỏi các service liên quan đến business. Tuy nhiên, cách này cũng làm tăng chi phí gọi network. Nhìn chung, nếu có nhiều trường hợp cần distributed ID thì ID generator service triển khai độc lập vẫn rất cần thiết.
Cũng cần lưu ý rằng nguồn gốc của tính “duy nhất” ở mỗi giải pháp không giống nhau:
- Database auto-increment và database segment mode phụ thuộc vào central storage và transaction allocation.
- Giải pháp Redis phụ thuộc vào atomic increment trên một key, persistence strategy và tính nhất quán master-slave.
- Snowflake phụ thuộc vào việc timestamp, Worker ID và sequence không xung đột khi kết hợp.
- UUID v4/v7 phụ thuộc vào chất lượng random và strategy của generator.
- Với primary key không thể chấp nhận trùng lặp, khi lưu cuối cùng vào database vẫn nên dùng database unique constraint để dự phòng.
Giải pháp tạo dựa trên database (stateful)
Database primary key auto-increment
Cách này khá đơn giản và trực tiếp: dùng primary key auto-increment của relational database để tạo unique ID.
Lấy MySQL làm ví dụ, có thể thực hiện như sau.
1. Tạo một database table.
CREATE TABLE `sequence_id` (
  `id` BIGINT UNSIGNED NOT NULL AUTO_INCREMENT,
  `stub` char(10) NOT NULL DEFAULT '',
  PRIMARY KEY (`id`),
  UNIQUE KEY `stub` (`stub`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
Field stub không có ý nghĩa, chỉ dùng để làm placeholder, giúp insert hoặc sửa dữ liệu. Đồng thời tạo unique index cho field stub để đảm bảo tính duy nhất.
2. Insert dữ liệu bằng REPLACE INTO.
BEGIN;
REPLACE INTO sequence_id (stub) VALUES ('stub');
SELECT LAST_INSERT_ID();
COMMIT;
⚠️ Rủi ro production của REPLACE INTO:
Ngữ nghĩa của REPLACE INTO là: nếu row mới không xung đột với PRIMARY KEY hoặc UNIQUE index thì insert trực tiếp; nếu xung đột thì xóa row cũ trước rồi insert row mới. Số row bị ảnh hưởng có thể là tổng số row bị xóa và row được insert.
- Mỗi thao tác đều kích hoạt việc xóa và tạo lại index, gây áp lực lớn hơn cho database.
- Nếu table có trigger, thao tác DELETE có thể vô tình kích hoạt trigger.
Giải pháp thay thế: nếu chỉ muốn tăng sequence table, có thể dùng INSERT ... ON DUPLICATE KEY UPDATE hoặc UPDATE một row để tránh ngữ nghĩa xóa của REPLACE. Trong production, segment mode phổ biến hơn: cập nhật current_max_id = current_max_id + step một lần, sau đó phân bổ trong memory.
Ưu nhược điểm của cách này khá rõ ràng:
- Ưu điểm: triển khai tương đối đơn giản, ID tăng có thứ tự, tốn ít storage.
- Nhược điểm: concurrency hỗ trợ không cao, có vấn đề single point ở database (có thể nâng cao availability bằng primary-standby, MGR, nhiều database cùng tạo segment, nhưng phải xử lý việc chuyển đổi master-slave, transaction commit, tạo ID trùng và lãng phí segment), ID không có business meaning cụ thể, có vấn đề an toàn (chẳng hạn có thể suy ra số đơn hàng mỗi ngày từ quy luật tăng của order ID, đây là bí mật thương mại!), mỗi lần lấy ID đều phải truy cập database (tăng áp lực lên database và tốc độ lấy cũng chậm).
Database segment mode
Với database primary key auto-increment, mỗi lần lấy ID đều phải truy cập database. Khi nhu cầu ID lớn thì chắc chắn không phù hợp.
Nếu có thể lấy theo batch rồi lưu trong memory, khi cần chỉ lấy trực tiếp từ memory thì sẽ giảm số lần truy cập database, đồng thời giảm latency và áp lực lên database. Đây chính là tạo distributed ID bằng database segment mode.
Database segment mode hiện là một trong những cách tạo distributed ID phổ biến. Tinyid do Didi open source cũng dựa trên cách này. Tuy nhiên, Tinyid tiếp tục tối ưu bằng double segment cache và hỗ trợ nhiều database.
Lấy MySQL làm ví dụ, có thể thực hiện như sau.
1. Tạo một database table.
CREATE TABLE `sequence_id_generator` (
  `id` INT NOT NULL,
  `current_max_id` BIGINT NOT NULL COMMENT 'Current maximum ID',
  `step` INT NOT NULL COMMENT 'Segment length',
  `version` INT NOT NULL COMMENT 'Version number',
  `biz_type` INT NOT NULL COMMENT 'Business type',
  PRIMARY KEY (`id`),
  UNIQUE KEY `uk_biz_type` (`biz_type`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
Field current_max_id và field step chủ yếu dùng để lấy batch ID. Khoảng batch ID lấy được là (current_max_id, current_max_id + step], tức không bao gồm chính giá trị cũ của current_max_id. Ví dụ, khi current_max_id = 0 và step = 100 trước đó, sau khi update thành công, khoảng ID có thể phân bổ trong lần này là 1~100.
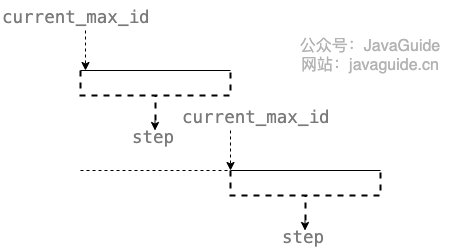
Field version chủ yếu dùng để giải quyết vấn đề concurrency (optimistic lock), quy trình đầy đủ như sau:
-- 1. Đọc giá trị hiện tại
SELECT current_max_id, step, version FROM sequence_id_generator WHERE biz_type = 101;
-- 2. CAS update (version là optimistic lock version)
UPDATE sequence_id_generator
SET current_max_id = current_max_id + step, version = version + 1
WHERE version = {read_version} AND biz_type = 101;
-- 3. Kiểm tra affected_rows, bằng 1 là thành công, bằng 0 là bị thread khác giành trước và cần retry
Sau khi thực thi UPDATE ... WHERE version = ? bắt buộc phải kiểm tra affected_rows. Nếu kết quả bằng 0, nghĩa là segment đã bị instance khác lấy trước. Khi đó cần đọc lại current_max_id và version, sau đó retry.
⚠️ Lưu ý retry khi concurrency cao: tại thời điểm segment cạn, nhiều thread có thể đồng thời tranh giành segment mới và CAS update có thể thất bại. Ở tầng code cần triển khai vòng retry với số lần giới hạn (chẳng hạn 3 lần) và exponential backoff để đảm bảo tính ổn định của request. Nếu vẫn thất bại sau retry, nên block chờ segment tiếp theo load xong, hoặc phát cảnh báo rồi đi vào quy trình circuit breaker và degradation. Không nên trả về “degraded ID”, vì có thể phá vỡ đảm bảo global unique.
biz_type chủ yếu dùng để biểu thị business type.
2. Insert trước một row dữ liệu.
INSERT INTO `sequence_id_generator` (`id`, `current_max_id`, `step`, `version`, `biz_type`)
VALUES
  (1, 0, 100, 0, 101);
3. Dùng SELECT để lấy batch unique ID của business được chỉ định
SELECT `current_max_id`, `step`, `version` FROM `sequence_id_generator` WHERE `biz_type` = 101Kết quả:
id current_max_id step version biz_type
1 0 100 0 101
4. Nếu không đủ, sau khi update chỉ cần SELECT lại.
UPDATE sequence_id_generator SET current_max_id = 0 + 100, version = version + 1 WHERE version = 0 AND `biz_type` = 101
SELECT `current_max_id`, `step`, `version` FROM `sequence_id_generator` WHERE `biz_type` = 101
Kết quả:
id current_max_id step version biz_type
1 100 100 1 101
So với database primary key auto-increment, database segment mode ít truy cập database hơn và áp lực lên database cũng thấp hơn.
Ngoài ra, để tránh single point, có thể nâng cao availability bằng mô hình master-slave hoặc triển khai nhiều database. Nếu dùng master-slave, thao tác update để tạo ID phải đi qua master database và phải đảm bảo sau khi failover không quay về current_max_id cũ. Với mô hình nhiều database, cần đảm bảo range segment, step hoặc business shard do mỗi database phân bổ không chồng lấn.
Segment mode cũng gây ra vấn đề “nhảy số”: sau khi instance xin segment, segment thường được cache trong memory; khi instance dừng hoặc restart, phần segment chưa dùng hết sẽ bị lãng phí. Lãng phí segment không ảnh hưởng tính duy nhất nhưng khiến ID không liên tục. Không nên thu hồi segment đã phân bổ nhưng chưa dùng chỉ để theo đuổi tính liên tục, vì có thể tạo ID trùng. Production cần monitor tốc độ tiêu thụ segment, tỷ lệ load thất bại và số lần retry.
Ưu nhược điểm của database segment mode:
- Ưu điểm: ID tăng dần theo xu hướng, tốn ít storage.
- Nhược điểm: có vấn đề single point ở database (có thể nâng cao availability bằng master-slave hoặc nhiều database, nhưng làm tăng độ phức tạp), ID không có business meaning cụ thể, có vấn đề an toàn (chẳng hạn có thể suy ra số đơn hàng mỗi ngày từ quy luật tăng của order ID, đây là bí mật thương mại!).
NoSQL
Thông thường, giải pháp NoSQL dùng Redis nhiều hơn. Có thể dùng lệnh INCR của Redis để thực hiện tăng ID theo thứ tự một cách atomic.
127.0.0.1:6379> set sequence_id_biz_type 1
OK
127.0.0.1:6379> incr sequence_id_biz_type
(integer) 2
127.0.0.1:6379> get sequence_id_biz_type
"2"
Để nâng cao availability và concurrency, có thể dùng Redis Cluster. Redis Cluster là giải pháp Redis cluster chính thức do Redis cung cấp (từ version 3.0).
Codis từng là một giải pháp Redis cluster open source phổ biến, nhưng project đã không active trong thời gian dài. Với project mới, thường nên ưu tiên đánh giá Redis Cluster, Redis cluster của cloud provider hoặc managed service tương thích giao thức Redis; Codis phù hợp hơn với hệ thống đang tồn tại, nhưng cần đánh giá riêng tình trạng maintenance trước khi dùng.
Ngoài availability và concurrency, Redis dựa trên memory nên cần persist dữ liệu để tránh mất dữ liệu sau khi restart hoặc machine failure. Redis hỗ trợ hai cách persistence khác nhau: snapshotting (RDB) và append-only file (AOF). Từ Redis 4.0, Redis cũng hỗ trợ hybrid persistence giữa RDB và AOF, được điều khiển bởi config aof-use-rdb-preamble: config mẫu Redis 4.0 mặc định tắt, config mẫu Redis 5.0+ mặc định bật. Giá trị mặc định cụ thể cần căn cứ vào version Redis mục tiêu, config file và config của bản managed do cloud provider cung cấp.
Về Redis persistence, bài viết này không giới thiệu quá sâu. Nếu chưa hiểu phần này, bạn có thể xem bài Giải thích chi tiết cơ chế Redis persistence.
Dù INCR của Redis có performance tốt, Redis persistence chỉ giảm rủi ro mất dữ liệu sau khi process restart, không thể loại bỏ hoàn toàn việc ID quay lui. Đặc biệt trong các trường hợp appendfsync everysec, RDB snapshot, async replication master-slave và failover, kết quả INCR gần nhất đều có thể bị mất. Cần đặc biệt lưu ý các failure path sau:
ID quay lui do persistence delay
- Tình huống: sau khi thực thi
INCR, Redis bị crash trước khi ghi RDB/AOF xuống disk. - Hậu quả: sau khi restart, ID quay về giá trị được persist lần gần nhất và có thể tạo ID trùng.
- Tình huống: sau khi thực thi
AOF rewrite gây block tạm thời
- Tình huống: AOF file quá lớn và kích hoạt rewrite.
- Hậu quả: process chính fork child process, có thể gây performance jitter tạm thời.
Hotspot trên một shard của Redis Cluster
- Tình huống: một counter key luôn rơi vào cùng một shard trong cluster.
- Hậu quả: shard đó có thể trở thành bottleneck khi concurrency cao.
Failover do async replication master-slave
- Tình huống: khi master node failover sang slave node, giá trị
INCRtrên slave có thể chậm hơn master. - Hậu quả: ID trên master node mới có thể quay về giá trị cũ.
- Tình huống: khi master node failover sang slave node, giá trị
Đề xuất config production:
# Config tham khảo cho Redis 7.0+
appendonly yes
appendfsync everysec
aof-use-rdb-preamble yes # Hybrid persistence (kết hợp RDB+AOF)- Tối ưu trong Redis 7.0+: Multi-part AOF cải thiện cách tổ chức và quản lý các base/incr file trong thời gian AOF rewrite, nhưng fork, disk IO và strategy
fsyncvẫn có thể gây jitter. - Phạm vi phù hợp: Redis phù hợp với sequence number, counter chu kỳ ngắn và trường hợp có thể deduplicate bằng business fallback. Nếu yêu cầu tính duy nhất của ID rất cao, chẳng hạn core primary key như order number hoặc payment transaction number, cần kết hợp business deduplication, persistence strategy, master-slave consistency strategy và database unique constraint, hoặc chuyển sang database segment mode, Leaf và các giải pháp khác.
Ưu nhược điểm của giải pháp Redis:
- Ưu điểm: performance khá tốt, và khi một key cùng một master hoạt động bình thường, ID tạo ra sẽ tăng dần.
- Nhược điểm: tương tự nhược điểm của database primary key auto-increment, đồng thời có rủi ro persistence delay, hotspot trên một shard và ID quay lui do master-slave switch.
Ngoài Redis, MongoDB ObjectId cũng thường được dùng làm giải pháp distributed ID.
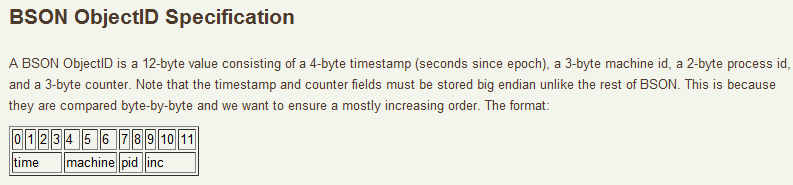
MongoDB ObjectId cần tổng cộng 12 byte để lưu trữ:
- 0~3: Unix timestamp đến giây (4 byte)
- 4~8: giá trị random (5 byte, mỗi client process tạo một lần để phân biệt machine và process)
- 9~11: counter auto-increment (3 byte, tăng dần trong mỗi client process)
ObjectId là unique identifier gần như có thứ tự, không cần central coordination. Nó thường đáp ứng được trường hợp dùng document _id, nhưng không phải sequence đơn điệu nghiêm ngặt trên toàn cục: nó chỉ có độ chính xác timestamp đến giây, nên các ObjectId tạo trong cùng một giây không đảm bảo thứ tự nghiêm ngặt; system time của các client machine khác nhau cũng có thể khác nhau.
Ưu nhược điểm của giải pháp MongoDB:
- Ưu điểm: performance khá tốt, ID tạo ra gần như có thứ tự theo creation time.
- Nhược điểm: không tăng dần đơn điệu nghiêm ngặt; khi system time giữa các machine không đồng nhất, thứ tự có thể không phản ánh đúng creation order. Ngoài ra, ID chứa thông tin thời gian nên có tính quy luật nhất định.
Giải pháp tạo dựa trên algorithm (stateless)
UUID
UUID là viết tắt của Universally Unique Identifier (định danh duy nhất phổ quát), về bản chất là một identifier 128 bit. Dạng string tiêu chuẩn thường có 36 ký tự (bao gồm hyphen); bỏ hyphen còn 32 ký tự hexadecimal.
JDK đã cung cấp sẵn method tạo UUID, chỉ cần một dòng code.
// Ví dụ output: cb4a9ede-fa5e-4585-b9bb-d60bce986eaa
UUID.randomUUID()
RFC 9562 đã thay thế RFC 4122, chuẩn hóa lại UUID và bổ sung v6, v7, v8. Tài liệu cũ vẫn có thể nói về RFC 4122, nhưng bài viết mới nên lấy RFC 9562 làm chính. Ví dụ về UUID trong RFC 9562 như sau:
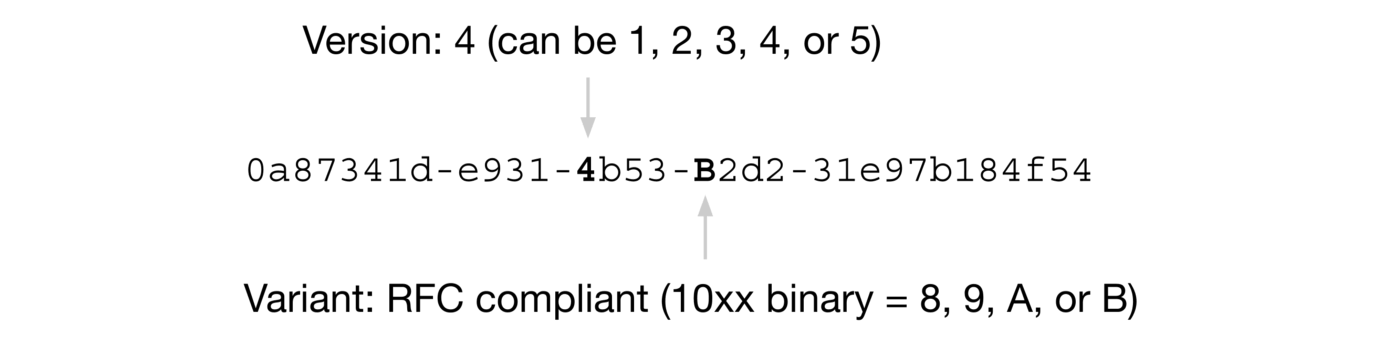
Ở đây hãy tập trung vào Version (version), vì mỗi version có quy tắc tạo UUID khác nhau.
Ý nghĩa tương ứng của 8 giá trị Version (version) khác nhau (tham khảo giới thiệu UUID trên Wikipedia):
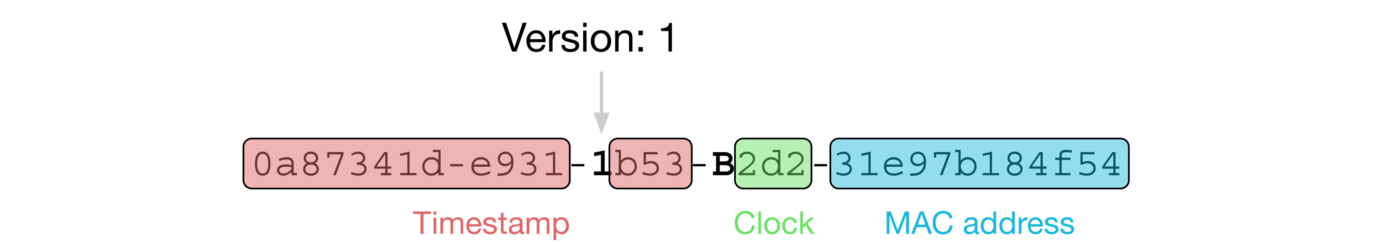
- Version 1 (dựa trên time và node ID): tạo dựa trên timestamp (thường là thời gian hiện tại) và node ID (thường là MAC address của thiết bị). Khi chứa MAC address, nó có thể đảm bảo tính duy nhất toàn cầu, nhưng cũng gây rủi ro lộ thông tin riêng tư.
- Version 2 (dựa trên identifier, time và node ID): tương tự version 1, cũng dựa trên time và node ID, nhưng bổ sung local identifier (chẳng hạn user ID hoặc group ID).
- Version 3 (MD5 hash dựa trên namespace và name): dùng MD5 hash algorithm, kết hợp namespace identifier (một UUID) và name string để tính toán. Cùng namespace và name luôn tạo ra cùng một UUID (tạo deterministic).
- Version 4 (dựa trên random): dùng pseudo-random number generator (PRNG) hoặc cryptographically secure random number generator (CSPRNG) để tạo. UUID v4 có 122 bit random, không gian giá trị là 2^122; theo birthday paradox, chỉ khi tạo khoảng 2^61 UUID thì xác suất collision mới gần 50%. Trong thực tế có thể xem là unique, nhưng về lý thuyết vẫn là đảm bảo xác suất.
- Version 5 (SHA-1 hash dựa trên namespace và name): tương tự version 3 nhưng dùng SHA-1 hash algorithm.
- Version 6 (dựa trên timestamp, counter và node ID): cải tiến version 1, đưa timestamp vào các bit có trọng số cao nhất (Most Significant Bit, MSB), giúp UUID có thể được sort trực tiếp theo time.
- Version 7 (dựa trên Unix millisecond timestamp): 48 bit cao là Unix millisecond timestamp; các bit còn lại sau khi trừ version và variant bit dùng cho random, đồng thời cho phép implementation dùng sub-millisecond time hoặc counter để tăng tính đơn điệu trong cùng một millisecond. Với system mới cần sort theo time và không có yêu cầu tương thích đặc biệt, UUID v7 thường được khuyến nghị hơn v1/v6; nhưng với system đang tồn tại, protocol compatibility và data format sẵn có vẫn cần được đánh giá riêng.
- Version 8 (experimental/vendor-customized): 122 bit dành cho implementation tùy chỉnh, chỉ yêu cầu version bit và variant bit cố định. Phù hợp với trường hợp cần nhúng thêm thông tin hoặc có giới hạn ứng dụng đặc biệt. Tính duy nhất do implementation đảm bảo, không được mặc định là có.
Dưới đây là ví dụ kết quả tạo UUID v1:
UUID tạo bằng method randomUUID() của UUID trong JDK mặc định có version là 4.
UUID uuid = UUID.randomUUID();
int version = uuid.version();// 4
Ngoài ra, Variant cũng có 4 giá trị khác nhau, mỗi giá trị tương ứng với một ý nghĩa. Ở đây không giới thiệu vì có vẻ trong thực tế cũng không cần chú ý nhiều.
Khi cần dùng, chỉ cần xem phần giới thiệu về Variant của UUID trên Wikipedia.
Từ phần giới thiệu trên có thể thấy, với implementation đúng và đủ tính ngẫu nhiên, UUID có thể được xem là unique trong engineering. Tính duy nhất của v4 về bản chất là đảm bảo xác suất; v1/v6 phụ thuộc vào node ID và timestamp nên có thể làm lộ thông tin riêng tư; tính duy nhất của v7/v8 phụ thuộc vào strategy của implementation.
Dù UUID có thể được xem là global unique trong engineering, chúng ta thường ít dùng nó.
Ví dụ, dùng UUID v4, một loại UUID không theo time, làm primary key cho MySQL database là không phù hợp:
- Primary key của database nên càng ngắn càng tốt. UUID về bản chất là 128 bit; nếu lưu dạng string thì thường là 36 ký tự gồm hyphen hoặc 32 ký tự hexadecimal; nếu lưu dạng binary thì có thể nén xuống 16 byte.
- UUID v4 là UUID không theo time và không có thứ tự. Với InnoDB engine, tính không có thứ tự của primary key ảnh hưởng nghiêm trọng đến performance database.
UUID v7 (RFC 9562) là một giải pháp tùy chọn đã được chuẩn hóa, có thứ tự theo xu hướng và không cần phân bổ Worker ID:
UUID v7 không cần phân bổ Worker ID như Snowflake nên chi phí tích hợp thấp; nhưng nó vẫn phụ thuộc vào chất lượng random và implementation của generator. Với primary key không thể chấp nhận trùng lặp, database unique constraint vẫn không thể bỏ qua.
| Đặc tính | Snowflake | UUID v7 |
|---|---|---|
| Quản lý Worker ID | Cần phân bổ tập trung (ZK/etcd) | Không cần phân bổ, dùng ngay |
| Rủi ro clock rollback | Cần xử lý bổ sung | Cho phép không theo thứ tự trong một millisecond; khi clock rollback, implementation của generator cần xử lý tính đơn điệu |
| Thân thiện với B+ tree | Tăng dần theo xu hướng | Có thứ tự theo xu hướng |
| Chuẩn hóa | Implementation giữa các bên khác nhau | RFC standard, tương thích cross-language |
| Cấu trúc | 64 bit (tùy chỉnh) | 128 bit (48 bit timestamp + field random/counter) |
Trường hợp sử dụng: distributed system quy mô vừa và nhỏ, không cần performance cấp Snowflake và muốn giảm chi phí vận hành Worker ID.
UUID v7 có lợi hơn UUID v4 cho việc ghi cục bộ vào B+ tree, nhưng vẫn là 128 bit nên tốn nhiều storage hơn Snowflake ID 64 bit. Trong database, nên ưu tiên dùng BINARY(16) hoặc native uuid type thay vì primary key dạng string; với table có write cao vẫn cần benchmark page split, kích thước index và cache hit rate.
UUID v8 (mục đích experimental): nếu cần nhúng thêm thông tin (chẳng hạn business identifier, cluster information) hoặc có giới hạn ứng dụng đặc biệt, có thể cân nhắc UUID v8. Tuy nhiên cần lưu ý: tính duy nhất của v8 do implementation đảm bảo, không được mặc định là tương thích với implementation khác.
⚠️ Lưu ý: mức độ hỗ trợ của database vẫn đang được phổ biến. PostgreSQL 18 (phát hành ngày 2025-09-25) bắt đầu cung cấp function uuidv7() tích hợp để tạo UUID có thứ tự theo time. UUID() của MySQL 8.0 tạo UUID liên quan đến time và node, thường được xem là kiểu v1; UUID_TO_BIN(uuid, 1) có thể sắp xếp lại phần time để cải thiện tính cục bộ của index, nhưng đây không phải function tạo UUID v7. UUID v7 thường cần được tạo ở application layer hoặc bằng custom function.
Cuối cùng, hãy phân tích ngắn gọn ưu nhược điểm của UUID (có thể được hỏi trong phỏng vấn!):
- Ưu điểm: tốc độ tạo thường khá nhanh, đơn giản và dễ dùng.
- Nhược điểm: tốn nhiều storage, không an toàn (algorithm tạo UUID dựa trên MAC address sẽ làm lộ MAC address), nhiều version không có tính tăng dần nghiêm ngặt và không có business meaning cụ thể; với trường hợp yêu cầu tính duy nhất rất cao, vẫn cần đánh giá chất lượng random, implementation strategy và cơ chế xử lý trùng.
Snowflake (thuật toán Snowflake)
Snowflake là distributed ID generation algorithm do Twitter open source. Snowflake gồm một số nhị phân 64 bit. 64 bit này được chia thành nhiều phần, mỗi phần lưu dữ liệu có ý nghĩa riêng:
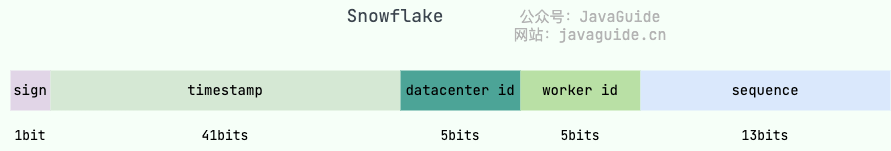
- sign (1 bit): sign bit (biểu thị dương/âm), luôn bằng 0, nghĩa là ID được tạo là số dương.
- timestamp (41 bits): tổng cộng 41 bit, dùng để biểu thị relative timestamp (số millisecond từ một mốc tùy chỉnh), hỗ trợ 2^41 millisecond (khoảng 69 năm). Thông thường mốc được đặt là thời điểm system online (chẳng hạn 2020-01-01), không phải Unix epoch.
- datacenter id + worker id (10 bits): thông thường 5 bit đầu biểu thị datacenter ID, 5 bit sau biểu thị machine ID (project thực tế có thể điều chỉnh tùy tình huống). Nhờ vậy có thể phân biệt node ở các cluster/datacenter khác nhau.
- sequence (12 bits): tổng cộng 12 bit, dùng để biểu thị sequence number. Sequence number là giá trị auto-increment. Với thiết kế sequence 12 bit tiêu chuẩn, một Worker tạo tối đa 4096 sequence number mỗi millisecond; nếu điều chỉnh số bit của sequence hoặc dùng algorithm cải tiến thì giới hạn sẽ thay đổi.
⚠️ Cảnh báo concurrency cao (Snowflake tiêu chuẩn): implementation tiêu chuẩn tạo tối đa 4096 sequence number mỗi node mỗi millisecond. Nếu số request trong một millisecond vượt quá 4096, một số implementation sẽ block chờ đến millisecond tiếp theo, có thể gây latency spike trong thời điểm concurrency cao như flash sale hoặc promotion lớn. Một số implementation cải tiến (chẳng hạn bản cải tiến của Seata, IdGenerator) giảm nhẹ giới hạn này bằng cách tăng dần toàn bộ timestamp/sequence hoặc “mượn time trong tương lai”, nhưng đổi lại thời gian tạo có thể tạm thời đi trước physical time. Production cần đánh giá peak QPS; khi cần, có thể sharding nhiều instance hoặc cải tiến algorithm để tăng số bit của sequence.
Trong project thực tế, chúng ta thường cải tiến algorithm Snowflake. Cách phổ biến nhất là thêm thông tin business type vào ID được tạo bởi algorithm Snowflake.
Vấn đề clock rollback của Snowflake và cách giải quyết
Nguyên nhân: NTP synchronization, điều chỉnh time thủ công hoặc clock drift của hardware có thể khiến system time đi lùi.
So sánh các giải pháp:
| Giải pháp | Ưu điểm | Nhược điểm | Trường hợp sử dụng |
|---|---|---|---|
| Từ chối cấp ID | Dễ triển khai | Hoàn toàn unavailable trong lúc clock rollback | Trường hợp không yêu cầu availability cao |
| Chờ bắt kịp | Đảm bảo ID unique | Nếu rollback lớn sẽ block lâu, có thể ảnh hưởng business | Rollback rất nhỏ |
| Worker ID dự phòng | High availability | Triển khai phức tạp, cần xử lý lease, split-brain và phục hồi instance cũ | System đã có reliable registry/lease mechanism |
Worker ID dự phòng là một giải pháp tùy chọn, không phải khuyến nghị chung. Nó phù hợp với system đã có reliable registry/lease mechanism; cách xử lý phổ biến hơn còn có chờ khi rollback nhỏ, từ chối tạo ID khi vượt threshold, persist last timestamp và dùng registry để đảm bảo lease của Worker ID là duy nhất. Các vấn đề về lease, split-brain và phục hồi instance cũ có thể được tìm hiểu cùng Giải thích chi tiết distributed coordination.
Bài toán phân bổ Snowflake Worker ID
Trong môi trường triển khai container (Kubernetes), phân bổ Worker ID của Snowflake trở thành điểm khó khăn lớn nhất:
Tình huống:
- IP và name của Pod là dynamic và sẽ thay đổi sau khi restart.
- Không thể cấu hình trước Worker ID cố định như với physical machine.
- Khi auto scaling, cần dynamic acquire và release Worker ID.
Các giải pháp phổ biến:
| Giải pháp | Cách triển khai | Ưu điểm | Nhược điểm |
|---|---|---|---|
| ZooKeeper registry | Khi service start, tạo ephemeral node trong ZK; sequence của node là Worker ID | Tự động thu hồi, giải phóng sau crash | Phụ thuộc ZK, tăng độ phức tạp vận hành |
| Redis registry | Dùng SETNX + expiration để acquire Worker ID | Nhẹ, không cần component khác | Cần xử lý tình huống Redis down |
| Database allocation | Khi start, phân bổ từ database và persist vào local file | Đơn giản, đáng tin cậy | Phụ thuộc database |
| Dynamic Worker ID | Dùng Pod IP hoặc UID hash để tạo | Không cần central component | Có thể xảy ra hash collision |
Khuyến nghị: production có thể dùng Meituan Leaf (chế độ Snowflake phụ thuộc vào ZooKeeper để quản lý workId), hoặc dùng giải pháp segment mode như Didi Tinyid để tránh bài toán phân bổ Worker ID.
Hãy tiếp tục xem ưu nhược điểm của algorithm Snowflake:
- Ưu điểm: tốc độ tạo khá nhanh, ID tạo ra tăng có thứ tự, linh hoạt (có thể cải tiến đơn giản algorithm Snowflake, chẳng hạn thêm business ID).
- Nhược điểm: rủi ro clock rollback (cần xử lý bổ sung, xem giải pháp bên trên), phụ thuộc vào machine ID nên không thân thiện với distributed environment (khi cần tự động start/stop hoặc tăng giảm machine, machine ID cố định có thể thiếu linh hoạt).
Nếu muốn dùng algorithm Snowflake, thông thường không cần tự viết lại từ đầu. Trong production có thể ưu tiên đánh giá implementation mature như Leaf, Tinyid, IdGenerator hoặc ID generator service của cloud provider, nhưng cần chọn dựa trên maintenance status, hệ sinh thái ngôn ngữ, strategy xử lý clock rollback, cách phân bổ Worker ID và kết quả benchmark.
Nếu cần giải mã thông tin từ Snowflake ID, phải xử lý theo cách phân bổ bit thực tế. Với cấu trúc phổ biến 41-bit timestamp + 10-bit worker + 12-bit sequence, right shift 22 bit sẽ lấy được relative timestamp, sau đó cộng custom epoch để có thời gian tạo; dùng bit mask để lấy Worker ID và sequence. Chỉ cần thay đổi số bit hoặc epoch thì logic parse cũng phải thay đổi theo.
Ngoài ra, Seata còn đưa ra “algorithm Snowflake cải tiến”, tối ưu và cải tiến nhất định từ algorithm Snowflake gốc, giải quyết vấn đề clock rollback và nâng cao đáng kể QPS. Có thể xem hai bài viết sau để tìm hiểu giới thiệu và nguyên lý cải tiến:
- Phân tích distributed UUID generator dựa trên algorithm Snowflake cải tiến của Seata
- Thấy một algorithm Snowflake cải tiến trong open source project, giờ nó là của bạn.
So sánh các open source framework tạo distributed ID cấp production
Khi đánh giá các framework này, không nên chỉ xem danh sách tính năng mà còn cần chú ý một số khía cạnh production: project còn được maintenance hay không, mức độ active gần đây của release/commit/issue, dependency component (MySQL, Redis, ZooKeeper, etcd...), strategy xử lý clock rollback, strategy phân bổ Worker ID, client mode hay server mode, cùng P99/TP999 latency trong điều kiện benchmark.
UidGenerator (Baidu)
UidGenerator là unique ID generator dựa trên Snowflake do Baidu open source.
Tuy nhiên, UidGenerator đã cải tiến Snowflake. Cấu tạo unique ID được tạo ra như sau:
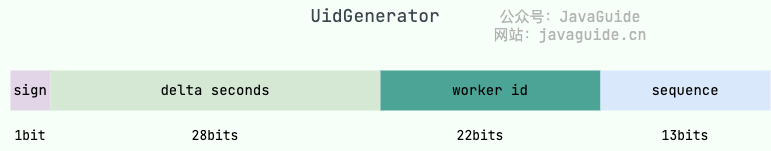
- sign (1 bit): sign bit (biểu thị dương/âm), luôn bằng 0, nghĩa là ID được tạo là số dương.
- delta seconds (28 bits): time hiện tại, là delta so với time base “2016-05-20”, đơn vị là giây, hỗ trợ tối đa khoảng 8,7 năm.
- worker id (22 bits): machine ID, hỗ trợ tối đa khoảng 4,2 triệu lần machine start. Implementation tích hợp mặc định được database phân bổ khi start; strategy mặc định là dùng xong bỏ, sau này có thể cung cấp strategy tái sử dụng.
- sequence (13 bits): sequence concurrency mỗi giây; 13 bit hỗ trợ 8192 concurrency mỗi giây.
Có thể thấy cấu tạo unique ID tạo bởi UidGenerator không hoàn toàn giống Snowflake gốc. Ngoài ra, các parameter trên đều có thể tùy chỉnh.
Giới thiệu trong tài liệu chính thức của UidGenerator như sau:
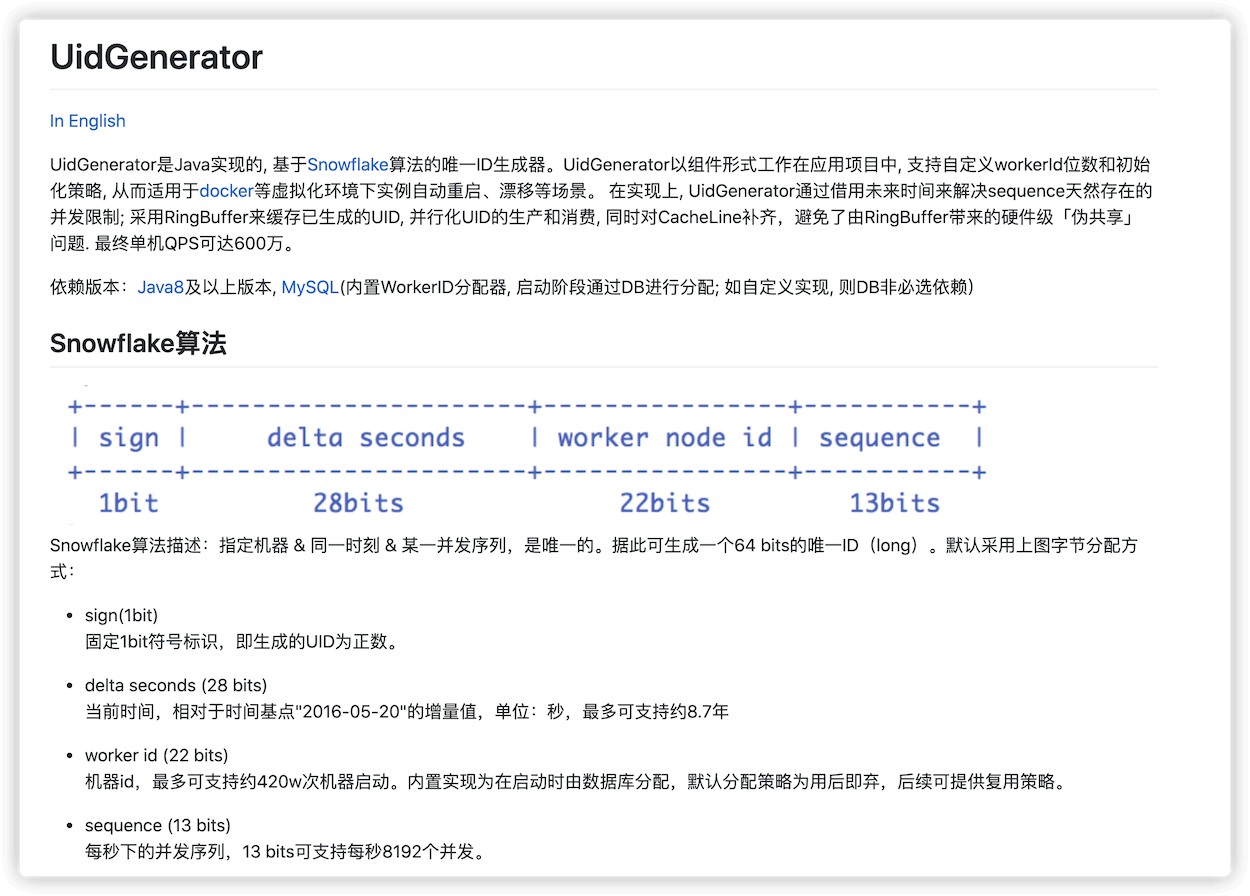
Official repository của UidGenerator đã không active trong thời gian dài. Project mới không nên chọn chỉ vì độ nổi tiếng, mà cần đánh giá trước maintenance status, dependency security và hệ sinh thái fork. Nếu muốn tìm hiểu thêm, có thể xem giới thiệu chính thức về UidGenerator.
Leaf (Meituan)
Leaf là một distributed ID solution do Meituan open source. Tên project Leaf bắt nguồn từ câu nói của nhà triết học và toán học Đức Leibniz: “There are no two identical leaves in the world” (trên thế giới không có hai chiếc lá giống hệt nhau). Tên gọi này cũng khá dễ nhận diện.
Leaf cung cấp hai mode segment mode và Snowflake để tạo distributed ID. Nó hỗ trợ double segment và giải quyết vấn đề clock rollback của Snowflake ID system. Tuy nhiên, việc giải quyết vấn đề clock cần dependency yếu với ZooKeeper (dùng ZooKeeper làm registry, quản lý workId bằng cách đọc và tạo child node tại path cụ thể).
Leaf ra đời chủ yếu để giải quyết vấn đề các business line khác nhau của Meituan dùng nhiều cách tạo distributed ID khác nhau và không đáng tin cậy.
Leaf tối ưu trọng tâm segment mode gốc bằng cơ chế Double Buffer:
Nguyên lý thiết kế: Leaf không chờ segment dùng hết mới xin segment từ database. Khi segment hiện tại tiêu thụ đến một threshold nhất định, async thread sẽ xin segment tiếp theo từ database trước và preload vào memory. Threshold và chi tiết implementation nên căn cứ vào source code của version Leaf hiện tại. Cơ chế Double Buffer giúp TP999 khi lấy ID ổn định hơn và giảm latency jitter do truy cập database.
(Ảnh từ bài viết chính thức của Meituan: 《Hệ thống tạo distributed ID của Meituan Dianping — Leaf》)

Theo mô tả benchmark trong bài viết của Meituan thời điểm đó và README của project, trên 4C8G VM và với cách gọi RPC của công ty, Leaf từng đạt gần 50.000 QPS, TP999 khoảng 1 ms. Dữ liệu này chỉ có tính tham khảo; performance thực tế còn phụ thuộc vào database, RPC framework, network, segment size và cách deploy.
Tinyid (Didi)
Tinyid là unique ID generator dựa trên database segment mode do Didi open source.
Nguyên lý database segment mode đã được giới thiệu ở trên. Tinyid có những điểm nổi bật nào?
Để làm rõ, trước tiên hãy xem một architecture đơn giản dựa trên database segment mode. (Ảnh từ official wiki của Tinyid: 《Giới thiệu nguyên lý Tinyid》)
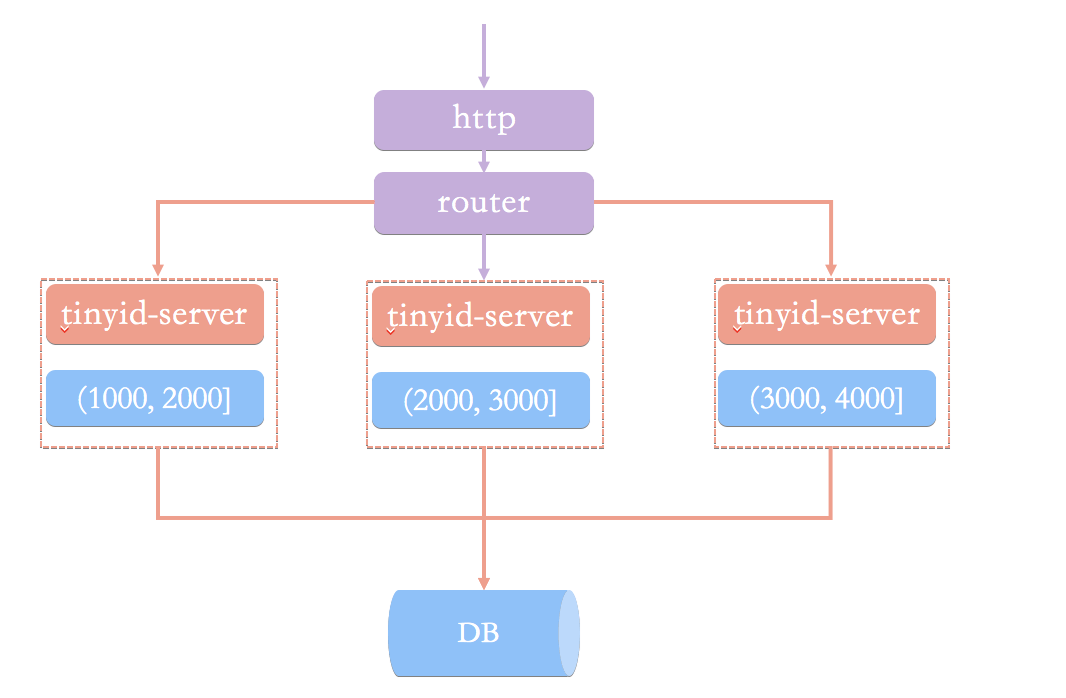
Trong architecture này, chúng ta gửi HTTP request đến ID generator service để xin unique ID. Load balancing router sẽ gửi request đến một trong các tinyid-server.
Giải pháp này có vấn đề gì? Theo tôi (official wiki của Tinyid cũng giới thiệu), chủ yếu có hai vấn đề sau:
- Khi lấy segment mới, tốc độ chương trình lấy unique ID tương đối chậm.
- Cần đảm bảo database high availability, việc này khá phức tạp và tốn tài nguyên.
Ngoài ra, HTTP call cũng có network overhead.
Nguyên lý của Tinyid khá đơn giản, architecture như sau:
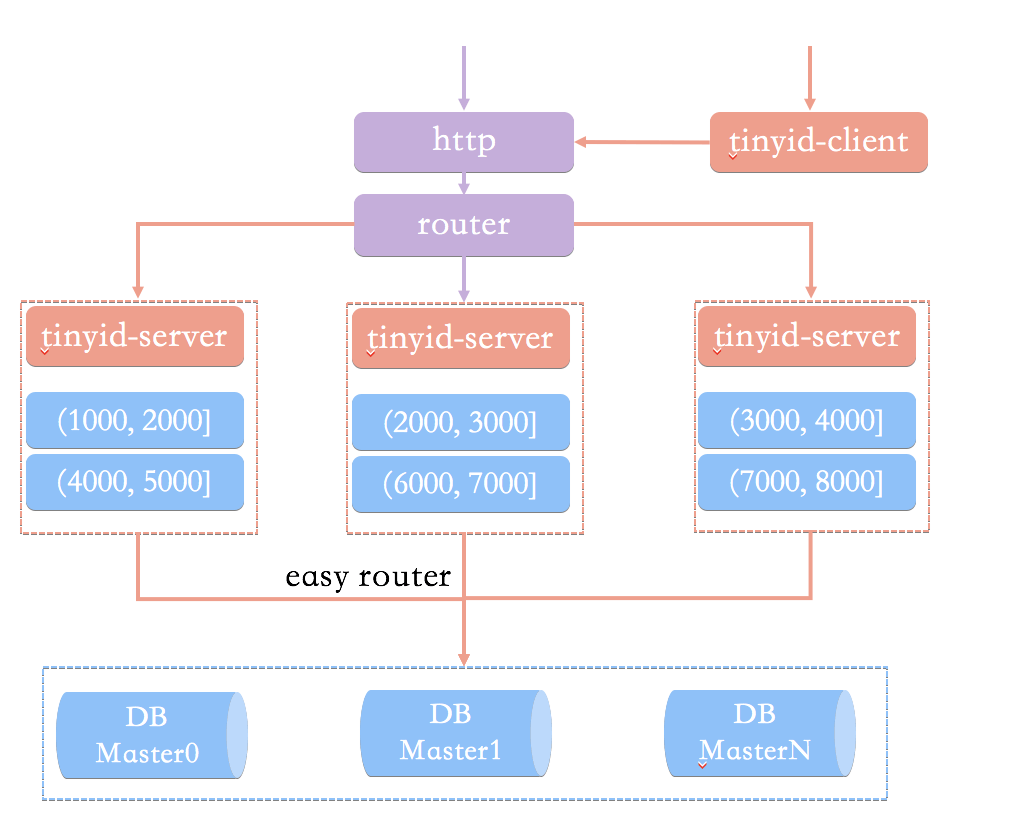
So với architecture đơn giản dựa trên database segment mode, giải pháp Tinyid chủ yếu có các tối ưu sau:
- Double segment cache: để tránh tốc độ lấy unique ID chậm khi lấy segment mới, khi segment của Tinyid dùng đến một mức nhất định, nó sẽ async load segment tiếp theo, đảm bảo trong memory luôn có segment khả dụng.
- Hỗ trợ nhiều database: hỗ trợ nhiều database để nâng cao availability. Điều kiện là range segment, step hoặc business shard do mỗi database phân bổ không được chồng lấn, đồng thời khi failover không được phân bổ lại segment đã phát ra.
- Bổ sung tinyid-client: thao tác hoàn toàn local, không tốn HTTP request, cải thiện đáng kể performance và availability.
Ở đây không phân tích ưu nhược điểm của Tinyid; chỉ cần kết hợp ưu nhược điểm của database segment mode với nguyên lý Tinyid là có thể hiểu được.
IdGenerator (cá nhân)
Giống UidGenerator và Leaf, IdGenerator cũng là unique ID generator dựa trên Snowflake.
Theo tự mô tả của IdGenerator, nó có các đặc điểm sau:
- Unique ID tạo ra ngắn hơn;
- Tương thích với mọi Snowflake algorithm (segment mode hoặc classic mode, của công ty lớn hoặc nhỏ);
- Native support C#/Java/Go/C/Rust/Python/Node.js/PHP (C extension)/SQL/... và cung cấp dynamic library (FFI) để gọi an toàn trong multi-thread;
- Giải quyết vấn đề clock rollback, hỗ trợ insert ID thủ công (khi business cần tạo ID trong time quá khứ, các bit dự phòng của algorithm này có thể tạo 5000 ID mỗi giây);
- Không phụ thuộc external storage system;
- Với config mặc định, ID có thể không trùng trong 71.000 năm.
Các parameter này phụ thuộc vào bit allocation, base time, Worker ID và sequence config. Trước khi dùng trong production, vẫn cần tính giới hạn capacity theo config của mình và benchmark; không nên xem số liệu quảng bá mặc định là cam kết cho mọi trường hợp.
Cấu tạo unique ID do IdGenerator tạo như sau:
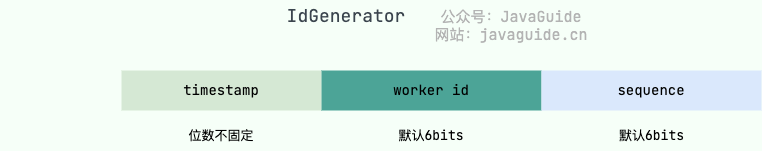
- timestamp (số bit không cố định): time difference, là tổng chênh lệch time (đơn vị millisecond) giữa system time lúc tạo ID và BaseTime (base time, còn gọi là origin time hoặc epoch time, mặc định là năm 2020). Ban đầu là 5 bit và tăng theo thời gian chạy. Nếu thấy giá trị mặc định quá cũ thì có thể đặt lại, nhưng cần lưu ý sau đó tốt nhất không thay đổi giá trị này.
- worker id (mặc định 6 bit): machine ID, machine code, parameter quan trọng nhất, là unique ID dùng để phân biệt machine hoặc application khác nhau. Giá trị lớn nhất do
WorkerIdBitLength(mặc định 6) giới hạn. Nếu một server deploy nhiều service độc lập, cần chỉ định WorkerId khác nhau cho từng service. - sequence (mặc định 6 bit): sequence number mỗi millisecond, do
SeqBitLength(mặc định 6) giới hạn. TăngSeqBitLengthgiúp performance cao hơn nhưng ID tạo ra cũng dài hơn.
Ví dụ sử dụng trong Java: https://github.com/yitter/idgenerator/tree/master/Java.
Tổng kết
Qua bài viết này, về cơ bản tôi đã tổng hợp các giải pháp tạo distributed ID phổ biến nhất.
Ngoài các cách đã giới thiệu, middleware như ZooKeeper cũng có thể hỗ trợ tạo unique ID. Không có giải pháp vạn năng; nhất định phải kết hợp project thực tế để chọn giải pháp phù hợp nhất.
Cuối cùng cần nhấn mạnh: đừng xem tính liên tục của ID là hard requirement. Phần lớn business chỉ yêu cầu unique, không yêu cầu liên tục; ID liên tục còn có thể làm lộ quy mô business. Segment mode, Snowflake và UUID đều có thể nhảy số, và nhảy số thường không phải bug. Khi cần sort, nên ưu tiên dùng field creation time, không nên hoàn toàn phụ thuộc vào việc sort theo ID.
Bảng so sánh ngang các giải pháp cốt lõi:
| Giải pháp | Performance | Tính có thứ tự | Chi phí vận hành | Trường hợp sử dụng |
|---|---|---|---|---|
| Database auto-increment | Thấp | Tăng dần nghiêm ngặt | Thấp | Business nhỏ, architecture đơn lẻ, backend system |
| Segment mode | Cao | Tăng dần theo xu hướng | Trung bình | High concurrency, business Internet theo đuổi throughput tối đa |
| Giải pháp Redis | Rất cao | Tăng dần khi một key hoạt động bình thường | Trung bình | Đã có Redis cluster, chấp nhận xác suất ID quay lui cực nhỏ |
| Snowflake | Cao | Tăng dần theo xu hướng | Trung bình | Distributed system vừa và lớn, cần xử lý Worker ID, clock rollback và capacity planning |
| UUID v7 | Cao | Tăng dần theo xu hướng | Rất thấp | Cloud-native, cluster không tập trung, muốn dùng ngay; với primary key vẫn nên có unique index dự phòng |
Tuy nhiên, bài viết này chủ yếu giới thiệu kiến thức lý thuyết về distributed ID. Trong phỏng vấn thực tế, interviewer có thể dùng business scenario cụ thể để đánh giá thiết kế distributed ID của bạn. Bạn có thể tham khảo bài viết Hướng dẫn thiết kế distributed ID (cũng rất hữu ích cho việc thiết kế distributed ID trong công việc thực tế).
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.