
Giải thích chi tiết về distributed coordination: Leader, Quorum, Lease, Fencing Token và Gossip
Một scheduled task được deploy với 3 instance. Đến 2 giờ sáng, rốt cuộc ai sẽ chạy batch task này?
Nếu cả 3 instance cùng chạy, dữ liệu có thể bị xử lý trùng; nếu cả 3 instance đều chờ instance khác chạy, task sẽ bị bỏ sót. Cache cluster, message queue, configuration center và distributed lock cũng gặp vấn đề tương tự: sau khi số node tăng lên, hệ thống phải có người quyết định “ai phụ trách việc gì”, “hiện tại ai còn sống” và “thay đổi lần này có hiệu lực theo thứ tự nào”.
Đó chính là vấn đề coordination trong distributed system.
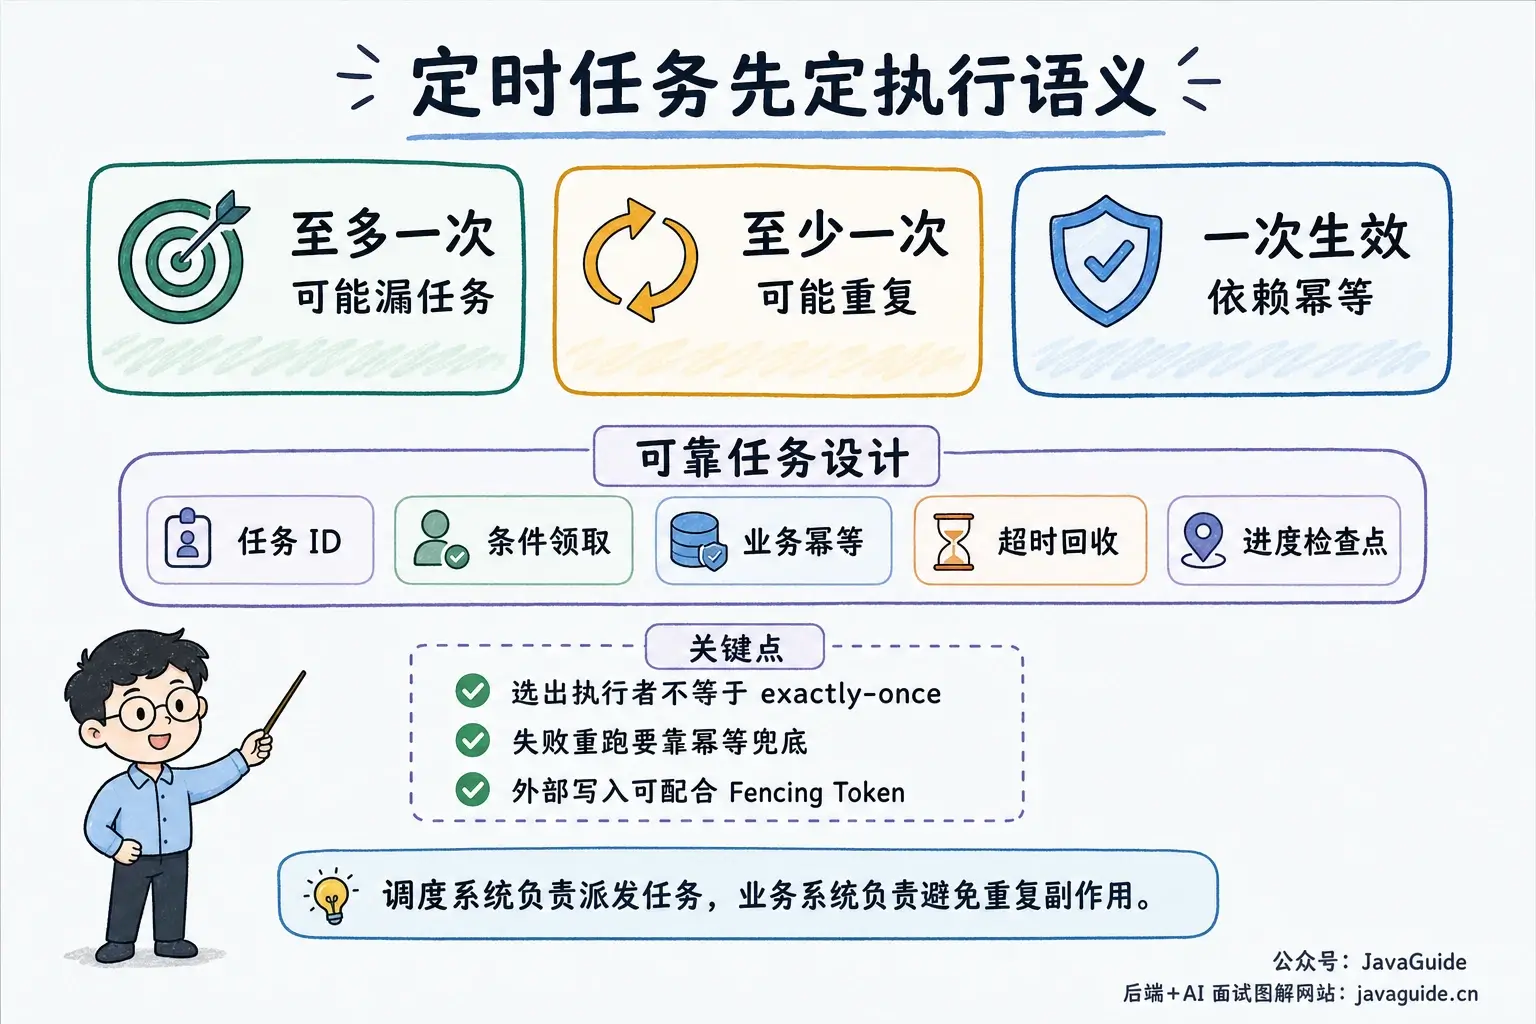
Tuy nhiên, trước hết cần phân biệt hai việc: chỉ chọn ra một executor và business chỉ có hiệu lực một lần.
Leader election, distributed lock hoặc database preemption có thể giảm khả năng nhiều instance thực thi đồng thời, nhưng không thể tự mình bảo đảm exactly-once ở đầu cuối. Execution node có thể đã xử lý thành công nhưng bị down trước khi cập nhật trạng thái task; để tránh bỏ sót task, scheduling system chỉ có thể dispatch lại. Tài liệu chính thức của Kubernetes CronJob cũng nhắc rằng thời điểm CronJob tạo Job chỉ mang tính gần đúng; trong một số trường hợp có thể tạo hai Job hoặc không tạo Job nào, vì vậy bản thân Job nên được thiết kế có tính idempotency.
Scheduled task trong production thường gần với mô hình “at-least-once + business idempotency”: dùng task ID, business unique key, state machine, deduplication table hoặc transaction constraint để bảo đảm việc thực thi lặp lại cùng một batch dữ liệu không tạo ra side effect bổ sung.
Bài viết này chỉ thảo luận về trade-off trong thiết kế, không đi sâu vào implementation hoàn chỉnh của các system cụ thể như ZooKeeper, etcd, Redis Cluster, Eureka. Nếu muốn xem consensus algorithm, bạn có thể đọc tiếp Giải thích chi tiết Raft algorithm và Giải thích chi tiết ZAB protocol; nếu muốn xem state propagation, bạn có thể đọc tiếp Giải thích chi tiết Gossip protocol; nếu muốn xem business mutual exclusion, bạn có thể đọc tiếp Giải thích chi tiết các giải pháp triển khai distributed lock.
Bài viết này có quan hệ thế nào với các bài viết khác?
Nhập môn distributed system giải quyết câu hỏi “vì sao hệ thống single-node trở nên phức tạp hơn sau khi tách thành nhiều node”. Giải thích chi tiết CAP theorem và BASE theory giải quyết câu hỏi “khi xảy ra partition thì nên đánh đổi consistency và availability như thế nào”. Raft, Paxos và ZAB giải quyết câu hỏi “một nhóm node làm thế nào để đạt được sự đồng thuận về một value hoặc thứ tự log”. Gossip giải quyết câu hỏi “state lan truyền giữa số lượng lớn node và hội tụ cuối cùng như thế nào”.
Bài viết này nằm ở giữa các chủ đề đó, tập trung trả lời một vấn đề mang tính engineering hơn: một distributed system thực sự coordination nhiều node như thế nào?
Để tránh trộn lẫn các khái niệm, trước hết hãy tách thành hai loại vấn đề:
- Decision problem: Ai có thể trở thành Leader? Một log entry có được commit không? Một resource hiện thuộc về ai? Một task có được phép thực thi không?
- Propagation problem: Member state, failure report, configuration version và cache metadata lan truyền đến các node khác như thế nào?
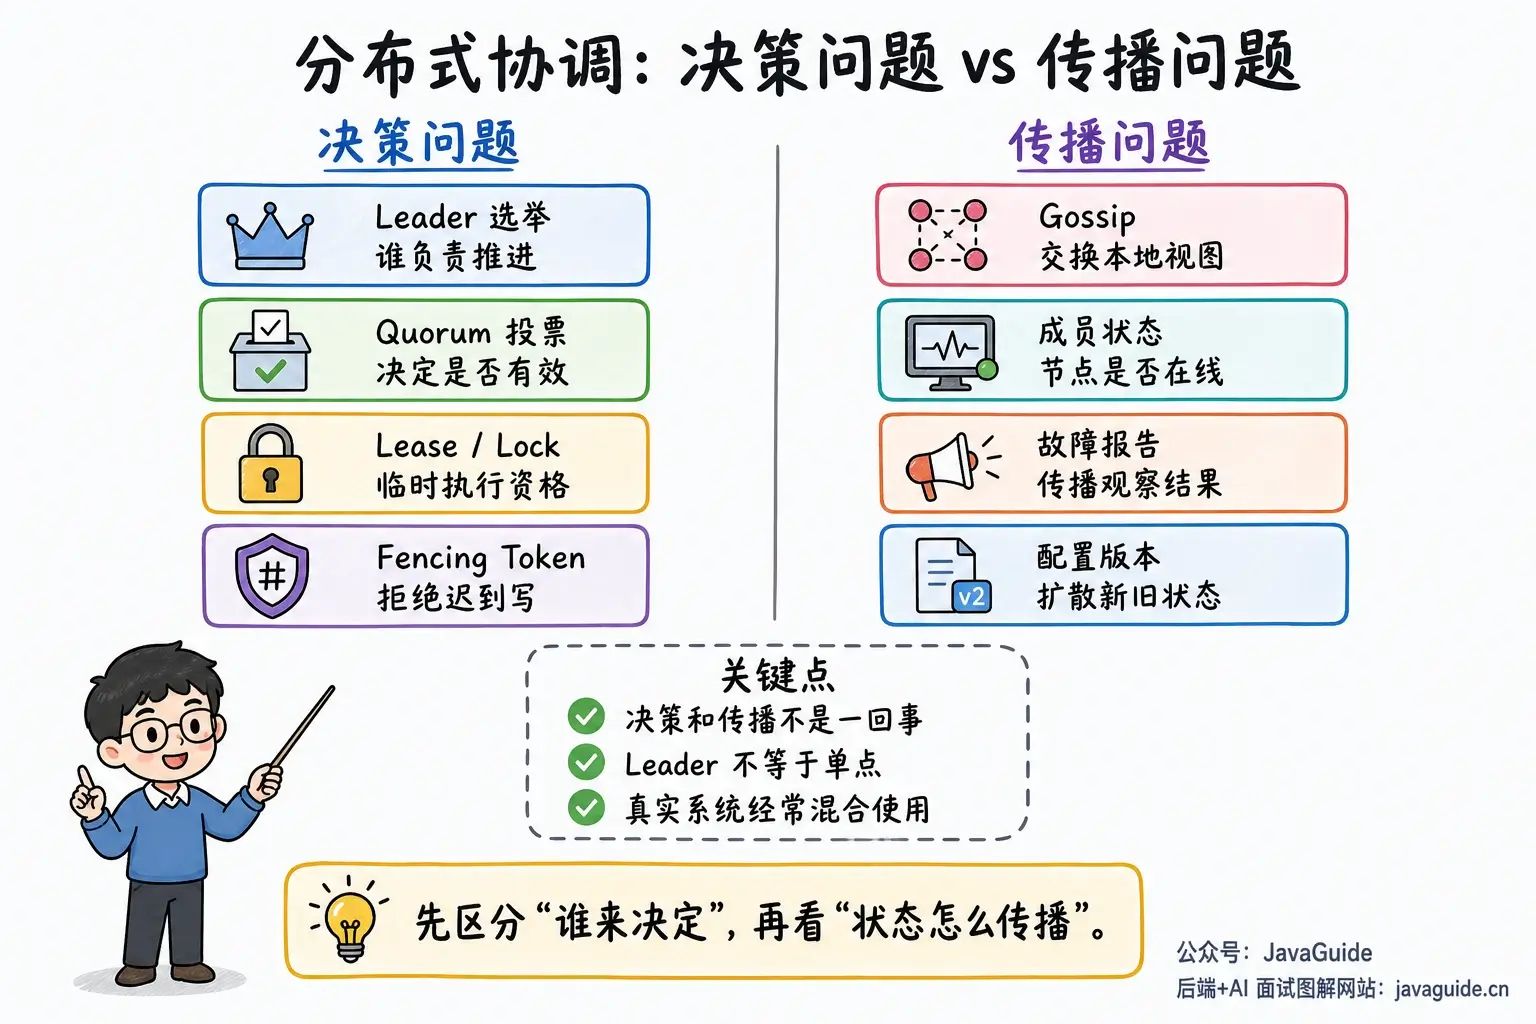
Leader, Quorum, Lease, Lock và Fencing Token chủ yếu xoay quanh decision và execution permission; Gossip chủ yếu giải quyết state propagation. Hệ thống thực tế thường kết hợp các cơ chế này, rất ít khi chỉ có lựa chọn nhị phân đơn giản “centralized” hoặc “decentralized”.
Vì sao distributed system cần coordination?
Trong single-node system, nhiều việc có thể hoàn thành trực tiếp nhờ local memory, database transaction hoặc process lock. Khi chuyển sang distributed system, những cách này đột nhiên không còn đủ.
Distributed system có thêm một tầng network, và uncertainty cũng xuất hiện theo.
Mỗi node chỉ nhìn thấy local state của mình và các message đã nhận được. Một node không phản hồi có thể thực sự đã down, nhưng cũng có thể do network chập chờn, GC pause, disk I/O bị kẹt hoặc thread pool đã đầy. Timeout mà caller nhìn thấy chỉ cho biết trong khoảng thời gian chỉ định caller chưa nhận được kết quả, không thể chứng minh phía bên kia chắc chắn chưa thực thi.
Coordination cần giải quyết các vấn đề này:
- Member management: Cluster có những node nào? Hiện tại node nào có thể tham gia làm việc?
- Task assignment: Shard, task, partition hoặc primary replica nên do ai phụ trách?
- Order control: Khi nhiều node cùng submit change, ai trước ai sau?
- Failover: Sau khi node phụ trách mất kết nối, ai tiếp quản? Trước khi tiếp quản cần xác nhận state nào?
- Version progression: Sau khi configuration, metadata hoặc kết quả leader election thay đổi, làm thế nào để node nhận biết state mới và cũ?
Các vấn đề này có thể giao cho Leader hiện tại thống nhất thúc đẩy, cũng có thể để một nhóm node cùng phán đoán thông qua Quorum, hoặc trước tiên lan truyền state đã quan sát được bằng Gossip, sau đó đưa ra quyết định dựa trên vote, version number hoặc business rule.
Leader/Quorum coordination: Ai đưa ra quyết định?
Nhiều system sẽ đưa vào Leader, Primary hoặc scheduling center. Các node khác chủ yếu thực thi task, hoặc cập nhật state dựa trên log, configuration và assignment result do Leader thúc đẩy.
Ở đây dễ có một hiểu lầm: có Leader không có nghĩa là có một single point mong manh. Leader trong những system như Raft và ZAB là role hiện tại được bầu ra từ nhiều replica, state vẫn được bảo vệ bởi log replication và Quorum. Điều thực sự cần xem là state phía sau Leader có được bảo vệ bằng replica không, sau khi Leader down có thể bầu Leader mới không, và Leader mới có thể tiếp nhận state cũ để tiếp tục làm việc không.
Leader thường có một số nhóm responsibility sau.
Nhóm thứ nhất là duy trì cluster view. Ví dụ Worker nào đang online, load của từng Worker ra sao, shard hiện thuộc về ai, replica nào bị chậm quá nhiều. Những thông tin này có thể đến từ heartbeat, report, probe, hoặc thông tin registration trong underlying storage.
Nhóm thứ hai là đưa ra assignment decision. Ví dụ scheduling system giao task cho một executor, distributed storage migrate shard sang một machine, message queue chuyển partition Leader sang replica khác. Worker không cần tự đoán; chỉ cần thực thi assignment result đã được xác nhận.
Nhóm thứ ba là kiểm soát thứ tự write. Nhiều distributed system không e ngại read request bị phân tán; vấn đề thực sự là write request. Khi nhiều node cùng thay đổi metadata mà không có thứ tự thống nhất, rất dễ xảy ra tình trạng hai node đều cho rằng mình đang giữ cùng một shard, hoặc hai task đều cho rằng mình là primary executor. Leader có thể nối các write thành một ordered log, sau đó replicate sang các node khác.
Leader giúp hành vi của system dễ hiểu hơn, đồng thời dễ tìm được decision entry hơn khi troubleshooting. Cái giá phải trả là coordination path có thể trở thành bottleneck, và vẫn phải xử lý misjudgment, split-brain cũng như failover.
Leader/Quorum coordination gặp những vấn đề nào?
Điều dễ nghĩ đến nhất là Leader single point.
Nếu state của Leader chỉ tồn tại trong memory của chính nó, khi Leader down, cluster sẽ không biết task assignment, shard ownership và metadata mới nhất là gì. Thiết kế này thực sự nguy hiểm. Cách làm engineering phổ biến hơn là để Leader chỉ đảm nhiệm role “current decision maker”, còn metadata và log được replicate vào nhiều replica. Sau khi Leader down, các node còn lại dựa trên log hiện có để bầu Leader mới.
Một vấn đề khác là bottleneck. Mọi coordination request đều đi qua Leader; CPU, network và việc ghi disk log của Leader sẽ ảnh hưởng đến toàn bộ system. Đặc biệt khi metadata change diễn ra thường xuyên, Leader sẽ trở thành giới hạn mở rộng của system. Nhiều system tách data plane và control plane: phân tán ordinary read/write càng nhiều càng tốt, chỉ những operation như leader election, metadata change và shard migration mới đi vào coordination path.
Khó xử lý hơn là misjudgment.
Heartbeat detection rất phổ biến, nhưng heartbeat không phải là “bằng chứng sống chết”. Leader không nhận được heartbeat của Worker chỉ có nghĩa là trong network và timeout hiện tại chưa nhận được response. Worker có thể vẫn đang thực thi task nhưng bị kẹt ở Full GC, network isolation hoặc disk write. Nếu Leader trực tiếp giao task cho Worker khác, sau khi Worker cũ khôi phục và tiếp tục ghi result thì có thể xảy ra duplicate write.
Split-brain cũng xuất phát từ đây.
Khi split-brain xảy ra, nhiều partition có thể đồng thời cho rằng mình có quyền tiếp tục thúc đẩy state của system. Ví dụ Leader cũ và một phần node bị cô lập, trong khi phần node còn lại đã bầu ra Leader mới. Nếu cả hai Leader đều có thể nhận write từ bên ngoài, sau khi partition khôi phục sẽ xuất hiện hai state line xung đột với nhau. Với các scenario như configuration center, distributed lock, primary-secondary switch và shard ownership, điều này thường không thể chấp nhận.
Vì vậy, điểm khó không chỉ là “chọn một Leader”, mà còn phải khiến Leader cũ không thể tiếp tục gây hại sau khi mất permission.
Làm thế nào giảm thiểu Leader single point và split-brain?
Chỉ cấu hình một standby node cho Leader là chưa đủ. Standby node muốn tiếp quản phải biết Leader đã đưa ra những decision nào, decision nào đã commit và decision nào mới chỉ được Leader cho là thành công.
Điều này cần replica, Quorum và protocol constraint.
Majority không phải đáp án hoàn chỉnh
Majority rule khá dễ hiểu: chỉ sau khi có hơn một nửa node đồng ý thì mới coi một decision là hợp lệ. Giả sử cluster có N voting node, majority là floor(N/2) + 1. 3 node cần 2 node đồng ý, 5 node cần 3 node đồng ý.
Công thức này mặc định một số tiền đề:
- Membership tương đối cố định;
- Trọng số của mỗi voting node giống nhau;
- Xử lý crash failure và network partition, không xét malicious node;
- Sử dụng ordinary majority Quorum, không phải weighted Quorum, Flexible Quorum hoặc BFT Quorum.
Majority có một property quan trọng: bất kỳ hai majority set nào cũng chắc chắn có intersection.
Nhưng chỉ “có intersection” vẫn chưa đủ. Protocol còn phải ràng buộc node nào có quyền được bầu và Leader mới khôi phục state như thế nào. Lấy Raft làm ví dụ, mỗi node trong cùng một Term nhiều nhất chỉ vote một lần, đồng thời log của candidate phải mới ít nhất bằng log của voter. Chỉ khi kết hợp majority intersection với việc kiểm tra log mới cũ thì mới bảo đảm log đã commit không bị mất trong những lần leader election sau. Raft gọi property này là Leader Completeness.
Vì vậy, majority cung cấp nền tảng intersection; tính safety thực sự còn đến từ election rule, log matching rule và commit rule.
Majority cũng có cost. Đối với coordination state hoặc replicated log phụ thuộc vào majority để bảo đảm safety, khi không lấy được Quorum thì thường nên dừng submit write mới. System có còn cung cấp old data read được hay không phụ thuộc vào protocol cụ thể và consistency requirement. 3 node chịu được 1 voting node failure, 5 node chịu được 2 voting node failure; 4 node vẫn chỉ chịu được 1 voting node failure, 6 node vẫn chỉ chịu được 2 voting node failure, vì vậy nhiều coordination system khuyến nghị số voting node là số lẻ.
Term/Epoch chỉ bảo vệ bên trong protocol
Leader election thường cần khái niệm term. Trong Raft gọi là Term, trong ZAB có Epoch. Mỗi lần leader election bước vào term mới, sau khi thấy term cao hơn, node sẽ từ chối request của term cũ; Leader cũ cũng nên quay về role ordinary node.
Điều này chủ yếu bảo vệ internal state của coordination protocol.
Term không tự động lan truyền đến mọi external business resource. Nếu Leader cũ bypass replication protocol để trực tiếp ghi vào database, object storage hoặc third-party interface, phía resource không biết Raft Term hoặc ZAB Epoch đã thay đổi. Muốn thực sự từ chối late write, resource side còn cần validate version number hoặc Fencing Token.
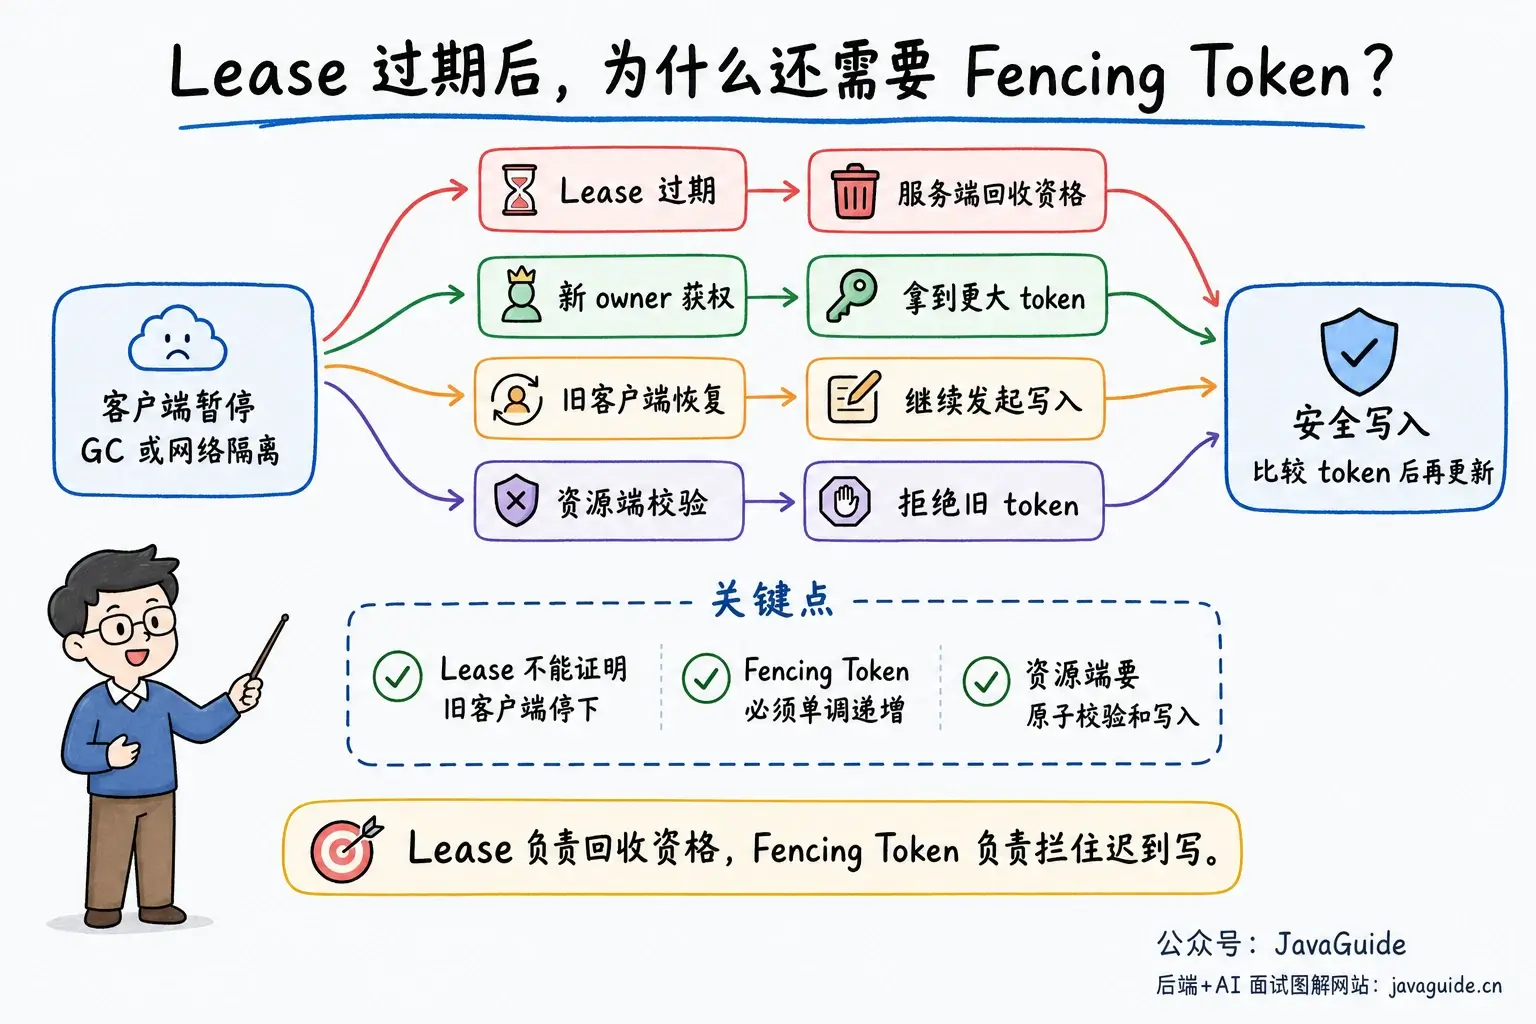
Lease giải quyết resource reclamation, không thể chứng minh old client đã dừng
Ví dụ một client lấy được lock rồi xảy ra GC trong thời gian dài. Lock service cho rằng client đã mất kết nối, nên giao lock cho client khác. Sau khi khôi phục, client cũ có thể vẫn cầm execution context cũ để ghi vào database, object storage hoặc external interface. Lock service đã đổi Leader hoặc đổi owner không có nghĩa là business thread trong tay client cũ lập tức biến mất.
Lease có thể được hiểu là authorization có thời hạn. Sau khi nhận Lease, client cần renew trong TTL; sau khi renew thất bại hoặc Lease hết hạn, coordination system có thể reclaim resource liên quan. Lease API của etcd chính là mô hình này: cluster cấp Lease có TTL, nếu trong TTL cluster không nhận được keepAlive thì Lease sẽ hết hạn, Key gắn trên Lease cũng bị xóa. TTL do etcd trả về phụ thuộc vào lựa chọn và response của server, không phải client tự dùng local clock để quyết định Lease đã hết hạn hay chưa.
Điều thực sự nguy hiểm là nhận thức của client về trạng thái Lease có thể đã lỗi thời. Client có thể vì GC dài, network isolation hoặc thread blocking mà không kịp phát hiện Lease đã hết hạn.
Vì vậy, Lease phù hợp để thực hiện liveness detection và tự động reclaim resource, nhưng không thể tự mình chứng minh client cũ đã dừng thực thi. Chỉ cần client cũ vẫn truy cập được shared resource thì vẫn có thể tạo ra late write.
Fencing Token từ chối executor đã hết hạn
Fencing Token xử lý trực tiếp hơn: mỗi lần quyền được cấp thành công, coordination system phát một token tăng dần. Khi write vào shared resource, client bắt buộc phải gửi kèm token này; phía resource ghi nhớ token lớn nhất từng thấy và từ chối write có token nhỏ hơn.
Ví dụ:
- Client A lấy được lock và nhận token=10.
- A bị pause trong thời gian dài, lock hết hạn.
- Client B lấy được lock, nhận token=11 và write thành công vào resource.
- Sau khi khôi phục, A tiếp tục write resource với token=10.
- Resource phát hiện
10 < 11và từ chối write của A.
Bản thân con số token không thể giải quyết vấn đề; việc resource validate mới là điểm mấu chốt. Resource tốt nhất nên thực hiện nguyên tử “so sánh token + update data + ghi nhận token mới nhất”. Nếu trước tiên query token rồi sau đó write data riêng, request concurrent vẫn có thể được chèn vào giữa.
Có thể xem Lease, Fencing Token và idempotency key cùng nhau:
| Cơ chế | Vấn đề được giải quyết | Không thể bảo đảm điều gì |
|---|---|---|
| Lease | Tự động reclaim permission của client mất kết nối | Client cũ đã dừng chạy |
| Fencing Token | Từ chối late write của old holder | Business operation tự thân có thể retry |
| Idempotency key | Ngăn cùng một business request tạo side effect lặp lại | Executor hiện tại chắc chắn là owner mới nhất |
Gossip state propagation: Cho phép các node trao đổi local view
Gossip không phụ thuộc vào một node cố định để duy trì complete cluster view. Mỗi node lưu local view của riêng mình và trao đổi state thông qua peer-to-peer communication.
Các node định kỳ chọn node khác để trao đổi thông tin, state lan truyền trong cluster như message diffusion. Một node biết member mới, failure mới hoặc version mới thì sau đó sẽ tiếp tục báo cho các node khác. Sau nhiều round trao đổi, phần lớn node sẽ nhìn thấy state gần giống nhau.
Bản thân Gossip phù hợp hơn để lan truyền “tôi đã quan sát thấy gì”, không phù hợp để tự mình quyết định “toàn bộ system bắt buộc phải chấp nhận điều gì”.
Gossip thường cung cấp propagation và convergence cuối cùng, không trực tiếp cung cấp mutual exclusion nghiêm ngặt hoặc global write order. Gossip propagation cần thời gian, nên tại cùng một thời điểm các node khác nhau có thể nhìn thấy state khác nhau. Cùng một message cũng có thể bị propagation lặp lại, cần dùng version number, message ID, timestamp hoặc cách khác để deduplicate. Khi xảy ra network partition, các partition khác nhau có thể tự đưa ra judgement khác nhau; sau khi khôi phục còn cần dựa vào version, term và conflict resolution strategy để hội tụ.
Tuy nhiên, điều này không có nghĩa mọi protocol không có Leader cố định chỉ có thể đạt eventual consistency. Các consensus protocol không có Leader cố định như EPaxos vẫn có thể cung cấp strong consistency, chỉ là implementation complexity và scenario phù hợp khác với các Leader-based protocol phổ biến.
Hệ thống thực tế thường kết hợp nhiều cơ chế. Redis Cluster là một ví dụ điển hình: các node dùng Cluster Bus và Gossip để lan truyền member state, slot information và failure observation; node có thể trước tiên đánh dấu node khác là PFAIL; sau khi majority Master có đủ observation về failure thì nâng cấp thành FAIL; việc promote Replica còn phải kết hợp majority vote, currentEpoch và configEpoch để phân biệt configuration mới và cũ.
Vì vậy, Gossip phù hợp hơn với “state propagation”, không phù hợp để tự mình đảm nhiệm “strict mutual exclusion” và “strict write order”. Nếu scenario yêu cầu tại mọi thời điểm chỉ có một owner, hoặc write phải linearizable, vẫn cần đưa vào consensus, majority vote, resource-side version validation hoặc Fencing Token.
Chọn các cơ chế này như thế nào?
Trước hết hãy xem hậu quả của decision sai.
Nếu việc thực thi lặp lại một task chỉ tiêu tốn thêm một ít resource, hoặc việc một node nhìn thấy old state trong thời gian ngắn có thể chấp nhận, thì state propagation và eventual convergence thường đã đủ. Ví dụ node discovery, health state propagation, cache metadata diffusion và non-critical state synchronization đều có thể cân nhắc Gossip hoặc cách peer-to-peer propagation tương tự.
Nếu decision sai có thể dẫn đến sai tiền, sai inventory, hỏng metadata hoặc hai primary node cùng write một data set, cần ưu tiên Leader/Quorum, consensus algorithm và majority commit, khi cần thì thêm Fencing Token. Hy sinh một phần availability và throughput trong trường hợp này thường rẻ hơn sửa data sau đó.
Tiếp theo hãy xem system scale và write path.
Với control plane quy mô nhỏ, dùng Leader để quản lý thường dễ maintain hơn. Khi số node rất lớn, state thay đổi thường xuyên và mỗi node chỉ cần approximate view, peer-to-peer propagation phù hợp hơn. Message của Gossip sẽ có redundancy, nhưng tránh được việc mọi state update đều dồn về một node cố định; đồng thời cũng làm tăng cost xử lý conflict, message deduplication và troubleshooting state.
Có thể dùng bảng dưới đây để phán đoán nhanh:
| Cơ chế | Chủ yếu giải quyết gì | Đặc điểm consistency | Scenario điển hình |
|---|---|---|---|
| Leader + log replication | Quyết định write order và metadata state | Có thể cung cấp strong consistency | Configuration publish, primary-secondary switch, metadata change |
| Quorum vote | Phán đoán một decision có hợp lệ không | Phụ thuộc set intersection và protocol rule | Log commit, Leader election, failure confirmation |
| Lease / Lock | Tạm thời cấp execution permission | Permission có thể hết hạn | Scheduled task, resource owner, short critical section |
| Fencing Token | Từ chối late write của old owner | Phụ thuộc resource-side validation | Database, object storage, external resource write |
| Gossip | Lan truyền member và state information | Thường hội tụ cuối cùng | Service discovery, health state, cache metadata |
| Queue / shard claiming | Phân phối work cho nhiều Worker | Thường at-least-once | Batch processing, consumption task, shard scan |
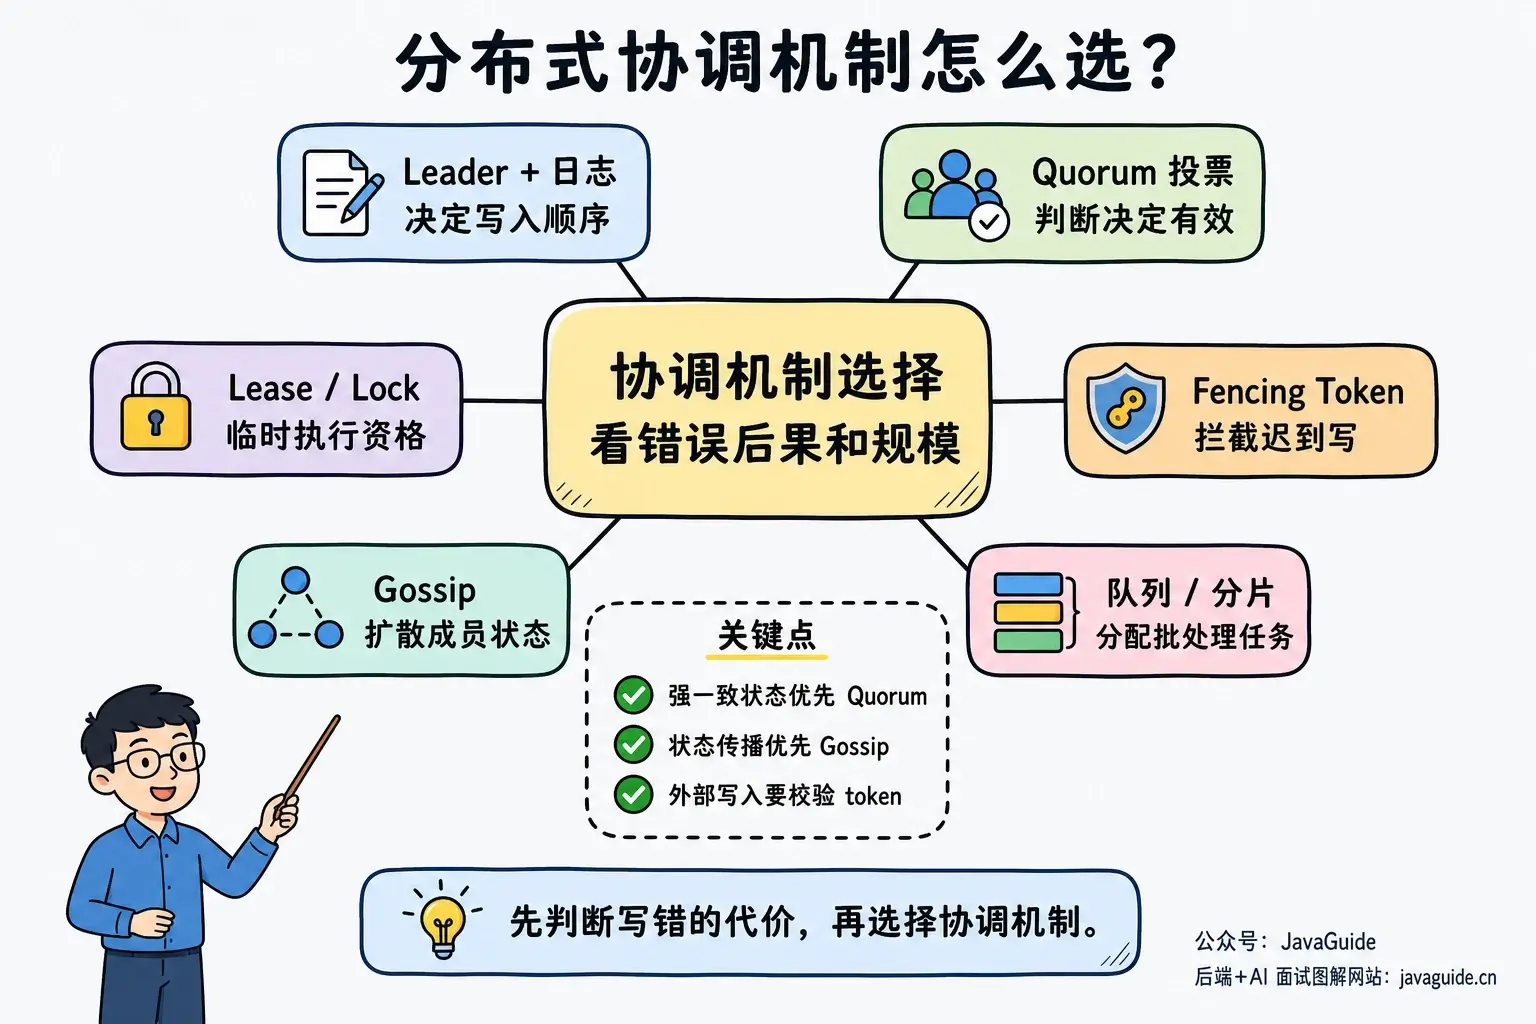
Hệ thống thực tế thường kết hợp các cơ chế này.
Ví dụ control plane dùng Leader và majority để bảo vệ metadata, còn data plane cố gắng phân tán request; member state của cluster được lan truyền bằng Gossip, nhưng primary-secondary switch thực sự vẫn phải thông qua vote và Epoch; task scheduling có thể có central scheduler, cũng có thể để executor tự trigger, nhưng underlying vẫn có thể phụ thuộc vào conditional update của database, ZooKeeper, etcd hoặc message queue.
Scheduled task của 3 instance nên được thiết kế như thế nào?
Scheduled task lúc 2 giờ sáng ở phần đầu có không chỉ một phương án phổ biến.
- Bầu ra một scheduling Leader và để nó tạo task.
- Tất cả instance cùng trigger, nhưng cạnh tranh execution permission thông qua database unique key, conditional update hoặc distributed lock.
- Scheduler chỉ tạo task message, sau đó consumer group nhận và xử lý theo shard.
- Chia task thành nhiều shard, mỗi instance chỉ xử lý phần mình nhận.
Bất kể dùng phương án nào, không nên chỉ dựa vào giả định “lần này chắc chắn chỉ có một instance thực thi”. Thiết kế vững chắc hơn thường bao gồm:
- Scheduling record có unique task ID;
- Việc nhận task sử dụng conditional update, version number hoặc lease;
- Business processing có idempotency;
- Task hỗ trợ timeout reclamation và nhận lại;
- Khi liên quan đến external shared resource, sử dụng Fencing Token hoặc resource version validation;
- Lưu execution progress, hỗ trợ khôi phục từ checkpoint sau khi failure.
Nếu task rất ngắn và cost chạy lại sau failure thấp, database unique key hoặc message queue thường đã đủ. Nếu task chiếm dụng external resource trong thời gian dài, hoặc executor cũ khôi phục rồi tiếp tục write gây hỏng data, cần đưa vào Lease, Fencing Token, idempotency key và state machine.
Trả lời phỏng vấn như thế nào?
Trong interview, nếu được hỏi “centralized và decentralized trong distributed system khác nhau như thế nào”, đừng ngay lập tức đặt Leader đối lập với Gossip. Thứ tự trả lời tốt hơn là: trước tiên nói vì sao cần coordination, sau đó tách vấn đề thành “decision” và “propagation”, cuối cùng bổ sung split-brain, Lease, Fencing Token và trade-off khi lựa chọn.
Có thể trả lời như sau:
Trong distributed system, để nhiều node cùng hoàn thành một việc, bắt buộc phải giải quyết các vấn đề coordination như member management, task assignment, failover và write order.
Tôi sẽ trước tiên tách vấn đề thành hai loại: một loại là decision problem, ví dụ ai là Leader, một log entry có được commit không, resource hiện thuộc về ai; loại còn lại là propagation problem, ví dụ member state, failure observation và configuration version lan truyền đến các node khác như thế nào.
Leader, Quorum và consensus protocol chủ yếu giải quyết decision problem. Leader không nhất thiết là single point; điểm mấu chốt là phía sau nó có log replication, nhiều replica và majority election hay không. Để tránh split-brain, thường cần majority, Term/Epoch, election restriction và log matching rule.
Gossip chủ yếu giải quyết state propagation problem. Nó phù hợp để lan truyền member state và health state, nhưng không phù hợp để tự mình đảm nhiệm strict mutual exclusion hoặc global write order. System thực tế thường kết hợp các cơ chế, ví dụ Gossip lan truyền failure observation, còn majority vote và Epoch quyết định việc promote primary node.
Nếu liên quan đến lock hoặc task owner, còn phải cân nhắc Lease và Fencing Token. Lease có thể reclaim permission của client mất kết nối, nhưng không thể chứng minh client cũ đã dừng chạy; Fencing Token cần resource-side validation để từ chối late write của old owner. Business side còn phải dùng idempotency key, unique constraint hoặc state machine để xử lý duplicate execution.
Câu trả lời này đã có thể bao quát phần lớn interview scenario. Nếu interviewer tiếp tục hỏi sâu, có thể mở rộng theo các nhóm câu hỏi dưới đây.
Có Leader thì chắc chắn là single point sao?
Không hẳn.
Nếu state của Leader chỉ tồn tại trong memory của chính nó, sau khi down không có replica tiếp quản thì đó là single point. Leader trong nhiều distributed system giống “current decision maker” hơn: nó phụ trách nhận write request, thúc đẩy log hoặc phân phối task, nhưng state sẽ được replicate đến nhiều node. Sau khi Leader down, các node còn lại có thể dựa trên log hiện có và majority election để bầu Leader mới.
Vì vậy, để phán đoán có phải single point hay không, không thể chỉ nhìn xem có Leader hay không; cần xem 3 việc:
- Leader state có persistence và multiple replica không;
- Sau khi Leader down có thể tự động bầu Leader mới không;
- Leader mới có thể nhận được state đã commit hay không.
Làm thế nào để tránh split-brain?
Risk của split-brain nằm ở việc nhiều partition đều cho rằng mình có quyền write.
Cách phổ biến là dùng majority và term control. Chỉ node set lấy được majority mới có thể bầu Leader hoặc commit write. 3 node cần ít nhất 2 node đồng ý, 5 node cần ít nhất 3 node đồng ý. Sau network partition, minority không lấy được majority nên không thể tiếp tục commit coordination write mới.
Term phụ trách phân biệt Leader mới và cũ. Term trong Raft và Epoch trong ZAB đều theo tư duy tương tự. Sau khi thấy term cao hơn, node phải từ chối protocol request của term cũ. Nhờ vậy, ngay cả khi Leader cũ khôi phục sau network isolation hoặc pause dài, nó cũng không thể tiếp tục dùng identity cũ để thúc đẩy internal log.
Tuy nhiên, điều này chủ yếu bảo vệ internal state của coordination system. Business resource vẫn có thể gặp vấn đề client cũ khôi phục rồi tiếp tục write; lúc này cần Fencing Token: mỗi lần lấy được lock hoặc permission thì nhận một token tăng dần, khi write resource phải gửi kèm token, resource side từ chối token cũ nhỏ hơn.
Gossip có phải chỉ đạt eventual consistency không?
State propagation thuần Gossip thường chỉ phụ trách information diffusion và eventual convergence, không trực tiếp cung cấp strict mutual exclusion và global write order.
Nhưng “không có Leader cố định” và “eventual consistency” không thể đánh đồng. Một số consensus protocol không có Leader cố định vẫn có thể cung cấp strong consistency, chỉ là engineering implementation phức tạp hơn. Trong project thực tế, cách kết hợp phổ biến hơn là: Gossip phụ trách lan truyền member state và failure report, còn Quorum, Epoch, log replication hoặc resource-side validation phụ trách đưa ra decision cuối cùng.
Đưa vào lựa chọn trong project như thế nào?
Khi trả lời về kinh nghiệm project, đừng chỉ nói “chúng tôi dùng ZooKeeper/Redis/etcd”. Quan trọng hơn là phải nói ra lý do lựa chọn.
Nếu là scenario distributed lock, configuration change, primary node switch hoặc shard ownership, có thể nói như sau:
Vì cost của việc ghi sai loại state này khá cao, tôi sẽ ưu tiên coordination component có majority và session/lease semantics. Sau khi lock hoặc owner hết hạn, còn phải cân nhắc late write sau khi client cũ khôi phục. Nếu resource side hỗ trợ version validation, tôi sẽ thêm Fencing Token để dự phòng.
Nếu là scenario service discovery, node state propagation hoặc cache cluster state, có thể nói như sau:
Những thông tin này cho phép không nhất quán trong thời gian ngắn, coi trọng khả năng mở rộng và cost propagation hơn. Có thể chấp nhận việc dần hội tụ thông qua Gossip hoặc cơ chế tương tự, nhưng phải xử lý message duplicate, old state và version conflict sau khi network partition khôi phục.
Trả lời interview đến mức này là đã vượt ra khỏi việc học thuộc định nghĩa “centralized vs decentralized”, bắt đầu trình bày các trade-off quan trọng nhất trong distributed system: decision, propagation, lease, idempotency và failure recovery.
Tài liệu tham khảo
- Kubernetes CronJob
- The Raft Consensus Algorithm
- In Search of an Understandable Consensus Algorithm
- ZooKeeper Internals: Atomic Broadcast, Leader Activation, Quorums
- ZooKeeper Administrator's Guide: Clustered Setup và khuyến nghị triển khai majority
- Redis Cluster Specification
- etcd API: Lease API
- EPaxos
- How to do distributed locking - Martin Kleppmann
- Epidemic Algorithms for Replicated Database Maintenance
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.