
Giải thích chi tiết thuật toán Consistent Hashing: hash ring, virtual node, data skew và ứng dụng trong distributed cache
Trước khi bắt đầu, hãy xem hai tình huống thường gặp:
- Load balancing: Vì có quá nhiều người truy cập, website của chúng ta được triển khai trên nhiều server cùng cung cấp một dịch vụ giống nhau, nhưng dữ liệu lưu trên mỗi server lại khác nhau. Để bảo đảm request được phản hồi chính xác, các request có cùng tham số (key) (chẳng hạn request từ cùng một IP hoặc request của cùng một user) cần được gửi đến cùng một server để xử lý.
- Distributed cache: Vì lượng dữ liệu cache quá lớn, chúng ta triển khai nhiều cache server cùng cung cấp dịch vụ cache. Dữ liệu cache cần được phân bố trên các cache server này một cách đồng đều nhất có thể, và có thể tìm thấy cache server tương ứng thông qua key.
Bản chất của hai tình huống này đều là cần thiết lập một quan hệ ánh xạ ổn định từ key đến server/node.
Trong chuyên đề protocol, Consistent Hashing giải quyết vấn đề phân bố data hoặc request lên các node như thế nào, không phải cách các replica đạt được consistency. Để tìm hiểu việc lan truyền trạng thái, hãy xem giải thích chi tiết Gossip protocol; để tìm hiểu thứ tự ghi và việc commit theo đa số, hãy xem giải thích chi tiết thuật toán Raft.
Để đạt được mục tiêu này, trước tiên bạn sẽ nghĩ đến giải pháp nào?
Thuật toán hash thông thường
Chắc hẳn bạn sẽ nhanh chóng nghĩ đến tổ hợp kinh điển “hash + modulo”. Tính giá trị hash của key bằng hàm hash, sau đó lấy modulo theo số lượng server để ánh xạ key đến một server cố định.
Công thức cũng rất đơn giản:
node_number = hash(key) % Nhash(key): Dùng hàm hash (khuyến nghị dùng non-cryptographic hash function có performance tốt, chẳng hạn SipHash, MurMurHash3, CRC32, DJB) để hash unique key.% N: Lấy modulo giá trị hash, ánh xạ giá trị hash vào một giá trị từ 0 đến N-1, trong đó N là số node/số server.
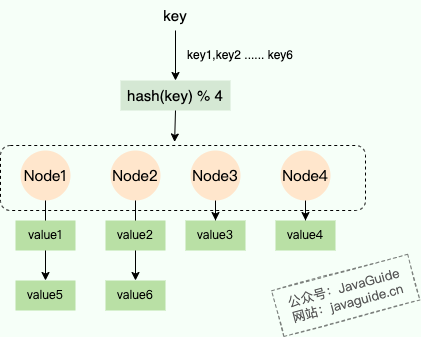
Tuy nhiên, thuật toán hash modulo truyền thống có một nhược điểm khá lớn: không thể giải quyết tốt tình huống số lượng machine/node giảm (chẳng hạn một machine bị down) hoặc tăng (chẳng hạn thêm một machine mới).
Hãy hình dung ban đầu có 4 server (N = 4), nếu một server bị down thì N sẽ còn 3. Lúc này, với cùng một key, kết quả của hash(key) % 3 rất có thể hoàn toàn khác với hash(key) % 4.
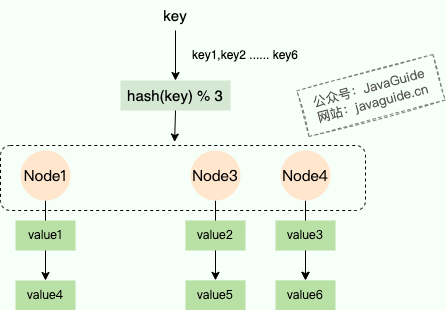
Điều này có nghĩa là gần như toàn bộ quan hệ ánh xạ dữ liệu sẽ bị xáo trộn. Trong tình huống distributed cache, điều này sẽ dẫn đến cache invalidation quy mô lớn và cache xuyên thấu (cache penetration), lập tức dồn toàn bộ áp lực lên database backend và gây ra cache avalanche.
Theo ước tính, khi số node giảm từ N xuống N-1, trung bình có tỷ lệ dữ liệu bằng (N-1)/N cần được migrate; tỷ lệ này tiến gần 100%. Hiệu ứng “động một chỗ, ảnh hưởng toàn bộ” này hoàn toàn không thể chấp nhận trong production environment.
Để giải quyết vấn đề này tốt hơn, thuật toán Consistent Hashing ra đời.
Thuật toán Consistent Hashing
Thuật toán Consistent Hashing được Massachusetts Institute of Technology đề xuất vào năm 1997 (địa chỉ đọc online bản PDF của paper này: https://www.cs.princeton.edu/courses/archive/fall09/cos518/papers/chash.pdf), là một thuật toán hash đặc biệt. Khi xóa hoặc thêm một server, thuật toán có thể thay đổi quan hệ ánh xạ giữa các request đã tồn tại và server xử lý request ở mức nhỏ nhất có thể. Consistent Hashing giải quyết các vấn đề như dynamic scaling của thuật toán hash truyền thống trong hash table phân tán (Distributed Hash Table, DHT).
Nguyên lý bên trong của thuật toán Consistent Hashing cũng rất đơn giản, điểm mấu chốt là việc đưa vào hash ring.
Hash ring
Thuật toán Consistent Hashing tổ chức hash space thành một cấu trúc hình vòng, ánh xạ cả data và node lên vòng đó, sau đó dựa trên quy tắc theo chiều kim đồng hồ để xác định data hoặc request cần được phân bổ cho node nào. Thông thường, điểm bắt đầu của hash ring là 0, điểm kết thúc là 2^32 - 1, và điểm bắt đầu nối với điểm kết thúc, vì vậy phạm vi phân bố số nguyên của vòng là [0, 2^32-1].
Thuật toán hash truyền thống lấy modulo theo số lượng server, còn thuật toán Consistent Hashing lấy modulo theo phạm vi của hash ring, là một giá trị cố định, thường là 2^32:
node_number = hash(key) % 2^32Server/node được ánh xạ lên hash ring như thế nào? Cũng bằng cách lấy hash modulo. Chẳng hạn, thông thường chúng ta hash IP hoặc hostname của server, sau đó lấy modulo.
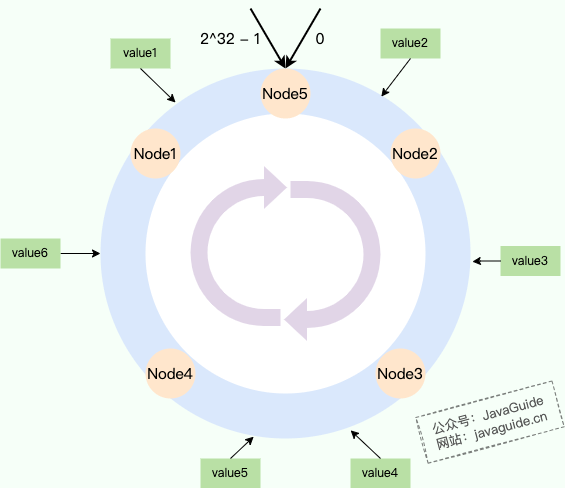
hash(server_ip) % 2^32Như hình dưới đây:
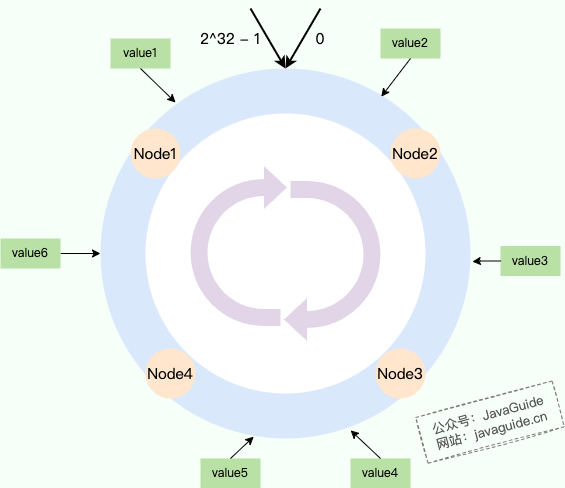
Chúng ta ánh xạ cả data và node lên hash ring, mỗi node trên vòng phụ trách một interval. Với hình trên, mỗi node phụ trách data như sau:
- Node1: phụ trách khu vực từ Node4 đến Node1 (bao gồm value6).
- Node2: phụ trách khu vực từ Node1 đến Node2 (bao gồm value1, value2).
- Node3: phụ trách khu vực từ Node2 đến Node3 (bao gồm value3).
- Node4: phụ trách khu vực từ Node3 đến Node4 (bao gồm value4, value5).
Xóa/thêm node
Khi thêm hoặc xóa node, việc đưa hash ring vào sử dụng có thể tránh phạm vi ảnh hưởng quá lớn và giảm lượng data cần migrate.
Vẫn lấy sơ đồ hash ring ở trên làm ví dụ. Giả sử node Node2 bị xóa, Node3 sẽ phụ trách data của Node2; chỉ cần migrate data của Node2 sang Node3, các node khác không bị ảnh hưởng.
Tương tự, nếu thêm một node Node5 giữa Node1 và Node2, một phần data vốn do Node2 phụ trách (tức data có giá trị hash nằm giữa Node1 và Node5, chẳng hạn value1 trong hình) giờ sẽ do Node5 phụ trách. Chúng ta chỉ cần migrate phần data này từ Node2 sang Node5; tương tự, chỉ các node lân cận bị ảnh hưởng nên phạm vi ảnh hưởng rất nhỏ.
Vấn đề data skew
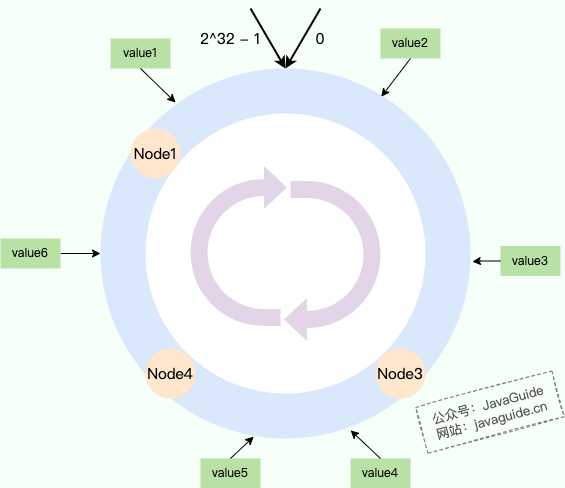
Trong điều kiện lý tưởng, các node được phân bố đồng đều trên vòng. Tuy nhiên, thực tế có thể không như vậy, đặc biệt khi số lượng node khá ít. Các node có thể được ánh xạ vào những khu vực gần nhau, dẫn đến phần lớn data do một node trong số đó phụ trách.
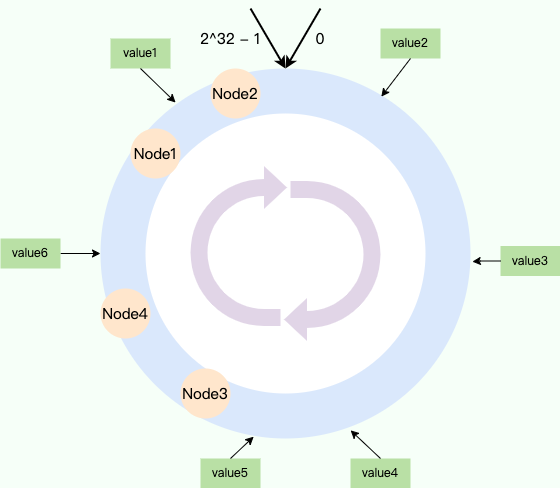
Với hình trên, mỗi node phụ trách data như sau:
- Node1: phụ trách khu vực từ Node4 đến Node1 (bao gồm value6).
- Node2: phụ trách khu vực từ Node1 đến Node2 (bao gồm value1).
- Node3: phụ trách khu vực từ Node2 đến Node3 (bao gồm value2, value3, value4, value5).
- Node4: phụ trách khu vực từ Node3 đến Node4.
Ngoài vấn đề data skew, còn có một rủi ro tiềm ẩn khác. Khi thêm hoặc xóa node, việc phân bổ data sẽ không cân bằng. Chẳng hạn, nếu Node3 bị xóa, toàn bộ data do Node3 phụ trách sẽ phải giao cho Node4, sau đó mọi request đều sẽ đổ dồn lên Node4. Giả sử năng lực xử lý của server Node4 khá kém, server này có thể bị quá tải và sập ngay. Trong điều kiện lý tưởng, nên có nhiều node hơn để chia sẻ áp lực.
Giải quyết các vấn đề này thế nào? Câu trả lời là đưa vào virtual node.
Virtual node
Virtual node là việc tạo ra một số node bản sao ảo của node vật lý thật trên hash ring. Data rơi vào node bản sao thực chất sẽ rơi vào node vật lý thật; các virtual node được phân tán đồng đều ở các khu vực khác nhau của hash ring.
Như hình dưới đây, 4 node Node1, Node2, Node3, Node4 đều tương ứng với 3 virtual node (hình dưới chỉ nhằm minh họa, trong thực tế các node sẽ không được phân bố có quy luật như vậy).
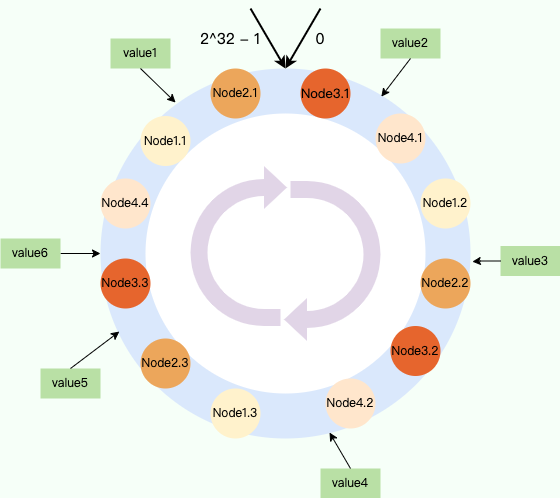
Với hình trên, cuối cùng mỗi node phụ trách data như sau:
- Node1: value4
- Node2: value1,value3
- Node3: value5
- Node4: value2,value6
Lợi ích của việc đưa virtual node vào là rất lớn:
- Cân bằng data: Càng nhiều virtual node, các “điểm server” trên vòng càng dày, data càng tự nhiên được phân bố đồng đều, từ đó giải quyết vấn đề data skew ngay từ gốc. Thông thường, mỗi node thật tương ứng với 100 đến 200 virtual node; chẳng hạn Nginx chọn phân bổ 160 virtual node cho mỗi weight. Weight ở đây dùng để phân biệt các server: server có năng lực xử lý càng mạnh thì weight càng cao, từ đó có nhiều virtual node tương ứng hơn và xác suất được chọn cũng lớn hơn.
- Tăng khả năng fault tolerance: Đây mới là điểm tinh tế nhất của virtual node. Khi một node vật lý bị down, nó tương đương với việc nhiều virtual node trên vòng đồng thời offline. Data và traffic vốn do các virtual node này phụ trách sẽ tự nhiên và đồng đều được phân tán cho nhiều node vật lý khác nhau trên vòng tiếp quản, thay vì dồn áp lực lên một node lân cận duy nhất. Điều này cải thiện đáng kể stability và fault tolerance của hệ thống.
Tham khảo
- Phân tích chuyên sâu thuật toán load balancing của Nginx: https://www.taohui.tech/2021/02/08/nginx/深入剖析Nginx负载均衡算法/
- Series học architecture qua việc đọc source code: Consistent Hashing: https://zhaoyang.me/posts/consistent-hash-algorithm/
- Tổng hợp nguyên lý thuật toán Consistent Hash: https://mp.weixin.qq.com/s/WTz1KA9kOGrqFVTtALJzjQ