
Vì sao Redis sử dụng skip list để triển khai sorted set
Lời mở đầu
Trong những năm gần đây, các câu hỏi phỏng vấn về Redis thường đề cập đến thiết kế bên trong của những cấu trúc dữ liệu phổ biến. Trong đó có một câu hỏi khá thú vị: “Vì sao sorted set bên trong Redis sử dụng skip list, thay vì balanced tree, red-black tree hoặc B+ tree?”.
Bài viết này lấy câu hỏi phỏng vấn thường gặp ở các công ty lớn làm điểm bắt đầu để giúp bạn tìm hiểu chi tiết về cấu trúc dữ liệu skip list.
Nếu bạn chỉ muốn nhanh chóng nắm được multi-level index, độ phức tạp truy vấn và khung trả lời phỏng vấn về skip list, có thể đọc trước Tổng hợp câu hỏi phỏng vấn về skip list, sau đó quay lại bài viết này để xem triển khai source code của Redis ZSet.
Bố cục tổng thể của bài viết như hình dưới đây. Tác giả sẽ trình bày từ cách sử dụng cơ bản của sorted set đến phân tích và triển khai source code của skip list, giúp bạn hiểu và nắm vững hơn về skip list bên trong sorted set của Redis.
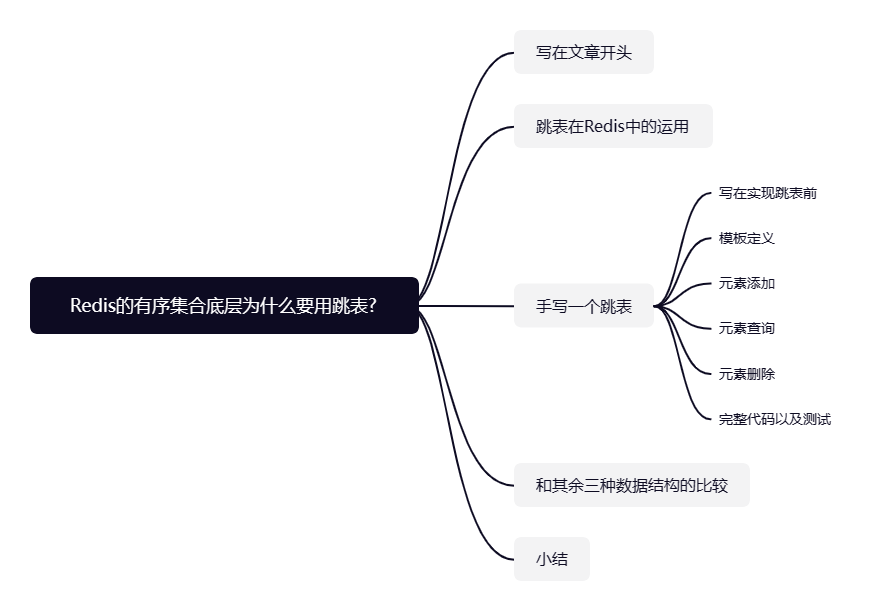
Skip list được sử dụng trong Redis
Trước hết, chúng ta cần tìm hiểu cách sử dụng sorted set, một cấu trúc dữ liệu mà Redis triển khai bằng skip list. Redis có một cấu trúc dữ liệu khá phổ biến gọi là sorted set (viết tắt là zset). Đúng như tên gọi, đây là một set có thể bảo đảm các phần tử có thứ tự và duy nhất, nên thường được dùng cho các trường hợp cần thống kê, xếp hạng như bảng xếp hạng.
Ở đây, chúng ta minh họa cách triển khai bảng xếp hạng bằng command line. Có thể thấy tác giả lần lượt nhập 3 người dùng: xiaoming, xiaohong, xiaowang, với score lần lượt là 60, 80, 60; cuối cùng được sắp xếp theo điểm từ cao xuống thấp.
127.0.0.1:6379> zadd rankList 60 xiaoming
(integer) 1
127.0.0.1:6379> zadd rankList 80 xiaohong
(integer) 1
127.0.0.1:6379> zadd rankList 60 xiaowang
(integer) 1

# Trả về các member trong khoảng được chỉ định của sorted set, theo index, score từ cao xuống thấp
127.0.0.1:6379> ZREVRANGE rankList 0 100 WITHSCORES
1) "xiaohong"
2) "80"
3) "xiaowang"
4) "60"
5) "xiaoming"
6) "60"
Lúc này, dùng lệnh object để xem cấu trúc dữ liệu của zset, có thể thấy sorted set hiện vẫn được lưu bằng ziplist (compressed list).
127.0.0.1:6379> object encoding rankList
"ziplist"
Do dữ liệu Redis được lưu trong memory, để tiết kiệm không gian memory quý giá, Redis sẽ sử dụng ziplist khi độ dài mỗi phần tử nhỏ hơn 64 byte và số lượng phần tử nhỏ hơn 128. Giá trị mặc định của các ngưỡng này đến từ hai cấu hình sau:
zset-max-ziplist-value 64
zset-max-ziplist-entries 128
Chỉ cần một phần tử trong sorted set vượt quá một trong hai ngưỡng này, nó sẽ chuyển sang skiplist (thực tế là dict+skiplist, đồng thời mượn dictionary để tăng hiệu quả lấy phần tử được chỉ định).
Hãy thử thêm một phần tử dài hơn 64 byte, có thể thấy cấu trúc lưu trữ bên dưới của sorted set chuyển sang skiplist.
127.0.0.1:6379> zadd rankList 90 yigemingzihuichaoguo64zijiedeyonghumingchengyongyuceshitiaobiaodeshijiyunyong
(integer) 1

# Vượt ngưỡng, chuyển sang skip list
127.0.0.1:6379> object encoding rankList
"skiplist"
Nói cách khác, ZSet có hai implementation khác nhau là ziplist và skiplist. Quy tắc chọn cấu trúc lưu trữ cụ thể như sau:
- Khi sorted set đồng thời thỏa mãn hai điều kiện sau, sử dụng ziplist:
- Số lượng cặp key-value mà ZSet lưu trữ ít hơn 128;
- Độ dài mỗi phần tử nhỏ hơn 64 byte.
- Nếu không thỏa mãn hai điều kiện trên thì sử dụng skiplist.
Tự viết một skip list
Để trả lời tốt hơn câu hỏi trên, cũng như hiểu và nắm vững hơn về skip list, bạn có thể tự viết một skip list đơn giản để tìm hiểu cấu trúc dữ liệu này.
Như chúng ta đã biết, độ phức tạp thời gian trung bình khi thêm, truy vấn và xóa trong linked list có thứ tự đều là O(n), tăng tuyến tính. Vì vậy, khi số lượng node đạt đến một quy mô nhất định, performance sẽ rất kém. Có thể hiểu skip list là việc xây dựng multi-level index trên linked list ban đầu, qua đó giảm độ phức tạp thời gian của các thao tác thêm, xóa, sửa, truy vấn xuống O(log n).
Có thể phần này hơi trừu tượng, hãy lấy skip list trong hình dưới đây làm ví dụ. Linked list ban đầu lưu tuần tự các số từ 1 đến 10 và có 2 cấp index; số lượng index ở mỗi cấp bằng một nửa số phần tử ở cấp bên dưới.
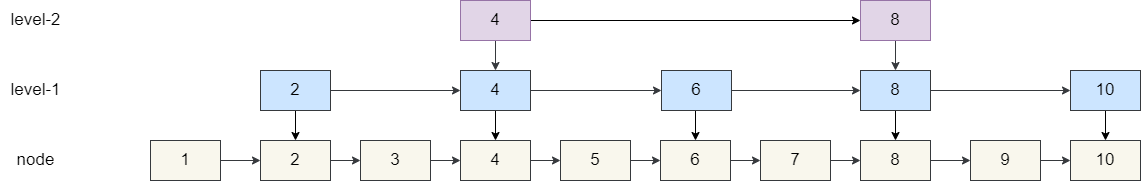
Giả sử cần truy vấn phần tử 6, quy trình thực hiện như sau:
- Bắt đầu từ index cấp 2, trước tiên đi đến node 4.
- Xem node kế tiếp của 4 là index cấp 2 của 8. Giá trị này lớn hơn 6, nghĩa là các index tiếp theo của index cấp 2 đều lớn hơn 6, không cần tìm tiếp về phía sau; ta tìm xuống dưới.
- Đi đến index cấp 1 của 4, đối chiếu node kế tiếp là 6 và kết thúc việc tìm kiếm.
So với linked list có thứ tự ban đầu cần 6 lần, skip list của chúng ta nhờ xây dựng multi-level index chỉ cần 2 lần là định vị trực tiếp được phần tử đích, độ phức tạp truy vấn được tối ưu trực tiếp thành O(log n).

Việc thêm phần tử cũng tương tự. Giả sử cần thêm phần tử 7 vào sorted set này, trước hết cần dùng skip list để tìm giá trị lớn nhất nhỏ hơn phần tử 7, tức vị trí của phần tử 6 trong hình dưới đây. Sau đó chèn phần tử 7 vào sau phần tử 6, để index của phần tử 6 trỏ đến node 7 mới chèn. Quy trình như sau:
- Bắt đầu từ index cấp 2 và định vị đến index của phần tử 4.
- Xem index kế tiếp của index 4 là 8, rồi tìm xuống cấp dưới.
- Đến index cấp 1, thấy index kế tiếp của index 4 là 6, nhỏ hơn phần tử cần chèn 7, nên con trỏ tiến đến vị trí của index 6.
- Tiếp tục so sánh, node kế tiếp của 6 là index 8, lớn hơn phần tử 7, nên tiếp tục tìm xuống.
- Cuối cùng đến node gốc của 6, thấy node kế tiếp là 7; con trỏ không thể tìm xuống tiếp. Từ đó biết phần tử 6 là giá trị lớn nhất nhỏ hơn phần tử cần chèn 7, nên chèn phần tử 7.
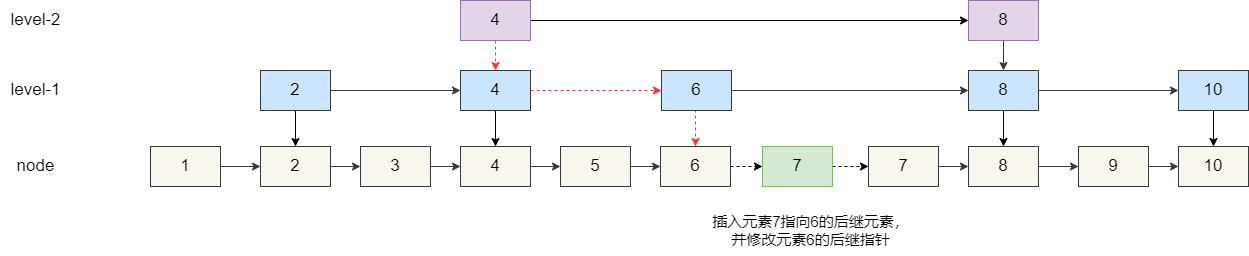
Ở đây lại xuất hiện một vấn đề: có cần xây dựng index cho phần tử 7 không, và index nên cao bao nhiêu?
Như đã nói ở trên, trường hợp lý tưởng là số phần tử ở mỗi cấp index bằng một nửa số phần tử ở cấp kế tiếp. Giả sử tổng cộng có 16 phần tử, số phần tử ở các cấp index tương ứng phải là:
1. Index cấp 1:16/2=8
2. Index cấp 2:8/2 =4
3. Index cấp 3:4/2=2
Từ đó, bằng quy nạp toán học, ta có:
1. Index cấp 1:16/2=16/2^1=8
2. Index cấp 2:8/2 => 16/2^2 =4
3. Index cấp 3:4/2=>16/2^3=2
Giả sử số phần tử là n, số phần tử r của index cấp k được tính theo công thức:
r=n/2^kTương tự, hãy suy ra chiều cao tối đa của index. Thông thường, số phần tử của index cấp cao nhất là 2. Gọi tổng số phần tử là n, chiều cao index là h; thay vào công thức trên ta được:
2= n/2^h
=> 2*2^h=n
=> 2^(h+1)=n
=> h+1=log2^n
=> h=log2^n -1
Redis lại là một in-memory database. Giả sử số phần tử tối đa là 65536, thay 65536 vào công thức trên thì chiều cao tối đa là 16. Vì vậy, chúng ta nên bảo đảm chiều cao index tạo cho một phần tử sau khi thêm không vượt quá 16.
Vì muốn cố gắng bảo đảm mỗi index cấp trên bằng một nửa index cấp dưới, khi triển khai thuật toán tạo chiều cao, có thể thiết kế như sau:
- Việc tính chiều cao của skip list bắt đầu từ linked list ban đầu. Theo mặc định, chiều cao của phần tử được chèn là 1, nghĩa là chỉ có node phần tử, chưa có index.
- Thiết kế một method tạo chiều cao index
levelcho phần tử được chèn. - Thực hiện một phép tính ngẫu nhiên, với giá trị ngẫu nhiên nằm trong khoảng từ 0 đến 1.
- Nếu số ngẫu nhiên lớn hơn 0.5 thì thêm một cấp index cho phần tử hiện tại. Nhờ đó, xác suất tạo index cấp 1 là 50%, bảo đảm trong trường hợp lý tưởng chỉ một nửa phần tử tạo index cấp 1.
- Tương tự, mỗi lần giá trị nhận được từ thuật toán ngẫu nhiên lớn hơn 0.5 thì tăng chiều cao index thêm 1. Như vậy, xác suất node tạo index cấp 2 là 25%, index cấp 3 là 12.5% …
Quay lại việc thêm 7 ở trên, thuật toán ngẫu nhiên cho kết quả 2, nên cần xây dựng index cấp 1 cho nó:
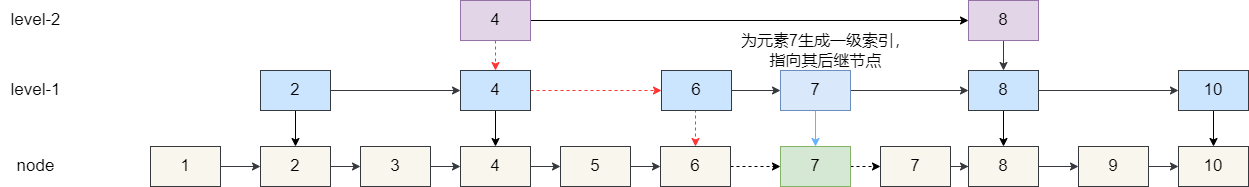
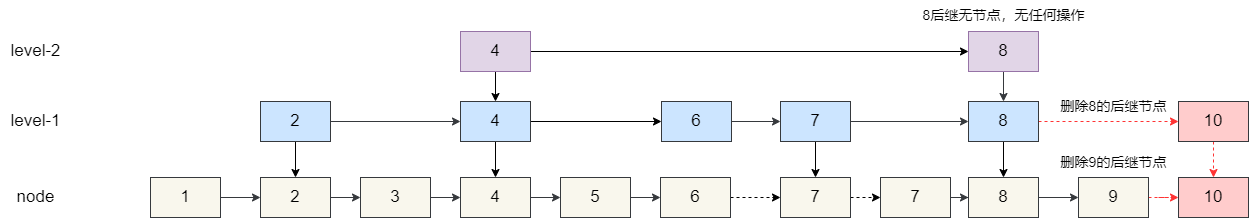
Cuối cùng là thao tác xóa. Giả sử cần xóa phần tử 10, phải định vị giá trị lớn nhất nhỏ hơn 10 ở từng cấp của skip list. Các bước thực hiện là:
- Node kế tiếp của index cấp 2 tại 4 là 8, con trỏ tiến lên.
- Index 8 không có node kế tiếp, cấp này không có phần tử cần xóa, con trỏ đi thẳng xuống.
- Node kế tiếp của index cấp 1 tại 8 là 10. Điều đó nghĩa là khi xóa, index cấp 1 tại 8 cần ngắt liên kết giữa con trỏ của mình và index cấp 1 tại 10, rồi xóa 10.
- Sau khi định vị xong ở index cấp 1, con trỏ đi xuống, node kế tiếp là 9, con trỏ tiến lên.
- Node kế tiếp của 9 là 10, tương tự cần cho nó trỏ đến null để xóa 10.
Định nghĩa template
Sau khi có ý tưởng tổng thể, chúng ta có thể bắt đầu triển khai một skip list. Trước hết, hãy định nghĩa Node trong skip list. Từ phần minh họa ở trên, có thể thấy mỗi Node bao gồm các thành phần sau:
- Giá trị value được lưu trữ.
- Địa chỉ của node kế tiếp.
- Multi-level index.
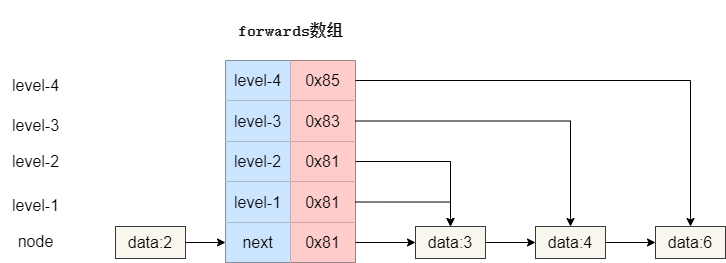
Để quản lý thống nhất hơn địa chỉ node kế tiếp của Node và địa chỉ phần tử mà multi-level index trỏ tới, tác giả đặt một array forwards trong Node, dùng để ghi lại node kế tiếp của node trong linked list ban đầu và node kế tiếp mà các multi-level index trỏ tới.
Như hình dưới đây, độ dài array forwards là 5. Trong đó, index 0 ghi địa chỉ node kế tiếp của node trong linked list ban đầu; các phần tử còn lại, từ dưới lên trên, biểu thị node kế tiếp mà index cấp 1 đến index cấp 4 trỏ tới.
Như vậy ta có định nghĩa code sau. Có thể thấy tác giả đặt cố định độ dài array là 16 (chiều cao tối đa được suy ra ở trên cũng là 16), mặc định data là -1, chiều cao tối đa của node maxLevel được khởi tạo là 1. Lưu ý, giá trị maxLevel này biểu thị tổng chiều cao của linked list ban đầu cộng với các index.
/**
 * Chiều cao tối đa của index skip list là 16
 */
private static final int MAX_LEVEL = 16;

class Node {
    private int data = -1;
    private Node[] forwards = new Node[MAX_LEVEL];
    private int maxLevel = 0;

}
Thêm phần tử
Sau khi định nghĩa node, trước hết hãy triển khai việc thêm phần tử. Khi thêm phần tử, trước tiên thiết lập data bằng cách gán value được truyền vào cho data.
Tiếp theo là thiết lập chiều cao maxLevel. Ở trên đã nêu cách thực hiện: chiều cao mặc định là 1, tức chỉ có một node trong linked list ban đầu; mỗi lần thuật toán ngẫu nhiên cho kết quả lớn hơn 0.5 thì chiều cao index tăng 1. Từ đó có thuật toán tính chiều cao randomLevel():
/**
 * Về lý thuyết, số phần tử trong index cấp 1 chiếm 50% dữ liệu ban đầu,
 * index cấp 2 chiếm 25%, index cấp 3 chiếm 12.5%, cho đến cấp cao nhất.
 * Vì xác suất thăng cấp ở mỗi cấp là 50%. Với mỗi node mới được chèn,
 * cần gọi randomLevel để tạo số cấp hợp lý.
 * Method randomLevel sẽ tạo ngẫu nhiên một số trong khoảng 1~MAX_LEVEL, và:
 * 50% xác suất trả về 1
 * 25% xác suất trả về 2
 * 12.5% xác suất trả về 3 ...
 * @return
 */
private int randomLevel() {
    int level = 1;
    while (Math.random() > PROB && level < MAX_LEVEL) {
        ++level;
    }
    return level;
}
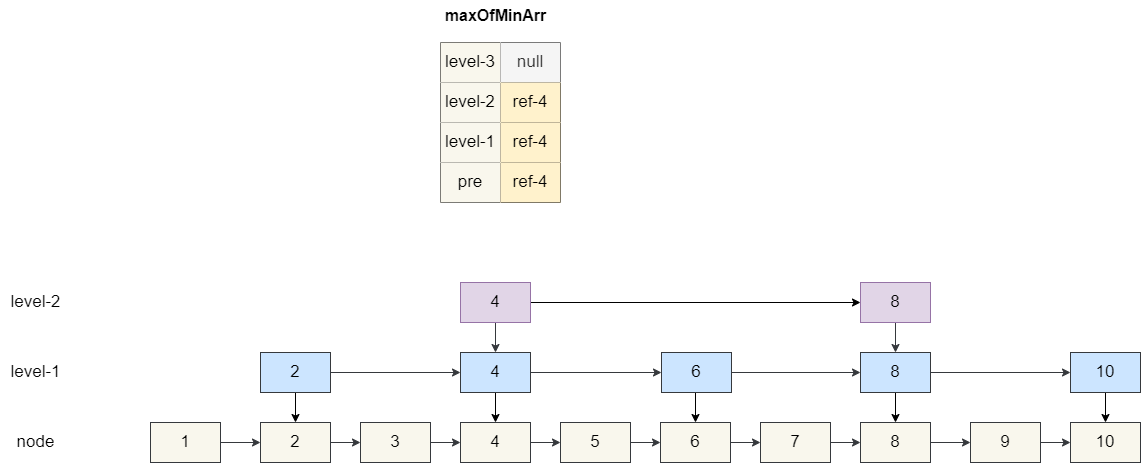
Sau đó thiết lập địa chỉ node kế tiếp của Node cần chèn và các index của Node đó. Bước này phức tạp hơn một chút. Giả sử chiều cao của node hiện tại là 4, tức 1 node cộng với 3 index, ta tạo một array có độ dài 4 là maxOfMinArr, rồi duyệt để tìm giá trị lớn nhất nhỏ hơn value trong các node index ở từng cấp.
Giả sử cần chèn value là 5. Kết quả tìm trong array cho thấy node tiền nhiệm của node cần chèn, node tiền nhiệm của index cấp 1 và cấp 2 đều là 4; index cấp 3 là null.
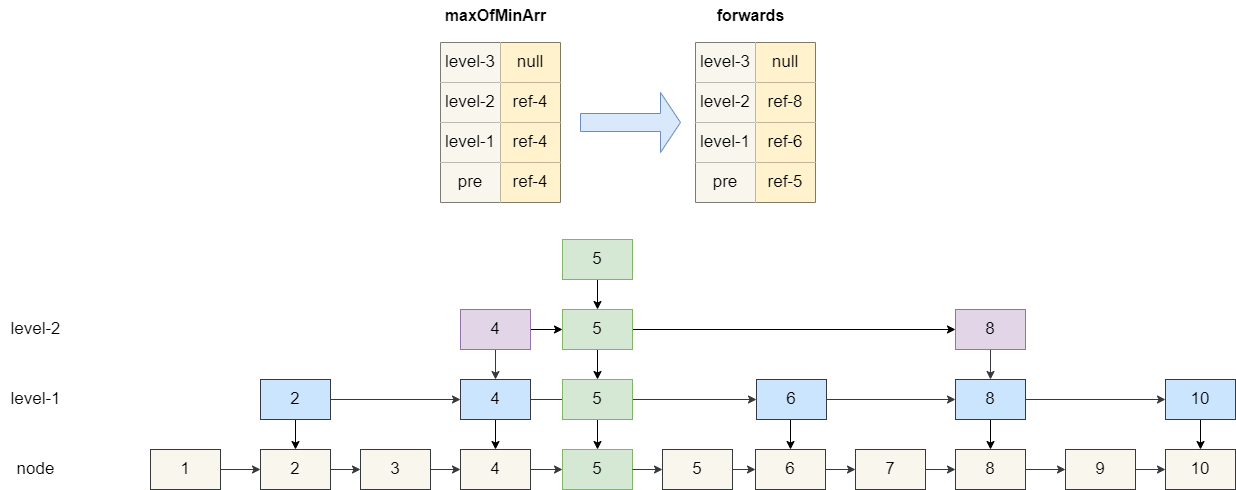
Sau đó, dựa trên array maxOfMinArr, định vị node kế tiếp ở từng cấp, để phần tử 5 được chèn trỏ đến các node kế tiếp này, còn maxOfMinArr trỏ đến 5. Kết quả như hình dưới đây:
Chuyển thành code sẽ có dạng sau, khá đơn giản phải không? Hãy tiếp tục:
/**
 * Chiều cao mặc định là 1, tức chỉ có một node duy nhất
 */
private int levelCount = 1;

/**
 * Node ở tầng thấp nhất của skip list, tức node đầu
 */
private Node h = new Node();

public void add(int value) {
    int level = randomLevel(); // Chiều cao ngẫu nhiên của node mới

    Node newNode = new Node();
    newNode.data = value;
    newNode.maxLevel = level;

    // Array dùng để ghi lại node trước ở mỗi cấp
    Node[] update = new Node[level];
    for (int i = 0; i < level; i++) {
        update[i] = h;
    }

    Node p = h;
    // Sửa chữa quan trọng: tìm kiếm bắt đầu từ cấp cao nhất hiện tại của skip list
    for (int i = levelCount - 1; i >= 0; i--) {
        while (p.forwards[i] != null && p.forwards[i].data < value) {
            p = p.forwards[i];
        }
        // Chỉ ghi lại node trước của các cấp cần cập nhật
        if (i < level) {
            update[i] = p;
        }
    }

    // Chèn node mới
    for (int i = 0; i < level; i++) {
        newNode.forwards[i] = update[i].forwards[i];
        update[i].forwards[i] = newNode;
    }

    // Cập nhật tổng chiều cao của skip list
    if (levelCount < level) {
        levelCount = level;
    }
}
Truy vấn phần tử
Logic truy vấn khá đơn giản: bắt đầu từ index cấp cao nhất của skip list để định vị giá trị lớn nhất nhỏ hơn value cần tìm. Lấy hình dưới đây làm ví dụ, ta muốn tìm node 8:
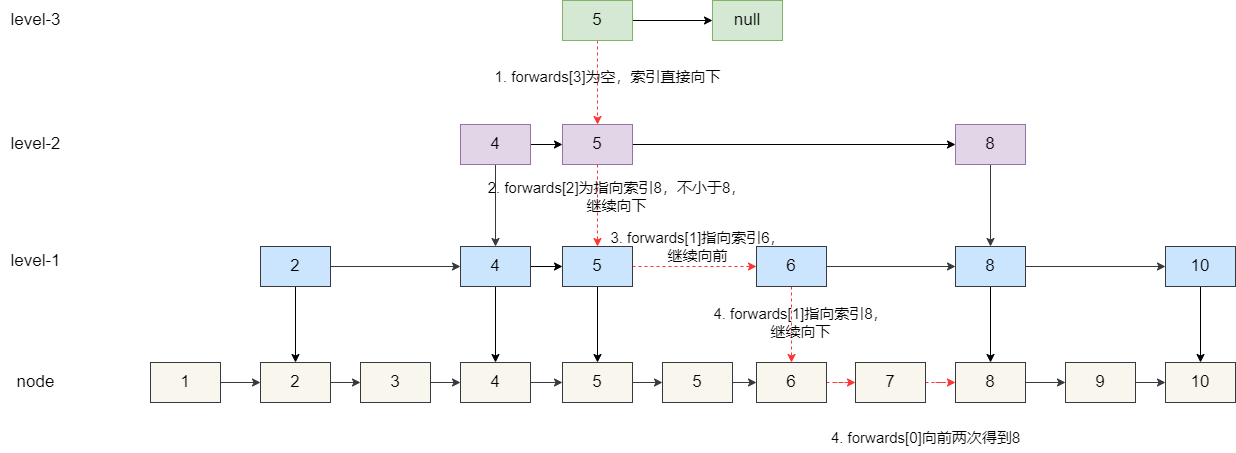
- Bắt đầu từ cấp cao nhất (index cấp 3): Con trỏ tìm kiếm
pbắt đầu từ node đầu. Ở index cấp 3, node kế tiếpforwards[2]củap(giả sử có 3 cấp cao nhất, index bắt đầu từ 0) trỏ đến node5. Vì5 < 8, con trỏpdi chuyển sang phải đến node5. Node5không có node kế tiếp ở index cấp 3,forwards[2]lànull(hoặc trỏ đến một node lớn hơn8nhưng không được vẽ trong hình). Việc tìm sang phải ở cấp hiện tại kết thúc, con trỏpdừng tại node5, di chuyển xuống index cấp 2. - Ở index cấp 2: Con trỏ hiện tại
plà node5. Node kế tiếpforwards[1]củaptrỏ đến node8. Vì8không nhỏ hơn8(tức8 < 8làfalse), việc tìm sang phải ở cấp hiện tại kết thúc (pkhông di chuyển đến node8). Con trỏpvẫn ở node5, di chuyển xuống index cấp 1. - Ở index cấp 1: Con trỏ hiện tại
plà node5. Node kế tiếpforwards[0]củaptrỏ đến node5ở tầng thấp nhất. Vì5 < 8, con trỏpdi chuyển sang phải đến node5ở tầng thấp nhất. Lúc này con trỏplà node5ở tầng thấp nhất.forwards[0]kế tiếp trỏ đến node6ở tầng thấp nhất. Vì6 < 8, con trỏpdi chuyển sang phải đến node6ở tầng thấp nhất. Con trỏphiện là node6ở tầng thấp nhất.forwards[0]kế tiếp trỏ đến node7ở tầng thấp nhất. Vì7 < 8, con trỏpdi chuyển sang phải đến node7ở tầng thấp nhất.forwards[0]kế tiếp trỏ đến node8ở tầng thấp nhất. Vì8không nhỏ hơn8(tức8 < 8làfalse), việc tìm sang phải ở cấp hiện tại kết thúc. Lúc này đã duyệt hết mọi cấp, vòng lặpforkết thúc. - Định vị và kiểm tra cuối cùng: Sau khi tìm ở mọi cấp, con trỏ
pdừng tại node7ở tầng thấp nhất (index cấp 0). Đây là node có giá trị lớn nhất nhỏ hơn giá trị đích8trong toàn bộ skip list. Kiểm tra node kế tiếp của node7(tứcp.forwards[0]):p.forwards[0]trỏ đến node8. Kiểm tra xemp.forwards[0].data(giá trị của node8) có bằng giá trị đích8hay không. Điều kiện thỏa mãn (8 == 8), tìm kiếm thành công, tìm thấy node8.
Vì vậy, cách triển khai code cũng gần giống các bước trên: bắt đầu từ index cao nhất và tìm sang phải; nếu node kế tiếp không null và nhỏ hơn giá trị cần tìm thì tiếp tục tìm, gặp node không nhỏ hơn thì đi xuống. Lặp lại như vậy cho đến khi nhận được node lớn nhất trong skip list hiện tại nhưng nhỏ hơn giá trị cần tìm, rồi kiểm tra node kế tiếp của nó có bằng giá trị cần tìm hay không:
public Node get(int value) {
    Node p = h; // Bắt đầu từ node đầu

    // Bắt đầu từ index cấp cao nhất, lần lượt đi xuống
    for (int i = levelCount - 1; i >= 0; i--) {
        // Tìm sang phải ở cấp hiện tại cho đến khi p.forwards[i] là null
        // hoặc p.forwards[i].data lớn hơn hoặc bằng giá trị đích value
        while (p.forwards[i] != null && p.forwards[i].data < value) {
            p = p.forwards[i]; // Di chuyển sang phải
        }
        // Lúc này p.forwards[i] là null hoặc p.forwards[i].data >= value
        // hoặc p là node lớn nhất nhỏ hơn value ở cấp hiện tại (nếu tồn tại)
    }

    // Sau khi tìm ở mọi cấp, p hiện là node lớn nhất trong linked list ban đầu
    // nhỏ hơn giá trị đích value (hoặc là node đầu nếu mọi phần tử đều lớn hơn hoặc bằng value)

    // Kiểm tra node kế tiếp của p trong linked list ban đầu có phải giá trị đích hay không
    if (p.forwards[0] != null && p.forwards[0].data == value) {
        return p.forwards[0]; // Đã tìm thấy, trả về node này
    }

    return null; // Không tìm thấy
}
Xóa phần tử
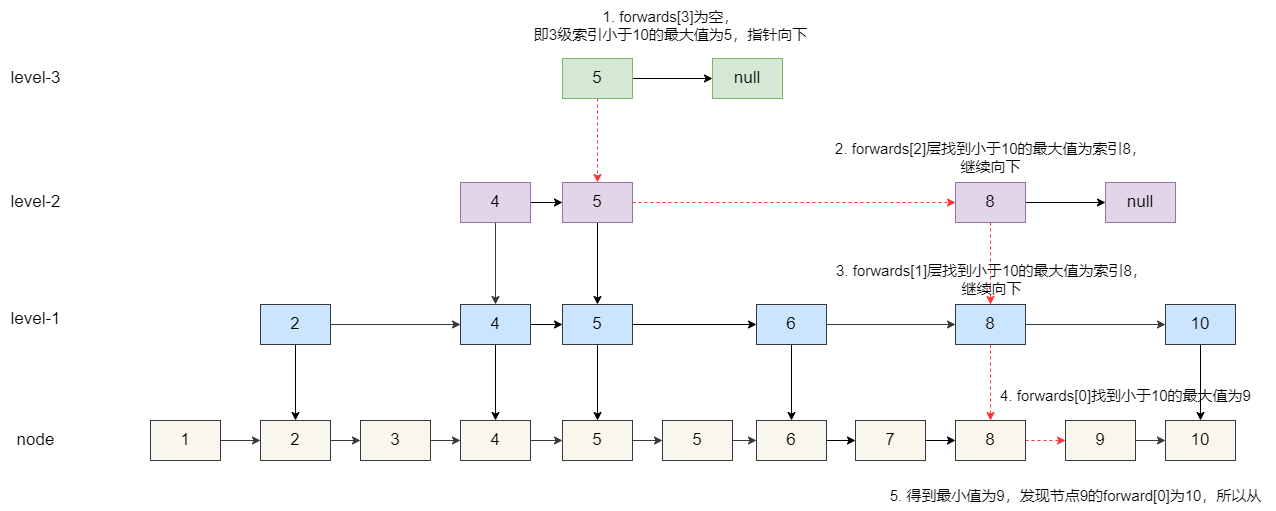
Cuối cùng là logic xóa. Cần tìm giá trị lớn nhất nhỏ hơn node cần xóa ở mỗi cấp. Giả sử cần xóa 10:
- Ở index cấp 3, giá trị lớn nhất nhỏ hơn 10 là 5, tiếp tục đi xuống.
- Ở index cấp 2, bắt đầu tìm từ index 5 và thấy giá trị lớn nhất nhỏ hơn 10 là 8, tiếp tục đi xuống.
- Tương tự, index cấp 1 cho kết quả 8, tiếp tục đi xuống.
- Ở node ban đầu tìm thấy 9.
- Bắt đầu từ index cấp cao nhất, kiểm tra node kế tiếp của từng node nhỏ hơn 10 có phải 10 hay không. Nếu bằng 10, cho node đó trỏ đến node kế tiếp của 10, rồi để GC thu hồi node 10 cùng các index của nó.
/**
 * Xóa
 *
 * @param value
 */
public void delete(int value) {
    Node p = h;
    // Tìm giá trị lớn nhất nhỏ hơn value ở mỗi cấp
    Node[] updateArr = new Node[levelCount];
    for (int i = levelCount - 1; i >= 0; i--) {
        while (p.forwards[i] != null && p.forwards[i].data < value) {
            p = p.forwards[i];
        }
        updateArr[i] = p;
    }
    // Kiểm tra node trước ở tầng ban đầu có bằng value hay không; nếu có nghĩa là tồn tại giá trị cần xóa
    if (p.forwards[0] != null && p.forwards[0].data == value) {
        // Bắt đầu từ index cấp cao nhất, kiểm tra node trước có bằng value hay không;
        // nếu có thì cho node hiện tại trỏ đến node kế tiếp của node value
        for (int i = levelCount - 1; i >= 0; i--) {
            if (updateArr[i].forwards[i] != null && updateArr[i].forwards[i].data == value) {
                updateArr[i].forwards[i] = updateArr[i].forwards[i].forwards[i];
            }
        }
    }

    // Bắt đầu từ cấp cao nhất, kiểm tra xem có cấp index nào rỗng không; nếu rỗng thì giảm cấp
    while (levelCount > 1 && h.forwards[levelCount - 1] == null) {
        levelCount--;
    }

}
Code hoàn chỉnh và test
Code hoàn chỉnh như sau, bạn có thể tự tham khảo:
public class SkipList {

    /**
     * Chiều cao tối đa của index skip list là 16
     */
    private static final int MAX_LEVEL = 16;

    /**
     * Xác suất mỗi node được thêm một cấp index là một phần hai
     */
    private static final float PROB = 0.5f;

    /**
     * Chiều cao mặc định là 1, tức chỉ có một node duy nhất
     */
    private int levelCount = 1;

    /**
     * Node ở tầng thấp nhất của skip list, tức node đầu
     */
    private Node h = new Node();

    public SkipList() {
    }

    public class Node {

        private int data = -1;
        /**
         *
         */
        private Node[] forwards = new Node[MAX_LEVEL];
        private int maxLevel = 0;

        @Override
        public String toString() {
            return "Node{"
                    + "data=" + data
                    + ", maxLevel=" + maxLevel
                    + '}';
        }
    }

    public void add(int value) {
        int level = randomLevel(); // Chiều cao ngẫu nhiên của node mới

        Node newNode = new Node();
        newNode.data = value;
        newNode.maxLevel = level;

        // Array dùng để ghi lại node trước ở mỗi cấp
        Node[] update = new Node[level];
        for (int i = 0; i < level; i++) {
            update[i] = h;
        }

        Node p = h;
        // Điểm chỉnh sửa quan trọng: tìm kiếm bắt đầu từ cấp cao nhất hiện tại của skip list
        for (int i = levelCount - 1; i >= 0; i--) {
            while (p.forwards[i] != null && p.forwards[i].data < value) {
                p = p.forwards[i];
            }
            // Chỉ ghi lại node trước của các cấp cần cập nhật
            if (i < level) {
                update[i] = p;
            }
        }

        // Chèn node mới
        for (int i = 0; i < level; i++) {
            newNode.forwards[i] = update[i].forwards[i];
            update[i].forwards[i] = newNode;
        }

        // Cập nhật tổng chiều cao của skip list
        if (levelCount < level) {
            levelCount = level;
        }
    }

    /**
     * Về lý thuyết, số phần tử trong index cấp 1 chiếm 50% dữ liệu ban đầu,
     * index cấp 2 chiếm 25%, index cấp 3 chiếm 12.5%, cho đến cấp cao nhất.
     * Vì xác suất thăng cấp ở mỗi cấp là 50%. Với mỗi node mới được chèn,
     * cần gọi randomLevel để tạo số cấp hợp lý. Method randomLevel
     * sẽ tạo ngẫu nhiên một số trong khoảng 1~MAX_LEVEL, và:
     * 50% xác suất trả về 1
     * 25% xác suất trả về 2
     * 12.5% xác suất trả về 3 ...
     *
     * @return
     */
    private int randomLevel() {
        int level = 1;
        while (Math.random() > PROB && level < MAX_LEVEL) {
            ++level;
        }
        return level;
    }

    public Node get(int value) {
        Node p = h;
        // Tìm giá trị lớn nhất nhỏ hơn value
        for (int i = levelCount - 1; i >= 0; i--) {
            while (p.forwards[i] != null && p.forwards[i].data < value) {
                p = p.forwards[i];
            }
        }
        // Nếu node kế tiếp của p bằng value thì trả về trực tiếp
        if (p.forwards[0] != null && p.forwards[0].data == value) {
            return p.forwards[0];
        }

        return null;
    }

    /**
     * Xóa
     *
     * @param value
     */
    public void delete(int value) {
        Node p = h;
        // Tìm giá trị lớn nhất nhỏ hơn value ở mỗi cấp
        Node[] updateArr = new Node[levelCount];
        for (int i = levelCount - 1; i >= 0; i--) {
            while (p.forwards[i] != null && p.forwards[i].data < value) {
                p = p.forwards[i];
            }
            updateArr[i] = p;
        }
        // Kiểm tra node trước ở tầng ban đầu có bằng value hay không; nếu có nghĩa là tồn tại giá trị cần xóa
        if (p.forwards[0] != null && p.forwards[0].data == value) {
            // Bắt đầu từ index cấp cao nhất, kiểm tra node trước có bằng value hay không;
            // nếu có thì cho node hiện tại trỏ đến node kế tiếp của node value
            for (int i = levelCount - 1; i >= 0; i--) {
                if (updateArr[i].forwards[i] != null && updateArr[i].forwards[i].data == value) {
                    updateArr[i].forwards[i] = updateArr[i].forwards[i].forwards[i];
                }
            }
        }
        // Bắt đầu từ cấp cao nhất, kiểm tra xem có cấp index nào rỗng không; nếu rỗng thì giảm cấp
        while (levelCount > 1 && h.forwards[levelCount - 1] == null) {
            levelCount--;
        }

    }

    public void printAll() {
        Node p = h;
        // Duyệt trên tầng không phải index thấp nhất; khi node kế tiếp không null,
        // in node hiện tại rồi di chuyển đến node kế tiếp
        while (p.forwards[0] != null) {
            System.out.println(p.forwards[0]);
            p = p.forwards[0];
        }

    }
}
Code test:
public static void main(String[] args) {
        SkipList skipList = new SkipList();
        for (int i = 0; i < 24; i++) {
            skipList.add(i);
        }

        System.out.println("**********Kết quả thêm**********");
        skipList.printAll();

        SkipList.Node node = skipList.get(22);
        System.out.println("**********Kết quả truy vấn:" + node+" **********");

        skipList.delete(22);
        System.out.println("**********Kết quả xóa**********");
        skipList.printAll();


     }
Đặc điểm của Redis skip list:
- Sử dụng doubly linked list, khác với ví dụ trên ở chỗ có thêm một con trỏ lùi. Nó chủ yếu dùng để đơn giản hóa thao tác; ví dụ khi xóa một phần tử, cần tìm node trước của phần tử đó, con trỏ lùi sẽ rất tiện.
- Giá trị
scorecó thể trùng nhau. Nếu giá trịscoregiống nhau thì sắp xếp theo thứ tự từ điển của ele (giá trị được lưu trong node, là sds). - Số cấp tối đa mặc định của Redis skip list là 32, được định nghĩa trong source code bằng
ZSKIPLIST_MAXLEVEL.
So sánh với ba cấu trúc dữ liệu còn lại
Cuối cùng, hãy trả lời câu hỏi phỏng vấn ở đầu bài viết: “Vì sao sorted set bên trong Redis sử dụng skip list, thay vì balanced tree, red-black tree hoặc B+ tree?”.
Balanced tree và skip list
Trước hết hãy so sánh với balanced tree. Balanced tree còn được gọi là AVL tree, là một balanced binary tree nghiêm ngặt. Điều kiện cân bằng phải được thỏa mãn: độ chênh lệch chiều cao giữa left subtree và right subtree của mọi node không vượt quá 1, tức balance factor nằm trong [-1,1]. Độ phức tạp thời gian thêm, xóa và truy vấn của balanced tree cũng giống skip list, đều là O(log n).
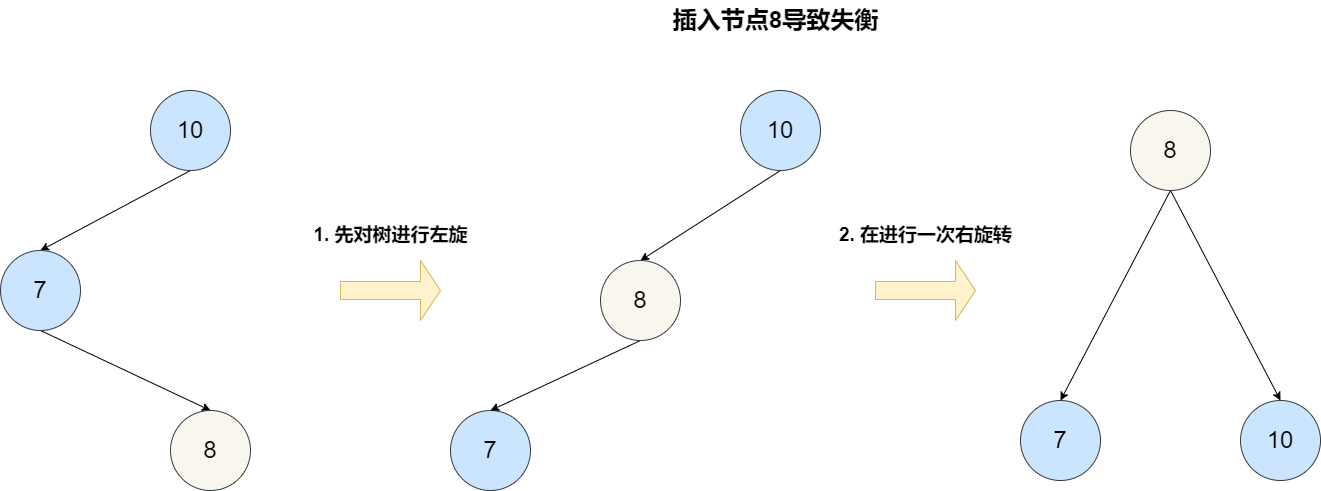
Đối với range query, balanced tree cũng có thể đạt hiệu quả giống skip list thông qua inorder traversal. Tuy nhiên, mỗi thao tác thêm hoặc xóa đều phải bảo đảm toàn bộ cây cân bằng tuyệt đối giữa các left subtree và right subtree. Chỉ cần mất cân bằng thì phải dùng thao tác rotation để duy trì cân bằng, quá trình này khá tốn thời gian.
Skip list ra đời với mục đích khắc phục một số nhược điểm của balanced tree. Tác giả của skip list đã trình bày chi tiết điều này trong bài luận 《Skip lists: a probabilistic alternative to balanced trees》:
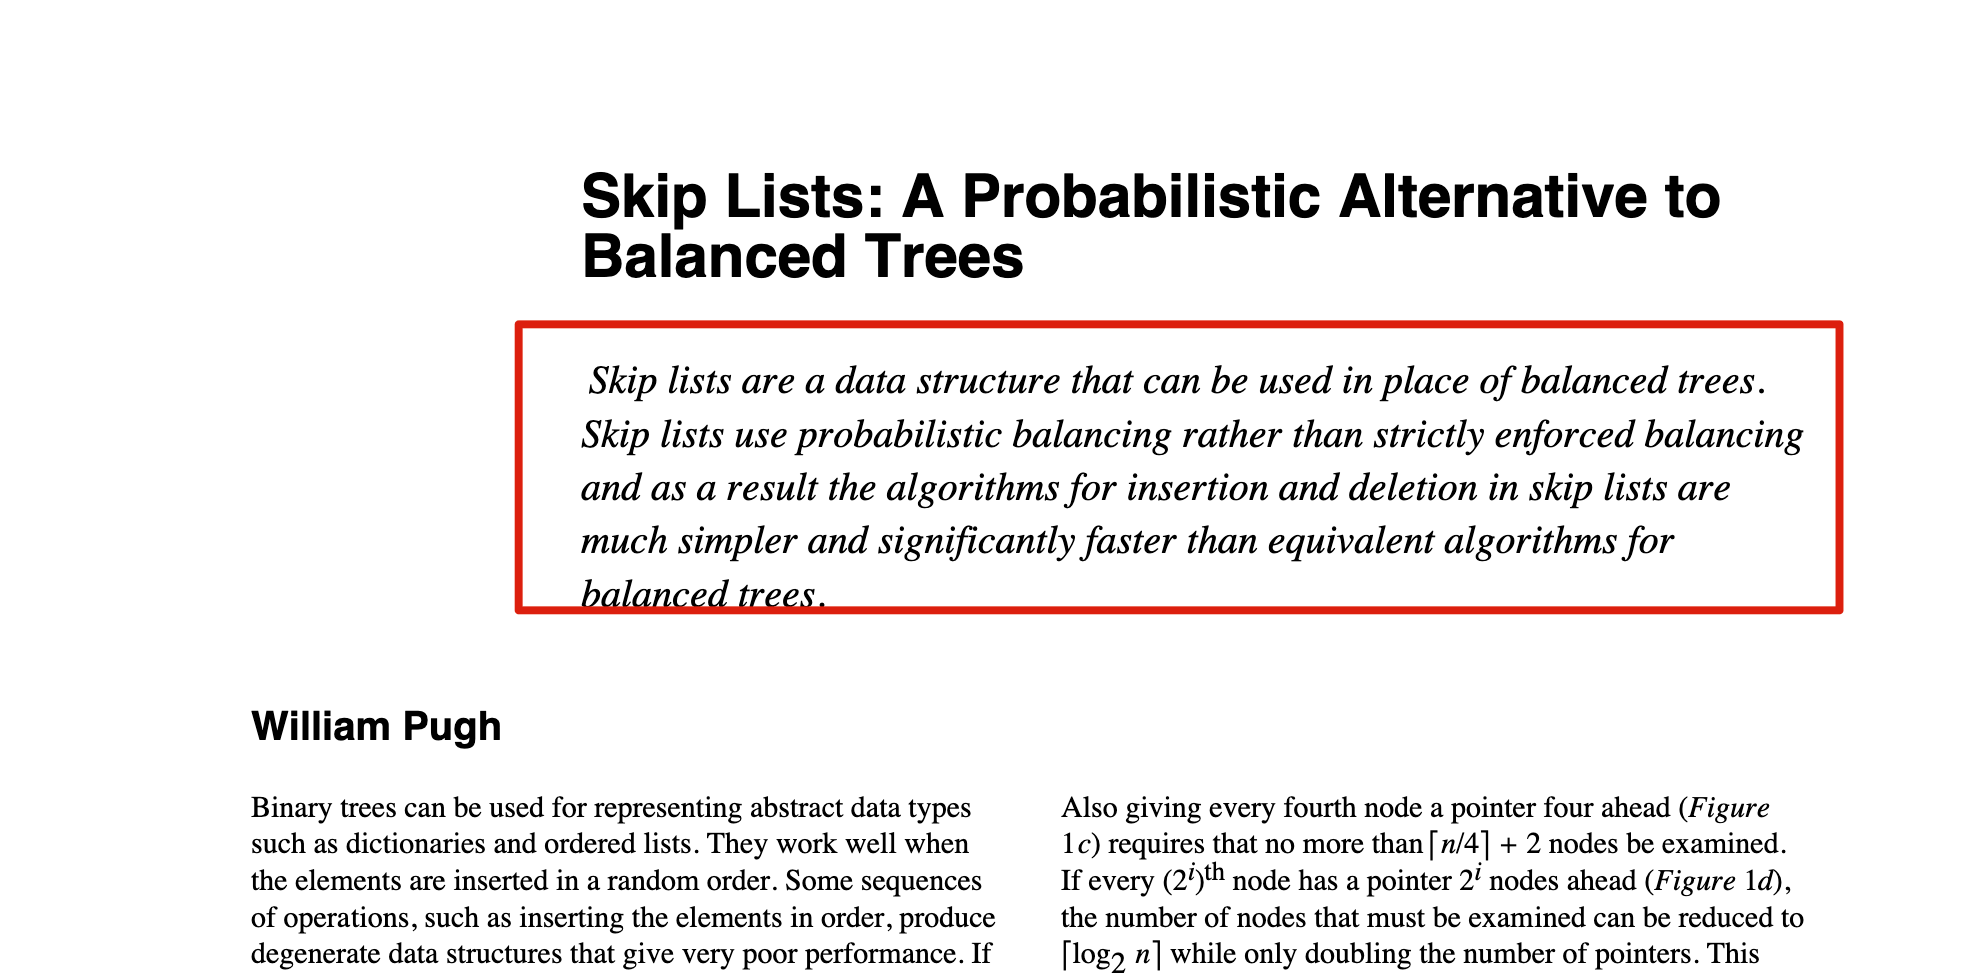
Skip lists are a data structure that can be used in place of balanced trees. Skip lists use probabilistic balancing rather than strictly enforced balancing and as a result the algorithms for insertion and deletion in skip lists are much simpler and significantly faster than equivalent algorithms for balanced trees.
Skip list là một cấu trúc dữ liệu có thể dùng để thay thế balanced tree. Skip list sử dụng cân bằng xác suất thay vì cân bằng bị ép buộc nghiêm ngặt. Vì vậy, thuật toán thêm và xóa trong skip list đơn giản hơn rất nhiều, đồng thời nhanh hơn đáng kể so với các thuật toán tương đương trong balanced tree.
Tác giả cũng đưa ra code cốt lõi của thao tác thêm trong AVL tree. Có thể thấy mỗi thao tác thêm đều cần recursive để định vị vị trí chèn, sau đó khi quay lui về root còn phải kiểm tra các node trên đường đi có mất cân bằng hay không, rồi điều chỉnh bằng cách rotation node.
// Thêm key và value mới vào binary search tree
public void add(K key, V value) {
    root = add(root, key, value);
}

// Chèn phần tử key và value vào binary search tree có node làm root, dùng thuật toán đệ quy
// Trả về root của binary search tree sau khi chèn node mới
private Node add(Node node, K key, V value) {

    if (node == null) {
        size++;
        return new Node(key, value);
    }

    if (key.compareTo(node.key) < 0)
        node.left = add(node.left, key, value);
    else if (key.compareTo(node.key) > 0)
        node.right = add(node.right, key, value);
    else // key.compareTo(node.key) == 0
        node.value = value;

    node.height = 1 + Math.max(getHeight(node.left), getHeight(node.right));

    int balanceFactor = getBalanceFactor(node);

    // Trường hợp LL cần right rotation
    if (balanceFactor > 1 && getBalanceFactor(node.left) >= 0) {
        return rightRotate(node);
    }

    // Mất cân bằng RR cần left rotation
    if (balanceFactor < -1 && getBalanceFactor(node.right) <= 0) {
        return leftRotate(node);
    }

    // LR cần left rotation thành dạng LL, sau đó right rotation
    if (balanceFactor > 1 && getBalanceFactor(node.left) < 0) {
        node.left = leftRotate(node.left);
        return rightRotate(node);
    }

    // RL
    if (balanceFactor < -1 && getBalanceFactor(node.right) > 0) {
        node.right = rightRotate(node.right);
        return leftRotate(node);
    }
    return node;
}
Red-black tree và skip list
Red-black tree (Red Black Tree) cũng là một binary search tree tự cân bằng. Performance truy vấn kém hơn AVL tree một chút, nhưng hiệu quả thêm và xóa cao hơn. Độ phức tạp thời gian thêm, xóa và truy vấn của red-black tree cũng giống skip list, đều là O(log n).
Red-black tree là một black-balanced tree, tức từ node bất kỳ đến một leaf node khác, số black node đi qua là như nhau. Khi thực hiện thao tác thêm, cần dùng rotation và đổi màu (red-black transformation) để bảo đảm black balance. Tuy nhiên, so với AVL tree, chi phí duy trì cân bằng thấp hơn. Bạn có thể xem bài viết Red-black tree để tìm hiểu chi tiết về red-black tree.
So với red-black tree, implementation của skip list cũng đơn giản hơn. Ngoài ra, trong thao tác tìm dữ liệu theo range, red-black tree không hiệu quả bằng skip list.

Code cốt lõi tương ứng của thao tác thêm trong red-black tree như sau, bạn có thể tự tham khảo để hiểu:
private Node < K, V > add(Node < K, V > node, K key, V val) {

    if (node == null) {
        size++;
        return new Node(key, val);

    }

    if (key.compareTo(node.key) < 0) {
        node.left = add(node.left, key, val);
    } else if (key.compareTo(node.key) > 0) {
        node.right = add(node.right, key, val);
    } else {
        node.val = val;
    }

    // Node trái không đỏ, node phải đỏ, thực hiện left rotation
    if (isRed(node.right) && !isRed(node.left)) {
        node = leftRotate(node);
    }

    // Chuỗi trái thực hiện right rotation
    if (isRed(node.left) && isRed(node.left.left)) {
        node = rightRotate(node);
    }

    // Đảo màu
    if (isRed(node.left) && isRed(node.right)) {
        flipColors(node);
    }

    return node;
}
B+ tree và skip list
Có lẽ những bạn sử dụng MySQL đều biết cấu trúc dữ liệu B+ tree. B+ tree là một cấu trúc dữ liệu phổ biến, có các đặc điểm sau:
- Cấu trúc multi-way tree: Đây là một multi-way tree, mỗi node có thể chứa nhiều node con, làm giảm chiều cao của cây và cho hiệu quả truy vấn cao.
- Hiệu quả lưu trữ cao: Non-leaf node lưu nhiều key, leaf node lưu value, giúp mỗi node có thể lưu nhiều key hơn; khi truy vấn theo range dựa trên index, hiệu quả truy vấn cao hơn.
- Tính cân bằng: Đây là một cây cân bằng tuyệt đối, chiều cao các nhánh của cây không chênh lệch nhiều, bảo đảm độ phức tạp thời gian truy vấn và thêm là O(log n).
- Truy cập tuần tự: Các node leaf được nối với nhau bằng con trỏ linked list, thể hiện tốt trong range query.
- Phân bố dữ liệu đồng đều: Khi thêm vào B+ tree, dữ liệu có thể được phân bố lại, giúp dữ liệu phân bố đồng đều hơn trong toàn cây và bảo đảm hiệu quả của range query và xóa.

Vì vậy, B+ tree phù hợp hơn để làm một trong các cấu trúc index phổ biến trong database và file system. Tư tưởng cốt lõi của nó là định vị được càng nhiều index càng tốt với càng ít I/O càng tốt để lấy dữ liệu truy vấn. Đối với in-memory database như Redis, điều này không thật sự cần thiết. Vì Redis là in-memory database nên không thể lưu lượng dữ liệu quá lớn; do đó index không cần được duy trì bằng cách như B+ tree, chỉ cần duy trì ngẫu nhiên theo xác suất là đủ, giúp tiết kiệm memory. Hơn nữa, khi dùng skip list để triển khai zset, implementation đơn giản hơn: khi thêm chỉ cần dùng index để chèn dữ liệu vào vị trí phù hợp trong linked list, rồi duy trì ngẫu nhiên một số index có chiều cao nhất định; không cần như B+ tree, khi phát hiện mất cân bằng lúc thêm lại phải split và merge node.
Lý do tác giả Redis đưa ra
Tất nhiên, chúng ta cũng có thể xem những lý do chính tác giả Redis đưa ra:
There are a few reasons:
1、They are not very memory intensive. It's up to you basically. Changing parameters about the probability of a node to have a given number of levels will make then less memory intensive than btrees.
2、A sorted set is often target of many ZRANGE or ZREVRANGE operations, that is, traversing the skip list as a linked list. With this operation the cache locality of skip lists is at least as good as with other kind of balanced trees.
3、They are simpler to implement, debug, and so forth. For instance thanks to the skip list simplicity I received a patch (already in Redis master) with augmented skip lists implementing ZRANK in O(log(N)). It required little changes to the code.
Dịch ra có nghĩa là:
Có một vài lý do:
- Chúng không sử dụng quá nhiều memory. Về cơ bản điều này phụ thuộc vào bạn. Việc thay đổi các tham số về xác suất một node có một số cấp nhất định sẽ giúp chúng tiết kiệm memory hơn B tree.
- Sorted set thường là đối tượng của nhiều thao tác ZRANGE hoặc ZREVRANGE, tức là duyệt skip list như một linked list. Với thao tác này, cache locality của skip list ít nhất cũng tốt như các loại balanced tree khác.
- Chúng dễ implementation, debug, v.v. hơn. Chẳng hạn, nhờ sự đơn giản của skip list, tôi đã nhận được một patch (đã có trong Redis master) dùng augmented skip list để triển khai ZRANK trong O(log(N)). Patch này chỉ yêu cầu thay đổi rất ít code.
Tóm tắt
Bài viết đã dành nhiều nội dung để giới thiệu nguyên lý hoạt động và implementation của skip list, giúp bạn hiểu sâu hơn về ưu nhược điểm của cấu trúc dữ liệu này. Cuối cùng, bài viết so sánh đặc điểm của các thao tác trên từng cấu trúc dữ liệu, từ đó giúp bạn hiểu tốt hơn câu hỏi phỏng vấn này. Khi tìm hiểu skip list, bạn nên cố gắng kết hợp với việc tự vẽ mô phỏng để nắm được chi tiết quá trình thêm, xóa, sửa, truy vấn.
Đọc thêm về cấu trúc dữ liệu
Nếu muốn ôn nhanh skip list dưới góc độ phỏng vấn, bạn có thể xem Tổng hợp câu hỏi phỏng vấn về skip list. Nếu muốn so sánh các cấu trúc khác phía sau Redis ZSet, bạn cũng có thể tiện thể ôn lại Giải thích chi tiết về red-black tree và Tổng hợp câu hỏi phỏng vấn về hash table.
Tham khảo
- Vì sao redis sử dụng skip list (skiplist) thay vì red-black?:https://www.zhihu.com/question/20202931/answer/16086538
- Skip List--skip list (bài viết skip list chi tiết):https://www.jianshu.com/p/9d8296562806
- Giải thích chi tiết về object và cấu trúc dữ liệu bên dưới của Redis:https://blog.csdn.net/shark_chili3007/article/details/104171986
- Sorted set (sorted set) của Redis:https://www.runoob.com/redis/redis-sorted-sets.html
- So sánh red-black tree và skip list:https://zhuanlan.zhihu.com/p/576984787
- Vì sao zset của Redis dùng skip list mà không dùng B+ tree?:https://blog.csdn.net/f80407515/article/details/129136998