
Giải thích chi tiết 3 chiến lược đọc ghi cache thường dùng
Tôi thấy nhiều bạn ghi trong CV rằng mình thành thạo sử dụng cache, nhưng khi được hỏi về 3 chiến lược đọc ghi cache thường dùng thì lại ngơ ngác.
Theo tôi, nguyên nhân của vấn đề này là khi học Redis, có thể chúng ta chỉ viết một vài Demo đơn giản mà chưa chú ý đến chiến lược đọc ghi cache, hoặc hoàn toàn không biết đến vấn đề này.
Tuy nhiên, hiểu rõ 3 chiến lược đọc ghi cache thường gặp sẽ giúp ích rất nhiều cho việc sử dụng cache trong công việc thực tế cũng như khi gặp câu hỏi về cache trong phỏng vấn!
Ba chế độ dưới đây đều có ưu và nhược điểm riêng, không có chế độ nào tốt nhất. Hãy chọn chế độ đọc ghi cache phù hợp với trường hợp sử dụng cụ thể.
Cache Aside Pattern (chế độ cache aside)
Đây là chế độ phổ biến và kinh điển nhất trong phát triển hằng ngày, gần như là tiêu chuẩn thực tế cho giải pháp cache của các ứng dụng Internet, đặc biệt phù hợp với trường hợp đọc nhiều, ghi ít.
Chế độ này được gọi là "Aside" (bên cạnh) vì thao tác ghi của ứng dụng hoàn toàn bỏ qua cache và thao tác trực tiếp với database.
Ứng dụng đóng vai trò là người điều phối dòng dữ liệu, đồng thời phải duy trì hai data source là Cache và DB.
Hãy cùng xem các bước đọc ghi cache trong chế độ này.
Thao tác ghi:
- Ứng dụng cập nhật DB trước.
- Sau đó xóa trực tiếp dữ liệu tương ứng trong Cache.
Dưới đây là một hình đơn giản để giúp bạn hiểu các bước ghi.

Thao tác đọc:
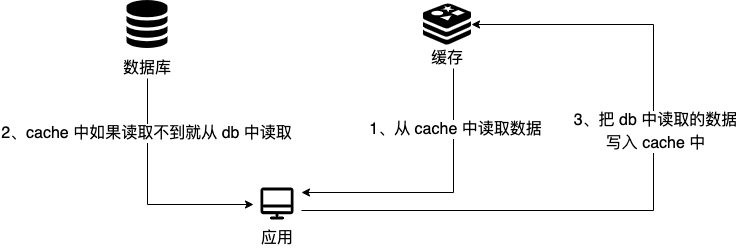
- Ứng dụng đọc dữ liệu từ Cache trước.
- Nếu hit (Hit), trả về ngay.
- Nếu miss (Miss), đọc dữ liệu từ DB, sau khi đọc thành công thì ghi dữ liệu trở lại Cache, rồi trả về.
Dưới đây là một hình đơn giản để giúp bạn hiểu các bước đọc.
Chỉ hiểu những nội dung trên là chưa đủ, chúng ta còn phải hiểu rõ nguyên lý bên trong.
Chẳng hạn, interviewer rất có thể sẽ hỏi thêm:
- Tại sao thao tác ghi là cập nhật DB trước, sau đó xóa Cache? Có thể đảo ngược thứ tự không?
- Vậy cập nhật DB trước, sau đó xóa Cache có tuyệt đối an toàn không?
- Tại sao lại xóa Cache thay vì cập nhật Cache?
Tiếp theo, tôi sẽ phân tích và giải đáp các câu hỏi này.
1. Tại sao thao tác ghi là “cập nhật DB trước, sau đó xóa Cache”? Có thể đảo ngược thứ tự không?
Trả lời: Tuyệt đối không thể. Nếu xóa Cache trước, sau đó cập nhật DB, high concurrency sẽ dẫn đến vấn đề dữ liệu không nhất quán kinh điển.
- Phân tích trình tự (request A ghi, request B đọc):
- Request A: Xóa dữ liệu trong Cache trước.
- Request B: Phát hiện Cache trống, nên đọc giá trị cũ từ DB và chuẩn bị ghi vào Cache.
- Request A: Ghi giá trị mới vào DB.
- Request B: Ghi giá trị cũ đã đọc trước đó vào Cache.
- Kết quả: DB chứa giá trị mới, còn Cache chứa giá trị cũ, dữ liệu không nhất quán.
2. Vậy “cập nhật DB trước, sau đó xóa Cache” có tuyệt đối an toàn không?
Câu trả lời: Cũng không tuyệt đối an toàn! Cách này vẫn có thể khiến dữ liệu database và cache không nhất quán.
- Phân tích trình tự (request A đọc, request B ghi):
- Request A: Cache miss, đọc được giá trị cũ từ DB.
- Request B: Nhanh chóng hoàn tất cập nhật DB và xóa Cache.
- Request A: Ghi giá trị cũ đã đọc trước đó vào Cache.
- Kết quả: DB chứa giá trị mới, còn Cache lại chứa giá trị cũ.
- Tại sao xác suất rất nhỏ? Vấn đề này về bản chất là vấn đề về trình tự concurrency: chỉ cần trong khoảng thời gian từ lúc “đọc DB → ghi Cache” có request ghi vừa hoàn tất cập nhật DB thì dữ liệu không nhất quán có thể xảy ra. Trong phần lớn nghiệp vụ, khoảng thời gian này tương đối ngắn và còn phải xảy ra đồng thời với request ghi, nên xác suất không cao, nhưng tuyệt đối không phải không thể xảy ra.
3. Tại sao lại “xóa Cache” thay vì “cập nhật Cache”?
- Chi phí performance: Thao tác ghi thường chỉ cập nhật một phần field của object. Nếu muốn cập nhật Cache thì phải truy vấn hoặc tính toán lại toàn bộ object trong cache, chi phí có thể rất lớn. Ngược lại, thao tác xóa nhẹ hơn.
- Tư tưởng lazy loading: Thao tác xóa tuân theo nguyên tắc lazy loading. Chỉ khi dữ liệu thực sự được cần đến ở lần đọc tiếp theo thì mới tải từ DB và ghi vào cache, tránh cập nhật cache không cần thiết.
- An toàn khi concurrency: Cập nhật cache trong high concurrency có thể xảy ra sai thứ tự cập nhật, làm tăng khả năng tạo ra dữ liệu bẩn.
Tất nhiên, tất cả điều này dựa trên một tiền đề quan trọng: dữ liệu cache có thể được tái tạo một cách xác định thông qua database, đồng thời nghiệp vụ có thể chấp nhận khoảng thời gian cực ngắn từ lúc xóa cache đến lần đọc và ghi lại tiếp theo, khi dữ liệu chưa nhất quán.
Bây giờ hãy tiếp tục phân tích nhược điểm của Cache Aside Pattern.
Nhược điểm 1: Request đầu tiên chắc chắn không có dữ liệu trong Cache
Giải pháp: Với dữ liệu hot có lượng truy cập rất lớn, có thể thực hiện làm nóng cache khi hệ thống khởi động hoặc trong thời gian thấp điểm.
Nhược điểm 2: Nếu thao tác ghi quá thường xuyên, dữ liệu trong Cache sẽ liên tục bị xóa, từ đó ảnh hưởng đến cache hit rate.
Giải pháp:
- Trường hợp cần tính nhất quán mạnh giữa database và cache: Khi cập nhật DB, đồng thời cập nhật Cache, nhưng cần thêm lock/distributed lock để bảo đảm không xảy ra vấn đề thread safety khi cập nhật Cache.
- Trường hợp có thể tạm thời cho phép database và cache không nhất quán: Khi cập nhật DB, đồng thời cập nhật Cache, nhưng đặt thời gian hết hạn tương đối ngắn cho cache, chẳng hạn 1 phút. Như vậy, ngay cả khi dữ liệu không nhất quán thì ảnh hưởng cũng tương đối nhỏ.
Read/Write Through Pattern (đọc ghi xuyên suốt)
Trong chế độ này, ứng dụng xem Cache là storage duy nhất và chính. Mọi request đọc ghi đều gửi trực tiếp đến Cache, còn chính dịch vụ Cache chịu trách nhiệm đồng bộ dữ liệu với DB.
Điều này trong suốt với ứng dụng, developer không cần quan tâm đến sự tồn tại của DB.
Có lẽ bạn cũng nhận ra chiến lược đọc ghi cache này rất ít gặp trong phát triển hằng ngày. Bỏ qua ảnh hưởng về performance, nguyên nhân lớn có thể là distributed cache Redis mà chúng ta thường dùng vốn không cung cấp chức năng để Cache ghi dữ liệu vào DB, nên phải tự triển khai ở phía nghiệp vụ hoặc trong middleware.
Ghi (Write Through):
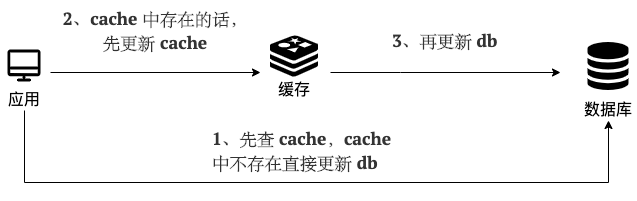
- Kiểm tra Cache trước; nếu dữ liệu không tồn tại trong Cache thì cập nhật DB trực tiếp.
- Nếu dữ liệu tồn tại trong Cache thì cập nhật Cache trước, sau đó chính dịch vụ Cache cập nhật DB. Chỉ khi cả Cache và DB đều ghi thành công thì mới trả về thành công cho tầng bên trên.
Dưới đây là một hình đơn giản để giúp bạn hiểu các bước ghi.
Đọc (Read Through):
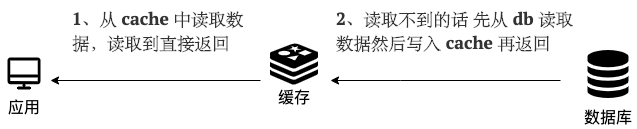
- Ứng dụng đọc dữ liệu từ Cache.
- Nếu hit, trả về ngay.
- Nếu miss, chính dịch vụ Cache chịu trách nhiệm tải dữ liệu từ DB. Sau khi tải thành công, dịch vụ ghi dữ liệu vào chính mình trước rồi trả về cho ứng dụng.
Dưới đây là một hình đơn giản để giúp bạn hiểu các bước đọc.
Read-Through thực tế chỉ là một lớp bao bọc trên Cache-Aside. Với Cache-Aside, khi có request đọc và dữ liệu tương ứng không tồn tại trong Cache, client tự chịu trách nhiệm ghi dữ liệu vào Cache. Còn với Read Through, chính dịch vụ Cache ghi dữ liệu vào cache, việc này trong suốt với client.
Xét về triển khai, Read-Through thực chất chuyển logic “Read Miss → Read DB → ghi lại vào Cache” của Cache-Aside xuống bên trong dịch vụ cache, trong suốt với client.
Giống như Cache Aside, Read-Through cũng gặp vấn đề request đầu tiên chắc chắn không có dữ liệu trong Cache. Với dữ liệu hot, có thể đưa dữ liệu vào cache trước.
Write Behind Pattern (ghi cache bất đồng bộ)
Write Behind (còn thường được gọi là Write-Back) Pattern khá giống Read/Write Through Pattern: cả hai đều để dịch vụ Cache chịu trách nhiệm đọc ghi Cache và DB.
Tuy nhiên, hai chế độ này có khác biệt rất lớn: Read/Write Through đồng bộ cập nhật Cache và DB, còn Write Behind chỉ cập nhật cache, không cập nhật DB trực tiếp mà chuyển sang cập nhật DB bất đồng bộ theo batch.
Thao tác ghi (Write Behind):
- Ứng dụng ghi dữ liệu vào Cache rồi trả về ngay.
- Dịch vụ Cache đưa thao tác ghi này vào một queue.
- Thông qua một thread/task bất đồng bộ độc lập, các thao tác ghi trong queue được ghi theo batch và gộp lại vào DB.
Chế độ này tạo ra thách thức về tính nhất quán dữ liệu, chẳng hạn hệ thống bị crash trước khi dữ liệu trong Cache kịp được ghi lại vào DB. Vì vậy, chế độ này không phù hợp với các trường hợp cần tính nhất quán mạnh, như giao dịch và hàng tồn kho.
Tuy nhiên, đặc tính bất đồng bộ và theo batch mang lại hiệu năng ghi vượt trội. Chế độ này được sử dụng rộng rãi trong nhiều hệ thống performance cao:
- Cơ chế InnoDB Buffer Pool của MySQL: Thay đổi dữ liệu trước hết được thực hiện trong Buffer Pool ở memory, sau đó được thread nền flush bất đồng bộ xuống disk.
- Page Cache của operating system: Ghi file cũng được thực hiện vào memory trước, sau đó operating system flush bất đồng bộ xuống disk.
- Trường hợp đếm tần suất cao: Với các trường hợp như lượt xem bài viết và số lượt thích bài đăng, có thể cho phép dữ liệu tạm thời không nhất quán nhưng yêu cầu ghi cực kỳ thường xuyên. Khi đó, có thể cộng dồn nhanh trong Redis trước, rồi đồng bộ bất đồng bộ về database bằng task định kỳ.
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.