
Tổng hợp câu hỏi phỏng vấn về hash table: hash collision, mở rộng dung lượng và Java HashMap
Hash table (còn gọi là bảng băm) có giá trị cao trong phỏng vấn vì một mặt gắn với việc tìm kiếm nhanh và đếm trong các bài toán thuật toán, mặt khác gắn với Java HashMap, cache, loại bỏ trùng lặp và định tuyến sharding trong distributed system.
Câu hỏi này xoay quanh việc: làm thế nào ánh xạ nhanh một key tới chỉ số array, đồng thời vẫn duy trì hiệu suất truy vấn chấp nhận được khi xảy ra collision, mở rộng dung lượng và xuất hiện dữ liệu ở trường hợp cực đoan.
Tổng quan nội dung:
- Hash table là gì?
- Hash table định vị từ key đến chỉ số array như thế nào?
- Hash collision, load factor và mở rộng dung lượng lần lượt giải quyết vấn đề gì?
- Java
HashMapcó quan hệ gì với hash table thông thường? - Hash table được dùng như thế nào trong các bài toán thuật toán và các trường hợp sử dụng thực tế?
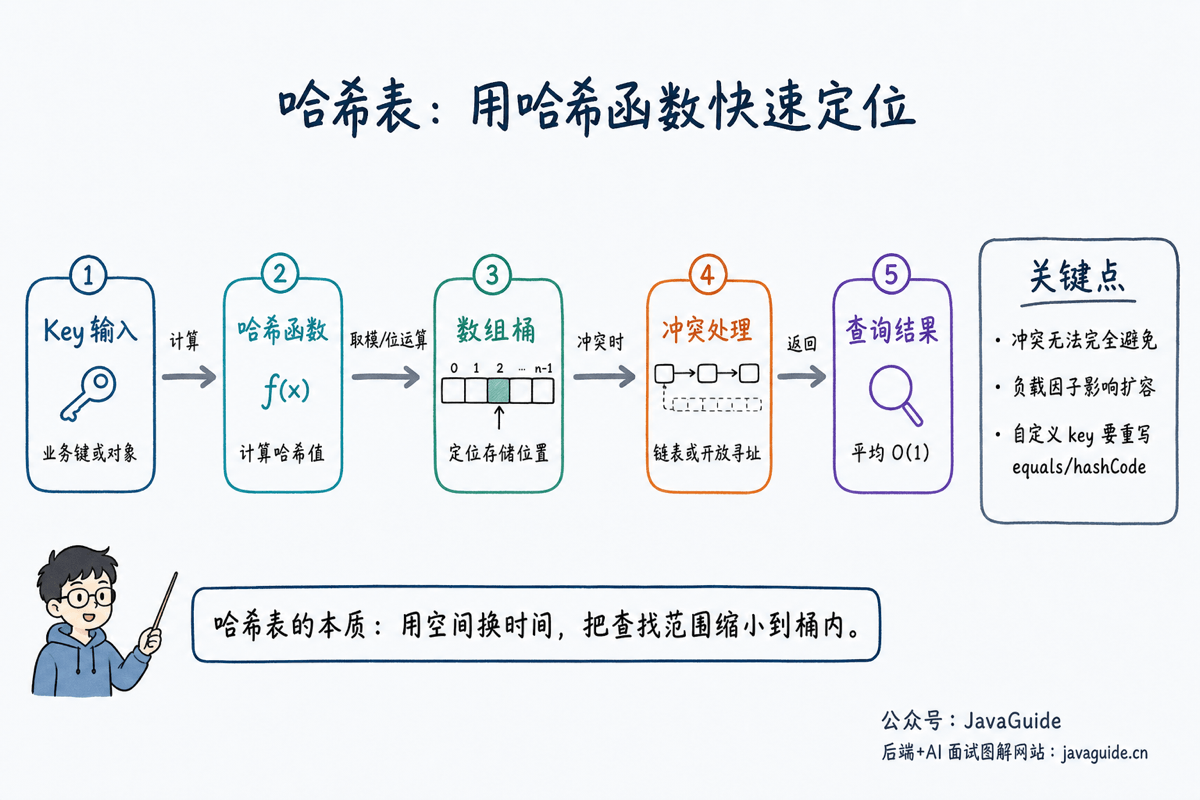
Hash table là gì?
Hash table là một data structure dùng để lưu trữ quan hệ ánh xạ key-value. Về bản chất, Map, Dictionary và Associative Array thường gặp đều có thể được triển khai bằng hash table.
Nếu key là các số nguyên liên tiếp, chẳng hạn mã số sinh viên vừa đúng từ 0 đến 999, chỉ cần dùng array là có thể thực hiện truy cập students[id] với độ phức tạp O(1). Nhưng key trong nghiệp vụ thực tế thường không quy củ như vậy: có thể là string, user ID, order number, URL hoặc custom object. Việc hash table cần làm là trước tiên chuyển các key khác nhau về kiểu và độ dài thành một số nguyên thông qua hash function, sau đó ánh xạ số nguyên này tới chỉ số array.
Có thể nhìn hash table thành ba lớp:
- Array: vị trí thực sự lưu trữ dữ liệu, thường còn được gọi là bucket.
- Hash function: chịu trách nhiệm chuyển key thành hash value.
- Chiến lược xử lý collision: khi nhiều key rơi vào cùng một bucket, quyết định cách tiếp tục lưu các key này.
Vì vậy, hash table không phải là “hoàn toàn không có quá trình tìm kiếm”, mà thu hẹp đáng kể phạm vi tìm kiếm thông qua hash function: trong trường hợp lý tưởng, chỉ cần định vị một lần là tìm được bucket mục tiêu; khi xảy ra collision, chỉ cần thực hiện một số ít phép so sánh bên trong bucket.
Vì sao cần hash table?
Giả sử cần kiểm tra một URL đã được crawl hay chưa. Cách trực tiếp nhất là đưa các URL đã crawl vào một list, mỗi khi có URL mới thì quét từ đầu một lần. Khi dữ liệu ít, vấn đề không lớn, nhưng nếu đã crawl vài triệu URL mà lần nào cũng quét tuyến tính, performance sẽ nhanh chóng không chịu nổi.
Ý tưởng của hash table là dùng không gian để đổi lấy thời gian: cấp thêm không gian cho array, phân tán URL vào các bucket khác nhau thông qua hash function. Khi truy vấn, không cần duyệt tất cả URL từ đầu nữa mà trước tiên tính hash value, rồi nhảy trực tiếp đến khu vực bucket tương ứng để tìm.
Đây cũng là lý do hash table phù hợp để tìm kiếm, đếm, loại bỏ trùng lặp và làm index cho cache. Nó không quan tâm đến quan hệ lớn nhỏ giữa các phần tử, cũng không đảm bảo thứ tự; điều nó quan tâm là “với key đã cho, có thể nhanh chóng tìm được value tương ứng hay không”.
Hash function cần giải quyết vấn đề gì?
Mục tiêu của hash function không phải là làm cho key trở nên bí ẩn, mà là cố gắng phân bố đều các key trong array. Một hash function tốt thường cần đáp ứng ba yêu cầu:
| Yêu cầu | Ý nghĩa |
|---|---|
| Ổn định | Tính nhiều lần trên cùng một key phải cho hash value nhất quán |
| Tính nhanh | Bản thân hash function không được quá chậm, nếu không sẽ triệt tiêu ưu thế performance của hash table |
| Phân bố càng đều càng tốt | Các key khác nhau nên rơi vào các vị trí khác nhau, giảm hash collision |
Cần lưu ý rằng hash function trong hash table thông thường không giống cryptographic hash. Hash table quan tâm nhiều hơn đến tốc độ và chất lượng phân bố; cryptographic hash quan tâm nhiều hơn đến các tính chất bảo mật như khả năng chống collision và chống giả mạo.
Trong Java, khi custom object làm key của HashMap, hashCode() và equals() phải phối hợp đúng: nếu hai object được xác định là bằng nhau thông qua equals(), hashCode() của chúng cũng phải giống nhau; nhưng hai object có hashCode() giống nhau không có nghĩa là chúng chắc chắn bằng nhau. Đây chính là một trong những nguyên nhân dẫn đến hash collision.
Trọng tâm phỏng vấn
- Hash function chịu trách nhiệm ánh xạ key thành chỉ số array.
- Không thể tránh hoàn toàn hash collision, chỉ có thể thiết kế chiến lược để xử lý.
- Tìm kiếm, chèn và xóa trong hash table có độ phức tạp trung bình là
O(1), nhưng trường hợp xấu nhất có thể suy biến. - Java
HashMapsử dụng array + linked list + red-black tree; từ JDK 8 trở đi, linked list quá dài sẽ được chuyển thành tree. - Hash table thường được dùng để tìm kiếm nhanh, đếm, loại bỏ trùng lặp và làm index cho cache.
Hash table hoạt động như thế nào?
Lấy việc chèn một key-value làm ví dụ, hash table thường thực hiện các bước sau:
- Tính hash value cho key.
- Dựa vào độ dài array để ánh xạ hash value thành chỉ số.
- Nếu vị trí đó trống, đưa phần tử vào trực tiếp.
- Nếu xảy ra collision, tiếp tục xử lý theo chiến lược xử lý collision.
int index = hash(key) & (table.length - 1);Khi capacity của HashMap là lũy thừa của 2, có thể dùng phép toán bit thay cho phép lấy modulo. Phép toán bit nhanh hơn và cũng thuận tiện cho việc phân bố lại sau khi mở rộng dung lượng.
hash(key) ở đây thường không trực tiếp sử dụng hashCode() nguyên bản của object, mà còn thực hiện thêm một bước perturbation để thông tin ở các bit cao cũng tham gia vào việc tính chỉ số ở các bit thấp. Nguyên nhân dễ hiểu: khi độ dài array là lũy thừa của 2, các bit thấp trong biểu diễn nhị phân của length - 1 đều là 1, nên phép & trực tiếp sẽ phụ thuộc nhiều hơn vào các bit thấp của hash value. Nếu phân bố ở các bit thấp không tốt, collision sẽ tập trung hơn.
Giải quyết hash collision như thế nào?
| Phương pháp | Ý tưởng | Ứng dụng điển hình | Điểm cần lưu ý |
|---|---|---|---|
| Chaining | Gắn linked list hoặc tree vào vị trí array | Java HashMap | Linked list quá dài sẽ ảnh hưởng truy vấn |
| Open addressing | Tiếp tục dò vị trí tiếp theo sau collision | Một số hash table hiệu năng cao | Xóa và xử lý load factor phức tạp hơn |
| Rehash | Đổi sang hash function khác sau collision | Thường gặp trong giải pháp lý thuyết | Chi phí triển khai cao hơn |
Java HashMap chủ yếu sử dụng chaining. Từ JDK 8, khi độ dài linked list đạt ngưỡng và capacity của array đủ lớn, linked list sẽ được chuyển thành red-black tree để giảm chi phí truy vấn khi xảy ra collision cực đoan.
Ưu điểm của chaining là triển khai trực quan và việc xóa cũng tương đối dễ. Mỗi bucket trong array không chỉ chứa một phần tử mà còn gắn một linked list; các phần tử bị collision được thêm vào linked list này. Khi truy vấn, trước tiên định vị bucket thông qua hash, sau đó so sánh key trong linked list hoặc tree của bucket.
Open addressing không gắn thêm linked list mà lưu tất cả phần tử bên trong array. Sau khi xảy ra collision, nó tiếp tục tìm vị trí khả dụng tiếp theo theo một quy tắc dò nào đó, chẳng hạn linear probing, quadratic probing hoặc double hashing. Ưu điểm là memory locality thường tốt hơn, nhưng việc xóa phần tử, kiểm soát load factor và xử lý hiện tượng dồn cụm liên tiếp sẽ phức tạp hơn.
Load factor và mở rộng dung lượng
Load factor biểu thị mức độ sử dụng của hash table:
Load factor = số lượng phần tử / capacity của arrayLoad factor mặc định của HashMap là 0.75. Khi số lượng phần tử vượt quá capacity * loadFactor, việc mở rộng dung lượng được kích hoạt và capacity thường tăng gấp đôi.
Mở rộng dung lượng sẽ phát sinh chi phí rehash một lần. Trong phỏng vấn có thể trả lời như sau: mỗi lần chèn vào hash table có độ phức tạp trung bình là O(1), nhưng lần chèn kích hoạt mở rộng dung lượng sẽ phải di chuyển các phần tử; xét theo góc độ amortized, nhiều lần chèn vẫn có thể được xem là trung bình O(1).
Không thể chỉ đánh giá load factor qua “mức sử dụng không gian”. Load factor càng cao, array càng đầy, tiết kiệm không gian hơn nhưng xác suất collision cũng tăng; load factor càng thấp, collision ít hơn nhưng sẽ lãng phí nhiều bucket hơn. 0.75 là sự cân bằng theo kinh nghiệm của Java HashMap giữa thời gian và không gian.
Vì sao hash table trung bình là O(1)?
O(1) của hash table nói đến trường hợp trung bình hoặc trường hợp kỳ vọng, không phải một bảo đảm tuyệt đối với mọi input.
Khi phân bố của hash function tương đối đồng đều và load factor được kiểm soát phù hợp, các phần tử sẽ phân tán tương đối đều, số lượng phần tử trong mỗi bucket rất ít. Vì vậy, chi phí chính khi truy vấn chỉ là: tính hash value, định vị chỉ số array và thực hiện một số ít phép so sánh trong bucket; các thao tác này có thể được xem là thời gian hằng số.
Nhưng nếu nhiều key rơi vào cùng một bucket, hash table sẽ suy biến. Khi dùng chaining, nếu linked list trong bucket quá dài, truy vấn sẽ gần với O(n); HashMap từ JDK 8 trở đi sẽ chuyển thành tree khi thỏa mãn điều kiện, đưa chi phí truy vấn trong bucket khi collision cực đoan xuống cấp độ O(logn), nhưng điều đó không có nghĩa hash table sẽ không bao giờ bị ảnh hưởng bởi collision.
Quan hệ với Java HashMap
Các câu hỏi thường gặp về HashMap:
- Vì sao capacity ban đầu được khuyến nghị là lũy thừa của 2?
- Vì sao load factor mặc định là
0.75? - Vì sao JDK 8 đưa red-black tree vào?
- Vì sao
HashMapkhông thread-safe? HashMapvàConcurrentHashMapkhác nhau như thế nào?
Các câu hỏi này đã vượt ra ngoài data structure thuần túy, nhưng về bản chất vẫn là hash table: array chịu trách nhiệm định vị, linked list hoặc red-black tree chịu trách nhiệm xử lý collision, còn mở rộng dung lượng chịu trách nhiệm kiểm soát load factor.
Mẫu bài toán thuật toán thường gặp
Two Sum:
int[] twoSum(int[] nums, int target) {
    Map<Integer, Integer> map = new HashMap<>();
    for (int i = 0; i < nums.length; i++) {
        int need = target - nums[i];
        if (map.containsKey(need)) {
            return new int[] {map.get(need), i};
        }
        map.put(nums[i], i);
    }
    return new int[] {-1, -1};
}
Đoạn code này thể hiện cách sử dụng phổ biến nhất của hash table: dùng không gian để đổi lấy thời gian, giảm một lần tìm kiếm từ O(n) xuống trung bình O(1).
Phân tích chi tiết bài toán tiêu biểu: subarray có tổng bằng K
560. Subarray Sum Equals K rất phù hợp để hiểu “prefix sum + hash table”. Bài toán yêu cầu đếm số lượng subarray liên tiếp có tổng bằng k.
Nếu chỉ duyệt mọi cặp điểm đầu và điểm cuối, độ phức tạp là O(n^2). Nhìn từ góc độ khác, giả sử prefix sum hiện tại là sum, ta muốn tìm một prefix sum trước đó prev sao cho:
sum - prev = kTức là prev = sum - k. Vì vậy, chỉ cần dùng hash table ghi lại số lần mỗi prefix sum đã xuất hiện, là có thể lập tức biết có bao nhiêu subarray kết thúc tại vị trí hiện tại và có tổng bằng k khi duyệt đến vị trí đó.
int subarraySum(int[] nums, int k) {
    Map<Integer, Integer> count = new HashMap<>();
    count.put(0, 1);

    int sum = 0;
    int ans = 0;
    for (int num : nums) {
        sum += num;
        ans += count.getOrDefault(sum - k, 0);
        count.put(sum, count.getOrDefault(sum, 0) + 1);
    }
    return ans;
}
count.put(0, 1) ở đây rất quan trọng, biểu thị prefix rỗng đã xuất hiện một lần. Nhờ vậy, khi tổng từ đầu array đến vị trí hiện tại vừa đúng bằng k, trường hợp đó cũng được đếm.
Một điểm dễ sai khác là “kiểm tra trước rồi mới thêm”. Nếu thêm sum hiện tại vào hash table trước rồi mới kiểm tra sum - k, khi k = 0 có thể tính cả prefix hiện tại vào chính nó, khiến đáp án lớn hơn thực tế.
Ví dụ nums = [1], k = 0. Cách “kiểm tra trước rồi mới thêm” đúng sẽ không tìm thấy subarray không rỗng có tổng bằng 0; nếu thêm prefix sum hiện tại 1 vào trước rồi kiểm tra sum - k = 1, prefix sum hiện tại sẽ được ghép với chính nó, khiến kết quả bị đếm thừa 1 lần.
Câu hỏi phỏng vấn mở rộng về Java HashMap
Chỉ trình bày khái niệm trong bài viết về hash table là chưa đủ; trong phỏng vấn backend Java, người phỏng vấn thường hỏi tiếp về HashMap. Có thể chuẩn bị theo các mức sau:
| Câu hỏi mở rộng | Trọng tâm trả lời |
|---|---|
| Vì sao capacity thường là lũy thừa của 2? | Thuận tiện dùng hash & (length - 1) để định vị, đồng thời việc di chuyển phần tử sau khi mở rộng dung lượng dễ hơn |
Vì sao load factor mặc định là 0.75? | Cân bằng giữa mức sử dụng không gian và xác suất collision; quá nhỏ thì lãng phí không gian, quá lớn thì collision tăng |
| Vì sao JDK 8 đưa red-black tree vào? | Khi collision cực đoan, truy vấn linked list sẽ suy biến; sau khi chuyển thành tree, chi phí truy vấn có thể giảm so với cấp độ độ dài linked list |
Vì sao HashMap không thread-safe? | Việc sửa đổi đồng thời trong nhiều thread có thể phá hỏng tính nhất quán của cấu trúc; đọc và ghi cũng không có bảo đảm về visibility và mutual exclusion |
| Cần lưu ý gì khi dùng custom key? | equals() và hashCode() phải nhất quán; không được sửa các field tham gia tính toán sau khi đưa vào |
Trong phỏng vấn không cần học thuộc toàn bộ chi tiết source code, nhưng phải trình bày rõ một mạch chính: định vị bằng array, xử lý collision, di chuyển khi mở rộng dung lượng và tối ưu collision cực đoan. Bốn việc này cùng quyết định performance của HashMap.
Điểm dễ sai
- Hash table trung bình
O(1)không có nghĩa là trong mọi trường hợp đều làO(1). - Khi dùng custom object làm key, cần override đúng
equals()vàhashCode(). - Mutable object không phù hợp để trực tiếp làm key của hash table.
- Khi đếm frequency, dùng array để đếm phù hợp hơn
HashMaptrong trường hợp character set rất nhỏ. - Hash table có thể tăng tốc tìm kiếm, nhưng sẽ cần thêm không gian.
Tự kiểm tra các câu hỏi thường gặp
- Vì sao truy vấn trong hash table trung bình là
O(1)? Khi nào nó sẽ suy biến? - Chaining và open addressing khác nhau như thế nào?
- Vì sao
HashMapcần mở rộng dung lượng? Nên hiểu chi phí mở rộng dung lượng như thế nào? - Vì sao khi dùng custom object làm key phải đồng thời override
equals()vàhashCode()? - Vì sao prefix sum + hash table phải “kiểm tra trước rồi mới thêm”?
Bài tập đề xuất
Tài liệu tham khảo
- Algorithms, 4th Edition: Hash Tables
- Java SE 21 API: HashMap
- OpenJDK: source code của HashMap
- Java SE 21 API: Object#hashCode
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.