
Tổng hợp câu hỏi phỏng vấn về LRU cache: hash table, doubly linked list và LinkedHashMap
LRU là viết tắt của Least Recently Used, nghĩa là ít được sử dụng gần đây nhất. Khi cache đầy, dữ liệu lâu nhất chưa được truy cập sẽ bị loại bỏ.
Trong các buổi phỏng vấn, tự viết LRU là câu hỏi rất thường gặp vì nó kết hợp hash table và doubly linked list: hash table chịu trách nhiệm tìm node trong O(1), còn doubly linked list chịu trách nhiệm di chuyển node và xóa node cuối trong O(1).
Tổng quan nội dung bài viết:
- LRU cache là gì?
- Vì sao LRU phù hợp với cache eviction?
- Vì sao cần hash table + doubly linked list?
- Tự viết
getvàputnhư thế nào? - Java
LinkedHashMaptriển khai LRU như thế nào? - LRU trong hệ thống thực tế còn phải cân nhắc điều gì?
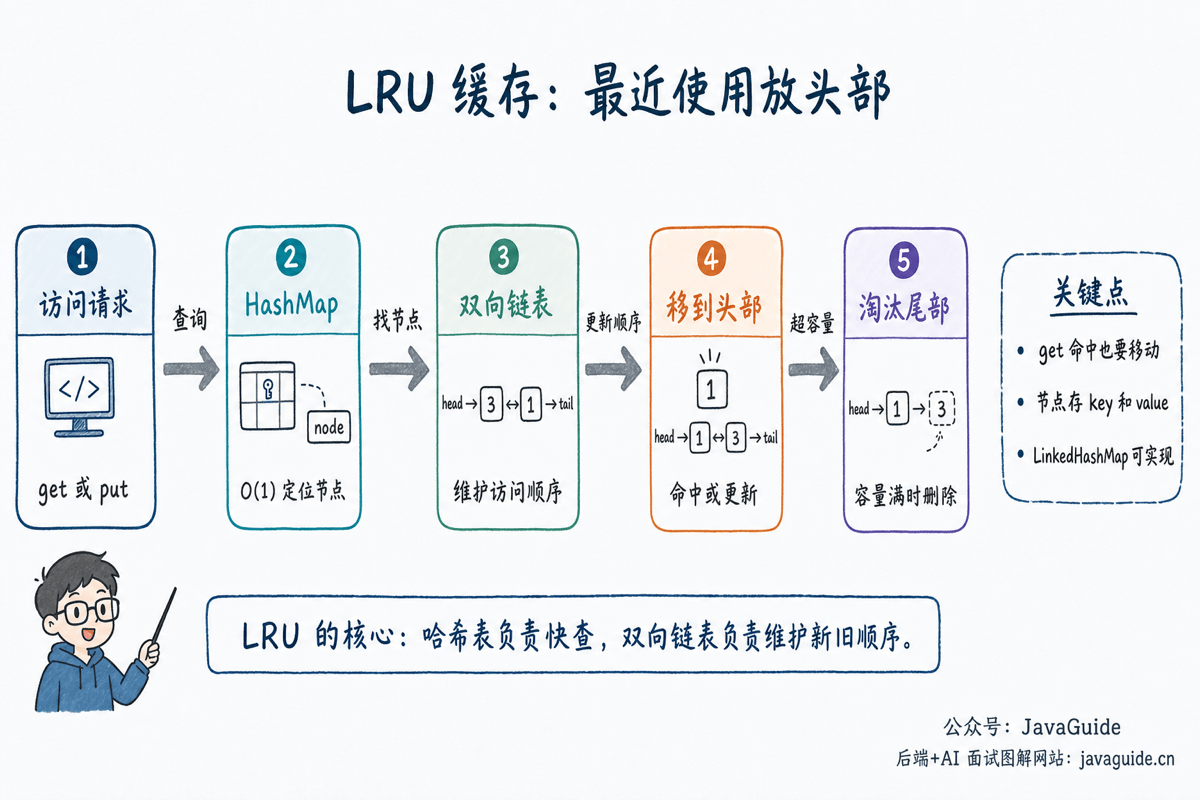
LRU cache là gì?
Mâu thuẫn cốt lõi của cache là: không gian có giới hạn, nhưng vẫn muốn giữ lại trong memory càng nhiều dữ liệu “sẽ còn được truy cập trong tương lai” càng tốt.
Vấn đề là chương trình không biết tương lai. LRU dùng việc truy cập gần đây để dự đoán gần đúng dữ liệu “có thể sẽ được truy cập tiếp”. Nếu một dữ liệu vừa được truy cập, khả năng cao nó sẽ được truy cập lại; nếu một dữ liệu đã lâu không được truy cập, khi cache đầy thì nó sẽ được ưu tiên loại bỏ.
Ví dụ, một cache có dung lượng 2 được truy cập theo thứ tự:
put(1, 1)
put(2, 2)
get(1)
put(3, 3)
Trước put(3, 3), cache chứa 1 và 2. Mặc dù 1 được thêm vào sớm hơn, nó vừa được get(1) truy cập, nên dữ liệu lâu nhất chưa được truy cập là 2; cuối cùng 2 sẽ bị loại bỏ.
Ví dụ này cũng cho thấy một điểm: LRU không xem “dữ liệu nào được thêm vào sớm nhất”, mà xem “dữ liệu nào đã lâu nhất không được truy cập”.
Vì sao cần chính sách cache eviction?
Cache không có dung lượng vô hạn. Dù là local memory cache, Redis, database Buffer Pool hay page cache của operating system, tất cả đều phải đối mặt với giới hạn dung lượng.
Sau khi dung lượng đầy, nếu không có chính sách eviction thì chỉ có thể từ chối dữ liệu mới hoặc xóa dữ liệu ngẫu nhiên. Xóa ngẫu nhiên đương nhiên đơn giản, nhưng có thể xóa nhầm dữ liệu đang được truy cập thường xuyên, khiến hit rate giảm. LRU sử dụng thứ tự thời gian truy cập để đưa ra phán đoán theo kinh nghiệm: dữ liệu lâu không được truy cập thường có xác suất được truy cập lại trong thời gian ngắn thấp hơn.
Các chính sách eviction thường gặp có thể được so sánh như sau:
| Chính sách | Tiêu chí loại bỏ | Đặc điểm |
|---|---|---|
| FIFO | Dữ liệu vào cache sớm nhất | Dễ triển khai nhưng không quan tâm dữ liệu có được truy cập thường xuyên sau đó hay không |
| LRU | Dữ liệu lâu nhất chưa được truy cập | Phù hợp với access pattern có temporal locality |
| LFU | Dữ liệu có số lần truy cập ít nhất | Phù hợp với trường hợp có hot data ổn định trong thời gian dài, nhưng cần duy trì thông tin tần suất |
| TTL | Thời gian hết hạn | Phù hợp với dữ liệu có thời hạn rõ ràng, không tương đương với capacity eviction |
LRU thường được đưa vào phỏng vấn vì vừa có bối cảnh kỹ thuật thực tế, vừa kiểm tra tốt khả năng kết hợp các data structure.
Trọng tâm phỏng vấn
- Giải thích rõ vì sao chỉ dùng hash table hoặc chỉ dùng linked list đều không đủ.
- Viết được
getvàput. - Giải thích được head và tail của doubly linked list lần lượt đại diện cho điều gì.
- Xử lý được các trường hợp biên như cache đầy, cập nhật key đã tồn tại và xóa node cuối.
- Biết Java
LinkedHashMapcó thể triển khai LRU.
Duy trì thứ tự truy cập của LRU như thế nào?
Trong LRU cache, mỗi lần truy cập đều làm thay đổi độ mới của dữ liệu.
Thông thường, quy ước là:
- Đầu linked list biểu thị dữ liệu được sử dụng gần đây nhất.
- Cuối linked list biểu thị dữ liệu lâu nhất chưa được sử dụng.
- Khi
get(key)hit, di chuyển node tương ứng lên đầu. - Với key mới trong
put(key, value), chèn node mới vào đầu. - Với key đã tồn tại trong
put(key, value), sau khi cập nhật value cũng phải di chuyển node lên đầu. - Khi cache vượt giới hạn dung lượng, xóa node ở cuối.
Điểm dễ bị bỏ sót nhất ở đây là get(). Nhiều bạn cho rằng get() chỉ đọc dữ liệu, không nên thay đổi structure. Nhưng với LRU, đọc cũng là một lần truy cập; chỉ cần cache hit, key đó được xem là vừa được sử dụng.
Thiết kế data structure
| Thành phần | Tác dụng |
|---|---|
HashMap<Integer, Node> | Nhanh chóng tìm node trong linked list theo key |
| Doubly linked list | Sắp xếp theo thứ tự truy cập, đầu là gần đây nhất, cuối là lâu nhất |
| Các node head và tail giả | Đơn giản hóa các trường hợp biên khi chèn và xóa |
Sau khi truy cập một key, cần di chuyển nó lên đầu linked list. Khi chèn key mới cũng đặt nó ở đầu. Khi cache vượt quá dung lượng, xóa node ngay trước tail.
Vì sao nhất thiết phải phối hợp hai data structure?
Chỉ dùng hash table thì có thể tìm value trong O(1), nhưng không biết key nào đã lâu nhất chưa được truy cập. Vẫn phải duy trì thêm thứ tự truy cập.
Chỉ dùng linked list thì có thể duy trì thứ tự truy cập, node ở cuối chính là node cần loại bỏ. Nhưng mỗi lần tìm node theo key phải quét từ đầu đến cuối, độ phức tạp là O(n).
Hash table + doubly linked list vừa đủ để bù trừ điểm yếu của nhau:
- Hash table giúp định vị trực tiếp node trong linked list theo key.
- Doubly linked list giúp di chuyển node và xóa node cuối nhanh chóng.
- Node đồng thời lưu key và value để khi loại bỏ node cuối, có thể xóa key tương ứng khỏi hash table.
Cách tự viết LRU khi phỏng vấn
LRU có nhiều chi tiết trong code, nên không nên bắt đầu bằng việc viết cả class. Trong phỏng vấn, trước hết có thể tách các thao tác:
- Xác định thứ tự của linked list: đầu biểu thị dữ liệu được sử dụng gần đây nhất, cuối biểu thị dữ liệu lâu nhất chưa được sử dụng.
- Định nghĩa
get: không tìm thấy thì trả về-1, tìm thấy thì di chuyển lên đầu. - Định nghĩa
put: key đã tồn tại thì cập nhật value và di chuyển lên đầu; key mới thì chèn vào đầu. - Cuối cùng xử lý eviction: khi cache vượt quá dung lượng, xóa node ngay trước tail và xóa key tương ứng khỏi hash table.
- Đóng gói các thao tác của linked list thành
addToHead,remove,moveToHead,removeTail.
Ưu điểm của cách viết này là get và put chỉ kết hợp một vài thao tác cơ bản của linked list, không lặp lại việc sửa pointer trong flow chính nên xác suất mắc lỗi thấp hơn nhiều.
Vì sao dùng doubly linked list?
Để di chuyển một node lên đầu, trước hết cần tách nó khỏi vị trí hiện tại, sau đó chèn nó ngay sau head node.
Nếu dùng singly linked list, khi xóa node hiện tại phải biết node đứng trước nó. Ngay cả khi hash table có thể tìm trực tiếp node hiện tại, vẫn không tìm được node đứng trước nó; cuối cùng vẫn phải duyệt từ đầu.
Node của doubly linked list có cả prev và next. Để xóa một node bất kỳ, chỉ cần sửa bốn pointer:
node.prev.next = node.next;
node.next.prev = node.prev;
Đây là lý do cốt lõi khiến LRU cần doubly linked list: không chỉ phải xóa node cuối mà còn phải di chuyển node bất kỳ lên đầu khi get() hit hoặc put() cập nhật key đã tồn tại.
Node head và tail giả cũng rất quan trọng. Với hai sentinel node head và tail, việc chèn đầu, xóa cuối và xử lý linked list rỗng đều dùng chung một bộ code, không cần kiểm tra null ở nhiều nơi.
Tự viết LRU
class LRUCache {
    private final int capacity;
    private final Map<Integer, Node> map = new HashMap<>();
    private final Node head = new Node(0, 0);
    private final Node tail = new Node(0, 0);

    LRUCache(int capacity) {
        this.capacity = capacity;
        head.next = tail;
        tail.prev = head;
    }

    int get(int key) {
        Node node = map.get(key);
        if (node == null) {
            return -1;
        }
        moveToHead(node);
        return node.value;
    }

    void put(int key, int value) {
        Node node = map.get(key);
        if (node != null) {
            node.value = value;
            moveToHead(node);
            return;
        }
        Node newNode = new Node(key, value);
        map.put(key, newNode);
        addToHead(newNode);
        if (map.size() > capacity) {
            Node removed = removeTail();
            map.remove(removed.key);
        }
    }

    private void moveToHead(Node node) {
        remove(node);
        addToHead(node);
    }

    private void addToHead(Node node) {
        node.prev = head;
        node.next = head.next;
        head.next.prev = node;
        head.next = node;
    }

    private void remove(Node node) {
        node.prev.next = node.next;
        node.next.prev = node.prev;
    }

    private Node removeTail() {
        Node node = tail.prev;
        remove(node);
        return node;
    }

    private static class Node {
        int key;
        int value;
        Node prev;
        Node next;

        Node(int key, int value) {
            this.key = key;
            this.value = value;
        }
    }
}
Độ phức tạp thời gian của get và put đều là O(1), độ phức tạp không gian là O(capacity).
Minh họa quá trình thao tác
Giả sử dung lượng là 2, thực hiện theo thứ tự:
put(1, 1)
put(2, 2)
get(1)
put(3, 3)
Trạng thái linked list thay đổi như sau, bên trái biểu thị dữ liệu được sử dụng gần đây nhất:
| Thao tác | Trạng thái linked list | Giải thích |
|---|---|---|
| Trạng thái ban đầu | Rỗng | Head và tail giả được nối với nhau, cache rỗng |
put(1, 1) | 1 | Node mới được chèn vào đầu |
put(2, 2) | 2 -> 1 | 2 là dữ liệu được sử dụng gần đây nhất |
get(1) | 1 -> 2 | Sau khi truy cập 1, di chuyển nó lên đầu |
put(3, 3) | 3 -> 1 | Vượt quá dung lượng, loại bỏ 2 ở cuối |
Bảng này giúp kiểm tra hai điểm: truy cập node đã tồn tại phải cập nhật thứ tự sử dụng; khi loại bỏ node, phải xóa node ở cuối, tức node lâu nhất chưa được sử dụng, chứ không phải node mới được thêm vào.
Triển khai bằng LinkedHashMap
Java LinkedHashMap hỗ trợ duy trì các phần tử theo thứ tự truy cập:
class LRUCacheWithLinkedHashMap extends LinkedHashMap<Integer, Integer> {
    private final int capacity;

    LRUCacheWithLinkedHashMap(int capacity) {
        super(capacity, 0.75f, true);
        this.capacity = capacity;
    }

    @Override
    protected boolean removeEldestEntry(Map.Entry<Integer, Integer> eldest) {
        return size() > capacity;
    }
}
Tham số thứ ba accessOrder trong constructor được đặt thành true, biểu thị việc duy trì thứ tự truy cập thay vì thứ tự chèn.
Tài liệu chính thức của LinkedHashMap cũng đề cập riêng rằng chế độ access-order này phù hợp để xây dựng LRU cache. Có hai điểm cần nhớ:
- Khi
accessOrder = false, thứ tự duyệt là thứ tự chèn; khiaccessOrder = true, thứ tự duyệt là thứ tự truy cập. removeEldestEntry()được gọi sau khi chèn mapping mới. Khi trả vềtrue, entry cũ nhất sẽ bị xóa.
Tuy nhiên, LinkedHashMap không thread-safe. Nếu muốn dùng trực tiếp nó làm local cache trong môi trường nhiều thread, cần tự thêm lock hoặc dùng một cache library đã được kiểm chứng.
LRU có quan hệ gì với Redis?
Khi dùng Redis làm cache, khi memory đạt giới hạn maxmemory, cũng cần thực hiện chính sách eviction. Redis hỗ trợ các chính sách như allkeys-lru, volatile-lru:
allkeys-lru: loại bỏ key lâu nhất chưa được truy cập trong toàn bộ key.volatile-lru: chỉ loại bỏ key lâu nhất chưa được truy cập trong các key đã đặt thời gian hết hạn.
Tuy nhiên, LRU của Redis không phải là “LRU chính xác” trong bài tự viết khi phỏng vấn. Để tiết kiệm memory và CPU, Redis sử dụng approximate LRU: lấy mẫu ngẫu nhiên một nhóm nhỏ key rồi chọn key lâu nhất chưa được truy cập để loại bỏ. Có thể điều chỉnh số lượng mẫu bằng maxmemory-samples.
Điều này cũng giúp hiểu sự khác biệt giữa hệ thống thực tế và bài toán phỏng vấn: bài toán phỏng vấn thường yêu cầu dùng hash table + doubly linked list để triển khai LRU chính xác; hệ thống thực tế sẽ cân bằng giữa memory, throughput, concurrency và hit rate.
Các trường hợp sử dụng trong thực tế
- Eviction của local cache.
- Page replacement trong operating system.
- Cache dữ liệu hot.
- Cache kết quả có dung lượng nhỏ trong gateway, client SDK hoặc middleware.
Trong hệ thống thực tế còn phải cân nhắc thread safety, thời gian hết hạn, memory tối đa, metrics và callback eviction. LRU tự viết trong phỏng vấn chủ yếu kiểm tra khả năng kết hợp data structure, không cần đưa tất cả những yếu tố này vào code.
Nếu là local cache trong dự án Java, nhiều trường hợp sẽ không tự viết LRU mà dùng trực tiếp các cache library như Caffeine. Lý do cũng rất thực tế: cache trong hệ thống không chỉ cần eviction theo dung lượng mà còn phải xử lý expiration, concurrency, loading, metrics, async refresh và weight riêng của từng entry. Tài liệu chính thức của Caffeine chia eviction thành nhiều loại như theo size, theo time và theo reference.
Câu hỏi phỏng vấn mở rộng
| Câu hỏi mở rộng | Trọng tâm trả lời |
|---|---|
Vì sao không dùng riêng HashMap? | HashMap có thể tìm value nhưng không biết key nào lâu nhất chưa được sử dụng |
| Vì sao không dùng riêng linked list? | Linked list duy trì được thứ tự nhưng tìm node theo key cần O(n) |
| Vì sao phải dùng doubly linked list? | Khi xóa node bất kỳ cần đồng thời nối node trước và sau; singly linked list không thể tìm node trước trong O(1) |
| Vì sao phải dùng node head và tail giả? | Thống nhất logic chèn, xóa của linked list rỗng, node đầu và node cuối, giảm số nhánh điều kiện |
LinkedHashMap triển khai LRU thế nào? | Bật accessOrder khi khởi tạo, override removeEldestEntry để kiểm soát dung lượng |
| Cache thực tế còn phải cân nhắc gì? | Thread safety, thời gian hết hạn, memory tối đa, callback eviction, metrics về hit rate và các vấn đề hệ thống như cache breakdown (sập cache) |
Điểm dễ sai
- Khi cập nhật key đã tồn tại, cũng phải di chuyển nó lên đầu.
- Sau khi xóa node cuối, đừng quên xóa key khỏi hash table.
- Khi xóa node trong doubly linked list, phải đồng thời sửa cả hai pointer trỏ đến node trước và node sau.
- Node head và tail giả giúp giảm việc kiểm tra trường hợp biên của linked list rỗng.
accessOrdercủaLinkedHashMapphải được đặt thànhtrue.
Tự kiểm tra bằng các câu hỏi thường gặp
- Vì sao LRU cần hash table và doubly linked list phối hợp?
- Vì sao thao tác
getcũng phải di chuyển node? - Khi cập nhật key đã tồn tại, vì sao không thể chỉ sửa value?
- Sau khi loại bỏ node cuối, vì sao còn phải xóa key khỏi hash table?
- Thứ tự chèn và thứ tự truy cập của
LinkedHashMapkhác nhau như thế nào?
Bài tập đề xuất
Tài liệu tham khảo
- Java SE 17 API: LinkedHashMap
- Redis Docs: Key eviction
- Operating Systems: Three Easy Pieces
- Caffeine Wiki: Eviction
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.