
Giải thích chi tiết Bloom Filter (nguyên lý, triển khai, trường hợp sử dụng)
Bloom Filter
Nếu chưa từng dùng Bloom Filter, có lẽ bạn cũng đã nghe nói về nó.
Bloom Filter chủ yếu được dùng để giải quyết bài toán xác định sự tồn tại trong tập dữ liệu lớn. Nó rất phù hợp với trường hợp cần xác định một phần tử có tồn tại trong một tập dữ liệu lớn hay không và chấp nhận sai số nhỏ (ví dụ cache penetration, deduplication dữ liệu lớn).
Tổng quan nội dung:
- Bloom Filter là gì?
- Giới thiệu nguyên lý của Bloom Filter.
- Trường hợp sử dụng Bloom Filter.
- Tự triển khai Bloom Filter bằng lập trình Java.
- Sử dụng Bloom Filter có sẵn trong Guava mã nguồn mở của Google.
- Bloom Filter trong Redis.
Bloom Filter là gì?
Trước hết, chúng ta cần tìm hiểu khái niệm Bloom Filter.
Bloom Filter (BF) được một người tên là Bloom đề xuất vào năm 1970. Có thể xem đây là một data structure gồm hai phần: binary vector (hay bit array) và một loạt random mapping function (hash function). So với các data structure thường dùng như List, Map, Set, nó chiếm ít không gian hơn và có hiệu suất cao hơn, nhưng nhược điểm là kết quả trả về mang tính xác suất chứ không hoàn toàn chính xác. Về lý thuyết, càng nhiều phần tử được thêm vào collection thì khả năng false positive càng cao. Ngoài ra, dữ liệu được lưu trong Bloom Filter không dễ xóa.
Bloom Filter sử dụng một bit array khá lớn để lưu toàn bộ dữ liệu. Mỗi phần tử trong array chỉ chiếm 1 bit và chỉ có thể là 0 hoặc 1 (đại diện cho false hoặc true). Đây cũng là điểm cốt lõi giúp Bloom Filter tiết kiệm memory. Theo cách tính này, một bit array gồm 1 triệu phần tử chỉ chiếm 1000000 Bit / 8 = 125000 Byte = 125000 / 1024 KB ≈ 122 KB.
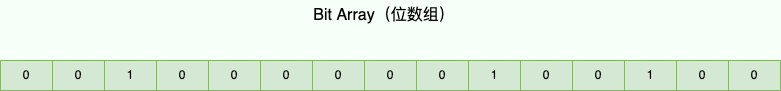
Tóm lại: một người tên Bloom đã đề xuất một data structure dùng để xác định phần tử có thuộc một collection lớn cho trước hay không. Data structure này hiệu quả và có performance tốt, nhưng có tỷ lệ nhận diện sai nhất định và khó xóa. Ngoài ra, về lý thuyết, càng nhiều phần tử được thêm vào collection thì khả năng false positive càng cao.
Giới thiệu nguyên lý của Bloom Filter
Khi một phần tử được thêm vào Bloom Filter, các thao tác sau sẽ được thực hiện:
- Dùng hash function trong Bloom Filter để tính hash value của phần tử (có bao nhiêu hash function thì thu được bấy nhiêu hash value).
- Dựa trên hash value thu được, đặt giá trị tại index tương ứng trong bit array thành 1.
Khi cần xác định một phần tử có tồn tại trong Bloom Filter hay không, các thao tác sau sẽ được thực hiện:
- Thực hiện lại phép tính hash tương tự với phần tử đã cho;
- Kiểm tra các bit tương ứng với những hash value này: nếu có một bit khác 1 thì phần tử chắc chắn chưa được insert; nếu tất cả đều là 1 thì chỉ có thể nói phần tử có thể đã được insert, vẫn có thể false positive.
Sơ đồ nguyên lý đơn giản của Bloom Filter như sau:
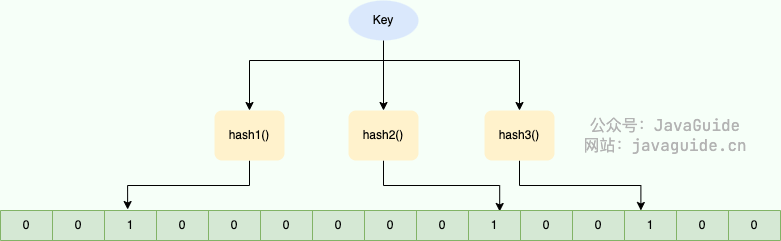
Như hình trên, khi một string được thêm vào Bloom Filter, string đó trước hết được đưa qua nhiều hash function để tạo ra các hash value khác nhau, sau đó các vị trí tương ứng trong bit array được đặt thành 1 (khi khởi tạo bit array, tất cả vị trí đều là 0). Khi query lại string đó, tất cả vị trí tương ứng đều là 1, vì vậy Bloom Filter sẽ trả về “có thể tồn tại”; cuối cùng có thực sự tồn tại hay không vẫn cần đối chiếu với business data để xác nhận.
Nếu cần xác định một string có nằm trong Bloom Filter hay không, chỉ cần thực hiện lại phép tính hash tương tự với nó. Nếu bất kỳ vị trí tương ứng nào là 0 thì phần tử chắc chắn chưa được insert; nếu tất cả vị trí tương ứng đều là 1 thì phần tử có thể đã được insert, cũng có thể là false positive do các phần tử khác cùng tạo nên.
Các string khác nhau có thể hash cho cùng một vị trí. Trong trường hợp này, có thể tăng kích thước bit array hoặc điều chỉnh hash function.
Từ đó có thể kết luận: khi Bloom Filter cho biết một phần tử tồn tại thì vẫn có một xác suất nhỏ là false positive. Khi Bloom Filter cho biết một phần tử không tồn tại thì phần tử đó chắc chắn không tồn tại.
Trường hợp sử dụng Bloom Filter
- Xác định dữ liệu đã cho có tồn tại hay không: ví dụ xác định một số có tồn tại trong một tập hợp gồm rất nhiều số hay không (tập hợp rất lớn, lên tới hàng trăm triệu phần tử), phòng chống cache penetration (xác định dữ liệu trong request có hợp lệ hay không để tránh request database trực tiếp, bỏ qua cache), lọc spam trong email (xác định một địa chỉ email có nằm trong danh sách spam hay không), chức năng blacklist (xác định một IP address hoặc số điện thoại có nằm trong blacklist hay không), v.v.
- Deduplication: ví dụ deduplication các URL đã crawl trong quá trình crawl một URL đã cho, deduplication một lượng lớn QQ number hoặc order number.
Trường hợp deduplication cũng cần xác định dữ liệu đã cho có tồn tại hay không, vì vậy Bloom Filter chủ yếu được dùng để giải quyết bài toán xác định sự tồn tại trong tập dữ liệu lớn.
Thực hành code
Tự triển khai Bloom Filter bằng lập trình Java
Trên đây đã trình bày nguyên lý của Bloom Filter. Sau khi hiểu nguyên lý, bạn có thể tự triển khai một Bloom Filter.
Nếu muốn tự triển khai, bạn cần:
- Một bit array có kích thước phù hợp để lưu dữ liệu
- Một vài hash function khác nhau
- Cách triển khai method thêm phần tử vào bit array (Bloom Filter)
- Cách triển khai method xác định phần tử đã cho có tồn tại trong bit array (Bloom Filter) hay không.
Dưới đây là đoạn code khá ổn (được cải tiến dựa trên code có sẵn trên Internet và áp dụng cho object thuộc mọi type):
import java.util.BitSet;

public class MyBloomFilter {

    /**
     * Kích thước bit array
     */
    private static final int DEFAULT_SIZE = 2 << 24;
    /**
     * Dùng array này để tạo 6 hash function khác nhau
     */
    private static final int[] SEEDS = new int[]{3, 13, 46, 71, 91, 134};

    /**
     * Bit array. Các phần tử trong array chỉ có thể là 0 hoặc 1
     */
    private BitSet bits = new BitSet(DEFAULT_SIZE);

    /**
     * Array chứa các class có hash function
     */
    private SimpleHash[] func = new SimpleHash[SEEDS.length];

    /**
     * Khởi tạo array gồm nhiều class có hash function, hash function trong mỗi class khác nhau
     */
    public MyBloomFilter() {
        // Khởi tạo nhiều hash function khác nhau
        for (int i = 0; i < SEEDS.length; i++) {
            func[i] = new SimpleHash(DEFAULT_SIZE, SEEDS[i]);
        }
    }

    /**
     * Thêm phần tử vào bit array
     */
    public void add(Object value) {
        for (SimpleHash f : func) {
            bits.set(f.hash(value), true);
        }
    }

    /**
     * Xác định phần tử được chỉ định có tồn tại trong bit array hay không
     */
    public boolean contains(Object value) {
        boolean ret = true;
        for (SimpleHash f : func) {
            ret = bits.get(f.hash(value));
            if(!ret)
              return ret;
        }
        return ret;
    }

    /**
     * Static inner class. Dùng cho thao tác hash!
     */
    public static class SimpleHash {

        private int cap;
        private int seed;

        public SimpleHash(int cap, int seed) {
            this.cap = cap;
            this.seed = seed;
        }

        /**
         * Tính hash value
         */
        public int hash(Object value) {
            int h;
            return (value == null) ? 0 : Math.abs((cap - 1) & seed * ((h = value.hashCode()) ^ (h >>> 16)));
        }

    }
}
Test:
String value1 = "https://javaguide.cn/";
String value2 = "https://github.com/Snailclimb";
MyBloomFilter filter = new MyBloomFilter();
System.out.println(filter.contains(value1));
System.out.println(filter.contains(value2));
filter.add(value1);
filter.add(value2);
System.out.println(filter.contains(value1));
System.out.println(filter.contains(value2));
Output:
false
false
true
true
Test:
Integer value1 = 13423;
Integer value2 = 22131;
MyBloomFilter filter = new MyBloomFilter();
System.out.println(filter.contains(value1));
System.out.println(filter.contains(value2));
filter.add(value1);
filter.add(value2);
System.out.println(filter.contains(value1));
System.out.println(filter.contains(value2));
Output:
false
false
true
true
Sử dụng Bloom Filter có sẵn trong Guava mã nguồn mở của Google
Mục đích của việc tự triển khai chủ yếu là để hiểu nguyên lý của Bloom Filter. Cách triển khai Bloom Filter trong Guava khá chuẩn, vì vậy trong project thực tế không cần tự triển khai Bloom Filter.
Trước hết, cần thêm dependency của Guava vào project. Nên để hệ thống quản lý dependency của project quản lý version tập trung và chọn version còn được duy trì từ Guava Releases:
<dependency>
    <groupId>com.google.guava</groupId>
    <artifactId>guava</artifactId>
    <version>${guava.version}</version>
</dependency>
Cách sử dụng thực tế như sau:
Một Bloom Filter được tạo với capacity dự kiến là 1500 số nguyên và false positive rate mục tiêu là 1% (0.01). 1500 ở đây là ước tính capacity, không phải hard limit khiến filter mất hiệu lực ngay khi đạt đến.
// Tạo object Bloom Filter
BloomFilter<Integer> filter = BloomFilter.create(
    Funnels.integerFunnel(),
    1500,
    0.01);
// Xác định phần tử được chỉ định có tồn tại hay không
System.out.println(filter.mightContain(1));
System.out.println(filter.mightContain(2));
// Thêm phần tử vào Bloom Filter
filter.put(1);
filter.put(2);
System.out.println(filter.mightContain(1));
System.out.println(filter.mightContain(2));
Trong ví dụ này, mightContain() trả về false nghĩa là phần tử chắc chắn chưa được insert; trả về true chỉ có nghĩa là phần tử có thể đã được insert. Tham số 0.01 biểu thị xác suất false positive mục tiêu khoảng 1% đối với truy vấn phần tử chưa được insert, khi ước tính capacity và các giả định triển khai được đáp ứng; không thể suy ra rằng “sau khi trả về true thì có 99% xác suất phần tử thực sự tồn tại”.
Bloom Filter của Guava được lưu trong memory của process hiện tại, dễ sử dụng và phù hợp với scenario chạy một process hoặc không cần share giữa các node. Nếu nhiều node cần dùng chung một trạng thái filter, có thể cân nhắc các giải pháp tập trung như RedisBloom.
Bloom Filter trong Redis
Giới thiệu
RedisBloom cung cấp Bloom Filter, Cuckoo Filter và các data structure dạng xác suất khác. Từ Redis 8, các khả năng này đã được tích hợp trong Redis Open Source, không cần cài image bên thứ ba rebloom cũ nữa. Có thể xem command cụ thể và hỗ trợ của client trong tài liệu chính thức về Redis Bloom Filter.
Cài đặt bằng Docker
Có thể khởi động Redis 8 bằng Docker để thử nghiệm. Trong project thực tế, nên cố định version cụ thể đã được kiểm chứng, không nên phụ thuộc vào tag latest:
docker run -d --name redis -p 6379:6379 redis:8
docker exec -it redis redis-cli
Khi cài đặt và lựa chọn version cho production, hãy tham khảo tài liệu cài đặt Redis Open Source.
Tổng quan các command thường dùng
Lưu ý: key: tên của Bloom Filter, item: phần tử được thêm vào.
BF.ADD: thêm phần tử vào Bloom Filter; nếu filter đó chưa tồn tại thì tạo filter. Format:BF.ADD {key} {item}.BF.MADD: thêm một hoặc nhiều phần tử vào Bloom Filter và tạo filter nếu chưa tồn tại. Cách hoạt động của command này giốngBF.ADD, nhưng cho phép nhiều input và trả về nhiều value. Format:BF.MADD {key} {item} [item ...].BF.EXISTS: xác định phần tử có tồn tại trong Bloom Filter hay không. Format:BF.EXISTS {key} {item}.BF.MEXISTS: xác định một hoặc nhiều phần tử có tồn tại trong Bloom Filter hay không. Format:BF.MEXISTS {key} {item} [item ...].
Ngoài ra, command BF.RESERVE cần được giới thiệu riêng:
Format của command này như sau:
BF.RESERVE {key} {error_rate} {capacity} [EXPANSION expansion].
Dưới đây là ý nghĩa cụ thể của từng parameter:
- key: tên của Bloom Filter
- error_rate: false positive rate mong muốn. Giá trị này phải nằm trong khoảng từ 0 đến 1. Ví dụ, với false positive rate mong muốn là 0.1% (1 trên 1000), error_rate cần được đặt là 0.001. Con số này càng gần 0 thì memory tiêu thụ cho mỗi item càng lớn và CPU cần dùng cho mỗi operation càng cao.
- capacity: số lượng phần tử dự kiến insert. Khi scalable filter vượt quá capacity này, một sub-filter sẽ được tạo; khi query, cần kiểm tra nhiều sub-filter hơn. Nếu dùng
NONSCALINGđể tạo fixed-capacity filter mà vẫn tiếp tục insert, false positive rate thực tế sẽ cao hơn giá trị đã đặt.
Parameter tùy chọn:
- expansion: nếu một sub-filter mới được tạo, size của nó sẽ bằng size của filter hiện tại nhân với
expansion. Giá trị expansion mặc định là 2. Điều này nghĩa là mỗi sub-filter tiếp theo sẽ có size gấp đôi sub-filter trước đó.
Sử dụng thực tế
127.0.0.1:6379> BF.ADD myFilter java
(integer) 1
127.0.0.1:6379> BF.ADD myFilter javaguide
(integer) 1
127.0.0.1:6379> BF.EXISTS myFilter java
(integer) 1
127.0.0.1:6379> BF.EXISTS myFilter javaguide
(integer) 1
127.0.0.1:6379> BF.EXISTS myFilter github
(integer) 0
Trọng tâm ôn tập phỏng vấn
4 câu hỏi phổ biến nhất khi phỏng vấn về Bloom Filter là: tại sao nhanh, tại sao tiết kiệm không gian, tại sao có false positive, tại sao khó xóa.
| Câu hỏi | Ý chính của câu trả lời |
|---|---|
| Tại sao tiết kiệm không gian? | Dùng bit array và nhiều hash function để biểu diễn collection, không lưu phần tử gốc |
| Tại sao có false positive? | Nhiều phần tử có thể đặt cùng một nhóm bit thành 1, khiến query tưởng rằng phần tử mục tiêu tồn tại |
| Có thể bỏ sót không? | Bloom Filter tiêu chuẩn không đánh giá phần tử đã được thêm là không tồn tại |
| Tại sao khó xóa? | Một bit có thể được nhiều phần tử dùng chung, đặt về 0 sẽ ảnh hưởng đến các phần tử khác |
Các scenario engineering điển hình:
- Cache penetration: trước tiên dùng Bloom Filter để xác định key có thể tồn tại hay không; nếu không thể tồn tại thì không query database.
- Deduplication quy mô lớn: ví dụ deduplication URL, lọc blacklist, lọc nội dung đã đọc trong recommendation system.
- Scenario distributed: giải pháp Guava trên một machine đơn giản, nhưng để share giữa các node thường sẽ cân nhắc RedisBloom.
Khi trả lời, cần chủ động bổ sung một hạn chế: Bloom Filter phù hợp với scenario “cho phép một lượng nhỏ false positive nhưng không chấp nhận false negative”. Nếu business yêu cầu kiểm tra sự tồn tại chính xác 100% thì không thể chỉ dựa vào Bloom Filter.
Các câu hỏi thường gặp
- False positive rate có quan hệ thế nào với kích thước bit array và số lượng hash function?
- Bloom Filter có thể xóa phần tử hay không?
- Cache penetration, cache breakdown, cache avalanche lần lượt là gì?
- Nên chọn Bloom Filter của Guava hay RedisBloom?
- Điều gì xảy ra nếu ước tính capacity sai?
Lời cuối
Nếu nội dung hữu ích với bạn, hãy tiện tay tặng JavaGuide một Star miễn phí để ủng hộ: GitHub | Gitee.
JavaGuide đã được duy trì gần bảy năm, tích lũy 6100+ commit, với sự chung tay hoàn thiện của 620+ contributor. Star, phản hồi và PR của bạn đều là động lực để dự án tiếp tục cập nhật.
Nếu bạn đang chuẩn bị phỏng vấn backend / phát triển ứng dụng AI, có thể tham khảo Knowledge Planet của tôi, bao gồm các project thực tế về backend và AI, tối ưu CV, hỏi đáp 1-1 và tài liệu về các trọng điểm thường gặp, đã được duy trì liên tục sáu năm.